


Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 요약 설명
17 Aug 2026 | Paper Review Embodied Agents Self-Evolving Agents Vision-Language-Action Models Rollout InfrastructureContents
- 요약
- 1. Introduction
- 2. Enabling Deployment-Time Evolution of Embodied Agents
- 2.1. Problem Formulation: Dual-Agent Governance and Evolutionary Architecture
- 2.2. System Challenges and Design Principles
- 2.3. Phase I: Empirical Failure Profiling and Baseline Establishment (Loop 1)
- 2.4. Phase II Stage 1: Failure Clustering and Causal Diagnosis
- 2.5. Phase II Stage 2: Critic-Guided Harness Repair and Validation
- 2.6. Phase III: Harness Consolidation, Packaging and Generalization
- 3. Z-Infra: Embodied Agent Rollout Infrastructure
- 4. Experiments
- 5. Related Work
- 6. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 17일(Arxiv)
- Ding, Xin, Mi, Liang, Huang, Mingzhe, Wang, Zixuan, Zhang, Chao, Hao, Zixu, Chen, Fu, Li, Xiangyu, Zheng, Yikai, Guo, Yaoyu, et al.
- Institute for AI Industry Research (AIR), Tsinghua University, Z-Trans AI
- 논문 링크
- Github
- Project Page
요약
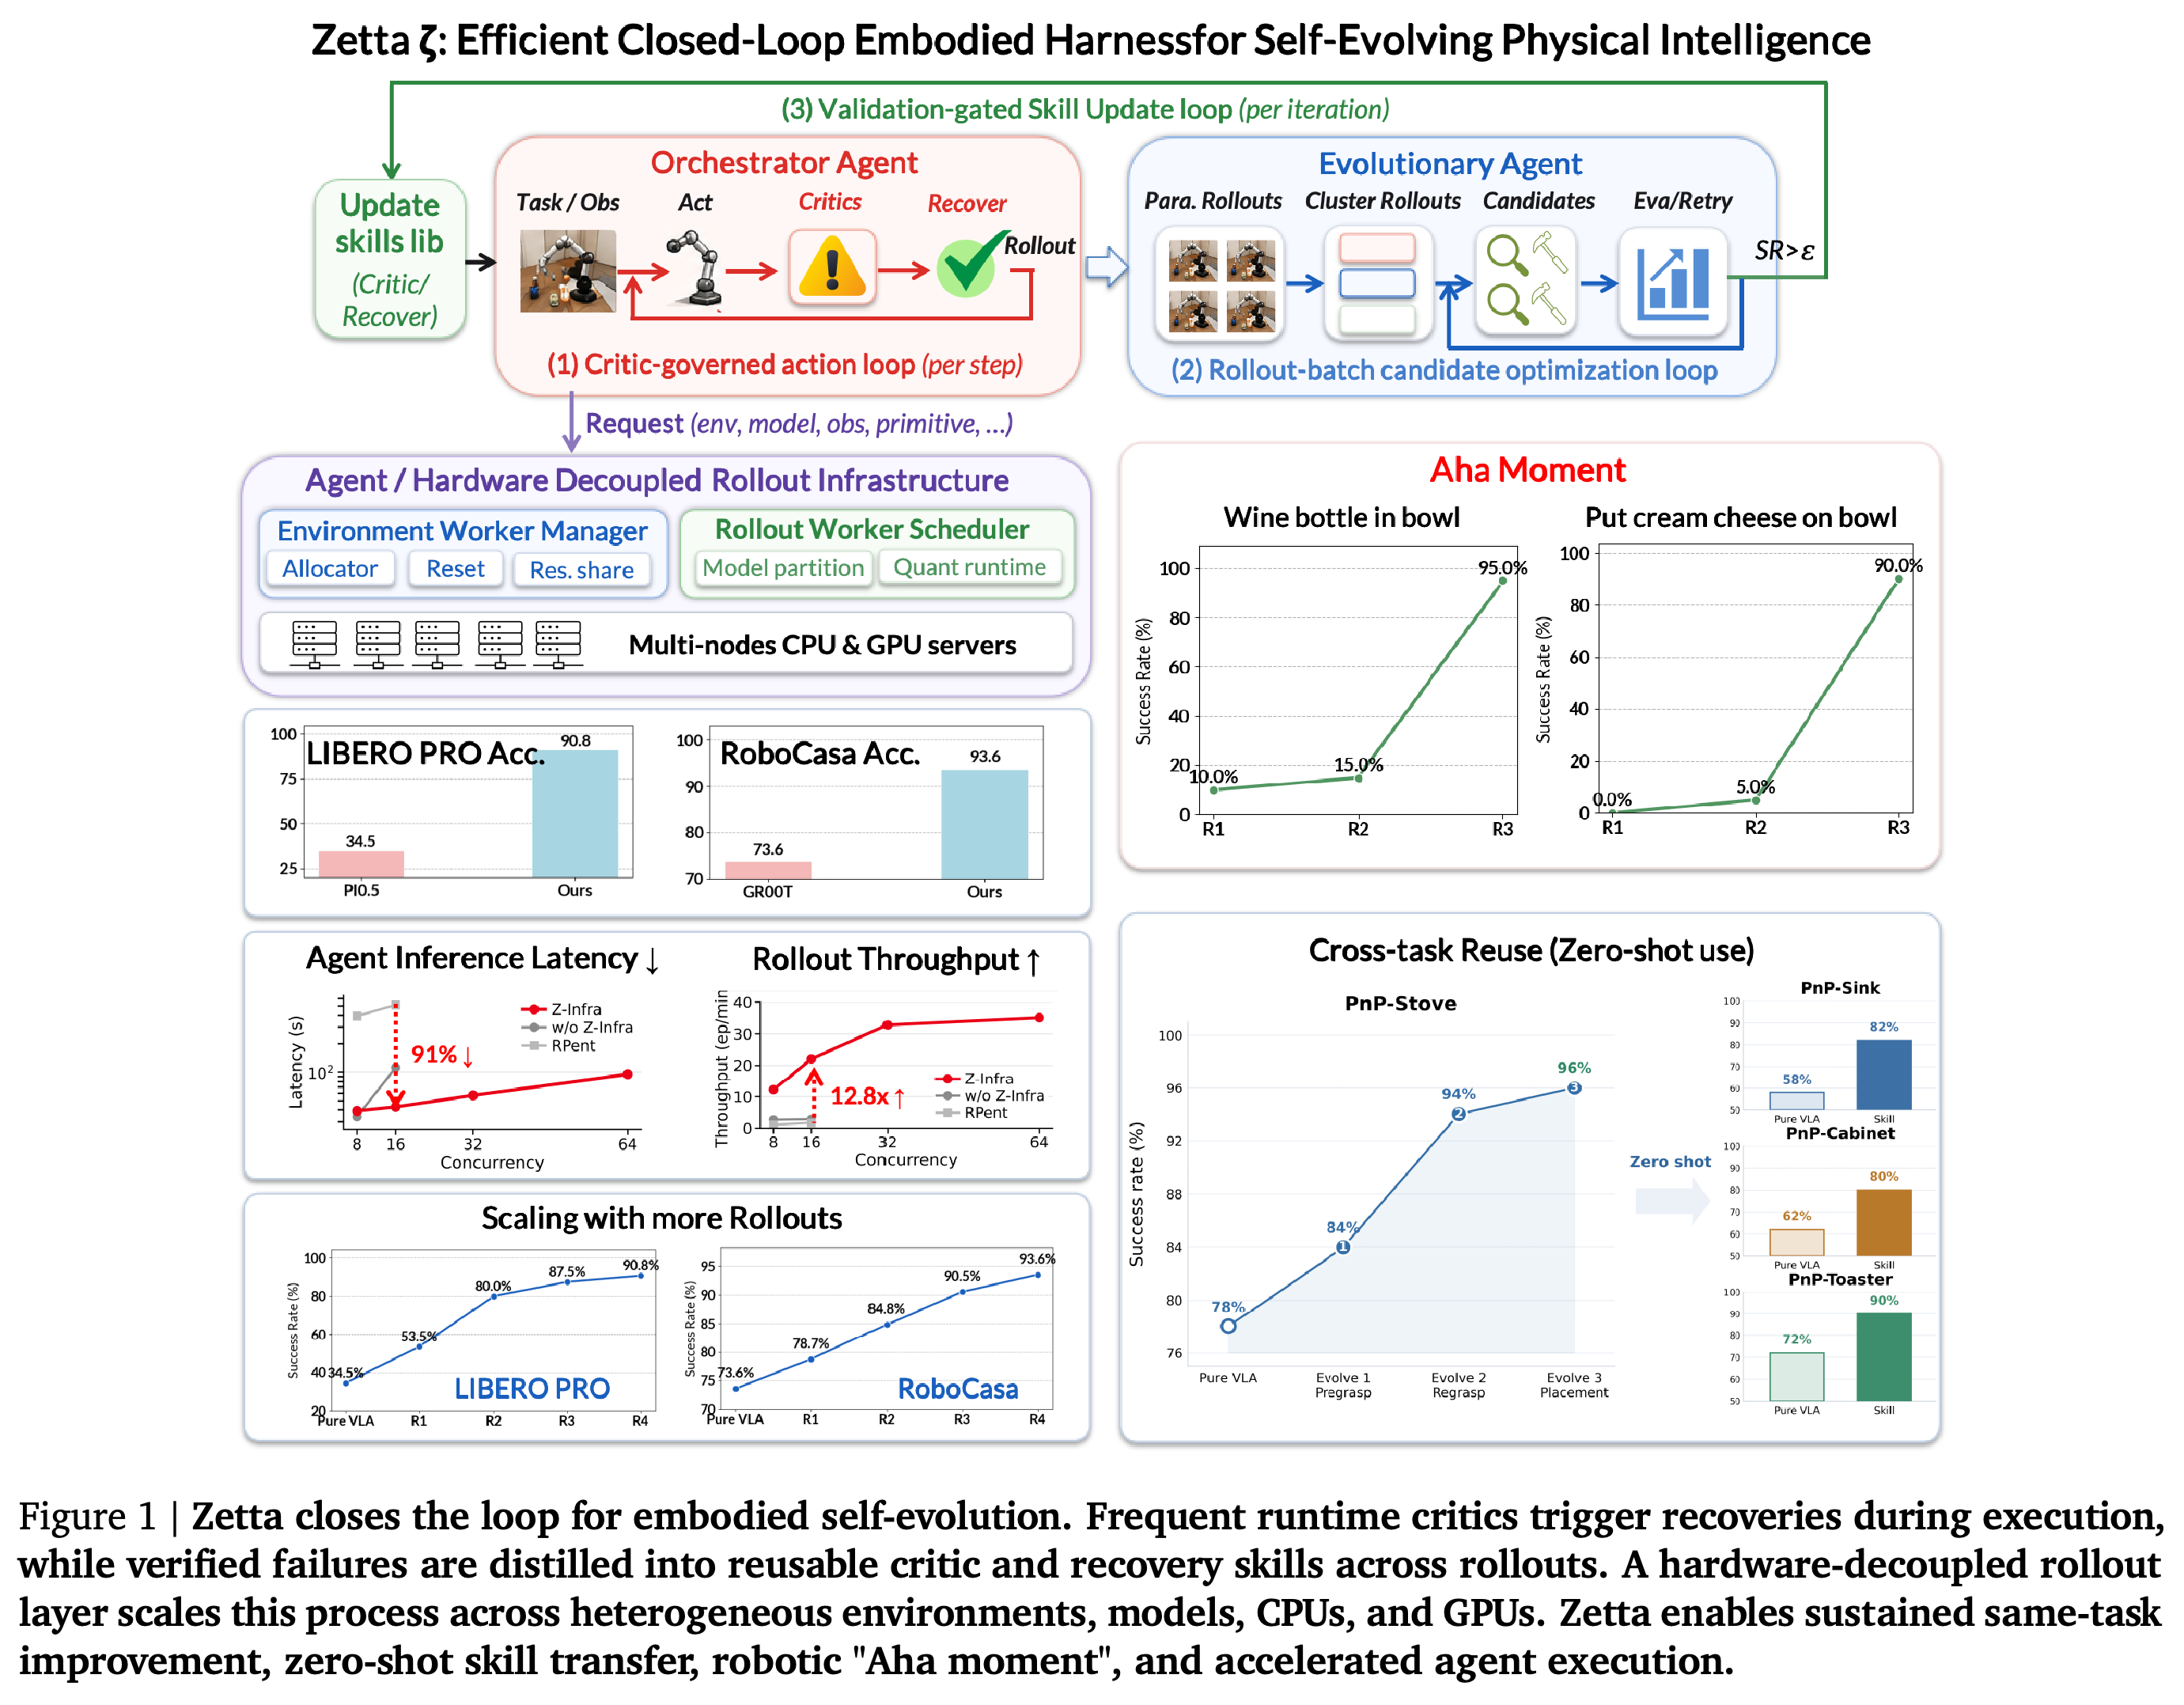
- Zetta는 고정된 VLA/WAM 정책은 유지하면서 코드 기반 런타임 비평기, 복구 플레이북, 도구를 진화시키는 폐루프 임바디드 하니스다. 행동 주파수 거버넌스, 롤아웃 배치 진단·복구, 검증 관문 기반 하니스 갱신, 이기종 롤아웃용 Z-Infra를 결합한다. 논문 초록은 명시한 롤아웃 예산에서 LIBERO-Pro 90.8%, RoboCasa 93.6%를 보고한다. 하니스에 대해서는 이 글을 참조하라.
개요는 Zetta의 비평기 거버넌스 행동 루프, 롤아웃 배치 후보 최적화 루프, 검증 관문 기반 갱신 루프를 하드웨어와 분리한 롤아웃 계층에 연결한다. 또한 보고한 벤치마크, 지연 시간, 처리량, 확장, 전이 결과를 요약한다.
1. Introduction
논문은 종단간 로봇 정책이 배포 환경 변화에 취약하며, 기존 에이전트 하니스 다수가 에피소드가 끝난 뒤에만 반성한다고 지적한다. Zetta는 런타임 비평기로 실행 중 물리적 편차를 감지하고, 검증한 실패 분석을 재사용 가능한 비평기와 복구 기제로 전환한다.
2. Enabling Deployment-Time Evolution of Embodied Agents
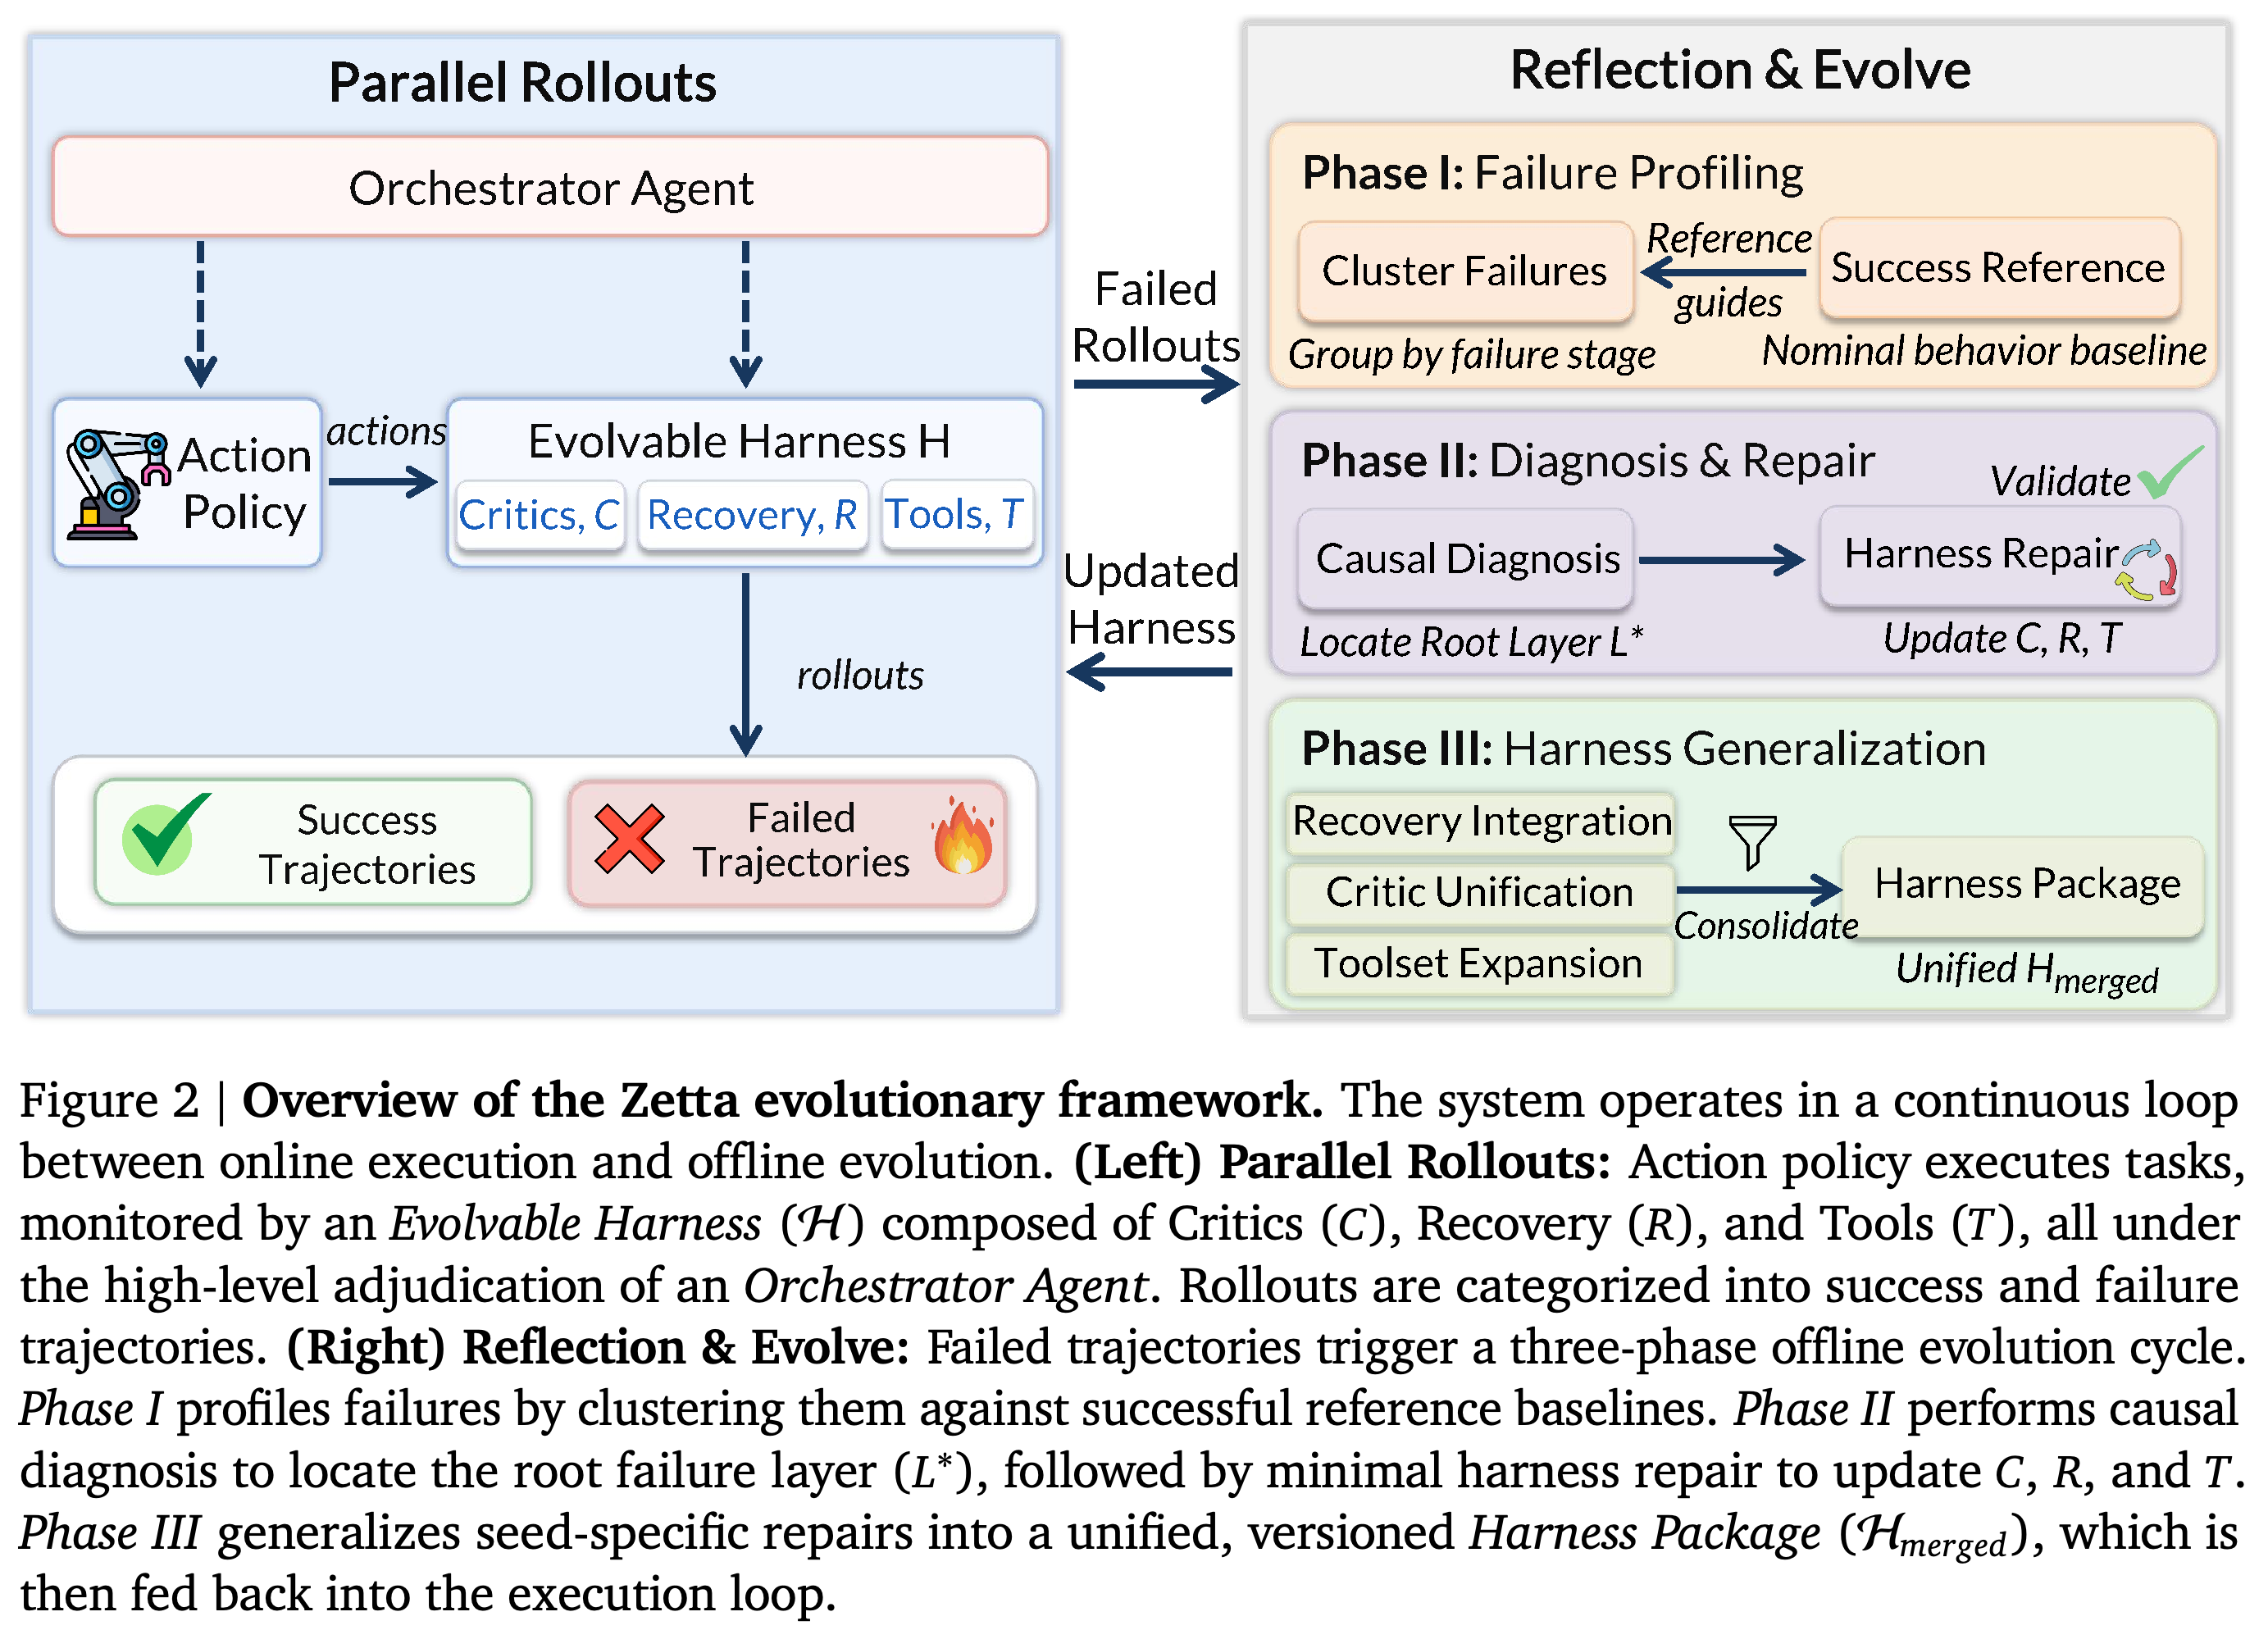
프레임워크는 고정된 Action Policy와 Orchestrator Agent를 비평기 C, 복구 플레이북 R, 도구 T로 구성한 진화 가능한 하니스 H와 분리한다. Orchestrator는 개입을 허용하기 전에 비평기가 제시한 증거를 검증하며, 오프라인 Evolutionary Agent는 실패 롤아웃을 바탕으로 H를 개선한다.
2.1. Problem Formulation: Dual-Agent Governance and Evolutionary Architecture
런타임 비평기는 증거를 생성하고 실행 모드를 제안하지만, 특수 도구가 기본 정책을 대체할지는 고정된 Orchestrator가 결정한다. 최적화 목적은 π와 A_orch를 고정한 채 H에 대한 기대 과제 성공률을 최대화하는 것이다: max_H J(H) = E_{g,s_0∼D}[Success(τ) | π, A_orch, H].
이 도식은 온라인 병렬 롤아웃과 실패 프로파일링, 인과 진단 및 복구, 하니스 일반화로 이루어진 3개 오프라인 진화 단계를 분리한다. 통합한 하니스가 롤아웃 루프로 되돌아가는 흐름을 보여 준다.
2.2. System Challenges and Design Principles
Zetta는 고주파 상태 거버넌스로 개방루프 의미론-물리 간극을 다루고, 하향식 최소 인과 개입으로 지나치게 특수화된 패치를 제한하며, 전문가 디버깅을 넘어선 일반화를 자동화한다. 진단 계층은 상태, 계획, 복구, 저수준 매개변수 변경보다 상위 수준의 평가와 비평기 논리를 먼저 검토한다.
2.3. Phase I: Empirical Failure Profiling and Baseline Establishment (Loop 1)
Phase I은 결정론적 라우팅으로 개발 시드에서 순수 정책 기준선을 설정하고, 인프라가 무효화한 시도는 다시 실행한다. 다중 모달 궤적을 기록하고 성공한 마일스톤 상태를 기준 참조로 색인하며, 이후 진단을 위해 각 실패 궤적의 First Missing Milestone을 식별한다.
2.4. Phase II Stage 1: Failure Clustering and Causal Diagnosis
Phase II Stage 1은 성공 참조 궤적과 비교한 Earliest Observable Divergence를 기준으로 실패 시드를 군집화하고, 상세 점검을 위해 메도이드 시드를 선택한다. 진단은 단일 시점 근거 기반 프로토콜을 사용하며 평가, 비평기, 상태, 계획·제어, 복구, 매개변수 계층 순서로 검토한다.
2.5. Phase II Stage 2: Critic-Guided Harness Repair and Validation
Repair Agent는 식별한 근본 계층에 맞춰 강화한 비평기, 복구 논리, 적응하거나 새로 합성한 도구를 포함하는 최소 하니스 패치를 구현한다. VLA 재진입 계약은 제어가 고정 정책으로 돌아가기 전에 실패 증거가 해소되고 물리적 안정성이 임계값을 넘어야 한다고 요구한다. 재생과 새 롤아웃 검증은 Orchestrator가 승인한 개입으로 목표에 도달해야 한다.
2.6. Phase III: Harness Consolidation, Packaging and Generalization
Phase III은 비평기 발동 조건을 통합하고 일반화한 복구를 결합하며 도구 집합을 확장해 시드별 패치를 버전 관리되는 H_merged로 통합한다. 승격하려면 원래 실패 군집에서 100% 성공하고 기본 정책보다 홀드아웃 성능이 개선되어야 한다. 수정에 사용한 홀드아웃 실패 사례는 개발 데이터가 되며, 새로 분리한 검증 집합이 필요하다.
3. Z-Infra: Embodied Agent Rollout Infrastructure
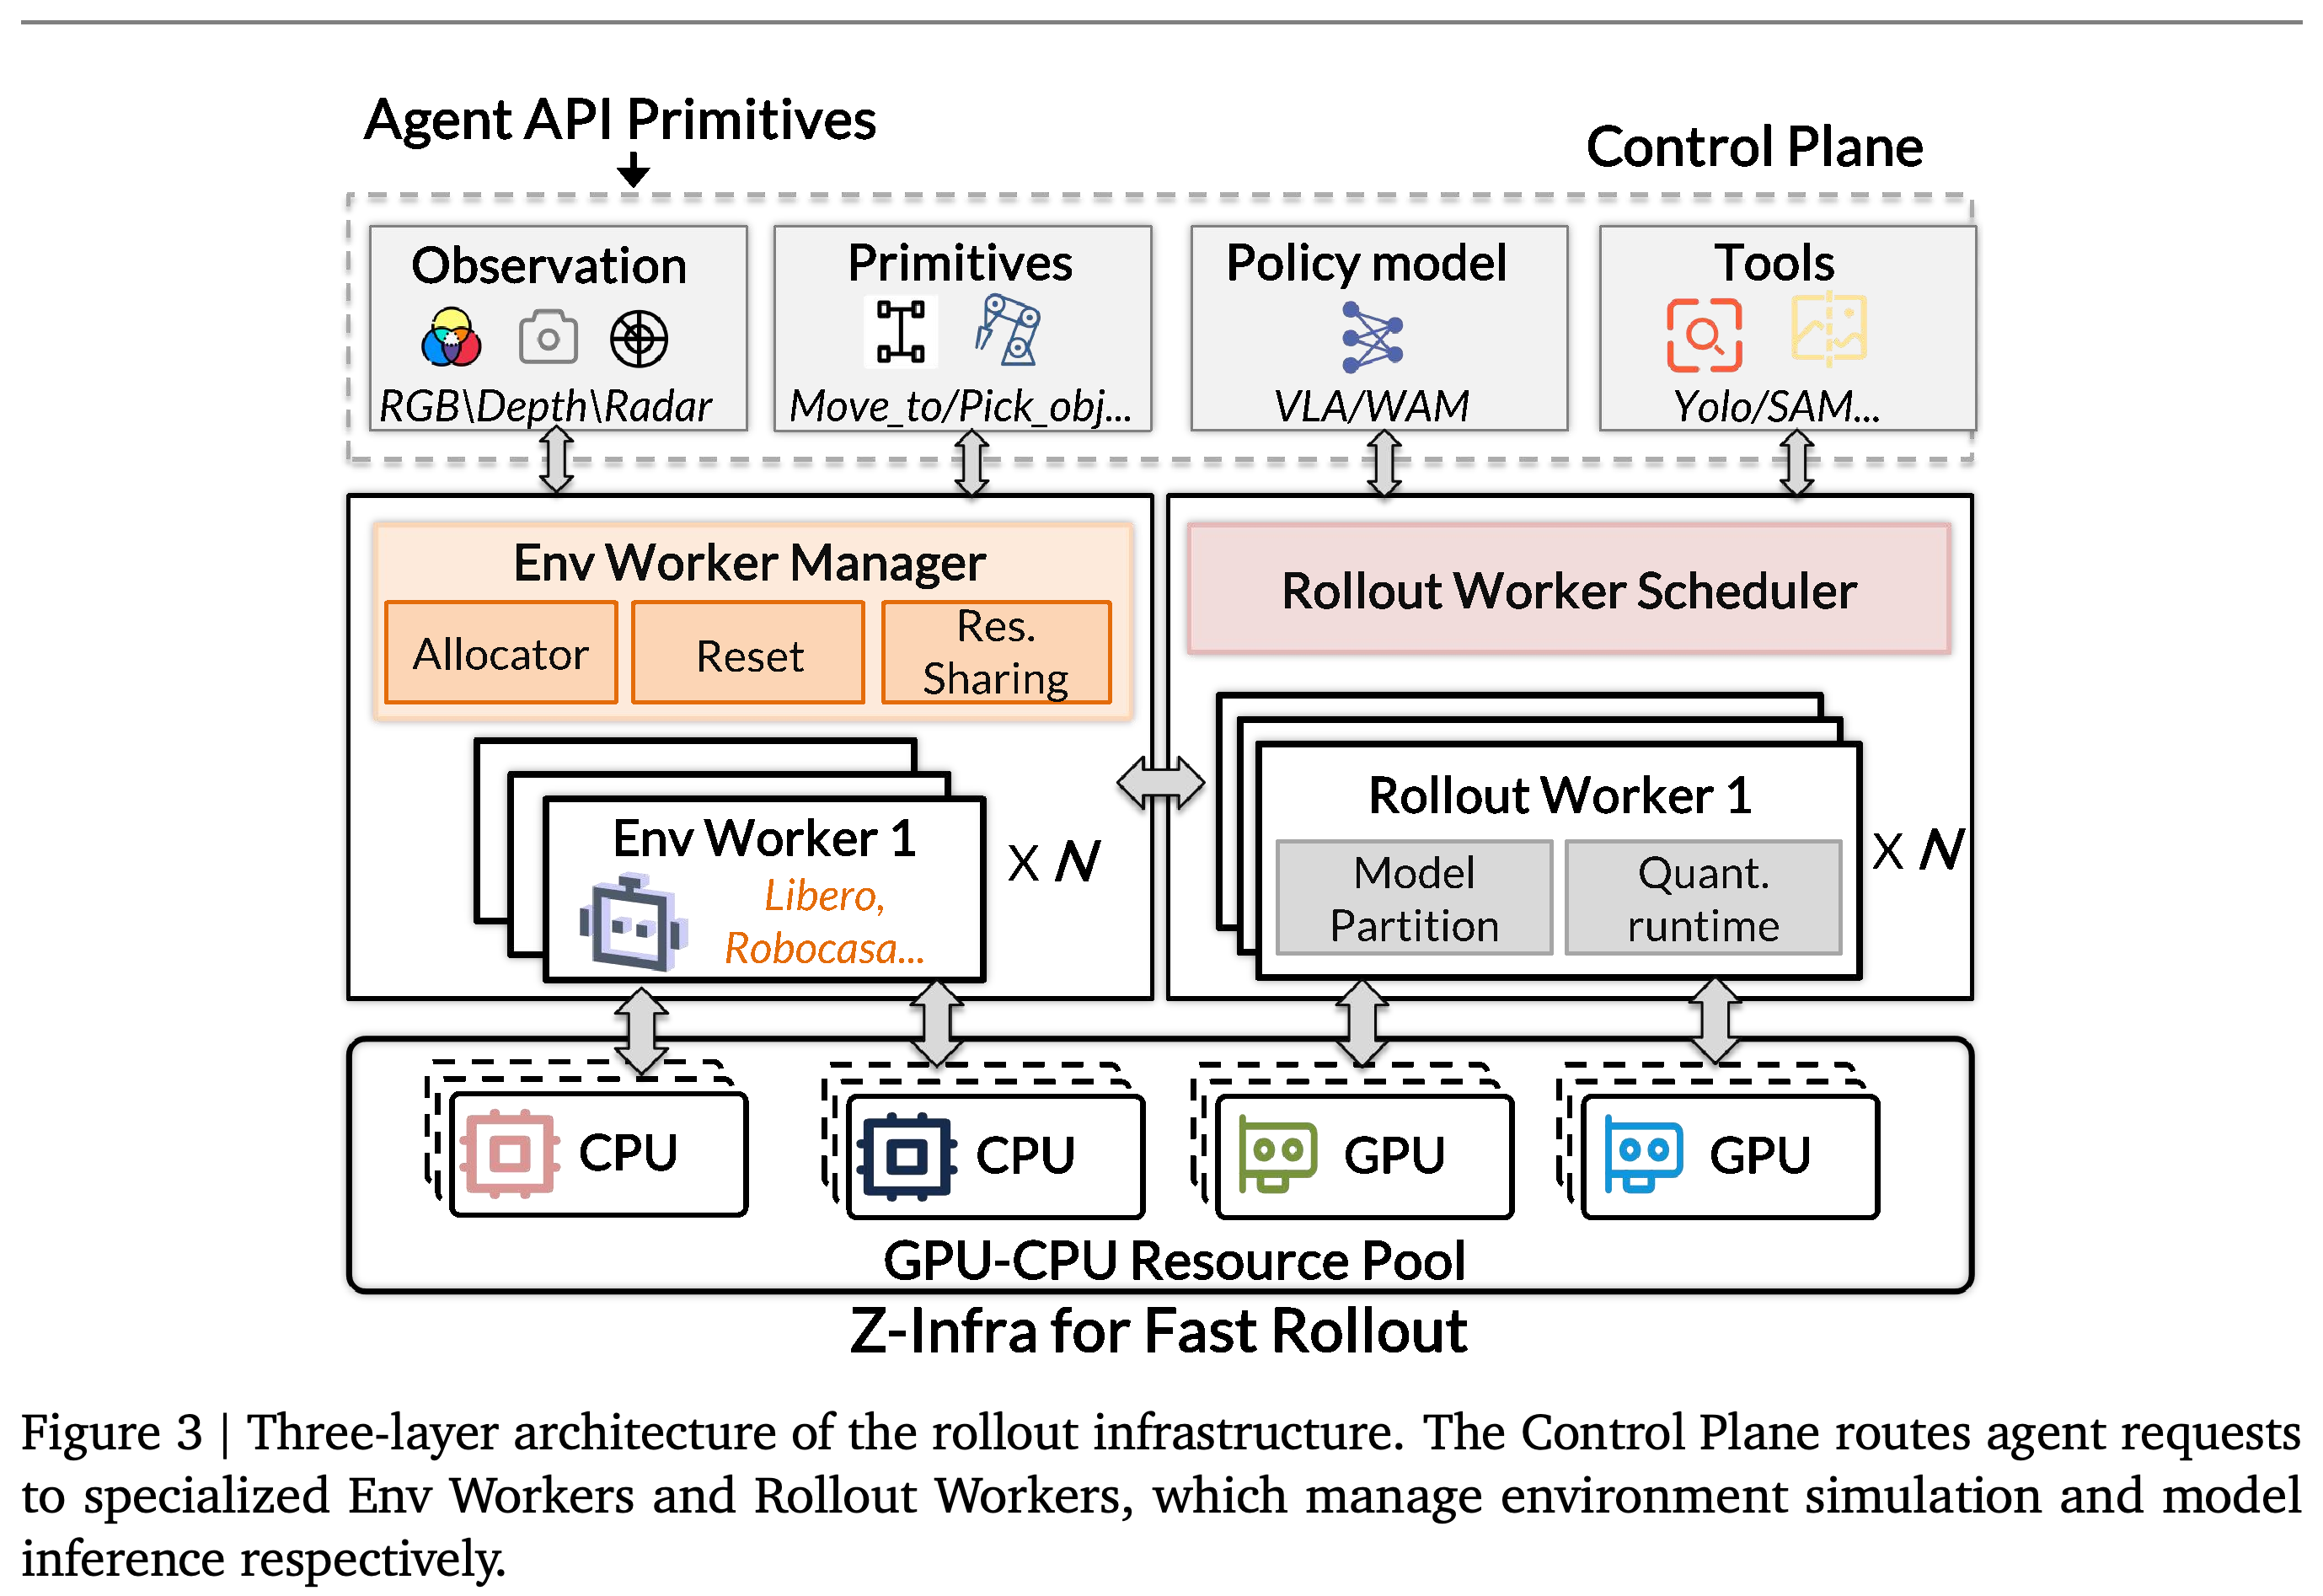
Z-Infra는 이기종 시뮬레이터와 컴퓨팅 자원 전반에서 동시 에이전트-환경 롤아웃을 실행하는 기반 계층이다. 공통 세션 인터페이스를 제공하면서 에이전트 논리를 환경 실행, 모델 서빙, 자원 할당과 분리한다.
3.1. Overview
롤아웃은 격리된 환경 세션을 준비하고 초기화한 뒤 관측을 반복 수집하고 정책, 지각 모델, 원시 연산을 호출하며 종료 시 세션을 해제한다. 이 인터페이스는 CPU 중심 MuJoCo/robosuite 시스템뿐 아니라 GPU 병렬 및 PhysX 기반 백엔드도 포괄하도록 설계했다.
3.2. Challenges and Key Ideas
이 인프라는 시뮬레이션, 렌더링, 정책 추론, 지각, 저지연 원시 연산과 간헐적인 에이전트 실행이 요구하는 이기종 작업 부하를 대상으로 한다. 가상 롤아웃 추상화는 에이전트가 실행할 작업을 지정하게 하고, 시스템은 배치 위치 선정, 라우팅, 배칭, 스케줄링을 처리한다.
3.3. System Architecture
Z-Infra는 유한 비동기 채널로 연결한 Control Plane, Environment Worker 계층, GPU 상주 Rollout Worker 계층으로 구성한다. Control Plane은 세션과 워커 상태를 추적하고, 환경 워커는 생명주기 관리를 격리하며 재사용 가능한 MuJoCo 자원을 공유한다. 롤아웃 워커는 호환되는 요청을 배치로 묶고 VLM과 Action Expert 단계를 분리하며 정책 모듈을 양자화할 수 있다.
아키텍처는 공유 CPU–GPU 자원 풀에서 Control Plane이 조정하는 Env Worker에 환경 생명주기 작업을, Rollout Worker에 모델 추론을 배정한다.
3.4. Programming Support
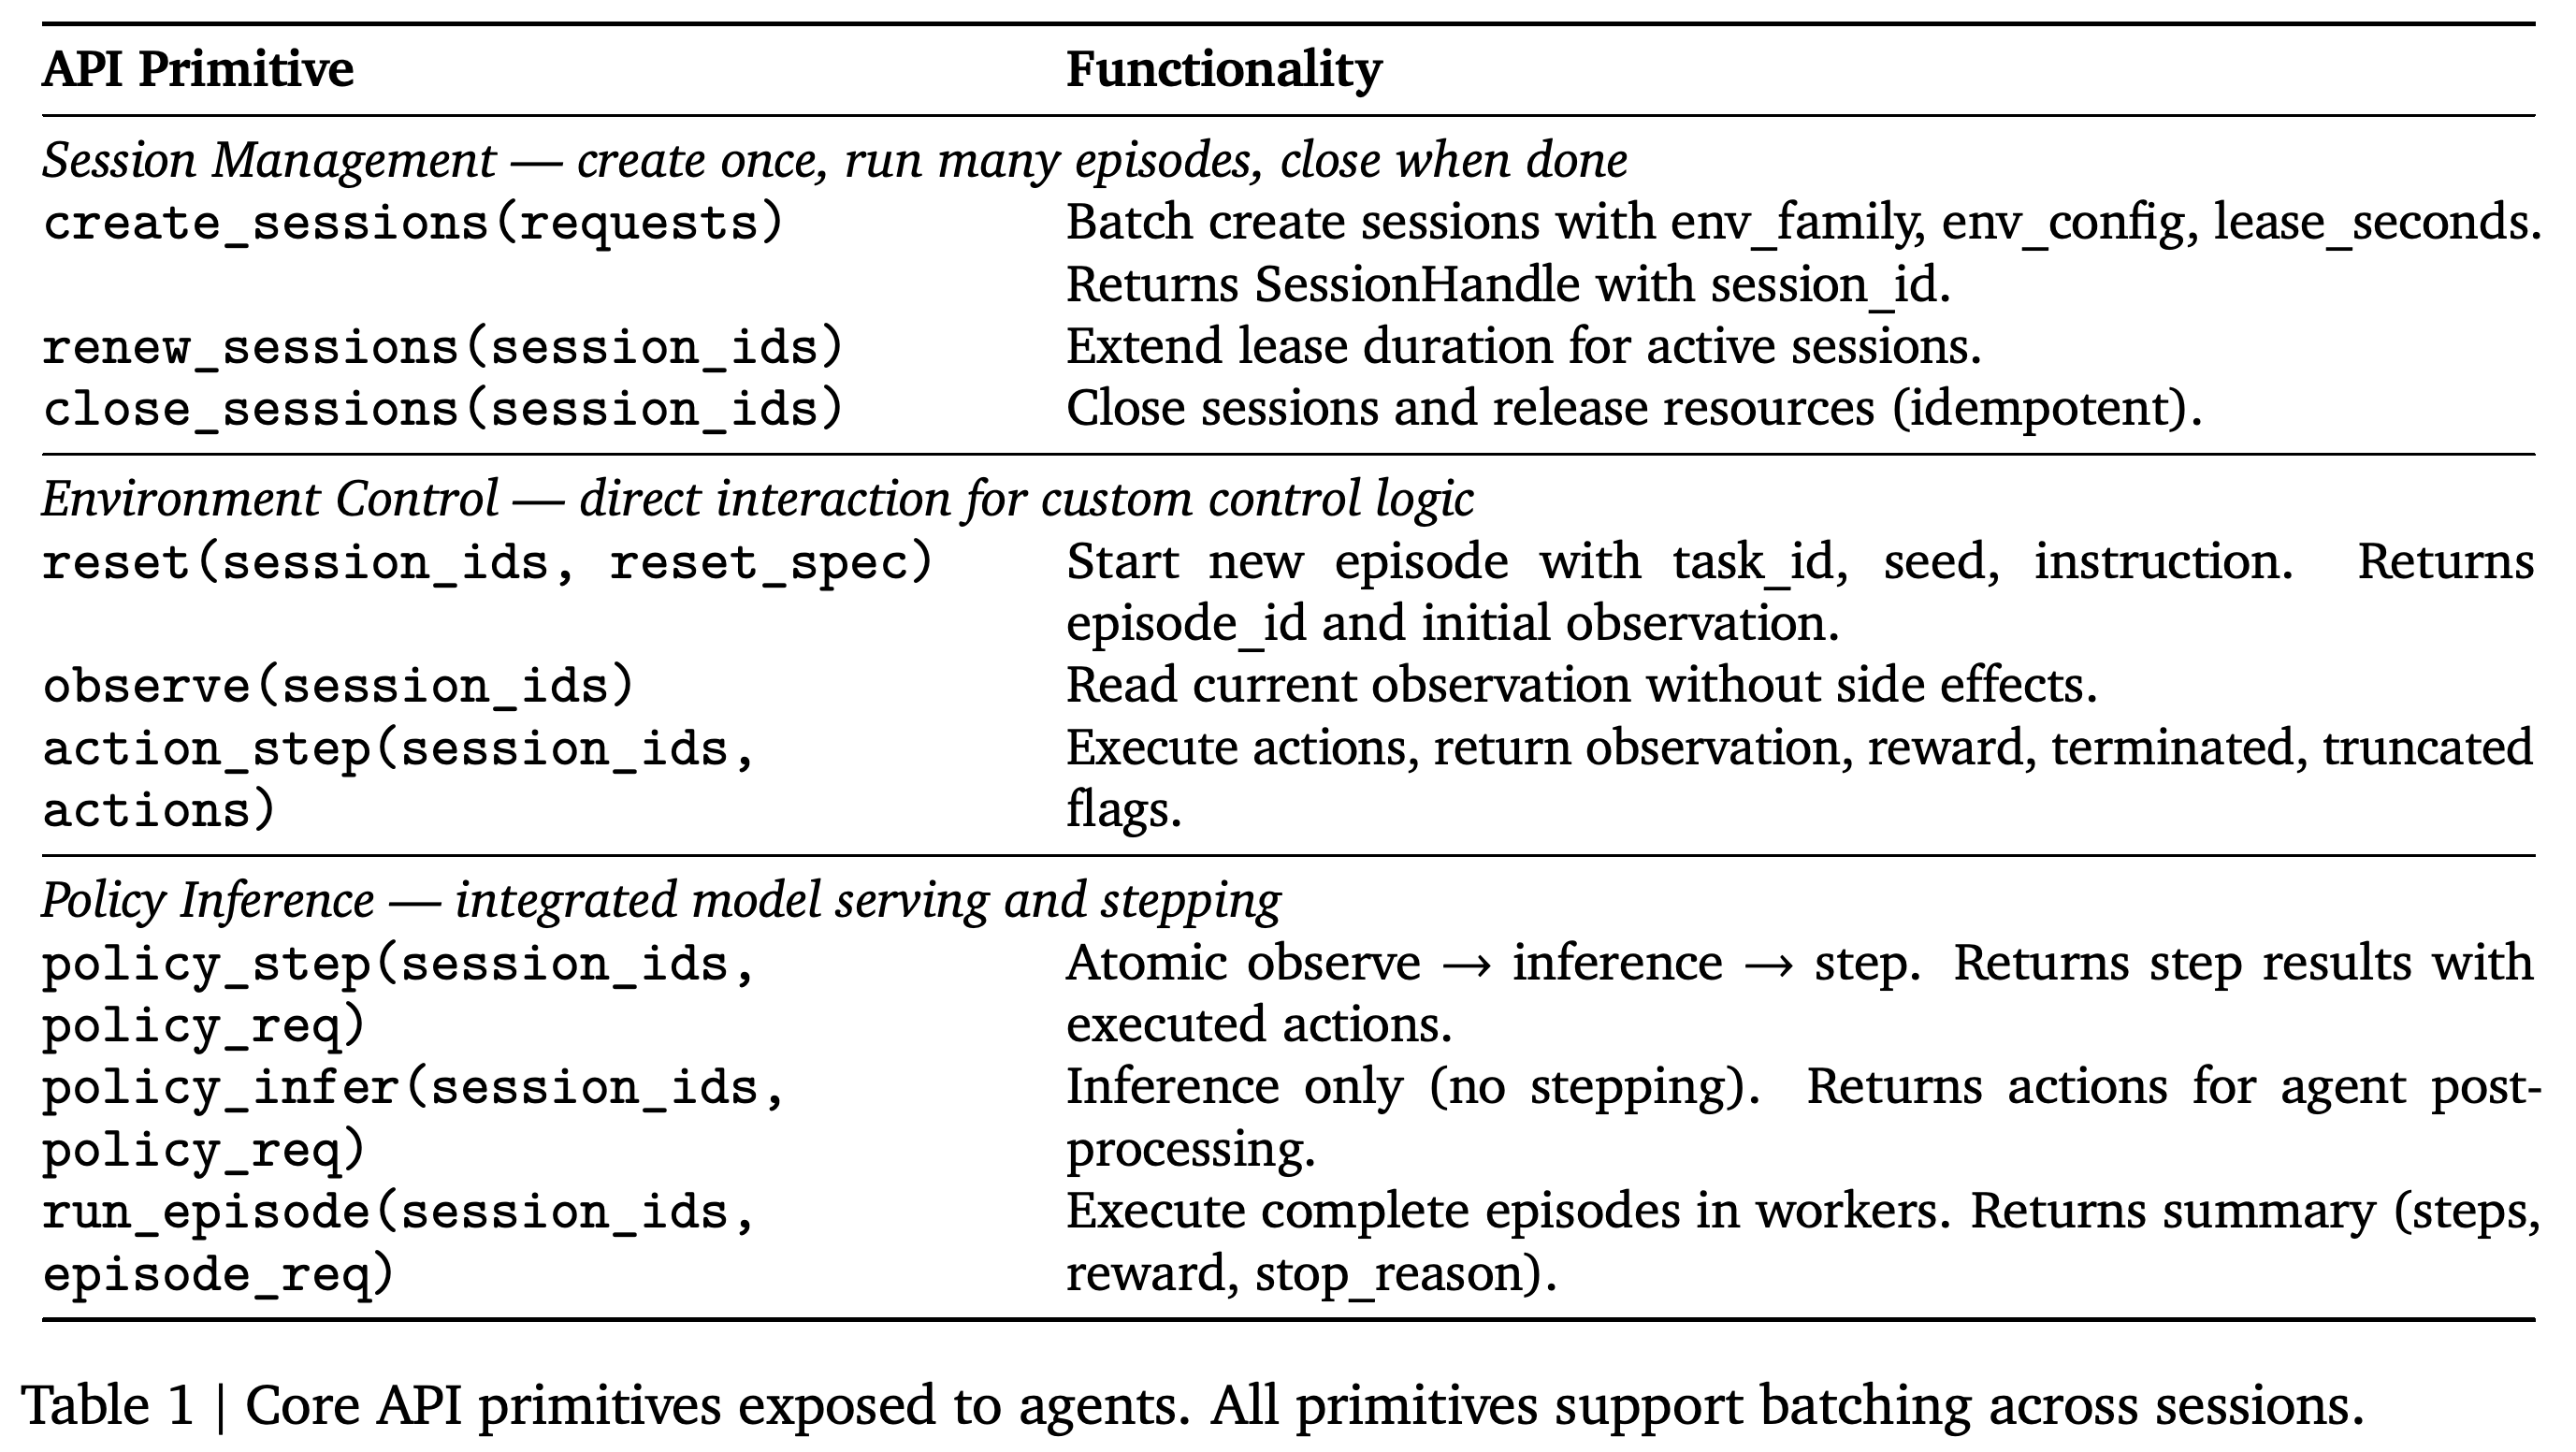
프로그래밍 모델은 세션, 에피소드, 스텝을 중심으로 생명주기 관리, 직접 환경 제어, 정책 추론, 지각 또는 계획용 API를 제공한다. policy_step 호출은 Env Worker의 관측과 지시를 배치 처리하는 Rollout Worker로 비동기 라우팅하고, 결과 행동을 반환해 환경 스텝을 수행한다.
이 표는 세션 관리, 환경 제어, 정책 추론, 에피소드 실행용 기본 연산을 명시한다. 각 연산은 여러 세션에 걸친 배칭을 지원한다.
4. Experiments
실험은 LIBERO-Pro에서 고정된 π0.5와 RoboCasa에서 고정된 GR00T N1.5를 평가하며, 하니스 진화, 제로샷 전이, 시뮬레이션 벤치마크 결과, 사례 연구, 롤아웃 효율을 다룬다. 배포 시점 개선은 기본 정책 가중치의 미세 조정이 아니라 하니스 변경에서 비롯된다고 설명한다.
4.1. Experimental Setup
벤치마크 진화에는 8× NVIDIA GeForce RTX 4090 클러스터를 사용한다. RoboCasa는 과제별로 50개의 개발 시드와 서로 겹치지 않는 50개의 테스트 시드를 사용한다. LIBERO-Pro는 시드 1–20을 제외한 50개의 개발 시드를 사용하고 홀드아웃 시드 1–20에서만 평가하며, 선택한 개발 시드가 최소 50% 성공할 때까지 개발 실패 군집을 대상으로 복구한다. 클러스터에 대해서는 이 글을 참조하라.
4.2. Physical Intelligence ``Aha’’ Moments
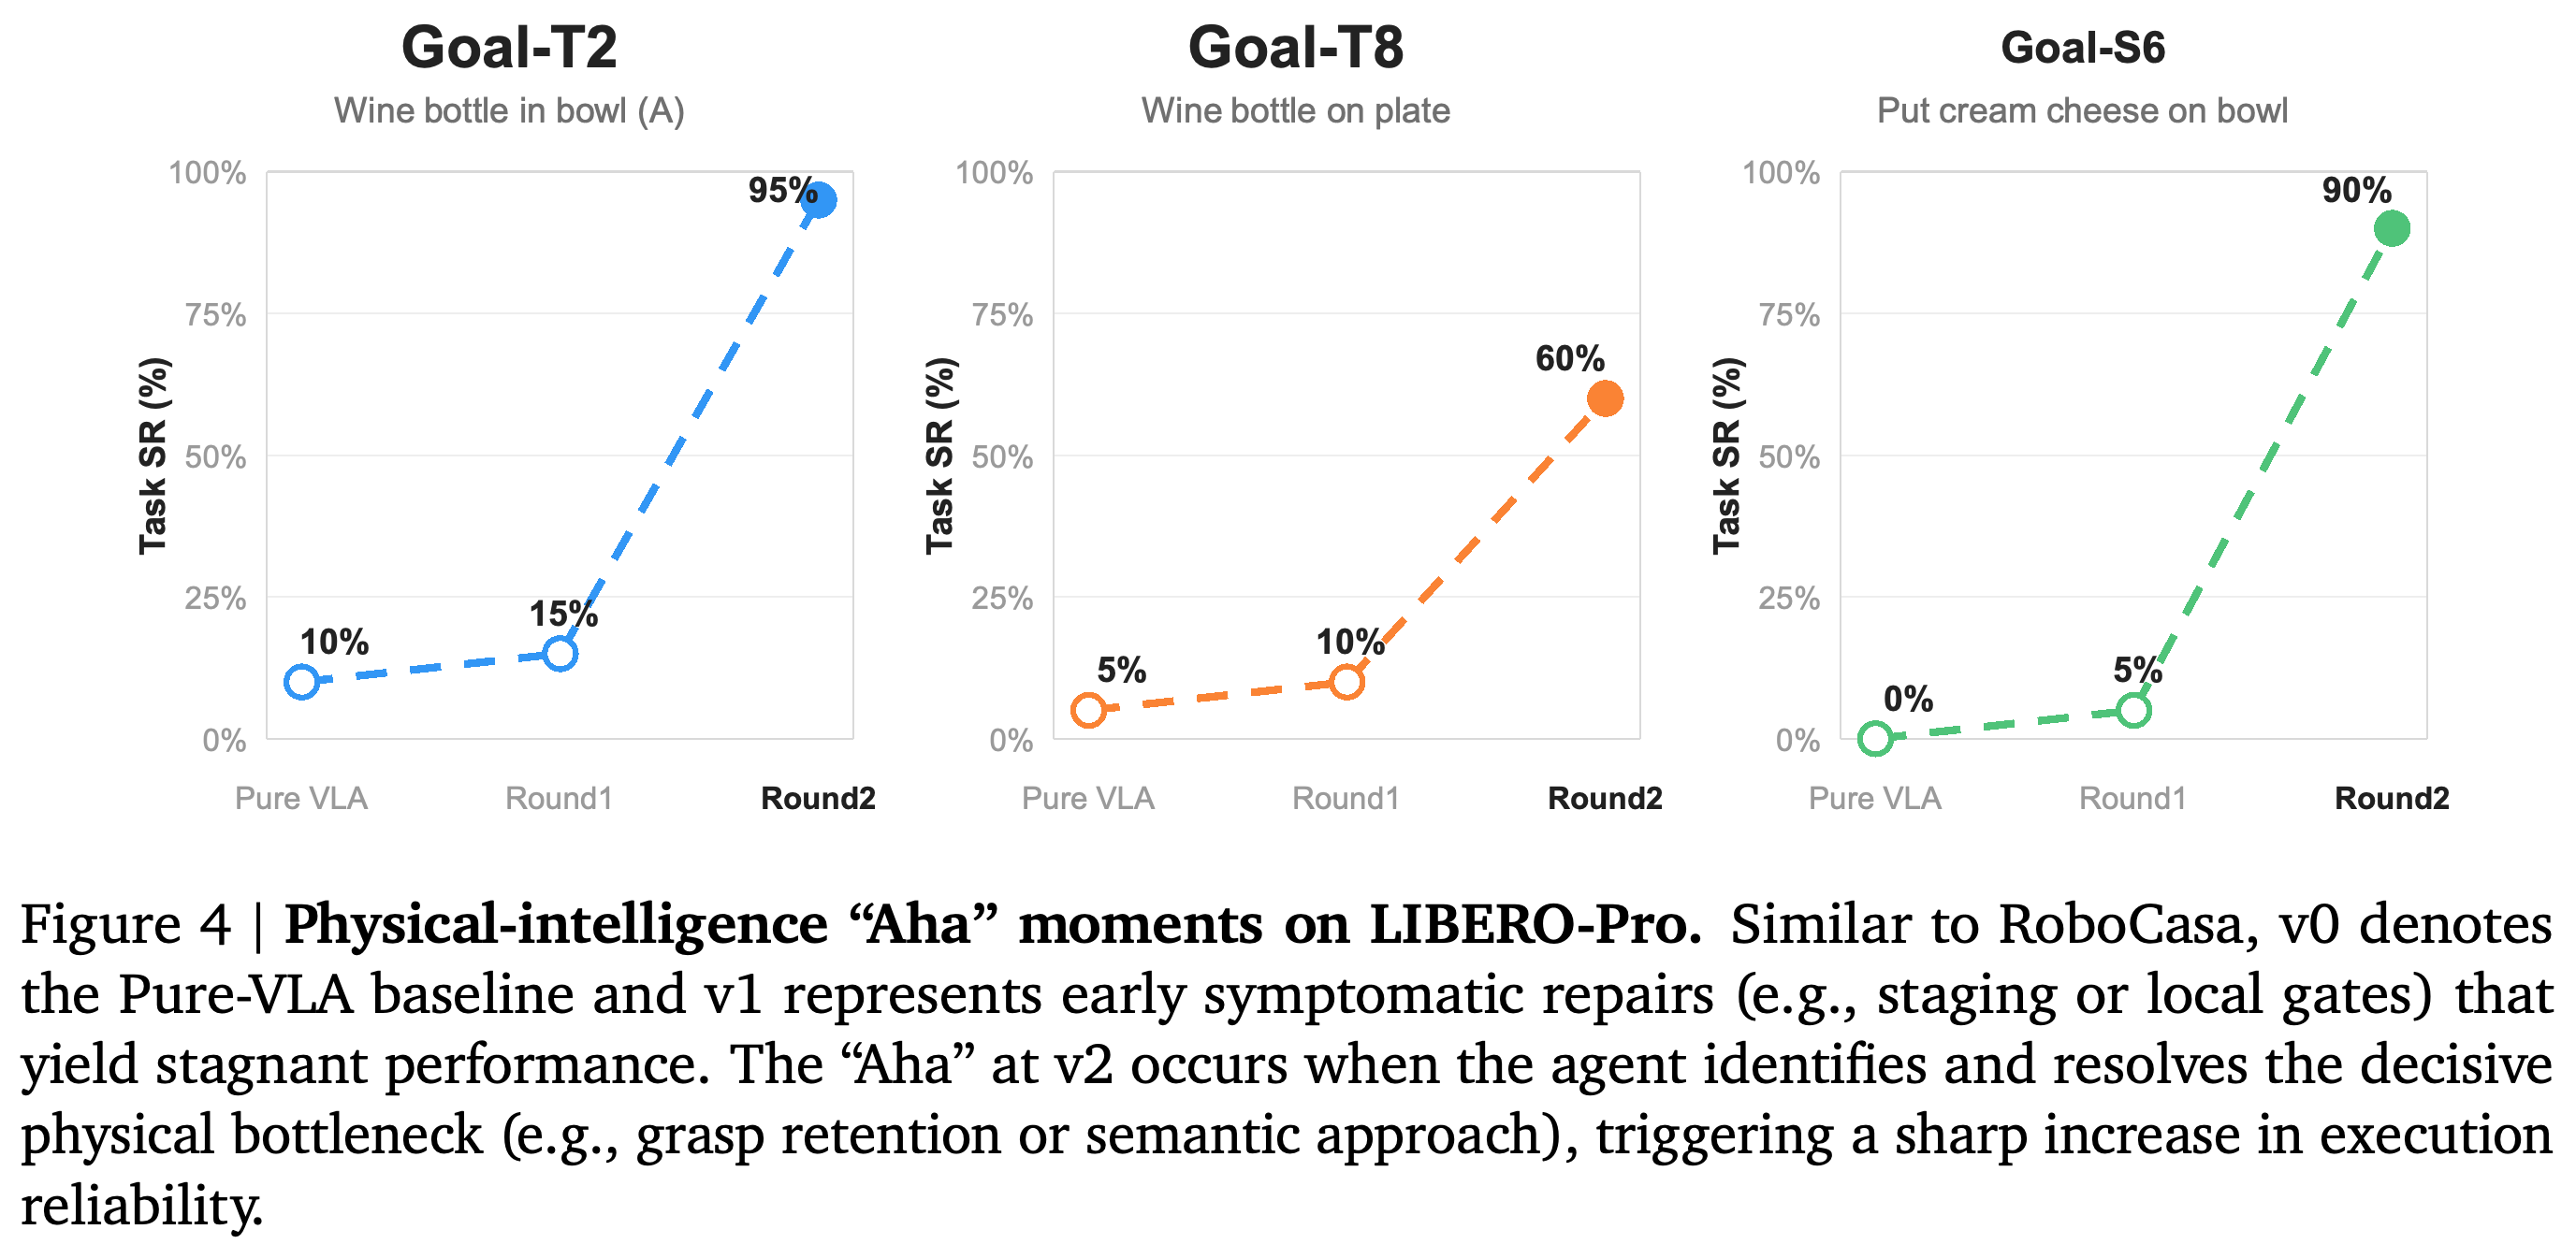
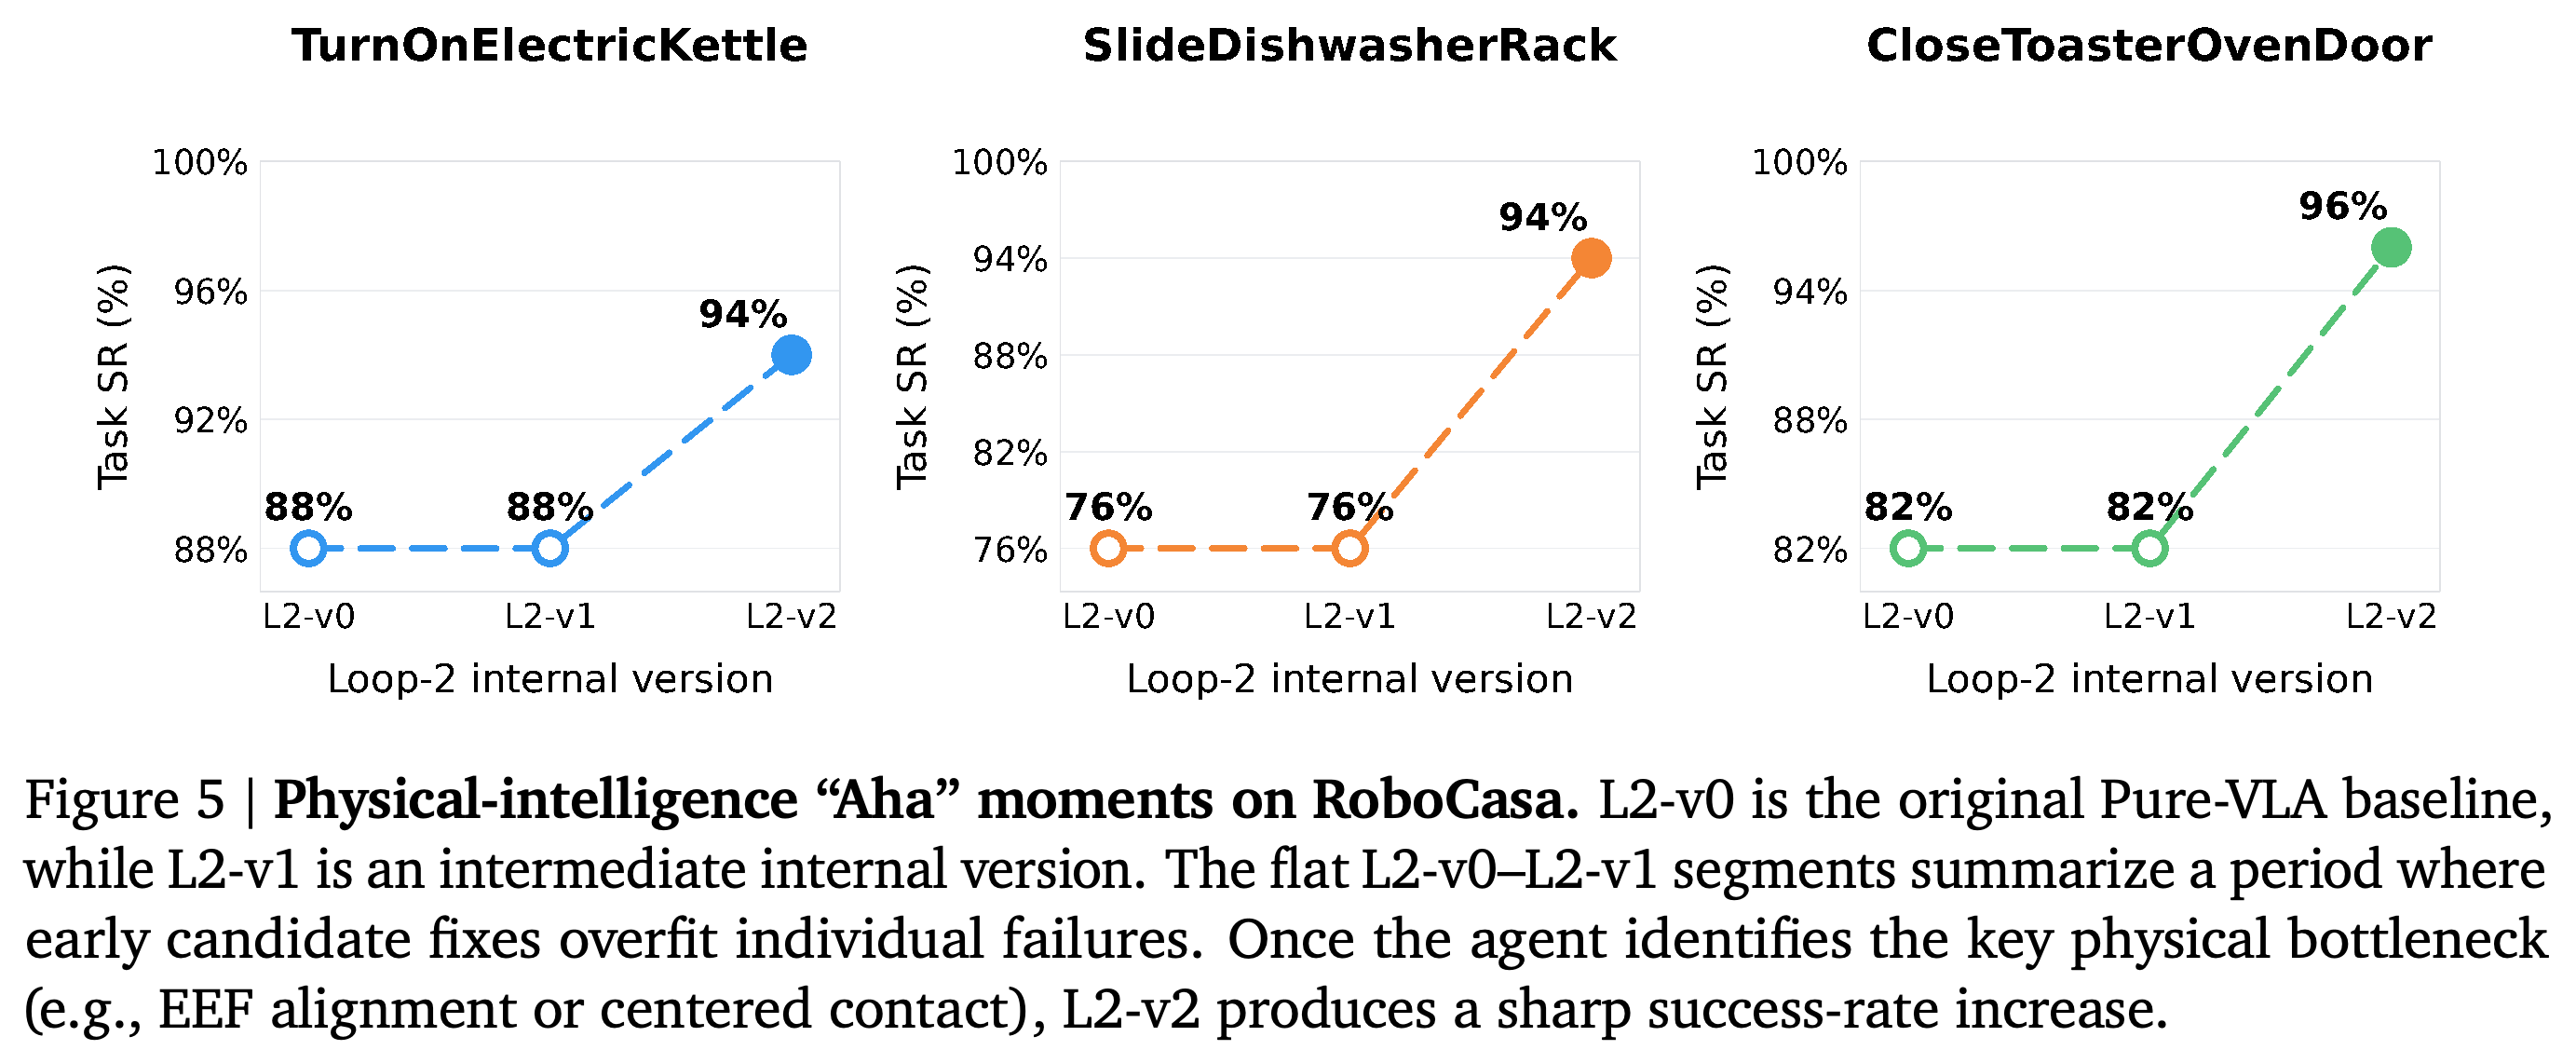
논문은 중간 복구 버전이 결정적인 물리 상태 변수가 아닌 증상만 다뤄 성능이 정체된 뒤 급격한 향상이 나타나는 현상을 로봇 “Aha” 순간으로 정의한다. LIBERO-Pro에서 Goal-T2는 10%에서 95%로, Goal-T8은 5%에서 60%로, Goal-S6는 0%에서 90%로 상승한다. 선택한 RoboCasa 사례는 각각 88%에서 94%, 76%에서 94%, 82%에서 96%로 개선된다.
3개 LIBERO-Pro 사례는 비평기-복구 갱신이 파지 유지 또는 접근 병목을 겨냥할 때, 제한적인 초기 향상 뒤 불연속적인 개선이 나타남을 보여 준다.
3개 RoboCasa 그래프는 시스템이 정렬 또는 중심 접촉 병목을 식별한 뒤 L2-v0에서 L2-v1까지 정체한 성능이 L2-v2에서 향상됨을 보여 준다.
4.3. Physical Intelligence Scaling and Zero-shot Capability
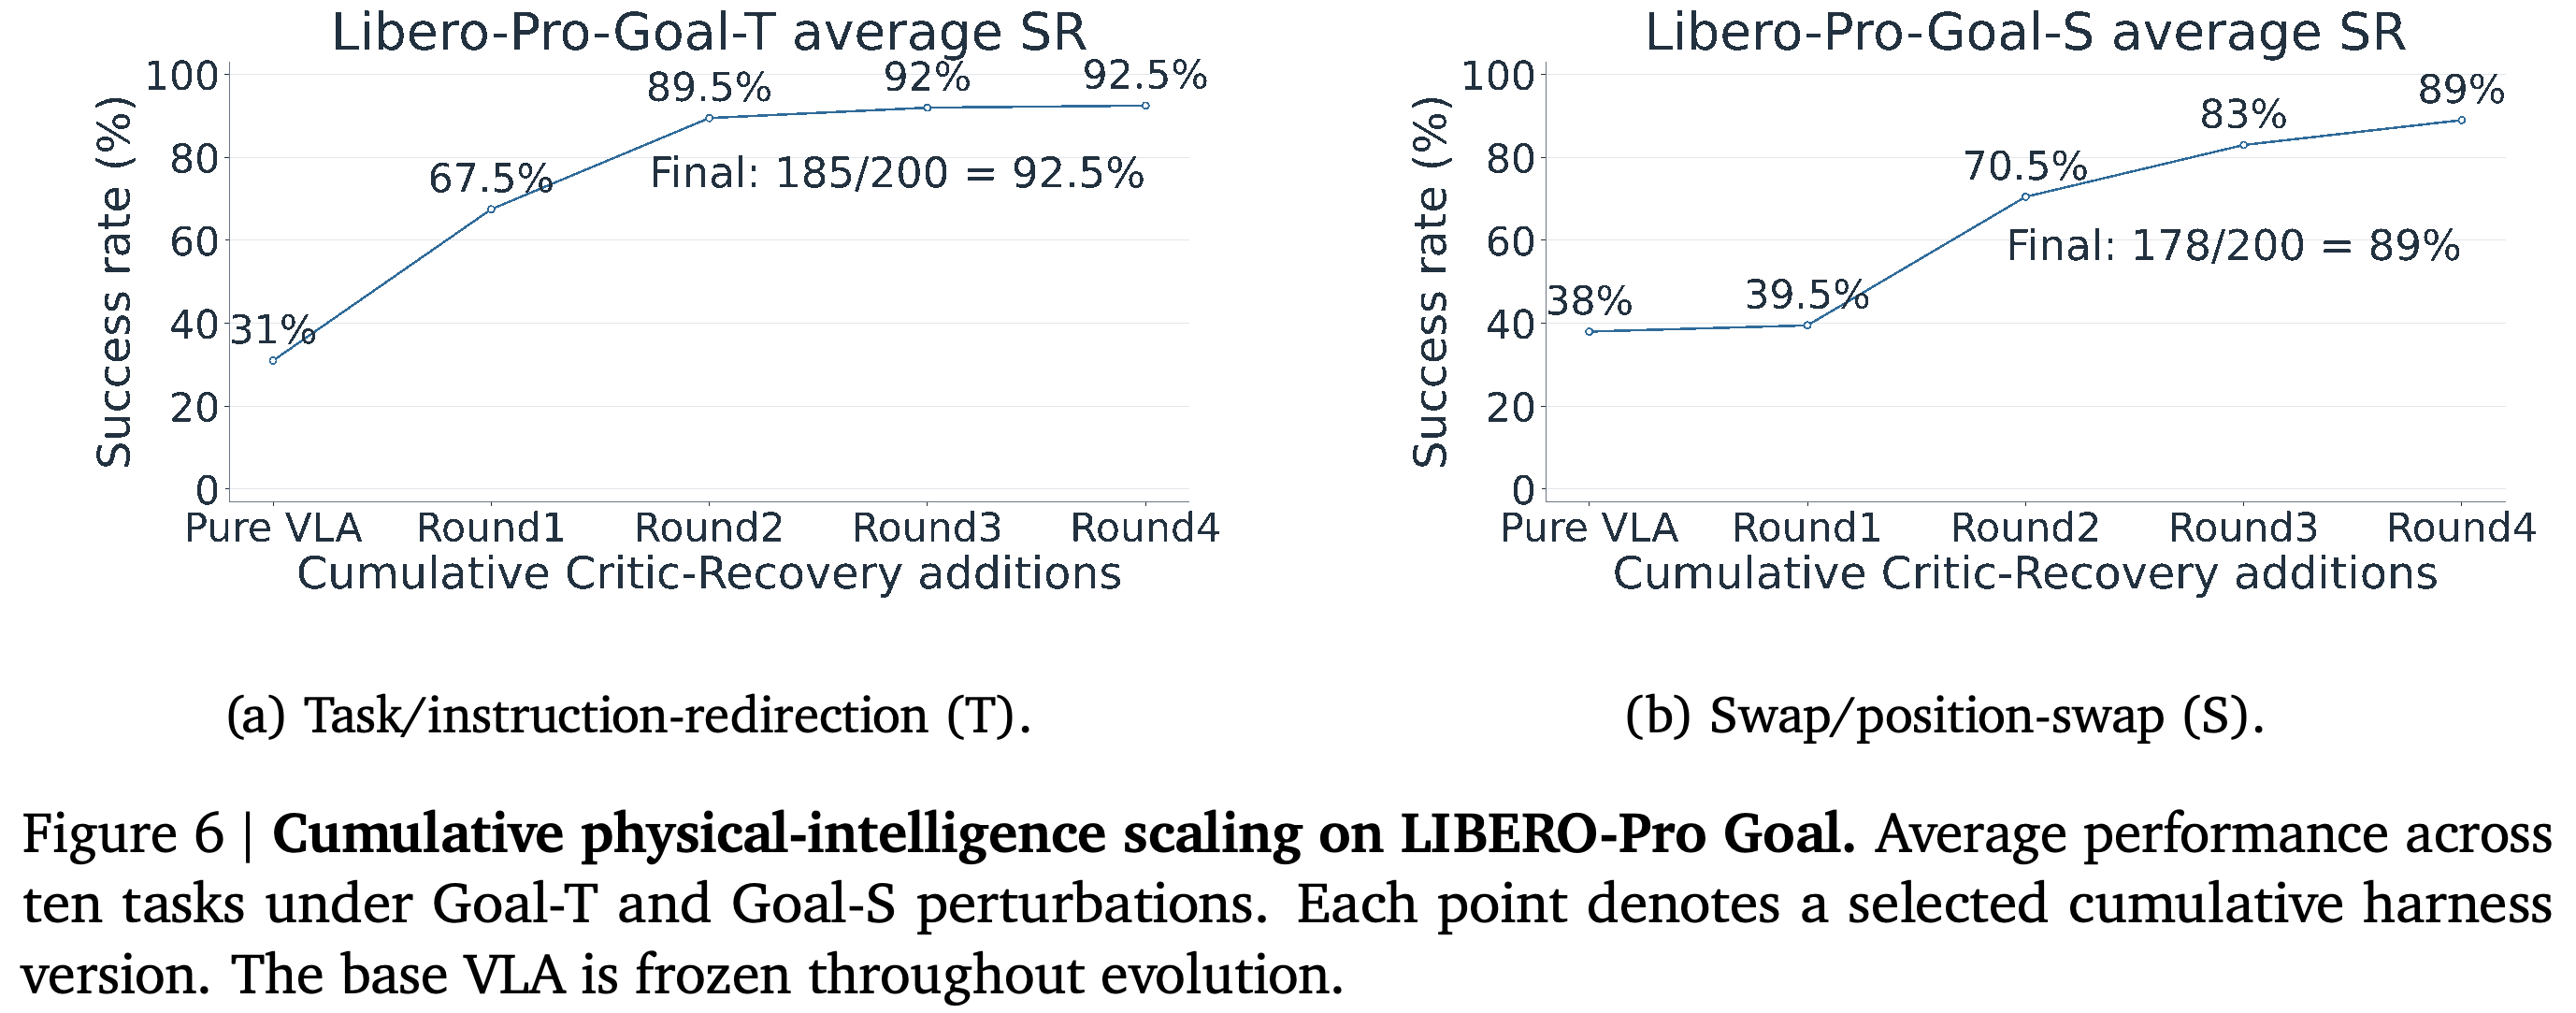
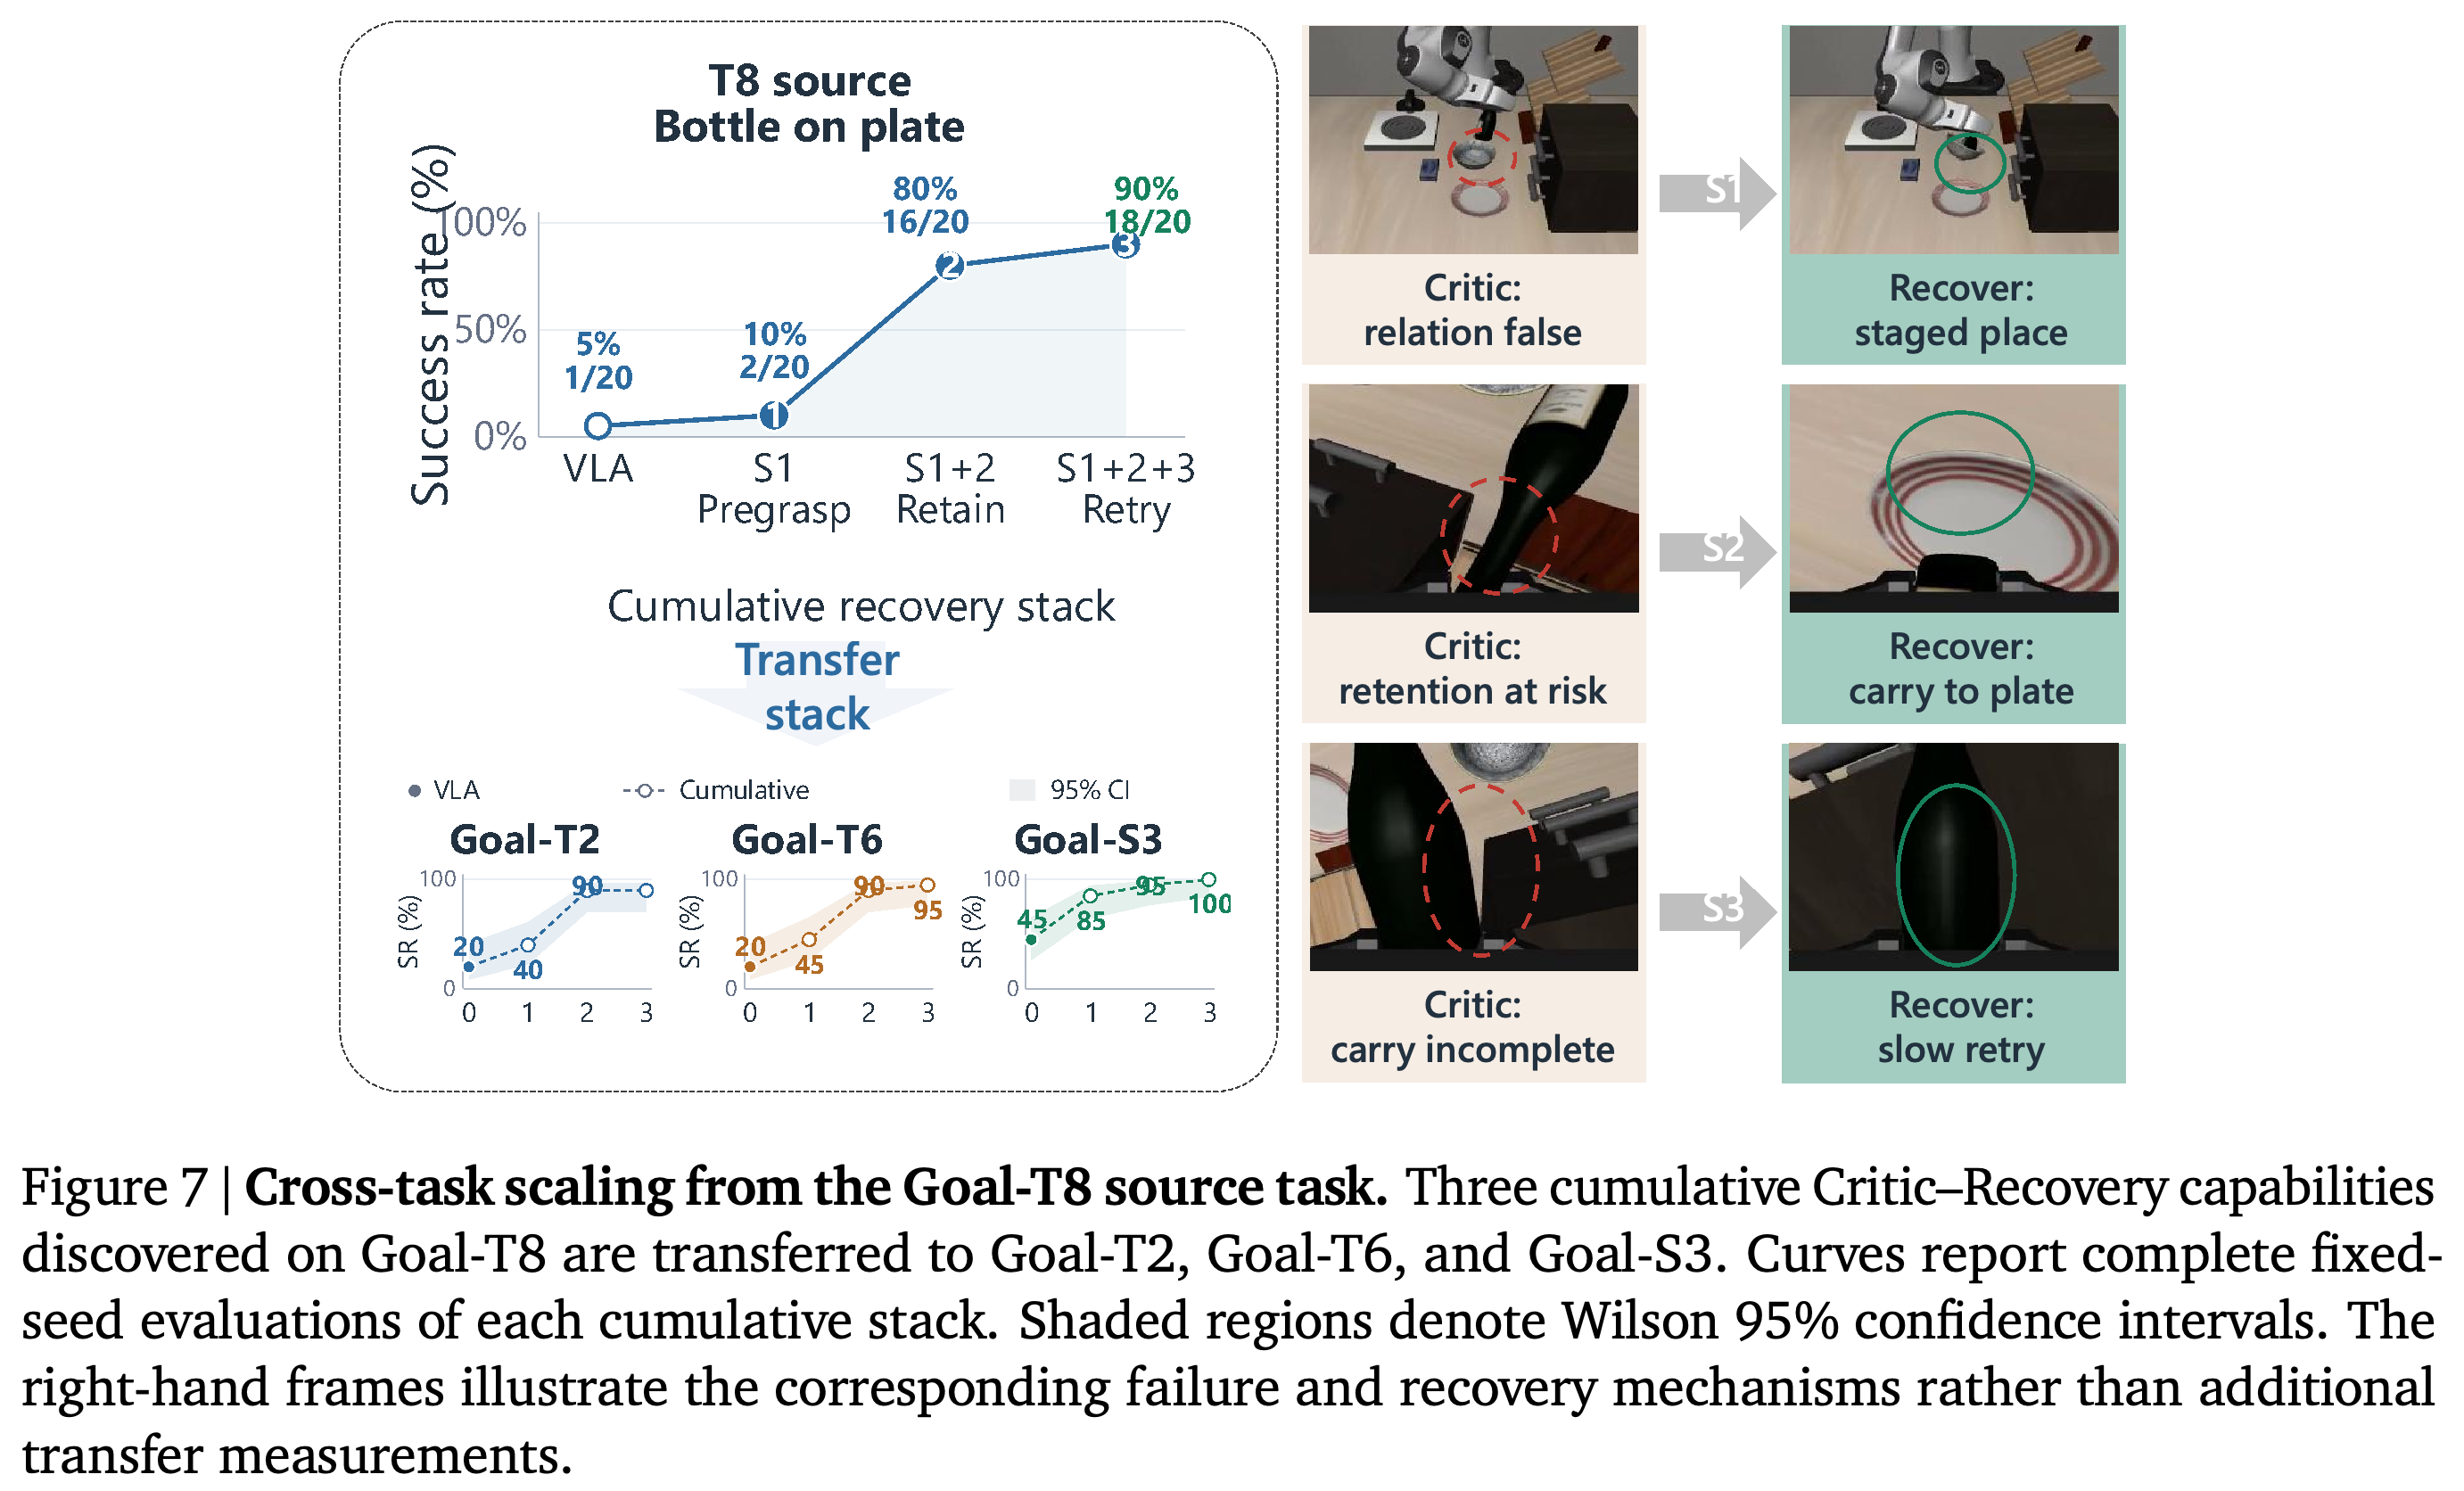
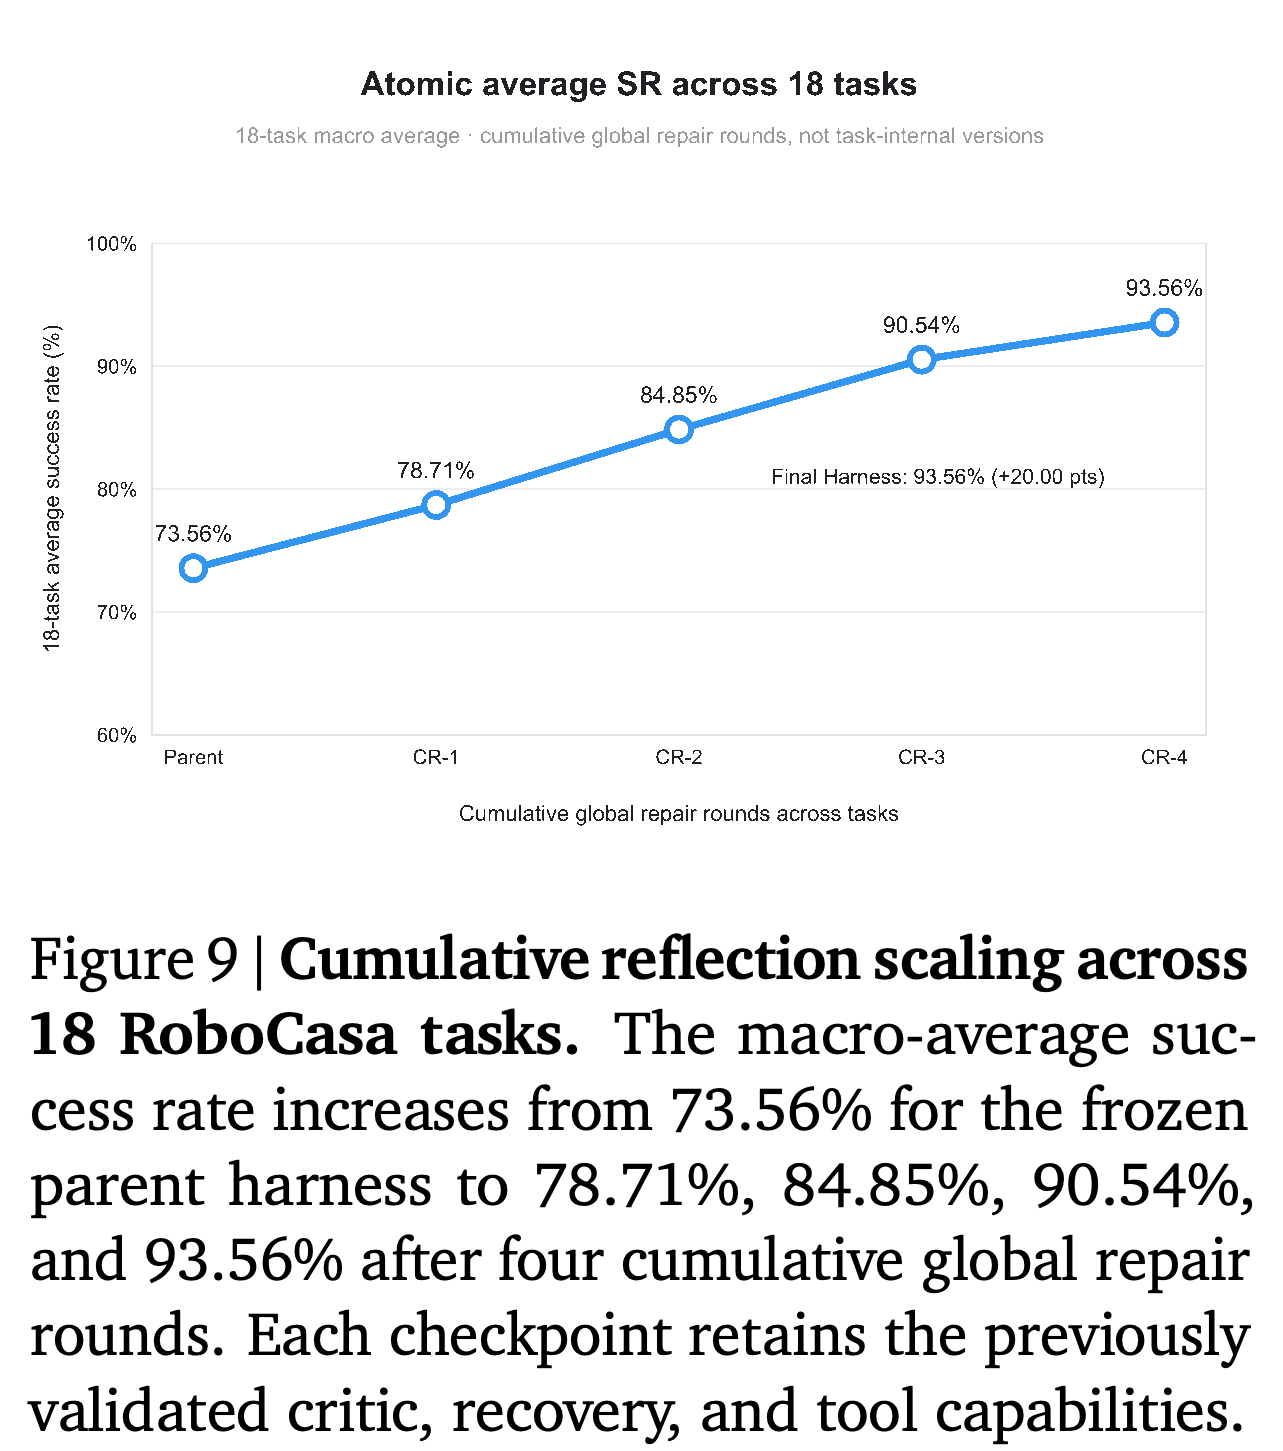
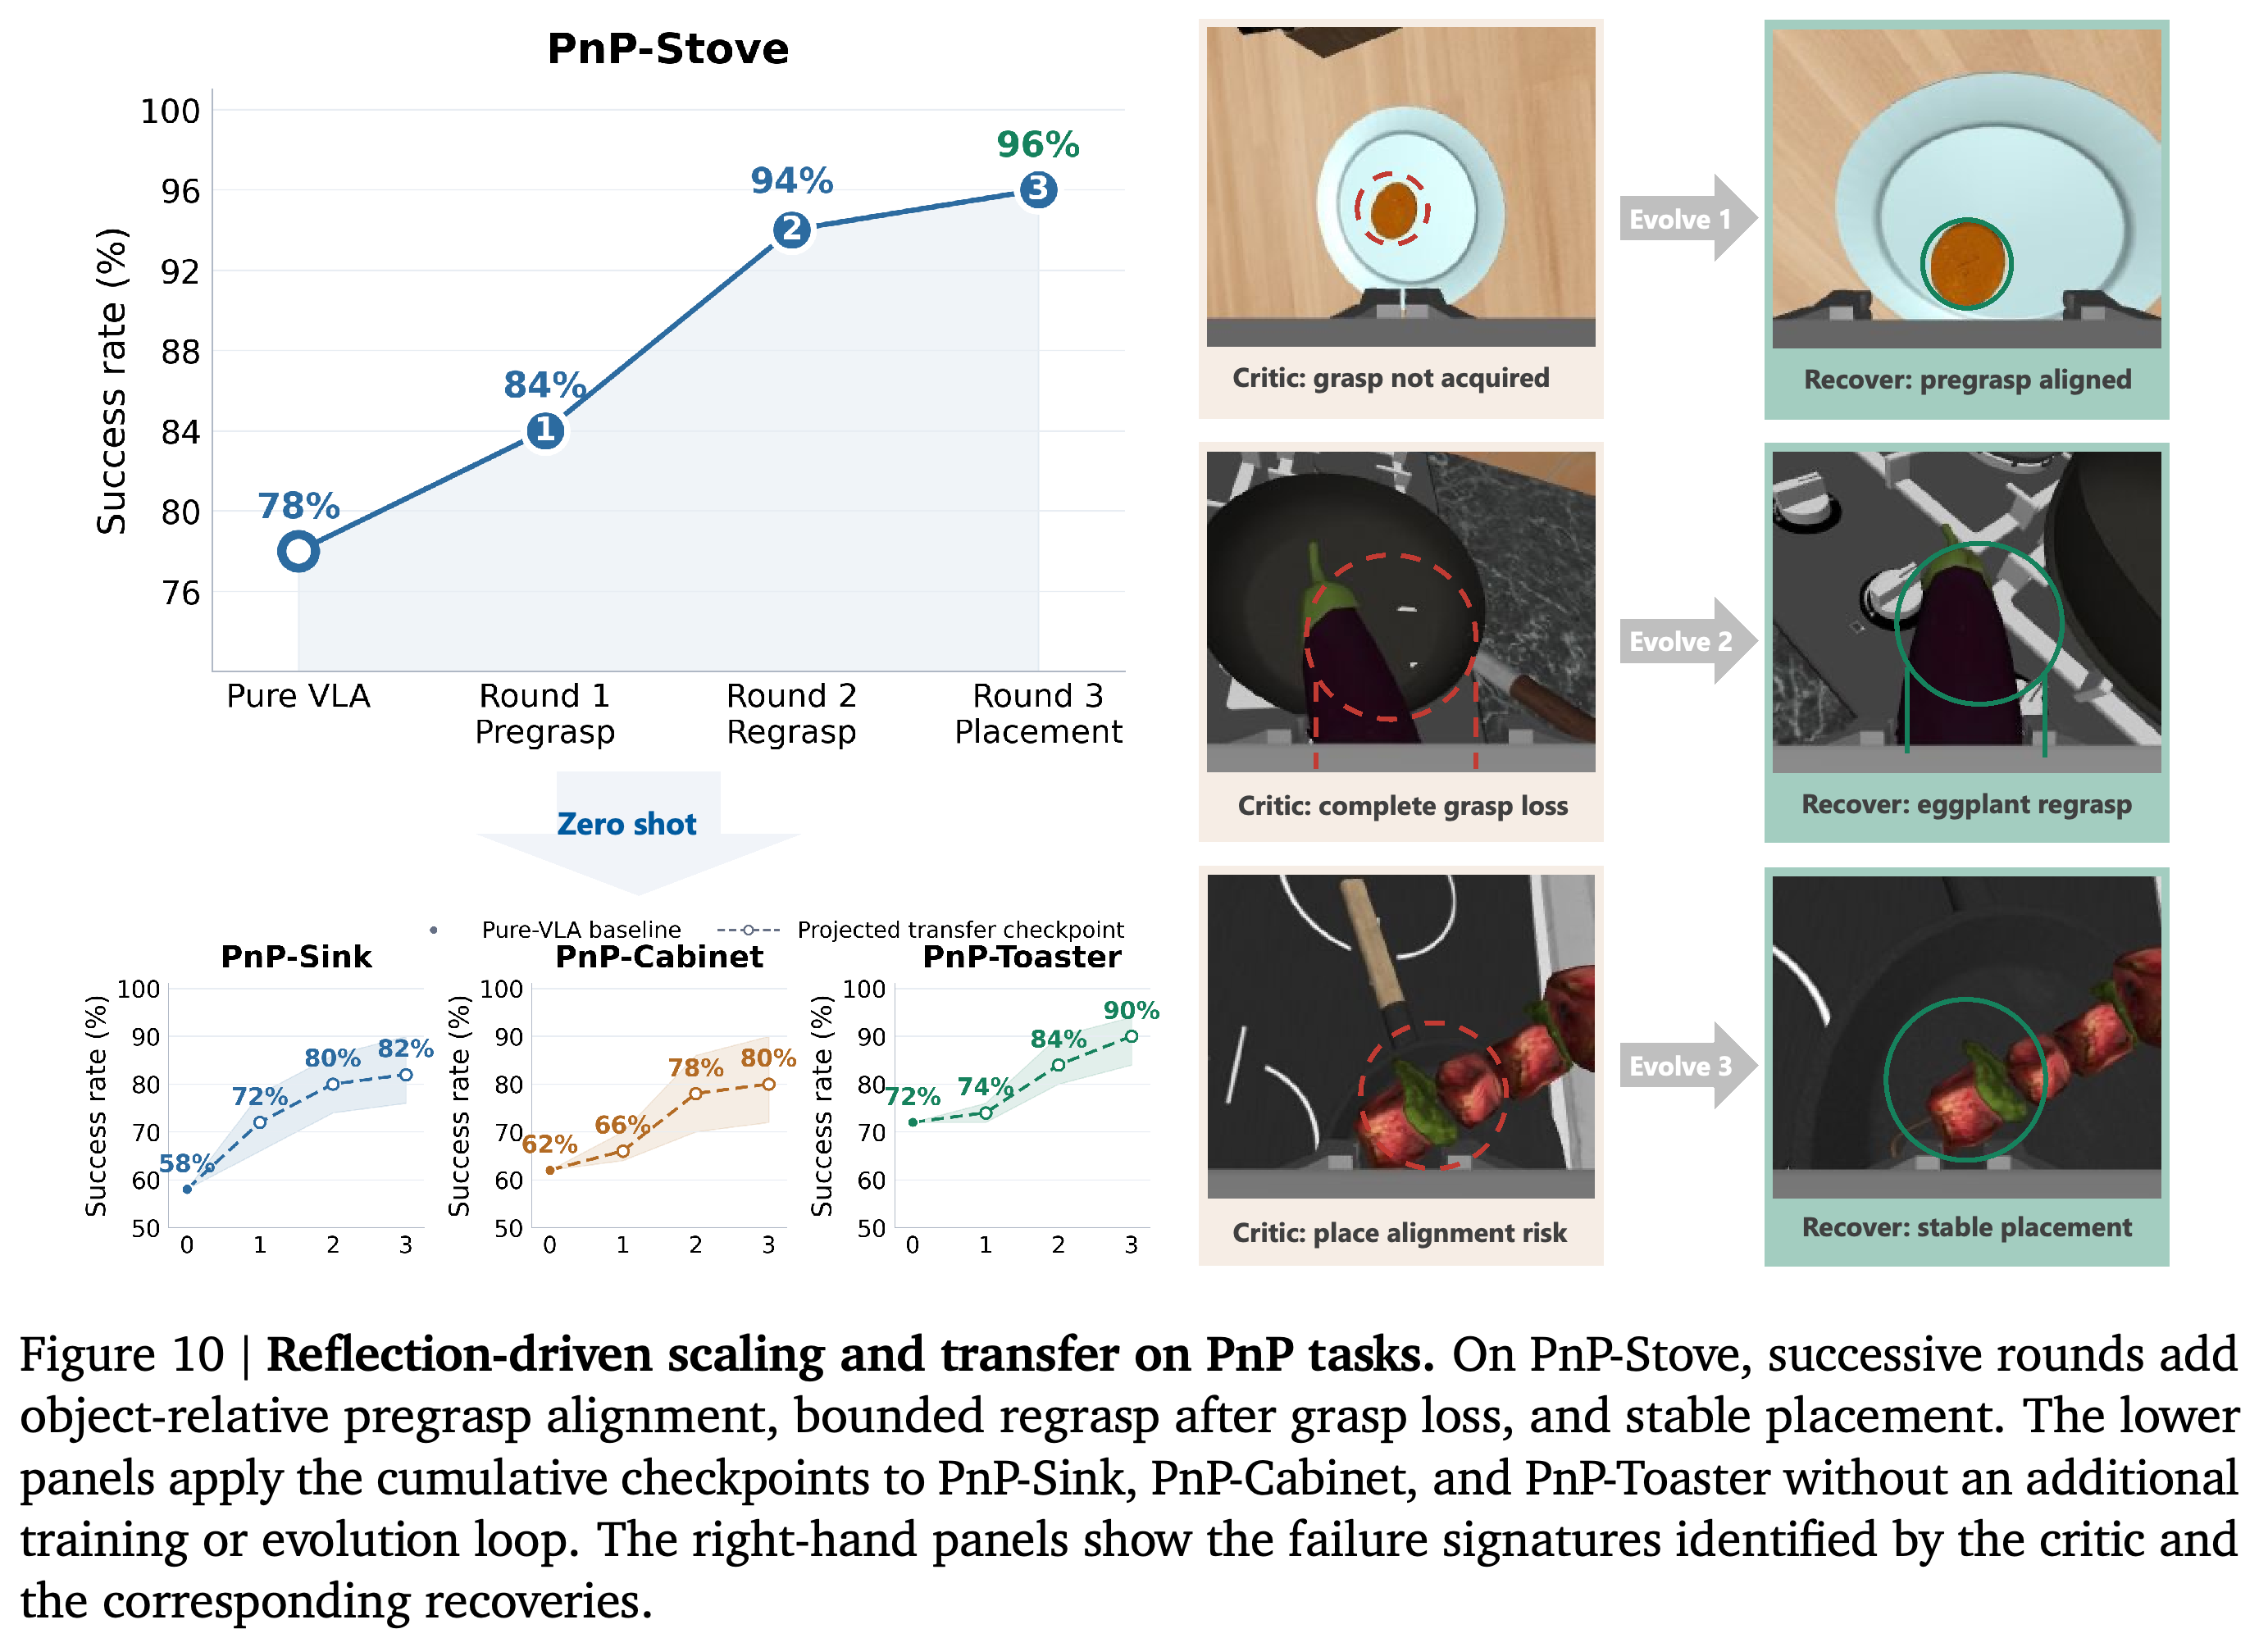
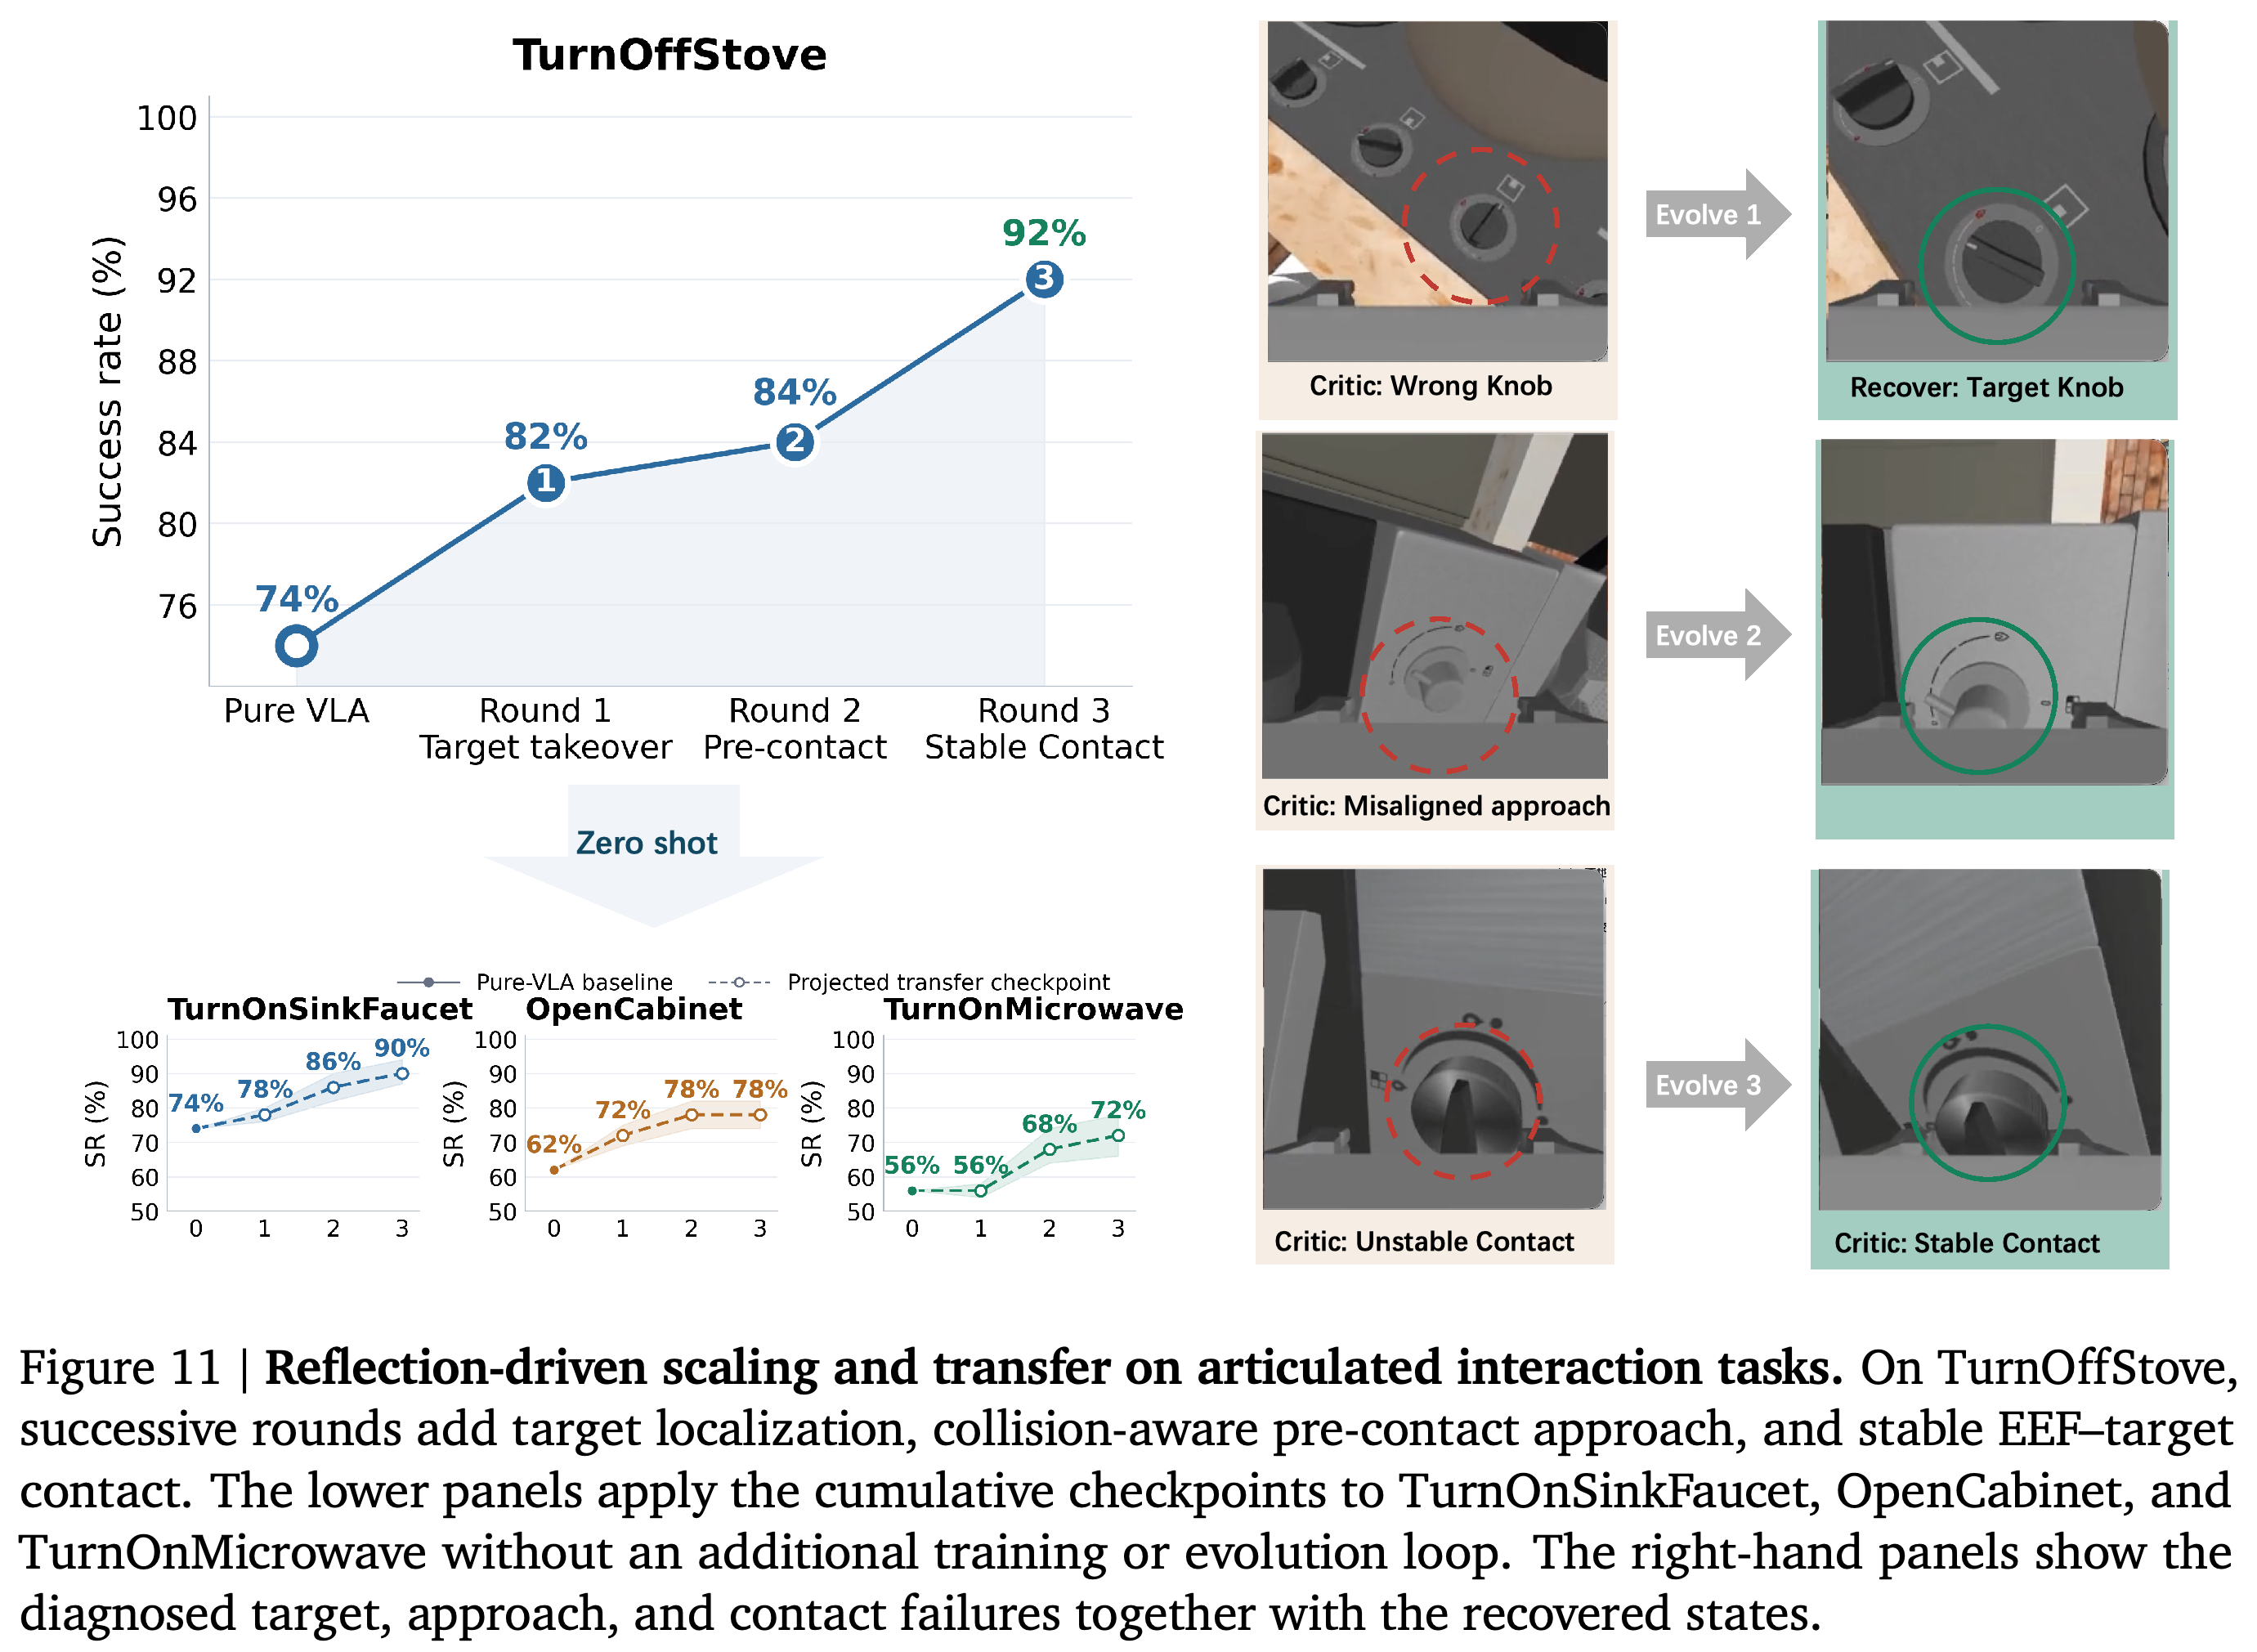
누적한 비평기-복구 기제는 LIBERO-Pro Goal-T를 31.0%에서 92.5%로, Goal-S를 38.0%에서 89.0%로 높인다. 4회의 전역 RoboCasa 복구 라운드는 18개 과제의 거시 평균을 73.56%에서 93.56%로 높인다. 제로샷 평가는 대상 과제 진화 없이 원천 과제 기제를 적용하며, pick-and-place 전이의 거시 평균은 64%에서 84%로, 관절형 상호작용 전이는 64%에서 80%로 향상된다.
이 곡선은 기본 VLA를 고정한 채 10개 Goal-T 과제와 10개 Goal-S 과제에서 비평기-복구 기제를 누적 추가해 얻은 개선을 정량화한다.
Goal-T8에서 학습한 사전 파지 준비, 유지 모니터링, 실패 관문 재시도 기제를 Goal-T2, Goal-T6, Goal-S3에서 누적 제로샷 스택으로 평가한다.
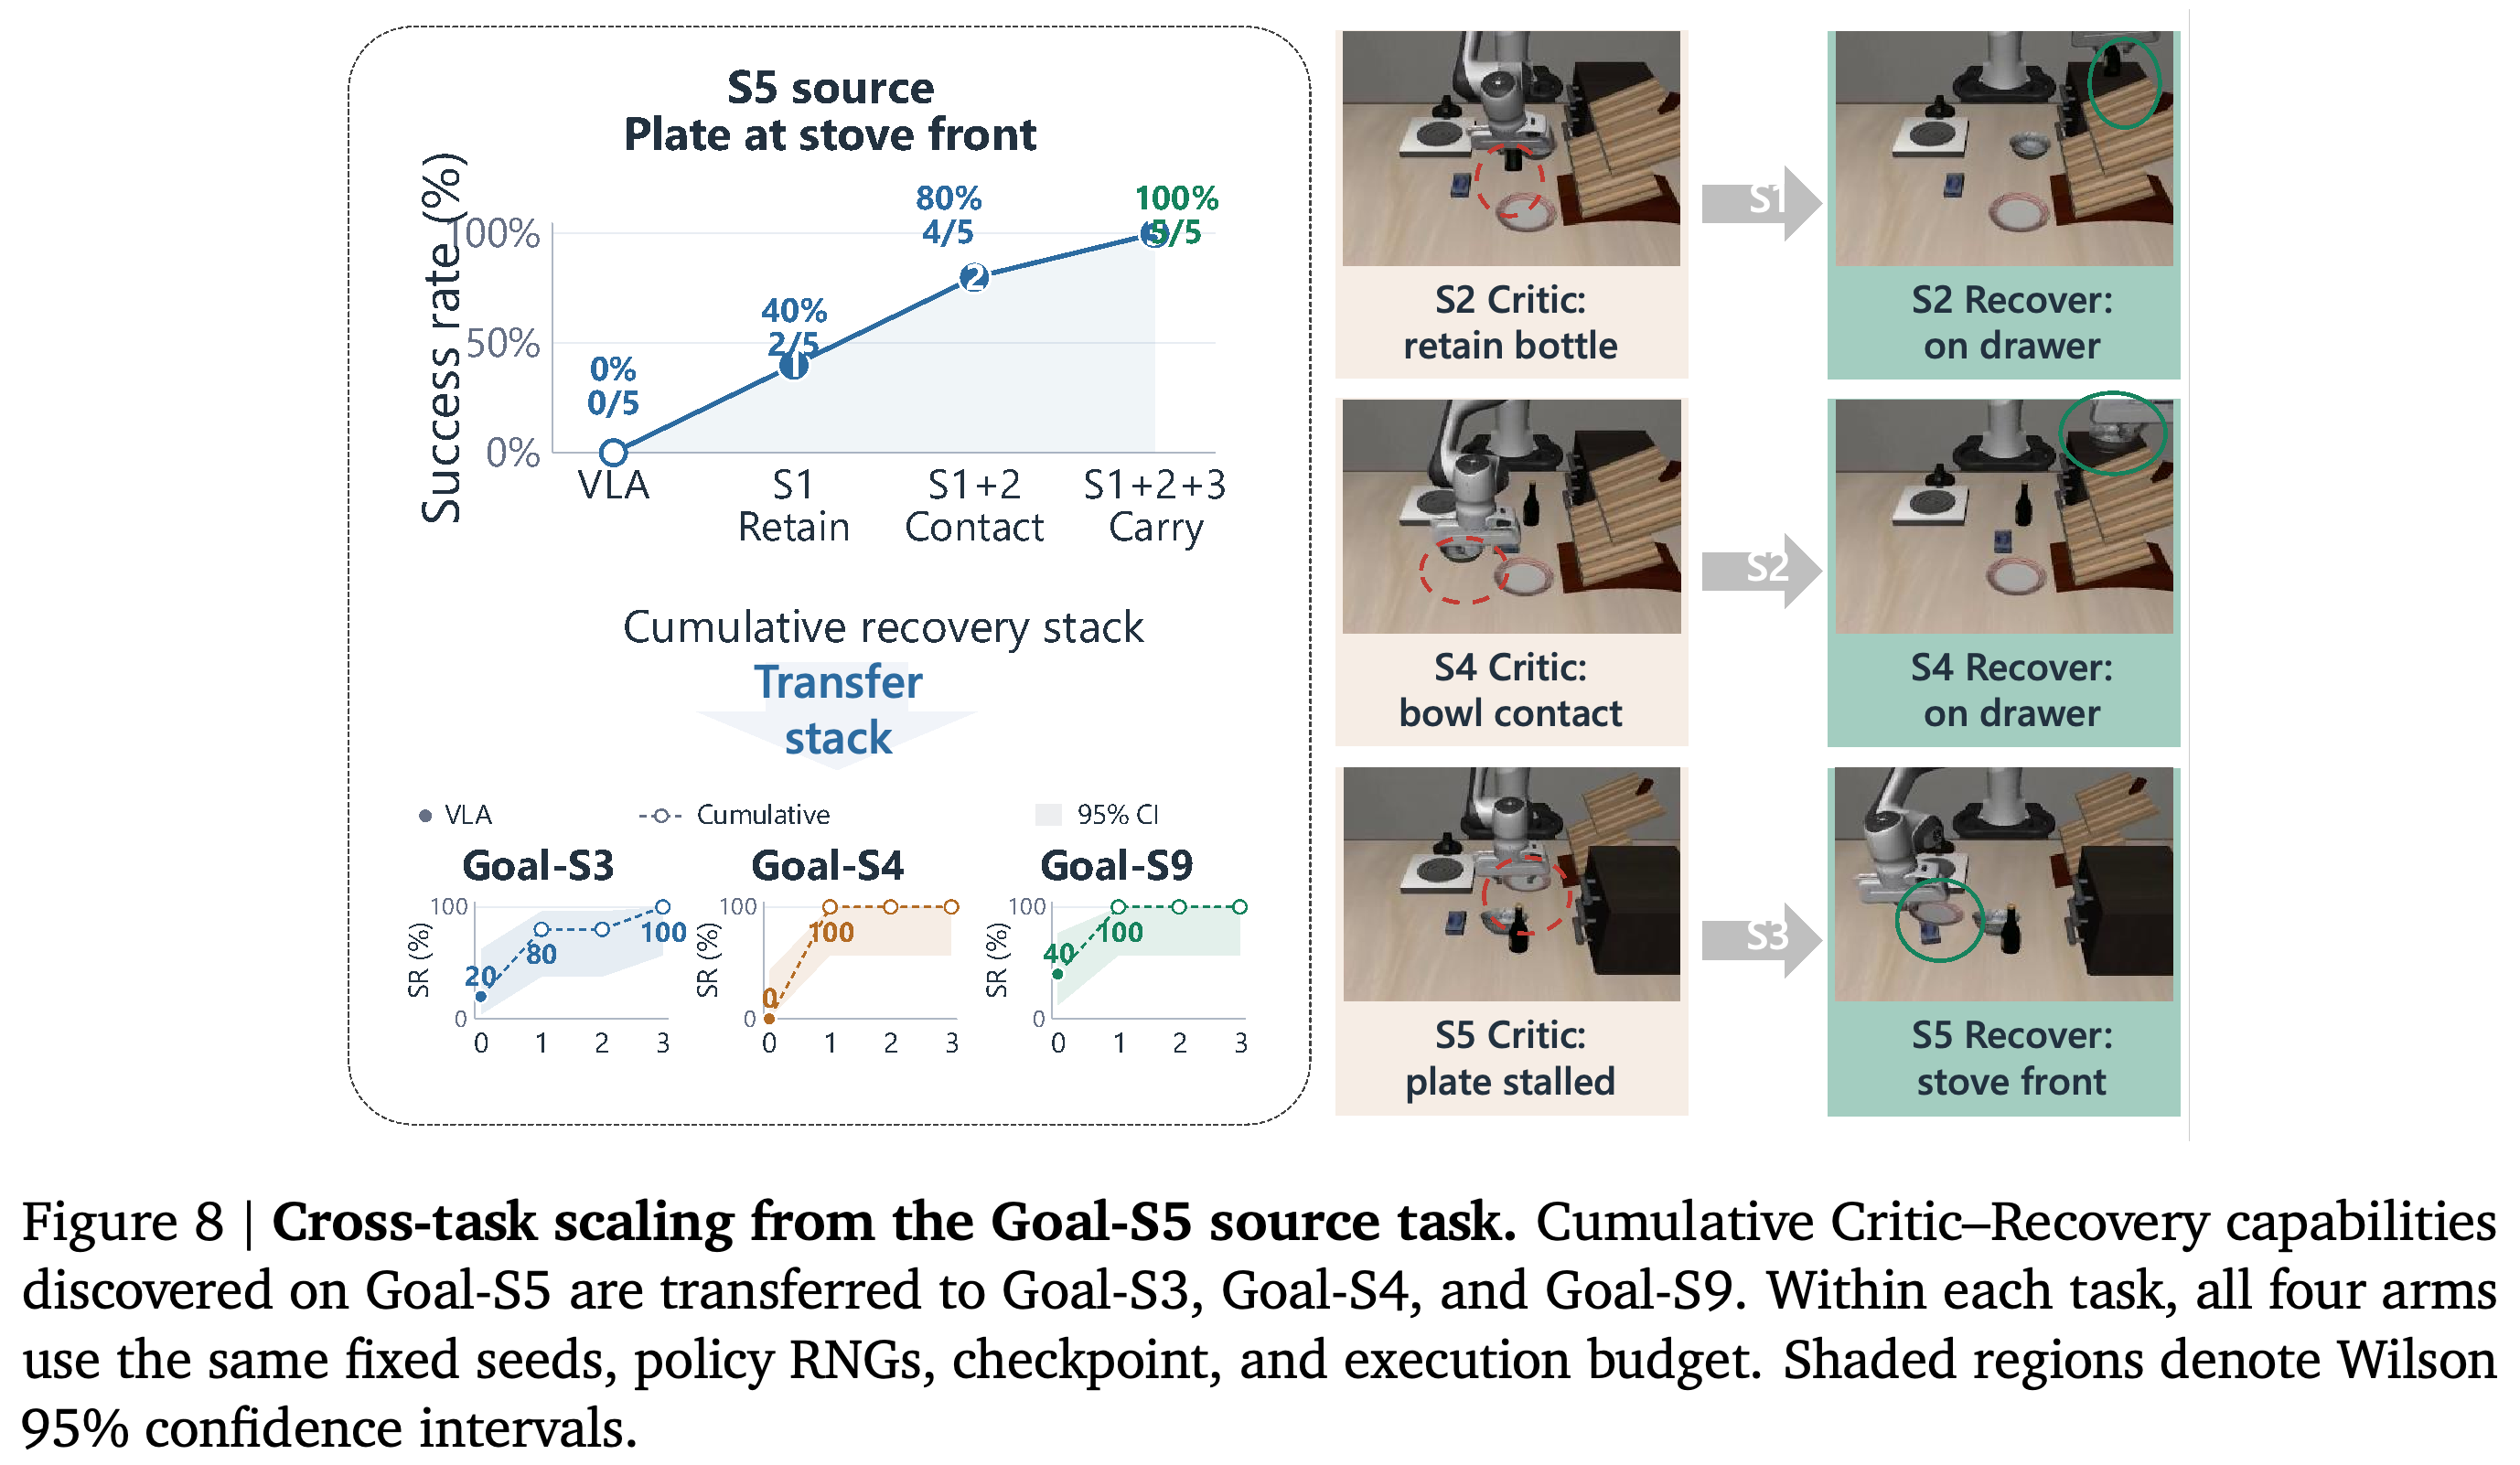
이 그림은 동일 시드, 정책 RNG, 체크포인트, 실행 예산에서 누적 Goal-S5 접촉 및 운반 기제를 Goal-S3, Goal-S4, Goal-S9로 전이한다.
18개 RoboCasa 과제의 거시 평균은 4회의 전역 복구 라운드를 거치며 부모 하니스의 73.56%에서 CR-4의 93.56%로 상승한다.
PnP-Stove의 성공률은 사전 파지, 재파지, 안정 배치 기제를 추가하면서 증가하며, 같은 스택을 Sink, Cabinet, Toaster 과제에서 제로샷으로 평가한다.
원천 과제 TurnOffStove는 목표 위치 파악, 충돌 인지 접근, 안정 접촉 기제를 누적하고, 이후 3개 관절형 과제에서 제로샷으로 평가한다.
4.4. Results on Simulation benchmark
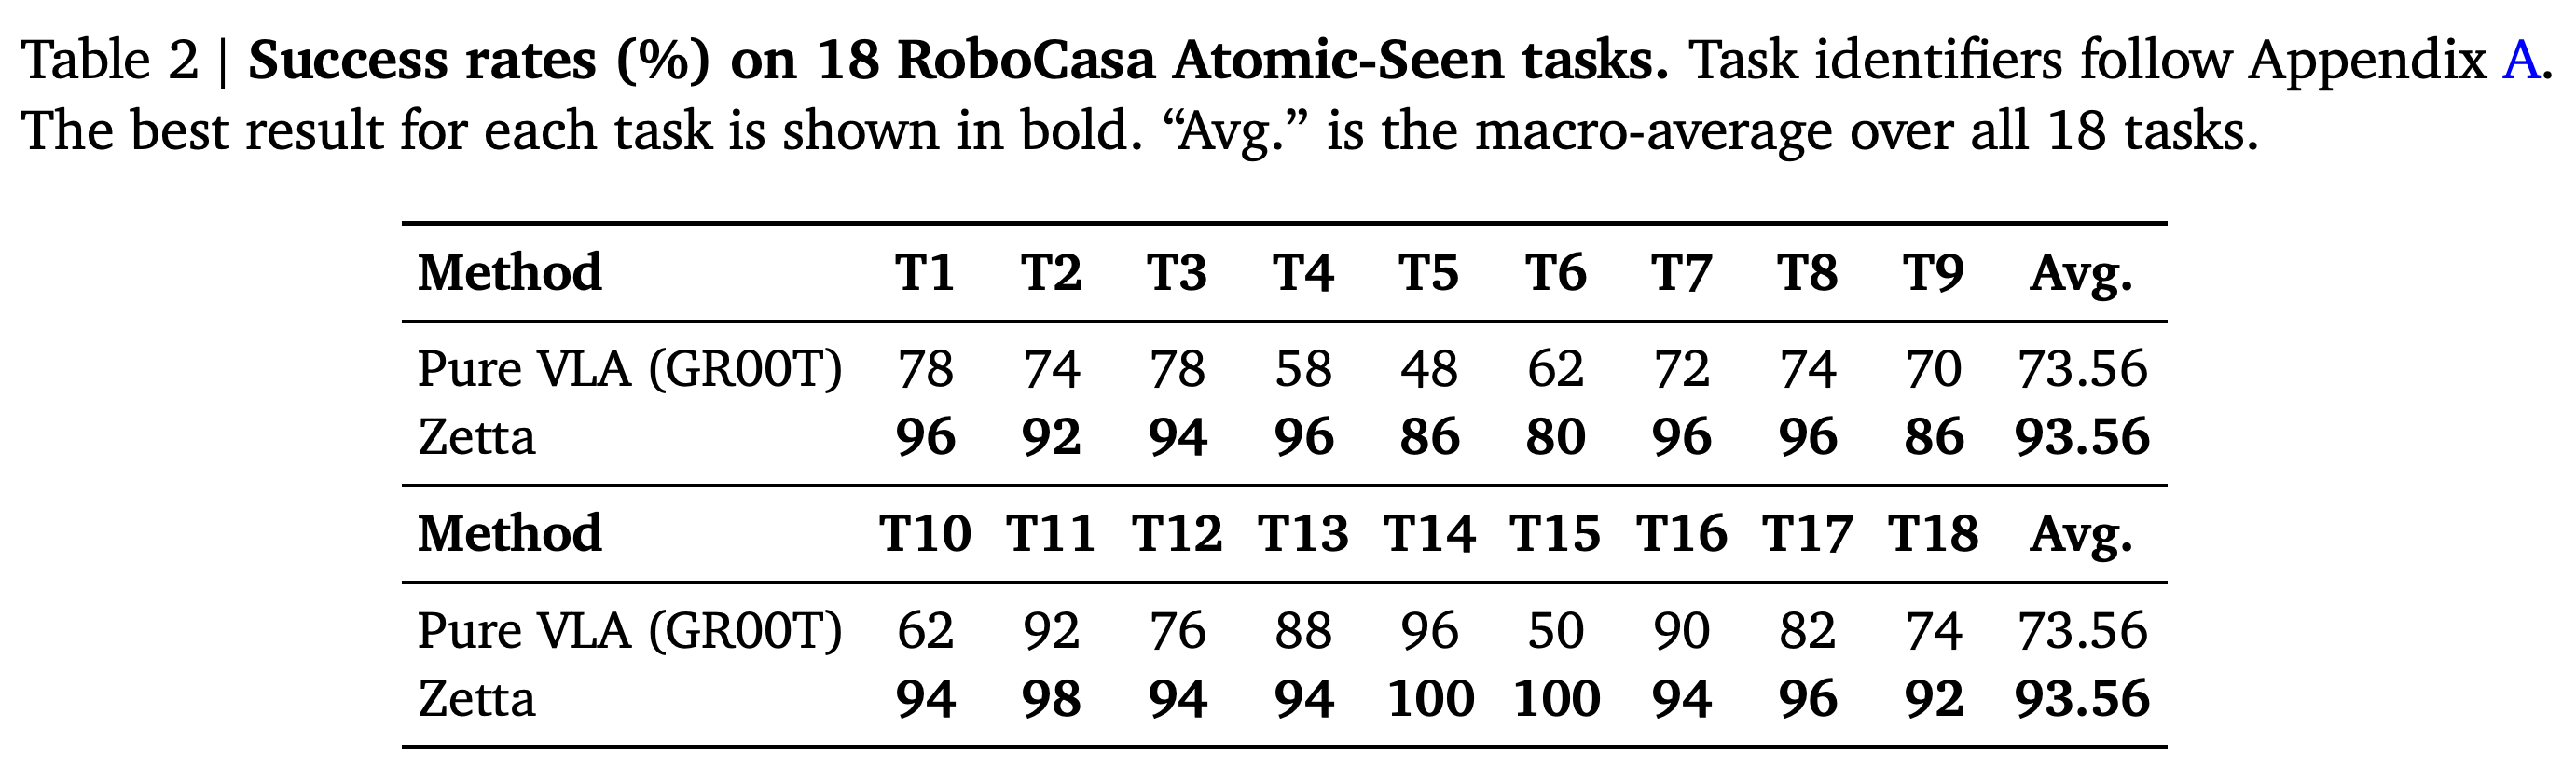
18개 RoboCasa Atomic-Seen 과제에서 Zetta는 고정된 GR00T의 거시 평균을 73.56%에서 93.56%로 높인다. 40개 LIBERO-Pro 과제-설정 쌍에서는 π0.5의 전체 거시 평균을 32.00%에서 71.13%로 높이고, 32개 쌍을 개선하며 8개에서는 기준선과 동일한 성능을 보인다.
과제별 결과는 Zetta가 나열한 모든 RoboCasa Atomic-Seen 과제에서 고정된 GR00T를 능가하며 거시 평균을 73.56%에서 93.56%로 높임을 보여 준다.
4.5. Case Studies
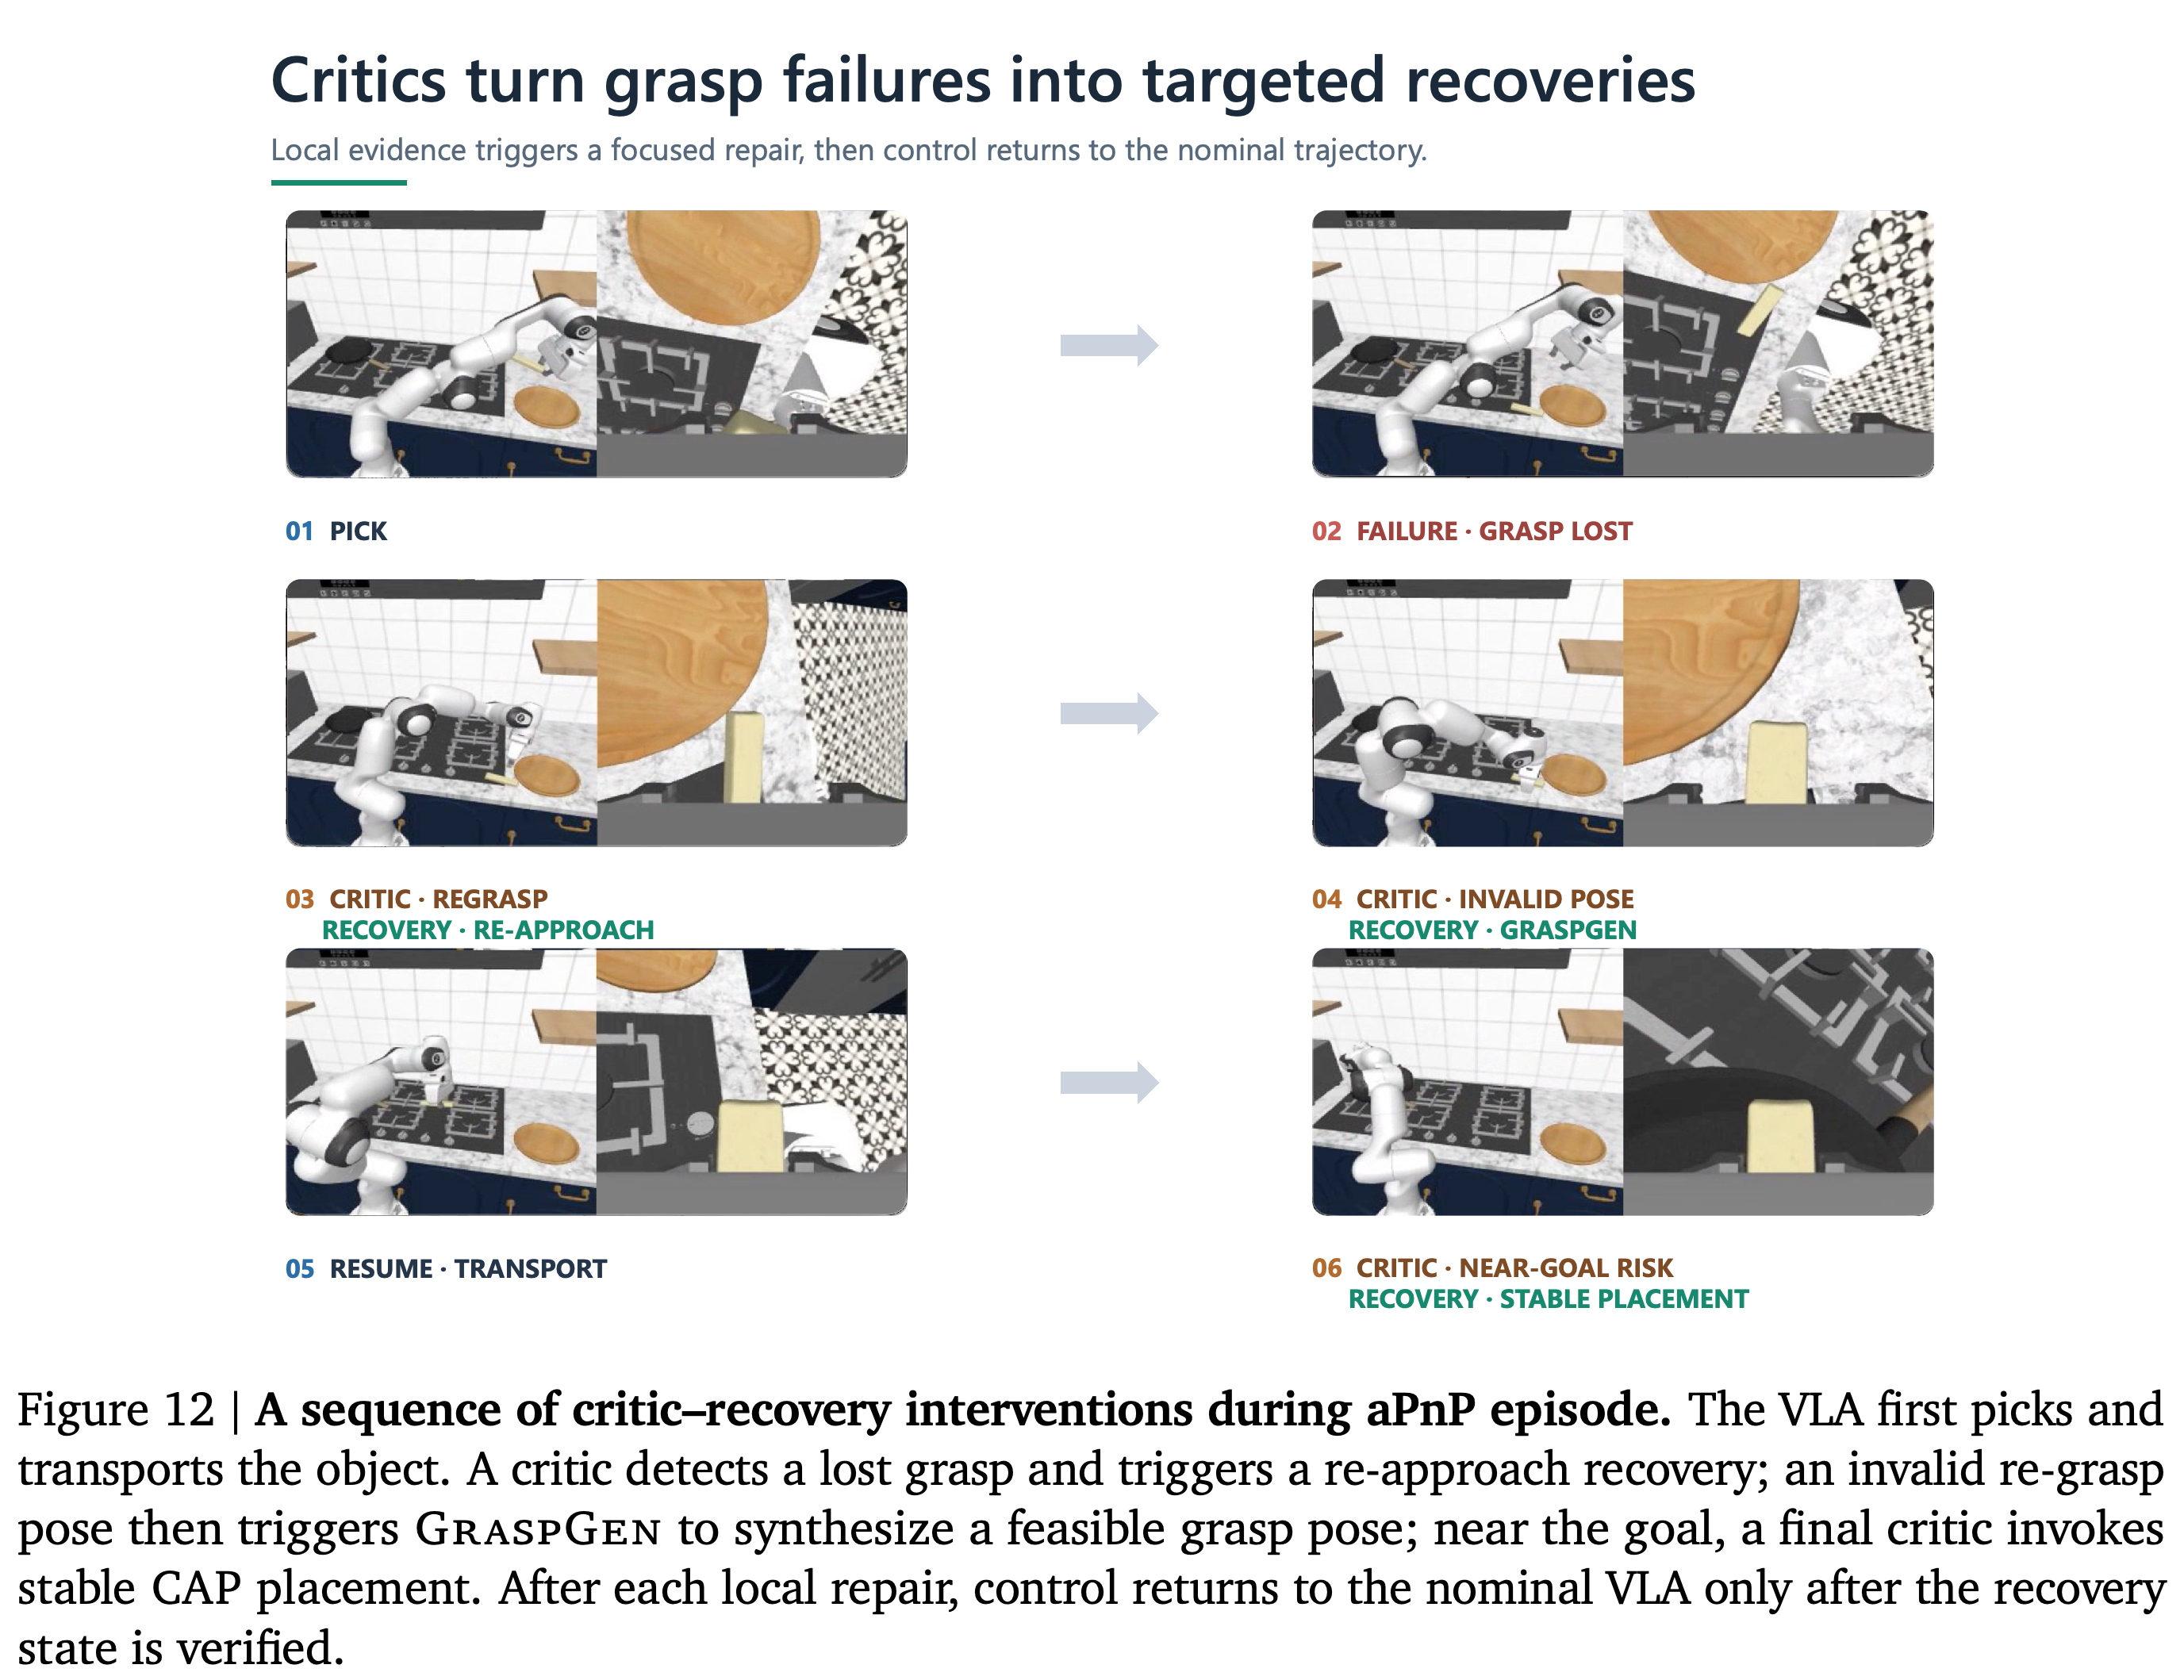
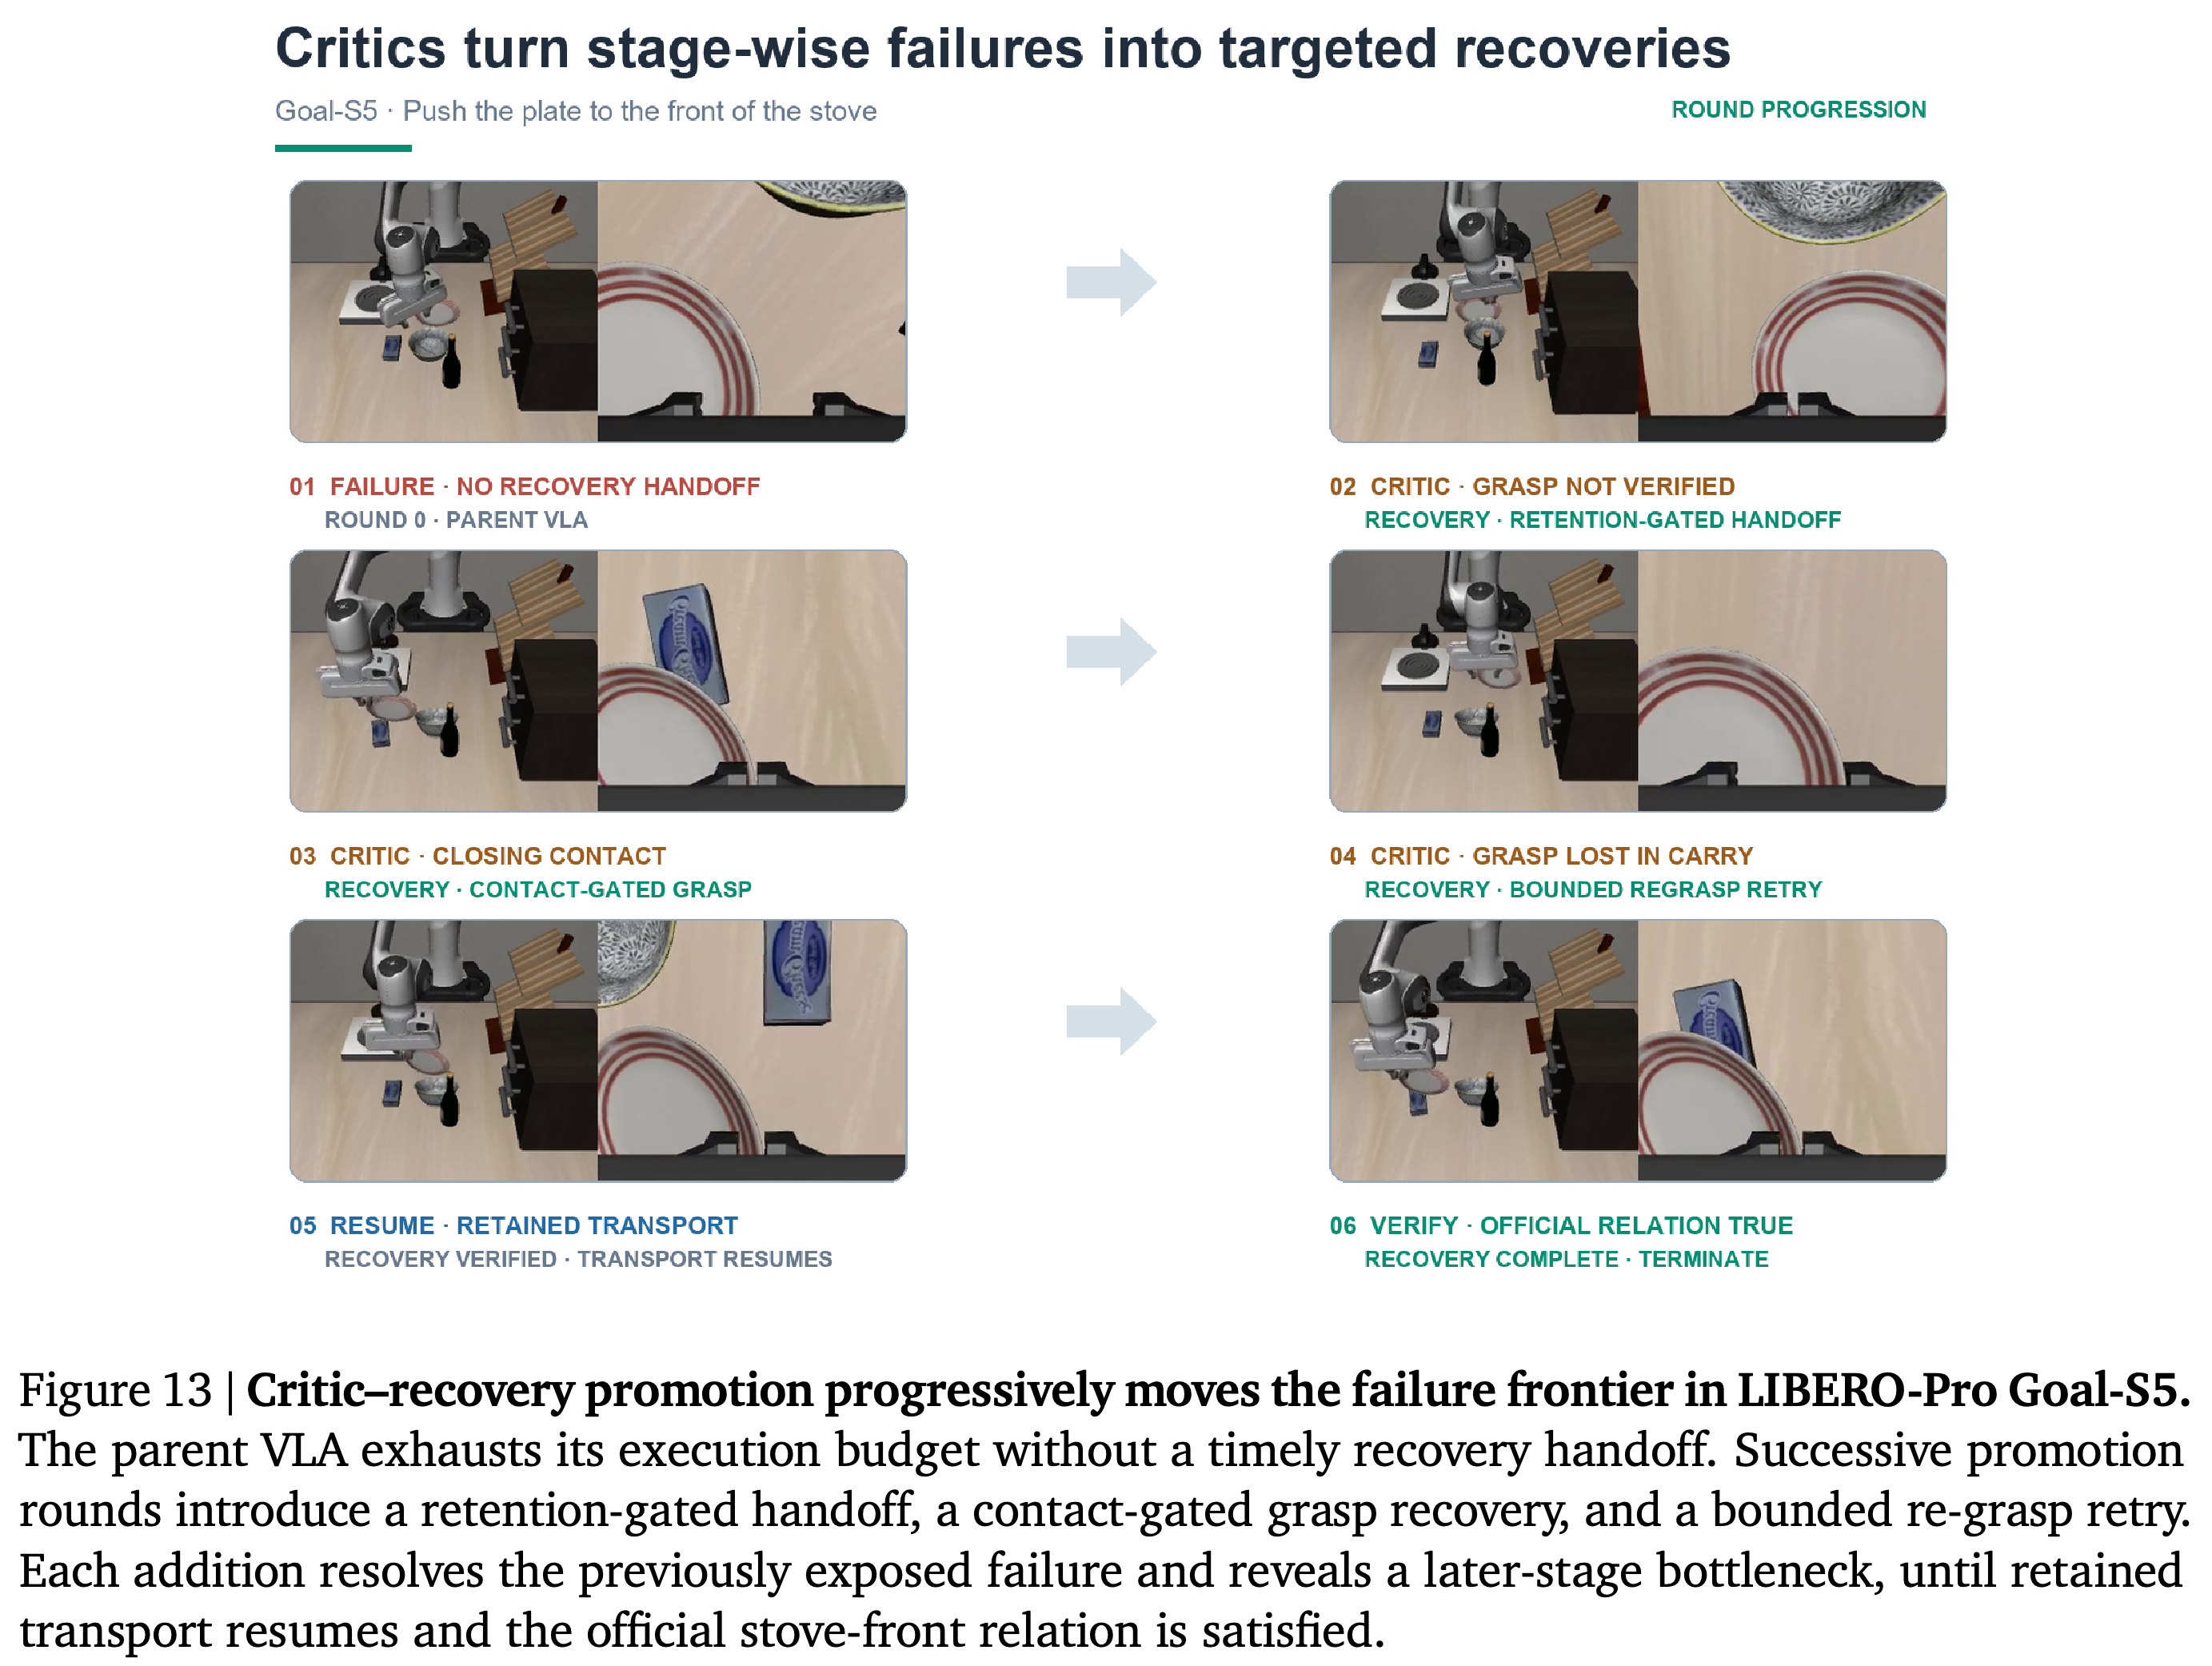
RoboCasa pick-and-place 실행에서 비평기는 물체 파지 손실, 불가능한 재파지 기하, 목표 근처 배치 위험을 차례로 감지하고, 검증된 VLA 재진입 전에 재접근, GraspGen, CAP 기반 안정 배치를 호출한다. LIBERO-Pro Goal-S5에서는 승격한 기술이 가장 이른 미해결 실패를 복구 인계 누락에서 파지 검증, 이어 운반 중 유지로 옮기며 제한된 재파지와 성공적 완료에 이른다.
이 순서는 1개 pick-and-place 에피소드 안에서 파지 손실 감지, 재접근, 실행 가능한 자세 생성, 운반 재개, 안정 배치가 이어지는 여러 국소 개입을 보여 준다.
연속된 승격 라운드는 Goal-S5에서 점차 뒤에 발생하는 실패를 해결하며, 복구 인계에서 접촉 관문 파지, 운반 중 제한된 재파지로 진행한다.
4.6. Z-Infra Performance Evaluation
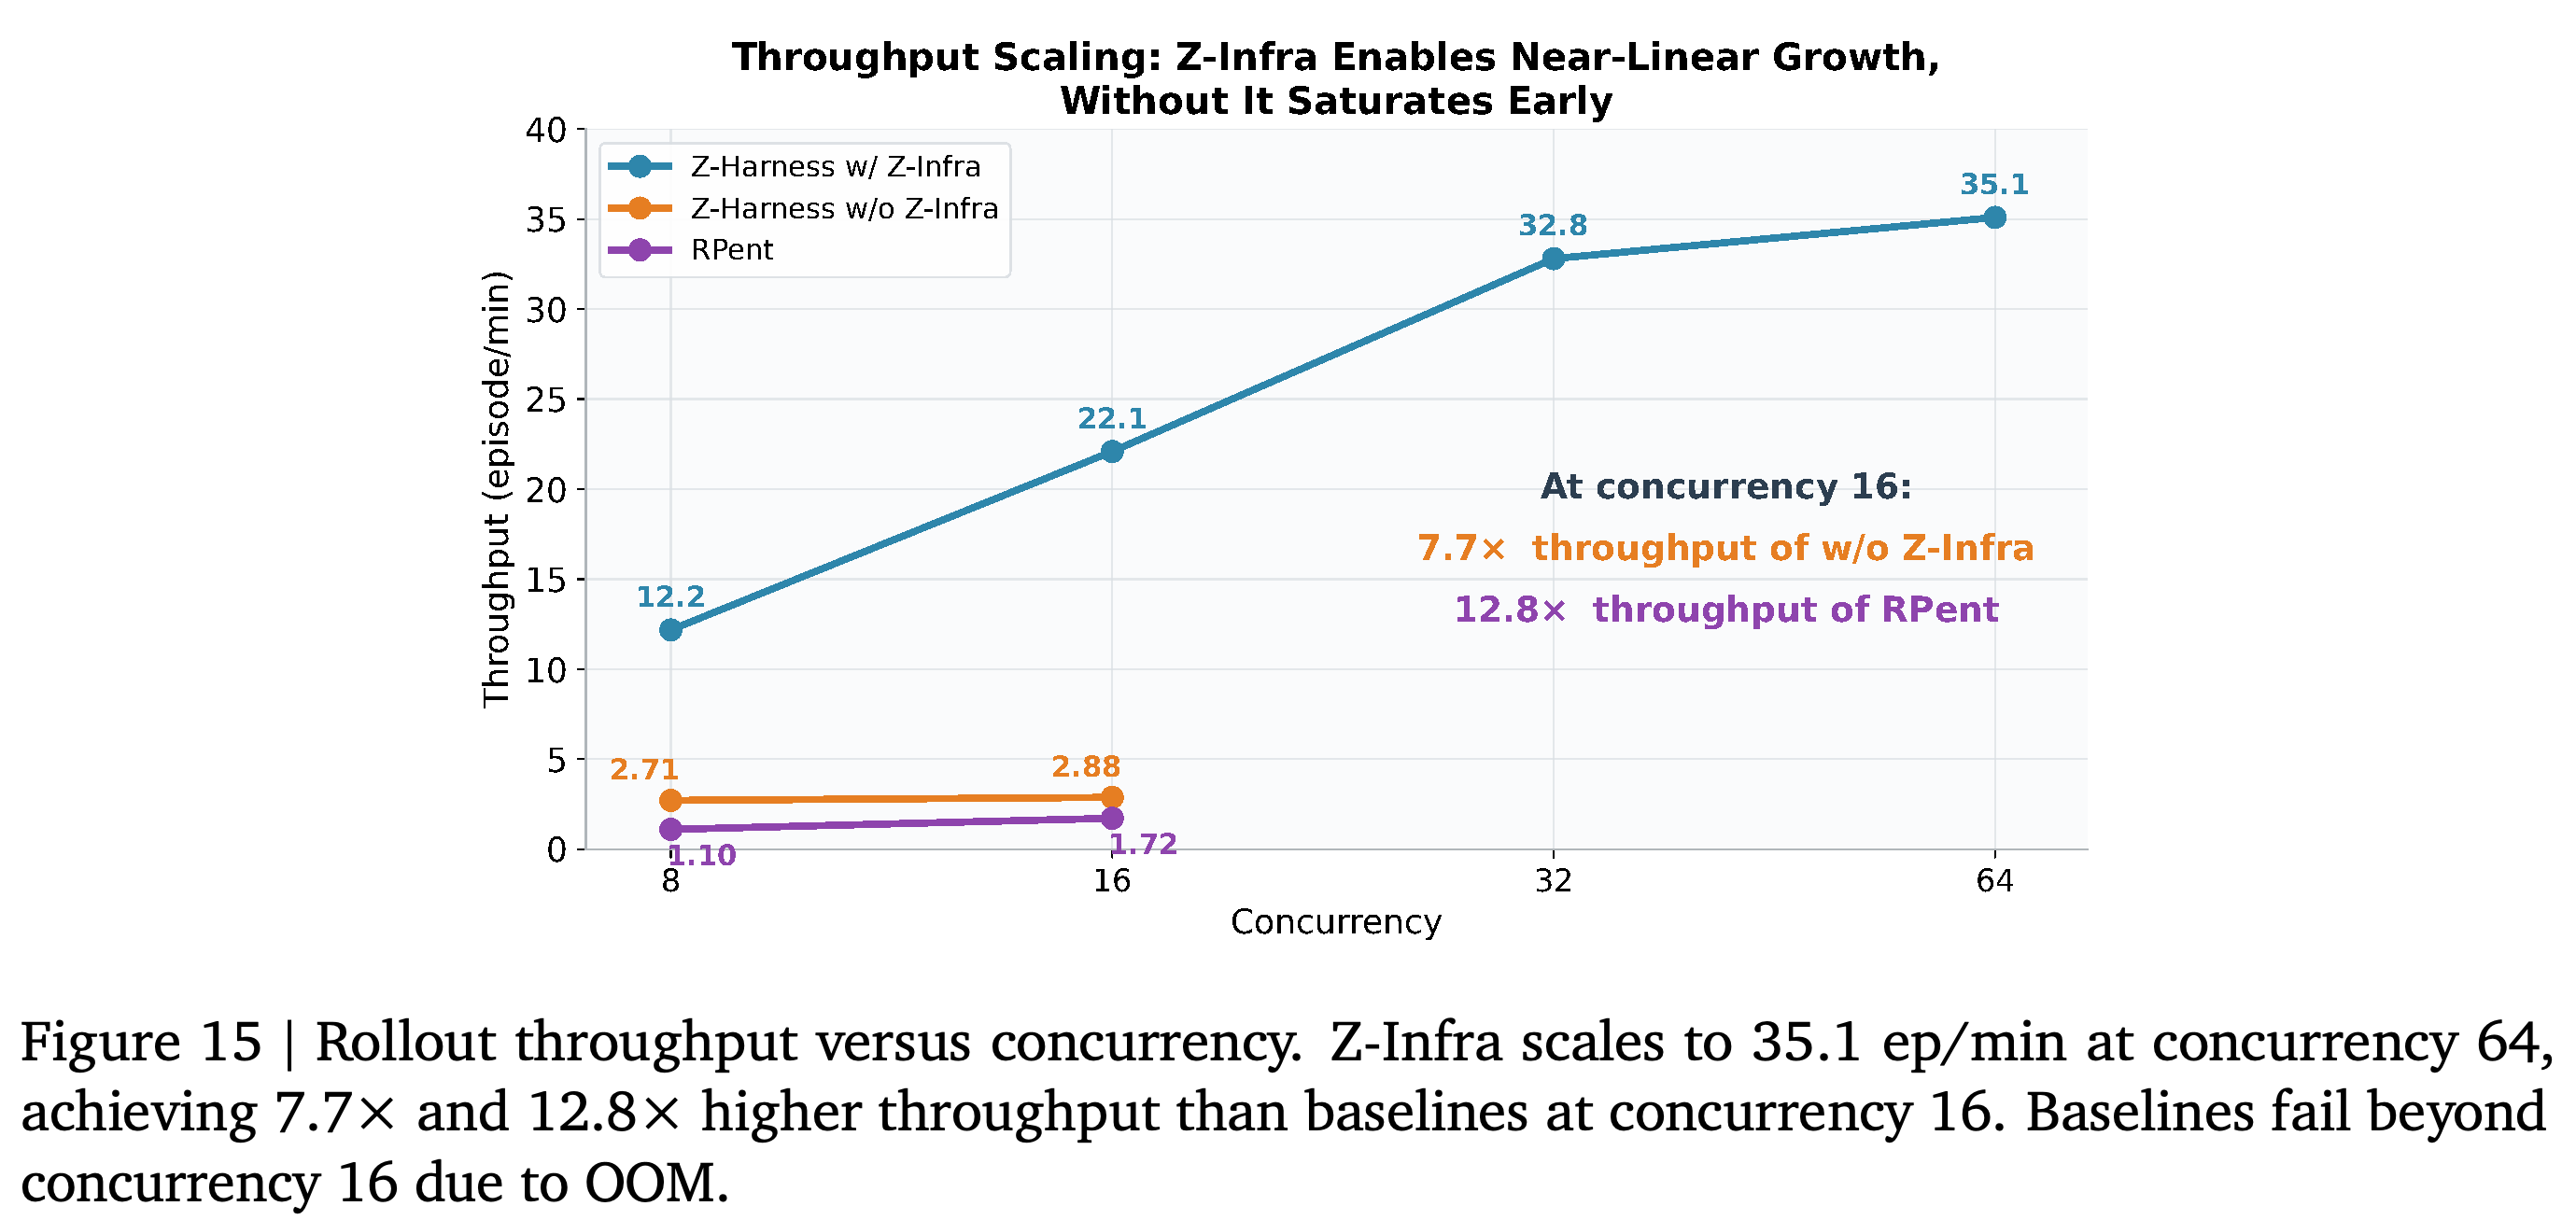
8×A100 GPU를 사용한 LIBERO Goal에서 Z-Infra는 동시성 64에서 35.1 episodes/min에 도달한다. 동시성 16에서는 처리량이 22.09 episodes/min으로, Z-Infra가 없는 하니스의 7.7×, RPent의 12.8×다. 2개 비교 시스템은 동시성 16을 넘어서면 OOM이 발생한다.
Z-Infra는 동시성이 증가할 때 에피소드당 지연 시간 증가를 제한한다. 반면 Z-Infra가 없는 하니스는 동시성 16에서 급격히 저하되며, RPent는 상당히 느린 상태로 유지된다.
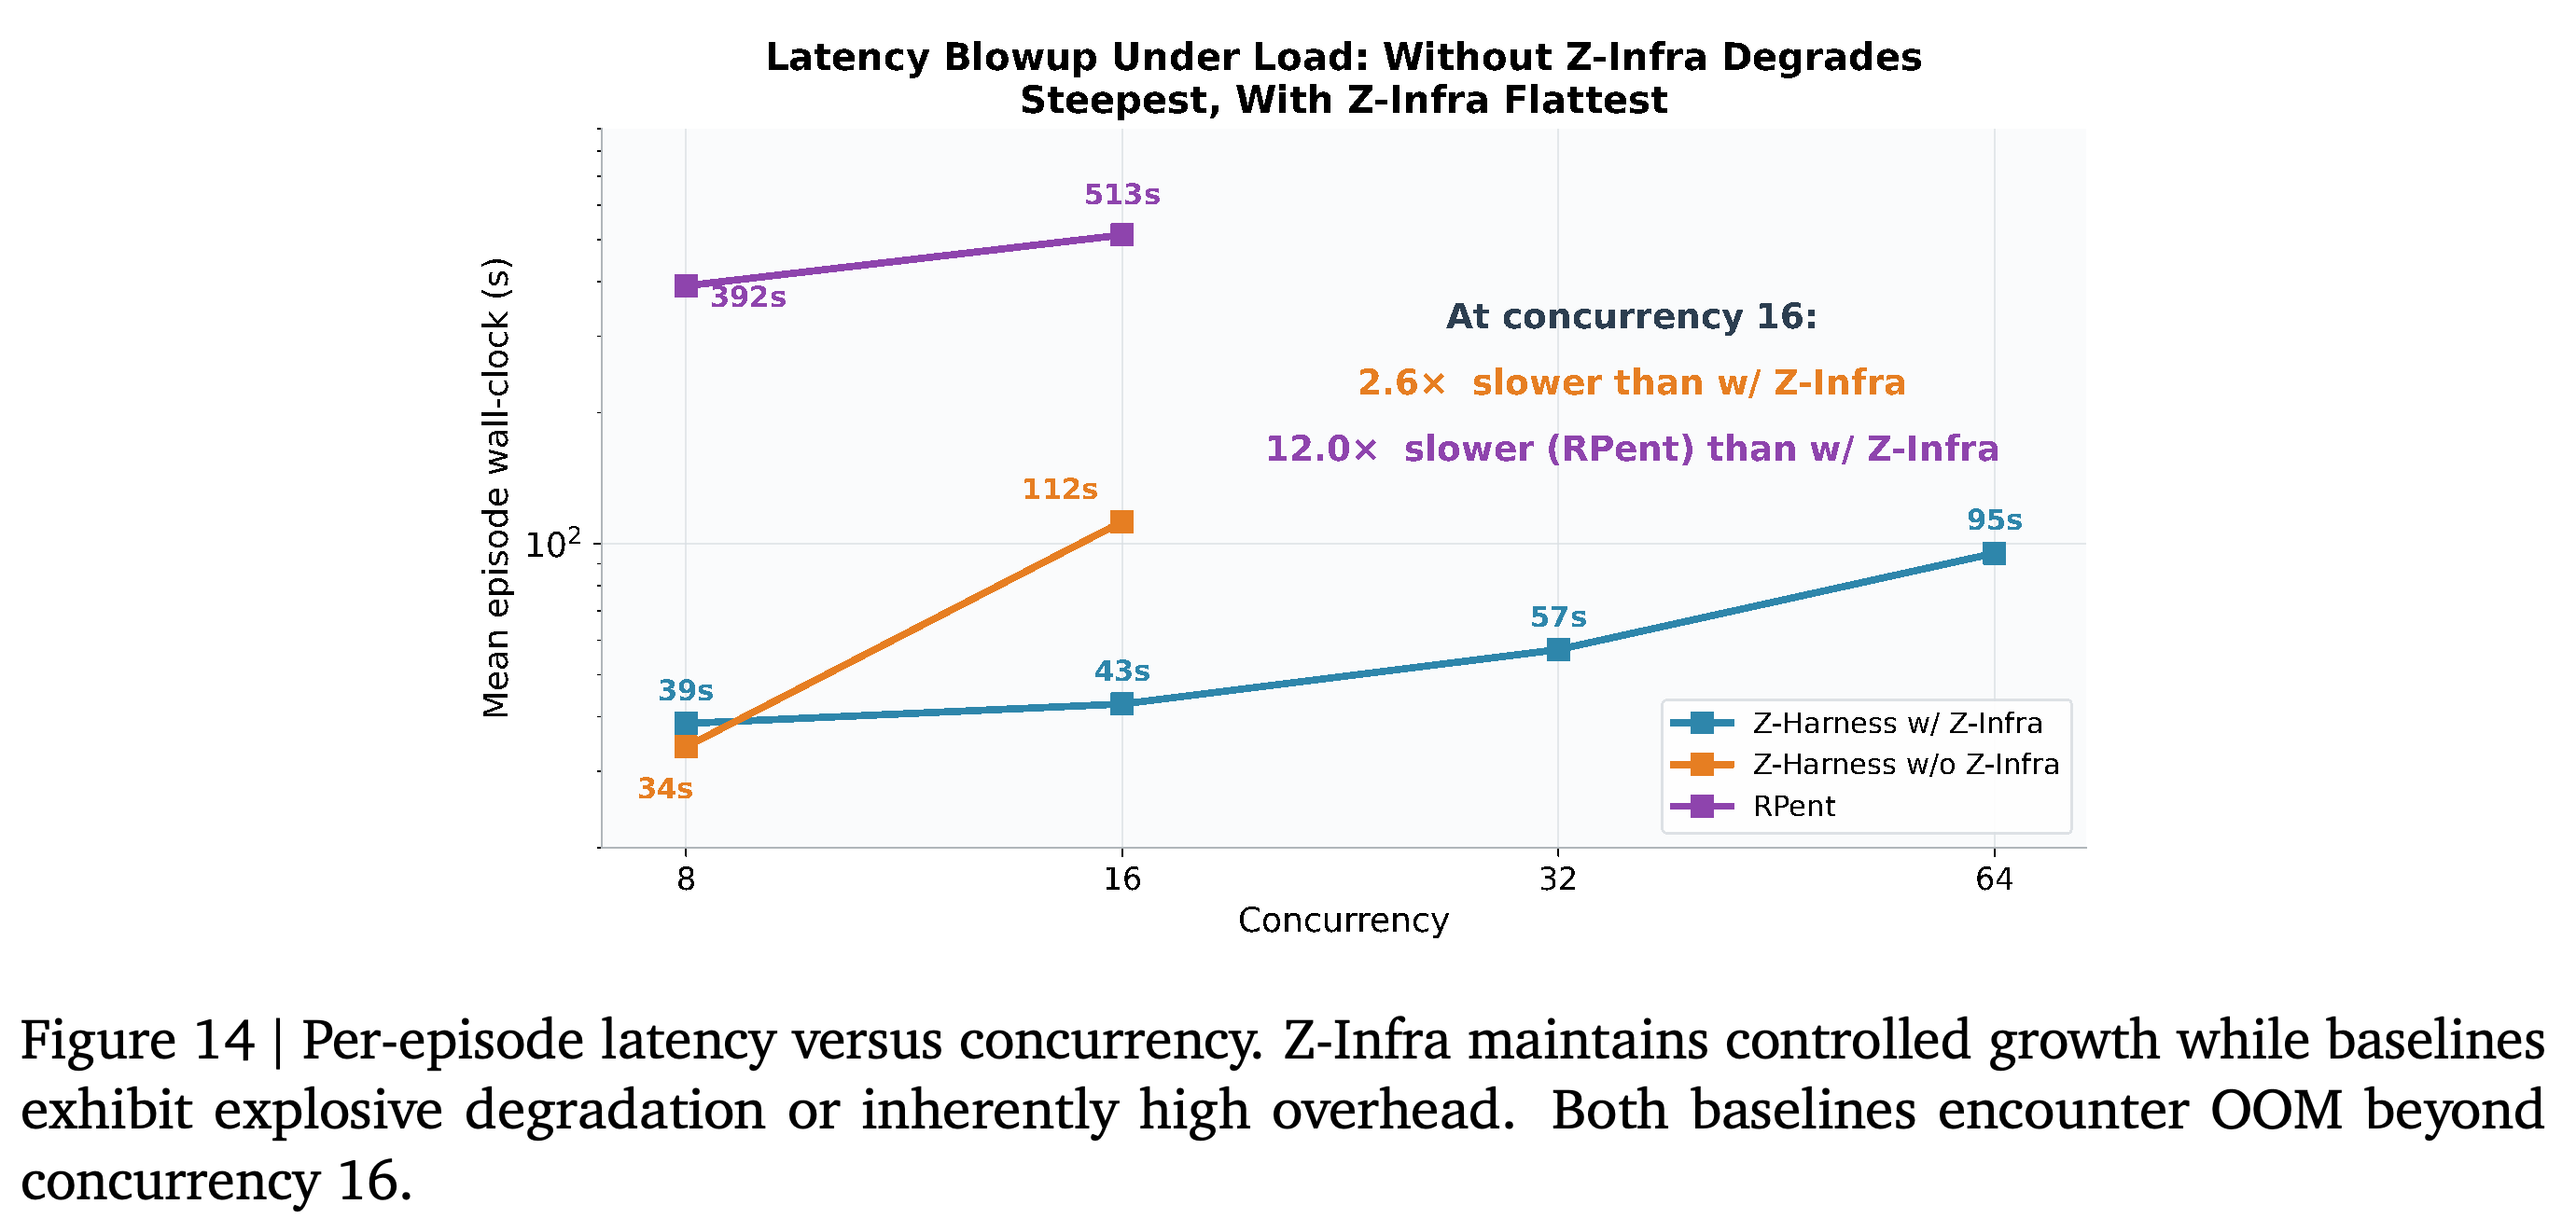
Z-Infra의 처리량은 동시성 8에서 12.18 episodes/min, 64에서 35.1 episodes/min으로 증가한다. 비교 시스템은 낮은 처리량에 머물고 동시성 16을 넘어서면 실패한다.
5. Related Work
Related Work는 임바디드 기반 정책, 실시간 자기 진화 하니스, 기존 롤아웃 인프라의 한계를 중심으로 구성한다. 저자들은 Zetta를 온라인 물리 거버넌스, 재사용 가능한 복구 기제, 이기종 고처리량 실행을 결합한 시스템으로 제시한다.
5.1. Embodied Foundation Model Gaps for Physical Intelligence Scaling
논문은 종단간 VLA/WAM 확장을 정책, 계획, 메모리, 검증, 도구, 복구를 조정하는 스캐폴딩 임바디드 에이전트와 대비한다. 높은 비용의 임바디드 데이터, 분포 변화, 연쇄적인 실행 오류를 지속적인 배포 한계로 지적한다.
5.2. Live Harness Gaps for Embodied Self-Evolution
기존 자기 진화 에이전트는 주로 비용이 낮은 이산 실행과 명시적 로그를 갖춘 디지털 영역에서 동작했다. 임바디드 에이전트에서는 연속적인 물리 상태 평가, 정책과 도구의 안전한 조정, 초기 오류가 회복 불가능해지기 전의 복구가 중요하다고 강조한다.
5.3. Rollout Infrastructure Gaps for Embodied Self-Evolution
표준 RL 롤아웃 시스템은 액터-학습자 분리와 확장 가능한 경험 수집을 제공하지만, VLA 추론, 행동 헤드, 지각, 도구, 시뮬레이터, 로봇, 메모리, 비평기가 섞인 작업 부하를 직접 대상으로 하지는 않는다. Z-Infra는 이 작업 부하를 위한 동적 배칭, 환경 자원 공유, CPU/GPU 제어를 갖춘 분리형 런타임으로 제시한다.
6. Conclusion
결론은 기본 정책을 변경하지 않고 롤아웃 경험을 검증된 비평기와 복구 기술로 전환하는 3개의 시간 척도 루프를 설명한다. 저자들은 실제 로봇 배포, 대규모 병렬 물리 롤아웃 수집, sim-to-real 통합을 향후 과제로 제시한다. 보고한 실증 근거는 시뮬레이션 벤치마크와 인프라 실험으로 제한된다.
부록
- Appendix A는 RoboCasa 식별자 T1–T18을 공식 Atomic-Seen 과제명에 대응시키고, Appendix B는 LIBERO-Pro 과제 식별자를 T와 S 교란 조건 아래 LIBERO-Goal 및 LIBERO-10 지시에 대응시킨다. Appendix C와 D는 제한된 재시도, 객체 상대 기하, 파지 유지 검사, Orchestrator 승인 개입을 사용하는 PnP-Stove와 Goal-T2의 단순화한 비평기 유도 알고리즘을 제공한다.
짧은 생각
가장 강한 근거는 고정 정책 설계, 분리한 홀드아웃 시드 프로토콜, 누적 확장 곡선, 상세한 동일 시드 복구 사례다. 실제 로봇 결과는 보고하지 않았으므로, 신뢰성 주장은 시뮬레이션 LIBERO-Pro와 RoboCasa 설정, 선택한 롤아웃 예산, 명시한 평가 프로토콜 안에서 해석해야 한다.