


PTXBench: Benchmark and Adapt LLMs for GPU Kernel Optimization with Architecture-specific PTX 요약 설명
18 Aug 2026 | Paper Review GPU Kernel Optimization PTX LLM Evaluation Supervised Fine-TuningContents
- 요약
- 1 Introduction
- 2 PTXBench
- 3 Adapting LLMs to Architecture-Specific PTX Programming
- 4 Benchmark Results
- 5 Adaptation Results
- 6 Related Work
- 7 Limitations
- 8 Conclusion
- 부록
- 짧은 생각
이번 글에서는 PTXBench: Benchmark and Adapt LLMs for GPU Kernel Optimization with Architecture-specific PTX 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 18일(Arxiv)
- Zhang, Genghan, Dong, Yixin, Fan, Chengze, Zeng, Zhichen, Yuan, Yueming, Zhu, Shaowei, Olukotun, Kunle.
- Stanford University, Carnegie Mellon University, RadixArk, Independent Researcher
- 논문 링크
- Github
- Project Page
요약
- PTXBench는 LLM이 인라인 아키텍처 특화 PTX를 포함한 CUDA 커널을 생성할 때 기능적으로 정확하고, 런타임에 요구한 명령어 계열을 실행하며, 최전선 라이브러리의 지연 시간에 근접할 수 있는지를 평가한다. H100과 B200에서 GEMM 및 어텐션을 평가한 결과, 모델은 역방향 어텐션에서 신뢰성이 크게 낮았고, 명령어 실행을 검증했다고 해서 경쟁력 있는 속도가 보장되지는 않았다. 논문은 Qwen3.6-27B를 복구 조건부 지도 미세 조정(SFT)한 Fixit도 분석하며, 성능 향상은 과제 범위, 데이터셋 균형, 추론 교사에 따라 달라진다고 보인다. 어텐션에 대해서는 이 글을 참조하라.
1 Introduction
논문은 PTX를 변화하는 GPU 메커니즘을 직접 활용할 수 있는 가장 저수준의 프로그래밍 가능한 CUDA 인터페이스로 제시한다. 반면 이식 가능한 CUDA나 고수준 커널 언어는 새로 도입된 하드웨어 기능을 노출하지 못할 수 있다. 기존 커널 벤치마크는 정확성과 속도를 측정하지만, PTXBench는 지정한 아키텍처 특화 메커니즘이 소스 코드에 단순히 포함되었는지가 아니라 런타임에 실제로 실행되는지도 추가로 검사한다.
2 PTXBench
PTXBench는 고정 워크로드와 최전선 라이브러리 기준 구현을 대상 GPU 및 요구 PTX 명령어 계열과 결합한다. MiniPTXAgent는 통제된 아키텍처 특화 문맥을 제공하고 CUDA–PTX 커널을 반복 생성·수정하며, 기능 정확성, 런타임 명령어 실행, 속도 향상을 각각 기록한다.
2.1 Benchmark Tasks and Controlled Context
각 과제는 고정된 FlashInfer-Trace 워크로드에 맞춰 인라인 PTX를 포함한 CUDA 커널을 처음부터 생성하도록 요구한다. 모든 궤적에는 아키텍처 매개변수, PTX 래퍼, 레이아웃·동기화·메모리 일관성 계약, 검증된 연산자의 전문가 검증 스케줄링 원칙을 담은 동일한 20k–30k-token 지식 묶음이 제공된다.
2.2 Multi-turn Evaluation Protocol
MiniPTXAgent는 고정된 호출 예산 동안 이전 커널과 실행 피드백을 유지한다. CPU 컨테이너에서 nvcc로 후보를 컴파일한 뒤, 컴파일에 성공한 코드를 격리된 프로파일링 서비스에 보내 메모리 안전성 검사, 런타임 진단, 수치 정확성, 지연 시간을 측정한다.
3 Adapting LLMs to Architecture-Specific PTX Programming
Fixit은 적응 전 모델의 실패 사례로 SFT 예제를 만든다. 프롬프트와 문맥 x, 실패한 커널 k−, 피드백 e가 주어지면 복구 교사는 정확성 필터를 통과한 복구 커널 k+를 생성하고, 추론 교사는 근거 r을 제공한다. 학생 모델은 (x, k−, e)에서 (r, k+)로 매핑하도록 학습한다. 실패 사례는 적응 전 체크포인트에서 1회 수집하므로, 데이터는 지속적으로 갱신한 실패가 아니라 해당 모델이 관측한 오류 상태를 대상으로 한다.
4 Benchmark Results
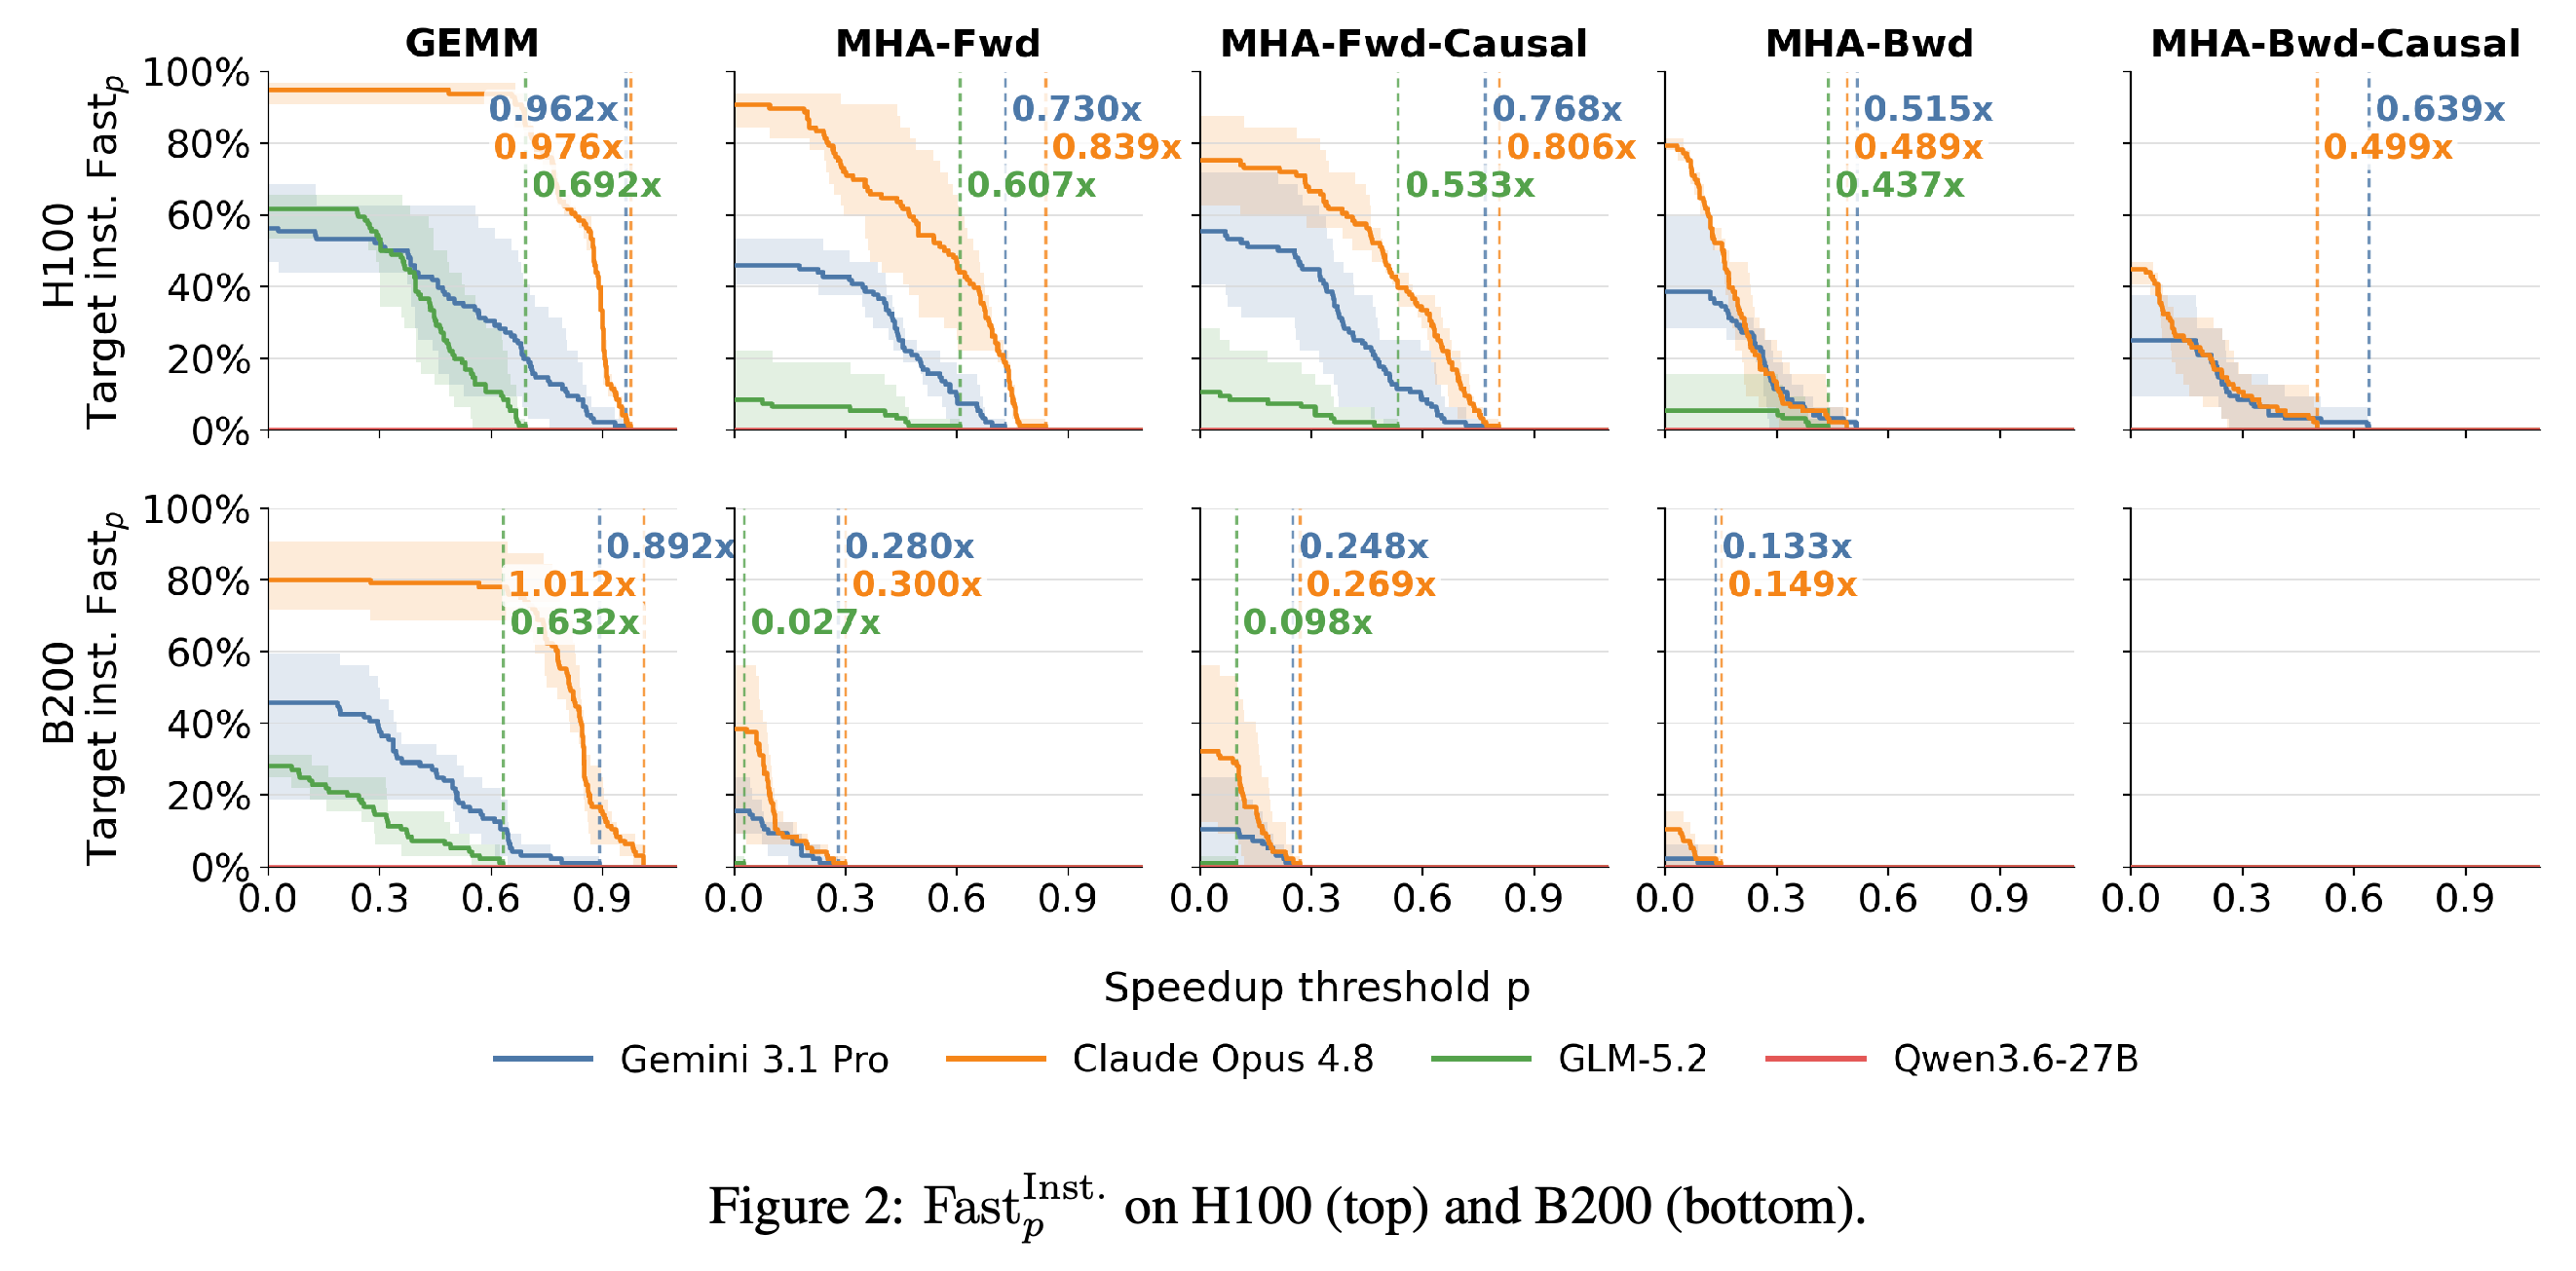
벤치마크는 H100과 B200의 GEMM 및 4개 어텐션 워크로드에서 Gemini 3.1 Pro, Claude Opus 4.8, GLM-5.2, Qwen3.6-27B를 비교한다. 적응 연구는 Qwen3.6-27B용 7개 LoRA 레시피를 평가하며, 직접 해법과 Fixit 지도, 학습 문제 구성, 균형, 근거 교사를 바꾼다.
4.1 Evaluation Metrics and Baselines
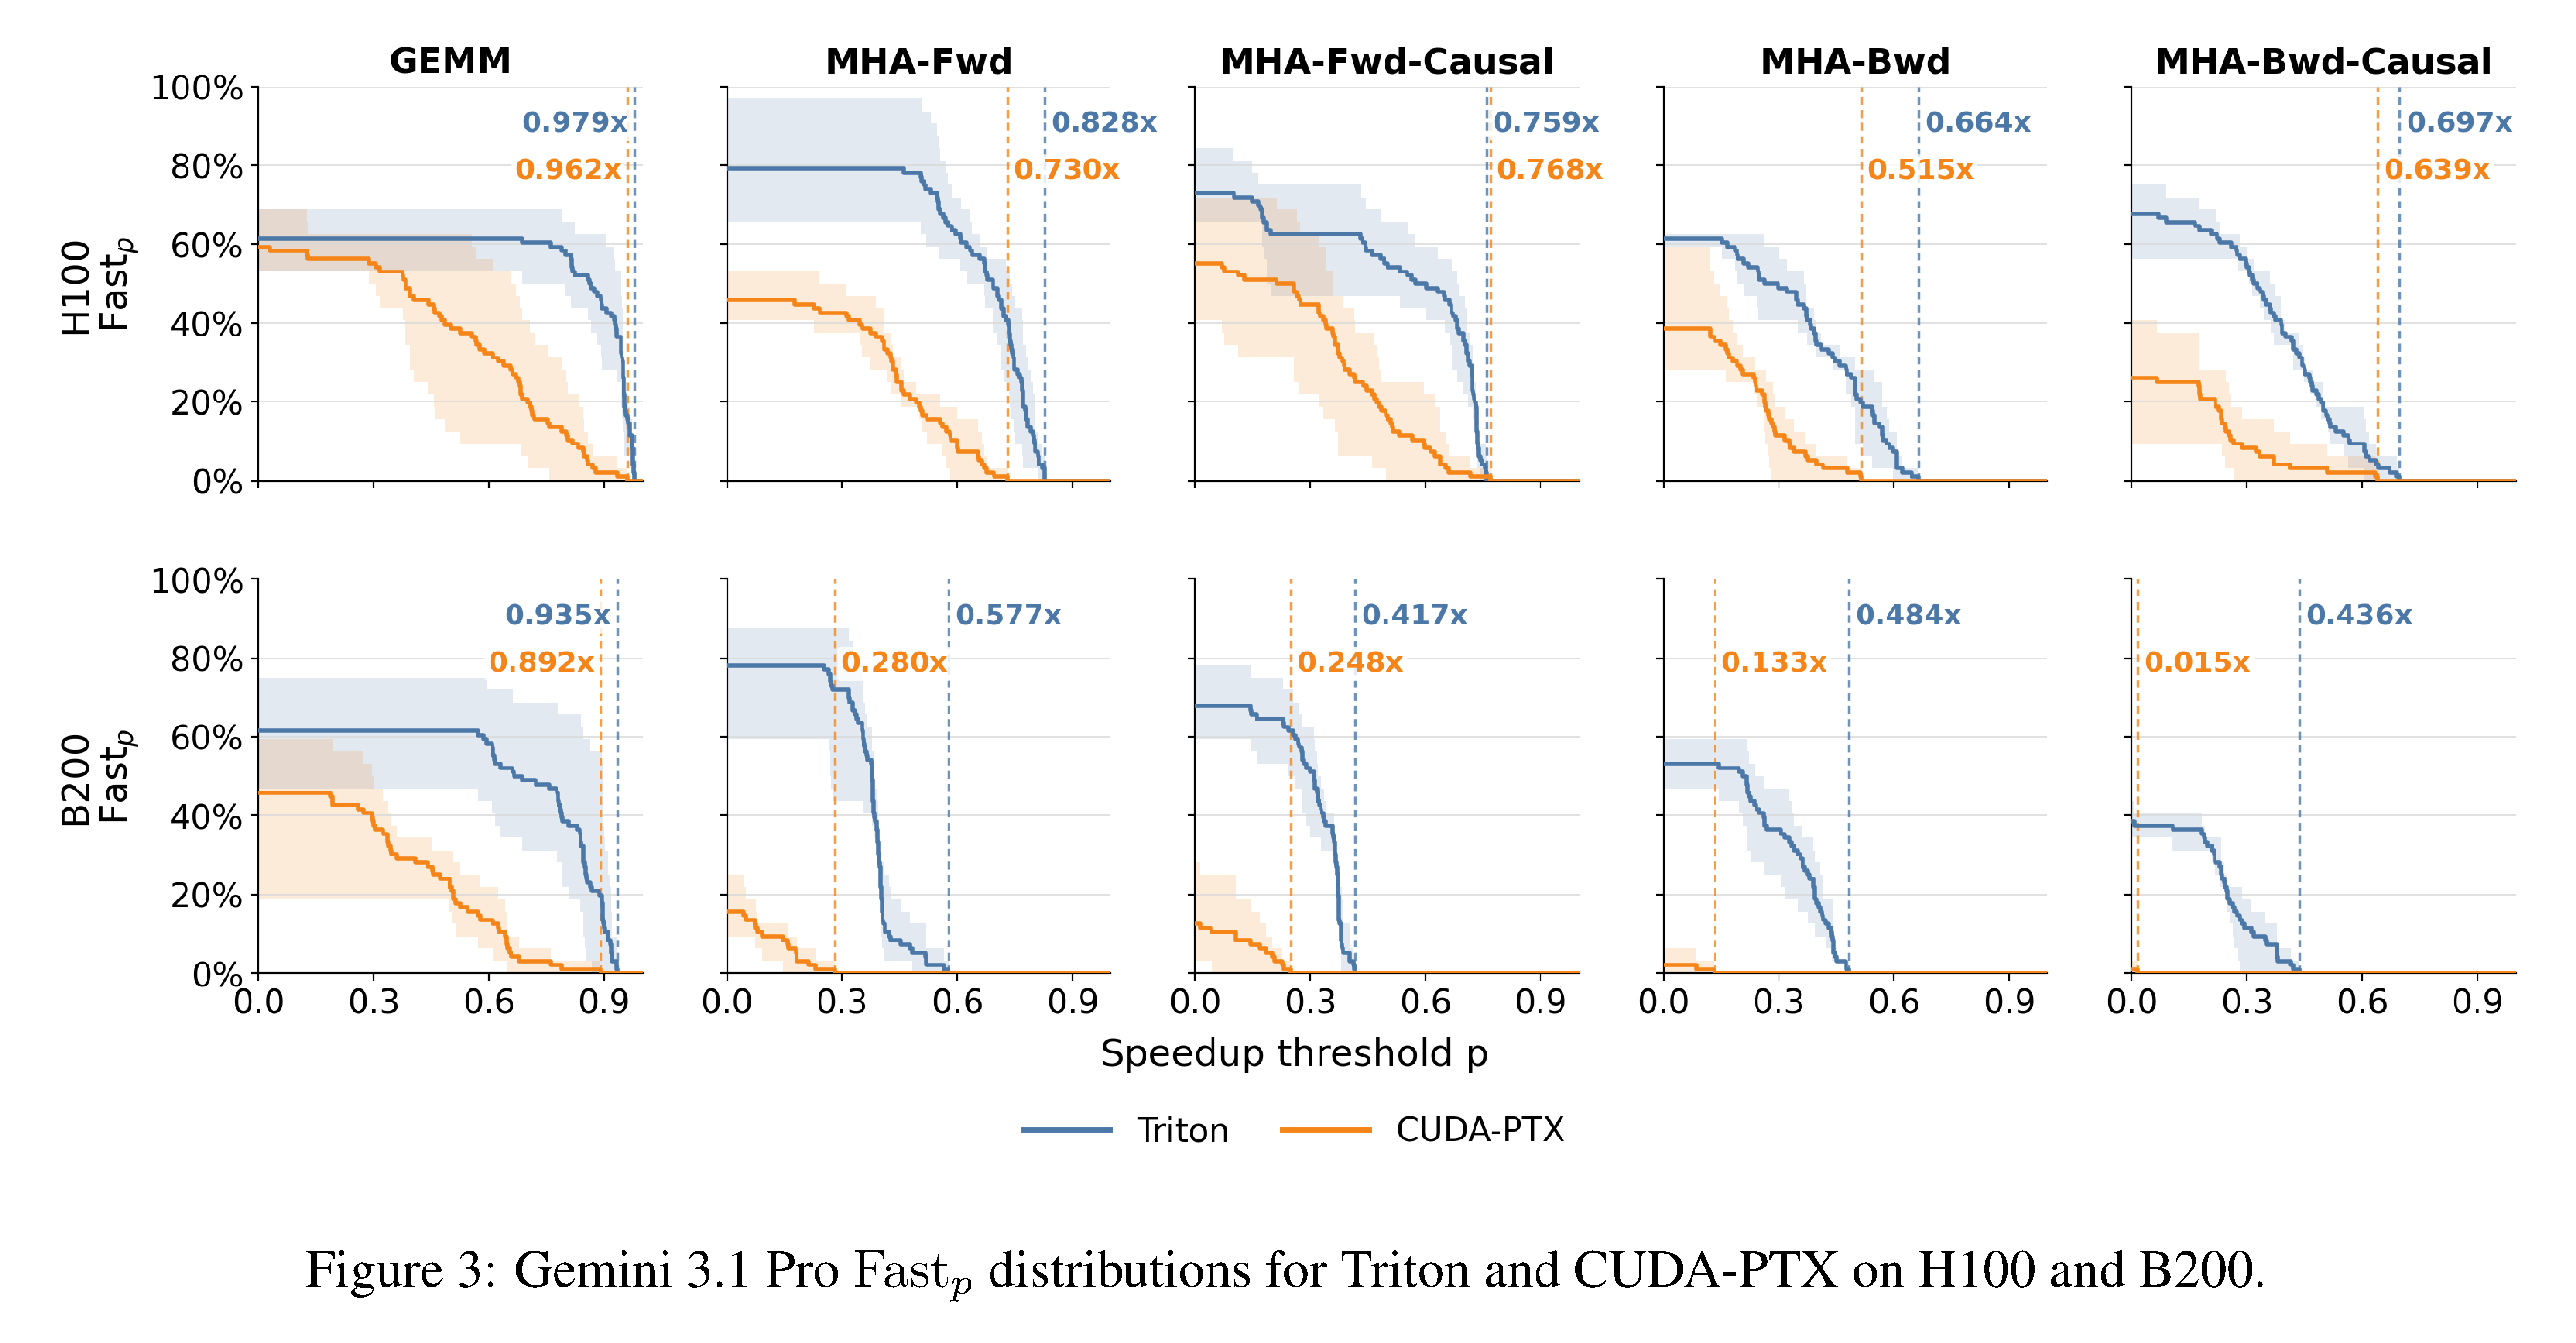
턴 정확도는 정확한 커널을 생성한 턴의 비율이며, 목표 명령어 턴 정확도는 선택한 명령어가 런타임에 실행되는 경우까지 요구한다. 연구는 최고 속도 향상과 Fast_p/FastInst._p도 보고한다. 이 지표는 속도 향상 임계값 p를 넘는 턴의 비율이며, FastInst._p는 정확성과 목표 실행을 모두 요구한다. 정확성은 atol=rtol=1e-2인 torch.allclose로 판정하고, 지연 시간은 10회 워밍업 뒤 50회 측정 반복의 중앙값으로 측정한다.
곡선은 정확하고 런타임에 목표 명령어를 실행하며 각 속도 향상 임계값을 넘는 턴의 비율을 보고한다. 특히 B200에서 GEMM은 역방향 어텐션보다 조건을 충족하는 성공 비율이 훨씬 높음을 보인다.
Gemini 3.1 Pro의 언어 비교는 Triton이 Blackwell 어텐션에서 특히 유리함을 보인다. 반면 CUDA-PTX는 Hopper에서 비교적 근접하며, Hopper 인과적 MHA 순전파에서는 최고 성능이 약간 더 높다.
4.2 Architecture-Specific PTX Capability Remains Uneven
역량은 아키텍처와 워크로드에 따라 크게 달라진다. Claude Opus 4.8은 B200 GEMM에서 cuBLAS의 1.012×에 도달했고 Gemini 3.1 Pro는 0.892×에 도달했지만, 두 모델 모두 Blackwell 어텐션을 Hopper 어텐션만큼 효과적으로 최적화하지 못했다. Qwen3.6-27B는 선택한 Blackwell 명령어를 실행하지 않은 정확한 B200 GEMM 커널 1개를 생성했으며, 이 설정에서는 정확한 Hopper 커널을 전혀 생성하지 못했다.
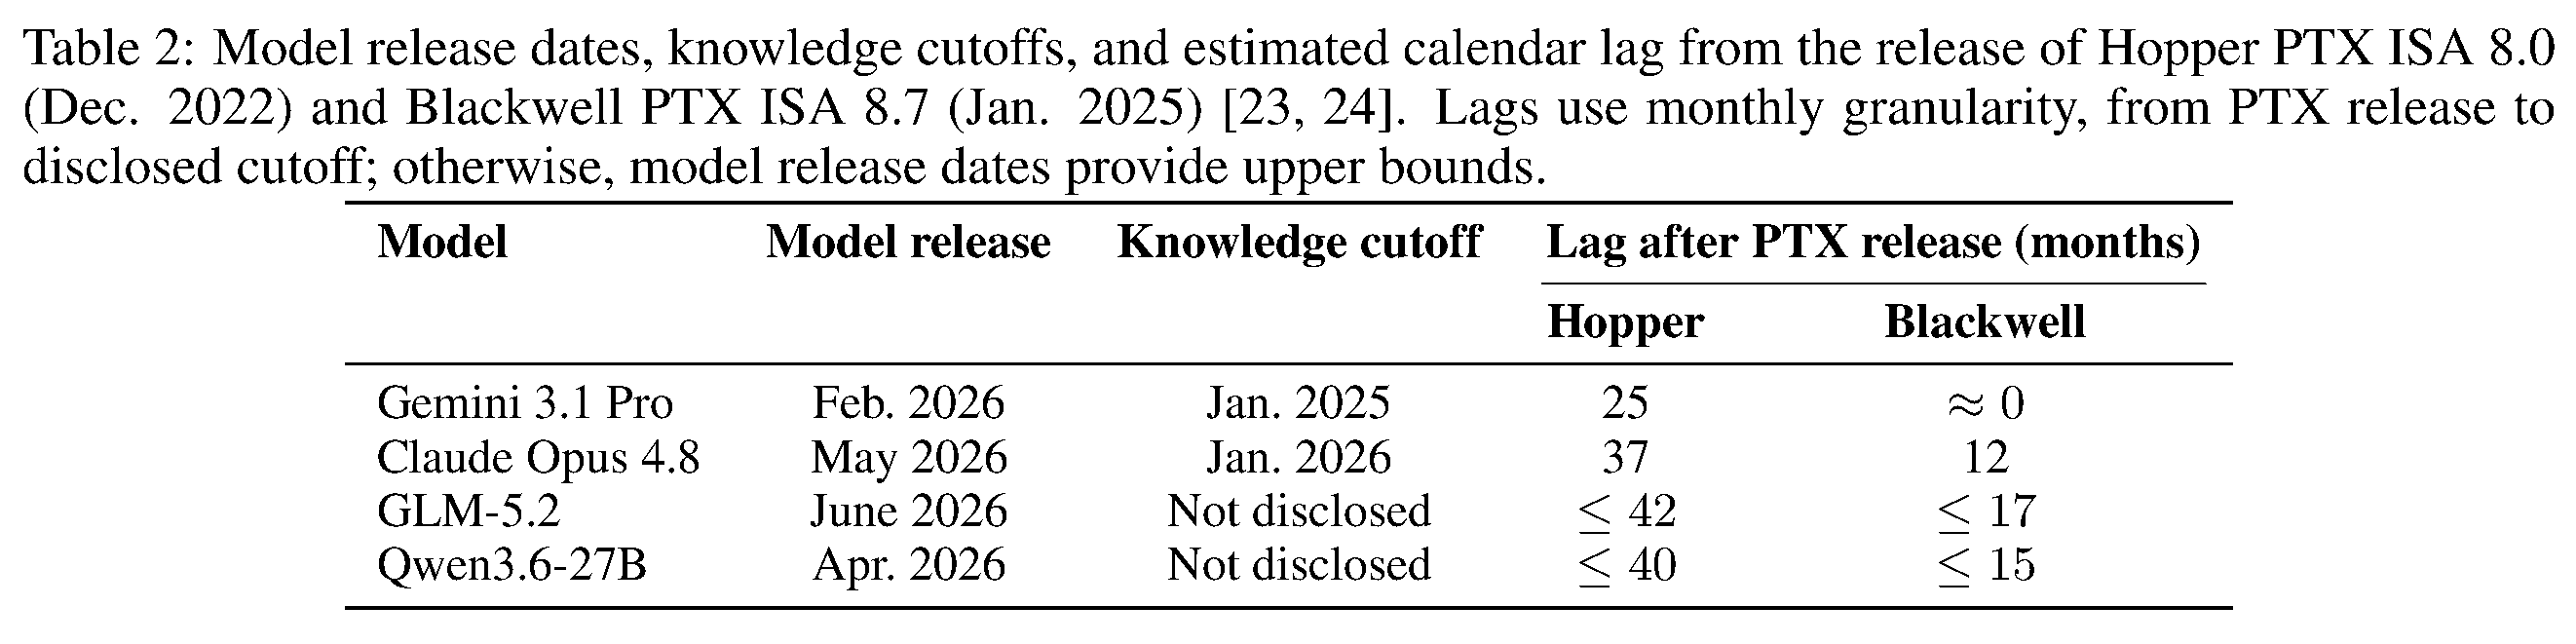
출시일, 공개한 지식 절단 시점, Hopper와 Blackwell PTX 문서에 대한 추정 시차는 각 모델이 해당 문서를 학습 데이터에 포함했을 수 있는 시점을 맥락화한다. 이는 아키텍처의 최신성이 Blackwell 난이도에 기여했을 가능성을 뒷받침하지만 확정하지는 않는다.
4.3 High-Level Kernel Languages Remain Valuable on New Architectures
Gemini 3.1 Pro에서 Triton과 CUDA-PTX는 Hopper에서 비교적 근접하다. CUDA-PTX는 인과적 MHA 순전파에서 Triton의 0.759× 대비 0.768×에 도달한다. Blackwell 어텐션에서는 Triton이 역방향 워크로드에서 더 강하며, CUDA-PTX의 0.133×와 0.015× 대비 0.484×와 0.436×에 도달한다. 저자들은 이 격차를 Blackwell의 더 특수화된 메커니즘과 더 최근의 PTX 생태계에 기인한다고 보면서도, 직접 작성한 저수준 코드가 때로는 고수준 구현과 맞먹거나 능가할 수 있다고 지적한다.
4.4 Explicit Architecture Knowledge Improves Target Instruction Execution
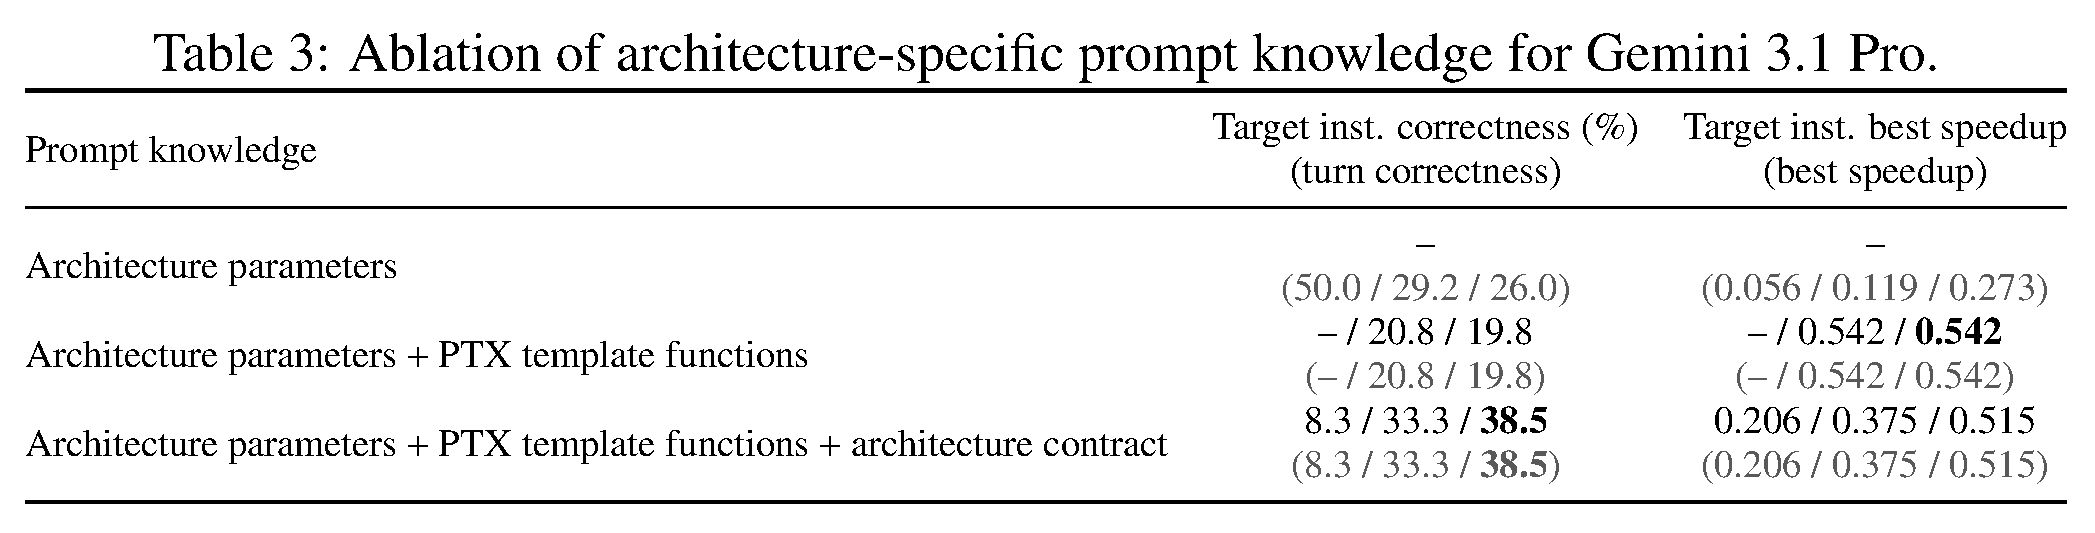
Gemini 3.1 Pro 절제 실험에서 아키텍처 매개변수만 제공했을 때 8턴의 제한 없는 정확한 턴은 26.0%였지만 목표 명령어 성공은 없었다. PTX 템플릿 함수를 추가하면 목표 실행이 가능해졌고, 아키텍처 계약을 추가하면 8턴의 목표 명령어 정확도가 38.5%로 올라 템플릿만 사용한 경우보다 18.7 %p 높아졌다. 이 계약은 최고 속도 향상을 반드시 극대화하기보다, 신뢰할 수 있고 정확한 명령어 실행을 개선한다.
절제 실험은 아키텍처 매개변수만으로는 목표 명령어 실행이 나오지 않음을 보인다. 템플릿은 이를 가능하게 하고, 아키텍처 계약은 조건을 충족하는 정확도를 더 높이지만 최고 속도 향상을 만들지는 않는다.
5 Adaptation Results
적응 실험은 Qwen3.6-27B의 262K-token 문맥이 긴 PTX 프롬프트와 추적 정보를 수용하고, 모델 규모가 통제된 LoRA 적응 및 자체 호스팅 평가를 가능하게 하므로 이 모델을 사용한다. Gemini 3.1 Pro는 복구 교사이며, 연구는 학습 형식, 범위, 균형, 추론 교사 선택, 전이, 프롬프트 시점 대안을 시험한다.
5.1 Training Format and Data Recipe Results
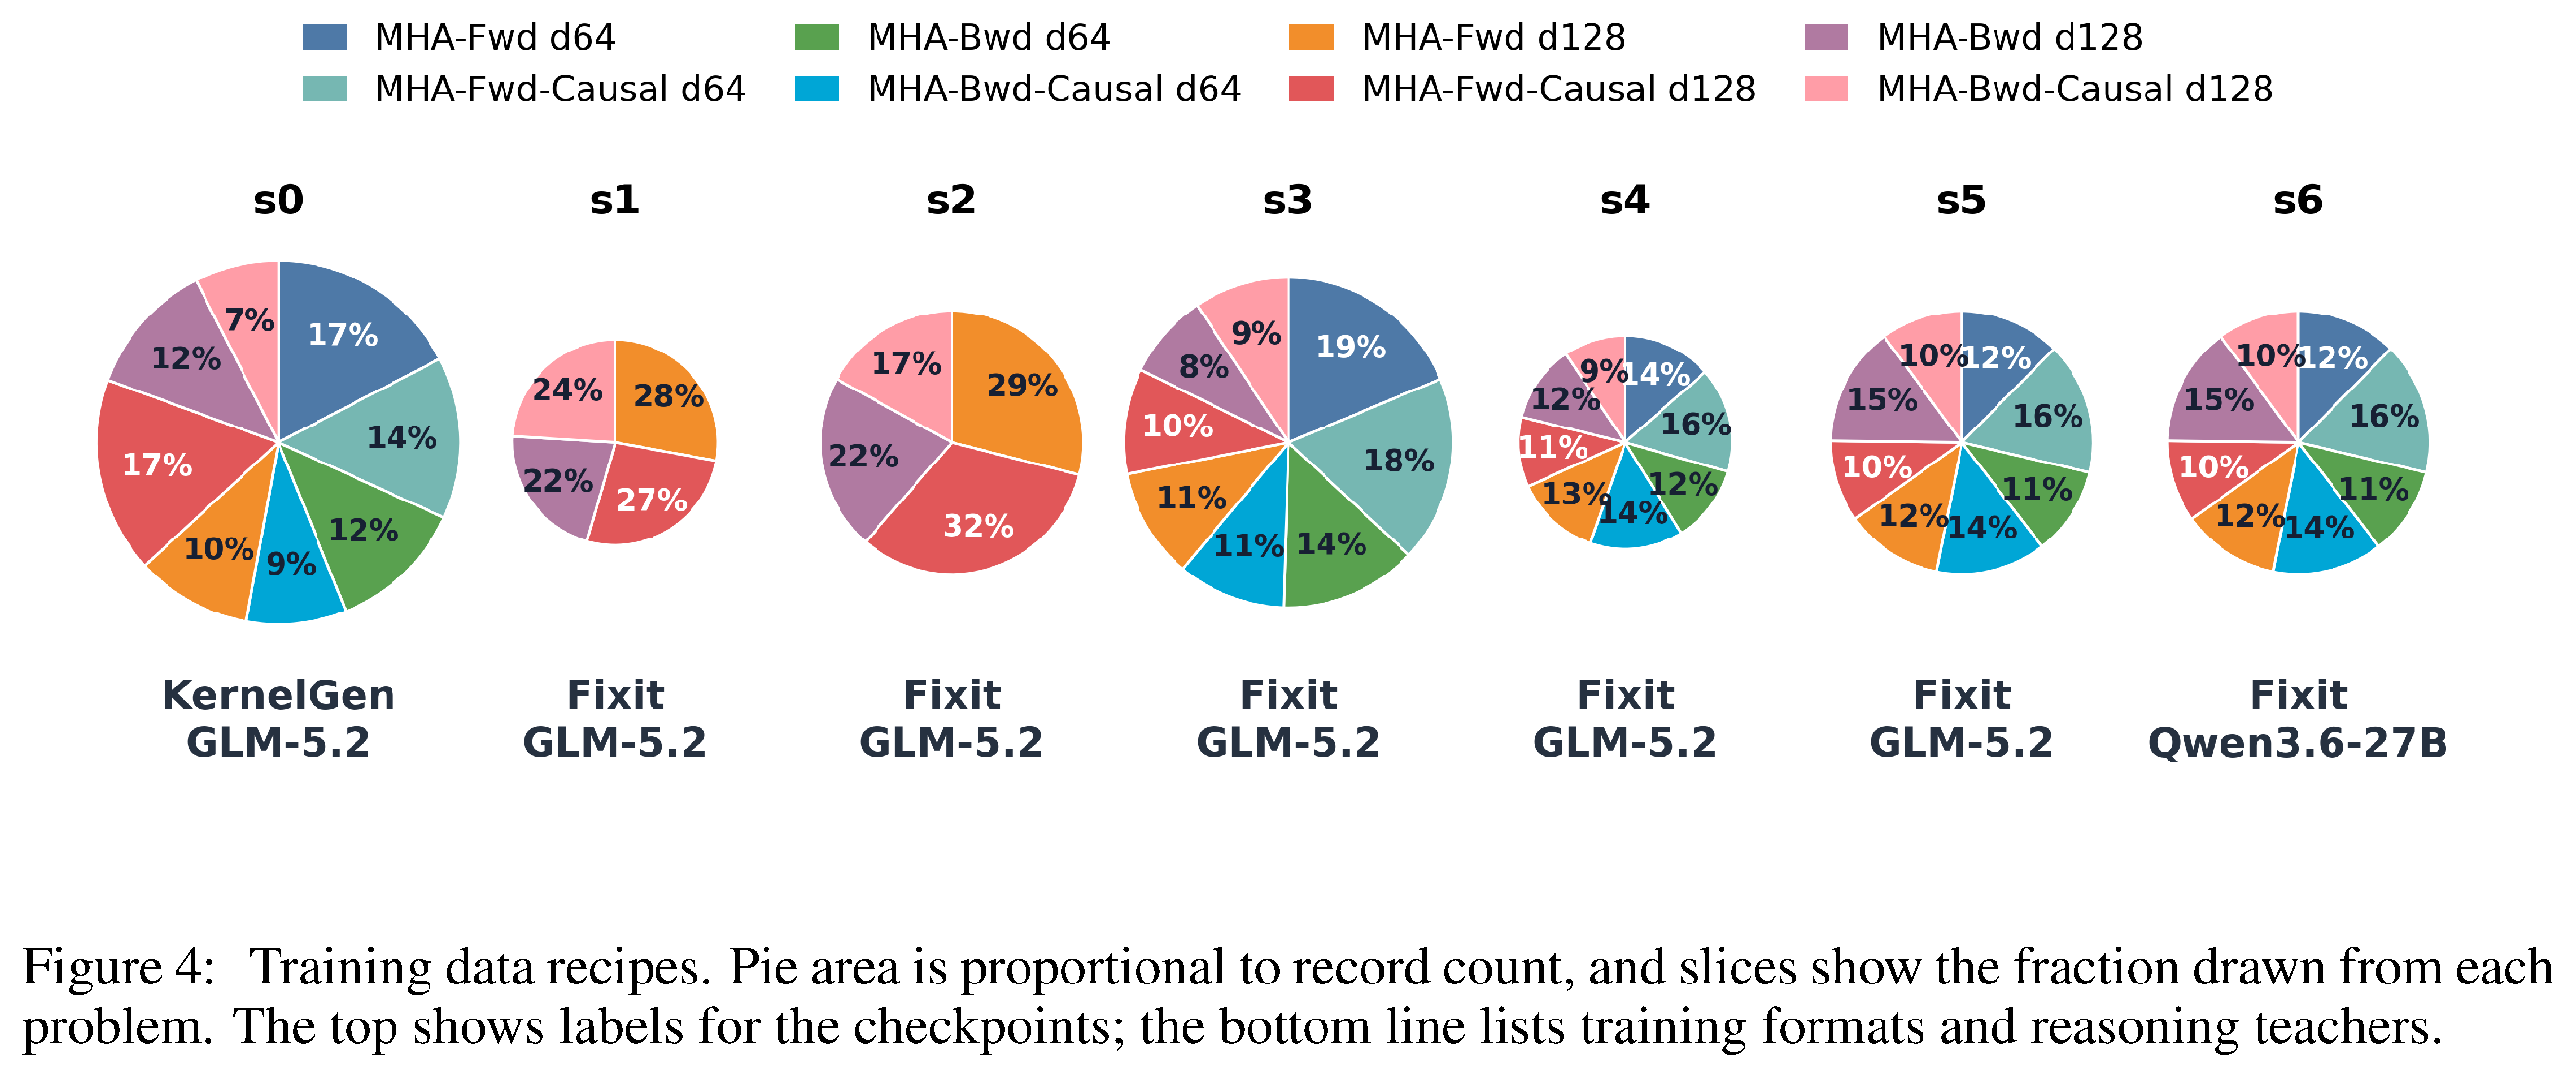
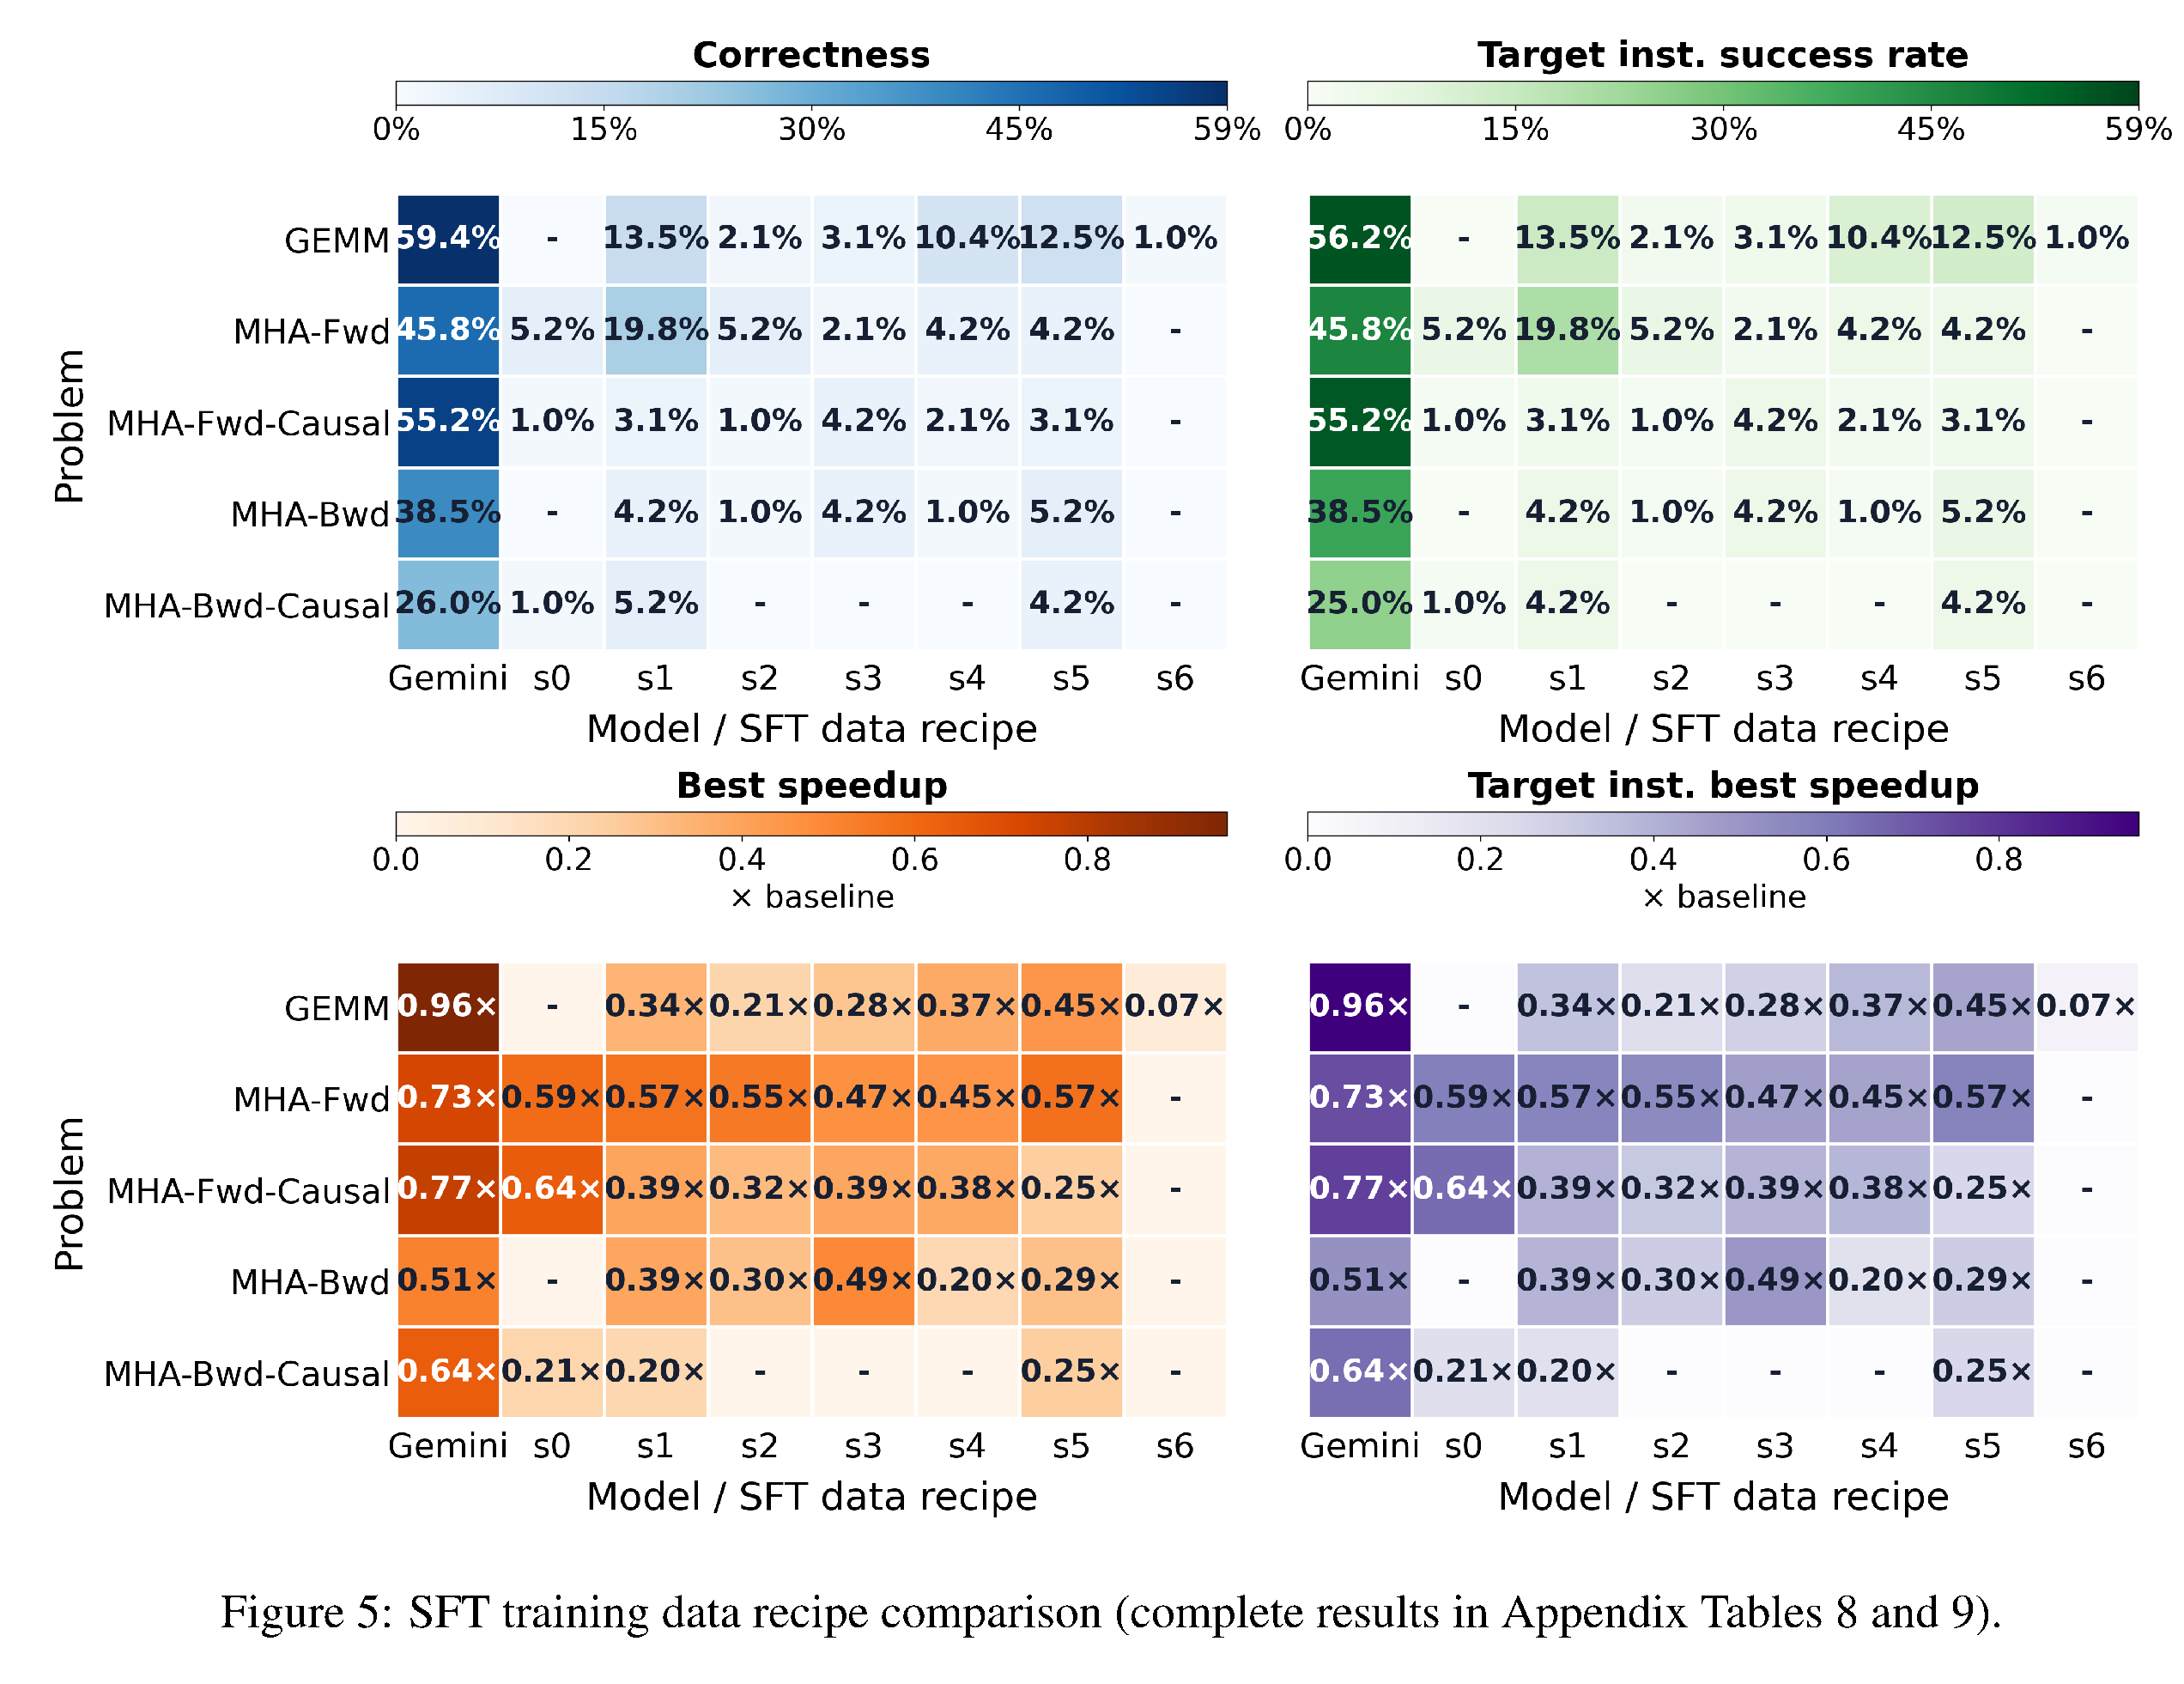
KernelGen은 Gemini 3.1 Pro의 직접적인 정답 해법과 GLM-5.2-generated 근거를 사용하며, Fixit은 복구 궤적으로 학습한다. 동일하게 8개 문제를 사용한 레시피에서 Fixit s3는 GEMM, MHA-Fwd-Causal, MHA-Bwd의 8턴 정확도를 개선하지만, MHA-Fwd와 MHA-Bwd-Causal에서는 KernelGen s0보다 낮다. 비교적 균형 잡힌 Fixit 레시피인 s1과 s5만이 5개 평가 문제를 모두 푼다. s6에서 근거 교사를 GLM-5.2 대신 Qwen3.6-27B로 바꾸면 성공은 GEMM에만 남는다.
원형의 면적은 SFT 레코드 수를 나타내며, 조각은 각 레시피가 문제별로 가져온 비율을 보인다. 이 그림은 KernelGen과 Fixit 형식, 학습 범위, 균형, 근거 교사 선택을 비교할 수 있게 한다.
히트맵은 기준 교사와 SFT 레시피 전반의 정확성, 목표 명령어 성공, 최고 속도 향상, 조건을 충족하는 최고 속도 향상을 비교한다. 어떤 레시피도 모든 워크로드에서 우세하지 않으며, 균형 잡힌 Fixit 레시피가 가장 넓은 과제 범위를 달성함을 보인다.
5.2 Effects and Generalization of Fixit SFT
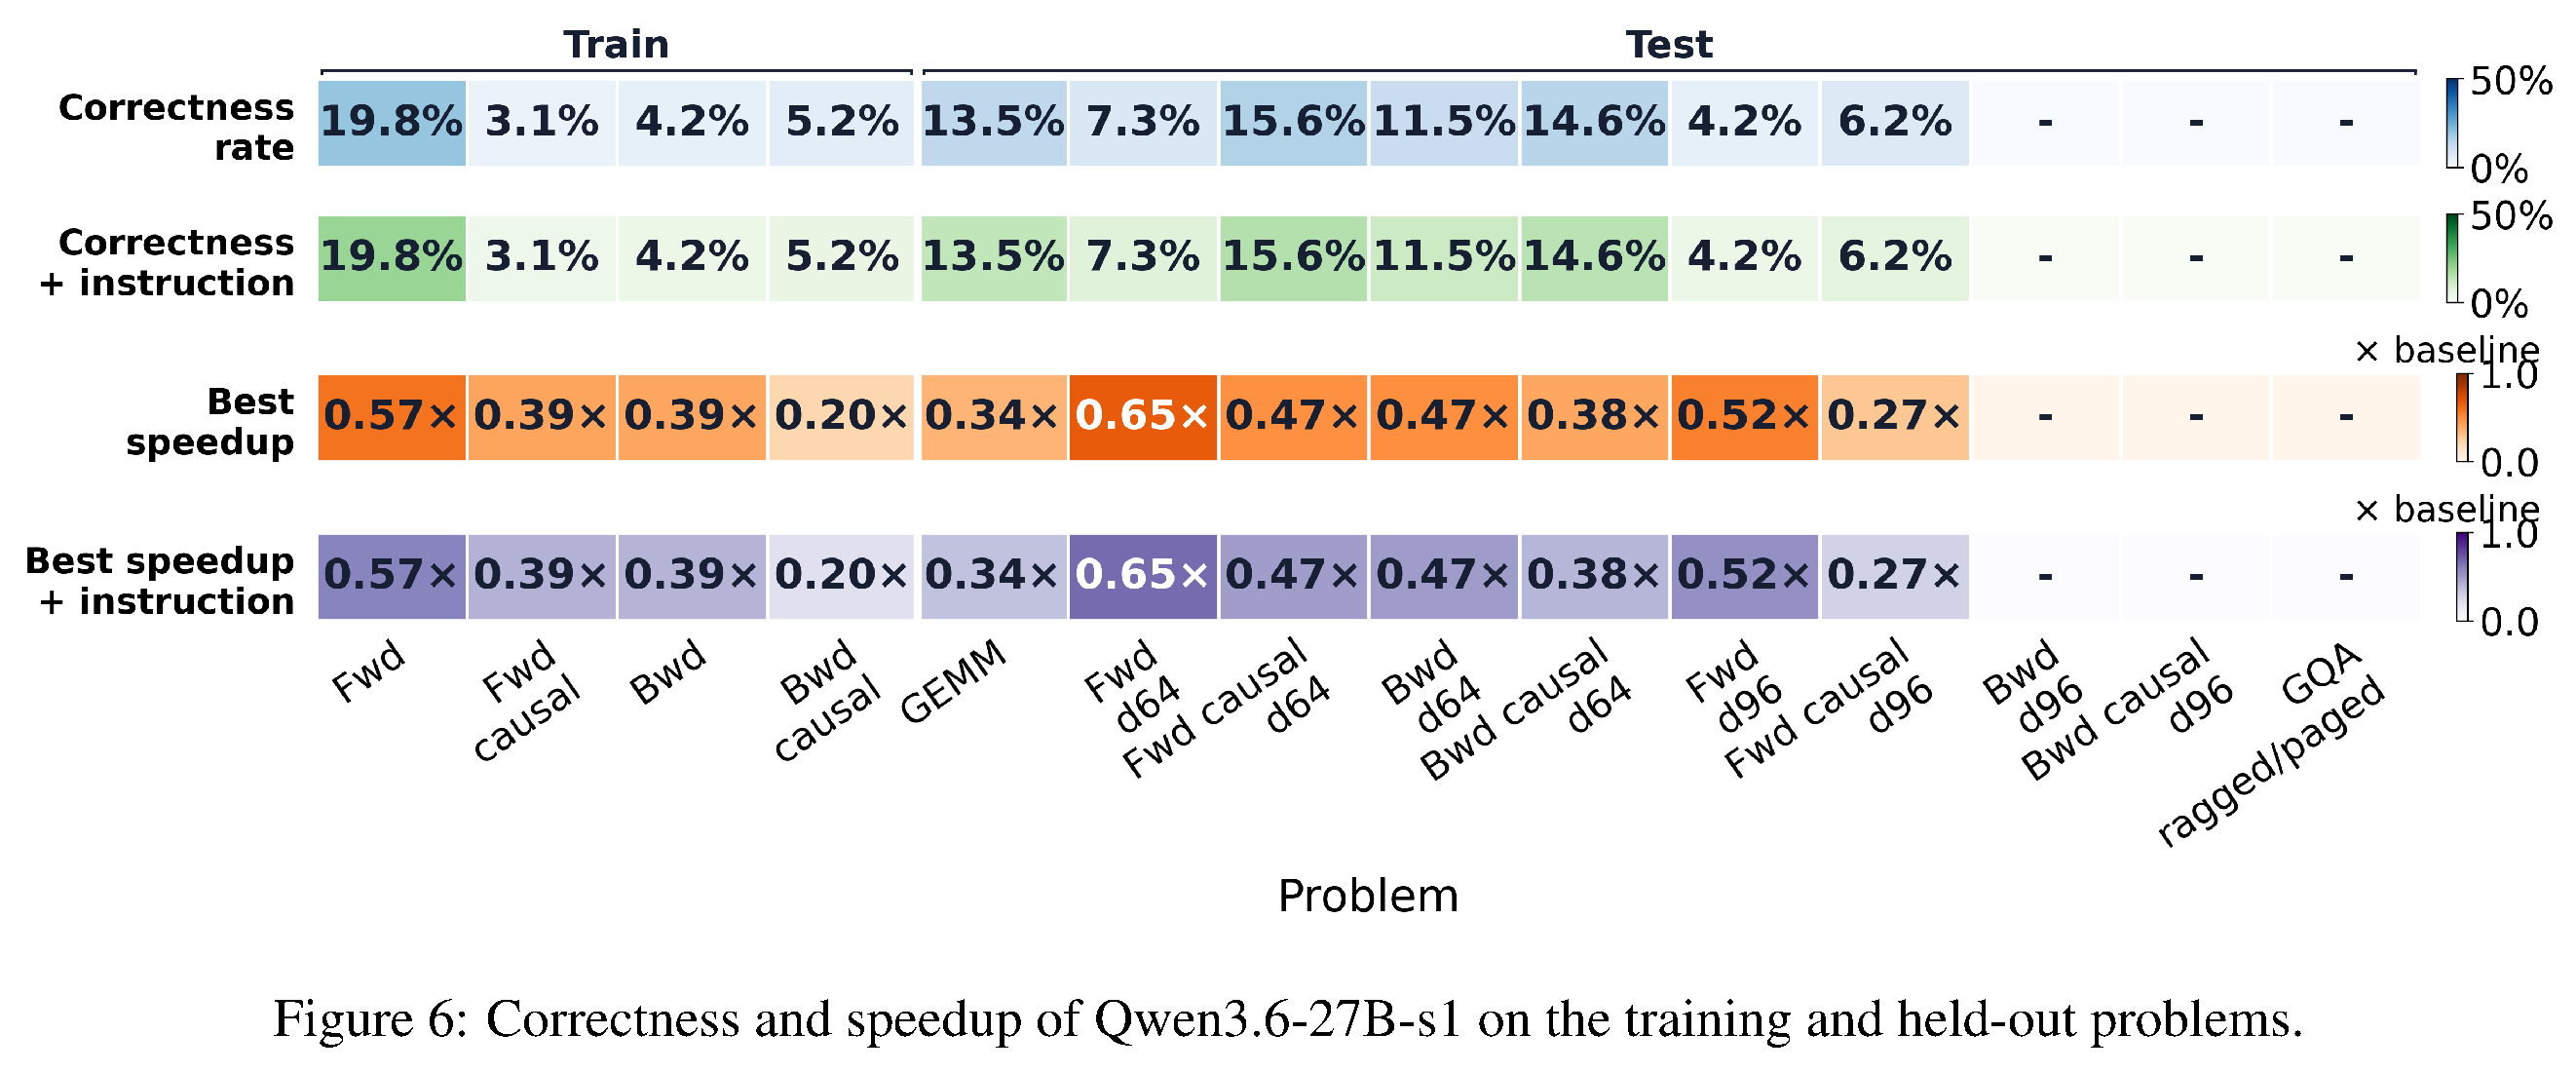
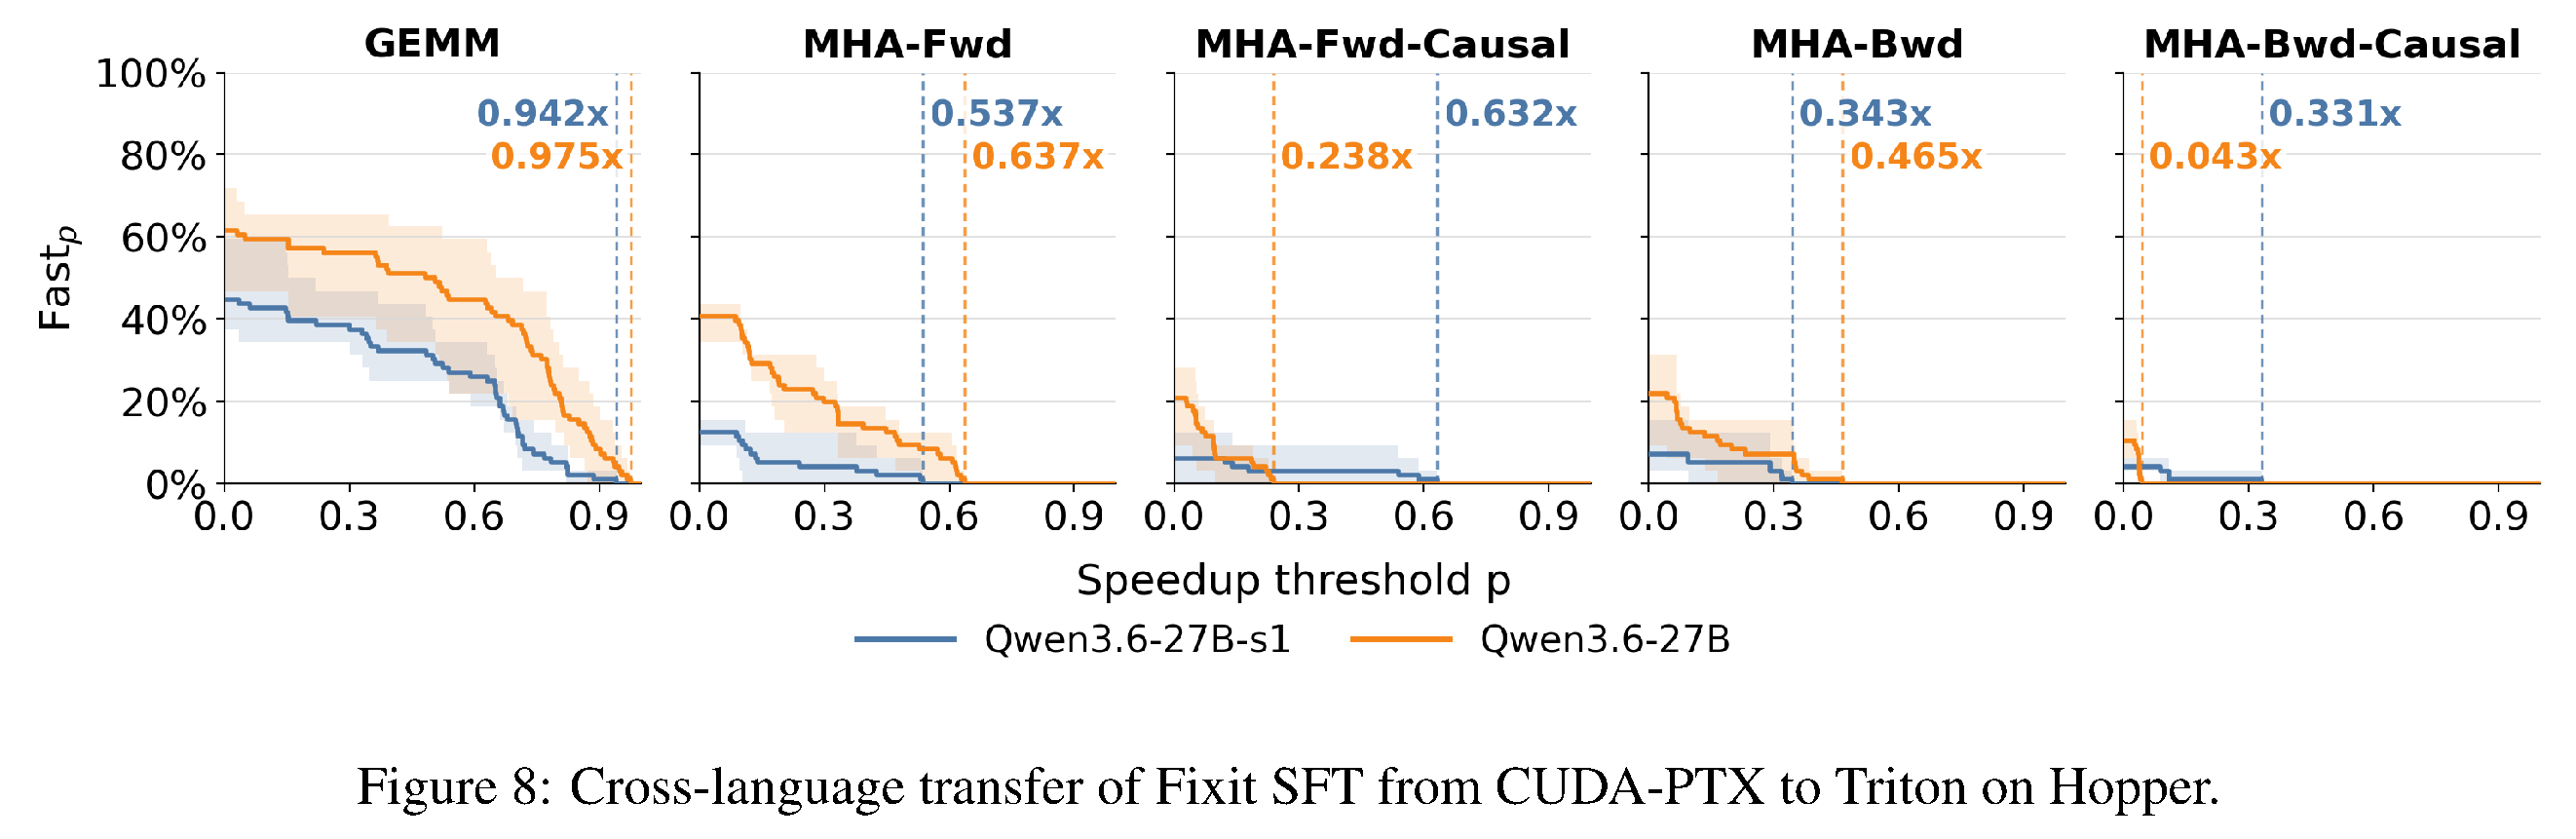
가장 작은 모든 과제 해결 레시피인 s1은 4개 d128 MHA 과제로 학습하며 GEMM, 모든 d64 MHA 과제, 2개 d96 순전파 과제로 전이한다. 그러나 정확한 d96 역방향 커널이나 GQA 커널은 생성하지 못한다. 논문은 d96 역방향의 어려움을 H100 WGMMA의 m64 타일과 맞지 않는 점에 연결한다. CUDA-PTX-to-Triton 전이는 모든 워크로드에서 턴 수준 정확도를 낮추지만, 인과적 순전파의 최고 정확 커널 속도 향상은 0.238×에서 0.632×로, 인과적 역방향에서는 0.043×에서 0.331×로 증가한다.
히트맵은 s1의 학습 과제와 보류한 시험을 구분하고, 목표 명령어 요구 여부에 따른 정확성과 속도 향상을 보고한다. GEMM, d64, d96-forward 과제로는 전이하지만 d96 역방향과 GQA에서는 정확한 출력이 없음을 보인다.
곡선은 CUDA-PTX 대신 Triton을 생성할 때 기본 모델과 s1 체크포인트를 비교한다. s1은 정확한 턴의 빈도를 낮추지만, 여러 과제에서 최고 속도를 개선하며 특히 인과적 어텐션 변형에서 변화가 크다.
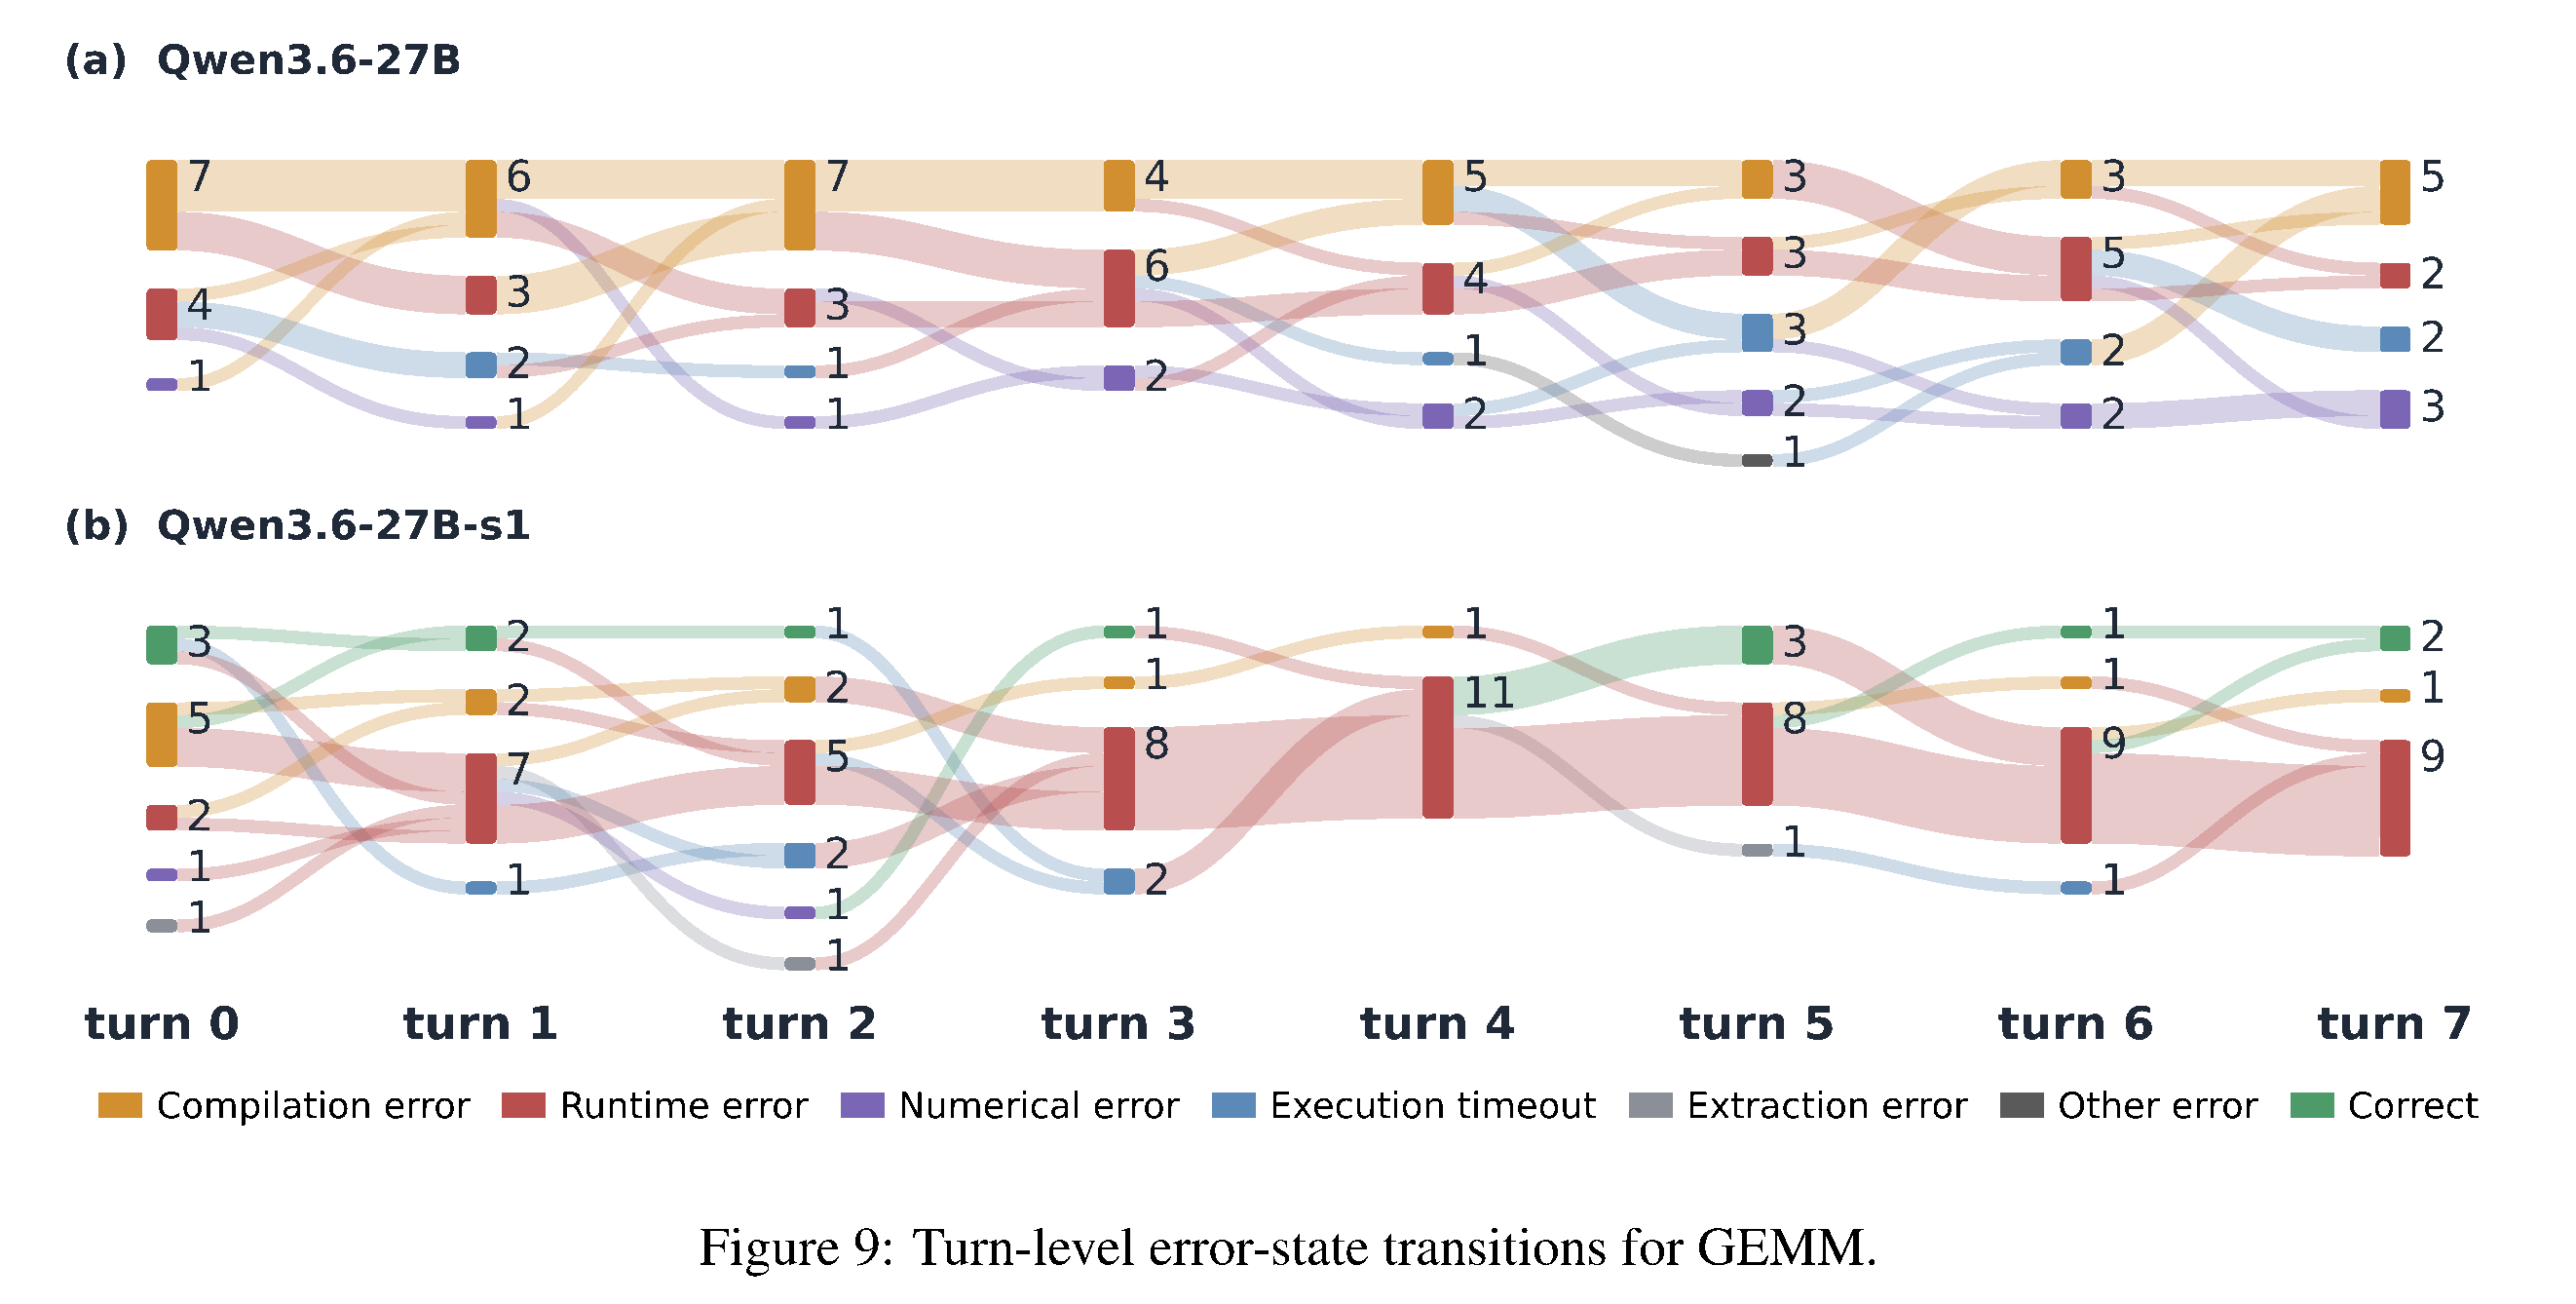
Sankey 형태 궤적은 8턴에 걸친 GEMM 오류 범주를 추적한다. 기본 모델과 비교하면 s1은 0턴부터 정확한 커널을 생성하지만, 남은 많은 실패는 컴파일 이후 런타임 또는 수치 오류로 발생한다.
5.3 SFT Versus In-context Supervision
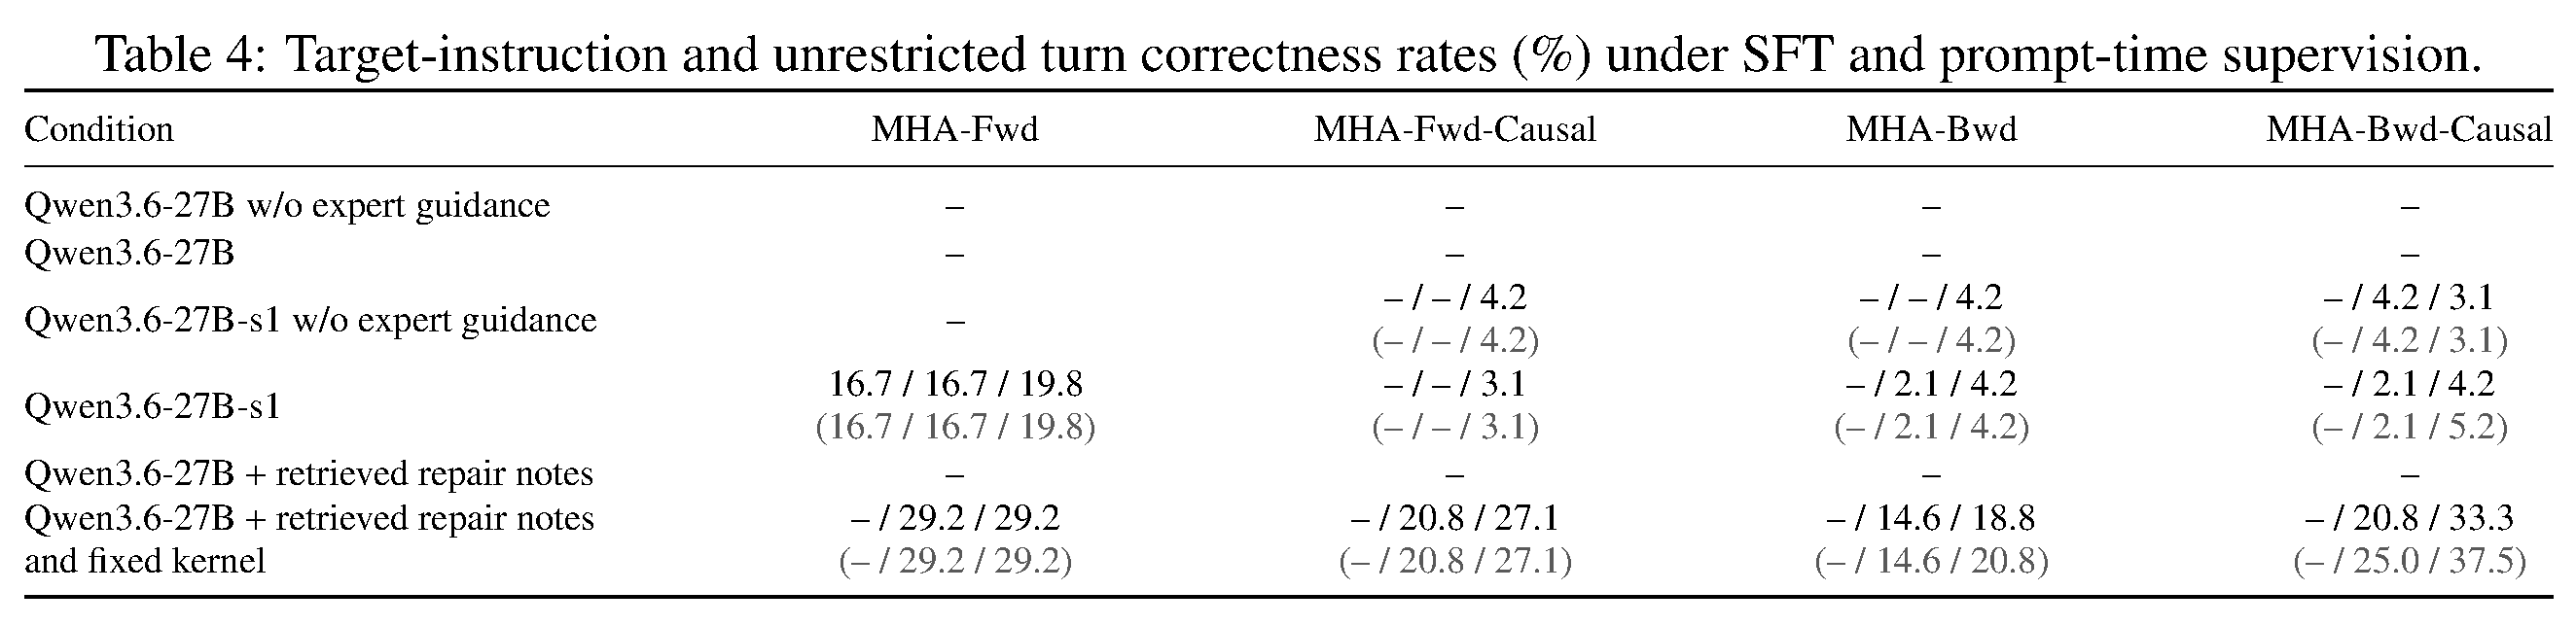
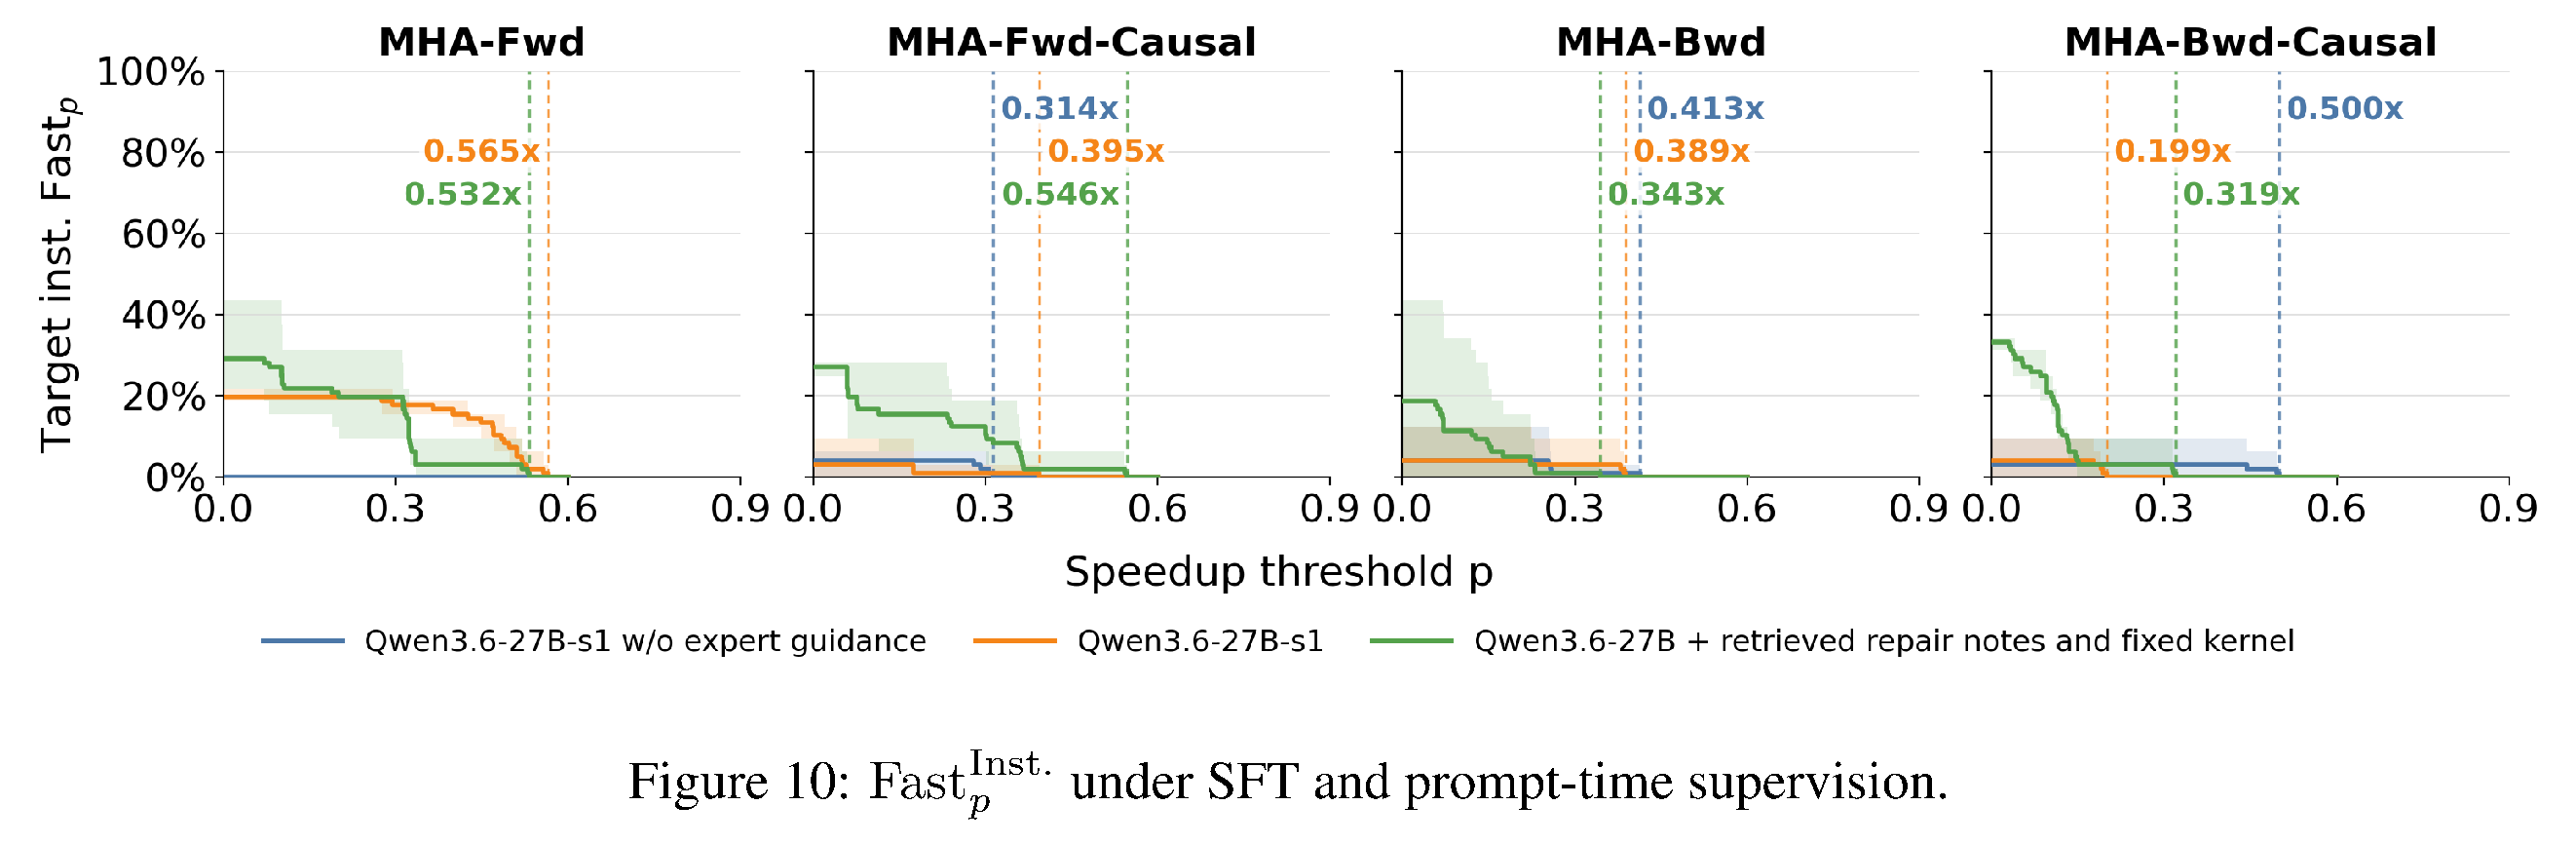
기본 모델은 전문가가 편집한 안내가 있어도 정확한 MHA 커널을 생성하지 못하지만, s1은 안내 없이 정확한 커널을 생성하고 안내가 있을 때 4개 문제 모두에서 0이 아닌 정확도를 보인다. 검색한 복구 메모만으로는 정확한 커널이 생성되지 않는다. 메모와 수정된 커널을 함께 제공하면 정확도가 크게 높아지지만, 이 조건은 해법을 담은 내용을 노출한다. 이 비교는 SFT가 기본 PTX 역량을 개선하는 반면, 검색 성능은 제공하는 정보에 좌우된다는 점을 보인다.
표는 SFT, 전문가 안내, 검색한 복구 정보 조건에서 목표 명령어 및 제한 없는 정확도를 비교한다. 검색한 메모만으로는 기본 모델에 도움이 되지 않지만, 고정 커널을 제공하면 해법을 담은 프롬프트 조건이 만들어진다.
조건을 충족하는 속도 향상 분포는 전문가 안내 유무에 따른 s1과 검색한 메모 및 고정 커널을 받은 기본 모델을 비교한다. 검색 조건도 성공할 수 있지만, 프롬프트에 수정된 구현이 포함되어 있다.
6 Related Work
PTXBench는 아키텍처와 PTX 명령어 계열을 고정하고, 벤더 라이브러리 포함을 금지하며, 요청한 메커니즘의 런타임 실행을 동적으로 검증한다는 점에서 KernelBench 계열 및 Triton/CUDA 벤치마크를 보완한다. 실행 피드백을 사용한 기존 SFT 및 RL 연구와 비교하면, 처음부터 인라인 PTX를 생성하는 작업을 대상으로 복구 조건화, 데이터 균형, 근거 지도, 전이를 분석한다.
7 Limitations
적응 결과는 작은 규모의 LoRA 데이터셋과 1개 27B base model에 한정되므로, 복구 조건화, 균형, 교사 품질의 효과가 더 큰 사후 학습 체계나 다른 모델 계열로 직접 전이되지 않을 수 있다. 벤치마크도 전체 GPU 연산자와 하드웨어 범위가 아니라 H100 및 B200에서 BF16 GEMM과 어텐션을 다룬다.
8 Conclusion
PTXBench는 정확성, 동적 명령어 실행, 최전선 라이브러리 대비 속도를 통해 아키텍처 특화 PTX 프로그래밍을 측정하는 감사 가능한 환경이다. 핵심 결과는 요청한 명령어 사용, 정확한 커널 생성, 경쟁력 있는 성능 달성 사이에 격차가 있다는 점이다. Fixit은 여러 과제를 개선하지만 직접 해법 지도를 일관되게 능가하지 못하며, 보류한 사례로도 신뢰성 있게 전이하지 못한다.
부록
- 부록은 H100 80 GB와 B200 컴파일 대상, 8회 호출 궤적, BF16 워크로드 형태, SASS 계열 일치, Nsight Compute 런타임 검사, LoRA 하이퍼파라미터를 명시한다. 또한 분류할 수 없는 프로파일링 결과의 보수적 처리, H100의 22,314 및 B200의 28,815 프롬프트 토큰 합계, 프로파일링 서비스 측정, 수정된 FlashAttention-3 의사 코드, 보충 결과를 문서화한다.
짧은 생각
논문의 핵심 방법론 기여는 소스 코드나 기능 정확성에서 아키텍처 사용을 추론하지 않고, 목표 명령어의 런타임 실행을 별도의 감사 가능한 결과로 다룬다는 점이다. 사후 학습 증거는 복구 데이터 양과 더 긴 근거만으로 충분하지 않음을 경고한다. 균형 잡힌 과제 범위와 더 강한 추론 교사가 성공 범위에 영향을 준다. 제한된 모델 및 워크로드 범위를 고려하면, 이 적응 결과는 GPU 커널 에이전트를 위한 일반적 처방이 아니라 통제된 증거다.