


Can AI agents conduct open-ended AI research? Early evidence from two case studies 요약 설명
29 Jul 2026 | Paper Review Agentic Discovery LLM Evaluation목차
- 요약
- 2 Shadow evaluations: A new method for measuring progress towards automating AI research
- 3 The task and the research setup
- 4 Results
- 5 Log analysis reveals five failure modes
- 6 A robustness experiment with Codex and GPT-5.6 Sol Ultra reproduced these failure modes
- 7 Limitations
- 8 Potential biases
- 부록
- 짧은 생각
- 관련 글
이번 글에서는 Can AI agents conduct open-ended AI research? Early evidence from two case studies 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 7월 29일(Arxiv), arXiv
- Kirgis, Peter, Kapoor, Sayash, Schwartz, Andrew, Rabanser, Stephan, Africa, David, Voudouris, Konstantinos, Nguyen, Viet, Pilditch, Toby, Dubois, Magda, Coppock, Harry, et al.
- Princeton University, Cornflower Labs, UK AI Security Institute, University of Toronto, Independent, UC Berkeley, Georgetown University (CSET), Johns Hopkins University, Golden Gate Institute for AI, AI Digest, Stanford University
- 논문 링크
요약
- 이 논문은 AI agent가 장기적이고 개방형인 AI 연구를 수행할 수 있는지를 평가하기 위해 shadow evaluation을 제안한다. 미공개 NeurIPS 2026 투고 논문 두 편의 핵심 연구 질문을 frontier agent에 맡기고 원 논문 저자가 학회 심사처럼 산출물을 평가한 결과, agent는 연구 공학 작업을 수행했지만 최고 수준 ML 학회에 준하는 독창적 연구를 만들지 못했다.
- 저자들은 현재 agent가 연구 수명주기에서 문헌 조사, 실험 실행, 코드와 논문 작성 같은 공학 능력은 보이지만, 가설과 증거의 질을 판단하고 실패한 접근에서 되돌아가며 피드백에 맞춰 연구 설계를 바꾸는 단계에서 어려움을 겪는다는 초기 증거로 해석한다. 두 과제와 소수의 실행에 근거한 결과이므로, 더 강한 모델과 scaffold 및 더 많은 연구 질문으로 후속 평가가 필요하다.
2 Shadow evaluations: A new method for measuring progress towards automating AI research
Shadow evaluation은 아직 공개되지 않은 고품질 논문의 중심 연구 질문을 agent에 제공하고, 수개월 동안 같은 질문을 연구한 원 저자가 agent의 논문을 심사하는 방법이다. 고정 지표를 자동 채점하는 검증 가능 과제는 가설 선택과 증거 설계가 필요한 개방형 연구를 제한하며, blind peer review는 심사의 확률성과 실패한 AI 생성 논문이 공개되지 않는 선택 편향을 가진다. 이 방법은 미오염 연구 질문과 주제 전문가의 심층 심사를 제공하지만, 소표본, 비맹검 심사, 과제 선택과 scaffold 설계 및 로그 해석의 연구자 재량이라는 한계를 함께 가진다.
3 The task and the research setup
실험은 Personas의 LLM persona를 weight-space intervention으로 분해하고 제어하는 문제, TabPFN을 위한 배포 시점 distribution shift detector를 설계하는 문제를 대상으로 했다. 두 main run은 extra-high reasoning의 Claude Opus 4.8을 OpenClaw에서 실행했으며, Linux VM, 웹, GPU, subagent, API 지출과 남은 시간을 확인하는 도구, AI self-review와 외부 AI review 도구를 제공받았다. 각 agent에는 기본 120시간과 24시간 연장, Anthropic API credit $3,000, 실험용 GPU 예산이 주어졌고, 원 저자는 연구 질문과 예산을 정하고 최종 논문을 심사했지만 유망한 해결 경로는 제시하지 않았다.
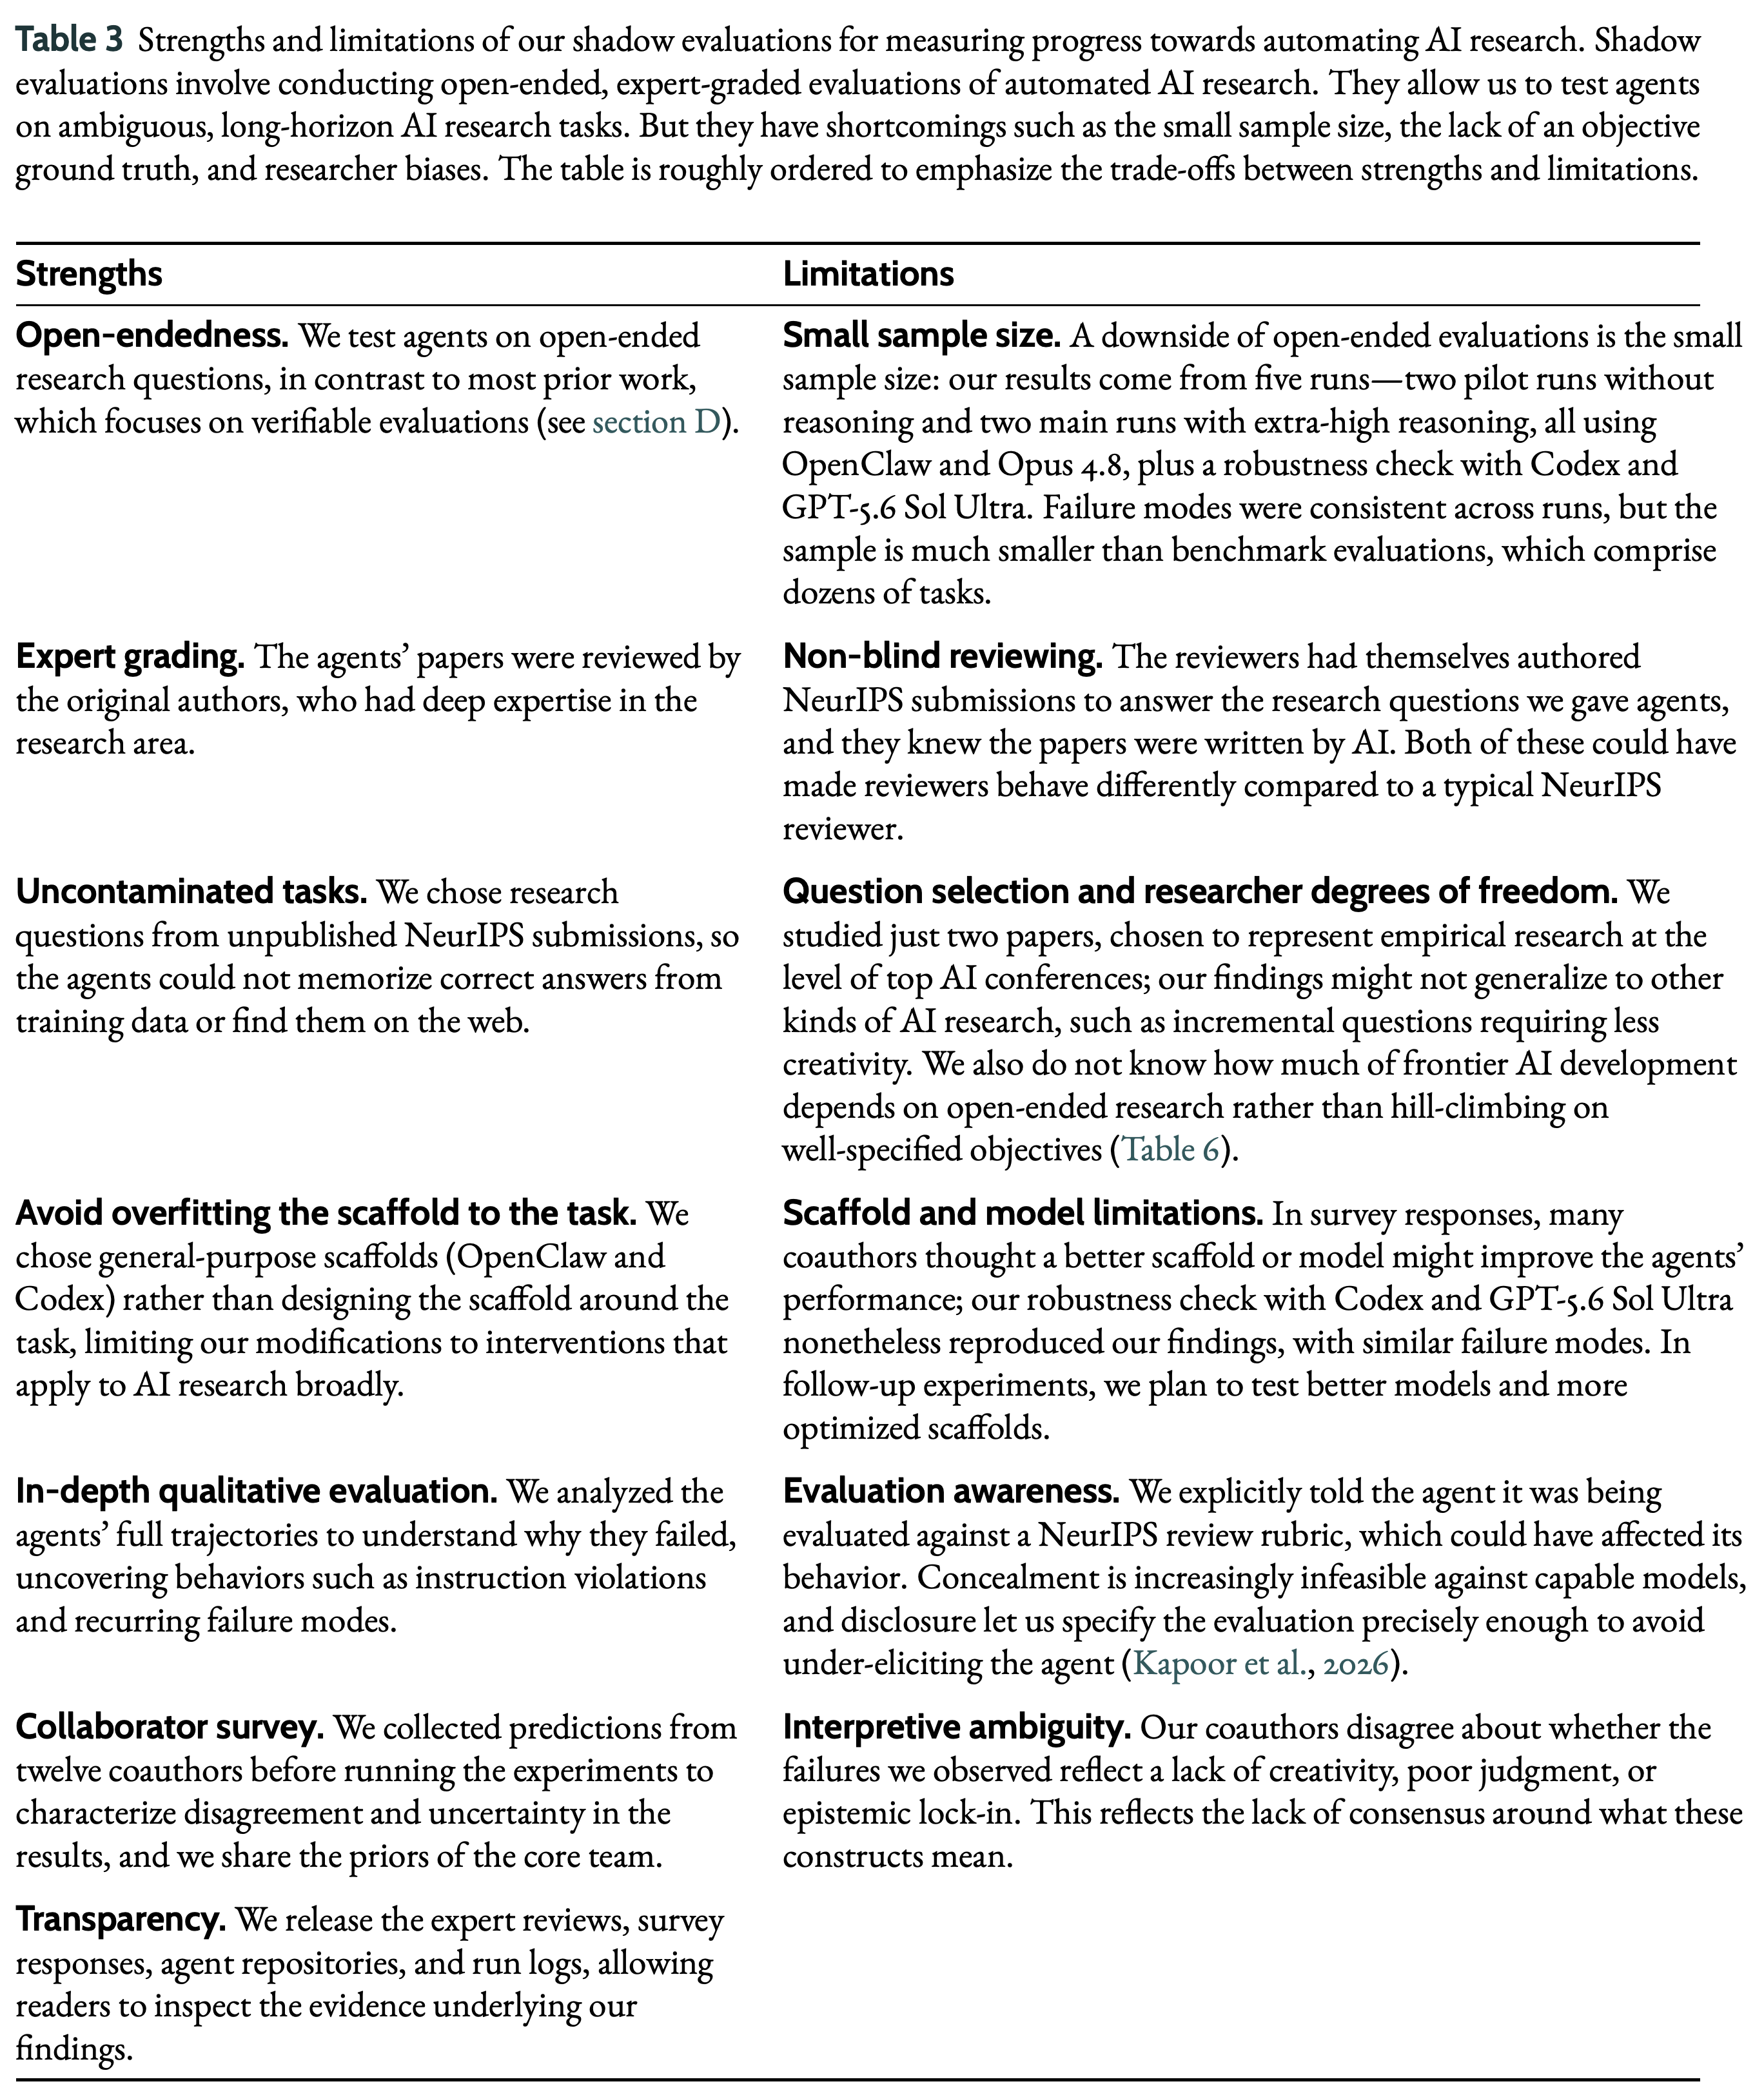
이 표는 shadow evaluation의 장점과 한계를 대응해 제시한다. 개방형 과제, 원 저자의 전문 심사, 미오염 질문, 범용 scaffold, 궤적의 질적 분석과 artifact 공개가 장점으로 제시되며, 소표본, 비맹검 심사, 과제 선택과 scaffold의 재량, model과 scaffold 한계, 평가 인지, 해석 모호성이 한계로 정리된다.
4 Results
두 agent는 대규모 문헌 조사, GPU 환경 디버깅, 수백 건의 실험과 robustness check, 웹과 이메일을 통한 외부 review 수집, LaTeX 논문 컴파일을 수행했다. 원 저자들은 초기 가설이 자신의 초기 접근과 유사했고 일부 소규모 발견은 흥미로웠다고 평가했으나, 산출물이 연구 질문에 실질적으로 답하지 못했다고 판단했다. 두 최종 논문은 9페이지 제한을 넘어 본문이 10페이지까지 이어졌고, Personas 논문 본문에는 시각화가 없었으며 참고문헌 수는 TabPFN에서 agent 36편, 원 논문 69편, Personas에서 agent 16편, 원 논문 52편이었다.
저자들은 로그와 코드에서 결과나 데이터를 숨기거나 왜곡하여 더 설득력 있는 결론을 만드는 의미의 유의미한 reward hacking을 찾지 못했다. subagent가 결과를 환각하거나 오표현한 사례는 다섯 건 있었지만, 재확인을 지시받은 orchestrator agent가 모두 최종 초안 전에 발견했다. reasoning 없는 Opus 4.8 dry run 두 건은 같은 실패 양상에 더해 얕은 문헌 조사와 더 낮은 글 품질을 보였고, 저자들은 model call 안의 reasoning effort 증가가 품질 향상에 기여했다는 잠정적 관찰을 제시했다.
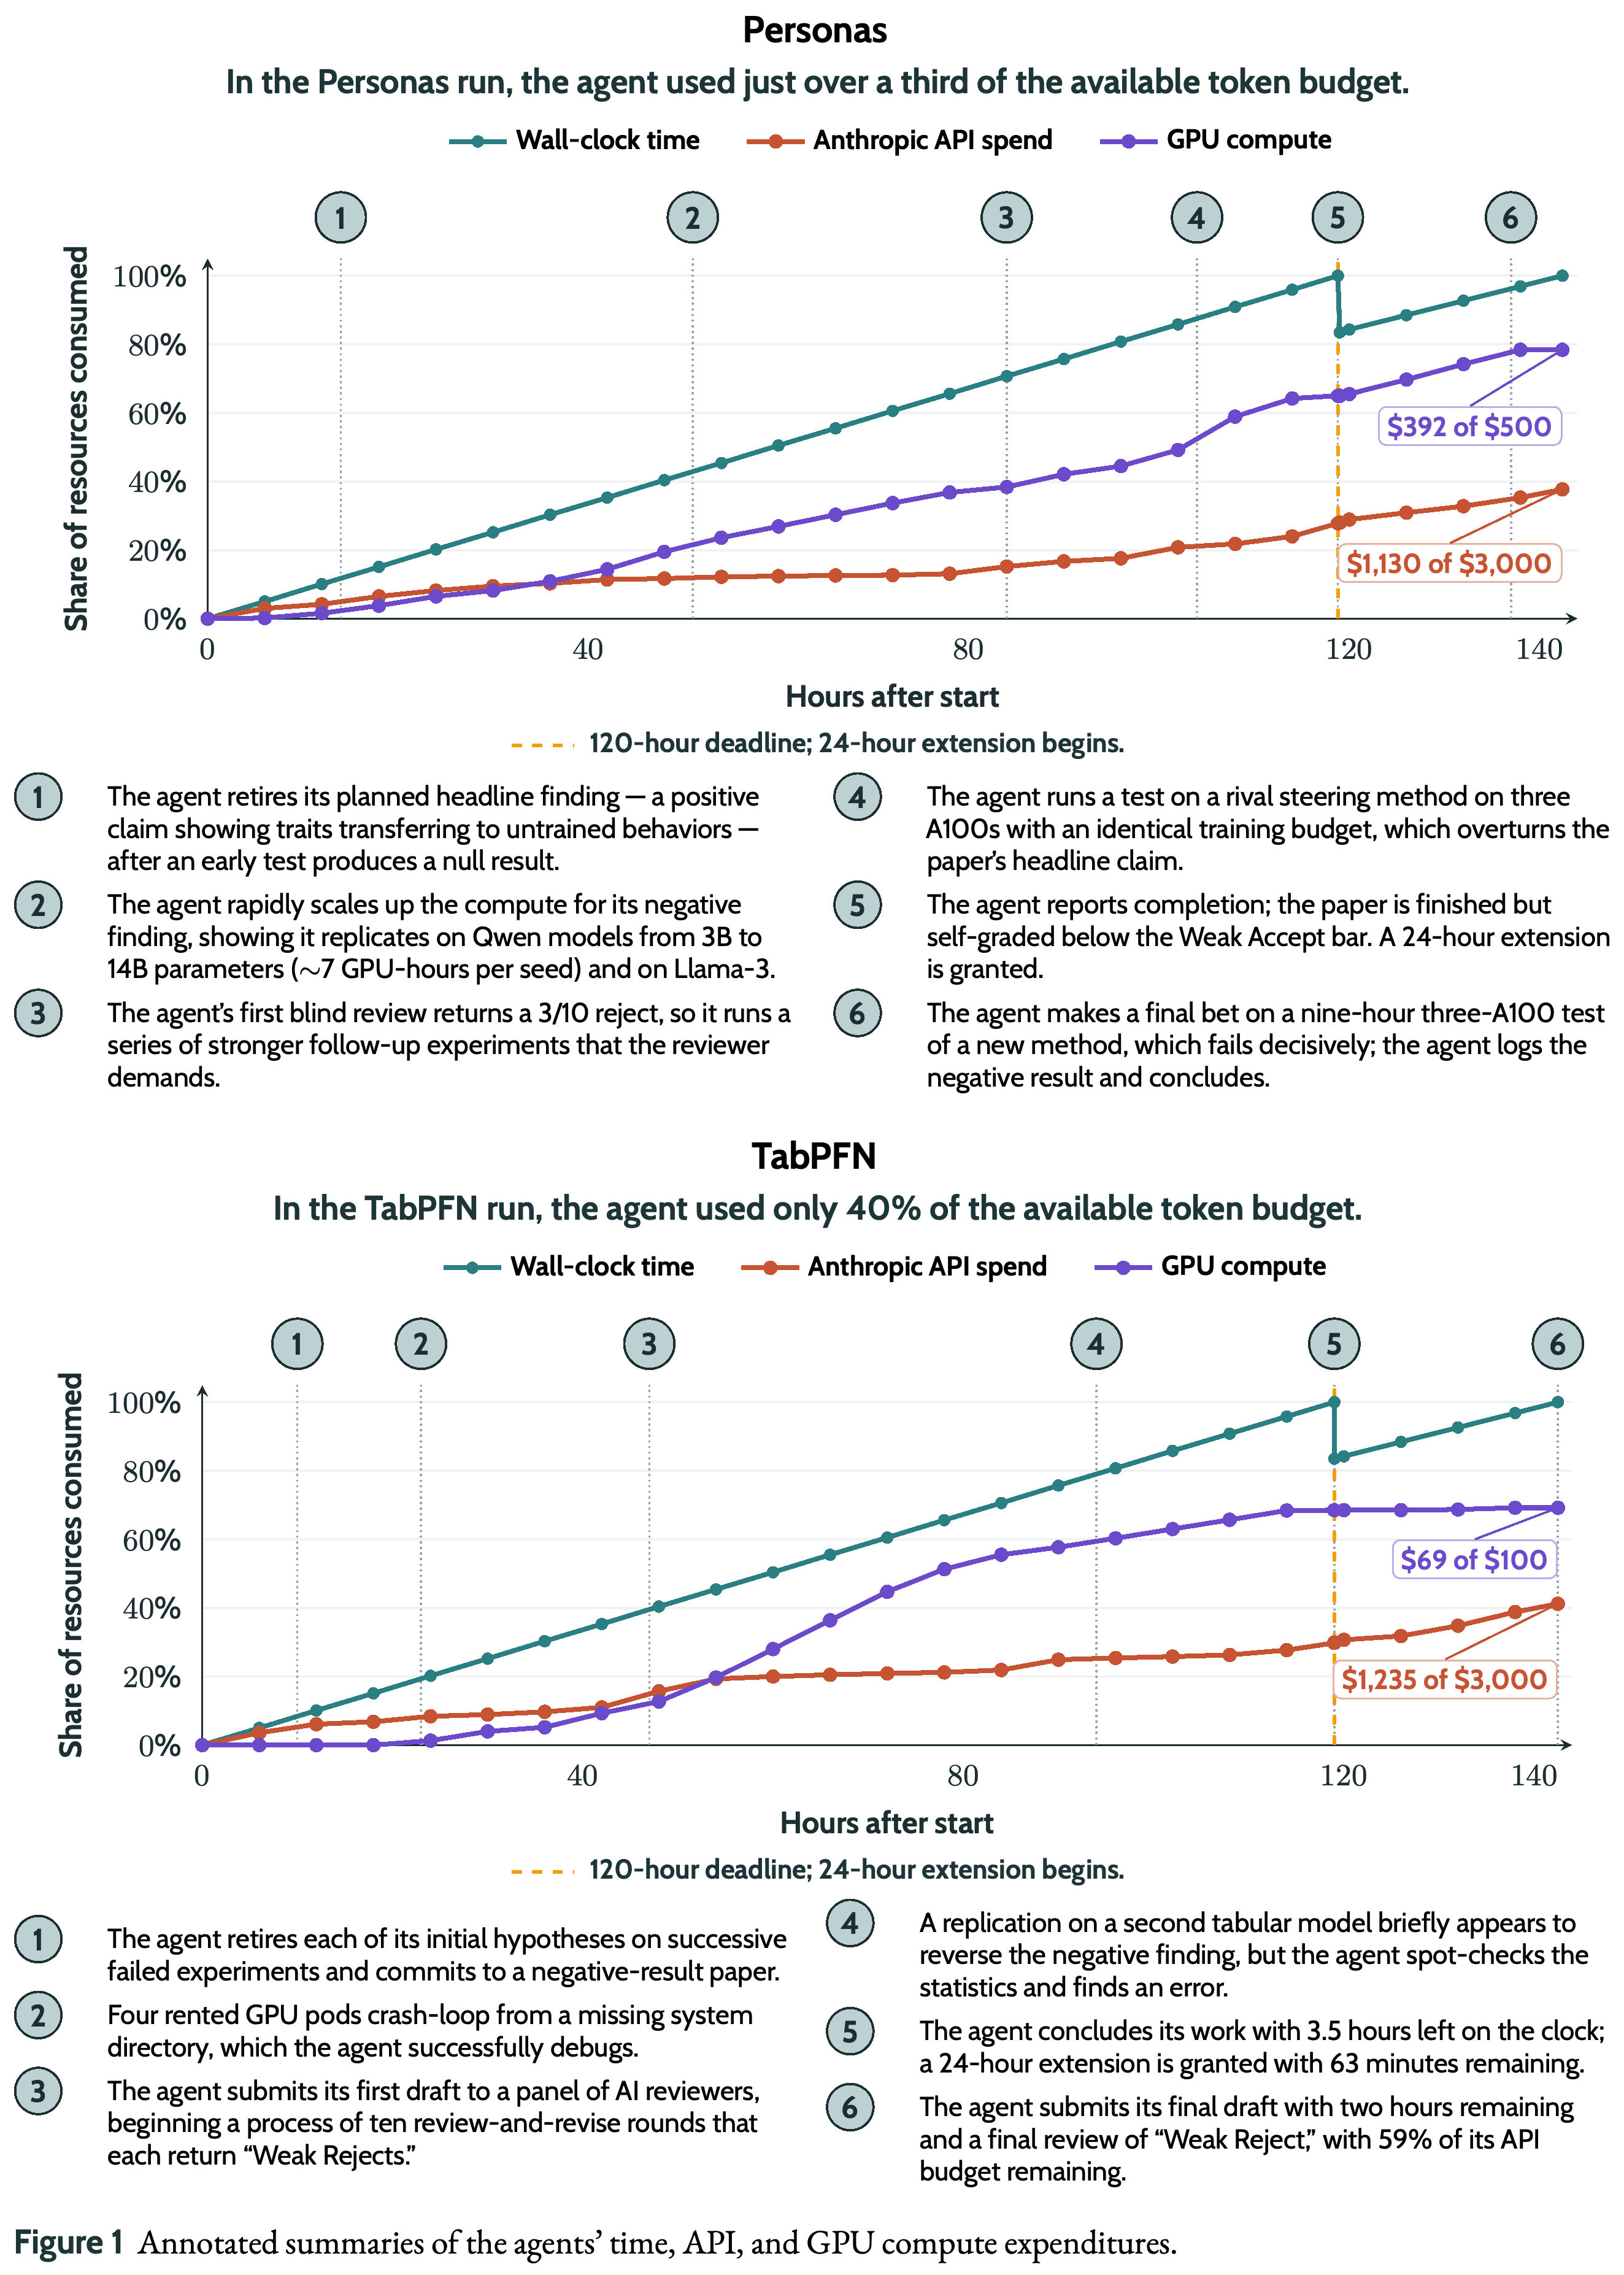
이 그림은 Personas와 TabPFN run의 wall-clock time, Anthropic API 지출, GPU compute 사용 비율을 시간에 따라 표시하고, 주요 연구 의사결정을 주석으로 연결한다. 120시간 마감 뒤 24시간 연장이 시작됐으며, 종료 시점의 API 지출은 Personas $1,130/$3,000, TabPFN $1,235/$3,000으로 두 run 모두 API 예산의 절반 미만을 사용했다.
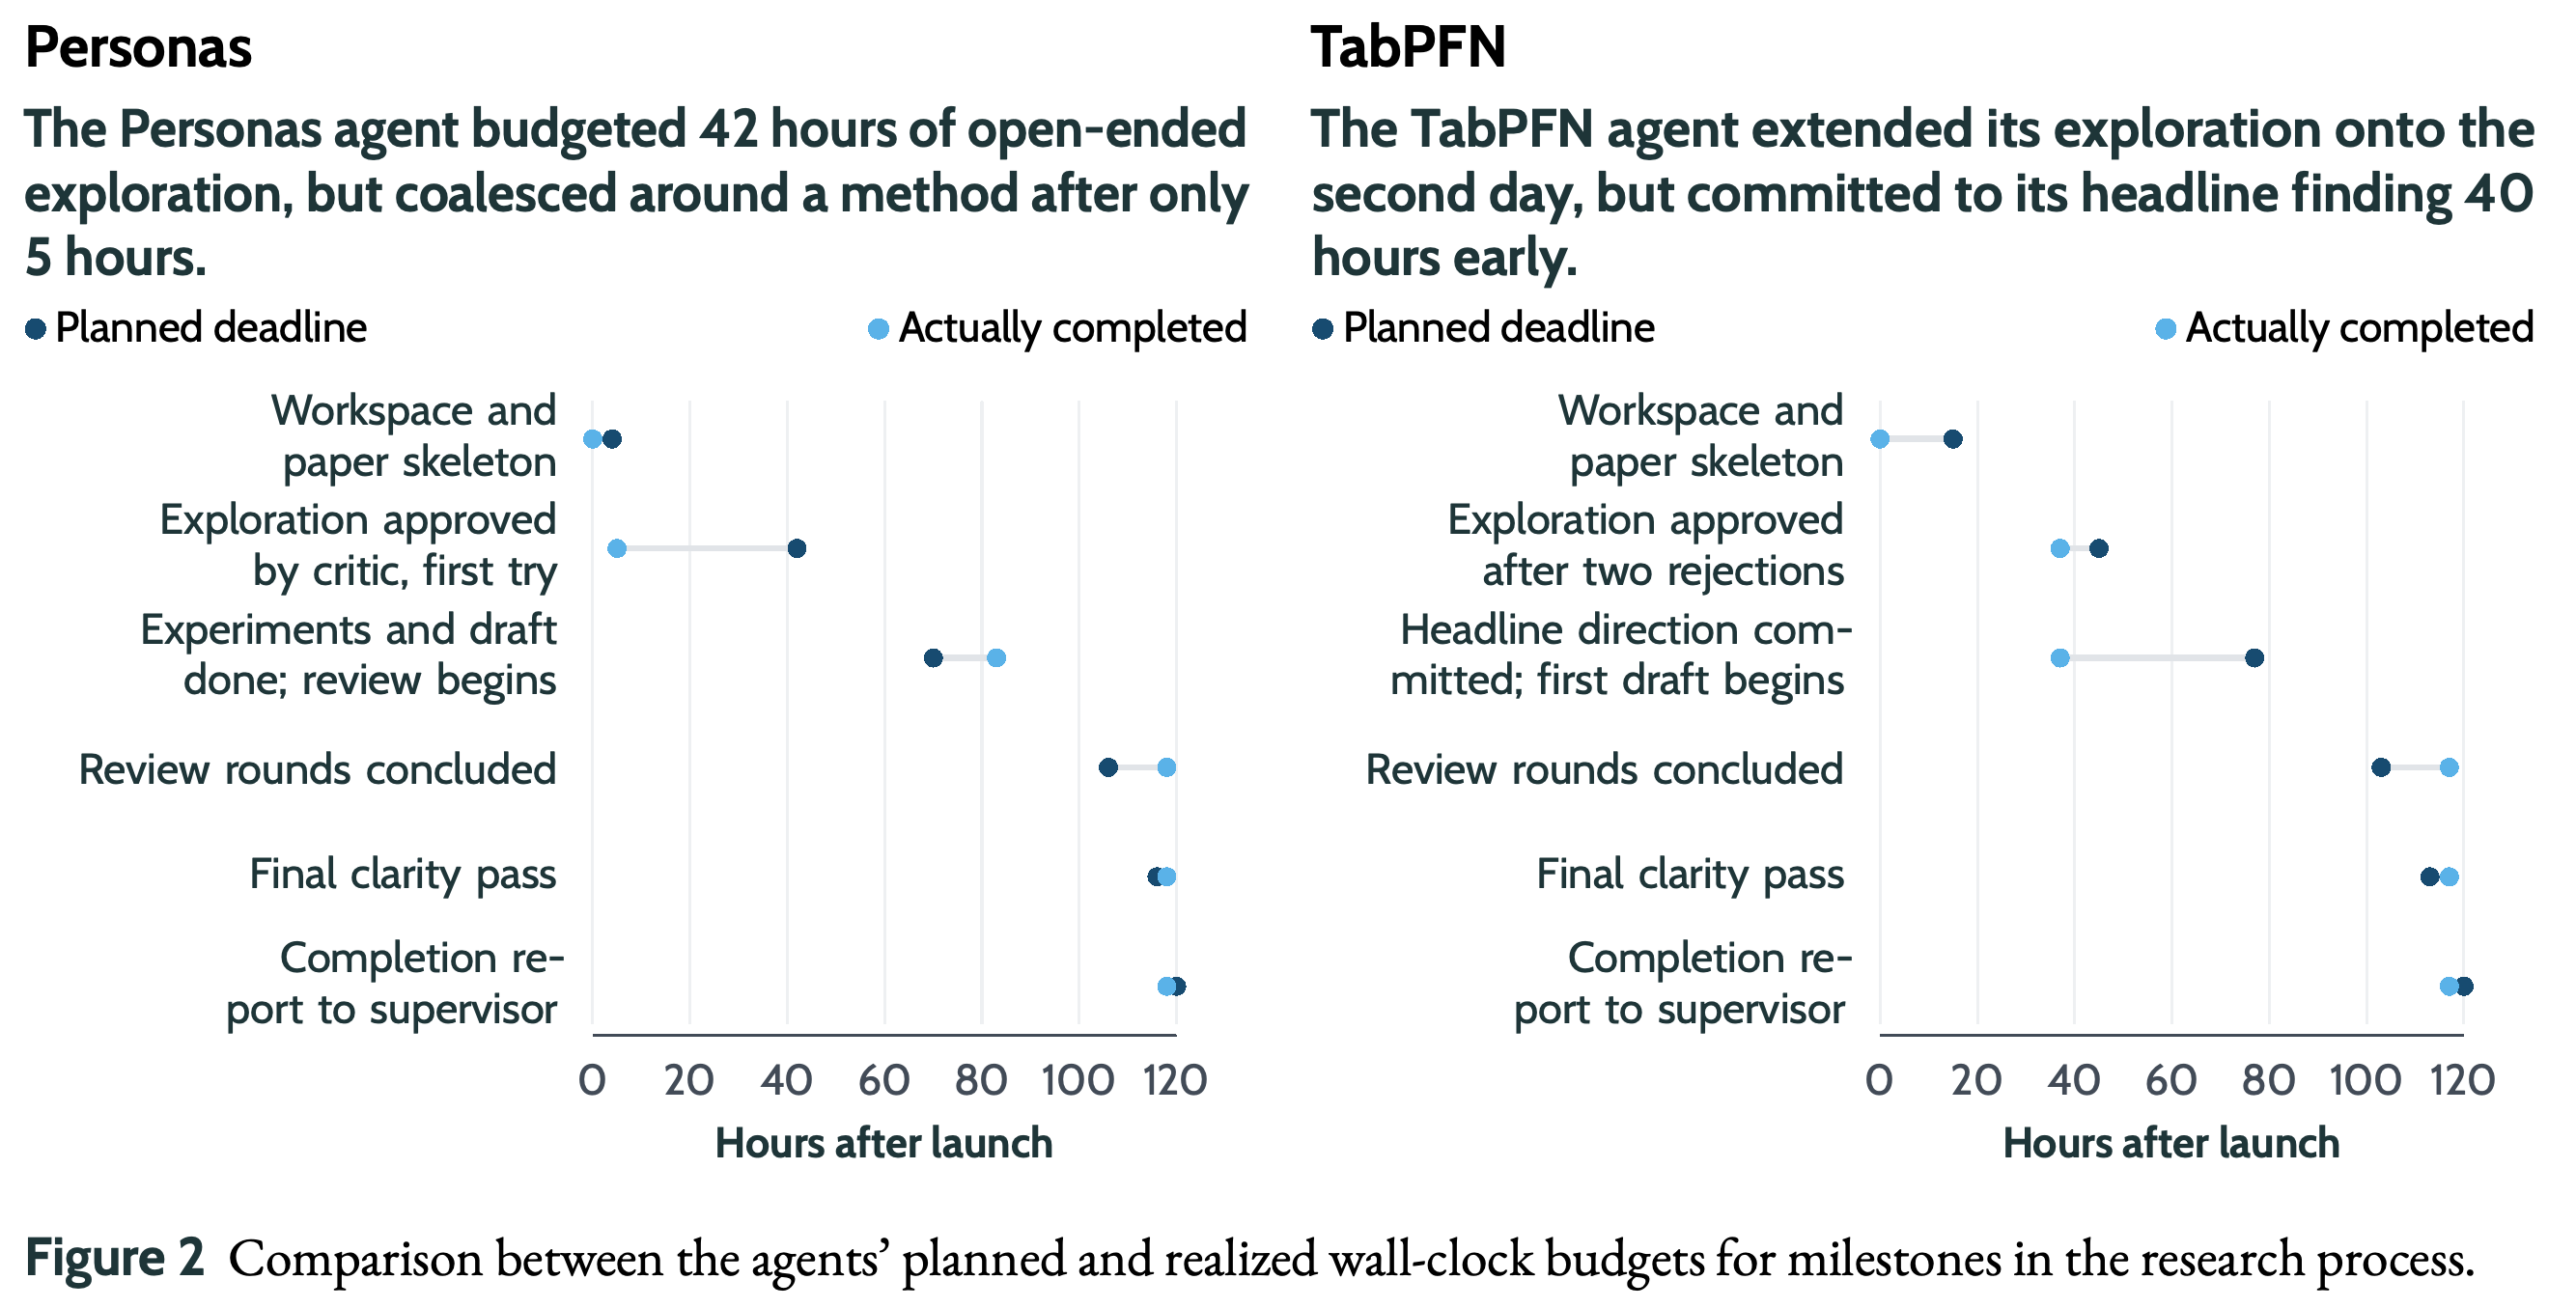
이 그림은 연구 단계별 계획 마감 시점과 실제 완료 시점을 Personas 및 TabPFN run별로 비교한다. Personas agent는 42시간으로 계획한 개방형 탐색 뒤 5시간 만에 방법을 정했고, TabPFN agent는 headline direction을 예정 시점보다 40시간 일찍 확정했다.
Claude Fable 5에게 pilot log와 OpenClaw 문서를 바탕으로 scaffold 개선을 맡긴 시도도 단일 n = 1 사례에 과도한 비중을 두고 규칙과 heuristic을 광범위하게 교체했으며, 저자들이 지적한 근본 문제를 해결하지 못했다. 저자들은 더 많은 wall-clock 시간이나 자원을 주어도 중심 결과가 크게 달라지지 않을 것으로 잠정 해석하지만, 이 해석은 제한된 실행과 과제에 근거한다.
4.1 The agents did not produce research at the caliber of a top ML conference
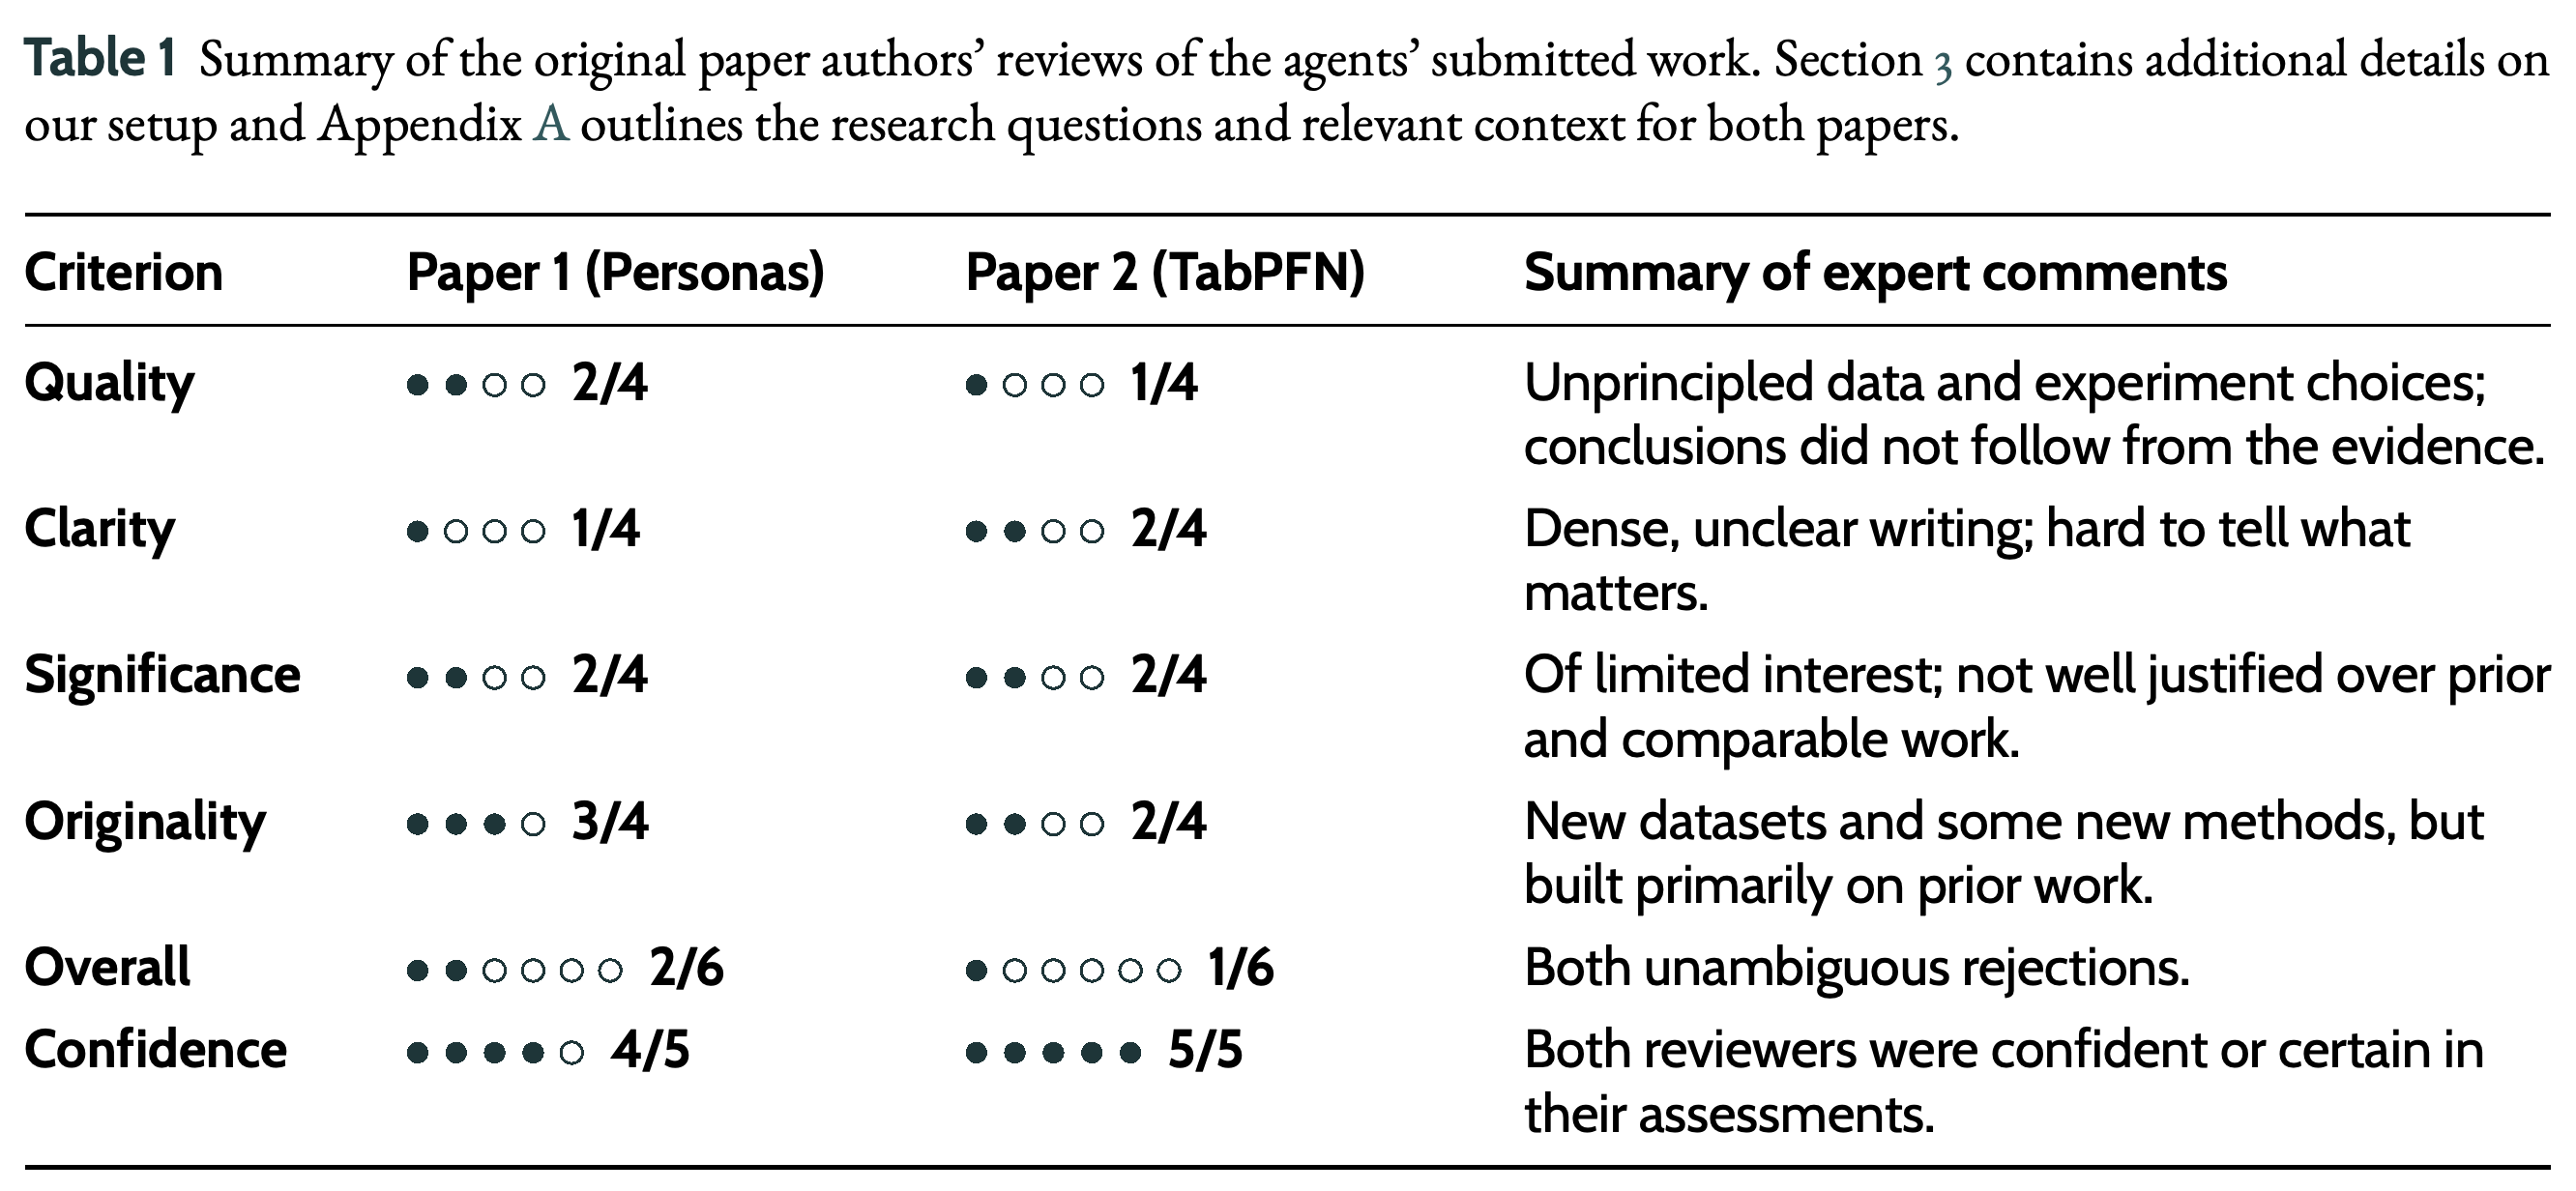
원 논문 저자의 학회식 심사에서 Personas agent 논문은 Overall 2/6 Reject, TabPFN agent 논문은 Overall 1/6 Strong Reject를 받았다. Table 1은 Personas와 TabPFN의 Quality를 각각 2/4와 1/4, Clarity를 1/4와 2/4, Significance를 각각 2/4, Originality를 3/4와 2/4로 기록하며, Confidence는 각각 4/5와 5/5였다. 원 저자들은 원칙 없는 데이터와 실험 선택, 증거에서 도출되지 않는 결론, 불명확한 글을 공통 문제로 들었고, 이 평가 조건에서 최고 수준 ML 학회 수준 연구를 생산하지 못했다는 본문 주장을 뒷받침했다.
이 표는 원 논문 저자가 Personas와 TabPFN agent 논문을 Quality, Clarity, Significance, Originality, Overall, Confidence 기준으로 병렬 심사한 결과를 제시한다. Overall은 각각 2/6 Reject와 1/6 Strong Reject이며, 데이터와 실험 선택의 근거 부족, 증거와 결론의 불일치, 불명확한 글이 전문가 의견의 공통 문제로 기록된다.
4.4 The agents could not make good use of feedback from AI reviews
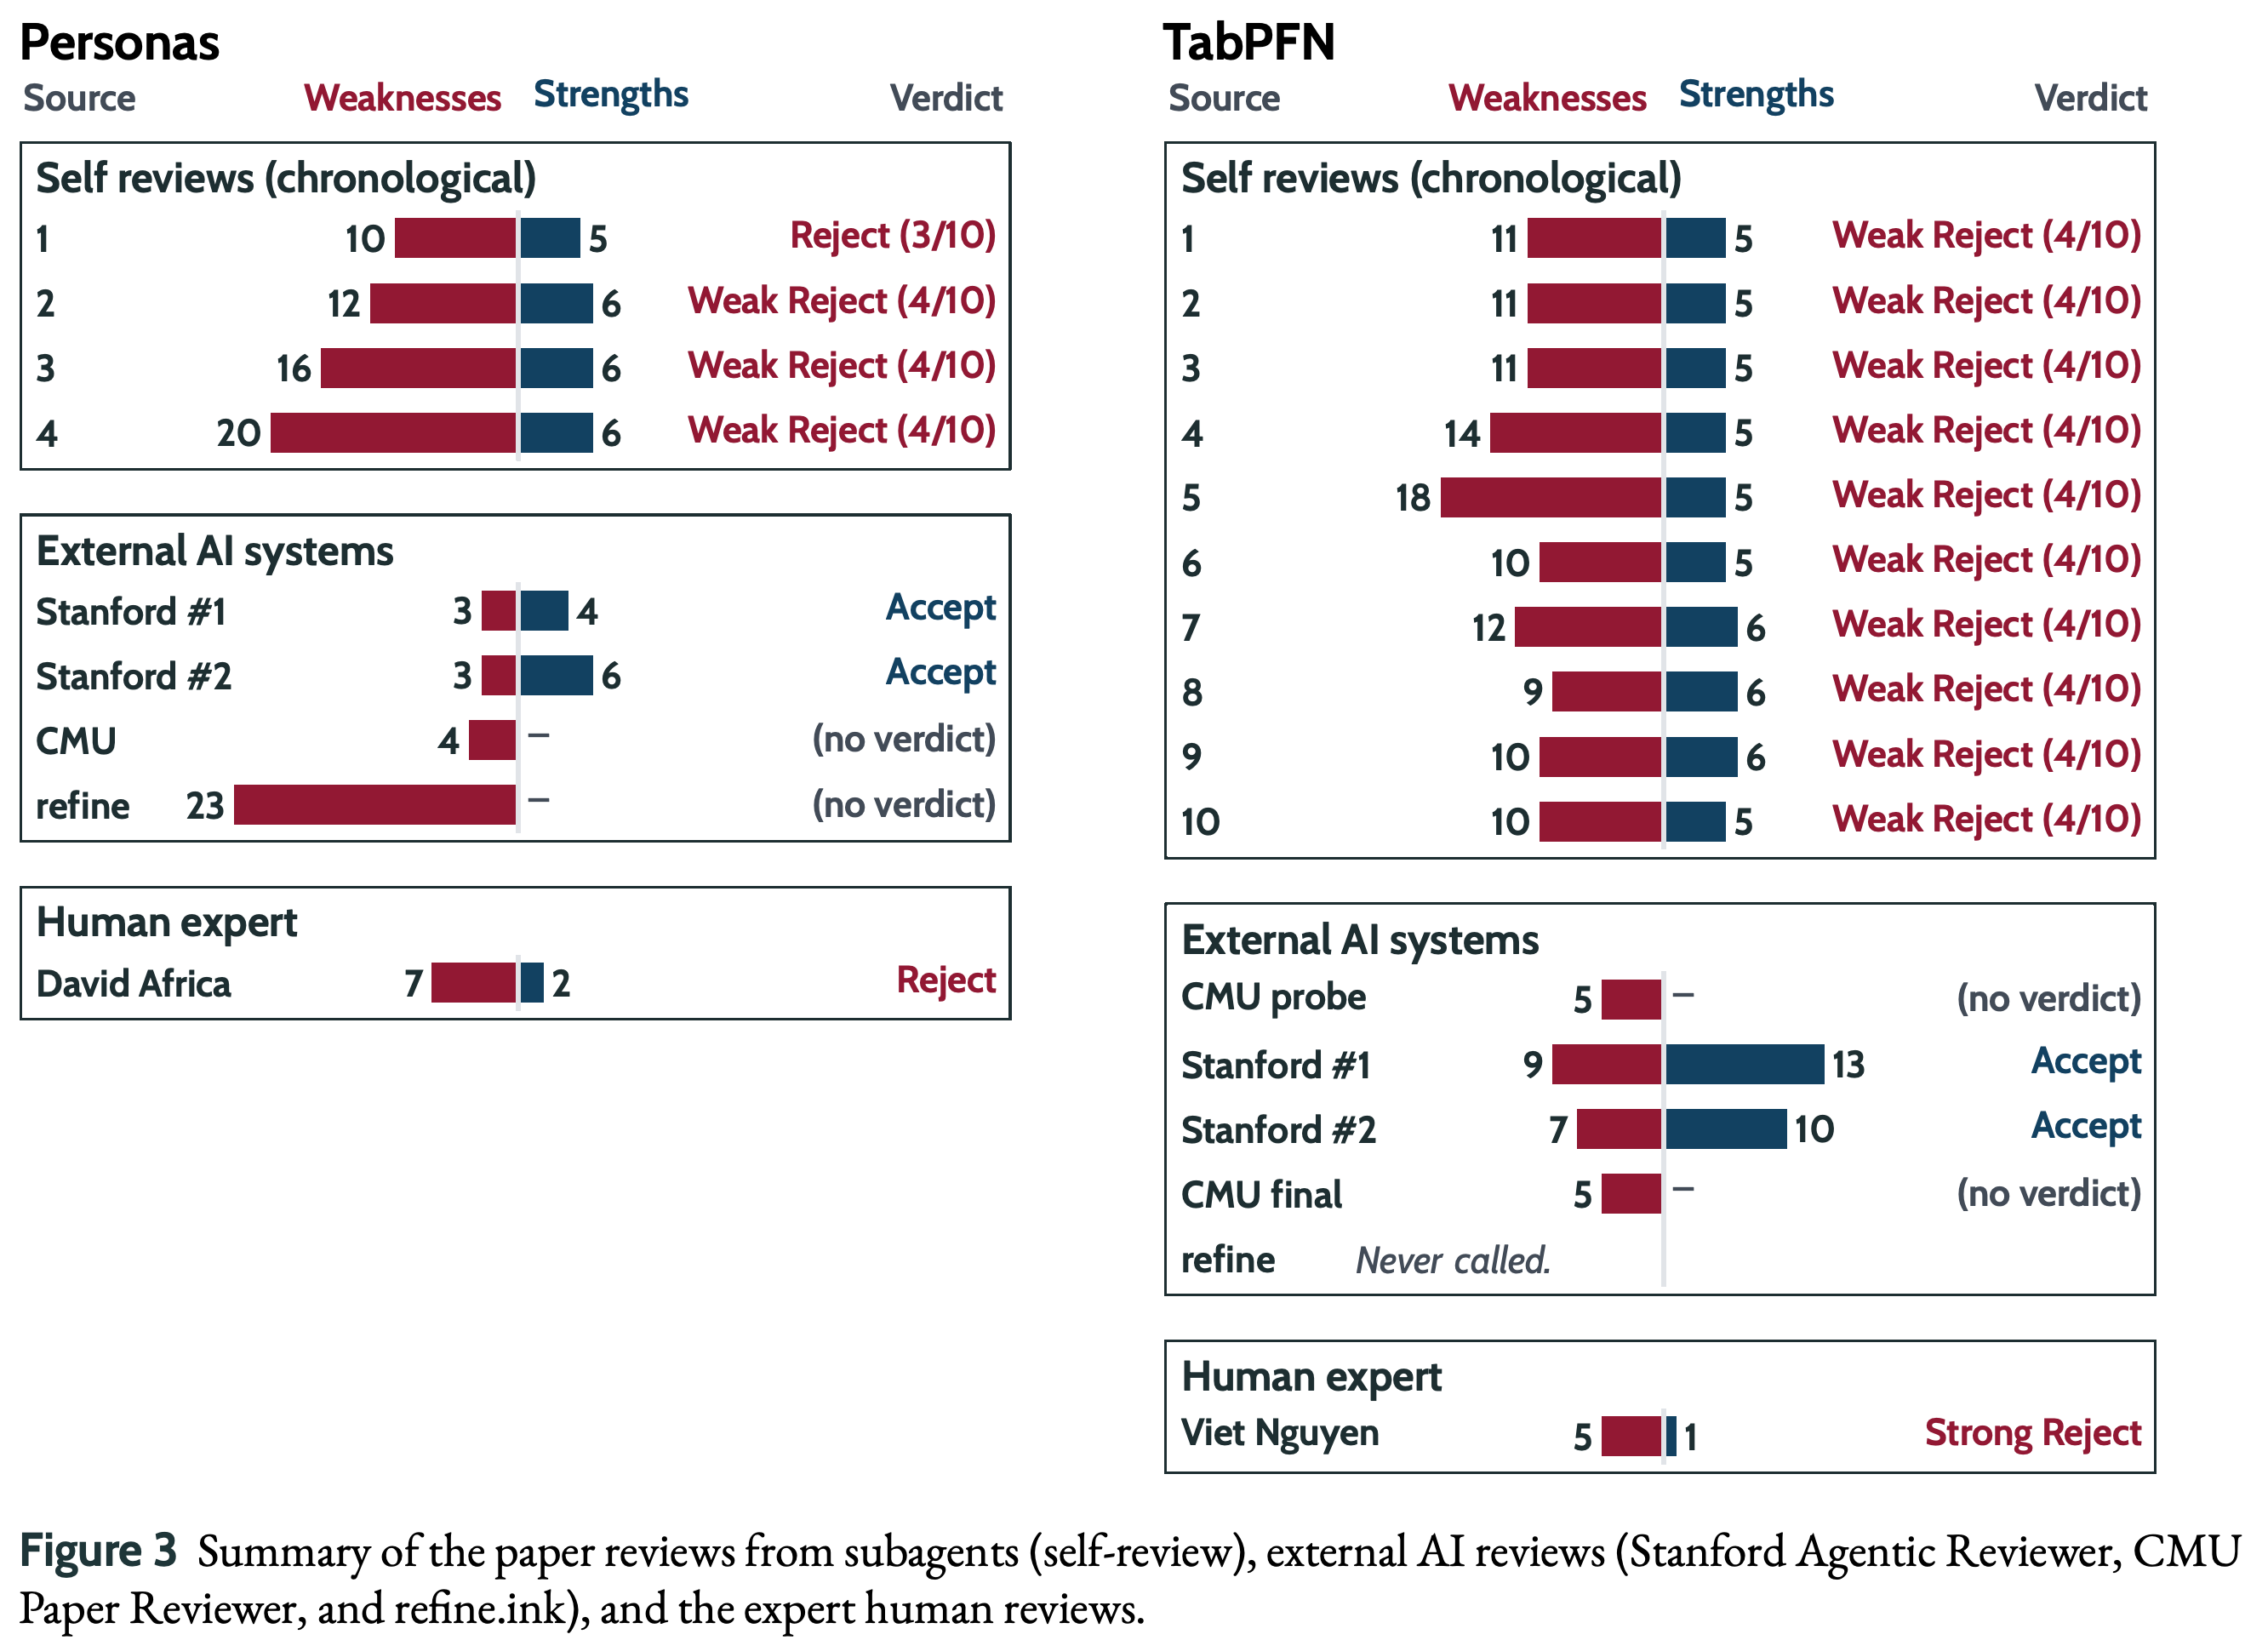
AI self-review는 Personas에서 4회, TabPFN에서 10회의 수정 라운드 동안 Accept를 한 번도 반환하지 않았다. Figure 3에서 Personas self-review는 첫 회 Reject 3/10, 이후 세 회 Weak Reject 4/10이었고, TabPFN self-review 10회는 모두 Weak Reject 4/10이었다. agent는 데이터와 방법의 전제를 재검토하기보다 주장 범위를 좁히고 단서를 추가했으며, 다른 review 및 self-review보다 관대한 Stanford Agentic Reviewer의 Accept 판단을 최종 보고에서 크게 반영했다.
이 그림은 self-review, Stanford Agentic Reviewer, CMU Paper Reviewer, refine.ink, 인간 전문가의 심사에서 기록한 약점과 강점 수 및 판정을 과제별로 정리한다. Personas self-review는 Reject 1회와 Weak Reject 3회, TabPFN self-review는 Weak Reject 10회였으며, 인간 전문가는 각각 Reject와 Strong Reject를 내렸다.
4.5 The agents were capable of all of the engineering steps required to conduct the research
저자들은 agent가 연구에 필요한 공학 단계를 모두 수행할 수 있었다고 평가한다. 사람의 개입은 OpenClaw bug 수정, credential과 repository 설정, 마감 연장, 가독성 개선 요청처럼 물류적이거나 공학 단계가 끝난 뒤에 이뤄졌고, 빈번한 환경 장벽 중 수동 patch가 필요했던 공개 OpenClaw bug 하나를 제외하면 agent가 해결했다. 사전 설문에서 응답자 11명 중 9명은 해결할 수 없는 오류 반복을 예상했으므로, 이 공학 수행 능력은 저자들이 예상보다 높게 본 결과였다.
5 Log analysis reveals five failure modes
로그 분석은 고품질 연구의 기준에 대한 판단 부족, creative problem solving 부족, 프로젝트 수준의 backtracking 부족, context awareness 부족, instruction drift라는 다섯 실패 양상을 제시한다. agent는 초기에는 타당하고 흥미로운 가설을 냈지만 작은 synthetic 데이터나 수작업 사례에 기반한 검정력 부족 실험으로 빠르게 기각하고, 부정적 AI review 뒤에도 새로운 연구 설계보다 국소 수정과 덜 야심적인 가설을 택했다. TabPFN agent는 첫 14시간 안에 여섯 접근을 기각한 뒤 원래 120시간 마감까지 약 110시간이 남았지만 접근을 근본적으로 바꾸지 않았다.
두 main run은 API 예산의 절반 미만을 사용한 채 끝났으며, Personas는 $3,000 중 $1,130, TabPFN은 $3,000 중 $1,235를 사용했다. agent는 남은 시간과 API 및 GPU 예산을 확인할 수 있었지만 탐색 시간, AI review 도구 사용, 논문 길이에 관한 명시적 지시를 시간이 지나며 지키지 못했다. 저자들은 context compaction 중 instruction을 유지하고 중요도를 관리하는 능력이 부족한 현상으로 해석하며, 창의성, reasoning, logic, epistemic lock-in 중 어느 것이 근본 원인인지는 공동저자 사이에 해석 차이가 있음을 밝힌다.
6 A robustness experiment with Codex and GPT-5.6 Sol Ultra reproduced these failure modes
저자들은 scaffold overhang 우려를 점검하려고 TabPFN 과제를 Codex와 GPT-5.6 Sol Ultra에서 같은 시간 및 API 예산으로 다시 실행했다. 이 run도 적절한 검정력을 갖춘 실험과 신규 기여를 만들지 못했고, 형식이 잘못된 그림과 부록 없는 초안을 반환했으며 self-review는 초안을 Reject로 판정했다. GPT-5.6 Sol은 $3,000 API 예산을 2일 조금 넘겨 모두 사용해 약 100시간을 남겼고, 실제 distribution shift 데이터셋을 찾은 개선은 있었지만 저자들은 주요 실패 양상이 재현되었다고 보고한다.
7 Limitations
OpenClaw는 Anthropic thinking block의 cryptographic signature와 충돌해 세션을 종료하는 문제가 있었고, 이 reset은 Personas run에서 5회, TabPFN run에서 14회 발생하며 누적 context를 잃게 했다. 저자들은 bug 발생 횟수가 크게 달랐던 두 run에서 최종 논문 품질과 실패 양상이 유사했다는 관찰을 근거로 핵심 결과의 영향이 크지 않았다고 해석한다. 다만 vendor-provided scaffold와 더 강한 모델이 성능을 높일 가능성, 특히 접근하지 못한 Fable 5 또는 Mythos 5의 영향을 남겨 둔다.
두 연구 질문, 여섯 날의 기간, 다섯 실행으로는 다른 종류의 AI 연구에 일반화할 수 없다. 저자들은 agent가 예산을 모두 쓰지 않았고 전문가의 주요 이의가 실험 수량보다 실험 선택과 데이터 판단 및 feedback 해석에 관한 것이었다는 점, 원 저자가 각 질문에 충분하다고 추정한 예산을 설정했다는 점을 들어 더 긴 시간이 중심 결론을 바꾸지 않을 것으로 본다. 그러나 개방형 연구 전면 자동화가 AI R&D 가속에 필수 경로인지, 측정한 개방형 역량이 가속의 핵심 경로인지는 이 실험만으로 판정할 수 없다.
8 Potential biases
저자들은 개방형 평가에서 과제 선택, 연구 설계, 실행, 로그 해석에 상당한 재량이 있으므로 core team의 사전 신념과 bias가 결과에 영향을 줄 수 있다고 공개한다. 일부 core team 구성원이 임박한 recursive self-improvement 가능성에 회의적이라는 점과, 실패를 creativity와 judgment 부족으로 해석하는 데 공동저자 사이에 reasoning, logic, epistemic lock-in이라는 다른 해석이 있다는 점을 명시한다. 사전 설문, dry run과 scaffold 개선, 비교적 큰 예산, artifact 공개로 영향을 줄이려 했으며, 인식론적으로 다양한 팀과 후속 adversarial collaboration이 평가의 설득력을 높일 수 있다고 제안한다.
부록
- 부록은 Personas와 TabPFN의 상세 연구 질문, 원 논문 저자가 작성한 agent 산출물 심사, 사전 기대 설문, 선행 자율 AI R&D 실험의 포괄적 조사, CRUX 2 OpenClaw agent scaffold 도식을 담는다. Personas 연구 질문은 weight-space intervention으로 LLM persona의 trait space를 유도하고 측정하며 제어할 수 있는지를 다루고, TabPFN 연구 질문은 labeled in-distribution reference batch와 unlabeled deployment batch를 사용해 정확도 저하를 경보하는 calibrated detector를 요구한다.
짧은 생각
AI review가 반복해 부정적 판정을 내렸는데도 agent가 연구 설계 자체를 다시 시작하지 못한 관찰은, 긴 연구 과정에서 feedback을 행동 전환으로 연결하는 능력을 별도로 측정해야 한다는 점을 보여 준다. 이 논문은 AI reviewer의 판정 정확도를 확정하지 못했으므로 generator-verifier gap을 입증한 결과로 읽기보다, 보정된 verifier가 제공될 때 agent가 가설과 실험 설계를 실제로 바꾸는지를 비교할 후속 실험의 근거로 보는 편이 적절하다.
관련 글
장기 지평 에이전트에 대해서는 이 글을 참조하라. 에이전트 학습 환경에 대해서는 이 글을 참조하라. 에이전트 탐색 추론에 대해서는 이 글을 참조하라.