


4DAnyone: Create Anyone in 4D from a Casual Monocular Video 요약 설명
20 Aug 2026 | Paper Review 4D Human Reconstruction Multiview Video Generation Video Diffusion Models 4D Gaussian SplattingContents
- 요약
- 1 Introduction
- 2 Related Work
- 3 Method
- 4 Experiments
- 5 Conclusion
- Acknowledgments
- A Model Details
- B Dataset Details
- C Training Details
- D HMR Details
- E Inference Details
- G Additional Results
- H Limitations and Failure Cases
- 부록
- 짧은 생각
이번 글에서는 4DAnyone: Create Anyone in 4D from a Casual Monocular Video 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 20일(Arxiv)
- Jin, Yudong, Xie, Tao, Zhang, Qihang, Shen, Zehong, Xu, Zhen, Shen, Yujun, Bao, Hujun, Zhou, Xiaowei, Xu, Yinghao.
- State Key Lab of CAD&CG, Zhejiang University, China, Robbyant, China, Chinese University of Hong Kong, China, Ant Group, China, Hong Kong University of Science and Technology, China
- 논문 링크
- Github
- Project Page
요약
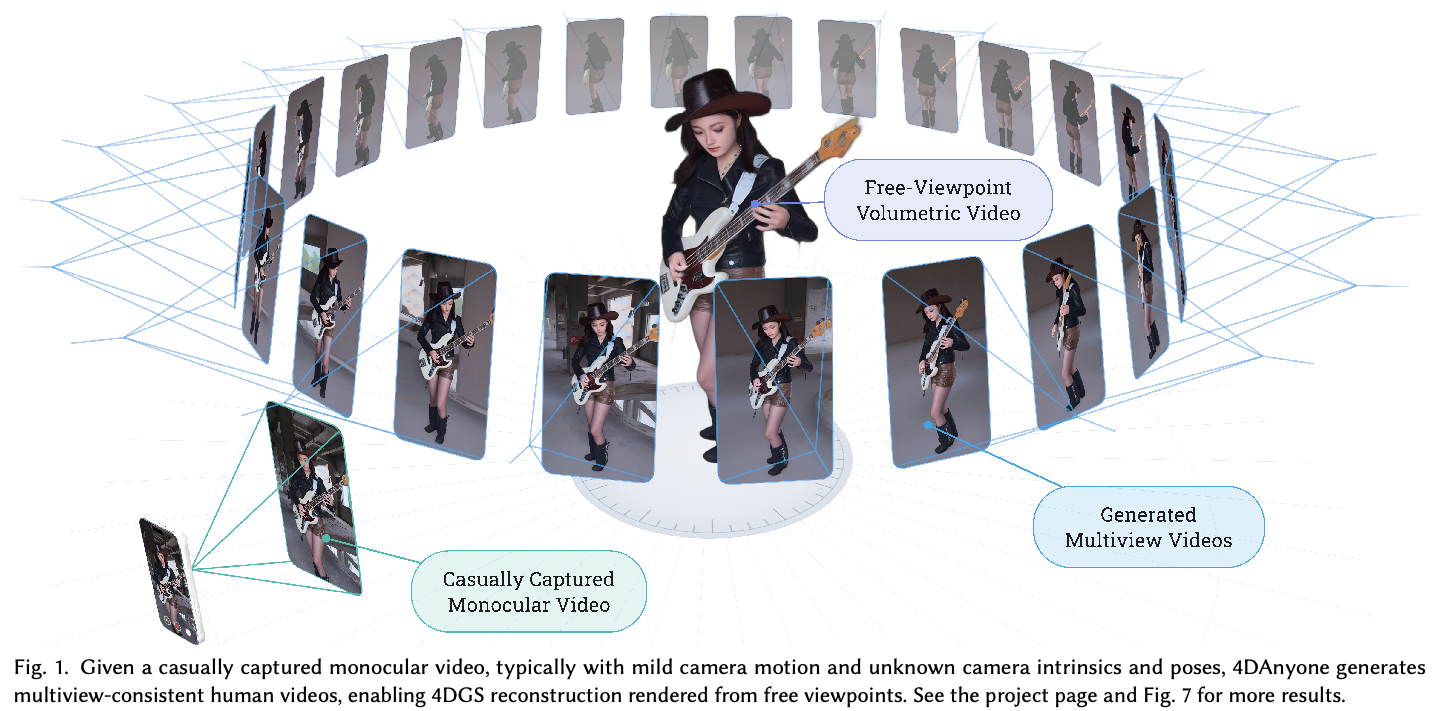
- 4DAnyone은 보정되지 않은 단안 비디오에서 자유 시점 4D 인간 표현을 복원한다. 복원에 적합한 다중 시점 비디오를 복원한 3D 스켈레톤으로 조건부 생성한 뒤 FreeTimeGS로 4D Gaussian Splatting(4DGS)으로 변환한다. Reference Context Packing(RCP)과 Target Context Routing(TCR)은 많은 대상 시점을 생성할 때의 일관성 문제를 해결한다.
도식은 일상적으로 촬영한 단안 인간 비디오를 다중 시점 비디오로 확장한 뒤 자유 시점 volumetric 시퀀스로 복원하는 파이프라인을 제시한다. 개별적으로 그럴듯한 시점이 아니라 생성 시점 사이의 일관성이 필요함을 보여 준다.
1 Introduction
이 논문은 일상적으로 촬영한 단안 인간 비디오와 4DGS에 통상 필요한 조밀한 보정 다중 시점 관측 사이의 격차를 다룬다. 대상 시점 수가 diffusion transformer의 실용적인 attention 예산을 넘으면 시점을 여러 그룹으로 나눠야 한다. 이때 reference context 비용이 증가하고 그룹 간 직접 정보 교환이 불가능해져 외형 불일치와 구조적 드리프트가 발생한다.
2 Related Work
기존 카메라 제어 비디오 생성 방법은 암묵적 카메라 조건과 명시적 조밀 기하 조건으로 나뉜다. 전자는 큰 시점 변화에서 드리프트할 수 있고, 후자는 제약 없는 비디오에서 신뢰성 있게 추정하기 어려운 깊이 또는 3D 좌표에 의존한다. 포즈 기반 애니메이션은 대체로 복원 수준의 신규 시점 합성보다 모션 전이에 중점을 둔다.
3 Method
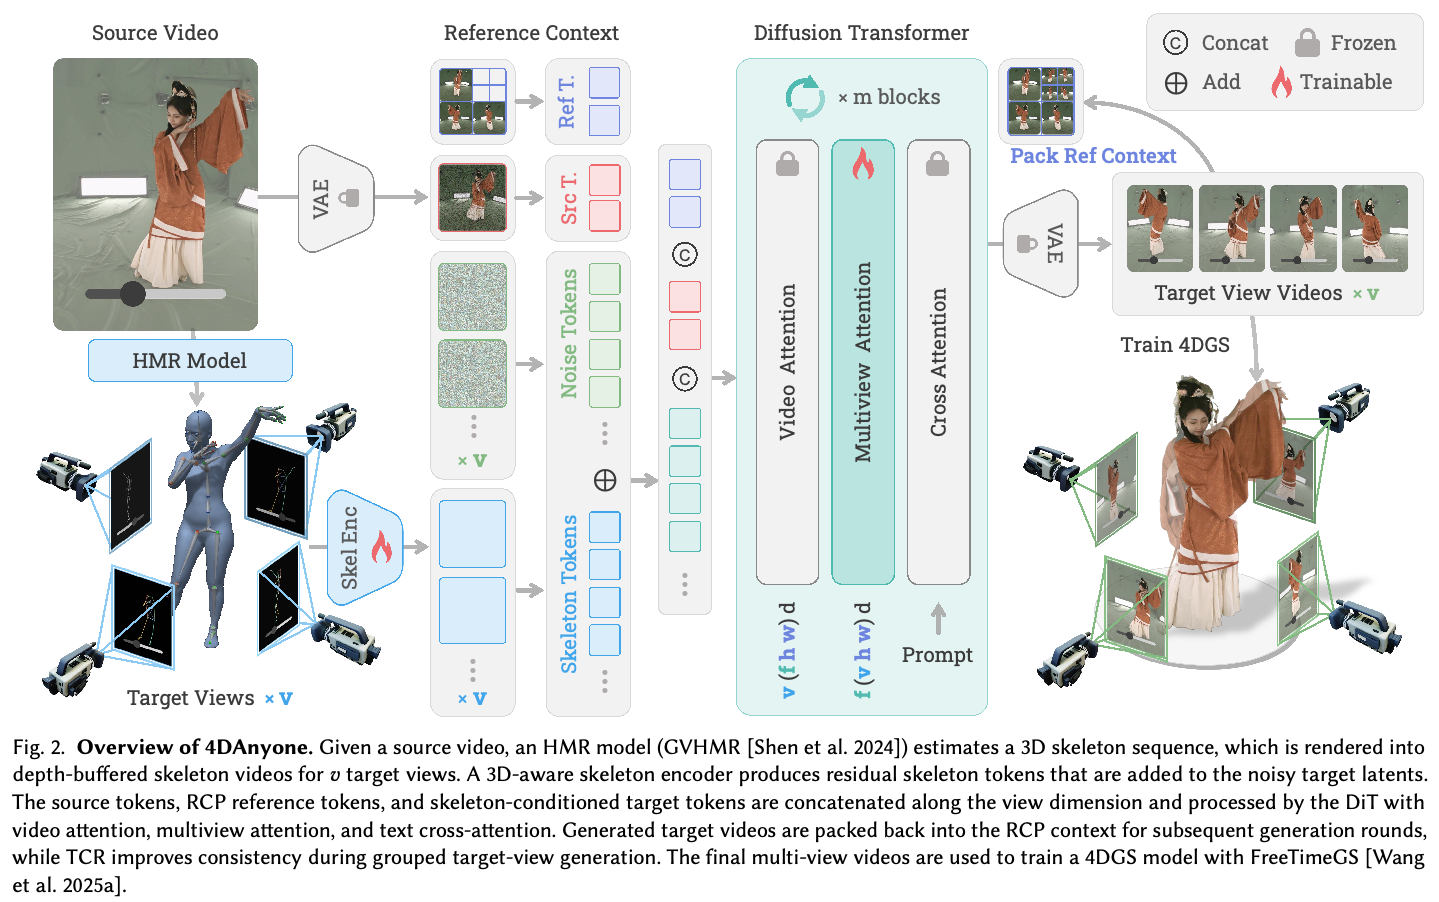
알 수 없는 내부 파라미터와 포즈를 지닌 소스 비디오 Vsrc ∈ R^{F×3×H×W}가 주어지면, 방법은 3D 스켈레톤 시퀀스를 추정하고 지정한 대상 시점에서 렌더링한다. Wan2.2-based DiT는 소스 토큰, 패킹된 참조 토큰, 스켈레톤 조건 대상 토큰을 비디오 attention, 다중 시점 attention, 텍스트 cross-attention으로 처리한다. 이후 FreeTimeGS가 최종 4DGS model을 복원한다.
3.1 Overview
파이프라인은 그룹별 고정 메모리 예산 안에서 피사체 주변의 대상 시점을 생성한다. HMR은 대상 시점 스켈레톤 조건을 제공하고, RCP는 생성된 참조 영상에서 제한된 외형 문맥을 제공한다. TCR은 denoising 중 대상 그룹 구성을 바꿔 그룹 간 구조 정보를 전달한다.
아키텍처는 HMR에서 얻은 대상 시점 스켈레톤부터 skeleton encoder와 diffusion transformer를 거쳐 생성 비디오 및 4DGS 학습으로 이어지는 데이터 흐름을 보여 준다. 생성한 시점이 이후 생성 라운드의 참조 문맥으로 다시 패킹됨을 나타낸다.
3.2 3D-Aware Skeleton Conditioning
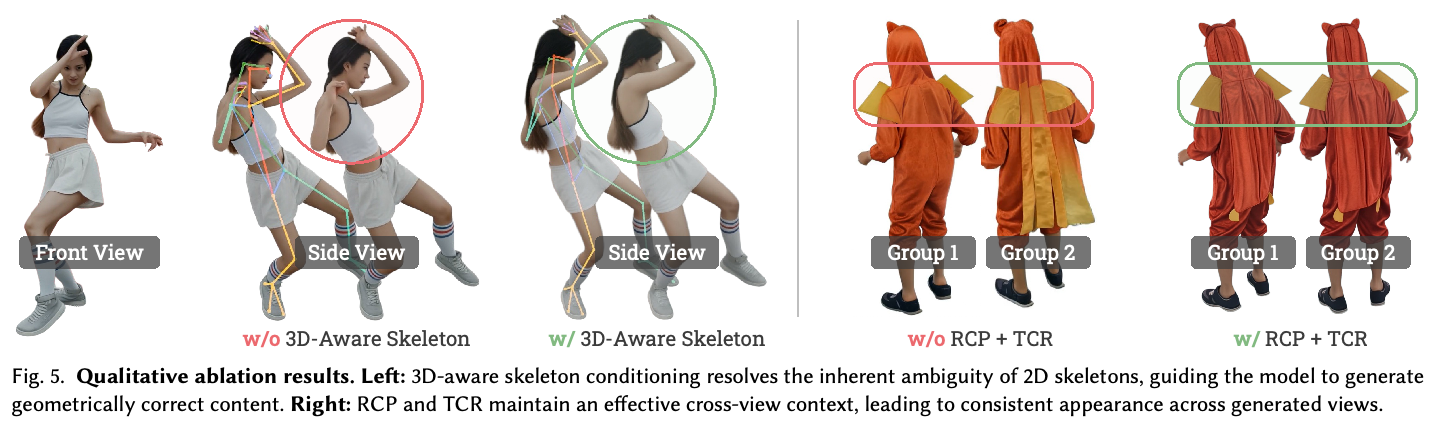
4DAnyone은 추정한 조밀 깊이 대신 희소한 3D 스켈레톤을 사용하며, 이는 밀도보다 정확도를 우선하는 원칙을 따른다. 픽셀 단위 z-buffer로 스켈레톤을 rasterize하여 가까운 팔다리가 먼 팔다리를 가리게 한다. 308개의 Goliath 키포인트 중 몸통, 발, 손바닥 수준 손, 목, 어깨, 팔꿈치 랜드마크에 해당하는 40개를 선택하고 얼굴 점과 개별 손가락 관절은 제외한다.
3.3 Scalable Multiview Consistency
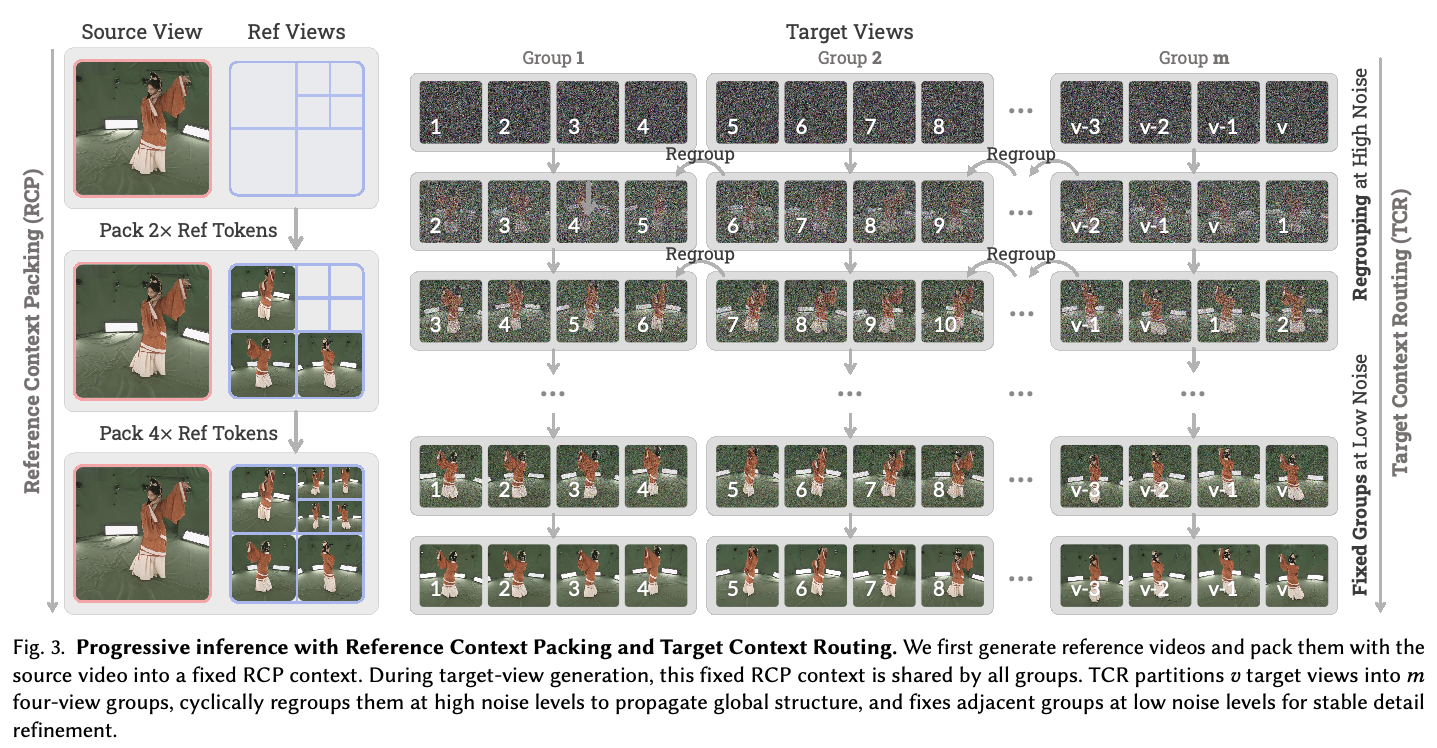
RCP는 생성된 참조 영상을 여러 공간 해상도에서 고정된 참조 토큰 슬롯에 패킹해 참조 문맥의 증가를 O(N)에서 O(1)로 바꾼다. 압축 비율 r ∈ {2, 4}와 고정 문맥 CR = [P1(Vsrc), {P2(Vaj)}^3_{j=1}, {P4(Vbj)}^4_{j=1}]를 사용한다. 점진적 추론은 먼저 farthest-point sampling으로 참조 시점을 생성한 뒤 이 문맥을 대상 그룹에 재사용한다.
그림은 점진적 추론에서 2가지 확장성 기법을 분리해 보여 준다. RCP는 참조 영상을 고정 문맥으로 패킹하고, TCR은 높은 noise에서 four-view target sets를 순환적으로 재그룹화하며 낮은 noise에서는 인접 그룹을 고정한다.
3.4 Training Protocol
학습은 3단계 커리큘럼으로 구성한다. 먼저 스켈레톤 조건 카메라 제어를 위해 전경만 남긴 DNA-Rendering을 사용하고, 다음으로 배경, 조명, 그림자 모델링을 위해 마스크를 적용하지 않은 다중 시점 데이터를 사용하며, 마지막으로 실제 환경 일반화를 위해 단안 Pexels와 TedTalk 데이터를 사용한다. 목적함수는 L = Llatent + λLLPIPS이고 λ = 0.25이며, 메모리 사용량을 줄이기 위해 LPIPS는 신체 부위를 고려한 crop에서 평가한다.
4 Experiments
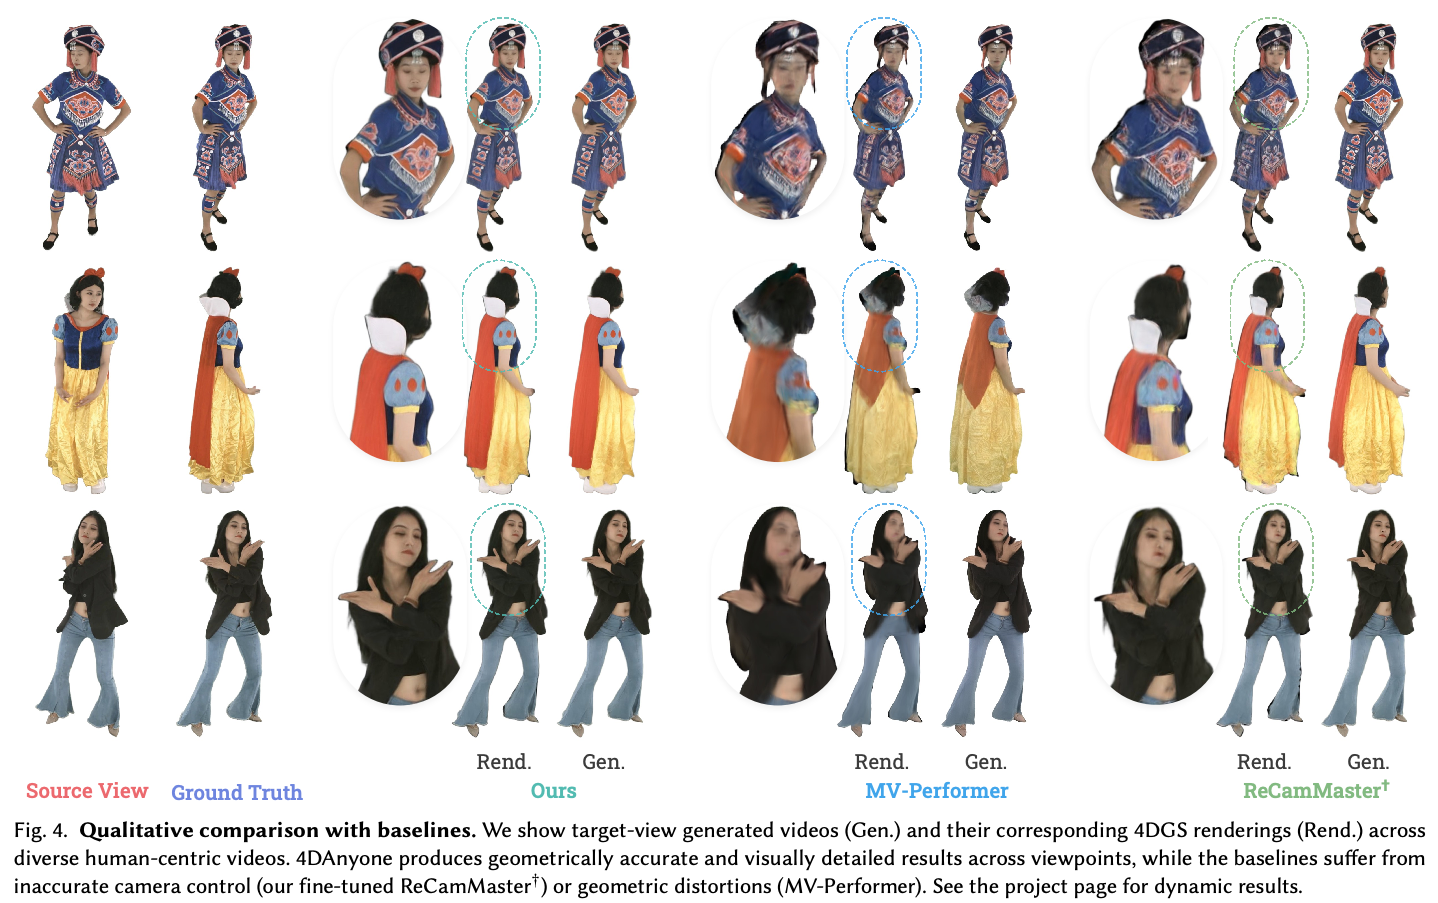
실험은 생성 비디오 일관성, 생성 시점으로부터의 4DGS 복원, ground truth에 대한 생성 비디오의 직접 복원을 평가한다. 비교 대상은 MV-Performer, TrajectoryCrafter, ReCamMaster†이며, †는 저자가 동일한 RCP와 TCR 전략을 적용해 fine-tuning한 ReCamMaster를 뜻한다.
4.1 Experimental Setup
모델은 Wan2.2-TI2V-5B를 기반으로 하며, 128 H20-3E GPU에서 704×1280 해상도와 learning rate 1 × 10⁻⁵로 학습한다. 3개 단계는 각각 약 0.5일, 1일, 1.5일이 걸린다. 정량 평가는 학습에서 보지 않은 DNA-Rendering 장면 10개와 out-of-distribution DyMVHumans 장면 3개를 사용하며, 각 장면은 대략 균일하게 배치한 카메라 16개와 프레임 98개를 갖는다. 추론은 denoising step 20회, four-view groups, ts/T = 0.2를 사용한다.
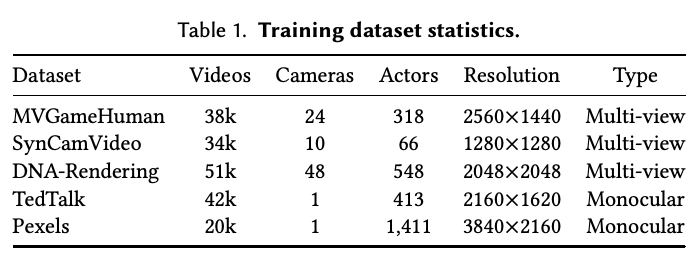
표는 학습 데이터의 규모와 modality를 기록한다. MVGameHuman은 카메라 24개와 배우 318명의 비디오 38k개를 제공하고, Pexels는 배우 1,411명에 걸친 단안 비디오 20k개를 제공한다.
4.2 Comparison with State-of-the-Art
4DAnyone은 보고한 모든 PSNR, SSIM, LPIPS 열에서 최고 성능을 보인다. DNA-Rendering에서 생성 비디오 일관성은 24.33 PSNR, 0.862 SSIM, 0.163 LPIPS이고, 4DGS 복원은 24.15, 0.863, 0.159이다. DyMVHumans에서 각각의 점수는 24.48/0.862/0.109 및 23.28/0.846/0.117이다.
정성 비교는 대상 시점 생성과 이에 대응하는 4DGS 렌더링을 함께 제시한다. 제안 방법과 비교해 MV-Performer의 기하 왜곡 및 fine-tuning한 ReCamMaster†의 카메라 제어 불일치를 보여 준다.
4.3 Ablation Study
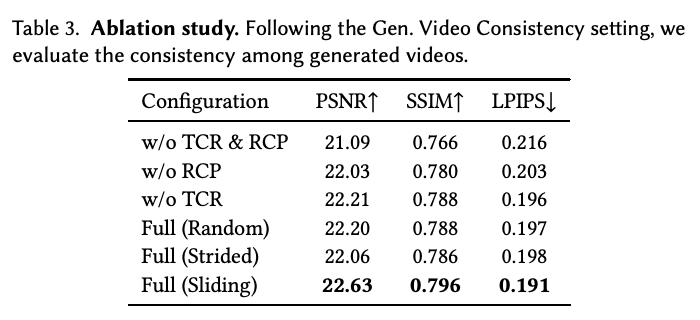
DNA-Rendering ablation에서 RCP 또는 TCR을 제거하면 생성 비디오 일관성이 저하된다. Full Sliding routing은 22.63 PSNR, 0.796 SSIM, 0.191 LPIPS를 달성하며, RCP가 없을 때의 22.03/0.780/0.203과 TCR이 없을 때의 22.21/0.788/0.196보다 높다. 보고한 설정에서 Sliding routing은 Random 및 Strided routing보다 우수하다.
Ablation은 RCP와 TCR을 분리하고 routing 전략을 비교한다. 두 구성 요소를 Sliding routing과 결합했을 때 가장 강한 생성 비디오 일관성 결과를 보이며, Random과 Strided routing은 이를 개선하지 못한다.
왼쪽 패널은 겹치는 팔다리에 대해 일반 스켈레톤 조건과 depth-buffered 스켈레톤 조건을 비교한다. 오른쪽 패널은 RCP와 TCR을 함께 사용했을 때 대상 그룹 사이의 외형 불일치가 줄어듦을 보여 준다.
4.4 Generalization to In-the-Wild Videos
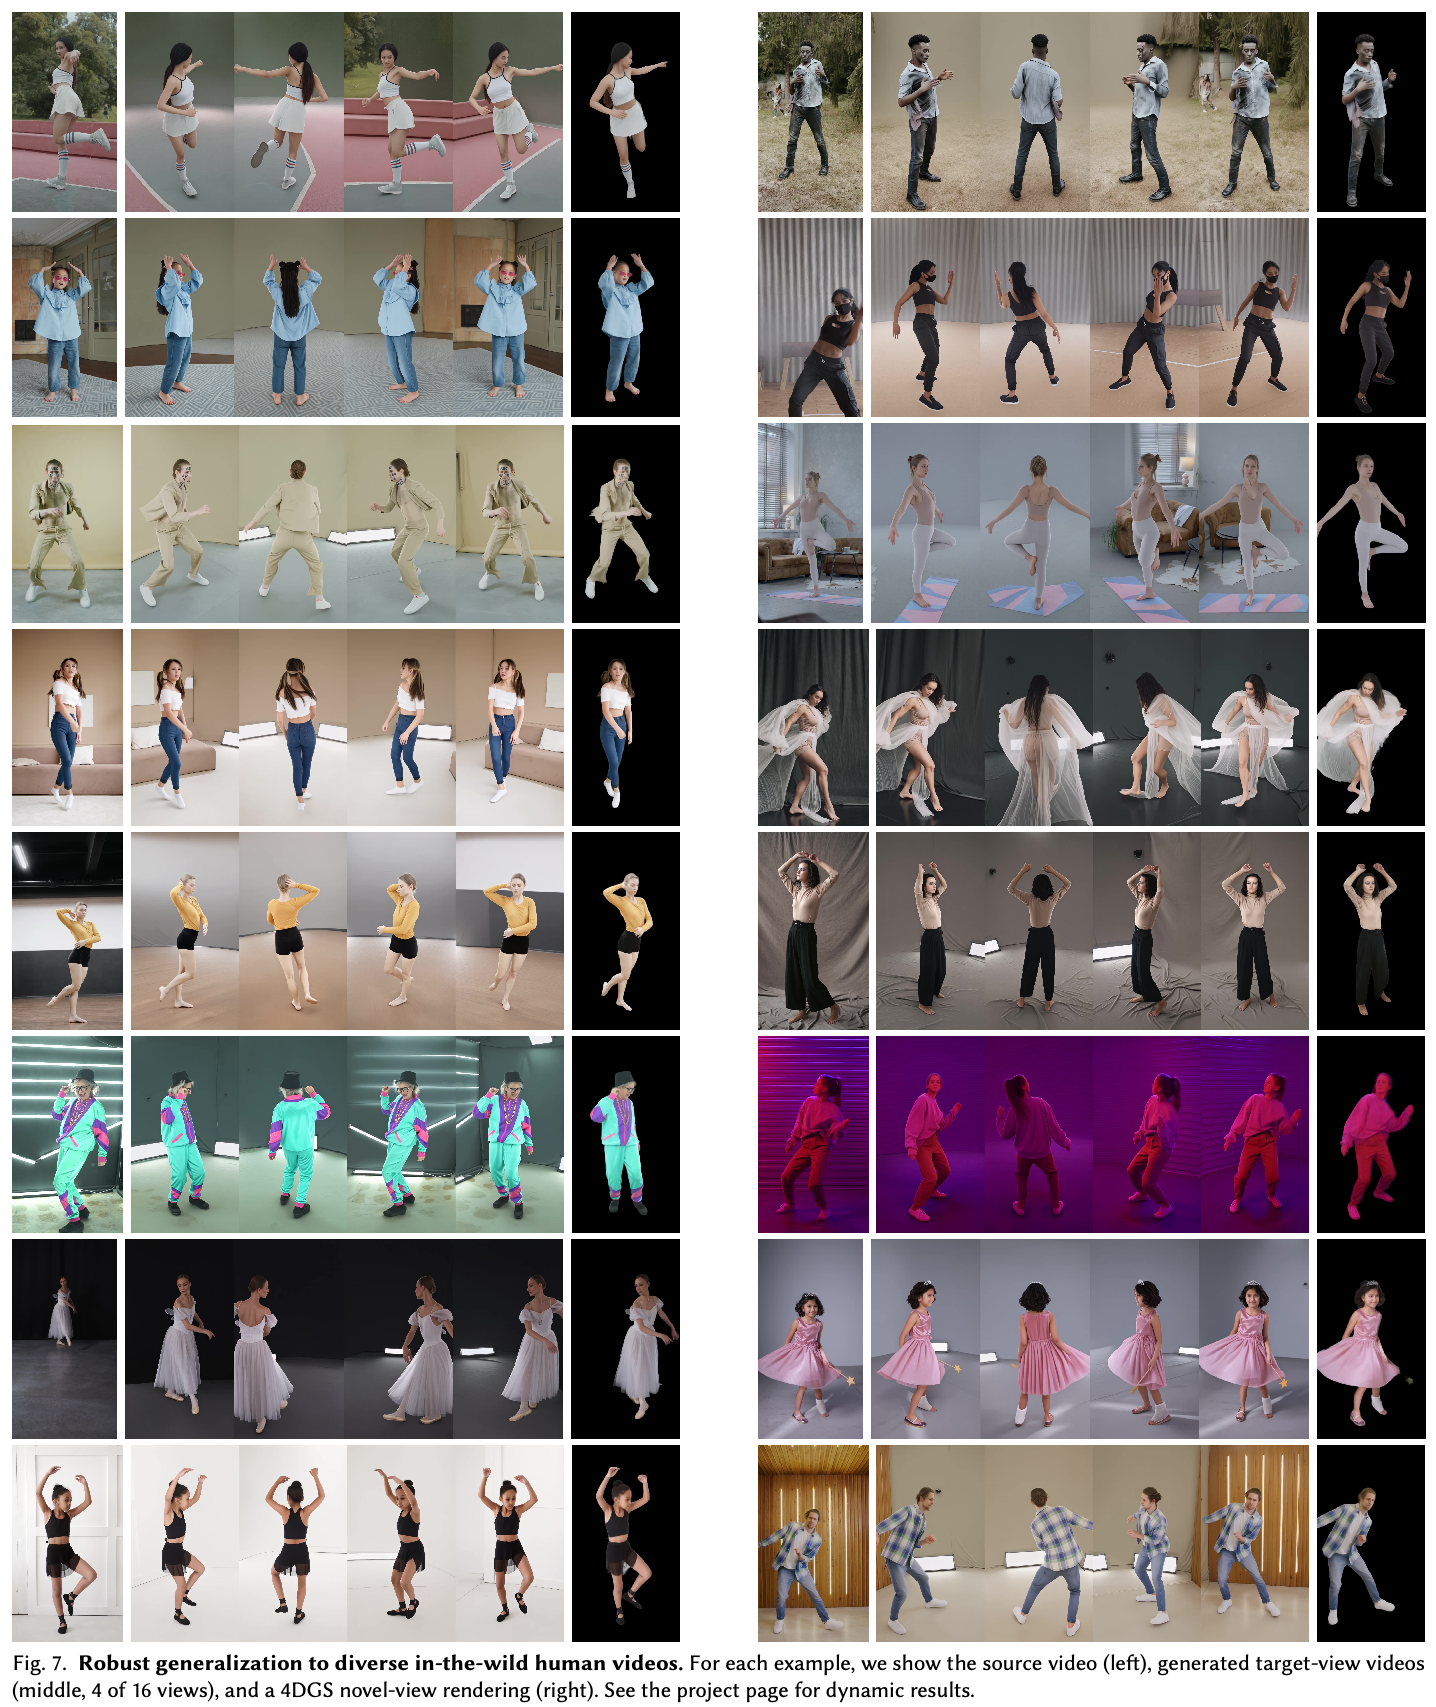
정성적 실제 환경 사례는 후면 입력, 복잡한 외형, 복잡한 동작과 그에 따른 4DGS 렌더링을 포함한다. 이는 통제된 benchmark 밖에서 의도한 동작을 보여 주지만, 별도의 정량적 실제 환경 평가는 아니다.
각 행은 소스 비디오를 생성 대상 시점 16개 중 4개 및 4DGS 신규 시점 렌더링과 연결한다. 이 갤러리는 다양한 실제 환경 비디오에서 생성부터 복원까지의 출력을 검토할 수 있게 한다.
5 Conclusion
결론은 희소 3D 스켈레톤 조건, RCP, TCR이 복원 수준의 다중 시점 생성을 가능하게 한다고 설명한다. 논문은 deepfake 악용, 개인정보 침해, 저작권 침해를 위험으로 지적하며, 합성 결과물의 공개와 묘사된 피사체의 동의를 권고한다.
Acknowledgments
이 연구는 National Key R&D Program of China(No. 2024YFB2809105), NSFC(No. U24B20154), Zhejiang Provincial Natural Science Foundation of China(No. LR25F020003), Ant Group, Zhejiang University의 Information Technology Center 및 State Key Lab of CAD&CG의 부분 지원을 받았다.
A Model Details
보충 자료의 모델 세부 사항은 다중 시점 attention 토큰을 (f, v·h·w, d)로 재배열해 같은 timestep의 시점들이 직접 attention할 수 있게 한다. 3D-aware skeleton encoder는 10개의 Conv3d 층 뒤에 zero-initialized 1×1×1 projection을 둔다. 2×와 4× RCP patchify 층은 표준 patchify 층보다 각각 1/4배와 1/16배의 토큰을 생성한다.
B Dataset Details
MVGameHuman은 2560×1440으로 렌더링한 동기화 다중 시점 비디오 38k개를 포함하며, 318명의 배우와 시퀀스당 가상 카메라 24개를 포괄한다. SynCamVideo, DNA-Rendering, TedTalk, Pexels와 함께 학습 커리큘럼에 필요한 다중 시점, 실제 촬영, 단안 데이터를 제공한다.
C Training Details
모든 단계는 λ = 0.25로 Wan2.2-TI2V-5B를 704×1280에서 fine-tuning한다. 학습 구성은 대상 카메라 수와 프레임 수의 곱을 거의 일정하게 유지하며, 예를 들어 6 × 41 ≈ 4 × 61 ≈ 1 × 121이다. Stage 3는 단안 손가락 검출이 noisy하기 때문에 손가락 키포인트를 제거한다.
D HMR Details
단안 입력에는 GVHMR이 지면 정렬 SMPL-X mesh 시퀀스를 추정하고, 희소 vertex-to-keypoint regressor가 z-buffer 렌더링을 위한 Goliath 키포인트를 추출한다. held-out 장면에서 이 regressor는 nearest-vertex baseline의 14.0 mm 대비 3.5 mm 평균 키포인트 오차를 보고한다.
E Inference Details
논문은 RTX 4090 1대에서 GVHMR 추론과 스켈레톤 렌더링에 약 2 min, H20 GPU 1대에서 denoising step 20회로 121-frame 비디오 4개를 생성하는 데 약 7 min, RTX 4090 1대에서 FreeTimeGS 최적화에 약 30 min이 걸린다고 보고한다. 카메라 16개와 프레임 121개에서는 FreeTimeGS를 Adam과 1.6 × 10⁻⁴로 50k iteration 동안 최적화한다.
G Additional Results
추가 결과는 Wan-Animate와 4DAnyone을 연결한다. 입력 이미지와 구동 모션 비디오는 먼저 단안 소스 비디오를 만들고, 4DAnyone은 이를 FreeTimeGS 복원을 위한 다중 시점 비디오로 변환한다. 이는 별도로 benchmark한 방법이 아니라 off-the-shelf animation 모델과 제안 파이프라인을 조합한 응용이다.
H Limitations and Failure Cases
제시한 실패 사례는 신체에서 멀리 움직이는 의상과 부정확한 HMR 포즈 추정이다. 흩날리는 천은 신체 스켈레톤으로 약하게만 제약되므로 시점 간 불일치가 발생할 수 있다. en-pointe 댄서의 평평한 발처럼 잘못된 포즈 추정은 생성 시점으로 전파된다.
부록
- 보충 자료는 아키텍처, 데이터셋, 학습, HMR, 추론, 평가 프로토콜, routing ablation, 추가 결과, 실패 사례를 자세히 설명한다. RCP와 TCR의 구현 선택을 문서화하고, 파이프라인이 신뢰할 수 있는 스켈레톤 안내에 의존함을 분명히 한다.
짧은 생각
논문은 복원 규모 다중 시점 diffusion의 2가지 상이한 확장 문제를 구분하고, 제한된 참조 문맥에는 RCP를, 그룹 간 대상 정보 교환에는 TCR을 배정한다. 근거는 직접 비디오 충실도, 일관성, 후속 4DGS 평가를 포괄한다. 다만 ReCamMaster† baseline은 fine-tuning한 반면 MV-Performer와 TrajectoryCrafter는 zero-shot으로 평가했으며, 실패 사례는 여전히 의상 동역학과 HMR 정확도에 연관된다.