


Kimi-VL Technical Report 요약 설명
10 Apr 2025 | Paper Review Vision-Language Models Mixture-of-Experts Reinforcement Learning Long-Context Reasoning목차
이번 글에서는 Kimi-VL Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 10일(Arxiv)
- Kimi Team, Du, Angang, Yin, Bohong, Xing, Bowei, Qu, Bowen, Wang, Bowen, Chen, Cheng, Zhang, Chenlin, Du, Chenzhuang, Wei, Chu, et al.
- The University of Hong Kong, Moonshot.ai
- 논문 링크
- Github
- Project Page
요약
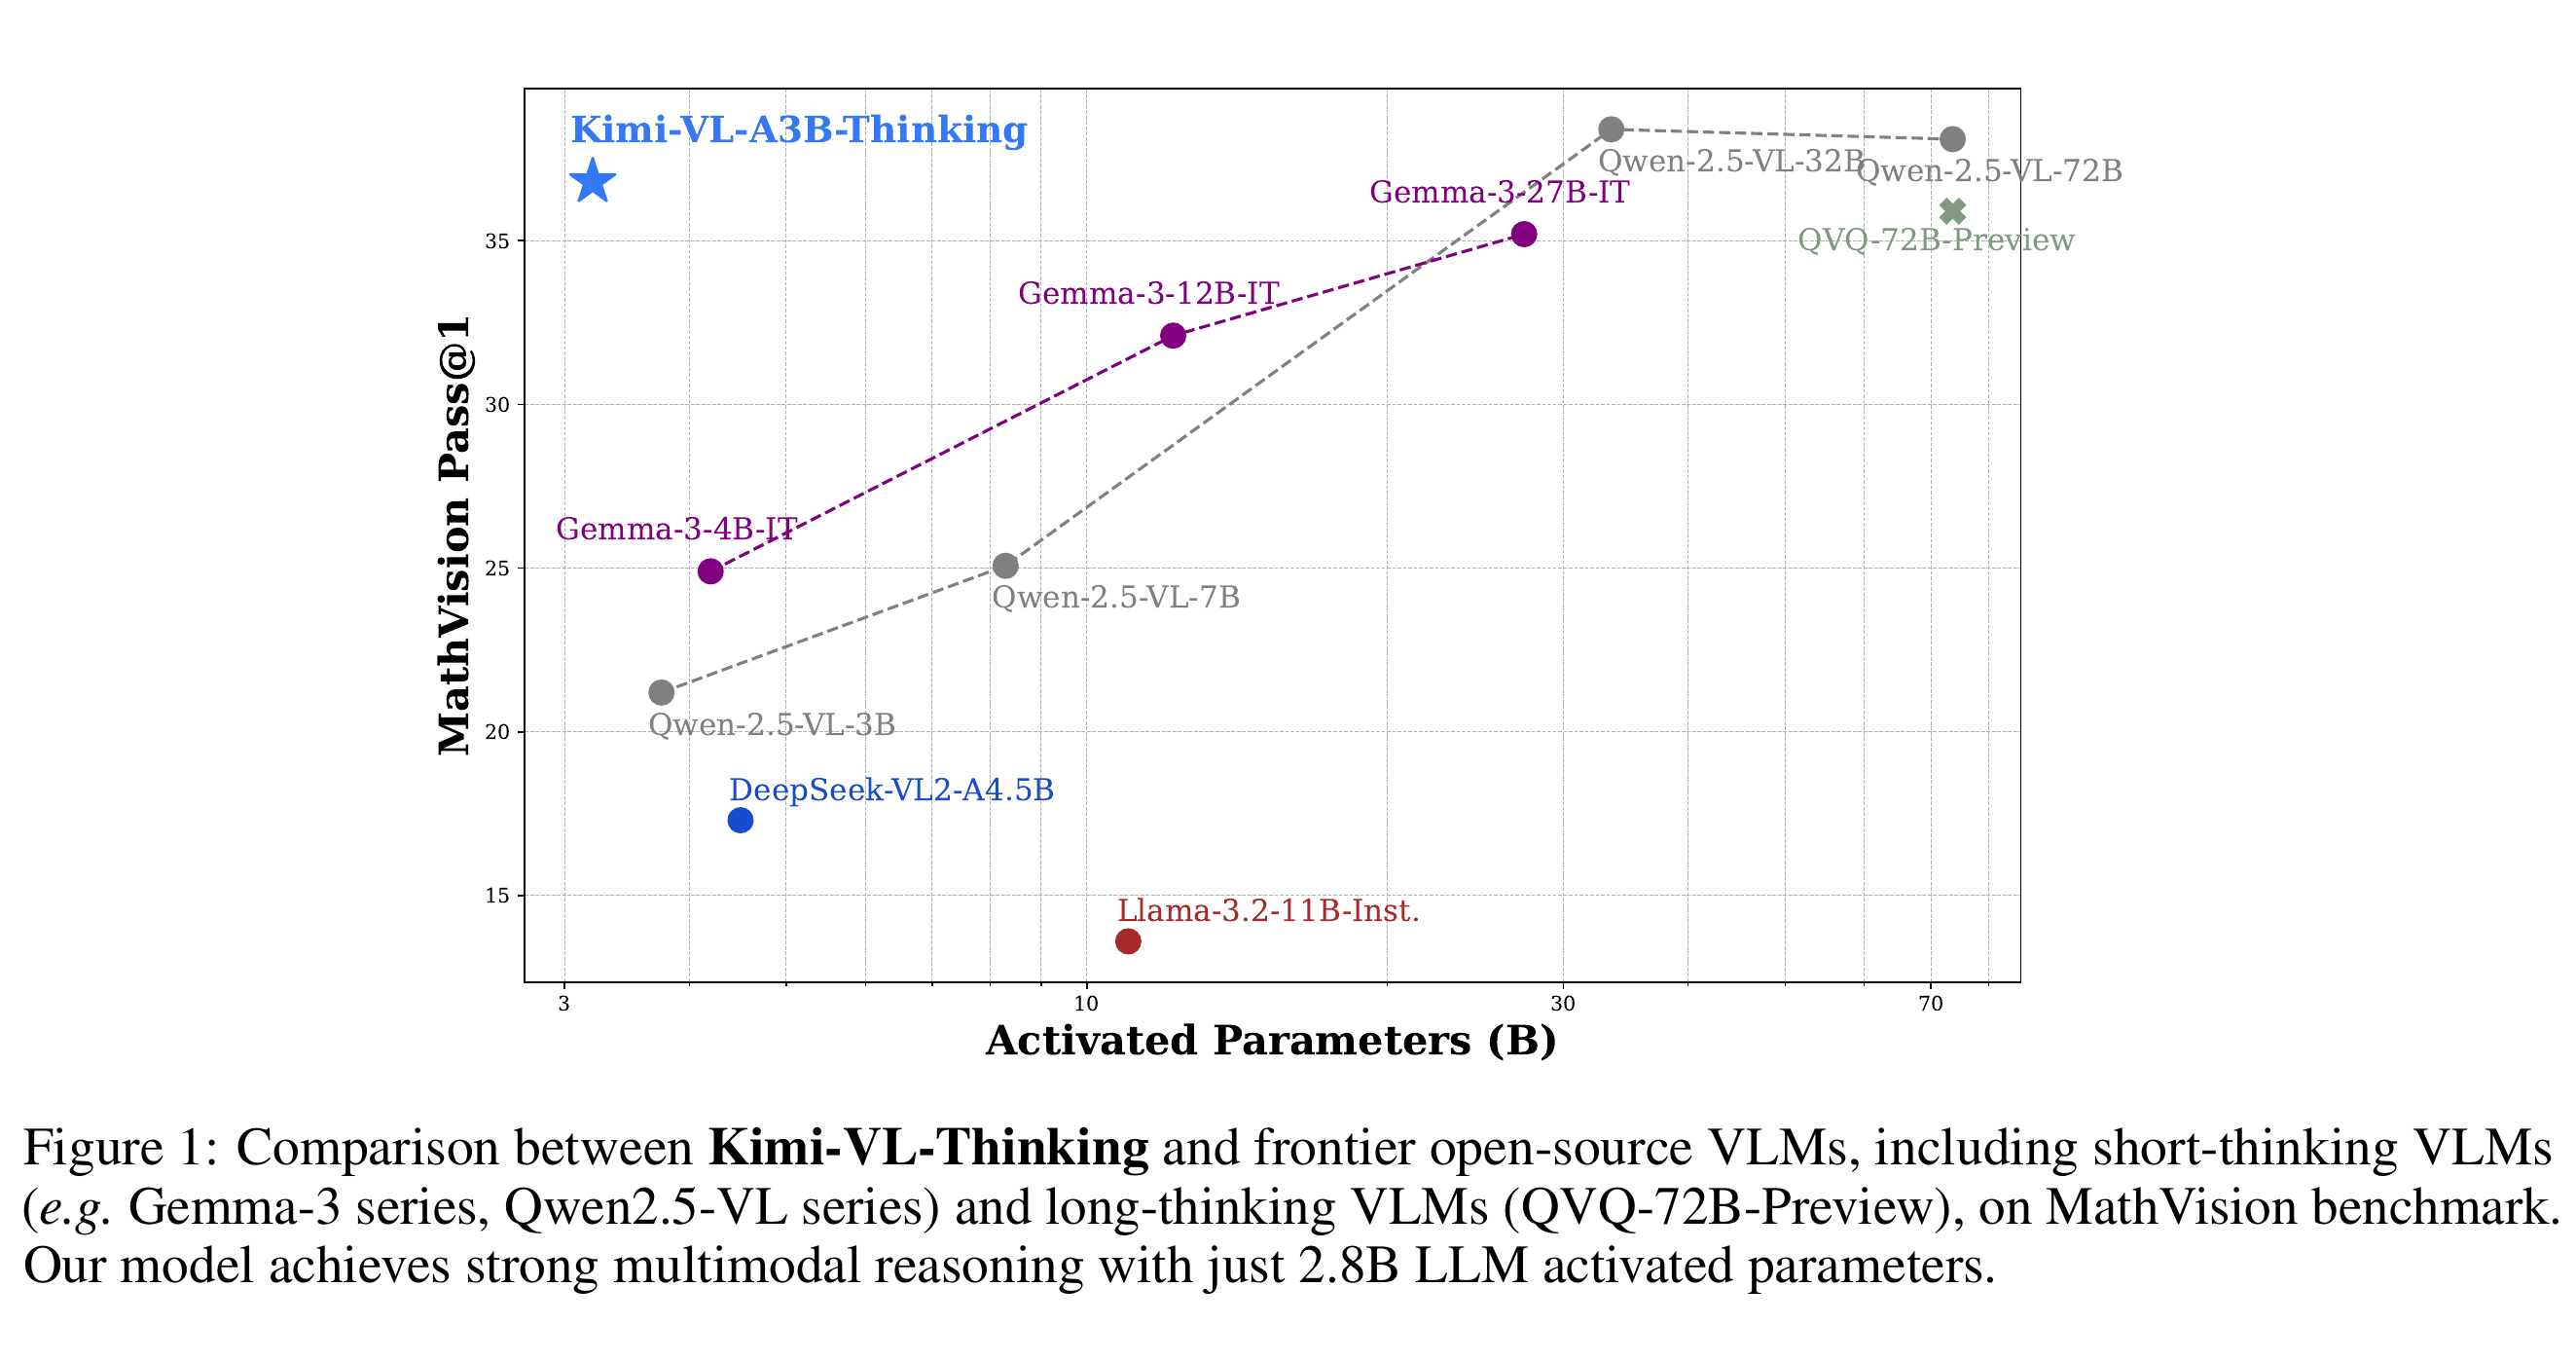
- 이 보고서는 이미지와 텍스트를 함께 처리하면서 시각적 문제를 추론하고 긴 문서, 동영상, 컴퓨터 인터페이스를 다루는 효율적인 시각-언어 모델을 구축하는 방법을 다룬다. 시각적 맥락을 포함한 수학 경시대회 문제 벤치마크인 MathVision 전체 세트에서 Kimi-VL-A3B-Thinking은 Pass@1 36.8%를 기록한다. Pass@1은 답변을 1회 생성했을 때의 성공률이다. Kimi-VL은 21.4%를 기록하며, 두 모델 모두 언어 디코더에서 2.8B 파라미터를 활성화한다.
- 모델은 다양한 해상도의 이미지를 처리하는 인코더 MoonViT와, 토큰을 선택된 전문가 모듈로 보내는 Mixture-of-Experts (MoE) 언어 모델 Moonlight를 결합한다. 학습에서는 텍스트와 멀티모달 데이터를 혼합하고, 최대 입력 시퀀스 길이인 컨텍스트 윈도를 131072 tokens까지 확장한다. 또한 중간 추론 과정을 명시하는 긴 chain-of-thought (CoT)를 도입한다. 이를 위해 예시 답변으로 학습하는 지도 미세조정(SFT)과 답변 보상으로 최적화하는 강화학습(RL)을 사용한다.
- 기존 Kimi-VL은 보고된 24개 벤치마크 중 19개에서 Qwen2.5-VL-7B를 앞선다. thinking 확장은 MathVista, MMMU, MathVision에서 기본 모델보다 높은 점수를 기록하지만, 모든 비교에서 가장 앞서지는 않는다. 보고서는 전문 문제와 까다로운 긴 컨텍스트 응용에서의 한계를 인정한다. 활성화 파라미터 수만으로 실제 배포 시 지연 시간이나 메모리 요구량을 판단할 수는 없다.
Kimi-VL-Thinking은 활성화 언어 모델 파라미터 2.8B로 MathVision에서 Pass@1 36.8%를 기록한다. 가로축으로 파라미터 수를 비교할 수 있지만, 지연 시간이나 메모리를 직접 측정한 결과는 아니다.
1 Introduction
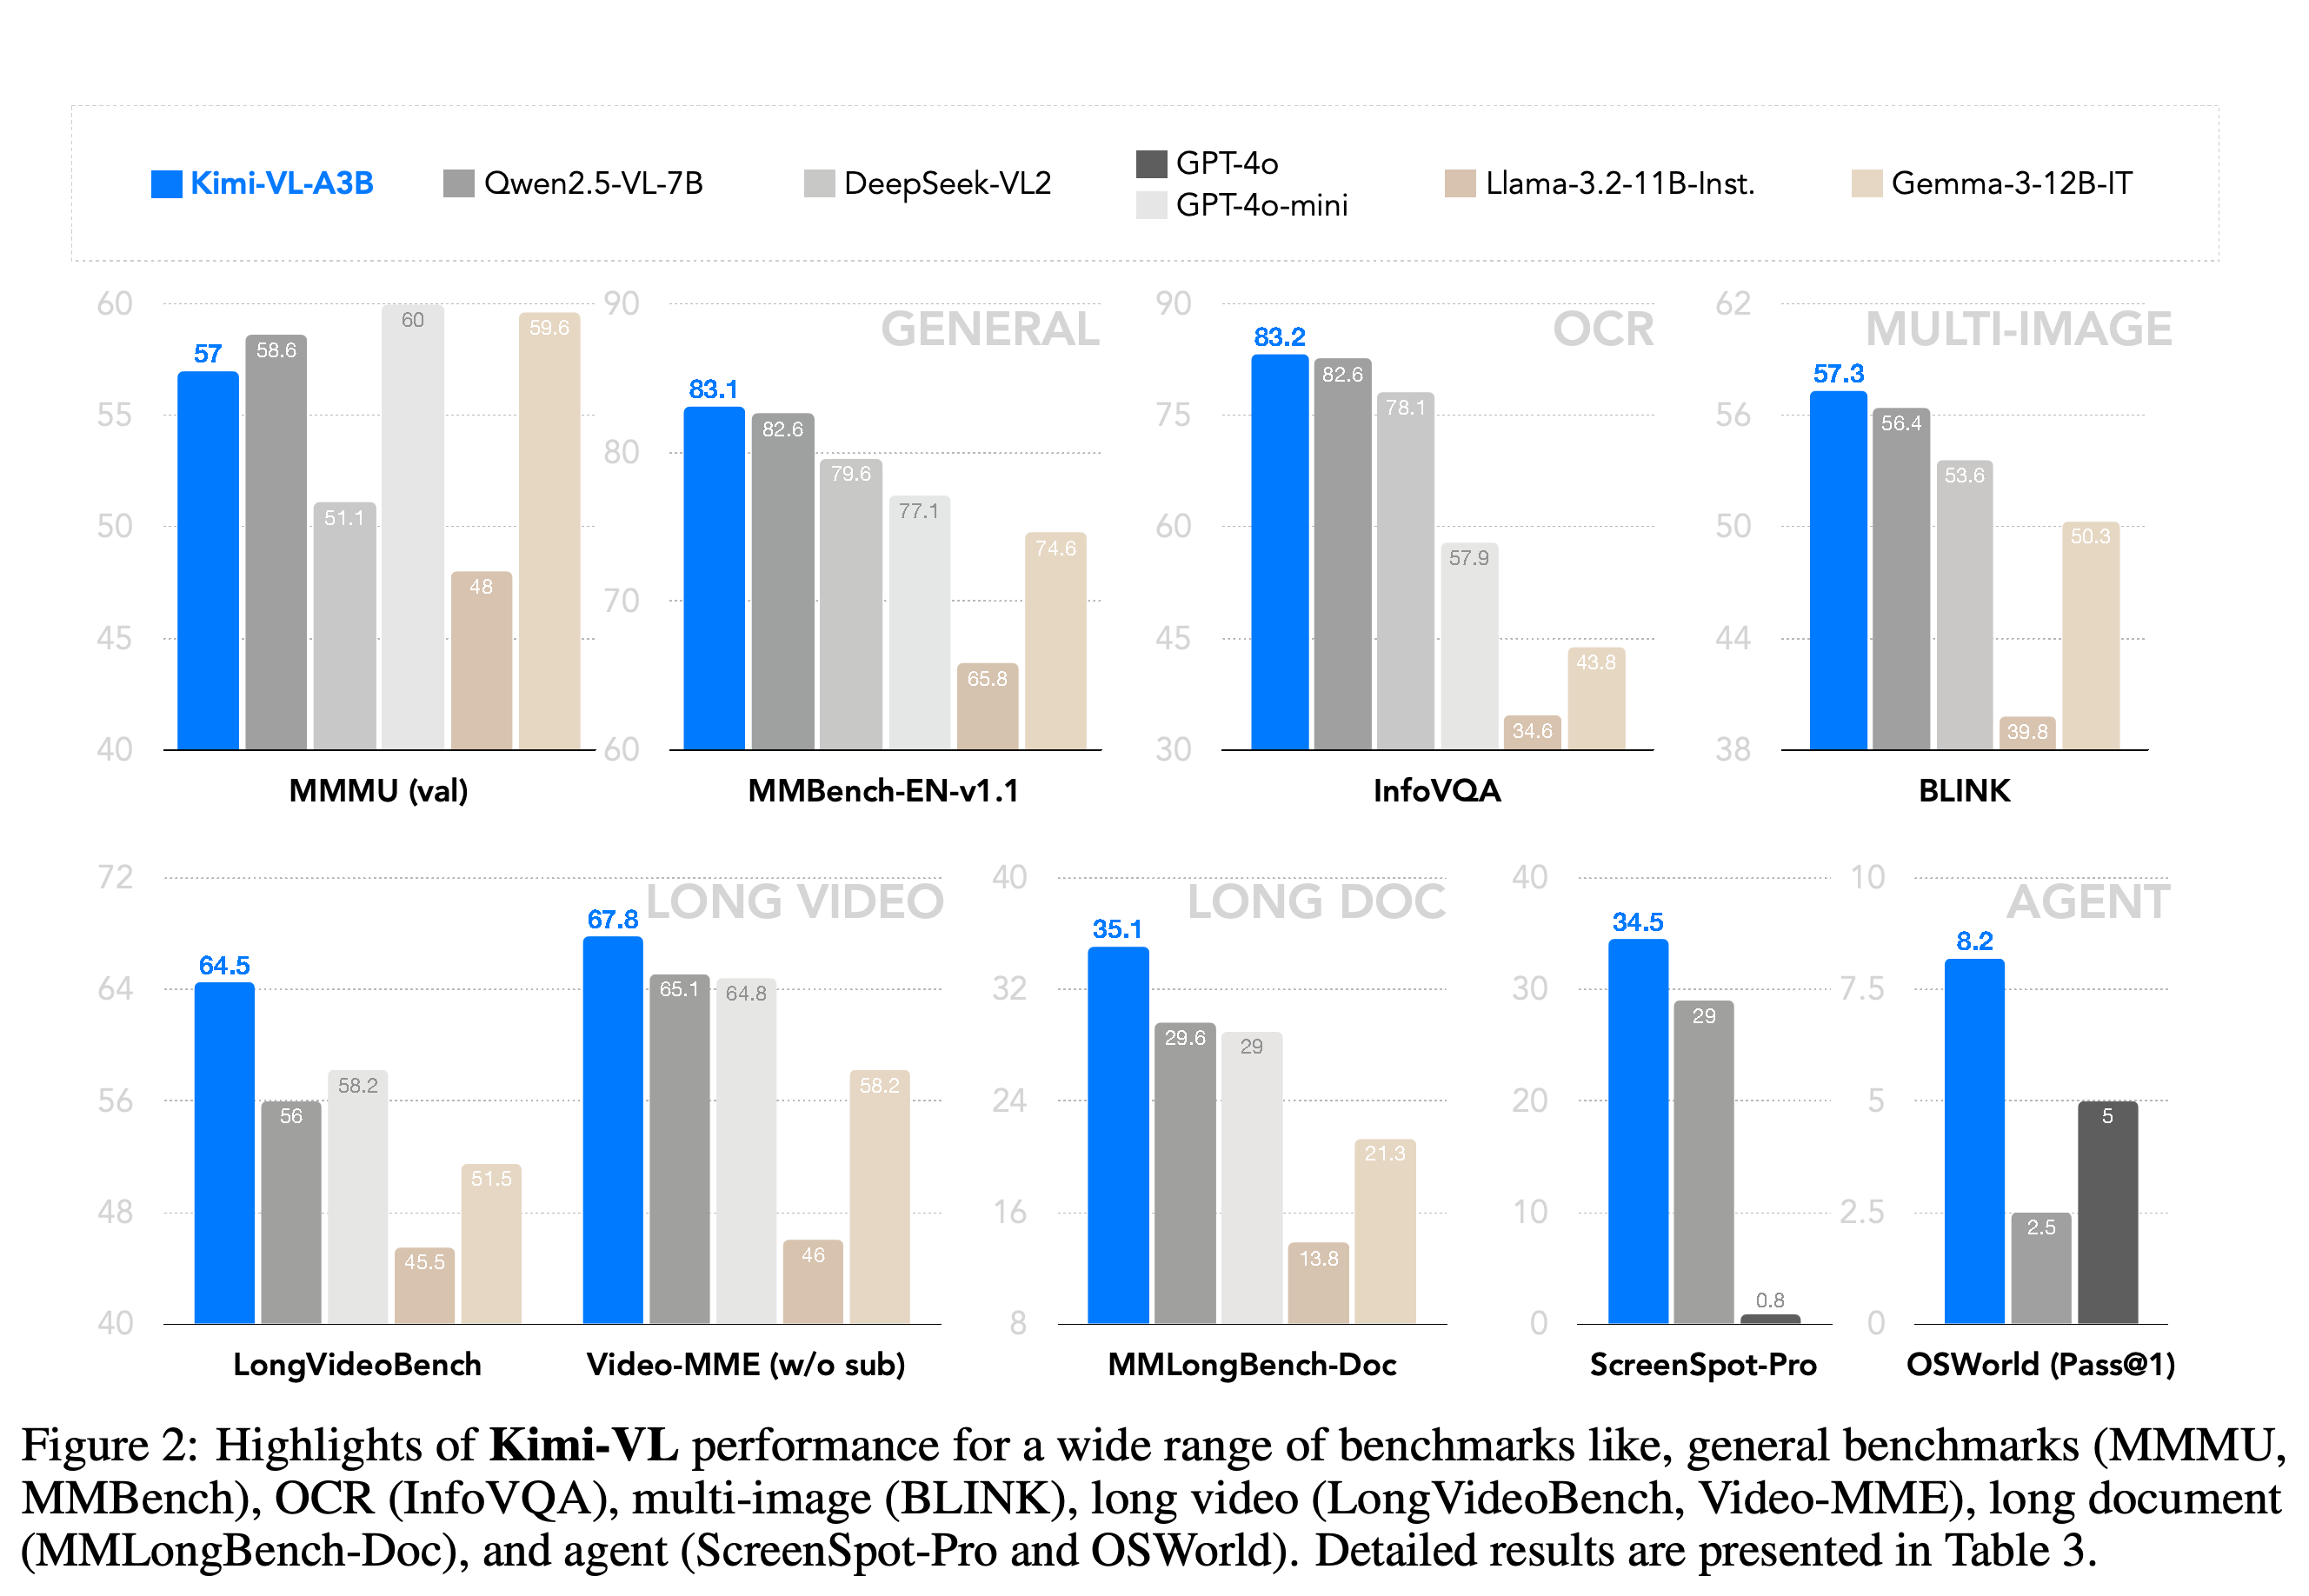
서론은 오픈소스 언어 모델과 시각-언어 모델 사이에 연산 효율, 컨텍스트 길이, 긴 추론 능력의 격차가 있다고 설명한다. Kimi-VL은 활성화 파라미터가 2.8B이고 전체 파라미터가 16B인 언어 디코더에 400M 시각 인코더를 결합하며, 단일 이미지, 다중 이미지, 동영상, 긴 문서 입력을 지원한다. Figure 1과 Figure 2는 활성화 파라미터 수에 따른 추론 성능과 여러 과제군의 결과를 요약한다.
제시된 결과는 인포그래픽 읽기, 다중 이미지, 긴 입력, 컴퓨터 상호작용을 포괄한다. MMMU 결과가 57.0이라는 점은 이러한 강점이 모든 학술 추론 과제에서의 우위를 뜻하지 않음을 보여준다.
2 Approach
제안 방법은 다양한 해상도의 이미지를 받는 원본 해상도 시각 인코더, 투영 네트워크, MoE 디코더를 결합한다. 여기에 텍스트와 멀티모달 데이터의 공동 사전학습, 지시 이행과 추론을 위한 사후학습을 적용한다. 시각적 이해 능력을 추가하면서 언어 능력을 유지한다는 목표에 따라, 언어 모델을 갱신하는 모든 단계에 텍스트 데이터를 포함한다.
2.1 Model Architecture
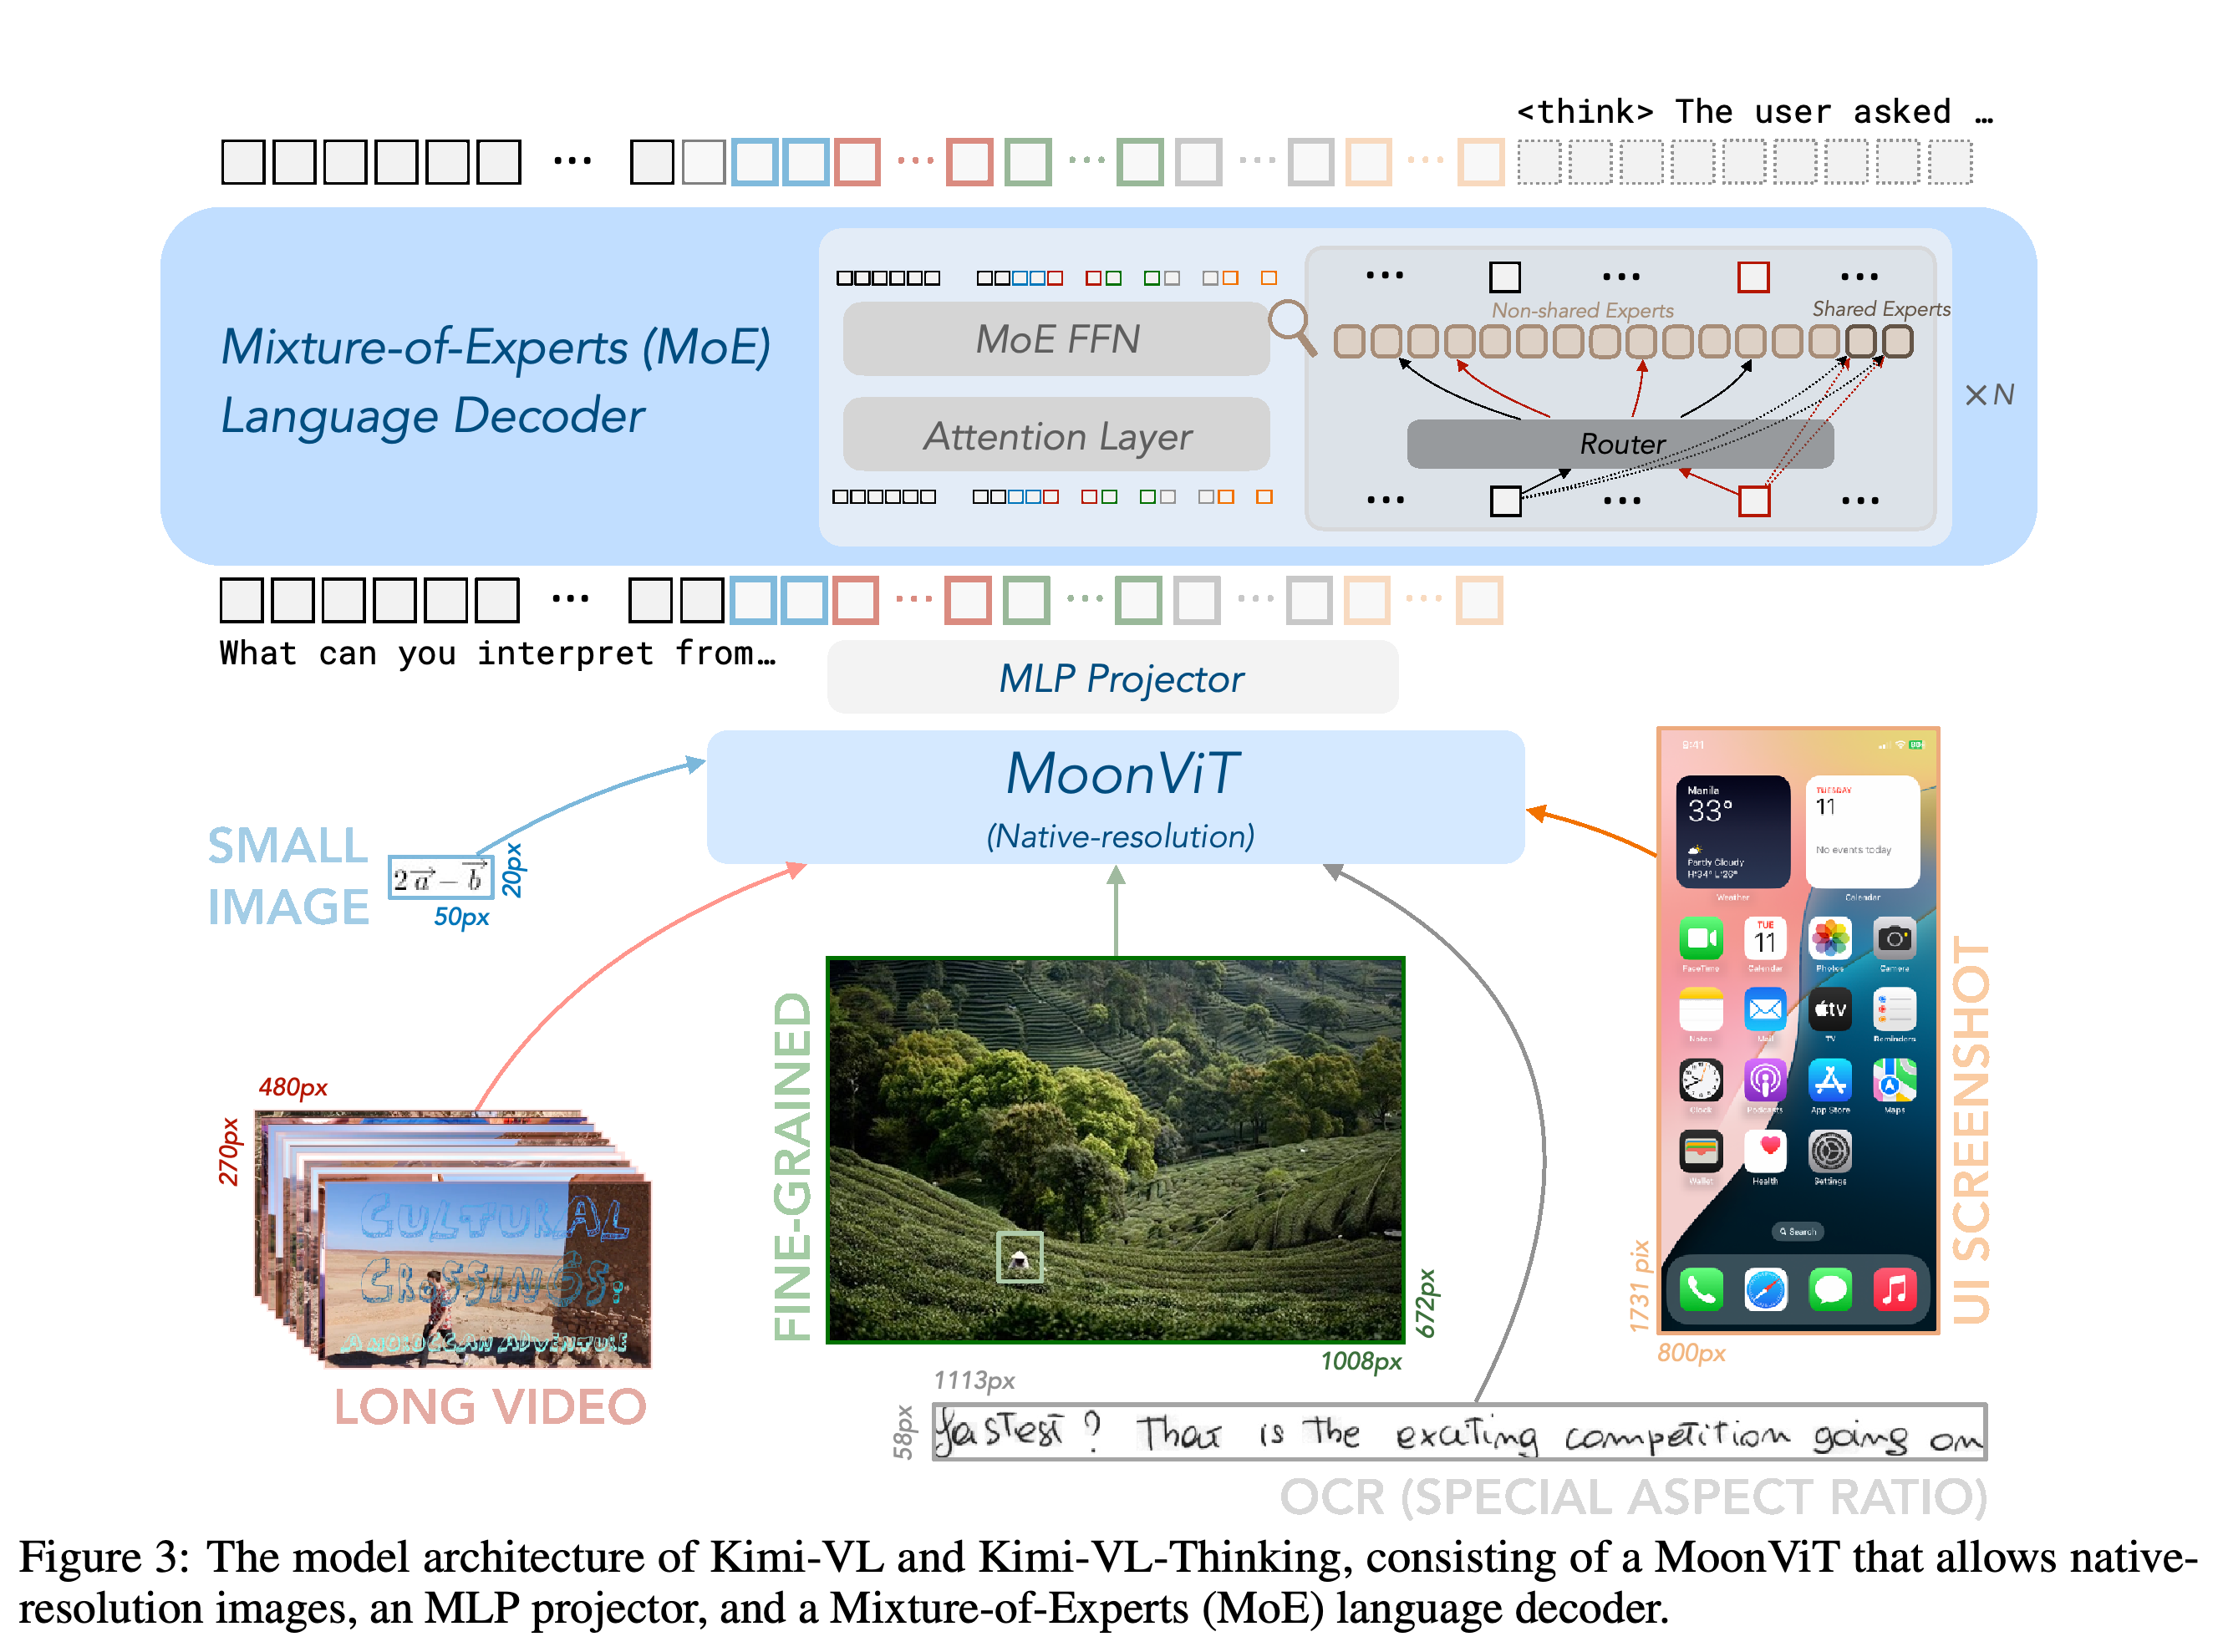
MoonViT는 크기와 종횡비가 다른 이미지를 처리하는 NaViT 방식을 따라, 다양한 해상도의 이미지를 패치로 나눈 뒤 시퀀스로 묶는다. 사전학습된 이미지-텍스트 인코더 SigLIP-SO-400M에서 시작하며, 보간한 절대 위치 임베딩과 이미지의 높이 및 너비 방향 위치를 표현하는 이차원 회전 위치 임베딩(RoPE)을 결합한다. Pixel-shuffle 연산으로 각 공간 차원의 크기를 반으로 줄이고 채널을 확장한 뒤, 피드포워드 투영 네트워크인 두 층의 다층 퍼셉트론(MLP)이 시각 특징을 언어 모델 임베딩으로 변환한다.
- Moonlight 디코더는 8192-token 컨텍스트 윈도에서 5.2T text tokens로 학습한 중간 체크포인트에서 시작하며, 이후 텍스트와 멀티모달 데이터를 합쳐 2.3T tokens를 추가로 사전학습한다.
크기와 종횡비가 다른 입력은 같은 MoonViT 인코더와 투영 경로를 거쳐 토큰을 선택된 전문가로 보내는 디코더에 도달한다. 예시는 작은 이미지, 동영상 프레임, 스크린샷, 가로로 긴 텍스트 이미지를 지원한다는 점을 보여준다.
2.2 Muon Optimizer
모델 파라미터를 갱신하는 알고리즘으로 개선된 Muon 옵티마이저를 사용하여 시각 인코더, 투영 네트워크, 언어 모델을 학습한다. 가중치 감쇠를 추가하고 파라미터별 갱신 규모를 조정하며, 옵티마이저 메모리의 중복을 줄이는 ZeRO-1 전략으로 옵티마이저 상태를 분산한다. 보고서는 Kimi-VL에서 옵티마이저만 달리한 통제 비교를 제공하지 않는다.
2.3 Pre-Training Stages
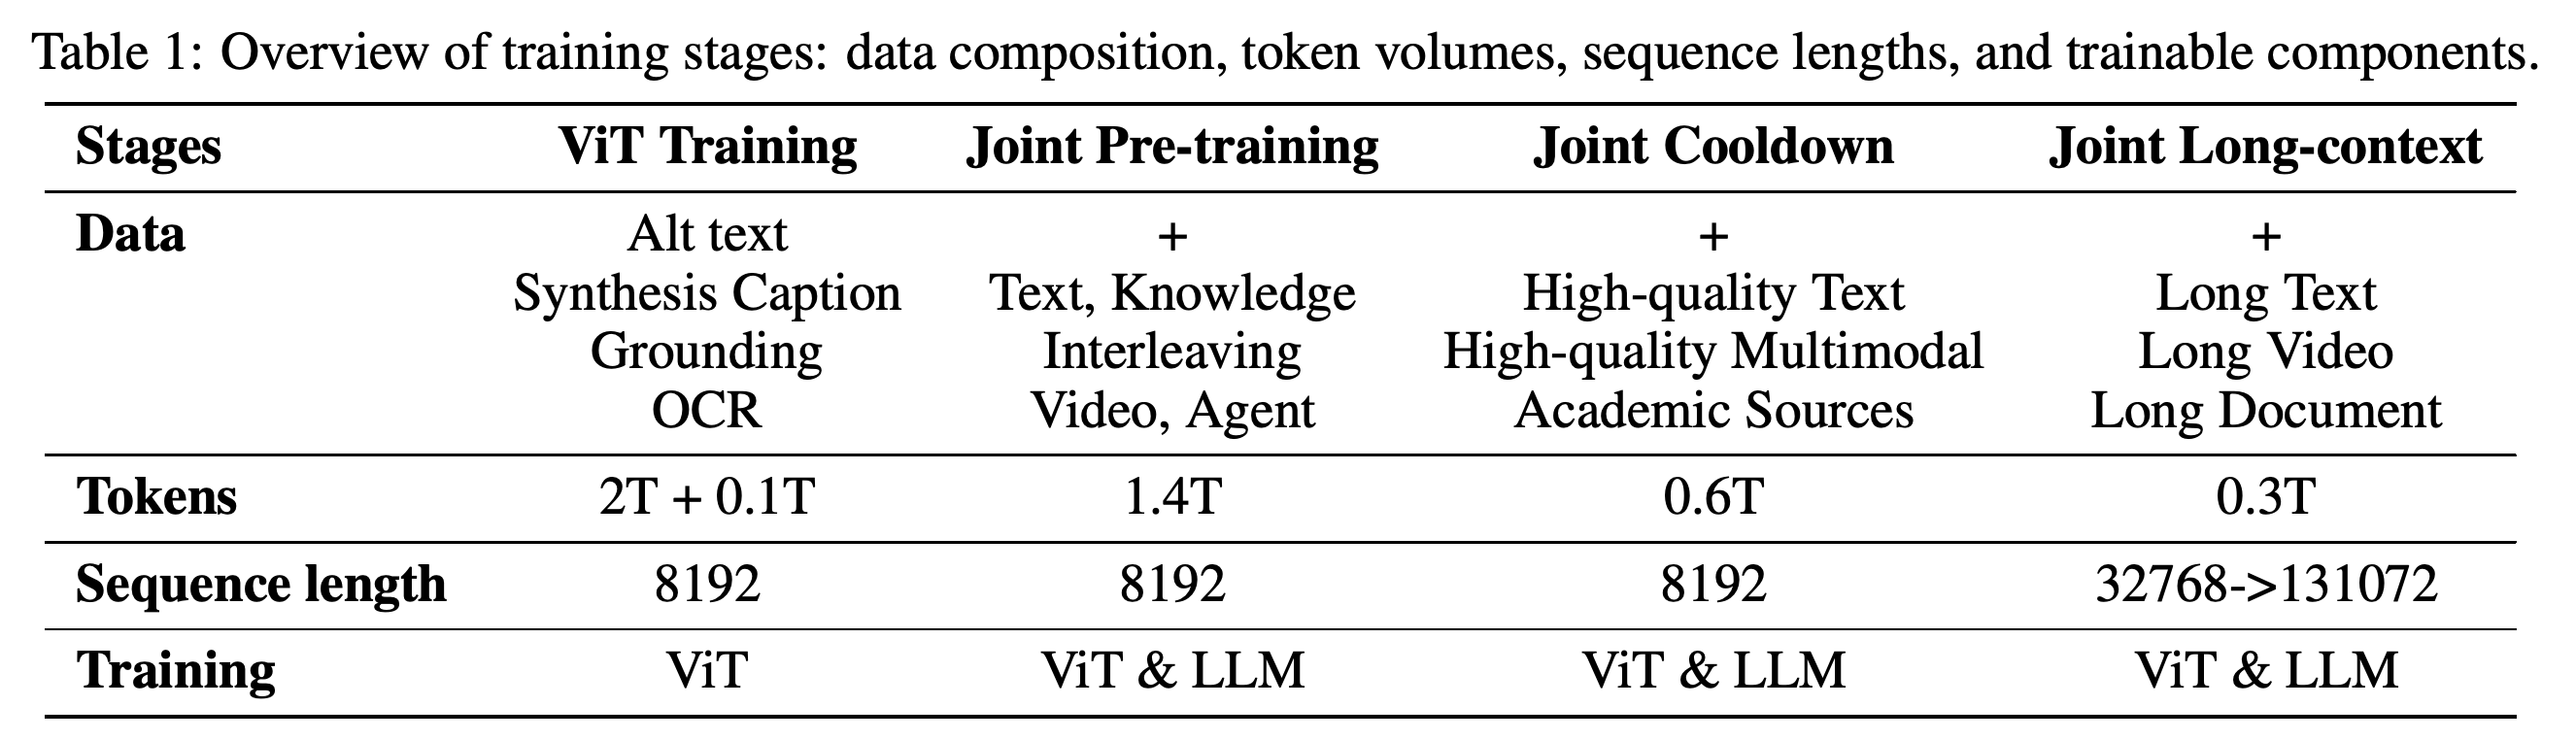
4단계 사전학습은 4.4T tokens를 사용한다. 시각 인코더 학습과 정렬에 2T + 0.1T, 공동 사전학습에 1.4T, 공동 cooldown에 0.6T, 공동 긴 컨텍스트 학습에 0.3T를 사용한다. 시각 학습 목적함수는 대응하는 이미지와 텍스트를 정렬하는 SigLIP 대조 손실과 이미지 조건부 캡션 생성을 결합하며, L = L_siglip + λL_caption이고 \(\lambda=2\)이다.
- 정렬 단계에서는 MoonViT와 투영 네트워크만 갱신한다. 공동 사전학습은 텍스트 데이터로 시작하여 멀티모달 데이터 비중을 점차 높인다. Cooldown에서는 합성한 질의응답 쌍을 제한된 비율로 포함한 고품질 텍스트 및 멀티모달 데이터로 학습을 이어간다.
- 긴 컨텍스트 활성화 과정에서는 윈도를 8192에서 131072 tokens까지 2단계에 걸쳐 각 단계마다 4배로 늘리고, RoPE base를 50,000에서 800,000으로 변경한다. 각 단계는 긴 데이터 25%와 짧은 데이터 재학습 75%로 구성한다.
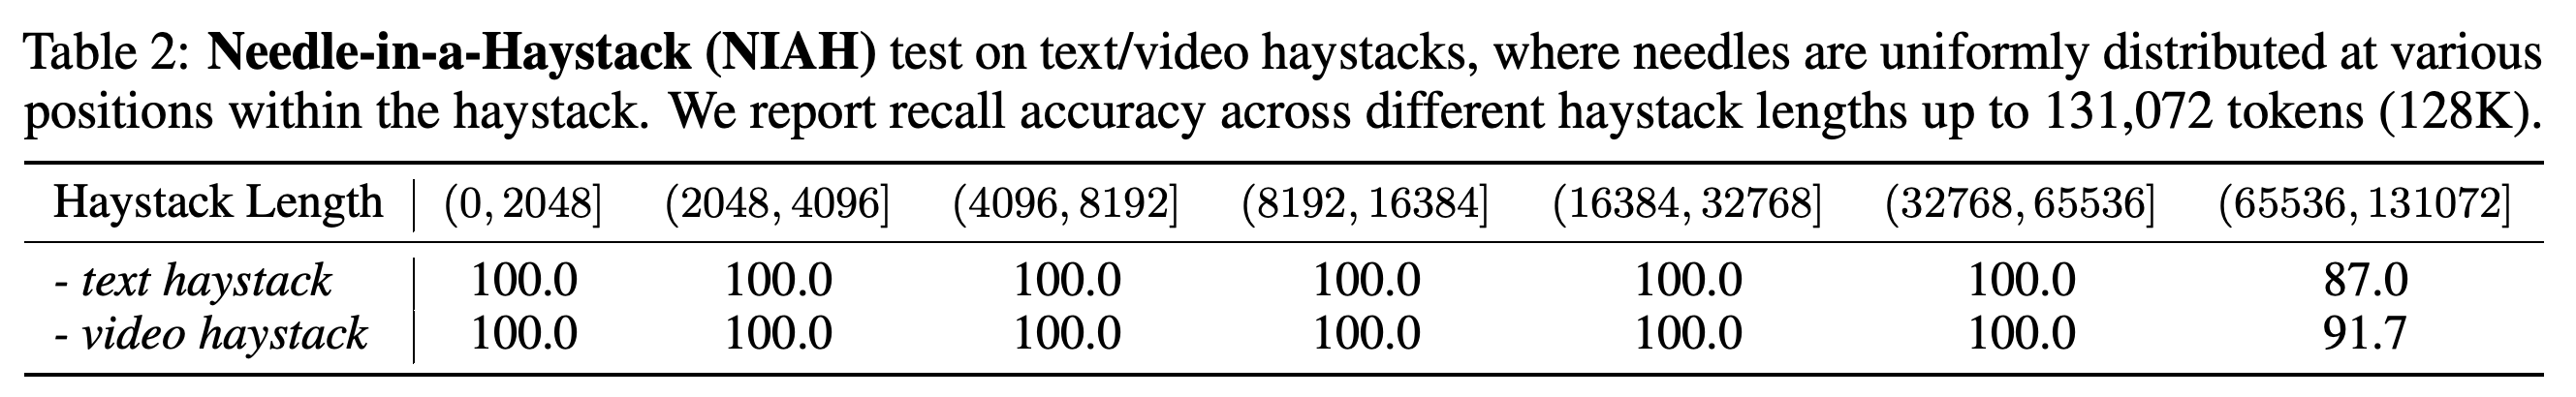
- 긴 텍스트나 동영상 시퀀스에 삽입한 정보의 검색 능력을 측정하는 Needle-in-a-Haystack (NIAH) 테스트에서 65536 tokens까지의 재현율은 100.0%이다. (65536, 131072] 구간에서는 텍스트가 87.0%, 동영상이 91.7%로 낮아진다.
도식은 디코더가 앞서 학습한 5.2T text tokens와 이후 4.4T-token 규모의 시각 및 공동 학습 과정을 구분한다. 디코더를 갱신하는 모든 단계에는 텍스트가 포함되며, 마지막 단계에서는 긴 텍스트, 동영상, 문서를 도입한다.
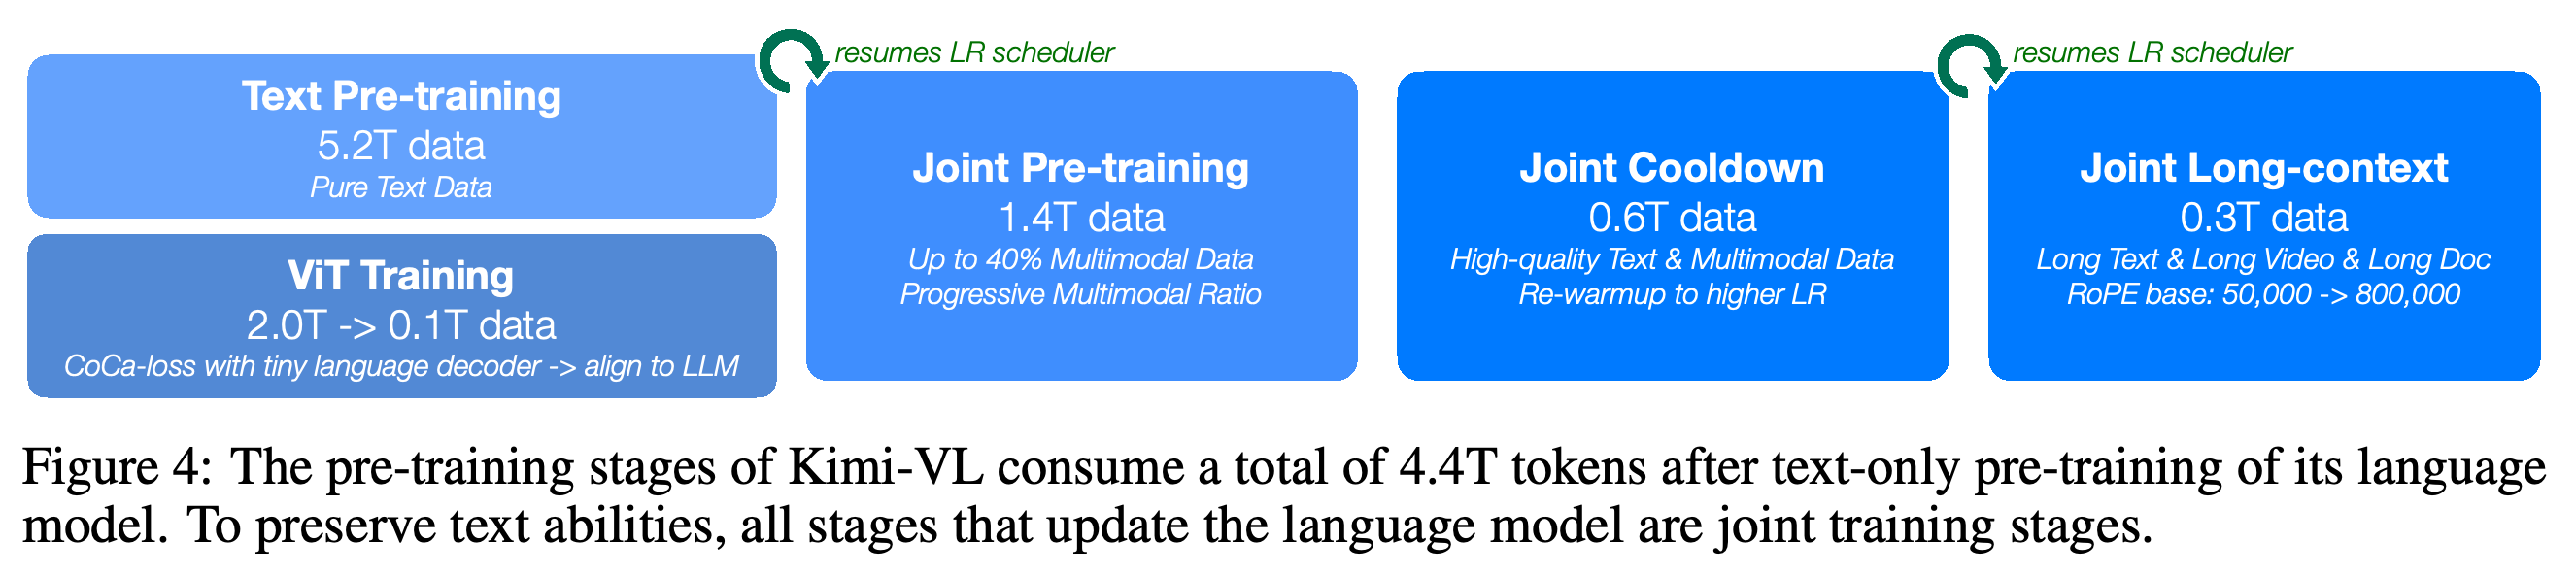
공동 학습 단계는 8192-token 시퀀스를 사용하며, 긴 컨텍스트 학습에서 32768을 거쳐 131072까지 확장한다. 시각 학습 열에는 학습 가능한 구성요소로 시각 인코더가 기재되어 있지만, 함께 제시된 정렬 설명에서는 투영 네트워크도 갱신한다고 명시한다.
65536 tokens까지는 모든 삽입 정보를 검색하지만, 가장 긴 구간에서는 재현율이 텍스트 87.0%, 동영상 91.7%로 낮아진다. 이 테스트는 제시된 컨텍스트 윈도 전반에서 검색이 가능하면서도 상한에 가까워지면 성능이 저하됨을 보여준다.
2.4 Post-Training Stages
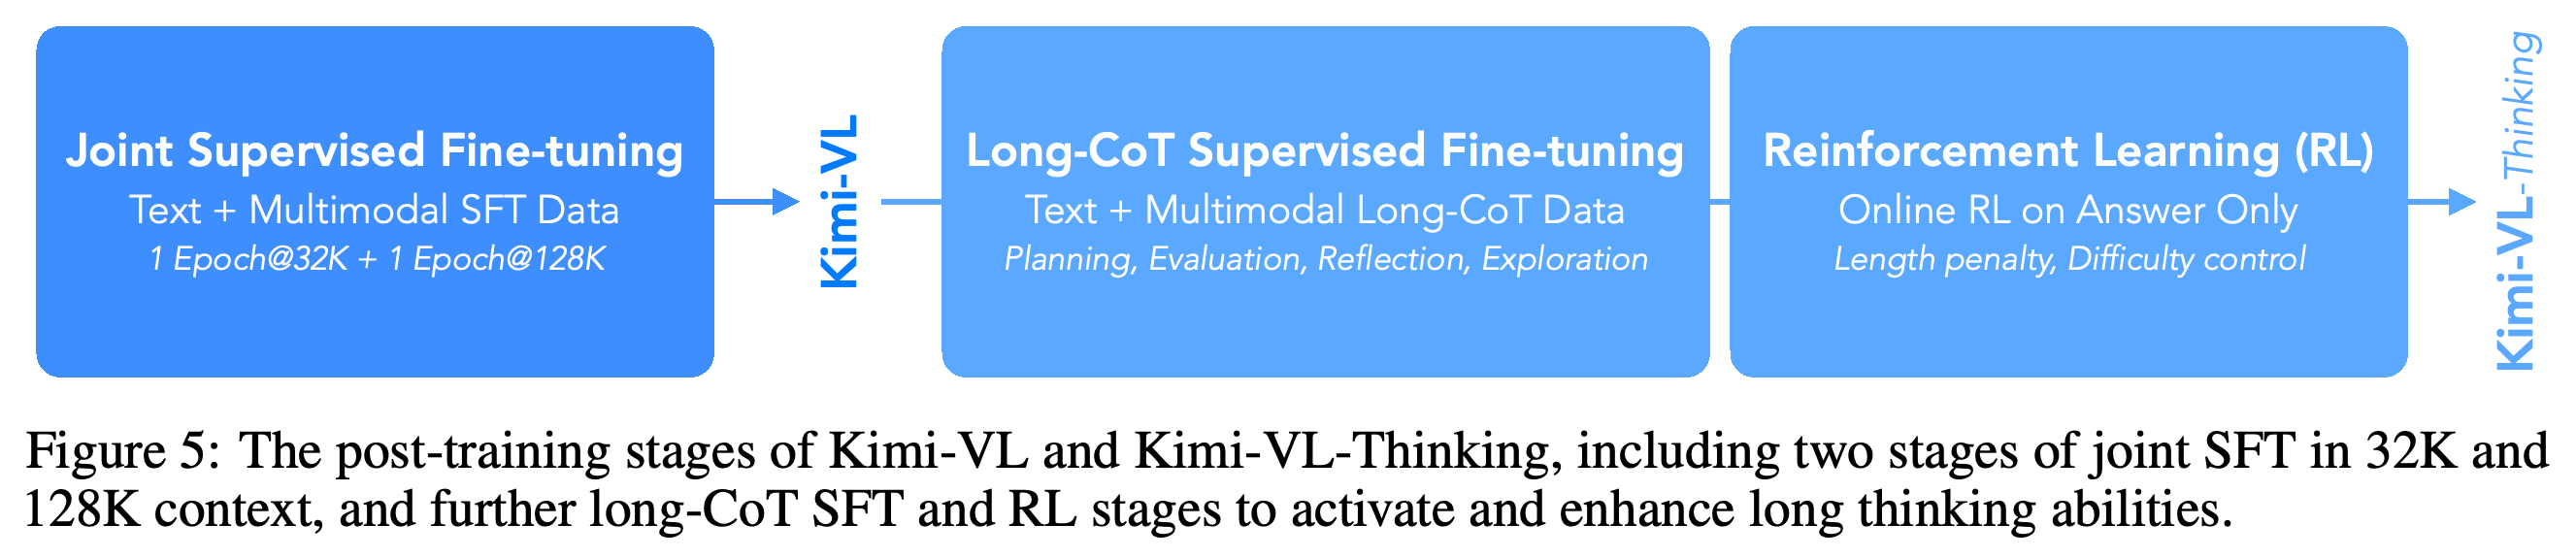
공동 SFT는 역할 표지가 명시된 대화 형식인 ChatML로 구성한 텍스트 및 시각-언어 대화를 사용하여 모델의 구성요소 3개를 모두 갱신한다. 답변과 특수 토큰에만 학습 신호를 적용하며, 시스템 및 사용자 프롬프트는 마스킹한다. 시퀀스 길이 32K tokens와 128K tokens에서 각각 1 epoch를 학습한다.
- 학습률은 1 step에서 2×10⁻⁵에서 2×10⁻⁶으로 감소한다. 2 step에서는 1×10⁻⁵로 높인 뒤 1×10⁻⁶까지 낮춘다.
- Long-CoT SFT는 계획, 평가, 성찰, 탐색을 포함한 검증된 추론 예시를 사용한다. 이후 RL은 online policy mirror descent의 변형을 사용한다. 이는 현재 참조 모델에서 벗어나는 정도에 페널티를 부과하면서 답변 보상을 높이는 반복 최적화 방법이다.
- 답변 보상은 정답과의 일치 여부에 따라 이진 값으로 부여한다. 응답 길이 페널티로 불필요한 추론을 억제하고, curriculum sampling과 prioritized sampling으로 난이도 레이블과 관측된 성공률에 따라 학습 예시를 선택한다. 추론 시에는 별도의 계획 알고리즘 없이 토큰을 순차적으로 생성한다.
분기 지점은 지시 이행용 Kimi-VL과 thinking 확장 모델을 구분한다. 예시 기반 추가 학습으로 긴 추론을 도입한 뒤 답변 보상을 최적화하며, RL 중에는 응답 길이와 예시 난이도를 제어한다.
2.5 Infrastructure
데이터 시스템은 시각 입력을 원래 형식 그대로 S3-compatible 객체 스토리지에 저장한다. 이는 데이터 객체를 저장하고 가져오는 클라우드 인터페이스이다. 셔플링, 혼합, 토큰화, 마스킹, 패킹은 학습 중에 수행한다. 실행이 중단된 뒤에도 데이터 순서를 유지하도록 작업자의 난수 상태를 제어한다. 학습에서는 서로 다른 배치를 처리하도록 모델을 복제하는 데이터 병렬화, 전문가 모듈을 분산하는 전문가 병렬화, 모델 층을 분산하는 파이프라인 병렬화, 긴 시퀀스를 장치에 나누는 컨텍스트 병렬화를 결합한다.
- ZeRO-1과 선택한 중간 활성값을 재계산하는 선택적 활성값 체크포인팅으로 메모리 사용량을 줄인다. 시퀀스가 길어지면 더 많은 층에서 재계산을 수행한다.
- 저자들은 Qwen2.5-7B 기반 모델처럼 선택된 전문가 대신 전체 파라미터를 사용하는 7B 밀집 시각-언어 모델보다 학습 처리량이 약 60% 높다고 보고한다. 해당 절에는 이 비교의 하드웨어 구성이나 세부 측정 조건이 명시되어 있지 않다.
3 Data Construction
데이터 구축은 텍스트, 이미지, 동영상 자료에 필터링, 합성, 중복 제거를 적용한다. 보고서는 폭넓은 능력을 위한 사전학습 데이터, 대화와 지시 이행을 위한 지시 데이터, long-CoT 학습과 RL을 위한 추론 데이터를 설명한다.
3.1 Pre-Training Data
멀티모달 사전학습 데이터는 캡션, 이미지와 텍스트가 교차 배치된 문서, 광학 문자 인식(OCR), 지식, 에이전트 상호작용, 동영상을 포함한다. OCR은 이미지 속 문자를 편집 가능한 텍스트로 변환하는 작업이다. 중국어와 영어 캡션으로 이미지와 텍스트를 정렬하고, 교차 배치 문서에서는 이미지와 주변 텍스트의 순서를 유지한다. 근거 없는 내용이 생성될 위험을 줄이기 위해 합성 캡션과 상세한 동영상 설명의 비중을 제한한다.
- OCR 데이터는 다국어 텍스트, 손글씨, 복잡한 레이아웃, 표, 수식, 도식, 여러 페이지 문서를 포함하며, 회전, 왜곡, 색상 변경, 노이즈 증강을 적용한다. 지식 데이터는 레이아웃 분석과 OCR로 처리한 학술 및 인터넷 자료를 활용한다.
- 에이전트 데이터는 가상 머신에서 수집한 스크린샷과 동작, 아이콘 데이터, 합성 추론을 덧붙인 사람의 컴퓨터 사용 시연을 결합한다. Grounding은 지시와 관련된 인터페이스 요소의 위치를 찾는 작업이다.
- 동영상 데이터는 긴 시퀀스와 세밀한 시공간 대응 관계를 지원한다. 텍스트 데이터는 Moonlight의 English, Chinese, Code, Mathematics & Reasoning, Knowledge 영역을 재사용한다. 출처를 평가하고, 선택한 하위 집합의 샘플링 빈도를 높이는 선택적 업샘플링을 적용한다.
3.2 Instruction Data
추론이 필요하지 않은 지시 과제에서는 사람이 작성한 주석으로 초기 모델을 학습한다. 이 모델이 여러 후보 답변을 생성하면 주석 작업자가 순위를 매기고 다듬는다. 시각적 코딩, 시각적 추론, 수학 또는 과학 문제에서는 rejection sampling으로 규칙 기반 또는 모델 기반 검증을 통과한 예시를 남긴다. 최종 표준 SFT 데이터셋의 텍스트 토큰과 이미지 토큰 비율은 약 1:1이다.
3.3 Reasoning Data
추론 데이터는 여러 단계의 추론이 필요하고 정답이 주어진 질의응답 예시에서 시작한다. 여기에는 수학과, 시각 입력에 관한 질문에 답하는 분야별 시각 질의응답이 포함된다. Kimi k1.5가 질문마다 여러 개의 상세한 추론 경로를 생성한다. 보상 모델은 예측을 정답 레이블과 비교하여 평가하고, 모델 판정과 규칙 기반 보상으로 잘못된 답변을 걸러낸다.
4.1 Comparison to the State-of-the-Art Models
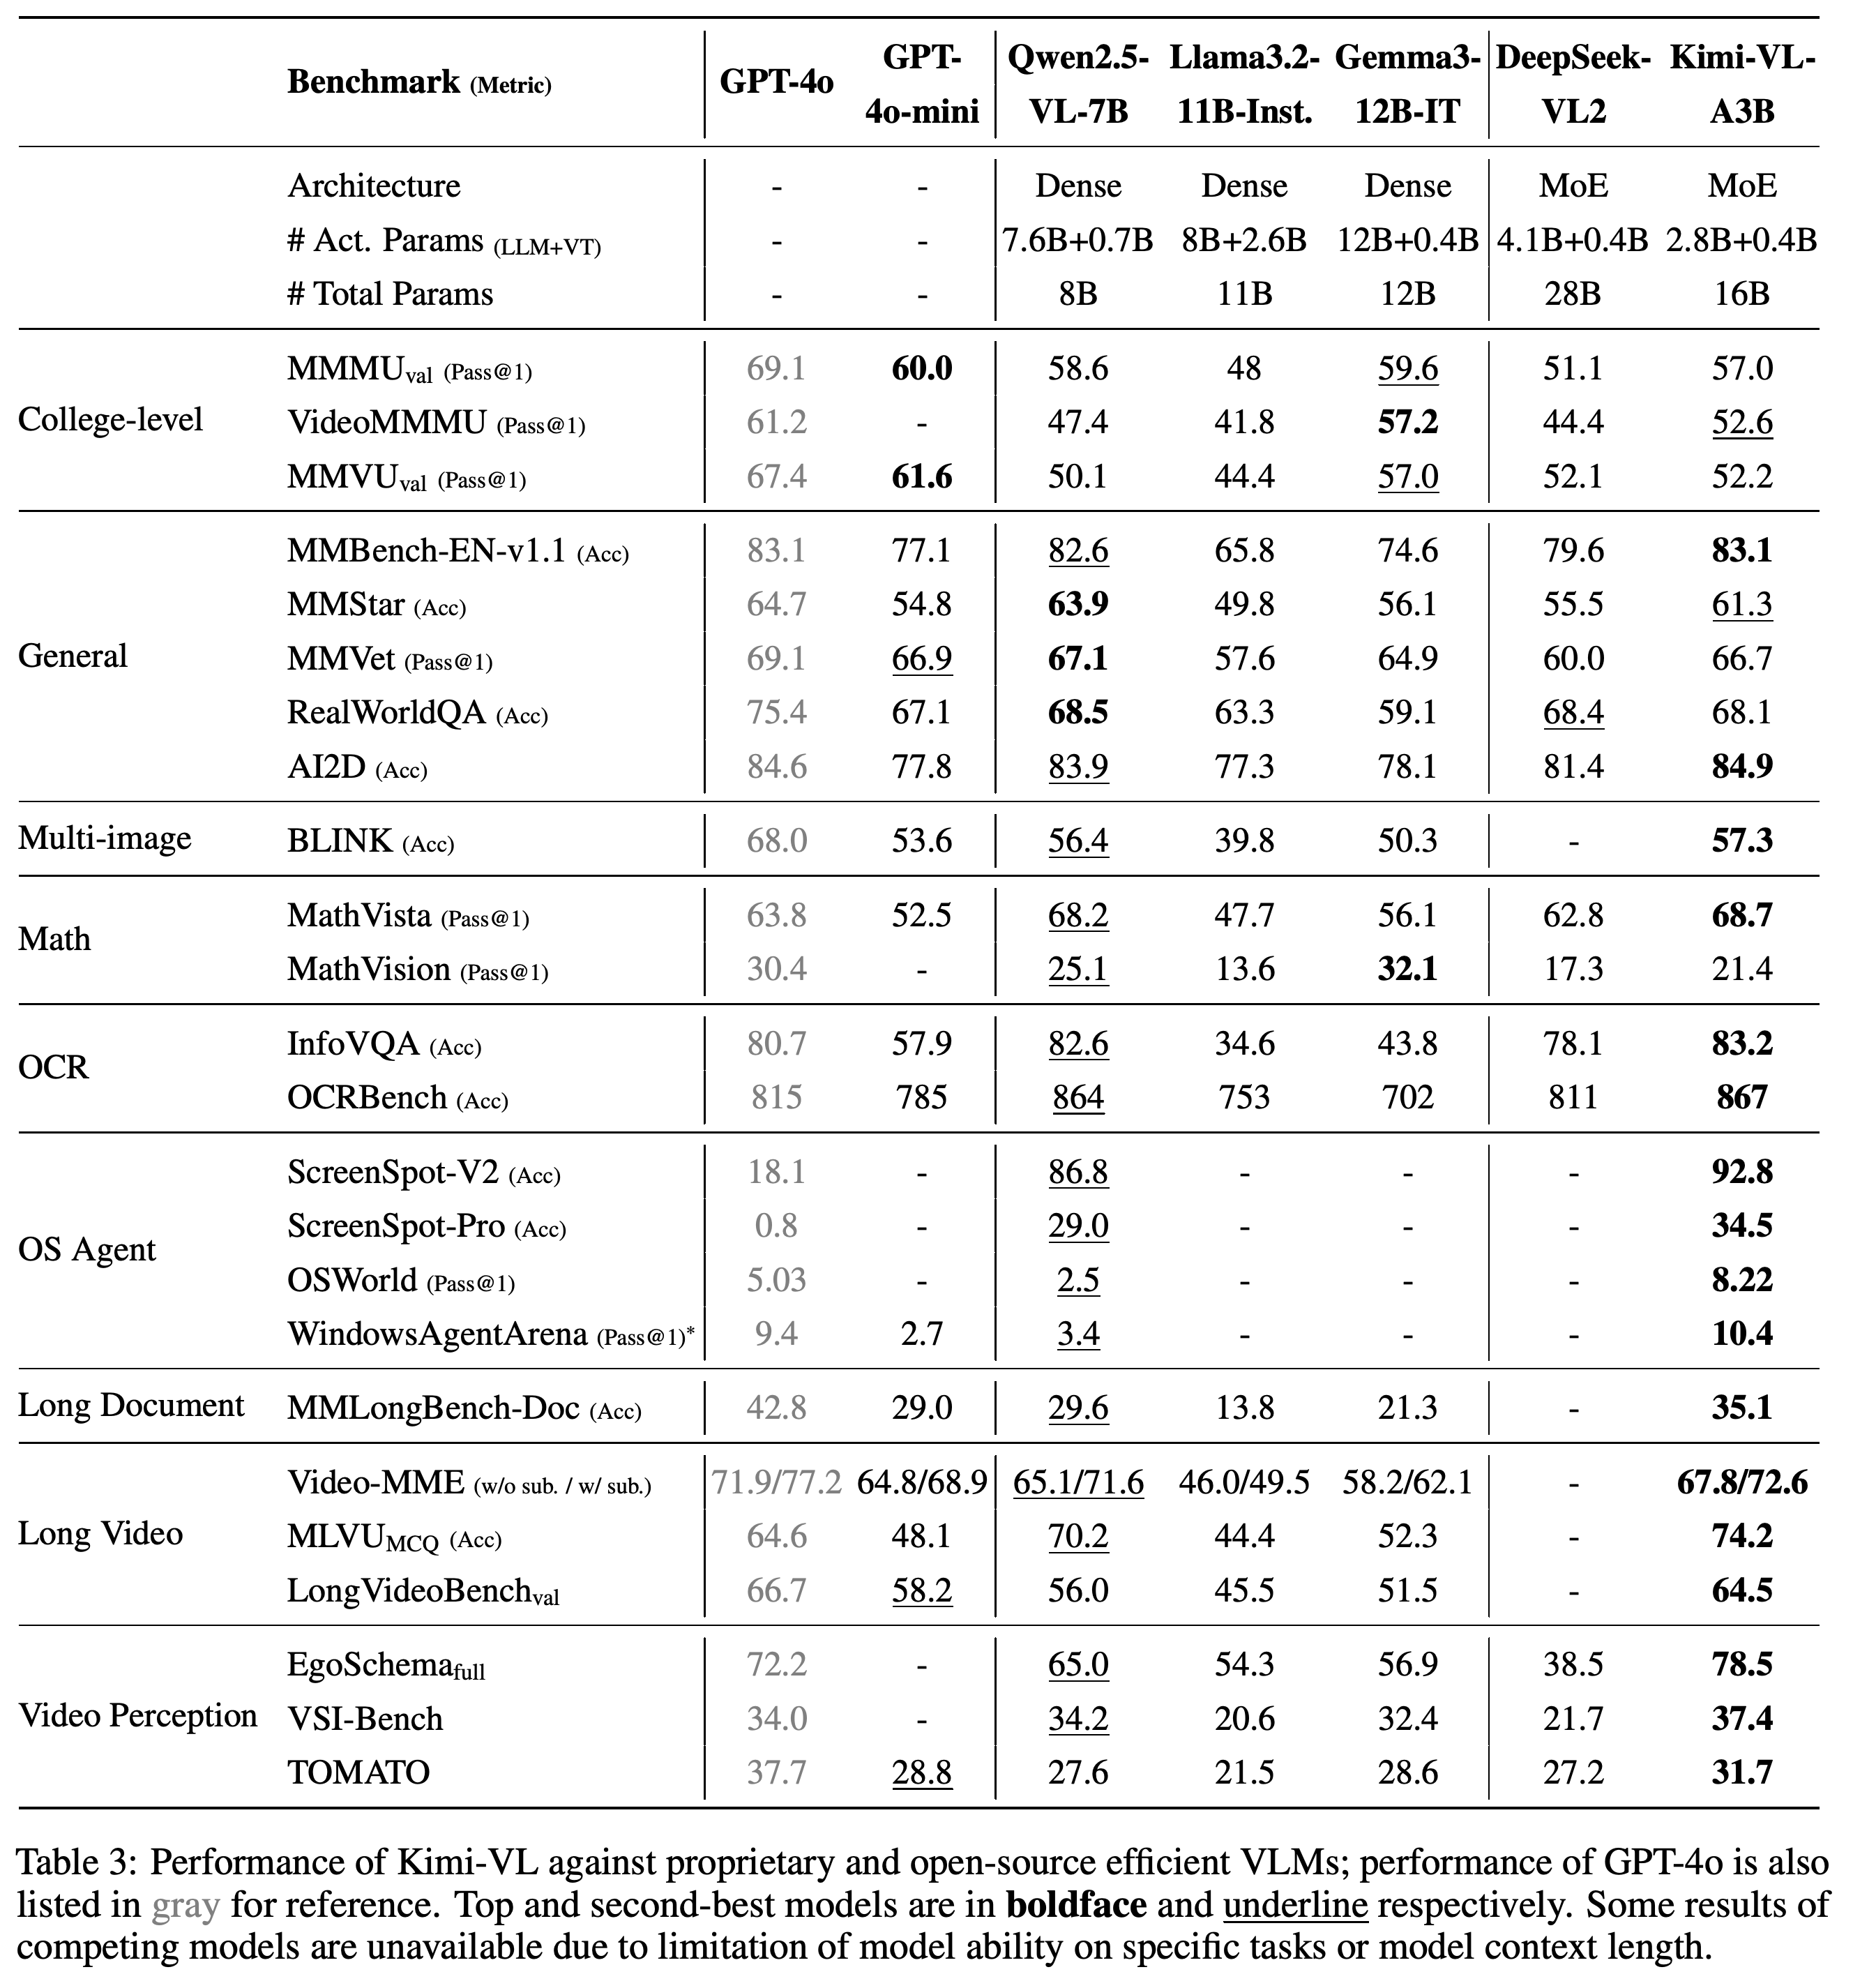
평가에서는 먼저 전반적인 성능을 비교한 뒤 개별 능력을 살펴본다. Table 3은 24개 벤치마크 행에서 Kimi-VL을 GPT-4o, GPT-4o-mini, Qwen2.5-VL-7B, Llama-3.2-11B-Inst., Gemma-3-12B-IT, DeepSeek-VL2와 비교한다. Kimi-VL은 언어 모델 파라미터 2.8B와 시각 파라미터 0.4B를 활성화하며, 19개 행에서 Qwen2.5-VL-7B를 앞선다. 누락된 결과가 있으므로 모델별 평가 범위는 서로 다르다.
- 표는 정확도와 Pass@1을 구분하며, 텍스트 인식 및 추출 벤치마크인 OCRBench를 1000점 척도로 보고한다.
- Windows 컴퓨터 상호작용 벤치마크인 WindowsAgentArena의 각주에 따르면 GPT-4o와 GPT-4o-mini는 UIA 없이 인터페이스 분석 구성요소 Omniparser를 사용한다. PDF는 UIA를 설명하지 않으므로, 보고서만으로는 이 설정 차이를 충분히 평가할 수 없다.
이 비교는 Qwen2.5-VL-7B 대비 24개 중 19개에서 앞선다는 결과를 뒷받침하면서, MathVision, MMMU, 여러 일반 시각 과제에서는 성능이 낮음을 보여준다. 언어와 시각 파라미터의 활성화 수를 구분하며, 경쟁 모델의 에이전트 평가 결과에 누락된 항목도 드러낸다.
4.1.1 College-level Academic Problems
대학 수준 멀티모달 질문 벤치마크인 MMMU validation에서 Kimi-VL은 57.0%를 기록한다. 이는 DeepSeek-VL2의 51.1%보다 높지만 Qwen2.5-VL-7B의 58.6%, Gemma-3-12B-IT의 59.6%보다 낮다. 대학 수준 동영상 지식 벤치마크인 VideoMMMU에서 Table 3은 52.6%를 보고한다. Qwen2.5-VL-7B, DeepSeek-VL2, Gemma-3-12B-IT는 각각 47.4%, 44.4%, 57.2%를 기록한다. 전문가 수준 동영상 이해 벤치마크인 MMVU validation에서는 52.2%로, GPT-4o-mini의 61.6%와 GPT-4o의 67.4%보다 낮다.
4.1.2 General Visual Ability
Kimi-VL은 폭넓은 지각 및 추론 벤치마크인 MMBench-EN-v1.1에서 GPT-4o와 같은 83.1%를 기록한다. 과학 도식 벤치마크인 AI2D에서는 84.9%로 GPT-4o의 84.6%보다 높다. 여러 시각-언어 능력의 조합을 평가하는 MMVet에서는 66.7%, 현실 세계의 공간 이해를 평가하는 RealWorldQA에서는 68.1%를 기록한다. 다중 이미지 지각 벤치마크인 BLINK에서는 57.3%로 Qwen2.5-VL-7B의 56.4%보다 높지만 GPT-4o의 68.0%보다 낮다.
4.1.3 Mathematical Reasoning
수학적 추론과 시각적 추론을 결합한 벤치마크인 MathVista에서 Kimi-VL은 68.7%를 기록하며, Qwen2.5-VL-7B는 68.2%, GPT-4o는 63.8%를 기록한다. MathVision에서는 21.4%로 Qwen2.5-VL-7B의 25.1%, Gemma-3-12B-IT의 32.1%보다 낮다. 이 과제들에서 thinking 확장 모델이 얻은 성능 향상은 Table 4에서 별도로 평가한다.
4.1.4 Document Understanding and OCR
복잡한 인포그래픽의 해석을 평가하는 InfoVQA에서 Kimi-VL은 83.2를 기록하며, Qwen2.5-VL-7B는 82.6, GPT-4o는 80.7을 기록한다. OCRBench에서는 1000점 만점에 867점으로 Qwen2.5-VL-7B의 864점, DeepSeek-VL2의 811점보다 높다. Table 3은 InfoVQA를 accuracy로 표시하지만, Appendix B.1은 테스트 세트 평가 지표를 ANLS로 명시하고 이를 정의하지 않는다. 따라서 여기서는 이 값을 일반적인 백분율 정확도로 해석하지 않는다.
4.1.5 Agent Grounding and Multi-turn Agent Interaction
Table 3에 따르면 Kimi-VL은 여러 플랫폼의 인터페이스 grounding을 평가하는 ScreenSpot-V2에서 92.8%, 고해상도 전문 인터페이스를 대상으로 하는 ScreenSpot-Pro에서 34.5%를 기록한다. Qwen2.5-VL-7B는 각각 86.8%, 29.0%를 기록한다. 실행 기반 컴퓨터 과제 벤치마크인 OSWorld에서 Kimi-VL은 Pass@1 8.22%로 GPT-4o의 5.03%를 앞서며, WindowsAgentArena에서는 10.4%로 9.4%를 앞선다. 상대적인 개선에도 불구하고 여러 단계가 필요한 과제의 절대 완료율은 낮다.
- 이 소절의 본문은 ScreenSpot-V2 성능을 92.0%로, Table 3은 92.8%로 제시한다. 위의 값은 표를 따른다.
4.1.6 Long Document and Long Video Understanding
100+ pages에 이르는 문서에 관한 질문을 다루는 MMLongBench-Doc에서 Kimi-VL은 35.1%를 기록한다. 이는 Qwen2.5-VL-7B의 29.6%보다 높고 GPT-4o의 42.8%보다 낮다. 동영상 질의응답 벤치마크인 Video-MME에서는 자막 없이 67.8%, 자막을 포함하면 72.6%를 기록하며, Qwen2.5-VL-7B는 각각 65.1%, 71.6%를 기록한다. 또한 여러 과제로 긴 동영상 이해를 평가하는 MLVU의 객관식 하위 집합에서 74.2%, 긴 동영상의 지각과 관계 이해를 평가하는 LongVideoBench validation에서 64.5%를 기록한다.
- GPT-4o는 MLVU에서 64.6%, LongVideoBench에서 66.7%를 기록한다. 따라서 긴 동영상 벤치마크마다 Kimi-VL의 우위가 달라진다.
4.1.7 Egocentric and Fine-grained Video Perception
1인칭 동영상 이해 벤치마크인 EgoSchema의 비공개 전체 테스트 세트에서 Kimi-VL은 78.5%를 기록하며, GPT-4o는 72.2%, Qwen2.5-VL-7B는 65.0%를 기록한다. 동영상의 공간 이해를 평가하는 VSI-Bench에서는 37.4%로 GPT-4o의 34.0%, Qwen2.5-VL-7B의 34.2%를 앞선다. 세밀한 시간적 추론을 평가하는 TOMATO에서는 31.7%로 Qwen2.5-VL-7B의 27.6%보다 높지만 GPT-4o의 37.7%보다 낮다.
4.2 Kimi-VL-A3B-Thinking: A Reasoning Extension of Kimi-VL
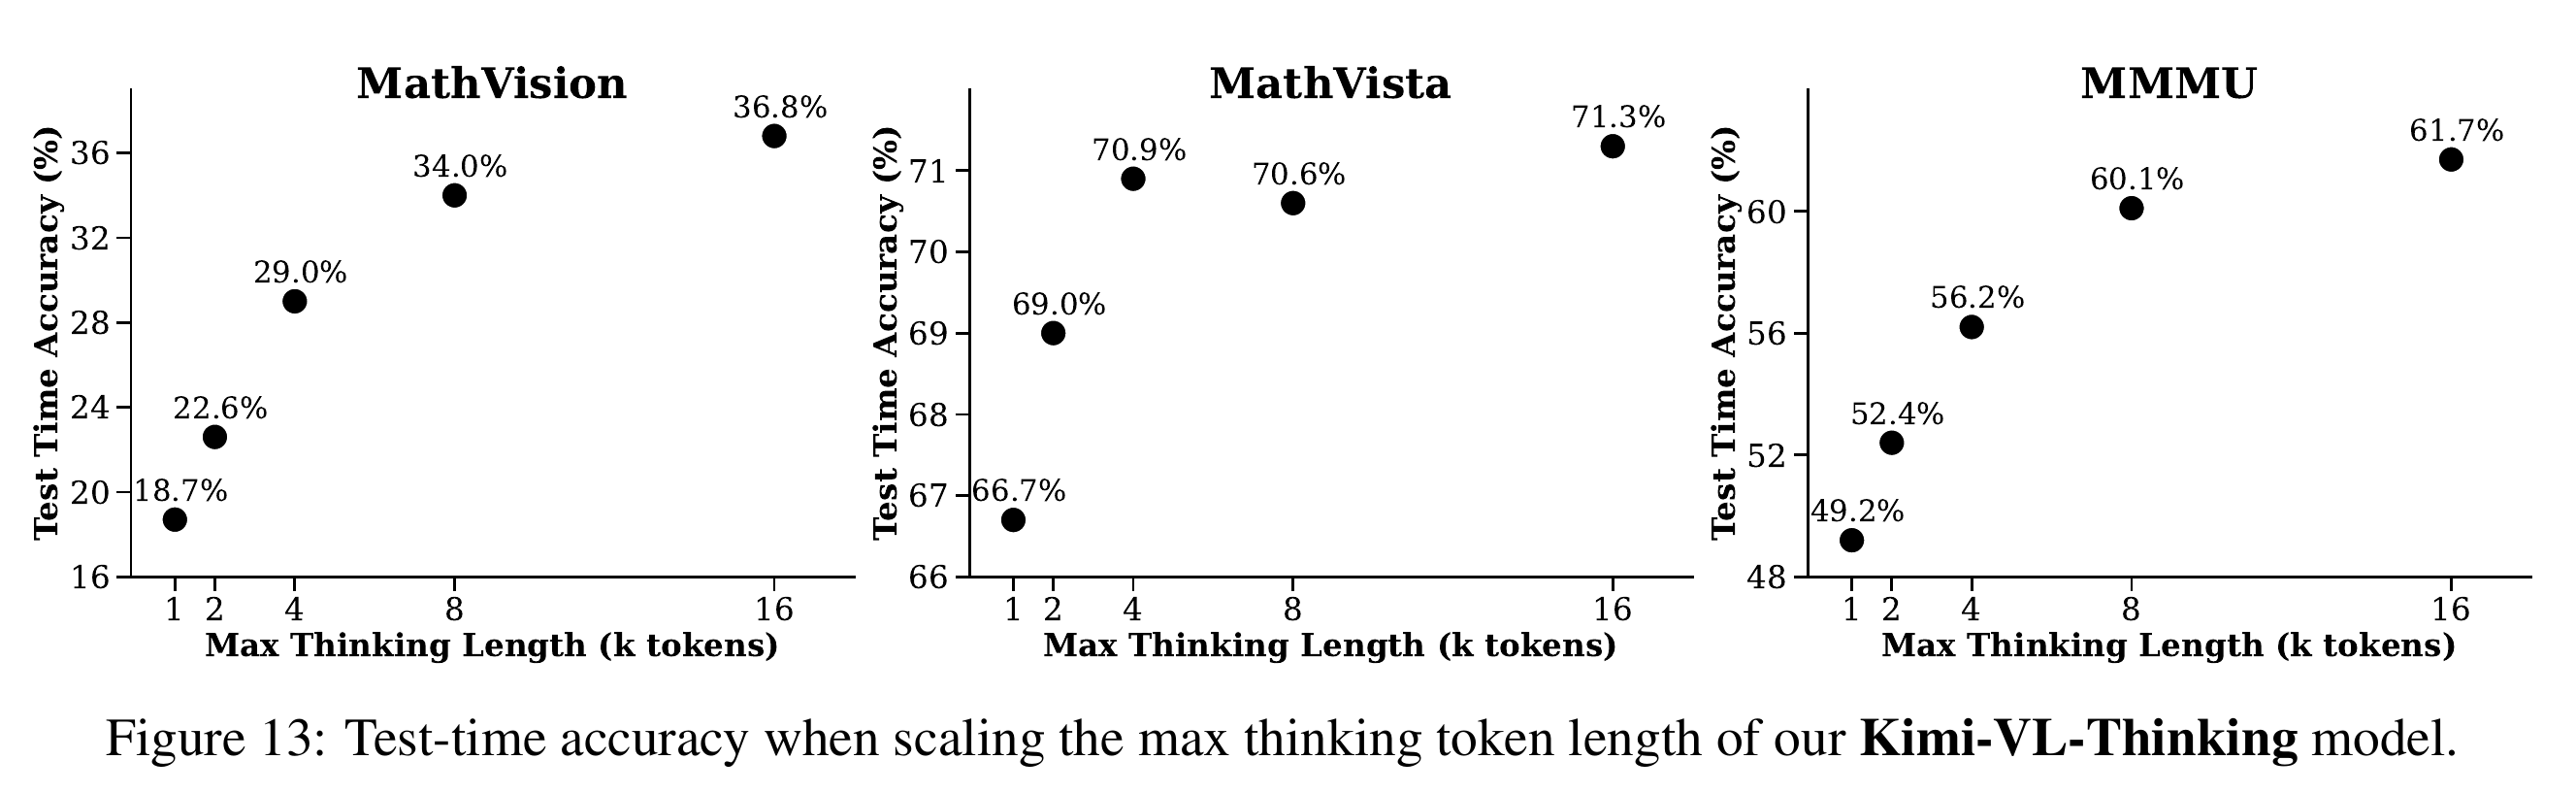
기존 Kimi-VL-A3B-Thinking은 MathVista mini에서 71.3%, MMMU validation에서 61.7%, MathVision full에서 36.8%를 기록한다. 이는 non-thinking 결과보다 각각 2.6, 4.7, 15.4 percentage points 높다. Figure 13은 추론 시 thinking 토큰 예산을 1k에서 16k까지 바꾸어 평가한다. MathVision은 18.7%에서 36.8%로, MMMU는 49.2%에서 61.7%로 상승한다. MathVista는 4k tokens 부근에서 대체로 포화되어 70.9%를 기록하며, 8k에서는 70.6%, 16k에서는 71.3%를 기록한다.
- 추론 시 허용하는 연산량을 바꾸는 이 test-time scaling 실험은 thinking 토큰 추가에 따른 효과가 과제마다 다름을 보여준다. 측정 대상은 벤치마크 전체 정확도이며, 더 긴 추론이 개별 답변을 각각 개선하는지는 측정하지 않는다.
Table 4는 MathVision, MathVista, MMMU에서 Kimi-VL-Thinking을 non-thinking 모델과 다른 모델에 비교한다. Kimi-VL-Thinking은 각각 36.8%, 71.3%, 61.7%를 기록하며 기본 Kimi-VL 결과보다 높지만, 일부 항목에서는 다른 모델이 앞선다.
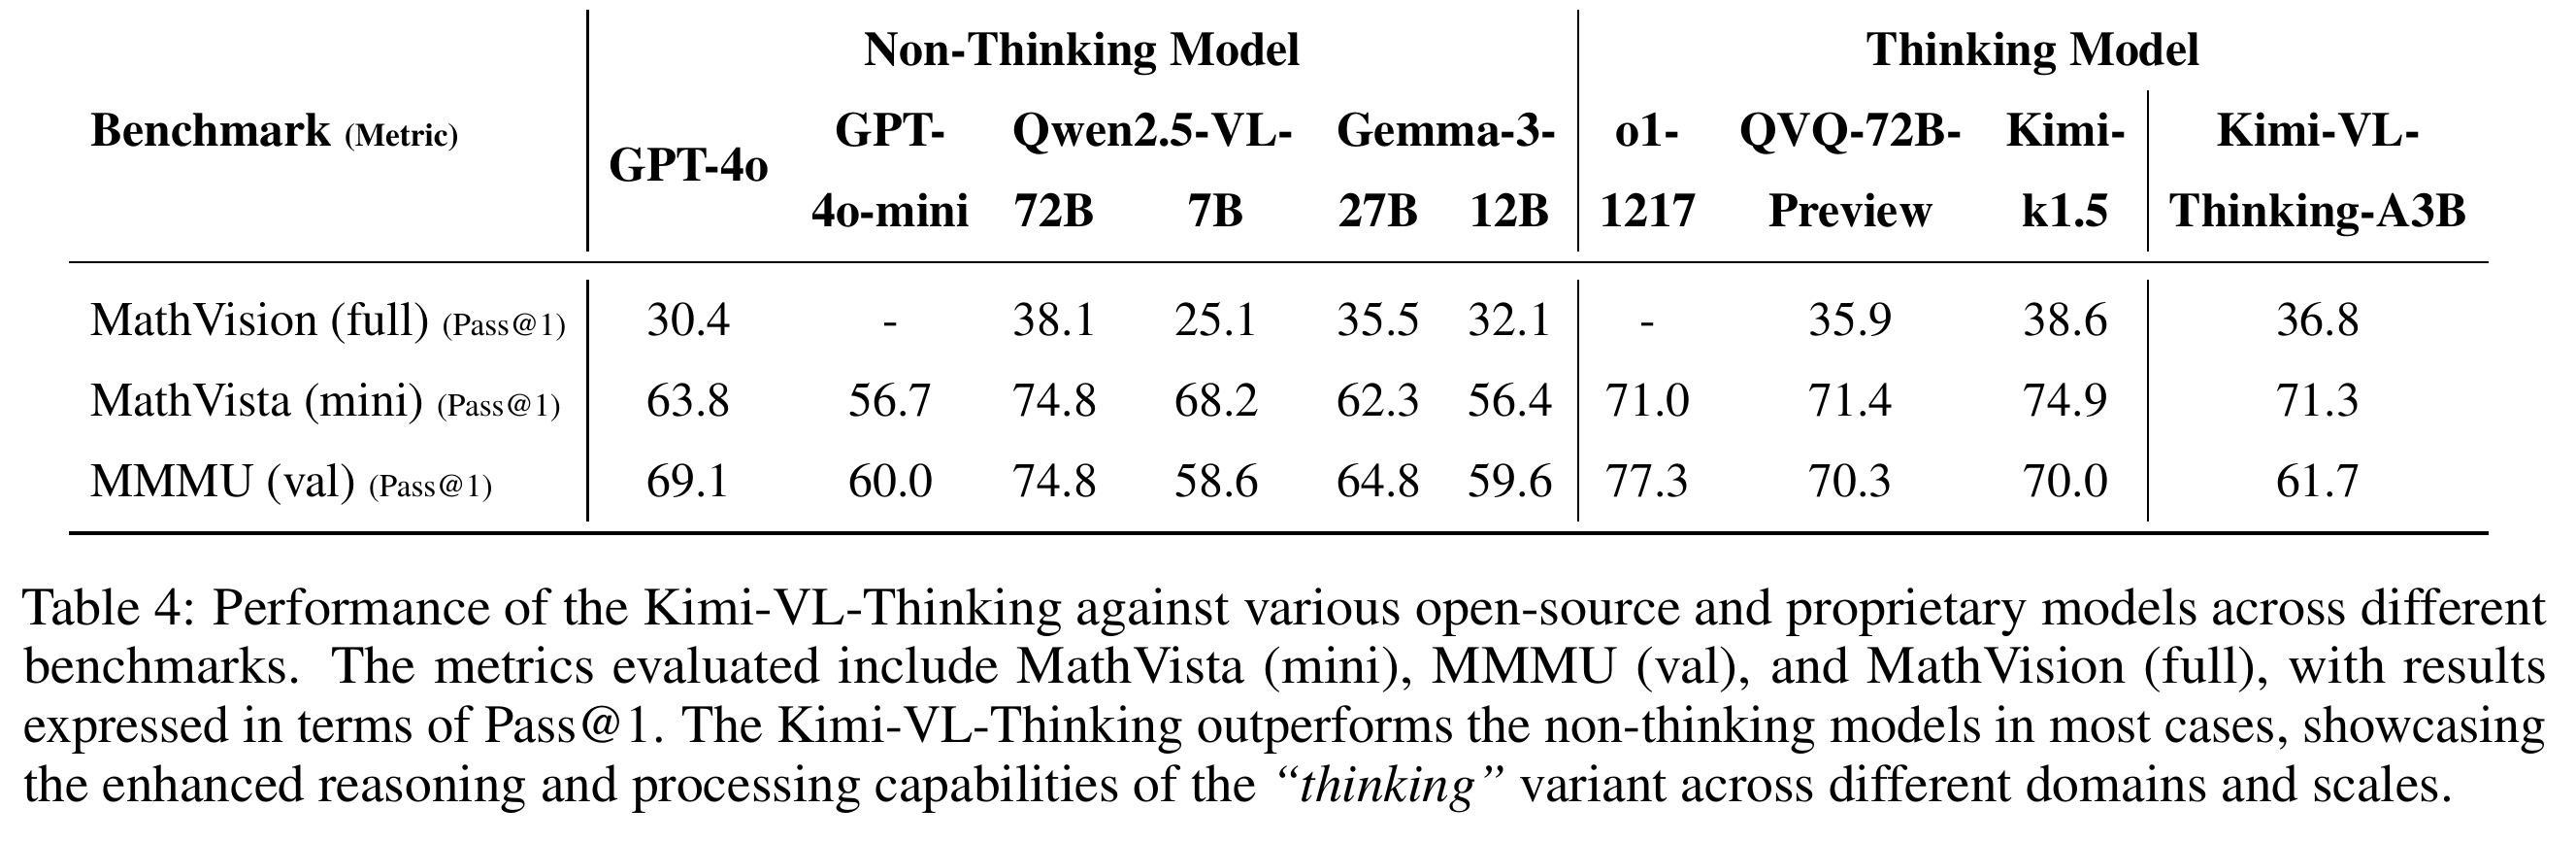
MathVision과 MMMU는 그래프에서 최대 thinking 예산을 늘릴 때마다 성능이 향상된다. MathVista는 4k에서 70.9%에 도달한 뒤 변화가 작고 8k에서는 소폭 하락한다. 이는 추론 연산량 추가의 효과가 과제마다 다름을 보여준다.
5 Conclusion, Limitation, and Future Work
저자들은 텍스트와 멀티모달 데이터의 공동 학습, 희소 전문가 활성화, 원본 해상도 지각, 추론 사후학습이 모델의 능력을 뒷받침한다고 설명한다. 또한 3가지 한계를 제시한다. 전문 문제나 언어 의존적 문제를 처리할 용량이 부족하고, 복잡한 다단계 추론이 여전히 어려우며, 128K 윈도에도 불구하고 특히 까다로운 긴 컨텍스트에서는 어텐션 층의 용량이 제한적이다. 향후 방향으로 더 큰 모델, 더 많은 사전학습 데이터, 사후학습 개선, 추론 시 연산량 확대를 제안한다.
부록
- A Contributions는 Core Contributors와 Contributors를 구분하고 Haoning Wu, Haoyu Lu, Y. Charles를 프로젝트 책임자로 표시한다. 저자 목록은 이름을 기준으로 알파벳순으로 정렬했다고 명시한다. # 표시가 붙은 저자의 소속 주석에는 The University of Hong Kong과 Moonshot.ai가 기재되어 있다.
- B Evaluation Details는 B.1 Image Benchmark, B.2 Video and Long Document Benchmark, B.3 Agent Benchmark를 설명한다. 예를 들어 MMMU는 질문 11.5K개, MathVision은 경시대회 문제 3,040개, VideoMMMU는 동영상 300개와 질문 900개, Video-MME는 동영상 900개와 질의응답 쌍 2,700개를 포함한다. OCRBench는 1000점 만점임을 명시하며, Video-MME는 자막 유무에 따른 평가를 구분한다.
- 에이전트 부록은 인터페이스 grounding과 실행 기반 컴퓨터 과제를 구분한다. ScreenSpot Pro는 고해상도 이미지 1,581개와 전문가가 주석을 작성한 과제를 포함하며, OSWorld는 Ubuntu, Windows, macOS에서 상호작용 과제를 지원한다. WindowsAgentArena는 OSWorld를 기반으로 현실적인 Windows 환경을 구성한다. 이러한 설명은 과제군의 성격을 알려주지만, 보고된 모든 모델 결과를 재현할 수 있는 완전한 절차를 제공하지는 않는다.
짧은 생각
가장 분명한 결과는 thinking 확장이 기본 Kimi-VL보다 MathVista, MMMU, MathVision에서 높은 점수를 기록했다는 점이다. 개별 설계 선택의 효과를 분리하는 통제 절제 실험은 없으므로, 보고서만으로는 인코더, 옵티마이저, 데이터 혼합, RL이 각각 얼마나 기여했는지 알 수 없다. 배포를 평가할 때에는 활성화 디코더 파라미터 2.8B뿐 아니라 전체 파라미터 16B, 시각 입력 크기, 출력 토큰 예산, 낮은 절대 컴퓨터 과제 성공률도 함께 고려해야 한다. 이 글은 2025년 4월 10일자 arXiv:2504.07491v1을 따른다. 코드와 모델 공개 URL은 https://github.com/MoonshotAI/Kimi-VL 이다.