


NVIDIA Nemotron 3: Efficient and Open Intelligence 요약 설명
24 Dec 2025 | Paper Review Mixture-of-Experts LLM Pretraining Reinforcement Learning Long-Context Language Models목차
이번 글에서는 NVIDIA Nemotron 3: Efficient and Open Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 24일(Arxiv)
- NVIDIA, Blakeman, Aaron, Grattafiori, Aaron, Basant, Aarti, Gupta, Abhibha, Khattar, Abhinav, Renduchintala, Adi, Vavre, Aditya, Shukla, Akanksha, Bercovich, Akhiad, et al.
- NVIDIA
- 논문 링크
요약
- NVIDIA Nemotron 3: Efficient and Open Intelligence는 추론, 대화, 에이전트 작업을 위한 Nano, Super, Ultra를 소개한다. 이 모델군은 하이브리드 Mamba-Transformer Mixture-of-Experts 아키텍처를 사용하며, 최대 1M 토큰의 컨텍스트를 지원한다. 다중 환경 강화학습과 추론 시점의 추론 예산 제어를 결합한다.
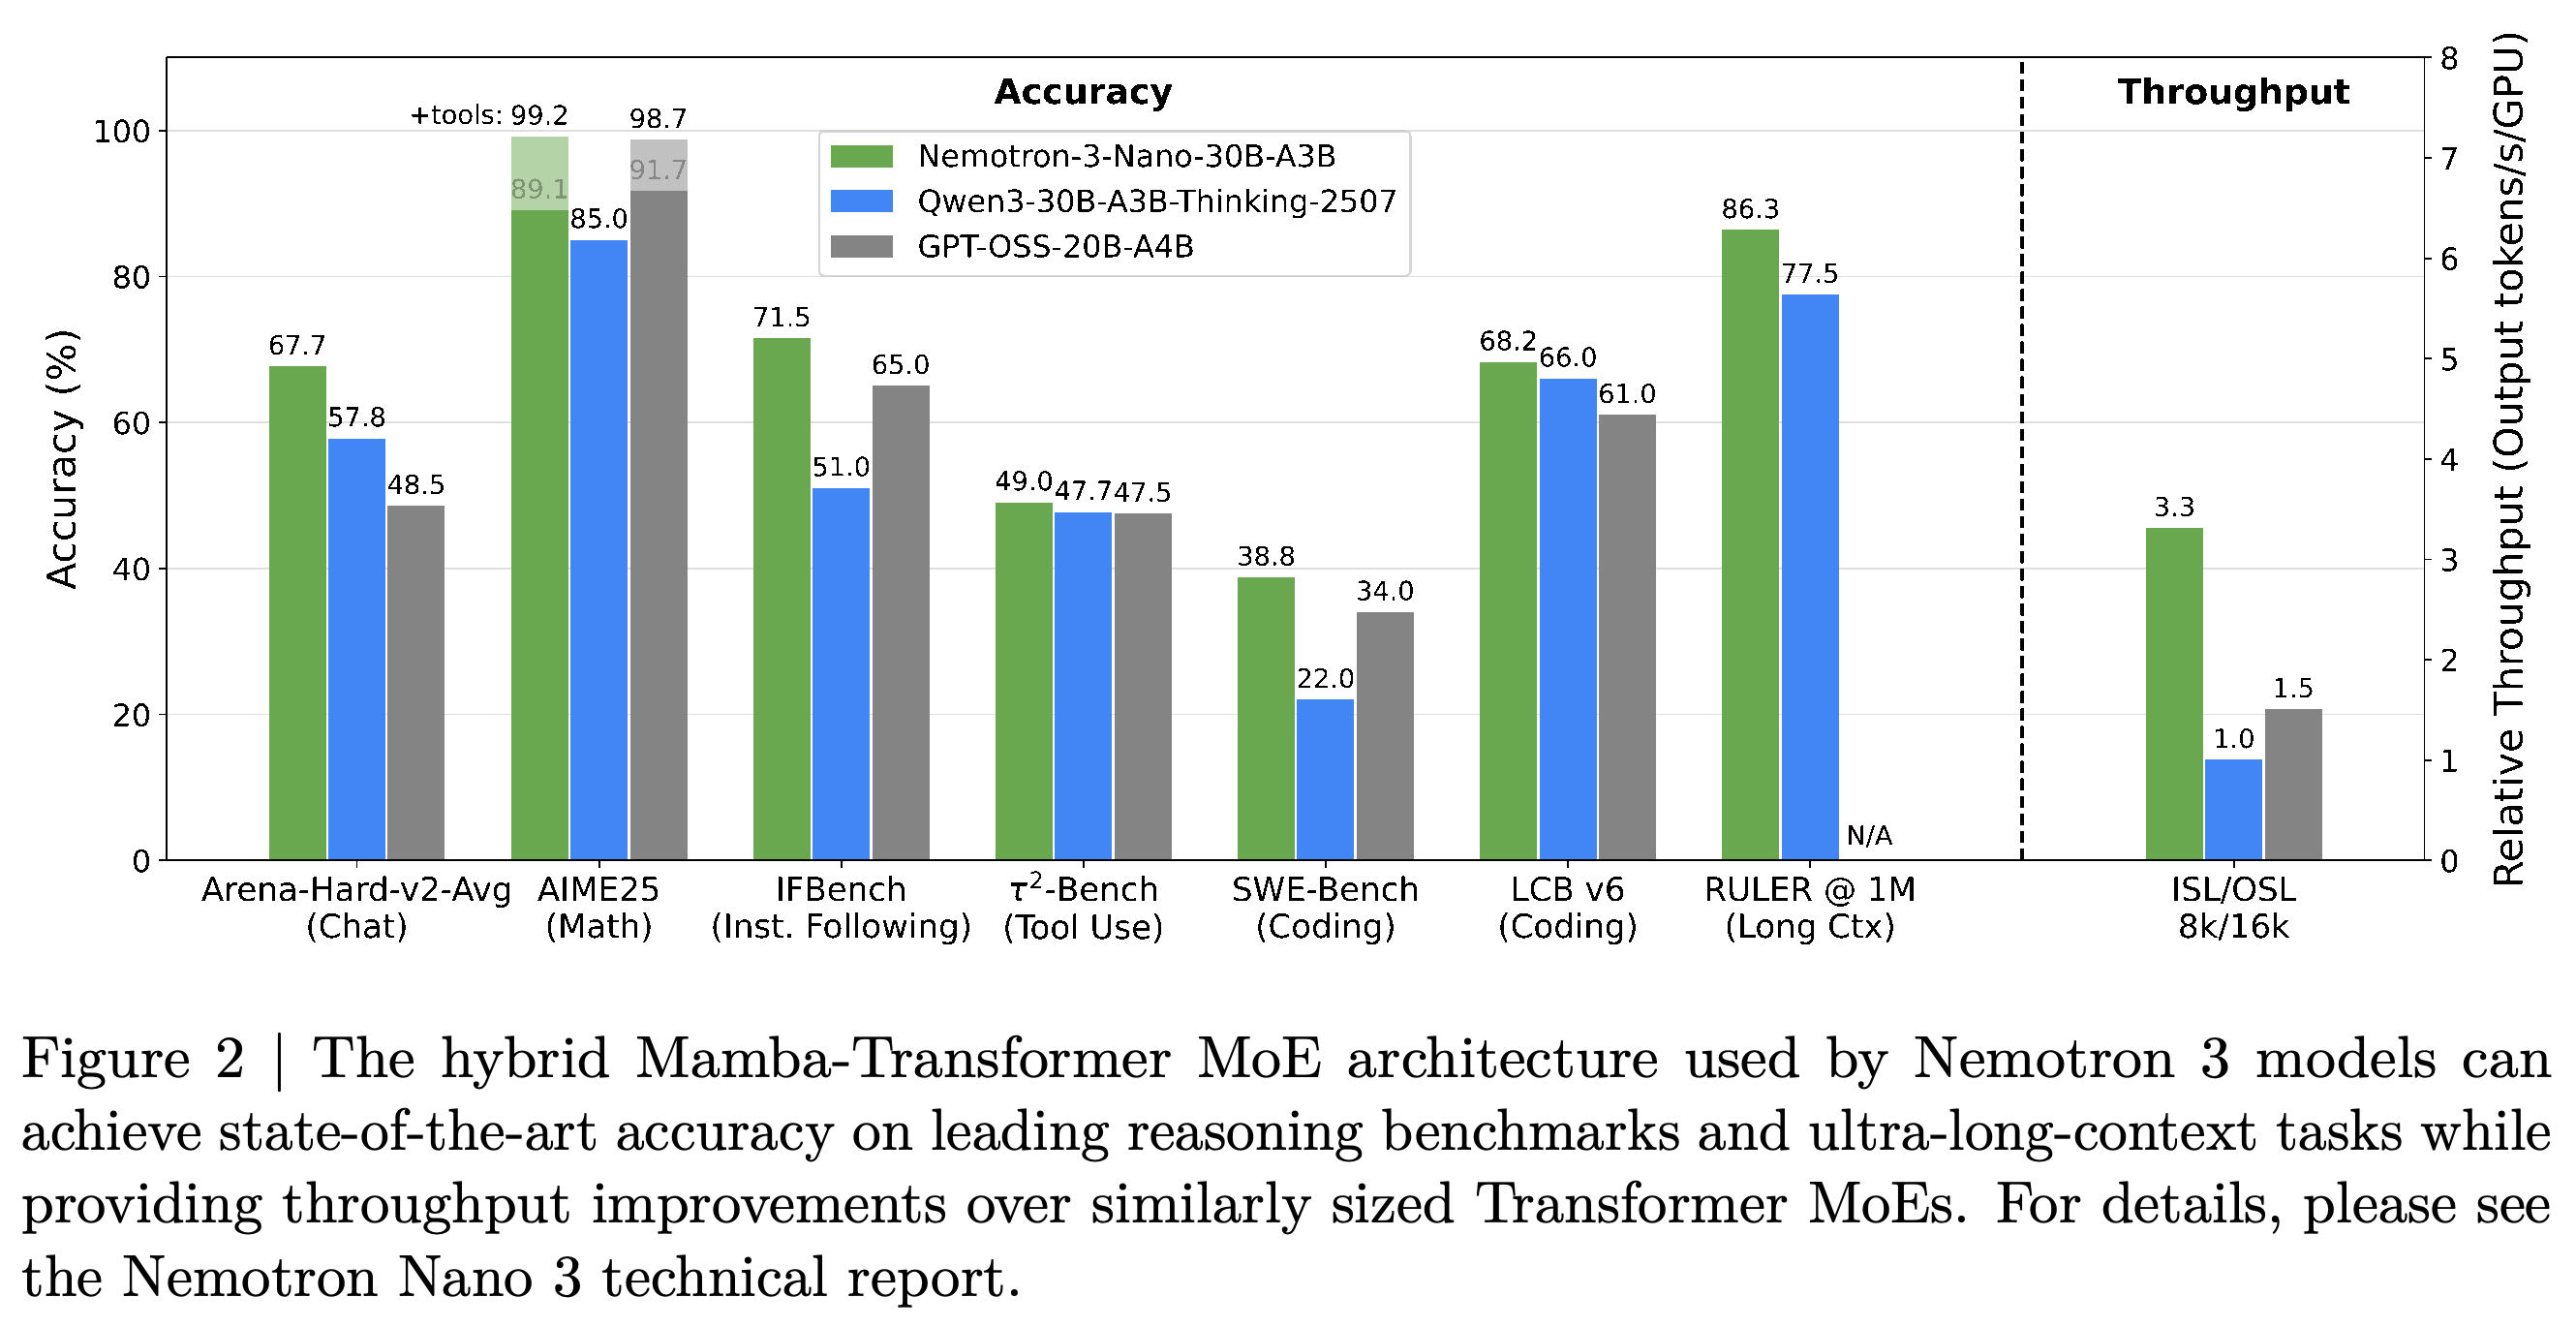
- Nemotron-3-Nano-30B-A3B는 입력 8k 토큰, 출력 16k 토큰 조건에서 Qwen3-30B-A3B 대비 처리량 비율 3.3을 달성한다. Figure 2에서 Nano는 제시된 대화, 지시 이행, 도구 사용, 코딩, 1M-token 검색 비교에서 더 높은 점수를 기록한다. AIME25 순위는 도구 사용 여부에 따라 달라진다.
- Super와 Ultra에는 LatentMoE, Multi-Token Prediction (MTP), NVFP4 학습을 적용한다. 약 8B-active-parameter 규모의 모델을 대상으로 각각 수행한 ablation 실험에서 LatentMoE는 5개의 과제 종합 점수를 모두 개선하고, MTP는 7개의 벤치마크 점수를 모두 개선한다. NVFP4-trained 모델은 BF16으로 평가했을 때 BF16-trained 모델과 비슷한 다운스트림 정확도를 보인다.
- 이 백서는 공개된 Nano의 결과와 함께 Super, Ultra의 설계 선택과 공개 계획을 제시한다. 구성 요소별 ablation 실험은 제공하지만, Super와 Ultra의 전체 평가, 상세한 처리량 측정 조건, 동시 강화학습의 안정성과 보상 해킹 억제 효과를 검증할 동일 조건 비교 실험은 제공하지 않는다.
1. Introduction
서론은 긴 추론 과정과 복잡한 에이전트 상호작용에 드는 추론 비용을 다룬다. 정확도와 처리량 사이의 절충을 개선하는 방법으로 하이브리드 아키텍처를 제시한다. 최대 1M 토큰의 컨텍스트는 긴 코드 시퀀스, 대화 이력, RAG 파이프라인에서 사용하는 문서를 처리하기 위한 것이다.
- 3개 모델 모두 다양한 강화학습 환경을 사용하며 추론 예산 제어를 지원한다.
- LatentMoE, NVFP4 학습, MTP는 Super와 Ultra에 추가로 적용하는 기능이다.
- 공개 계획에는 모델 가중치, 학습 레시피, 사전학습과 후속 학습 소프트웨어, 10 trillion 토큰을 넘는 데이터셋이 포함된다. 데이터 공개 범위는 재배포 권한에 따른다.
2. Features and Technologies
기술 절은 Hybrid MoE, LatentMoE, MTP, NVFP4 학습, 긴 컨텍스트를 위한 학습 준비, 다중 환경 강화학습, 추론 예산 제어의 7개 구성 요소를 설명한다. 이 구성 요소들은 생성 비용, expert 메모리와 통신 비용, 학습 정밀도, 컨텍스트 확장, 후속 학습을 다룬다.
2.1. Hybrid MoE
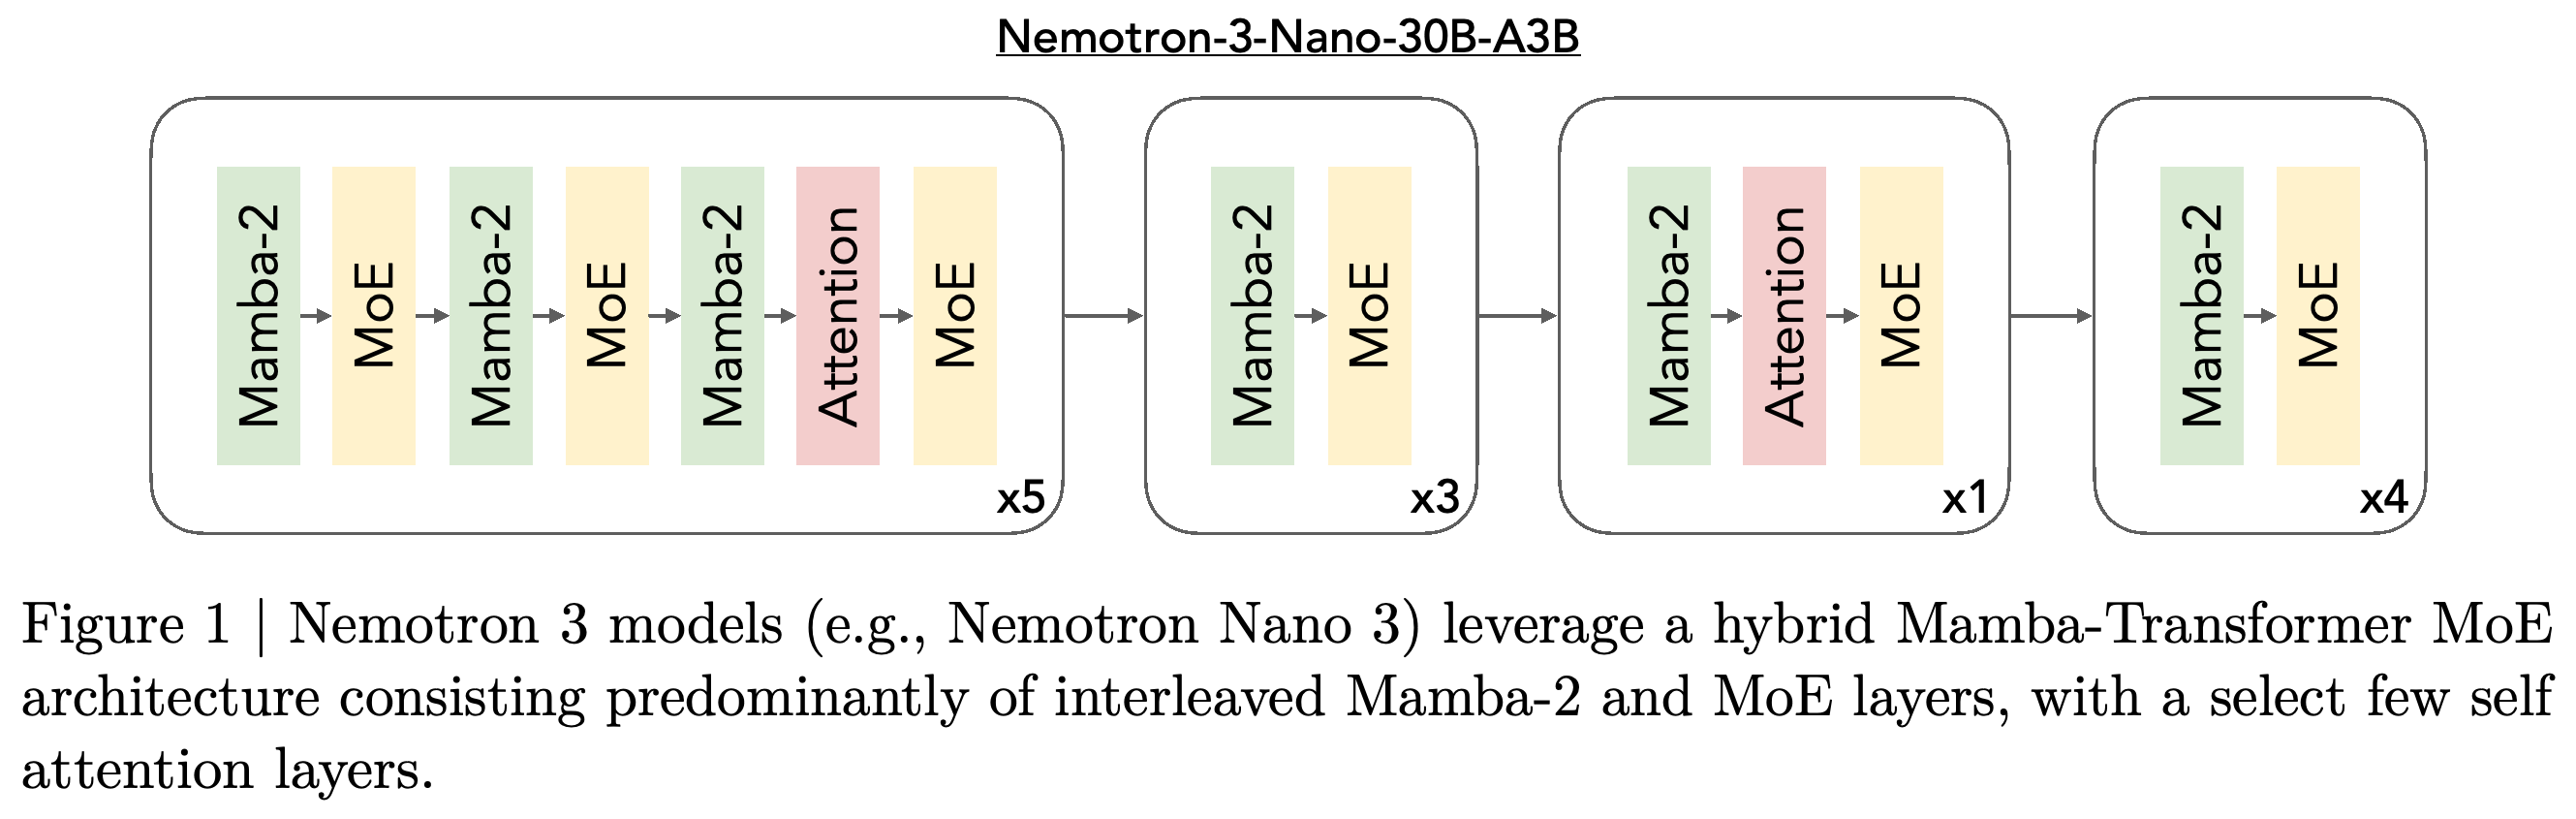
Nemotron 3는 주로 Mamba-2 층과 MoE 층을 번갈아 배치하고, 소수의 self-attention 층을 유지한다. Mamba-2는 생성 중에 고정된 크기의 순환 상태를 유지한다. 남겨 둔 attention 층은 토큰 사이에서 정보를 직접 전달하며, 여전히 attention 캐시가 필요하다. self-attention에 대해서는 이 글을 참조하라.
- Figure 1은 Nano의 층 배치를 보여준다. Mamba-2/MoE/Mamba-2/MoE/Mamba-2/Attention/MoE 블록을 5회, Mamba-2/MoE 블록을 3회 반복한 뒤 Mamba-2/Attention/MoE 블록을 1회 배치하고, 마지막으로 Mamba-2/MoE 블록을 4회 반복한다.
- MoE는 희소 활성화를 통해 파라미터 규모를 확장한다. 생성 중 상태 크기가 일정하다는 특성은 Mamba-2 층에 해당하며, 전체 하이브리드 모델에는 해당하지 않는다.
반복 블록은 시퀀스를 처리하는 대부분의 단계가 Mamba-2와 MoE를 결합하고, 선택한 위치에 attention을 삽입함을 보여준다. 이 도식은 attention을 제한적으로 사용하면서도 Nano에 attention 층이 남아 있음을 보여준다.
입력 8k 토큰, 출력 16k 토큰 조건에서 Figure 2가 보고한 GPU당 상대 출력 처리량은 Nemotron-3-Nano-30B-A3B가 3.3, Qwen3-30B-A3B-Thinking-2507이 1.0, GPT-OSS-20B-A4B가 1.5다. 1M 토큰 조건의 RULER 점수는 Nano가 86.3, Qwen이 77.5다. GPT-OSS의 해당 비교 결과는 보고되지 않았다.
- Arena-Hard-v2-Avg 점수는 각각 67.7, 57.8, 48.5이며, IFBench 점수는 71.5, 51.0, 65.0이고, τ²-Bench 점수는 49.0, 47.7, 47.5다.
- SWE-Bench 점수는 각각 38.8, 22.0, 34.0이며, LCB v6 점수는 68.2, 66.0, 61.0이다.
- AIME25 점수는 Nano가 89.1, Qwen이 85.0, GPT-OSS가 91.7이다. Nano의 도구 사용 점수는 99.2로 명시되어 있다. Figure 2에는 GPT-OSS의 98.7도 표시되지만, 백서는 이 추가 값의 도구 사용 조건을 명시하지 않는다. 자세한 평가 조건은 별도의 Nano 기술 보고서에서 확인하도록 안내한다.
Nano는 표시된 정확도 비교 대부분에서 앞서며, ISL/OSL 8k/16k 조건에서 Qwen의 상대 처리량 1.0 대비 3.3을 달성한다. Nano의 AIME25 점수는 89.1이며, 도구를 사용한 값은 99.2로 명시되어 있다. GPT-OSS에는 91.7과 98.7이 표시되지만, 이 그림은 두 번째 값의 도구 사용 조건을 명시하지 않는다. GPT-OSS의 1M 토큰 RULER 결과는 보고되지 않았다.
2.2. LatentMoE: Hardware-Aware Expert Design for Improved Accuracy per Byte
LatentMoE는 수십에서 수백 토큰을 처리하며 지연 시간을 중시하는 환경에서는 expert 가중치의 메모리 전송량을, 수천 토큰을 처리하며 처리량을 중시하는 환경에서는 all-to-all 통신을 줄이는 데 초점을 둔다. Expert 행렬의 크기는 d × m이고, 통신량은 K와 d에 선형으로 비례한다. 유효 비선형 연산 예산은 대략 K × m에 비례한다고 설명한다.
- 여기서 d는 모델의 은닉 차원, m은 expert FFN의 중간 차원, K는 토큰당 활성 expert 수다.
- 라우팅되는 입력의 차원을 줄이면 가중치를 읽는 데 필요한 전송량과 통신 데이터 크기를 모두 줄일 수 있다. m을 줄여도 토큰을 expert에 전달하는 통신량은 직접 줄어들지 않는다.
토큰을 은닉 차원 d에서 더 작은 잠재 차원 ℓ < d로 투영해 라우팅된 expert 연산을 수행한 뒤, 다시 d로 투영한다. Expert별 가중치 로딩량과 전달할 데이터 크기는 d/ℓ배 감소하며, 보통 약 4배 감소한다. 제안한 확장 방식은 이 절감분을 활용해 N′ = N · d/ℓ와 K′ = K · d/ℓ에 따라 expert 수를 늘린다.
- 라우팅 게이트, 공유 expert, expert가 아닌 층은 원래 은닉 차원 d를 유지한다.
- 실험의 Standard MoE는 d = 4096, 전체 expert 128개, 활성 expert 6개를 사용한다. LatentMoE는 ℓ = 1024, 전체 expert 512개, 활성 expert 22개를 사용한다. 실험에서 사용한 활성 expert 수는 설명용으로 제시한 4배 확장과 다르다.
하향 투영과 상향 투영 사이에서 라우팅된 expert 연산과 통신을 수행해, 더 많은 expert가 더 낮은 차원의 표현을 처리할 수 있다. 공유 expert와 router는 이 압축 과정 밖에 남는다. 이는 본문에서 라우팅되는 연산과 라우팅되지 않는 연산을 구분한 설명과 일치한다.
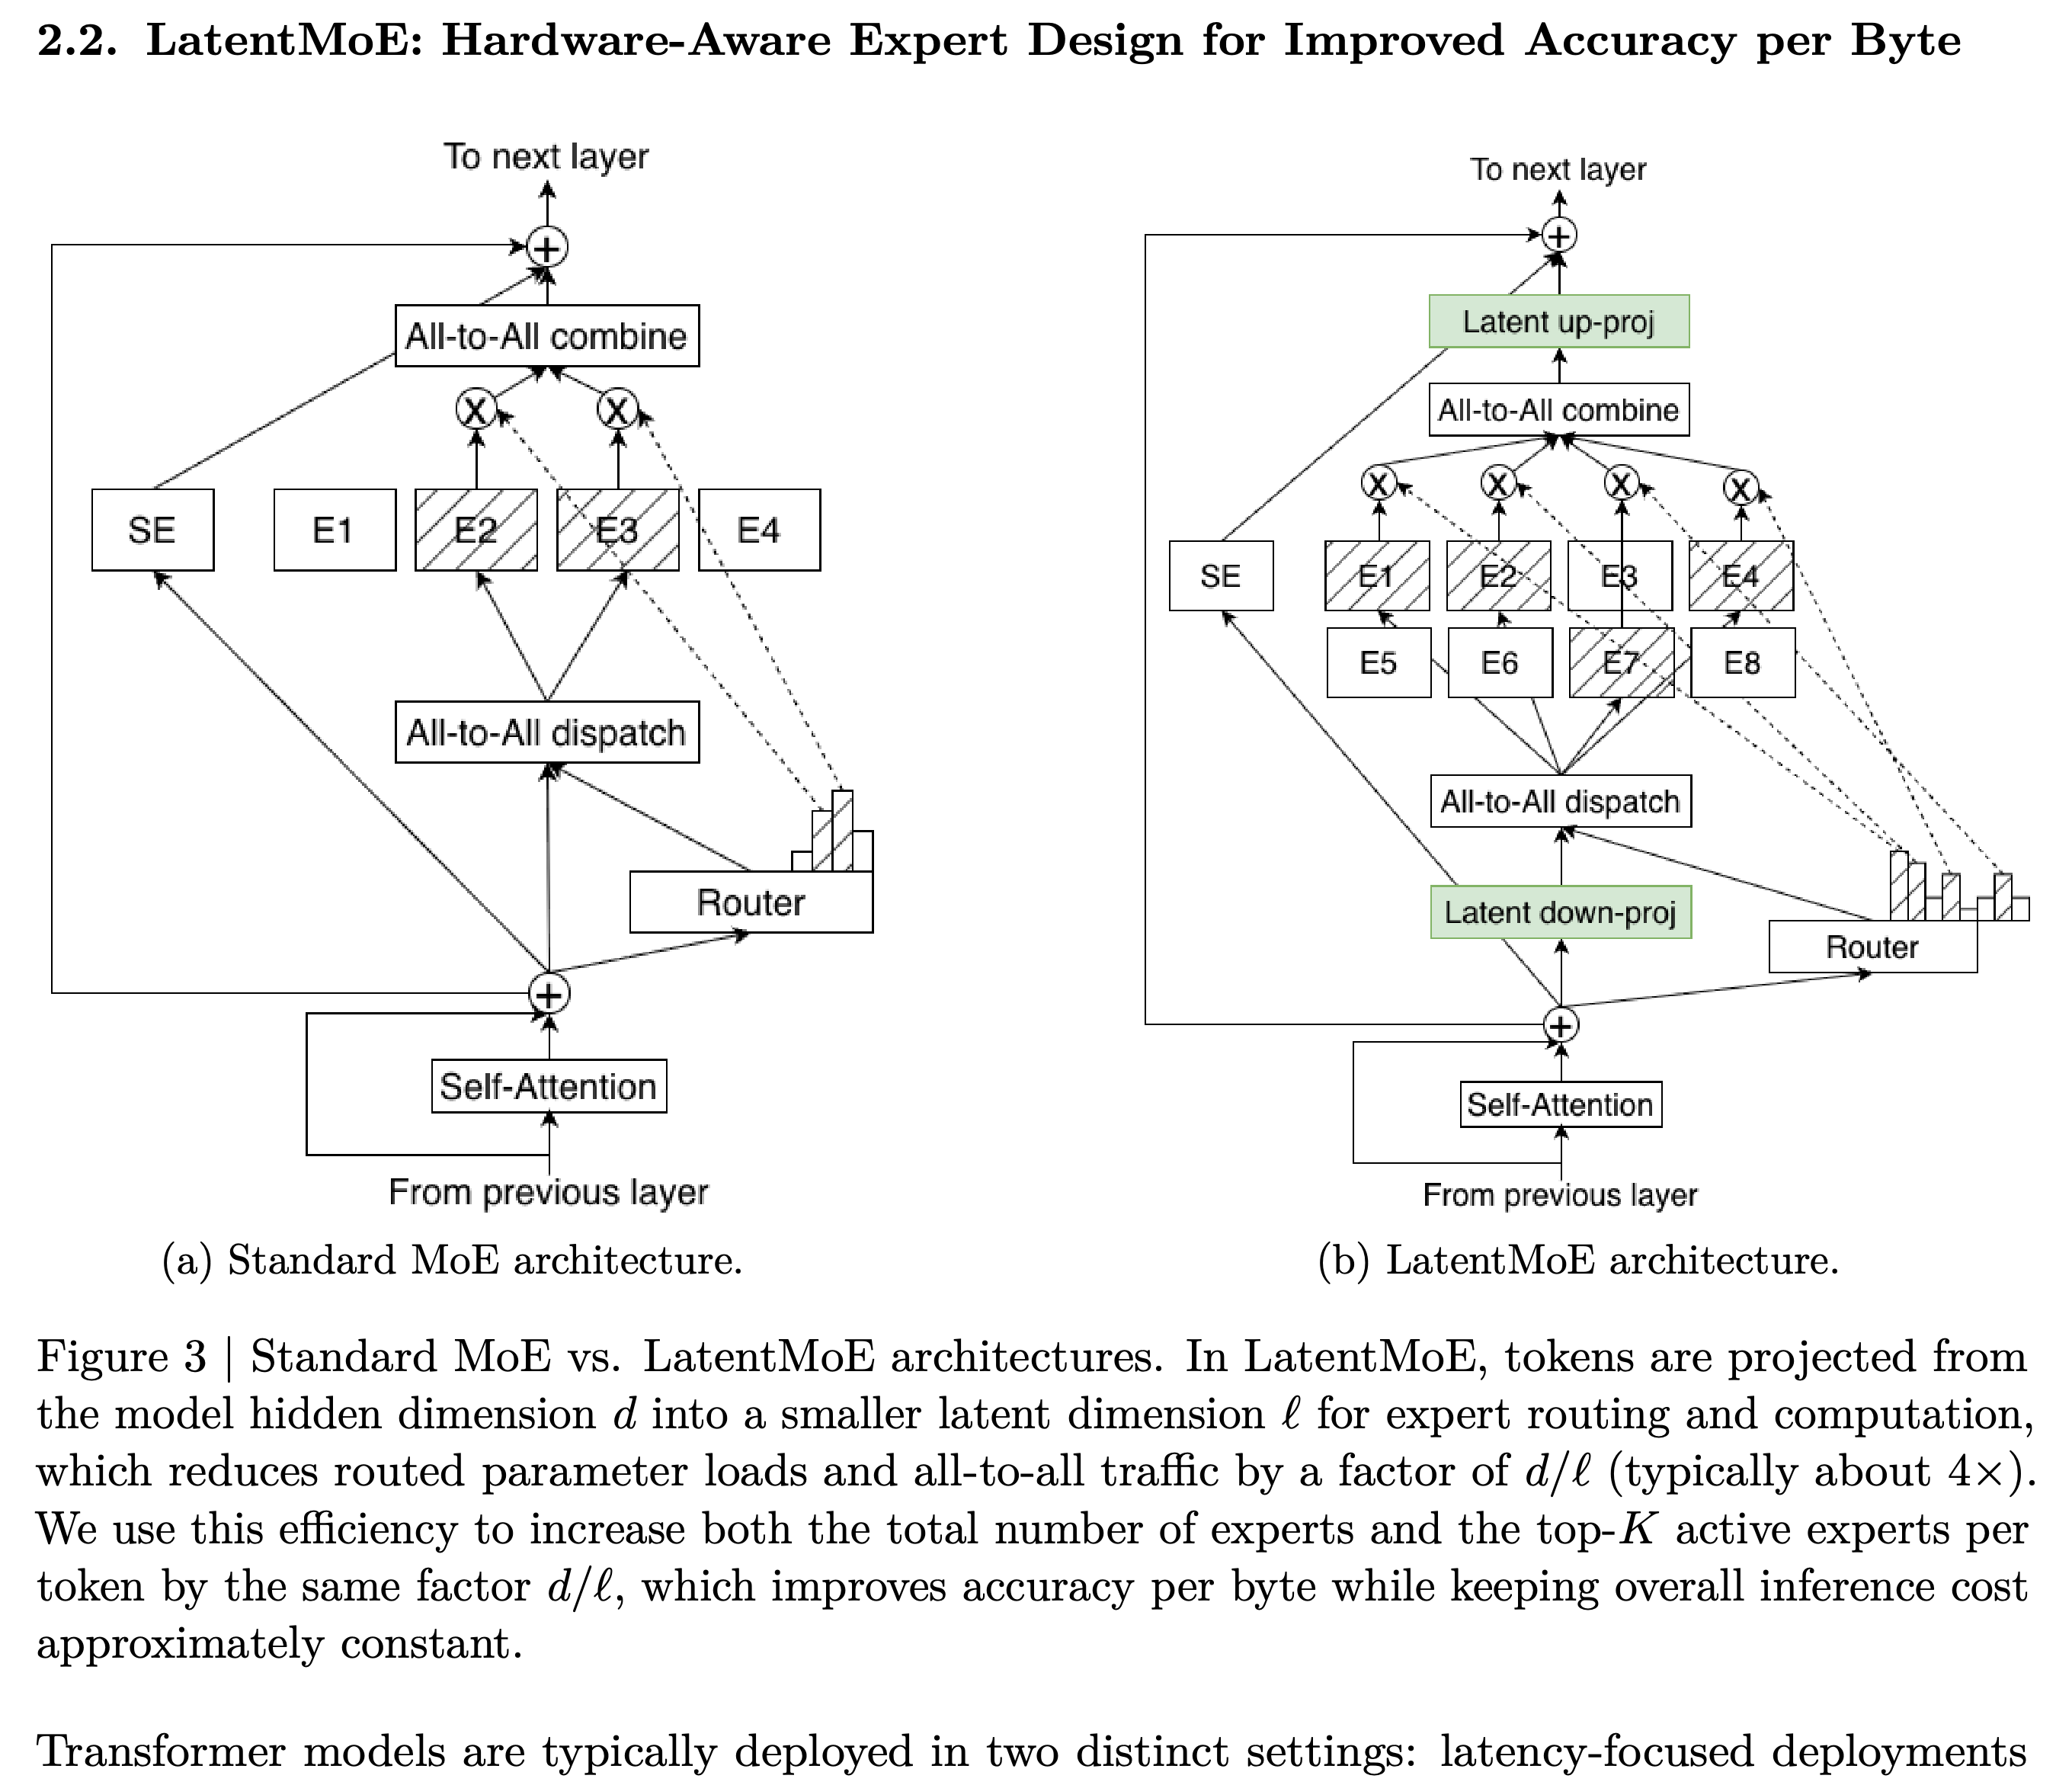
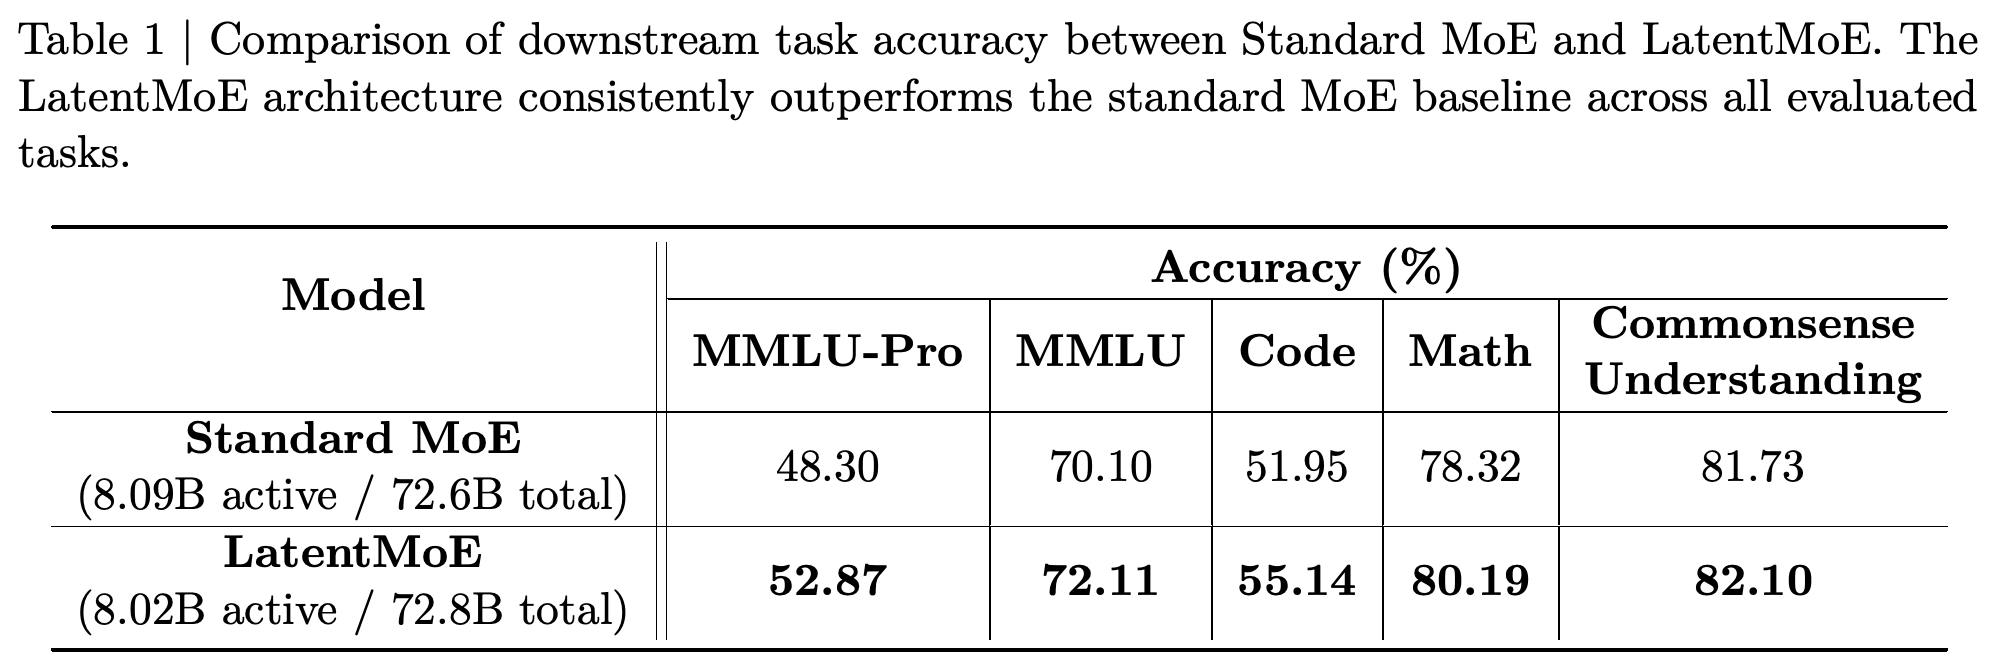
Table 1은 활성 파라미터 8.09B, 전체 파라미터 72.6B인 Standard MoE와 활성 파라미터 8.02B, 전체 파라미터 72.8B인 LatentMoE를 비교한다. 두 모델은 동일한 하이퍼파라미터로 1 trillion 토큰을 학습한다. LatentMoE는 MMLU-Pro를 48.30에서 52.87로, MMLU를 70.10에서 72.11로, Code를 51.95에서 55.14로, Math를 78.32에서 80.19로, Commonsense Understanding을 81.73에서 82.10으로 개선한다.
- Code는 HumanEval, HumanEval+, MBPP, MBPP+의 평균이며, Math는 GSM8K CoT와 MATH-500의 평균이다.
- Commonsense Understanding은 RACE, ARC-Challenge, HellaSwag, Winogrande의 평균이다.
- 이 비교는 파라미터 수가 거의 같은 조건에서 정확도가 향상됨을 보여주지만, 측정한 지연 시간이나 처리량은 제공하지 않는다.
동일한 하이퍼파라미터와 거의 같은 파라미터 수로 1 trillion 토큰을 학습한 뒤, LatentMoE는 5개 열 모두에서 Standard MoE를 앞선다. 절대 개선 폭이 가장 큰 항목은 48.30에서 52.87로 오른 MMLU-Pro이며, 가장 작은 항목은 81.73에서 82.10으로 오른 Commonsense Understanding이다. 표에는 추론 비용 측정값이 없다.
2.3. Multi-Token Prediction (MTP)
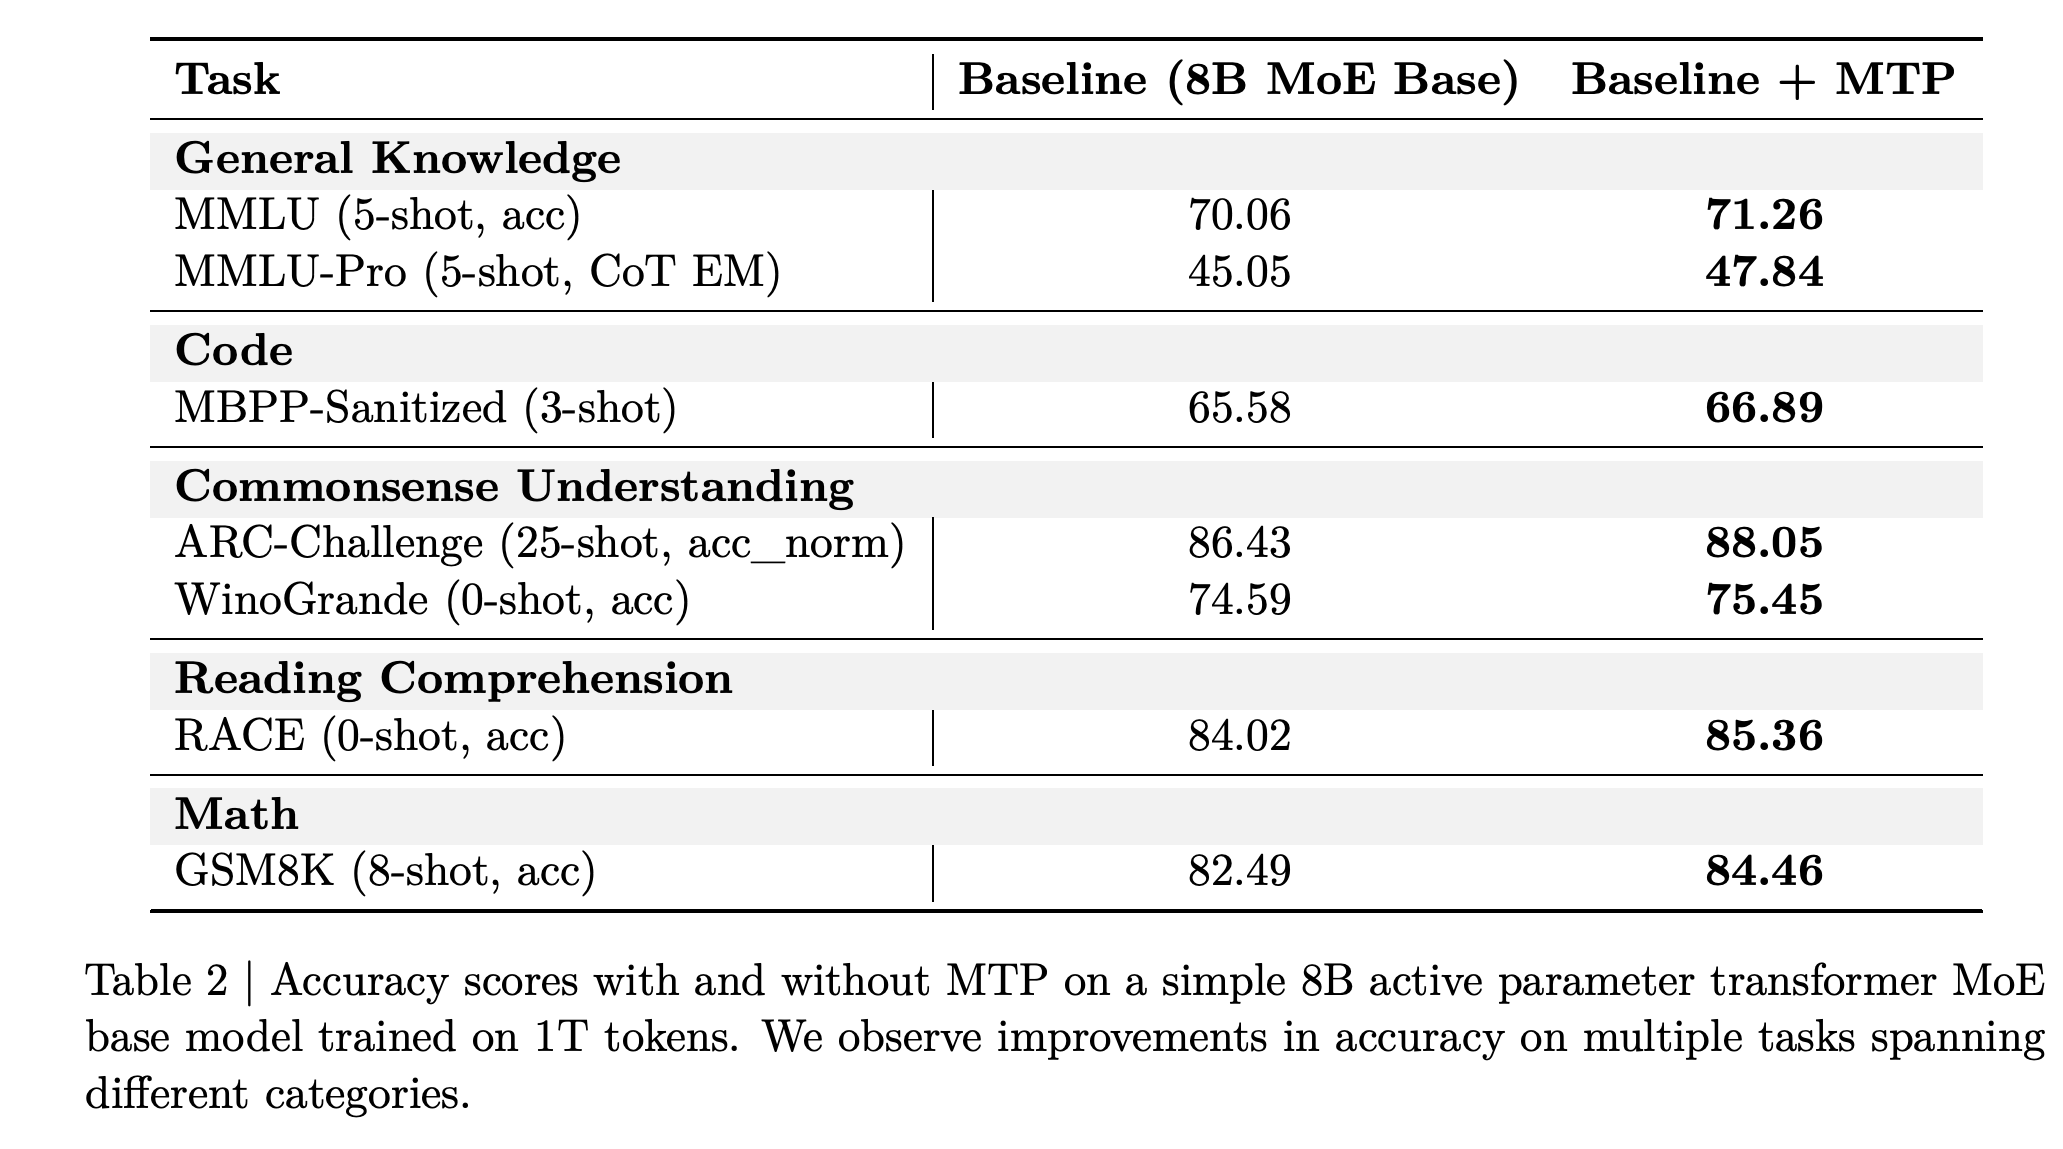
MTP는 여러 미래 토큰을 예측해 보조 학습 신호를 제공하고, 별도의 초안 모델 없이 speculative decoding에 사용할 초안 토큰을 생성한다. 1T 토큰으로 학습한 8B-active-parameter Transformer MoE 기본 모델에서 Table 2는 일반 지식, 코드, 상식 이해, 독해, 수학 전반의 개선을 보여준다. 저자들은 평균 개선 폭을 약 2.4%로 보고한다.
- MMLU (5-shot, acc)는 70.06에서 71.26으로, MMLU-Pro (5-shot, CoT EM)는 45.05에서 47.84로, MBPP-Sanitized (3-shot)는 65.58에서 66.89로 개선된다.
- ARC-Challenge (25-shot, acc_norm)는 86.43에서 88.05로, WinoGrande (0-shot, acc)는 74.59에서 75.45로, RACE (0-shot, acc)는 84.02에서 85.36으로, GSM8K (8-shot, acc)는 82.49에서 84.46으로 개선된다.
- 8B-active MoE ablation 실험에서 경량 MTP 모듈은 처음 예측한 2개 토큰에 대해 약 97%의 수락률을 달성한다. 이 절은 전체 디코딩 과정의 속도 향상 측정값을 제공하지 않는다.
MTP를 추가하면 명시된 평가 조건에서 보고된 모든 벤치마크 점수가 개선된다. 개선 폭은 WinoGrande의 0.86 %p부터 MMLU-Pro의 2.79 %p까지다. 이 Transformer MoE ablation 실험은 7개의 과제 전반에서 이점을 보여준다.
2.4. NVFP4 Training
저자들은 Transformer Engine의 cuBLAS 백엔드를 통해 네이티브 NVFP4 GEMM을 사용하고, 최대 25T 토큰까지 하이브리드 Mamba-MoE 사전학습을 안정적으로 수행했다고 보고한다. 가중치, 활성값, 그래디언트를 양자화하면 레시피에서 정한 정밀도 예외를 제외하고 fprop, dgrad, wgrad에 NVFP4 연산을 사용할 수 있다. 인용된 GB300의 FP4-versus-FP8 처리량 비율 3은 하드웨어의 최대 처리량 비교다.
- NVFP4는 16개 원소 단위의 마이크로 블록 스케일링, E4M3 블록 스케일 계수, 2단계 FP32 전역 스케일, E2M1 원소를 사용한다.
- 레시피에는 2차원 가중치 블록 스케일링, wgrad 입력에 적용하는 Random Hadamard Transforms, 그래디언트의 확률적 반올림이 포함된다.
- 네트워크의 마지막 15%는 높은 정밀도를 유지한다. 잠재 투영과 MTP 층은 BF16을 유지한다.
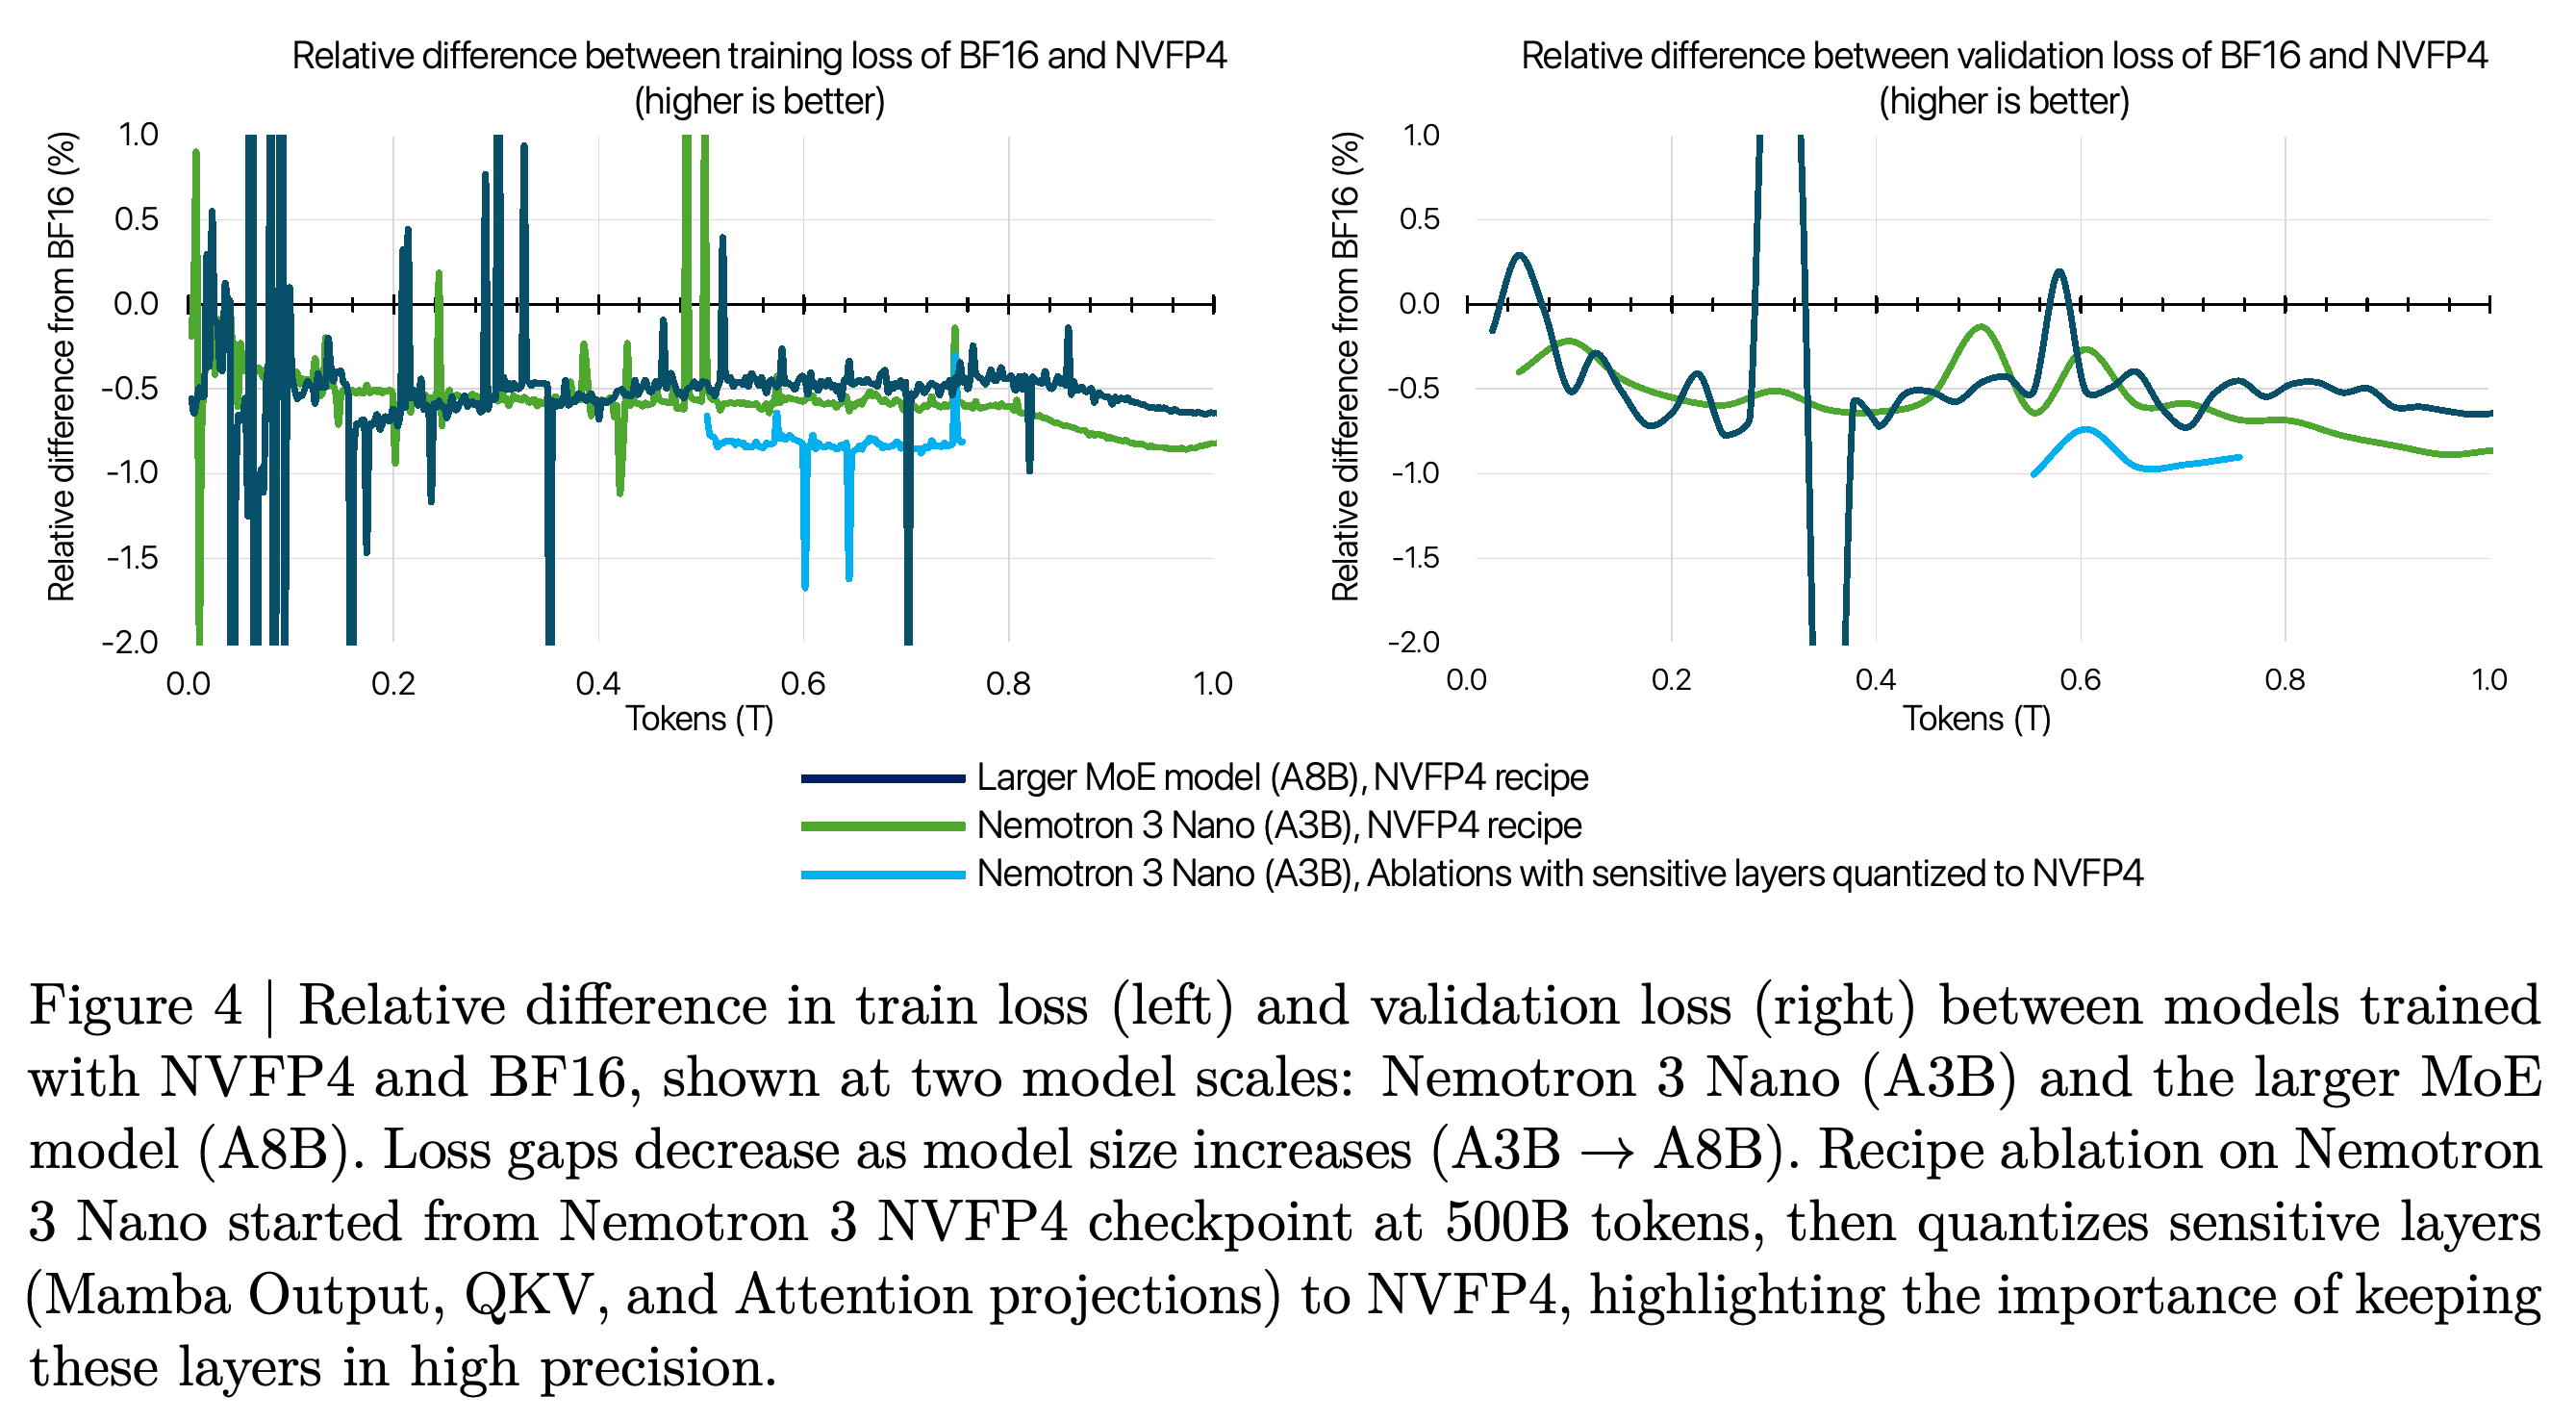
QKV와 attention 투영은 BF16을 유지한다. Nano에서 Mamba 출력 투영을 NVFP4로 양자화하면 값의 최대 40%가 0으로 처리될 수 있으므로, 이 투영은 MXFP8을 유지한다. Attention 층은 KV head가 2개뿐인 GQA를 사용한다.
- Figure 4는 혼합 정밀도 레시피와, 500B 토큰을 학습한 Nano 체크포인트에서 시작해 민감한 층을 양자화하는 ablation 실험을 비교한다. Ablation 실험에서는 손실 격차가 더 커진다.
- 저자들은 BF16 대비 상대 손실 차이가 Nano에서 1% 미만이고, 더 큰 8B-active MoE 모델에서 0.6% 미만이라고 보고한다. Figure 4에는 일시적으로 이 범위를 벗어나는 구간이 있으므로, 이 기준이 모든 체크포인트에 적용되는 것은 아니다.
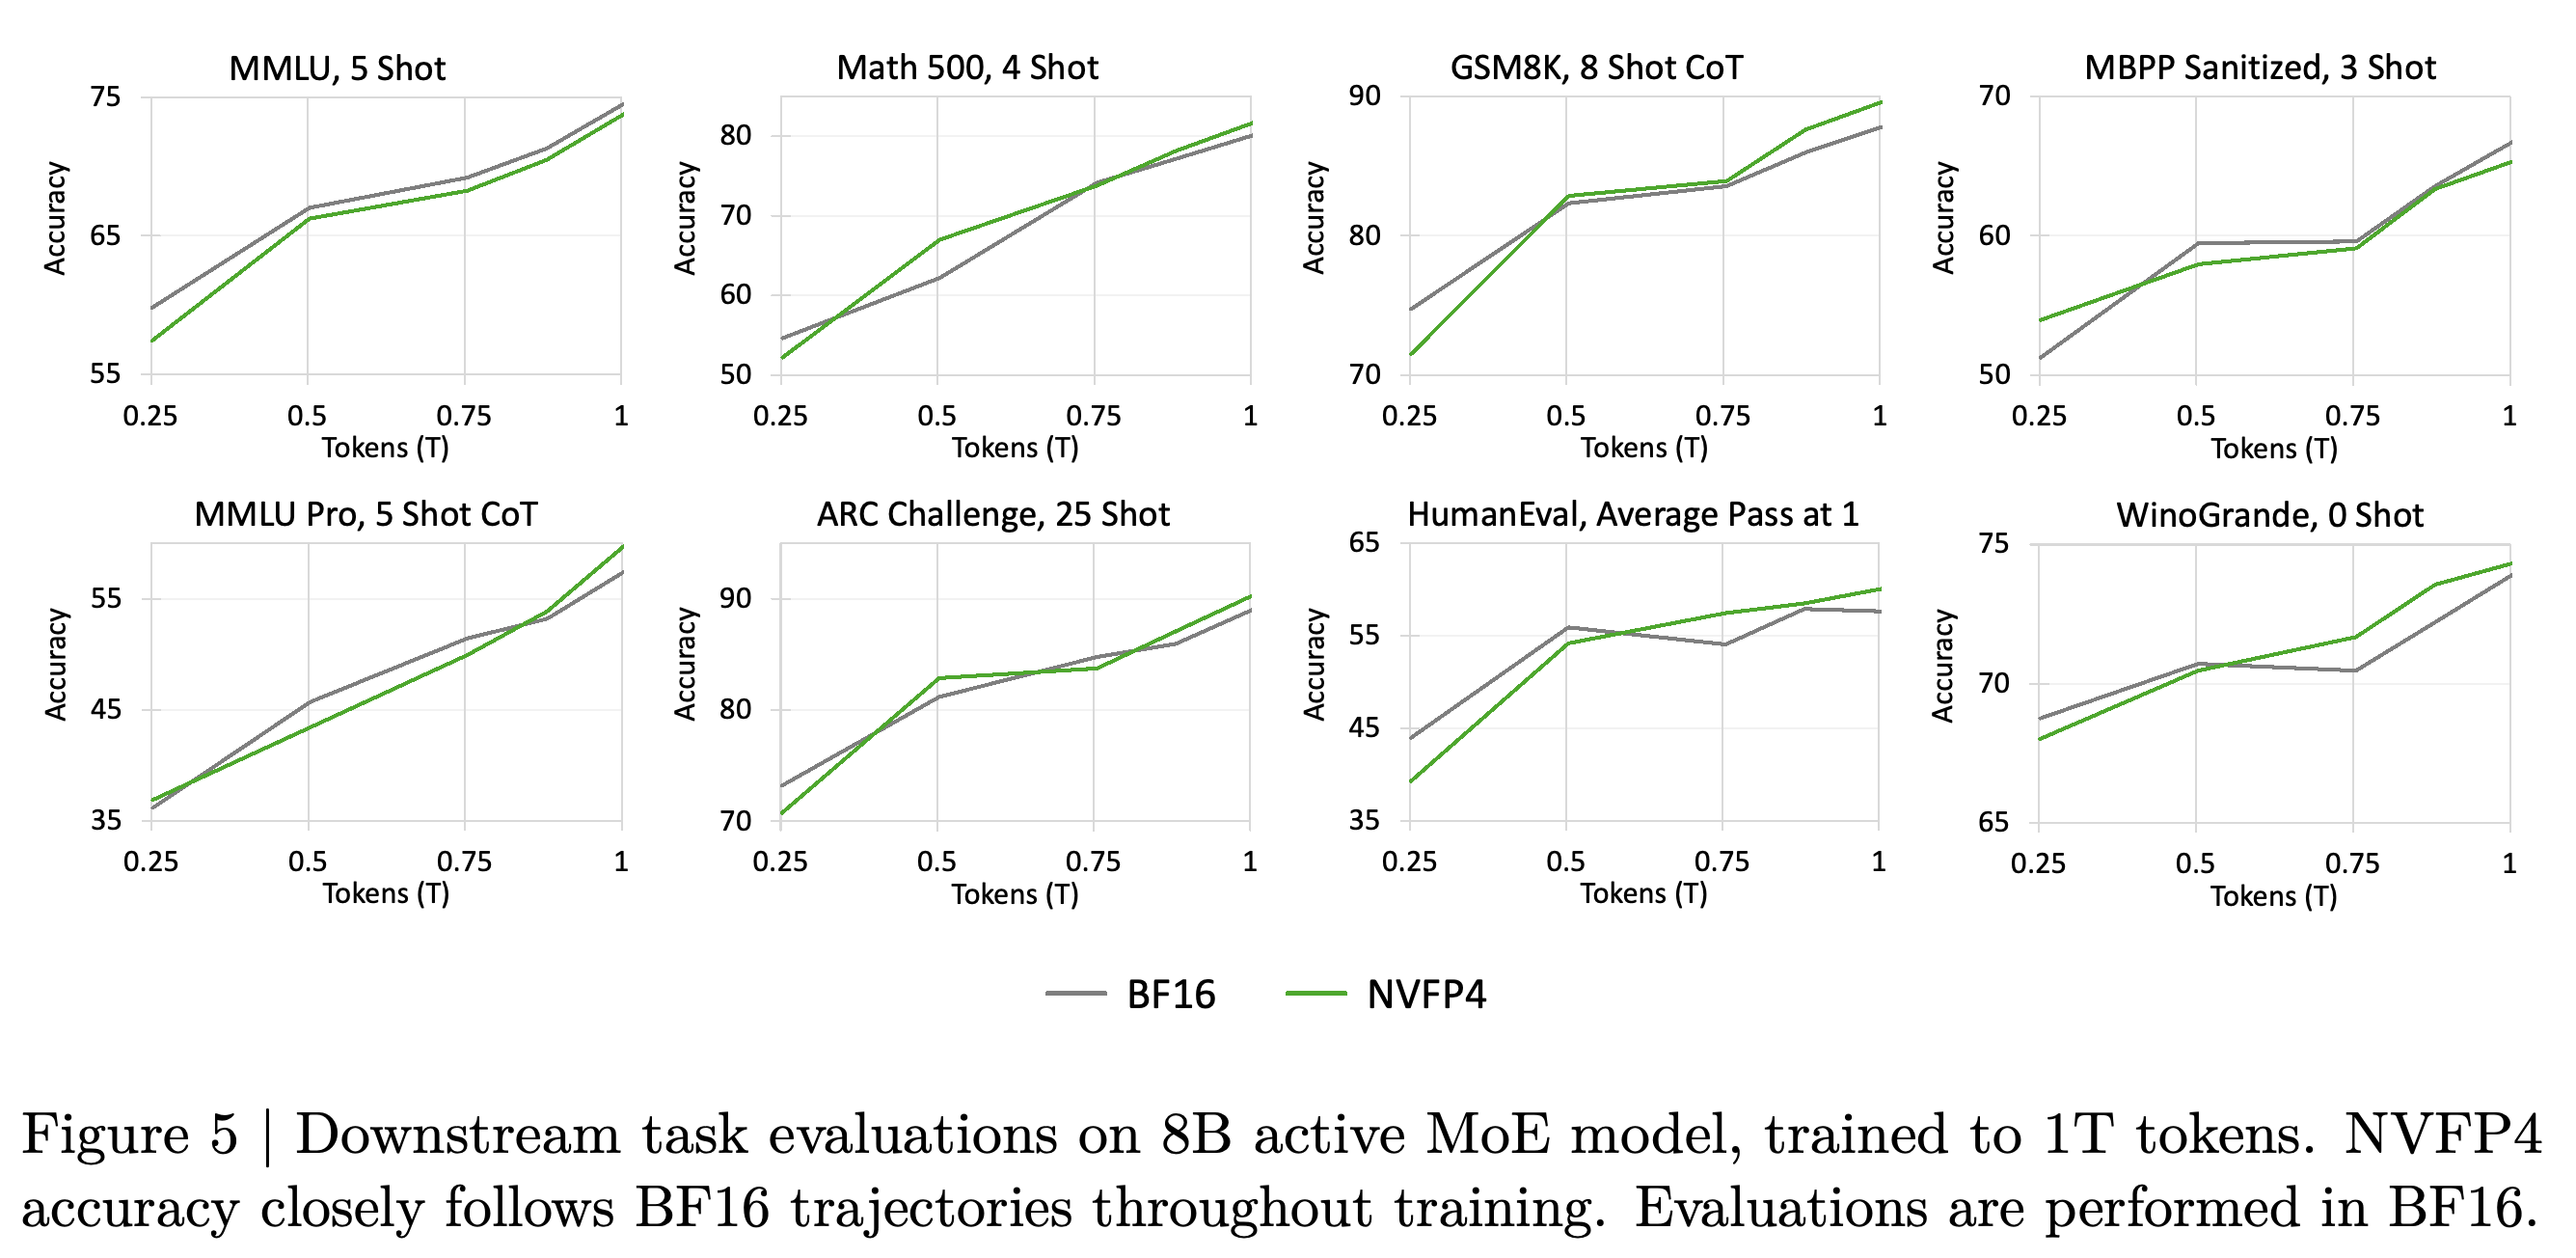
- Figure 5는 8B-active 모델을 학습 토큰 1T까지 추적하며, 비슷한 다운스트림 성능 추이를 보여준다. 표시된 평가는 모두 BF16을 사용하므로, 학습 품질에 관한 근거를 제공하며 NVFP4 추론 정확도를 검증하지는 않는다.
후반부 손실 추이에서 A8B는 A3B보다 BF16과의 격차가 작지만, 학습 곡선에는 일시적으로 격차가 커지는 구간도 있다. 500B 토큰 체크포인트 이후 Nano의 민감한 층을 양자화하면 격차가 커진다. 이는 선택한 투영에 더 높은 정밀도를 사용하는 레시피를 뒷받침한다.
8개의 다운스트림 과제에서 NVFP4-trained 모델과 BF16-trained 모델은 1T 토큰까지 대체로 비슷한 정확도 추이를 보이며, 어느 쪽이 높은지는 구간에 따라 달라진다. 평가는 BF16을 사용하므로, 이 비교는 학습 정밀도가 학습된 모델의 품질에 미치는 영향을 검증한다.
2.5. Long Context
Nemotron 3는 Mamba 층이 암묵적인 위치 정보를 제공하므로 attention 층에서 RoPE를 사용하지 않는다. Nano는 시퀀스 길이 512k에서 추가 사전학습하고, 256k에서 지도 미세조정하며, 최대 32k 토큰의 긴 컨텍스트 입력으로 강화학습한다. 3개 단계 모두 검색, 다중 홉 추론, 여러 문서의 정보 집계를 위한 합성 데이터를 사용한다.
- 저자들은 추가 사전학습할 때 길이를 8k에서 512k까지 단계적으로 늘릴 필요가 없었다고 보고한다.
- 지원하는 1M-token 컨텍스트는 추가 사전학습에 사용한 시퀀스 길이 512k를 넘으므로, 1M에서의 성능은 길이 외삽에 의존한다.
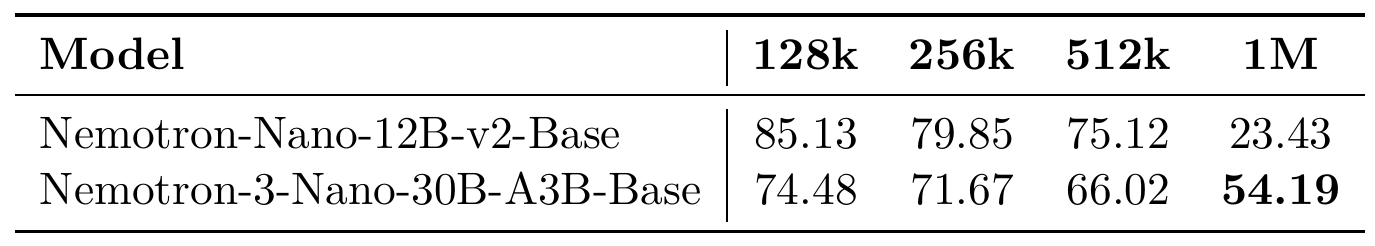
Table 3은 최대 시퀀스 길이 512k로 학습한 2개 기본 모델을 비교한다. 1M 토큰 조건의 RULER에서 Nemotron-3-Nano-30B-A3B-Base는 54.19를 기록해 Nemotron-Nano-12B-v2-Base의 23.43보다 높지만, 128k, 256k, 512k에서는 점수가 더 낮다. 이 비교는 학습 길이를 넘는 구간에서 더 안정적인 외삽 성능을 뒷받침한다.
- 밀집 하이브리드의 점수는 128k, 256k, 512k에서 각각 85.13, 79.85, 75.12이며, MoE 하이브리드의 점수는 74.48, 71.67, 66.02다.
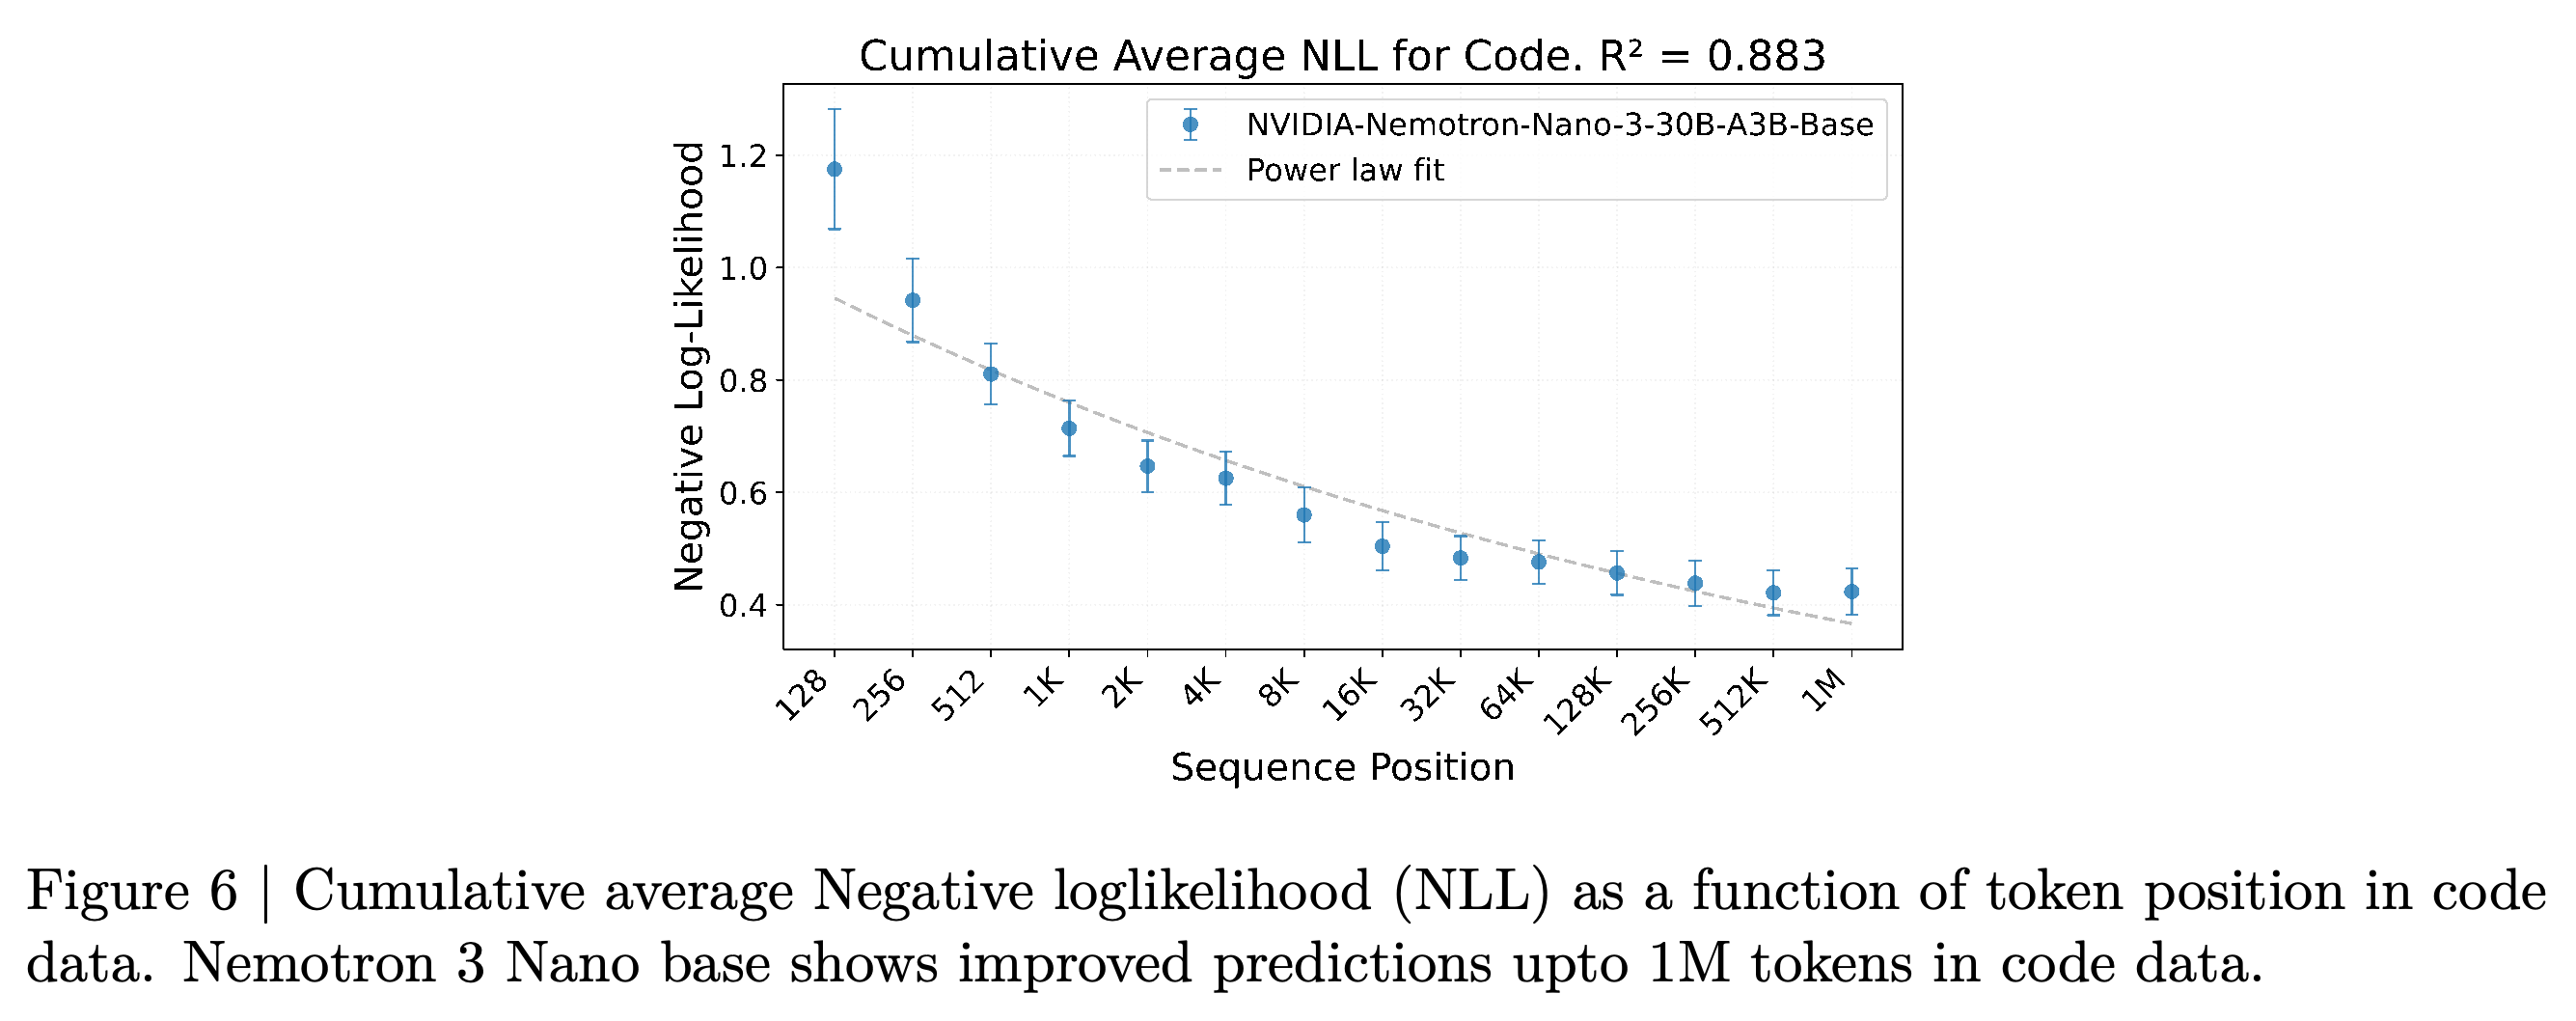
- Figure 6은 학습에 사용하지 않은 저장소 단위 코드 시퀀스에서 누적 평균 NLL이 감소하는 모습을 보여준다. 시퀀스는 1 million 토큰보다 길며, 멱법칙 적합 결과는 R² = 0.883이다.
- 이 NLL 추이는 긴 코드 컨텍스트에서 유용한 예측이 가능하다는 해석과 부합한다. 다만 누적 평균만으로는 멀리 떨어진 토큰의 기여를 분리하거나 1M 토큰에서 에이전트 과제 성능을 입증할 수 없다.
밀집 하이브리드는 128k, 256k, 512k에서 앞서지만, 점수가 512k의 75.12에서 1M의 23.43으로 하락한다. 같은 구간에서 MoE 하이브리드는 66.02에서 54.19로 하락한다. 이는 공통 최대 학습 길이인 512k를 넘을 때 MoE 하이브리드가 더 안정적으로 외삽함을 보여준다.
평가하는 코드 시퀀스가 1M 토큰에 가까워질수록 누적 평균 NLL이 감소하며, 표시된 멱법칙 적합 결과는 R² = 0.883이다. 이 추이는 긴 코드 컨텍스트에서 유용한 예측이 가능하다는 해석과 부합하지만, 특정한 원거리 토큰의 기여를 분리하지는 못한다.
2.6. Multi-environment Reinforcement Learning Post-training
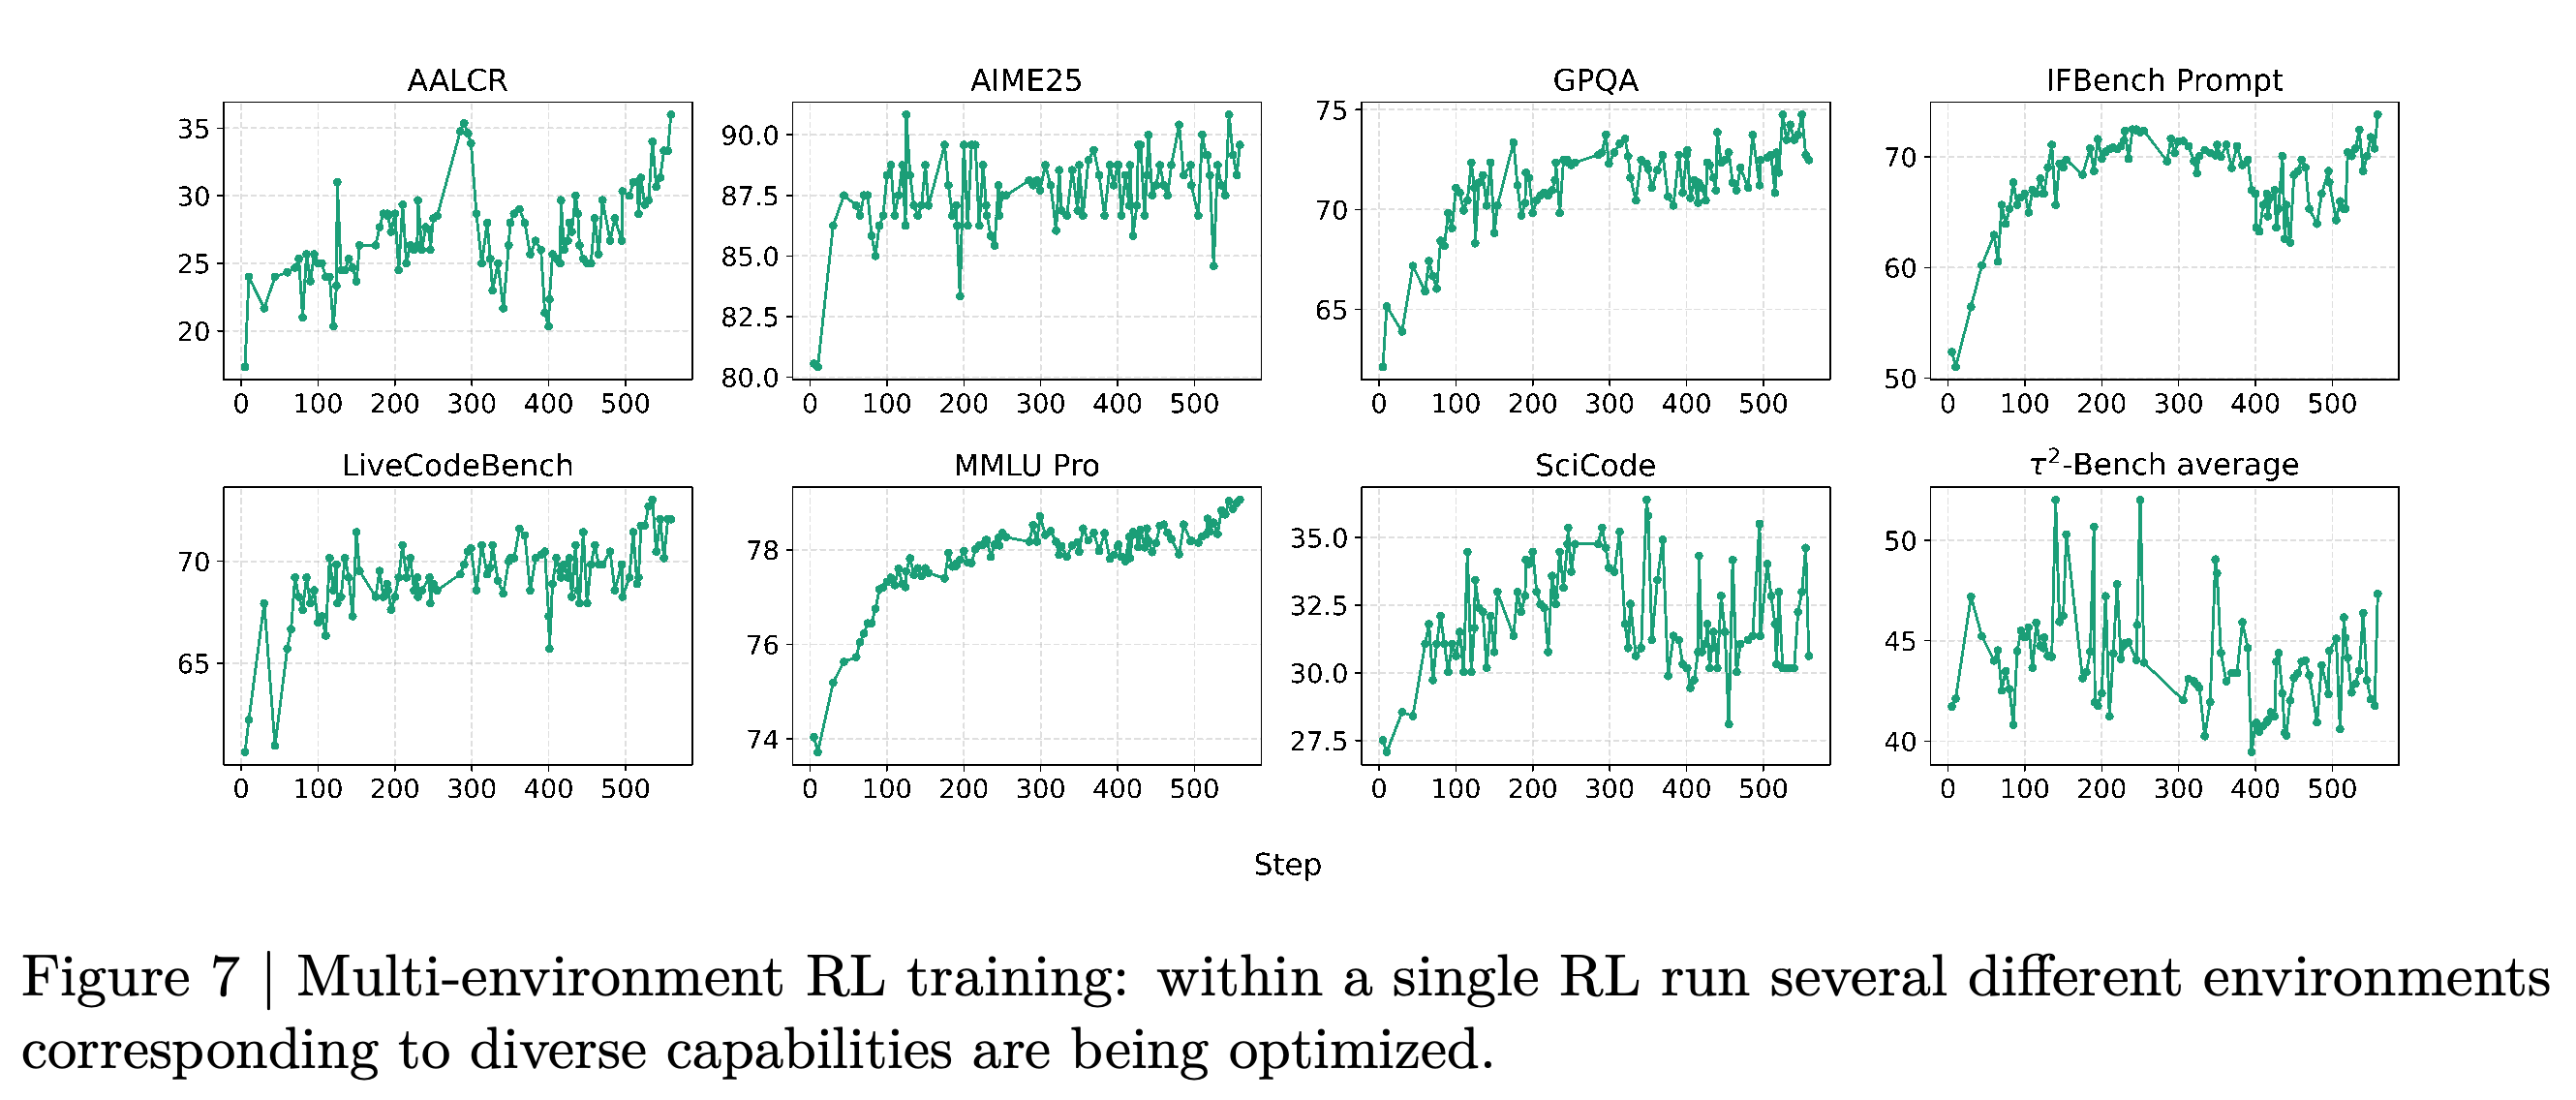
후속 학습은 수학과 과학 추론, 경쟁 프로그래밍, 지시 이행, 소프트웨어 엔지니어링, 검색, 대화, 도구 사용, 긴 컨텍스트 과제를 함께 최적화한다. 저자들은 이전의 단계별 접근보다 안정성이 높고 보상 해킹이 적다고 보고한다. Figure 7은 Nano의 RL 실행 중 벤치마크 성능 추이를 보여준다.
- GPQA, LiveCodeBench, MMLU Pro를 비롯한 여러 곡선은 뚜렷하게 개선된다. SciCode와 τ²-Bench는 변동이 크다.
- 그림은 공동 최적화 과정을 보여주지만, 동일 조건의 단계별 학습 비교나 보상 해킹의 정량적 측정값은 포함하지 않는다.
학습 시스템은 비동기 RL로 추론과 최적화를 분리하고, MTP로 rollout 생성을 가속한다. Masked importance sampling을 적용한 GRPO는 학습 정책과 rollout 정책 사이의 차이를 반영한다.
- 논문은 후속 학습 소프트웨어 스택을 Apache 2.0으로 오픈소스 공개했다고 명시한다.
- NeMo-RL은 https://github.com/NVIDIA-NeMo/RL 에서 확장 가능한 학습을 구현하고, NeMo-Gym은 https://github.com/NVIDIA-NeMo/Gym 에서 환경을 제공한다.
GPQA, LiveCodeBench, MMLU Pro와 여러 다른 벤치마크는 RL 실행 중 개선된다. SciCode는 초반 상승 이후 변동하며, τ²-Bench는 지속적인 상승 추세 없이 크게 변동한다. 이 그래프는 여러 능력을 함께 최적화하는 과정을 보여주며, 모든 성능이 일관되게 단조 증가하지는 않는다.
2.7. Granular Reasoning Budget Control at Inference Time
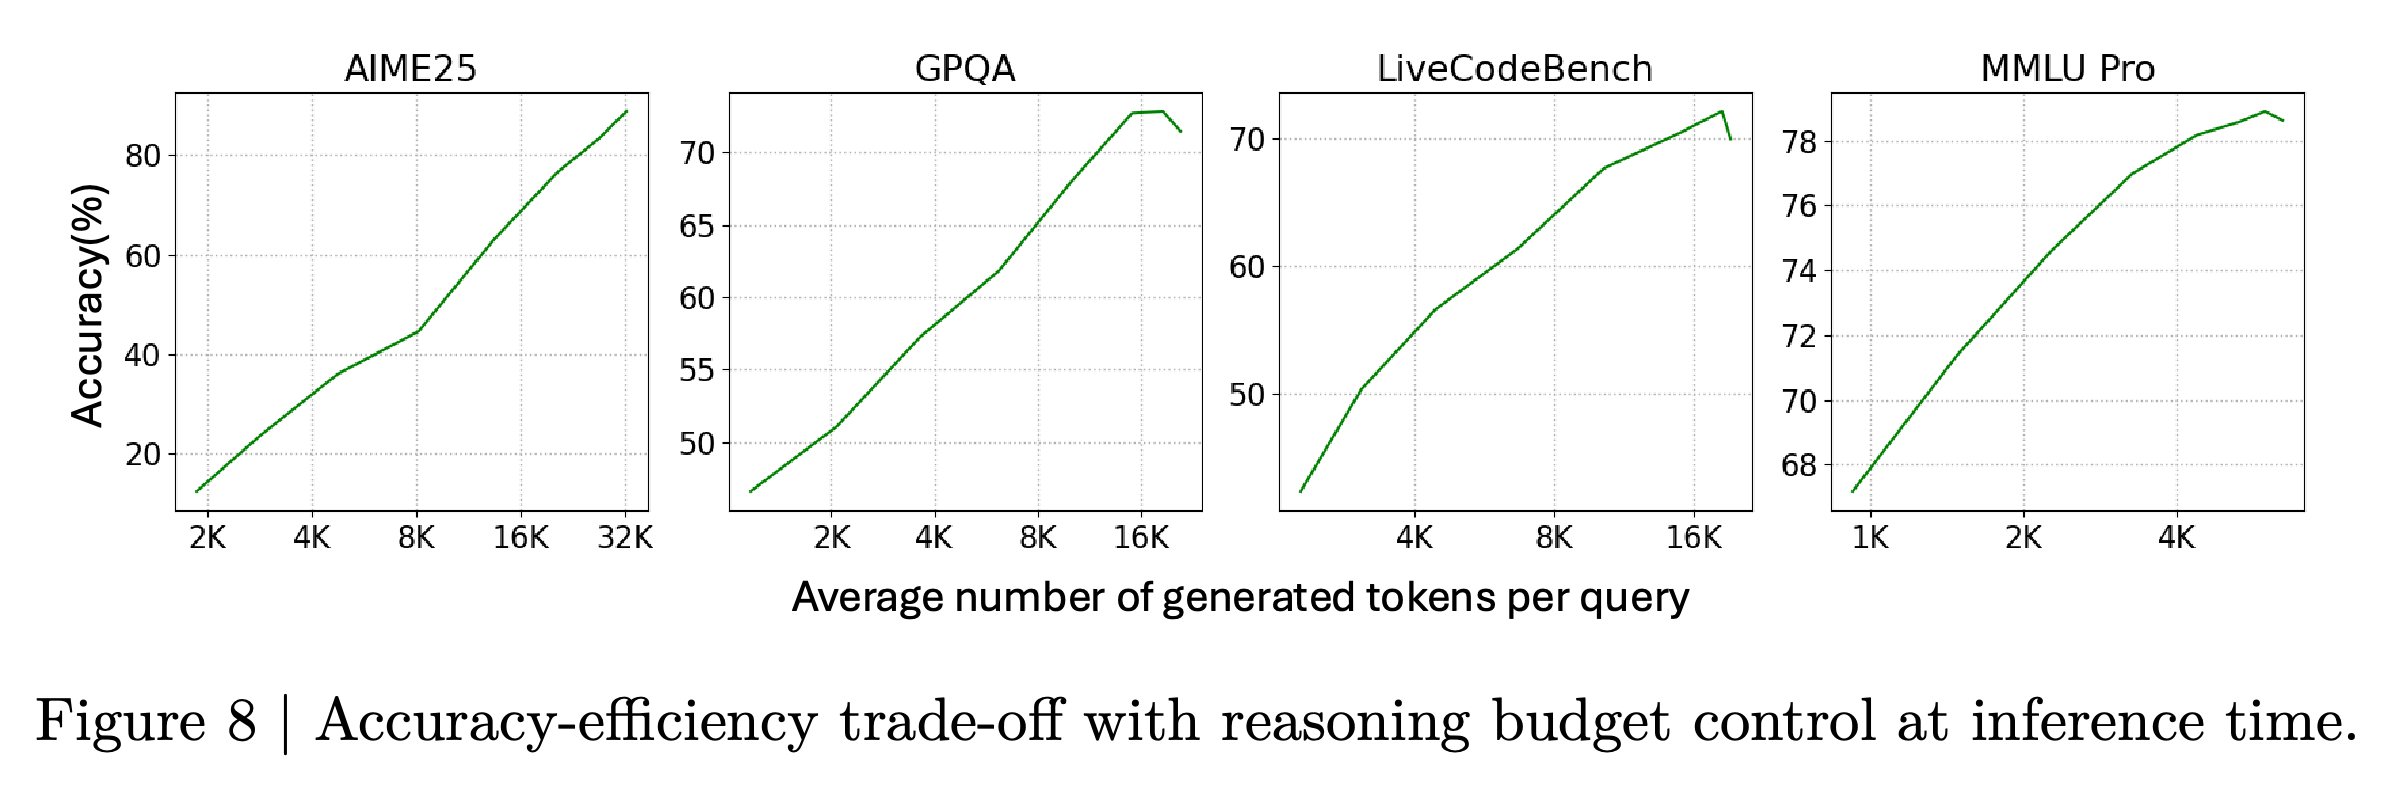
사용자는 사고 과정의 토큰 수를 제한하고, 예산에 도달하면 </think>를 덧붙여 모델이 그때까지의 사고 과정을 바탕으로 답하도록 할 수 있다. Figure 8은 AIME25, GPQA, LiveCodeBench, MMLU Pro에서 질의당 평균 생성 토큰 수에 따른 정확도를 보여준다.
- 정확도는 대체로 생성 길이가 늘어날수록 높아진다. 포화 지점은 과제마다 다르며, 표시된 최대 예산 부근의 일부 구간에서는 정확도가 소폭 하락한다.
- 가로축은 질의당 평균 생성 토큰 수를 나타내며, 실제 경과 시간이나 배포 비용을 측정하지 않는다.
평균 생성 길이가 길어지면 대체로 정확도가 높아지며, 유용한 길이 범위는 과제마다 다르다. AIME25는 생성 토큰 수가 32K에 가까워질 때까지 계속 개선된다. GPQA, LiveCodeBench, MMLU Pro는 표시된 최대 길이 부근에서 정체하거나 소폭 하락한다. 이 결과는 과제별 예산 선택을 뒷받침한다.
3. Key Takeaways
결론은 공통 하이브리드 아키텍처, 다중 환경 RL, 추론 예산 제어, 최대 1M 토큰 컨텍스트 지원을 다시 제시한다. LatentMoE, NVFP4 학습, MTP는 Super와 Ultra의 추가 기능으로 명시한다. Nano는 백서와 함께 공개되며, Super와 Ultra는 이후 수개월 내에 공개할 계획이라고 밝힌다.
- 공개 계획에는 모델 가중치, 학습 소프트웨어, 레시피, 대부분의 학습 데이터가 포함된다. 데이터 공개 범위는 재배포 권한에 따른다.
- 보고된 근거는 Nano 비교와 구성 요소별 ablation 실험으로 이루어지며, Super와 Ultra의 전체 평가는 제시하지 않는다.
Contributors
Contributors 절은 Pretraining Data, Architecture, Pretraining Software, Pretraining, NVFP4, Long Context, Posttraining Software, Posttraining의 기여자를 명시한다. 이어서 Evaluation, Safety and Release, Infrastructure, Quantization, Inference, Compression, Deployment, Legal and Compliance, Marketing, Project Management, Product, Leadership의 기여자를 명시한다.
부록
- 제공된 논문에는 원문 부록이 없다. 주요 기술 절 뒤에 Contributors와 References가 이어진다. 기술 절은 Nano의 자세한 평가 조건을 별도의 Nemotron Nano 3 기술 보고서에서 확인하도록 안내한다.
짧은 생각
LatentMoE는 expert 가중치 전송량과 전달 데이터 크기를 결정하는 차원을 줄이고, 절감분으로 expert 수를 늘린다. Table 1은 활성 파라미터와 전체 파라미터 수가 거의 같은 조건에서 정확도 향상을 뒷받침한다. 다만 제안한 시스템상의 이점을 검증하려면 지연 시간과 통신 비용을 측정해야 한다.
정밀도 ablation 실험은 민감한 층을 식별하고 혼합 정밀도 레시피를 BF16과 비교한다. 제시된 다운스트림 비교는 학습 토큰 1T까지 이어진다. 이 실험과 인용된 하드웨어 최대 처리량만으로는 최대 25T-token 학습을 수행했다고 보고한 전체 실행에서 다운스트림 품질이나 실제 학습 속도를 입증할 수 없다.
MoE 기본 모델은 평가한 짧은 길이에서는 밀집 비교 모델보다 낮은 점수를 기록하지만, 512k에서 1M 토큰으로 외삽할 때 RULER 정확도를 더 많이 유지한다. 공동 RL 곡선은 여러 벤치마크에서 개선을 보여준다. 다만 곡선의 변동이 크고 단계별 학습 대조군이 없어, 제시된 비교는 주장한 안정성과 보상 해킹 억제 효과를 검증하지 못한다.