


Agentic Learner with Grow-and-Refine Multimodal Semantic Memory 요약 설명
26 Nov 2025 | Paper Review Agent's Memory Multimodal Learning Inference-Time Learning이번 글에서는 Agentic Learner with Grow-and-Refine Multimodal Semantic Memory 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 11월 26일(Arxiv)
- Bo, Weihao, Zhang, Shan, Sun, Yanpeng, Wu, Jingjing, Xie, Qunyi, Tan, Xiao, Chen, Kunbin, He, Wei, Li, Xiaofan, Zhao, Na, et al.
- Nanjing University of Science and Technology, Baidu Inc, AIML, Adelaide University, Singapore University of Technology and Design
- 논문 링크
- Github
- Project Page
요약
- 멀티모달 대규모 언어 모델(MLLMs)은 이미지와 텍스트로 질문에 답하는 모델이다. 각 질문을 독립적으로 풀면 시각 정보 해석 오류와 추론 오류를 반복할 수 있다. 비교 조건 모두에 단계별 추론 프롬프트를 적용했을 때, 시각 메모리와 논리 메모리를 분리한 ViLoMem은 GPT-4.1의 MathVision 정확도를 47.47%에서 53.95%로 높인다. MathVision은 시각 정보에 기반한 수학 추론 벤치마크다. 향상 폭은 질문마다 생성한 답변 1개의 정확도를 나타내는 pass@1 기준으로 6.48 percentage points다.
- 이 프레임워크는 생성한 답변을 참조 답변과 비교해 오답을 확인하면 교정 메모리를 생성한다. 유사한 지침은 병합하고 서로 다른 지침은 추가한다. 시각 메모리 검색은 먼저 이미지 유사도로 메모리를 선택한 뒤 질문과 관련된 지침을 걸러낸다. 논리 메모리 검색은 질문의 분야와 핵심 개념을 분석한 결과를 사용한다.
- 보고된 구성 요소 제거 실험에서는 어느 메모리 경로를 제거해도 2개 벤치마크에서 GPT-4.1의 정확도가 낮아진다. 구성 요소 제거 실험은 특정 구성 요소를 비활성화해 기여도를 측정하는 실험이다. 다른 모델이 만든 메모리는 더 작은 문제 풀이 모델인 Qwen3-VL-8B-Instruct의 성능을 추가로 높인다. 효과는 메모리의 관련성과 과제 적합성에 따라 달라진다. 벤치마크 간 전이는 때때로 정확도를 낮춘다. 검색된 시각 단서와 관련된 영역을 강조하는 히트맵인 어텐션 맵도 수학 추론의 성능을 낮출 수 있다. 확장성 실험은 이전에 접한 과제의 성능 유지 여부를 직접 측정하지 않는다.
1. Introduction
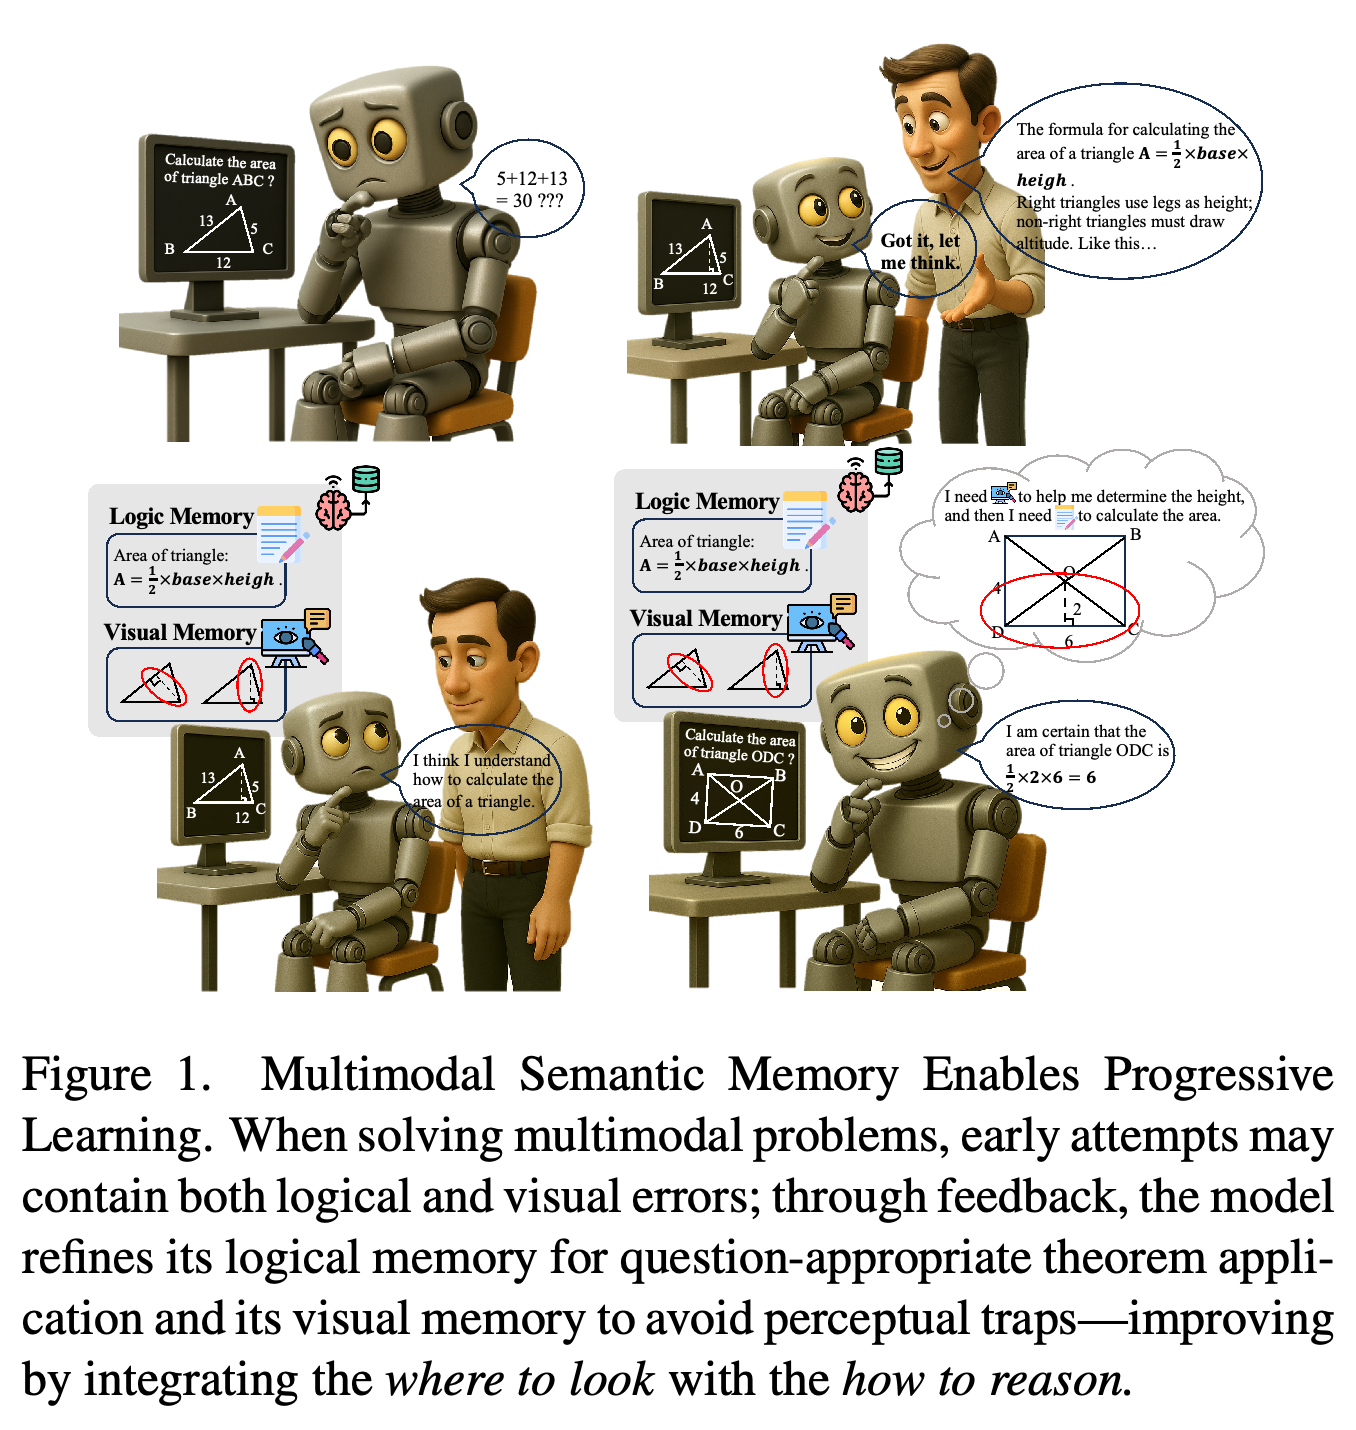
“ViLoMem: Agentic Learner with Grow-and-Refine Multimodal Semantic Memory”는 텍스트로 요약한 추론만 저장하면 이후 이미지 기반 질문을 푸는 데 필요한 지각 단서를 잃는다고 주장한다. 의미 메모리는 경험에서 추출한 구조화된 지식을 지속적으로 보관한다. 이 논문에서는 어디를 봐야 하는지에 관한 지침과 어떻게 추론해야 하는지에 관한 지침을 분리한다.
- 시각 오류는 논리 오류로 이어질 수 있다. 도형에서 잘못된 특징을 선택하면 적절한 공식을 사용해도 풀이가 틀릴 수 있다.
- Figure 1은 삼각형 넓이 공식을 기억하는 것과 함께 밑변과 그에 대응하는 높이를 정확히 식별해야 하는 이유를 보여준다.
- 프로젝트 페이지 주소는 https://weihao-bo.github.io/ViLoMeo-page/다. 제공된 PDF에는 arXiv:2511.21678v2와 2026년 5월 2일이라는 날짜가 명시되어 있다.
삼각형 사례는 공식을 기억하는 일과 공식 적용에 필요한 시각적 수량을 식별하는 일을 구분한다. 정리 적용과 도형 해석을 교정하는 지식을 따로 관리해야 하는 이유를 보여주지만 성능 측정 결과가 아니라 개념을 설명하는 사례다.
2. Related Work
관련 연구에서는 모델에 제공하는 문맥을 바꾸는 접근법과 외부 메모리를 지속적으로 유지하는 접근법을 연결한다. ViLoMem은 논리 지침과 함께 시각 오류 패턴을 명시적으로 표현하고 각 메모리 경로에 서로 다른 매칭 절차를 적용한다.
2.1. Context Engineering
문맥 공학은 모델 가중치를 바꾸지 않고 입력 프롬프트를 수정해 모델의 동작을 개선한다. 논문은 추론과 행동을 결합하는 ReAct, 실패에 대한 언어적 피드백을 사용하는 Reflexion, 프롬프트 개선을 위해 기울기와 유사한 텍스트 피드백을 생성하는 TextGrad, 실행 기록을 바탕으로 진화적 프롬프트 최적화를 수행하는 GEPA를 다룬다. 일시적인 문맥과 반복적인 축약으로 유용한 세부 정보가 사라지는 간결성 편향을 한계로 지적한다. 이를 구조화된 메모리를 지속적으로 유지해야 하는 이유로 제시한다.
2.2. Long-term Memory
Dynamic Cheatsheet는 이전 추론에서 얻은 전략을 저장한다. ACE(Agentic Context Engineering)는 생성, 성찰, 정제를 거쳐 문맥 지침서를 점진적으로 관리한다. 논문은 이 접근법들이 논리에 집중한다고 주장한다. 시각 표현과 논리 표현을 분리하는 설계는 중앙 허브가 모달리티별 표현을 통합한다는 인간 의미 메모리의 hub-and-spoke 관점에서 착안했다. 이 인지적 비유는 아키텍처를 설계하는 근거지만 생물학적 동등성을 입증하지는 않는다.
3. Method
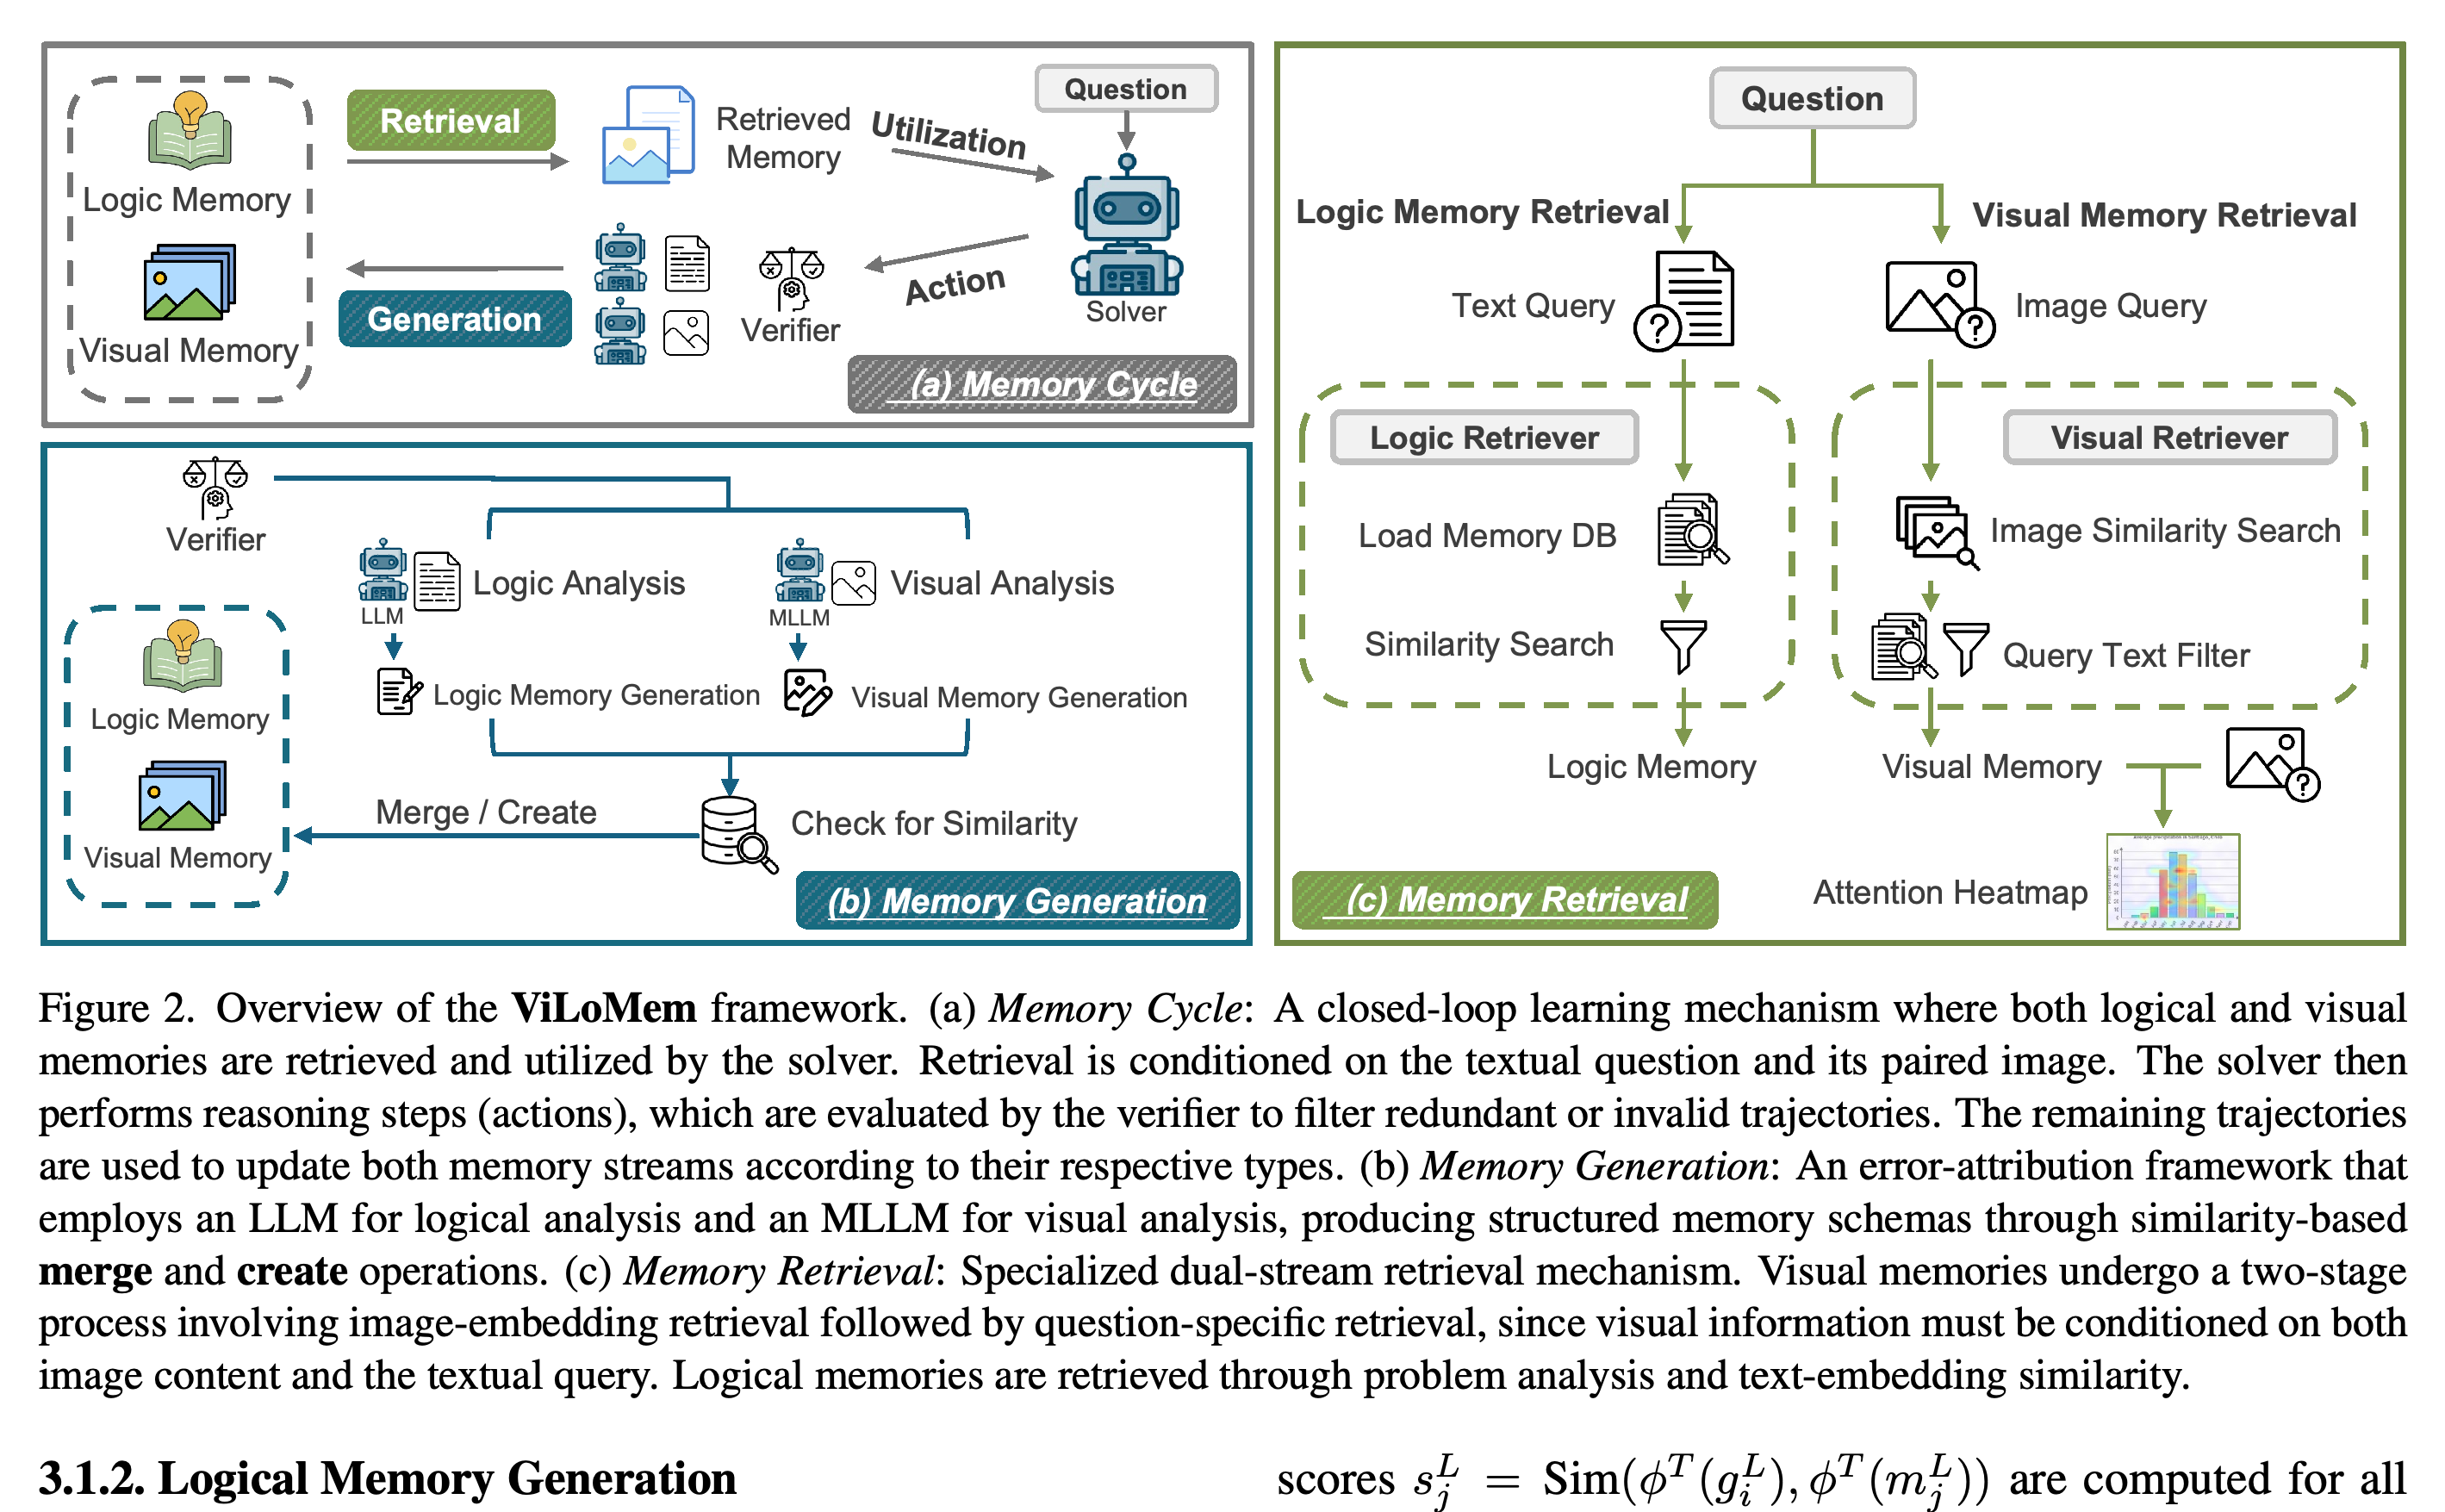
ViLoMem은 텍스트 추론 지침을 담은 논리 메모리와 원본 이미지에 지침을 연결한 시각 메모리를 유지한다. Memory Cycle은 양쪽 메모리에서 검색한 지침을 문제 풀이 모델에 제공한다. 생성된 답변을 정답과 비교해 검증하고 답변이 틀리면 메모리 생성을 시작한다.
- 매칭에는 임베딩의 정규화된 내적인 코사인 유사도를 사용한다. 식은 \(\operatorname{Sim}(u,v)=\frac{u\cdot v}{\|u\|\|v\|}\)이며, 임베딩은 텍스트나 이미지를 벡터로 표현한 것이다.
- 대규모 언어 모델은 질문과 추론 기록을 분석해 분야와 핵심 개념을 식별한다. 원래 질문과 이 분석 결과를 함께 사용해 검색 질의를 확장한다.
- 초록에서는 성공과 실패 경험 모두에서 학습한다고 설명하지만 실제 갱신 규칙은 오류를 기준으로 작동한다.
3.1. Memory Generation
Memory Generation은 오답에 포함된 시각 오류와 논리 오류를 병렬로 분석한다. “3.1.1. Visual Memory Generation”에서 분석기는 이미지, 질문, 잘못된 추론, 참조 답변을 입력받는다. “3.1.2. Logical Memory Generation”에서 분석기는 이미지 없이 텍스트 입력만 받는다.
- 시각 분석은 객체 혼동, 놓친 기호, 잘못 파악한 공간 관계 등의 해석 오류를 식별하고 이를 교정하는 관찰 지침을 생성한다.
- 논리 분석은 오류를 Logical 또는 Non-Logical로 분류하고 계산 실수나 공식 오용 같은 논리 오류일 때만 지침을 생성한다.
- 텍스트 유사도로 지침을 가장 가까운 기존 항목과 병합할지 새 항목으로 추가할지 결정한다. 수식에는 유사도 임계값이 사용되지만 제공된 실험 세부 사항에는 그 수치가 명시되어 있지 않다.
3.2. Memory Retrieval and Utilization
“3.2.1. Visual Memory Retrieval”에서는 이미지 임베딩으로 후보 메모리를 먼저 선택한다. 이어서 텍스트 임베딩으로 각 지침과 확장된 질문을 비교해 순위를 매기고 임계값을 적용한다. “3.2.2. Logical Memory Retrieval”은 논리 지침을 확장된 질문과 직접 매칭한다. “3.2.3. Solution Generation with Dual Memory”는 원본 이미지, 질문, 양쪽에서 검색한 지침을 문제 풀이 모델의 입력으로 사용한다.
- 이미지 단계는 후보를 시각적으로 유사한 사례로 제한한다. 텍스트 단계는 후보의 교정 지침이 현재 질문과 관련되는지 확인한다.
- 선택적으로 사용하는 질문 기반 어텐션 맵은 검색된 시각 단서와 관련된 영역을 강조하며 원본 이미지와 함께 보조 이미지로 제공된다.
- 논문은 답변 생성을 ỹᵢ = Gen(Iᵢ,qᵢ,Rᵢᴸ,Rᵢⱽ)로 표현한다. Iᵢ와 qᵢ는 이미지와 질문이고, Rᵢᴸ와 Rᵢⱽ는 검색된 논리 지침과 시각 지침이며 Gen은 문제 풀이 모델이다. 제공된 구현 세부 사항에는 검색 개수가 명시되어 있지 않다.
이 아키텍처는 문제 풀이 모델과 검증기의 순환, 병렬 오류 분석, 각 메모리에 특화된 검색을 분리한다. 시각 경로는 이미지 검색과 질문 기반 필터링을 결합하고 논리 경로는 텍스트 매칭을 사용한다. 유사도 검사로 메모리를 병합할지 새로 생성할지 결정한다.
4. Experiments
실험은 시각 정보에 기반한 수학, 환각과 실제 환경에서의 견고성, 시각적 이해가 필요한 지식을 다루는 6개 벤치마크를 평가한다. 환각은 제공된 근거와 일치하지 않는 답변을 뜻한다. 추가 분석에서는 개별 메모리 구성 요소, 메모리 사용, 문제 풀이 모델과 벤치마크 사이의 전이, 수학 메모리 저장소의 확장을 살펴본다.
4.1. Experimental Setup
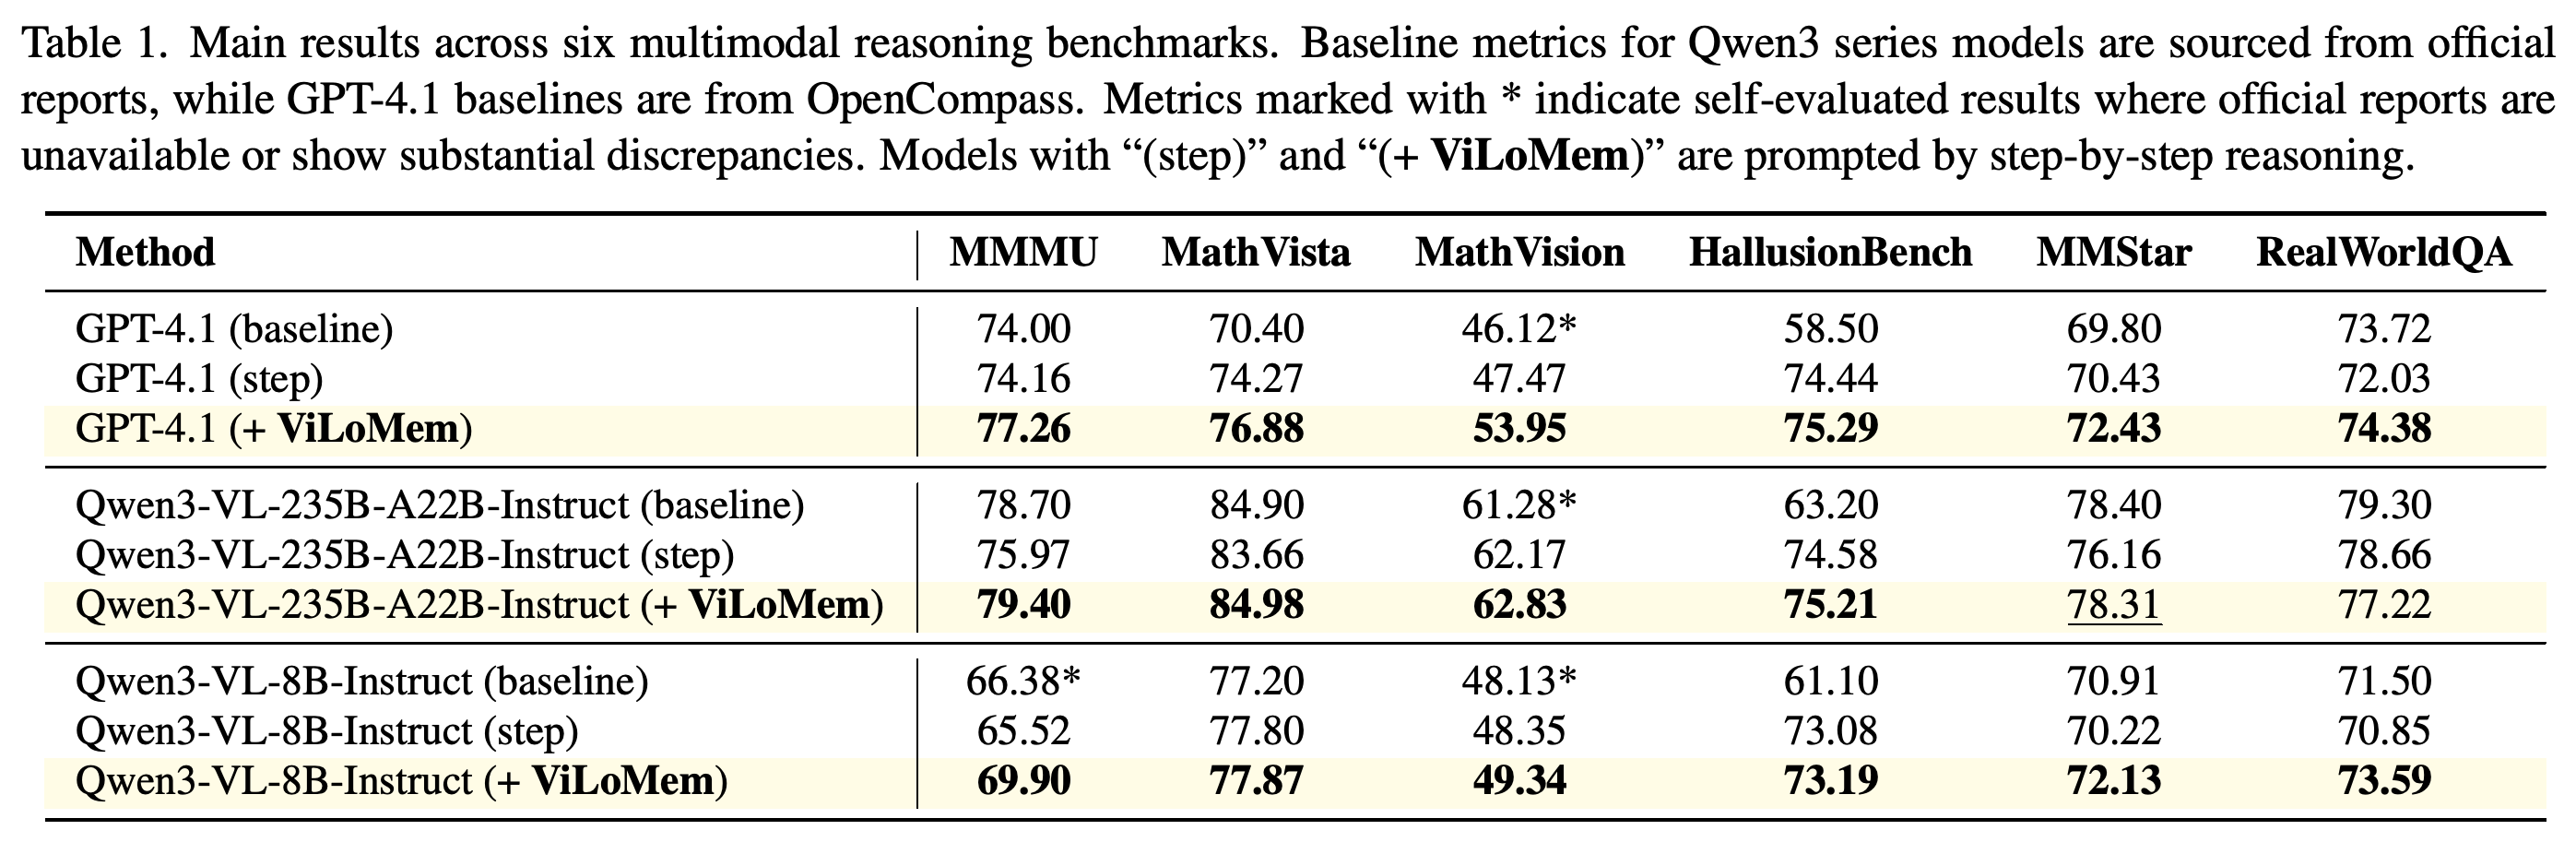
주요 문제 풀이 모델은 GPT-4.1, Qwen3-VL-235B-A22B-Instruct, Qwen3-VL-8B-Instruct다. 비교 조건은 기본 프롬프트를 사용하는 Baseline, 명시적인 단계별 추론 프롬프트를 사용하는 Step, 단계별 추론 프롬프트와 검색된 메모리를 사용하는 +ViLoMem이다. 추가된 메모리 시스템의 효과를 평가하려면 Step이 더 적합한 비교 기준이다.
- 벤치마크는 6개 분야의 대학 수준 질문 1,050개로 설명된 MMMU(val), 시각 정보에 기반한 수학을 평가하는 MathVista(mini)와 MathVision(mini), 대조군과 짝지어진 질문 1,129개로 환각과 착시를 평가하는 HallusionBench, 표본 1,500개로 시각 정보가 필요한 추론을 평가하는 MMStar, 자연 장면 765개로 공간 추론을 평가하는 RealWorldQA다.
- 논리 메모리 생성에는 Qwen3-235B-A22B-Instruct를, 시각 메모리 생성에는 Qwen3-VL-235B-A22B-Instruct를 사용한다. 매칭에는 Qwen3-Embedding과 Qwen2.5-VL-Embedding을 사용한다.
- 평가에는 평가 도구 모음인 VLMEvalKit을 사용하고 답변 매칭이 모호할 때는 언어 모델을 판정자로 사용한다. Table 1에는 외부에서 보고된 기준 점수와 별표로 표시한 자체 평가 점수가 함께 포함되어 있다. 보충 자료의 표에서는 MMMU를 val이 아닌 dev로 표기한다.
4.2. Main Results on Multimodal Benchmarks
Step과 비교하면 GPT-4.1은 6개 벤치마크 모두에서 개선된다. 점수는 MMMU 74.16→77.26, MathVista 74.27→76.88, MathVision 47.47→53.95, HallusionBench 74.44→75.29, MMStar 70.43→72.43, RealWorldQA 72.03→74.38이다. Qwen3-VL-8B-Instruct도 6개 모두에서 개선되지만 MathVista에서는 77.80→77.87로 향상 폭이 작다.
- Qwen3-VL-235B-A22B-Instruct는 Step 대비 5개 벤치마크에서 개선되지만 RealWorldQA에서는 78.66→77.22로 하락한다. MMStar 점수 78.31도 보고된 기본 프롬프트 기준 점수인 78.40보다 낮다.
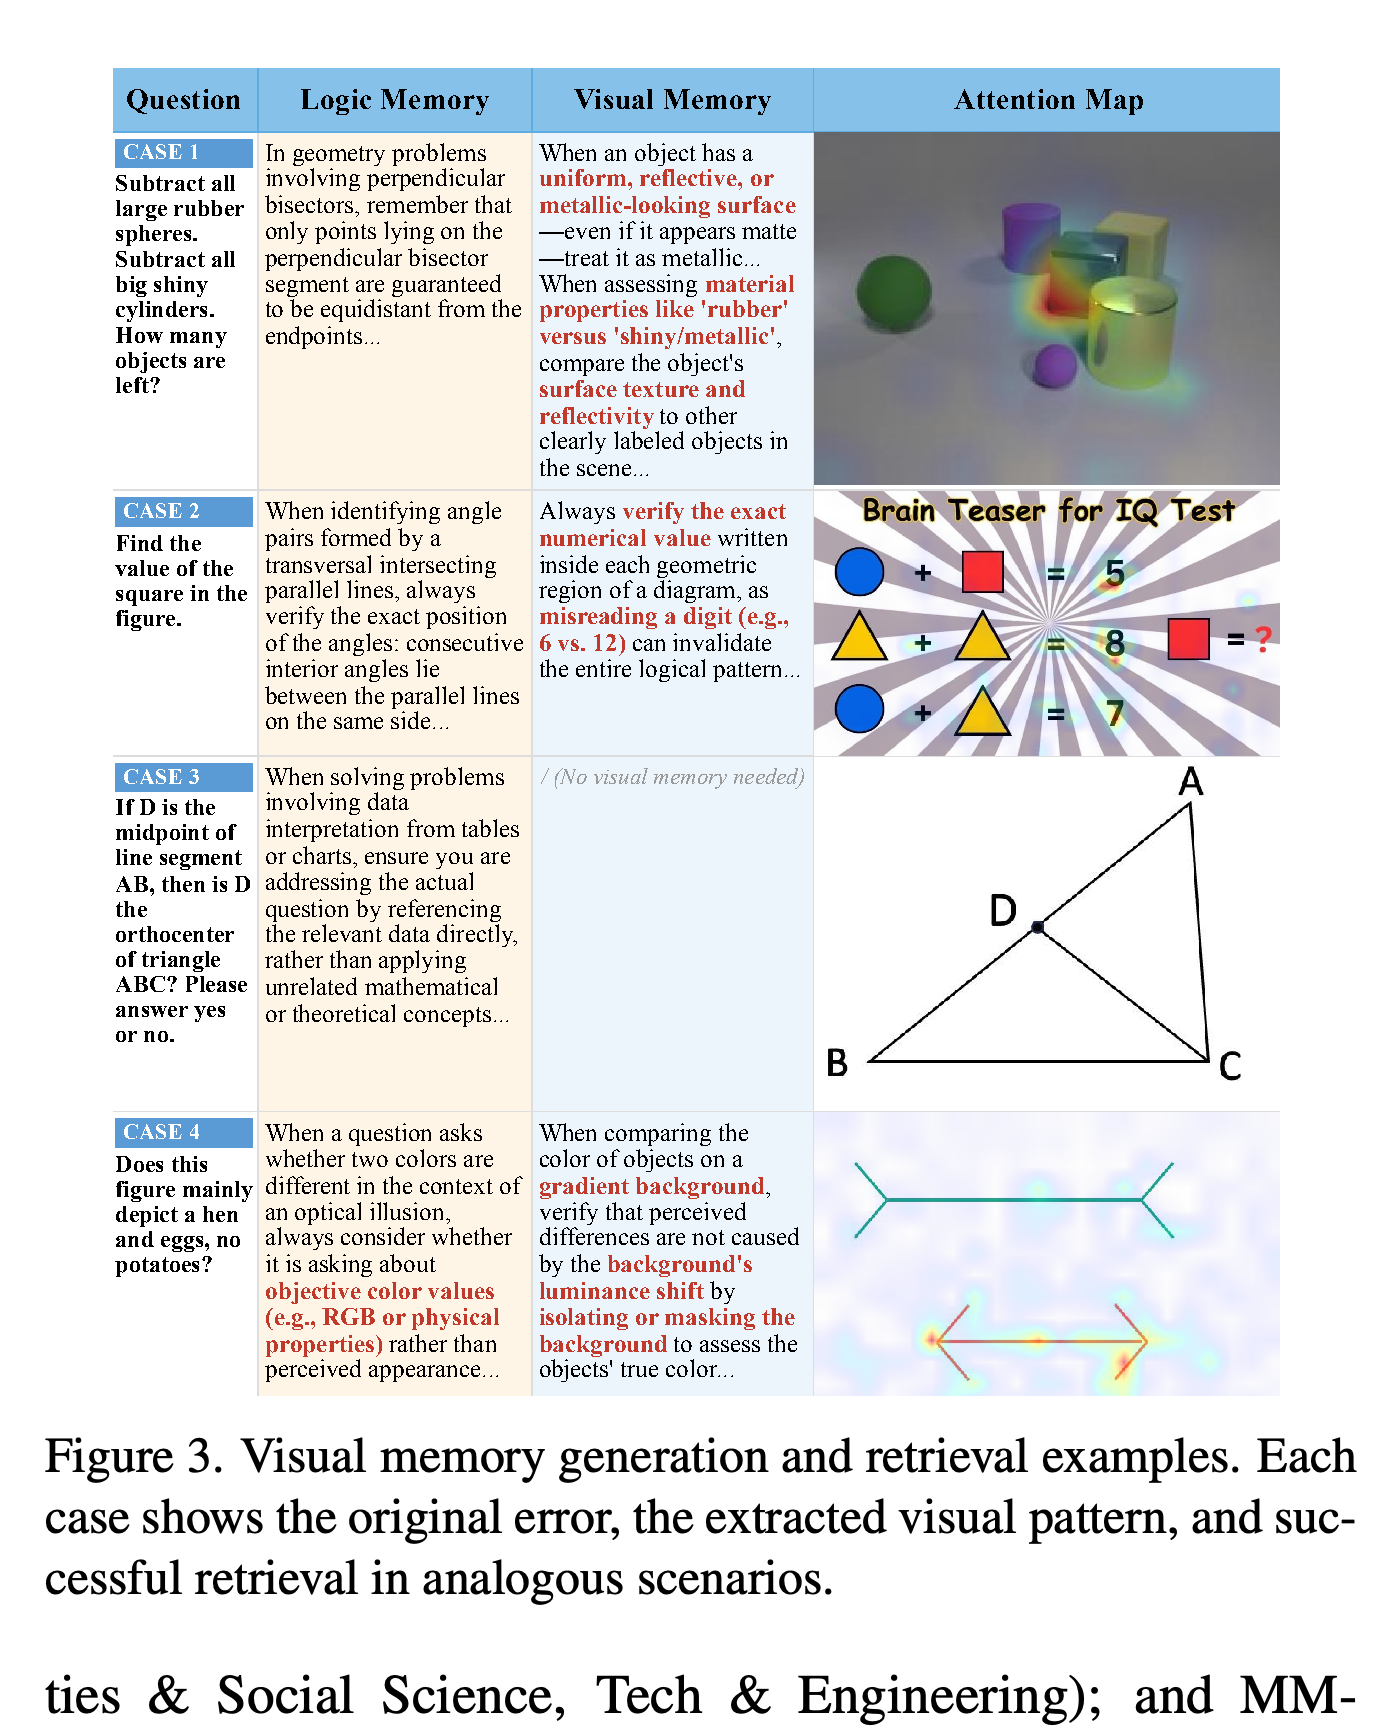
- 정성적 사례에서는 시각 지침이 표면 반사도, 도형에 적힌 숫자, 배경 때문에 발생하는 색 착시를 다룬다. 반면 검색된 논리 지침 중 일부는 시각 질문과 관련이 없다.
- 저자들은 문제 풀이 모델의 추론에 시각적 근거가 빠지거나 복잡한 도형의 설명이 부실하면 시각 오류와 논리 오류를 구분하기 어려워져 오류 원인 분류에 실패할 수 있다고 지적한다.
Step 행은 ViLoMem과 가장 유사한 프롬프트 비교 조건을 제공한다. GPT-4.1과 8B 문제 풀이 모델은 6개 벤치마크 모두에서 개선되지만 235B 문제 풀이 모델은 RealWorldQA에서 하락한다. 기본 프롬프트와의 비교에는 외부에서 가져온 기준 점수와 별표로 표시한 자체 평가 점수도 함께 사용된다.
이 사례들은 시각 지침이 재질의 외관, 도형에 적힌 정확한 숫자, 배경에 따른 색 지각을 다룸을 보여준다. 여러 논리 항목은 당장의 시각 과제와 관련이 없고, 기하 사례에는 시각 지침이 없다.
4.3. Ablation Study
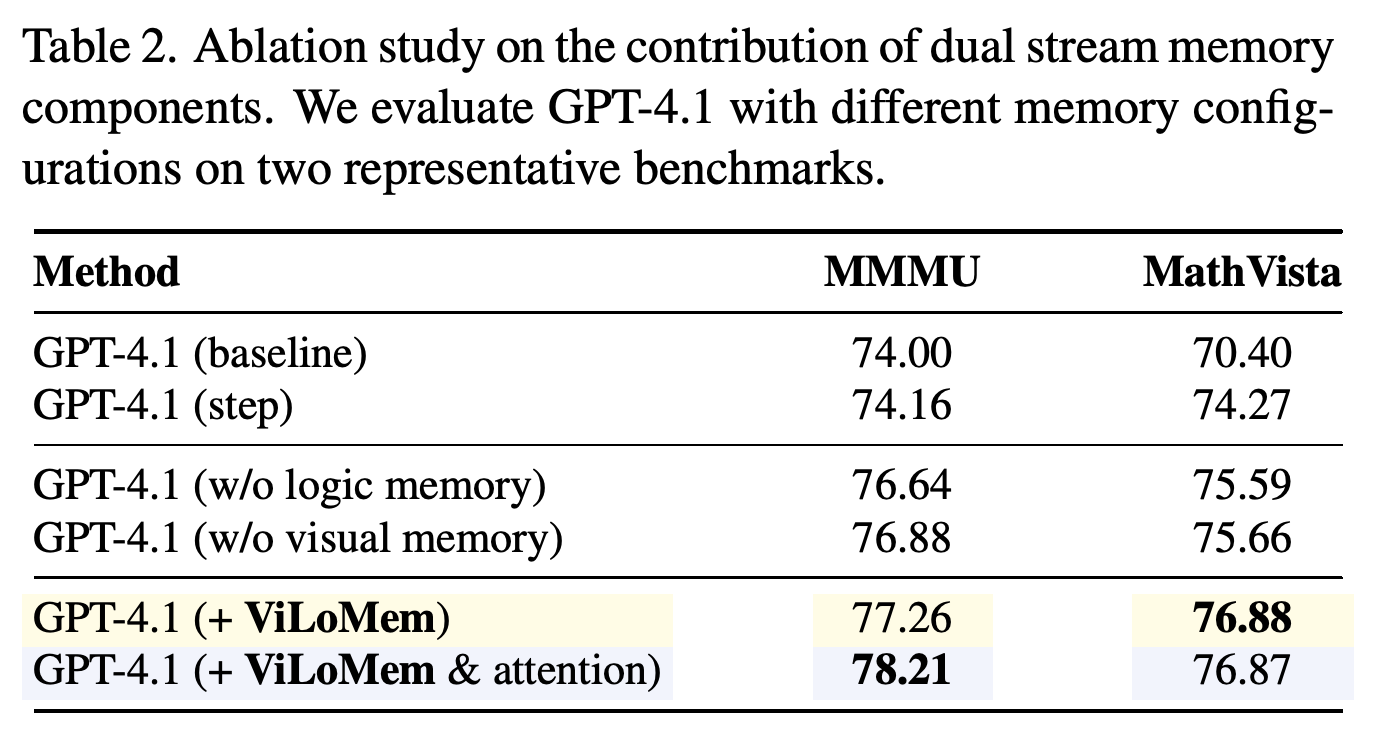
GPT-4.1에서 논리 메모리를 제거하면 MMMU/MathVista 정확도가 77.26/76.88에서 76.64/75.59로 바뀐다. 시각 메모리를 제거하면 76.88/75.66으로 바뀐다. 이 결과는 평가한 2개 벤치마크에서 양쪽 메모리가 상호 보완적으로 기여함을 뒷받침한다. 논리 메모리의 기여는 MMMU보다 MathVista에서 더 크다.
- 어텐션 맵을 추가하면 MMMU 점수는 78.21로 올라가지만 MathVista 점수는 76.87로 바뀌어 76.88보다 조금 낮아진다.
- 어텐션을 사용하는 변형은 추가 설정이므로, 그 결과를 표준 ViLoMem 결과와 구분해야 한다.
어느 메모리 경로를 제거해도 MMMU와 MathVista에서 전체 ViLoMem보다 정확도가 낮아진다. 어텐션은 MMMU 점수를 0.95 percentage points 높이지만 MathVista 점수는 −0.01만큼 바꾼다. 보조 히트맵의 효과가 2개 벤치마크에서 다름을 보여준다.
4.4. Memory Usage Analysis
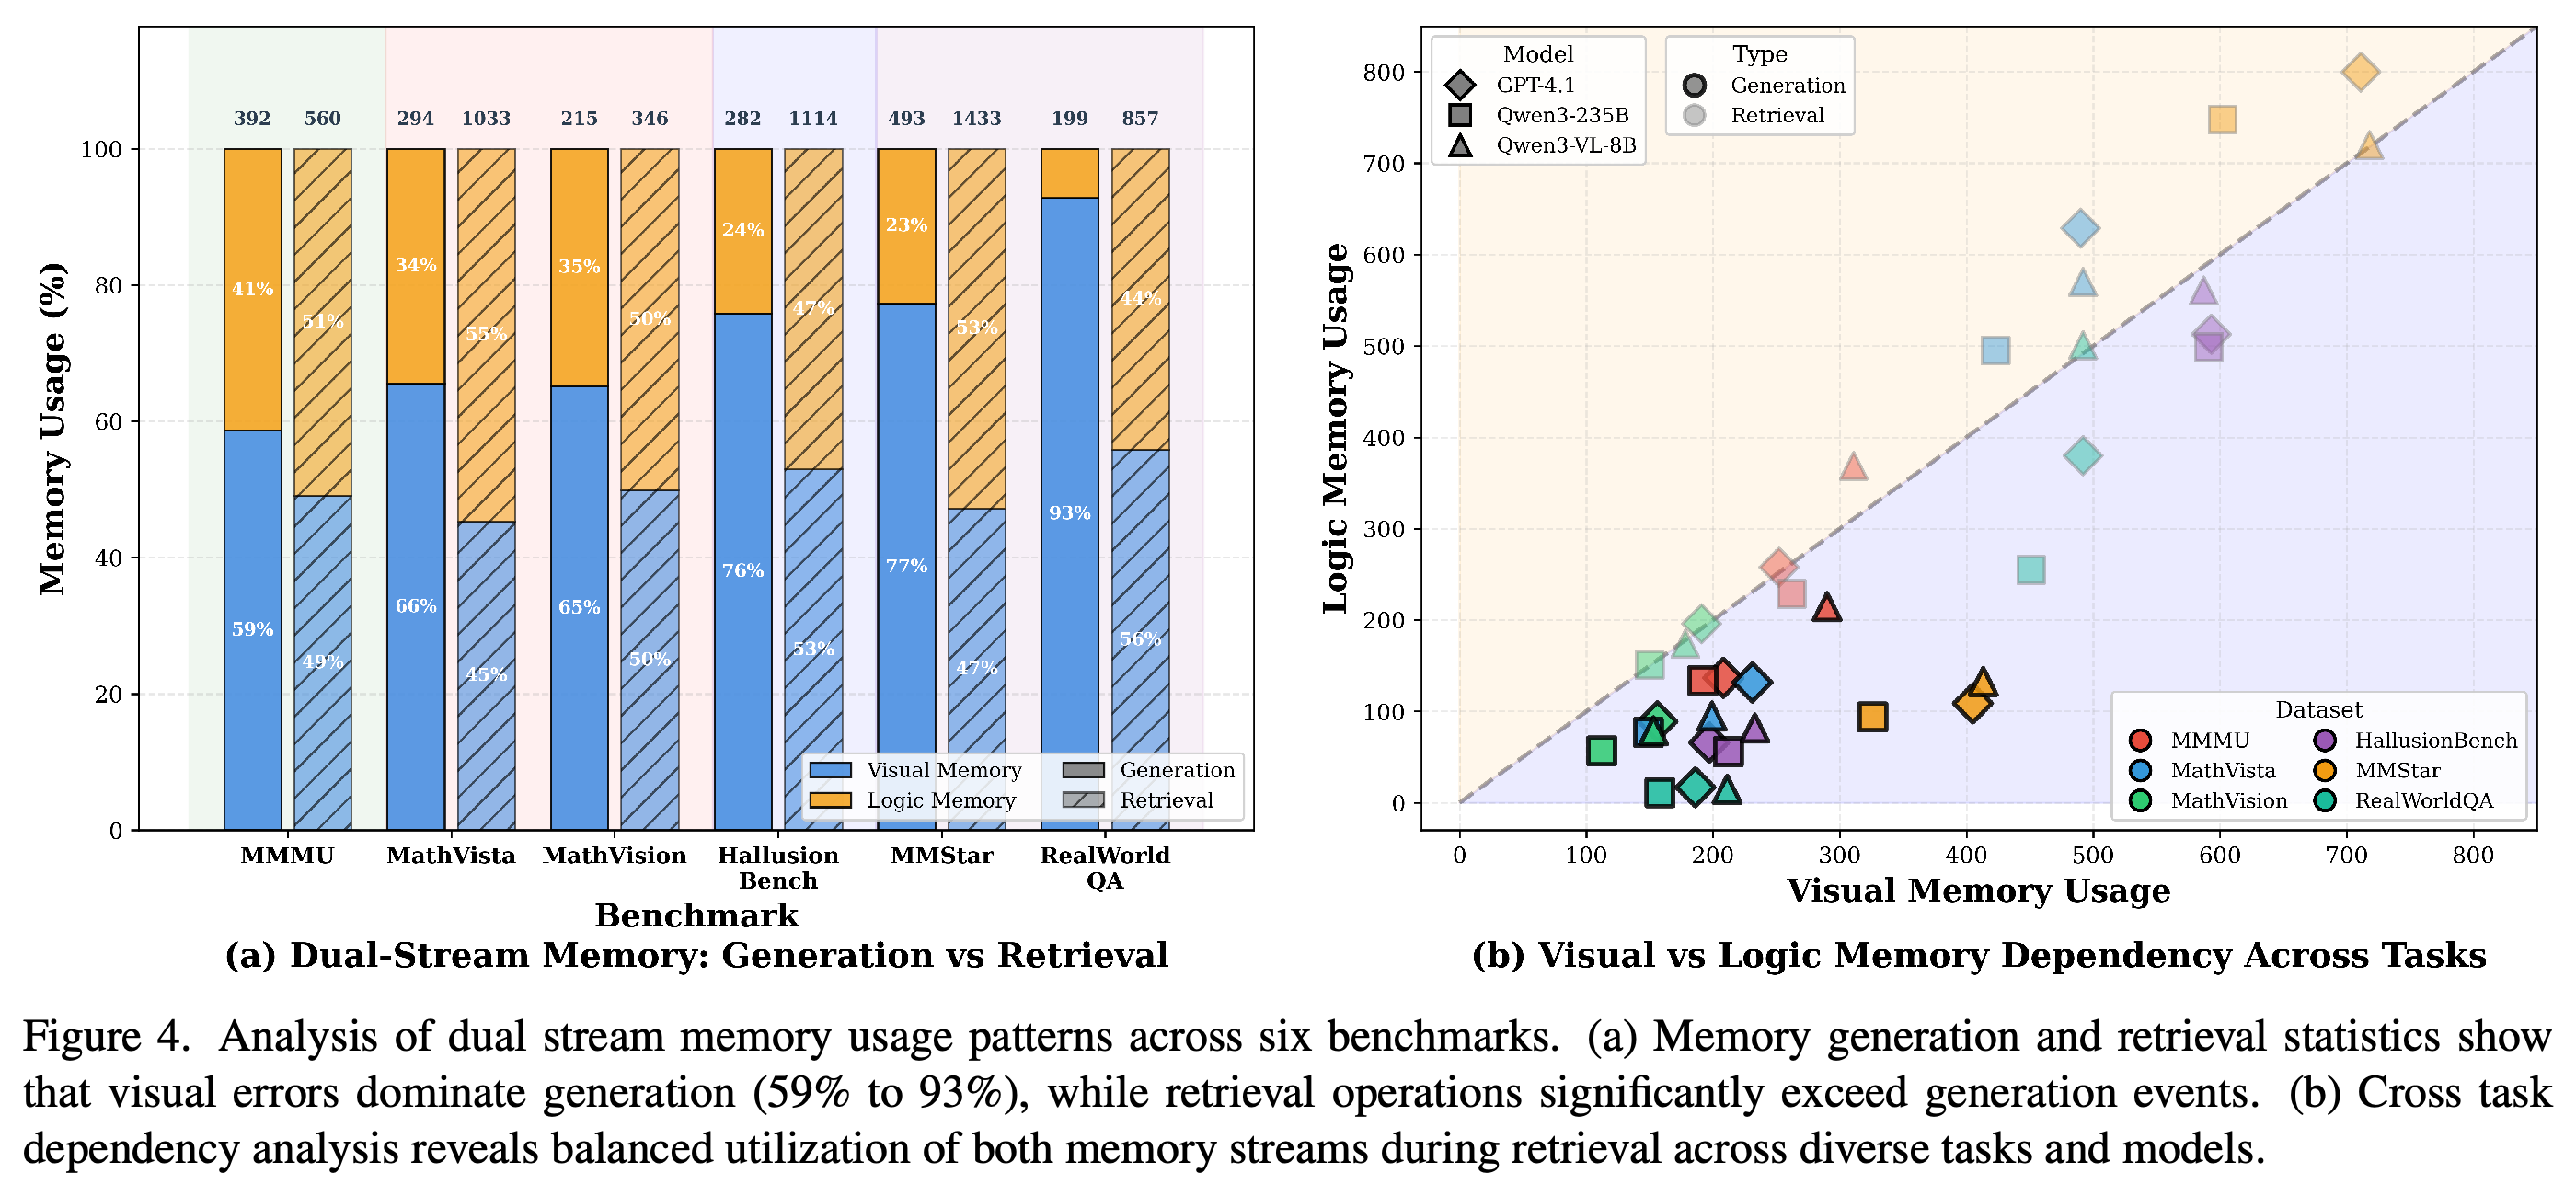
6개 벤치마크에서 생성된 메모리 중 시각 메모리가 59%–93%를 차지한다. 반면 검색된 메모리는 시각 메모리와 논리 메모리의 비중이 더 고르게 나뉜다. 검색 횟수도 생성 횟수보다 많아 이전에 저장한 지침을 재사용함을 보여준다.
- 이 통계는 프레임워크 자체의 오류 원인 분류와 메모리 연산을 반영한다. 모든 모델 오류를 독립적으로 주석 처리해 집계한 결과는 아니다.
- 3개 문제 풀이 모델에서 비슷한 검색 패턴이 나타나 양쪽 메모리를 사용함을 보여주지만 횟수만으로 검색된 모든 항목의 유용성을 입증할 수는 없다.
생성된 메모리는 시각 메모리가 59%에서 93%를 차지하지만 검색에서는 양쪽 경로를 더 고르게 사용한다. 이 패턴은 시스템 자체의 오류 원인 분류 방식에 따른 생성 빈도 차이와 메모리 재사용을 보여준다.
4.5. Cross-Model Memory Transfer
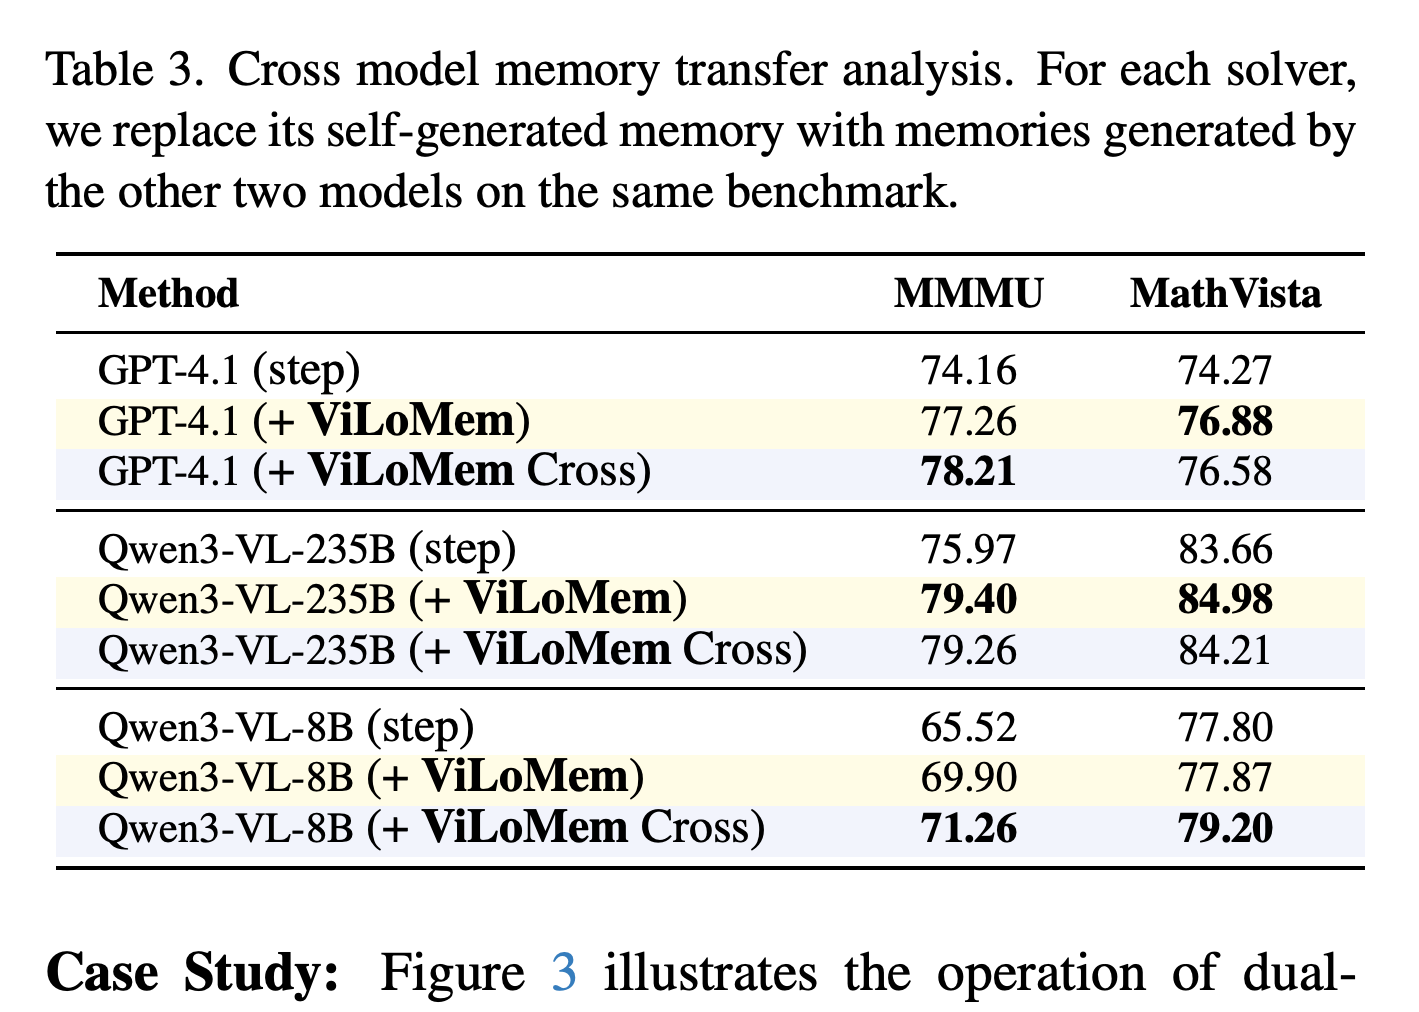
Cross-Model Memory Transfer는 각 문제 풀이 모델의 자체 메모리를 같은 벤치마크에서 다른 2개 모델이 생성한 메모리로 대체한다. Qwen3-VL-8B는 MMMU에서 69.90에서 71.26으로, MathVista에서 77.87에서 79.20으로 개선된다. 가중치 미세 조정 없이 각각 1.36 및 1.33 percentage points의 향상을 얻는다.
- GPT-4.1은 MMMU에서 77.26→78.21로 개선되지만 MathVista에서는 76.88→76.58로 하락한다.
- Qwen3-VL-235B는 평가한 2개 벤치마크 모두에서 79.40→79.26 및 84.98→84.21로 조금 하락한다. 이 실험에서는 더 작은 문제 풀이 모델이 가장 큰 전이 효과를 얻는다.
문제 풀이 모델의 자체 메모리를 다른 2개 모델의 메모리로 대체하면 8B 문제 풀이 모델은 평가한 2개 벤치마크 모두에서 개선된다. GPT-4.1의 변화는 엇갈리고 235B 문제 풀이 모델은 양쪽 모두에서 조금 하락한다. 따라서 모델 간 전이가 보편적으로 유익하다고 볼 근거는 제한적이다.
4.6. Cross-Benchmark Memory Generalization
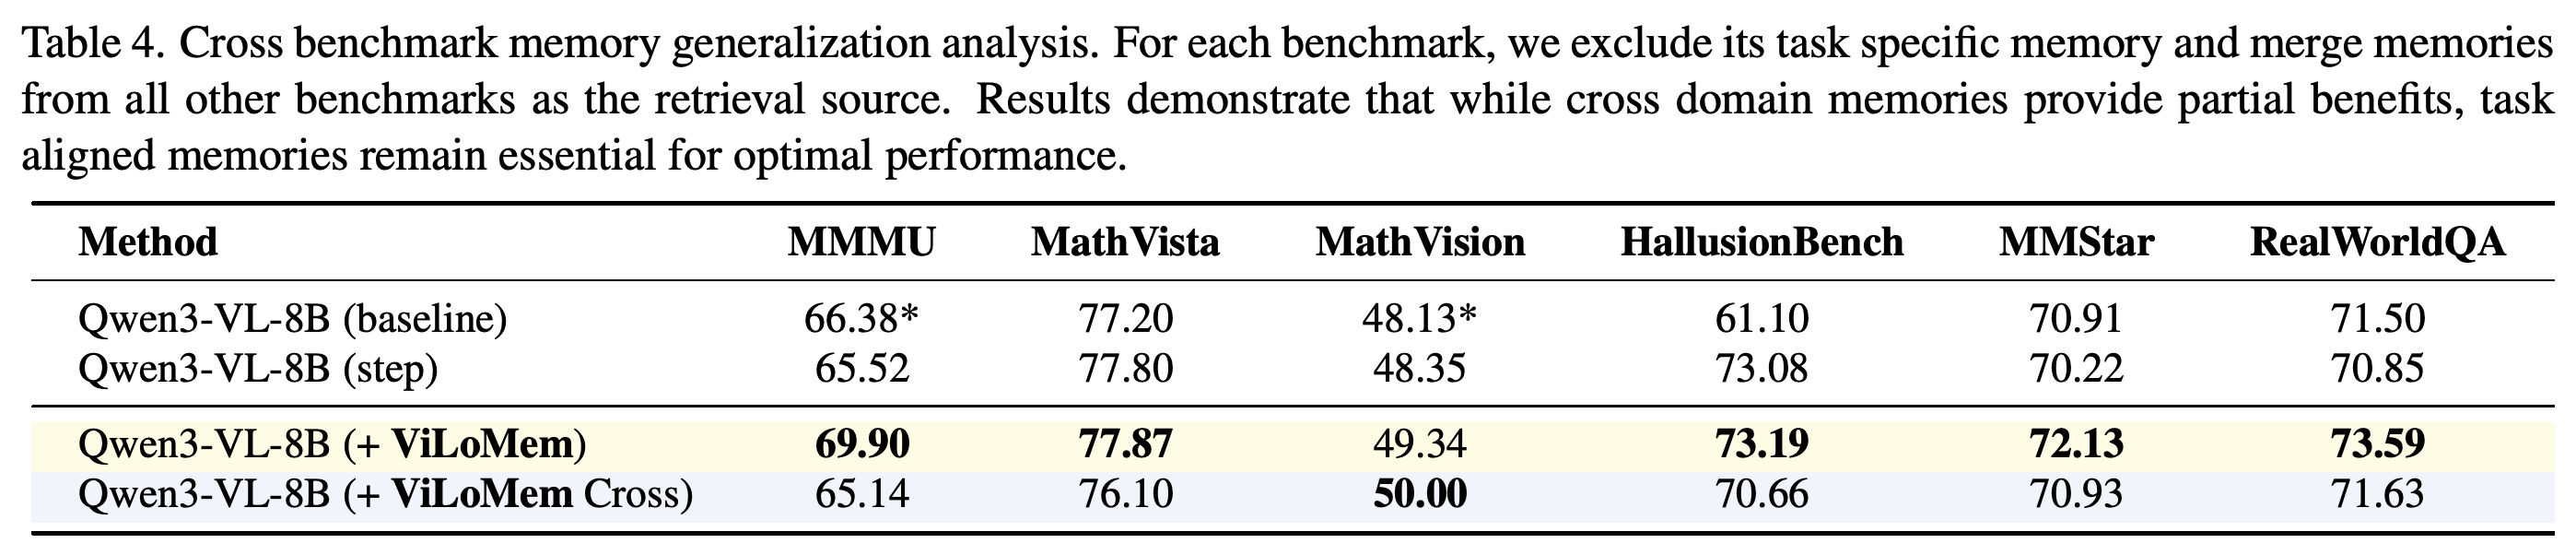
Cross-Benchmark Memory Generalization은 목표 벤치마크의 메모리를 제외하고 나머지 모든 벤치마크의 메모리를 Qwen3-VL-8B-Instruct에 적용한다. Step 대비 MathVision은 48.35→50.00, MMStar는 70.22→70.93, RealWorldQA는 70.85→71.63으로 상승한다. 반면 MMMU는 65.52→65.14, MathVista는 77.80→76.10, HallusionBench는 73.08→70.66으로 하락한다.
- 과제별 ViLoMem 메모리와 비교하면 다른 벤치마크에서 가져온 메모리는 6개 중 5개에서 성능이 낮다. 예외는 MathVision으로, 49.34→50.00으로 상승한다.
- 이 결과는 전이 효과가 과제에 따라 달라짐을 보여주며, 맞지 않는 메모리가 간섭을 일으킬 수 있다는 해석과도 부합한다.
목표 벤치마크의 메모리를 제외하면 전이 효과가 엇갈린다. Step 대비 MathVision, MMStar, RealWorldQA의 정확도는 오르지만 MMMU, MathVista, HallusionBench의 정확도는 떨어진다. 과제별 메모리는 6개 벤치마크 중 5개에서 더 높은 성능을 보인다.
4.7. Memory Scalability
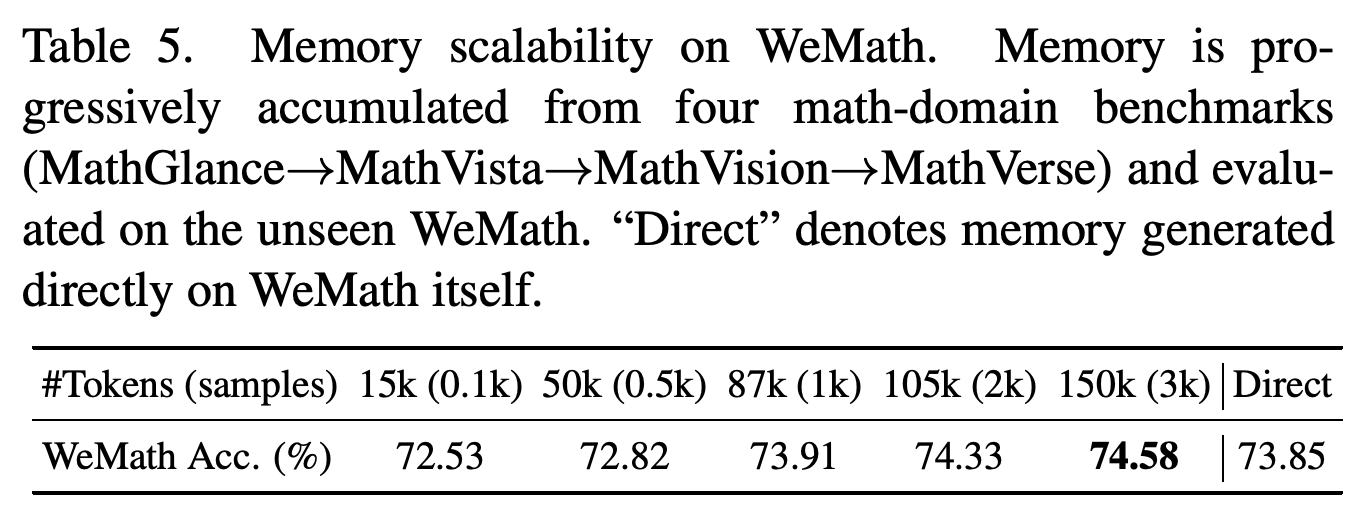
Memory Scalability는 MathGlance→MathVista→MathVision→MathVerse 순서로 메모리를 축적하고 아직 접하지 않은 WeMath에서 평가한다. MathGlance는 수학 도형 지각 벤치마크이고, MathVerse는 시각 수학 벤치마크이며 WeMath는 수학 추론 벤치마크다. 정확도는 15k tokens(0.1k samples)에서 72.53%, 50k(0.5k)에서 72.82%, 87k(1k)에서 73.91%, 105k(2k)에서 74.33%, 150k(3k)에서 74.58%로 상승한다. 이는 WeMath에서 직접 생성한 메모리를 사용할 때의 73.85%보다 높다.
- 이 실험은 점진적으로 축적한 수학 메모리 저장소가 WeMath에서 점점 더 유용해짐을 보여준다.
- 평가 대상이 계속 WeMath이므로, 이후 경험을 쌓으면서 이전 과제의 성능이 떨어지는 파국적 망각을 직접 검증한 결과는 아니다.
보고된 메모리 크기의 각 측정 지점에서 WeMath 정확도가 상승한다. 150k tokens에서 74.58%에 도달해 Direct 조건의 73.85%를 넘는다. 이는 축적된 수학 메모리가 WeMath에 유용함을 뒷받침하지만 이전 과제의 성능 유지 여부를 직접 입증하지는 않는다.
5. Conclusion
결론에서는 ViLoMem의 성능 향상을 시각 지침과 논리 지침의 분리, 각 메모리에 특화된 검색, 점진적인 병합과 생성 갱신으로 설명한다. Step과의 비교, 구성 요소 제거 실험, 더 작은 문제 풀이 모델로의 전이는 이러한 작동 방식을 뒷받침한다. 다만 이전 과제의 성능 유지 여부를 직접 측정하지 않았으므로 더 넓은 지속 학습 주장을 뒷받침하는 근거에는 한계가 있다.
부록
- Supplementary Material의 “6. Additional Results and Ablation Study”는 “6.1. Integration with more models”부터 시작하며 평가를 GLM4.1v, InternVL3-38B, Gemini2.5-flash로 확장한다. 3개 모델 모두 보고된 6개 벤치마크에서 Step보다 개선되지만 GLM4.1v와 Gemini2.5-flash는 RealWorldQA에서 기본 프롬프트 기준 점수보다 낮다. “6.2. Attention Mechanism Ablation”에서는 효과가 엇갈린다. 어텐션을 사용하면 GPT-4.1의 MathVision 점수는 53.95에서 50.66으로 떨어지고, HallusionBench 점수는 75.29에서 75.73으로 오른다. 저자들은 수학 과제에서의 한계를 히트맵의 정밀도와 해석 문제로 설명한다. “6.3. Additional Case Study”는 신호등 확인, 자의 정렬, 공간 기준 좌표계, 차트 읽기, 착시 사례를 보여준다.
- “6.4. Comparison with Existing Memory Methods”는 원래의 누적 문맥 대신 텍스트만으로 매칭하는 검색 기반 Dynamic-Cheetsheet 변형을 평가한다. MathVista에서 ViLoMem과 비교 방법의 점수는 76.88% 대 73.87%, 검색 지연 시간은 120 대 325 ms, 저장 용량은 6.12 대 18.44 MB, 메모리 크기는 73K 대 221K tokens다. 논문은 비교 방법이 모든 사례에서 메모리를 갱신하는 반면 ViLoMem은 오답일 때만 항목을 생성하므로 메모리 저장소가 더 작아진다고 설명한다. 이 측정은 검색과 저장만 다루며, 메모리 생성, 질문 분석, 어텐션 맵 생성, 문제 풀이를 포함한 전체 비용은 반영하지 않는다.
- 2단계 검색 분석에서 메모리가 150k tokens일 때 WeMath 정확도는 74.58%, 사례당 지연 시간은 61.6 ms다. 텍스트만 검색하는 방식은 73.41%와 115 ms다. 본문은 지연 시간이 22.3배 줄었다고 주장하지만 표의 수치로 계산하면 약 1.87배다. 87k tokens에서 2단계 검색은 73.91%와 20.4 ms를 기록하고 텍스트만 검색하는 방식은 73.22%와 22.8 ms를 기록한다.
- “6.5. Failure Case Analysis”는 GPT-4.1로 평가한 MMMU 표본 1,041개에서 성능이 악화된 사례 66개를 식별한다. 22개 사례(33.3%)는 일반적인 시각 지침과 관련되고 44개(66.7%)는 검색 결과가 비어 있는 경우다. 보고된 순향상 +8.86%와 본표의 74.00→77.26 결과 사이의 차이는 설명되지 않는다. “6.6. Visual Memory Characterization”은 분야를 맞춘 표본 835개를 분석한다. 전체 시스템에서 시각 메모리를 제거해 측정한 시각 메모리 기여도는 Tech & Engineering에서 +9.8이고, 논리 메모리를 제거해 측정한 논리 메모리 기여도는 Health & Medicine에서 +8.1이다. Business에서는 양쪽 기여도가 모두 음수다. “6.7. Results on Visual Perception Benchmarks”는 MathGlance에서 시각 항목 166개와 논리 항목 16개를 생성하고 평균 정확도가 +1.87% 향상되었다고 보고한다. 다만 현재의 이진 오류 기반 갱신 방식은 문자 매칭 점수로 평가하는 지각 벤치마크인 OCRBench와 DocVQA를 직접 지원하지 않는다고 설명한다.
- “7. Additional Experimental Details”는 온도를 0.7로 설정하고 최대 출력 길이를 문제 풀이 모델은 8,192 tokens, 문제 분석은 1,024 tokens, 메모리 생성은 2,048 tokens로 명시한다. 로컬에 배포한 모델 대부분은 배치 추론 엔진인 vLLM을 사용한다. Qwen3-VL-235B-A22B-Instruct와 독점 모델은 제공업체의 애플리케이션 프로그래밍 인터페이스(APIs)를 사용하며 거절된 요청이 보고된 점수에 잡음을 더한다. 어텐션 맵은 Qwen2.5-VL-3B로 토큰 수준의 중요도를 생성해 이미지에서 강조되는 영역을 표시한다. 답변 매칭이 모호할 때는 답변 검증 도구인 Math-Verify와 판정 모델인 Qwen3-8B-Instruct를 사용한다. “8. Prompt Templates”는 Step, 문제 분석, 논리 메모리, 시각 메모리, 답변 검증의 템플릿을 제공한다. 검증은 추론의 품질과 별개로 최종 답변의 일치 여부를 평가한다.
짧은 생각
구성 요소 제거 실험과 정성적 사례는 추론 규칙과 함께 시각 관찰 오류를 교정하는 전략을 저장하는 접근법을 뒷받침한다. 실제 배포를 평가하려면 메모리 구축 사례와 평가 사례의 명시적인 분리, 검색 설정의 수치, 참조 답변의 확보 여부, 전체 처리 과정의 비용도 확인해야 한다. 제공된 실험 절차에서는 이 사항들이 해결되지 않은 채 남아 있다. 벤치마크별 예외, Business의 음수 기여도, 성능 악화 사례를 고려하면 메모리의 관련성도 반드시 평가해야 한다.