


SIMA 2: A Generalist Embodied Agent for Virtual Worlds 요약 설명
04 Dec 2025 | Paper Review Embodied Agents Vision-Language-Action Models Self-Evolving Agents이번 글에서는 SIMA 2: A Generalist Embodied Agent for Virtual Worlds 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 4일(Arxiv)
- SIMA team, Bolton, Adrian, Lerchner, Alexander, Cordell, Alexandra, Moufarek, Alexandre, Bolt, Andrew, Lampinen, Andrew, Mitenkova, Anna, Hallingstad, Arne Olav, Vujatovic, Bojan, et al.
- Google DeepMind
- 논문 링크
요약
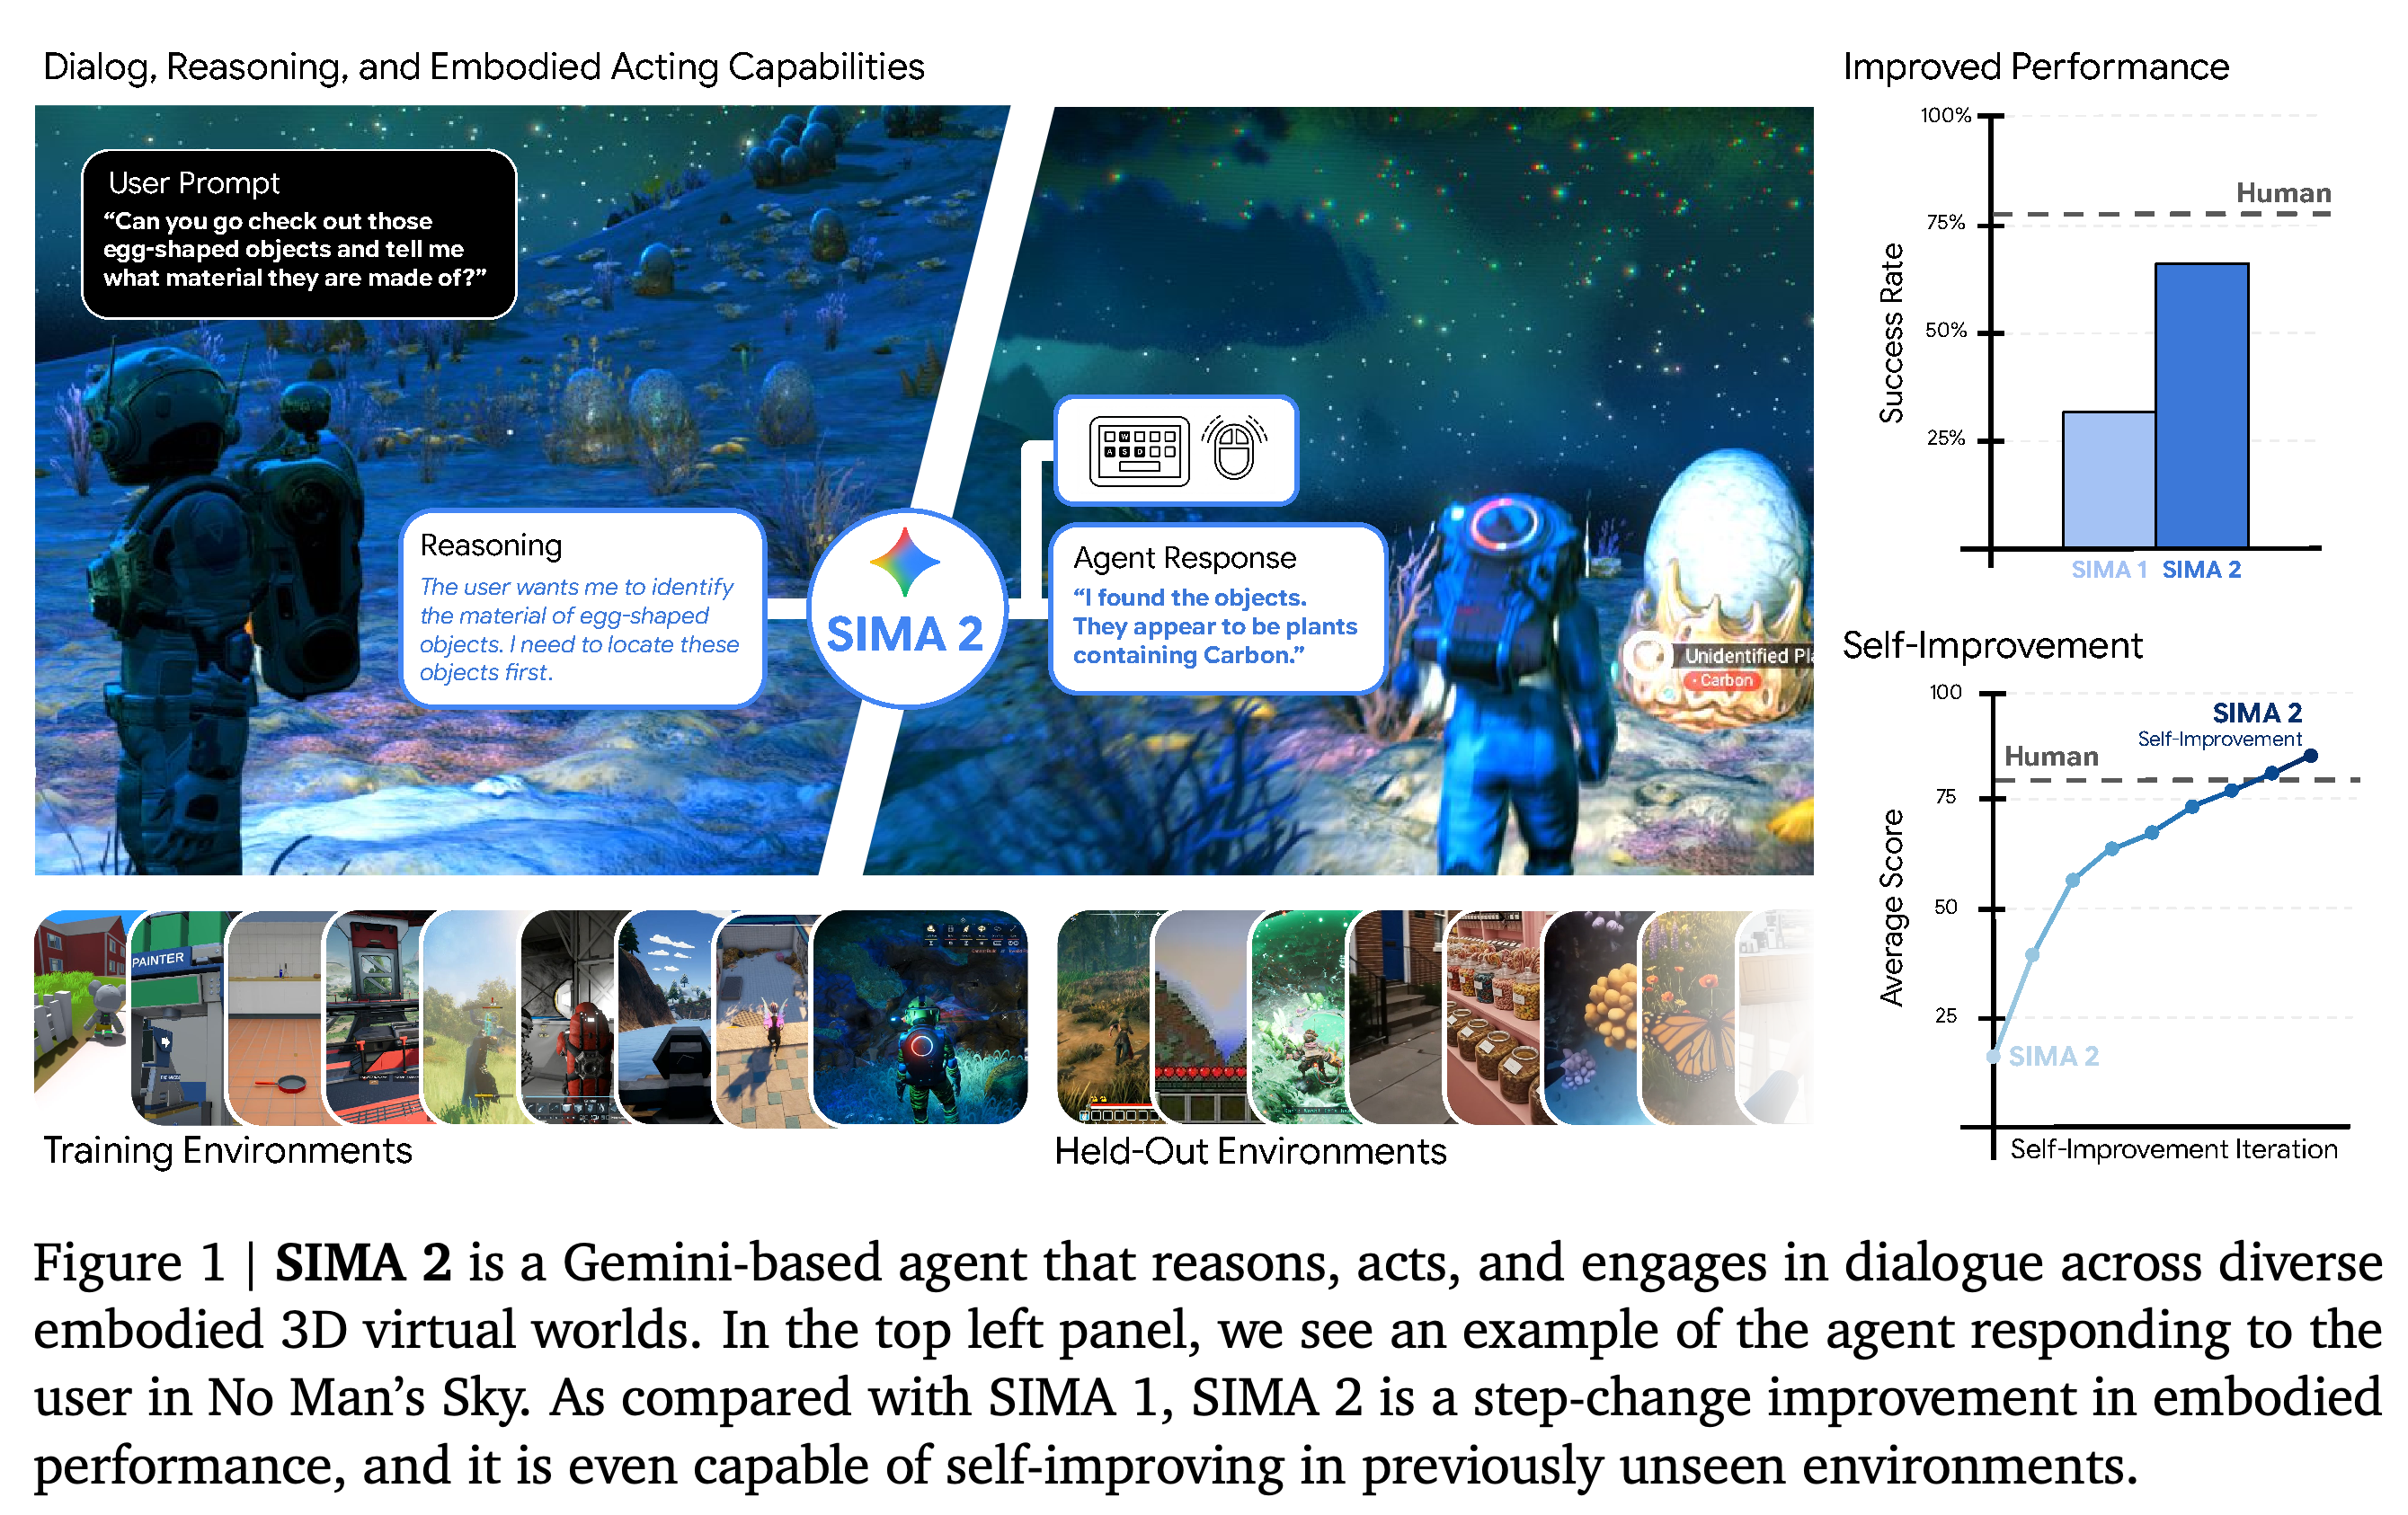
- 이 논문은 이미지와 언어를 처리하는 사전 학습된 멀티모달 모델을, 행동을 통해 다양한 3D 게임 환경을 관찰하고 변화시키는 체화 에이전트로 만드는 방법을 다룬다. 개정된 평가 모음에서 학습 환경 내의 홀드아웃 과제를 평가한 결과, SIMA 2의 성공률은 인간 평가에서 65%, 자동 평가에서 66%다. SIMA 1의 성공률은 각각 33%, 30%다. SIMA는 Scalable Instructable Multiworld Agent의 약자다.
- 에이전트는 예시에서 배우는 지도 미세 조정(SFT)으로 Gemini Flash-Lite를 체화 과제에 맞게 학습한 뒤, 보상을 통해 행동을 개선하는 강화 학습(RL)을 수행한다. 인간의 게임 플레이 데이터로 키보드와 마우스 제어를 배우고, 대화와 추론을 행동에 연결하는 합성 bridge data로 상호작용 능력을 학습한다. 일반 능력을 유지하기 위해 게임 플레이 외의 사전 학습 데이터도 함께 사용한다.
- SIMA 2는 바이킹 마을을 건설하는 생존 게임 ASKA와 Minecraft 과제 벤치마크 MineDojo에서도 작동한다. 해당 환경에서 체화 학습을 수행하지 않았지만 전이가 가능하며 절대 성공률은 여전히 낮다. 스토리 중심의 액션 어드벤처 게임 The Gunk와 상호작용 가능한 가상 환경을 생성하는 모델 Genie 3에서도 정성적 시연을 제시한다. 별도의 Gemini Pro 모델은 상위 수준의 지시와 호출 사이에 전달할 텍스트 요약을 제공할 수 있다.
- 달성 가능한 지시를 제안하는 Gemini 과제 설정 모델과 기록된 시도를 채점하는 보상 모델을 통해, ASKA와 Genie 3 환경에서 스스로 생성한 경험으로 학습한다. 실험은 유한한 학습 반복 과정에서 성능이 개선됨을 보여준다. 매우 긴 과제, 짧은 상호작용 기억, 정밀한 제어, 복잡한 장면 이해는 여전히 한계로 남으며 적응 후에는 일반 추론 벤치마크 점수가 하락한다.
1. Introduction
논문은 정적인 인터넷 데이터를 바탕으로 추론하는 능력과 환경에서 성공적으로 행동하는 능력 사이의 차이를 체화 학습의 동기로 제시한다. SIMA 1은 화면 이미지를 보고 짧고 직접적인 지시를 수행했지만 대화하거나 이미지 기반 지시를 받아들이지 못했고 새로운 상황으로의 일반화도 불안정했다.
- SIMA 2는 Gemini를 통합해 상위 수준의 목표를 해석하고 여러 단계의 계획을 세우며, 자신의 행동에 관해 대화한다. 또한 인간 플레이어가 사용하는 시각 입력과 키보드, 마우스 인터페이스로 행동한다.
- 실험은 가상 게임에서 수행한다. 물리적 로봇으로의 전이는 제안된 응용 방향이며 평가된 결과는 아니다.
개요는 대화를 통한 정보 탐색을 키보드 및 마우스 행동과 연결하고 SIMA 1 대비 과제 성공률 향상과 자체 생성 경험을 통한 추가 개선을 요약한다. 인간 참조선은 각각 특정 과제 평가와 채점 절차에 해당한다.
2. Background & Related Works
관련 연구는 게임 기반 에이전트 연구, 월드 모델, 사전 학습된 체화 모델, 자율적인 과제 및 보상 생성을 연결한다. SIMA 2는 시각 및 언어 입력을 행동 출력과 결합하는 vision-language-action model이며, 3D 가상 세계에 맞게 미세 조정한 모델이다.
- Games & Simulation Driving Agent Research는 제약이 많은 게임에서 시각적으로 복잡한 오픈 월드 환경으로 발전한 과정을 다룬다. 이러한 환경은 탐색을 허용하며 다양한 기술과 명시적으로 정의한 목표를 요구한다.
- World Models는 관찰과 행동으로 미래 결과를 예측하는 모델을 설명한다. Genie는 전이와 학습 실험에 사용할 새로운 상호작용 환경을 생성한다.
- Foundation Models in Embodied Agents와 Open-Ended Self-Improvement는 사전 학습된 지식을 제어 능력과 결합하고 별도의 파운데이션 모델을 에이전트, 과제 설정 모델, 보상 모델로 사용하는 근거를 제시한다. 여기서 개방형 학습은 새로운 과제를 지속적으로 생성하고 기술을 습득하려는 목표를 뜻한다.
3. Methods
제안 방법은 여러 환경에서의 학습, 공통 화면 및 입력 인터페이스, 인간과 합성 게임 플레이 데이터, 후속 보상 기반 학습을 결합한다. 평가는 익숙한 환경에서 학습에 포함되지 않은 시작 상태와 완전히 새로운 환경을 구분한다.
3.1. Environments
학습에는 Construction Lab, Playhouse, WorldLab, Goat Simulator 3, Hydroneer, No Man’s Sky, Satisfactory, Space Engineers, Valheim, Wobbly Life의 10개 환경을 사용한다. Space Engineers는 SIMA 1에 비해 새로 추가된 환경이다. 자원 채굴, 건설, 가변 중력, 6자유도 제트팩 이동을 포함하며 3개 축을 따라 병진 이동과 회전이 가능하다.
- 3.1.1. Held-Out Environments는 학습에 포함되지 않은 저장된 시작 상태와, 시각적 요소, 메뉴, 게임 방식이 낯선 완전히 새로운 게임을 구분한다.
- ASKA와 Minecraft는 정량적으로 평가한다. MineDojo 부분집합은 Combat, Harvest, Tech Tree 범주의 50개 과제로 구성되며, 각 과제는 환경 구성을 지정하는 무작위 시드 15개로 평가한다. Tech Tree 과제는 제작 의존 관계에 따라 진행해야 한다.
- The Gunk에서는 이동과 흡입 도구 사용이 필요하다. Genie 3는 정성적 평가를 위해 자연 풍경과 도시를 사실적으로 표현한 새로운 환경을 생성한다.
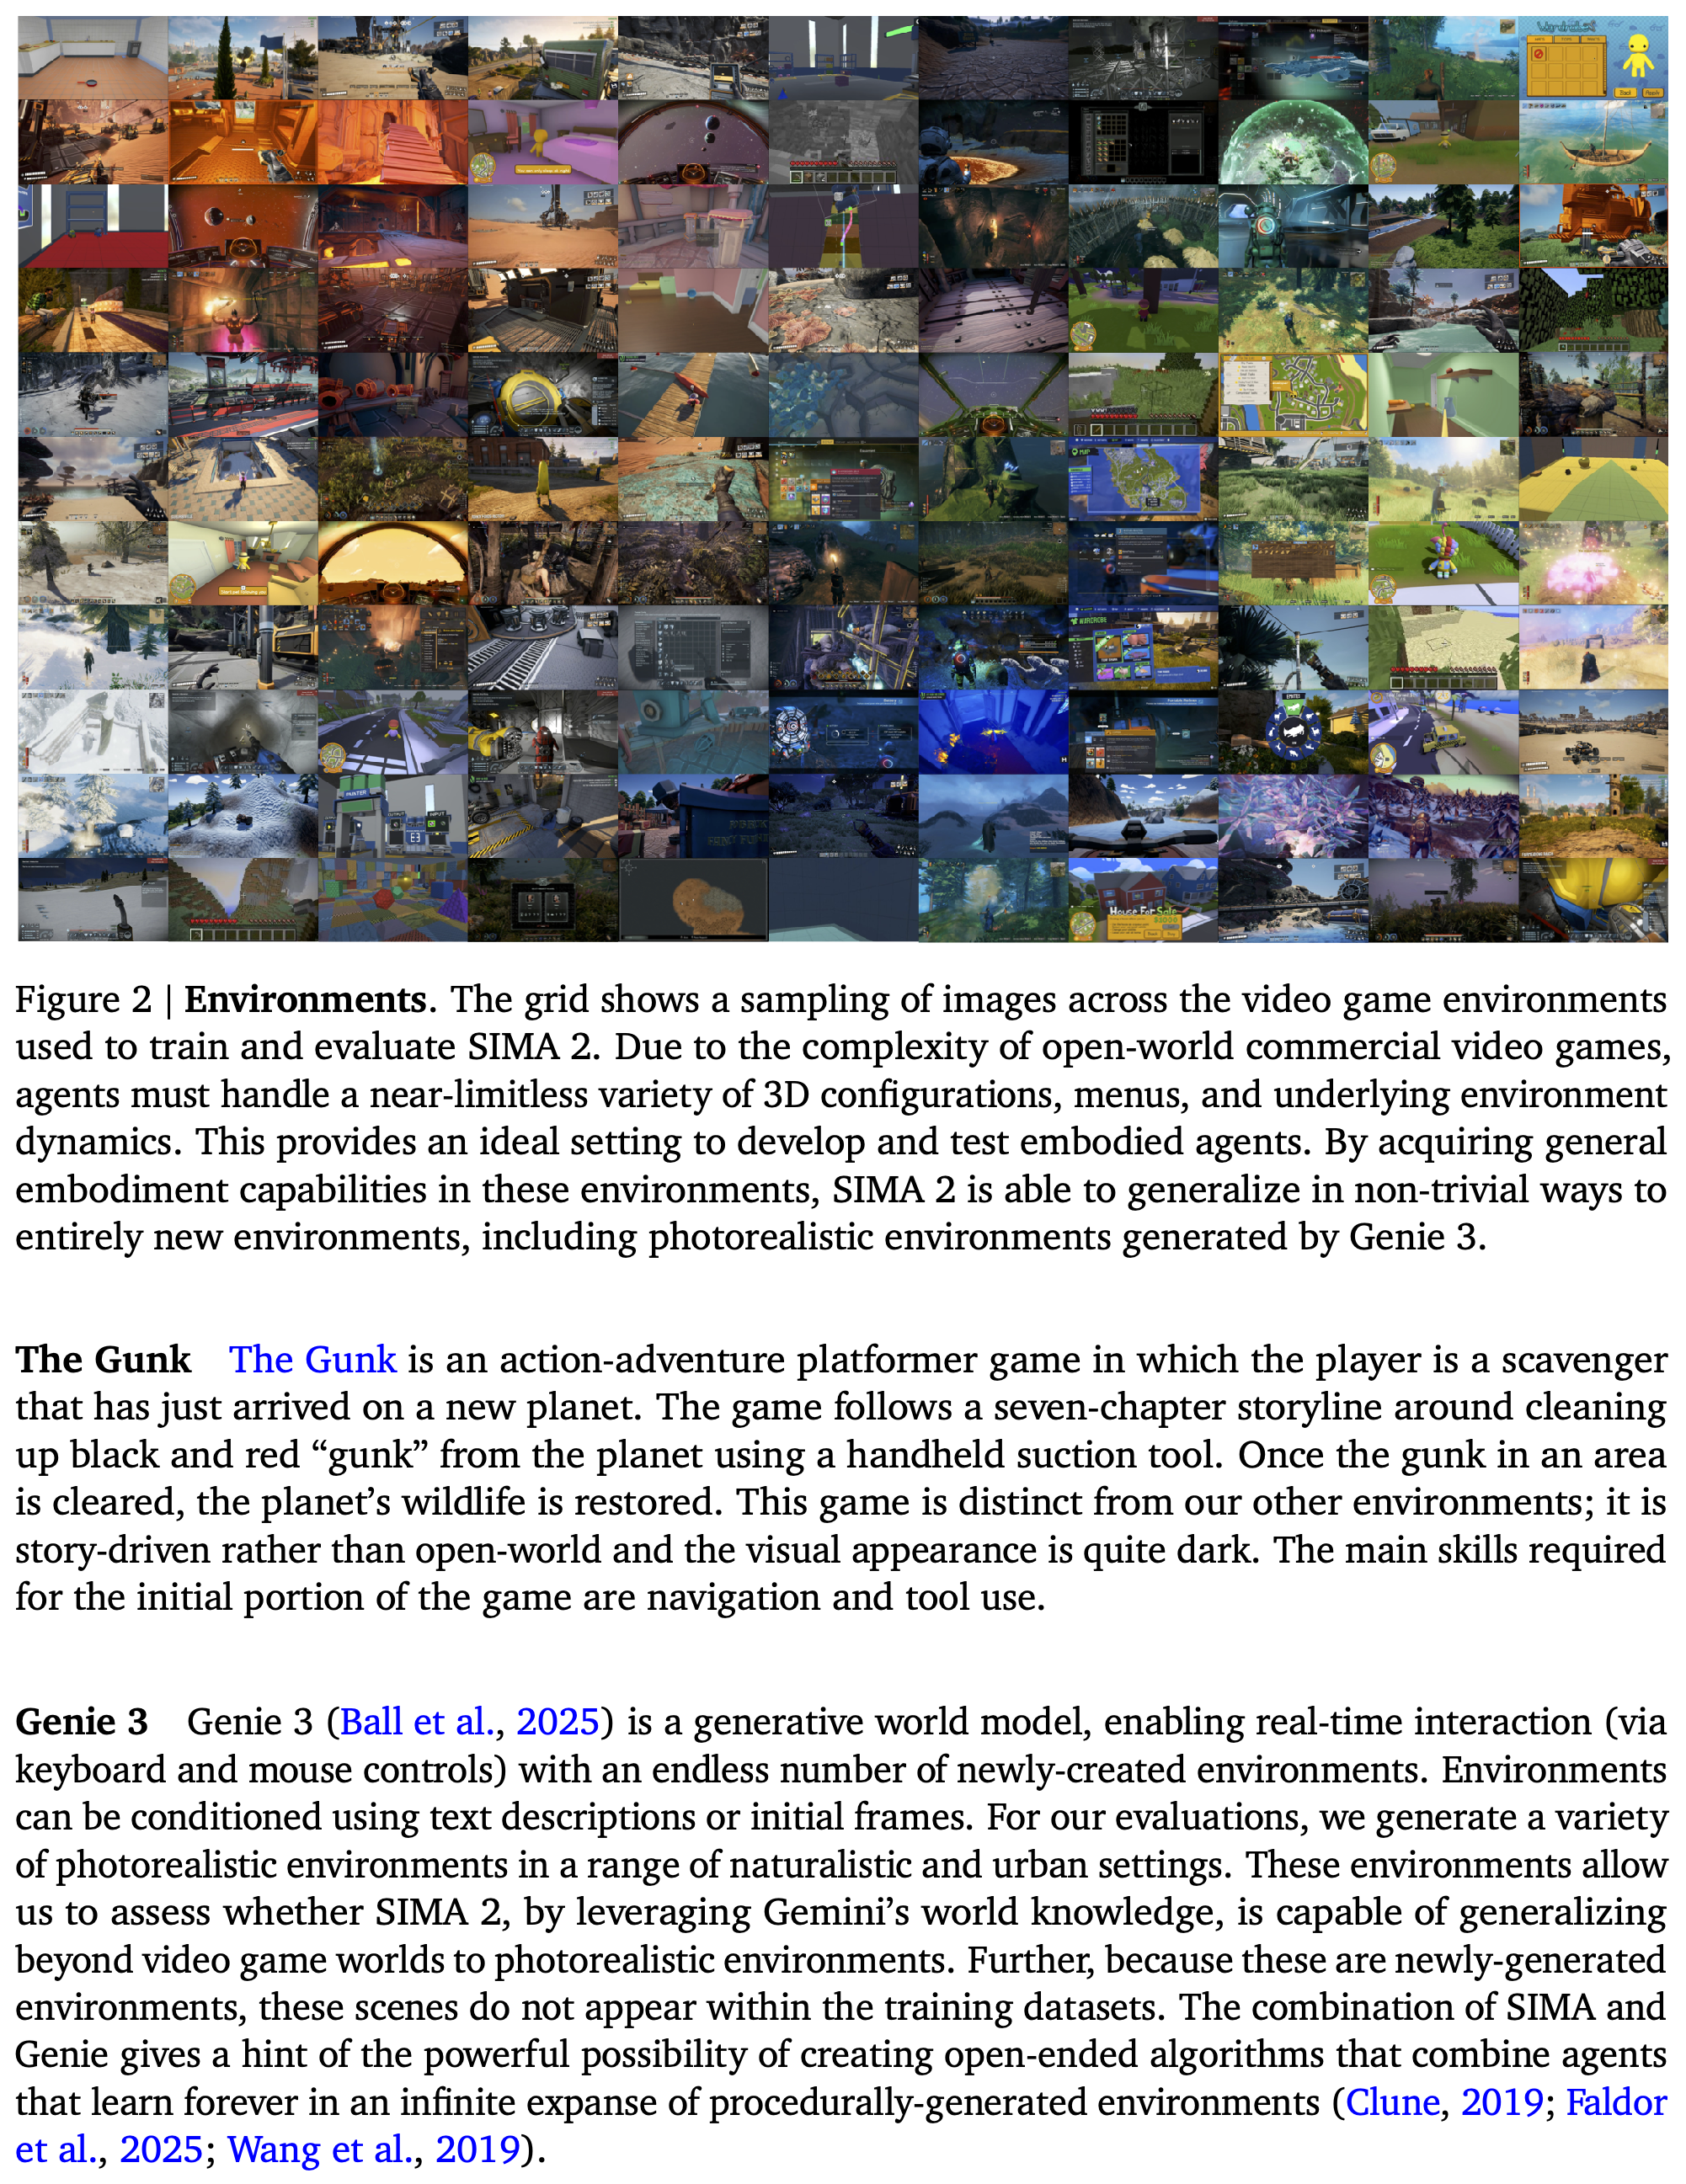
스크린샷 모음은 학습 및 평가 환경에 걸쳐 장면, 인터페이스, 시야 조건이 달라지는 모습을 보여준다. 실험 환경의 다양성을 나타내며, 정량적인 전이 결과는 뒤에서 제시한다.
3.2. Agent-Environment Interface
에이전트는 빨강, 초록, 파랑 채널로 색상을 표현하는 720p RGB 영상 프레임과 함께 지시 이력 및 자신이 생성한 텍스트를 입력받는다. 내부 게임 상태에 대한 특권 정보는 제공받지 않는다. 출력은 구조화된 텍스트이며 정해진 규칙에 따라 파싱해 환경에 적용할 제어 시퀀스인 action chunk, 대화, 내부 추론으로 변환한다.
- 행동 인터페이스에는 표준 키보드 키 96개, 마우스 클릭, 이산화한 상대 마우스 이동이 포함된다.
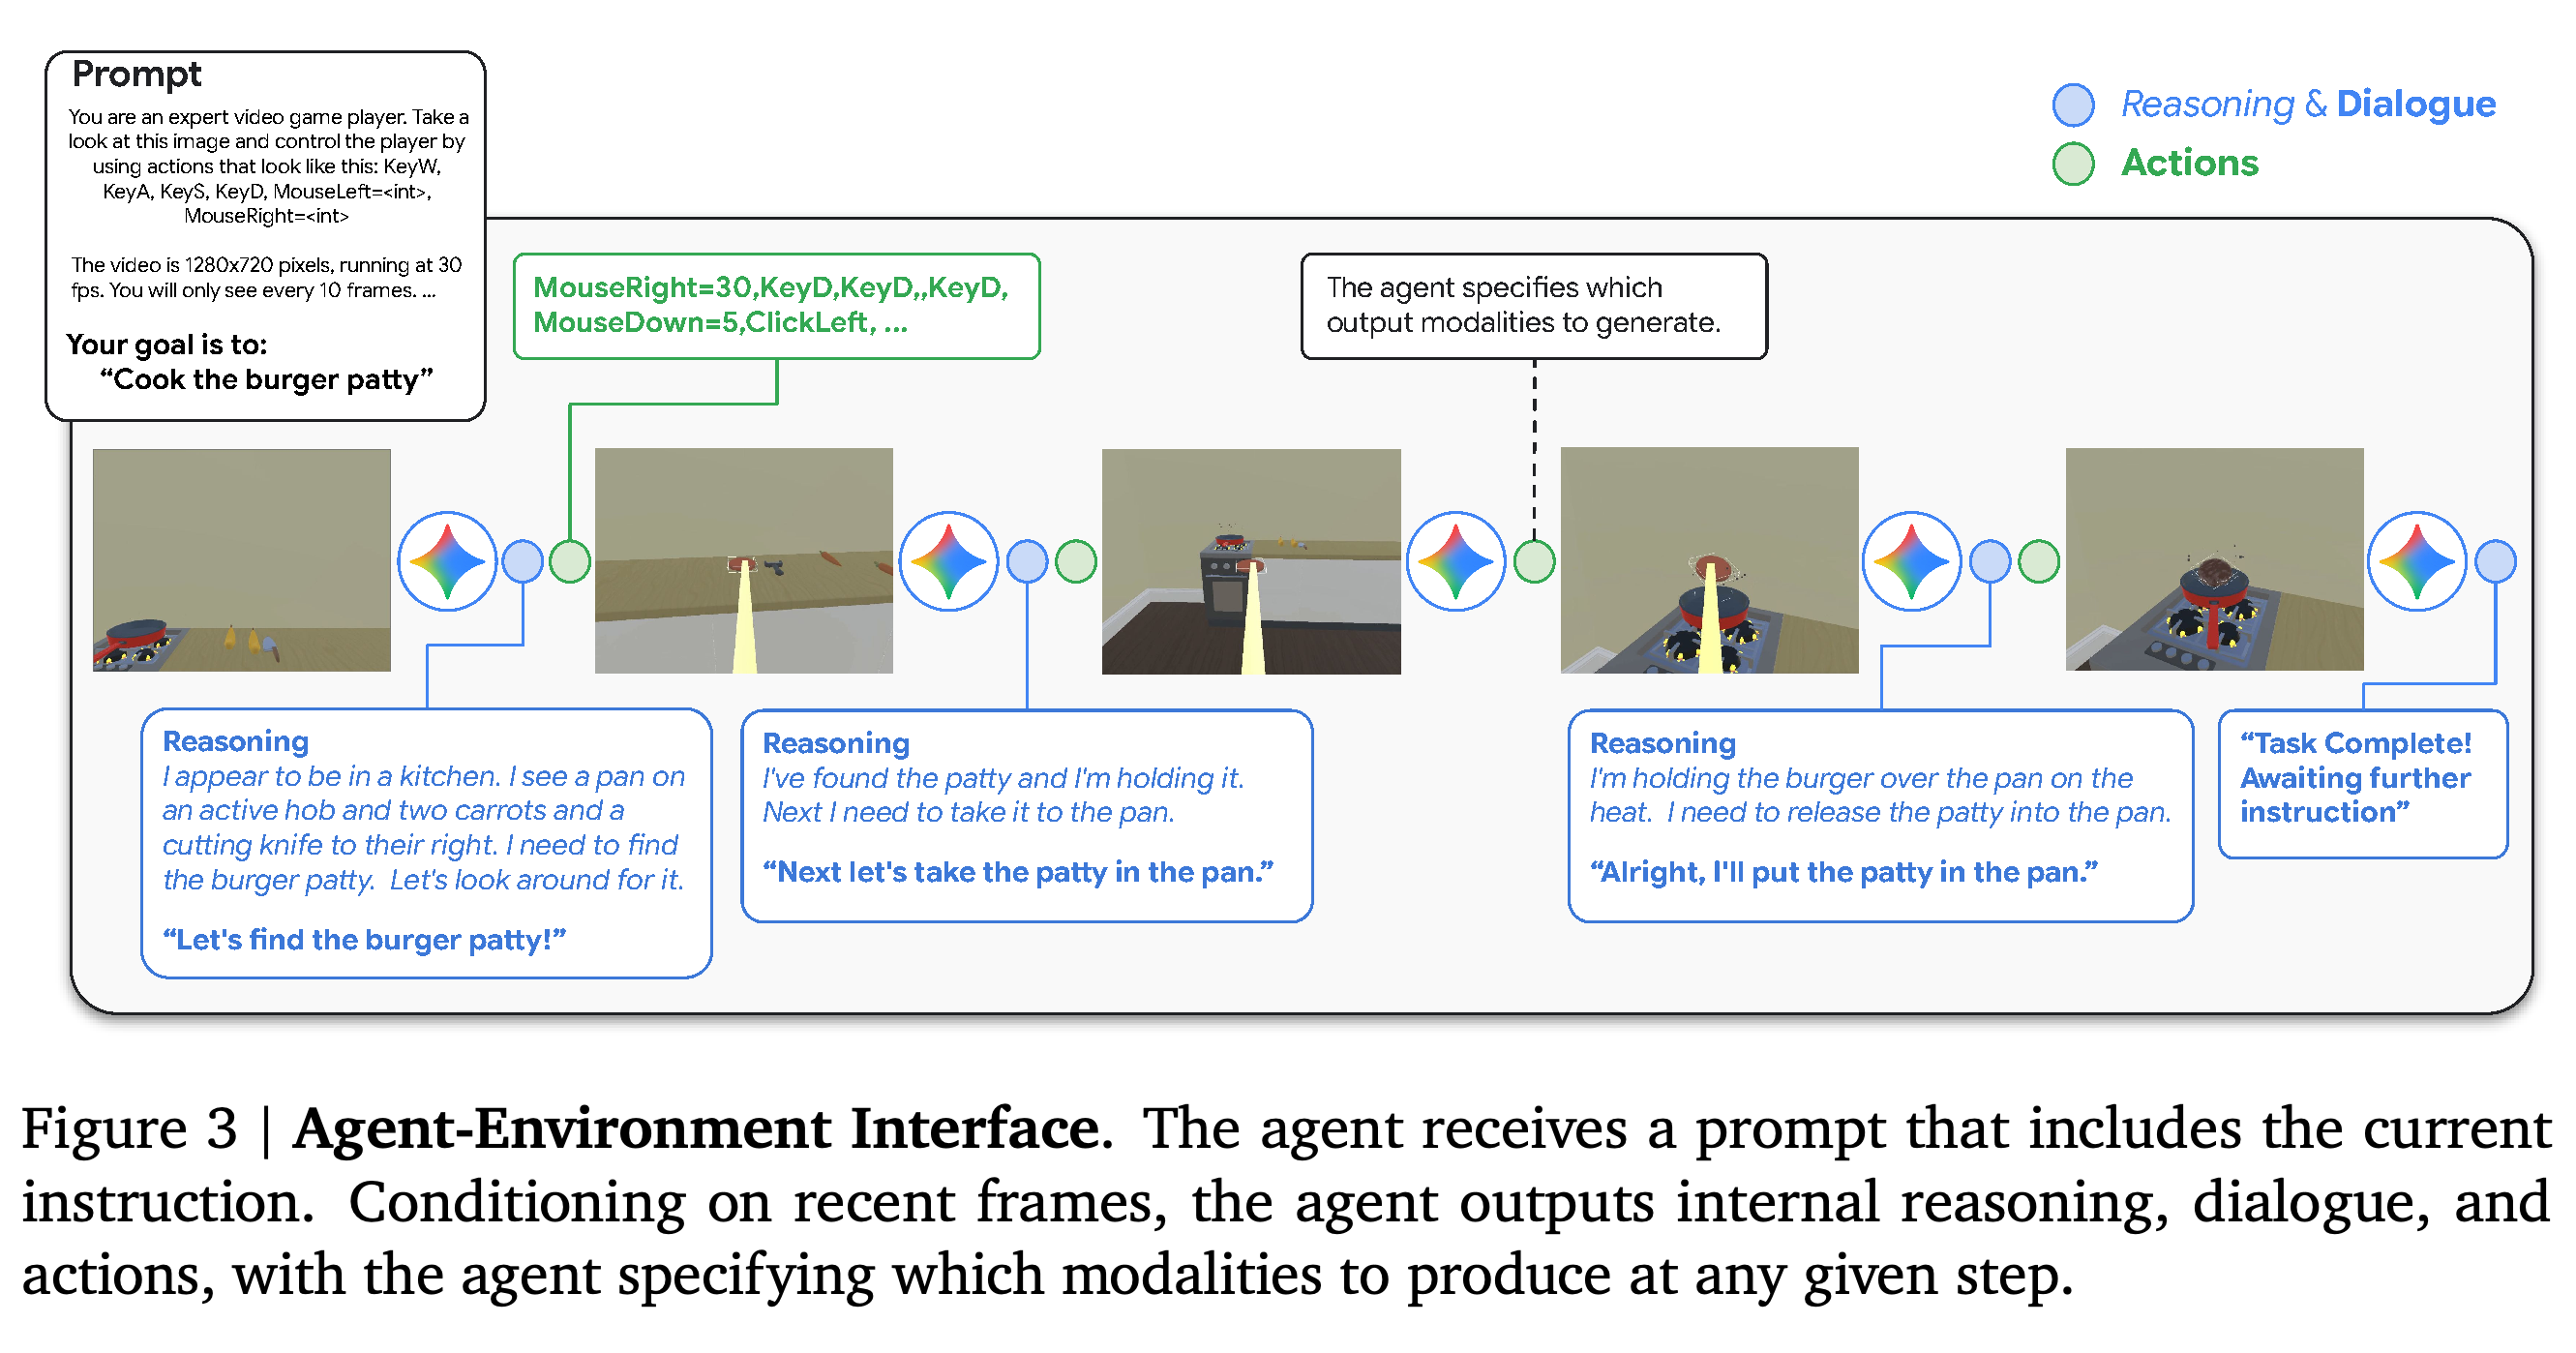
- 에이전트는 각 단계에서 생성할 출력 유형을 선택한다. Figure 3은 햄버거 조리 과제에서 이러한 출력이 번갈아 나타나는 모습을 보여준다.
햄버거 조리 시퀀스는 단일 모델이 프레임 해석, 대화 및 추론 텍스트 생성, 제어 출력 사이를 오가는 모습을 보여준다. 언어와 행동은 상호작용 이력을 공유하며 에이전트는 과제가 완료되었다고 판단하면 이를 알린다.
3.3. Data, Agent & Training
Gemini Flash-Lite는 게임 플레이 데이터와 Gemini 사전 학습 데이터를 혼합해 미세 조정한다. 저자들은 시각 이해, 대화, 추론, 프롬프트에 대한 반응성을 유지하려면 게임 플레이 외의 데이터를 계속 사용하는 것이 필수적이라고 보고한다.
- 관찰과 행동을 순서대로 기록한 인간 궤적이 학습 데이터 분량의 대부분을 차지하며 저수준 제어를 가르친다.
- 합성 bridge data는 상위 수준의 사용자 상호작용을 추론 및 행동과 연결한다. 논문은 데이터셋 크기나 혼합 비율의 구체적인 수치를 공개하지 않는다.
3.3.1. Human Data는 사전에 동의하고 참여 보상을 받은 참여자의 게임 플레이 영상, 키보드 및 마우스 행동, 언어 주석을 결합한다. 수집 방식에는 자유로운 플레이 후 주석 달기, 실시간 Setter-Solver 상호작용, 사전에 정의한 Game-Tasks, 궤적의 성공 여부나 상대적 품질에 대한 인간 판단이 포함된다.
- Setter-Solver의 상호작용 사례(1 case)에서는 한 참여자가 지시를 내린 뒤 다른 참여자가 해당 행동을 수행한다. 이 방식은 사후 주석보다 언어를 이후 행동에 더 직접적으로 연결한다. Game-Tasks는 지시와 시작 상태가 지정된 에피소드다.
- 전처리에서는 프레임 크기를 조정하고 저품질 데이터를 걸러내며, 환경과 데이터셋의 가중치를 조정한다. 또한 궤적을 지시 1개와 그에 해당하는 프레임 및 행동을 포함하는 구간으로 나눈다.
- Gemini는 추가적인 합성 언어 및 추론 주석을 제공한다.
3.3.2. Bridge Data는 학습 환경 전반에서 수집한 비교적 소규모의 고품질 성공 궤적에서 시작한다. Gemini Pro가 화면에 보이는 장면과 에이전트의 1인칭 관점에서 수행한 행동에 부합하는 추론 및 대화를 추가해, 언어와 행동이 번갈아 나타나는 예시를 생성한다.
- 예시는 오류 수정, 지시 수행과 연속 수행, 시각적 관찰에 관한 질문에 답하기, 기억 활용, 긴 시퀀스에 걸친 행동을 다룬다.
- 다양한 학습 프롬프트를 사용해 강건성을 높이고, 행동하지 않는 단계인 no-op을 통해 과제 완료 후 가만히 머무르는 법을 가르친다.
- 주석은 생성된 추론을 기록된 행동과 맞춘다. 논문은 이 추론 텍스트의 기여만 분리해 측정하는 통제 실험을 보고하지 않는다.
3.3.3. Reinforcement Learning은 초기 게임 상태, 텍스트 지시, 검증 함수로 정의된 검증 가능한 과제에서 온라인 경험을 활용한다. 과제를 완료하거나 환경에 근거한 질문에 올바르게 답하면 보상을 받는다. 일부 과제는 지시 수행과 제어 가능성을 개선하기 위한 추가 피드백인 보상 shaping도 사용한다.
- 참여자는 무작위 상태에서 달성 가능한 과제를 제안하며 검증 함수는 인간 궤적에서 추가로 과제가 완료된 시점을 찾아낸다.
- 정해진 제한 시간 안에 인간이 완료할 수 있는 과제를 선별한다. 대화 과제는 스크린샷과 인간이 제안한 질문 및 답변을 묶어 구성한다.
- 이 학습 단계에는 ASKA와 MineDojo 같은 홀드아웃 환경을 포함하지 않는다.
3.4. Evaluations
평가에는 내부 환경 상태에 기반한 정답 검증, 화면과 행동에 기반한 프로그램 검증, 또는 영상마다 수행하는 독립적인 인간 평가 5건을 사용한다. 프로그램 검증에는 화면의 텍스트를 인식하는 광학 문자 인식과 픽셀 색상 및 행동 휴리스틱이 포함된다. 이 방식은 해당 규칙으로 감지할 수 있는 결과만 평가할 수 있다.
- SIMA Evaluation Suite 2.0 expands tasks는 평가 모음의 과제 확장을 뜻한다. 또한 텍스트의 지속적인 표시 여부 확인, 완료 후 행동 제한, 모든 하위 과제의 성공을 요구하는 순차 과제를 통해 완료 기준을 강화한다.
- 더 엄격한 평가 모음에서는 SIMA 1의 점수가 원래 보고된 결과보다 낮아진다. 따라서 개정된 평가 모음에서 에이전트들을 비교해야 한다.
- 인간 기준선은 대체로 에이전트와 동일한 과제별 제한 시간을 적용한다. 인간은 순차 과제의 모든 단계를 한꺼번에 받지만 에이전트는 앞선 과제를 완료한 뒤 다음 지시를 받는다. 익숙한 환경에서는 숙련된 플레이어로 기준선을 설정하고 전이 평가에서는 ASKA와 MineDojo에 익숙하지 않은 플레이어로 기준선을 설정한다.
4. Results
결과에서는 새로운 상호작용 능력, 익숙한 환경과 낯선 환경에서의 과제 성공, 적응시키지 않은 Gemini와의 비교, Gemini Pro와의 결합, 스스로 생성한 경험을 통한 학습을 살펴본다. 종합 과제 평가는 성공률을 측정하고 선별된 시연은 특정 행동을 보여준다.
4.1. New Capabilities
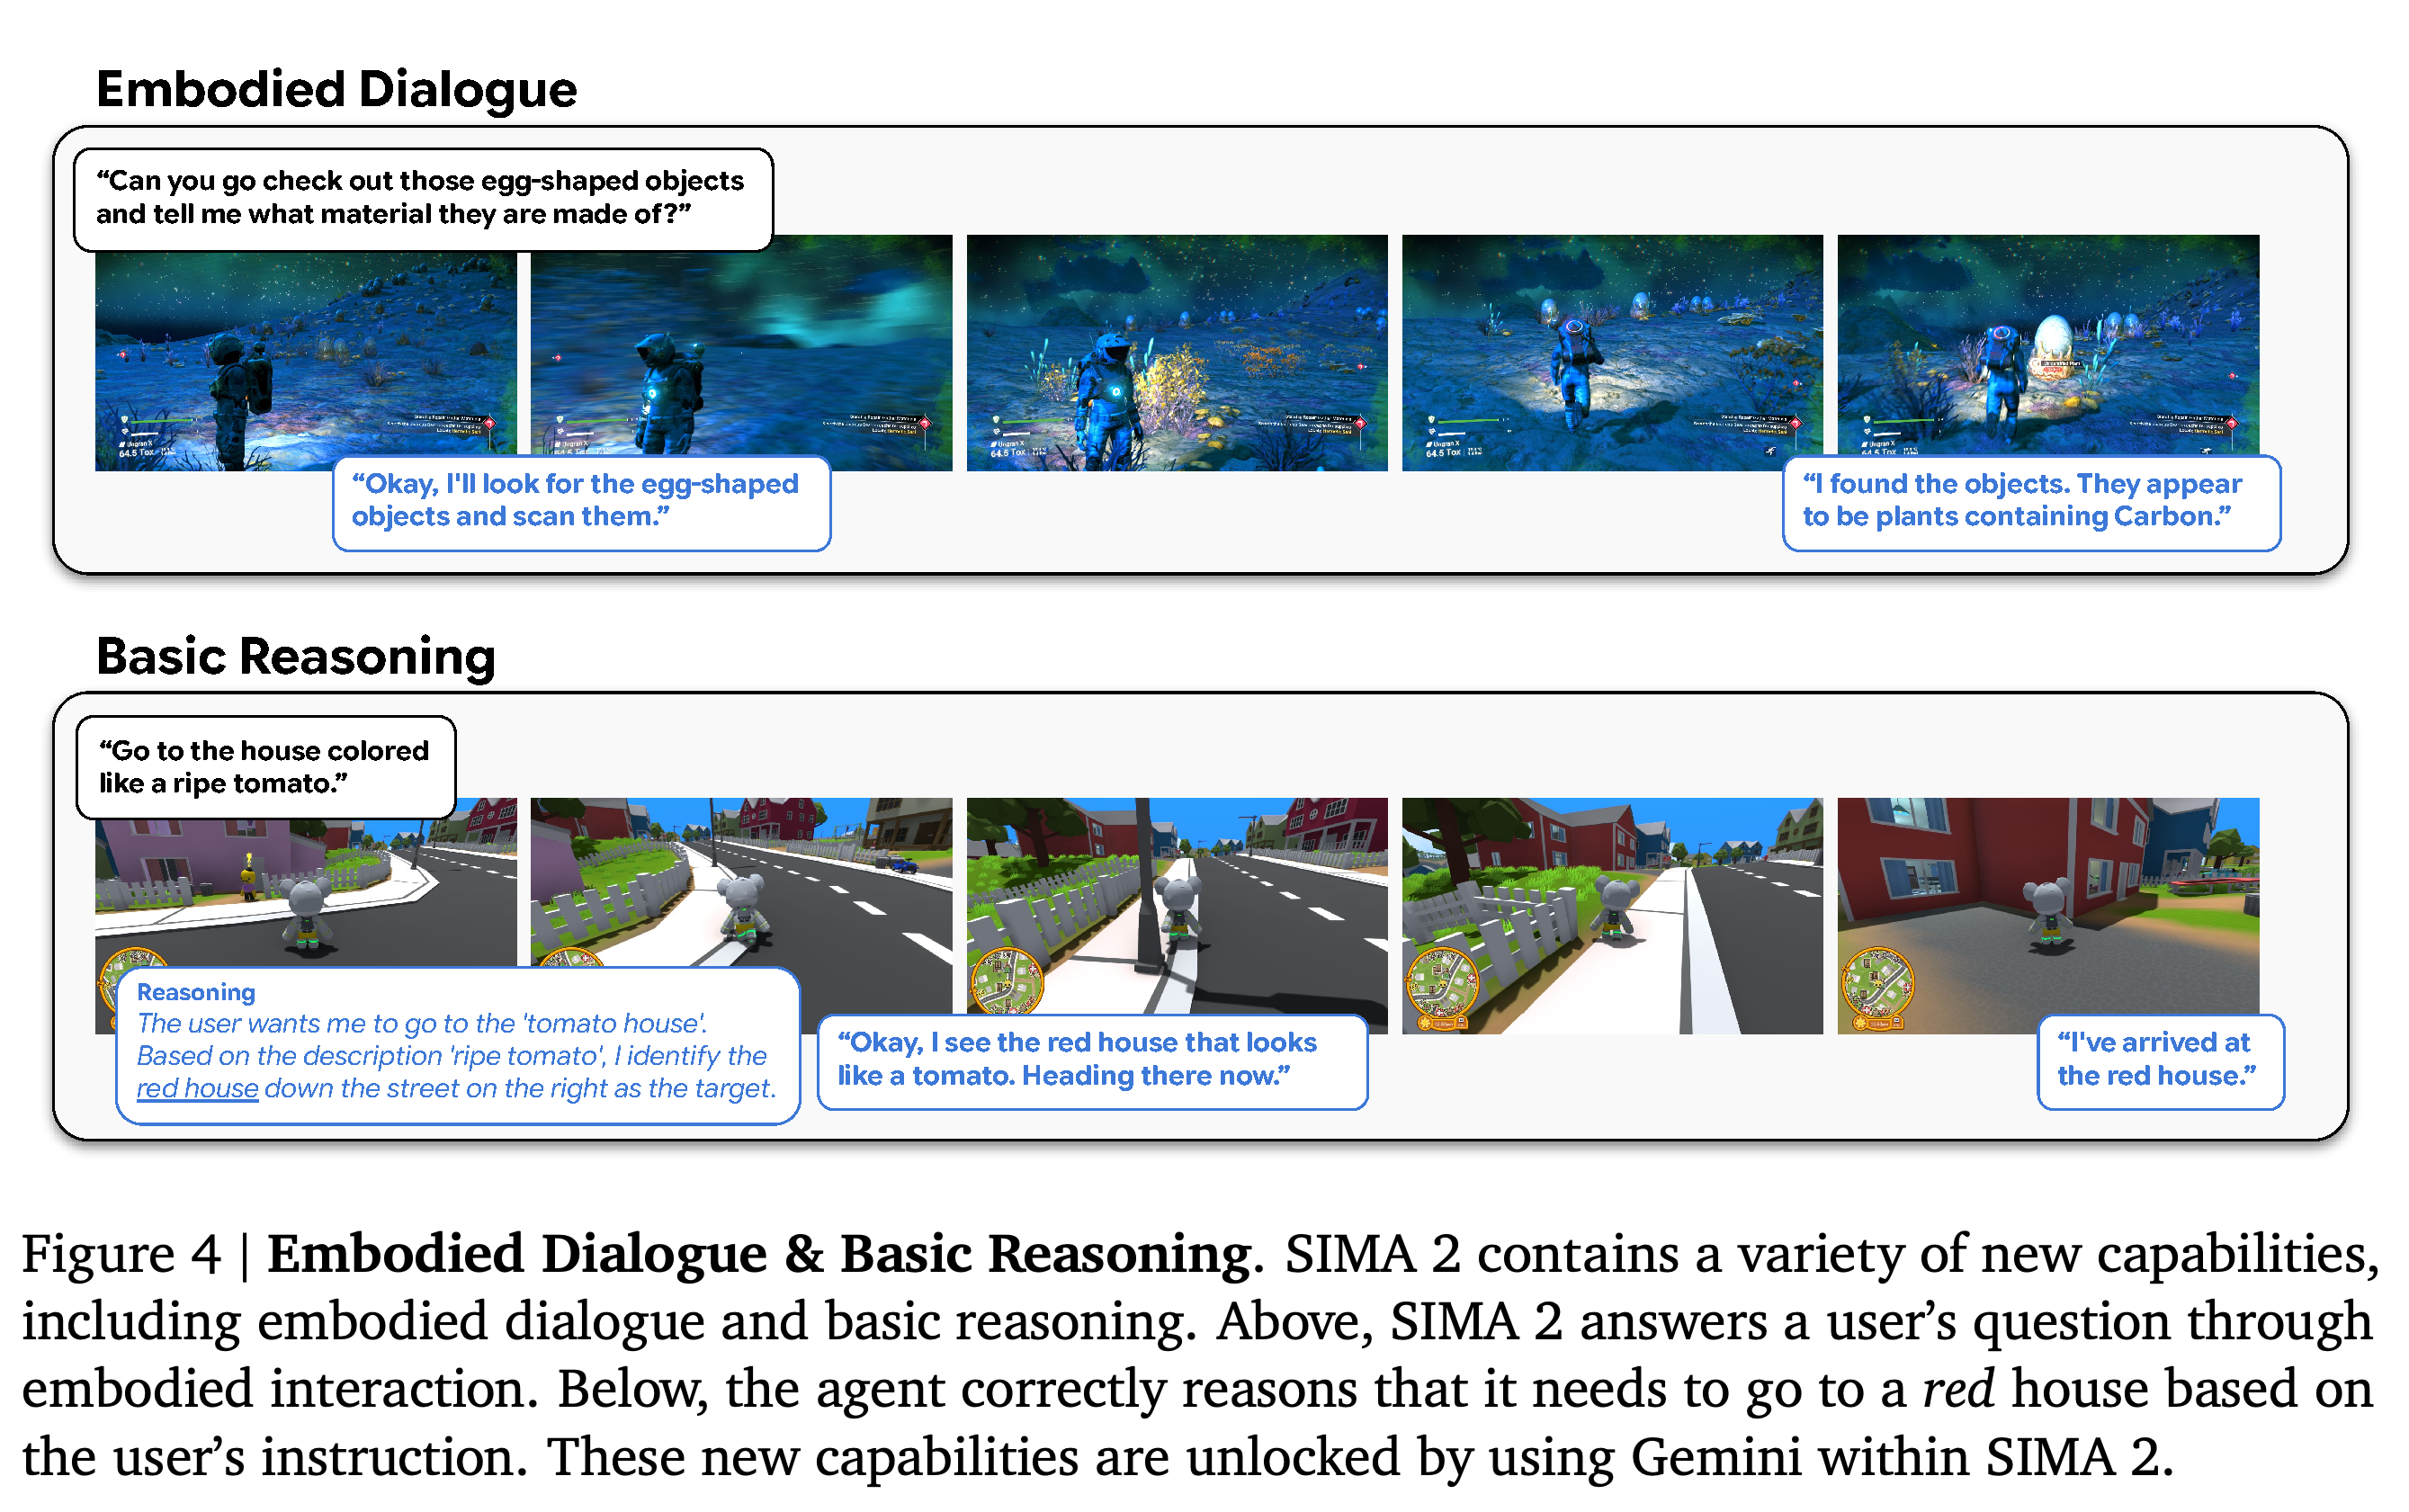
SIMA 2는 정보를 얻기 위해 행동한 뒤 질문에 답하는 Embodied Dialogue와, 사전 학습된 지식으로 간접적인 지시를 해석하는 Basic Reasoning을 지원한다. 예시에서는 No Man’s Sky의 물체에 접근해 재료 정보를 읽고, 잘 익은 토마토 같은 색의 집이라는 표현을 빨간 집으로 해석한다.
- Complex Instructions에는 영어로만 체화 학습을 수행했음에도 처리하는 프랑스어, 독일어, 표준 중국어 지시, 이모지 지시, 여러 단계의 이동 지시가 포함된다.
- Multi-modal Prompting에는 물체, 위치, 경로를 지정하는 스케치가 포함된다. 나무 스케치를 받은 에이전트는 나무를 찾아 베어낸다.
- 논문은 예시를 제공하지만 다국어, 스케치 기반, 간접 지시의 종합 성공률은 제시하지 않는다.
한 시퀀스에서는 재료에 관한 질문에 답하기 전에 물체 쪽으로 이동해야 한다. 다른 시퀀스에서는 간접적인 색상 묘사를 이동 목표로 변환한다. 이 예시들은 정보 탐색과 의미 해석을 보여주지만 성공 빈도를 측정하지는 않는다.
4.2. Embodied Task Performance
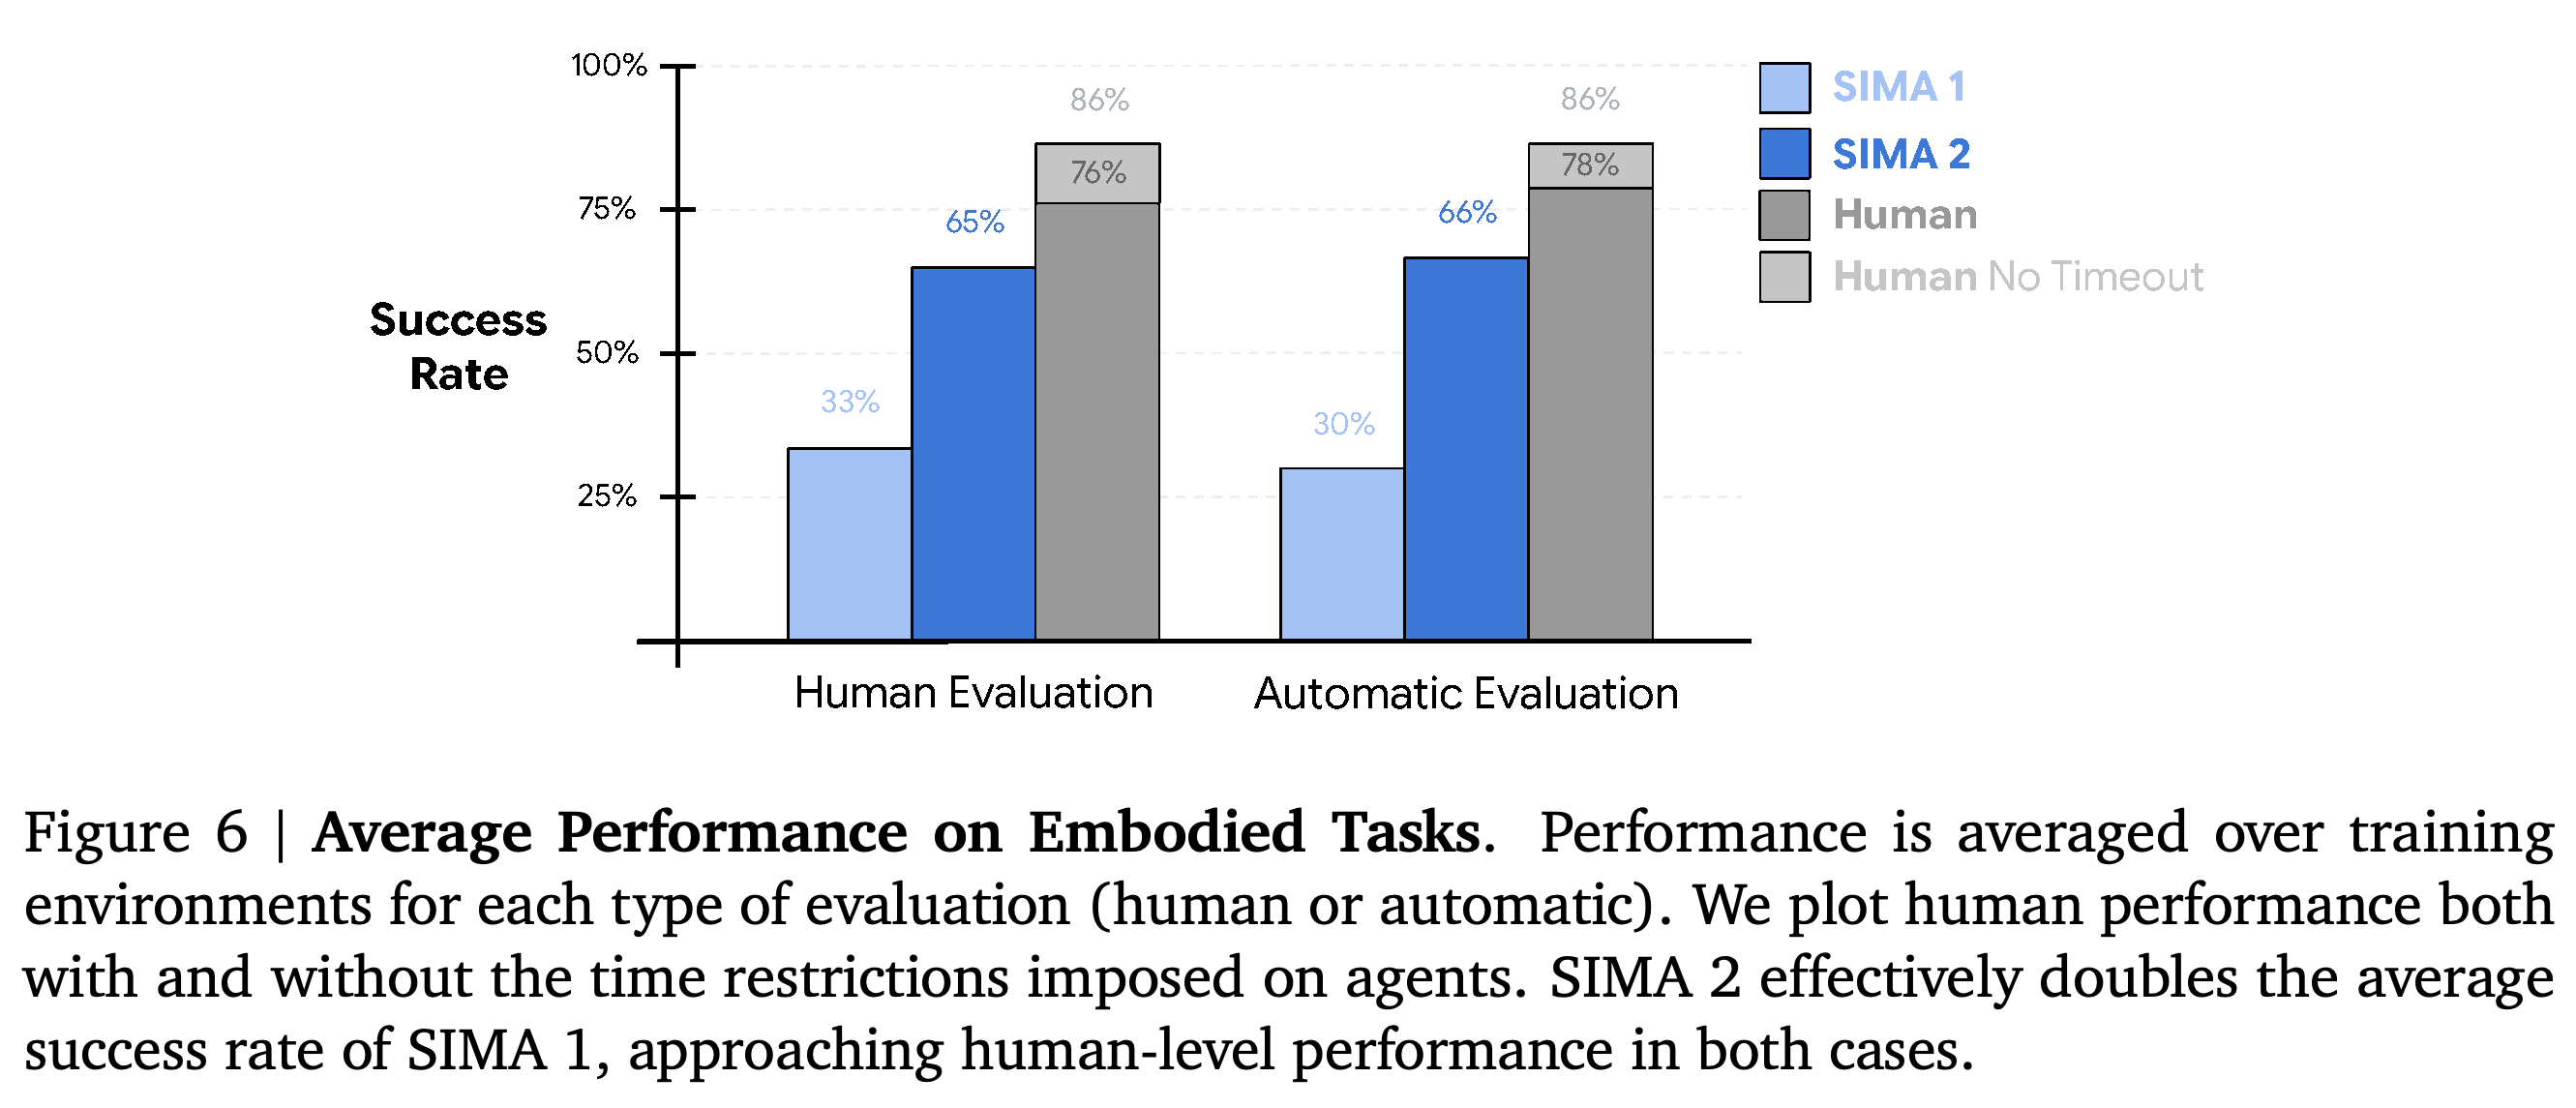
4.2.1. Performance in Training Environments는 환경별 성공률의 평균을 보고한다. 인간 평가에서는 SIMA 2가 65%, SIMA 1이 33%이며, 자동 평가에서는 각각 66%, 30%다. 동일한 제한 시간을 적용한 숙련된 인간의 성공률은 각각 76%, 78%이며, 시간제한을 없애면 두 평가 유형 모두 86%로 상승한다.
- 이는 학습에서 본 환경 내의 홀드아웃 과제와 시작 상태를 평가한 결과다.
- 일부 제한 시간은 3초에 불과하다. 논문은 인간의 부주의, 인프라 지연, 정밀한 운동 제어 요구를 이 비교에 영향을 미치는 요인으로 제시한다.
SIMA 2는 인간 평가 성공률을 33%에서 65%로, 자동 평가 성공률을 30%에서 66%로 높인다. 동일한 제한 시간을 적용한 인간은 각각 76%, 78%를 기록하며 시간제한을 없애면 두 평가 경우(2 cases) 모두 86%를 기록한다. 이를 통해 남은 격차와 시간제한이 비교에 미치는 영향을 확인할 수 있다.
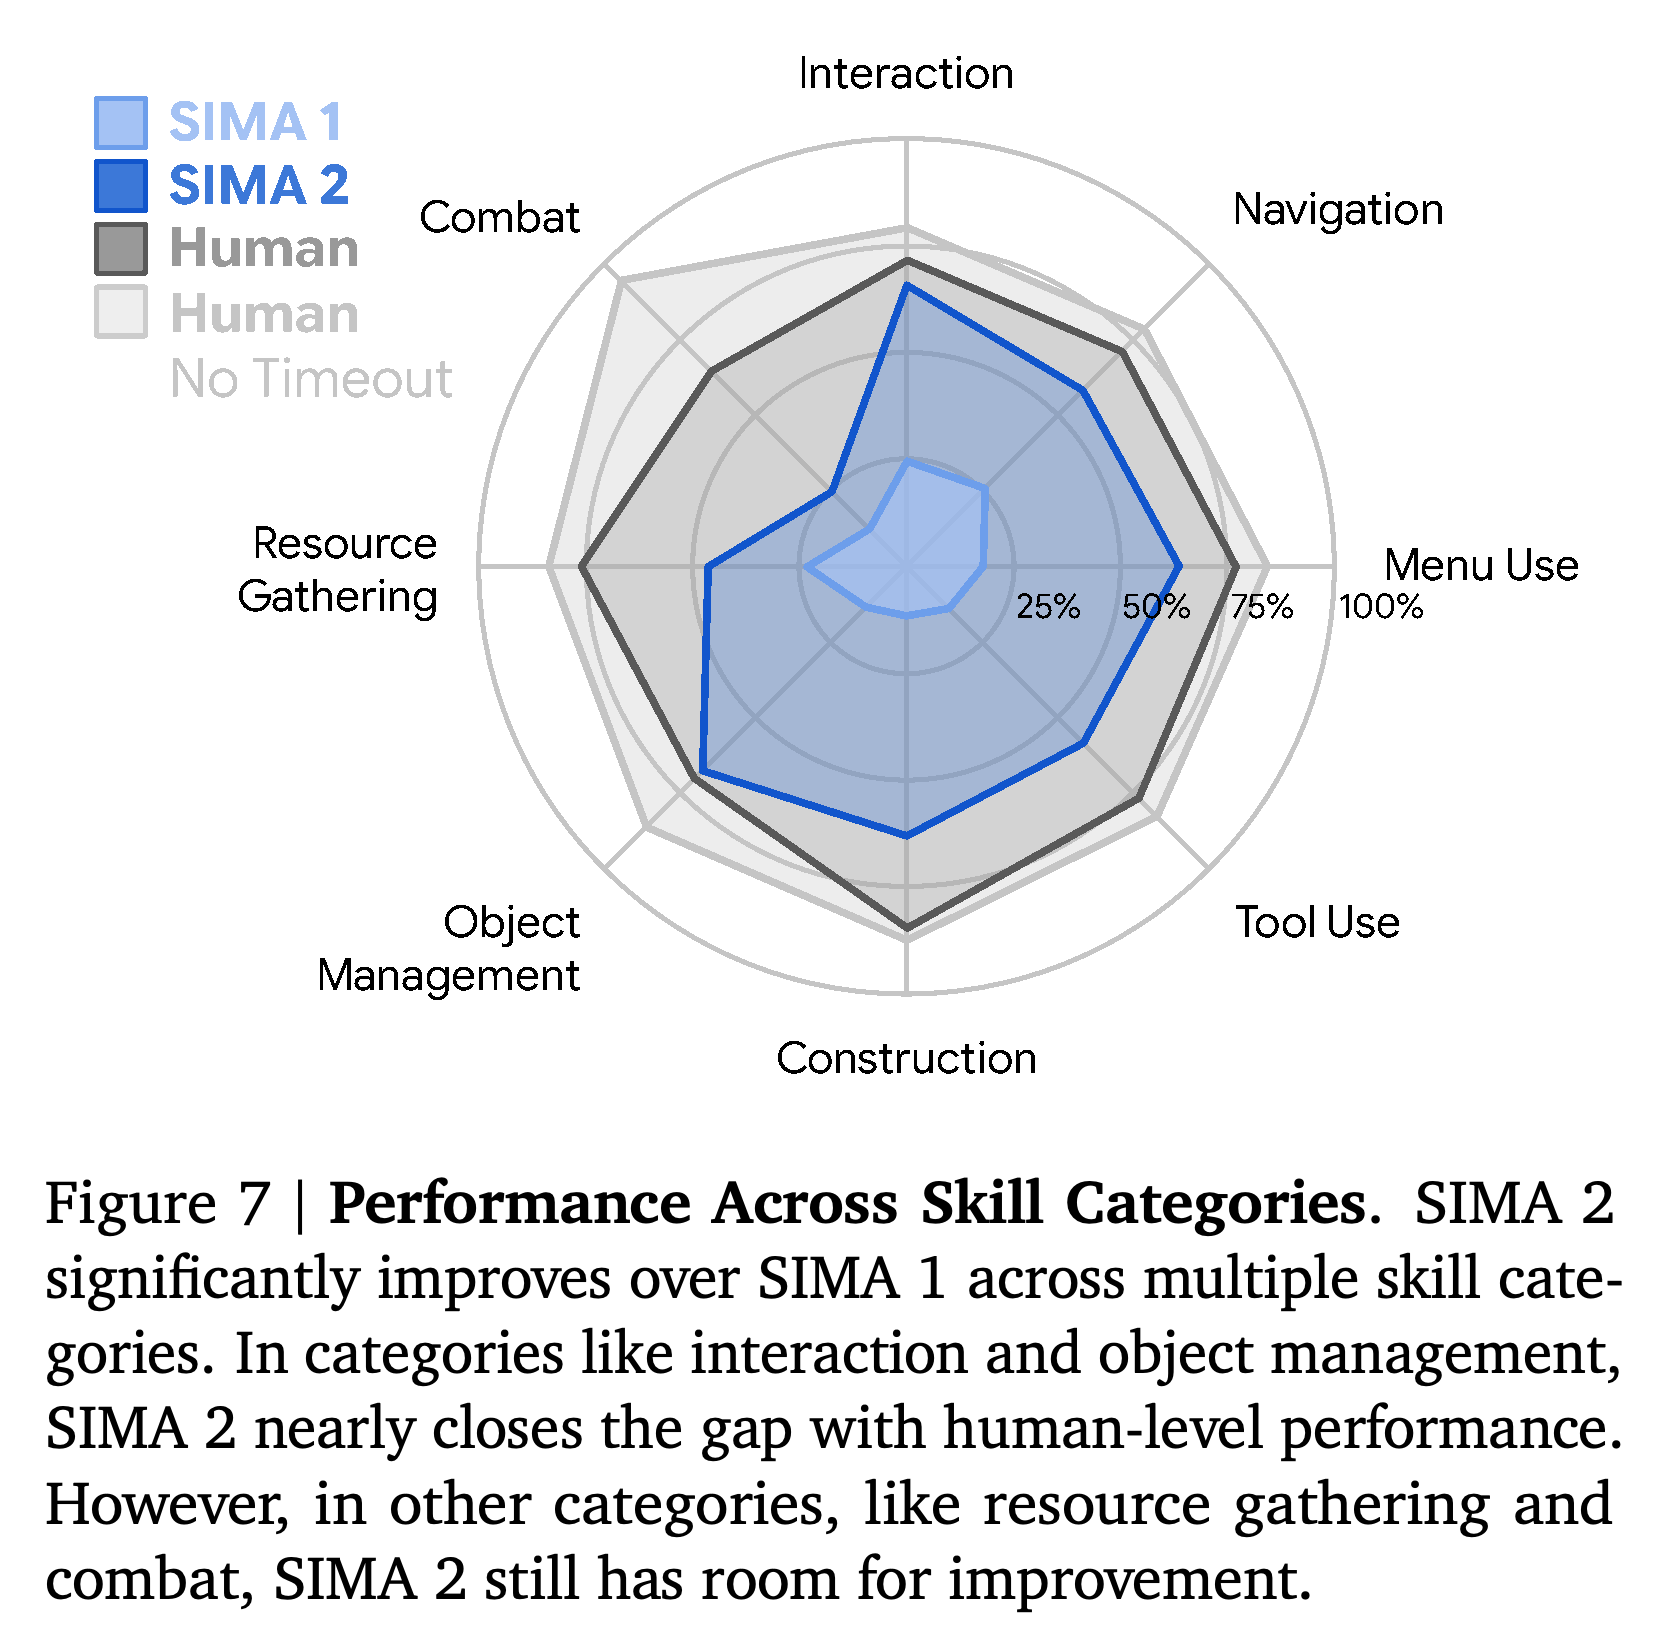
환경별 결과에서는 평가한 환경 전반에 걸쳐 성능이 향상되며, 여러 상용 게임에서 특히 큰 개선을 보인다. 8개 기술 범주 중 상호작용과 물체 관리에서는 SIMA 2가 인간 성능에 더 가까워지지만 자원 수집과 전투에서는 더 큰 격차가 남는다.
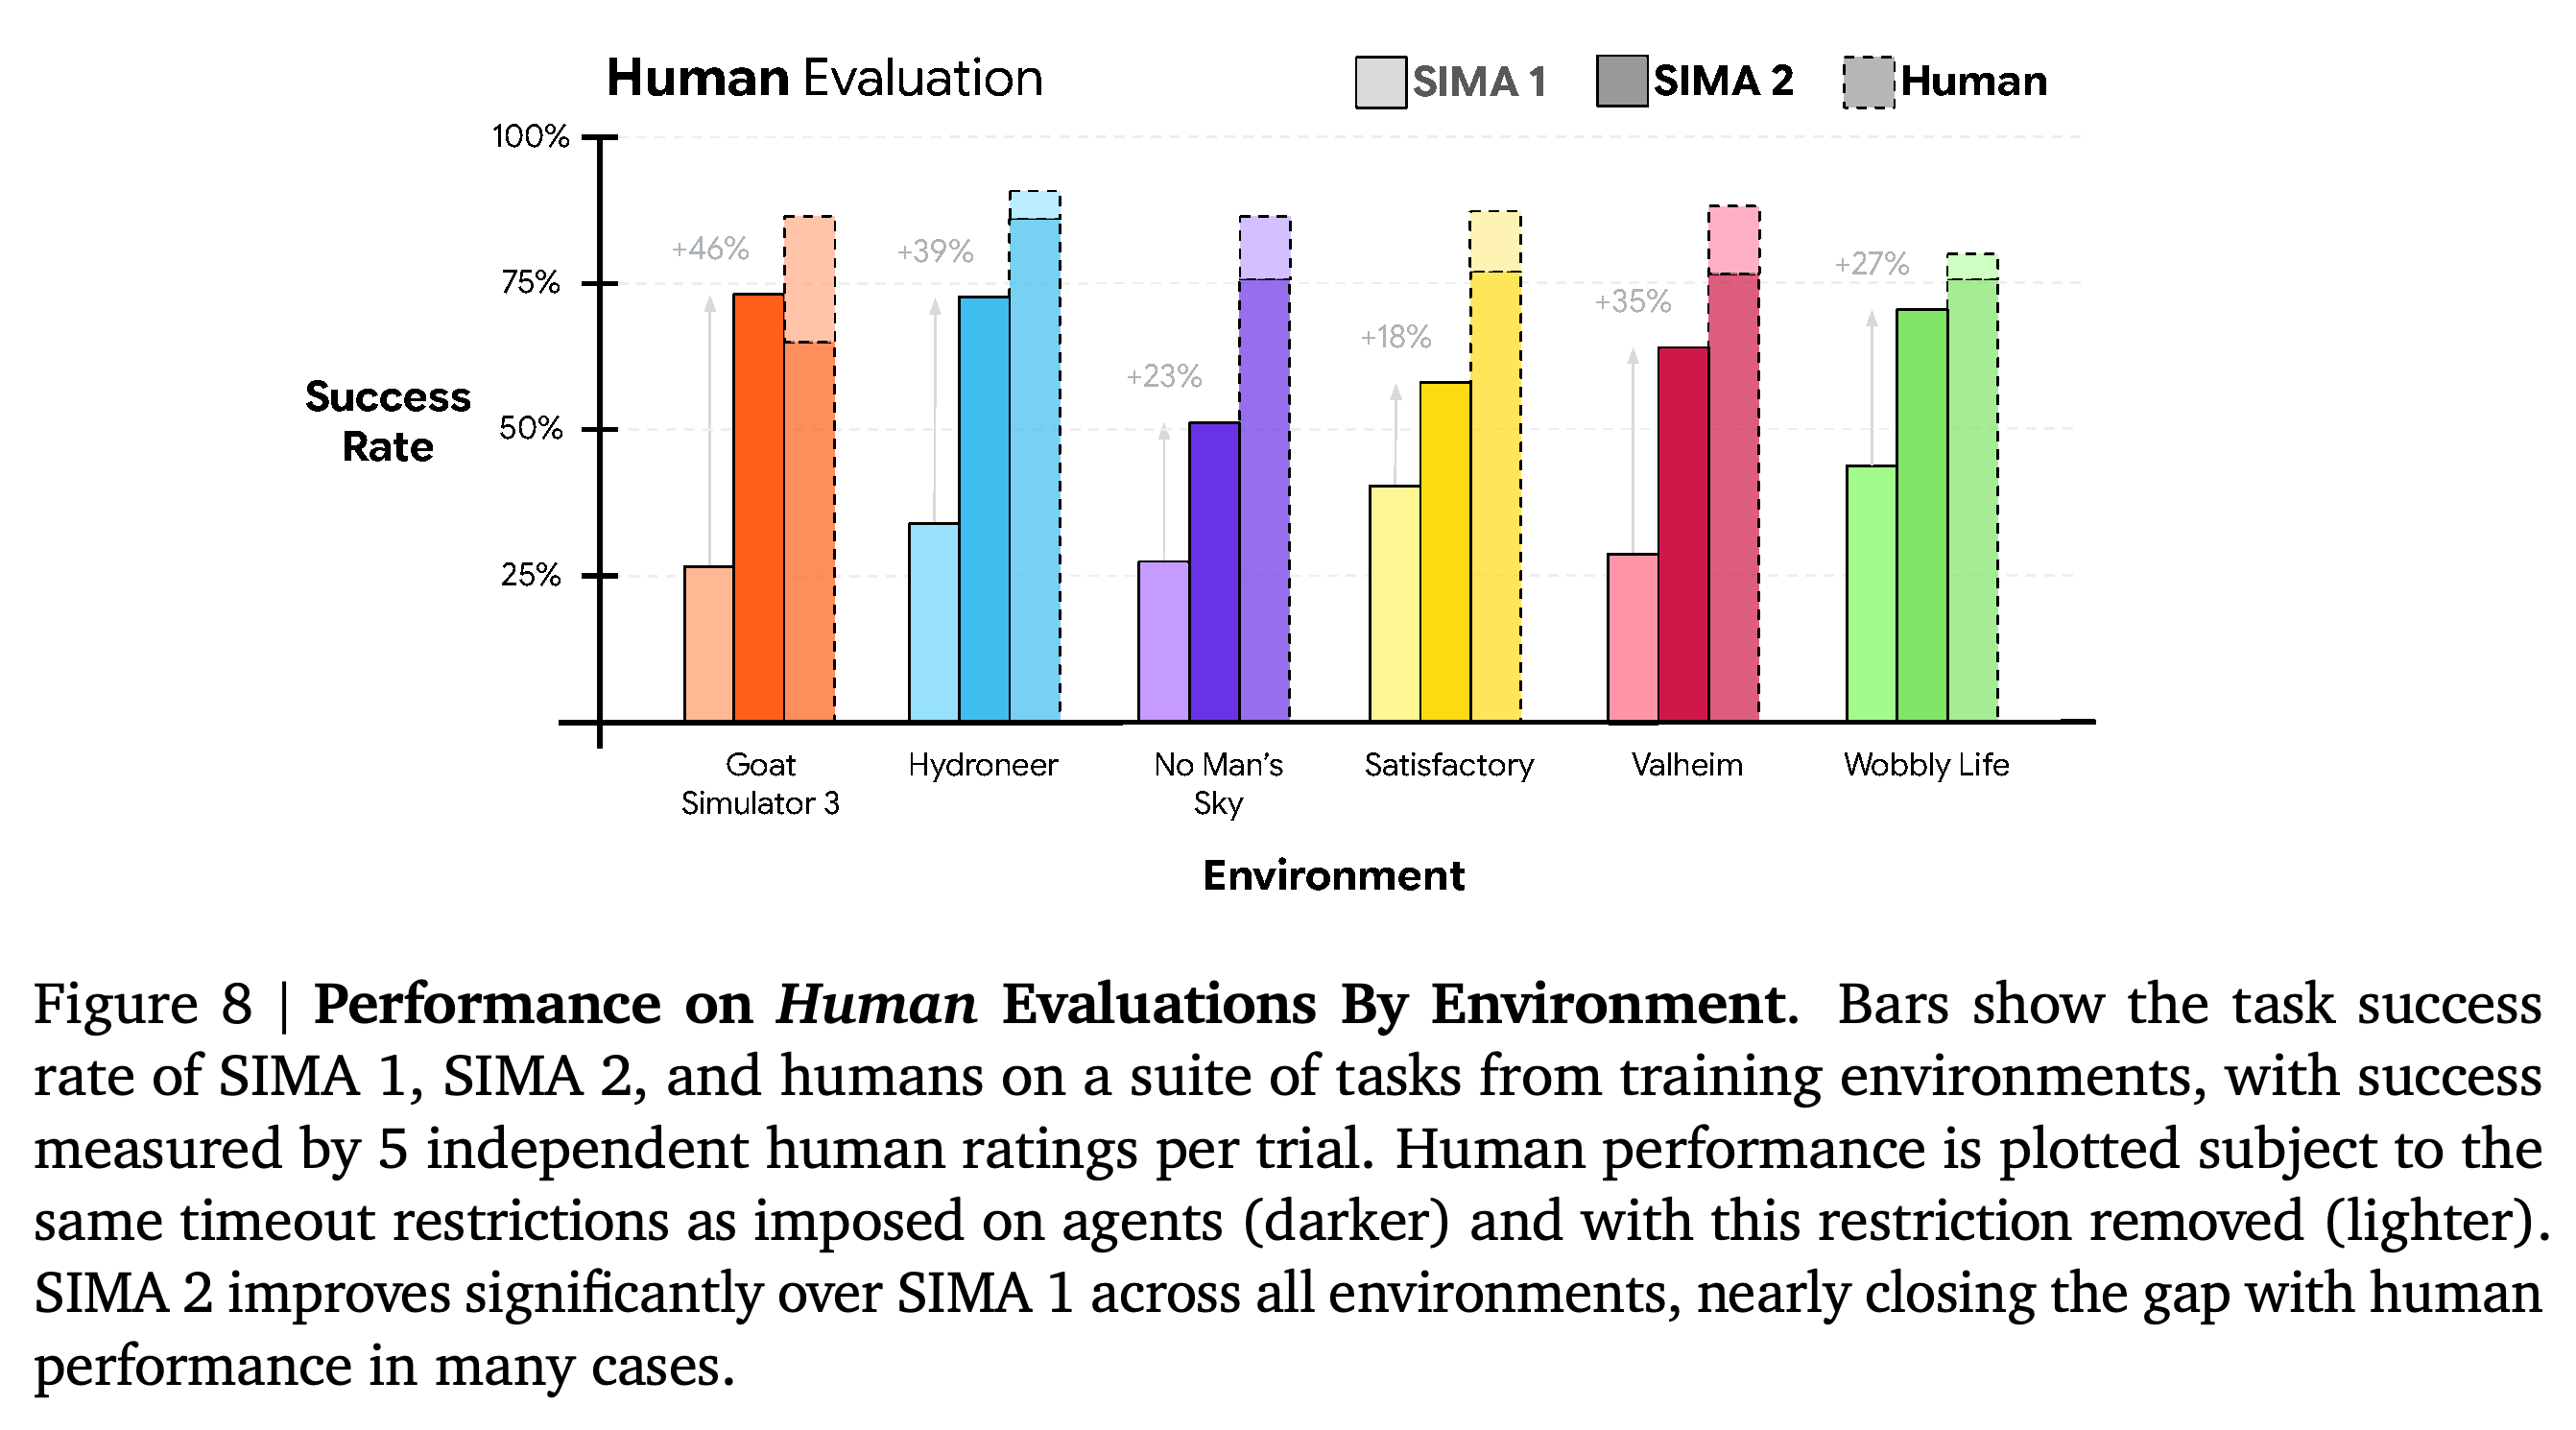
- Figure 8에 제시된 인간 평가의 개선 폭은 Satisfactory의 18%p부터 Goat Simulator 3의 46%p까지다.
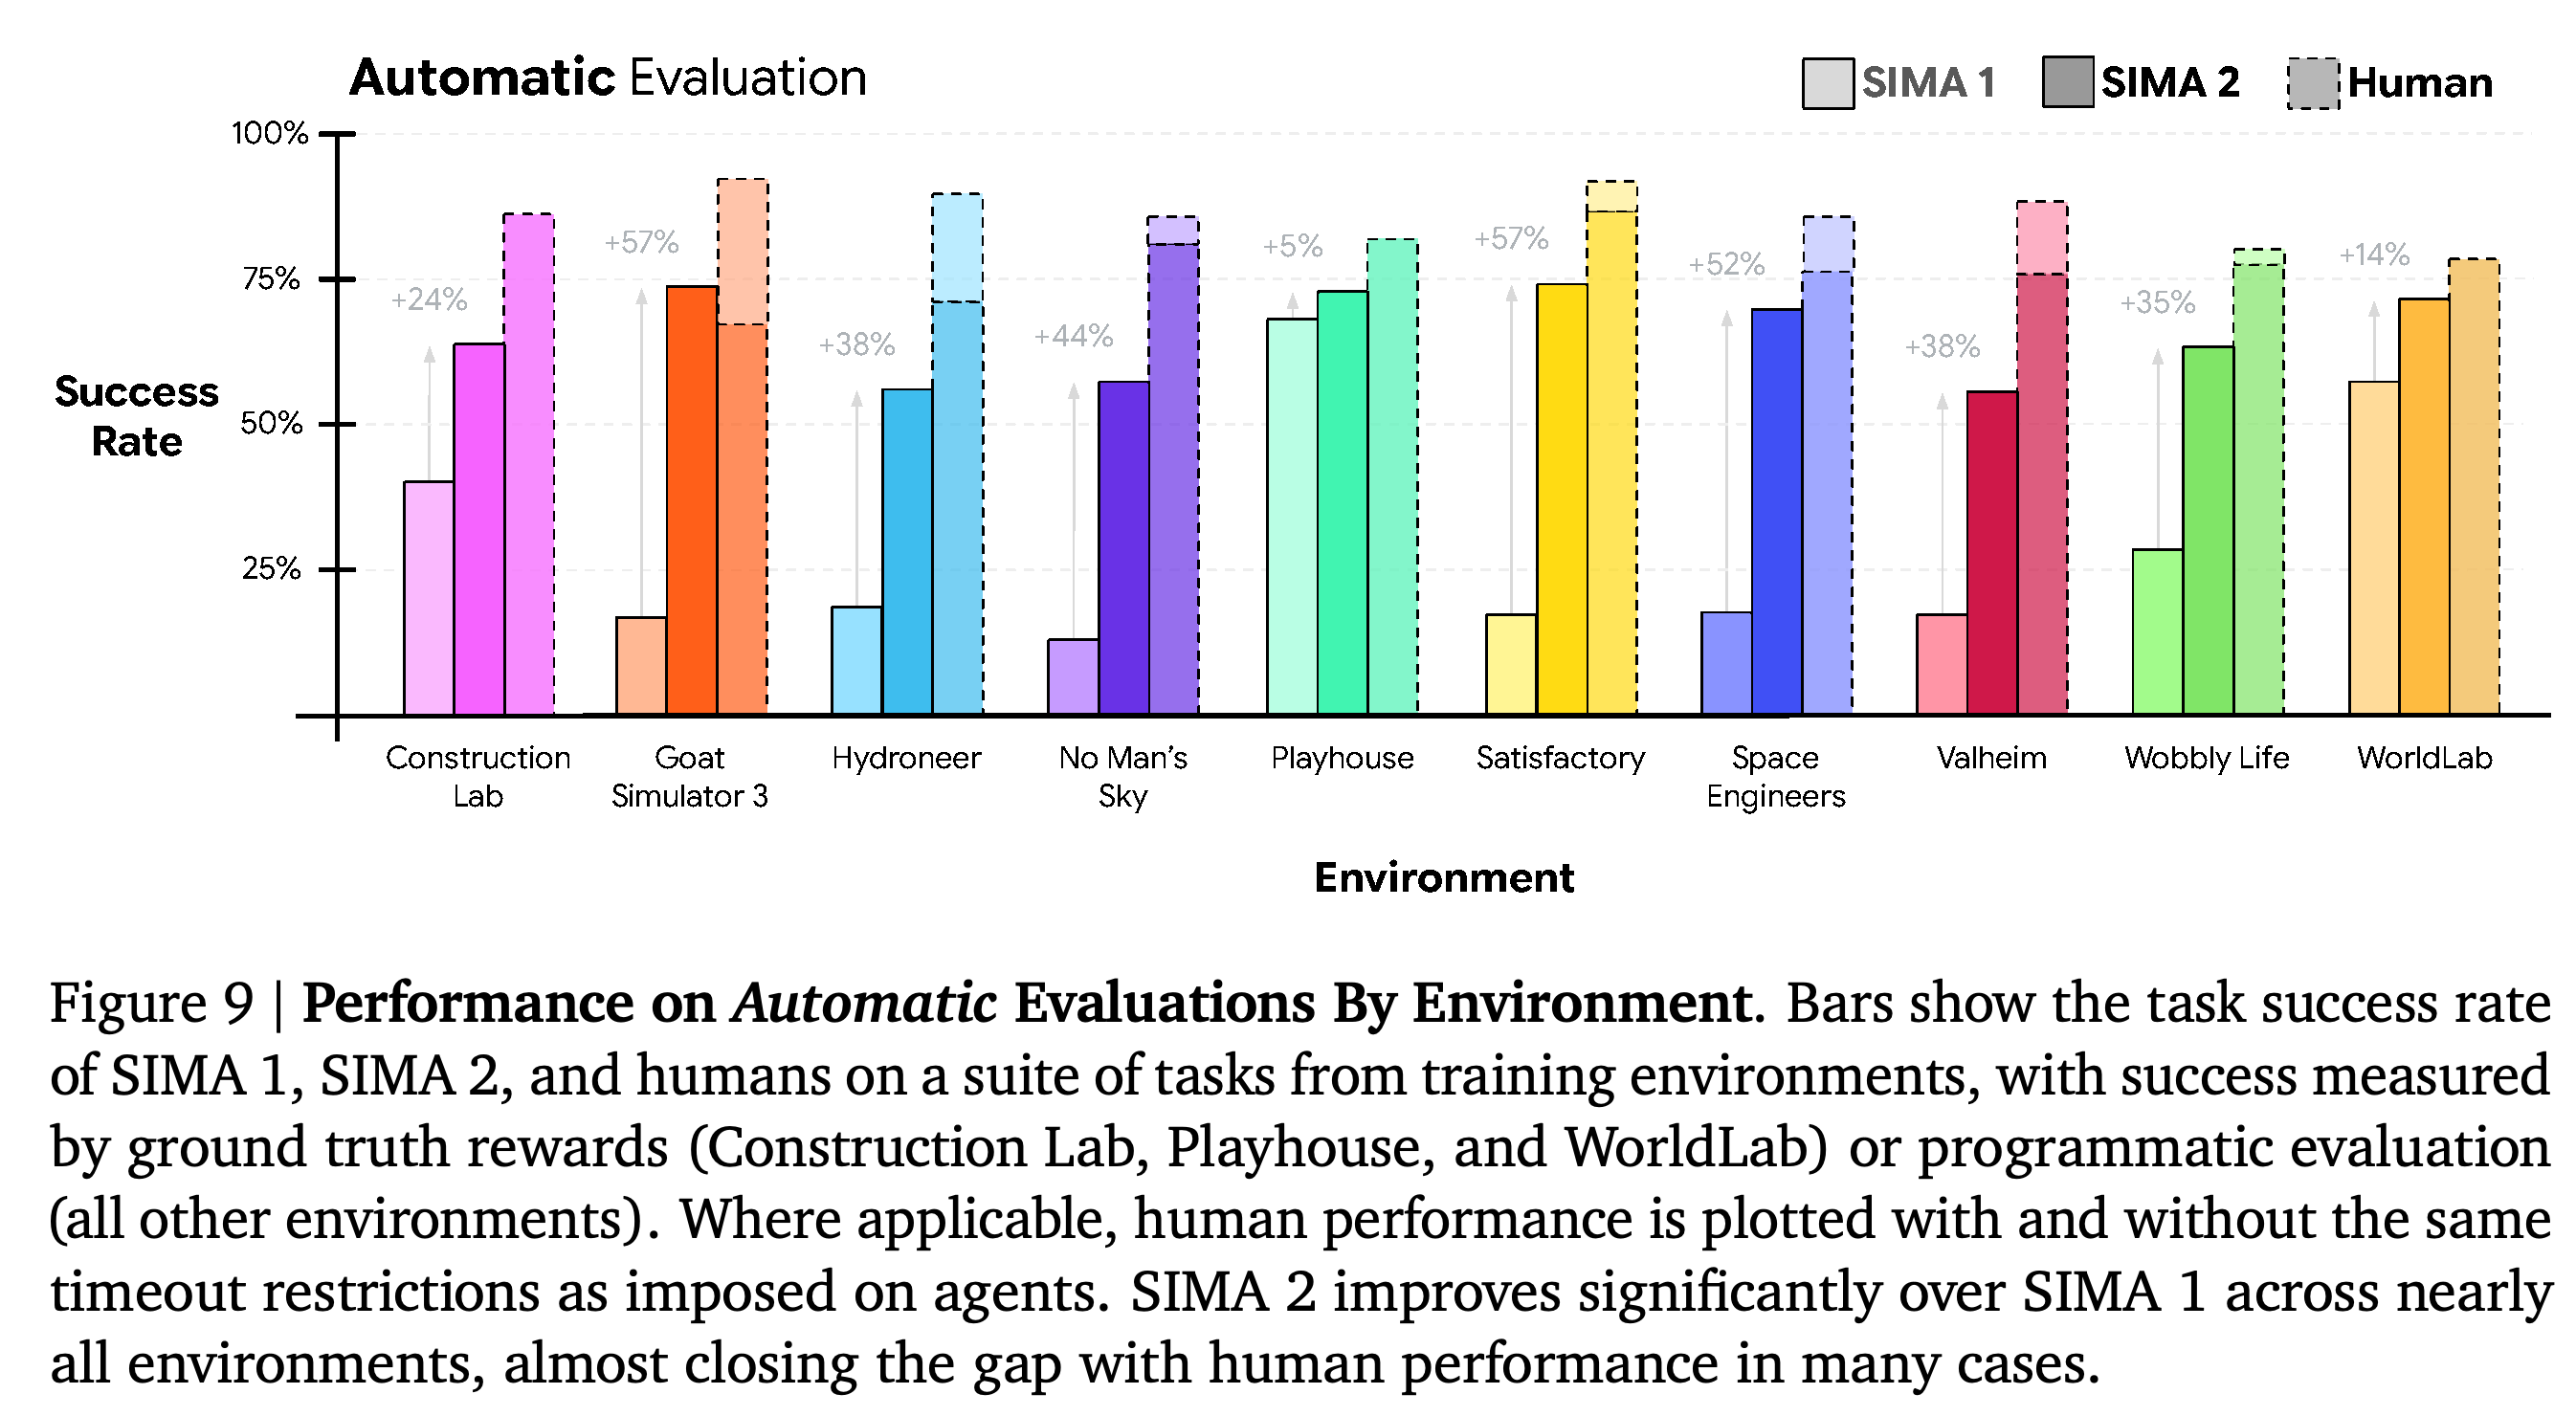
- Figure 9에서 자동 평가의 개선 폭은 Playhouse의 5%p부터 Goat Simulator 3와 Satisfactory의 57%p까지다.
- 전투에는 빠른 판단과 정밀한 움직임이 필요하다. 논문의 Valheim 사슴 사냥 예시는 이러한 운동 제어의 어려움이 여전히 남아 있음을 보여준다.
레이더 차트는 8개 기술 범주 전반에서의 개선을 보여준다. 상호작용과 물체 관리는 인간 곡선에 더 가까워지지만 전투와 자원 수집은 여전히 취약한 영역이다.
상용 학습 환경 6곳에서 각 시도의 성공 여부를 독립적인 인간 평가 5건으로 측정한다. 표시된 SIMA 2의 개선 폭은 18부터 46%p까지이며 2개 인간 기준선은 시간제한 유무가 비교에 미치는 영향을 보여준다.
자동 평가는 실제 상태 검증이나 프로그램 검증을 통해 학습 환경 10곳 전체로 비교를 확장한다. 개선 폭은 Playhouse의 5%p부터 Goat Simulator 3와 Satisfactory의 57%p까지다.
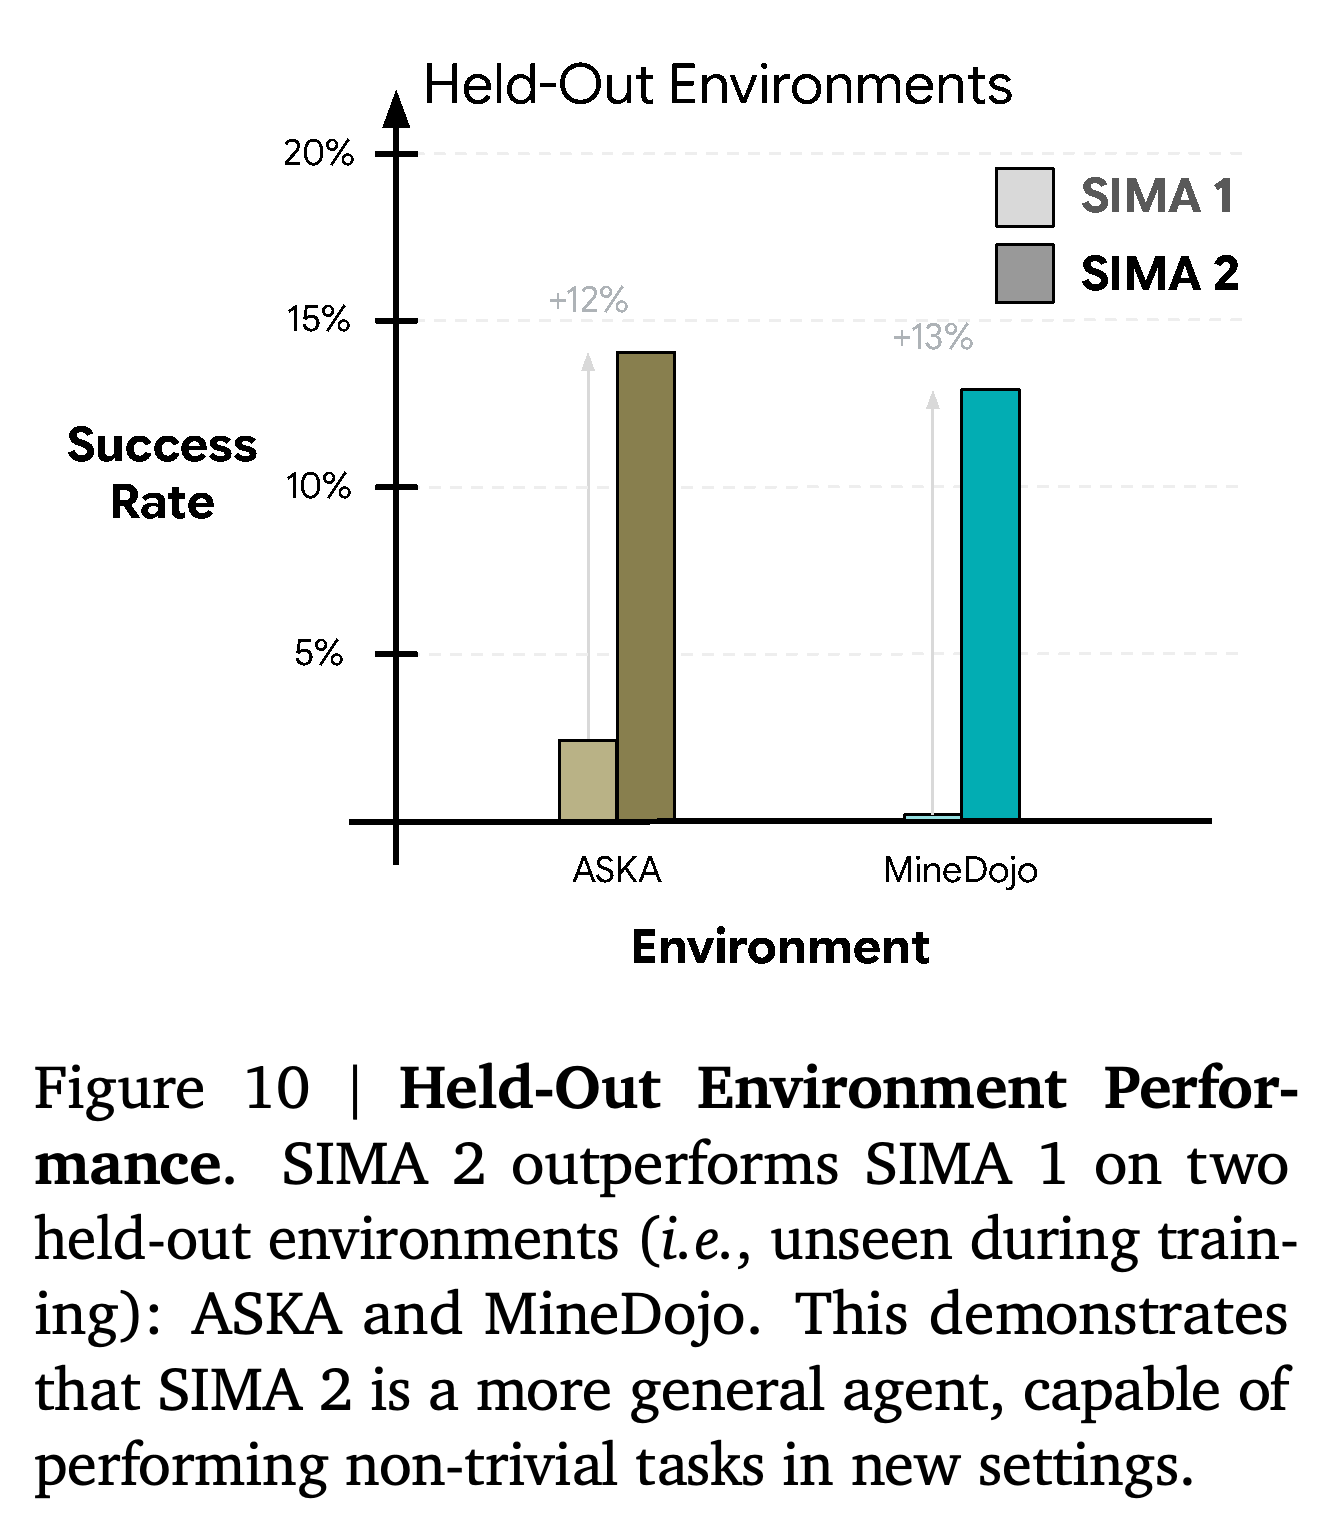
4.2.2. Performance in Held-Out Environments에서는 SIMA 1보다 ASKA에서 12%p, MineDojo에서 13%p 개선되지만 그래프에 표시된 SIMA 2의 성공률은 여전히 15% 미만이다. MineDojo에서 SIMA 2 completes tasks라는 결과는 전체 50개 과제 범주 중 26에서 과제를 완료했다는 뜻이다. 반면 SIMA 1은 harvest dirt와 combat spider에서만 성공한다.
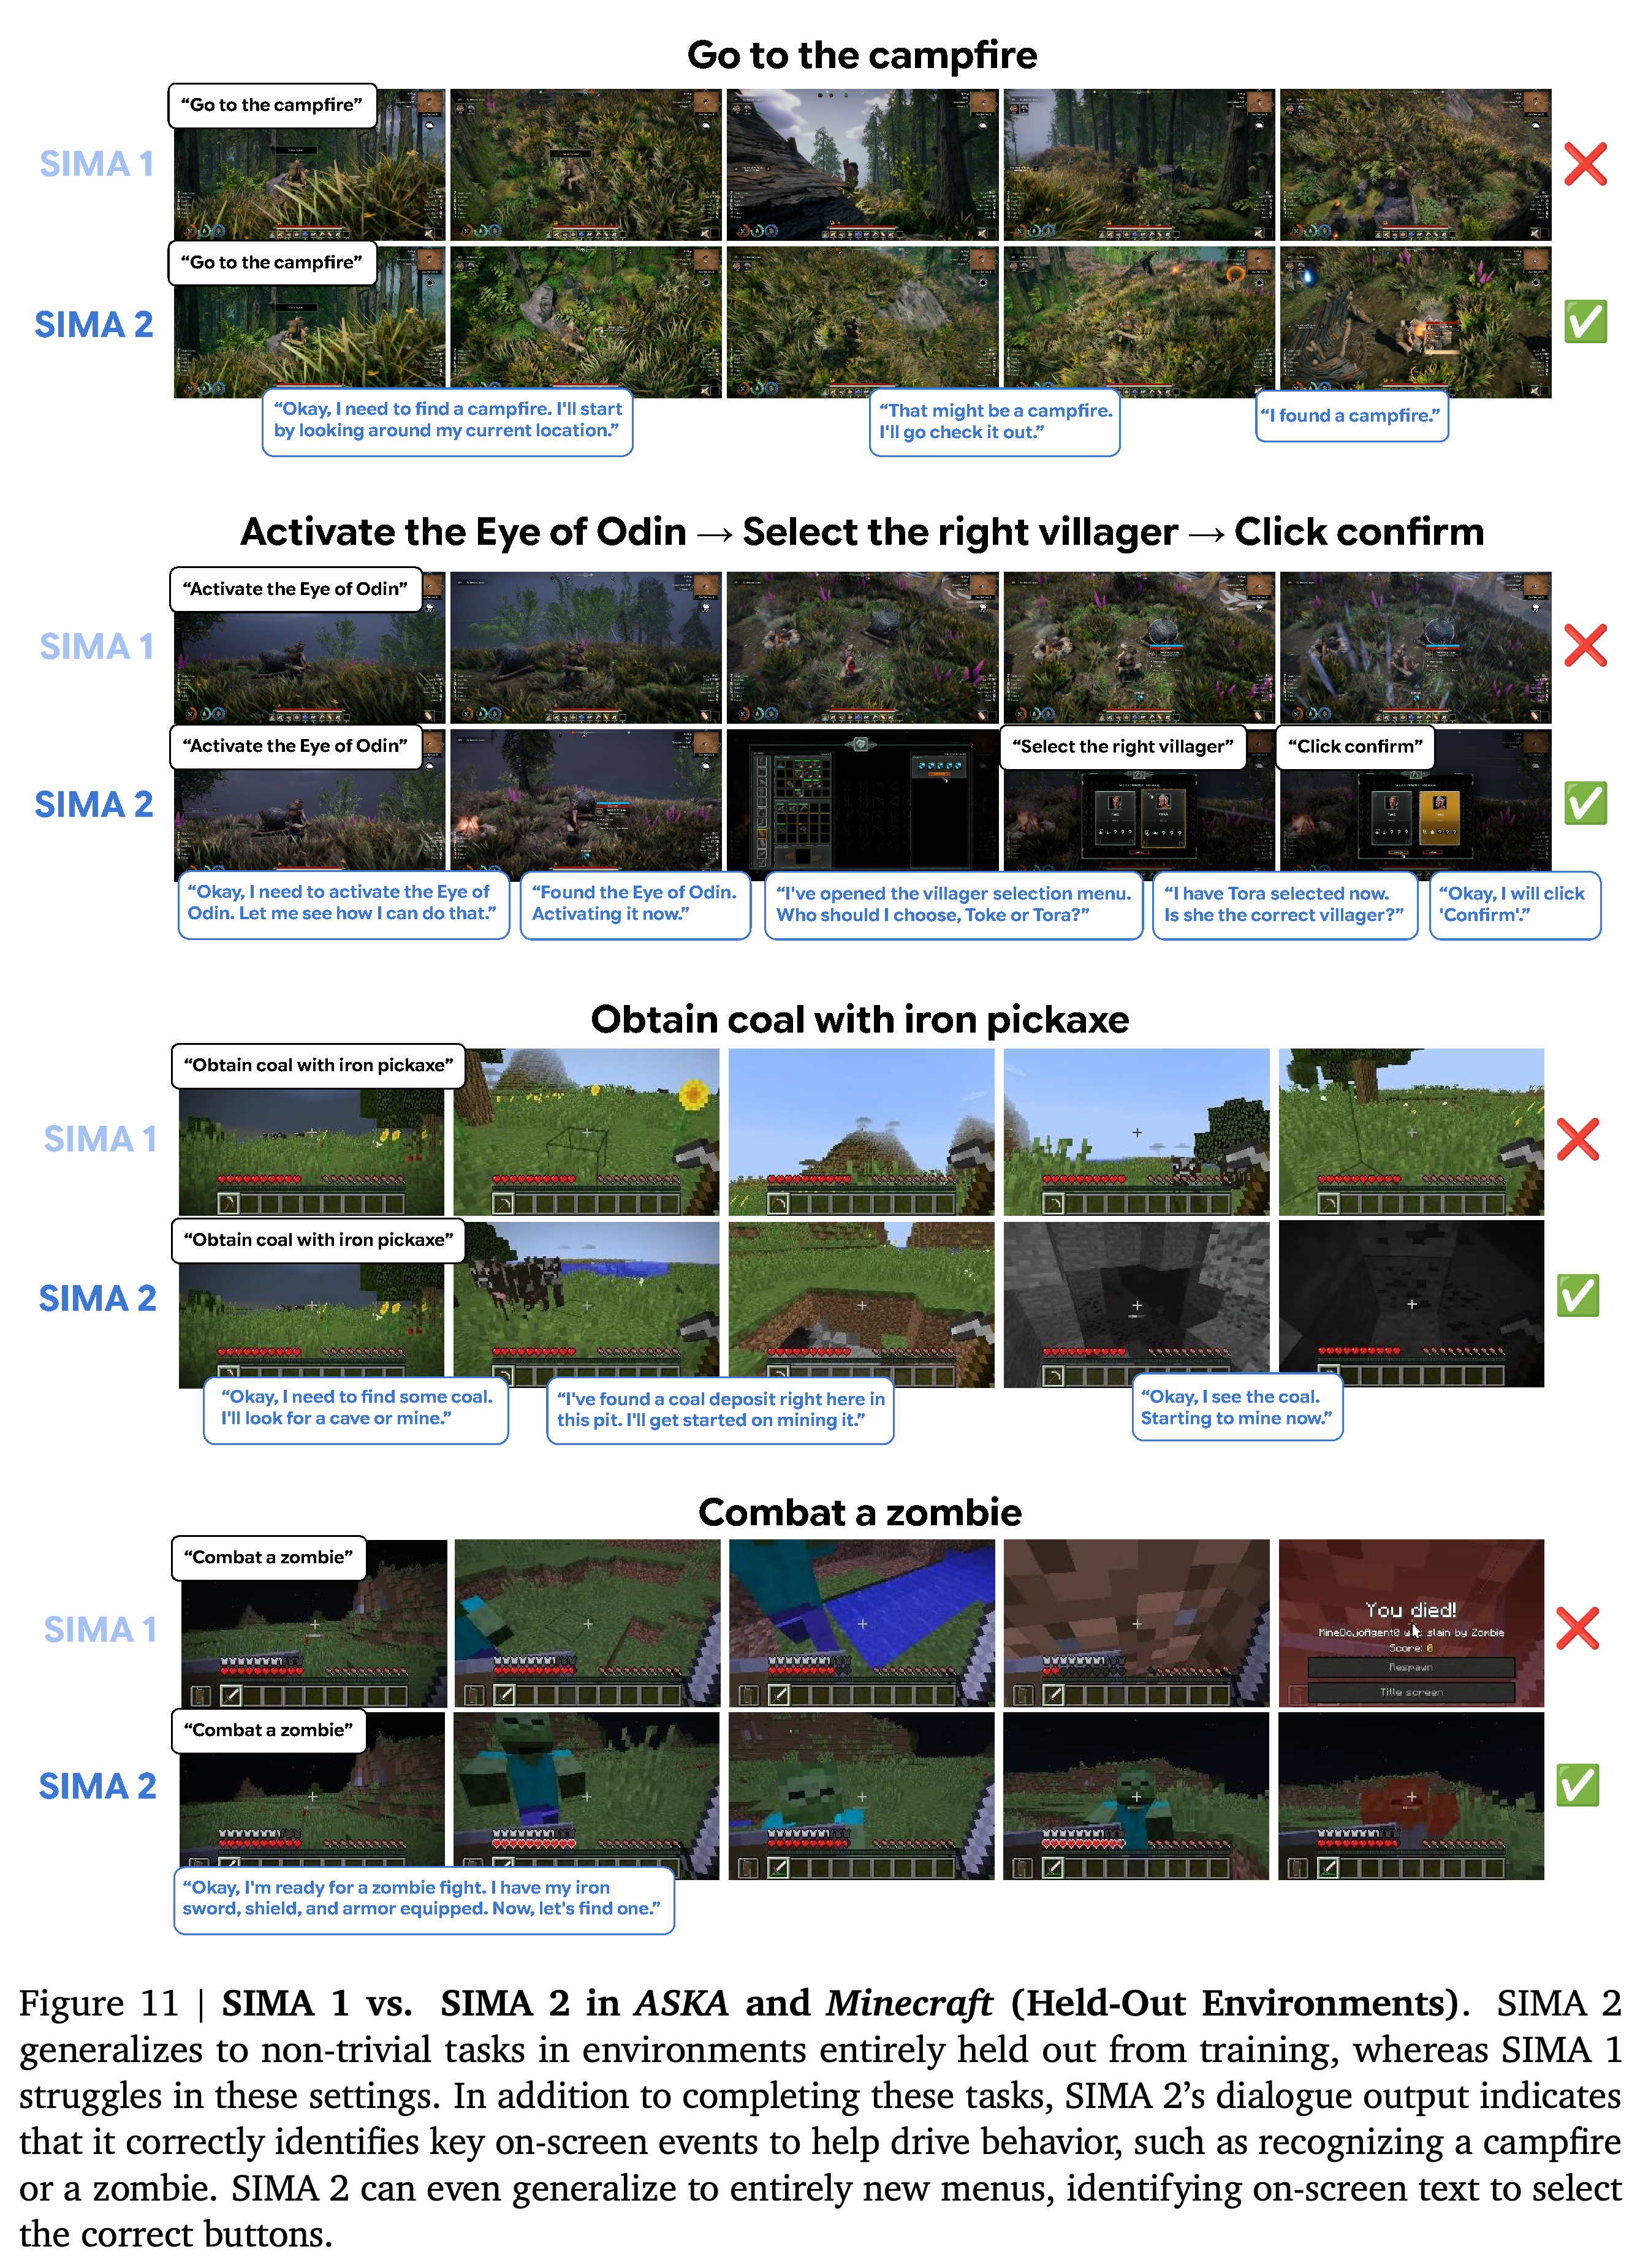
- ASKA에는 프로그램 평가를, MineDojo에는 실제 환경 상태에 기반한 평가를 사용한다. 성공 예시에는 모닥불 찾기, 낯선 주민 선택 메뉴 사용, 석탄 채굴, 좀비와의 전투가 포함된다.
- 인간의 첫 시도 기준선은 MineDojo의 16개 과제 부분집합에서 약 19%, ASKA의 25개 과제 부분집합에서 약 32%다. 이 부분집합 결과로 전체 평가 모음에서 인간과 직접 조건을 맞춘 비교를 했다고 볼 수는 없다.
- 저자들은 인간이 시간제한 때문에 실패하는 경우가 많지만 에이전트는 비효율적인 탐색으로 실패하는 경우가 많으므로 직접적인 성능 비교를 과도하게 해석하지 않도록 주의를 요구한다.
그래프는 초기 체화 학습에서 제외한 게임으로의 전이를 분리해 보여준다. ASKA의 12%p와 MineDojo의 13%p 개선은 SIMA 1 대비 상당하지만 SIMA 2의 절대 성공률은 두 환경 모두 15% 미만이다.
비교 궤적은 SIMA 1이 실패한 상황에서 SIMA 2가 모닥불로 이동하고 낯선 메뉴를 사용하며 석탄을 채굴하고 좀비와 싸우는 데 성공한 모습을 보여준다. 이러한 선별 사례는 전이 점수를 해석하는 데 도움이 되지만 결과의 전체 분포를 대표하지는 않는다.
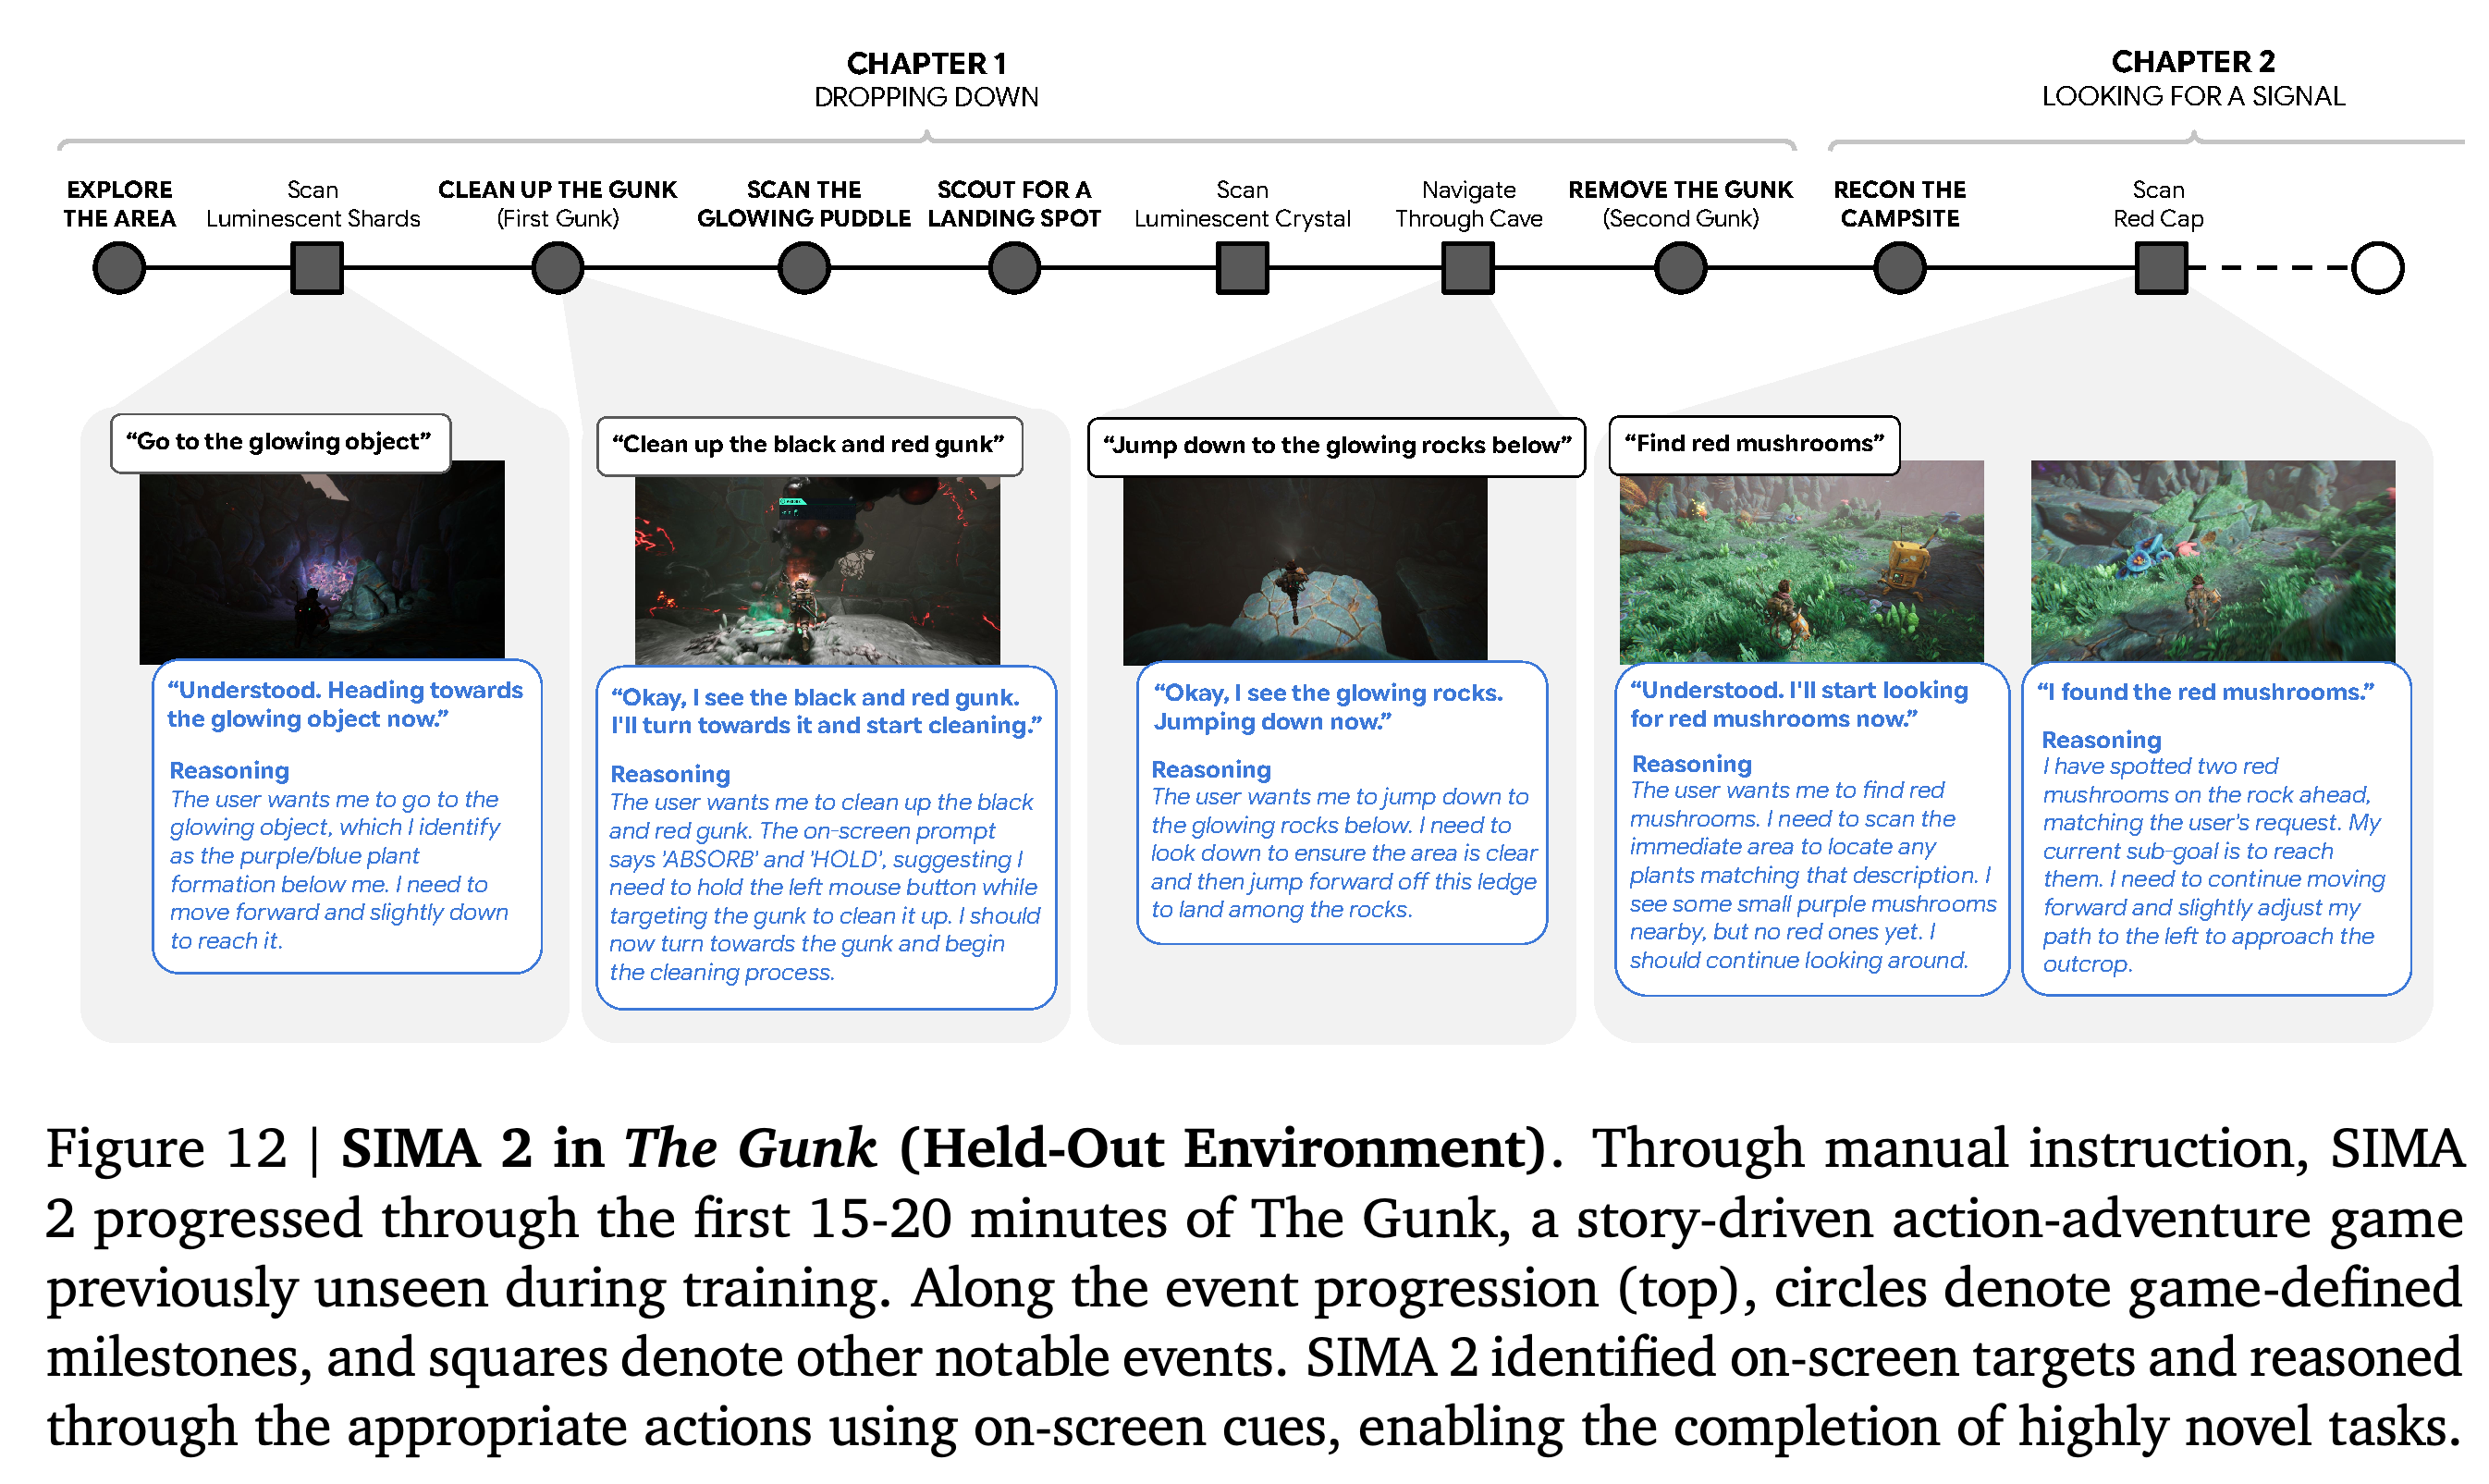
수동으로 지시하면 SIMA 2는 The Gunk의 처음 15–20분 구간을 진행해 Campsite 체크포인트에 도달한다. 이 과정에서 스캔, 턱 오르기, 틈 뛰어넘기, 2개 구역의 오염물 제거를 수행한다. Genie 3 환경의 정성적 예시는 자연 풍경과 사실적인 도시 장면에서 목표로 이동하는 모습을 보여준다.
- The Gunk에서 에이전트는 화면에 표시된 ABSORB와 HOLD를 활용해, 낯선 흡입 도구를 사용할 때 마우스 왼쪽 버튼을 계속 누르는 행동을 선택한다.
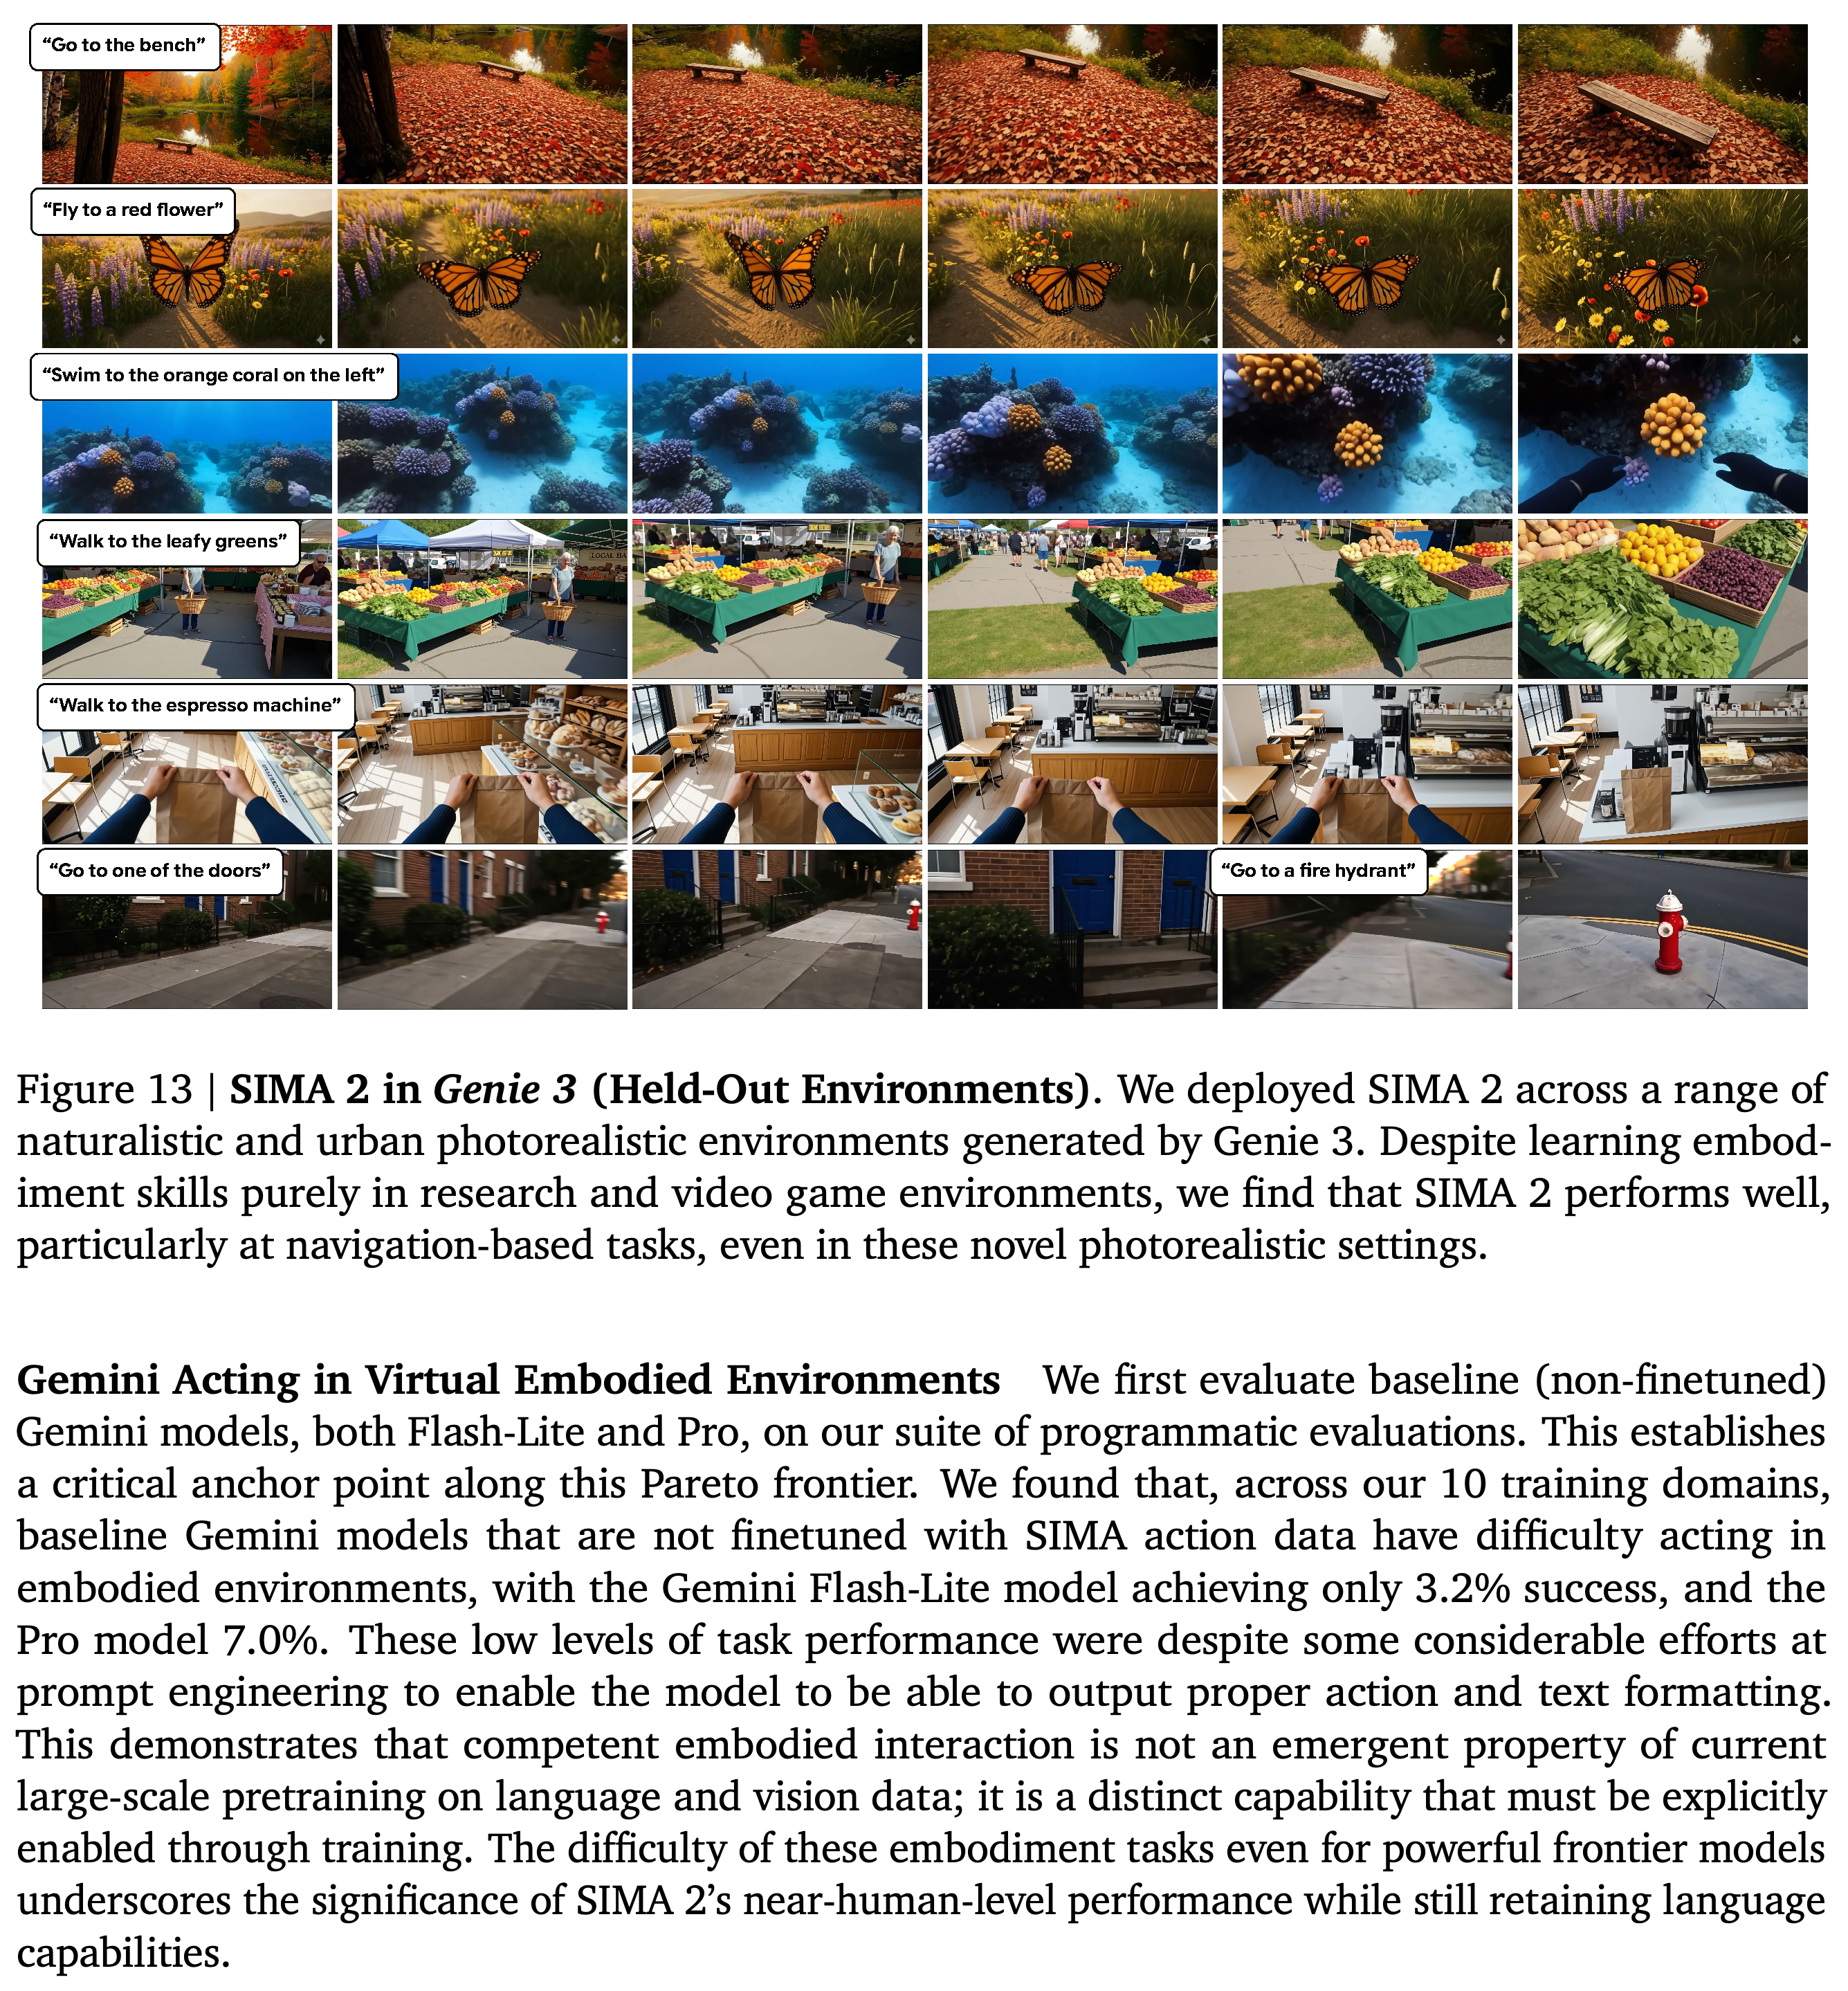
- Genie 3 시연에는 벤치, 빨간 꽃, 주황색 산호, 잎채소, 에스프레소 머신, 문, 소화전에 접근하는 행동이 포함된다.
- 이 시연에 대한 종합 성공률이나 물리적 세계에서의 평가는 보고하지 않는다.
타임라인은 수동 지시로 The Gunk의 처음 15–20분 구간을 진행한 기록을 보여준다. 선별된 사건들은 눈에 보이는 목표와 인터페이스 단서가 낯선 지형에서의 이동과 흡입 도구 사용을 어떻게 안내하는지 보여준다.
궤적은 생성된 숲, 수중 장면, 시장, 카페, 거리에서 목표를 향해 이동하는 모습을 보여준다. 게임에서 학습한 제어가 새롭고 사실적인 가상 장면에서도 작동할 수 있다는 정성적 근거를 제공한다.
4.3. Comparison to Baseline Gemini Models
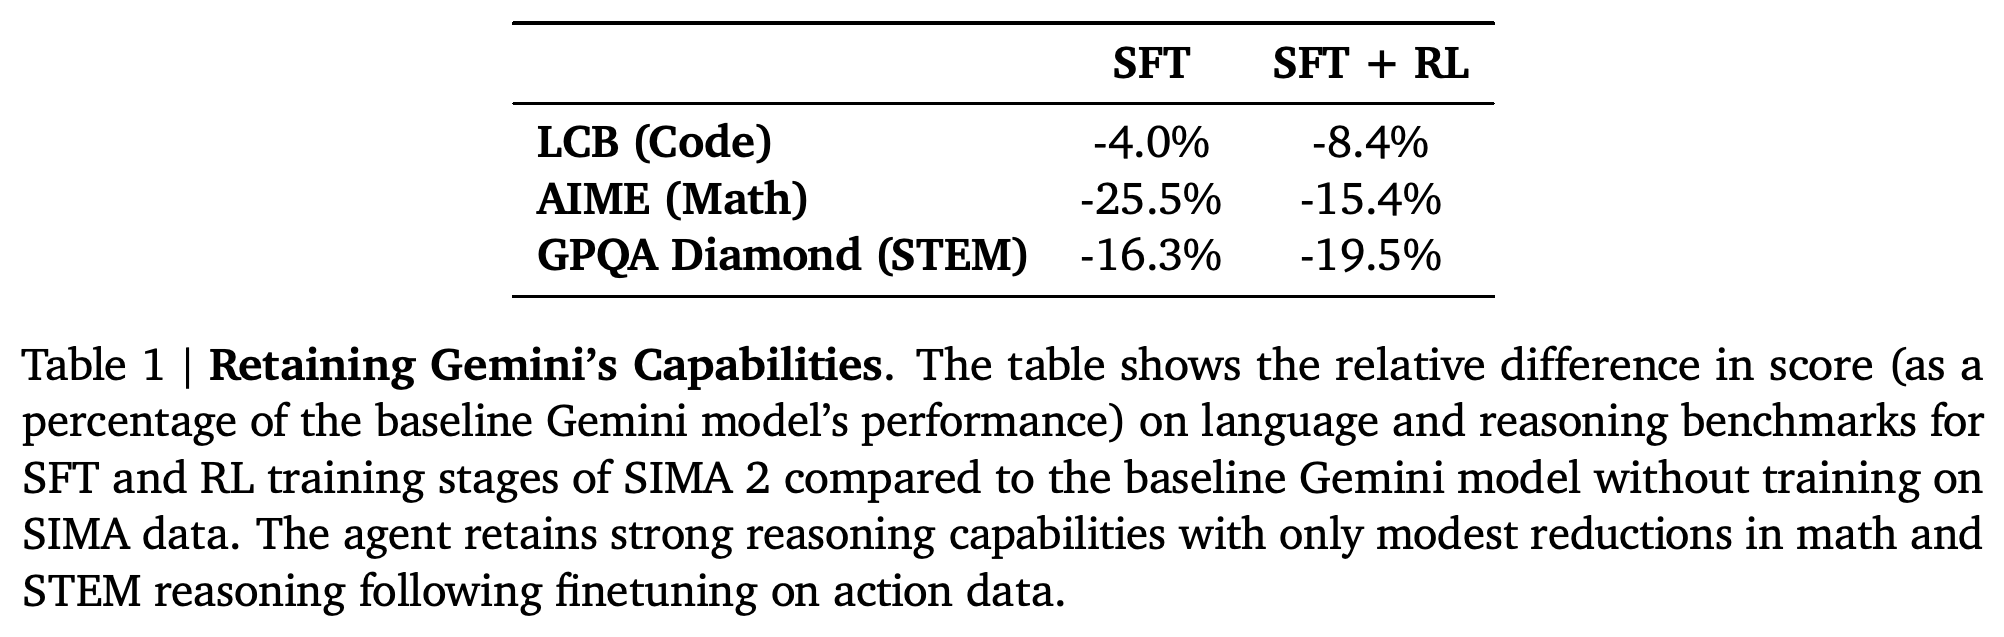
SIMA 행동 데이터로 적응시키지 않은 Gemini Flash-Lite는 3.2%, Gemini Pro는 7.0%의 성공률을 보인다. 이는 올바른 출력 형식을 유도하려는 프롬프트 조정에도 불구하고 10개 학습 영역에 대한 논문의 프로그램 평가에서 얻은 결과다. 일반 능력의 유지 여부는 코드 생성 벤치마크 LiveCodeBench(LCB), American Invitational Mathematics Examination 데이터셋인 AIME, 어려운 과학 질의응답 벤치마크 GPQA Diamond로 평가한다.
- 지도 미세 조정 후 기준 Gemini 모델 대비 상대적인 점수 변화는 LCB (Code)에서 -4.0%, AIME (Math)에서 -25.5%, GPQA Diamond (STEM)에서 -16.3%다. STEM은 과학, 기술, 공학, 수학을 뜻한다.
- 지도 미세 조정과 강화 학습을 모두 수행한 뒤의 변화는 각각 -8.4%, -15.4%, -19.5%다. 이는 벤치마크 점수의 상대적인 변화이며 정확도의 퍼센트포인트 차이는 아니다.
- 결과는 능력이 유지되는 동시에 측정 가능한 성능 저하도 발생함을 보여준다. 강화 학습은 AIME의 상대적 성능을 개선하지만 코딩과 GPQA Diamond의 상대적 성능은 악화시킨다. 표에는 불확실성 추정이나 유의성 검정이 없다.
표는 기준 Gemini 대비 상대적인 점수 변화를 보고한다. 모든 항목은 음수다. 강화 학습을 추가하면 SFT 결과는 코딩에서 -4.0%에서 -8.4%로, 수학에서 -25.5%에서 -15.4%로, 과학 추론에서 -16.3%에서 -19.5%로 바뀐다.
4.4. Gemini Instructing SIMA 2
계층적 구성에서는 Gemini Pro를 SIMA 2의 상위에 둔다. Pro는 k단계마다 최근 영상을 검토하고 자연어 지시를 내리며, 텍스트 요약을 다음 호출로 전달해 연속된 호출 사이의 정보를 유지하는 순환 기억으로 사용한다. 이를 통해 느린 상위 수준의 추론과 지연이 짧은 행동 모델을 분리한다.
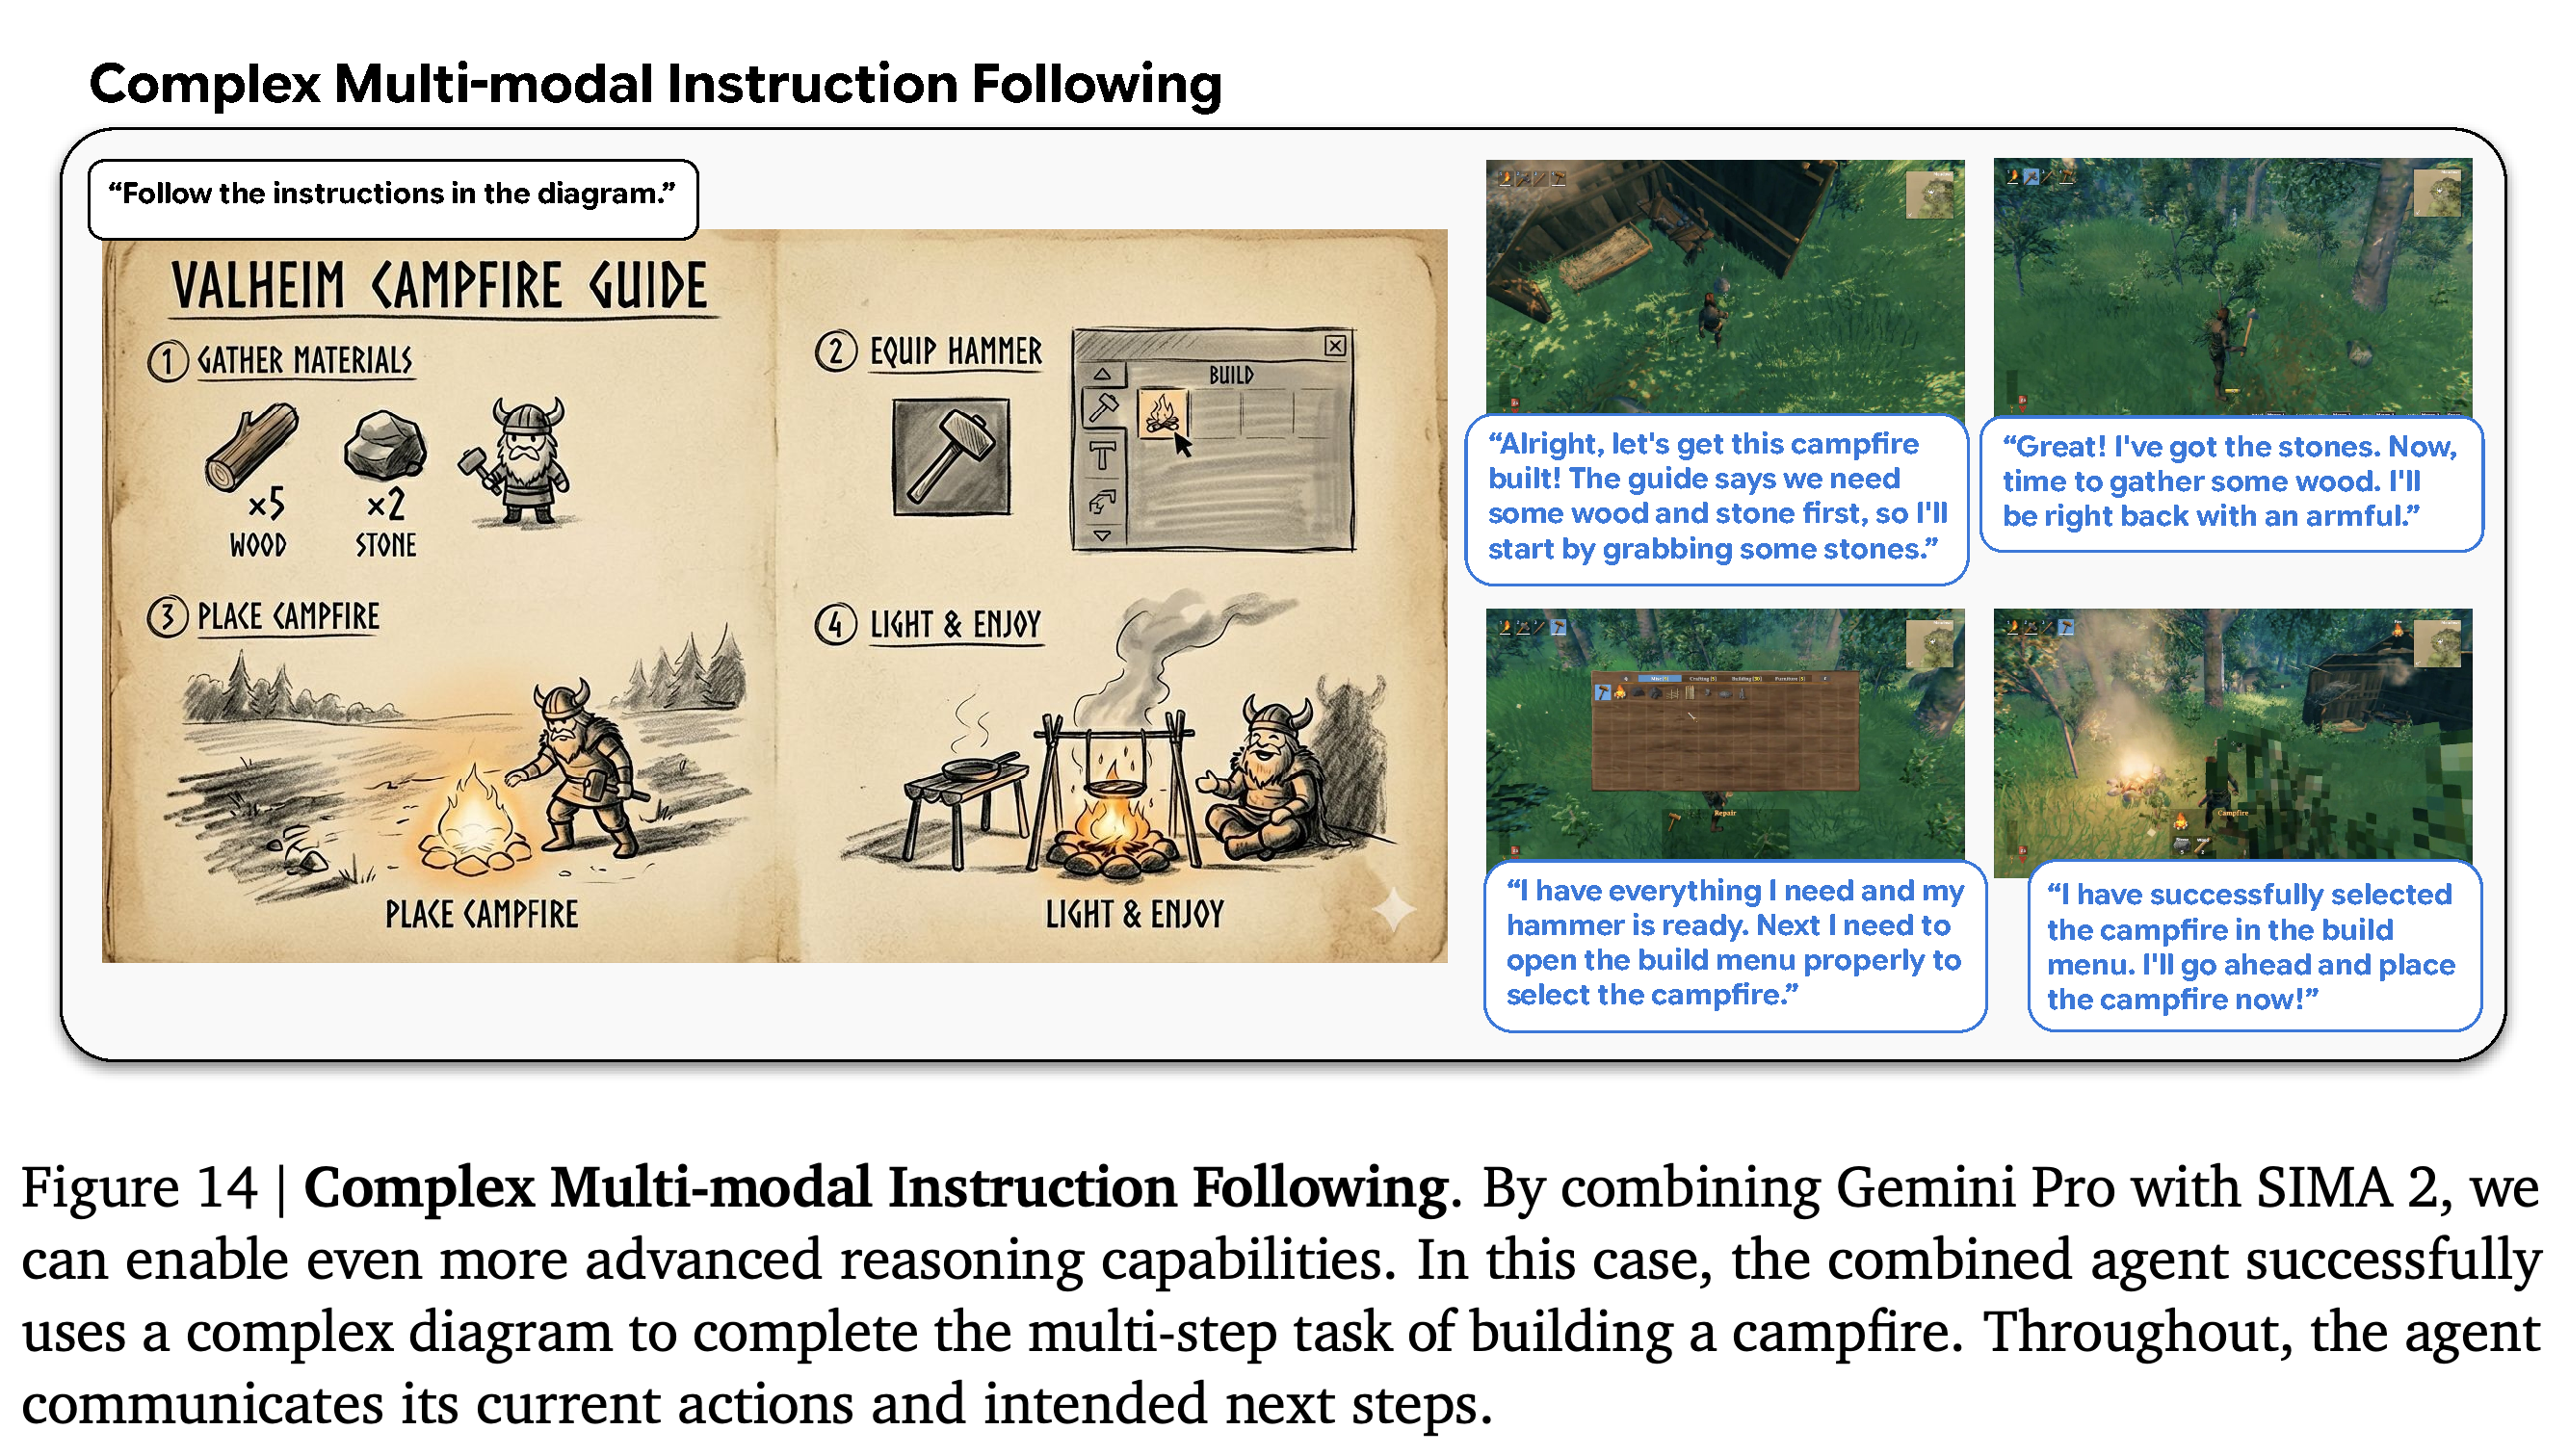
- 주요 예시는 그림으로 된 Valheim 모닥불 제작 안내서를 사용한다. 결합된 시스템은 도식을 해석하고 재료를 모으며 망치를 장착한 뒤 모닥불을 선택하고 배치한다.
- 시연은 이러한 결합으로 예시 과제를 완료할 수 있음을 보여주지만 논문은 SIMA 2 단독 사용과의 통제된 종합 비교를 보고하지 않는다.
결합된 Gemini Pro + SIMA 2 system은 그림으로 된 모닥불 안내서를 자원 수집, 도구 준비, 메뉴 선택, 배치 행동으로 변환한다. 이 예시는 도식 해석과 진행 상황 추적이 필요한 일련의 행동을 조율하는 모습을 보여준다.
4.5. Self-Improvement
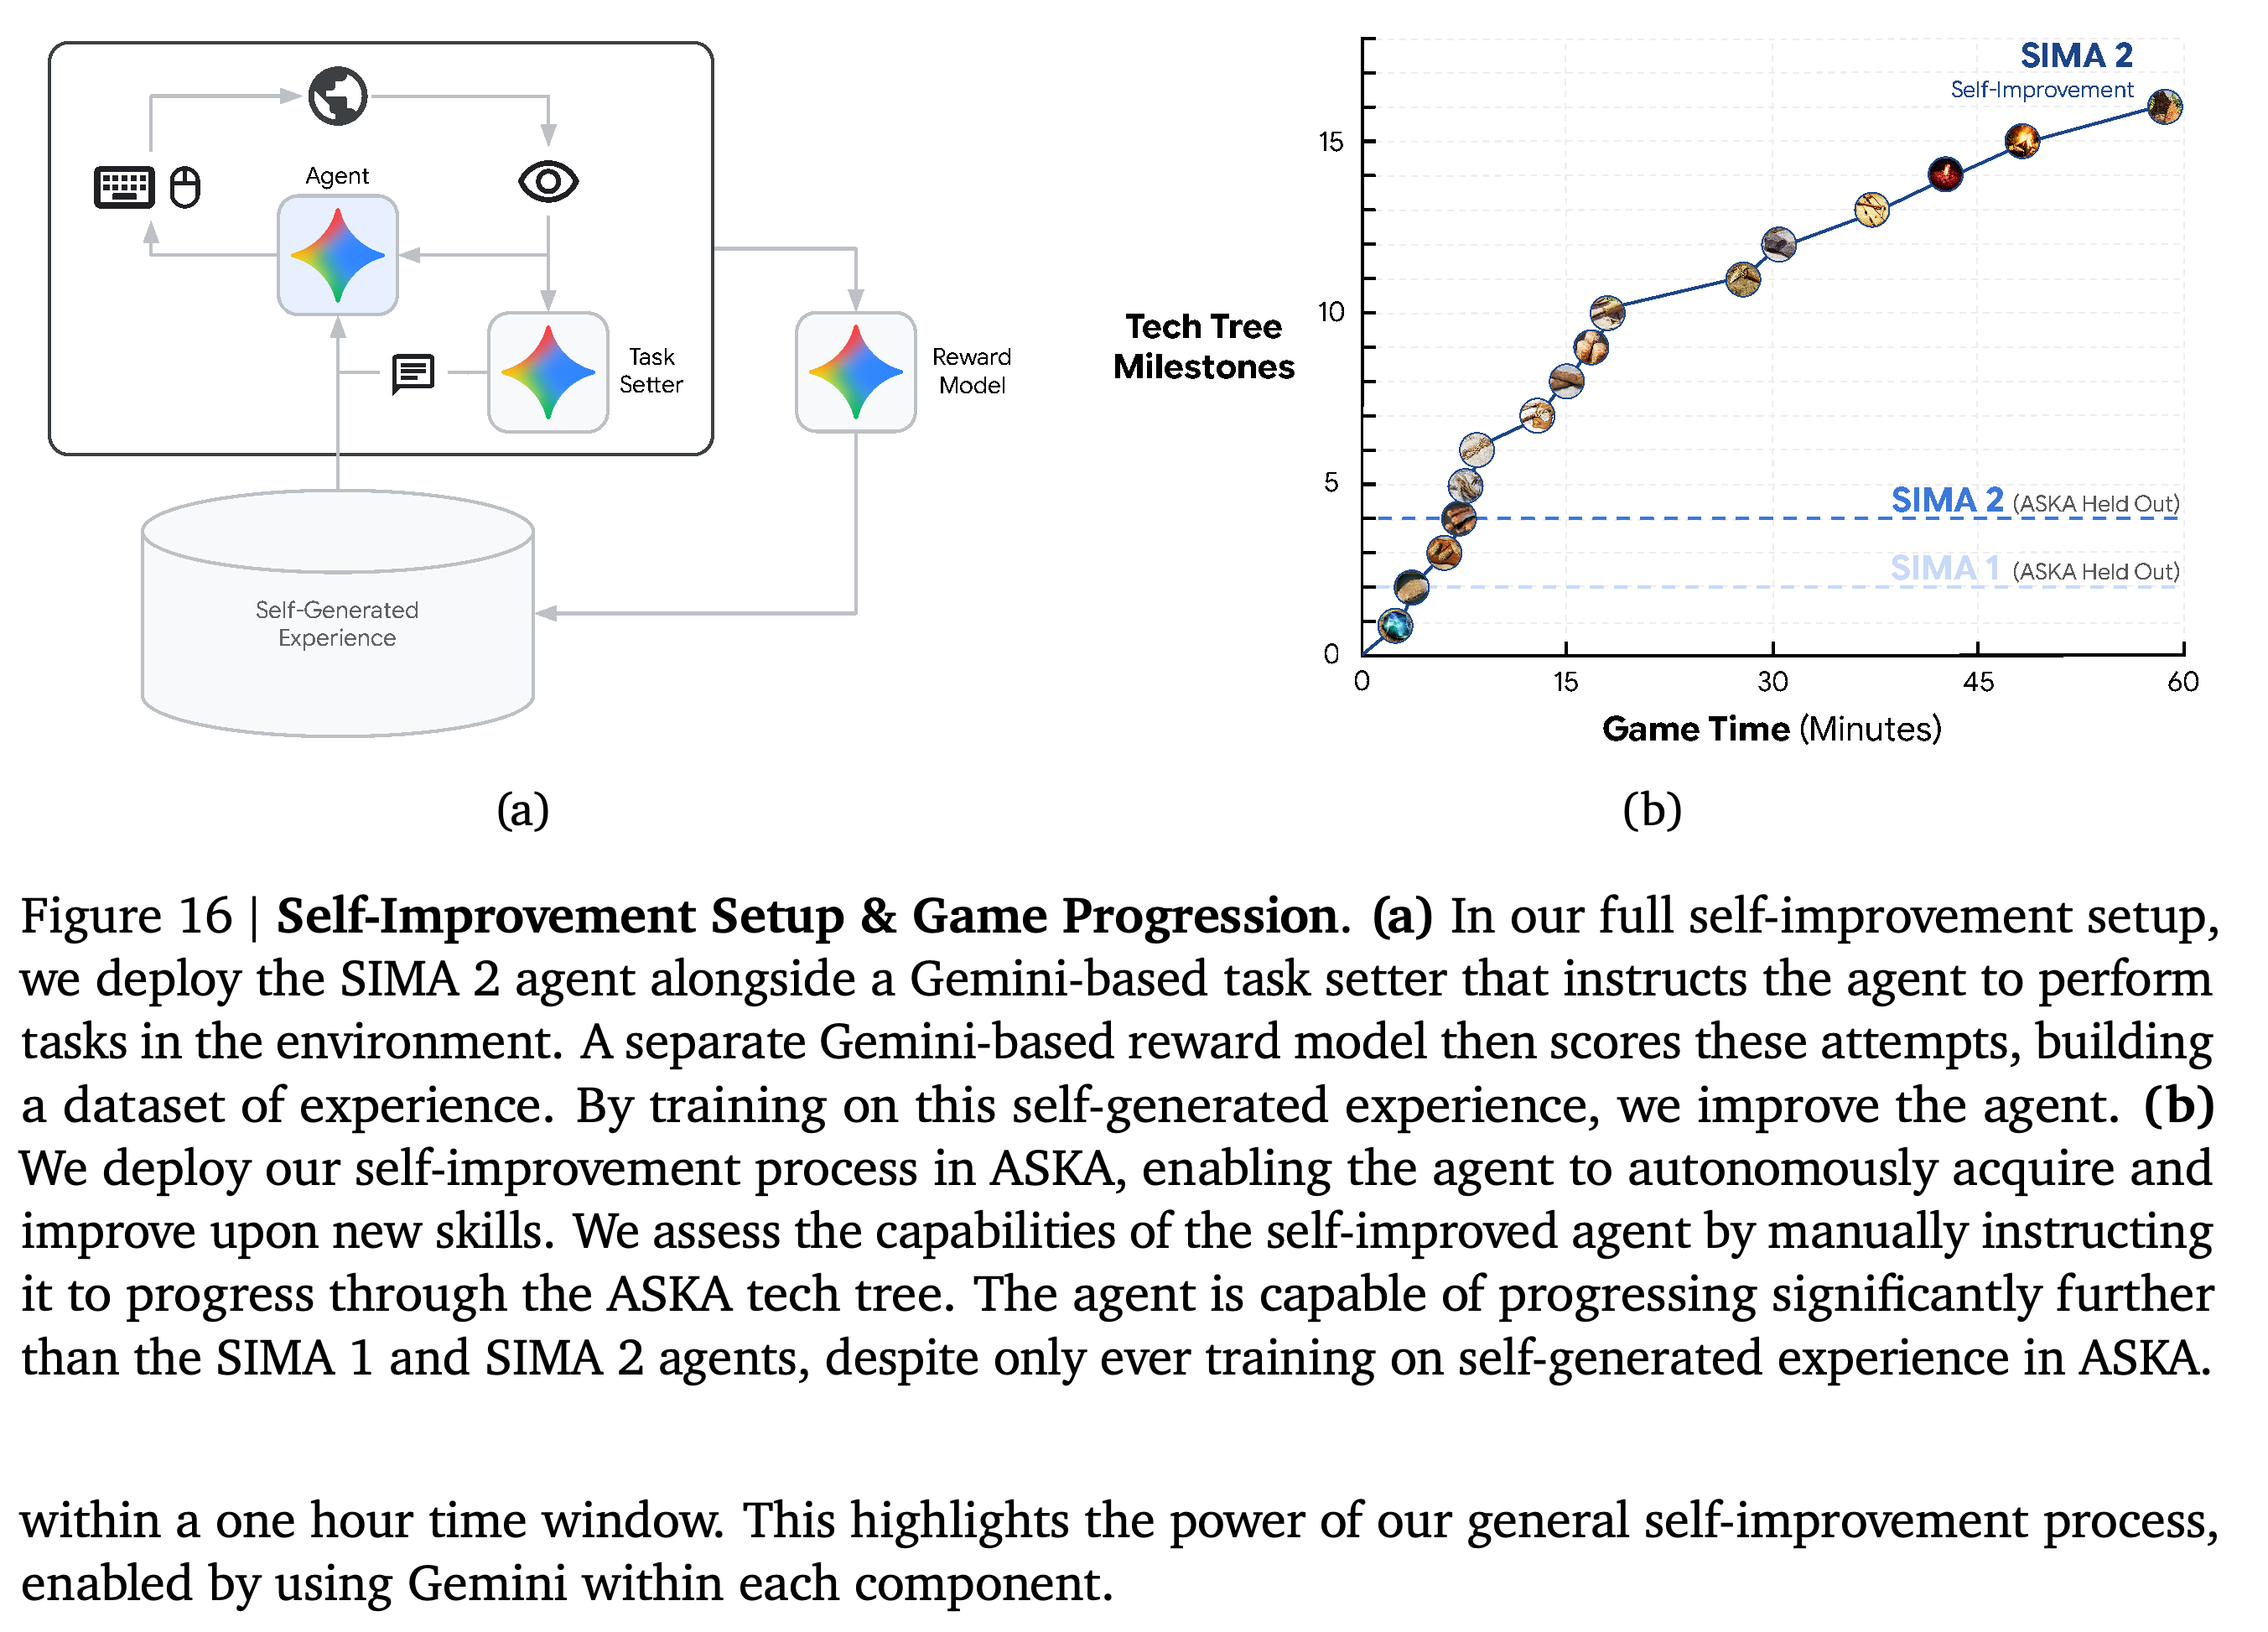
자기 개선 과정은 SIMA 2를 Gemini-Based Task Setter 및 별도의 Gemini-Based Reward Model과 결합한다. 과제 설정 모델은 현재 장면에서 달성 가능한 지시를 제안하며 부족한 기술을 연습하도록 방향을 바꿀 수 있다. 보상 모델은 내부 게임 상태 변수를 사용하지 않고 지시와 화면에 보이는 근거로 궤적 영상을 채점한다.
- 채점 기준은 과제 완료와 불필요한 행동 없이 목표를 향해 진행하는 정도에 대해 0부터 100까지의 점수를 부여한다. 50 이상의 점수는 성공으로 간주한다.
- 채점 기준 프롬프트는 소규모 궤적 데이터셋의 인간 선호 쌍을 기준으로 보정한다.
- 채점된 자체 생성 궤적은 학습 데이터가 된다. 이 모델 기반 채점 과정은 초기 강화 학습 단계에서 사용한 검증 가능한 보상과 다르다.
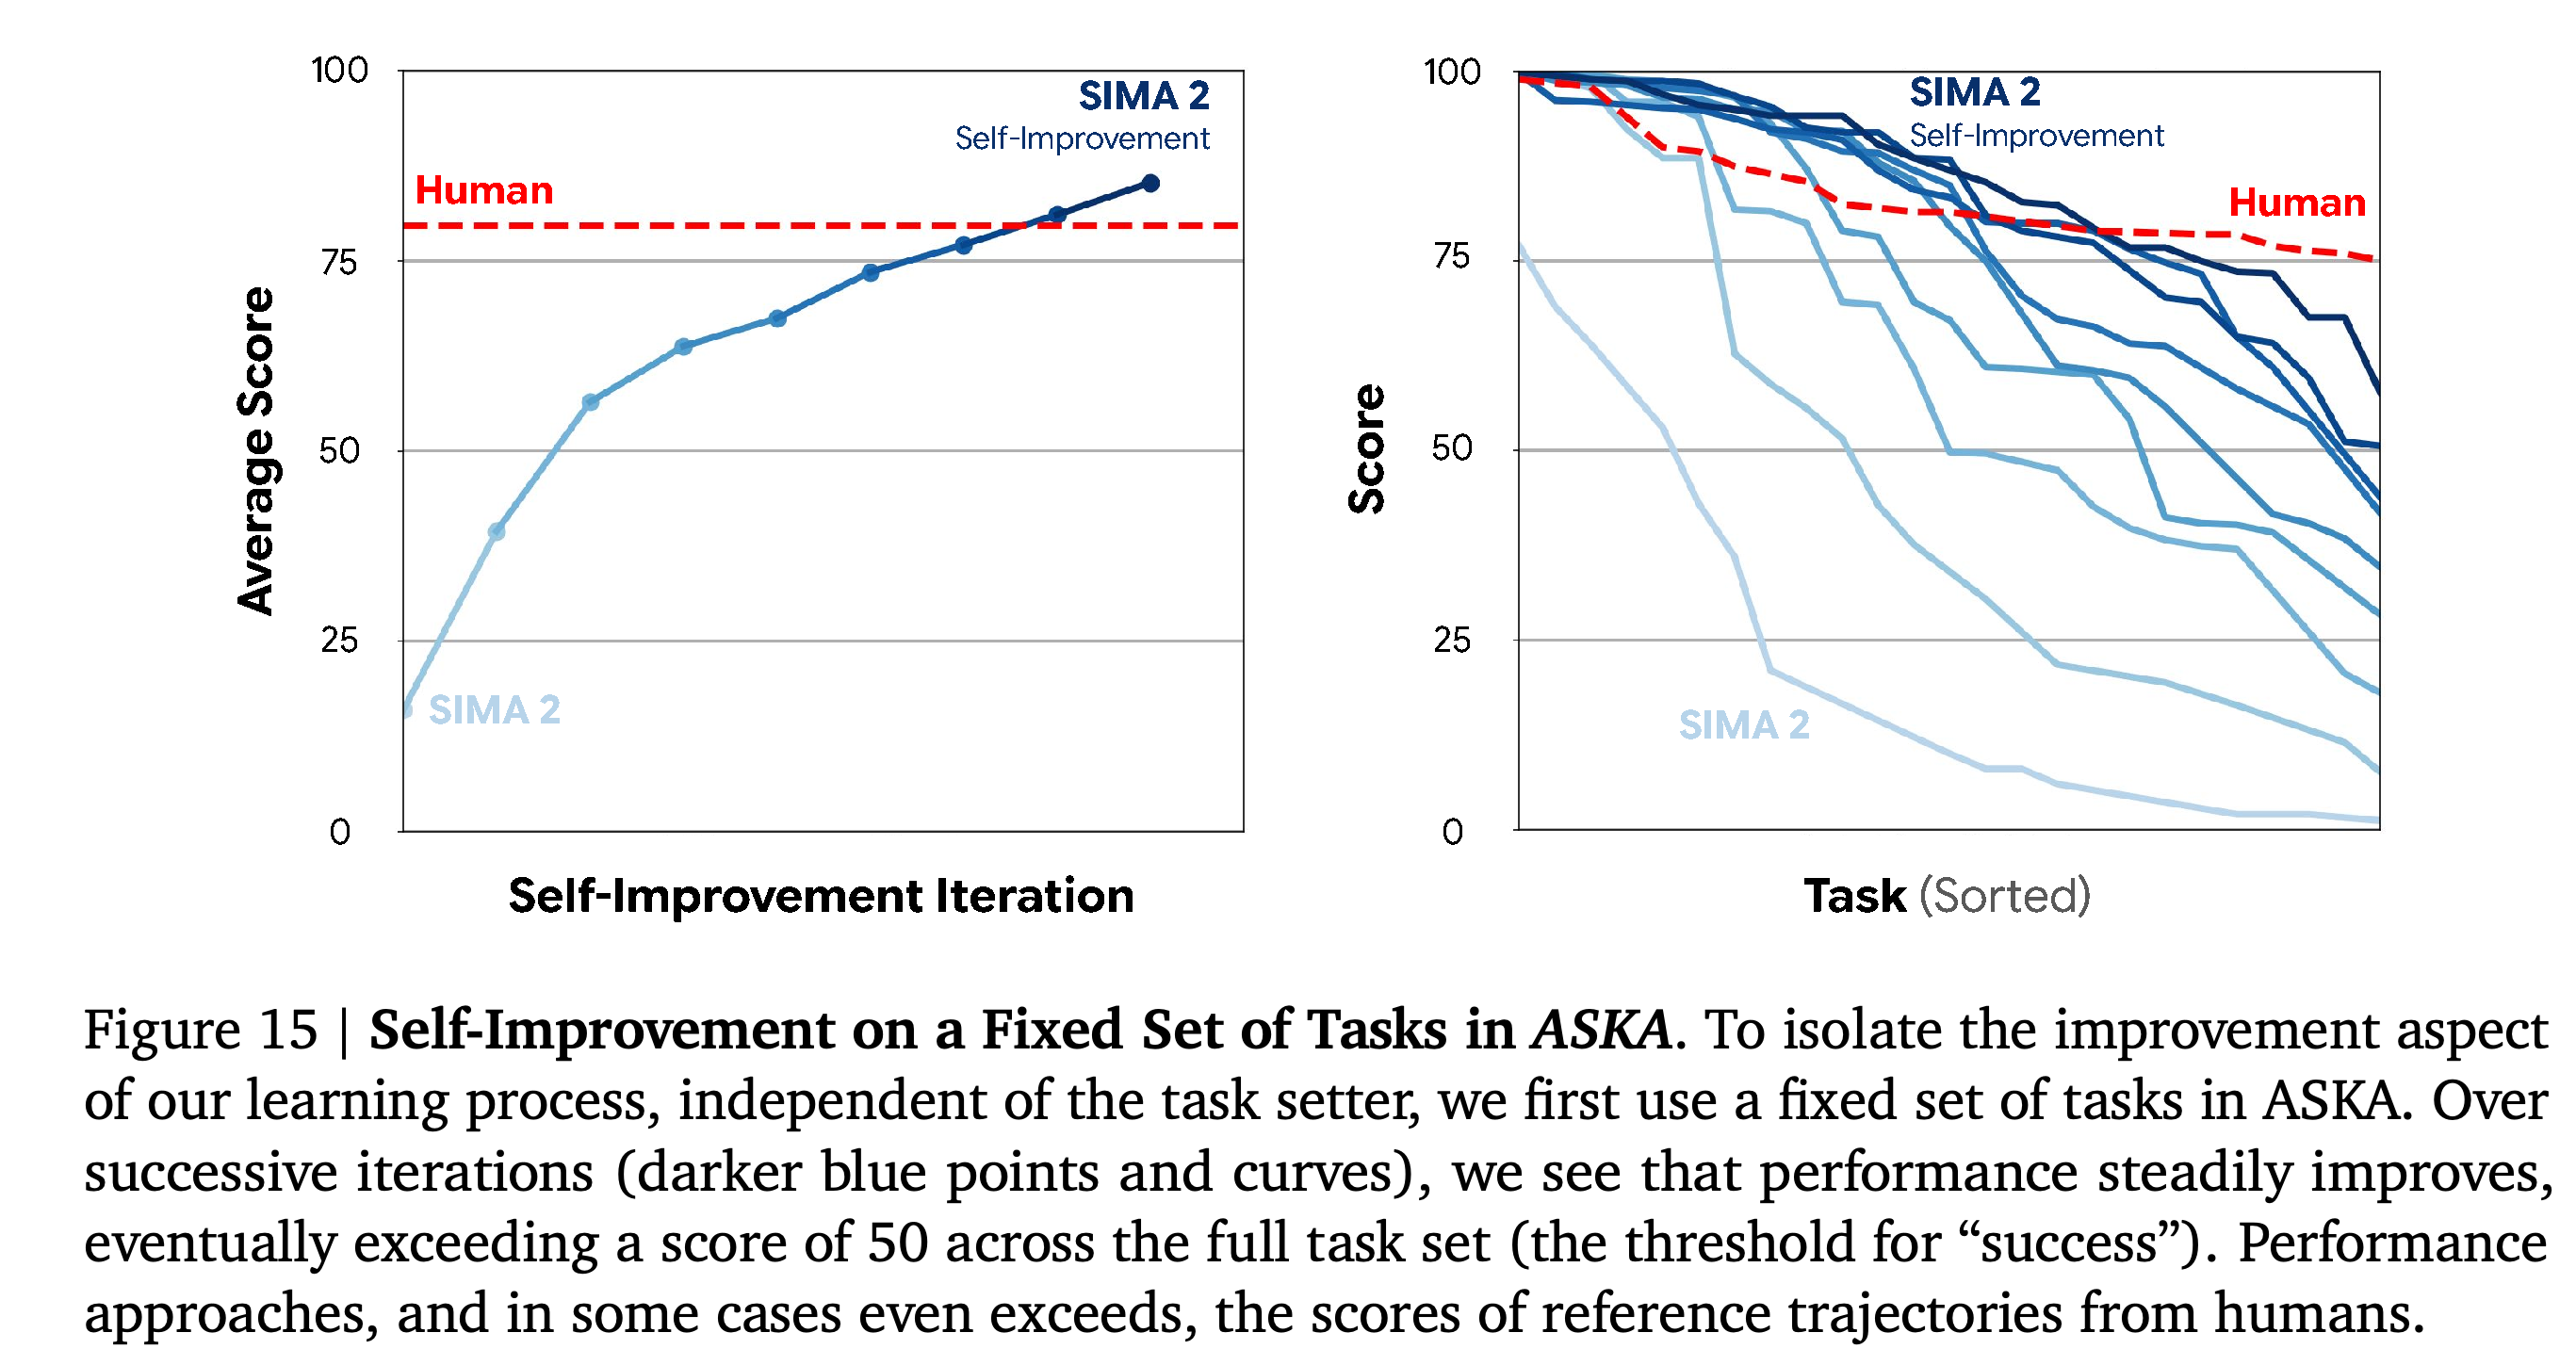
4.5.1. ASKA에서는 먼저 자원 수집, 상호작용, 이동, 메뉴 사용을 포함하는 고정 과제 집합에서의 개선을 분리해 살펴본다. 초기 에이전트가 성공한 과제는 전체를 넷으로 나눈 몫에도 못 미치지만 학습을 반복하면서 결국 모든 과제에서 보상 모델의 성공 임계값을 넘고 숙련된 인간의 참조 궤적 평균 점수도 초과한다.
- 이 비교는 에이전트와 인간 궤적 모두에 Gemini 보상 모델 점수를 사용한다. 따라서 인간 플레이어보다 전반적으로 우수함을 입증하는 결과는 아니다.
- 게임 진행에 초점을 맞춘 자동 과제 생성을 통해 에이전트는 자신의 경험에서 낯선 제작 및 메뉴 사용 기술을 학습한다.
- 학습된 에이전트는 ASKA 기술 트리를 따라 수동 지시로 평가되며, 1시간 안에 거처를 건설해 기존 SIMA 1과 SIMA 2보다 더 멀리 진행한다.
연속된 곡선은 고정된 ASKA 과제 집합에서 평균 및 과제별 Gemini 보상 모델 점수가 상승하는 모습을 보여준다. 최종 에이전트는 집합의 모든 과제에서 성공 임계값을 넘으며 평균 인간 참조 점수도 초과한다. 에이전트와 인간은 동일한 채점 기준으로 평가한다.
왼쪽 패널은 과제 제안, 에이전트 상호작용, 궤적 채점, 수집한 경험을 통한 학습을 구분한다. 오른쪽 패널은 적응한 에이전트를 ASKA 기술 트리를 따라 수동 지시로 평가하며 1시간 동안 더 멀리 진행한 모습을 보여준다.
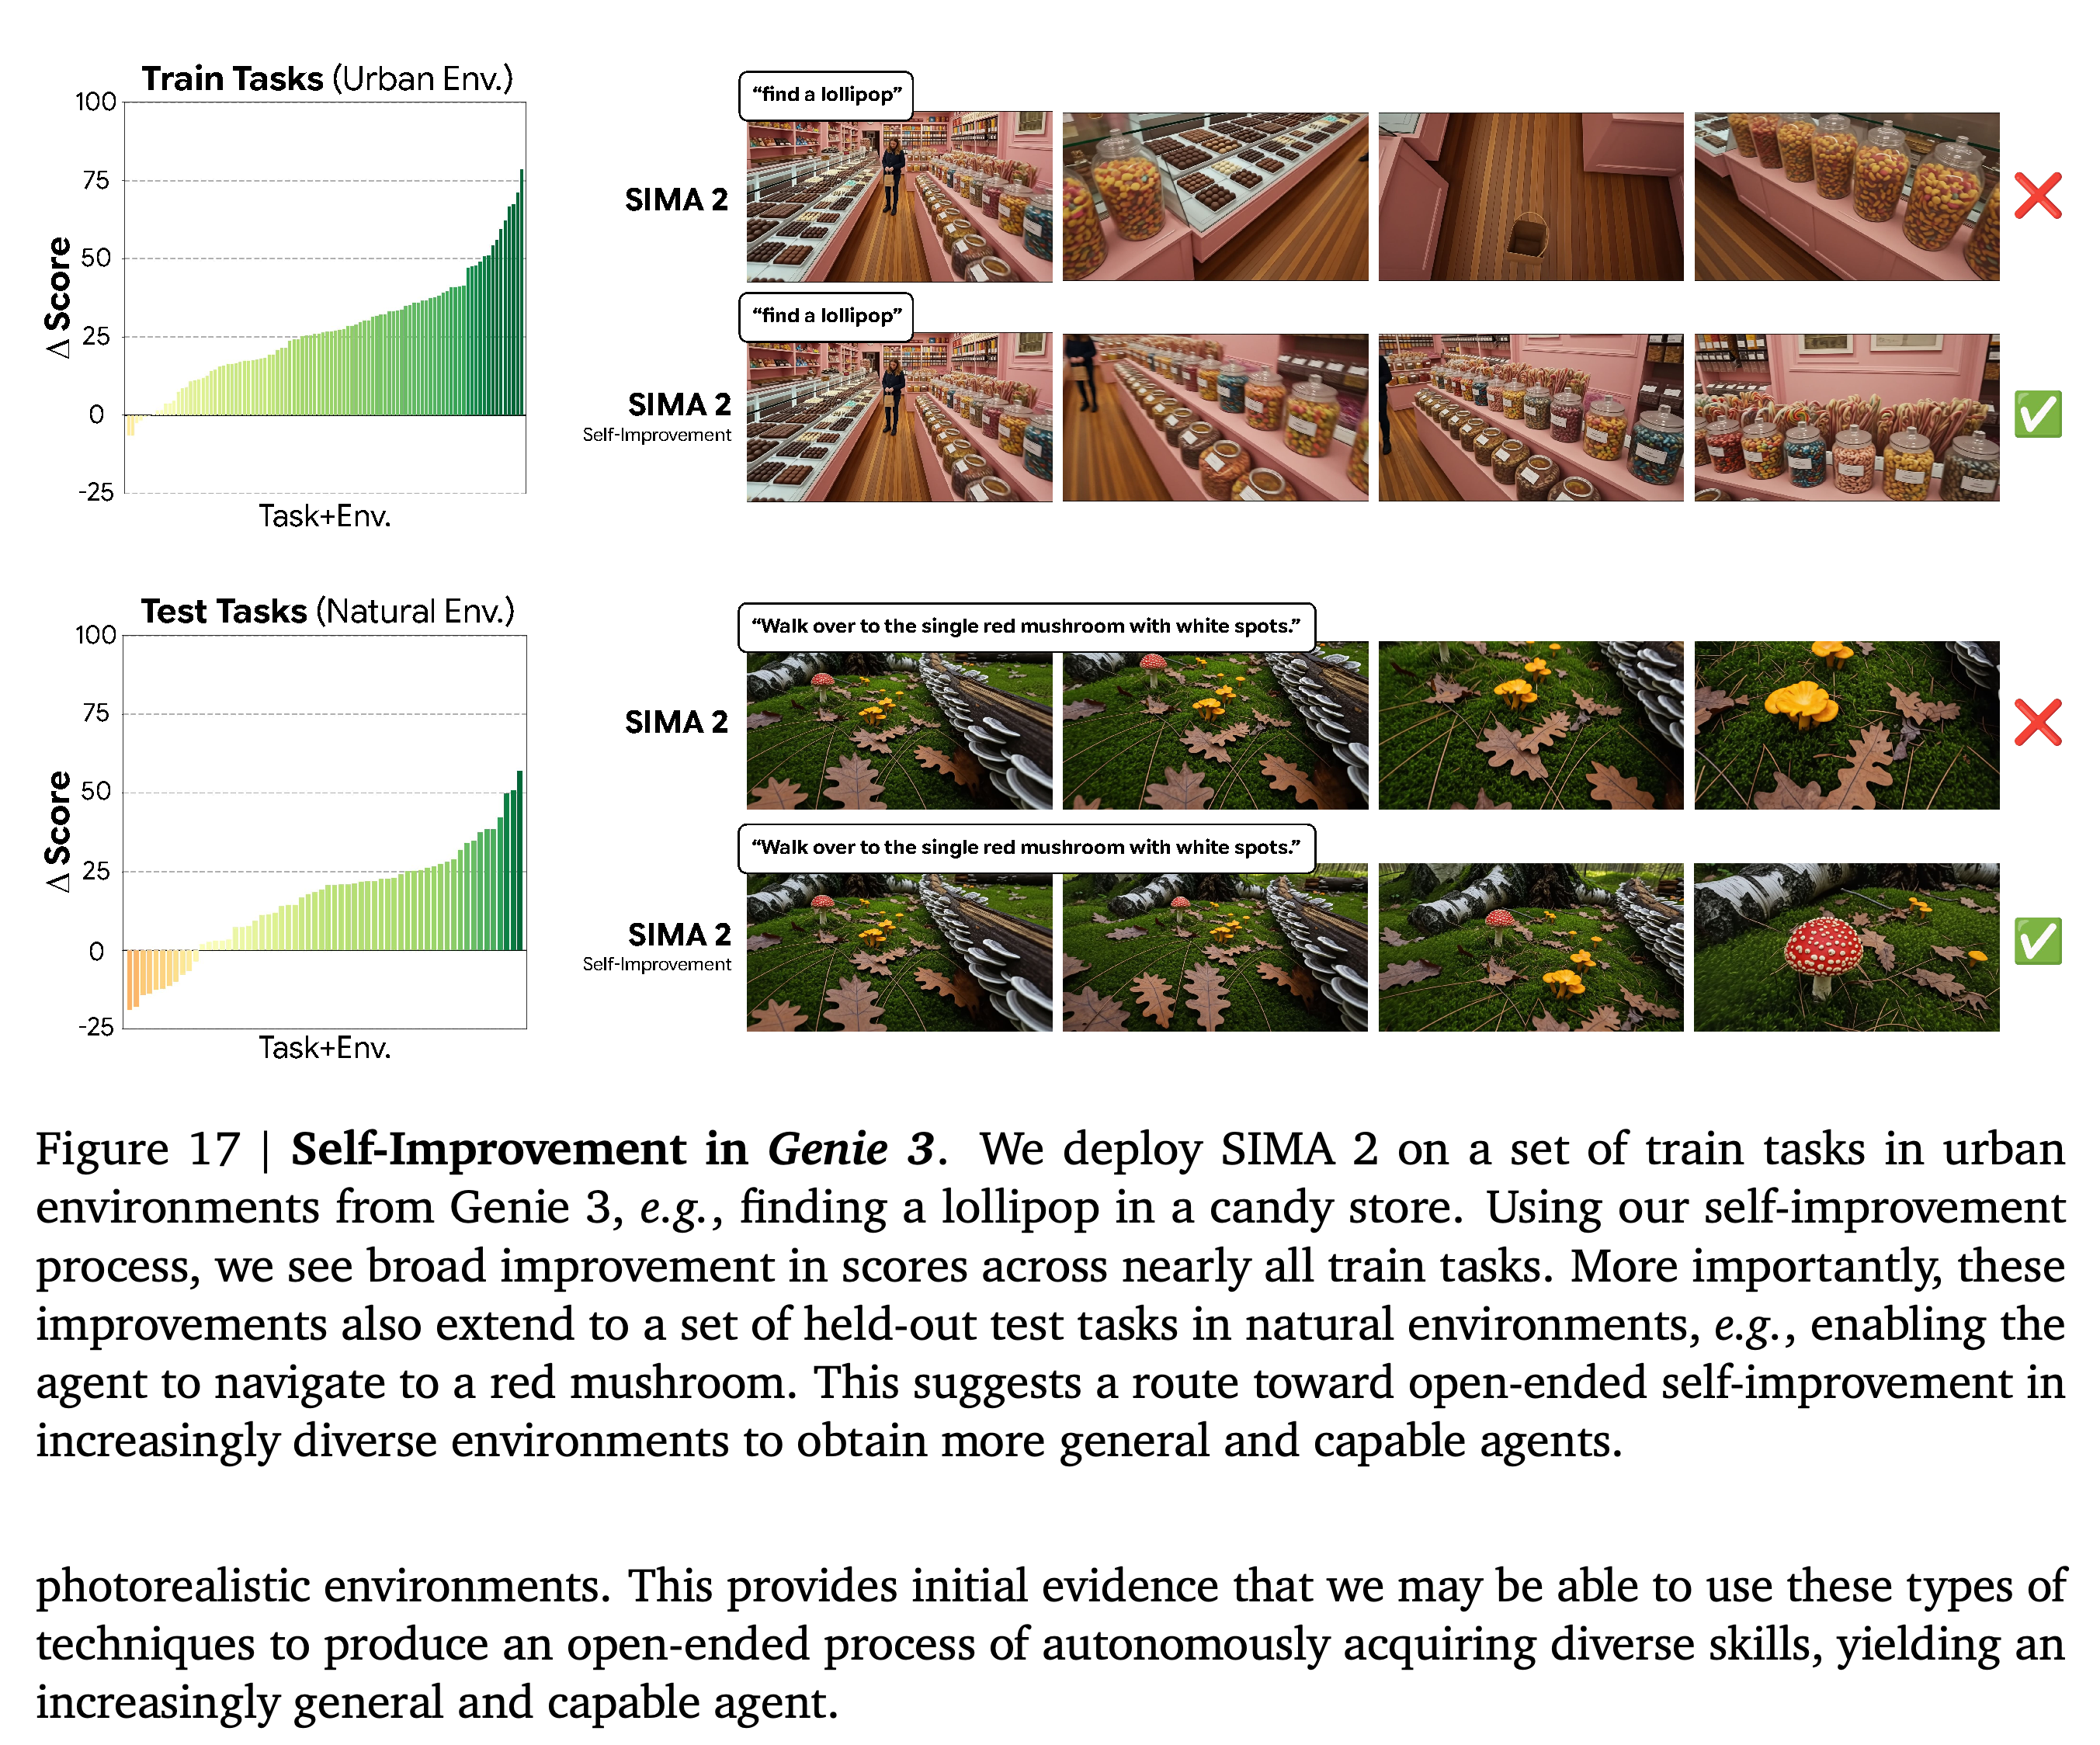
4.5.2. Genie 3에서는 생성된 환경을 도시 학습 환경과 자연 테스트 환경으로 나누며, 과제는 주로 이동을 다룬다. 스스로 생성한 경험을 통해 거의 모든 학습 과제의 점수가 개선되고 개선 폭은 흔히 25점 이상이다. 홀드아웃 자연 환경 과제에서도 과반의 점수가 개선된다.
- Figure 17은 도시의 사탕 가게에서 막대사탕으로 이동하는 행동과 자연 장면에서 빨간 버섯으로 이동하는 행동이 개선된 모습을 보여준다.
- 일부 과제, 특히 테스트 집합에서는 점수가 하락한다. 개선은 폭넓게 나타나지만 균일하지 않다.
- 이 실험은 적응 후 생성된 환경 유형 사이에서 전이가 가능하다는 예비 근거를 제공한다. 학습을 무기한 지속하는 경우는 검증하지 않는다.
과제별 점수 변화는 거의 모든 도시 학습 과제와 대부분의 자연 테스트 과제에서 개선을 보이며 일부 성능 저하도 함께 나타낸다. 선별된 막대사탕과 버섯 궤적은 적응 후 목표를 향한 이동이 개선된 모습을 보여준다.
5. Discussion
논의에서는 매우 긴 과제, 다단계 추론과 목표 검증, 제한된 상호작용 기억, 정밀한 키보드 및 마우스 제어, 복잡한 3D 장면의 안정적인 이해를 미해결 과제로 제시한다. 모델이 활용할 수 있는 최근 상호작용 이력인 짧은 컨텍스트 윈도는 지연이 짧은 상호작용을 지원하지만 기억을 제한한다. 물리적 세계로의 전이는 향후 방향으로 남아 있다.
- SIMA 2는 소규모 학계 연구자와 게임 개발자에게 조기 접근을 제공하는 제한적인 연구 프리뷰로 소개된다.
- SIMA 2 Team은 기여자를 이름의 알파벳순으로 나열하며 SIMA 2: A Generalist Embodied Agent for Virtual Worlds의 단체 인용 저자를 SIMA Team, 연도를 2025로 제시한다.
부록
- A. Embodied Skill Categories는 Interaction, Navigation, Menu Use, Tool Use, Construction, Object Management, Resource Gathering, Combat을 정의한다. Table 2는 설명과 예시를 제공해 본문의 기술별 비교에 사용한 범주를 명확히 한다.
- B. Additional Results Combining Gemini Pro & SIMA 2는 기억한 규칙을 이후 요청에 적용하는 Abstract Reasoning과, 정보를 얻기 위해 움직임과 질문을 선택하는 Active Exploration의 정성적 예시를 제공한다. 결합된 에이전트는 이후 요청과 반대로 행동하라는 지시를 기억한다. 또한 환경을 탐색하고 사용자 답변을 활용해 물체를 식별하는 21 questions 게임을 수행한다.
- C. Additional Self-Improvement Results는 적응 후 습득한 ASKA 행동인 빗물 수집기 접근과 모닥불 끄기를 보여준다. ASKA Technology Tree 도식은 첫 주민을 소환하는 데 필요한 최소 의존 관계를 제시하며 본문의 게임 진행 실험을 이해할 맥락을 제공한다.
짧은 생각
가장 분명한 기여는 사전 학습된 멀티모달 지식과 명시적으로 학습한 저수준 제어의 결합이다. SIMA 1 대비 개선과 적응시키지 않은 Gemini의 낮은 성공률은 이러한 과제에서 체화 학습의 가치를 뒷받침한다. 논문은 개별 학습 요소를 제거하는 통제 비교인 상세한 구성 요소 제거 실험을 보고하지 않으므로, 각 데이터 요소, 생성된 추론, 보상 기반 학습이 얼마나 기여하는지에 대한 직접적인 근거는 부족하다. 일반화는 의미가 있지만 완전하지는 않다. 낯선 게임의 성공률은 여전히 15% 미만이며 The Gunk와 초기 Genie 3 결과는 정성적이다. 상승하는 채점 기준 점수와 구체적으로 습득한 행동이 자기 개선을 뒷받침한다. 추가적인 독립 평가가 있다면 보상 모델 점수와 수동 지시를 통한 진행 시연 외에도 신뢰성을 평가하는 데 도움이 된다. 능력 유지에는 측정 가능한 비용이 따른다. 최종 모델은 보고된 3개 코딩 및 추론 벤치마크에서 상대적으로 8.4%, 15.4%, 19.5% 하락한다.