


Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 요약 설명
17 Aug 2026 | Paper Review Embodied Agents Self-Evolving Agents Vision-Language-Action Models Rollout Infrastructure목차
- 요약
- 1. Introduction
- 2. Enabling Deployment-Time Evolution of Embodied Agents
- 2.1. Problem Formulation: Dual-Agent Governance and Evolutionary Architecture
- 2.3. Phase I: Empirical Failure Profiling and Baseline Establishment (Loop 1)
- 2.4. Phase II Stage 1: Failure Clustering and Causal Diagnosis
- 2.5. Phase II Stage 2: Critic-Guided Harness Repair and Validation
- 2.6. Phase III: Harness Consolidation, Packaging and Generalization
- 3. Z-Infra: Embodied Agent Rollout Infrastructure
- 4. Experiments
- 부록
- 짧은 생각
이번 글에서는 Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 8월 17일(Arxiv)
- Ding, Xin, Mi, Liang, Huang, Mingzhe, Wang, Zixuan, Zhang, Chao, Hao, Zixu, Chen, Fu, Li, Xiangyu, Zheng, Yikai, Guo, Yaoyu, et al.
- Institute for AI Industry Research (AIR), Tsinghua University, Z-Trans AI
- 논문 링크
- Github
- Project Page
요약
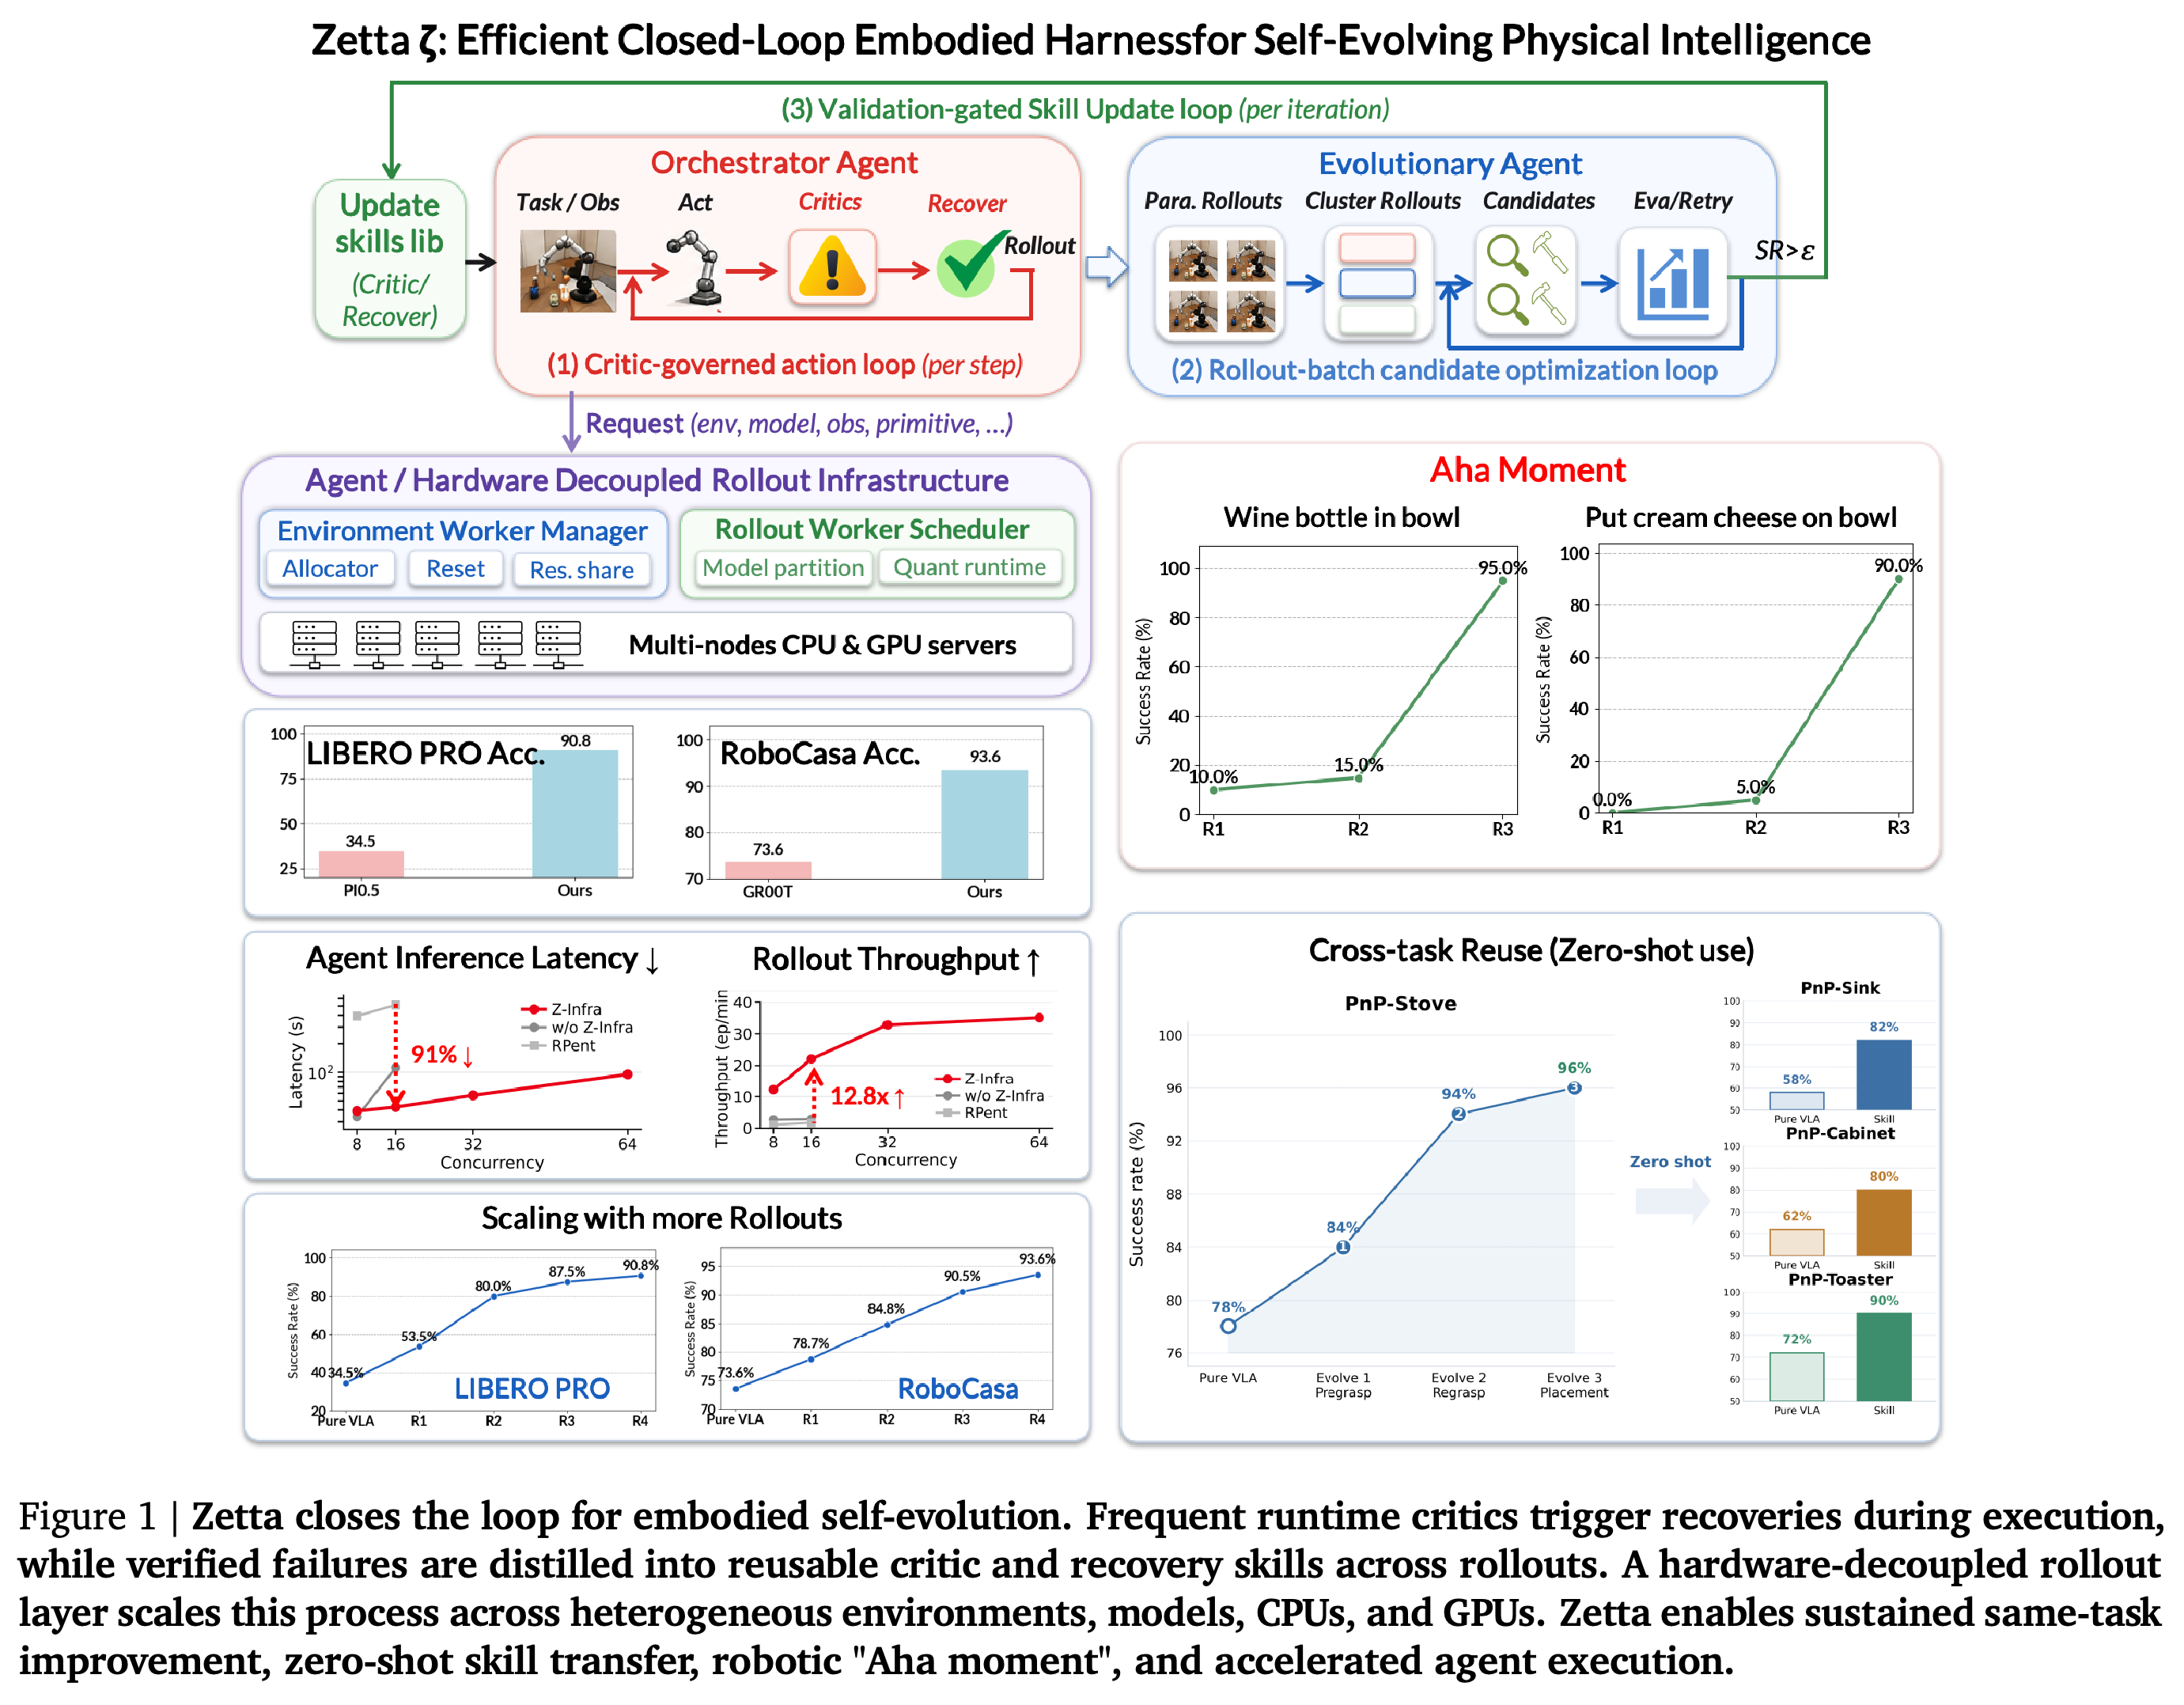
- Zetta는 기본 VLA 또는 world-action policy를 고정한 채 코드 기반 runtime critic, recovery playbook, tool을 발전시키는 closed-loop embodied harness다. 하드웨어와 분리된 rollout 시스템인 Z-Infra와 함께 구성되며, 논문은 RoboCasa macro-average 성공률 93.56%, LIBERO-Pro Goal 평균 T 92.5%와 S 89.0%, Z-Infra 시스템 평가에서 최대 35.1 episodes/min을 보고한다. harness에 대해서는 이 글을 참조하라. harness에 대해서는 이 글을 참조하라.
개요는 3가지 시간 척도를 연결한다. action-frequency critic 및 recovery 실행, rollout-batch candidate optimization, validation-gated skill update가 그것이다. 또한 논문이 주장하는 동일 task scaling, transfer, “Aha” moment, latency, throughput 결과를 제시한다.
1. Introduction
논문은 episode 종료 뒤의 반성만으로는 빠르게 변하는 물리 상태를 제어할 수 없고, 매 action마다 대형 agentic model을 호출하는 방식은 비현실적이라고 주장한다. 따라서 self-exploration으로 재사용 가능한 runtime mechanism을 학습하고, rollout throughput을 성능 향상의 제한 요인으로 본다.
2. Enabling Deployment-Time Evolution of Embodied Agents
Deployment-time evolution은 고주파 state governance와 자동 복구 및 일반화로 구성된다. 이 설계는 경량 critic으로 편차를 감지하고, evaluation logic부터 저수준 parameter까지 계층적으로 진단하며, expert debugging에만 의존하지 않고 held-out validation을 사용한다.
2.1. Problem Formulation: Dual-Agent Governance and Evolutionary Architecture
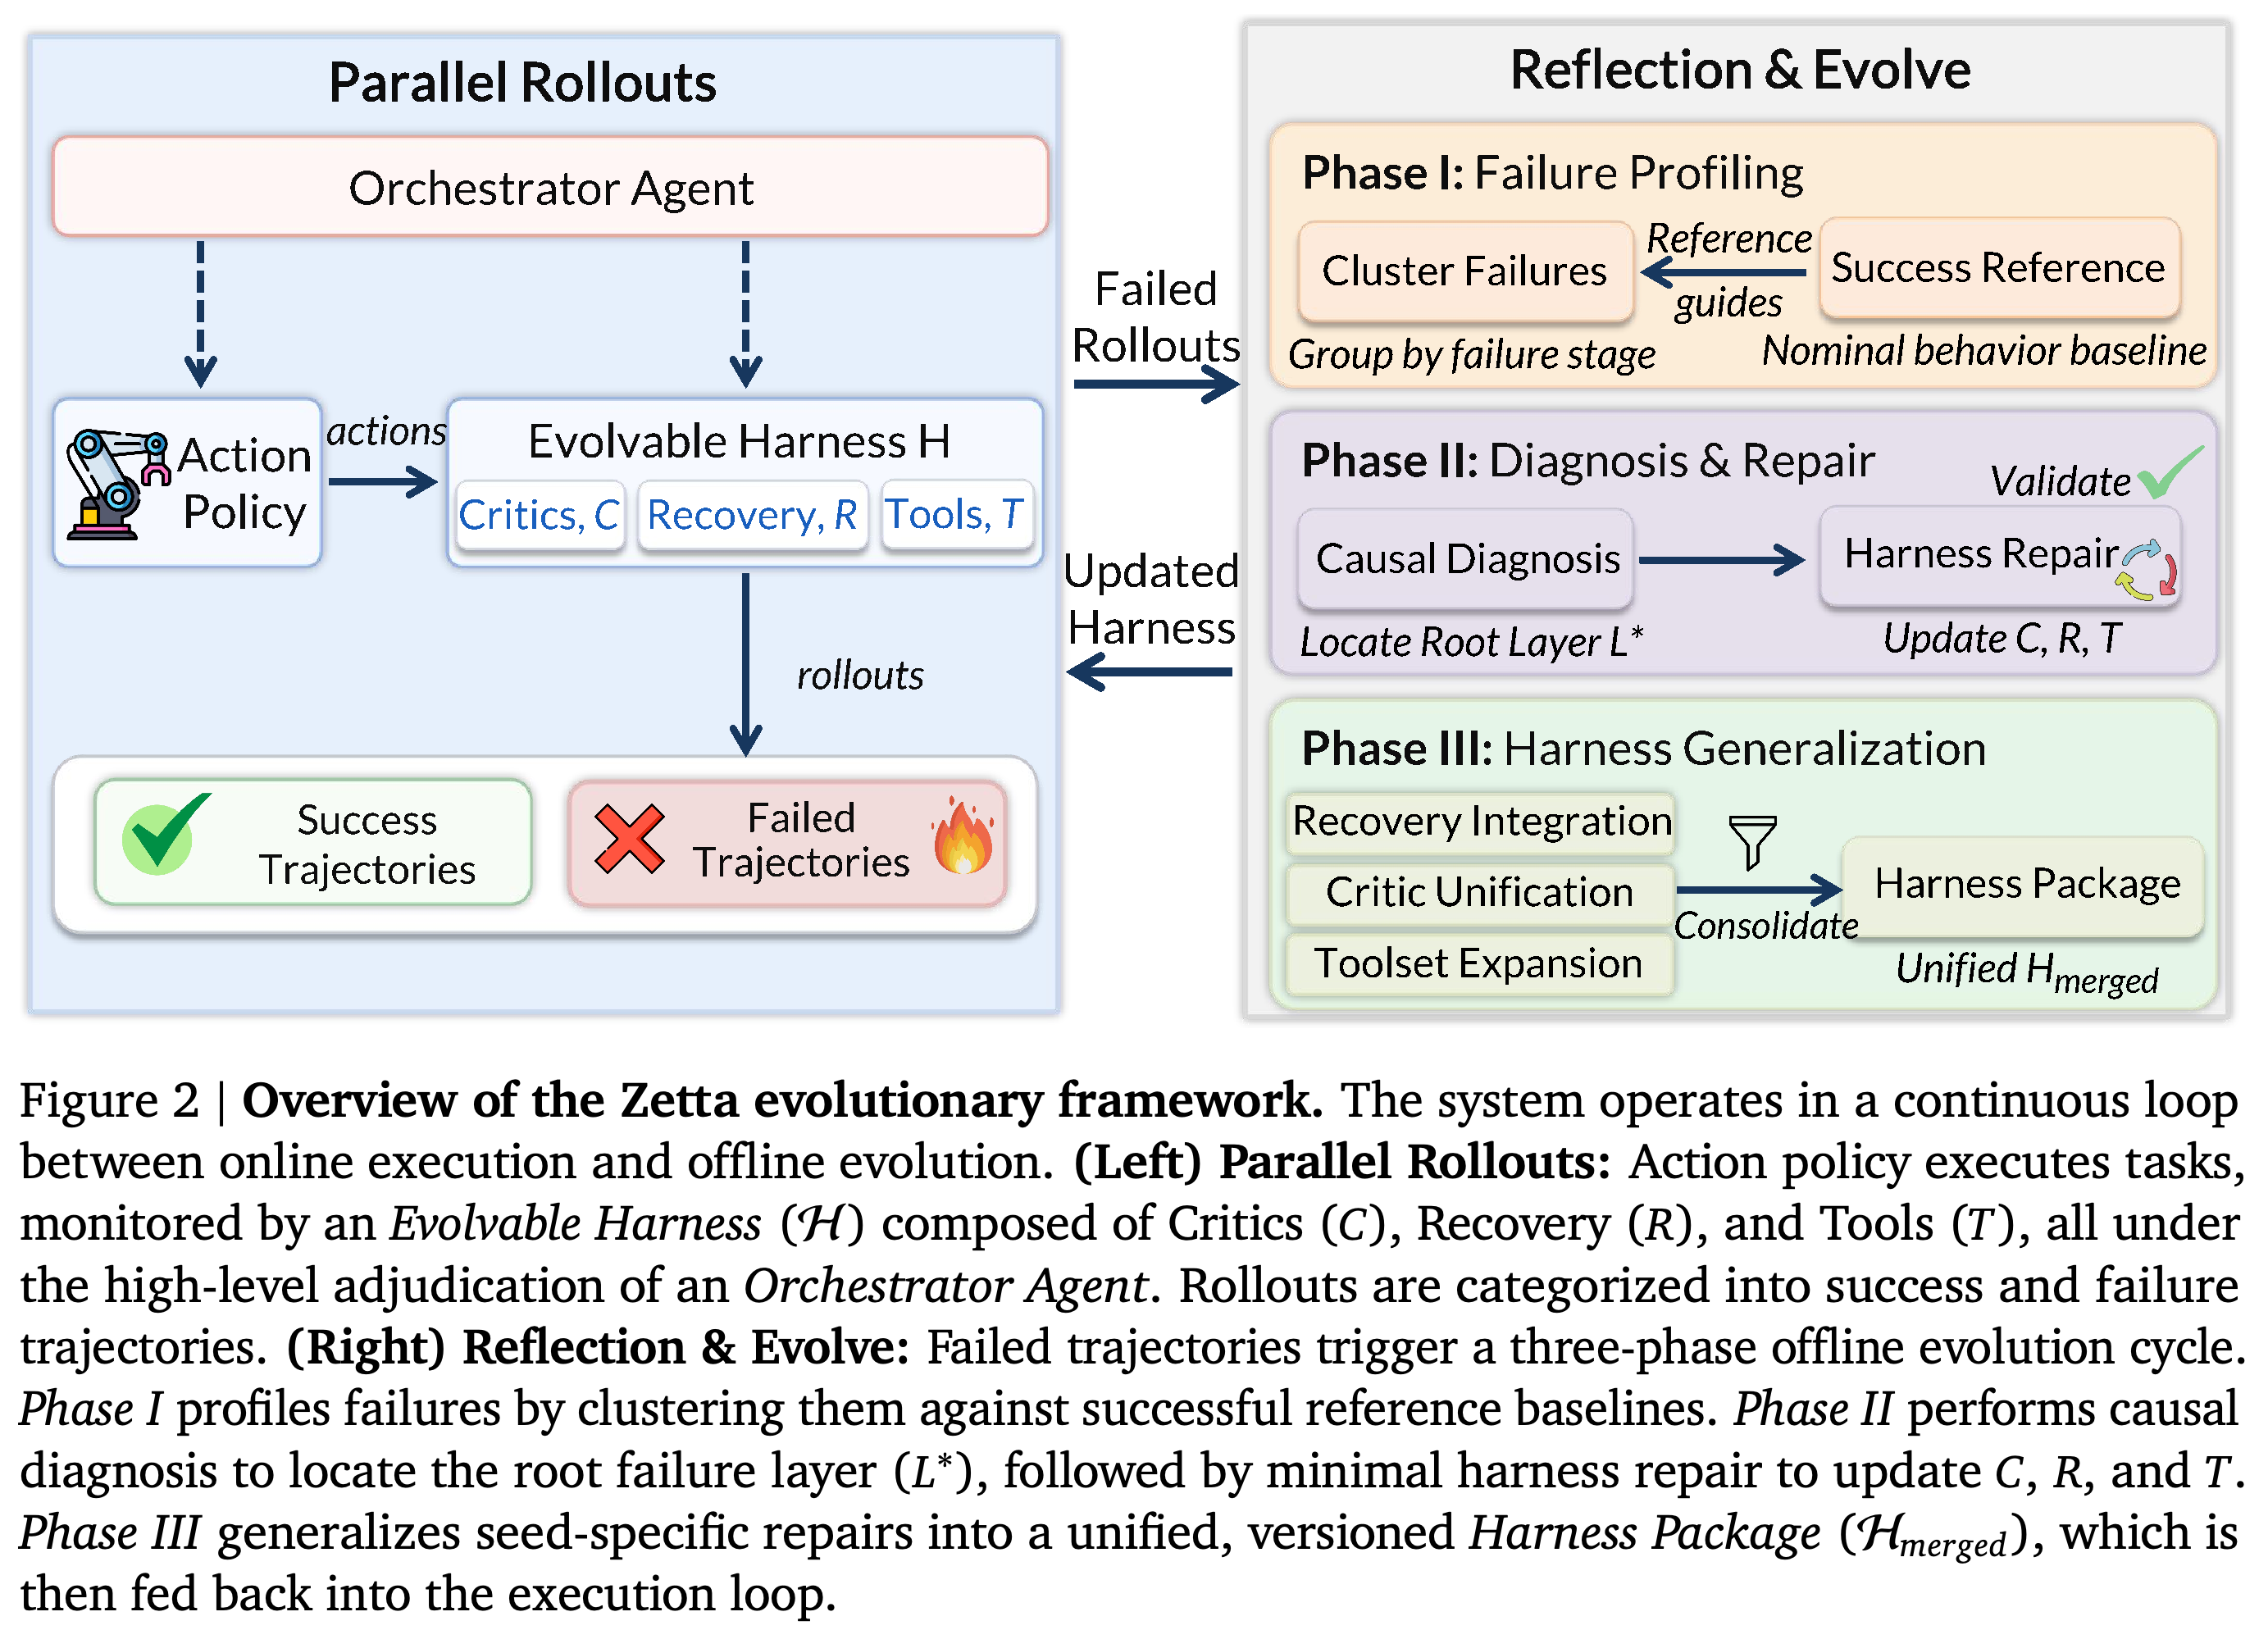
고정된 runtime 구성 요소는 action policy π와 Orchestrator Agent이며, 발전 가능한 harness는 runtime critic, recovery playbook, heterogeneous toolset으로 이루어진 H = {C, R, T}다. Critic은 evidence와 mode proposal을 제출하고, Orchestrator는 intervention을 판정하며, offline Evolutionary Agent는 π와 Orchestrator를 고정한 채 H를 갱신한다.
도식은 online parallel rollout과 offline profiling, diagnosis, repair, consolidation을 분리한다. 실패 trajectory는 harness update로 이어지며, action policy와 Orchestrator는 고정된 상태로 유지한다.
2.3. Phase I: Empirical Failure Profiling and Baseline Establishment (Loop 1)
Loop 1은 deterministic routing으로 development seed에서 pure-policy baseline을 수립하고, infrastructure-invalid 시도는 다시 실행한다. multimodal trajectory를 기록하고 성공 state를 milestone별로 색인하며, 실패에는 First Missing Milestone을 할당해 진단할 단계를 식별한다.
2.4. Phase II Stage 1: Failure Clustering and Causal Diagnosis
실패한 seed에 대해 diagnosis agent는 성공 reference state와 비교하여 Earliest Observable Divergence를 식별하고, failure signature로 실패를 군집화하며, 상세 분석을 위해 medoid seed를 선택한다. 기본 visual view를 사용하고 필요할 때 simulator state와 physical signal을 함께 사용하며, evaluation, critic, state, planning/control, recovery, parameter layer를 순서대로 점검한다.
2.5. Phase II Stage 2: Critic-Guided Harness Repair and Validation
Repair Agent는 진단된 root layer에 맞춰 최소한의 critic, recovery, tool patch를 만든다. VLA Re-entry Contract는 failure evidence가 해소되고 contact stability가 threshold를 넘은 뒤에만 제어를 반환한다. Validation에는 divergence 감지와 Orchestrator가 판정한 intervention을 거친 새로운 성공 closed-loop rollout이 필요하다.
2.6. Phase III: Harness Consolidation, Packaging and Generalization
검증된 seed-level patch는 일반화된 critic, recovery, tool과 SKILL.md, tools/, plans/, params/를 포함하는 versioned package file로 통합한다. Promotion에는 원래 cluster 전반의 성공과 held-out seed에서 고정된 policy 대비 성능 향상이 필요하다. Repair에 사용한 held-out failure는 development로 옮기고 최종 validation 전에 교체한다.
3. Z-Infra: Embodied Agent Rollout Infrastructure
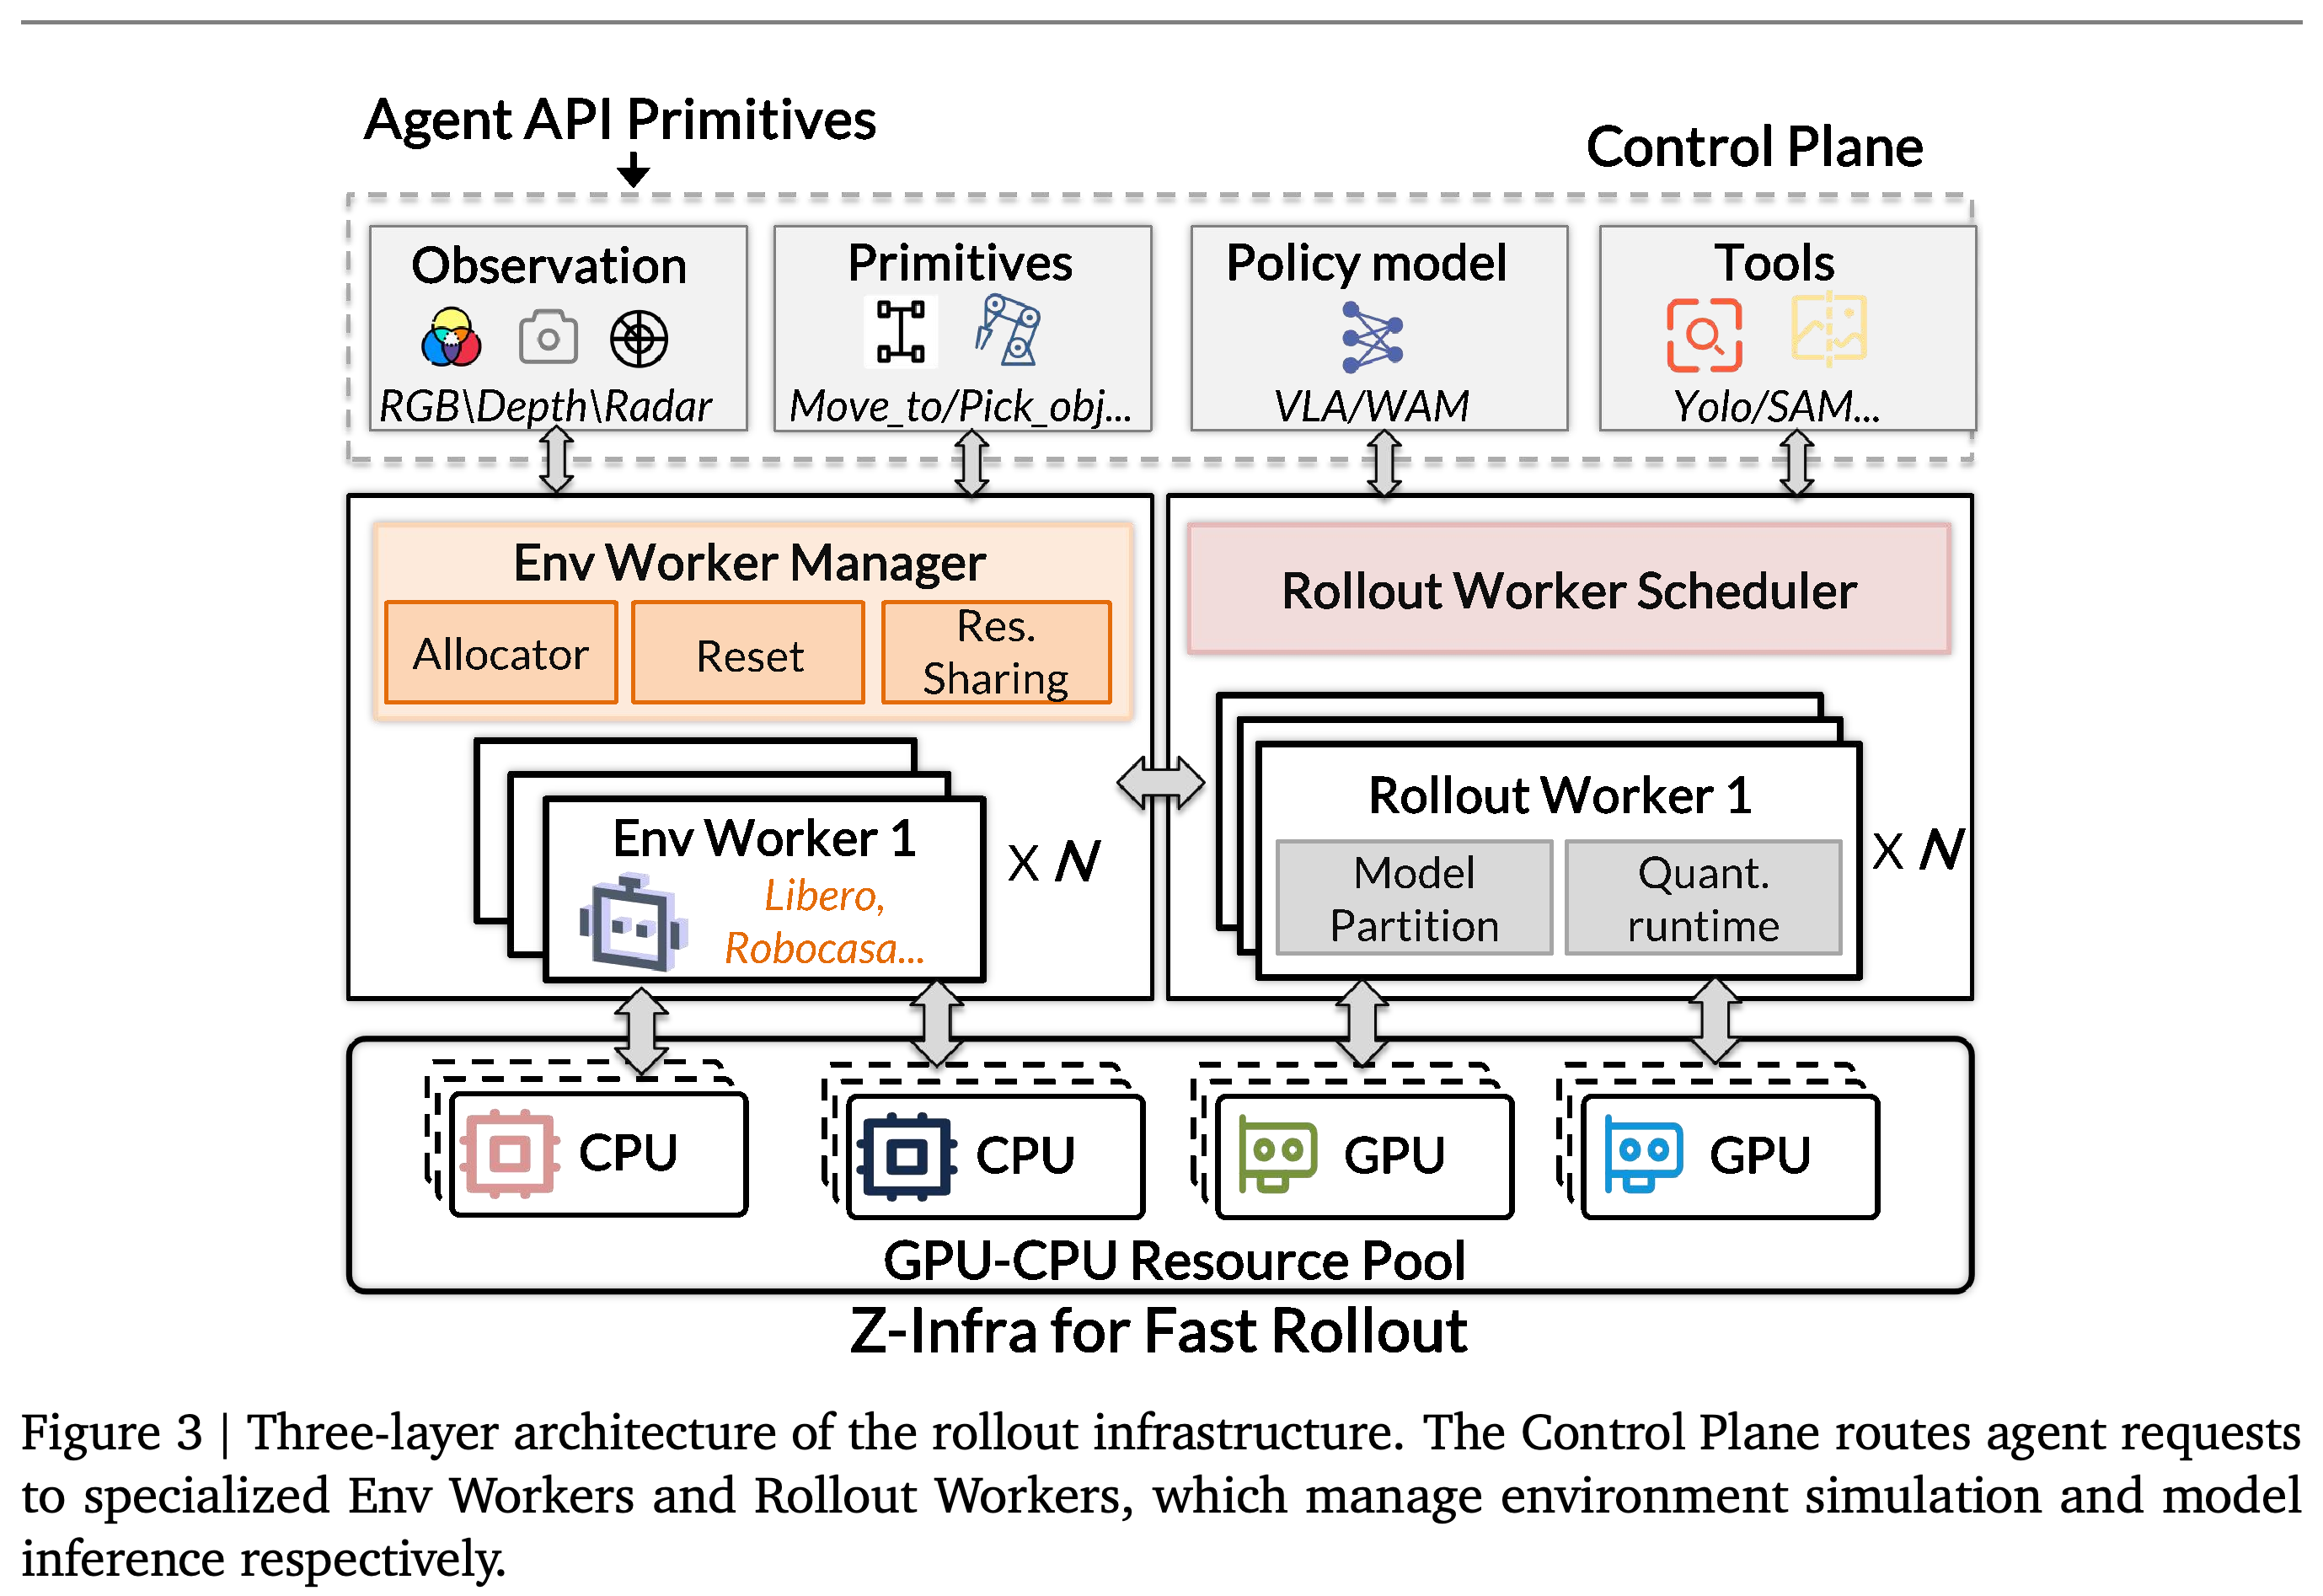
Z-Infra는 동시 agent-environment rollout을 수행하는 execution backbone이며, session interface 뒤에서 서로 다른 simulator와 hardware의 세부 사항을 숨긴다. CPU simulation, GPU rendering, policy inference, perception, low-latency primitive operation 등의 workload를 하나의 homogeneous resource pool에 배치하지 않고 분리한다.
3.3. System Architecture
3 system은 bounded asynchronous channel로 연결된 Control Plane, Environment Worker, GPU-resident Rollout Worker로 구성된다. Control Plane은 session, routing, worker health를 관리하고, environment worker는 session state를 격리하며 immutable MuJoCo resource를 공유한다. Rollout worker는 호환되는 request를 batch 처리하고 routing token으로 결과를 비동기 반환한다.
이 architecture는 session 및 resource coordination을 Control Plane에, simulation을 Environment Worker에, model serving을 Rollout Worker에 할당한다. 이 분리는 CPU와 GPU resource를 hardware-decoupled 방식으로 scheduling할 수 있게 한다.
3.4. Programming Support
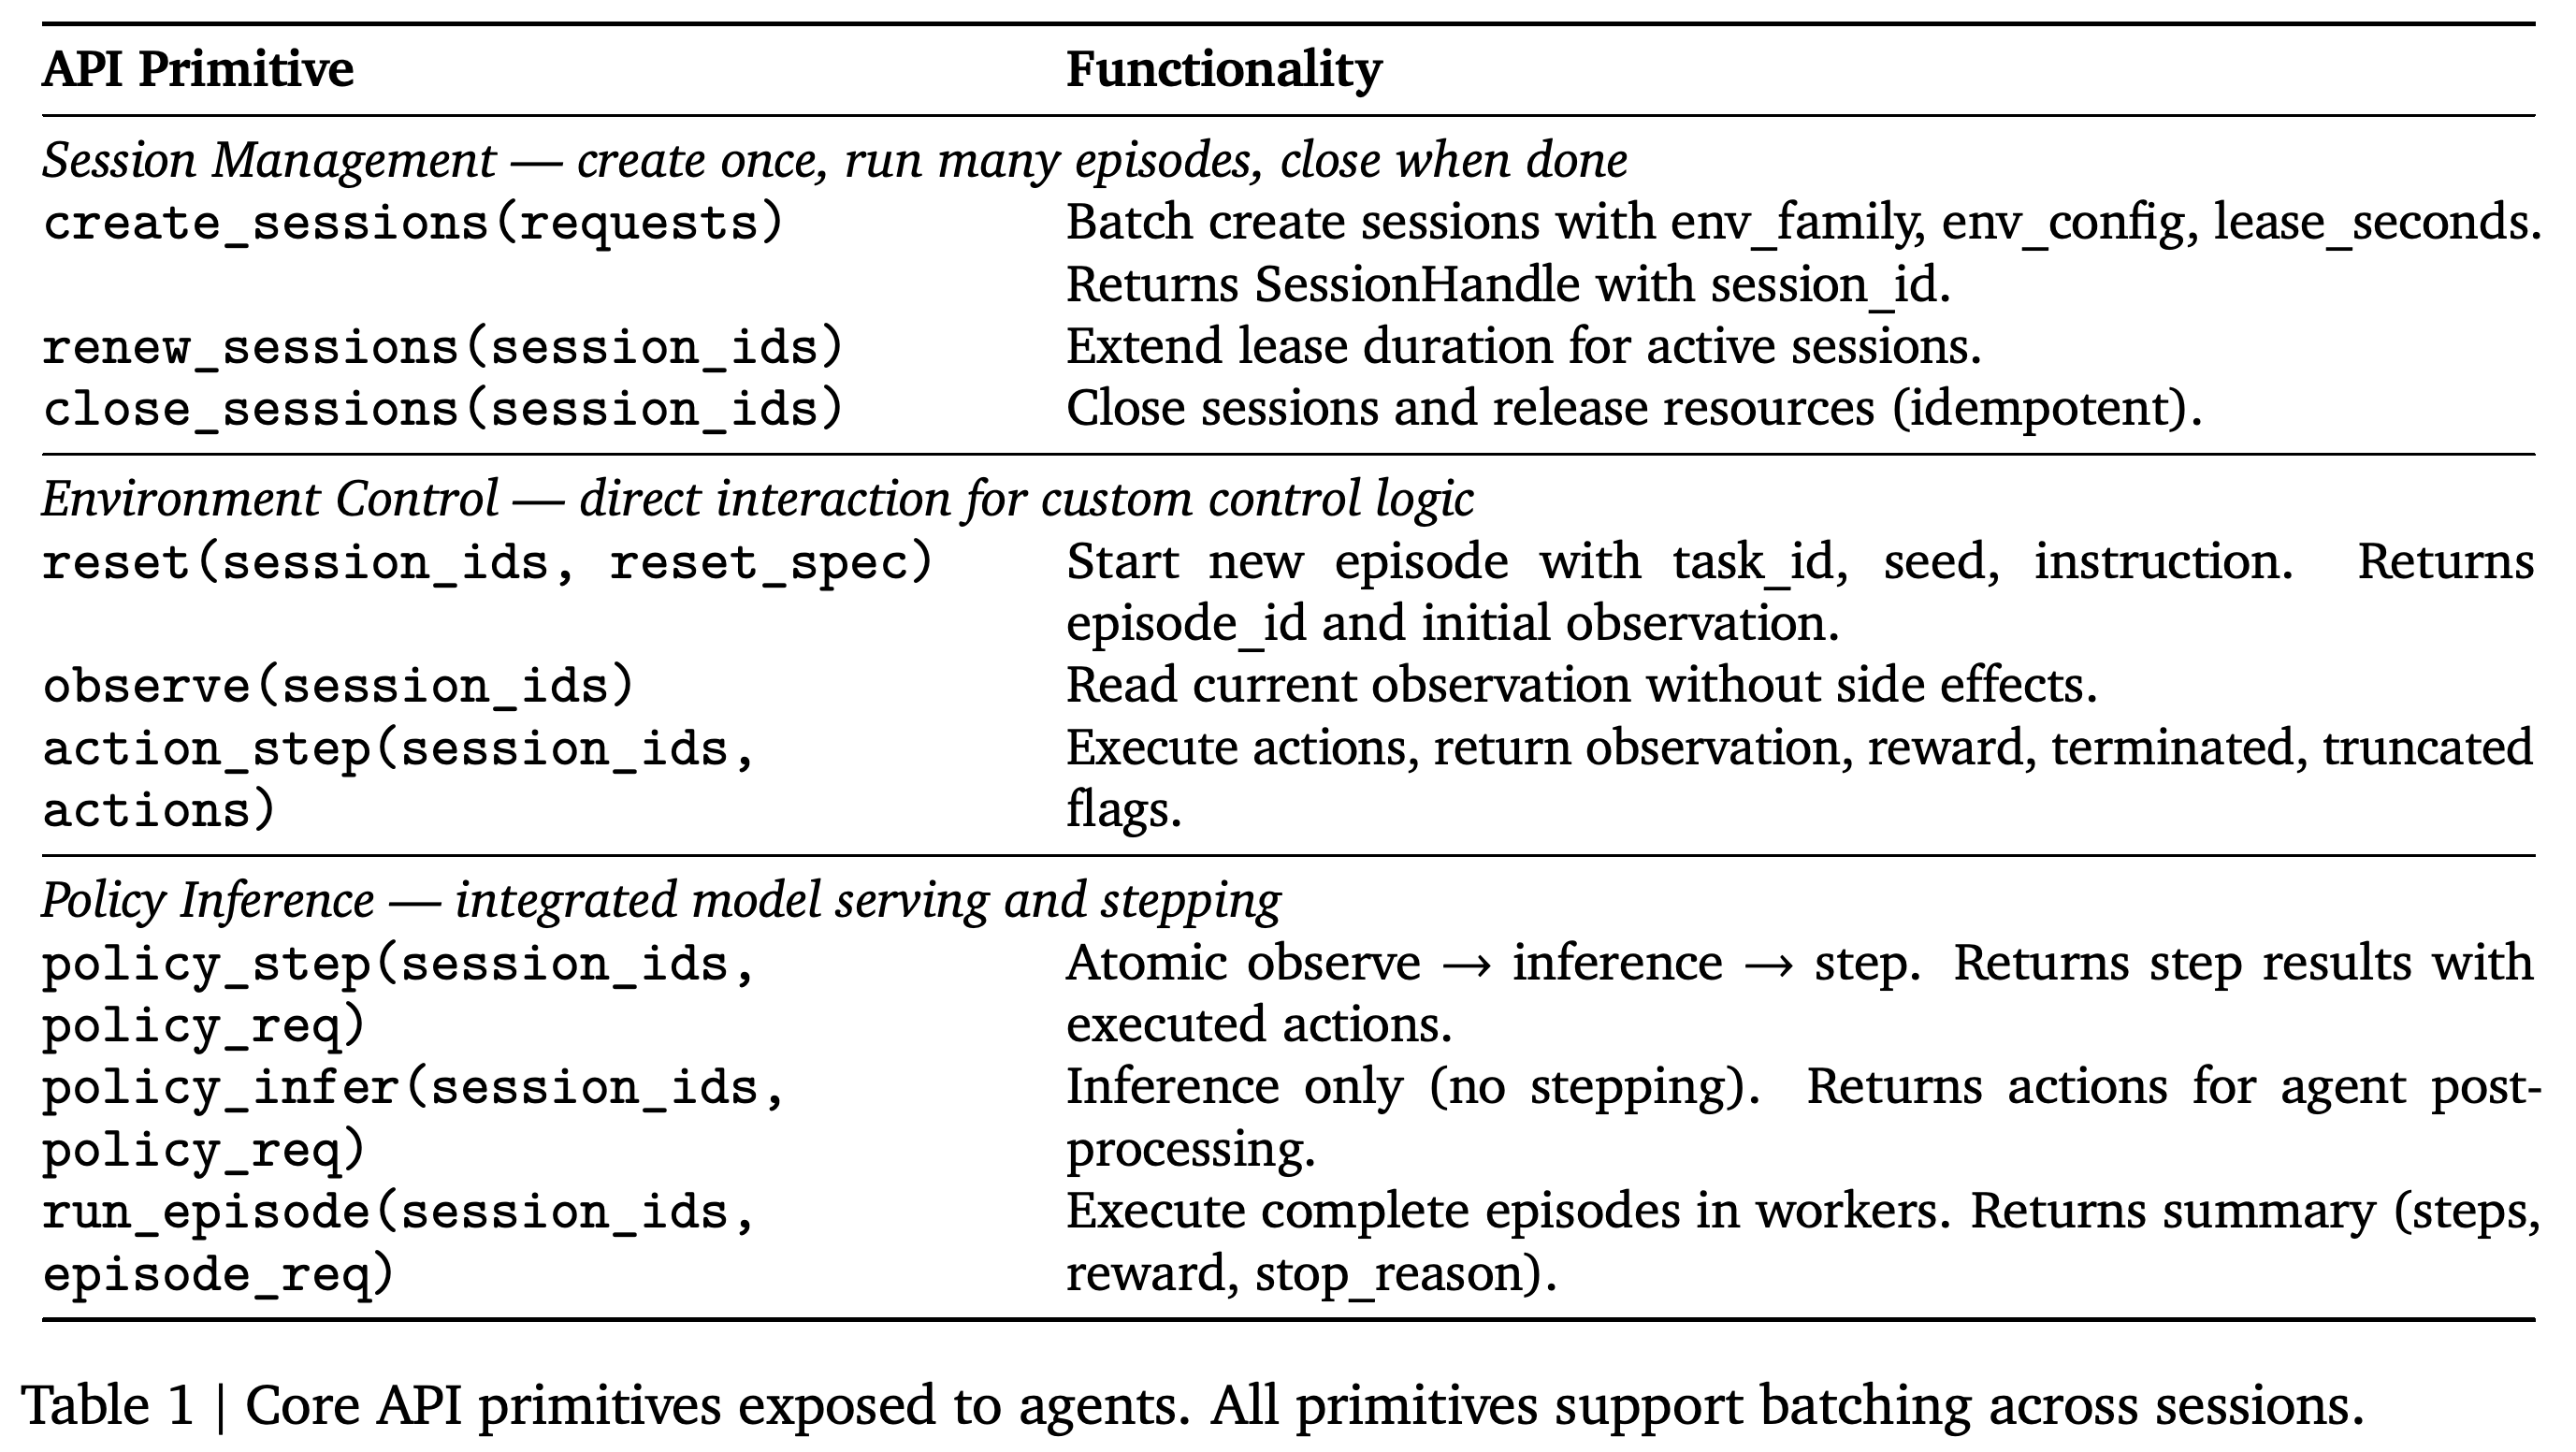
Programming model은 managed session, episode, step을 제공하며 environment control, policy inference, perception, planning용 API를 노출한다. π0.5에서 Vision-Language Model과 Action Expert를 CUDA IPC로 분리하면 평균 inference latency가 53% 감소하고 200 ms SLO에서 goodput이 2.4× 향상된다. W8A8 prefix-MLP quantization은 RTX 4090에서 보고된 LIBERO 성공률 저하 없이 1.18×–1.32× 속도 향상을 낸다.
표는 session management, direct environment control, integrated policy inference, 전체 episode execution을 위한 agent-facing API boundary를 정의한다. 나열된 모든 primitive는 session 간 batched operation을 지원한다.
4. Experiments
실험은 LIBERO-Pro에서 고정된 π0.5를, RoboCasa에서 고정된 GR00T N1.5를 사용한다. RoboCasa는 task당 50개의 development random seed와 서로 겹치지 않는 50개의 held-out random seed를 사용하며, LIBERO-Pro는 50개의 parent development seed에서 발전시키고 분리된 seed 1–20에서만 평가한다.
4.2. Physical Intelligence “Aha” Moments
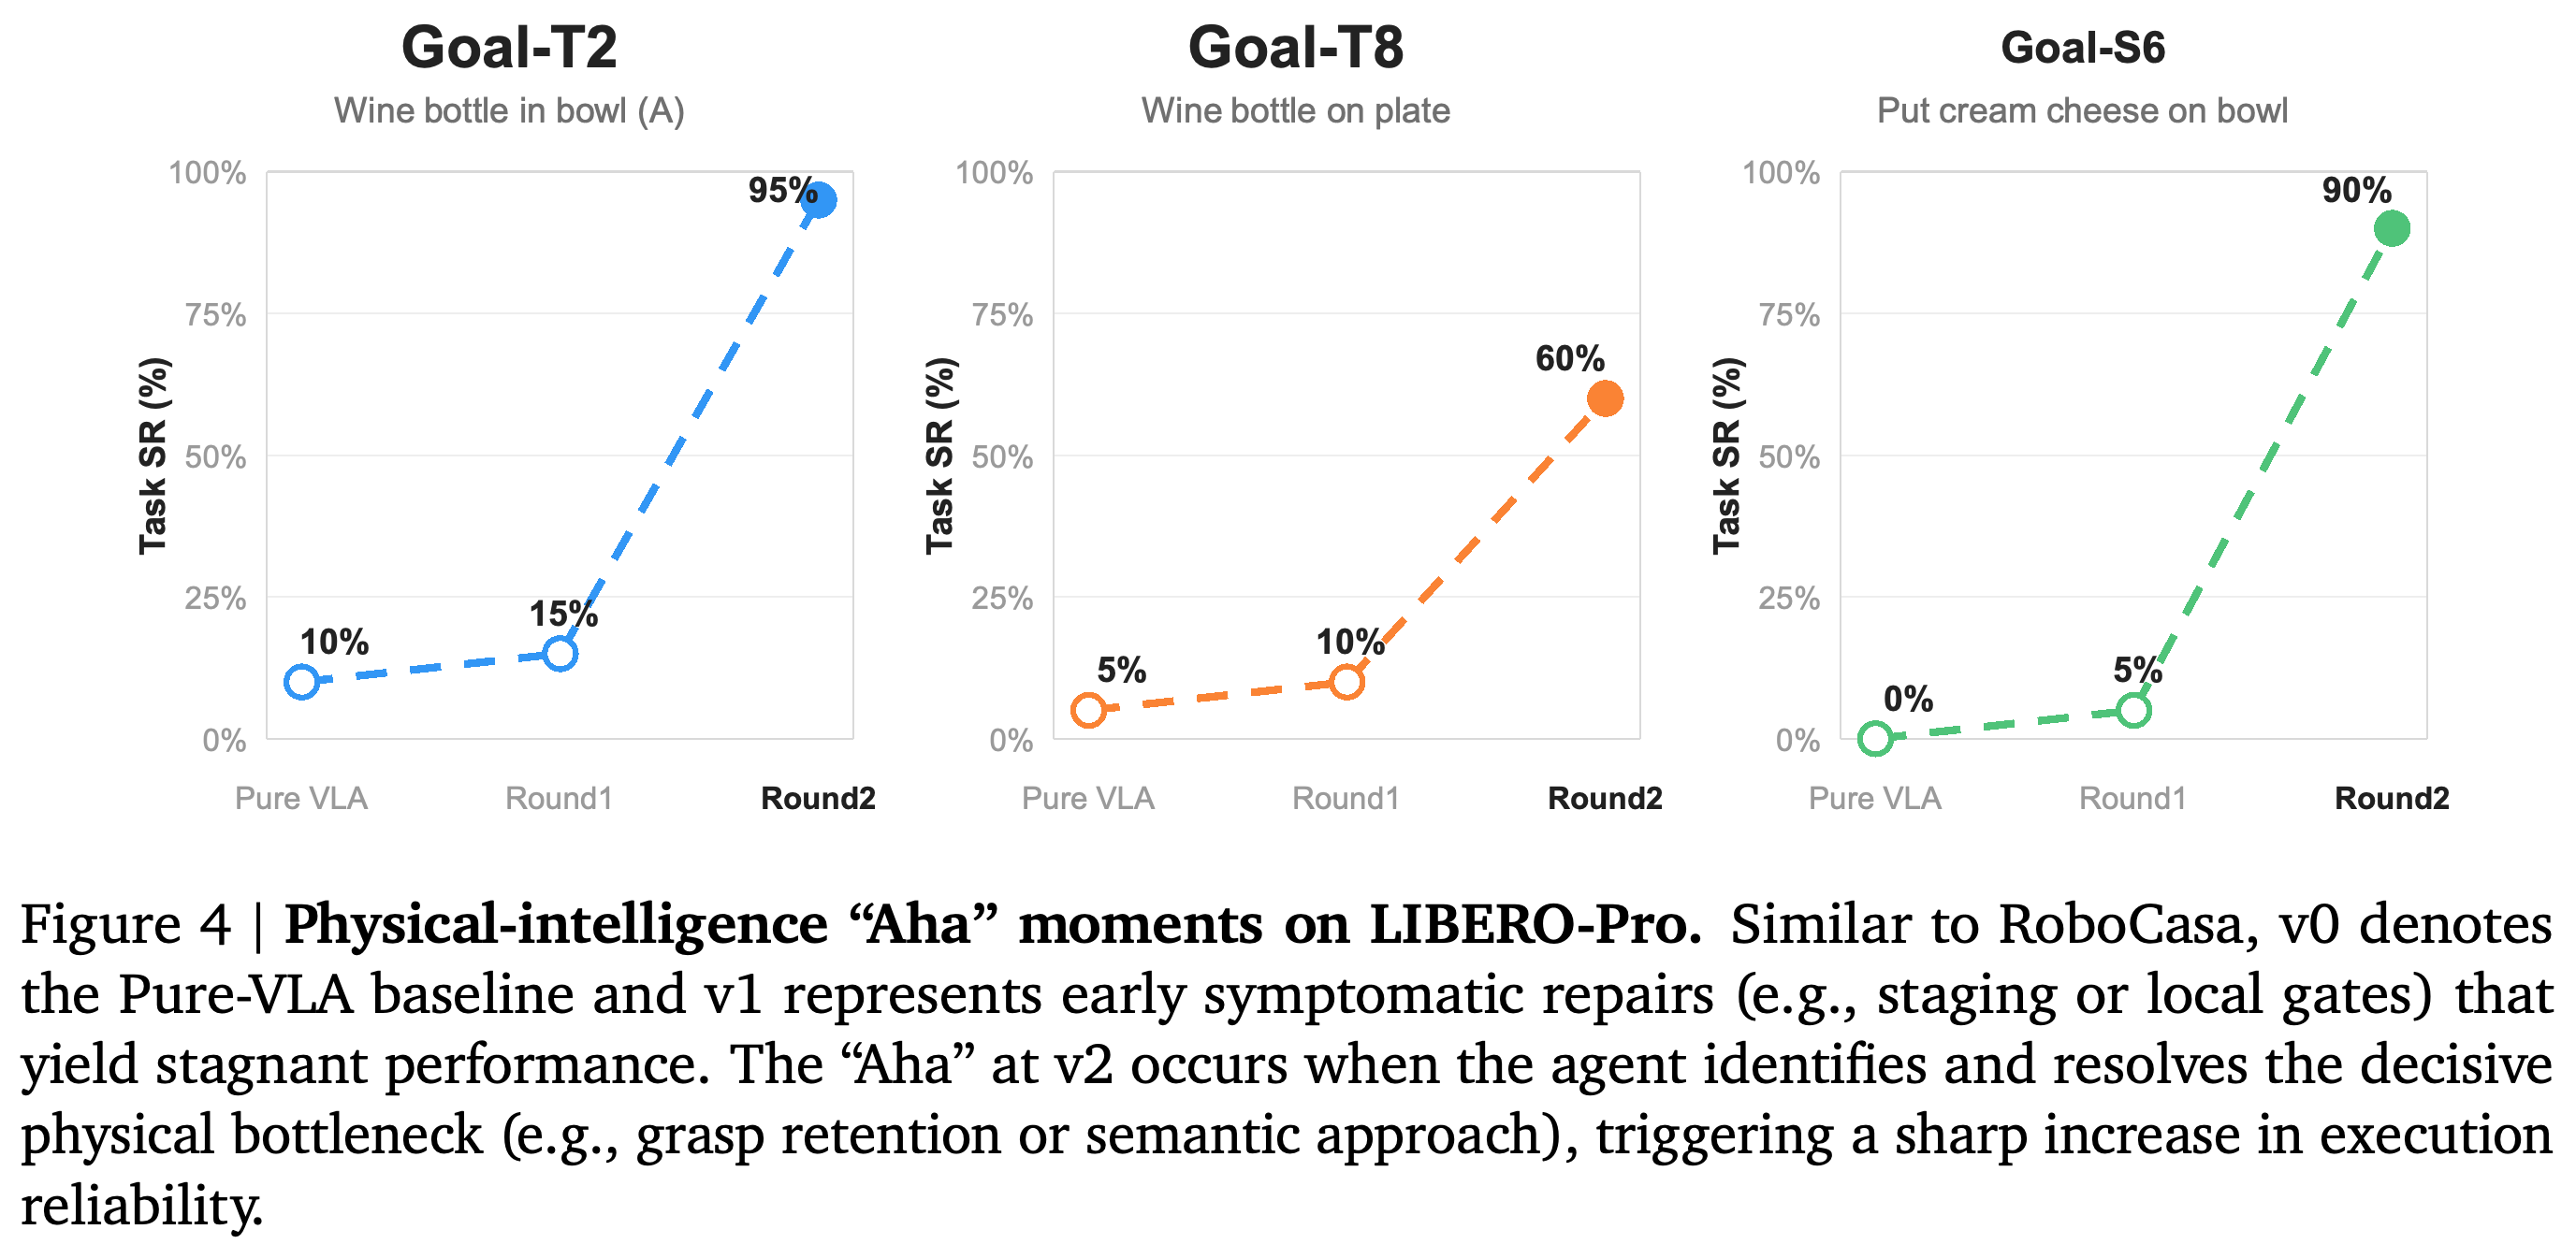
저자는 critic-recovery revision이 국소 증상 대신 물리적 bottleneck을 식별한 뒤 성공률이 급격히 증가하는 현상을 “Aha” moment로 정의한다. LIBERO-Pro에서 Goal-T2는 초기 repair 뒤 15%에서 이후 95%로, Goal-T8은 이후 60%로, Goal-S6은 각 후속 repair 뒤 90%로 상승한다.
3개의 LIBERO-Pro trace는 초기 revision 뒤에는 개선이 작고, 이후 root-cause repair 뒤에는 급격히 향상됨을 보인다. 보고된 순서는 Goal-T2가 10%→15%→95%, Goal-T8이 5%→10%→60%, Goal-S6이 0%→5%→90%다.
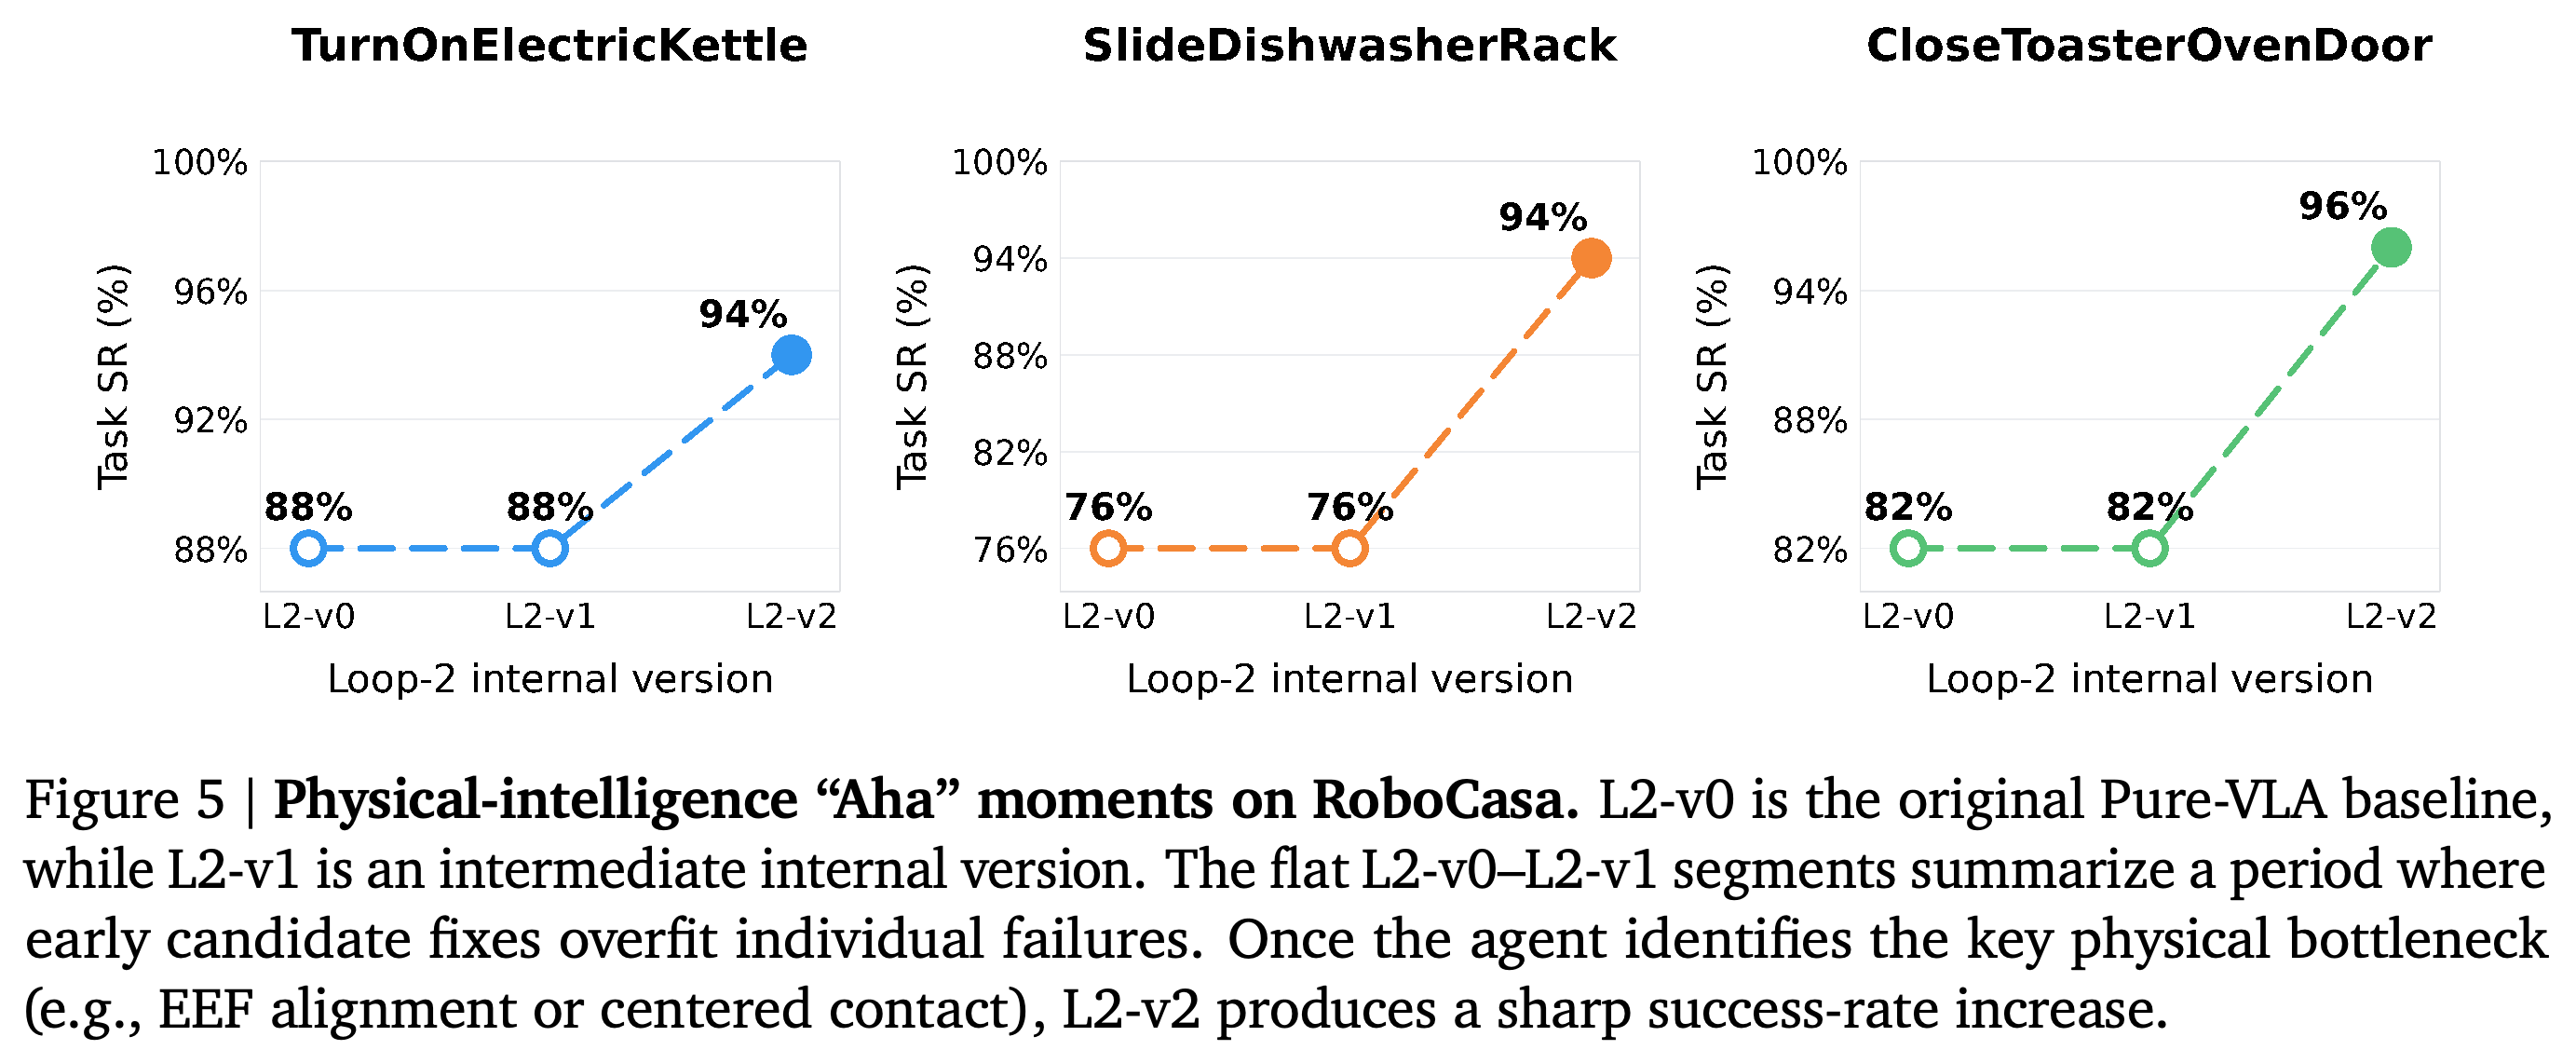
RoboCasa 예시는 L2-v0에서 L2-v1까지 성능이 정체된 뒤 L2-v2에서 향상된다. 최종 변화는 TurnOnElectricKettle이 88%→94%, SlideDishwasherRack이 76%→94%, CloseToasterOvenDoor가 82%→96%다.
4.3. Physical Intelligence Scaling and Zero-shot Capability
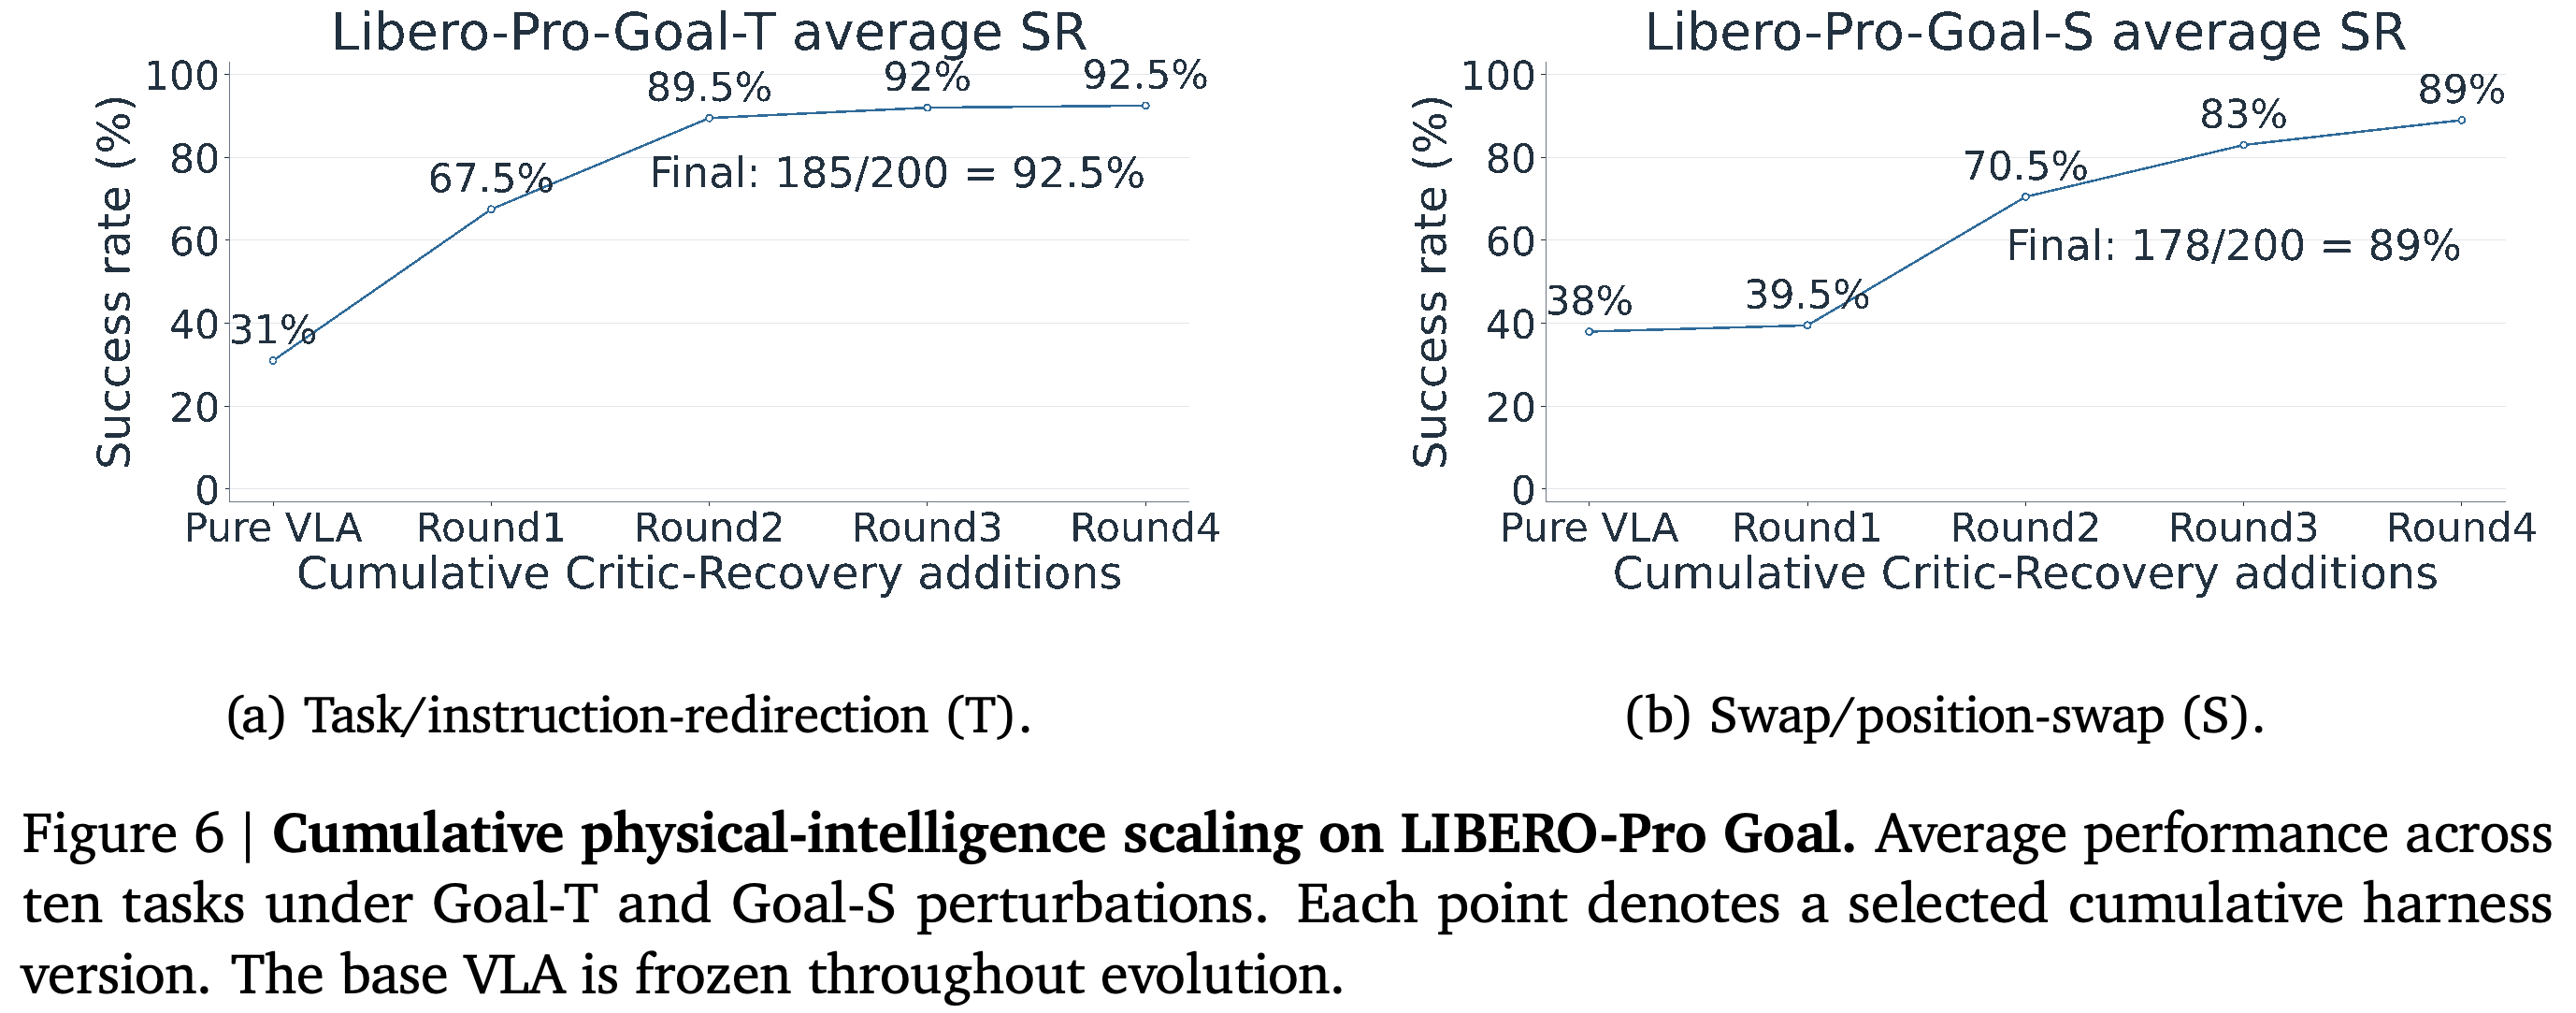
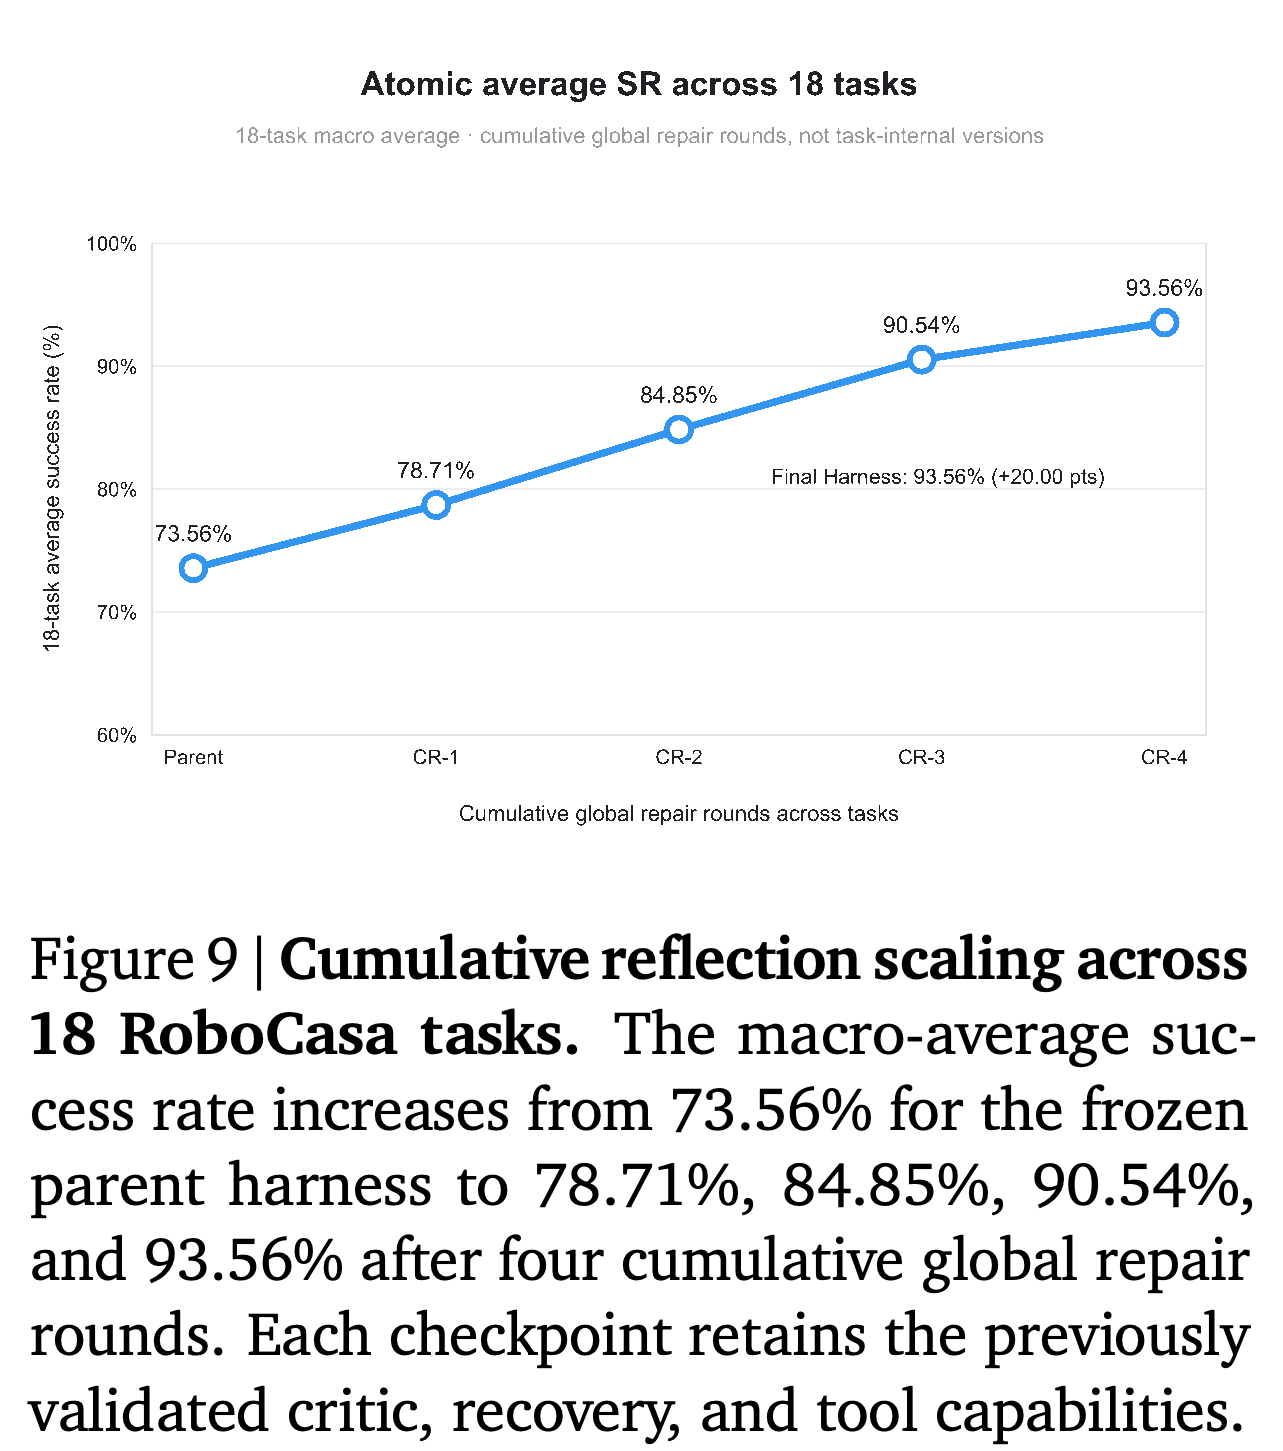
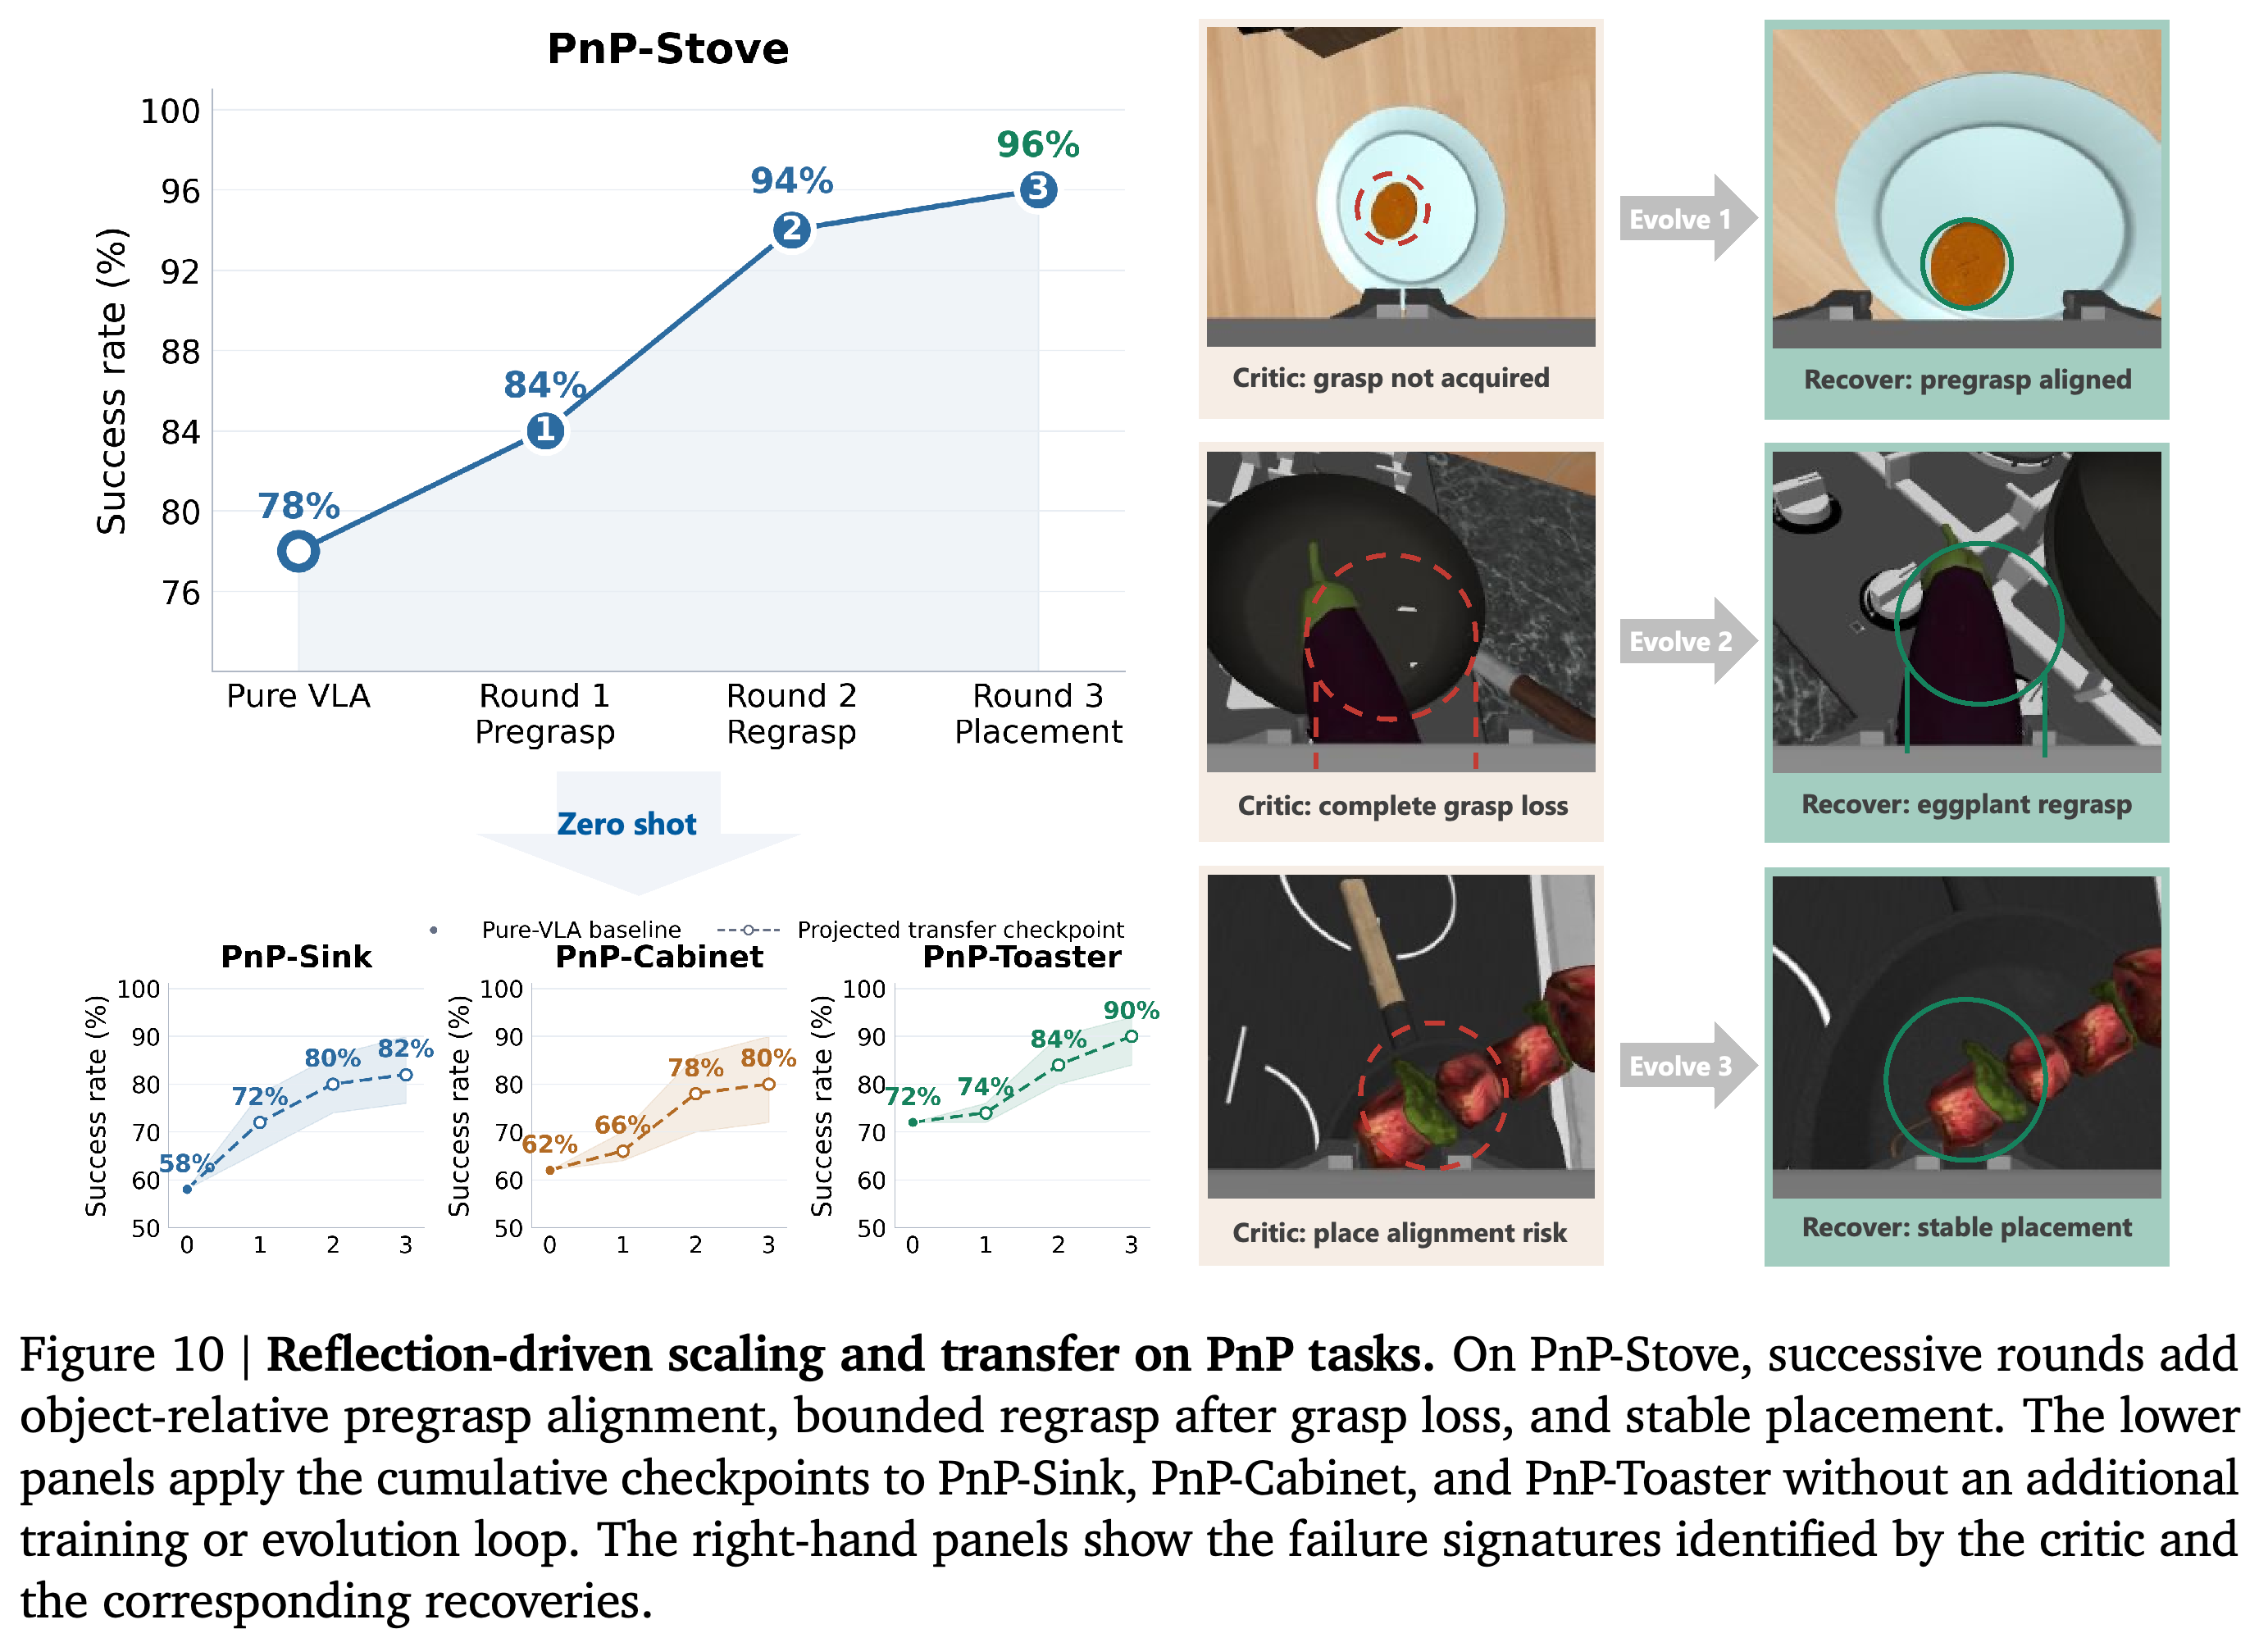
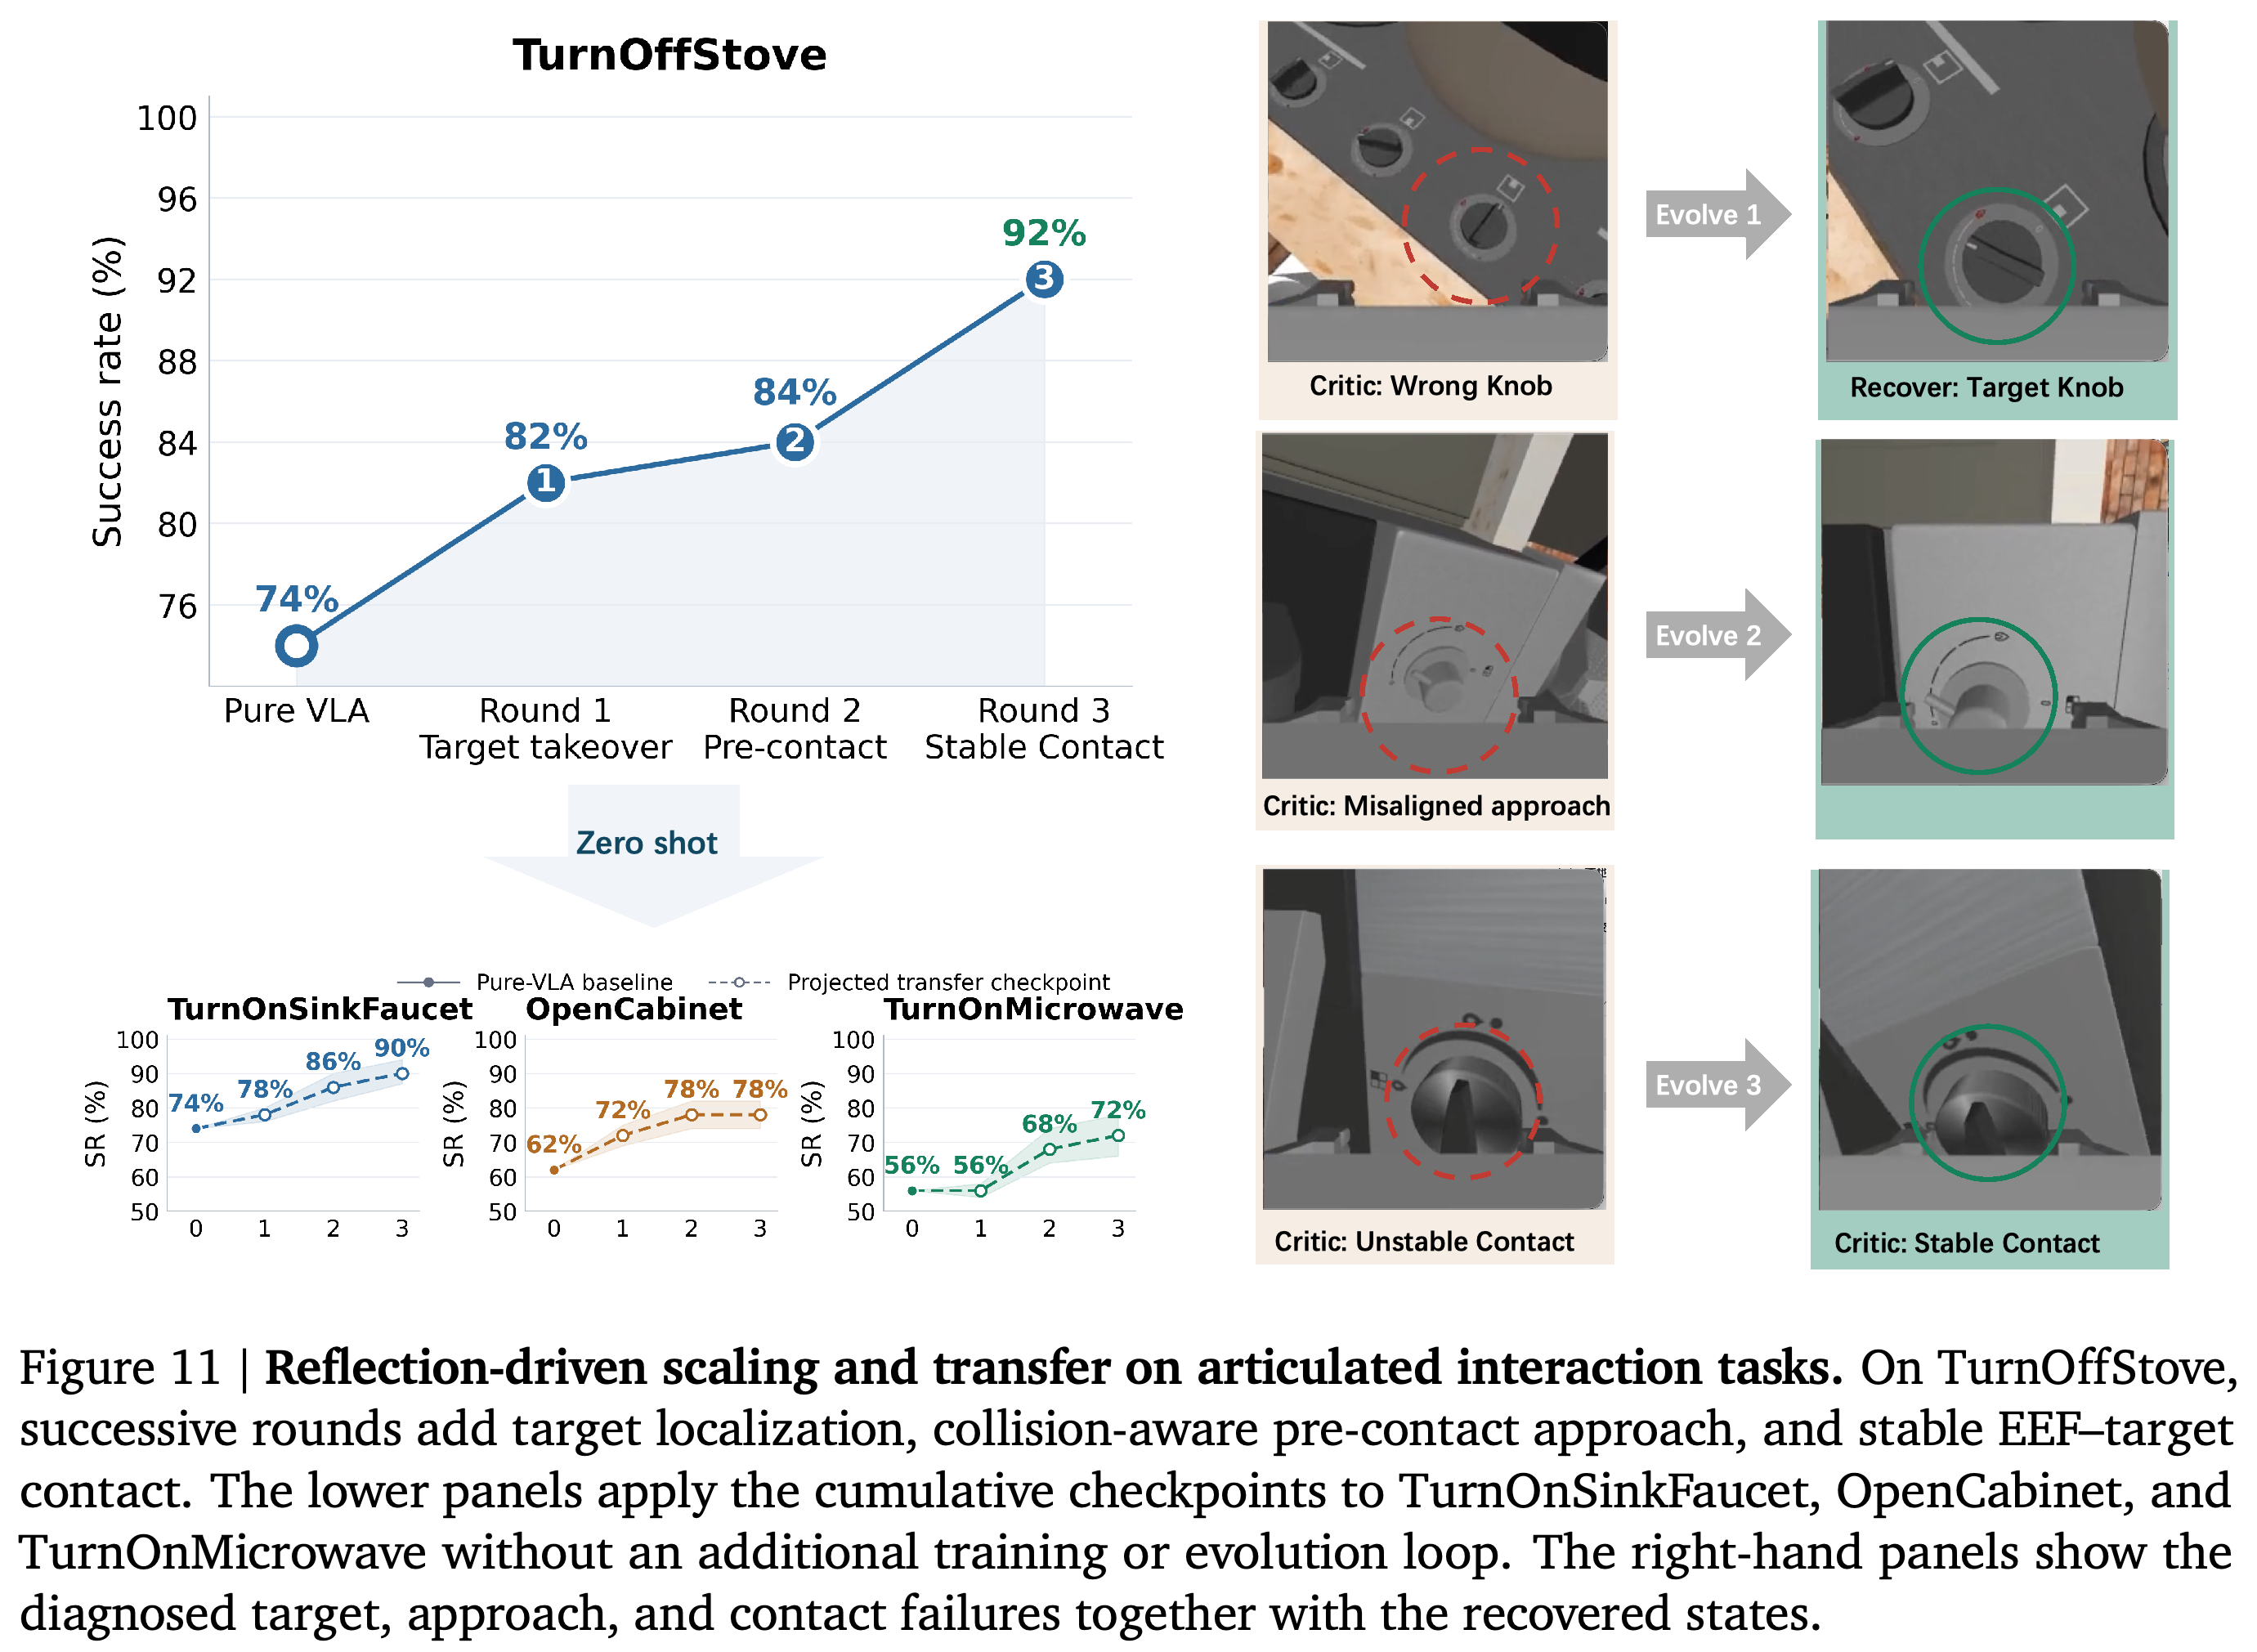
누적 mechanism은 LIBERO-Pro Goal-T를 31.0%에서 92.5%로, Goal-S를 38.0%에서 89.0%로 높인다. 4회의 global repair round는 18-task RoboCasa macro-average를 73.56%에서 93.56%로 높인다. 보고된 zero-shot 연구에서 pick-and-place transfer는 64%에서 84%로, articulated-interaction transfer는 64%에서 80%로 상승한다.
그림은 기본 VLA를 고정한 상태에서 Goal-T 10개와 Goal-S 10개 task에 걸친 누적 harness version을 보고한다. 4회 round 뒤 Goal-T는 92.5% (185/200), Goal-S는 89.0% (178/200)에 도달한다.
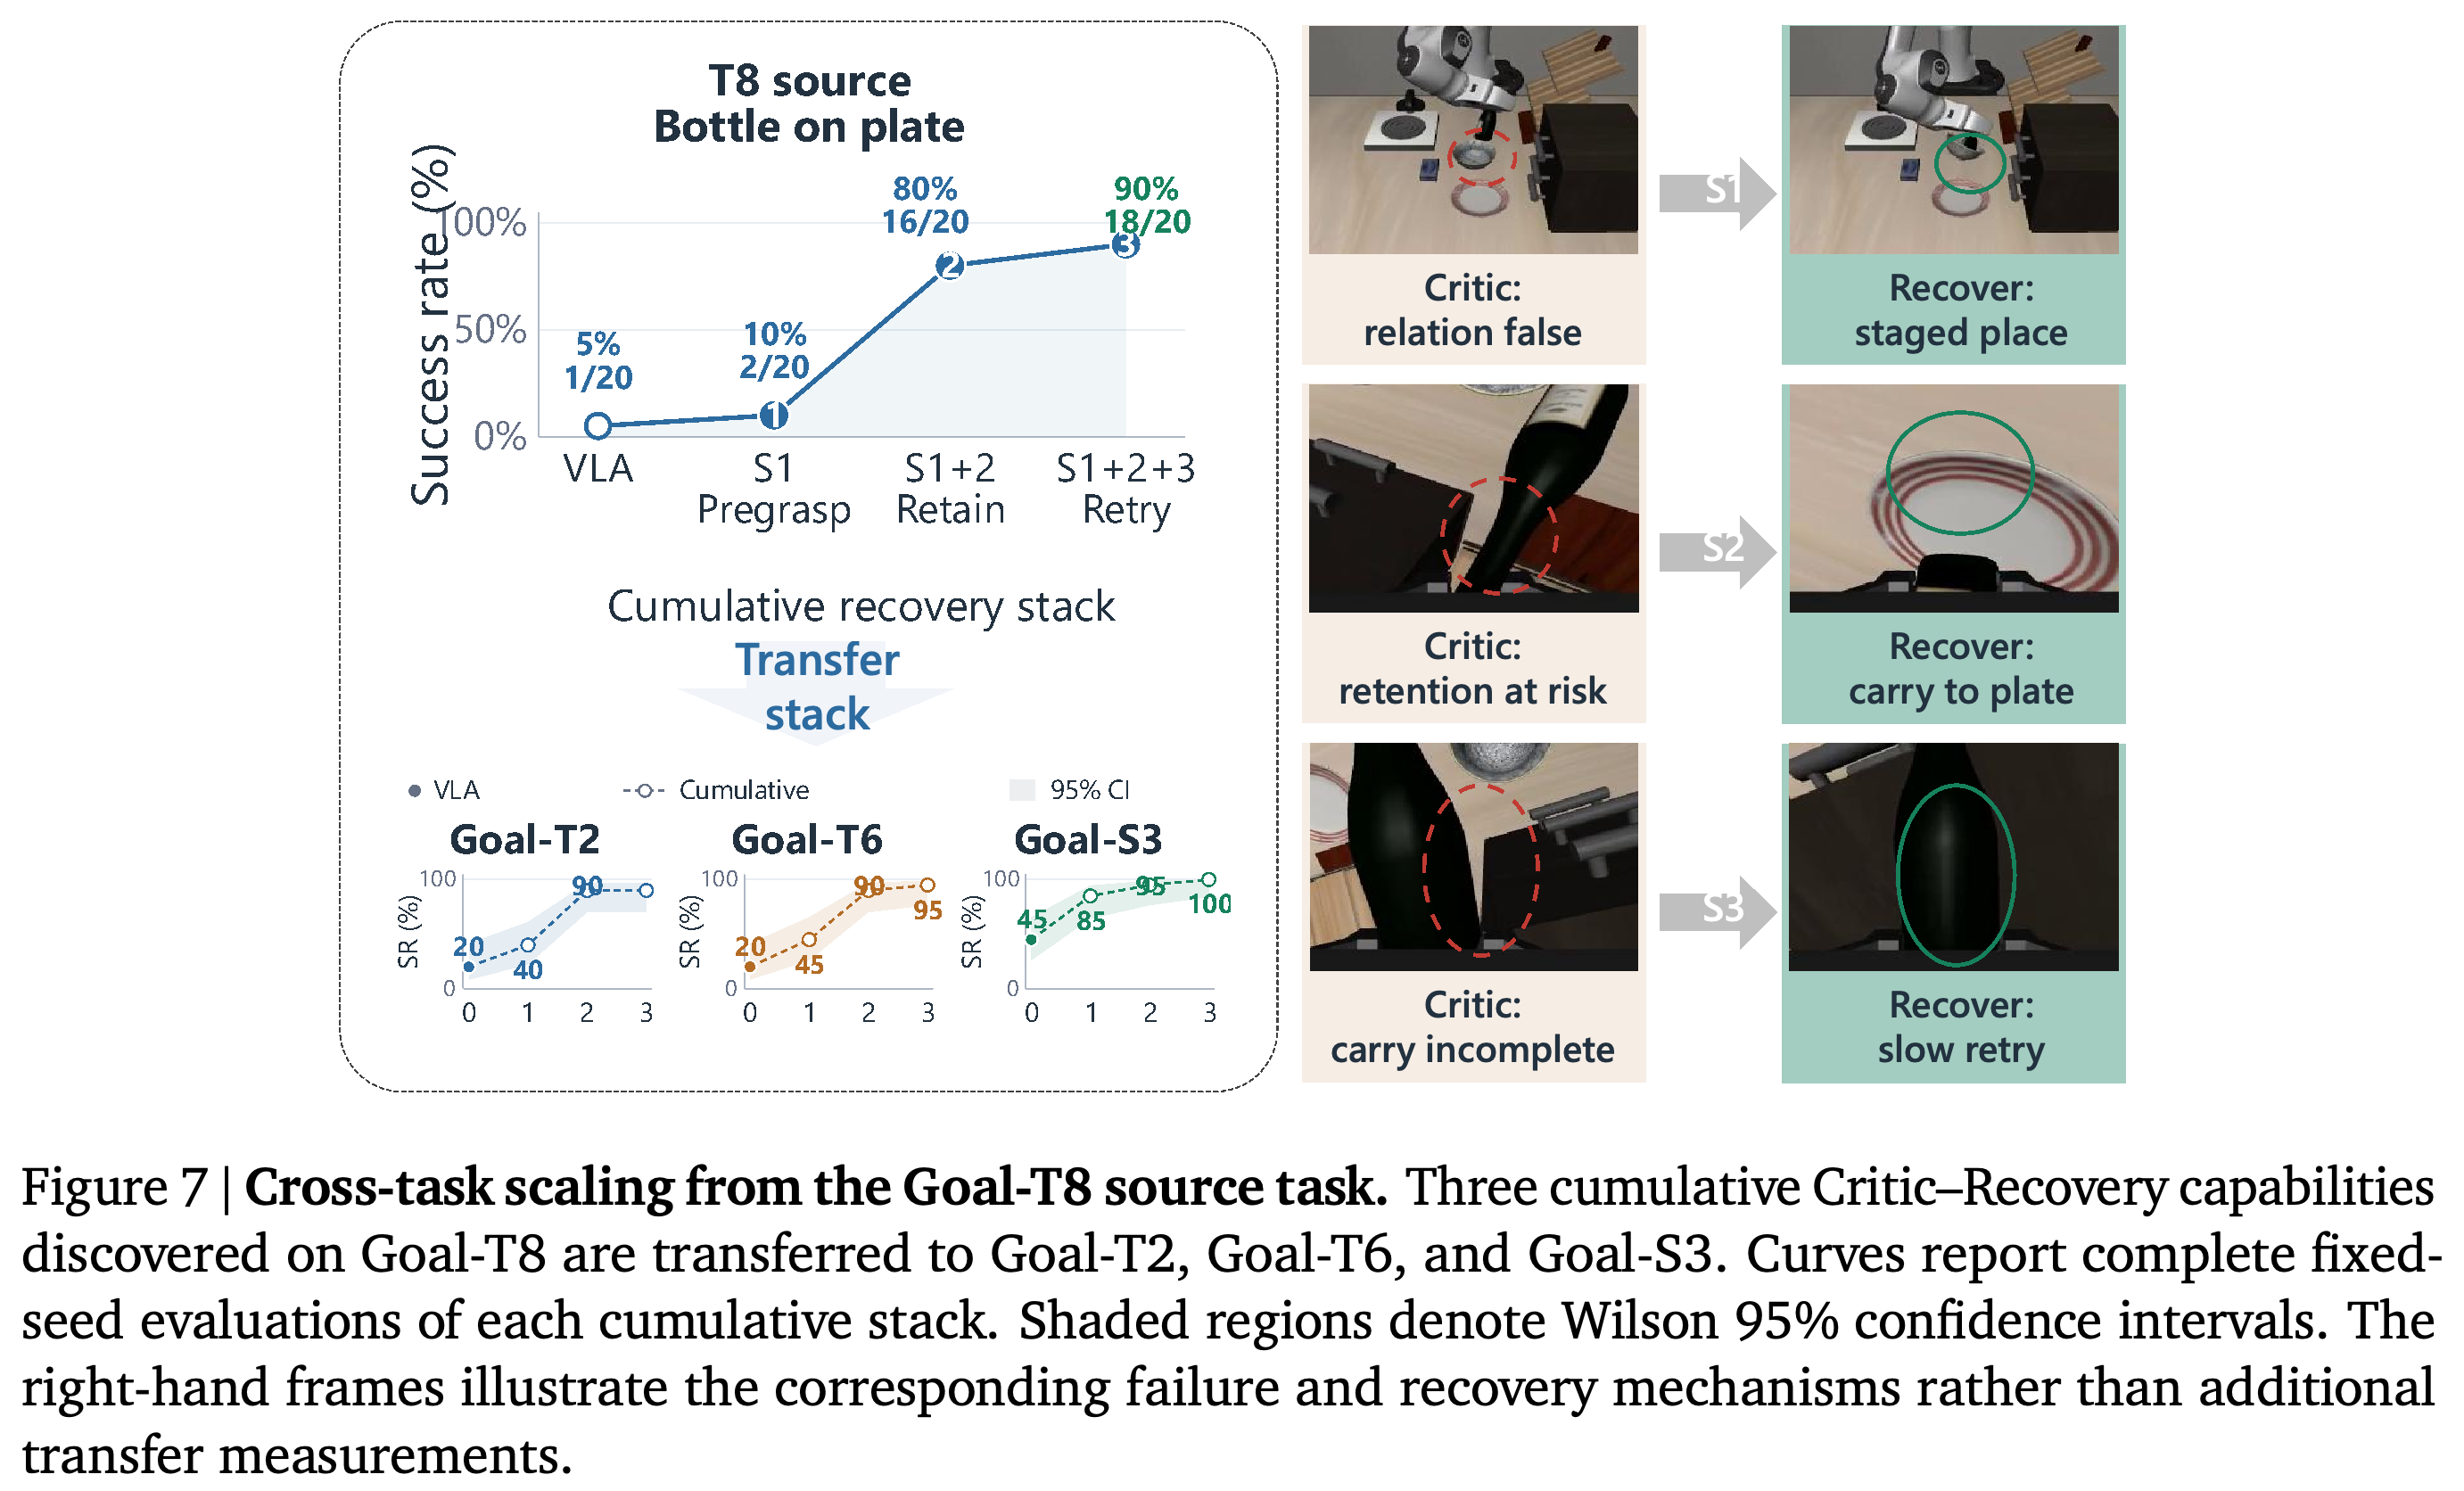
Goal-T8에서 학습한 pre-grasp staging, grasp-retention monitoring, failure-gated retry의 3개 mechanism을 고정된 seed로 다른 3개 task에 누적 적용해 평가한다. 보고된 transfer에는 Goal-S3가 9/20에서 20/20으로 증가한 결과가 포함된다.
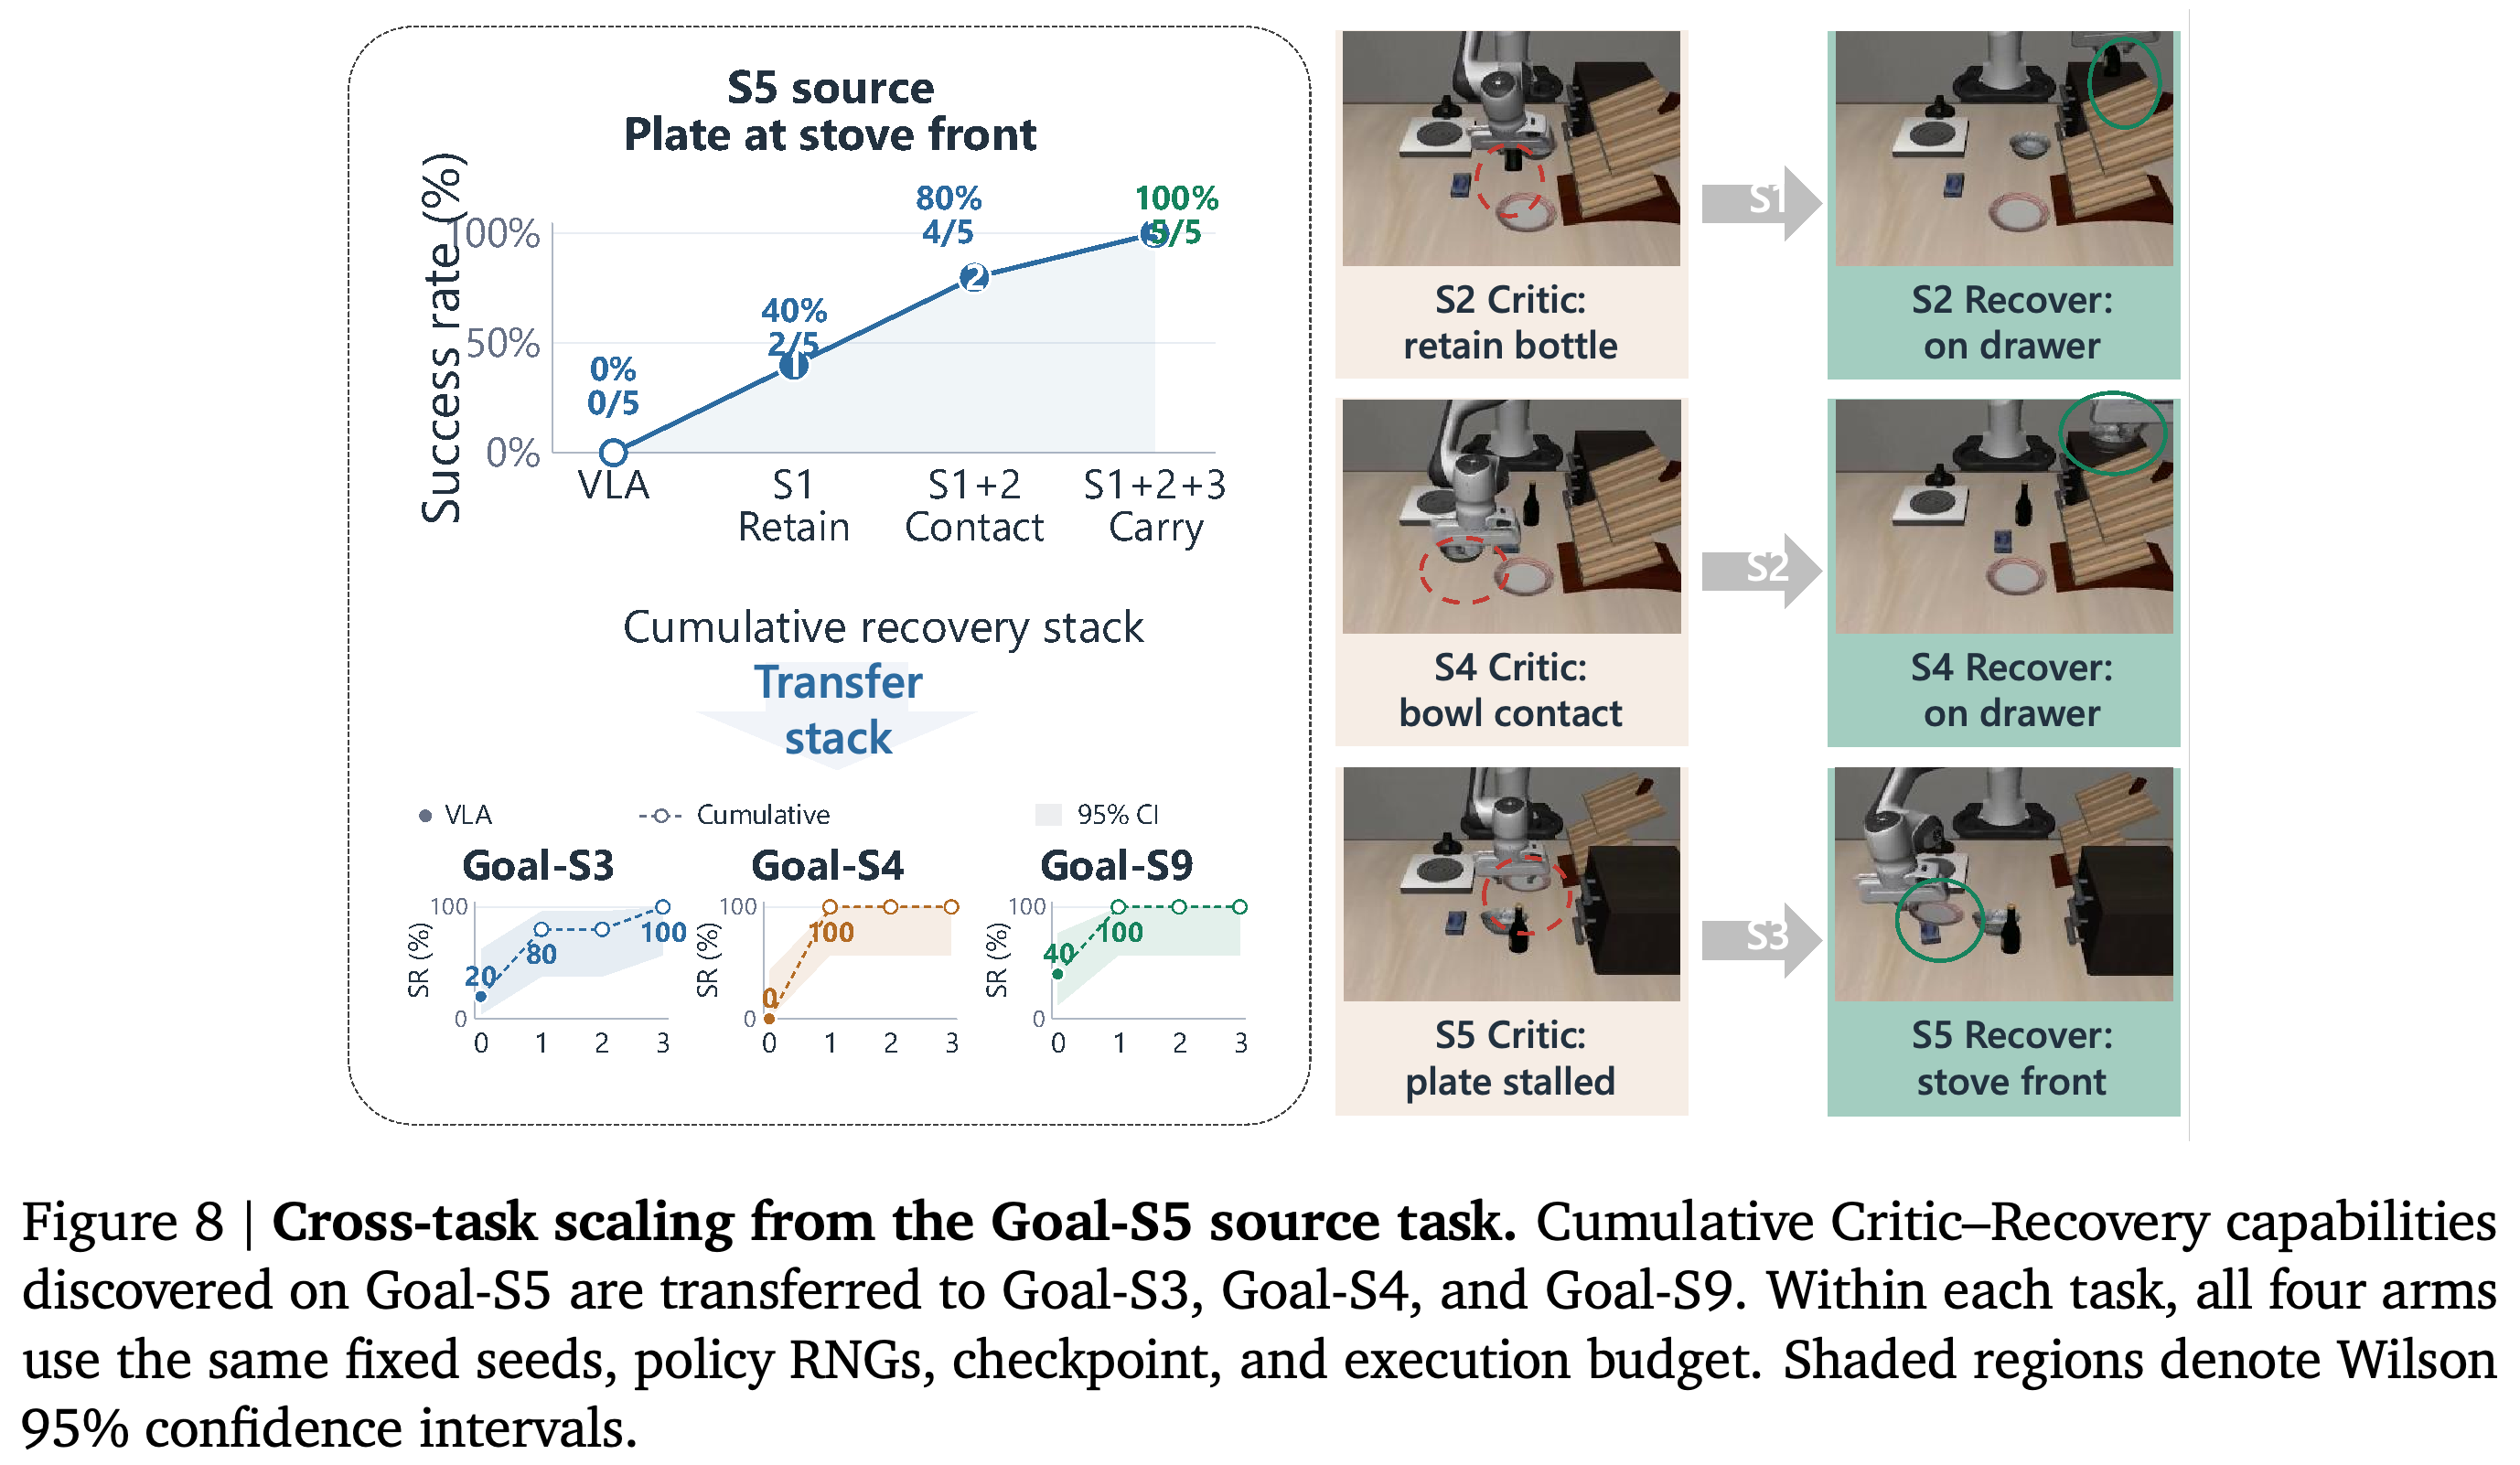
이 보완적 transfer 실험은 Goal-S5를 source로 사용하고 누적 mechanism stack을 Goal-S3, Goal-S4, Goal-S9에 적용한다. 각 target task 안에서는 seed, policy RNG, checkpoint, execution budget을 arm 간에 고정한다.
차트는 18개 RoboCasa task에 걸친 global repair round를 집계한다. Macro-average 성공률은 73.56%에서 78.71%, 84.85%, 90.54%, 93.56%로 증가한다.
PnP-Stove에서 pre-grasp alignment, re-grasp, placement mechanism은 source-task 성공률을 78%에서 96%로 높인다. 누적 checkpoint를 PnP-Sink, PnP-Cabinet, PnP-Toaster에 적용하면 보고된 transfer macro-average는 64%에서 84%로 증가한다.
Source TurnOffStove task는 target localization, collision-aware approach, stable-contact 추가 후 74%에서 92%로 상승한다. Target-task evolution 없이 source stack을 faucet, cabinet, microwave task에 적용해 보고된 transfer macro-average를 64%에서 80%로 높인다.
4.4. Results on Simulation benchmark
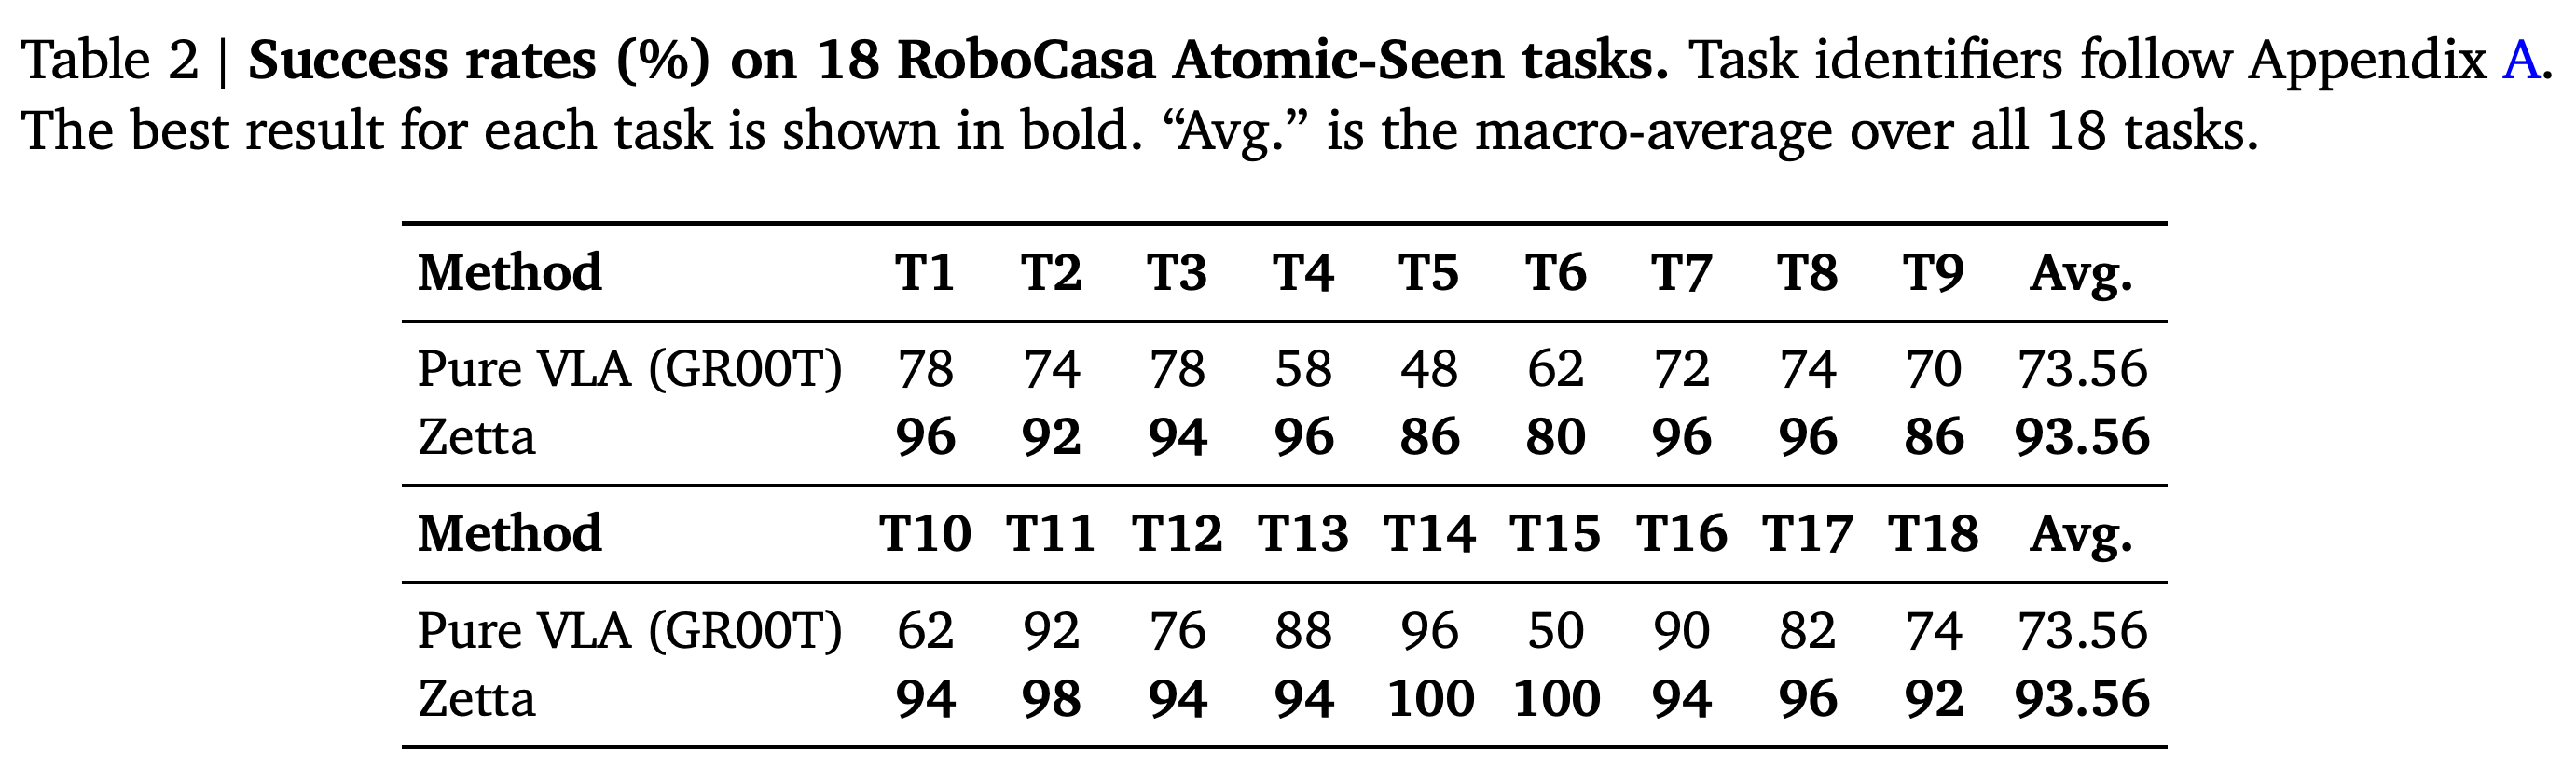
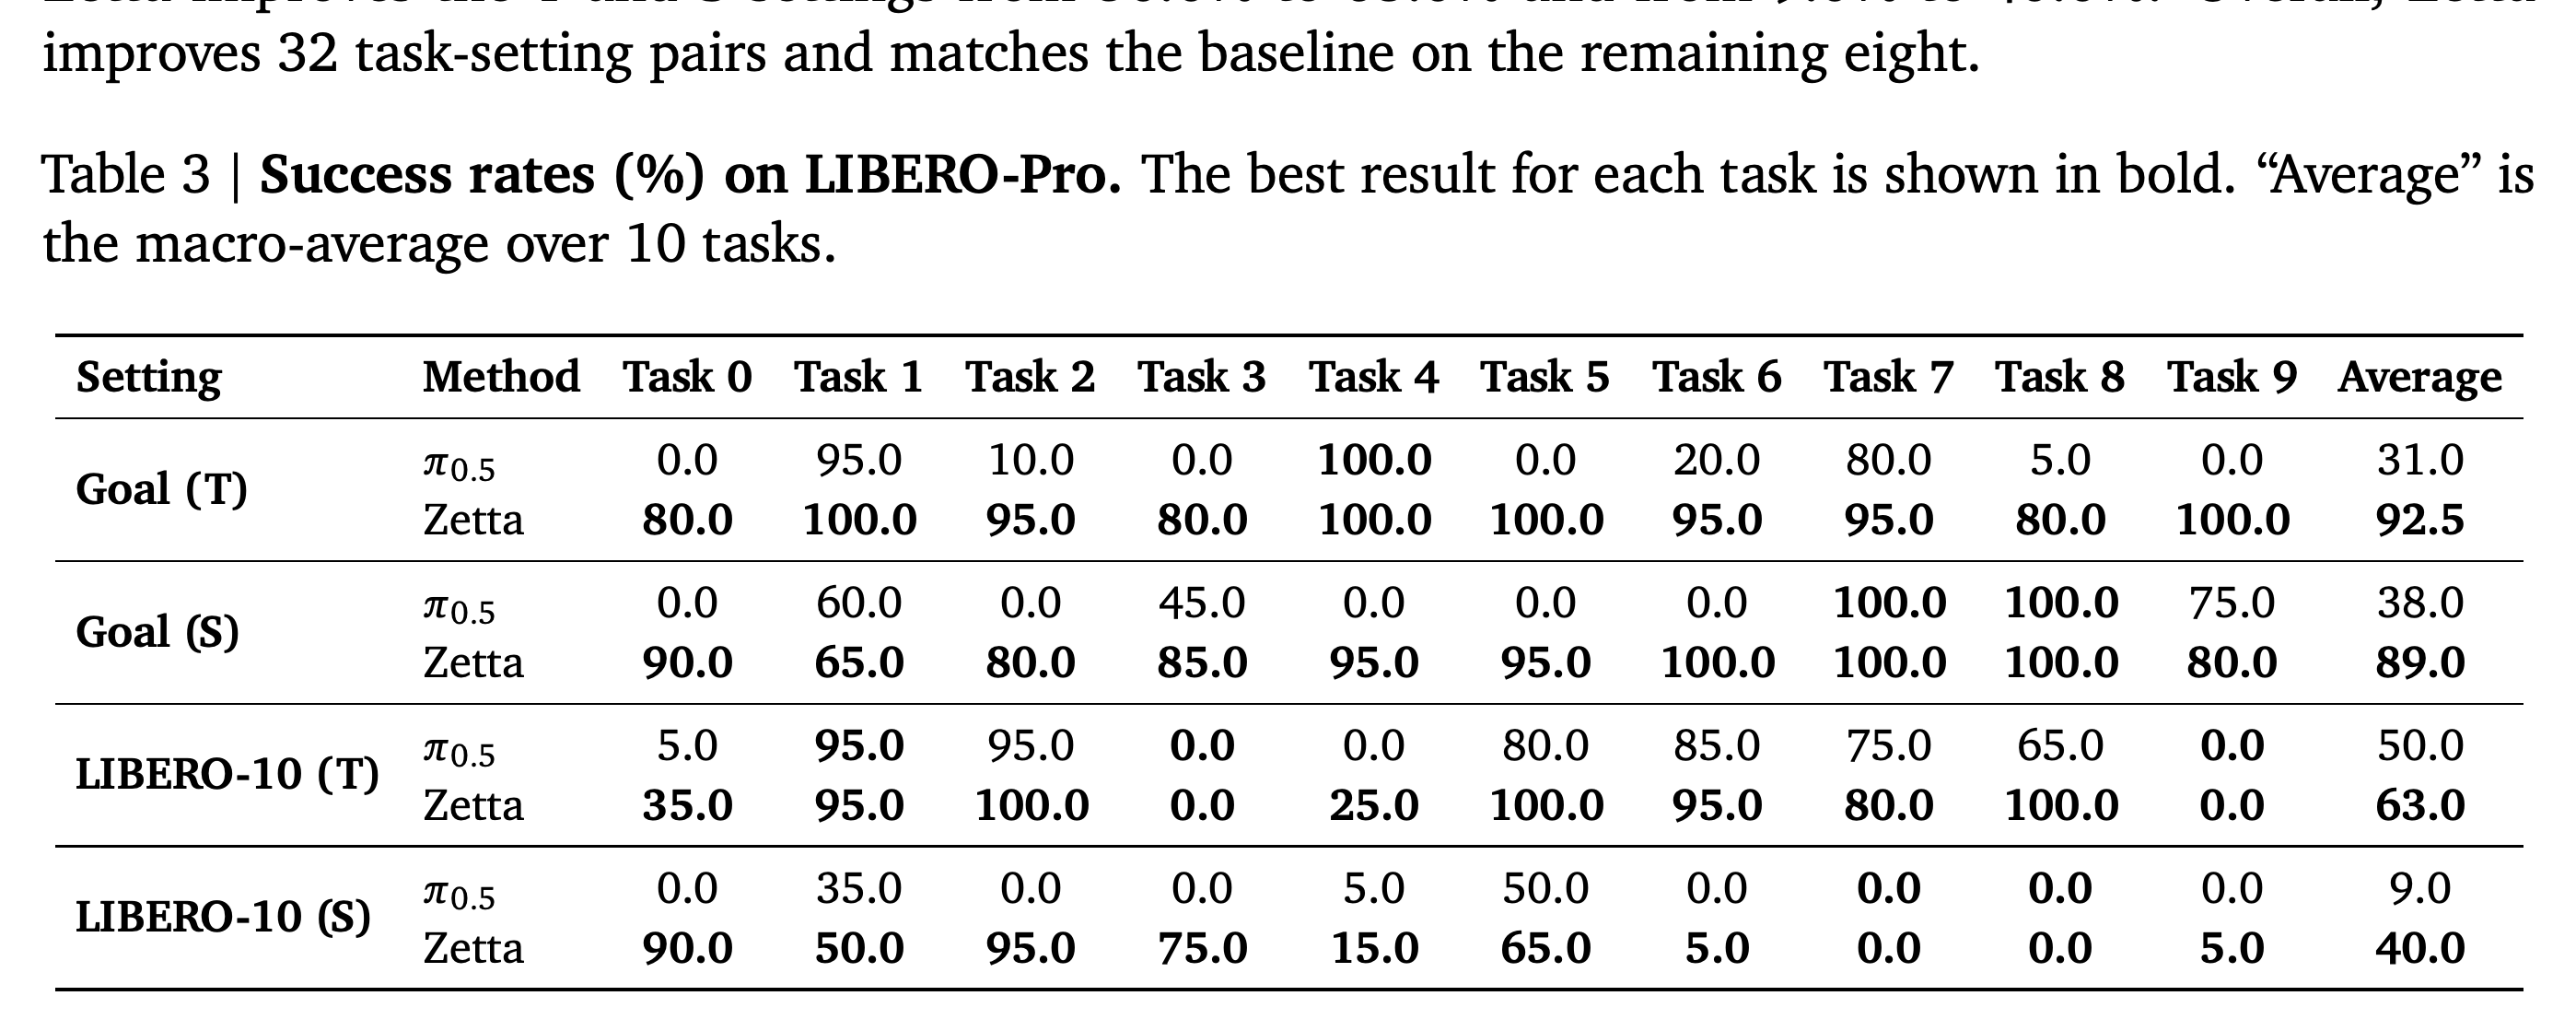
18개의 RoboCasa Atomic-Seen task에서 Zetta는 GR00T macro-average를 73.56%에서 93.56%로 높인다. 40개의 LIBERO-Pro task-setting pair에서 π0.5 overall macro-average를 32.00%에서 71.13%로 높이며, Goal-T와 Goal-S는 각각 31.0%에서 92.5%, 38.0%에서 89.0%로 향상된다.
표는 task별 RoboCasa Atomic-Seen 성공률을 제공하며, 18개 identifier 모두에서 향상됨을 보인다. Macro-average는 Pure VLA (GR00T)의 73.56%에서 Zetta의 93.56%로 20.00 percentage point 상승한다.
결과는 aggregate만 제시하지 않고 Goal과 LIBERO-10 task-setting pair 전반에 걸친 향상을 보여 준다. Zetta는 32개 pair에서 baseline을 개선하고 8개에서 동일 성능을 보이며, 낮은 LIBERO-10 (S) 평균도 확인할 수 있다.
4.6. Z-Infra Performance Evaluation
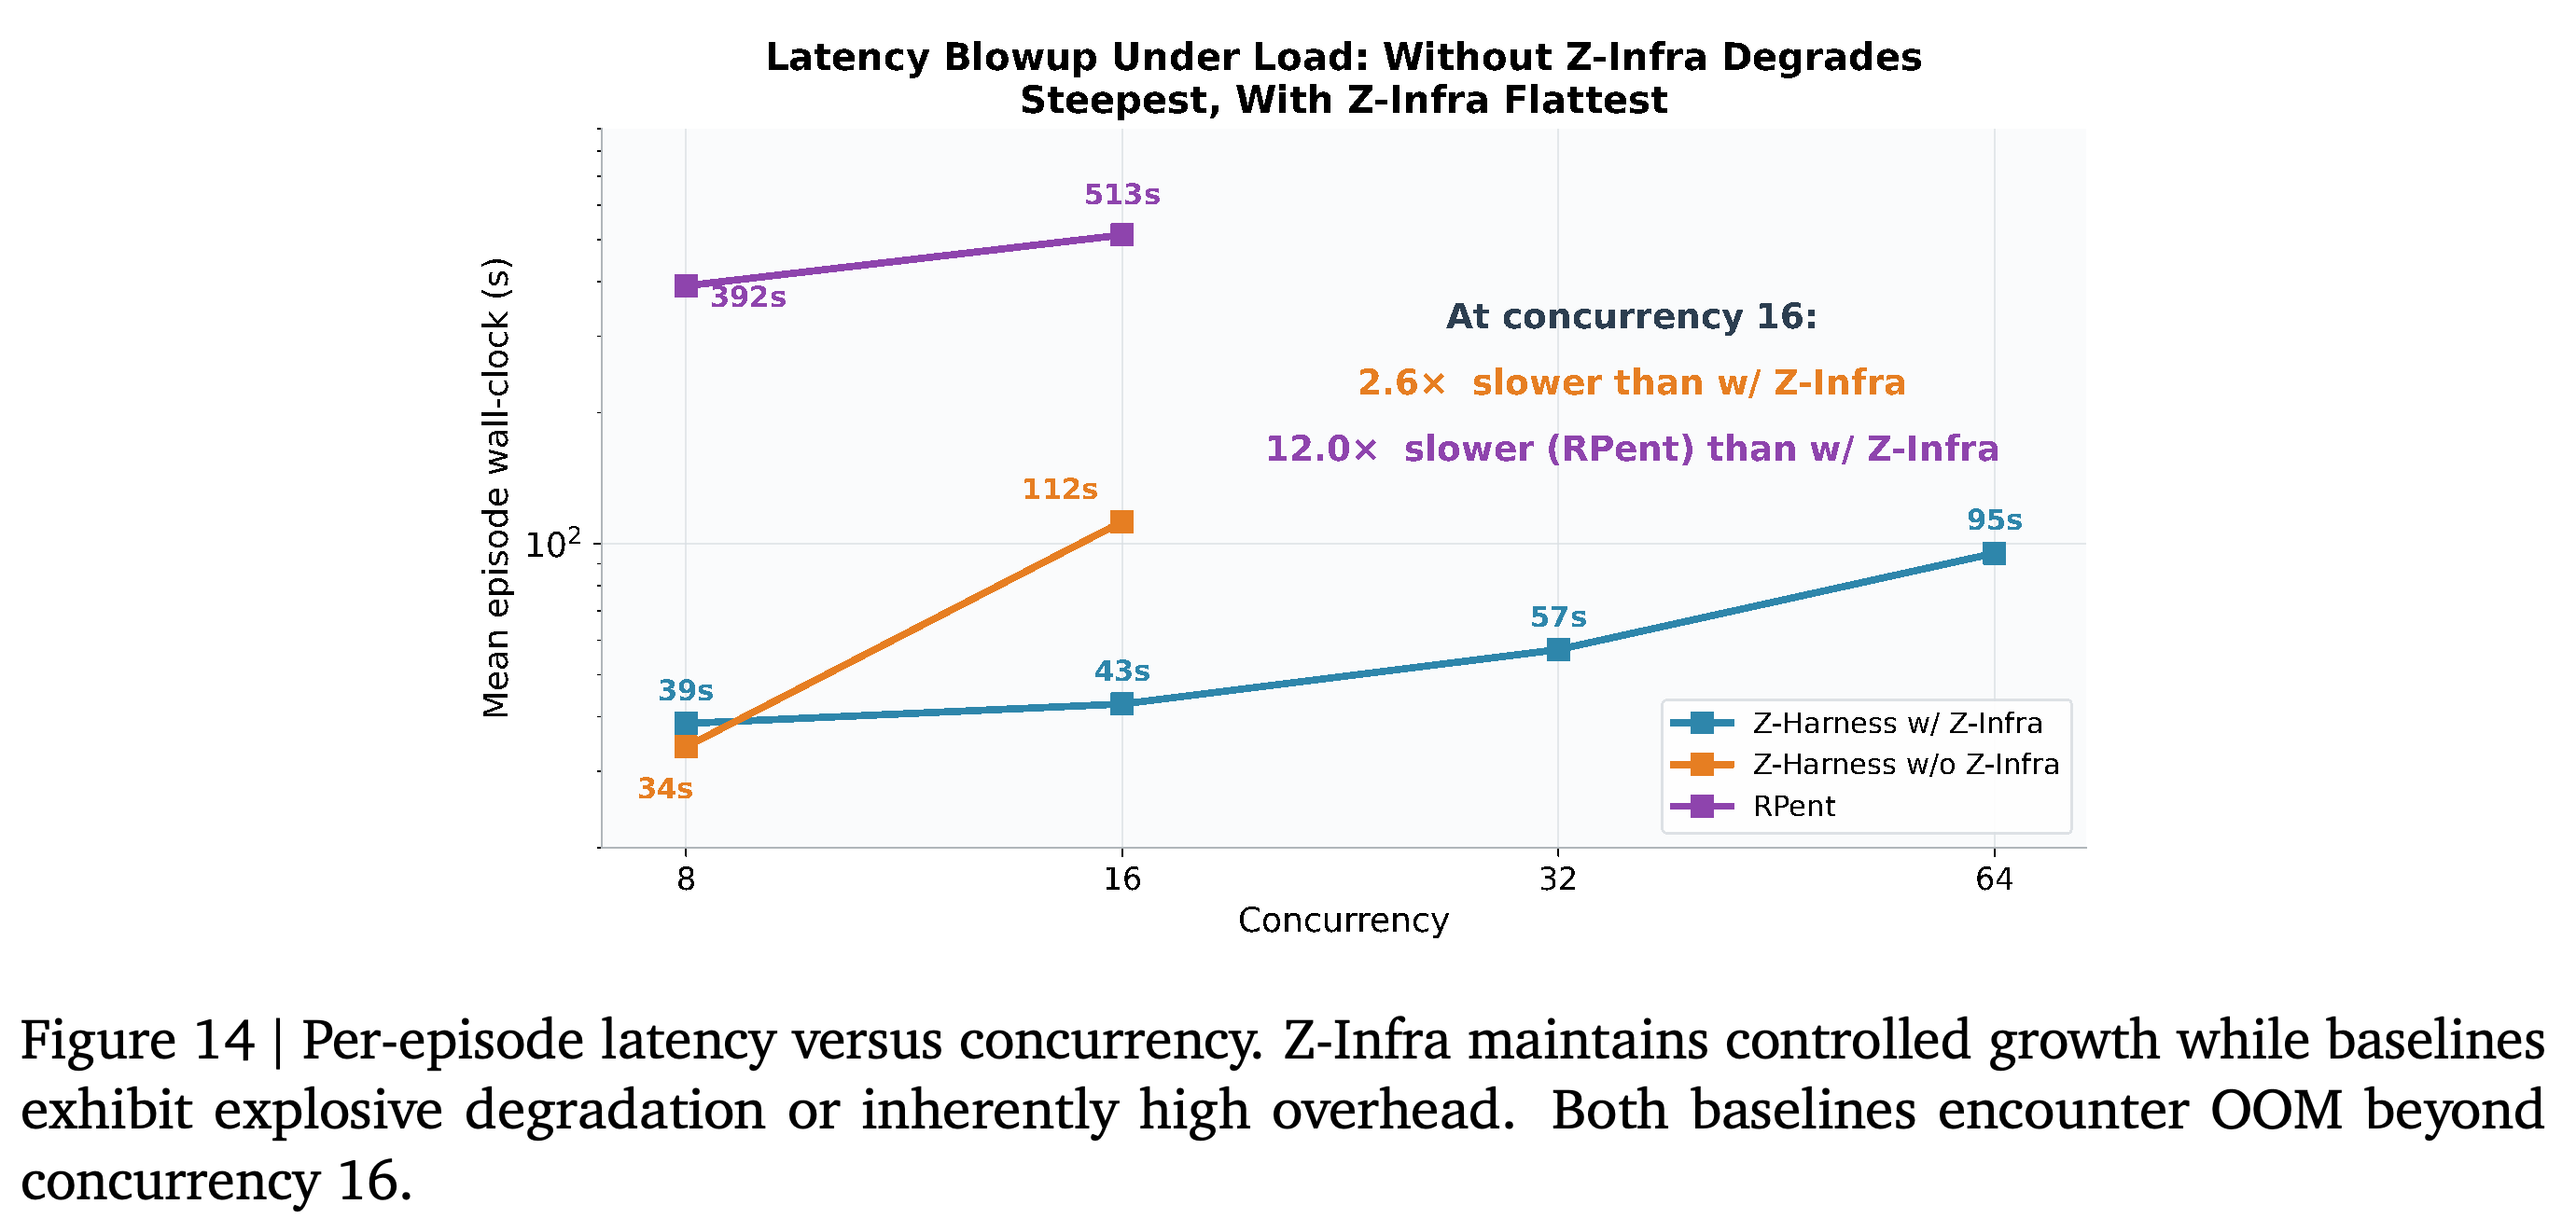
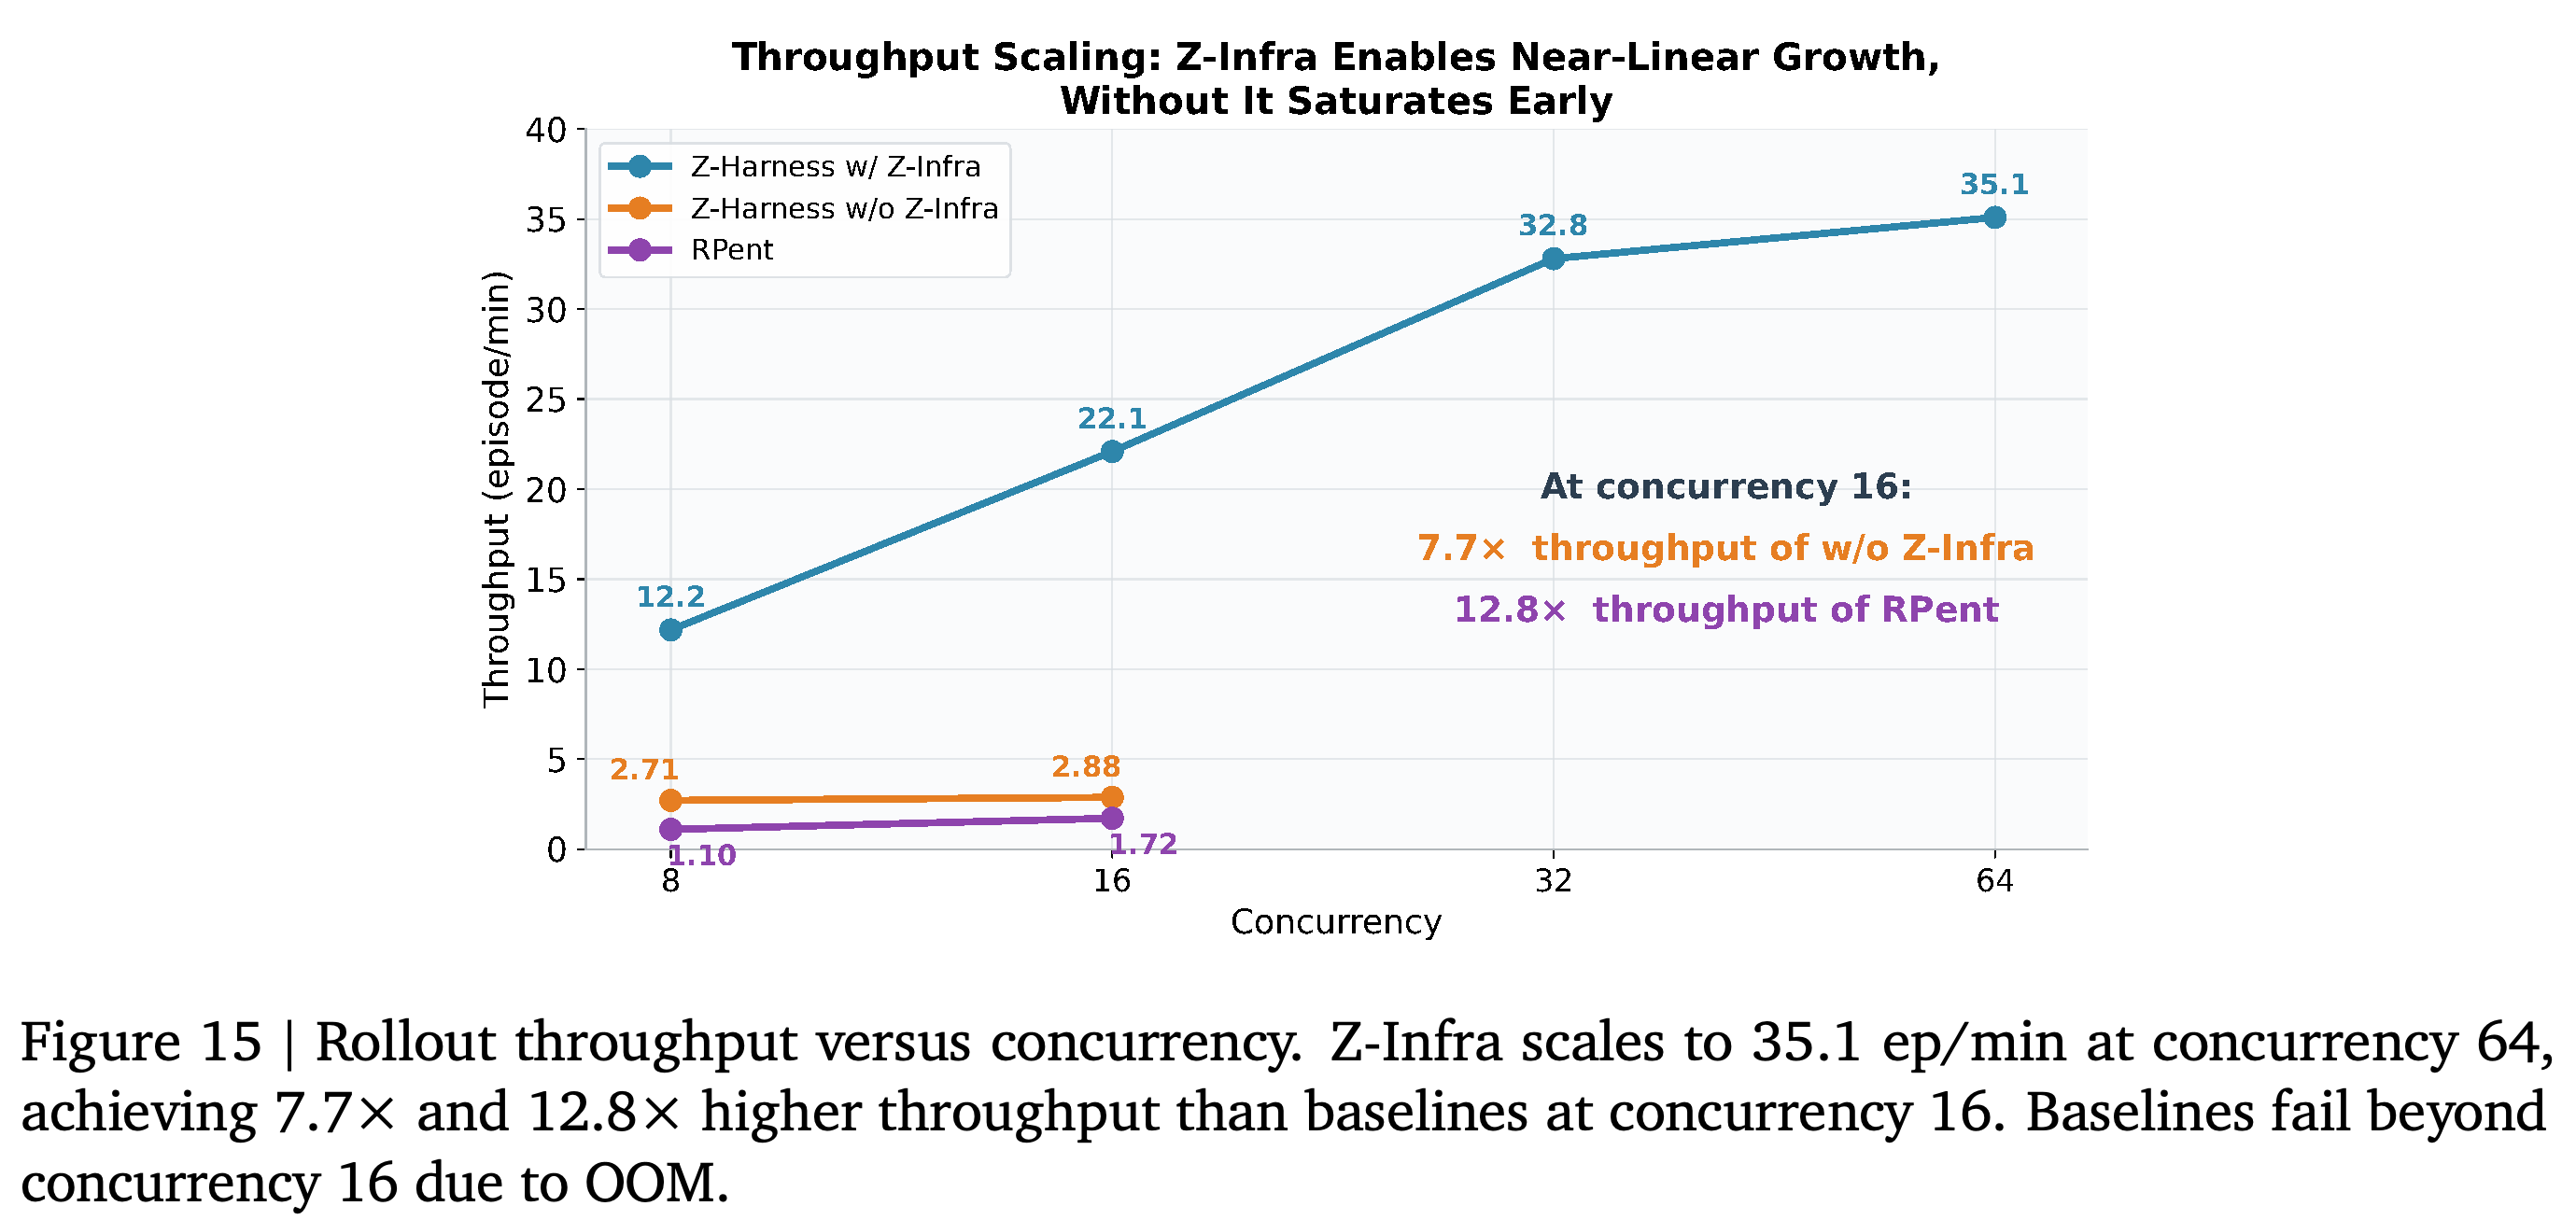
RoboCasa pick-and-place 사례 연구는 nominal VLA로 검증된 복귀 전에 grasp loss, 실행 불가능한 re-grasp pose, goal 근처 placement risk에 대응하는 online intervention을 보인다. 8×A100 GPU에서 Z-Infra는 concurrency 64일 때 35.1 episodes/min에 도달한다. Concurrency 16에서는 22.09 episodes/min을 보고하며, 이는 no-Z-Infra variant의 7.7×, RPent의 12.8×이다. 두 baseline은 concurrency 16을 넘으면 memory 부족으로 실행하지 못한다.
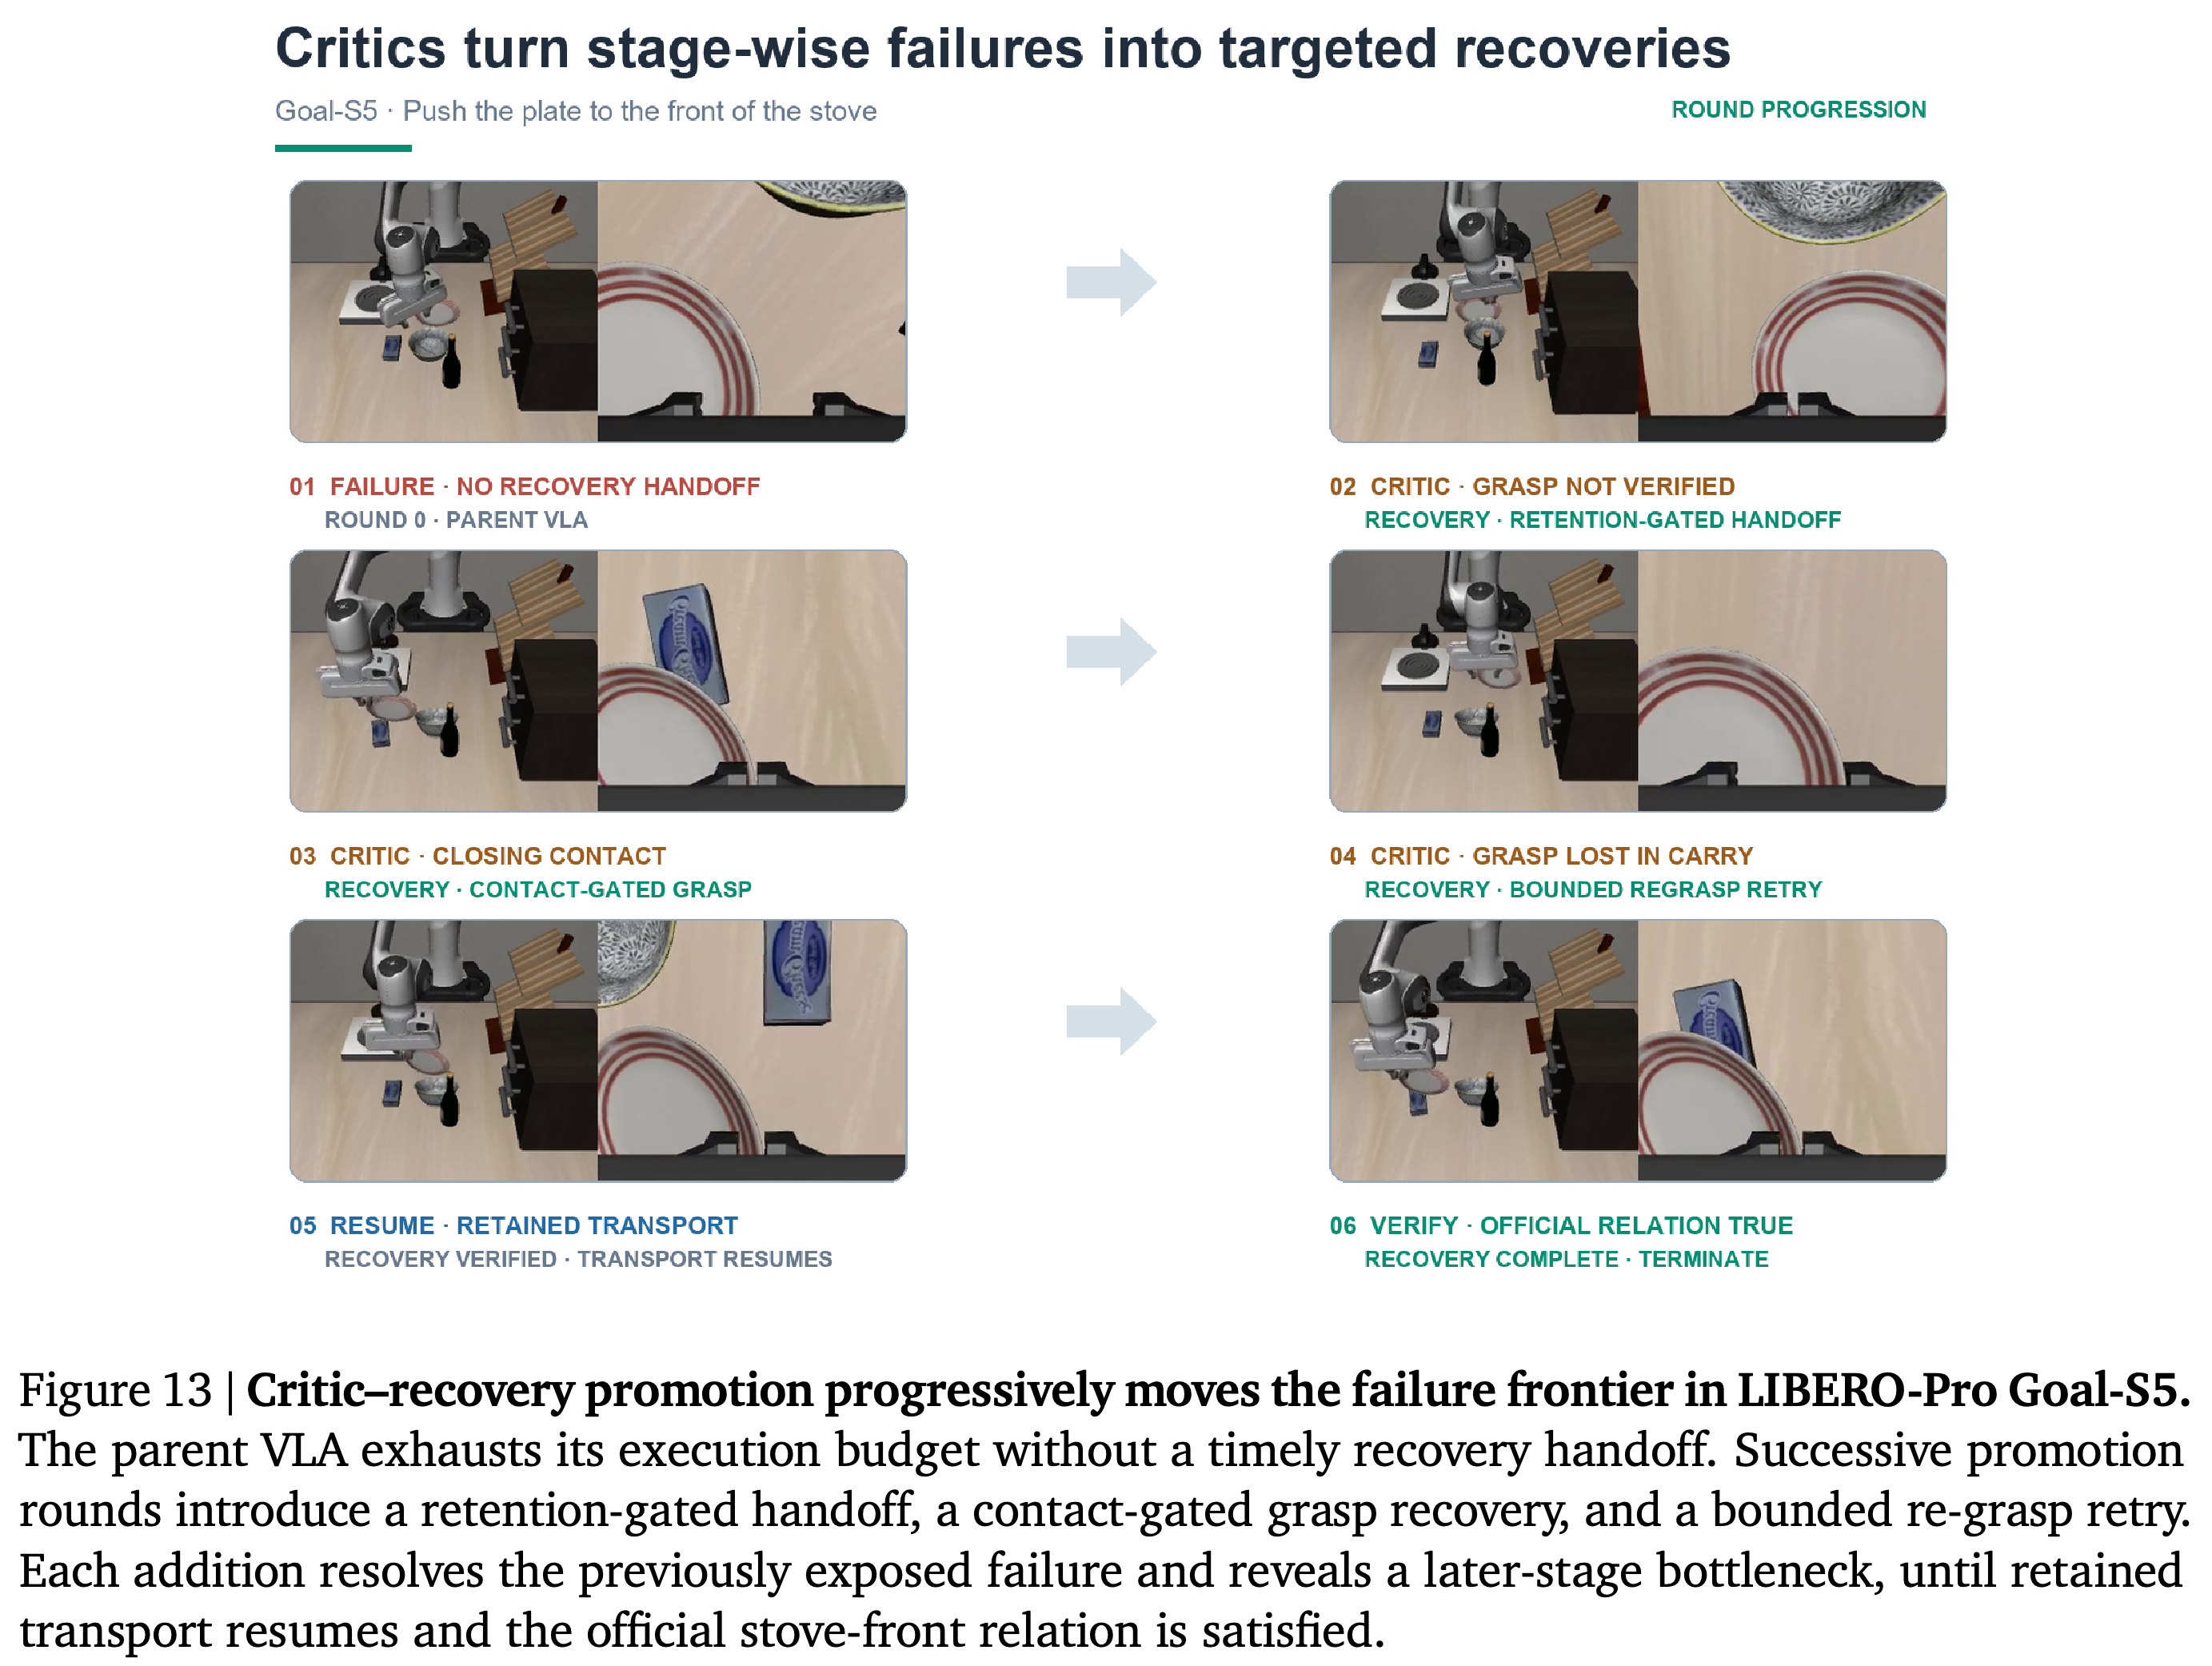
연속된 promotion round는 Goal-S5 failure sequence의 더 뒤 단계인 recovery handoff 부재, 검증되지 않은 grasp, transport 중 lost grasp를 다룬다. 최종 bounded re-grasp retry는 termination 전에 retained transport를 복원한다.
Concurrency 8, 32, 64에서 Z-Infra의 평균 episode wall-clock time은 각각 39 s, 57 s, 95 s다. No-Z-Infra variant는 8에서 34 s, 16에서 112 s로 증가하며, RPent는 8과 16에서 392 s 및 513 s다. 두 baseline은 OOM 때문에 16을 넘어서 사용할 수 없다.
Z-Infra throughput은 concurrency 8에서 12.2 episodes/min, 64에서 35.1 episodes/min으로 증가하며 32 이후 plateau를 보인다. Concurrency 16에서 22.1 episodes/min은 no-Z-Infra의 2.88, RPent의 1.72와 비교된다.
부록
- Appendix는 18개의 RoboCasa Atomic-Seen identifier와 LIBERO-Pro task index를 공식 task name 및 instruction에 대응시킨다. 또한 critic이 proposal을 만들고 Orchestrator가 intervention을 승인하며 실패한 grasp 시도를 retry용으로 기록하는 PnP-Stove와 Goal-T2의 bounded critic-guided recovery pseudocode를 제공한다.
짧은 생각
보고된 성능 향상은 held-out-seed protocol을 적용한 simulation benchmark에서 얻었으며, policy weight는 harness update와 분리한다. 시스템은 task milestone, physical signal, runtime critic, 사용 가능한 recovery tool에 의존한다. 논문은 Zetta와 Z-Infra를 실제 robot으로 확장하는 일을 future work로 제시한다.