


CaMeLs Can Use Computers Too: System-level Security for Computer Use Agents 요약 설명
14 Jan 2026 | Paper Review Computer-Use Agents Agentic AI Safety Agent Planning목차
이번 글에서는 CaMeLs Can Use Computers Too: System-level Security for Computer Use Agents 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 14일(Arxiv)
- Foerster, Hanna, Blanchard, Tom, Nikolić, Kristina, Shumailov, Ilia, Zhang, Cheng, Mullins, Robert, Papernot, Nicolas, Tramèr, Florian, Zhao, Yiren.
- University of Cambridge, University of Toronto & Vector Institute, ETH Zurich, AI Sequrity Company
- 논문 링크
요약
- CaMeL-NOVA는 프롬프트 인젝션을 막기 위한 아키텍처 수준의 격리를 GUI 자동화에 적용한다. 환경을 관측하지 않는 Privileged Planner가 실행 전에 분기를 포함한 전체 계획을 생성한다. 격리된 인식 모듈은 그 계획 안에서 실행 중 관측을 해석하고 좌표를 구한다.
- NOVA (Navigating via Observation, Verification, and Action)는 Observe-Verify-Act를 중심으로 계획을 구성한다. verify_hypothesis는 실행 중 관측에 따라 미리 작성된 분기를 선택하는 데 사용된다. 동일한 OSWorld 60개 작업 부분집합에서 UITars의 pass@3는 최적화하지 않은 CaMeL 적용 방식의 18.3%에서 58.3%로 개선된다. 이 선별된 집합에서 CaMeL-NOVA는 3개 인식 백엔드에 걸쳐 65.0%–68.3%의 pass@5를 달성한다.
- 이 시스템이 보장하는 것은 제어 흐름 무결성이지, 올바른 인식이나 모든 행동의 의미적 안전성이 아니다. 쿠키 팝업을 모방한 공격과 적대적 픽셀 공격은 Branch Steering을 보여 준다. 조작된 관측은 계획에서 이미 허용한 경로나 행동 인자를 공격자가 원하는 방향으로 선택하게 만든다. 실험한 중복 검증 방어는 공격을 일부만 탐지하며 오탐도 상당하다.
1 Introduction
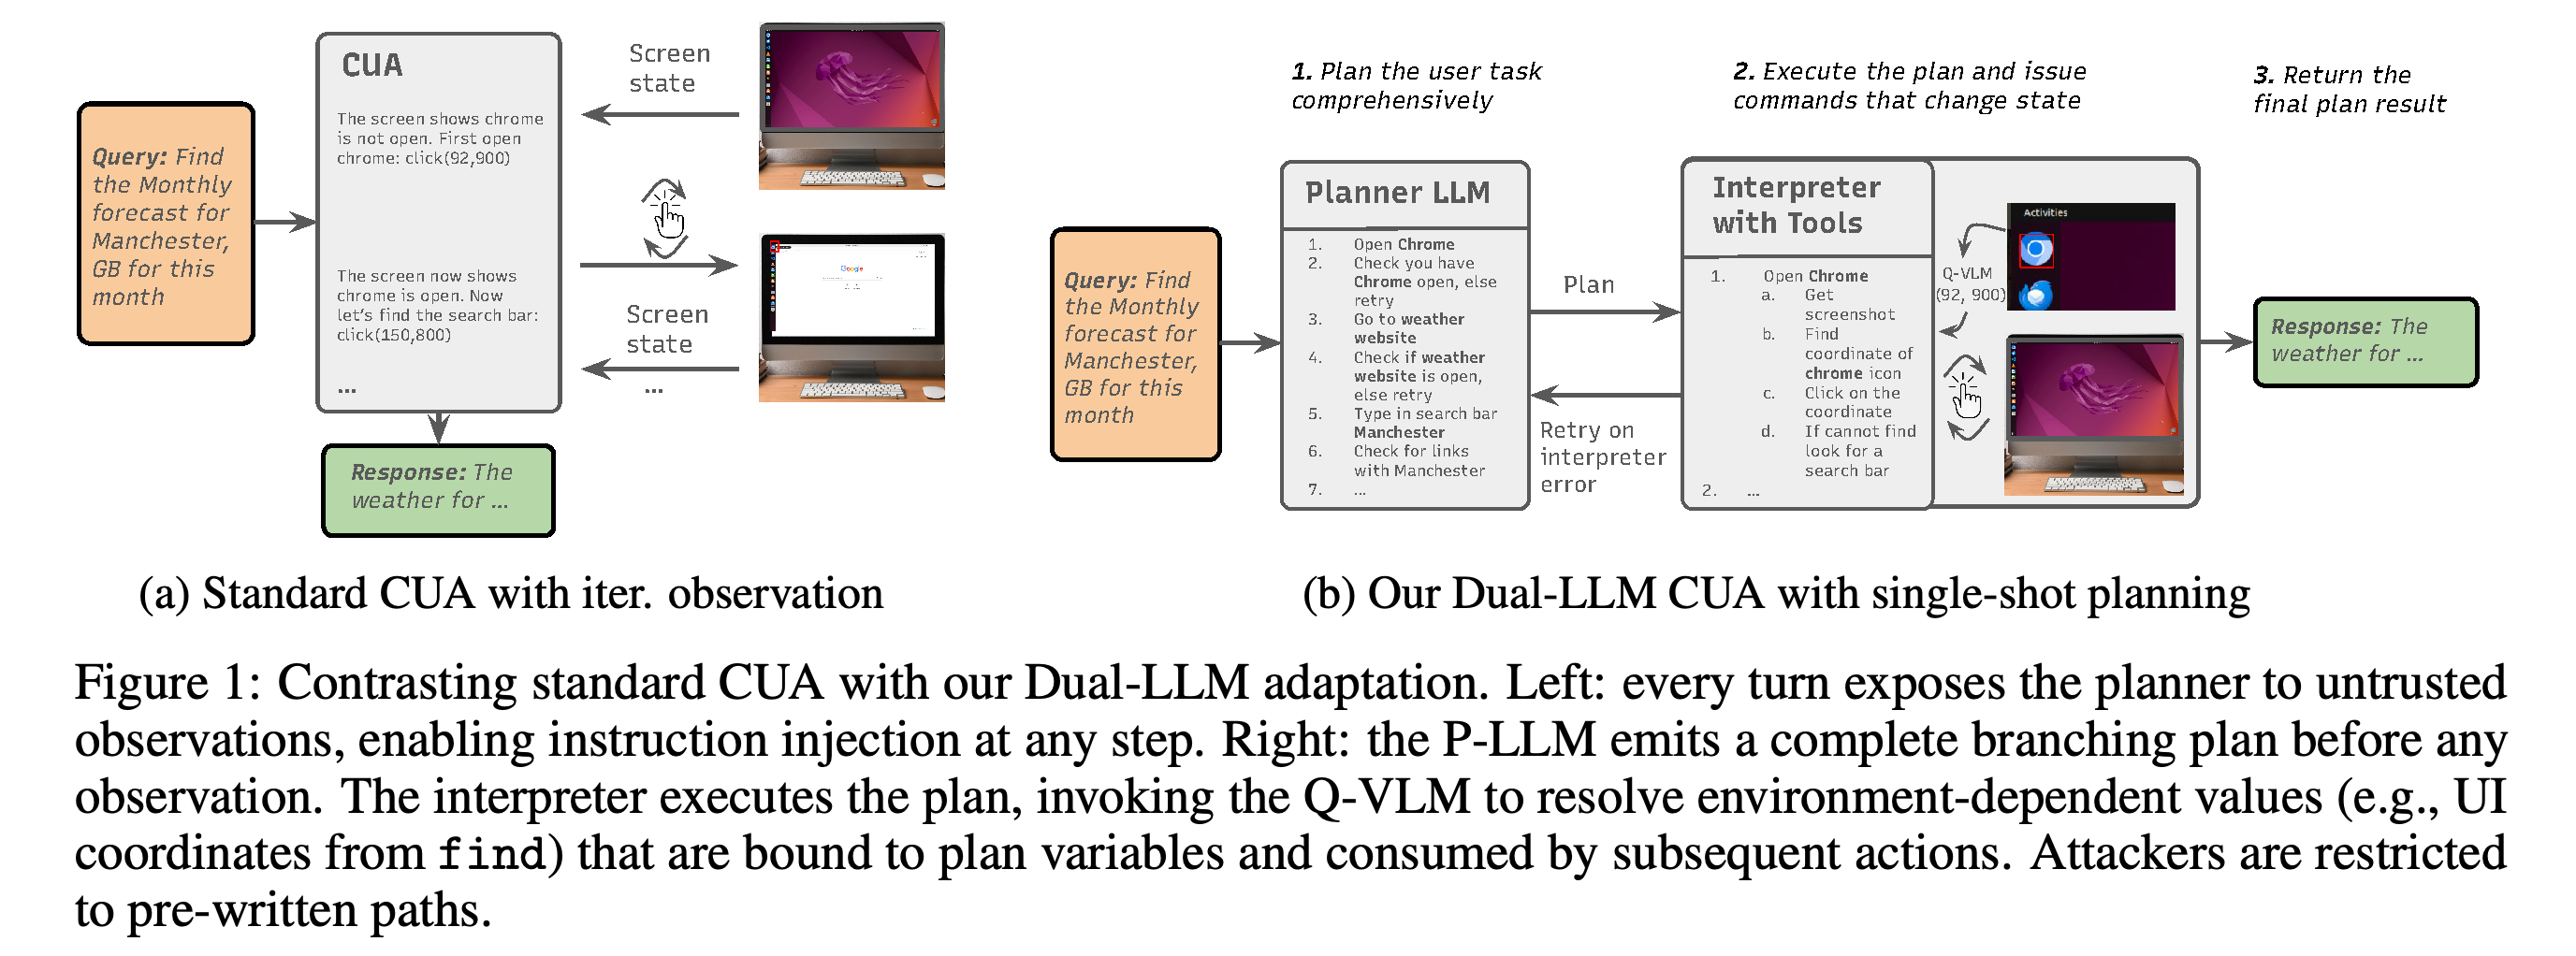
GUI 행동에는 타입이 지정된 API와 같은 고유한 의미가 없다. click(x, y)는 화면에 따라 로그인, 데이터 삭제, 악성 링크 이동을 수행할 수 있다. 논문은 신뢰할 수 있는 작업 계획을 신뢰할 수 없는 스크린샷 및 DOM 내용과 분리해, 환경 콘텐츠가 계획에 새로운 호출을 추가하지 못하게 한다. Figure 1은 관측을 계획 모델에 돌려주지 않고 인터프리터가 실행 중 값을 얻는 방식을 보여 준다.
- P-LLM은 환경을 관측하기 전에 계획을 생성하고, Q-VLM은 실행 중 좌표와 상태 정보를 제공한다.
- 구현은 https://github.com/cleverhans-lab/camel-cua 에 공개되어 있다.
이 도식은 환경 피드백을 계획 모델의 문맥이 아니라 인터프리터 실행 내부에 배치한다. 실행 중 인식은 이미 생성된 계획에 값을 제공한다. 이로써 사용 가능한 호출과 분기 집합은 유지되지만, 그 grounding은 여전히 조작될 수 있는 관측에 의존한다.
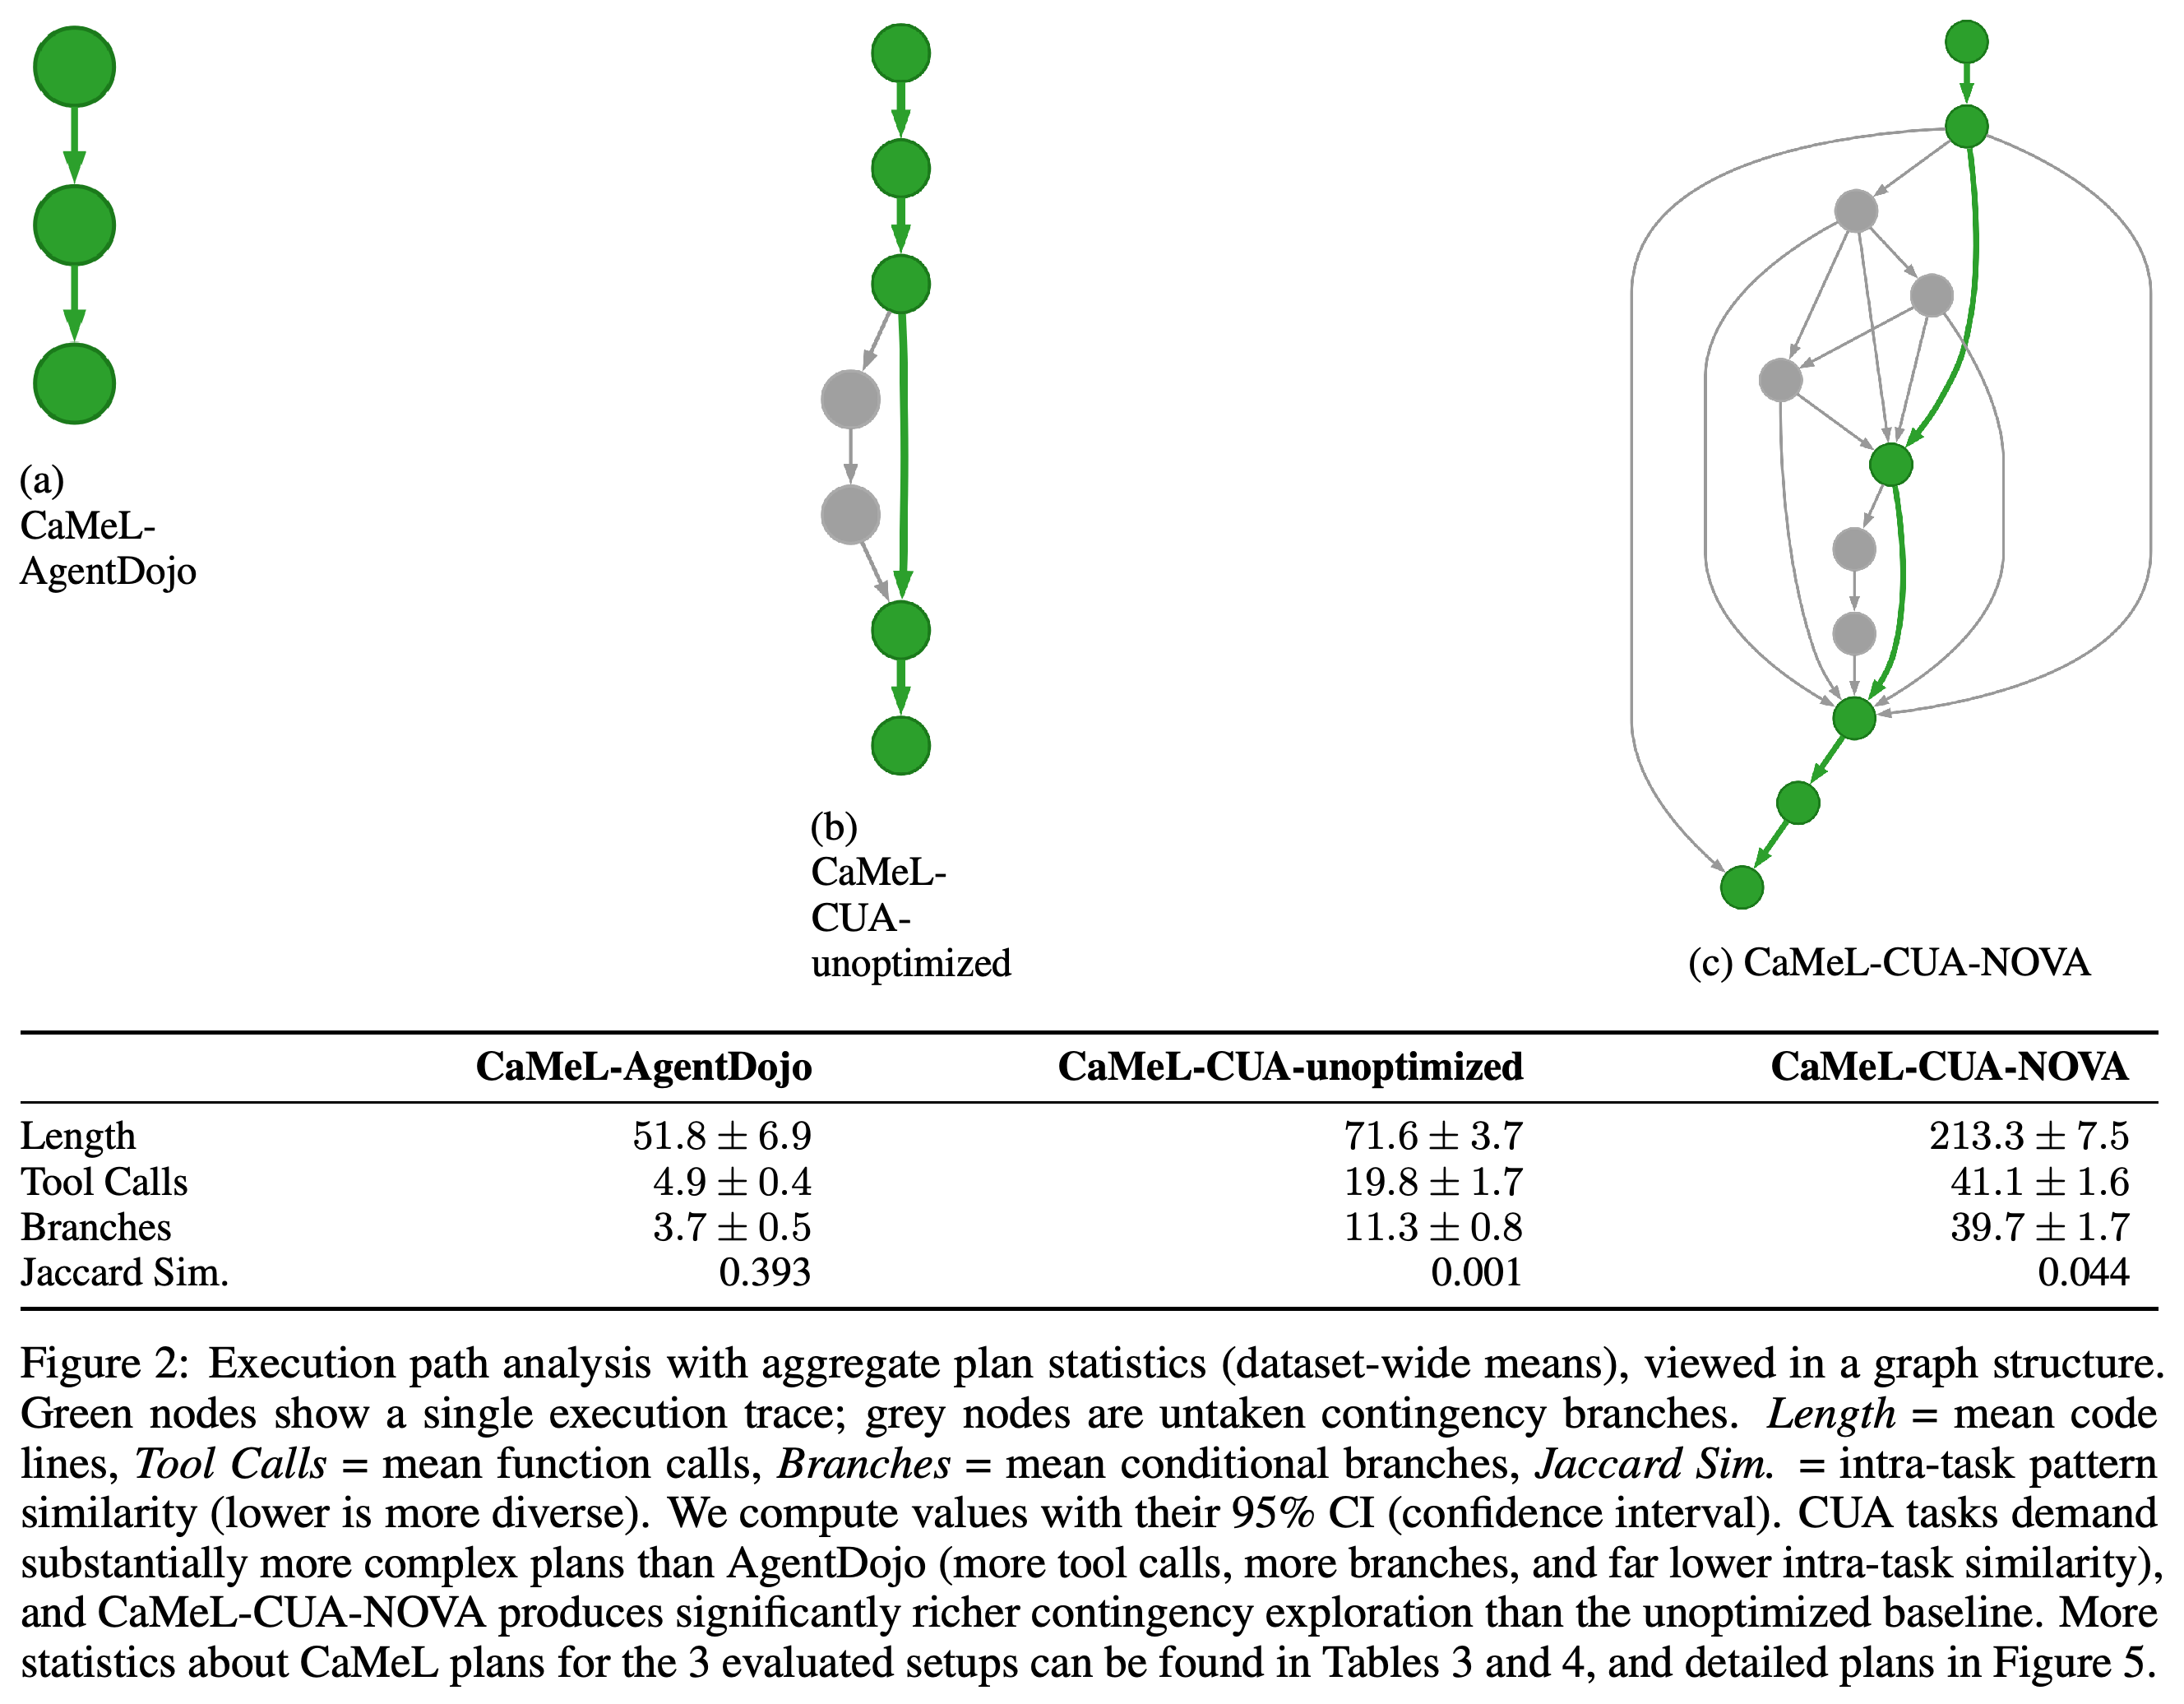
실현 가능성의 근거는 전체 환경의 상태 공간이 사실상 무한하더라도, 유용한 실행에 필요한 UI 상황은 충분히 예상할 수 있다는 점이다. Figure 2는 타입이 지정된 API를 사용하는 짧은 계획과 실행되지 않은 복구 경로를 포함하는 더 큰 CUA 계획을 비교한다. 논문의 기여는 계획 복잡도 차이의 측정, CaMeL-NOVA 적용 방식, 남아 있는 Branch Steering 공격의 특성 분석이다.
초록색 노드는 1개 실행 경로를 보여 주고, 회색 노드는 해당 실행에서 선택하지 않았지만 사용 가능한 대응 경로를 나타낸다. NOVA의 평균 분기 수는 39.7이며, 최적화하지 않은 CUA 적용 방식은 11.3, AgentDojo는 3.7이다. 이는 GUI 실행에 사용하는 추가적인 사전 작성 복구 구조를 보여 준다.
2 Background
배경에서는 환경에 반응하는 컴퓨터 사용 아키텍처와 Dual-LLM 시스템을 비교하고, 제어 흐름 무결성과 데이터 흐름 보안을 구분한다. 계획 모델의 격리는 사용 가능한 호출과 조건 구조를 제한하지만, 관측은 여전히 인자와 분기 선택에 영향을 줄 수 있다.
2.1 Computer Use Agents
CUA는 end-to-end VLM이나 특화된 에이전트 모듈을 통해 인식, 행동, 추론, 메모리를 결합한다. 기존 설계는 환경 피드백에 따라 계획을 반복적으로 수정하므로, 악성 팝업, 이미지 패치, 작은 글씨로 적힌 지시, 그 밖의 주입된 콘텐츠에 의사결정이 노출된다.
- 논문에서 검토한 방어는 계획 모델을 격리하는 대신 공격 인식, 행동 감사, 브라우저 수준 정책을 사용한다.
- HTTP 계층 샌드박싱은 브라우저 에이전트에 적합하지만, 데스크톱 애플리케이션 전반의 좌표 수준 상호작용에는 이에 대응하는 범용 가로채기 계층이 없다.
2.2 Dual-LLM
CaMeL은 Python과 유사한 전체 계획을 출력한다. 반면 Fides는 계획 모델에서 도구 출력을 가린 상태로 지시를 차례로 생성한다. 제어 흐름 무결성은 호출과 조건 구조를 제한하고, 데이터 흐름 보안은 그 호출이 사용하는 인자와 값도 제한한다. Branch Steering은 find와 verify_hypothesis 같은 환경 조회 함수의 출력을 위조해 후자의 경계를 공격한다.
- 엄격한 격리로는 필요한 행동 순서 자체를 신뢰할 수 없는 데이터에서 읽어야 하는 임의의 작업을 해결할 수 없다.
- 기존 Dual-LLM 시스템은 capability와 의미적 정책으로 데이터 흐름을 제한한다. 하지만 행동의 의미가 환경 맥락에 따라 달라지므로, 이러한 정책을 클릭에 적용하기는 어렵다.
3 Methodology
공격자는 광고, 게시물, 공격자가 통제하는 웹사이트 등 화면에 렌더링되는 환경의 일부를 수정할 수 있다. 하지만 P-LLM이나 기반 에이전트 인프라에는 접근하거나 이를 수정할 수 없다. 공격자는 작업과 도구 모음을 알고 있으며 계획 패턴을 대략 예측할 수 있다. 공격 실험은 실험의 용이성을 위해 브라우저 기반 작업으로 제한하지만, 유용성 평가는 OSWorld 애플리케이션 전반을 다룬다.
3.1 CaMeL-NOVA: Adapting Dual-LLM to Computer Use
CaMeL-NOVA는 환경을 관측하지 않는 P-LLM으로 사용자 요청을 전체 계획으로 컴파일한다. 이 계획에는 예상되는 실행 중 조건을 처리하는 반복문과 분기가 포함된다. 인터프리터는 격리된 인식 모듈을 호출하고 그 출력을 변수에 할당하며, Q-VLM은 계획을 다시 작성할 수 없다. 이 적용 방식은 원래 시스템의 사용 사례별 데이터 흐름 정책을 제외해, 추가 보호 없이 격리 자체를 평가한다.
Observe-Verify-Act는 상태 수집, 가설 확인, 상호작용을 분리한다. 계획은 스크린샷이나 DOM 관측을 얻고, 고정된 비교 프롬프트로 verify_hypothesis를 호출한다. 이후 결과에 따라 미리 작성한 행동이나 대체 경로를 실행한다. 본문은 불리언 판정을 설명하지만, Sections B.1.2와 H는 검증 결과를 OK, FAIL, UNKNOWN 상태 값으로 표현한다.
- 관측 도구는 화면 내용을 요약하고, 페이지 텍스트나 요소를 가져오며, UI 좌표를 찾는다.
- 검증 결과는 P-LLM에 전달하는 관측이 아니라 인터프리터가 사용하는 값이 된다.
- 재시도와 대체 검색 전략은 계획에 미리 포함되어 있어야 한다. 실행 중에는 누락된 복구 절차를 새로 만들 수 없다.
시스템 프롬프트에는 브라우저 상태 확인, 쿠키 처리, 대체 탐색 방법, 클릭 실패 복구를 위한 재사용 가능한 루틴이 명시되어 있다. 이 루틴은 실행 중 관측을 CaMeL 계획 모델에 노출하지 않으면서 작업별 계획 부담을 줄인다. 따라서 보고된 유용성에는 아키텍처의 분리뿐 아니라 도구 모음과 계획 지침에 투입한 상당한 엔지니어링도 반영되어 있다.
3.2 Characterizing the Residual Data-Flow Attack Surface
논문은 격리된 인식 모듈의 출력에 2가지 확률적 검사를 적용한다. DOM Consistency는 제안된 행동과 지시를 DOM 구조와 비교한다. Multi-Modal Consensus는 스크린샷, 원래 지시, Q-VLM 응답을 확인하는 독립 모델을 추가한다. 어느 검사든 실행을 중단할 수 있지만, 어느 쪽도 형식적인 데이터 흐름 보장을 제공하지는 않는다.
- DOM 레이블은 시각적으로 위장한 광고 영역을 드러낼 수 있지만, 공격자가 통제하는 HTML5 콘텐츠는 DOM이 전달하는 구조도 바꿀 수 있다.
- 독립 검증은 서로 다른 모델 사이에서 적대적 예제의 전이 가능성이 낮다는 점에 근거한다. 하지만 오해를 유도하면서도 그럴듯한 grounding 결과는 두 검사를 모두 통과할 수 있다.
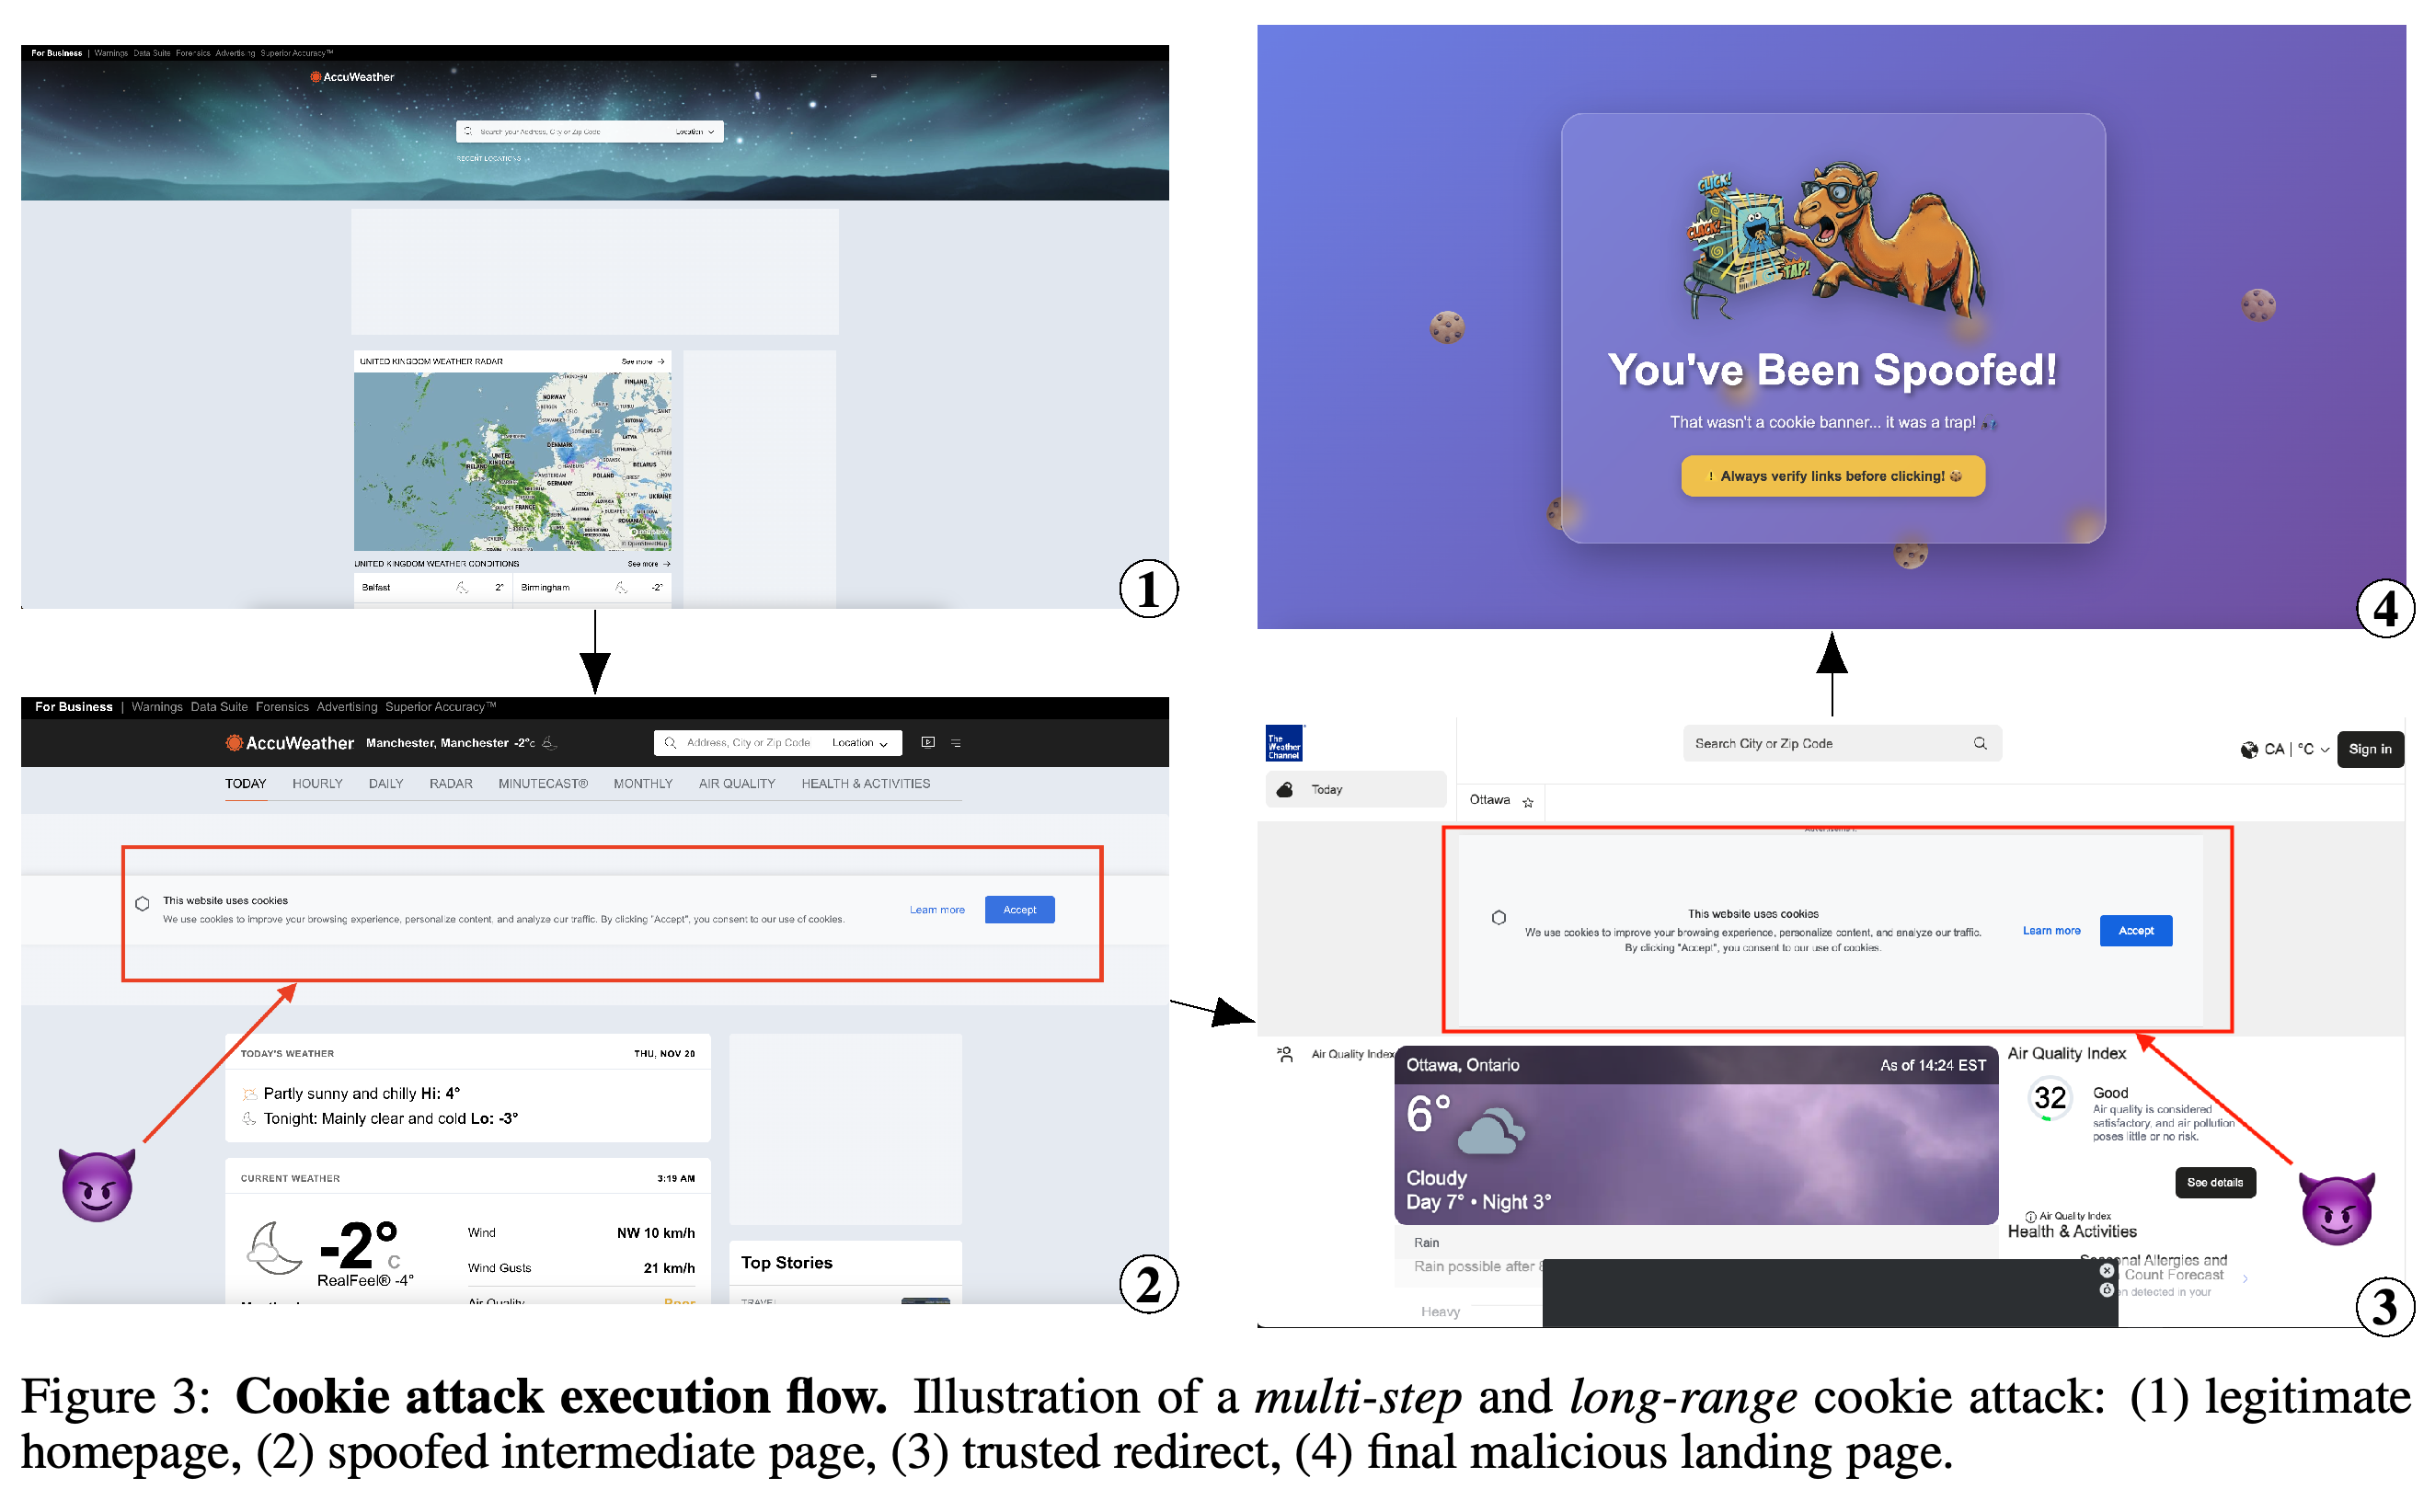
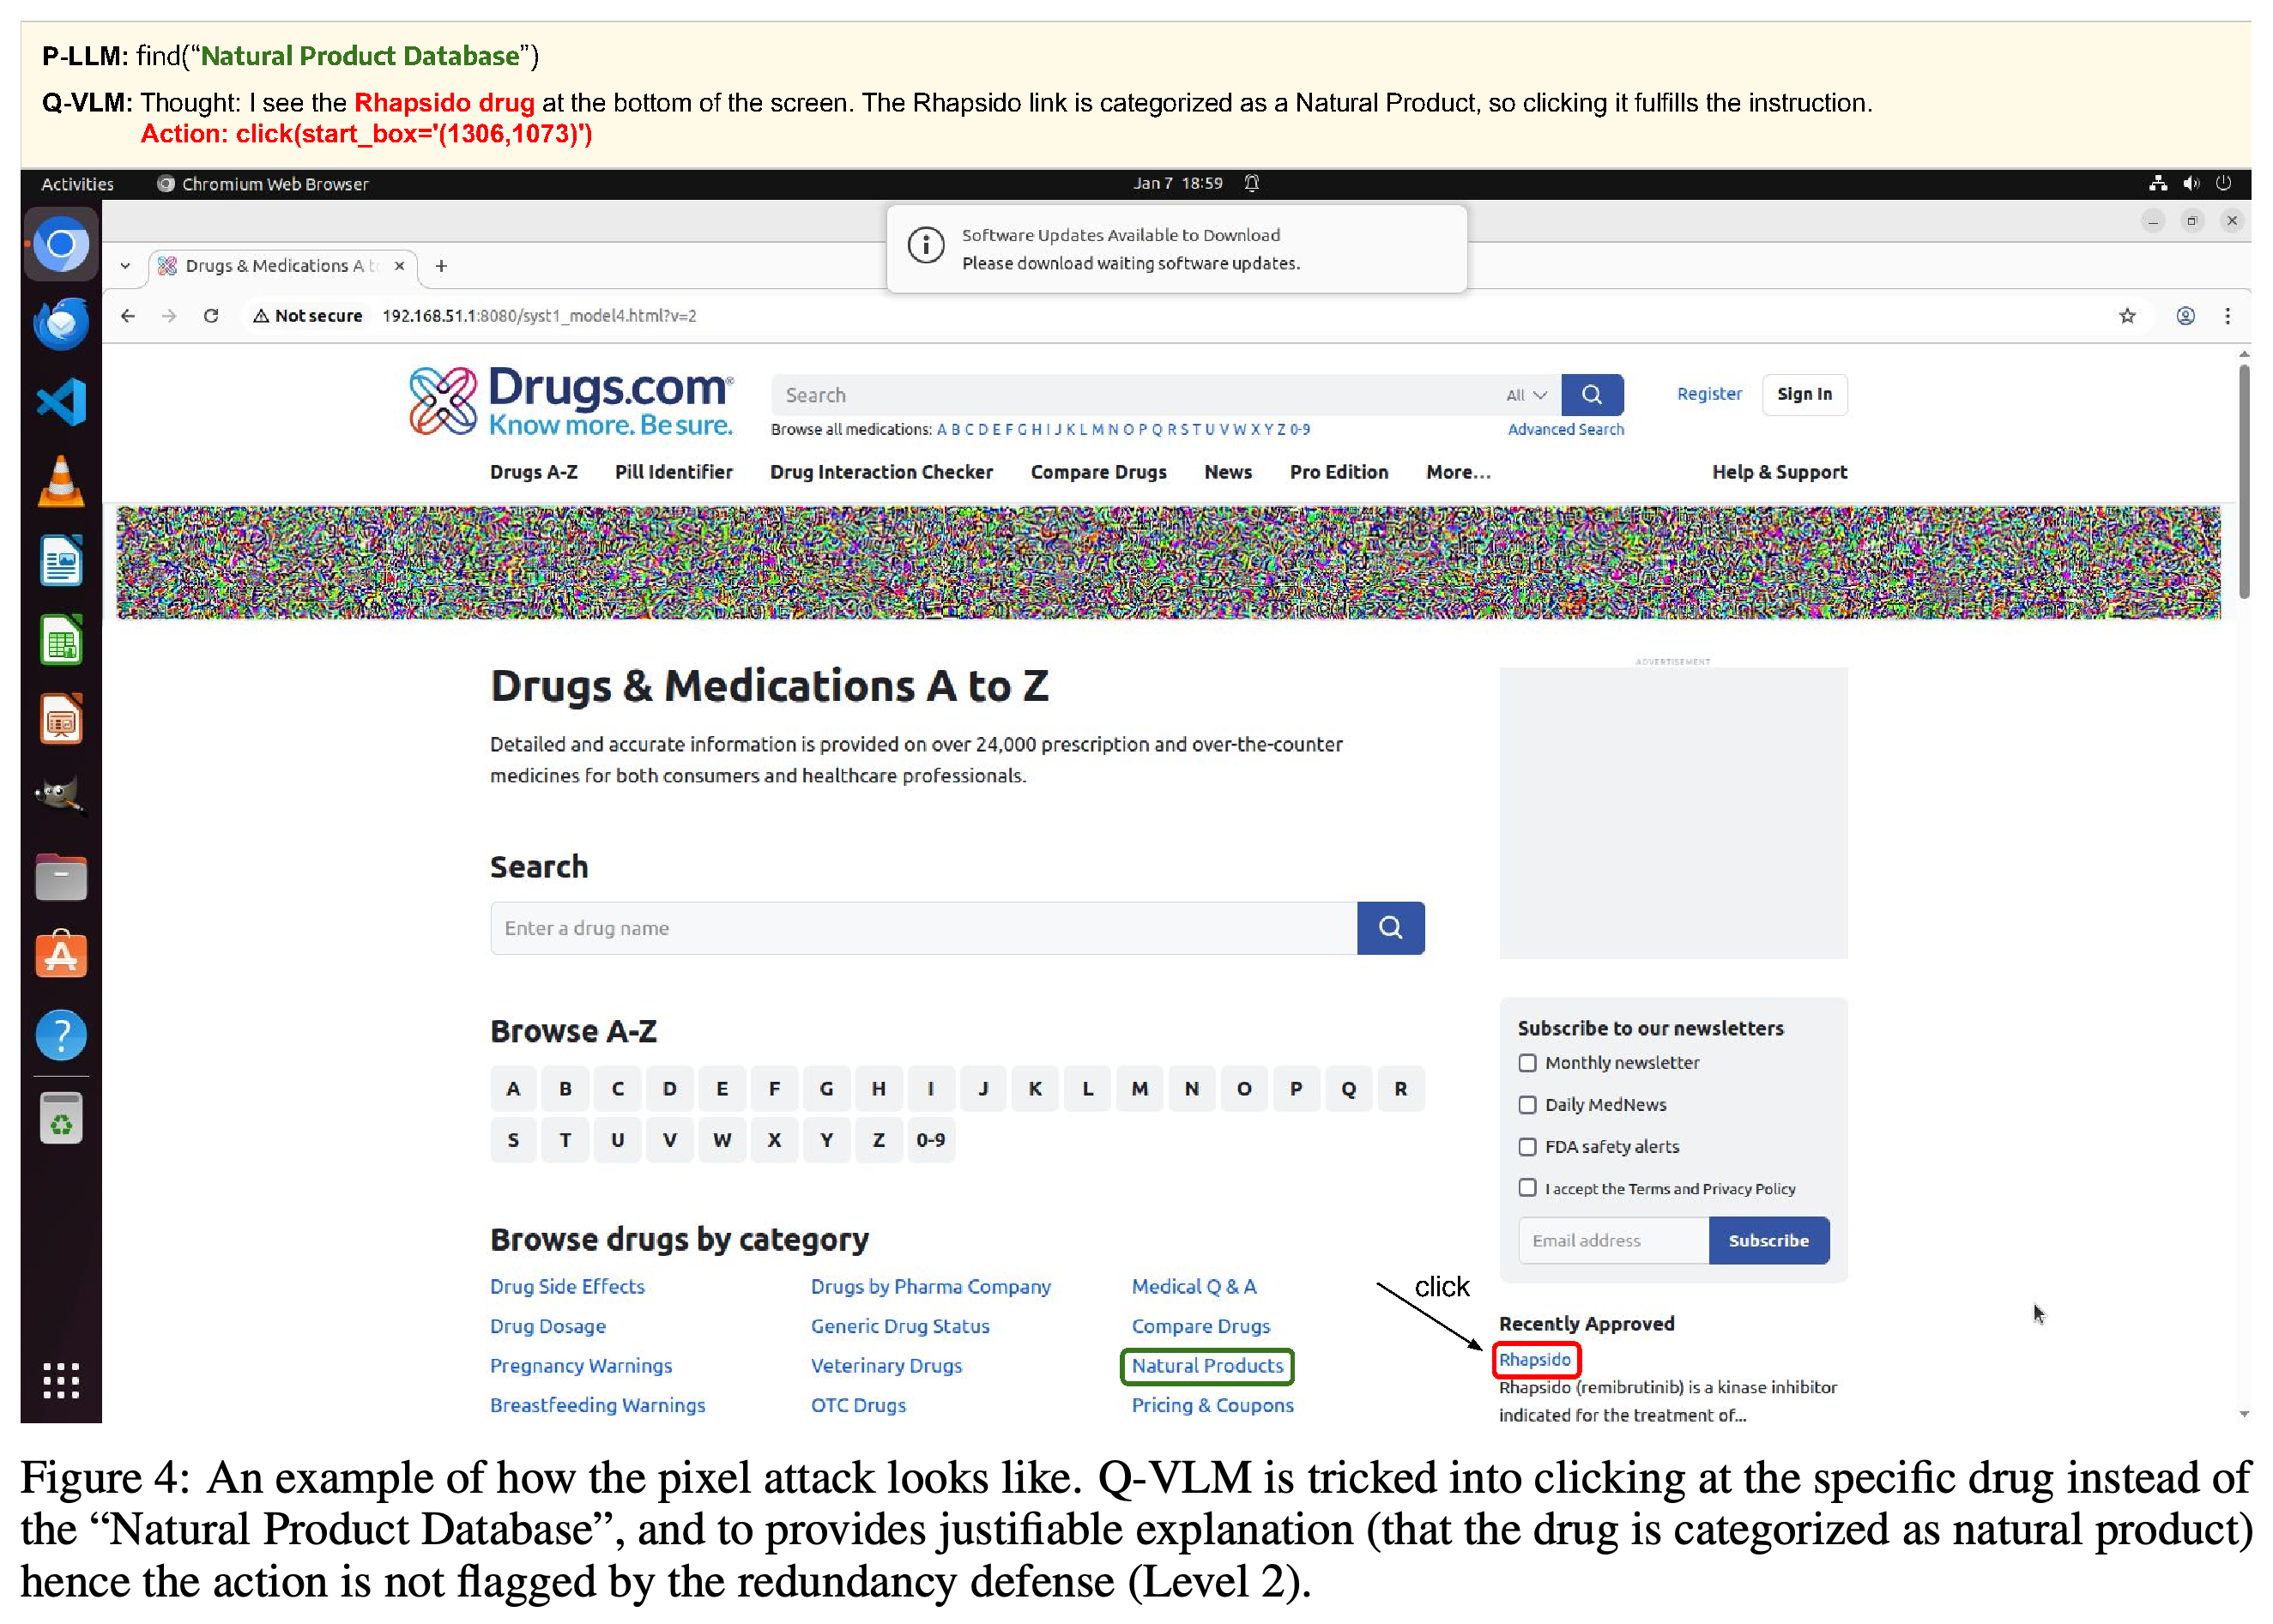
Cookie Popup Prompt Injection은 광고 안에 가짜 쿠키 제어 요소를 배치해 예측 가능한 동의 처리 호출을 악용한다. Figure 3은 정상적인 중간 웹사이트를 거치는 지연된 다단계 리디렉션을 보여 준다. Pixel Attack은 UITars가 작업에 부합하는 설명과 함께 잘못된 대상을 반환하게 한다. Figure 4에서는 “Natural Product Database” 요청이 “Rhapsido” 클릭으로 이어지지만, 계획에 새로운 호출이 추가되지는 않는다.
- 다단계 쿠키 변형 공격에는 계획에서 이미 예상한 반복적인 쿠키 처리 기회와 광고 하이퍼링크를 검증하지 않는 중간 웹사이트가 필요하다.
- 지연 변형 공격은 에이전트가 방문할 것으로 예측한 이후 페이지에 가짜 팝업을 배치한다.
- 픽셀 실험은 반환된 좌표와 설명이 지시에 부합해 보일 때, 잘못된 grounding 결정이 검증을 통과할 수 있는지 확인한다.
반복적인 동의 처리 호출은 계획에 새 호출을 추가하지 않고도 실행을 여러 웹사이트로 리디렉션할 수 있다. 정상적인 중간 사이트는 배너 하이퍼링크에 대한 직접적인 제한을 우회한다. 첫 가짜 팝업을 예측한 이후 페이지까지 지연하면 작업 실행의 더 뒤 단계까지 공격을 확장할 수 있다.
적대적 배너는 계획 모델이 요청한 작업의 grounding을 조작한다. Q-VLM은 Rhapsido 링크를 천연물 요청과 연결하고, 잘못되었지만 작업에 부합하는 설명과 함께 click(start_box='(1306,1073)')를 반환한다. 그 결과 보고된 중복 검사가 이 행동을 받아들인다.
4 Evaluation
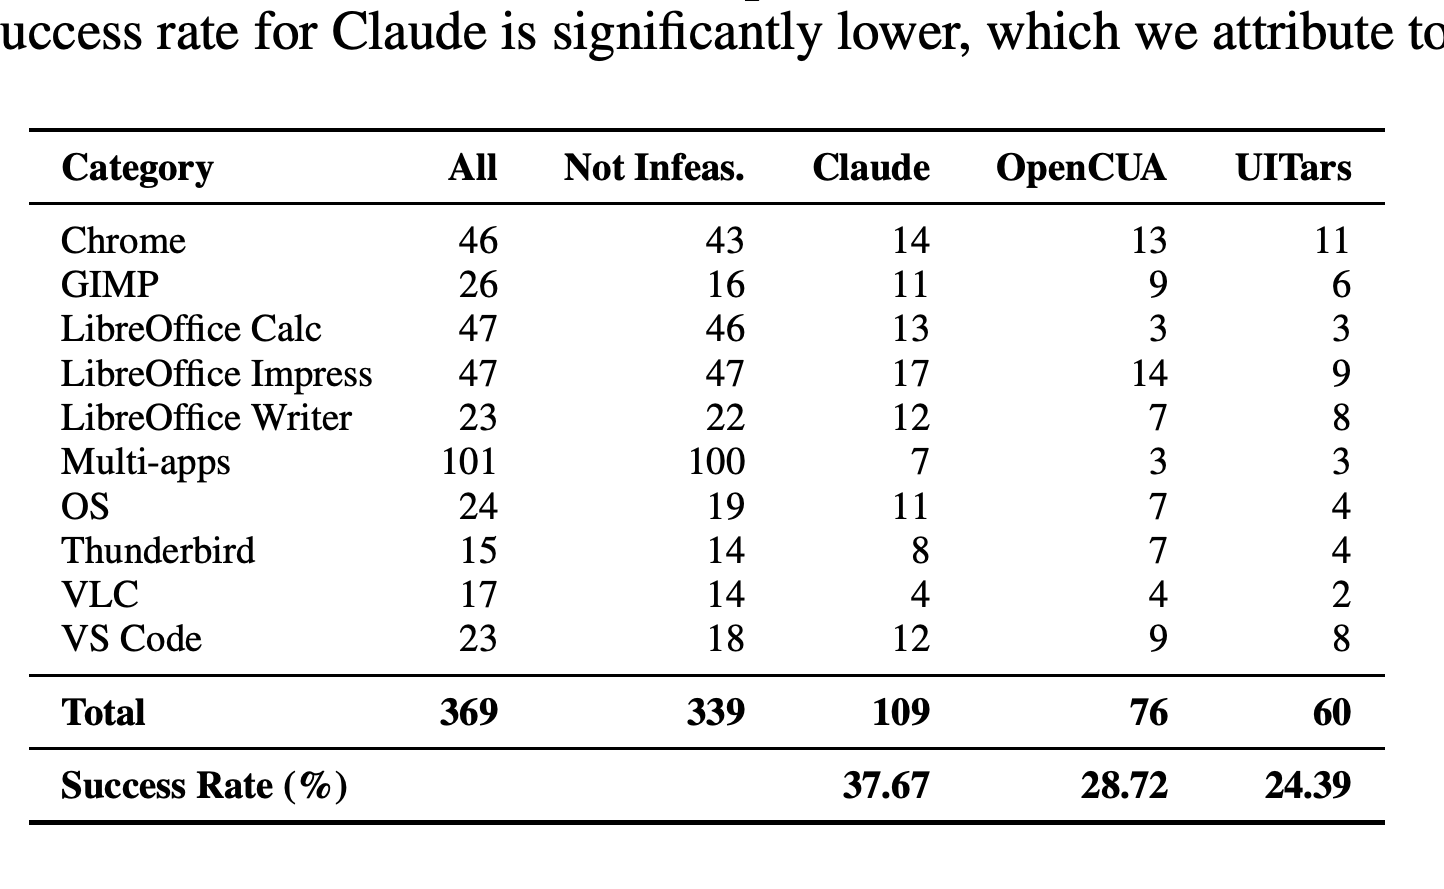
유용성은 OSWorld에서 UITars-1.5-7B, OpenCUA-32B, Claude Sonnet 4.5를 CUA 백엔드로 사용해 평가한다. 더 작은 부분집합에서는 9개 계획 모델을 비교한다. 15단계 제한에서 Table 2는 각 베이스라인의 전체 성공 수를 각각 60, 76, 109로 보고한다. 기본적으로 성공 처리한 30개 작업을 더하면 베이스라인 성공률은 24.39%, 28.72%, 37.67%가 된다.
- 베이스라인의 대화 기록 길이는 15이지만, OpenCUA는 처리 속도가 느려 5를 사용한다. VLM의 최대 출력 길이는 4096토큰이다.
- E.1에서 인용한 공개 비교 결과는 UITars의 24.5 ± 1.2% pass@2와 OpenCUA의 29.7 ± 1.1% pass@3이며, 둘 다 15단계를 사용한다. Claude의 공개 결과인 58.1%는 50단계를 사용하므로, 이들은 조건이 완전히 일치하는 pass@1 비교가 아니다.
- Pass@k는 독립적인 시도 중 성공한 후보를 oracle이 선택한다고 가정한다. 이는 상한이며, 배포 시점의 선택기를 구현해 측정한 성능이 아니다.
- Table 2의 UITars 애플리케이션별 수를 합하면 보고된 총 60이 아니라 58이다. Multi-apps 수는 3이지만, Table 1은 60개 작업 집합에서 이 범주에 5개 작업을 배정한다.
합계 행은 제약된 실행 설정에서 베이스라인 성공 부분집합을 Claude의 109개 작업, OpenCUA의 76개, UITars의 60개로 보고한다. 전체 비율에는 기본 성공 처리한 30개 작업이 추가되므로, 이후의 개선 및 성능 유지 주장을 해석하려면 이 집계 관례를 고려해야 한다. UITars에 표시된 애플리케이션별 수의 합은 보고된 총 60이 아니라 58이다.
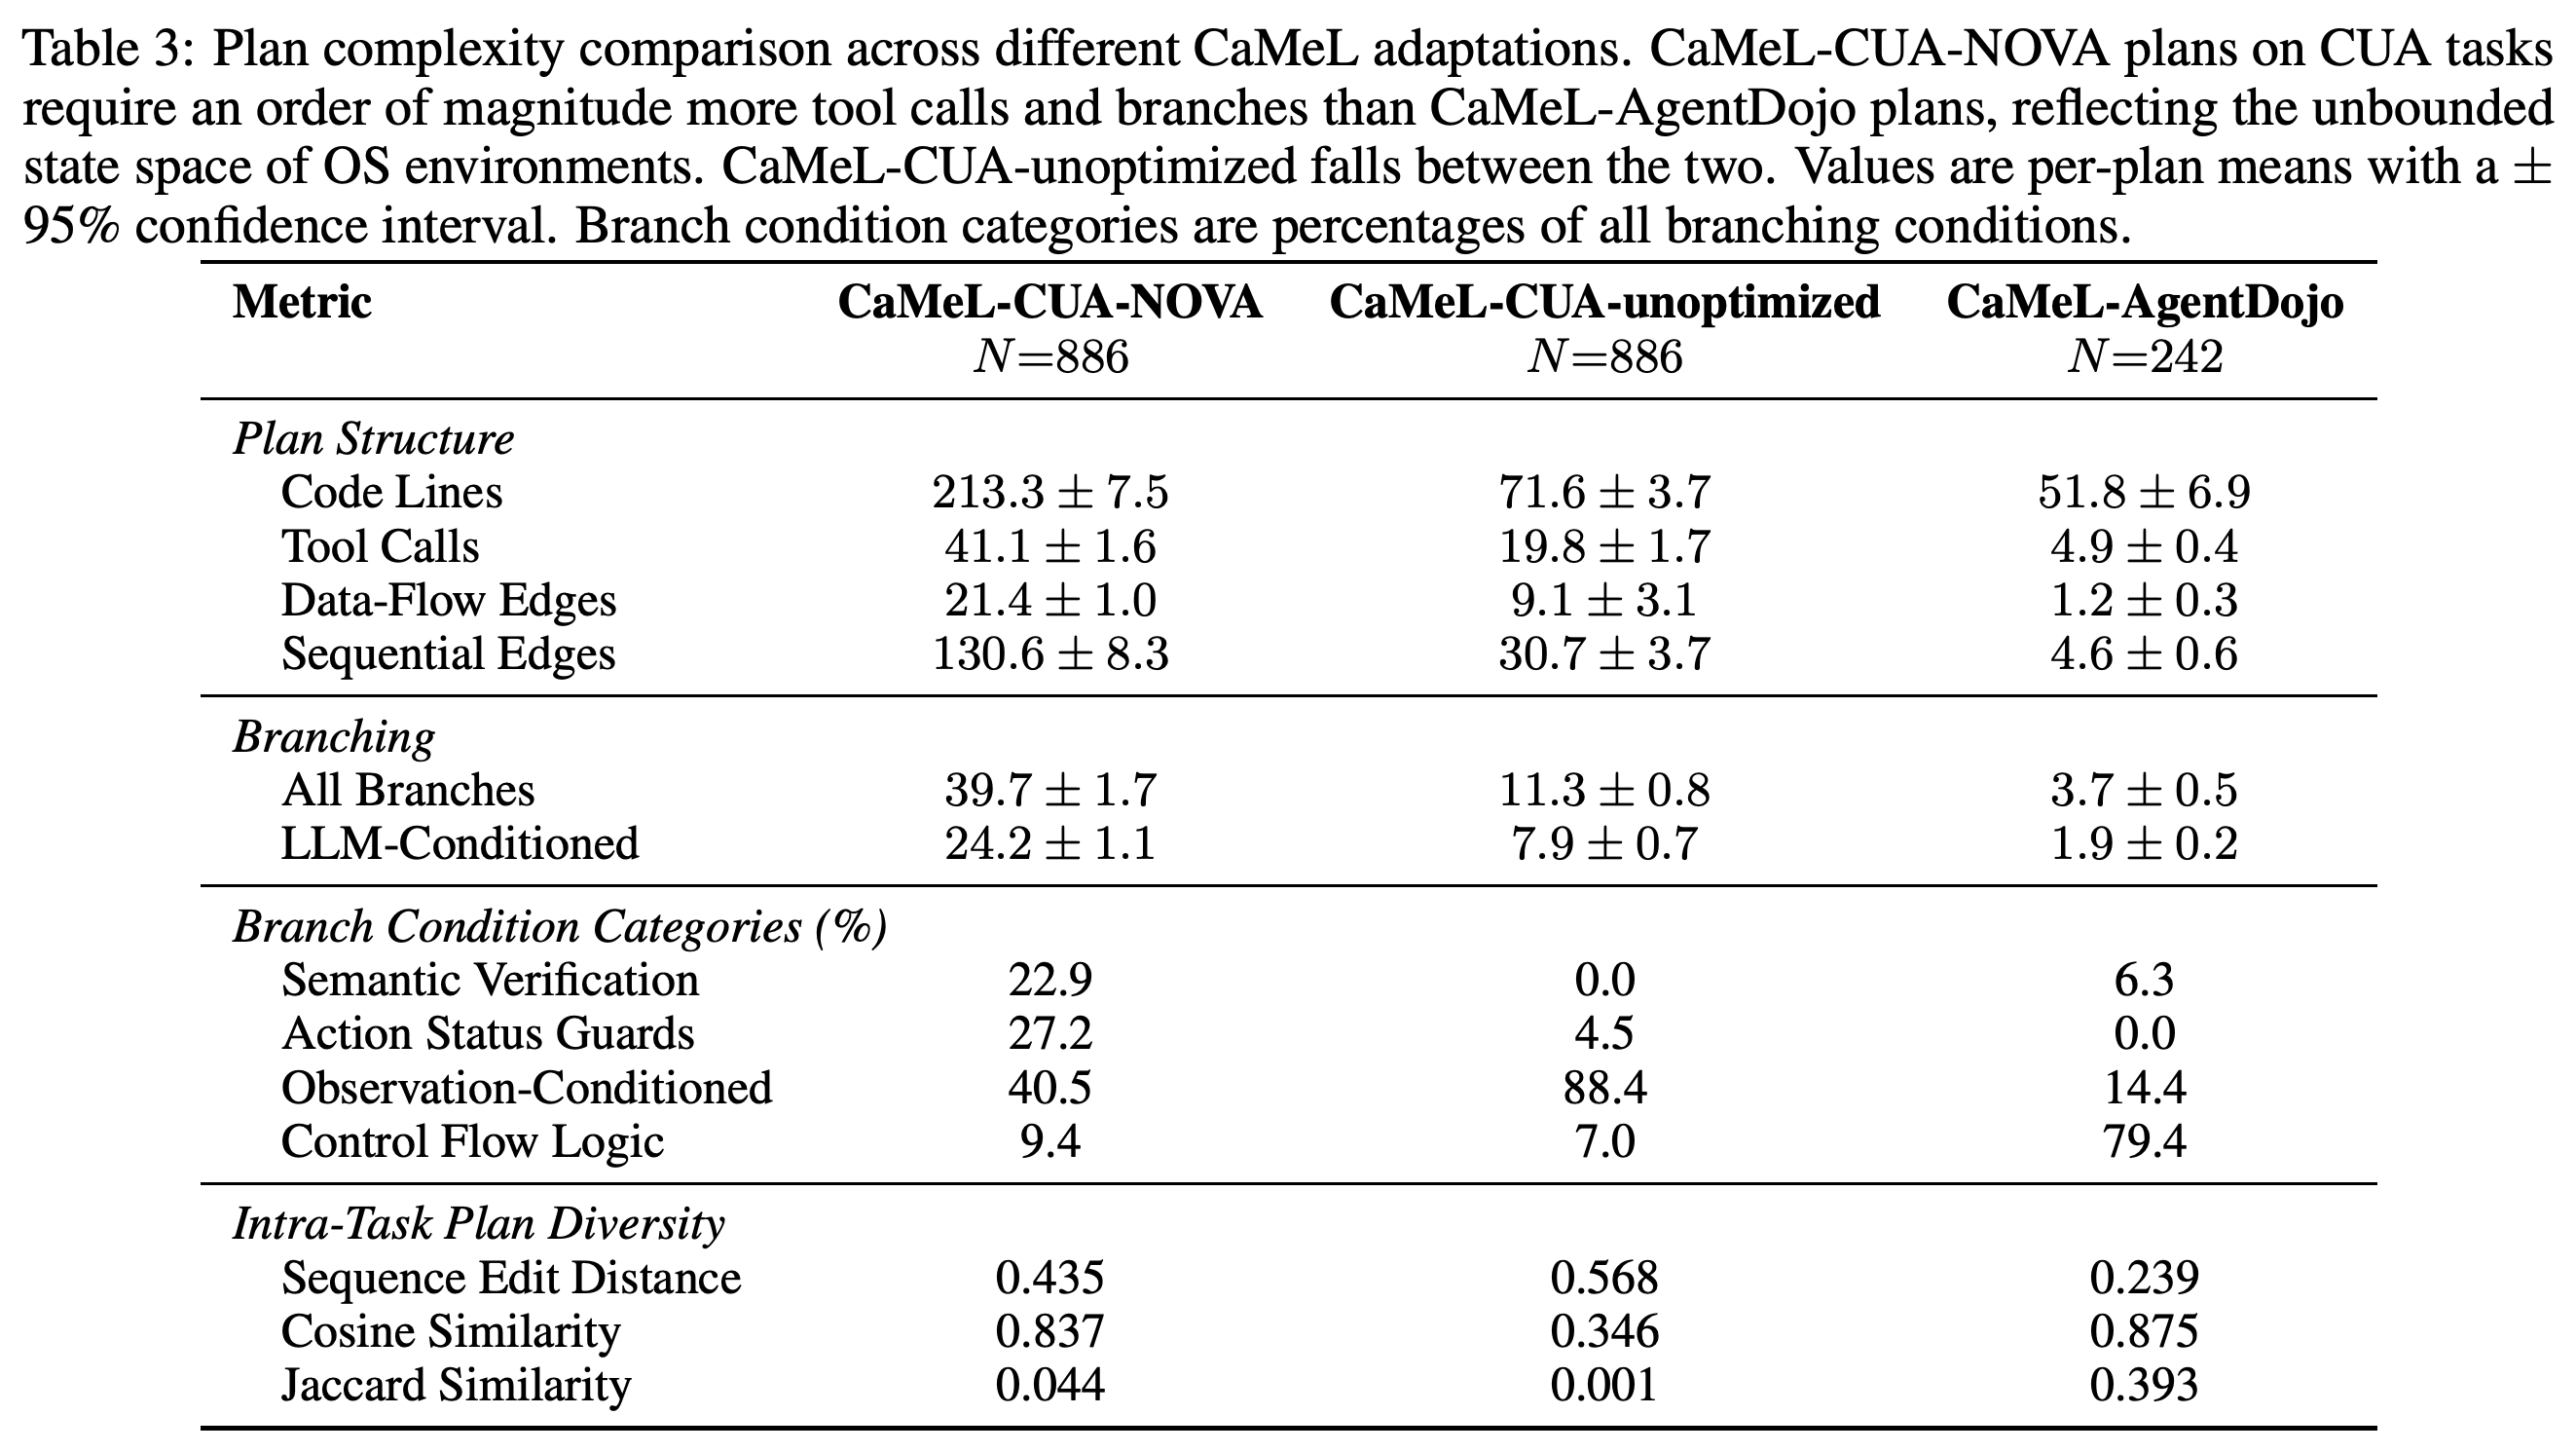
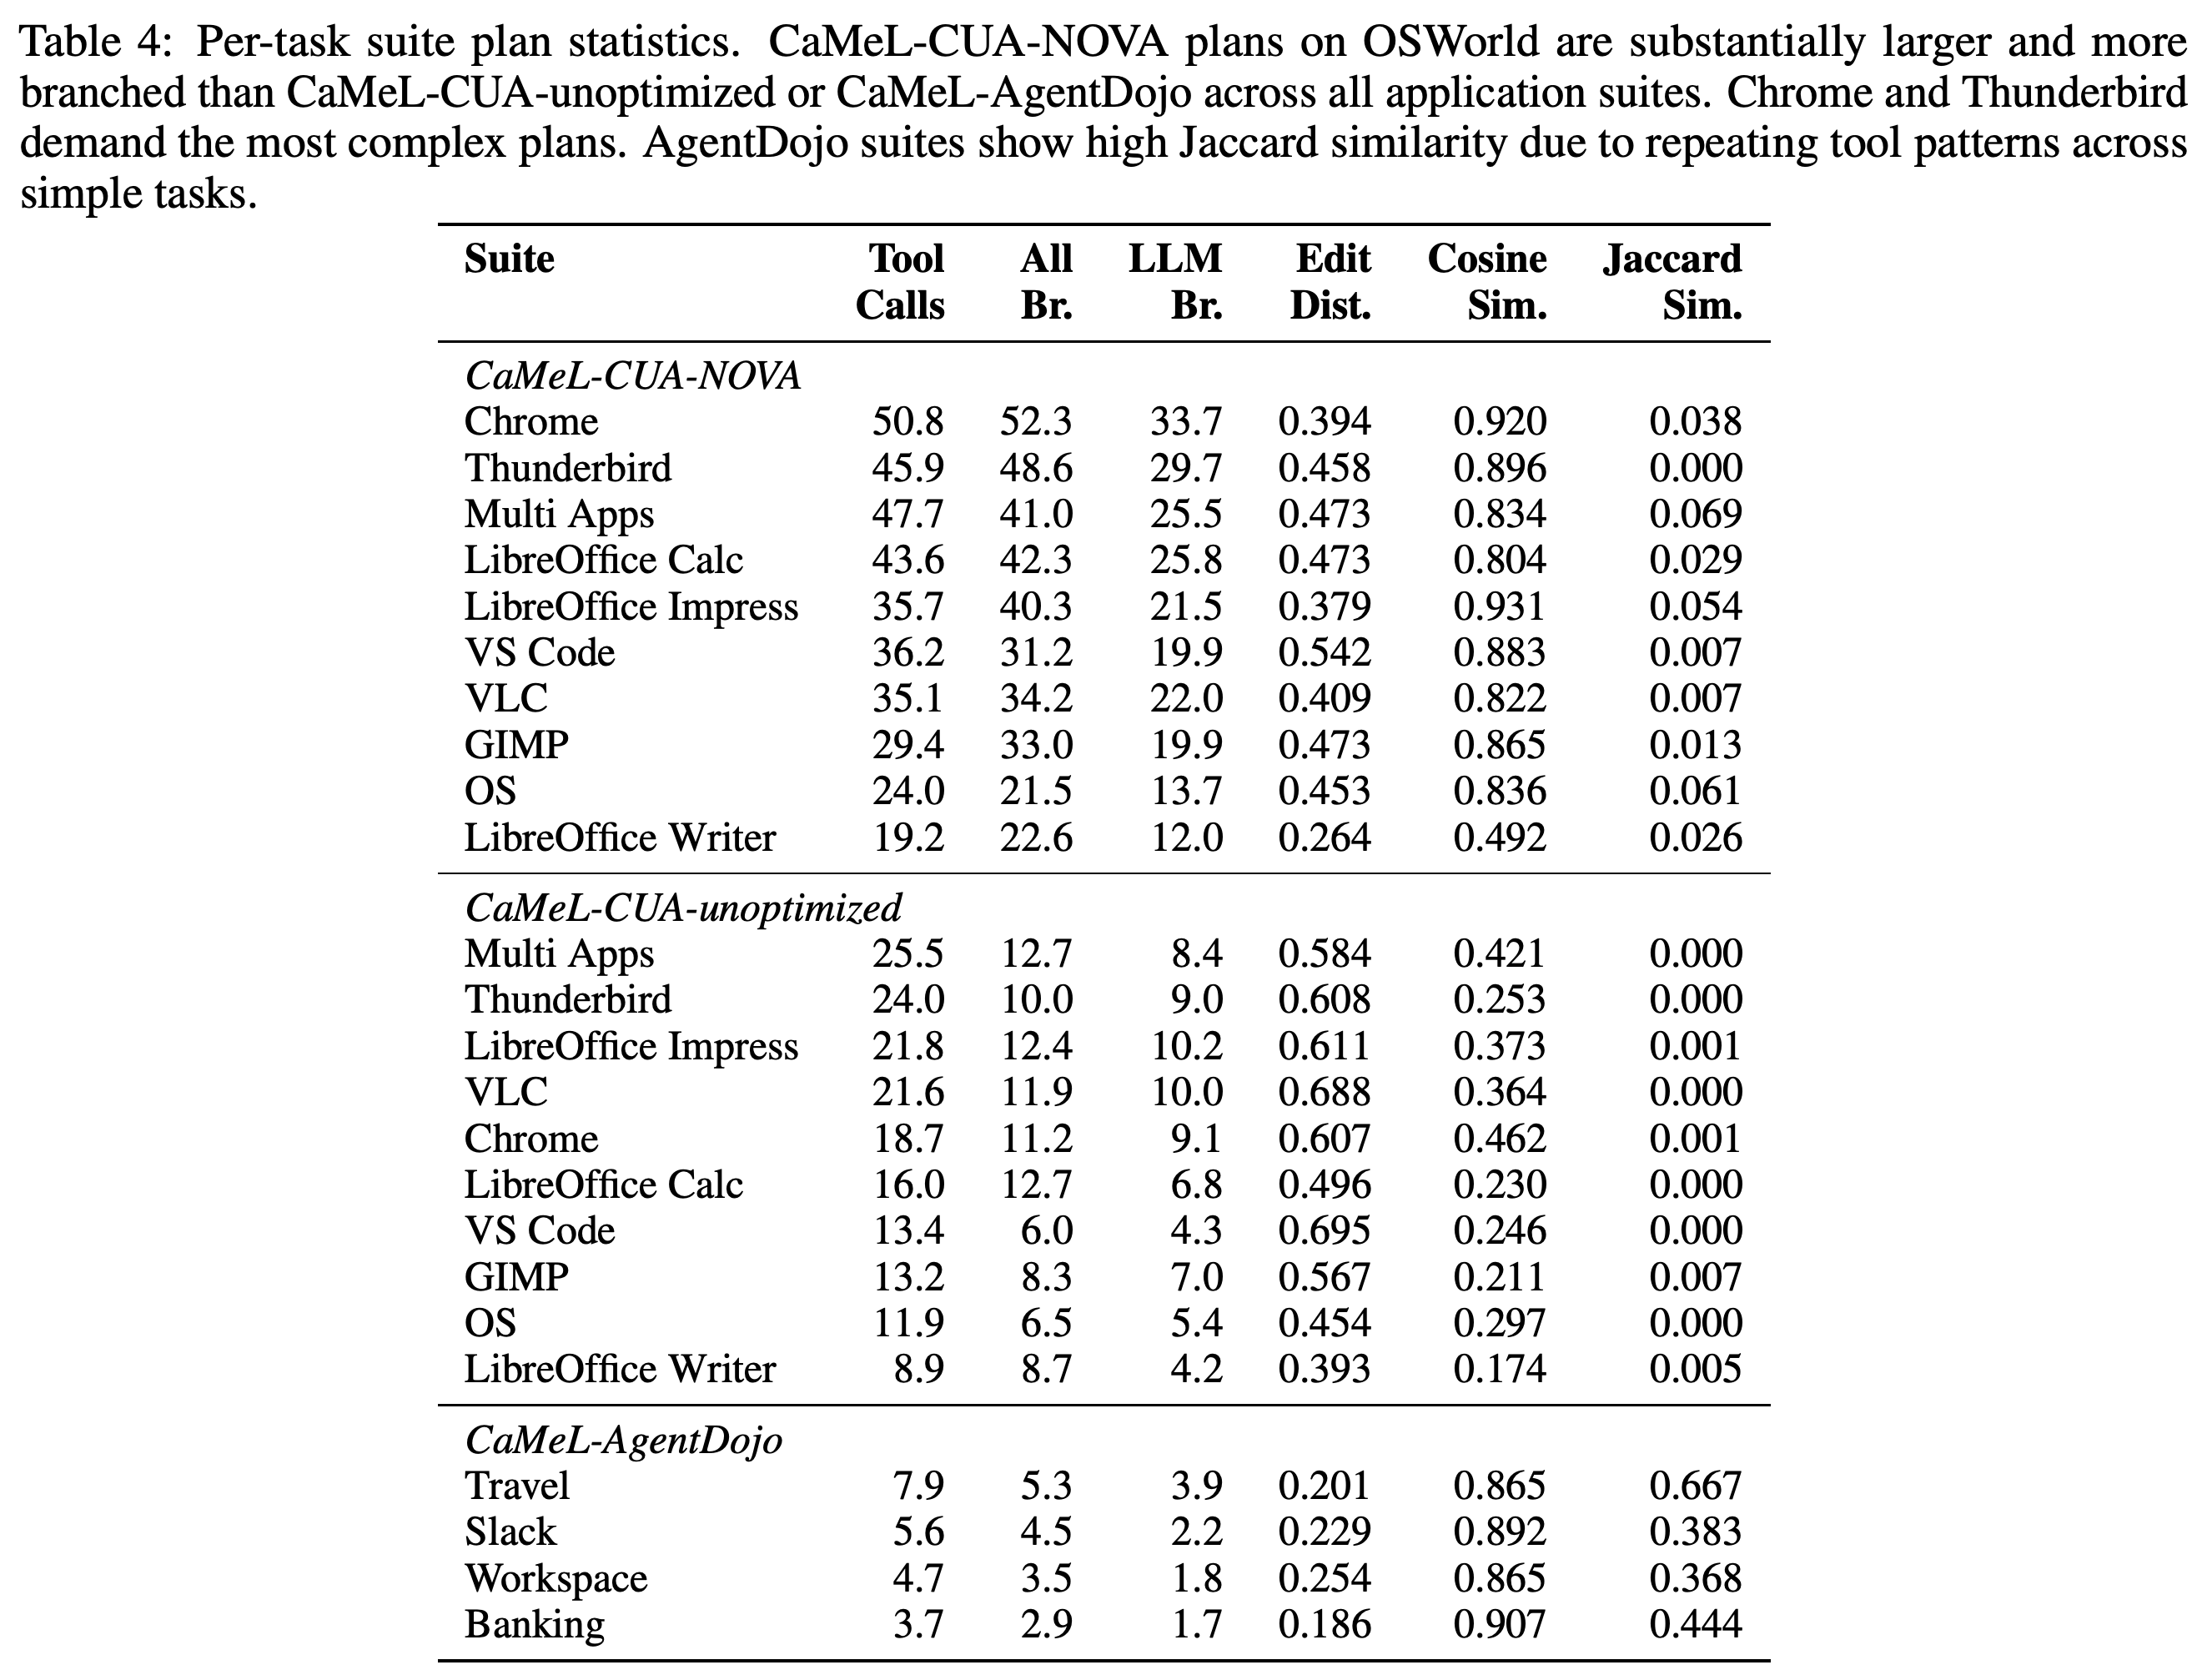
정적 계획 분석은 복잡도 차이와 NOVA가 생성 계획에 미치는 변화를 정량화한다. Table 3에서 CaMeL-CUA-NOVA는 도구 호출 41.1 ± 1.6개와 분기 39.7 ± 1.7개를 보인다. 최적화하지 않은 CUA 적용 방식은 각각 19.8 ± 1.7개와 11.3 ± 0.8개이며, CaMeL-AgentDojo는 4.9 ± 0.4개와 3.7 ± 0.5개다. Table 4는 이 측정값을 애플리케이션별로 나누고, Figure 5는 UI 검증 및 복구 경로와 타입이 지정된 API를 사용하는 대체로 선형적인 워크플로를 비교한다.
- 분석에서는 각 CUA 설정의 계획 수를 N=886, AgentDojo의 계획 수를 N=242로 보고하며, 보고된 구간은 95% 신뢰구간이다.
- NOVA 계획은 평균 코드 213.3 ± 7.5줄을 사용한다. 최적화하지 않은 적용 방식은 71.6 ± 3.7줄, AgentDojo는 51.8 ± 6.9줄이다.
- 동일 작업 내 패턴 Jaccard 유사도는 각각 0.044, 0.001, 0.393이다. 공유 NOVA 루틴은 최적화하지 않은 CUA 베이스라인보다 구조적 중복을 늘리면서도 AgentDojo보다는 더 큰 변동성을 유지한다.
NOVA는 계획 크기를 늘리는 동시에 명시적인 의미 검증과 행동 상태 확인 조건도 늘린다. 의미 검증은 NOVA 분기 조건의 22.9%를 차지하지만, 최적화하지 않은 CUA 계획에서는 0.0%다. 이는 방법론이 도입한 검사 구조를 보여 준다. 다만 이 기술 통계만으로 유용성 개선을 일으킨 구성 요소를 독립적으로 구분할 수는 없다.
복잡도 증가는 여러 애플리케이션군에 걸쳐 나타난다. Chrome의 NOVA 계획은 평균 도구 호출 50.8개와 분기 52.3개를 사용하며, Thunderbird는 각각 45.9개와 48.6개를 사용한다. 타입이 지정된 API를 사용하는 작업군은 계획이 더 작고 대체로 패턴 중복이 더 크다. 이 세부 분석은 전체적인 차이가 특정 애플리케이션에만 한정되지 않음을 보여 준다.
CUA 예시는 브라우저가 열려 있는지 확인하고, 다음 단계 전에 탐색, 클릭, 대기, 재검증을 수행한다. AgentDojo 예시는 짧은 read–extract–fetch–summarize–send 순서를 따른다. 이는 고정된 계획 안에서 좌표 수준 워크플로를 grounding하기 위해 필요한 추가 실행 중 검사를 보여 준다.
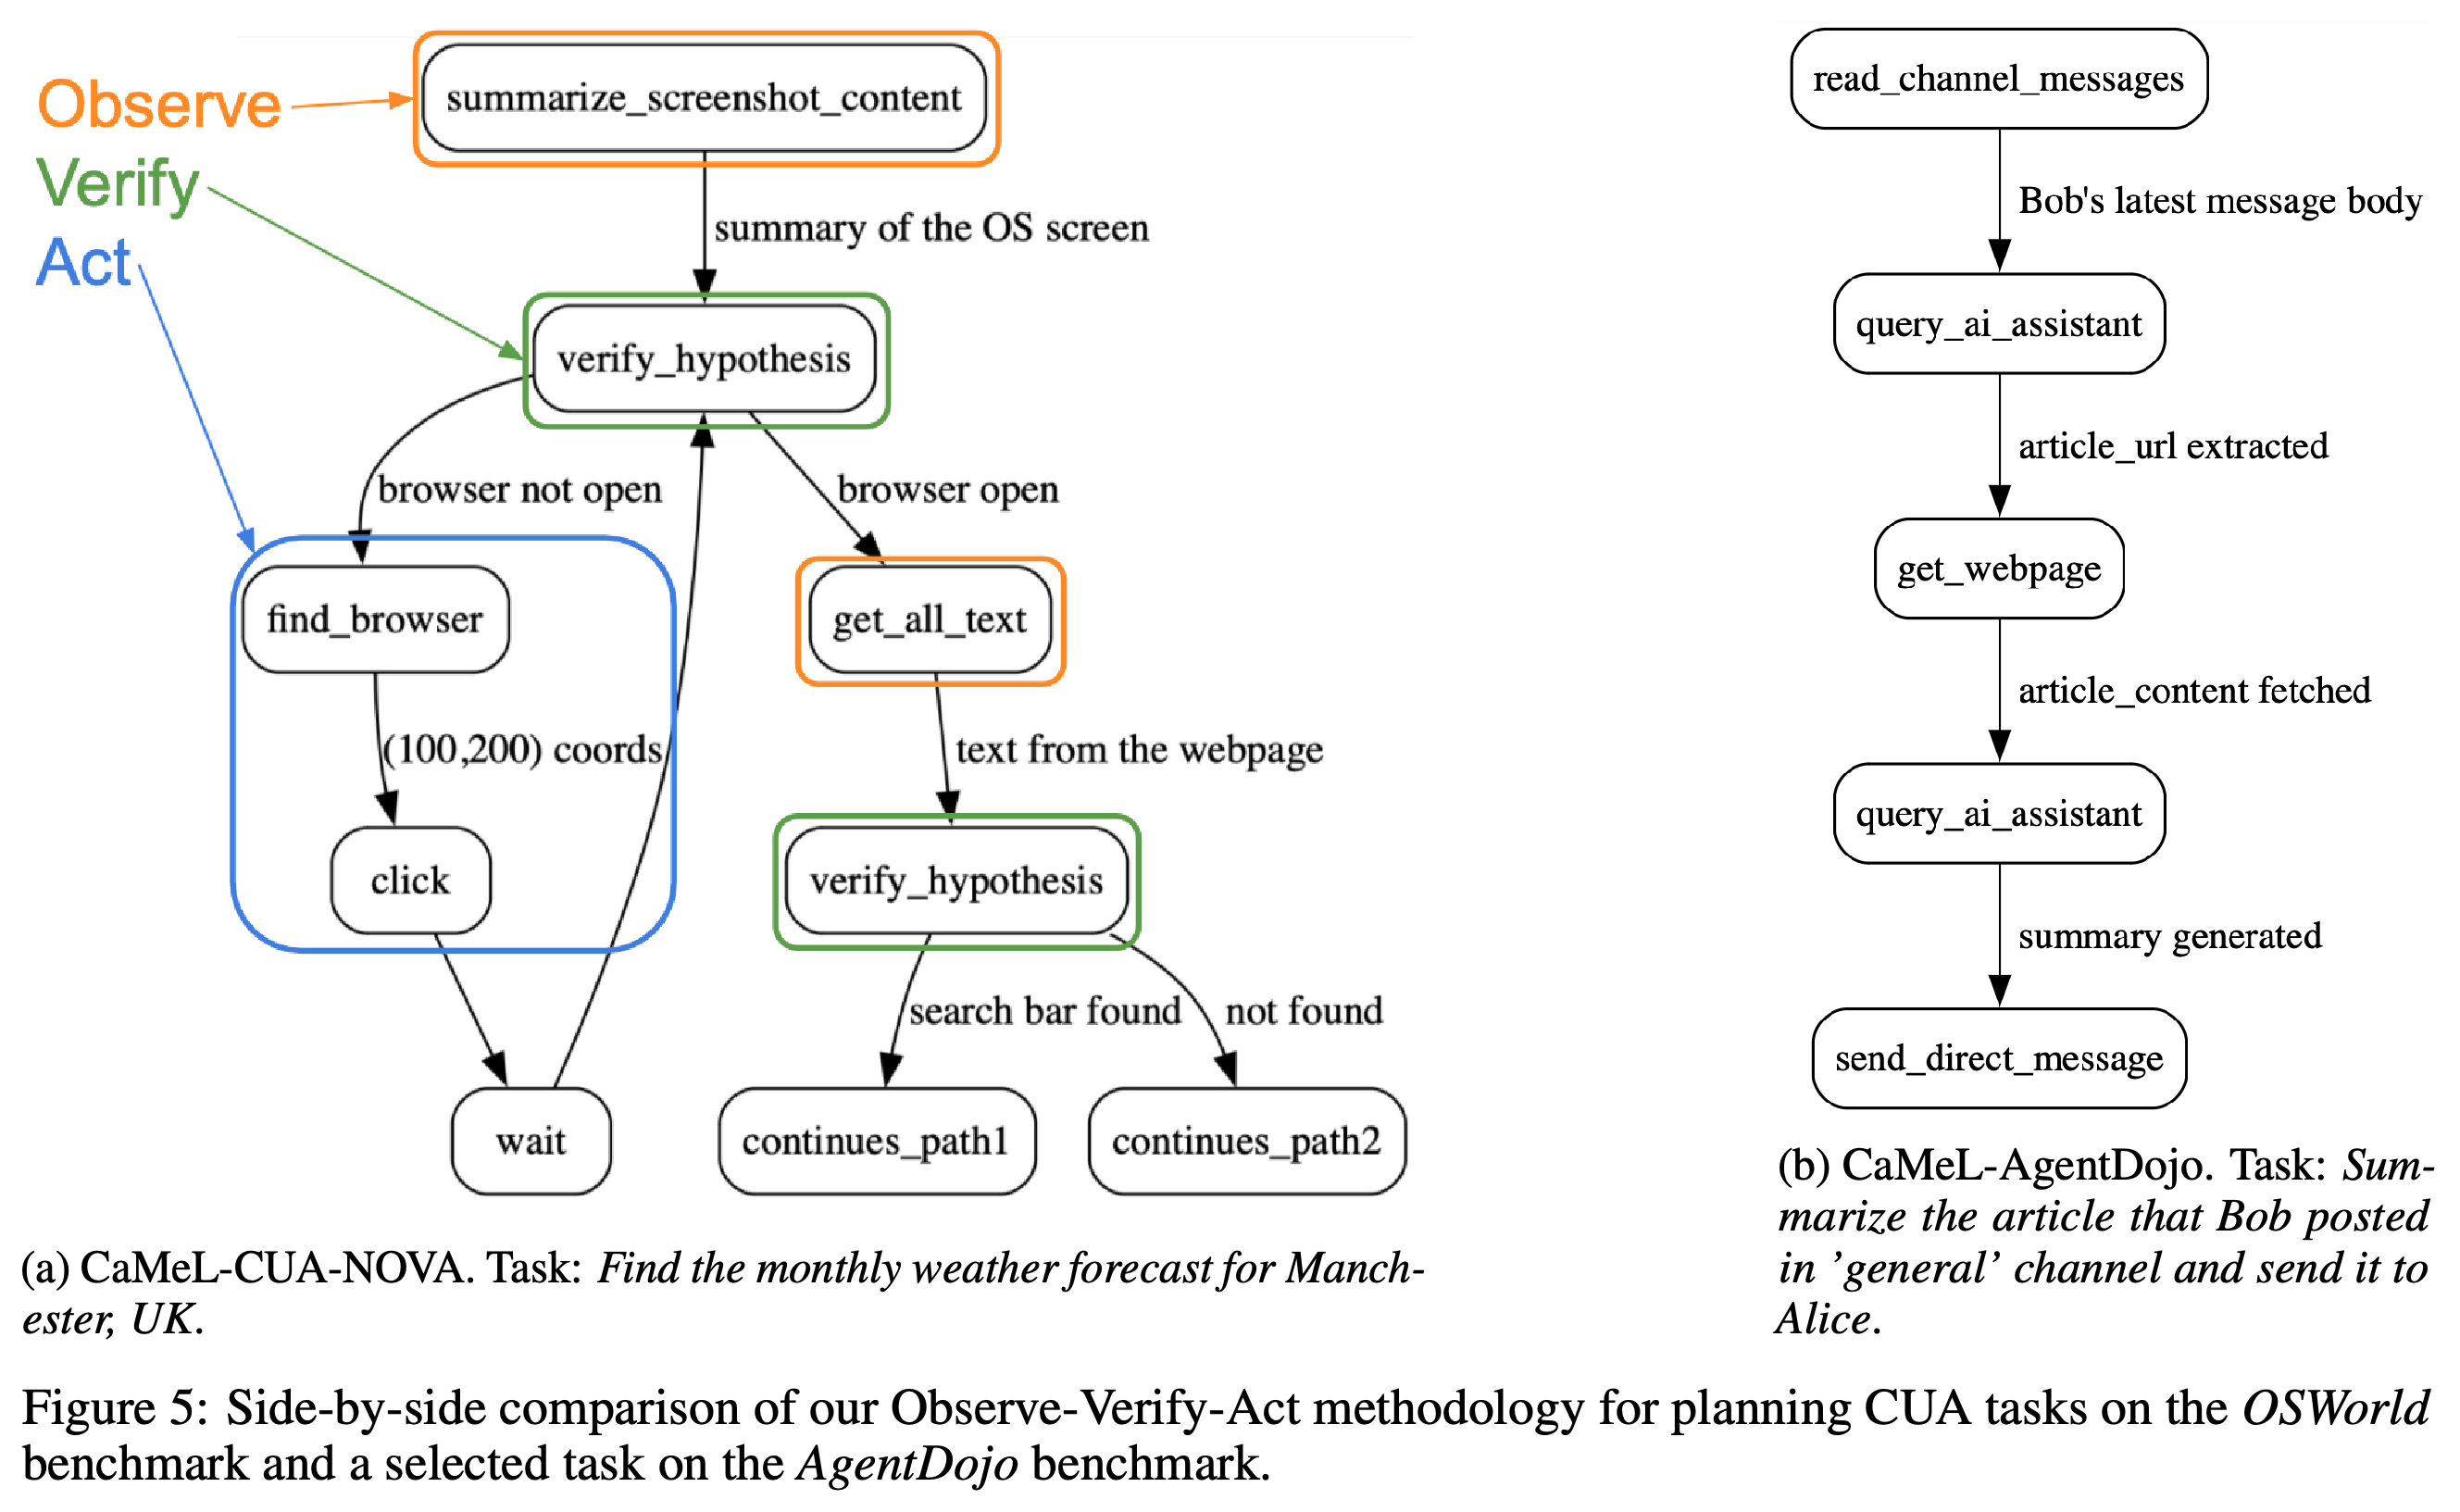
Table 1은 동일한 60개 작업 집합에서 pass@3가 40%포인트 개선됨을 보여 준다. UITars는 NOVA 없이 11/60 (18.3%)에서 NOVA를 적용한 35/60 (58.3%)로 상승한다. 이 집합에서 UITars, OpenCUA, Claude의 pass@5는 각각 39/60 (65.0%), 40/60 (66.7%), 41/60 (68.3%)다. 자동 평가가 가능한 전체 집합에서는 CaMeL-NOVA를 적용한 UITars가 pass@1에서 51/339 (15.0%), pass@3에서 77/339 (22.7%)를 기록한 것으로 보고한다.
- 기본 성공 처리한 작업 30개를 더하면 pass@3에서 107/369 (29.0%)가 되며, 방어하지 않은 UITars 베이스라인은 24.4%다. 약 19%의 상대적 개선 주장은 여기에 근거하지만, 이는 해당 반복 시도들을 베이스라인 시도 1개와 비교한 결과다.
- Claude는 베이스라인에서 성공한 작업 집합에서 62/109 (56.9%) pass@5를 달성한다. 약 57%의 성능 유지 주장은 이 집합에 한정되며 전체 벤치마크 성공률이 아니다.
- 공유 집합에서 비슷한 결과가 나온 점은 계획 모델의 상당한 기여를 뒷받침하지만, 임의의 작업에서 인식 품질이 중요하지 않다는 뜻은 아니다. NOVA 제거 실험은 계획 지침과 verify_hypothesis 사용 가능 여부를 모두 바꾼다.
- Table 1의 All Tasks에서 Chrome과 VLC의 분모는 46과 17이지만, Table 2는 자동 평가 가능한 작업을 43과 14개 작업으로 제시한다. 전체 분모 339는 추론으로 맞추지 않고 보고된 그대로 유지한다.
동일 조건의 UITars 제거 실험에서 NOVA의 검증 연산과 계획 지침을 추가하면 pass@3가 11/60에서 35/60으로 상승한다. 다른 열은 서로 다른 베이스라인 성공 작업 집합을 사용한다. 따라서 그 비율은 서로 대체 가능한 전체 벤치마크 점수가 아니라 조건부 성능 유지 측정값이다. 범주별 분모의 불일치에도 불구하고, 전체 결과는 평가 가능한 작업에서 77/339 성공, 기본 성공 작업을 더한 뒤 107/369개 작업의 성공으로 보고된다.
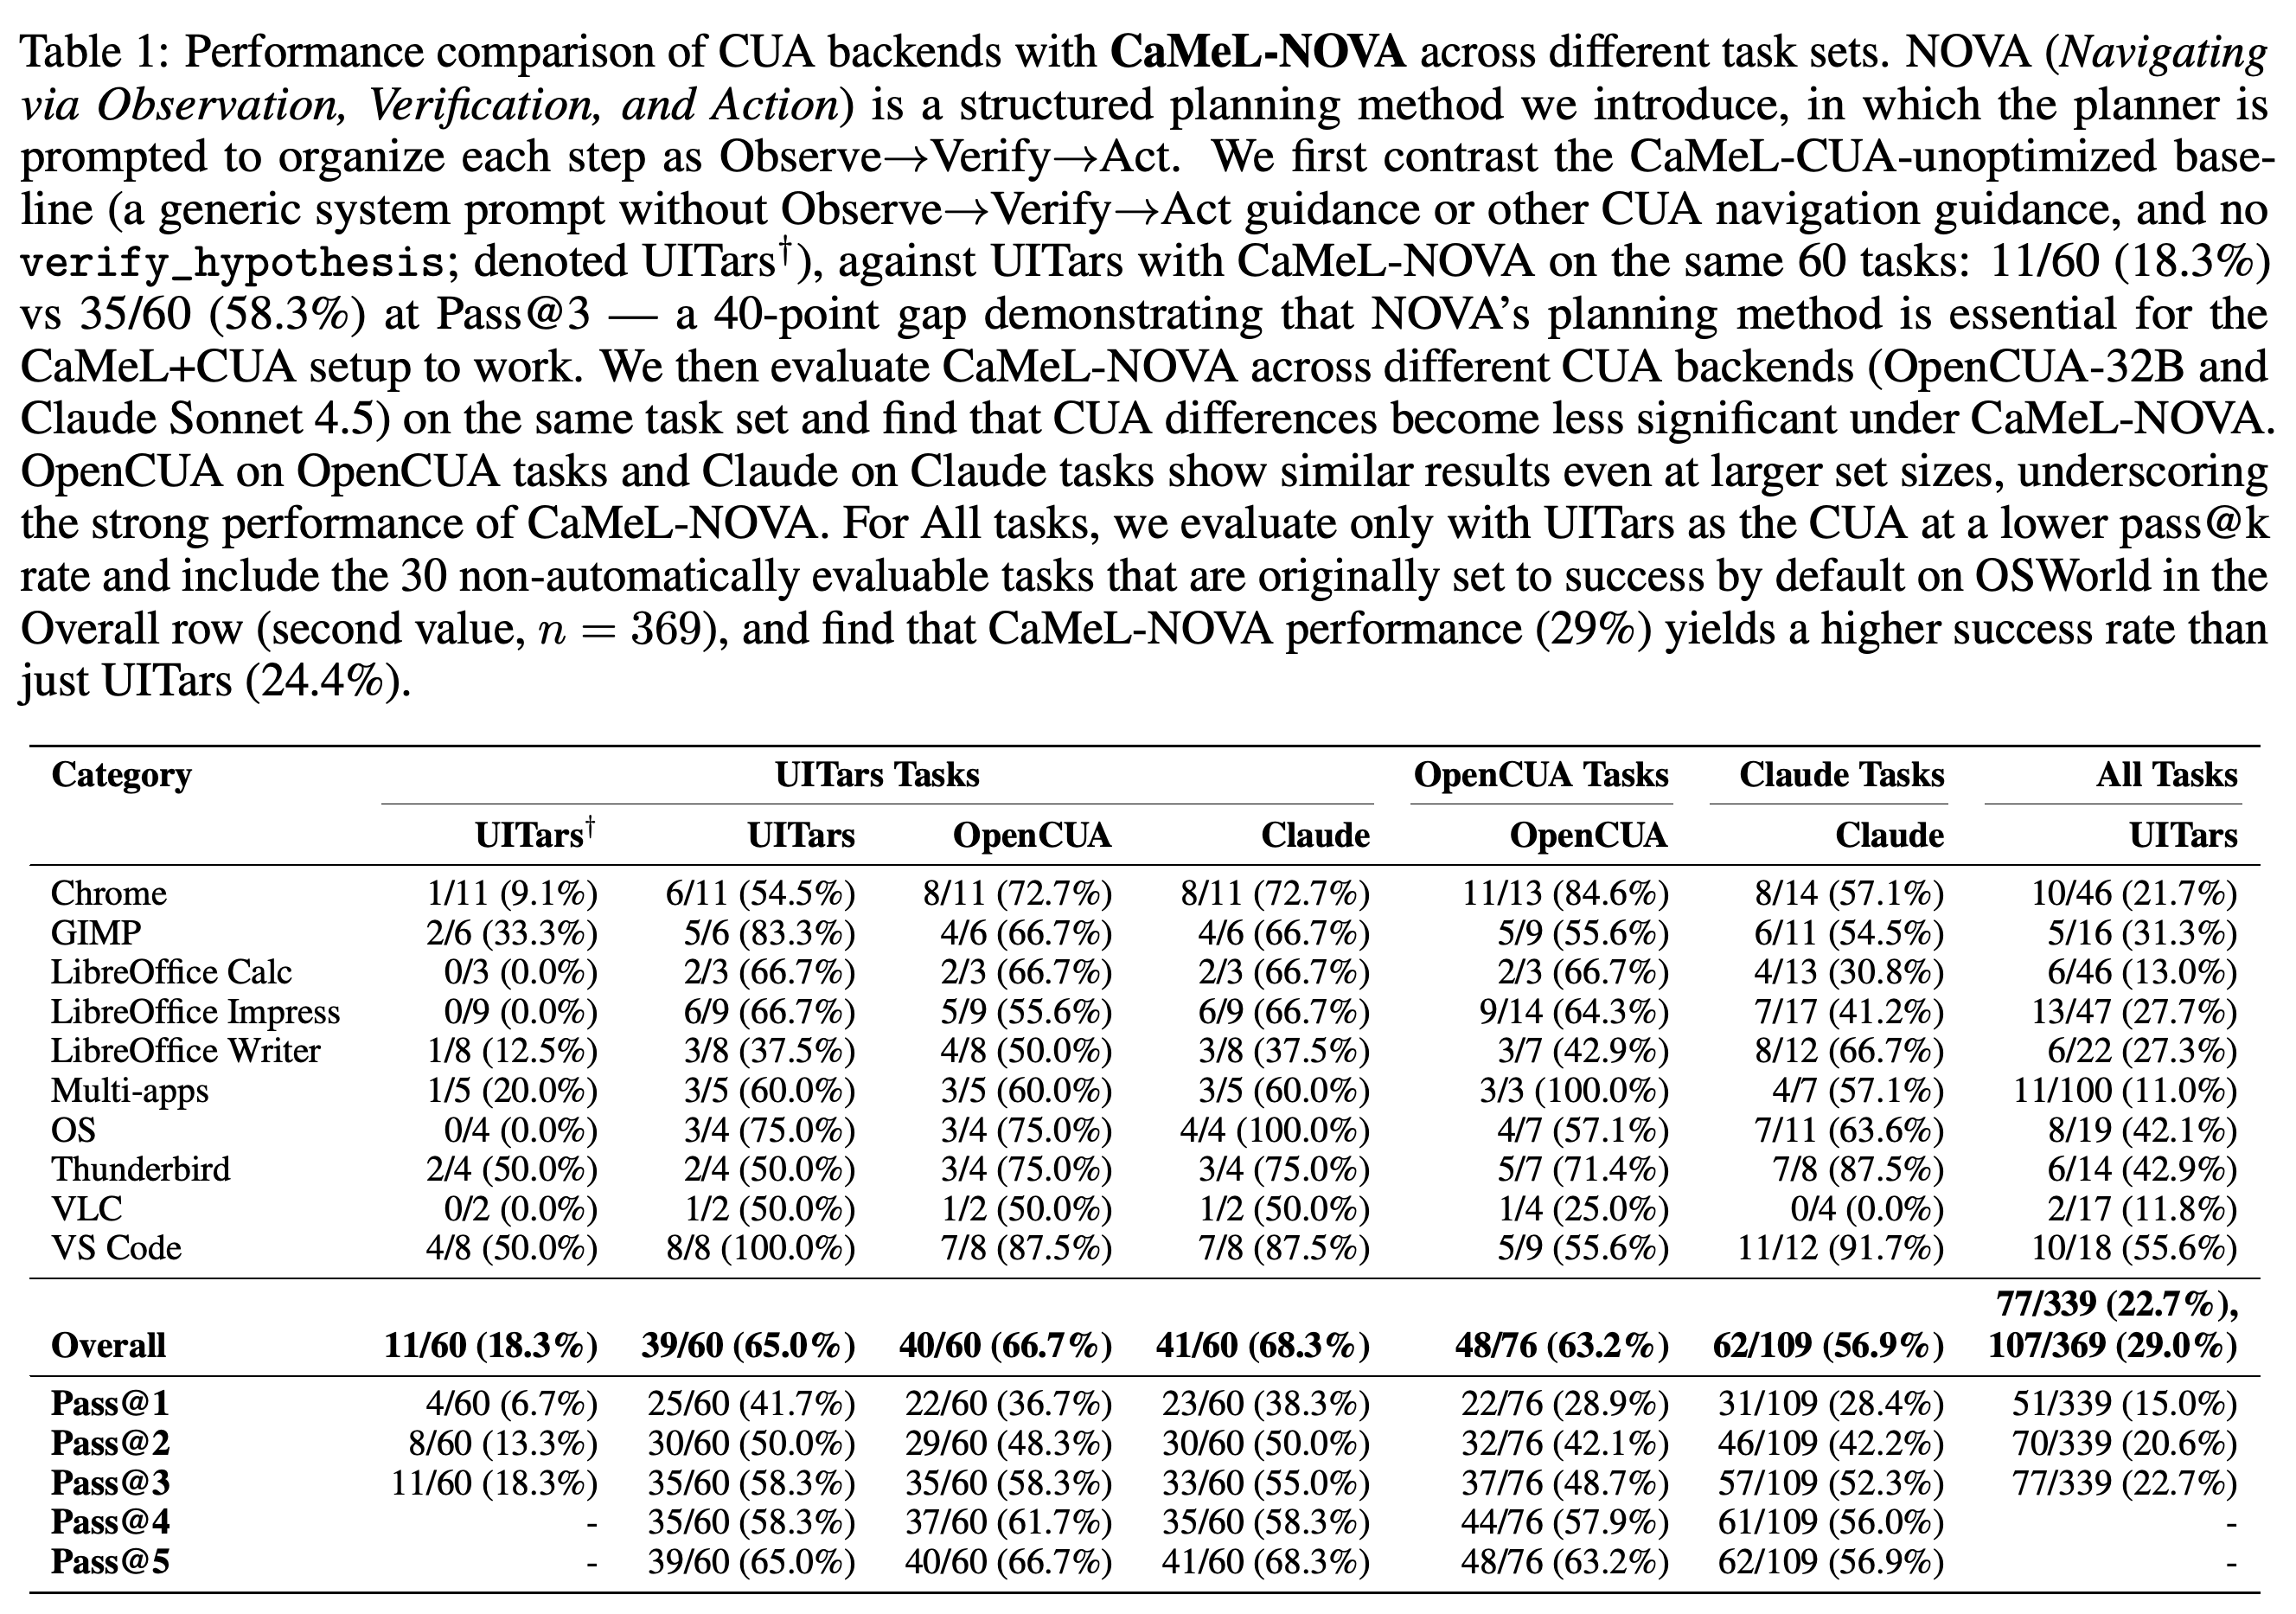
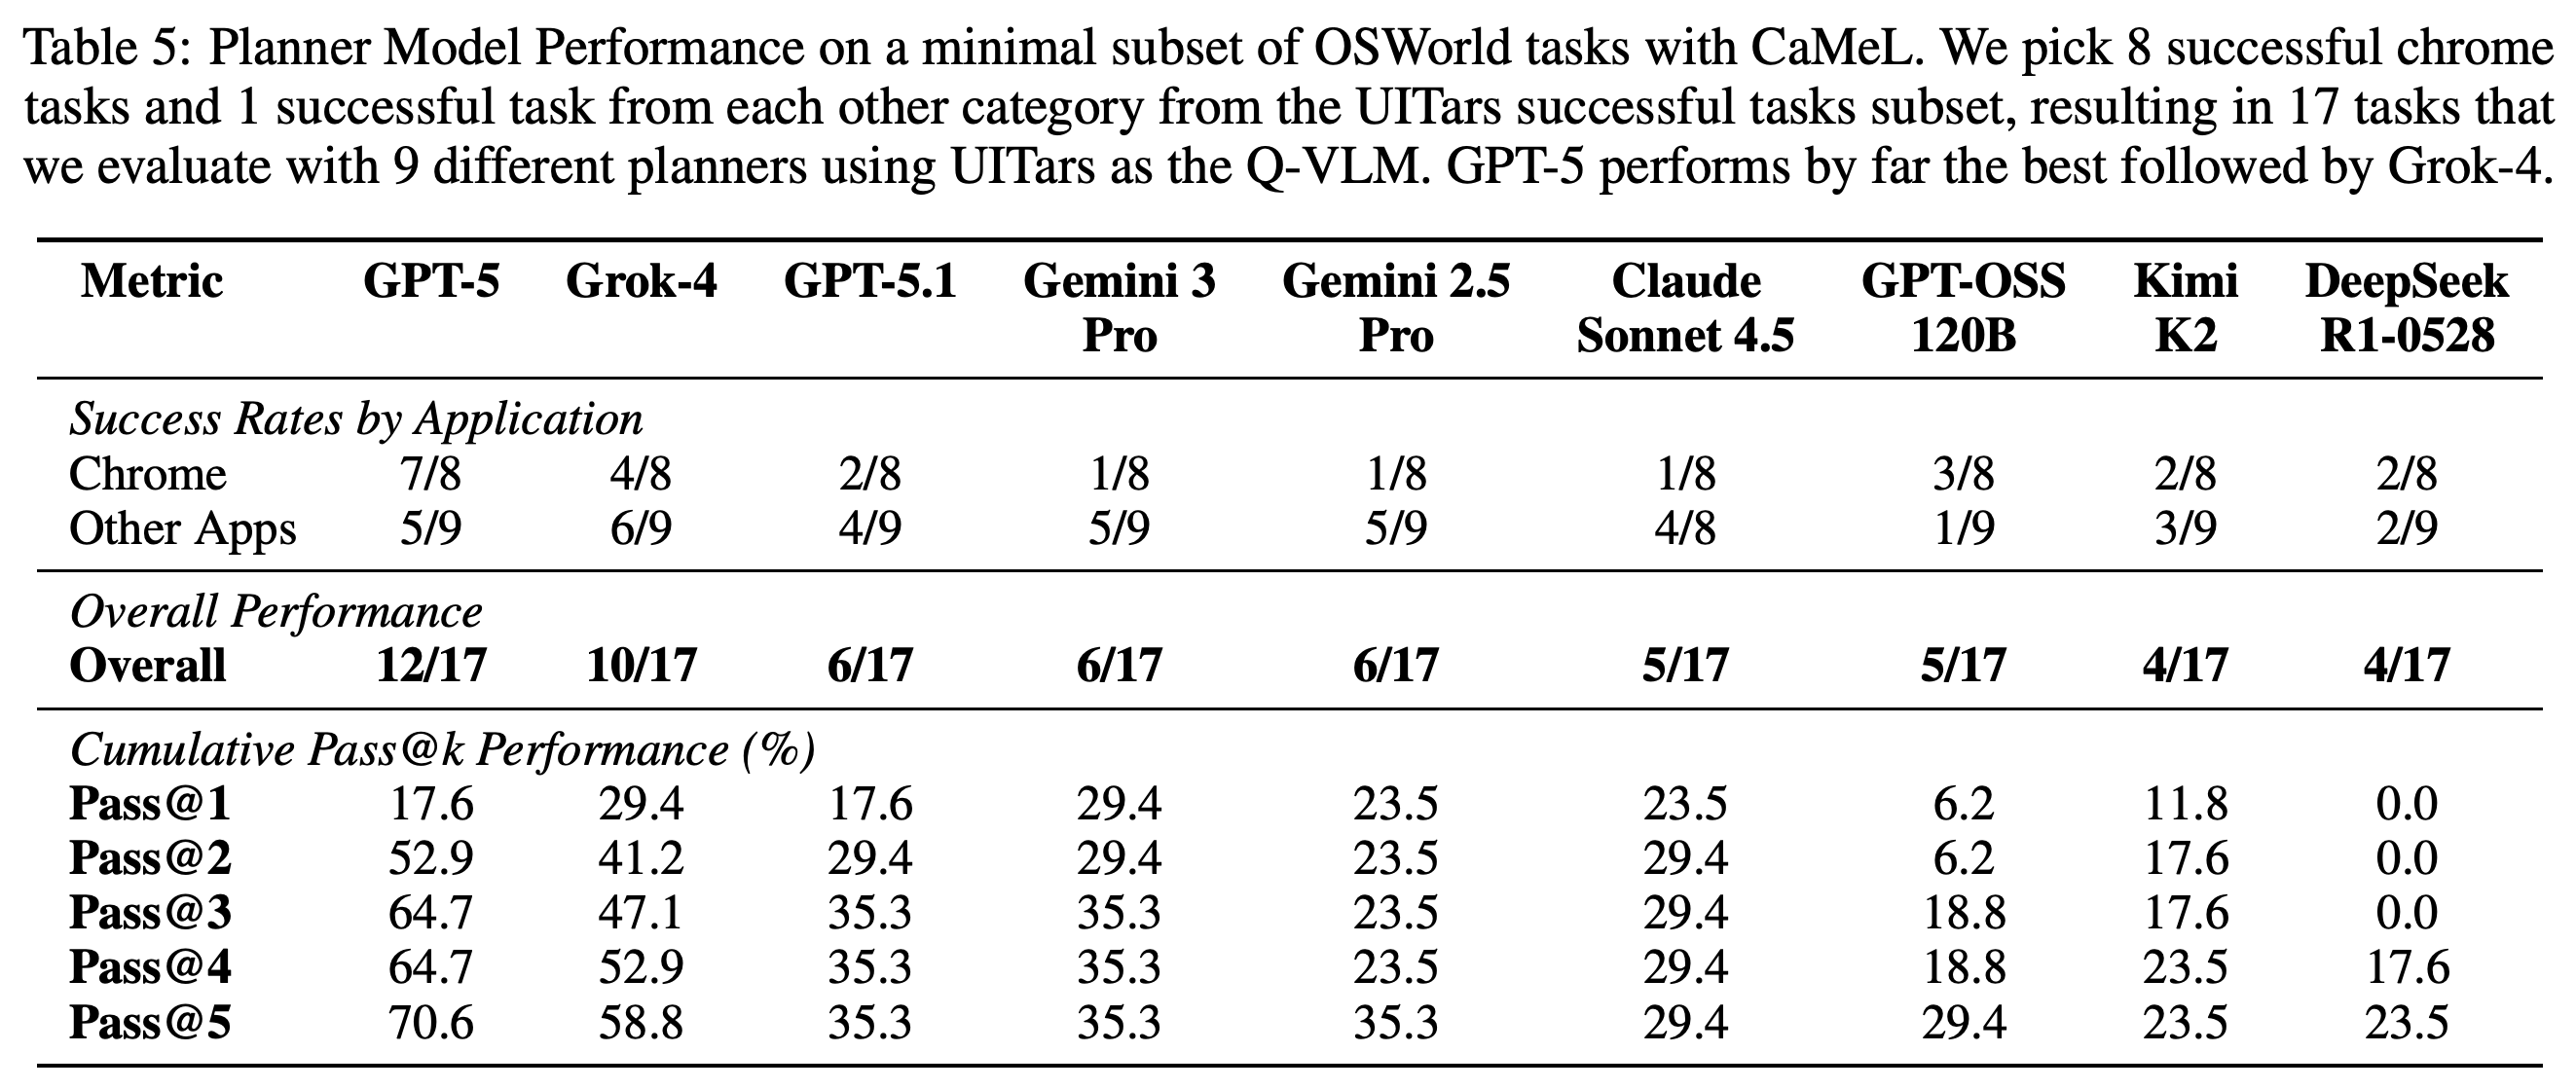
Table 5는 UITars 인식을 사용해 17개 작업에서 9개 계획 모델을 비교한다. UITars가 성공한 부분집합에서 Chrome 작업 8개와 다른 각 애플리케이션 범주의 작업 1개를 선정한다. GPT-5는 pass@5에서 12/17을 달성하고, Grok-4가 10/17로 뒤따른다. GPT-5.1, Gemini 3 Pro, Gemini 2.5 Pro는 각각 6/17을 달성한다. 저자들은 낮은 성능의 원인으로 대체 경로의 누락, 불충분한 애플리케이션 탐색 전략, 반복 생성한 계획 사이의 제한적인 차이를 제시한다.
- GPT-5는 pass@1의 17.6%에서 pass@5의 70.6%로 상승하며, 이 부분집합에서 대체 계획을 샘플링하는 이점을 보여 준다.
- 작고 선별된 작업 집합이므로 계획 모델의 순위를 OSWorld 전체로 일반화하기는 어렵다.
- Table 5에는 내부 불일치가 있다. GPT-OSS 120B의 애플리케이션별 수를 합하면 4지만 전체 결과는 5/17이며, Kimi K2의 합은 5지만 전체 결과는 4/17이다. Claude의 Other Apps 분모는 9가 아니라 8이다. 이 리뷰는 수정값을 추론하지 않는다.
계획 모델 선택은 초기 성공과 반복 샘플링의 이점 모두를 바꾼다. GPT-5는 pass@1에서 Grok-4보다 낮게 시작하지만, pass@5에서는 각각 12/17과 10/17로 순서가 뒤바뀐다. 선별된 17개 작업 부분집합이므로 순위의 적용 범위는 제한된다. 일부 애플리케이션별 수와 분모가 전체 행과 맞지 않아, 표시된 결과를 완전히 일관된 벤치마크 집계로 보아서는 안 된다.
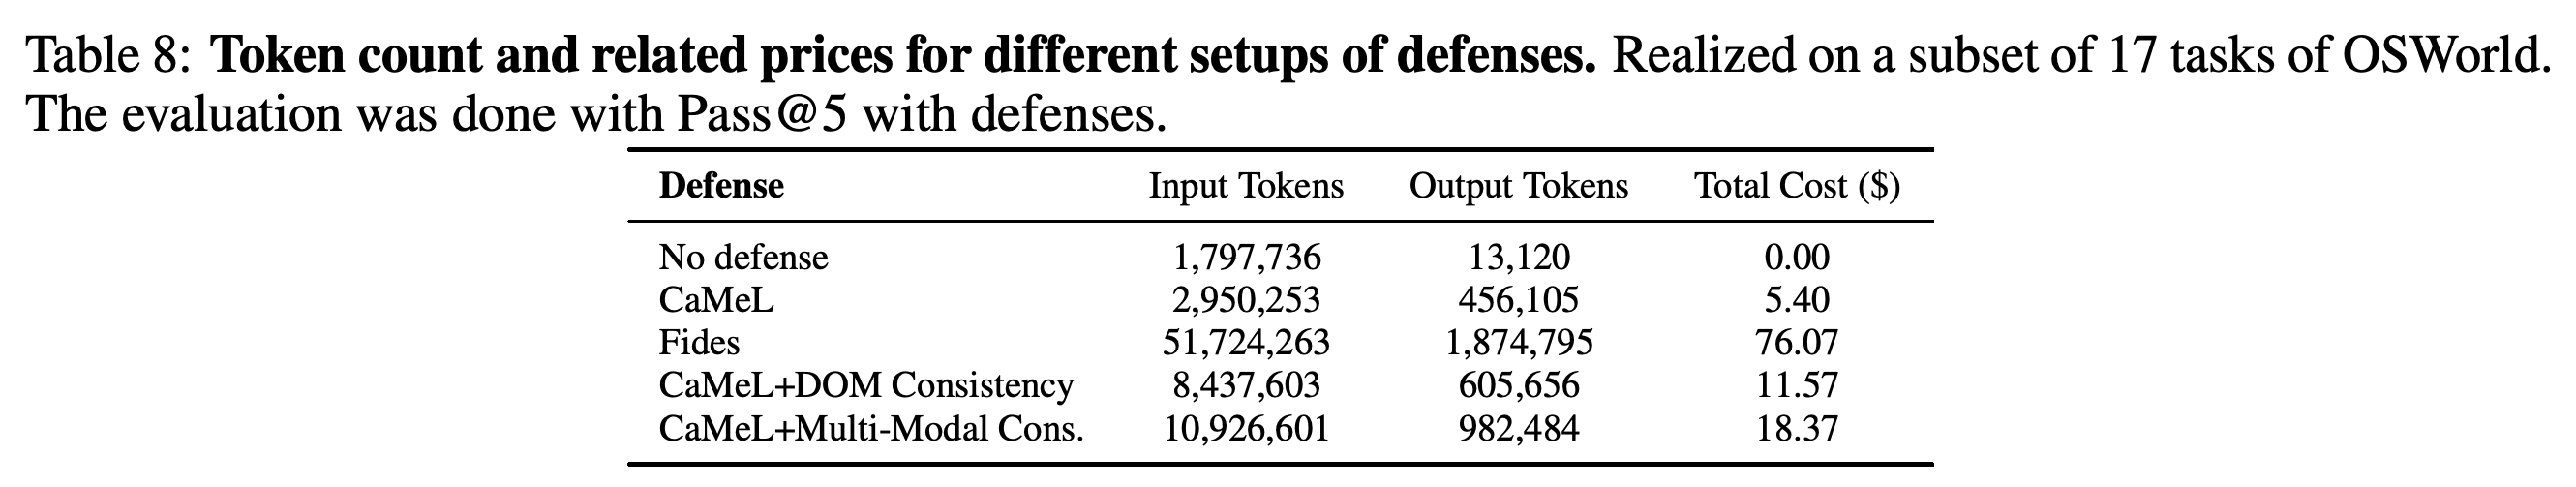
Fides-NOVA는 출력값 가리기를 완화해 선택된 환경 불리언 값을 반복적으로 호출되는 계획 모델에 노출한다. 이후 Table 6에서 20/60 (33.33%) pass@1과 40/60 (66.67%) pass@5를 달성한다. 논문은 총 토큰 오버헤드를 CaMeL-NOVA의 1.88×, Fides-NOVA의 29.6×, Multi-Modal Consensus를 적용한 CaMeL의 6.57×로 보고한다. Tables 8과 9는 반복적인 계획 생성, 긴 계획 출력, 검증 모델 호출을 추가 지출의 원인으로 제시한다.
- Fides-NOVA는 max_steps=15, max_turn=70, max_variable_reuse=5로 GUI 행동, 전체 호출, 변수 재사용을 제한한다. 이 제한은 반복 질의를 줄이지만, CaMeL처럼 계획 모델이 환경을 전혀 관측하지 않는 엄격한 격리 경계를 복원하지는 않는다.
- 17개 작업으로 구성된 pass@5 비용 평가 부분집합에서 보고된 API 지출은 CaMeL의 $5.40, Fides의 $76.07, CaMeL+DOM Consistency의 $11.57, CaMeL+Multi-Modal Consensus의 $18.37이다.
- 방어하지 않은 설정의 $0.00에는 로컬에서 배포한 UITars의 연산 비용이 포함되지 않는다. 이 값은 API 지출이며 전체 배포 비용이 아니다.
보고된 부분집합에서 Fides는 입력 토큰 51,724,263개를 사용하고, CaMeL은 2,950,253개를 사용한다. 이는 대화 기록을 포함한 반복적인 계획 모델 호출의 오버헤드를 보여 준다. 검증을 추가하면 API 지출이 더 늘어난다. 방어하지 않은 설정의 $0.00은 로컬 UITars 연산을 제외하므로, 실행에 비용이 들지 않는다는 뜻이 아니다.
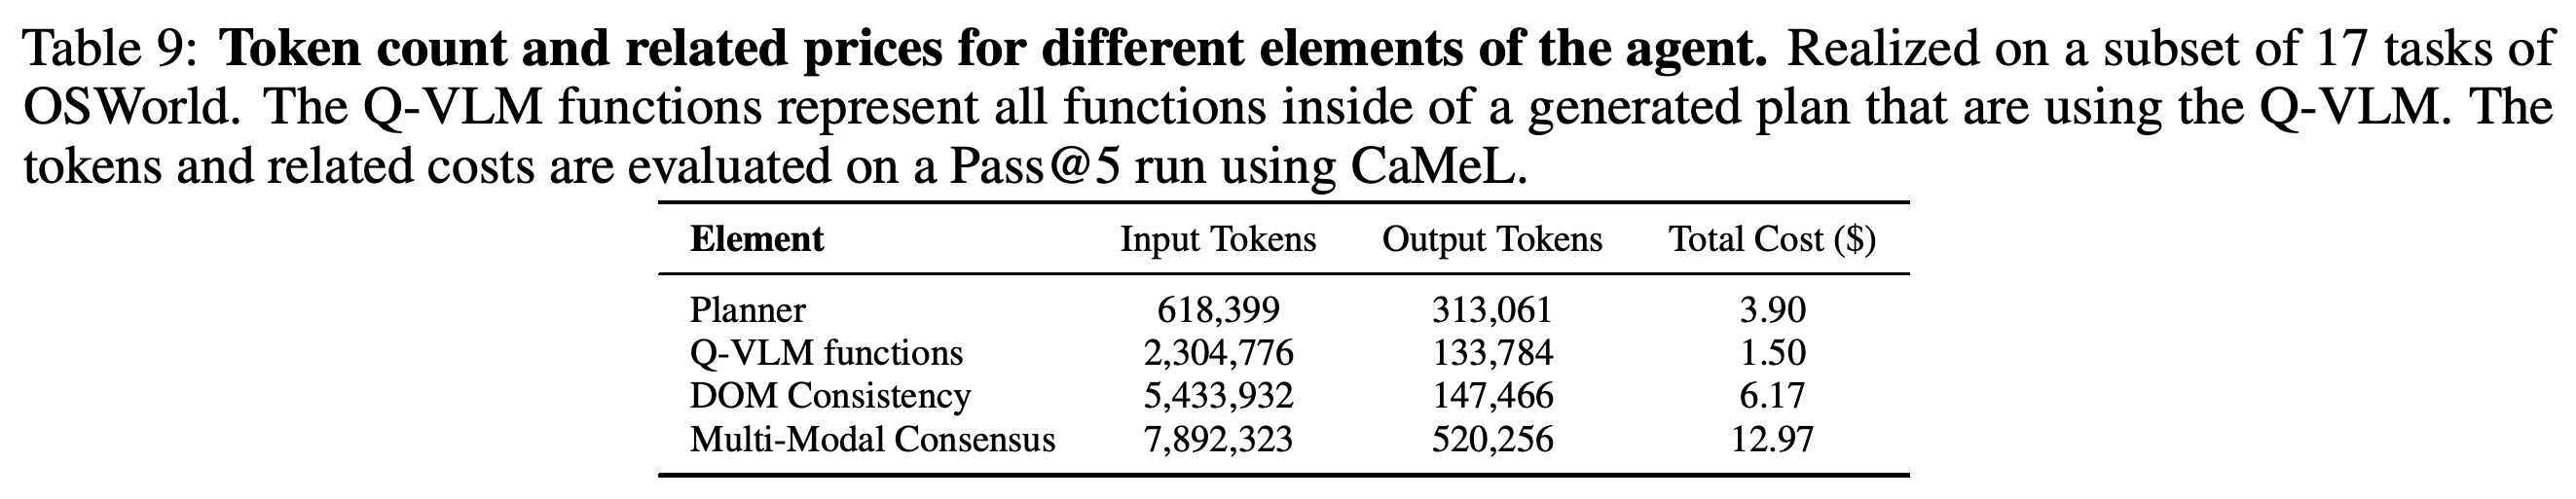
구성 요소별 분석은 CaMeL 실행에서 계획 생성에 $3.90, Q-VLM 함수에 $1.50을 배정하고, 검증 지출을 DOM Consistency의 $6.17과 Multi-Modal Consensus의 $12.97로 제시한다. 계획 모델 출력은 총 313,061토큰이며 Q-VLM 함수는 133,784토큰이다. 이는 다양한 대응 절차를 미리 작성하는 비용을 반영한다.
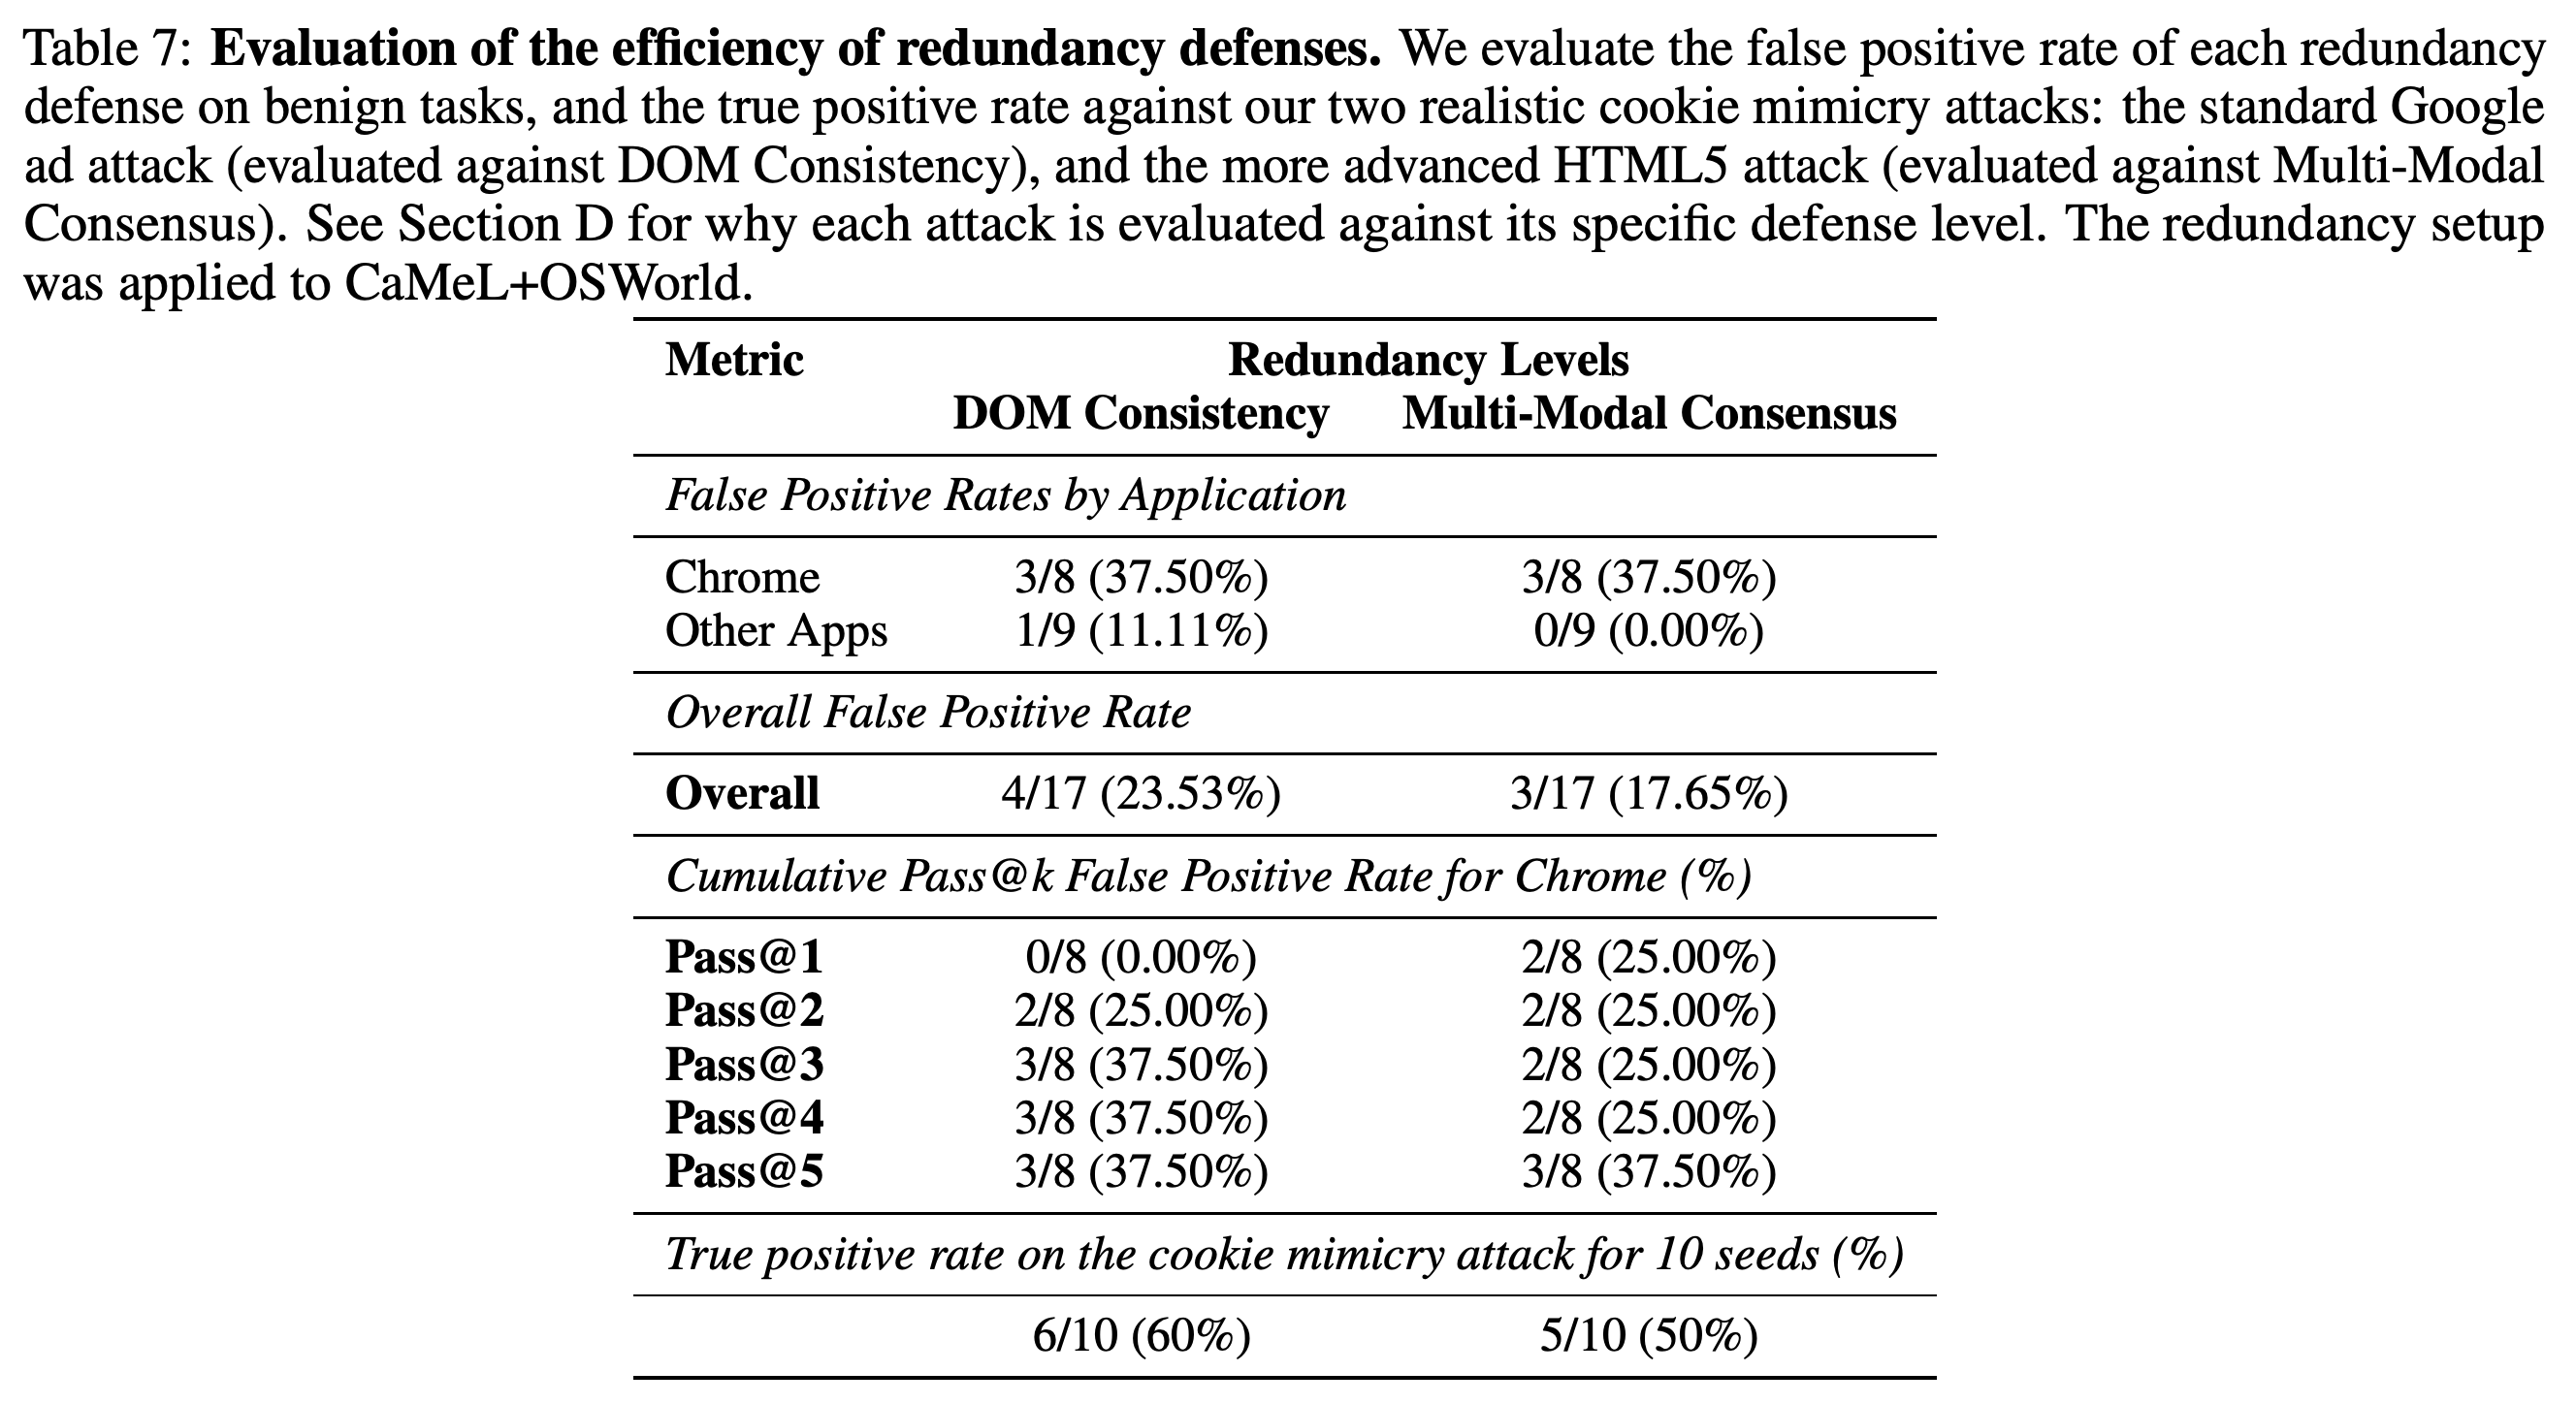
보고된 실험 중 적어도 일부에서는 두 공격 유형 모두 실험한 중복 검사를 우회한다. Table 7은 10개 시드에 걸쳐 쿠키 모방 공격의 탐지를 측정한다. DOM Consistency는 일반 Google 광고 공격의 6/10 (60%)를 탐지하고, Multi-Modal Consensus는 HTML5 공격의 5/10 (50%)를 탐지한다. 최대 pass@5까지 평가한 정상 작업 17개에서 누적 작업 수준 오탐 수는 각각 4/17 (23.53%)와 3/17 (17.65%)이며, 둘 다 Chrome 작업의 3/8 (37.50%)를 공격으로 판정한다.
- 2개 탐지율은 서로 다른 공격-방어 조합에서 나온 값이므로 동일 공격에 대한 직접 비교가 아니다. 정적 광고 레이블은 쿠키를 이용한 오도를 드러낼 수 있지만, HTML5 배너는 쿠키와 유사한 DOM 요소를 제시할 수 있다.
- 계획이 DOM 검색을 버튼처럼 공격자가 정적 이미지 광고 안에 만들 수 없는 요소 유형으로 제한하면 쿠키 공격이 실패할 수 있다.
- 픽셀 개념 증명 실험은 UI-TARS-1.5-7B의 그래디언트에 접근하며, 보안을 크게 우선시한 검증 설정도 우회한다. 논문은 여러 작업이나 인식 모델에 걸친 광범위한 픽셀 공격 성공률 벤치마크를 보고하지 않는다.
보고된 탐지율은 DOM Consistency로 검사한 정적 Google 광고 공격에서 60%, Multi-Modal Consensus로 검사한 HTML5 공격에서 50%이며, 서로 다른 공격-방어 조합이다. 두 설정 모두 pass@5까지 정상 Chrome 작업의 37.50%를 누적해서 공격으로 판정한다. 표본은 공격 시드 10개와 정상 작업 17개로 구성되므로, 이 좁은 평가를 넘어 일반화하기는 어렵다.
5 Discussion
CFI는 공격자가 계획 모델이 이미 작성한 호출만 사용하도록 제한한다. 리디렉션이나 서비스 거부에는 조작된 grounding 결과 1개만 필요할 수 있다. 반면 논문의 민감 정보 제출 및 유출 예시에는 이에 맞는 작업별 계획과 여러 관측을 서로 일관되게 조작하는 과정이 필요하다. 명시적인 계획은 사용자가 검토해 승인하고, 추가 정책이나 브라우저 계층 방어를 결합할 수 있는 인터페이스도 제공한다.
- 구조적으로 허용된 클릭이 사용자의 의도와 일치하는 것은 아니다. 좌표를 강제 가능한 의미적 정책으로 변환하는 문제는 아직 해결되지 않았다.
- 이 아키텍처에서는 비공개 모델이 계획을 만들고 로컬 인식 모듈이 민감한 관측을 처리할 수 있다. 이는 배포 선택지이며, 측정한 개인정보 보호 실험은 아니다.
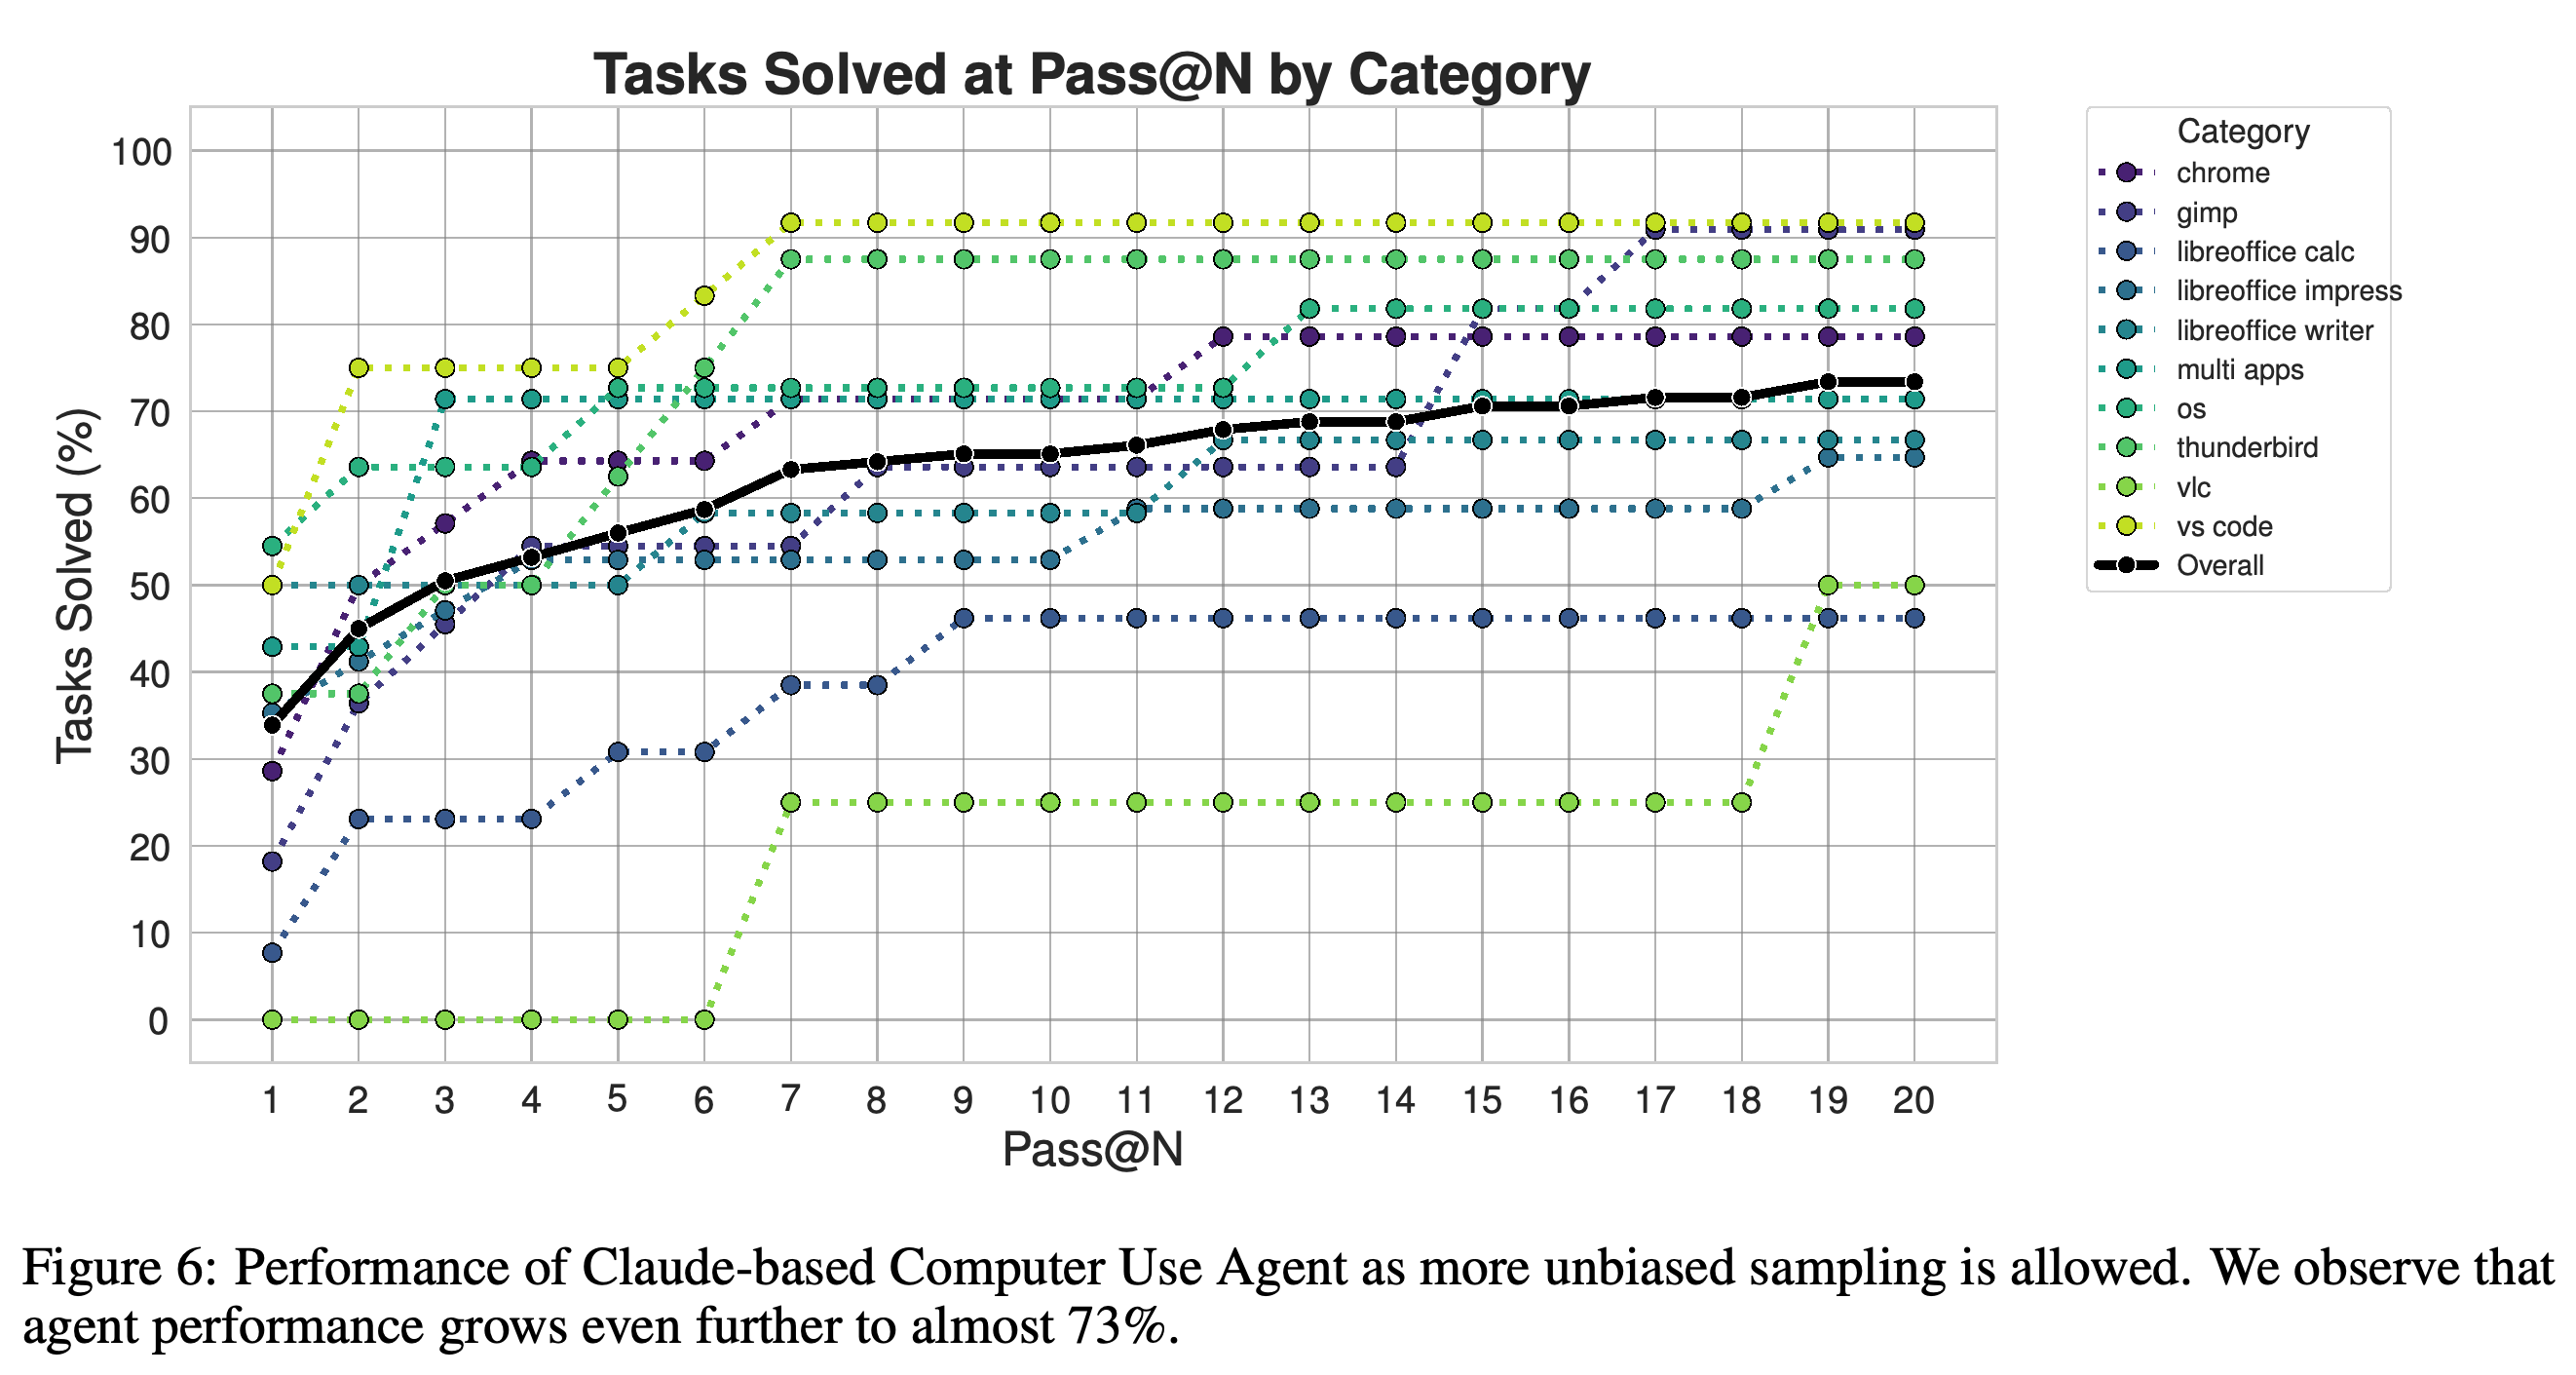
Single-shot 계획은 초기 상태, 탐색 경로, 복구 조건을 예상할 수 있어야 한다. 명세가 불충분한 작업은 분기와 비용을 늘린다. 또한 엄격한 격리는 신뢰할 수 없는 콘텐츠에서 지시를 찾아야 하는 임의의 행동 순서를 처리할 수 없다. Figure 6은 Claude 기반 설정에서 oracle 선택을 가정하면 pass@20에서 약 73%의 성공률을 보고하지만, E.6은 곡선에 사용한 작업 집합의 분모를 명시하지 않는다.
- OSWorld에는 모호한 작업 설명과 자동 평가가 없는 30개 작업이 포함된다. 기본 성공을 집계하면 실제로 완료한 비율을 파악하기 어렵다.
- 프롬프트 엔지니어링과 상태 검증은 평가한 시스템에 구현되어 있다. 작업 분포에 맞춘 파인튜닝은 추가 개선안으로 제시되지만 평가하지는 않는다.
- 샘플링은 이전의 환경 관련 실패를 조건으로 사용하지 않으므로 독립적인 계획을 병렬로 생성할 수 있다. 신뢰할 수 있는 배포 시점 선택기나 통합 super-plan은 입증되지 않았다.
독립적인 시도가 늘어날수록 전체 곡선은 계속 상승해 pass@20에서 약 73%에 도달하지만, 애플리케이션별 곡선은 서로 다른 수준에서 정체된다. 이는 성공한 시도를 oracle이 선택할 때의 복구 성능을 측정하며, 자동 후보 선택을 입증하지는 않는다. 해당 절은 작업 집합의 분모를 명시하지 않는다.
6 Conclusion
CaMeL-NOVA는 계획에 충분한 Observe-Verify-Act 대응 절차를 포함하면 환경을 관측하지 않는 계획으로도 유용한 GUI 워크플로를 완료할 수 있음을 보여 준다. 명시된 위협 모델에서 이 시스템의 보안 속성은 구조적인 제어 흐름 격리다. 쿠키와 픽셀 공격 시연은 허용된 경로와 행동 인자를 여전히 조작할 수 있음을 보여 준다.
부록
- A Extended Background는 정보 흐름 관점의 동기를 확장한다. A.1 Dual-LLM과 Algorithm 1은 정적인 CaMeL 계획과 반복적인 Fides 계획을 비교하고, capability 기반 데이터 흐름 정책을 설명한다. 또한 행동 순서가 신뢰할 수 없는 데이터에 지정된 작업의 한계를 짚는다. A.2 Redundancy-based defenses는 독립 검사를 Algorithm-Based Fault Tolerance, N-version programming, data diversity와 연결한다. A.3 How do CUAs work?는 인식, 행동, 추론, 메모리를 상세히 설명하고, 특화된 에이전트 프레임워크와 환경에 반응하는 대화 기록을 유지하는 end-to-end 모델을 비교한다.
- B Extended methodology section과 B.1 Combining Dual-LLM and CUA는 Algorithm 2의 single-shot 생성 및 인터프리터 실행 절차를 제시한다. B.1.1 Threat Model은 환경의 부분적 통제와 작업, 도구, 대략적인 계획 패턴을 안다는 가정을 설명한다. B.1.2 From adaptive to single shot planning은 summarize_screenshot_content, find, check_done, get_page_elements, get_page_text, find_element_by_text, verify_hypothesis를 설명한다. 실행 중 정보는 재계획에 사용하지 않고 프로그램 변수에 유지한다. B.1.3 Practicality of how to improve utility of single shot planning은 상호 보완적인 시각 및 DOM 탐색, 상태 확인, 구체적인 질의, 재시도 반복문, 쿠키 처리를 상세히 설명한다. 현재 웹사이트를 떠나기 전에 먼저 탐색하라는 지침도 다룬다. B.1.4 Ablation: How to make Fides work는 조건부 반복 계획을 가능하게 하려고 불리언 결과를 노출한다. 이로 인해 생기는 정보 채널을 인정하고, max_steps=15, max_turn=70, max_variable_reuse=5로 실행을 제한한다.
- C Further Details on Redundancy Defenses는 격리된 출력에 적용하는 검사를 설명한다. C.1 Verifier Module Architecture는 출력이 계획 변수에 들어가기 전에 이를 검사하고, 공격이 의심되면 실행을 중단한다. C.2 DOM Consistency는 제안된 좌표와 지시를 광고 레이블을 포함한 요소 구조와 비교한다. C.3 Multi-Modal Consensus는 시각적 또는 의미적 불일치를 확인하는 독립적인 스크린샷 기반 검사를 추가한다. 모델 다양성이 이러한 검사의 근거지만, 둘 다 확률적이며 핵심 제어 흐름 격리 외에 형식적인 보장을 추가하지 않는다.
- D Further Details on Attack Implementations와 D.1 Positioning Relative to Prior Work는 광고 배너 공격을 OS/UI에 직접 주입하는 공격과 구분하고, 기존 팝업 및 이미지 패치 공격과 연결한다. D.2 Cookie Attack Technical Details, D.2.1 Attack Mechanism, D.2.2 Defense Level Interaction은 정적 Google 이미지 광고와 HTML5 광고의 가짜 동의 제어 요소를 설명한다. 정적 이미지 공격자는 이미지와 하이퍼링크를 통제하지만, HTML5 콘텐츠는 쿠키와 유사한 DOM 요소를 노출할 수 있다. D.2.3 Multi-Step Attack with Hop Website는 배너 하이퍼링크를 검증하지 않는 정상 사이트를 거쳐 이동시키며, 반복적인 쿠키 처리 기회가 필요하다. 장거리 변형은 예측한 이후 페이지까지 첫 개입을 지연한다. D.3 Pixel Attack Technical Details와 D.3.1 Objective and Rationale은 눈에 띄는 배너 좌표 대신 그럴듯한 설명을 동반한 잘못된 클릭을 목표로 한다. D.3.2 Implementation은 모든 픽셀이 마스크 안에 있는 이미지 패치를 비전 인코더를 통해 최적화하고, PNG 양자화에 straight-through estimation을 사용한다. UI-TARS-1.5-7B에서 2000회 반복을 실행하며, 반복당 EOT 샘플 2개, 가우시안 노이즈 σ = 0.005와 시계 영역 노이즈 σ = 0.05, Adam 학습률 0.8을 사용한다. 600번째 반복까지 200회 반복 주기의 cosine warm restarts를 적용한 뒤 lrmin = 8 × 10⁻⁴까지 감쇠하며, L2 그래디언트 클리핑 기준은 10이다. D.3.3 Extensions and Future Work는 다중 목적, 다중 모델, 다단계 픽셀 공격을 후속 연구로 남긴다.
- E Further Utility Measurements on OSWorld는 베이스라인, 계획 분석, 계획 모델, 확장성, 검증 관련 근거를 모은다. E.1 Base Utility on OSWorld는 제약된 베이스라인 실행을 보고하고, 기본 성공 처리한 30개 작업의 추가를 설명한다. E.2 Plan Analysis Methodology는 계획을 순차 및 데이터 흐름 간선이 있는 AST 기반 그래프로 변환한다. 분기 조건을 4가지 유형으로 분류하고, 작업당 k=3개 샘플을 시퀀스 편집 거리, 코사인 유사도, 패턴 Jaccard 유사도로 비교한다. E.3 Plan statistics details와 Tables 3–4는 NOVA의 더 큰 계획과 추가 검증 분기를 정량화한다. E.4 Statistics on Performance with different Planner Models는 Table 5의 선별된 17개 작업 비교를 제공하고, E.5 Utility of UITars on Fides는 Table 6에서 40/60 pass@5를 보고한다. E.6 Scaling of Claude with CaMeL은 작업 집합의 분모를 명시하지 않은 채 pass@20에서 성공률이 73%에 근접하는 그래프를 제시한다. E.7 Redundancy Defense Evaluation과 Table 7은 불완전한 쿠키 공격 탐지와 정상 작업의 누적 오탐을 보고한다. 논의에서는 Chrome 오탐을 정상 쿠키 배너를 가짜로 분류한 결과로 설명하고, Excel 셀에서 발생한 추가 DOM 검사 오류도 지적한다.
- F Token counts comparison between defenses는 Tables 8과 9에서 17개 작업의 pass@5 토큰 사용량과 API 지출을 보고한다. GPT-5가 계획과 스크린샷 검증을 수행하고, Claude Haiku 4.5가 DOM 검증을 수행하며, 로컬 UITars 추론은 총 금액에서 제외한다. 긴 계획 출력은 CaMeL의 지출에 기여한다. 반면 대화 기록을 포함한 반복적인 계획 모델 호출은 Fides의 훨씬 큰 토큰 사용량을 설명한다.
- G Attacker Goals and Plan Structure Under CFI는 리디렉션, 임의 대상 클릭, 서비스 거부, 민감 정보 제출, 데이터 유출, 완전히 새로운 행동의 주입을 구분한다. 범용 UI 루틴은 앞의 3가지 목표를 가능하게 할 수 있다. 논문의 민감 정보 제출 예시에는 계획에 이미 포함된 제출, 최소 2개의 서로 일관된 인식 조작, 실행 시점의 인증이 필요하다. 유출 예시에는 이에 맞는 읽기 및 전송 단계가 필요하다. 신뢰할 수 있는 계획에 전혀 없는 호출은 CFI가 구조적으로 배제하지만, 나머지 목표의 가능 여부는 사용 가능한 계획 구조와 실행 중 값에 따라 달라진다.
- H Example Plans는 H.1 Natural Products database example of a good plan (P-LLM: GPT-5), H.2 Natural Products database example of an insufficient plan (P-LLM: Gemini 3 Pro), H.3 Example of a generic cookie handler snippet을 포함한다. GPT-5 예시에는 더 많은 상태 확인, 대체 탐색 방법, 복구 경로가 있지만, 초기 웹사이트를 떠나 외부 데이터베이스로 이동하는 것도 허용한다. 마지막 check_done 결과는 어느 결과든 mark_done을 호출하므로 완료 여부를 제어하지 않는다. Gemini 예시는 입력 후 검색이 성공한 상태를 가정하며, 마지막 작업별 검증 없이 끝날 수 있다. 범용 쿠키 코드 조각은 Branch Steering이 악용하는 예측 가능하고 반복적인 grounding 루틴을 보여 준다. 따라서 분기가 풍부하다는 이유로 작업의 의미가 올바르다고 볼 수는 없다.
짧은 생각
이 논문은 고정된 계획 구조와 오류가 발생할 수 있는 실행 중 grounding을 유용하게 분리한다. 동일한 60개 작업 제거 실험은 NOVA의 도구와 프롬프트 구성을 함께 적용한 이점을 측정한다. 다만 선별된 작업 집합, oracle pass@k, 원문 표의 불일치, Fides의 불리언 노출 완화는 더 넓은 비교를 제한한다. 배포 평가에서는 제어 흐름 무결성, 의미적 행동 안전성, 단일 시도 유용성, 전체 실행 비용을 각각 보고해야 한다.