


Unify-Agent: A Unified Multimodal Agent for World-Grounded Image Synthesis 요약 설명
31 Mar 2026 | Paper Review Text-to-Image Generation Search Agents Supervised Fine-Tuning목차
- 요약
- 1 Introduction
- 2 Related Works
- 3 Preliminary
- 4 Data Pipeline
- 5 Methodology
- 6 Experiments
- 7 Conclusion
- Limitations and Future Work
- 부록
- 짧은 생각
이번 글에서는 Unify-Agent: A Unified Multimodal Agent for World-Grounded Image Synthesis 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 31일(Arxiv)
- Chen, Shuang, Shou, Quanxin, Chen, Hangting, Zhou, Yucheng, Feng, Kaituo, Hu, Wenbo, Zhang, Yi-Fan, Lin, Yunlong, Huang, Wenxuan, Song, Mingyang, et al.
- University of California, Los Angeles, Tencent Hunyuan, The Chinese University of Hong Kong, The Hong Kong University of Science and Technology
- 논문 링크
- Github
요약
- Unify-Agent는 모델 파라미터에 고유한 외형이 충분히 반영되지 않은 희귀 대상과 롱테일 개념의 사실적 이미지 생성 문제를 다룬다. Bagel을 Think–Research–Recaption–Generate 파이프라인에 맞춰 조정하여 텍스트와 시각적 근거를 검색한다. 이어서 정체성 요건과 장면 요건을 분리하고, 근거 기반 명세와 선택한 참조 이미지로 이미지를 합성한다.
- 저자들은 검증된 실행 궤적-이미지 쌍 143K개를 구축하고, 12개 하위 범주에 걸쳐 프롬프트 2,462개를 포함하는 FactIP를 제안한다. 보고된 FactIP 결과는 프롬프트 500개로 구성된 FactIP-Mini 분할을 사용한다. Unify-Agent는 FactIP Overall을 Bagel의 50.9에서 73.2로 높였으며, WiSE에서 0.77, KiTTEN에서 4.08, T2I-FactBench의 SKCI와 MKCC 수준에서 각각 77.4와 71.5를 기록한다.
- 이미지 검색을 제거하면 FactIP Overall이 56.2로, recaptioning을 제거하면 62.9로 낮아진다. 이는 시각적 근거와 구조화된 근거 통합의 가치를 뒷받침한다. 다만 시스템은 비교적 얕은 워크플로에 머물고, 평가는 자동 평가자에 의존하며, 비교 대상 중 가장 강력한 상용 모델은 여전히 FactIP와 WiSE에서 앞선다.
1 Introduction
논문은 시각적 그럴듯함과 사실 충실도를 구분한다. 이미지가 그럴듯해도 잘못된 인물, 캐릭터, 제품 또는 문화적 대상을 묘사할 수 있다. 이를 해결하기 위해 추론 시 외부 지식에 접근한 뒤, 학습된 변환 과정을 통해 그 지식을 시각적 제약으로 바꾸는 방법을 제안한다.
- Unify-Agent는 프롬프트 해석, 근거 탐색 행동, recaptioning, 생성을 공통된 통합 멀티모달 모델 안에서 수행하되, 외부 검색 도구는 유지한다.
- Recaption은 정체성을 결정하는 특징과 사용자가 지정하는 자세, 의상, 환경, 구도, 스타일을 분리한다.
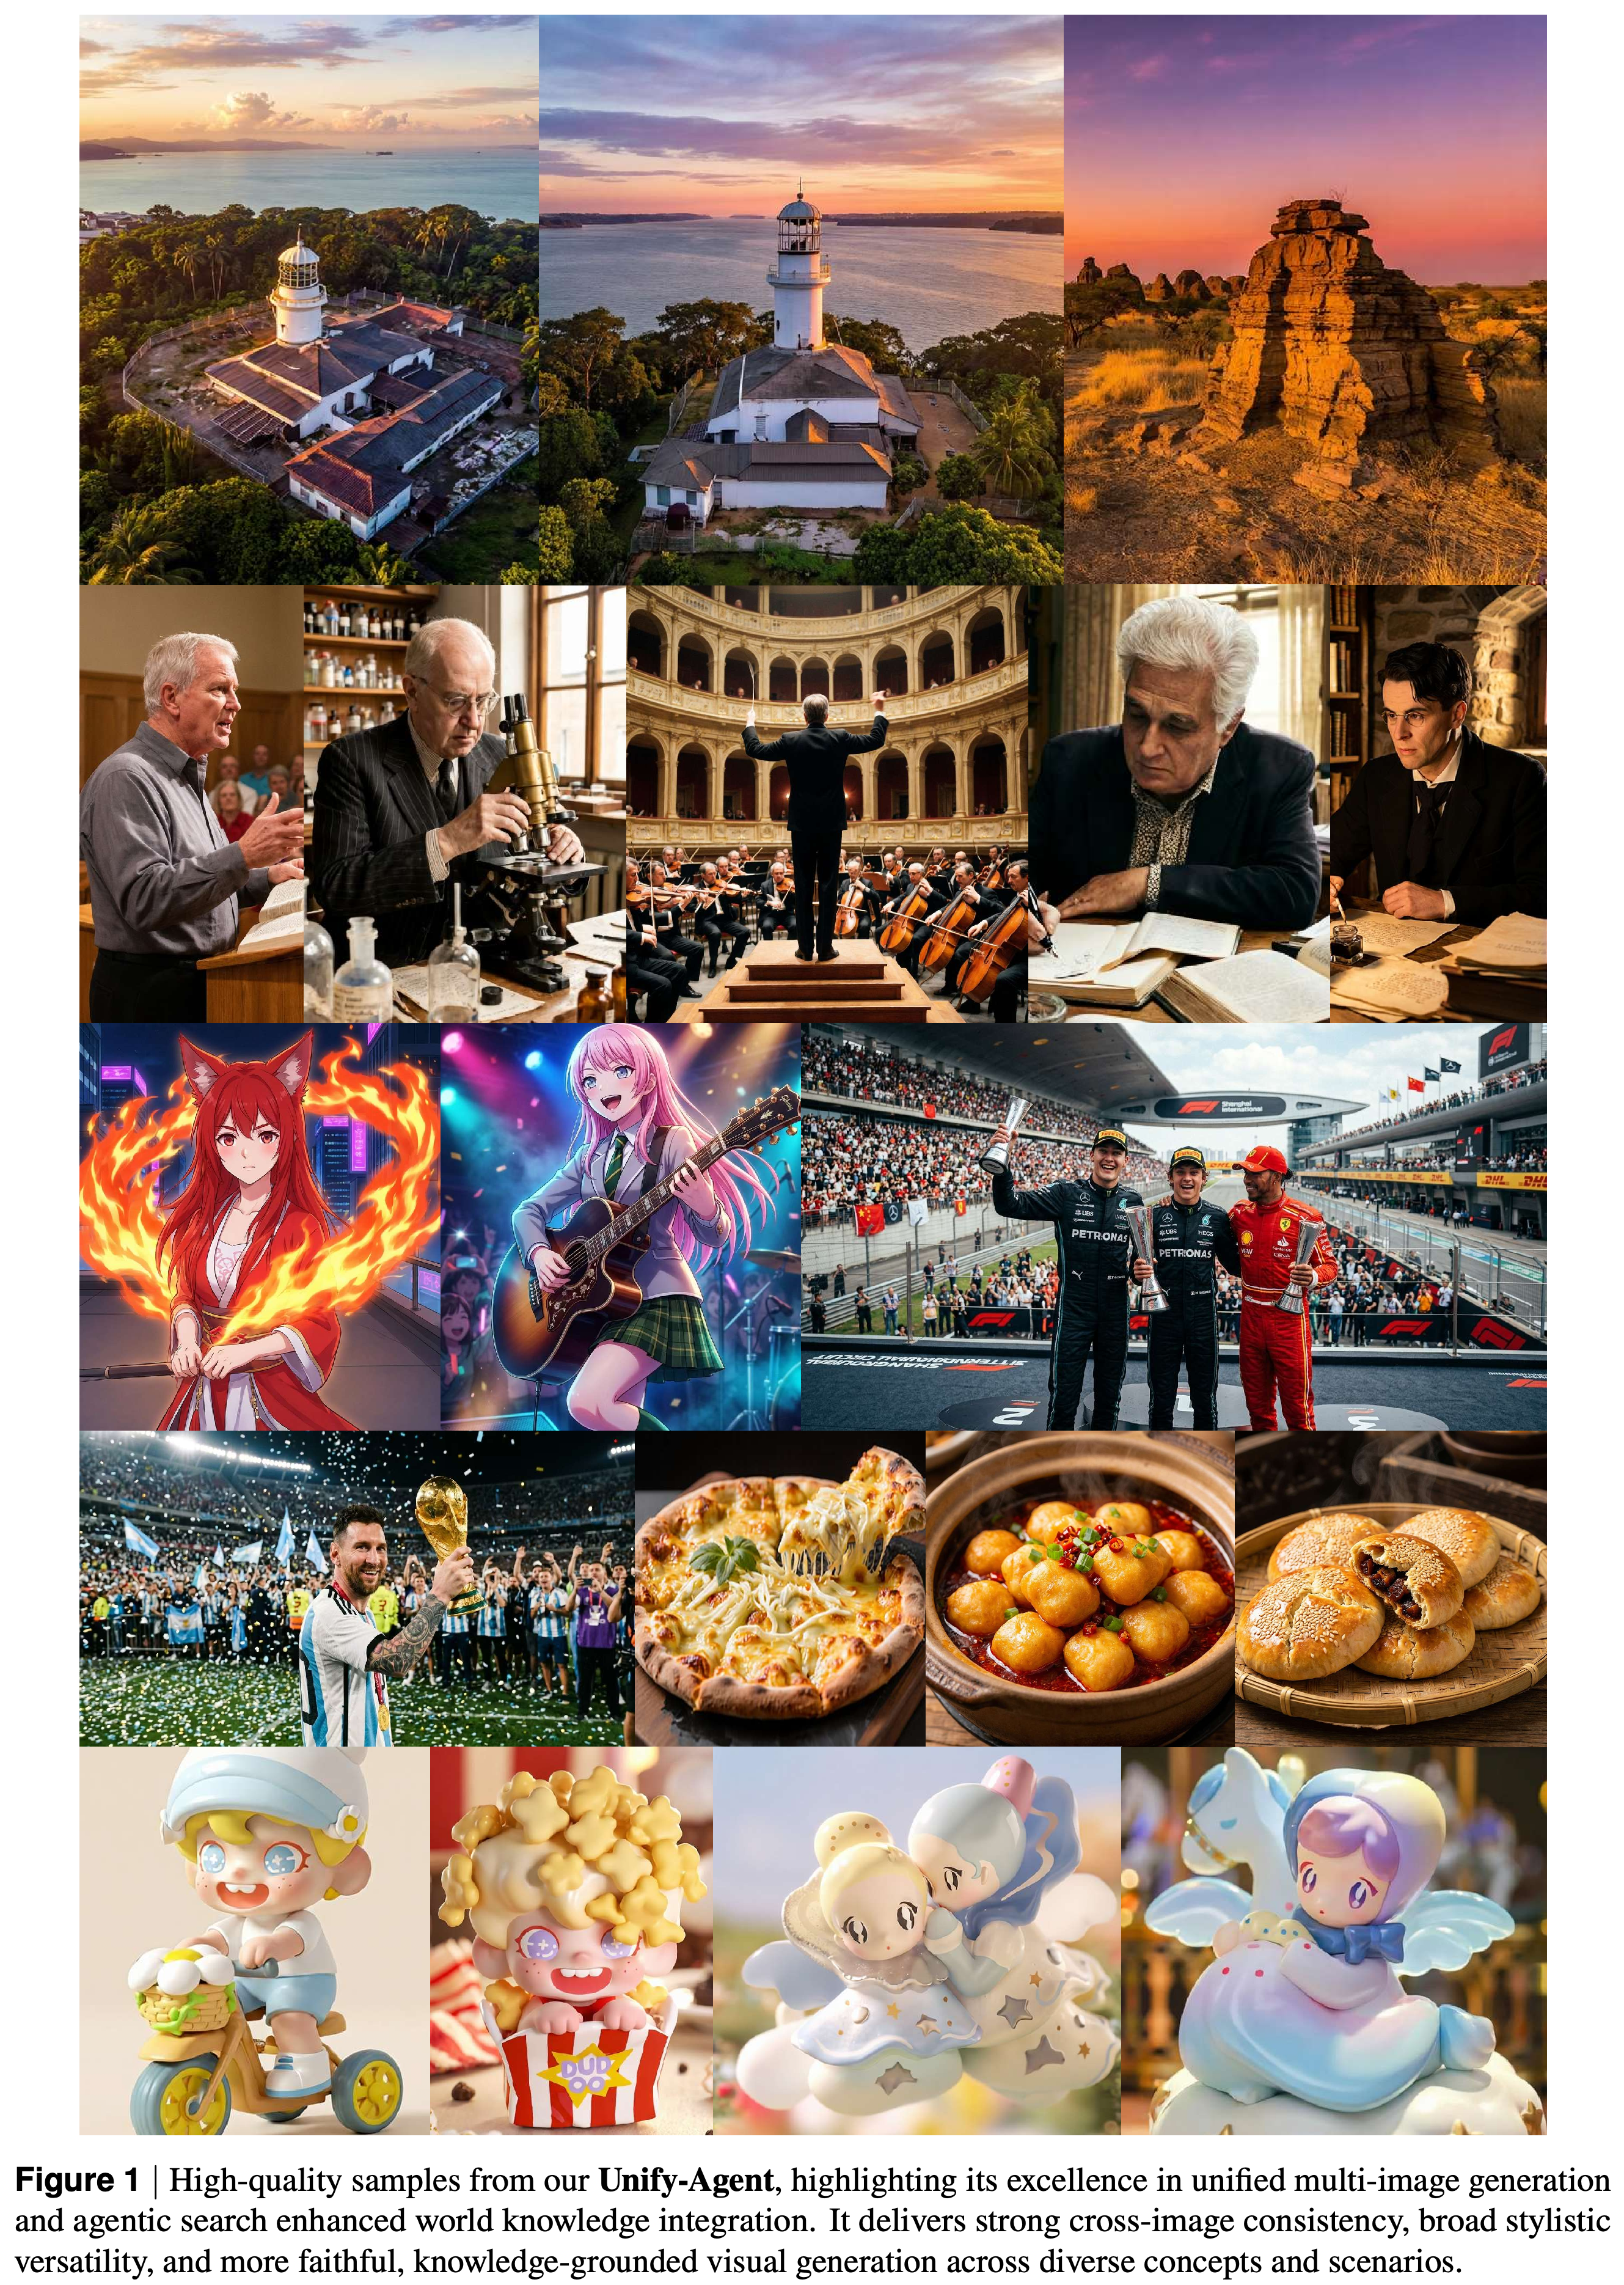
- Figure 1은 생성된 대상과 스타일의 범위를 보여준다. 선별된 예시만으로 일반적인 신뢰성을 입증할 수는 없다.
- 프로젝트 URL은 https://github.com/shawn0728/Unify-Agent 이다.
모음 이미지는 랜드마크, 실제 인물, 가상 캐릭터, 음식, 디자이너 토이를 아우르며, 대상의 정체성이 중요한 합성과 스타일 적용이 지향하는 범위를 보여준다. 통제된 비교 없이 선별한 출력은 예시를 보여줄 뿐, 성공률의 추정치를 제시하지는 않는다.
2 Related Works
관련 연구에서는 이해와 생성을 통합한 아키텍처, 외부 도구를 사용하는 에이전트 워크플로, 이미지 합성의 사실성 평가를 연결한다. Unify-Agent는 근거 수집에 대한 지도 학습과 근거 기반 recaptioning을 통해 이 연구 방향들을 통합한다.
2.1 Unified multimodal models
Janus 계열과 Show-o 같은 통합 멀티모달 모델은 시각적 이해와 합성을 위한 아키텍처 자원을 공유한다. 저자들은 추론이 사전 학습 중 내재화된 지식에 의존하는 경우, 이러한 능력만으로 롱테일 대상의 사실적 생성 문제를 해결할 수 없다고 주장한다.
- 외형에 대한 환각과 정체성 이탈은 합성 전에 외부 근거를 수집해야 하는 이유가 된다.
- 핵심 차이는 이해와 생성이 백본을 공유하는지 여부가 아니라, 추론 시 외부 근거를 활용하는지 여부다.
2.2 Agentic workflows
기존 에이전트 기반 이미지 생성 시스템은 여러 API를 통해 계획기, 검색 도구, 별도 생성기를 연결하는 경우가 많다. 저자들은 미흡한 근거 통합과 연쇄 오류를 한계로 지적하고, 대신 통합 모델이 조사와 recaptioning 실행 궤적을 생성하도록 학습한다.
- 통합은 학습된 추론 및 생성 구성요소에 적용되며, 실행 과정에는 외부 텍스트 및 이미지 검색이 계속 포함된다.
- 실험에는 학습 데이터와 검색 접근 조건을 맞추고 계획기와 생성기를 따로 학습한 파이프라인이 포함되지 않는다. 따라서 아키텍처 통합의 효과를 다른 이점과 분리해 확인할 수는 없다.
2.3 World knowledge and factual evaluation.
T2I-FactualBench, KiTTEN, WiSE는 미적 품질과 일반적인 프롬프트 정합성을 넘어 지식의 정확성이 중요한 생성 과제를 평가한다. FactIP는 희귀 대상과 문화적으로 중요한 개념에 대한 참조 기반 평가를 추가하고, 대상을 규정하는 시각적 속성의 보존을 강조한다.
3 Preliminary
예비 설명에서는 Bagel의 텍스트 및 이미지 학습 목표를 제시하고, 추가 학습 없이 외부 지식을 주입하는 실험을 수행한다. 또한 명시적인 중간 근거 변수를 포함하는 실행 궤적으로 합성을 정식화한다. 이러한 구성요소는 근거 수집 정책과 recaption 인터페이스의 필요성을 뒷받침한다.
3.1 Unified Multimodal Model: Bagel
Bagel은 이해와 생성 전용 전문가를 둔 Mixture-of-Transformers 아키텍처를 사용한다. Multimodal Understanding은 자기회귀 방식의 다음 토큰 예측을 사용하고, Multimodal Generation은 연속 VAE 잠재 공간에서 rectified-flow 속도장을 예측한다.
- 텍스트 학습 목표는 앞선 토큰과 멀티모달 문맥 C를 조건으로 목표 토큰의 음의 로그우도를 최소화한다.
- 이미지 학습 목표는 예측한 잠재 속도장과 목표 잠재 속도장 사이의 기대 제곱 오차를 최소화하며, 연속 시간 단계는 (0, 1)에서 균일하게 샘플링한다.
- Unify-Agent는 에이전트 실행 궤적에 맞춰 모델을 조정할 때 두 학습 목표를 모두 유지한다.
3.2 Motivating Evidence for World-Grounded Synthesis
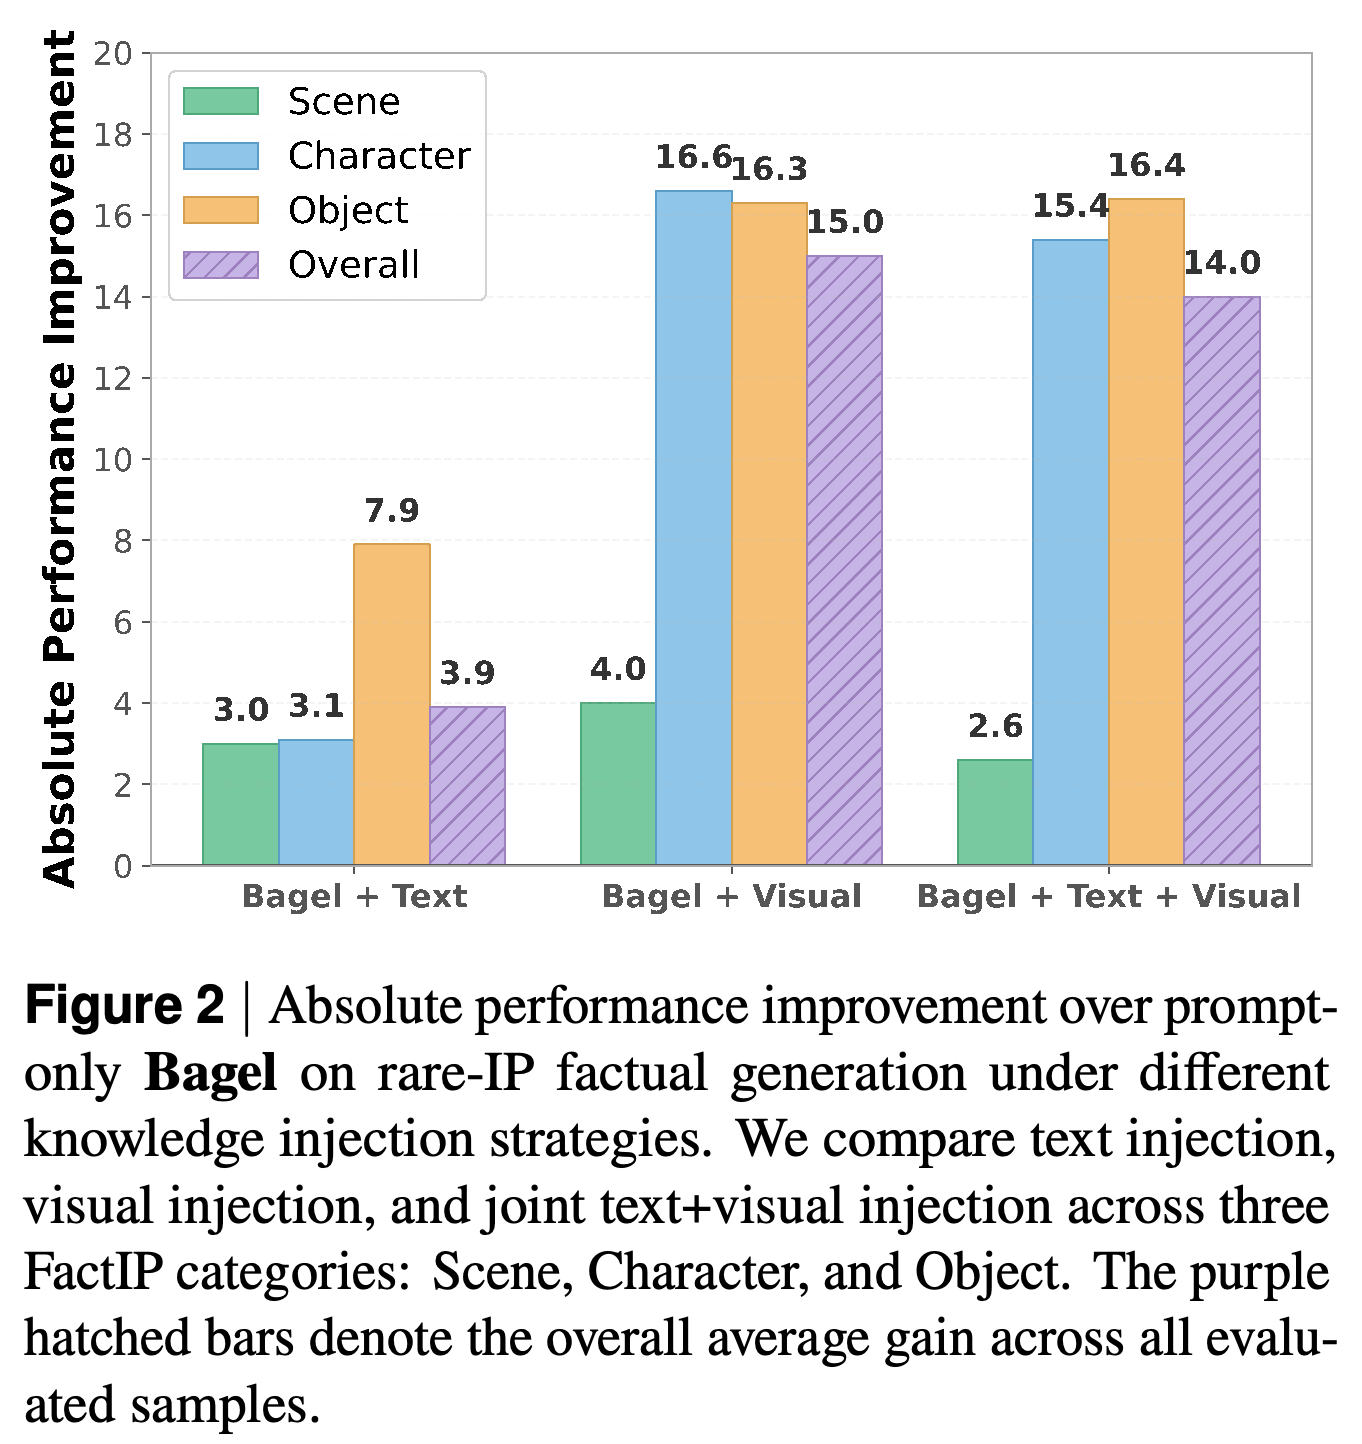
학습 없이 수행한 연구에서는 Scene, Character, Object의 FactIP 예시 200개를 사용해 프롬프트만 입력한 Bagel과 텍스트 주입, 정답 시각 참조 2개 주입, 텍스트와 시각 참조의 공동 주입을 비교한다. Figure 2에서 전체 성능의 절대 증가 폭은 각각 3.9, 15.0, 14.0이다.
- 시각 정보 주입은 Character를 16.6, Object를 16.3 높인 반면, 텍스트 주입의 증가 폭은 각각 3.1과 7.9다.
- 공동 주입은 전체적으로 시각 정보만 주입한 경우보다 성능이 낮다. 이는 가공하지 않은 조건 정보를 더 많이 제공하면 항상 도움이 된다고 가정하기보다 근거를 정리해야 함을 시사한다.
- 시각 정보 주입에는 정답 참조 이미지를 제공하므로, 이 실험은 자율 검색의 신뢰성이 아니라 외형 근거가 줄 수 있는 잠재적 이점을 측정한다.
학습 없이 예시 200개로 수행한 연구에서 정답 시각 참조 2개는 프롬프트만 입력한 Bagel 대비 전체 점수를 15.0점 높인다. 텍스트 주입은 3.9점, 공동 주입은 14.0점 높인다. 공동 주입의 향상 폭이 더 작다는 점은 근거를 정리할 필요성을 시사하지만, 이 실험은 자율 검색 품질을 검증하지 않는다.
3.3 Problem Formulation
정식화에서는 이미지 y를 생성하기 전에 인지적 정보 부족 평가 g, 텍스트 근거 궤적 τt, 시각적 근거 궤적 τv, 근거 기반 recaption c를 도입한다. Equation 3은 실행 궤적을 pθ(y, c, τt, τv, g | x) = pθ(g | x) · pθ(τt, τv | x, g) · pθ(c | x, g, τt, τv) · pθ(y | c, τv)로 분해한다.
- 각 인자는 정보 부족 탐지, 근거 수집, recaptioning, 시각적 합성을 나타낸다.
- 최종 생성 인자는 원래 프롬프트와 이전 텍스트 추론 이력에 대한 직접적인 조건화를 제외한다. 관련 정보는 recaption과 시각적 근거를 통해 생성 단계에 전달되어야 한다.
- 이 조건부 독립 설계는 어텐션 제한으로 구현한 모델링 가정이며, 사실적 생성에서 독립적으로 입증된 속성은 아니다.
4 Data Pipeline
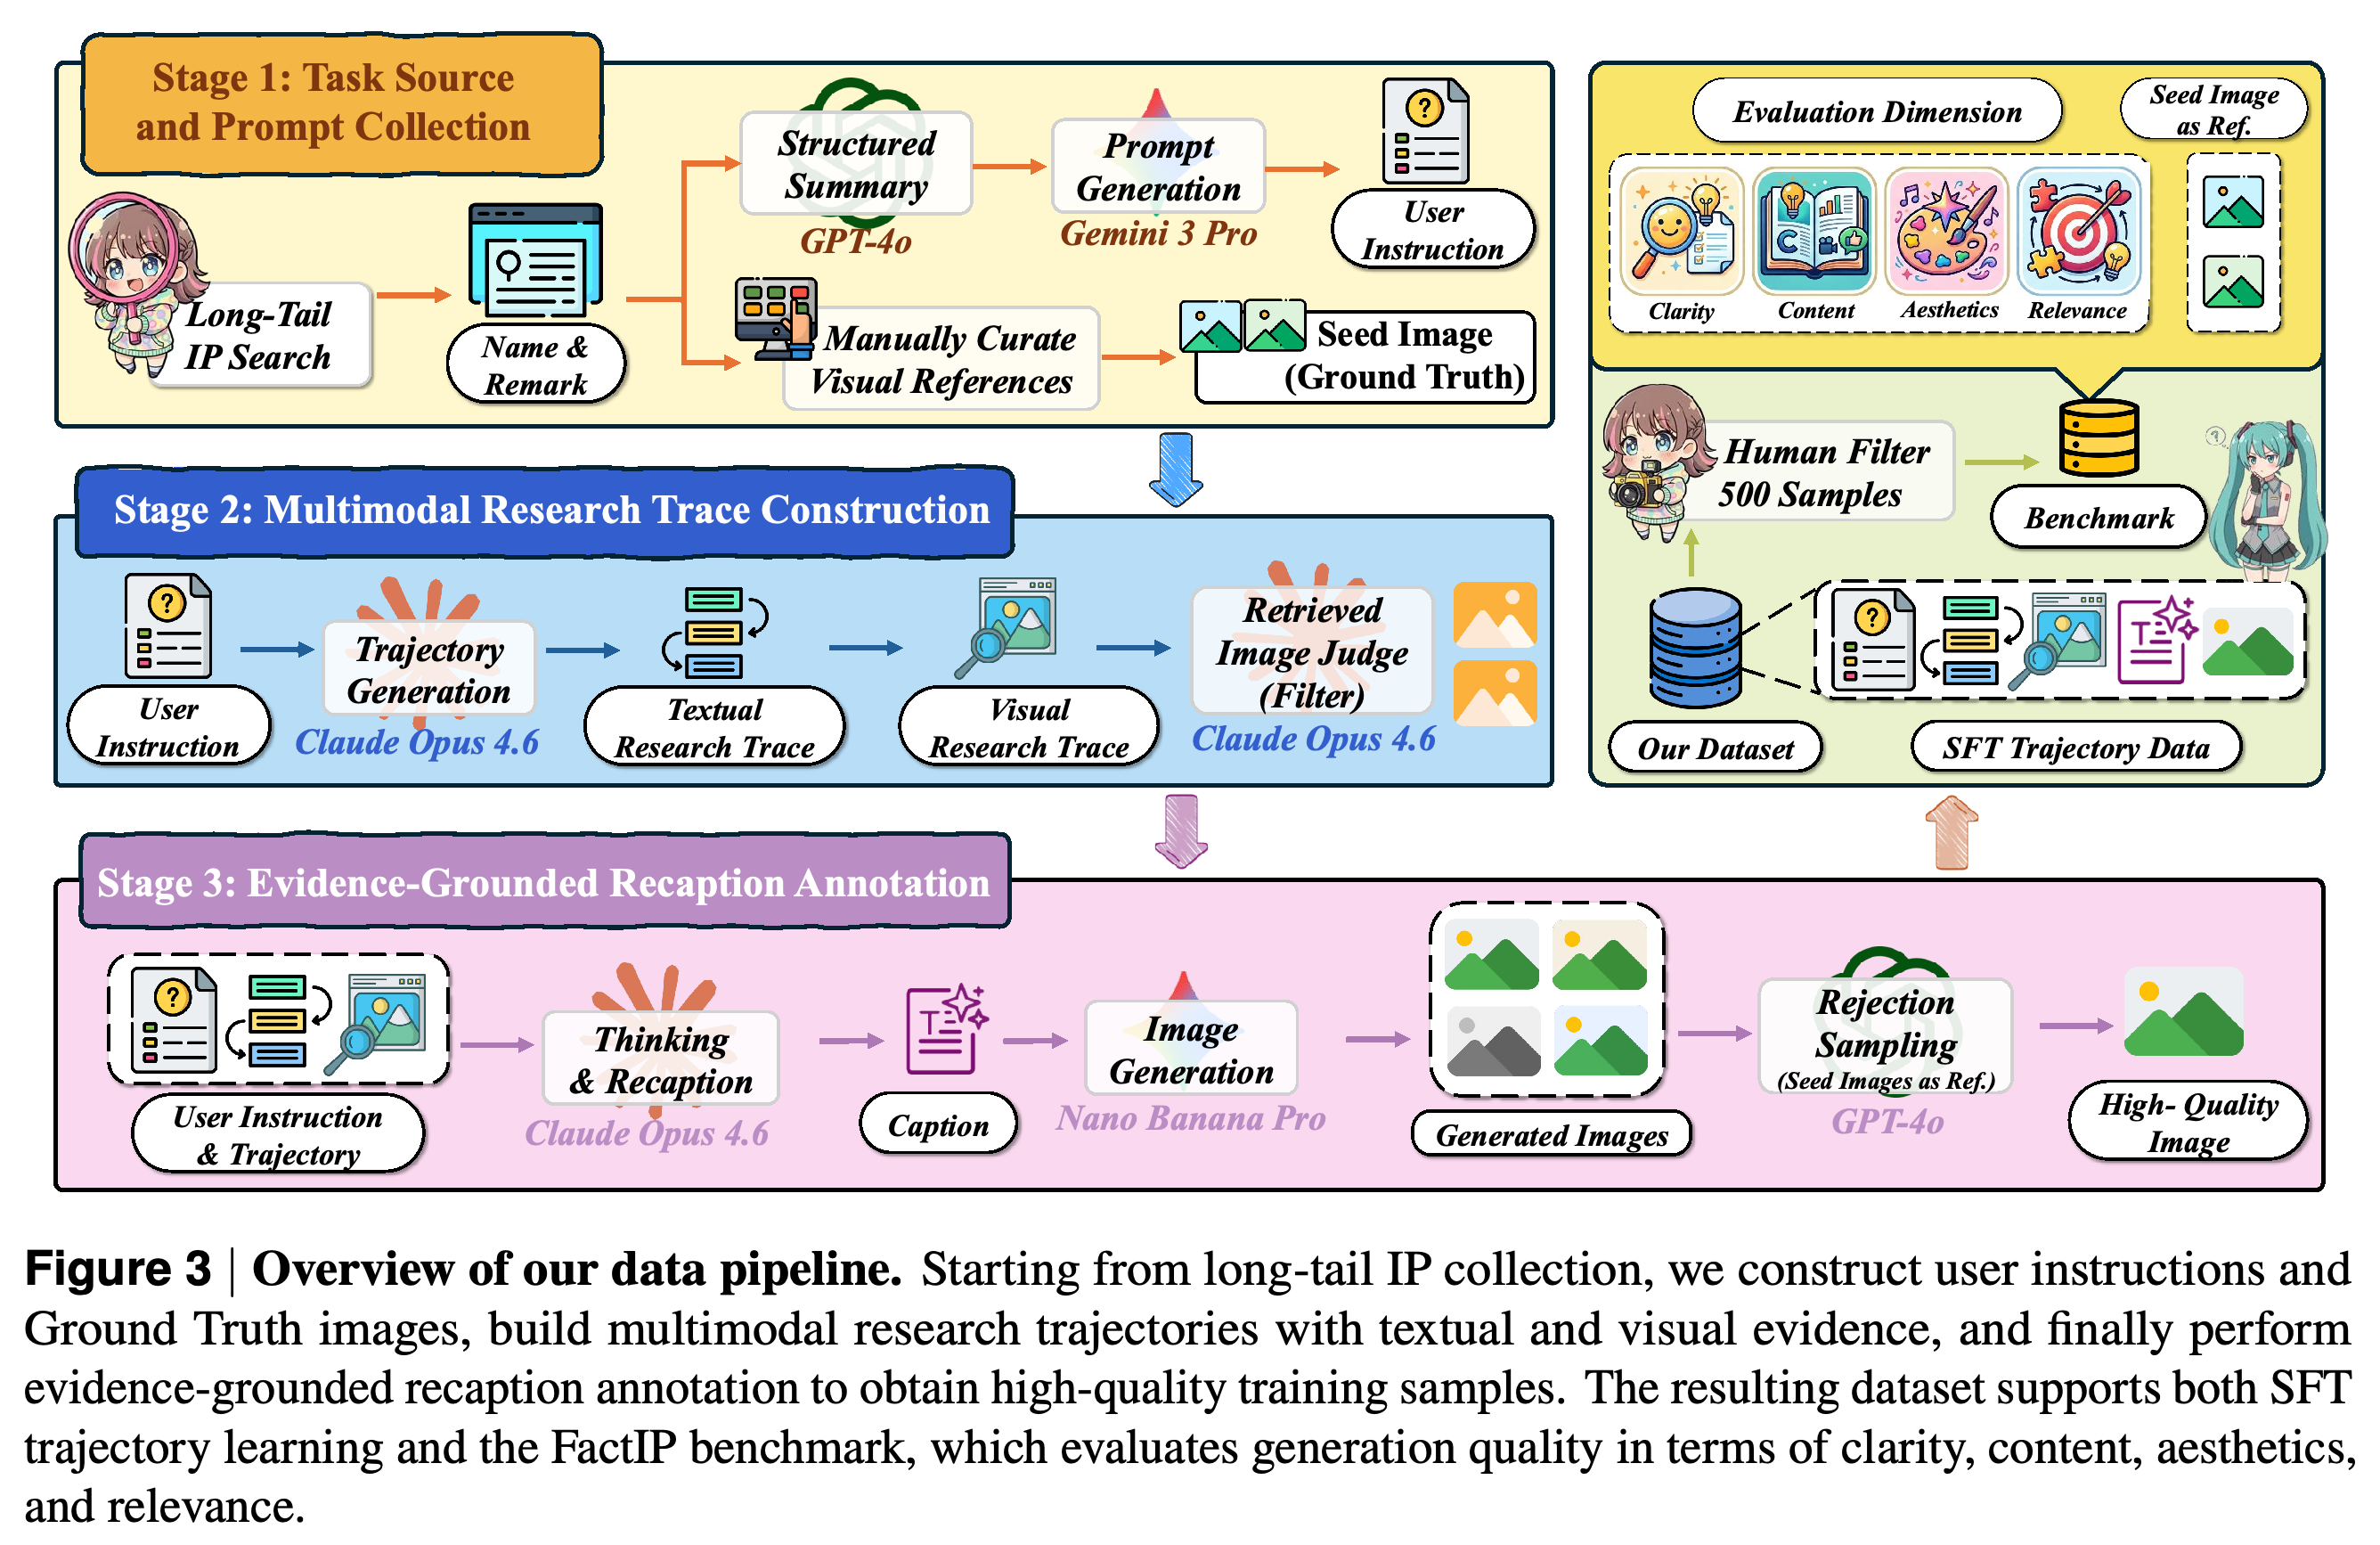
데이터 파이프라인은 에이전트 미세 조정을 위한 과정 지도 데이터와 별도의 평가 벤치마크를 만든다. Figure 3은 개념 수집, 프롬프트와 참조 준비, 멀티모달 조사, recaption 주석 작성, 생성 기반 검증 과정을 보여준다.
- 학습 지도는 최종 합성 목표뿐 아니라 근거 수집과 변환도 다룬다.
- 벤치마크는 같은 과제 풀에서 구축하지만, 지도 미세 조정에서 제외한 별도의 부분집합을 사용한다.
4.1 Training Data Construction
Training Data Construction은 12개 도메인에 걸쳐 수작업으로 검증한 예시 456K개에서 시작한다. BabelNet과 Wikipedia 정보, 대표 시드 이미지 2개, GPT-4o 메타데이터 요약, Gemini 3 Pro 프롬프트를 사용한다. 조사 과정 구축과 생성 기반 검증을 거쳐 실행 궤적-이미지 쌍 143K개를 남긴다.
- 4.1.1 Task Source and Prompt Collection: 주석 작성자는 잘못된 메타데이터, 품질이 낮은 참조, 지나치게 흔한 개념을 제거한다. 생성된 프롬프트는 정체성을 보존하도록 요구하면서 자세, 의상, 장면, 조명, 스타일을 다양하게 바꾼다.
- 4.1.2 Multimodal Research Trace Construction: Claude Opus 4.6은 텍스트 조사 후 시각적 조사를 구성하여, 의미를 명확히 한 결과가 이미지 쿼리에 반영되도록 한다.
- 텍스트 조사는 실행한 쿼리와 검색된 근거의 요약을 기록한다. 시각적 조사는 프롬프트, 정보 부족 평가, 앞선 텍스트 근거를 조건으로 쿼리를 작성한다.
- 본문은 Gemini 3 Flash를 후보 이미지 평가자로 명시한다. 이 평가자는 정체성 일관성, 대상의 두드러짐, 선명도, 워터마크가 없는 정도를 평가한 뒤 상위 이미지 2개를 선택한다. 반면 Figure 3은 검색 평가자를 Claude Opus 4.6으로 표기한다.
- Trace representation and supervision은 텍스트 쿼리와 근거에 이어 시각적 쿼리와 선택된 이미지를 기록하여, 근거 수집을 명시적인 지도 학습 목표로 삼는다.
- 4.1.3 Evidence-Grounded Recaption Annotation은 사용자가 요청한 구도, 의미적 배경, 정체성에 중요한 시각적 단서를 생성 명세로 결합한다.
- Nano Banana Pro는 recaption과 참조 이미지 2개로 검증 이미지를 생성한다. GPT-4o는 시드 이미지와 비교하여 정체성 일관성을 확인한다. 거부 샘플링은 최대 5회 시도를 허용하며, 이후에도 실패한 실행 궤적은 폐기한다.
도식은 생성 전에 조사와 근거 변환을 지도하고, 이후 생성 기반 거부 샘플링을 수행하는 과정을 보여준다. 벤치마크 준비와 학습 데이터 생성을 구분한다. 검색 평가자 표기는 Claude Opus 4.6으로, 본문에서 명시한 Gemini 3 Flash 평가자와 다르다.
4.2 FactIP Evaluation Benchmark
FactIP는 Character, Object, Scene에 걸쳐 시각적으로 식별 가능한 롱테일 개념을 12개 세부 하위 범주로 평가한다. 전체 벤치마크는 프롬프트 2,462개를 포함하고, FactIP-Mini는 범주 분포를 유지하면서 500개를 샘플링한다. Appendix D.2는 보고된 모든 FactIP 결과가 이 미니 분할을 사용한다고 명시한다.
- 각 샘플은 사용자 지시, 정답 시드 이미지 2개, 목표 메타데이터를 포함한다. 평가 사례는 미세 조정에서 제외한다.
- 선정 과정은 지식 집약적인 개념, 명확한 시각적 정체성, 암기만으로 생성하기 어려운 대상, 범주 다양성을 우선한다.
- Seed2.0은 참조 이미지를 함께 고려하면서 Clarity, Content, Aesthetics, Relevance를 각각 정수 0–10 척도로 독립적으로 평가한다.
- 가중 점수는 Clarity에 0.05, Content에 0.10, Aesthetics에 0.10, Relevance에 0.75를 부여하고, 결과에 10을 곱해 [0, 100] 점수를 산출한다.
- Section 4.2.1은 수작업으로 필터링한 샘플 2,500개를 설명하지만, 서론과 Appendix D는 감소 과정을 자세히 설명하지 않고 전체 벤치마크 크기를 2,462개로 제시한다.
5 Methodology
방법론은 텍스트와 이미지가 교차 배치된 에이전트 실행 궤적에 대한 지도 학습과 추론 시 근거 수집 및 통합을 결합한다. 핵심 인터페이스는 정체성 제약을 사용자가 요청한 구도와 스타일에서 분리하는 근거 기반 recaption이다.
5.1 Unified Fine-Tuning on Multimodal Agent Trajectories
Unified Fine-Tuning on Multimodal Agent Trajectories는 서로 다른 유형의 샘플을 시퀀스로 패킹하고 LSFT = Ltext + Limage를 최적화한다. 텍스트 지도는 추론, 도구 호출, recaptioning을 다루며, 이미지 지도는 VAE를 동결한 상태에서 잠재 공간의 flow matching을 유지한다.
- <think>, <tool_call>, <recaption> 같은 특수 실행 궤적 토큰에는 더 높은 교차 엔트로피 가중치를 부여하여 구조적 경계와 실행 가능한 형식을 강화한다.
- 별도의 지도 마스크가 학습 목표를 제어한다. 텍스트 전용 실행 궤적 구간은 Ltext에 기여하고, 이미지 생성 샘플은 Ltext와 Limage 모두에 기여한다.
- 혼합 마스크는 텍스트 추론에 인과적 어텐션을 적용하고, 참조 시각 토큰 블록 내부에는 완전 어텐션을 적용한다.
- 생성 토큰은 참조 시각 토큰과 recaption 토큰에 접근할 수 있지만, 이전 조사 텍스트나 원래 텍스트 입력에는 직접 접근할 수 없다. Figure 6은 이 제한을 시각화한다. 다만 이 제한은 문맥화된 표현을 통한 이전 정보의 간접 전달까지 배제하지는 않는다.
5.2 Unify-Agent: Inference-Time Multimodal Agentic Pipeline
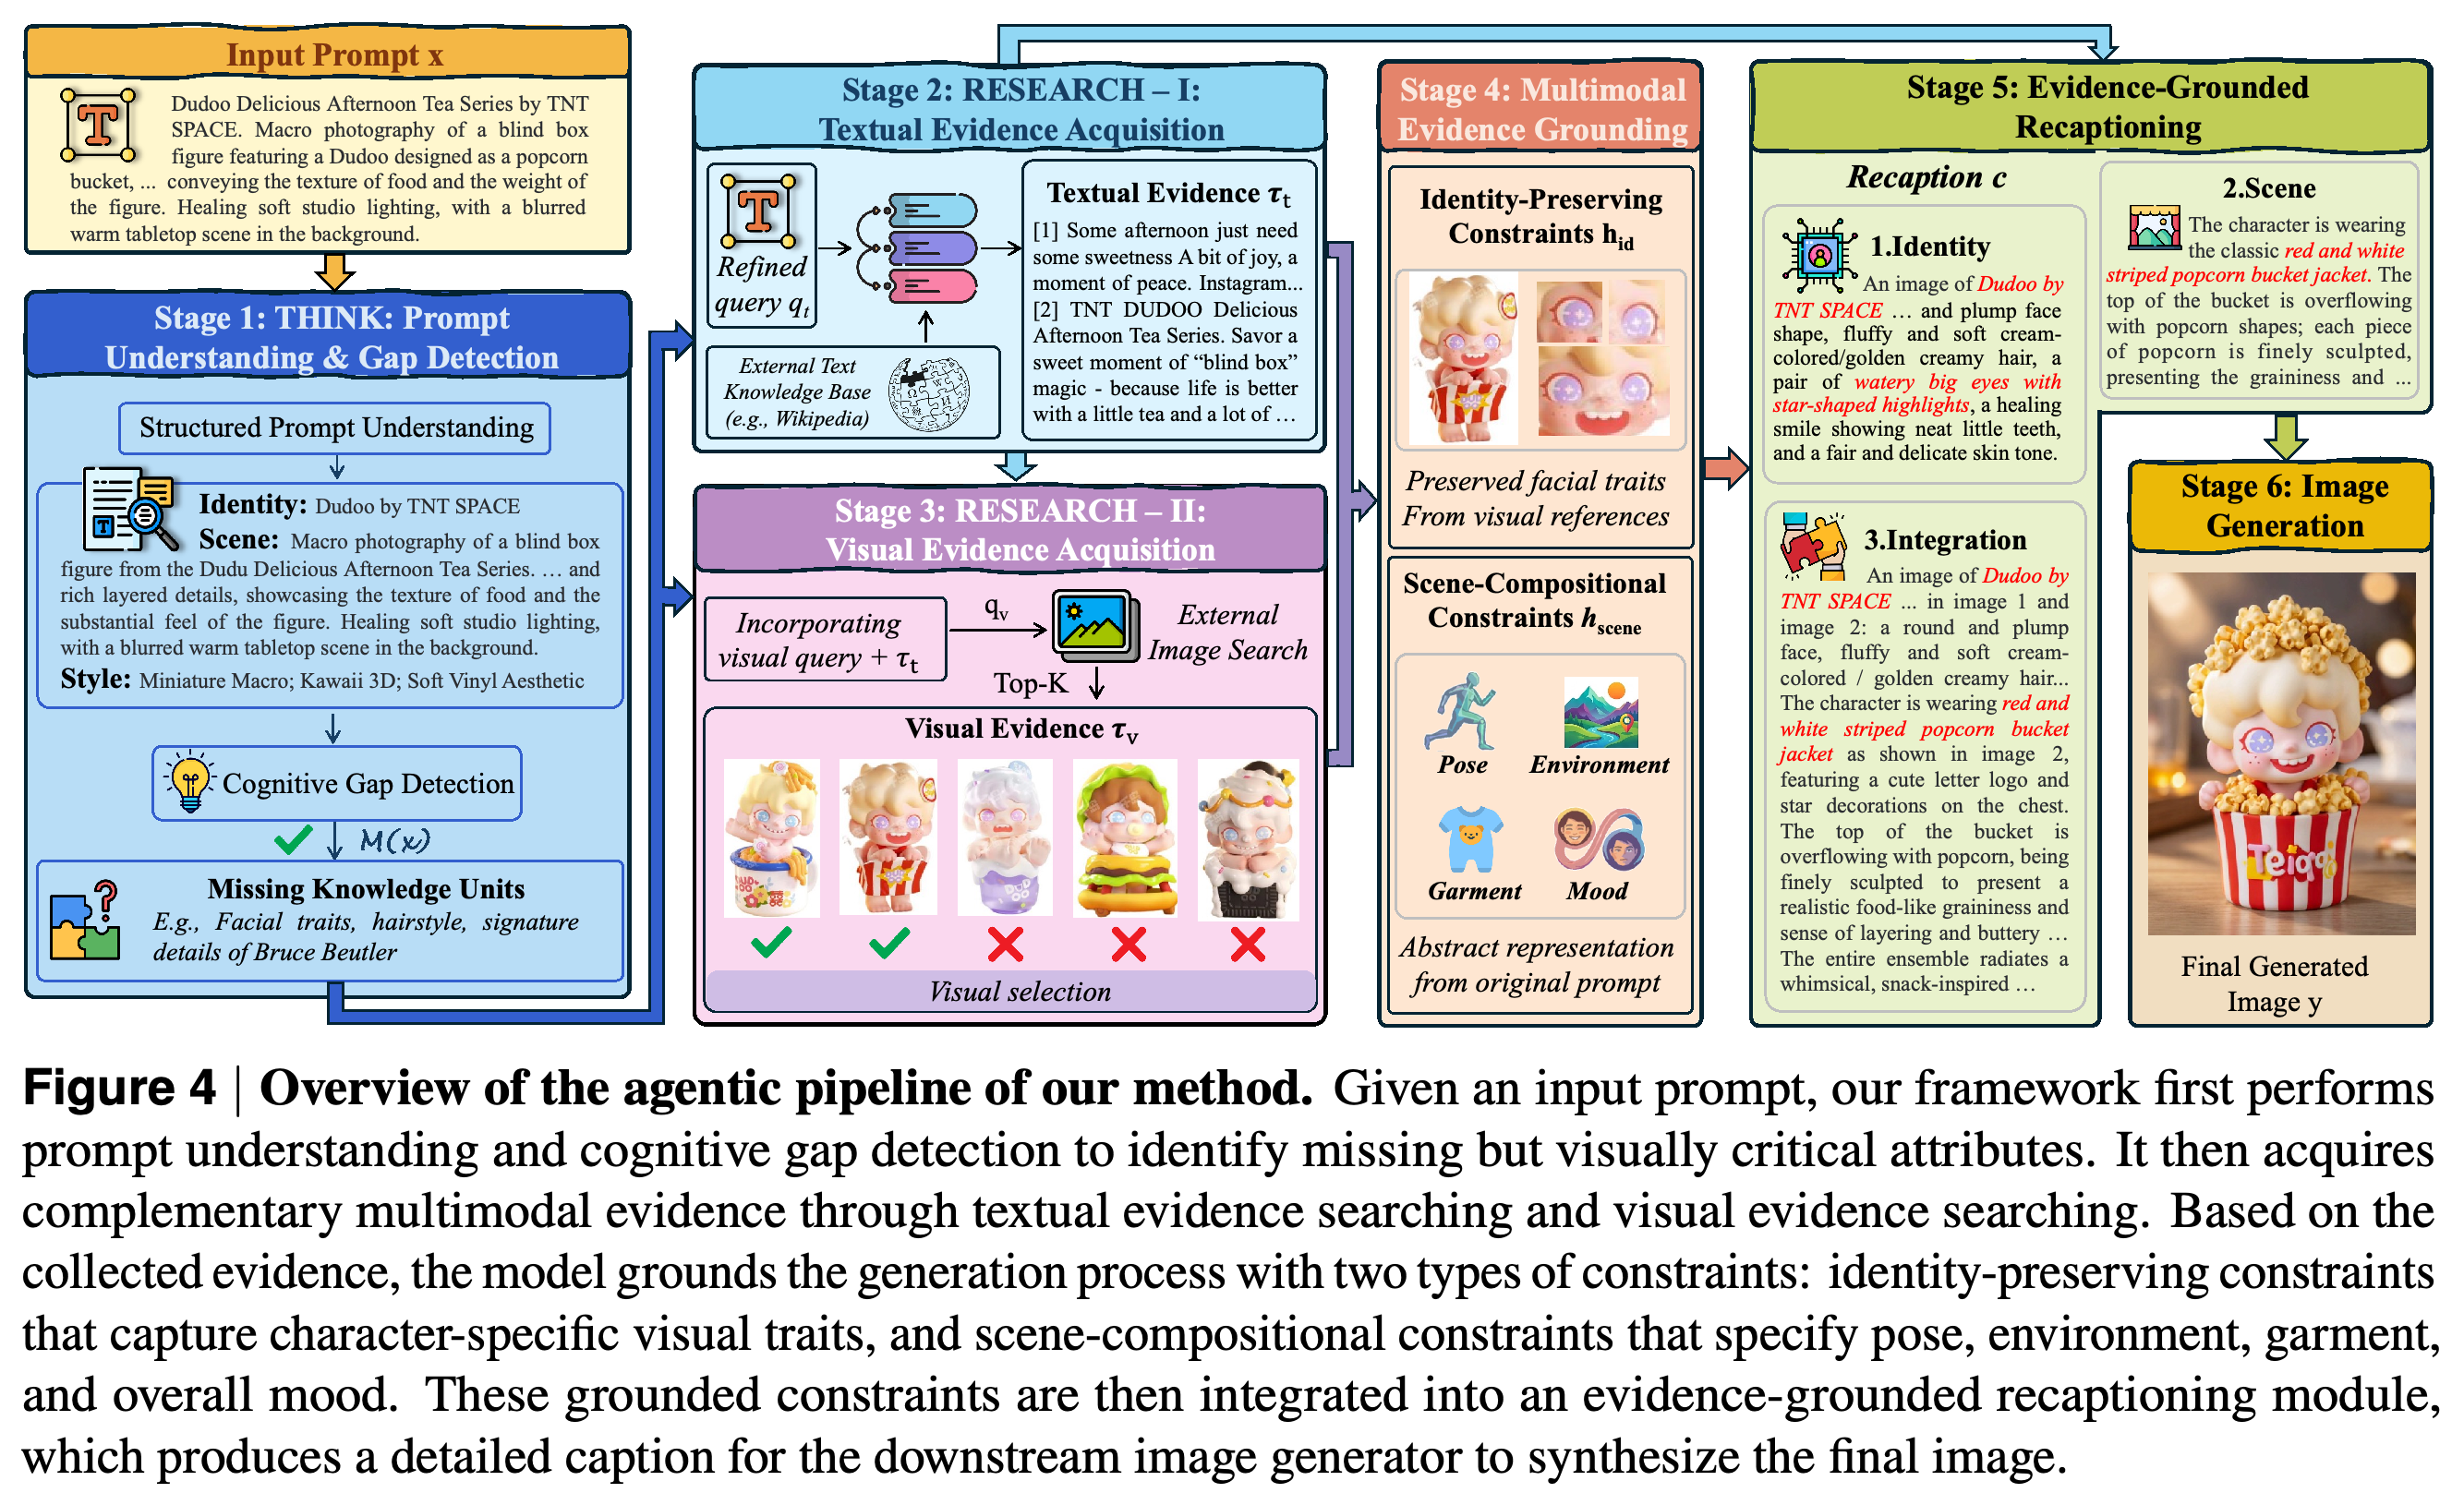
추론 시 Think는 프롬프트를 분해하고, 시각적으로 중요한 정보 중 무엇이 부족한지 파악한다. Research는 텍스트 근거를 확보한 뒤 적합한 시각 참조를 검색한다. Recaption은 근거를 정체성 보존 제약과 장면 구성 제약으로 변환하고, Generate는 recaption과 시각적 참조를 바탕으로 이미지를 합성한다.
- Think는 부족한 정보를 얼굴 구조, 머리 모양, 고유한 외형, 객체 기하 구조, 사실에 부합하는 장면 세부사항 같은 지식 단위로 표현한다. 정보 부족이 발견되지 않으면 모델은 조사를 생략할 수 있다.
- Research는 개체 이름만 사용하는 대신 프롬프트 의도와 앞선 텍스트 근거를 조건으로 시각적 쿼리를 작성한다.
- Recaption은 대상 고유의 외형을 유지하면서 자세, 환경, 의복, 분위기, 구도, 표현 방식을 명시한다.
- Generate는 이전 텍스트 이력 전체에 대한 직접적인 조건화를 차단하고, 제어 가능한 묘사는 recaption에, 외형은 시각적 참조에 의존한다.
- Figure 4는 DUDOO 팝콘 버킷 피규어와 매크로 사진 요청을 통해 이 단계들을 보여준다.
DUDOO 예시는 짧은 제품 프롬프트가 상세한 합성 명세로 변환되는 과정을 보여준다. 선택한 참조에서 추출한 외형 속성을 매크로 사진 및 장면 요건과 분리한 뒤 recaption에 통합한다.
6 Experiments
실험은 참조에 기반한 대상 정체성 합성, 폭넓은 세계 지식, 세밀한 개체 정합성, 사실적 개념 구성을 평가한다. 벤치마크 비교와 함께 파이프라인, 제약, recaption 단계의 시각 표현에 대한 제거 실험을 수행한다.
6.1 Experimental Details
비교 대상에는 상용 생성기, 생성 전용 모델, 통합 멀티모달 모델이 포함되며, Bagel을 기본 모델 기준으로 사용한다. GPT-4o는 WiSE, KiTTEN, T2I-FactualBench를 평가하고, Seed2.0은 FactIP를 평가한다.
- 상용 비교 모델에는 Seedream 계열, Nano Banana 변형, DALLE-3, GPT-Image 모델이 포함된다. 그 밖의 비교 대상에는 FLUX, Stable Diffusion, Qwen-Image, Janus, Emu, Hunyuan-Image가 포함된다.
- Appendix A는 NVIDIA H20 GPU 64개에서 약 10일 동안 10,000번의 그래디언트 스텝으로 Bagel-14B를 미세 조정했다고 보고한다.
- 학습에는 AdamW를 사용한다. 워밍업 500스텝 이후 학습률을 5 × 10⁻⁵로 고정하고, 최대 그래디언트 노름을 5.0으로 설정한다. CE와 MSE 가중치는 모두 1.0이며, 특수 토큰 CE 가중치는 3.0이다.
- 논문은 검색 예산을 맞춘 비교, 추론 지연 시간 비교, 신뢰 구간, 평가자 일치도를 종합적으로 확인한 인간 검증 연구를 보고하지 않는다.
6.2 Main Results
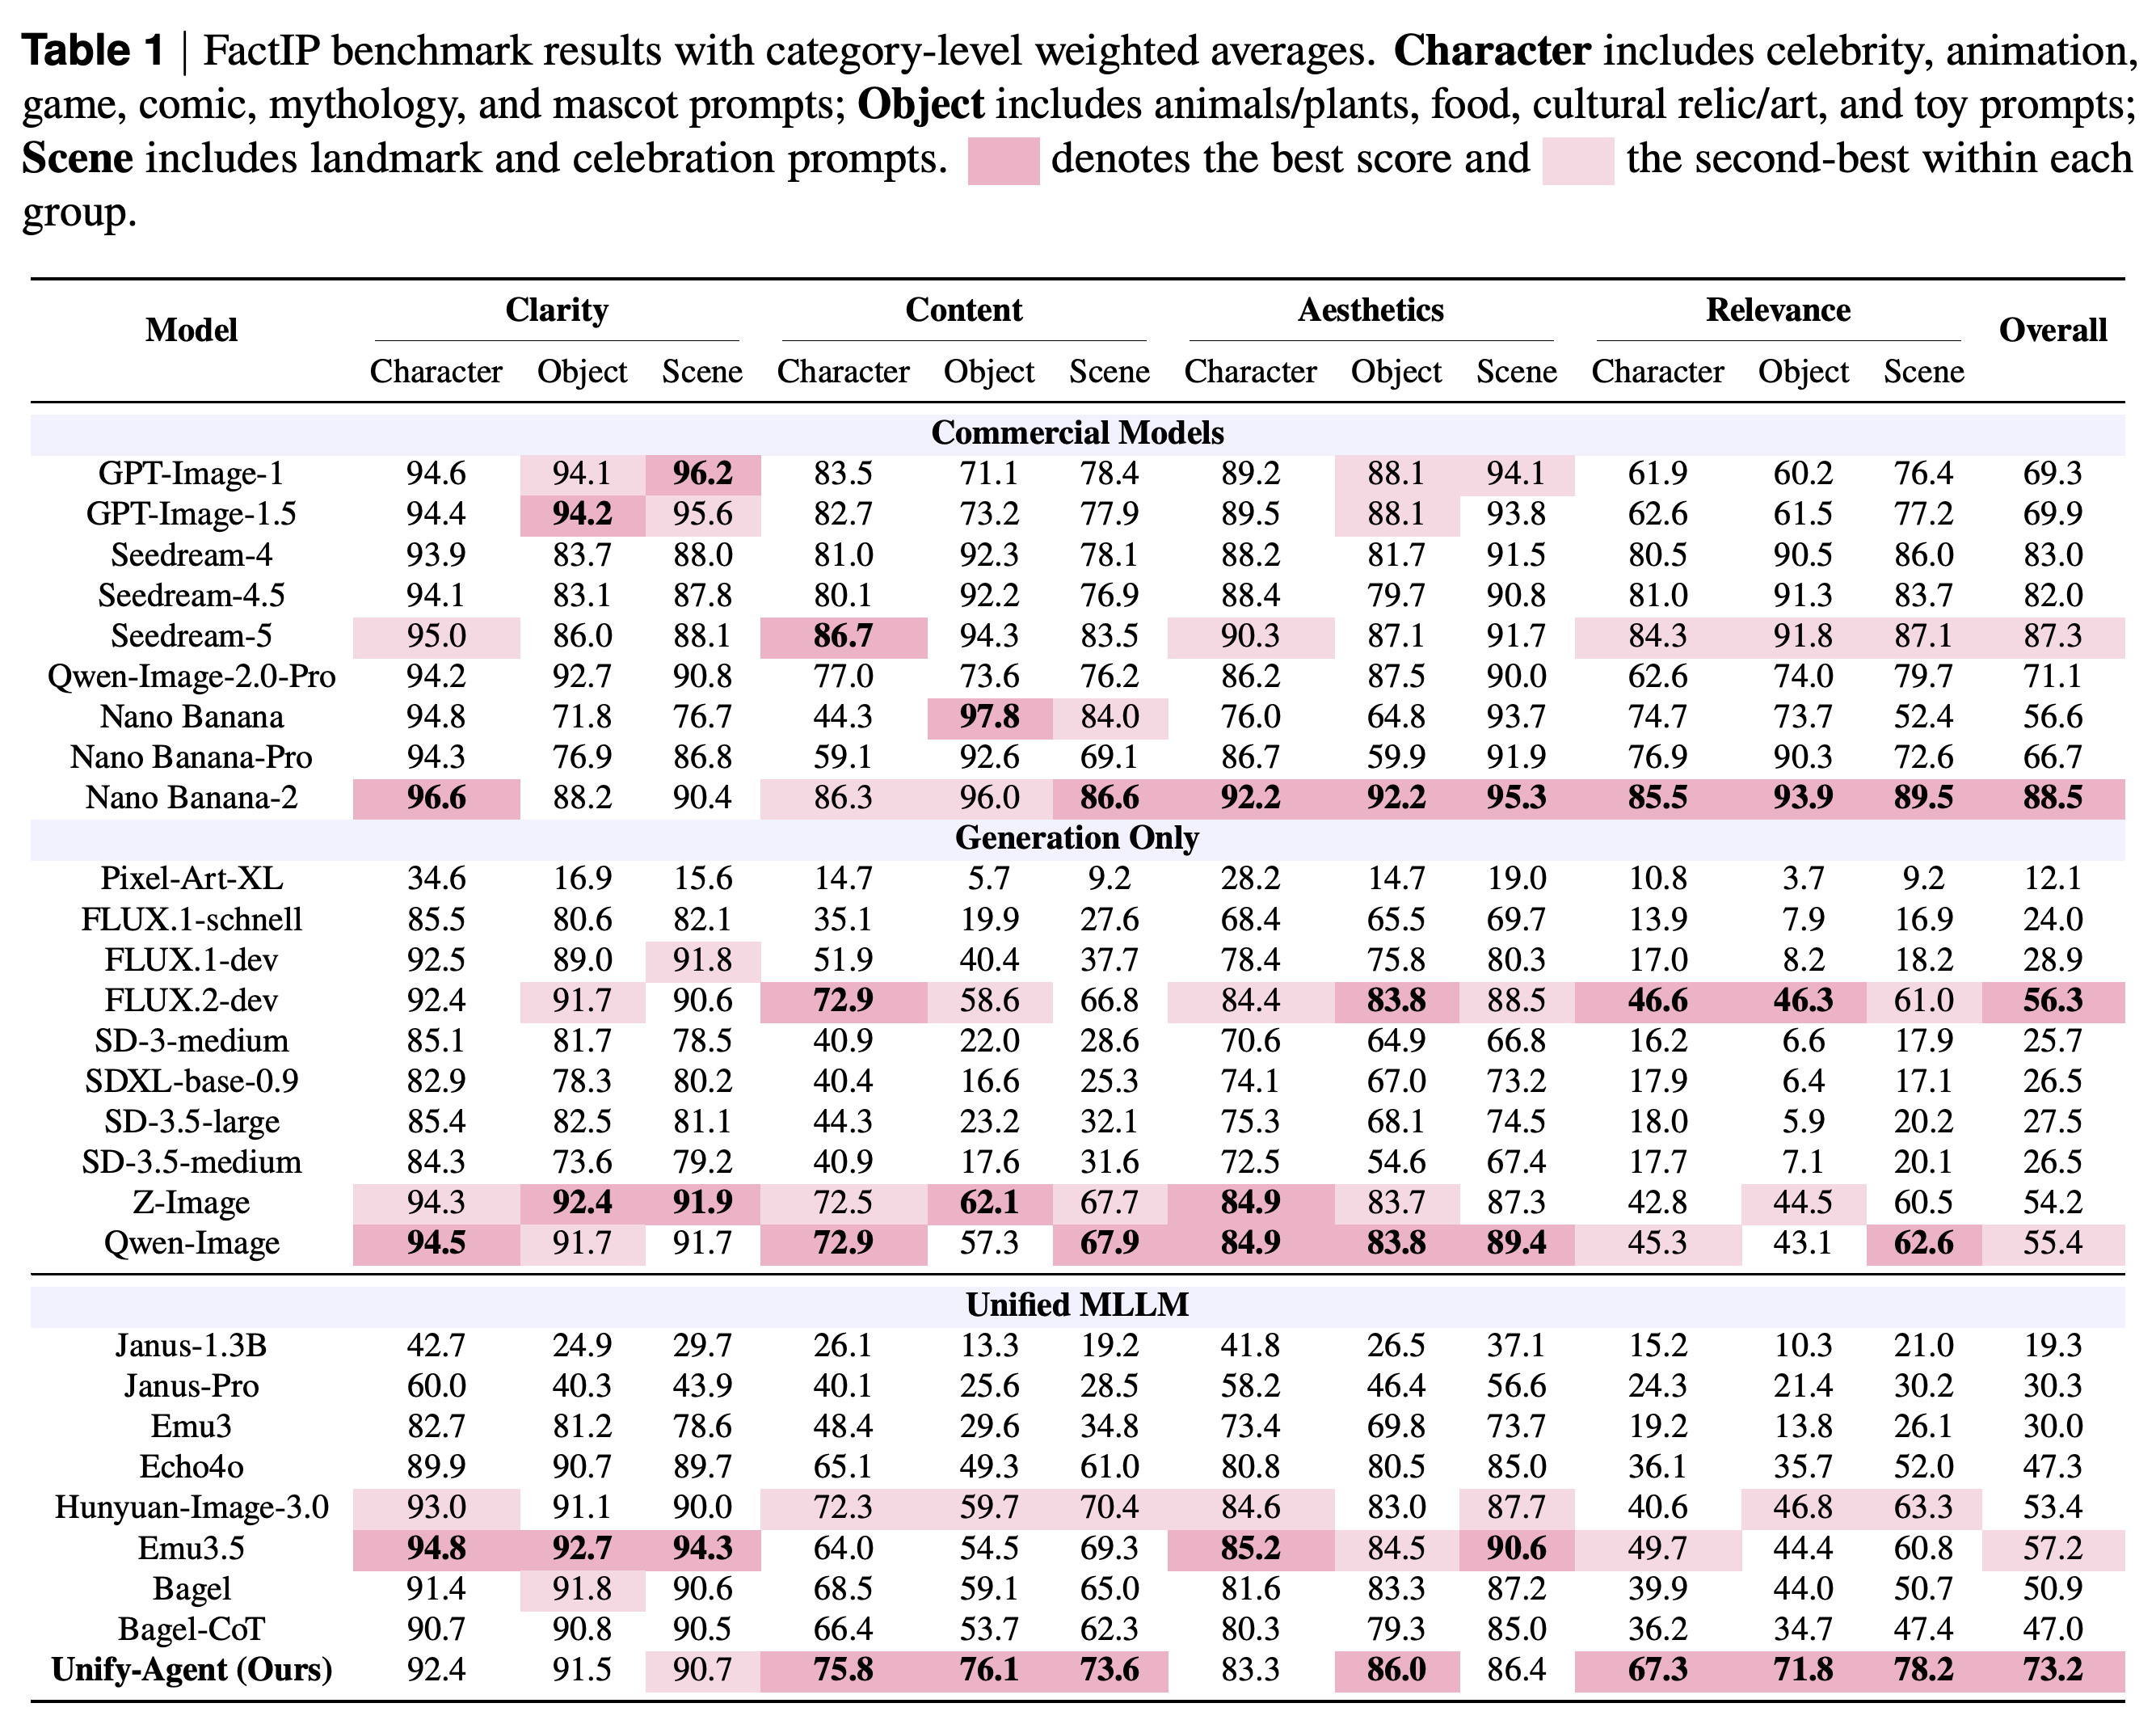
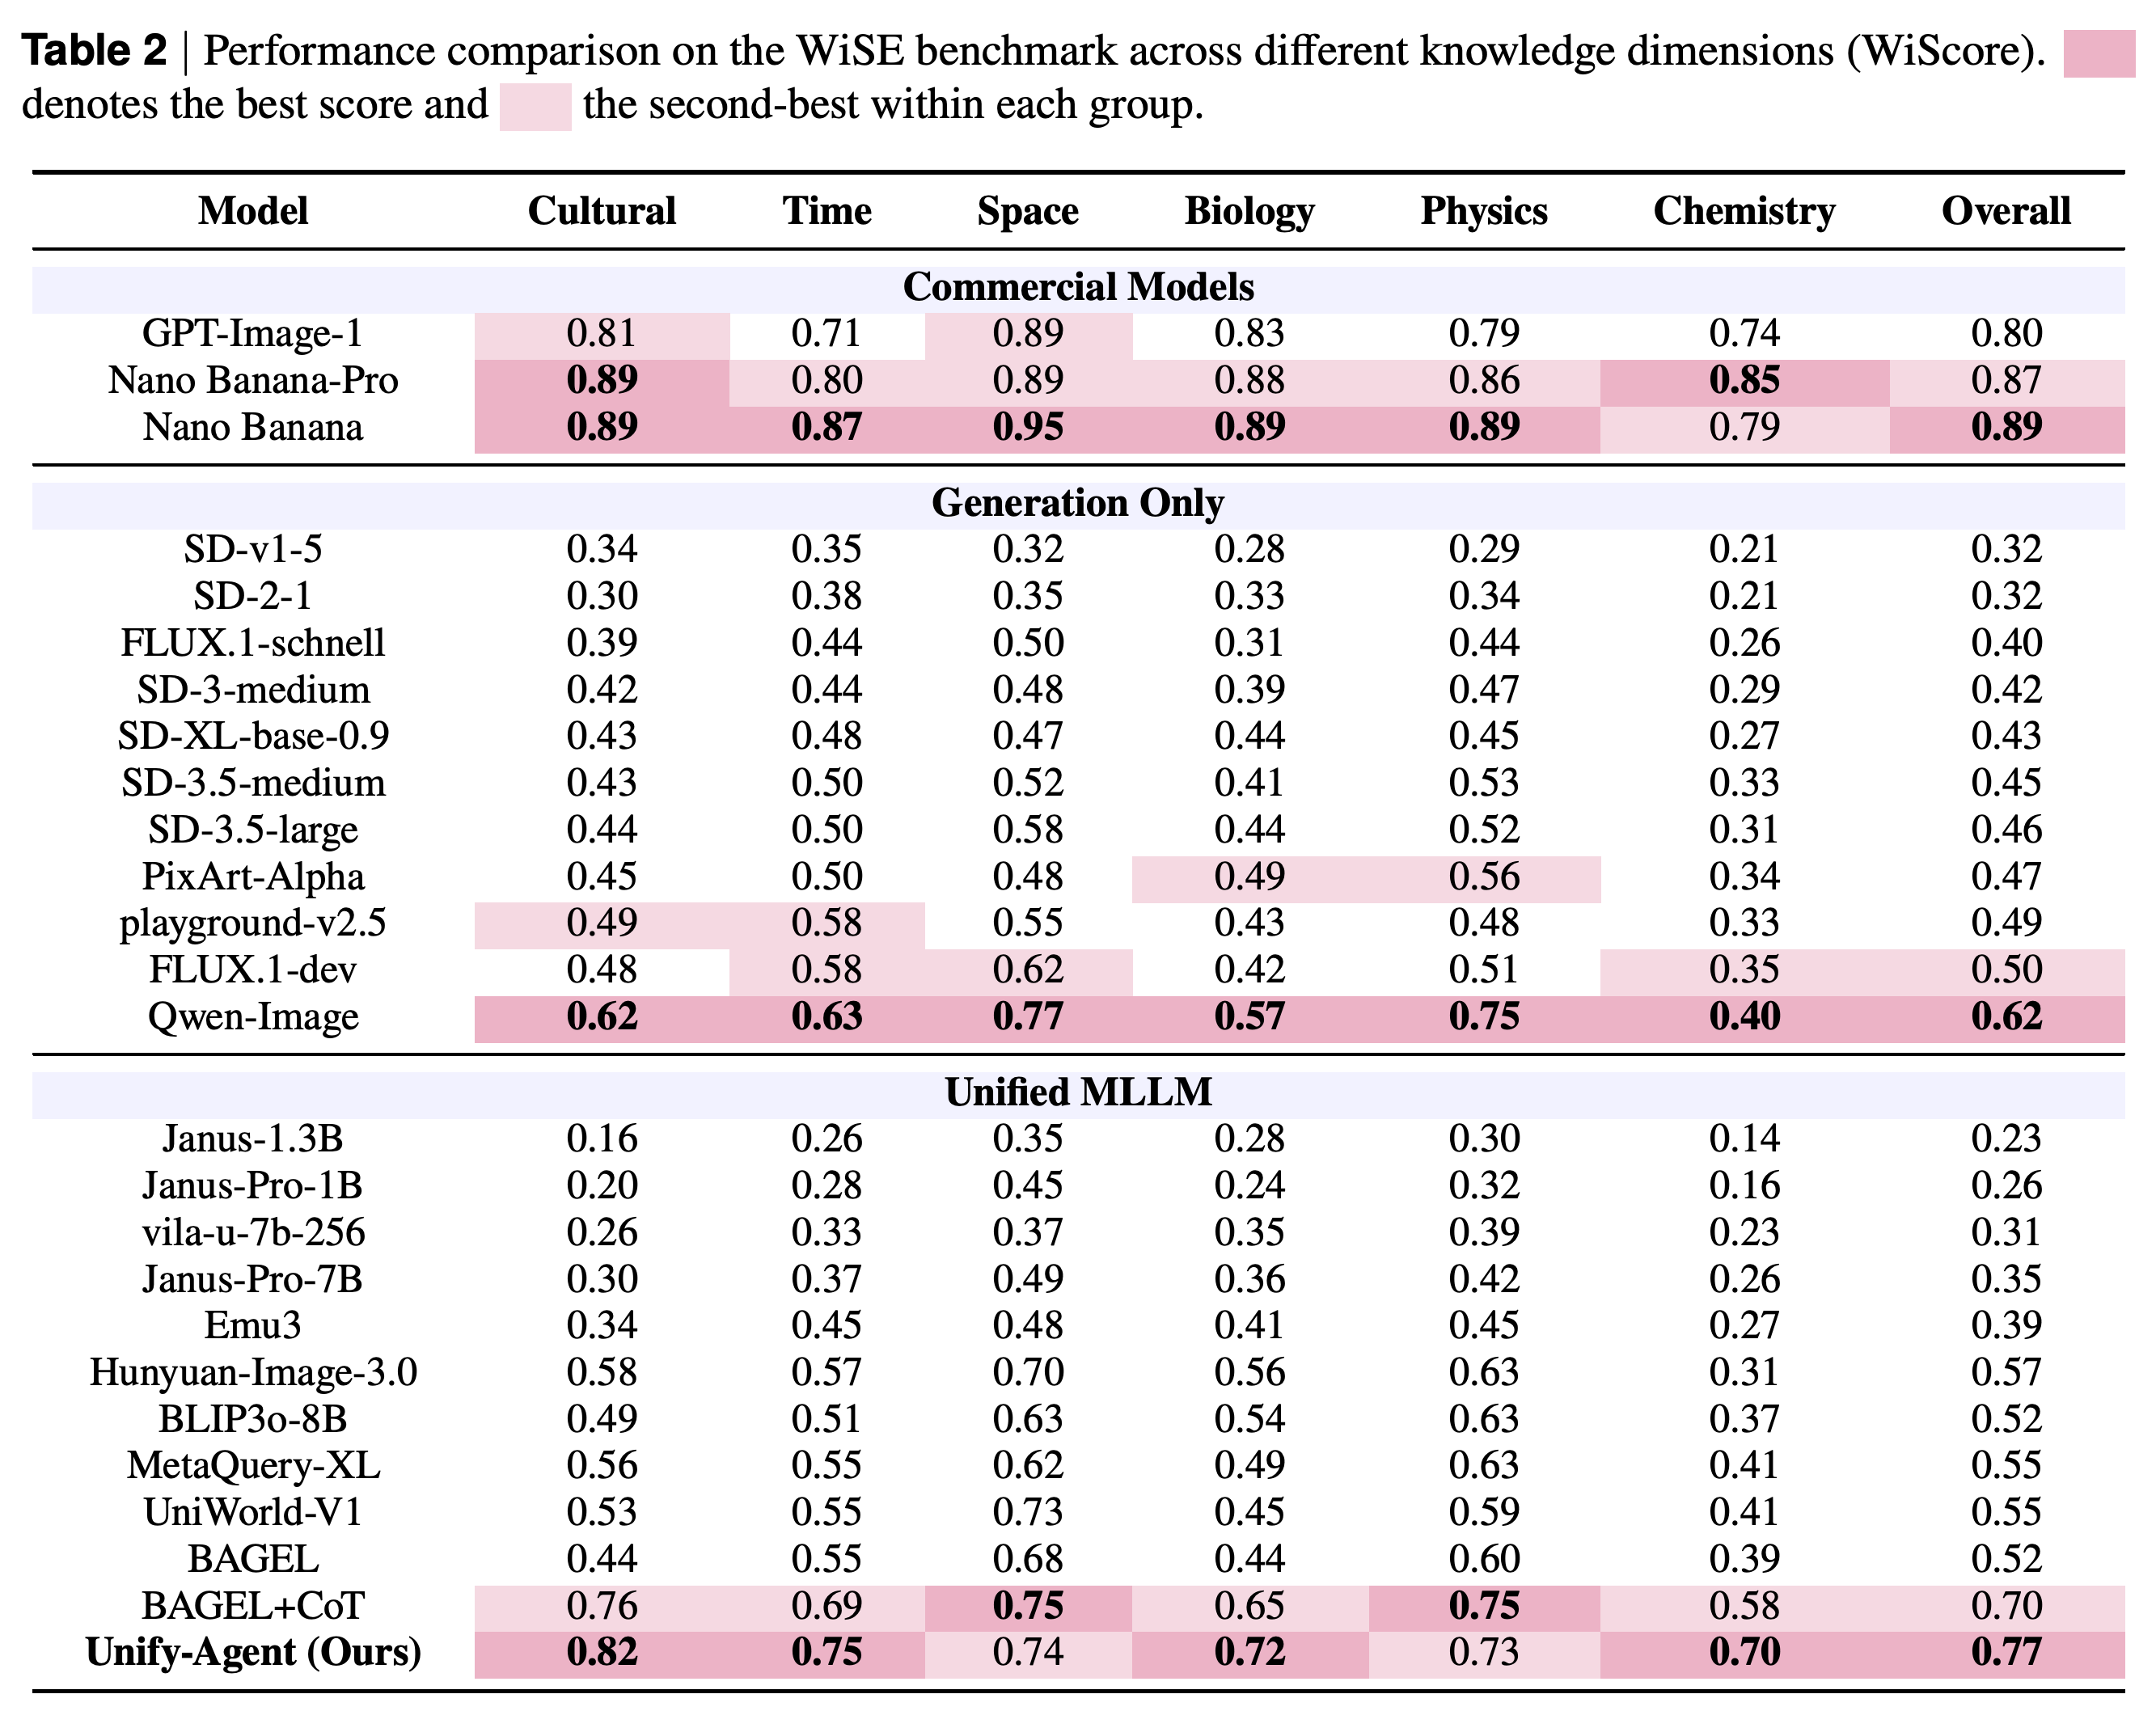
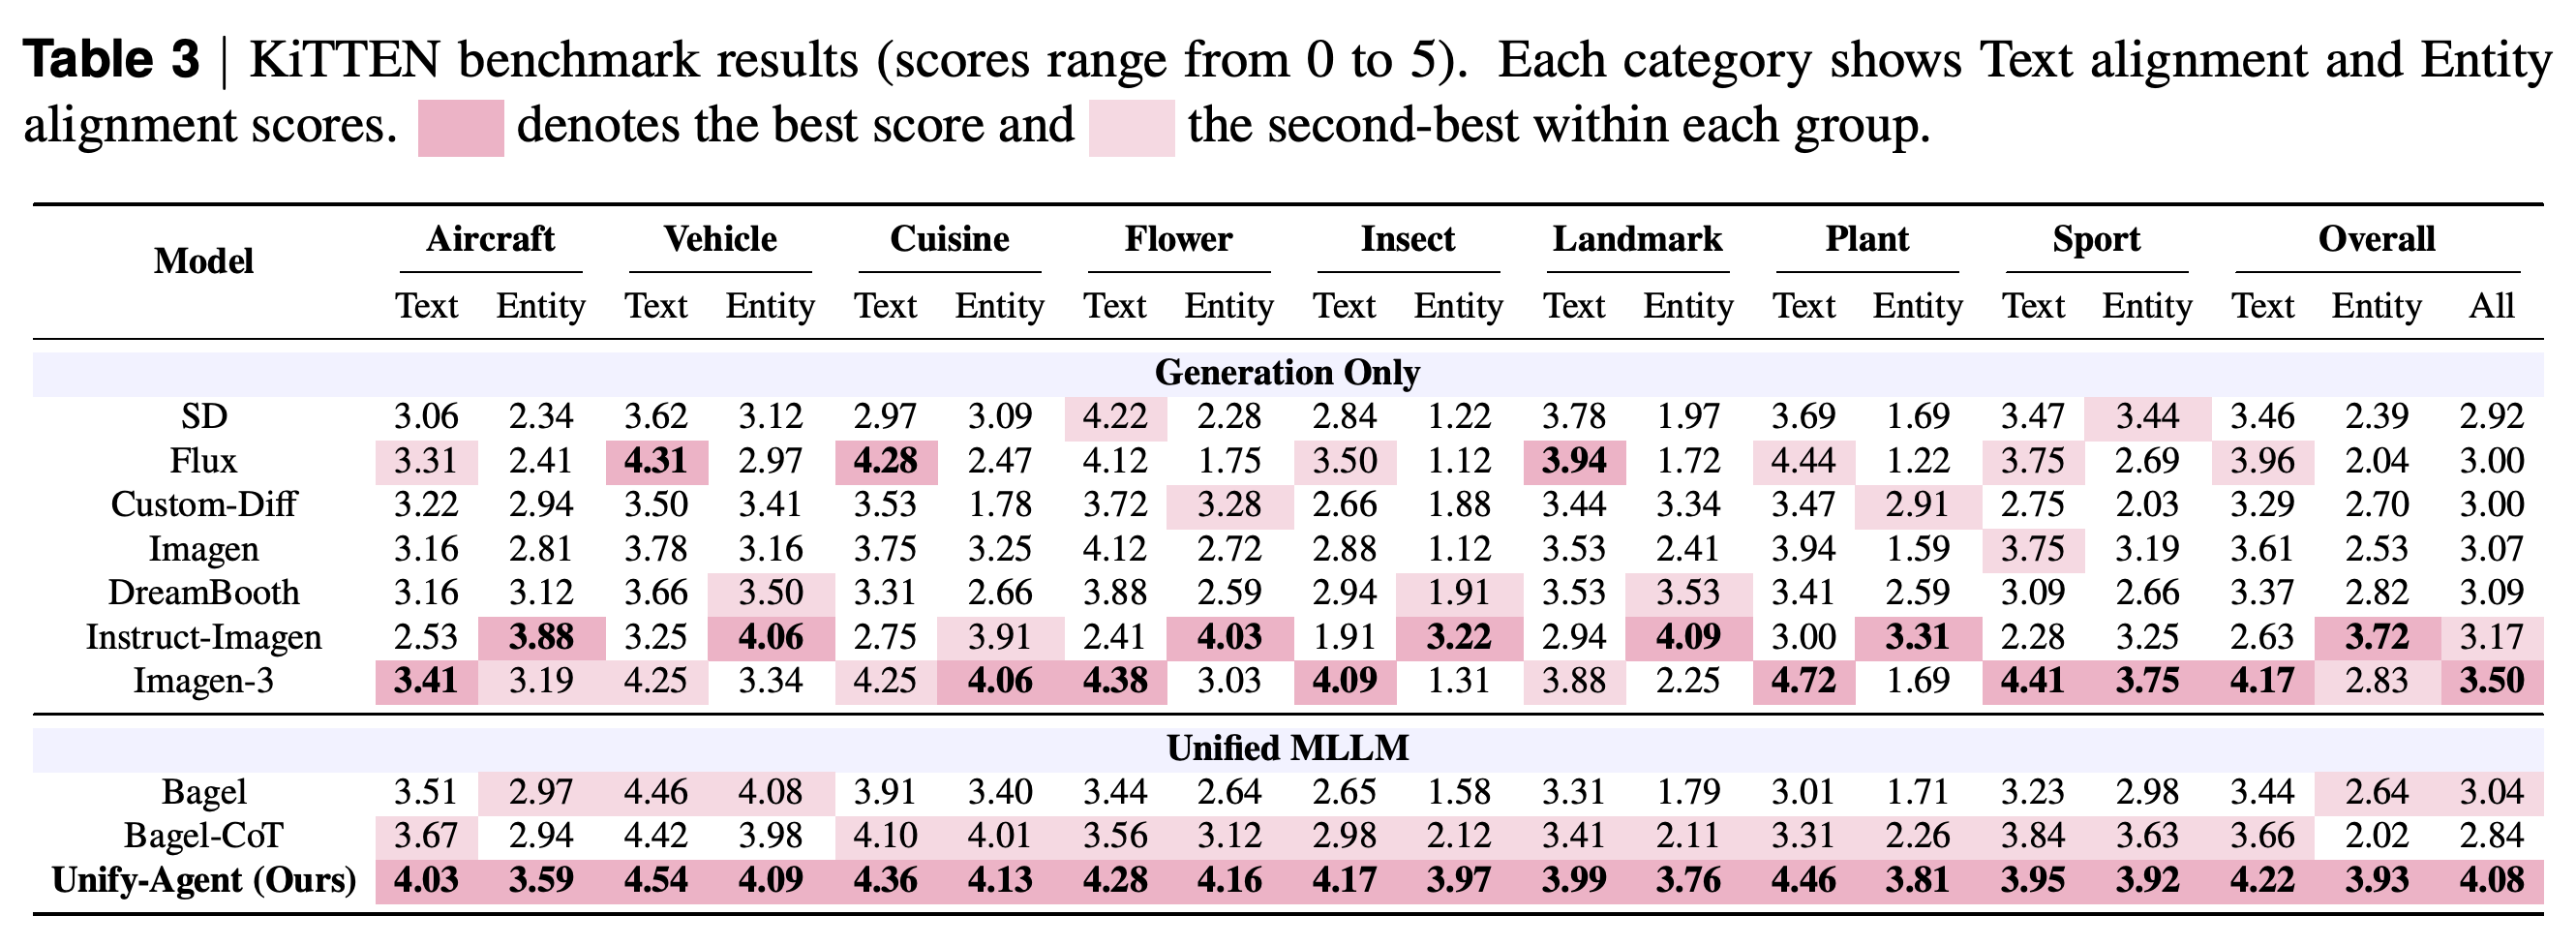
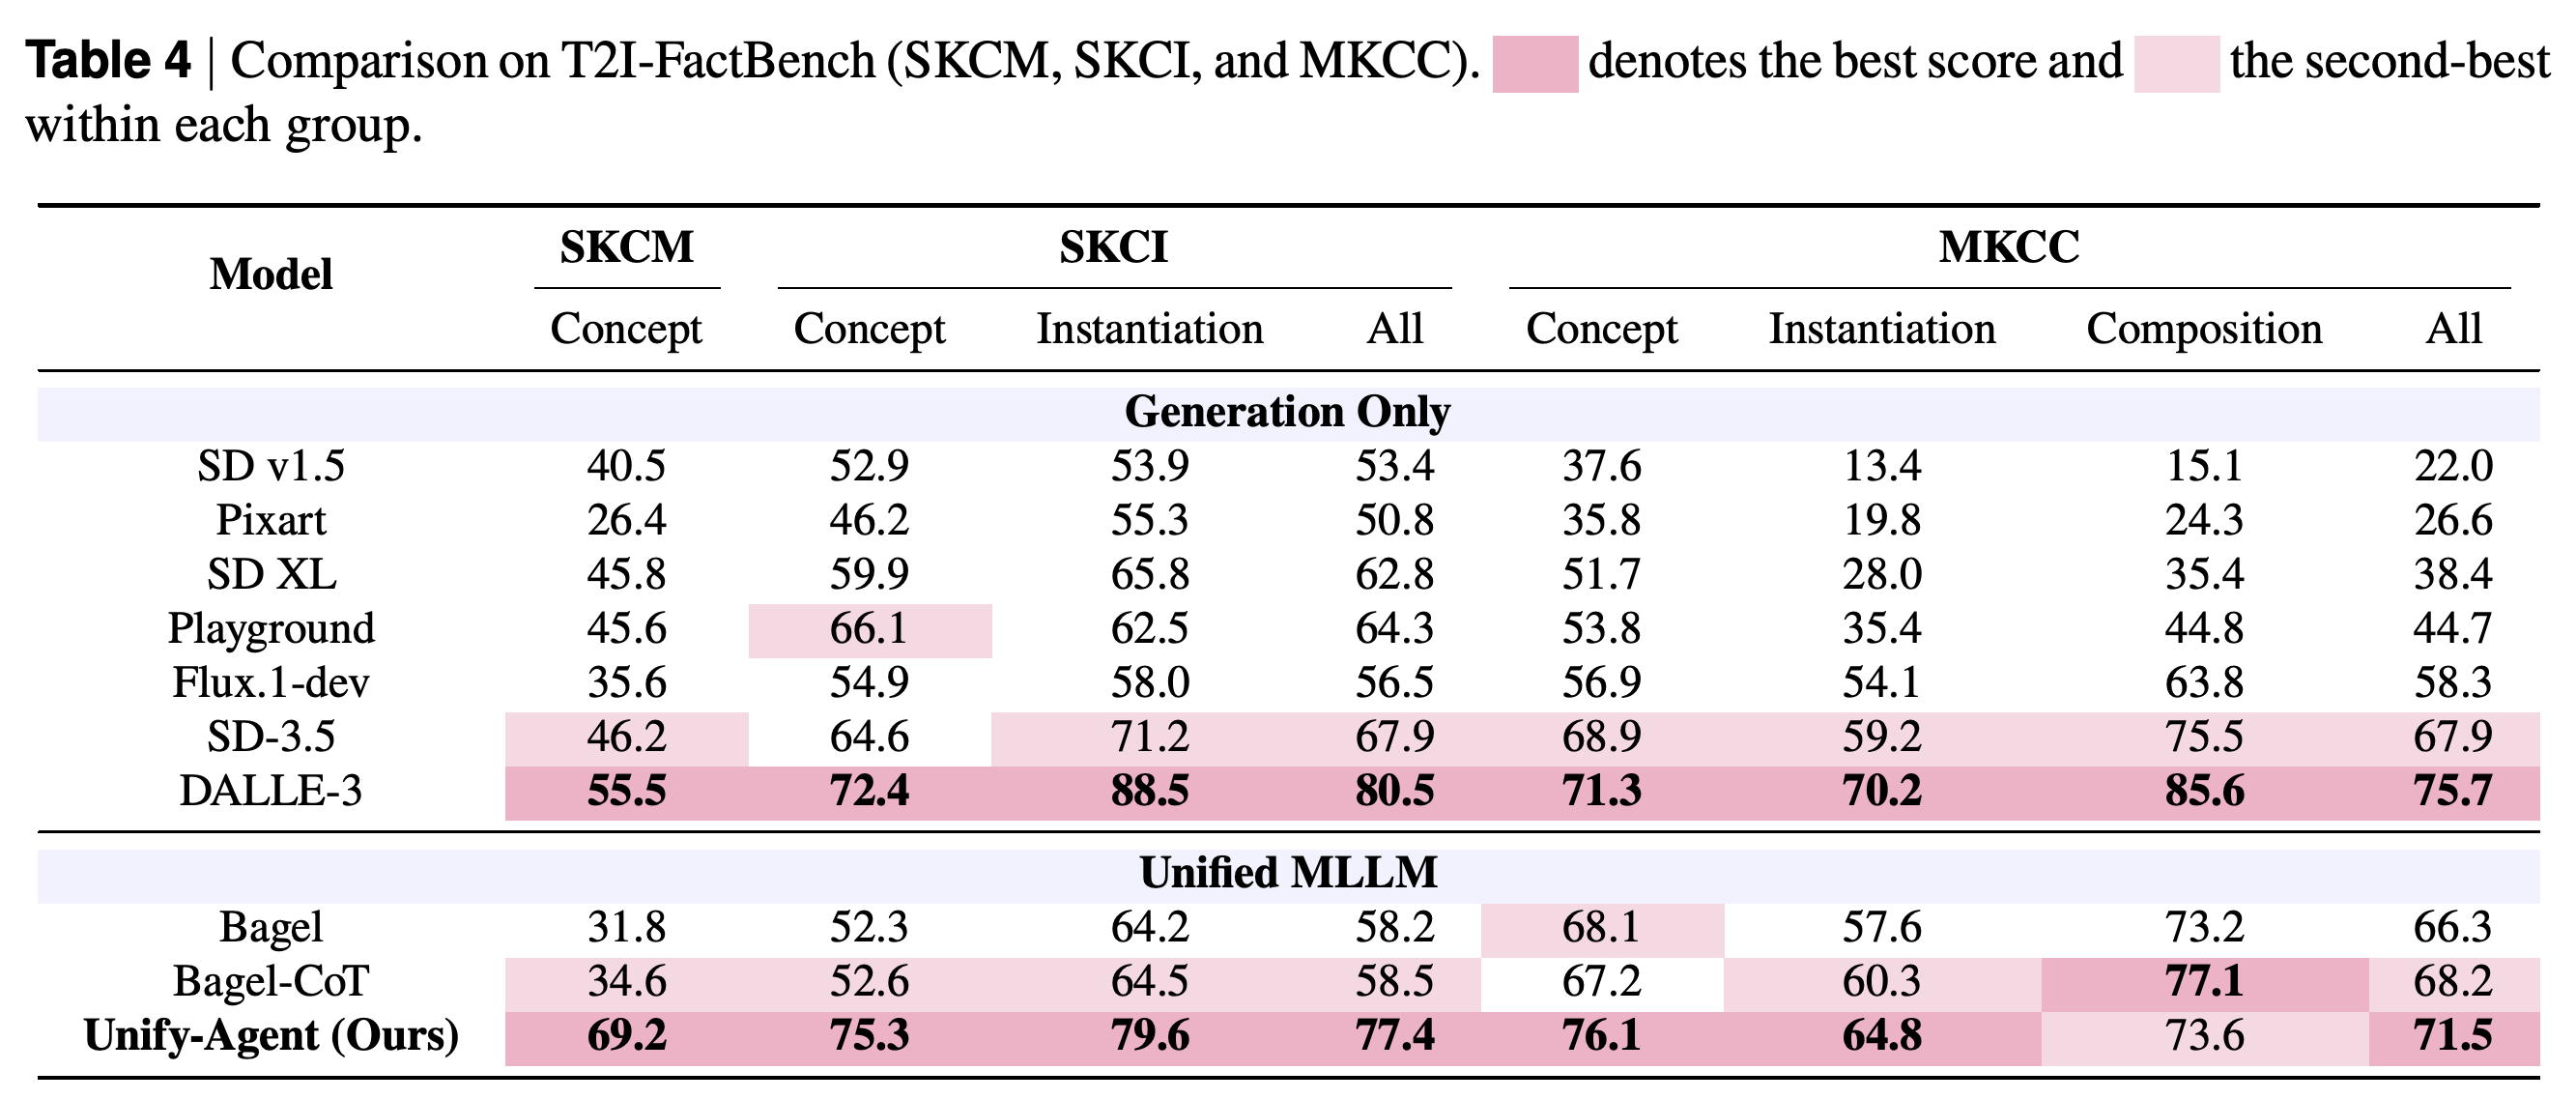
Tables 1–4는 4개 벤치마크 모두에서 Bagel 대비 개선을 보고하며, FactIP의 향상은 정체성 관련성에 집중된다. Unify-Agent는 주요 점수에서 나열된 통합 모델 중 가장 높은 성능을 보이지만, 이 평가 전반에서 가장 강력한 상용 생성기를 능가하지는 않는다.
- FactIP: Overall은 50.9에서 73.2로 22.3점 상승한다. Character, Object, Scene의 Relevance는 각각 67.3, 71.8, 78.2에 도달한다. Nano Banana-2와 Seedream-5의 Overall은 각각 88.5와 87.3으로 더 높다.
- WiSE: Unify-Agent는 0.77을 기록하며, BAGEL은 0.52, BAGEL+CoT는 0.70이다. Cultural, Biology, Chemistry 점수는 각각 0.82, 0.72, 0.70이다. Space와 Physics에서는 BAGEL+CoT가 약간 높으며, Nano Banana의 Overall은 0.89다.
- KiTTEN: Text alignment는 4.22, Entity alignment는 3.93, Overall은 4.08이며, Imagen-3의 해당 점수는 각각 4.17, 2.83, 3.50이다. Unify-Agent는 Overall에서 나열된 모델을 앞서지만, 개별 범주 점수가 모두 가장 높지는 않다.
- T2I-FactBench: SKCM Concept는 69.2, SKCI All은 77.4, MKCC All은 71.5에 도달하며, Bagel의 해당 점수는 각각 31.8, 58.2, 66.3이다. DALLE-3는 SKCI All에서 80.5, MKCC All에서 75.7로 여전히 더 높다.
- KiTTEN의 Bagel-CoT 행은 종합 Entity alignment를 2.02로 보고한다. 이는 해당 행의 모든 범주별 Entity 점수보다 낮으므로, 표시된 범주 점수에 음이 아닌 가중치를 적용한 평균으로는 설명할 수 없다.
Unify-Agent는 나열된 통합 모델 중 가장 높은 Overall인 73.2를 기록하며, Bagel은 50.9다. 범주별 Relevance는 크게 개선되지만, Nano Banana-2와 Seedream-5의 Overall은 각각 88.5와 87.3으로 여전히 더 높다.
Unify-Agent의 WiSE Overall은 0.77로, BAGEL의 0.52와 BAGEL+CoT의 0.70보다 높다. Cultural, Time, Biology, Chemistry에서는 통합 모델 그룹을 앞서지만, Space와 Physics에서는 그렇지 않다. Overall은 나열된 상용 모델보다 여전히 낮다.
Unify-Agent는 Text alignment 4.22, Entity alignment 3.93, Overall 4.08을 보고하며, 모든 범주에서 앞서지는 않지만 표시된 종합 점수에서는 가장 높다. Bagel-CoT의 종합 Entity 점수 2.02는 표시된 모든 범주별 Entity 점수보다 낮아, 해결되지 않은 보고 불일치를 보여준다.
SKCM Concept는 Bagel의 31.8에서 69.2로 상승하며, SKCI All과 MKCC All은 각각 77.4와 71.5에 도달한다. 다중 개념 구성 성능은 여전히 고르지 않다. Unify-Agent의 Composition 점수 73.6은 Bagel-CoT의 77.1과 DALLE-3의 85.6보다 낮다.
6.3 Analysis of Experimental Results
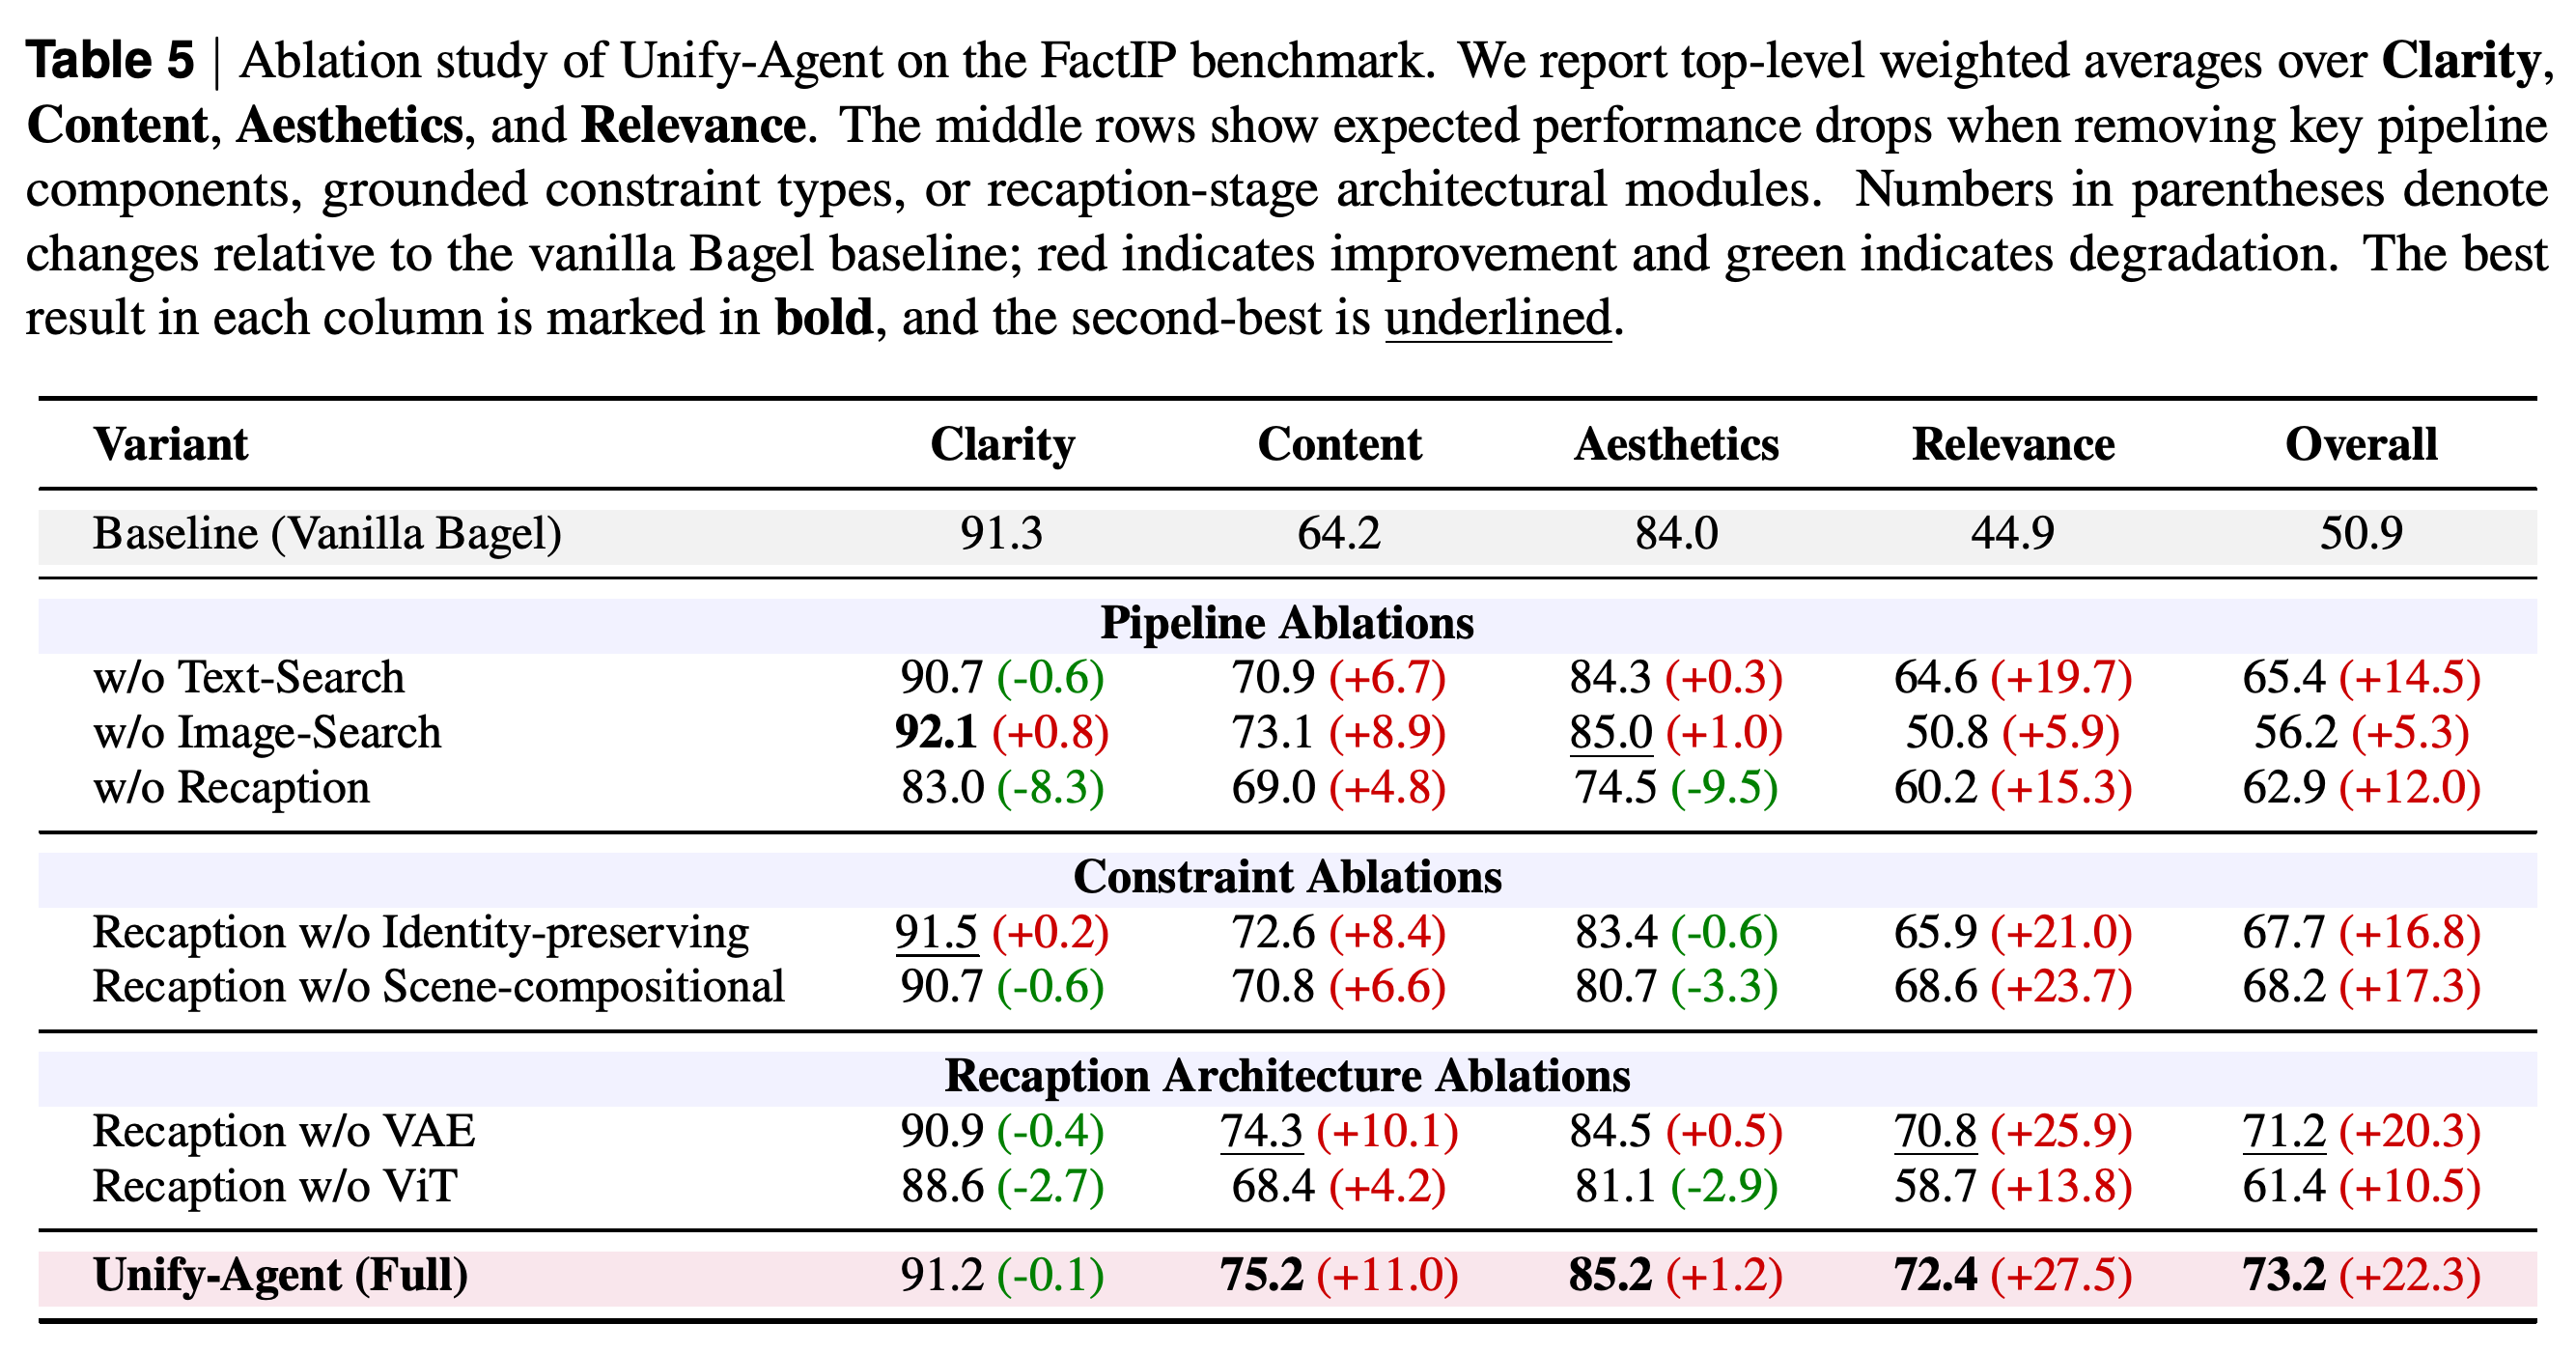
Table 5에서 전체 파이프라인은 FactIP Relevance를 44.9에서 72.4로 높이지만, Clarity는 기본 Bagel의 91.3과 거의 같은 91.2다. 따라서 측정된 이점은 지각적 품질의 전반적인 개선보다 대상의 정체성을 사실에 맞게 보존하는 데 있다.
- 파이프라인 제거 실험: Text-Search, Image-Search, Recaption을 제거하면 Overall은 73.2에서 각각 65.4, 56.2, 62.9로 낮아진다.
- Image-Search를 제거하면 파이프라인 수준에서 Relevance가 가장 크게 하락하여 72.4에서 50.8이 된다. 이는 외형을 직접 참조할 수 있는 시각적 근거의 중요성과 부합한다.
- Recaption을 제거하면 Clarity도 83.0, Aesthetics도 74.5로 낮아진다. 이는 구조화된 근거 통합이 정체성 일치뿐 아니라 합성 품질에도 도움이 됨을 시사한다.
- 제약 제거 실험: 정체성 보존 제약을 제거하면 Relevance가 65.9로 낮아진다. 장면 구성 제약을 제거하면 Content가 70.8, Aesthetics가 80.7로 낮아진다.
- 표 주변의 본문은 전체 모델이 모든 지표에서 가장 좋다고 주장하지만, 표에서는 이미지 검색을 제거한 변형의 Clarity가 92.1로 더 높다.
이미지 검색을 제거하면 파이프라인 수준에서 Overall이 가장 크게 하락하며, recaptioning 제거도 선명도와 미적 품질을 낮춘다. ViT 제거는 VAE 제거보다 영향이 커서 상호보완적인 시각 표현의 유용성을 뒷받침한다. 다만 이 생성 점수는 이해 능력 자체의 개선을 직접 입증하지 않는다.
6.4 Finding: Why Generation Helps Understanding in a Unified Model
저자들은 recaption 아키텍처 제거 실험을 생성 표현이 멀티모달 이해를 도울 수 있다는 근거로 해석한다. VAE 입력을 제거하면 Overall이 73.2에서 71.2로 낮아지고, ViT 입력을 제거하면 61.4로 낮아진다. 이는 두 표현이 상호보완적이지만 기여도가 서로 다름을 보여준다.
- ViT를 제거하면 Relevance가 58.7로 낮아지며, VAE를 제거한 경우에는 70.8이다. 이 실험에서는 의미적 경로가 더 큰 영향을 미친다.
- 저자들은 ViT 토큰이 정체성과 관계 해석을 지원하고, VAE 잠재 표현은 recaptioning에 유용한 질감, 재질, 색상, 국소 구조를 유지한다고 설명한다.
- 이 후속 생성 점수는 시스템 내 이중 시각 표현의 유용성을 뒷받침한다. 그러나 이해 능력 자체를 직접 측정하거나 생성 학습의 일반적인 이점을 입증하지는 않는다.
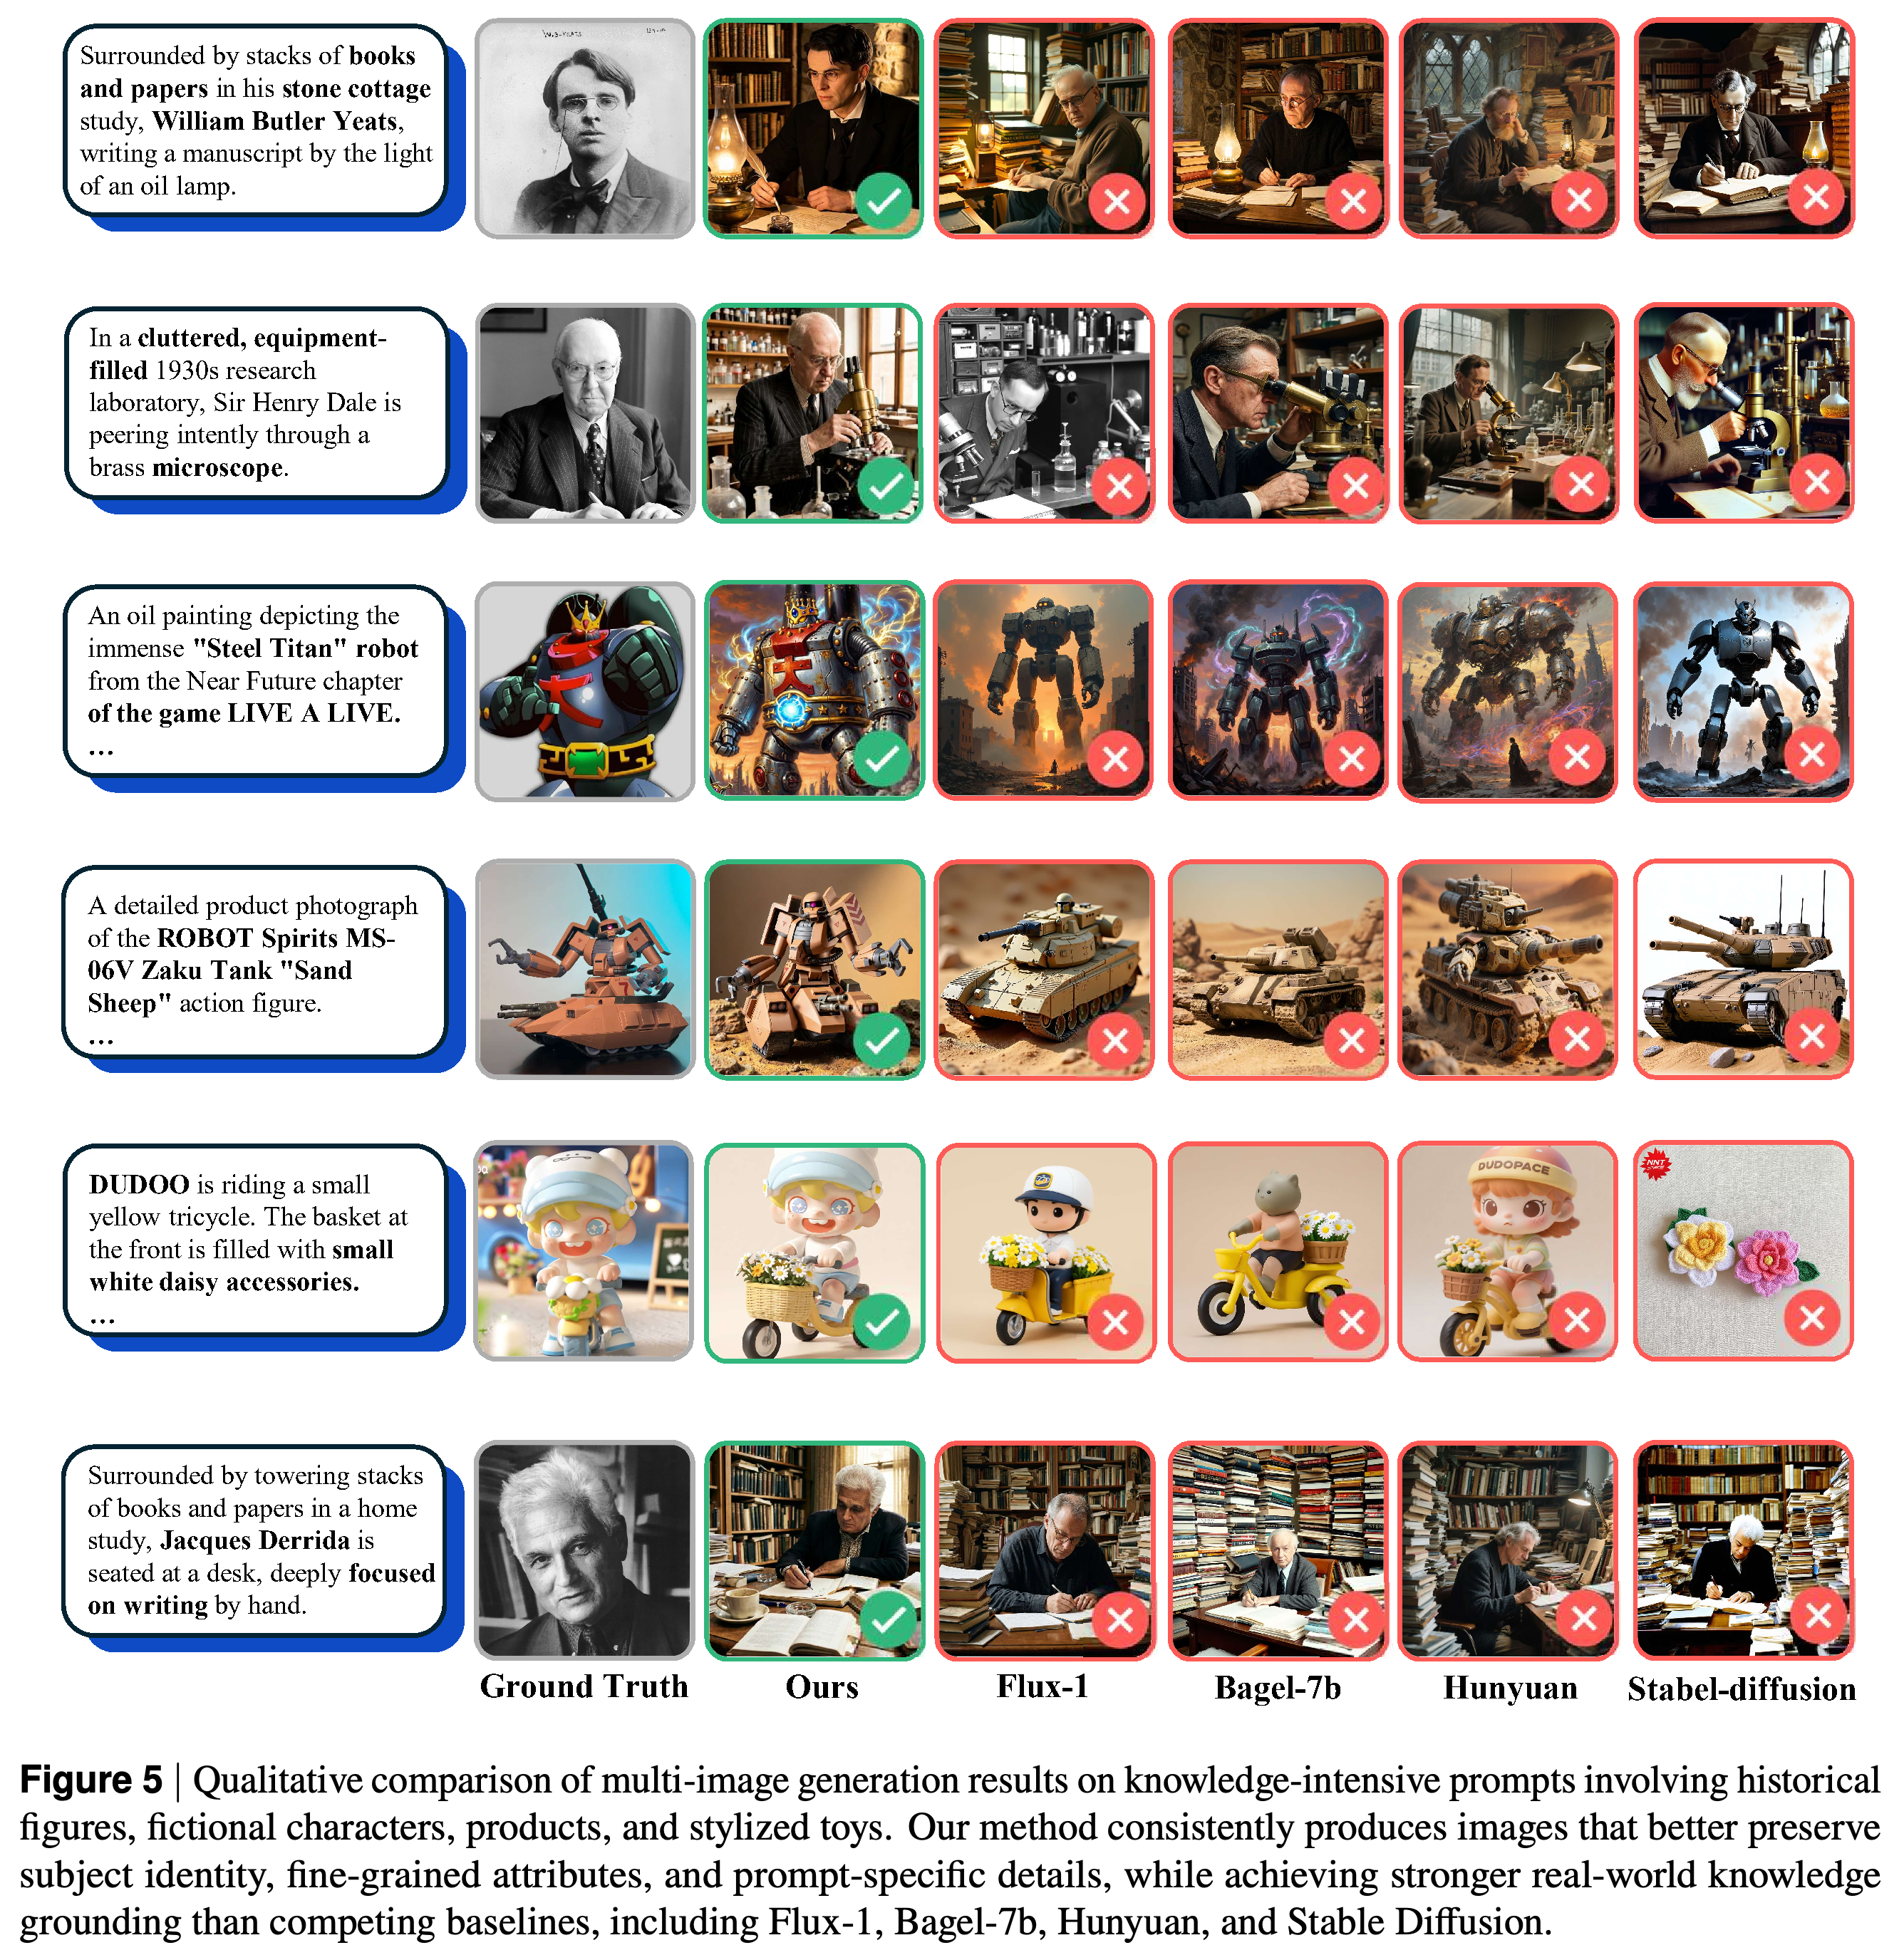
- 6.4.1 Visualization comparison results: Figure 5는 역사적 인물, LIVE A LIVE의 Steel Titan, Zaku Tank 모형, DUDOO, Jacques Derrida를 비교한다. 선별된 출력은 일반적이거나 대상과 맞지 않는 기본 모델 출력에 비해 대상 고유의 외형을 유지하는 모습을 보여준다.
선별된 비교는 대상 고유의 얼굴, 가상 로봇 디자인, 수집용 제품 구조, 장난감 외형을 일반적이거나 대상과 맞지 않는 기본 모델 출력과 대조한다. 정체성에 대한 근거 활용이 지향하는 이점을 보여주지만, 예시 선정과 성공 표시는 독립적인 정량 평가가 아니다.
7 Conclusion
결론은 사실적 합성을 멀티모달 추론과 근거 통합 과제로 설명한다. 이를 뒷받침하는 실증적 근거는 4개 벤치마크에서의 Bagel 대비 개선과 검색, recaptioning, 근거 기반 제약을 제거했을 때 나타나는 성능 하락이다.
Limitations and Future Work
저자들은 Bagel의 제한적인 긴 문맥 처리 능력과 비교적 적은 이미지 지원 수가 복잡한 에이전트 행동을 제약한다고 인정한다. 이 방법을 검색, 성찰, 재계획을 지속적으로 교차 수행하는 반복형 에이전트가 아니라, 비교적 얕은 단일 통과 워크플로로 설명한다.
- 입증된 범위는 주로 IP와 개념 중심의 합성이며, 여행 계획이나 학술 보고서 작성 같은 장기 과제는 아니다.
- 제안된 확장 방향에는 더 강력한 통합 백본, 반복 검색, 장기 계획, 적응적 추론이 포함된다.
- 상용 모델과의 격차와 자동 평가에 대한 의존 역시 벤치마크 개선을 폭넓게 해석하는 데 한계가 된다.
부록
- A Implementation Details: Table 6은 Bagel-14B, SigLIP-SO400M-14 (NaViT), 동결된 FLUX VAE, ViT 패치 크기 14, VAE 잠재 패치 크기 2를 명시한다. 샘플당 최대 토큰 수와 배치당 기대 토큰 수는 모두 40,240이며, 패킹된 토큰의 하드 한도는 41,520이다. 분산 학습에는 FSDP (HYBRID_SHARD)를 사용한다. 미세 조정은 VAE를 동결한 채 언어 모델, ViT 인코더, 멀티모달 커넥터를 갱신한다.
- B Attention Masking Strategy: Figure 6은 텍스트 추론의 인과적 어텐션, 참조 시각 토큰 블록 내부의 완전 어텐션, 참조 이미지와 recaption으로 제한된 생성 조건화를 보여준다. 마스크는 이전 텍스트 이력에 대한 직접 접근을 차단하지만, 유용하거나 잡음이 섞인 이전 정보는 recaption이나 문맥화된 참조 표현을 통해 여전히 전달될 수 있다.
- C Evaluation Protocols: WiSE는 GPT-4o로 Consistency, Realism, Aesthetic Quality를 0–2 척도로 평가하고, 각각 0.7, 0.2, 0.1의 가중치를 적용한다. 부록은 Table 2에 보고된 척도로 정규화하는 방법을 명시적으로 설명하지 않는다. KiTTEN은 Text Alignment와 Entity Alignment를 각각 1에서 5까지 독립적으로 평가하지만, Table 3의 캡션은 0에서 5까지라고 명시하고 종합 점수도 추가한다. T2I-FactBench는 개념의 형태, 색상, 질감, 세부 특징, 구체적 구현을 순차적인 이진 VQA로 확인하며, MKCC에서는 구성도 확인한다.
- FactIP Benchmark Evaluation은 Seed2.0으로 독립적인 0–10 점수 4개를 부여하고, 가중 점수 중 0.75를 Relevance에 배정한 뒤 가중 결과에 10을 곱한다. 안정적인 정체성 단서는 GT1과 GT2를 함께 고려해 추론하며, 참조 이미지 2개 사이에 이미 존재하는 차이를 지나치게 감점하지 않는다.
- D More Details about FactIP benchmark: Table 7은 Animation 438개, Comic 363개, Celebrity 300개, Game 272개, Mascot 77개, Mythology 50개, Food 316개, Cultural Relic / Art 126개, Toy 123개, Animal / Plant 50개, Landmark 297개, Festival / Celebration 50개의 프롬프트를 나열하며, 합계는 2,462개다. Figure 7은 계층 구조와 범주별 비교를 제시하지만, 표시된 그룹별 개수는 Table 7과 일치하지 않는다. D.2는 모든 결과가 FactIP-Mini를 사용한다고 명시한다. Table 8은 Unify-Agent Overall을 Tables 1과 5의 73.2가 아닌 71.7로 보고하며, 차이를 설명하지 않는다.
- E Prompt는 E.1 System Prompt, E.2 Evluation Prompt, E.3 Judge Prompt, E.4 Prompt-Generation Prompt, E.5 Recaption Prompt, E.6 Summary Prompt를 문서화한다. 템플릿은 text_search와 search_image 인터페이스, 시각 참조 필터링, 국적에 따른 프롬프트 언어 선택, 명시적인 image_1 및 image_2 근거 활용, 보존 조건 명시, 쿼리 중심 웹페이지 요약을 설명한다. E.2는 점수 5개와 필드 6개를 요청하지만, 평가 차원은 4개를 나열하고 점수 4개와 근거 설명을 표시한다.
- F Image Generation Showcases는 Figures 8–12에서 Copper Combustion, DUDOO Tasty Afternoon Tea Series, William Butler Yeats, Grigory Perelman, Bruce Beutler를 제시한다. 각 실행 궤적은 순서대로 녹색 불꽃 근거 검색, 장난감 정체성과 제품 세부사항의 통합, 별장에서 글을 쓰는 장면을 위한 인물 참조 활용, 아파트 장면을 위한 외형 추출, 참조에 기반한 실험실 장면 적용을 보여준다. 이는 시연이며 독립적인 사실 검증은 아니다. 구리 예시는 연소 설명과 구리 화합물의 불꽃 반응 설명을 혼합한다. DUDOO 예시는 두 번째 검색에서 관련 페이지를 찾지 못하며, 표시된 search_image 호출은 텍스트 검색 단계라는 표기와 충돌한다.
- G FactIP Benchmark Evaluation Showcases는 Figures 13–16에서 Gregg Popovich, Max Weber, Habatan, Scottie Pippen을 제시하며, 표시된 Overall 점수는 각각 9, 5, 9, 2다. 평가자는 Popovich의 닮은 정도와 농구 맥락을 긍정적으로 평가하고, Weber의 정체성 불일치와 현대식 마이크를 감점한다. Habatan의 스타일 표현을 칭찬하면서 신발 색상 불일치를 주장하고, Pippen의 닮은 정도, 아티팩트, 유니폼 세부사항을 감점한다. 표시된 Overall 점수는 Appendix C의 가중 공식에서 직접 산출되지 않으며, Habatan의 신발 색상에 대한 주장은 제시된 참조 이미지로 뒷받침되지 않는다.
짧은 생각
가장 명확한 기여는 recaption 인터페이스다. 검색된 근거를 생성 전에 명시적인 정체성 및 구도 제약으로 바꾸며, recaption 제거 실험은 이 설계를 뒷받침한다. 반면 생성이 이해를 개선한다는 더 넓은 주장은 직접적인 근거가 부족하다. 이를 뒷받침하는 실험이 이해 능력을 독립적으로 측정하지 않고 후속 합성을 측정하기 때문이다. 학습 데이터, 참조, 검색 예산을 맞춘 분리형 에이전트와 비교하면 아키텍처 통합의 가치를 따로 확인하는 데 도움이 된다. 평가자 보정, 일관된 종합 점수 보고, FactIP의 73.2와 71.7 차이에 대한 설명은 재현성에 중요하다. 결과는 지식 집약적 합성에서 Bagel 대비 상당한 개선을 입증하지만, 신뢰할 수 있는 개방 세계 멀티모달 에이전트를 위한 일반적인 해결책을 입증하지는 않는다.