


LLaDA2.0-Uni: Unifying Multimodal Understanding and Generation with Diffusion Large Language Model 요약 설명
22 Apr 2026 | Paper Review Diffusion Language Models Unified Multimodal Models Semantic Tokenization목차
- 요약
- 1 Introduction
- 2 Model Design
- 3 Data Preparation
- 4 Model Training
- 5 Experiments
- 6 Conclusion and Future Directions
- 부록
- 짧은 생각
이번 글에서는 LLaDA2.0-Uni: Unifying Multimodal Understanding and Generation with Diffusion Large Language Model 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 22일(Arxiv)
- AI, Inclusion, Bie, Tiwei, Chen, Haoxing, Chen, Tieyuan, Cheng, Zhenglin, Cui, Long, Gan, Kai, Huang, Zhicheng, Lan, Zhenzhong, Li, Haoquan, et al.
- AGI Research Center, Inclusion AI
- 논문 링크
- Github
요약
- LLaDA2.0-Uni는 시각 이해, 이미지 생성, 편집, 텍스트와 이미지가 교차하는 출력에 공통 이산 의미 이미지 토큰을 사용한다. 아키텍처는 SigLIP-VQ, 16B Mixture-of-Experts 이산 확산 언어 모델, 별도로 학습한 6B 확산 디코더로 구성된다. 디코더는 의미 토큰에서 이미지를 복원한다.
- 모델은 MMStar에서 64.1, GenEval에서 0.89, UniGenBench에서 79.63, MICo-Bench에서 47.1을 달성한다. 다만 이해와 편집 성능이 비교 대상 중 가장 강한 전문 모델에 항상 필적하지는 않는다. SPRINT는 백본의 평균 처리량을 24.3 TPS에서 39.8 TPS로 높이며, 보고된 평균 점수는 0.6 감소한다. 디코더 증류는 논문의 단일 GPU 측정 조건에서 디코더 지연 시간을 32.95 s/img에서 2.90 s/img로 줄인다.
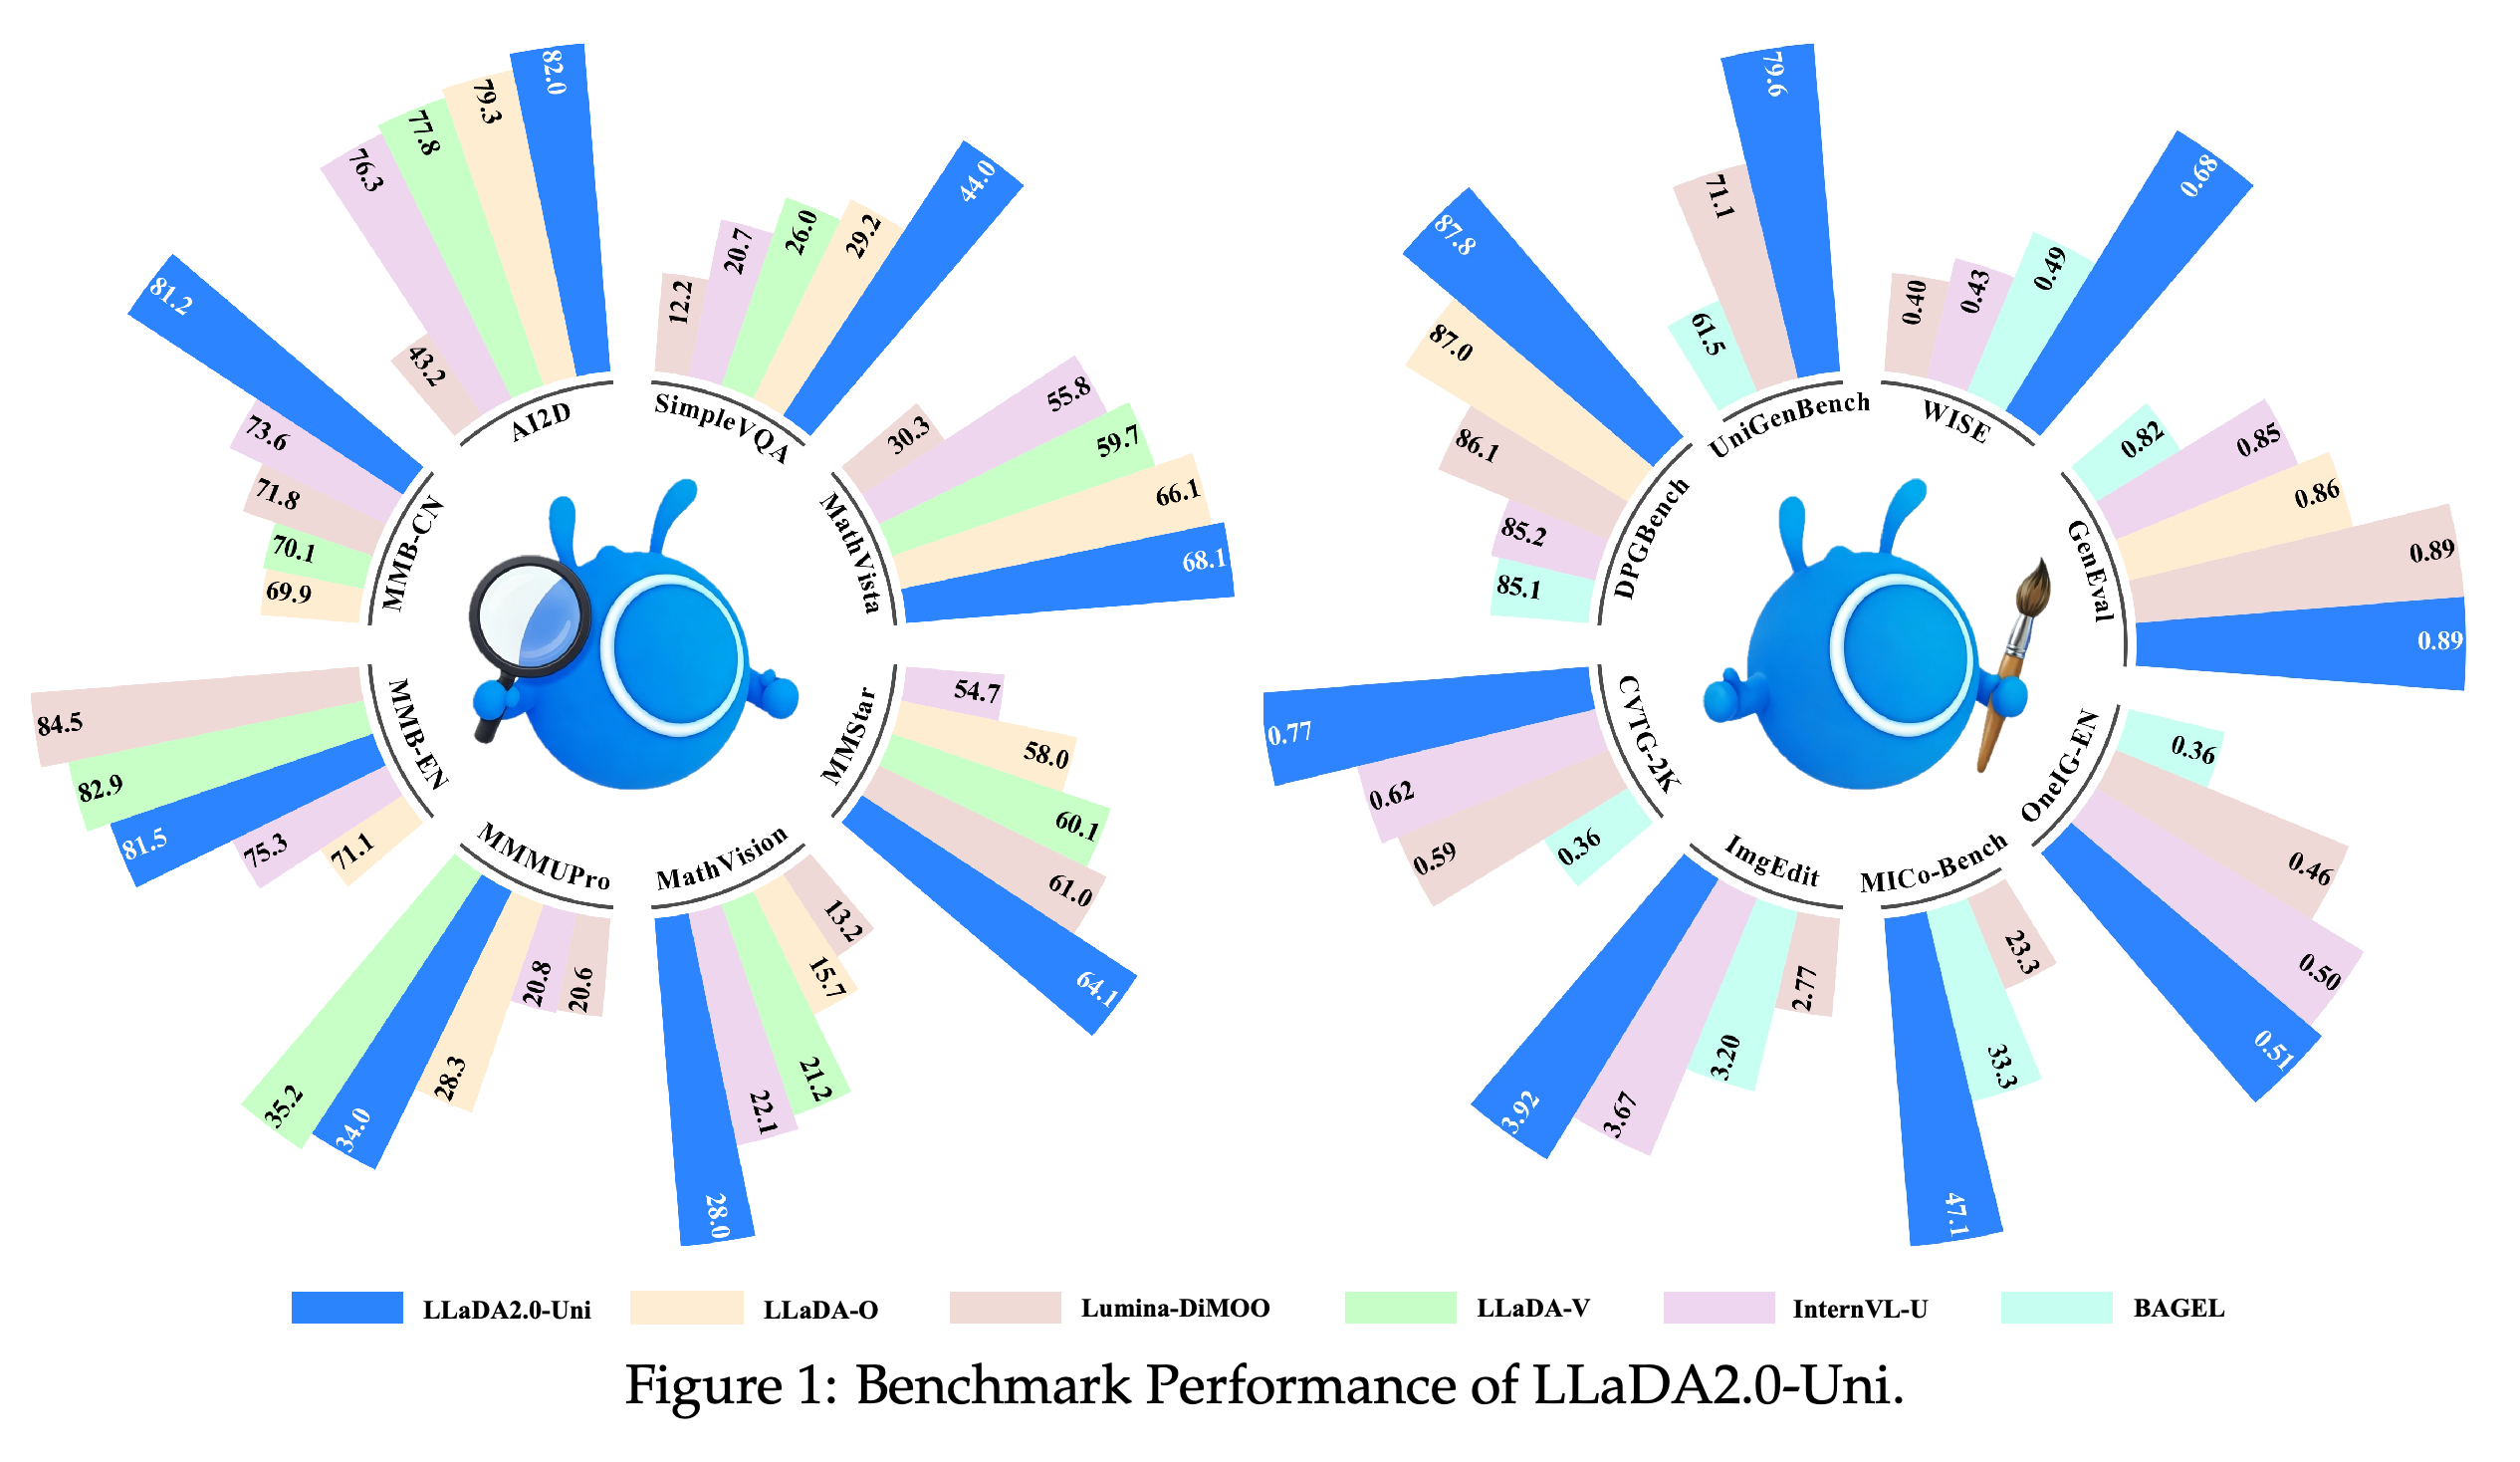
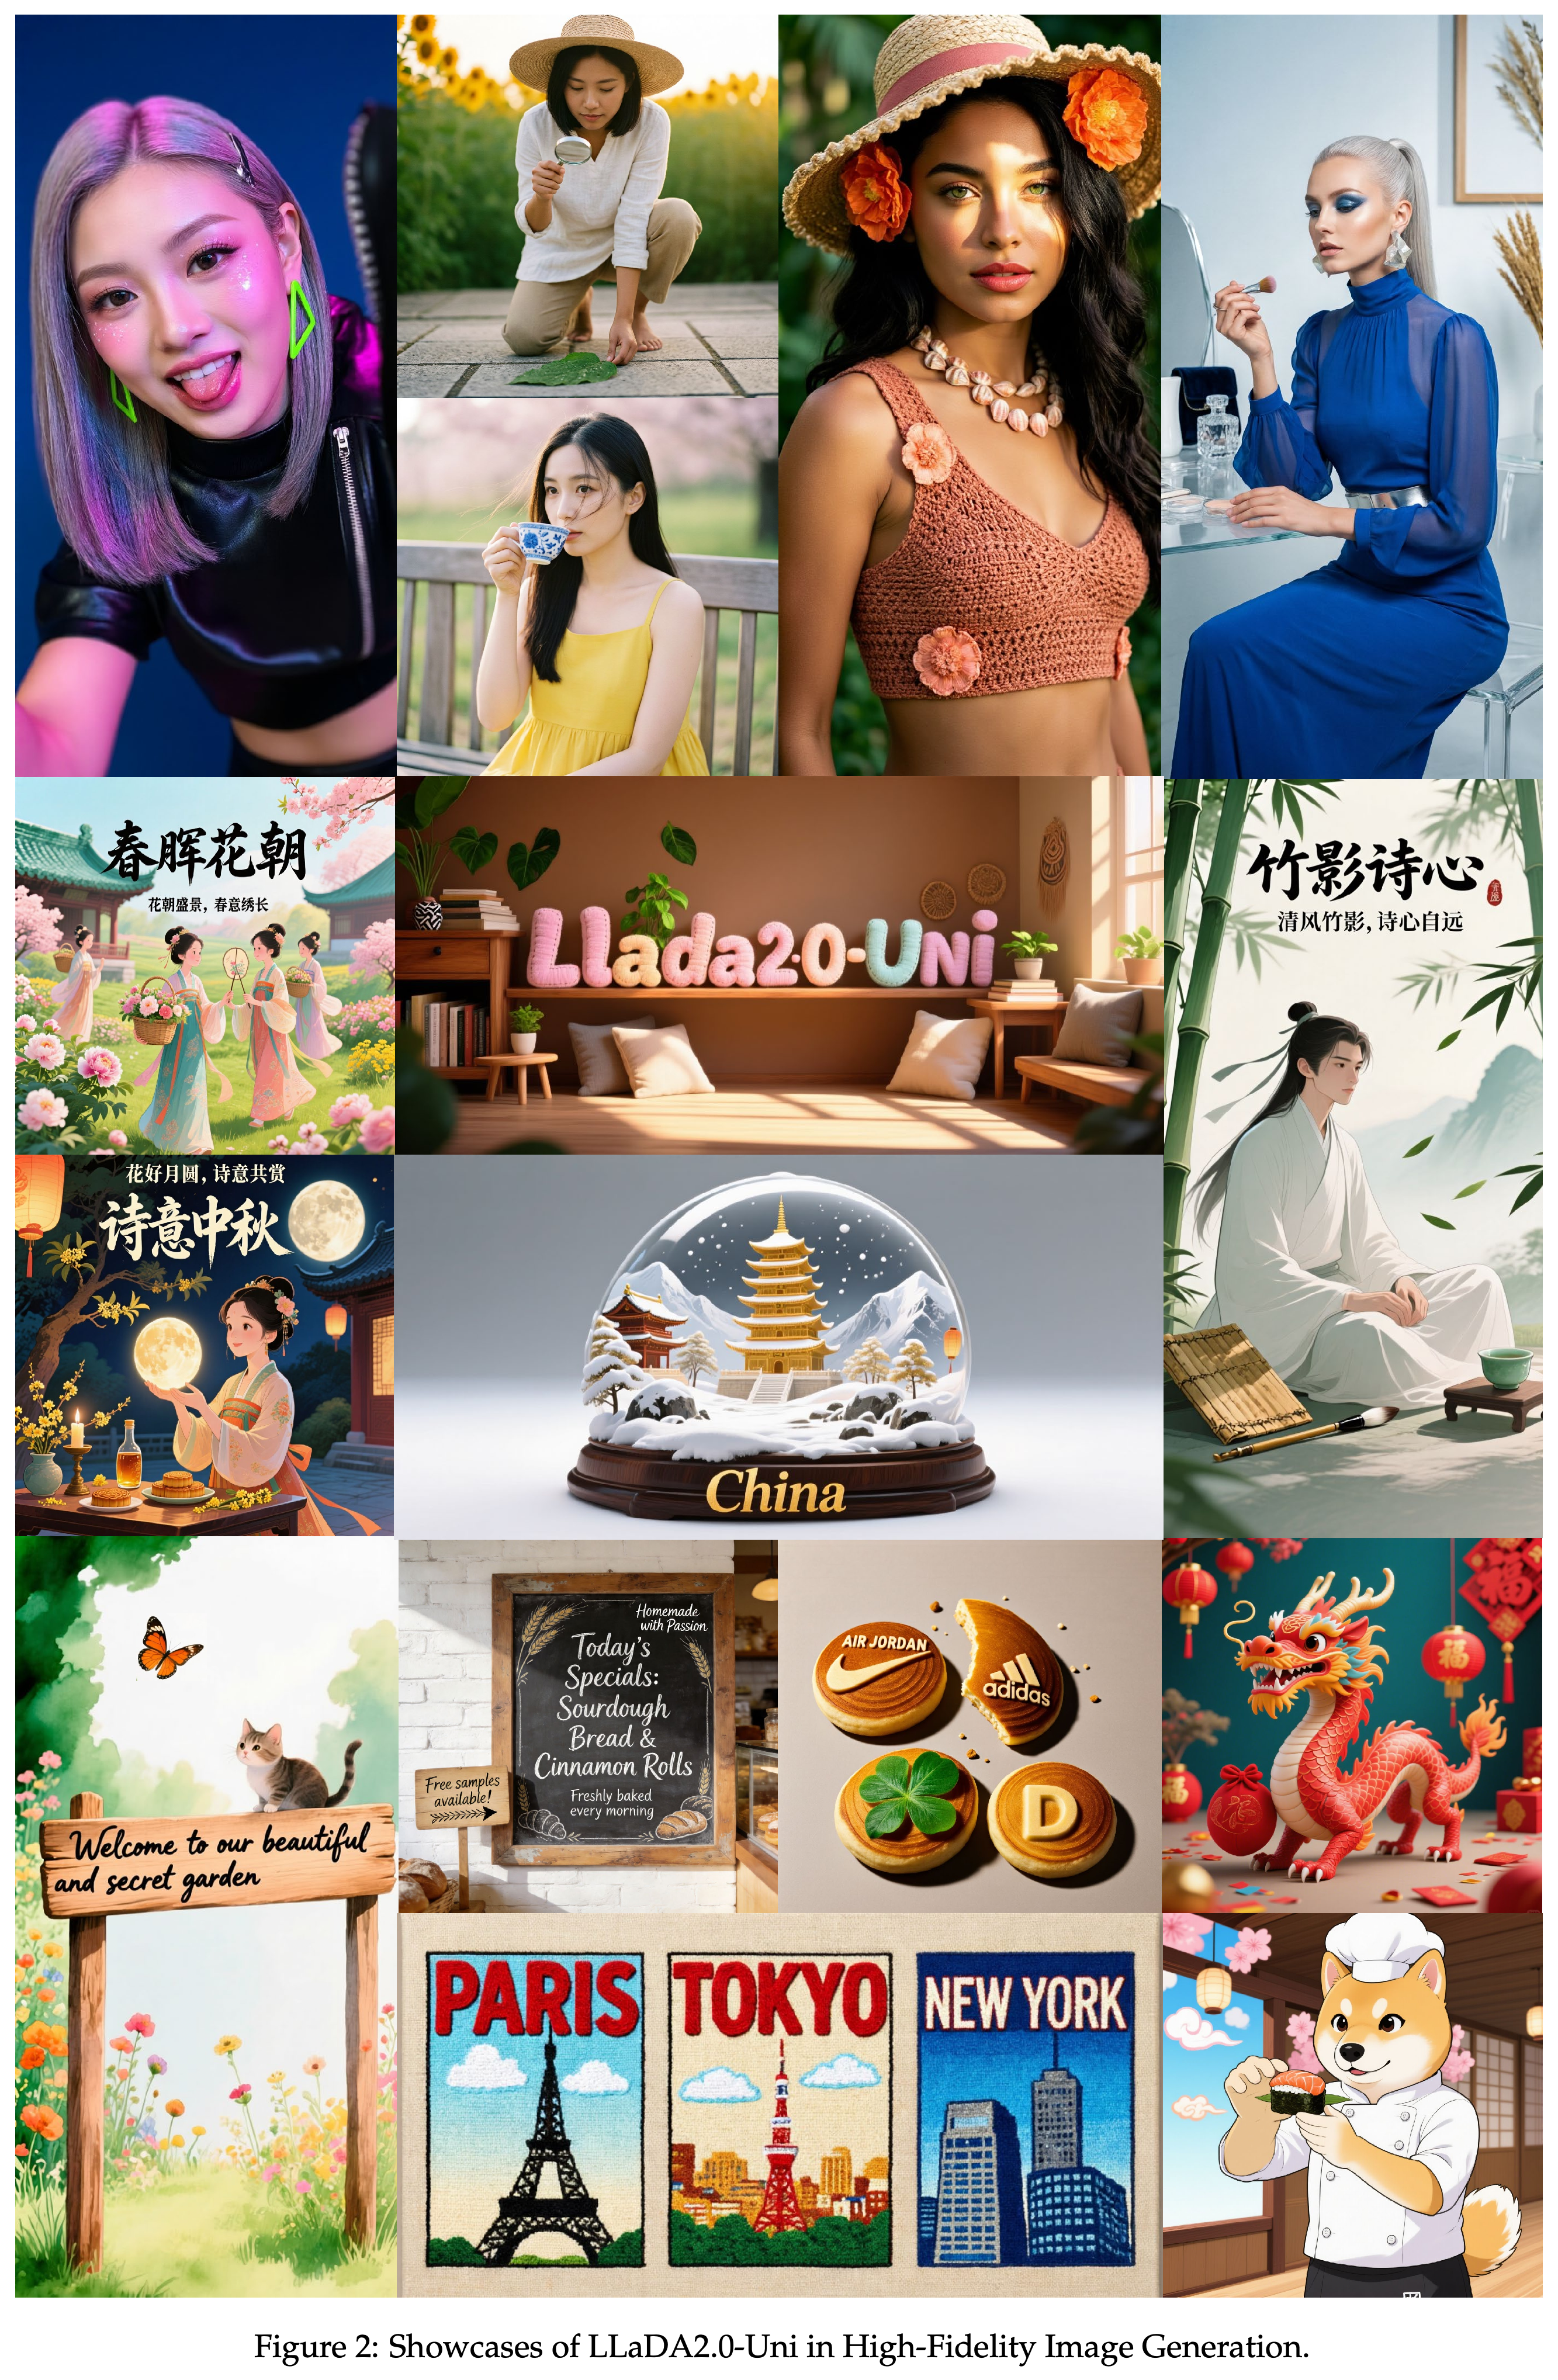
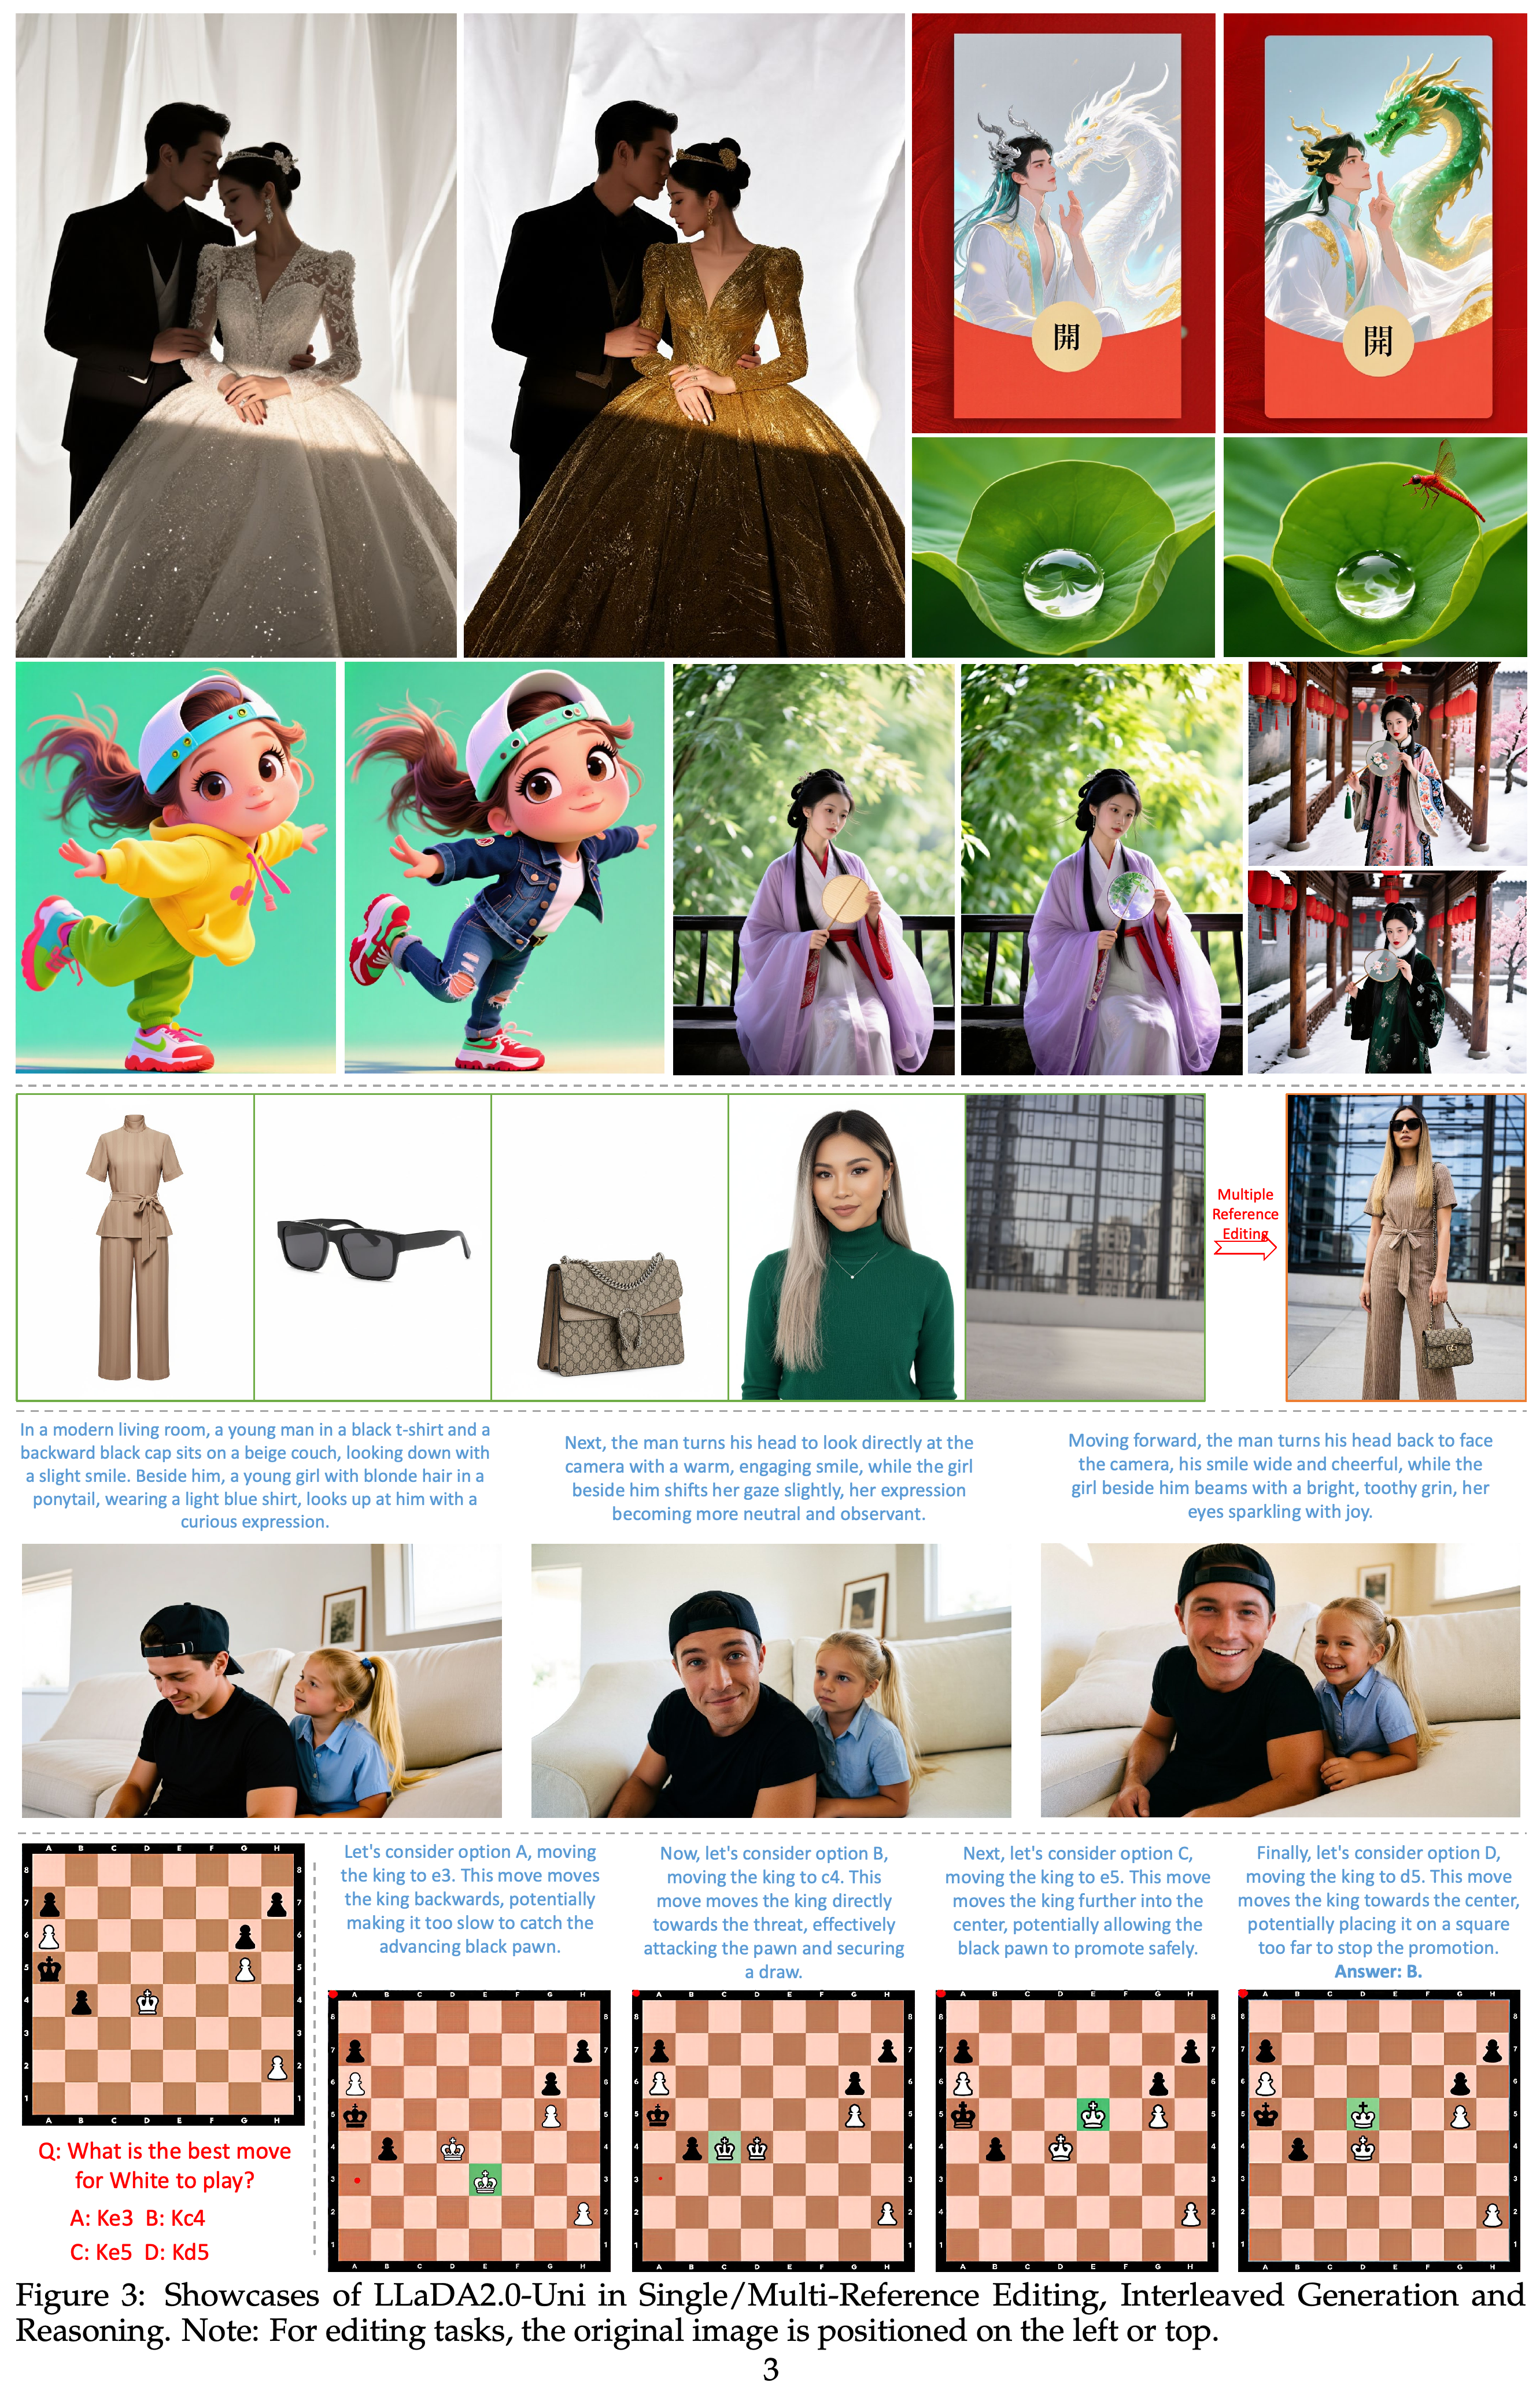
- 세밀한 시각 정보와 밀집된 텍스트 렌더링에는 여전히 한계가 있다. 텍스트와 이미지가 교차하는 추론도 정량 평가가 아닌 일부 사례로만 뒷받침된다. 교차 생성은 저자들이 만든 150개 샘플의 InterGen 벤치마크로 평가한다. Emu3.5 대비 개선 폭은 작고, 설명 과제의 결과는 평가 모델에 따라 달라진다. Figure 1은 벤치마크 결과를 요약하고, Figures 2와 3은 생성, 편집, 교차 출력 사례를 보여준다.
방사형 비교는 왼쪽에 이해 성능을, 오른쪽에 생성과 편집 성능을 요약한다. 정확한 값은 상세 표와 항상 일치하지 않는다. Lumina-DiMOO의 GenEval은 0.89로 표시되지만 Table 3에서는 0.88이며, LLaDA2.0-Uni의 MathVision은 28.0으로 표시되지만 Table 2에서는 26.7이다. LLaDA-o의 GenEval 표시값 0.86은 Table 3과 일치한다.
갤러리는 사진풍 인물, 일러스트, 사물, 이미지에 포함된 영어와 중국어 텍스트를 보여준다. 다양한 스타일과 눈에 보이는 텍스트 렌더링을 예시하지만, 대표적인 생성 품질을 확인할 수 있는 프롬프트, 샘플링 절차, 실패율 정보는 제공하지 않는다.
편집 전후 쌍은 국소적 변경을 보여주며, 다중 참조 사례는 의류, 액세서리, 인물, 장면을 결합한다. 아래 패널은 체스 상태 시각화를 포함해 설명과 이미지를 번갈아 출력하는 모습을 보여준다. 정량 평가가 아니라 선택된 능력 시연 사례다.
1 Introduction
논문은 자기회귀 및 하이브리드 멀티모달 시스템과 비교했을 때 통합 마스크 확산 모델이 갖는 한계를 다룬다. 저자들은 기존 모델의 약점이 복원 중심 시각 토크나이저, 과도한 이미지 압축, 제약 없는 양방향 어텐션, 고정 길이 이해 출력에서 비롯된다고 본다. LLaDA2.0-Uni는 이해와 생성에 공통 의미 이미지 토큰을 사용하고, 블록 단위 마스크 확산으로 텍스트와 이미지를 예측하며, 이미지 복원은 전용 디코더에 맡긴다.
- 논문이 제시하는 기여는 공통 의미 토큰 아키텍처, 교차 생성과 추론, 추론 가속, 폭넓은 벤치마크 평가다.
- PDF에 제시된 리소스는 https://github.com/inclusionAI/LLaDA2.0-Uni 및 https://huggingface.co/inclusionAI/LLaDA2.0-Uni 이다.
2 Model Design
모델은 의미 시퀀스 모델링과 이미지 복원을 분리한다. 텍스트와 시각 토큰은 dLLM 백본과 마스크 예측 목적함수를 공유하고, 확산 디코더는 생성된 시각 의미 토큰을 이미지로 변환한다. 따라서 통합 대상은 백본의 표현과 목적함수이며, 모든 구성요소를 하나의 손실로 공동 학습하는 방식은 아니다.
2.1 Motivation and Design Principles
핵심 설계 원칙은 시각 이해와 생성에 모두 완전히 이산화된 의미 이미지 토큰을 사용하는 것이다. 저자들은 이를 복원 기반 VQ 토큰이나 이해와 생성에 별도 인코더를 사용하는 시스템과 대비한다. 토큰을 공유하면 2개 과제에 별도 시각 표현을 둘 필요가 없지만, 이미지 복원에는 여전히 전용 디코더가 필요하다.
2.2 Architecture
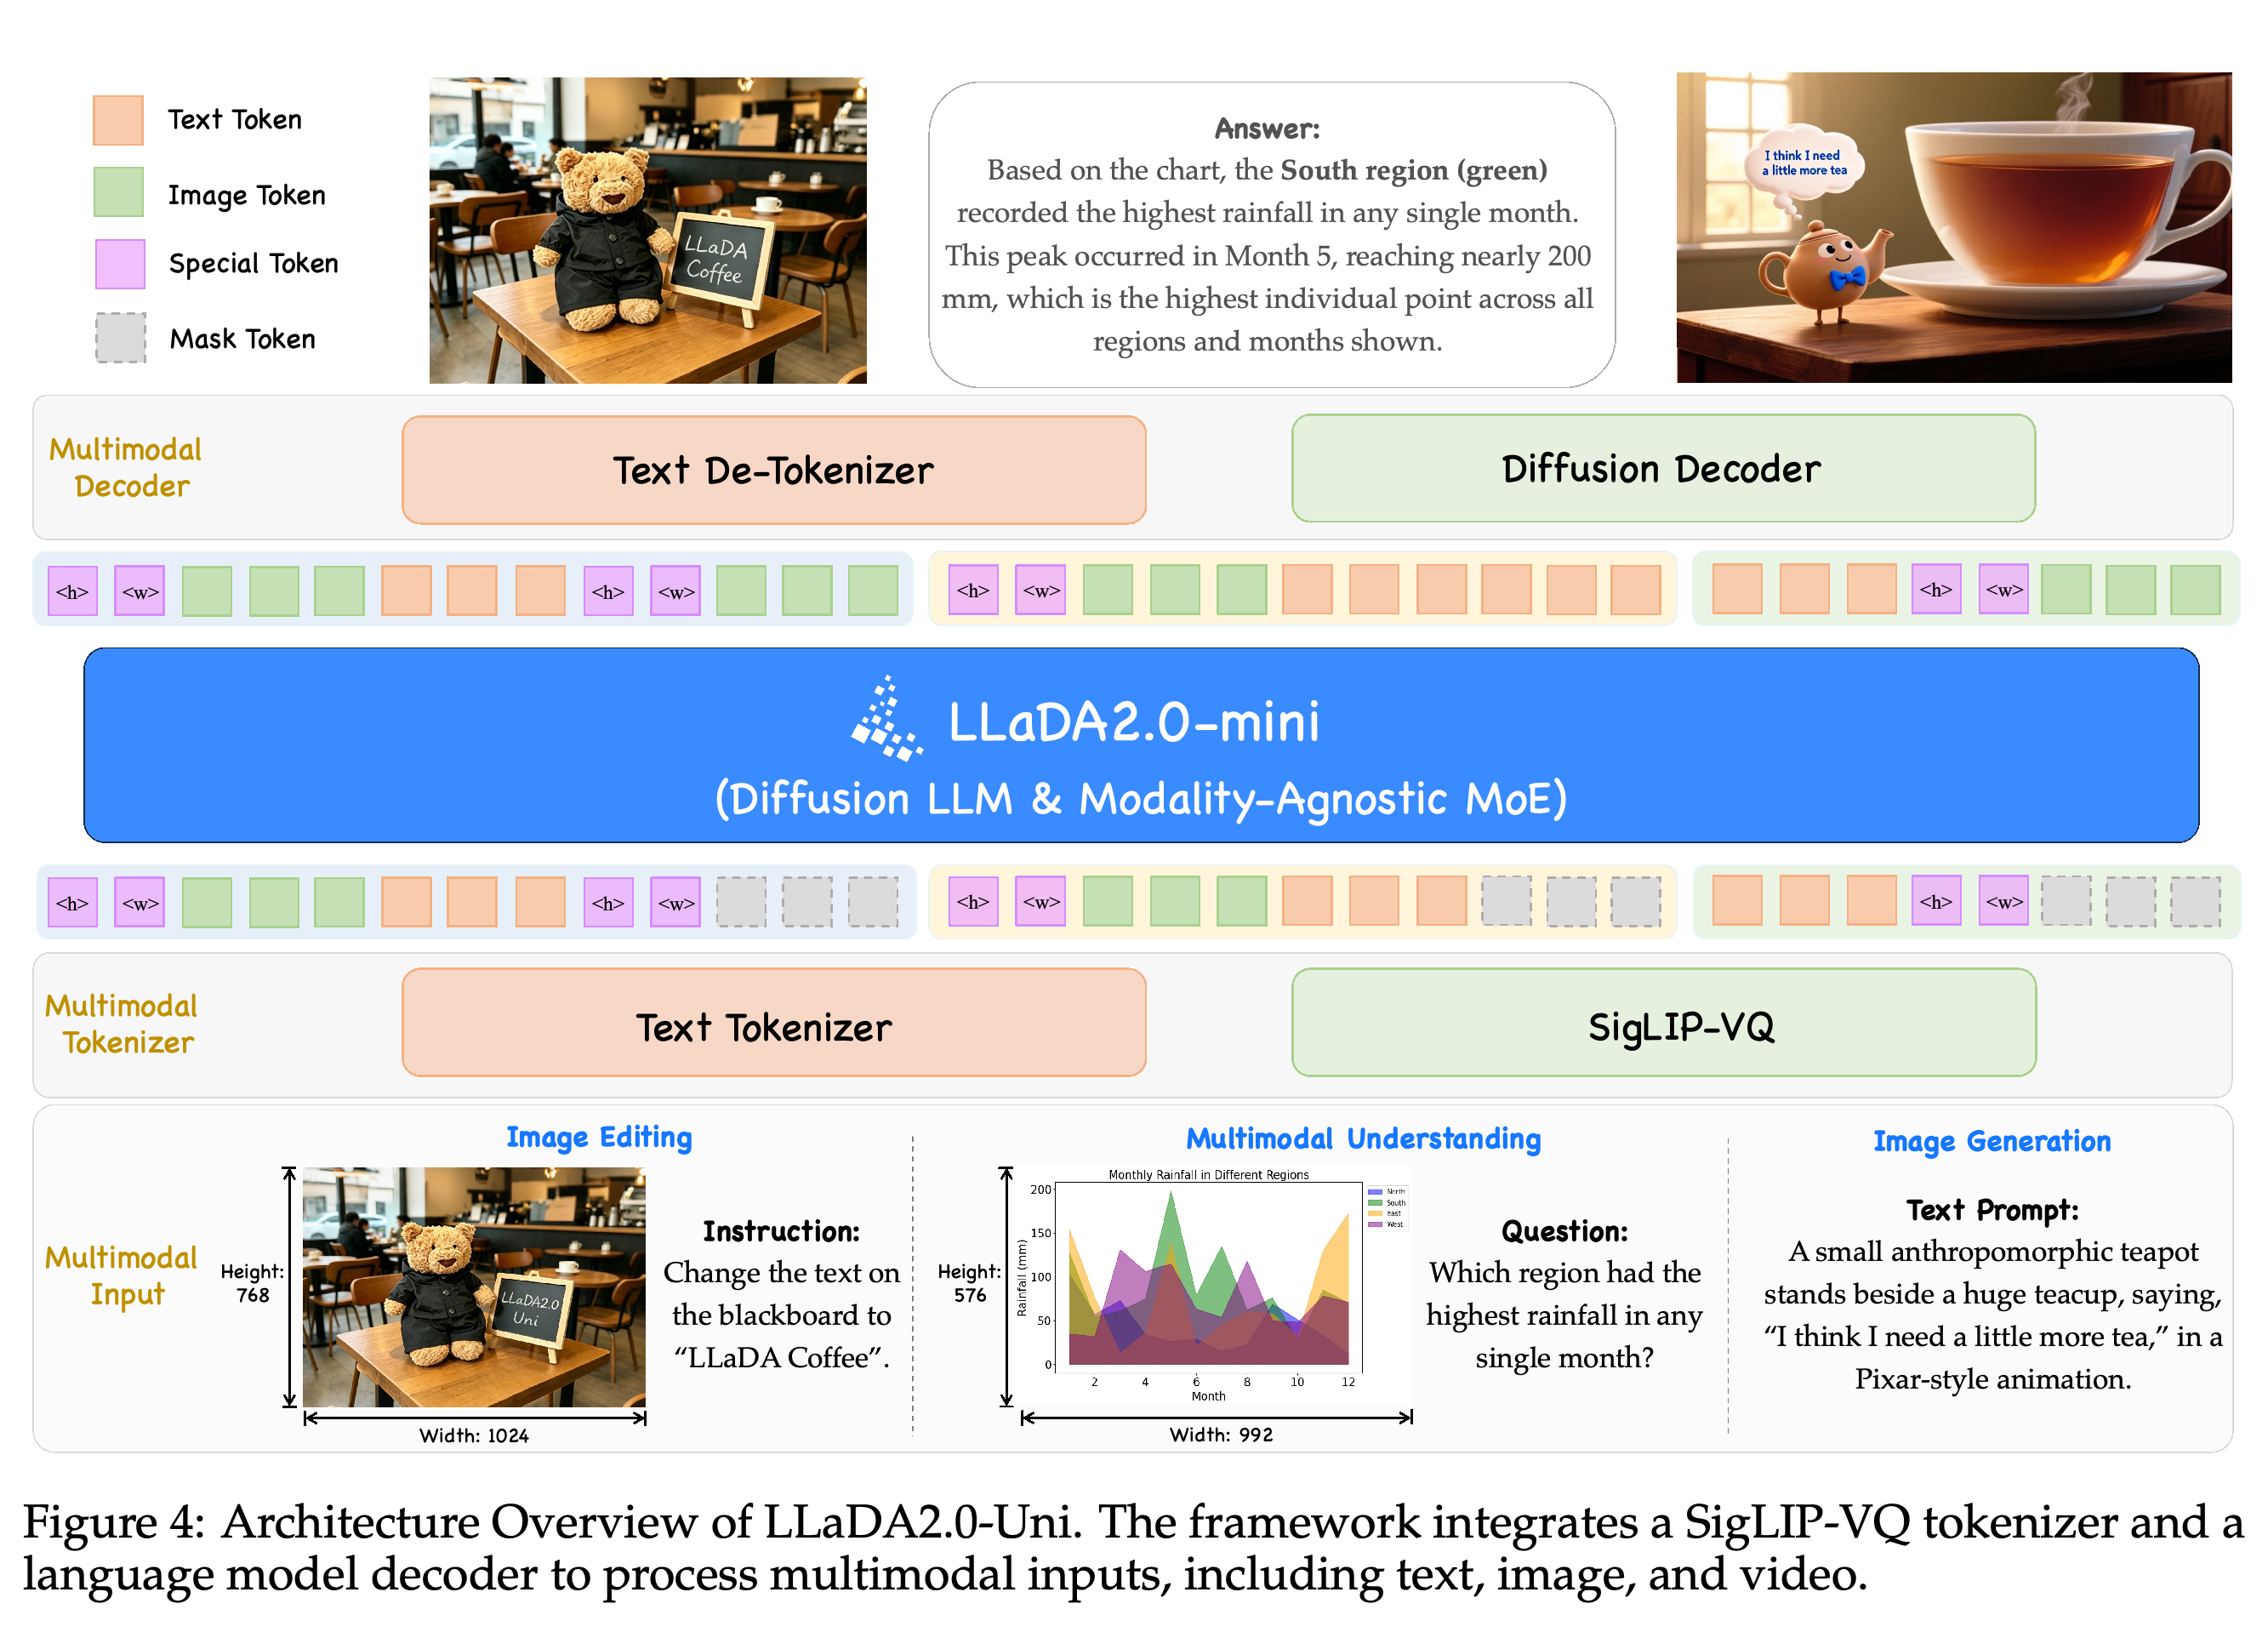
아키텍처는 의미 이산 토크나이저, 모달리티에 구애받지 않는 MoE 확산 언어 모델, 확산 디코더로 구성된다. Figure 4는 같은 백본으로 이해, 편집, 텍스트 기반 이미지 생성을 수행하는 구조를 보여준다. 과제별 마스킹을 적용하고 텍스트나 이미지를 별도로 디코딩한다.
- 2.2.1 Semantic Discrete Tokenizer: SigLIP-VQ는 X-Omni를 기반으로 하며 동적 해상도를 지원하는 사전 학습된 SigLIP2-g ViT를 사용한다. 픽셀 복원이 아니라 이해 과제로 학습하며, 코드북 어휘 크기는 16,384이고 차원은 2,048이다.
- 2.2.2 Diffusion Large Language Model: LLaDA-2.0-mini는 총 16B MoE 파라미터를 갖는다. 시각 코드북 항목과 특수 토큰으로 어휘를 확장한다. 기존 언어 임베딩과 예측 헤드 가중치는 유지하고, 새 시각 임베딩은 무작위로 초기화한다.
- 블록 단위 어텐션은 앞선 블록을 조건으로 사용하면서 블록 내부에서는 양방향 처리를 허용한다. 저자들은 Qwen2.5와 정렬하는 과정에서 SigLIP-VQ 토큰이 자기회귀 편향을 물려받았다는 점을 근거 중 하나로 제시한다. 기존 1D RoPE를 유지하며, 평탄화된 시각 시퀀스 앞에 <height>와 <width> 토큰을 두어 이미지 크기를 나타낸다. 예시는 <imgsize 512>다.
- 2.2.3 Diffusion Decoder: 6B Z-Image-Base 파생 모델은 추가 텍스트 프롬프트 없이 시각 의미 토큰만을 조건으로 받는다. 업샘플링한 의미 토큰으로 2× 초해상도를 수행하며, CFG를 사용하는 50-step 샘플링에서 CFG 없이 실행하는 8-step 추론으로 증류한다.
텍스트와 SigLIP-VQ 이미지 토큰은 같은 LLaDA2.0-mini 백본에 입력된다. 이해는 텍스트 토큰을 출력하고, 편집과 생성은 확산 디코더로 전달할 이미지 토큰을 출력한다. 높이와 너비 토큰은 이미지 크기를 나타낸다.
2.3 Training-free Inference Acceleration
SPRINT는 Sparse Prefix Retention with Inference-time Non-uniform Token Unmasking의 약자로, 재학습 없이 블록 단위 확산을 가속한다. 이후 노이즈 제거 단계에서 사용하는 접두부 KV 캐시를 가지치기하고, 신뢰도가 높은 예측을 적응적으로 확정해 단계 수를 줄인다. 표준 디코딩은 B개 블록마다 T번의 노이즈 제거를 수행하므로 (B \times T)번의 순전파가 필요하다.
- Sparse Prefix Retention은 각 블록의 1 step에서 전체 계산을 수행한 뒤, α = 0.5로 설정한 (s_i = \alpha\bar I_i + (1-\alpha)c_i)로 접두부 위치의 순위를 매긴다. Ī_i는 평균으로 정규화한 키 노름이고, c_i는 top-1 소프트맥스 신뢰도다. 텍스트와 이미지에 별도 유지 비율을 적용해 지시와 추론 토큰은 보존하고 중복 이미지 토큰은 제거하려 한다.
- 제시된 설정은 rtext = 1.0, rimg = 0.8 및 rtext = rimg = 1.0이다. 본문은 두 설정 모두에 전역 유지 비율 r = 0.5를 적용한다고도 쓰지만, 모달리티별 비율과 어떤 관계인지 설명하지 않는다.
- Non-uniform Token Unmasking은 신뢰도가 τ를 넘는 모든 마스크 위치의 예측을 확정하며, τ ∈ {0.93, 0.95}를 검토한다. 임곗값에만 의존하지 않고 각 단계에서 최소 ⌈m/(T − t)⌉개를 확정해 종료를 보장한다.
3 Data Preparation
데이터 준비는 멀티모달 이해, 이미지 생성, 이미지 편집, 교차 시퀀스, 추론을 추가한 사례를 다룬다. 공개 데이터셋, 웹 이미지, 합성 편집 쌍, 비디오에서 추출한 시퀀스, 모델을 활용한 필터링과 캡셔닝을 결합한다.
3.1 Multimodal Understanding
이해 사전 학습은 이미지-캡션 데이터에 OCR, grounding, counting, 세계 지식, 추론, 텍스트 전용 자료를 결합한다. SFT 데이터는 약 60 million개 샘플로 구성되며, 텍스트 전용 데이터와 멀티모달 데이터의 비율은 1:5다. 대화, 다중 이미지, VQA, 차트, 표, 수학 추론을 포함한다.
- OCR 지도에는 PaddleOCR 의사 레이블을 Qwen3-VL로 보정해 사용한다. Objects365와 RefCOCO의 grounding 데이터에는 신뢰도 필터링과 Qwen3-VL-235B-A22B 검증을 적용한다. 좌표는 [0, 1000]으로 정규화하며, 검증된 경계 상자는 counting 사례에도 사용한다.
- 텍스트 전용 데이터는 Ling2.0과 LLaDA2.0에서 가져온다. SFT 품질 관리를 위해 Qwen3-VL이 정보가 적은 질의를 제거하고 모호한 질의를 다시 작성한다. 규칙으로 응답의 구조적 오류를 수정하고, GPT-OSS가 정답 참조와 비교해 의미적 편향을 걸러낸다.
3.2 Image Generation
생성 데이터는 200 million개가 넘는 웹 이미지에서 시작해 메타데이터, 미적 품질, 전반적 품질을 필터링한 뒤 140 million개를 남긴다. 생성이 어려운 사례를 다루기 위해 인체와 렌더링된 텍스트가 있는 이미지의 비중을 높인다. Qwen3-VL-235B-22B가 캡션을 다시 작성하며, 구체적인 현실 세계 지식을 보존하도록 원래 웹 설명 중 유용한 정보를 반영한다.
- 메타데이터 필터링은 짧은 변이 512 pixels 미만인 이미지와 (Height×Width)/Filesize < 0.15를 만족하는 이미지를 제거한다. PDF는 파일 크기의 단위를 명시하지 않는다.
- 미적 품질 필터링은 ArtiMuse 점수가 60 미만인 이미지를 제거하고, 전반적 품질 필터링은 DeQA-Score가 4.0 미만인 이미지를 제거한다.
3.3 Image Editing
편집 데이터는 X2Edit, OmniEdit, Nano-consistent-150k, Pico-Banana, UniWorld, StructVisuals, UnicEdit, CrispEdit에 생성 데이터에서 만든 합성 쌍을 결합한다. Qwen3-VL-235B-22B가 눈에 띄는 변화가 없거나 시각적 결함이 있는 편집을 제거하고, 부정확하거나 모호한 지시는 실제 변환을 설명하도록 다시 작성한다.
3.4 Interleaved Data
교차 학습 데이터는 Koala36M 비디오에서 구성하며, 정제된 클립 6M개를 얻는다. 5 seconds마다 프레임을 추출해 2–6개 이미지의 시퀀스를 만든다. Qwen3-VL-235B-A22B가 동작과 장면 변화를 설명하고, SFT에 사용할 사용자 지시를 생성한다.
- 30 seconds보다 길거나 10 seconds보다 짧은 클립은 버린다. 품질 필터링은 미적 점수(> 4.0)와 선명도(> 0.7)를 기준으로 상위 50%를 남긴다. 정적인 이미지 출력을 억제하기 위해 움직임 점수는 4를 넘어야 한다.
- 논문은 필터링으로 원본 데이터의 약 75%를 제거했다고 보고한다. 그러나 Koala36M에서 남긴 클립 6M개와 이 비율을 대조하는 데 필요한 초기 부분집합 크기는 제시하지 않는다.
3.5 Reasoning-Augmented Data
Flux-6M, Zebra-CoT, Weave에서 가져온 약 8M개 SFT 샘플은 추론 기반 이미지 생성과 교차 추론을 지도한다. 이 사례들은 이미지 합성 전 텍스트 chain-of-thought와 텍스트·이미지를 번갈아 사용하는 다단계 추론을 지원한다. 논문은 이 데이터 조합의 효과를 별도의 ablation 실험으로 검증하지 않는다.
4 Model Training
백본 학습은 시각-언어 정렬, 다중 과제 사전 학습, 지도 미세 조정 순으로 진행한다. 최적화에는 블록 확산, MoE 부하 균형, SFT 전용 마스킹과 손실 재가중을 결합한다. 이미지 디코더는 별도의 flow matching과 증류 절차로 학습한다.
4.1 Training Recipe
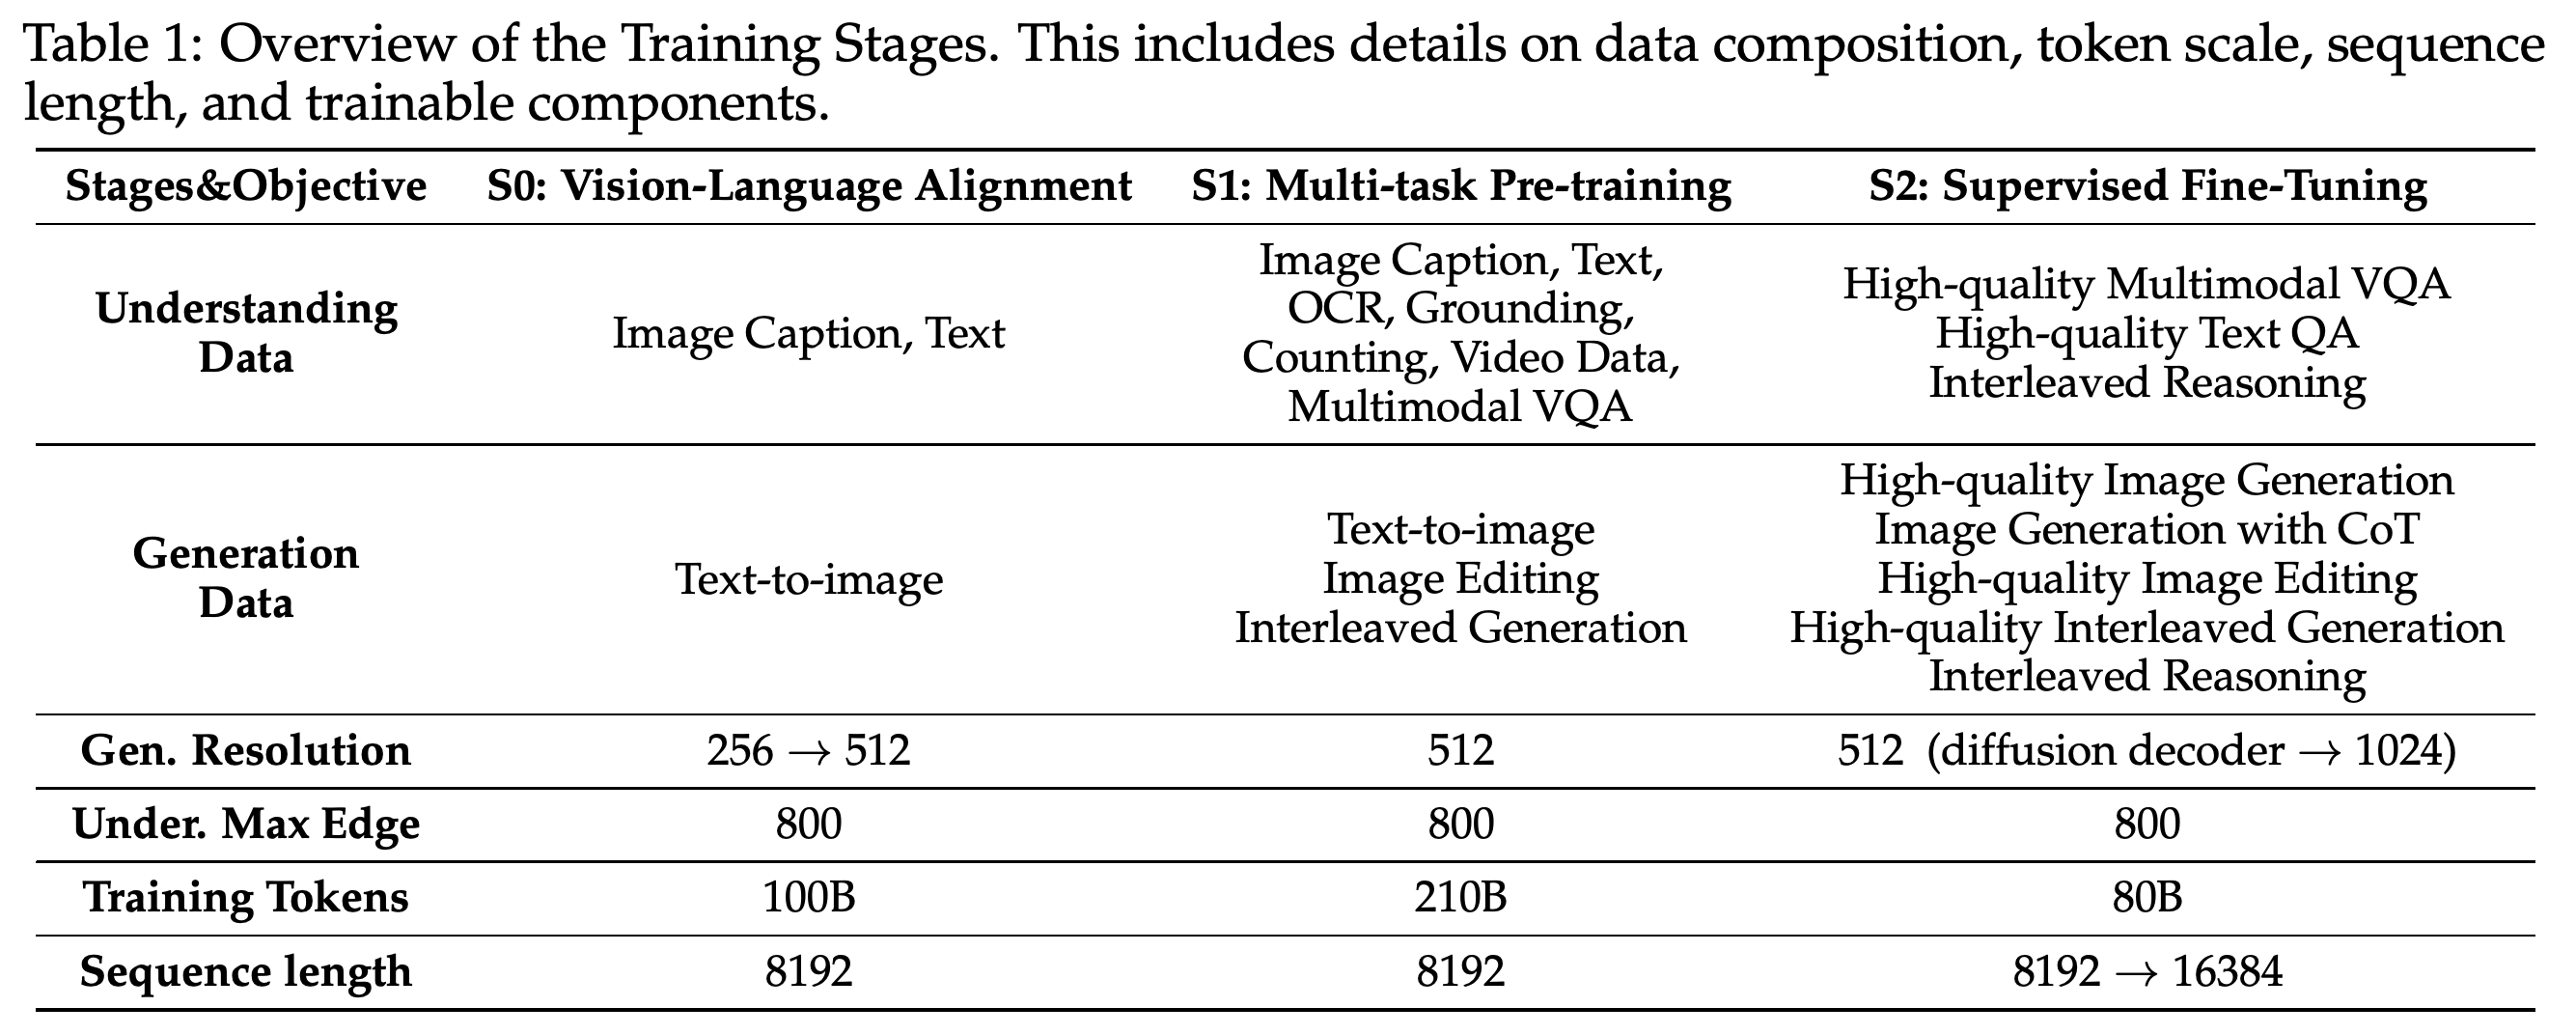
Table 1은 S0에 100B, S1에 210B, S2에 80B 학습 토큰을 사용한다고 명시한다. 문맥 길이는 S0와 S1에서 8192이며, S2에서 8192에서 16384로 확장한다. 생성 해상도는 S0에서 256에서 512로 높이고, 이후 백본 단계에서는 512를 유지하며, 확산 디코더를 통해 1024에 도달한다.
- Stage 0: Vision–Language Alignment는 이미지-캡션 쌍, 시각 지식, 순수 텍스트를 사용한다. 생성 과제는 이미지 토큰만, 이해 과제는 텍스트 토큰만 마스킹한다. 생성은 256 × 256(∼256 tokens)에서 512 × 512(∼1024 tokens)로 진행한다.
- 이해에는 최대 변 길이가 800인 임의 해상도 처리를 사용한다. 본문은 800 × 800 입력이 약 2048 tokens라고 설명한다.
- Stage 1: Multi-task Pre-training은 OCR, counting, grounding, 비디오, 편집, 참조 기반 스타일 전이, 피사체 중심 생성, 제어 가능한 생성, 다중 시점 과제를 도입한다.
- Stage 2: Supervised Fine-tuning은 먼저 8k 문맥에서 지시 이행 능력을 학습한 뒤, 교차 과제와 CoT를 추가한 과제를 포함하는 복잡한 시각 추론과 생성을 위해 16k로 확장한다.
단계별 비교는 100B, 210B, 80B 토큰을 사용하는 학습 과정을 정리하며, S2에서 문맥을 16384로 확장한다. 해상도 512의 백본 생성과 해상도 1024의 디코더 출력을 구분하고, 편집, 교차 생성, 추론 데이터의 도입을 보여준다.
4.2 Pre-Training Optimization
사전 학습은 Block Diffusion Language Model 목적함수를 사용한다. 앞선 깨끗한 블록과 현재의 노이즈 블록을 바탕으로 현재 블록의 마스크 토큰을 예측한다. 손실에는 마스크 위치 지시자와 확산에서 유도한 시간 가중치 (-\frac{\alpha’_t}{1-\alpha_t})가 포함된다. 이 방식은 블록 내부 병렬 예측과 블록 간 순차적 조건화를 결합한다.
- Equation (3)은 블록 수를 K = Ltotal/LB로 정의하며, LB는 블록 크기다. 마스킹된 위치만 예측 항에 기여한다.
- MoE 최적화는 보조 손실 없는 부하 균형을 사용하고, 수치적 안정성을 위해 라우팅 게이트 출력에 2.5를 곱한다. Equation (4)는 현재 전문가 부하 분포와 균등 목표 분포를 이용해 전문가 편향 업데이트에 RMSNorm 방식의 정규화를 적용한다.
4.3 Supervised Fine-Tuning Optimization
SFT는 입력 프롬프트를 블록 확산 목적함수의 조건으로 사용하고, 같은 MoE 균형 전략을 유지한다. 샘플 길이 차이가 최대 2 orders of magnitude에 이르므로, Mask Token Reweighting Loss는 마스크 토큰 수의 제곱근 역수를 사용해 긴 샘플과 짧은 샘플의 영향력을 조절한다. 상보적 마스킹은 서로 반대인 마스크를 적용한 손상 시퀀스 쌍을 제공한다.
- Mask Token Reweighting Loss: Equation (6)은 LMTRS = (∑j βj LSFT^(j))/(∑j βj)로 정의하며, βj는 샘플 j의 마스크 토큰 수에 대한 제곱근 역수다. 토큰 단위 평균에서 긴 시퀀스가 지배하는 문제와 샘플 단위 평균에서 짧은 출력을 유도하는 문제를 피하려는 목적이다.
- Complementary Masking: 각 깨끗한 시퀀스에서 기본 노이즈 입력과 역마스크 입력을 만들므로, 각 위치는 쌍마다 정확히 1번 손상되지 않은 상태로 나타난다. 정보 활용도를 높이고 토큰 수준 샘플링 편향을 줄이려는 전략이다.
4.4 Diffusion Decoder Training
디코더는 시각 의미 토큰을 조건으로 예측 속도와 목표 속도 사이의 제곱 오차를 최소화하는 flow matching으로 학습한다. 워밍업에서는 의미 처리기를 고정하고, 다중 도메인 일반화 단계에서는 모든 파라미터를 학습한 뒤, 고품질 데이터로 정제한다. 일관성 기반 증류로 CFG 없는 8-step 디코딩을 구현한다.
- Equation (7)은 LFM(θ) = E[‖vθ,t(xt, z) − vt‖²₂]로 주어지며, z는 의미 토큰 조건 신호다.
- Few-step Generation: 증류에는 추론 시 제거하는 보조 최종 투영층을 추가한다. Equation (8)은 flow matching과 stop-gradient 출력 및 그 시간 미분을 사용하는 일관성 항을 결합한다.
- 시간 미분은 Jacobian-vector product이며, UCGM의 2차 차분 기법으로 근사한다.
4.5 Infrastructure for Training Efficiency
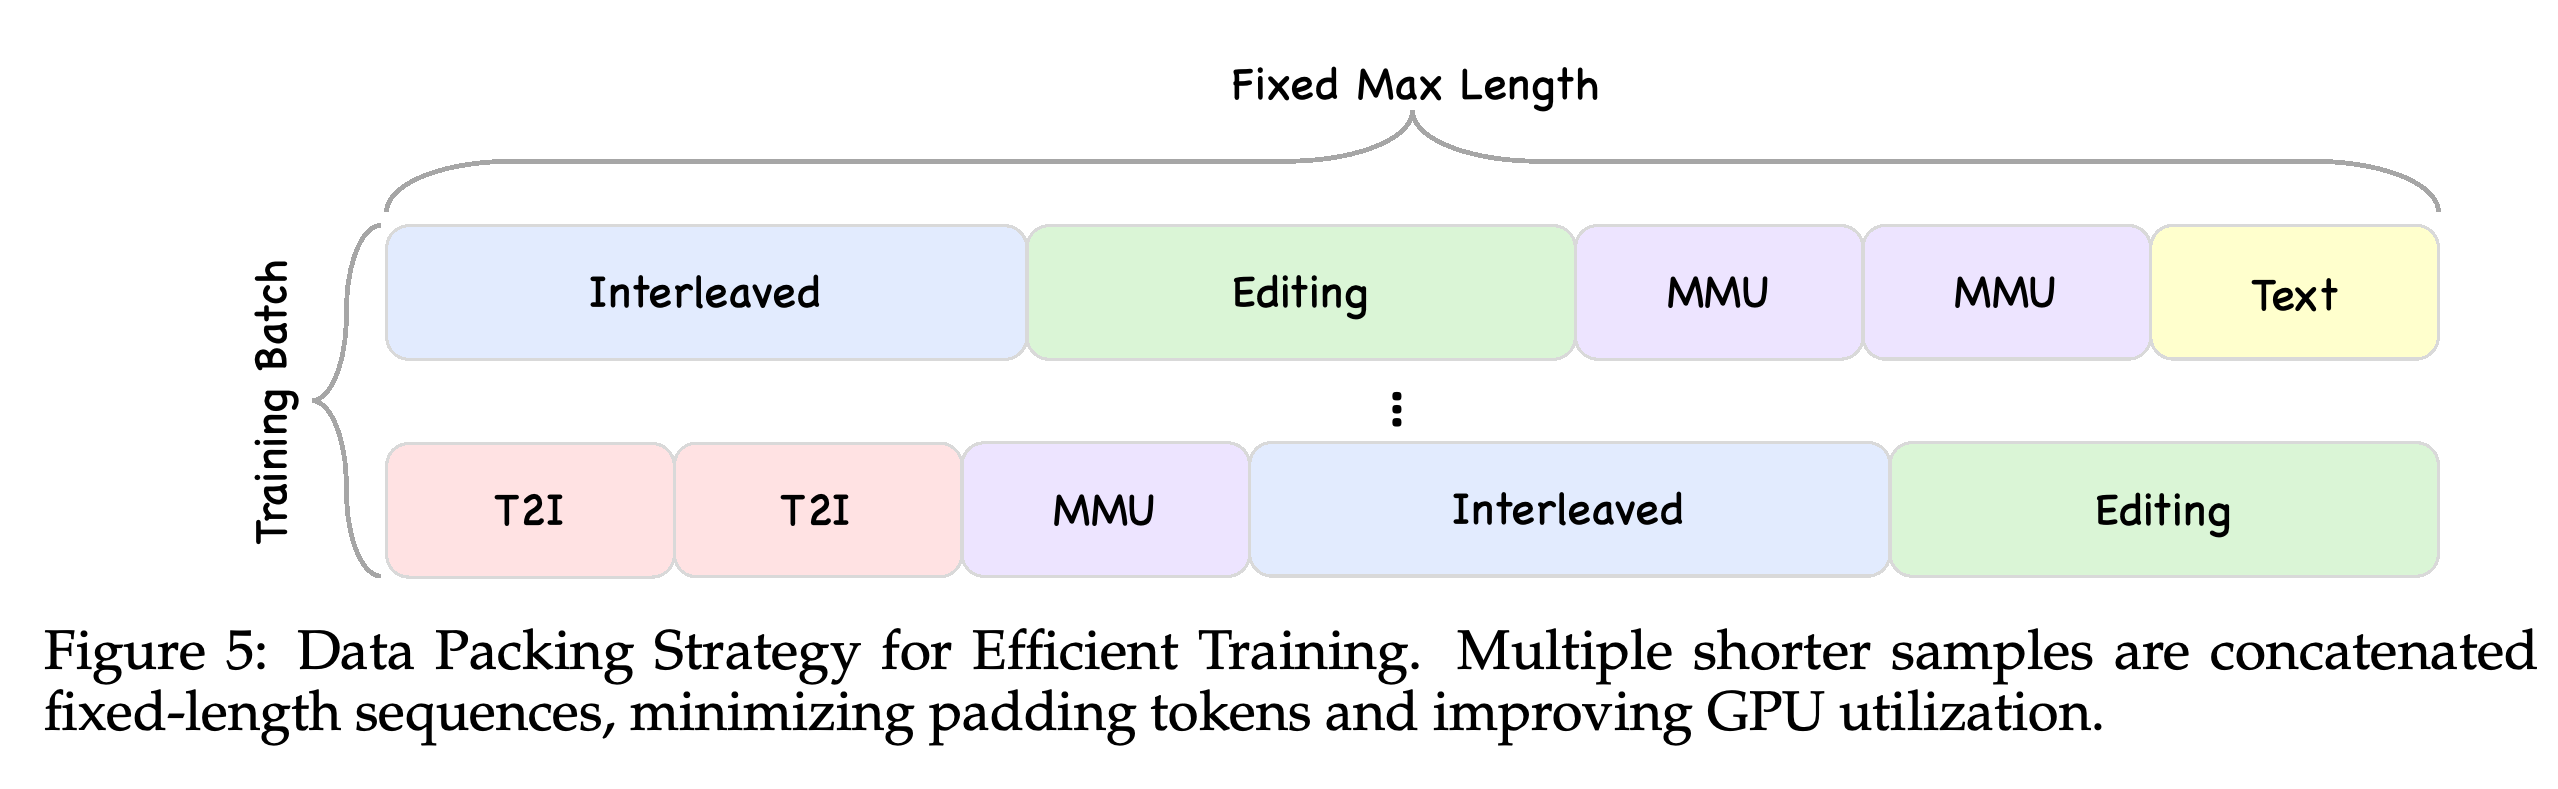
학습 효율을 위해 오프라인 시각 토큰 추출, 오프라인 시퀀스 패킹, VeOmni 기반 dFactory를 통한 분산 실행을 사용한다. 백본 학습 전에 이미지를 고정된 토크나이저로 처리하고 토큰 인덱스를 디스크에 저장한다. Figure 5는 길이가 다양한 과제에서 패딩을 줄이도록 짧은 샘플을 고정 길이 시퀀스에 묶는 방식을 보여준다.
- 이 방식은 시각 인코더의 반복 계산을 피하고 배치에서 유용한 토큰의 비중을 높인다. 다만 이 절은 각 인프라 변경에 대한 통제된 처리량 비교를 보고하지 않는다.
서로 다른 과제의 샘플을 각각 가장 긴 샘플에 맞춰 패딩하지 않고, 같은 고정 길이 패킹 시퀀스의 일부 구간에 배치한다. 자원 활용도를 높이려는 방식을 설명하지만, 논문은 패킹만의 가속 효과를 정량화하지 않는다.
5 Experiments
실험은 멀티모달 이해, 일반 및 텍스트 중심 이미지 생성, 추론을 활용한 생성, 지시 기반 및 다중 참조 편집, 교차 출력을 다룬다. 전문 모델, 자기회귀 통합 모델, 자기회귀-확산 하이브리드 시스템, 이산 확산 모델을 비교한다. 별도의 가속 분석에서는 SPRINT와 디코더 증류를 측정한다.
5.1 Multimodal Understanding
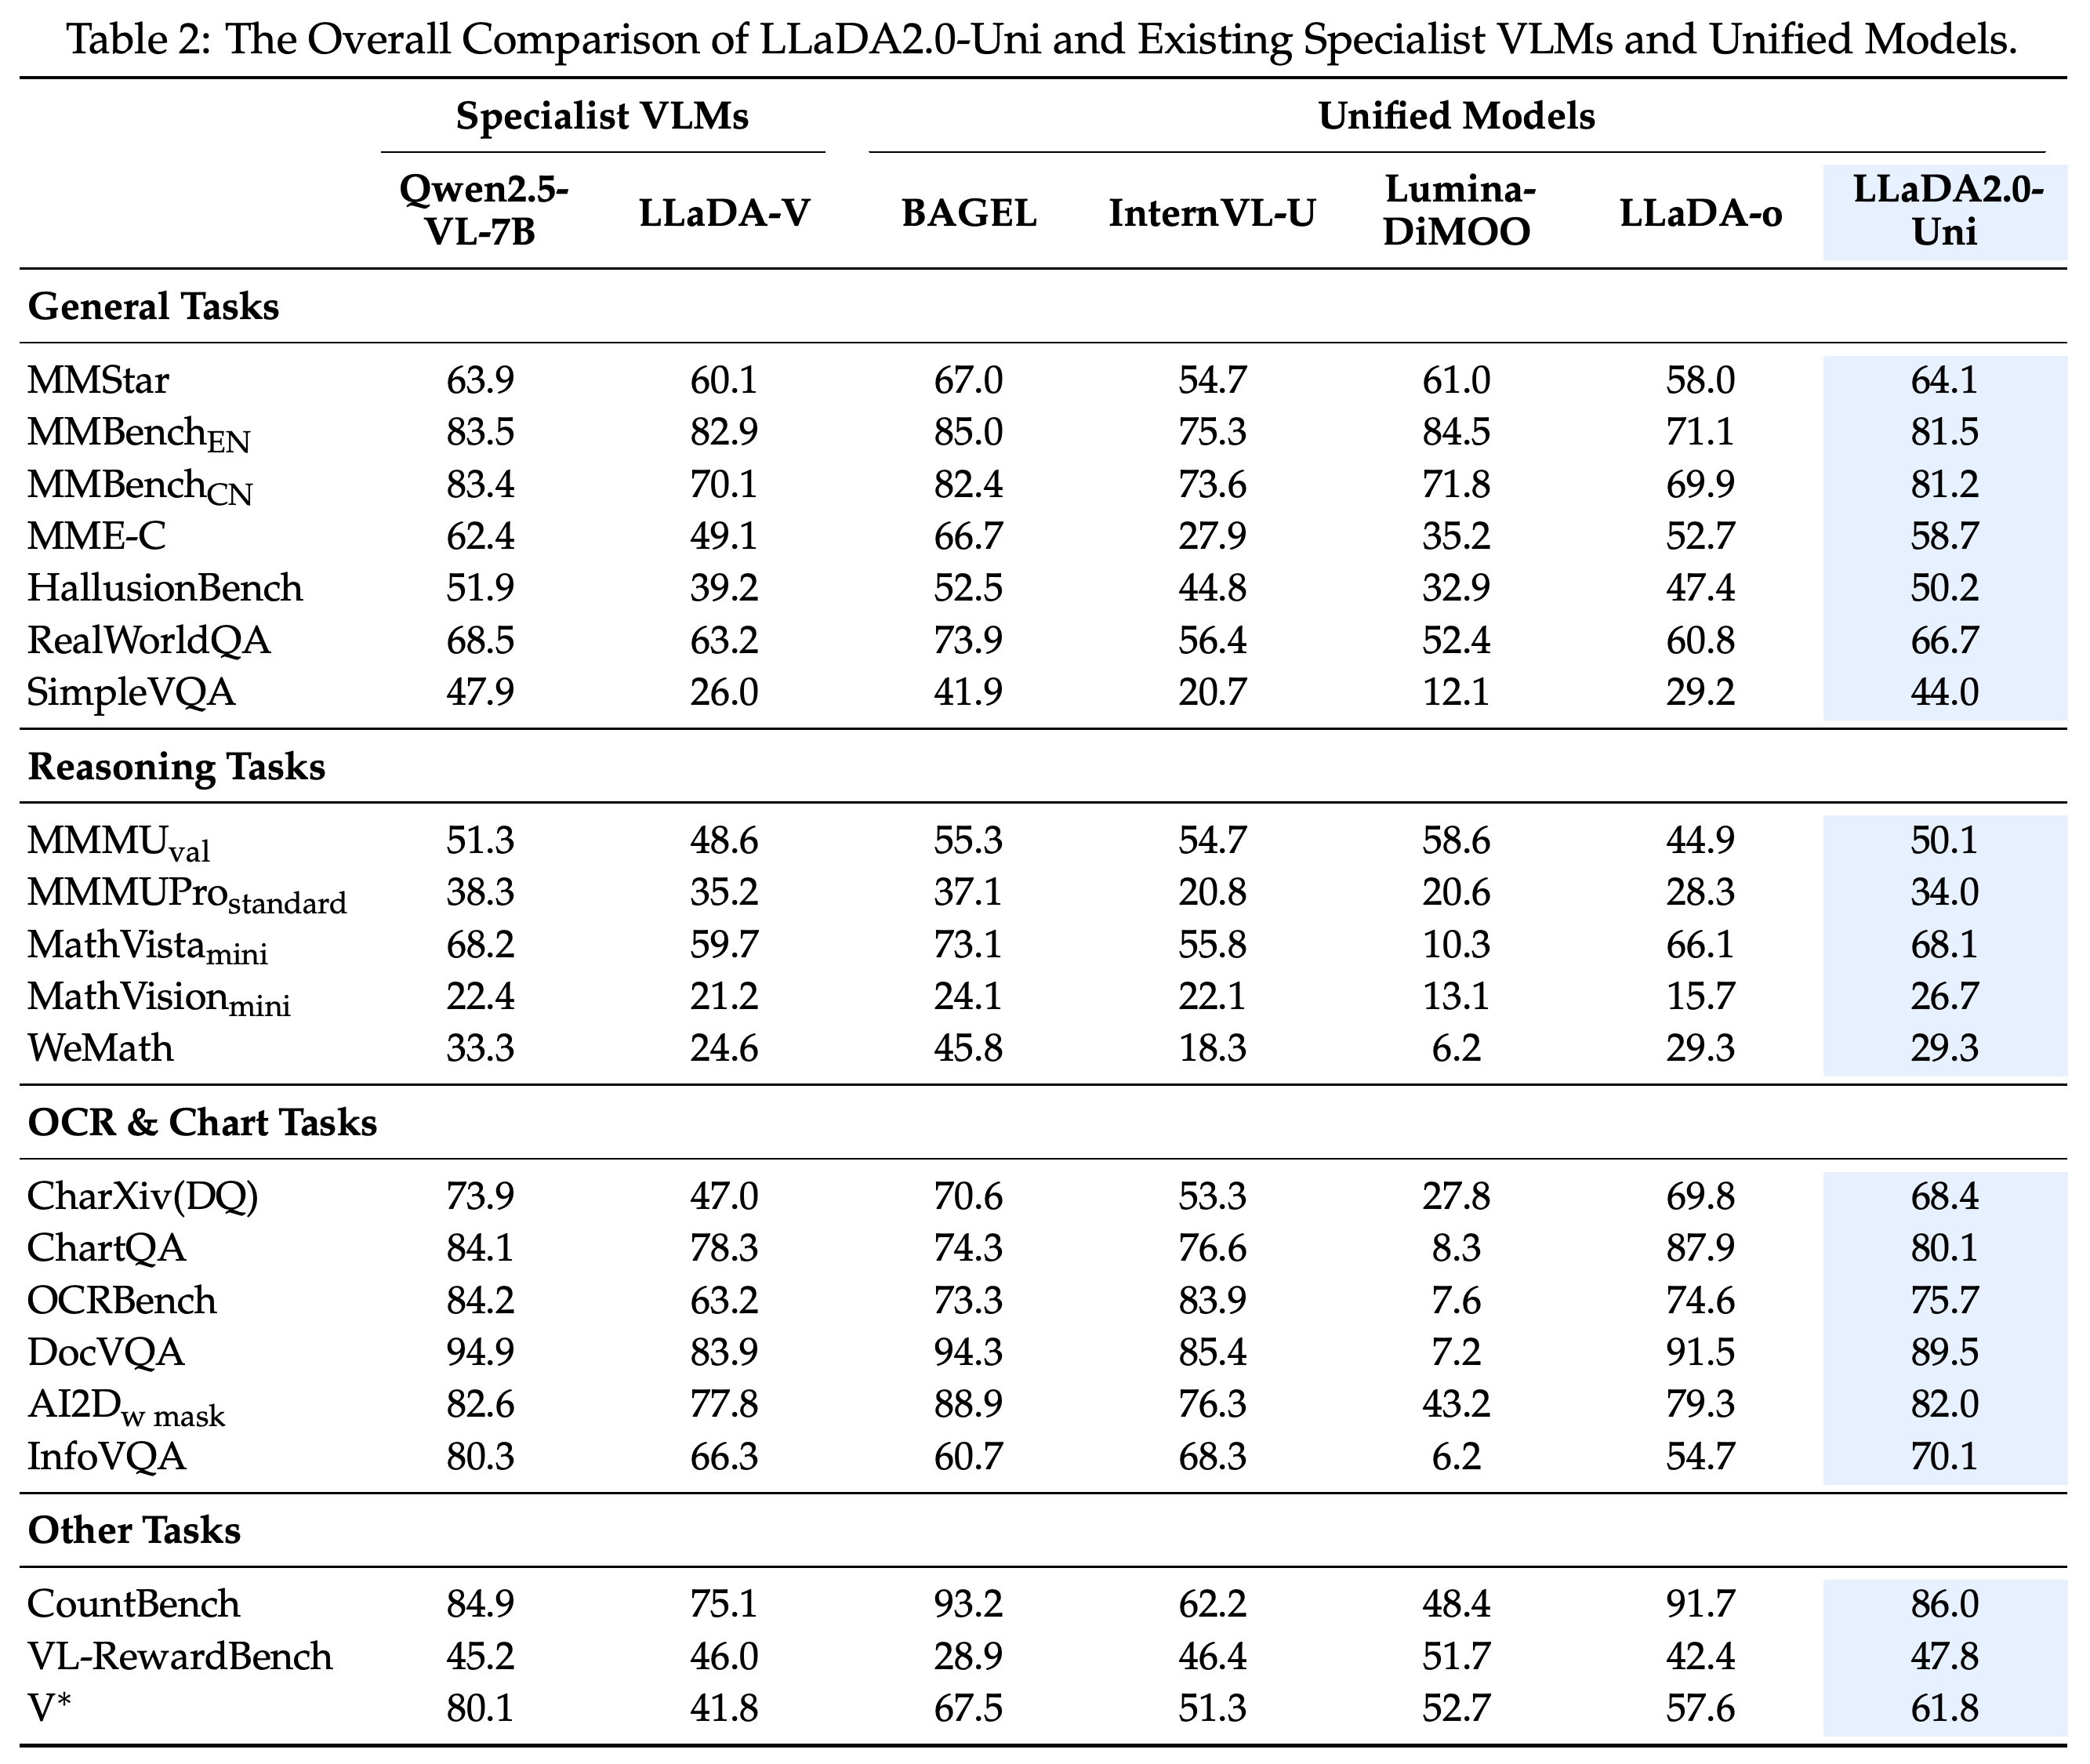
Table 2는 경쟁력 있는 이해 성능을 보여주지만, 전문 VLM과 일관되게 대등하거나 다른 통합 확산 모델보다 항상 우수하지는 않다. LLaDA2.0-Uni는 MMStar에서 64.1, CountBench에서 86.0으로 Qwen2.5-VL-7B의 63.9와 84.9를 웃돈다. 반면 OCRBench는 75.7 대 84.2, DocVQA는 89.5 대 94.9, V*는 61.8 대 80.1로 뒤처진다.
- 5.1.1 Evaluation Settings: 논문은 일반 VQA, 추론, OCR/문서, 기타 과제에 걸쳐 21개 벤치마크를 나열하고 Qwen2.5-VL-7B, LLaDA-V, BAGEL, InternVL-U, Lumina-DiMOO, LLaDA-o와 비교한다. Table 2는 20개 벤치마크를 다루는 결과 행 21개를 포함한다. MMBench는 영어와 중국어로 나뉘며, 목록에 있는 MathVerse의 결과는 표시되지 않는다.
- 5.1.2 Multimodal Understanding Performance: MathVista는 68.1로 Qwen2.5-VL-7B의 68.2와 비교되며, MathVision은 26.7 대 22.4다. MMMU는 50.1로 Lumina-DiMOO의 58.6보다 낮고, ChartQA는 80.1로 LLaDA-o의 87.9보다 낮다.
- 결과는 폭넓은 이해 능력과 Lumina-DiMOO보다 크게 개선된 OCR/문서 성능을 보여준다. 그러나 모든 주요 범주에서 통합 확산 기준 모델 2개를 모두 앞선다는 논문의 포괄적 주장을 뒷받침하지는 않는다.
결과는 경쟁력 있는 일반 이해와 Lumina-DiMOO보다 훨씬 강한 OCR 성능을 뒷받침하지만, 전문 모델과 모든 과제에서 대등하지는 않다. LLaDA2.0-Uni는 표시된 MathVision 비교에서 26.7로 가장 높지만, OCRBench, DocVQA, V*에서는 Qwen2.5-VL-7B보다 낮다. 표에는 21개 행이 있으며, MMBench는 언어별로 나뉘고 MathVerse 결과는 없다.
5.2 Text-to-Image Generation
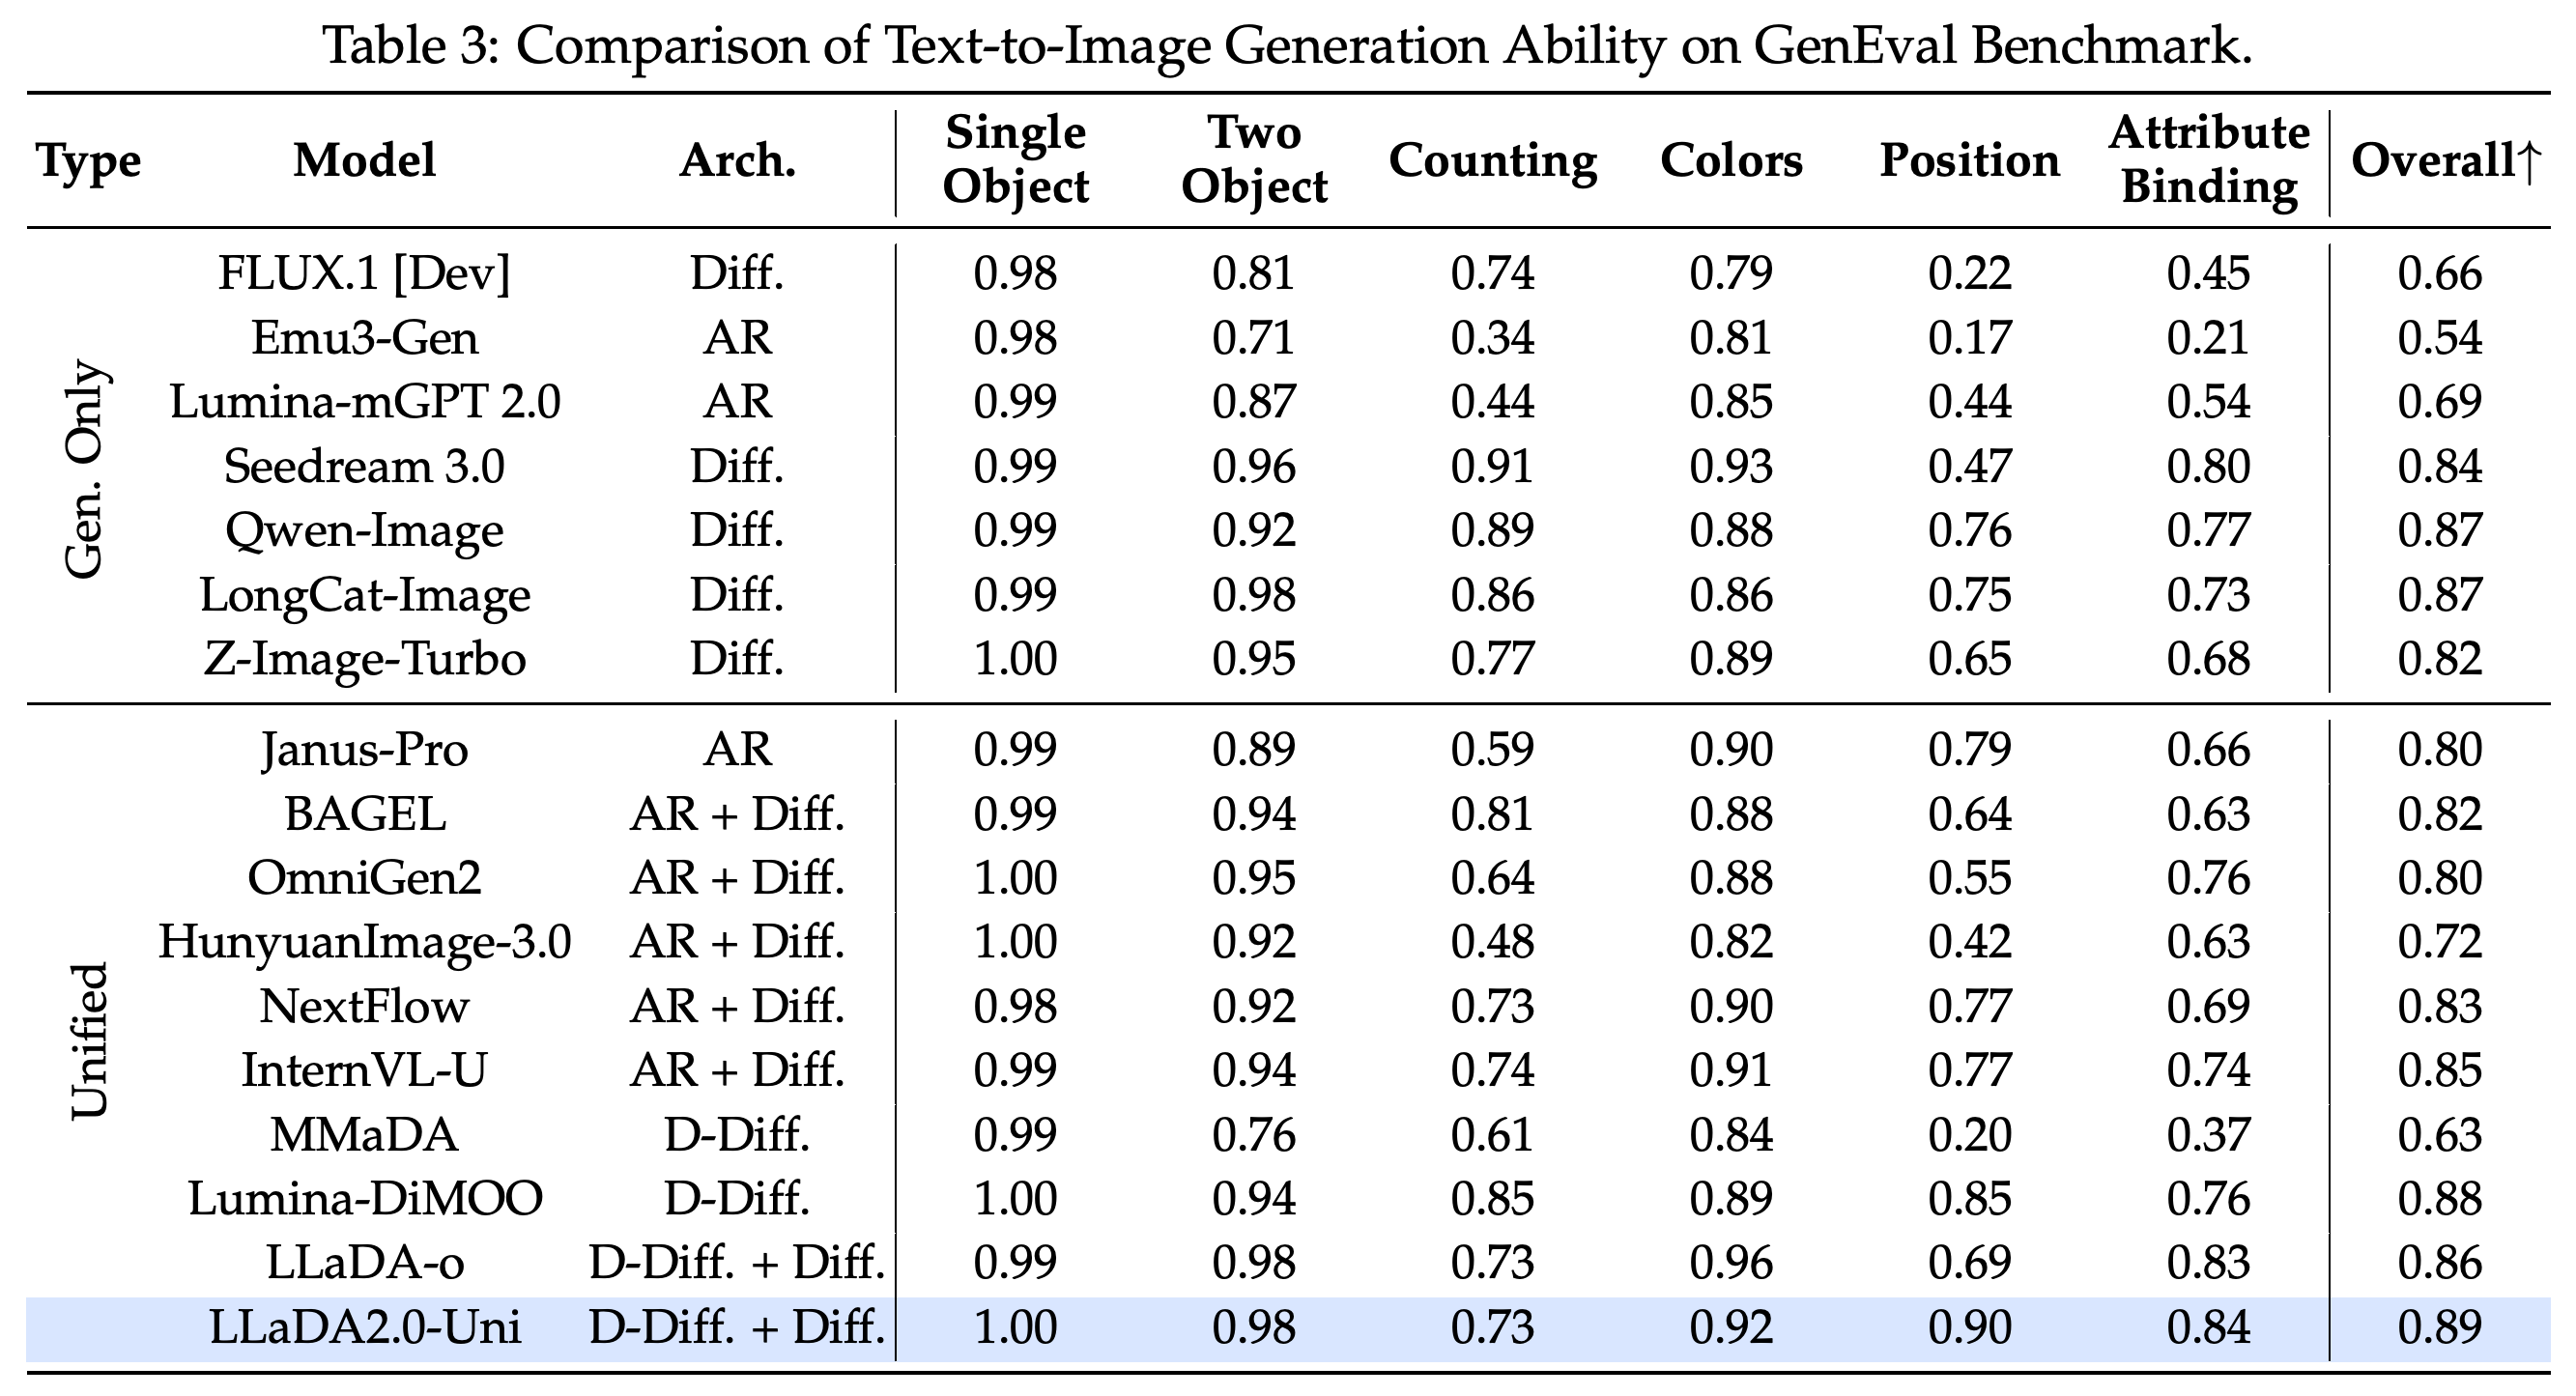
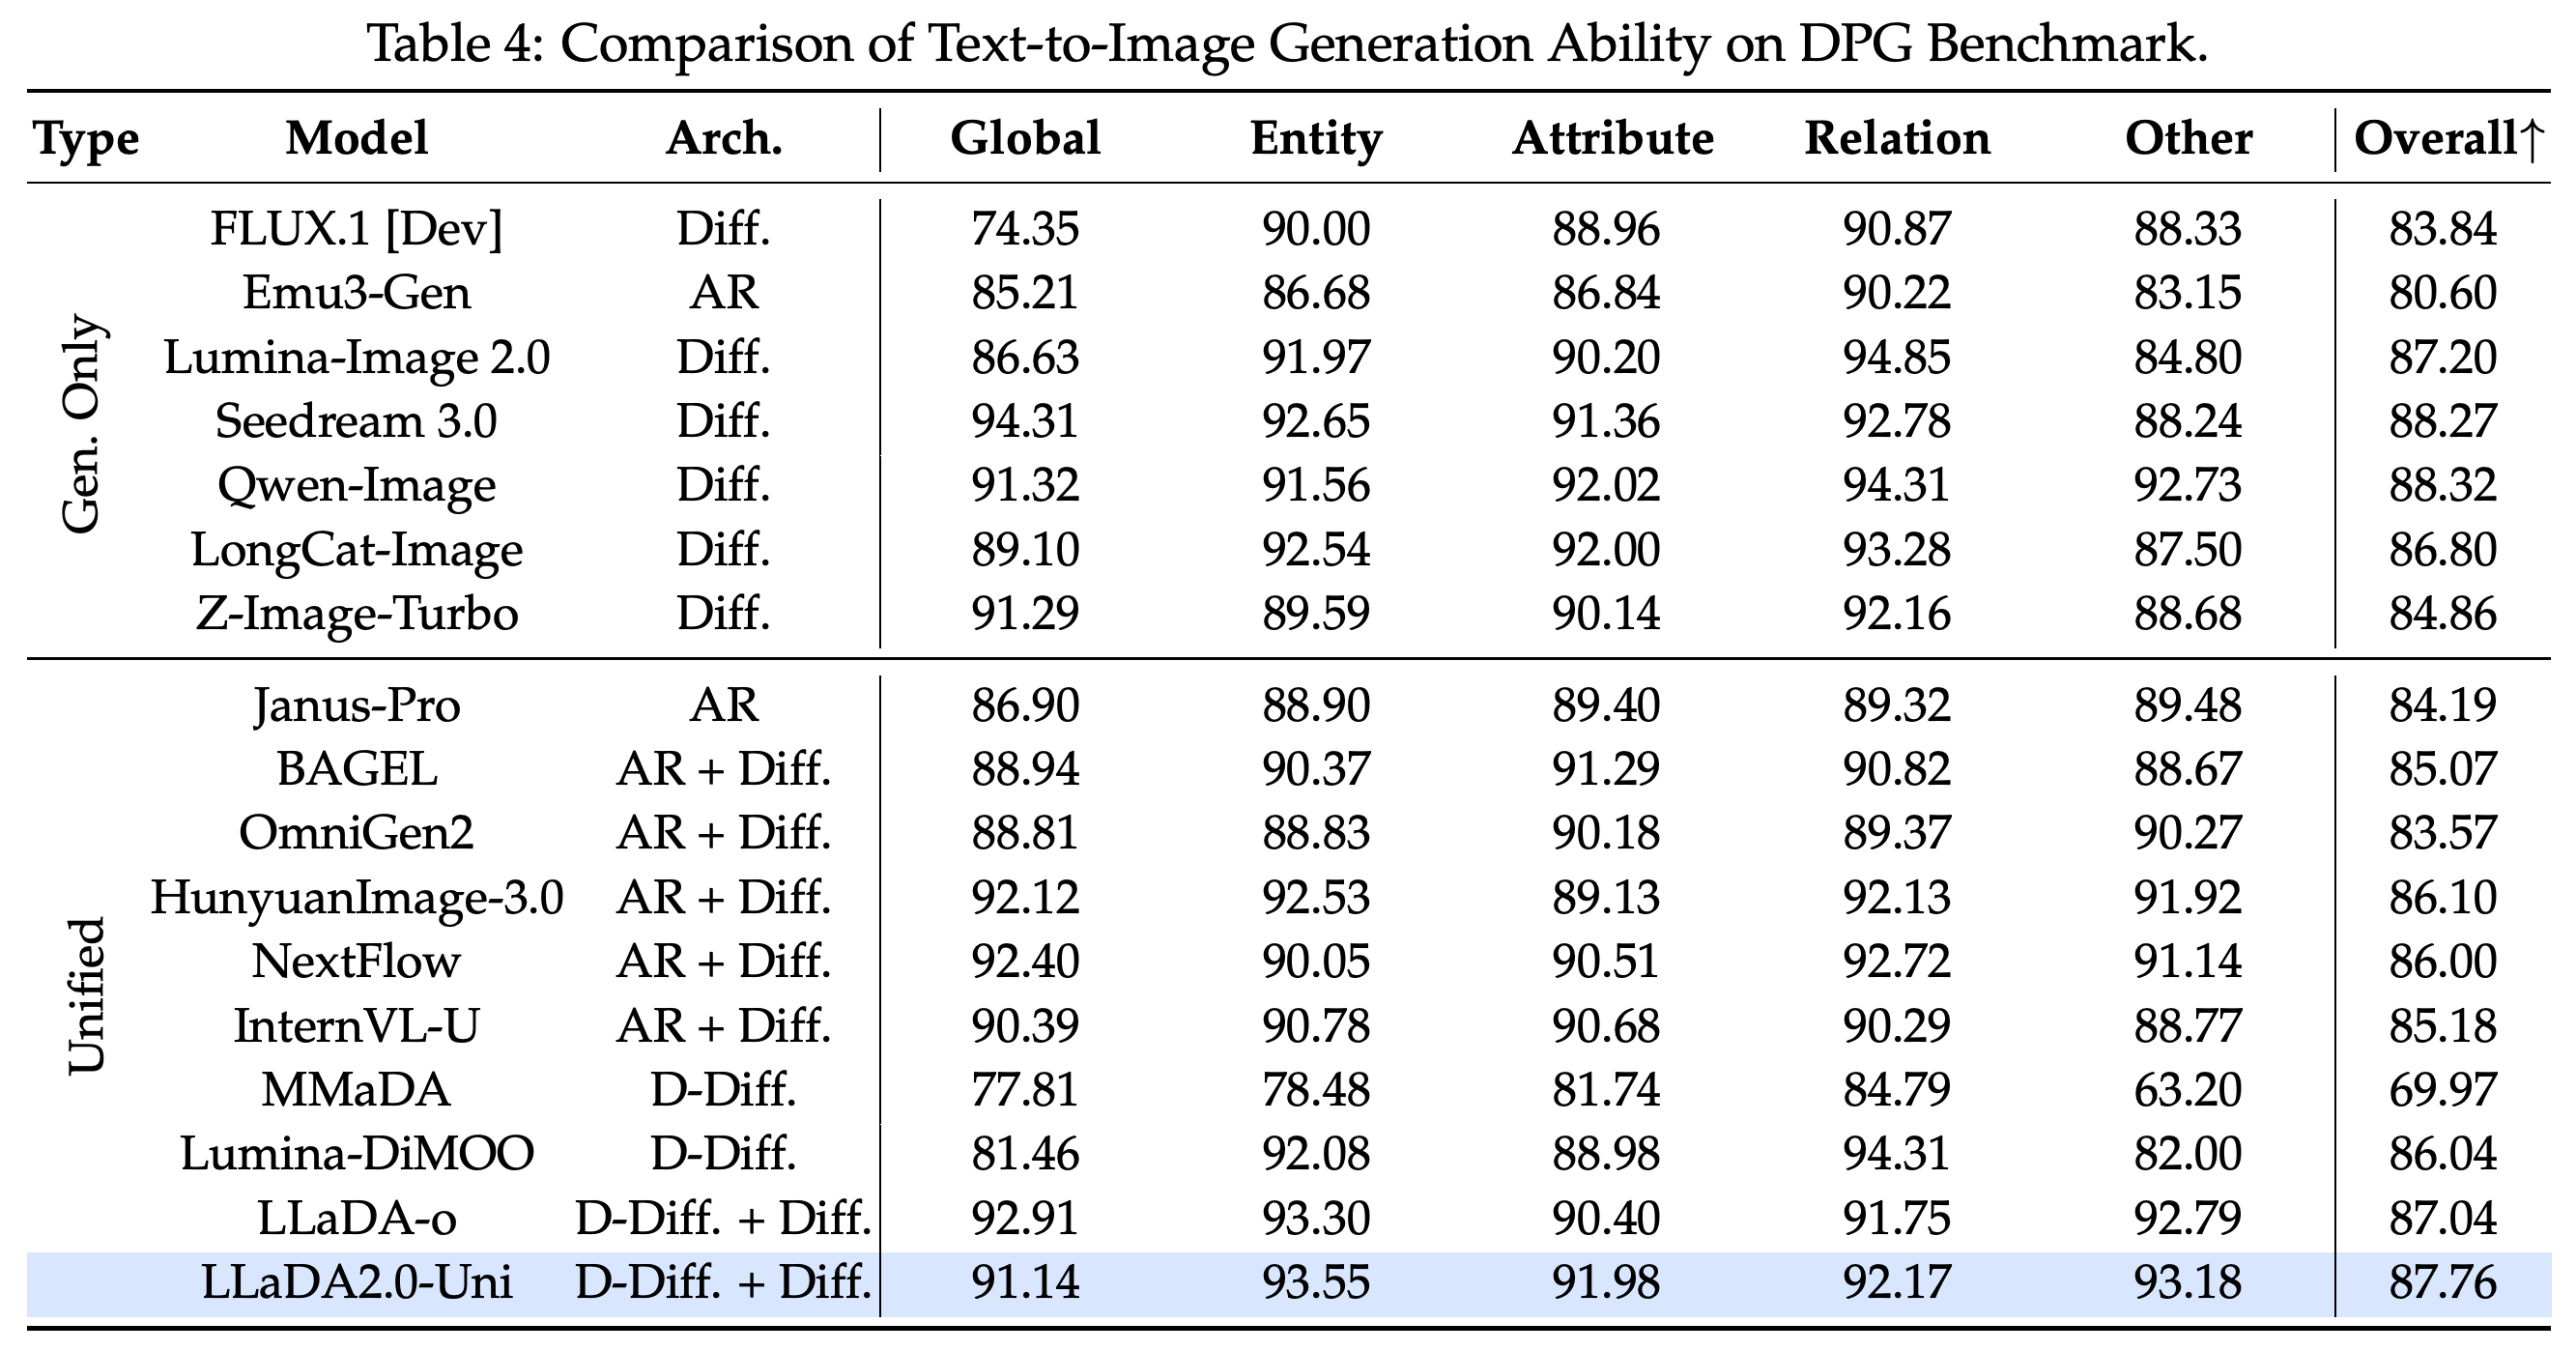
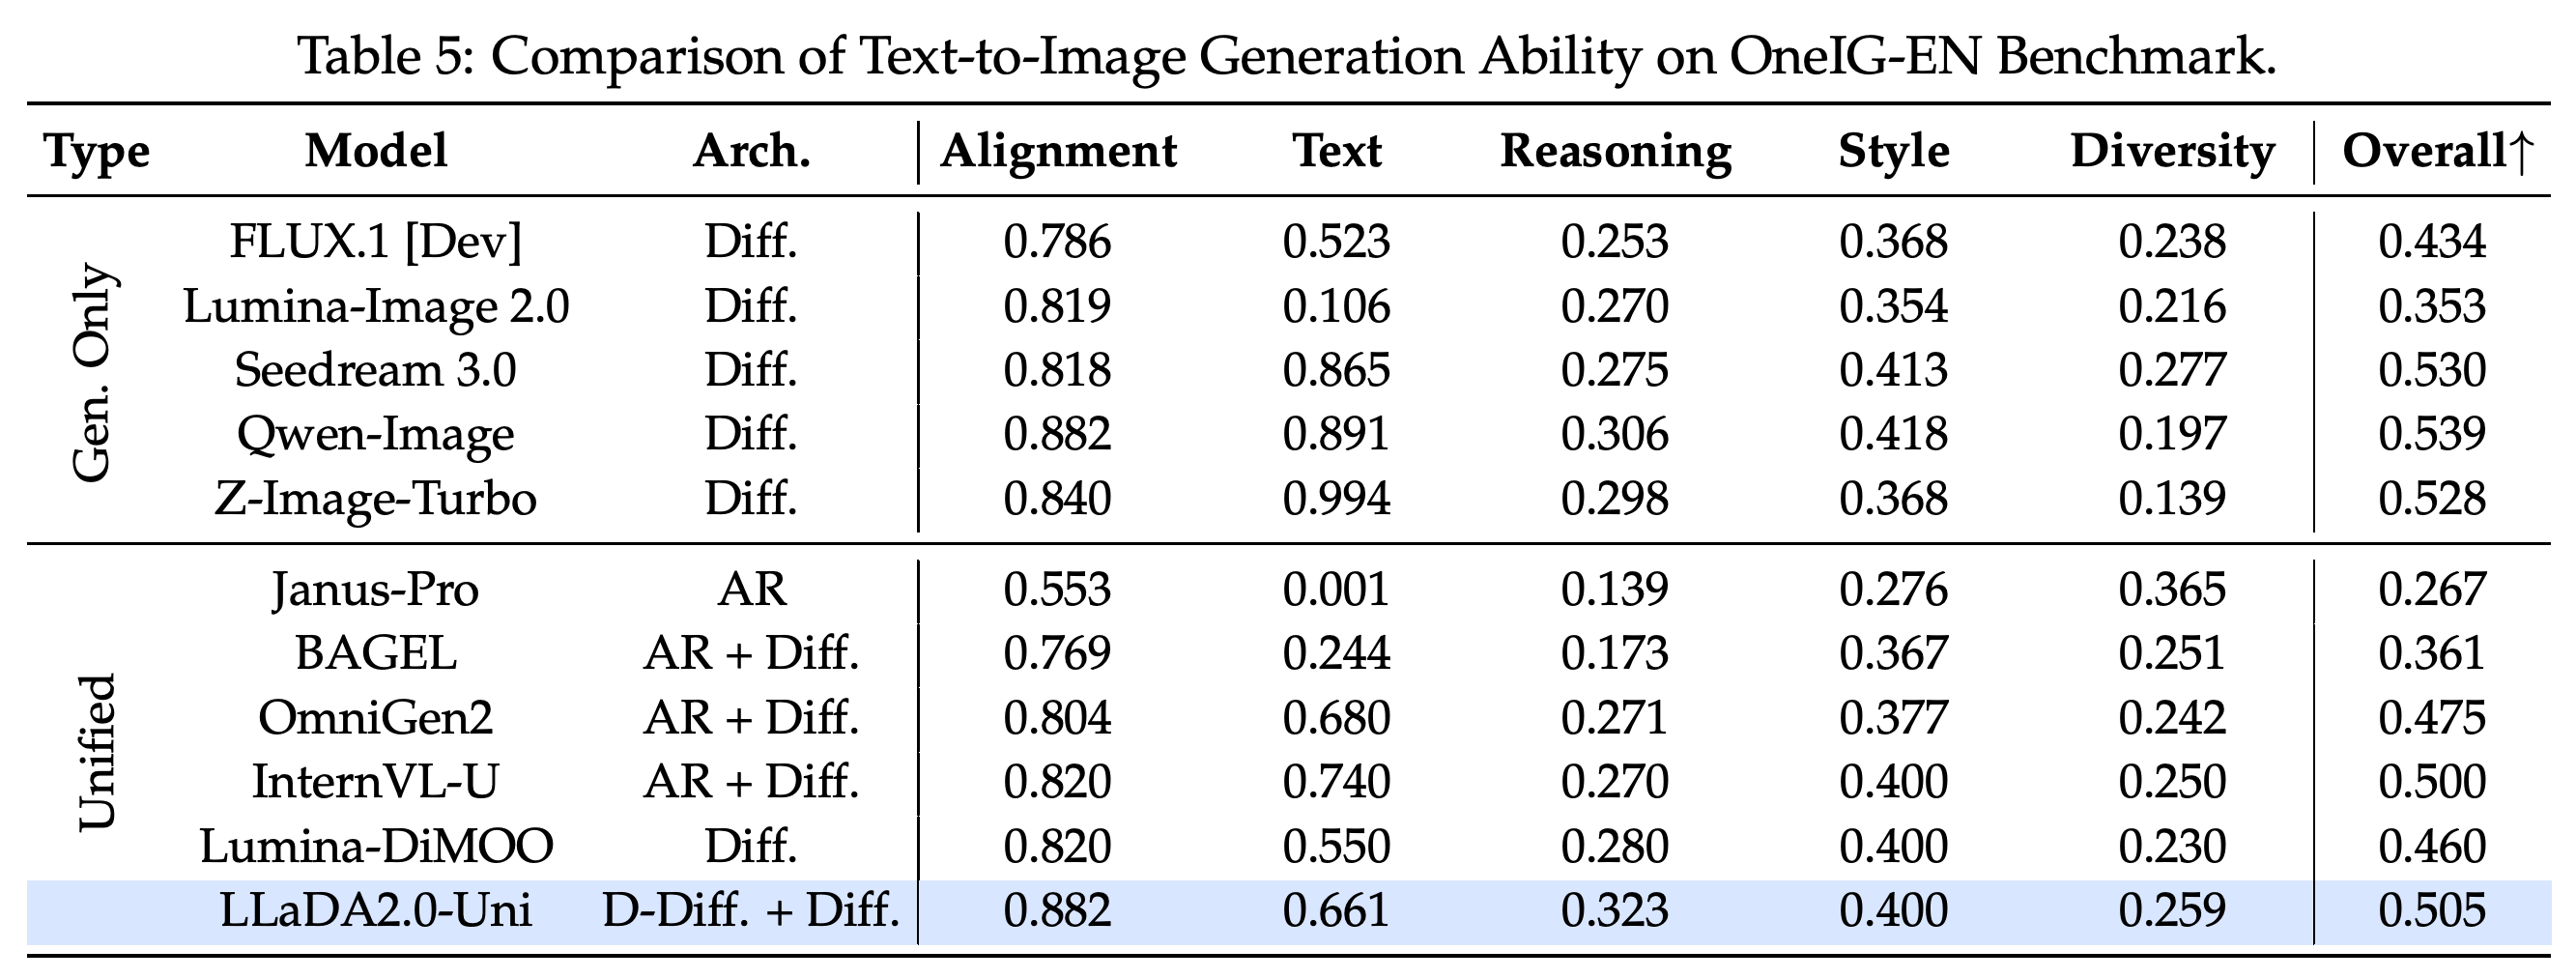
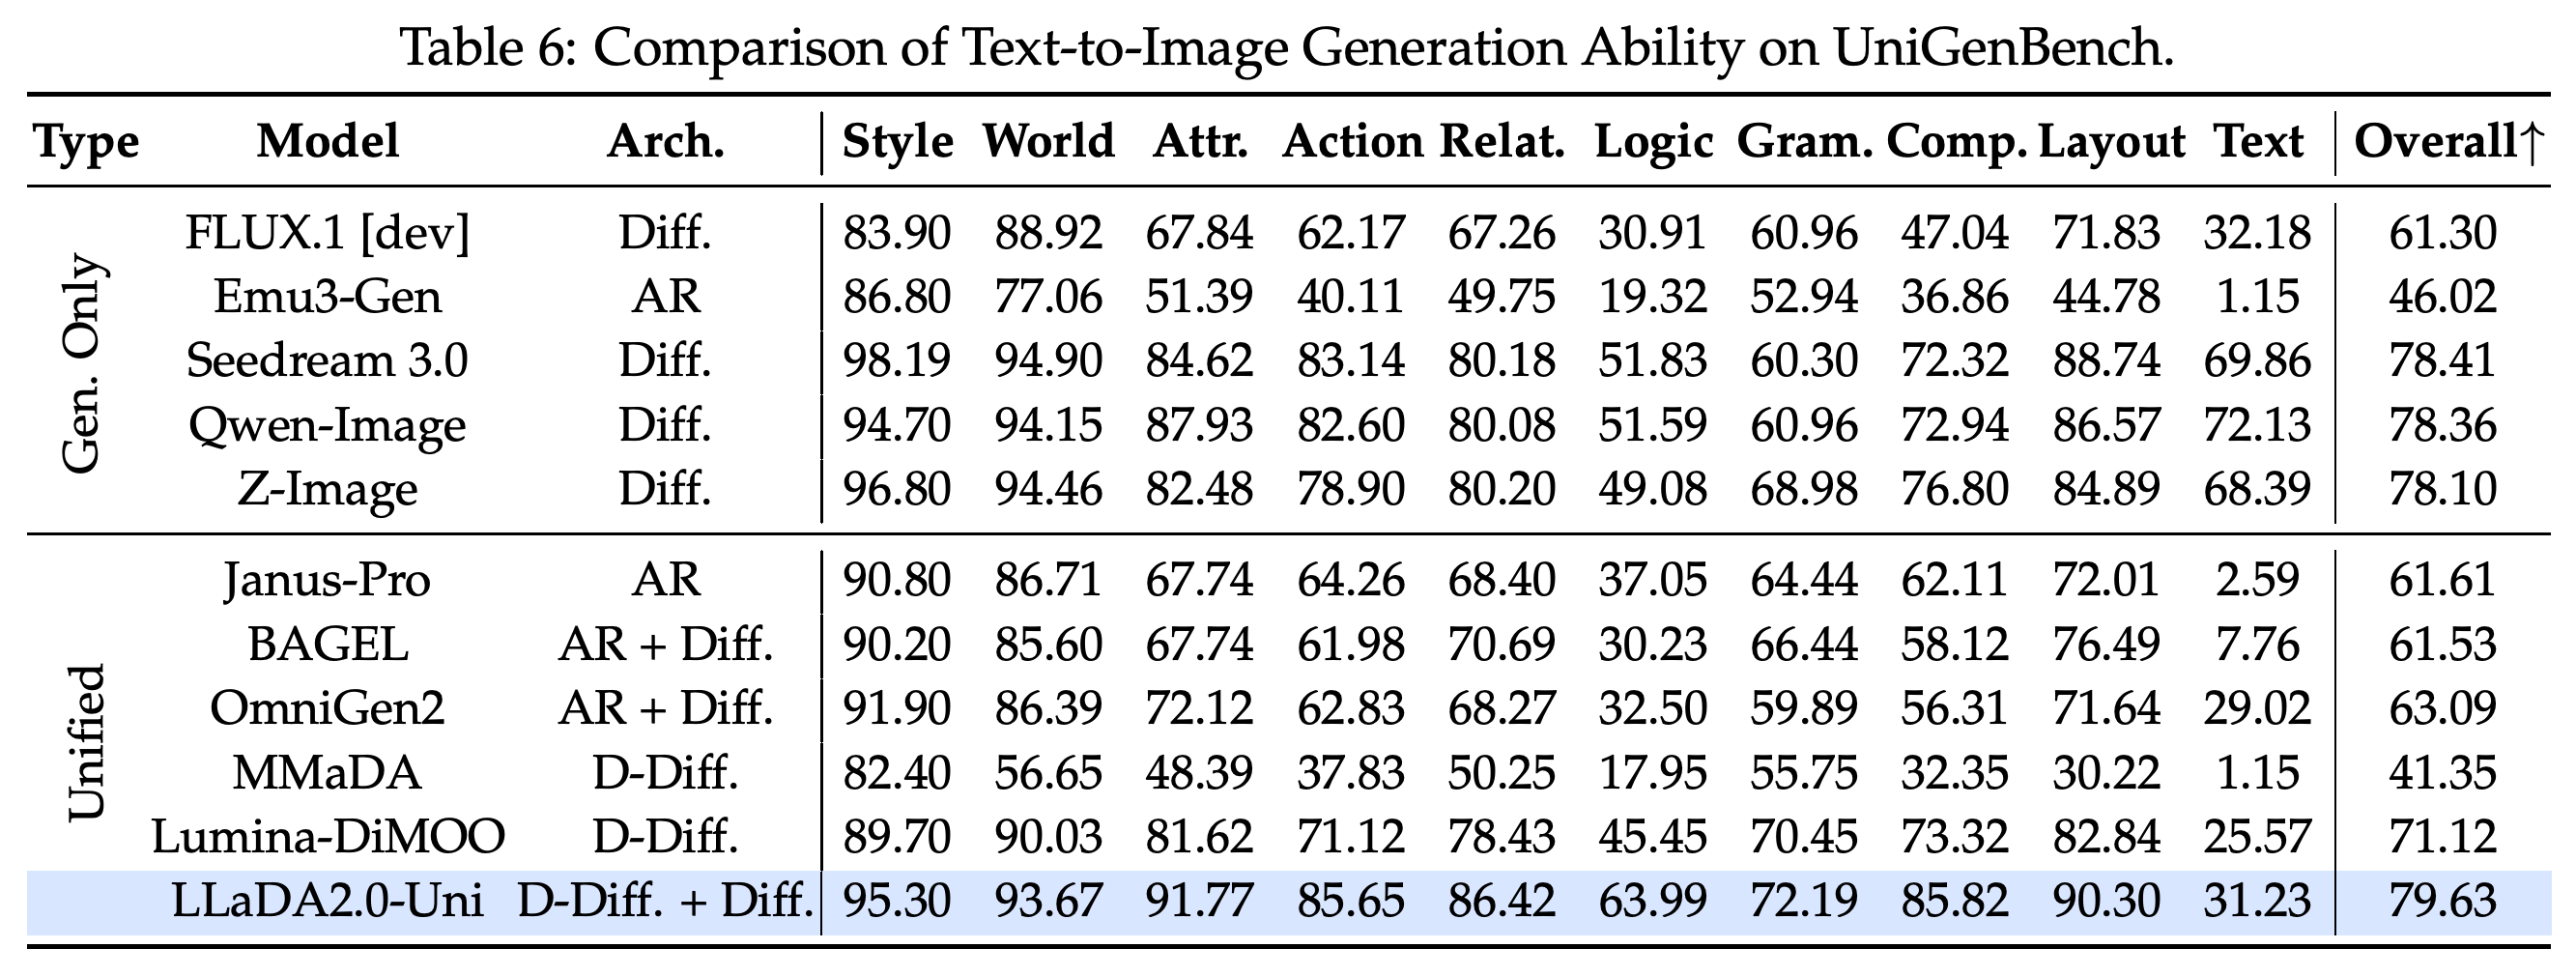
LLaDA2.0-Uni는 GenEval에서 0.89, DPG에서 87.76, OneIG-EN에서 0.505, UniGenBench에서 79.63을 달성한다. 각 표에 나열된 통합 모델 중 가장 높은 전체 점수지만, 여러 텍스트 렌더링 및 전체 생성 지표에서는 전문 모델이 더 강하다.
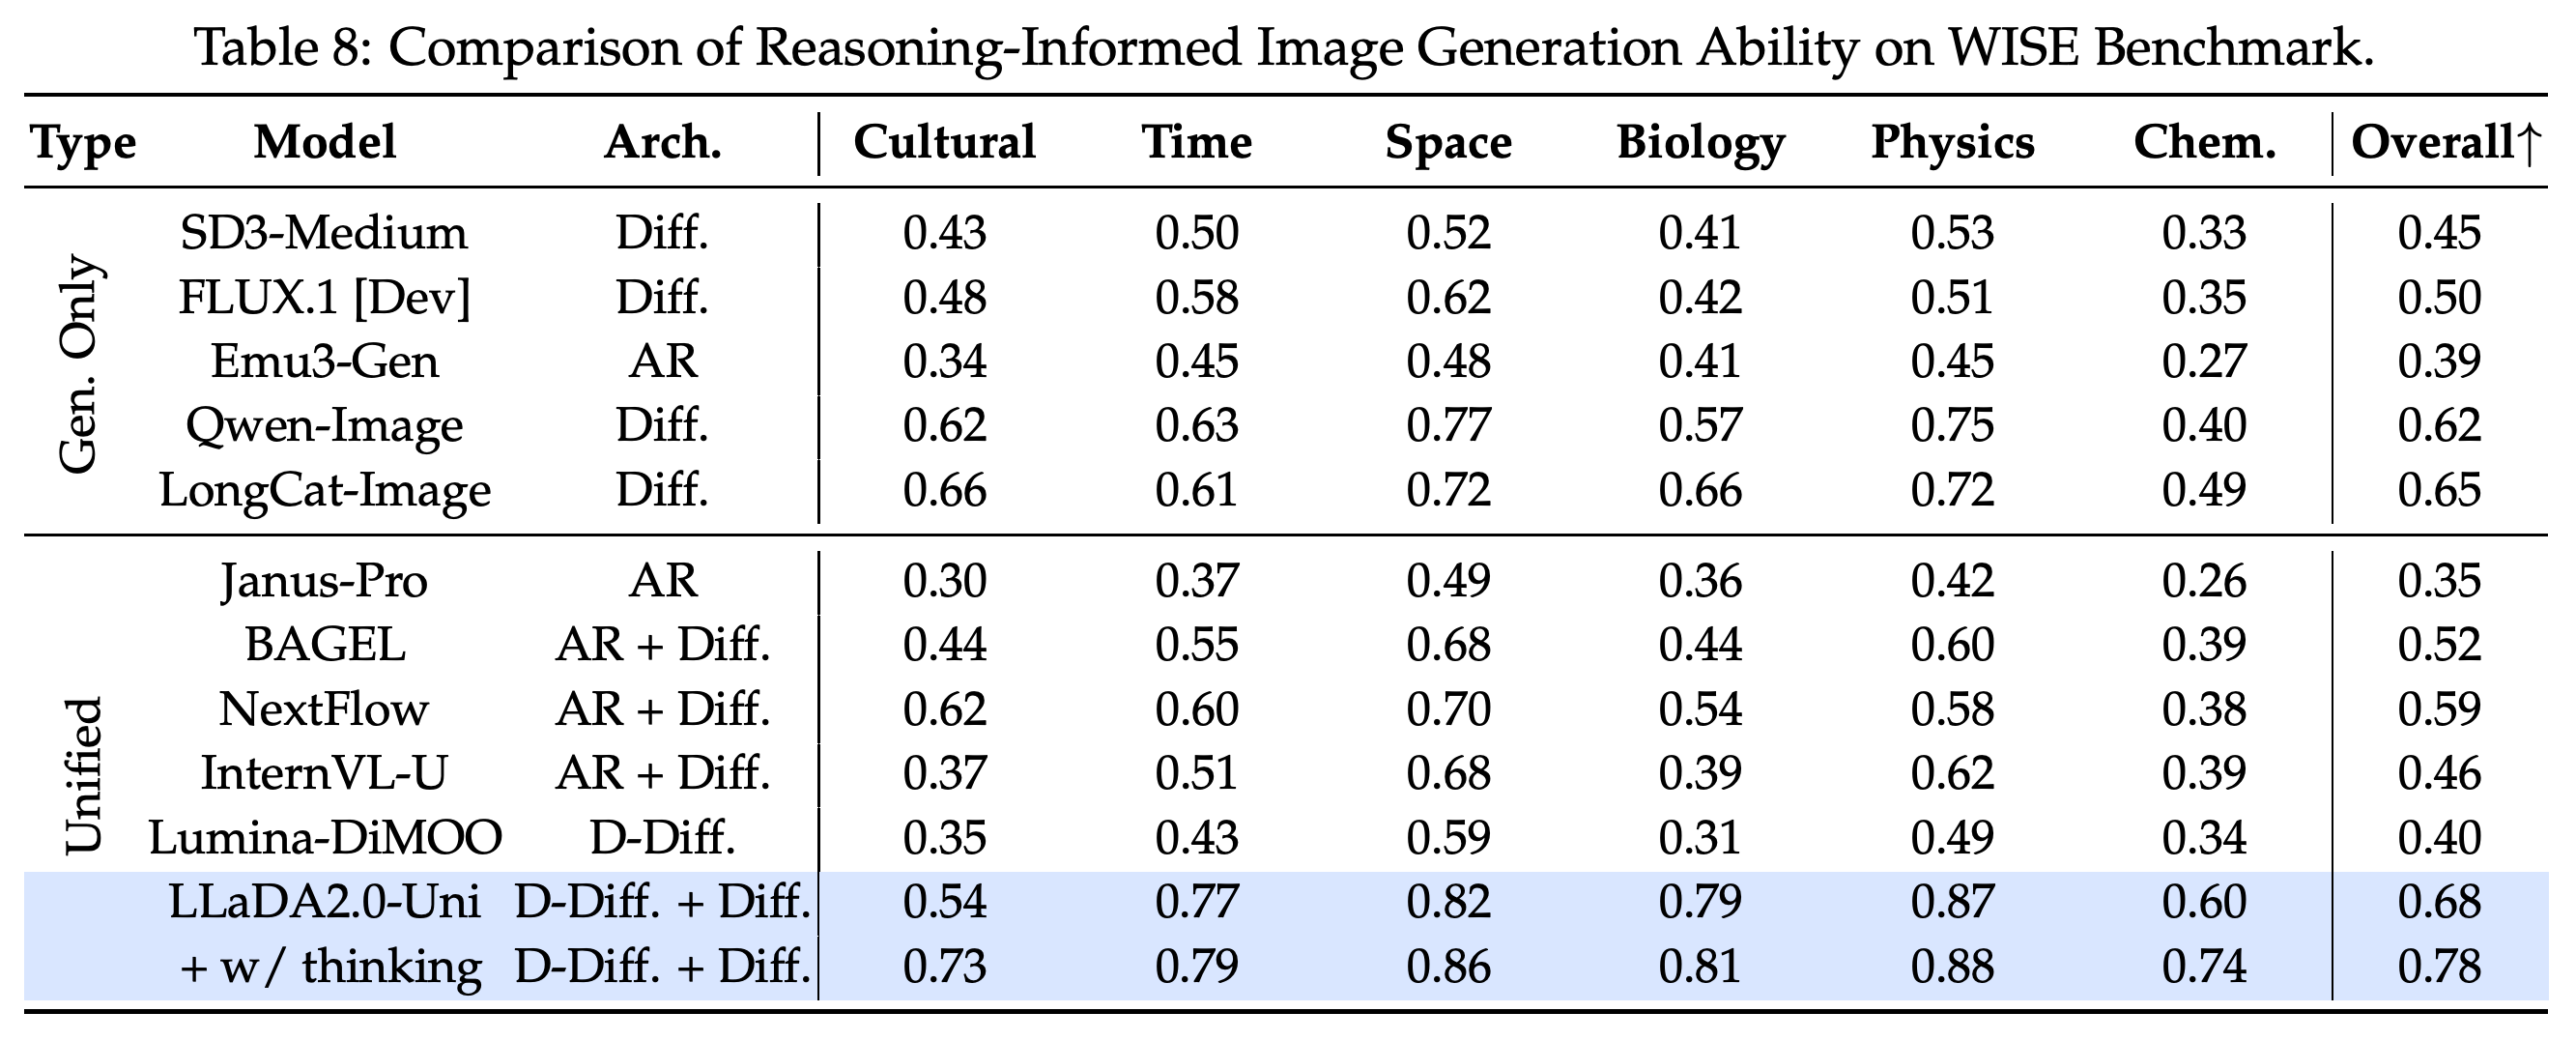
- 5.2.1 Evaluation Settings: GenEval, DPG-Bench, One-IG Bench, UniGenBench는 일반 생성을 평가하고, CVTG-2K는 텍스트 렌더링을, WISE-Bench는 추론을 활용한 생성을 평가한다. Tables 3–8은 생성 전용 전문 모델과 자기회귀, 하이브리드, 확산 기반 통합 모델을 비교한다.
- 5.2.2 General Image Generation Performance: Table 3은 Position 0.90과 Attribute Binding 0.84를 보고하지만, Counting은 0.73으로 Seedream 3.0의 0.91보다 낮다. Position이 비교 대상 중 가장 높다는 본문의 주장은 Table 3과 일치한다. LLaDA-o는 0.69, Lumina-DiMOO는 0.85다. Table 4는 Entity 93.55와 Other 93.18을 보고하지만, 본문은 Other를 94.04로 제시한다.
- OneIG-EN에서 Alignment는 0.882, Reasoning은 0.323이다. 그러나 Text는 0.661로 Qwen-Image의 0.891과 Z-Image-Turbo의 0.994보다 낮다. UniGenBench에서 Logic은 63.99, Layout은 90.30이며, Text는 31.23으로 Qwen-Image의 72.13보다 낮다.
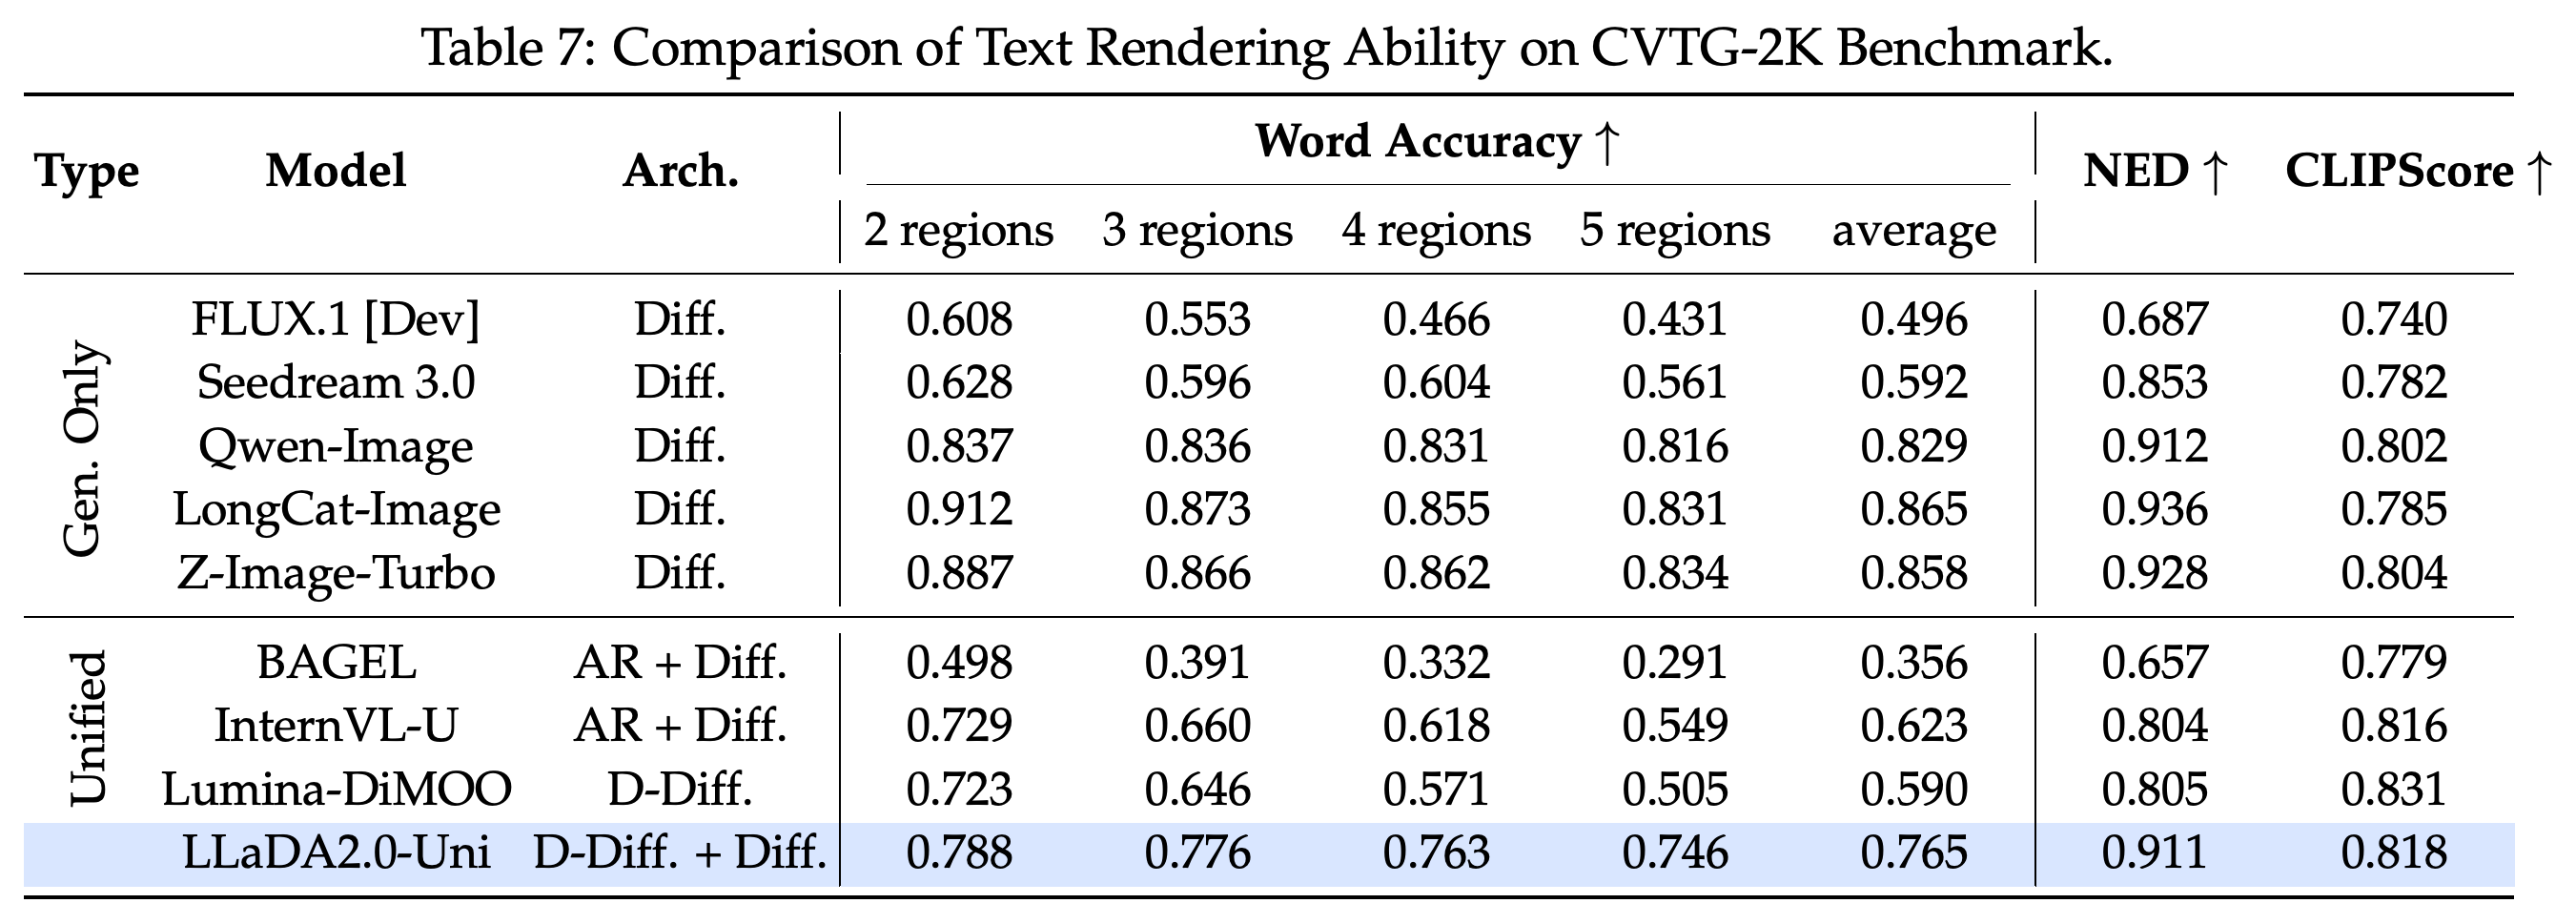
- 5.2.3 Text-Centric Image Generation Performance: CVTG-2K의 평균 단어 정확도는 0.765이며, 영역이 2개일 때 0.788에서 5개일 때 0.746으로 감소한다. 감소 폭은 비교한 통합 기준 모델보다 작지만, 평균 정확도는 LongCat-Image의 0.865보다 낮다.
- 5.2.4 Reasoning-Informed Image Generation Performance: thinking을 사용하면 WISE가 0.68에서 0.78로 높아진다. 이는 점수가 절대값으로 0.10 score points 증가한 것이다. 논문은 추가 10% 개선이라고 설명하지만, 절대 변화와 상대 변화를 구분하지 않는다.
LLaDA2.0-Uni는 표시된 GenEval 전체 점수에서 0.89로 가장 높고, Position도 0.90으로 가장 높으며, Attribute Binding은 0.84다. Counting은 0.73에 머물러, 공간 및 속성 합성이 강하다고 해서 개수 제어도 같은 수준으로 강한 것은 아님을 보여준다.
전체 점수 87.76은 비교한 통합 모델 중 가장 높지만, Qwen-Image의 88.32보다는 낮다. 표는 Other를 본문의 94.04가 아니라 93.18로 보고하며, Entity는 표시된 점수 중 가장 높은 93.55다.
Alignment 0.882는 Qwen-Image와 같고, Reasoning 0.323은 비교한 기준 모델보다 높다. Text 0.661은 여러 전문 모델과 일부 통합 경쟁 모델보다 낮으며, 전체 성능 0.505도 가장 강한 생성 전용 모델보다 낮다.
전체 결과 79.63은 비교한 모든 모델을 웃돌며, Logic 63.99, Composition 85.82, Layout 90.30에서 강한 점수를 보인다. Text 31.23은 선도적인 전문 모델보다 상당히 낮으므로, 전체 점수만으로는 능력별 편차가 드러나지 않는다.
텍스트 영역이 2개에서 5개로 늘어나면 단어 정확도는 0.788에서 0.746으로 감소한다. 감소 폭은 비교한 통합 기준 모델보다 작다. 평균 0.765는 LongCat-Image의 0.865와 Z-Image-Turbo의 0.858보다 낮다.
thinking을 추가하면 WISE 전체 점수가 0.68에서 0.78로 높아지며, Cultural knowledge와 Chemistry에서 특히 큰 변화가 나타난다. 표는 추론 모드에서 점수가 개선됨을 뒷받침하지만, 추가 추론 비용은 보고하지 않는다.
5.3 Image Editing
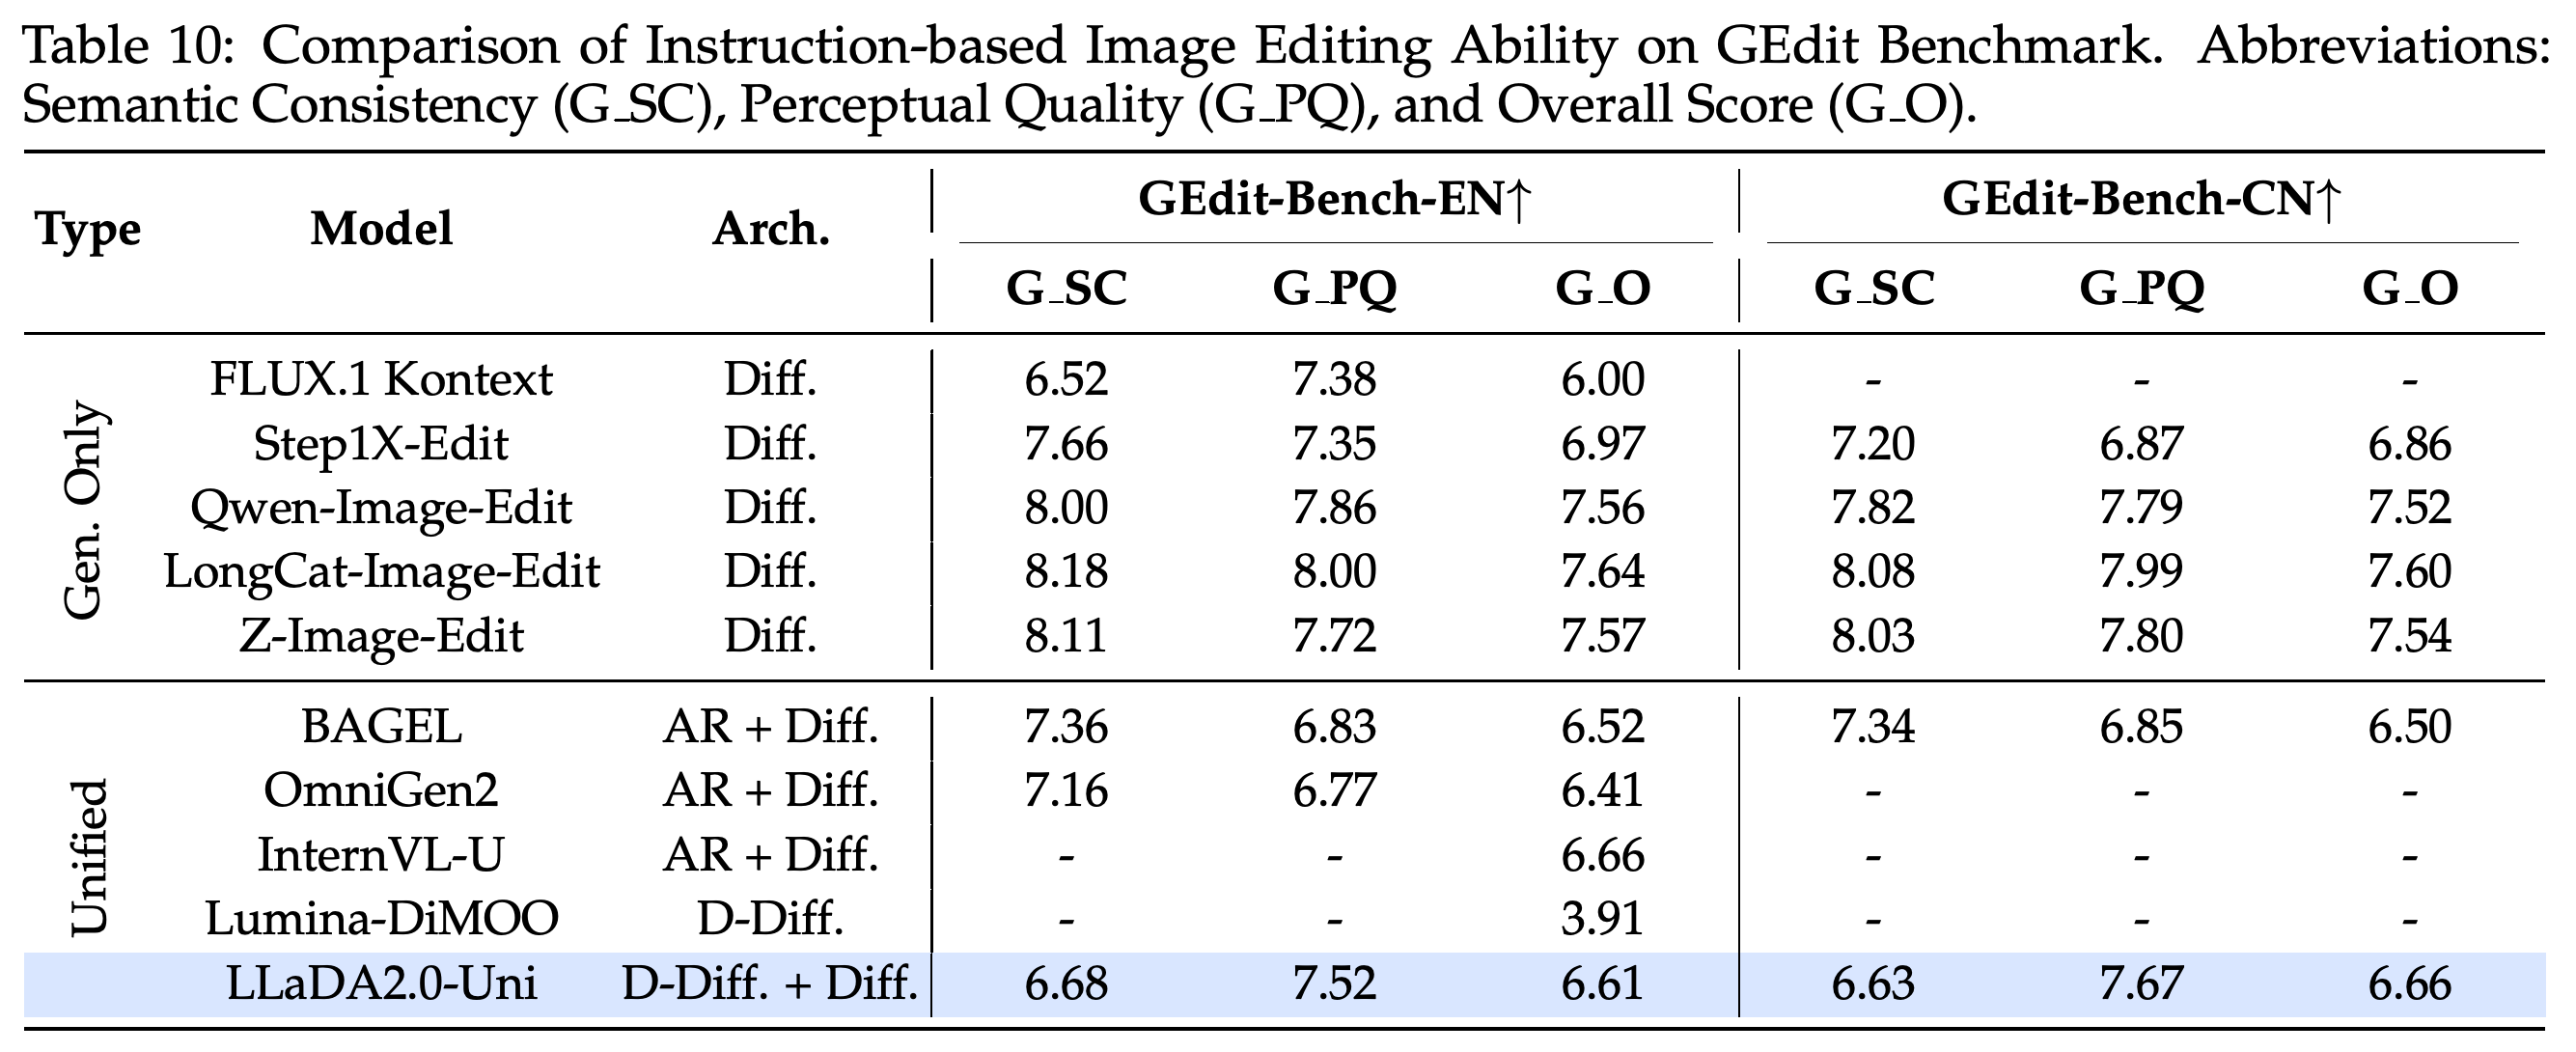
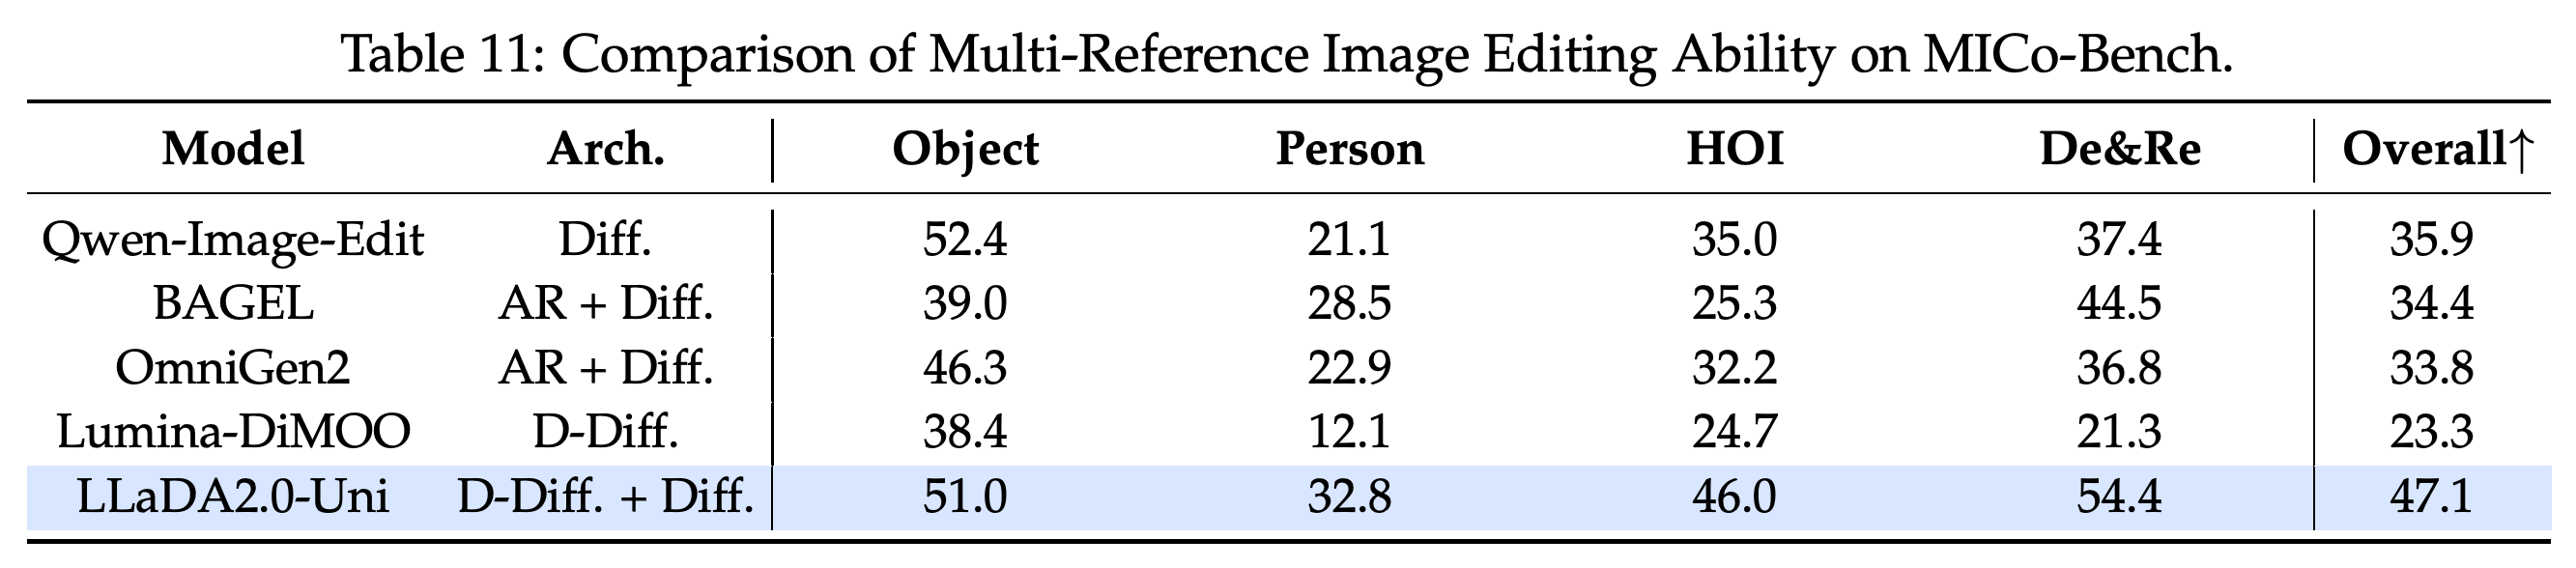
편집 결과는 다중 참조 합성에서 가장 강하며, 일반 편집은 여전히 선도적인 전문 모델보다 낮다. LLaDA2.0-Uni는 ImgEdit에서 비교한 통합 모델 중 최고인 3.92를 기록하고, MICo-Bench에서 모든 비교 모델을 웃도는 47.1을 달성한다. GEdit 전체 점수는 영어 6.61, 중국어 6.66으로 가장 강한 편집 전문 모델보다 낮다.
- 5.3.1 Evaluation Settings: ImgEdit-Bench와 GEdit-Bench는 지시 기반 편집을, MICo-Bench는 다중 참조 합성을 평가한다. 기준 모델에는 FLUX.1 Kontext, Step1X-Edit, Qwen-Image-Edit, Z-Image-Edit, BAGEL, OmniGen2, InternVL-U, Lumina-DiMOO가 포함된다.
- 5.3.2 General Image Editing Performance: ImgEdit의 Adjust와 Hybrid 점수는 4.16과 3.97이다. GEdit의 지각적 품질은 영어 7.52, 중국어 7.67이지만, 의미적 일관성은 6.68과 6.63이다. 영어 전체 점수도 InternVL-U의 6.66보다 낮다.
- 5.3.3 Multi-Reference Image Editing Performance: MICo-Bench 결과는 Object 51.0, Person 32.8, HOI 46.0, De&Re 54.4다. Object는 Qwen-Image-Edit의 52.4보다 낮지만, 나머지 범주와 전체 점수는 비교 대상 중 가장 높다.
- MICo-Bench 결과는 강한 합성 능력을 뒷받침하지만, 실험은 아키텍처의 효과와 학습 데이터의 효과를 분리하지 않는다.
전체 점수 3.92는 통합 모델군에서 가장 높고, Hybrid 3.97은 비교한 모든 모델을 웃돈다. 일반 편집은 여전히 Qwen-Image-Edit의 전체 점수 4.35보다 낮으며, Extract는 2.40으로 상대적으로 약하다.
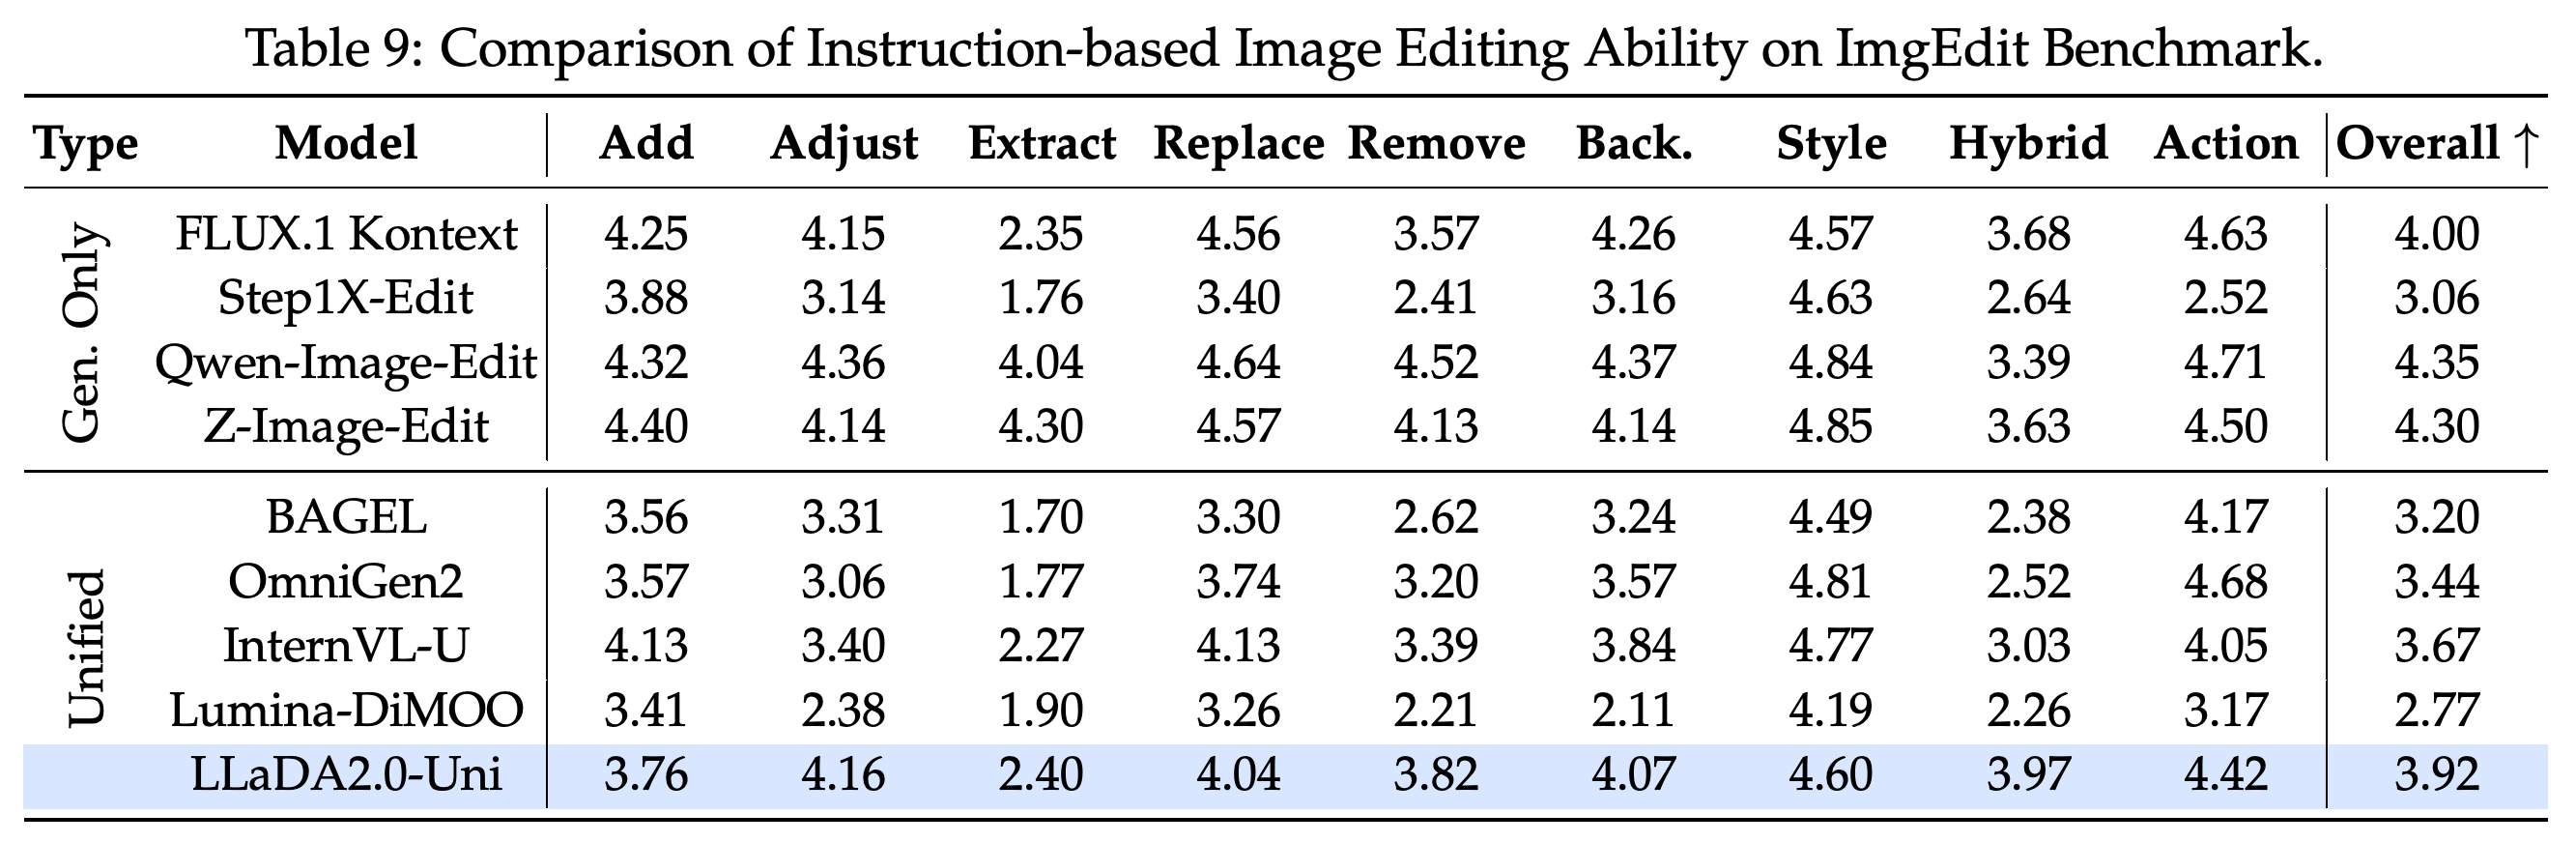
LLaDA2.0-Uni의 지각적 품질 점수는 영어 7.52, 중국어 7.67로 BAGEL보다 높지만, 의미적 일관성 점수는 더 낮다. 이 결과는 시각적으로 그럴듯한 편집과 편집 지시를 충실히 수행하는 능력을 구분한다.
전체 결과 47.1은 Qwen-Image-Edit의 35.9, BAGEL의 34.4, OmniGen2의 33.8을 웃돈다. LLaDA2.0-Uni는 Person, HOI, De&Re에서 가장 높지만, Object 범주에서는 Qwen-Image-Edit가 근소하게 앞선다.
5.4 Interleaved
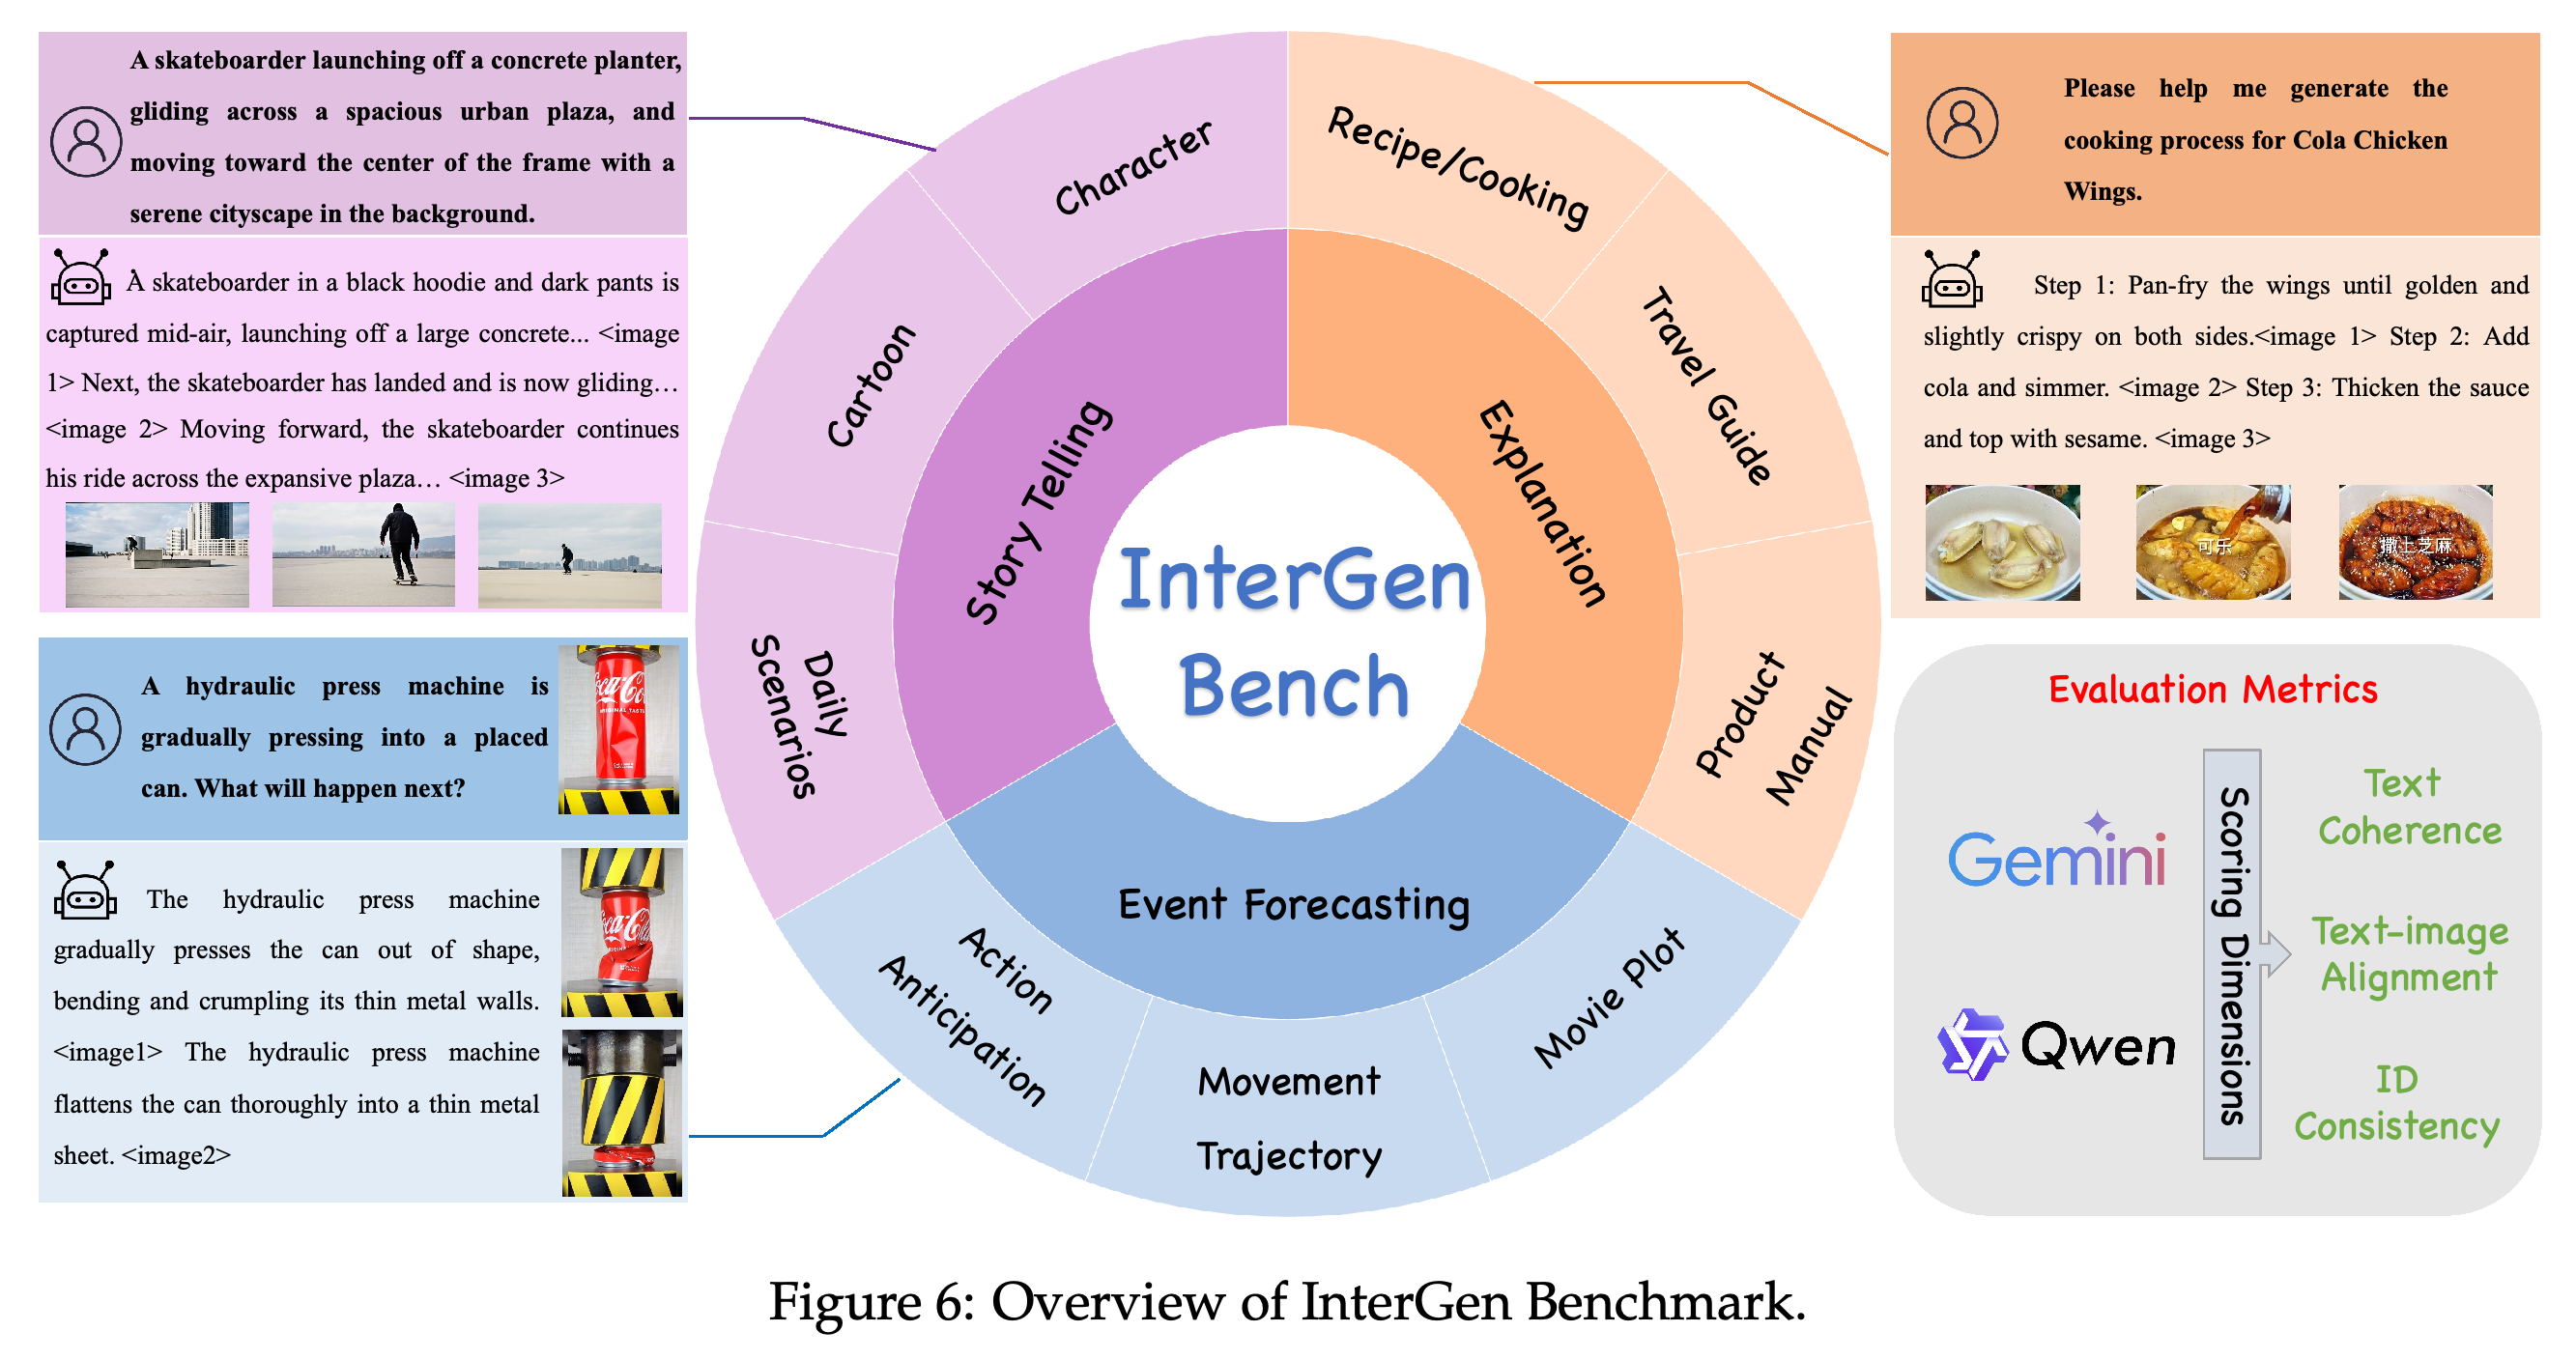
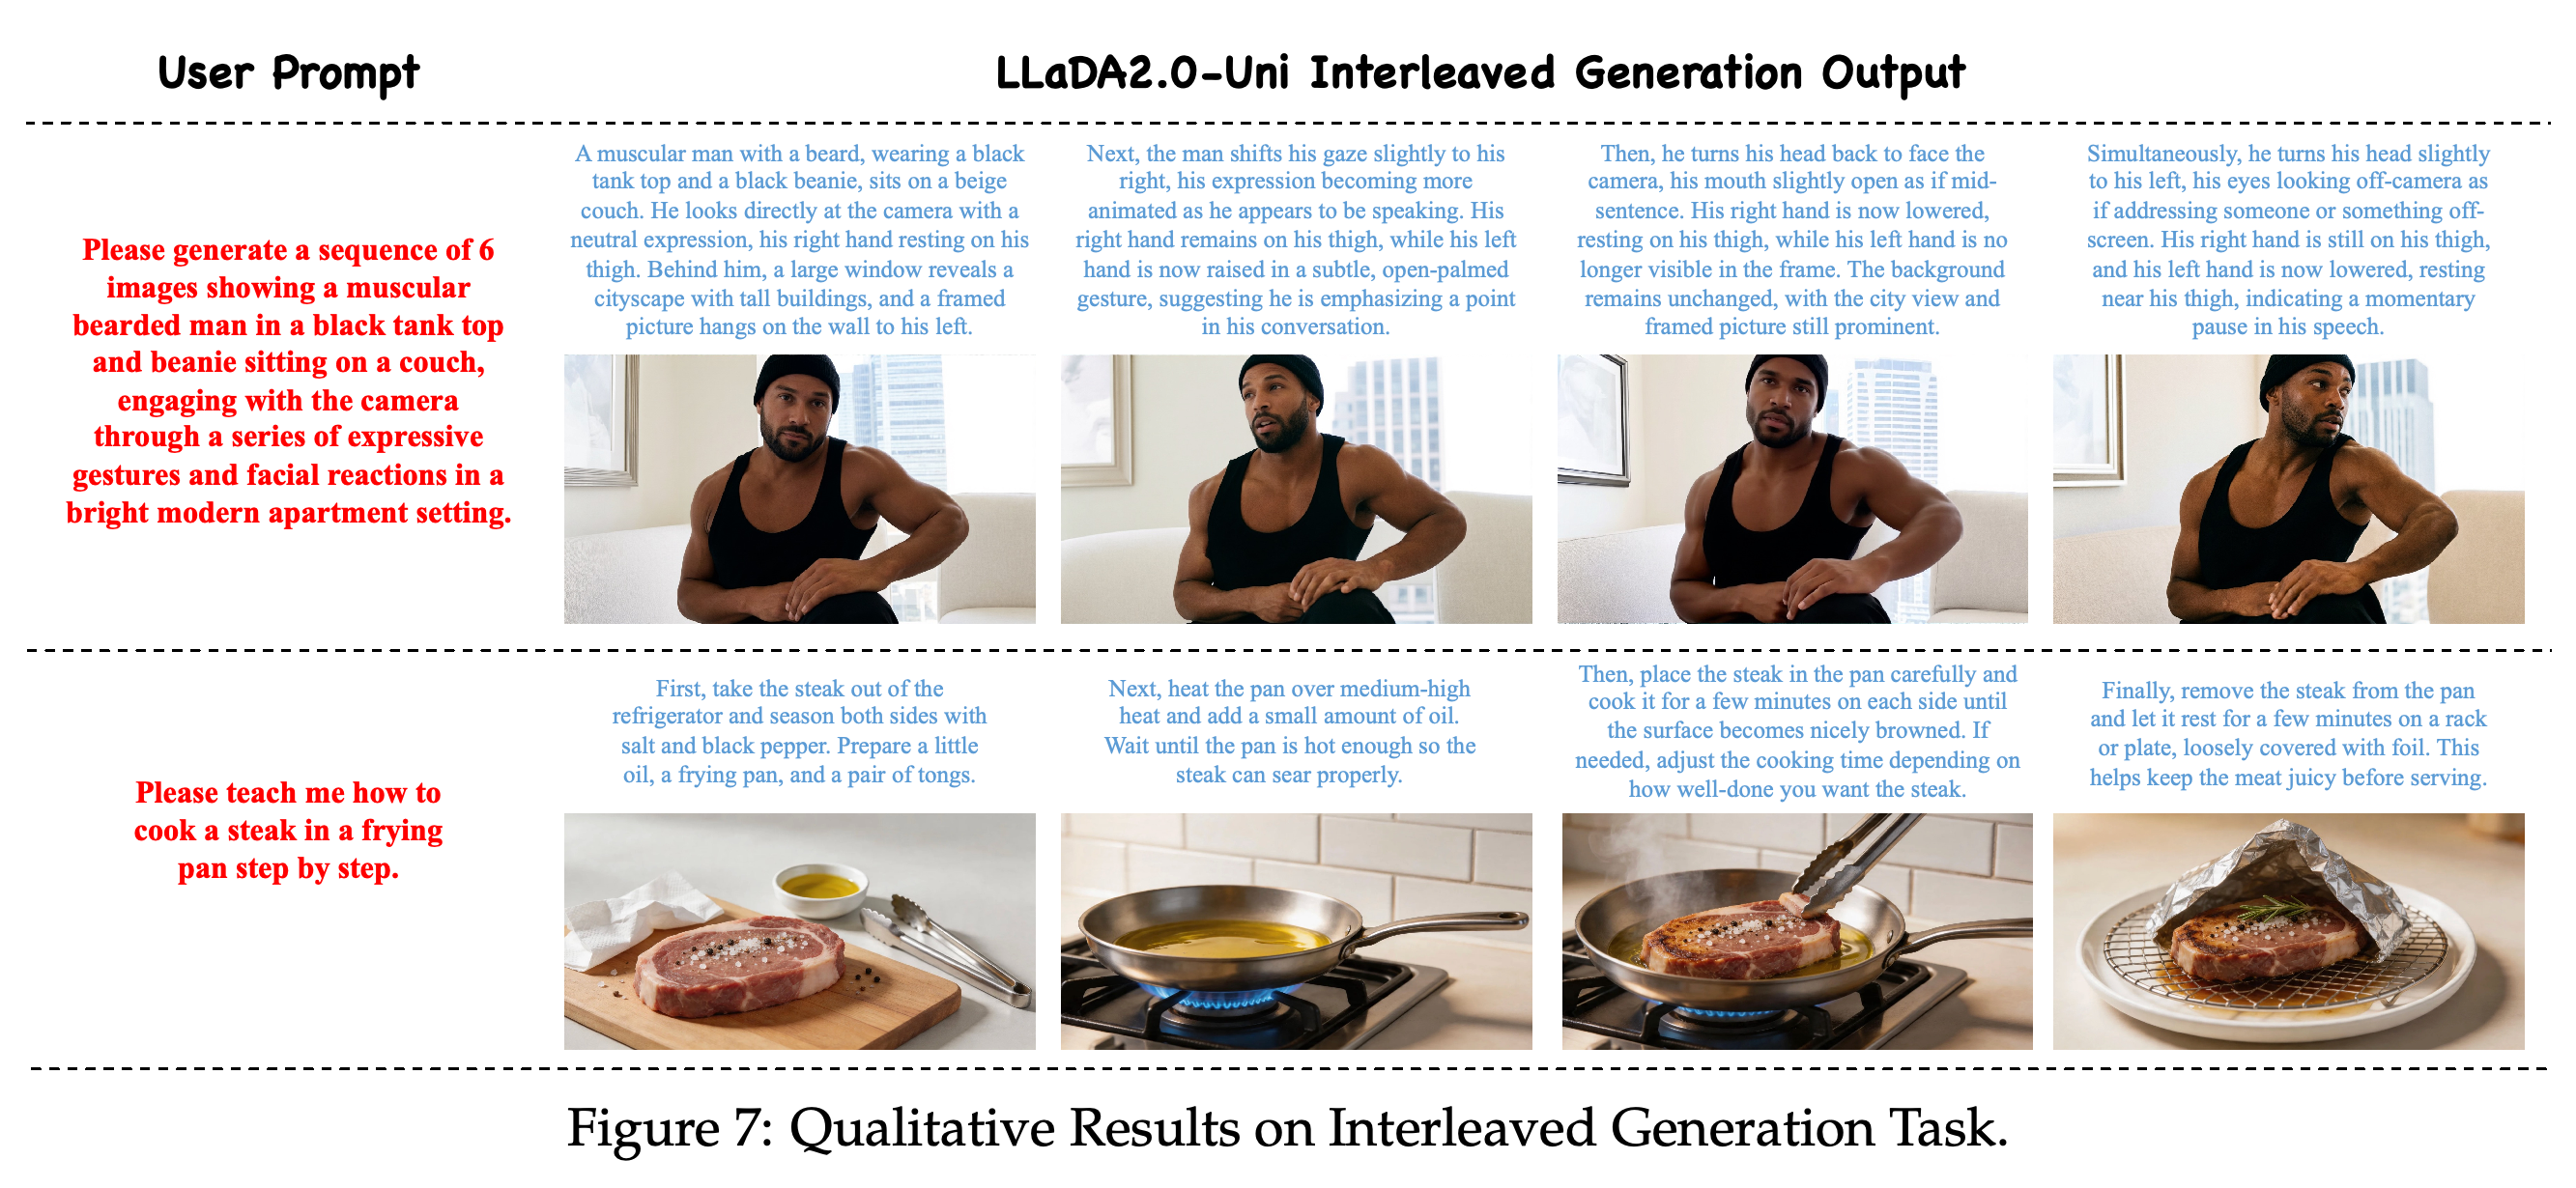
저자들은 Story Telling, Explanation, Event Forecasting을 위한 150개 샘플의 InterGen 벤치마크를 제안하고 Gemini-3와 Qwen3-VL로 평가한다. LLaDA2.0-Uni는 두 평가 모델에서 모두 storytelling과 forecasting에서 Emu3.5를 소폭 웃돌지만, explanation 결과는 평가 모델에 따라 달라진다. Figures 6–8은 벤치마크 설계, 교차 생성 사례, 초기 추론 시연을 제시한다.
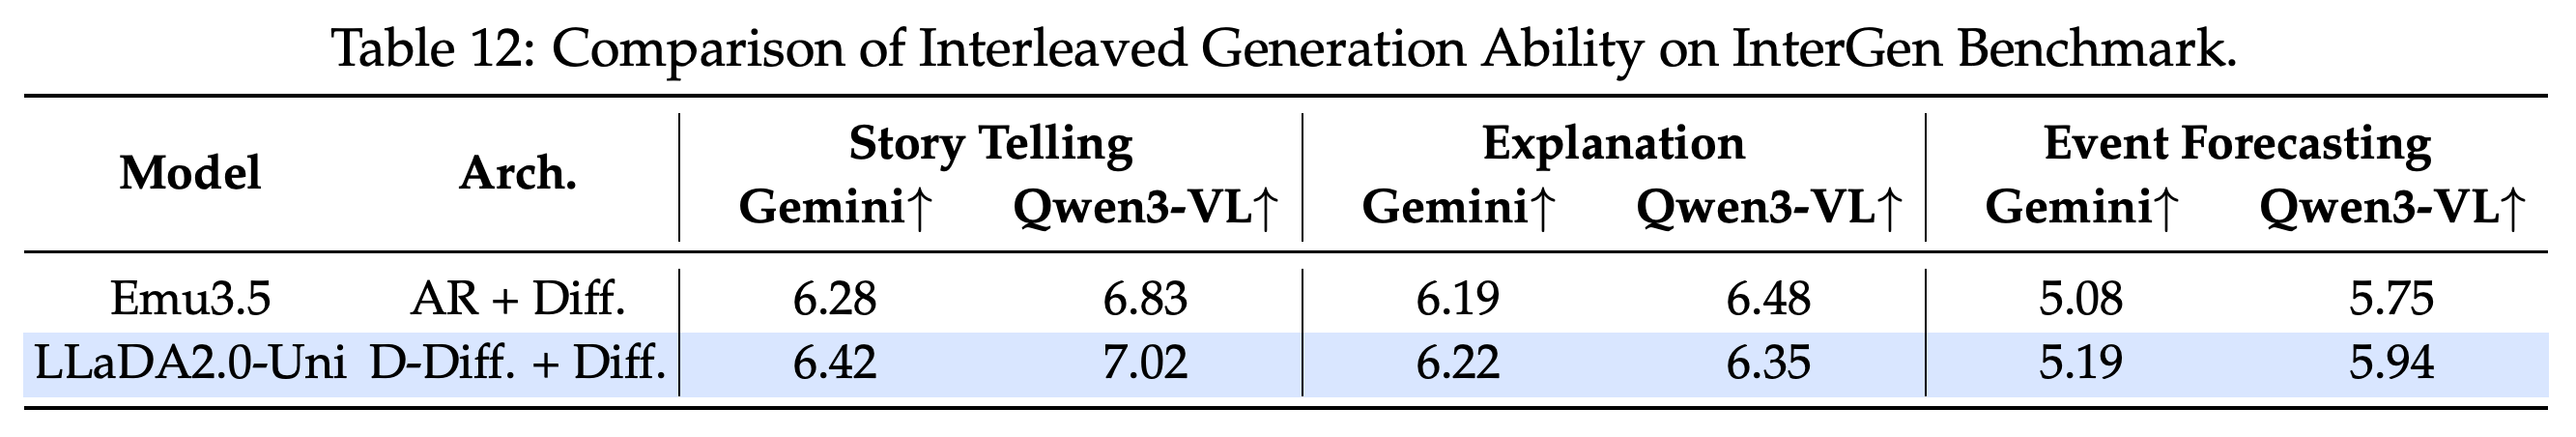
- 5.4.1 Interleaved Generation: 평가 모델은 텍스트 일관성, 텍스트-이미지 정렬, ID 일관성을 평가한다. Table 12의 Gemini/Qwen3-VL 점수는 Story Telling에서 6.42/7.02로 Emu3.5의 6.28/6.83과 비교되며, Event Forecasting에서는 5.19/5.94로 5.08/5.75와 비교된다.
- Explanation 점수는 6.22/6.35 대 6.19/6.48이므로 평가 모델 전반에서 일관된 개선은 아니다. 비교 대상은 Emu3.5뿐이며, 저자들은 다른 관련 시스템이 아직 오픈소스로 공개되지 않았다고 설명한다.
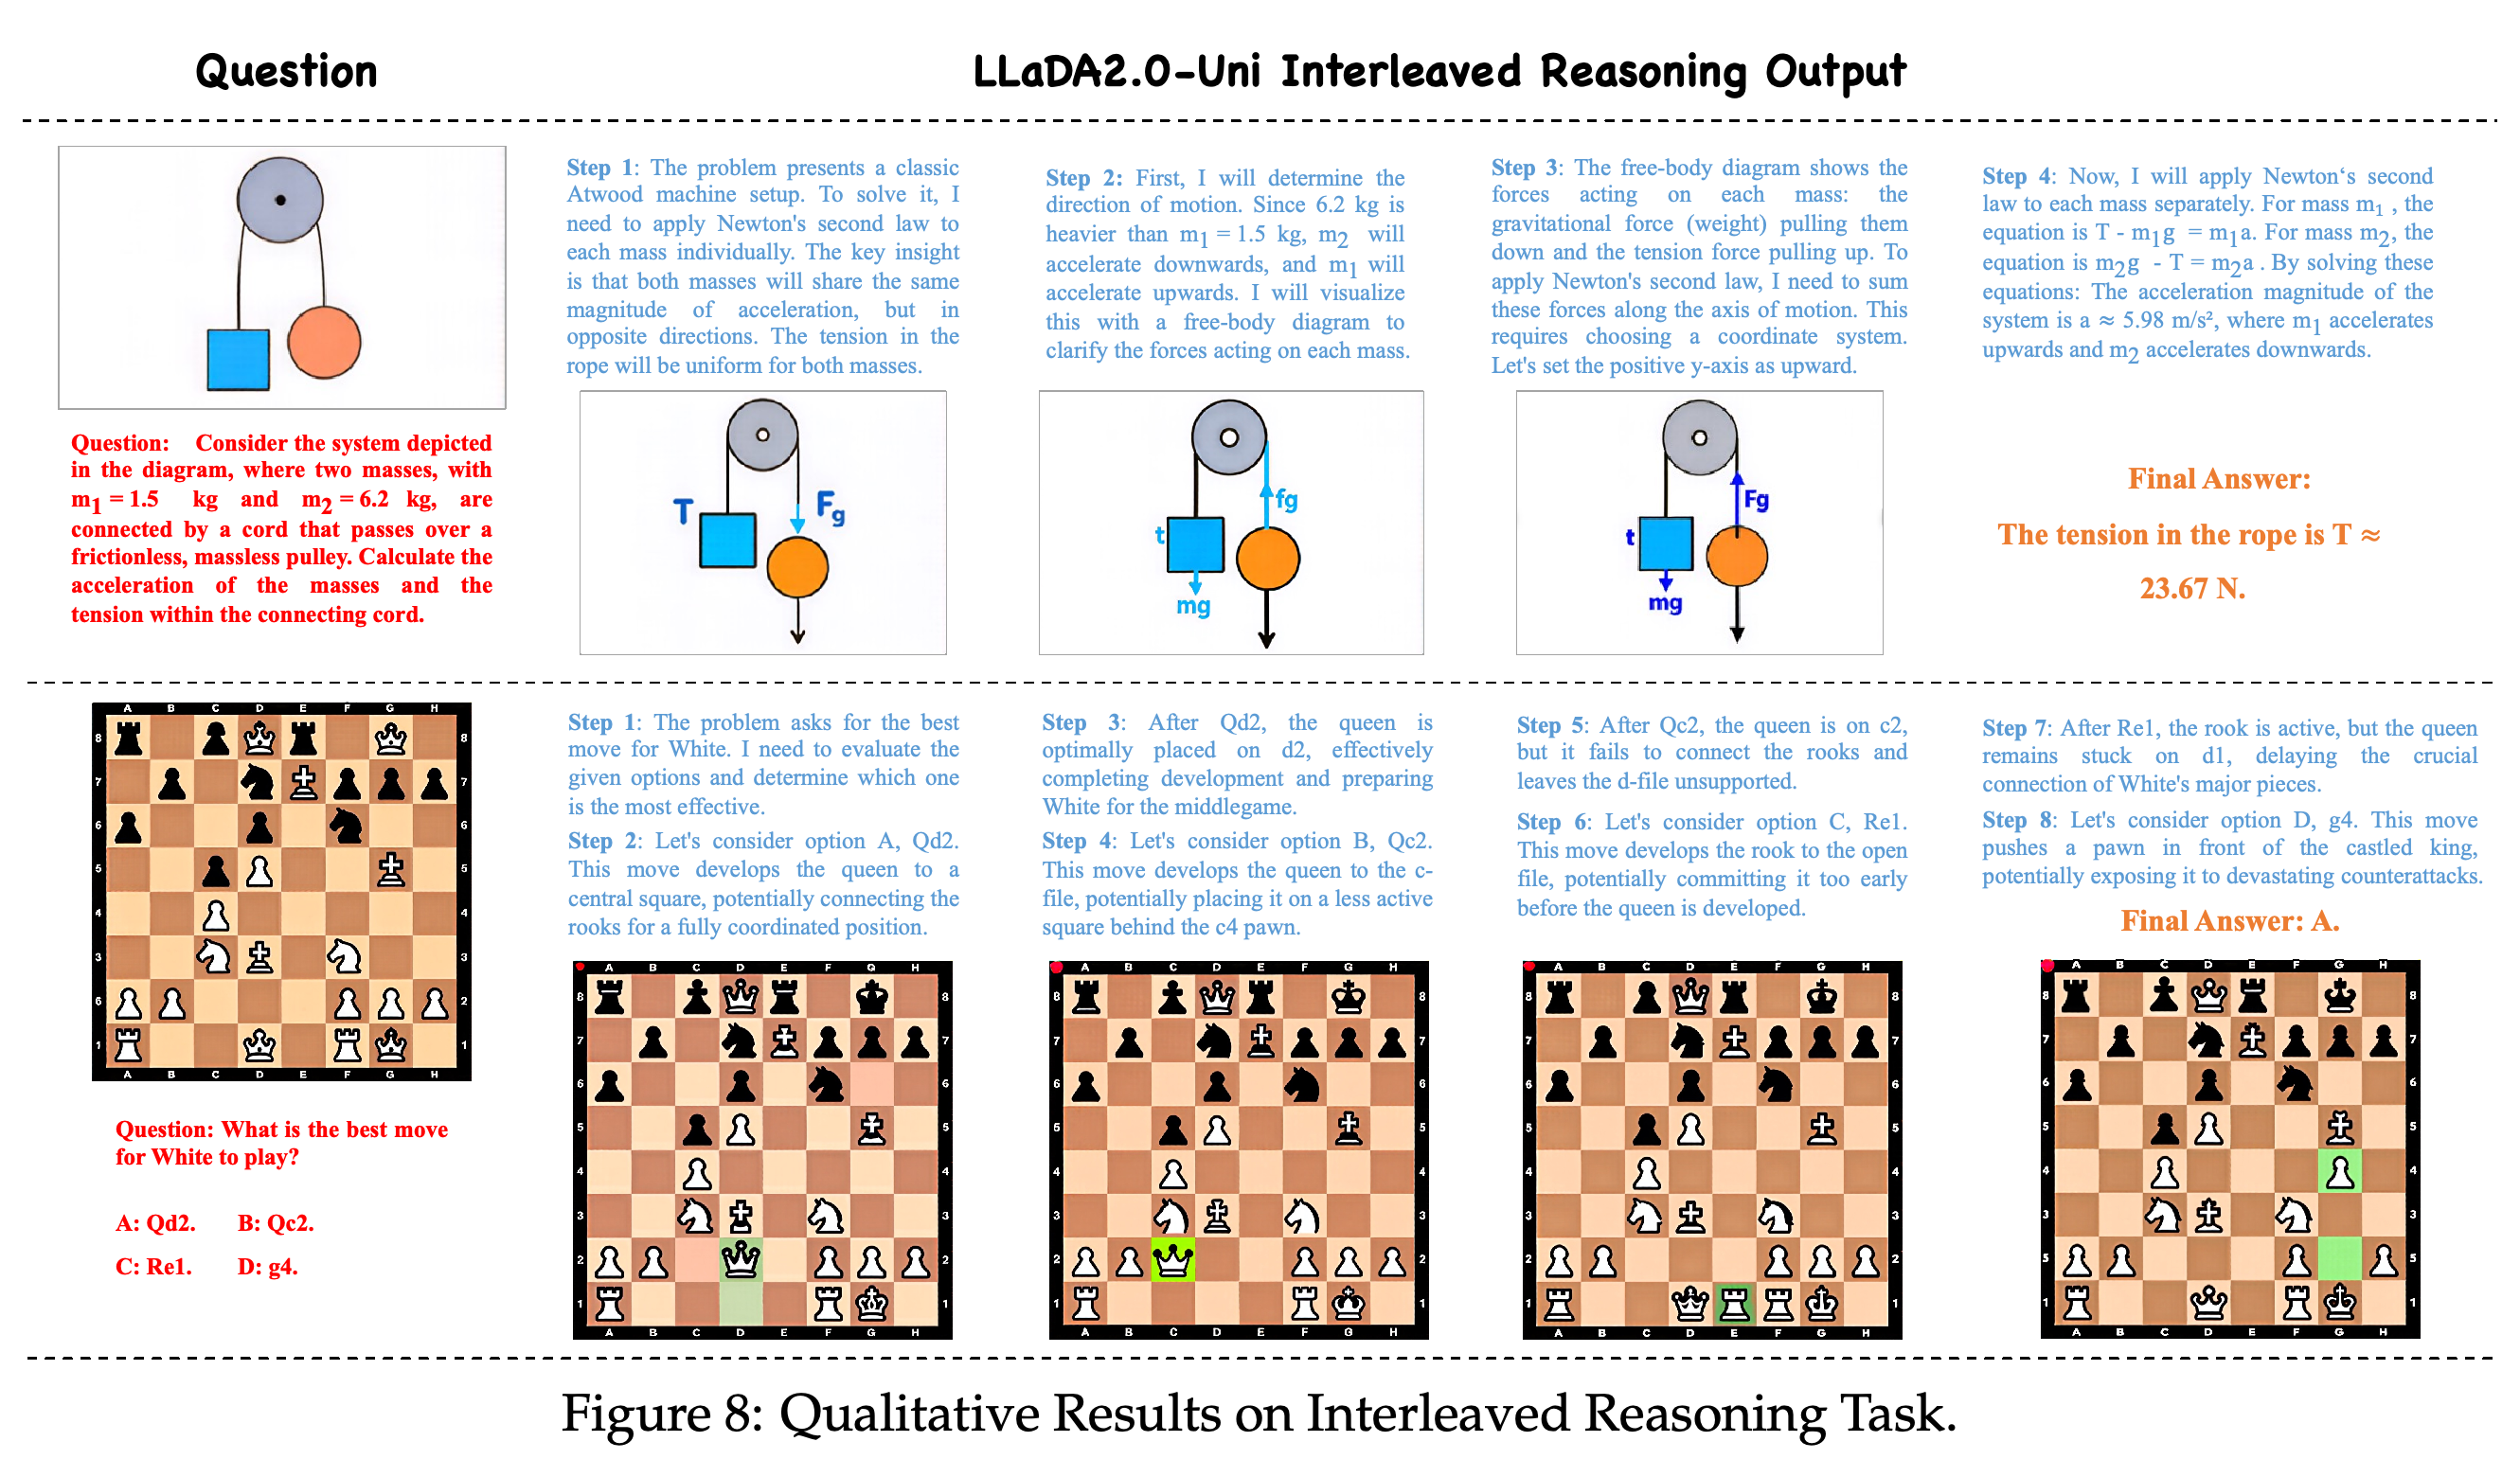
- 5.4.2 Interleaved Reasoning: Figure 8은 생성한 물리 도식이나 체스 배치와 텍스트 추론을 번갈아 제시한다. 이 사례들은 출력 형식을 보여주지만, 전체 정확도, 추론의 충실성, 중간 이미지를 생성하는 이점을 입증하지는 않는다.
- 저자들이 구성한 작은 벤치마크이고 불확실성 추정도 보고되지 않아, InterGen의 작은 점수 차이에서 내릴 수 있는 결론은 제한적이다.
InterGen은 요리 절차와 행동 예측 등을 포함해 과제를 Story Telling, Explanation, Event Forecasting으로 구분한다. 평가 패널은 일관성, 정렬, 정체성 일관성이 정답과 직접 대조하는 항목이 아니라 VLM이 판단하는 평가 차원임을 보여준다.
캐릭터 시퀀스는 반복 등장하는 외형과 장면 연속성을 보여주고, 요리 시퀀스는 절차 설명 텍스트와 이미지를 결합한다. 캐릭터 프롬프트는 이미지 6개를 요청하지만 표시된 이미지는 4개뿐이다. 따라서 패널은 요청을 완전히 이행했는지 또는 더 긴 시퀀스에서도 신뢰할 수 있는지를 입증하지 않는다.
두 평가 모델은 storytelling과 event forecasting에서 LLaDA2.0-Uni에 Emu3.5보다 소폭 높은 점수를 준다. Explanation 결과는 엇갈린다. Gemini는 조금 더 높게 평가하지만 Qwen3-VL은 더 낮게 평가하므로, 일관된 우위를 주장할 수는 없다.
물리 사례는 텍스트 풀이와 함께 힘 도식을 생성하고, 체스 사례는 후보 보드 상태를 생성한다. 표시된 물리 응답은 가속도를 약 5.98 m/s², 장력을 약 23.67 N으로 보고한다. 이는 개별 모델 출력이며, 추론 정확도의 종합적 근거는 아니다.
5.5 Ablation Study
가속 실험은 백본과 이미지 디코더에서 서로 다른 절충을 보여준다. SPRINT는 평균 처리량을 보고된 기준으로 1.6× 높이면서 보고된 평균 벤치마크 점수를 76.3에서 75.7로 낮춘다. Decoder Turbo는 디코더만을 기준으로 보고된 11.4× 가속을 제공하며, 5개 생성 벤치마크에서 점수 변화는 작다.
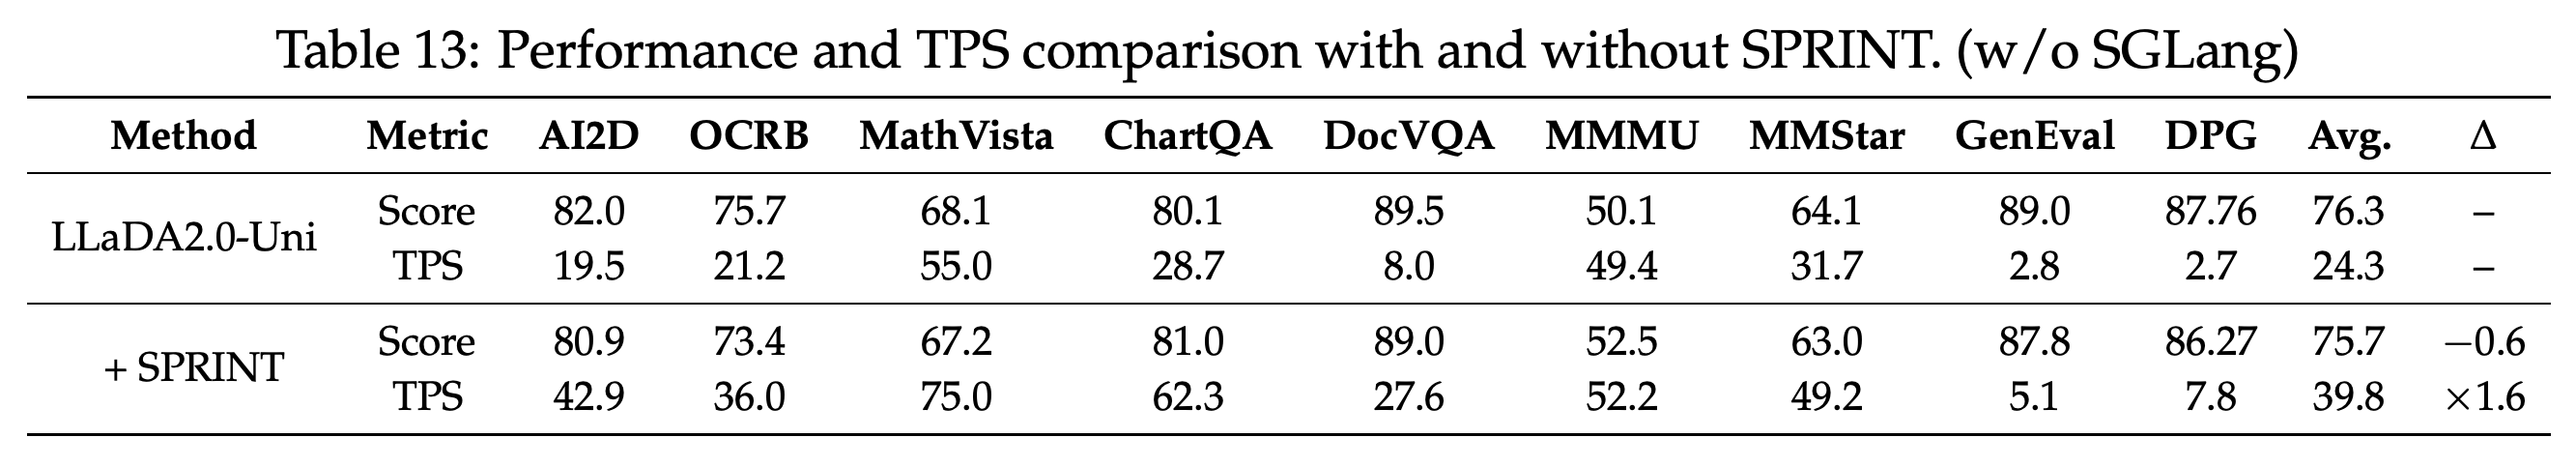
- 5.5.1 Analysis of SPRINT Acceleration: Table 13은 SGLang 없이 9개 벤치마크를 측정한다. 평균 처리량은 24.3 TPS에서 39.8 TPS로 높아진다. OCRBench는 75.7에서 73.4로, DPG는 87.76에서 86.27로 낮아지지만, MMMU는 50.1에서 52.5로 높아진다.
- DocVQA 처리량은 8.0 TPS에서 27.6 TPS로 높아지며, 보고된 개선 폭은 3.5×다. 저자들은 신뢰도에 따른 적응적 확정이 어려운 위치에 정제 계산을 재배분한다고 추정한다. 그러나 접두부 가지치기와 적응적 마스크 해제의 효과를 별도의 ablation 실험으로 분리하지 않는다. SGLang 통합은 진행 중인 작업으로 설명한다.
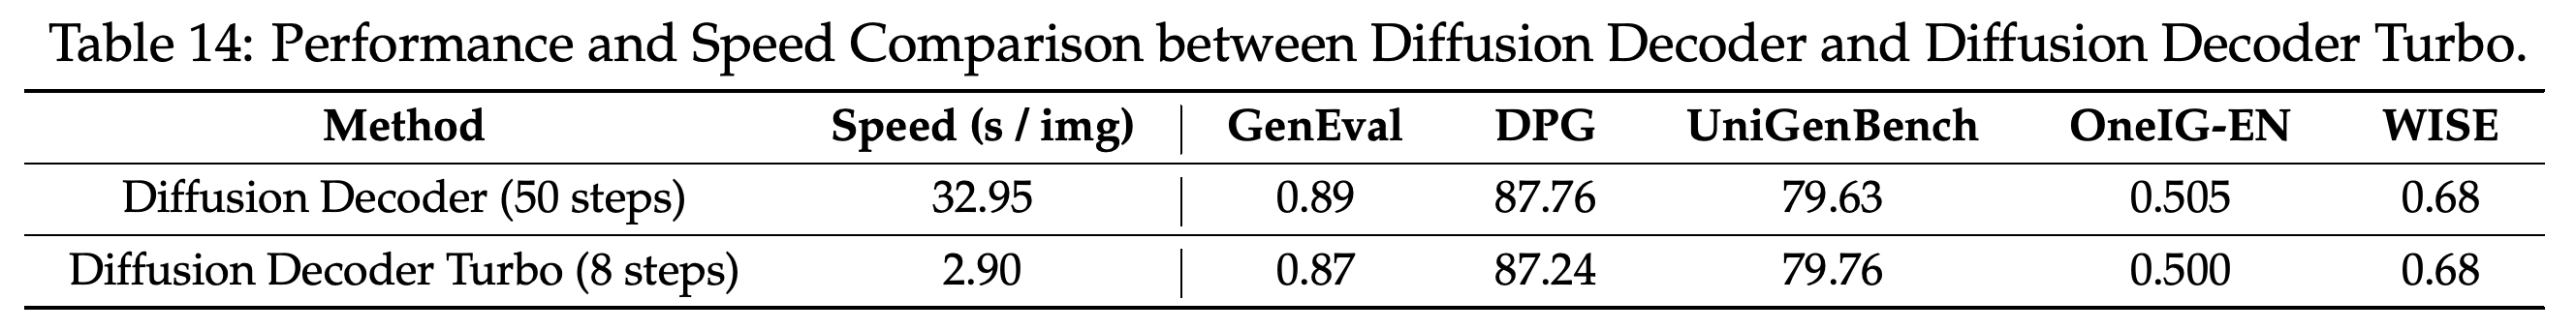
- 5.5.2 Analysis of Diffusion Decoder: Table 14는 단일 GPU에서 1024 × 1024 해상도, 배치 크기 1, BF16 정밀도로 측정하며, GPU 모델은 명시하지 않는다. 샘플링을 50에서 8 steps로 줄이면 디코딩 시간은 32.95에서 2.90 s/img로 감소한다.
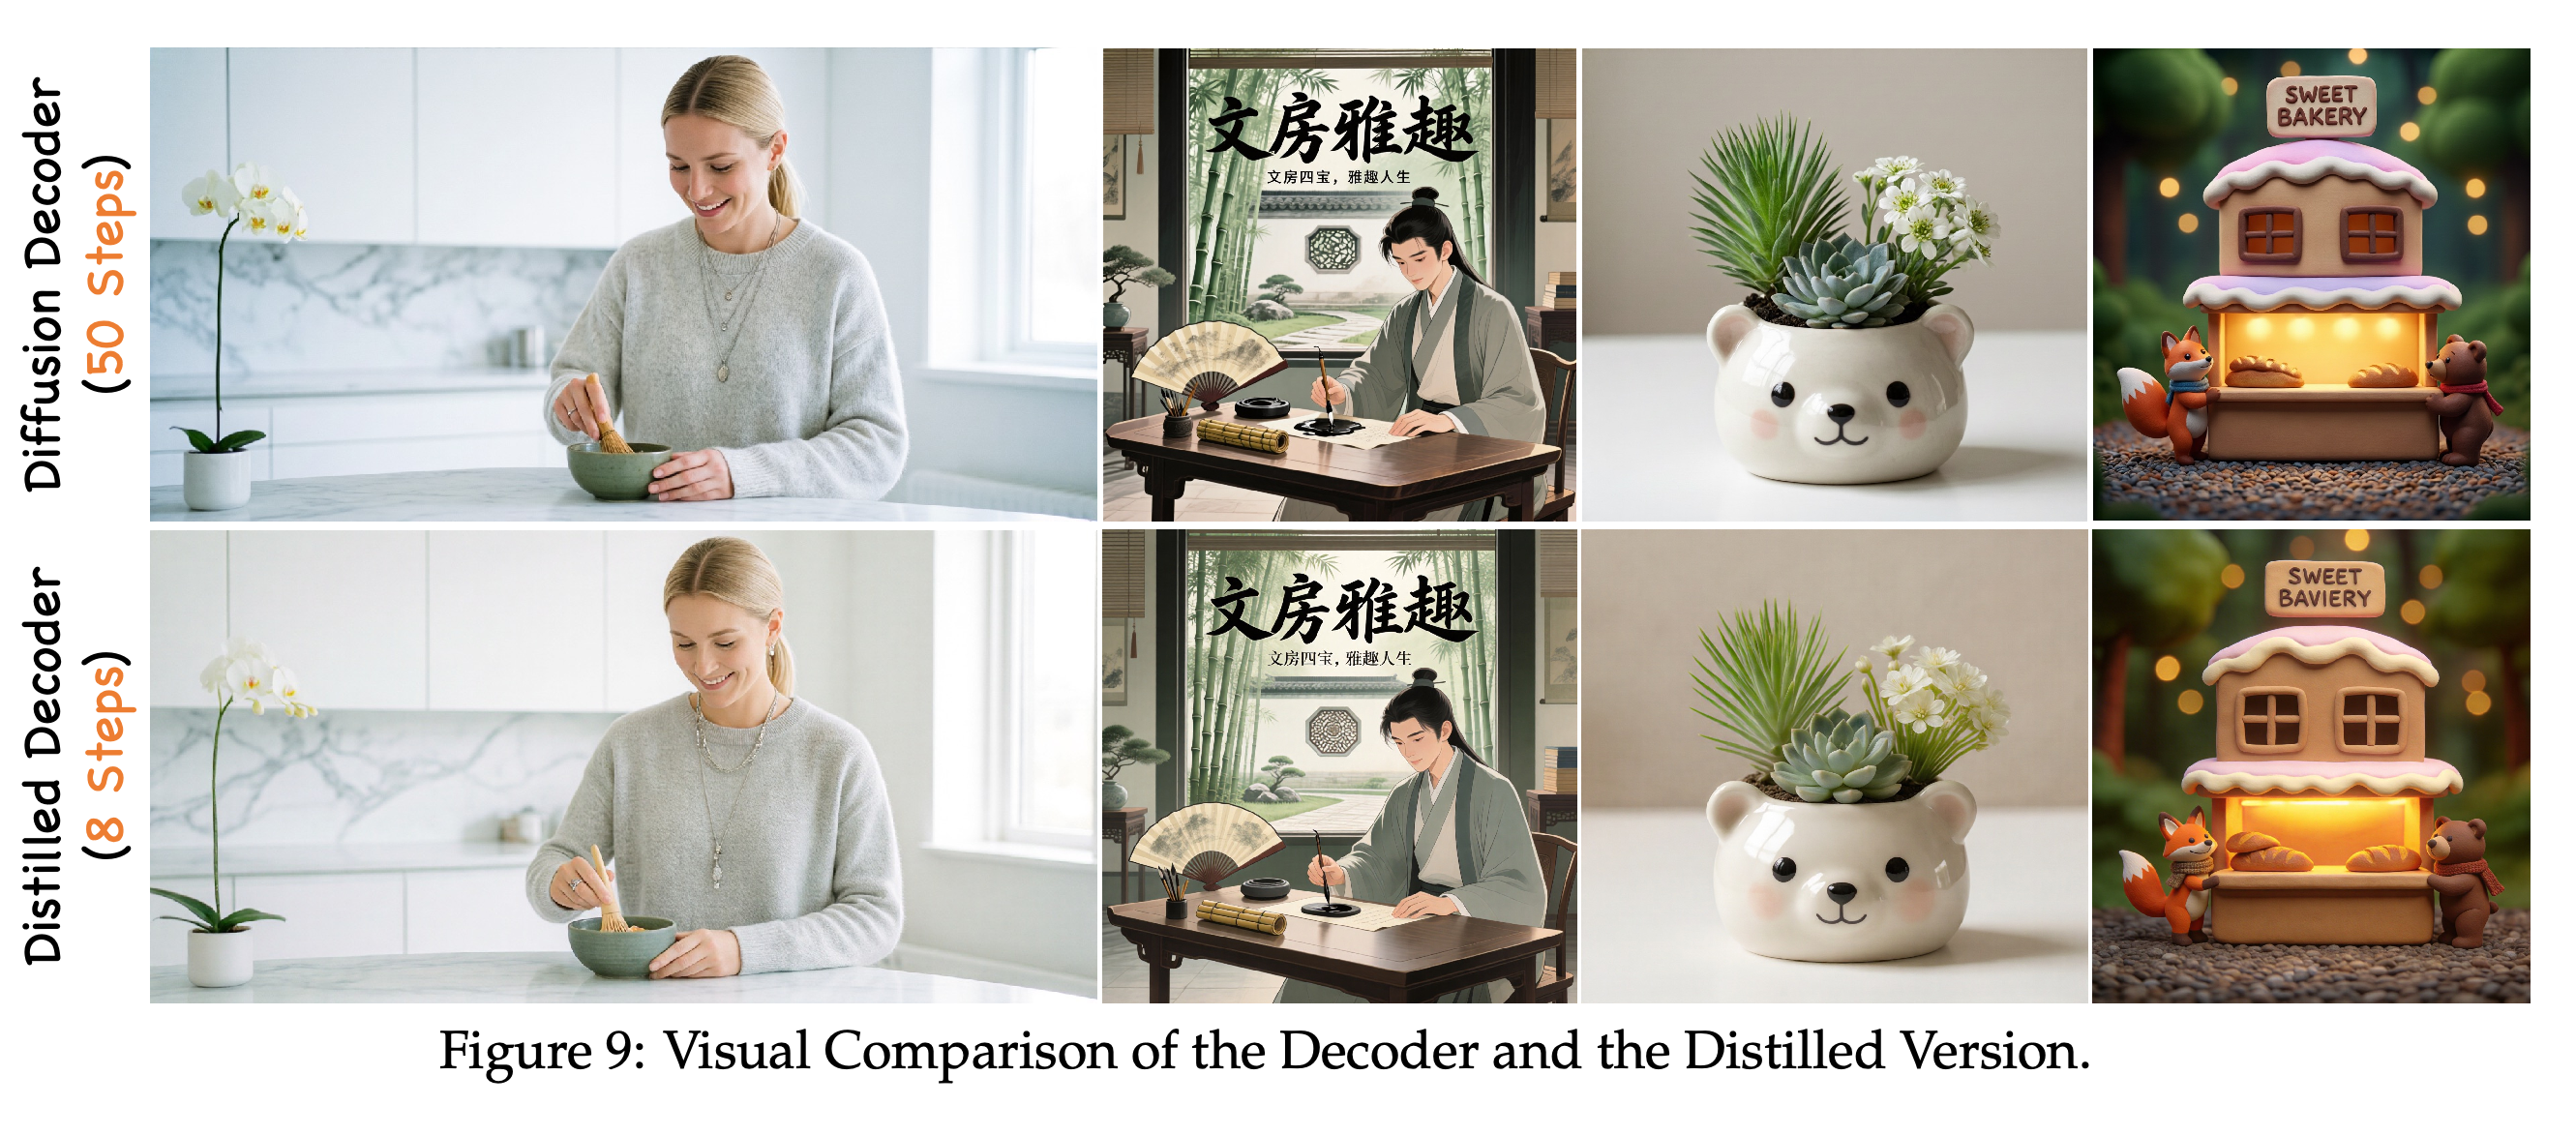
- Turbo 점수는 GenEval 0.87 대 0.89, DPG 87.24 대 87.76, UniGenBench 79.76 대 79.63, OneIG-EN 0.500 대 0.505이며, WISE는 모두 0.68이다. Figure 9는 선택된 출력의 유사성을 보여주며, 통제된 지각적 동등성 검사는 아니다.
- 디코더 가속에는 백본 토큰 생성이 포함되지 않으므로, 전체 파이프라인이 11.4× 빨라졌다고 해석해서는 안 된다. SPRINT의 평균은 의미가 서로 다른 벤치마크 점수를 합친 것이며, 공통으로 보정된 척도에서 품질을 측정한 값이 아니다.
SPRINT는 보고된 평균 처리량을 24.3 TPS에서 39.8 TPS로 높이는 대신, 보고된 평균 점수를 0.6 낮춘다. 과제별 결과는 절충을 드러낸다. OCRBench는 2.3 points 하락하고 MMMU는 2.4 상승하며, DocVQA는 보고된 처리량 배수가 가장 크다. 이 표의 GenEval은 100-point 척도로 표현된다.
50-step과 8-step 디코더의 출력 쌍은 4개 사례에서 비슷한 피사체, 배치, 스타일을 유지한다. 국소적인 차이가 눈에 보이므로, 이 그림은 지각적으로 구분할 수 없음을 입증하기보다 정성적인 보존을 뒷받침한다.
단일 GPU, 1024 × 1024, 배치 크기 1, BF16 조건에서 디코더 지연 시간은 32.95 s/img에서 2.90 s/img로 감소한다. GenEval과 DPG는 소폭 낮아지고, UniGenBench는 소폭 높아지며, WISE는 변하지 않는다. 이 시간에는 백본 토큰 생성 파이프라인이 포함되지 않는다.
6 Conclusion and Future Directions
결론은 의미 이산 토큰과 블록 단위 확산을 통합 이해와 생성의 기반으로 제시한다. 저자들은 SigLIP-VQ가 특히 편집에 중요한 세밀한 시각 정보를 잃는다는 점을 인정하며, 교차 데이터와 모델 용량을 확대하겠다고 제안한다. 강화 학습은 최적화 문제가 아직 해결되지 않은 진행 중 작업으로 설명하며, 평가된 기여는 아니다.
부록
- 제공된 25페이지 PDF에는 부록이 없다. 20–25페이지는 References이며, 추가 부록 실험, 구현 세부사항, 보충 결과는 없다.
짧은 생각
주요 기여는 공통 의미 이산 모델링과 연속 이미지 복원을 분리한 설계다. 벤치마크 결과는 이 설계의 유용성을 뒷받침한다. 그러나 토크나이저, 어텐션, 데이터 조합에 대한 통제된 ablation 실험이 없어 성능 개선을 특정 구성요소의 효과로 돌릴 수는 없다. 디코더 비교는 해상도, 배치 크기, 정밀도를 명시한 조건에서 가장 명확한 효율성 근거를 제공하지만, 하드웨어 모델은 빠져 있다. SPRINT는 처리량을 높이는 대신 OCR과 생성에서 측정 가능한 성능 손실을 보이며, 가지치기 설정도 충분히 설명되지 않는다. 교차 추론은 아직 탐색적 단계다. 선택된 체스와 물리 사례만으로는 신뢰할 수 있는 시각 추론이나 텍스트 전용 추론 대비 이점을 입증할 수 없다. 수치 불일치에는 본문과 Table 4의 DPG Other, Figure 1과 상세 표의 GenEval 및 MathVision 표시가 포함된다. 평가 설정에는 MathVerse가 나열되어 있지만 결과는 없다. 이 리뷰의 정량 판단은 상세 표를 기준으로 한다.