


Introspective Diffusion Language Models 요약 설명
13 Apr 2026 | Paper Review Diffusion Language Models Parallel Decoding Speculative Decoding LLM Serving목차
- 요약
- 1 Introduction
- 2 Background and Motivation
- 3 Introspective Diffusion Language Model
- 4 Experiments
- 5 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Introspective Diffusion Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 13일(Arxiv)
- Yu, Yifan, Jian, Yuqing, Wang, Junxiong, Zhou, Zhongzhu, Zhuang, Donglin, Fang, Xinyu, Yanamandra, Sri, Wu, Xiaoxia, Wu, Qingyang, Song, Shuaiwen Leon, et al.
- Together AI, University of Illinois Urbana-Champaign, The University of Texas at Austin, Princeton University, Stanford University
- 논문 링크
- Github
- Project Page
요약
- 논문은 diffusion language model의 품질 격차가 발생하는 원인 중 하나로 토큰 생성 분포와 해당 토큰을 공개한 뒤 모델이 예측하는 분포 사이의 불일치를 지목한다. I-DLM은 causal attention, next-token logit shifting, masked 위치와 clean 위치를 모두 감독하는 학습을 통해 사전 학습된 autoregressive 모델을 변환한다.
- Introspective Strided Decoding (ISD)은 이전 제안의 검증과 새로운 제안의 생성을 같은 forward pass에서 수행한다. 엄격한 수락 규칙과 보정은 모델의 causal anchor 분포를 보존한다. Residual ISD (R-ISD)는 gated LoRA를 사용해 이 anchor를 원래 base AR 분포와 동일하게 유지한다.
- 모델 변환에는 생성된 추론 응답으로 구성된 4.5B 토큰 데이터셋을 사용하며, 학습은 H100 GPU 8개에서 수행한다. I-DLM-8B는 AIME-24에서 69.6, LiveCodeBench-v6에서 45.7을 기록하며, LLaDA-2.1-mini (16B)의 43.3과 30.4보다 높다. 다만 여러 고난도 추론 벤치마크에서는 Qwen3-8B보다 낮은 성능을 보인다.
- SGLang 기반 구현은 causal KV-cache 재사용, CUDA graphs, stationary-batch 스케줄링, 융합된 검증 연산을 결합한다. 논문은 출력 길이가 고정된 burst workload에서 동시성 C=64일 때 기존 DLM보다 2.9–4.1× 높은 처리량을 보고한다.
1 Introduction
서론은 diffusion language model을 실용화하는 데 장애가 되는 2가지 문제를 지적한다. 생성 품질이 낮고, 추론 오버헤드 때문에 토큰 병렬성이 서빙 처리량 향상으로 이어지지 않는다는 점이다. 저자들은 diffusion을 점차 AR처럼 바꾸는 대신, 사전 학습된 AR 모델에서 출발해 causal 예측 구조를 보존하면서 병렬 제안을 추가한다.
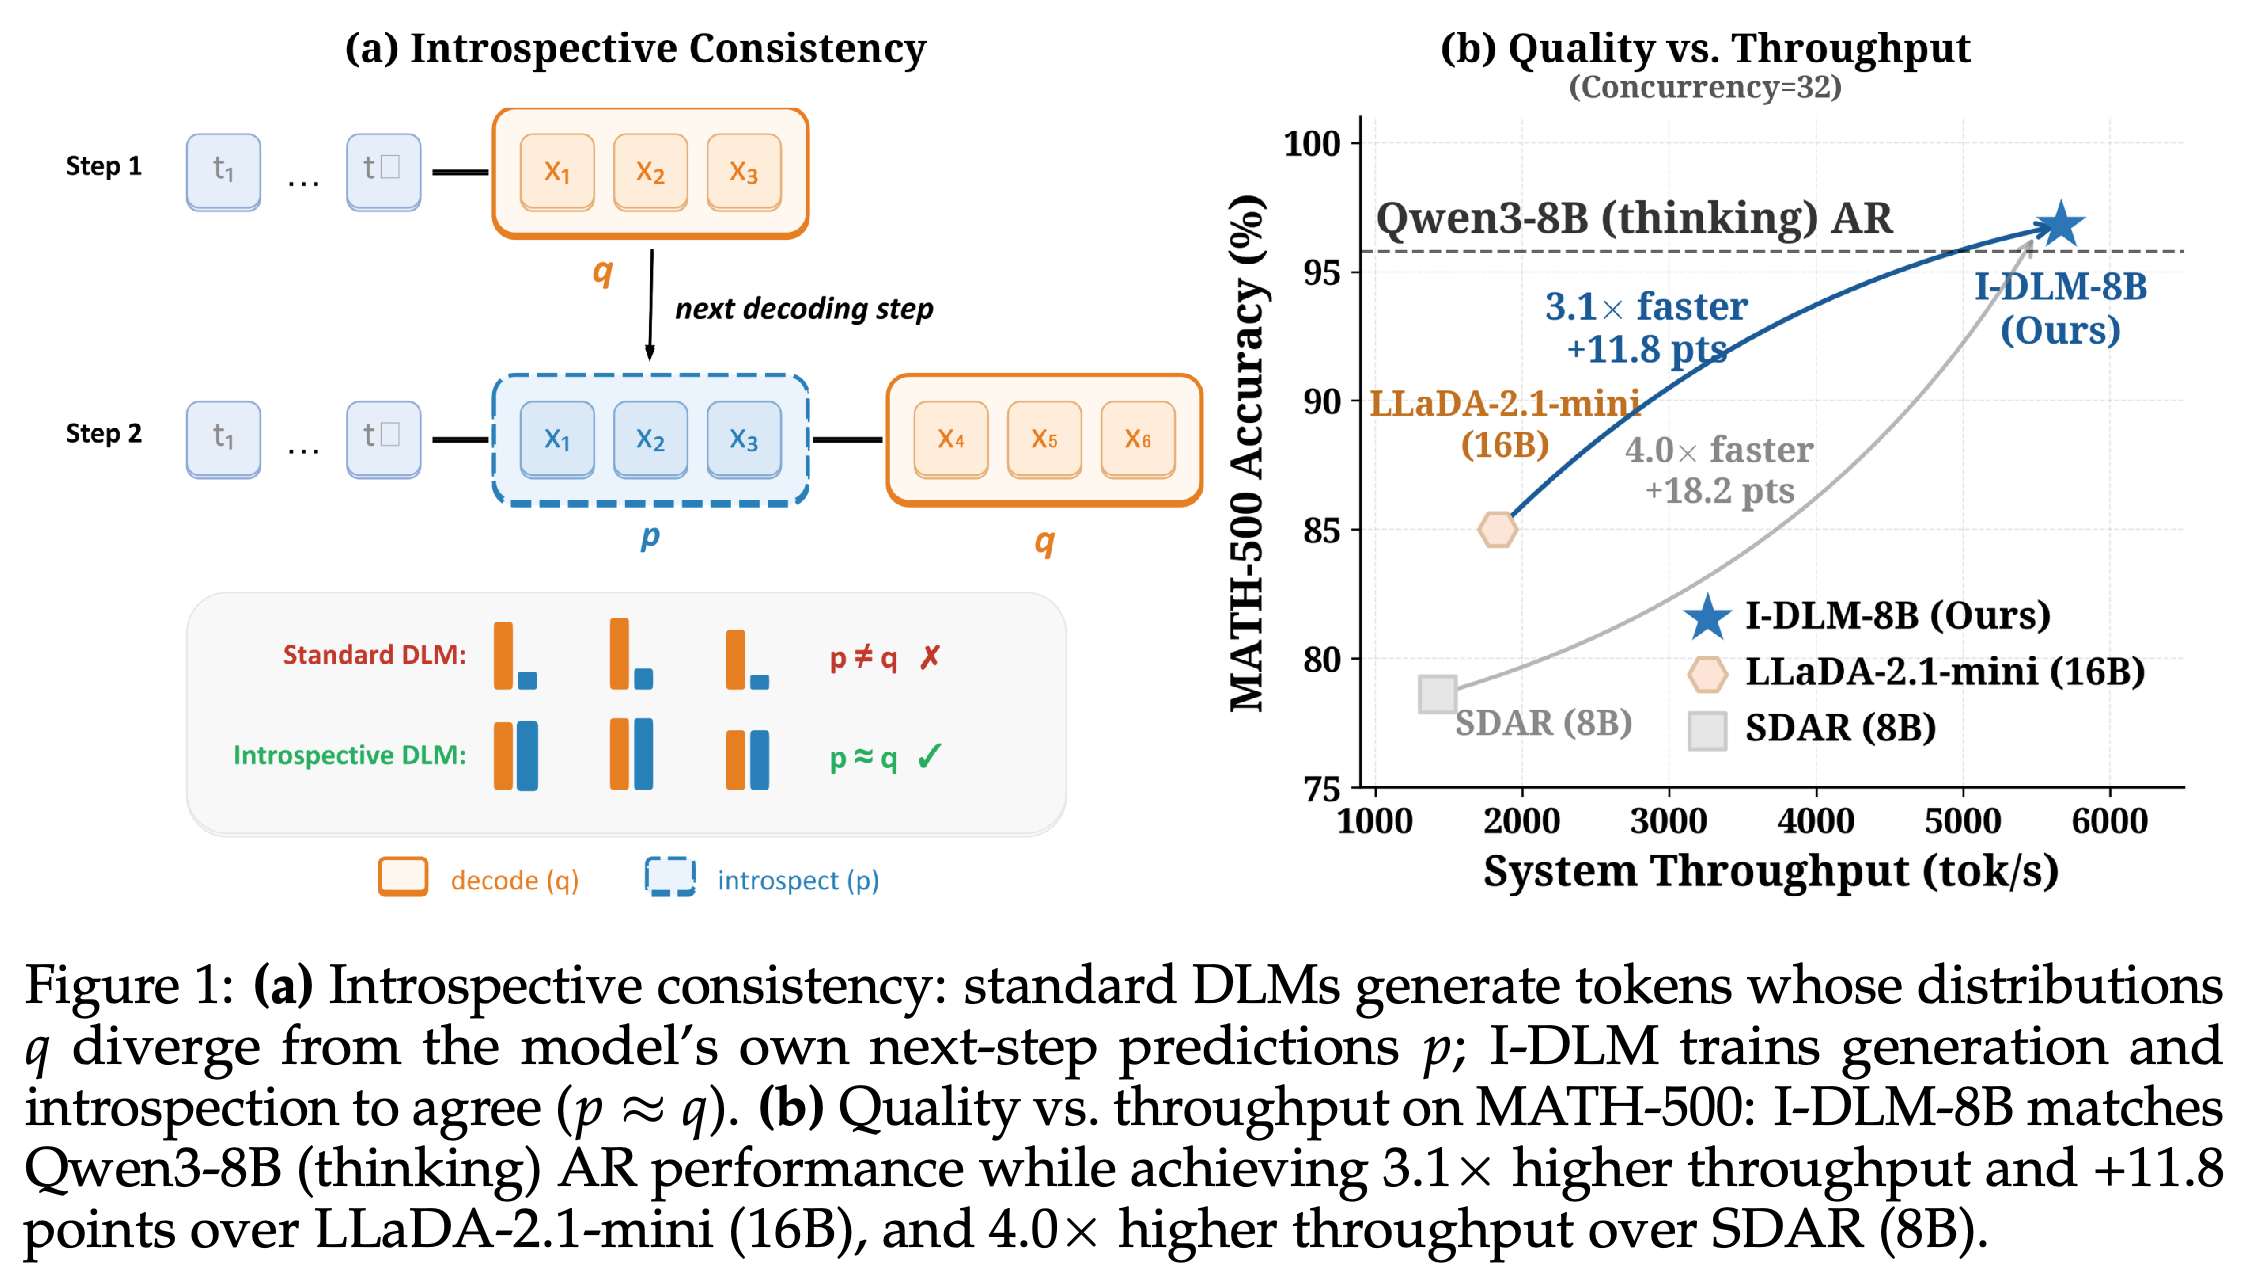
- 제안하는 원리는 introspective consistency다. 제안한 토큰을 공개했을 때 모델의 causal 예측 분포가 해당 토큰의 제안 분포와 일치해야 한다는 원리다.
- Figure 1은 동시성 32에서 MATH-500 결과를 비교한다. I-DLM-8B의 정확도는 96.8%이며, LLaDA-2.1-mini는 85.0%, SDAR은 78.6%다.
왼쪽 패널은 제안 분포와 공개된 문맥에서의 예측을 비교한다. 오른쪽 패널에서 I-DLM-8B는 동시성 32의 MATH-500에서 Qwen3-8B의 정확도 기준선에 가깝고, 그래프에 표시된 diffusion baseline 2개보다 처리량이 높다. 이는 특정 workload에서의 비교이며 종합적인 품질 결과는 아니다.
2 Background and Motivation
Introspective acceptance rate는 (\alpha=\frac{1}{L}\sum_k\min\left(1,\frac{p_k(x_k)}{q_k(x_k)}\right))다. 여기서 qk는 토큰 xk를 생성하고, pk는 시퀀스가 공개된 뒤 causal 예측 규칙에 따라 해당 토큰을 평가한다. Figure 2는 IFEval에서 I-DLM이 0.984, Qwen3-8B가 1.000, SDAR이 0.699, LLaDA 2.0이 0.568을 기록했다고 보고한다. LLaDA 2.1은 편집 없이 0.933, 편집을 적용하면 0.949를 기록한다.
- 이 통계는 생성과 introspection 사이의 일치도를 측정한다. 답변이 사실적으로나 논리적으로 옳은지를 측정하지는 않는다.
- 배치 크기 8에서 그래프에 표시된 처리량 대 TPF 기울기는 I-DLM이 549, SDAR이 84다. 이 조건에서는 I-DLM의 토큰 병렬성 증가가 처리량 향상으로 더 효과적으로 이어진다.
각 패널은 생성–introspection 일치도, 분석적으로 계산한 query 오버헤드, 측정된 batching 동작을 구분한다. I-DLM의 수락률 0.984는 AR 기준값 1.000에 가깝다. 배치 크기 8에서 처리량 대 TPF 기울기는 I-DLM이 549로 SDAR의 84보다 크다. 이 그림은 실험 조건에서 제안 분포의 일치도와 실질적인 서빙 성능의 관계를 보여준다.
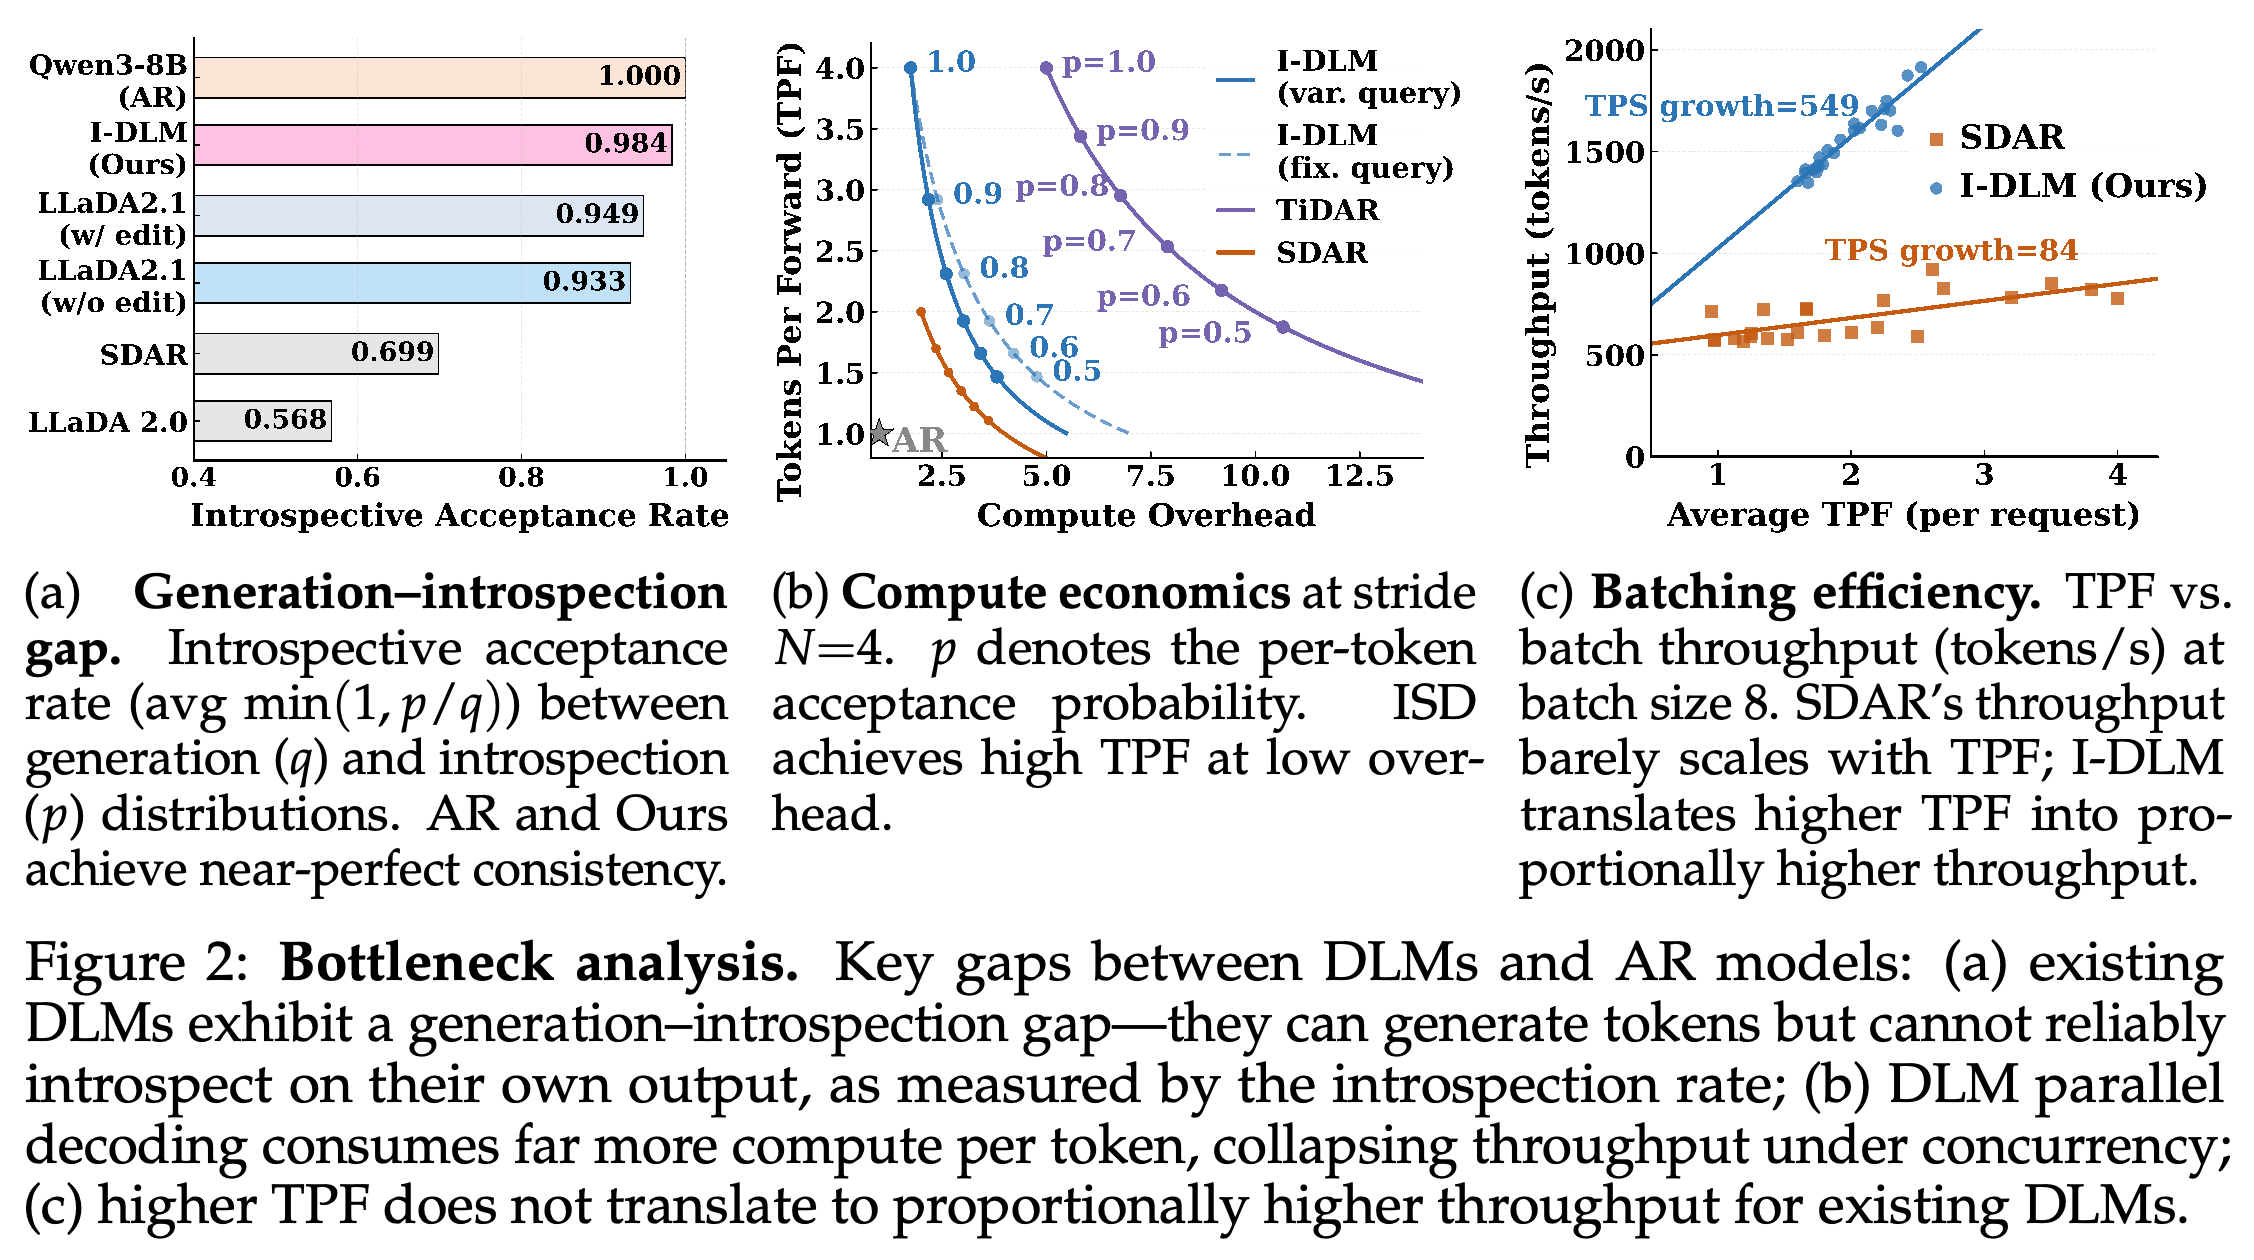
분석은 forward pass당 토큰 수(TPF)와 AR 디코딩 대비 오버헤드를 구분한다. 본문은 N=4이고 TPF가 약 2.5일 때 I-DLM의 오버헤드가 약 2.5×, TiDAR의 오버헤드가 약 7.8×라고 보고한다. 분석한 실행 방식에서 SDAR의 TPF는 2.0으로 제한된다. 블록 denoising에 별도의 KV-commit pass가 필요하기 때문이다.
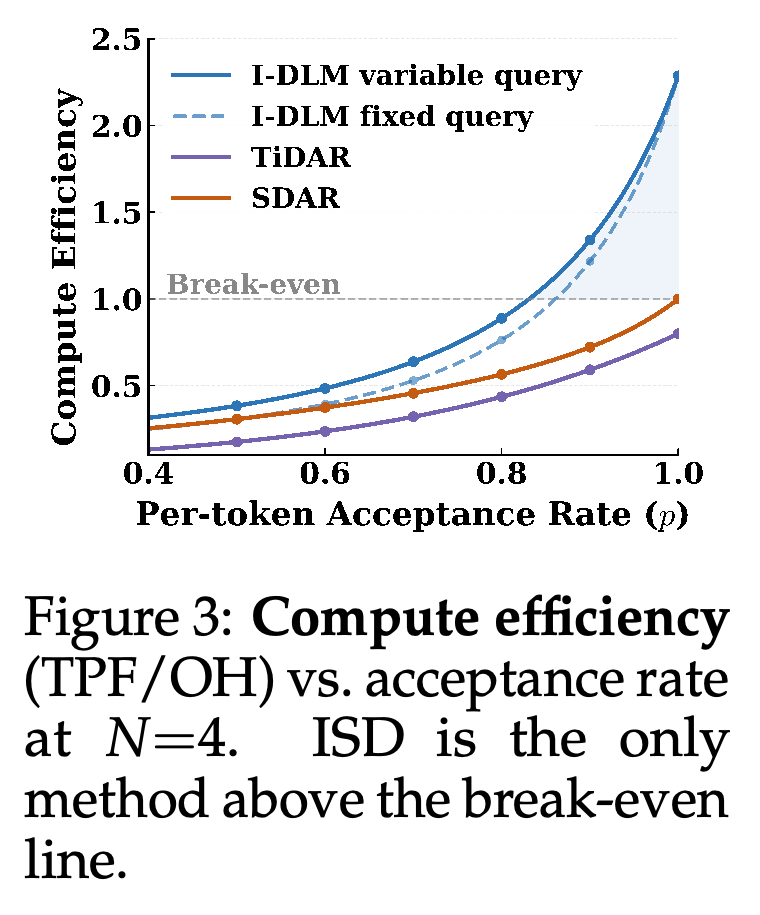
- Figure 3은 계산 효율을 TPF/OH로 정의한다. ISD는 variable query에서 수락 확률 약 0.83, fixed query에서 약 0.86일 때 제시된 손익분기점을 넘는다.
- Appendix B는 FLOPs를 직접 측정하지 않고 출력 토큰당 query 토큰 수로 오버헤드를 모델링한다. 실제 실행 시간은 메모리 대역폭, 커널, 스케줄링, 동시성에도 영향을 받는다.
ISD의 variable-query 및 fixed-query 곡선은 수락률이 충분히 높을 때만 TPF/OH=1 기준선을 넘는다. 따라서 높은 제안 일치도는 논문이 제시하는 효율 이점의 조건이다. 이 지표는 TPF와 분석적인 query 오버헤드를 결합하므로, 실제 실행 시간의 속도 향상으로 직접 해석해서는 안 된다.
3 Introspective Diffusion Language Model
I-DLM은 3가지 설계를 결합한다. masked 제안과 clean causal 예측을 함께 학습하고, ISD로 제안을 검증하며, causal 실행을 유지해 기존 AR 서빙 인프라를 재사용한다. Causal anchor는 분포 검증과 캐시 재사용을 지원하고, 제안 경로는 별도의 draft 모델 없이 병렬성을 제공한다.
3.1 Introspective-Consistency Training
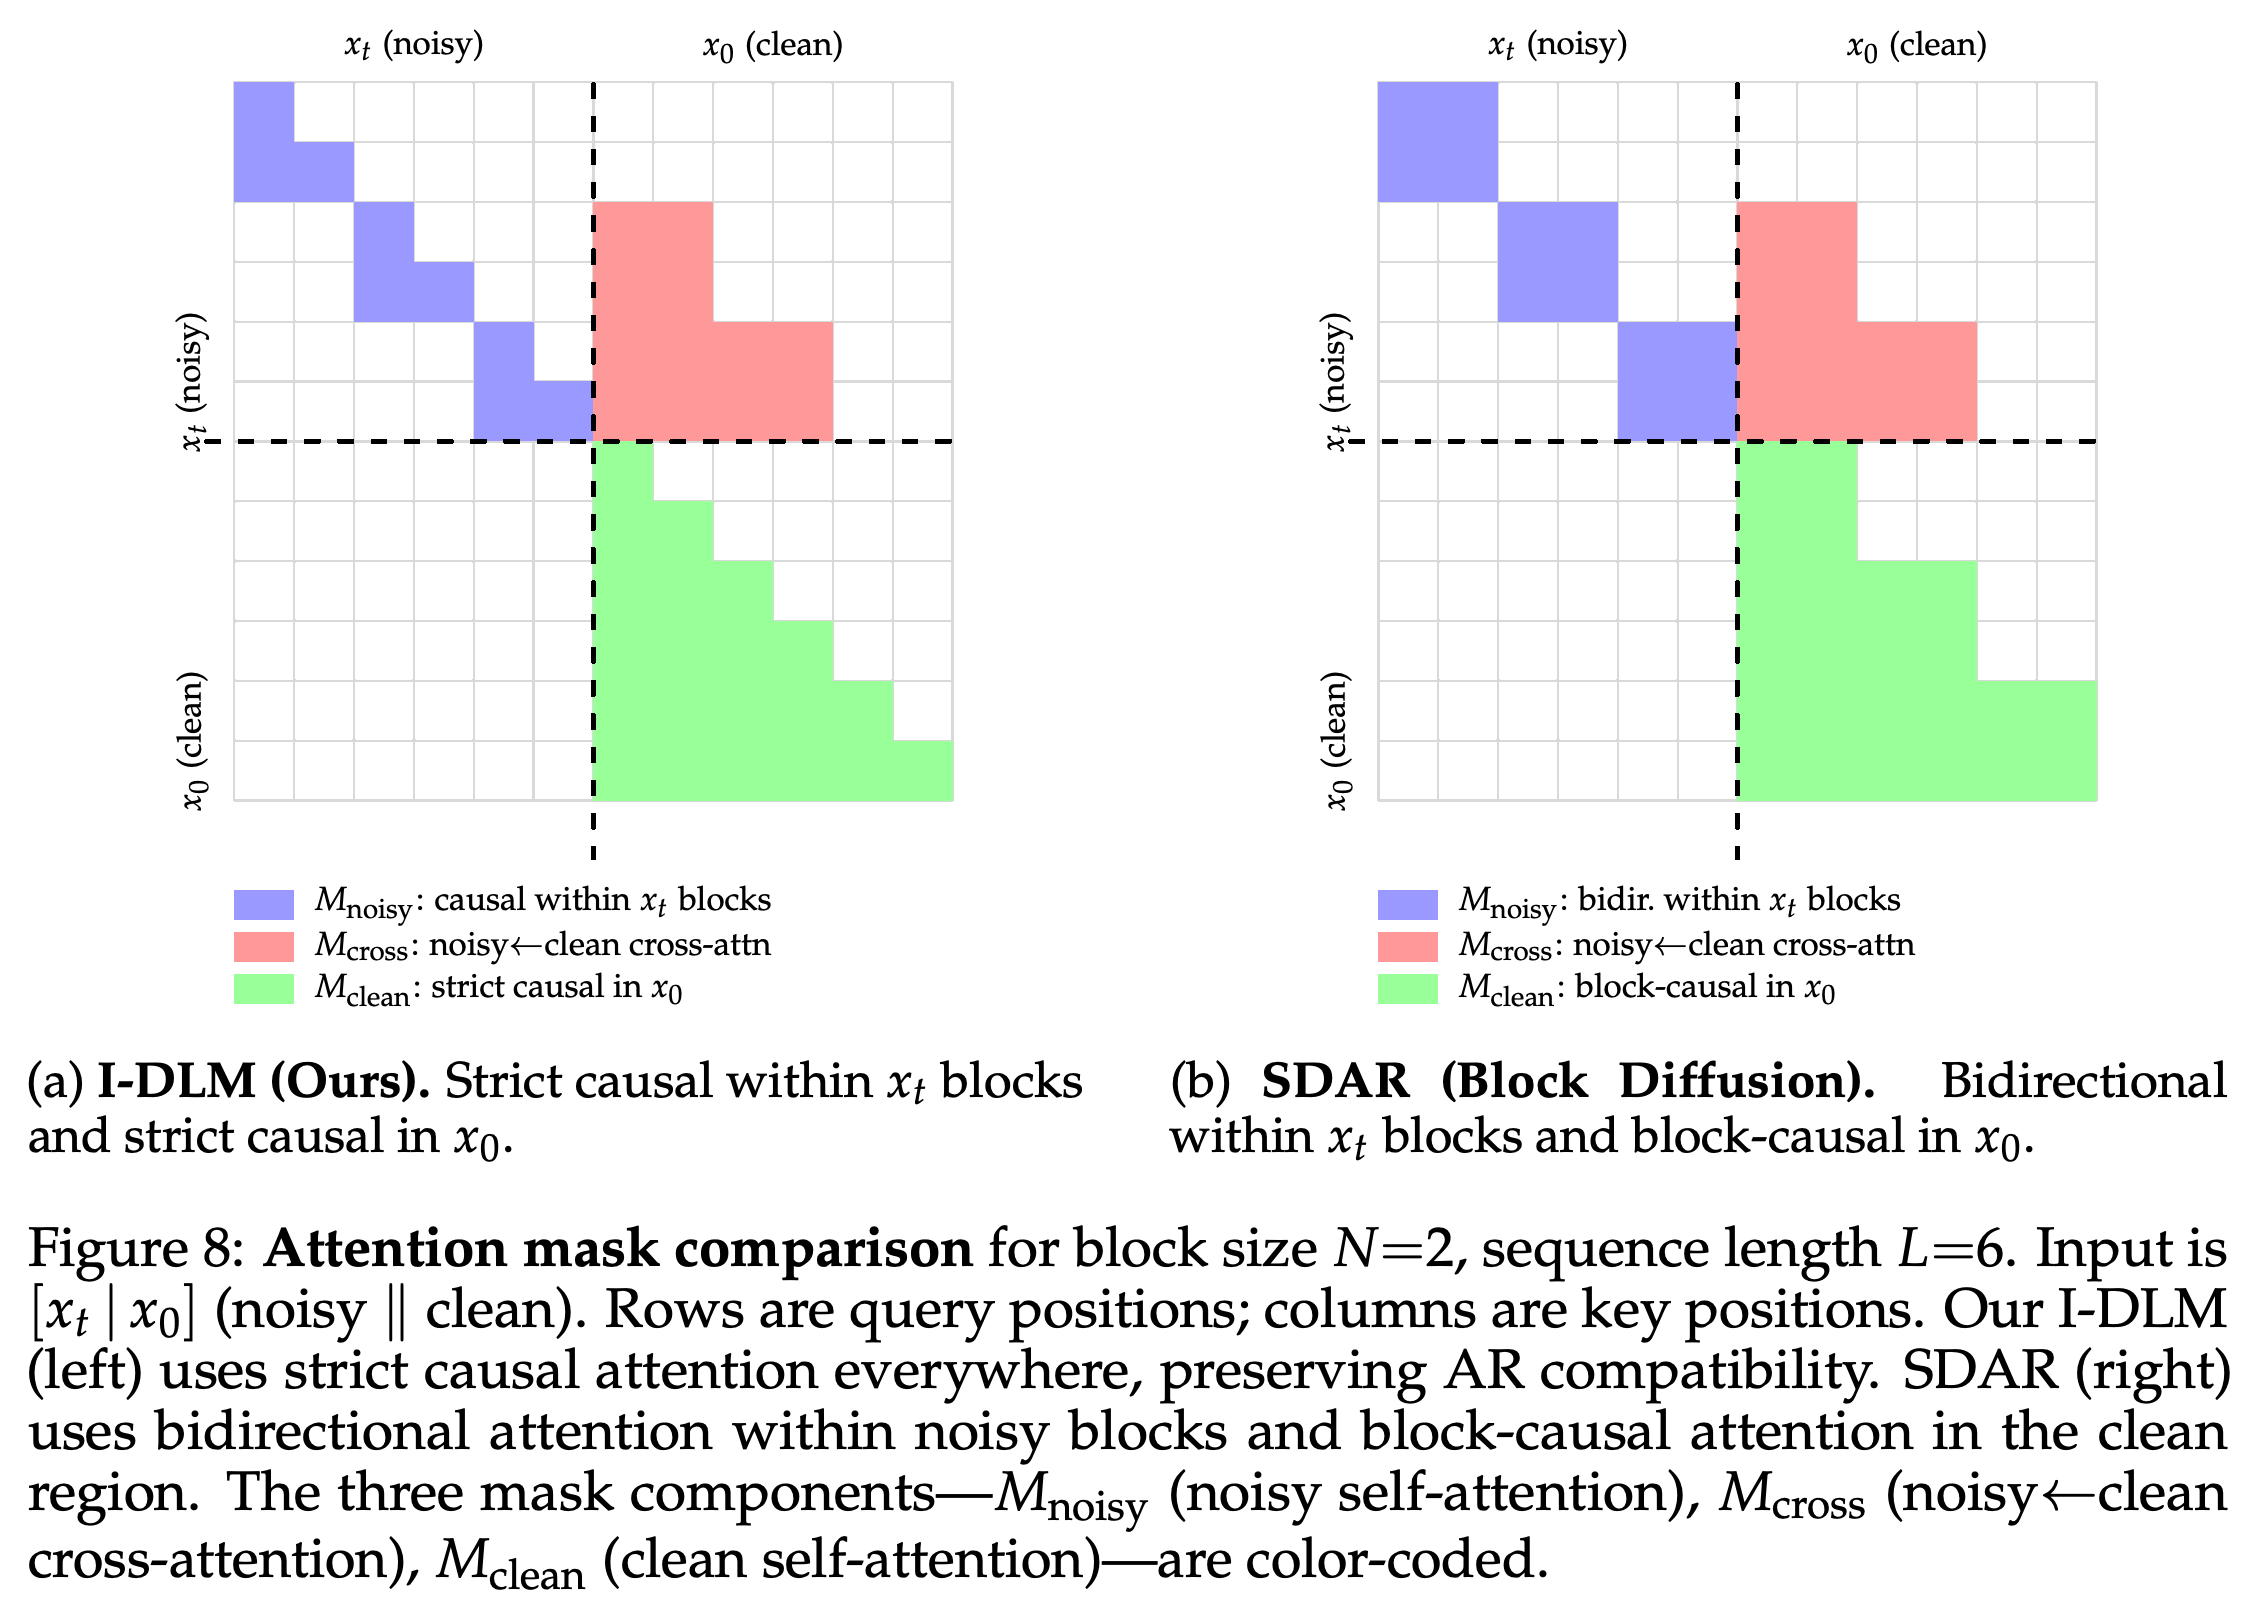
학습은 masked 위치에서 token[i] 자체를 예측하는 대신, AR의 logits[i] → token[i+1] 대응을 유지한다. 입력은 모든 위치가 masked인 영역 xt와 clean 참조 x0를 이어 붙여 구성하며, shifted cross-entropy loss로 각 영역을 모두 감독한다. Figure 8과 Appendix E는 noisy 블록 내부의 causal attention, 앞선 clean 블록을 참조하는 noisy-to-clean attention, clean 영역 내부의 엄격한 토큰 단위 causal attention을 명시한다.
- Clean 위치는 causal anchor p를 학습하고, masked 위치는 제안 분포 q를 학습한다.
- 모든 위치를 masked로 두고 감독하면, 토큰 중 일부만 무작위로 masking할 때 생기는 비감독 위치를 피할 수 있다.
- Appendix E의 블록 구조 mask는 Section 3.1의 간단한 설명과 달리, 이어 붙인 입력 전체에 적용되는 단일 하삼각 causal mask가 아니다.
행렬은 causal 학습 설명에 사용된 블록 구조의 학습 mask를 보여준다. I-DLM은 noisy 블록 내부의 양방향 attention을 제거하고 clean 영역에 토큰 단위 causal attention을 사용한다. Noisy 블록은 앞선 clean 블록에서 참조 문맥을 받는다. 이러한 영역 간 접근은 이어 붙인 입력 전체에 global causal mask를 적용한다는 설명보다 구체적이다.
제안하는 auto-balanced 목적함수는 L = Lmask + ŝ·Lclean이며, ŝ = Lmask/Lclean은 매 step에서 gradient를 차단한 스칼라로 취급한다. 이 방식은 teacher 모델이나 별도의 distillation 목적함수 없이 2개 손실의 가중 크기를 같게 맞춘다. 다만 gradient norm까지 같다는 뜻은 아니다.
- Clean 위치에 대한 감독은 더 어려운 masked 예측 과제를 학습하는 동안 검증 경로도 유지한다.
- Appendix H는 일반적인 학습 방식에 예외가 있음을 명시한다. 초기 8B stride 확장에서는 clean-loss scale을 0.2로 고정하며, 32B 학습도 auto-balanced 목적함수 대신 0.2로 고정한 scale을 사용한다.
3.2 Introspective Strided Decoding (ISD)
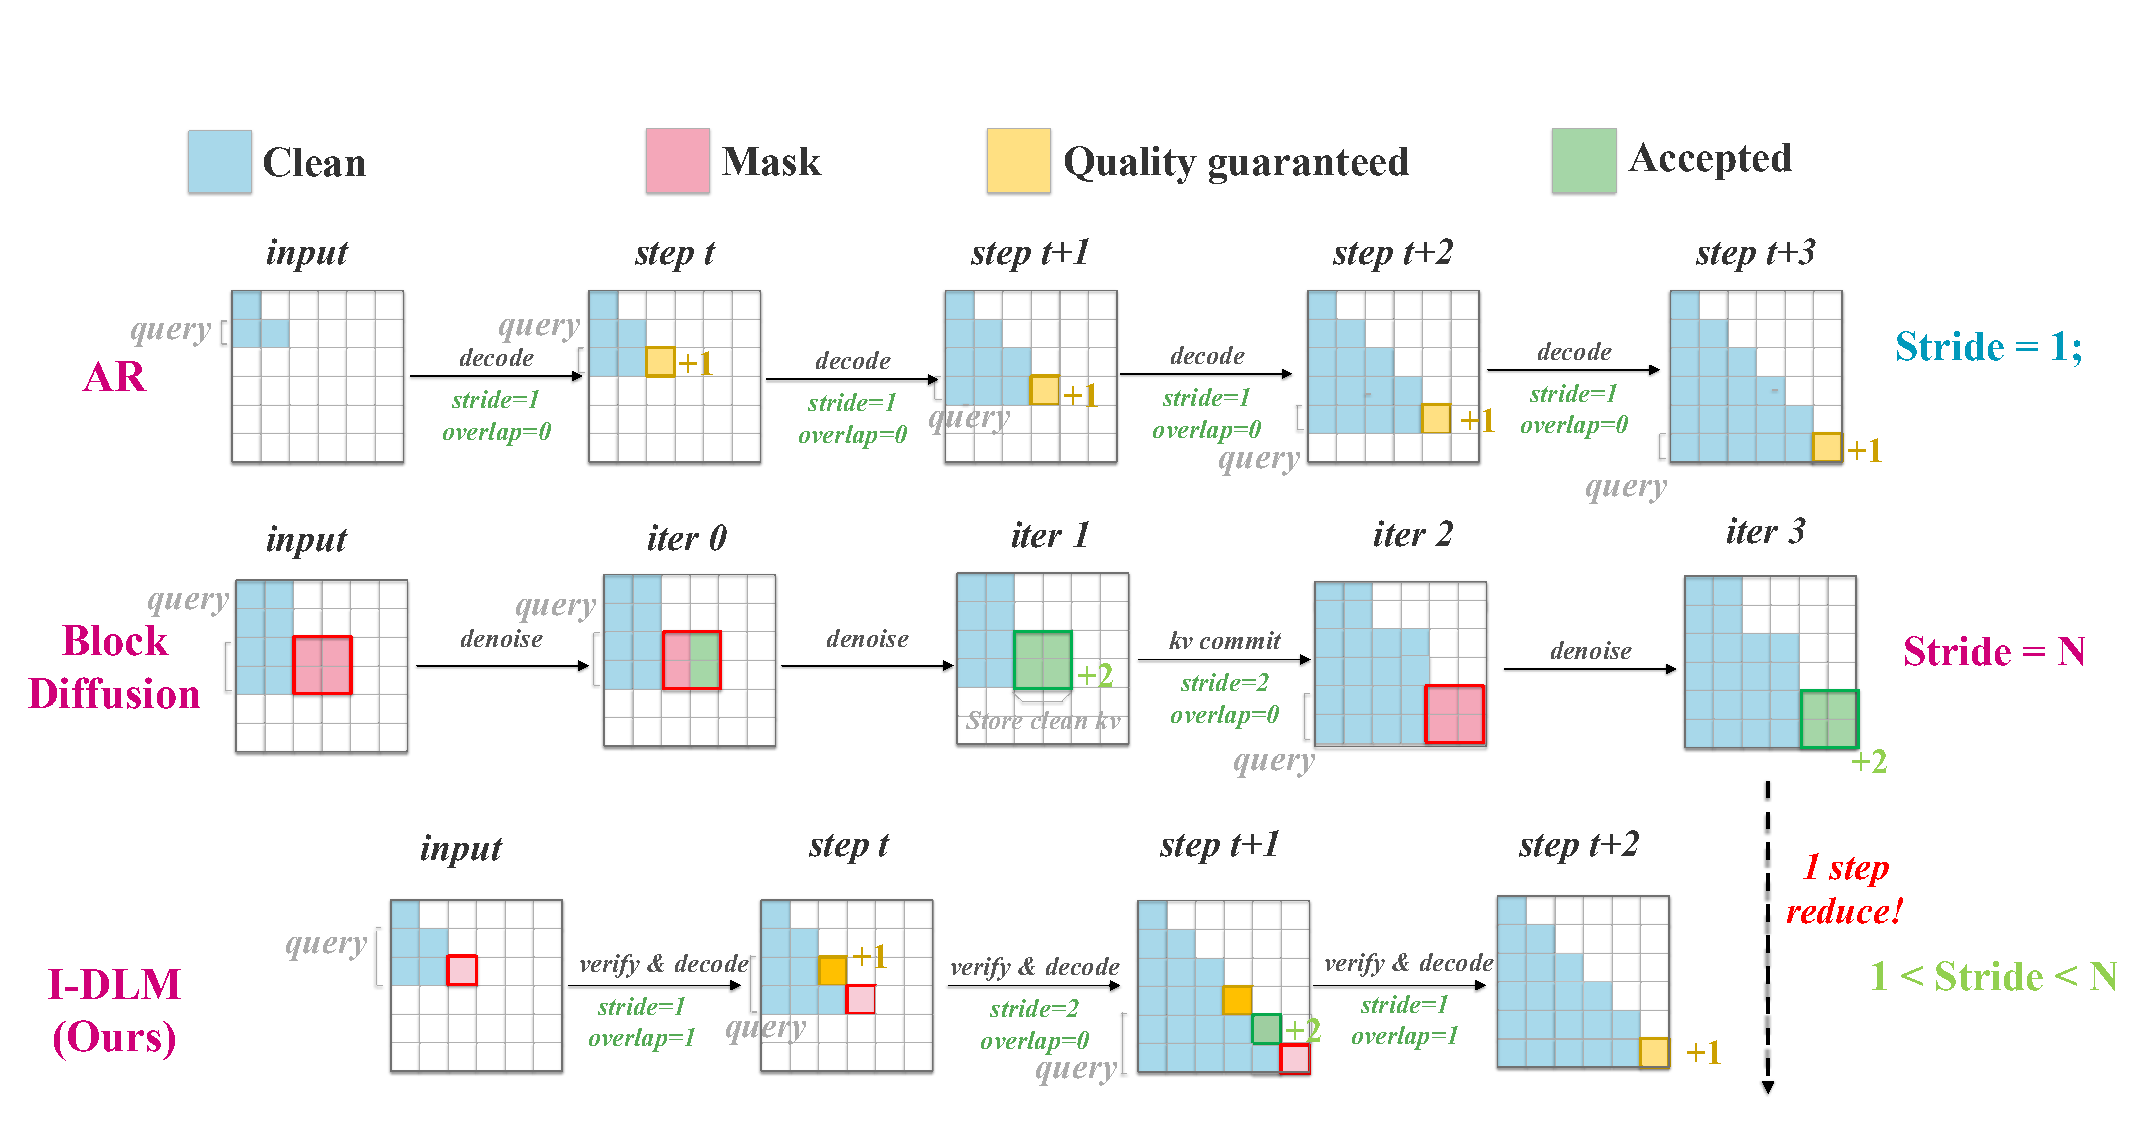
ISD는 표준 AR prompt prefill로 시작한다. Algorithm 1에서는 마지막 clean 위치가 anchor 분포를 따르는 토큰 1개를 생성하고, N−1개의 mask 위치가 speculative 제안을 생성한다. 이후 실행에서는 이 제안의 검증과 새로운 masked-token 예측을 융합한다. Figure 4는 이러한 중첩 실행을 순차적인 AR 디코딩, 그리고 denoising과 KV-commit 단계를 분리하는 block diffusion과 비교한다.
- 각 제안은 (\min\left(1,\frac{p_k(x_k)}{q_k(x_k)}\right))의 확률로 수락된다. 처음 거절이 발생하면 ISD는 normalize(max(0, pk−qk))에서 샘플링하고 이후 제안을 버린다. 이 수락과 보정 절차가 함께 anchor 분포를 보존한다.
- 모든 제안이 통과하면 마지막 causal anchor에서 토큰을 추가로 샘플링할 수 있다. 거절이 발생한 다음 step에서는 이전 speculative suffix를 검증하지 않고 제안을 생성한다.
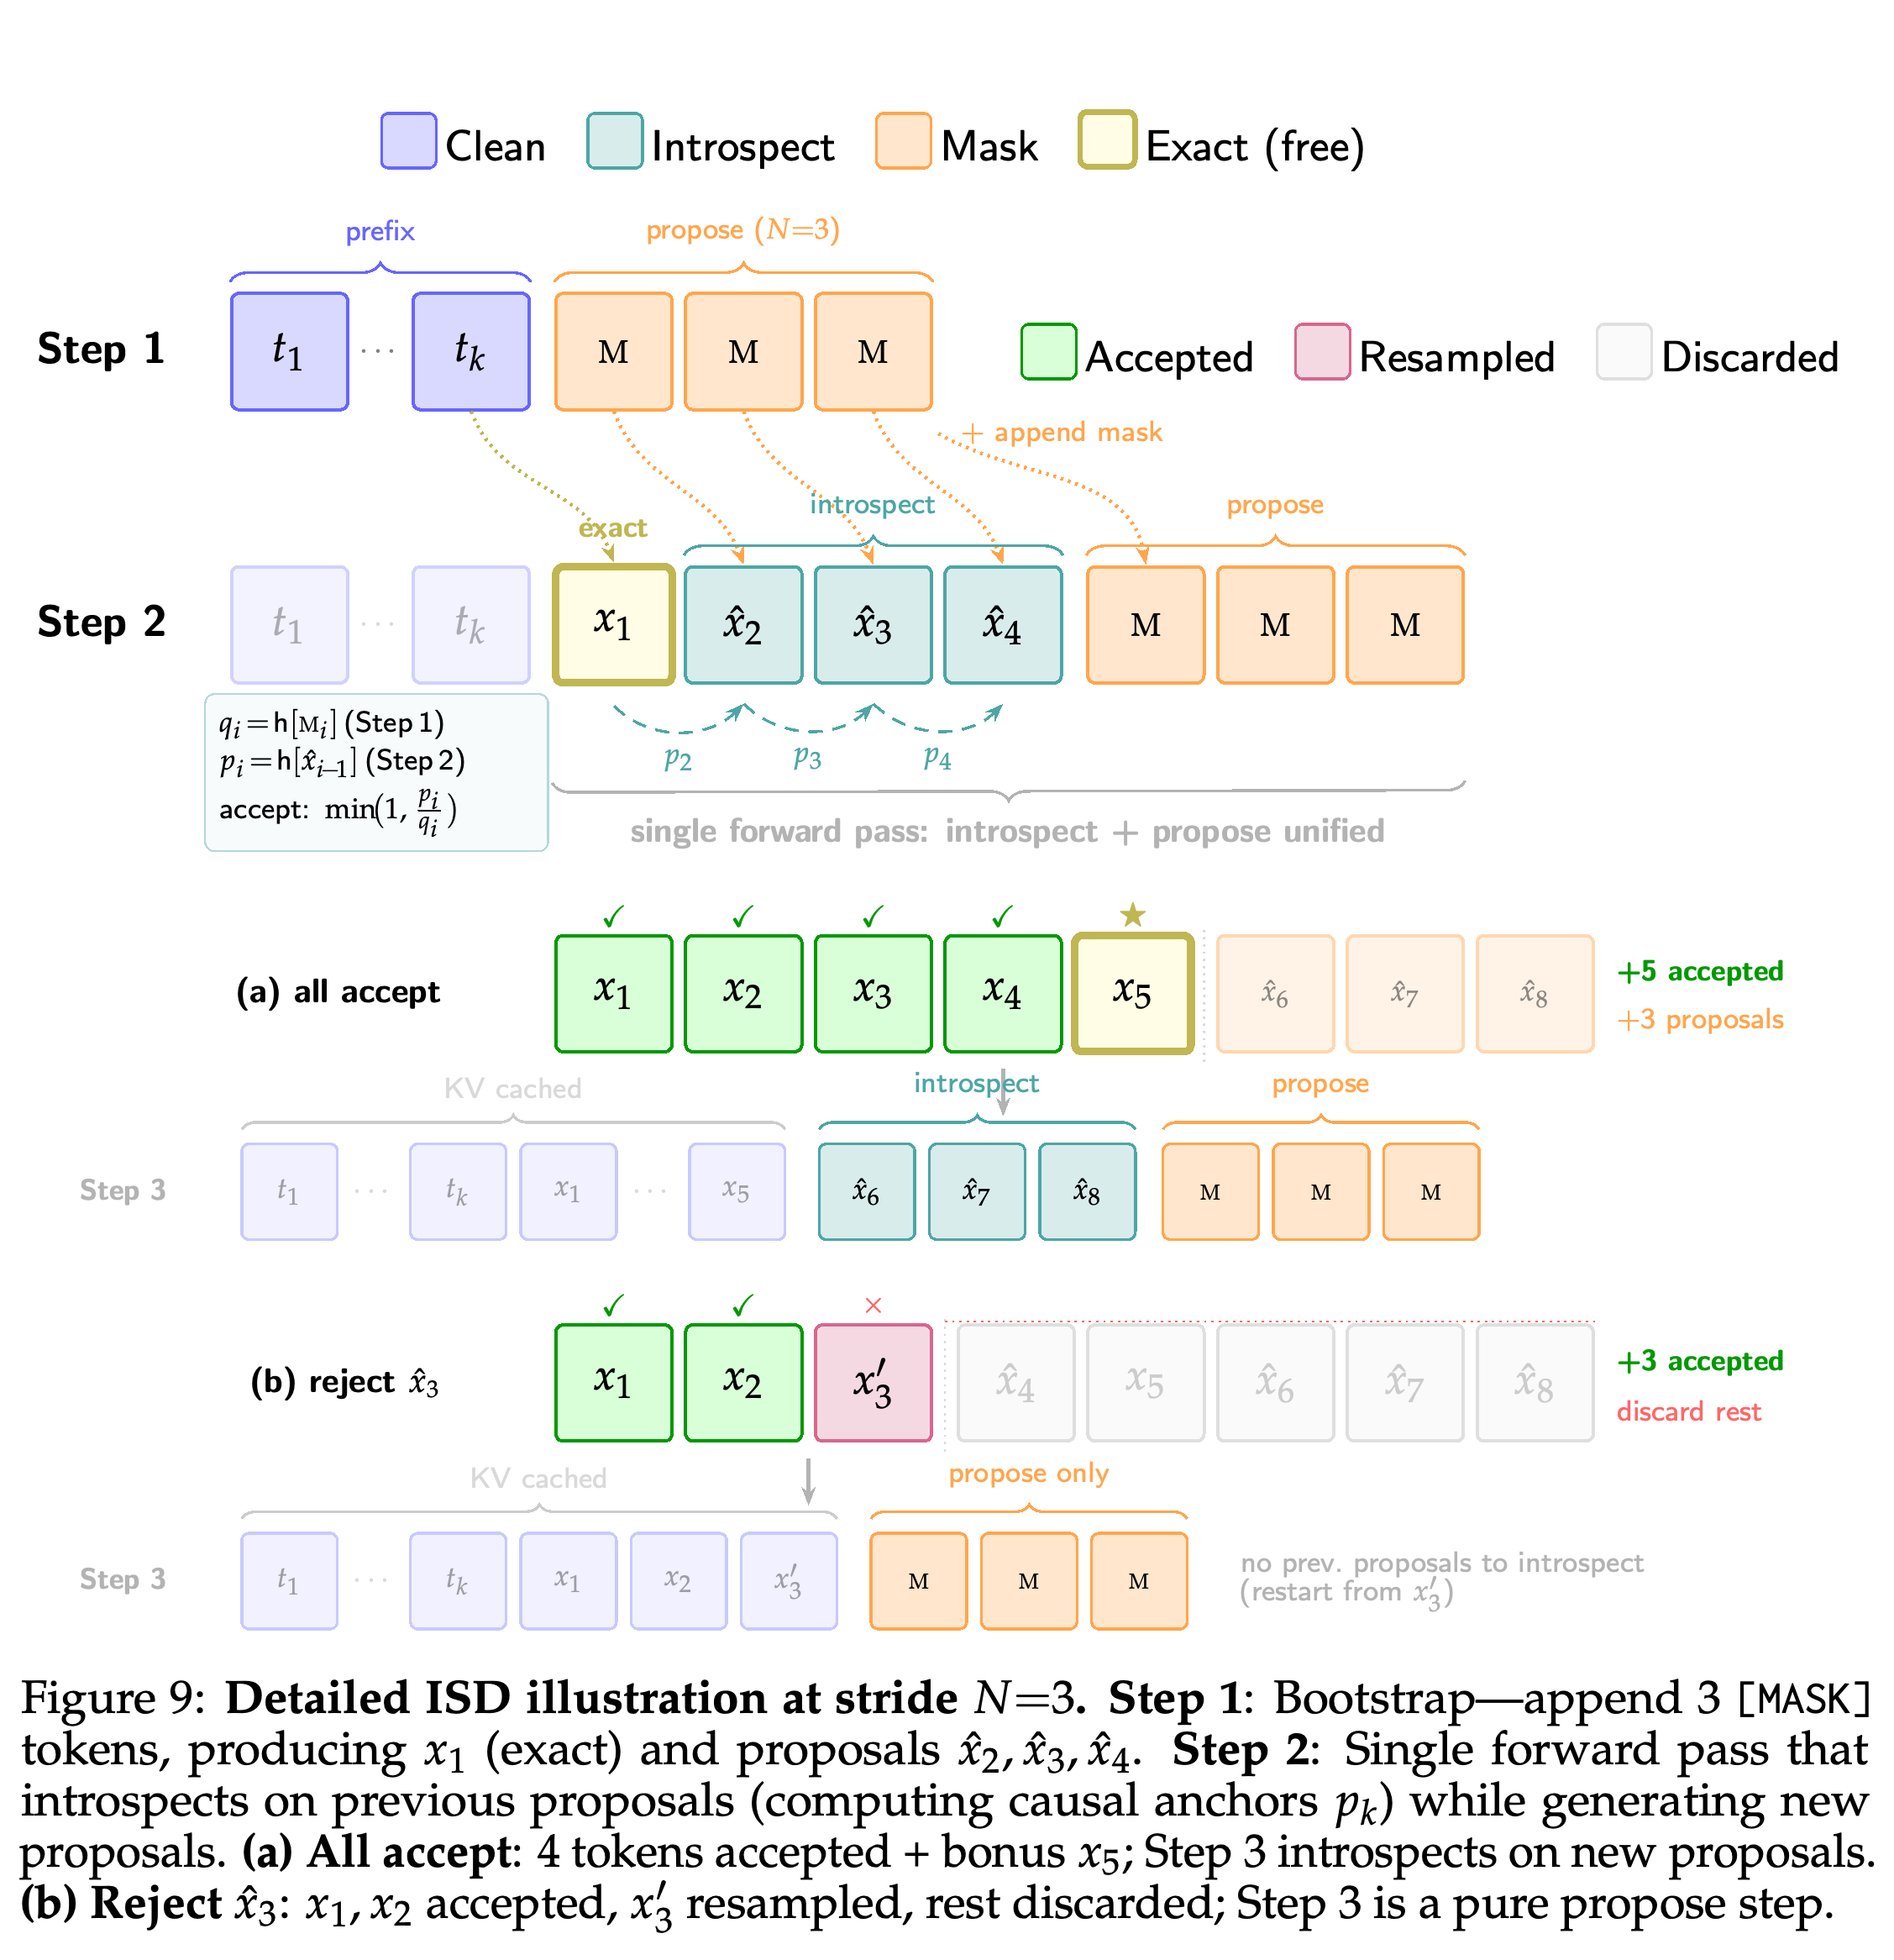
- Figure 9는 수락 경로와 거절 경로를 모두 보여준다. 다만 N=3 예시에서 정확한 토큰 외에 mask 3개와 제안 3개를 사용하므로, Algorithm 1의 N−1개 mask 규칙과 다르다.
Attention grid의 연속 도식은 AR이 한 번에 토큰 1개씩 진행하고, block diffusion이 캐시 commit 단계를 추가하며, I-DLM이 검증과 제안 생성을 중첩하는 모습을 보여준다. Causal 구조 덕분에 수락된 토큰의 캐시 항목을 유지할 수 있으며, 그림의 baseline처럼 양방향 블록을 별도로 commit할 필요가 없다.
모든 제안이 수락된 경로는 제안을 유지하고 다음 융합 step으로 이어진다. 거절 경로는 처음 거절된 제안을 보정하고 suffix를 버린 뒤 제안 생성을 다시 시작한다. 이 그림은 mask 3개를 N=3으로 표시하므로, stride N에 N−1개의 mask를 사용하는 Algorithm 1의 규칙과 다르다.
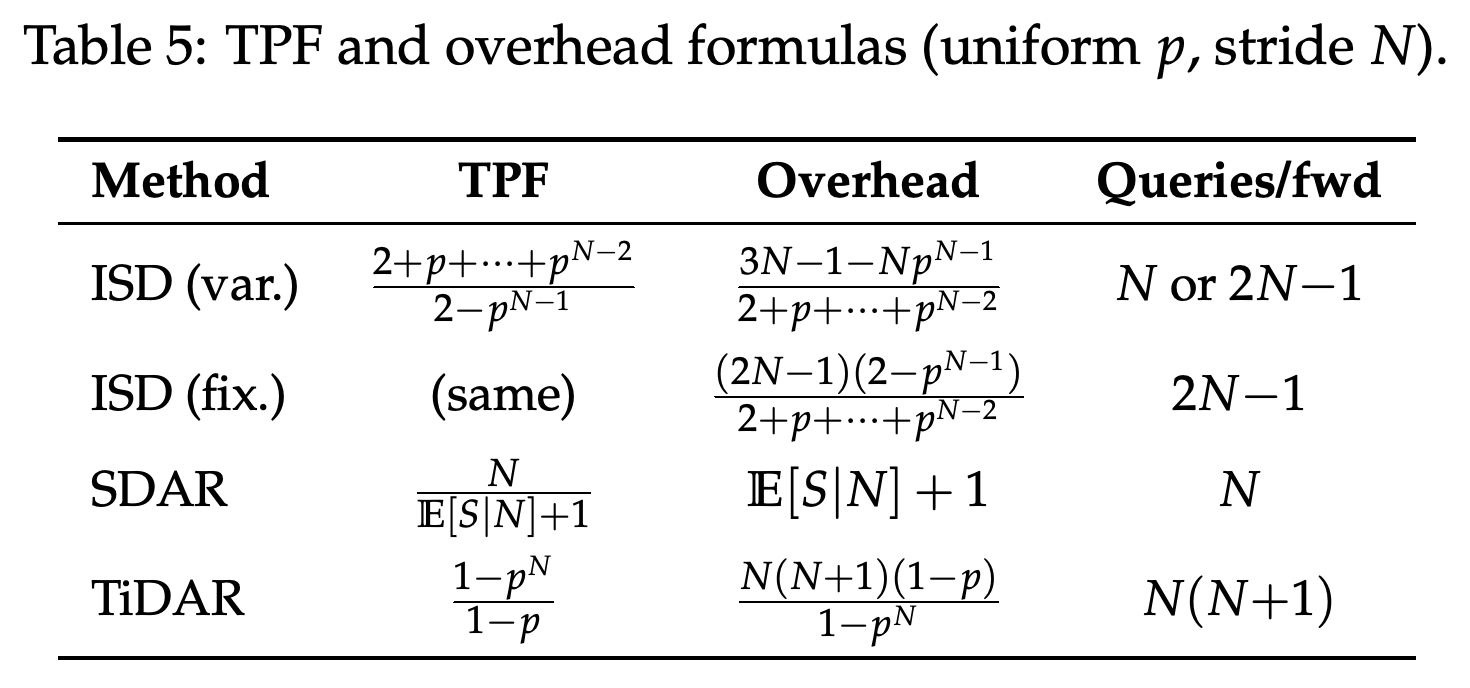
논문은 누적 제안 수락 확률 Pk에 대해 TPFN = (2 + P1 + ⋯ + PN−2)/(2 − PN−1)을 유도한다. 모든 제안이 수락되면 TPF=N이고, 수락률이 0이면 TPF=1이다. Table 5는 query 오버헤드 공식을 정리하고, ISD의 제안 전용 복구 step을 SDAR의 commit pass 및 TiDAR의 폐기되는 분기와 비교한다.
- Fixed-query ISD는 forward당 2N−1개의 query 토큰을 처리한다. Variable-query 방식은 제안 전용 복구 step에서 N개의 query를 처리한다.
- 실행 시간 기준 속도 향상 ≈ TPF라는 근사는 stride가 달라져도 forward 지연 시간이 거의 변하지 않는 memory-bound 디코딩에 적용된다. 모든 서빙 환경에 적용되는 것은 아니다.
공식은 query 연산이 발생하는 서로 다른 원인을 구분한다. ISD는 제안 전용 복구, SDAR은 별도의 commit forward, TiDAR는 사용하지 않는 speculative 분기에서 연산이 발생한다. 이 공식은 균일한 수락률을 가정하고 query 토큰 오버헤드를 모델링하며, GPU FLOPs나 지연 시간을 측정하지는 않는다.
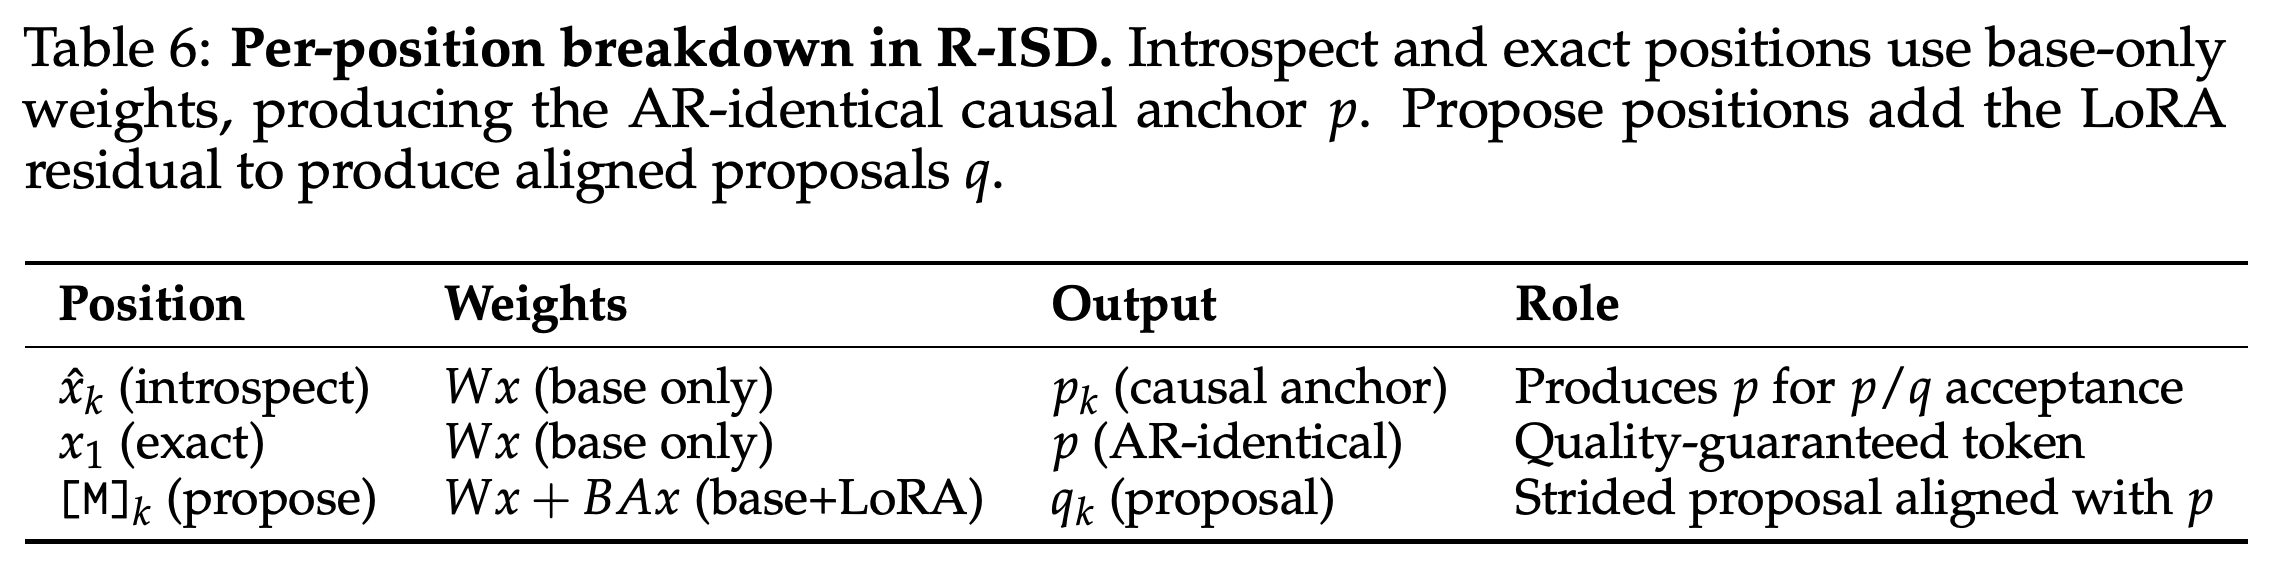
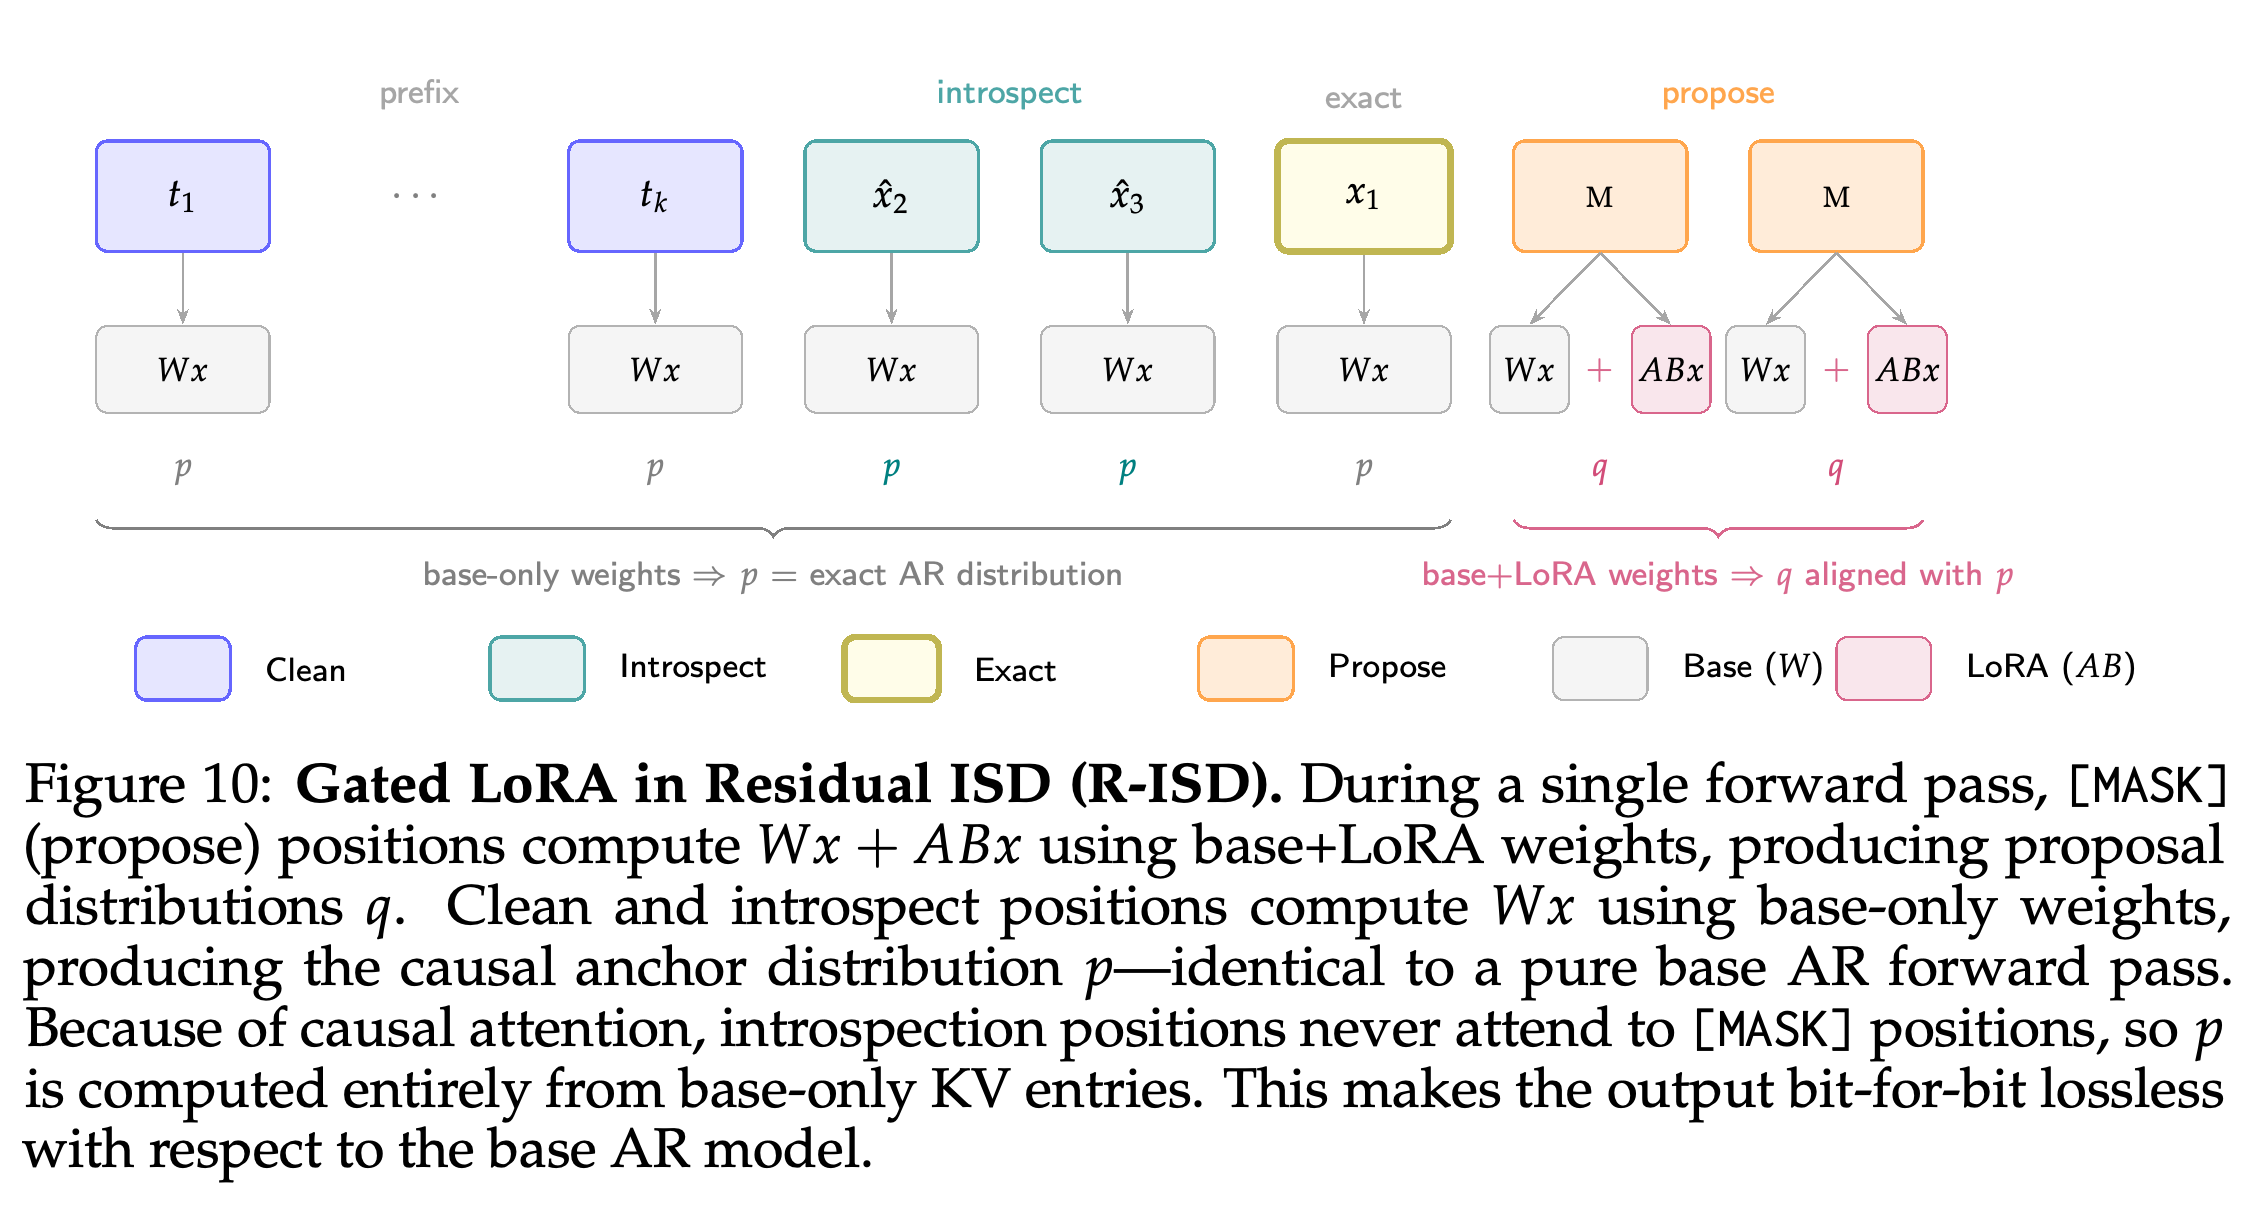
R-ISD는 [MASK] 위치에만 LoRA residual을 적용하고, clean 위치와 introspection 위치에는 변경하지 않은 base 가중치를 사용한다. Mask를 clean 위치 뒤에 붙이면 엄격한 causal attention 덕분에 clean 위치의 anchor와 확정된 KV 항목이 적응된 제안 위치에 영향을 받지 않는다. Figure 10과 Table 6은 이러한 위치별 분리를 설명한다.
- 일반적인 strict ISD는 변환된 모델의 causal anchor 분포를 보존한다. 원래 사전 학습 모델의 분포까지 보존한다고 보장하지는 않는다.
- R-ISD는 명시된 gating과 causal 실행 조건에서 원래 base AR의 목표 분포를 보존한다. 논문은 출력을 “bit-for-bit lossless”라고 부르지만, 분포 보존만으로 임의의 난수 및 수치 연산 방식에서 동일한 샘플 시퀀스를 보장하지는 않는다.
위치별 구분은 제안 경로를 적응시켜도 검증은 바뀌지 않는 이유를 설명한다. Introspection 위치와 정확한 토큰 위치는 base 가중치만 사용하고, masked 제안 위치는 LoRA를 활성화한다. 이 분리와 causal attention이 함께 R-ISD의 원래 AR anchor를 보존한다.
도식은 masked 제안 위치에만 LoRA 연산을 적용하고 clean 위치와 introspection 위치는 base 경로에 남긴다. Causality 덕분에 이 위치의 anchor는 뒤에 있는 적응된 mask에 영향을 받지 않으며, 이는 목표 분포 보존을 뒷받침한다. 동일한 샘플 시퀀스를 보장하려면 난수와 수치 연산에 대한 추가 가정이 필요하다.
3.3 I-DLM Serving Stack: AR-Compatible Serving
서빙 구현은 ISD를 2N−1개의 causal query 토큰을 사용하는 SGLang extend 연산으로 구현하고, paged KV cache, continuous batching, tensor parallelism을 재사용한다. Extend forward를 CUDA graph로 캡처해 재생한다. 최대 9개 토큰을 추가하는 짧은 확장에서는 단일 paged attention 커널이 ragged-attention, paged-attention, merge로 이어지는 연산을 대체한다.
- Figure 7은 이 연속 연산의 forward 지연 시간 오버헤드가 C=1에서 +4%, C=64에서 +20%로 증가한다고 보고한다.
- Stationary-batch 루프는 배치 객체와 메타데이터를 재사용하고, batched scatter로 KV 슬롯을 할당하며, 거절된 항목과 masked 항목을 제거한다. 중요하지 않은 I/O는 다음 GPU-forward 구간으로 미룬다.
융합된 Triton 검증 커널은 online softmax와 Gumbel-max 보정을 사용하며, 일반적인 수락 경로에서는 보정 연산을 생략한다. 서빙 스택은 argmax 제안과 엄격한 검증으로 목표 출력 분포를 보존한다. 이때 검증 규칙은 실제 제안 방식의 분포를 사용해야 한다. Segment-gated LoRA는 CUDA graphs 안에서 R-ISD를 지원한다.
- 논문은 약 78%의 위치가 일반적인 수락 경로를 따른다고 보고한다.
- 토큰 수가 적을 때 LoRA 구현은 segmented GEMV 대신 cuBLAS를 사용한다. 별도의 CUDA stream에서는 LoRA shrink 연산을 base projection과 중첩 실행한다.
4 Experiments
실험은 변환된 Qwen3-8B와 Qwen3-32B 모델을 diffusion 모델 및 EAGLE-3와 비교하고, 벤치마크 품질과 서빙 성능을 별도로 측정한다. 학습 설계 ablation, 누적 시스템 ablation, stride 확장, 완화된 수락 규칙을 통해 품질과 효율 사이의 trade-off를 여러 측면에서 살펴본다.
4.1 Evaluation Methodology
품질 평가는 thinking mode, temperature 1.0, top-k=50, top-p=0.95를 사용하고, 3회 실행 결과를 평균한다. Table 1은 N=4 ISD와 sampling을 사용한다고 명시한다. Appendix H에 제시된 최대 생성 길이는 thinking block을 포함해 32,768 토큰이다.
- 논문은 벤치마크 15개를 언급하지만 Table 1에는 벤치마크 행이 14개 있다. Table 10은 TriviaQA도 나열하지만, 이에 대응하는 본문의 품질 결과는 없다.
- 코드 과제는 추출한 Python 코드를 테스트에 실행해 pass@1을 측정하며, 제한 시간은 10초다. IFEval은 thinking block을 제거한 뒤 공식 evaluator로 평가한다.
- LLaDA-2.1-mini, SDAR, EAGLE-3는 SGLang으로 재현한다. 다른 diffusion baseline의 결과는 각 논문에서 가져오므로, 비교 조건이 모두 동일하게 통제되지는 않는다.
서빙 평가는 MBPP, MATH-500, LMSYS-Chat에서 요청별 tokens/s와 서버 전체 tokens/s를 구분한다. Appendix H는 요청을 한꺼번에 제출하는 burst 방식, 고정된 2,048 토큰 출력, 측정에서 제외하는 warmup 요청 5개를 명시한다. 처리량은 첫 완료 시점부터 마지막 완료 시점까지의 경과 시간으로 전체 토큰 수를 나누어 측정한다.
- 본문은 C ∈ {1, 2, 4, 8, 16, 32, 64}를 평가하고, Table 11은 C=48도 나열한다.
- 주요 서빙 환경은 NVLink를 갖춘 H100 80GB SXM, CUDA 12.9, FlashInfer를 사용한다. 8B 구성은 서버당 GPU 1개를 사용하고, 32B 구성은 GPU 2개에 걸쳐 tensor parallelism을 사용한다.
- 이 조건은 가변 출력 길이, 지속적인 확률적 요청 도착, tail-latency 서비스 수준 목표를 직접 검증하지 않는다.
4.2 End-to-End Performance
Table 1은 나열된 diffusion baseline 대비 큰 개선을 보여주지만, 같은 규모의 AR 모델과 비교한 결과는 과제마다 다르다. I-DLM-8B는 ARC-C에서 95.8, IFEval에서 84.7로 Qwen3-8B와 같고, MATH-500에서는 96.8로 Qwen3-8B의 95.8보다 높다. 반면 AIME-25에서는 60.8로 65.4보다 낮고, LiveCodeBench-v6에서는 45.7로 50.3보다 낮다.
- LLaDA-2.1-mini (16B) 대비 I-DLM-8B는 AIME-24에서 26.3점, LiveCodeBench-v6에서 15.3점 높다.
- 32B에서 I-DLM은 AIME-24에서 83.3으로 Qwen3-32B의 76.7보다 높지만, GPQA에서는 58.7로 65.0보다 낮다.
- 표에는 불확실성 구간이나 통계 검정이 없다. 과제별 결과만으로 AR 모델과 통계적으로 동등하다고 결론 내릴 수는 없다.
N=4 결과는 주요 diffusion baseline 대비 큰 개선을 보여주지만 AR과의 비교는 과제마다 다르다. I-DLM-8B는 MATH-500에서 1.0점 높지만, AIME-25와 LiveCodeBench-v6에서는 모두 Qwen3-8B보다 4.6점 낮다. 원문 캡션은 벤치마크 15개를 언급하지만, 표에는 벤치마크 행이 14개 있다.
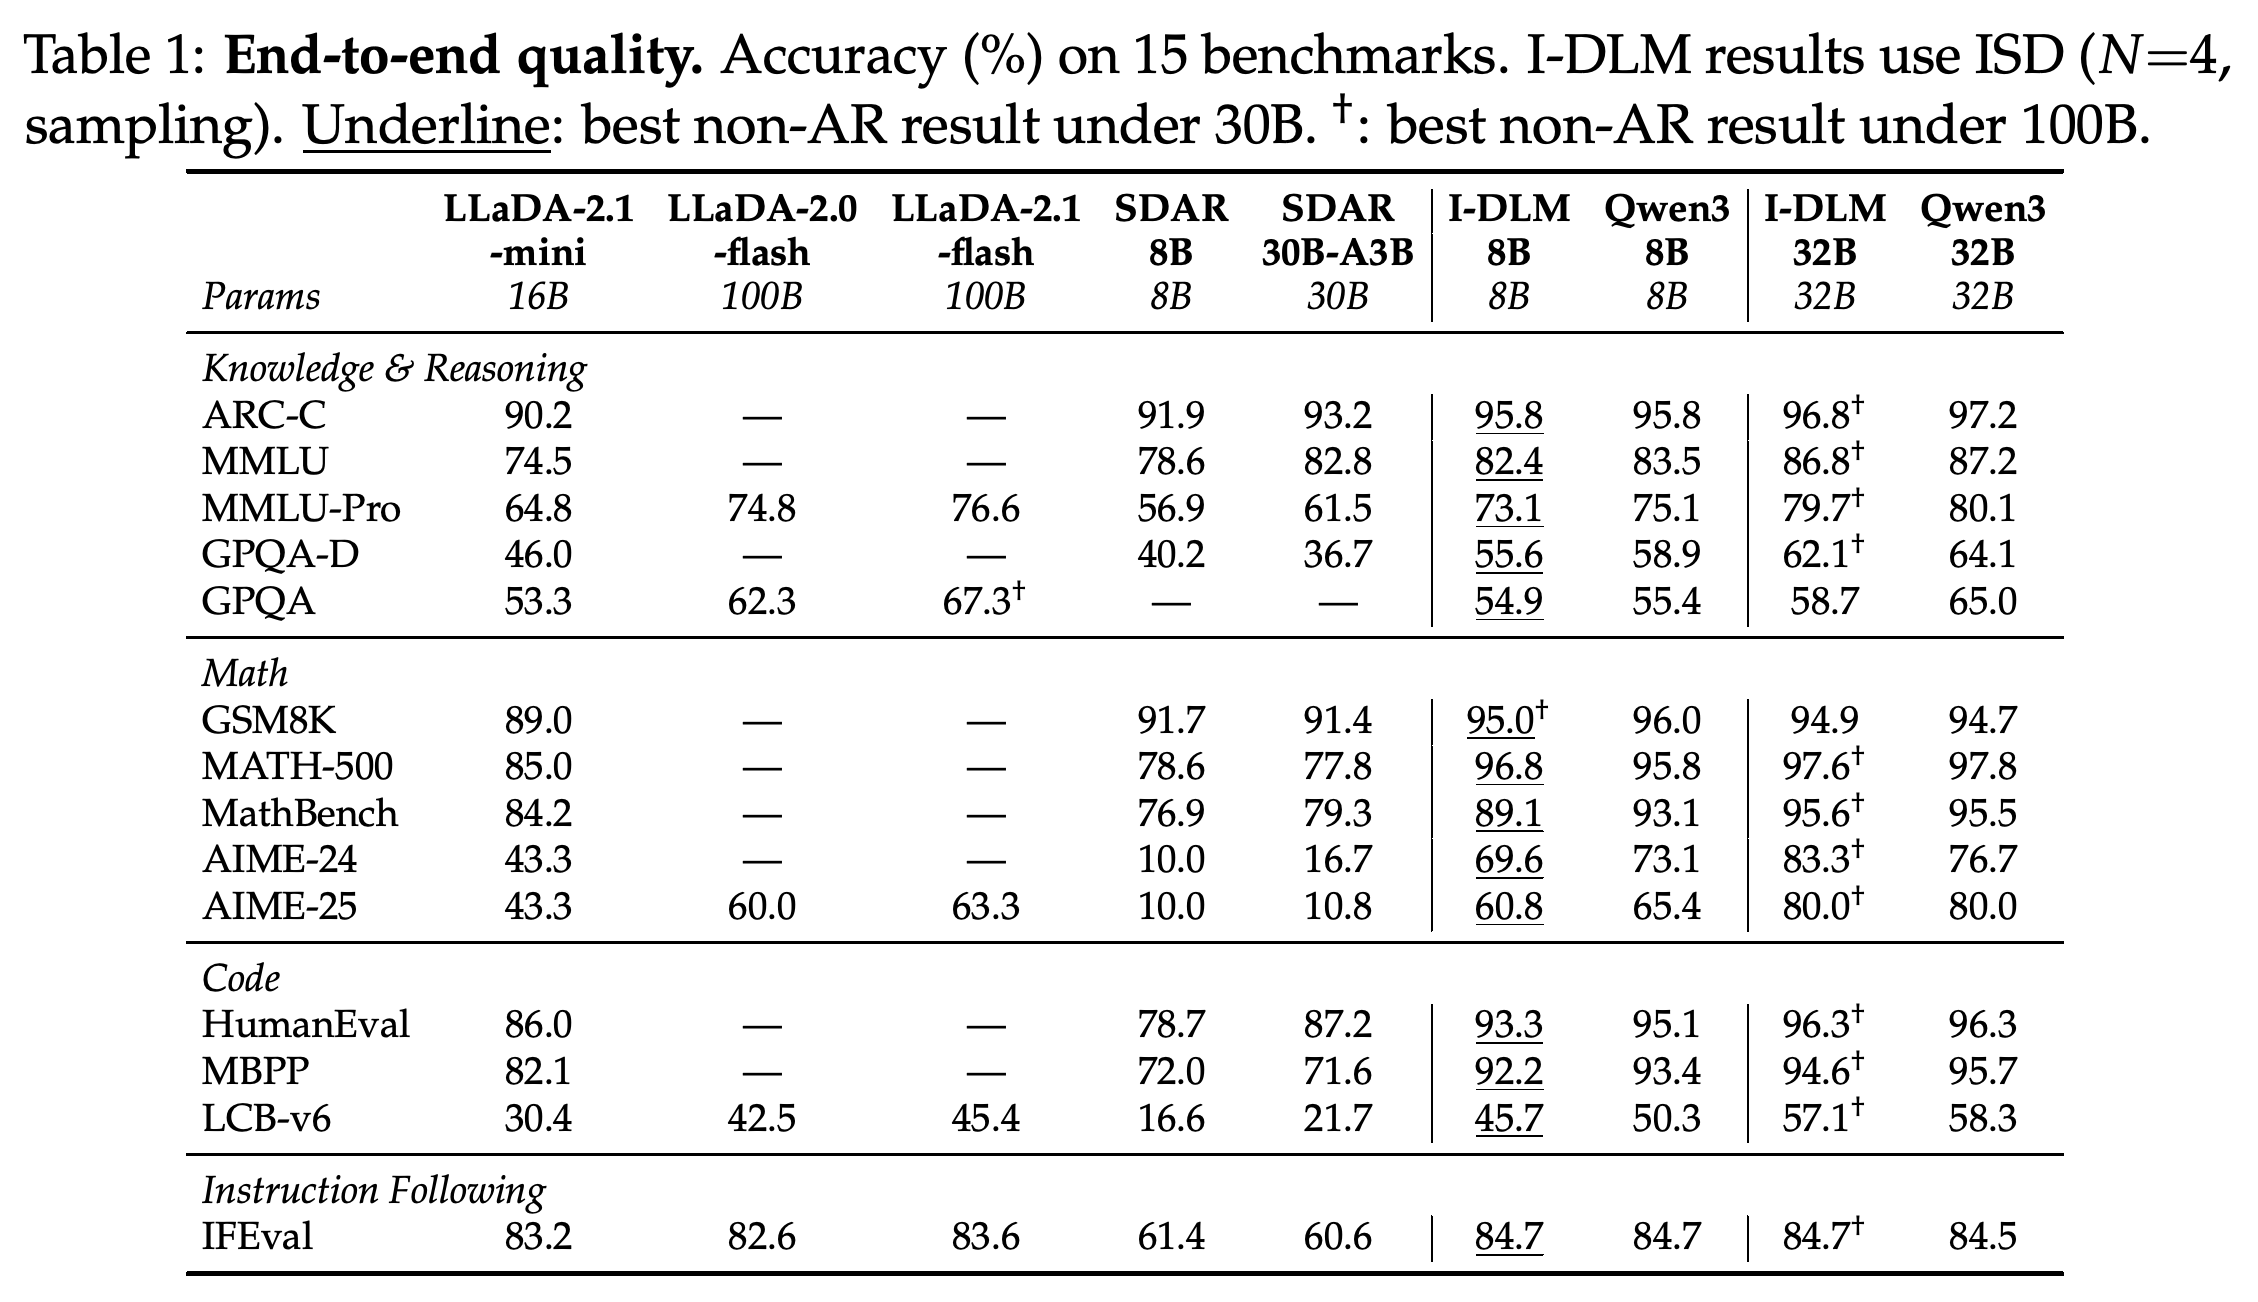
Table 2는 공통으로 보고된 과제에서 NBDiff, Jacobi Forcing, WeDLM, LightningRL, TiDAR, DREAM, Fast-dLLM, 비공개 diffusion 모델까지 비교를 확장한다. I-DLM-8B는 HumanEval에서 93.3, MBPP에서 92.2를 기록한다. 이는 Mercury Coder Small의 90.0과 76.6, Gemini Diffusion의 89.6과 76.0보다 높다.
- Section 4.2는 비공개 모델의 HumanEval 및 MBPP 점수를 오해하기 쉬운 비교 쌍으로 제시한다. 모델과 점수의 대응은 Table 2에서 확인할 수 있다.
- I-DLM이 보고된 모든 diffusion 비교에서 앞서는 것은 아니다. MMLU에서 NBDiff는 82.9, I-DLM은 82.4를 기록한다.
- 보고되지 않은 결과는 “—”로 표시되어 있으므로, 해당 과제에 대해서는 표로부터 결론을 내릴 수 없다.
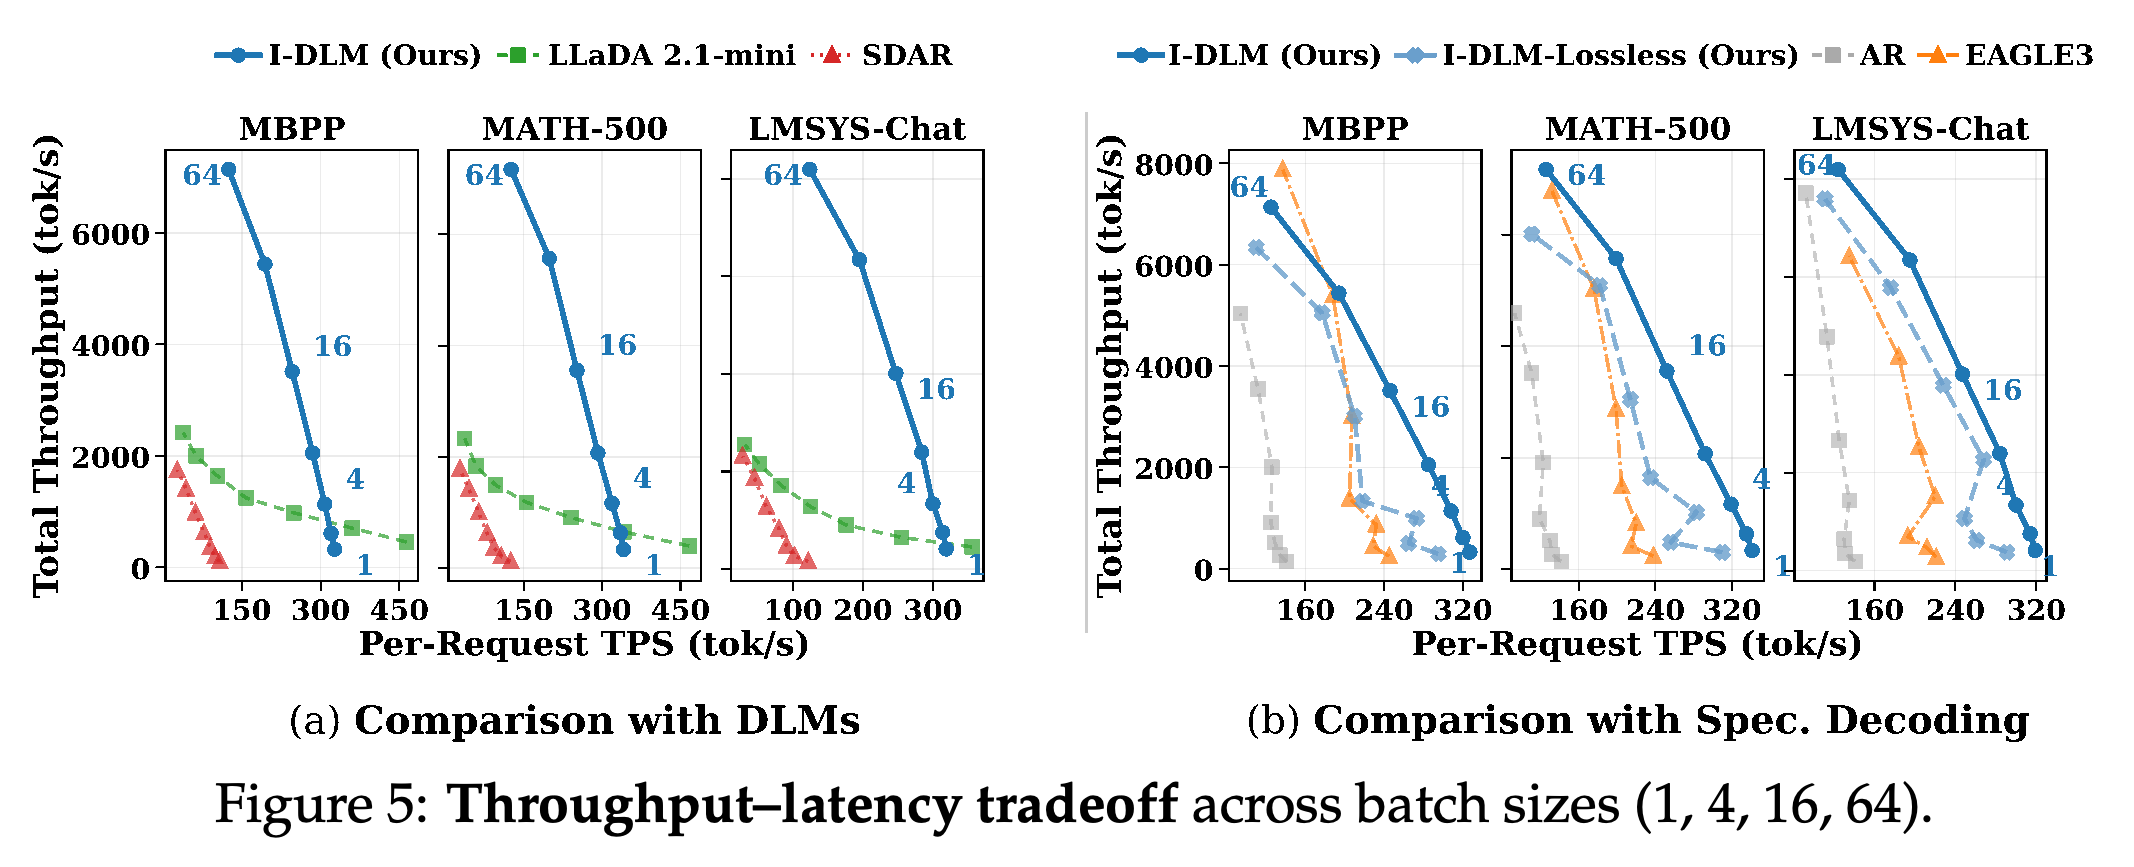
Figure 5는 동시성이 높아질수록 SDAR 및 LLaDA-2.1-mini 대비 I-DLM의 서빙 이점이 커짐을 보여준다. C=16–32에서 보고된 처리량은 LLaDA-2.1-mini보다 2.2–3.8×, SDAR보다 3.7–4.5× 높다. C=64에서 논문은 요청당 약 125 tok/s와 2.9–4.1× 높은 전체 처리량을 보고한다.
- MATH-500의 C=1에서 요청별 속도는 I-DLM이 341 tok/s, EAGLE-3가 238 tok/s다. 본문은 I-DLM-Lossless의 속도를 310 tok/s로 보고한다.
- C=32에서 I-DLM과 EAGLE-3의 속도는 MATH-500에서 각각 199 tok/s와 176 tok/s, LMSYS-Chat에서 각각 195 tok/s와 184 tok/s다.
- 논문은 C=32까지 EAGLE-3보다 유리하다고 주장하며, 모든 동시성에서 유리하다고 주장하지는 않는다. 부록의 최대 속도 측정은 구성과 lossless 속도가 다르다.
곡선은 동시성이 증가할 때 요청별 생성 속도와 전체 처리량이 어떻게 변하는지 함께 보여준다. 중간 및 높은 동시성에서 I-DLM은 표시된 diffusion baseline보다 높은 처리량을 유지한다. EAGLE-3와의 비교 결과는 동시성과 일반 I-DLM 또는 lossless I-DLM 중 무엇을 사용하는지에 따라 달라진다.
4.3 Ablation Studies
Figure 6은 같은 데이터 예산에서 causal/logit-shift 학습과 block-diffusion 학습을 비교한다. 그래프의 값은 HumanEval에서 93.3 대 60.3, MBPP에서 92.2 대 67.4, MathBench에서 89.1 대 71.6, MMLU에서 82.4 대 80.0이다. 관측된 차이는 MMLU보다 코드 및 수학 과제에서 더 크다.
- 함께 제시된 본문은 HumanEval에 92.7, MBPP에 92.8을 사용해 그래프 값과 다르다.
- 이 비교는 causal attention과 logit shifting을 함께 바꾼다. 따라서 각 요소의 기여를 분리하지 못하며, 수락률이 품질 차이를 만드는 유일한 메커니즘임을 입증하지도 않는다.
- 누적 시스템 ablation에서 처리량은 C=1일 때 111에서 282 tok/s로, C=8일 때 829에서 2,084 tok/s로, C=32일 때 2,791에서 5,882 tok/s로 증가한다. 보고된 단계별 증가량은 CUDA graphs에서 가장 크다.
학습 패널은 MMLU보다 코드와 수학에서 더 큰 품질 차이를 보여주지만, causal attention과 logit shifting을 함께 바꾼다. 시스템 패널은 구현 최적화가 속도에 상당히 기여함을 보여준다. 누적 최적화된 스택은 단순한 baseline 대비 2.1–2.5×의 처리량을 달성한다.
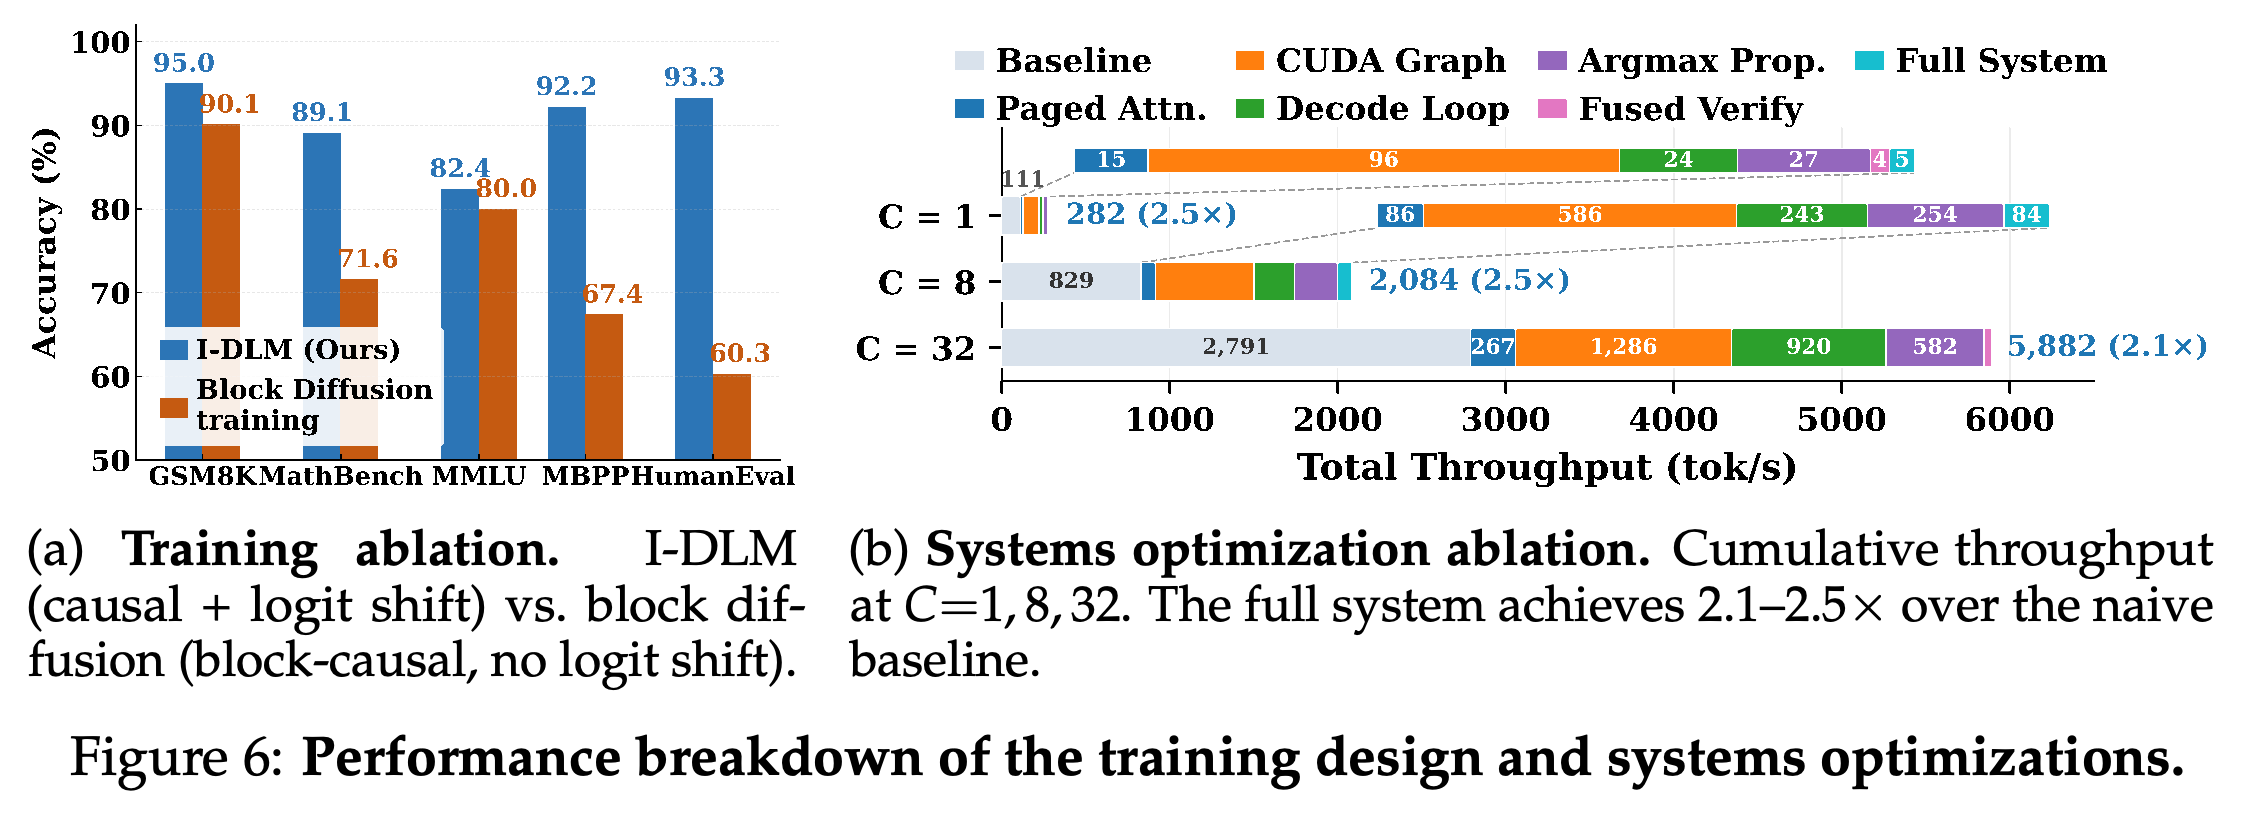
Table 3은 H100 1개와 배치 크기 1에서 stride를 측정한다. N을 2에서 8로 늘리면 TPF는 1.80에서 4.01로, TPS는 209.6에서 445.1로 증가한다. 반면 MATH-500은 96.8에서 94.6으로, MBPP는 93.4에서 88.3으로 감소한다.
- N=4에서 표는 TPF=2.96, TPS=324.5, MATH-500=96.8, MBPP=92.2를 보고한다.
- 더 큰 stride의 checkpoint에는 추가 학습을 수행한다. 따라서 동일한 가중치에서 추론 시 stride만 바꾼 실험은 아니다.
- 결과는 속도 향상에 측정 가능한 품질 저하가 따르며, 특히 MBPP에서 그 저하가 크다는 점을 보여준다. TPF는 상당히 증가하지만 stride에 정비례하지는 않는다.
더 큰 stride로 학습하면 forward당 토큰 수와 단일 요청 속도가 증가하지만, N=8에서는 특히 MBPP의 품질이 낮아진다. Stride 확장에 추가 학습이 포함되므로, 각 행은 추론 파라미터만 바꾼 효과를 분리하지 못한다.
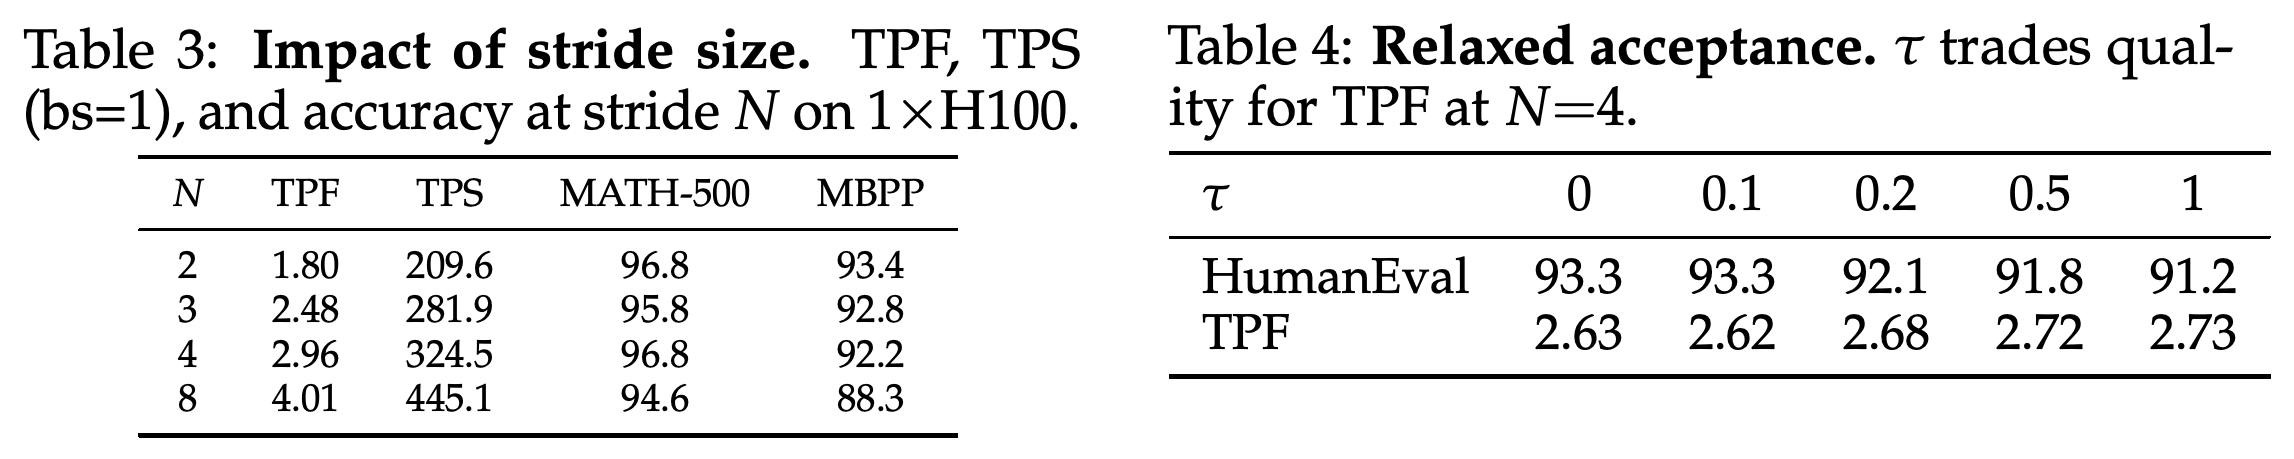
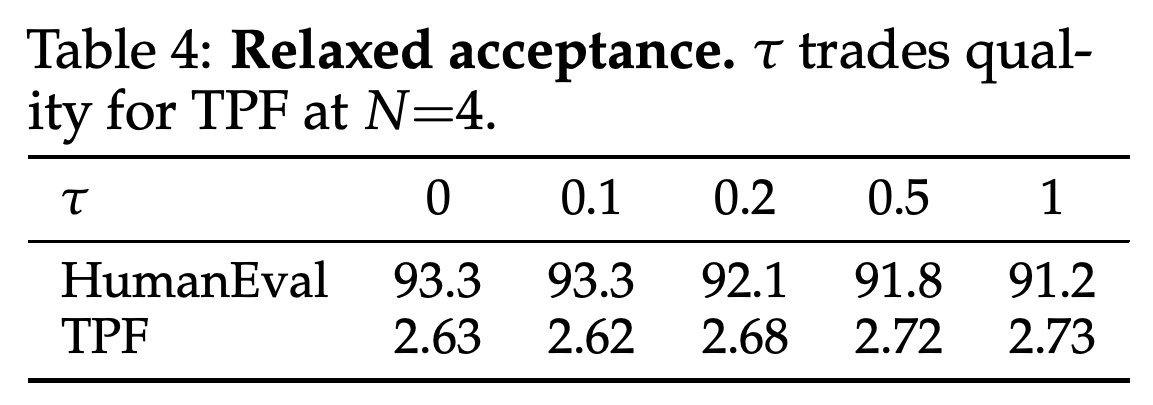
Table 4는 N=4에서 수락 규칙에 쓰이는 확률비에 1+τ를 곱해 수락 조건을 완화한다. τ=0에서 τ=1로 바꾸면 TPF는 2.63에서 2.73으로 증가하고 HumanEval은 93.3에서 91.2로 감소한다. 이는 2.1점 감소지만, 본문은 1.6점이라고 서술한다.
- τ=0.1에서 HumanEval은 93.3을 유지하며, TPF는 2.62로 strict 설정보다 조금 낮다.
- 수락 규칙을 완화하면 정확한 목표 분포 보존을 포기하게 된다. 측정된 TPF 증가는 strict 설정 대비 크지 않다.
수락 규칙을 τ=0에서 τ=1로 완화하면 TPF는 0.10 증가하고 HumanEval은 2.1점 감소한다. 측정된 이득은 크지 않으며, 점수 차이는 본문에 명시된 1.6점 감소와 일치하지 않는다. 완화된 검증은 더 이상 정확한 목표 분포를 보존하지 않는다.
5 Conclusion
결론은 introspective consistency를 AR 모델의 causal 예측 구조를 유지하면서 병렬 생성기로 변환하는 원리로 제시한다. 결과는 주요 diffusion baseline보다 훨씬 높은 품질과 동시 요청을 처리하는 서빙에서 더 높은 처리량을 보여준다. 원래 base AR 분포의 정확한 보존은 gated R-ISD 구성에만 해당한다.
부록
- A Detailed Related work는 masked diffusion 모델, AR-to-diffusion 변환 방법, speculative decoding, multi-token prediction, DLLM 전용 가속 기법과 관련해 I-DLM의 위치를 설명한다. I-DLM은 별도의 draft 모델이나 confidence만으로 판단하는 수락 방식 대신, 공유 모델의 causal 검증, shifted masked 제안, 서빙과 호환되는 실행을 결합한다.
- B TPF and Compute Overhead Analysis와 B.1 ISD (Ours)는 제안 전용 step 이후 검증과 제안을 함께 수행하는 step이 이어지는 renewal cycle의 기댓값을 유도한다. 균일한 수락 확률 p에서 TPFISD = (2+p+⋯+p^(N−2))/(2−p^(N−1))이다. 오버헤드는 variable query에서 (3N−1−Np^(N−1))/(2+p+⋯+p^(N−2)), fixed query에서 (2N−1)(2−p^(N−1))/(2+p+⋯+p^(N−2))이다.
- B.2 Block Diffusion (SDAR)는 commit forward를 포함해 TPF=N/(E[S|N]+1), OH=E[S|N]+1을 제시한다. B.3 Branched Self-Speculative Decoding (TiDAR)는 forward당 N(N+1)개의 query를 사용하며 TPF=1+p+⋯+p^(N−1)을 제시한다. B.4 Summary는 이 공식을 Table 5에 모아 정리한다. 모든 제안이 수락될 때 TiDAR의 TPF/OH는 N/(N+1)이고, 분석한 방식에서 SDAR은 forward당 N/2 토큰으로 제한된다.
- C Why Block Diffusion Requires a Separate KV Commit Pass는 평가에 사용한 SGLang 구현의 캐시 기록 pass를 설명하고 https://github.com/sgl-project/sglang/pull/19044 링크를 제공한다. Commit과 denoising을 융합하려면 위치별로 다른 attention 패턴, 더 큰 query, 더 복잡한 batching이 필요하다. 이는 조사한 커널에서의 구현상 장애를 설명하며, 모든 block-diffusion 시스템에서 불가능하다는 결과는 아니다.
- D Attention Kernel Overhead는 3개 커널로 이어지는 attention 연산과 이를 layer당 paged 커널 1개로 대체하는 방식을 분석한다. E Attention Mask Structure는 학습 mask를 noisy self-attention, noisy-to-clean cross-attention, clean self-attention으로 분해한다. 앞선 clean 블록은 masked 블록에 문맥을 제공한다.
- F ISD Step-by-Step Illustration은 Figure 9로 모든 제안이 수락된 뒤의 연속 실행과 거절 후 복구를 보여준다. G Lossless ISD with Gated LoRA는 (h_j\leftarrow Wx_j+\mathbf{1}_{[j\in\mathcal{M}]}BAx_j)를 설명한다. Mask 위치에만 LoRA residual을 적용하고, clean 위치는 base만 사용하는 anchor를 유지한다. Table 6과 Figure 10은 이 분리를 보여주지만, Figure 10은 residual을 방정식의 BAx 대신 ABx로 표기한다.
- H Training, Serving, and Evaluation Details와 H.1 Training Setup은 학습 코드베이스로 https://github.com/JetAstra/SDAR 링크를, 데이터셋으로 생성된 추론 응답 4.5B 토큰을 명시한다. 8B 학습은 N=2 이후 N=3 순서로 2 epochs 동안 진행하고, 32B 학습은 rank-1024 LoRA로 N=2에서 1 epoch 동안 진행한다. 일반 hyperparameter는 learning rate 1×10^-5, cosine decay, warmup ratio 0.03, effective batch size 32, sequence length 4096, bf16이다. 추가 lossless adapter는 rank 128과 learning rate 2e-4를 사용한다.
- H.2 Hardware와 H.3 Serving Configuration은 H100 80GB SXM, NVLink, CUDA 12.9, FlashInfer, SGLang을 명시하며, 공통 설정으로 mem-fraction-static=0.85, attention-backend=flashinfer, disable-radix-cache=true를 사용한다. Tables 7–9는 blockN3, blockN5, gated-LoRA 구성과 EAGLE-3를 나열한다. EAGLE-3의 draft identifier는 Tengyunw/qwen3 8b eagle3이며 설정은 steps=3, topk=1, d=4다. 32B lossless 서빙 행은 rank 1024를 명시해, H.1에서 설명한 rank-128 추가 lossless adapter와 다르다.
- H.4 Evaluation Configuration은 Table 10에 벤치마크별 문제 수, 답변 추출, baseline 재현 정보를 제공한다. H.5 Throughput Benchmark Configuration은 https://github.com/sgl-project/genai-bench 링크를 제공하고 Table 11에 burst-mode 측정 조건을 명시한다. H.6 Infrastructure Ablation Configuration은 Table 12에 서빙 옵션을 나열한다. 보고된 실험은 H100 1개에서 C=1, 8, 32를 사용해 최적화를 누적해서 추가한다.
- I Additional Results와 I.1 Peak Throughput on Different Hardware는 낮은 동시성과 긴 생성 길이의 유리한 조건에서 측정한 결과를 Table 13에 보고한다. 나열된 최대 속도는 GSM8K에서 B200 GPU 2개와 N=8을 사용한 925 TPS, MBPP에서 H100 GPU 2개와 N=8을 사용한 685 TPS, MATH-500에서 H100 1개와 N=4를 사용한 341 TPS를 포함한다. 표는 MATH-500에서 N=3 I-DLM-8B의 272 TPS와 rank-128 R-ISD의 240 TPS도 보고한다. 이는 구성별 최대 속도이며 일반적인 서빙 속도는 아니다.
짧은 생각
이 논문의 기여는 causal anchor를 중심으로 학습, 검증, 서빙을 일관되게 설계한 데 있다. 품질 표, 학습 요소를 함께 바꾼 ablation, 동시성 곡선은 강력한 AR 모델에 병렬 제안을 추가하는 실용적인 방법으로 이 설계를 뒷받침한다. 다만 introspective consistency가 기존 DLM의 품질 격차를 설명하는 유일한 원인임을 입증하지는 않는다.
논문의 포괄적인 동등 성능 및 무손실 주장은 조건을 구분해 해석해야 한다. 일부 과제에서는 여전히 AR보다 성능이 낮고, baseline 결과에는 재현 측정과 기존 발표 결과가 섞여 있으며, 분포 보존만으로 동일한 샘플 시퀀스를 보장하지는 않는다. 본문과 부록은 일부 점수, stride 규칙, loss 일정, adapter 구성에서도 차이가 있다. 학습 요소별 ablation, 불확실성 추정, 일관된 구성 보고, 고정 길이 burst 이외의 서빙 실험이 이러한 한계를 해소하는 데 도움이 된다.