Minerva 논문 설명(Solving Quantitative Reasoning Problems with Language Models)
10 Jul 2022 | Mathematical Reasoning Minerva Paper Review목차
- 요약
- 1. Introduction
- 2. Training and Evaluation
- 3. Results
- 4. Performance Analysis
- 5. Memorization
- 6. Conclusions and Discussion
- 부록
- 짧은 생각
Google Research의 Minerva는 수식 표기를 보존한 기술 문서로 언어 모델을 추가 학습하고, 여러 풀이의 최종 답에 다수결을 적용하여 수학·과학 문제 해결 성능을 높인 연구이다.
- 논문: Solving Quantitative Reasoning Problems with Language Models
- 저자: Aitor Lewkowycz, Anders Andreassen, David Dohan, Ethan Dyer, Henryk Michalewski, Vinay Ramasesh, Ambrose Slone, Cem Anil, Imanol Schlag, Theo Gutman-Solo, et al.
- 소속: Google Research
- 최초 공개: 2022년 6월 29일
- 설명 기준: arXiv v2 PDF, 2022년 7월 1일 개정판. 아래 성능과 비교 모델은 이 논문의 실험 시점을 기준으로 한다.
요약
- Minerva는 PaLM 8B·62B·540B에 수학 웹 문서와 arXiv 논문으로 continued pretraining을 수행한다. 자연어와 수학 기호를 함께 학습하여 정량적 추론 문제의 풀이를 생성한다.
- 웹 문서의 HTML 태그를 제거하면서 LaTeX 수식과 주변 설명을 보존한다. 이렇게 수집한 기술 코퍼스는 38.5B tokens이다.
- 추론할 때는 풀이가 포함된 few-shot 예제를 주고 여러 답변을 생성한다. 최종 답이 같은 풀이들을 묶어 가장 많이 나온 답을 선택한다.
- Minerva 540B의 MATH 정확도는 단일 greedy 답변에서 33.6%, 64개 풀이의 다수결에서 50.3%이다. 같은 표의 PaLM 540B 단일 답변은 8.8%이다.
- 대학 수준의 평가를 위해 MIT OpenCourseWare에서 272문제를 수집했다. Minerva 540B는 64개 풀이의 다수결로 이 문제의 30.8%를 맞혔다.
- 풀이 생성 중 계산기나 Python을 호출하지 않는다. 평가 시 최종 답의 수학적 동치 여부를 확인하는 데에는 SymPy를 사용한다.
- 최종 답이 맞아도 추론 과정이 틀릴 수 있다. 논문은 정답률과 별도로 풀이 오류와 문제·정답의 암기 가능성을 분석한다.
1. Introduction
정량적 추론 문제는 자연어 독해뿐 아니라 관련 지식의 회상, 식 세우기, 수치 계산, 기호 변환을 함께 요구한다. 문장을 자연스럽게 이어 쓰는 모델도 중간 계산 한 번을 틀리면 최종 답을 얻지 못한다.
이 논문은 문제와 풀이를 자연어 및 LaTeX로 표현하여 일반 언어 모델의 다음 토큰 예측 능력으로 다룬다. 외부 도구 없이 문제부터 답까지 완결된 풀이를 생성하게 한 뒤, 도메인 데이터와 모델 크기, 추론 시 샘플링이 각각 얼마나 도움이 되는지 살펴본다.
1.1 Our Contribution
Minerva의 주된 기여는 수학 표기와 자연어 설명을 함께 보존한 학습 데이터와 이를 이용한 대규모 추가 학습이다. 수학 경시대회 문제와 물리·화학의 서술형 문제에 모두 자연어와 LaTeX로 풀이를 생성한다.
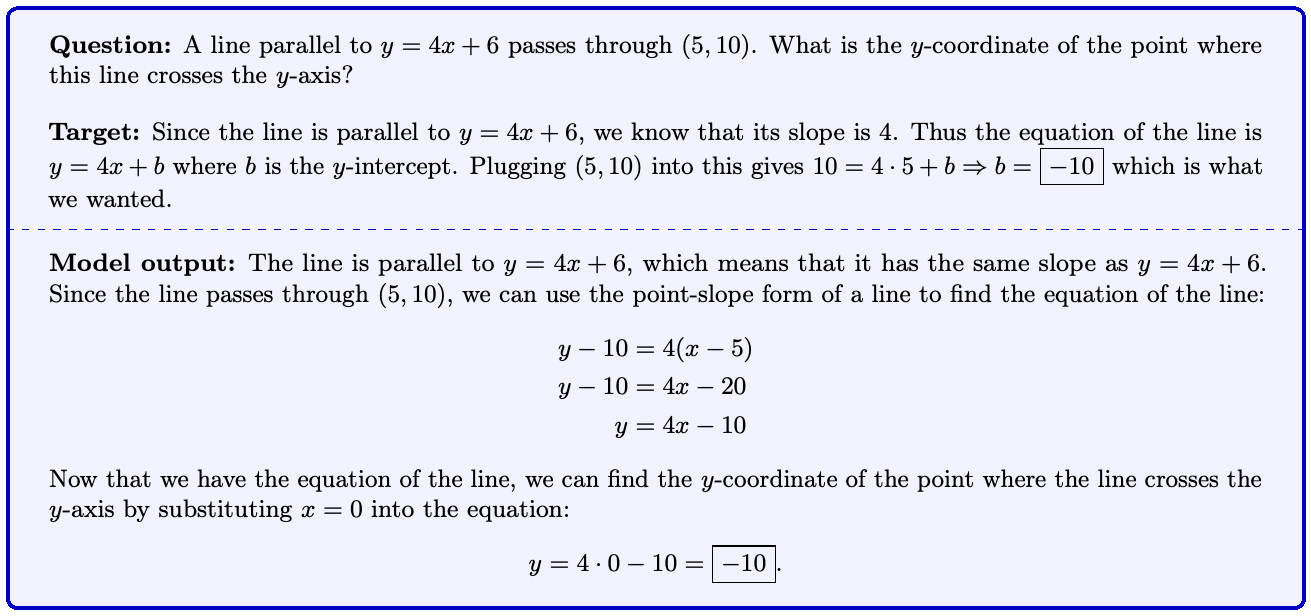
아래 예시는 직선의 기울기와 한 점을 이용해 절편을 구한 결과이다. 모델은 정답 풀이와 다른 순서로 식을 전개하면서도 같은 답에 도달한다. 논문은 이런 사례와 별도로 전체 벤치마크 성능을 측정한다.
또한 수학 문제집을 넘어선 평가를 위해 MIT OpenCourseWare에서 대학 수준 STEM 문제를 수집한다.
1.2 Related Works
논문은 scratchpad와 chain-of-thought처럼 중간 과정을 출력하게 하는 연구, 여러 후보를 생성한 뒤 선택하는 연구와 연결된다. 특히 답변 다수결은 별도로 학습한 verifier 없이도 사용할 수 있는 추론 방법이다.
코드 생성 모델은 Python이나 수학 라이브러리에 계산을 맡길 수 있고, Lean·Coq 같은 형식 체계는 증명의 유효성을 기계적으로 검사할 수 있다. Minerva는 자연어로 풀이를 생성하는 능력을 직접 측정한다. 저자들은 이 접근들이 서로 보완될 수 있다고 설명한다.
2. Training and Evaluation
기본 실험은 기술 문서로 추가 학습한 모델을 MATH·GSM8K 등의 few-shot 문제로 평가한다. 해당 평가셋의 풀이로 지도 미세조정하는 실험은 부록에서 별도로 다룬다.
2.1 Mathematical Training Dataset
수학 관련 웹 페이지와 arXiv 논문에서 모은 기술 코퍼스는 합계 38.5B tokens이다. 여기에 PaLM이 원래 학습했던 일반 자연어 데이터를 섞는다.
| 데이터 출처 | 학습 혼합 비중 | 원본 코퍼스 토큰 수 | 역할 |
|---|---|---|---|
| Math Web Pages | 47.5% | 17.5B | 수학 설명, 예제 및 수식을 함께 학습한다. |
| arXiv | 47.5% | 21.0B | 과학·수학 분야의 기술 문서를 학습한다. |
| General Natural Language Data | 5% | 100B 초과 | 일반 자연어 데이터를 계속 노출한다. |
혼합 비중은 학습 시 샘플링 비율이고, 오른쪽 토큰 수는 각 데이터 소스의 크기이다.
웹 문서는 MathJax 수식을 포함하는 페이지에서 수집한다. HTML 태그를 정리하면서 수학 기호와 LaTeX 형식을 남기므로, 모델이 식과 주변 설명을 함께 학습할 수 있다.
2.2 Models and Training Procedure
PaLM의 decoder-only Transformer를 초기값으로 사용하고 autoregressive objective로 추가 학습한다. 즉 앞부분의 토큰을 보고 다음 토큰을 예측하는 기본 학습 방식은 유지한다.
| 모델 | 실제 파라미터 수 | 추가 학습 토큰 수 |
|---|---|---|
| Minerva 8B | 8.63B | 164B |
| Minerva 62B | 62.50B | 109B |
| Minerva 540B | 540.35B | 26B |
추가 학습 토큰 수는 같은 데이터를 반복해서 읽은 횟수까지 포함한 누적량이다. 540B 모델은 작은 모델보다 적은 토큰을 추가 학습했지만 더 높은 성능을 보였다. 모델별 학습량이 다르므로 이 결과에서 파라미터 수만의 효과를 분리할 수는 없다.
2.3 Evaluation Datasets
평가 입력은 왼쪽을 잘라 최대 1,024 tokens로 맞추고, 답변은 최대 512 tokens를 생성한다. 단일 답변은 greedy decoding을 사용한다. 여러 답변을 만들 때는 temperature 0.6, nucleus sampling의 $p=0.95$를 사용한다.
| 평가셋 | 측정 대상 | 프롬프트 및 채점 |
|---|---|---|
| MATH | 대수·기하·정수론 등 수학 문제 해결 | 고정된 4-shot 풀이 예제를 사용하고 최종 답을 채점한다. |
| GSM8K | 여러 계산 단계를 거치는 수학 문장제 | 기존 chain-of-thought 프롬프트를 사용하며 계산기를 호출하지 않는다. |
| MMLU-STEM | 과학·기술·공학·수학 분야 지식과 추론 | 기본 5-shot 평가와 풀이를 생성한 뒤 다수결하는 평가를 구분한다. |
| OCWCourses | 대학 수준 STEM의 수치·기호 문제 | 최종 답이 수치 또는 기호로 검증되는 문제를 평가한다. |
정답은 문자열이 똑같은지만 비교하지 않는다. 예를 들어 $1/\sqrt{3}$과 $\sqrt{3}/3$은 표기가 달라도 같은 답이므로 SymPy로 동치성을 검사한다. 이 검사는 최종 답을 평가하기 위한 것이며 모델의 중간 추론을 증명하지는 않는다.
2.4 Undergraduate-Level STEM Problems
OCWCourses는 MIT OpenCourseWare에서 정리한 272문제이다. 이 가운데 191문제는 수치 답, 81문제는 기호 답을 갖는다. 미분방정식, 고체화학, 정보와 엔트로피, 특수상대성이론 등 여러 과목을 포함한다.
문제는 외부 문맥 없이 읽을 수 있도록 정리하고 최종 답을 분리했다. 증명 문제와 답을 자동 비교하기 어려운 개방형 서술 문제는 평가에서 제외했다.
2.5 Inference-Time Techniques
같은 문제에서 $k$개의 풀이를 샘플링하고, 각 풀이에서 최종 답을 추출한다. 추출·정규화한 최종 답을 기준으로 묶은 다음 가장 빈도가 높은 답을 고른다. 논문은 이를 maj1@k로 표시한다. 답을 선택하는 이 단계에서는 정답을 참조하지 않는다.
이 절차를 간단히 쓰면 다음과 같다. $a_i$는 $i$번째 풀이에서 추출하고 정규화한 최종 답이다.
\[\hat{a}=\operatorname*{arg\,max}_{a}\sum_{i=1}^{k}\mathbf{1}[a_i=a]\]같은 정답에 도달하는 풀이가 여러 개 존재할 수 있는 반면, 잘못된 답은 다양한 값으로 분산될 수 있다는 직관이다. 하지만 특정 오개념 때문에 같은 오답이 반복되면 다수결도 실패한다.
pass@k는 $k$개 중 정답이 하나라도 있으면 성공으로 센다. 정답을 참조해 후보들을 채점하는 지표이고, maj1@k는 다수결로 선택한 답을 채점하는 지표이다. $k$를 늘리면 출력 생성 비용과 지연도 늘어난다.
3. Results
아래는 원문 Table 3이다. 표의 Published SOTA는 2022년 논문에 실린 이전 연구의 기록이다. 위첨자 a·b·c는 각각 기존 GPT-2, PaLM 540B 다수결, Chinchilla 결과를 인용했다는 표시이다.
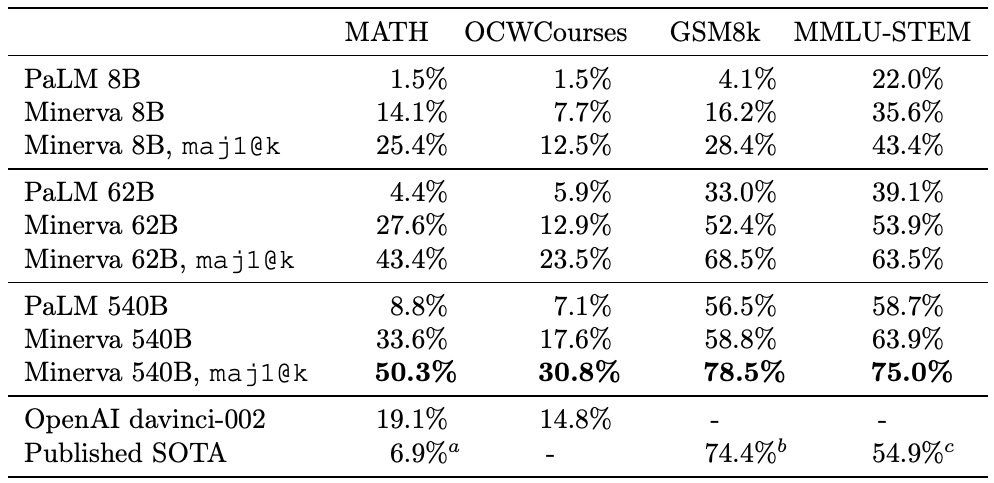
540B 모델의 주요 결과를 분리해서 보면 다음과 같다.
| 평가셋 | PaLM 540B 기본 평가 | Minerva 540B 기본 평가 | Minerva 540B 다수결 | 다수결 후보 수 |
|---|---|---|---|---|
| MATH | 8.8% | 33.6% | 50.3% | 64 |
| OCWCourses | 7.1% | 17.6% | 30.8% | 64 |
| GSM8K | 56.5% | 58.8% | 78.5% | 40 |
| MMLU-STEM | 58.7% | 63.9% | 75.0% | 16 |
MATH·OCWCourses·GSM8K의 기본 평가는 단일 greedy 답변이다. MMLU-STEM 기본 평가는 5-shot 선택지 점수 평가이고, 다수결 평가는 chain-of-thought 프롬프트로 여러 풀이를 생성한다. 따라서 마지막 행의 차이를 다수결 한 요소의 효과로만 해석하지 않는다.
MATH에서는 추가 학습으로 8.8%에서 33.6%가 되고, 여기에 다수결을 적용하면 50.3%가 된다. 반면 GSM8K는 기본 평가의 개선 폭보다 다수결 이후의 개선 폭이 크다. 데이터, 모델 크기, 추론 예산을 함께 명시해야 비교의 의미가 분명해진다.
3.1 Basic arithmetic
별도 산술 실험에서 Minerva 540B는 10자리 덧셈에서 80% 초과, 18자리 덧셈에서 20% 초과의 정확도를 보인다. 자릿수가 늘어나면서 계산 정확도가 낮아진다.
4. Performance Analysis
정답률만으로는 모델이 어떤 단계에서 실패하는지 알 수 없다. 논문은 풀이 오류와 최종 답만 우연히 맞는 사례를 따로 검토한다.
4.1 Model Mistakes
저자들은 두 모델의 다수결 최상위 답이 각각 최소 15%의 표를 얻은 문제 중 8B와 62B의 정오가 엇갈리는 216문제를 살펴본다. 62B가 맞고 8B가 틀린 201문제에서 주요 오류는 다음과 같다.
| 8B 모델의 오류 유형 | 사례 수 |
|---|---|
| 잘못된 추론 | 82 |
| 잘못된 계산 | 70 |
| 문제를 잘못 이해함 | 22 |
| 틀린 사실을 사용함 | 16 |
| 지나치게 짧은 풀이 | 4 |
| 존재하지 않는 수학적 대상을 만들어냄 | 4 |
| 기타 | 3 |
이 표의 조사 대상은 두 모델의 성패가 갈린 부분집합이다. 따라서 추론·계산 오류의 빈도는 이 201문제 안에서의 분포이며, 전체 MATH의 오류 분포는 별도로 조사해야 한다.
4.2 False Positives
이 절에서 false positive는 최종 답은 맞지만 풀이 과정이 틀리거나 불완전한 경우를 뜻한다. 분류기에서 음성 사례를 양성으로 오인하는 일반적인 FPR과는 문맥이 다르다.
MATH에서 난이도별 20문제씩 뽑은 100문제와 Minerva 62B의 greedy 답변을 사람이 검사한 결과, 최종 답이 맞은 사례 중 잘못된 풀이의 비율을 평균 약 8%로 추정한다. 이 표본에서는 어려운 문제일수록 해당 비율이 높았다.
Minerva 62B의 pass@256은 84.5%이지만, 정답 후보가 단 하나만 나온 경우에는 우연히 최종 답이 맞았을 가능성이 섞인다. 저자들은 다수결에는 실패하고 단일 정답 후보 덕분에 pass@256만 통과한 사례를 따로 검사한다. 따라서 높은 pass@k를 곧바로 안정적인 풀이 능력으로 해석할 수 없다.
5. Memorization
저자들은 학습·평가 문항의 중복, 문항 변형 후 성능, 생성한 풀이와 정답 풀이의 유사도로 암기 가능성을 조사한다.
5.1 Training and Evaluation Dataset Overlap
62B 모델이 높은 다수결 비율로 맞힌 100문제를 골라 Math Web Pages의 500자 구간들과 BLEU 유사도를 비교한다. 유사도가 높은 250개 문서 구간을 수동 확인했을 때 조사 대상 문제와 일치하는 사례는 찾지 못했다.
조사 범위는 선택한 100문제와 Math Web Pages이며, PaLM의 전체 사전학습 자료는 이 비교에 포함되지 않는다.
5.2 Performance on Modified MATH Problems
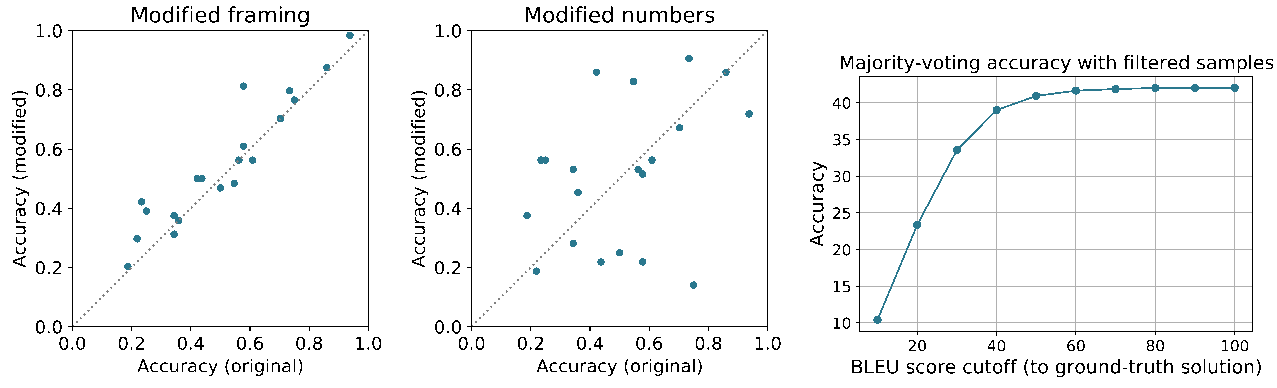
다수결로 맞힌 20문제를 뽑아 문장 표현을 바꾸거나 숫자와 그에 따른 정답을 수정한다. 원래 문제와 수정 문제의 샘플별 정답률은 상관관계를 보였고, 원래 문항에만 일관되게 유리한 편향은 관찰되지 않았다.
5.3 BLEU Score Between Ground Truth and Generated Solutions
MATH의 각 문제에서 256개 답변을 생성하고 정답 풀이와의 BLEU 유사도를 조사한다. 유사도가 높은 출력을 제거한 뒤에도 다수결 성능이 유지되는지를 측정한다.
일정 수준까지 유사도 기준을 낮춰도 성능이 유지되므로, 저자들은 정답 풀이의 문자적 복제만으로 전체 성능을 설명하기는 어렵다고 해석한다. 이 검사는 BLEU로 포착할 수 있는 표현 중복을 대상으로 한다.
6. Conclusions and Discussion
Minerva는 PaLM에 기술 코퍼스를 추가 학습하여 수학·과학 문제의 정확도를 높였다. 추론 시 여러 풀이에 다수결을 적용하면 정확도가 더 높아졌으며, 개선 폭은 평가셋에 따라 달랐다.
6.1 Limitations of Our Approach
- 최종 답 채점과 달리 전체 추론의 정당성을 자동 검증하지 못한다.
- 계산기나 인터프리터가 없으므로 복잡하거나 긴 수치 계산에서 오류가 발생한다.
- 대규모 코퍼스를 학습한 결과이기 때문에 어떤 세부 능력이 언제 형성됐는지 직접 제어하기 어렵다.
- 다수결의 추가 비용과 benchmark별 후보 수 차이를 고려해야 한다.
6.2 Societal Impact
논문은 수학 교육을 지원하는 도구로서의 활용 가능성과 오답·잘못된 설명에 따른 위험을 논의한다. 학습자에게 제시할 풀이의 검증이 과제로 남아 있으며, 교육 효과를 측정한 실험은 포함하지 않는다.
부록
부록 A–C는 저자별 기여, 데이터 수집·전처리, 모델과 추가 학습 절차를 설명한다. D–H는 MATH·OCWCourses·MMLU-STEM의 프롬프트와 채점 방식, 추가 평가, 산술 실험을 다룬다. I에는 정답·오답 풀이 사례와 오류 분류가, J에는 학습 문항 중복·문항 변형·풀이 유사도 분석의 세부 절차가 실려 있다.
짧은 생각
수식 보존 전처리가 Minerva의 성능에 얼마나 기여했는지는 더 분리해서 보고 싶다. PaLM과 Minerva의 비교에서는 학습 문서의 분야와 추가 학습량도 함께 바뀐다. 같은 문서를 같은 토큰 예산으로 학습하되 수식 표기를 보존한 조건과 제거한 조건을 비교하면, 성능 차이가 문서의 전문 지식에서 오는지 수학 표기에서 오는지 판단하는 데 도움이 될 것이다.
다수결을 평가할 때는 최종 답이 맞은 풀이의 오류에도 관심이 간다. 저자들은 정답을 얻고도 풀이가 잘못된 사례를 발견했지만, 주된 성능표는 최종 답의 정확도를 보고한다. 같은 후보 집합에서 다수결로 선택한 최종 답을 낸 풀이들의 정당성까지 채점하면, 높아진 정답률이 설명을 신뢰할 수 있는 정도와 얼마나 함께 움직이는지 확인할 수 있다.