


OPRD: On-Policy Representation Distillation 요약 설명
04 Jun 2026 | Paper Review On-Policy Distillation Representation Distillation Mathematical Reasoning목차
- 요약
- 1 Introduction
- 2 Background and Problem Setup
- 3 On-Policy Representation Distillation
- 4 Experiments
- 5 Discussion
- 6 Related Work
- 7 Conclusion and Future Work
- 부록
- 짧은 생각
이번 글에서는 OPRD: On-Policy Representation Distillation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 4일(Arxiv), Preprint
- Yang, Shenzhi, Zhu, Guangcheng, Song, Bowen, Wang, Haobo, Xia, Mingxuan, Zheng, Xing, Ma, Yingfan, Chen, Zhongqi, Wang, Weiqiang, Zhao, Junbo, et al.
- Zhejiang University, Ant Group
- 논문 링크
- Github
요약
- OPRD: On-Policy Representation Distillation은 학생이 생성한 응답에서 다음 토큰 분포 대신 중간 은닉 상태를 맞춘다. LM-head 출력에서만 감독 신호를 추출하지 않고, 교사의 계층별 표현을 직접 활용한다.
- 표현이 정렬된 R1-distill-1.5B 학생과 JustRL-1.5B 교사를 사용하면, OPRD-Vanilla는 AIME24, AIME25, AIMO에서 Avg@16 49.8%, 34.6%, 79.1%를 달성한다. 교사와의 격차는 각각 1.0, 1.0, 0.4%p다. 8×A100 (80G)에서 optimizer step 500회에 걸리는 시간은 OPD top-16의 812분에서 563분으로 줄고, actor 업데이트 중 일시적으로 증가하는 메모리는 GPU당 45.0 GB에서 20.5 GB로 줄어든다.
- OPRD-Bridge는 계층별 저랭크 projector를 고정해 이종 모델에도 방법을 확장하며, 아키텍처와 tokenizer가 다른 모델 간 전이를 보고한다. 서로 다른 아키텍처를 사용한 실험에서는 sampled-token OPD와 Best@16이 같지만 Avg@16은 낮다. 가장 뚜렷한 장점은 응답이 짧고 어휘 반복이 적다는 점이다.
1 Introduction
서론은 sampled-token OPD의 토큰 샘플링 잡음과 출력 공간 목적함수에 중간 표현을 직접 감독할 목표가 없다는 점에서 OPRD의 필요성을 설명한다. OPRD는 학생이 생성한 궤적을 유지하되, 교사 감독 신호를 추출하는 위치를 바꾼다.
- OPRD-Vanilla에는 서로 비교할 수 있는 표현 좌표가 필요하다. 실험에서는 학생의 원래 checkpoint를 RL로 학습해 교사를 만들어 이 조건을 확보한다. 아키텍처가 같다는 사실만으로 표현 좌표를 비교할 수 있는 것은 아니다.
- OPRD-Bridge는 깊이, 너비, 학습 이력이 달라 은닉 상태에 직접 MSE를 적용하기 어려울 때 공통 표현 인터페이스를 학습한다.
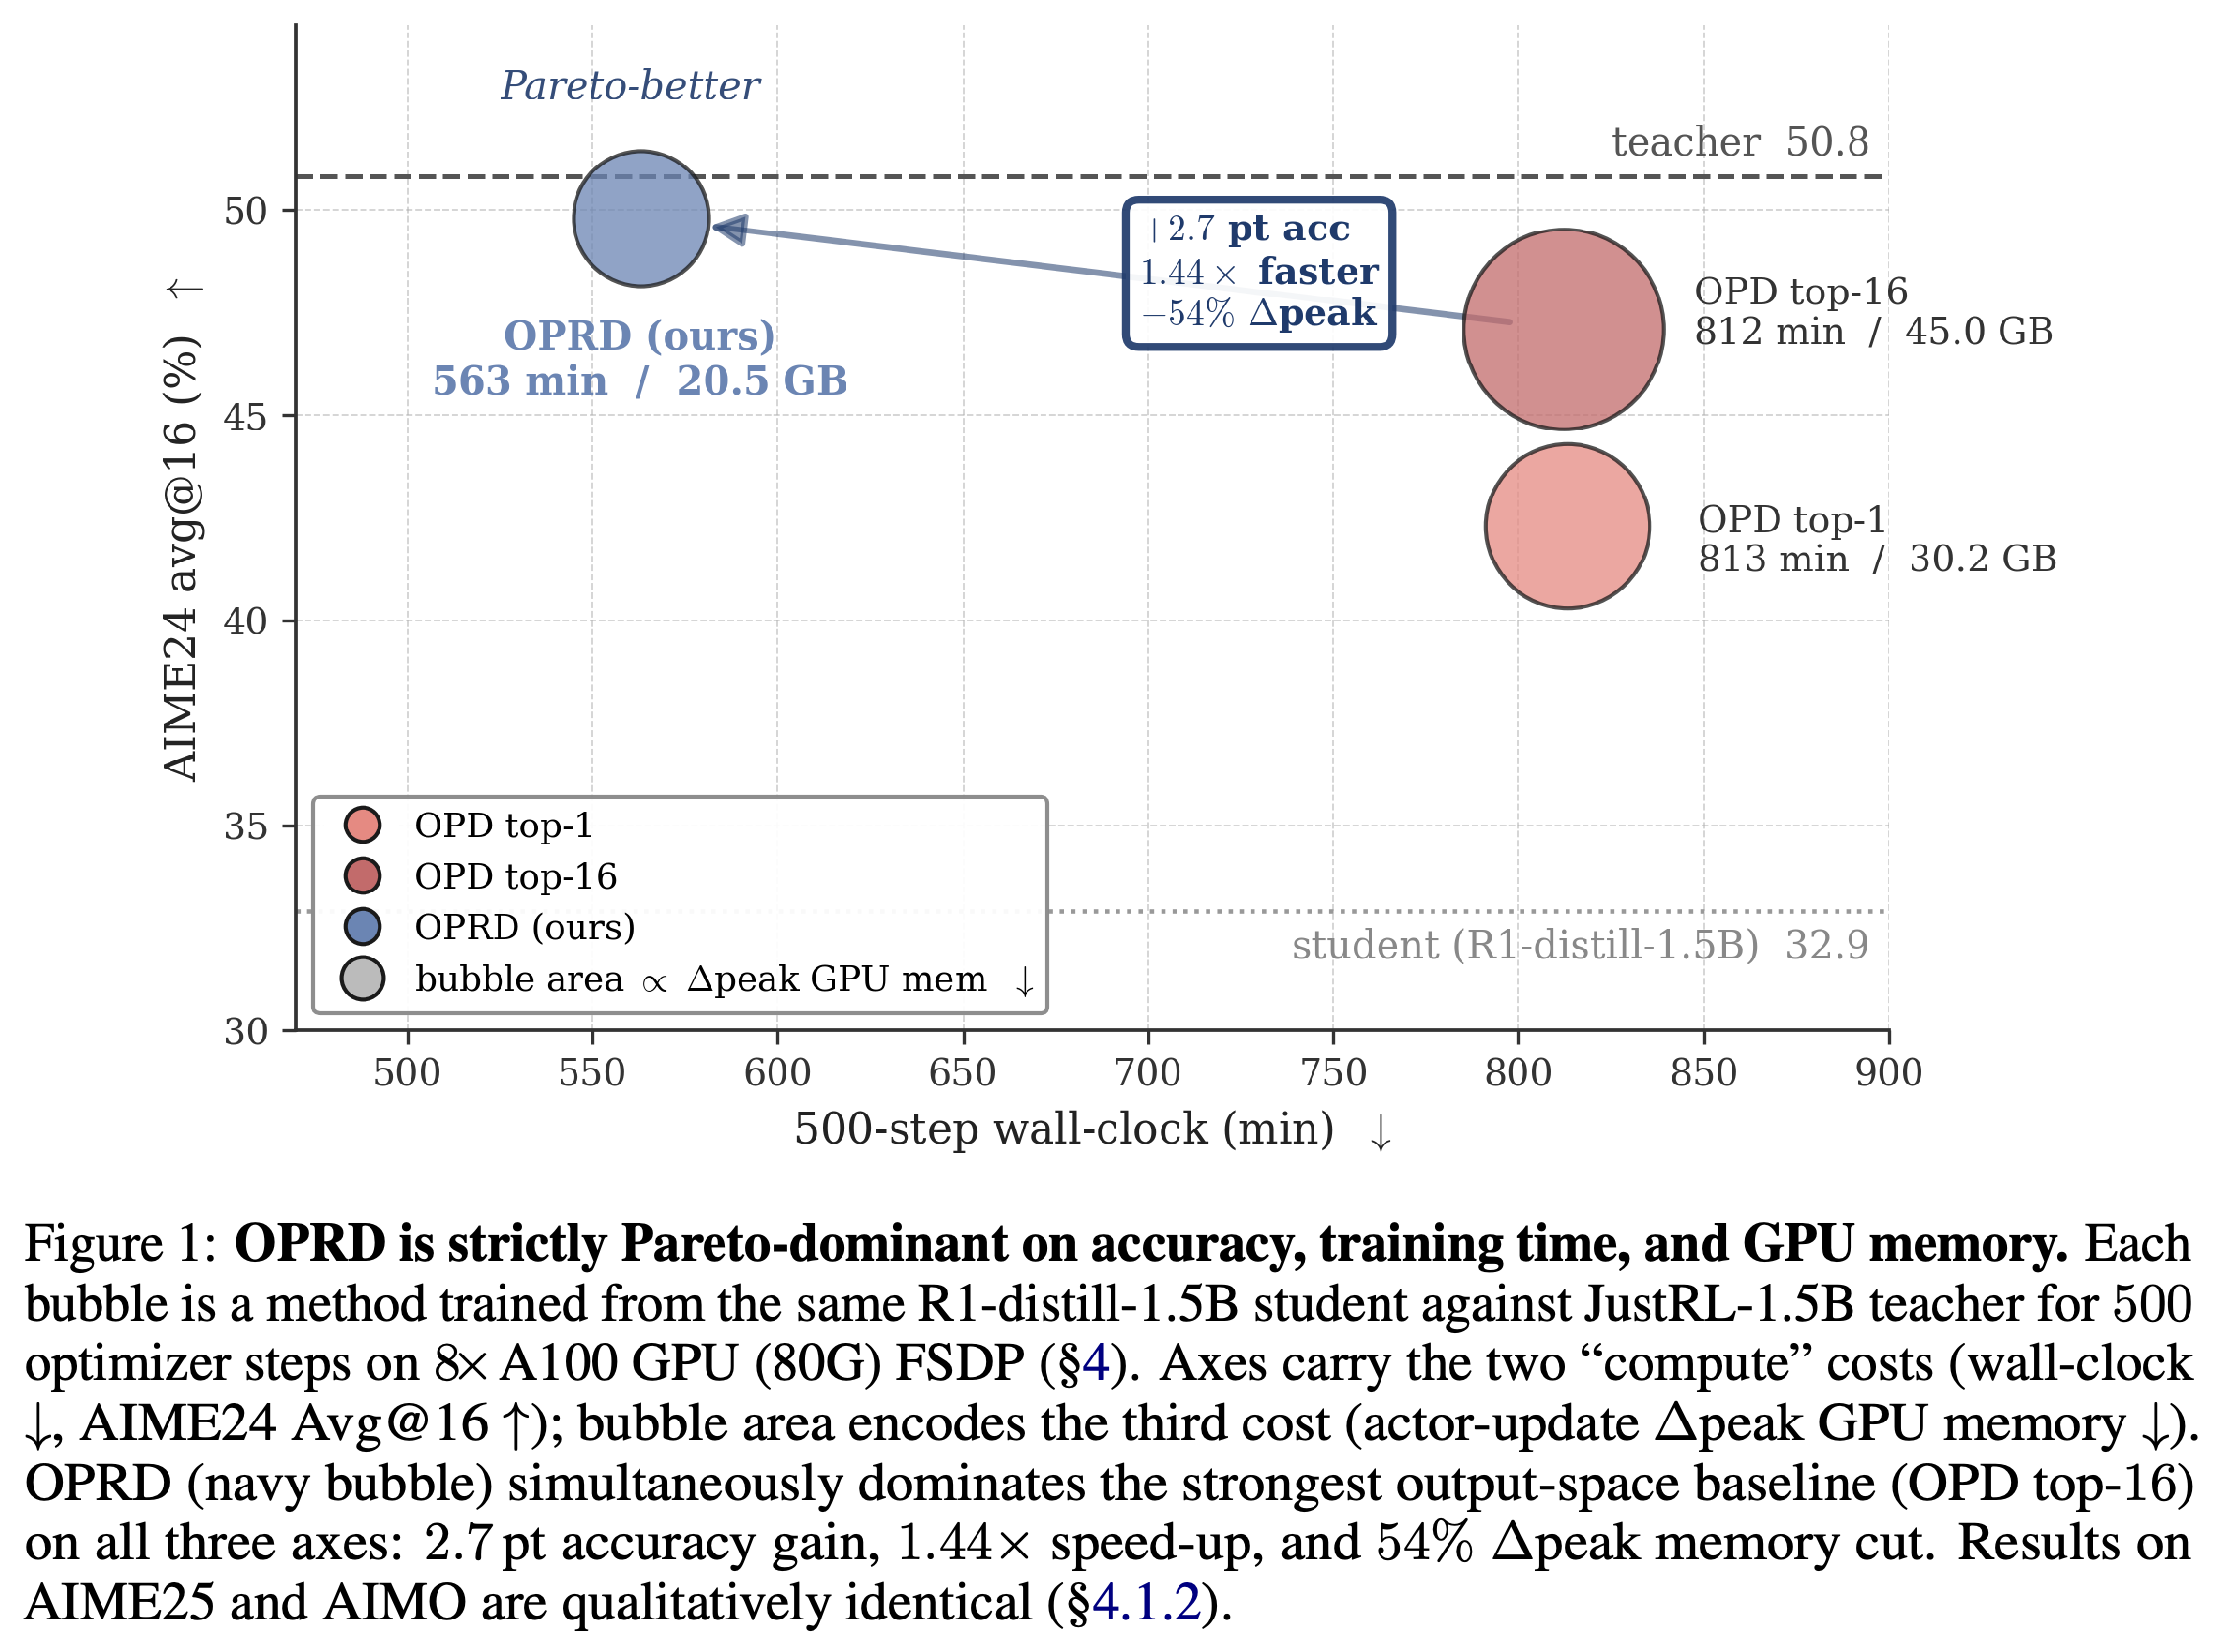
- 구현은 https://github.com/ShenzhiYang2000/OPRD 에 공개되어 있다. Figure 1은 동일 아키텍처에서 측정한 정확도, 시간, 일시적 메모리 사용량의 절충 관계를 요약한다.
OPRD는 평가한 OPD baseline보다 AIME24 정확도가 높고 실행 시간이 짧으며 일시적 메모리 사용량도 적다. 이는 표현이 정렬된 1.5B 모델 쌍과 500-step 설정에서 측정한 Pareto 개선이며, 모든 아키텍처에 대한 일반적인 결과는 아니다.
2 Background and Problem Setup
배경 절은 on-policy 샘플링과 감독 공간의 선택을 구분한다. 어휘를 공유하는 학생과 교사 모델을 정의하고, sampled-token, full-vocabulary, top-k 출력 목적함수를 비교한다. 이 방법들이 모두 다음 토큰 분포에 의존한다는 점도 설명한다.
2.1 Notation
학생 정책 πθ의 매개변수 θ는 학습 대상이며, 교사 πT는 고정한다. 두 모델은 같은 프롬프트와 샘플링된 응답 prefix를 처리한다. 중간 은닉 상태는 transformer 계층과 응답 위치로 구분한다.
- L과 d는 공유하는 transformer 깊이와 은닉 차원을 나타낸다. LS, LT, dS, dT는 이종 모델의 깊이와 은닉 차원을 구분한다.
- LM head는 마지막 은닉 상태를 어휘 logits으로 변환한다. 어휘 공유 가정은 초기 OPD 설정에 적용되며, 모든 OPRD-Bridge 실험에 적용되는 것은 아니다.
2.2 The On-Policy Distillation Framework
각 학습 단계에서 학생이 응답을 샘플링하고, 학생이 방문한 prefix에서 교사의 출력을 계산한다. 기본 OPD 목적함수는 학생과 교사의 다음 토큰 분포 사이에서 토큰별 reverse KL을 합한 값의 기댓값이다.
- 학생이 생성한 prefix를 사용하면 고정된 교사 궤적에서 발생하는 학습과 추론 사이의 불일치를 줄일 수 있다.
- 정확한 reverse KL은 응답의 각 위치에서 전체 어휘에 걸친 합을 계산해야 하므로, 어휘가 클 때는 근사가 필요하다.
2.3 Three Output-Space Variants
Sampled-token OPD는 생성한 토큰의 학생과 교사 간 로그 확률 비율로 reverse KL을 추정한다. Full-vocabulary OPD는 전체 어휘에 걸친 발산을 정확히 계산하고, top-k OPD는 학생이 가장 높은 확률을 부여한 토큰으로 감독 범위를 제한한다. 각 방식은 토큰 샘플링 분산, 어휘 크기에 비례하는 계산량, 지지집합 절단 사이에서 절충한다.
- Eq. (5)는 선택한 지지집합에서 재정규화한 분포로 top-k KL을 정의한다.
- 반면 실험 설정은 재정규화 없이 top-16 토큰의 로그 비율을 확률로 가중해 합한다고 명시한다. 따라서 공식 목적함수와 실험에서 평가한 목적함수가 다르다.
- 재정규화한 Eq. (5)에서 원소가 하나인 지지집합의 KL은 0이다. 따라서 논문이 제시한 유사성과 달리 sampled-token 로그 비율 목적함수로 환원되지 않는다.
2.4 A Shared Structural Limitation
출력 공간의 3가지 변형은 모두 다음 토큰 분포를 비교하며, 중간 은닉 상태에는 별도의 목표를 제공하지 않는다. 논문은 softmax 불변성과 일부 LM-head 방향의 낮은 민감도로 인해 출력이 일치해도 표현이 일치한다고 보장할 수 없다고 주장한다.
- 가장 명확한 구조적 차이는 마지막 출력만이 아니라 여러 중간 계층을 직접 감독한다는 점이다.
- 행이 많은 LM-head 행렬도 열 완전계수일 수 있다. 따라서 d가 어휘 크기보다 훨씬 작다는 사실만으로 은닉 상태에 비자명한 영공간이 있다고 결론 내릴 수 없다.
3 On-Policy Representation Distillation
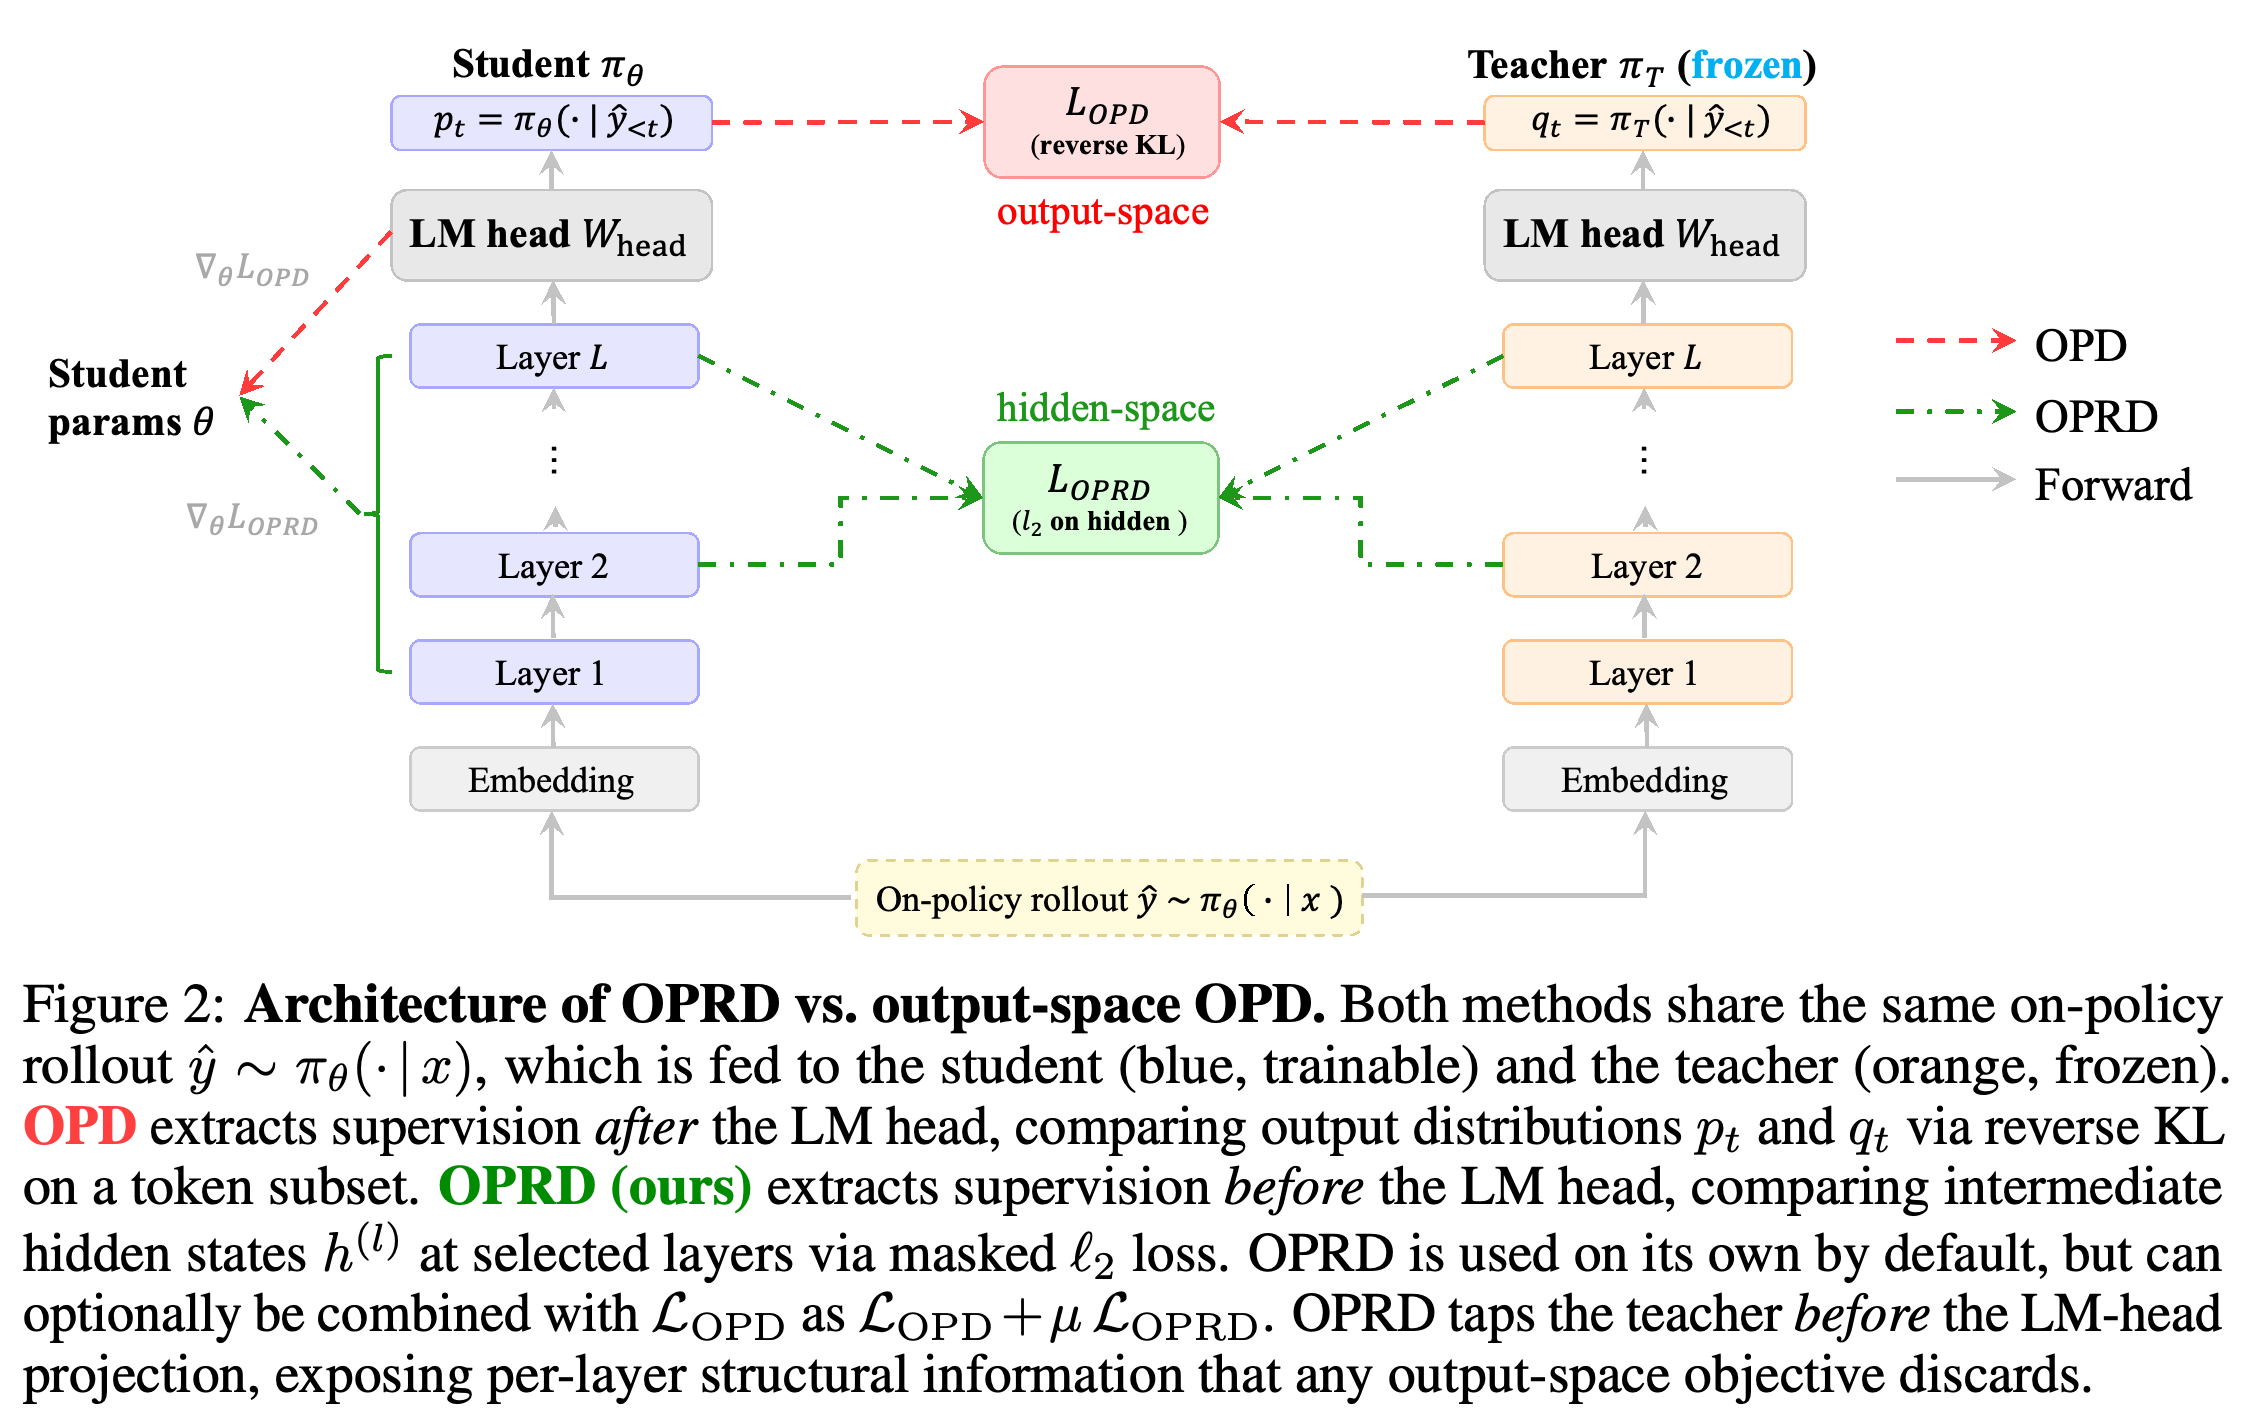
OPRD는 같은 on-policy 시퀀스에서 LM head 이전의 학생과 교사 은닉 상태를 선택해 비교한다. Figure 2는 은닉 공간 손실의 계산 경로와 출력 공간 reverse KL의 계산 경로를 구분한다.
- OPRD의 핵심은 계층별 목표를 제공하고, 고정된 rollout의 MSE gradient에 토큰 샘플링으로 인한 추가 무작위성을 도입하지 않으며, 학생의 증류 손실 경로에서 어휘 크기의 tensor를 피한다는 점이다.
- OPRD-Vanilla는 은닉 상태를 직접 맞추고, OPRD-Bridge는 고정된 저랭크 인터페이스를 통해 표현을 비교한다.
- OPRD는 단독으로 사용하거나, 같은 rollout과 교사 forward pass를 사용하는 OPD 목적함수에 추가할 수 있다.
두 네트워크는 학생이 생성한 같은 시퀀스를 처리한다. OPD는 LM-head 출력을 비교하고, OPRD는 선택한 중간 표현을 비교하며 학생을 통해서만 역전파한다.
3.1 The OPRD Objective
OPRD 목적함수는 선택한 계층과 유효한 감독 위치에서 학생과 교사의 은닉 상태 차이를 제곱해 평균한다. 1/d로 정규화하고 교사에는 stop-gradient를 적용한다. 응답의 유효 길이를 벗어난 위치는 mask로 제외한다.
- 주요 OPRD-Vanilla 설정은 모든 transformer 계층과 응답의 마지막 k = 2000개 토큰을 감독한다.
- 선택적으로 사용하는 결합 목적함수는 Eq. (7)에 명시된 L(θ) = LOPD(θ) + µLOPRD(θ), µ ≥ 0이다.
- OPRD-only 학습은 별도의 설정이다. Eq. (7)에서 µ = 0이면 OPD-only가 되지만, §4.1.1은 이 설정을 OPRD-only로 표기한다.
3.2 Why OPRD Works
Theorem 1은 고정된 prefix에서 gradient가 결정적이라는 점으로 OPRD의 근거를 제시한다. Theorem 2는 softmax에 영향을 주지 않거나 출력에 약하게 전달되는 표현 방향을 논의한다. 이 논증은 학습 후반의 확률적 변동을 없애고 반드시 0이 아닌 영공간 방향을 드러낸다는 논문의 주장보다 좁게 해석해야 한다.
- 고정된 prefix에서 은닉 상태 MSE, full-vocabulary KL, 고정된 지지집합의 top-k KL은 결정적이다. 샘플링된 전체 rollout을 고정하면 재사용하는 sampled-token 추정량도 결정적이다. 이 추정량의 토큰 샘플링 분산은 현재 샘플링된 토큰을 조건으로 고정하기 전에 정의된다.
- 유효 영공간은 NW = {∆h ∈ R^d : Whead∆h ∈ span{1}}이다. 이는 logits에 상수 이동을 만드는 교란을 나타내지만, 0 벡터만 포함할 수도 있다.
- 정확도 정체 구간은 gradient 분산을 직접 측정하지 않으며, LM-head의 영공간 방향이 남은 정확도 격차를 유발했다고 입증하지도 않는다.
3.3 OPRD-Bridge: Cross-Architecture Extension
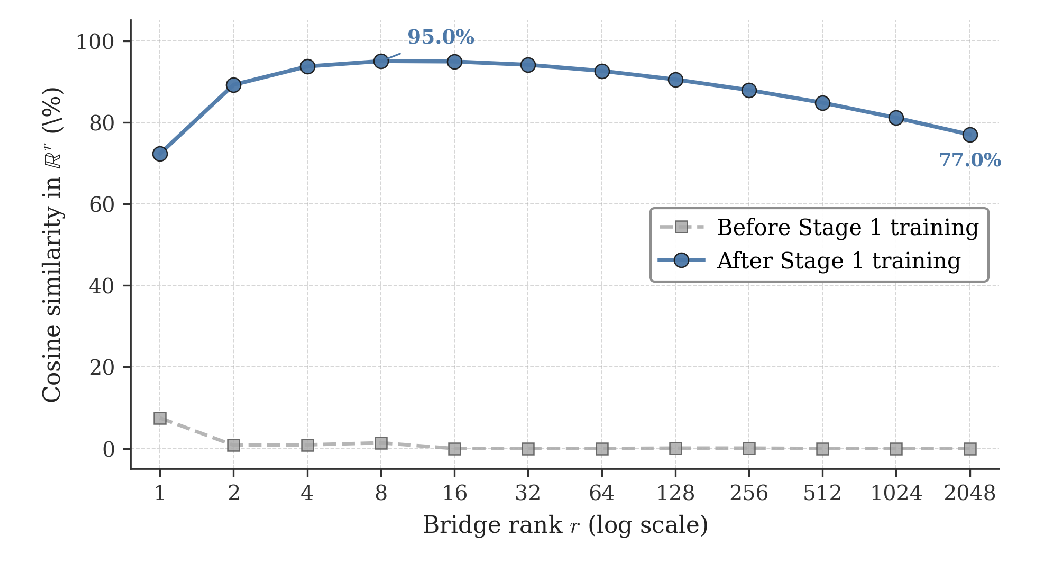
3.3.1 The Shared Low-Rank Structure는 DAPO-Math-17K 프롬프트 2K개에 대한 학생 응답에서 수집한 Qwen3-4B와 Qwen3-1.7B 표현으로 bridge의 근거를 제시한다. 학생 표현을 교사의 PCA 좌표로 변환하는 선형 매핑을 학습하면, rank 8의 평균 투영 cosine similarity는 95.0%이고 rank 2048에서는 77.0%다.
- 3.3.2 Stage 1: Bridge Construction은 비례 간격으로 계층을 연결한다. 매핑은 ϕ(lS) = round(((lS − 1)/(LS − 1)) · (LT − 1)) + 1이다.
- 교사 projector는 계층당 최대 16,384개의 토큰 행을 샘플링하고, 중심화한 은닉 상태의 공분산으로 구한다. 두 backbone을 고정한 채 학생 projector를 20 epochs 동안 학습한다.
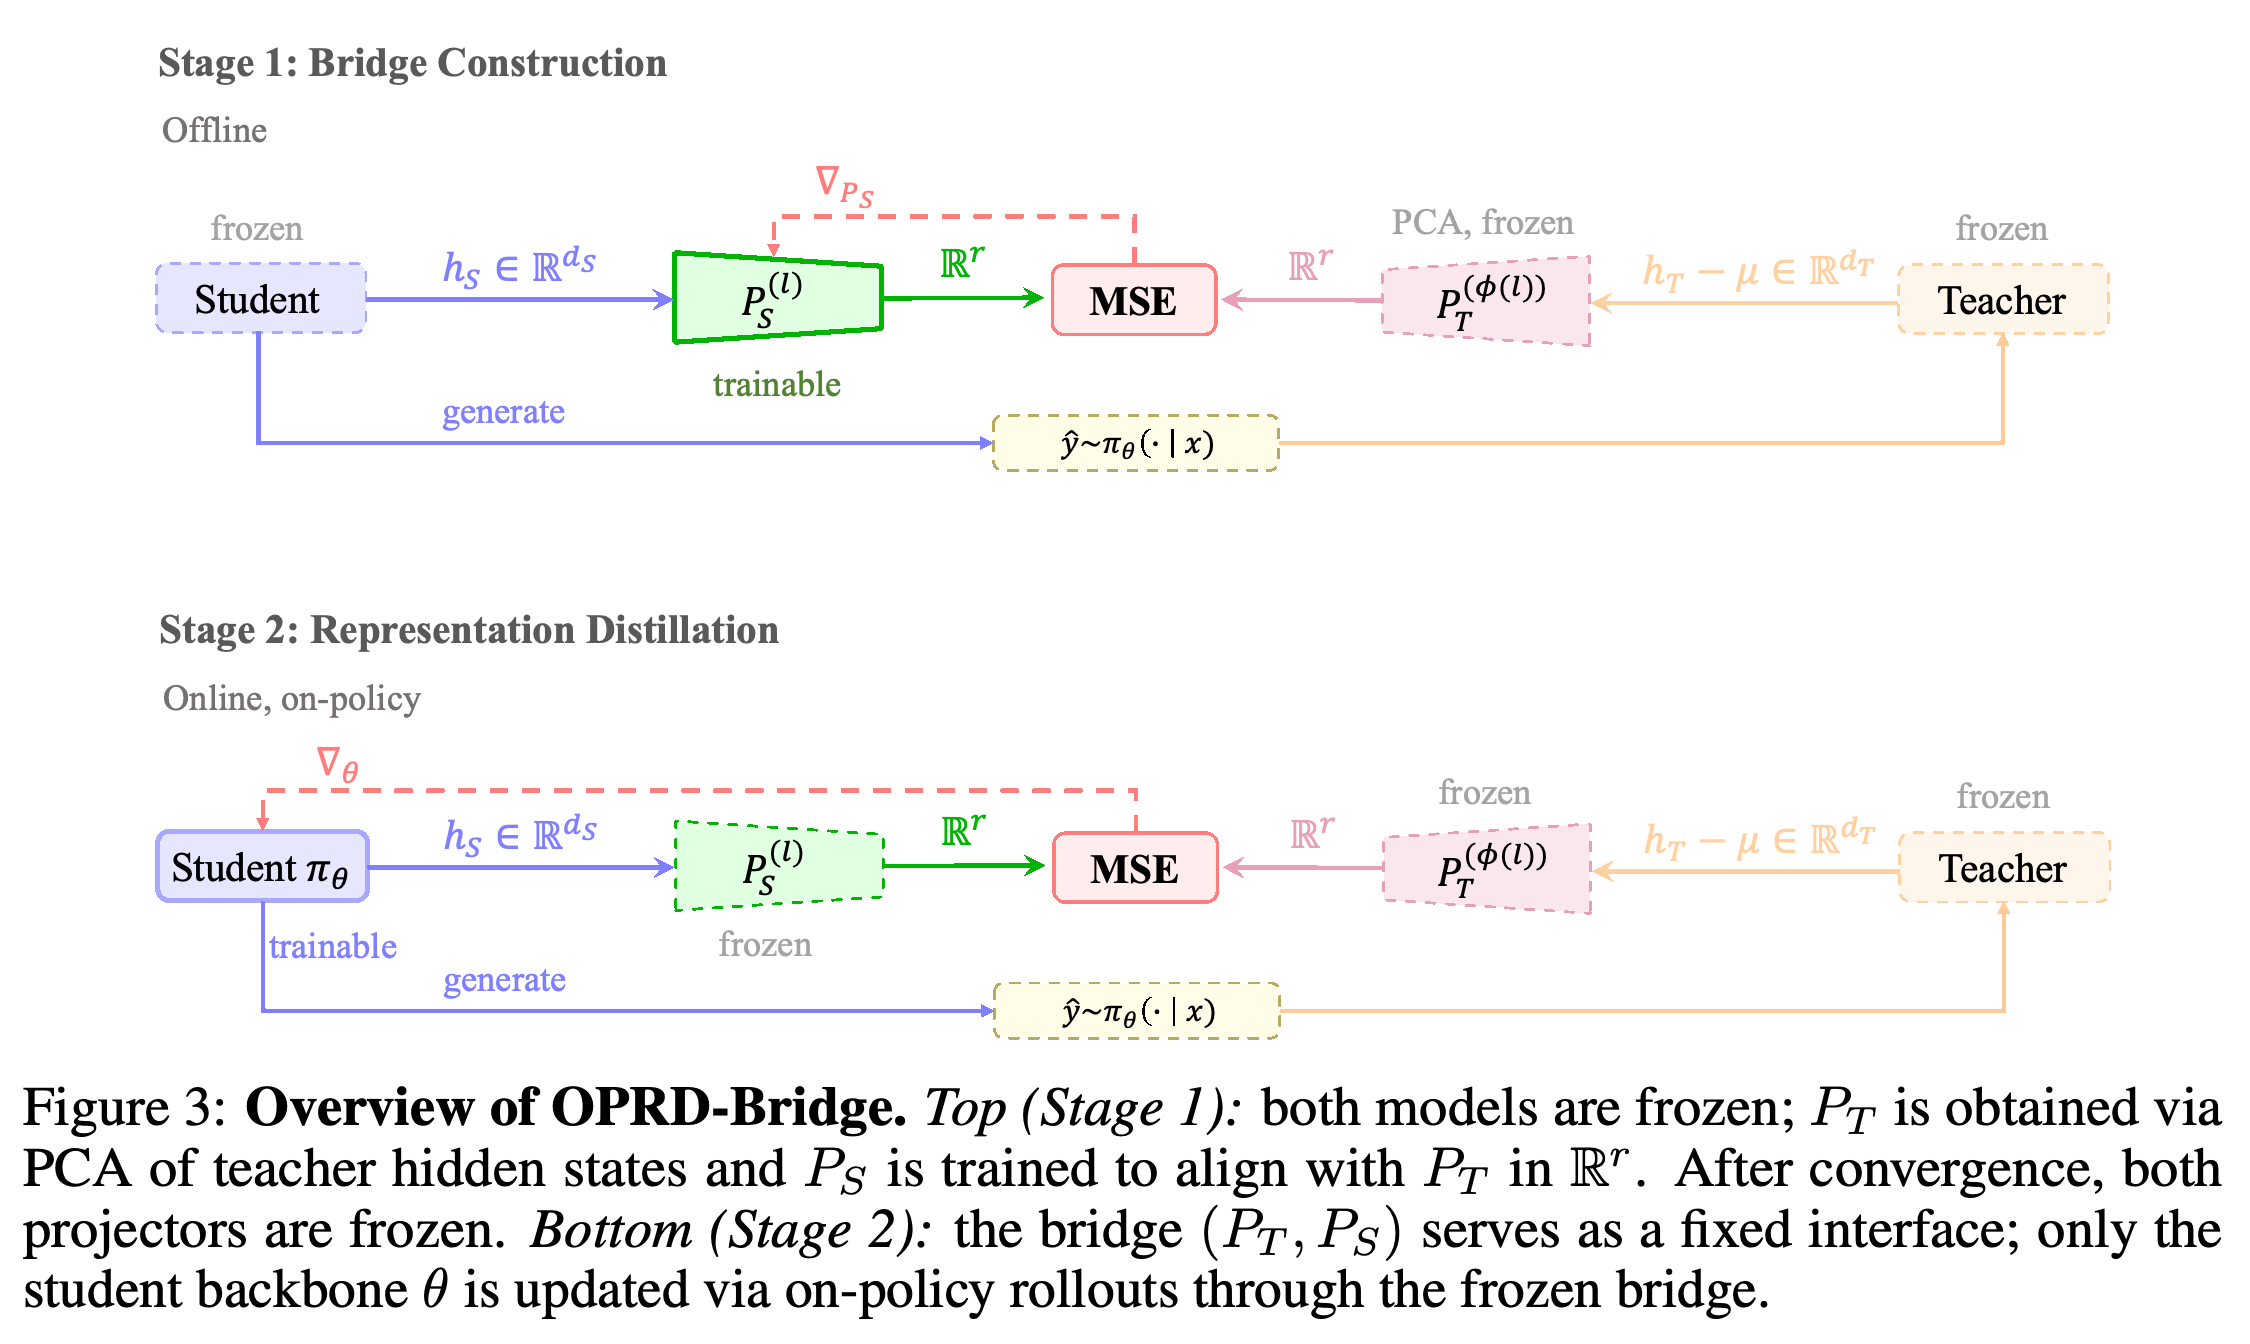
- 3.3.3 Stage 2: Bridge-Based Distillation은 두 projector 집합을 고정하고 학생 backbone만 업데이트한다. 투영 벡터를 L2-normalized 형태로 만든 뒤 MSE를 적용하며, 응답 토큰 중 마지막 2000개를 감독한다. Algorithm 1은 두 단계를 요약한다.
Stage 1은 두 backbone을 고정한 채, 고정된 교사 PCA 목표에 맞춰 학생 정렬 매핑을 학습한다. Stage 2에서는 매핑을 고정하고 gradient를 매핑을 통해 학생 backbone으로 전달한다.
3.3.4 Design Philosophy는 projector 쌍을 logit 증류의 공유 어휘와 비슷한 고정 인터페이스로 본다. 저랭크 bridge는 잘 정렬된 변동은 유지하고, 잘 맞지 않는 아키텍처 고유 방향은 제외하도록 설계한다.
- Figure 3은 bridge 구성 단계와 backbone 증류 단계에서 학습하는 구성 요소가 어떻게 바뀌는지 보여준다. Table 1은 표현 인터페이스와 어휘 공간 정렬을 비교한다.
- Theorem 3은 PCA의 재구성 최적성과, 제외한 예측 가능 신호 및 포함한 예측 잔차 사이의 절충 모델을 결합한다. 전체 cosine similarity가 높다고 해서 과제에 필요한 정보가 모두 보존된다고 보장하지는 않는다.
- 논문은 학생 projector를 공동 학습하면 성능이 낮아진다고 서술하지만, projector를 고정하는 경우와 공동 학습하는 경우의 정량 비교는 제공하지 않는다.
4 Experiments
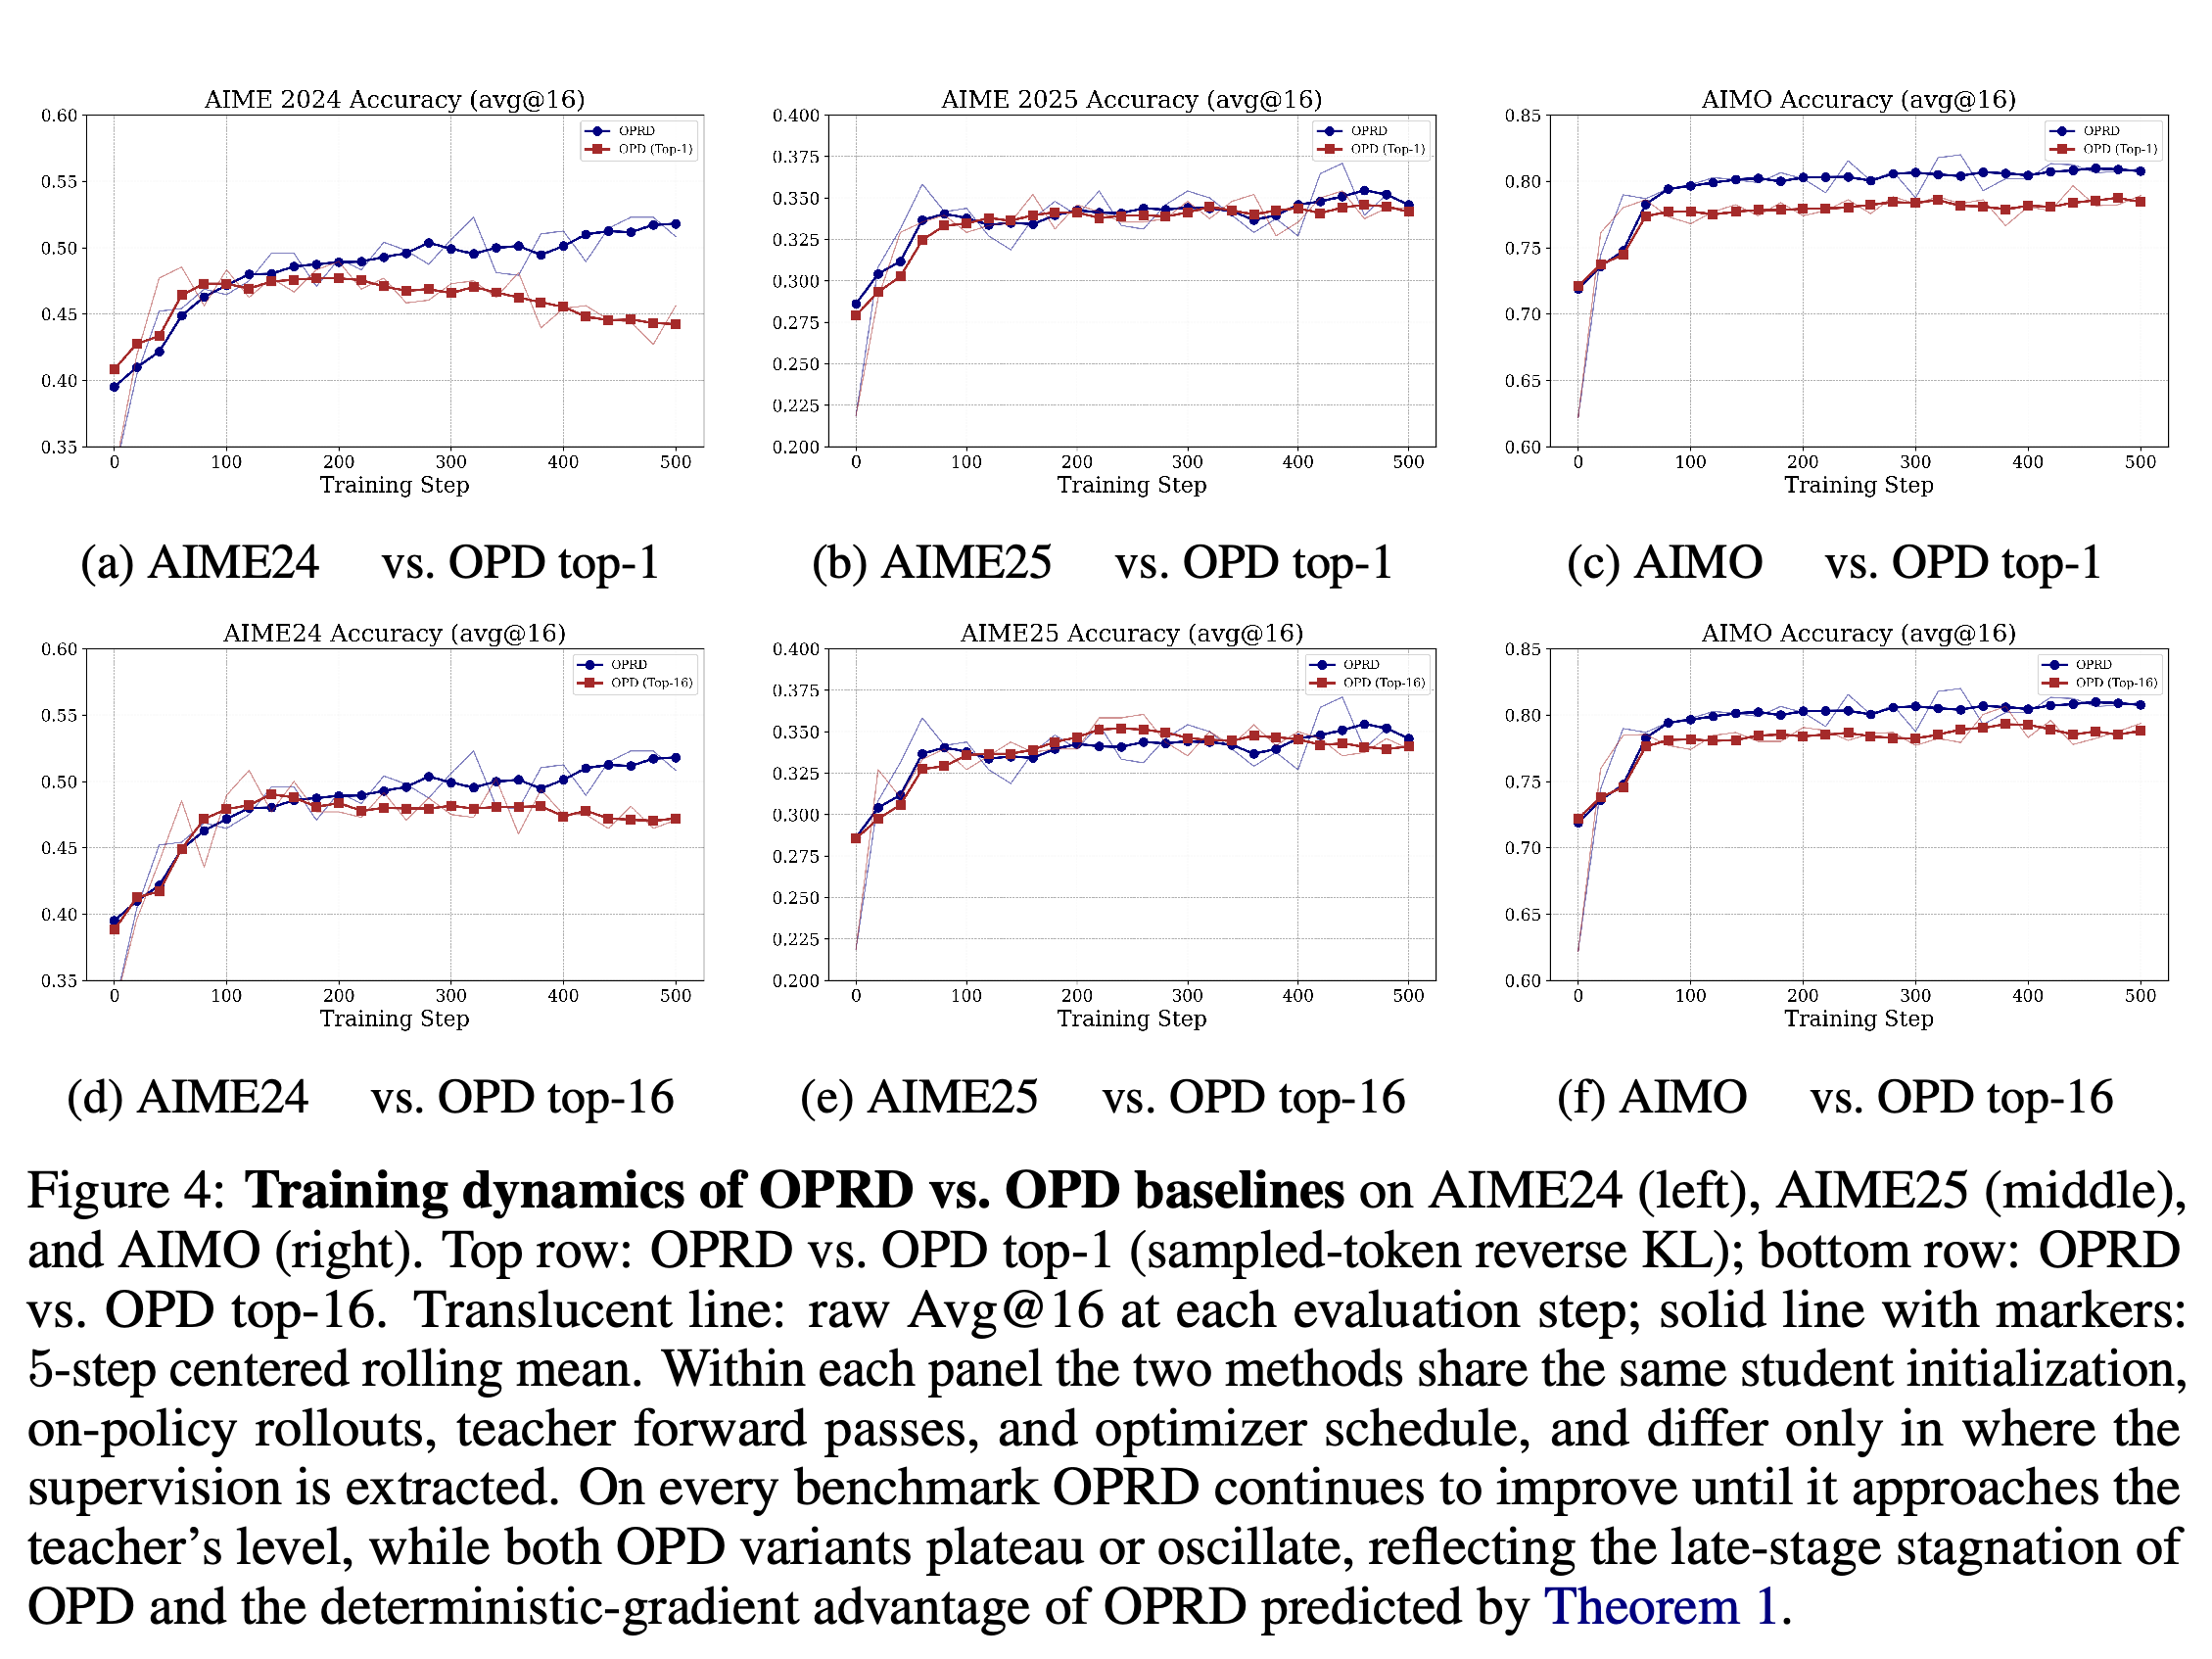
실험은 표현이 정렬된 동일 아키텍처 모델 쌍에서 OPRD-Vanilla를 평가하고, 이종 모델 쌍에서 OPRD-Bridge를 평가한다. Figure 4는 AIME24, AIME25, AIMO에서 학습 후반에 OPRD와 출력 공간 baseline 사이의 차이가 나타나는 모습을 보여준다.
- 곡선은 원래 Avg@16 측정값과 5-step 중심 이동 평균을 보여준다.
- 차이는 AIME24와 AIMO에서 가장 크고 AIME25에서는 더 작다. 곡선에는 변동이 있으며, 성능이 엄격히 단조 증가하지는 않는다.
- 동일 아키텍처 실험은 sampled-token 및 top-16 OPD와 정량 비교하며, full-vocabulary OPD와는 비교하지 않는다.
학습 후반의 차이는 AIME24와 AIMO에서 가장 뚜렷하고 AIME25에서는 더 작다. 곡선은 변동하며 최적화 결과를 나타낸다. Gradient의 신호 대 잡음비를 직접 측정하지는 않는다.
4.1 OPRD-Vanilla: Same-Architecture Distillation
4.1.1 Experimental Setup은 JustRL-Deepseek-1.5B를 고정 교사로, DeepSeek-R1-Distill-Qwen-1.5B를 학생으로 사용한다. 교사와 학생은 transformer 계층 28개, 은닉 차원 1536, 약 151K개 어휘 항목을 가진 Qwen2.5-1.5B backbone을 공유하며, 같은 checkpoint에서 이어진 학습 계보를 갖는다.
- 학습에는 DAPO-Math-17K를 사용한다. global step당 프롬프트 8개, 프롬프트당 학생 응답 2개, 샘플링 temperature 1.0, 최대 생성 길이 16,384개 토큰으로 설정한다.
- 모든 방법은 AdamW optimizer step 500회, 최대 learning rate 1×10⁻⁵, 3% linear warm-up, cosine decay, bf16, FSDP를 사용하며 8×A100 (80G)에서 학습한다. 보고된 micro-batch는 B = 8이다.
- 평가는 temperature 0.7과 문제당 응답 16개를 사용한다. AIME24와 AIME25는 각각 30문제이며, AI-MO/aimo-validation-amc는 83문제다. Boxed answer는 exact match로 채점한다.
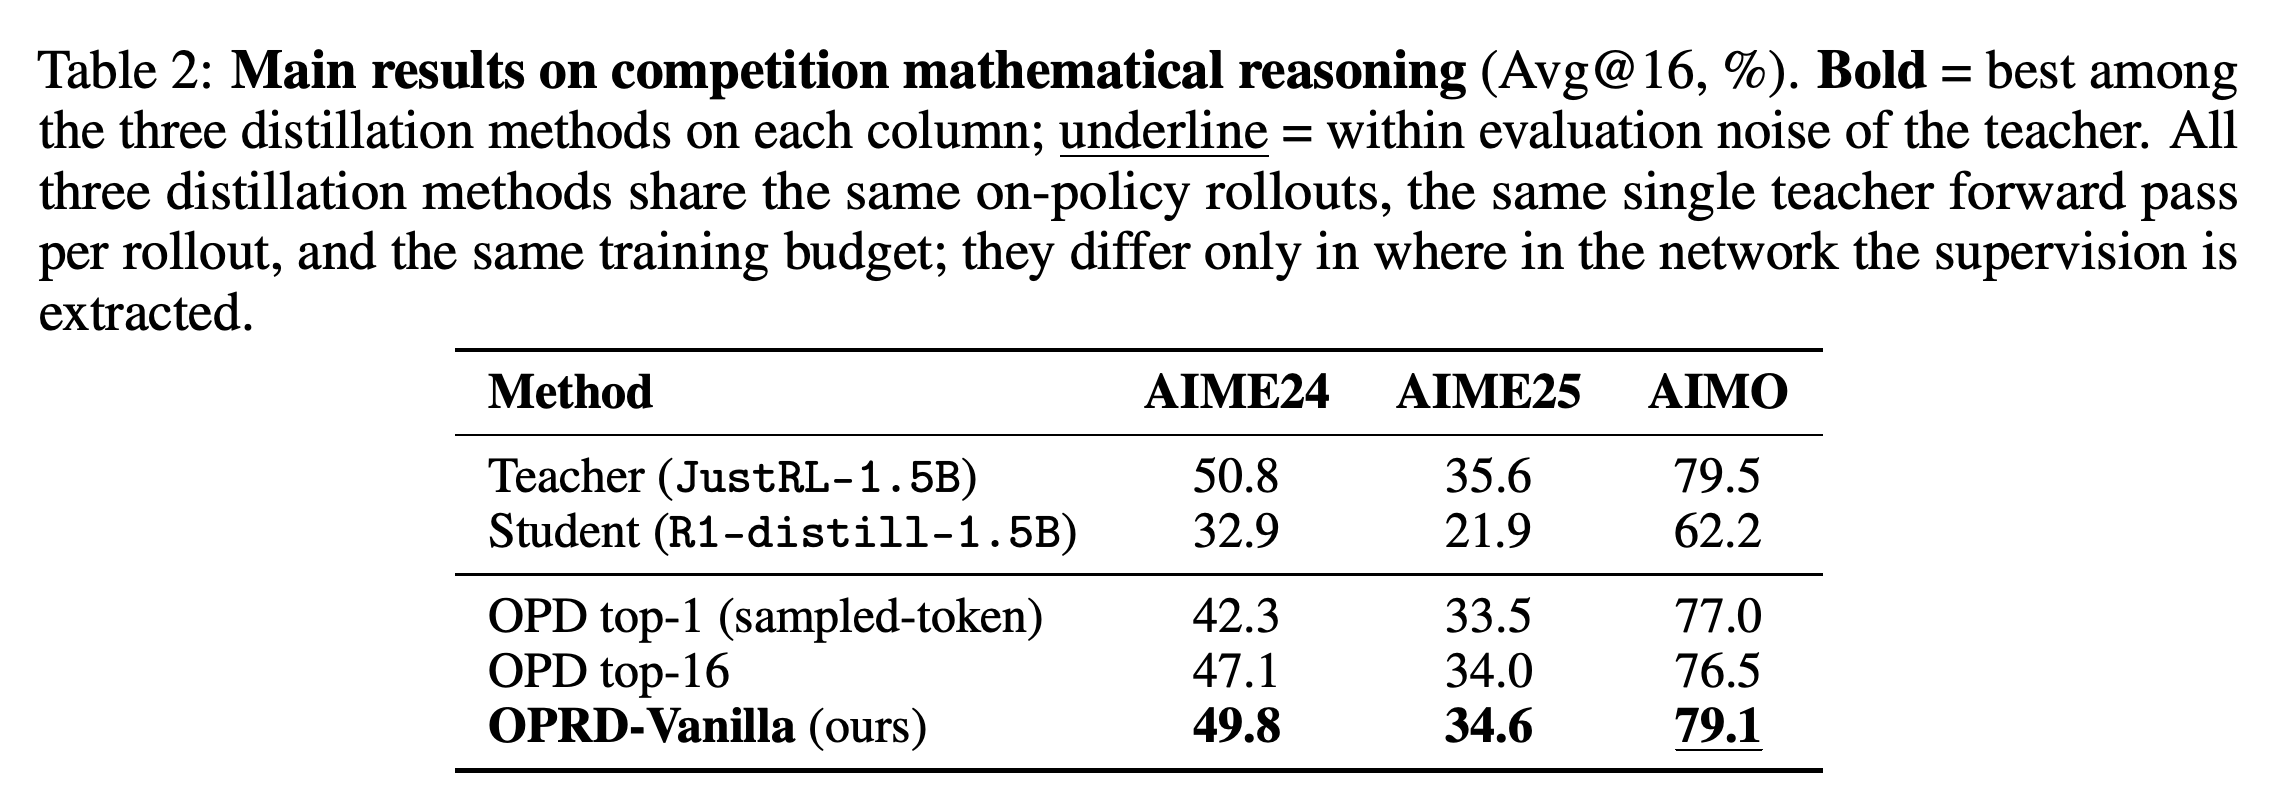
4.1.2 Main Results에서 OPRD-Vanilla의 AIME24/AIME25/AIMO Avg@16은 49.8/34.6/79.1이며, 교사 점수는 50.8/35.6/79.5다. 각 benchmark에서 더 강한 OPD baseline은 47.1/34.0/77.0을 기록하므로, OPRD의 향상 폭은 2.7/0.6/2.1%p다.
- 원래 학생 점수는 32.9/21.9/62.2이며, OPRD는 이를 16.9/12.7/16.9포인트 높인다.
- OPD top-1은 42.3/33.5/77.0, OPD top-16은 47.1/34.0/76.5를 기록한다. 따라서 출력 지지집합을 늘려도 모든 benchmark가 개선되지는 않는다.
- 저자들은 남은 교사 격차가 평가 잡음 범위 안에 있다고 설명하지만, Table 2에는 신뢰구간이나 반복 학습 seed에 따른 추정치가 없다.
OPRD는 동일 아키텍처의 3개 benchmark 모두에서 평가한 OPD 변형을 앞선다. 교사와의 격차는 1.0, 1.0, 0.4%p지만, 불확실성 추정치가 없어 통계적 동등성은 평가할 수 없다.
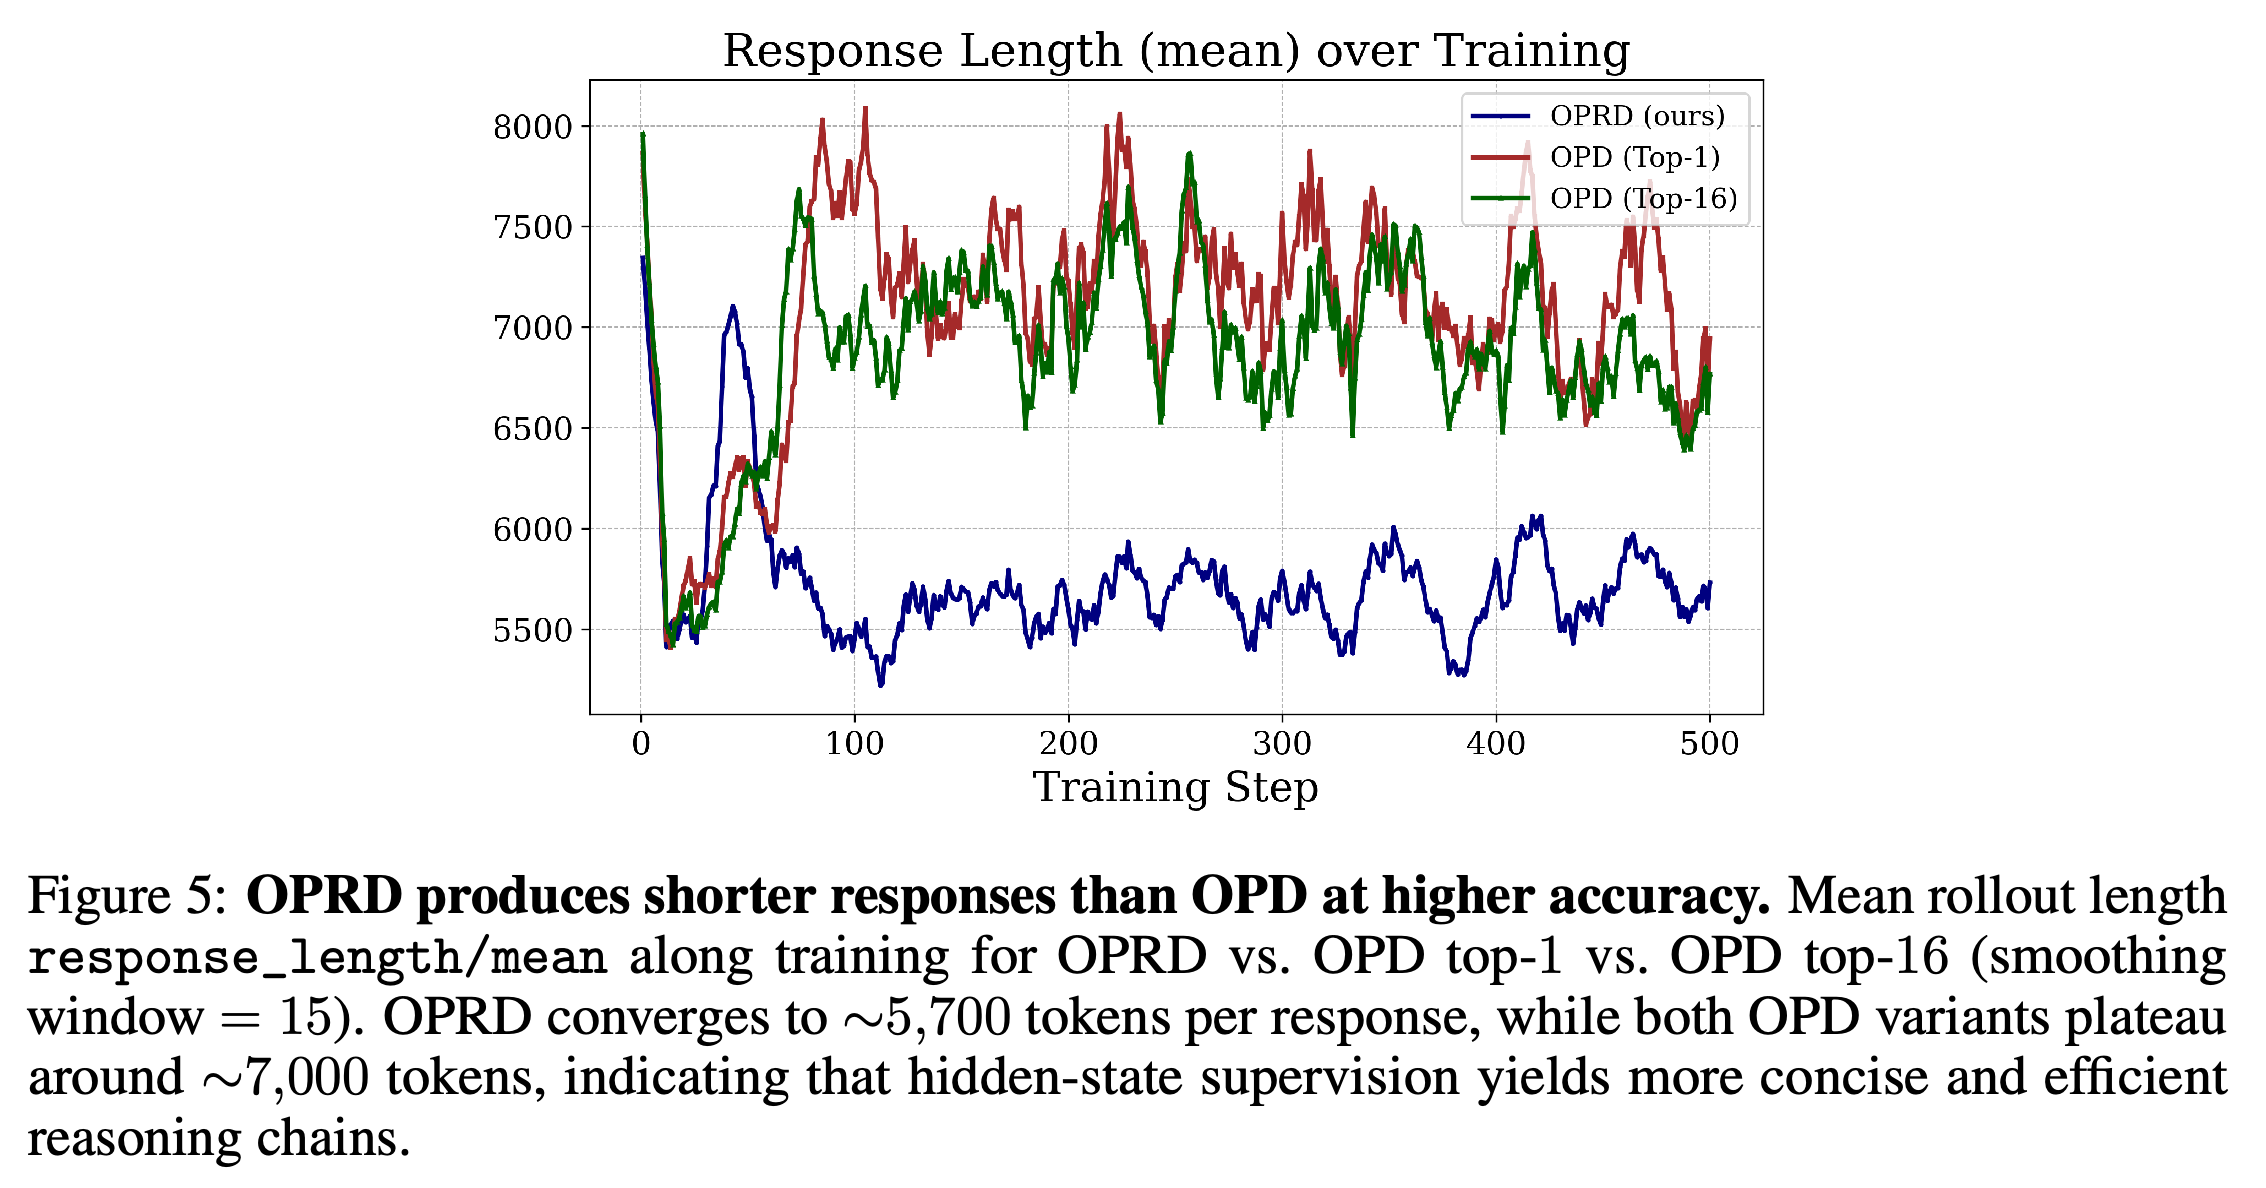
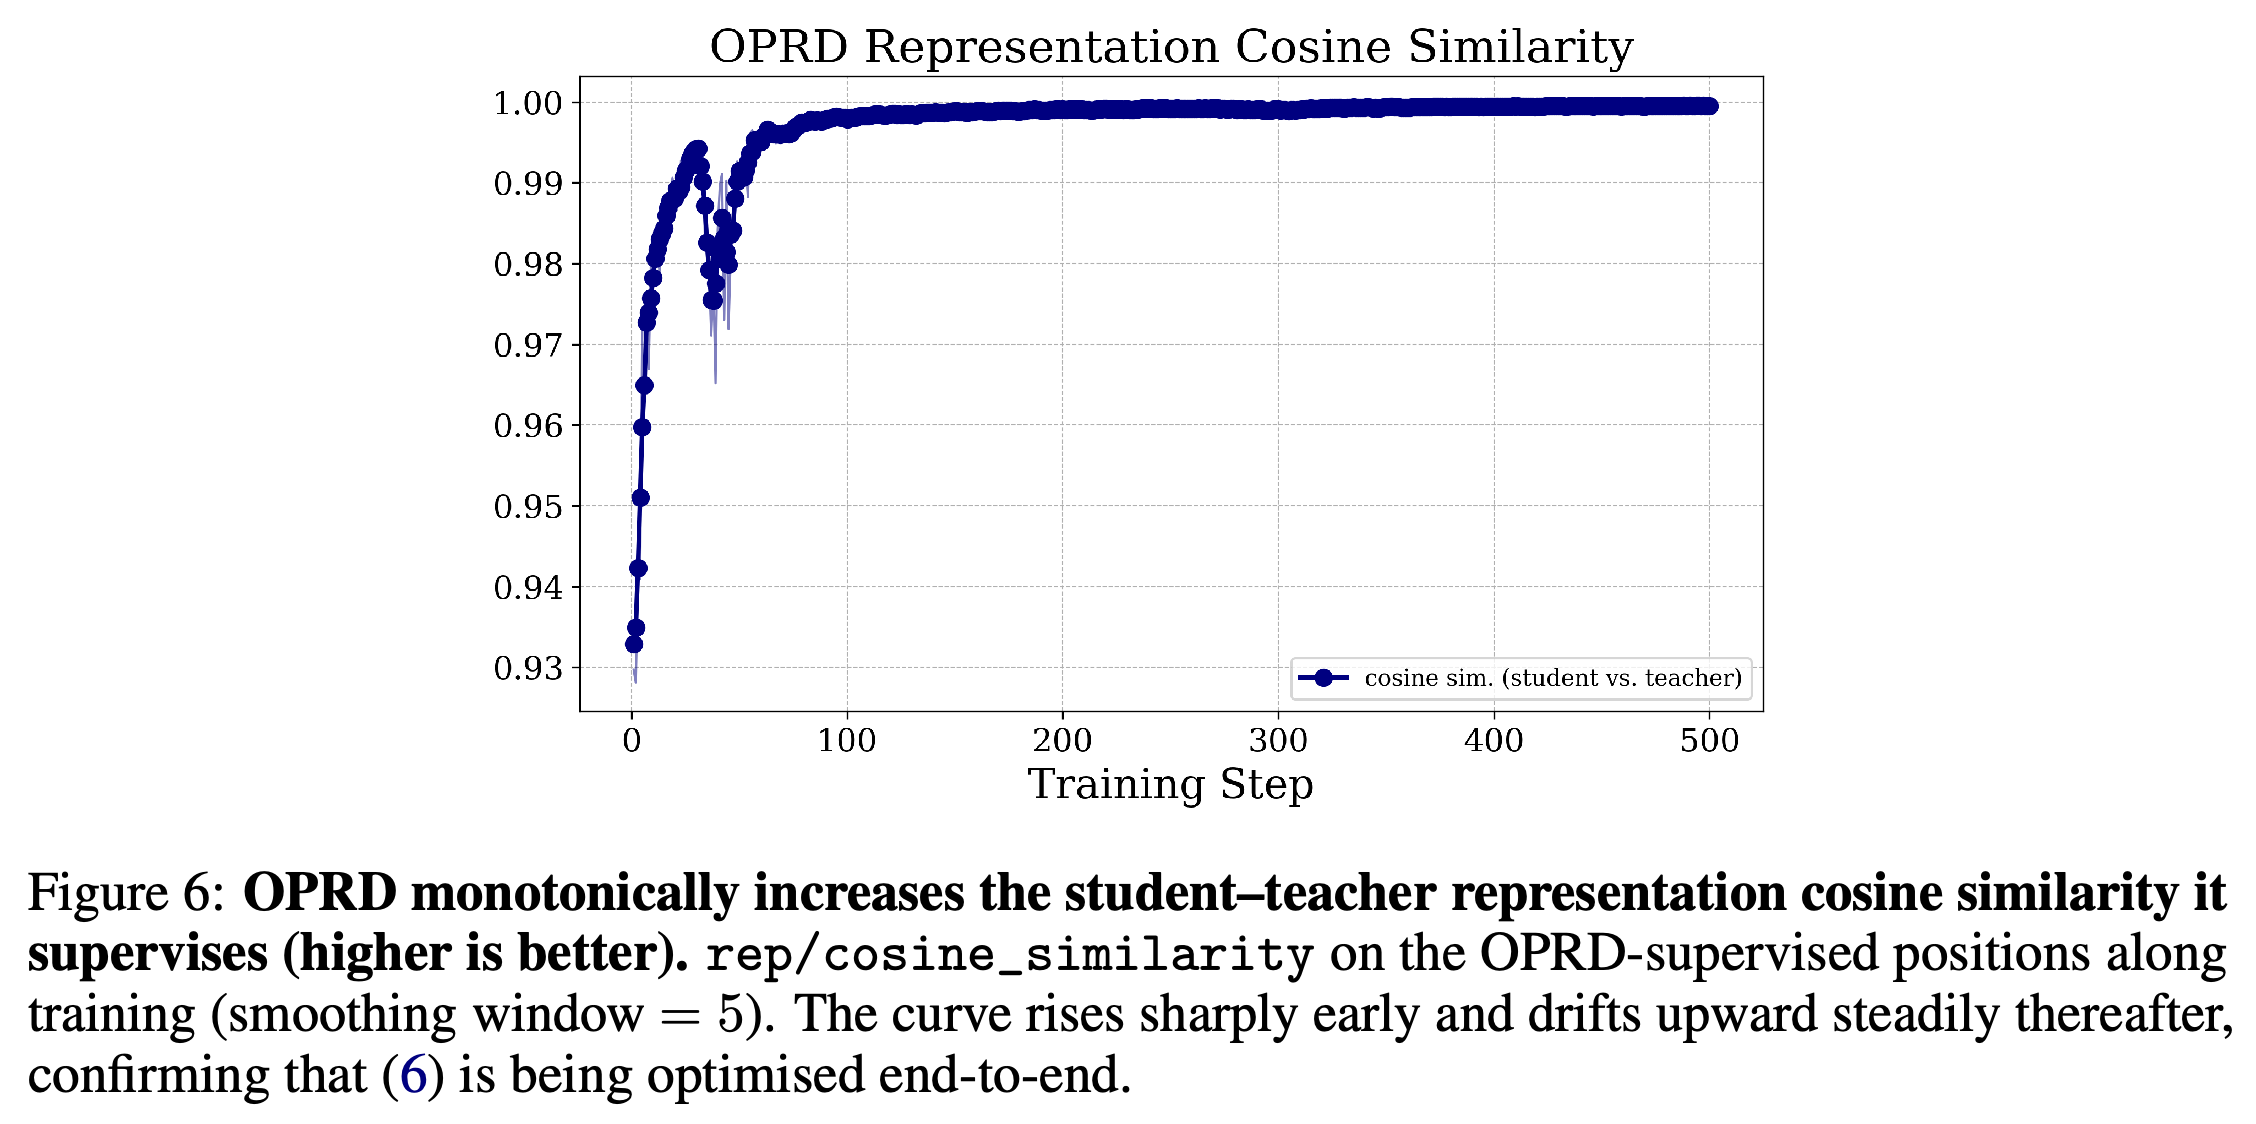
4.1.3 Training Dynamics는 정확도, rollout 길이, 표현 cosine similarity를 비교한다. Figures 5와 6에서 OPRD 응답은 약 5,700개 토큰으로 안정되는 반면 OPD는 약 7,000개 토큰을 생성한다. 감독한 표현의 similarity는 1.0에 가까워진다.
- 응답 길이 지표는 response_length/mean이며, window 15로 평활화한다.
- 표현 지표는 rep/cosine_similarity이며, window 5로 평활화한다. 그래프에서는 초기 하락 이후 지속적인 개선이 나타난다.
- 이 측정값은 생성 길이가 짧아지고 목표 표현과 더 잘 정렬됨을 보여준다. 다만 정확도와 함께 변한다는 사실만으로 인과적 메커니즘이 입증되지는 않는다.
초기 변동 이후 OPRD는 어느 OPD 학습보다도 상당히 짧은 rollout을 생성한다. Table 2와 함께 보면, 표현이 정렬된 모델 설정에서 생성 토큰이 줄면서 보고된 정확도는 높아짐을 보여준다.
감독한 표현의 cosine similarity는 초기 하락 이후 1.0에 가까워진다. 곡선은 측정한 위치에서 목표 정렬도가 높아짐을 보여준다. 엄격히 단조적인 궤적이나 정확도 향상의 독립적인 인과 설명을 제시하지는 않는다.
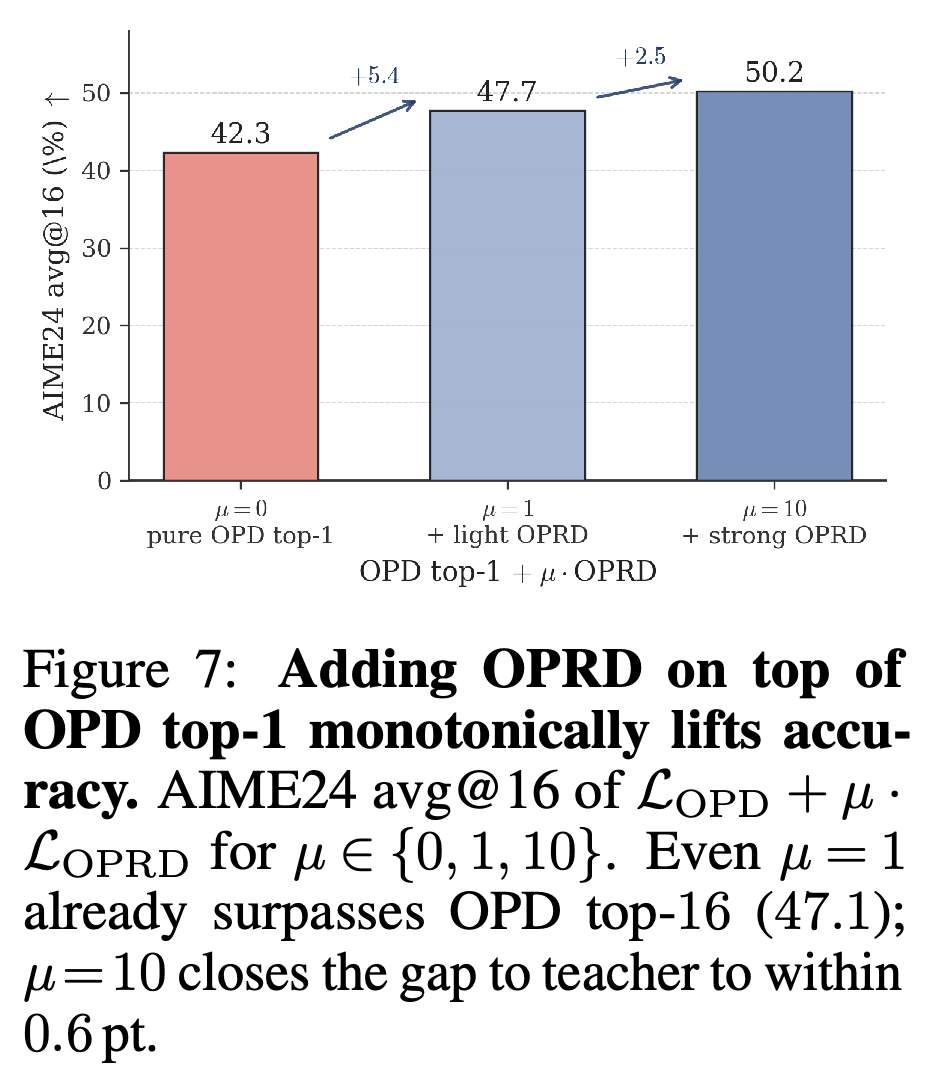
결합 실험은 sampled-token OPD에 µ ∈ {0, 1, 10}으로 OPRD를 추가한다. Figure 7의 AIME24 Avg@16은 각각 42.3, 47.7, 50.2다.
- µ = 1은 단독 OPD top-16의 47.1을 넘는다. µ = 10은 교사의 50.8과 0.6포인트 차이를 남긴다.
- 이 실험은 해당 설정의 3가지 가중치에서 상호 보완 효과를 보여주며, 임의의 가중치나 과제에 대한 견고성을 입증하지는 않는다.
시험한 OPRD 가중치 0, 1, 10에서 AIME24 정확도는 42.3, 47.7, 50.2로 높아진다. 이 3개 점은 해당 실험 범위의 상호 보완 효과를 보여주지만, 일반적인 단조 관계나 폭넓은 튜닝 견고성을 입증하지는 않는다.
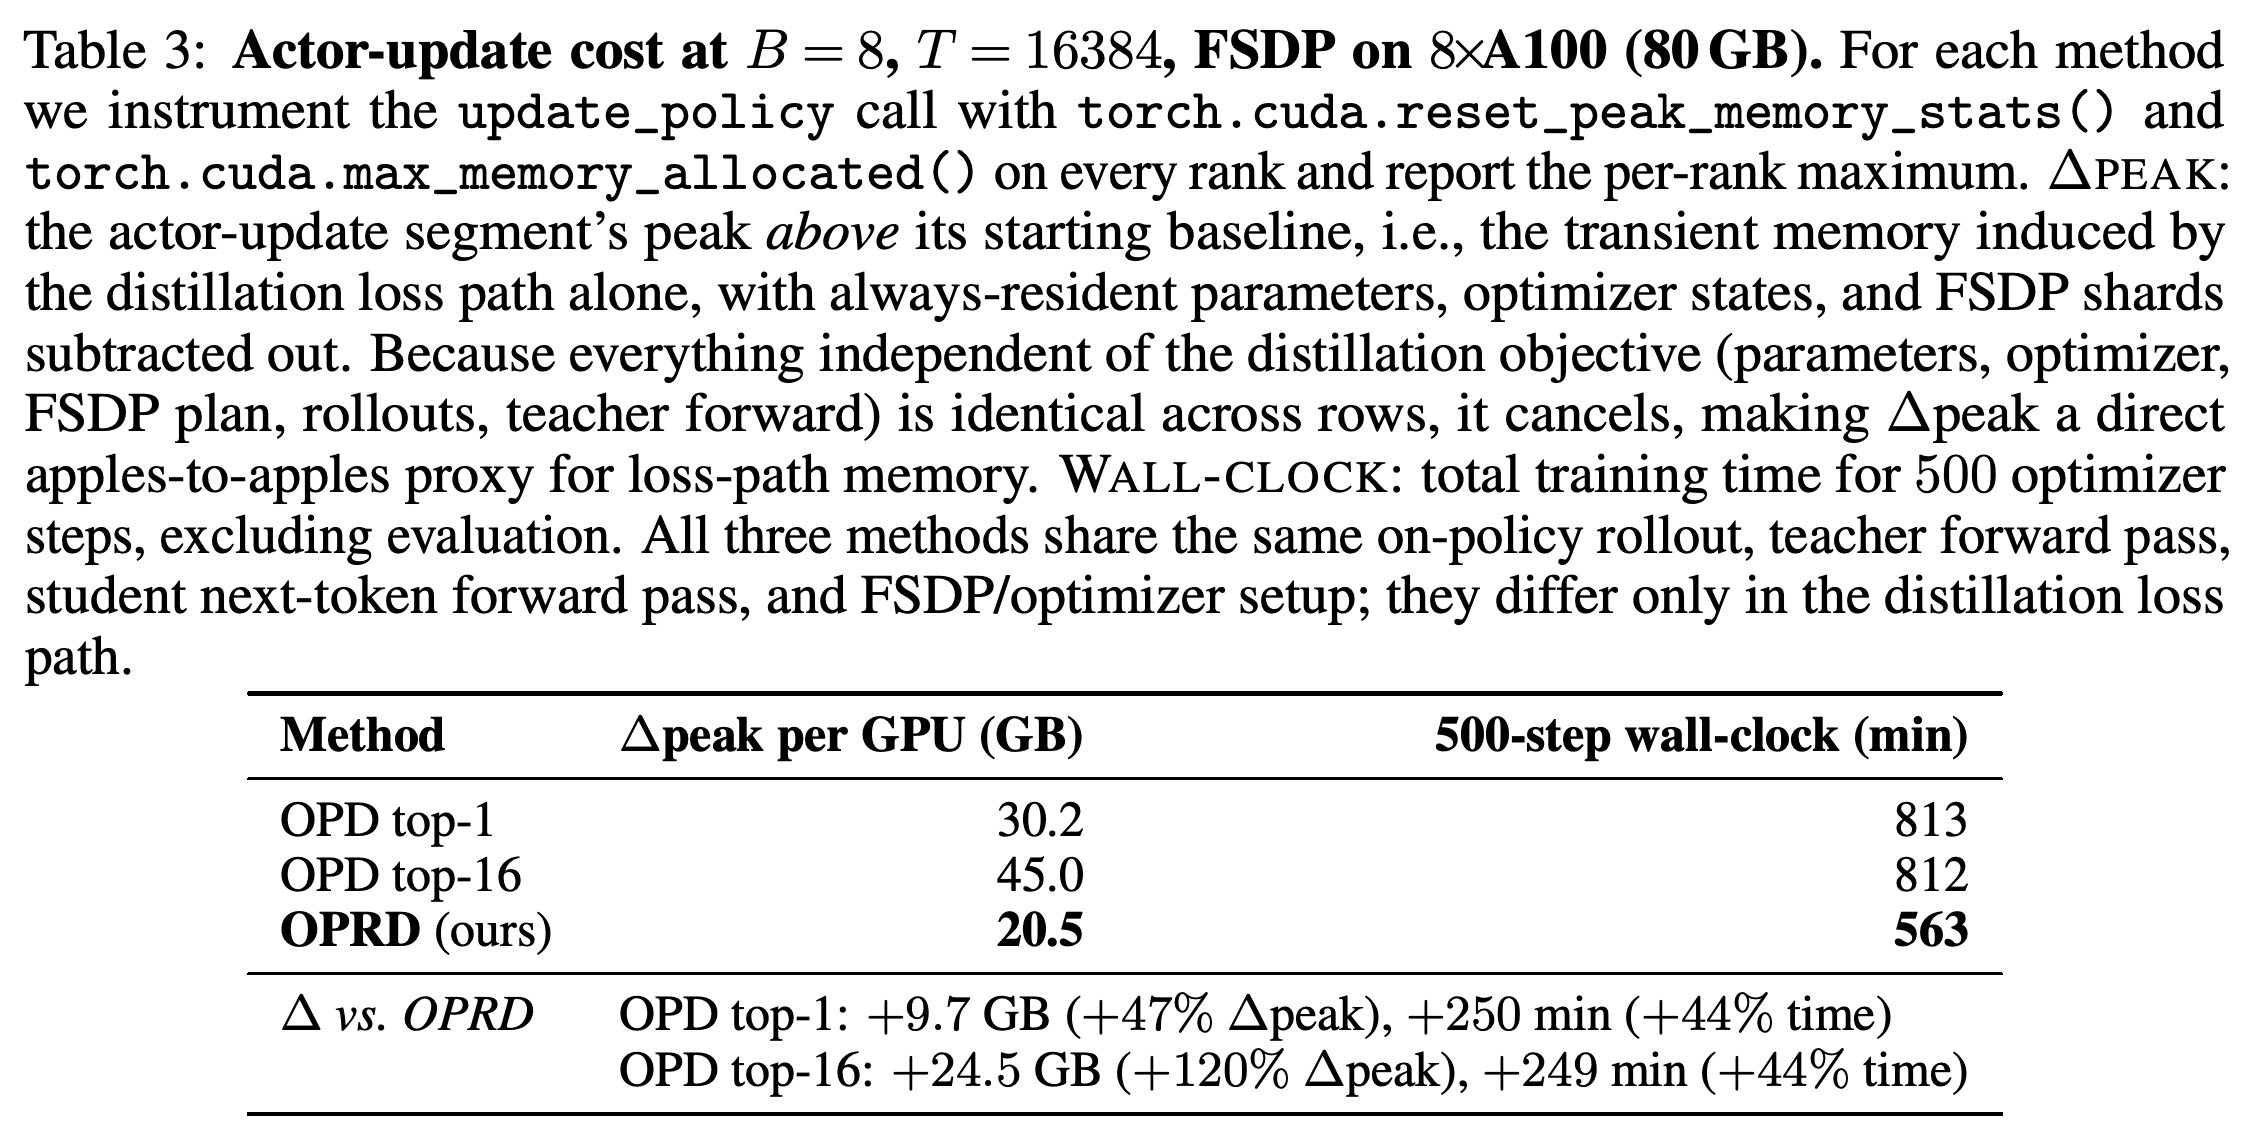
4.1.4 Efficiency는 전체 GPU 메모리가 아니라 actor 업데이트 시작 시점 대비 최대 메모리 증가량을 측정한다. Table 3의 GPU당 값은 OPD top-1 30.2 GB, OPD top-16 45.0 GB, OPRD 20.5 GB다.
- update_policy 구간에서 torch.cuda.reset_peak_memory_stats()와 torch.cuda.max_memory_allocated()로 측정하며, 보고값은 rank 전체의 최댓값이다.
- 평가를 제외한 500-step 실행 시간은 각각 813, 812, 563분이다. OPRD는 실행 시간을 약 31% 줄이며, 이는 1.44× 속도 향상에 해당한다.
- 일시적 메모리 증가량은 top-1 대비 32%, top-16 대비 54% 줄어든다. 교사 구현은 여전히 전체 logits을 계산한 뒤 버리므로, 이 절감이 어휘 크기에 비례하는 모든 계산을 제거했다는 뜻은 아니다.
절감 대상은 actor 업데이트 시작 시점 대비 일시적 메모리 증가량과 평가를 제외한 500-step 학습 시간이다. OPRD는 20.5 GB와 563분을 사용하고, top-16 OPD는 45.0 GB와 812분을 사용한다.
4.1.5 Mechanistic Analysis는 응답의 시작과 끝에서 초기 학생과 교사의 마지막 계층 cosine similarity를 비교해 후반부 감독의 근거를 제시한다. Figure 8의 값은 마지막 50개 토큰에서 91.65%, 처음 1600개 토큰에서 97.69%, 전체 응답에서 95.42%다.
- 초기에는 후반부보다 prefix의 정렬도가 높다. 이는 last-k 휴리스틱의 경험적 근거가 된다.
- 이 진단은 first-k, last-k, 전체 위치 학습의 downstream 정확도를 비교하는 ablation이 아니다.
Figure 9는 결합 학습의 actor/pg_loss를 추적한다. OPRD를 추가하면 손실 급증 시점이 앞당겨진다. 최종 정확도는 다르지만 모든 학습은 결국 policy-gradient loss가 약 0에 가까워진다.
- 저자들은 이 급증을 정책의 phase transition일 가능성으로 해석하며, 메커니즘은 계속 조사 중이라고 설명한다.
- Policy-gradient loss가 0에 가깝다고 해서 학생과 교사의 분포가 같다고 볼 수 없으며, 남은 격차가 LM-head 영공간에 있다는 증거도 되지 않는다.
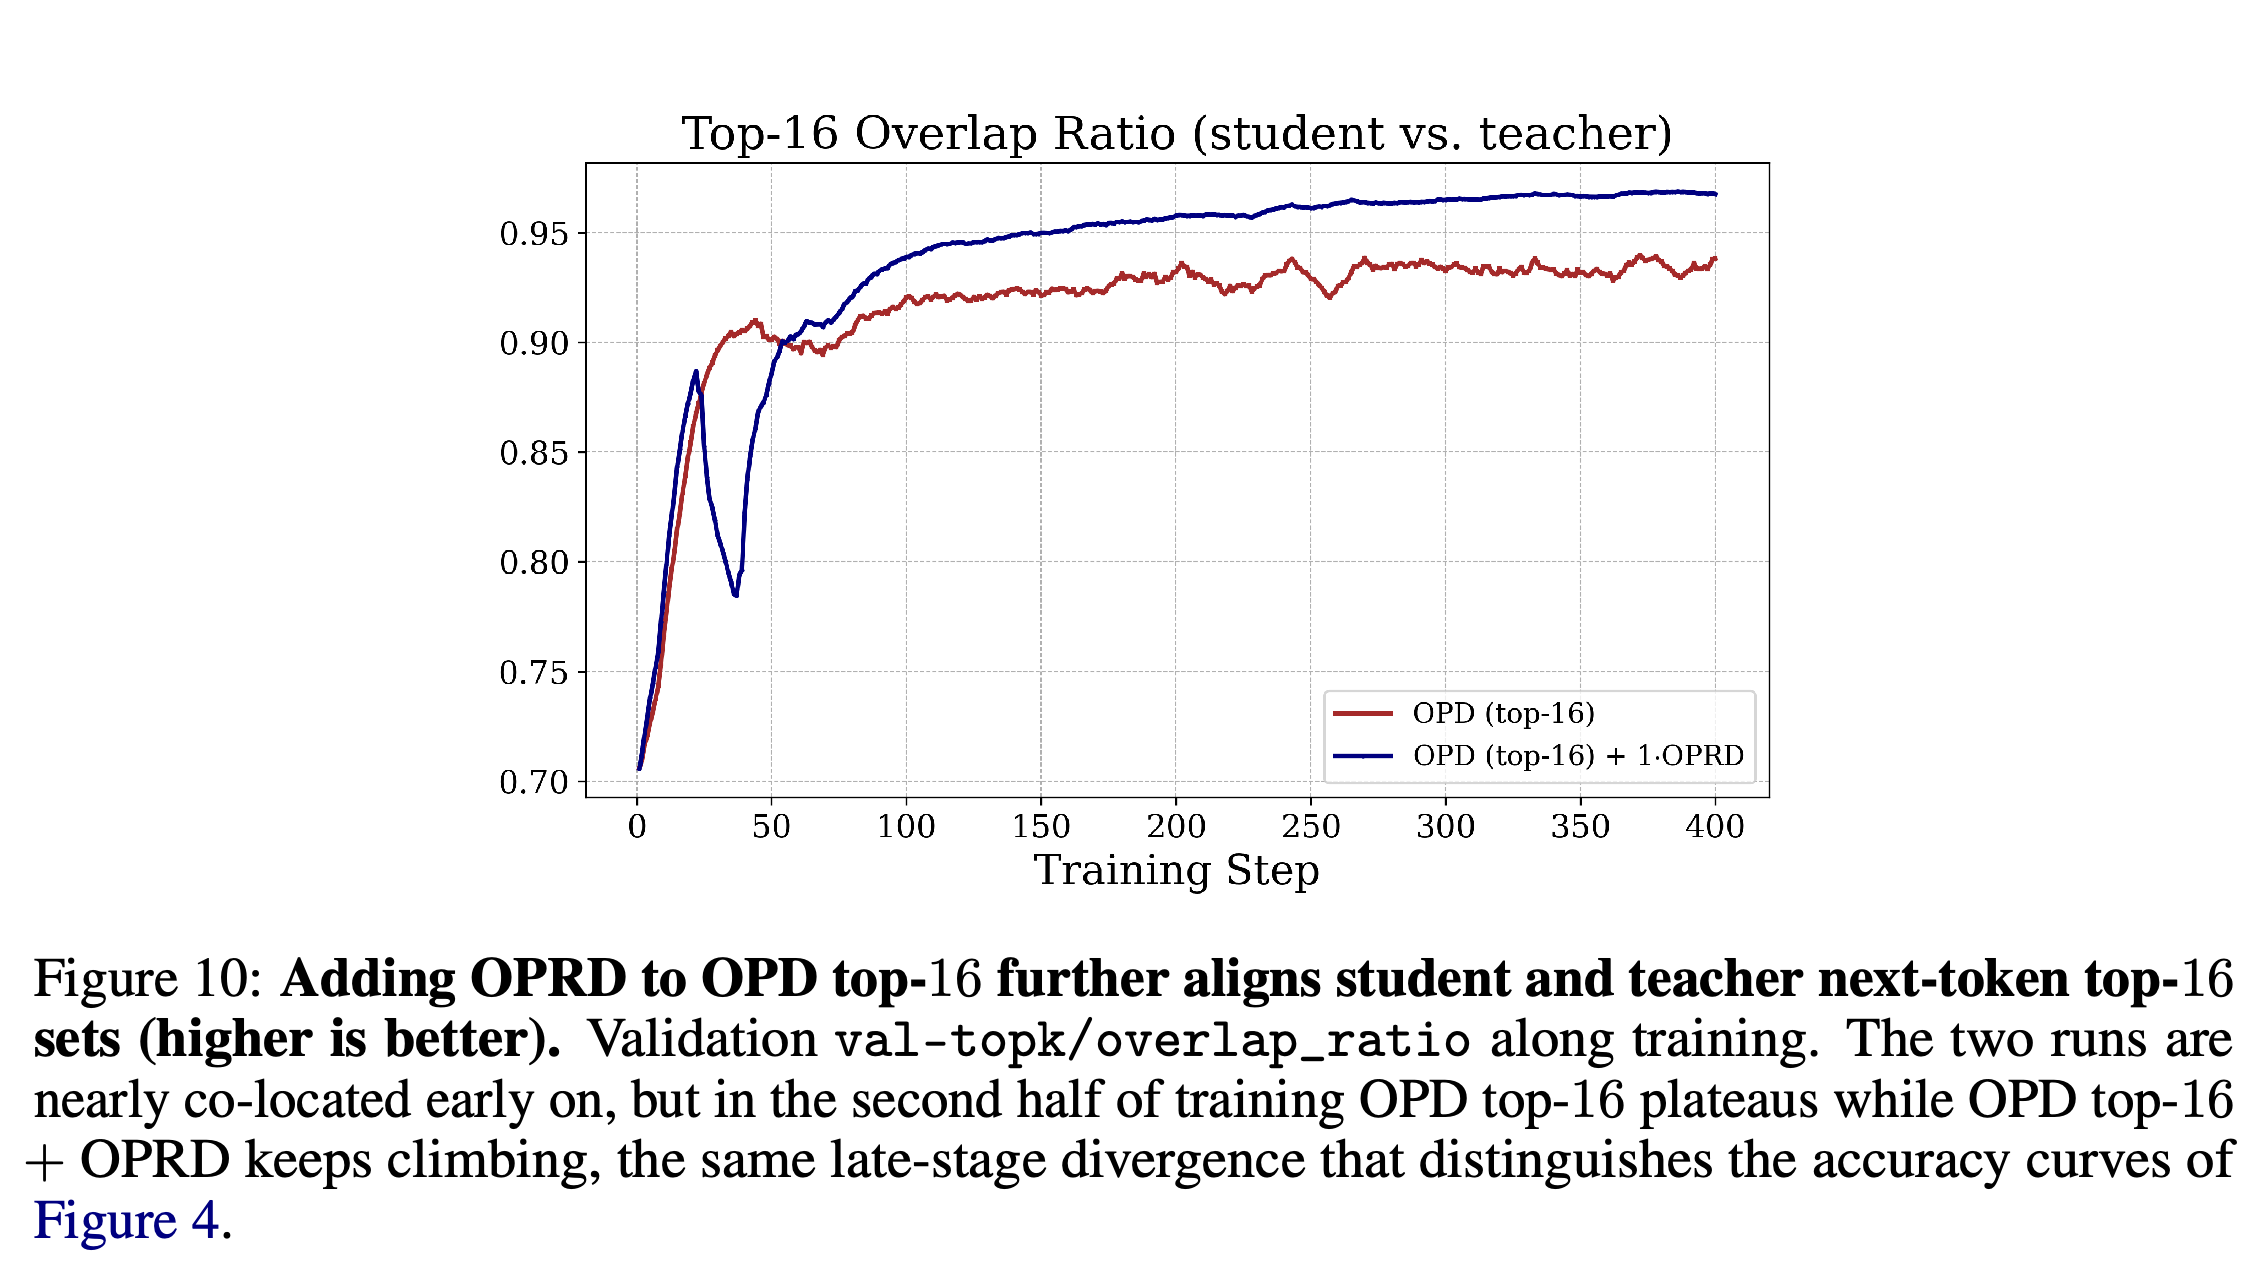
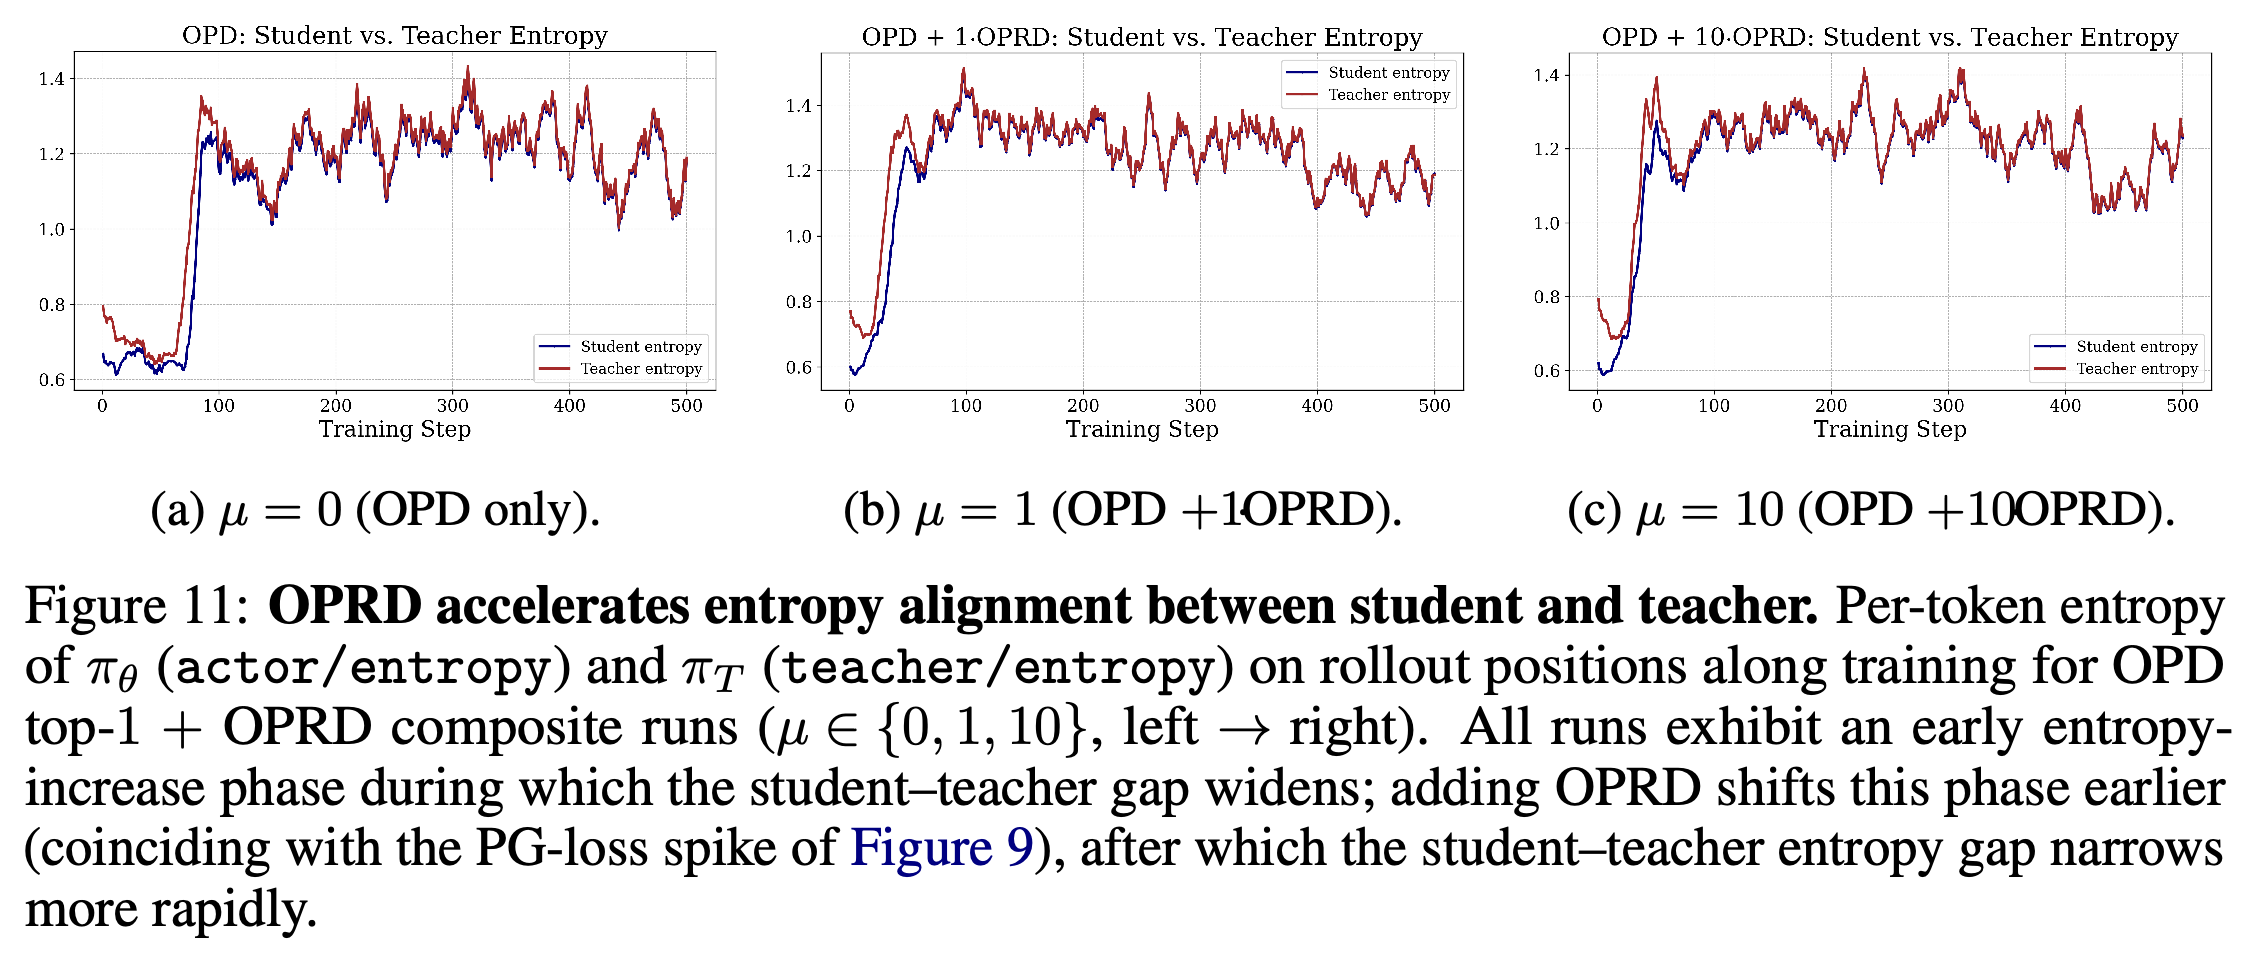
Figures 10과 11은 은닉 상태 감독에 따른 출력 수준의 변화를 살펴본다. OPD top-16에 OPRD를 더하면 최종적으로 단독 OPD top-16보다 val-topk/overlap_ratio가 높아진다. OPRD를 추가한 sampled-token 학습에서는 entropy 변화도 더 일찍 나타난다.
- Top-16 overlap은 학생과 교사의 top-16 토큰 집합이 겹치는 원소 수를 16으로 나눈 값이다. 결합 곡선은 초기에 하락한 뒤 회복해 baseline을 넘는다.
- actor/entropy와 teacher/entropy는 같은 rollout 위치에서 측정하며, 이 위치는 계속 바뀐다. 따라서 교사 매개변수를 고정해도 교사 entropy는 변할 수 있다.
- 이 진단은 정책 행동의 변화가 시간상 함께 나타남을 보여주지만, 제안한 재구성 메커니즘을 규명하지는 않는다.
결합 목적함수에서는 overlap이 초기에 하락한 뒤 회복해 단독 OPD를 넘는다. 따라서 표현 감독은 출력 일치도를 바꾸지만, 궤적이 계속 개선되기만 하는 것은 아니다.
시험한 OPRD 기여도가 큰 경우 entropy 변화가 더 일찍 시작되며, 이후 학생과 교사 궤적은 비슷하게 움직인다. 교사 entropy는 계속 바뀌는 학생 rollout에서 측정하므로, 고정 목표가 아니라 변화하는 분포 기준이다.
4.2 OPRD-Bridge: Cross-Architecture and Cross-Tokenizer Distillation
4.2.1 Experimental Setup은 계층 36개와 은닉 차원 2560을 가진 Qwen3-4B를, 계층 28개와 은닉 차원 2048을 가진 Qwen3-1.7B-Base와 연결한다. 이 모델들은 약 151K개 어휘를 공유하므로 일반적인 토큰 수준 OPD와 비교할 수 있다.
- Stage 1은 DAPO-Math-17K 프롬프트 2000개와 projector 학습 20 epochs를 사용한다. 기본 bridge rank는 r = 8이다.
- Stage 2는 L2-normalized 투영 벡터의 MSE로 학생의 모든 28개 계층과 응답 토큰 중 마지막 2000개를 감독한다. 프롬프트당 응답 2개, temperature 1.0, step당 프롬프트 8개, 최대 응답 길이 16,384를 사용한다. 최대 learning rate 1×10⁻⁵와 cosine decay를 적용한 AdamW, bf16, FSDP를 사용하며 8×A100 (80G)에서 학습한다.
- 평가는 Avg@16, Best@16, Dist-4g, 평균 응답 길이를 보고한다. 별도로 명시한 validation set이 아니라, 3개 평가 benchmark의 평균 성능이 가장 좋은 checkpoint에서 결과를 선택한다.
4.2.2 Main Results는 정확도와 생성 특성 사이의 절충을 보여준다. Table 4에서 rank-8 OPRD-Bridge의 평균 Avg@16은 11.2%다. 이는 OPD top-1의 15.3%보다 낮지만 OPD top-16의 10.4%보다 높다.
- OPRD-Bridge의 AIME24/AIME25/AIMO Avg@16은 5.0/3.8/24.8이며, OPD top-1은 8.5/6.3/31.0이다.
- Best@16은 20.0/13.3/59.0으로, 보고된 OPD top-1의 3개 값 및 평균 30.8%와 같다.
- Best@16은 16번의 시도 중 적어도 한 번 성공했는지를 측정한다. 일반적인 능력의 상한도 아니며, 응답별 신뢰성을 대신하는 지표도 아니다.
OPRD-Bridge는 보고된 sampled-token OPD의 Best@16과 같지만 Avg@16은 낮다. 후속 OPD 학습은 평균 Best@16을 33.9%로 높이지만, 평균 Avg@16은 여전히 단독 sampled-token OPD보다 낮다. 학생의 AIMO Best@16 항목도 Avg@16과 모순된다.
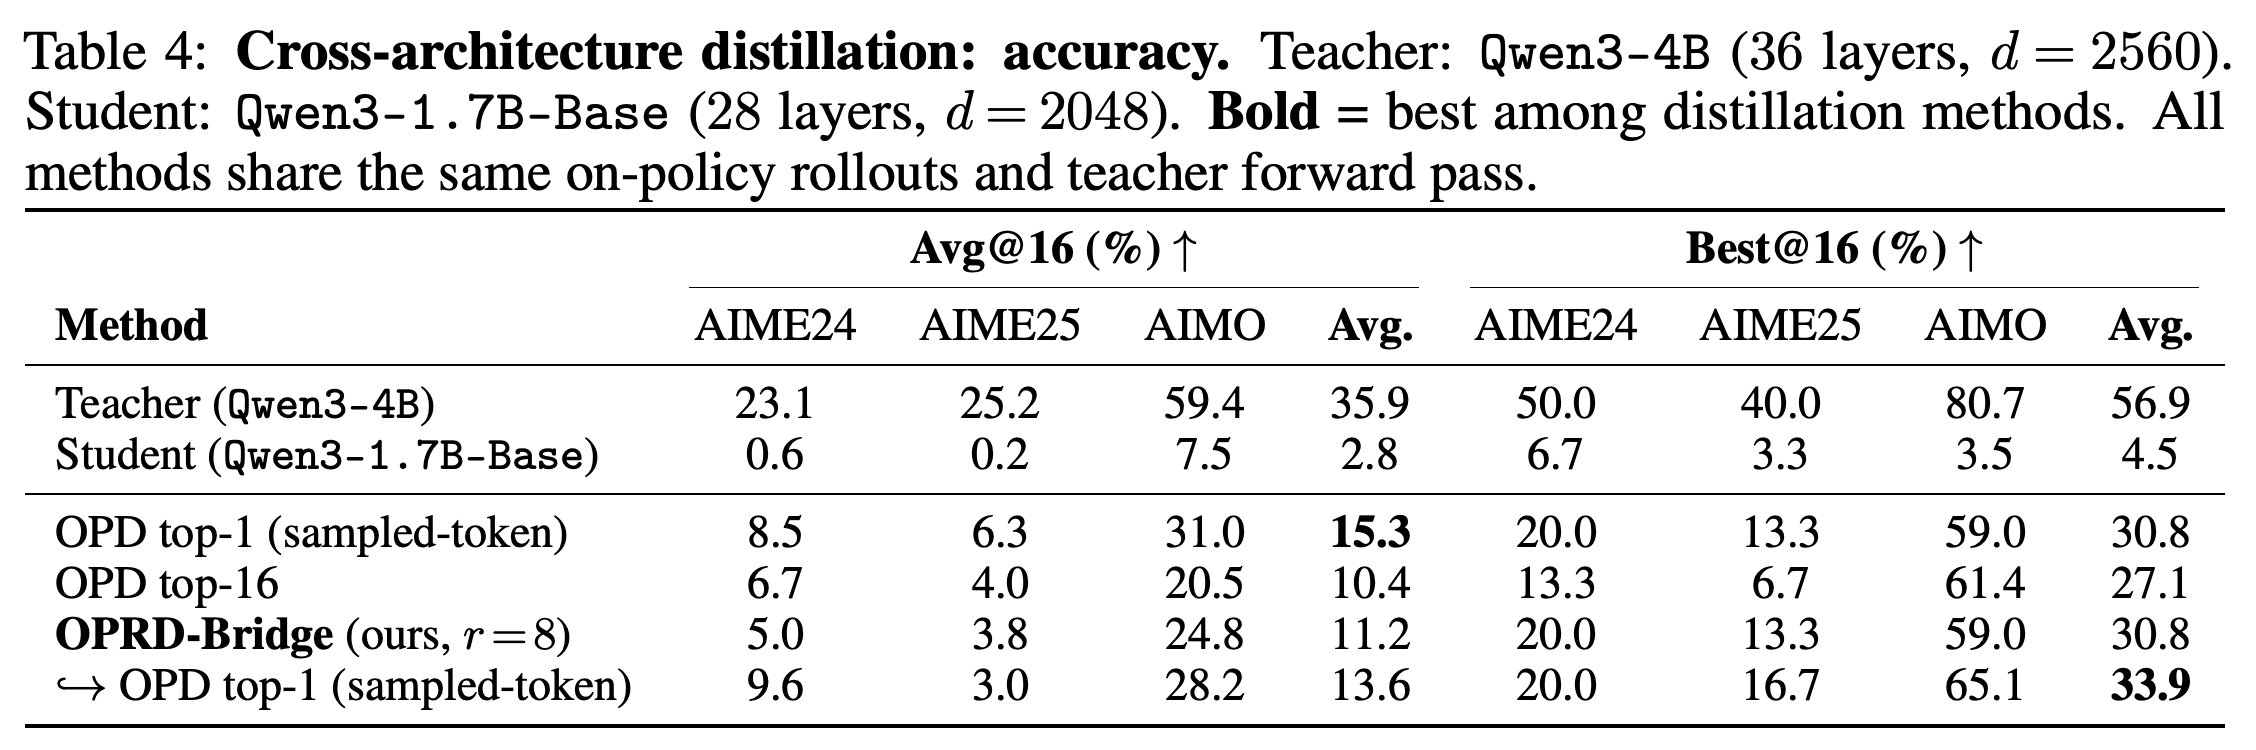
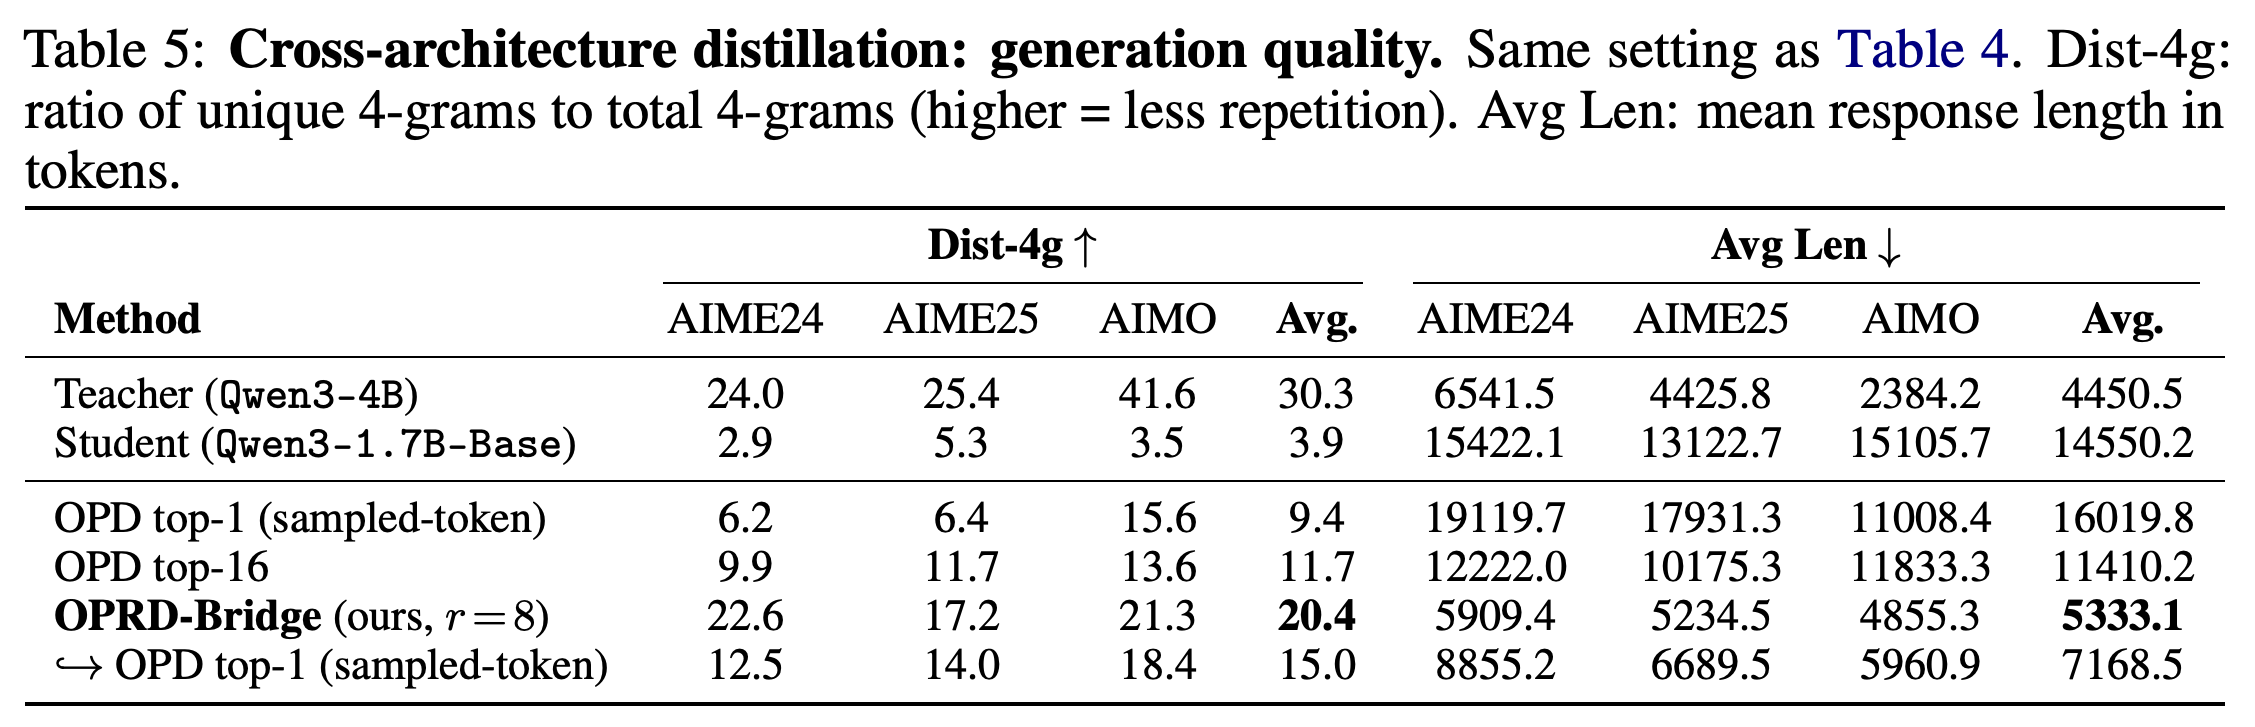
Table 5는 생성 행동이 크게 바뀜을 보여준다. OPRD-Bridge의 평균 Dist-4g는 20.4이고 평균 응답 길이는 5333.1개 토큰이다. OPD top-1은 9.4와 16019.8개 토큰, OPD top-16은 11.7과 11410.2개 토큰이다.
- Bridge의 benchmark별 Dist-4g는 22.6/17.2/21.3이고, 응답 길이는 5909.4/5234.5/4855.3개 토큰이다.
- Dist-4g는 4-gram의 고유 항목 수를 전체 항목 수로 나눈 비율이다. 추론의 정답 여부나 풀이 전략의 다양성이 아니라 어휘 반복을 측정하므로, 큰 길이 차이와 함께 해석해야 한다.
- 응답이 짧고 반복이 적은 대신 Avg@16은 sampled-token OPD보다 낮다. 평균 정답률에서 bridge가 이 baseline보다 우수한 것은 아니다.
Bridge는 단독 증류 방법 중 고유 4-gram 비율이 가장 높고 응답이 가장 짧으며, Table 4의 정확도 절충이 함께 나타난다. 일부 OPD 평균 길이는 명시한 학습 생성 한도를 넘지만, 별도의 평가 한도는 명시되어 있지 않다.
OPRD-Bridge checkpoint에서 OPD top-1 학습을 이어가면 평균 Best@16은 30.8%에서 33.9%로, Avg@16은 11.2%에서 13.6%로 높아진다. 논문은 출력 수준 fine-tuning이 정렬된 backbone을 토큰 확률로 변환하는 매핑을 보정한다는 설명을 제안한다.
- 순차 학습의 평균 Dist-4g는 15.0, 평균 응답 길이는 7168.5개 토큰이 된다. 이는 단독 bridge와 단독 OPD 사이의 생성 특성이다.
- 평균 Avg@16은 여전히 단독 OPD top-1의 15.3%보다 낮다.
- 추가 학습 단계에는 총 학습 예산을 맞춘 대조군이 없다. LM-head 보정이라는 설명도 head만 학습하는 ablation으로 분리해 검증하지 않는다.
4.2.3 Ablation Studies는 bridge rank를 r ∈ {1, 2, 4, 8, 16, 32, 64, 128, 256, 512, 1024, 2048}로 바꾼다. Figure 12에서 투영 cosine similarity는 r = 8일 때 95.0%로 가장 높다. 이후 r = 32에서 94.1%, r = 256에서 87.9%, r = 2048에서 77.0%로 낮아진다.
- Projector 학습 전 similarity는 최대 7.5%이며, 학습 후 rank 1에서는 72.3%에 도달한다.
- 보고된 높은 정렬도 구간은 rank 4–16이며, 값은 93.7–95.0%다.
- 이 실험은 rank별 downstream 정확도가 아니라 정렬도를 측정한다. 따라서 rank 8이 최적의 증류 rank임을 입증하지 않으며, 방향별 정렬도 감소를 직접 측정하지도 않는다.
학습한 투영 정렬도는 rank 8에서 가장 높고, 교사 PCA 방향을 더 포함할수록 낮아진다. 이는 작은 정렬 인터페이스를 뒷받침하지만, downstream 정확도를 최대화하는 rank를 결정하거나 가정한 방향별 상관 임계값을 직접 검증하지는 않는다.
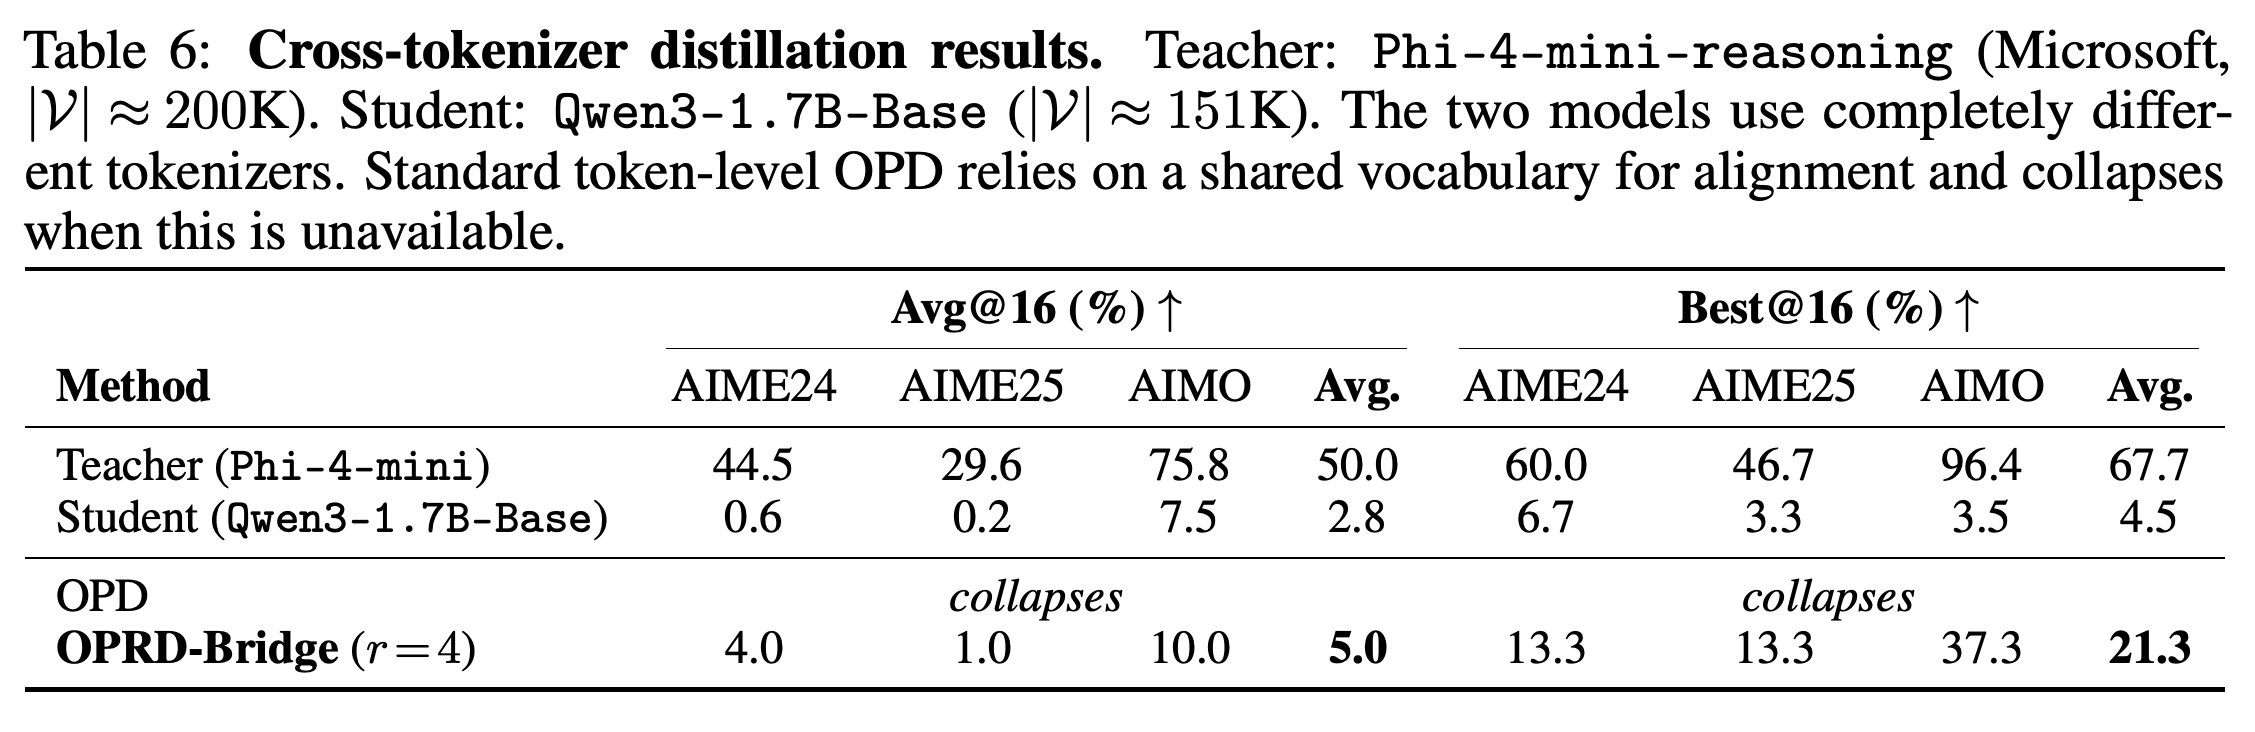
4.2.4 Cross-Tokenizer Distillation은 Phi-4-mini-reasoning을 교사로, Qwen3-1.7B-Base를 학생으로 사용하며 bridge rank는 r = 4다. 교사는 계층 32개, 은닉 차원 3072, tiktoken 기반의 약 200K개 어휘를 가진다. 학생은 Qwen BPE와 약 151K개 어휘를 사용한다.
- Table 6의 bridge Avg@16은 4.0/1.0/10.0이고 Best@16은 13.3/13.3/37.3이다. 보고된 평균은 각각 2.8%에서 5.0%로, 4.5%에서 21.3%로 높아진다.
- OPD 행에는 수치 결과나 tokenizer가 다른 모델 사이의 상세한 출력 정렬 baseline 없이 “collapses”라고만 적혀 있다.
- 방법 설명에는 은닉 상태를 맞출 때 서로 다른 교사와 학생의 토큰 경계를 어떻게 정렬하는지 명시하지 않는다. 핵심 구현 세부사항이 해결되지 않은 채 남아 있다.
Rank-4 bridge는 tokenizer가 다른 모델 사이에서 보고된 평균을 높이지만, 교사에는 크게 못 미친다. OPD에는 정성적인 collapse 표기만 있다. 학생의 AIMO Best@16은 Avg@16보다 낮아 명시한 정의와 모순된다.
5 Discussion
논의 절은 표현 정렬을 직접 매칭의 전제조건으로 보고, bridge를 제한된 공통 인터페이스를 구성하는 방법으로 설명한다. 응용으로 여러 모델의 RL merging과, 교사에만 제공되는 정보를 활용한 on-policy self-distillation을 제안한다.
- 다중 교사 merging과 교사 전용 정보를 활용한 self-distillation은 모두 실험으로 평가하지 않는다.
- Alignment-aware pre-training은 공유 초기화, 표현 regularization, co-distillation으로 표현 불일치를 줄이려는 제안이다. 너비가 다르면 여전히 차원 adapter가 필요하다.
- 이는 제안된 확장 방향이며, 보고된 실험으로 입증된 이점은 아니다.
6 Related Work
관련 연구 절은 OPRD를 출력 공간 knowledge distillation, on-policy 언어 모델 증류, 중간 feature matching과 연결한다. 차별점은 계속 바뀌는 학생 생성 autoregressive prefix에서 표현을 감독한다는 조합에 있다.
- MiniLLM [8]과 GKD [1]는 on-policy 분포 매칭의 근거가 된다. FitNets [28], TinyBERT [17], MobileBERT [33], MiniLM/MiniLMv2 [34, 35]는 feature 수준 전이의 근거가 된다.
- 논문은 예측에 쓰이는 prefix의 목표 표현과 고정 corpus의 feature matching을 대비하고, auxiliary supervision, DINO [3], representation engineering [49]를 인접한 접근법으로 논의한다.
- 새로움에 대한 주장은 표현 매칭 일반이 아니라, on-policy autoregressive 샘플링과 교사·학생 은닉 상태 증류의 결합에 관한 것이다.
7 Conclusion and Future Work
결론은 동일 아키텍처에서 측정된 학습 비용을 낮추면서 교사에 가까운 수학 정확도를 달성하고, 이종 모델 사이에서도 표현 공간 전이를 수행했다는 점을 강조한다. 수학 추론을 넘어선 전이, cross-modal 증류, adaptive supervision, 제안한 phase-transition 메커니즘은 후속 연구로 남긴다.
- 다른 제안 방향으로는 on-policy representation self-distillation, attention-map matching, alignment-aware pre-training, 표현 수준 진단이 있다.
- 실험은 작은 모델 쌍과 3개 long-chain-of-thought 수학 benchmark를 사용한다. 코드 생성, 대화, agent 상호작용, 더 큰 모델, multimodal 설정은 시험하지 않는다.
- 명시적인 수렴 속도 bound와 더 정밀한 spectral 특성화는 향후 이론 연구로 제시한다.
부록
- A Notation Summary는 정책, 아키텍처 차원, 응답 분포, 목적함수, bridge projector, 이론적 수량을 다루는 표 2개를 제공한다. 표기는 혼합 가중치 µ와 계층별 교사 중심화 평균을 구분한다. 그런데 Table 7은 µ가 OPD의 가중치라고 설명하는 반면 Eq. (7)은 OPRD에 가중치를 적용한다. 또한 §3.1에 있다고 표시한 차원 adapter W는 해당 절에 정의되어 있지 않다.
- B Formal Theoretical Guarantees, B.1 Setup and Assumptions, B.2 Variance of Sampled-Token OPD, B.3 OPRD Gradient Is Deterministic, B.4 Signal-to-Noise Ratio Collapse of Sampled-Token OPD는 미분 가능성, 유한 Fisher information, 유계 로그 비율, 유계 Jacobian을 가정하고 고정된 prefix의 gradient를 분석한다. 고정된 prefix의 MSE gradient는 결정적이다. 그러나 Eq. (17)은 가중치 없는 score 추정량을 정의하고, 이후 결과는 로그 비율로 가중한 REINFORCE 추정량을 사용한다. 이들은 서로 다른 추정량이다. 제시된 논증은 분산 하한이나 주장한 O(δ²) 제곱 gradient scaling을 입증하지 못한다. 표현 오차가 0이 아니라고 해서 매개변수 gradient도 0이 아닌 것은 아니다.
- B.5 Formal Results for Theorem 2: LM-Head Information Bottleneck은 logits의 상수 이동에 대한 softmax 불변성을 유도하고 LM-head의 특이벡터 방향에 따른 민감도를 논의한다. 불변성 항등식은 명시한 유효 영공간에서 성립하지만, 열 완전계수인 head에서는 이 공간에 0이 아닌 벡터가 없을 수도 있다. KL의 이차 근사 논증은 개별 샘플의 로그 비율에 같은 bound가 성립함을 입증하지 못한다. 개별 로그 비율은 음수일 수 있고 일차로 변할 수 있다. 제시된 spectral 유도는 추가 정규화 없이는 명시한 조건수 식이 아니라 1/σd²를 포함한 bound를 준다.
- B.6 Formal Results for Theorem 3: Optimality of the Low-Rank Bridge에는 B.6.1 Setup, B.6.2 Rate–Distortion Optimality, B.6.3 Bias–Variance Decomposition of Distillation Error가 포함된다. PCA는 rank-r 직교 투영 중 교사 재구성 MSE를 최소화한다. 한편 모델링한 총 오차는 방향별 정렬도가 단조적이라는 가정 아래, 제외한 예측 가능 신호와 포함한 선형 예측 잔차를 더한다. 한계 오차는 (\lambda_r(1-2\rho_r^2))이므로 (\rho_r^2=\frac{1}{2}) 근처에서 임계값이 생긴다. 그러나 이 대리 목적함수는 투영 MSE만을 뜻하지 않으며, 최적의 downstream rank를 입증하지도 않고, 유한 rate에서 완전한 rate–distortion 구성을 제공하지도 않는다.
짧은 생각
가장 강한 기여는 실용적이다. 표현이 정렬된 교사·학생 쌍은 학생 증류 손실 경로에 어휘 크기의 tensor를 두지 않고도 직접적인 다층 감독의 이점을 얻는다. Tables 2와 3은 이 결론을 뒷받침한다. Bridge 결과가 뒷받침하는 주장은 더 제한적이다. 평균 정답률이 더 높다는 것이 아니라, 더 짧고 반복이 적은 출력으로 전이가 가능하다는 점이다.
이종 모델 결과에는 더 명확한 보고와 더 강한 대조 실험이 필요하다. Tables 4와 6은 학생의 AIMO Best@16을 3.5%로 보고하며, 이는 Avg@16 7.5%보다 낮아 명시한 지표 정의와 모순된다. 또한 Table 5는 별도의 평가 길이 제한을 명시하지 않은 채 학습 생성 한도인 16,384개 토큰을 넘는 일부 평균 길이를 보고한다. 반복 학습 seed, 불확실성 구간, 독립적인 checkpoint 선택, 예산을 맞춘 순차 학습 baseline, downstream rank ablation이 있으면 비교를 더 명확히 해석할 수 있다. 재현성과 bridge 메커니즘을 평가하려면 tokenizer가 다른 모델 간 토큰 위치 정렬 방법과, projector를 고정하는 경우 및 공동 학습하는 경우의 정량 비교가 필요하다. 관측한 곡선은 출력 공간 증류에서 보편적인 SNR 붕괴가 발생함을 입증하지 않는다. 높은 투영 cosine similarity를 추론 능력의 전이와 동일시할 수도 없다.