


Towards Autonomous Mathematics Research 요약 설명
10 Feb 2026 | Paper Review Mathematical Reasoning AI Research Agents Test-Time Scaling Tool Use목차
- 요약
- 1. Introduction
- 2. The Aletheia agent: From Olympiads to Research-level Mathematics
- 3. Summary of Mathematical Research Results
- 4. FirstProof
- 5. Analysis and Discussion
- 6. Representing AI contributions to mathematics
- 7. Reflections on the Impact of AI in Mathematics
- 8. Related Work
- 9. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Towards Autonomous Mathematics Research 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 10일(Arxiv)
- Feng, Tony, Trinh, Trieu H., Bingham, Garrett, Hwang, Dawsen, Chervonyi, Yuri, Jung, Junehyuk, Lee, Joonkyung, Pagano, Carlo, Kim, Sang-hyun, Pasqualotto, Federico, et al.
- Google DeepMind, UC Berkeley, Brown University, Yonsei University, Concordia University, Korea Institute for Advanced Study, UC San Diego, Caltech
- 논문 링크
요약
- Towards Autonomous Mathematics Research는 해법 생성, 자연어 검증, 수정을 분리한 Gemini Deep Think 기반 에이전트 Aletheia를 소개한다. 핵심 과제는 경시대회 수학에서 보인 추론 능력을 전문 연구로 확장하는 것이다. 전문 연구에서는 전문 문헌, 긴 논증, 모호한 문제 서술, 정확한 인용 때문에 더 높은 신뢰성이 필요하다.
- Aletheia는 필수적인 인간 개입 없이 Eigenweights for Arithmetic Hirzebruch Proportionality의 수학적 내용을 생성했고, 여러 공동 연구 논문에도 기여했다. Erdős 문제 700개에 적용한 결과, 인간 검토를 거쳐 의도된 문제에 올바르게 답한 답변 13개를 얻었다. 여기에는 새로운 완전 해결 2개와 새로운 부분 해결 2개가 포함된다. FirstProof에서는 best-of-2 평가로 문제 10개 중 6개를 해결했다고 판정했으나, P8에 대한 전문가의 긍정 평가는 5/7에 그쳤다.
- 이 결과는 일관되게 신뢰할 수 있는 자율 수학 연구보다는 일부 문제에서 유용한 연구 지원 능력을 보여준다. 판정이 완료된 Erdős 후보 답변 200개 중 137개에는 근본적인 결함이 있었고, FirstProof의 개별 실행에도 실질적인 오류가 있었다. 논문은 AI 역량의 진전과 수학적 성과를 구분하기 위해 자율성과 수학적 중요성을 별도 축으로 평가하고, Human-AI Interaction Cards를 함께 사용할 것을 제안한다.
1. Introduction
경시대회 문제는 대체로 문제 자체에 필요한 정보가 모두 담겨 있지만, 연구에는 전문 지식과 방대한 문헌을 종합하는 능력이 필요하다. Aletheia는 더 강력한 Gemini Deep Think 모델, 추론 시점 스케일링, 검색과 브라우징을 결합한다. 서론은 자율적인 eigenweight 계산, independence polynomial 공동 연구, 광범위한 Erdős 평가, 중간 명제의 개선을 주요 근거로 제시한다.
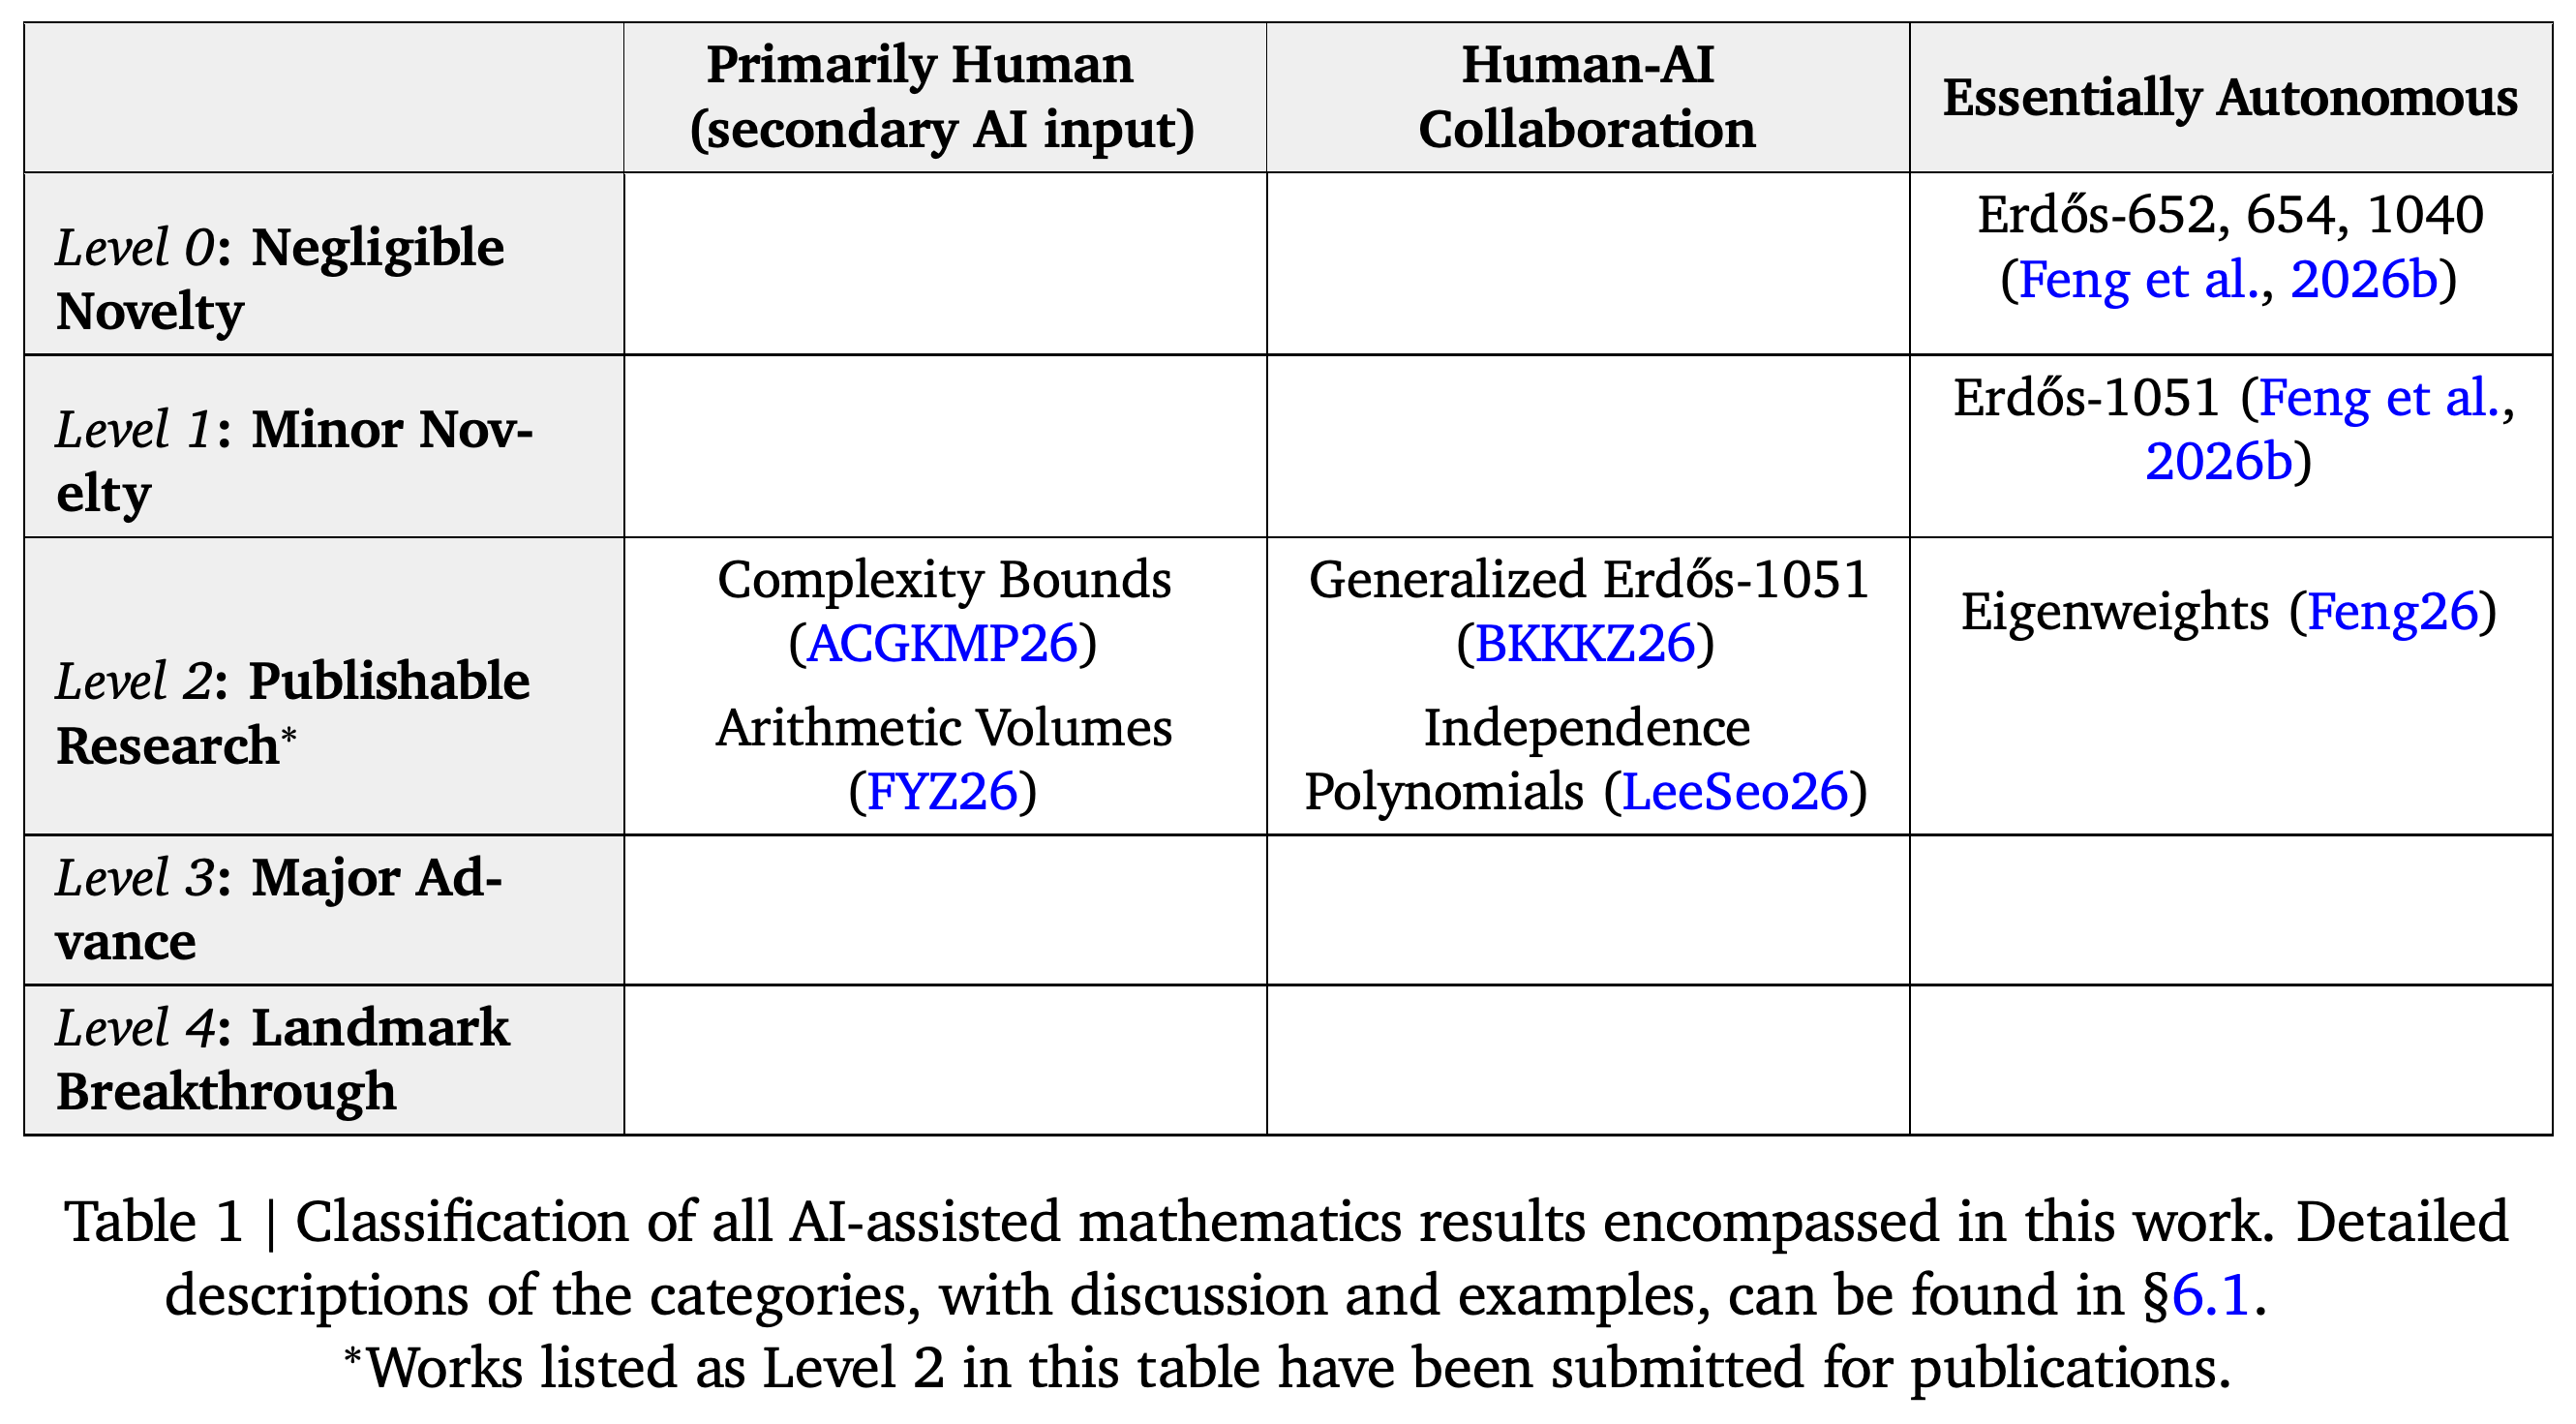
- Table 1은 AI의 관여 정도와 수학적 중요성을 구분한다. 보고된 결과 중 Major Advance나 Landmark Breakthrough로 분류된 결과는 없다.
- 자율적인 eigenweight 연구는 수학적 내용의 생성에 관한 것이며, 인간 없이 논문을 출판했다는 뜻은 아니다. 인간이 최종 논문을 작성했고 정확성, 서술, 출처 표기에 대한 책임을 맡았다.
- 프롬프트와 출력은 https://github.com/google-deepmind/superhuman/tree/main/aletheia 에서 확인할 수 있다.
이 행렬은 eigenweight 연구를 본질적으로 자율적인 출판 가능 연구 칸에 배치하고, independence polynomial과 일반화된 Erdős-1051 연구를 협업 칸에 배치한다. Major Advance와 Landmark Breakthrough 행은 비어 있어, 이 사례들을 더 중요한 수학적 성과와 구분한다. 각주는 Level 2 연구가 출판을 위해 제출된 상태임을 명시한다.
2. The Aletheia agent: From Olympiads to Research-level Mathematics
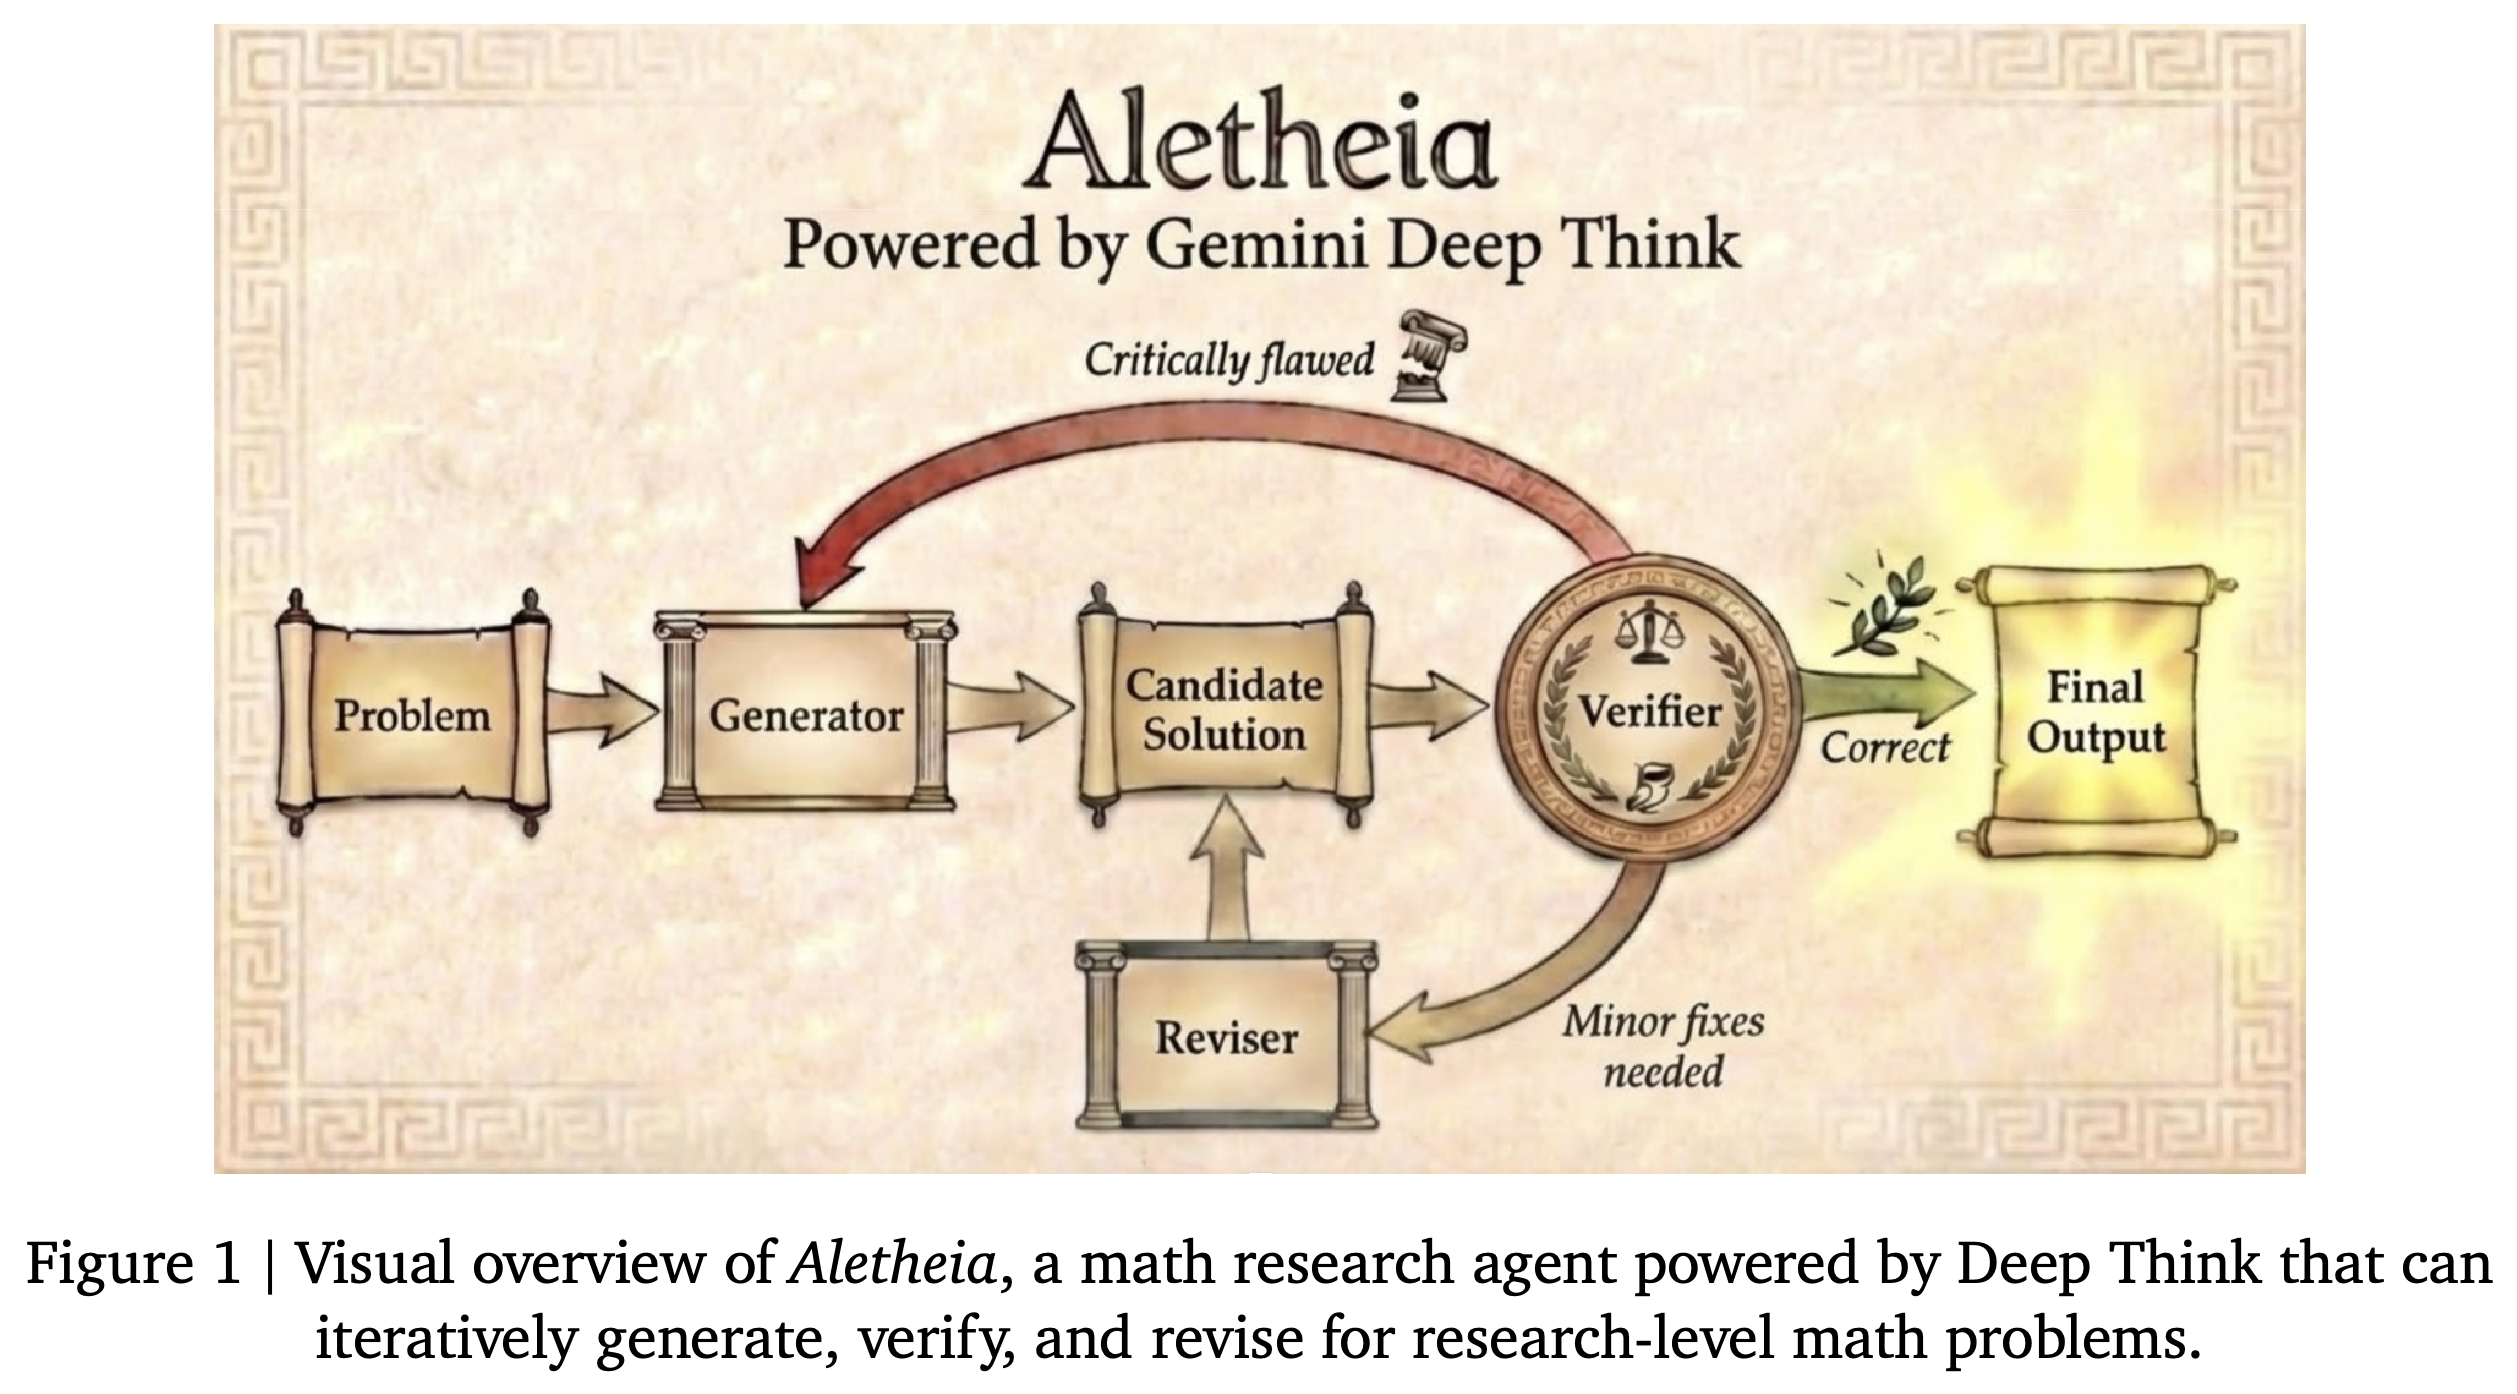
Aletheia는 Generator, Verifier, Reviser라는 하위 에이전트 3개를 조율하며, 각 에이전트는 내부에서 Gemini 기반 모델을 호출한다. Verifier가 해법을 승인하거나 미리 정한 시도 횟수에 도달할 때까지 생성과 검사를 반복한다. AlphaGeometry와 AlphaProof가 사용하는 형식 언어와 달리, 모든 과정은 자연어로 진행된다.
- Figure 1은 후보 해법에 치명적인 결함이 있을 때 다시 생성하는 과정과 사소한 수정만 필요할 때 수정하는 과정을 구분한다.
- 이 구조는 모델이 사전학습으로 폭넓은 수학 지식을 갖췄어도 여전히 발생하는 오류와 환각을 줄이기 위한 것이다.
Verifier는 치명적인 결함이 있는 후보를 생성 단계로 돌려보내고, 사소한 수정이 필요한 후보는 Reviser로 보낸다. 승인된 후보는 최종 출력이 된다. 이는 자연어로 반복 검사하는 절차이며, 형식적 증명 인증 절차가 아니다.
2.1. Scaling Laws and the Evolution of Deep Think
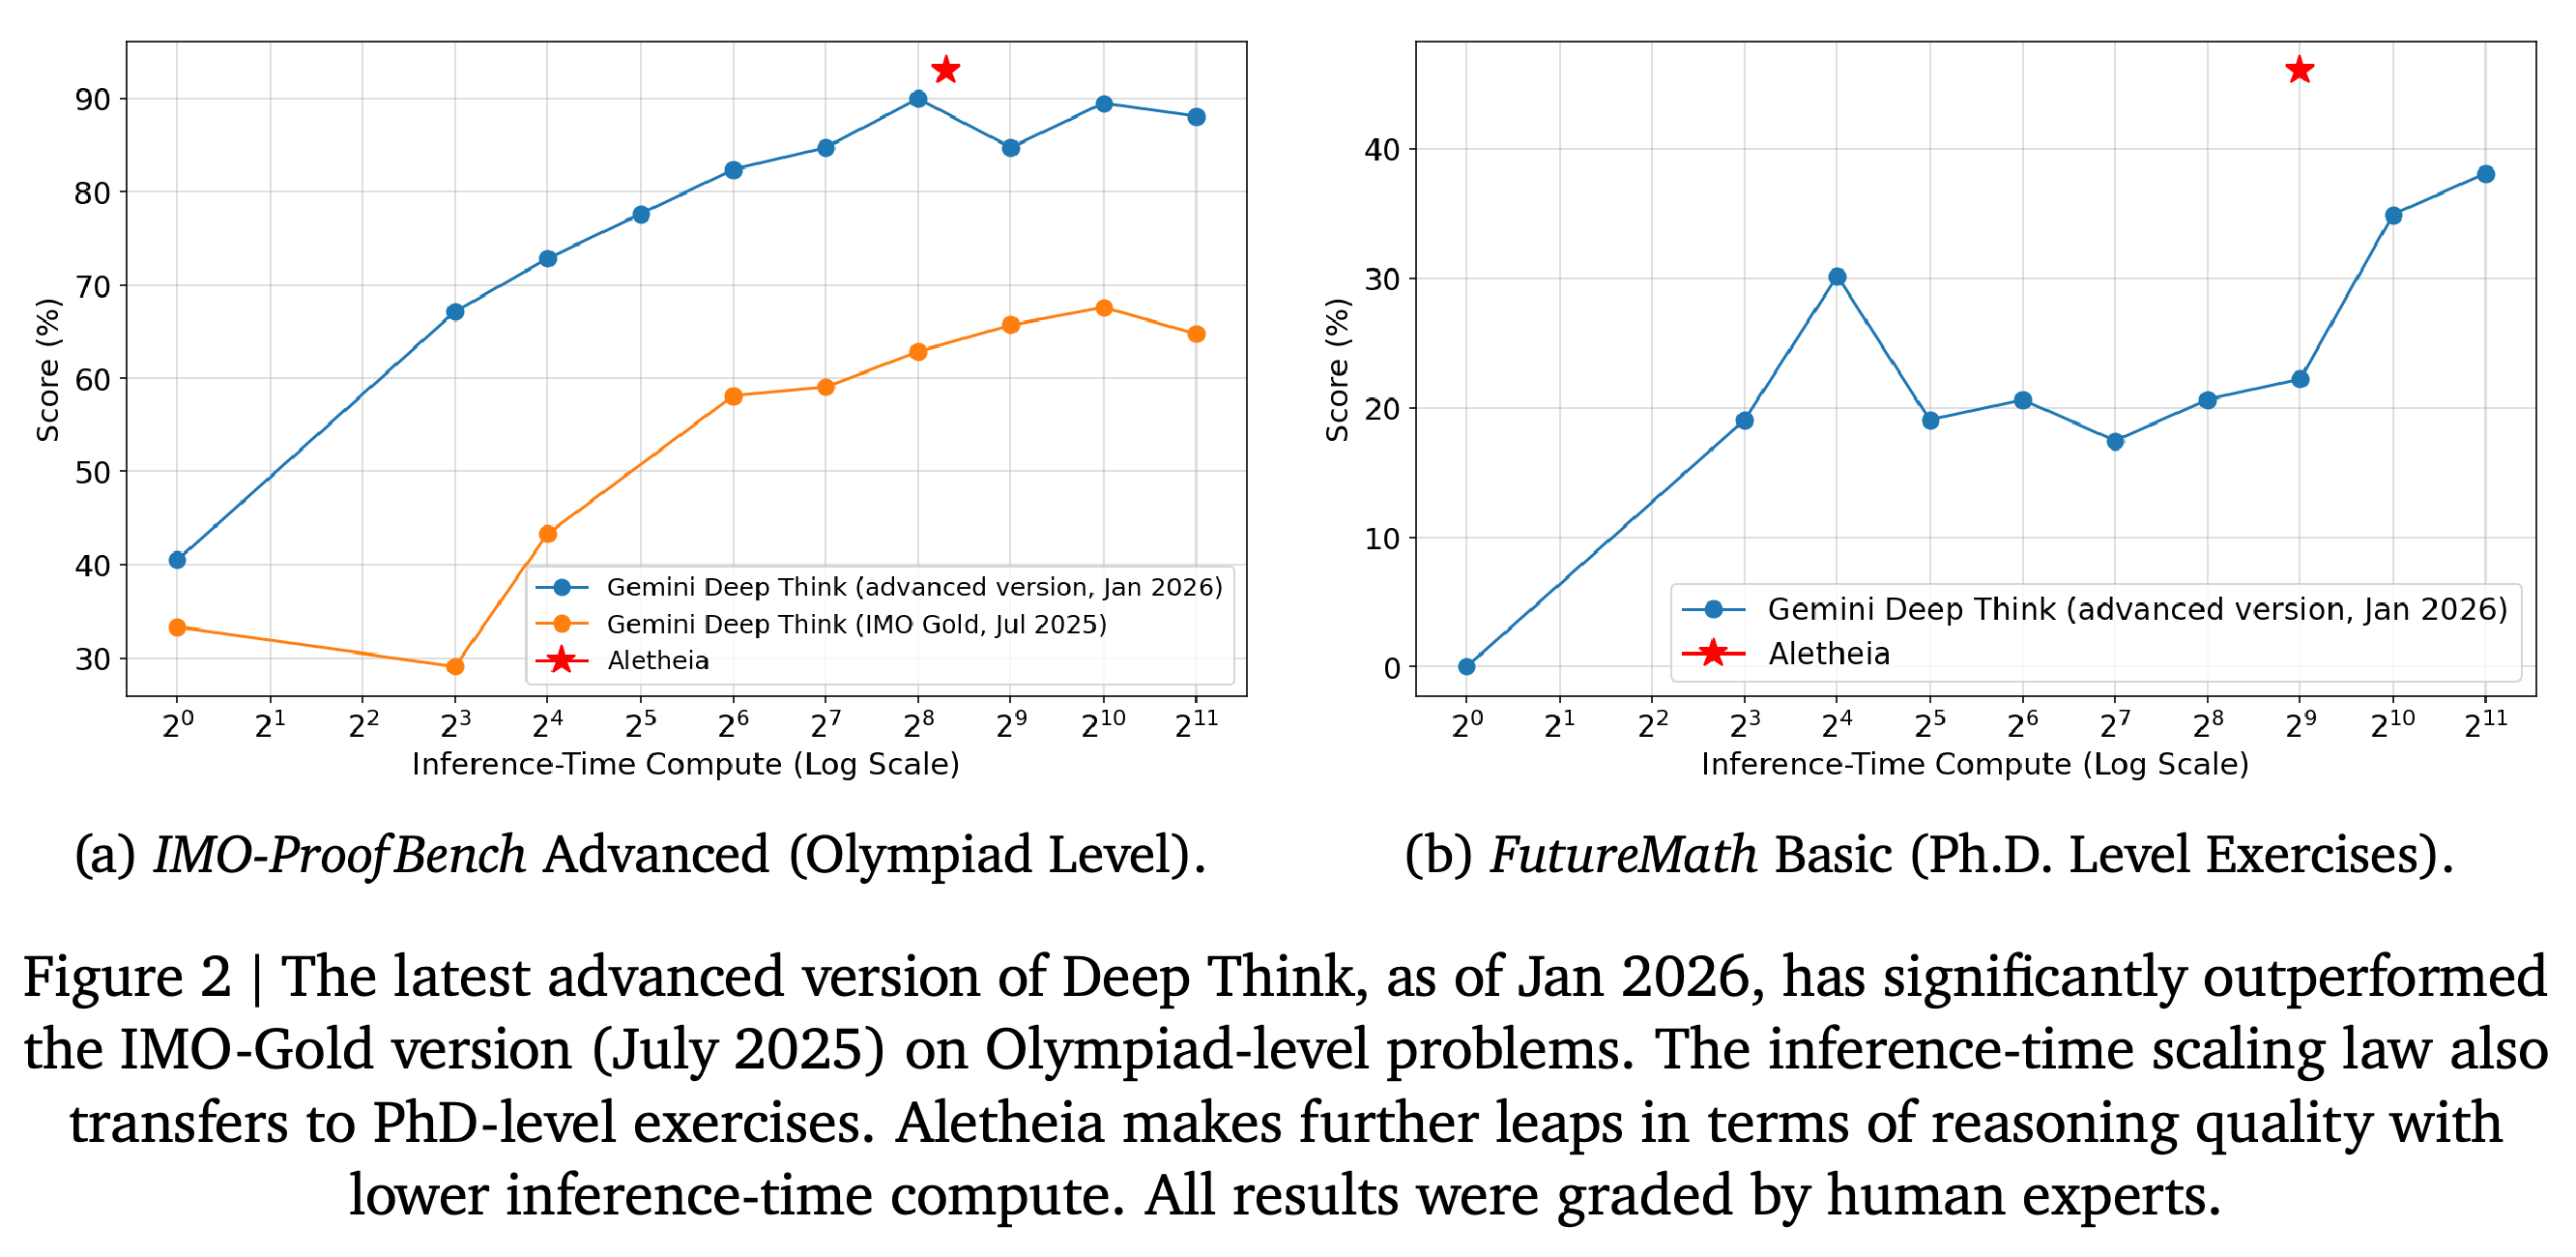
추론 스케일링 실험에서는 각 계산 규모에서 모델을 문제마다 반복 없이 실행하고, 도구를 비활성화한 뒤 인간이 채점했다. 문제 30개로 구성된 IMO-Proof Bench Advanced 하위 집합에서 Deep Think의 January 2026 모델은 July 2025 모델과 같은 성능을 내는 데 필요한 계산량을 약 100x 줄였다. FutureMath Basic에서도 스케일링의 이점이 나타났지만, 박사과정 수준의 연습문제에서는 정확도가 훨씬 낮았다.
- Figure 2는 계산량에 따른 성능 향상 이후 정체나 변동이 나타나는 양상과 Aletheia의 하네스가 얻은 더 높은 점수를 보여준다.
- July 2025 모델은 IMO 문제 6개 중 5개를 완벽하게 해결했다. January 2026 모델은 IMO 2025 Problem 6와 IMO 2024 변형 문제에서 추가로 진전했지만, 저자들은 공개된 문제에 노출되었을 가능성을 명시적으로 경고한다.
- 논문은 새로운 학습 개선을 언급하지만, 이를 재현할 만큼 자세한 정보는 제공하지 않는다. 스케일링 결과는 경험적 관찰이며, 명시적인 해석적 법칙은 아니다.
2.2. Developing Agentic Harnesses for Research-Level Math
하네스는 후보 해법의 최종 출력과 중간 사고 토큰을 분리하고 검증 절차를 적용한다. 이를 통해 모델은 생성 과정에서 놓친 오류를 찾아낼 수 있다. Aletheia는 도구 없이 IMO-Proof Bench Advanced에서 전체 점수 93%를 달성했고, 전체 문제 30개 중 답변한 29개에서 조건부 정확도 96%를 기록했다. FutureMath Basic에서는 문제의 60% 미만에 답변했고, 조건부 정확도는 82%를 넘었다.
- Aletheia는 실험한 계산 규모 전반에서 같은 기반 모델을 사용하는 Deep Think보다 성능이 높았다. 다만 동적인 계산량 사용을 정밀하게 통제할 수는 없었다.
- 이후 February 2026에 Gemini 3 모델을 기반으로 한 Aletheia는 도구 없이 IMO-Proof Bench Advanced에서 점수 95%를 기록했다.
- 저자들은 전문가의 검증 여력이 제한될 때 답변을 보류하는 것이 유용하다고 본다. 허세를 유도하는 학습 유인이나 오해를 일으키는 사고 맥락에 관한 설명은 아직 가설이다.
올림피아드 패널에서는 비슷한 계산량에서 January 2026 모델이 July 2025 모델보다 높은 성능을 보인다. 반면 박사과정 연습문제 패널의 점수는 훨씬 낮다. 표시된 Aletheia 결과는 해당 Deep Think 곡선보다 높아, 스케일링만으로 설명되지 않는 하네스의 이점을 뒷받침한다. 다만 동적 예산 때문에 계산량을 정확하게 맞추기는 어렵다.
2.3. Importance of Tool Use
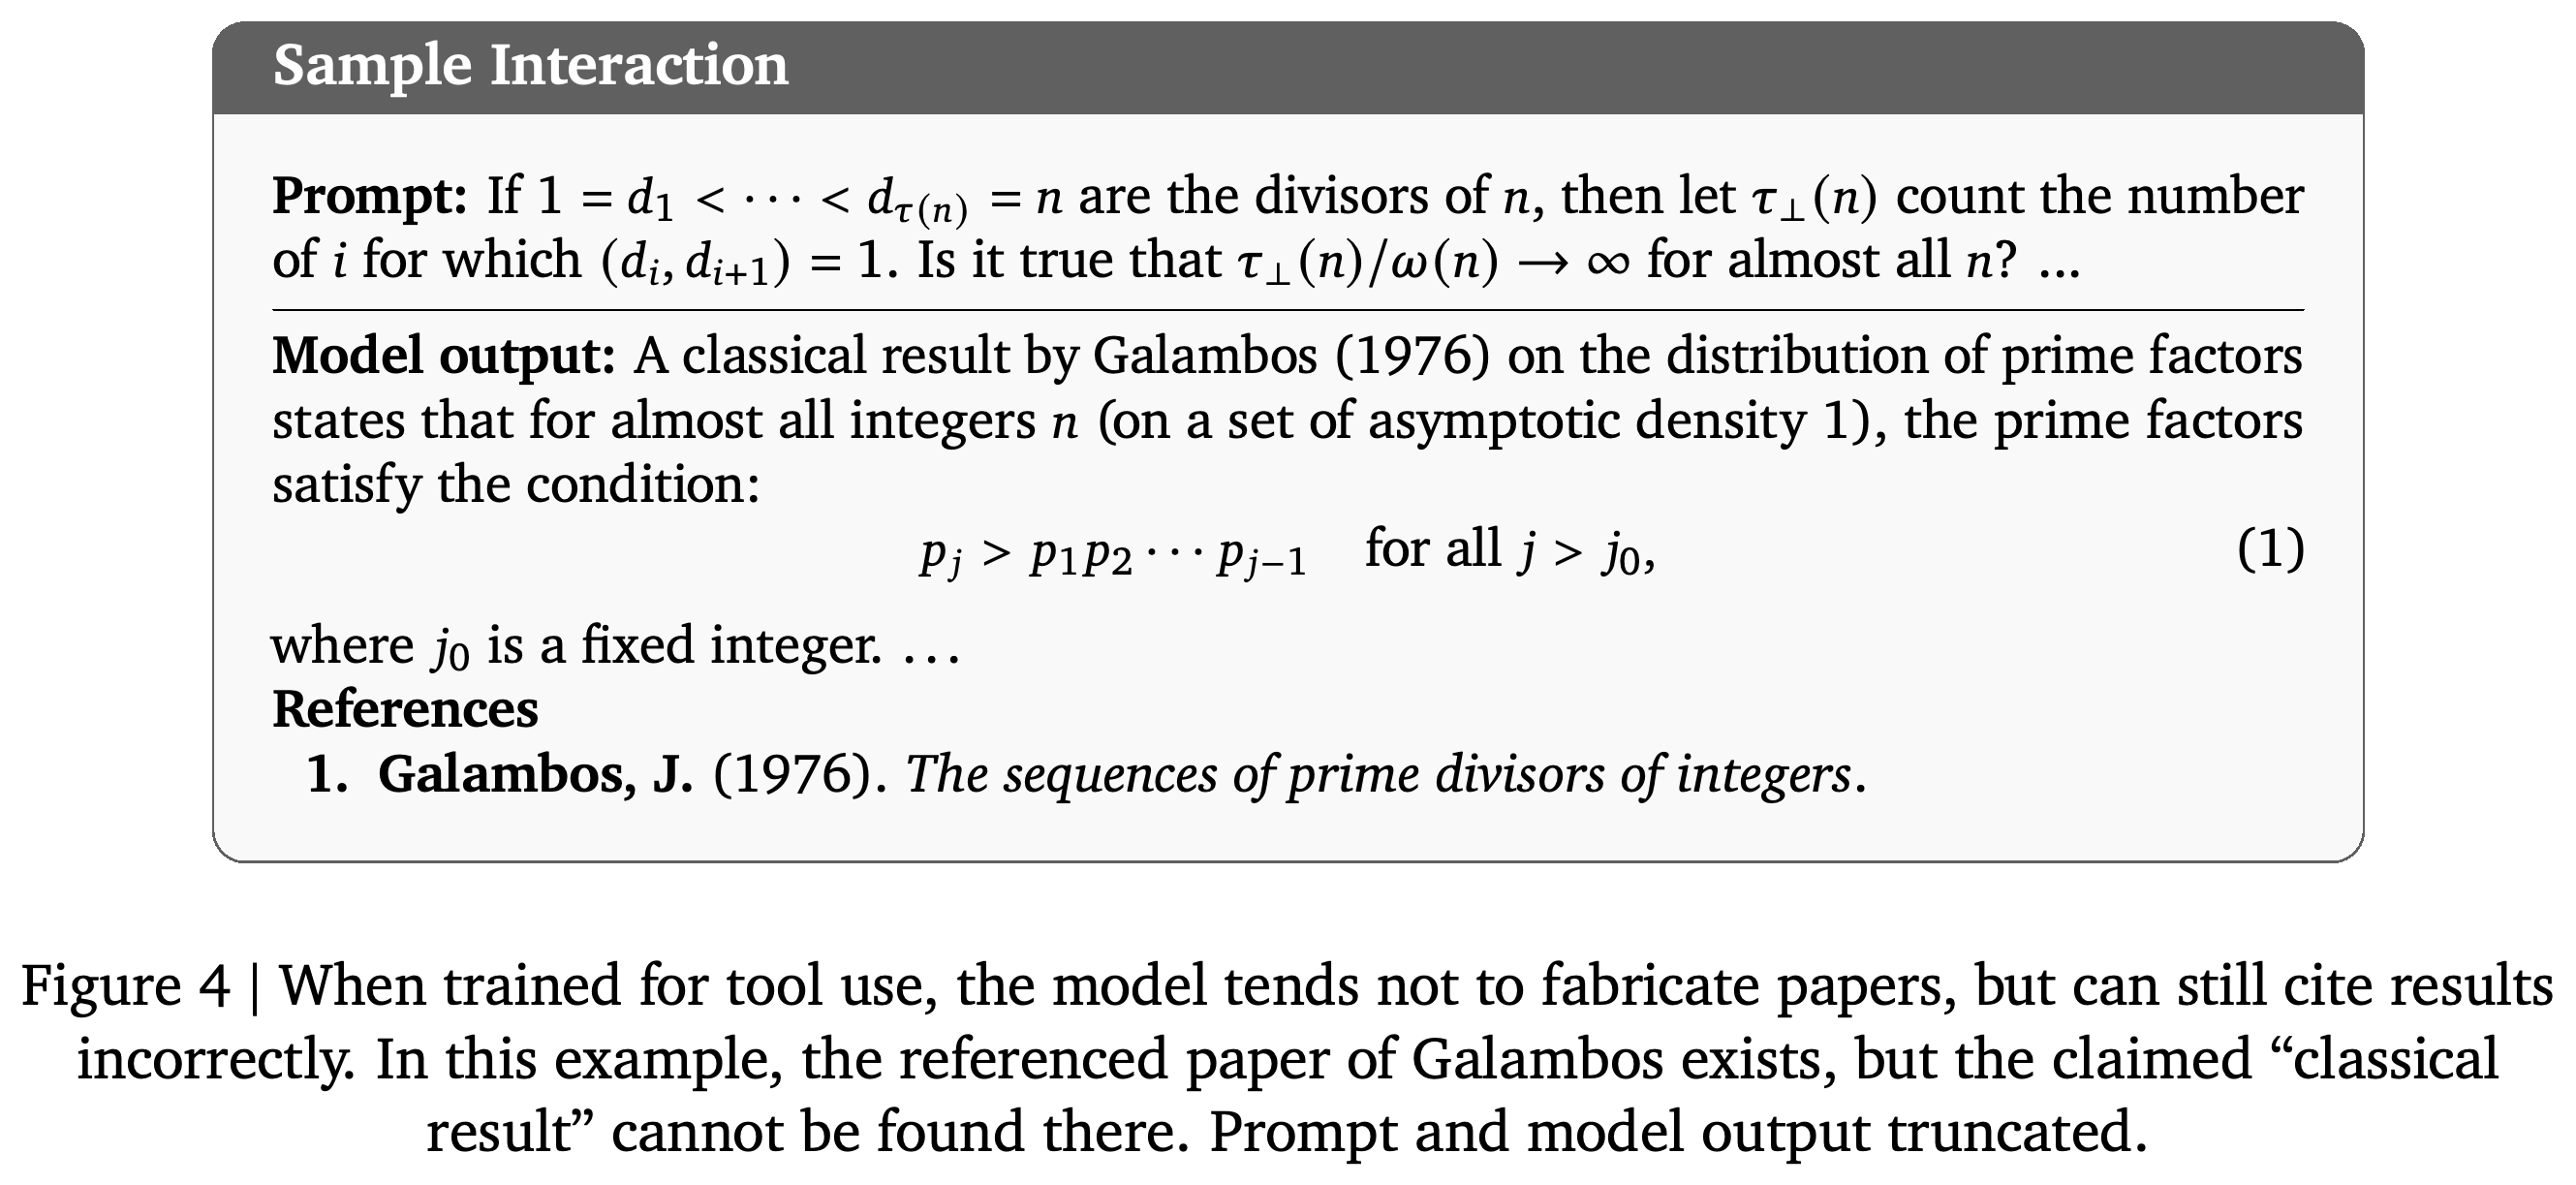
광범위한 도구 사용 학습과 검색·브라우징을 결합하자 명백히 지어낸 인용이 줄었다. 인터넷 접근만으로는 충분하지 않았다. 실제 논문의 결과를 잘못 설명하는 오류는 남았고, Python을 추가해도 계산 관련 환각은 소폭만 개선되었다.
- Figure 3은 pretzel knot P(−3, 5, 13)에 관한 주장을 뒷받침하기 위해 지어낸 참고문헌을 사용한 사례를 보여준다.
- Figure 4는 다른 실패를 보여준다. Galambos의 논문은 실제로 존재하지만, 모델이 주장한 소인수에 관한 고전적 결과는 그 논문에 없다.
- 따라서 참고문헌의 존재 여부만 확인해서는 충분하지 않으며, 그 수학적 내용이 논증을 실제로 뒷받침하는지도 확인해야 한다.
모델은 실제 Galambos 논문을 인용하지만, 그곳에 없는 소인수 관련 명제를 해당 논문의 결과로 제시한다. 이는 서지 정보의 진위와 수학적 근거를 구분하며, 도구 사용 학습 후에도 남는 실패 유형을 보여준다.
3. Summary of Mathematical Research Results
여기서 요약한 연구 논문들은 November 2025 모델을 기반으로 한 Aletheia를 활용했다. 이 모델은 앞서 비교한 July 2025 버전과 January 2026 버전 사이에 해당한다. 모든 최종 논문은 인간 저자들이 모델 출력을 바탕으로 작성했다. 저자로 이름을 올리는 것은 형식 검증만으로 보장할 수 없는 출처 표기와 서술까지 포함해 모든 내용에 책임을 진다는 뜻이기 때문이다.
3.1. Milestone A: Eigenweights for Arithmetic Hirzebruch Proportionality
Eigenweights for Arithmetic Hirzebruch Proportionality(Feng26)는 Feng–Yun–Zhang(FYZ26)의 산술적 비례성 체계에서 미분 연산자를 결정하는 구조 상수를 구한다. 이미 알려진 계열에 대한 초기 벤치마크 성공을 계기로 인간 저자들은 기존 증명을 대체했다. 이후 Aletheia는 필수적인 인간 개입 없이 일반적인 eigenweight를 계산했으며, 저자들에게 익숙하지 않은 대수적·조합론적 기법을 사용했다.
- 배경에는 shtuka 모듈라이 공간에서 Chern class의 산술적 부피와 Gross motive의 L-function에 미분 연산자를 적용한 값 사이의 관계가 있다.
- 뒤에 나오는 상호작용 카드는 Atiyah–Bott localization, Schur polynomial 조작, Frobenius character 항등식, Murnaghan–Nakayama rule을 사용한 Type A, Type C, Type D 군의 해법을 기록한다.
- 이 성과는 Feng26의 수학적 내용을 자율적으로 생성했다는 데 있다. 자율적으로 저자 역할을 수행했다거나 중대한 수학적 돌파구를 이루었다는 주장은 아니다.
3.2. Milestone B: Lower Bounds for Multivariate Independence Polynomials
Lower bounds for multivariate independence polynomials and their generalisations(LeeSeo26)는 독립집합과 여러 유형의 상호작용 입자를 모델링하는 확장에 대한 부등식을 제시한다. Deep Think가 Sah–Sawhney–Stoner–Zhao의 결과를 일반화하는 초기 부등식을 증명한 뒤, Aletheia는 더 어려운 확장에 대한 큰 틀의 전략을 제시했다. 인간 저자들은 이를 엄밀한 증명으로 완성했다.
- 독립집합은 이웃한 위치를 동시에 점유할 수 없는 배치를 모델링한다. 확장에서는 입자 유형 2개를 허용하며, 서로 다른 유형의 입자끼리는 반발하지 않는다.
- Aletheia는 쌍대 집합, 그 집합의 로그 볼록성, 환원 기법, semiproper colouring에 필요한 핵심 보조정리에 기여했다.
- 이 협업은 일반적인 문제 분해 방식과 반대로 진행됐다. AI가 전체 전략을 제시하고 인간이 엄밀한 증명을 완성했으며, 제안된 명제를 독립적으로 다시 증명하기도 했다.
- 다른 모델들도 초기 질의를 해결할 수 있었지만, 더 어려운 질의에서 저자들이 유용하다고 평가한 출력을 낸 모델은 실험한 모델 중 Aletheia뿐이었다.
3.3. Milestone C: The Erdős Problems
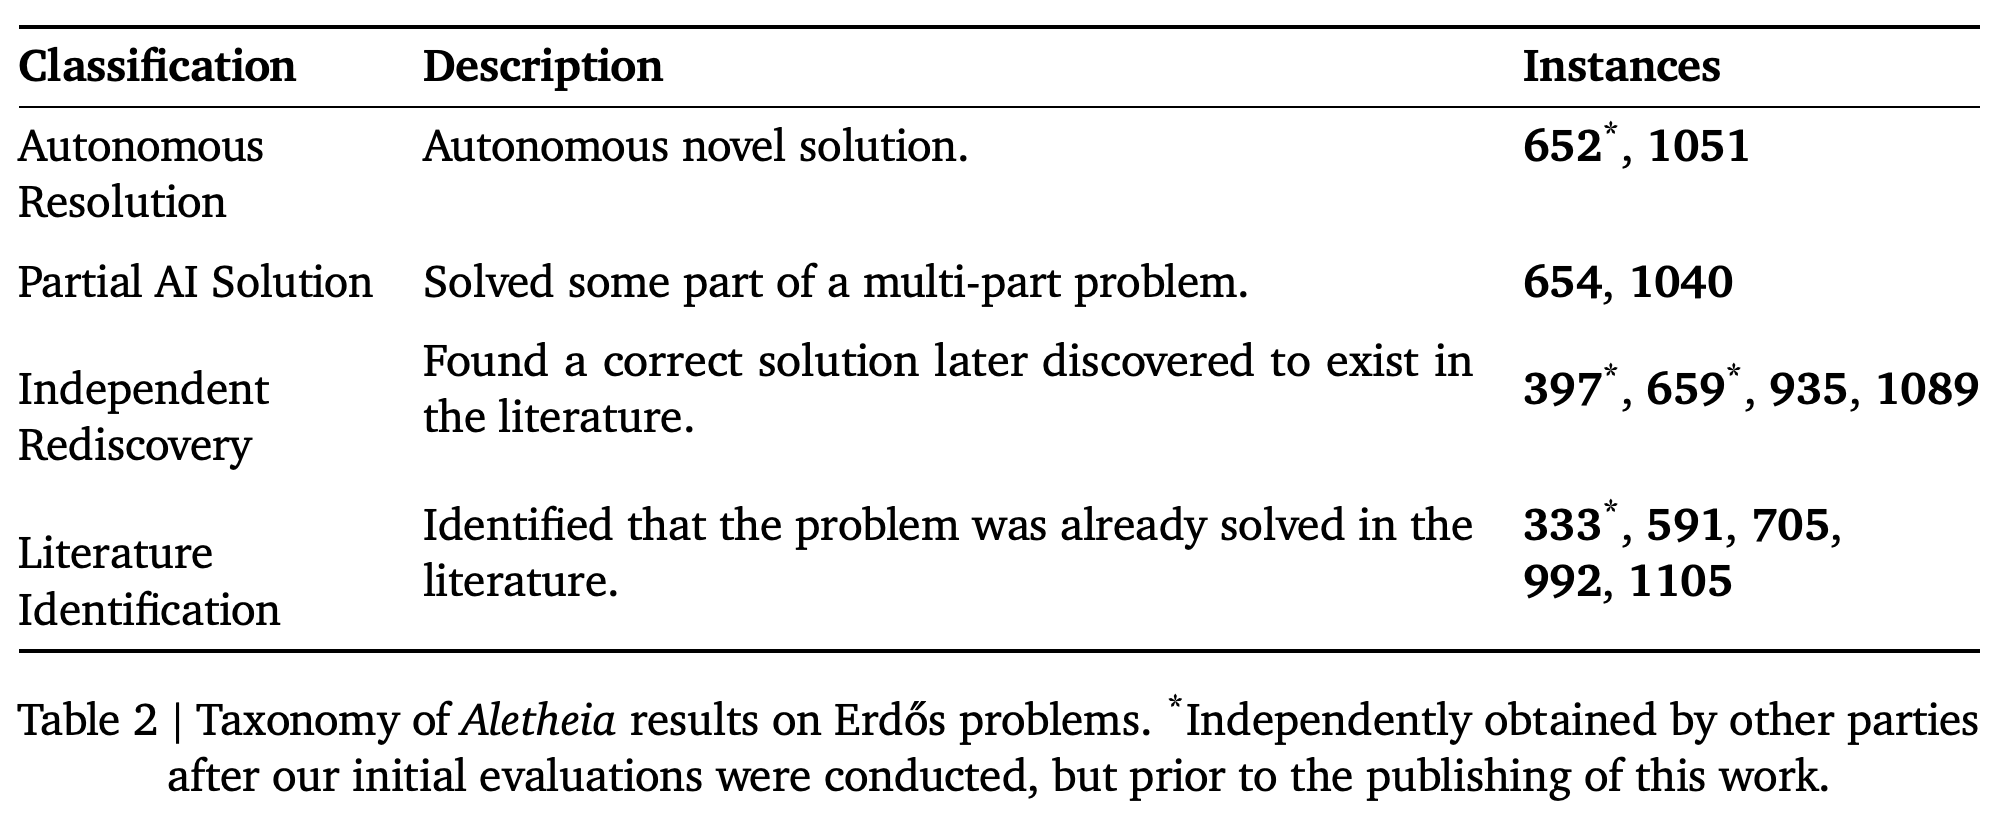
December 2–9, 2025에 Aletheia는 November 2025 버전의 Gemini 3 모델을 기반으로 당시 https://www.erdosproblems.com/ 에서 Open으로 표시된 Erdős 문제 700개를 모두 시도했다. 검증기는 올바를 가능성이 있는 답변 212개를 남겼다. 인간의 선별과 분야 전문가의 검토를 거쳐 기술적으로 올바른 해법 63개를 확인했으나, 의도된 질문에 답한 해법은 13개뿐이었다. 별도로 모호한 후보 답변 12개도 있었다. 검토 과정에서는 사소한 부정확성을 수정한 경우도 있었다.
- Autonomous Resolution에 해당하는 Erdős-652와 Erdős-1051에는 완전하고 수학적으로 실질적인 해법이 제시됐으며, 문헌 검토 후 새로운 해법으로 판단됐다.
- Partial AI Solution에 해당하는 Erdős-654와 Erdős-1040에는 여러 질문으로 구성된 문제의 일부에 대한 새로운 해법이 제시됐다. 논문이 집계한 자율 해법 4개에는 이 결과들과 완전 해결 2개가 포함된다.
- Independent Rediscovery에 해당하는 Erdős-397, Erdős-659, Erdős-935, Erdős-1089에서는 이후 기존 문헌의 해법이 발견됐다. 추론 로그 검토에서는 직접 검색한 흔적이 없었지만, 사전학습 중 간접적으로 노출됐을 가능성은 배제할 수 없다.
- Literature Identification에 해당하는 Erdős-333, Erdős-591, Erdős-705, Erdős-992, Erdős-1105는 데이터베이스의 상태와 달리 문헌에서 이미 명시적으로 해결된 문제였다.
- 새로움에 대한 분류는 추가 문헌이 발견되면 낮아질 수 있는 상한이다. 새로운 해결 4개 중 어느 것도 단독으로는 저자들이 정한 연구 논문 기준을 충족하지 못했지만, Erdős-1051을 공동으로 일반화한 연구는 BKKKZ26으로 이어졌다.
의도된 문제에 올바르게 답한 Erdős 답변 13개는 완전한 자율 해결 2개, 새로운 부분 해법 2개, 재발견 4개, 문헌 식별 5개로 구성된다. 새로운 자율 해결 4개라는 집계에는 앞의 2개 범주만 포함된다. 별표는 초기 평가 후 출판 전에 다른 곳에서도 독립적으로 얻은 사례를 표시한다.
3.4. Bounds for Polynomial Dyadics
Strongly Polynomial Policy Iteration for L∞ Robust MDPs(ACGKMP26)에서 Aletheia는 주어진 수들의 특정한 유계 결합을 포함하는 dyadic 구간의 개수에 상한을 주는 정수론적 요소를 개선했다. 인간의 논증과 IMO Gold Deep Think 해법만으로도 알고리즘 적용에는 충분했지만, Aletheia는 독립적으로 Siegel’s Lemma를 사용해 보고된 시도 중 가장 강한 상한을 얻었다. 이 상한은 논문에 채택됐다.
- 이 기여는 중간 명제를 개선한 것이며, Robust Markov Decision Processes 연구 프로젝트 전체를 자율적으로 생성한 것은 아니다.
- 현재 논문은 이 상한의 명시적인 공식을 제시하지 않는다.
4. FirstProof
FirstProof는 AI 기업과 독립적으로 학계 수학자들이 선정한 연구 수준의 질문 10개를 제공했다. 대부분은 수학자들이 진행 중인 연구에서 가져온 기술적 보조정리였다. 문제는 February 5, 2026에 공개됐고, 공식 해법은 마감 시각인 February 13, 2026의 11:59pm PST에 공개됐다. 따라서 공개된 해법이 평가를 오염시키기 전에 제한된 평가 기간이 확보됐다.
- 모든 질문은 수학자들이 이미 해결한 것이었다. Problem 1의 개요를 찾을 수 있었다는 예외를 제외하면 해법은 온라인에 없었다.
- 이 벤치마크는 인터넷을 사용하는 연구 평가가 사실상 1회만 유효하다는 문제에 대응한다. 해법이 공개되면 이후 시스템은 문제를 독립적으로 풀기보다 해법을 검색할 수 있기 때문이다.
4.1. Aletheia’s results on FirstProof
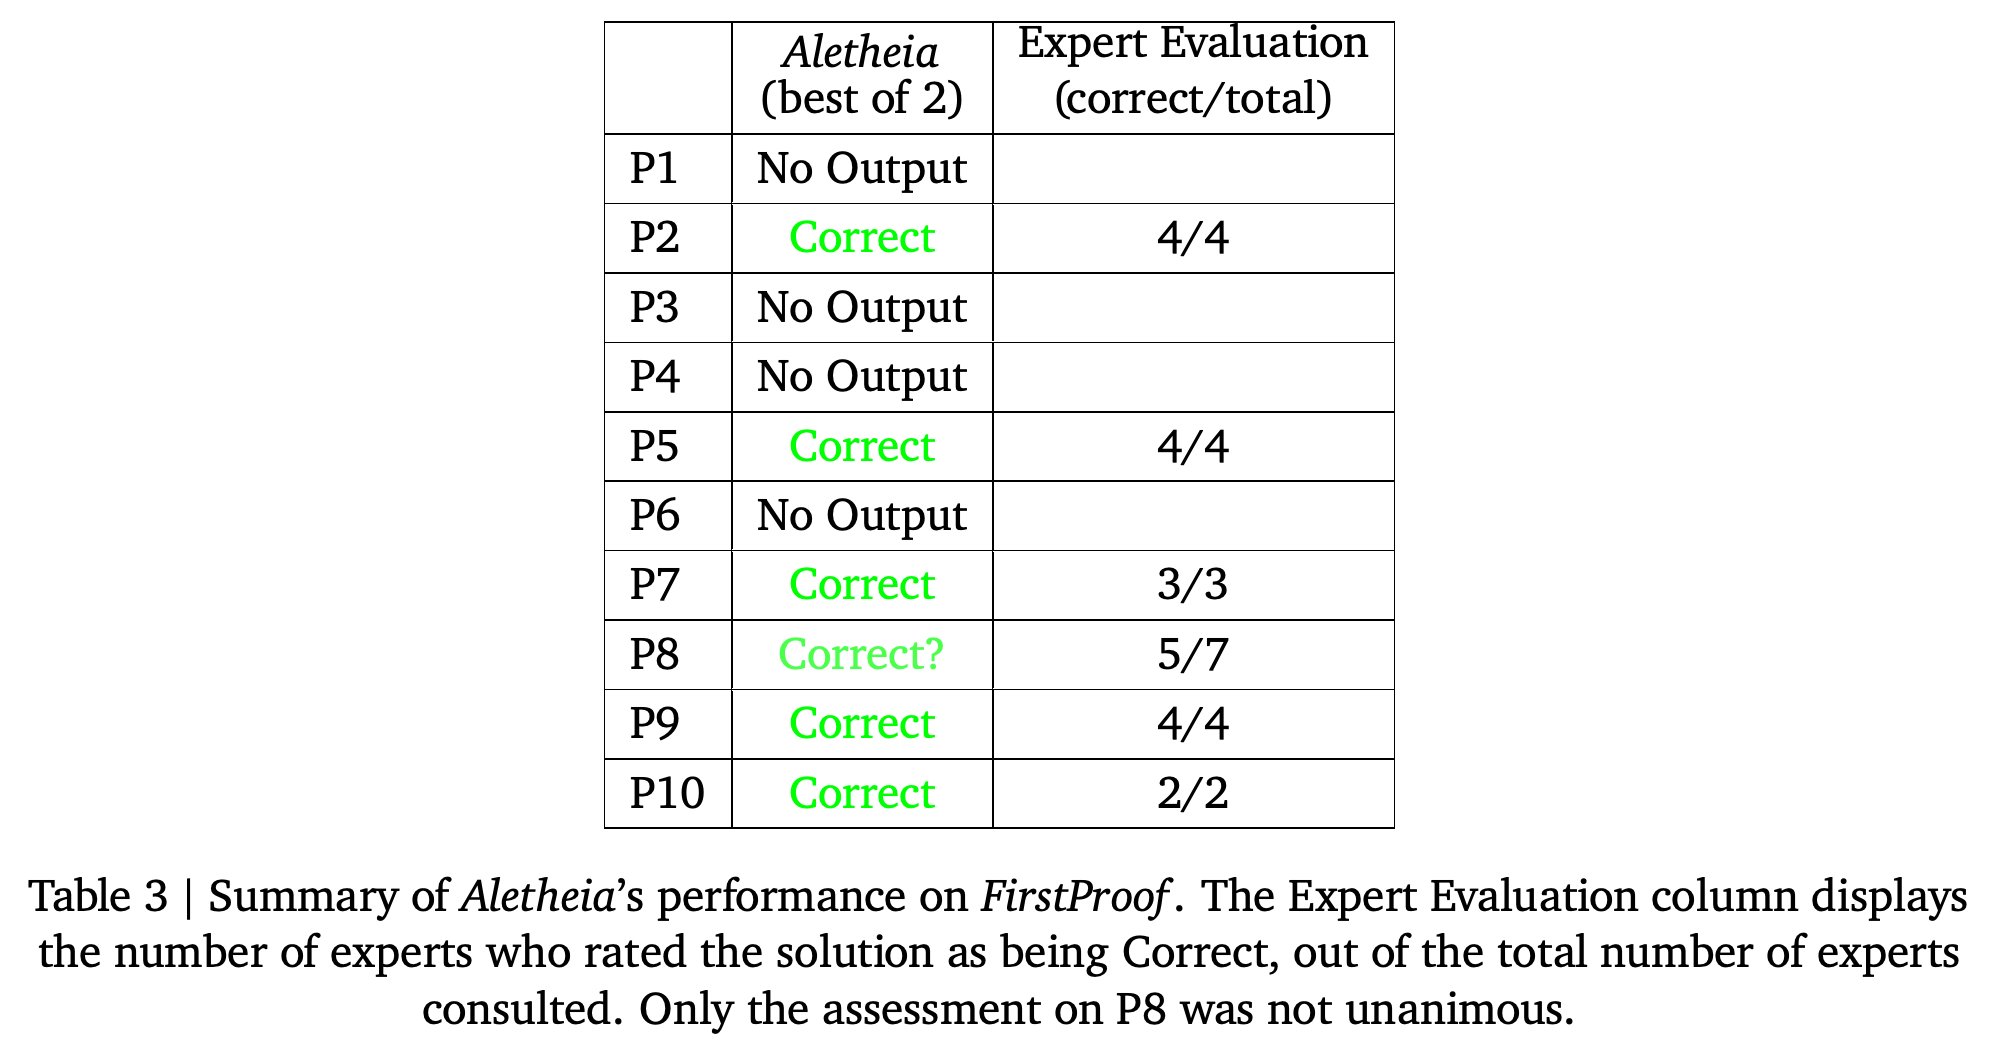
Aletheia는 Gemini의 January 2026 버전 및 February 2026 모델을 기반으로 FirstProof를 2회 실행했다. 각 실행은 FirstProof LaTeX 파일에서 수정 없이 복사한 문제를 입력받았다. 미리 정한 검증·추출 프롬프트가 출력을 걸러내고, 중간에 수동 편집을 거치지 않은 채 LaTeX를 생성했다. Table 3은 후보 중 더 나은 결과에 대한 전문가 판정을 보고한다.
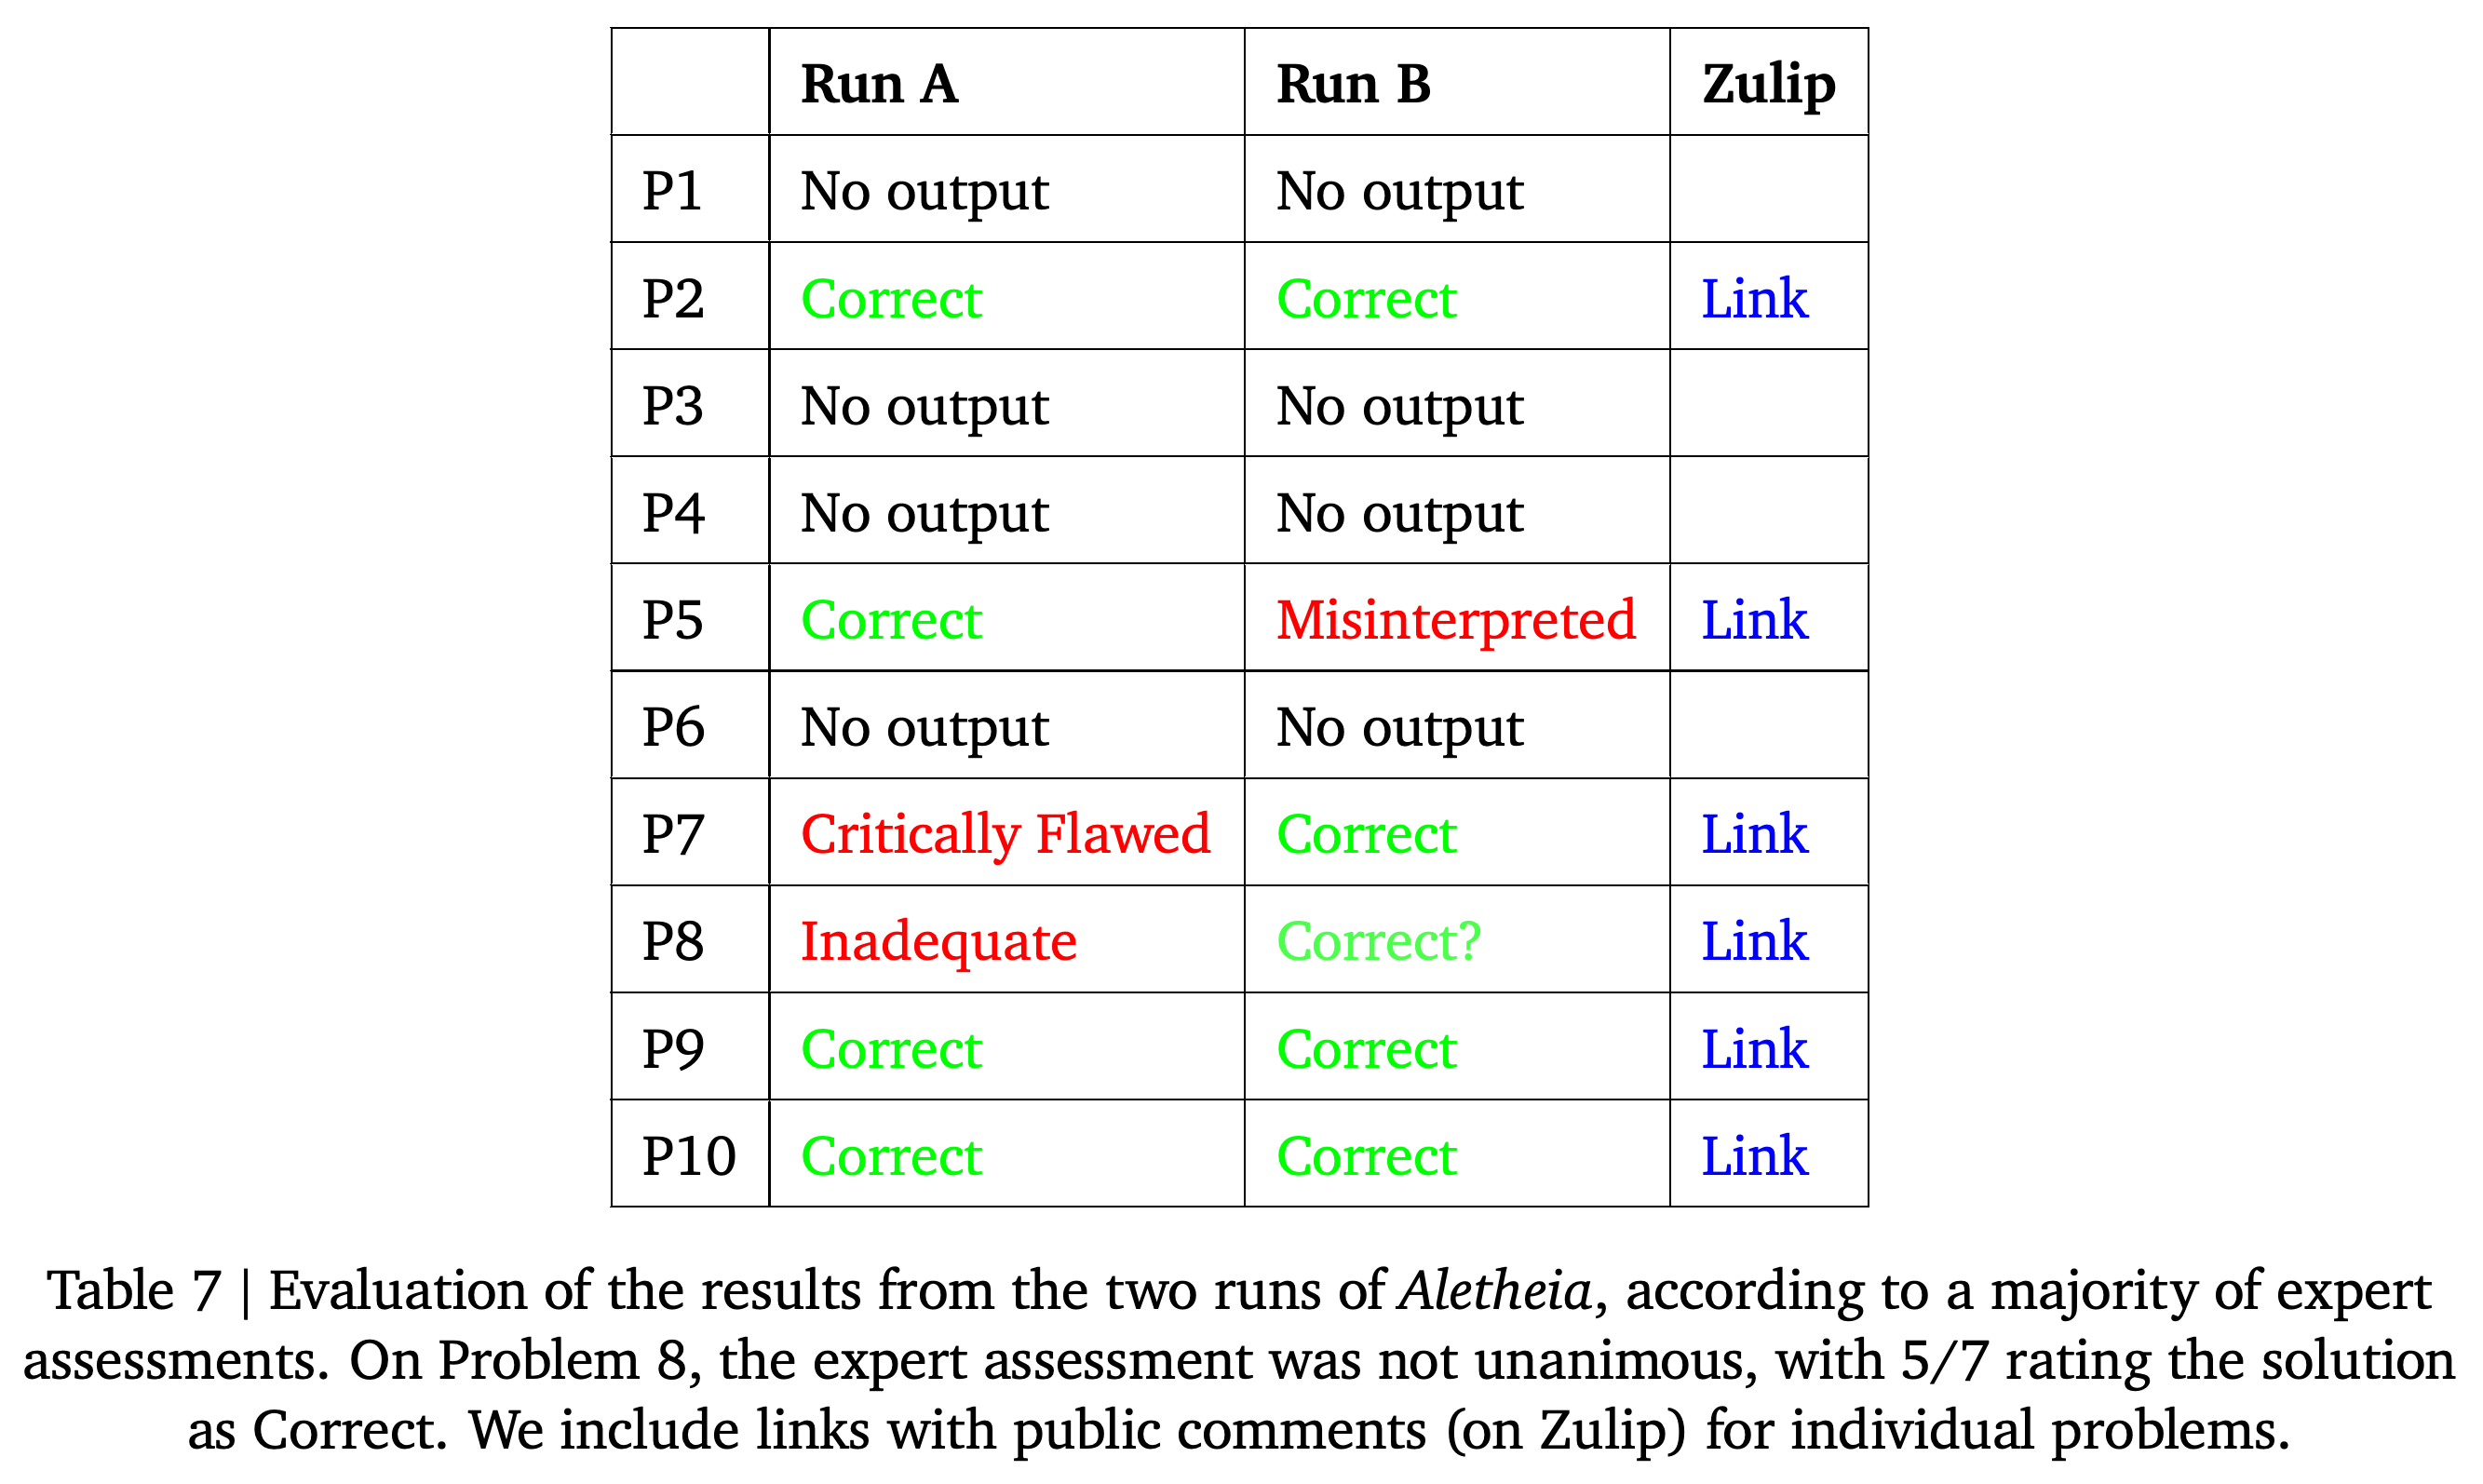
- P2, P5, P7, P9, P10은 만장일치로 긍정 평가를 받았고, P8은 5/7을 받았다. P1, P3, P4, P6은 어느 실행에서도 해법을 내지 못했다.
- P7은 이전에 미해결 문제로 알려졌지만, 벤치마크 공개 전에 Cappell–Weinberger–Yan이 해결한 상태였다. 저자들은 Aletheia의 다른 해법을 최초 해결이 아니라 FK26에 별도로 기록할 가치가 있는 결과로 본다.
- 문제 6개를 해결했다는 결과는 사소한 수정 후 출판할 수 있다는 기준에 따른 것이다. 1회 실행에서 오류 없는 해법 6개를 얻었다는 뜻은 아니다.
Best-of-2 출력은 P2, P5, P7, P9, P10에서 만장일치의 긍정 판정을 받았으며, 투표 결과는 각각 4/4, 4/4, 3/3, 4/4, 2/2였다. P8은 5/7을 받아 Correct?라는 유보적 표기가 남았다. 다른 문제 4개에서는 출력이 없었다.
4.2. Comparisons
논문은 별도 개입 없이 GPT 5.2 Pro가 얻은 P9와 P10 해법, Gemini 3 Deep Think가 얻은 P10 해법을 공개 모델의 기준선으로 사용한다. 또한 OpenAI가 내부 모델로 정답 가능성이 매우 높은 해법 6개를 얻었다고 주장했지만 P2에는 결함이 있었고, 공개되지 않은 인간 지도가 개입했다고 보고한다. Cursor 연구자들이 자율적으로 생성한 P6 해법도 언급한다.
- 이 비교는 통제된 직접 비교가 아니다. 모델 접근, 인간 개입, 계산량이 표준화되지 않았다.
- 다른 제출물에 대한 설명은 저자들이 이해한 전문가 평가에 한정되며, 독립적이고 포괄적인 검토 결과는 아니다.
4.3. Inference computation
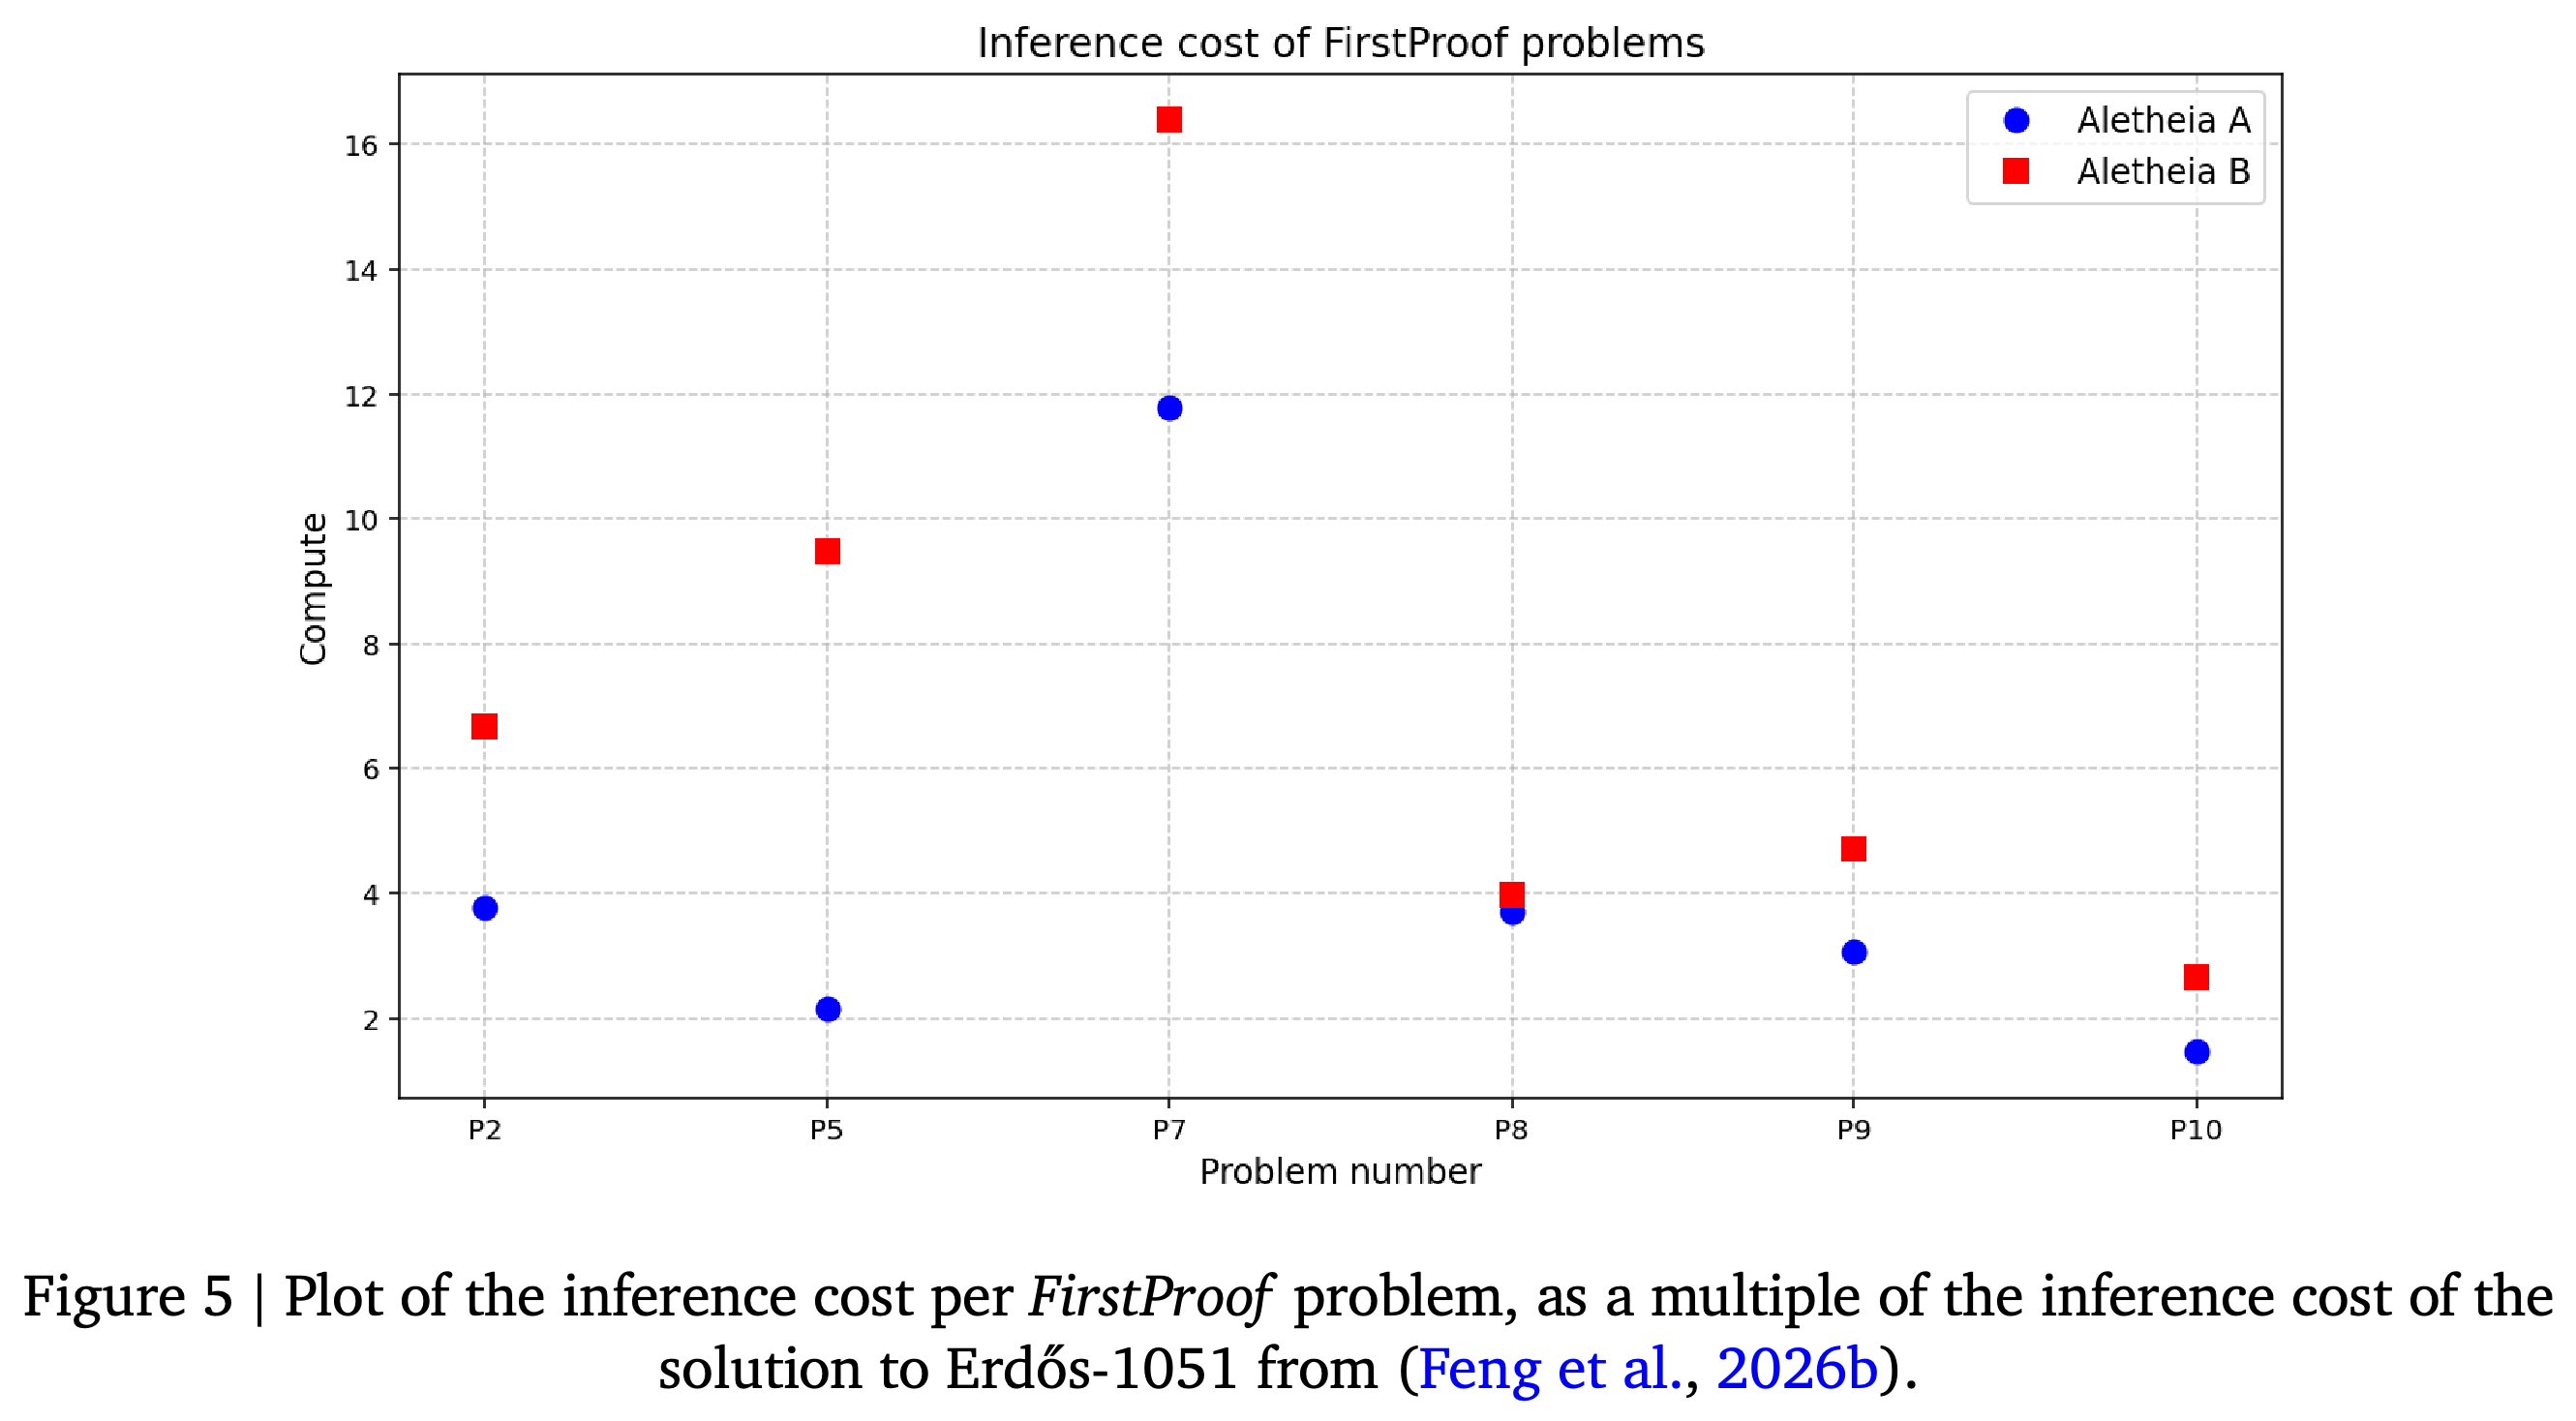
Figure 5는 후보 해법이 나온 FirstProof 문제 6개의 추론 비용을 이전 Erdős-1051 해법의 비용으로 정규화한다. 모든 후보의 비용은 기준 비용보다 높았고, P7은 이전에 관찰된 계산 규모를 한 차수 웃돌았다. 기반 모델이 달랐기 때문에 이 비교는 난이도를 대략적으로 가늠하는 데만 쓸 수 있다.
- 그래프의 비용은 2회 실행 모두의 P2, P5, P7, P8, P9, P10에 대한 것이다. 해법을 내지 못한 문제들은 포함하지 않는다.
- 동적인 추론 비용은 에이전트에 종속된 대리 지표이며, 모델과 무관한 수학적 난이도 척도는 아니다.
2회 실행 모두 그래프에 표시된 모든 FirstProof 문제에서 Erdős-1051 기준 비용보다 더 많은 비용을 사용했고, P7의 비용이 뚜렷하게 가장 높았다. 그래프는 문제마다 동적인 계산 요구량이 다름을 보여주지만, 기반 모델이 달라 벤치마크 간 통제된 비교는 할 수 없다.
5. Analysis and Discussion
분석에서는 같은 기반 모델을 사용하는 Deep Think와 에이전트 하네스를 비교한 뒤, 정확성과 정성적 한계를 살펴본다. 선정된 성공 과제에서는 Aletheia가 더 나았지만, 더 광범위한 Erdős 적용 결과와 FirstProof의 개별 실행에서는 여전히 상당한 오류가 드러났다.
5.1. Ablation studies
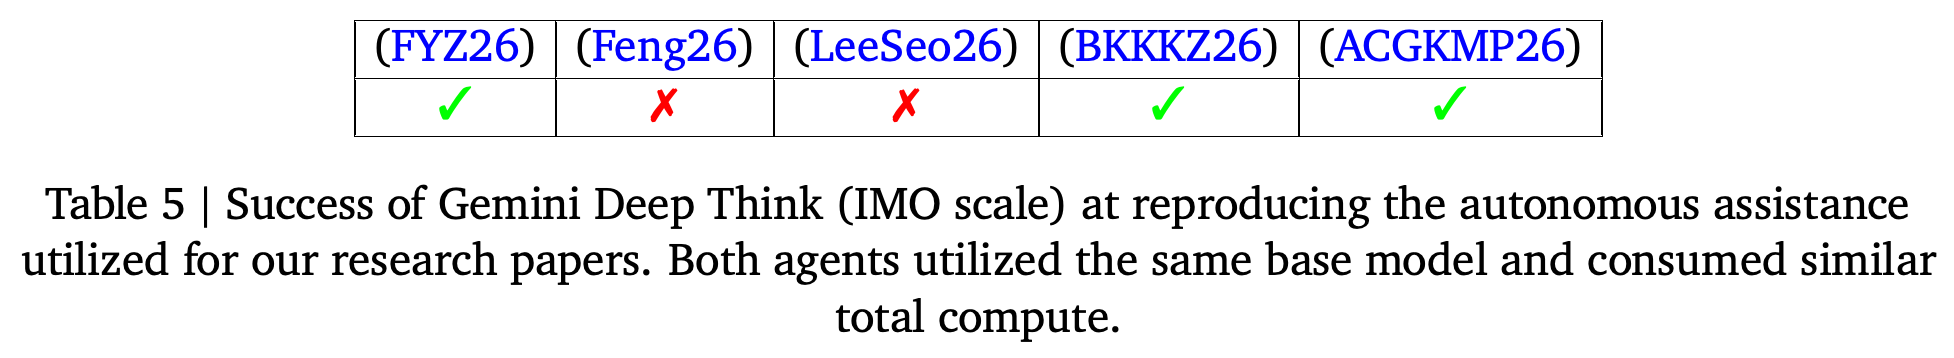
Aletheia가 의도된 문제를 올바르게 해결한 Erdős 문제 13개에서, 같은 기반 모델을 사용하는 IMO Gold 규모의 Deep Think는 Aletheia 대비 문제당 평균 계산량을 약 2× 사용하면서 8개를 해결했다. 연구 논문 프롬프트에서는 총 계산량이 비슷했지만, Deep Think는 Feng26 질의 3개 모두와 LeeSeo26의 핵심적인 2번째 질의에 실패했다.
- Table 4는 Erdős-591, Erdős-705, Erdős-992, Erdős-1040, Erdős-1105에서의 실패를 기록한다.
- Table 5는 FYZ26에서의 성공, 상호작용을 완벽하게 재현하지는 못했지만 BKKKZ26에서의 핵심적인 성공, ACGKMP26에서의 만족스럽지만 더 약한 상한을 기록한다.
- 평가 집합은 Aletheia가 성공한 과제에서 선정됐다. 따라서 이 결과는 해당 과제에서 하네스가 유리하다는 근거이지, 연구 문제 전반의 개선에 대한 편향 없는 추정이나 검증만의 독립적인 인과 효과를 보여주는 근거는 아니다.
Deep Think는 Aletheia의 성공 사례에서 선정한 Erdős 문제 13개 중 8개에 성공하고, 591, 705, 992, 1040, 1105에서는 실패한다. 평균 계산량이 약 2배였다는 점은 선정된 과제에서 Aletheia의 우위가 단순히 더 큰 추론 예산 때문만은 아니라는 근거를 제공한다.
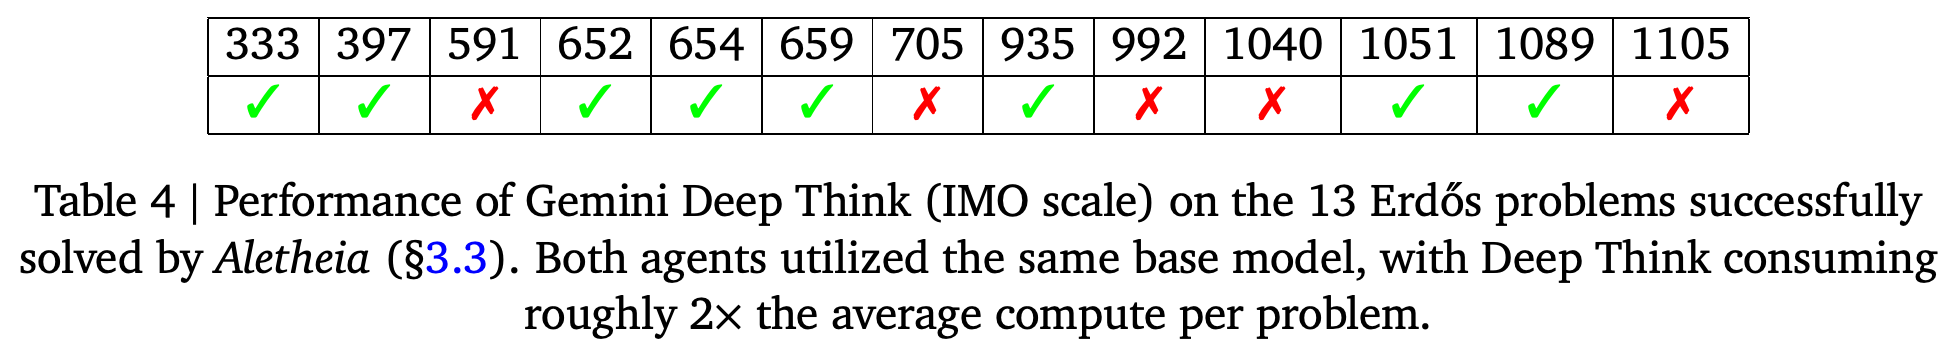
성공과 실패로 나눈 요약은 Deep Think가 FYZ26, BKKKZ26, ACGKMP26에서는 성공하고 Feng26, LeeSeo26에서는 실패했다고 기록한다. 본문은 필요한 단서를 덧붙인다. BKKKZ26은 정확하게 재현되지 않았고, ACGKMP26의 상한은 더 약했으며, LeeSeo26에서는 초기 질의에 성공했지만 핵심 확장에는 실패했다.
5.2. Accuracy
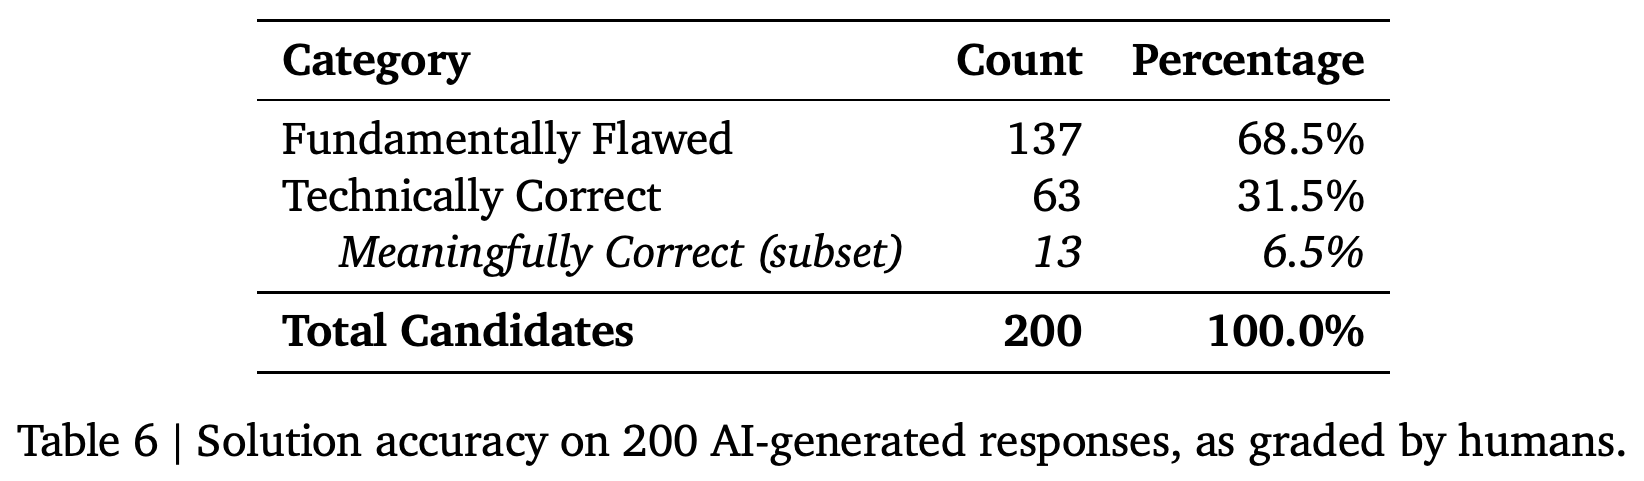
확정 판정이 내려진 Erdős 후보 답변 200개 중 137개는 근본적인 결함이 있었고(68.5%), 63개는 기술적으로 올바랐으며(31.5%), 의도된 문제에 올바르게 답한 답변은 13개뿐이었다(6.5%). FirstProof에서는 2회 실행 모두 같은 질문들에 답했지만, 2회 실행 중 최선의 결과를 택한 평가는 P5의 잘못된 해석, 치명적인 결함이 있는 P7 해법, 불충분한 P8 해법을 포함한 실행들의 결과를 조합한 것이다.
- Erdős 비율은 판정된 후보 답변 집합을 기준으로 한 조건부 비율이며, 시도한 문제 700개 전체에 대한 비율이 아니다. 모호한 답변 12개는 제외됐다.
- Table 7은 P2, P9, P10이 2회 실행 모두에서 올바랐음을 보여준다. Run A는 P5를 해결했지만 P7과 P8에서는 실질적으로 실패했다. Run B는 P5를 잘못 해석했지만 P7을 해결했고, P8에서는 단서가 붙은 긍정 평가를 받았다.
- 저자들은 FirstProof 결과 중 출판 수준에 해당하는 것은 P7뿐이라고 보며, 이 기준의 성적은 1/10이다. 벤치마크 문제 대부분은 독립적인 논문이 아니라 기술적 보조정리로 의도됐다.
- Erdős 평가에는 더 약한 November 2025 모델이 사용됐다. 따라서 그 정확도를 이후 FirstProof에 사용된 모델들에 직접 적용할 수는 없다.
판정된 후보 답변 200개 중 63개는 기술적으로 올바르지만, 의도된 질문에 올바르게 답한 것은 13개뿐이다. 의도된 문제에 대한 정확성은 추가 범주가 아니라 기술적 정확성의 부분집합이다. 분모에는 모호한 후보와 검증기가 남긴 답변이 없는 문제가 포함되지 않는다.
실행별 결과는 best-of-2 보고에 단서가 필요한 이유를 보여준다. Run B는 P5를 잘못 해석했고, Run A의 P7에는 치명적인 결함이 있었으며 P8은 불충분했다. P2, P9, P10은 2회 실행 모두에서 올바르지만, 나머지 같은 문제들에서는 어느 실행도 출력을 내지 못했다.
5.3. Weaknesses of AI
저자들은 자율적으로 얻은 결과가 일반적인 인간 연구 논문보다 짧고 초등적이며, 수학적 창의성을 명확히 보여주기보다는 기술적 조작이나 폭넓은 지식 검색에 의존하는 경우가 많다고 설명한다. Aletheia는 검증을 거쳐도 오류가 잦고, 모호한 질문을 쉽지만 의도와 다른 방식으로 해석하는 경향이 있다. 실제 참고문헌에 없는 결과를 지어내거나 그 내용을 잘못 설명할 수도 있다.
- 기술적으로는 올바르지만 실질적인 내용이 없는 Erdős 답변 50개는 해석 문제를 보여준다. 논문은 이를 specification gaming 및 reward hacking과 연결한다.
- 검색 범위의 넓이와 창의성의 구분은 정성적이고 명시적으로 주관적인 판단이며, 측정된 인과적 결과가 아니다.
6. Representing AI contributions to mathematics
최전선의 수학 연구를 평가하려면 확보하기 어려운 분야별 전문성이 필요하며, 형식적으로 올바른 증명이라도 새로움이나 중요성을 보장하지는 않는다. 논문은 이런 평가의 공백과 홍보 유인이 결합되기 때문에 AI 기여를 투명하게 보고해야 한다고 주장한다. 또한 기업이 정한 보편적 기준보다는 학계 공동체가 주도하는 분류 체계가 필요하다고 본다.
6.1. Autonomous Mathematics Levels
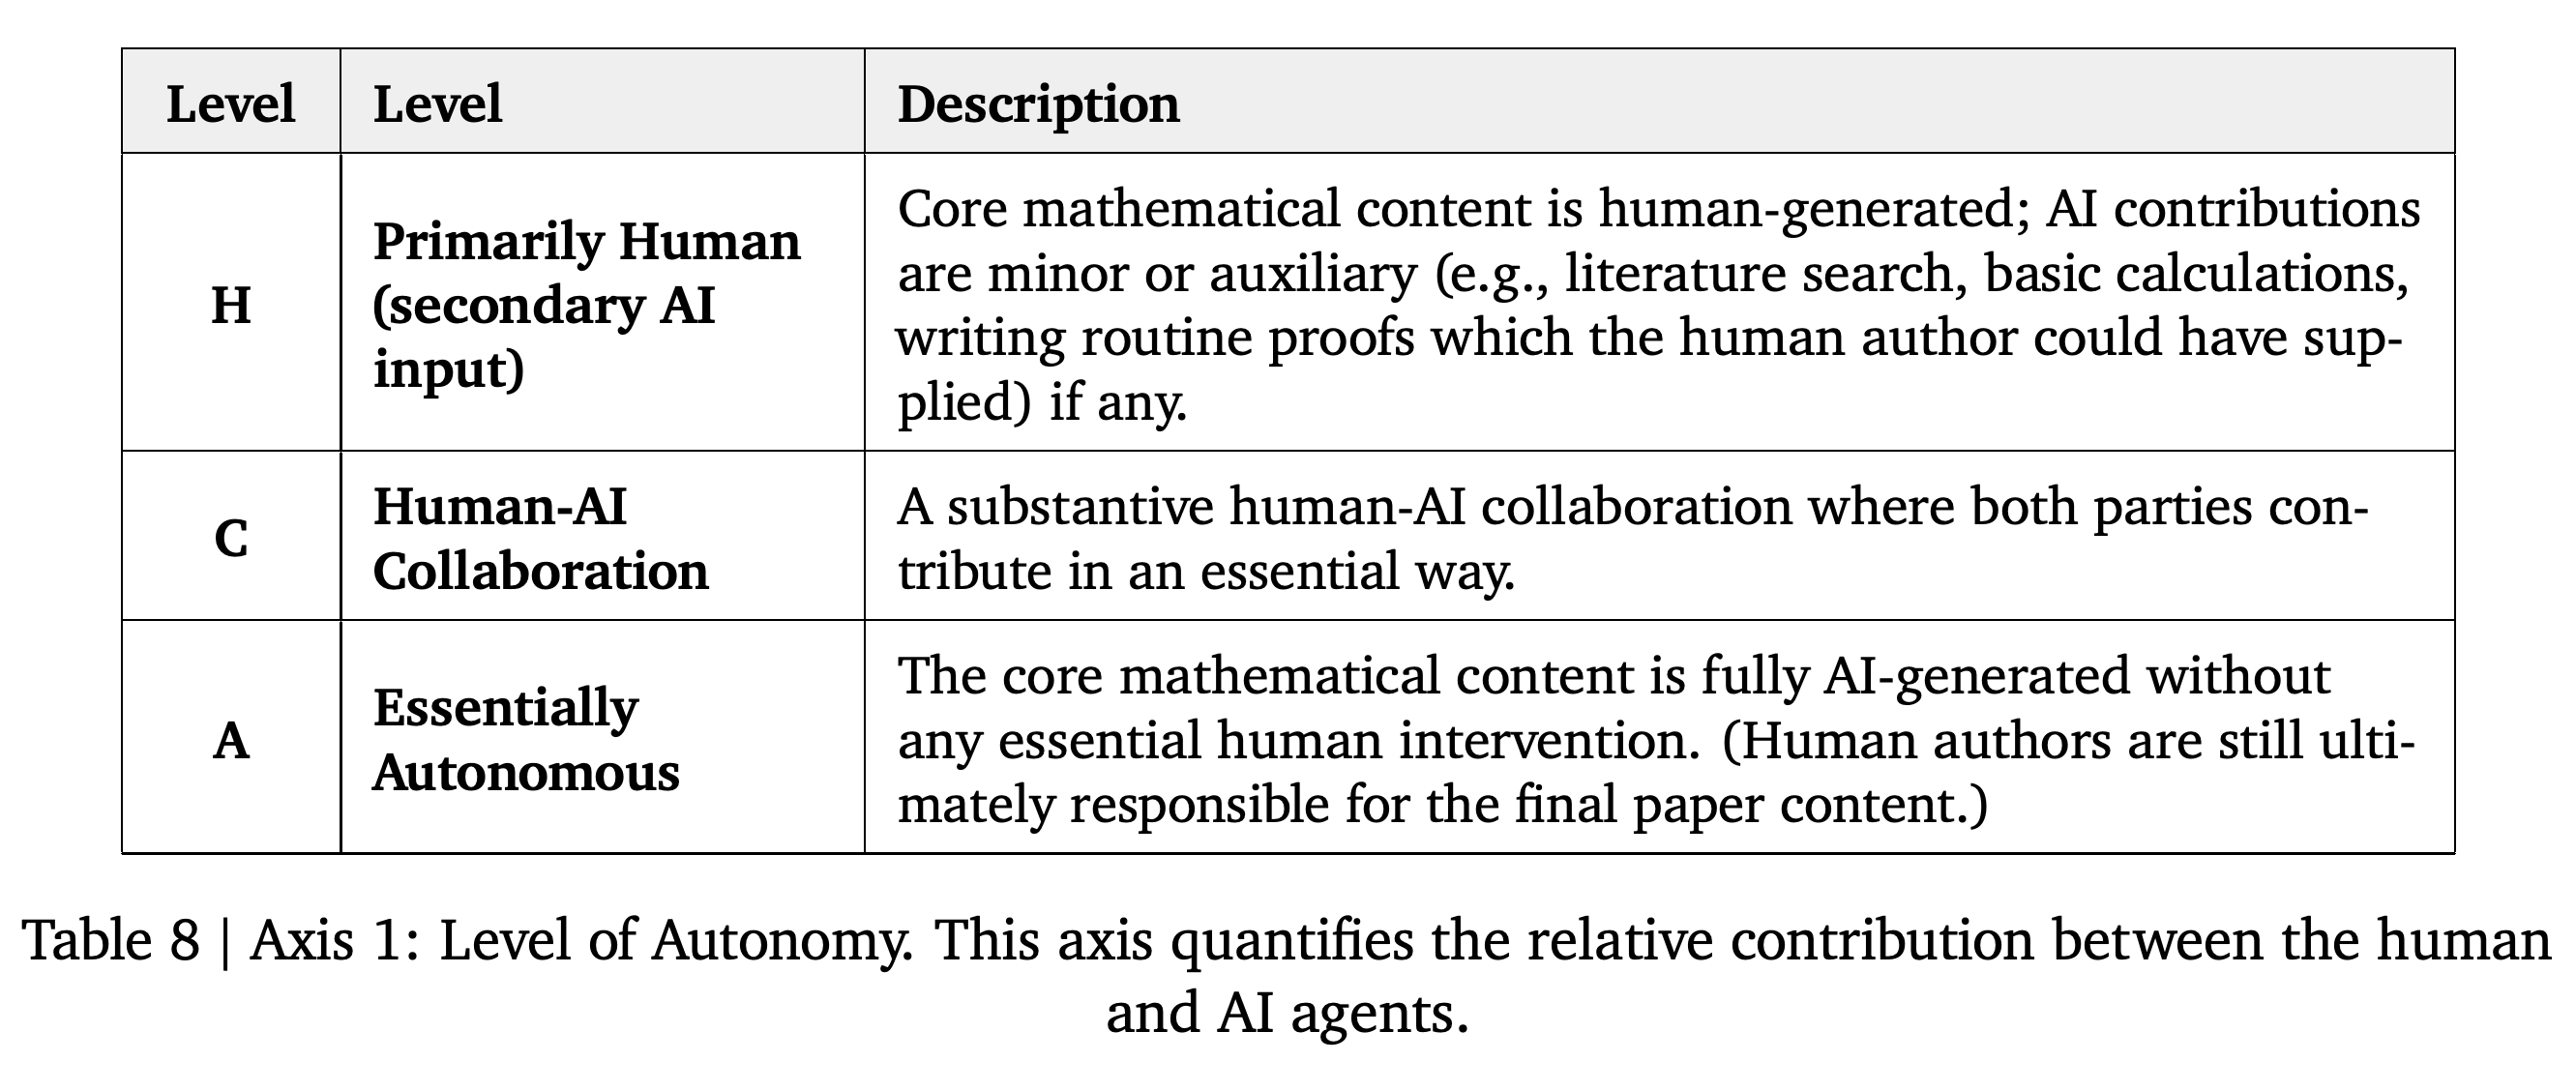
제안한 분류 체계에는 독립적인 축 2개가 있다. 자율성 수준은 H, C, A로, 중요성 수준은 0–4로 구분한다. Table 8은 주로 인간이 수행한 연구, 인간과 AI의 필수적인 협업, 본질적으로 자율 생성된 수학적 내용을 구분한다. Table 9는 미미한 새로움, 소규모의 새로움, Publication Grade, Major Advance, Landmark Breakthrough를 구분한다.
- 6.1.1. Discussion and Examples for Level of Autonomy에서는 Feng26을 A, LeeSeo26과 BKKKZ26을 C, FYZ26과 ACGKMP26을 H로 분류한다. AI가 실질적인 수학적 내용을 직접 제공하지 않았다면, AI가 영감만 제공한 경우는 여전히 H에 해당한다.
- 6.1.2. Discussion and Examples for Level of Significance에서는 Erdős-652, 654, 935, 1040을 A0, Erdős-1051을 A1, Feng26을 A2, LeeSeo26과 BKKKZ26을 C2, FYZ26과 ACGKMP26을 H2로 분류한다.
- Level 2는 의도적으로 출판 가능한 수학 연구의 넓은 범위를 포괄한다. 따라서 A2나 C2가 인간 수학자와 동등한 능력을 입증하지는 않으며, 보고된 결과 중 Level 3이나 Level 4에 도달한 것은 없다.
- Table 1은 Level 2 연구를 동료 심사가 완료된 연구가 아니라 출판을 위해 제출된 연구로 표시한다. 수학적 중요성은 해당 분야 전문가가 판단해야 한다.
자율성 축은 AI의 보조적 기여, 인간과 AI 모두의 필수적인 기여, 필수적인 인간 개입 없이 AI가 핵심 수학적 내용을 생성한 경우를 구분한다. 자율 범주에서도 최종 논문에 대한 인간의 책임은 유지되므로, 내용 생성과 책임을 구분한다.
6.2. Documenting Human-AI Collaboration
Human-AI Interaction Cards는 질문, 아이디어, 증명, 개선을 누가 제공했는지 기록한다. Feng26, LeeSeo26, BKKKZ26의 카드는 자율 해법, AI가 생성한 개요, 엄밀하지 않은 일반화 휴리스틱을 구분한다. 원본 상호작용은 https://github.com/google-deepmind/superhuman/tree/main/aletheia 에서 확인할 수 있다.
- Feng26에서는 인간이 Type A, Type C, Type D eigenweight 질의를 차례로 제시했고, Aletheia가 수학적 해법을 제공했다.
- LeeSeo26에서는 Aletheia가 semiproper colouring에 대한 핵심 개요를 제공했고, 인간이 세부 내용과 더 간단한 증명을 개발했다.
- BKKKZ26에서는 Aletheia가 Erdős-1051을 해결했고, Deep Think가 가중 곱 일반화를 제안했다. 인간은 가정을 lim = ∞에서 lim sup = ∞로 완화하고, 증명을 완성하며 최적성을 보여주는 예를 제공했다.
- C 또는 A 결과에 대해 제안하는 투명성의 최소 기준은 AI가 생성한 새로운 통찰을 담은 핵심 원본 프롬프트와 출력을 적어도 공개하는 것이다. 구체적인 기준은 수학 공동체가 정하도록 남겨 둔다.
7. Reflections on the Impact of AI in Mathematics
저자들은 이 결과를 수학자의 대체가 아니라 비교 우위의 관점에서 해석한다. 모델은 전문 지식의 깊이는 얕지만 회상할 수 있는 지식의 범위가 유난히 넓고, 인간과 같은 방식으로 시간과 주의력의 제약을 받지 않는다. eigenweight 사례는 분야를 넘나드는 기법의 활용을 보여준다. Erdős 연구는 간과된 질문이 중대한 수학적 진전은 아니더라도 해결 가능한 문제일 수 있음을 보여준다.
- 이 논의는 AI가 인간의 수학적 능력에 도달했음을 입증하지 않으며, 앞으로 도달할 것이라고 보장하지도 않는다.
8. Related Work
관련 연구 논의는 수학적 추론의 발전, 구체적인 AI 보조 연구 성과, 다양한 인간-AI 협업 구조를 다룬다. 논문은 이러한 발전을 AI가 생성한 수학의 투명한 기록, 평가, 전달이 필요하다는 점과 연결한다.
Advances in Mathematical Reasoning
논문은 최근의 IMO 금메달 수준 성능과 IMO-Proof Bench 결과를 FrontierMath 및 미해결 질문 벤치마크 같은 새로운 연구 지향 평가와 연결한다. 이러한 평가는 경시대회 성능을 넘어 고급 수학 추론과 연구 질문으로 평가 범위를 넓힌다.
AI-Assisted Research Results
기존 AI 보조 수학 연구의 예로는 모듈라이 공간의 극값 descendant integral, 종수 0 사상의 motivic class, Nesterov 가속 경사법의 점 수렴이 있다. 인용 문헌은 이산 해석, 볼록 해석, 조합론, 접근 가능한 추측, 수학 인접 분야 전반의 탐색도 다룬다.
Frameworks for Human-AI Collaboration
논문은 스스로 검증하고 수정하는 에이전트 구조, AlphaEvolve 같은 탐색 시스템, AI를 연구 실무에 통합하는 대화형 절차를 구분한다. 수학 연구에 맞게 이들을 적용하는 과정은 아직 초기 단계라고 설명하며, AI 기여를 투명하게 보고할 것을 요구한다.
9. Conclusion
결론은 특화된 자연어 추론 에이전트를 수학자를 위한 도구로 제시한다. 자연어 시스템은 여전히 오류와 환각을 수정해야 하며, 형식 검증 시스템은 아직 많은 최전선 연구 질문을 쉽게 정식화하지 못한다. 따라서 Aletheia의 비형식 검증은 연구를 돕는 수단이지, 정확성을 보장하거나 전문가의 책임을 대신하는 수단이 아니다.
부록
- A. Case Study: FutureMath Basic은 q ≥ 3, N ≥ 2, β > 0에서 평균장 Potts 분배 함수의 극한 자유 에너지가 언제 β/(2q) + log q가 되는지 묻는 FM-Grad-011을 제시한다. Aletheia solution: 아래의 Large Deviation Analysis of the Phase Transition in the Mean-Field Potts Model이라는 해법에서 모델은 경험적 측도, Sanov’s Theorem, Varadhan’s Lemma를 사용한다. 경쟁하는 최댓값을 1차원 최적화로 환원하고 (\beta_{\max}=\frac{2(q-1)}{q-2}\log(q-1))을 제시한다. Introduction and Formulation via Empirical Measures는 변분 표현을 세우고, The Uniform Distribution and Symmetry Breaking은 경쟁하는 분포를 식별한다. Determination of the Critical Inverse Temperature는 정상점 조건과 최댓값의 높이가 같은 조건을 사용한다. Conclusion은 균등분포가 임계값까지는 전역 최대화 분포로 남지만, 그보다 높은 값에서는 그렇지 않다고 결론짓는다.
- B. Case Study: FutureMath Basic은 FM-Grad-011과 같은 제목의 Aletheia 해법을 반복해서 제시하며, 검색 도구로 해결한 예라고 명시한다. 경험적 측도를 이용한 정식화, 균등분포와 대칭이 깨진 분포의 비교, 정상점 조건과 최댓값의 높이가 같은 조건의 계산으로 같은 임계 역온도를 얻는다. 임계값 아래와 위에서 등식이 성립하는지에 대한 결론도 같다. 이는 원문에서 반복된 사례 연구이며, 별개의 2번째 벤치마크 성공이 아니다.
- C. Case Study: Solving IMO 2025 Problem 6는 각 행과 열에 덮이지 않은 칸이 1개씩 있는 2025 × 2025 격자를 다루며, 직사각형 타일의 최소 개수를 2112개로 보고한다. January 2026 Deep Think는 인터넷이나 외부 도구 없이 규모 2¹²에서 증가·감소 부분수열에 기반한 Theoretical Lower Bound와 중앙 타일 1936개 및 가장자리 타일 176개를 사용하는 Optimal Tiling Construction을 제시했다. 그러나 증명되지 않았고 존재하지 않을 가능성이 높은 결과에 의존했기 때문에 비공식 추정 점수는 1–3점에 그쳤다. 인간이 제공한 수정 프롬프트를 규모 2⁸에서 적용하자 저자들이 올바르다고 보고한 해법이 나왔다. The Rectilinear Partition Formula는 모서리를 세고, Segment Bounds and Chords는 내부 선분 수의 경계를 구한다. Forcing Penalties via Monotonic Subsequences는 하한을 제시하며, The Optimal Construction은 그 하한을 달성해 최종 답 2112를 얻는다. 재현된 출력에는 오탈자로 인한 불일치가 있다.
- D. IMO 2024 Case Studies는 Problem 3를 더 견고하게 변형한 PB-Advanced-021을 규모 2⁷에서 풀었으나 사소한 오류가 있었다고 보고한다. 모델이 균일한 빈도 상한을 정당화하려면 유한 집합에 대한 논증과 앞서 얻은 큰 값에 대한 상한을 함께 사용해야 했다. Model-Generated Solution은 생성 규칙을 재정식화하고, 큰 수의 빈도에 상한을 두며, 무한히 반복되는 원소의 특성을 규명한다. 이어서 엄격한 교대를 보이고, 유계인 횟수 차이와 유한 상태의 결정적 전이를 이용해 결국 주기적이 됨을 증명한다. 함정 3000개가 있는 3002 × 3001 표에 관한 Problem 5의 견고한 변형인 PB-Advanced-023은 규모 2⁸에서 해결됐다. 하한을 위한 적대적 전략은 최소 2회의 페널티를 강제하고, Safe Probing과 “Drop to Finish” 동작은 최대 2회를 보장해 최종 답 n = 3을 얻는다. On Solution Novelty는 이 상태 추적 접근을 공개된 기하학적 전략과 대비하지만, 학습 데이터 오염 가능성 때문에 독립적 발견이라는 주장에는 한계가 있다.
짧은 생각
같은 기반 모델을 사용한 비교는 전체 하네스가 더 큰 계산 예산에만 의존하지 않고도 선정된 연구 과제의 결과를 개선한다는 근거를 제공한다. 다만 어느 구성 요소가 개선을 일으키는지는 분리해 보여주지 않는다. Erdős 연구에서 기술적 정확성과 의도된 문제에 대한 정확성 사이의 차이, 그리고 FirstProof의 실행별 실패가 가장 분명한 한계다. Aletheia는 자율성, 중요성, 실패를 명시적으로 보고하면서 일부 문제의 연구를 돕는 시스템으로 이해하는 것이 적절하다. 전반적으로 신뢰할 수 있는 자율 수학자는 아니다.