


From Bytes to Ideas: Language Modeling with Autoregressive U-Nets 요약 설명
17 Jun 2025 | Paper Review Byte-Level Language Models Transformer Architectures Scaling Laws목차
이번 글에서는 From Bytes to Ideas: Language Modeling with Autoregressive U-Nets 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 6월 17일(Arxiv)
- Videau, Mathurin, Idrissi, Badr Youbi, Leite, Alessandro, Schoenauer, Marc, Teytaud, Olivier, Lopez-Paz, David.
- FAIR at Meta, TAU, INRIA and LISN, CNRS & Université Paris-Saclay, INSA Rouen Normandy, LITIS, Rouen, France
- 논문 링크
- Github
요약
- 텍스트를 입력 단위로 나누는 고정 토큰화는 언어 모델의 처리 단위와 예측 단위를 미리 정해 제한한다. Autoregressive U-Net (AU-Net)은 원시 바이트를 더 큰 단위의 표현으로 압축한 뒤, 다음 바이트를 예측하도록 다시 확장한다. 사전학습 연산량을 엄격히 통제하면 AU-Net은 강력한 Byte-Pair Encoding (BPE) 기준 모델과 전반적으로 비슷한 성능을 보인다. BPE는 자주 등장하는 바이트열을 반복해서 병합하여 어휘를 구성한다.
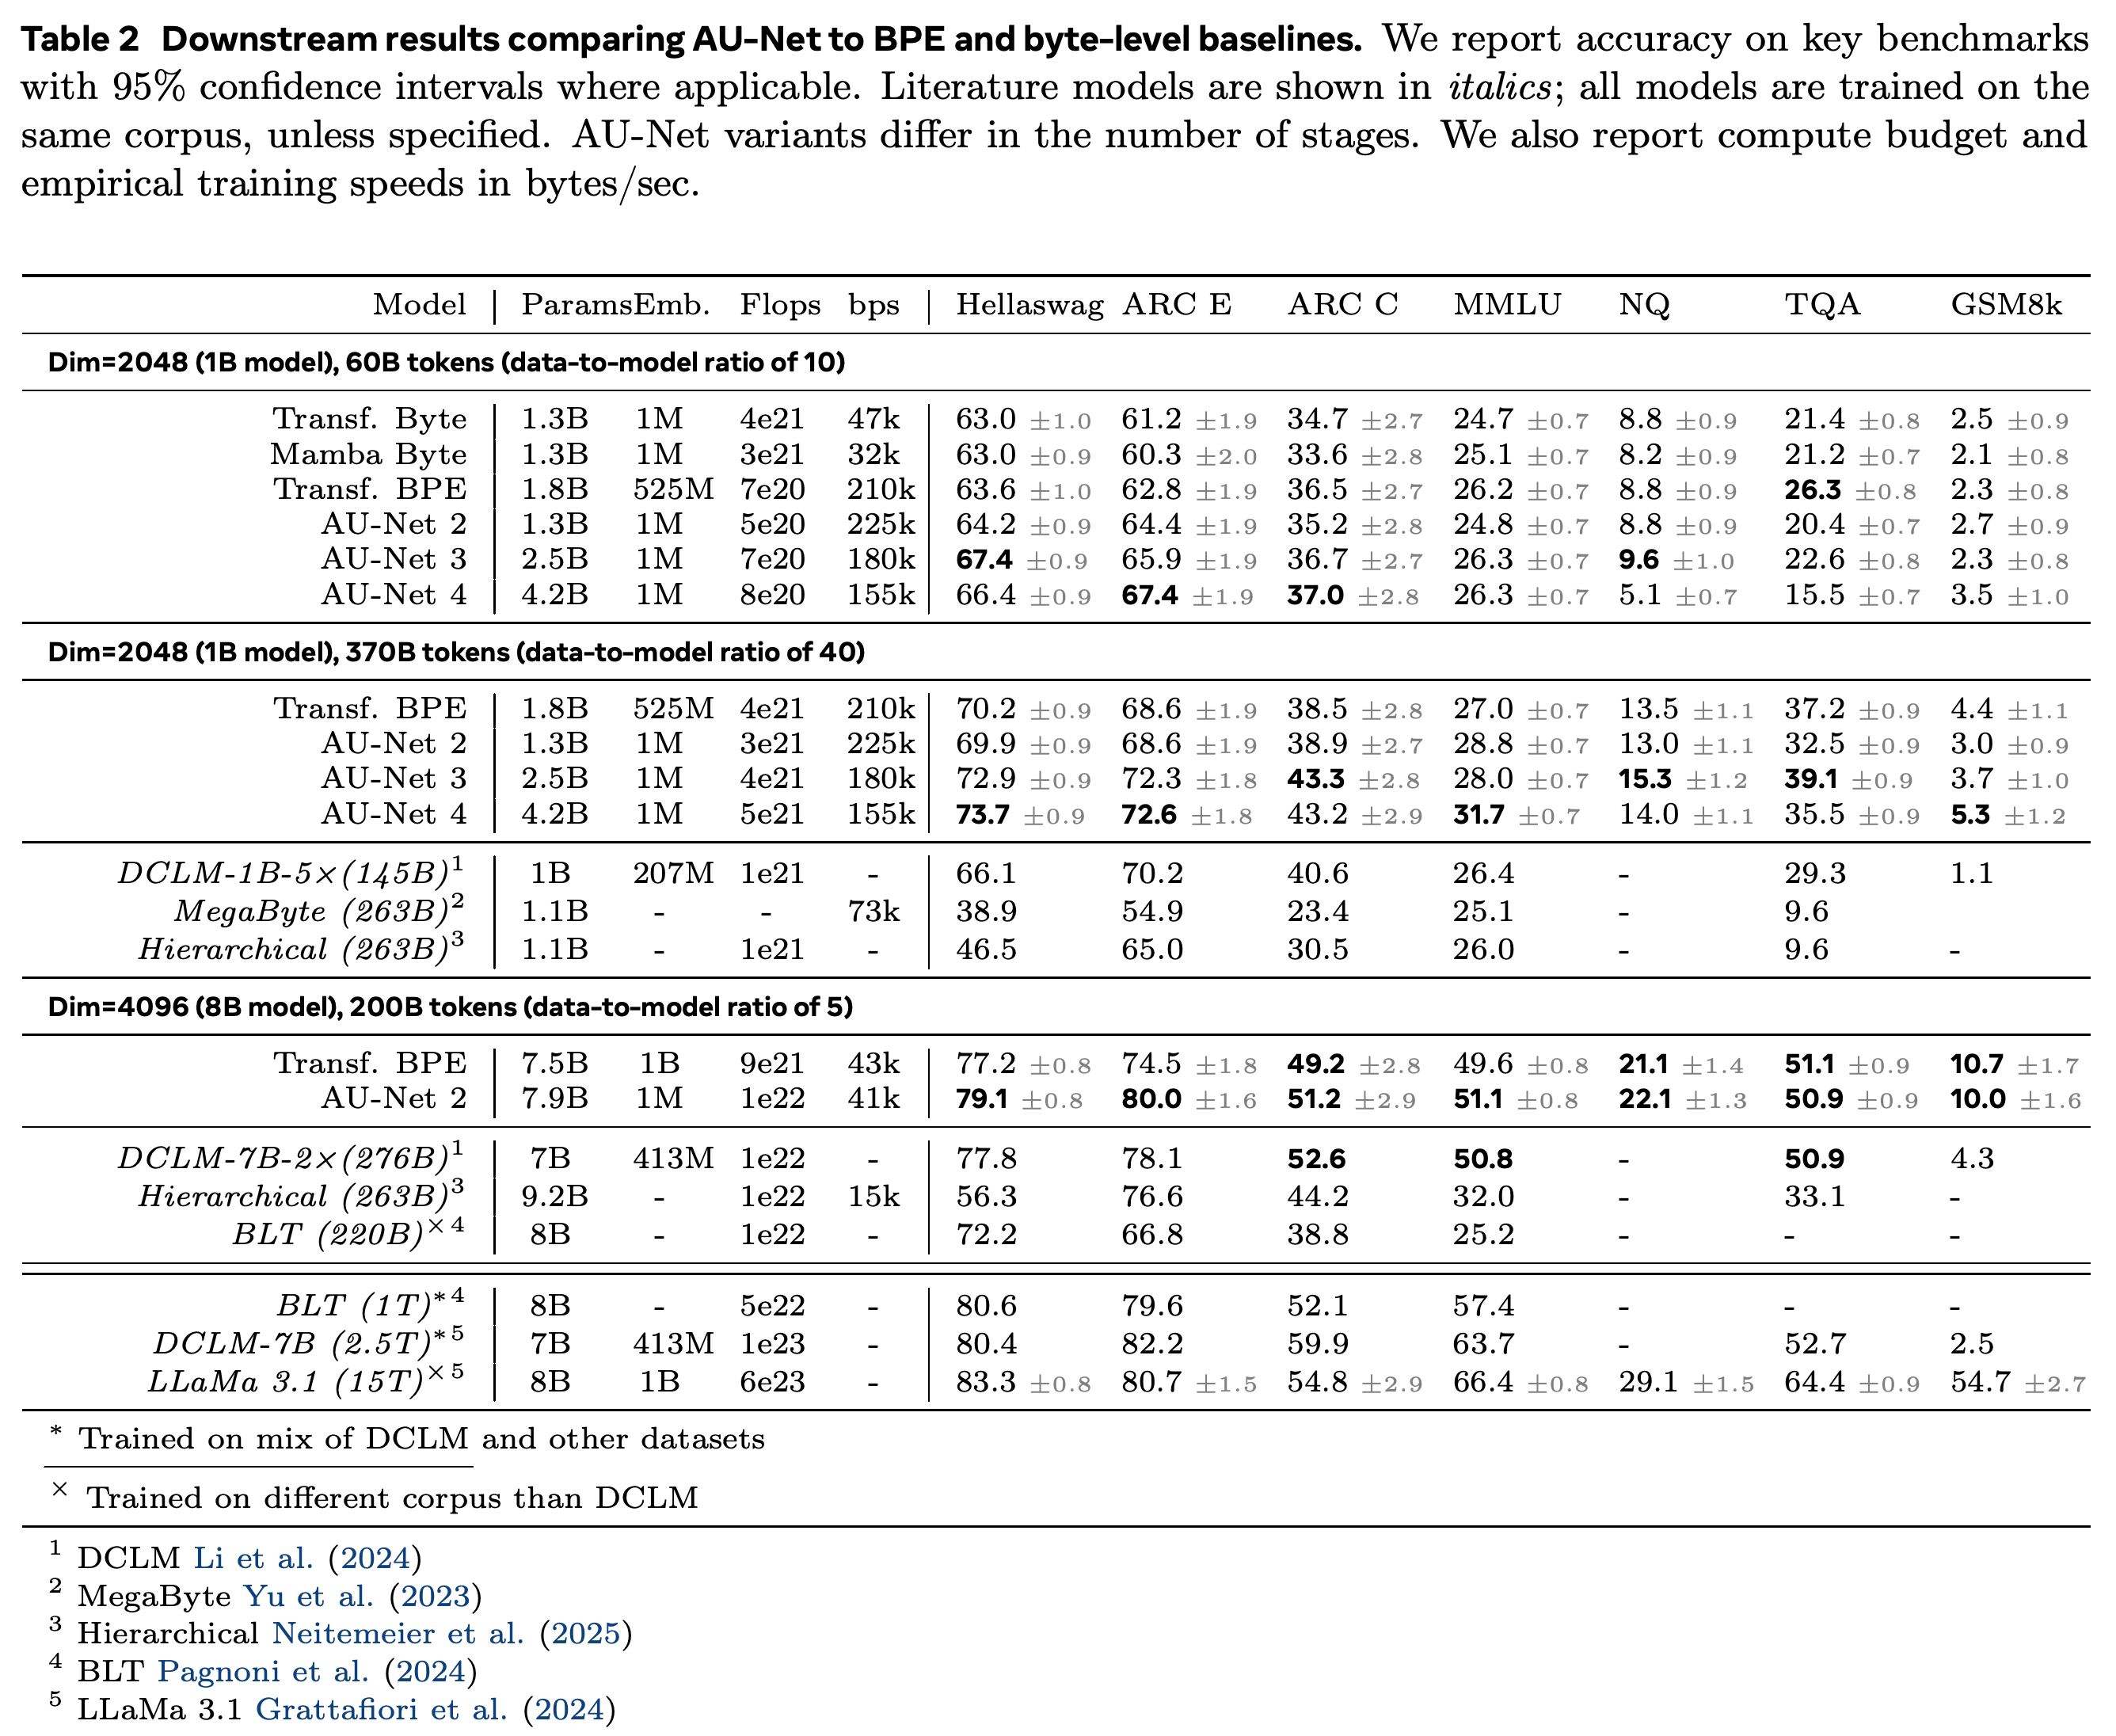
- AU-Net은 미리 정한 분할 규칙을 유지하면서 바이트, 단어, 2단어, 4단어 단위의 문맥 표현을 학습한다. LLaMa 3 기준 370B 토큰에 해당하는 데이터로 학습했을 때, AU-Net 3은 객관식 벤치마크인 Hellaswag에서 72.9 ± 0.9를 기록하며 BPE의 70.2 ± 0.9를 앞선다. Table 2는 양쪽 모델의 연산량을 모두 4e21 부동소수점 연산(FLOPs)으로 표기하지만, 상세 설정 표에 기재된 비용은 서로 다르다. FLOPs는 연산량을 나타내는 척도다.
- 바이트 기반 아키텍처는 일부 문자 조작 과제와 저자원 번역에서 성능을 높이지만, 이점은 과제와 문자 체계에 따라 달라진다. 계층이 깊어질수록 파라미터 수가 늘고 학습 처리량은 줄어든다. 연산량을 통제한 실험에서도 일부 규모에서는 지식과 수학 추론 벤치마크 성능이 더 낮다.
1 Introduction
서론은 텍스트 분할과 입력 단위를 벡터로 바꾸는 임베딩을 구분한다. 독립적인 조회 테이블 임베딩은 공통된 문자 구조를 드러내기 어렵고, 단일 고정 토큰화는 후속 층이 처리 단위를 바꾸지 못하게 한다.
- AU-Net은 대규모 토큰 조회 테이블을 바이트에서 직접 학습한 문맥 표현으로 대체한다.
- 깊은 단계는 별도의 예측 손실 없이 여러 단어에 걸친 예측을 유도한다. 앞선 표현을 후속 층으로 직접 전달하는 skip connection은 세부 정보를 보존한다.
- 논문은 계층적 표현, 고정된 단어 어휘에 대한 의존 해소, 경쟁력 있는 다운스트림 성능, 실측 학습 처리량, 아키텍처에 맞춘 최적화 스케일링을 기여로 제시한다.
2 Method
제안 방법은 시퀀스를 줄였다가 복원하는 계층 구조, 축소 경계를 정하는 분할 함수, 모델 규모별 연산량 기반 비교를 결합한다. 아키텍처는 구간 표현을 학습하며, 실험에서는 수동으로 지정한 분할 규칙을 유지한다.
2.1 Autoregressive U-Net
AU-Net은 축소 경로와 확장 경로에 decoder-only Transformer 층을 배치한다. 이 층은 attention을 통해 앞선 입력의 정보를 결합한다. 축소된 단계는 더 짧은 시퀀스를 더 큰 은닉 차원, 즉 더 넓은 표현 벡터로 처리한다. Skip connection은 세부 표현을 확장 경로로 전달하며, 가장 긴 바이트 단위 단계는 attention 범위를 sliding window로 제한한다.
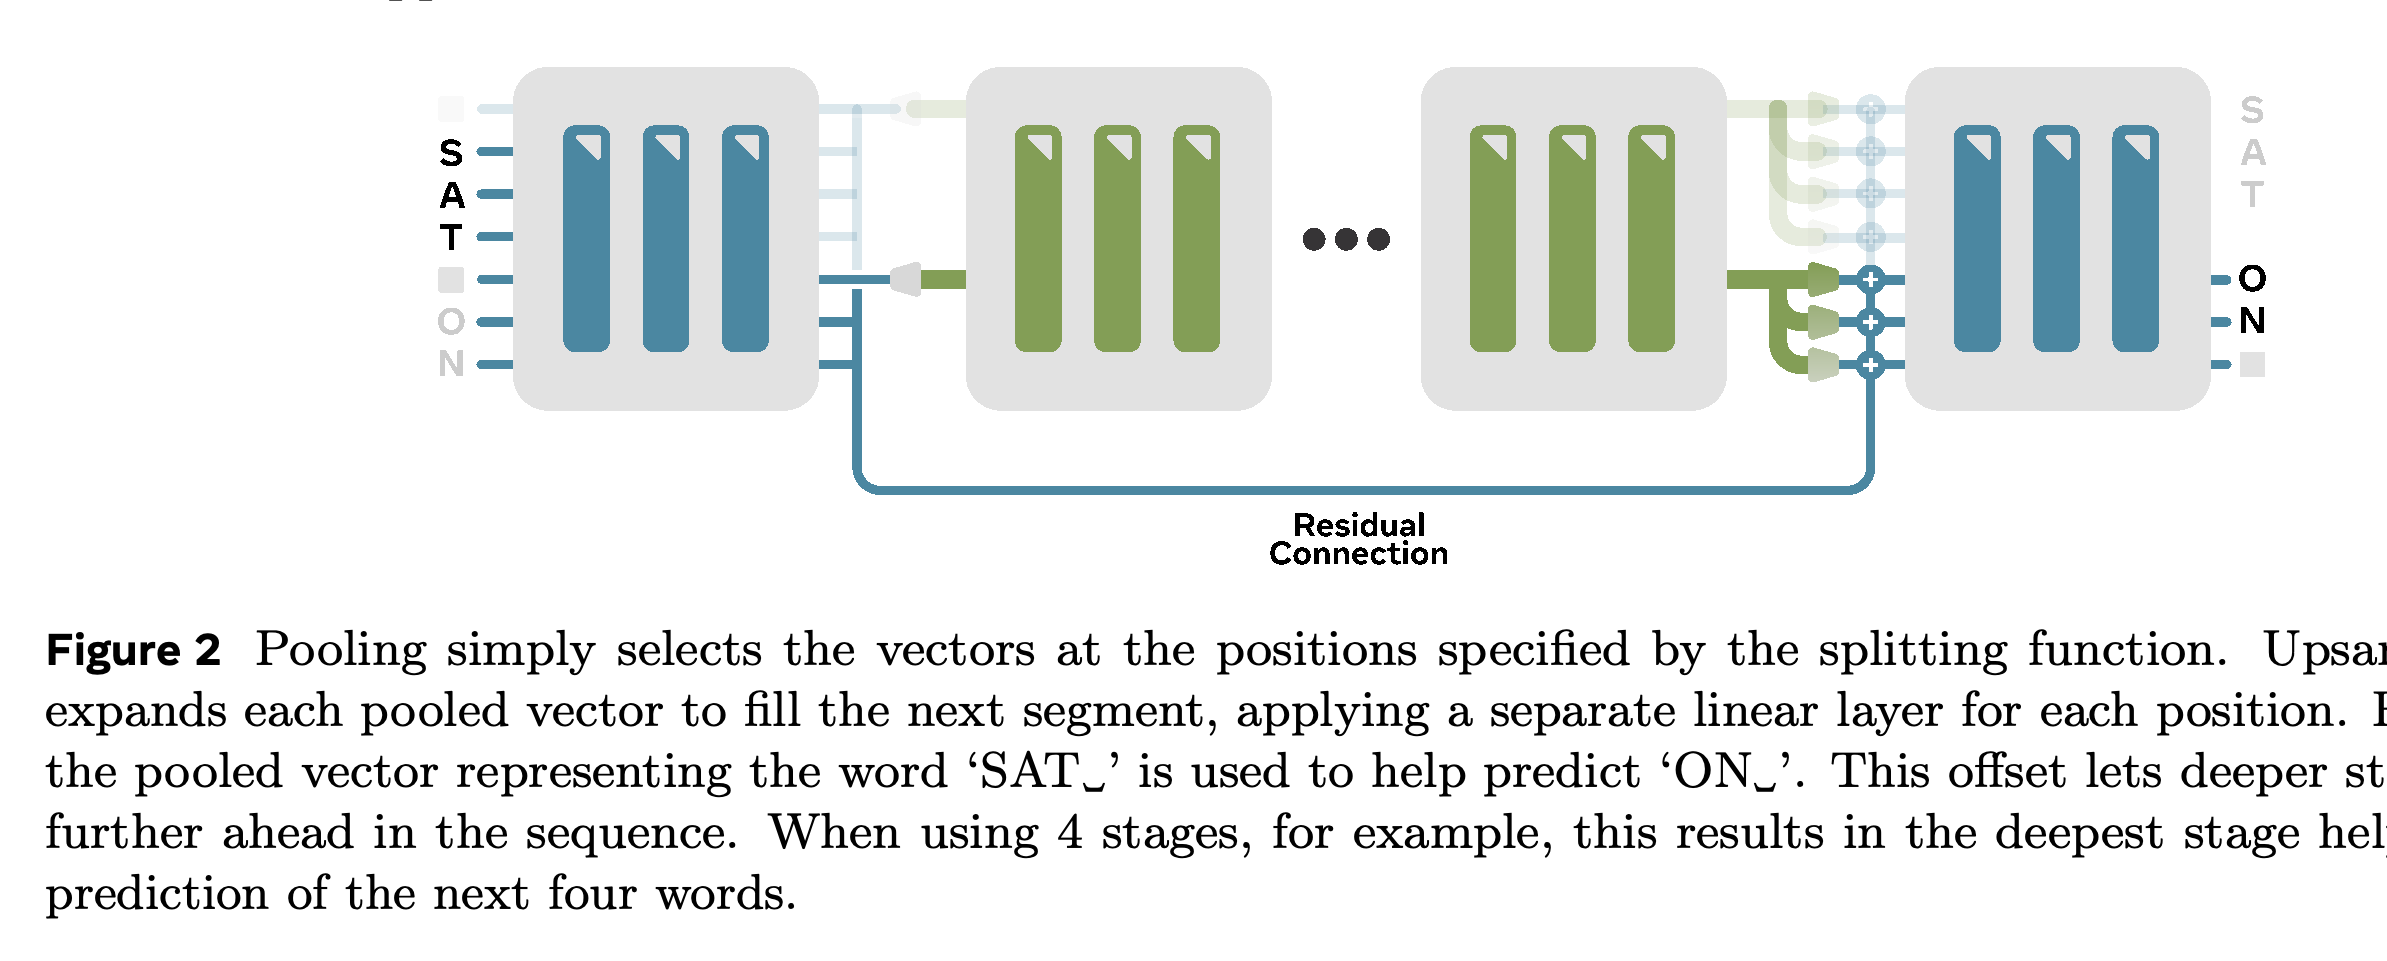
- 2.1.1 Pooling and Upsampling: pooling은 분할 경계의 문맥 벡터를 선택하고 다음 단계의 차원으로 투영하여 시퀀스 길이를 줄인다. Multi-Linear Upsampling은 큰 단위의 벡터를 다음 구간의 각 위치로 복제하고, 상대 위치마다 서로 다른 선형 변환을 적용하여 더 세밀한 위치별 표현을 복원한다.
- 다음 구간에 표현을 전달하면 예측 오프셋을 유지할 수 있다. “SAT ”의 표현은 “ON ”을 예측하는 데 쓰이며, 4단계 모델의 가장 깊은 단계는 다음 4개 단어의 예측을 돕는다.
- 2.1.2 Generation: 학습 시에는 모든 단계를 병렬로 처리한다. 앞선 바이트로 후속 바이트를 차례로 예측하는 자기회귀 생성 시에는 pooling 경계에 따라 깊은 단계가 활성화되므로, 각 단계의 최신 출력 벡터를 캐시에 보관해야 한다.
이 도식은 세부 바이트 정보를 skip connection으로 보존하면서 대부분의 계산을 더 짧고 넓은 시퀀스로 옮기는 방식을 보여준다. 이 3단계 예시에서는 중앙 단계에 FLOPs의 70%를 배정하여 가장 큰 처리 단위에 연산량을 집중한다.
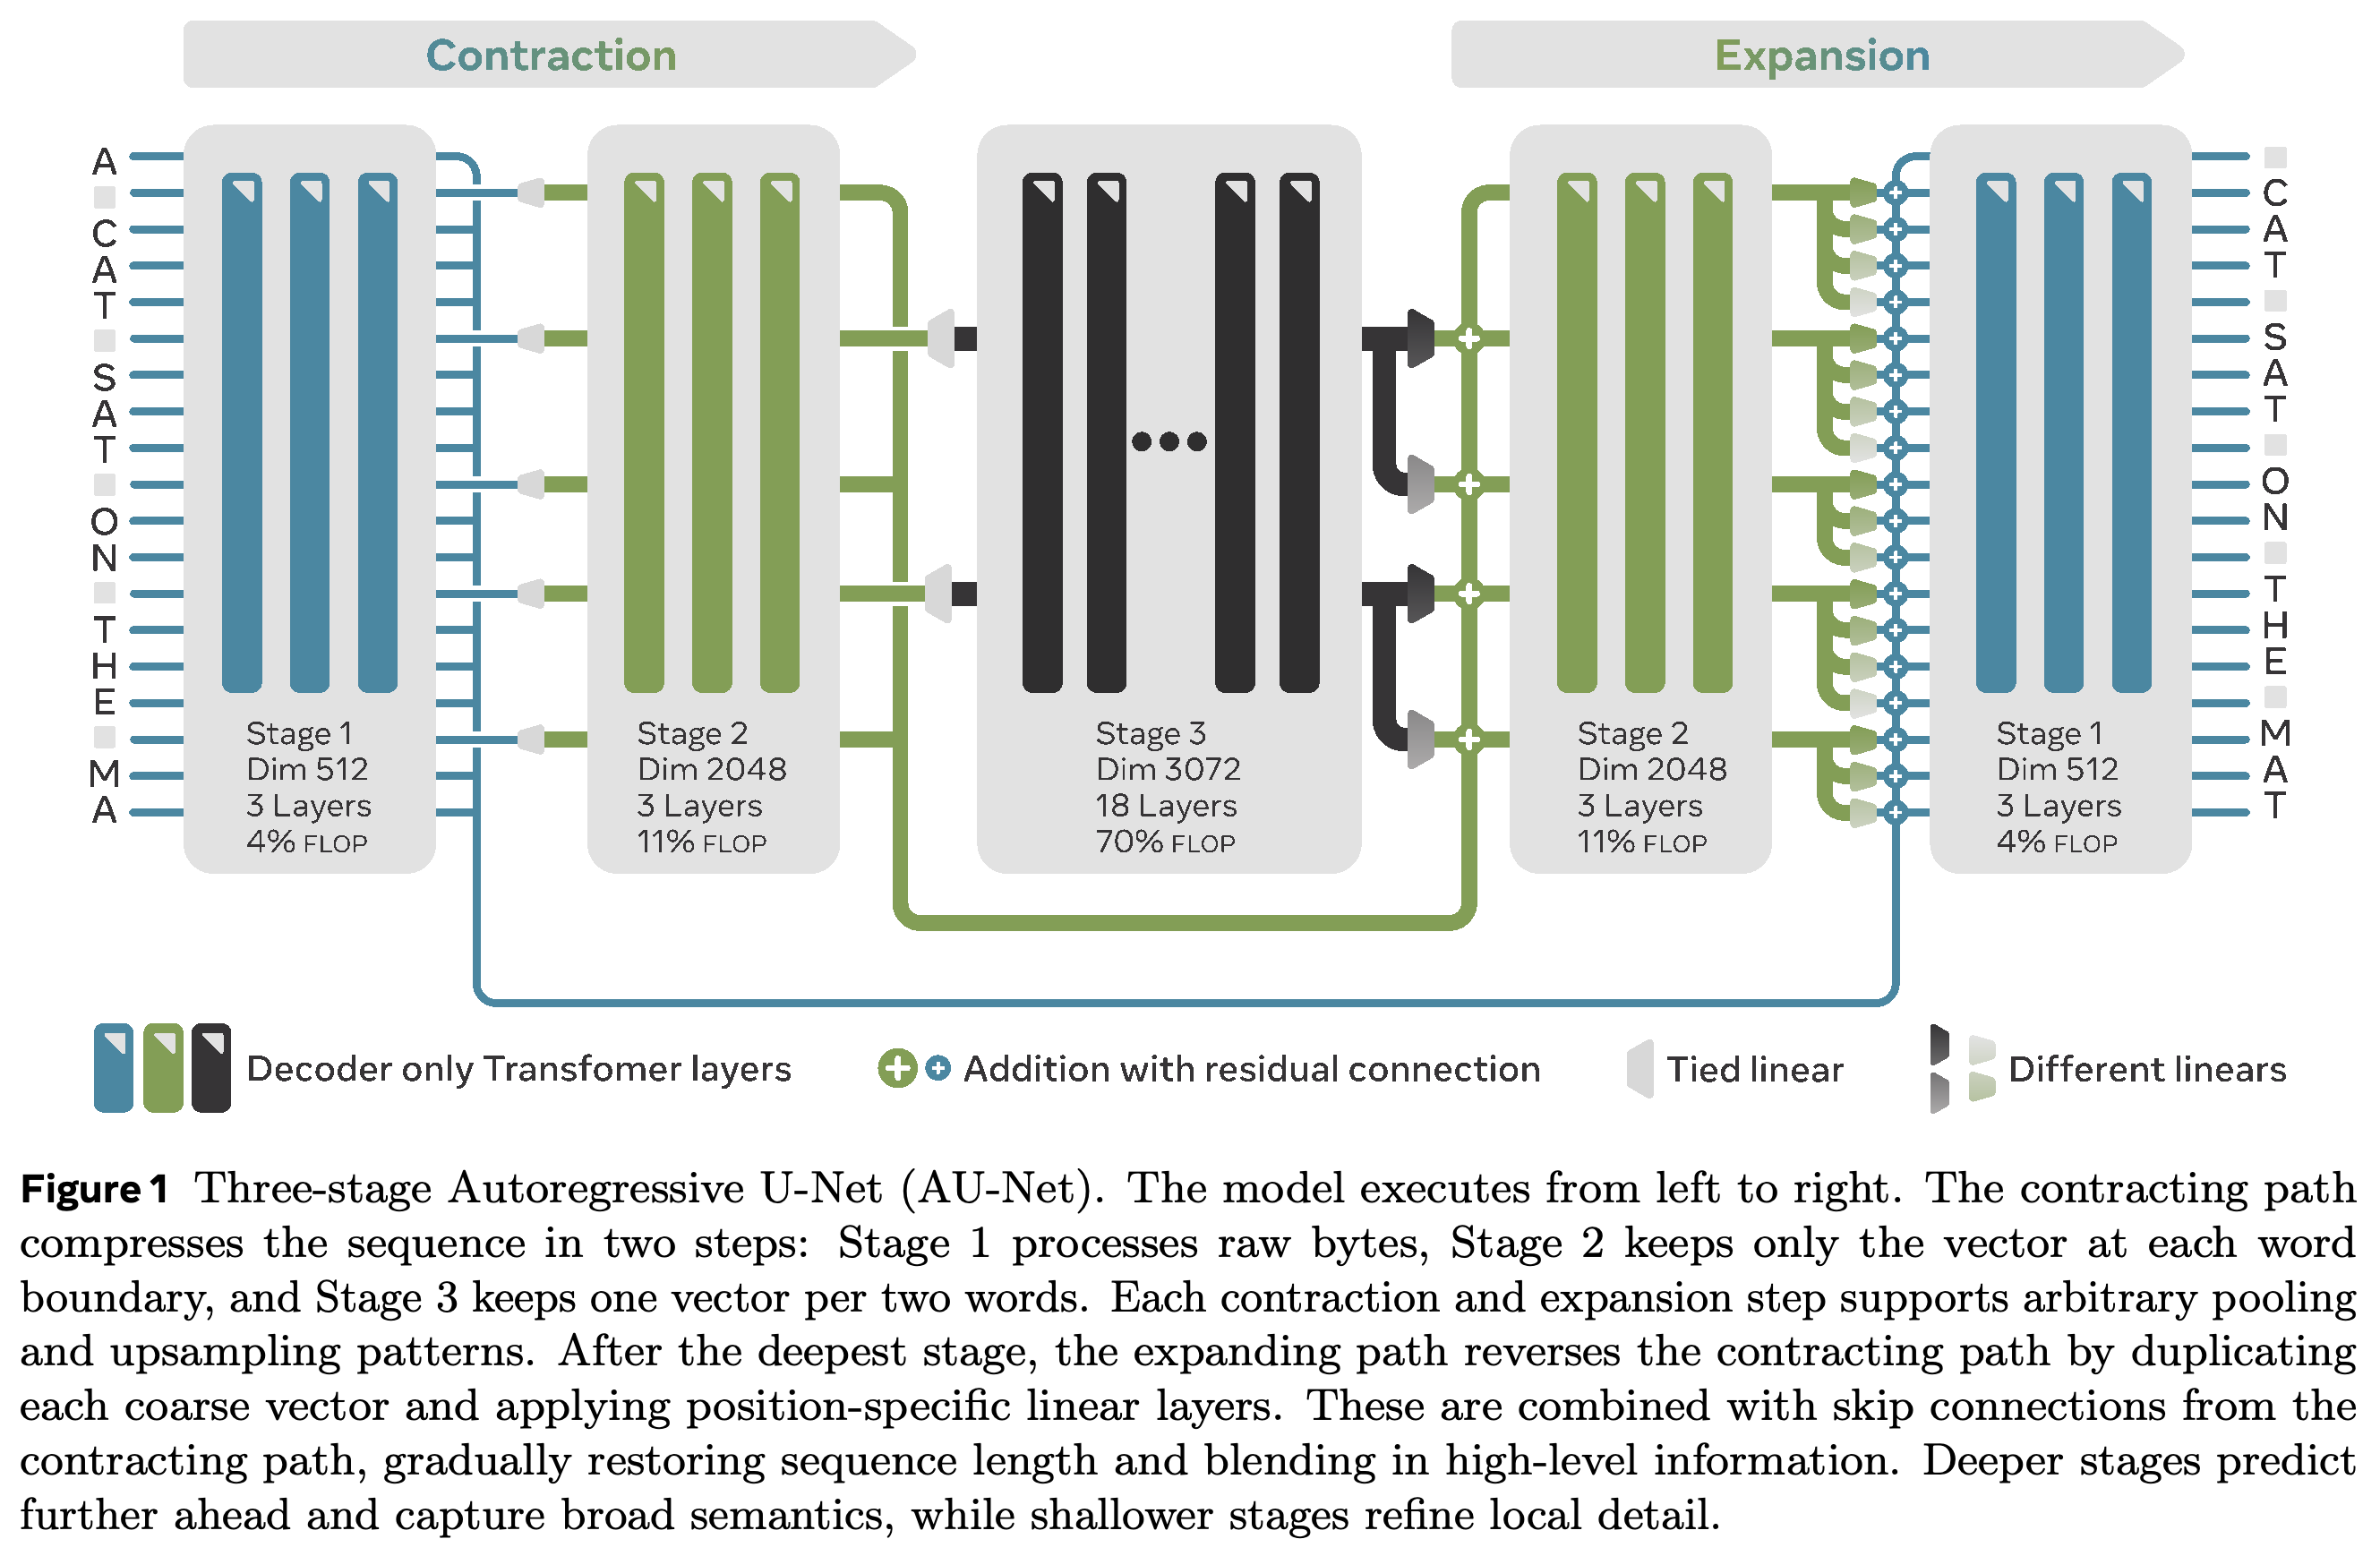
Pooling한 구간과 확장된 표현을 받는 구간 사이의 오프셋은 계층 구조가 다음 내용을 예측하는 원리를 설명한다. 완성된 “SAT ”의 표현은 다음 구간의 바이트에 접근하지 않고 “ON ”을 예측하는 데 기여한다.
2.2 Splitting Function
분할 함수는 오른쪽에 내용을 추가해도 안정적이어야 한다. 즉, 바이트를 덧붙여도 앞서 내린 pooling 결정이 바뀌지 않아야 한다. 실험에서는 텍스트 패턴을 찾는 규칙인 정규 표현식으로 단어 경계를 식별한 뒤, 2단어와 4단어 뒤 또는 문장 끝에서 pooling을 수행한다.
- 이 프레임워크는 가변 구간 길이와 다른 분할 함수를 허용하지만, 평가한 규칙은 공백에 의존하며 라틴 문자에 적합하다.
- 명확한 구분자가 없는 언어에서도 안정적으로 작동하는 분할 방식은 후속 과제로 남는다.
2.3 Evaluating on different scales
논문은 총 사전학습 연산량 C = Fmodel/input-unit × Ninput-unit으로 규모를 측정한다. 여기서 F는 입력 단위당 순전파와 역전파 연산량이며, N은 학습 입력 단위의 수다. Decoder-only Transformer의 단위당 연산량은 Fmodel/input-unit = 6Nparams(no-embed) + 6dLS로 추정한다. Nparams(no-embed)는 임베딩을 제외한 파라미터 수, d는 표현 너비, L은 층 수, S는 시퀀스 길이다.
- 데이터 대 모델 비율은 γinput-unit = Ninput-unit / Fmodel/input-unit이다. 사전학습 코퍼스인 DataComp-LM (DCLM)에서 LLaMa 3 토큰 시퀀스는 바이트 시퀀스보다 짧으며, 길이 비율은 k ≈ 4.56 times로 제시된다. 이에 따라 γbyte = k²γtoken이 된다.
- AU-Net의 바이트당 연산량은 각 단계의 비용을 해당 단계의 축소 비율로 나눈 뒤 합산한다. 깊은 단계는 더 적은 위치를 처리하므로, 비슷한 연산 예산으로 더 많은 파라미터를 사용할 수 있다.
- 소형 모델 탐색에서는 최상의 검증 손실에서 1% 이내인 설정을 남긴 뒤 배치 크기와 학습률 곡선을 적합한다. 검증 손실은 학습에 쓰지 않은 데이터에서 측정한 예측 오류 척도다.
적합한 AU-Net 규칙은 BSZ_AU-Net(C) = 0.66C^0.321과 LR_AU-Net(C) = 6.6 × C^−0.176이다. BSZ는 업데이트마다 처리하는 입력량인 배치 크기이며, LR은 최적화 시 이동 폭을 정하는 학습률이다. 이에 대응하는 BPE 규칙은 BSZ_BPE(C) = 29.9C^0.231과 LR_BPE(C) = 19.3 × C^−0.177이다.
- 배치 크기 지수가 서로 다르므로, 일정한 바이트 대 토큰 환산 비율만으로는 연산 예산 전반에서 양쪽의 적합된 배치 크기 곡선을 모두 재현할 수 없다.
3 Experimental Results
실험은 동일한 학습 데이터 예산에서의 성능, 연산량 증가에 따른 성능, 다국어 과제와 문자 조작 과제를 살펴본다. 동일 데이터 비교 표에서는 연산 비용이 서로 다를 수 있으며, 스케일링 연구에서는 연산량에 따른 성능을 직접 비교한다.
3.1 Experimental Setup
모든 실험은 DCLM을 사용한다. 이 코퍼스는 토큰 수 집계에 사용하는 GPTNeoXTokenizer 기준으로 약 4T 토큰이며, 대부분 영어로 구성되고 코드와 수학 데이터는 적다. 기준 모델에는 LLaMa 3 BPE Transformer, 바이트 단위 Transformer, 바이트 단위 Mamba가 포함된다. Mamba는 입력의 누적 표현을 갱신하는 선택적 상태 공간 기반 시퀀스 모델이다. 학습 데이터 273B 바이트는 LLaMa 3 기준 약 60B 토큰에 해당한다.
- 배치 크기와 학습률은 파라미터 25M부터 500M까지의 모델로 조정한 뒤, 더 큰 예산으로 외삽한다.
- 객관식 과제에서는 문자 수로 정규화한 음의 로그우도를 최소화하는 답을 선택한다. 이 점수는 답의 확률이 높을수록 낮아진다. 개방형 과제에서는 생성한 답을 사용한다. 논문은 평가를 프롬프트 예시가 없는 zero-shot으로 설명하면서도, 일부 프롬프트에는 소수의 예시가 포함된다고 밝힌다.
- 표에는 해당하는 경우 재표집으로 불확실성을 추정한 bootstrap 95% 신뢰구간을 제시한다. 학습 처리량은 H100 80GB 하드웨어에서 그래픽 처리 장치당 초당 바이트 수로 측정한다.
구현에는 여러 예제를 학습 시퀀스로 묶는 sequence packing, 모델 상태를 여러 장치에 분산하는 Fully Sharded Data Parallelism (FSDP), 모델 컴파일 기능인 torch.compile을 사용한다. 가변 길이 계층 구조를 컴파일하기 위해 단계마다 최대 시퀀스 길이를 고정하고, 이를 넘는 출력은 자르며 짧은 출력은 패딩한다.
- 이 길이 제한은 pooling 경계를 가변적으로 유지하면서도, 컴파일에 필요한 연산 형태가 고정된 정적 계산 그래프를 구성할 수 있게 한다.
3.2 Equal Data Budget Results
명목상 1B 규모에서 60B 토큰에 해당하는 데이터로 학습하면, AU-Net 3은 Hellaswag 성능을 63.6 ± 1.0에서 67.4 ± 0.9로 높인다. Table 2에서 반올림한 연산량은 BPE와 동일한 7e20 FLOPs다. 실제 파라미터 수는 각각 2.5B와 1.8B이며, 처리량은 장치당 초당 210k 바이트에서 180k 바이트로 줄어든다.
- 370B 토큰에 해당하는 데이터에서 AU-Net 3은 객관식 추론 벤치마크인 ARC-Challenge 성능을 38.5 ± 2.8에서 43.3 ± 2.8로 높인다. 지식 집약적 답변 생성 벤치마크인 TQA 성능은 37.2 ± 0.9에서 39.1 ± 0.9로 높인다. Table 2는 양쪽 모델의 연산량을 모두 4e21 FLOPs로 반올림하지만, Table 10은 AU-Net 3을 4.0e21, BPE를 3.6e21로 기재한다.
- AU-Net 4는 정답률로 평가하는 지식 벤치마크인 MMLU에서 31.7 ± 0.7을 기록하며 BPE의 27.0 ± 0.7을 앞선다. 다만 Table 2의 연산량은 BPE의 4e21보다 많은 5e21 FLOPs다.
- 60B 토큰 조건에서는 AU-Net 4의 TQA 성능이 BPE의 26.3 ± 0.8보다 낮은 15.5 ± 0.7에 그친다. 이는 계층을 추가해도 모든 과제에서 성능이 좋아지지는 않음을 보여준다.
명목상 8B 규모에서 200B 토큰에 해당하는 데이터로 학습하면, AU-Net 2는 Hellaswag에서 79.1 ± 0.8, 더 쉬운 ARC 객관식 벤치마크인 ARC-Easy에서 80.0 ± 1.6을 기록한다. BPE는 각각 77.2 ± 0.8과 74.5 ± 1.8을 기록한다. 이 비교에서 파라미터 수는 각각 7.9B와 7.5B, 반올림한 연산량은 1e22와 9e21 FLOPs, 처리량은 장치당 초당 41k와 43k 바이트다.
- 이 규모에서 TQA 결과는 50.9 ± 0.9와 51.1 ± 0.9로 비슷하지만, 수학 추론 벤치마크인 GSM8k에서는 AU-Net 성능이 여전히 조금 낮다.
- Table 10에 기재된 더 정밀한 연산량은 AU-Net 2가 1.2e22, BPE가 9.5e21이다. 기존 문헌의 모델과 비교할 때는 학습 데이터의 양과 코퍼스 구성도 다르므로, 차이를 아키텍처만의 효과로 보기 어렵다.
동일 데이터 조건의 정확도를 비교할 때는 파라미터 수, 반올림한 FLOPs, 처리량을 함께 고려해야 한다. AU-Net 3은 비슷한 반올림 연산량에서 여러 결과를 개선하지만, AU-Net 4는 성능 향상이 고르지 않고 처리량도 낮다. 더 큰 AU-Net 2 모델은 BPE에 가까운 처리량을 유지한다. Table 10의 상세 연산량을 보면, 반올림한 값이 같은 모든 항목을 정확히 동일한 연산량으로 볼 수는 없다.
3.3 Scaling laws
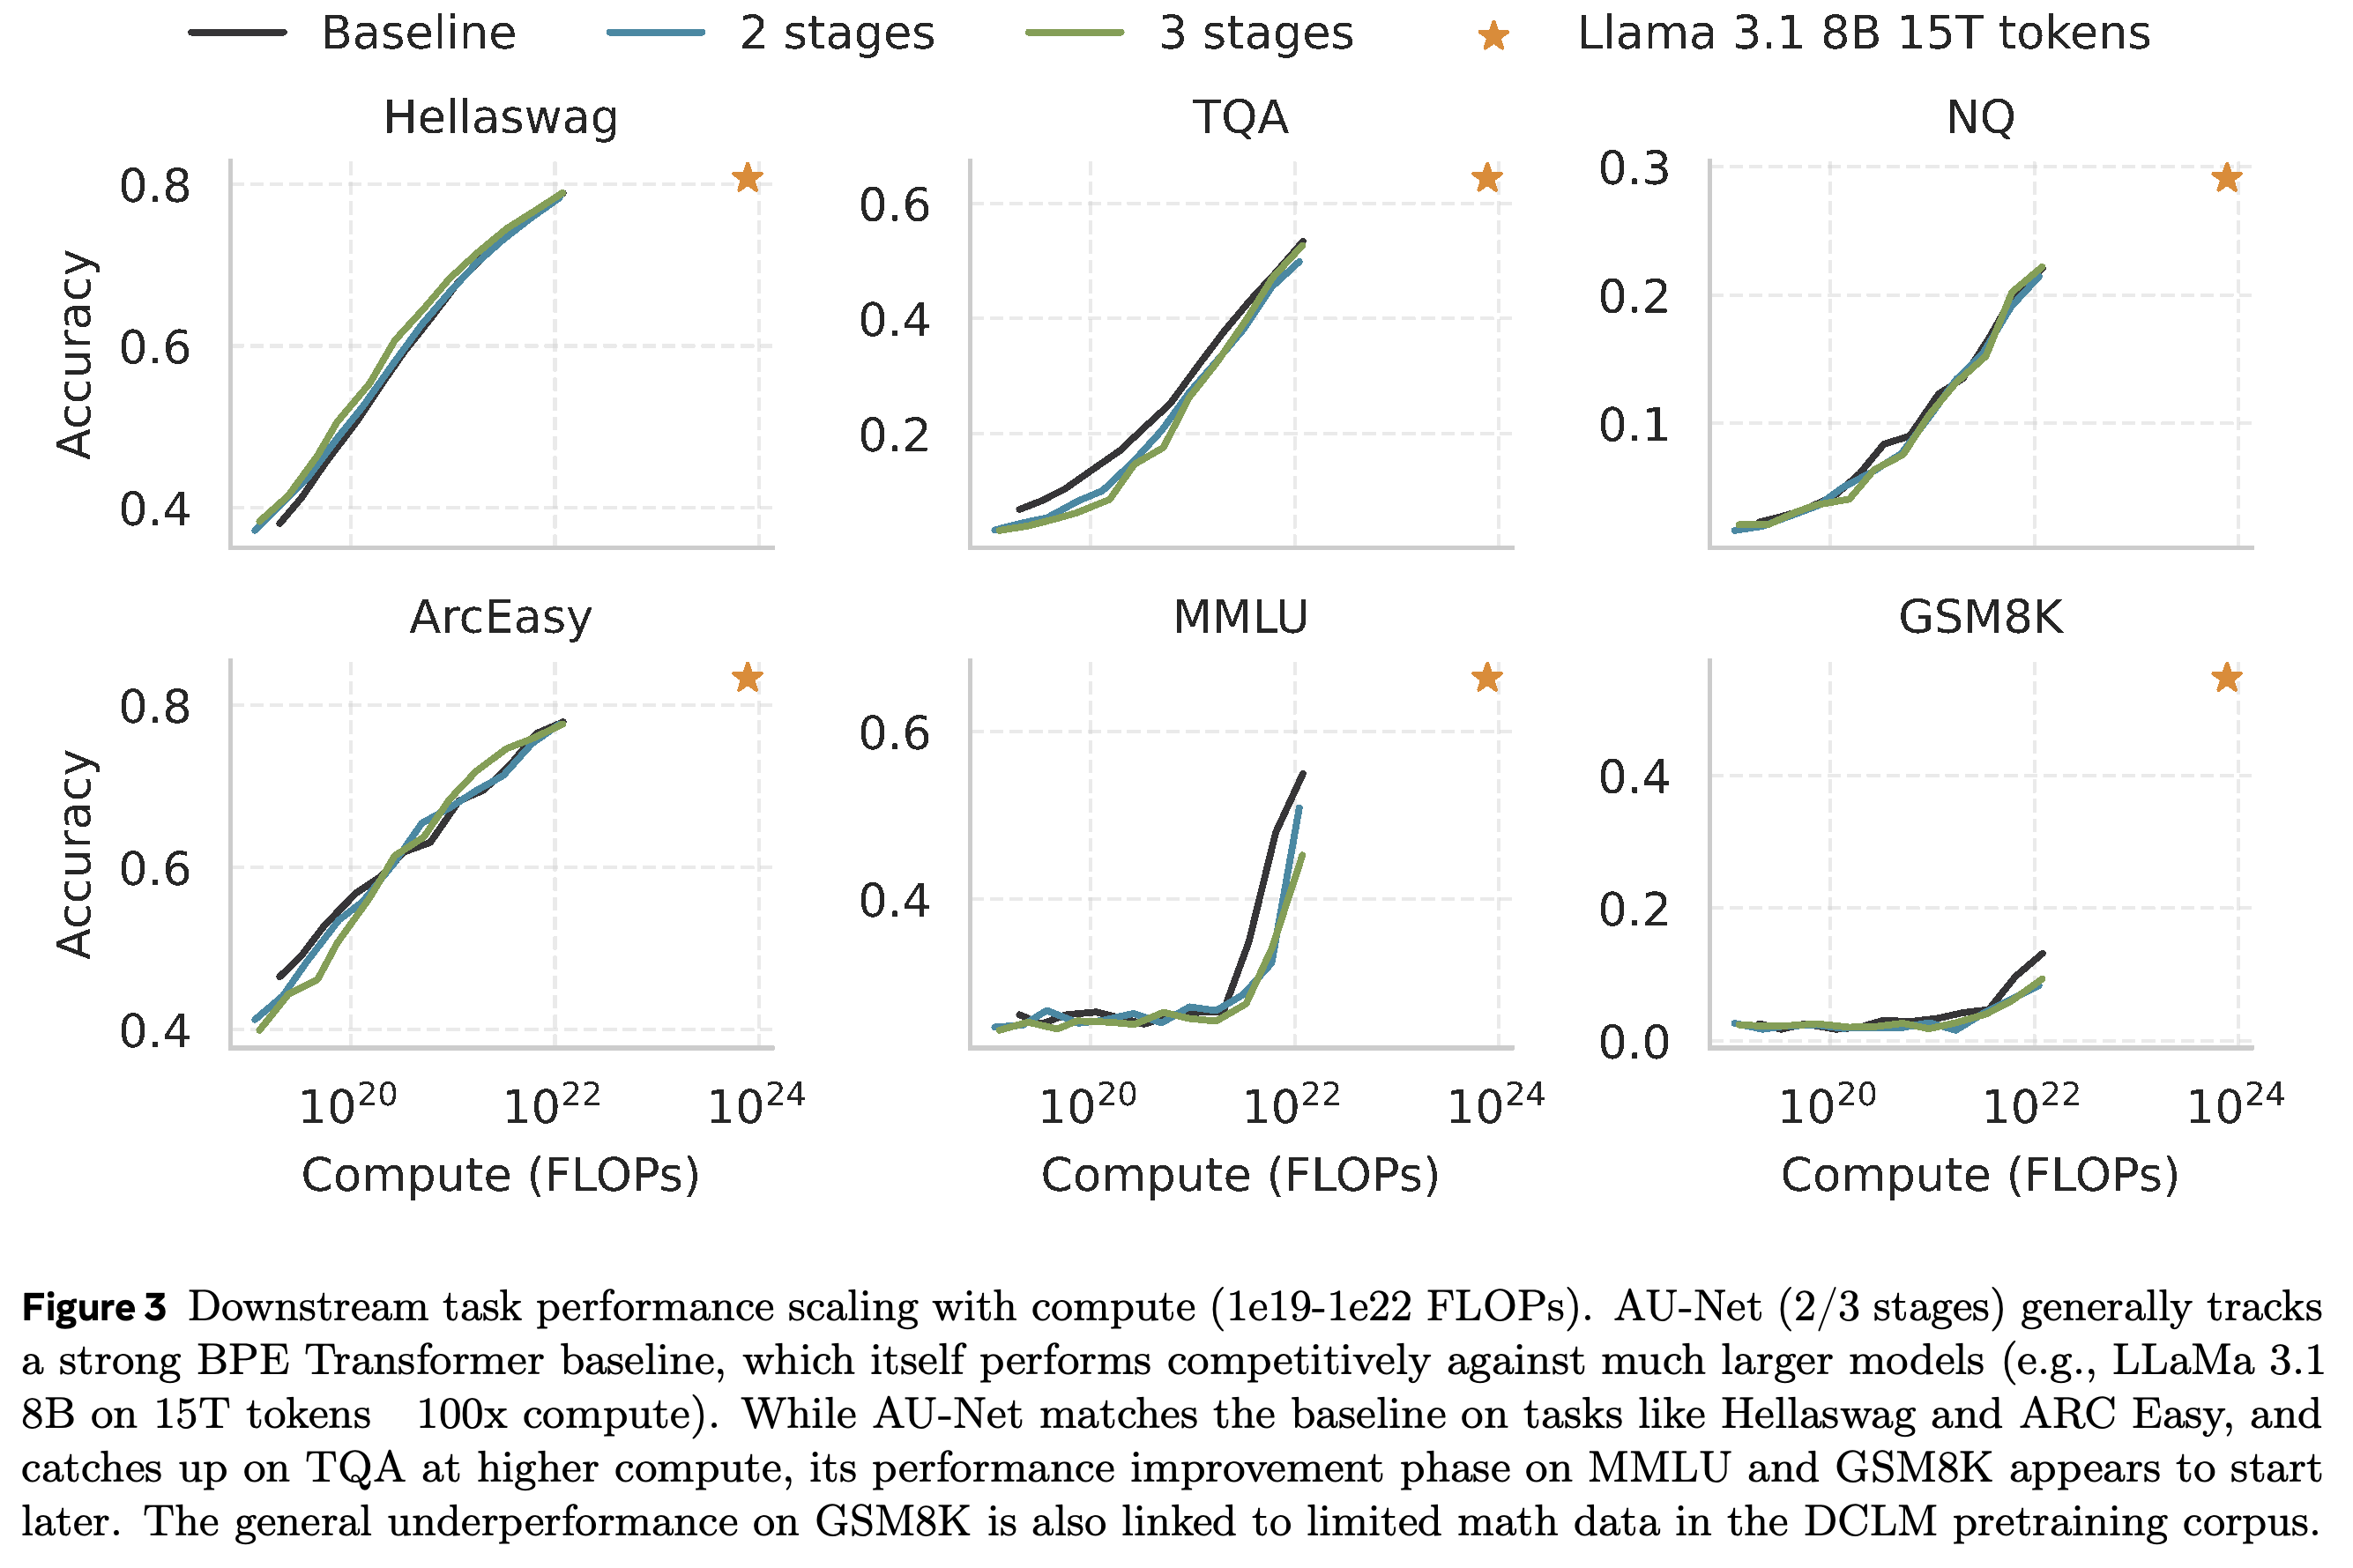
논문에 제시된 1e19–1e22 FLOP 범위에서 두 단계와 세 단계 AU-Net은 Hellaswag, ARC-Easy, 개방형 질의응답 벤치마크인 NQ에서 대체로 BPE와 비슷한 성능을 보인다. 단계가 3개인 모델은 1e22 FLOPs 부근에서 TQA 성능 격차를 해소하지만, 범위 상단의 MMLU와 GSM8K에서는 양쪽 변형 모두 BPE보다 뒤처진다.
- 저자들은 MMLU와 GSM8K에서 성능이 뒤늦게 상승하는 현상을 지연된 성능 전환일 가능성으로 해석한다. 실험 범위를 넘어선 이점은 검증되지 않았다.
- 논문은 전반적으로 약한 수학 추론 성능의 원인 중 하나로 DCLM의 적은 수학 데이터를 제시하지만, 이를 통제된 데이터 절제 실험으로 검증하지는 않았다.
- Section 3.3 앞 문단은 데이터 대 모델 비율을 2로 제시하지만, Section 3.3은 10으로 제시한다. 본문은 이 불일치를 해소하지 않는다.
곡선은 Hellaswag, ARC-Easy, NQ에서 전반적으로 경쟁력 있는 연산 효율을 뒷받침하는 한편, 범위 상단의 MMLU와 GSM8K에서는 격차를 보여준다. 측정 범위 안에서 과제에 따라 성능이 대등함을 확인할 수 있지만, 범위를 넘어선 성능 향상을 입증하지는 않는다.
3.4 Extended Evaluations
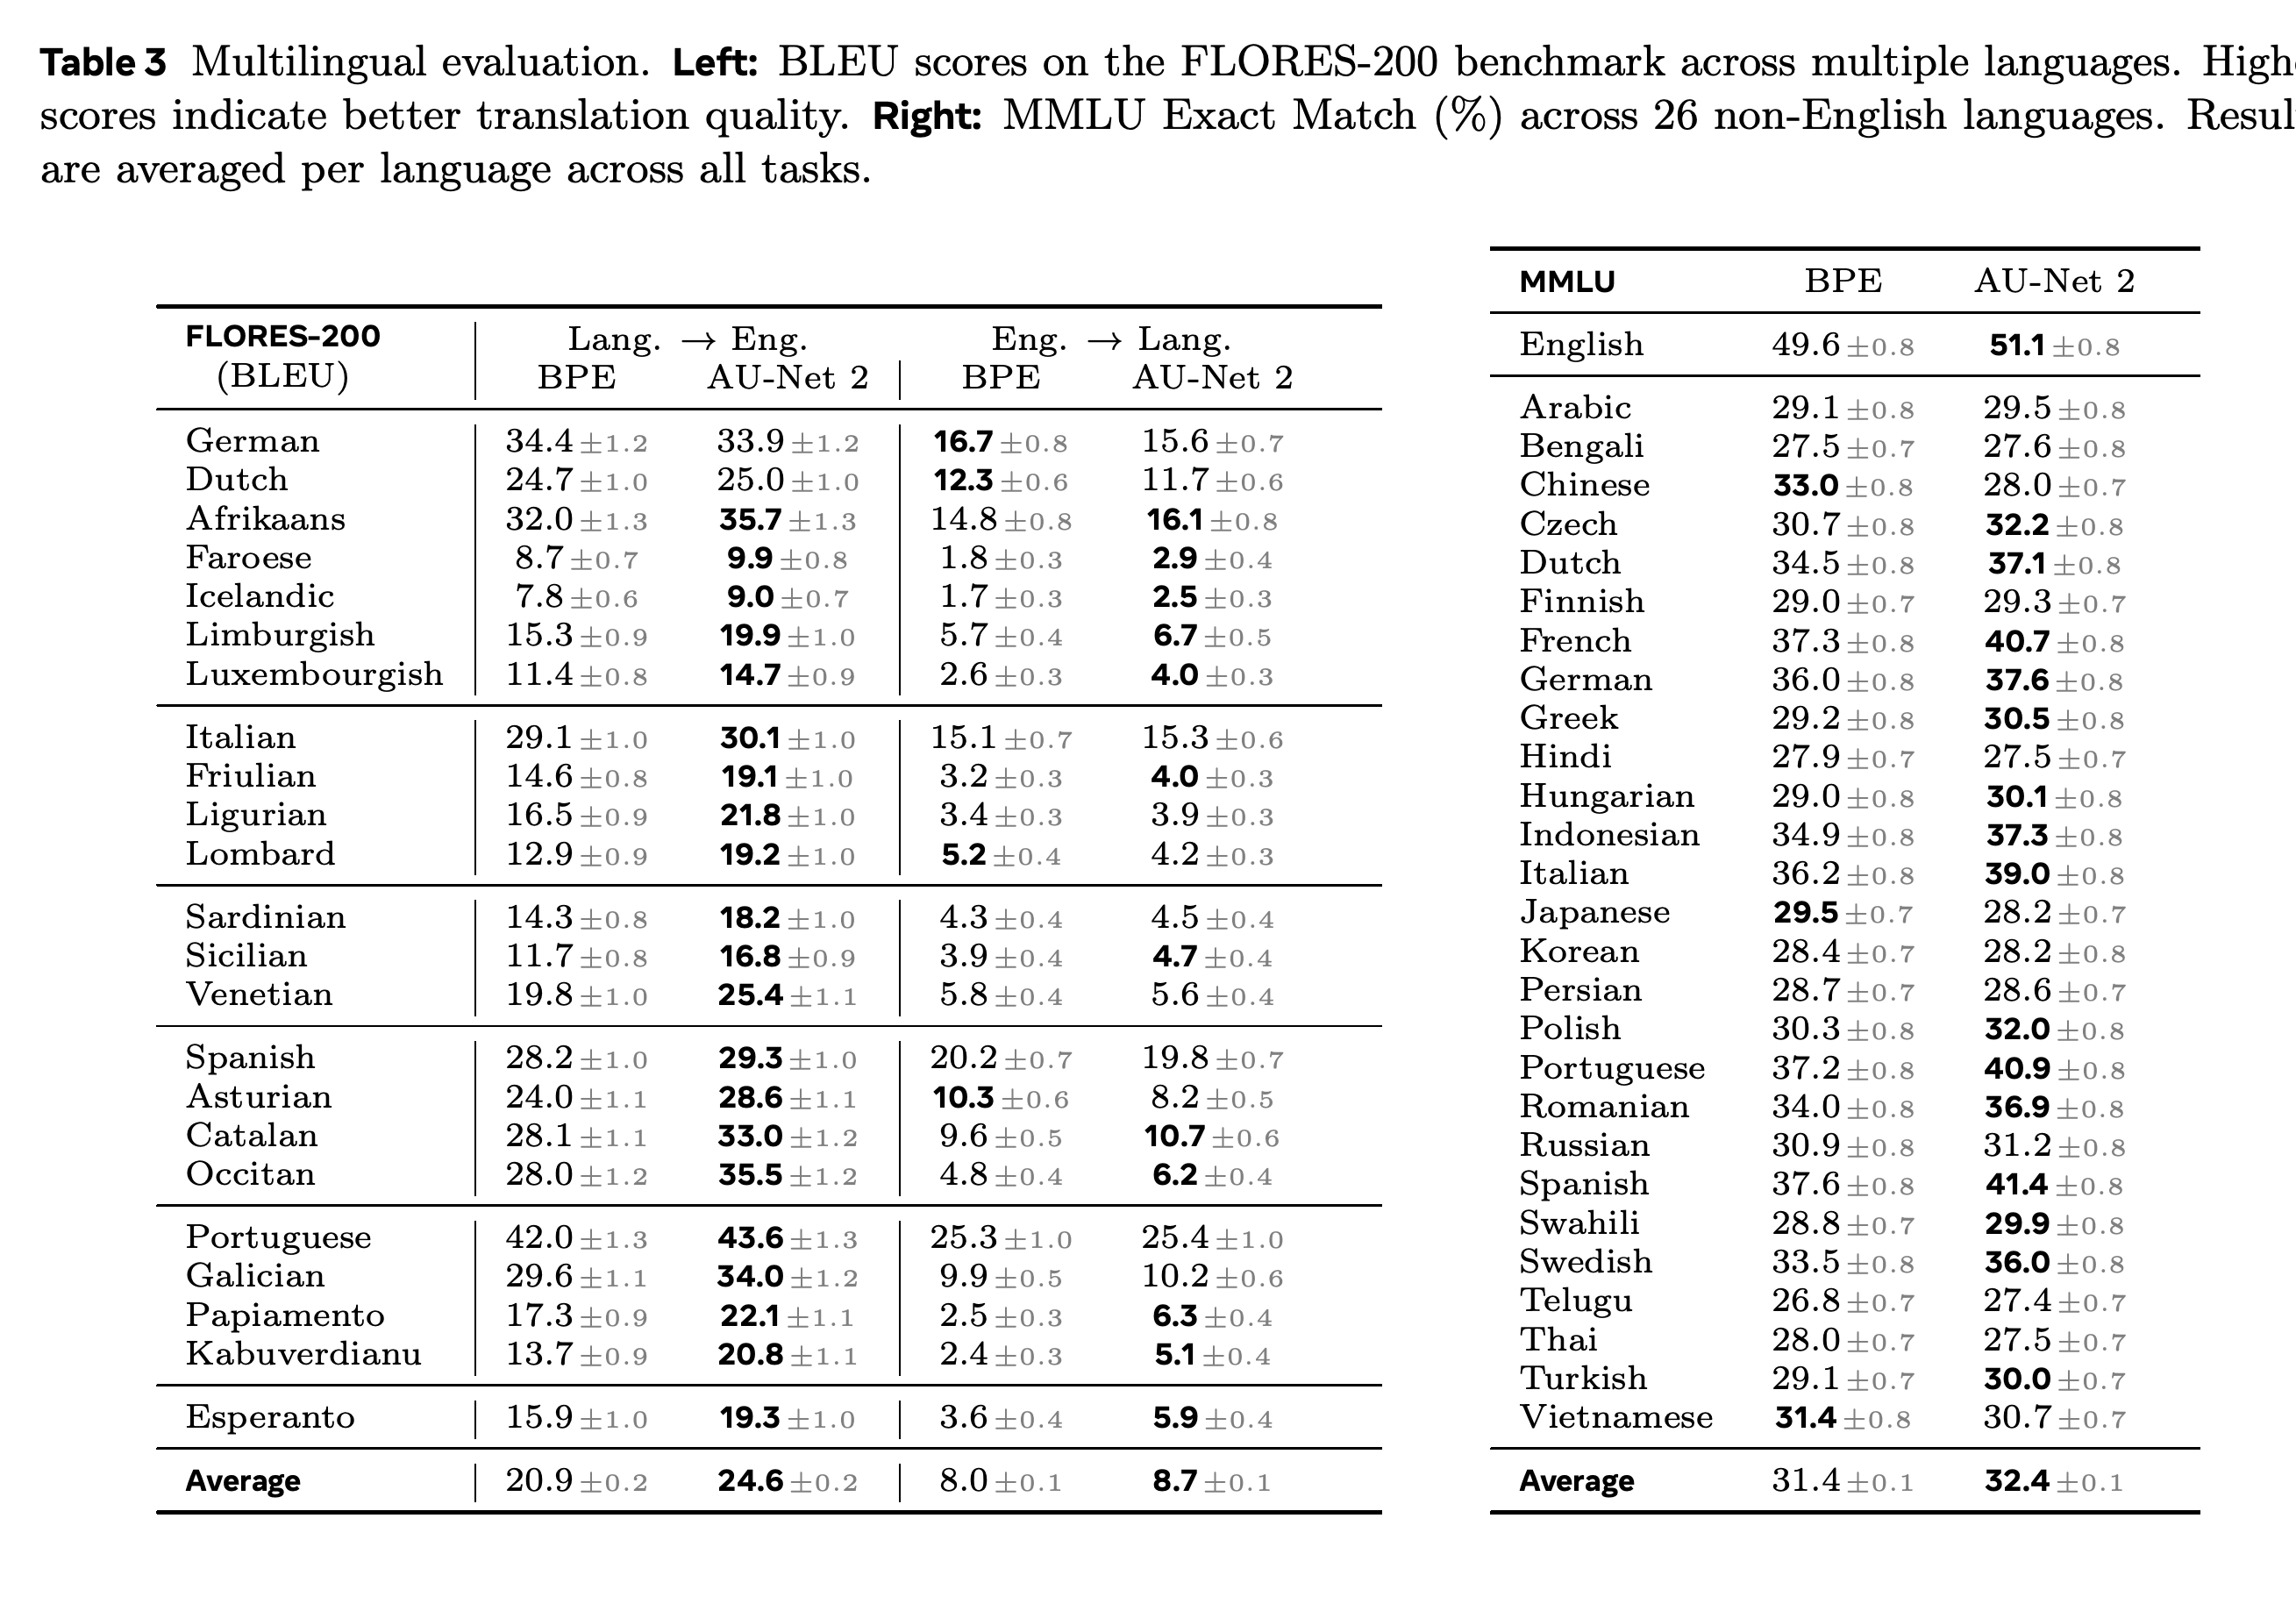
다국어 번역 벤치마크인 FLORES-200에서 AU-Net 2는 영어로 번역하는 평균 성능을 20.9 ± 0.2에서 24.6 ± 0.2 BLEU로 높인다. BLEU는 높을수록 좋은 번역 품질 점수다. 영어에서 다른 언어로 번역하는 성능은 8.0 ± 0.1에서 8.7 ± 0.1로 더 적게 향상되며, 다국어 MMLU 평균 정답률은 31.4 ± 0.1에서 32.4 ± 0.1로 높아진다.
- 성능 향상은 라틴 문자를 사용하는 서로 관련된 언어에 집중된다. 이는 공통된 철자와 단어 구조를 통해 전이가 일어난다는 저자들의 설명과 부합하지만, 이 비교만으로 해당 메커니즘을 분리해 확인할 수는 없다.
- 모든 언어에서 이점이 나타나지는 않는다. 중국어 MMLU 성능은 33.0 ± 0.8에서 28.0 ± 0.7로 낮아진다.
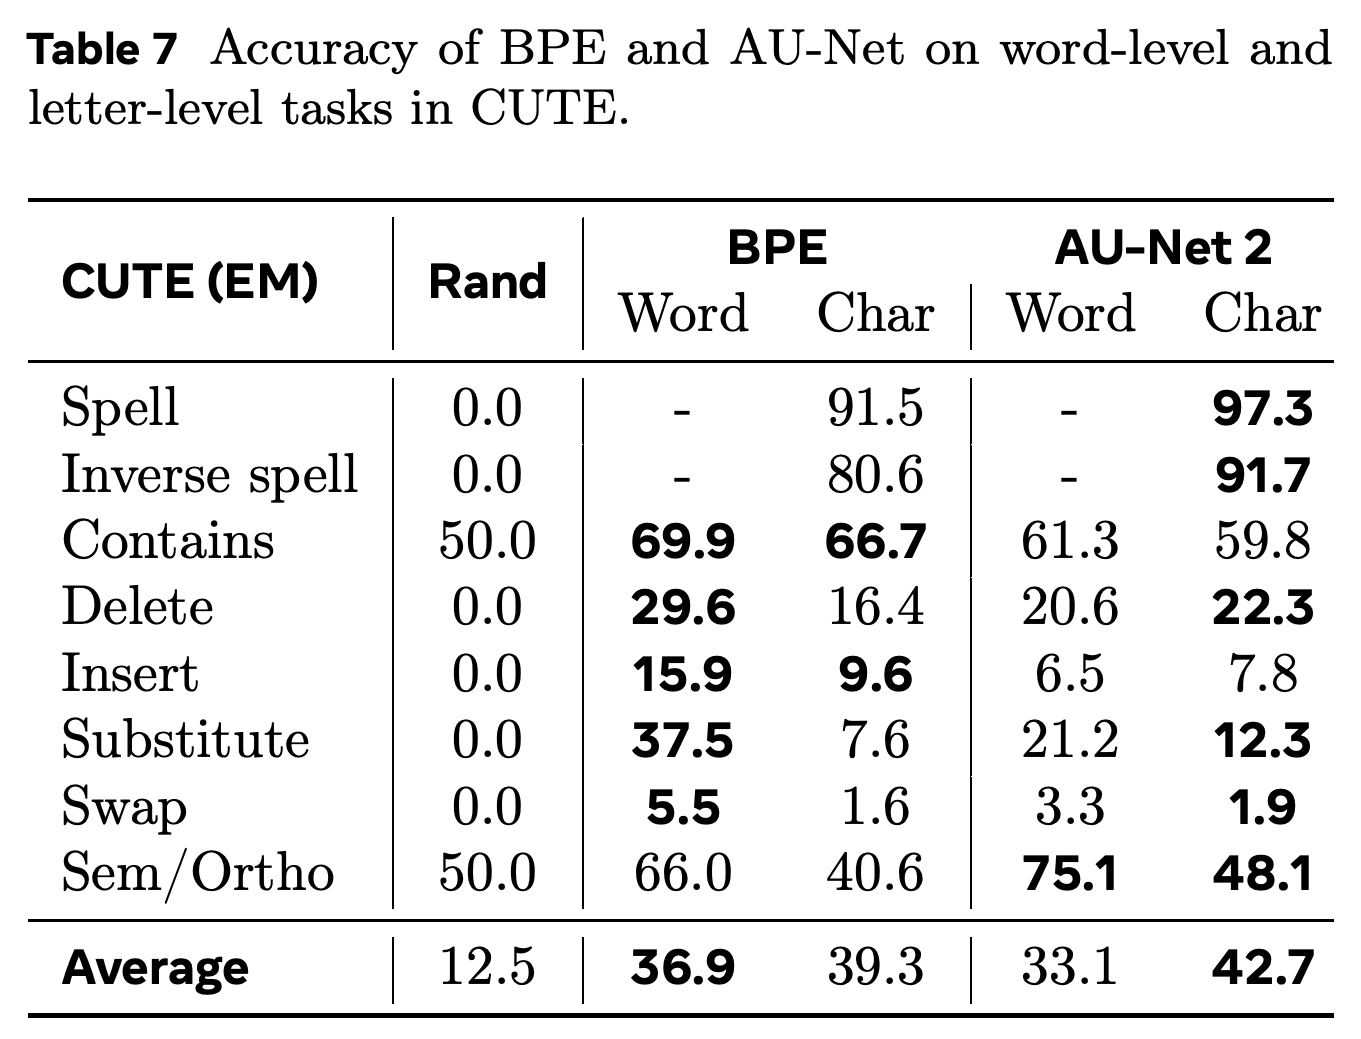
- 단어와 문자 조작 벤치마크인 CUTE에서는 답이 목표와 정확히 일치하는 비율인 문자 단위 평균 exact-match 정확도가 39.3에서 42.7로 높아지지만, 단어 단위 정확도는 36.9에서 33.1로 낮아진다.
평균 번역 성능 향상은 영어에서 다른 언어로 번역할 때보다 영어로 번역할 때 더 크며, 다국어 지식 성능 향상은 언어와 문자 체계에 따라 달라진다. 여러 라틴 문자 언어에서 성능이 높아지는 동시에 중국어에서는 낮아지므로, 전이 효과를 일반화하는 데 한계가 있다.
개별 과제를 보면 spelling과 여러 문자 편집에서 성능이 높아지지만, 문자 단위 포함 여부 판별과 삽입에서는 낮아진다. 전체 문자 정확도는 높아지고 전체 단어 정확도는 낮아져, 과제에 따른 상충관계가 드러난다.
4 Related Work
관련 연구에서는 AU-Net을 고정 어휘 대신 바이트 처리, 적응적 분할, 학습한 텍스트 압축을 사용하는 모델들과 함께 다룬다. AU-Net의 차별점은 가변 길이 처리 단계를 여러 개 두고, 문맥을 반영한 경계 표현과 skip connection을 갖춘 축소, 확장 아키텍처를 결합한다는 점이다.
- 다중 규모 바이트 모델인 MEGABYTE는 고정 크기 블록과 지역 모델을 사용한다. 논문은 특화된 분할 함수로 바이트를 처리하는 Byte Latent Transformers, SpaceByte와도 비교하여 AU-Net의 더 깊은 계층 구조를 설명한다.
- 기존의 계층적 U-Net 방식 언어 모델은 고정 pooling을 사용했으며, 주로 다음 입력 단위의 예측 품질 척도인 perplexity에 초점을 맞춰 더 작은 규모에서 평가했다.
5 Conclusion
결론은 계층적 바이트 처리를 고정 어휘 임베딩의 대안으로 제시한다. 실험은 연산량을 통제했을 때 전반적으로 경쟁력 있는 성능과 일부 문자 처리, 다국어 전이 과제에서의 향상을 뒷받침한다. 다만 계층이 깊어질 때의 상충관계는 과제에 따라 달라진다.
- 구현은 https://github.com/facebookresearch/lingua/tree/main/apps/aunet 에 공개되어 있다.
Limitations and further work
평가한 시스템에는 미리 정한 분할 함수가 필요하며, 공백 기반 경계가 없는 언어를 안정적으로 처리하지 못한다. 저자들은 또한 3단계 또는 4단계에서 파라미터 수가 늘고 처리 위치 수가 줄어들면, FSDP가 통신과 계산을 겹쳐 수행하기 어려워진다고 보고한다.
- 분할 함수를 학습하는 방식은 후속 과제로 제안한다.
- 실측 학습 처리량은 실용적인 학습 성능 비교를 뒷받침하지만, 논문은 이에 대응하는 생성 속도 실측 결과를 제공하지 않는다.
- 대부분 영어로 구성되고 수학 데이터가 적은 코퍼스를 사용하므로, 다국어 지원 범위와 수학 추론에 관한 결론에는 제약이 있다.
부록
- A Scaling Laws는 파라미터와 attention의 연산 항을 유도하고, 배치 크기와 학습률을 함께 조정할 때 안정적으로 작동하는 범위를 논의한다. B Regular expression은 1–16자의 알파벳 단어, 1–3자리 숫자, 구두점 묶음, 줄바꿈, 공백을 처리하는 분할 구성 요소를 정리한다.
- C.1 Pooling and Upsampling을 포함한 C Ablation은 경계 선택, 평균, 2개 표현 시퀀스 사이의 정보를 집계하는 cross-attention, 학습한 임베딩을 검색하는 메모리 층, 여러 확장 전략을 비교한다. Table 4에서 단순 upsampling을 Multi-Linear Upsampling으로 바꾸면 3단계 모델의 Hellaswag 정확도가 60.6 ± 1.0에서 66.0 ± 0.9로 높아진다. 이는 깊은 계층 구조에서 확장 방식의 설계가 중요함을 뒷받침한다.
- C.2 Layer Allocations는 가장 깊은 단계에 전체 층의 75%를 배치하는 설정을 선택한다. Table 5는 25%, 50%, 75% 배치에 대해 Hellaswag 점수를 각각 65.3, 66.0, 67.4로 보고한다. D Hyperparameters는 BPE의 시퀀스 길이 2048과 AU-Net의 8192, 파라미터를 정규화하는 weight decay 0.1, 기울기 크기를 제한하는 gradient clipping 0.2, 코사인 곡선에 따라 학습률을 낮추는 cosine learning-rate schedule 등 최적화 규칙을 정리한다.
- E CUTE Benchmark Detailed results는 문자 단위와 단어 단위 성능의 상충관계를 보여준다. Spelling 정확도는 91.5에서 97.3으로, inverse spelling 정확도는 80.6에서 91.7로 높아지지만, 여러 단어 조작 과제에서는 BPE가 더 우수하다. F Evaluation Benchmarks Details와 G List of Models는 16페이지에 설명 본문 없이 제목만 제시되어 있다. 확장된 벤치마크 결과는 15페이지의 Table 8에 제시된다.
- H Model Configuration Tables는 Table 9에 아키텍처 차원과 층 배치를, Table 10에 학습 비용과 실행 설정을, Table 11에 옵티마이저 설정을 제공한다. 이 기록에는 요약된 기본 설정과 다른 값도 포함된다. 일부 동일 데이터 실험의 BPE 시퀀스 길이는 4096이며, weight decay 값과 모델별 warmup 횟수도 다르다. Warmup 횟수는 학습률을 높여 가는 초기 스텝 수를 뜻한다.
짧은 생각
가장 분명한 기여는 여러 처리 단위의 문맥적 바이트 표현이 세심하게 조정한 BPE 기준 모델과 경쟁할 수 있음을 보여준다는 점이다. 서로 다른 조건에서 학습한 기존 문헌의 모델과의 비교보다 연산량 스케일링 곡선이 이 평가를 더 직접적으로 뒷받침한다. 동일 데이터 조건에서 나타난 일부 성능 향상에는 더 많은 파라미터나 더 높은 연산량도 수반된다. 이 방법은 수동 분할을 유지하므로, 학습되는 부분은 표현의 계층 구조다. 더 낮은 중국어 성능, 고르지 않은 문자 조작 성능 향상, 깊은 계층 구조에서 느려지는 학습은 구체적인 상충관계를 보여준다. 더 큰 규모에서의 성능 향상은 여전히 가설이다. 명시된 스케일링 비율이 서로 다르고, 결과 표의 반올림한 연산량과 상세 설정의 비용에도 차이가 있으므로 비교를 재구성할 때 주의가 필요하다.