


2026년 3월 AI 논문 동향
31 Mar 2026 | Paper Review Monthly Papers Multimodal Pretraining Transformer Architectures Agentic Reinforcement Learning목차
이달의 트렌드
3월의 아키텍처 연구에서는 자원 배분 방식을 학습하는 접근이 공통적으로 나타난다. Beyond Language Modeling은 세분화된 Mixture-of-Experts 라우팅으로 언어와 시각에 용량을 배분하며, 활성 연산량을 대략 고정한 상태에서 두 모달리티의 성능을 높인다. Attention Residuals는 이전 층 출력의 혼합 가중치를 토큰별로 학습하여, 고정된 잔차 누적을 깊이 방향의 선택적 참조로 대체한다. 이 결과는 모델 크기를 늘리는 것과 함께 용량 배분과 표현 재사용 방식도 재검토할 필요가 있음을 뒷받침한다. 1, 2
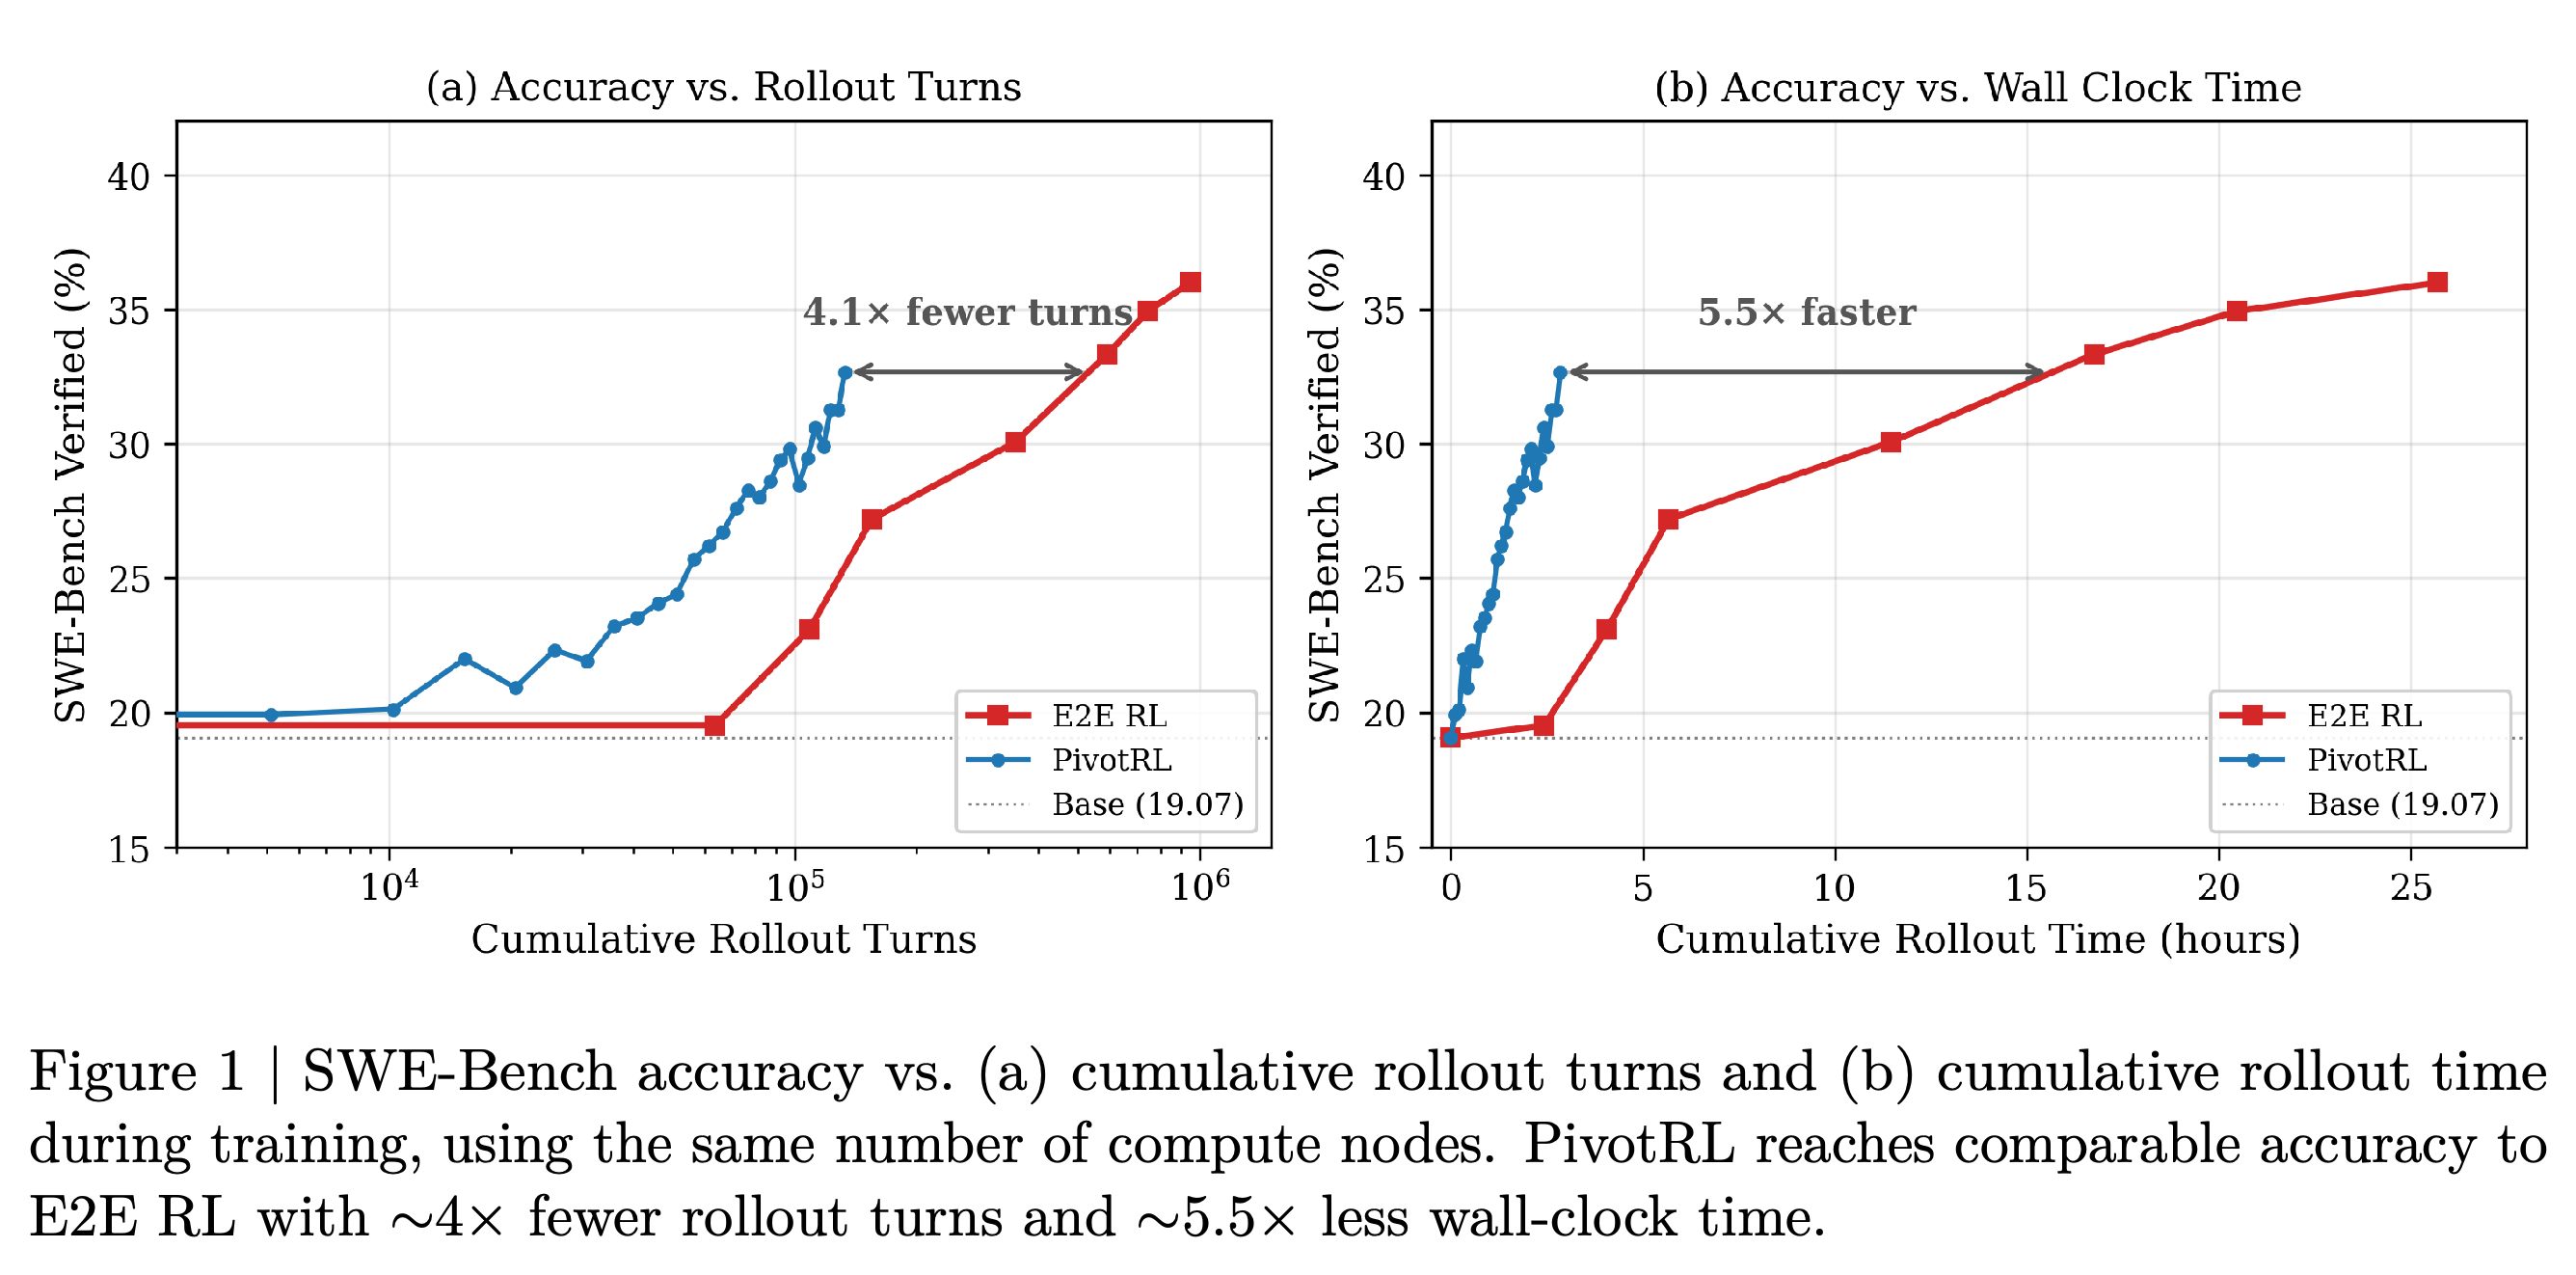
학습 효율에서는 어떤 예제에 연산을 배정하는지가 점점 중요해진다. 여러 통제된 VQA·내비게이션 비교에서 다양한 멀티모달 데이터를 추가하는 방식이 과제별 데이터를 더 늘리는 방식보다 좋은 성능을 보인다. PivotRL은 성공과 실패가 섞여 나타나는 시연의 중간 상태를 선택하고, 전체 궤적을 다시 생성하는 대신 국소 검증을 거친 짧은 후속 응답으로 학습한다. 다만 각 연구의 효율 지표는 구분해야 한다. 활성 FLOPs를 맞춰도 하드웨어 비용이 같다는 뜻은 아니며, Attention Residuals의 1.25× 연산량 이점은 적합한 곡선에 기반한 값이지 실제 실행 시간의 단축이 아니다. PivotRL의 rollout 절감량에도 시연 생성과 오프라인 profiling 비용이 완전히 포함되지는 않는다. 3
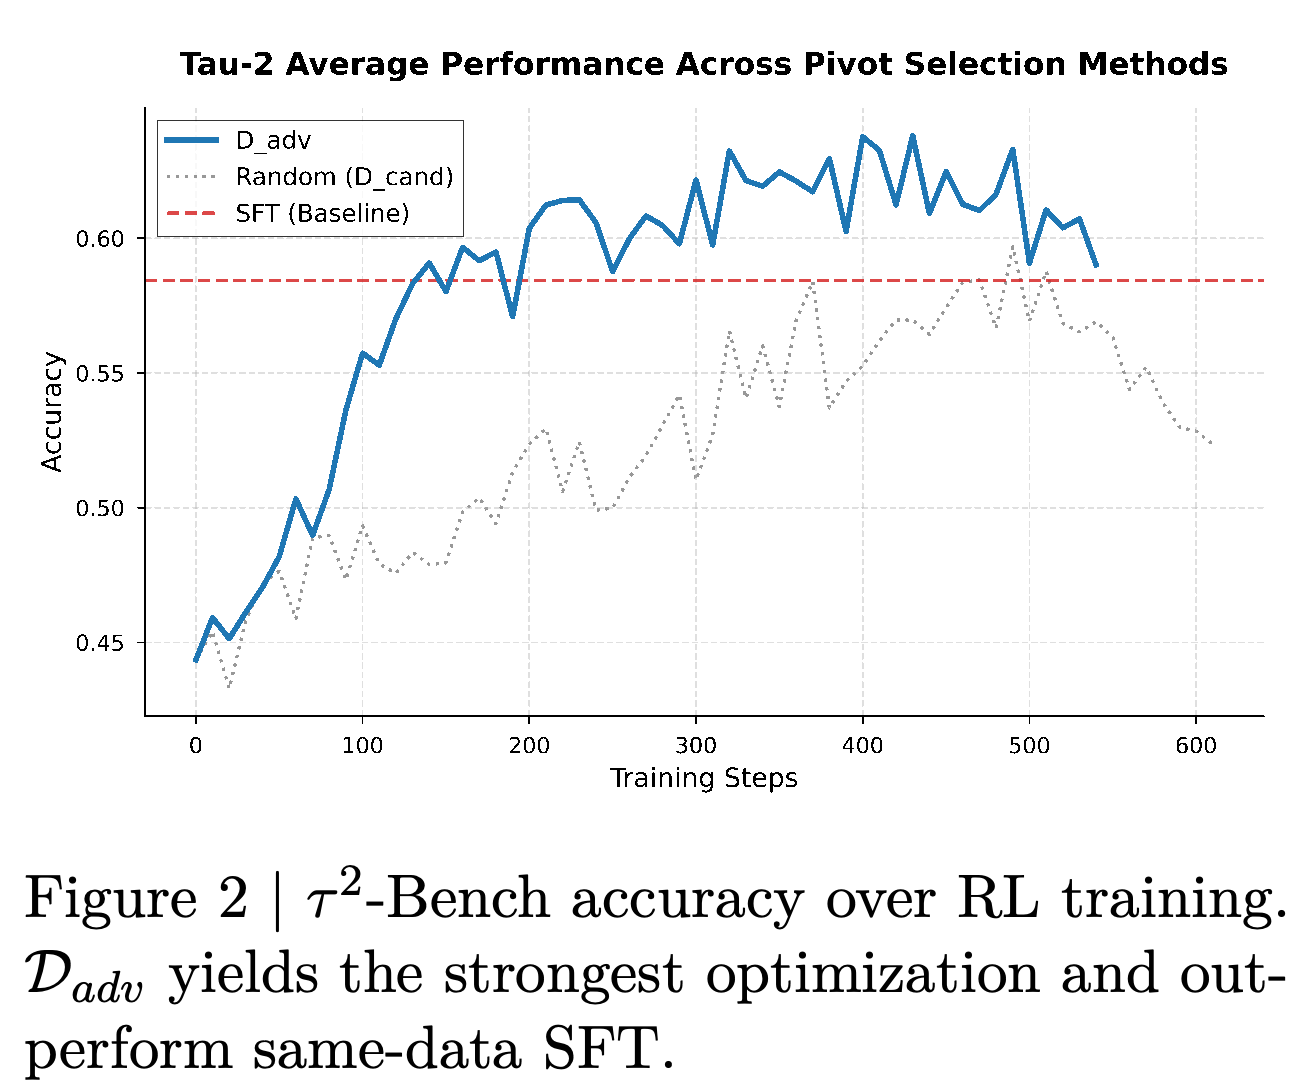
목표 과제의 성능 향상과 기존 역량의 유지는 별도로 평가해야 한다. 실험한 모든 멀티모달 데이터 혼합은 유용한 시각적 전이를 보이면서도 텍스트 전용 사전학습보다 Notes perplexity가 나빠진다. PivotRL은 분포 밖 벤치마크 8개에서 기반 모델에 가까운 평균 성능을 유지하며, 같은 데이터를 사용한 지도 미세조정에서는 상당한 성능 저하가 나타난다. 그러나 SWE-Bench Verified에서는 PivotRL의 점수가 SFT보다 낮다. 어느 결과도 모든 역량이 보존됨을 입증하지는 않는다.
2026년 3월의 주요 논문
1. Beyond Language Modeling: An Exploration of Multimodal Pretraining
- https://arxiv.org/abs/2603.03276
- Beyond Language Modeling: An Exploration of Multimodal Pretraining 요약 설명
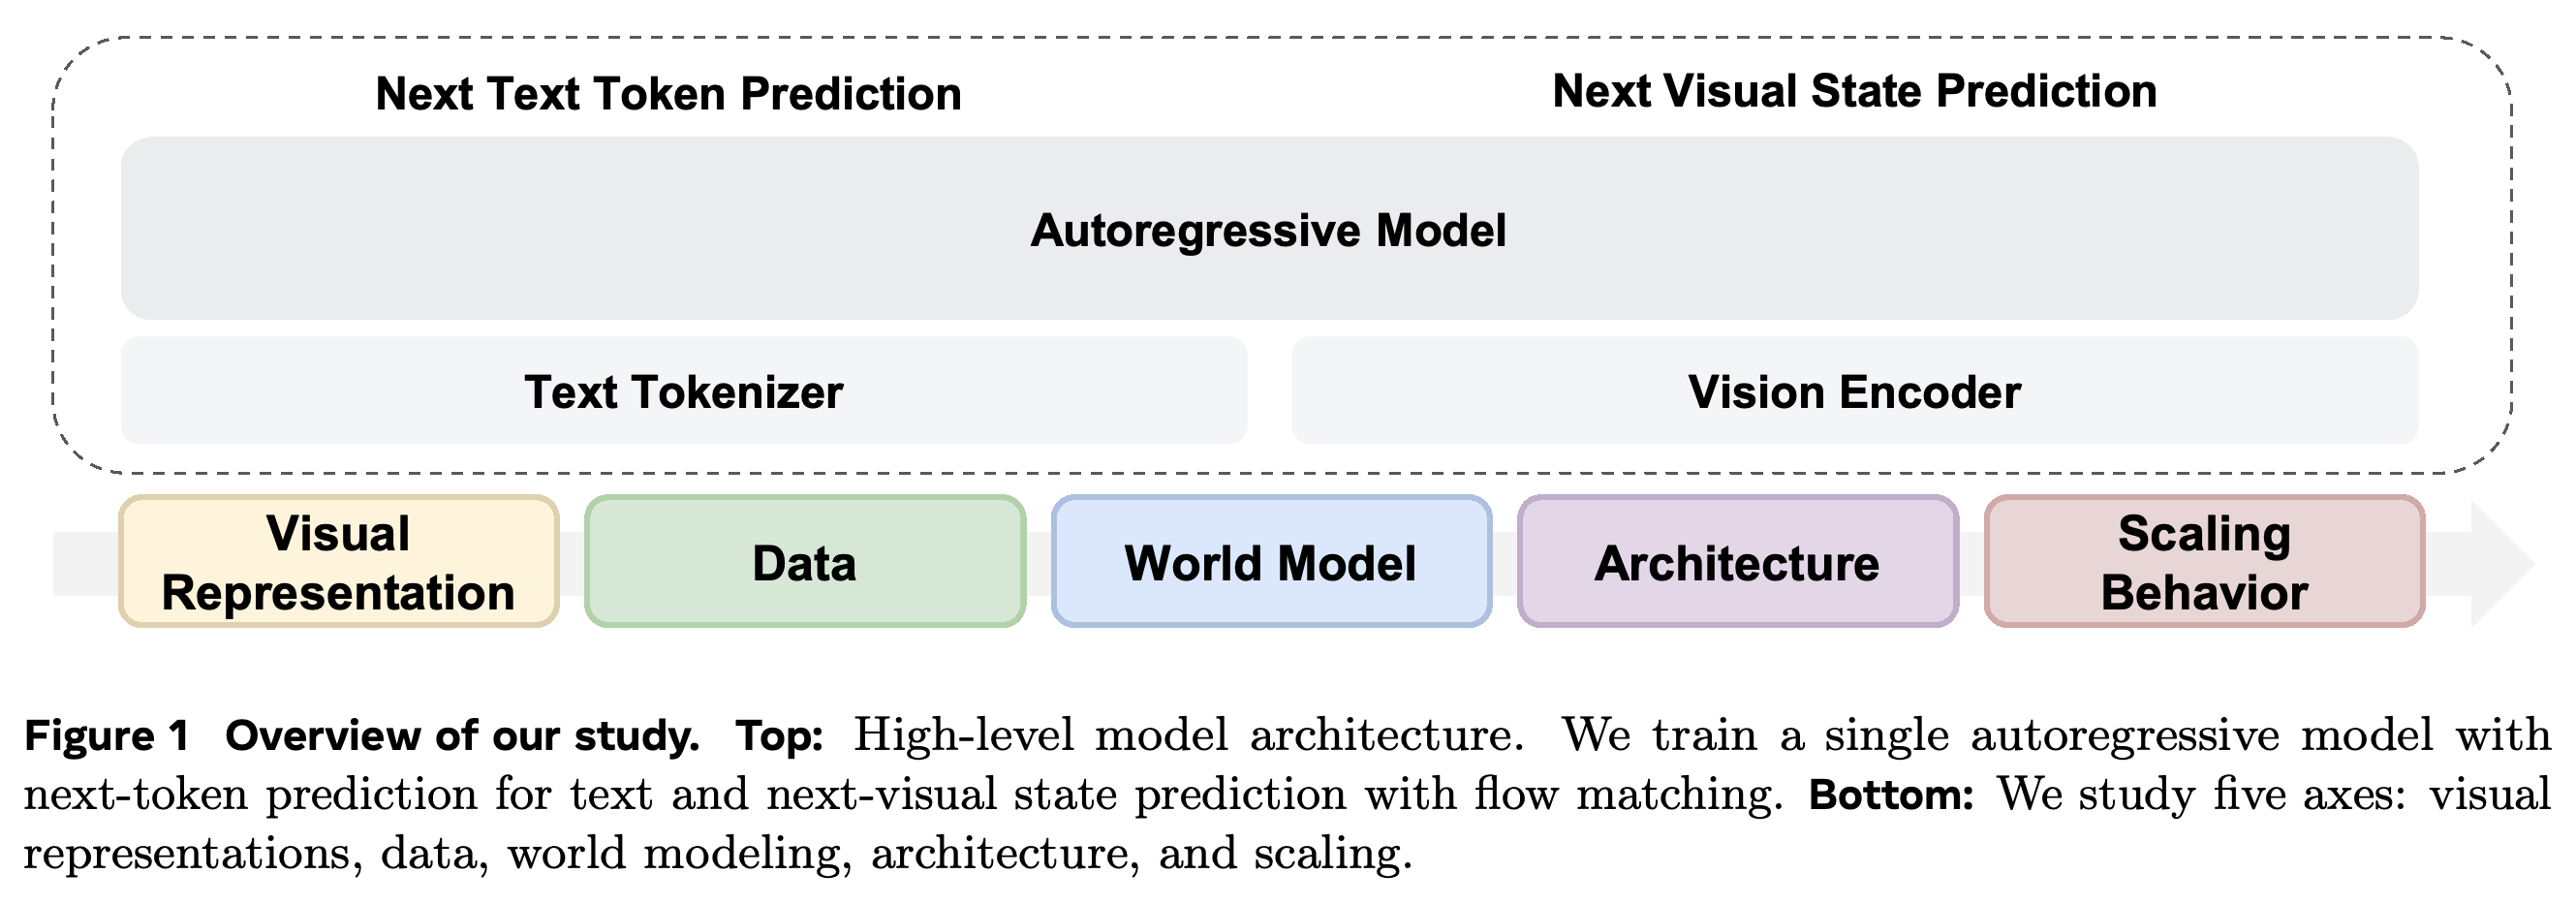
- Beyond Language Modeling: An Exploration of Multimodal Pretraining은 표현, 데이터, 아키텍처, 월드 모델링, 스케일링의 효과를 분리해 연구한다. 동결된 사전학습 시각 인코더와 사전학습 디코더를 유지하면서, 언어에는 Transfusion 방식의 다음 토큰 예측을, 시각에는 flow matching을 적용해 Transformer 백본을 처음부터 학습한다. 단일 SigLIP 2 Representation Autoencoder는 실험한 표현 중 이해와 생성을 종합한 성능이 가장 좋다.
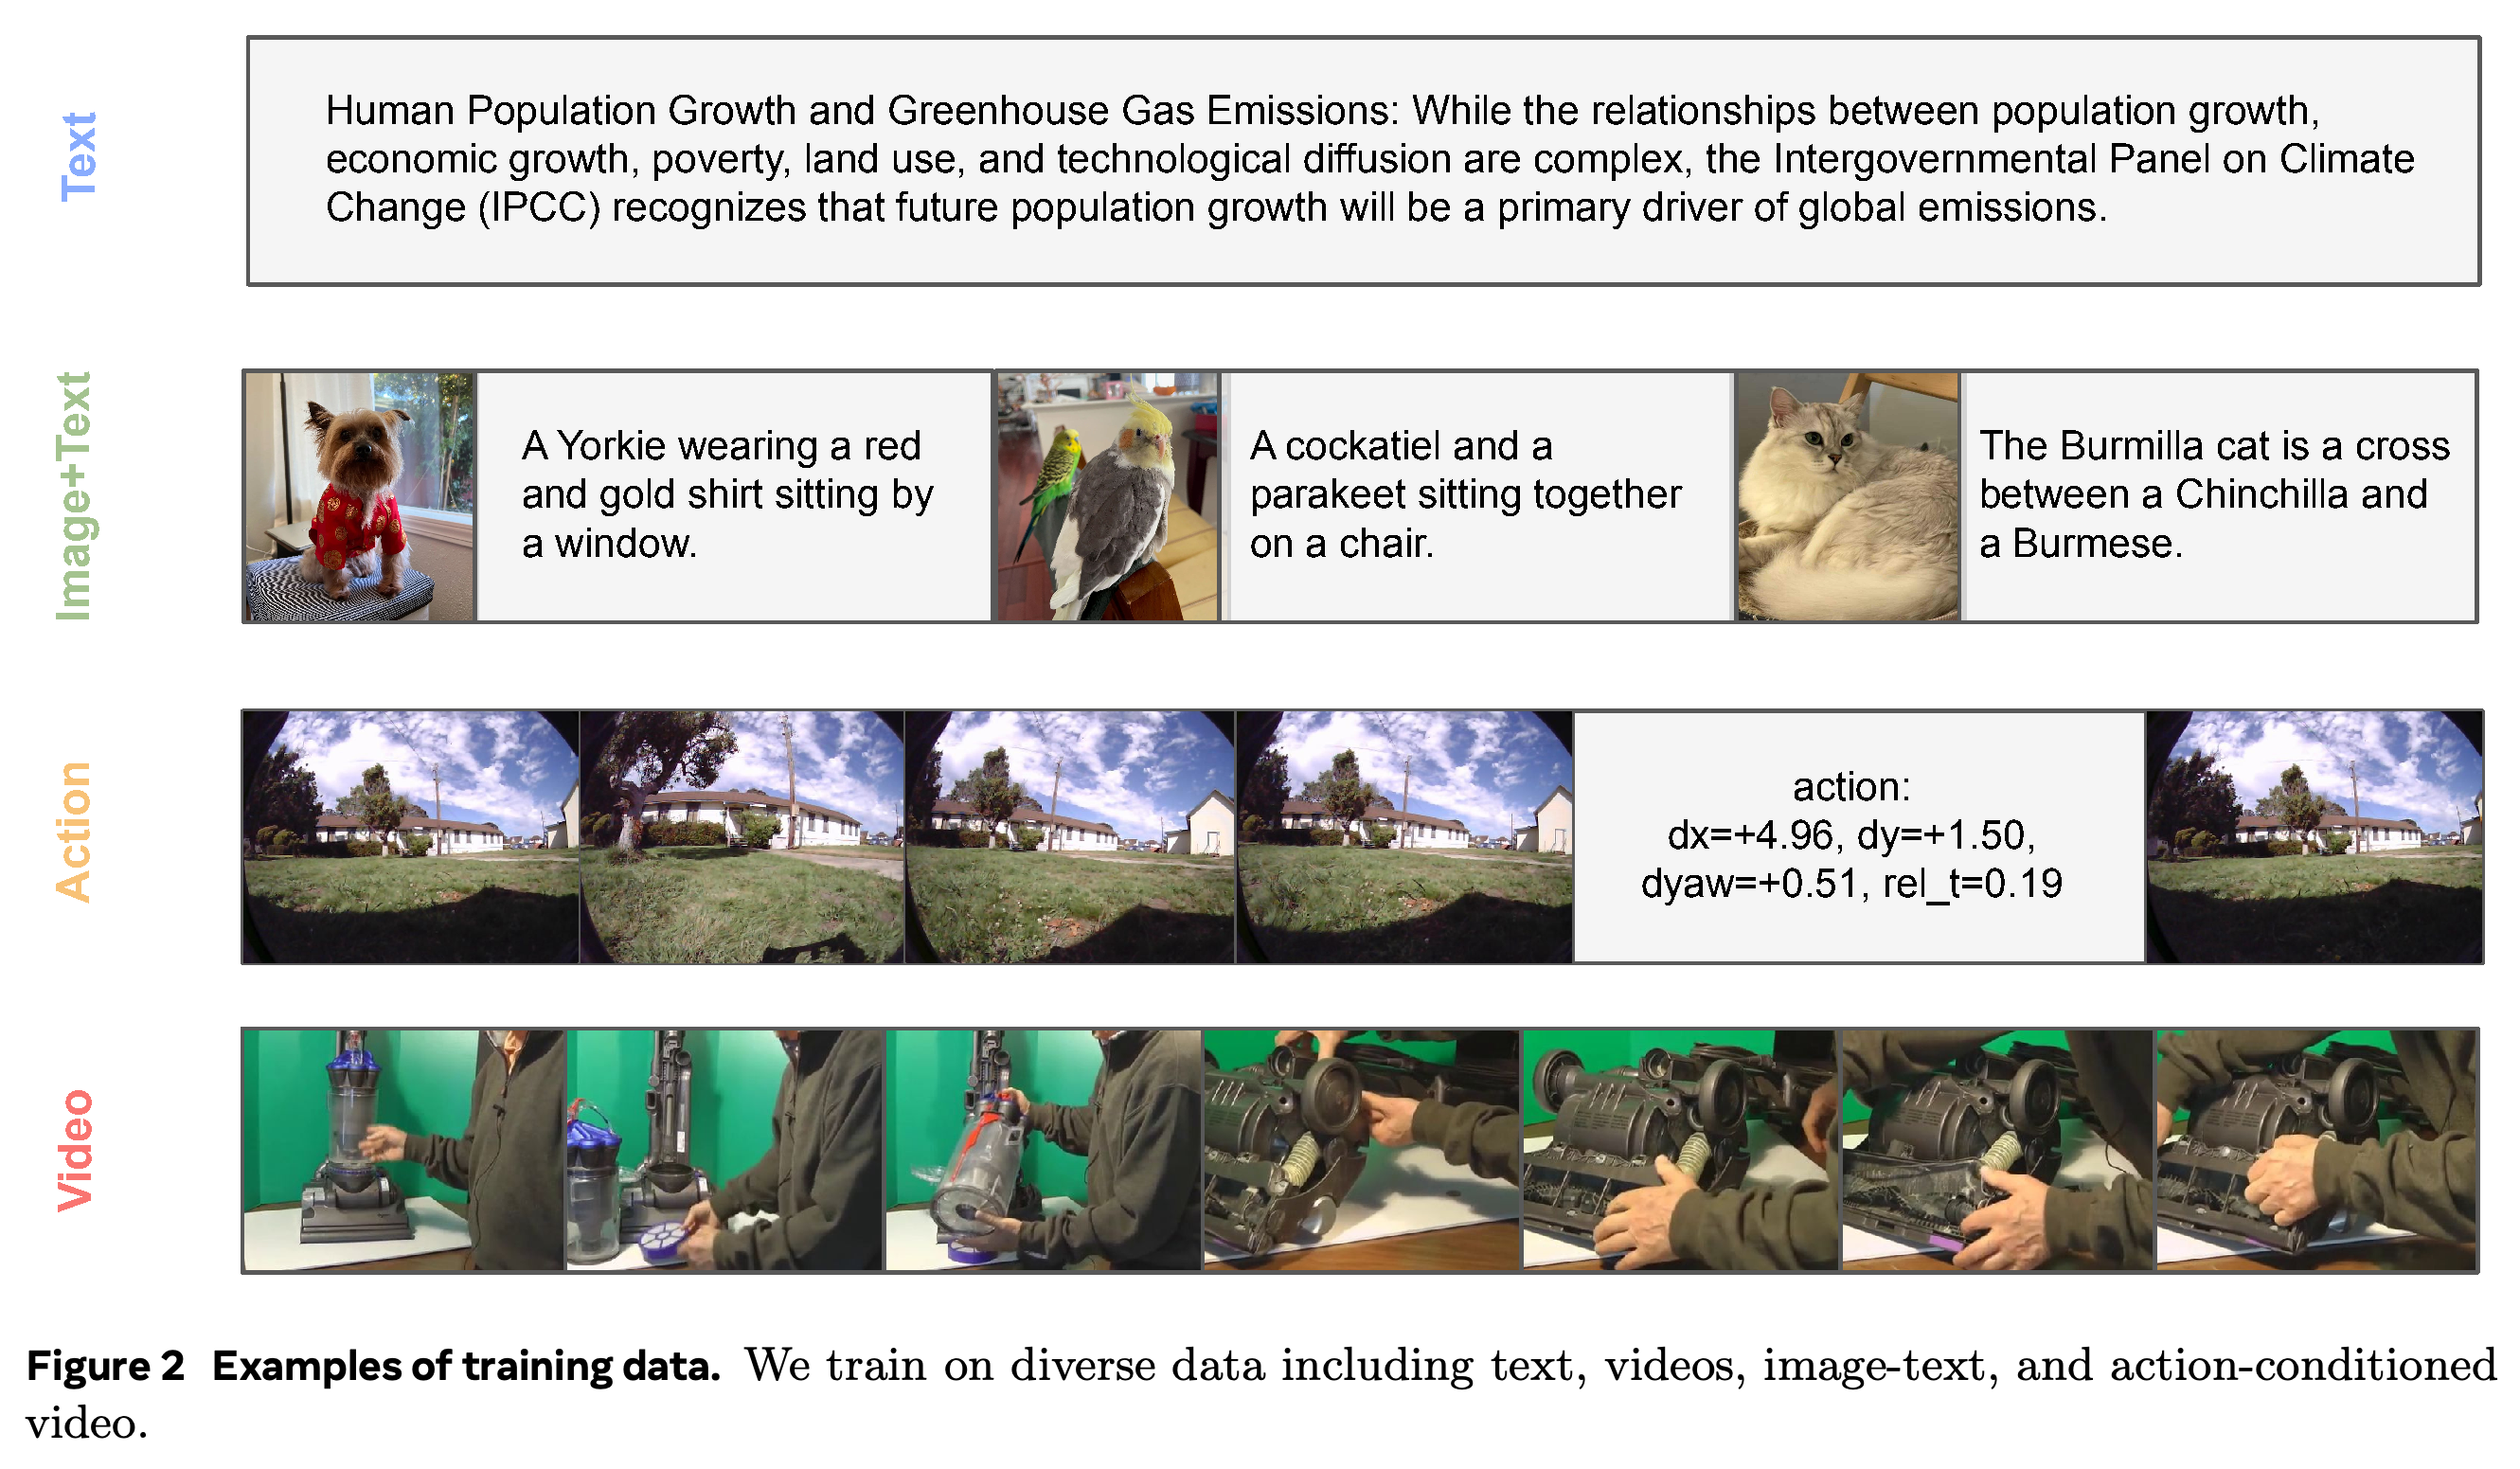
- 범용 데이터를 추가하면 특화 데이터를 늘리는 것보다 좋은 성능을 얻을 수 있다. VQA 토큰 20B와 텍스트 토큰 80B로 학습하면 평균 VQA 정확도가 37.9%로, VQA 전용 토큰 100B로 학습한 모델의 35.7%보다 높다. 내비게이션에서는 NWM 토큰 50B와 원시 비디오 토큰 50B를 사용하면 절대 궤적 오차가 1.410, 상대 자세 오차가 0.414다. NWM 전용 토큰 100B를 사용한 모델은 각각 1.669와 0.450을 기록한다. 내비게이션 데이터 약 1%로 얻은 결과는 고정된 200B 토큰 예산에서 측정했으며, 이 조건에도 도메인 정렬 데이터가 포함된다.
- 하이퍼파라미터, 데이터, 토큰 수, FLOPs를 맞춘 조건에서 모달리티별 FFN, SigLIP 2, MoE를 차례로 적용하면 Transfusion 기준 모델의 PPL은 15.93에서 12.49로, DPG는 0.45에서 0.63으로 개선된다. 최종 구성을 x-pred로 바꾸면 DPG는 0.65로 높아지지만 PPL은 12.69로 나빠진다. IsoFLOP 적합 결과에서 시각과 언어의 학습 데이터 스케일링 지수 차이는 dense 모델의 0.10에서 MoE의 0.05로 줄지만 사라지지는 않는다.
2. Attention Residuals
- https://arxiv.org/abs/2603.15031
- Attention Residuals 요약 설명
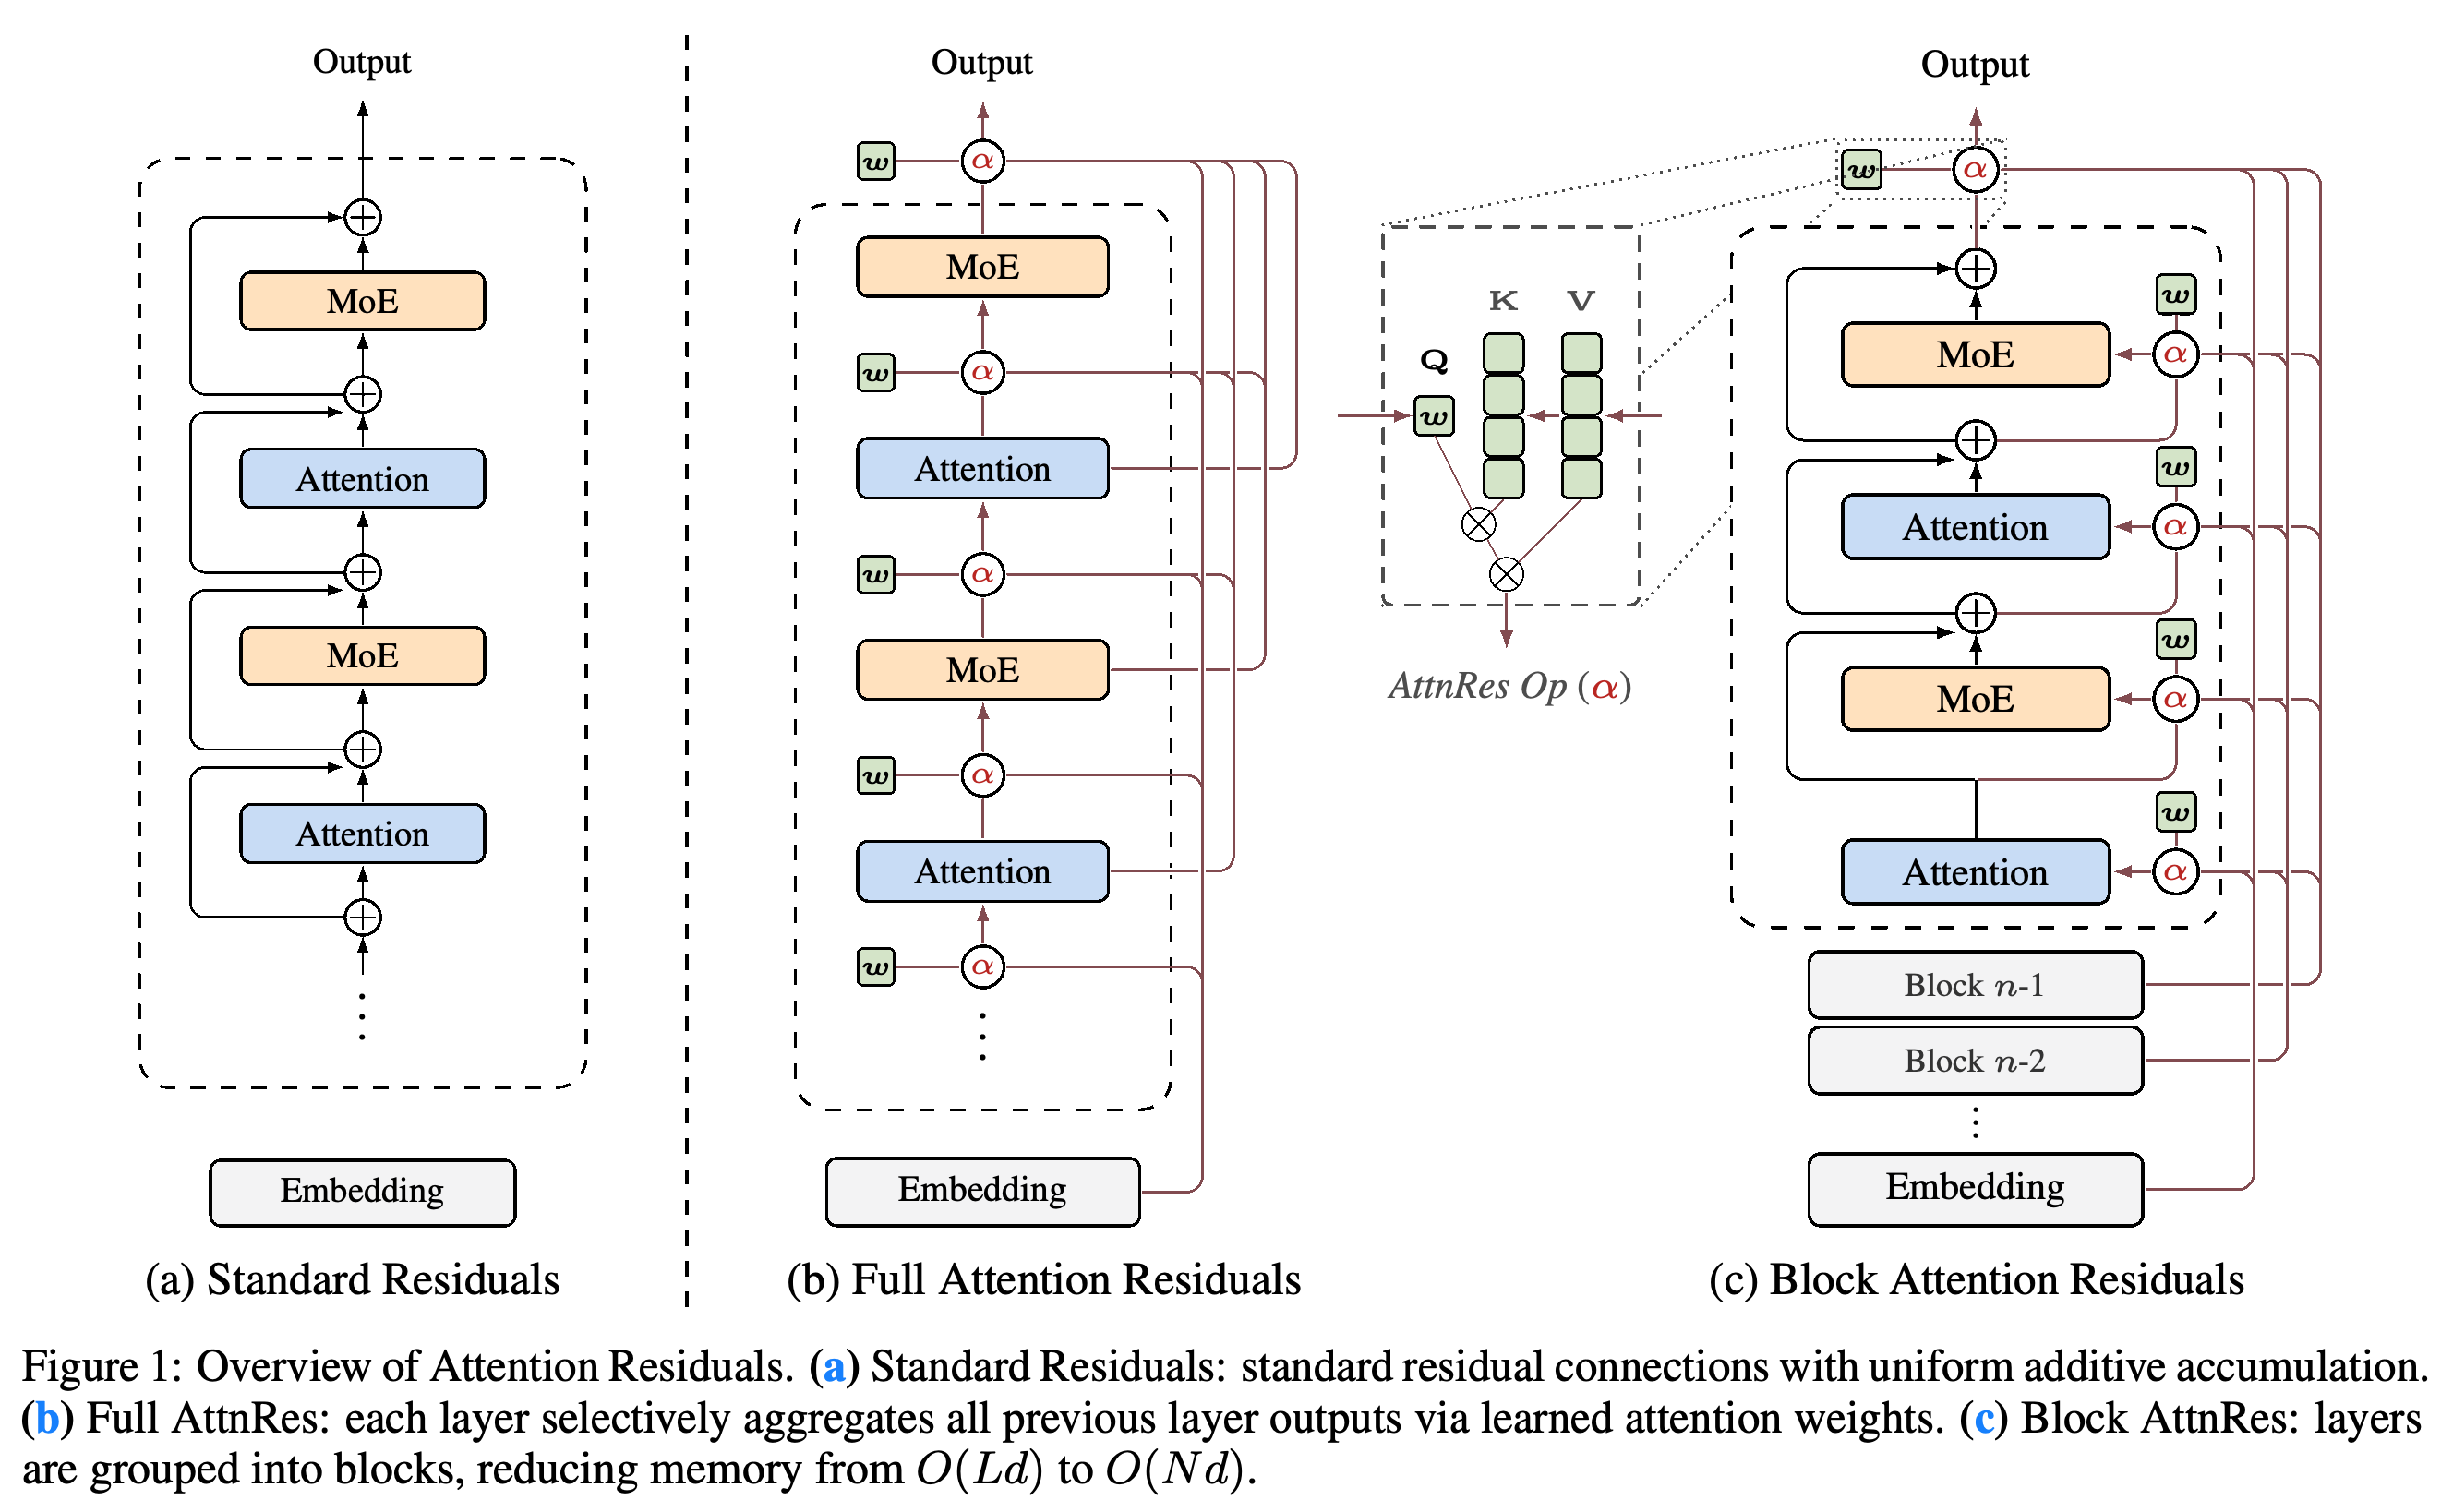
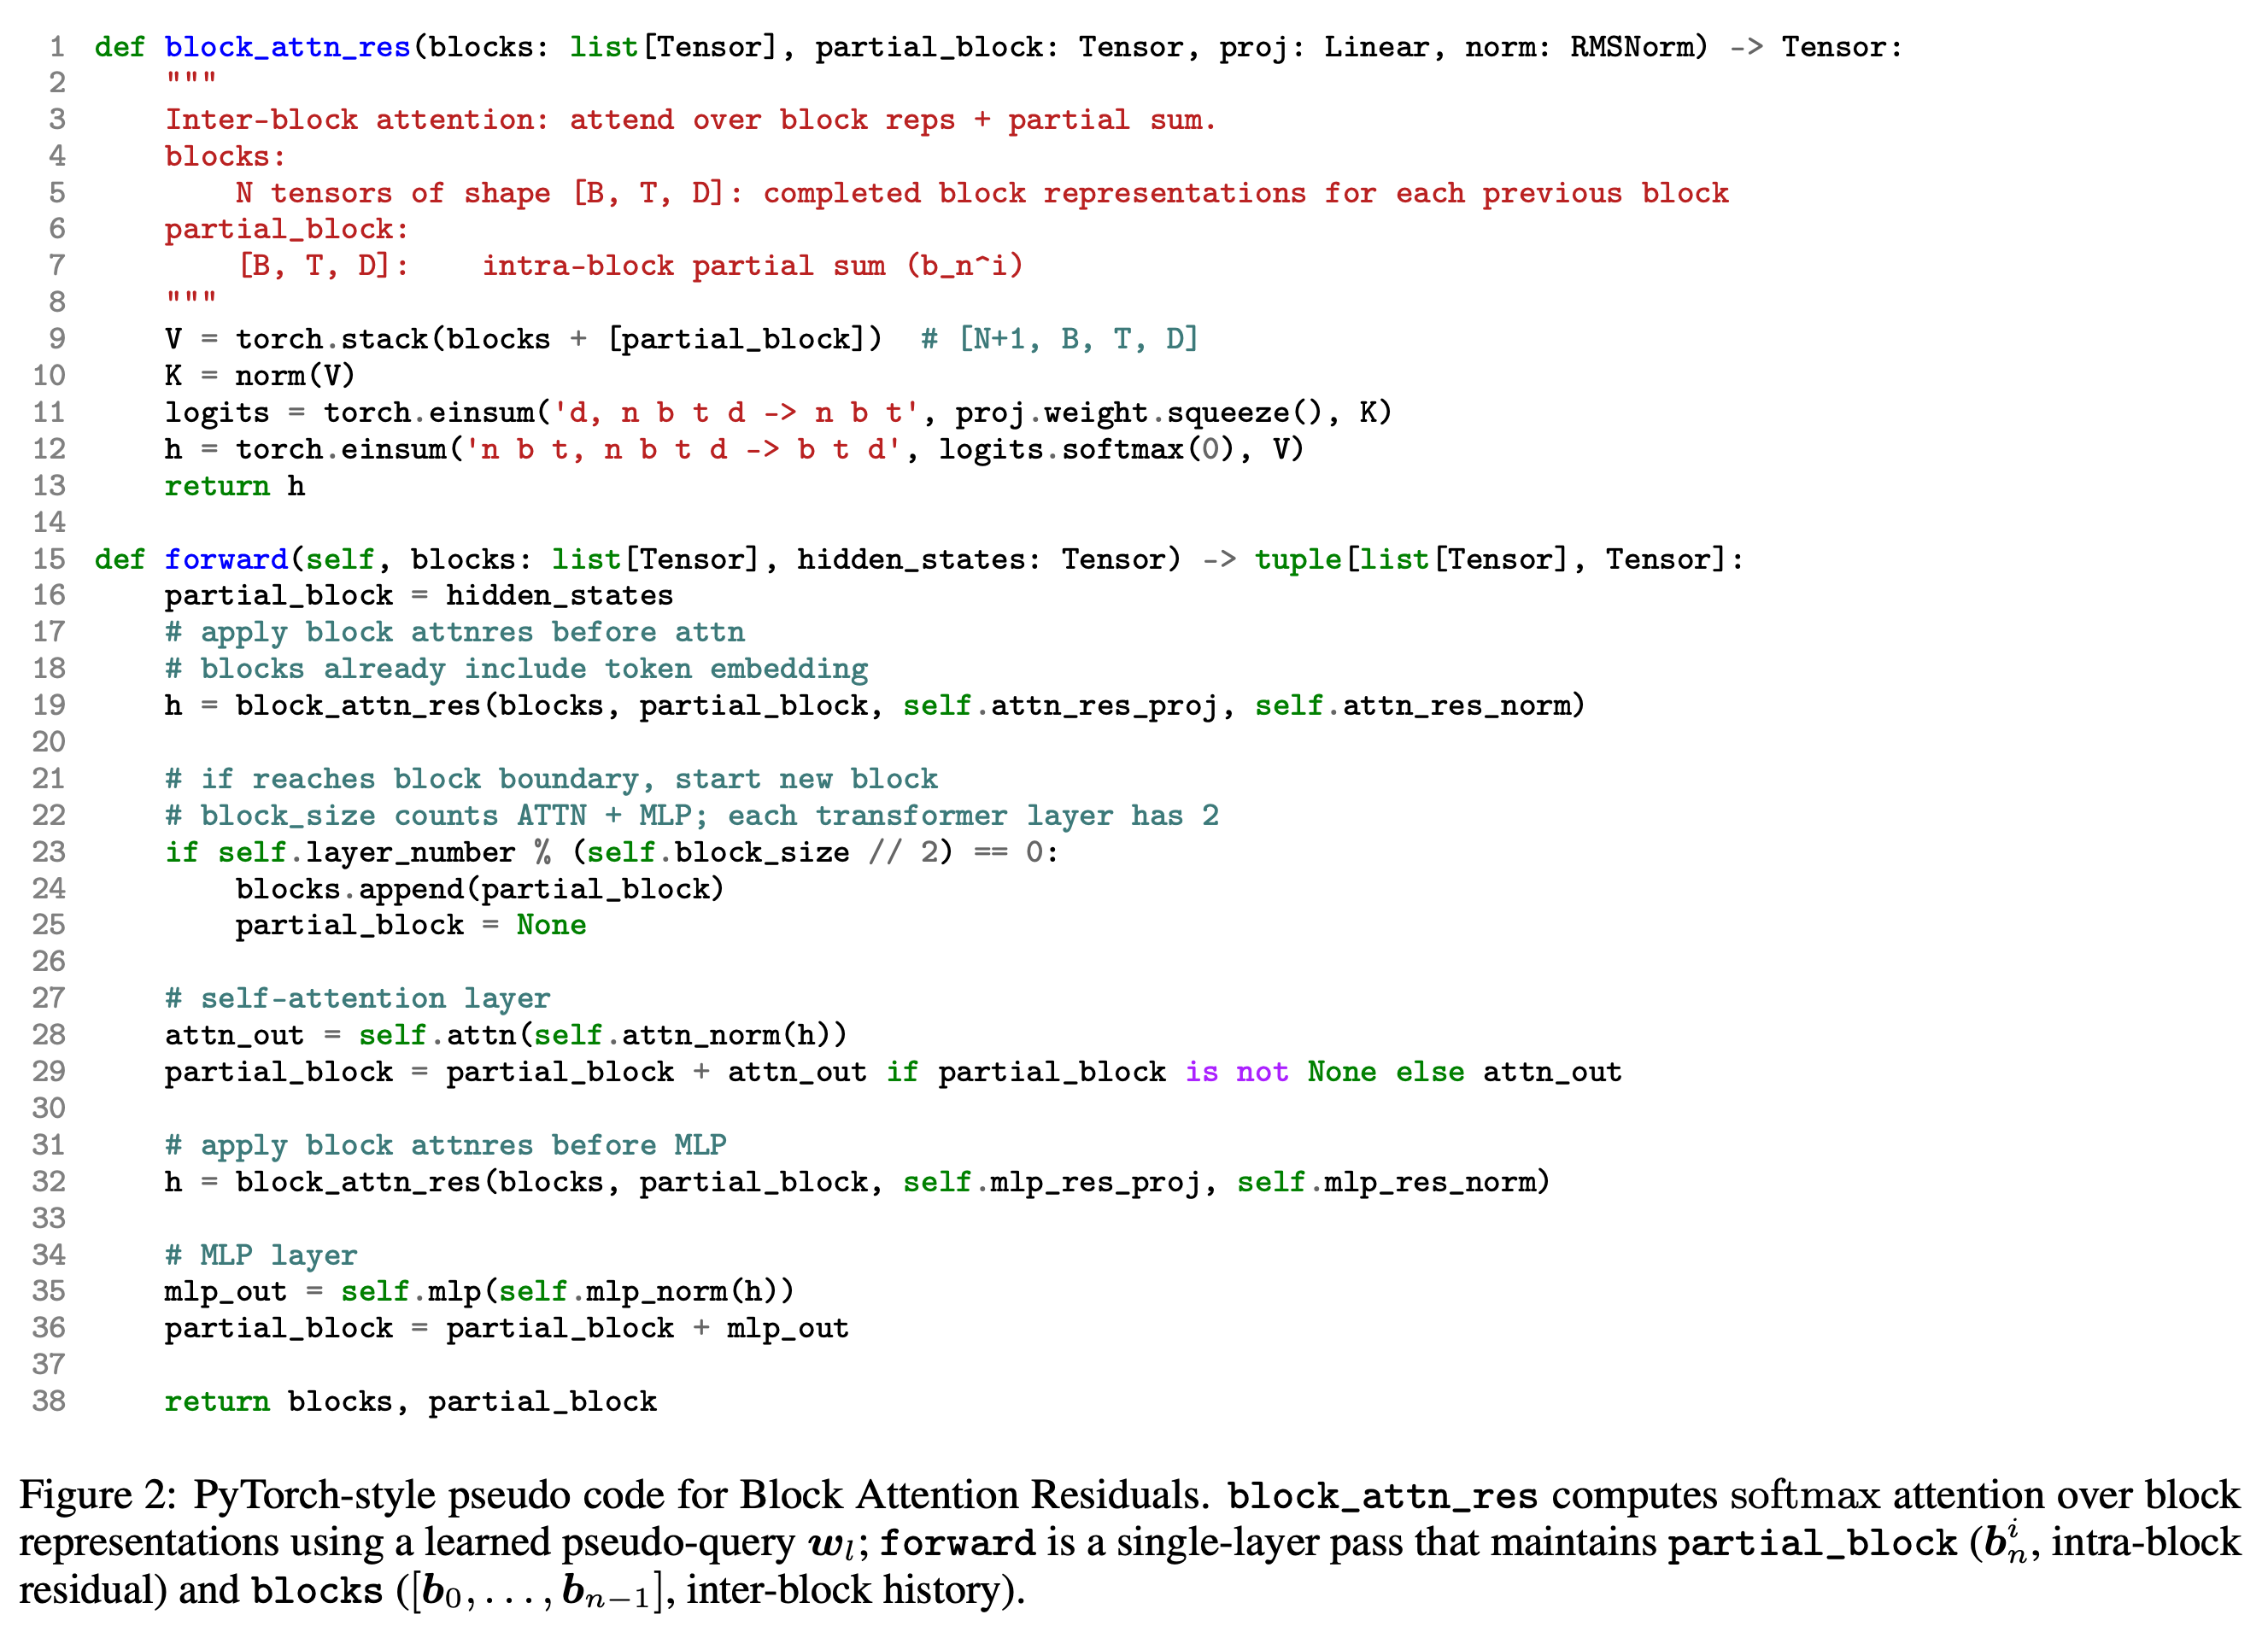
- Attention Residuals는 고정된 잔차 덧셈을 이전 층 출력에 대한 softmax 가중 검색으로 대체한다. 각 층은 학습된 pseudo-query와 RMSNorm으로 정규화한 토큰별 key를 사용하므로, 깊이 방향의 혼합 가중치는 입력에 따라 달라진다. Block AttnRes는 개별 출력을 모두 보관하는 대신 출력들을 합산한 그룹을 저장한다. 이로써 이력 저장 공간과 단계 간 전송량이 층 수가 아니라 블록 수에 비례하도록 줄어들지만, 완료된 블록 내부의 개별 출력을 선택할 수는 없게 된다.
- 임베딩을 제외한 활성 파라미터가 194M부터 528M까지인 MoE 크기 5개에서 Full과 Block AttnRes 모두 PreNorm보다 검증 손실이 낮다. 실제 측정한 가장 큰 모델의 손실은 PreNorm이 1.719, Block이 1.693, Full이 1.692다. 이 스케일링 실험에서는 약 8개 블록으로 성능 향상의 대부분을 얻는다. 보고된 1.25× 연산량 이점은 적합한 손실 곡선에서 산출한 값이다.
- 동일한 학습 설정을 사용한 Kimi Linear 비교에서는 총 파라미터 48B, 활성 파라미터 3B인 모델을 토큰 1.4T로 학습했으며, 보고된 벤치마크 15개 중 14개에서 성능이 향상되고 MMLU-Pro에서는 동률을 기록한다. GPQA-Diamond는 36.9에서 44.4로, HumanEval은 59.1에서 62.2로 높아진다. 이 결과는 연구한 아키텍처 계열에서 집계 방식을 바꾸는 효과를 뒷받침한다. 다만 반복 실행에 따른 불확실성은 보고하지 않으며, 깊이 방향 검색이 추론 성능 향상으로 이어진다는 설명은 아직 가설이다.
3. PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost
- https://arxiv.org/abs/2603.21383
- PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost 요약 설명
- PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost는 전문가 궤적을 중간 assistant 턴에서 시작하는 짧은 on-policy RL 에피소드로 변환한다. 오프라인 profiling에서는 경험적 보상 분산이 양수이고 보상 평균이 난이도 임계값 λdiff보다 낮은 상태를 남긴다. 도메인별 검증기는 시연된 후속 응답을 정확히 재현하는 대신 국소적으로 허용되는 행동에 보상을 준다. 선택한 상태 집합은 RL 전에 고정하며, 난이도 임계값의 수치는 제공하지 않는다.
- 별도로 학습한 도메인 모델 4개는 모두 Qwen3-30B-A3B-Thinking-2507에서 시작한다. Base 대비 평균 in-domain 개선 폭은 +14.11 %p이며, 같은 데이터를 사용한 SFT는 +9.94 %p다. 학습 실행 4개와 OOD 벤치마크 8개에 걸친 평균 변화는 각각 +0.21 %p와 −9.83 %p다. PivotRL은 in-domain 벤치마크 4개 중 3개에서 SFT보다 높지만, SWE-Bench Verified에서는 32.67로 SFT의 37.40보다 낮다.
- SWE-Bench Verified 정확도를 32.67%로 맞추면 PivotRL은 약 133K rollout 턴을 사용하고, end-to-end RL은 약 542K 턴을 사용한다. 같은 수의 연산 노드에서 PivotRL의 누적 rollout 시간은 약 5.5× 짧다. End-to-end RL은 이후 더 높은 정확도에 도달한다. 따라서 이 비교는 공통 정확도 목표에서의 절감 효과를 입증하며, 더 높은 최종 성능이나 더 낮은 전체 학습 비용을 입증하지는 않는다.
출처
[1] Beyond Language Modeling: An Exploration of Multimodal Pretraining
[3] PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost