2026년 8월 AI 논문 동향
31 Aug 2026 | Paper Review Monthly PapersContents
이달의 트렌드
적응형 환경은 고정된 에이전트 주변에서 학습 가능한 계층으로 다뤄지고 있다. SPADE는 실행 가능한 MDP를 온라인으로 생성하고, EnvHarness는 인터페이스 수준 wrapper로 상호작용 조건을 바꾸며, Zetta는 기반 정책을 유지한 채 런타임 비평기와 복구 플레이북을 발전시킨다. 1, 2, 3
세 연구 모두 적응 loop 안에 검증 절차를 둔다. SPADE는 유효하지 않은 생성 프로그램을 제외하고 힌트 유무의 반환을 측정하며, EnvRigger는 새 rollout으로 wrapper를 채택·거부·수정하고, Zetta는 재생, 새 rollout, 군집, held-out 검사를 거친 뒤에만 harness 갱신을 승격한다. 1, 2, 3 harness에 대해서는 이 글을 참조하라.
보고된 평가는 직접적인 base-policy fine-tuning 없이 적응하는 방식을 강조하지만, 적용 범위는 다르다. SPADE는 추론 게임과 tool use를 다루고, EnvHarness는 텍스트 기반 agent benchmark를 평가하며, Zetta의 physical-intelligence 결과는 시뮬레이션에 한정된다. 1, 2, 3
2026년 8월의 주요 논문
1. SPADE: Self-Play in Adaptive Synthetic Executable Environments
- https://arxiv.org/abs/2608.19197
- 내가 쓴 글
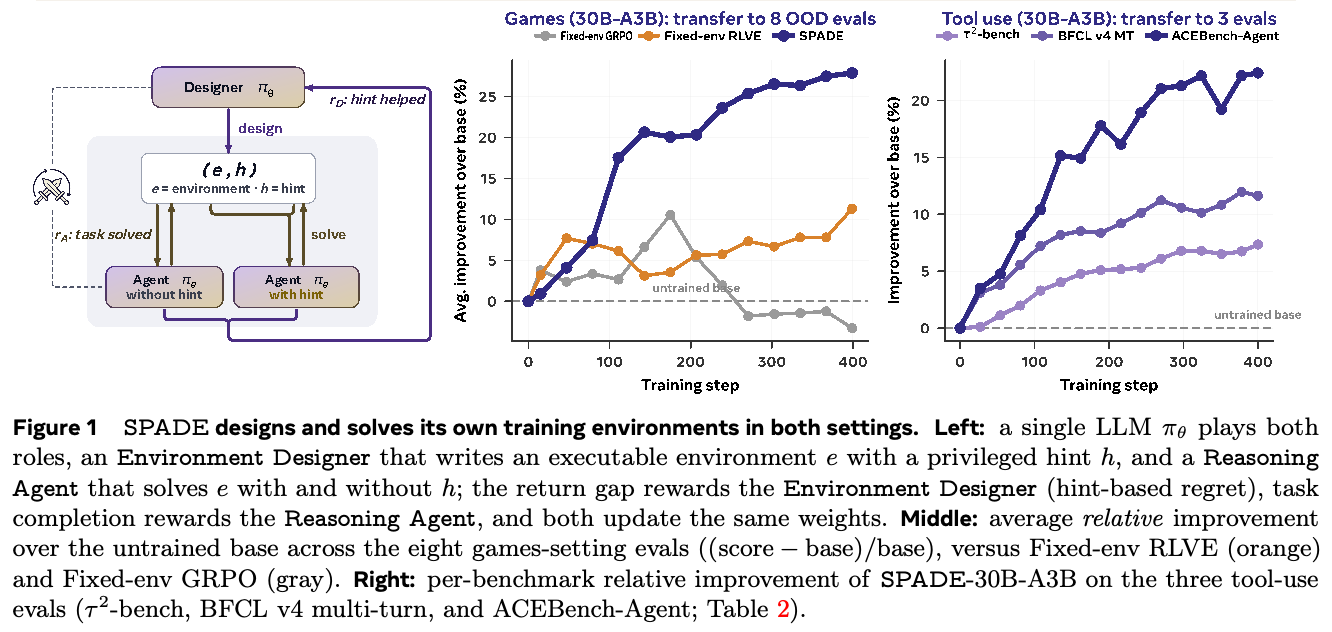
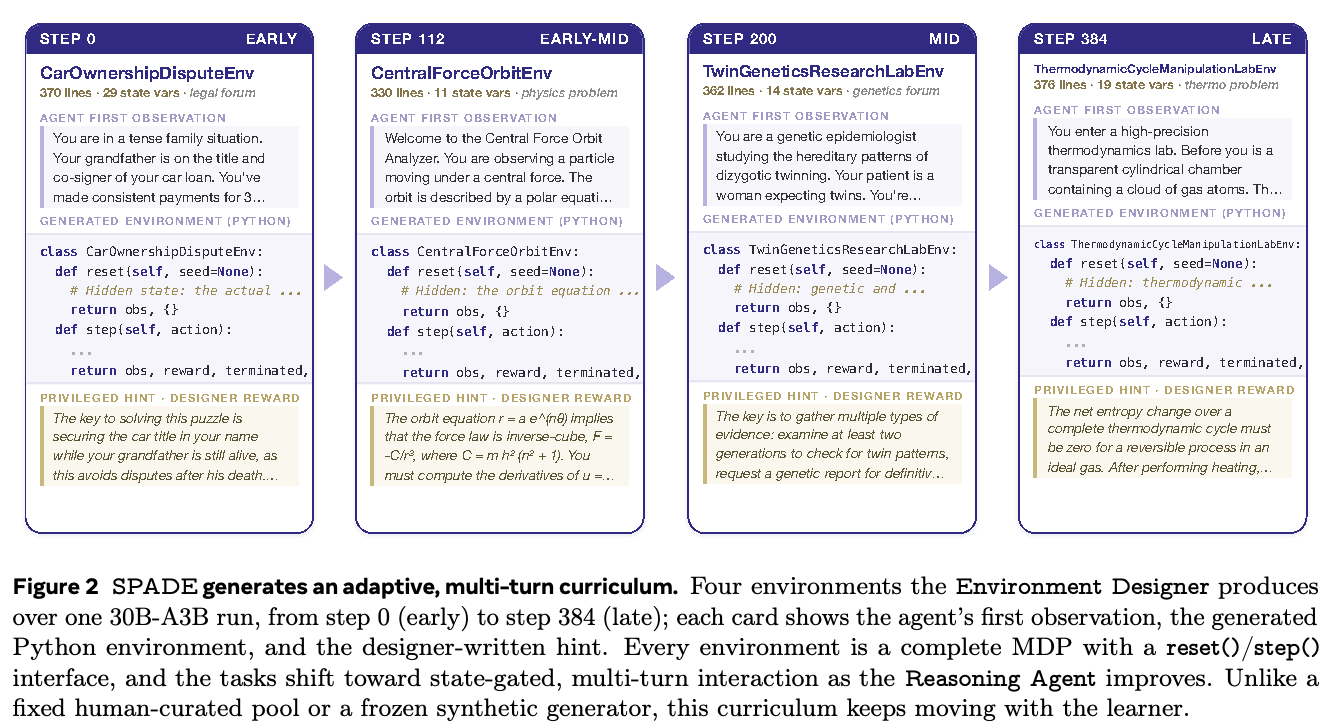
- SPADE는 하나의 공유 LLM을 두 역할로 학습한다. Environment Designer는 검증된 실행 가능 Python MDP와 특권 힌트를 작성하고, Reasoning Agent는 힌트가 있는 rollout과 없는 rollout의 쌍을 푼다. Designer는 반환 차이로 보상받으며, 코퍼스 grounding, 메모리, 난이도 anchor는 과제를 에이전트 능력 경계 근처에 유지하도록 설계됐다. 실행 가능 Python MDP에 대해서는 이 글을 참조하라. 메모리에 대해서는 이 글을 참조하라.
- Qwen3-30B-A3B에서 논문은 게임 suite 평균 58.3을 보고하며, 이는 base 모델의 50.2와 Fixed-env RLVE의 53.0보다 높다. 같은 backbone의 tool use에서는 BFCL v4 multi-turn에서 +5.7, τ²-bench에서 +3.6, ACEBench-Agent에서 +13.9 향상을 보고한다. 외부 reference 행은 protocol-matched되지 않았다.
- Ablation에서 메모리를 제거하면 선정한 8개 benchmark 평균이 58.3에서 53.2로 낮아지고, 코퍼스 grounding을 제거하면 53.5로 낮아진다. 저자들은 환경 생성의 유효성, base 모델과 생성 예산의 제약, open-ended growth를 직접 측정하지 않고 고정 과제로 평가했다는 한계도 제시한다.
2. EnvHarness: Awakening Static Worlds for Agent Learning
- https://arxiv.org/abs/2608.19880
- 내가 쓴 글
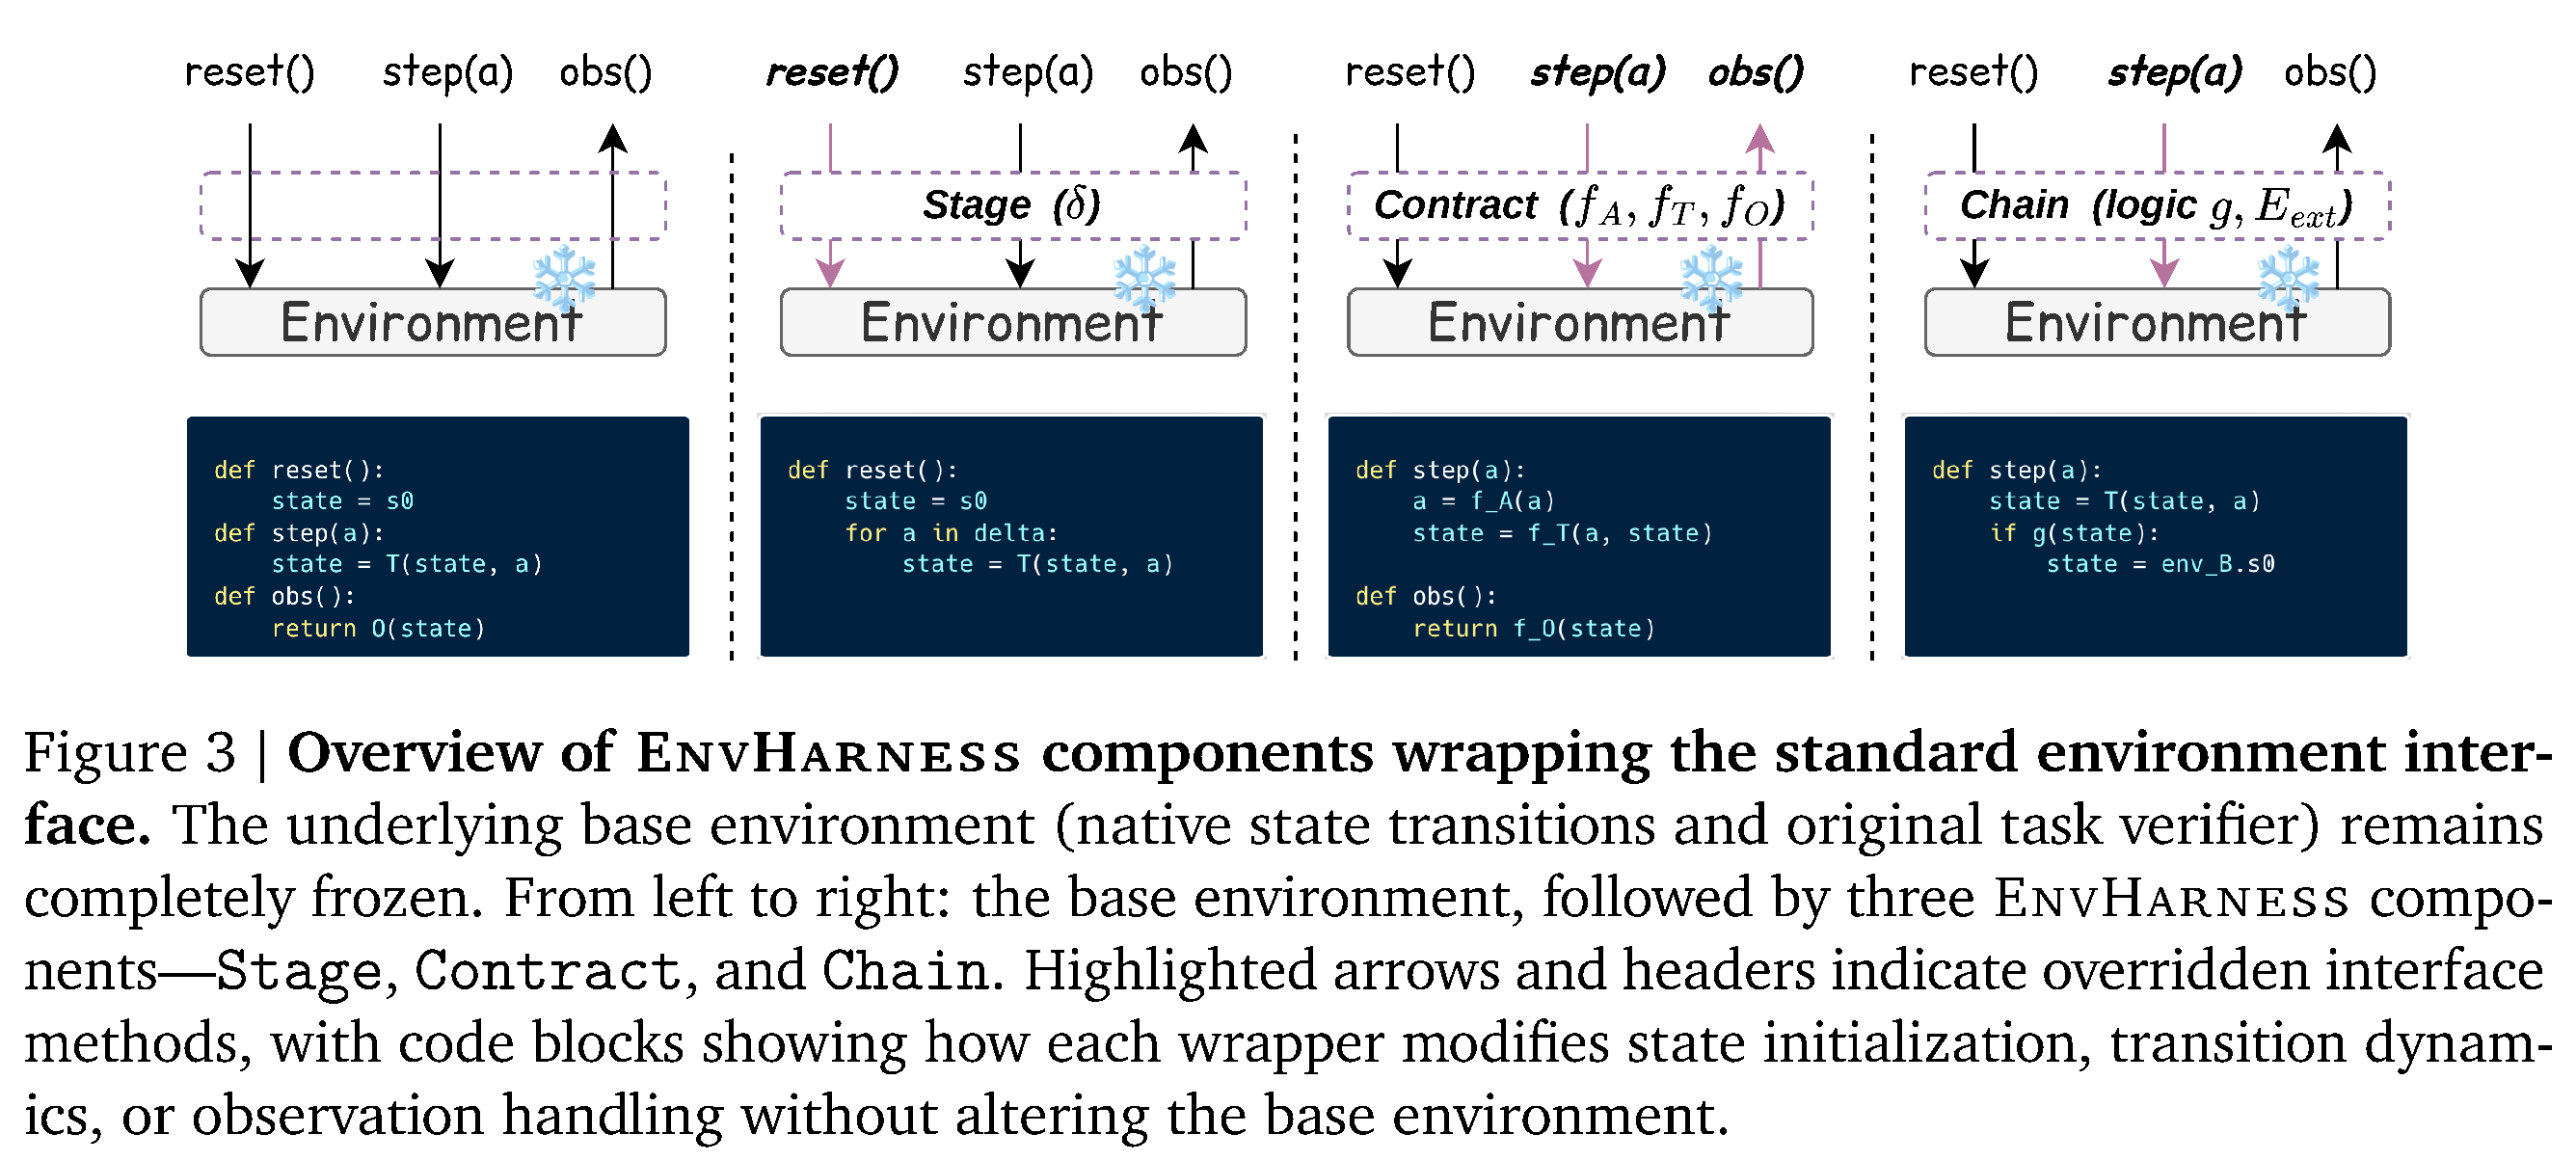
- EnvHarness는 simulator나 verifier를 교체하지 않고 기존 환경을 외부에서 적응시킨다. Stage, Contract, Chain wrapper는 reset에서 파생된 상태, step 시점의 action 또는 observation, episode 구성을 바꾼다. EnvRigger는 rollout으로 black-box policy를 진단하고 후보 wrapper를 작성한 뒤 새 rollout에서 검증한다. Contract에 대해서는 이 글을 참조하라.
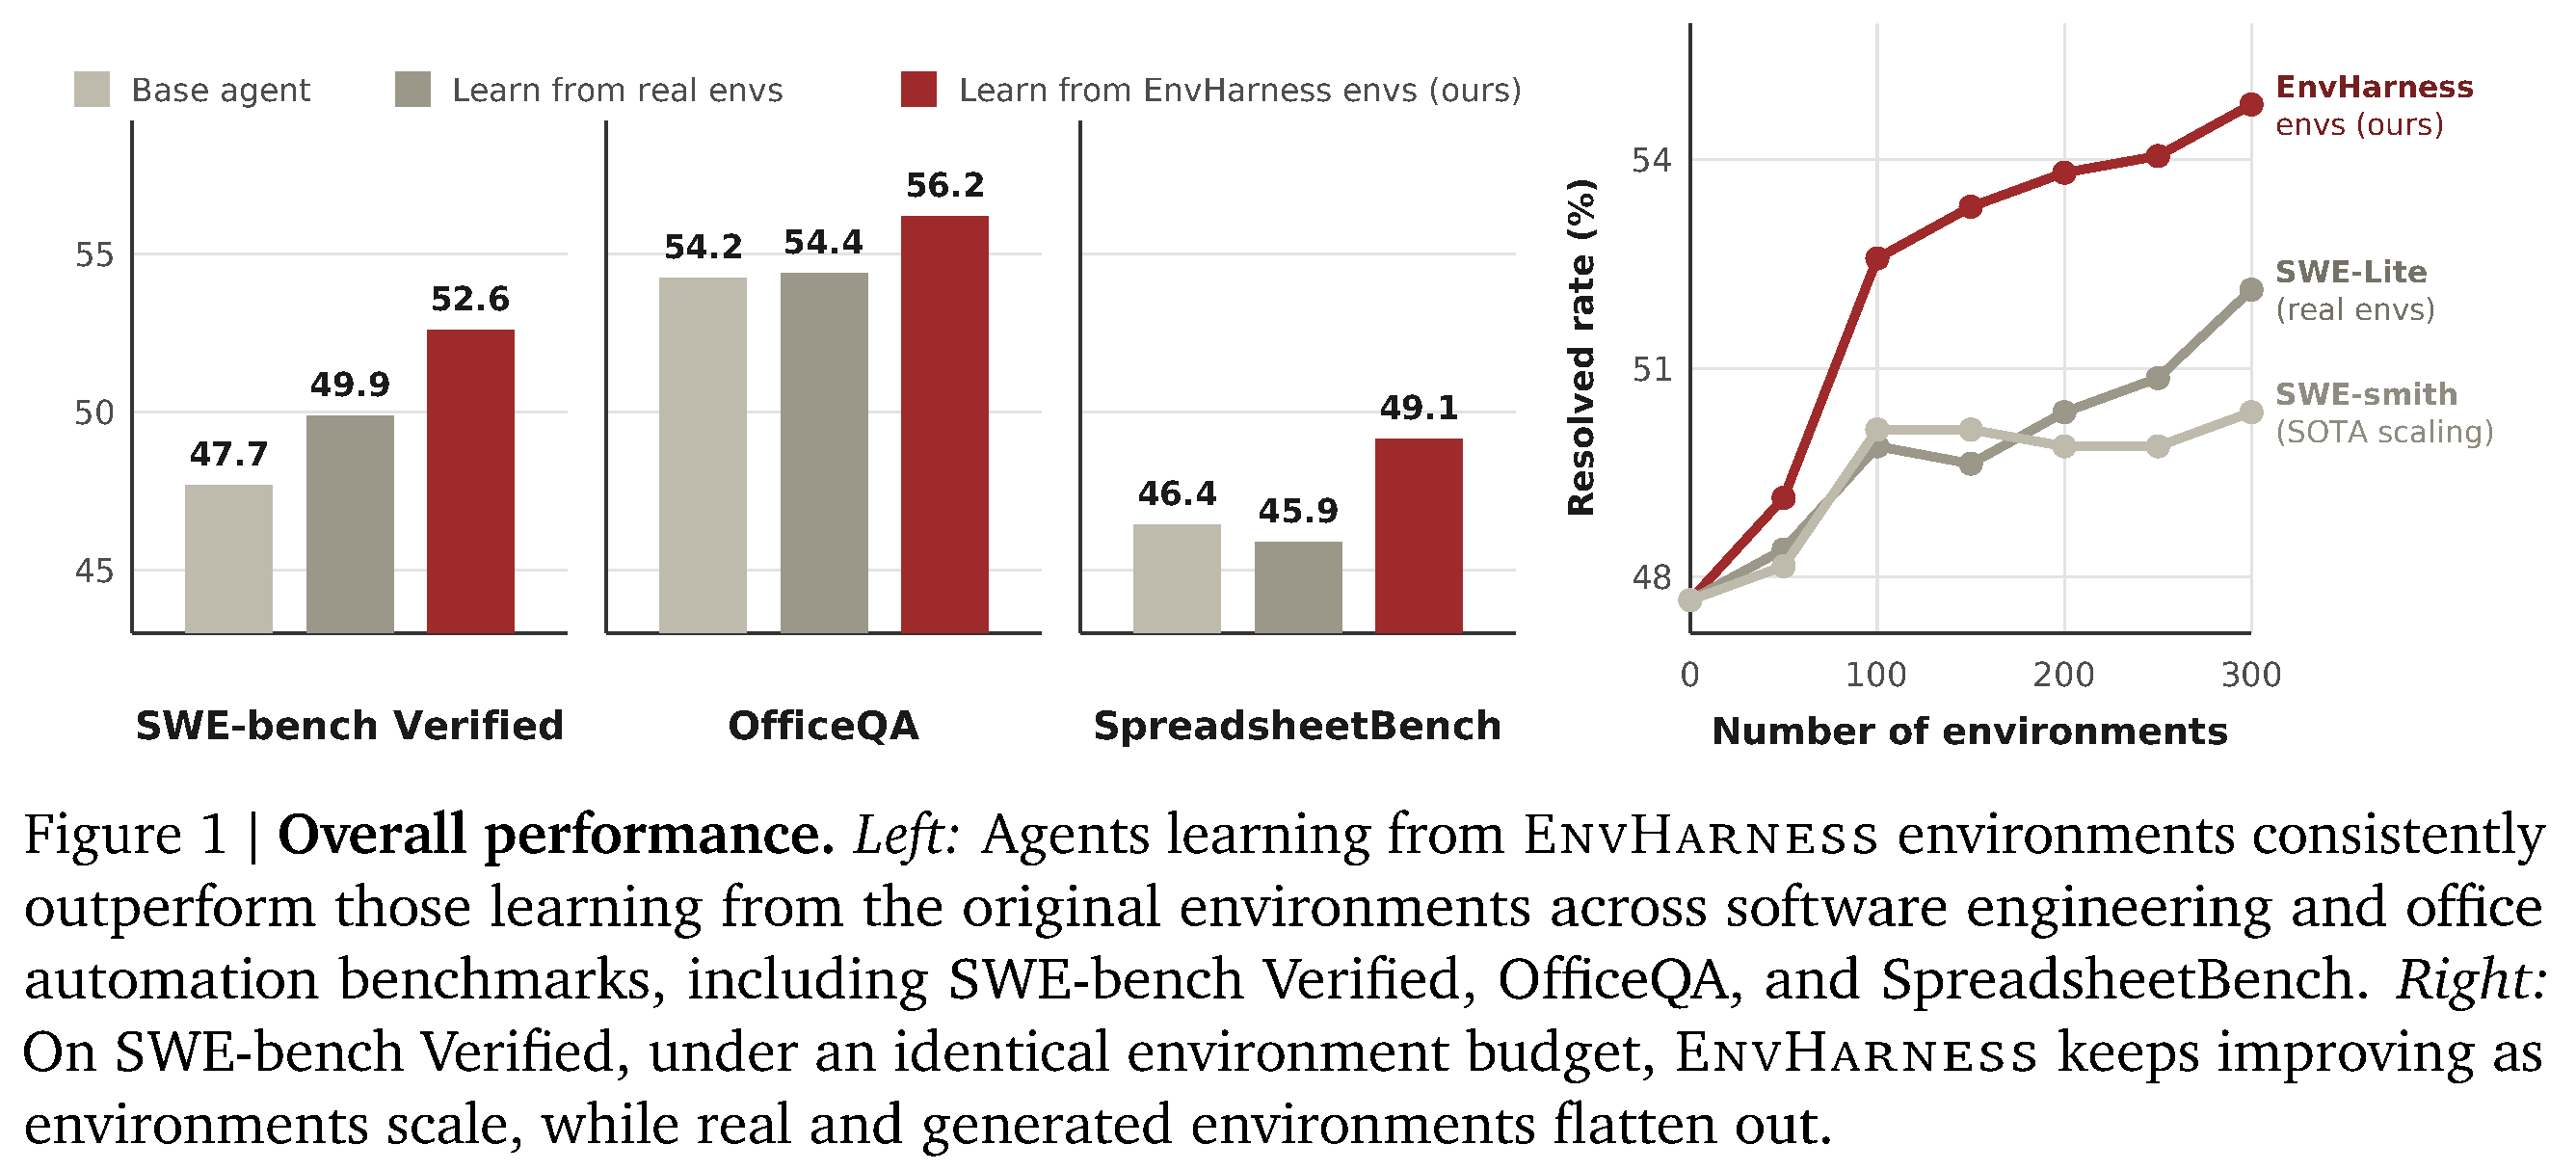
- ALFWorld, WebArena, SWE-bench Verified, OfficeQA, SpreadsheetBench 전반에서 EnvHarness 환경에서 추출한 skill은 보고된 비교에서 원래 환경에서 추출한 skill을 능가한다. SWE-bench Verified에서는 success rate 52.58, 평균 단계 수 49.61을 보고했으며, Original Envs는 각각 49.88과 55.01이다.
- Scaling 실험은 명시된 공통 예산에서 EnvHarness 환경 300개일 때 SWE-bench Verified resolved rate 54.79를 보고한다. 이는 원래 환경의 52.13, 생성 환경의 50.37과 비교된다. 결과는 reset 가능한 주로 텍스트 기반 환경, 작은 rollout-validation 표본, 평균적으로는 양수이지만 균일하지 않은 transfer에 한정된다.
3. Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence
- https://arxiv.org/abs/2608.16590
- 내가 쓴 글
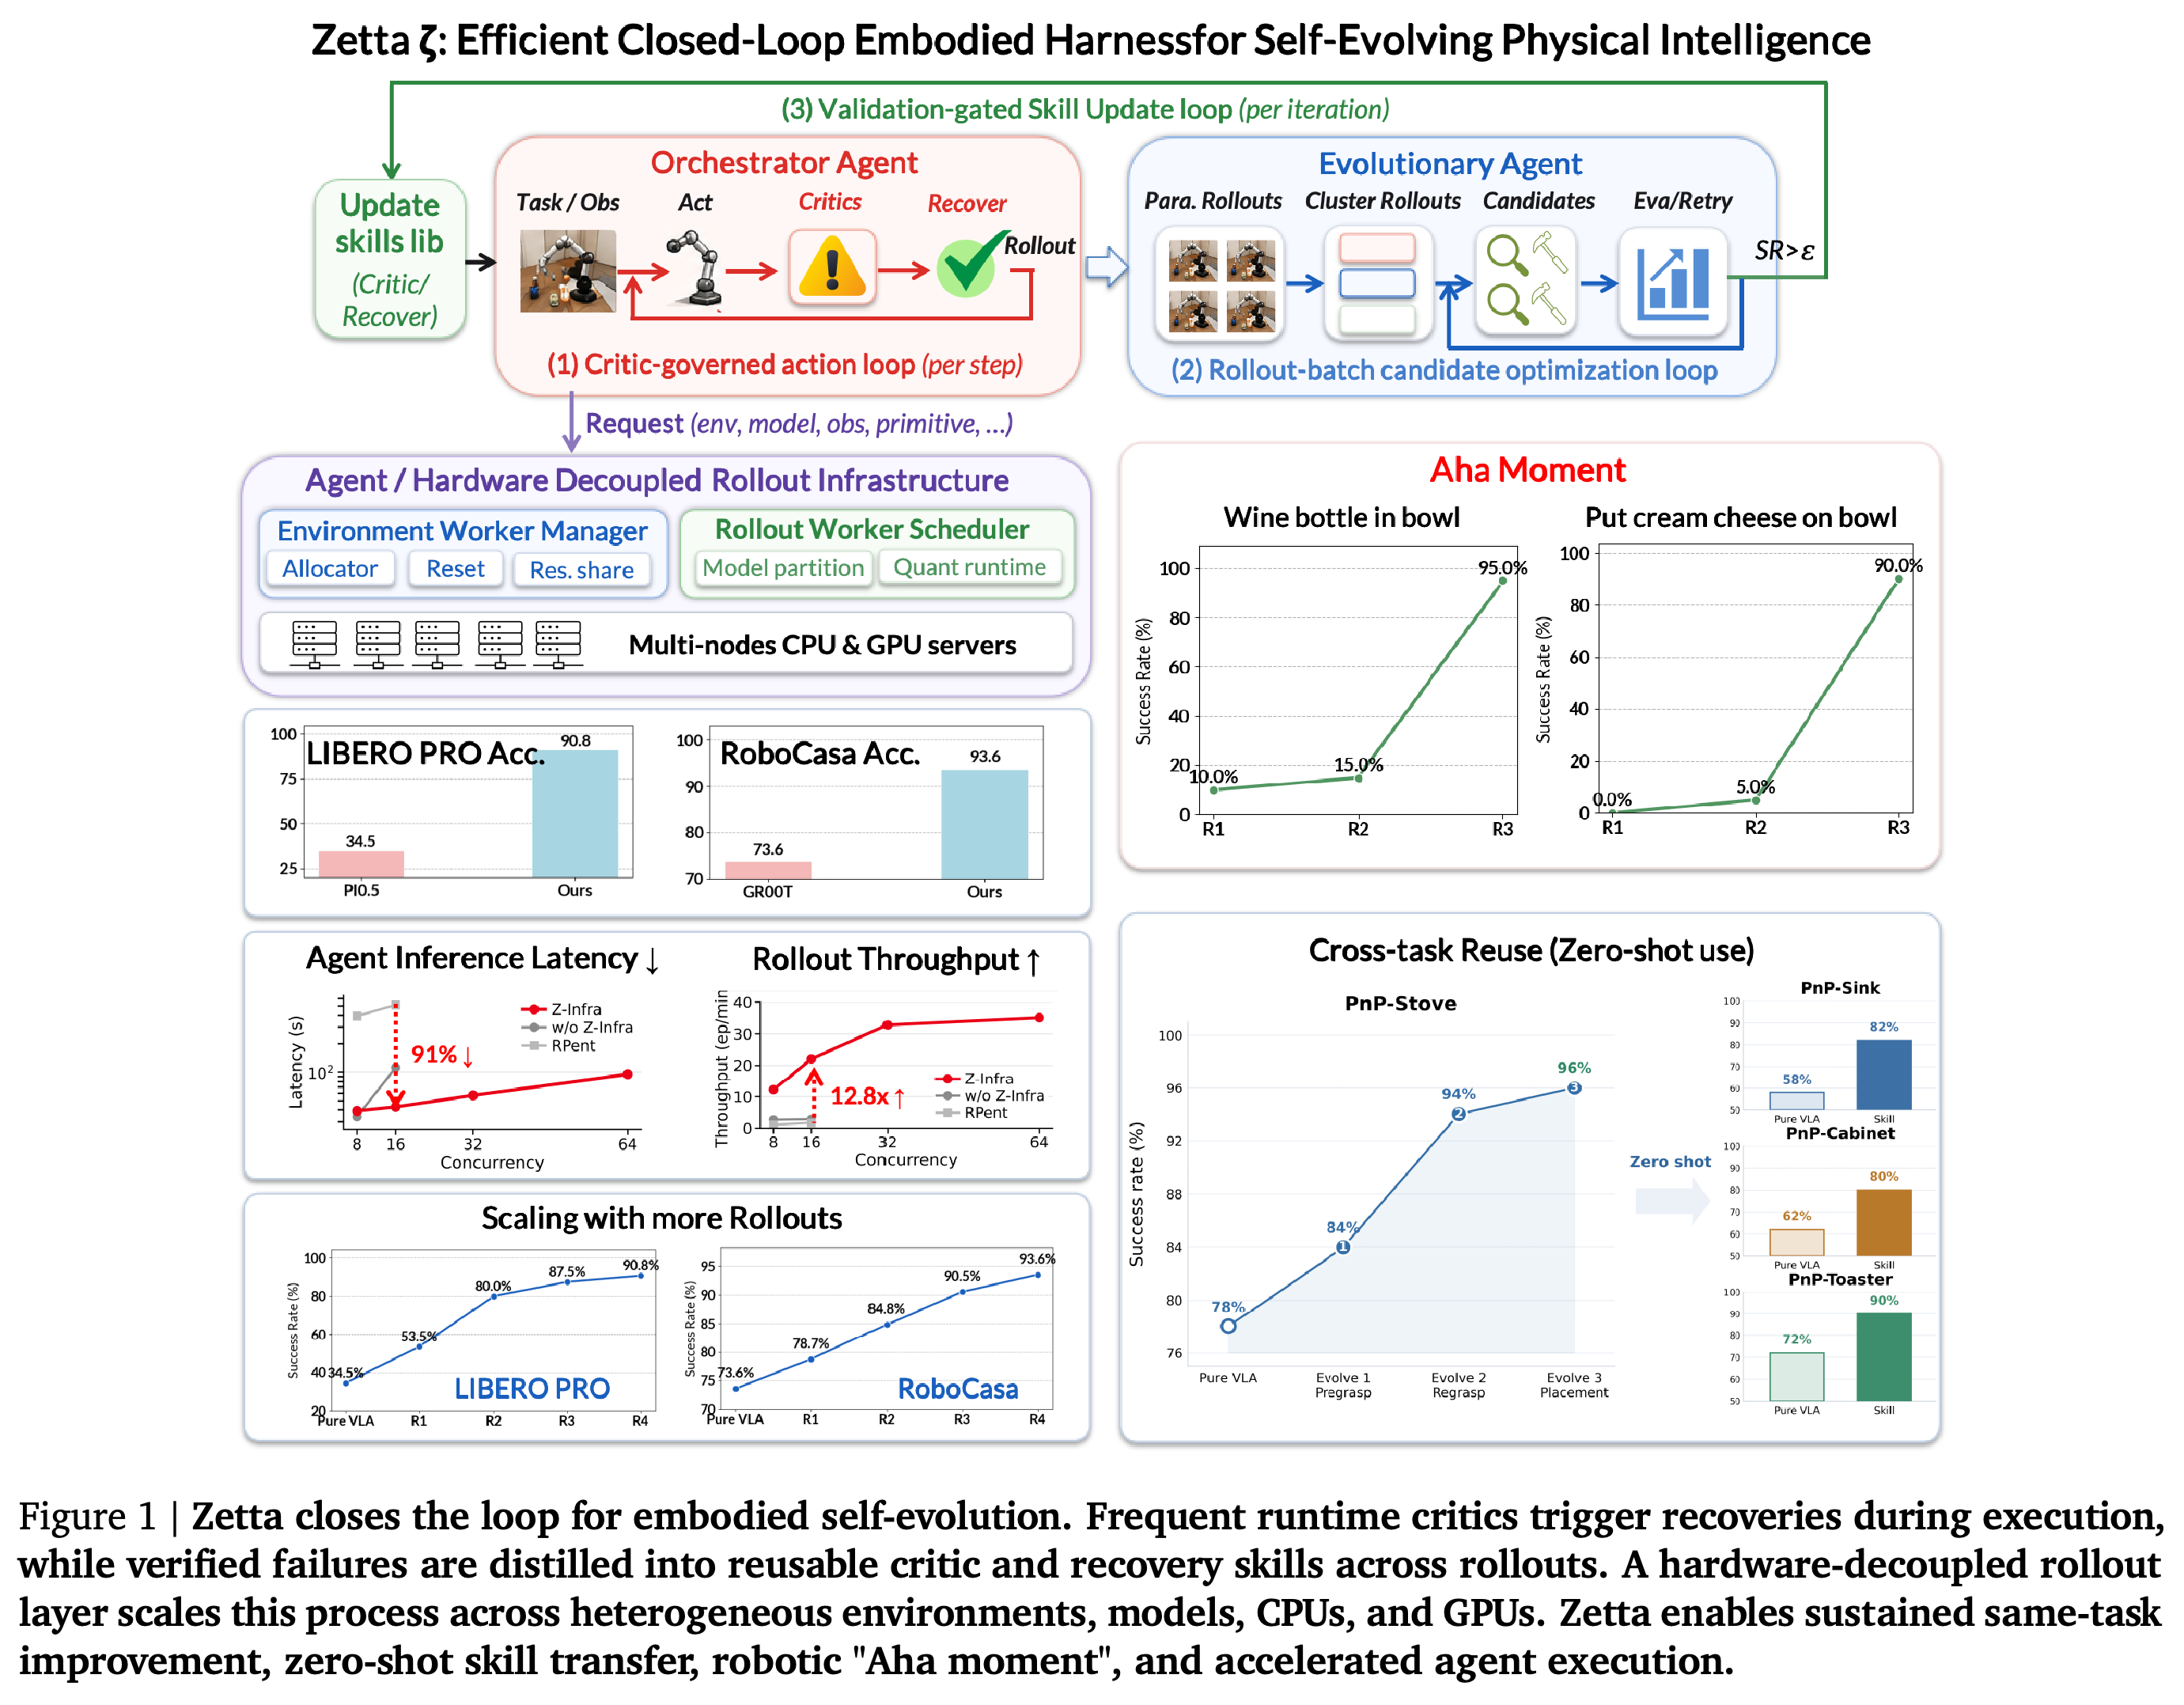
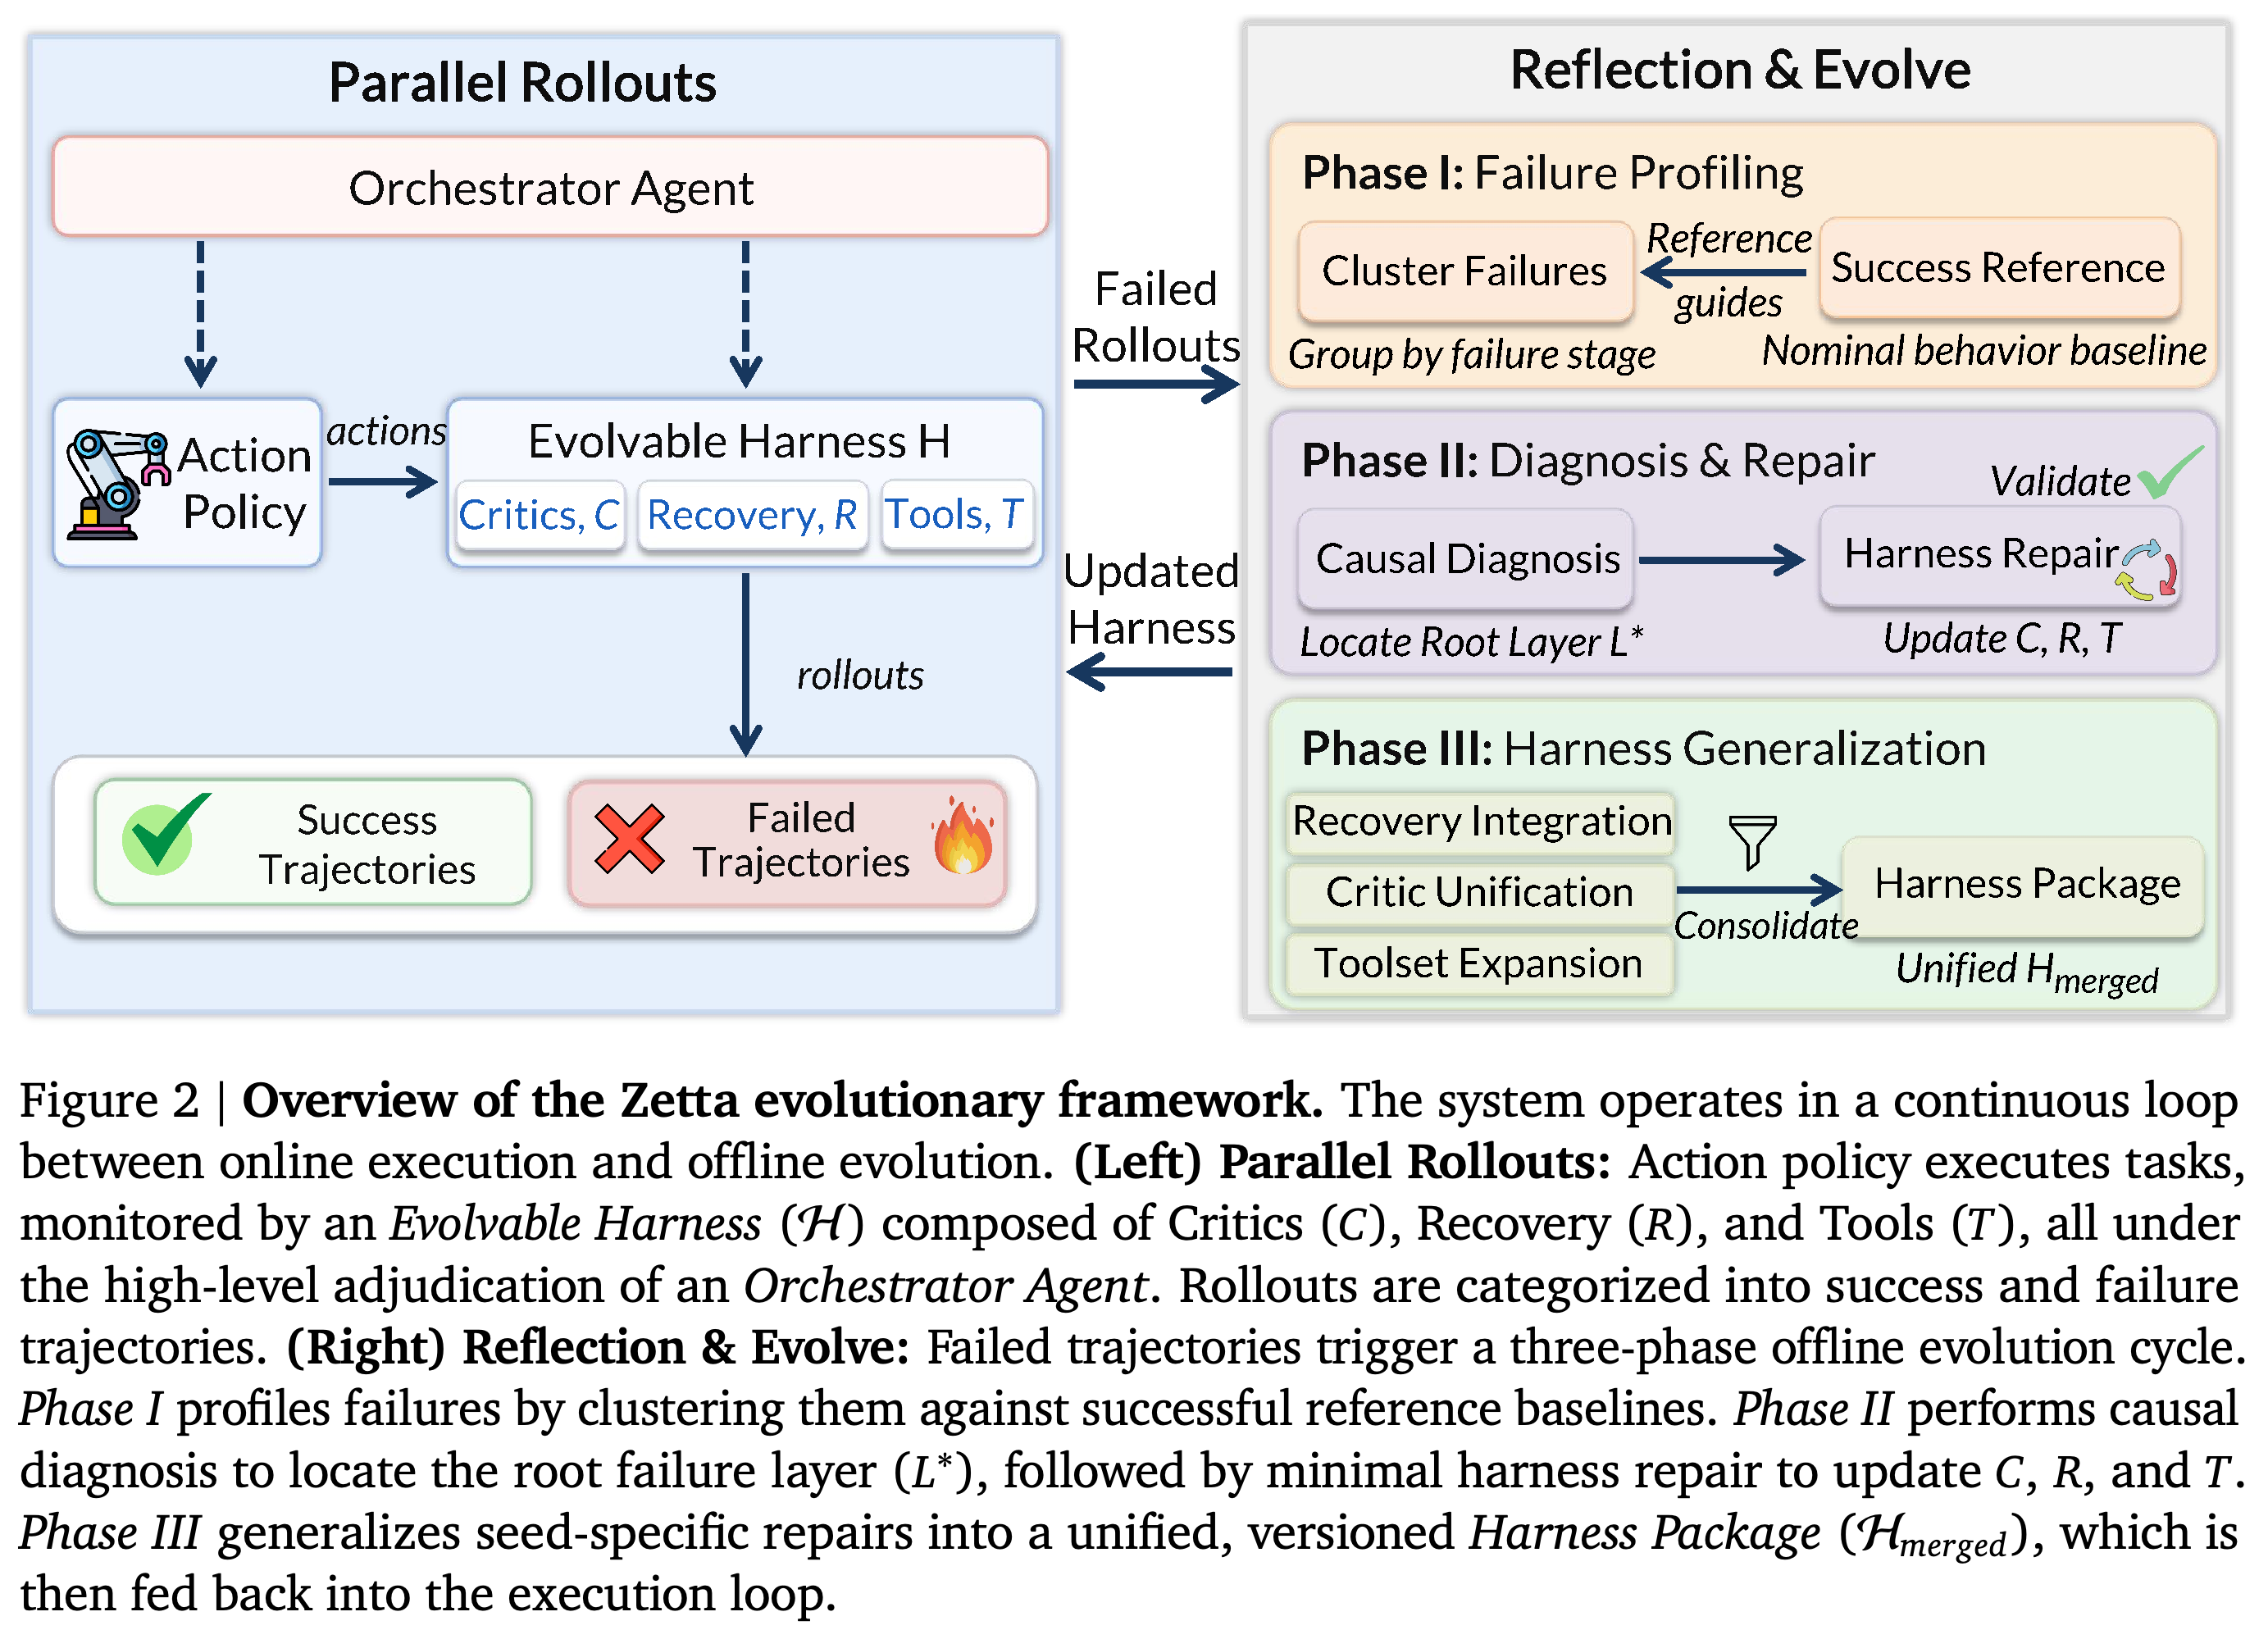
- Zetta는 VLA/WAM action policy와 Orchestrator를 고정한 채 런타임 비평기, 복구 플레이북, 도구로 구성한 코드 기반 harness를 발전시킨다. 비평기는 물리적 편차의 증거를 제공하지만, Orchestrator가 이를 검증해야 개입이나 고정 정책으로의 복귀를 허용한다. harness에 대해서는 이 글을 참조하라.
- 시뮬레이션 benchmark에서 논문은 Zetta가 고정된 GR00T N1.5의 18개 RoboCasa Atomic-Seen 과제 거시 평균을 73.56%에서 93.56%로 높인다고 보고한다. 40개 LIBERO-Pro 과제-설정 쌍에서는 고정된 π0.5의 32.00%를 71.13%로 높였고, 32개 쌍을 개선하며 8개에서는 기준선과 같은 성능을 보였다.
- Z-Infra는 환경 실행과 모델 추론을 분리하고 이기종 rollout을 배치 처리한다. 8×A100 GPU를 사용한 LIBERO Goal에서 동시성 64일 때 35.1 episodes/min에 도달한다. 동시성 16에서 보고한 22.09 episodes/min은 Z-Infra 없는 harness의 7.7×, RPent의 12.8×다. 근거는 실제 로봇이 아니라 시뮬레이션과 인프라 실험에 한정된다.
출처
[1] SPADE: Self-Play in Adaptive Synthetic Executable Environments
[2] EnvHarness: Awakening Static Worlds for Agent Learning
[3] Zetta $\zeta$: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence