


2026년 2월 AI 논문 동향
28 Feb 2026 | Paper Review Monthly Papers LLM Agents Agent Training Data Reinforcement Learning목차
이달의 트렌드
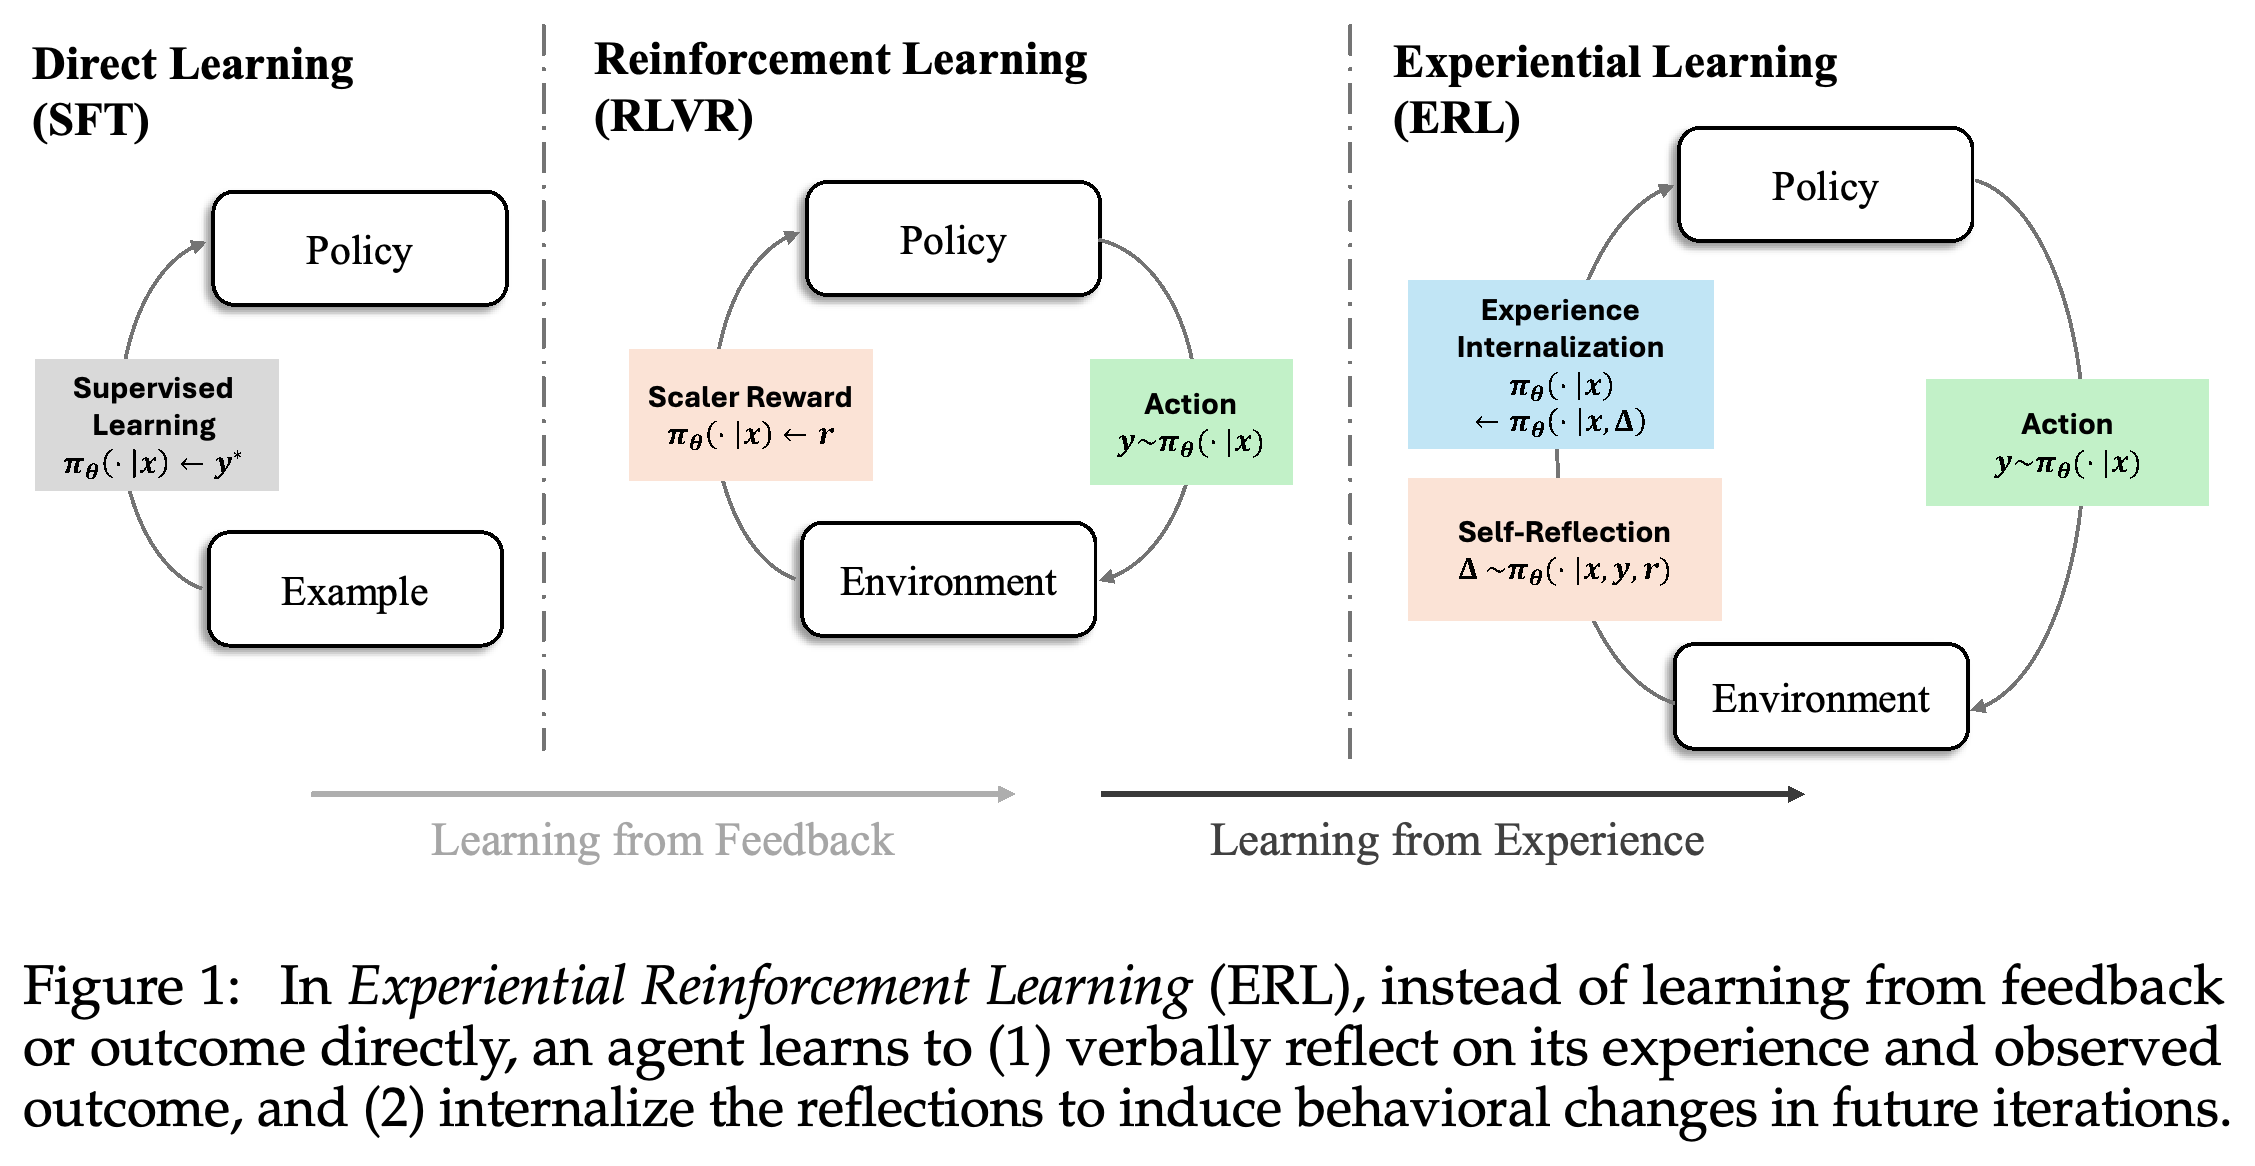
에이전트 학습은 환경과의 상호작용을 중심으로 구성되는 추세다. GLM-5는 비동기 강화학습을 실행 가능한 소프트웨어·터미널 과제와 결합한다. Terminal-Task-Gen은 기존 프롬프트를 변환하거나 과제를 합성해 다중 턴 시연을 구축한다. Experiential Reinforcement Learning은 피드백을 바탕으로 성찰하고 재시도한다. 이 연구들은 환경 구축과 궤적 처리를 학습 과정의 주요 구성 요소로 다룬다. 1, 2, 3
실패한 시도를 학습에 활용하는 방식은 논문마다 다르다. GLM-5는 오류가 있는 구간을 컨텍스트에 남기되 SFT 손실에서는 마스킹한다. Terminal-Corpus는 합성 궤적 전체를 유지할 때 성능이 더 높지만, 필터링하면 표본 수도 크게 줄어든다. ERL은 수정 지침을 명시적으로 생성하고, 양의 보상을 받은 재시도를 배포 시 성찰이 필요 없는 정책에 증류한다. 이 결과들은 오류 복구를 학습하는 방식을 시험할 근거를 제공하지만, 실패 궤적만으로 성능 향상이 발생했다고 입증하지는 않는다.
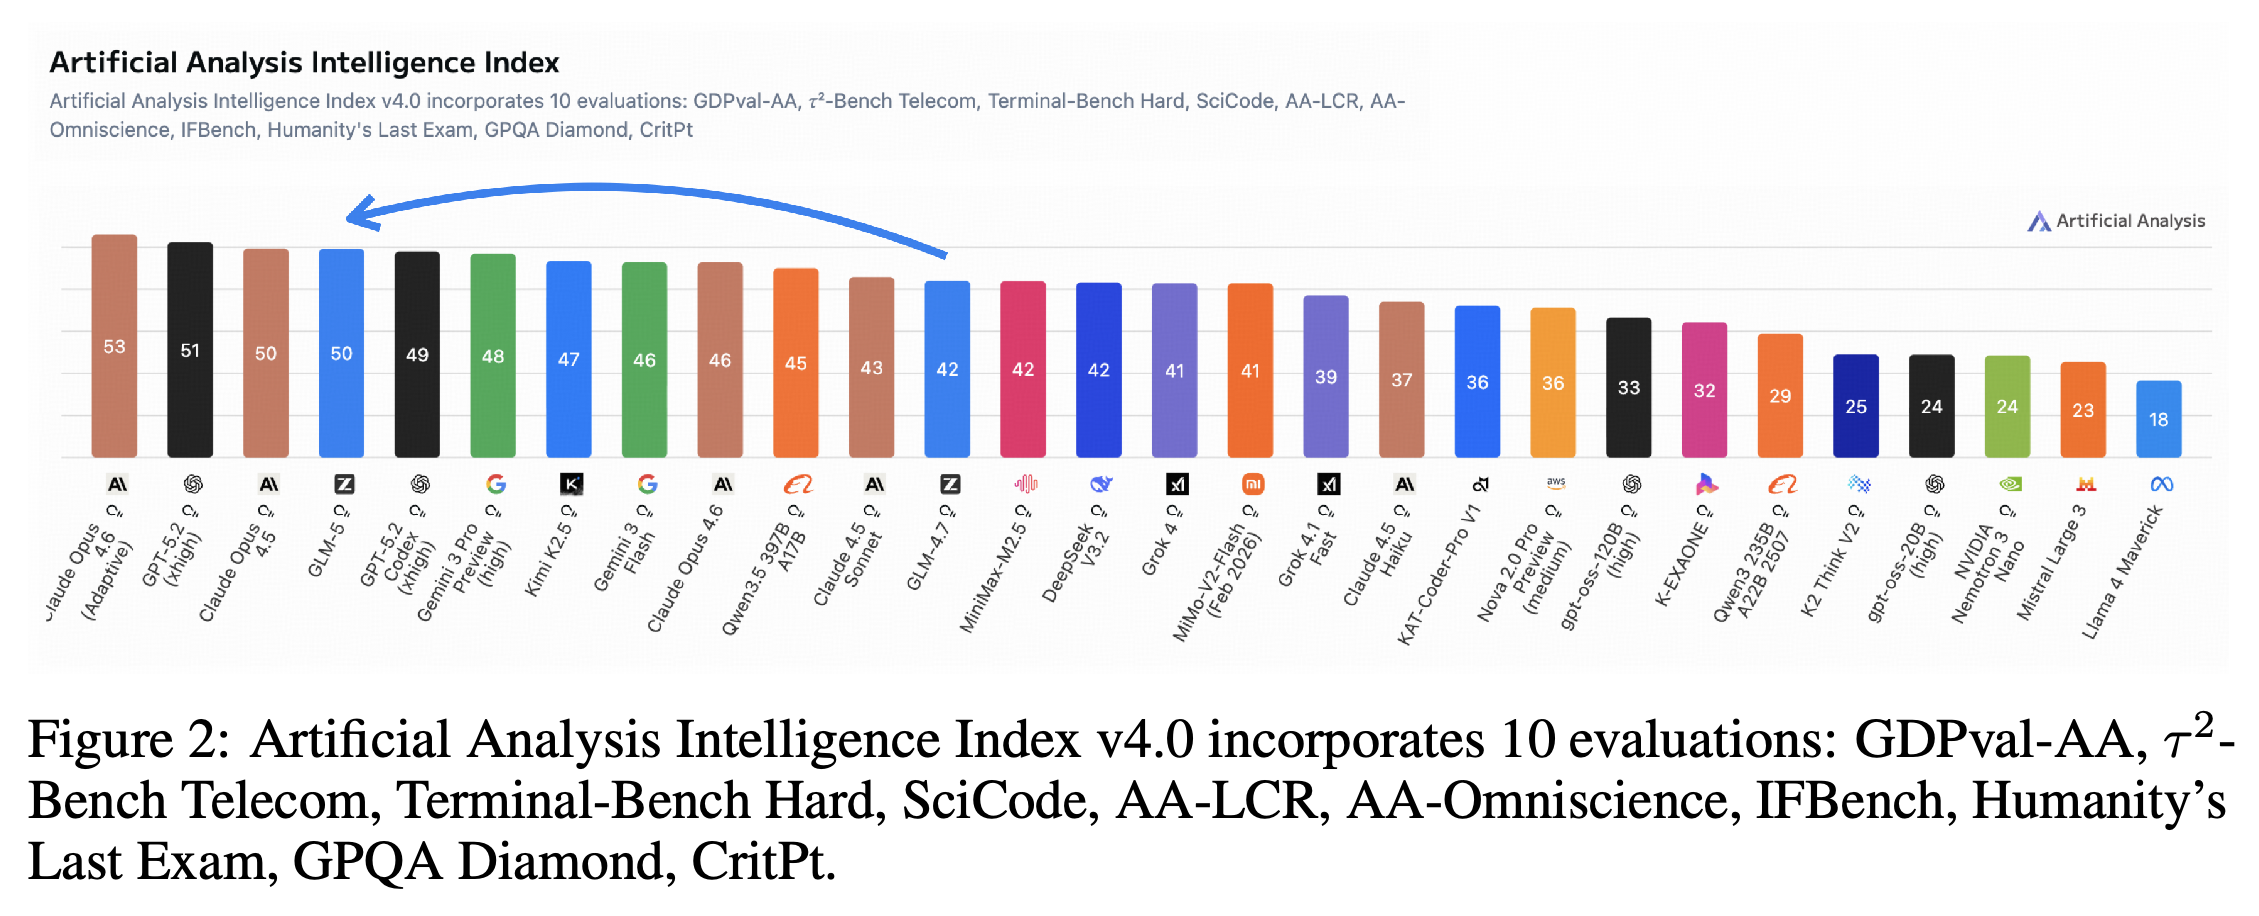
보고된 개선은 성공 기준과 평가 조건에 따라 달라진다. GLM-5는 빌드 성공과 개별 체크 항목에서 높은 점수를 얻지만, 프로젝트 전체 완료와 연쇄 과제에서는 Claude Opus 4.5보다 성능이 낮다. Nemotron-Terminal은 Terminal-Bench 2.0에서 크게 개선되지만 여러 분야의 점수는 여전히 0이다. ERL의 가장 큰 개선은 행동을 8회로 제한한 결정론적 제어 에피소드에서 나타난다. 따라서 이 결과들은 특정 능력의 향상을 뒷받침하며, 자율 실행의 전반적인 신뢰성을 입증하지는 않는다.
2026년 2월의 주요 논문
1. GLM-5: from Vibe Coding to Agentic Engineering
- https://arxiv.org/abs/2602.15763
- GLM-5: from Vibe Coding to Agentic Engineering 요약 설명
- GLM-5: from Vibe Coding to Agentic Engineering은 긴 상호작용에 걸쳐 소프트웨어를 계획하고 구현하며 수정하는 공개 가중치 모델을 제시한다. 744B-parameter MoE는 40B 파라미터를 활성화한다. 보고된 기반 모델 학습량은 28.5 trillion 토큰이며, 컨텍스트를 200K까지 확장한다. 학습 파이프라인은 DeepSeek Sparse Attention, 순차적인 Reasoning RL·Agentic RL·General RL, 마지막 on-policy 단계 간 증류를 결합한다. on-policy 단계 간 증류에 대해서는 이 글을 참조하라.
- 에이전트 학습 인프라는 rollout 생성과 최적화를 분리한다. Token-in-Token-out은 샘플링한 토큰을 그대로 보존하고, 중요도 샘플링은 정책 간 차이가 지나치게 큰 토큰을 마스킹하며, 오래된 궤적 필터링은 정책 지연을 제한한다. 터미널·검색 과제와 함께 9개 언어를 다루는 10,000개가 넘는 SWE 환경에서 실행 기반 피드백을 얻는다. 이 기법들은 구체적인 학습 실패에 대응하지만, 개별 기여도와 동기식 학습 대비 효율 향상은 정량화하지 않는다.
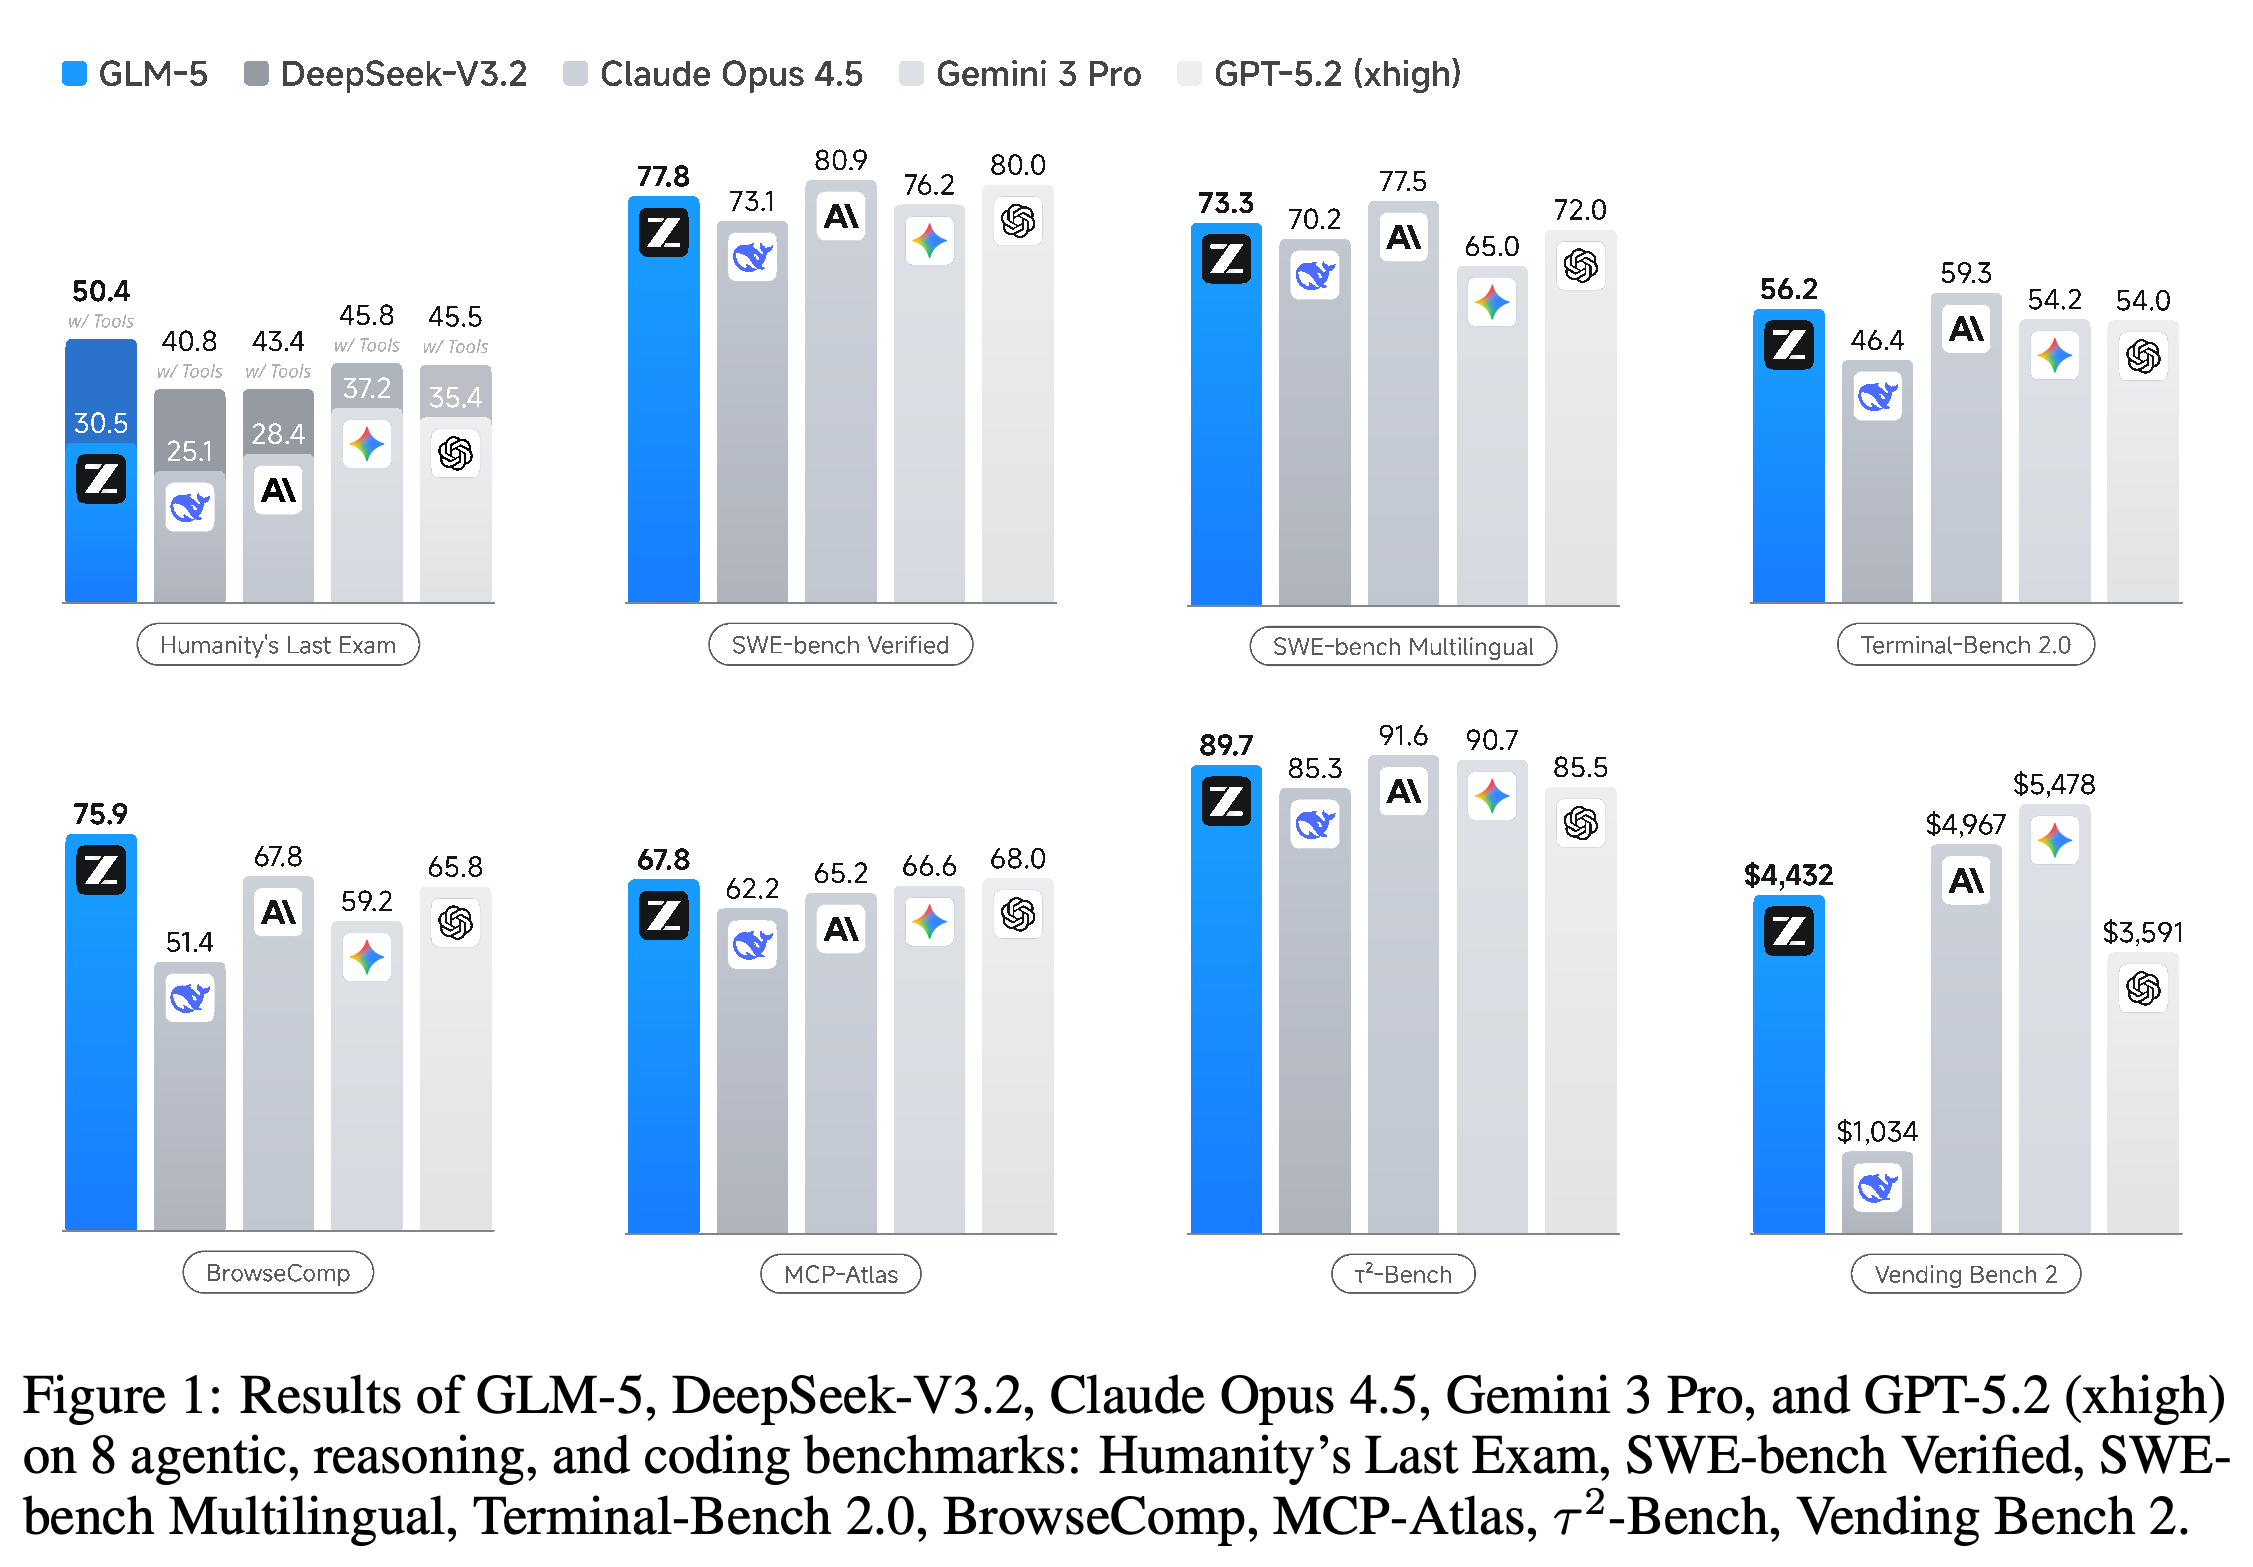
- SWE-bench Verified에서 77.8, SWE-bench Multilingual에서 73.3을 기록하며, 원본 Terminal-Bench 2.0에서는 실험한 두 하네스 모두 56.2를 기록한다. 수정·검증한 Terminal-Bench 세트에서는 Terminus-2로 60.7, Claude Code로 61.1을 얻지만, 다른 모델의 원본 세트 결과와 동일한 조건의 비교는 아니다. BrowseComp는 컨텍스트 관리를 적용하면 75.9에 도달한다. 다만 보고서는 해당 조건을 Hierarchical Context Management와 discard-all로 다르게 설명한다.
2. On Data Engineering for Scaling LLM Terminal Capabilities
- https://arxiv.org/abs/2602.21193
- On Data Engineering for Scaling LLM Terminal Capabilities 요약 설명
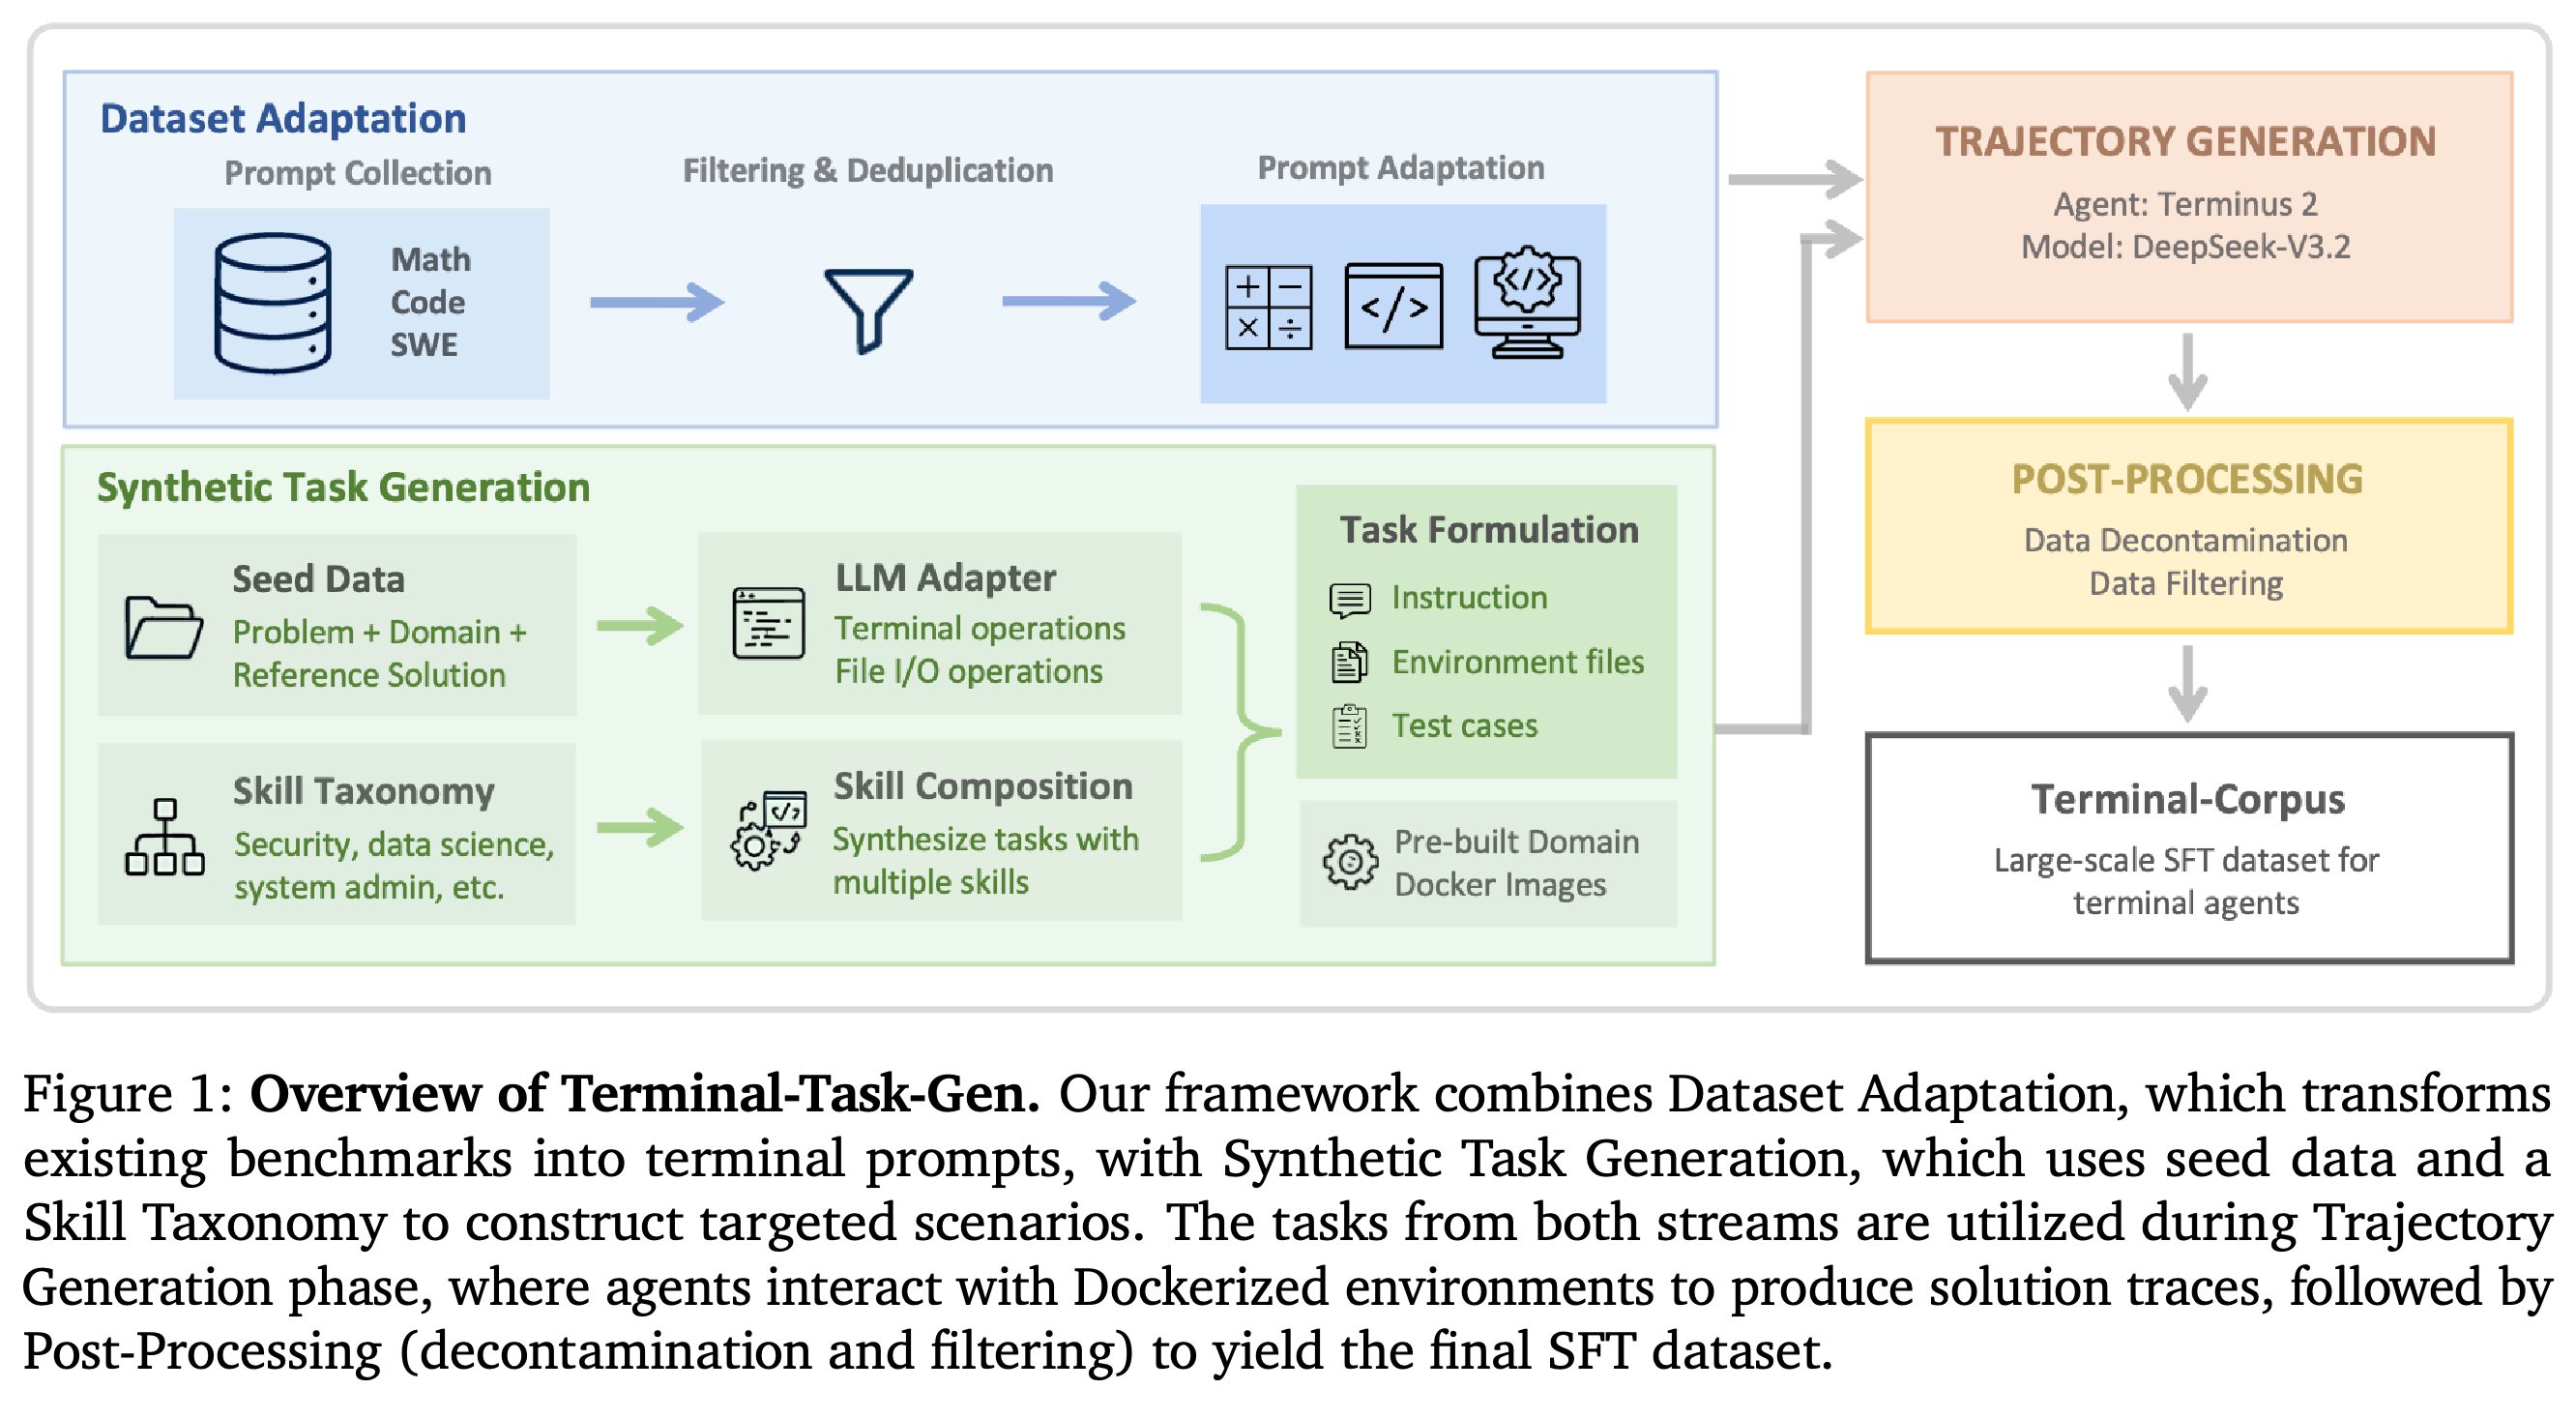
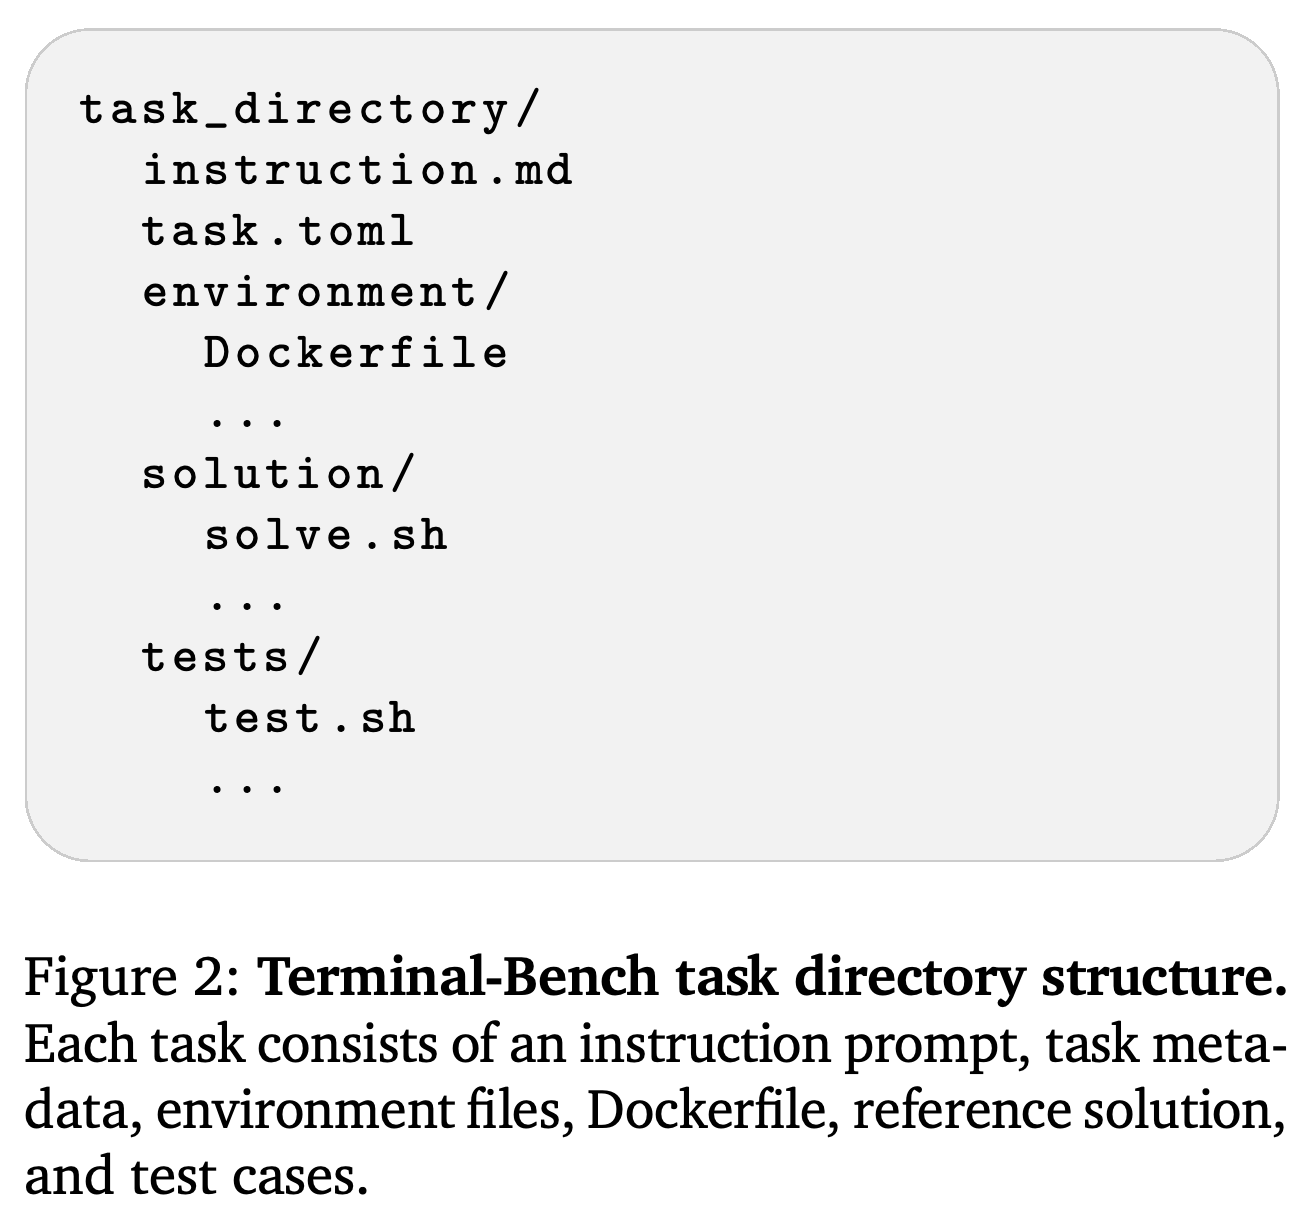
- On Data Engineering for Scaling LLM Terminal Capabilities는 Terminal-Task-Gen과 Terminal-Corpus를 소개한다. 기존 수학·코드·SWE 프롬프트로 폭넓은 과제를 확보하고, 시드 기반 생성과 스킬 조합 기반 생성으로 터미널 특화 과제를 추가한다. DeepSeek-V3.2는 Terminus 2를 통해 궤적을 수집한다. 생성된 과제는 분야별 공유 Docker 이미지 9개와 합성 pytest 검사를 사용하지만, 생성된 oracle solution은 없다. 기존 프롬프트를 변환한 과제에는 검증 테스트가 없다.
- Terminus 2 scaffold를 고정한 채 SFT로 Nemotron-Terminal-8B, -14B, -32B를 학습한다. Terminal-Bench 2.0 점수는 각각 13.0 ± 2.2, 20.2 ± 2.7, 27.4 ± 2.4이며, 대응하는 Qwen3 기준 모델은 2.47 ± 0.5, 4.04 ± 1.3, 3.37 ± 1.6을 기록한다. 비교한 일부 대형 모델보다 평균 점수가 높지만, 일부 불확실성 범위는 겹치며 평가한 최상위 시스템은 여전히 앞선다.
- Qwen3-8B 절제 실험에서는 데이터를 혼합한 단일 단계 SFT가 13.03 ± 2.16으로, 어댑터 데이터 다음에 합성 데이터를 학습하는 방식의 10.39 ± 1.71보다 높다. 합성 궤적 264,207개를 모두 유지하면 12.4 ± 2.29를 기록한다. 완료된 궤적 104,603개만 사용하면 6.74 ± 2.20, 성공한 궤적 83,448개만 사용하면 5.06 ± 2.11을 기록한다. 실패한 시도를 유지하는 것이 도움이 될 수 있지만, 이 비교는 궤적 내용과 난이도뿐 아니라 데이터 양도 바꾼다.
3. Experiential Reinforcement Learning
- https://arxiv.org/abs/2602.13949
- Experiential Reinforcement Learning 요약 설명
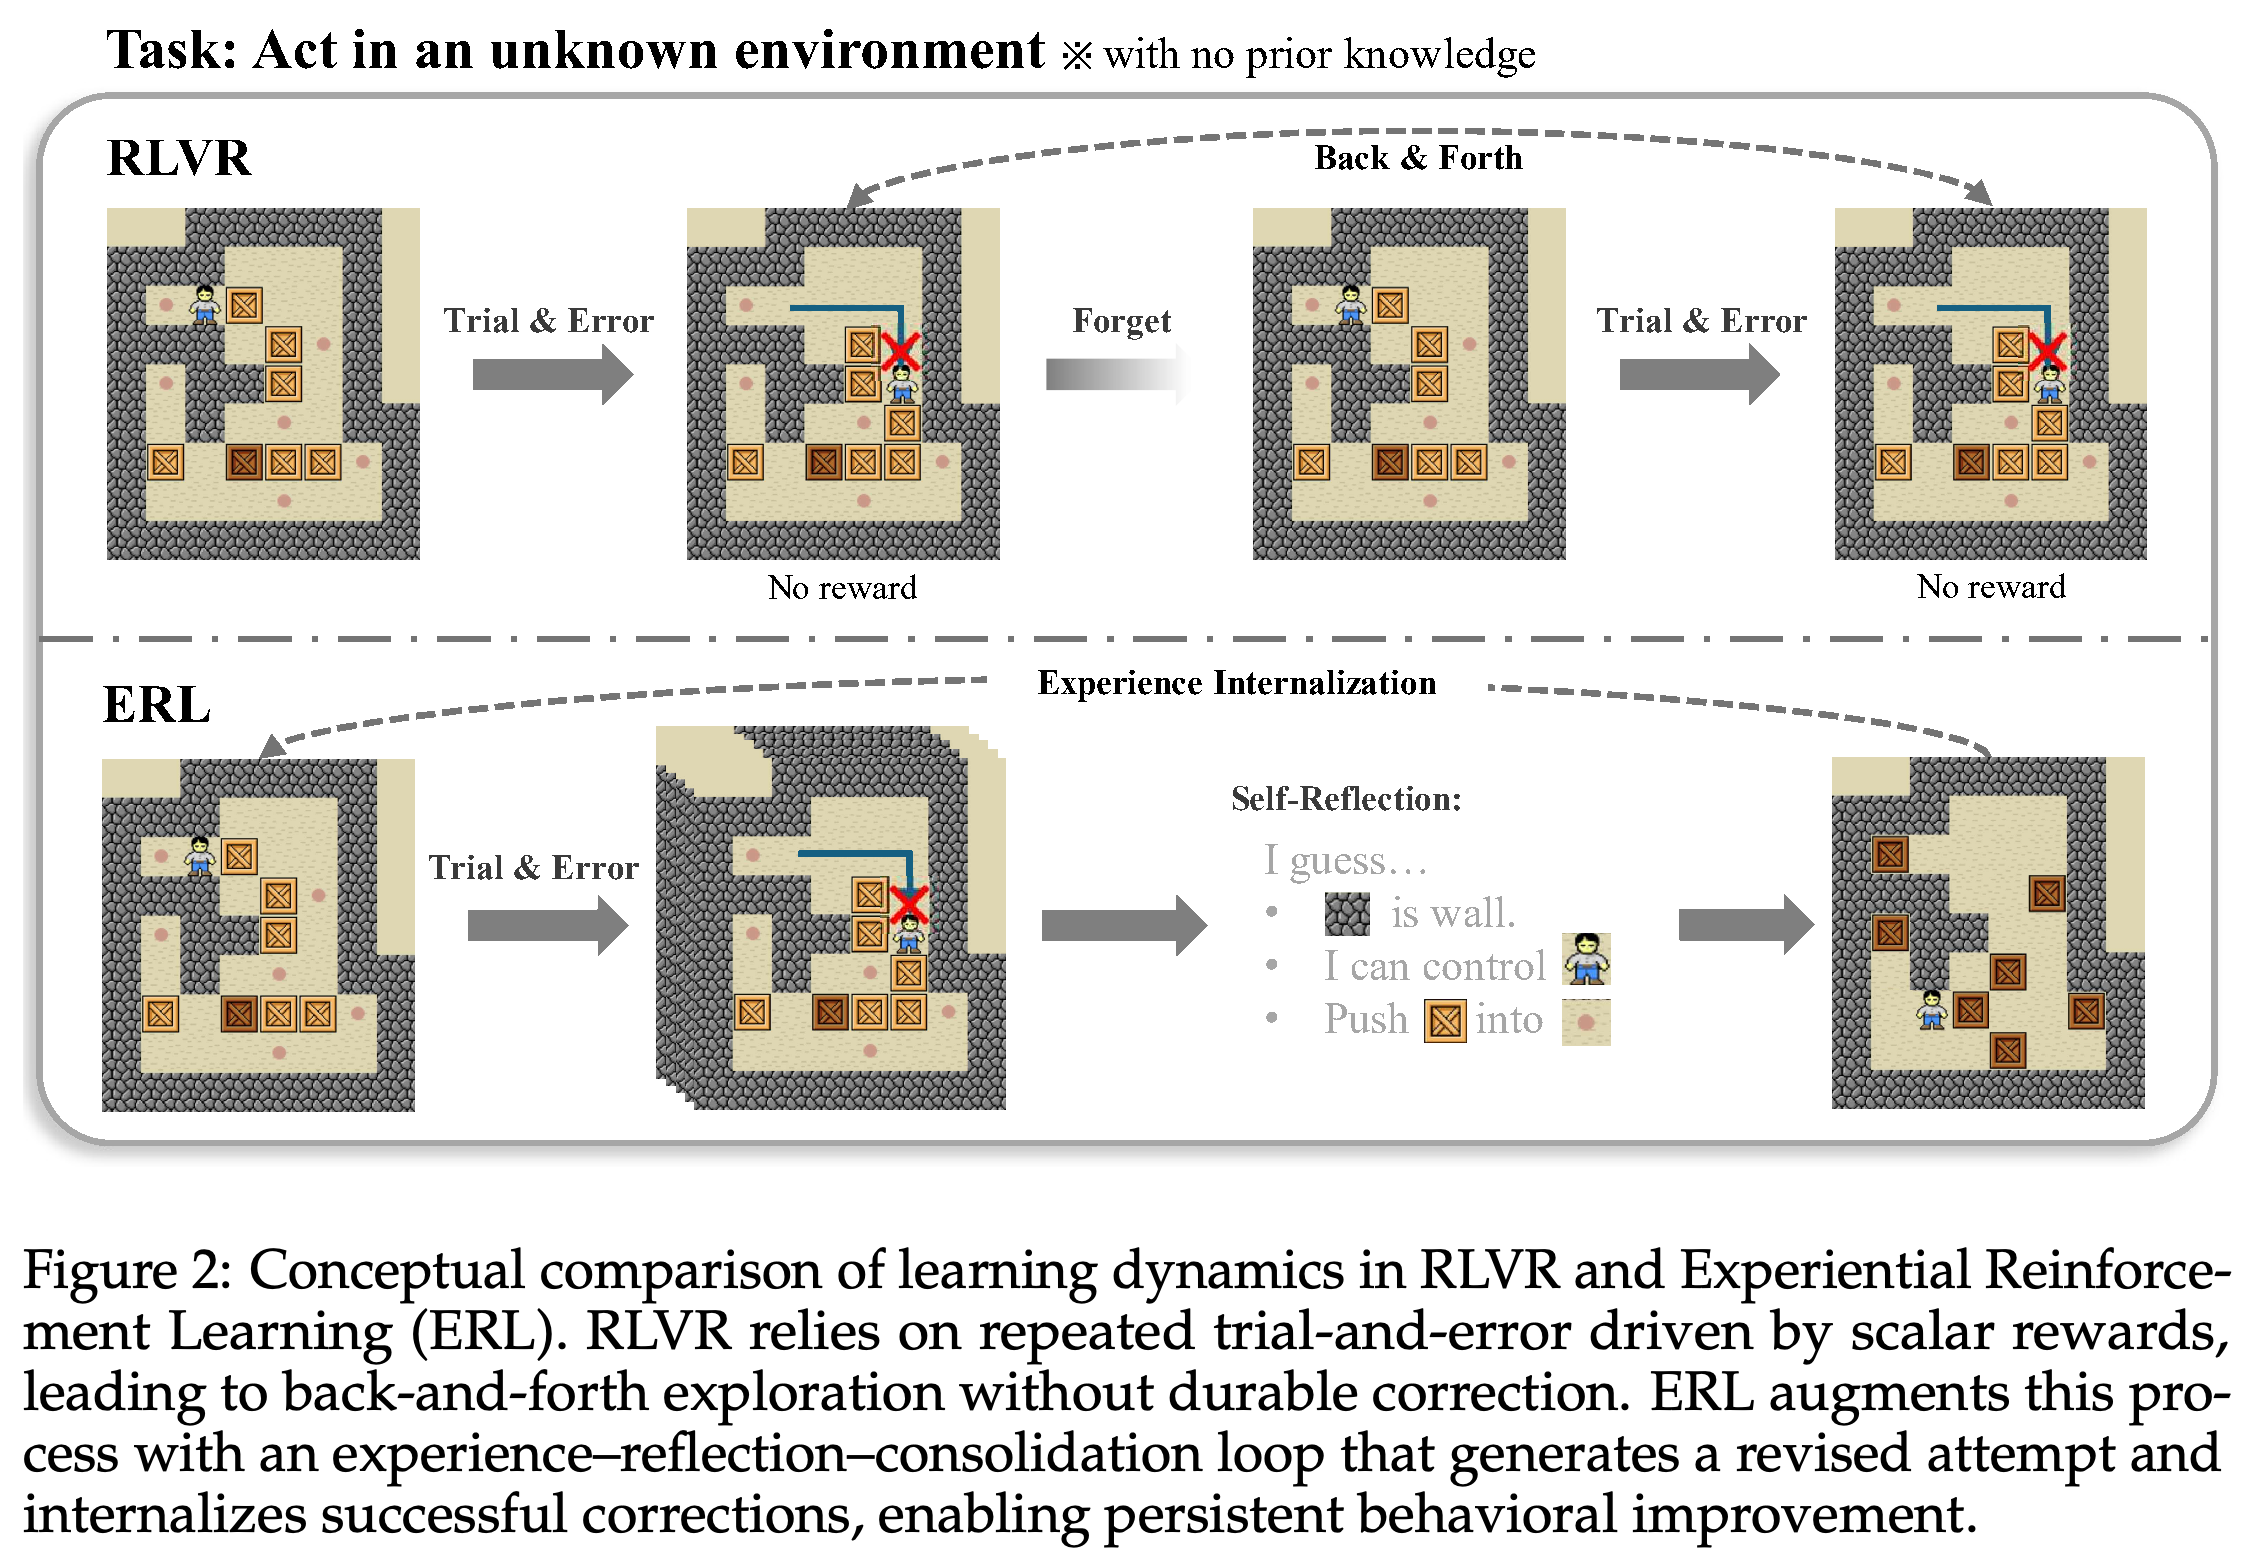
- Experiential Reinforcement Learning은 경험·성찰·내재화를 반복하며 학습한다. 최초 시도의 보상이 1보다 낮으면 같은 모델이 피드백을 바탕으로 지침을 생성하고 재시도한다. 성찰에는 재시도의 보상을 부여하며, 선택적 자기 증류는 원래 과제 맥락에서 수정된 출력을 학습한다. 증류 필터는 재시도의 보상이 양수일 것을 요구할 뿐, 최초 시도보다 개선되었을 것을 요구하지는 않는다. 배포 시에는 학습 때의 성찰 단계나 이전 시도의 피드백이 필요하지 않다.
- ERL은 6개 과제–백본 비교 모두에서 GRPO 기반 RLVR보다 높은 평가 보상을 얻는다. Qwen3-4B-Instruct-2507의 평가 보상은 Frozen Lake에서 0.86에서 0.94로, HotpotQA에서 0.45에서 0.56으로, Sokoban에서 0.06에서 0.87로 높아진다. Olmo-3-7B-Instruct의 보상은 같은 순서로 0.39에서 0.66, 0.47에서 0.50, 0.04에서 0.20으로 높아진다. 가장 큰 개선은 보상의 절대 증가폭 0.81이며, 상대 증가율 81%가 아니다.
- 구조화된 성찰을 제거하면 모든 설정에서 최종 보상이 낮아진다. 이 대조군도 두 번의 시도를 유지하며, 이전 궤적과 일반적인 개선 지시를 제공한다. 메모리의 효과는 일관되지 않다. 메모리를 제거해도 Qwen의 HotpotQA와 Sokoban 보상은 변하지 않으며, Olmo의 Sokoban 보상은 0.20에서 0.24로 높아진다. 따라서 에피소드 간 메모리보다 명시적인 수정 지침의 효과가 더 일관되게 뒷받침된다. 내재화만 제거한 절제 실험은 없다.
출처
[1] GLM-5: from Vibe Coding to Agentic Engineering
[2] On Data Engineering for Scaling LLM Terminal Capabilities