


On Data Engineering for Scaling LLM Terminal Capabilities 요약 설명
24 Feb 2026 | Paper Review Terminal Agents Synthetic Data Supervised Fine-Tuning목차
- 요약
- 1. Introduction
- 2. Related Work
- 3. Background
- 4. Synthetic Data Generation
- 5. Experiments
- 6. Conclusion
- 부록
- 짧은 생각
이번 글에서는 On Data Engineering for Scaling LLM Terminal Capabilities 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 24일(Arxiv)
- Pi, Renjie, Lam, Grace, Shoeybi, Mohammad, Jannaty, Pooya, Catanzaro, Bryan, Ping, Wei.
- NVIDIA
- 논문 링크
- Project Page
요약
- On Data Engineering for Scaling LLM Terminal Capabilities는 학습 데이터 설계가 명령줄 에이전트에 미치는 영향을 연구한다. Terminal-Task-Gen은 기존 수학, 코드, 소프트웨어 엔지니어링 프롬프트를 활용하는 어댑터와 시드 기반 및 스킬 기반 태스크 생성을 결합해 지도 미세조정용 Terminal-Corpus를 만든다.
- Qwen3 모델을 미세조정한 Nemotron-Terminal-8B, -14B, -32B는 Terminal-Bench 2.0에서 각각 13.0 ± 2.2, 20.2 ± 2.7, 27.4 ± 2.4를 기록한다. Terminus 2 에이전트 프레임워크에서 각 모델에 대응하는 베이스라인 점수는 2.47 ± 0.5, 4.04 ± 1.3, 3.37 ± 1.6이다.
- 실험에서는 데이터를 혼합한 단일 단계 학습, 전체 합성 궤적 유지, 기본 컨텍스트 설정이 유리했다. 다만 필터링은 데이터셋 크기도 바꾸며, 평가는 태스크 89개로 구성된 벤치마크 1개에 집중한다. 따라서 이 결과만으로 실패 궤적의 효과를 분리하거나 일반적인 터미널 작업 능력을 입증할 수는 없다.
1. Introduction
터미널 에이전트 학습에는 데이터와 관련된 병목이 2가지 있다. 태스크 프롬프트, 필요한 의존 파일, 준비된 환경이 부족하며, 매번 새로 구성한 환경에서 다중 턴 궤적을 수집하는 데 비용이 많이 든다. 논문은 상호 보완적인 전략으로 이를 해결한다. 어댑터는 다양한 작업을 효율적으로 확보하고, 합성 생성은 터미널 특화 스킬, 난이도, 태스크 조합을 겨냥한다.
- 주요 기여는 Terminal-Task-Gen, 필터링·데이터 혼합·컨텍스트 길이·스케일링에 관한 연구, Nemotron-Terminal 모델군이다.
- 모델 체크포인트와 대부분의 합성 데이터셋은 https://huggingface.co/collections/nvidia/nemotron-terminal 에 공개한다.
2. Related Work
관련 연구에서는 에이전트 scaffold 개선과 기반 모델 개선을 구분한다. 또한 터미널 태스크 생성을 기존 합성 지시 데이터 생성 방법과 연결하고, 생성 효율과 생성 데이터로 SFT한 모델의 평가를 강조한다.
Agent Design.
기존 터미널 에이전트는 scaffold를 통해 성능을 높이지만, 이러한 설계는 특정 모델에 맞춰질 수 있고 상당한 엔지니어링 작업이 필요하다. 이 연구는 Terminus 2 scaffold를 고정하고 지도 미세조정으로 모델 능력을 개선한다. 다른 scaffold 설계와의 실험적 비교는 수행하지 않는다.
Dataset Adapters.
데이터셋 어댑터는 기존 프롬프트를 터미널 환경에서 실행해 재사용하며, 이를 통해 경쟁 프로그래밍과 수학 등 여러 분야의 데이터를 수집한다. 논문은 어댑터 데이터 출처와 필터링 방식을 연구하면서, 원본 데이터셋이 순차적인 환경 상호작용을 위해 설계된 것은 아니라는 점을 짚는다.
Synthetic Task Generation.
논문은 합성 지시 생성의 선행 사례로 Evol-Instruct, Code Evol-Instruct, AgentInstruct, LAB, MAGPIE를 참고한다. 여러 에이전트가 태스크를 구상하고 환경을 구성하며 산출물을 검증하는 기존 터미널 태스크 파이프라인과 달리, Terminal-Task-Gen은 조율 과정을 단순화하고 공유 환경을 사용한다.
3. Background
실험 인터페이스는 컨테이너에서 실행할 수 있는 태스크와 특정 모델에 종속되지 않는 터미널 에이전트를 결합한다. 태스크 명세와 검증은 명령을 선택하는 언어 모델과 분리된다.
3.1. Terminal-Bench
Terminal-Bench 2.0은 scientific computing, software engineering, machine learning, security, system administration, data science를 아우르는 수작업 태스크 89개로 구성되며, 사람이 검증했다. 이 태스크들은 개별 함수 생성이 아니라 컴파일, 모델 학습, 시스템 설정, 환경 디버깅과 같은 전체 작업 과정을 요구한다.
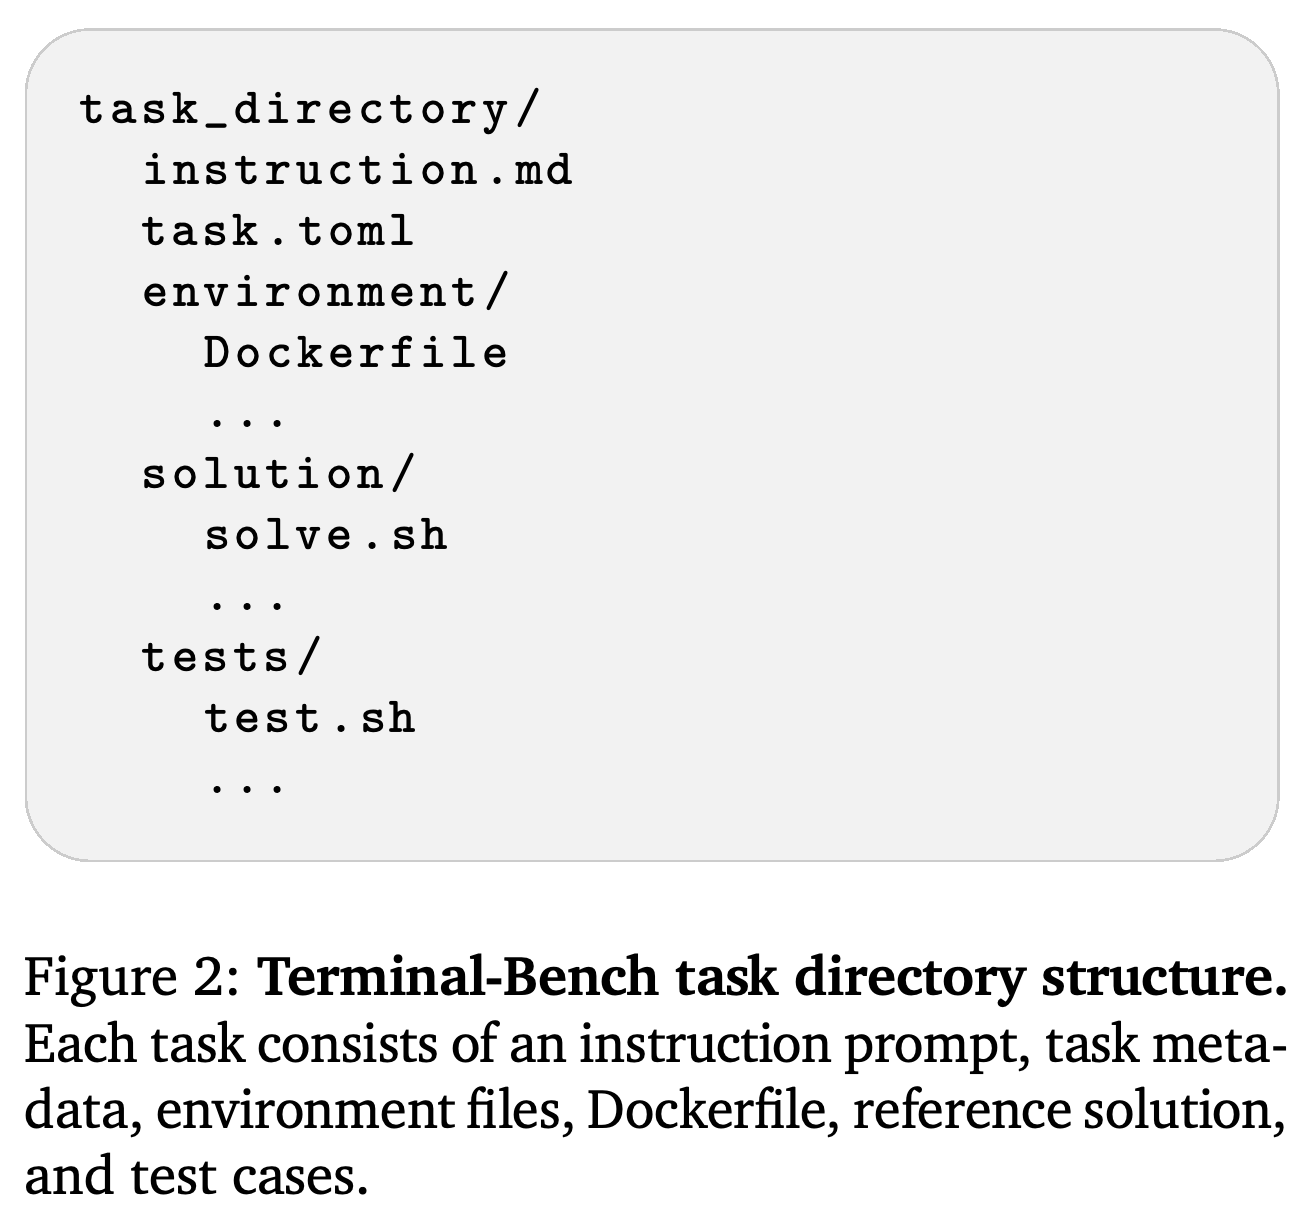
- 벤치마크 태스크에는 자연어 지시, Docker 환경, 검증 테스트, oracle solution이 포함된다.
- 디렉터리에는 instruction.md, task.toml, environment/, solution/, tests/가 포함된다. 연구는 체크포인트 간 일관된 평가를 위해 Terminus 2를 사용한다.
디렉터리 구조는 에이전트가 볼 수 있는 지시와 환경을 해법 및 검증 산출물과 분리한다. 이는 파이프라인에서 재사용하는 실행 가능한 태스크 인터페이스를 정의한다. 다만 생성 태스크는 oracle solution을 생략하고, 어댑터 태스크는 테스트를 생략한다.
3.2. Terminus 2 Agent Framework
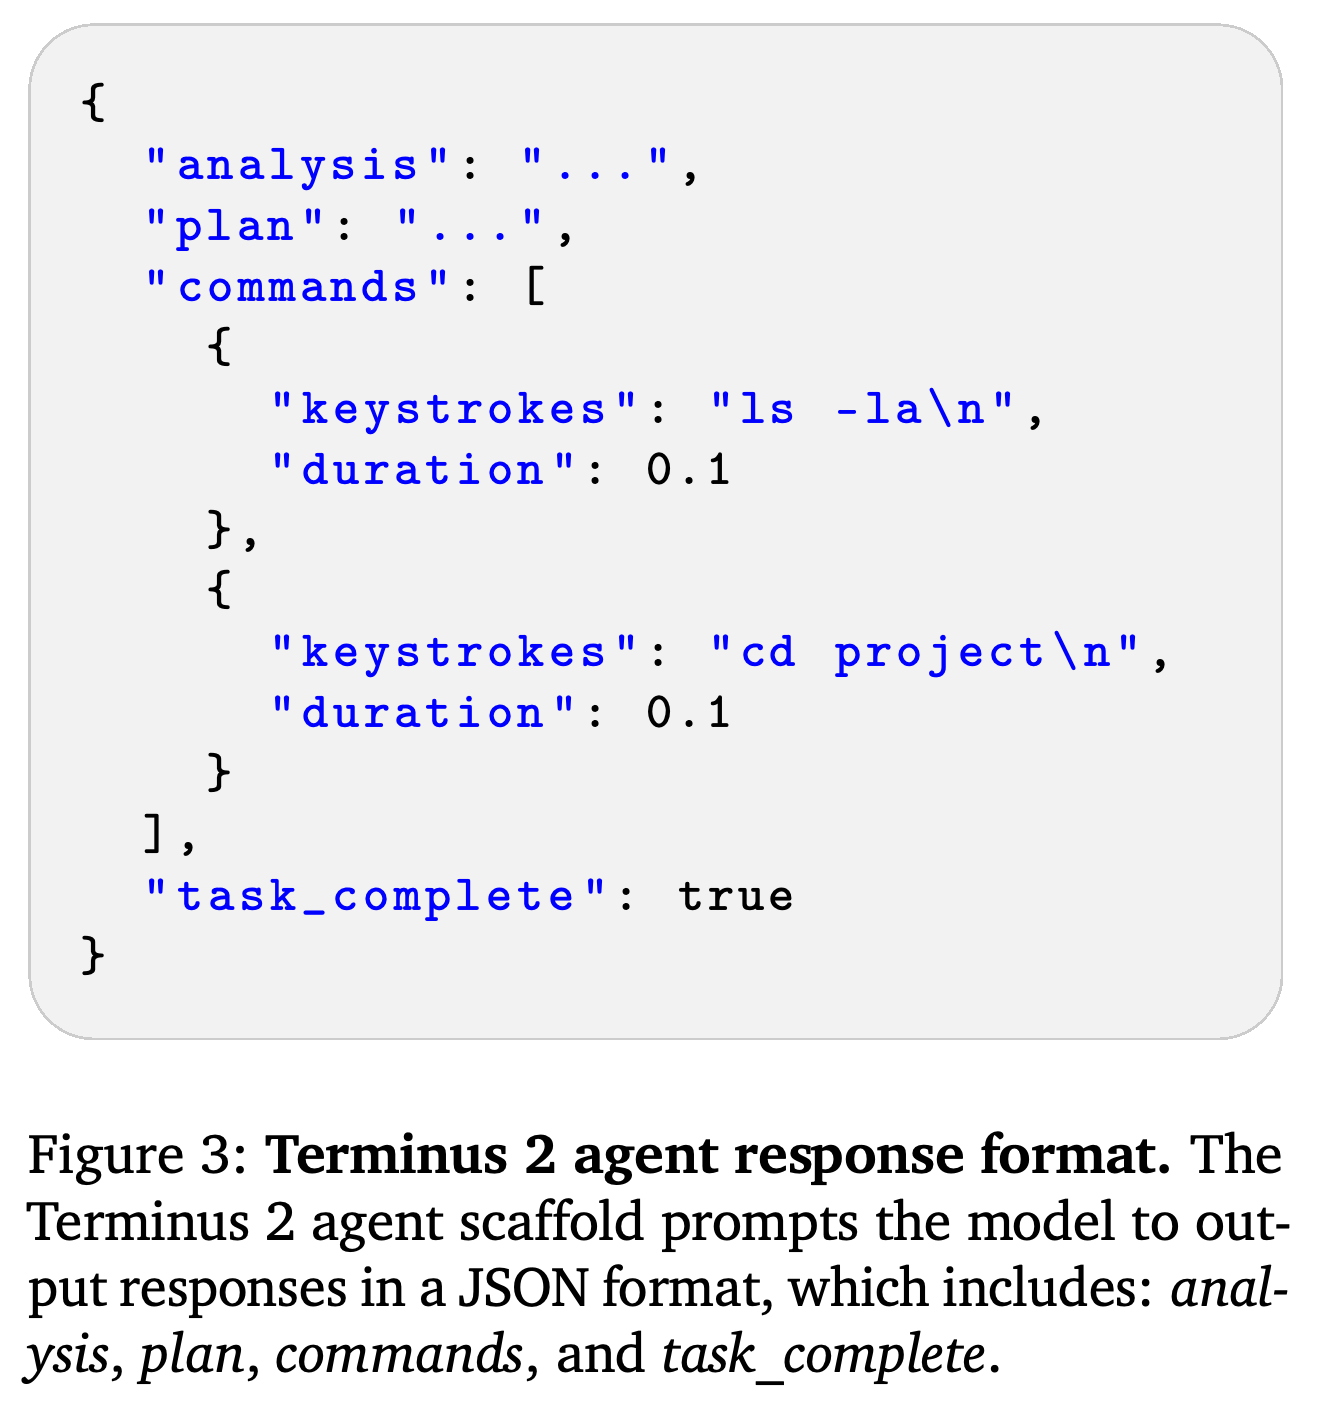
Terminus 2는 개별 전문 도구 모음 대신 샌드박스 Docker 컨테이너 안의 대화형 tmux 세션을 제공한다. 각 단계에서 모델은 터미널 출력을 받고, analysis, plan, commands와 선택적인 task_complete 플래그를 포함한 구조화된 JSON을 출력한다.
- 명령 객체는 keystrokes와 선택적인 실행 대기 시간을 초 단위로 지정한다. 에이전트는 이를 통해 사용 가능한 명령줄 도구를 호출하고 실행을 기다릴 수 있다.
응답 예시는 분석, 계획, 완료 상태와 함께 명령 keystrokes와 대기 시간으로 터미널 행동을 표현한다. 같은 행동 표현을 시연 궤적 수집과 학습한 모델의 평가에 사용한다.
4. Synthetic Data Generation
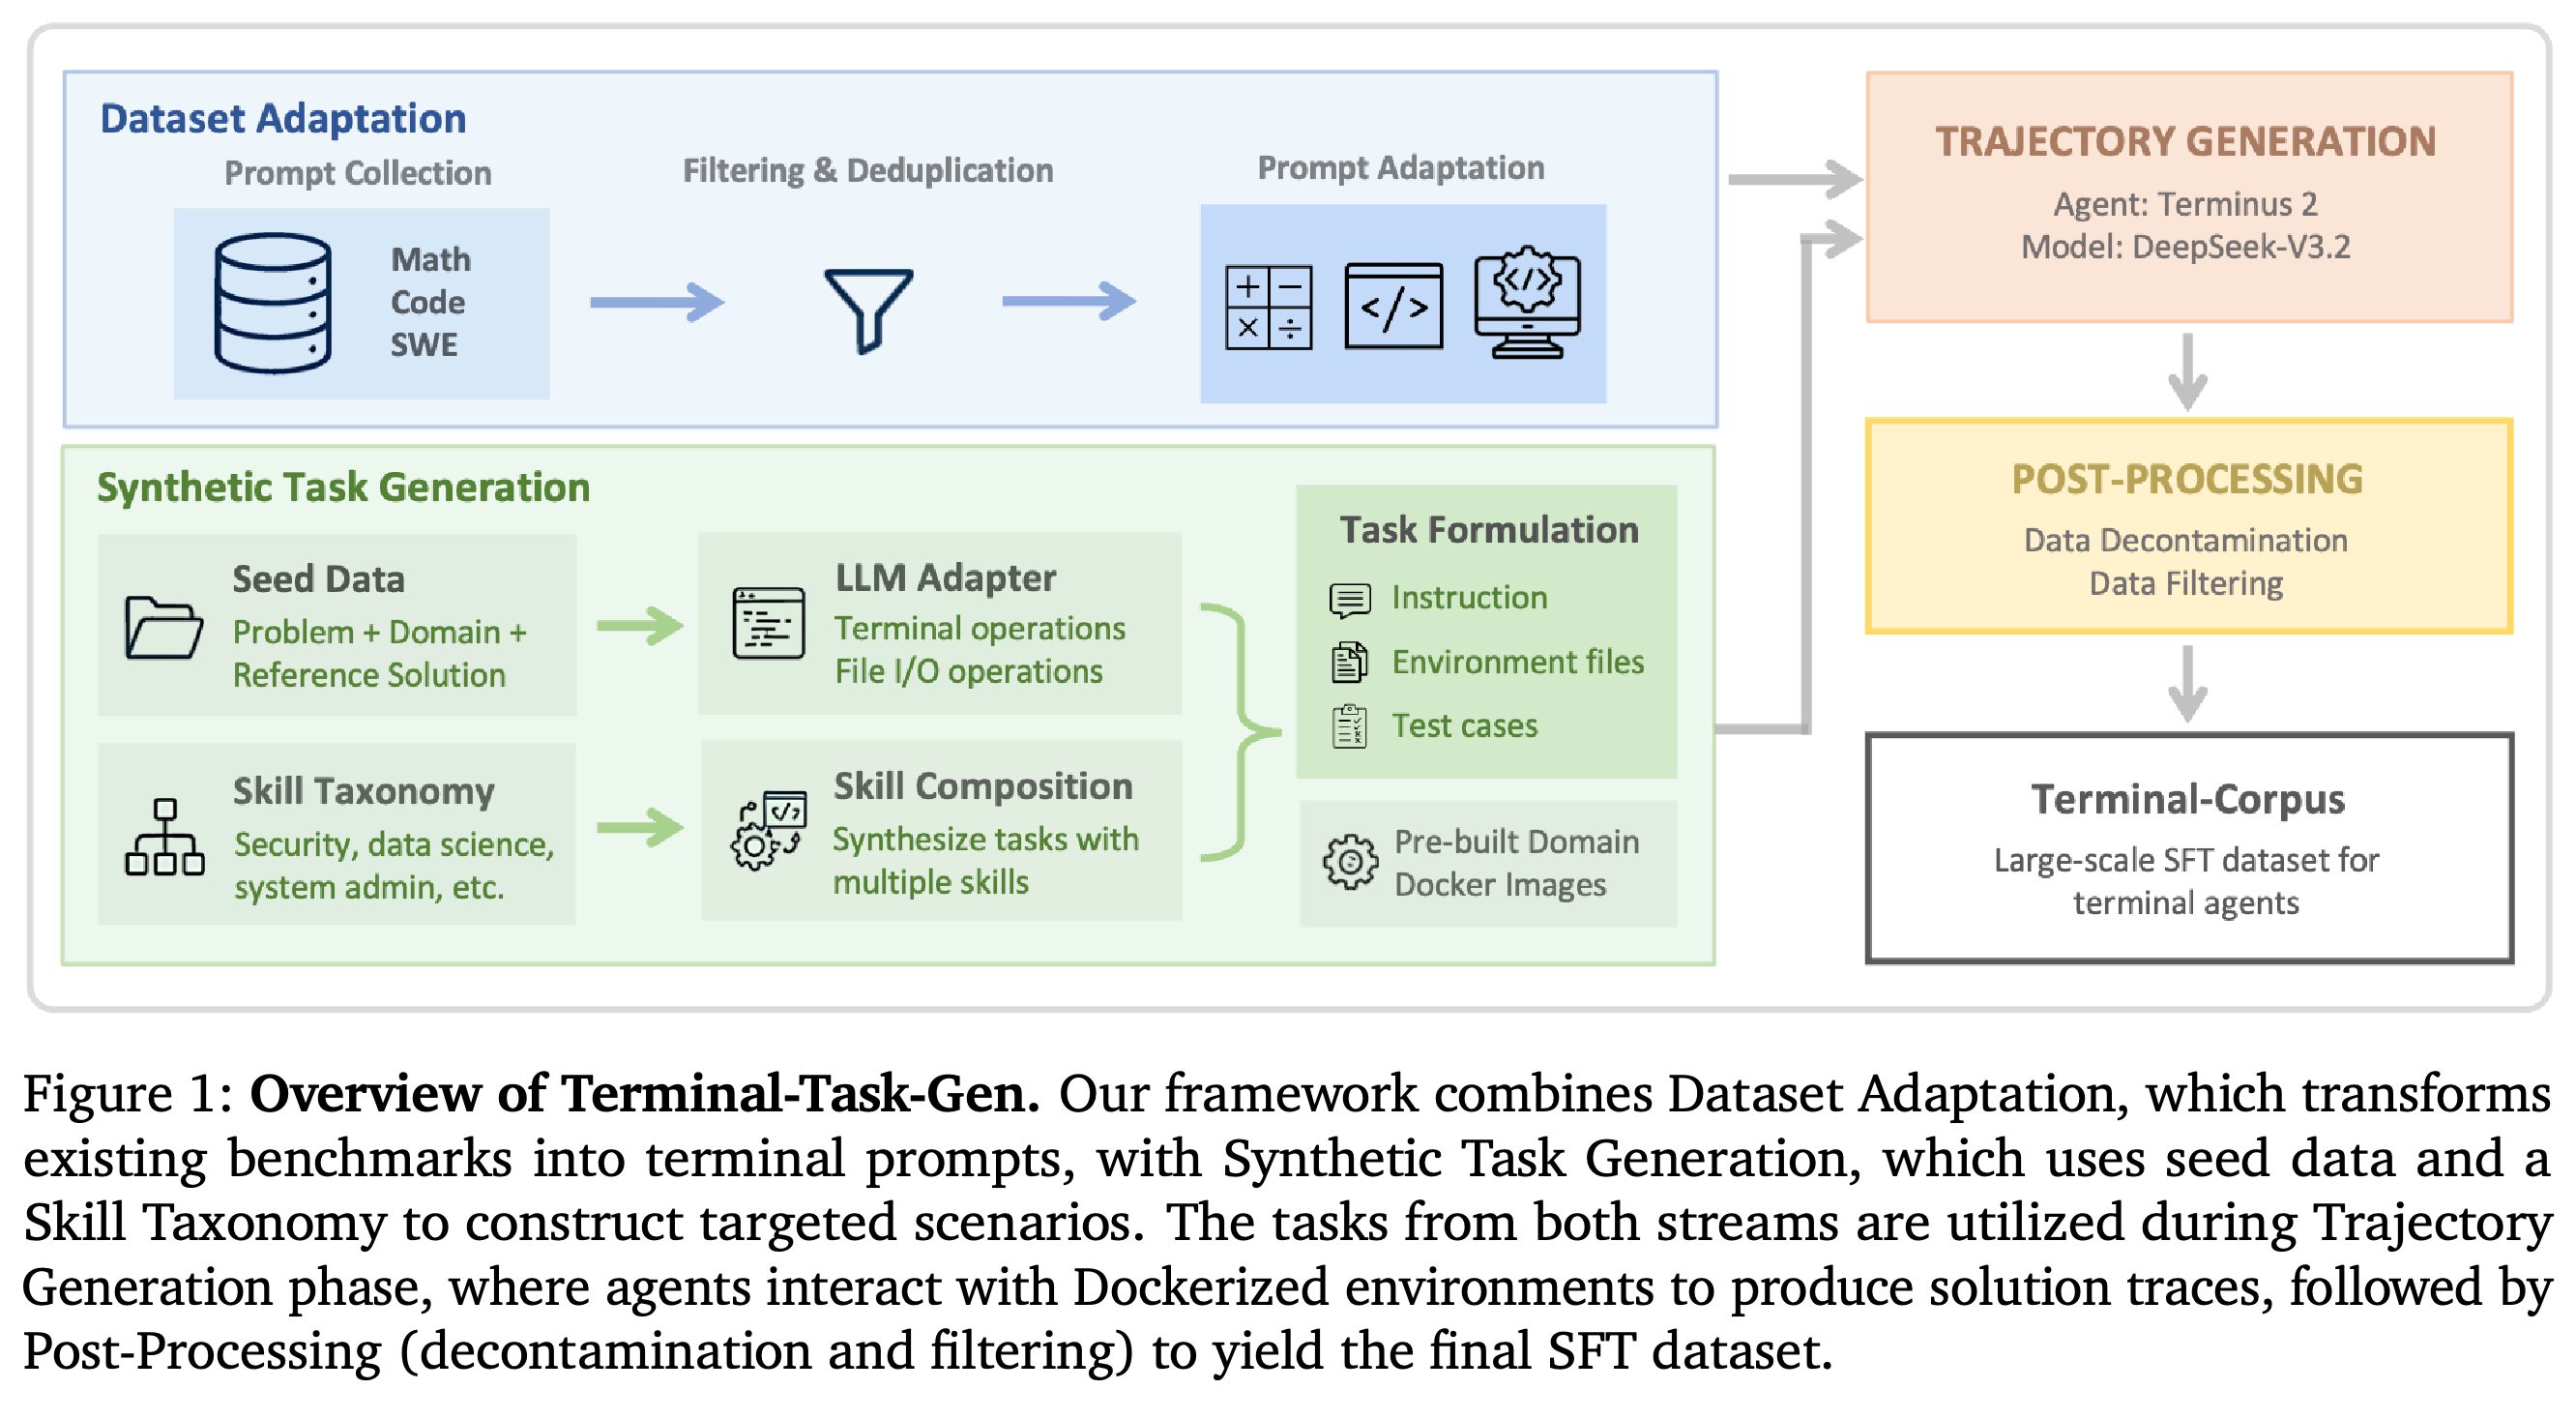
데이터 파이프라인은 다양한 프롬프트의 변환과 특정 목적에 맞춘 실행 가능한 태스크 구성을 분리한다. 양쪽 데이터는 모두 Terminus 2를 통해 DeepSeek-V3.2의 궤적 생성에 사용된다. 이후 평가 데이터와의 중복 제거와 품질 필터링을 거쳐 SFT 데이터셋을 구성한다.
- Coarse-to-fine 설계는 상호 보완적인 데이터 생성 전략을 뜻한다. 실제 학습에서는 이 전략으로 얻은 궤적을 혼합해 단일 단계로 학습한다.
2개의 데이터 생성 경로가 같은 궤적 수집기로 이어진다. 프롬프트 변환은 기존 문제를 제공하고, 시드 및 스킬 기반 합성은 태스크 파일과 테스트를 제공한다. 분야별 공유 이미지가 합성 경로를 지원하며, 후처리를 거쳐 Terminal-Corpus를 만든다.
4.1. Dataset Adapters
데이터셋 변환은 LLM을 변환 과정에 사용하지 않고 기존 프롬프트를 Terminal-Bench 형식의 지시와 환경으로 바꾼다. 원본은 Nemotron-Cascade Stage-2의 수학·코드 프롬프트와 SWE 코드 수정 프롬프트다. 이 데이터는 프롬프트만 제공하므로, 변환된 학습 태스크에는 검증 테스트가 없다.
- Math Prompts. 원본에는 고유한 OpenMathReasoning 프롬프트 163K개가 포함된다. DeepSeek-R1 응답이 2K tokens보다 짧은 질문은 제외한다.
- Code Prompts. 원본에는 OpenCodeReasoning 프롬프트 79K개가 포함된다. 필터링과 중복 제거를 거쳐 프롬프트 35K개를 남긴다.
- SWE Prompts. 원본에는 SWE-Bench-Train, SWE-reBench, SWE-Smith, SWE-Fixer-Train의 인스턴스 127K개가 포함된다. 필터링과 중복 제거를 거쳐 고유 프롬프트 32K개를 남기며, 제공된 버그 코드 파일을 환경에 배치한다.
- Adapter Format. 원본 프롬프트를 {instruction}에 넣고 분야별 접미 지시를 추가한다. 수학 답은 /app/solution.txt에, Python 해법은 /app/solution.py에, SWE SEARCH/REPLACE 수정 내용은 /app/solution.patch에 저장한다.
4.2. Synthetic Task Generation
4.2.1. Generation from Seed Data는 기존 프롬프트를 단순히 감싸는 대신, 기존 문제를 참고해 새로운 터미널 태스크를 만든다. 시드에는 문제 설명, 선택적인 분야 라벨, 선택적인 참조 해법이 포함된다. 생성기는 구체적인 패키지, 입력 경로, 구현, 출력 경로 요구사항을 추가한다.
- Seed Data Structure. 참조 해법이 있으면 테스트 기대값을 정하는 정답으로 사용하지만, 태스크를 푸는 에이전트에는 공개하지 않는다.
- Task Adaptation. 생성기는 입력 파일과 pytest 검사를 만든다. 검사 항목에는 파일 존재 여부, 형식, 적절한 부동소수점 허용 오차를 적용한 수치 정확도, 경계 사례가 포함된다.
- Conversion Guidelines. 복잡한 문제는 검증 가능한 단위로 나눌 수 있다. 입력 크기, 정밀도 요구사항, 출력 형식은 명확하게 지정한다.
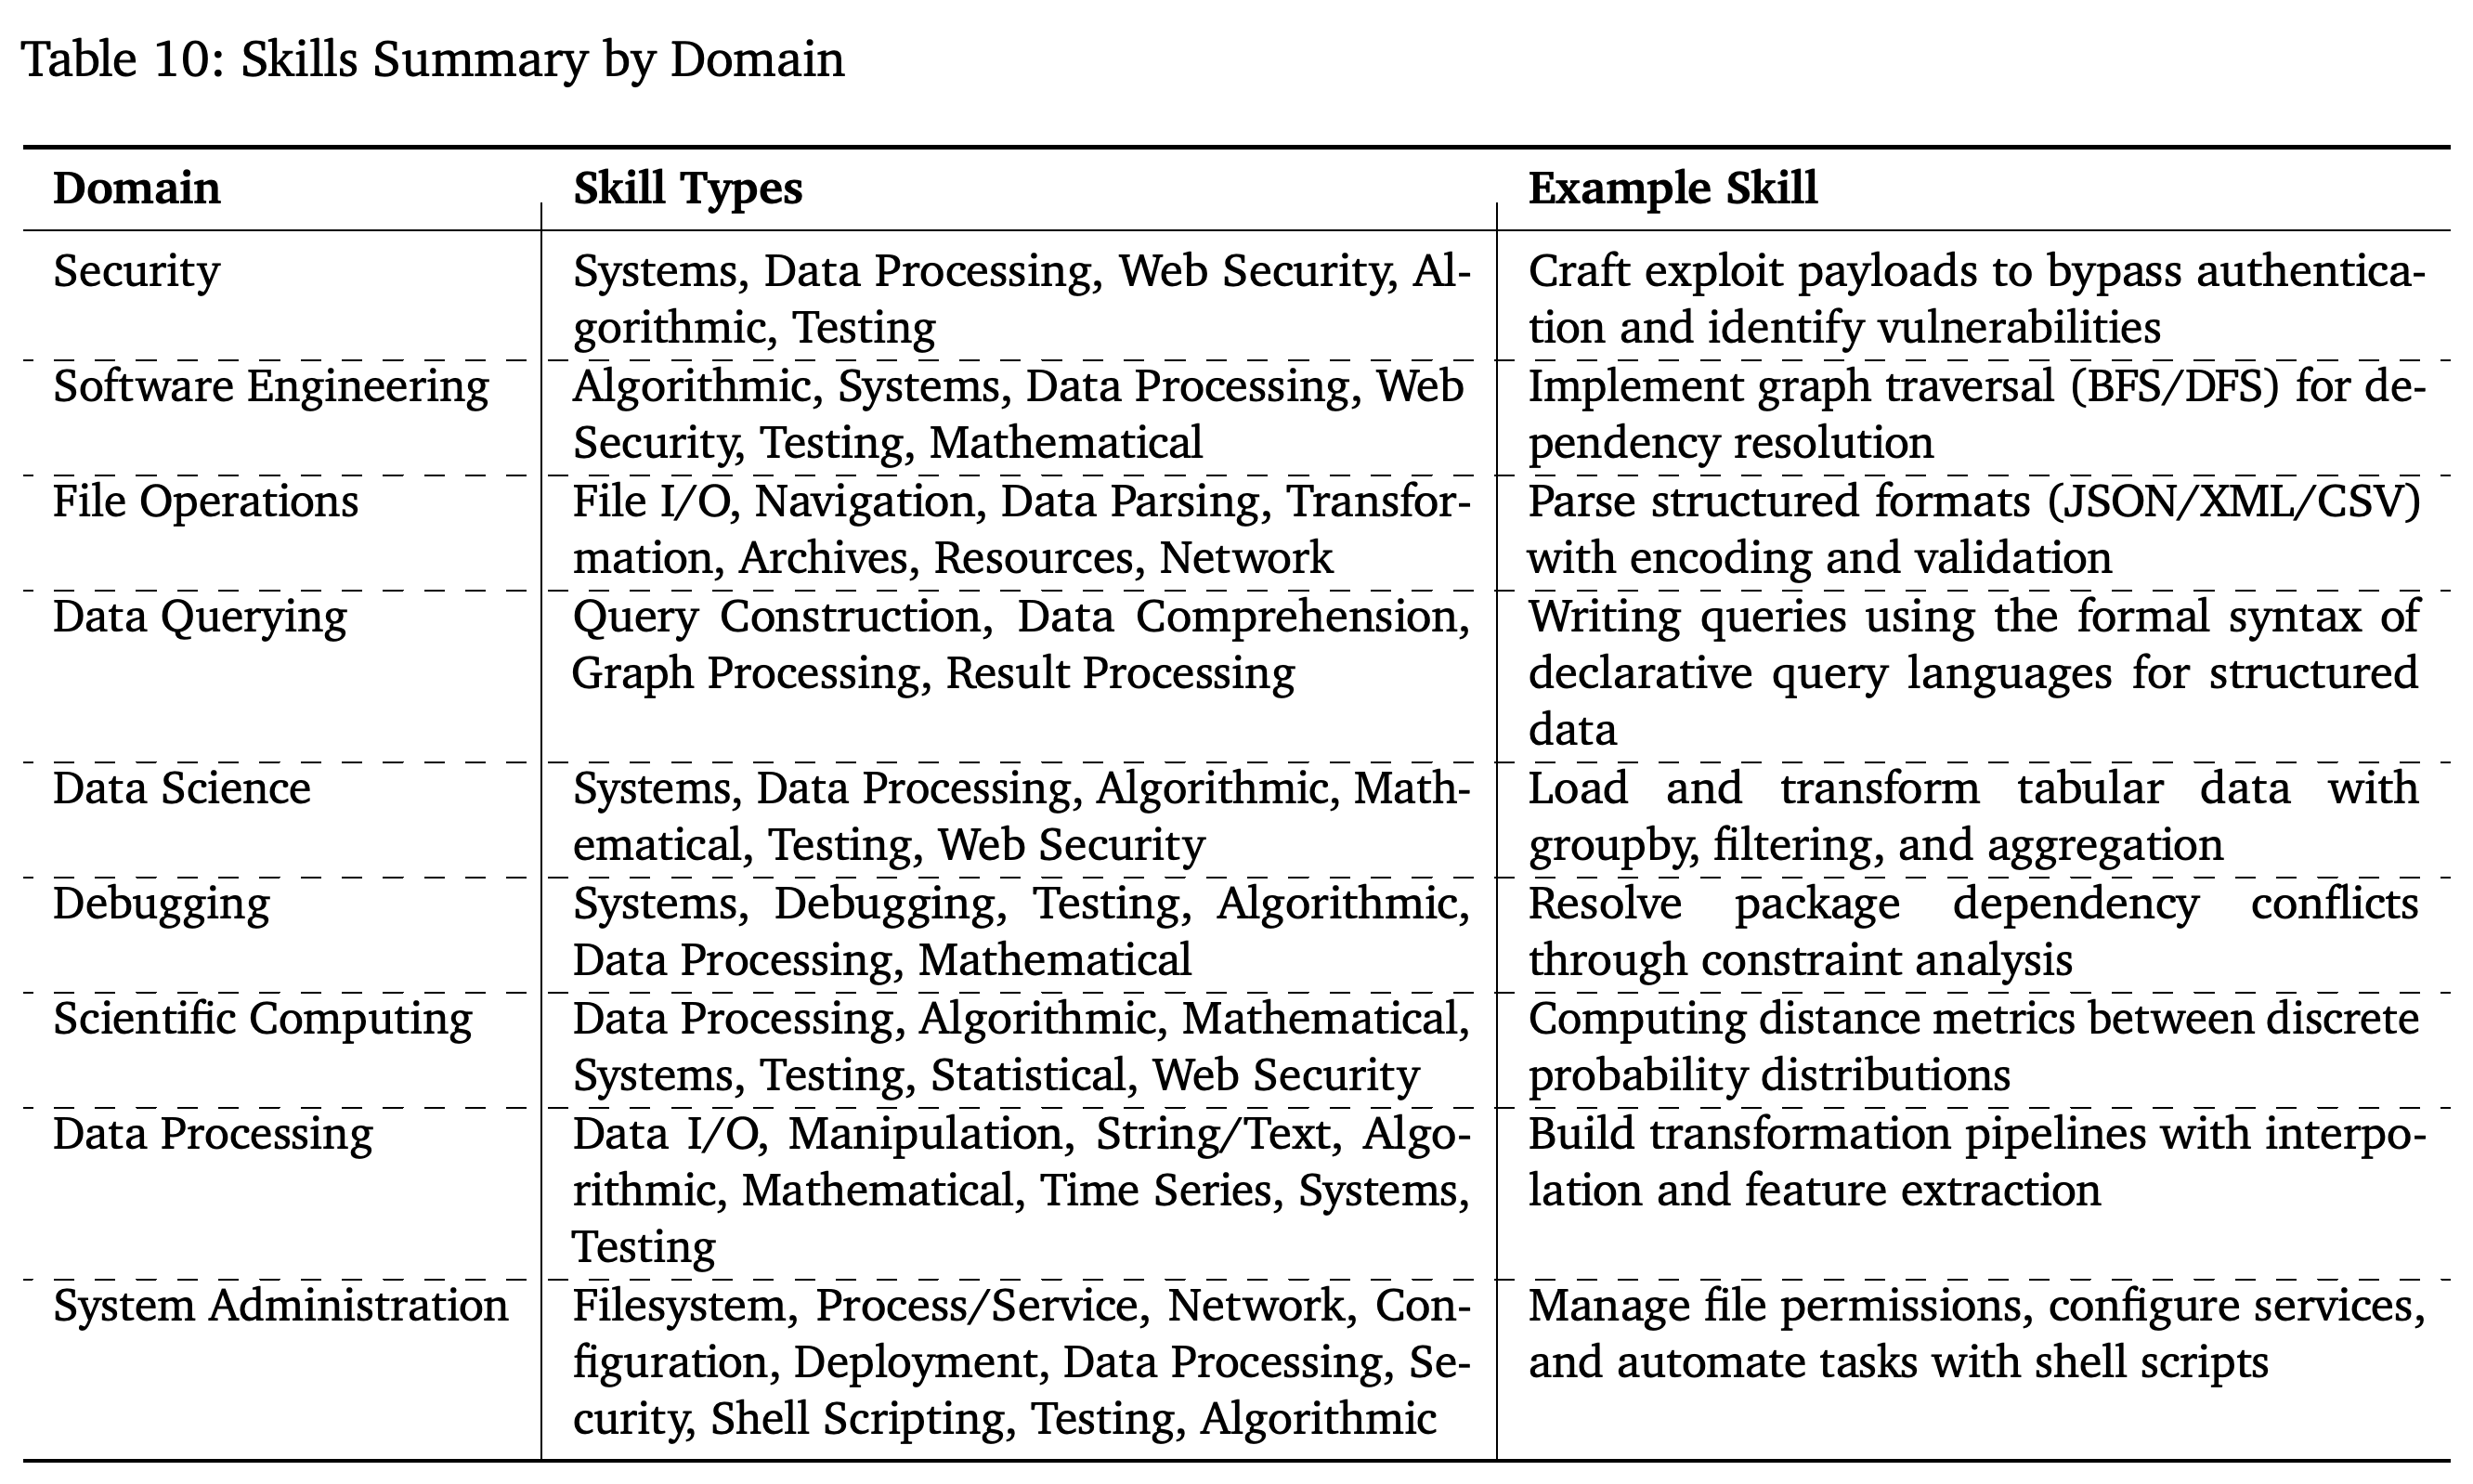
4.2.2. Generation from Primitive Skills는 선별한 터미널 작업 스킬 분류 체계를 조합해 태스크를 합성한다. 본문은 data processing, data querying, data science, debugging, dependency management, file operations, scientific computing, security, software engineering의 9개 분야를 정의하며, 보통 태스크마다 primitive 3–5개를 조합한다.
- Domain-Specific Generation. 분야별 전용 프롬프트가 통계 변환, 암호 및 접근 제어 검사와 같은 태스크 생성을 안내한다.
- Skill Taxonomy. Primitive 유형에는 알고리즘, 시스템, 데이터 처리, 수학, 테스트, 웹·보안 스킬이 포함된다.
- Compositional Task Synthesis. 프롬프트는 개별 스킬 연습이나 표준 튜토리얼 재현이 아니라 새로운 통합 시나리오를 요구한다.
- Table 10과 부록 모듈은 본문의 분야 목록에서 dependency management로 표기한 부분을 System Administration으로 부른다. 문서는 이 명칭 차이를 설명하지 않는다.
이 분류 체계는 터미널 사용을 셸 문법만으로 보지 않고, 운영 스킬과 알고리즘, 수학, 테스트를 결합한다. System Administration 분야 명칭은 본문 목록의 dependency management와 다르다.
4.2.3. Task Format and Execution Environment는 생성된 태스크를 지시, 가중치가 있는 pytest 테스트, 보조 입력 파일, 분야별 Docker 환경으로 표준화한다. 사람이 검증한 Terminal-Bench 태스크와 달리, 이 합성 태스크에는 생성된 oracle solution이 없다. 대신 합성한 테스트로 에이전트 출력을 평가한다.
- Solution Isolation. 생성 프롬프트는 에이전트가 볼 수 있는 태스크에 알고리즘, 구현, 해법 코드를 공개하지 못하게 한다. 시드 해법은 테스트 기대값을 도출하는 데 사용한다.
- Pre-Built Docker Images. 파이프라인은 태스크마다 Dockerfile을 생성하는 대신 분야별 공유 base image 9개를 사용한다. 이를 통해 반복적인 Dockerfile 수정을 피하고 이미지 저장 공간을 줄인다.
- 안정적인 base image는 환경 준비와 태스크 생성을 분리한다. 에이전트는 여전히 실행 시 필요한 의존성을 설치할 수 있다.
4.3. Teacher Model
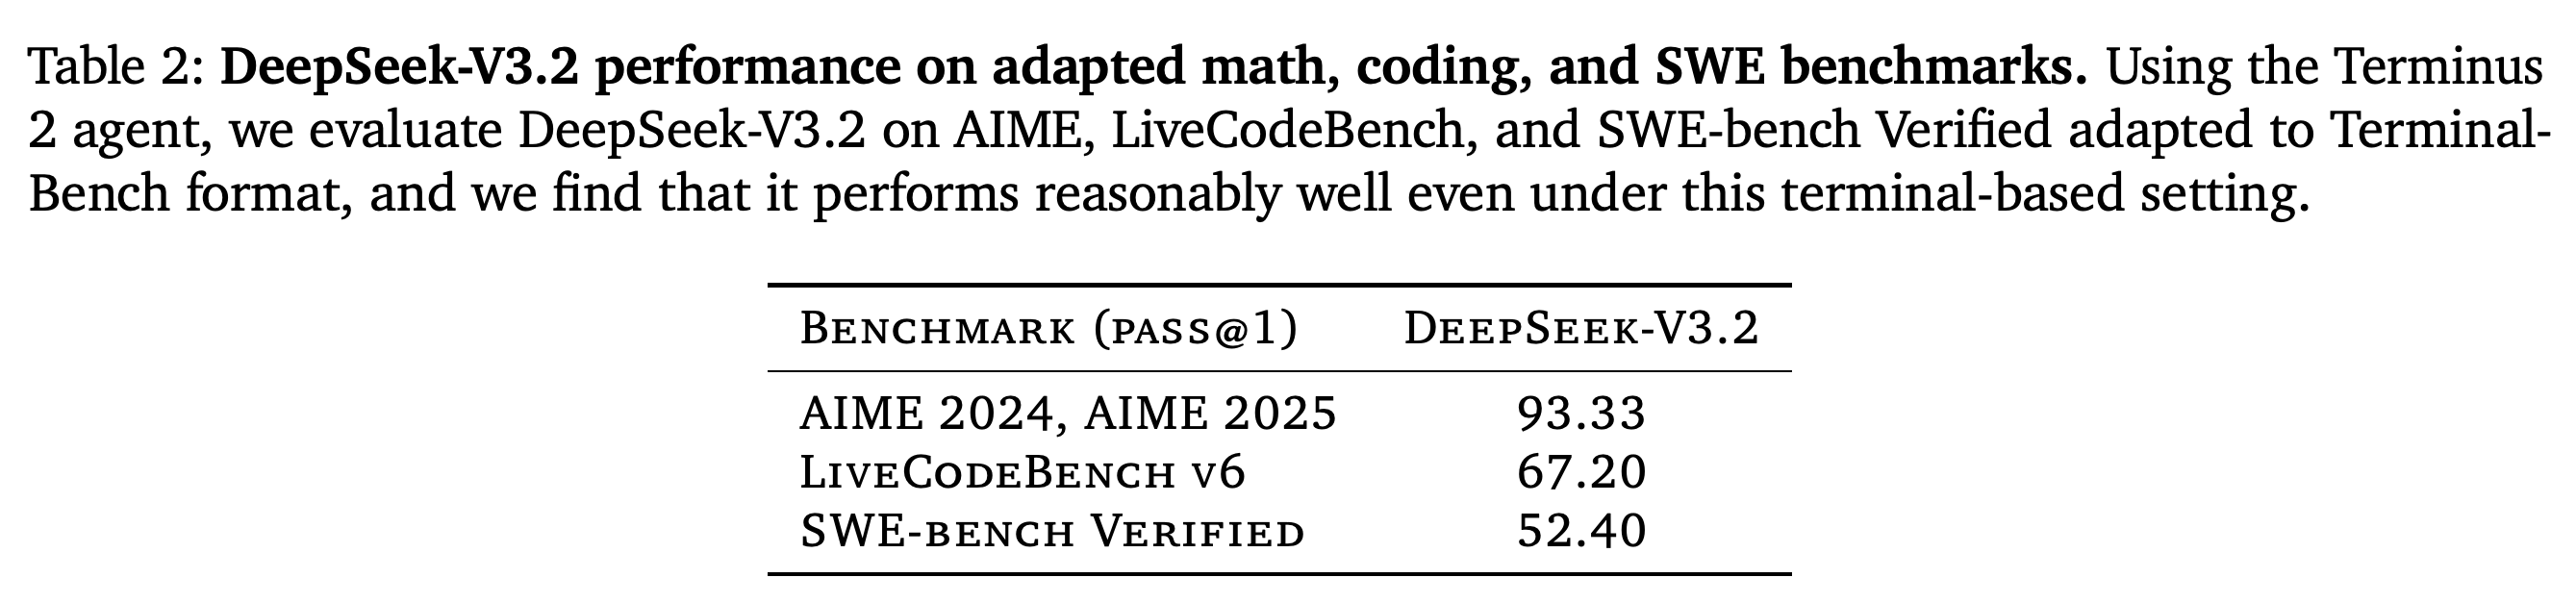
DeepSeek-V3.2는 태스크와 궤적이라는 2개 항목을 생성한다. 이 모델을 선택한 근거 중 하나는 Terminal-Bench 2.0 점수 38.2 ± 2.9다. 변환된 벤치마크를 Terminus 2로 실행하면, AIME 2024, AIME 2025를 통합한 항목에서 pass@1 93.33, LiveCodeBench v6에서 67.20, SWE-bench Verified에서 52.40을 달성한다.
- 이 검사는 교사 모델이 변환된 태스크를 풀 수 있음을 뒷받침한다. 다만 생성된 모든 태스크나 테스트 모음을 독립적으로 검증하지는 않는다.
DeepSeek-V3.2는 표준 수학, 코딩, SWE 벤치마크를 Terminus 2로 실행했을 때 상당수 문제를 해결한다. 이 점수는 어댑터 궤적을 생성할 교사 모델의 선택을 뒷받침하지만, 합성 태스크의 유효성을 보증하지는 않는다.
4.4. Data Filtering
파이프라인은 Terminal-Bench 2.0 테스트 샘플과 14-gram이 겹치는 학습 프롬프트를 제거한다. 이어 품질 필터로 모델 정체성을 드러내는 응답과 중국어 문자가 포함된 응답을 제거한다. 추가 실험에서는 미완료 궤적을 버리거나, 검증 테스트가 있는 경우 테스트를 통과한 궤적만 유지한다.
- 실험의 No filter 라벨은 추가적인 완료 또는 성공 필터를 적용하지 않았다는 뜻이다. 평가 데이터와의 중복 제거와 기본 품질 관리를 생략했다는 뜻은 아니다.
5. Experiments
실험은 Terminal-Bench 2.0의 전체 및 분야별 성능을 측정하고, 데이터 출처, 궤적 필터링, 컨텍스트 길이, 커리큘럼, 데이터 규모의 영향을 비교한다. 주된 ablation 모델은 Qwen3-8B이며, 더 큰 모델에서의 결과를 살펴보기 위해 Qwen3-14B와 Qwen3-32B도 사용한다.
5.1. Experimental Setup
별도 명시가 없으면 SFT는 learning rate 2e-5, weight decay 1e-4, 2 epochs, 최대 시퀀스 길이 32,768 tokens, global batch size 128, GPU당 micro-batch size 1을 사용한다. 최적화에는 β = 0.9, 0.95인 AdamW, 10% warmup을 적용한 cosine learning-rate schedule, 1.0의 gradient clipping을 사용한다.
- 8B와 14B 모델은 GPU 8개가 있는 노드 4개를 사용하며, 총 GPU 수는 32개이고 sequence parallelism은 2다. 32B 모델은 노드 16개와 총 GPU 128개를 사용한다. 모든 실험에서 CPU offloading을 사용한다.
- Harbor가 궤적 생성을 관리하며, HPC 배포에는 Singularity 확장을 사용한다. 저자들은 합성 생성 중 드물게 발생하는 fakeroot-overlay 실패를 허용한다.
- 평가에는 Daytona의 격리된 클라우드 샌드박스를 사용하고, SFT에는 veRL을 사용한다.
- 점수와 함께 불확실성 값을 보고하지만, 실험 설정에는 평가 반복 횟수나 표에 제시한 모든 불확실성 값의 계산 방법이 명시되어 있지 않다.
5.2. Main Results
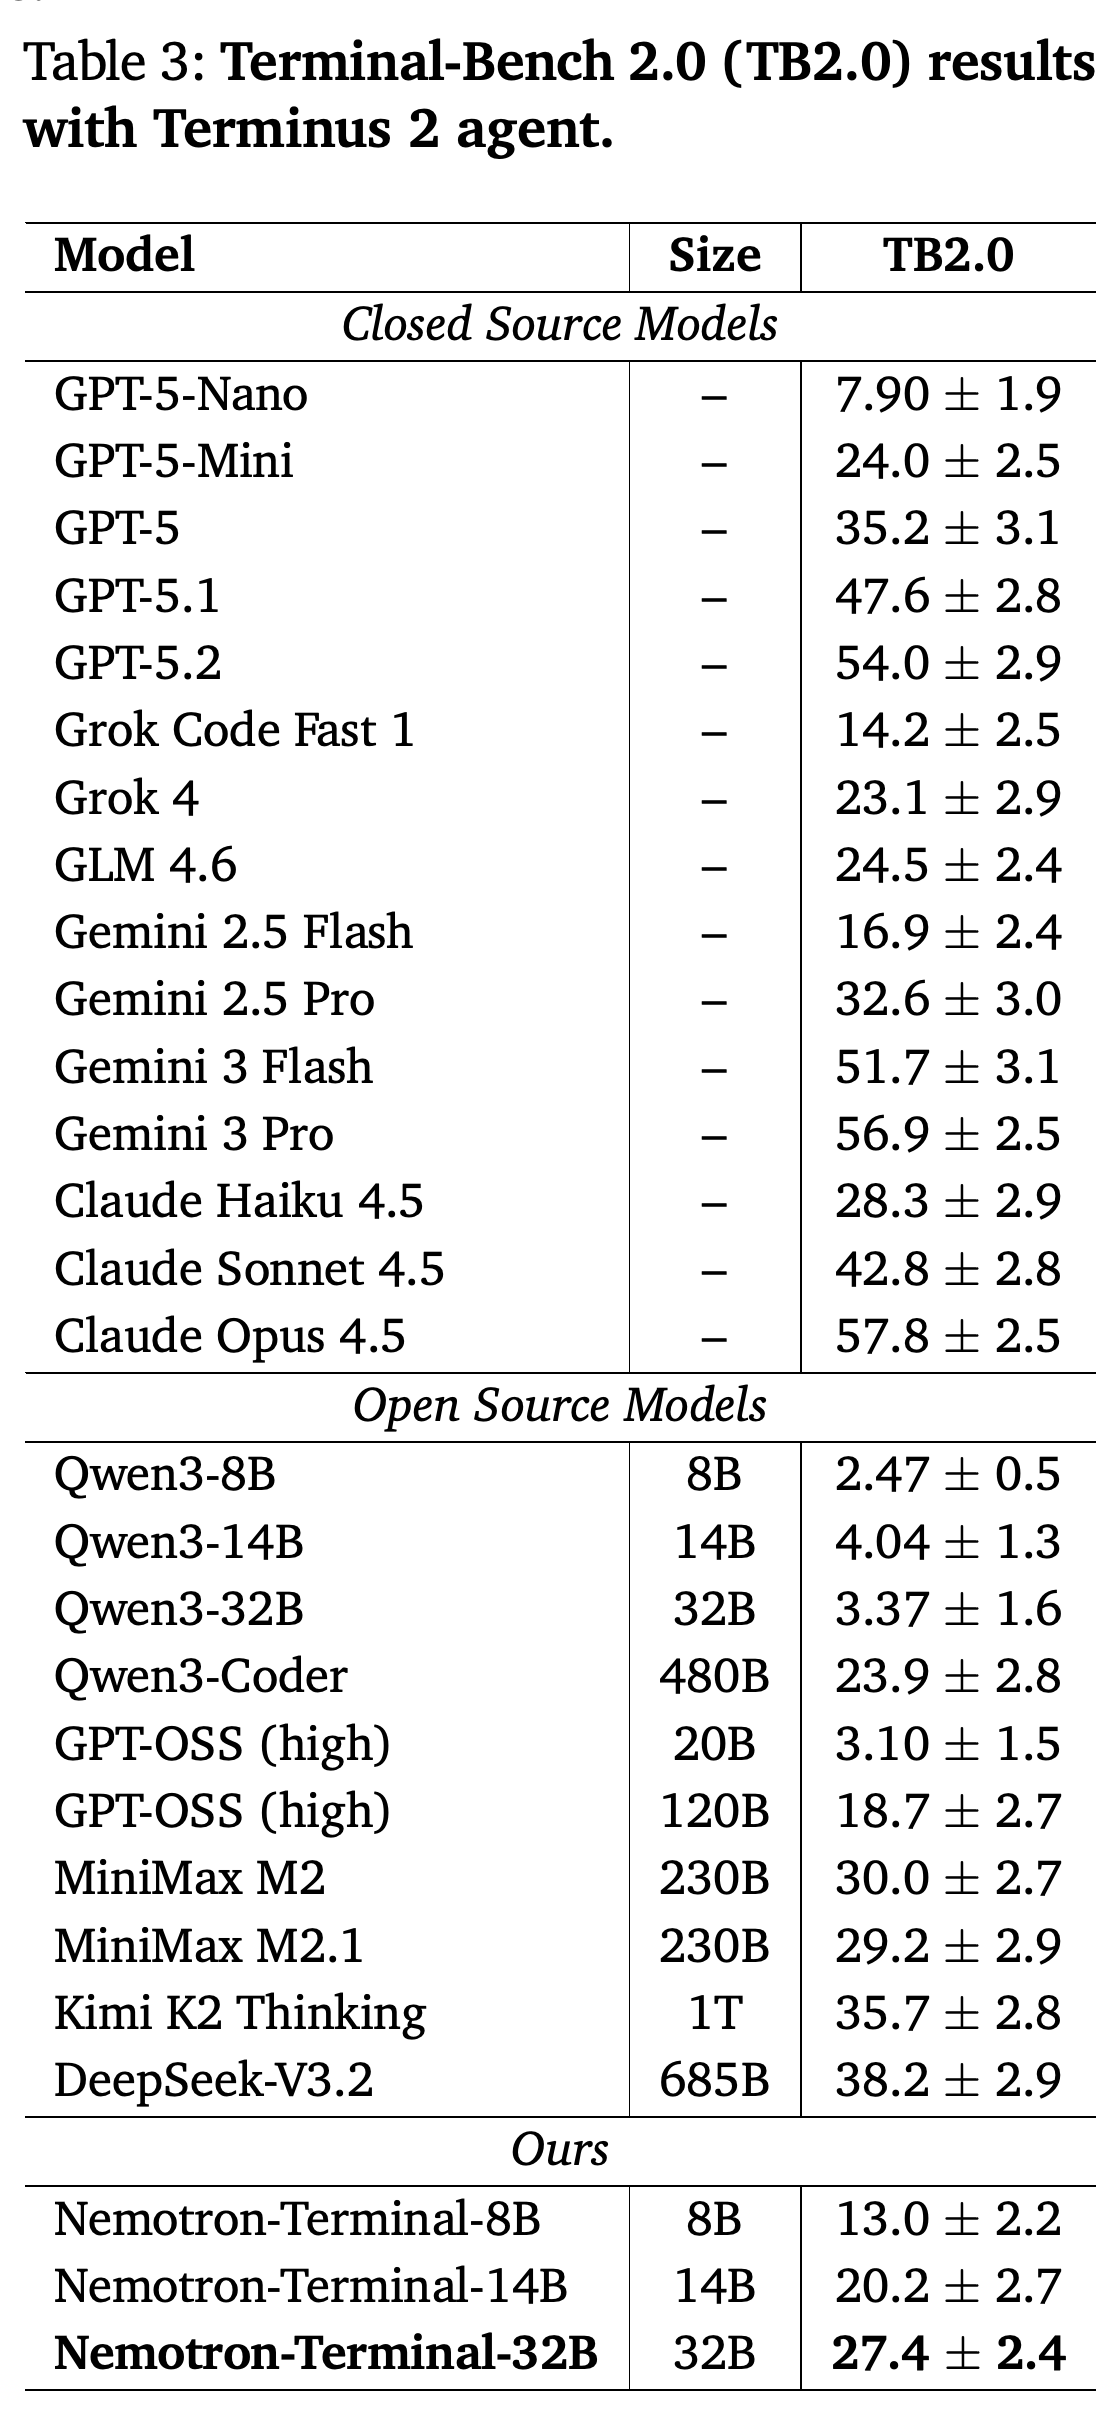
Nemotron-Terminal은 각 Qwen3 베이스라인보다 성능이 높다. 8B는 2.47 ± 0.5에서 13.0 ± 2.2로, 14B는 4.04 ± 1.3에서 20.2 ± 2.7로, 32B는 3.37 ± 1.6에서 27.4 ± 2.4로 향상된다. 14B 모델의 평균은 18.7 ± 2.7인 GPT-OSS (high) 120B보다 높고, 32B 모델의 평균은 23.9 ± 2.8인 Qwen3-Coder 480B보다 높다. 다만 보고된 불확실성 범위는 겹친다.
- 이 비교는 일부 더 큰 시스템과의 경쟁력을 보여줄 뿐, 평가한 최상위 모델과 동등함을 보여주지는 않는다. DeepSeek-V3.2는 38.2 ± 2.9, Claude Opus 4.5는 57.8 ± 2.5를 기록한다. 논문은 더 큰 모델과의 비교에 대한 유의성 검정을 보고하지 않는다.
Nemotron-Terminal 모델 3개 모두 대응하는 Qwen3 모델보다 성능이 높다. 일부 더 큰 모델은 평균 점수가 더 낮지만, 평가한 최상위 시스템은 여전히 앞선다. 더 큰 모델과의 비교 중 일부는 불확실성 범위가 겹친다.
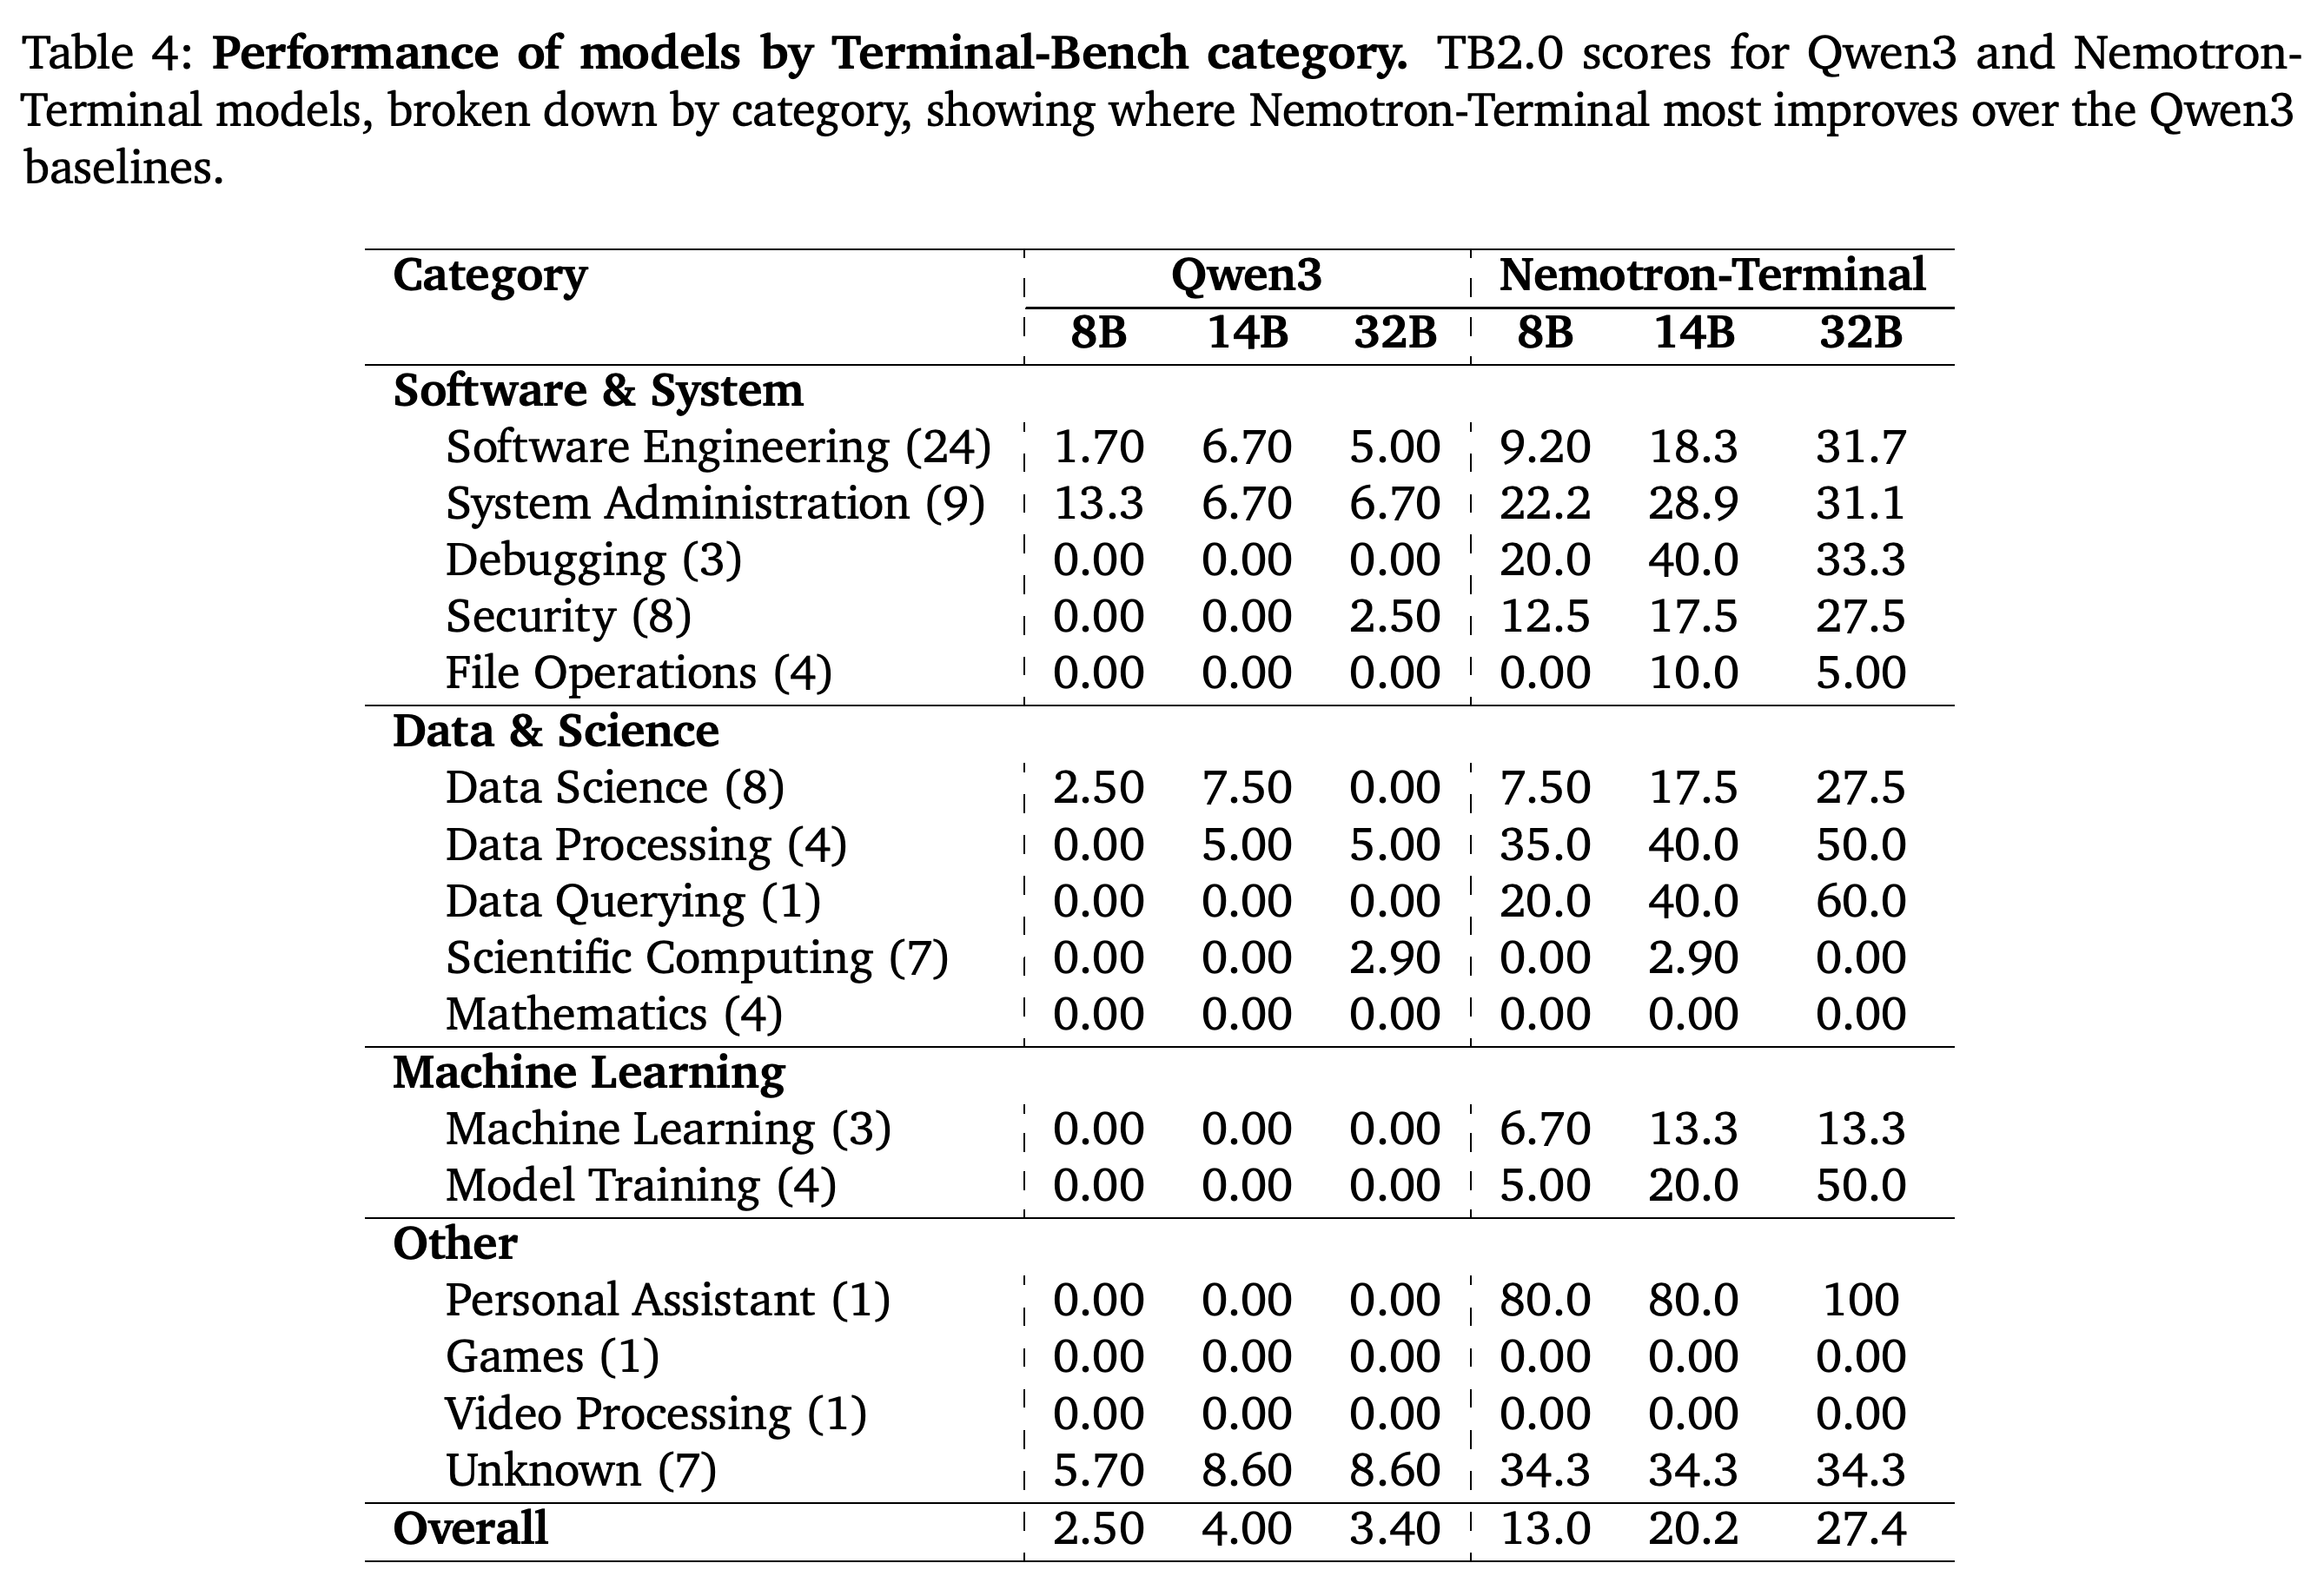
분야별 결과는 큰 개선과 함께 불균형을 보여준다. 32B에서 Data Processing은 5.00에서 50.0으로, Security는 2.50에서 27.5로, Software Engineering은 5.00에서 31.7로, Model Training은 0.00에서 50.0으로 향상된다.
- Data Querying은 60.0을 기록하지만 태스크가 1개뿐이다. Debugging은 태스크 3개로 구성되며 33.3을 기록한다.
- Mathematics, Games, Video Processing은 학습한 모든 모델 크기에서 0.00에 머문다. Scientific Computing도 8B, 14B, 32B에서 각각 0.00, 2.90, 0.00으로 낮은 성능을 보인다.
- 분야별 태스크 수가 적고 실패가 지속되므로, 폭넓은 터미널 작업 능력에 관한 결론에는 한계가 있다.
세부 결과는 data processing, security, software engineering, model training의 개선과 함께 mathematics와 scientific computing의 지속적인 약점을 보여준다. 괄호 안의 태스크 수는 태스크가 1개인 분야의 결과로 폭넓은 능력을 입증할 수 없는 이유를 보여준다.
5.3. Ablation on Dataset Components
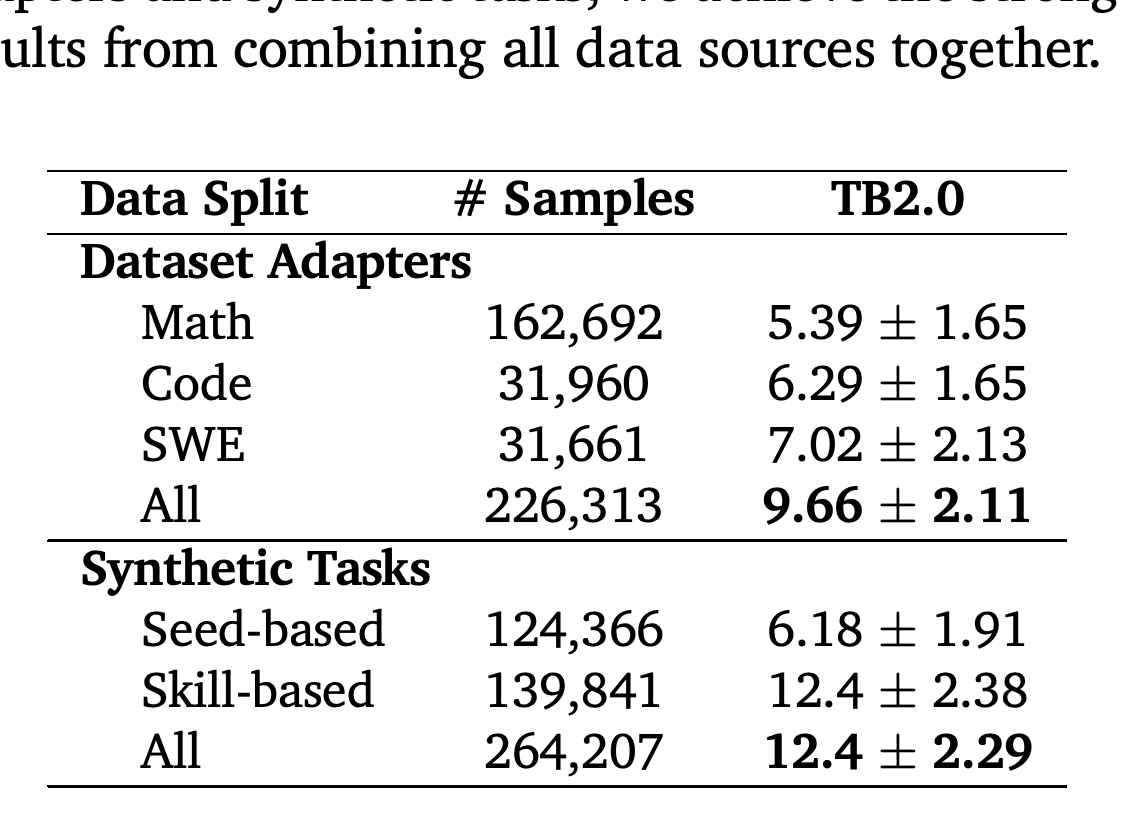
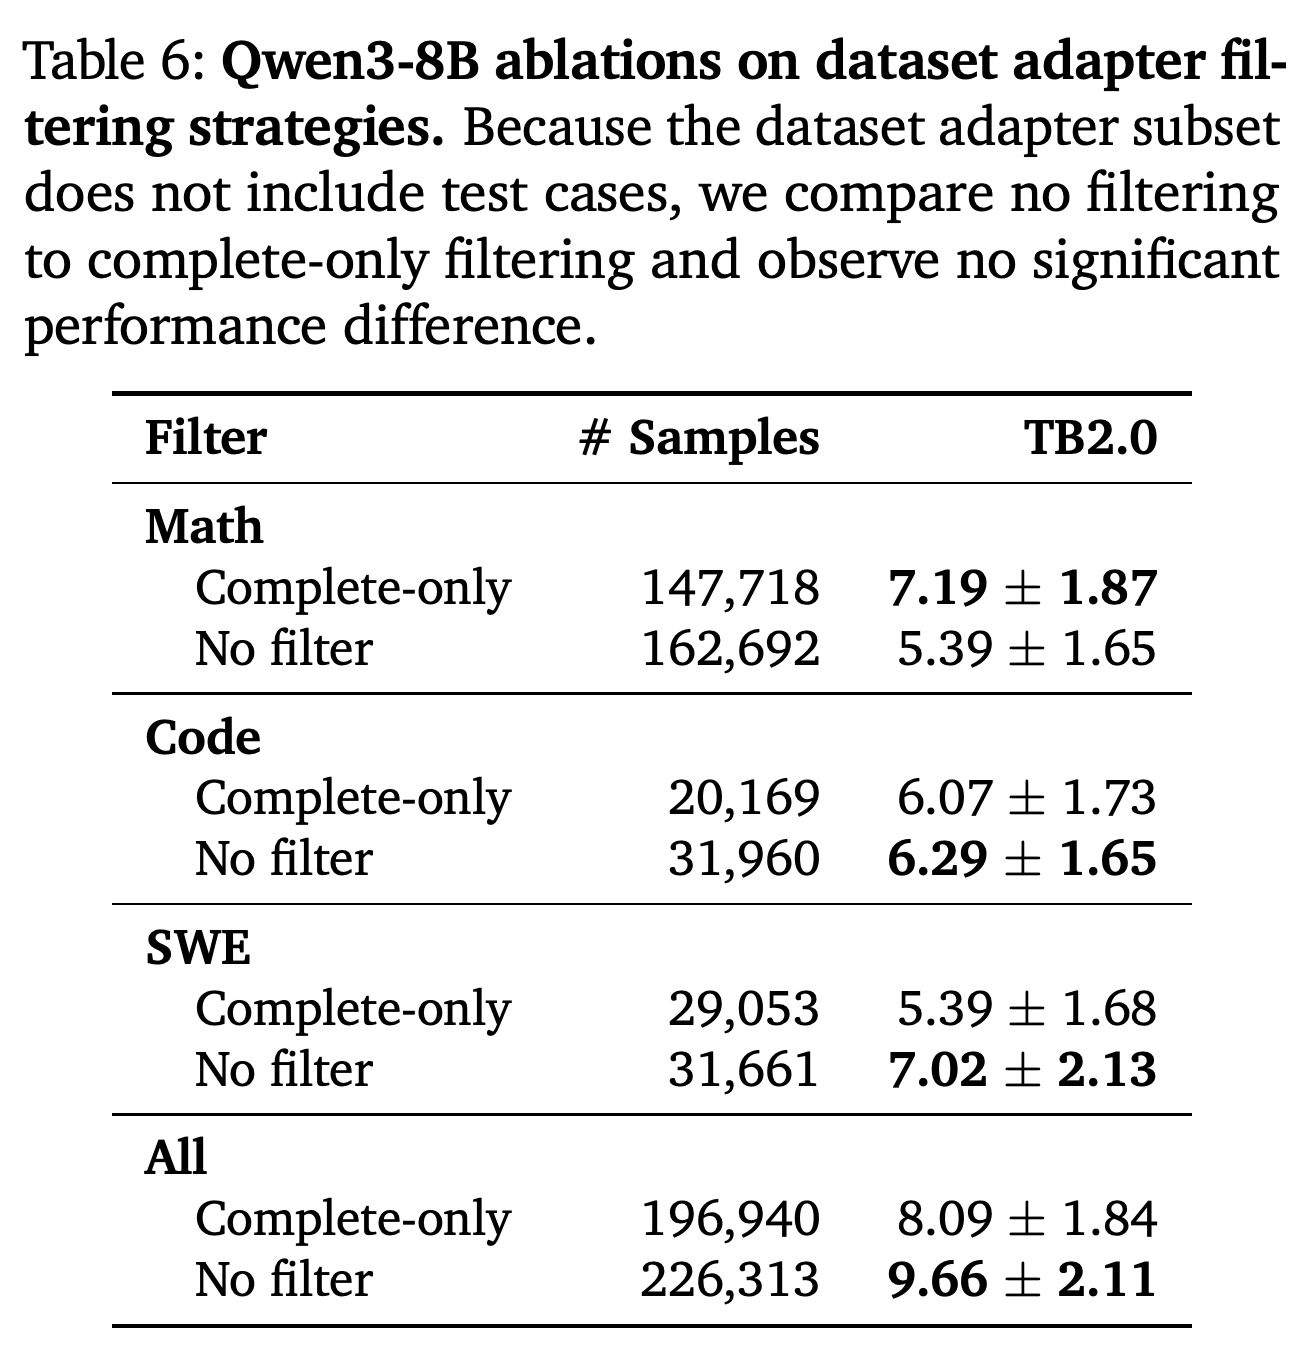
어댑터 데이터를 결합하면 성능이 높아진다. Math만 사용하면 5.39 ± 1.65, Code는 6.29 ± 1.65, SWE는 7.02 ± 2.13이며, 어댑터 샘플 226,313개를 모두 사용하면 9.66 ± 2.11을 기록한다. 스킬 기반 합성 데이터는 12.4 ± 2.38로, 시드 기반 데이터의 6.18 ± 1.91보다 높다.
- 어댑터 데이터는 Math 샘플 162,692개, Code 샘플 31,960개, SWE 샘플 31,661개로 구성된다.
- 합성 데이터는 시드 기반 샘플 124,366개와 스킬 기반 샘플 139,841개로 구성된다. 이를 결합하면 샘플 264,207개가 되며 12.4 ± 2.29를 기록한다.
- 시드 기반 데이터를 추가해도 스킬 기반 데이터만 사용했을 때보다 보고된 평균이 높아지지 않는다. 불확실성 값이 조금 작아졌다는 사실만으로 논문이 주장하는 강건성 향상을 입증할 수는 없다.
- 데이터 출처를 결합하면 샘플 수도 늘어나므로, 이 ablation은 분야 다양성의 효과와 데이터 양의 효과를 분리하지 못한다.
어댑터 분야를 결합하면 개별 어댑터 출처를 사용할 때보다 평균이 높아진다. 개별 합성 데이터 출처 중에서는 스킬 기반 태스크가 가장 높은 성능을 보인다. 시드 기반 태스크를 추가해도 평균은 같고 보고된 불확실성 값만 조금 줄어들므로, 이것만으로 강건성을 입증할 수는 없다.
5.4. Filtering Strategies
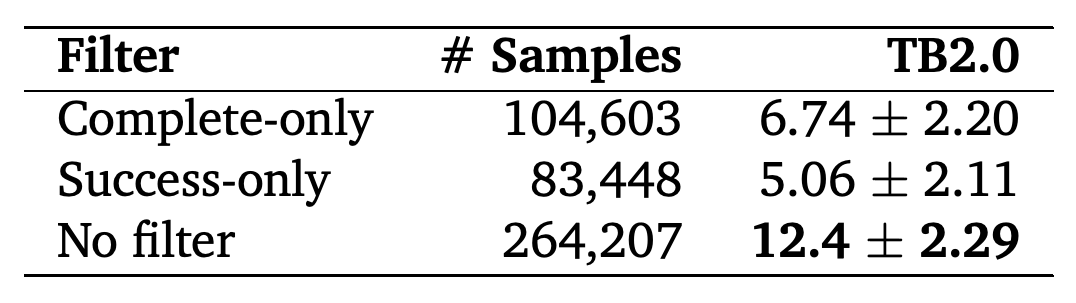
Trajectory Filtering 실험에서는 전체 어댑터나 전체 합성 태스크로 학습할 때 모든 궤적을 유지하는 편이 유리하다. 어댑터의 No filter는 샘플 226,313개로 9.66 ± 2.11을 기록하고, complete-only는 샘플 196,940개로 8.09 ± 1.84를 기록한다. 합성 데이터는 추가 필터링 없이 12.4 ± 2.29, complete-only 필터링에서 6.74 ± 2.20, success-only 필터링에서 5.06 ± 2.11을 기록한다.
- 합성 데이터의 complete-only와 success-only에는 각각 샘플 104,603개와 83,448개가 포함된다. 추가 필터링이 없을 때는 264,207개다.
- 어댑터 결과는 출처마다 다르다. Math는 complete-only의 평균이 필터링하지 않았을 때보다 높고, Code는 변화가 작으며, SWE는 필터링하지 않는 편이 유리하다.
- 저자들은 실패 궤적이 유용한 오류 상태와 복구 패턴을 제공한다고 해석한다. 하지만 엄격한 필터링은 합성 데이터의 절반 이상을 제거하므로, 이 실험은 실패 궤적의 내용과 남은 데이터 양 또는 태스크 난이도의 효과를 분리하지 못한다.
완료 필터링의 효과는 어댑터 출처마다 다르다. Math는 complete-only 평균이 더 높고, SWE는 모든 궤적을 유지하는 편이 유리하며, Code는 변화가 작다. 결합 데이터셋은 추가 필터링을 하지 않을 때 더 유리하며, 이 설정은 샘플도 더 많이 유지한다.
합성 궤적 264,207개를 유지하면 제한된 하위 집합보다 평균이 높다. Complete-only와 success-only 필터링은 각각 샘플 수를 104,603개와 83,448개로 줄인다. 따라서 이 비교는 궤적 내용과 학습 데이터 규모를 동시에 바꾼다.
5.5. Long Context Training and Evaluation
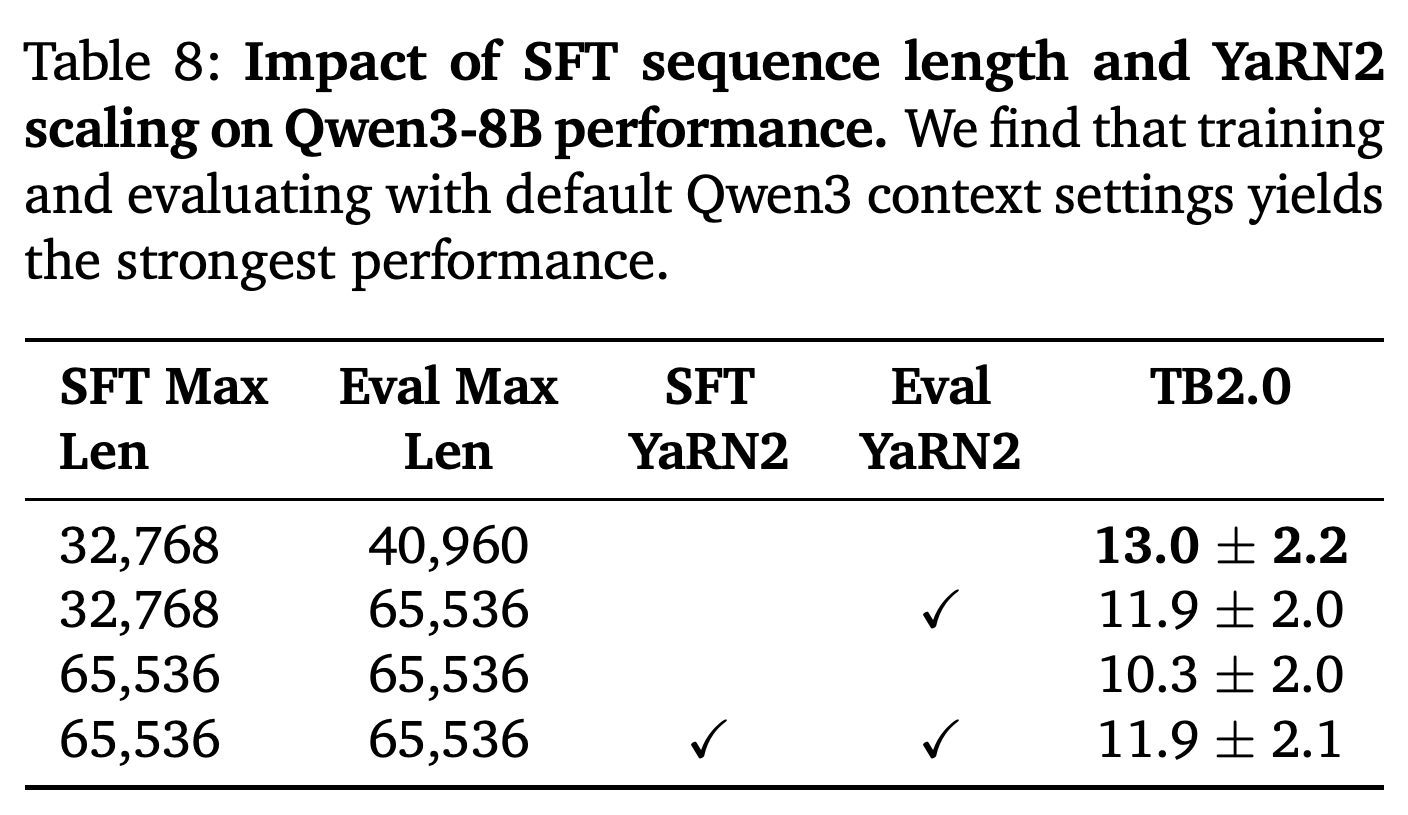
대부분의 궤적은 32,768 tokens 안에 들어간다. 더 긴 궤적을 처리하기 위해 65,536 tokens 길이의 SFT와 YaRN2 컨텍스트 확장을 비교한다. 기본 설정인 32,768 tokens SFT와 40,960 tokens 평가는 가장 높은 점수인 13.0 ± 2.2를 기록한다. 실험한 확장 컨텍스트 설정의 점수는 10.3 ± 2.0에서 11.9 ± 2.1 사이에 분포한다.
- 평가에만 YaRN2를 적용하고 65,536 tokens 윈도우를 사용하면 11.9 ± 2.0을 기록한다. YaRN2 없이 65,536 tokens로 SFT와 평가를 수행하면 10.3 ± 2.0이며, 양쪽에 YaRN2를 적용하면 11.9 ± 2.1이다.
- Figure 5에서 어댑터 궤적의 토큰 수는 평균 17,507, 중앙값 13,861이며, 합성 태스크는 평균 17,363, 중앙값 17,836이다. 어댑터 분포는 토큰 수가 큰 쪽의 꼬리가 더 두껍다.
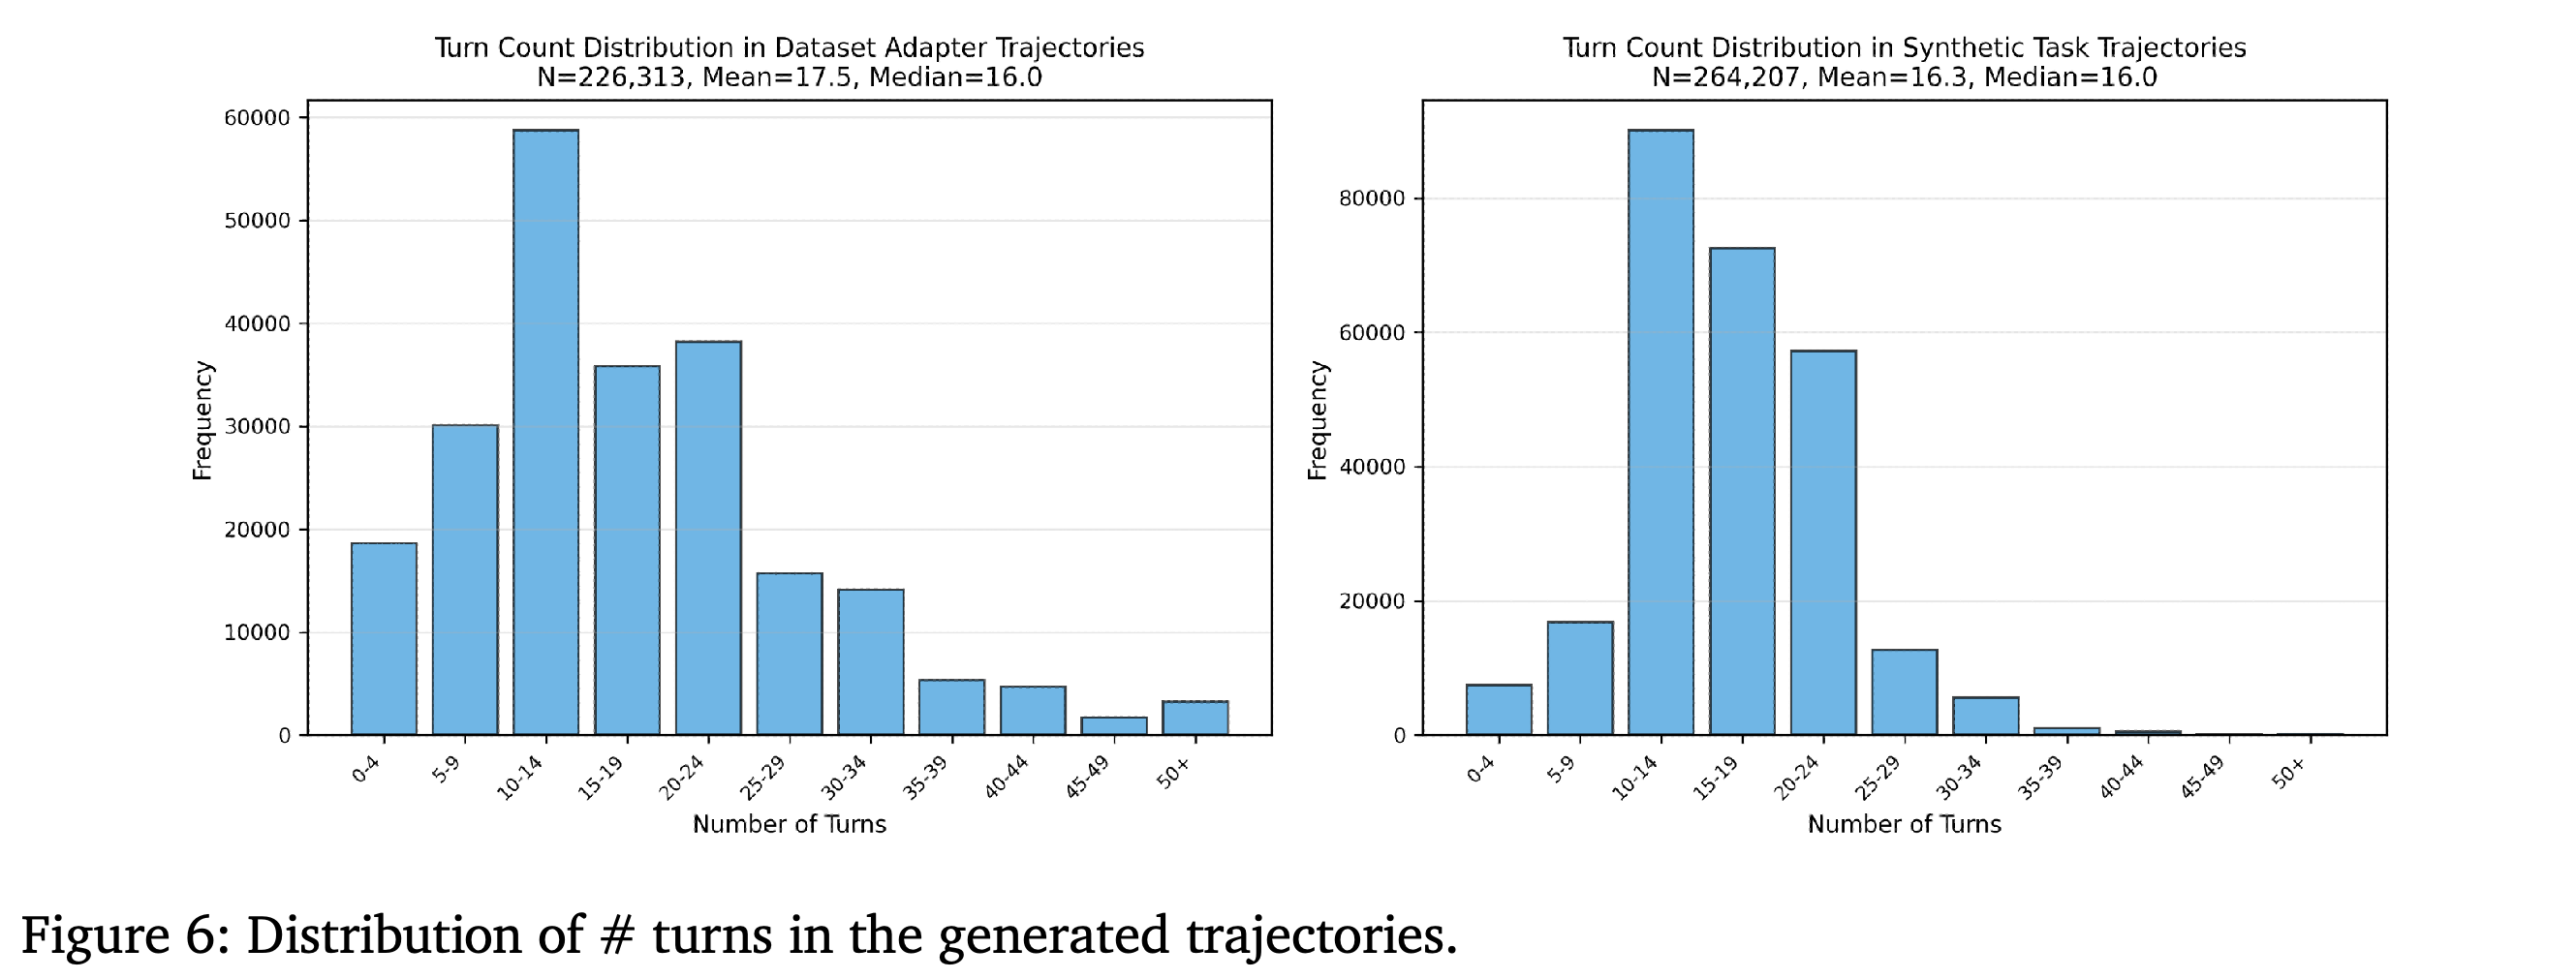
- Figure 6의 평균 턴 수는 어댑터가 17.5, 합성 태스크가 16.3이며, 중앙값은 모두 16.0이다.
- 저자들은 긴 궤적에 노이즈가 많고 유용한 정보가 적어서 이득이 없다고 해석하지만, 길이에 따른 품질을 직접 측정하지는 않는다. 결과는 실험한 확장 설정에서 이득이 없음을 보여줄 뿐, 긴 컨텍스트가 일반적으로 해롭다는 뜻은 아니다.
기본 학습 및 평가 컨텍스트 설정이 가장 높은 평균 점수를 기록한다. 더 긴 윈도우와 YaRN2는 실험 설정에서 성능을 높이지 못한다. 보고된 불확실성 범위는 겹치며, 유의성 검정은 제공하지 않는다.
두 궤적 집단 모두 턴 수 중앙값이 16.0턴이며, 평균은 어댑터가 17.5, 합성 태스크가 16.3이다. 히스토그램은 다중 턴 상호작용을 보여주며, 어댑터 궤적에서 턴 수가 많은 쪽의 꼬리가 더 넓게 나타난다.
5.6. Curriculum Learning
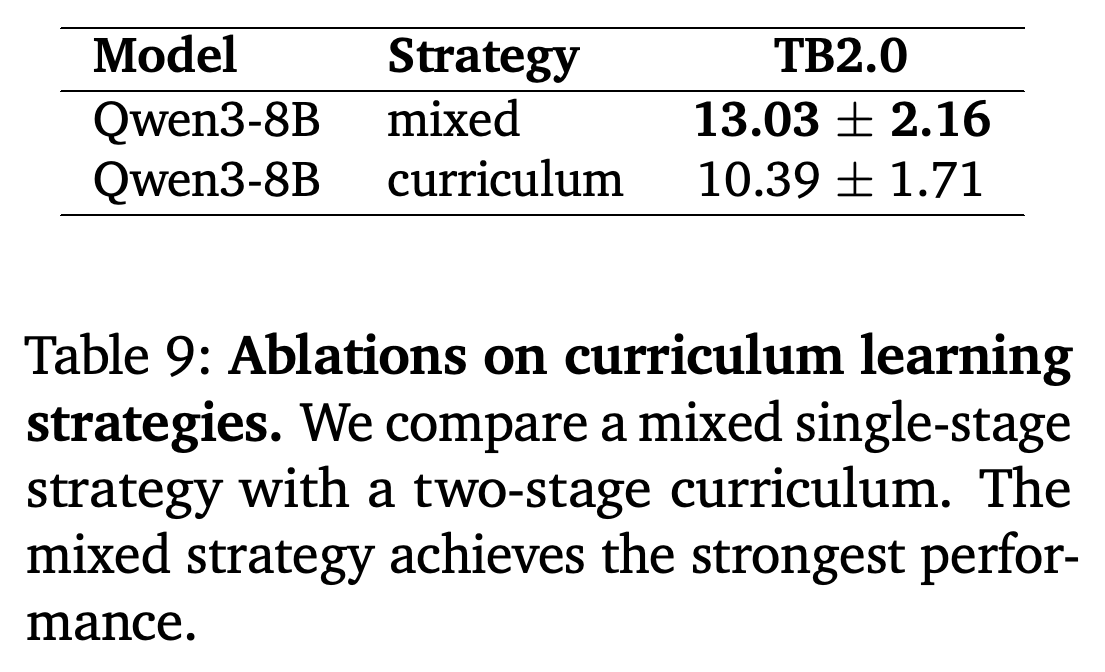
커리큘럼 실험은 어댑터를 먼저 학습하고 합성 태스크를 나중에 학습하는 방식과 모든 출처를 함께 학습하는 방식을 비교한다. 데이터를 혼합한 단일 단계 SFT는 13.03 ± 2.16으로, 2단계 커리큘럼의 10.39 ± 1.71보다 높다. 다른 실험에는 단일 단계 방식을 사용한다.
- 이 비교에서는 어댑터를 먼저 학습하고 합성 데이터를 나중에 학습하는 순서가 유리하지 않았다. 다른 난이도 기반 커리큘럼이나 적응형 커리큘럼은 평가하지 않는다.
혼합 단일 단계 학습은 13.03 ± 2.16을 기록하며, 어댑터 후 합성 데이터를 학습하는 방식은 10.39 ± 1.71을 기록한다. 이는 실험한 순서보다 단순한 학습 방식이 유리함을 보여줄 뿐, 커리큘럼 학습 전반을 배제하는 결과는 아니다.
5.7. Scaling Experiments
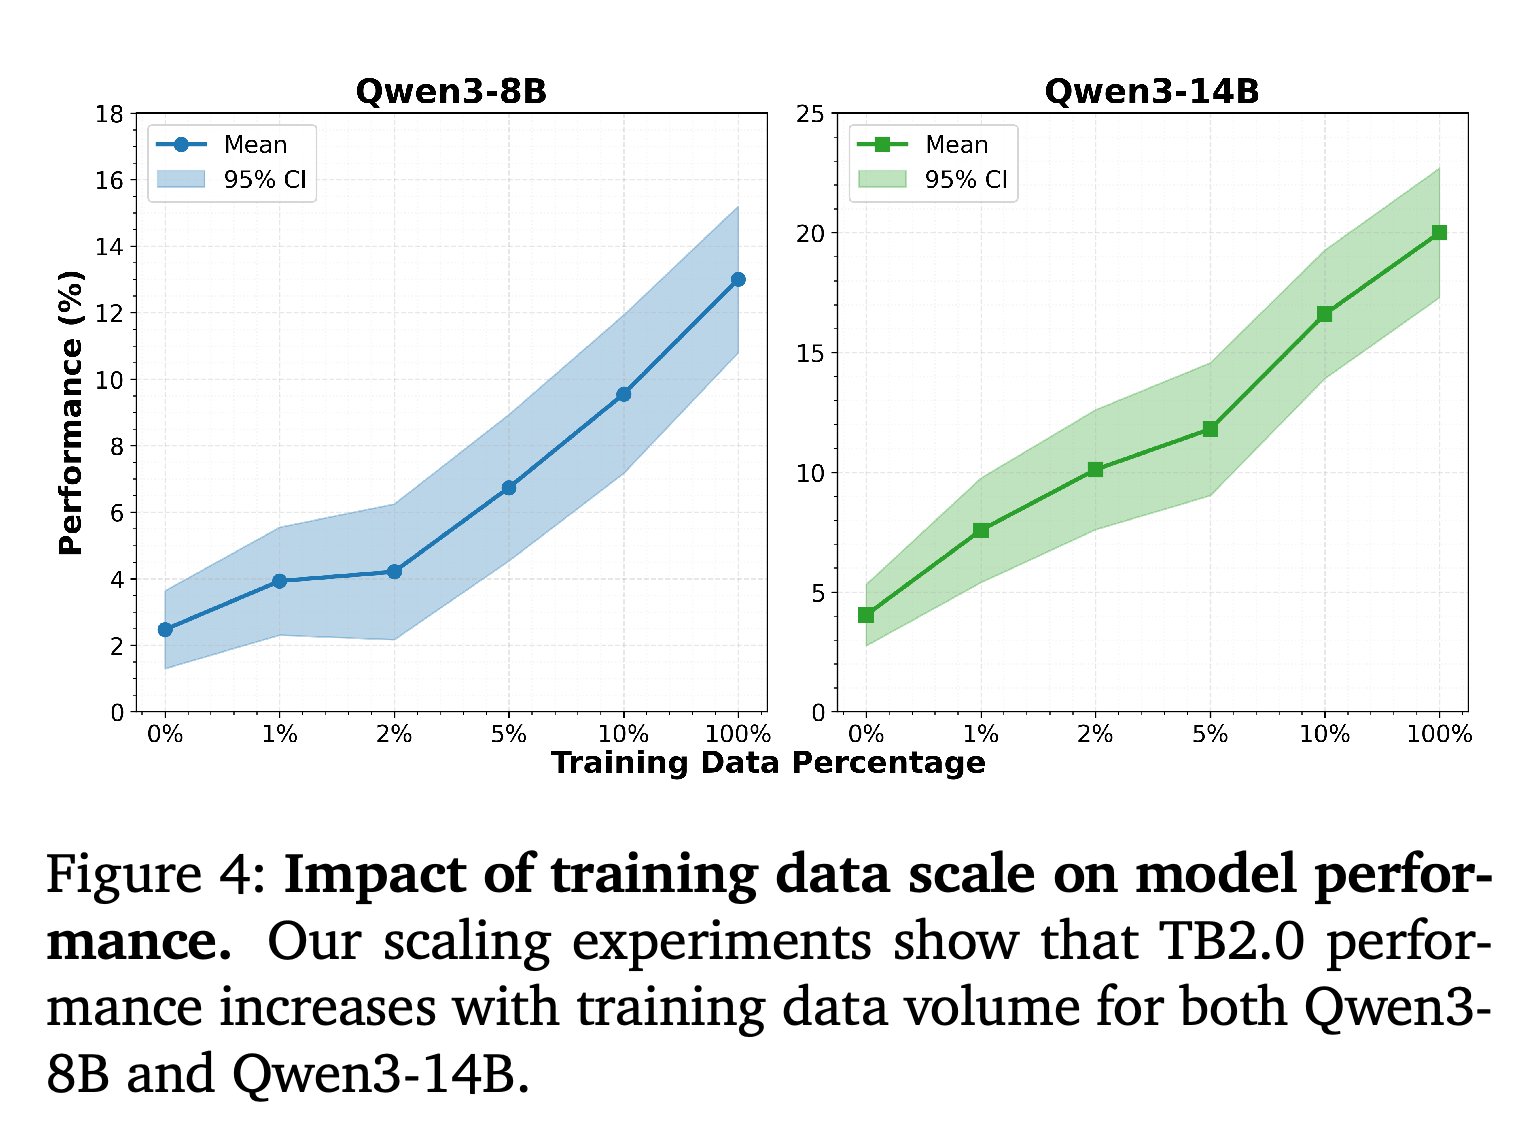
스케일링 실험은 합성 학습 데이터의 0%, 1%, 2%, 5%, 10%, 100%를 사용해 Qwen3-8B와 Qwen3-14B를 미세조정한다. Figure 4에서 두 크기 모두 Terminal-Bench 2.0 성능이 전반적으로 높아진다. 14B는 모든 실험 비율에서 더 높은 성능을 보이며, 최소 데이터 설정에서 최대 설정까지의 성능 증가 폭도 더 크다.
- 그래프에서 14B의 평균은 1%에서 2% 사이에 조금 낮아지므로, 추세가 엄밀히 단조 증가하지는 않는다.
- 그림에는 95% 신뢰구간이 포함된다. 실험한 비율은 데이터 증가에 따른 경험적 성능 추세를 보여주지만, 데이터에 맞춘 스케일링 법칙이나 가용 데이터셋을 넘어선 포화에 관한 근거는 아니다.
두 모델 모두 실험한 데이터 비율 전반에서 성능이 높아지고, 14B는 8B보다 높은 성능을 유지한다. 다만 14B 평균은 1%에서 2%로 갈 때 조금 낮아진다. 음영으로 표시한 95% 신뢰구간은 불확실성을 보여준다. 이 그림은 스케일링 법칙을 데이터에 맞추거나 데이터 추가에 따른 이득이 어디서 포화되는지 밝히지는 않는다.
6. Conclusion
논문은 데이터셋 변환과 목적에 맞춘 태스크 합성이 실험한 Qwen3 터미널 에이전트를 개선한다고 결론짓는다. 모델과 어댑터·스킬 기반 하위 집합을 포함한 대부분의 합성 데이터셋을 공개한다. 검증 가능한 실행 피드백을 활용한 강화학습은 평가한 구성 요소가 아니라 향후 연구로 제안한다.
- 결과는 실험 조건에서 파이프라인의 효과를 뒷받침한다. 다만 궤적 품질이 파라미터 규모보다 중요하다는 결론의 더 넓은 주장을 입증하지는 않는다.
부록
- A.1. Synthetic Trajectory Analysis는 어댑터 궤적 226,313개와 합성 태스크 궤적 264,207개의 토큰 수 및 턴 수 히스토그램을 제공한다. 이 분포는 긴 컨텍스트 실험의 배경이 되는 길이 차이를 보여주며, 어댑터 궤적 분포가 긴 쪽으로 더 길게 이어진다는 점을 보여준다.
- A.2. Details for Trajectory Generation은 {instruction}과 {terminal_state} 자리표시자, 구조화된 JSON 행동, 명령 대기 시간 규칙을 포함한 Terminus 2 템플릿을 제공한다. Figures 8–10은 /app/solution.txt, /app/solution.py, /app/solution.patch용 어댑터 접미 지시를 설명한다. 여기에는 버그 위치를 찾아 SEARCH/REPLACE 수정 내용을 생성해야 한다는 SWE 요구사항도 포함된다.
- A.3. Details for Synthetic Task Generation은 Curation of Primitive Skills와 Prompts for Synthetic Task Generation을 다룬다. Table 10은 의존성 해결을 위한 그래프 탐색, 구조화된 파일 파싱, 통계 변환, 서비스 설정 등 분야별 예시를 제공한다. Figures 11–20은 공유 생성 템플릿과 분야별 모듈 9개를 제시한다. 생성 산출물은 <prompt>, <tests>, <weights>, <info>, <files>, <test_requirements>를 사용하며, 외부 설명 없이 이해할 수 있는 명세, 프로그램을 통한 검증, 해법 유출 금지를 요구한다.
짧은 생각
핵심 기여는 학습 후 성능을 비교하는 ablation을 갖춘 재현 가능한 데이터 구성 방법이다. 공유 환경, 스킬을 조합한 태스크, 혼합 SFT는 에이전트 scaffold를 바꾸지 않고 성능을 높인다. 합성 데이터 필터링 결과는 실패 궤적을 자동으로 버리지 말아야 할 근거를 제공한다. 다만 이를 유지하는 것이 왜 도움이 되는지 설명하려면 샘플 수를 통제한 비교가 필요하다.
실험 근거가 뒷받침하는 범위는 논문의 가장 넓은 결론보다 좁다. 생성 태스크에는 독립적으로 검증된 oracle solution이 없고, 일부 벤치마크 분야는 태스크 수가 매우 적으며, 일부 능력의 점수는 0에 머문다. 추가 터미널 벤치마크와 데이터 양, 난이도, 궤적 품질을 통제한 비교가 있다면 결과를 더 강하게 뒷받침할 수 있다.