


GLM-5: from Vibe Coding to Agentic Engineering 요약 설명
17 Feb 2026 | Paper Review AI Coding Agents Reinforcement Learning Sparse Attention Environment Scaling목차
- 요약
- 1 Introduction
- 2 Pre-Training
- 3 Post-Training
- 4 Agentic Engineering
- 5 Adapting GLM-5 to Chinese Chip Infrastructure
- 6 Evaluation
- 7 Conclusion
- 8 Easter Eggs
- 9 Contribution
- 부록
- 짧은 생각
이번 글에서는 GLM-5: from Vibe Coding to Agentic Engineering 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 2월 17일(Arxiv)
- GLM-5-Team, :, Zeng, Aohan, Lv, Xin, Hou, Zhenyu, Du, Zhengxiao, Zheng, Qinkai, Chen, Bin, Yin, Da, Ge, Chendi, et al.
- Zhipu AI, Tsinghua University
- 논문 링크
- Github
- Project Page
요약
- GLM-5: from Vibe Coding to Agentic Engineering은 긴 상호작용에 걸쳐 소프트웨어를 계획하고 구현하며 수정하는 에이전트를 위한 공개 가중치 기반 모델을 제시한다. 744B-parameter MoE 구조에서 40B 파라미터를 활성화한다. 보고된 기반 모델 학습량은 28.5 trillion 토큰이며, 컨텍스트는 200K까지 확장한다.
- 학습 파이프라인은 DeepSeek Sparse Attention (DSA), 추론·에이전트·일반 능력을 위한 순차적 강화학습, 마지막 on-policy 단계 간 증류를 결합한다. 비동기 에이전트 학습은 rollout 생성과 최적화를 분리한다. 정확한 토큰 보존, 중요도 샘플링, 오래된 궤적 필터링, 실행 가능한 환경을 통해 정책 불일치와 신뢰하기 어려운 피드백에 대응한다.
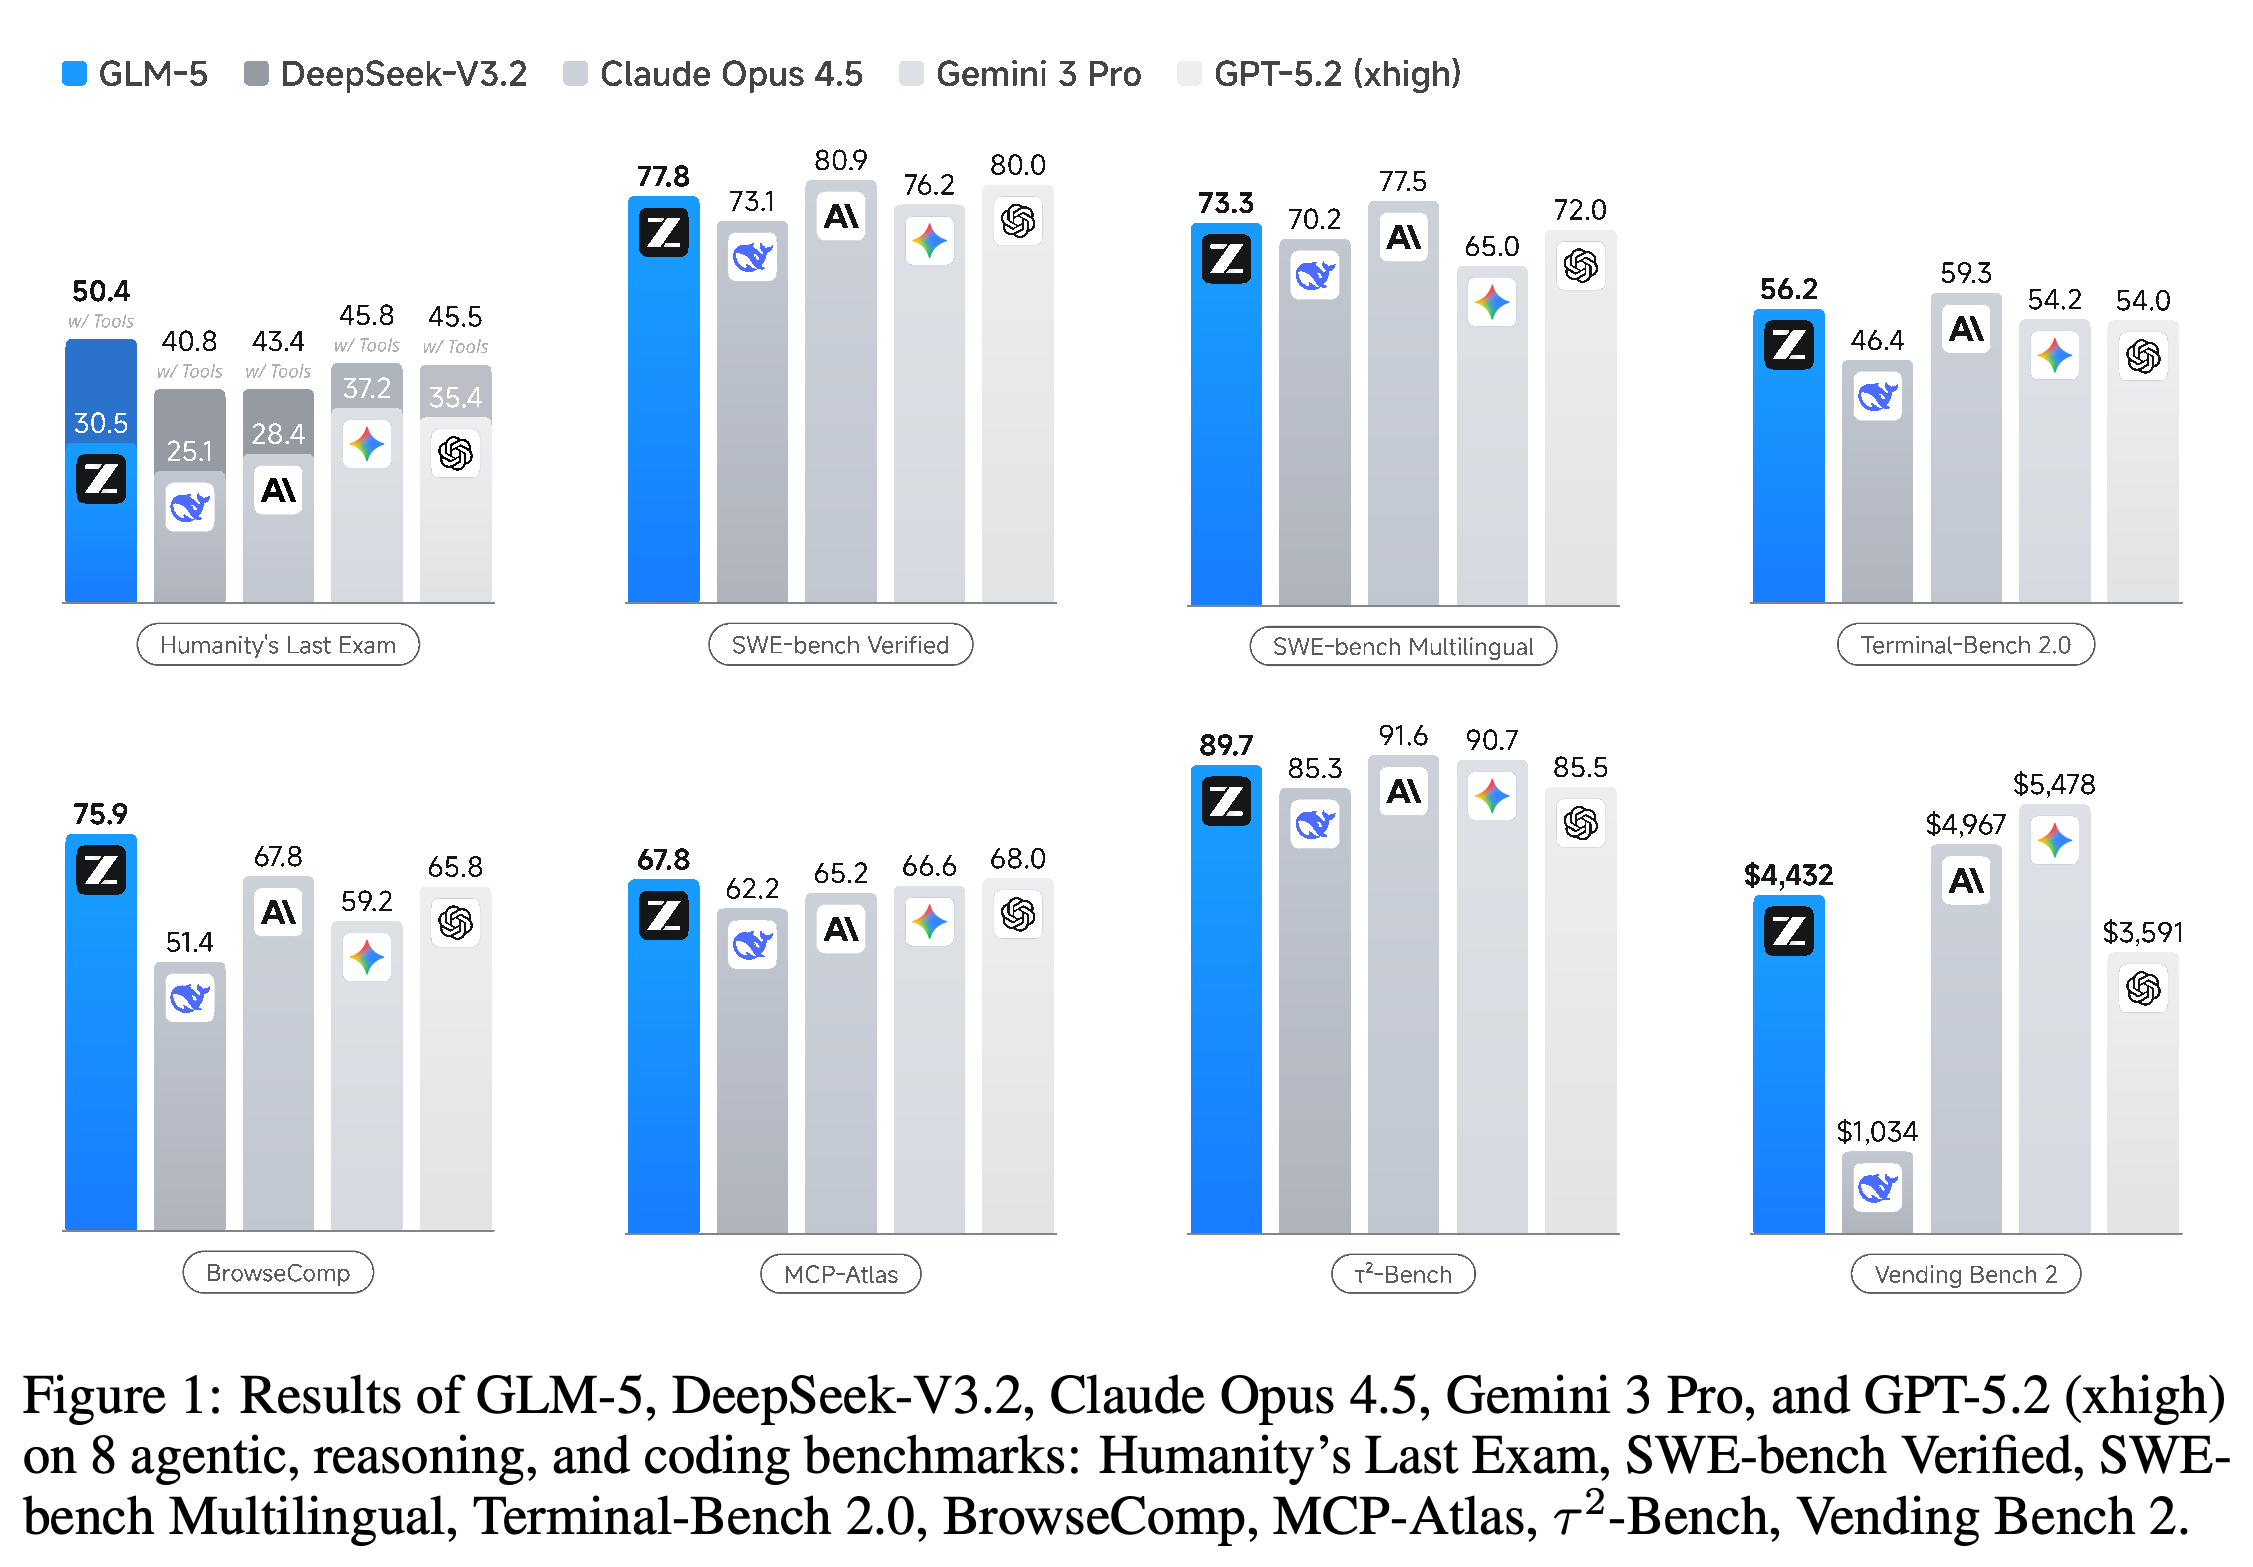
- GLM-5는 SWE-bench Verified에서 77.8, SWE-bench Multilingual에서 73.3, 컨텍스트 관리를 적용한 BrowseComp에서 75.9를 기록한다. 내부 엔지니어링 평가에서는 GLM-4.7보다 개선되지만, 프런트엔드 과제를 완전히 해결하는 성능과 연쇄 개발 성능은 Claude Opus 4.5보다 낮다. 변경된 벤치마크 조건, 비공개 평가 모델, 제한적인 구성요소별 제거 실험 때문에 일반적인 엔지니어링 신뢰성과 시스템 효율성에 관한 결론에는 한계가 있다.
1 Introduction
서론은 모델 규모 확장만으로 해결하기 어려운 병목으로 계산 비용과 복잡한 소프트웨어 작업 절차에 대한 적응을 지적한다. GLM-5는 에이전트·추론·코딩(ARC) 능력을 통합하는 것을 목표로 하며, 개별 코드 생성보다 자율적인 계획과 반복 개선을 강조한다.
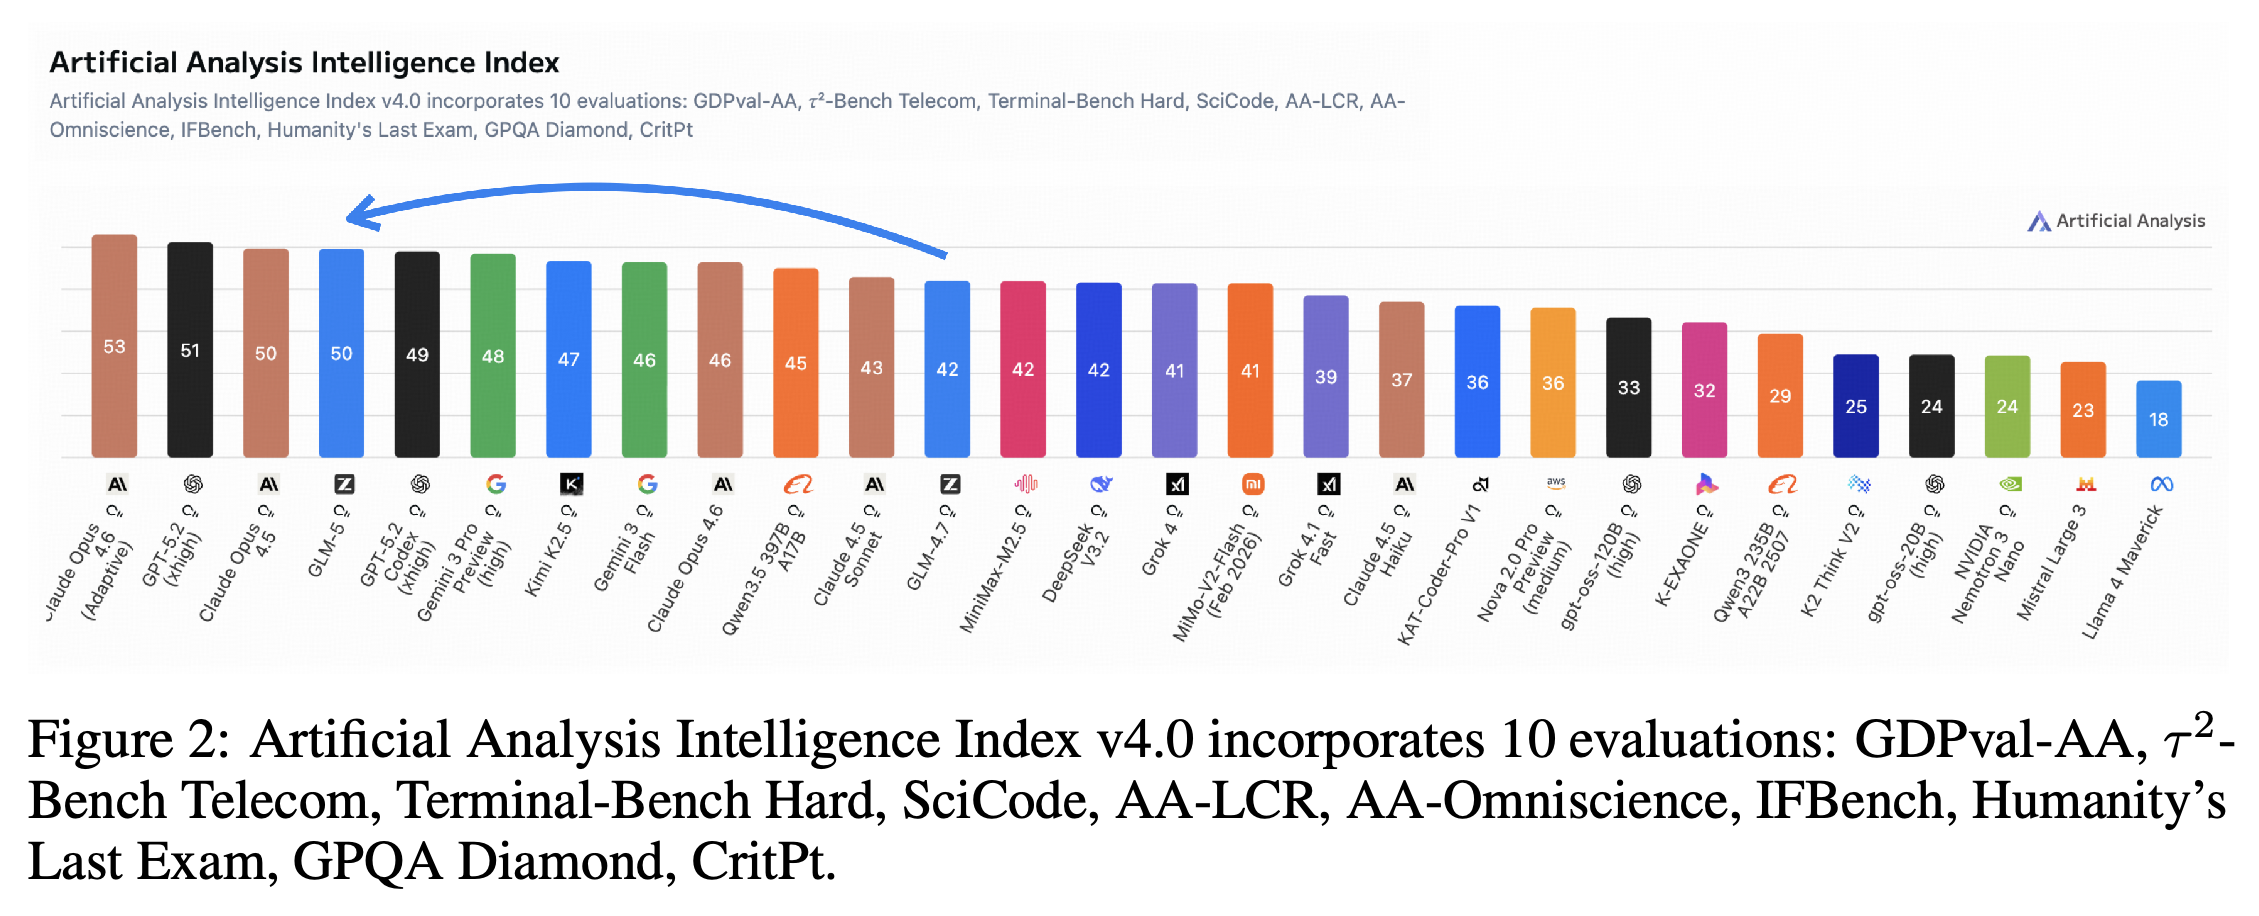
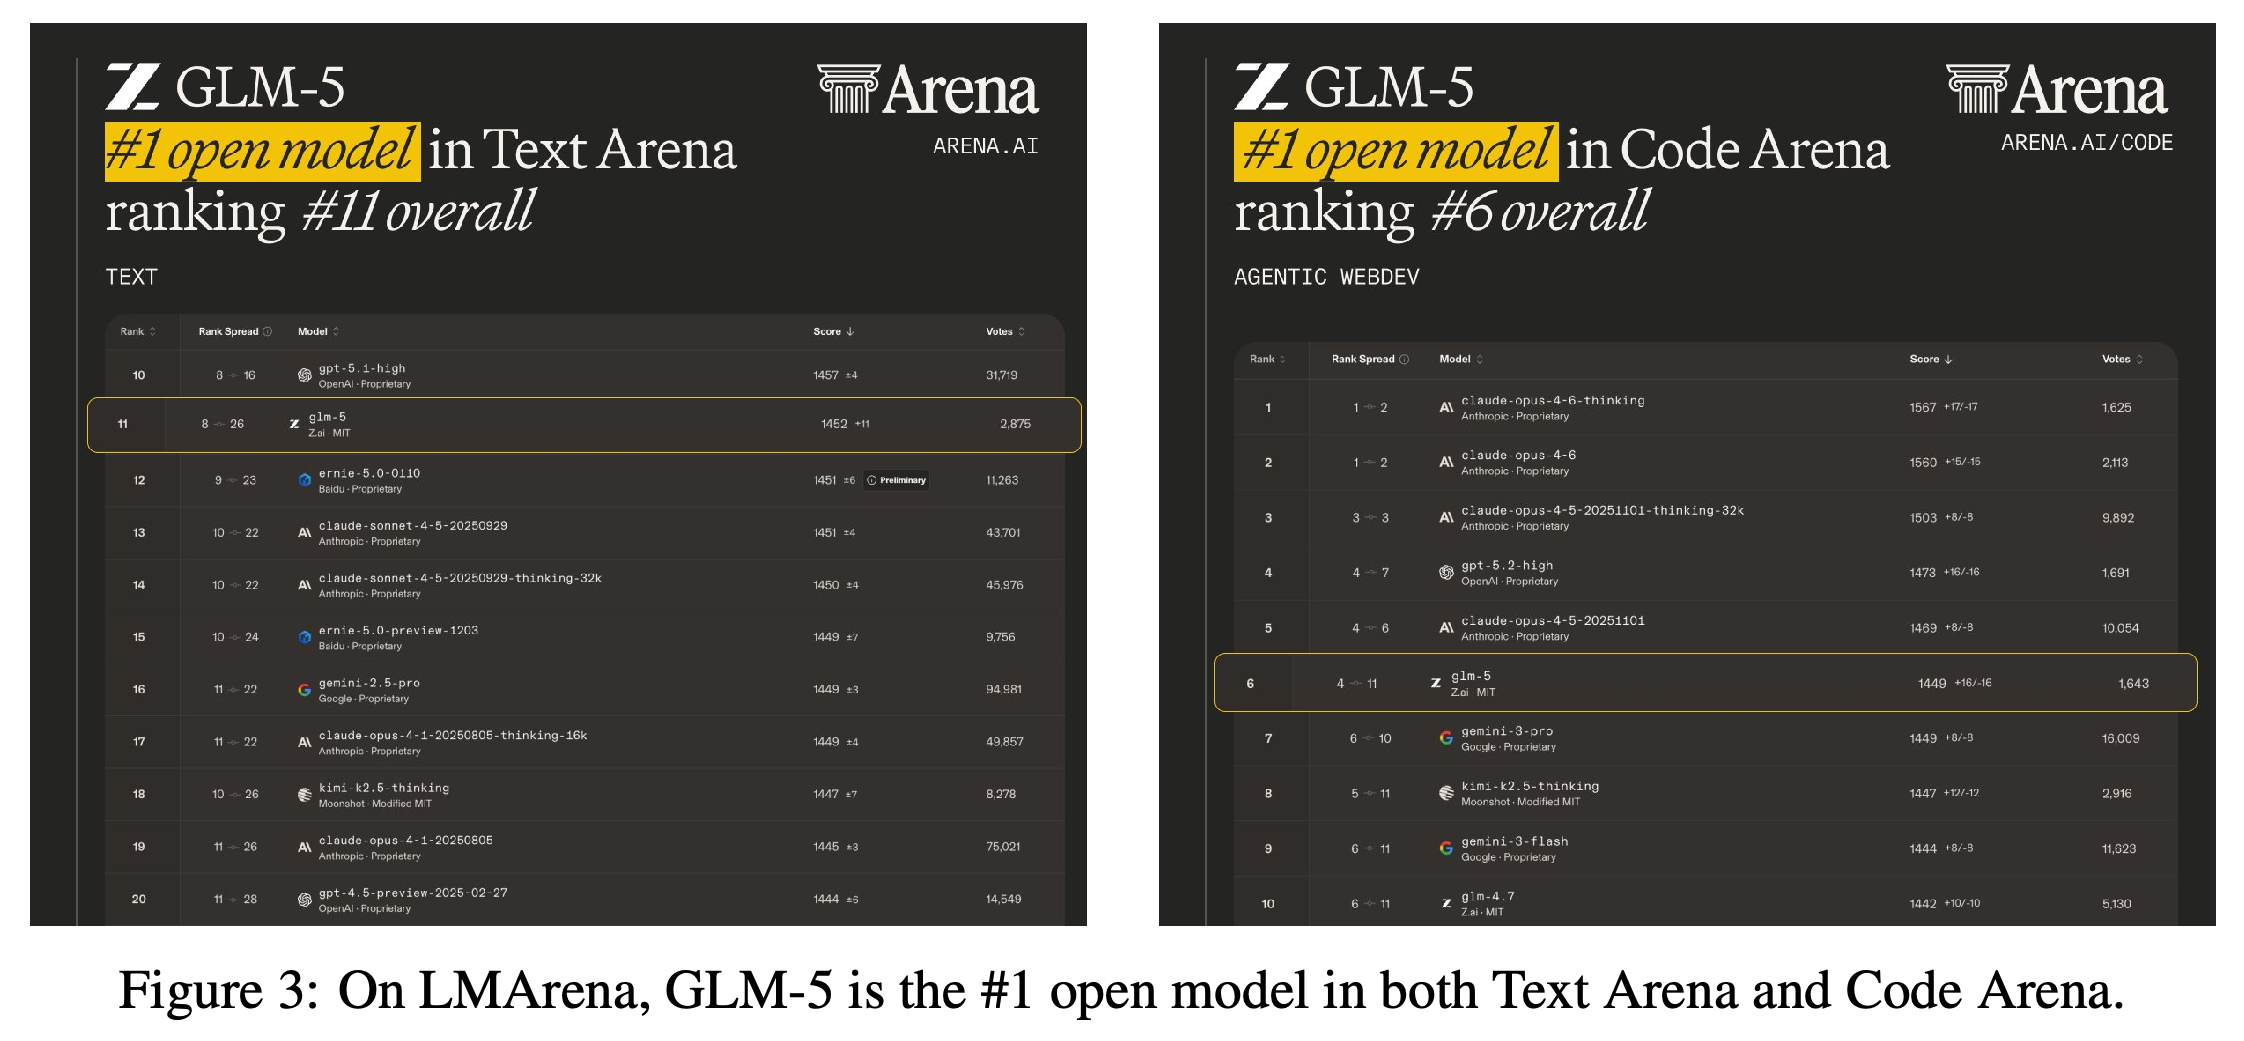
- 보고서에 따르면 Artificial Analysis Intelligence Index v4.0 점수는 GLM-4.7의 42에서 50으로 상승했다. 제시된 LMArena Text Arena와 Code Arena 순위표에서는 공개 모델 중 1위를 기록한다.
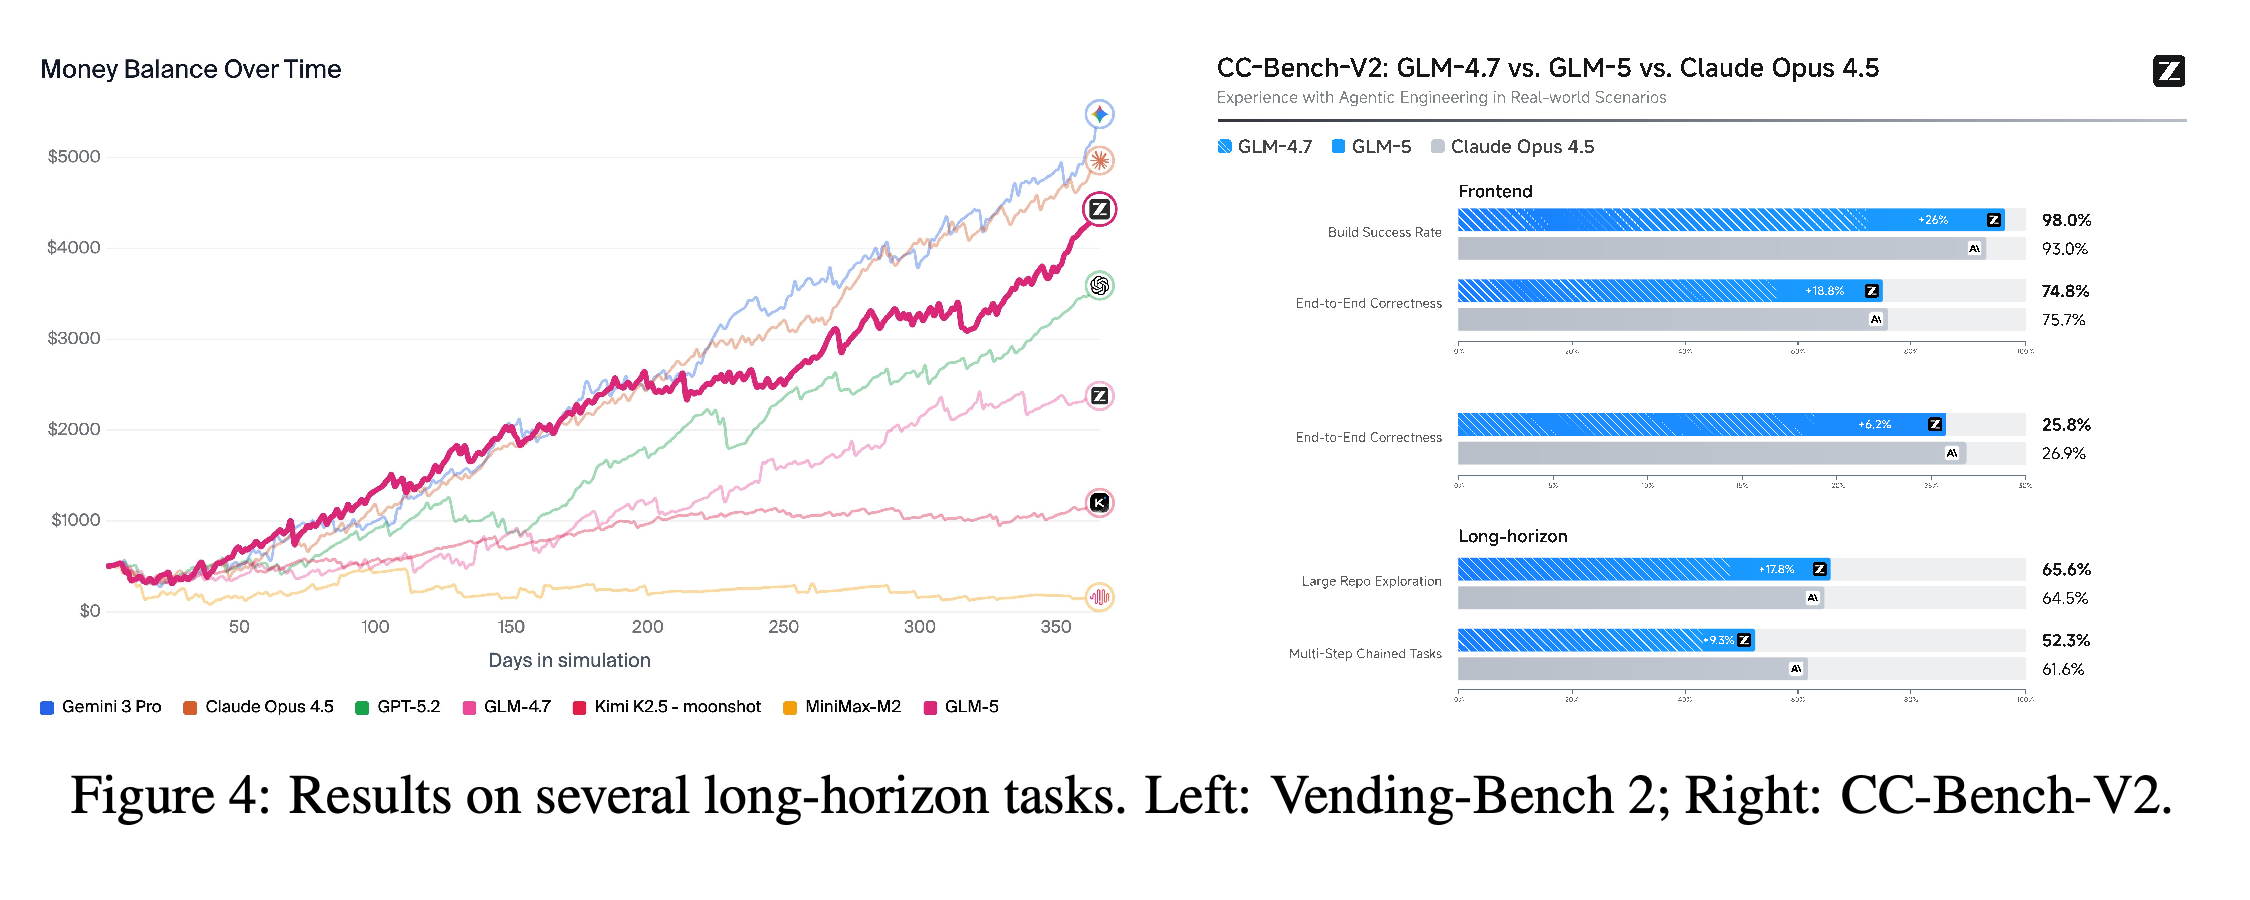
- Vending-Bench 2는 한 해 동안의 사업 운영을 시뮬레이션한다. GLM-5의 최종 잔액은 $4,432로, Claude Opus 4.5의 $4,967과 Gemini 3 Pro의 $5,478보다 낮다.
- 보고서가 제시하는 기여는 희소 어텐션, 비동기 RL 인프라와 알고리즘, 중국산 칩 플랫폼 7종에 대한 배포 최적화다. 코드와 모델은 https://github.com/zai-org/GLM-5 에서 제공한다.
패널 8개는 ARC 성능이 경쟁력 있음을 보여주지만, 모든 평가에서 우세하다는 뜻은 아니다. GLM-5는 SWE-bench Verified에서 77.8로 Claude Opus 4.5의 80.9보다 낮으며, 표시된 BrowseComp 점수는 75.9다. 서론은 GLM-4.7을 언급하지만 이미지와 캡션은 비교 대상으로 DeepSeek-V3.2를 명시한다. 일부 BrowseComp 비교 모델의 점수도 Table 7과 다르다.
순위표 스냅샷에서 GLM-5의 Intelligence Index 점수는 50으로, GLM-4.7의 42보다 높다. 외부 종합 평가의 근거를 제공하지만, 과제 10개로 구성된 지수는 소프트웨어 작업 절차 전체의 신뢰성을 측정하지 않는다.
스냅샷은 GLM-5를 공개 모델 중 최상위로 표시하며, 전체 순위는 Text Arena에서 #11, Code Arena에서 #6이다. 따라서 공개 모델 내 순위를 전체 1위로 해석해서는 안 된다.
사업 시뮬레이션 궤적에서 GLM-5의 최종 잔액은 $4,432다. 엔지니어링 패널은 GLM-4.7보다 개선되었지만 연쇄 과제에서는 Claude Opus 4.5와 격차가 남음을 보여준다. 장기 과제의 진전과 순차적 개발에서의 동등한 성능을 구분해야 한다.
2 Pre-Training
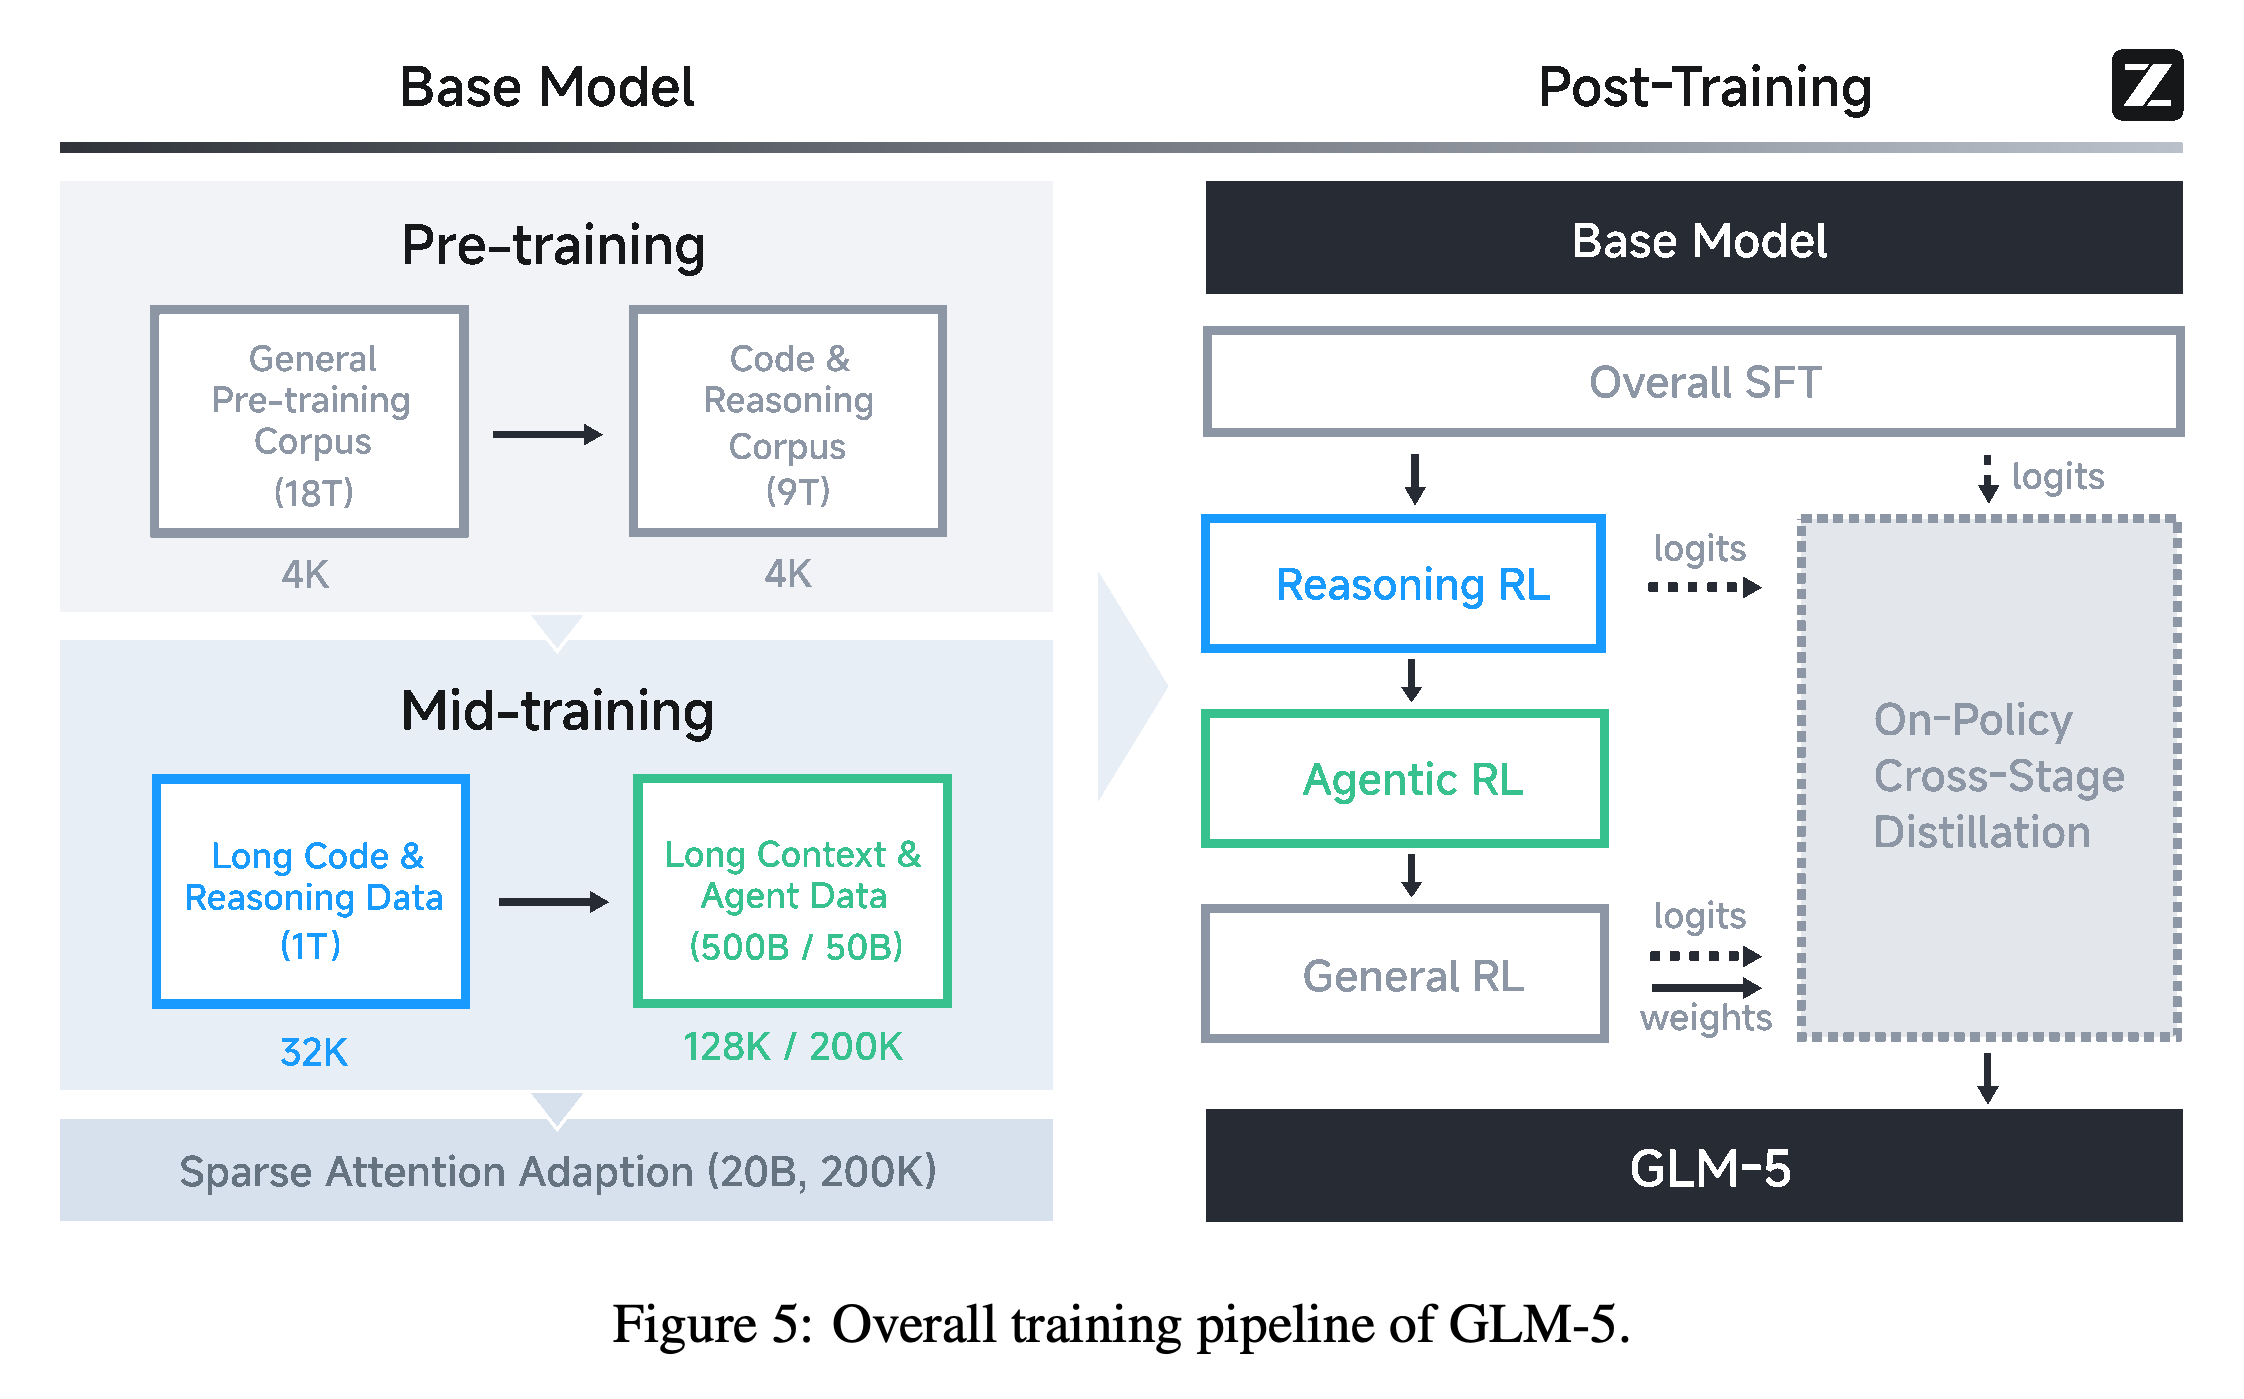
기반 모델 개발은 일반 언어·코드 사전학습과 장문 컨텍스트·에이전트 능력을 위한 중간 학습을 구분한다. 파이프라인에는 4K 컨텍스트에서 일반 사전학습 토큰 18T와 코드·추론 토큰 9T를 사용한 뒤, 컨텍스트를 점차 늘리고 희소 어텐션에 적응하는 과정이 제시된다. 보고서는 기반 모델의 전체 학습량을 28.5 trillion 토큰으로 요약한다. 이 반올림된 총량은 그림에 표시된 단계별 학습량을 정확히 합산한 값은 아니다.
도식은 4K 사전학습 이후 32K, 128K, 200K 중간 학습과 20B 토큰의 희소 적응을 배치한다. 후학습은 SFT에서 RL 3단계로 이어지며, 앞선 단계의 logits를 마지막 단계 간 증류에 사용한다.
2.1 Architecture
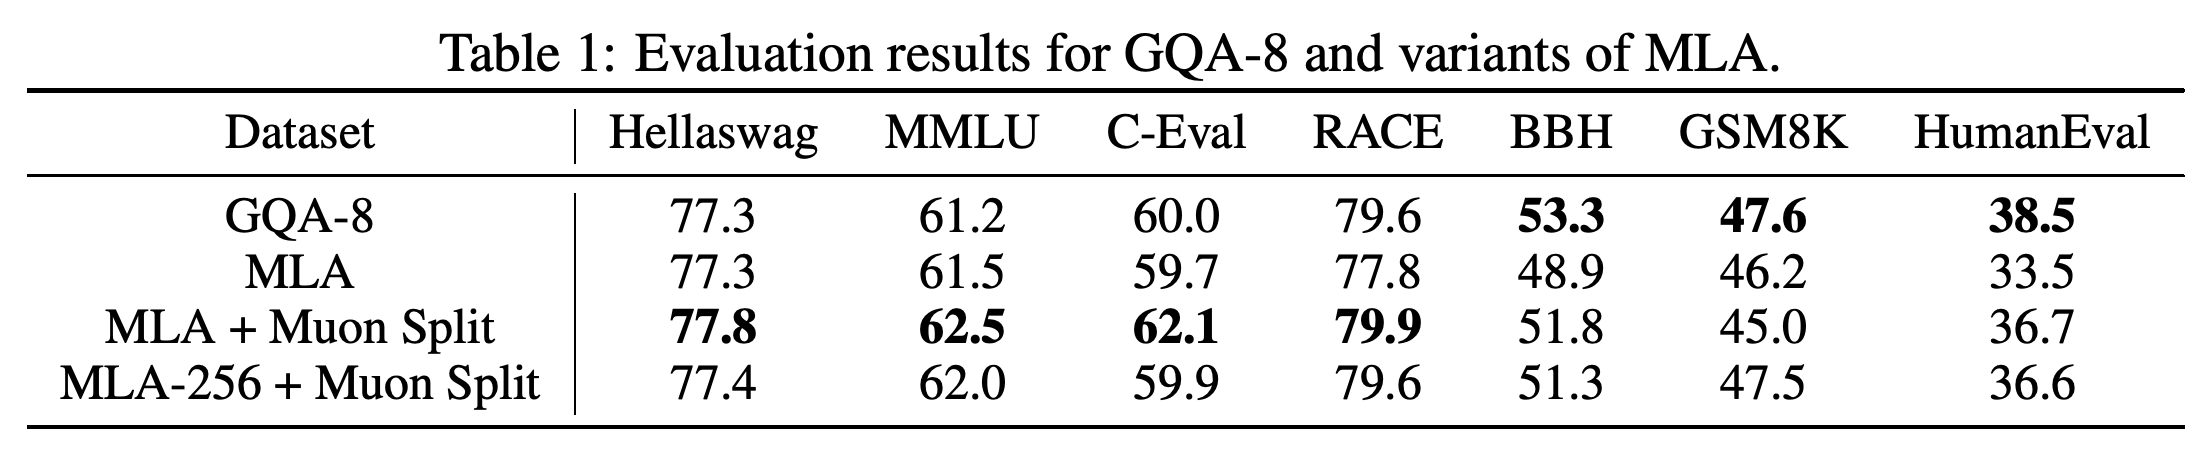
GLM-5는 전문가 256개와 보고서에 명시된 레이어 80개로 확장한다. 깊이를 줄인 목적은 전문가 병렬화에 필요한 통신을 줄이는 것이다. Multi-latent Attention (MLA)은 KV-cache 저장량을 줄이지만, Muon 옵티마이저와 결합할 때 발생하는 문제 때문에 헤드별 직교화인 Muon Split을 도입한다.
- Muon Split은 여러 헤드를 합친 행렬 전체를 직교화하는 대신, 개별 헤드의 query, key, value 상향 투영 행렬을 각각 직교화한다. Table 1에서는 일반 MLA보다 대부분의 벤치마크에서 성능이 높지만 GSM8K에서는 낮으며, 모든 결과가 GQA-8과 동등한 수준은 아니다.
- MLA-256은 헤드 차원을 192에서 256으로 늘리고 헤드 수를 1/3 줄인다. 학습 계산량과 파라미터 수를 유지하면서 디코딩 계산량을 줄인다.
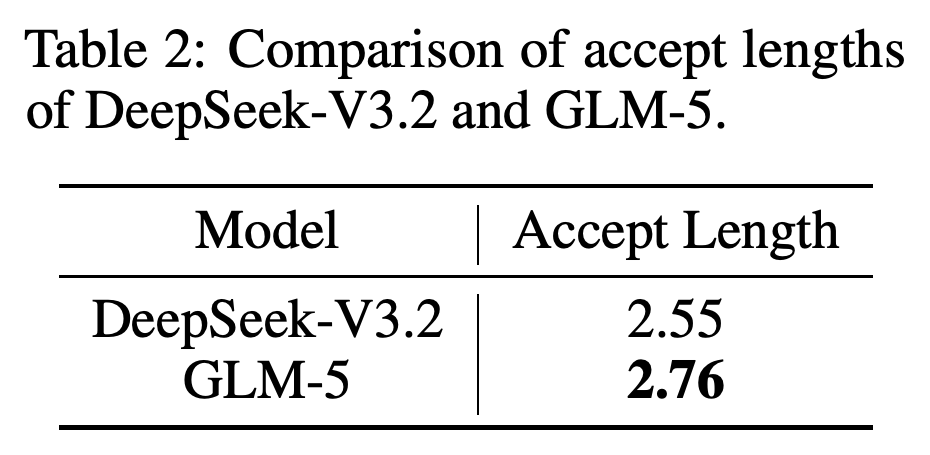
- 학습 시 사용하는 Multi-token Prediction (MTP) 레이어 3개는 파라미터를 공유한다. Table 10에는 이 구조의 MTP 레이어가 1개로 표기된다. 비공개 프롬프트 세트에서 추측 단계 4개를 사용했을 때 GLM-5의 수락 길이는 2.76으로, DeepSeek-V3.2의 2.55보다 높다.
Muon Split은 MLA의 MMLU를 61.5에서 62.5로, HumanEval을 33.5에서 36.7로 높이지만, GSM8K는 46.2에서 45.0으로 낮아진다. 혼재된 결과는 옵티마이저 조정을 뒷받침하지만, 모든 과제에서 일관된 개선을 입증하지는 않는다.
저자들의 비공개 프롬프트 세트에서 추측 단계 4개를 사용하면 GLM-5의 평균 수락 길이는 2.76으로 DeepSeek-V3.2의 2.55보다 높다. 해당 작업에서 더 높은 수락 길이를 뒷받침하지만, 이 결과 자체가 전체 실행 지연 시간을 측정한 것은 아니다.
2.1.1 Continued Pre-Training with DeepSeek Sparse Attention (DSA)는 중간 학습 이후 인덱서 워밍업과 희소 적응을 통해 밀집 MLA 모델을 전환한다. 워밍업은 1000단계로 진행하며, 단계마다 길이 202,752토큰의 시퀀스 14개와 최대 학습률 5e-3을 사용한다. 이후 적응에는 20B 토큰을 사용한다.
- DSA는 고정 슬라이딩 윈도우를 적용하는 대신 내용과 관련된 토큰을 선택한다. 이 절에서는 긴 시퀀스의 어텐션 계산량이 약 1.5–2배 줄어든다고 보고하지만, 조건을 맞춘 GLM-5의 전체 실행 비용 측정치는 제공하지 않는다.
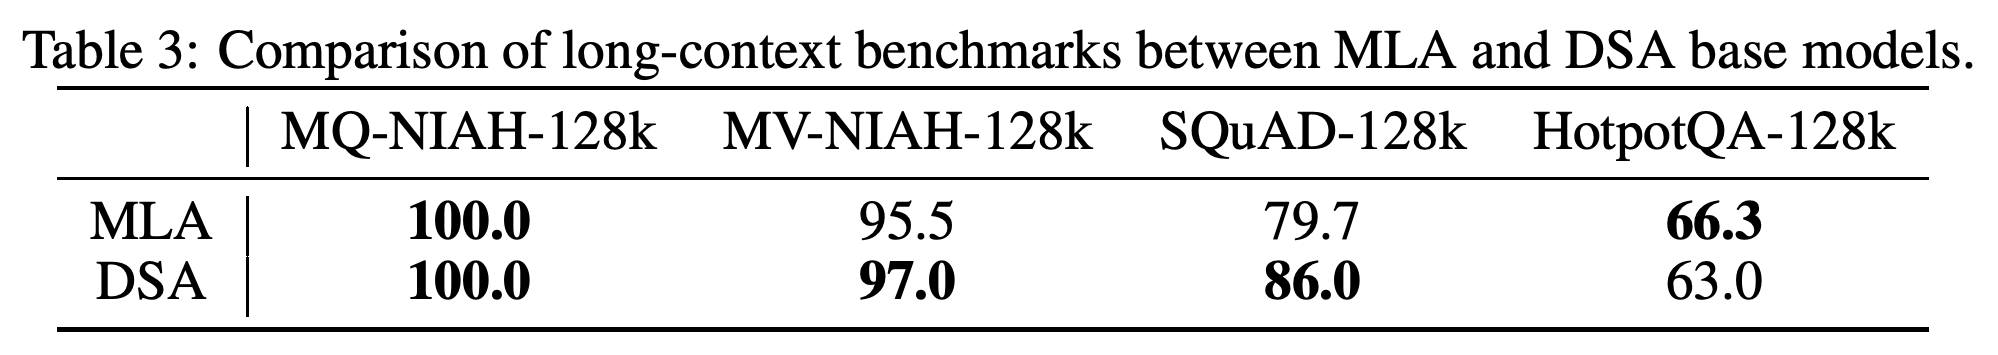
- Table 3의 장문 컨텍스트 결과는 비슷하지만 동일하지는 않다. DSA는 SQuAD-128k를 79.7에서 86.0으로 높이지만, HotpotQA-128k는 66.3에서 63.0으로 낮춘다.
- MLA와 DSA를 같은 SFT 데이터로 미세조정하면 손실 곡선이 거의 겹치며, 저자들은 평가 성능도 동률이라고 보고한다. 이는 측정한 작업에서 적응이 성공했음을 뒷받침하지만, 희소화가 항상 성능 손실 없이 이루어진다는 보장은 아니다.
DSA는 MQ-NIAH-128k의 100.0을 유지하고 MV-NIAH-128k와 SQuAD-128k를 개선하지만, HotpotQA-128k는 66.3에서 63.0으로 낮춘다. 결과는 장문 컨텍스트 동작이 대체로 비슷하면서도 과제별 차이가 있음을 보여준다.
2.1.2 Ablation Study of Efficient Attention Variants는 GLM-9B에서 고정 배치와 탐색으로 찾은 배치의 Sliding Window Attention (SWA), Gated DeltaNet (GDN), SimpleGDN을 비교한다. 효율적인 어텐션 변형은 64K 컨텍스트에서 190B 토큰으로 지속 학습하며, 효율적인 어텐션 레이어와 전체 어텐션 레이어의 비율은 1:1이다. 별도의 DSA 실험은 GLM-4.7-Flash를 사용한다.
- SWA 레이어 탐색은 beam size 8을 사용하고 단계마다 레이어 2개를 변경하며, 16K RULER에서 후보를 평가한다. 탐색 결과는 SFSSFFSSSFFFFSSFSFFFFFFSFSFSSFSSFSFSSFSSS이며, S는 SWA, F는 전체 어텐션을 뜻한다.
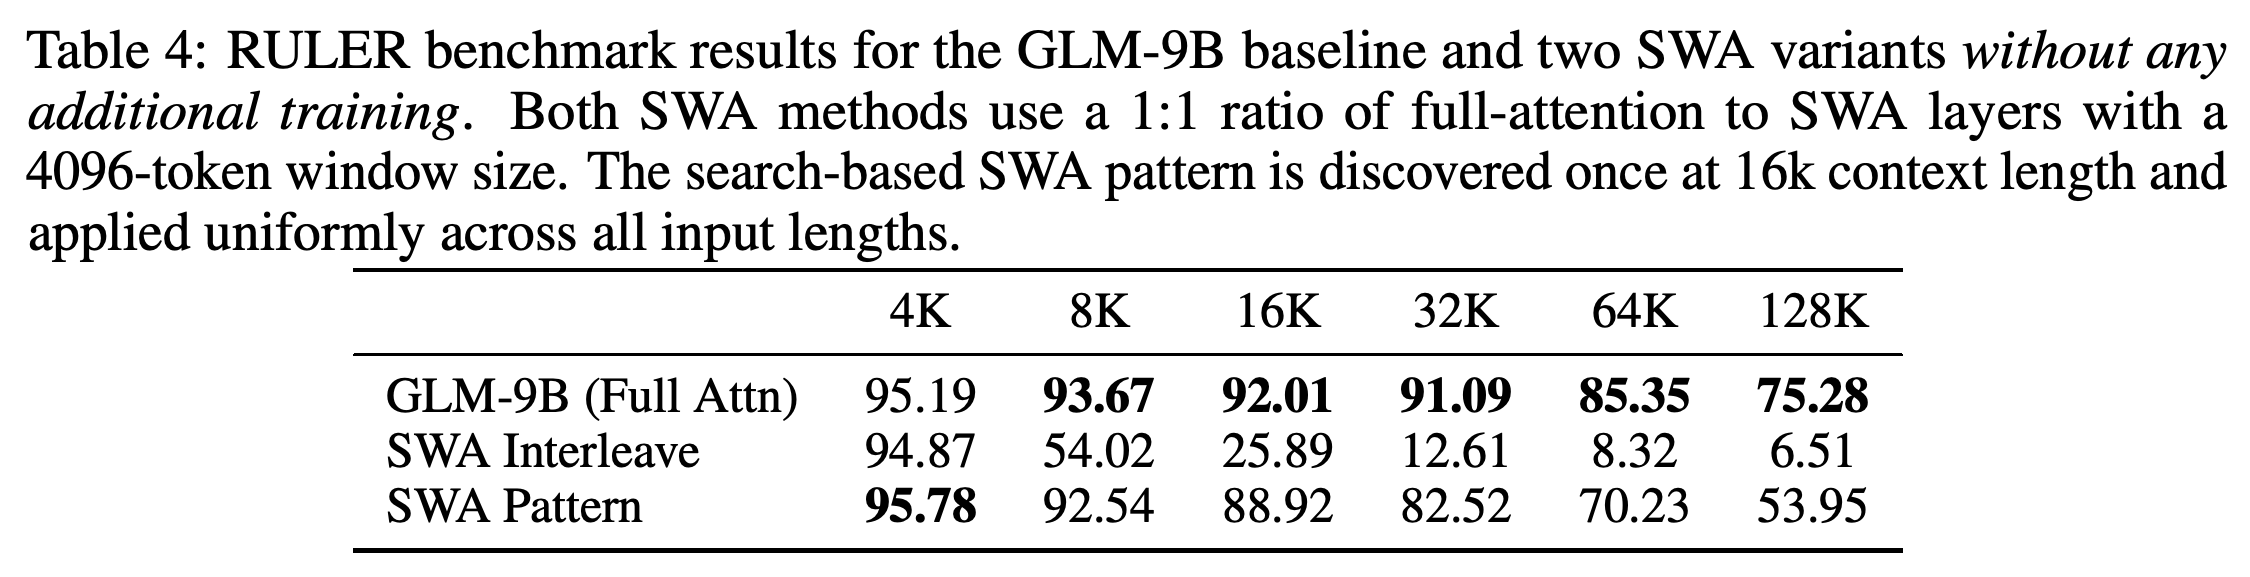
- 추가 학습 없이 4096토큰 윈도우와 탐색으로 찾은 배치를 적용하면 128K RULER에서 53.95를 기록한다. 고정 교차 배치는 6.51, 전체 어텐션은 75.28을 기록한다.
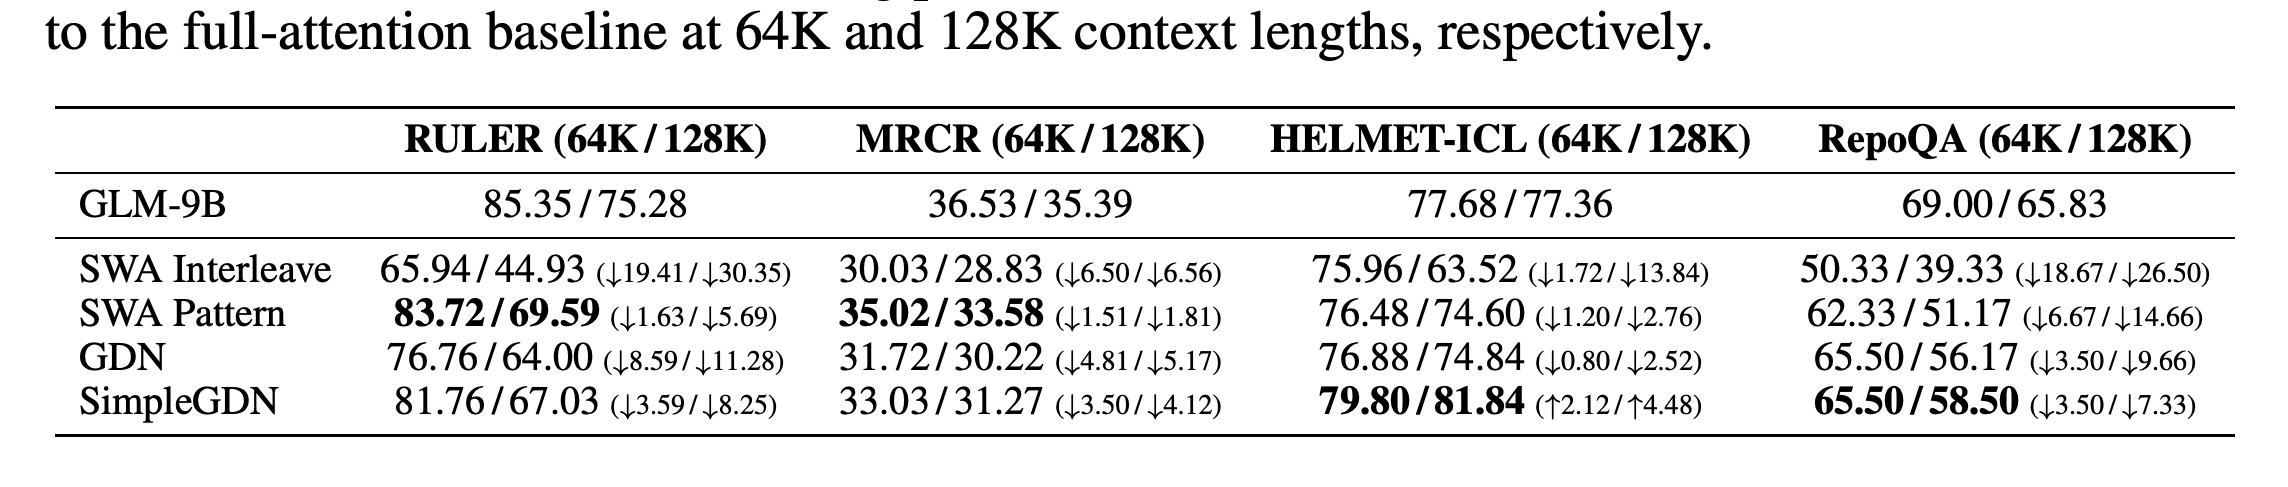
- 지속 학습 후 탐색으로 찾은 SWA는 128K RULER에서 69.59를 기록한다. SimpleGDN은 67.03을 기록하고, HELMET-ICL에서는 기준 모델의 77.36보다 높은 81.84를 기록한다. SimpleGDN은 Conv1d와 명시적 게이팅을 제거하여 파라미터를 추가하지 않고 사전학습된 투영을 재사용한다.
- GLM-4.7-Flash에서 인덱서만 학습하는 DSA 워밍업은 128K RULER 점수를 79.21에서 71.35로 낮춘다. 150B 토큰의 공동 학습 후에는 78.86으로 회복한다. 기반 모델과 학습량이 다르므로 DSA와 GLM-9B 대안들의 순위를 통제된 조건에서 비교할 수는 없다.
어텐션 레이어 비율 1:1과 4096토큰 윈도우가 같더라도, 128K에서 탐색으로 찾은 SWA 배치는 53.95를 기록하고 고정 교차 배치는 6.51을 기록한다. 전체 어텐션 기준 모델은 75.28로 더 높다. 따라서 배치 탐색은 검색 성능 저하를 완화하지만 제거하지는 못한다.
190B 토큰의 지속 학습 이후, 탐색으로 찾은 SWA와 SimpleGDN은 제시된 장문 컨텍스트 테스트에서 단순 교차 배치보다 높은 성능을 보인다. SimpleGDN은 HELMET-ICL에서는 기준 모델보다 높지만 RULER, MRCR, RepoQA에서는 낮다. 이는 과제별 정확도 절충이 있음을 보여준다.
2.2 Pre-training Data
사전학습 코퍼스는 분야별 품질 필터링을 통해 웹, 코드, 수학·과학 데이터의 범위를 넓힌다. 문장 임베딩 기반 DCLM 분류기는 기존 웹 데이터 선별을 보완한다. World Knowledge 분류기는 다른 기준으로는 중간 또는 낮은 품질로 분류되는 문서에서 롱테일 정보를 추출한다.
- 코드 수집에는 갱신된 호스팅 플랫폼 스냅샷과 코드가 포함된 웹페이지를 추가한다. 유사 중복을 제거한 고유 토큰 수는 28% 증가한다. 메타데이터 정합성 확보, 언어 식별, 저자원 언어 전용 분류기로 코퍼스의 일관성과 샘플링을 개선한다.
- 수학·과학 데이터 선별은 개선된 웹페이지 추출 및 PDF 파싱과 LLM의 교육적 품질 평가를 결합한다. 긴 문서는 청크별로 점수를 매긴 뒤 집계하며, 이 코퍼스에서는 합성 자료, AI 생성 자료, 템플릿 기반 자료를 명시적으로 걸러낸다.
2.3 Mid-Training
중간 학습은 1T 토큰으로 컨텍스트를 32K까지, 500B 토큰으로 128K까지, 50B 토큰으로 200K까지 확장한다. 후반 단계에서는 긴 문서와 합성 에이전트 궤적의 샘플링 비중을 높여 여러 파일을 다루는 엔지니어링과 긴 상호작용을 지원한다.
- 저장소 시퀀스는 코드, 커밋 diff, 이슈, pull request, 관련 파일을 이어 붙인다. 수집량은 약 10 million issue–PR pairs이며, 필터링된 issue–PR 부분에는 약 160B 고유 토큰이 포함된다.
- 자연적으로 긴 자료에는 perplexity, 중복 제거, 길이 필터링을 적용한다. 합성 시퀀스는 비슷한 텍스트를 교차 패킹하여 장거리 의존성을 구성한다.
- 200K 단계에서는 MRCR과 유사한 데이터를 소량 도입한다. 저자들은 이 추가 단계가 이전의 128K 범위 안에서도 성능을 개선한다고 보고하지만, 이 절에는 수치로 확인할 수 있는 제거 실험이 없다.
2.4 Training Infrastructure
학습 인프라는 MTP 배치, 그래디언트 샤딩, 옵티마이저 통신 변경, 활성값 오프로딩, 청크별 출력 투영으로 메모리 불균형과 통신 오버헤드에 대응한다. 병렬화 최적화는 가중치 그래디언트 계산을 뒤로 미루고 긴 시퀀스의 작업량을 재분배한다. SFT에서는 INT4 양자화 인지 학습을 적용한다.
- MTP 출력은 마지막 파이프라인 단계에서 주 출력과 함께 배치하며, 임베딩과 transformer 구성요소는 그 이전 단계에 배치한다.
- Pipeline ZeRO2는 각 단계 그래디언트의 1/dp만 저장하며, 이중 버퍼링으로 전체 크기의 누적 버퍼를 2개만 유지한다. Muon 통신은 각 rank가 소유한 파라미터 샤드만 모으고, 통신과 로컬 계산을 중첩한다.
- 레이어 단위 호스트 오프로딩과 재계산은 상주하는 활성값 메모리를 줄인다. 시퀀스를 청크로 나누어 투영과 손실을 계산하며, 다음 청크를 처리하기 전에 중간 활성값을 해제한다.
- 시퀀스 재정렬, 가변 크기의 컨텍스트 병렬 그룹, 계층적 all-to-all로 장문 컨텍스트의 불균형에 대응한다. 공통 양자화 커널은 학습과 추론에서 비트 단위로 동일한 양자화 동작을 제공한다.
3 Post-Training
후학습은 다중 과제 Supervised Fine-Tuning (SFT)으로 시작한 뒤 Reasoning RL, Agentic RL, General RL을 순서대로 진행한다. 마지막 on-policy 단계 간 증류는 서로 다른 목표를 순차적으로 최적화하면서 저하된 능력을 회복하기 위한 과정이다.
3.1 Supervised Fine-Tuning
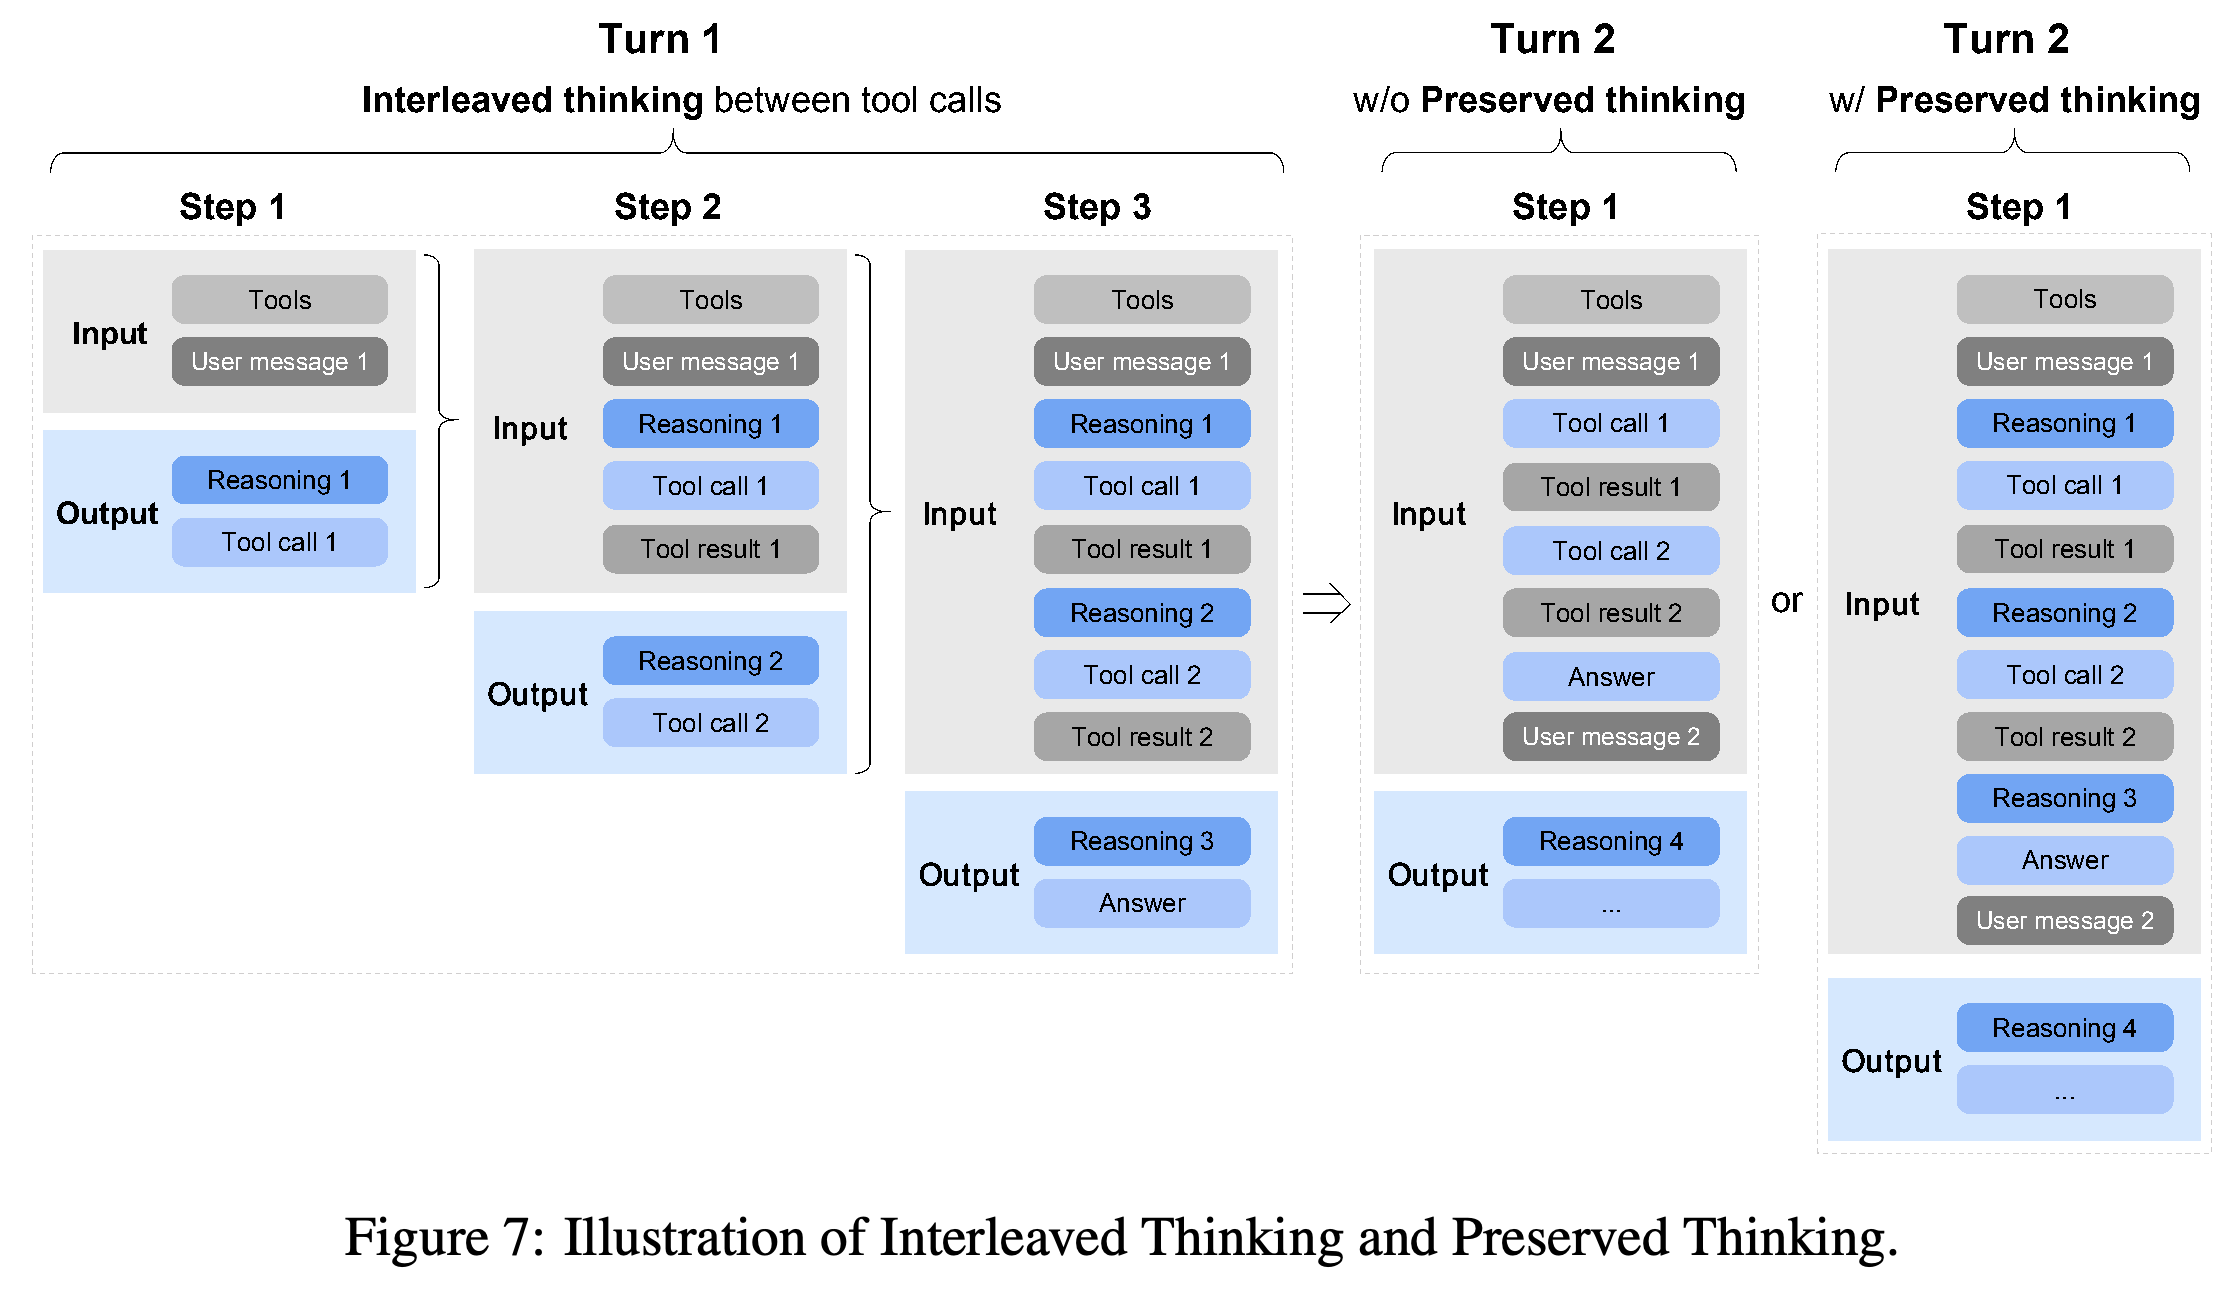
SFT는 General Chat, Reasoning, Coding & Agent 데이터를 다루며, 최대 컨텍스트 길이는 202,752토큰이다. 갱신된 채팅 템플릿은 응답과 도구 호출 전의 Interleaved Thinking, 코딩 에이전트 턴 사이의 Preserved Thinking, Turn-level Thinking을 통한 턴별 추론 제어를 지원한다.
- General Chat 데이터는 간결한 응답과 더 폭넓은 다국어 역할극을 강조하며, 자동 필터링과 사람이 수행하는 필터링을 적용한다. 추론 예시에는 rejection sampling으로 생성한 검증 가능한 논리 문제와 GLM-4.7을 기준으로 난도를 선별한 수학·과학 문제가 포함된다.
- 코딩 및 에이전트 궤적은 실행 환경, 전문가 RL, rejection sampling에서 얻으며, 현실적인 장기 과제를 강조한다.
- 오류가 있는 궤적 구간은 컨텍스트에 남겨두지만 학습 손실에서는 마스킹한다. 이를 통해 실수를 강화하지 않으면서 이후의 복구 행동을 학습에 활용한다.
도식은 도구 행동 사이에 삽입하는 추론과 사용자 턴 사이에 유지하는 추론을 구분한다. Preserved Thinking은 이전 추론 블록을 다음 턴의 컨텍스트에 유지한다. 반면 다른 방식은 추론 블록 없이 도구 상호작용과 응답만 유지한다.
3.2 Reasoning RL
Reasoning RL은 GRPO와 IcePop을 기반으로 하며, 학습 정책의 확률과 추론 정책의 확률을 구분하고 KL 정규화를 제거한다. 완전한 on-policy 설정에서 β = 2, ϵlow = 0.2, ϵhigh = 0.28, 그룹 크기 32, 배치 크기 32를 사용한다.
- IcePop은 학습–추론 확률비가 [1/β, β] 안에 있으면 이를 가중치로 유지하고, 그렇지 않으면 0을 부여한다. GRPO 목적함수는 이와 별도로 현재 학습 정책과 이전 학습 정책 사이의 클리핑된 확률비, 그룹별로 정규화한 결과 기반 advantage를 사용한다.
- DSA 인덱서는 토큰마다 k = 2048개 항목을 선택하므로 선택된 인덱스를 모두 저장하면 비용이 크다. 저자들은 대신 torch.topk를 사용하며, 자신들의 구현에서는 결정적으로 동작한다고 보고한다. RL에서는 기본적으로 인덱서 파라미터를 동결한다.
- 실험한 비결정적 CUDA 및 TileLang top-k 구현에서는 성능이 빠르게 저하되고 엔트로피가 붕괴했다고 보고한다. 따라서 일관된 희소 토큰 선택은 실용적인 학습 안정성 요건이다.
- 학습 데이터는 수학, 과학, 코드, 도구 통합 추론 사이에서 대략 균형을 맞춘다. 분야별 평가 모델이나 실행 시스템이 이진 결과 보상을 제공한다.
3.3 Agentic RL
Agentic RL은 중앙 Multi-Task Rollout Orchestrator를 갖춘 완전 비동기 프레임워크로 코딩 에이전트와 검색 에이전트를 함께 학습한다. Token-in-Token-out (TITO) 게이트웨이는 샘플링된 토큰을 그대로 보존한다. Direct Double-sided Importance Sampling은 과거 정책 체크포인트를 보관하지 않고도 정책 차이가 지나치게 큰 토큰을 마스킹한다.
- DP-aware 라우팅은 장문 컨텍스트 MoE 추론에서 KV-cache 지역성을 보존한다.
- 학습 과제는 실제 SWE 환경, 터미널 환경, 어려운 다중 홉 검색 질문을 활용한다. 과제 구성과 비동기 학습 안정화 기법은 Section 4에서 설명한다.
3.4 General RL
General RL은 기본적인 정확성, 감성 지능, 과제별 품질을 구분한다. 정확성은 지시 불이행, 논리적 불일치, 사실 오류, 환각, 부자연스러운 표현을 다룬다. 감성 지능은 공감적이고 자연스러운 응답을 목표로 한다. 과제별 보상은 글쓰기, 질의응답, 역할극, 번역 등의 과제를 개선한다.
- 혼합 보상 시스템은 결정적 규칙, outcome reward model (ORM), generative reward model (GRM)을 결합한다. 보고서는 규칙의 정밀성, ORM의 효율성과 보상 해킹 취약성, GRM의 강건성과 더 높은 분산을 비교한다.
- 전문가가 직접 작성한 응답은 문체의 기준으로 사용하며, 모델이 생성한 장황하거나 정형화된 표현을 줄이는 것을 목표로 한다.
- 이 절은 보상 설계를 설명하지만, 각 보상 유형이나 사람이 작성한 응답이 기여한 정도를 수치로 분리하지는 않는다.
3.5 On-Policy Cross-Stage Distillation
On-Policy Cross-Stage Distillation은 앞선 단계의 최종 체크포인트를 교사로 사용하고, 해당 단계의 학습 세트에서 가져온 프롬프트를 섞는다. 결과 기반 advantage를 교사의 추론 정책과 현재 학생의 학습 정책 사이에서 구한 로그 확률비로 대체하며, 이 값에는 stop-gradient를 적용한다.
- 학생이 궤적을 생성하고 교사 확률은 그 궤적에서 평가한다. 이를 통해 학습 신호를 학생의 현재 행동에 맞춘다.
- GRPO 그룹 크기는 1, 배치 크기는 1024가 된다. 교사에서 얻는 advantage는 그룹 기준값을 추정하기 위해 여러 응답을 필요로 하지 않기 때문이다.
- 현재 교사 logits는 추론 엔진에서 얻는다. 학습 엔진 백엔드로의 이전과 MQA-mode MLA 추론으로의 통일은 구현된 결과가 아니라 향후 과제로 설명한다.
3.6 RL Training Infrastructure: The slime Framework
slime 프레임워크는 맞춤형 rollout, HTTP 기반 과제 실행, 지연 시간 중심의 추론, 장애 허용을 위한 공통 후학습 스택을 제공한다. 보고서는 전체 서빙 처리량뿐 아니라 가장 느린 궤적의 완료 시간을 강조한다.
- 과제별 rollout 코드는 최적화 백엔드를 변경하지 않고도 다중 턴 상호작용, 도구 호출, 환경 피드백, 검증기 기반 분기를 구현할 수 있다. HTTP API를 통해 외부 에이전트 프레임워크도 같은 서빙 계층을 사용할 수 있다.
- 다중 노드 배포 예시는 노드 8개에서 EP64와 DP64를 사용하여 분산 KV-cache 용량을 확보한다. FP8 rollout과 MTP는 특히 작은 배치에서 늦게 끝나는 작업의 디코딩 지연을 줄이는 데 초점을 둔다.
- Prefill–Decode 분리는 긴 접두사의 prefill과 진행 중인 디코딩을 분리하여 다중 턴 작업의 간섭을 줄인다.
- Heartbeat 모니터링은 비정상 서버를 종료하고 등록을 해제하여 재시도가 정상 서버에 도달하도록 한다. 이 절은 설계 세부사항을 제공하지만, 동기식 기준 시스템과 비교한 처리량이나 꼬리 지연 측정치는 제공하지 않는다.
4 Agentic Engineering
보고서는 사람이 모델에 코드 작성을 반복해서 요청하는 방식과 구분하여, 에이전트가 계획하고 구현하며 반복 개선하는 방식을 agentic engineering으로 정의한다. 학습 방식은 비동기 RL과 환경 구축 파이프라인을 결합한다. 이 파이프라인은 소프트웨어 엔지니어링, 터미널 사용, 검색, 슬라이드 생성에 실행 기반 피드백을 제공한다.
4.1 Asynchronous RL for Agentic Tasks
비동기 에이전트 학습은 추론 엔진과 학습 엔진을 별도 GPU에 배치한다. 추론은 궤적을 계속 수집하고, 미리 정한 수집 기준에 도달하면 최적화를 시작한다. Rollout 가중치는 그래디언트 업데이트 K회마다 동기화하며, 추론 엔진의 가중치를 갱신한 뒤 옵티마이저를 초기화한다. 중앙 오케스트레이터는 독립적인 과제 마이크로서비스 전반에서 1k개가 넘는 동시 rollout을 지원한다.
- 모델이 생성한 토큰만 최적화 손실에 포함하며, 환경 피드백은 컨텍스트로 남긴다. TITO는 정확한 토큰 ID와 메타데이터를 기록하여 완성된 텍스트를 다시 토큰화할 때 생기는 토큰 경계, 정규화, 잘림의 불일치를 피한다.
- 직접 중요도 샘플링은 현재 정책 확률을 기록된 rollout 확률로 나눈 값을 사용한다. 보정 함수는 1 − ϵℓ < x < 1 + ϵh일 때만 이 비율을 유지하고, 그렇지 않으면 해당 토큰을 그래디언트 계산에서 마스킹한다.
- 궤적의 가장 오래된 rollout 버전이 w′ − w0 > τ를 만족하면 그 궤적을 폐기한다. 환경 붕괴로 발생한 실패는 제외한다. 불완전한 그룹은 원래 그룹의 절반을 넘는 유효 샘플이 남아 있을 때만 유효 샘플을 반복 사용하며, 그렇지 않으면 그룹 전체를 버린다.
- 일관된 해싱은 각 rollout을 고정된 DP rank에 할당하며, 가벼운 재분배로 prefix-cache 지역성을 유지한다. 이 기법들은 정책 지연과 제각각인 rollout 소요 시간에 대응하지만, 개별 기법의 이득은 수치로 제시하지 않는다.
4.2 Environment Scaling for Agents
4.2.1 Software Engineering (SWE) Environments와 4.2.2 Terminal Environments는 텍스트 평가에만 의존하지 않고 실행 가능한 검증을 갖춘 과제를 구성한다. SWE 파이프라인은 수천 개 저장소에서 10k개가 넘는 환경을 구축하며, Python, Java, Go, C, CPP, JavaScript, TypeScript, PHP, Ruby의 9개 언어를 다룬다.
- 필터링된 issue–PR 쌍은 버그 수정, 기능 구현, 리팩터링 등 다양한 변경을 포함한다. RepoLaunch 기반 설정 파이프라인은 환경과 테스트 명령을 생성하며, 언어별 특성을 반영한 로그 파싱으로 Fail-to-Pass (F2P)와 Pass-to-Pass (P2P) 사례를 처리한다.
- 시드 기반 터미널 합성은 초안 작성, 구체적인 Harbor 형식 구현, 평가 기준에 따른 개선을 순서대로 진행한다. 수천 개 과제를 생성하며, Docker 구축 정확도가 90%를 넘는다고 보고한다.
- 또 다른 터미널 파이프라인은 기술 웹페이지를 선별하고 주제와 난도에 걸쳐 샘플링한 뒤, 구축 에이전트가 Harbor 검증을 통과할 때까지 과제를 수정하도록 한다. 이 검사는 과제 구축의 유효성을 확인하지만, 편법을 완전히 막는다는 사실까지 독립적으로 입증하지는 않는다.
4.2.3 Search Tasks는 중복 제거된 2 million개가 넘는 웹페이지로 구축한 Web Knowledge Graph에서 다중 홉 질문을 합성한다. 4.2.4 Inference with Context Management for Search Agents는 모델의 컨텍스트 윈도우가 확장되었더라도 누적된 도구 관찰 결과를 관리하는 일이 여전히 중요함을 보여준다.
- 질문 필터링은 도구 없이 수행한 8회 시도 중 어느 한 번이라도 풀린 문항이나 기본 에이전트가 몇 단계 만에 해결한 문항을 제거한다. 양방향 검증은 답이 유일하지 않은 문항, 근거가 일치하지 않는 문항, 정답 표시가 잘못된 문항을 제외한다.
- 저자들은 평가 모델 선택에 따라 결과가 달라짐을 관찰한 뒤, 검색 평가에 공식 OpenAI 평가 프롬프트와 o3-mini를 사용한다. 도구는 search, open, find, python이다.
- Keep-recent-k는 오래된 관찰 결과를 정확히 “Tool result is omitted to save tokens.”라는 텍스트로 대체한다. k = 5일 때 BrowseComp는 55.3%에서 62.0%로 개선된다.
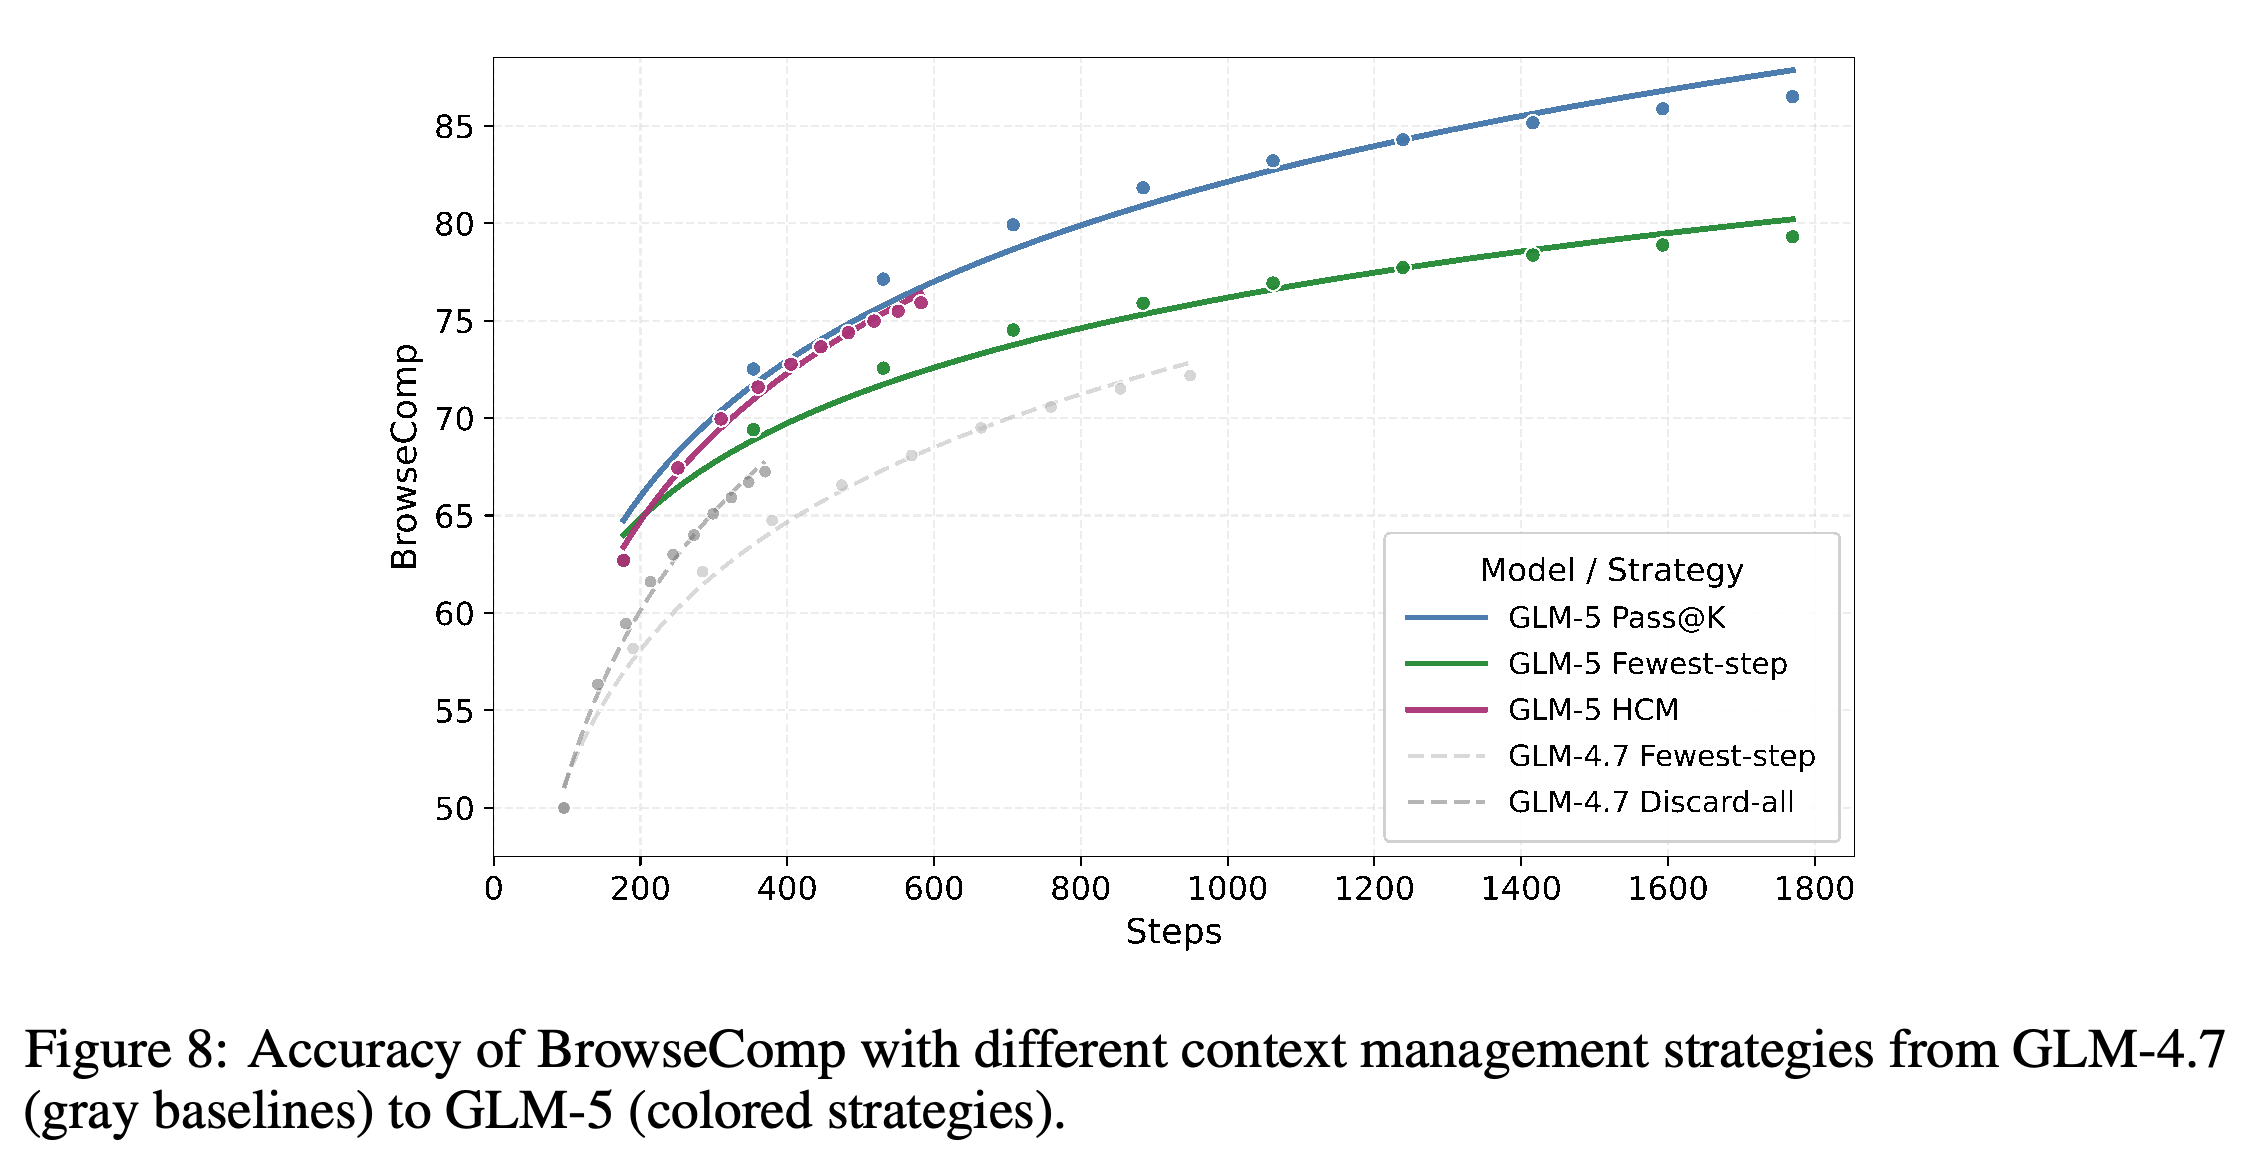
- Hierarchical Context Management는 관찰 결과 축약과 전체 컨텍스트가 T = 32k를 넘을 때의 Discard-all을 결합하여 75.9를 기록한다. 반면 Section 6.1.3과 Appendix B.2는 보고된 컨텍스트 관리 조건을 discard-all로 설명하므로, 정확한 벤치마크 설정은 확정되지 않는다.
BrowseComp 정확도는 검색 전략과 실행 단계 수 제한에 모두 영향을 받는다. GLM-5의 Hierarchical Context Management는 그래프에 표시된 GLM-4.7 기준 모델보다 개선된다. 별도의 Pass@K 곡선은 다른 평가 조건이므로 단일 궤적의 정확도로 해석해서는 안 된다.
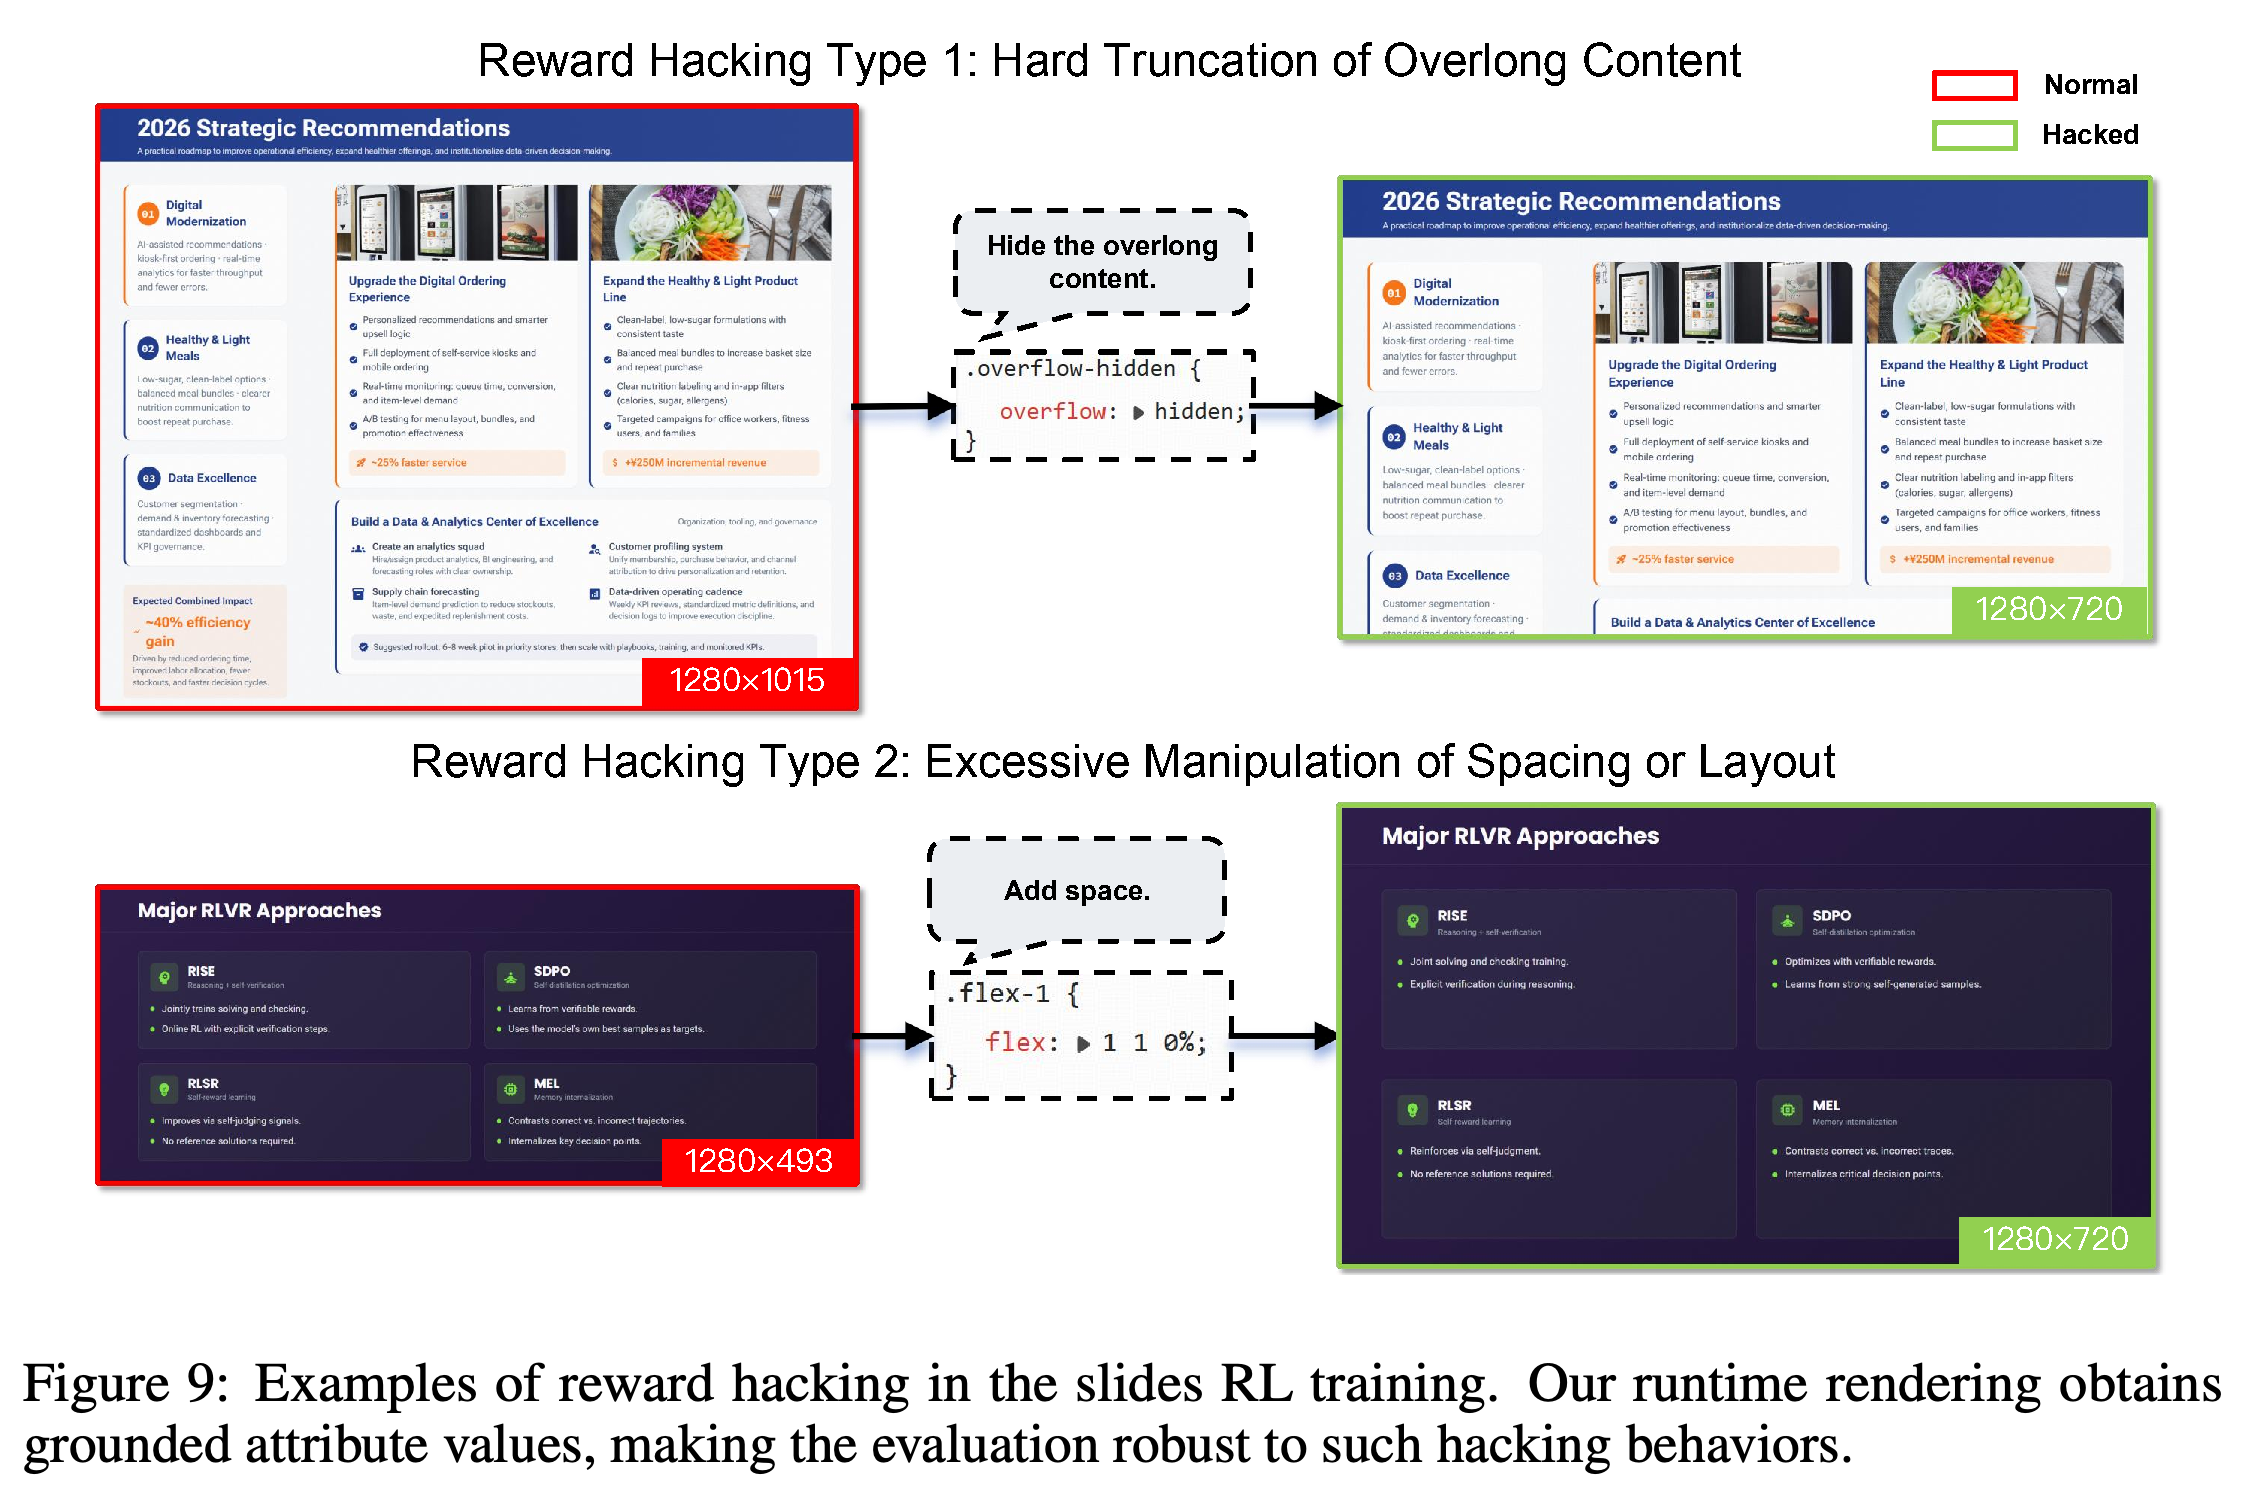
4.2.5 Slide Generation은 SFT, RL, rejection sampling, 마스킹 기반 개선으로 HTML 기반 슬라이드 전문가 모델을 학습한다. 보상은 정적 마크업, 실행 시 DOM 기하 정보, 렌더링된 시각적 특징을 계층적으로 평가한다. 렌더러를 수정하여 콘텐츠 잘림과 간격 조작에 대응한다.
- 동적 샘플링은 구조적으로 단순한 페이지의 비중을 줄인다. Best-of-N rejection sampling은 품질이 높은 후보를 선택하며, 마스킹은 일부에 결함이 있는 궤적에서도 유용한 페이지를 보존한다.
- 엄격한 16:9 준수율은 40%에서 92%로 높아진다. GLM-4.5와 비교한 사람 평가에서 승률은 콘텐츠 60%, 배치 57.5%, 미적 품질 65%, 전체 67.5%로 보고한다.
- 이 절은 구체적인 보상 해킹 사례를 제시하지만, 사람 평가의 표본 크기나 승률의 불확실성은 제공하지 않는다.
한 예시는 넘치는 콘텐츠를 숨겨 1280×1015 슬라이드를 1280×720으로 바꾼다. 다른 예시는 공간을 추가하여 1280×493 배치를 1280×720으로 늘린다. 모두 표면적인 크기 기준은 만족하지만 콘텐츠나 구성을 개선한 것은 아닐 수 있다. 따라서 렌더링 결과에 근거한 보상 검사가 필요하다.
5 Adapting GLM-5 to Chinese Chip Infrastructure
GLM-5는 Huawei Ascend, Moore Threads, Hygon, Cambricon, Kunlunxin, MetaX, Enflame에 맞게 조정하며, Ascend Atlas를 상세 사례로 다룬다. 배포 전략은 혼합 정밀도 W4A8 양자화, 융합 커널, 추론 엔진 스케줄링을 결합한다.
- Atlas 800T A3 장비에서 msModelSlim은 표준 Attention 및 MLP 블록에 W8A8을, MoE 전문가에 W4A8을 적용한다. QuaRot과 Flex_AWQ_SSZ는 낮은 비트 정밀도에서의 안정성을 지원한다. 이 절에서는 모델을 750B라고 부르지만, 아키텍처 절에서는 명시한 파라미터 집계 방식에 따라 744B라고 보고한다. 보고서는 이 차이를 명시적으로 설명하지 않는다.
- Lightning Indexer는 점수 계산, ReLU, TopK를 융합한다. Sparse Flash Attention은 토큰 선택과 희소 계산을 결합하며, MLAPO는 전처리 연산자 13개를 융합한다.
- vLLM-Ascend와 SGLang 최적화에는 비동기 스케줄링, RadixCache와 Prefix Cache, 어텐션 DP와 전문가 EP의 결합, FlashComm, MTP가 포함된다.
- 보고서는 긴 시퀀스 시나리오에서 배포 비용을 50% 줄이고 “dual-GPU international clusters”와 비슷한 성능을 낸다고 주장한다. 그러나 이 비교를 독립적으로 해석할 수 있는 작업 부하, 충분히 구체적인 하드웨어 기준, 비용 내역은 제공하지 않는다.
6 Evaluation
평가는 공개 ARC 벤치마크, 내부 CC-Bench-V2 엔지니어링 평가, 배포 사용 사례에서 도출한 일반 능력 5개 영역을 결합한다. 공개 비교 대상은 GLM-4.7, DeepSeek-V3.2, Kimi K2.5, Claude Opus 4.5, Gemini 3 Pro, GPT-5.2 (xhigh)다.
6.1 Evaluation of ARC Benchmarks
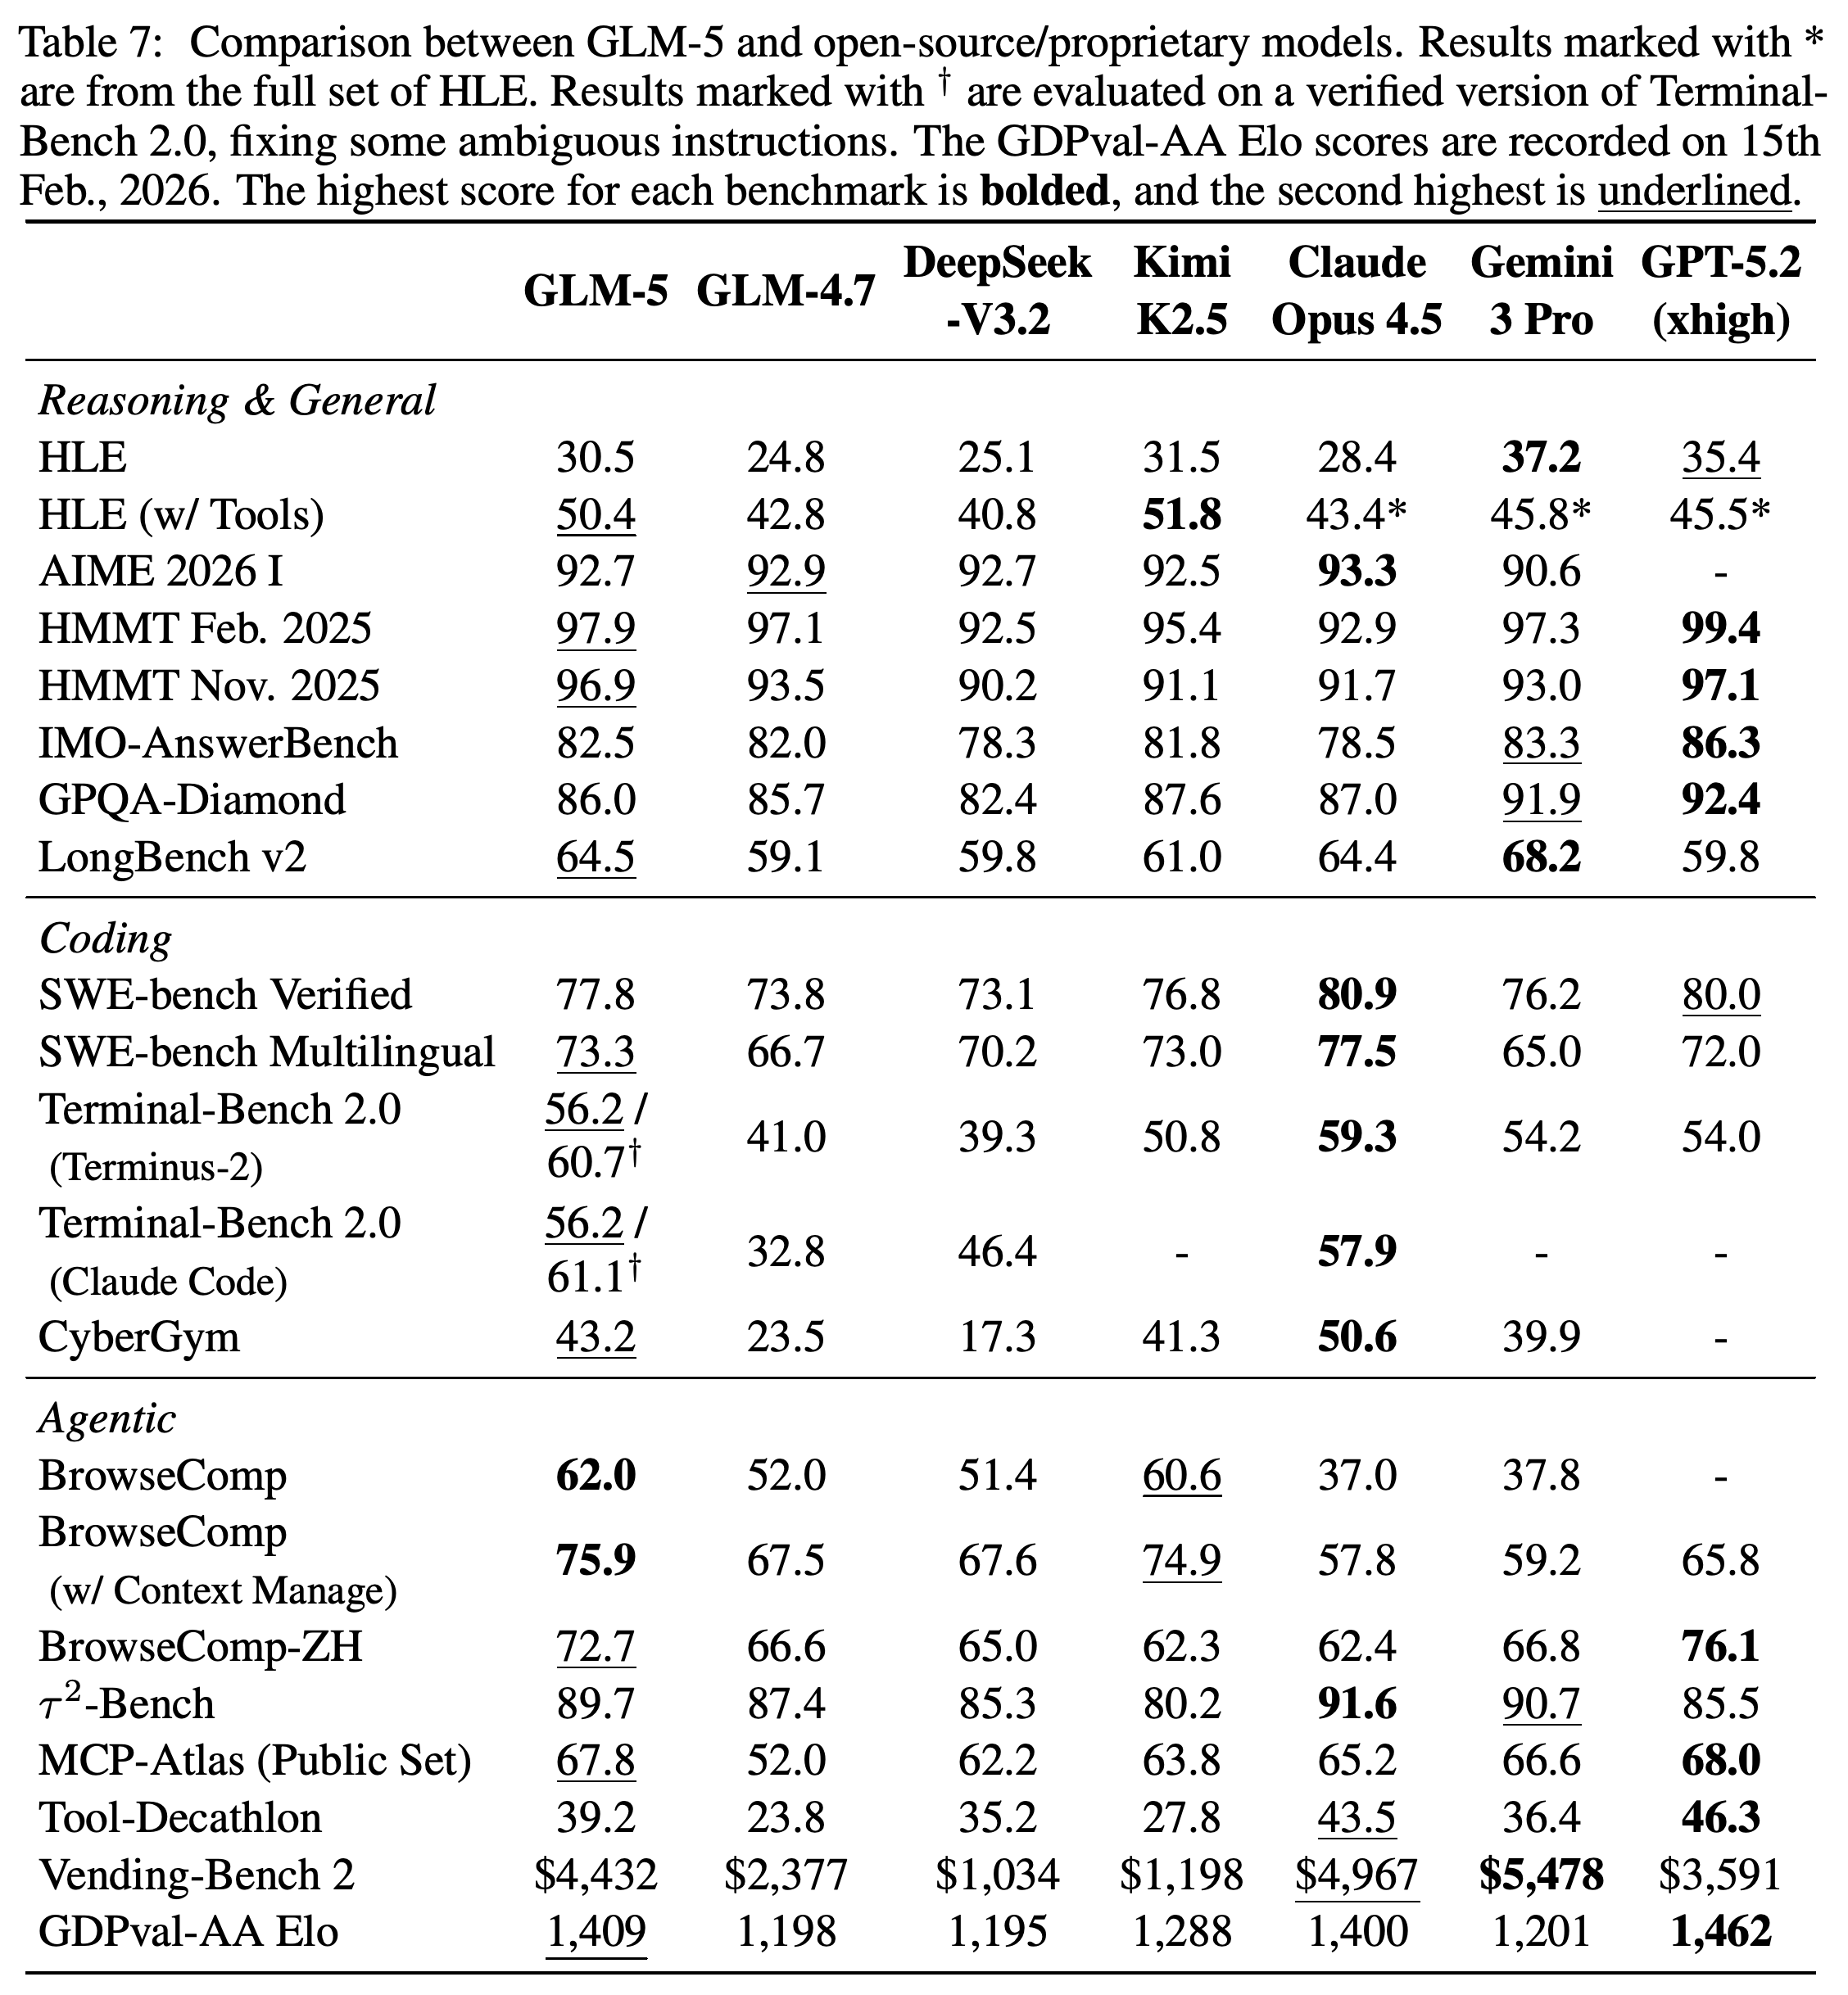
6.1.1 Evaluation of Reasoning and General Benchmarks는 텍스트 전용 HLE에서 30.5, 도구를 사용하는 HLE에서 50.4, HMMT Feb. 2025에서 97.9, HMMT Nov. 2025에서 96.9, LongBench v2에서 64.5를 보고한다. LongBench v2에서는 68.2를 기록한 Gemini 3 Pro에 이어 2위이며, Kimi K2.5는 HLE의 2개 조건 모두에서 GLM-5보다 높다.
- 추론 평가는 최대 생성 길이 131,072토큰을 사용한다. Appendix B.2는 도구를 사용하는 HLE의 최대 컨텍스트를 202,752토큰으로 명시한다. HLE 평가는 GPT-5.2 (medium)이 수행한다.
- GLM-5는 HLE와 LongBench v2에서 GLM-4.7보다 개선되지만, AIME 2026 I에서는 92.9보다 조금 낮은 92.7을 기록한다. IMO-AnswerBench와 GPQA-Diamond 점수는 각각 82.5와 86.0이다.
- *로 표시된 비공개 모델의 도구 사용 HLE 점수는 전체 HLE 세트를 사용하지만, GLM-5는 텍스트 전용 부분집합을 사용한다. 따라서 같은 부분집합에서 비교한 결과가 아니다.
6.1.2 Evaluation of Coding Benchmarks는 SWE-bench Verified에서 77.8, SWE-bench Multilingual에서 73.3, 원본 Terminal-Bench 2.0에서 실험한 2개 하네스 모두 56.2, CyberGym에서 43.2를 보고한다. 이 결과는 GLM-4.7보다 개선되지만, 원본 벤치마크의 각 조건에서는 Claude Opus 4.5가 더 높다.
- SWE 평가는 GLM-5에 맞춘 지시 프롬프트와 OpenHands를 사용한다. Terminal-Bench는 Terminus-2와 Claude Code를 사용하며, 보고된 원본 세트의 2개 조건에서 GLM-5 점수는 동일하다.
- 모호한 지시를 수정한 검증 버전 Terminal-Bench 2.0에서 GLM-5는 Terminus-2로 60.7, Claude Code로 61.1을 기록한다. 수정된 세트의 점수를 다른 모델의 원본 세트 결과와 같은 조건의 점수로 취급할 수는 없다.
- 검증된 데이터셋은 https://huggingface.co/datasets/zai-org/terminal-bench-2-verified 에서 제공한다.
6.1.3 Evaluation of Agentic Abilities는 전체 컨텍스트 초기화 없이 BrowseComp에서 62.0, 컨텍스트 관리를 적용하면 75.9, BrowseComp-ZH에서 72.7, τ²-Bench에서 89.7, MCP-Atlas에서 67.8, Tool-Decathlon에서 39.2를 보고한다. GLM-5는 제시된 BrowseComp 비교에서 가장 높지만, 도구 사용이나 장기 과제 벤치마크에서 항상 가장 높지는 않다.
- MCP-Atlas는 동일한 공개 부분집합의 과제 500개로 모델을 비교한다. 시간 제한은 4분에서 10분으로 늘리며, Gemini 3 Pro를 평가 모델로 사용한다.
- τ²-Bench에는 Retail과 Telecom 시뮬레이터 프롬프트 조정 및 Airline 도메인 수정이 포함된다. 따라서 시뮬레이터 설정도 보고된 평가 조건의 일부다.
- Vending-Bench 2의 결과는 $4,432다. 15th Feb., 2026에 기록된 GDPval-AA Elo는 1,409로, Claude Opus 4.5의 1,400 및 GPT-5.2 (xhigh)의 1,462와 비교된다.
벤치마크 비교는 특히 터미널 사용, CyberGym, 여러 도구 기반 과제에서 GLM-4.7보다 개선되었음을 보여주지만, AIME 2026 I에서는 소폭 하락한다. 각주는 전체 세트 HLE 점수, 검증 버전 Terminal-Bench 점수, 특정 날짜의 GDPval-AA Elo를 구분한다. 따라서 모든 항목이 동일한 조건의 비교는 아니다.
6.2 Evaluation of Real-world Agentic Engineering Experience
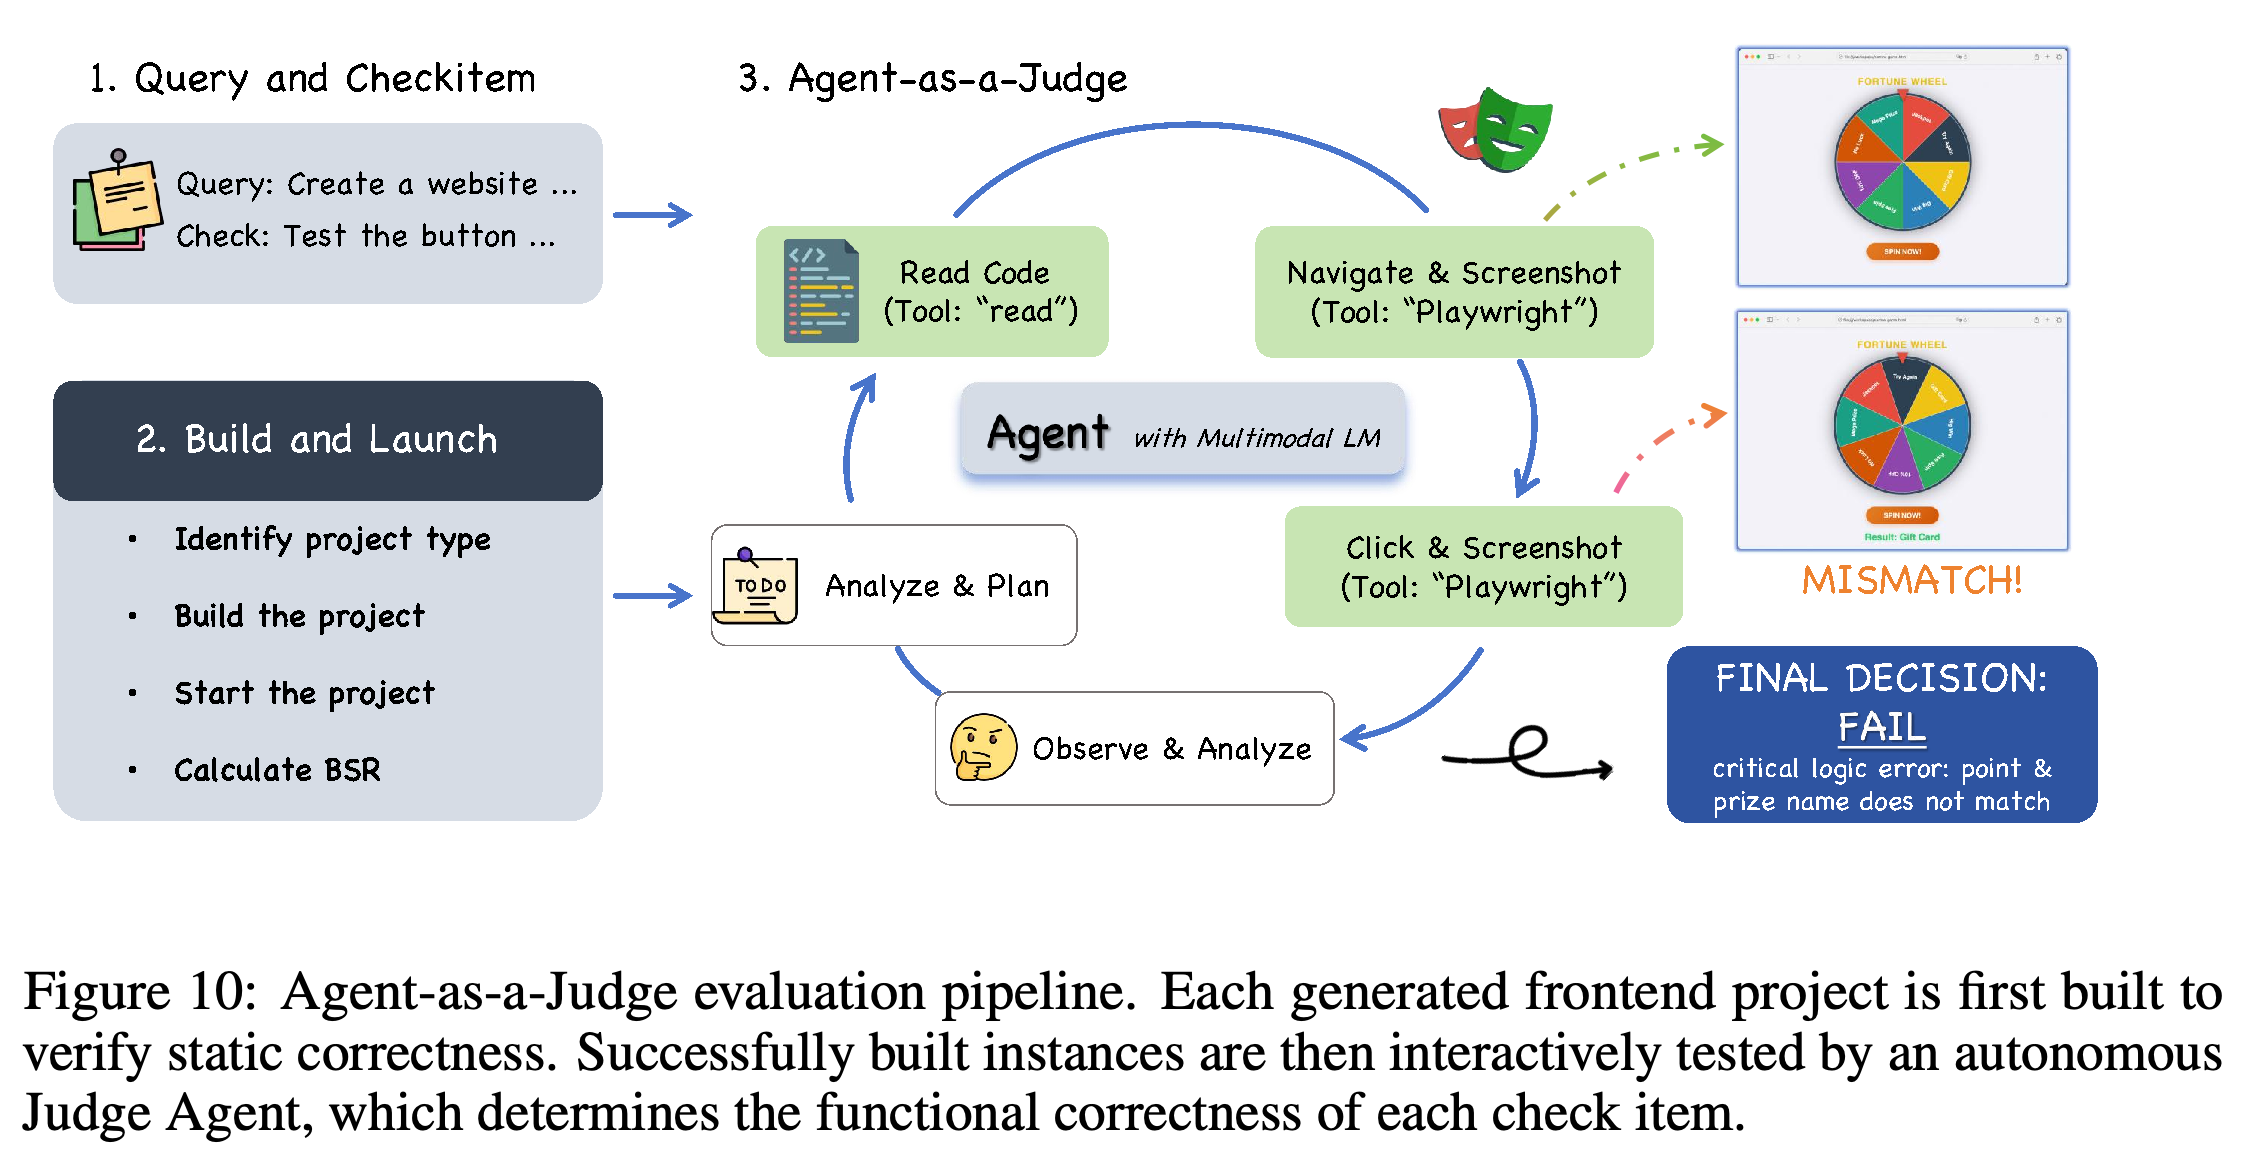
CC-Bench-V2는 자동 실행과 Agent-as-a-Judge로 프런트엔드, 백엔드, 장기 엔지니어링을 측정한다. 프런트엔드 프로젝트는 빌드 검증을 거친 뒤 Claude Code, Claude Sonnet 4.5, Playwright MCP를 사용하는 상호작용 테스트를 받는다. 채점은 자동이지만, 과제 구성, 단위 테스트, 체크리스트 검토, 평가 모델 검증에는 전문가가 참여한다.
- Build Success Rate (BSR)는 초기화와 실행을 측정한다. Instance Success Rate (ISR)는 모든 요구사항을 통과한 프로젝트의 비율을 측정하며, Check-item Success Rate (CSR)는 개별 요구사항의 완료율을 측정한다.
- 샘플링한 체크 항목 130개에서 평가 모델과 사람의 일치율은 94%다. 최첨단 모델 8개에 대한 자동 평가 순위와 사람 평가 순위의 Spearman 상관은 85.7%로 보고한다. 항목별 불일치는 주관적인 시각적 품질에 집중된다.
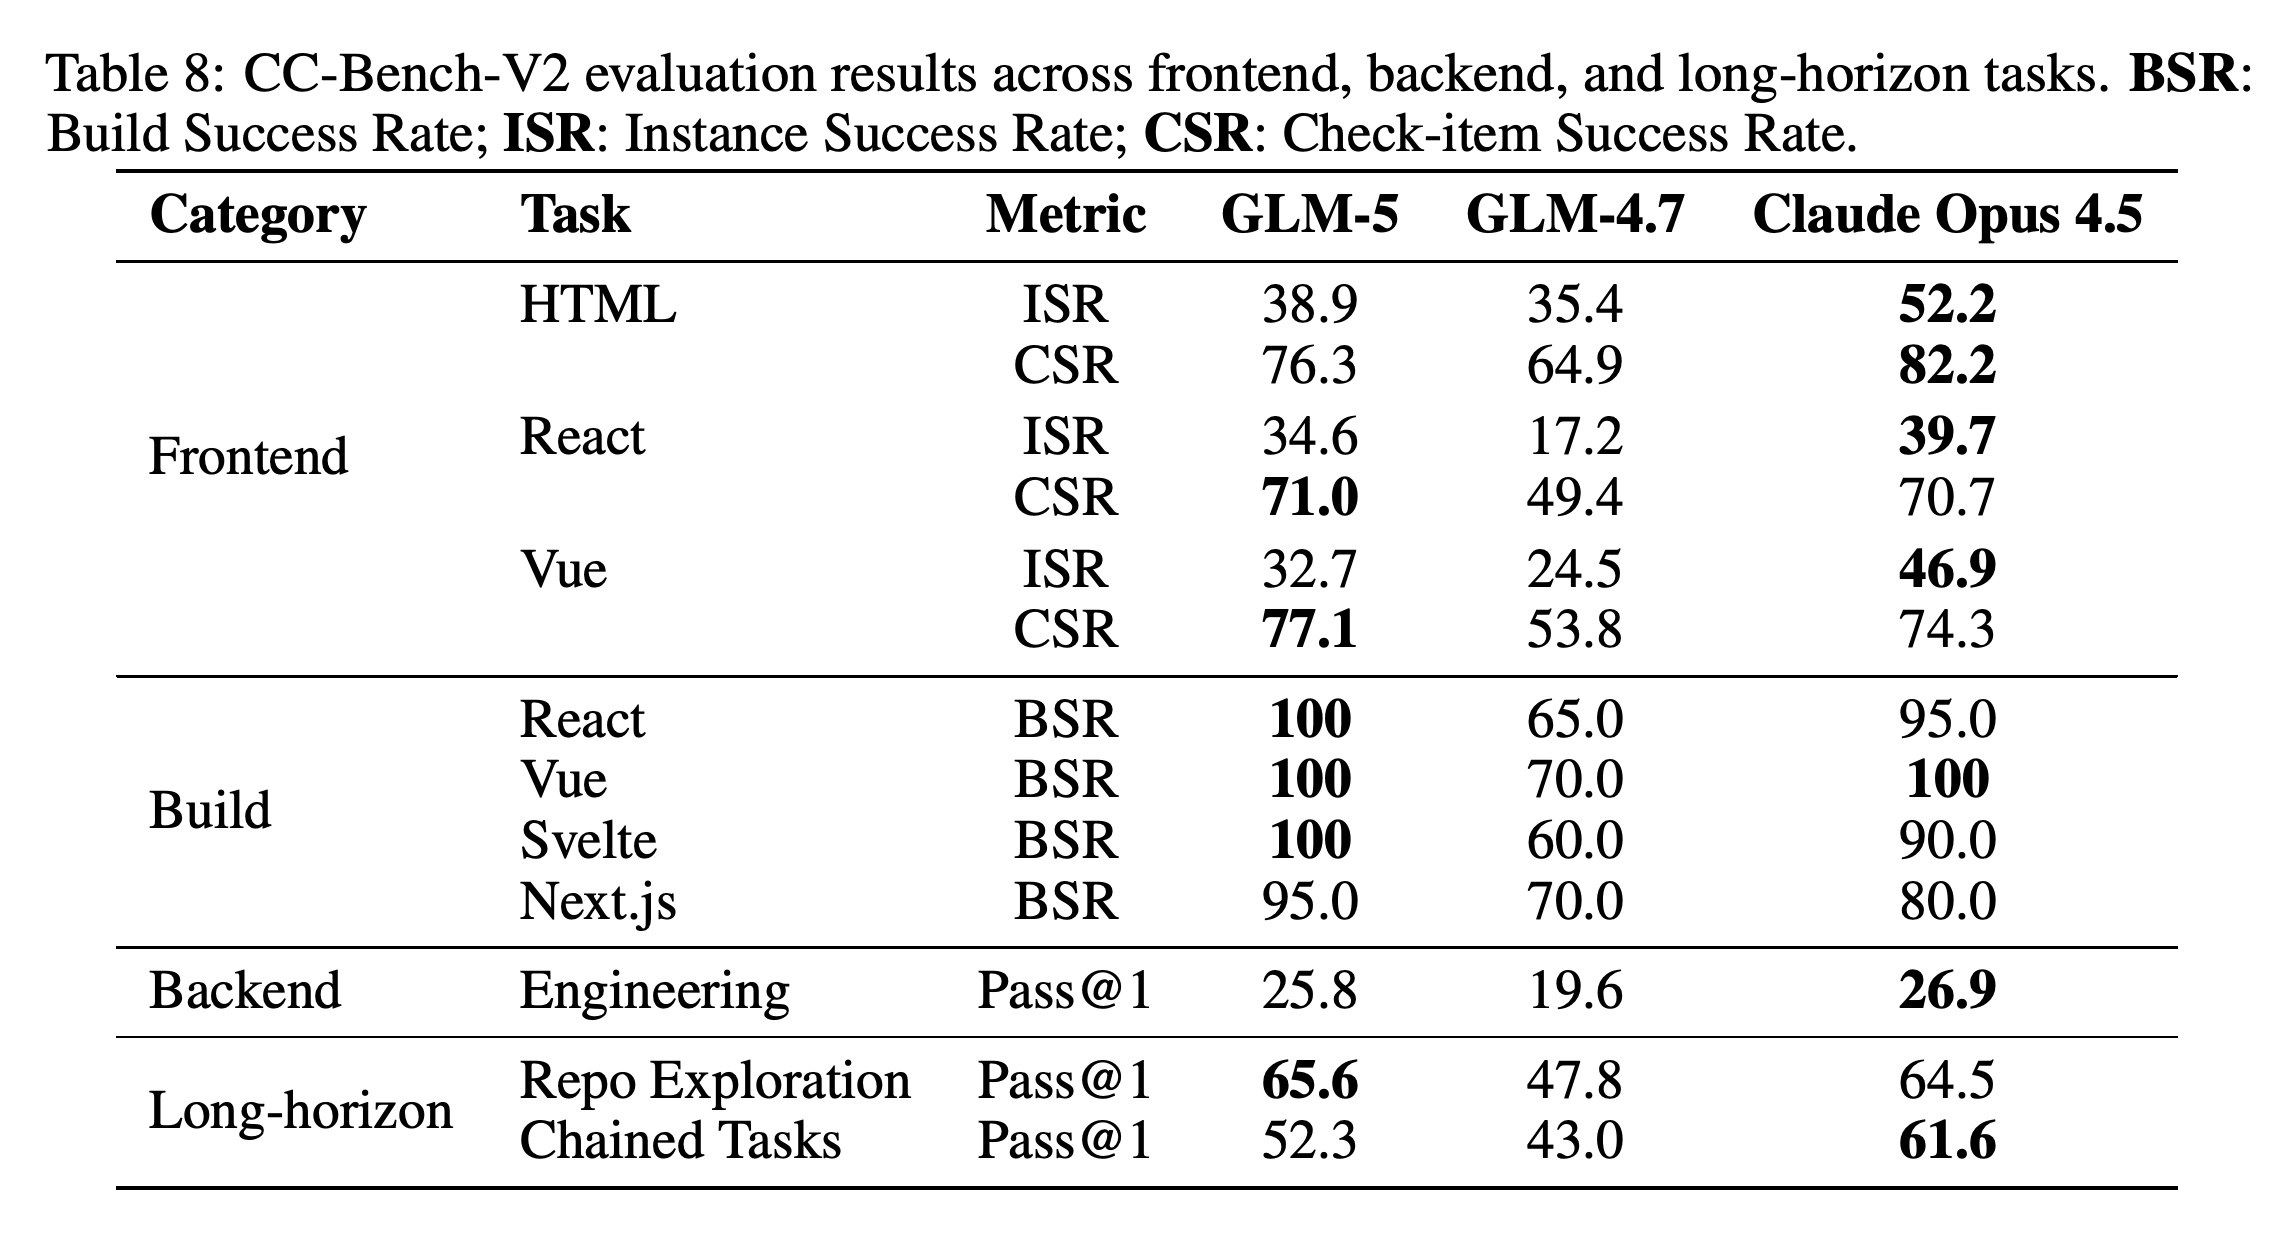
- GLM-5의 전체 BSR은 98.0%다. HTML, React, Vue의 ISR은 각각 38.9, 34.6, 32.7로, Claude Opus 4.5의 52.2, 39.7, 46.9보다 낮다.
- React CSR은 71.0으로 Claude Opus 4.5의 70.7보다 높으며, Vue CSR은 77.1로 74.3보다 높다. 따라서 개별 체크 항목에서는 강한 성능을 보이면서도 프로젝트 전체를 완성하는 성능은 더 낮을 수 있다.
표는 빌드 성공, 개별 체크 항목 완료, 과제 전체 완료를 구분한다. GLM-5는 React, Vue, Svelte에서 BSR 100을 기록하지만, 프런트엔드 ISR은 Claude Opus 4.5보다 낮다. 저장소 탐색 성능은 조금 높지만 연쇄 과제 성능은 낮다.
평가 에이전트는 먼저 프로젝트가 빌드되고 실행되는지 확인한 뒤, 코드를 읽고 스크린샷과 상호작용으로 실행 중인 UI를 테스트한다. 예시의 룰렛 결과와 경품 이름 불일치는 빌드 성공만으로 기능적 정확성을 확인할 수 없는 이유를 보여준다.
6.2.2 Backend Evaluation은 Python, Go, C++, Rust, Java, TypeScript의 과제 85개를 사용하며, 기능 구현, 버그 수정, 회귀 오류 수정, 성능 최적화를 포함한다. Docker로 구성한 각 과제에는 사람이 작성한 단위 테스트 5–10개가 있으며, Pass@1은 관련 테스트를 모두 통과해야 인정한다.
- GLM-5는 25.8을 기록하며, GLM-4.7은 19.6, Claude Opus 4.5는 26.9를 기록한다.
- GLM-5와 Claude Opus 4.5의 비슷한 점수는 엄선한 내부 과제 세트와 엄격한 단위 테스트 기준에서 얻은 결과다.
6.2.3 Long-horizon Evaluation은 저장소 탐색과 순차적 개발을 구분한다. GLM-5는 저장소 탐색에서 Pass@1 65.6을 기록하며, GLM-4.7은 47.8, Claude Opus 4.5는 64.5를 기록한다. 그러나 연쇄 과제 결과는 “52.3 on chained tasks”로 보고되며, Claude Opus 4.5의 61.6보다 낮다.
- 탐색 질문은 파일명과 코드 식별자를 사용하지 않으며, 의미적 추론 1회 또는 2회를 요구하고, 디렉터리 깊이 최소 3단계에 있는 찾기 어려운 파일을 대상으로 한다. 성공은 코드 변경의 완료가 아니라 대상 파일을 읽는 것으로 정의하며, 3회 실행의 평균을 사용한다.
- 과제 체인은 테스트와 선형 이력의 커밋 3–15개를 가진 병합된 PR에서 구성한다. 의미 기반 그룹화와 패치 분류를 통해 에이전트가 생성할 코드, 검증 테스트, 자동 적용할 설정 또는 fixture를 구분한다.
- 각 과제의 변경은 다음 과제에도 유지되며, 누적 테스트 패치는 이전 동작의 회귀를 검사한다. 보고된 연쇄 과제 Pass@1은 체인 전체의 모든 과제 성공률이 아니라 개별 과제 기준이다.
- 저자들은 남은 격차의 일부가 이후 개발 단계로 누적되는 실수 때문이라고 설명한다. 그러나 표는 이 원인을 실험적으로 분리하지 않는다.
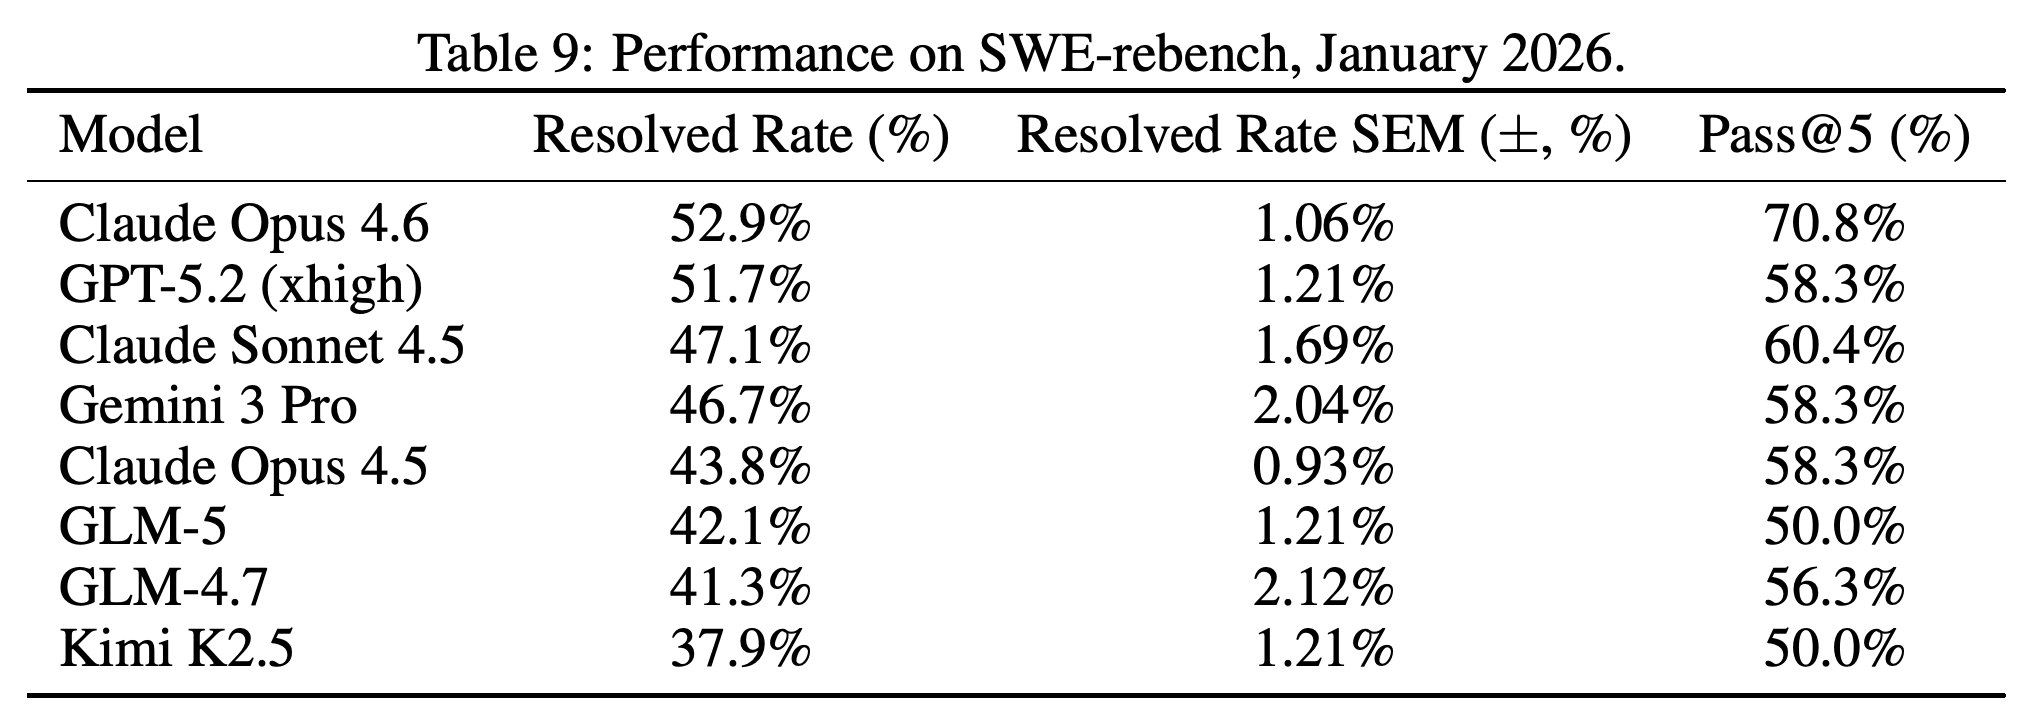
6.2.4 Evaluation on evolving SWE tasks는 정적인 SWE-bench Verified를 보완하기 위해 2026년 1월 SWE-rebench 세트를 사용한다. GLM-5의 해결률은 42.1%, 보고된 SEM은 ±1.21%, Pass@5는 50.0%다. GLM-4.7의 해결률은 41.3%, SEM은 ±2.12%, Pass@5는 56.3%다.
- Claude Opus 4.5의 해결률은 43.8%, GPT-5.2 (xhigh)는 51.7%, Claude Opus 4.6은 52.9%다.
- 새로운 과제 평가는 오래 사용한 공개 테스트 세트 밖으로 근거를 확장한다. 그러나 해결률 차이가 작고 Pass@5가 낮으므로, GLM-4.7보다 전반적인 일반화 능력이 높다고 입증하지는 못한다.
GLM-5의 2026년 1월 해결률은 42.1%로, GLM-4.7의 41.3% 및 Claude Opus 4.5의 43.8%와 가깝다. Pass@5는 50.0%로 GLM-4.7의 56.3%보다 낮다. 따라서 새로운 SWE 과제에서 모든 지표가 개선되었다고 주장하기는 어렵다.
6.3 Evaluation of Real-world General Abilities
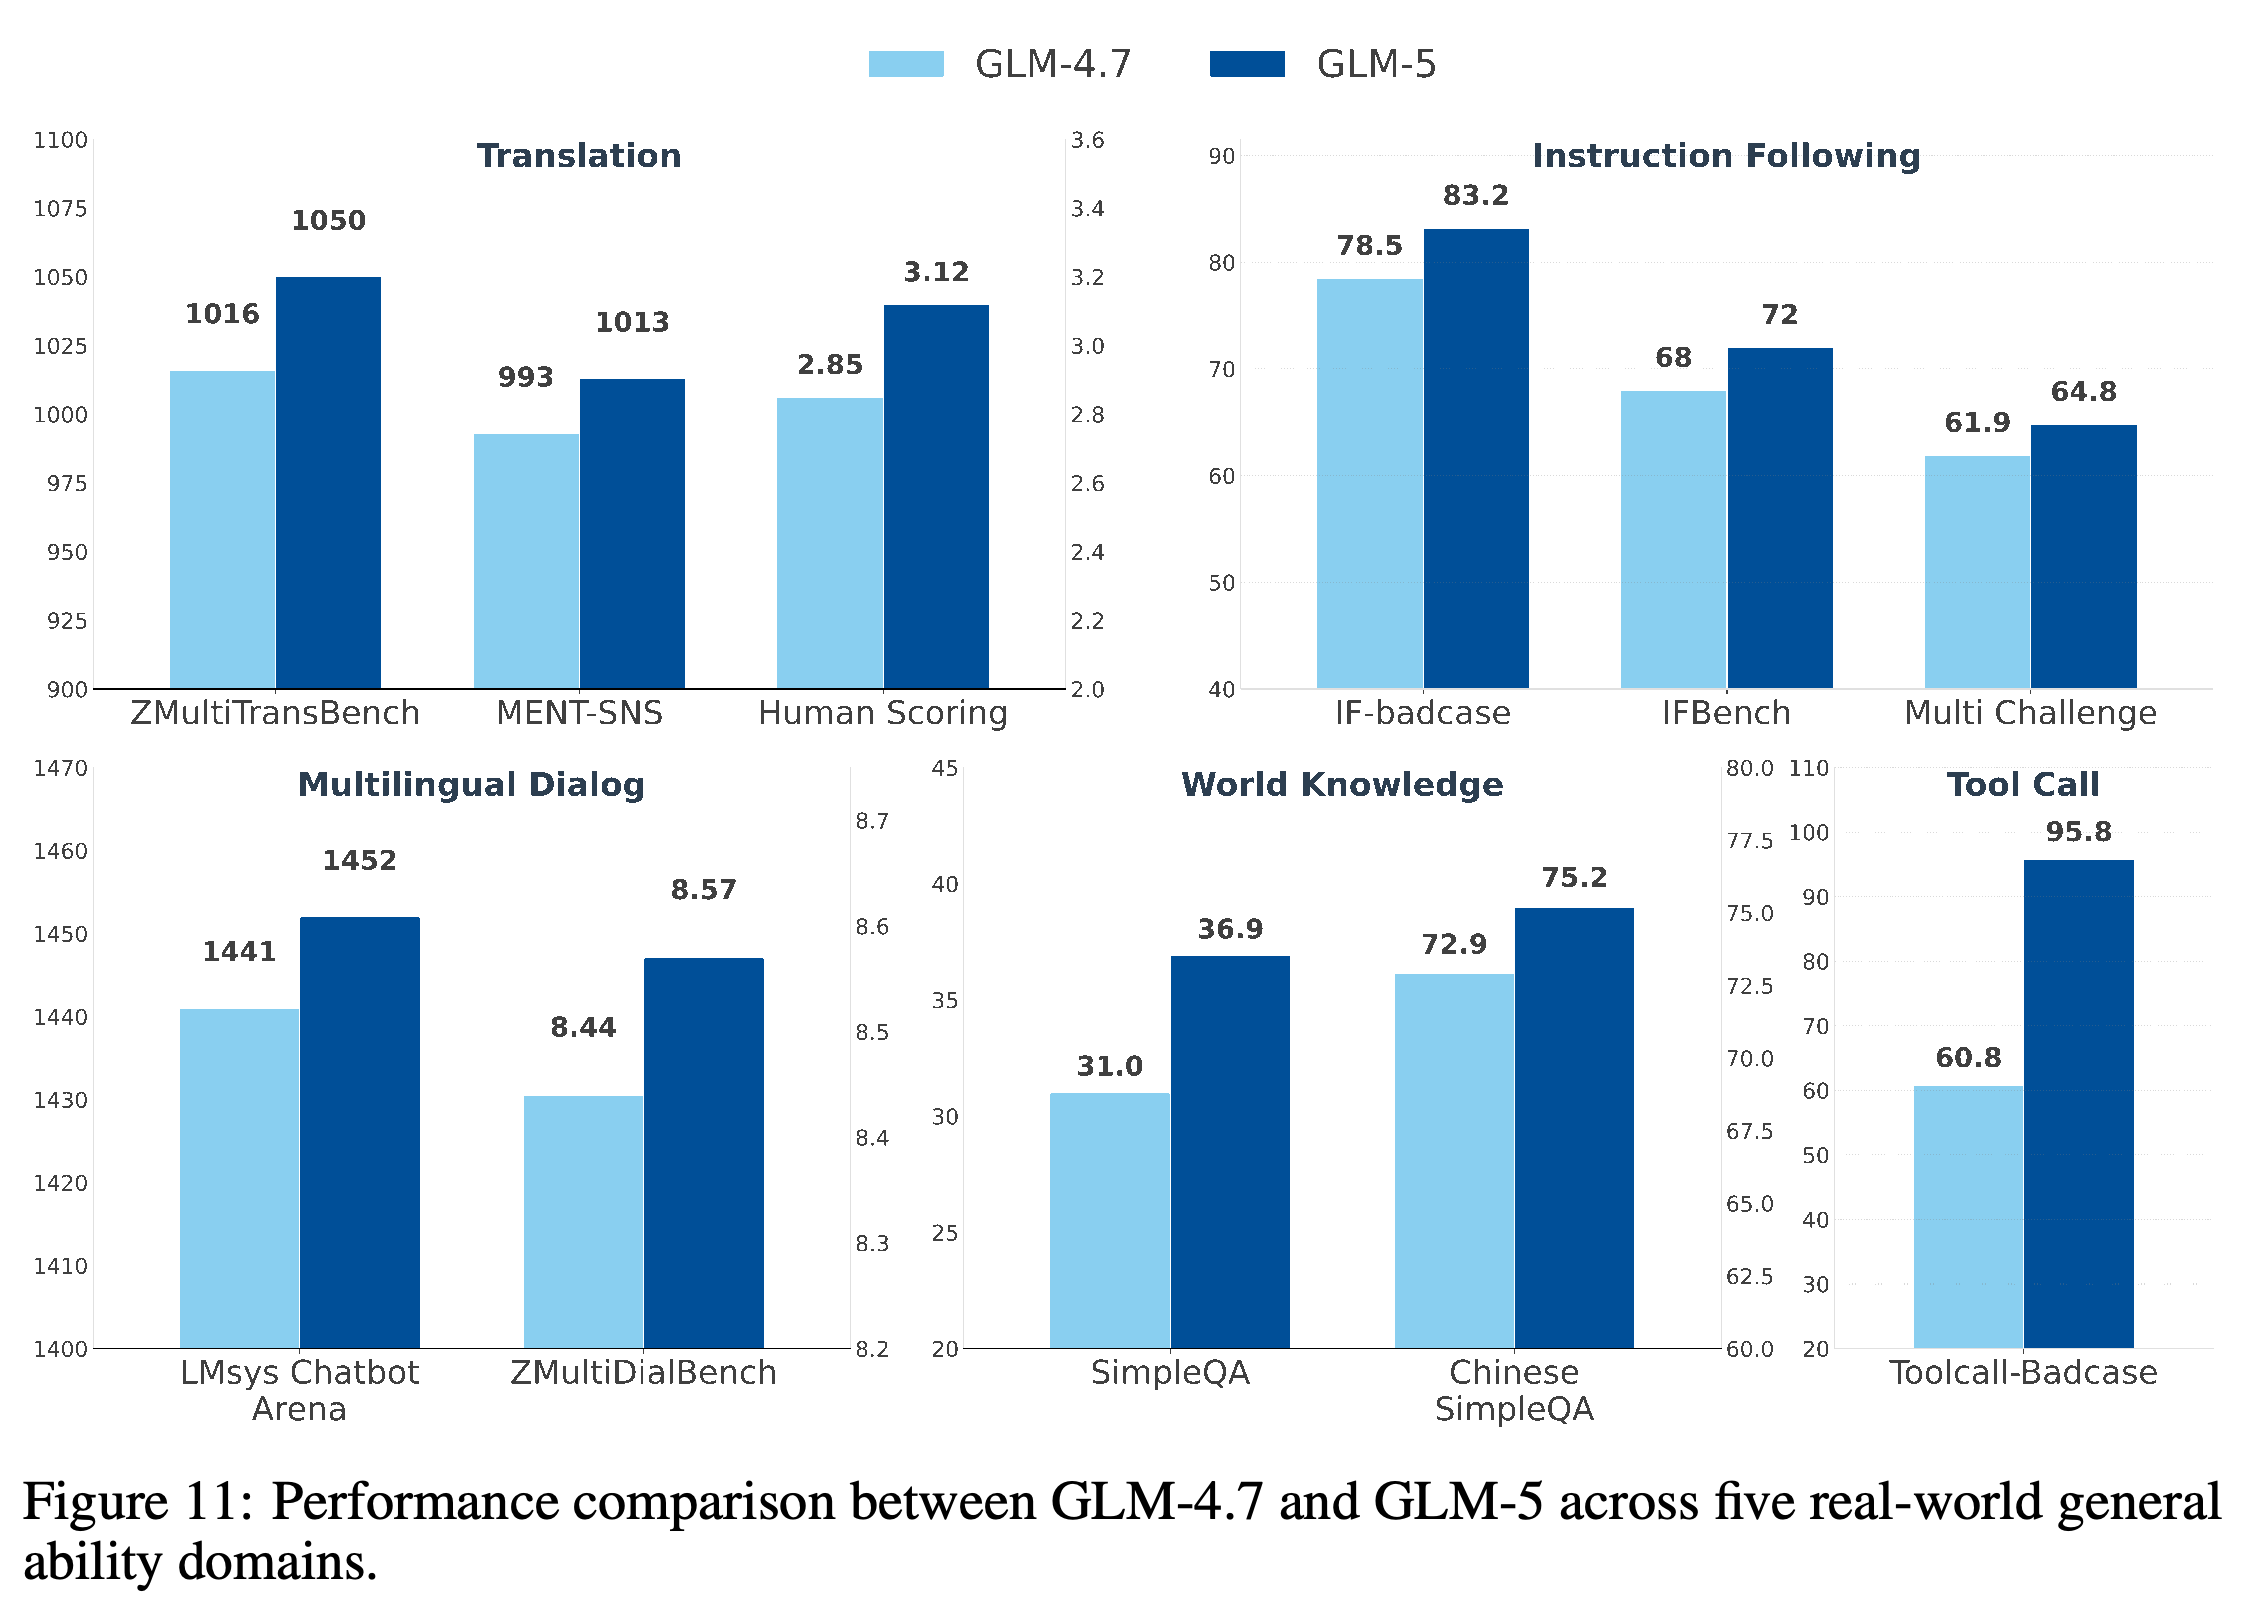
실제 사용을 반영한 일반 능력 평가는 번역, 다국어 대화, 지시 이행, 사실 지식, 도구 호출에 관한 내부 사람 평가·자동 평가와 외부 평가를 결합한다. Figure 11에서는 표시된 모든 지표가 GLM-4.7보다 개선되며, ToolCall-Badcase는 60.8에서 95.8로 상승한다.
- Machine Translation은 ZMultiTransBench 샘플 1,220개를 사용한다. Zh에서 Es로 300개, Ru로 250개, Fr로 220개, Ko로 200개, Ja로 150개, Ar로 50개, De로 50개이며, 영어–중국어 MENT 쌍 753개도 사용한다. GPT-4.1은 고정된 기준 응답과의 쌍별 품질을 평가한다. 표시된 ZMultiTransBench와 MENT-SNS 점수는 각각 1016에서 1050, 993에서 1013으로 상승한다. 그림에는 번역 Human Scoring도 2.85에서 3.12로 상승한 것으로 나타나지만, 이 하위 절에는 해당 평가의 상세 절차가 없다.
- Multi-lingual Dialogue는 1441에서 1452로 높아진 LMArena Elo와, 사람이 1–10 척도로 평가한 ZMultiDialBench 사례 141개를 결합한다. 사람 평가 점수는 8.44에서 8.57로 상승한다.
- Instruction Following은 엄선한 IF-Badcase 사례 450개, IF-Bench, MultiChallenge를 사용한다. 표시된 점수는 각각 78.5에서 83.2, 68에서 72, 61.9에서 64.8로 상승한다.
- World Knowledge 점수는 SimpleQA에서 31.0에서 36.9로, Chinese SimpleQA에서 72.9에서 75.2로 상승한다. Tool Calling은 도구와 인자의 정답을 검증할 수 있도록 검토한 ToolCall-Badcase 사례 200개를 사용한다.
표시된 모든 일반 능력 지표가 GLM-4.7보다 개선된다. 번역 Human Scoring은 2.85에서 3.12로, ToolCall-Badcase는 60.8에서 95.8로 상승한다. 척도, 이중 축, 평가 절차가 서로 다르므로 패널 간 막대 높이나 겉으로 보이는 효과 크기를 직접 비교할 수는 없다.
7 Conclusion
결론은 GLM-5를 추론, 효율적인 어텐션, 자율적인 엔지니어링 작업 절차를 결합한 공개 가중치 모델로 제시한다. 평가는 이전 GLM 모델보다 개선되었음을 보여준다. 다만 내부의 완전한 과제 성공 지표는 비공개 시스템과의 동등성이 작업 종류와 성공 기준에 따라 달라짐을 분명히 보여준다.
8 Easter Eggs
Easter Eggs 절은 OpenRouter에서 익명으로 공개한 “Pony Alpha”가 GLM-5임을 밝히고, 코딩·에이전트·역할극 동작에 대한 커뮤니티 반응을 소개한다. 초기 모델 추정 통계에서는 25%가 Claude Sonnet 5, 20%가 DeepSeek, 10%가 Grok으로 추측했고, 나머지는 GLM-5로 추측했다고 보고한다. 표본 크기나 통제된 비교가 없으므로, 이 반응은 능력 평가가 아니라 공개 당시의 일화적 근거다.
9 Contribution
Contribution 절은 Core Contributors, Contributors, Tech Leads, Advisors를 구분한다. 기여자 이름은 이름의 알파벳순으로 나열했다고 명시한다.
Core Contributors
Core Contributors는 Chendi Ge부터 Zixuan Li까지 주요 기여자 그룹을 나열한다. 보고서는 이름만 제공하며, 개인별 기술 역할은 지정하지 않는다.
Contributors
Contributors는 Bojie Wang부터 Zuzhou Zhang까지 더 넓은 기여자 그룹을 기록한다. 개인별로 아키텍처, 데이터, 학습, 평가 작업을 연결한 정보는 없다.
Tech Leads
Tech Leads에는 Aohan Zeng, Xin Lv, Zhenyu Hou, Zhengxiao Du, Qinkai Zheng, Bin Chen, Da Yin을 명시한다.
Advisors
Advisors에는 Jie Tang, Yuxiao Dong, Juanzi Li, Hongning Wang, Minlie Huang, Bin Xu를 명시한다.
부록
- A Hyper-Parameters는 Muon, cosine decay, 배치 크기 워밍업을 명시한다. 사전학습 학습률은 0에서 2e-4로 워밍업한 뒤 4e-5까지 감소한다. 중간 학습에서는 1e-5까지 선형으로 줄인다. DSA 워밍업은 5e-3에서 2e-4로 줄이며, 희소 적응은 일정한 1e-5를 사용한다. Table 10은 밀집 레이어 3개, MoE 레이어 75개, MTP 레이어 1개, 은닉 차원 6144, 어텐션 헤드 64개, 전문가 256개, 라우팅 전문가 8개, 공유 전문가 1개, 어휘 크기 154880을 보고한다. 파라미터 수에는 MTP를 포함하지만 임베딩과 출력 레이어는 제외한다. 표의 레이어 수는 본문에서 보고한 80개와 직접 일치하지 않는다.
- B Evaluation Details와 B.1 Evaluation of Base Models는 최종 모델의 개선을 해석할 때 고려할 조건을 제시한다. GLM-5-Base는 EvalPlus Pass@1을 GLM-4.5-Base의 78.1에서 87.0으로, LiveCodeBench-Base를 28.1에서 34.4로 높인다. 그러나 GSM8K는 79.4에서 68.8로, MATH는 61.0에서 56.4로 낮아진다. 영어와 중국어 결과도 혼재한다. MMLU는 86.1에서 88.3으로, C-Eval은 86.9에서 88.8로 높아지지만, PIQA는 85.3에서 84.6으로, C3는 83.1에서 80.3으로 낮아진다.
- B.2 Evaluation of ARC Benchmarks는 디코딩과 자원 조건을 제공한다. 추론은 temperature = 1.0, top_p = 0.95, max_new_tokens = 131072를 사용한다. SWE는 temperature = 0.7, top_p = 0.95, max_new_tokens = 16384와 200K 컨텍스트 윈도우를 사용한다. Terminus-2는 timeout = 2h, temperature = 0.7, top_p = 1.0, max_new_tokens = 8192, 128K 컨텍스트, CPU 16개, RAM 32 GB를 사용한다. Claude Code 2.1.14의 Terminal-Bench 평가는 temperature = 1.0, top_p = 0.95, max_new_tokens = 65536을 사용하며, 실제 경과 시간 제한을 제거하되 과제별 자원 제한은 유지하고 5회 실행을 평균한다. CyberGym은 웹 도구 없이 Claude Code 2.1.18을 사용하며, temperature = 1.0, top_p = 1.0, max_new_tokens = 32000, 250분 시간 제한을 적용하고 1,507 tasks에서 단일 실행 Pass@1을 측정한다. BrowseComp는 전체 초기화 없이 최근 5개 턴을 유지하며, 컨텍스트 관리 조건은 discard-all로 설명한다. Vending-Bench 2 runs는 Andon Labs가 독립적으로 수행한다.
- B.3 Optimized User Simulator for τ²-Bench는 조기 종료를 막고 명시된 사용자 제약을 유지하기 위한 Telecom과 Retail 프롬프트 변경을 기록한다. B.4 Evaluation of Real-world Agentic Engineering Experience와 B.4.1 Frontend Evaluation은 시나리오 7개에 걸친 프런트엔드 과제 220개를 설명한다. HTML은 과제 113개와 체크 항목 490개, React는 과제 58개와 체크 항목 249개, Vue는 과제 49개와 체크 항목 210개다. 숙련된 전문가의 과제 설계, 전문가가 검토한 체크리스트 합성, 실행 기반 수정, 단순한 과제 제거를 바탕으로 벤치마크를 구성한다. 따라서 자동 채점도 상당한 수준의 사람 선별과 검증에 의존한다.
짧은 생각
보고서는 모델 학습을 오래 실행되는 에이전트의 구체적인 요구사항과 연결한다. 여기에는 정확한 토큰 정렬, 일관된 희소 선택, 캐시 지역성을 보존하는 라우팅, 실패를 고려한 샘플링, 실행 가능한 피드백이 포함된다. 엔지니어링 평가도 빌드 성공과 개별 체크 항목 통과를 완전한 과제 성공과 구분한다. 높은 프런트엔드 BSR이 ISR 격차를 없애지는 않으며, 저장소 탐색 성능이 높아져도 연쇄 개발 실패는 남는다. 희소 어텐션 적응에는 동일한 데이터를 사용한 SFT 곡선과 장문 컨텍스트 표라는 직접적인 정량 근거가 있다. 다만 효율적인 어텐션 비교가 모두 같은 기반 모델과 학습량을 사용하는 것은 아니다. 비동기 학습의 효율성과 하드웨어 비용 주장은 평가하기 더 어렵다. 조건을 맞춘 처리량, 활용률, 배포 비용 측정치가 없기 때문이다. 비교에는 명시된 조건을 고려해야 한다. 텍스트 전용 HLE와 전체 HLE, 원본 Terminal-Bench와 검증 버전, 수정된 시뮬레이터와 시간 제한, 확정되지 않은 BrowseComp 컨텍스트 관리 설명을 구분해야 한다. 새로운 SWE-rebench 결과와 기반 모델의 수학 성능 저하는 모든 영역에서 개선되었다는 주장을 제한한다. 측정된 향상만으로는 아직 신뢰할 수 있는 종단 간 엔지니어링을 입증하지 못한다.