


2026년 4월 AI 논문 동향
30 Apr 2026 | Paper Review Monthly Papers Generalist Vision 3D World Generation Diffusion Language Models목차
이달의 트렌드
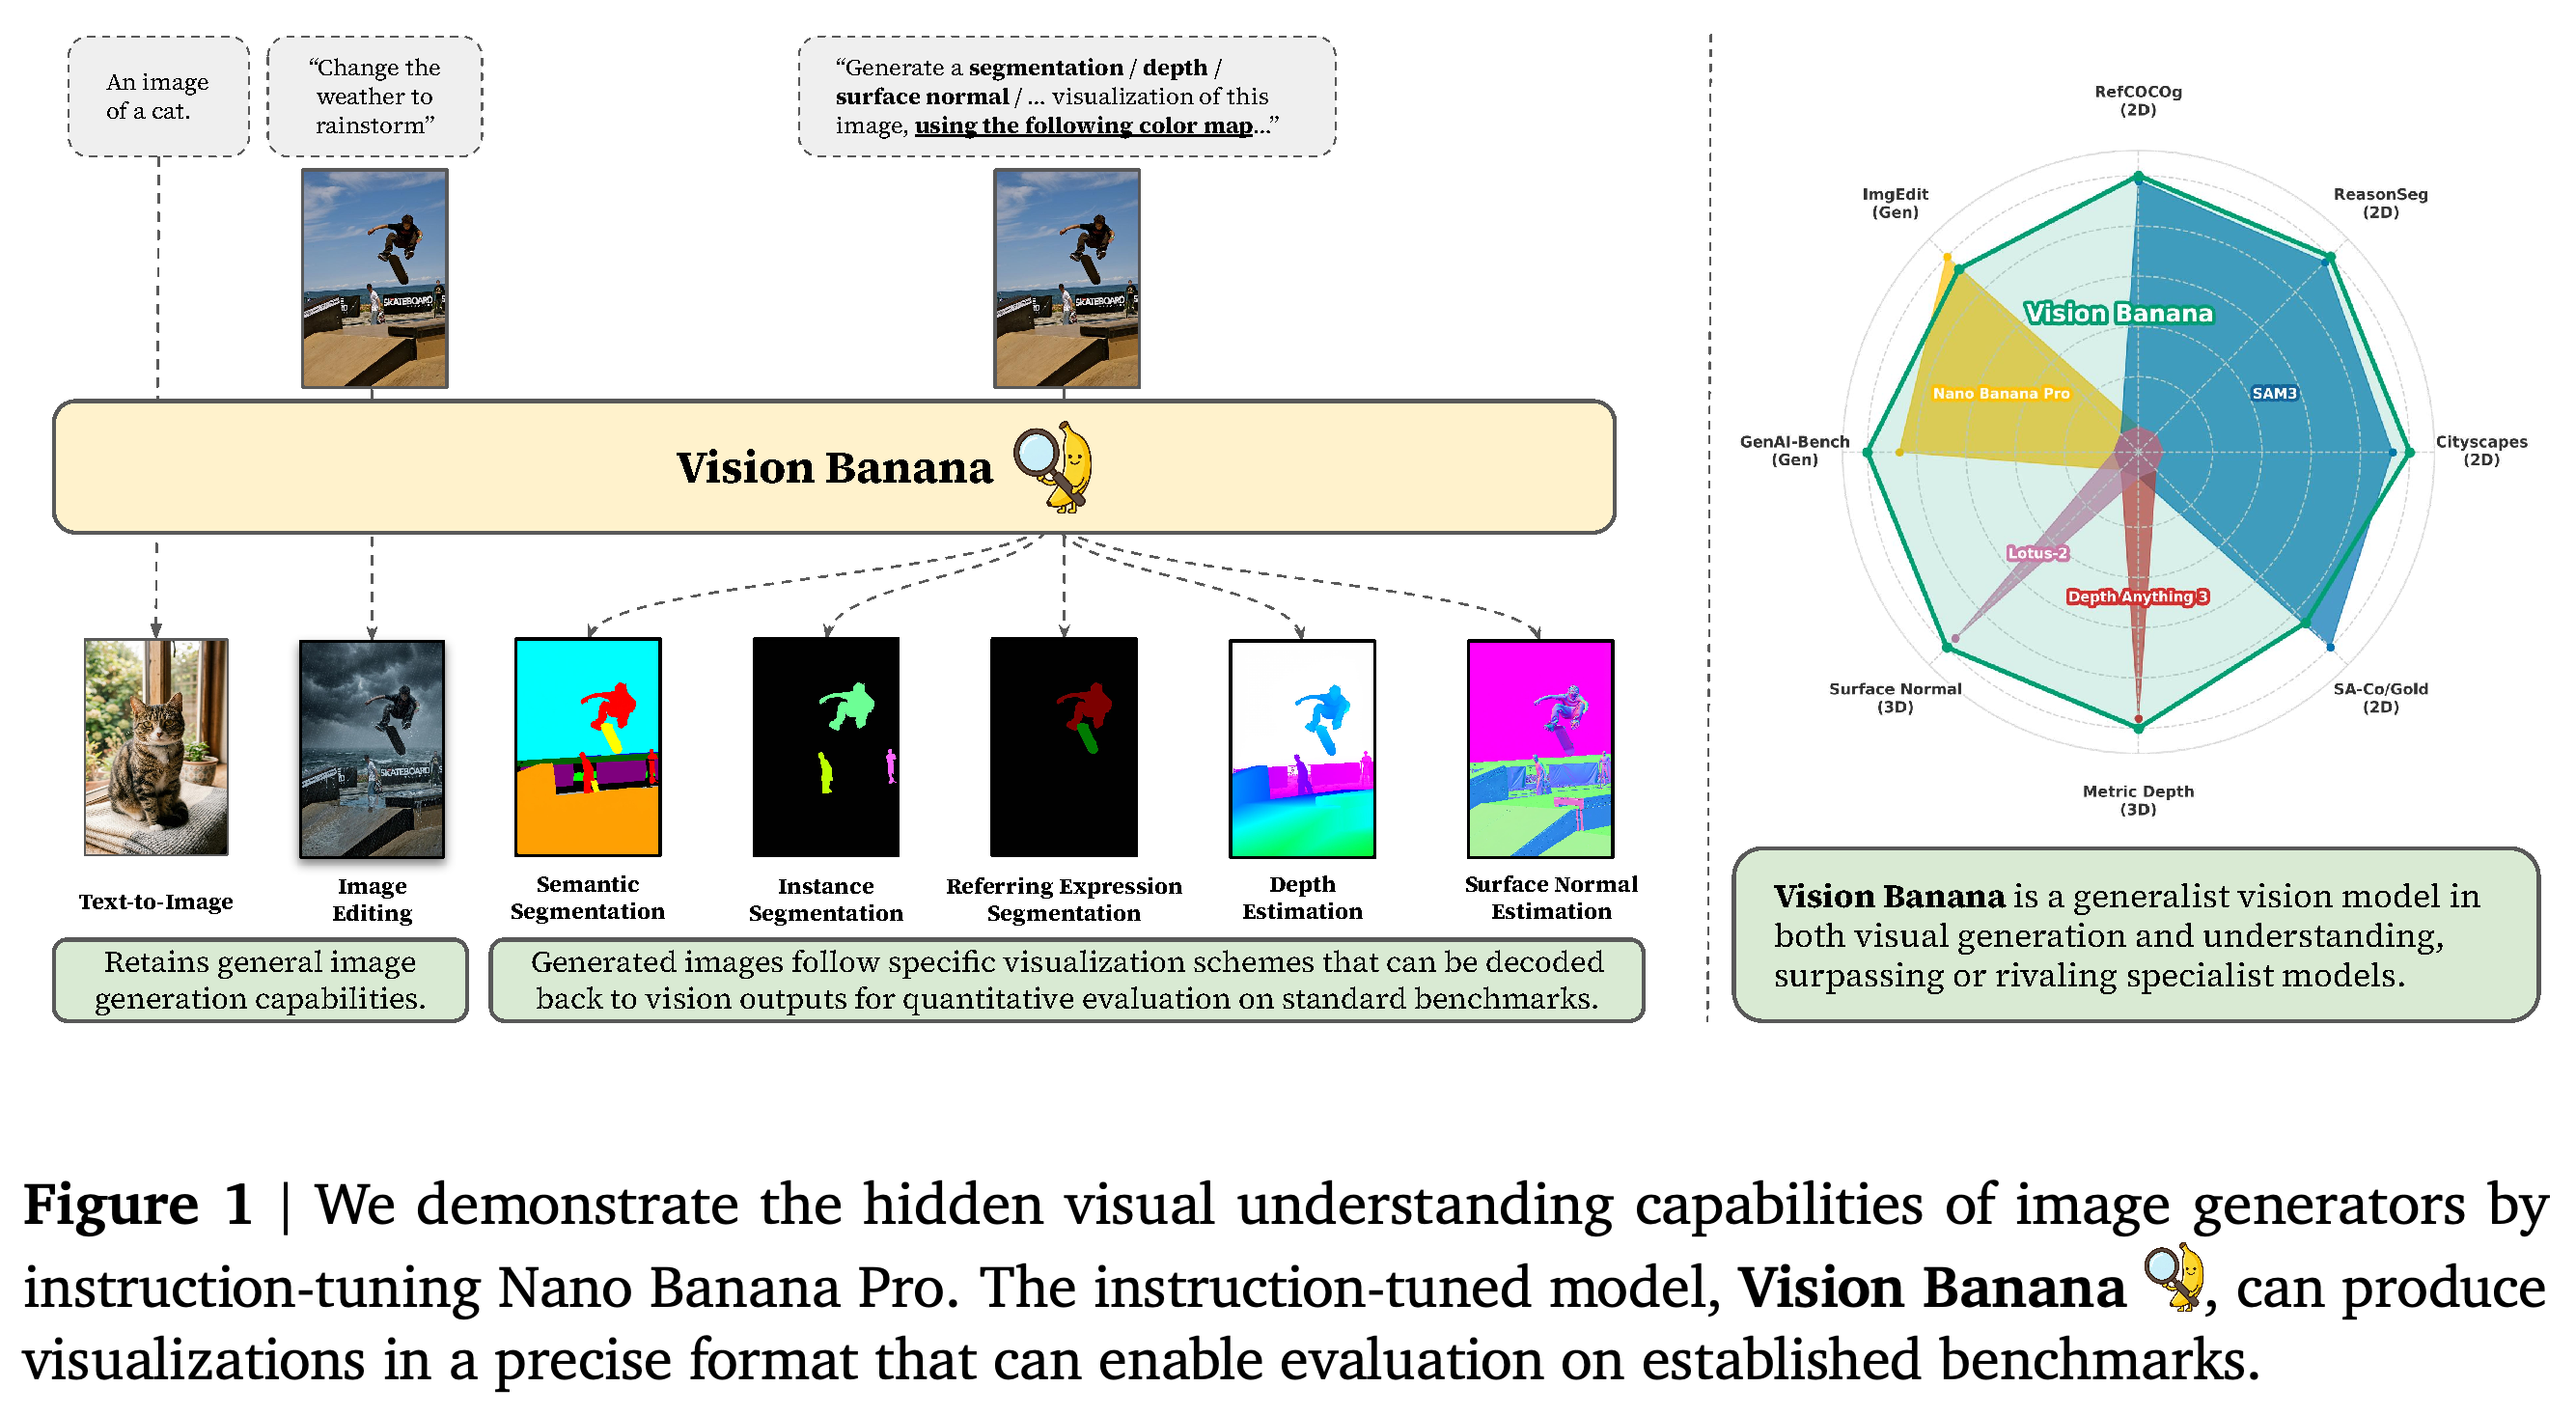
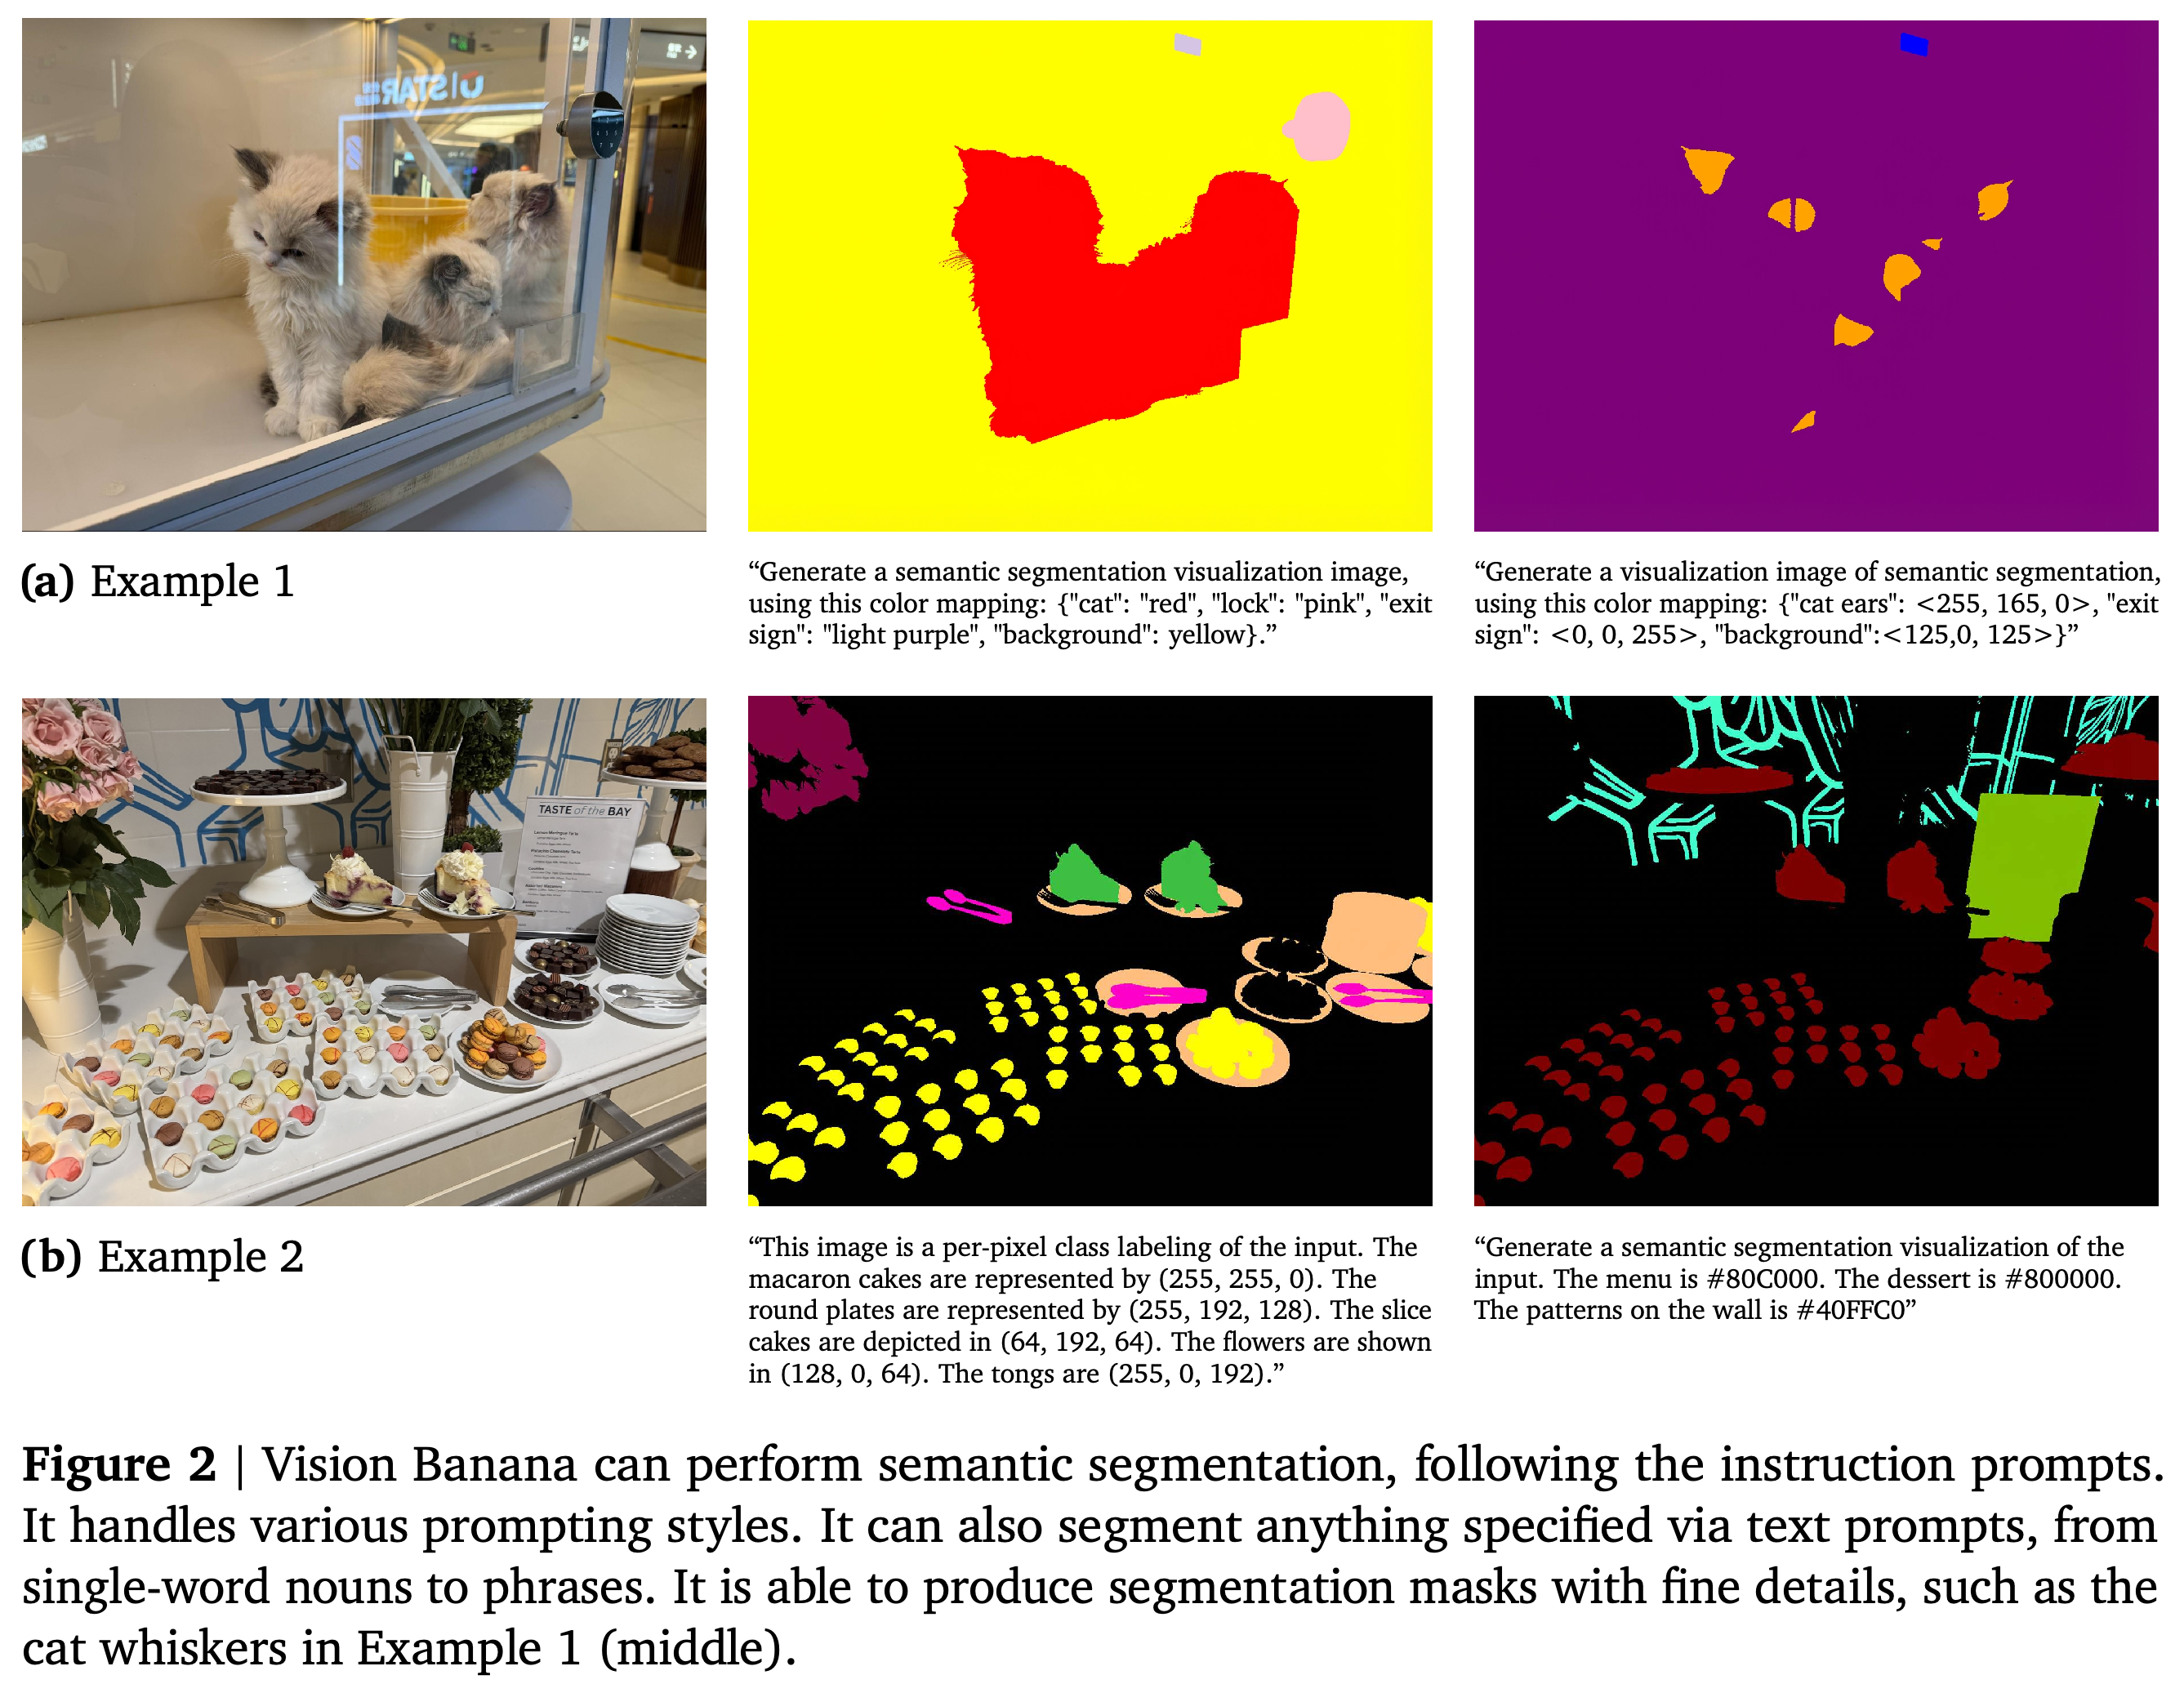
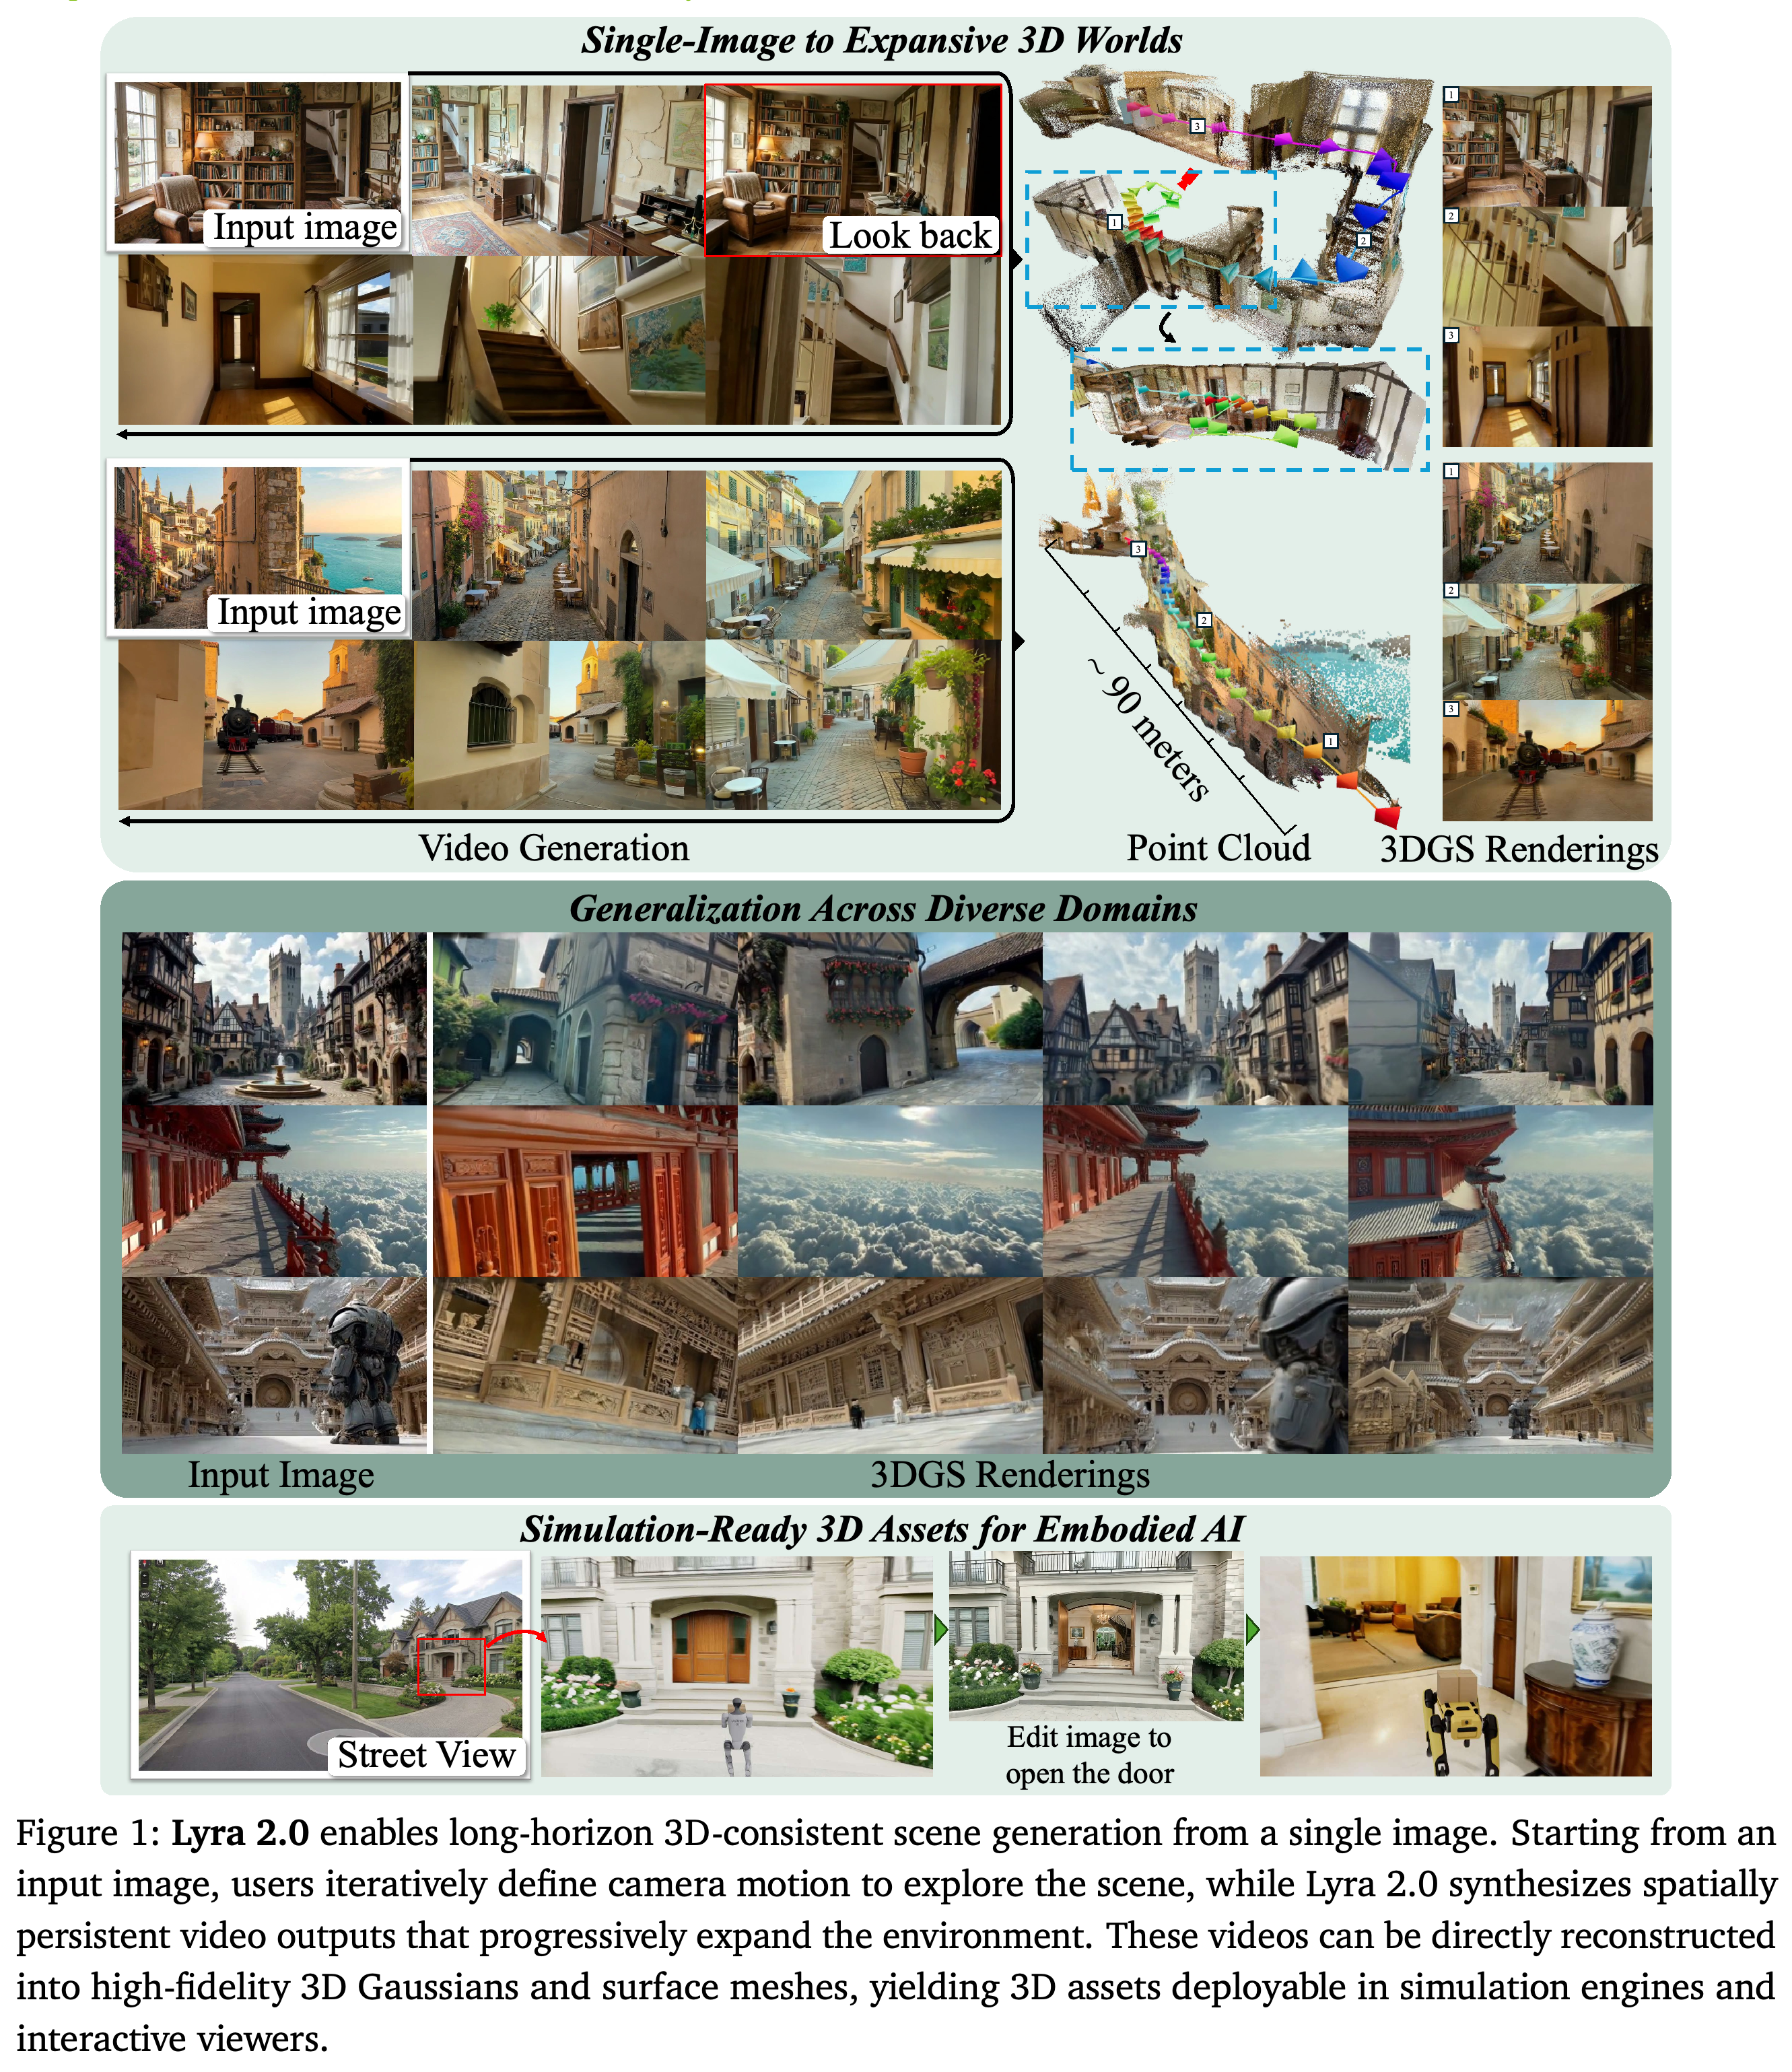
생성 백본을 활용해 인식 결과와 공간 구조를 정량적으로 평가할 수 있는 시스템을 만드는 연구가 이어진다. Vision Banana는 segmentation, 깊이, surface normal을 디코딩 가능한 RGB 이미지로 표현하면서 이미지 생성과 편집 능력을 유지한다. Lyra 2.0은 카메라 궤적으로 제어하는 비디오를 생성하고, 이를 명시적인 3D Gaussians와 메시로 재구성한다. 두 연구는 인식 벤치마크와 재구성한 장면의 지표를 사용해 시각적 그럴듯함을 넘어 생성 결과를 평가한다. 1, 2
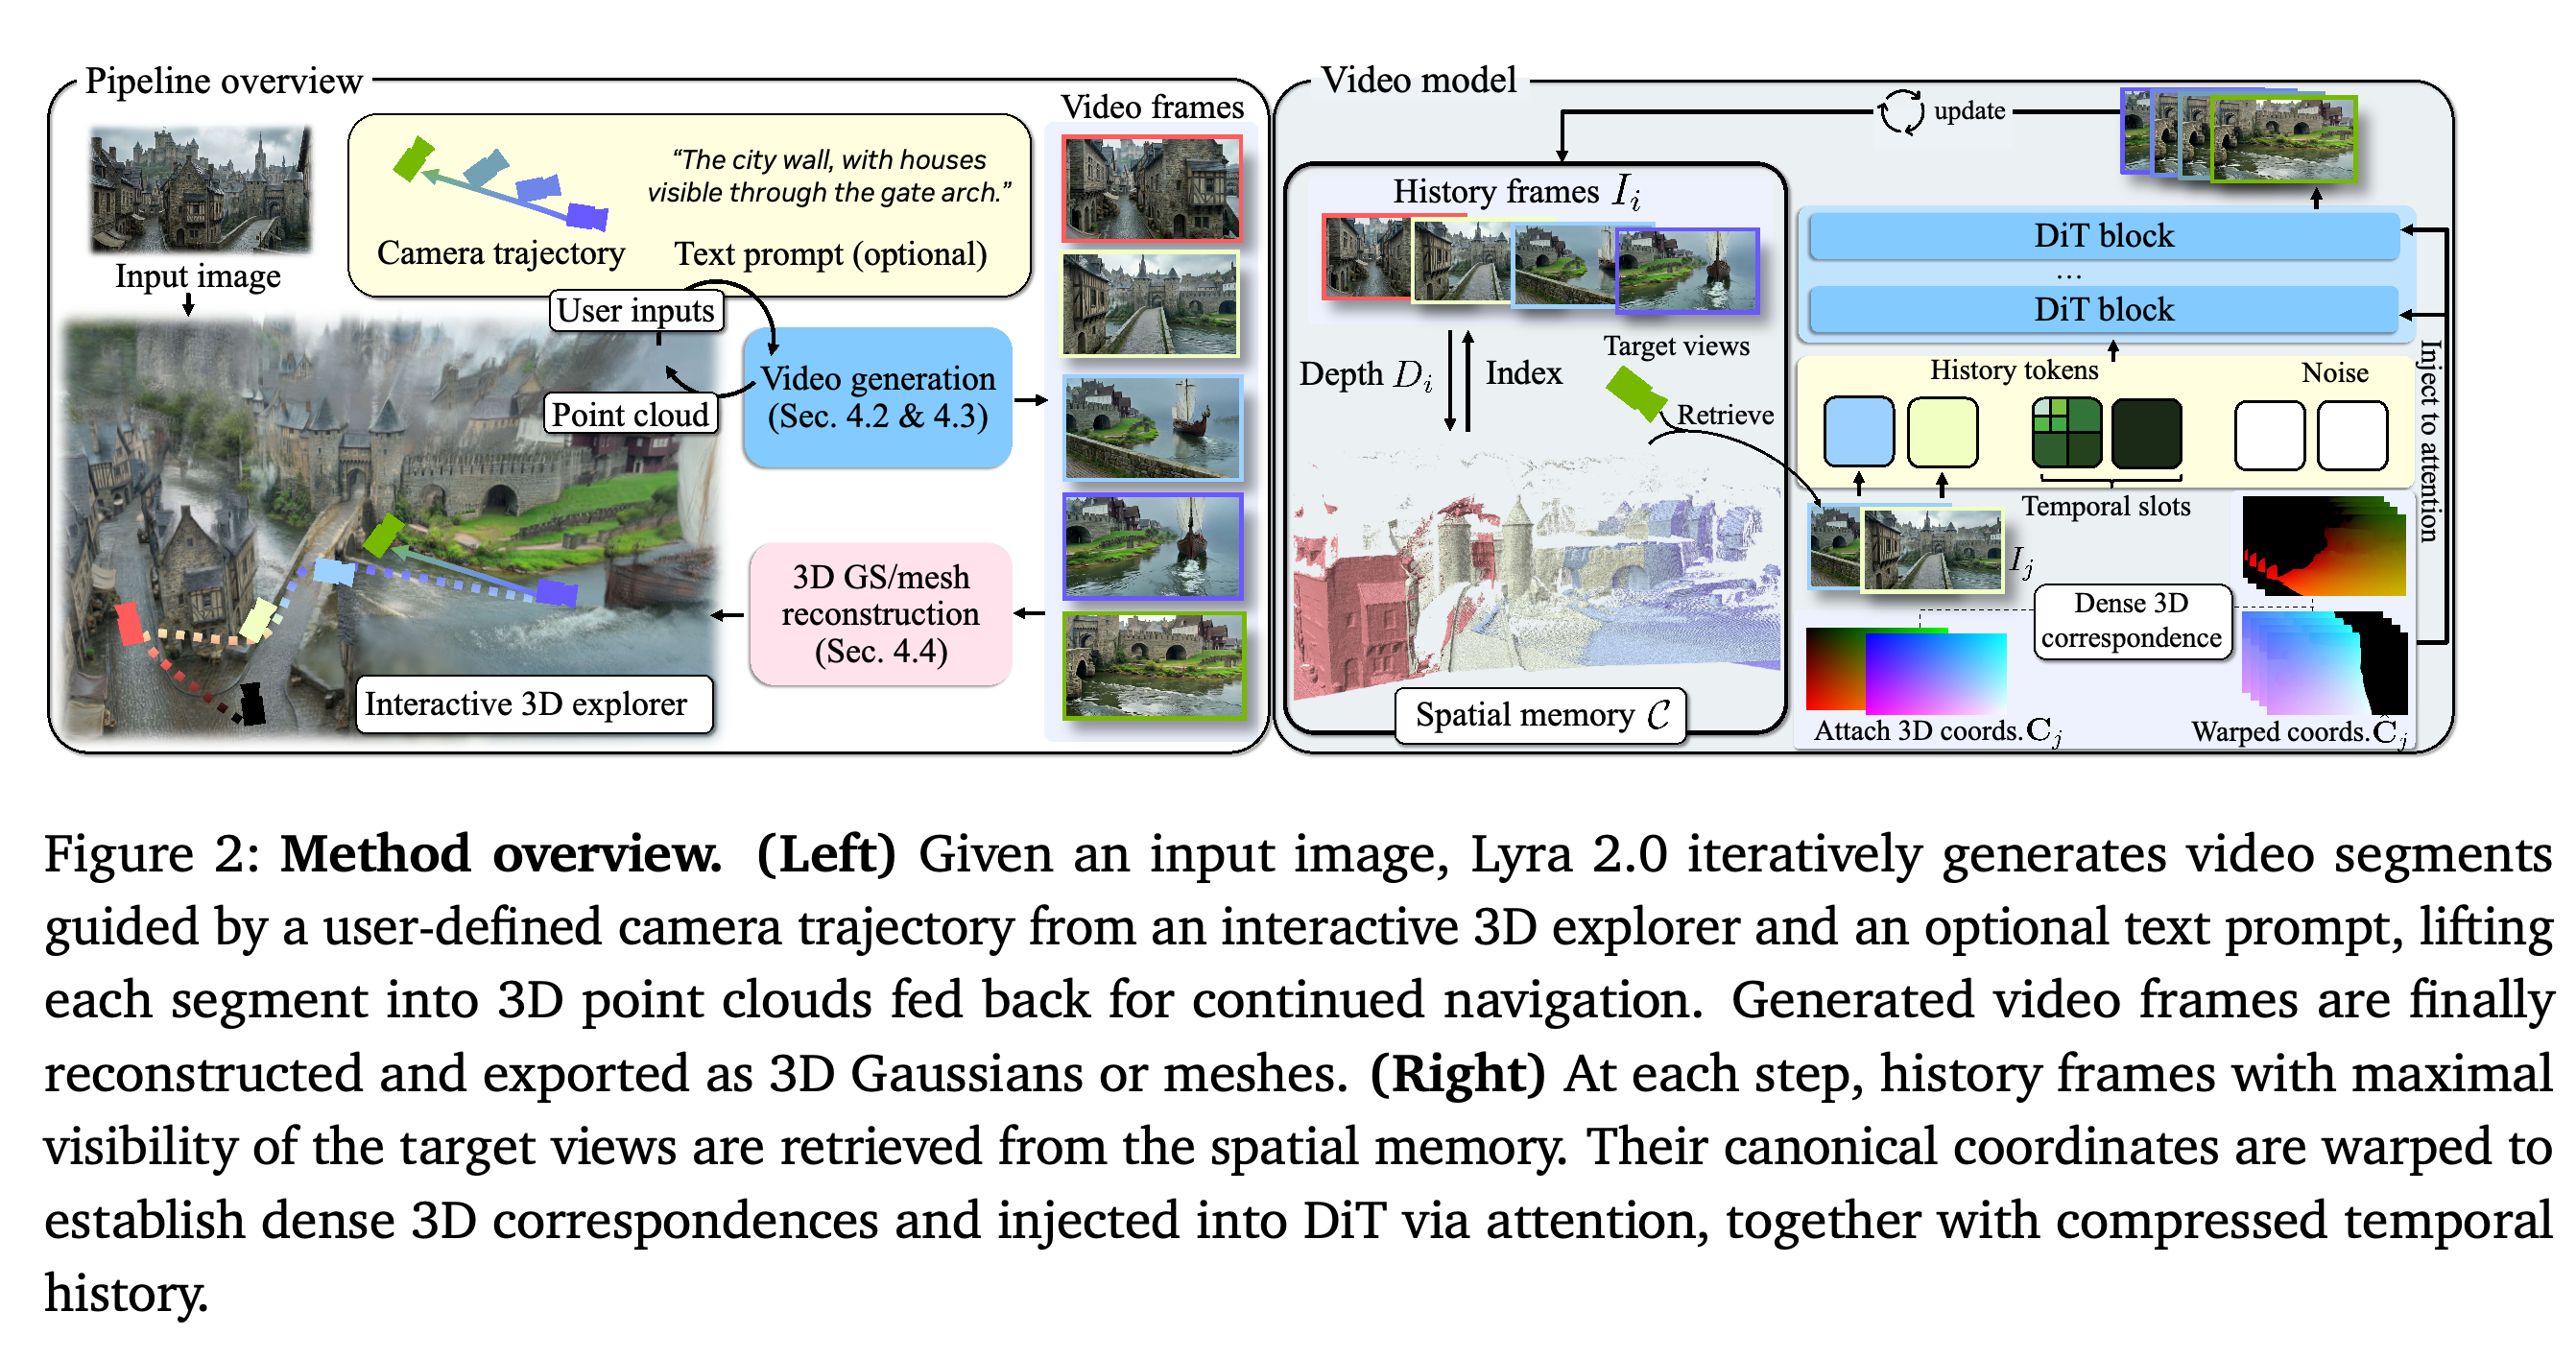
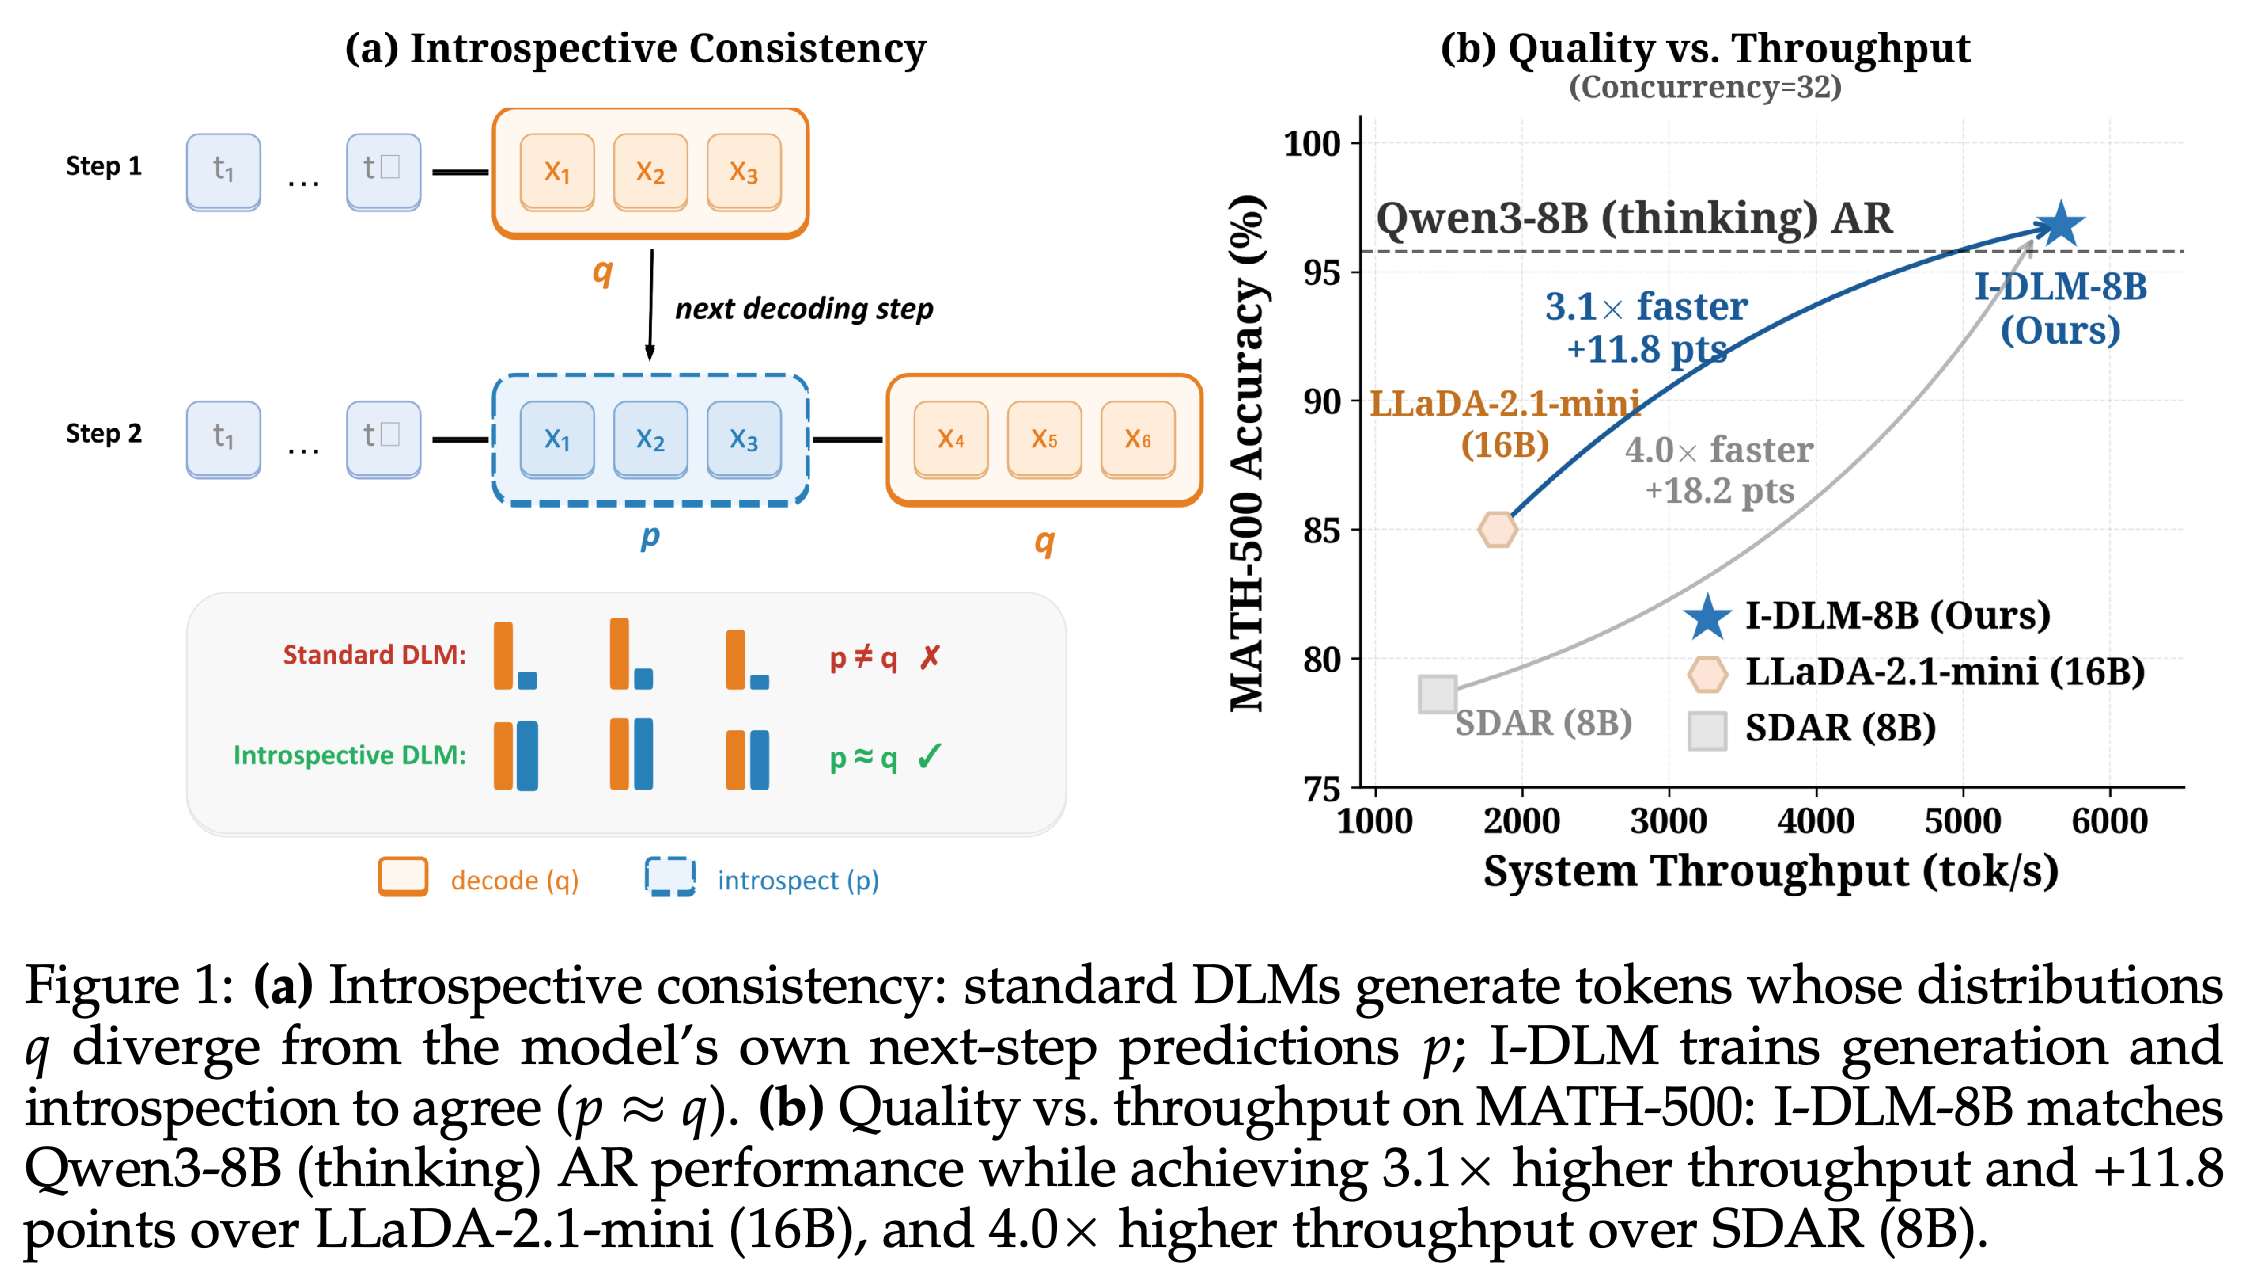
과거 관측이나 인과적 예측을 명시적으로 활용해 일관성을 높이는 방법도 연구한다. Lyra 2.0은 프레임별 기하 정보로 과거 이미지를 검색하고, 불완전하게 생성된 과거 관측을 조건으로 복원하는 능력을 학습한다. I-DLM은 마스크 위치의 제안과 깨끗한 위치의 인과적 예측을 함께 학습하고, 제안 검증과 후속 생성을 같은 순전파에서 수행한다. 결과는 이러한 결합 설계를 뒷받침하지만, 어느 메커니즘도 성능 향상의 유일한 원인임을 입증하지는 않는다. 3
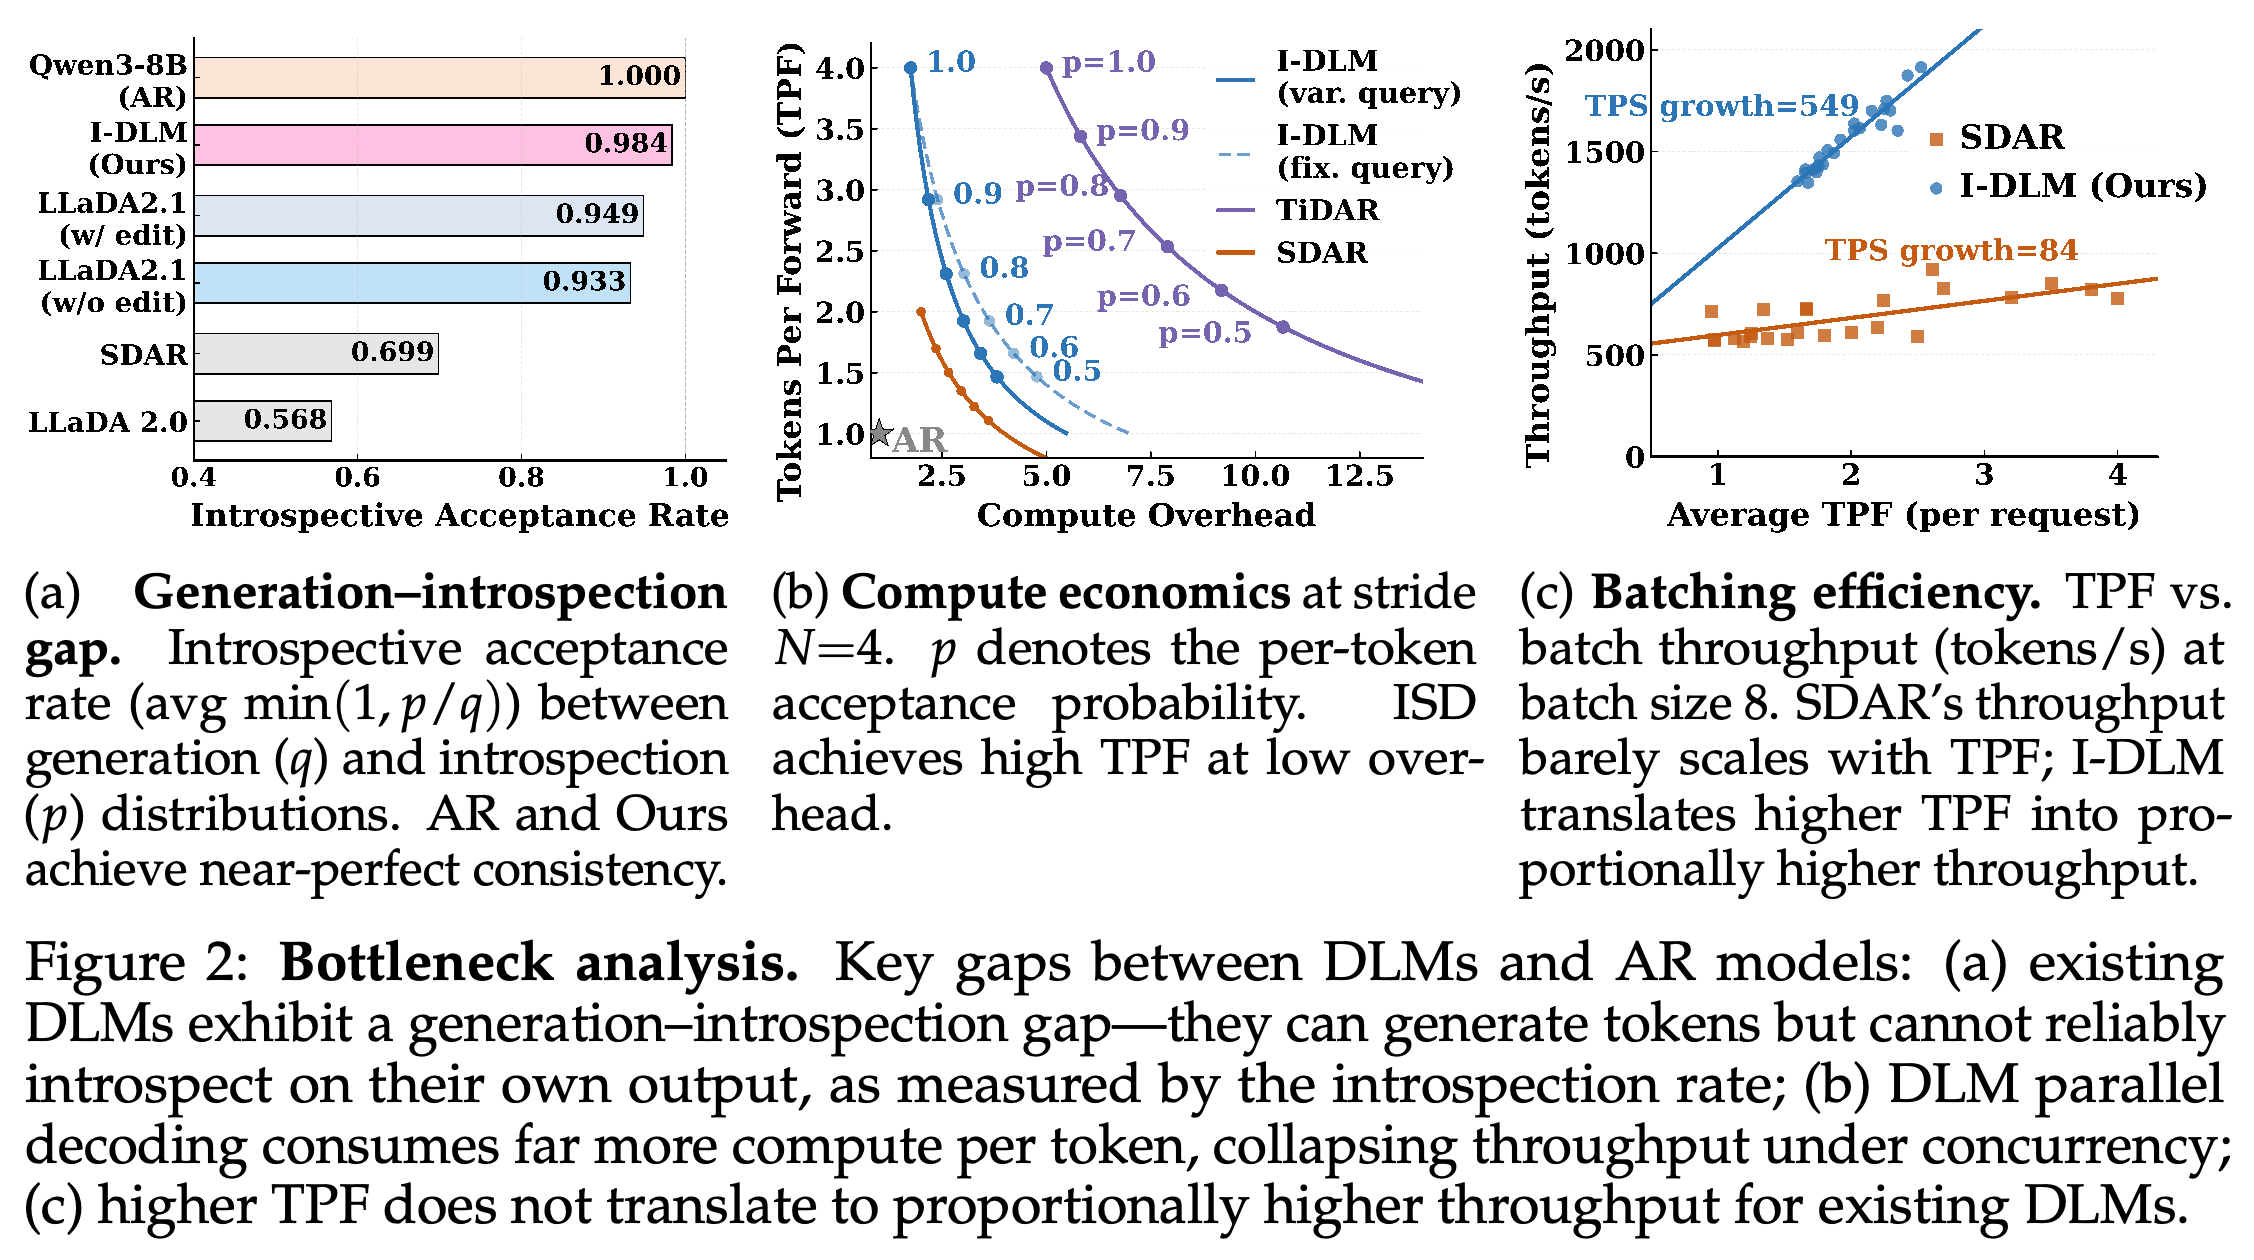
효율 개선은 실행 조건에 따라 달라지며, 품질 목표 사이에는 상충 관계가 남는다. Lyra 2.0의 증류 모델은 구간 생성을 가속하지만, Tanks and Temples에서는 카메라 제어와 스타일 일관성이 낮아진다. I-DLM은 출력 길이가 고정된 burst workload에서 더 높은 동시 요청 처리량을 보고하지만, 더 큰 stride로 학습하면 일부 벤치마크 점수가 낮아진다. Vision Banana는 경량 인식 전문 모델보다 연산 부담이 크다고 밝히면서도 지연 시간이나 비용 비교는 제공하지 않는다.
2026년 4월의 주요 논문
1. Image Generators are Generalist Vision Learners
- https://arxiv.org/abs/2604.20329
- Image Generators are Generalist Vision Learners 요약 설명
- Image Generators are Generalist Vision Learners는 Nano Banana Pro의 기존 생성 데이터에 낮은 비율의 시각 과제 데이터를 섞어 instruction tuning을 수행하고, Vision Banana를 만든다. Segmentation, metric depth, surface normal은 디코딩 가능한 RGB 출력 인터페이스를 공유하며, 과제별 전용 아키텍처나 맞춤 손실 함수를 사용하지 않는다. 정확한 혼합 비율, 예제 수, 튜닝 기간, 연산량은 보고하지 않는다.
- Cityscapes에서 Vision Banana는 69.9 mIoU를 기록해, 나열된 zero-shot transfer 방법 중 SAM 3의 65.2를 앞선다. 벤치마크 데이터로 학습한 SegMan-L은 84.2를 기록한다. RefCOCOg UMD val에서는 73.8 cIoU를 얻는다. 여기서 zero-shot transfer는 벤치마크의 도메인 내 학습 분할을 사용하지 않았다는 뜻이며, 과제 감독 신호를 전혀 받지 않았다는 뜻은 아니다. 이 조건만으로는 기반 모델의 사전학습 데이터에 무엇이 포함되었는지도 알 수 없다.
- 두 segmentation 결과는 보조 모델을 사용하는 파이프라인을 평가한다. ReasonSeg val에서는 Gemini 2.5 Pro가 추론 쿼리를 서술적 지칭 표현으로 바꾸고 Vision Banana가 segmentation을 수행해 79.3 gIoU를 얻는다. SA-Co/Gold의 47.5 cgF1은 Gemini 3.1 Flash-Lite가 대상 존재 여부를 필터링하는 파이프라인의 결과다. 이 점수를 Vision Banana 단독의 추론이나 대상 존재 여부 탐지 성능으로 해석해서는 안 된다.
2. Lyra 2.0: Explorable Generative 3D Worlds
- https://arxiv.org/abs/2604.13036
- Lyra 2.0: Explorable Generative 3D Worlds 요약 설명
- Lyra 2.0: Explorable Generative 3D Worlds는 검색–생성–갱신을 반복해 이미지 한 장에서 사용자가 지정한 카메라 궤적을 따라 장면을 확장한다. 공간 메모리는 융합한 전역 재구성 결과 대신 프레임별 기하 정보를 독립적으로 저장한다. 검색한 이미지는 외관을 제공하고, 깊이로 워핑한 정준 좌표는 기하 대응 관계를 통해 어텐션을 유도한다. FramePack과 자기 증강 학습으로 시간적 드리프트를 줄인다.
- 전체 모델은 DL3DV와 Tanks and Temples의 주요 외관 및 스타일 지표에서 평가한 기준 모델들을 앞서지만, 카메라 제어와 재투영 오차는 GEN3C가 더 좋다. DL3DV에서 Lyra 2.0의 Camera Controllability는 64.67, 재투영 오차는 0.076이며, GEN3C는 각각 69.54와 0.068이다. 따라서 외관 개선이 기하 정확도나 제어 성능의 일관된 우위를 뜻하지는 않는다.
- Depth Anything v3를 조정한 재구성 모델은 적은 수의 3D Gaussians와 표면 메시를 만든다. Gaussian 헤드에 k = 2의 다운샘플링을 적용해 Gaussian 수를 4배 줄인다. 생성 비디오로 미세 조정하면 두 데이터셋에서 나열된 모든 재구성 장면 지표가 개선되며, Tanks and Temples의 LPIPS-P는 0.409에서 0.372로 낮아진다. LPIPS-P는 재구성을 통해 일관성을 간접적으로 측정하는 지표이며, 정답 기하 구조에 대한 정확도를 측정하지는 않는다.
3. Introspective Diffusion Language Models
- https://arxiv.org/abs/2604.11035
- Introspective Diffusion Language Models 요약 설명
- Introspective Diffusion Language Models는 causal attention, next-token logit shifting, 마스크 위치와 깨끗한 위치에 대한 감독을 사용해 사전학습된 자기회귀 모델을 변환한다. Introspective Strided Decoding (ISD)은 같은 순전파에서 이전 제안을 검증하고 새 제안을 생성하며, 별도의 draft 모델 없이 causal KV-cache를 재사용한다. 모델 변환에는 생성된 추론 응답 4.5B 토큰을 사용하고, H100 GPU 8개에서 학습한다.
- 엄격한 ISD 수락 규칙과 거절 시 보정은 변환된 모델의 causal anchor 분포를 보존한다. Residual ISD (R-ISD)는 마스크 제안 위치에서만 gated LoRA를 활성화하고, 깨끗한 검증 위치에는 변경하지 않은 기반 모델 가중치를 사용한다. 명시된 인과적 실행 조건에서는 원래 AR 목표 분포를 보존한다. 다만 분포 보존만으로 임의의 난수 생성 방식이나 수치 연산 방식에서 동일한 샘플 시퀀스를 보장하지는 않는다.
- I-DLM-8B는 AIME-24에서 69.6, LiveCodeBench-v6에서 45.7을 기록하며, LLaDA-2.1-mini (16B)는 각각 43.3과 30.4를 기록한다. Qwen3-8B와의 비교는 과제마다 다르다. I-DLM-8B의 MATH-500 점수는 Qwen3-8B의 95.8보다 높은 96.8이지만, AIME-25는 65.4보다 낮은 60.8, LiveCodeBench-v6는 50.3보다 낮은 45.7이다. 불확실성 추정치가 없고 재현한 기준 모델 결과와 기존 발표 결과가 섞여 있어, 전반적으로 동등한 성능을 낸다는 주장은 제한해서 해석해야 한다.
출처
[1] Image Generators are Generalist Vision Learners