


2026년 1월 AI 논문 동향
31 Jan 2026 | Paper Review Monthly Papers Long-Context Reasoning Knowledge Distillation Transformer Architectures목차
이달의 트렌드
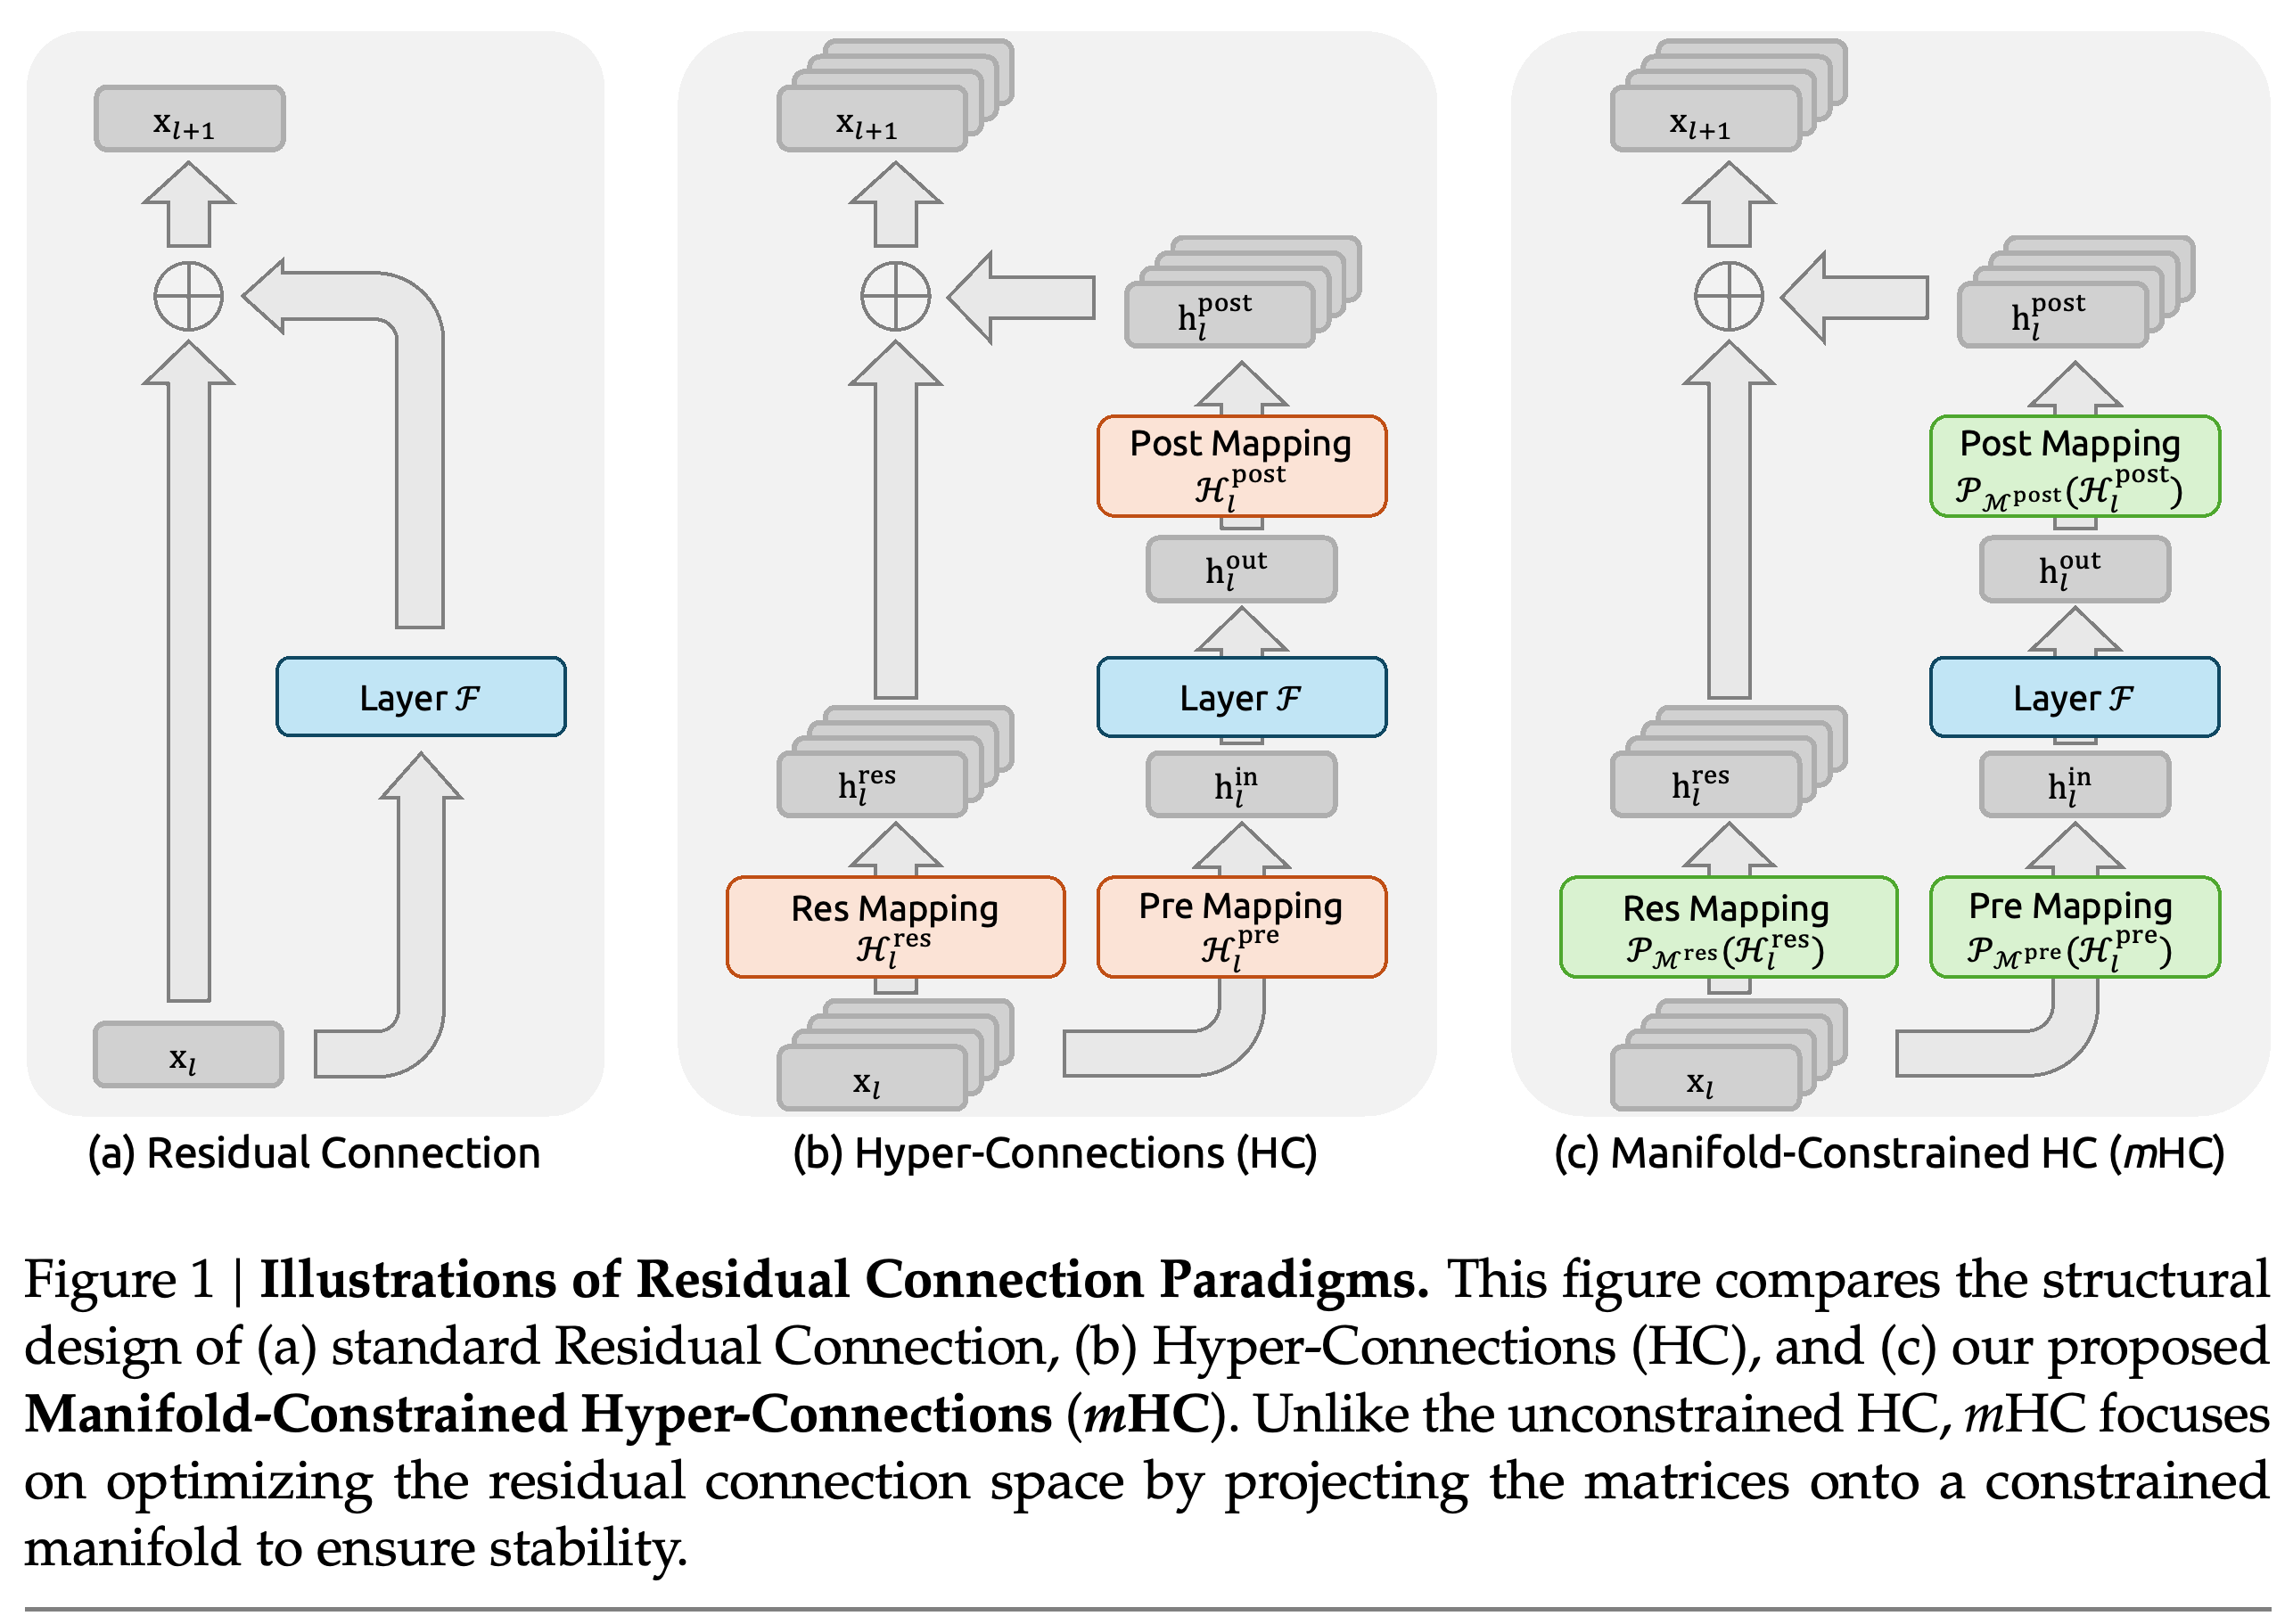
이 연구들은 언어 모델의 연산 구성 방식이 능력에 미치는 영향을 살펴본다. Recursive Language Models는 영속적으로 저장하는 입력과 중간 상태를 크기가 제한된 신경망 컨텍스트에서 분리한다. Ministral 3는 점진적인 가지치기와 증류로 사전학습된 가중치를 재사용한다. mHC는 병렬 residual stream들이 여러 층에 걸쳐 정보를 교환하는 방식을 바꾼다. 각 방법은 추론, 모델 구축, 사전학습 아키텍처라는 서로 다른 단계에 개입하므로, 결과도 해당 설정 안에서 평가해야 한다. 1, 2, 3
효율성을 판단하려면 컨텍스트 길이, 파라미터 수, FLOPs 외의 비용도 고려해야 한다. RLM은 외부 저장소를 활용해 수백만 토큰의 입력을 처리하지만, 순차적인 하위 호출 때문에 지연 시간과 비용의 분포에 긴 꼬리가 나타난다. Ministral이 보고한 자식 모델의 학습량에는 부모 모델의 최초 사전학습 비용이 포함되지 않으며, 여러 샘플을 사용하는 추론 평가 점수는 단일 생성 정확도가 아니다. mHC는 수치적 안정성과 함께 메모리 트래픽과 pipeline 통신 비용을 명시적으로 다룬다. 이러한 결과는 명목상 모델 사양만으로 효율성을 판단하기보다, 명시된 과제·샘플링·구현 조건에서 능력과 자원 사용량을 함께 평가해야 함을 뒷받침한다.
2026년 1월의 주요 논문
1. Recursive Language Models
- https://arxiv.org/abs/2512.24601
- Recursive Language Models 요약 설명
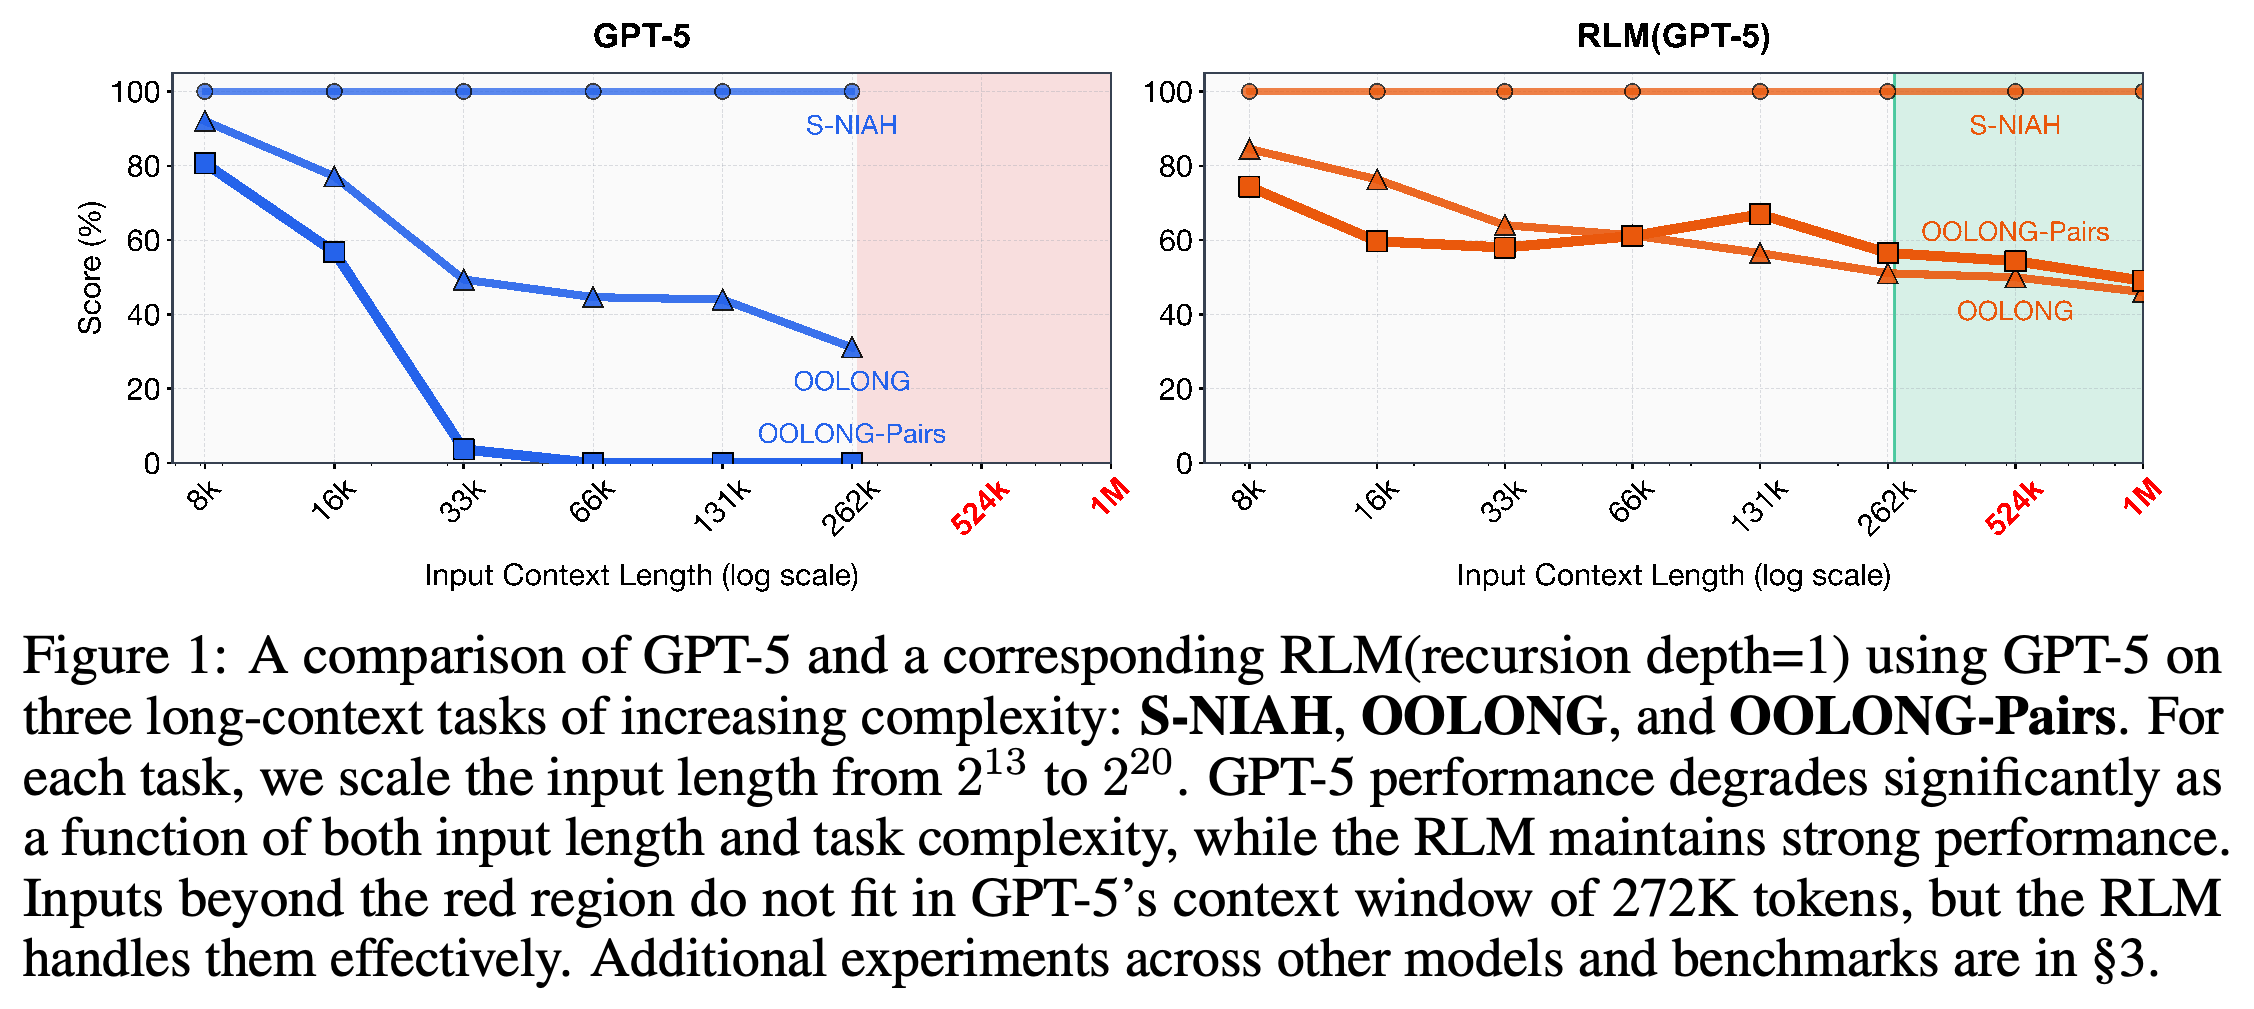
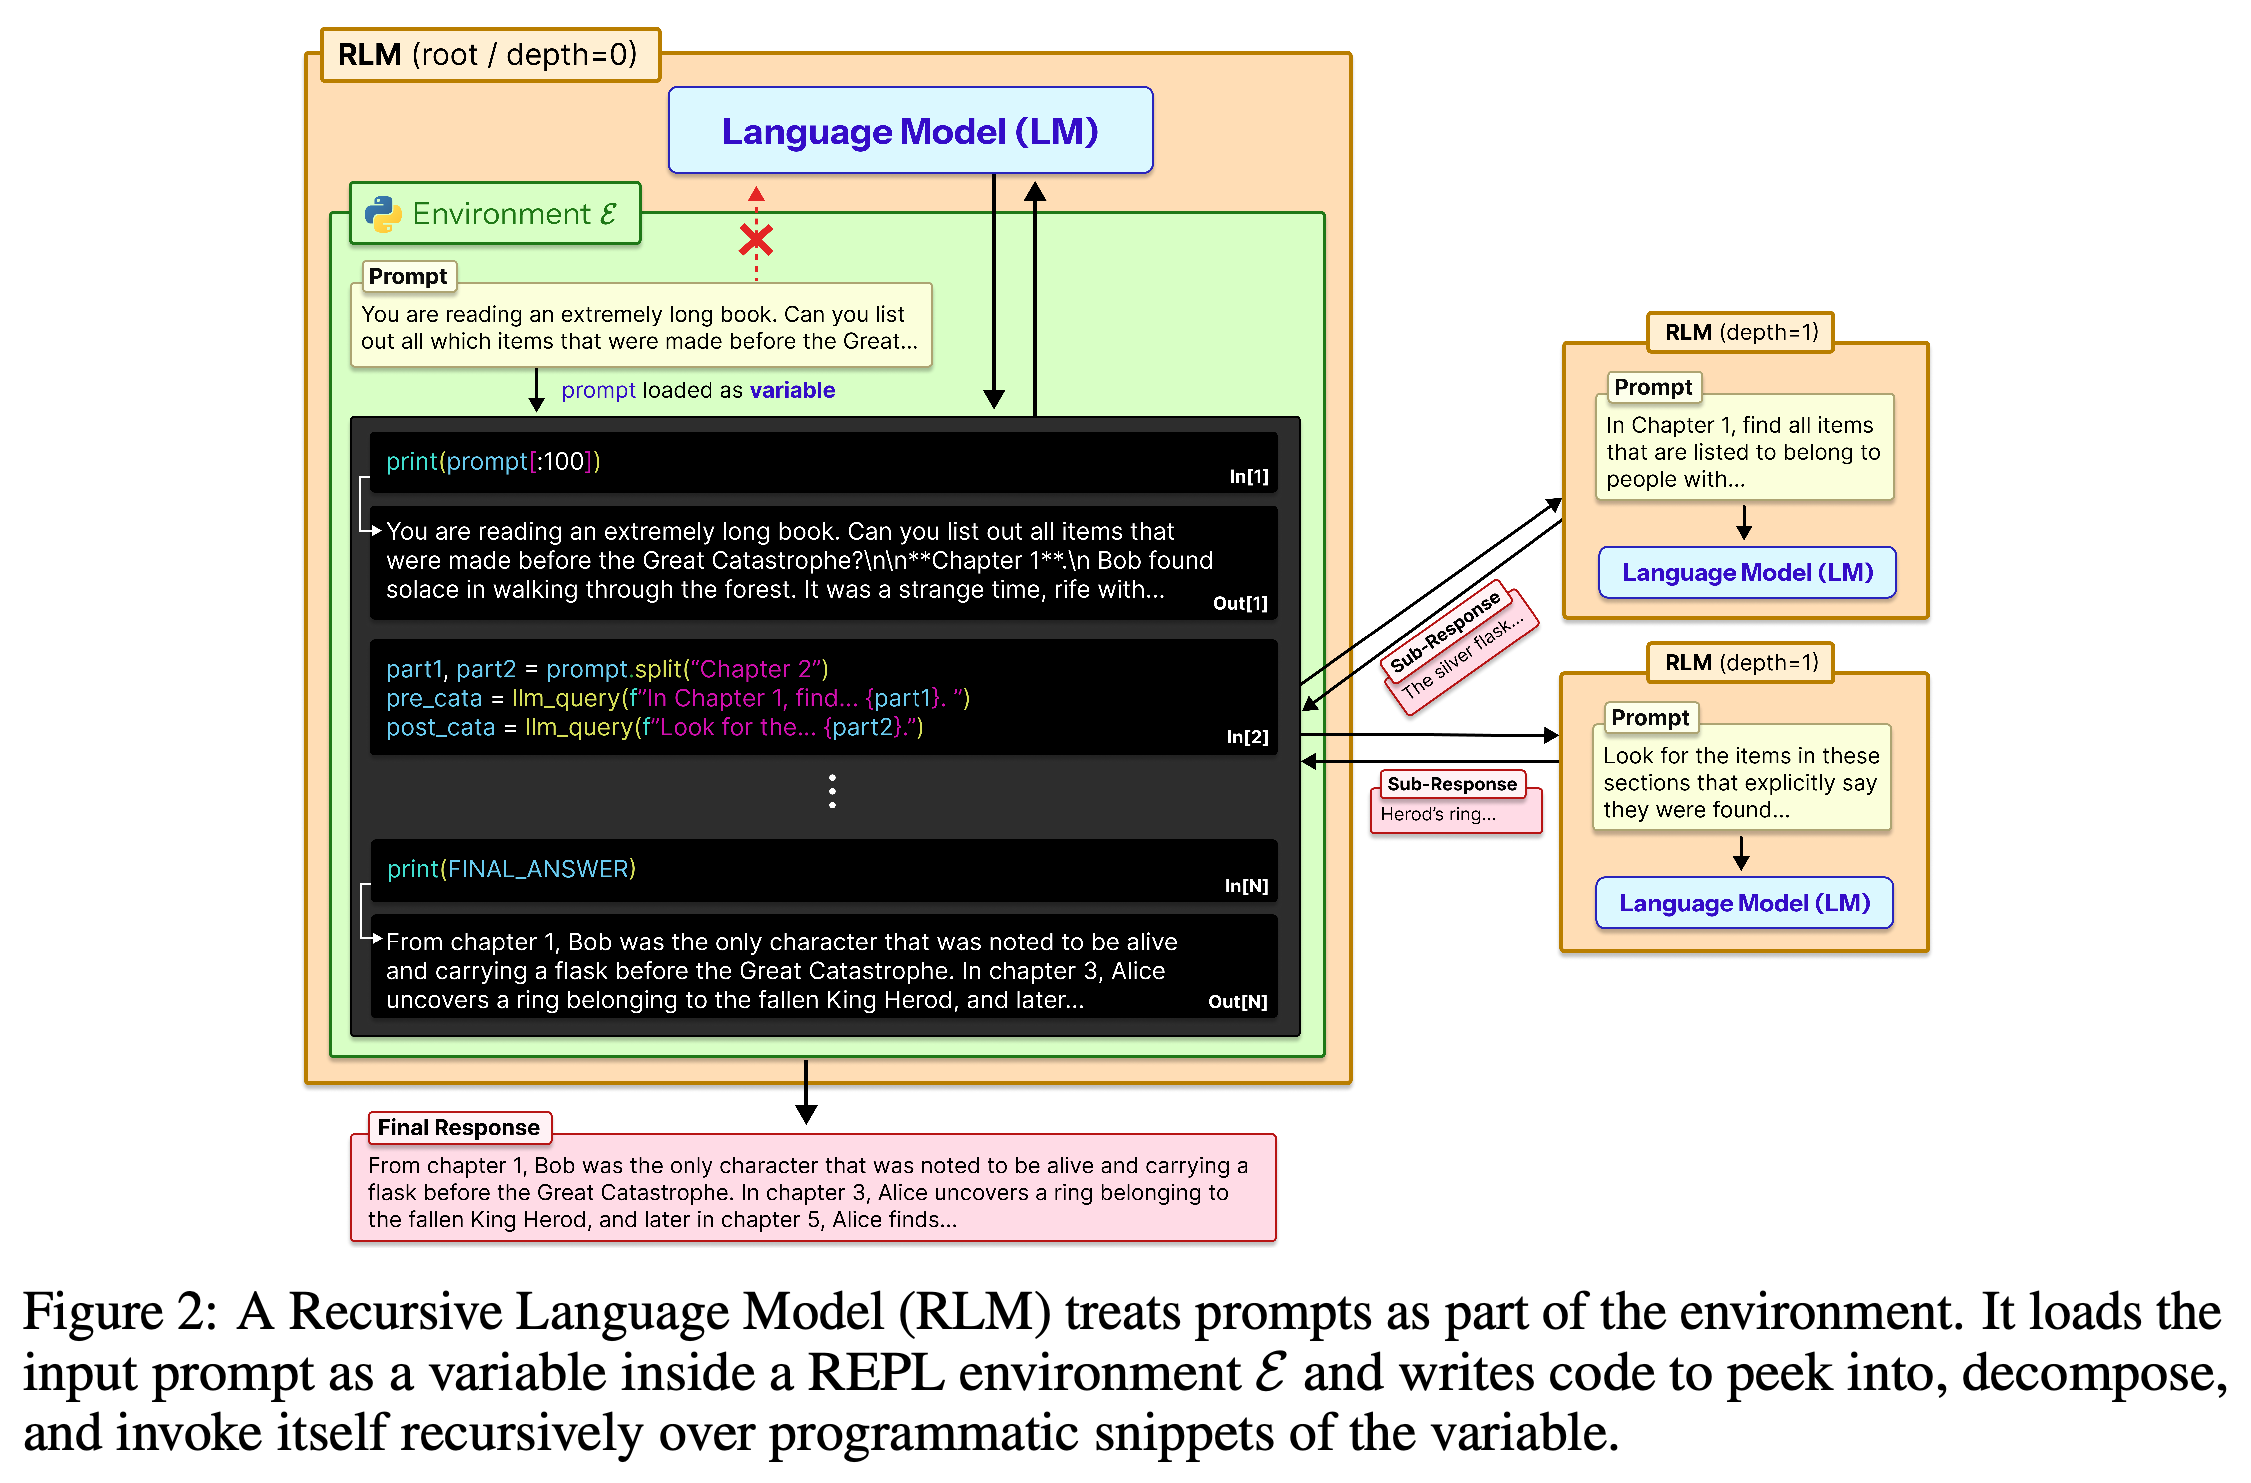
- Recursive Language Models(RLM)는 프롬프트를 영속적인 프로그래밍 환경에 저장하는 추론 프레임워크다. 루트 모델은 코드를 작성해 입력의 일부를 살펴보고, 프로그램으로 모델을 호출해 의미 처리 작업을 위임하며, 변수에 출력을 구성한다. 전체 프롬프트나 모든 중간 결과를 루트 모델의 컨텍스트에 넣지 않으면서도 문자열 입력·출력 인터페이스를 유지한다.
- 입력 길이가 6M–11M 토큰인 BrowseComp-Plus에서 depth=1 RLM(GPT-5)은 정답률 91.3%를 달성하며, 과제당 평균 API 비용은 $0.99 ± $1.22다. 32K-token OOLONG-Pairs에서는 F1 58.0%를 기록해 GPT-5 직접 호출의 0.1%보다 높다. GPT-5 실험은 루트에 GPT-5를, 하위 호출에 GPT-5-mini를 사용한다. BrowseComp-Plus의 직접 호출 결과는 컨텍스트 한계에 도달한 조건에서 얻었다.
- 구성 요소 제거 실험은 외부 컨텍스트 접근과 재귀의 효과를 구분한다. GPT-5의 OOLONG-Pairs F1은 하위 호출이 없을 때 43.9%이며, 재귀 깊이 1, 2, 3에서 각각 58.0%, 65.5%, 76.0%로 높아진다. 그러나 재귀가 깊어질수록 항상 유리한 것은 아니다. Qwen3-Coder의 OOLONG 점수는 depth=1의 48.0에서 depth=2의 26.0으로 낮아지며, 컨텍스트를 외부로 옮긴 OpenCode는 BrowseComp-Plus에서 GPT-5 RLM 변형들보다 높은 성능을 보인다.
2. Ministral 3
- https://arxiv.org/abs/2601.08584
- Ministral 3 요약 설명
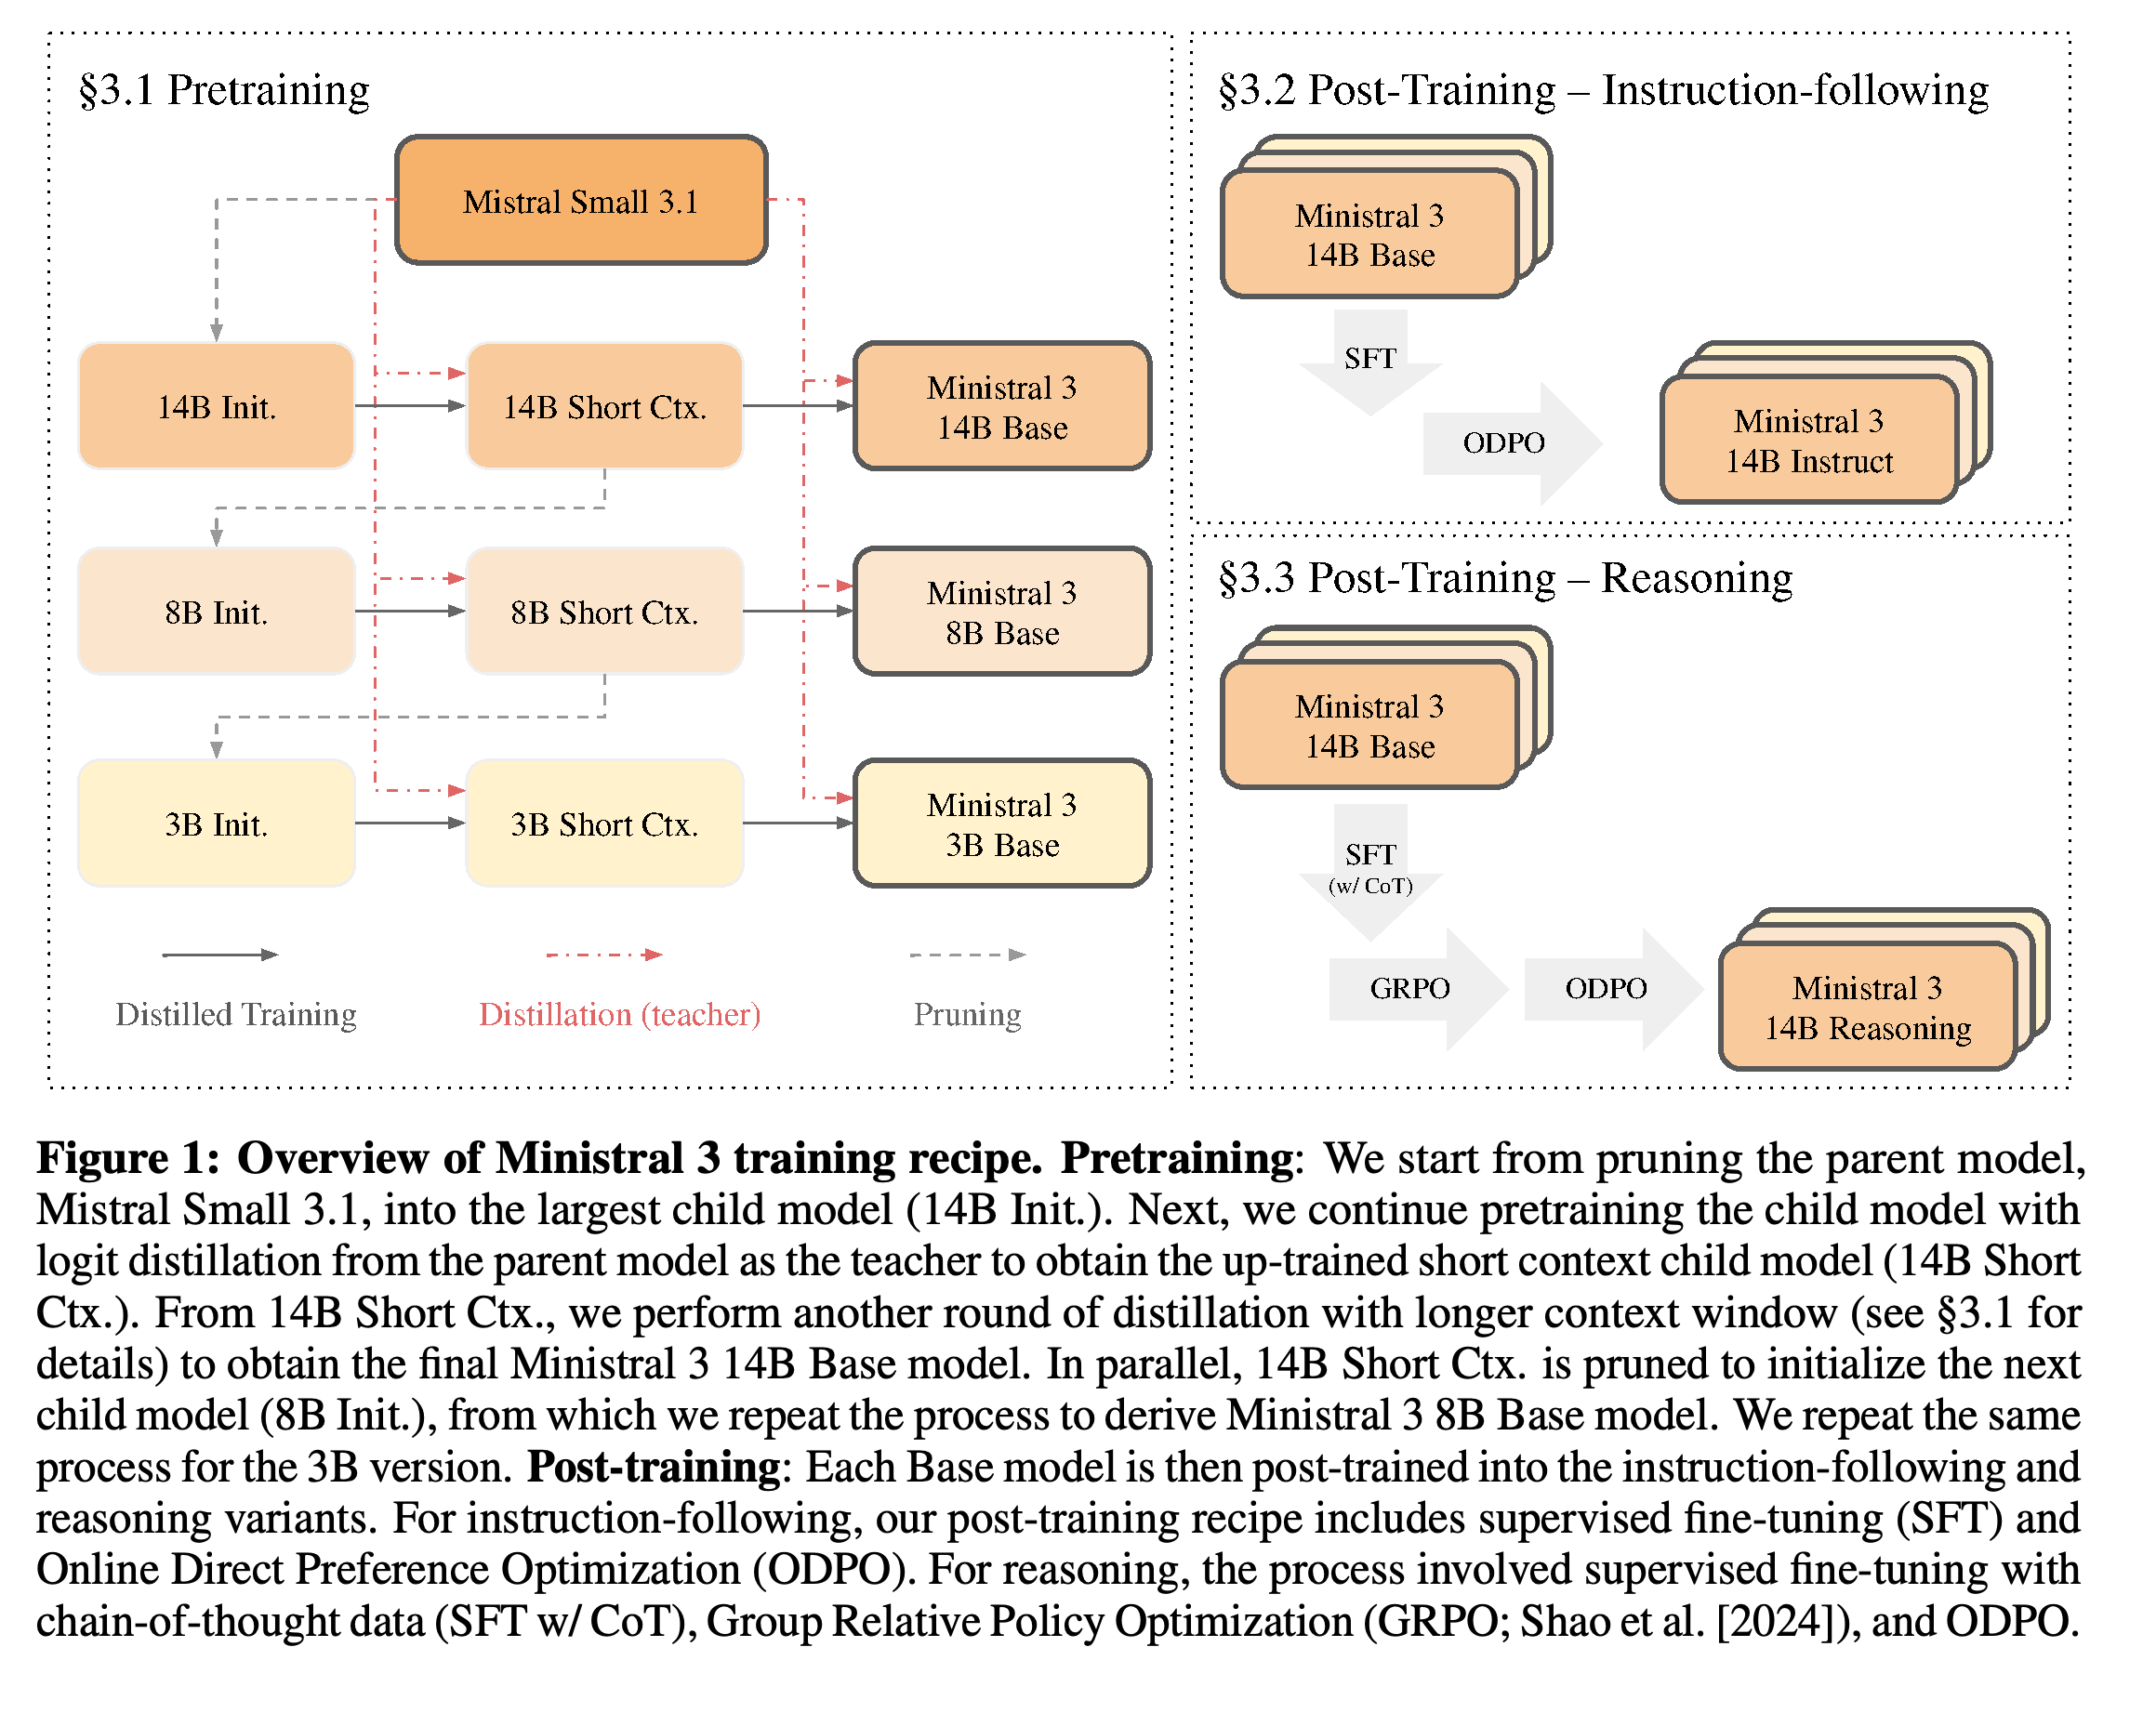
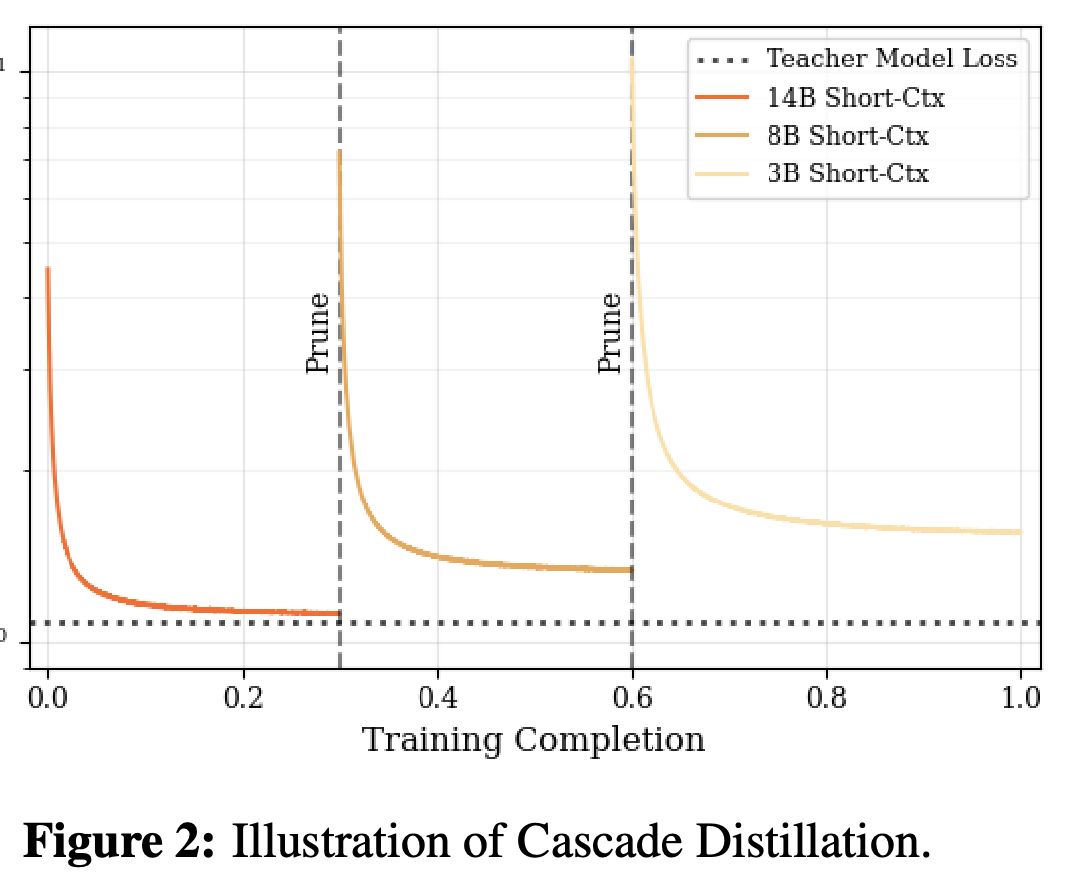
- Ministral 3는 3B, 8B, 14B 규모마다 Base, Instruct, Reasoning을 제공하는 9개의 밀집 모델을 Apache 2.0 오픈 웨이트로 공개한다. 모든 모델이 이미지 이해를 지원한다. Cascade Distillation은 24B Mistral Small 3.1 부모 모델에서 14B, 8B, 3B로 이어지는 가지치기·증류·반복 과정을 따른다. 점차 작아지는 체크포인트는 초기화 가중치를 제공하고, 사전학습의 로짓 교사는 원래 부모 모델로 유지한다.
- 14B Base 모델은 부모 모델의 능력을 상당 부분 유지한다. MMLU-Redux는 부모 모델의 82.7에 비해 82.0이며, MBPP는 71.6으로 같고, MATH는 부모 모델의 55.8보다 높은 67.6을 기록한다. 다만 능력을 유지하는 정도는 과제에 따라 다르다. 모델이 작아질수록 NaturalQS 점수는 낮아지며, MathVista는 부모 모델의 51.3에서 14B, 8B, 3B 자식 모델의 43.6, 35.7, 23.3으로 낮아진다.
- Ministral 3 14B Reasoning은 보고된 추론 벤치마크 6개 모두에서 Qwen 3 14B보다 높은 점수를 기록한다. AIME 2025는 85.0 대 73.7이며, LiveCodeBench v6는 64.6 대 59.3이다. 보고서는 pass@16으로 평가하되 LiveCodeBench에는 pass@5를 사용한다고 명시한다. 8B 비교 결과는 엇갈린다. Ministral은 AIME 2024에서 Qwen3-VL과 동률이고 LiveCodeBench에서는 앞서지만, 나머지 벤치마크 4개에서는 뒤진다.
3. mHC: Manifold-Constrained Hyper-Connections
- https://arxiv.org/abs/2512.24880
- mHC: Manifold-Constrained Hyper-Connections 요약 설명
- mHC: Manifold-Constrained Hyper-Connections는 Hyper-Connections의 확장된 residual stream에서 발생하는 신호 증폭을 다룬다. Sinkhorn-Knopp 정규화로 음이 아닌 이중 확률 residual 혼합 행렬을 근사한다. 정확한 이중 확률성을 만족하면 stream 사이에서 정보를 교환하면서 평균을 보존하고, residual 혼합 연산이 노름을 키우지 않도록 한다. 이는 모든 표현을 그대로 유지한다는 뜻이 아니며, 전체 비선형 네트워크의 안정성을 입증하지도 않는다.
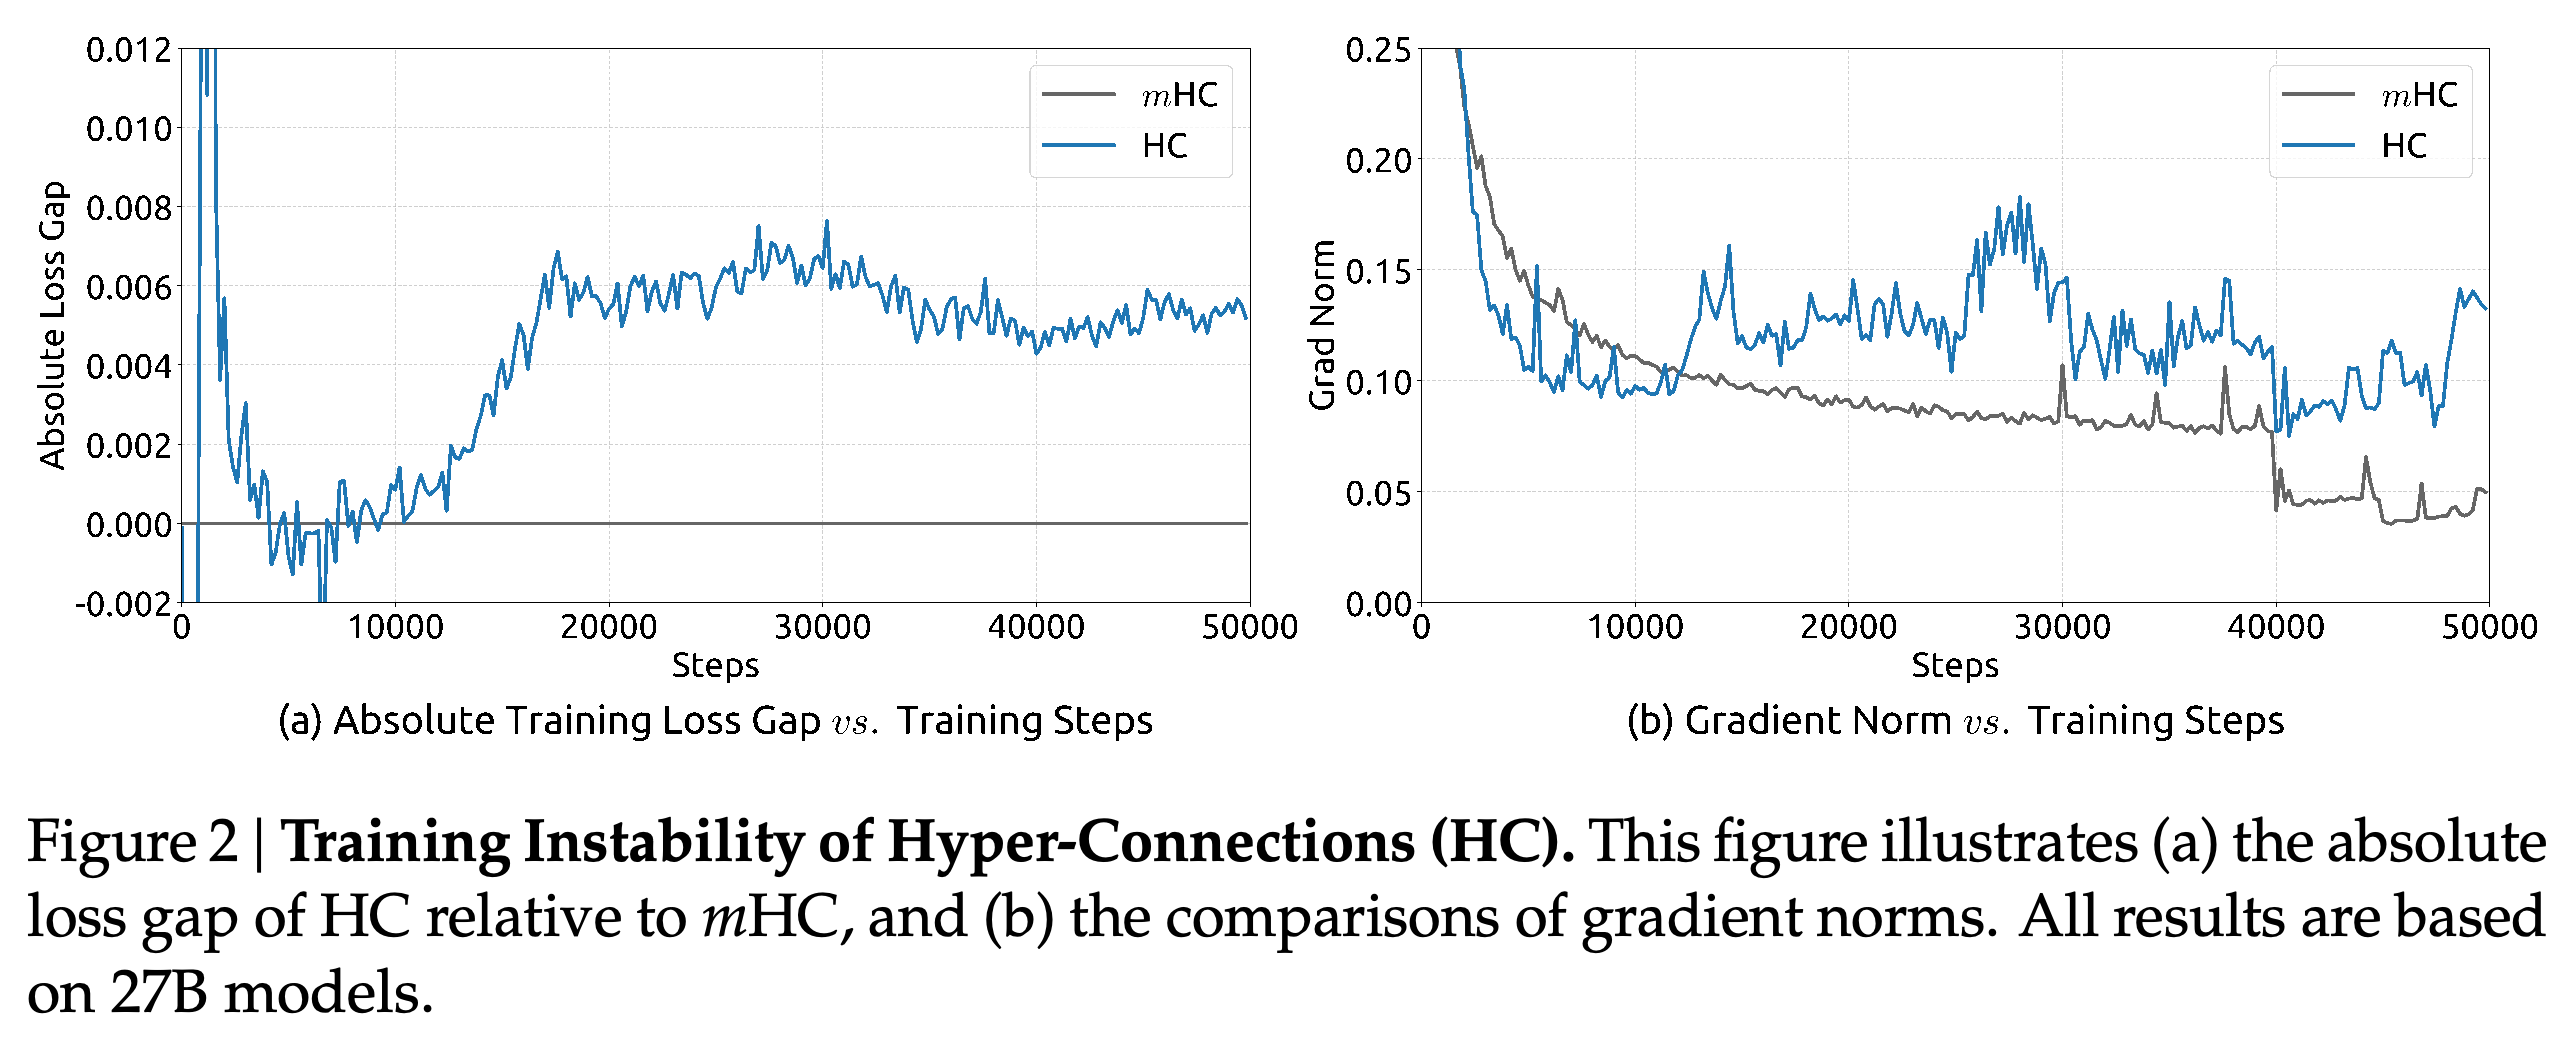
- 공개된 스케일링 실험은 residual 확장률 4와 Sinkhorn-Knopp 반복 20회를 적용한 3B, 9B, 27B MoE 모델을 사용한다. 27B 모델에서 mHC는 표준 residual connection 기준 모델보다 최종 학습 손실을 0.021 낮추고, downstream 벤치마크 8개 모두에서 성능을 높인다. HC보다는 7개에서 앞선다. 예외인 MATH 4-shot exact match 점수는 mHC가 26.0, HC가 26.4, 기준 모델이 22.0이다.
- 측정된 합성 역방향 residual 전파 이득의 최댓값은 HC에서 3000에 가깝지만, mHC에서는 약 1.6이다. 이는 선택한 시퀀스에서 행 합과 열 합으로 측정한 진단값이지, 전체 네트워크 Jacobian의 상한이 아니다. 유한한 정규화 반복은 근사 오차도 남긴다. 융합한 혼합 정밀도 커널, 선택적 재계산, 확장된 DualPipe 스케줄은 넓어진 상태의 오버헤드를 줄인다. 저자들은 확장률 4인 내부 대규모 학습에서 추가 학습 시간이 6.7%였다고 보고하지만, 다른 환경에서도 같은 결과가 유지되는지 확인할 하드웨어별 시간 분석은 제공하지 않는다.
출처
[2] Ministral 3