


Recursive Language Models 요약 설명
31 Dec 2025 | Paper Review Recursive Language Models Long-Context Language Models Test-Time Scaling Supervised Fine-Tuning목차
- 요약
- 1 Introduction
- 2 Recursive Language Models
- 3 Scaling Long Context Tasks
- 4 Results and Discussion
- 5 Analyses of RLM Trajectories
- 6 Related Works
- 7 Limitations and Future Work
- 8 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Recursive Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 31일(Arxiv), Preprint
- Zhang, Alex L., Kraska, Tim, Khattab, Omar.
- MIT CSAIL
- 논문 링크
요약
- Recursive Language Models는 사용자 프롬프트를 기반 LLM의 컨텍스트 윈도에 직접 넣지 않고 외부 프로그래밍 환경에 저장하는 추론 프레임워크를 제안한다. 모델은 코드를 작성해 프롬프트를 살펴보고 변환하며, 프로그램으로 모델을 호출하고 영속 변수에 중간 결과와 최종 출력을 구성한다.
- 실험에서는 희소 검색을 조밀한 집계 및 쌍 열거와 구분하고, 주요 장문 컨텍스트 벤치마크 4개에서 GPT-5와 Qwen3-Coder-480B-A35B를 평가한다. 입력이 6M–11M 토큰인 BrowseComp-Plus에서 RLM(GPT-5, depth=1)은 평균 API 비용 $0.99로 91.3%를 달성한다. 32K-token OOLONG-Pairs에서는 F1 58.0%를 달성하며, 직접 호출한 GPT-5는 0.1%에 그친다.
- 컨텍스트를 외부에 저장하는 것만으로도 성능이 개선되는 경우가 많으며, 하위 호출은 조밀한 처리 작업에서 추가 이득을 제공한다. 재귀 깊이가 깊어질수록 성능이 항상 좋아지는 것은 아니다. 주요 구현은 순차 실행을 사용하며, 지연 시간과 비용의 분포에 긴 꼬리가 나타난다.
- 소규모 사후 학습은 모든 말단 계산을 학습시키기보다 루트 모델이 환경을 조작하고 작업을 위임하는 능력을 학습시킨다. 논문은 RLM-Qwen3-8B가 평가 작업 4개에서 RLM scaffold에 배치한 미학습 Qwen3-8B보다 중앙값 기준 28.3% 개선되었다고 보고한다. 별도의 강화학습 실험에서는 MRCRv2에서 입력 길이와 needle 수에 대한 일반화를 보여준다.
1 Introduction
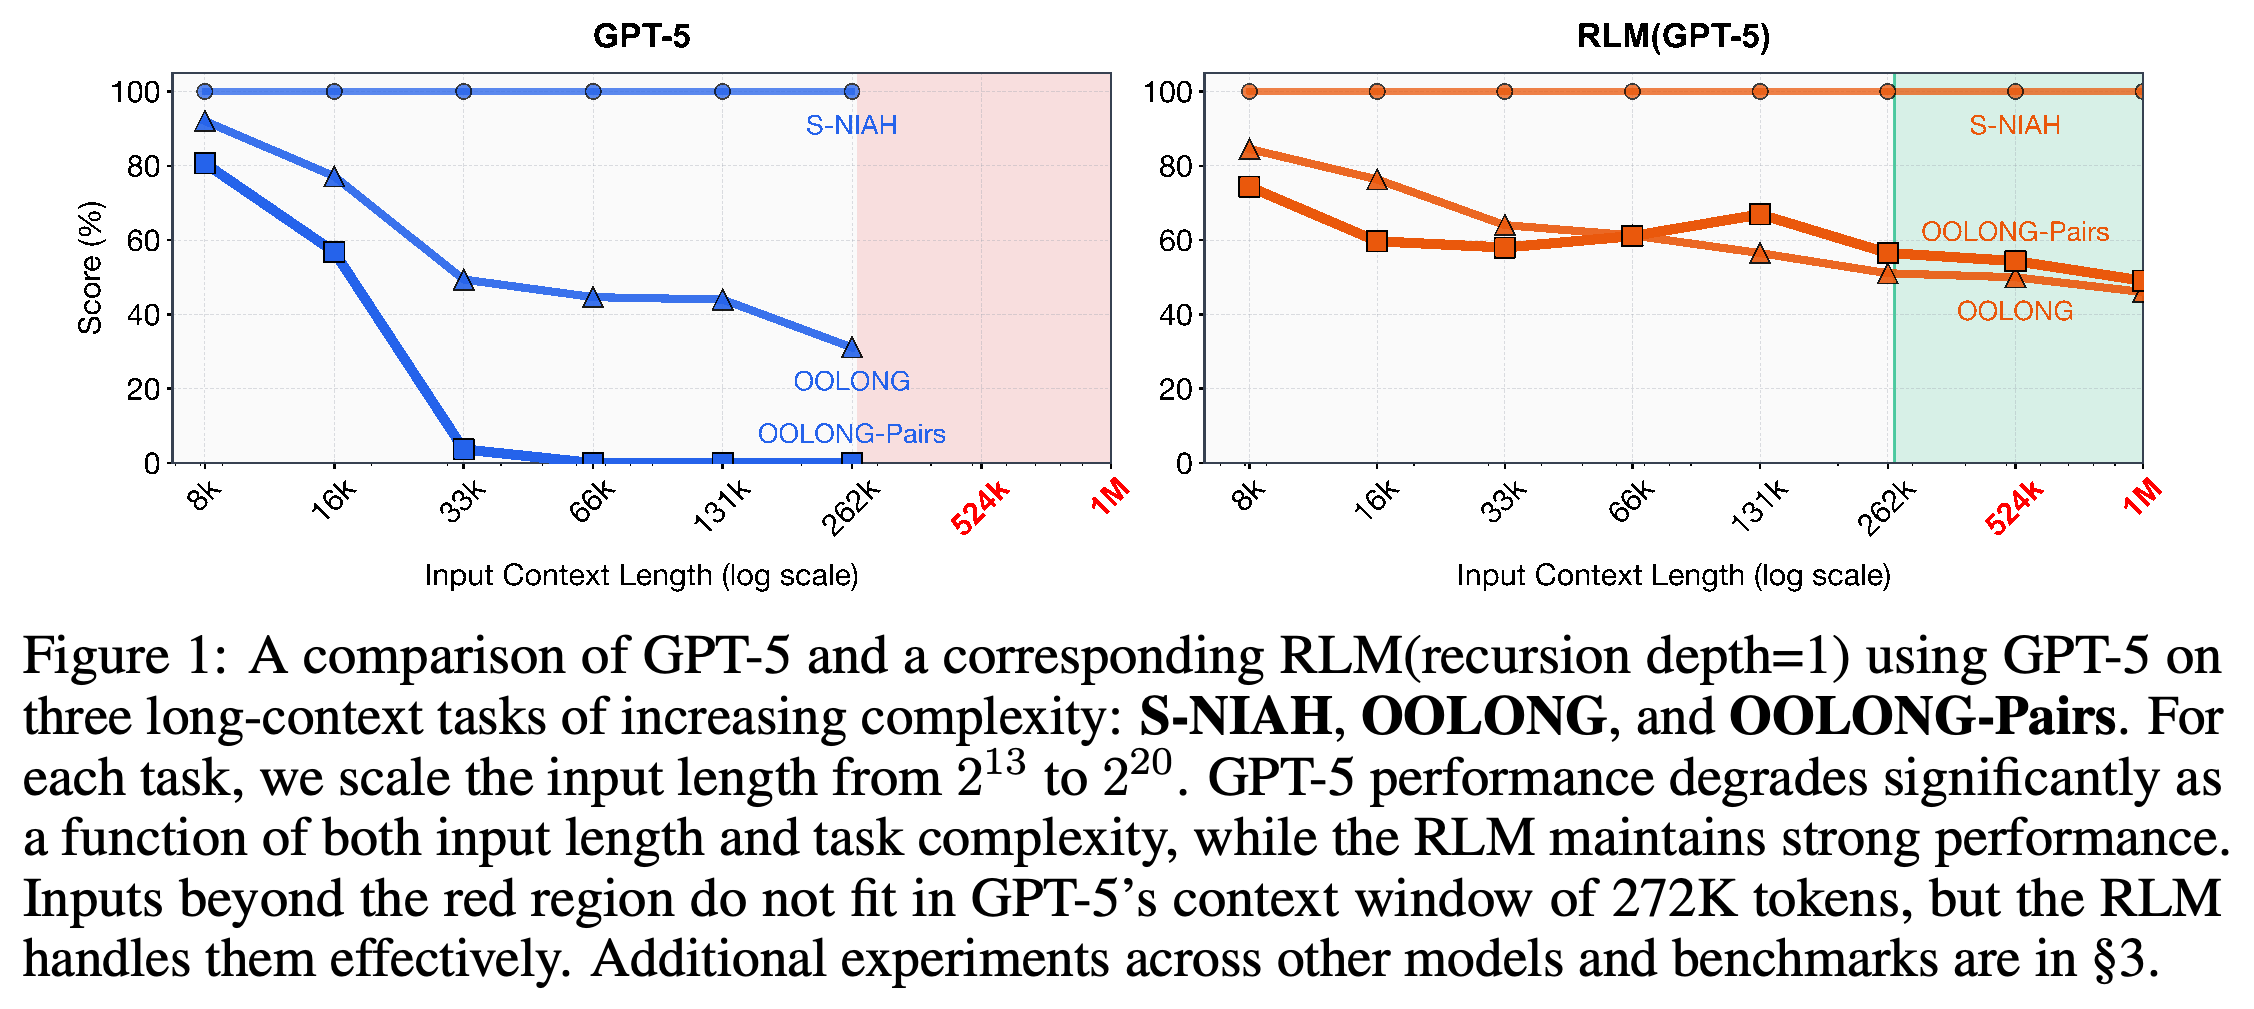
논문은 컨텍스트 윈도의 절대적인 한계와 그 한계 안에서 발생하는 context rot을 함께 다룬다. Figure 1에서 GPT-5는 single-needle 검색 성능을 높게 유지하지만, OOLONG과 OOLONG-Pairs에서는 더 짧은 입력부터 성능이 저하된다. 따라서 유효 컨텍스트 길이를 평가할 때 입력 길이와 작업 복잡도를 함께 고려해야 한다.
- 스케일링 실험의 입력 길이는 2^13부터 2^20 토큰까지이며, GPT-5의 명시된 컨텍스트 윈도는 272K 토큰이다.
- Compaction은 누적된 컨텍스트를 반복해서 요약하지만, 이후 조밀한 집계에 필요한 세부 정보를 버릴 수 있다.
single-needle 검색 성능은 높게 유지되지만 조밀한 작업의 점수는 빠르게 떨어진다. 이는 컨텍스트 윈도 크기만으로 능력을 측정하기 어렵다는 점을 보여준다. RLM(GPT-5)은 OOLONG-Pairs에서 훨씬 높은 성능을 유지하고 기반 모델의 272K-token 윈도를 넘어도 작동한다. 다만 입력이 더 길어지면 조밀한 작업의 점수는 여전히 하락한다.
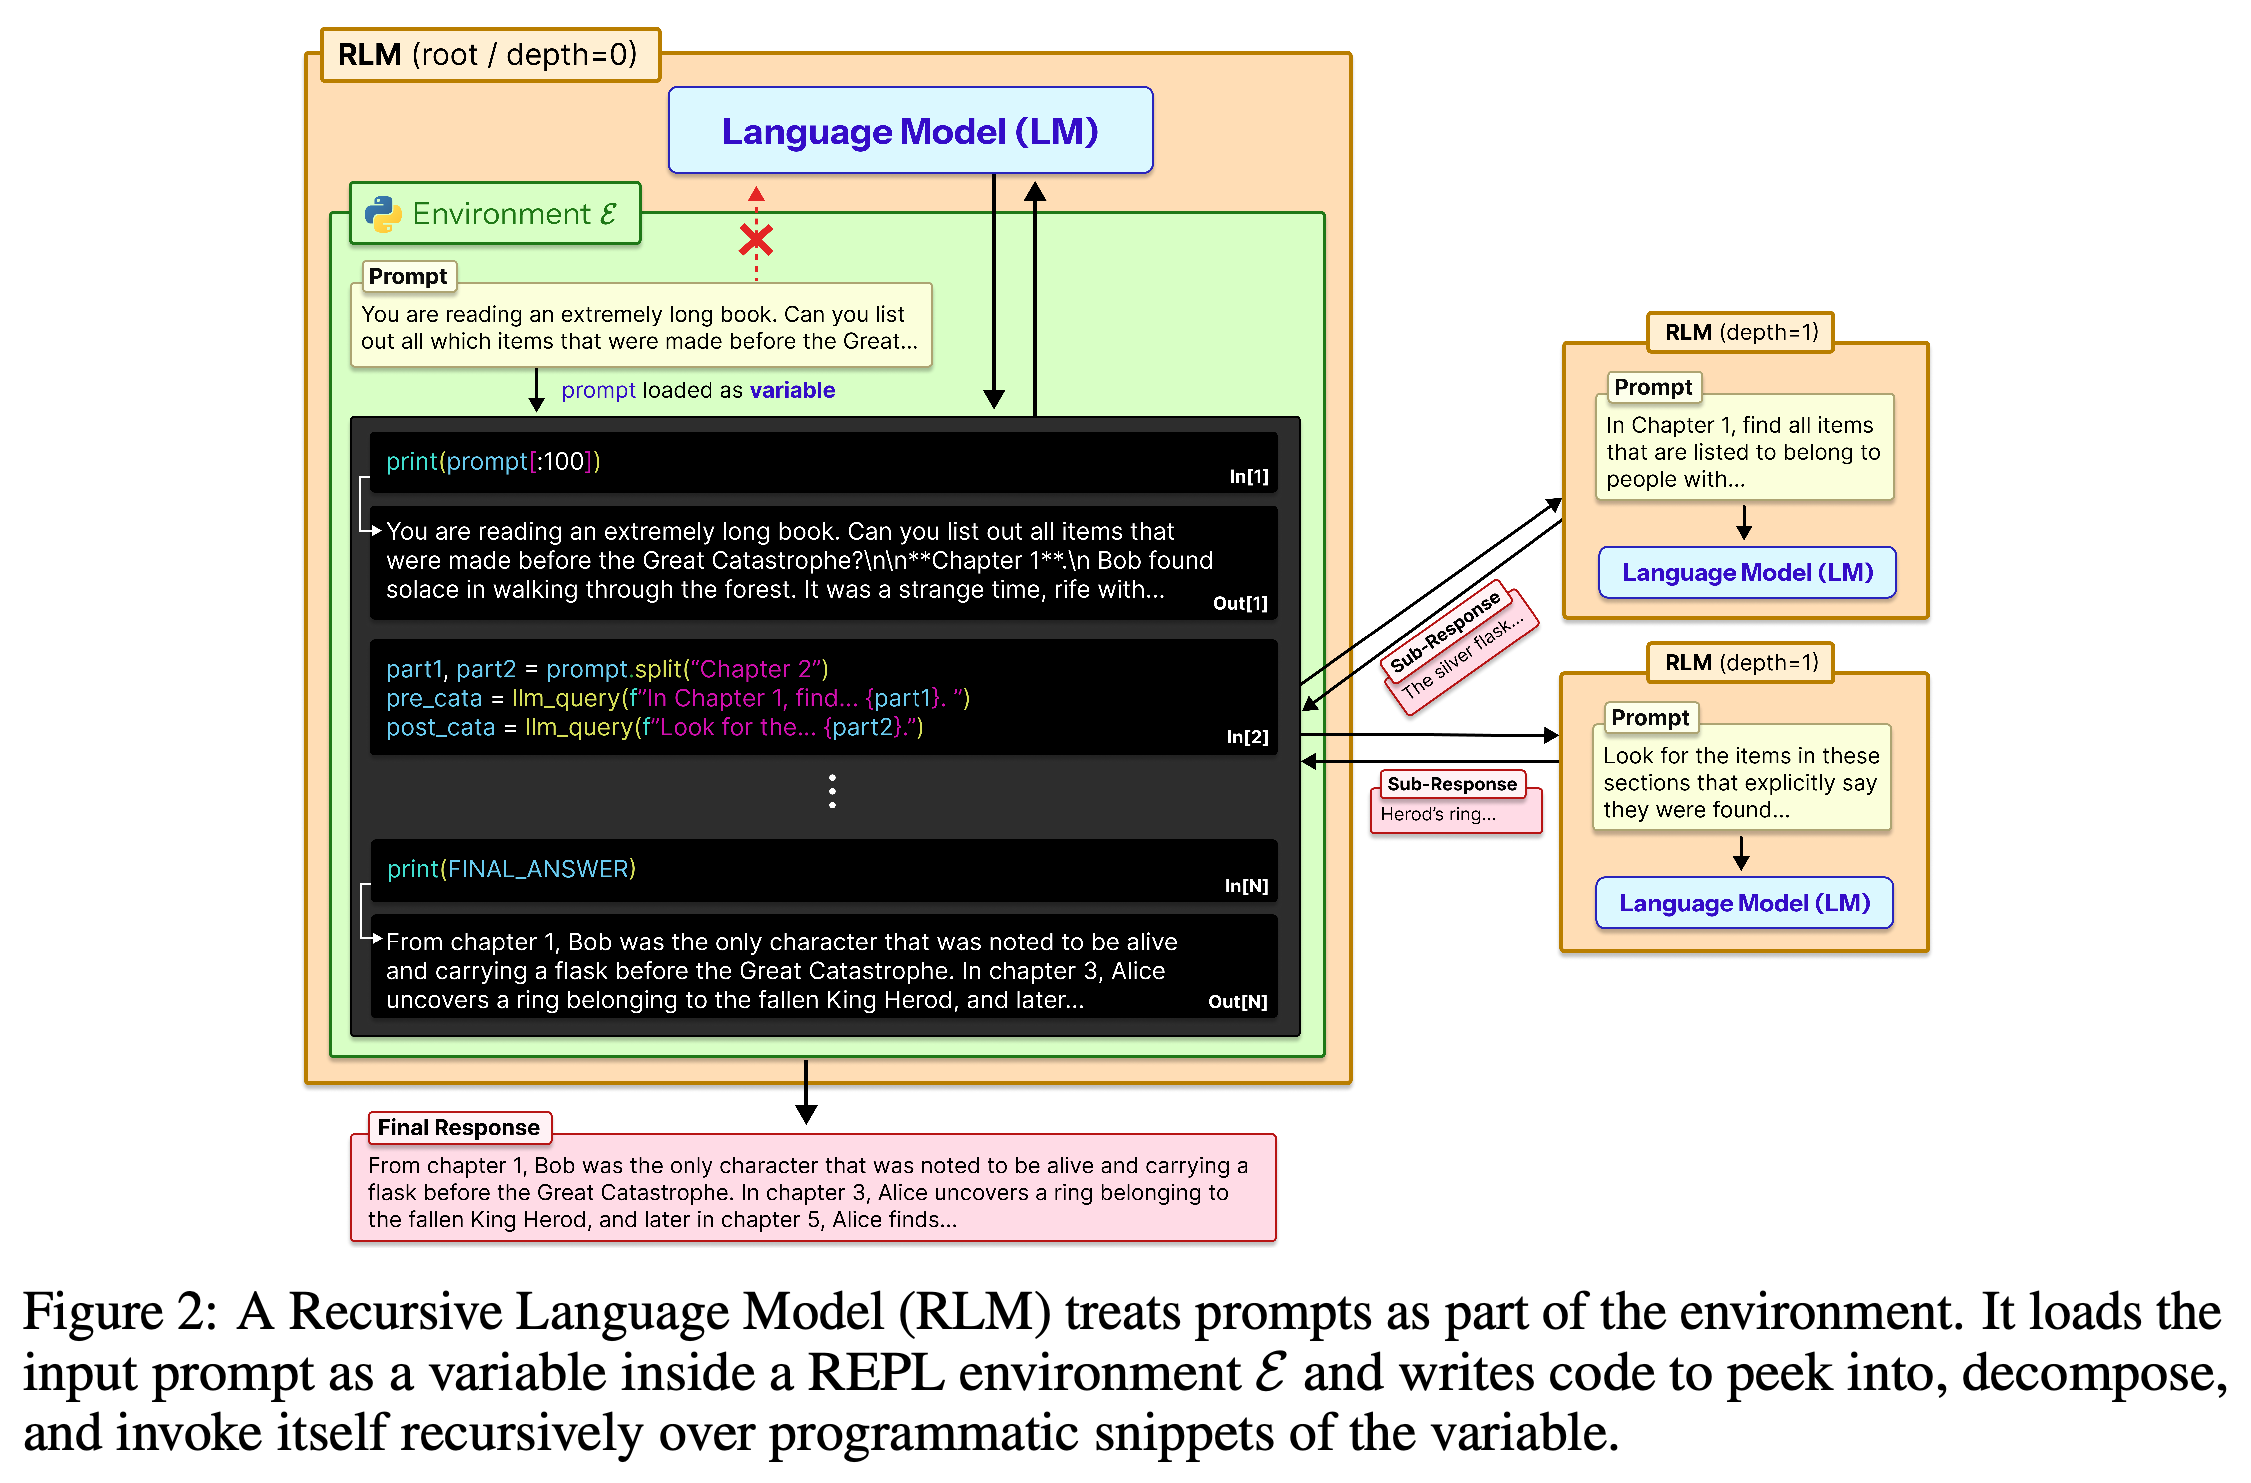
RLM은 문자열 입력과 문자열 출력 인터페이스를 유지하면서 프롬프트를 Read-Eval-Print Loop(REPL) 환경으로 옮긴다. Figure 2는 루트 모델이 전체 입력과 모든 중간 결과를 자신의 이력에 복사하는 대신, 프롬프트에 대한 심볼릭 접근, 영속 버퍼, 하위 호출을 활용하는 방식을 보여준다.
- 저자들은 프로그램으로 생성하는 하위 호출과 루트 모델이 각 요청을 개별적으로 언어로 표현해야 하는 위임 방식을 구분한다.
- 구현은 https://github.com/alexzhang13/rlm 에 공개되어 있다.
도식은 긴 프롬프트와 중간값이 루트 모델의 신경망 컨텍스트가 아니라 환경에 저장되는 구조를 보여준다. 코드는 모든 텍스트를 루트 이력에 복사하지 않고도 하위 모델의 응답을 저장하고 결합할 수 있다. 다만 개별 신경망 호출과 누적되는 루트 이력에는 여전히 한계가 있다.
2 Recursive Language Models
| 최대 컨텍스트 크기가 K인 기반 모델 M에 대해, 이 프레임워크는 임의 길이의 프롬프트 P ∈ Σ⋆를 받아 영속 환경 E를 통해 Y ∈ Σ⋆를 반환한다. 설계 목표는 |P| ≫ K인 입력을 처리하고, 모델의 단일 생성 범위를 넘는 출력을 구성하며, 프로그램으로 생성한 호출을 통해 (\Omega( | P | )) 또는 (\Omega( | P | ^2))의 의미 처리 작업을 지원하는 것이다. |
- Algorithm 1은 프롬프트와 하위 RLM 함수로 REPL을 초기화한 뒤, 환경에 Final이 생길 때까지 코드를 반복해서 생성하고 실행한다.
- 루트는 처음에 프롬프트 메타데이터를 받고, 이후에는 길이가 제한된 stdout 관측값을 받는다. 긴 문자열과 중간값은 환경에 남는다.
- 생성한 코드와 관측값이 쌓이면서 루트 이력도 계속 늘어난다. 따라서 다수의 하위 호출을 실행할 수 있어도 실제 반복 횟수나 자원 한계가 사라지지는 않는다.
Algorithm 2와 비교하면 설계상의 선택 3가지가 드러난다. 입력에 심볼릭 방식으로 접근하고, 환경에서 출력을 구성하며, 실행 가능한 코드 안에서 하위 모델을 호출한다. 반대로 P를 모델 이력에 넣고, 답을 직접 출력하며, 위임을 별도 행동으로만 제공하는 scaffold에는 입력, 출력, 위임의 병목이 남는다.
- 실제 구현은 Python REPL을 사용하며, 모델 질의 함수를 모듈로 제공하고 출력된 텍스트를 잘라서 전달한다.
- 형식적으로 정의한 알고리즘은 환경 변수를 반환하지만, 실험 구현은 최종 답을 직접 생성하는 것도 허용한다. 일부 실행 과정에서는 이 유연성이 실패 원인이 된다.
3 Scaling Long Context Tasks
평가에서는 프롬프트 길이와 질의에 답하는 데 필요한 정보량을 모두 변화시킨다. needle 수가 고정된 검색 벤치마크만으로는 거의 모든 항목을 의미적으로 처리하거나 조건에 맞는 쌍을 대량으로 열거해야 하는 작업을 평가할 수 없다.
- S-NIAH는 대략 일정한 정보량을 요구하고, OOLONG은 선형 규모의 의미 레이블링과 집계를 요구하며, OOLONG-Pairs는 잠재적으로 이차 규모의 쌍 출력을 요구한다.
- 이차 규모의 출력이 반드시 이차 규모의 신경망 처리를 요구하지는 않는다. 실행 과정에서 하위 호출로 항목을 분류한 뒤 Python으로 쌍을 열거할 수 있다.
- BrowseComp-Plus와 CodeQA는 각각 문서 조사와 저장소 이해 작업을 추가한다.
3.1 Tasks
S-NIAH는 무관한 텍스트 속에서 구절이나 숫자를 찾는 single-needle 작업 50개로 구성된다. BrowseComp-Plus는 무작위로 뽑은 질문 150개를 사용한다. 각 질문에는 정답 문서와 근거 문서를 반드시 포함하도록 무작위로 선택한 문서 1000개를 제공하며, 정답 비율로 성능을 측정한다.
- BrowseComp-Plus는 여러 문서의 근거를 연결하는 multi-hop 작업을 요구하지만, 필요한 근거 집합은 전체 말뭉치에 비해 여전히 작다.
- 주요 BrowseComp-Plus 입력의 길이는 6M–11M 토큰이다.
OOLONG은 trec_coarse의 작업 50개를 사용하며, 거의 모든 질문의 의미 레이블을 추론하고 집계해야 한다. OOLONG-Pairs는 조건에 맞는 사용자 ID 쌍의 목록을 요구하는 질의 20개를 도입하고 F1으로 평가한다. LongBench-v2 CodeQA는 코드 저장소에 관한 객관식 질문을 제시한다.
- Table 1은 OOLONG을 131K 토큰에서, OOLONG-Pairs를 32K 토큰에서 평가한다.
- CodeQA 입력의 길이는 23K부터 4.2M 토큰까지다.
- 쌍 열거는 조건에 맞는 쌍의 수만 세는 것이 아니라, 입력 전반을 조밀하게 처리하고 긴 출력을 구성하는 능력을 평가한다.
3.2 Methods and Baselines
주요 모델 설정은 medium reasoning과 기본 샘플링 매개변수를 사용하는 GPT-5, 공개된 샘플링 매개변수를 사용하는 Qwen3-Coder-480B-A35B다. 베이스라인에는 모델 직접 호출, BM25 또는 하위 호출을 사용하는 CodeAct, 반복적 compaction, OpenCode, Claude Code가 포함된다. 코딩 에이전트는 컨텍스트를 직접 받는 변형과 파일로 접근하는 변형을 평가한다.
- BM25 검색기는 BrowseComp-Plus에 제공한다. Appendix C.1에서는 다른 작업의 검색 기능을 제거한다.
- GPT-5 compaction은 수백만 토큰을 읽는 비용을 줄이기 위해 GPT-5-nano로 요약하고 GPT-5로 최종 답을 생성한다.
- Claude Code v2.0.0은 Claude Opus 4.1을 사용하므로 모델과 scaffold가 모두 달라진다. 비용은 해당 모델의 OpenAI, Fireworks, Anthropic 가격을 적용한다. Table 1에는 OpenCode 비용이 제공되지 않는다.
RLM depth=0은 외부 컨텍스트 조작만 허용하고 하위 호출은 허용하지 않는다. depth=1은 일반 LLM 호출을 허용하며, 더 깊은 설정은 RLM 호출을 허용한다. GPT-5 실험은 루트에 GPT-5를, 재귀 호출에 GPT-5-mini를 사용한다. 따라서 이 scaffold는 단일 모델을 반복해서 사용하는 방식이 아니라 이종 모델을 결합한 추론 시스템이다.
- 평가한 최대 재귀 깊이는 0–3이며, 깊이를 명시하지 않으면 depth=1로 가정한다.
- 본문에서는 Qwen3-Coder-480B-A35B를 루트로, Qwen3-8B를 하위 호출 모델로 사용하는 RLM이 생성한 LongBenchPro 실행 기록을 필터링한 뒤 1,000개로 RLM-Qwen3-8B를 학습했다고 설명한다.
- 학습은 루트가 REPL을 조작하고 위임 시점을 결정하는 능력을 대상으로 한다. 말단 요청은 일반적인 추론 작업으로 취급한다.
4 Results and Discussion
Table 1은 RLM이 기반 모델의 윈도를 넘는 입력을 처리하고, 윈도 안에서도 조밀한 처리 성능을 개선할 수 있음을 보여준다. depth=1에서 GPT-5는 CodeQA 62.0, BrowseComp-Plus 91.3, OOLONG 56.0, OOLONG-Pairs F1 58.0을 기록한다. 모델 직접 호출 점수는 각각 24.0, 0.0, 44.0, 0.1이다.
- CodeQA와 BrowseComp-Plus의 직접 호출 결과에는 컨텍스트 한계에 도달했다는 표시가 있다. 따라서 전체 입력을 읽은 상태에서의 추론 품질만을 측정한 결과는 아니다.
- BrowseComp-Plus에서 depth=1 RLM은 compaction 에이전트의 70.5와 BM25를 사용하는 CodeAct의 51.0을 넘지만, 컨텍스트를 외부로 옮긴 OpenCode의 94.0에는 못 미친다.
- OOLONG-Pairs에서 GPT-5 depth=1 RLM의 비용은 $0.33 ± $0.20 per task로 보고된다. BM25를 사용하는 CodeAct는 $0.75 ± $0.43이며, 하위 호출을 사용하는 CodeAct는 $1.11 ± $0.62다.
이 비교는 컨텍스트를 외부로 옮기는 효과와 재귀적 위임의 효과를 구분하고, 모델과 작업의 상호작용을 드러낸다. GPT-5는 재귀 깊이를 늘리면 OOLONG-Pairs 성능이 개선되는 반면, Qwen3-Coder는 하위 호출 없이 최고 CodeQA 점수를 얻는다. 컨텍스트를 외부로 옮긴 OpenCode는 BrowseComp-Plus에서 GPT-5 RLM 변형들보다 높은 성능을 보인다. 컨텍스트 한계 표시와 제공되지 않은 OpenCode 비용 때문에 전반적인 우위를 단순하게 주장할 수는 없다.
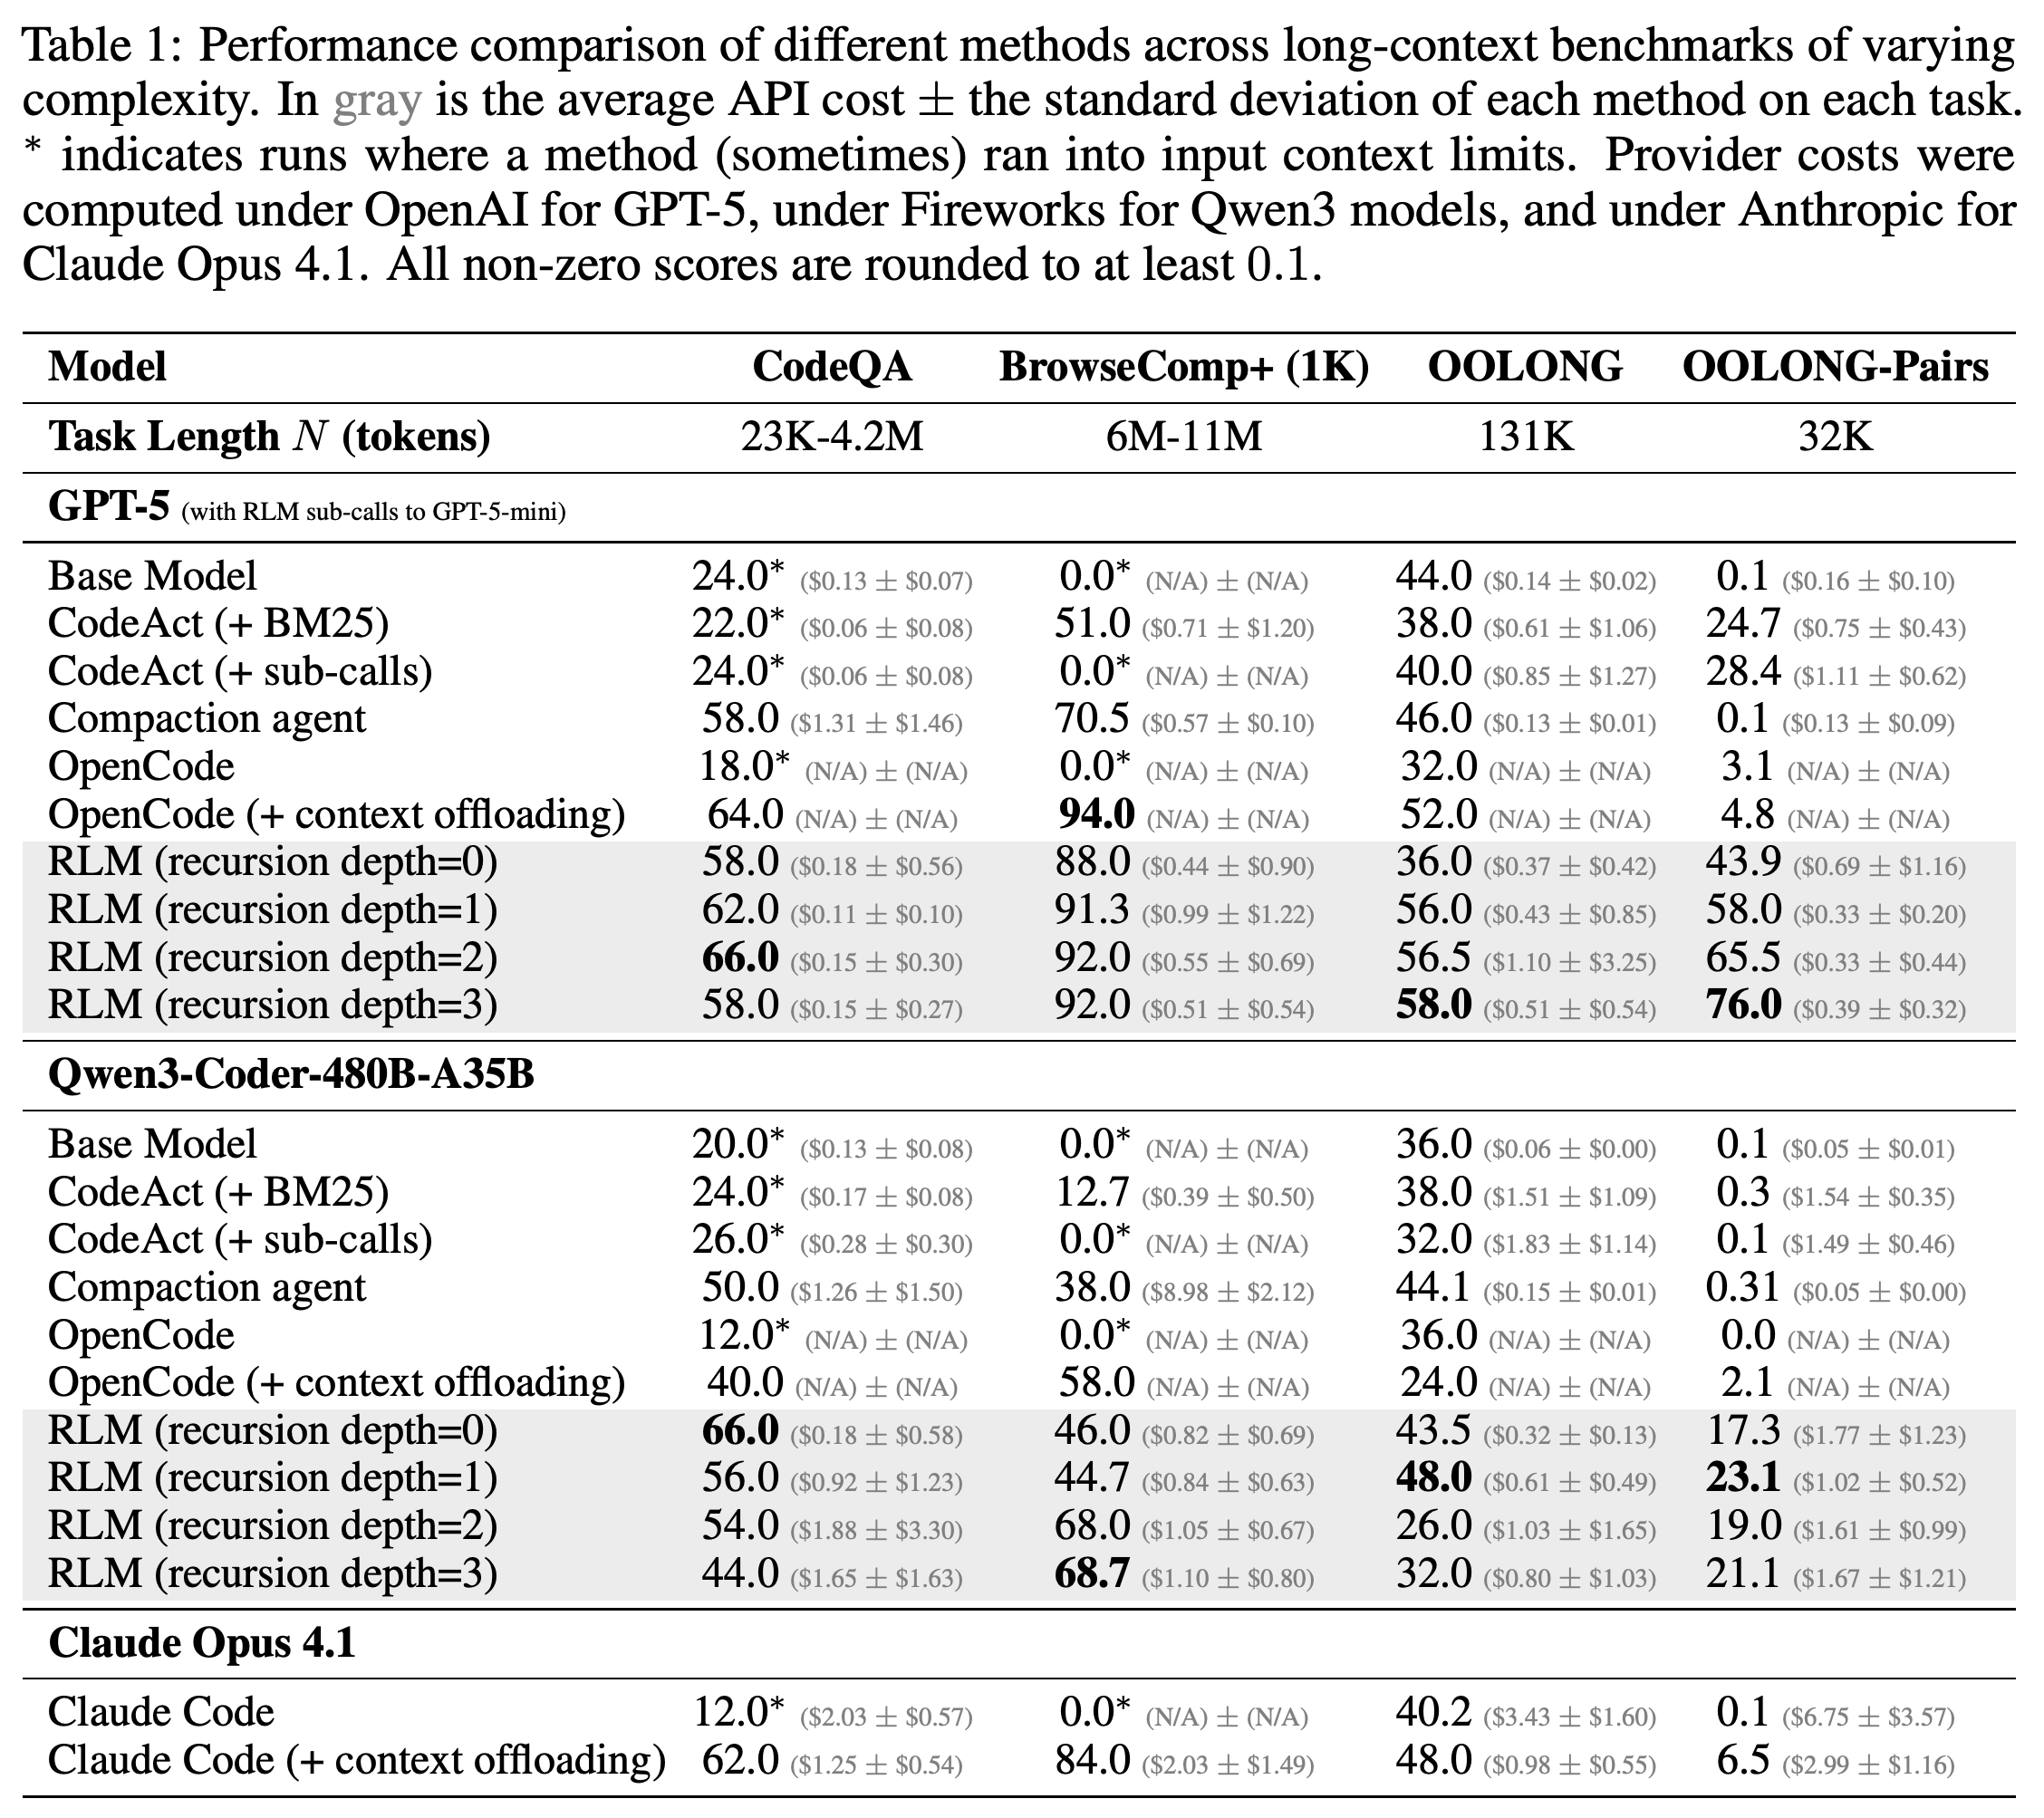
외부 컨텍스트 저장이 성능 이득의 상당 부분을 설명하며, 재귀적 의미 처리가 작업에 따라 추가 이득을 제공한다. GPT-5의 OOLONG-Pairs F1은 depth=0의 43.9에서 깊이 1, 2, 3의 58.0, 65.5, 76.0으로 증가한다. 반면 Qwen3-Coder의 최고 CodeQA 점수는 depth=0에서 기록한 66.0이다.
- Qwen3-Coder의 OOLONG 점수는 depth=1의 48.0에서 depth=2의 26.0으로 떨어진다. 이는 재귀 깊이를 늘려도 성능이 일반적으로 단조 증가하지는 않음을 보여준다.
- GPT-5의 CodeQA 점수는 depth=2에서 66.0으로 최고점에 도달하고, depth=3에서 58.0으로 떨어진다.
- 저자들은 Qwen3-Coder의 성능 저하 일부를 재귀적 하위 RLM 호출로 전파되는 구문 오류 때문이라고 설명한다.
비용을 비교할 때는 작업과 베이스라인을 고려해야 한다. GPT-5 depth=1 RLM의 BrowseComp-Plus 비용은 $0.99 ± $1.22이며 compaction은 $0.57 ± $0.10이다. OOLONG에서는 RLM이 $0.43 ± $0.85, 기반 모델이 $0.14 ± $0.02다.
- GPT-5-mini가 6M–11M 토큰을 읽는 데 $1.50–$2.75가 든다는 논문의 추정은 선형 외삽이다. 전체 컨텍스트를 실제로 처리할 수 있는 베이스라인의 비용은 아니다.
- 일부 이상치 실행이 평균 비용을 중앙값보다 크게 높일 수 있다. 비용 분포 그래프를 모든 경우에 더 저렴한 추론을 입증한 결과로 해석해서는 안 된다.
- 주요 실험의 LM 호출은 blocking 방식으로 순차 실행된다. 실행 시간은 구현, 요청 지연 시간, 하드웨어에도 좌우되므로 API 비용이 비슷하다고 지연 시간까지 비슷한 것은 아니다.
Table 2는 GPT-5.2를 사용해 평가를 LongCoT-mini로 확장한다. 전체 해결률은 기반 모델의 38.7에서 depth=1 RLM의 50.6으로 증가하며, 명시적인 분해 힌트를 받은 RLM은 65.6을 기록한다. 이는 논문이 보고한 힌트 제공 변형의 상대적 증가율 69.5%에 해당한다.
- 힌트가 없을 때 성능은 분야별로 고르지 않다. MATH는 26.0에서 5.6으로, CS는 40.4에서 11.0으로 떨어지는 반면, LOGIC은 86.7, CHESS는 93.0에 도달한다.
- 힌트를 제공하면 MATH는 32.0, CHEM은 52.0, CS는 46.0을 기록하며, LOGIC과 CHESS는 모두 99.0을 기록한다.
- LongCoT-mini 실험은 다른 harness를 사용하며, 힌트 제공 변형에는 작업별 분해 지침을 추가한다. 이는 작업에 특화하지 않은 주요 벤치마크 설정과 구분해야 한다.
전체 성능 향상만 보면 뚜렷한 분야별 차이가 드러나지 않는다. 힌트가 없는 RLM은 LOGIC과 CHESS에서 개선되지만 MATH와 CS에서는 기반 모델보다 낮은 성능을 보인다. 명시적인 분해 힌트는 모든 분야에서 기반 모델 대비 성능을 개선한다. 따라서 오케스트레이션 지침은 scaffold 설정에 실질적인 변화를 주며 결과에도 큰 영향을 미친다.
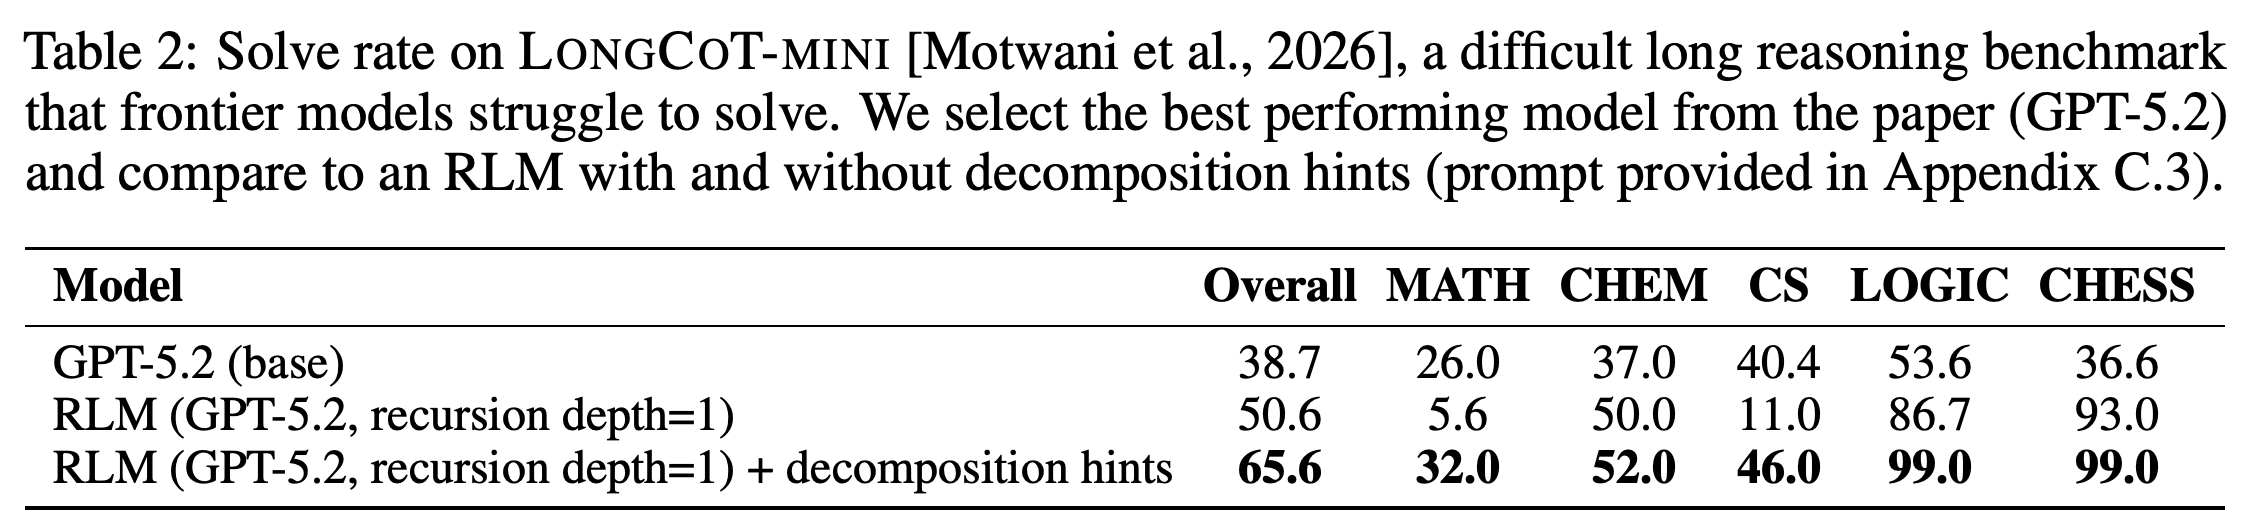
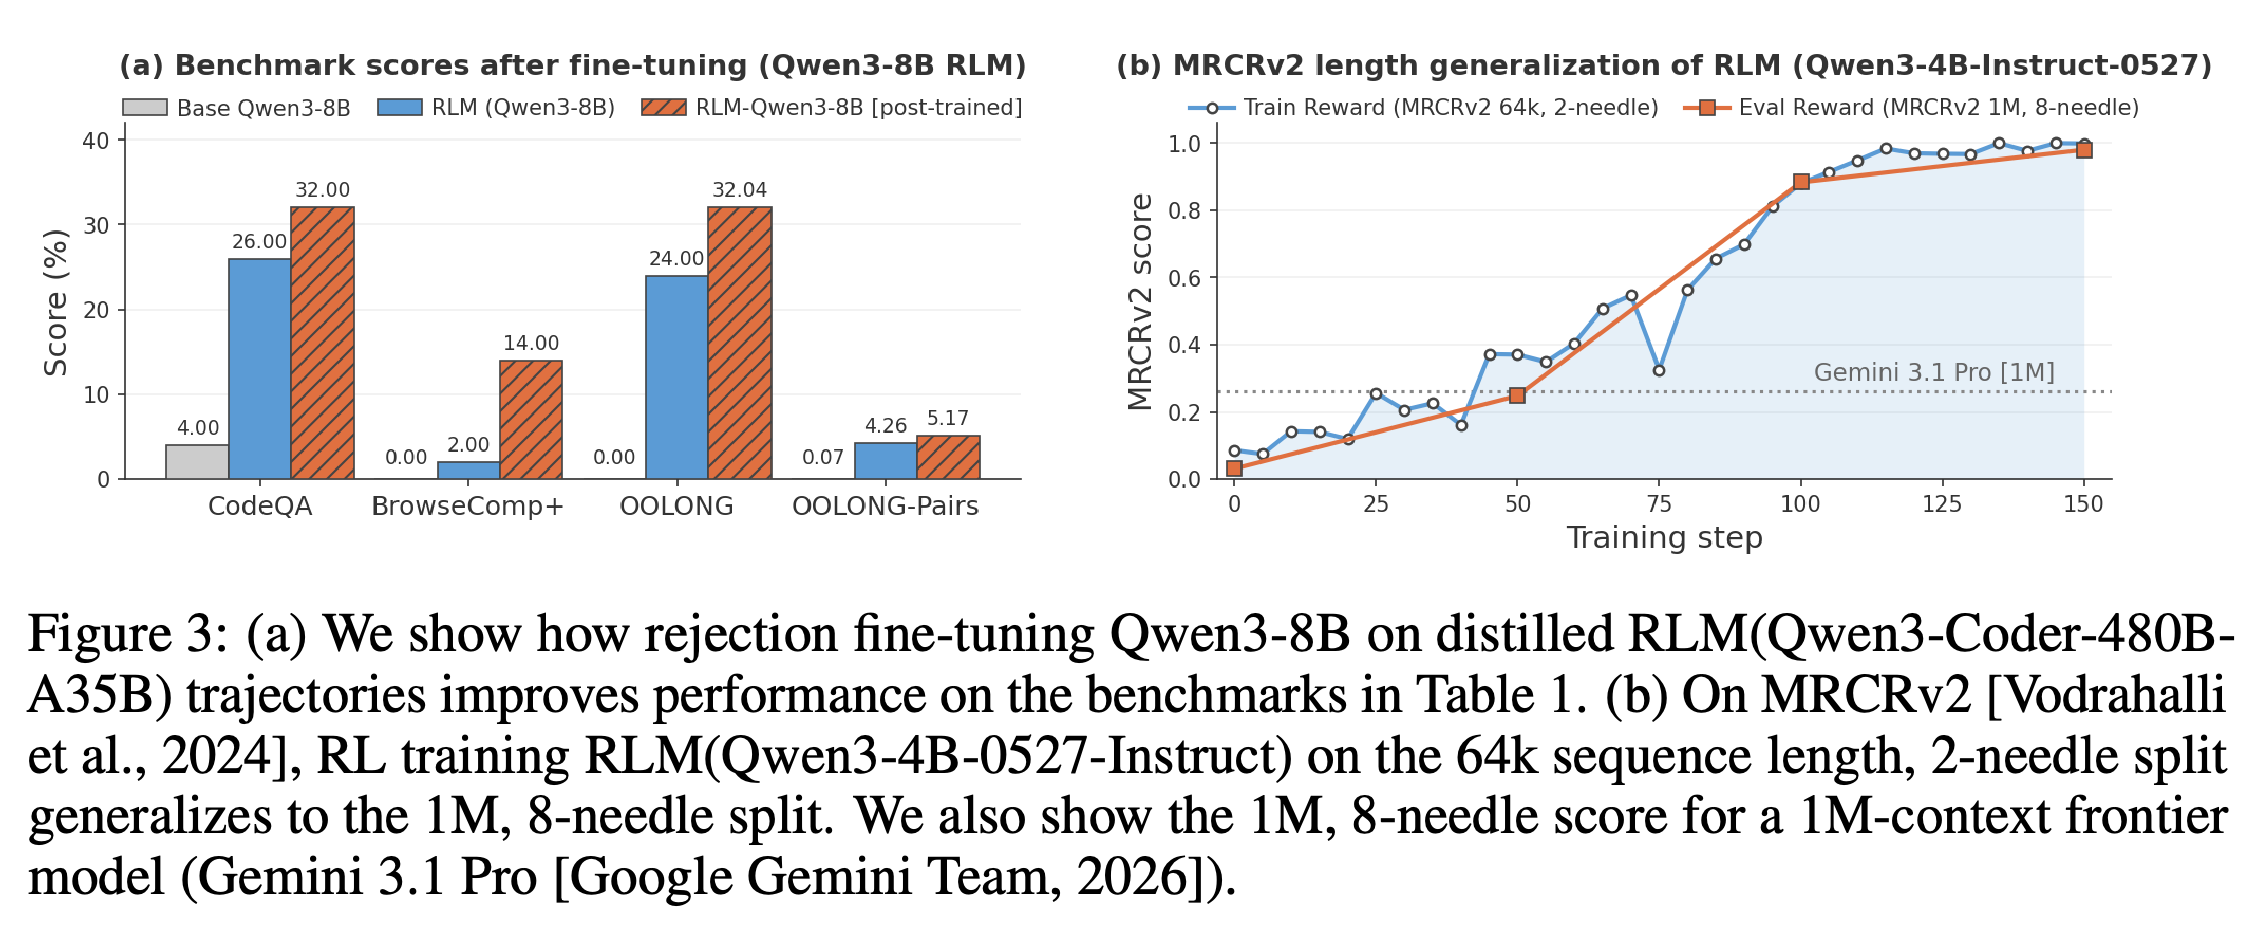
Figure 3은 RLM scaffold를 추가해서 얻은 이득과 사후 학습으로 얻은 이득을 구분한다. scaffold 안에서 미학습 Qwen3-8B와 사후 학습한 Qwen3-8B의 점수는 CodeQA에서 26.00과 32.00, BrowseComp-Plus에서 2.00과 14.00, OOLONG에서 24.00과 32.04, OOLONG-Pairs에서 4.26과 5.17이다.
- 학습은 오케스트레이션을 대상으로 하지만, 이 집계 결과만으로 오케스트레이션의 효과를 모델 행동의 다른 변화와 분리할 수는 없다. 사후 학습한 8B 모델의 성능은 여전히 최상위 RLM 결과보다 낮다.
- 별도의 Qwen3-4B-Instruct-0527 RLVR 실험은 MRCRv2의 32K–64K 토큰, needle 2개 설정으로 학습하고 512K–1M 토큰, needle 8개 설정으로 평가한다.
- MRCRv2 학습 곡선은 이 합성 작업 안에서 입력 길이와 needle 수에 대한 일반화를 뒷받침한다. 임의의 장문 컨텍스트 문제로의 외삽을 뒷받침하지는 않는다.
왼쪽 패널은 scaffold로 얻은 이득과 루트 모델 학습 후의 추가 이득을 구분한다. 주요 작업 4개 모두에서 개선되지만 BrowseComp-Plus와 OOLONG-Pairs의 절대 점수는 낮다. 오른쪽 패널은 짧은 입력 분할로 학습하는 동안 더 길고 needle 수가 많은 분할의 MRCRv2 평가 성능이 높아지는 모습을 보여준다. 이는 이 합성 벤치마크 안에서의 일반화를 뒷받침한다.
5 Analyses of RLM Trajectories
관찰한 RLM 실행 과정은 대체로 입력을 탐색하고, 분해 방식을 선택한 뒤, 일부 의미 처리 작업을 위임한다. 희소한 조사 작업에서는 모델의 사전 지식을 활용한 regex 검색을 자주 사용한다. 조밀한 작업에서는 하위 호출로 레이블을 부여한 뒤 Python으로 집계하거나 쌍을 구성한다.
- 영속 변수를 사용하면 루트 모델이 모든 항목을 다시 생성하지 않고도 출력을 연결할 수 있다.
- 일부 실행 과정에서는 검증을 지나치게 반복하거나, 이미 완료한 계산을 다시 수행하거나, 구성해 둔 답을 반환하지 못한다.
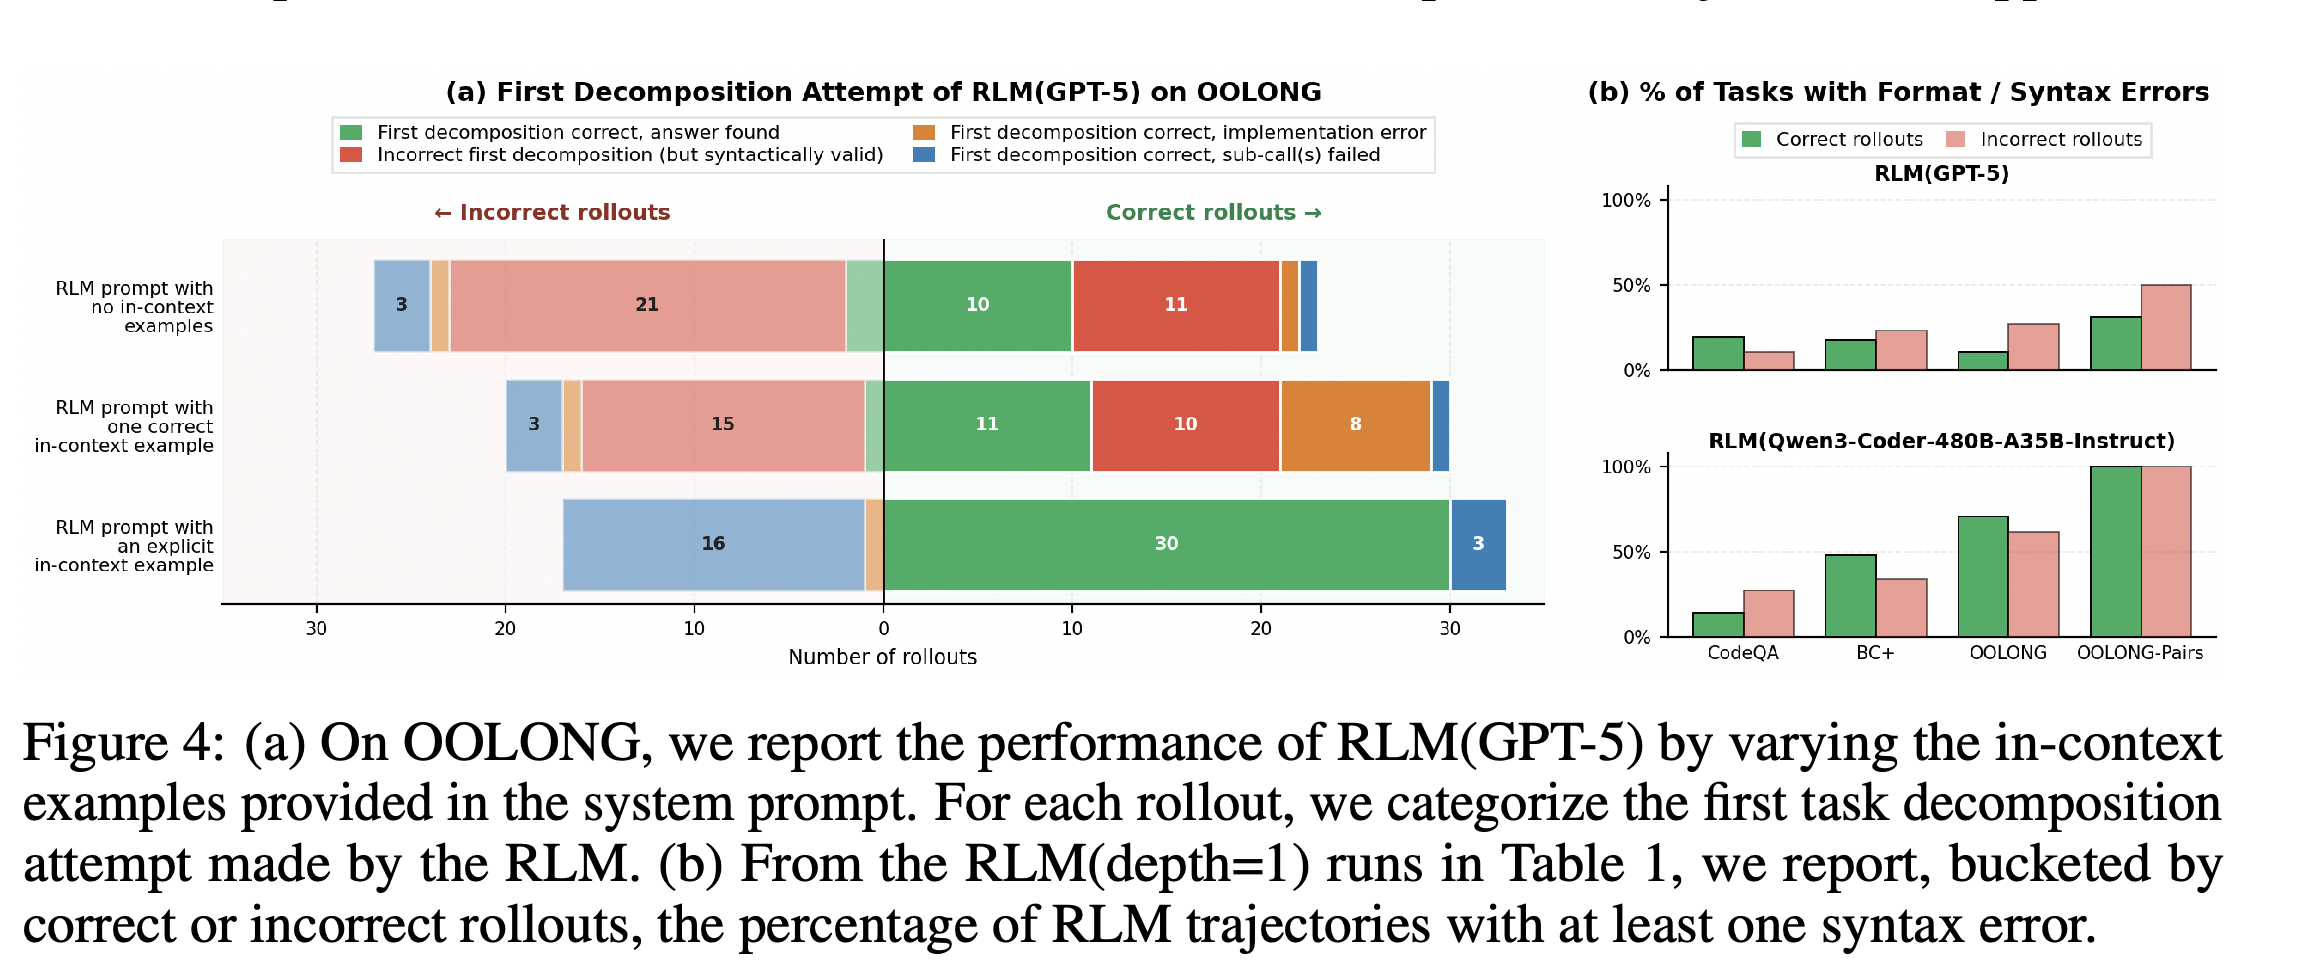
Figure 4는 첫 분해 시도와 실행 신뢰성이 결과와 어떤 관계가 있는지 보여준다. In-context 예시는 실제 작업과 무관해도 OOLONG 성능을 개선한다. Qwen3-Coder 실행 기록에는 GPT-5보다 구문 또는 형식 오류가 훨씬 많이 나타난다.
- 분해 방식이 올바르더라도 구현 실수나 잘못된 하위 호출 결과로 실패할 수 있다.
- 처음에 잘못 분해했더라도 실행 피드백으로 수정할 수 있는 경우가 있다. 따라서 첫 시도의 품질은 중요하지만 결과를 결정하지는 않는다.
- 오류 비교는 재귀 깊이에 따른 실패에 관한 저자들의 설명을 관찰 결과로 뒷받침한다. 원인을 분리한 인과적 개입 실험은 아니다.
분해 ablation은 예시가 초기 전략과 최종 성공 여부를 바꾼다는 점을 보여준다. 결과 범주는 계획 실패를 구현 실패 및 하위 호출 실패와 구분한다. 오류율 패널에서는 성공한 Qwen3-Coder 실행에도 오류가 자주 나타난다. 이는 오류에서 회복하는 능력을 보여주는 동시에 재귀 깊이가 깊어질 때 오류가 전파될 수 있다는 우려를 뒷받침한다.
6 Related Works
논문은 RLM을 컨텍스트 윈도를 확장하는 아키텍처 기법이 아니라 추론 scaffold로 분류한다. 또한 손실이 발생하는 compaction, 명시적인 메모리 계층, 사람이 설계한 위임 워크플로, 하위 모델 호출을 포함한 일회성 프로그램과 구분한다.
- 저자들이 주장하는 재귀적 위임 시스템과의 차이는 사용자 입력 자체를 심볼릭 방식으로 조작한다는 점이다. 여기에는 기반 모델의 윈도를 넘는 입력도 포함된다.
- RLM은 프로그램을 1번만 생성하는 방식과 달리, 지속적인 실행 피드백을 통해 코드와 분해 결정을 수정할 수 있다.
- 이 scaffold는 기반 신경망 아키텍처를 교체할 필요가 없으며, 더 긴 컨텍스트 윈도를 가진 모델에도 적용할 수 있다.
7 Limitations and Future Work
저자들은 실제 데이터로 구성된 어려운 장문 컨텍스트 작업에 대한 평가가 제한적이고, 가드레일 연구가 부족하며, 하위 호출 비용이 급증할 수 있다는 점을 미해결 한계로 제시한다. 비동기 실행과 샌드박스 REPL을 구현 방향으로 제안하지만, 순차 실행을 사용한 주요 실험에서는 그 이점을 입증하지 않는다.
- 소형 모델은 코딩 능력이 부족하면 어려움을 겪을 수 있다. 추론 모델은 REPL 행동을 완료하기 전에 출력 예산을 소진할 수 있다.
- FINAL()과 FINAL_VAR()를 통한 종료는 취약하다. 모델이 계획만 제시하고 조기에 종료하거나, 저장된 유효 결과를 반환하지 못할 수 있다.
- 소규모 학습 결과만으로는 RLM 자체를 학습하는 방식의 scaling law를 확립할 수 없다.
8 Conclusion
논문은 코드를 통한 외부 컨텍스트 접근과 프로그램 기반 모델 위임이 평가한 장문 컨텍스트 및 추론 작업에서 효과적인 추론 프레임워크를 구성한다고 결론짓는다. 결과는 영속적인 심볼릭 상태를 크기가 제한된 신경망 컨텍스트와 분리하는 접근을 뒷받침한다. 다만 학습 방법, 재귀 정책, 가드레일, 실행 구현은 여전히 열린 과제로 남는다.
부록
- A Additional Training Details는 영어 LongBenchPro의 750 tasks에서 후보 실행 기록 2250개를 수집하고, 점수가 0인 기록과 단일 턴 기록을 제거해 1,072개를 남긴 뒤, 루트 턴을 지도 학습 예시로 변환하는 과정을 설명한다. 추가 필터링에서는 약 100k-character 한도를 넘는 턴을 제거하고 템플릿 오류를 수정한다. 턴의 16%는 FINAL을, 13%는 FINAL_VAR를 잘못 사용한다. 파인튜닝에는 prime-rl, 배치 크기 64, 300 steps, 48 H100 시간을 사용한다. 본문에서 제시한 실행 기록 1,000개는 근사치다. Figure 5는 필터링 후 실행 기록 953개와 턴 샘플 4724개를 보고하며, Appendix A는 중간 필터링 단계에서 1,072개를 보고한다.
- A Additional Training Details의 Figure 6은 사후 학습 후 Qwen3-8B RLM의 평균 실행 시간이 CodeQA에서 272에서 86초로, BrowseComp-Plus에서 341에서 101로, OOLONG에서 12449에서 1649로, OOLONG-Pairs에서 5113에서 532로 줄었다고 보고한다. 이어지는 MRCRv2 실험은 150 steps 동안 강화학습을 수행하며, 배치 크기 128과 예시당 rollout 4개를 사용한다. 학습 분할은 32k–64k-token, needle 2개 설정이다. 각 턴은 출력 토큰 4096개를 허용하며, RLM 반복 한도는 20이다. 평가는 0부터 시작해 50 steps마다 512K–1M-token, needle 8개 분할에서 수행한다.
- B Negative Results: Things We Tried That Did Not Work.는 모델별 프롬프팅, 부족한 코딩 능력, 출력 예산 소진, 순차 호출의 지연 시간, 취약한 최종 답 처리 문제를 기록한다. GPT-5 프롬프트를 Qwen3-Coder에 재사용하면 위임이 지나치게 늘어나므로 배치 처리 경고를 추가해야 했다. Qwen3-235B-A22B는 OOLONG에서 30%에서 38%로 개선되었지만, 일부 실행에서는 행동을 완료하기 전에 thinking 토큰으로 출력 예산을 소진했다.
- C Additional Methods and Baseline Details와 C.1 Prompts for Experiments는 실험 프롬프트 템플릿과 모델별 변경 사항을 제공한다. 인터페이스에는 context, llm_query, rlm_query, FINAL(), FINAL_VAR()가 포함된다. 더 깊은 재귀에서는 rlm_query(context, query)를 사용하고 깊이 한계에 도달하면 llm_query로 전환한다. 주요 작업의 RLM 프롬프트는 작업 전반에서 고정하지만, Qwen3-Coder에는 배치 처리 경고를 추가하고 Qwen3-8B에는 약 32k-token 윈도에 맞춘 조정을 적용한다. CodeAct에는 BrowseComp-Plus용 BM25 검색을 제공하며, 다른 작업에는 검색 기능이 없는 프롬프트를 제공한다.
- C.2 Summary agent baseline은 반복적으로 입력을 읽고, 컨텍스트가 가득 차면 요약하며, 모델 윈도보다 큰 입력은 청크로 나누는 방식을 명시한다. GPT-5 베이스라인의 요약은 GPT-5-nano가 수행한다. BrowseComp-Plus 샘플 20개로 확인한 결과, GPT-5로 요약할 때와 비슷한 성능을 보였다. 이 선택은 비용 비교에 영향을 준다. Qwen3-Coder 요약 에이전트의 BrowseComp-Plus 비용은 거의 15배 더 높다고 보고한다.
- C.3 LongCoT-mini experiment.는 샌드박스 실행과 다른 최종 답 처리 방식을 갖춘 Prime Intellect의 rlm-harness를 사용한다. 분해 지침은 의존성 그래프를 계획하고, 준비된 노드를 llm_batch로 풀고, 검증된 값을 캐싱하며, 저장한 답으로 최종 결과를 구성하도록 안내한다. harness는 /task/answer.txt에 작성한 답을 채점한다. Table 3은 기반 모델 대조군을 추가한다. 분해 힌트는 MATH를 26.0에서 37.0으로 개선하지만, GPT-5.2의 전체 해결률은 38.7에서 28.6으로 낮춘다.
- D Additional Benchmark Details와 D.1 OOLONG-Pairs Benchmark는 입력 길이 [1024, 2048, 4096, 8192, 16384, 32768, 65536, 131072, 262144, 524288, 1048576]에서 합성 질의 20개를 정의한다. 질의는 의미 레이블 6개 중 해당 레이블을 추론하고 조건에 맞는 사용자 ID 쌍을 반환하도록 요구하며, 일부에는 날짜나 개수 제약이 있다. 쌍을 명시적으로 출력해야 하므로 열거를 개수만 세는 방식으로 대체할 수 없다. D.2 Scaling Huge Document Corpora in BrowseComp+는 원래 질문 150개 중 20개를 평가하고 ReAct w/ GPT-5 + BM25와 GPT-5 + pre-query BM25 베이스라인을 추가한다. 문서 1000개에서 RLM(GPT-5)은 100%, 재귀를 제거한 ablation은 90%를 달성한다. 이 부분집합 결과를 더 큰 주요 평가와 혼동해서는 안 된다.
- E Additional RLM Trajectories는 성공과 실패 사례를 제시한다. E.1 RLM(GPT-5) on BrowseComp-Plus-Query_74는 regex 탐색, 추출, 검증 호출을 통해 8.3M 토큰 말뭉치에서 Maria Dalmacio를 $0.079에 찾는다. E.2 RLM(Qwen3-Coder) on OOLONG-Pairs-Query_3는 $1.12를 쓰고, 의미 분류의 정확성에 따라 정답 여부가 달라지는 후보 답을 구성한다. 이후 답을 반복해서 다시 구성하다가 저장한 결과를 반환하는 대신 잘못된 응답을 생성해 실패한다. E.3 RLM(Qwen3-Coder) on OOLONG-Query_212는 과도한 하위 호출을 사용하지만 $0.38에 올바른 집계 비교에 도달한다. E.4 RLM(GPT-5) on CodeQA-Query_44는 900k-token 저장소에서 $0.27에 정답인 선택지 1을 고른다.
- F Additional Quantitative Results와 F.1 Additional Quantitative Analysis of Main Results는 각 방법이 성공한 사례의 중복과 하위 호출 수를 비교한다. RLM은 추가 사례를 해결하지만 모든 베이스라인보다 항상 우수하지는 않다. 정답을 낸 Qwen3-Coder의 OOLONG 실행은 평균 약 500회의 하위 호출을 사용하며, 미학습 Qwen3-8B는 오답 실행에서 더 많이 위임하는 경우가 많다. F.2 Additional Runtime and Cost Analysis of RLMs는 분산이 크고 긴 꼬리를 가진 분포를 보고한다. 드물게 발생하는 매우 긴 실행은 주로 순차 하위 호출 때문이라고 설명한다. 또한 입력 길이 스케일링 실험의 평균 API 비용을 제공하고, 타임아웃 로직과 비동기 호출을 구현상의 해결책으로 논의한다. 이는 주요 실험에서 입증한 개선 사항은 아니다.
짧은 생각
가장 중요한 기여는 재귀 자체가 아니라 신경망 컨텍스트와 영속적인 심볼릭 상태를 분리한 점이다. depth=0 ablation과 컨텍스트를 외부로 옮긴 코딩 에이전트는 외부 입력 접근만으로도 상당한 이득을 얻는다는 점을 보여준다. OOLONG-Pairs는 의미 처리를 위한 하위 호출을 프로그램 기반 집계 및 출력 구성과 결합하는 효과를 가장 분명하게 보여준다.
결과는 분해와 실행 신뢰성이 중요한 평가 대상임을 보여주지만, 장문 컨텍스트 추론이 항상 더 저렴하거나 임의로 높은 신뢰성을 달성할 수 있음을 입증하지는 않는다. 모델에 따라 달라지는 깊이 효과, GPT-5/GPT-5-mini의 이종 모델 실행, 제공되지 않은 OpenCode 비용, 작업에 특화된 LongCoT-mini 힌트는 종합 비교를 제한한다. 실패 사례는 명시적인 비용 상한, 신뢰할 수 있는 종료, 실제 데이터로 구성된 조밀한 처리 작업에 대한 평가가 필요함을 보여준다.