SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence 요약 설명
18 Jun 2025 | Paper Review LLM Agents Multi-Agent Coordination Particle Swarm Optimization목차
이번 글에서는 SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 6월 18일(Arxiv)
- Zhang, Yao, Lin, Chenyang, Tang, Shijie, Chen, Haokun, Zhou, Shijie, Ma, Yunpu, Tresp, Volker.
- LMU Munich, Technical University of Munich, Munich Center for Machine Learning
- 논문 링크
요약
- 역할과 지침을 부여한 언어 모델 에이전트들이 협력하는 시스템을 설계할 때는 보통 역할과 워크플로를 사람이 정한다. 이러한 방식은 새로운 과제에 대한 적응을 제한할 수 있다. 생성된 시스템을 GPT-4o로 실행했을 때, SwarmAgentic은 사용자 제약을 따르는 여행 계획 벤치마크인 TravelPlanner에서 최종 통과율 32.2%를 달성한다. 에이전트 코드를 탐색하는 비교 방법인 Automated Design of Agentic Systems (ADAS)는 8.9%를 기록하며, 논문은 이를 261.8%의 상대적 향상으로 보고한다.
- 이 방법은 각 후보가 이전에 찾은 최적 해와 전체 집단의 최적 해를 참고하는 집단 탐색 기법인 Particle Swarm Optimization (PSO)을 에이전트와 워크플로의 구조화된 언어 표현에 적용한다. 대규모 언어 모델(LLM)은 실행 실패를 진단하고, 실패한 수정과 성공한 설계를 참고해 변경안을 제안한다. 이어서 에이전트 행동을 규정하는 지침인 정책과 협업 구조에 변경안을 적용한다.
- SwarmAgentic은 각각 후보 시스템을 나타내는 입자 5개와 최적화 반복 10회를 사용하며, 계획, 창작, 수학 추론에 걸친 6개 과제에서 보고된 최종 점수 비교에서 가장 높은 성능을 보인다. 구성 요소 제거 실험은 에이전트와 워크플로를 함께 최적화하는 접근을 뒷받침한다. 다만 비교 실험만으로 동일 비용에서의 탐색 효율이 입증되지는 않으며, 이 프레임워크에도 언어 모델의 사실 오류와 텍스트 전용 상호작용이라는 한계가 남는다.
1 Introduction
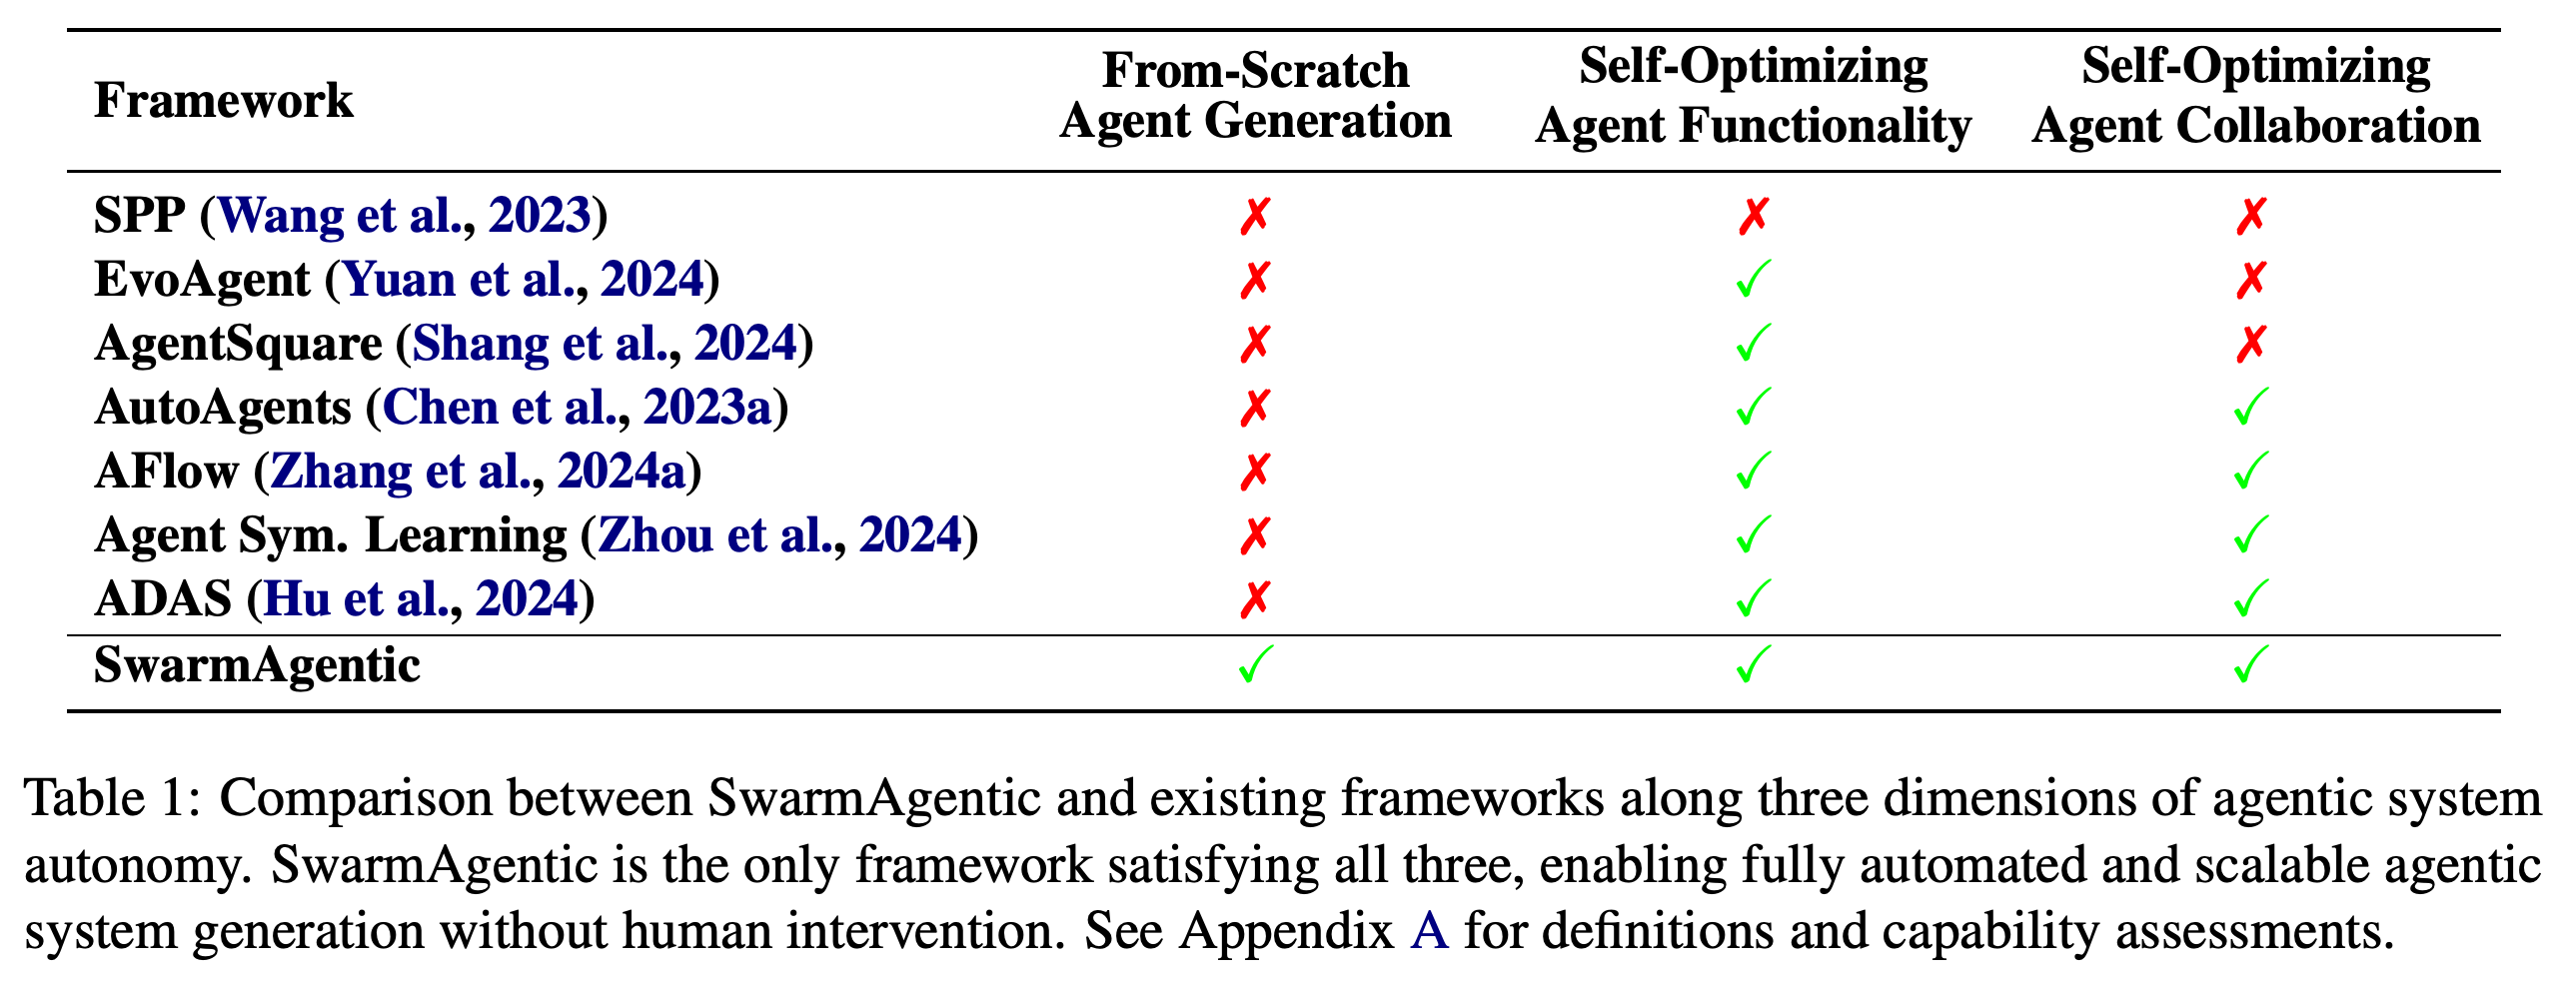
서론은 자율적인 에이전트 시스템 생성에 필요한 3가지 요건을 정의한다. From-Scratch Agent Generation은 사전 정의된 기능 모듈 없이 과제별 에이전트를 생성하고, Self-Optimizing Agent Functionality는 피드백으로 에이전트 행동을 수정하며, Self-Optimizing Agent Collaboration은 협업 방식과 실행 구조를 수정한다. Table 1은 SwarmAgentic이 3가지 요건을 모두 충족한다고 분류한다. 비교 대상 프레임워크는 템플릿, 초기 에이전트 또는 고정된 상호작용을 유지한다.
- 논문은 구조화된 언어 표현, 실패 진단, 집단 내 최적 해를 활용해 전체 시스템을 탐색하는 미분 없는 탐색 방법을 기여로 제시한다. 이 방법은 과제 점수의 미분값을 요구하지 않는다.
- 초록에는 github.com/SwarmAgentic이 표시되어 있으며, PDF의 하이퍼링크는 https://yaoz720.github.io/SwarmAgentic/ 을 가리킨다.
저자들은 제시된 프레임워크 중 SwarmAgentic만 자율성 속성 3가지를 모두 충족한다고 분류한다. 이는 Appendix A가 뒷받침하는 정의 기반 역량 평가이며, 실험적 성능 비교는 아니다.
2 Related Work
관련 연구에서는 에이전트 팀을 구성하는 연구와 에이전트 행동 및 협업 방식을 최적화하는 연구를 구분한다. 이러한 구분을 바탕으로 에이전트 기능과 협업 구조를 함께 탐색할 필요성을 제시한다.
2.1 Agentic System Generation
기존 생성 방법에는 구조화된 페르소나 프롬프팅으로 여러 페르소나의 협업을 모사하는 SPP, 전문가 팀을 구성하는 AgentVerse, 토론으로 에이전트를 개선하는 AutoAgents, 에이전트 구성을 진화시키는 EvoAgent가 있다. 논문은 사전에 정의된 협업 패턴이 이러한 방법을 제약한다고 주장하며, SwarmAgentic은 과제별 역할과 협업 전략을 함께 생성한다고 설명한다.
2.2 Agentic System Optimization
최적화 연구에는 실행 기록을 활용한 에이전트 정책 개선, 에이전트 간 협업 방식 탐색, 보상 피드백으로 의사결정을 개선하는 강화학습 기반 워크플로 최적화, 사전 정의된 모듈의 조합 탐색이 포함된다. 텍스트 피드백을 프롬프트나 파이프라인의 수정 방향으로 사용하는 방법도 있다. 논문은 에이전트 기능과 협업 방식을 상호 의존적인 탐색 변수로 취급하고, 언어 기반 집단 탐색으로 함께 수정한다는 점을 차별점으로 제시한다.
3 Preliminary
기초 개념 절에서는 에이전트 시스템을 에이전트 집합과 협업 실행 구조가 결합된 것으로 정의한다. 이어서 언어 기반 갱신 절차의 바탕이 되는 수치 PSO의 수식을 소개한다.
3.1 Agentic System Optimization
각 후보 시스템은 식별자, 책임, 실행 정책으로 기술된 에이전트와 각 과제에 에이전트를 배정하는 워크플로 단계로 구성된다. 후보를 평가하는 점수 규칙인 과제별 적합도 함수는 전체 시스템에 점수를 부여한다. 최적화 과정에서는 에이전트 집합과 협업 구조를 모두 변경할 수 있다.
3.2 Particle Swarm Optimization
수치 PSO에서 입자의 위치는 후보 해를 나타낸다. 속도는 이전 속도에 개인 최적 위치와 전역 최적 위치를 향하는 성분을 결합한 갱신값을 나타낸다. 무작위 계수는 각 최적 위치의 영향력을 조절한다. SwarmAgentic은 위치를 구조화된 시스템 설명으로, 속도를 텍스트 수정 계획으로 재해석하여 언어 모델의 변환으로 이산적인 구성을 갱신한다.
4 SwarmAgentic
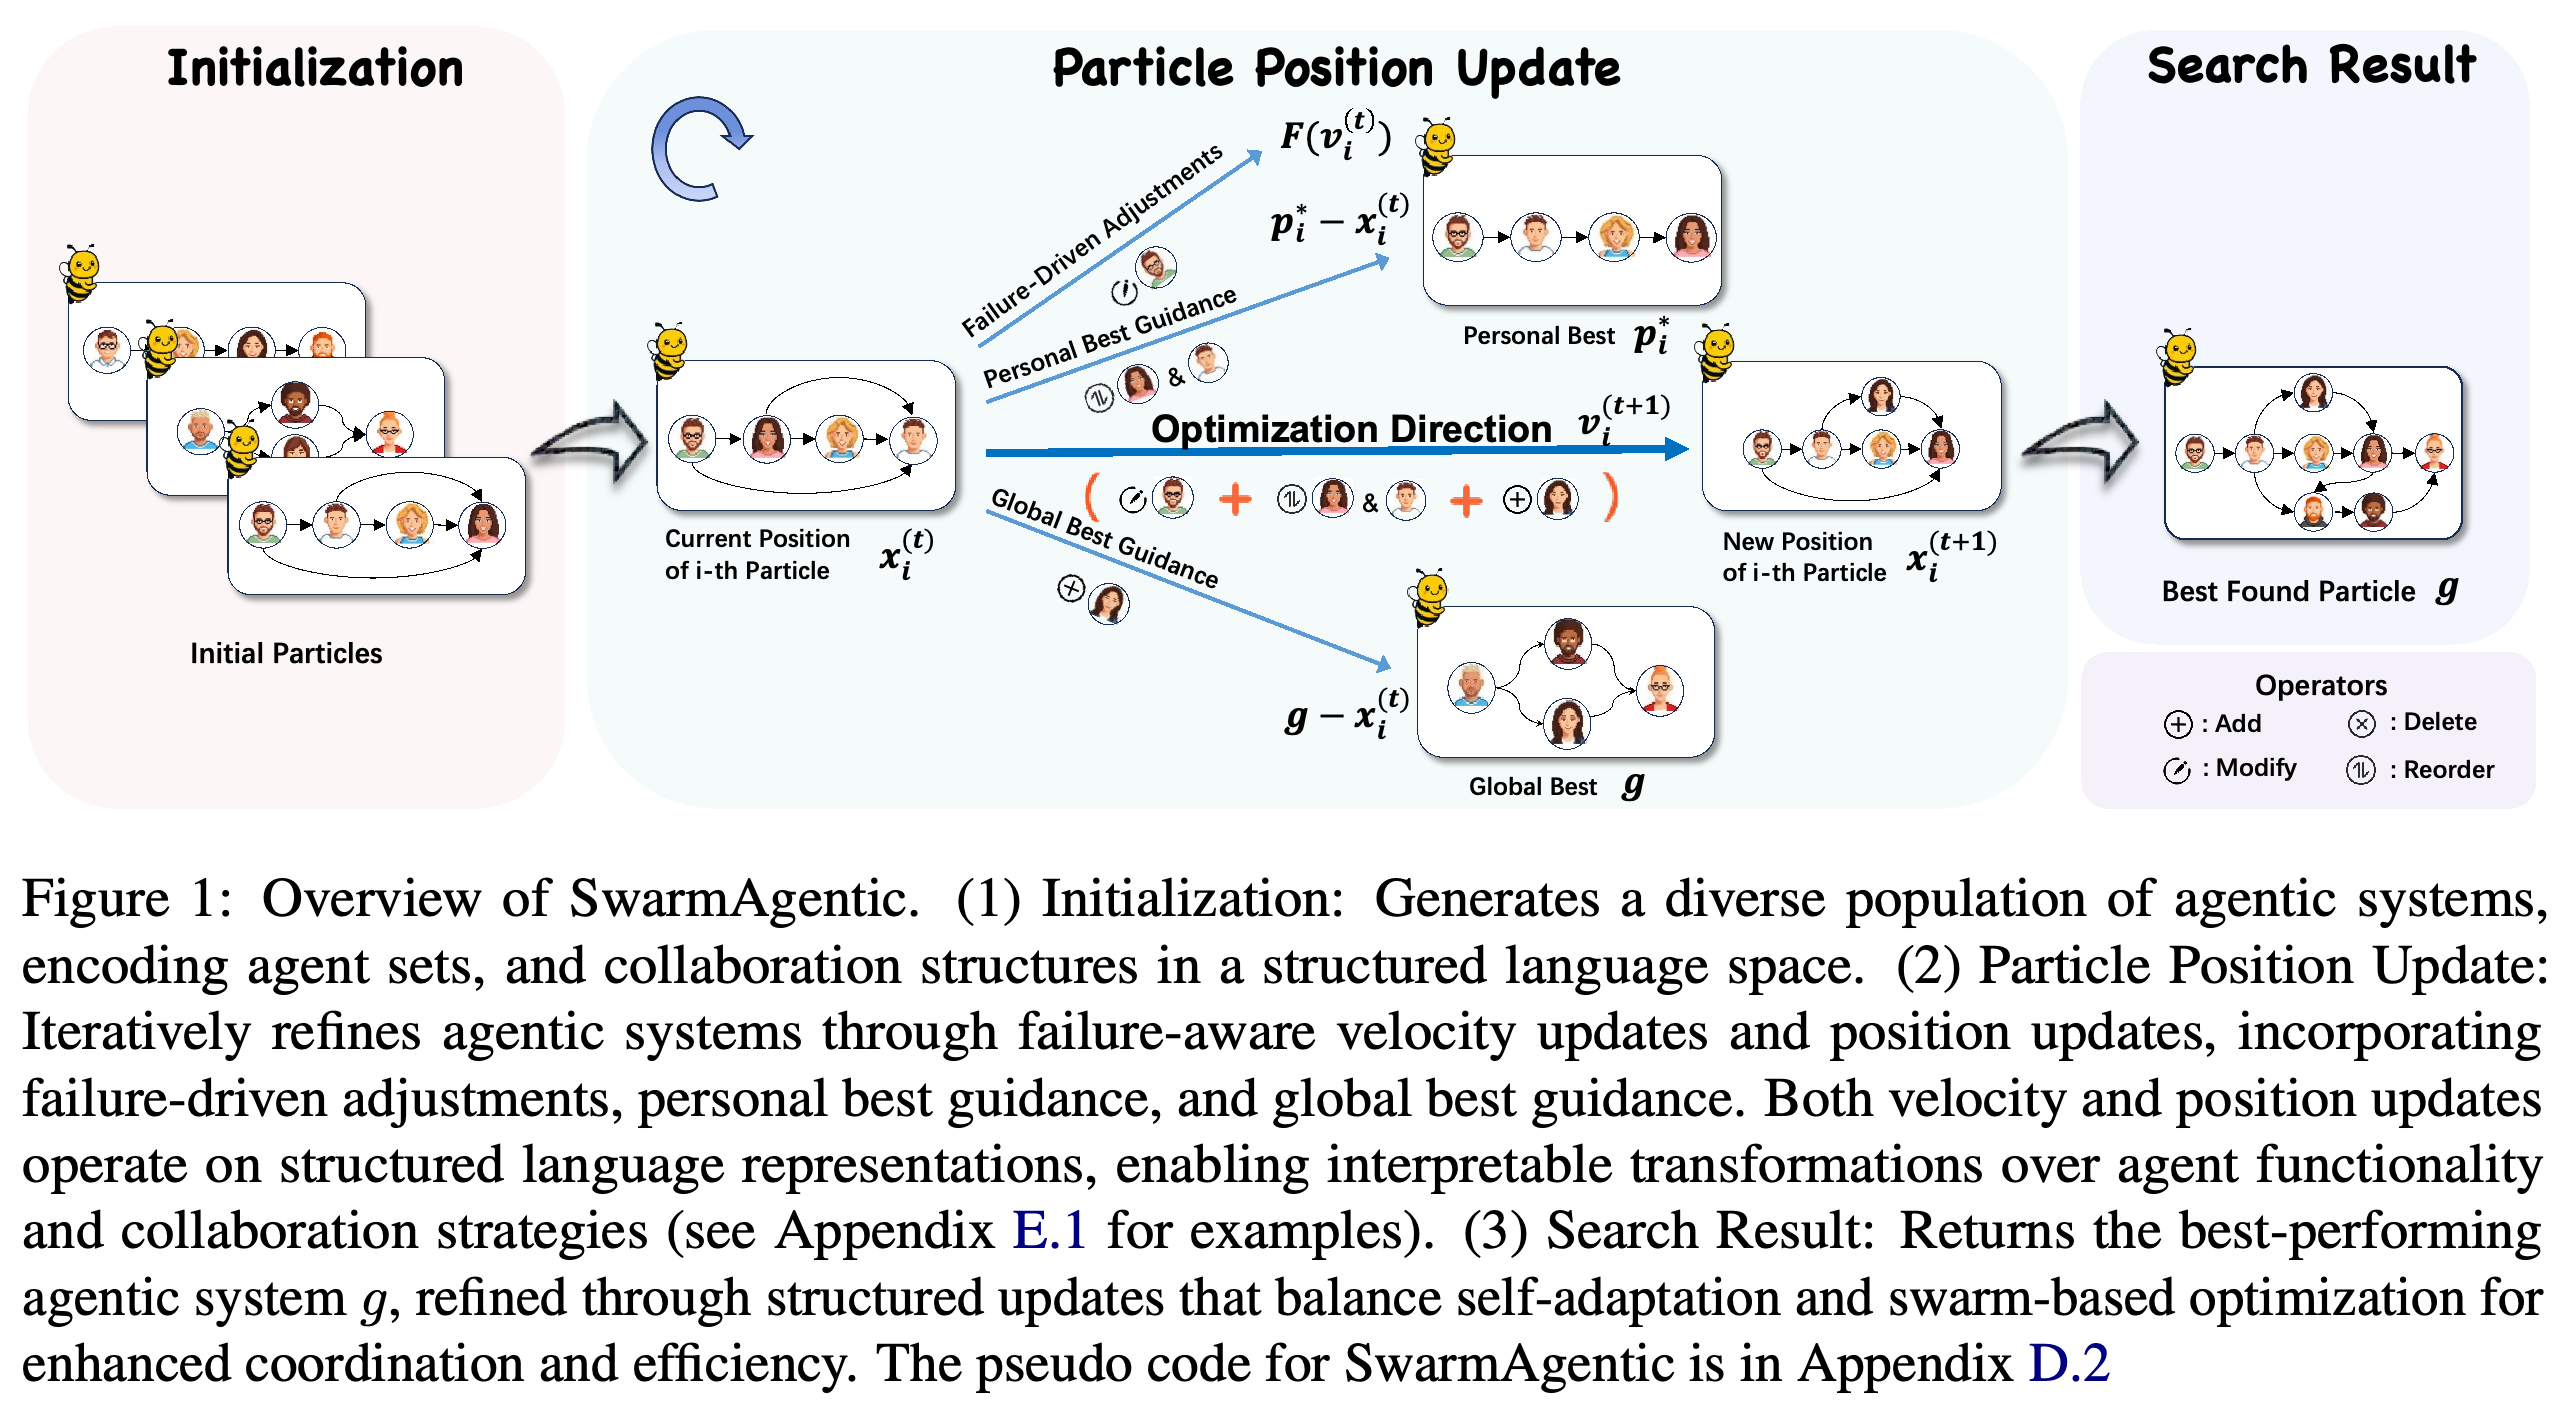
SwarmAgentic은 집단을 초기화한 뒤 후보 시스템을 반복해서 평가, 진단, 수정하면서 성능이 가장 좋은 구성을 보존한다. Figure 1은 실패 기반 조정, 개인 최적 해와 전역 최적 해에서 얻은 개선점을 결합하여 시스템 구성 요소를 추가, 삭제, 수정하거나 순서를 바꾸는 갱신 계획을 만드는 과정을 보여준다.
각 입자는 완전한 에이전트 팀과 워크플로를 나타낸다. 3가지 개선 정보가 역할과 실행 구조를 바꾸는 텍스트 수정안을 만들고, 탐색 과정은 평가된 후보 중 최적의 후보를 보존한다.
4.1 Particle Initialization
초기화 과정에서는 구조적 다양성을 확보하기 위해 언어 모델의 temperature를 달리하여 후보 시스템을 샘플링한다. Temperature는 출력의 변동성을 조절하는 샘플링 설정이다. 낮은 temperature는 안정적인 구성을, 높은 temperature는 탐색을 유도하며, 초기 수정 계획은 평가된 시스템과 진단된 결함을 활용한다. 각 입자는 초기 시스템을 개인 최적 해로 설정하고, 초기 집단을 모두 평가한 뒤 전역 최적 해를 선택한다.
4.2 Flaw Identification
LLM은 목적 함수로 평가하면서 확인한 오류와 현재 시스템을 함께 분석하여 에이전트와 워크플로의 결함을 식별한다. 에이전트 결함에는 누락되거나 중복된 역할과 모호한 정책이 포함된다. 워크플로 결함에는 누락되거나 중복된 단계, 불충분한 맥락 입력, 후속 단계로 오류를 전파하는 부적절한 출력이 포함된다.
4.3 Failure-Aware Velocity Update
Failure-Aware Velocity Update는 개선을 위한 3가지 텍스트 정보를 결합한다. Failure-Driven Adjustments는 이전 및 현재 결함을 이전 수정 계획과 비교한다. Personal Best Guidance는 해당 입자의 최적 구성에서 관련 개선점을 추출하고, Global Best Guidance는 집단 내 최적 시스템에서 개선점을 추출한다.
- 별도의 LLM 변환으로 이 3가지 권고안을 생성하고, 또 다른 LLM 변환으로 이를 다음 갱신 계획에 통합한다.
- 구성 간 차이는 수치 연산처럼 표현되지만, 시스템을 수치로 인코딩한 뒤 뺄셈하는 것이 아니라 의미를 비교하는 작업이다.
4.4 Position Update
위치 갱신은 현재 시스템에 텍스트 수정 계획을 적용한다. Agent-Level Adaptation은 개별 에이전트를 수정하며 역할을 추가하거나 제거할 수 있다. Collaborative Structures Reconfiguration은 실행 순서, 의존 관계, 입력, 출력, 워크플로 단계의 포함 여부를 수정한다. 본문은 역할, 책임, 정책을 변경한다고 설명하지만, 공개된 위치 갱신 프롬프트는 기존 역할을 수정할 때 정책만 변경하도록 제한한다.
5 Experiments
실험은 자동으로 생성한 시스템이 계획, 생성, 추론 과제의 성능을 높이는지 평가한다. SwarmAgentic을 직접 프롬프팅, 반복적인 답변 개선, 자동 에이전트 설계 방법과 비교한다.
5.1 Experimental Setup
6개 과제는 TravelPlanner (TP), 자연어 계획 벤치마크인 Natural Plan (NP)의 Trip Planning, Meeting Planning, Calendar Scheduling, 순서 없는 핵심 내용으로 일관된 문단을 생성하는 Creative Writing (CW), 수학 추론 벤치마크인 MGSM이다. 비교 방법에는 고정 프롬프트로 답하는 Direct, 단계별 추론을 유도하는 Chain-of-Thought (CoT), 자기 피드백으로 답변을 수정하는 Self-Refine, SPP, EvoAgent, ADAS가 포함된다.
- 시스템 설계와 수정안을 제안하는 최적화 모델은 GPT-4o-mini-0718이다. 발견된 시스템을 실행하는 모델에는 GPT-3.5-turbo-0125, GPT-4o-0806, Claude-3.5-sonnet-0620, DeepSeek-V3, Gemini-1.5-Pro가 포함된다.
- SwarmAgentic은 입자 5개와 최적화 반복 10회를 사용하고, ADAS에는 최대 30회의 반복을 허용한다. 이 설정만으로 토큰 수, 호출 수 또는 금전적 예산이 같다고 볼 수는 없다.
5.2 Results
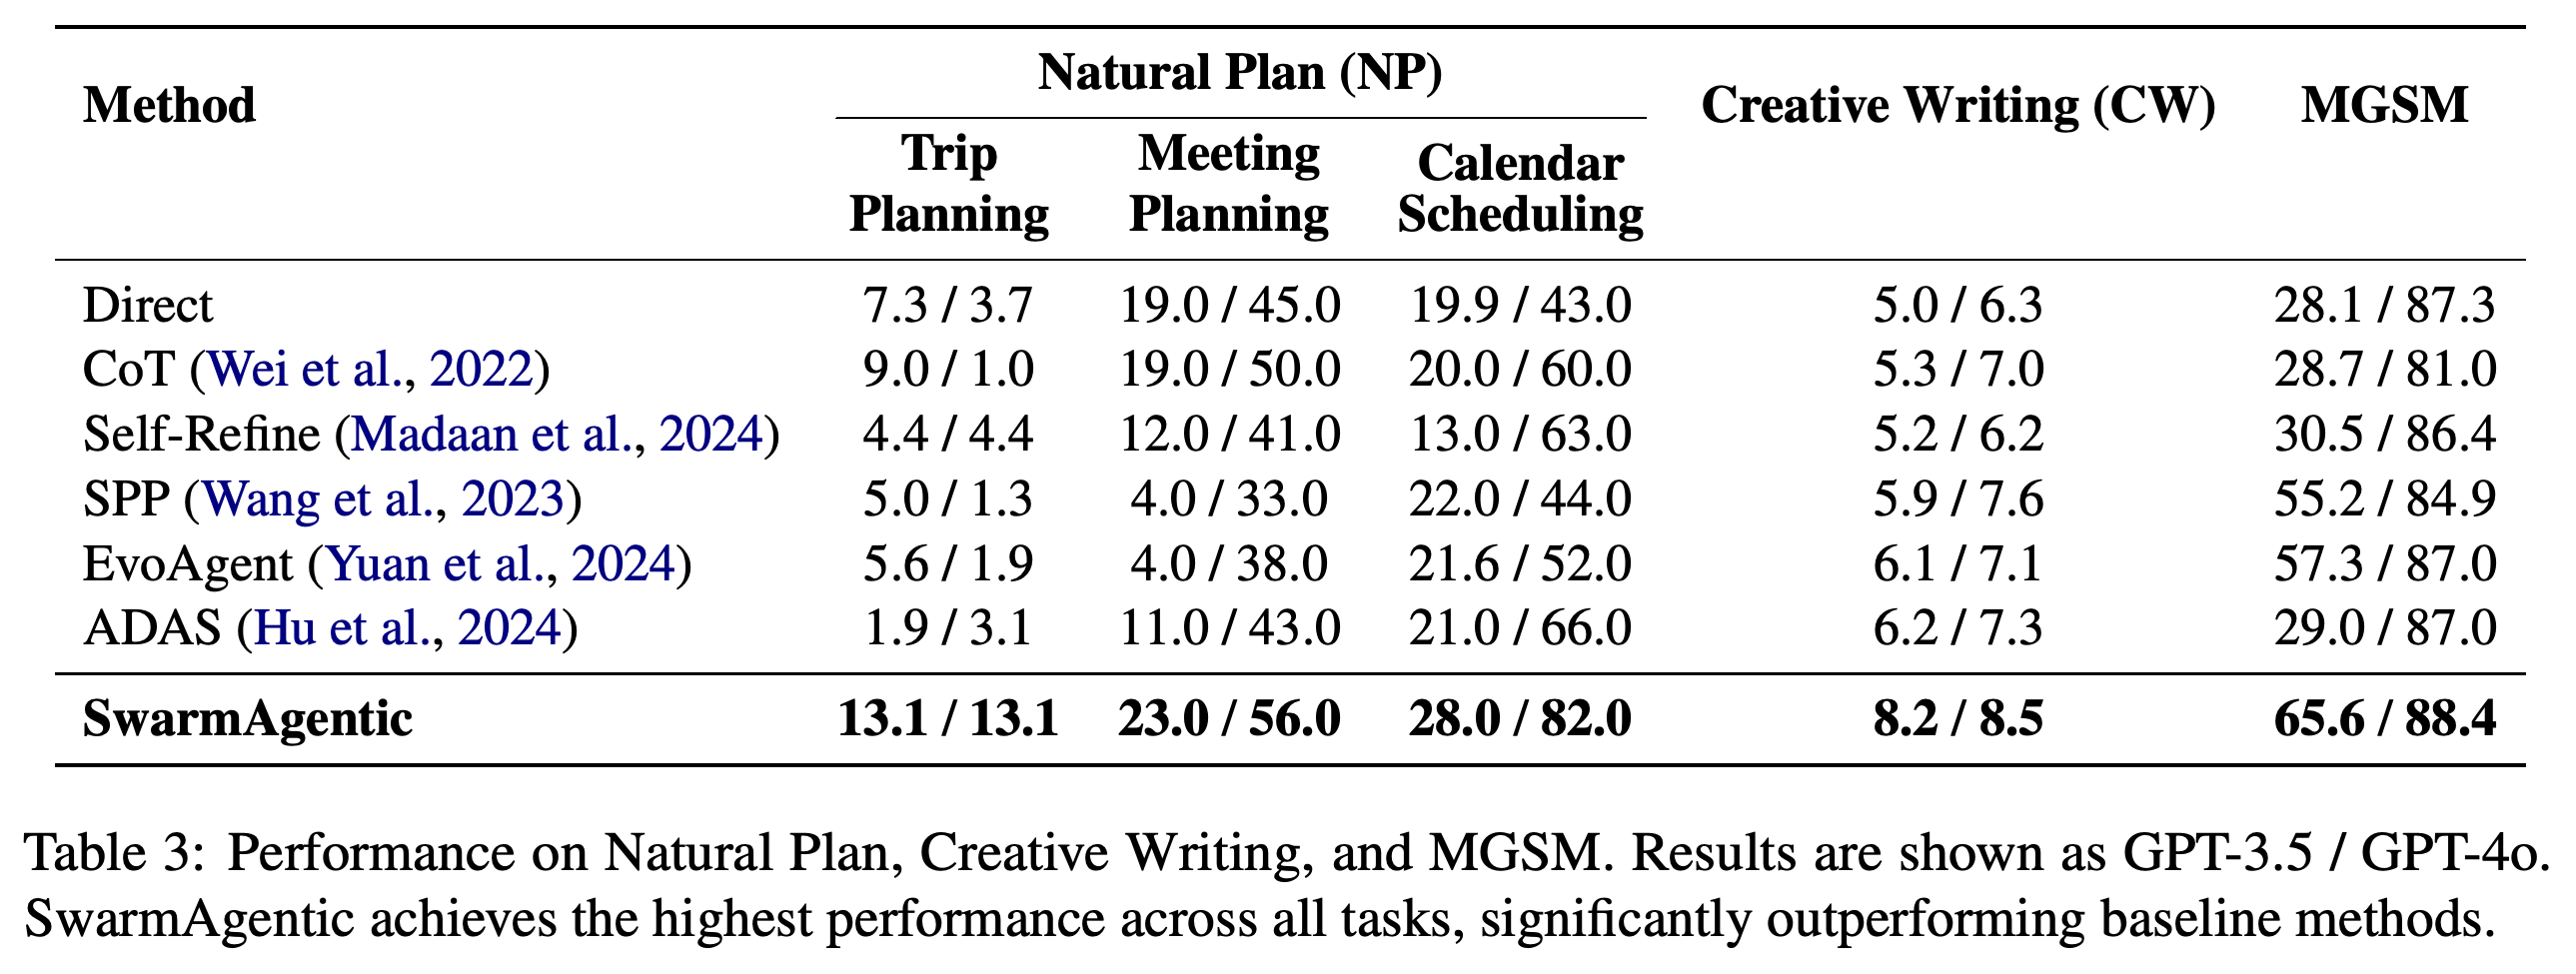
Table 2와 Table 3에서 SwarmAgentic은 GPT-3.5와 GPT-4o 실행 조건 모두에서 가장 높은 최종 과제 점수를 기록한다. TravelPlanner의 최종 통과율은 3.3% / 32.2%이며, ADAS는 1.1% / 8.9%다. 일부 중간 제약 지표에서는 동률이므로 표의 모든 항목에서 앞서는 것은 아니다.
- GPT-4o를 사용할 때 SwarmAgentic은 Trip Planning에서 13.1, Meeting Planning에서 56.0, Calendar Scheduling에서 82.0, Creative Writing에서 8.5, MGSM에서 88.4를 기록한다. 계획과 수학 과제는 참조 답안과의 일치 여부를 확인하는 완전 일치 평가를 사용하고, 글쓰기 과제는 LLM이 1–10점으로 평가한다.
- 이에 대응하는 GPT-3.5 점수는 13.1, 23.0, 28.0, 8.2, 65.6이다. 구조화된 수학 과제에서도 성능이 향상되지만, 향상 폭은 과제와 실행 모델에 따라 크게 다르다.
GPT-4o로 실행하면 최종 통과율이 ADAS의 8.9%에서 32.2%로 높아지며, 응답 제출률은 두 방법 모두 100.0%를 유지한다. 이 향상은 계획의 전체 요건을 충족하는 성능에 해당한다. 일부 GPT-3.5 중간 제약 지표에서는 동률이다.
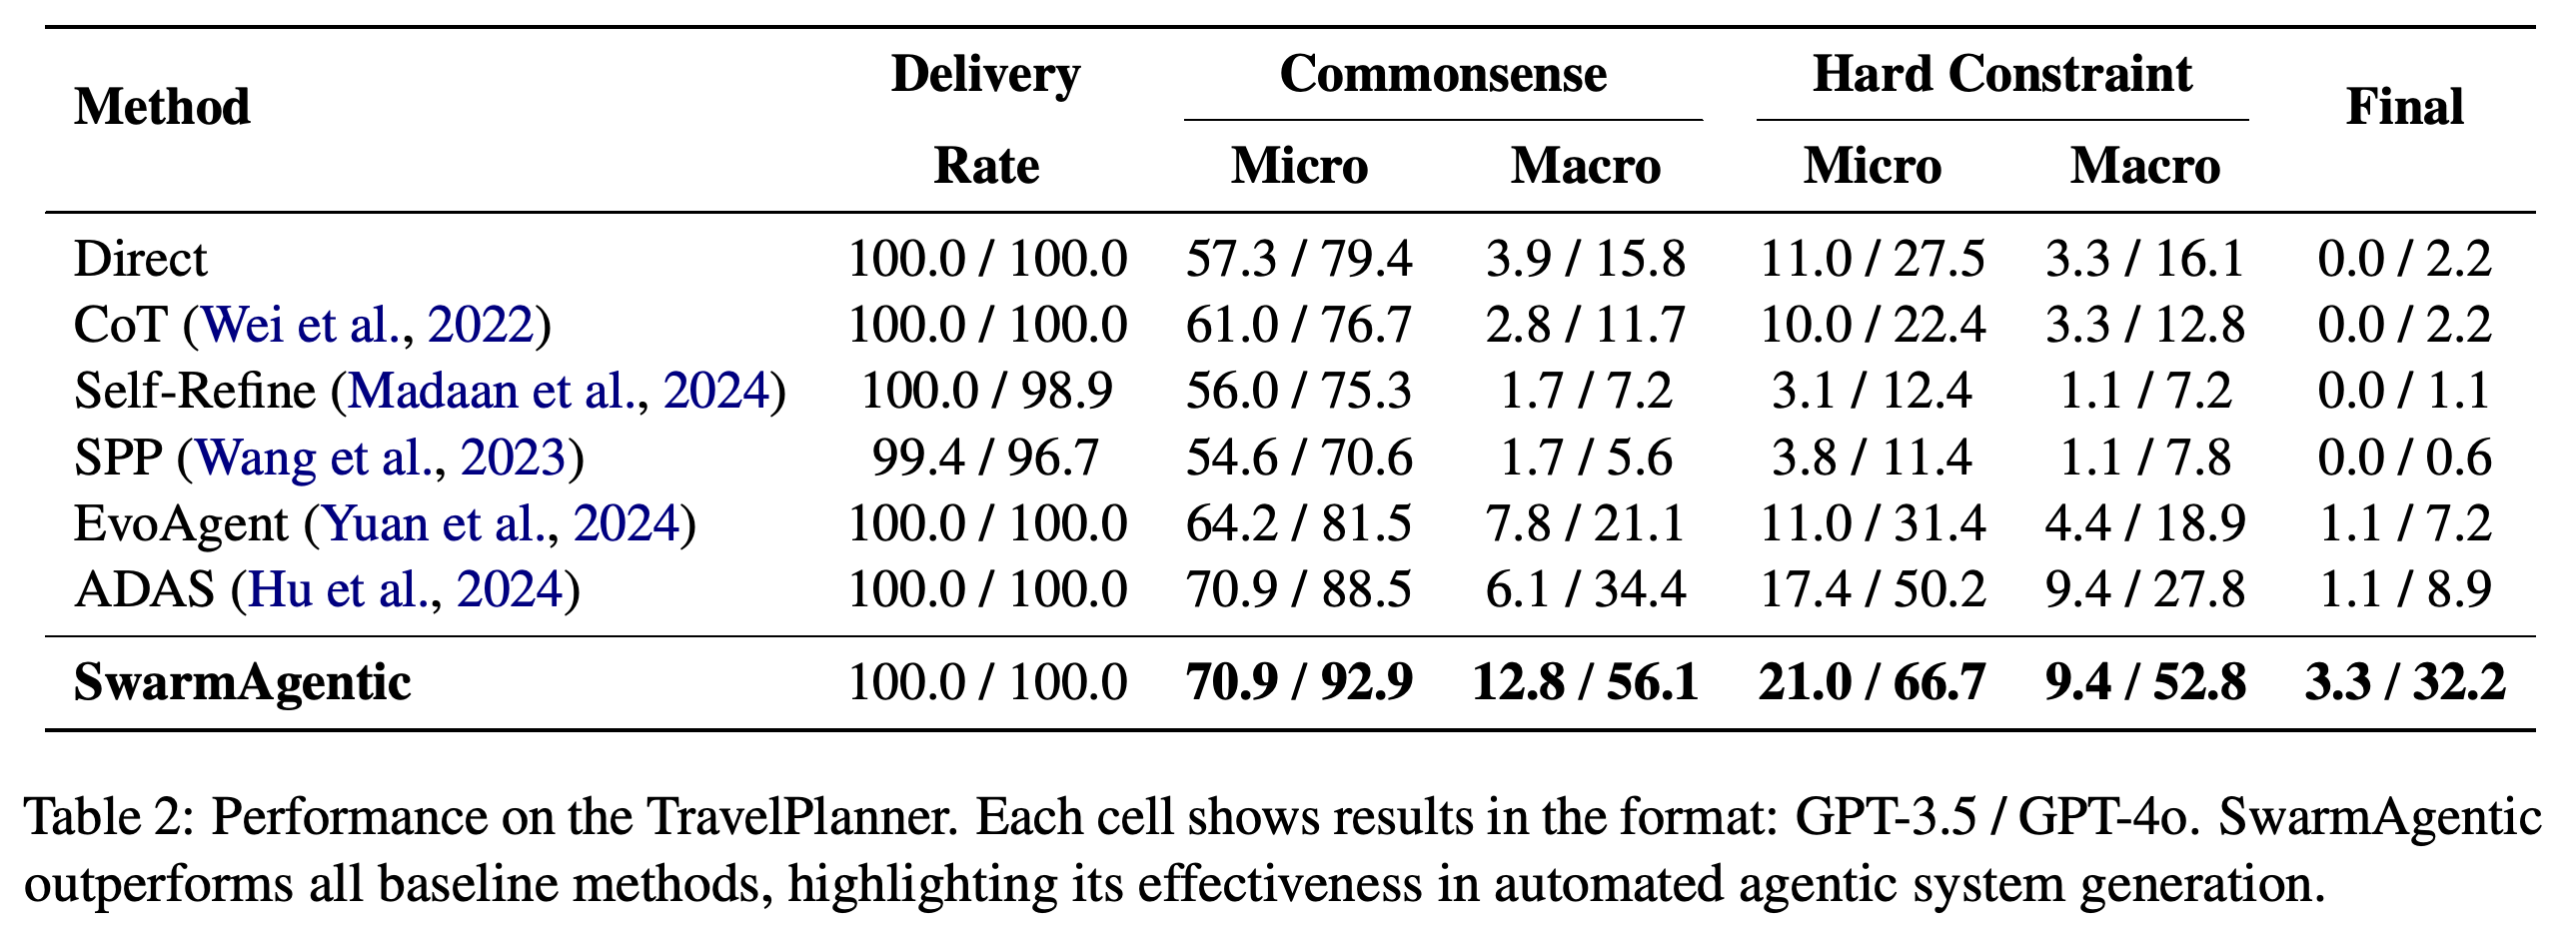
SwarmAgentic은 두 실행 모델 모두에서 보고된 모든 과제 열의 최고 점수를 기록한다. GPT-4o의 Calendar Scheduling 점수는 82.0으로 가장 성능이 좋은 비교 방법의 66.0을 앞선다. MGSM에서는 88.4 대 87.3으로 차이가 더 작다.
6 Analysis
분석에서는 발견된 시스템을 다른 실행 모델로 전이하는 실험, 개별 최적화 메커니즘을 제거하는 실험, TravelPlanner의 탐색 과정을 살펴본다. 이 실험들은 전이 가능성, 구성 요소의 기여, 탐색 중 이루어진 구체적인 변경을 평가한다.
6.1 Cross-Model Transferability Analysis
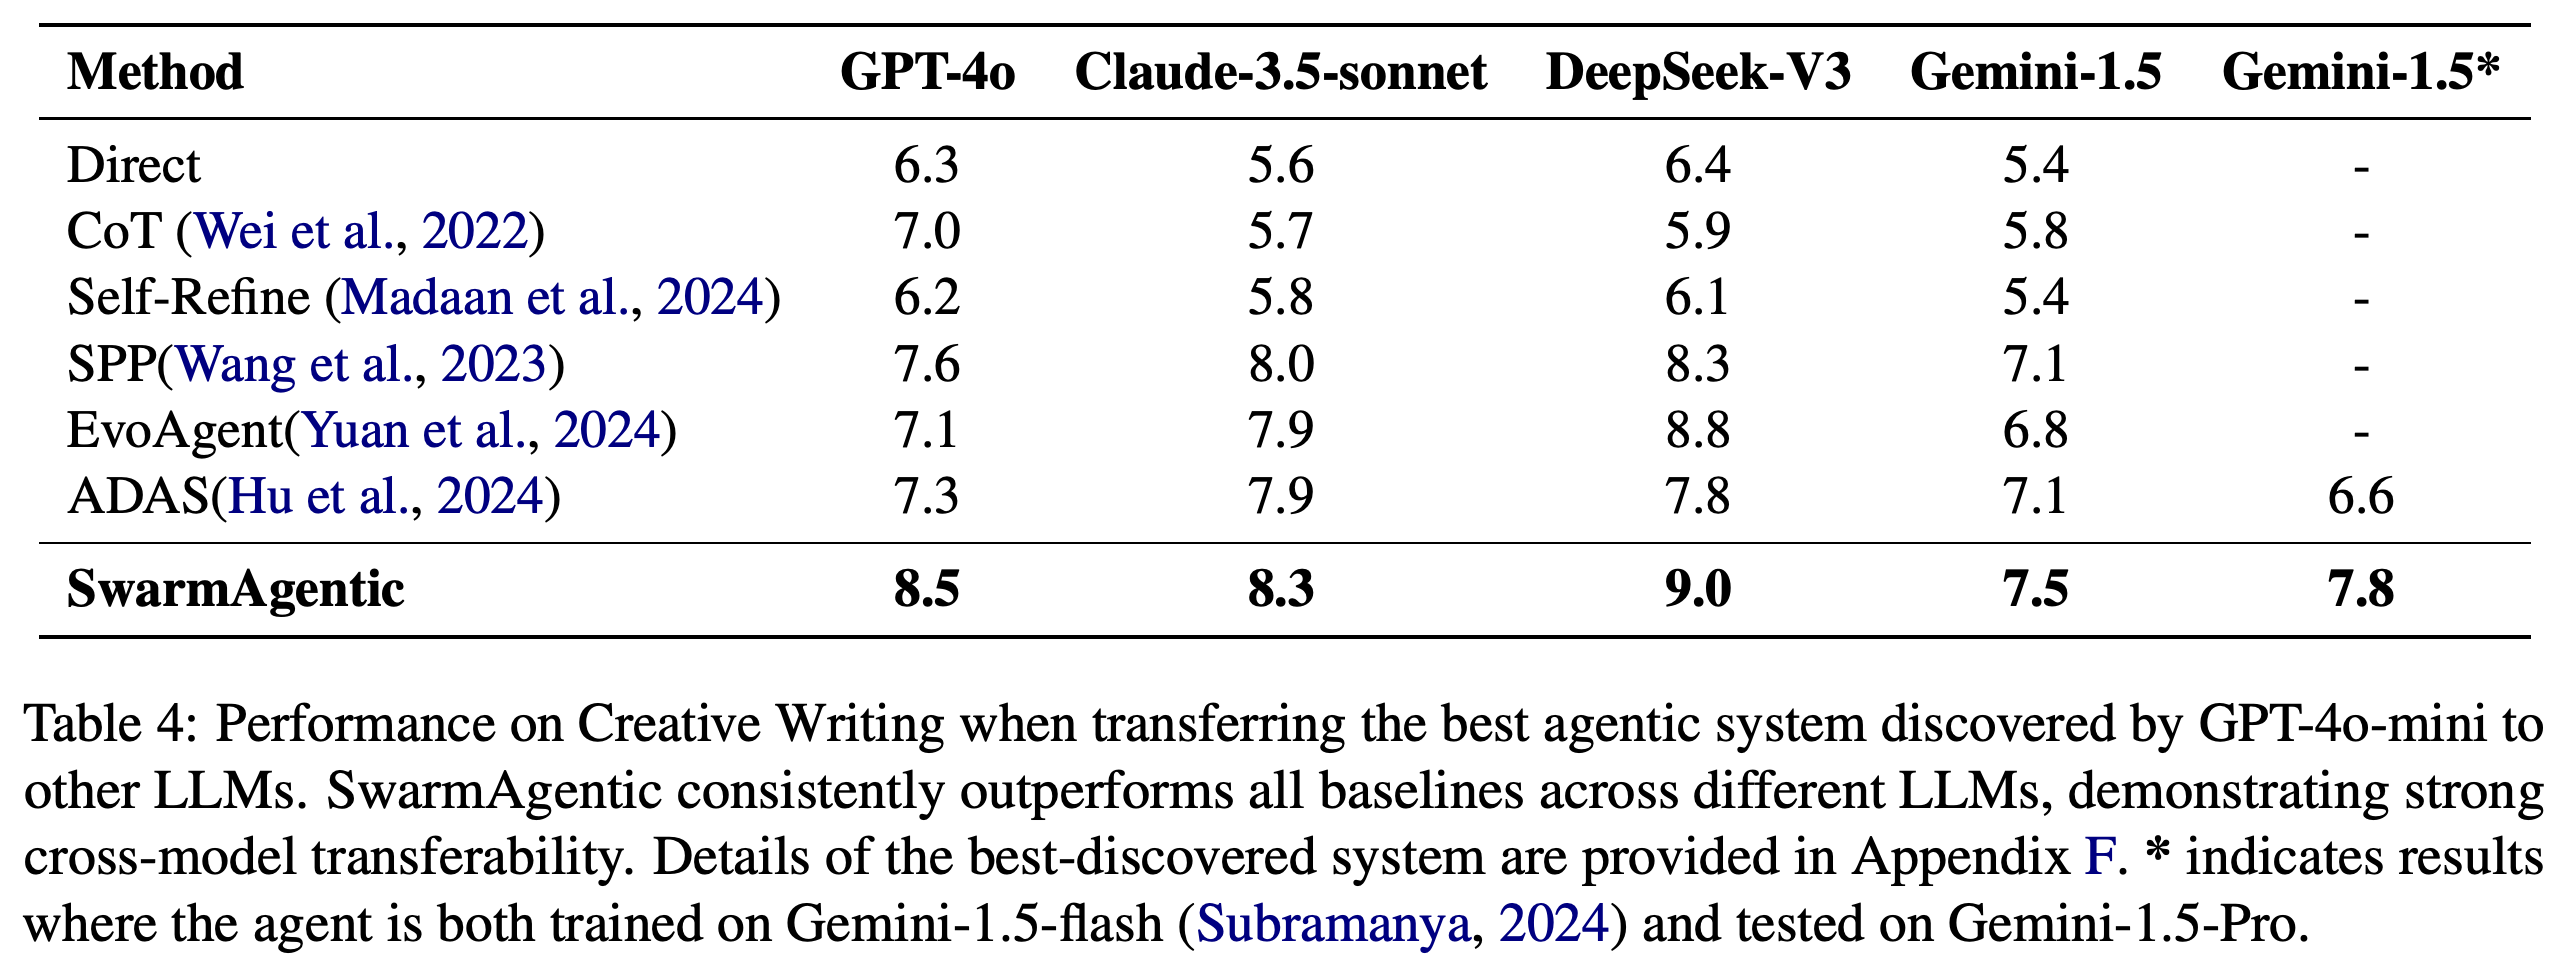
Creative Writing에서 GPT-4o-mini로 발견한 시스템은 GPT-4o에서 8.5, Claude-3.5-sonnet에서 8.3, DeepSeek-V3에서 9.0, Gemini-1.5에서 7.5를 기록하며 각 열에 제시된 비교 방법을 앞선다. 이는 이 과제에서 평가한 모델 간 전이 가능성을 뒷받침한다.
- Gemini-1.5* 점수는 7.8이다. Table 4는 Gemini-1.5-flash에서 최적화하고 Gemini-1.5-Pro에서 테스트했다고 명시하지만, 주변 본문은 Gemini-1.5-Pro에서 직접 최적화하고 평가했다고 설명한다. 논문 안에서 정확한 조건이 일치하지 않는다.
발견된 Creative Writing 워크플로는 실행 모델 4개에서 제시된 비교 방법을 앞선다. 별표가 붙은 Gemini 조건에서는 SwarmAgentic 점수가 7.5에서 7.8로 높아진다. 캡션은 Gemini-1.5-flash에서 최적화하고 Gemini-1.5-Pro에서 평가했다고 명시하며, 이는 함께 제시된 본문 설명과 다르다.
6.2 Ablation Study
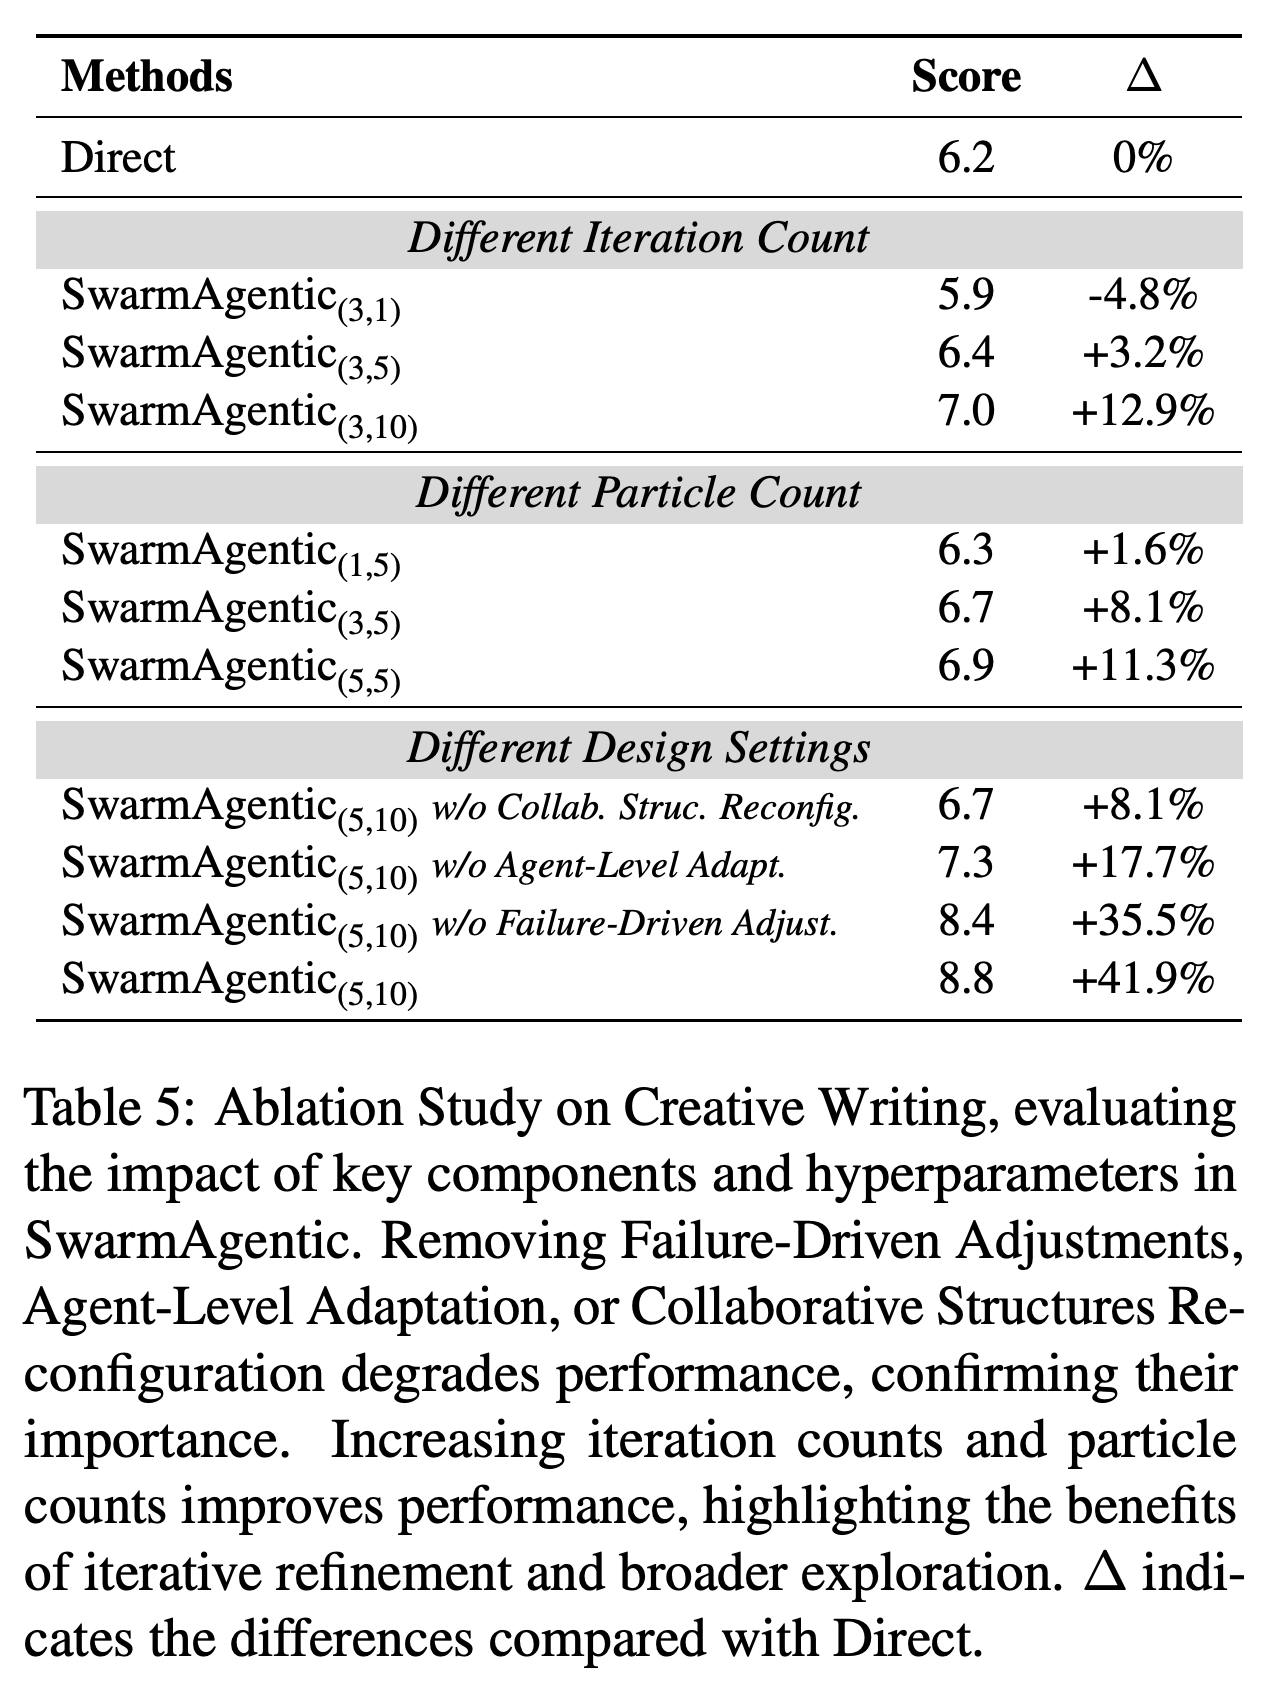
구성 요소 제거 실험은 Creative Writing의 20개 인스턴스를 사용한다. 입자 5개로 구성된 전체 10-iteration system은 8.8을 기록한다. Collaborative Structures Reconfiguration을 제거하면 6.7, Agent-Level Adaptation을 제거하면 7.3, Failure-Driven Adjustments를 제거하면 8.4로 점수가 낮아진다.
- 워크플로 재구성을 제거했을 때 관찰된 성능 하락이 가장 크다. 실패 기반 조정을 제거했을 때는 이 실험에서 0.4점이라는 더 작은 차이가 나타난다.
- 입자 3개에서 반복 횟수를 1회, 5회, 10회로 늘리면 점수는 5.9, 6.4, 7.0이다. 별도로 제시한 입자 수 비교에서는 반복 5회일 때 입자 1개, 3개, 5개의 점수가 6.3, 6.7, 6.9다.
- Table 5는 동일한 입자 3개, 반복 5회 설정을 서로 다른 블록에서 6.4와 6.7로 보고하며 차이를 설명하지 않는다. 따라서 탐색 규모 비교를 정밀하게 해석하는 데 한계가 있다.
워크플로 재구성을 제거하면 전체 시스템의 점수가 8.8에서 6.7로 낮아지며, 이는 제시된 구성 요소 제거 중 가장 큰 하락이다. 탐색 규모를 비교한 각 블록에서는 반복 횟수나 입자 수가 늘수록 점수가 높아지지만, 중복된 입자 3개, 반복 5회 설정의 점수는 블록 간에 일치하지 않는다.
6.3 Case Study: Search Trajectory on TP
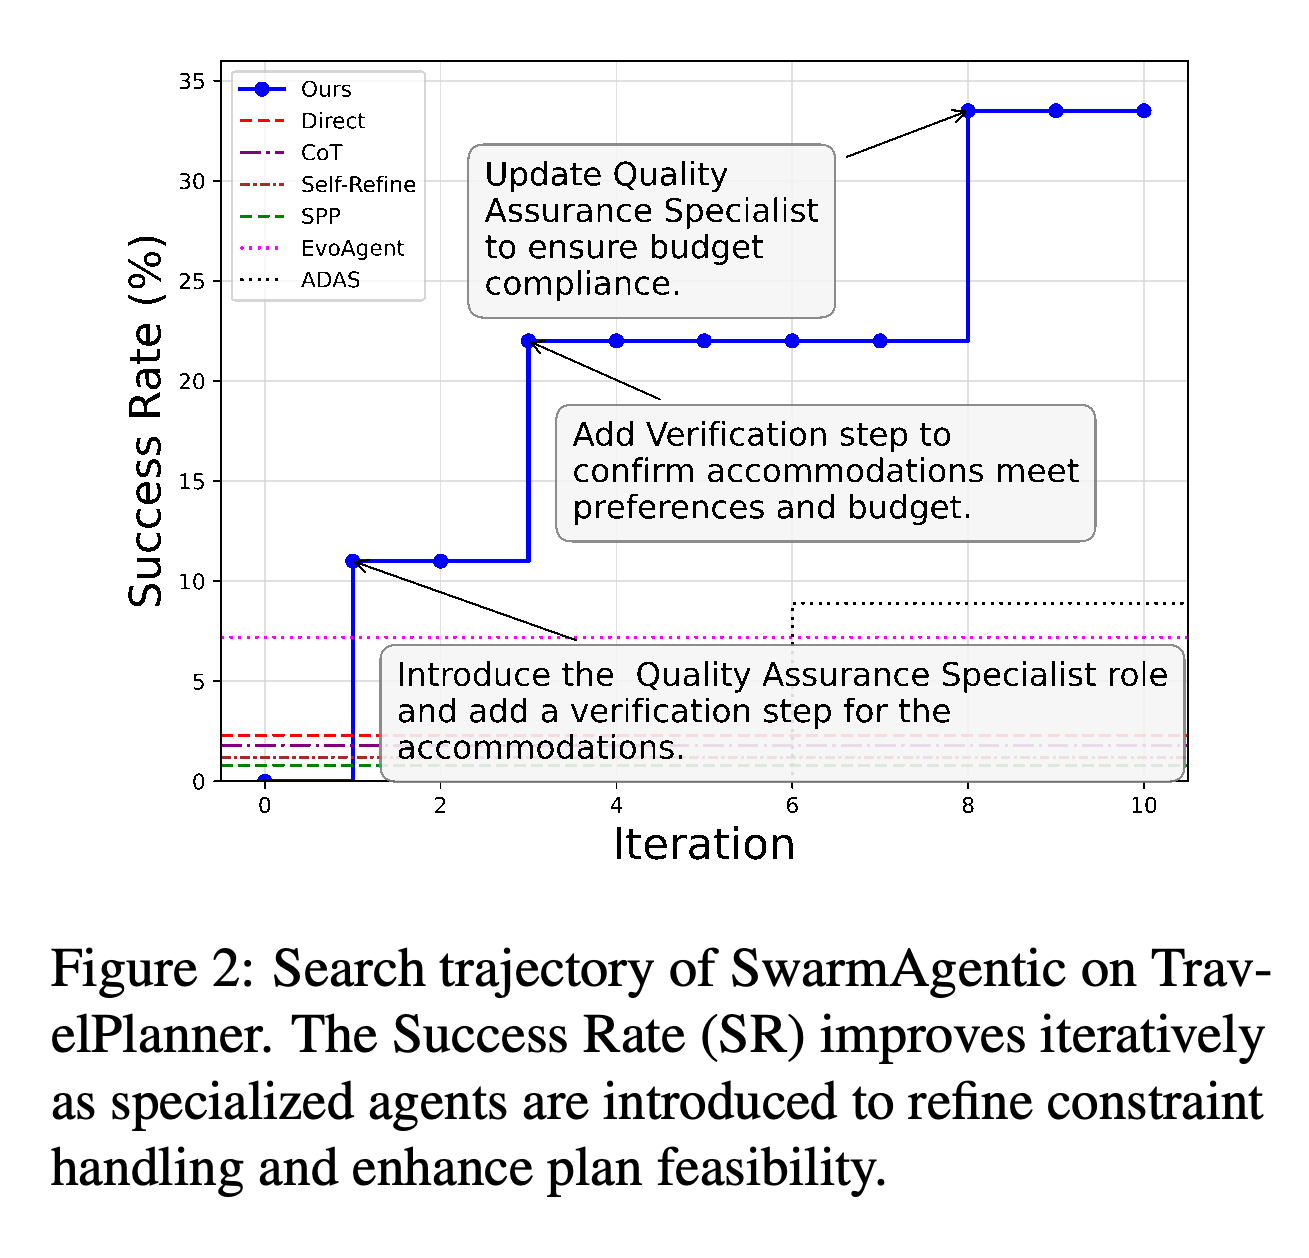
예시로 제시된 TravelPlanner 탐색 과정에서는 계획의 요건 준수 여부를 검토하는 Quality Assurance Specialist 역할과 숙박 검증을 도입한 뒤 성공률이 11%에 도달한다. 예산과 선호 사항을 추가로 확인한 뒤에는 22%, 예산 준수를 명시적으로 강제한 뒤에는 33%에 도달한다. Figure 2는 이러한 상승을 구체적인 역할 및 워크플로 변경과 연결하지만, 반복 탐색 간 변동을 제시하지 않는 예시 과정이다.
단계별 탐색 과정은 성공률이 11%, 22%, 33%로 높아지는 것을 검증 책임과 강화된 예산 준수 요구에 연결한다. 성능 향상과 함께 이루어진 변경을 보여주지만, 독립적인 탐색 간 변동은 정량화하지 않는다.
7 Conclusion
결론은 SwarmAgentic을 에이전트 집합과 협업 구조를 동적으로 개선하는 언어 기반 PSO 프레임워크로 제시한다. 실험은 보고된 벤치마크 조건에서 과제 성능이 향상됨을 뒷받침하며, 사람이 과제별 초기 에이전트를 제공하지 않아도 과제에 맞는 시스템을 발견할 수 있음을 보여준다.
Limitations
저자들은 3가지 한계를 제시한다. 도메인별 템플릿을 사용하지 않으면 구조화된 환경에서 수렴이 느려질 수 있고, 그럴듯하지만 틀린 언어 모델 출력이 최적화 과정에서 전파될 수 있으며, 텍스트 전용 프레임워크에는 멀티모달 지각과 물리적 행동 능력이 없다. 향후 방향으로 탐색을 안내하는 사전 가정인 구조적 사전 지식, 외부 지식, 멀티모달 모델이나 체화된 에이전트와의 통합을 제안하지만, 이러한 확장은 평가하지 않는다.
부록
- A Agentic System Generation Autonomy는 A.1 Defining Autonomy: Three Core Properties와 A.2 Evaluation of Existing Agentic Frameworks를 포함하며, Table 1의 정의와 프레임워크별 판단 근거를 제공한다. From-Scratch Agent Generation은 입출력 래퍼와 추상 인터페이스처럼 과제에 종속되지 않는 최소한의 기본 틀을 허용하지만, 과제별 추론과 협업 방식은 새로 생성하도록 요구한다. 평가에서는 SPP가 어떤 속성도 충족하지 않는다고 보고, EvoAgent와 AgentSquare는 기능 최적화만, AutoAgents, AFlow, Agent Symbolic Learning, ADAS는 기능 및 협업 최적화를 충족한다고 본다. 이들 중 From-Scratch Agent Generation으로 분류된 방법은 없다.
- B Comparison with MODEL SWARMS: From Model Fusion to Agentic System Generation은 모델 가중치나 토큰 확률을 탐색하는 방식과 실행 가능한 에이전트 시스템을 탐색하는 방식을 구분한다. MODEL SWARMS는 기존 전문가 집합을 단일 모델로 변환하는 반면, SwarmAgentic은 역할, 정책, 협업 흐름을 다시 작성한다. 따라서 PSO에서 공통으로 영감을 받았더라도 탐색 공간과 출력은 다르다.
- C Experimental Setup은 C.1 Dataset Statistics and Evaluation과 C.2 Baselines and Configurations에서 MGSM의 학습 질문 128개와 테스트 질문 800개, Creative Writing의 학습 과제 5개와 평가 과제 95개, TravelPlanner의 학습 질의 9개와 평가 질의 180개를 명시한다. Natural Plan은 Trip Planning 학습 예시 8개와 Meeting Planning, Calendar Scheduling 학습 예시 각각 10개를 사용한다. 평가는 학습 데이터와 겹치지 않고 난이도 분포가 일치하는 전체 데이터셋의 10%에서 수행한다. Trip Planning은 도시 3–10개, Meeting Planning은 친구 1–10명을 다룬다. Calendar Scheduling은 회의 3–7개가 있는 1일 일정과 날짜 간격이 1–5일인 2일 일정을 다룬다.
- C.1은 TravelPlanner를 응답 제출률, 제약 통과율, 최종 통과율로 평가한다. Natural Plan은 계획의 세부 사항을 추출한 뒤 완전 일치로 평가하고, MGSM은 정수 답을 참조 답안과 직접 비교한다. Creative Writing은 과제 시범 없이 평가하는 zero-shot LLM 채점으로 1–10 범위의 점수를 부여하며, 출력마다 5 samples의 점수를 평균한다. C.2 follows official baseline implementations라는 설명에 따라 비교 방법의 공식 구현을 사용하되 과제에 맞게 프롬프트 문구를 조정한다. ADAS는 초기 에이전트 7개와 후보 시스템 코드를 생성하고 수정하는 Meta Agent Search 절차를 유지한다.
- D SwarmAgentic Implementation은 D.1 Basic Structure of Agentic System, D.2 Pseudo Code for SwarmAgentic, D.3 Prompt Repository를 포함한다. Role과 Team 클래스는 에이전트와 협업 방식을 표현하고, 생성된 Python 함수는 team.call을 통해 워크플로를 실행한다. Algorithm 1은 집단 평가와 갱신 절차를 명시하며, 프롬프트 저장소는 초기화, 진단, 실패한 조정 식별, 최적 시스템에서 개선점을 얻는 과정, 변경 적용을 다룬다. 프롬프트는 모듈화된 정보 흐름, 워크플로 단계마다 책임 역할 1개, 최종 통합을 요구한다. 또한 기존 역할의 정책을 수정할 때 이름과 책임을 보존하도록 하여 탐색에 일반적인 구조 규칙을 부여한다.
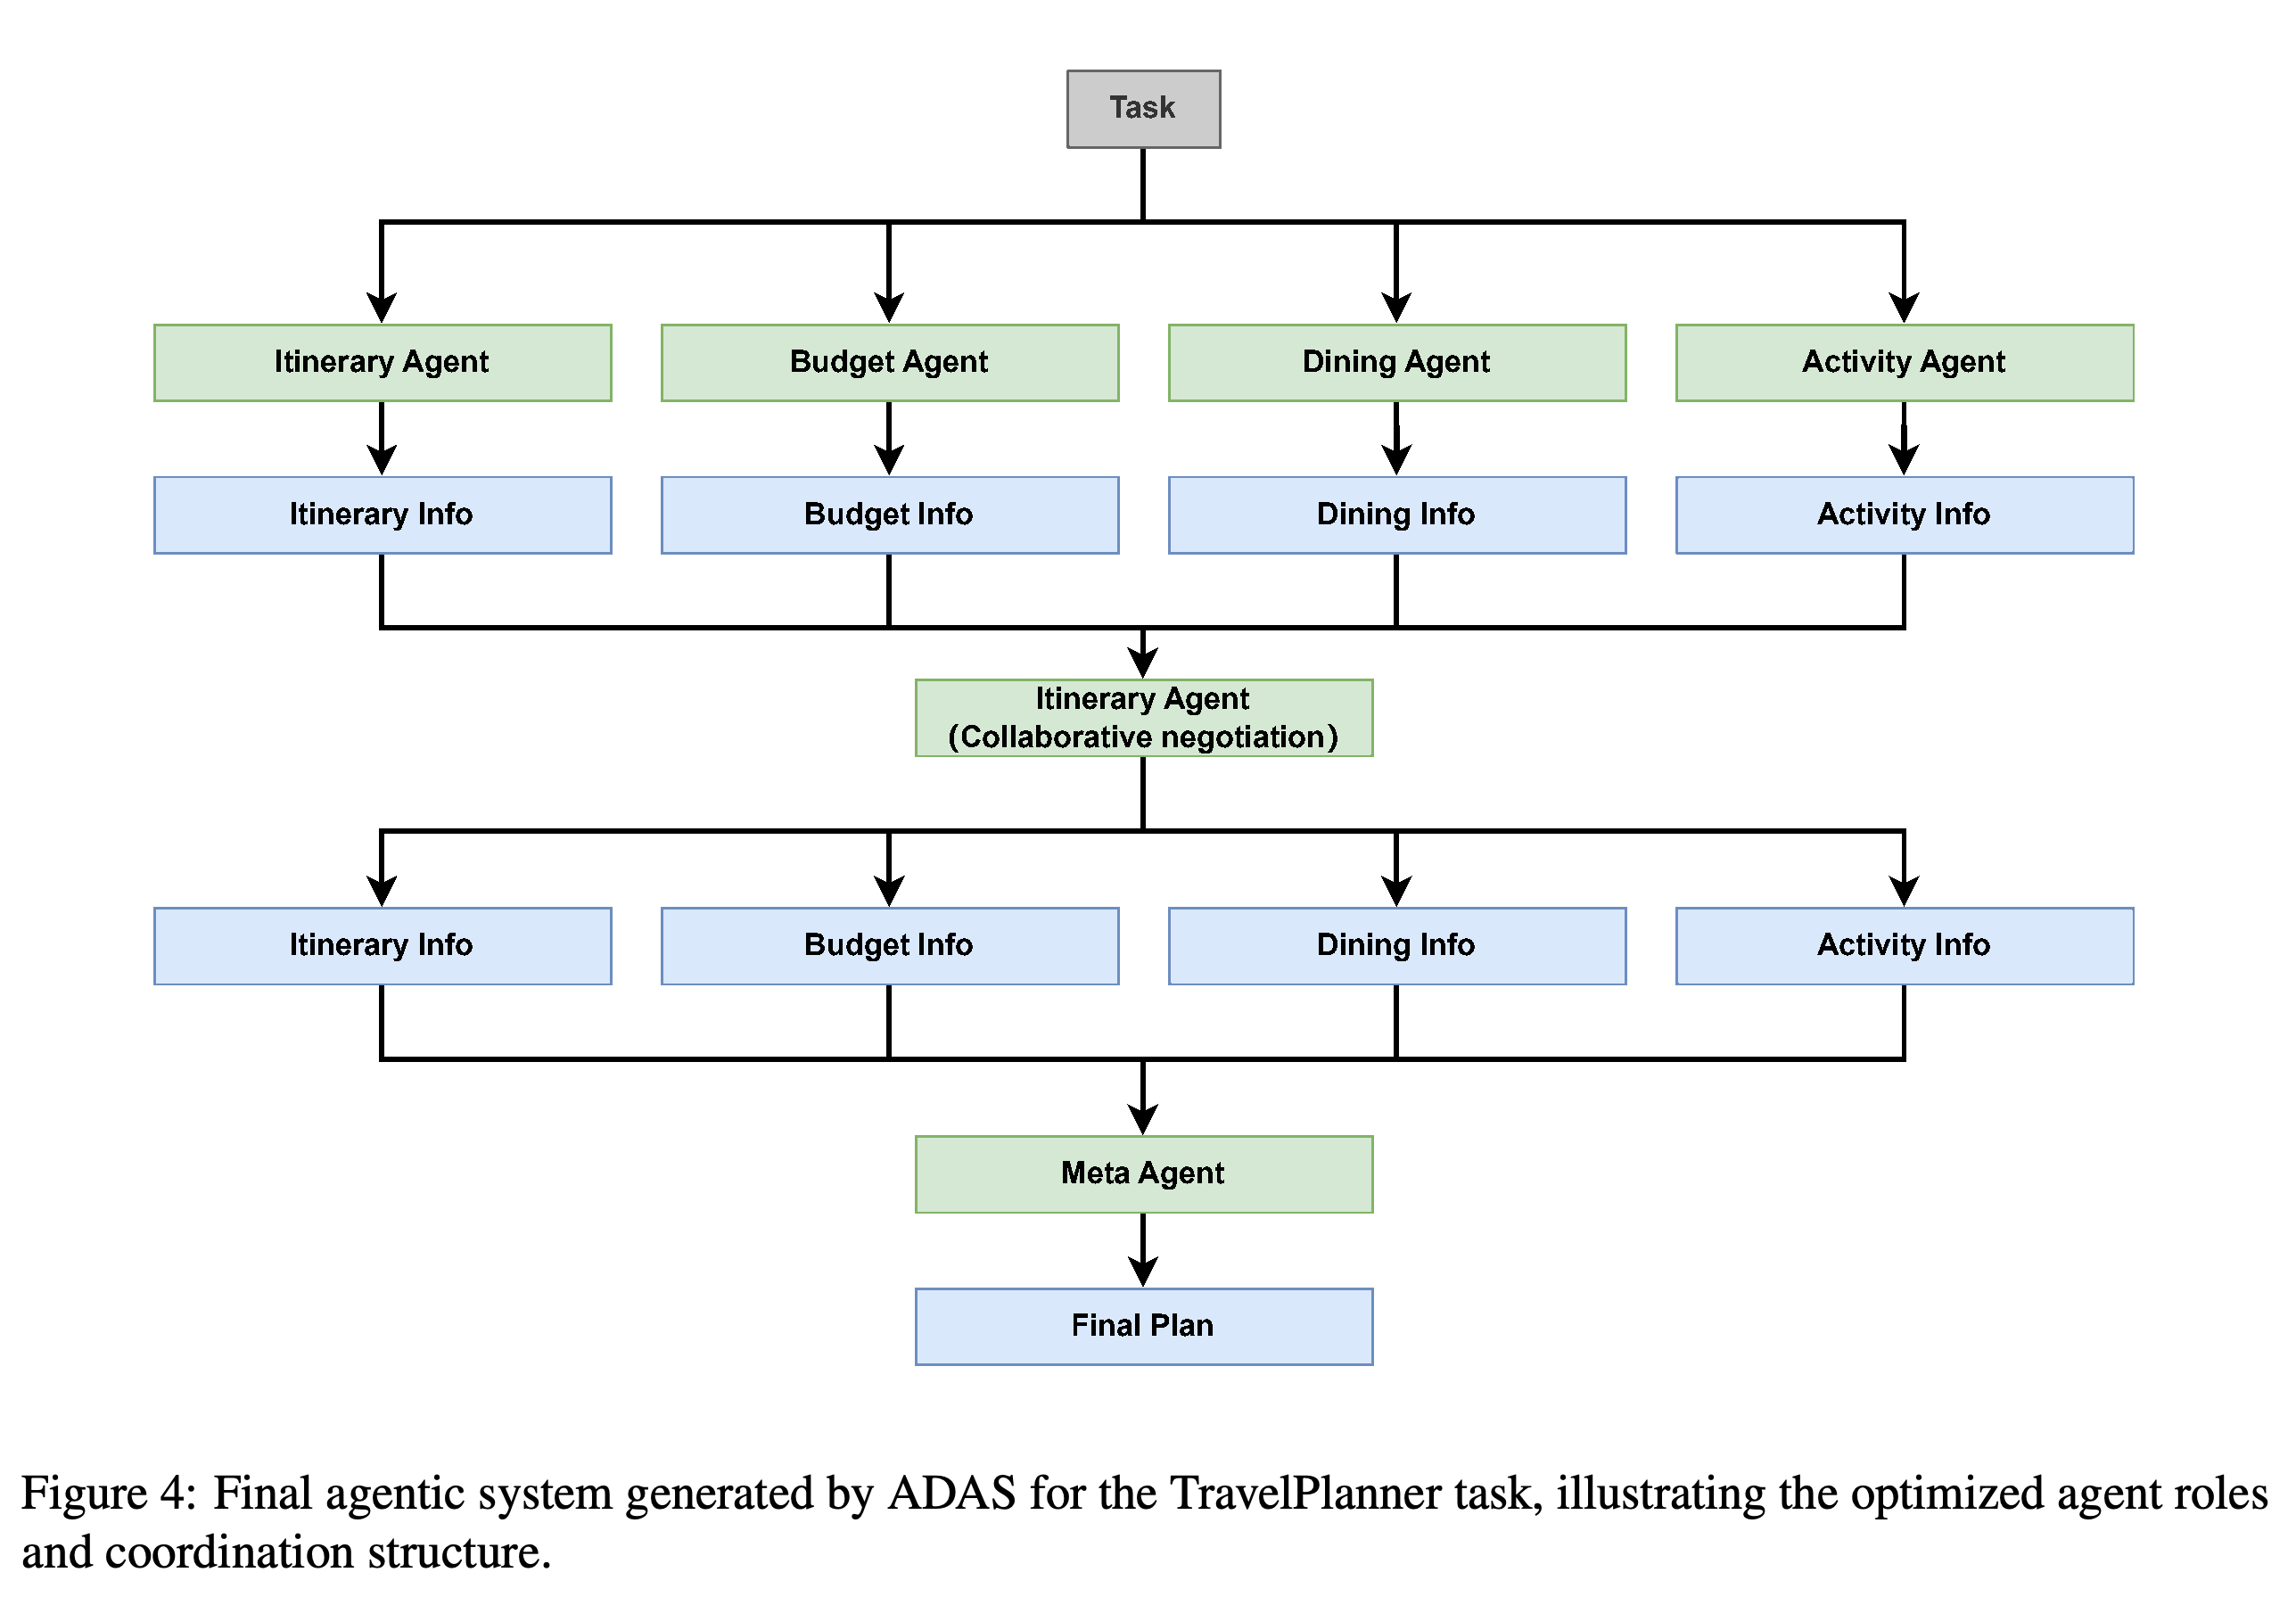
- E Case Study와 E.1 Illustrative Optimization Process는 개인 최적 해에서 가져온 숙박 검증, 전역 최적 해에서 가져온 Quality Assurance Specialist 도입, 실패에 따른 예산 확인 강화를 보여준다. F Best-Discovered Agentic System은 F.1 MGSM에서 분석, 계산 계획, 검토, 실행, 형식화로 구성된 워크플로를 제공한다. F.2 Creative Writing은 서사 구성과 검토 단계, F.3 Meeting Scheduling은 이동 시간 검증과 일정 검증, F.4 TravelPlanner는 교통, 숙박, 식사, 관광 명소, 품질 보증, 통합을 다룬다. F.5 Comparison with ADAS-Discovered Agentic System은 ADAS 예시의 숙박 관련 실패 원인을 전담 책임의 부재와 부족한 통합으로 진단하고, 커지는 워크플로 아카이브가 탐색을 복잡하게 한다고 주장한다. 이는 저자들의 진단이며, 해당 설명을 검증한 통제 실험 결과는 아니다.
짧은 생각
구성 요소 실험은 에이전트 행동과 정보 흐름을 함께 최적화하는 접근을 가장 분명하게 뒷받침한다. 워크플로 재구성을 제거했을 때 성능 하락이 가장 크고, TravelPlanner 예시는 구체적인 검증 의존 관계를 보여준다. Figure 3과 Figure 4는 발견된 구조를 직접 살펴볼 수 있게 한다. SwarmAgentic은 숙박과 품질 보증 책임을 배정하고, ADAS 예시는 전문가 제안을 협상과 메타 에이전트를 통해 통합한다. 대표 결과인 상대적 향상 261.8%는 8.9%에서 32.2%로 23.3%포인트 상승한 결과에 해당한다. TravelPlanner 질의 대부분은 여전히 해결하지 못한다. 보고된 비교에는 불확실성 추정과 동일한 비용 조건에서 측정한 탐색 비용이 없다. 전이 실험은 Creative Writing에서 수행하고 구성 요소 제거 실험은 사례 20개를 사용한다. Table 5의 중복 설정과 일치하지 않는 Gemini 조건도 효율이나 견고성에 대한 더 강한 주장을 제한한다. 공개된 프롬프트 덕분에 탐색 절차를 더 쉽게 검토할 수 있다. 다만 프롬프트의 모듈화 및 순차 실행 규칙을 고려하면 구조적 제약 없이 생성한다는 논문의 설명에는 단서가 필요하다.
ADAS 예시는 여행 일정, 예산, 식사, 활동 제안으로 시작해 협업 협상을 거친 뒤 메타 에이전트로 최종 통합한다. 전담 숙박 역할이 없다는 점은 Appendix F.5에서 논의하는 구조적 문제다. 다만 이 도식만으로 해당 문제가 성능에 미치는 인과적 영향을 입증할 수는 없다.