


Towards a Science of Scaling Agent Systems 요약 설명
09 Dec 2025 | Paper Review Multi-Agent Coordination LLM Agents Scaling Laws목차
이번 글에서는 Towards a Science of Scaling Agent Systems 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 9일(Arxiv)
- Kim, Yubin, Gu, Ken, Park, Chanwoo, Park, Chunjong, Schmidgall, Samuel, Heydari, A. Ali, Yan, Yao, Zhang, Zhihan, Zhuang, Yuchen, Liu, Yun, et al.
- Google Research, Google DeepMind, Massachusetts Institute of Technology
- 논문 링크
요약
- Towards a Science of Scaling Agent Systems는 환경의 피드백을 바탕으로 추론하고 행동하는 언어 모델 에이전트를 추가할 때 상호작용 과제의 성능이 언제 개선되는지 살펴본다. 프롬프트, 도구, 계산 예산을 동일하게 맞춘 조건에서, 오케스트레이터가 작업을 위임하고 검증하는 Centralized는 Finance Agent의 금융 분석 성능을 단일 에이전트 대비 +80.8% 높인다. 반면 독립적으로 생성한 출력을 검증 없이 합치는 Independent는 PlanCraft의 순차적 Minecraft 계획 성능을 −70.0% 낮춘다.
- 이 연구는 상호작용 벤치마크 6개, 조정 아키텍처 5개, 대규모 언어 모델(LLM) 계열 3개에 걸쳐 구성 260개를 평가한다. 회귀 모델은 학습에서 제외한 구성에 대한 예측 적합도를 나타내는 교차 검증 R² = 0.373을 달성한다. 각 모델의 벤치마크 6개 평균 단일 에이전트 성능인 Agentic Capability Index(ACI)를 사용하면 이 값은 0.413으로 높아진다.
- 저자들은 단일 에이전트 성능이 높아질수록 협업 이득이 줄어드는 능력 포화를 가장 일관되게 뒷받침되는 패턴으로 보고, 기준 성능 약 45%를 임계값으로 제안한다. 도구 사용에 따른 조정 부담과 아키텍처에 따른 오류 전파도 관찰한다. 다만 같은 벤치마크에 속한 구성 사이의 의존성을 고려하면 관련 회귀 효과 중 일부는 통계적 유의성을 잃는다.
- 평가한 과제 유형 안에서 학습에서 제외한 구성의 아키텍처 선택 정확도는 87%로, 무작위 선택의 20%와 능력만 사용하는 모델의 54%보다 높다. 이 결과만으로 미평가 모델에서도 신뢰할 만한 선택이 가능하다고 볼 수는 없다. 부록에서는 웹 정보 검색 벤치마크인 BrowseComp-Plus에서 학습에서 제외한 최신 모델 3개 모두에 대해 방정식이 Hybrid를 잘못 선택했다고 보고한다. Hybrid는 오케스트레이터와 에이전트 간 통신을 결합한 아키텍처다.
- 결과는 에이전트 팀을 확대하기 전에 작업을 병렬 하위 과제로 나눌 수 있는 정도인 과제 분해 가능성을 기준 성능, 조정 비용과 함께 평가해야 함을 뒷받침한다. 근거의 범위는 벤치마크 영역 6개, 사례 20개로 구성된 소프트웨어 및 터미널 평가 부분집합, 개별 최적화 없이 공유한 프롬프트, 예비 단계의 팀 규모 및 모델 혼합 실험으로 제한된다.
1. Introduction
서론은 에이전트 확장을 이해하는 데 걸림돌이 되는 문제 2개를 제시한다. 기존 비교에서는 아키텍처와 함께 프롬프트, 도구, 계산량도 달라지는 경우가 많고, 최종 정확도만으로는 조정 비용과 오류 전파를 파악하기 어렵다. Single-Agent System(SAS)은 순차적 추론 루프 1개를 유지한다. Multi-Agent System(MAS)은 여러 에이전트에 작업을 분배해 병렬 탐색과 검증을 수행하지만 문맥을 에이전트별로 나누고 메시지를 교환해야 한다.
- 논문은 관찰과 행동을 반복해야 하는 과제를 강조한다. 에이전트가 서로 다른 정보를 얻고 실수가 이후 실행에 영향을 미치는 상황에서는 독립적인 답변에 투표해 얻는 이득이 그대로 이어지지 않을 수 있다.
- 이 연구는 아키텍처를 통제된 조건에서 비교하고 경험적 성능 모델을 제시한다. 아키텍처 선택 근거는 알려진 과제 유형 안에서 가장 강하며 미평가 영역의 절대 성능을 예측하는 데는 여전히 한계가 있다.
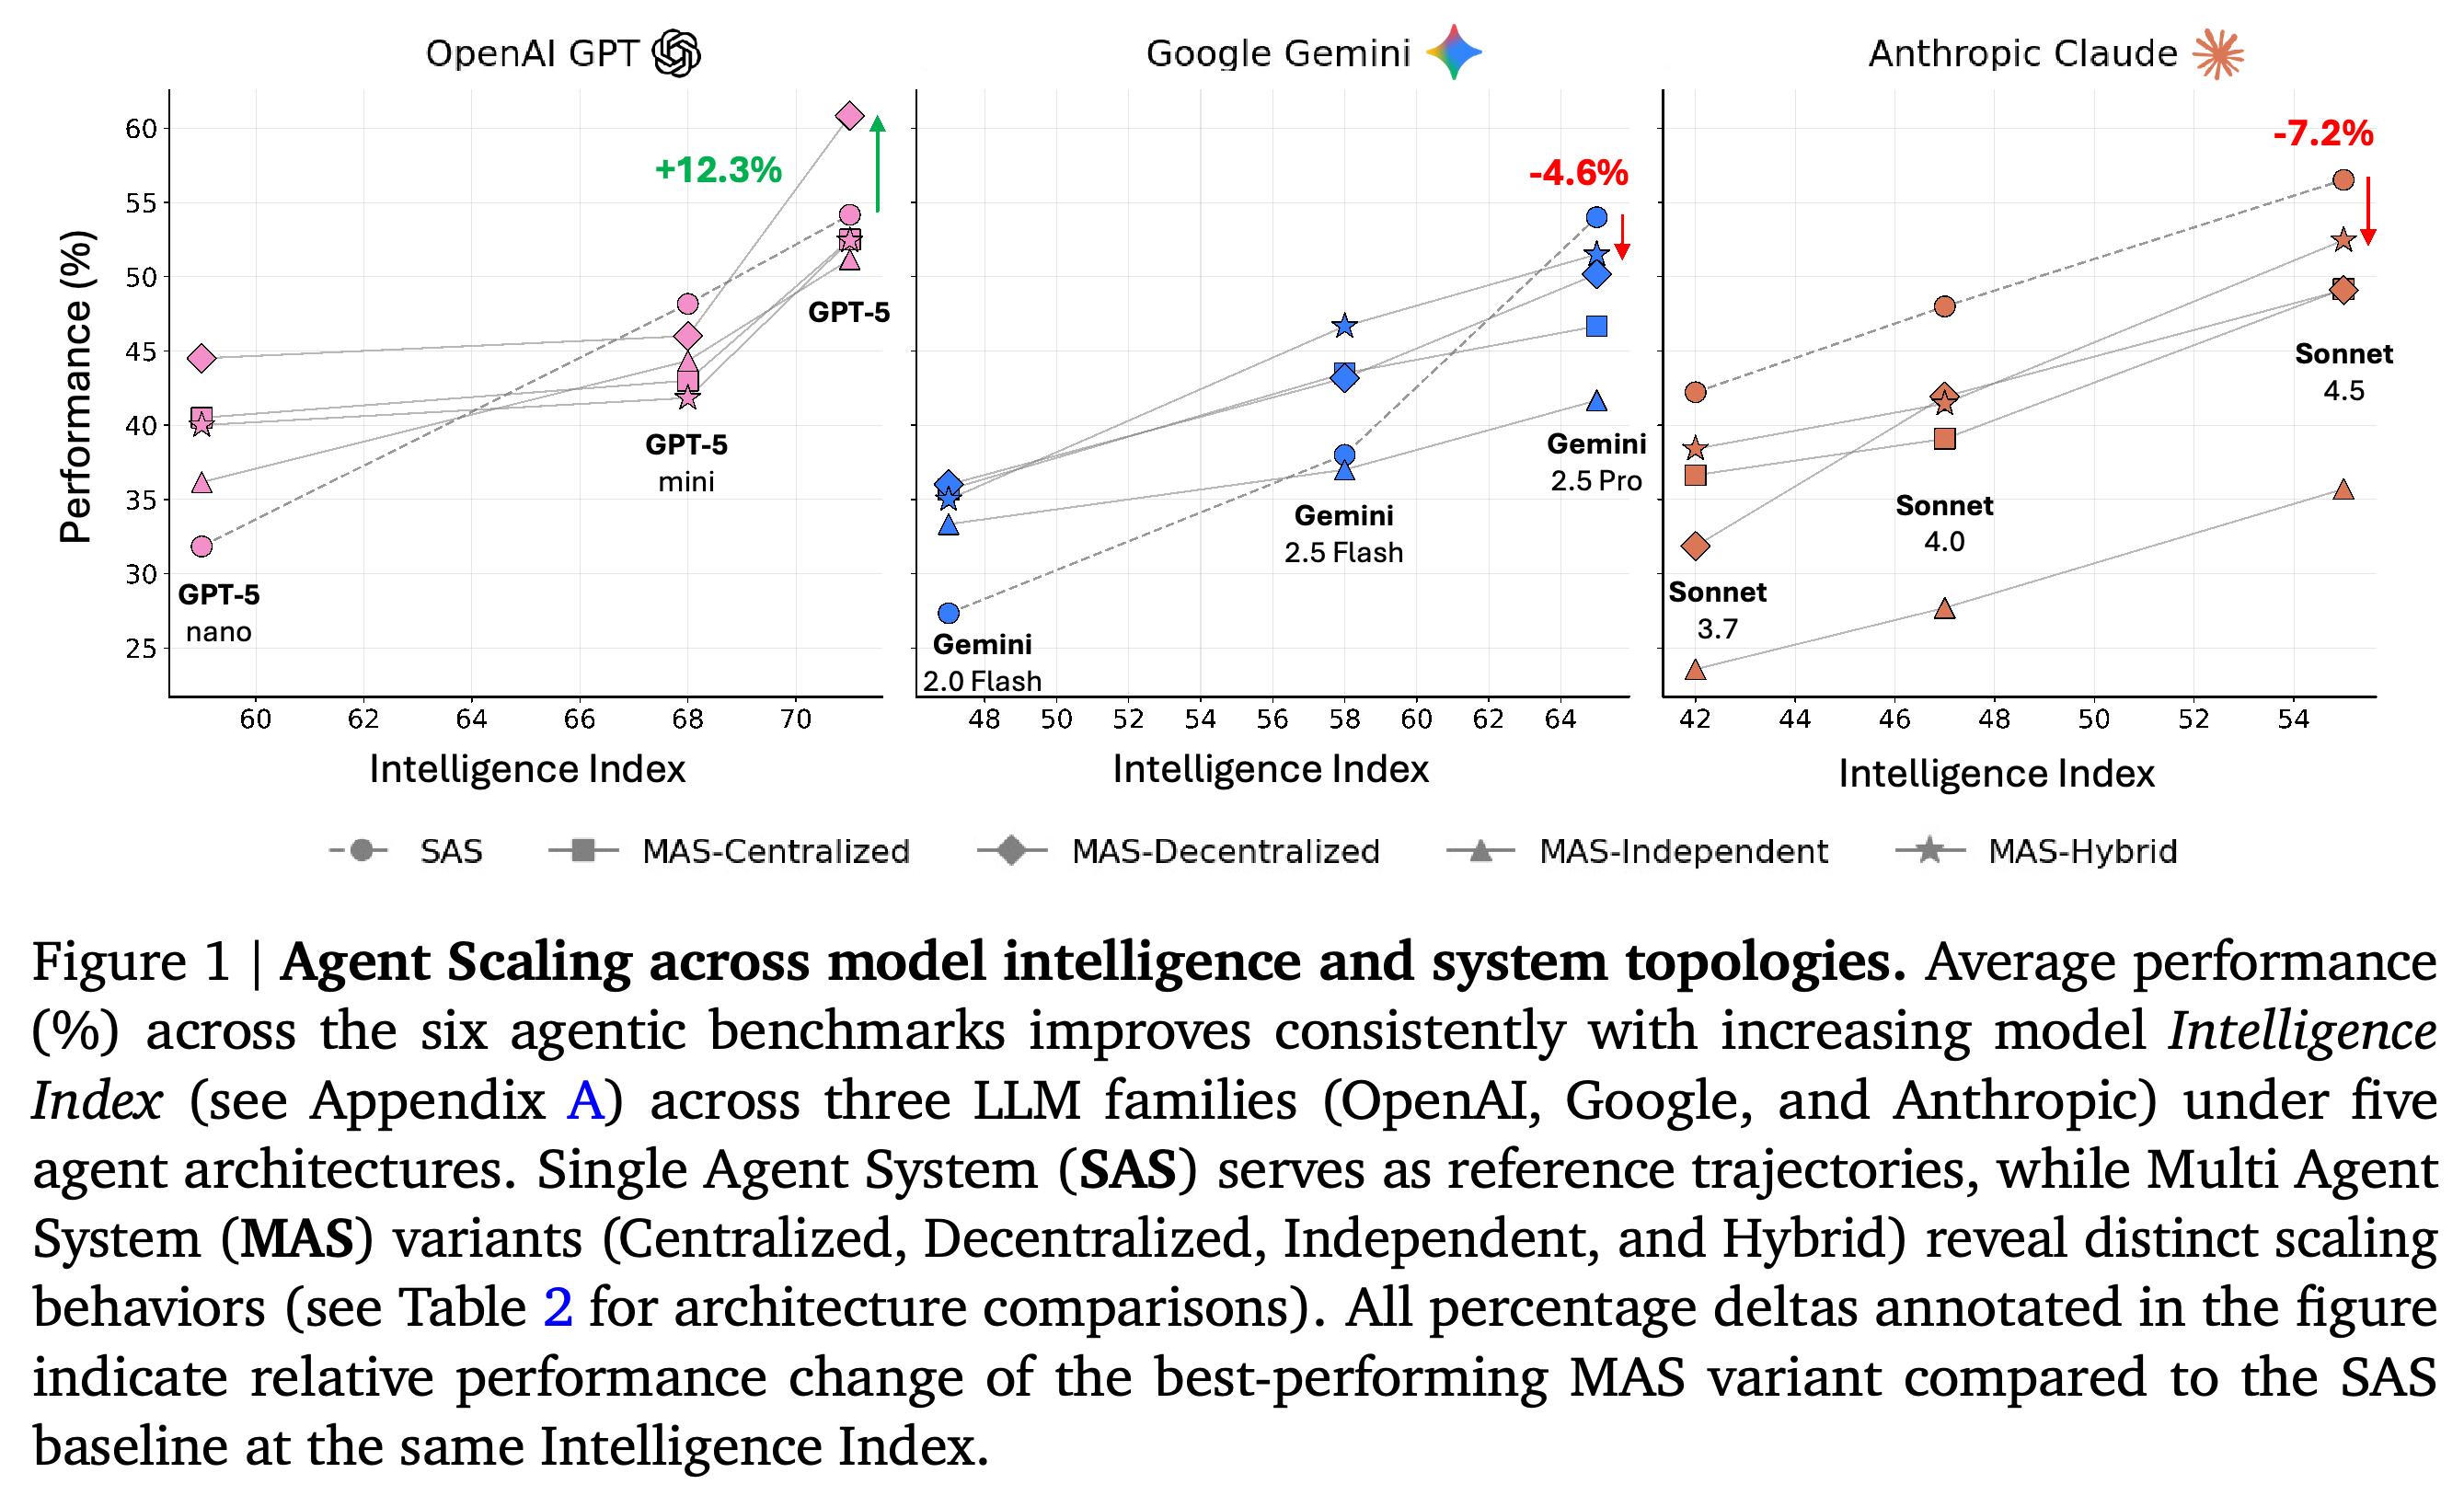
각 모델 계열 안에서는 Intelligence Index가 높을수록 평균 과제 성능도 대체로 높지만 협업의 이점은 달라진다. 각 계열에서 표시된 가장 강한 모델을 기준으로, 최선의 MAS는 같은 Intelligence Index의 SAS 대비 OpenAI에서 +12.3%, Google에서 −4.6%, Anthropic에서 −7.2%의 성능 변화를 보인다.
2. Related Work
관련 연구에서는 단일 에이전트와 다중 에이전트 설계, 상호작용 벤치마크, 협업 확장을 검토한다. 협업 확장은 에이전트 상호작용이나 팀 규모가 늘어날 때 성능이 어떻게 달라지는지를 뜻한다. 저자들은 조정 구조와 모델 능력이 다른 시스템에 공통 평가 통제를 적용한다는 점에서 기존 벤치마크 정의 연구와 구별한다.
- 논문이 인용한 선행 연구는 기본 모델이 개선될수록 이득이 줄어드는 현상, 조정 실패, 상당한 토큰 비용을 보고한다. 이는 정확도와 함께 과제 구조와 운영 비용을 평가해야 할 근거가 된다.
- 신경망 스케일링 법칙은 모델 성능과 파라미터 수, 학습 계산량 같은 자원 사이의 관계를 설명한다. 그러나 추론 시점의 에이전트 협업을 어떻게 확장해야 하는지 직접 규정하지는 않는다.
3. Agent Systems and Tasks
이 절은 에이전트 시스템과 벤치마크 선정에 사용한 상호작용 과제의 속성을 정의한다. 비교에서는 정보 교환 방식인 통신 토폴로지와 에이전트의 활동을 지시하고 결과를 결합하는 규칙인 오케스트레이션 정책을 바꾼다.
3.1. System Definition
에이전트 시스템은 에이전트, 공유 환경, 통신 토폴로지, 오케스트레이션 정책으로 구성된 S = (A, E, C, Ω)로 정의한다. 각 에이전트는 추론 정책, 도구 사용을 위한 행동 공간, 내부 메모리, 관찰 이력에 따라 다음 행동을 결정하는 함수를 갖는다. 이력에는 행동–관찰 쌍을 추가하며 MAX_TOKENS 제한에 따라 문맥을 잘라낸다.
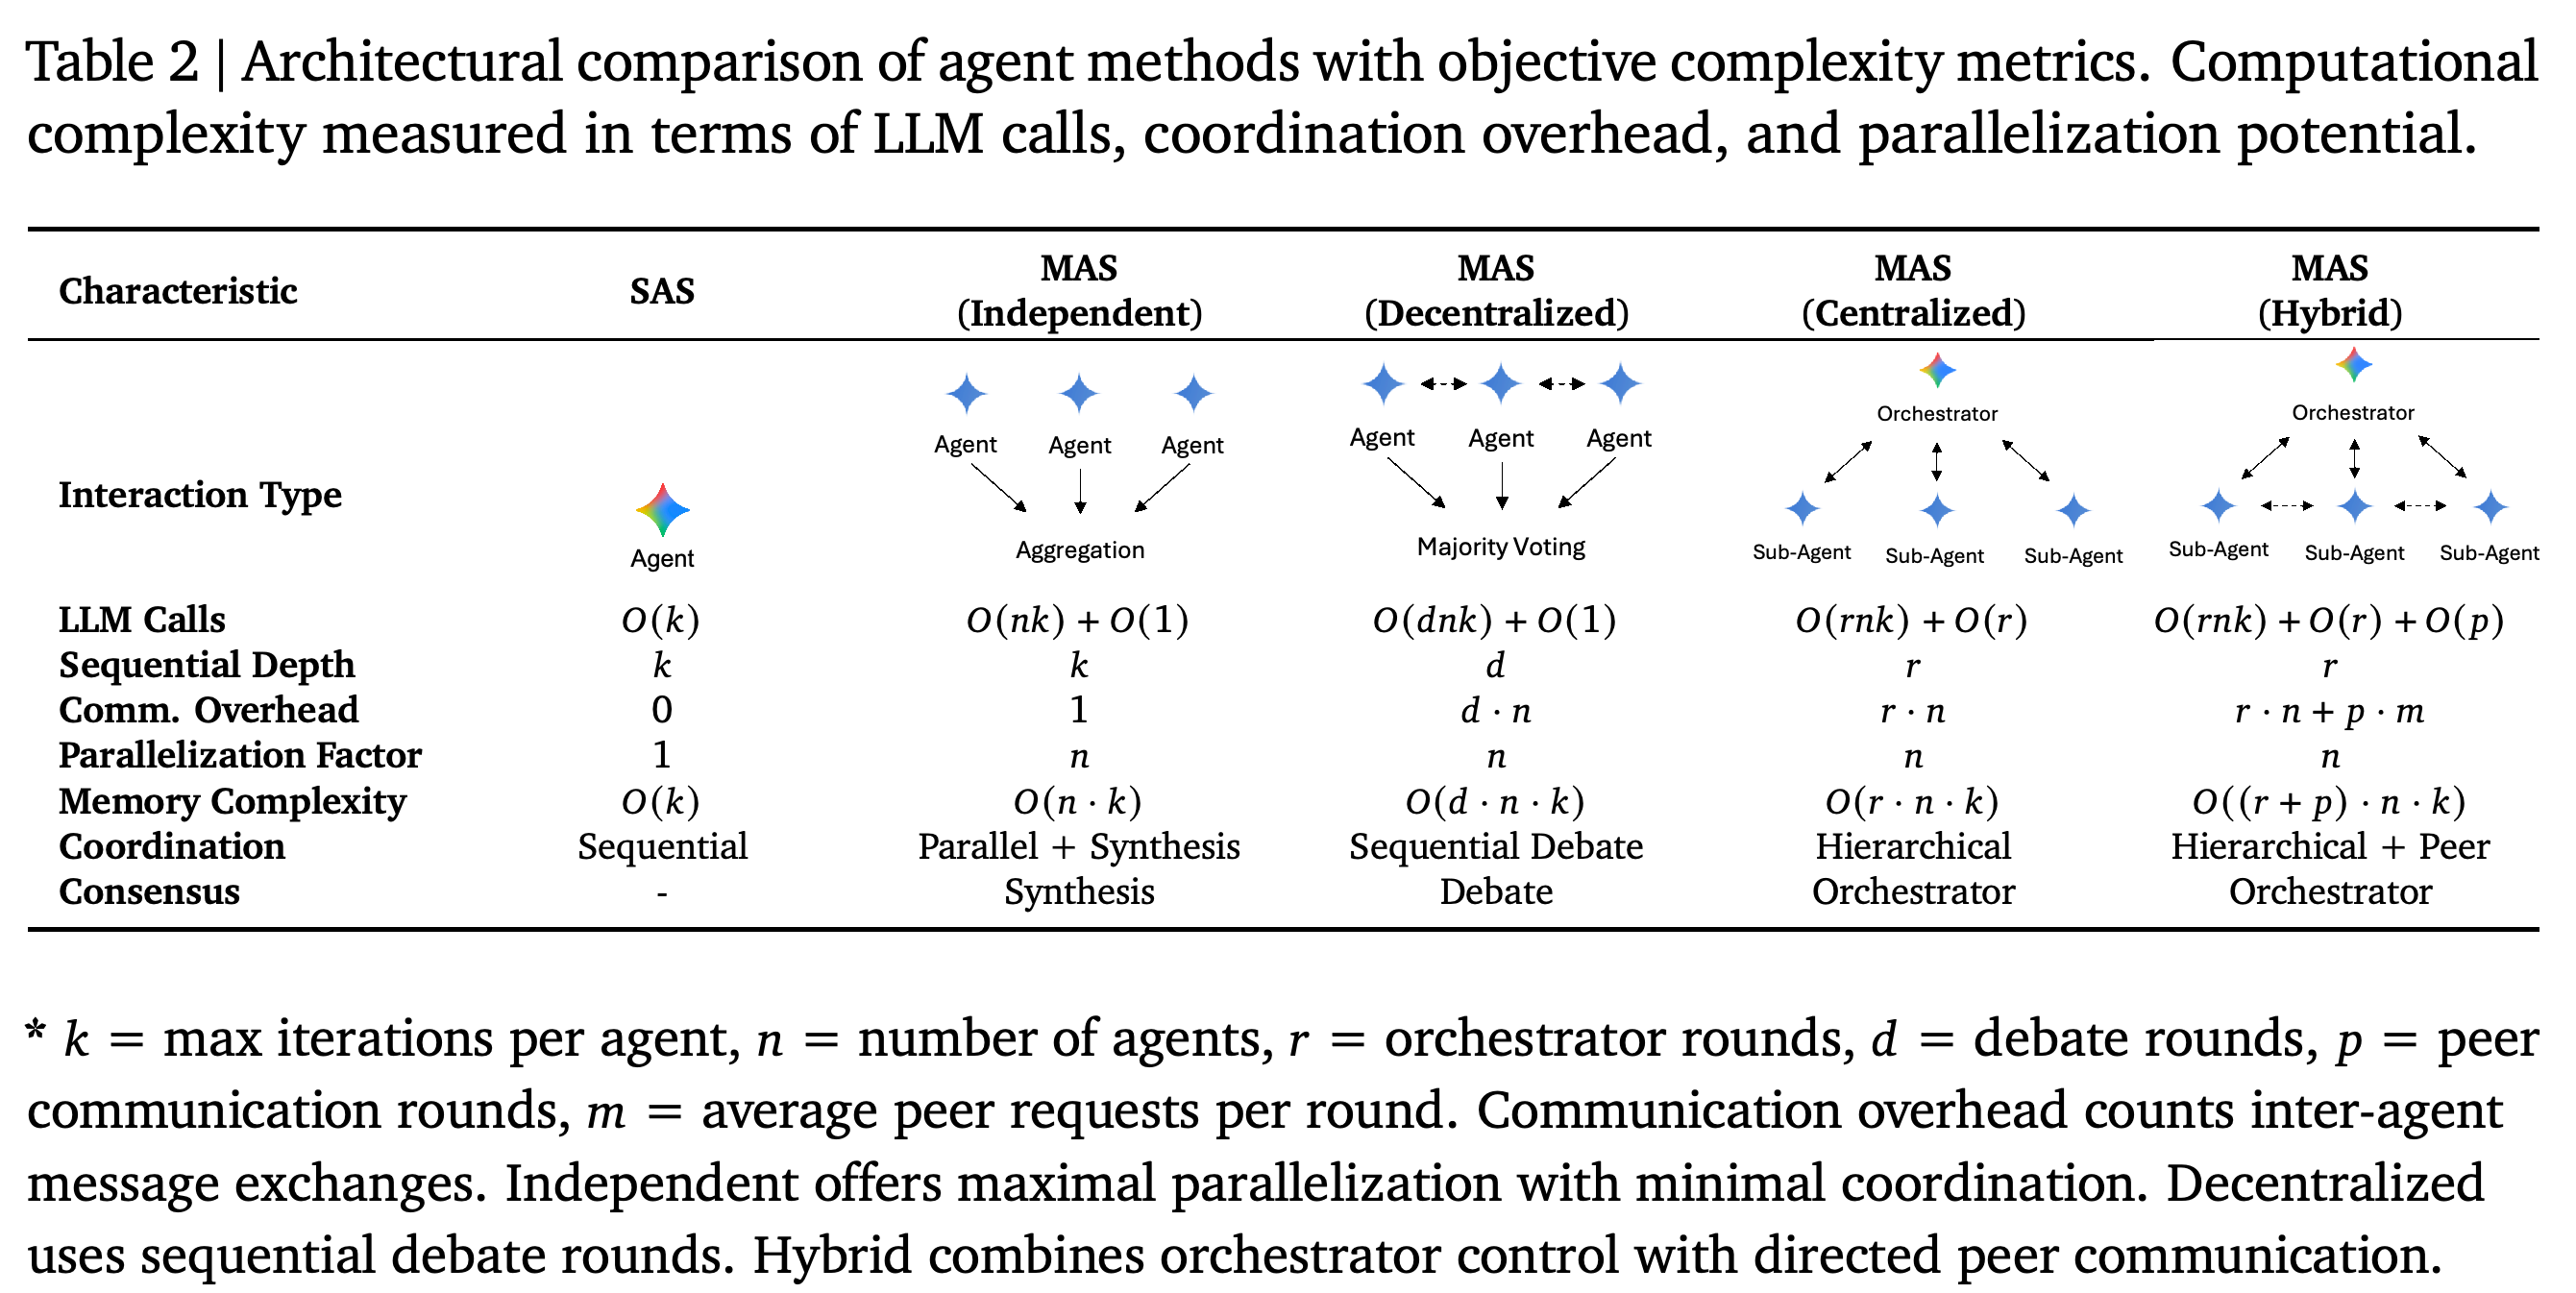
- Independent는 독립적인 에이전트의 출력을 synthesis_only 방식으로 합친다. 이 방식은 분석적 비교, 교차 검증, 다수결 투표 없이 출력을 이어 붙인다. Centralized는 오케스트레이터가 작업자를 지휘하고 Decentralized는 오케스트레이터 없이 에이전트끼리 토론한다. Hybrid는 계층적 통제와 제한적인 에이전트 간 교환을 결합한다.
- 이 아키텍처들은 오케스트레이터와 에이전트 간 통신의 유무에 따라 조정 메커니즘을 추가하거나 제거하는 구조적 ablation 비교를 구성한다. 순차적 처리 깊이, 메시지 오버헤드, 병렬화, 메모리 요구량이 서로 다르다.
- 과제 수준의 오류 증폭은 E_MAS/E_SAS이며, E = 1 − P이고 P는 과제 성공률이다. 실행 기록 수준의 증폭은 조정 실패에 따른 추가 계산 작업을 측정한다. 보고된 4.4×와 17.2×는 이 실행 기록 지표를 뜻하며 최종 과제 실패율의 배수가 아니다.
3.2. Agentic Tasks and Benchmarks
최적의 상호작용 정책이 최선의 단일 순전파 방식보다 과제별 임계값을 넘는 상당한 성능 이득을 보이면, 그 과제를 평가상 에이전트형 과제로 정의한다. 필요한 속성은 이후 행동이 앞선 관찰에 의존하는 순차적 상호의존성, 관련 정보가 처음에는 숨겨져 있는 부분 관측 가능성, 새로운 근거에 따라 행동을 갱신하는 적응적 전략 형성이다.
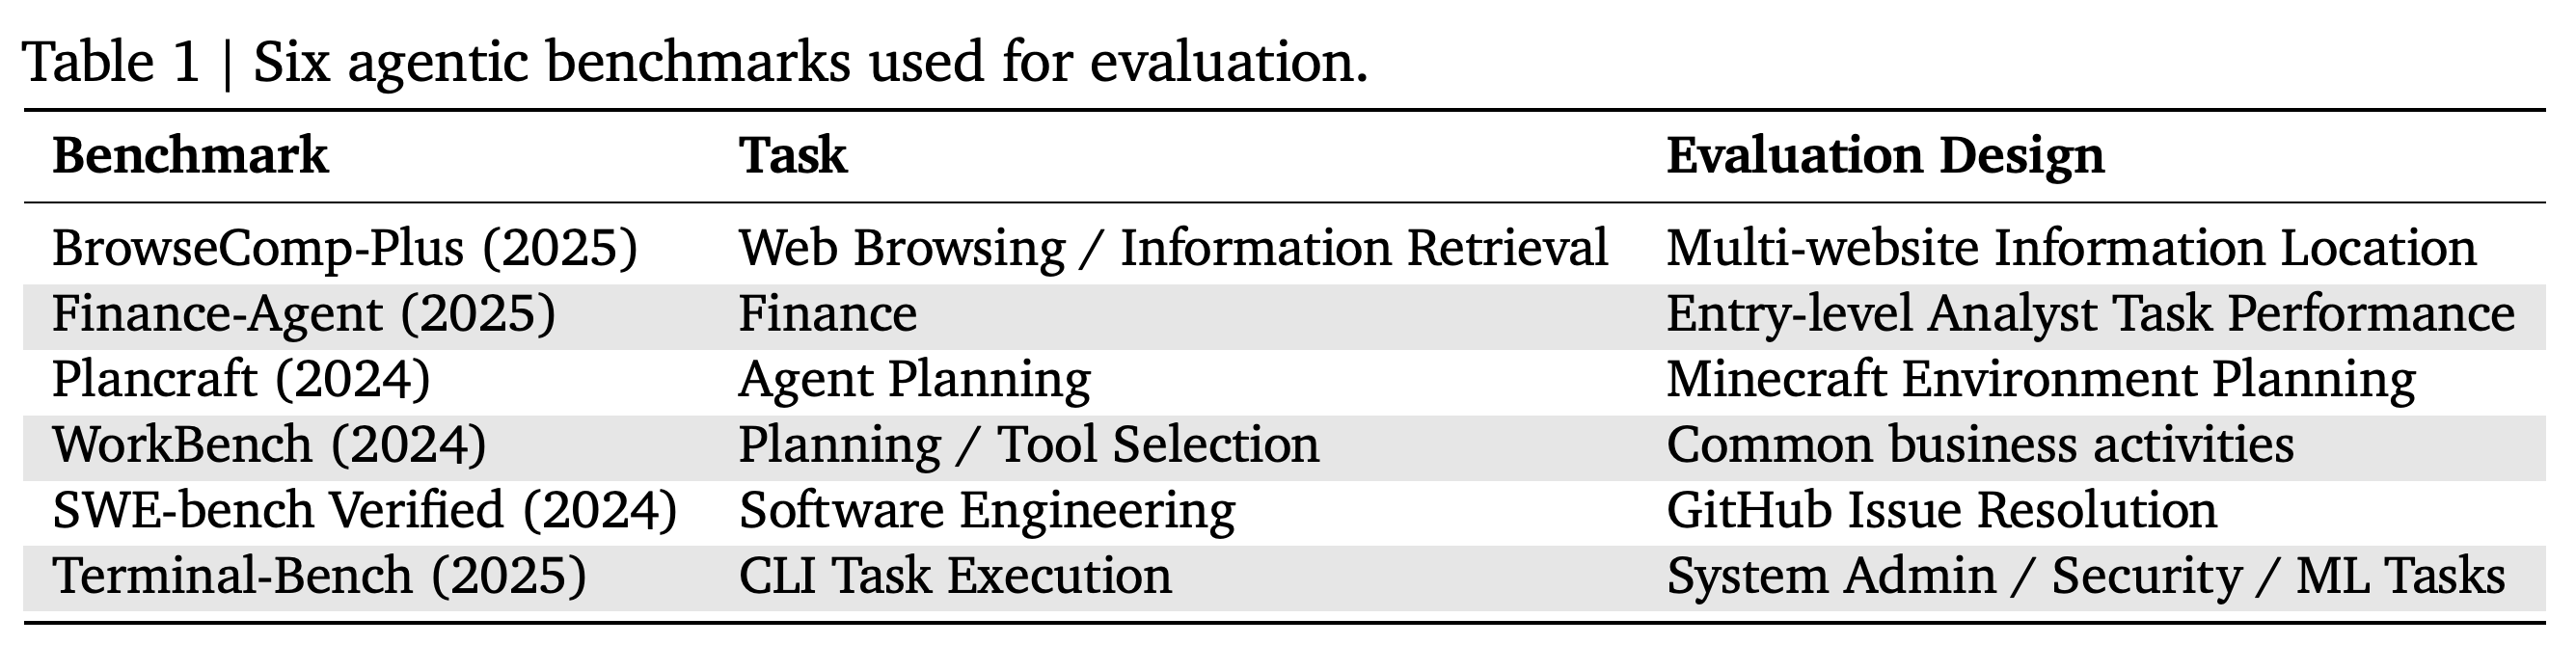
- 벤치마크 6개는 웹 정보 검색, 금융 분석, Minecraft 계획, 직장 내 도구 작업 흐름, GitHub 이슈 해결, 터미널 과제 실행을 다룬다.
- 아키텍처 비교를 통제하기 위해 동일한 도구 인터페이스와 관찰 구조, 기준 성능으로 정규화한 비교, 길이 L > 3인 행동–관찰 궤적을 사용한다. 과제에 상호작용이 필요한지는 현재 모델의 능력에 따라 달라진다.
벤치마크 6개는 여러 웹사이트에서 정보를 검색하는 작업부터 저장소 이슈 해결과 터미널 과제 실행까지 서로 다른 형태의 상호작용을 요구한다. 이 차이는 과제에 따른 조정 이득 분석을 뒷받침하지만 벤치마크 6개만으로는 실제 배포 환경을 폭넓게 다루기 어렵다.
4. Experiments & Results
실험은 어떤 모델, 과제, 조정 요인이 성능을 결정하는지, 협업이 언제 성공률을 높이거나 낮추는지, 측정 가능한 시스템 속성으로 아키텍처 선택을 예측할 수 있는지를 묻는다. 분석에서는 과제 결과와 함께 추론 및 행동을 담은 실행 기록을 사용해 비용, 통신, 중복, 오류를 측정한다.
4.1. Setup
BrowseComp-Plus, Finance Agent, PlanCraft, Workbench는 각각 모델 9개 × 아키텍처 5개로 구성 45개를 제공한다. SWE-bench Verified와 Terminal-Bench는 각각 모델 8개 × 아키텍처 5개로 구성 40개를 제공한다. 앞의 벤치마크 4개는 구성당 사례 50–100개를 사용하고 뒤의 벤치마크 2개는 사례 20개로 구성된 부분집합을 사용한다. 사용 가능한 도구 수는 {2, 3, 4, 5, 7, 16}이다.
- 모델은 GPT-5-nano, GPT-5-mini, GPT-5, Gemini-2.0 Flash, Gemini-2.5 Flash, Gemini-2.5 Pro, Claude Sonnet 3.7, Claude Sonnet 4, Claude Sonnet 4.5다. 논문은 컨테이너 환경에서 과제를 실행하는 소프트웨어인 Docker로 평가한 벤치마크 2개에서는 Claude Sonnet 3.7을 사용할 수 없었다고 밝힌다.
- 추론, 코딩, 지식 평가를 통합한 능력 점수인 Intelligence Index는 회귀 모델을 적합한 구성에서 42–71 범위다. 논문은 최대 총 반복 횟수를 맞추고, 시행당 평균 총 추론 토큰 예산을 4,800 토큰으로 설정했으며 팀에서는 에이전트별 할당량을 줄였다고 보고한다. Appendix A는 일부 능력 점수가 재구성한 추정치라고 명시한다.
- 조정 오버헤드는 추론 턴의 상대적 증가량을 측정하고 메시지 밀도는 추론 턴당 메시지 수를 센다. 중복도는 에이전트 출력 사이의 유사성을 측정하며 조정 효율은 성공률을 상대적 턴 수로 정규화한다. 모델 가중치는 미세 조정 없이 고정하며 과제 프롬프트는 모델별로 따로 최적화하지 않고 공유한다.
Independent는 병렬 작업자와 결과 취합을 도입하며 토론과 오케스트레이션은 순차적 라운드와 메시지 교환을 추가한다. 따라서 작업자 수가 비슷해도 조정 비용과 메모리 비용은 달라질 수 있으며 에이전트 수만으로는 시스템 규모를 충분히 설명할 수 없다.
4.2. Main Results
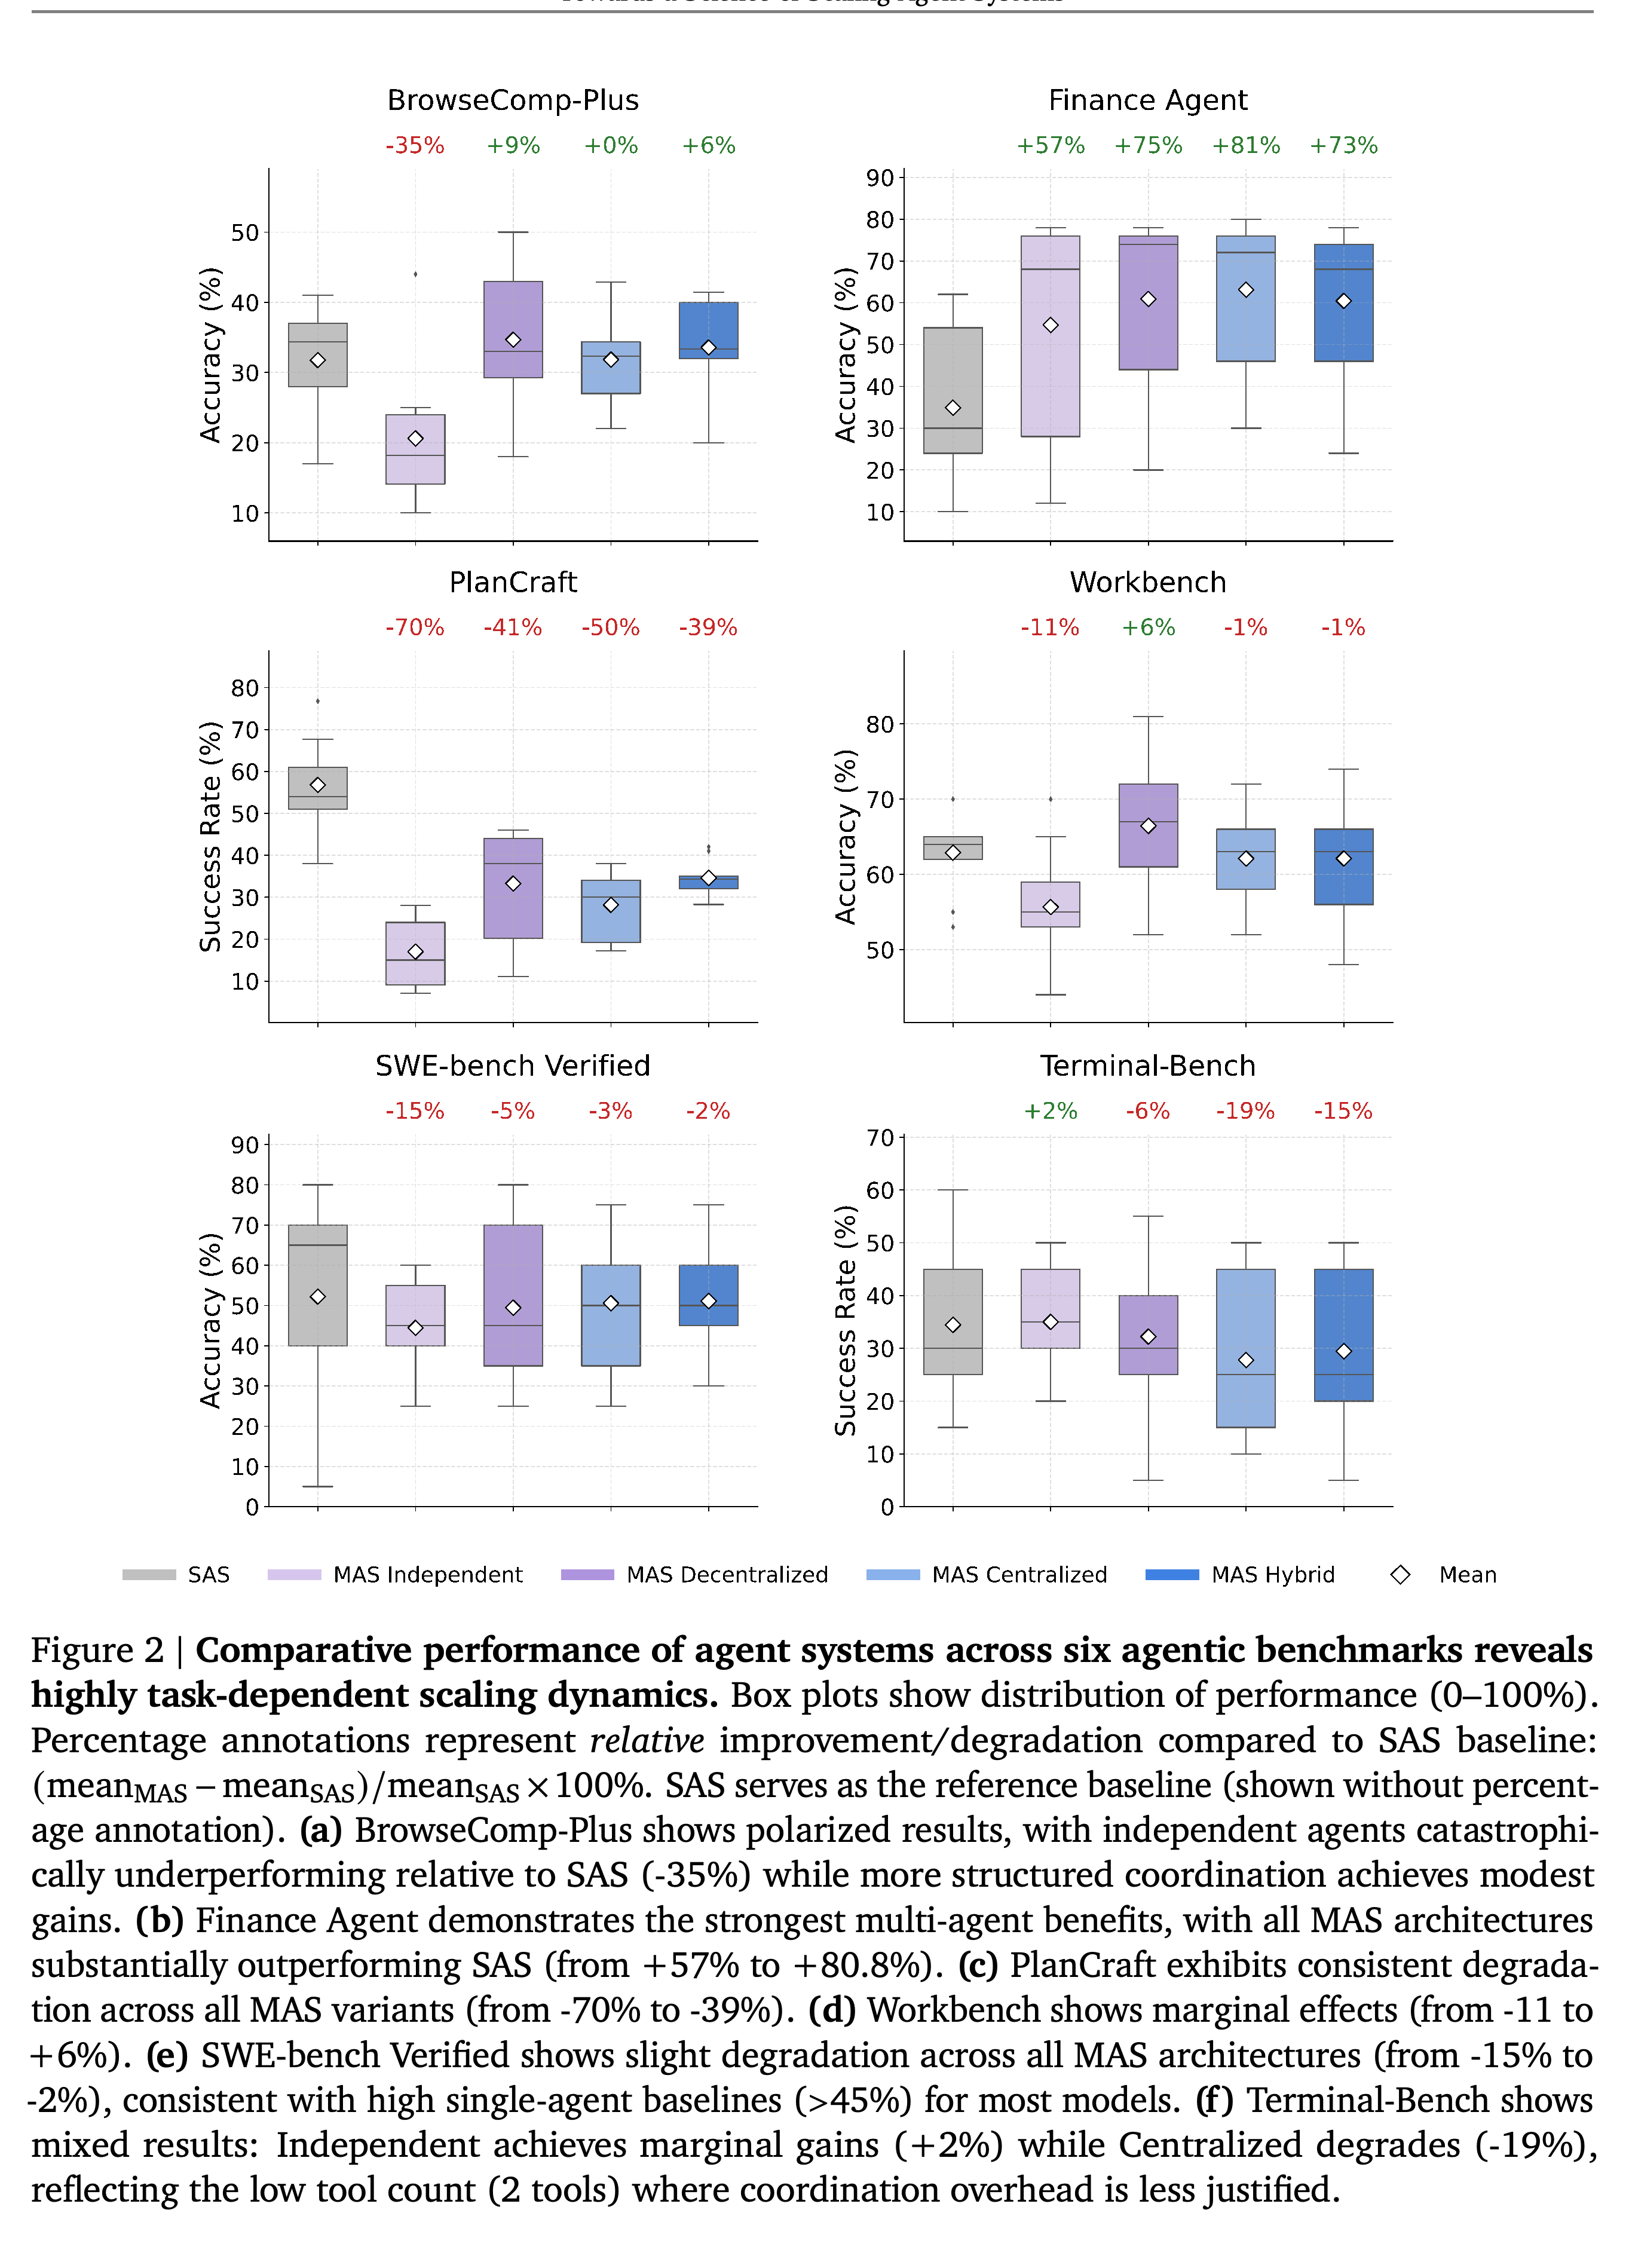
성능 변화는 벤치마크에 따라 크게 달라진다. Finance Agent에서 Centralized의 평균 성공률은 0.631로 SAS의 0.349보다 높다(+80.8%). 반면 PlanCraft에서는 모든 MAS 변형의 성능이 낮아진다. SAS가 0.568인 데 비해 Independent는 0.170(−70.0%), Centralized는 0.282(−50.3%), Decentralized는 0.332(−41.5%), Hybrid는 0.346(−39.1%)이다.
- Decentralized는 BrowseComp-Plus에서 0.318 대비 0.347(+9.2%), Workbench에서 0.629 대비 0.664(+5.6%)로 더 작은 이득을 보인다. 금융 과제의 실행 기록 예시는 조사를 상호 보완적인 정보 탐색으로 나눈다. 계획 과제의 예시는 짧은 순차 실행 경로에 중복된 제작법 및 인벤토리 확인을 추가한다.
- 모든 MAS 변형은 SWE-bench Verified의 평균 성능을 SAS의 0.522보다 낮춘다. 상대 변화는 Hybrid의 −2.1%부터 Independent의 −14.9%까지다. Terminal-Bench의 결과는 혼재한다. Independent는 SAS의 0.344 대비 0.350(+1.7%)을 달성하지만 Centralized는 0.278(−19.2%)이다.
- 벤치마크와 아키텍처 전반에서 보고된 MAS의 평균 상대 변화는 −0.3%다. 추정치 주변의 불확실성 범위인 95% 신뢰구간은 [−58.7%, +77.2%]이고 표준편차는 37.5%다. Finance Agent와 PlanCraft는 영역 복잡도 점수가 비슷하지만 결과는 반대여서, 이 점수만으로 조정 이득을 결정할 수 없음을 보여준다.
모든 MAS 변형은 금융 벤치마크의 평균 성능을 높이고 계획 성능을 낮춘다. 직장 업무의 이득은 작고, 소프트웨어 결과는 평균적으로 하락하며 터미널 결과는 엇갈린다. 표시된 수치는 퍼센트포인트 차이가 아니라 평균 성능의 상대 변화다.
4.3. Scaling principles
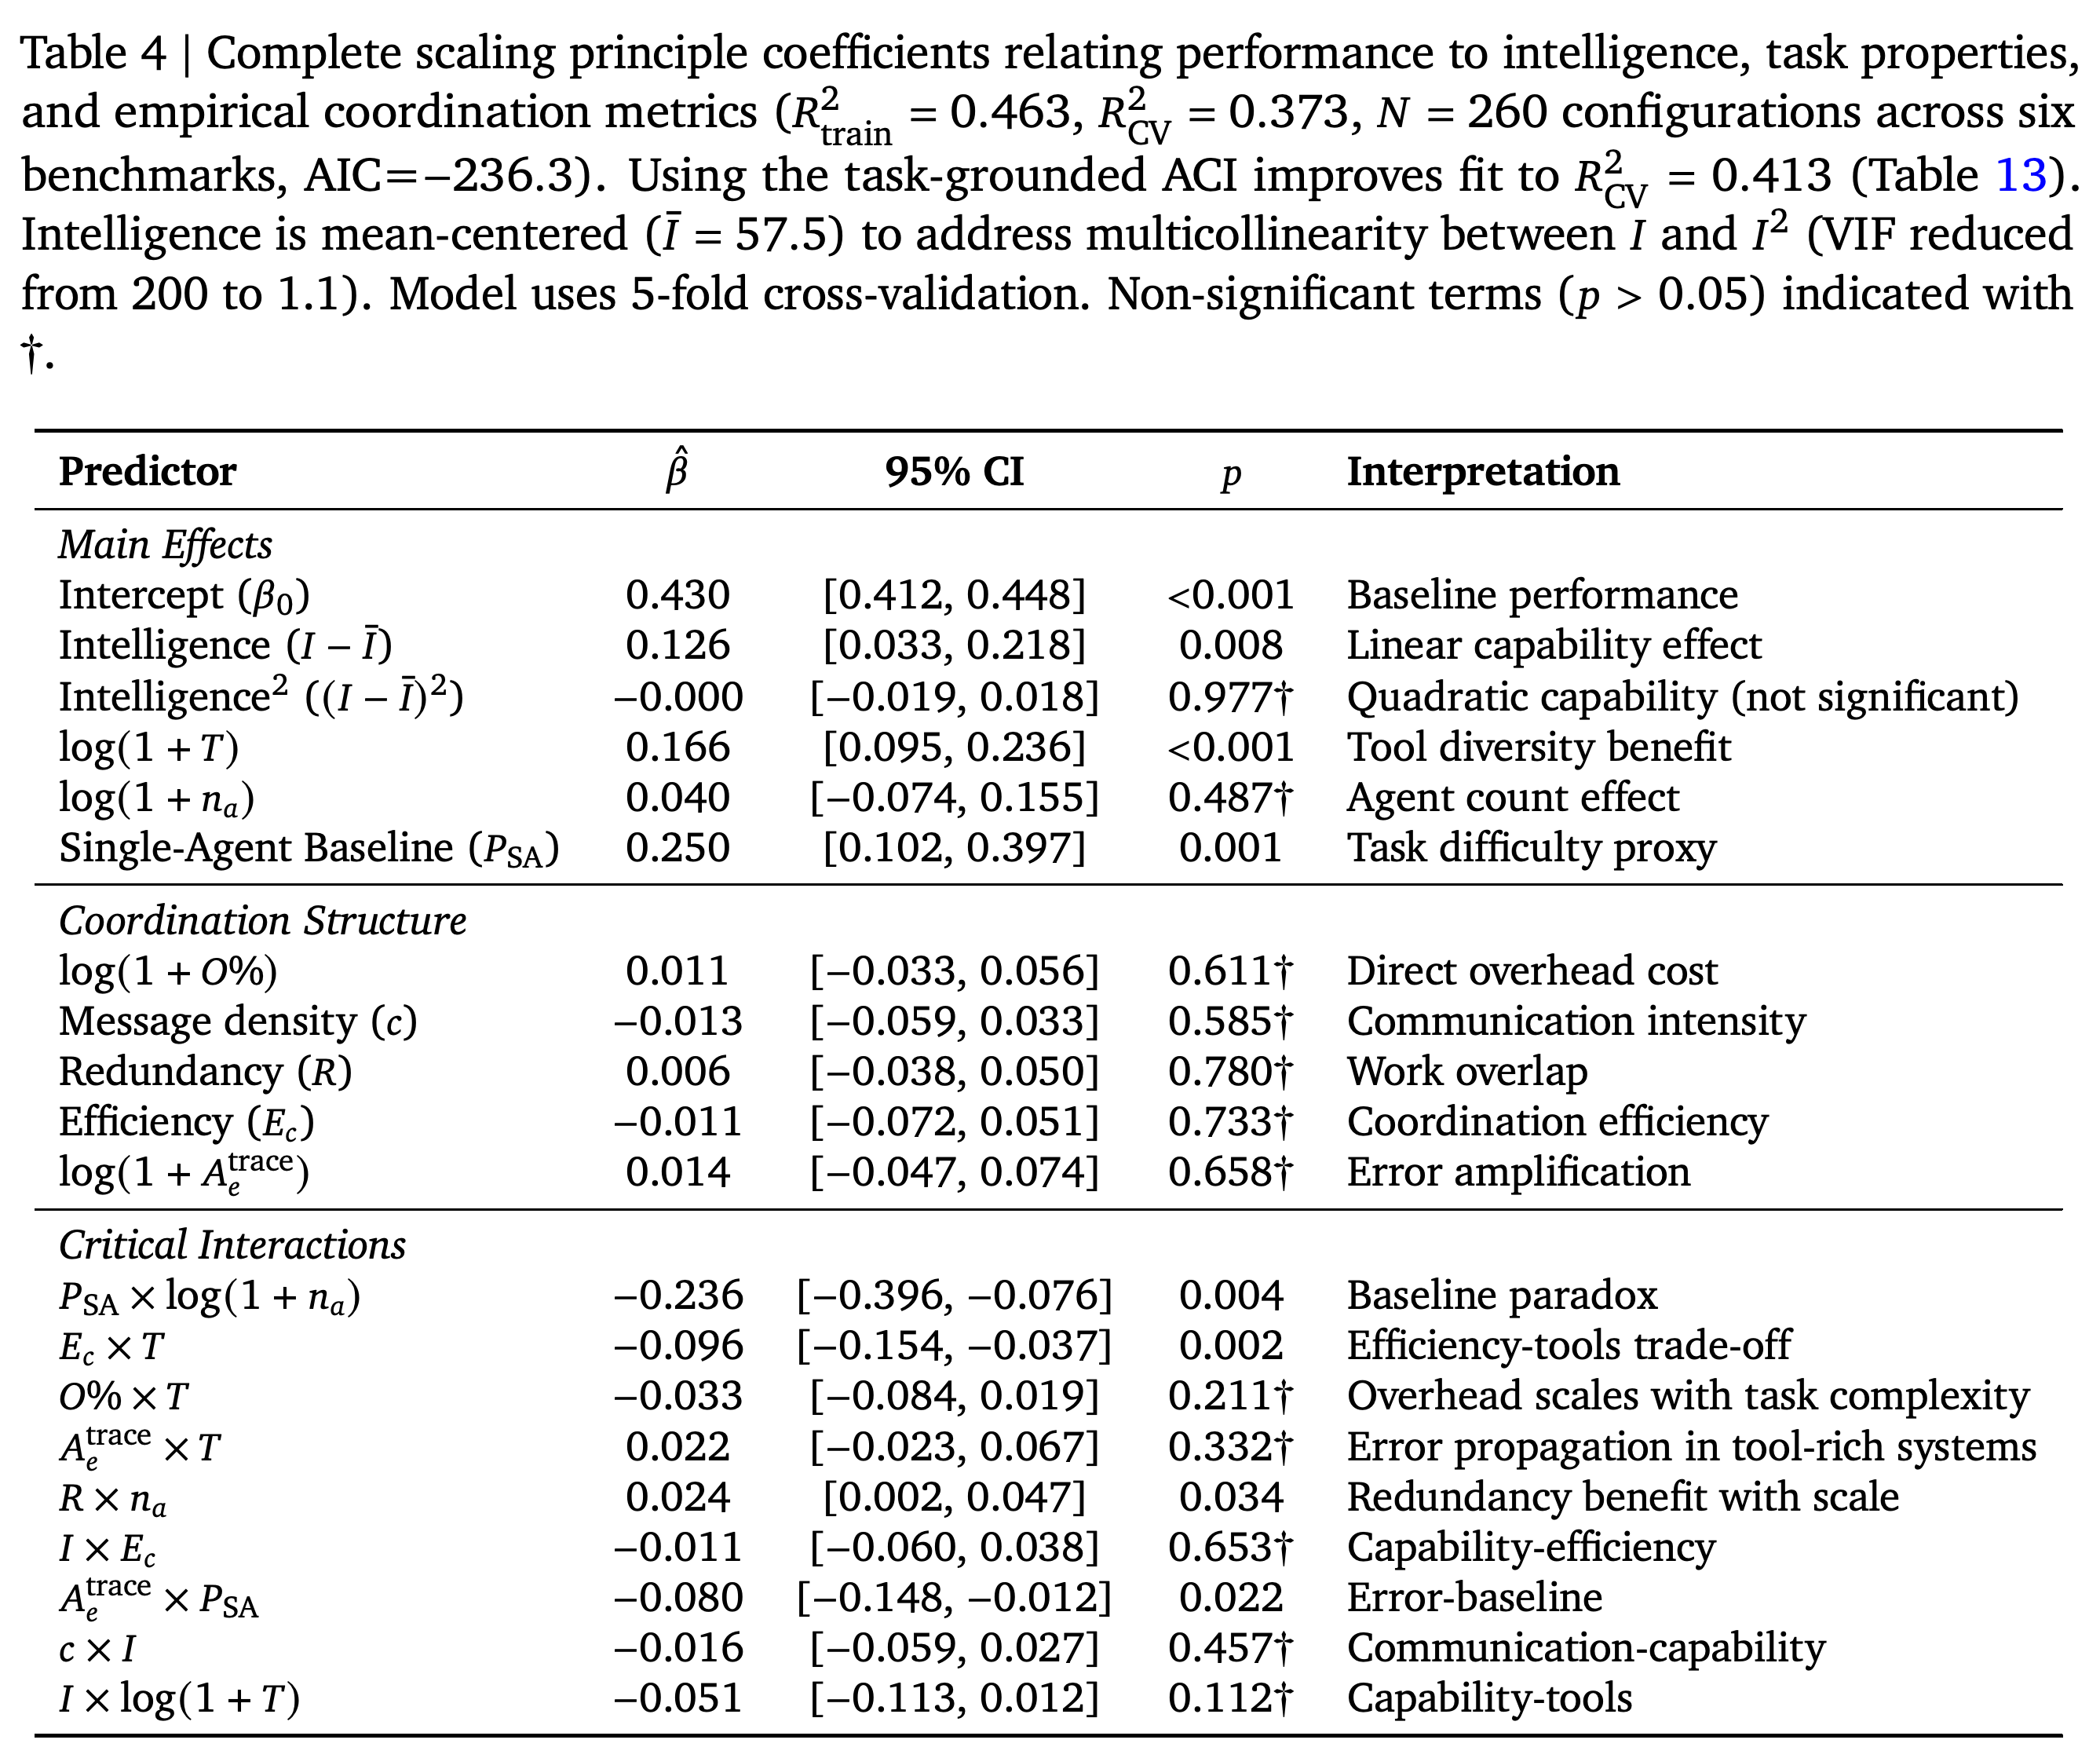
스케일링 방정식은 모델 능력, 에이전트와 도구 수, 단일 에이전트 기준 성능, 경험적 조정 지표, 예측 변수 사이의 결합 관계를 나타내는 상호작용 항 9개를 포함한 파라미터 20개를 사용한다. 예측 변수는 지정된 경우 변환하고 평균 0과 표준편차 1로 표준화한다. 실험 구성을 학습에서 제외하는 5배 교차 검증에서 Intelligence Index를 사용하면 R²_train = 0.463, R²_CV = 0.373(±0.170 SD)을 얻는다. SD는 표준편차를 뜻한다.
- Intelligence Index를 ACI로 바꾸면 R²_train은 0.481, R²_CV는 0.413(±0.130 SD)으로 높아지며, 예측 변수의 유의성이 뒤집힌 사례는 보고되지 않는다. ACI와 Intelligence Index의 상관은 r = 0.45로 중간 수준이며 ACI를 얻으려면 벤치마크를 실행해야 한다.
- 기준 성능–에이전트 상호작용은 β = −0.236으로 음수이며 잔차 제곱합을 최소화하는 회귀 방식인 ordinary least squares(OLS)에서 p = 0.004다. 효율–도구 상호작용도 β = −0.096으로 음수이며 95% 신뢰구간은 [−0.154, −0.037], p = 0.002다. 이 표준화 계수를 변환 전 예측 변수 값에 직접 곱하면 안 된다.
- 전체 모델은 Intelligence + Tools + Agents 모델보다 교차 검증 R²를 0.360에서 0.373으로 소폭 높인다. Table 3에서 전체 모델의 AIC는 −236.3이고, 조정 구조 모델은 −243.2다. 모델 복잡도에 페널티를 부여하는 적합도 지표인 Akaike information criterion(AIC)은 낮을수록 좋으므로, 이 표는 전체 모델의 AIC가 가장 좋다는 캡션의 주장과 모순된다.
조정을 추가하면 달러 비용은 늘지만 모델 계열 전반에서 일관된 성능 이득이 발생하지는 않는다. OpenAI 패널에서 Decentralized는 Centralized나 Hybrid보다 평균 성능이 높고 비용이 낮다. 따라서 이 아키텍처 2개가 이득을 제공한다는 원문 캡션의 주장에는 조건을 붙여야 한다. 그래프는 벤치마크 4개의 구성 180개를 다루며, 오차 막대는 평균의 불확실성을 보여준다.
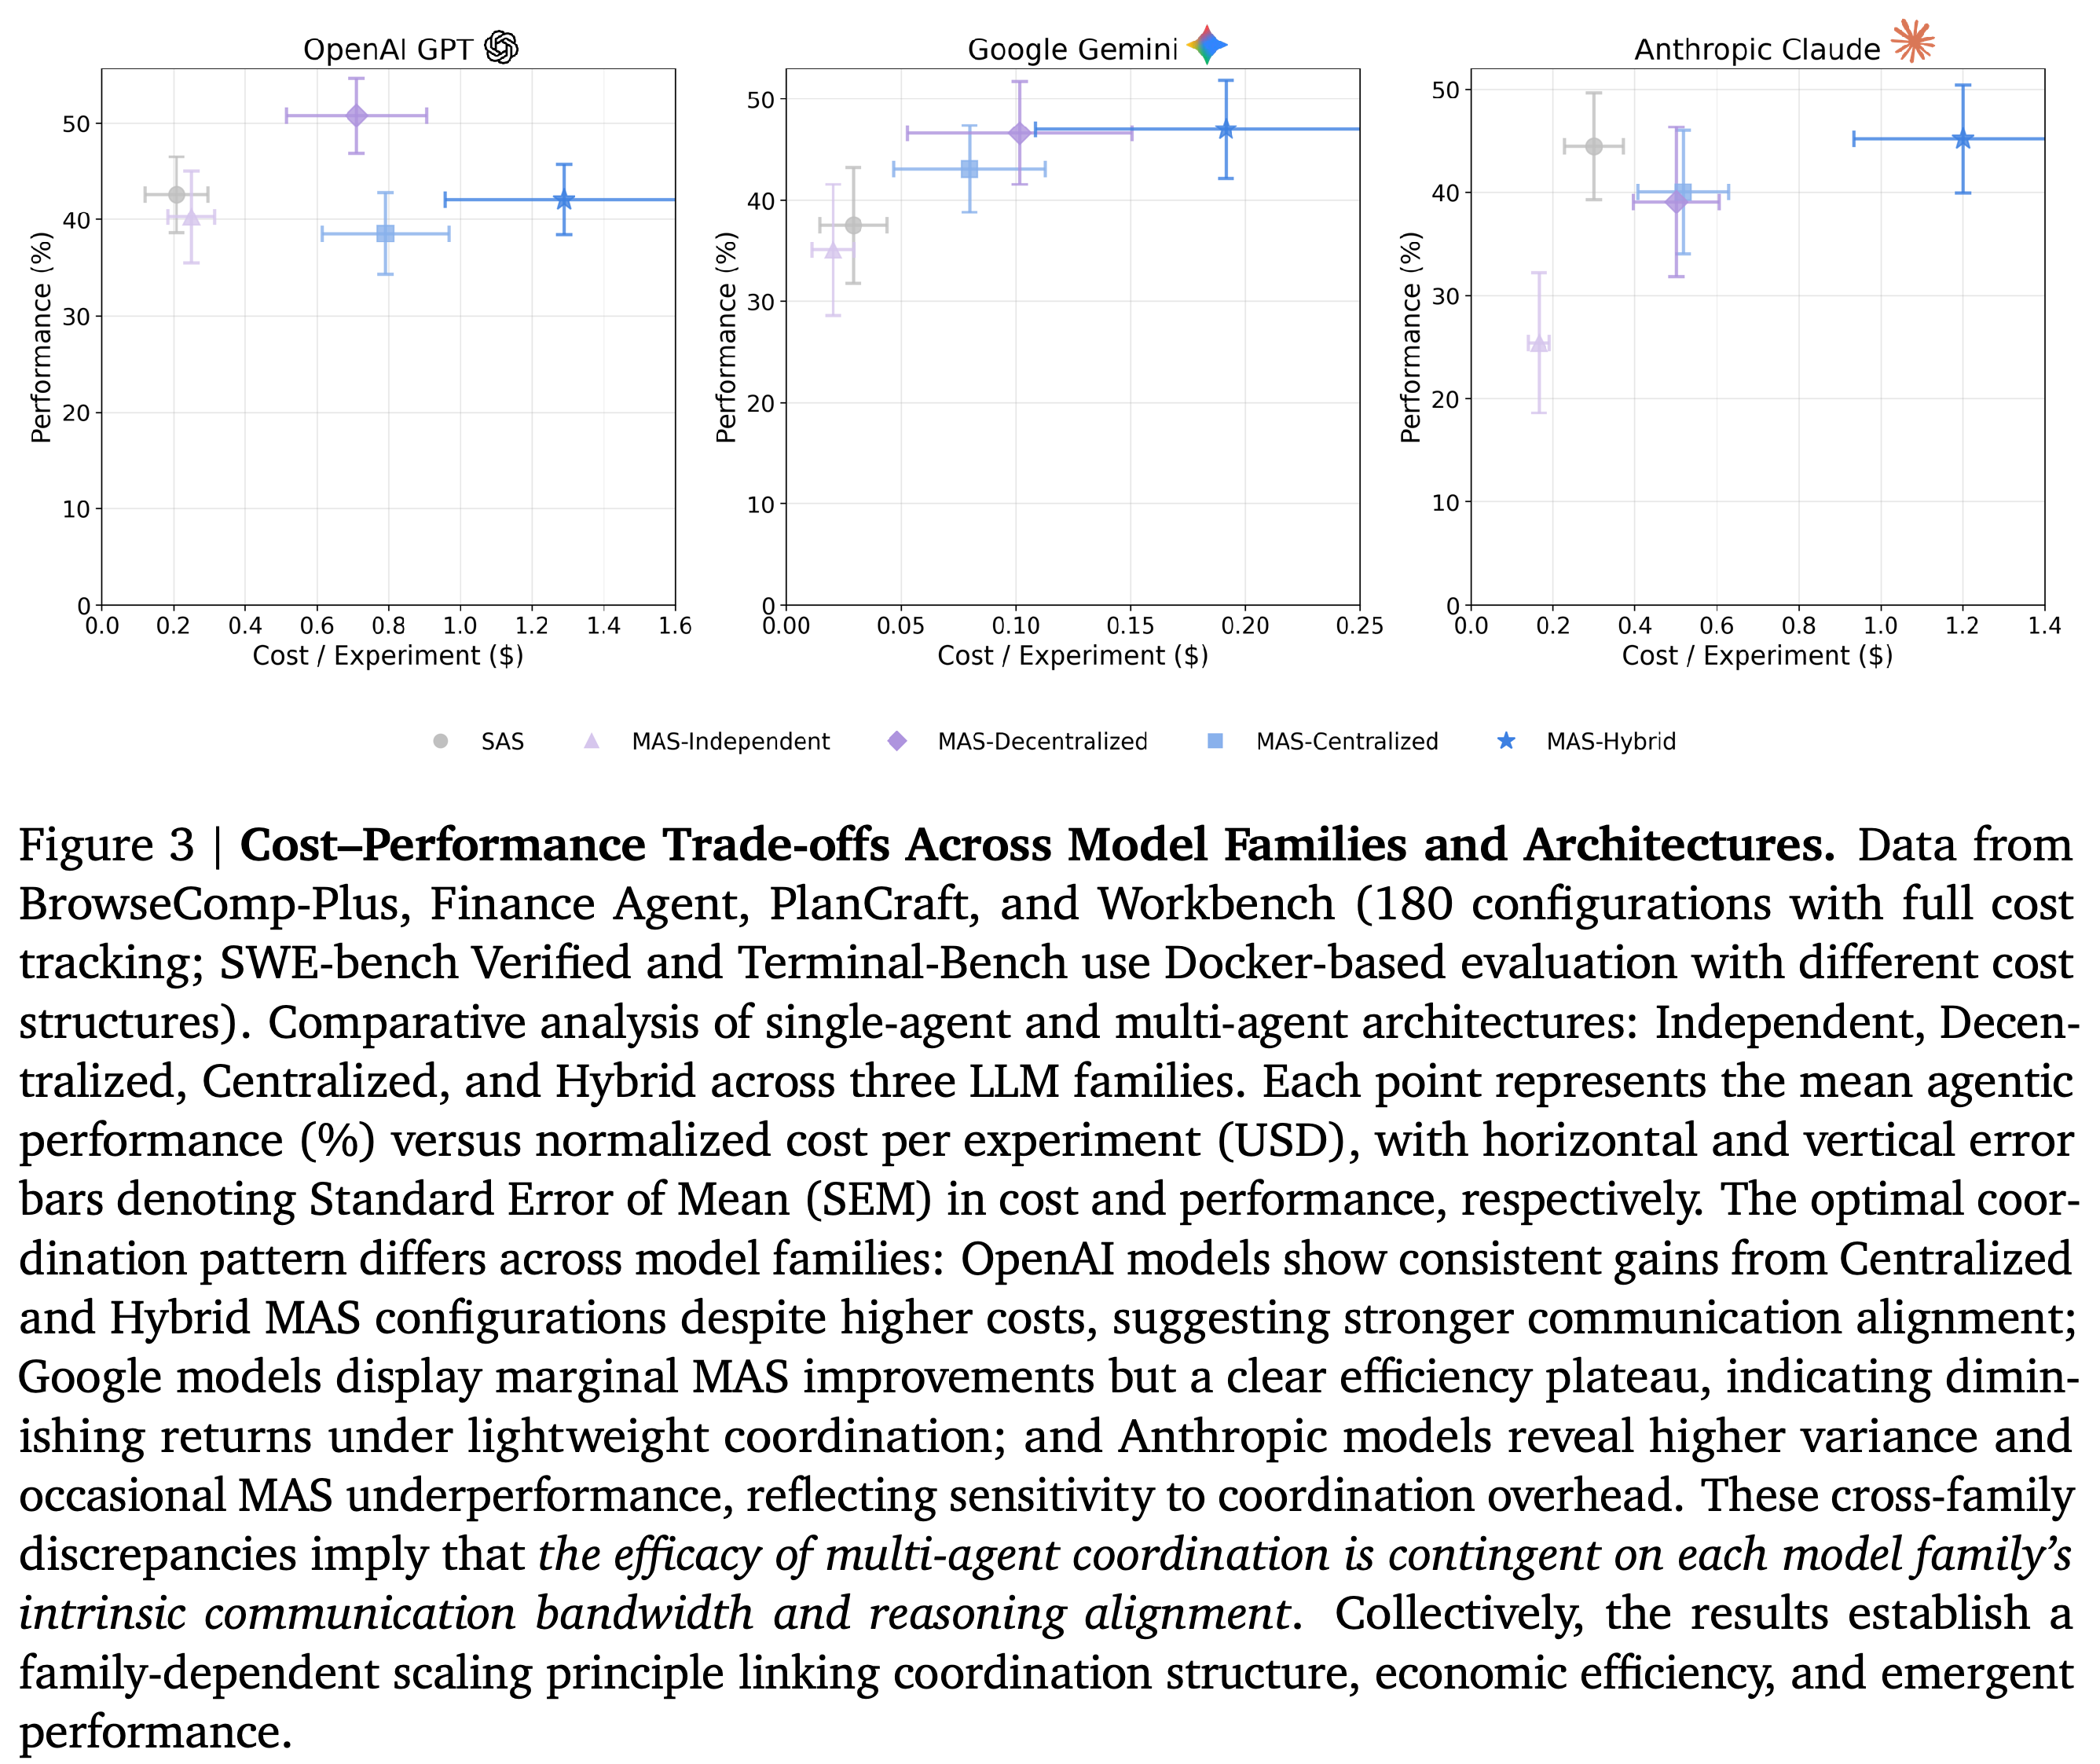
논문은 에이전트 수 계수와 기준 성능–에이전트 계수로부터 정규화 전 단일 에이전트 성능 약 45%를 경계로 도출한다. 같은 영역 안에서 학습에서 제외한 구성을 평가한 결과, 올바른 아키텍처 선택률은 87%로 무작위 선택의 20%, 능력만 사용하는 선택의 54%를 웃돈다.
- 대표적인 과제 유형에서는 순차적 계획에 SAS, 분해 가능한 분석에 Centralized, 일부 도구 사용이 많은 작업 흐름에 Decentralized가 유리하다. Workbench는 기준 성능이 높은데도 소폭의 협업 이득을 보이므로, 이 임계값은 보편적 규칙이 아니라 경험적 경향이다.
- 모델에는 데이터셋별 파라미터가 없지만 데이터셋 전체를 학습에서 제외한 평가 결과는 미평가 영역의 절대 성능에 관한 주장을 제한한다. 조정 예측 변수는 모든 벤치마크에 동일하게 적용하는 아키텍처 수준의 상수이므로, 과제별 조정 행동을 표현하는 데 한계가 있다.
전체 상호작용 모델은 파라미터 수를 4개에서 20개로 늘리면서 교차 검증 R²를 0.360에서 0.373으로 높인다. 표시된 AIC가 가장 낮은 모델은 −243.2의 조정 구조 모델이다. 전체 모델의 교차 검증 적합도가 더 좋다는 결과는 AIC도 가장 좋다는 원문 캡션의 주장을 뒷받침하지 않는다.
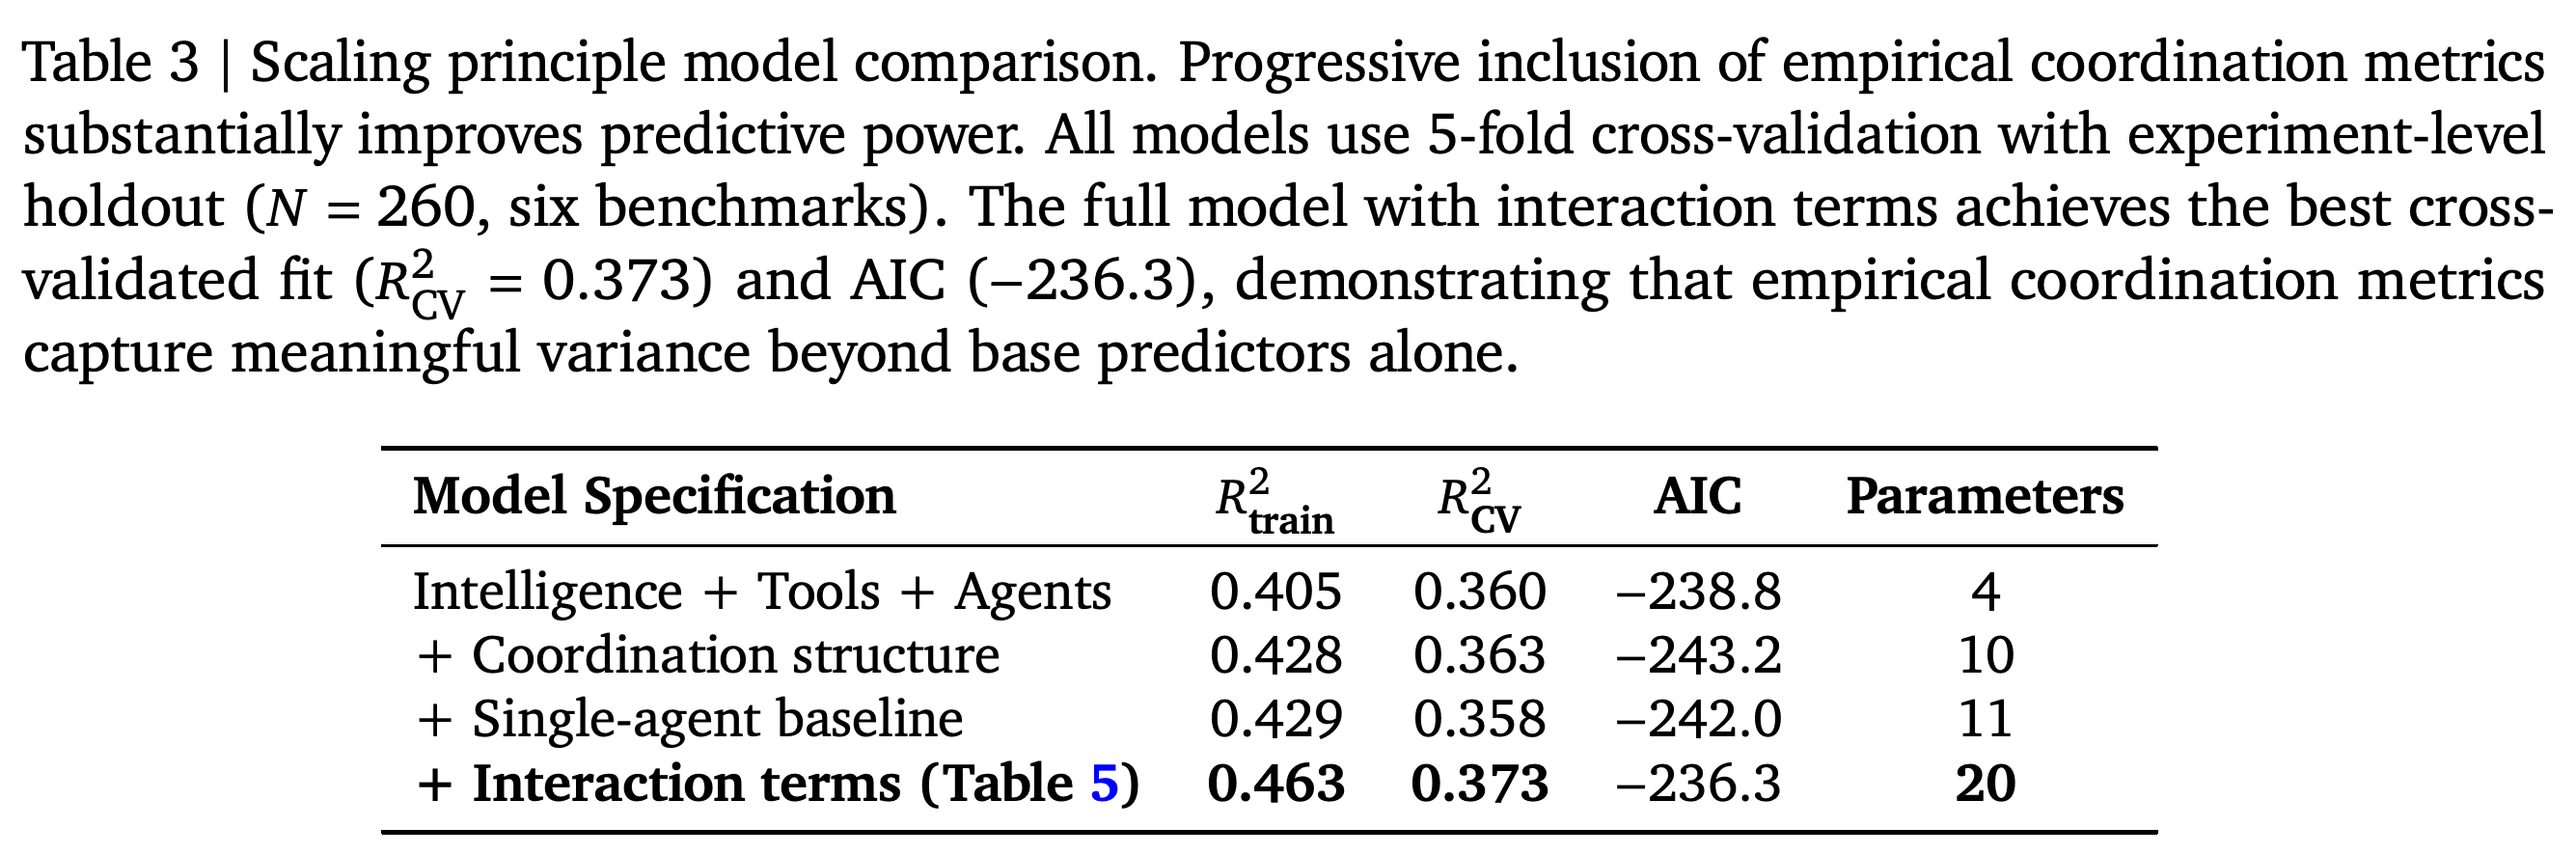
음의 기준 성능–에이전트 상호작용과 효율–도구 상호작용은 단순 OLS에서 초기의 포화 및 도구 비용 해석을 뒷받침한다. 에이전트 수 자체, 능력의 제곱항, 오류 증폭의 주효과는 유의하지 않다. 이후 강건성 검사에서는 처음에 유의했던 일부 항의 근거가 약해진다.
4.4. Coordination Efficiency, Error Dynamics, and Information Transfer
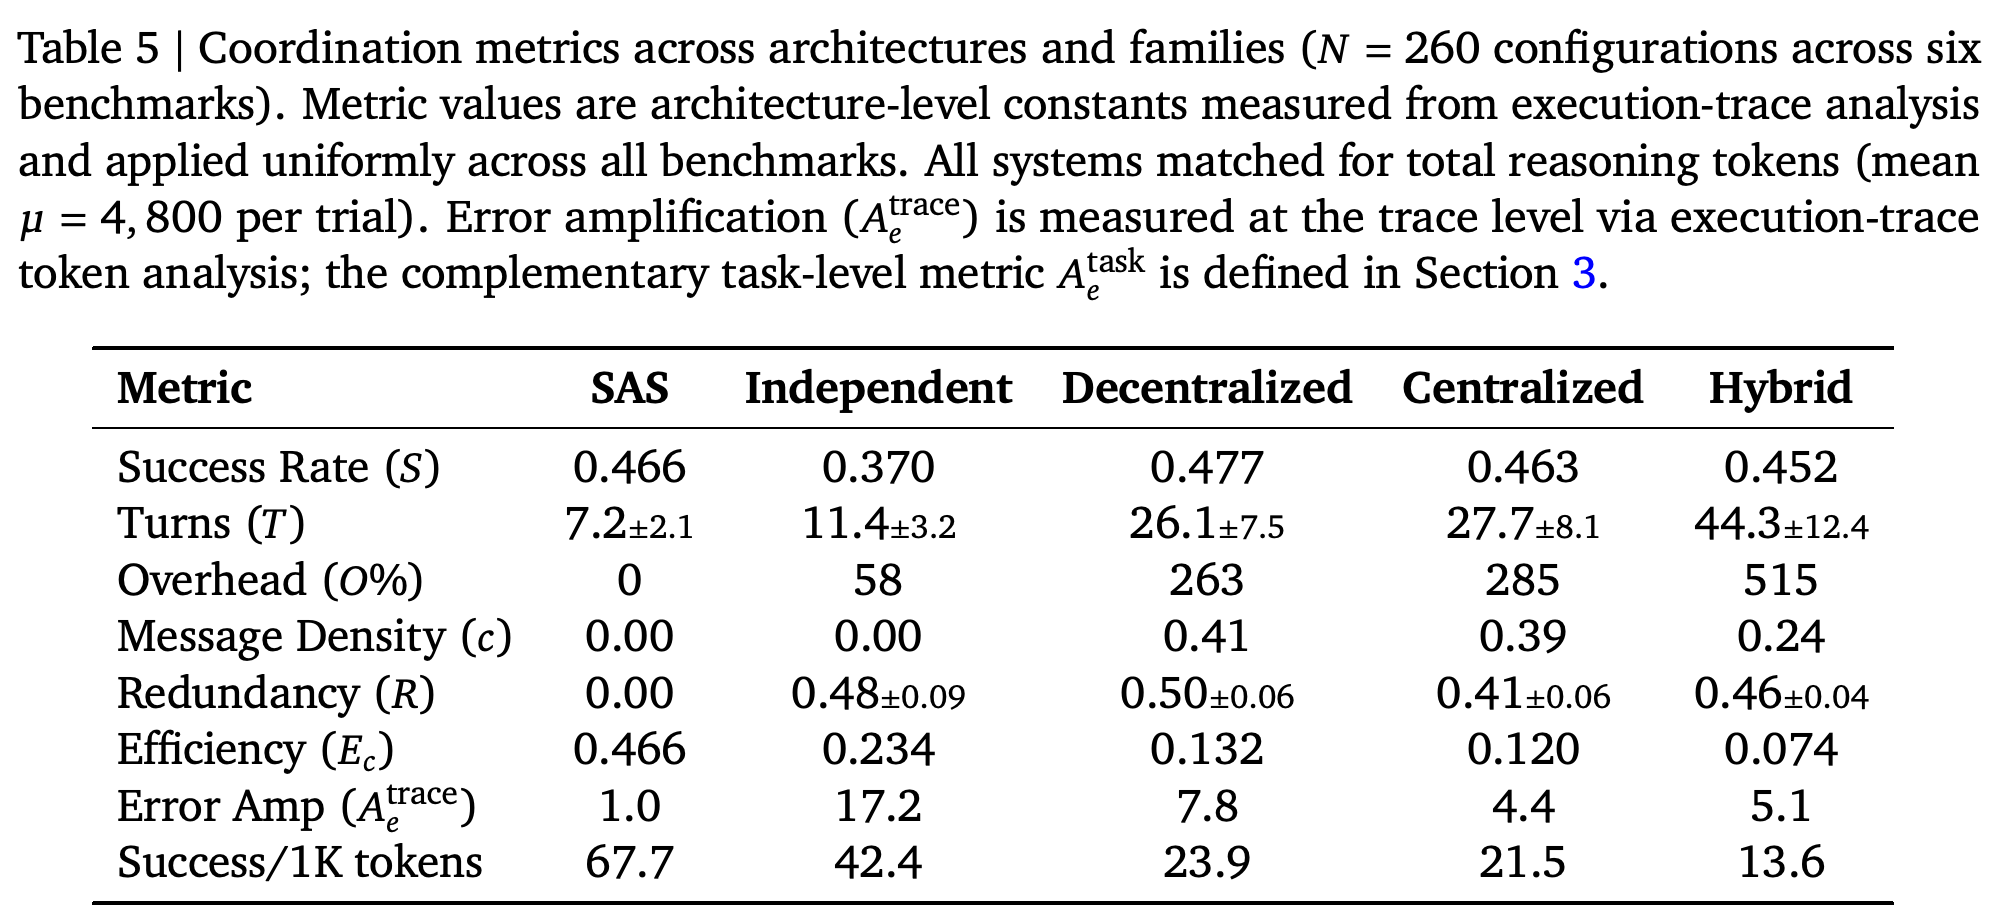
실행 기록은 상당한 조정 비용을 보여준다. 평균 턴 수는 SAS의 7.2에서 Independent의 11.4, Decentralized의 26.1, Centralized의 27.7, Hybrid의 44.3으로 늘어난다. 이에 대응하는 오버헤드는 58%, 263%, 285%, 515%다. 조정 효율은 SAS의 0.466에서 각각 0.234, 0.132, 0.120, 0.074로 낮아진다.
- 아키텍처별로 집계한 평균에 적합한 기술적 관계식은 T = 2.72 × (n + 0.5)^1.724, R² = 0.974이며, 지수의 신뢰구간은 [1.685, 1.763]이다. 같은 팀 규모에서도 아키텍처 사이의 차이가 커서 이를 에이전트 수에 관한 일반 법칙으로 해석하기는 어렵다. 메시지 밀도의 적합식도 통신하는 MAS 구성만 설명한다.
- 실행 기록 수준의 오류 증폭은 SAS의 1.0을 기준으로 Independent 17.2, Decentralized 7.8, Centralized 4.4, Hybrid 5.1이다. 검증이 있는 아키텍처는 사실 오류를 평균 22.7% 줄이는 것으로 보고되며, 95% 신뢰구간은 [20.1%, 25.3%]다. 다만 다른 지표를 통제하면 오류 증폭의 회귀 주효과는 유의하지 않다.
- 조정 이후 과제 불확실성이 얼마나 줄었는지 추정한 정보 이득은 구조화된 영역에서 협업 이득과 상관을 보인다(r = 0.71, p < 0.001). Finance Agent의 성공 시행은 평균 1.4 bits, 실패 시행은 0.4 bits다. 다른 영역에서는 관계가 약해 일반화에 한계가 있다.
Decentralized의 전체 성공률은 0.477로 SAS의 0.466보다 약간 높지만 턴 수는 7.2에서 26.1로 늘어난다. Hybrid는 오버헤드가 515%로 가장 높고 조정 효율은 0.074로 가장 낮다. Centralized의 실행 기록 수준 오류 증폭은 4.4이며 Independent는 17.2다. 이 예측 변수들은 모든 벤치마크에 동일하게 적용하는 아키텍처 수준의 상수다.
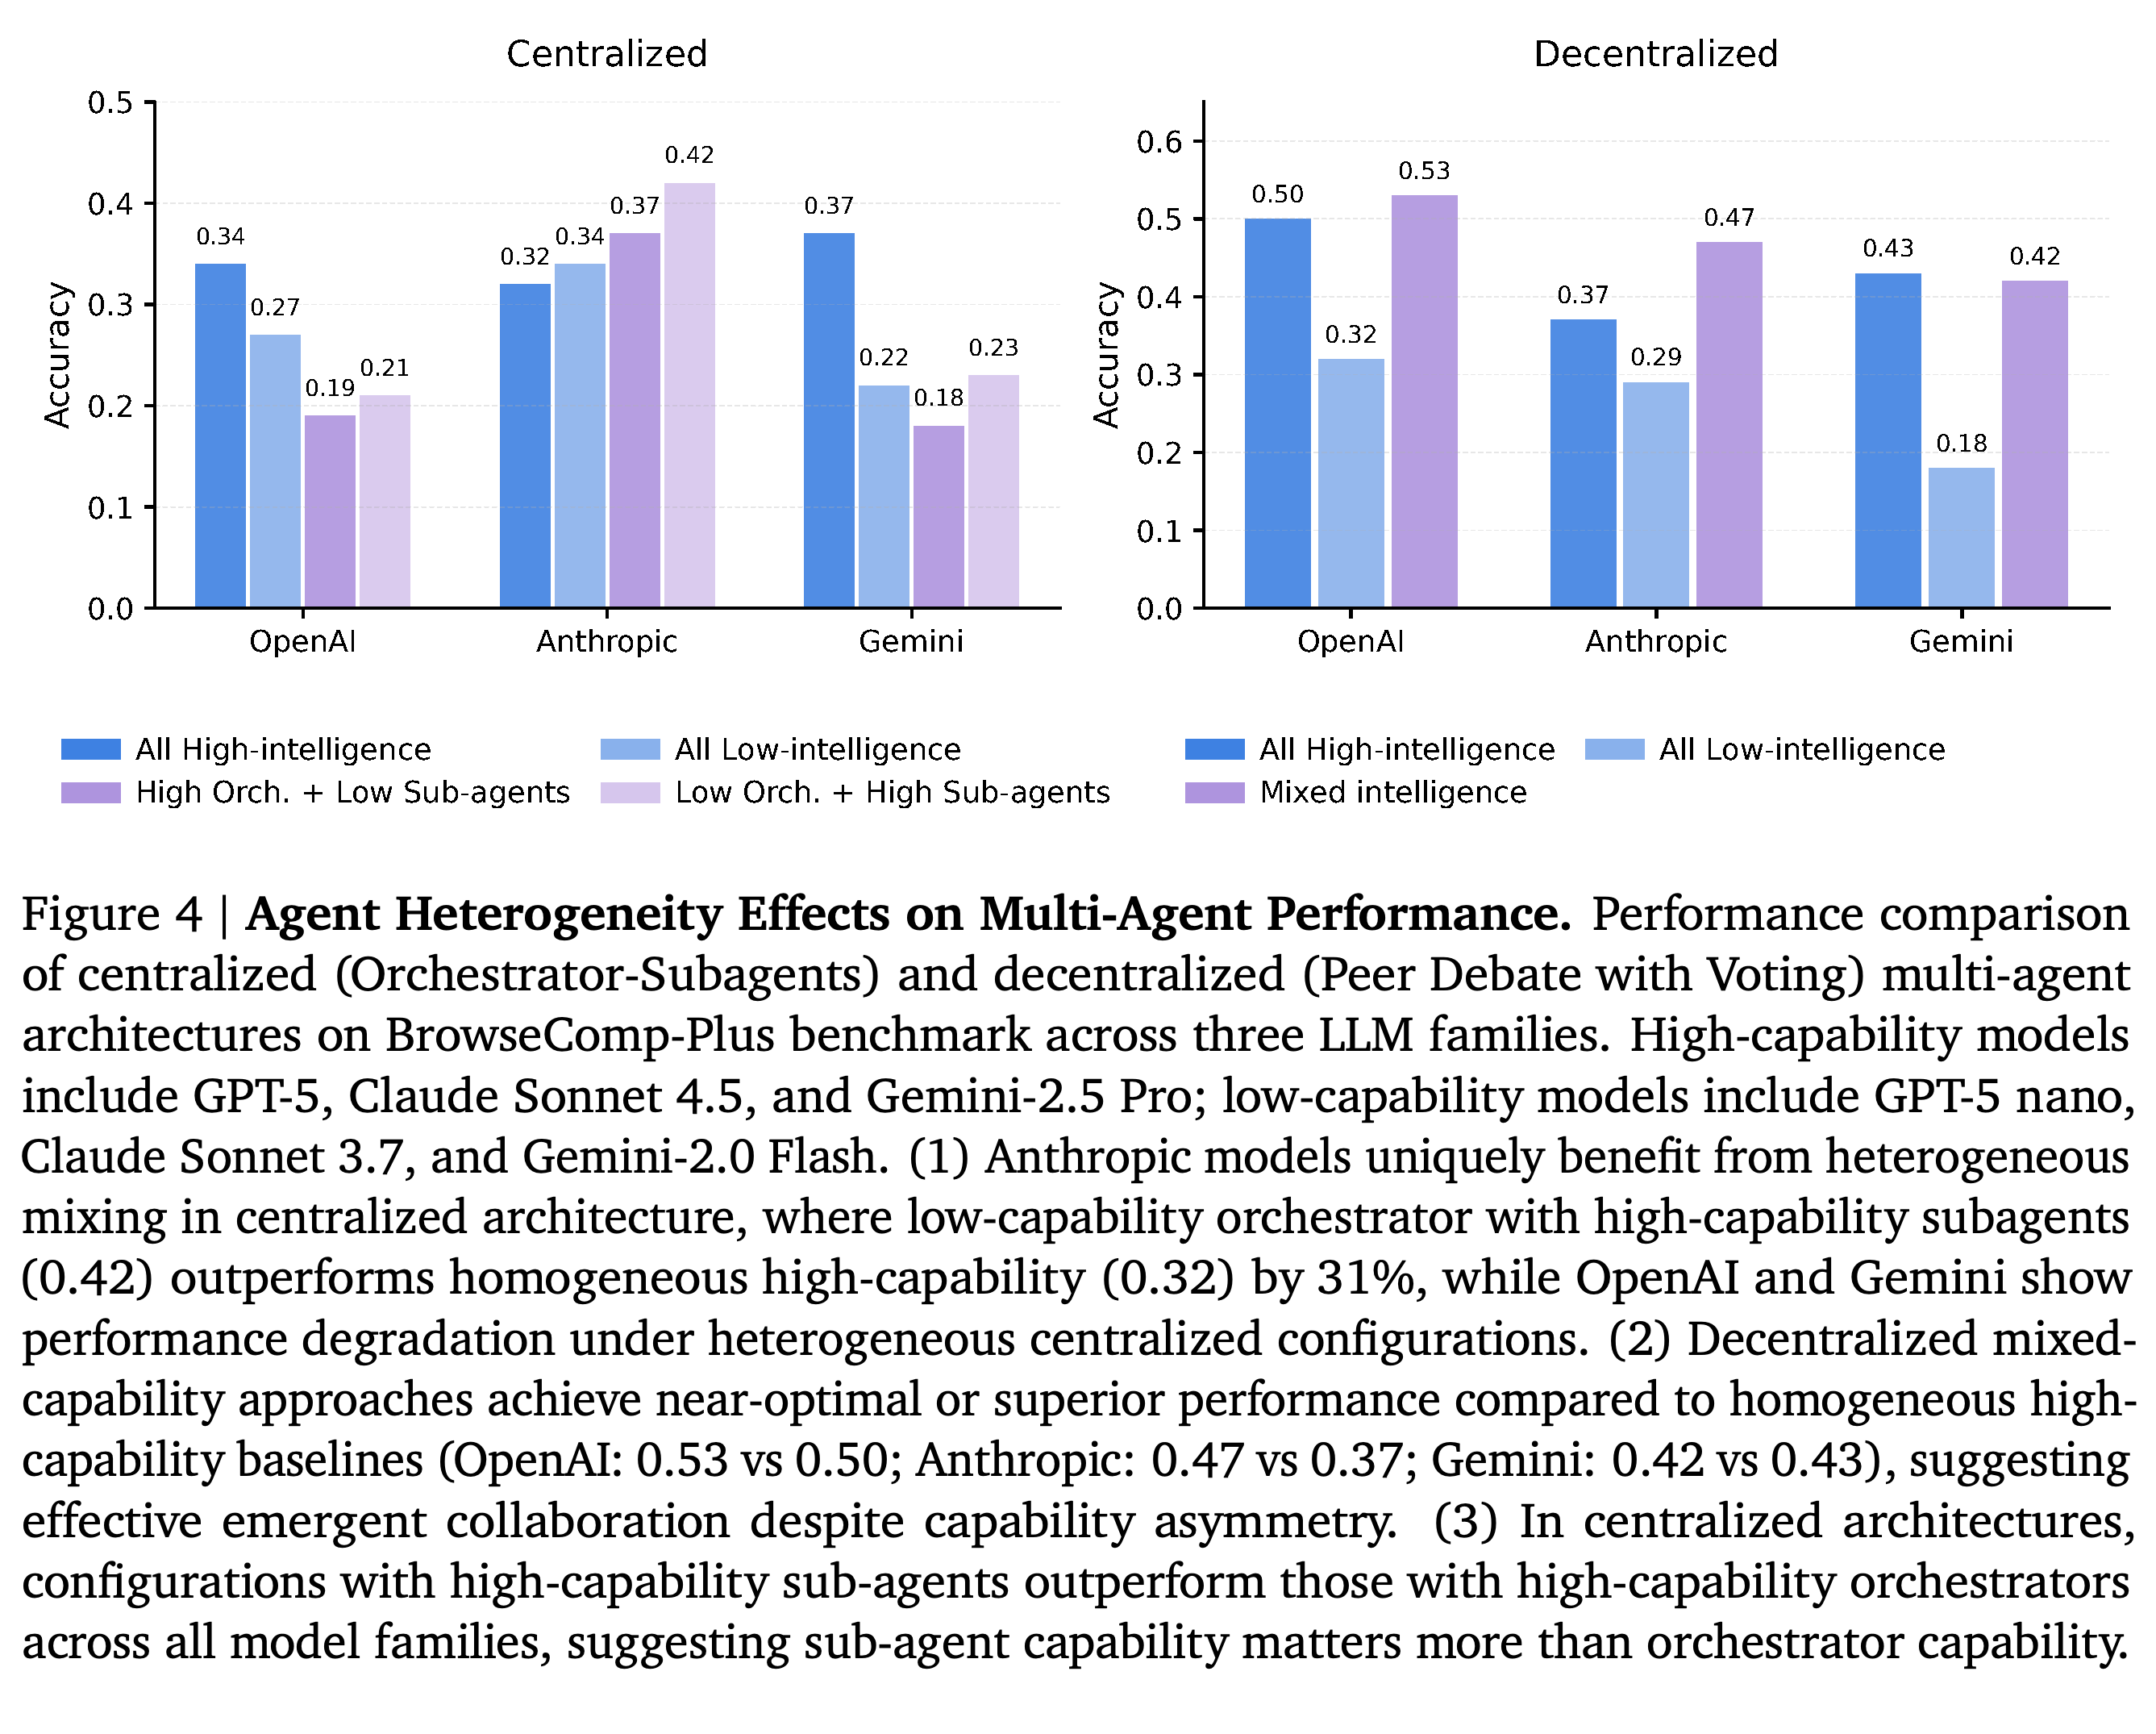
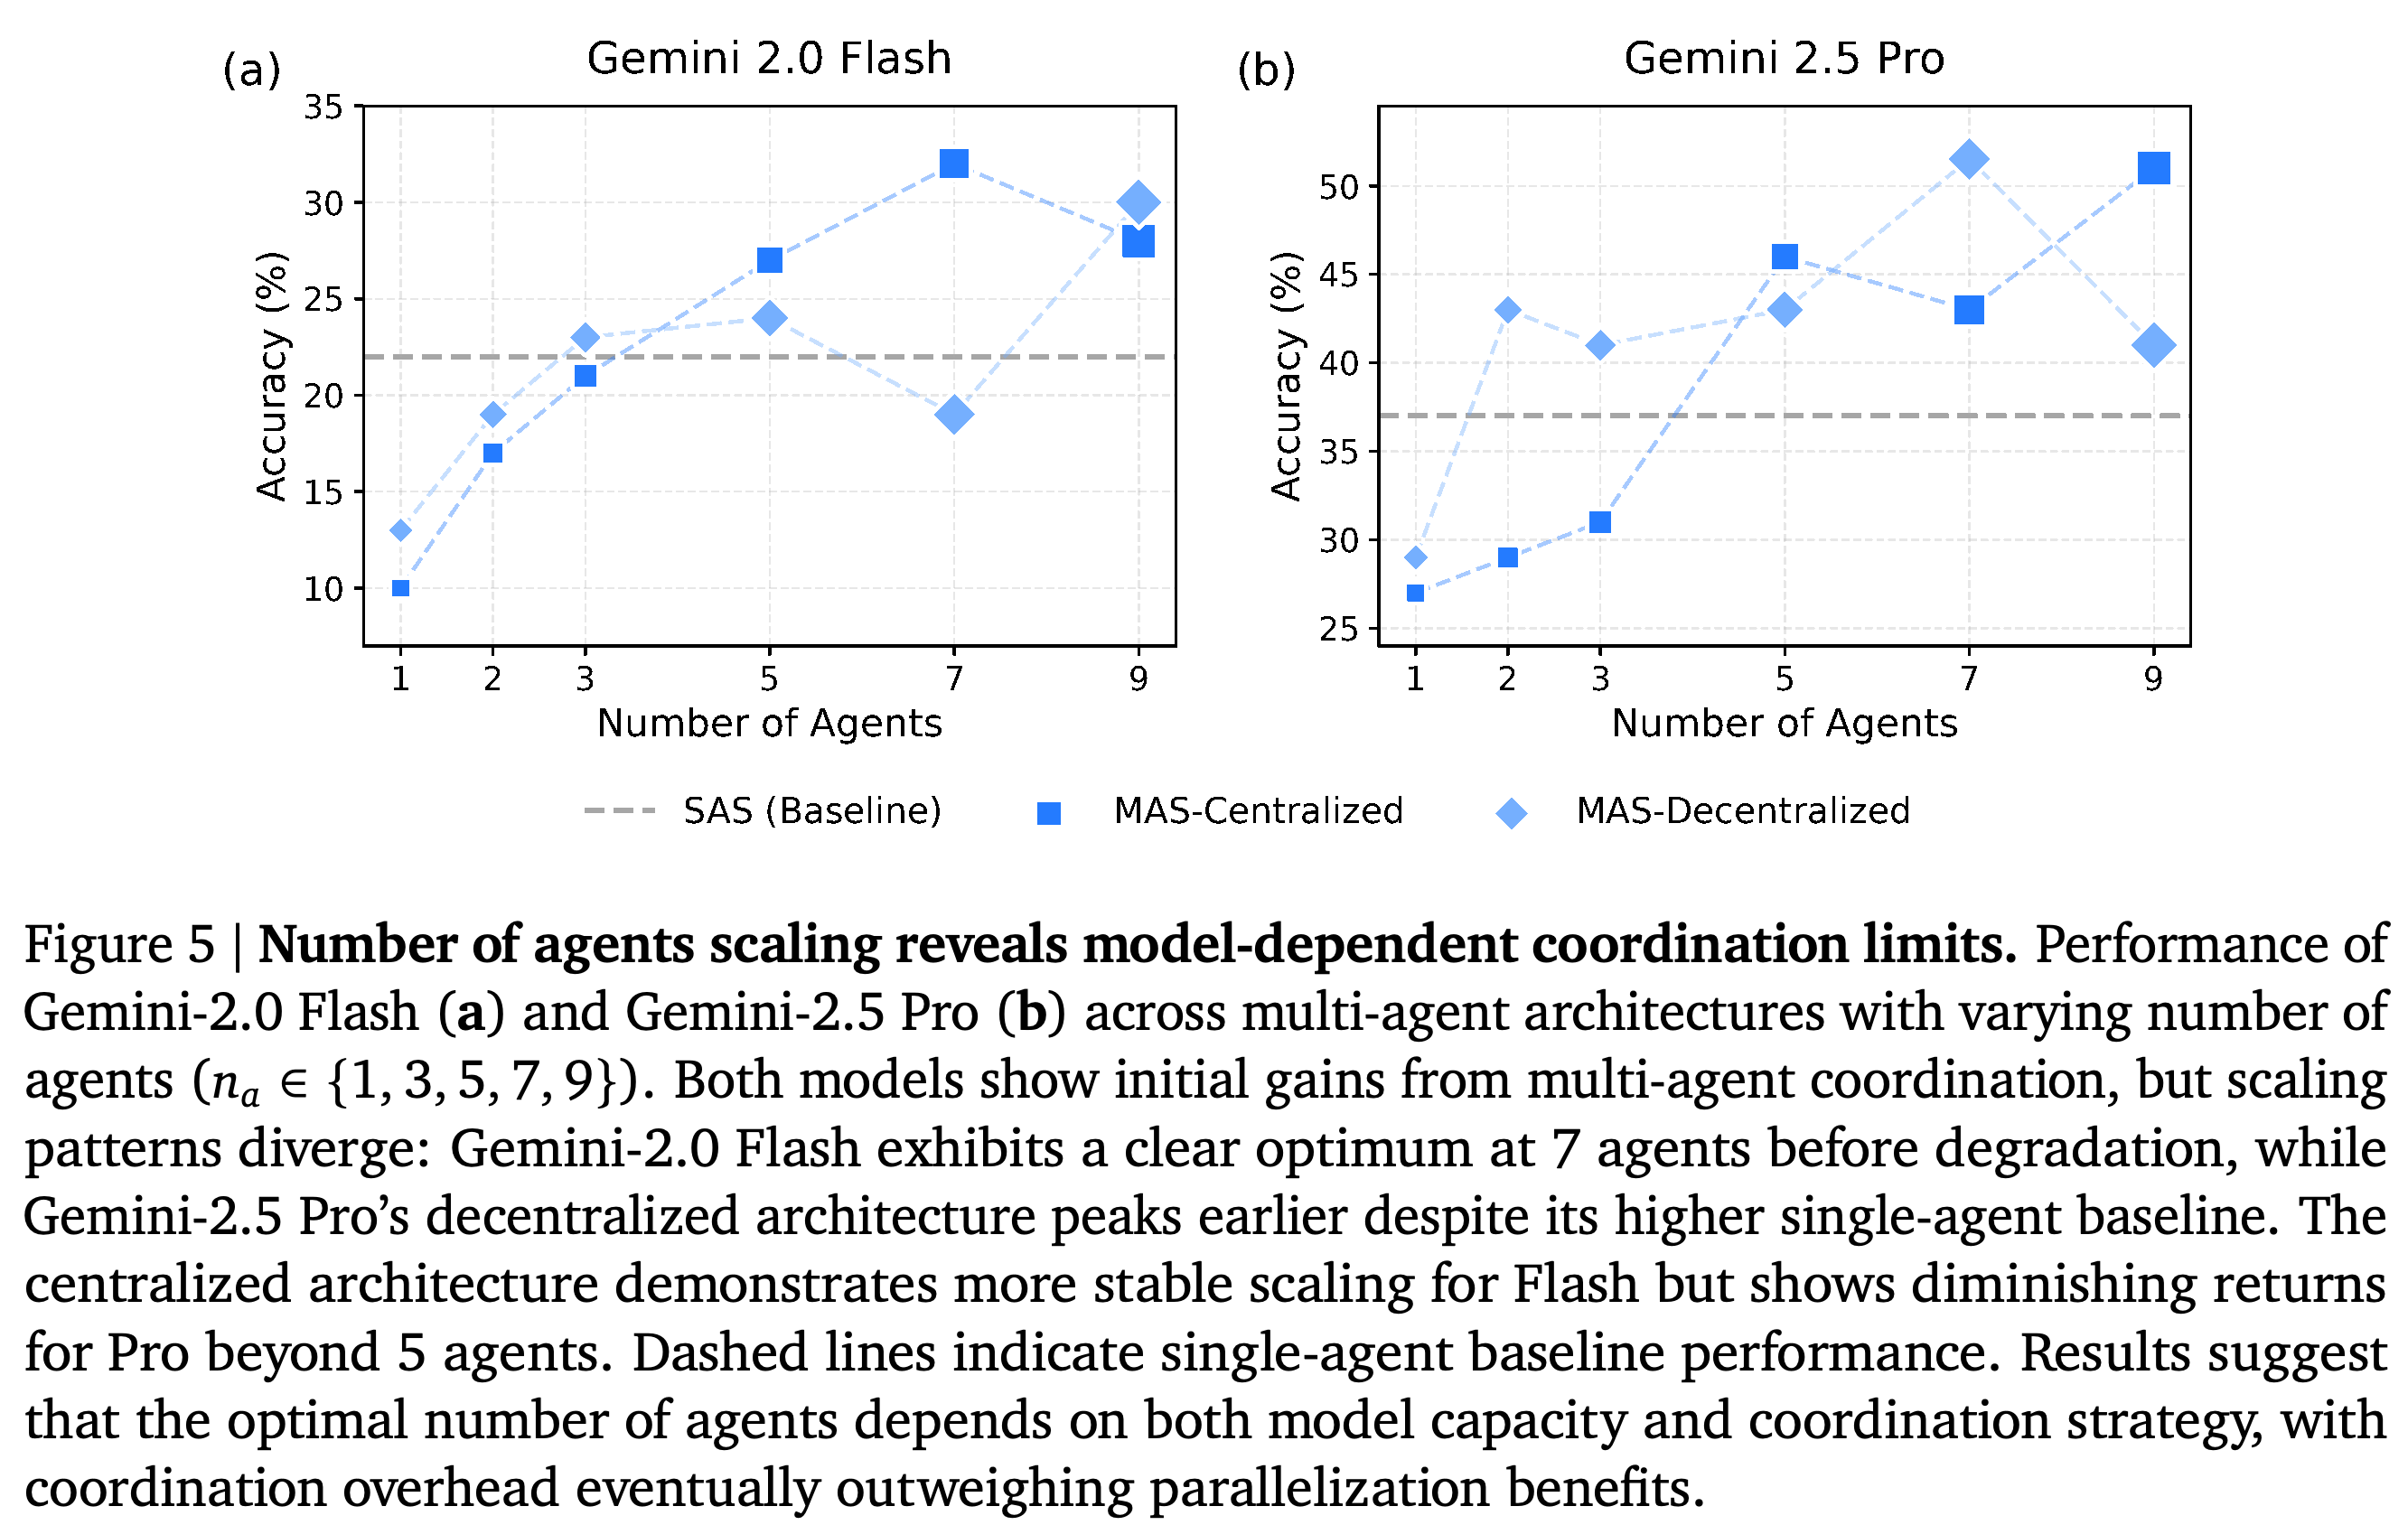
탐색적 실험은 서로 다른 능력의 모델을 사용하는 에이전트로 구성된 이질적 팀과 더 큰 팀 규모를 살펴본다. BrowseComp-Plus에서 Figure 4는 모델 혼합이 일부 Decentralized 구성과 Anthropic의 Centralized 역할 배치 1개에 도움이 될 수 있음을 보여준다. Figure 5는 에이전트를 추가할 때 모델에 따라 불규칙한 반응이 나타남을 보여준다.
- Figure 4에서 Anthropic은 낮은 능력의 오케스트레이터와 더 강한 작업자를 결합할 때 정확도 0.42를 기록하며 모두 높은 능력의 모델로 구성한 팀은 0.32다. Table 12는 강한 모델의 기준 성능을 다르게 설정해 같은 혼합 구성의 차이를 −0.01로 제시한다. 이 불일치 때문에 이득의 크기를 단정하기 어렵다.
- 더 큰 팀의 그래프에는 성능 하락과 이후 회복이 나타나며, Gemini-2.5 Pro Centralized도 에이전트 9개에서 회복한다. 이는 아키텍처별 민감성을 뒷받침하며 특정 팀 규모가 보편적 최적점임을 입증하지는 않는다.
- 메시지 해석, 과제 배분, 상태 동기화 오류를 포함한 조정 실패율은 Hybrid가 12.4%로 가장 높고, Centralized는 1.8%, Decentralized는 3.2%다. 논문은 모델 내부 메커니즘을 분리해 검증하지 않았으므로 공급자별 차이를 경험적 특성으로 다룬다.
혼합된 Decentralized 팀은 OpenAI와 Anthropic에서 모두 높은 능력의 모델로 구성한 기준 팀과 같거나 더 높은 성능을 보인다. 반면 Centralized에서 모델을 혼합하면 OpenAI와 Gemini의 성능이 낮아진다. Anthropic의 Centralized 예외는 더 약한 오케스트레이터와 더 강한 작업자를 사용하지만 강한 모델의 기준 성능이 Table 12와 달라 이득의 크기를 단정하기 어렵다.
Gemini-2.0 Flash Centralized는 에이전트 7개에서 정점에 도달한 뒤 9개에서 하락하지만 Decentralized 곡선은 9개에서 표시된 최고값에 도달한다. Gemini-2.5 Pro는 변동하며 Decentralized는 7개에서 정점에 도달하고 Centralized는 9개에서 회복한다. 이 곡선들은 모델과 아키텍처에 따라 양상이 달라짐을 뒷받침한다. 그래프 축에는 에이전트 2개도 포함되어 있지만 원문 캡션이 나열한 집합에서는 이 값이 빠져 있다.
4.5. Robustness and Sensitivity Analysis
강건성 검사는 벤치마크 6개 각각에 속한 구성 사이의 의존성과 예측 변수 계수 19개를 검정하는 문제를 고려한다. 데이터셋 안의 관측값 사이에 상관을 허용하는 불확실성 추정치인 군집 강건 표준오차는 단순 OLS 대비 최대 2.9× 커진다. Table 14에서는 single_agent_baseline이 p = 0.004, error_x_baseline이 p = 0.030으로 유의성을 유지한다.
- 동시에 수행하는 검정 전반에서 거짓 양성을 통제하는 Holm–Bonferroni 보정 후에도 log_tools는 p_Holm < 0.001, single_agent_baseline은 0.018, efficiency_x_tools는 0.026으로 유의성을 유지한다. 이 보정은 단순 OLS의 p값을 사용하며 군집화와 별도로 보고된다.
- 음의 baseline_x_agents 상호작용은 군집 강건 추론에서 p = 0.105, Holm 보정에서 p_Holm = 0.084로 모두 통상적인 유의성을 잃는다. 따라서 저자들의 능력 포화 해석에는 조건을 붙여야 한다. 임계값 도출에 사용한 바로 그 상호작용이 어느 보정에서도 유의성을 유지하지 못한다.
- 논문은 SWE-bench Verified와 Terminal-Bench의 모델×벤치마크 구성 16개에서 약 45% 임계값과 94%의 일치율을 보고하며 p < 0.001이다. 본문은 군집 강건 추론에서 single_agent_baseline만 유의성을 유지한다고도 서술하지만 이는 error_x_baseline을 유의하게 제시한 Table 14와 충돌한다.
5. Limitations
이 연구는 대표적인 조정 패턴과 최대 에이전트 9개까지의 예비 확장 실험을 다룬다. 전문화된 팀이나 더 큰 팀의 전체 설계 공간을 포괄하지는 않는다. 과제 프롬프트를 공유하면 비교를 더 잘 통제할 수 있지만 별도 프롬프트 최적화로 이득을 얻을 아키텍처나 모델 계열에는 불리할 수 있다.
- SWE-bench Verified와 Terminal-Bench는 각각 사례 20개만 사용한다. 관측값을 재표집해 얻는 불확실성 범위인 부트스트랩 구간은 재표집 10,000회를 사용하며 보통 셀별로 약 ±20 percentage points에 걸쳐 있다. 따라서 개별 아키텍처 비교의 검정력이 부족하다.
- 텍스트 기반 벤치마크 영역 6개만으로는 물리적 환경에서 행동하는 체화 시스템, 여러 데이터 유형을 다루는 멀티모달 상호작용, 실제 환경의 피드백 루프, 장기간의 시간적 의존성으로의 전이를 입증할 수 없다. 모델 혼합 검사는 예비 단계이며 전문화된 팀이 포화를 극복한다고 입증하지는 않는다.
- 통계 분석을 뒷받침하는 데이터셋 군집은 6개뿐이다. 자연어 통신에도 비용과 지연이 발생한다. 다른 통신 표현이나 라우팅 정책을 사용하면 확장 양상이 달라질 수 있다.
6. Conclusion
결론은 능력 포화를 저자들이 가장 확실한 근거가 있다고 해석하는 패턴으로 제시하고 도구 관련 부담과 실행 기록 수준의 오류 증폭을 추가적인 방향성 패턴으로 설명한다. 통제된 비교는 조정 이득이 과제 구조에 따라 달라짐을 보여준다. 예측 모델의 아키텍처 선택 근거는 평가한 과제 유형 안에서 학습에서 제외한 구성에 대해 가장 강하다. 최신 모델 결과는 BrowseComp-Plus 안에서 수치 예측에 관한 예비 근거만 제공한다.
Data Availability
논문은 공개 벤치마크 출처로 BrowseComp-Plus(https://arxiv.org/abs/2508.06600, 사례 100개), Finance-Agent(https://arxiv.org/abs/2508.00828, 사례 50개), PlanCraft(https://arxiv.org/abs/2412.21033, 사례 100개), Workbench(https://arxiv.org/abs/2405.00823, 사례 100개)를 제시한다. SWE-bench Verified(https://www.swebench.com/)는 시드 42로 결정론적으로 섞어 사례 500개 중 20개를 선택한다. TerminalBench(https://www.tbench.ai/)는 사례 86개 중 처음 20개를 사용하며 사례별 결과는 etc/analysis/에 보고한다.
Code Availability
저장소 https://github.com/ybkim95/agent-scaling에는 평가 프레임워크, 구성, 프롬프트 템플릿, 분석 스크립트, 민감한 정보를 제거한 대표 실행 기록이 포함되어 있다. 논문은 완전한 재현에 필요한 추가 자료를 저장소 문서에서 확인하도록 안내한다.
부록
- A. Model Intelligence Index는 Artificial Analysis Intelligence Index(https://artificialanalysis.ai/evaluations/artificial-analysis-intelligence-index)를 확장하는 방법을 설명한다. 공개되지 않은 모델 점수는 Intelligence Index v3.0에 맞춘 동일 가중치 공식으로 재구성하며 별표가 붙은 구성 요소 점수는 추정치다. 저자들은 비공개 테스트를 사용할 수 없다는 점, 비결정성, 장문맥 평가의 근사성을 인정한다.
- B. Out-of-Sample Validation은 BrowseComp-Plus에서 GPT-5.2, Gemini-3.0 Pro, Gemini-3.0 Flash를 평가한다. 모두 Intelligence Index = 75로, 모델 적합에 사용한 42–71 범위를 벗어난다. 예측 15개에서 예측 성공률과 관측 성공률의 절대 차이를 평균한 mean absolute error(MAE)는 전체 0.077, MAS 0.061, SAS 0.138이다. 그러나 방정식은 모델 3개 모두에서 Hybrid가 최선이라고 예측하지만 실제로는 Centralized나 Decentralized가 가장 좋다. Hybrid의 평균 상대 예측 오차는 +37.0%다. 수치 예측이 관측값에 비교적 잘 맞는다고 최신 모델의 아키텍처 선택까지 성공했다고 볼 수는 없다.
- C. Domain Complexity, C.1. Complexity Score Assignment, C.2. Domain Characterisation은 순차적 상호의존성, 실행 중 환경 변화의 정도인 상태 공간 복잡도, 관찰된 조정 오버헤드 민감도로 서열형 점수 D ∈ [0, 1]을 정의한다. 점수는 Workbench 0.000, Finance Agent 0.407, PlanCraft 0.419, BrowseComp-Plus 0.839, SWE-bench Verified 0.255, Terminal-Bench 0.414다. C.3. Critical Threshold는 D ≈ 0.40을 제안한다. 하지만 이 값보다 높은 금융 과제에서는 이득이 발생하고 낮은 소프트웨어 과제에서는 성능이 떨어지며, MAS 결과에 맞춰 점수를 보정했으므로 독립적인 사전 선택 규칙으로서의 가치는 제한된다.
- D. Datasets는 벤치마크 과제와 채점 방식을 명시한다. 금융 전문가의 평가 기준, 웹 답변 평가, 예상 직장 업무 함수 호출 순서, 단계 제한 안에서의 Minecraft 제작 성공, 테스트를 통과하는 저장소 패치, 객관적인 터미널 과제 완료를 사용한다. E. Implementation Details와 E.1. Technical Infrastructure는 공급자 인터페이스용 LiteLLM(https://www.litellm.ai/), 오케스트레이션용 LangChain(https://www.langchain.com/), 웹 검색용 Tavily(https://tavily.com/)와 Python 실행을 포함한 도구를 설명한다.
- E.2. Agent Configuration은 SAS의 최대 반복 횟수를 10회, Independent를 에이전트 3개, Centralized를 작업자 3개와 오케스트레이터 1개 및 최대 오케스트레이션 5라운드, Decentralized를 에이전트 3개와 토론 3라운드로 설정한다. E.3. Prompt Compilation System은 구조화된 텍스트 형식인 YAML을 템플릿과 역할별 확장에 사용한다. E.4. Evaluation Methodology는 공유 인터페이스, 일관된 문맥 잘라내기, 고정 가중치, 벤치마크 부분집합 크기를 보고한다. 부록의 아키텍처별 반복 제한만으로는 본문에서 밝힌 최대 총 반복 횟수 일치를 어떻게 보장했는지 설명되지 않는다.
- E.5. Information Gain Computation은 ΔI = 1/2 log(Var[Y|s_pre]/Var[Y|s_post])를 추정한다. Y는 이진 과제 성공 여부이며 상태는 조정 전후의 추론을 나타낸다. 출력 변동을 조절하는 샘플링 설정인 온도 τ = 0.7에서 상태마다 실행 기록 K = 10개를 샘플링하며 Var[Y|s] = p̂(s)(1 − p̂(s))를 사용한다. F. SWE-bench Verified and Terminal-Bench Results는 이질적 팀 비교, 대체 능력 지표를 사용한 적합 결과, 통계적 보정, 95% 부트스트랩 구간을 제공한다. Table 16에는 gemini-3-flash도 포함되어 있지만 본문의 설정은 이 벤치마크들에서 각각 모델 8개를 사용했다고 설명한다.
짧은 생각
Finance Agent와 PlanCraft에서 효과가 반대로 나타난 결과는 팀 규모를 늘리기 전에 과제 분해와 검증을 시험해야 할 유용한 근거다. 예측 모델은 더 신중하게 다뤄야 한다. 단순 기준 모델 대비 R² 개선 폭이 작고, 군집화를 고려하면 일부 상호작용이 약해지며, 부록에서는 최신 모델의 아키텍처 선택에 실패한다. 이 패턴을 바탕으로 실제 사용할 작업에서 비교 실험을 설계하고 약 45% 임계값과 아키텍처 순위를 검증하는 데 활용하고자 한다.