


Nexus : An Agentic Framework for Time Series Forecasting 요약 설명
14 May 2026 | Paper Review Time Series Multi-Agent Coordination Reasoning목차
- 요약
- 1. Introduction
- 2. Problem Formulation
- 3. The Nexus Framework
- 4. Experiments
- 5. Related Works
- 6. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Nexus : An Agentic Framework for Time Series Forecasting 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 14일(Arxiv)
- Das, Sarkar Snigdha Sarathi, Goyal, Palash, Parmar, Mihir, Peng, Nanyun, Tirumalashetty, Vishy, Li, Chun-Liang, Zhang, Rui, Yoon, Jinsung, Pfister, Tomas.
- Google, Pennsylvania State University
- 논문 링크
요약
- Nexus : An Agentic Framework for Time Series Forecasting은 수치 이력과, 사용 가능한 경우 타임스탬프가 있는 텍스트 맥락을 결합하는 파이프라인을 제안한다. 파이프라인은 전적으로 LLM으로 작동한다. 전체 작업을 1개의 프롬프트에 맡기는 대신 과거 맥락 구성, 거시적·미시적 예측, 최종 종합을 분리한다.
- Calibration agent는 모델 파라미터를 업데이트하지 않고 과거 예측 오차를 검토해 예측 지침을 생성한다. 과거 fold에서 공통으로 도출한 지침은 별도로 남겨 둔 검증 fold에서 성능을 최소 5% 개선할 때만 사용한다. 실험에서는 백테스트 분할 6개를 사용한다.
- Gemini-3.1-Pro와 Claude-4.5-Sonnet을 사용해 US 대도시권 15곳의 Zillow 주간 매물 재고 수와 주식 7종목의 주간 종가를 평가한다. 보고된 모든 모델·데이터셋·입력 조합에서 Nexus는 CoT baseline보다 예측 구간 평균 MAPE와 RMSE가 낮다. 다만 개별 예측 구간에서는 예외가 있으며, TimesFM-2.5와의 비교는 수치만 사용하는 예측으로 제한한다.
- 서로 다른 모델을 평가자로 사용하는 비교에서 Nexus 설명의 전체 선호 승률은 모델과 데이터셋에 따라 63.5%–97.1%다. 다만 데이터셋 2개, 1회 실행 평가, 서로 다른 설명 길이 지시, 인과 검증의 부재로 인해 근거의 범위가 제한된다.
1. Introduction
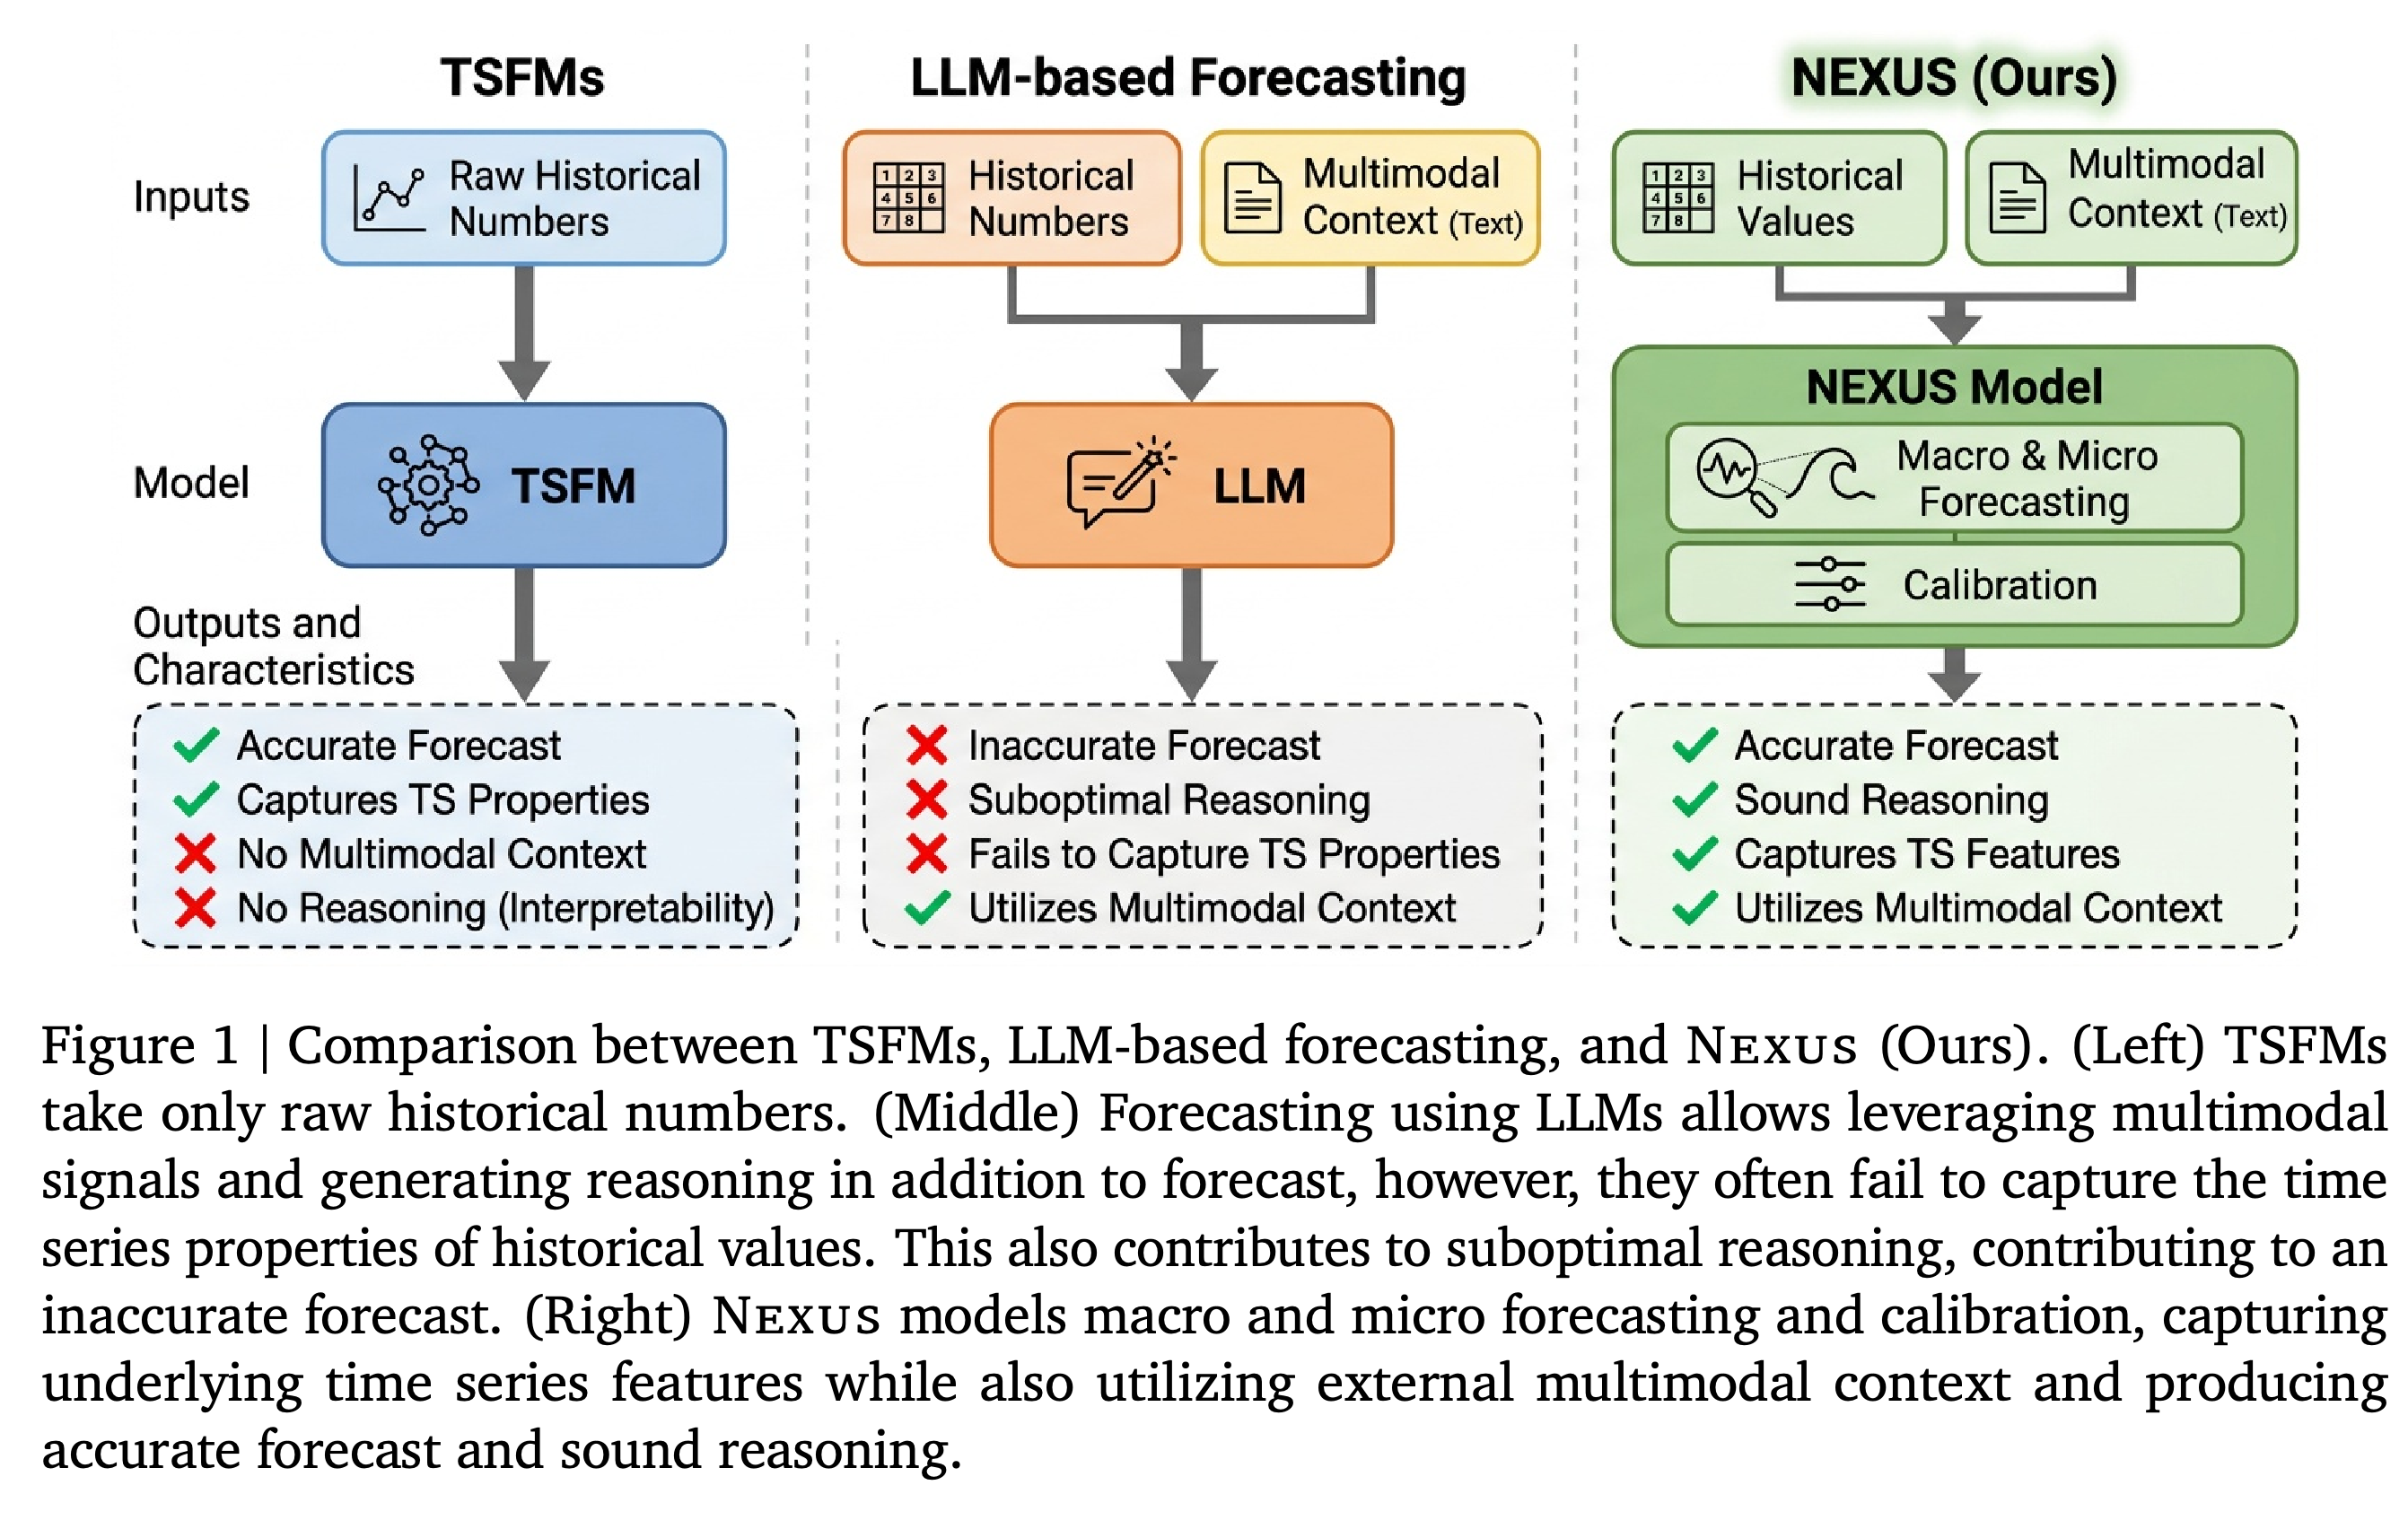
서론은 수치 예측과 맥락 해석 사이의 차이를 지적한다. Time Series Foundation Models (TSFMs)는 시간적 패턴을 포착하지만 비정형 텍스트 근거를 직접 처리하지 못한다. 반면 직접 프롬프트를 받은 LLM은 텍스트를 해석할 수 있지만 수치의 변화 양상을 다루는 데 어려움을 겪는다. Figure 1은 통계 모델 사이에서 결과를 선택하는 대신 작업을 분해해 이러한 능력을 결합하는 방법으로 Nexus를 제시한다.
- 저자들은 Nexus를 모델 선택, 진단, 도구 사용을 주로 자동화하는 agentic 시스템과 구분한다. Nexus에서는 텍스트 근거와 시간적 추론이 예측에 직접 기여한다.
- 제안하는 기여는 개괄적 전망과 세부 전망의 분리, 이들을 최종 예측으로 종합하는 과정, 과거 오차 피드백을 통한 종합 전략의 조정이다.
이 도식은 설계상의 상충 관계를 제시한다. 수치 기반 TSFM은 시간적 구조를 모델링하고, 직접 프롬프트를 받은 LLM은 텍스트를 입력받으며, Nexus는 별도의 시간적 전망과 calibration을 추가한다. 체크 표시는 측정으로 보장된 성질이 아니라 저자들의 개념적 구분을 나타낸다. 실험 표에는 예측 구간별 예외가 존재한다.
2. Problem Formulation
이 작업은 단변량 수치 이력 X₁:τ와 이에 정렬된 텍스트 관측 E₁:τ를 받아 과거 맥락 (\mathcal{C}{1:\tau}=(\mathbf{X}{1:\tau},\mathbf{E}{1:\tau}))를 구성한다. 다음 T개 시점의 값과 자연어 설명을 출력하며, 이 관계는 (\mathcal{F}(\mathbf{X}{1:\tau},\mathbf{E}{1:\tau})\rightarrow(\mathbf{X}{\tau+1:\tau+T},\mathbf{R}))로 나타낸다. 논문은 이러한 설명을 인과적 근거로 표현하지만, 평가는 인과 효과를 식별하기보다 개연성과 일관성을 측정한다.
3. The Nexus Framework
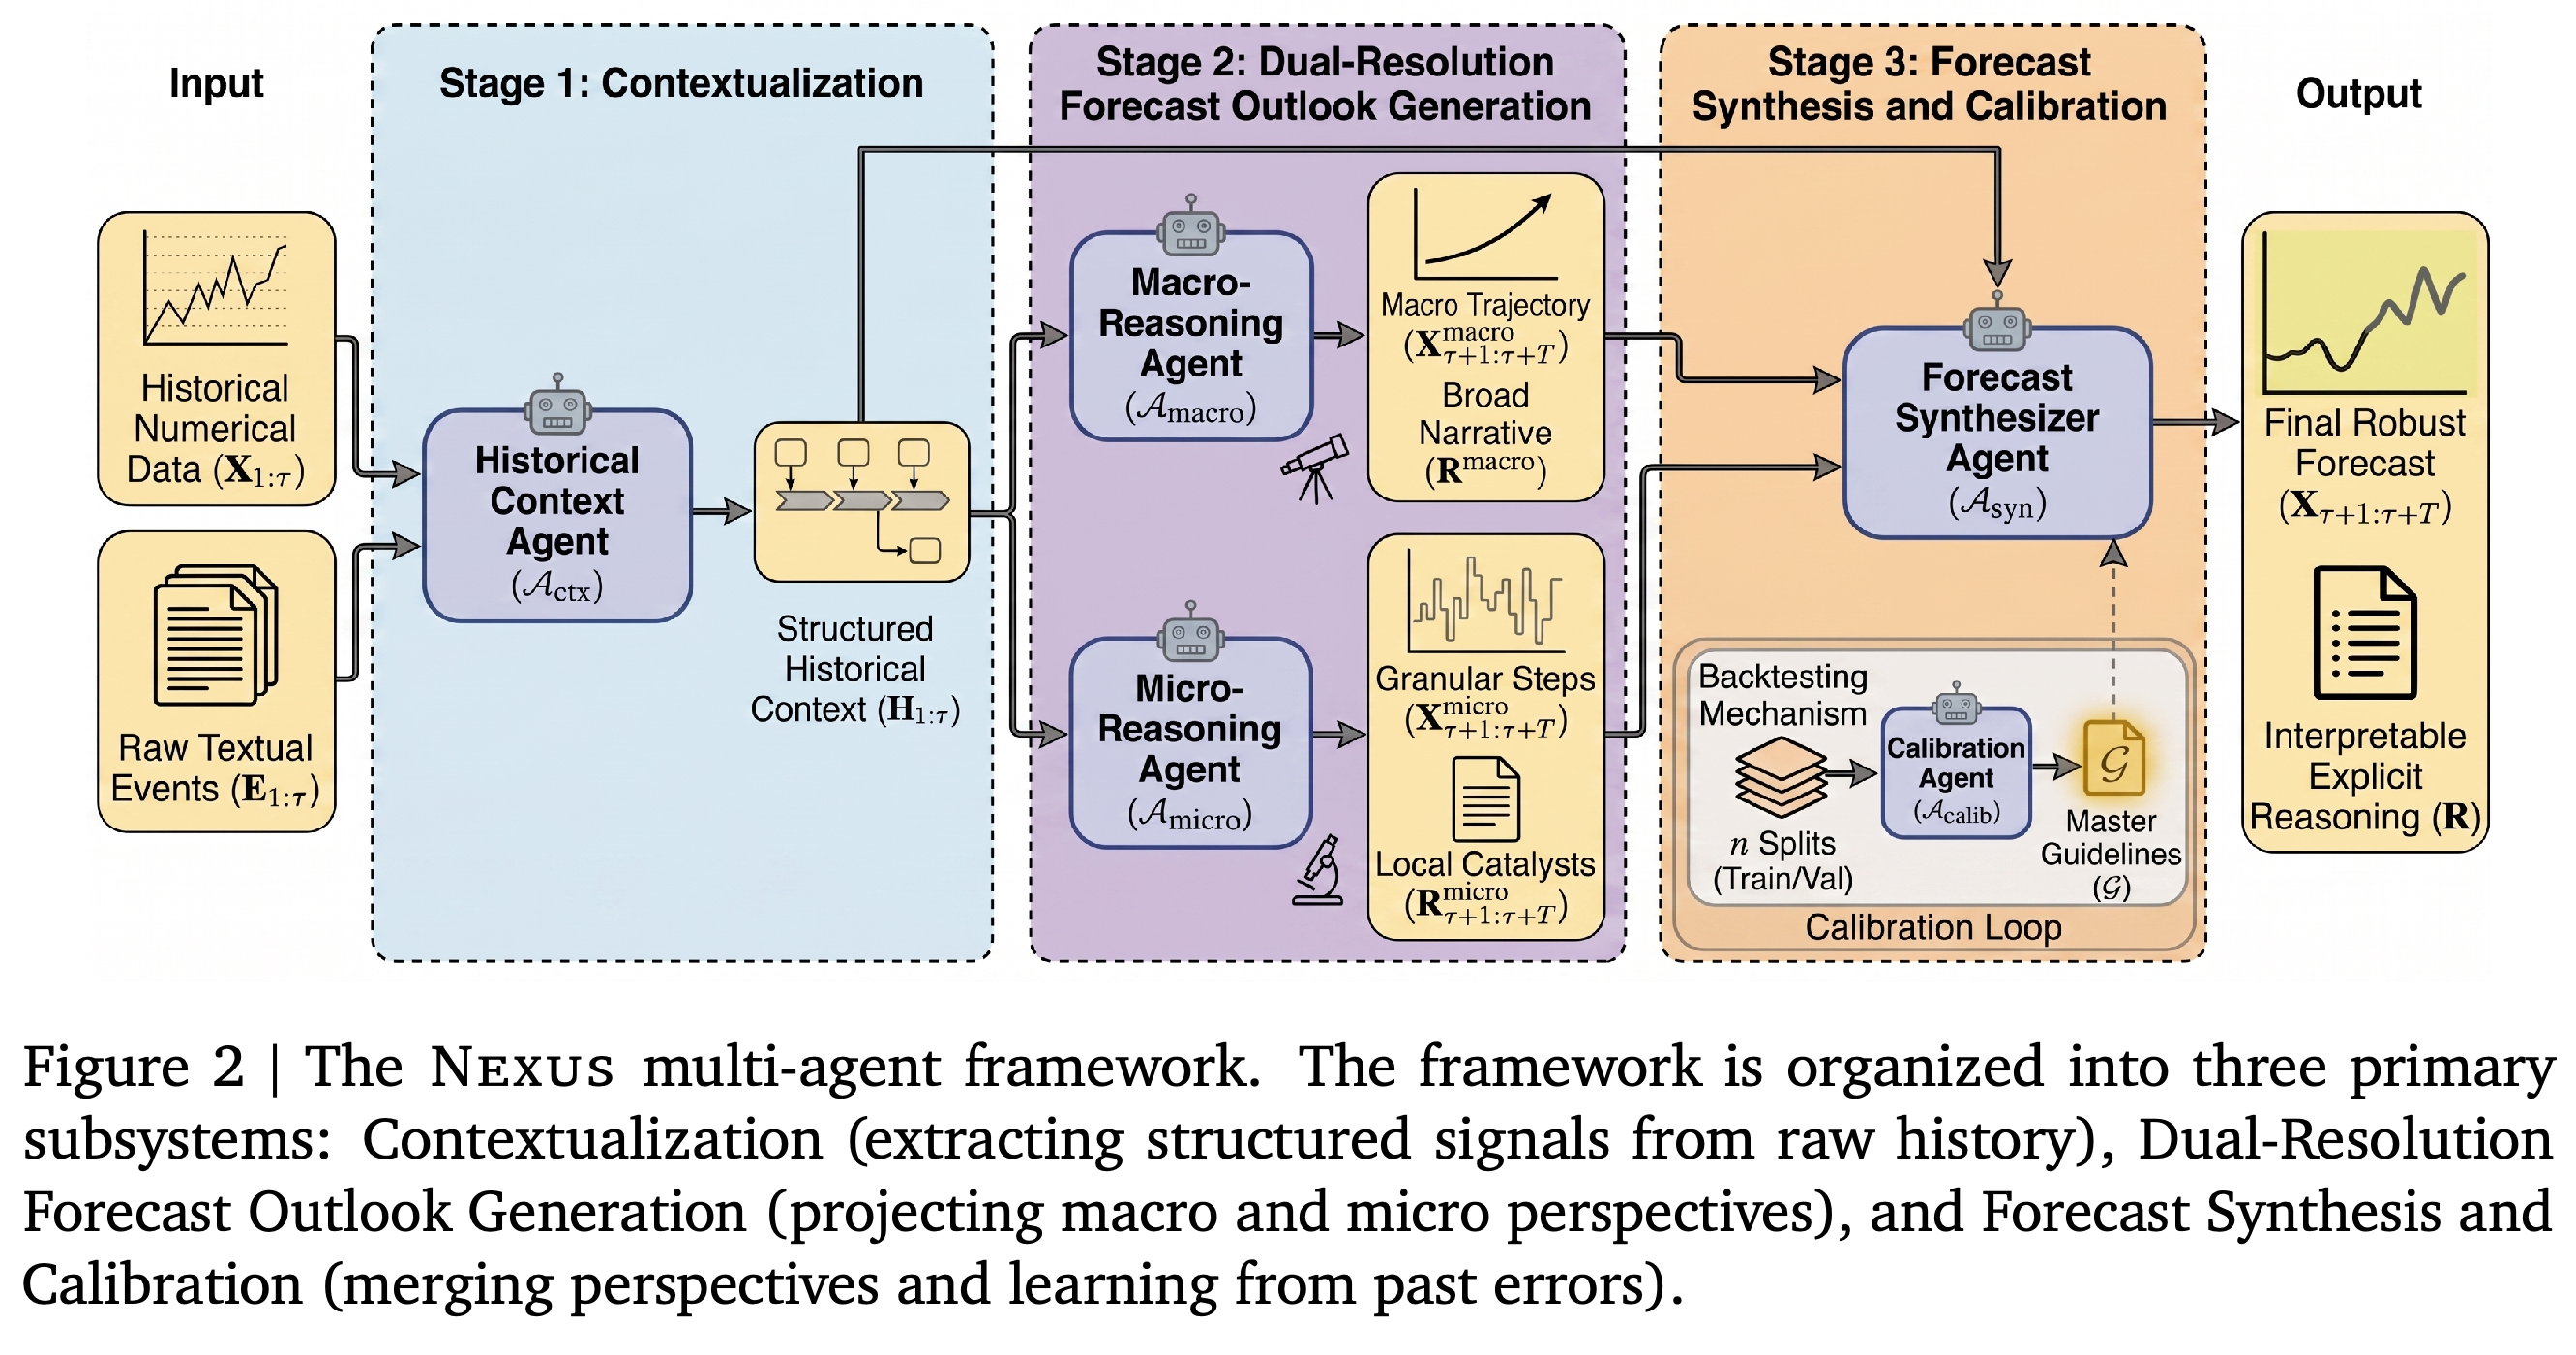
Nexus는 Contextualization, Dual-Resolution Forecast Outlook Generation, Forecast Synthesis and Calibration의 3단계로 구성된다. Figure 2에서는 Historical Context Agent가 상호 보완적인 예측 agent 2개에 정보를 전달한다. Forecast Synthesizer Agent는 calibration 지침을 바탕으로 이들의 수치 전망과 설명을 결합한다.
- LLM은 외부 TSFM 예측을 기준으로 삼지 않고 예측값을 생성한다.
- Calibration은 synthesizer에 제공하는 텍스트 지침을 바꾸는 과정이다. 모델 가중치를 학습하거나 확률적 불확실성을 보정하는 과정은 아니다.
구조화된 이력은 macro와 micro agent가 공유하고 synthesizer에도 전달된다. 과거 백테스트는 별도의 calibration 반복 과정을 통해 통합 지침을 제공한다. 출력은 수치 시퀀스와 설명이며, 외부 TSFM 예측을 기준으로 사용하는 구조는 나타나지 않는다.
3.1. Contextualization
Historical Context Agent는 원시 값, 관련 텍스트, 기본 시계열 특성을 시간순 타임라인 H₁:τ로 변환한다. 각 항목은 타임스탬프와 수치 값을 관련 사건에 대한 정리된 설명과 연결한다. 이를 통해 후속 agent가 긴 맥락을 해석하는 부담을 줄이고자 한다.
- 본문은 잡음을 걸러내고 중요한 요인을 유지하는 데 중점을 둔다. 반면 Appendix B.1 템플릿은 제공된 사실, 사건, 세부 사항을 하나도 빠뜨리지 말라고 명시한다.
- 논문은 타임라인의 충실도를 별도로 평가하지 않으며, 제공하는 기본 시계열 특성을 어떻게 계산하는지도 명시하지 않는다.
3.2. Dual-Resolution Forecast Outlook Generation
Macro-Reasoning Agent는 전체 예측 구간의 큰 추세와 예상 국면을 전망한다. Micro-Reasoning Agent는 즉각적인 촉발 요인, 단기 변화, 국소적 변동성을 고려해 미래의 각 시점에 대한 수치 예측과 사건 기반 설명을 생성한다.
- 두 agent는 동일한 구조화된 과거 맥락을 사용하지만, 장기 방향성과 국소적 세부 정보를 유지하도록 전망을 서로 다르게 구성한다.
- 제공된 macro 프롬프트도 미래 시점 전반에 대한 추론을 요청한다. 따라서 실제 구현에서의 구분은 개괄적 전망과 세부 전망이라는 개념적 설명만큼 명확하지 않다.
3.3. Forecast Synthesis and Calibration
Forecast Synthesizer Agent는 구조화된 이력, 두 전망, 지침 집합 G를 결합해 최종 값을 생성하고 두 관점을 어떻게 조정했는지 설명한다. Calibration은 앞선 백테스트 fold에서 비평 규칙 Gᵢ를 생성하고 G = ⋂ᵢ₌₁ⁿ⁻¹ Gᵢ로 교집합을 구한다. 마지막 과거 fold는 검증용으로 남겨 둔다.
- 모든 fold에서 baseline 예측을 병렬로 생성한다. 비평 과정은 예측 오차와, 예상 사건을 수치 변화로 변환할 때 사용한 추론을 검토한다.
- 지침은 따로 남겨 둔 검증 fold에서 성능을 최소 k% 개선할 때만 최종 테스트 세트에 적용한다. 실험에서는 n = 6과 k = 5로 설정한다.
- 논문은 자연어 지침 집합의 교집합을 계산하는 방법과 검증 통과 여부를 결정하는 성능 지표를 명시하지 않는다. 따라서 정확한 재현에 한계가 있다.
4. Experiments
실험은 수치와 텍스트를 함께 사용하는 예측과 수치만 사용하는 예측을 평가한 뒤, 설명의 쌍대 비교와 구성 요소 ablation을 수행한다. 이를 통해 텍스트 맥락의 기여와, 텍스트 없이도 작업을 agent별로 분해하는 방식이 예측을 개선하는지 확인한다.
4.1. Experimental Setup
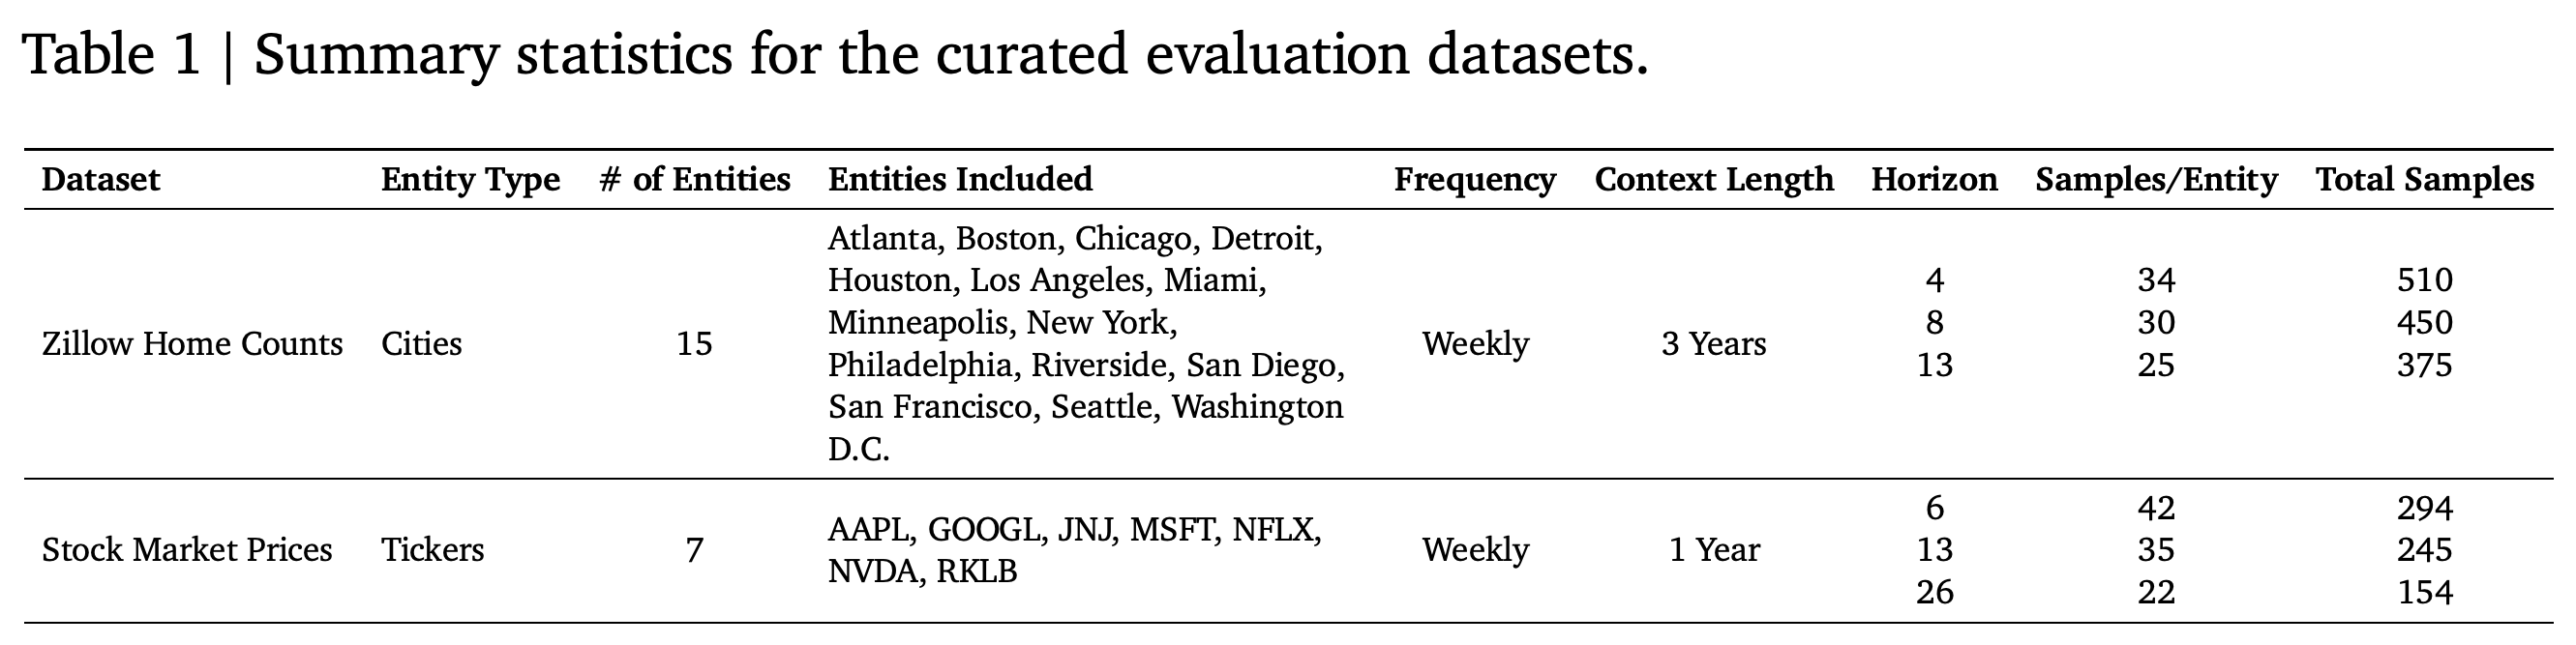
Zillow 평가는 2025년 2월부터 2025년 10월까지의 주간 매물 재고 수를 사용한다. 수치 이력은 3년이며 예측 구간은 4주, 8주, 13주다. 주식 평가는 2025년 2월부터 2025년 12월까지의 주간 종가를 사용한다. 이력은 1년이며 예측 구간은 6주, 13주, 26주다. Table 1은 평가 대상과 예측 구간별 표본 수를 제시한다.
- 대도시권 15곳은 Atlanta, Boston, Chicago, Detroit, Houston, Los Angeles, Miami, Minneapolis, New York, Philadelphia, Riverside, San Diego, San Francisco, Seattle, Washington D.C.다. 종목 코드 7개는 AAPL, GOOGL, JNJ, MSFT, NFLX, NVDA, RKLB다.
- Zillow의 3개 예측 구간별 표본 수는 각각 510, 450, 375개이며, 주식은 294, 245, 154개다. 대상별 표본 수는 Zillow가 34, 30, 25개이고, 주식이 42, 35, 22개다.
- Vertex AI를 통해 Gemini-3.1-Pro와 Claude-4.5-Sonnet을 temperature 0.1로 사용한다. 지원하는 맥락 길이는 각각 1M과 200K tokens다. 저자들은 지식 기준 시점을 2025년 1월로 보고하고, 사전학습 데이터 누출을 줄이기 위해 이후 기간을 평가 대상으로 선택한다. 다만 PDF 자체가 누출의 부재를 독립적으로 입증하지는 않는다.
- 수치 전용 입력에는 값과 타임스탬프가 포함된다. 멀티모달 입력에는 TFRBench를 따라 시간순으로 정렬한 텍스트가 추가된다. Baseline은 TimesFM-2.5와 연구자가 구성한 zero-shot CoT 프롬프트이며, 예측 지표는 MAPE와 RMSE다.
평가는 주간 단위로 대도시권 15곳과 주식 7종목을 다루지만, 도메인은 2개로 제한된다. 예측 구간이 길수록 표본 수가 줄어든다. Zillow의 총표본 수는 510개에서 375개로, 주식은 294개에서 154개로 감소한다. 따라서 예측 구간 간 비교에서 표본 수는 동일하지 않다.
4.2. Forecasting with Multimodal Context
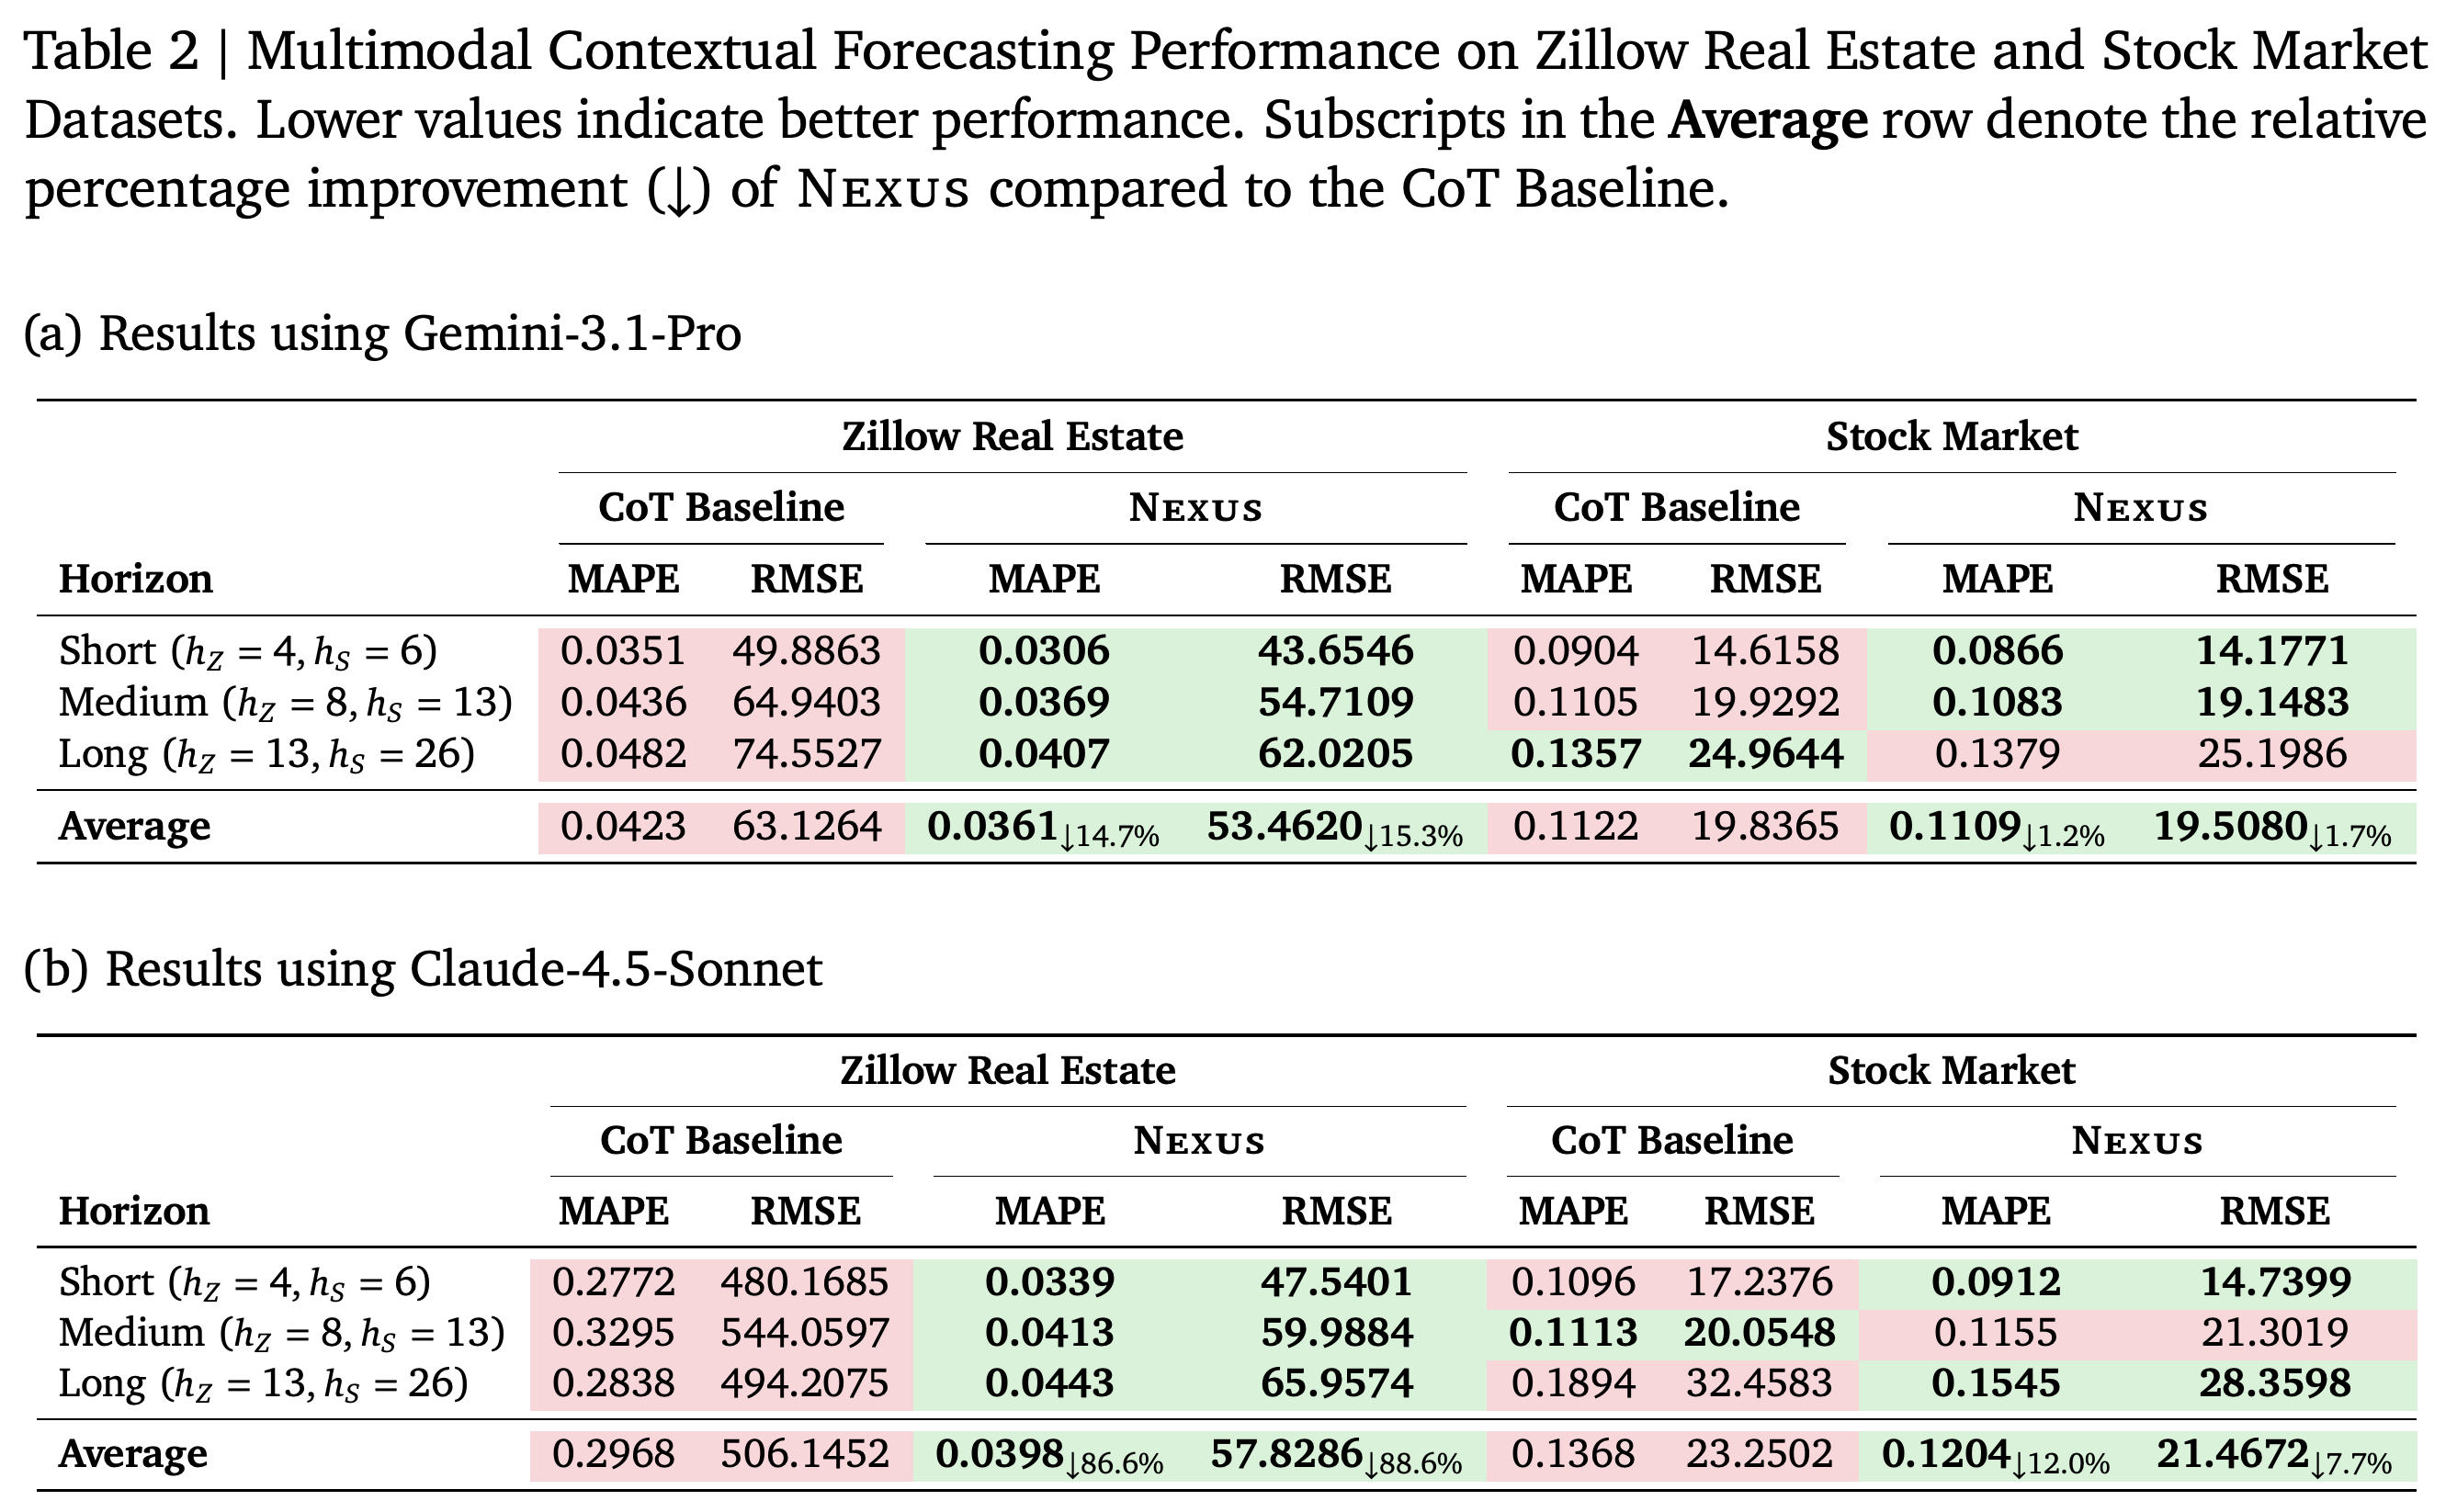
Table 2에서 멀티모달 Nexus는 두 모델과 데이터셋 모두에서 CoT보다 예측 구간 평균 오차가 낮다. Gemini-3.1-Pro의 Zillow 평균 MAPE는 0.0423에서 0.0361로, RMSE는 63.1264에서 53.4620으로 감소한다. 보고된 개선율은 각각 14.7%와 15.3%다. 주식 개선율은 1.2%와 1.7%로 더 작다.
- Claude-4.5-Sonnet의 Zillow 평균 MAPE는 0.2968에서 0.0398로, RMSE는 506.1452에서 57.8286으로 감소한다. 보고된 개선율은 각각 86.6%와 88.6%다. 주식 평균 MAPE는 0.1368에서 0.1204로, RMSE는 23.2502에서 21.4672로 개선된다.
- 저자들은 Claude의 낮은 Zillow baseline 성능이 긴 맥락에서 시간적 변화 양상을 추출하는 어려움 때문일 수 있다고 설명한다. 실험은 이 가설을 분리해 검증하지 않는다.
- 개선은 모든 구간에서 나타나지 않는다. Gemini의 26주 주식 MAPE는 0.1357에서 0.1379로 증가하고, Claude의 13주 주식 MAPE는 0.1113에서 0.1155로 증가한다. 두 비교에서 RMSE도 악화된다.
가장 큰 멀티모달 개선은 Claude의 Zillow 결과에서 나타나며, 평균 MAPE가 0.2968에서 0.0398로 감소한다. 주식의 개선 폭은 더 작고 일관되지 않다. 두 모델 모두 평균은 개선되지만, Gemini의 장기 구간과 Claude의 중기 구간에서는 Nexus가 CoT보다 성능이 낮다.
4.3. Forecasting with Numerical Context Only
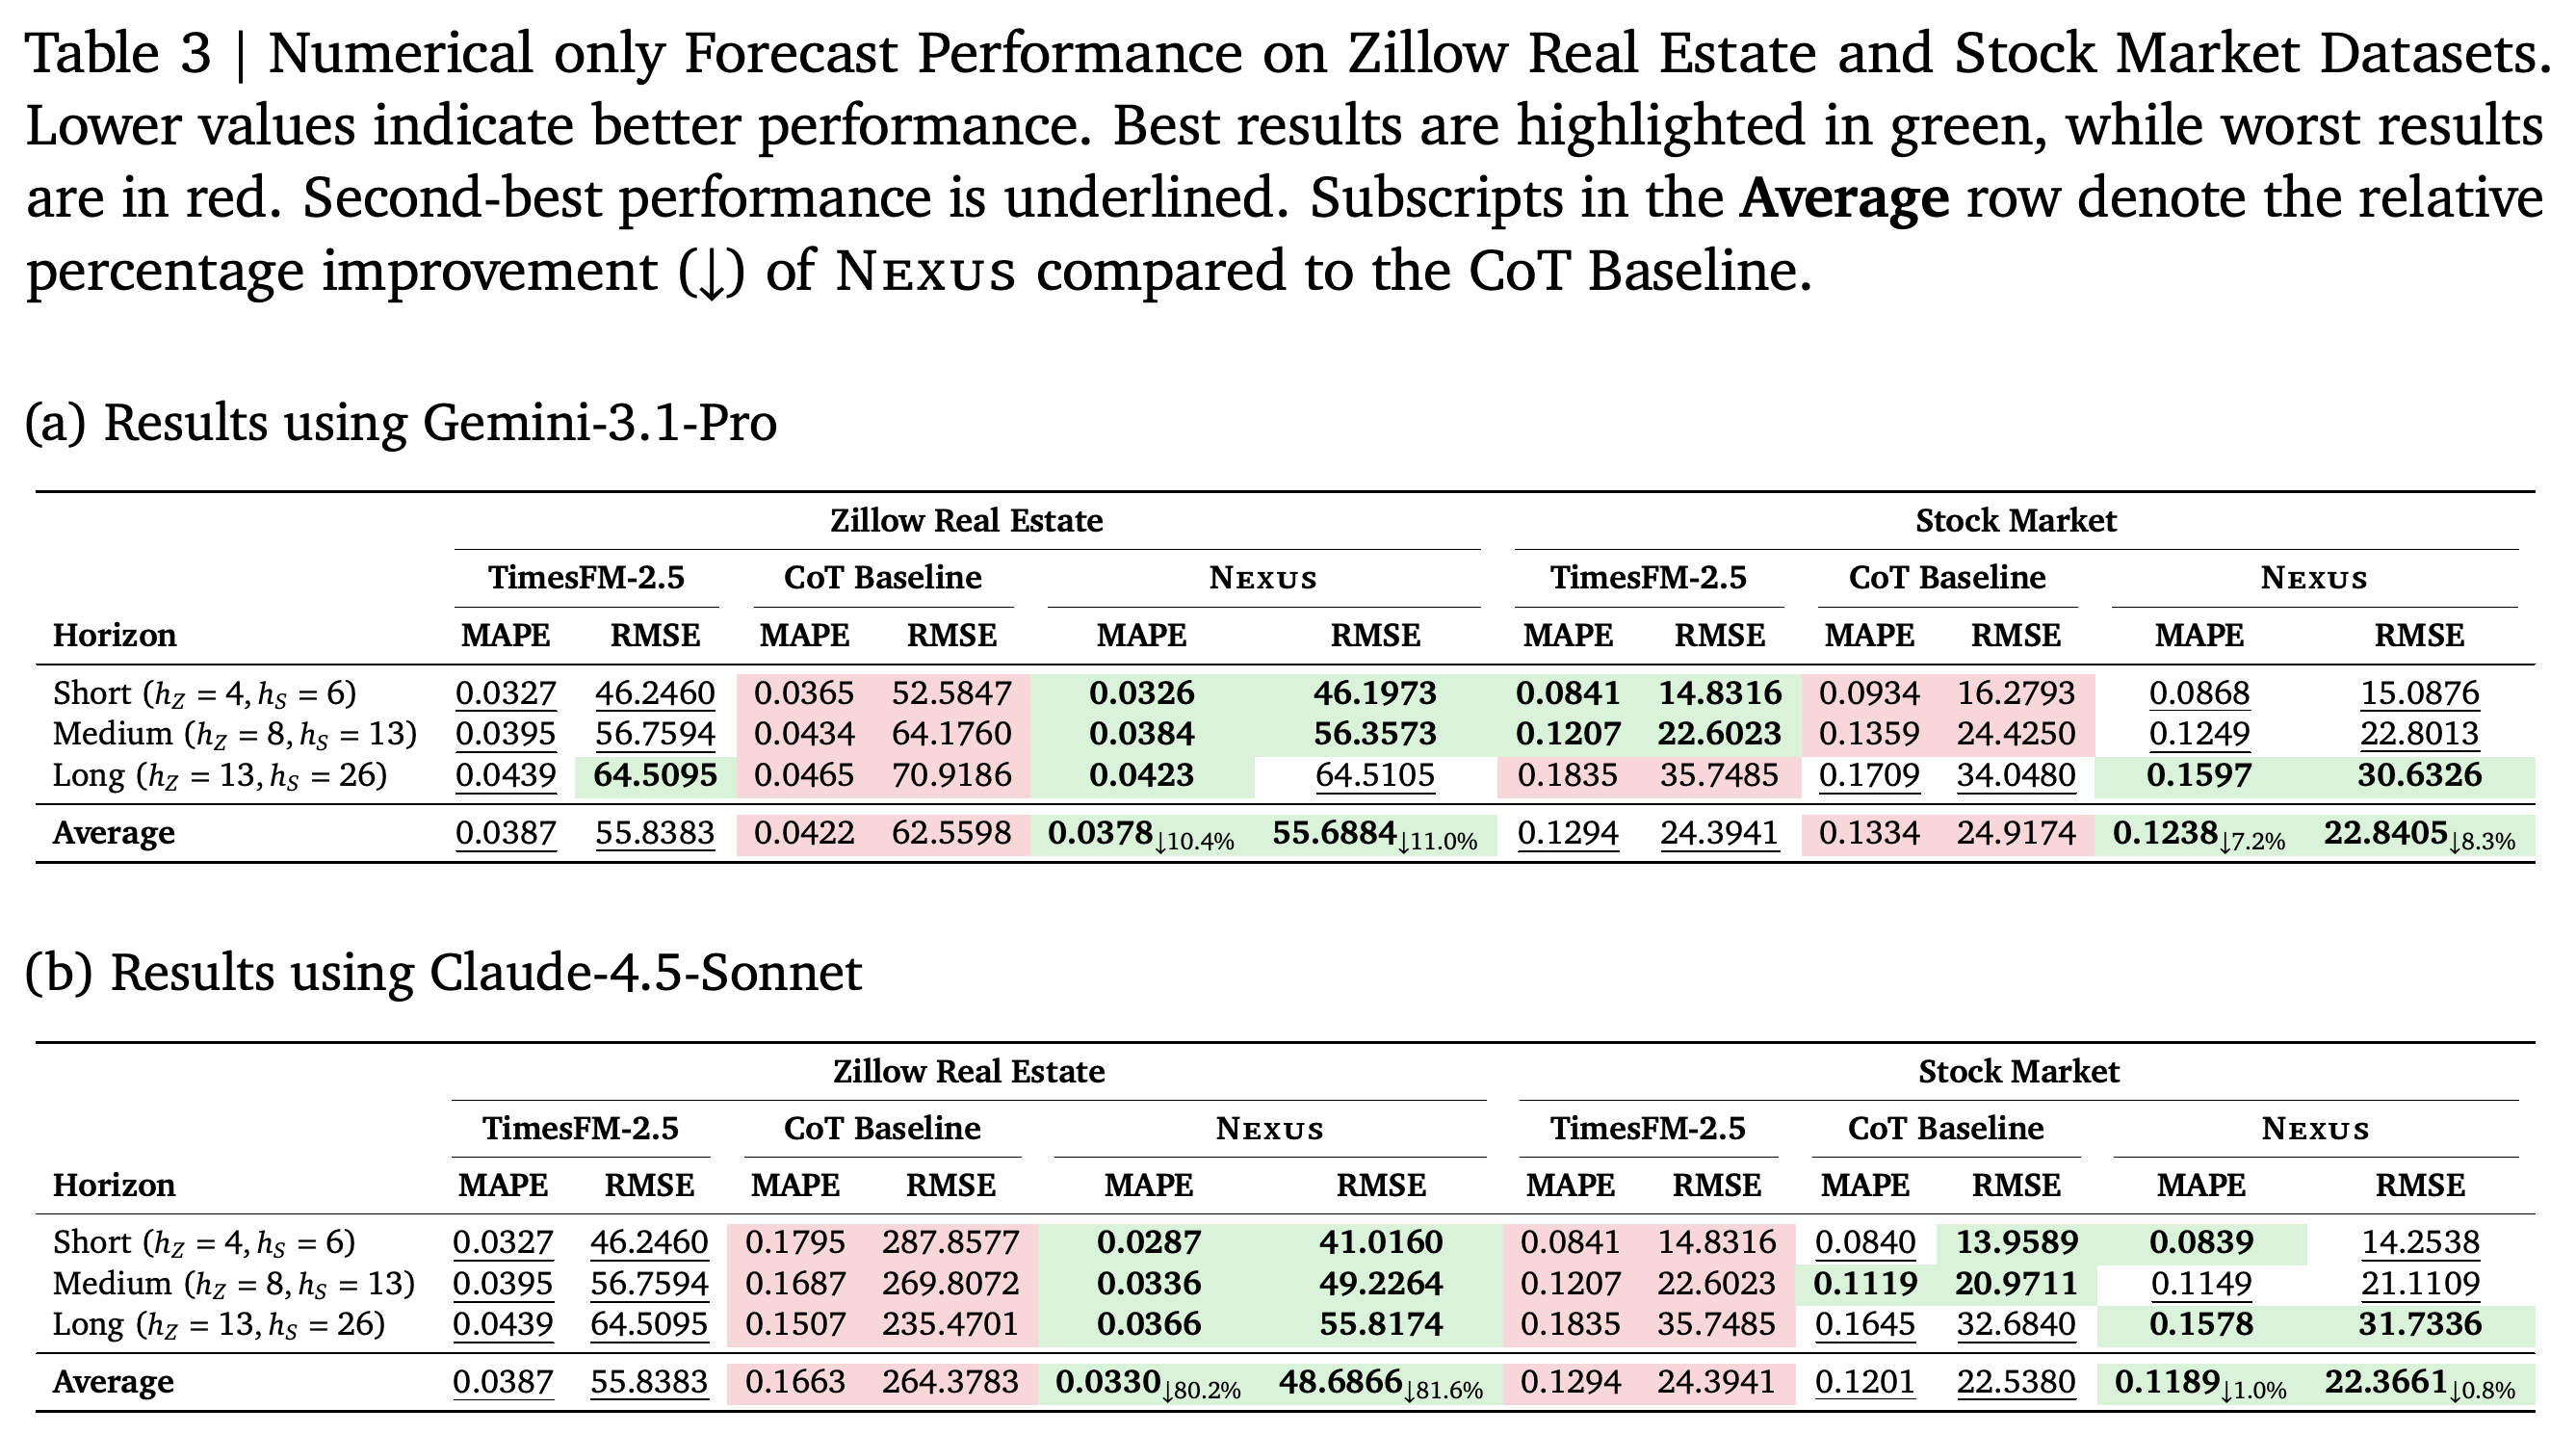
Table 3에서 수치 전용 Nexus는 TimesFM-2.5보다 예측 구간 평균 오차가 낮다. Gemini-3.1-Pro Nexus의 Zillow 평균은 MAPE 0.0378과 RMSE 55.6884이며, TimesFM-2.5는 0.0387과 55.8383이다. 주식에서 Nexus의 해당 평균은 0.1238과 22.8405이며, 비교 모델의 평균은 0.1294와 24.3941이다.
- Claude-4.5-Sonnet Nexus의 Zillow 평균은 MAPE 0.0330과 RMSE 48.6866이며, 주식 평균은 MAPE 0.1189와 RMSE 22.3661이다. 모두 해당 TimesFM-2.5 평균보다 낮다.
- CoT 대비 Zillow 평균 감소율은 Gemini가 MAPE 10.4%와 RMSE 11.0%이며, Claude는 80.2%와 81.6%로 보고된다. Claude의 주식에서 CoT 대비 개선율은 MAPE 1.0%와 RMSE 0.8%에 그친다.
- TimesFM-2.5는 단기·중기 주식에서 Gemini Nexus보다 성능이 좋으며, 장기 Zillow RMSE에서도 근소하게 앞선다. Claude CoT는 중기 주식과 단기 주식 RMSE에서 Claude Nexus보다 성능이 좋다. 따라서 평균 개선이 모든 예측 구간에서의 우위를 뜻하지는 않는다.
- 텍스트 맥락이 항상 도움이 되지는 않는다. Claude Nexus의 Zillow 평균 MAPE는 텍스트를 사용할 때 0.0398이며, 사용하지 않을 때 0.0330이다. 주식 평균 MAPE도 각각 0.1204와 0.1189다.
수치 전용 Nexus는 평가한 두 LLM과 데이터셋 모두에서 TimesFM-2.5보다 예측 구간 평균 오차가 낮다. 다만 개별 결과에는 예외가 있다. TimesFM-2.5는 단기·중기 주식에서 Gemini Nexus보다 성능이 좋고, 장기 Zillow RMSE에서도 근소하게 앞선다. Claude CoT도 일부 주식 비교에서 Claude Nexus보다 성능이 좋다.
4.4. Reasoning Quality Evaluation
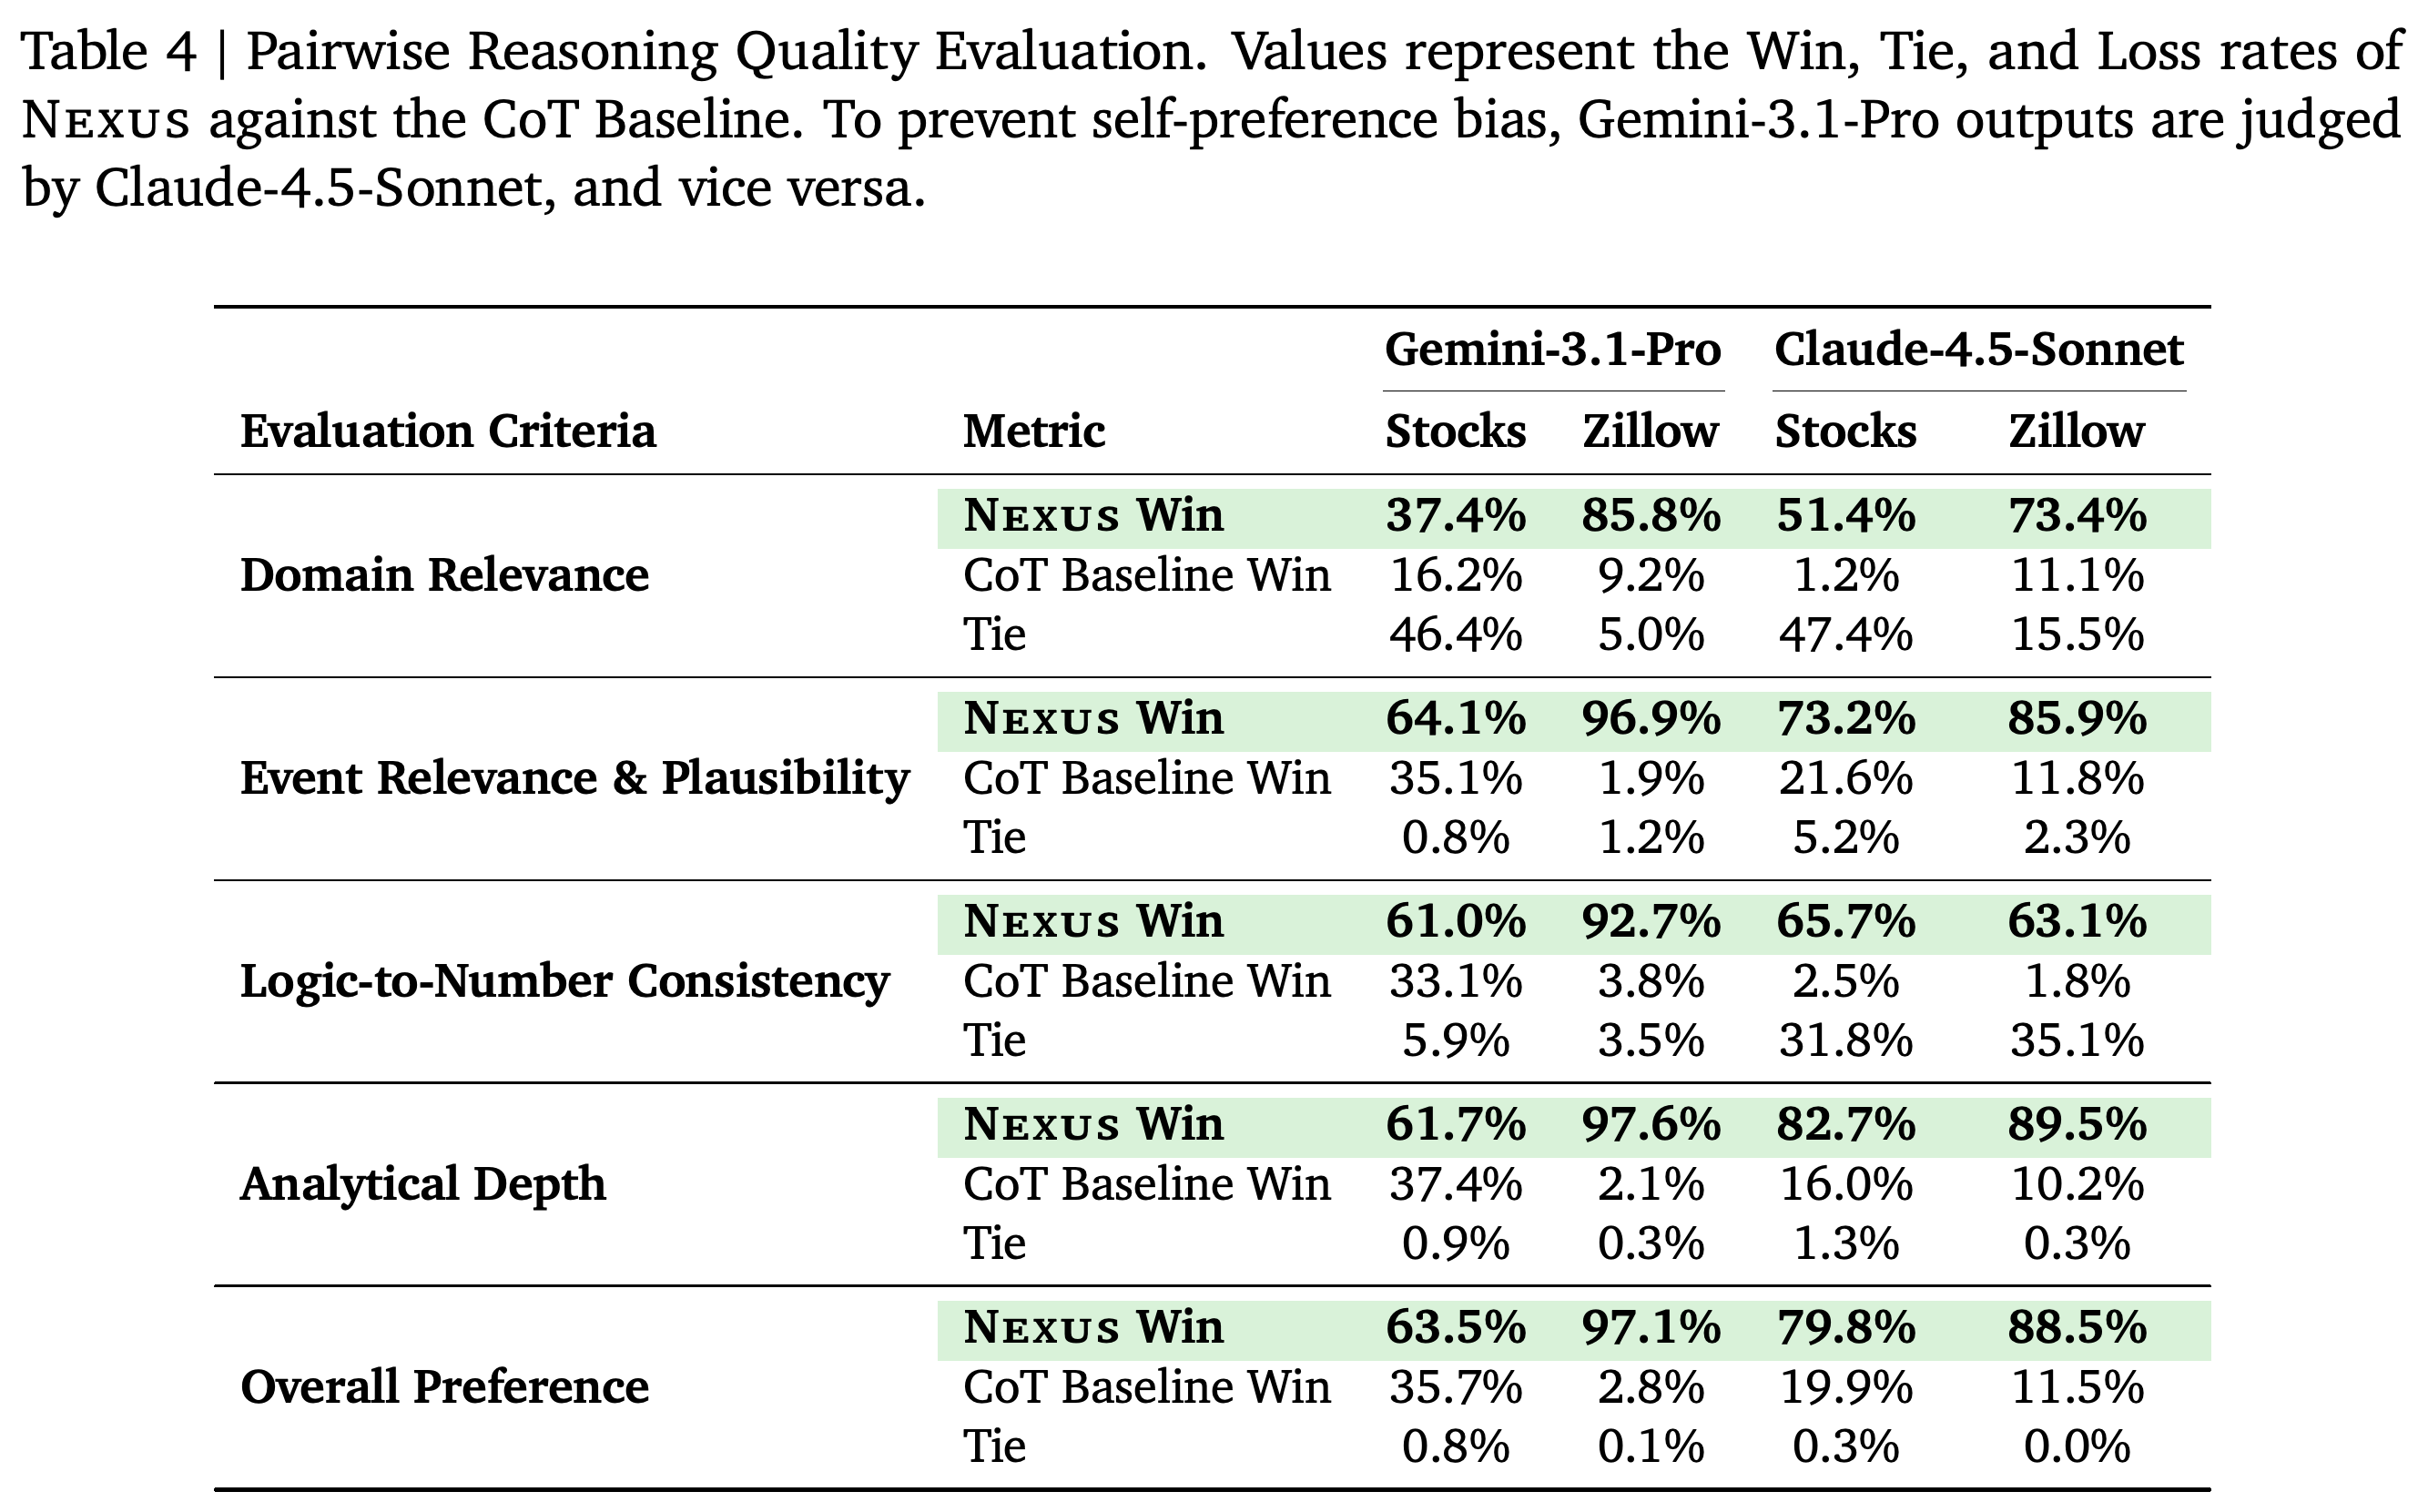
추론 품질은 무작위 순서의 쌍대 비교와 교차 모델 평가로 측정한다. Claude-4.5-Sonnet은 Gemini-3.1-Pro 출력을 평가하고, Gemini는 Claude 출력을 평가한다. 평가자는 예측 구간에 실제로 발생한 사건, 생성된 설명, 예측값을 받지만 실제 수치 정답은 받지 않는다.
- 평가 기준 4개는 Domain Relevance, Event Relevance & Plausibility, Logic-to-Number Consistency, Analytical Depth이며, 이어서 Overall Preference를 평가한다.
- Table 4에서 Nexus의 전체 승률은 Gemini 주식 63.5%, Gemini Zillow 97.1%, Claude 주식 79.8%, Claude Zillow 88.5%다.
- Gemini Zillow 설명은 Event Relevance & Plausibility에서 96.9%, Analytical Depth에서 97.6%로 특히 높은 Nexus 승률을 보인다. 주식의 Domain Relevance에서는 동률 비율이 Gemini 46.4%, Claude 47.4%로 높다.
- 교차 평가와 무작위 순서는 특정 선호 편향에 대응하지만 설명의 충실도나 인과적 정확성을 입증하지는 않는다. 실제로 발생한 미래 사건을 제공하므로 이 평가는 사후적 개연성 평가에 해당한다. 서로 다른 설명 길이 지시도 여전히 교란 요인으로 남는다.
전체 선호는 모델·데이터셋 조합 4개 모두에서 Nexus에 유리하며, 승률은 63.5%부터 97.1%다. 주식의 Domain Relevance에서 높은 동률 비율은 모든 기준에서 우위가 똑같이 뚜렷하지는 않음을 보여 준다. 이러한 선호는 실제 수치 정답 없이 사후적 서술의 개연성을 평가한 결과다.
4.5. Component Analysis
Table 5는 Gemini-3.1-Pro의 멀티모달 단기 예측 설정에서만 micro reasoning, macro reasoning, calibration을 제거해 비교한다. 이때 h_Z = 4와 h_S = 6이다. 전체 파이프라인은 두 데이터셋 모두에서 가장 낮은 MAPE와 RMSE를 기록하지만, 차이는 작고 반복 실행에 따른 불확실성은 보고하지 않는다.
- Zillow MAPE는 전체 파이프라인에서 0.0306이며, micro reasoning을 제거하면 0.0314, macro reasoning을 제거하면 0.0317, calibration을 제거하면 0.0309다.
- 주식 MAPE는 전체 파이프라인에서 0.0866이며, micro reasoning을 제거하면 0.0877, macro reasoning을 제거하면 0.0882, calibration을 제거하면 0.0877이다.
- 이 ablation은 해당 설정에서 구성 요소들이 상호 보완적으로 기여한다는 근거다. 모든 모델, 입력 설정, 더 긴 예측 구간에서 각 구성 요소가 반드시 필요하다는 근거는 아니다.
5. Related Works
관련 연구는 LLMs for Time Series Forecasting, Time-Series Foundation Models, Semantic, Adaptive, and Agentic Forecasting으로 구성된다. Nexus는 LLM backbone을 재프로그래밍하거나 외부 수치 예측 중에서 선택하는 방법이 아니라, 텍스트 근거와 시간적 전망, 진단 피드백을 결합하는 추론 시점의 워크플로로 제시된다.
- 논문은 직접 프롬프팅과 GPT4TS/FPT, TEMPO, Time-LLM, UniTime 등의 적응 방법을 다룬다. 언어 사전학습이 이들의 예측 성능 향상을 반드시 설명하지는 않는다는 근거도 논의한다.
- 시간적 사전학습 모델로는 Chronos, TimesFM, Lag-Llama, MOMENT, MOIRAI를 비교한다. 의미 정보와 agentic 접근을 다루는 논의에는 LoFT-LLM, T-LLM, TimeSAF, Synapse, TimeCopilot, TimeSeriesScientist, AlphaCast, Cast-R1이 포함된다.
6. Conclusion
결론은 Nexus의 성과를 수치와 텍스트가 혼합된 입력의 구조화, 큰 추세와 국소적 촉발 요인의 분리, 이들을 종합하는 과정의 calibration으로 설명한다. 표는 보고된 설정에서 예측 구간 평균 성능이 개선됨을 뒷받침한다. 그러나 모든 예측 구간에서 두 baseline을 일관되게 능가한다는 결론의 주장은 뒷받침하지 않는다.
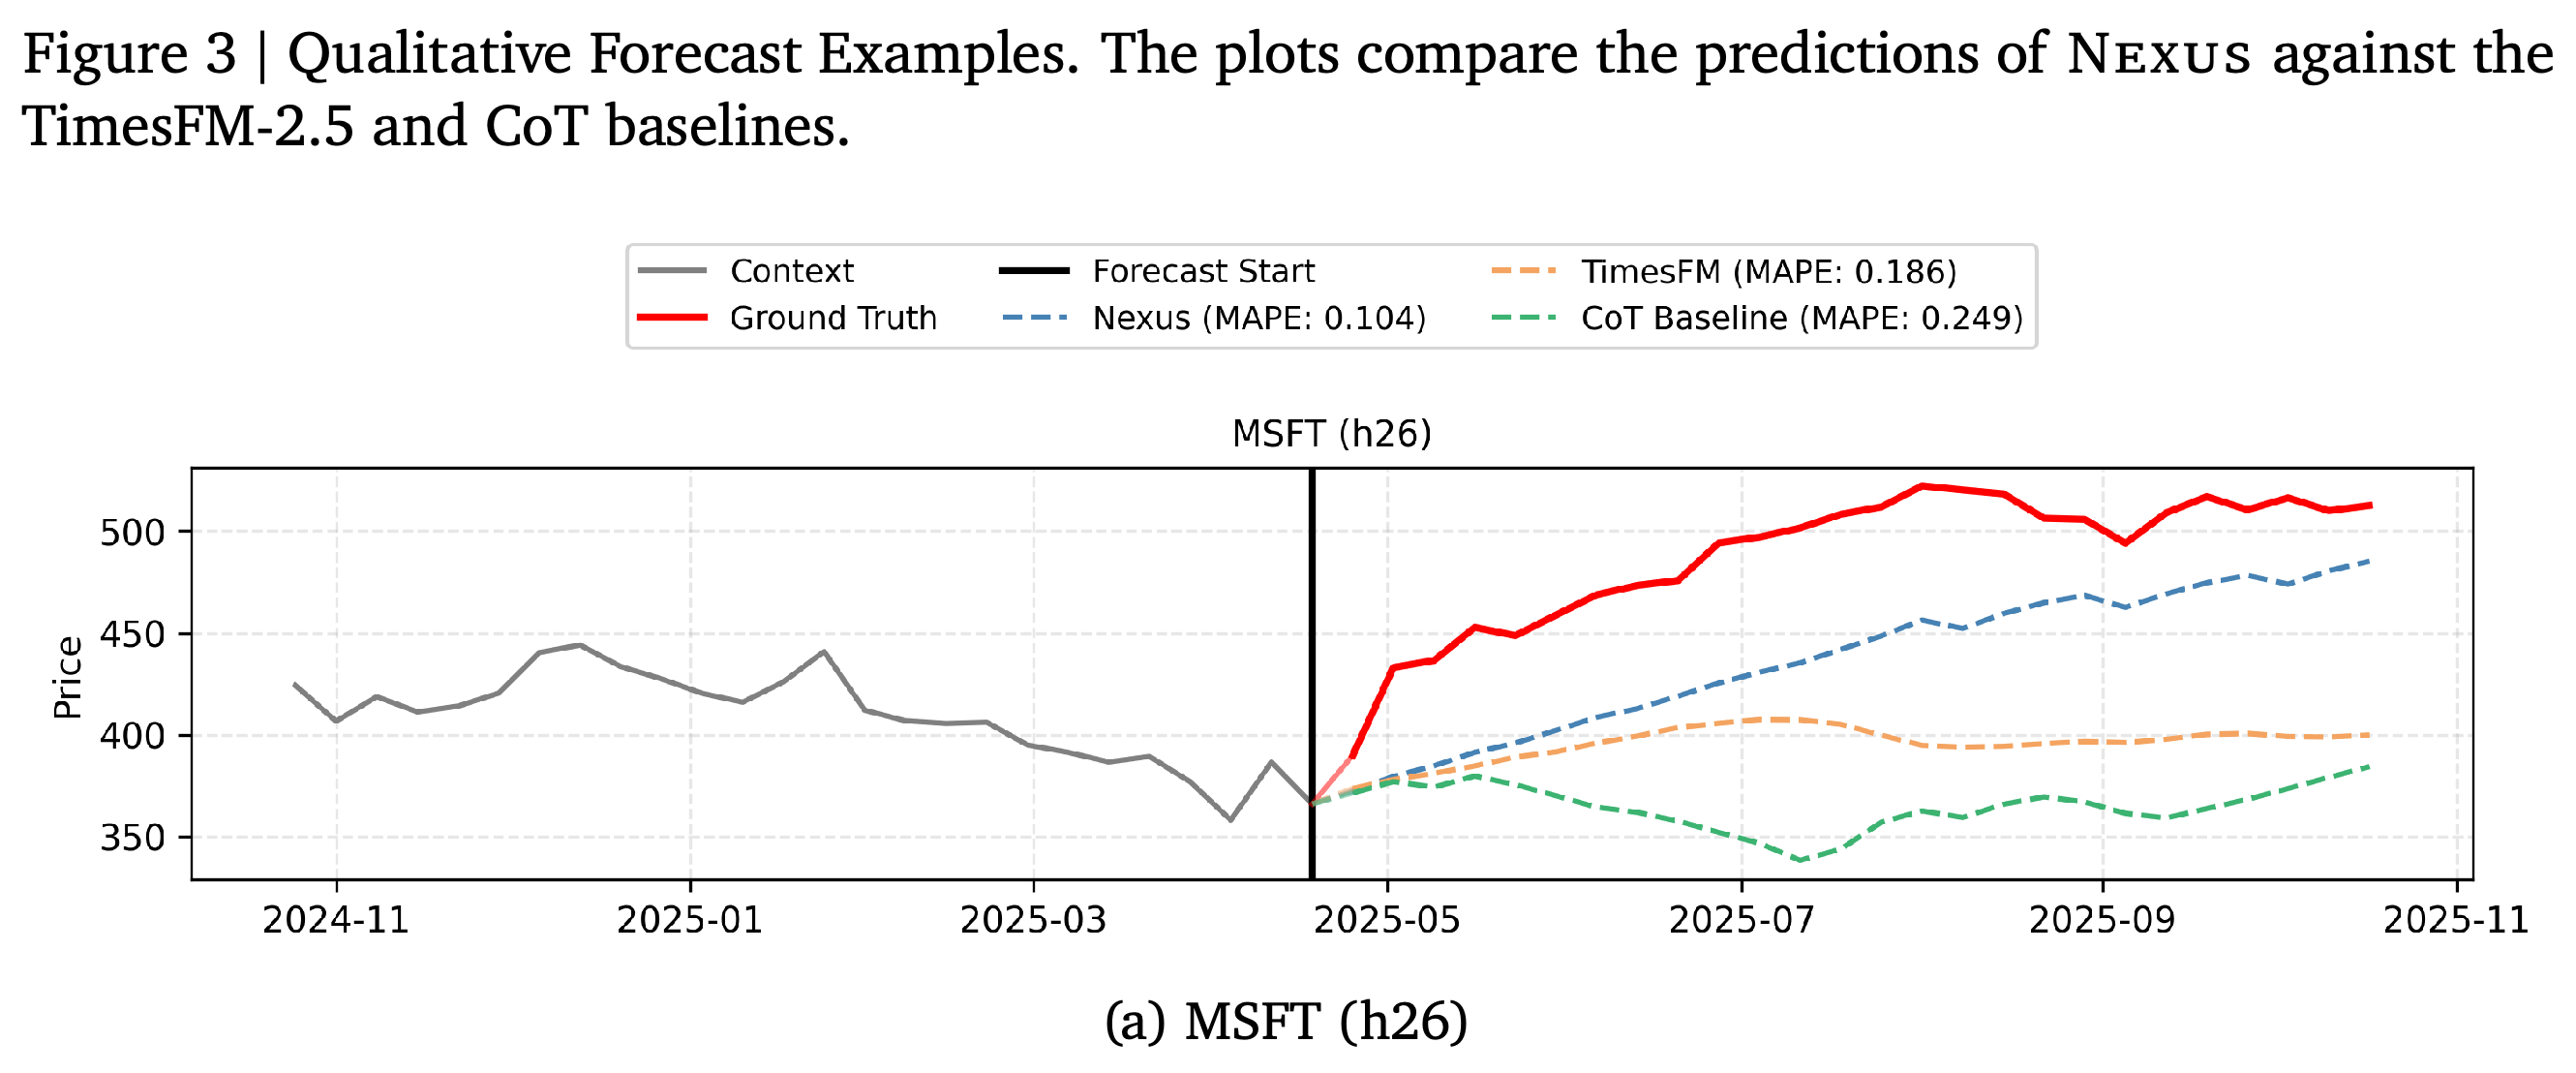
- Figure 3은 성공과 실패를 함께 보여 준다. Nexus는 여러 계절적 회복과 주가 상승 추세를 따라가지만, RKLB 패널 (m)과 (n)에서는 실제 가격이 하락하는데도 상승을 예측한다.
- Washington_DC_msa_VA 사례에서 Nexus는 봄철 회복을 과대 예측하고, TimesFM-2.5가 실제 추세를 더 가깝게 따라간다. 이러한 사례는 일관된 맥락 설명과 방향·규모의 정확한 예측이 별개임을 보여 준다.
패널 16개는 유용한 추세 포착과 큰 실패를 함께 보여 준다. MSFT (h26)의 범례에 표시된 MAPE는 Nexus 0.104, TimesFM 0.186, CoT 0.249다. 여러 Los_Angeles_CA_msa 패널에서도 봄철 회복을 가깝게 따라간다. 반면 RKLB 패널 (m)과 (n)은 가격이 하락하는데도 상승을 예측한다. Washington_DC_msa_VA 패널 (o)와 (p)은 TimesFM-2.5에 비해 회복을 과대 예측한다.
부록
- A. Limitations는 타임스탬프로 정렬된 공개 수치·텍스트 데이터셋이 드물어 평가를 Zillow와 주식으로 제한했다고 설명한다. 저자들은 사전학습 데이터 누출을 우려 사항으로 제시한다. 또한 다중 agent의 반복 호출에 비용과 계산 자원이 많이 들어 1회 실행 평가만 보고한다.
- B. Nexus : Agent Prompts는 agent 템플릿을 제공한다. B.1. Historical Context Agent는 {ts_features}, {domain}, {history_str}를 입력받는다. 제공된 사실과 사건을 모두 유지하면서 Date/Timestamp, Value, Textual Content를 포함하는 시간순 출력을 생성하도록 명시한다.
- B.2. Macro-Reasoning Forecaster Agent는 <reasoning> 태그 안에 미래 시점에 대한 상세한 설명을, <forecasted_values> 태그 안에 정확히 {horizon}개의 수치 값을 요청한다. 시스템 프롬프트는 지식 기준 시점을 2025년 1월로 명시한다.
- B.3. Micro-Reasoning Forecaster Agent는 timestamp, date, day_info, reasoning, adjusted_forecast_value를 포함하는 timestamp_forecasts 목록을 명시한다. reasoning 객체는 movement_label과 key_drivers를 포함해 각 미래 시점의 예상 사건과 방향에 대한 설명을 명시적으로 드러낸다.
- B.4. Calibration Agent는 value predictor의 프롬프트, 설명, 수치 예측, MAPE, 앞선 macro와 micro의 MAPE, 과거에 실제로 발생한 사건과 값을 검토한다. 서술을 수치적 규모로 변환할 때 발생한 오류에 초점을 맞춰 <diagnosis>와 짧고 일반화된 <guidelines> 문단을 반환한다.
- B.5. Value Predictor Agent는 이력, 미래 날짜, macro와 micro 전망, 지침과 사건 예측 placeholder를 사용하는 최종 종합 템플릿을 제공한다. 두 관점을 어떻게 조정했는지 설명하고, <forecasted_values> 태그 안에 정확히 {horizon}개의 값을 출력하도록 요청한다.
- C. CoT-Baseline Prompt는 과거 기록과 사건 정보를 제공하고, 이들이 계절성과 어떻게 상호작용하는지 고려하도록 요청한다. Nexus의 상세한 설명 지시와 달리 BRIEF ANALYSIS를 명시하며, <prediction> 태그 안에 쉼표로 구분한 예측값을 정확히 {horizon}개 넣도록 한다. 이러한 비대칭은 추론 품질 비교를 해석할 때 중요하다.
- D. LLM-as-a-Judge Prompt는 실제 수치 정답 없이 실제 사건을 사용해 서술 품질을 평가한다. 출력 식별자는 domain_relevance_winner, event_relevance_winner, logic_to_number_winner, analytical_depth_winner, overall_preference, justification이다. 선호 라벨로는 Model A, Model B, Tie를 사용한다.
- E. Qualitative Forecast Examples는 Figure 3의 패널 16개에서 과거 맥락, 실제값, Nexus, TimesFM-2.5, CoT를 비교한다. 선택된 사례에는 계절적 회복과 주가 상승 예측뿐 아니라 RKLB의 추세 반전을 놓친 사례와 Washington_DC_msa_VA를 과대 예측한 사례도 포함된다. 이 사례들이 전체 정량 평가를 대신하지는 않는다.
- F. Qualitative Reasoning Examples는 그래프에 대응하는 서술을 제공한다. F.1. Example 1, MSFT (h26)는 회복을 AI 수익화, 클라우드 성장, 관세 충격의 흡수로 설명한다. F.2. Example 2, AAPL (h6)는 iPhone 17 판매, M5 하드웨어, 실적, 금리 인하 가능성, 연말 수요를 근거로 성장을 전망한다. F.3. Example 3, RKLB (h6)는 $5.6 billion 규모의 NSSL Phase 3 Lane 1 계약과 실적 모멘텀을 근거로 삼는다. F.4. Example 4, NFLX (h26)는 광고 요금제 성장, 스포츠 생중계, 실적을 근거로 2025년 10월까지 115 수준으로 상승할 것으로 전망한다.
- F.5. Example 5, San_Diego_CA_msa (h8)는 더 낮은 2025 baseline에 과거 봄철 증가와 지역 사건을 결합한다. F.6. Example 6, Los_Angeles_CA_msa (h13)는 겨울과 산불로 인한 저점에서 회복한 뒤 4월 중순에 정점에 도달할 것으로 예상한다. F.7. Example 7, Los_Angeles_CA_msa (h8)는 안정화와 봄철 회복을 강조한다. F.8. Example 8, Los_Angeles_CA_msa (h4)는 과거의 1월 이후 회복 패턴에 산불 영향과 지역 활동 재개를 결합한다.
- F.9. Example 9, RKLB (h6)는 Neutron 적격성 검증과 국방 프레임워크 참여를 근거로 $20s 초반에서 $20s 중후반으로 회복할 것으로 전망한다. F.10. Example 10, GOOGL (h13)는 예상 통화정책, 실적, 광고 수요를 바탕으로 2025-09-05부터 2025-11-28까지 날짜별 주간 전망을 제시하며, 최종 값은 238.10이다. F.11. Example 11, Houston_TX_msa_TX (h8)와 F.12. Example 12, Riverside_CA_msa_CA (h4)는 봄철 증가를 과거 계절성, 날씨, 지역 사건으로 설명한다. 이는 모델이 생성한 설명이며, 독립적으로 입증된 인과 효과는 아니다.
- F.13. Example 13, RKLB (h6)는 발사, 실적, 애널리스트 목표가에 관한 서술을 바탕으로 66.50, 69.10, 72.80, 75.20, 76.80, 78.40을 예측한다. 하지만 대응하는 그래프에서 실제값은 급락한다. F.14. Example 14, RKLB (h6)도 그래프에 나타난 하락 추세와 달리 실적에 따른 상승 모멘텀을 예상한다. F.15. Example 15, Washington_DC_msa_VA (h13)와 F.16. Example 16, Washington_DC_msa_VA (h8)는 계절적 회복, 휴일, Cherry Blossom Festival을 근거로 삼지만, 그래프의 예측값은 실제 회복을 과대 추정한다.
짧은 생각
가장 분명한 결과는 모델 가중치를 바꾸거나 TSFM 예측에 의존하지 않고도 구조화된 LLM 추론으로 예측을 개선할 수 있다는 점이다. 수치 전용 비교가 이를 뒷받침하며, 특히 Claude의 Zillow 결과에서 두드러진다. 다만 주식의 개선 폭이 작고 예측 구간별 예외가 있어 효과는 과제에 따라 달라진다.
실험은 역할 전문화, 과거 피드백, 맥락 재구성, 추가 추론 연산의 효과를 충분히 분리하지 못한다. 1회 실행 ablation의 차이가 작고 계산량을 맞춘 baseline도 없어 성능 향상의 원인을 특정하기 어렵다. 서로 다른 설명 지시와 RKLB 실패 사례 역시 평가자가 선호한 서술을 충실한 인과 설명이나 신뢰할 수 있는 사건 예측으로 간주해서는 안 된다는 점을 보여 준다.