


Verifiable Environments Are LEGO Bricks: Recursive Composition for Reasoning Generalization 요약 설명
10 Jun 2026 | Paper Review Environment Scaling Reinforcement Learning With Verifiable Rewards Reasoning목차
이번 글에서는 Verifiable Environments Are LEGO Bricks: Recursive Composition for Reasoning Generalization 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 10일(Arxiv), Preprint
- Xiang, Hao, Tang, Qiaoyu, Yu, Le, Lu, Yaojie, Han, Xianpei, He, Ben, Sun, Le, Yu, Bowen, Wang, Peng, Lin, Hongyu, et al.
- University of Chinese Academy of Sciences, Chinese Information Processing Laboratory, Institute of Software, Chinese Academy of Sciences, Qwen Team, Alibaba Group
- 논문 링크
요약
- RACES(Recursive Automated Composition for Environment Scaling)는 타입이 호환되는 환경을 재귀적으로 조합하여 유한한 실행 가능 추론 환경 집합을 확장한다. SEQUENTIAL, PARALLEL, SORT, SELECT의 4가지 연산자는 상태 추적, 독립적인 계산, 연산 순서 추론, 부분집합 선택이 필요한 과제를 생성한다.
- 기본 환경 300개를 사용하고 학습 인스턴스 수와 RL 스텝 수를 맞춘 실험에서, RACES는 보고된 벤치마크 평균 점수를 DeepSeek-R1-Distill-Qwen-14B에서 48.2에서 51.3으로, Qwen3-14B에서 58.8에서 61.1로 높인다. 개별 환경으로 RL을 수행한 경우보다 각각 2.5점과 1.0점 높으며, 표에 제시된 모든 벤치마크 열에서 성능이 향상된다.
- 환경 집합 크기 비교에 사용한 2개 백본 모두에서, 기본 환경 50개를 사용하는 RACES가 환경 300개로 학습한 개별 환경 RL보다 높은 성능을 보인다. 깊이 분석에서는 난도와 학습 가능성 사이의 절충 관계가 나타난다. 조합이 깊어질수록 최적화가 어려워지며, 전이 성능이 일관되게 향상되지는 않는다. 작은 모델의 희소 보상, 긴 컨텍스트 요구, 아직 탐구하지 않은 조건 분기와 반복 횟수가 제한된 루프가 실험으로 입증된 적용 범위를 제한한다.
1 Introduction
이 논문은 환경을 개별적으로 구축할 때 검증 가능한 RL 학습 분포를 확장하는 데 드는 비용을 다룬다. 하나의 환경에서 많은 입력 인스턴스를 생성할 수는 있지만, 새로운 변환 유형을 추가하려면 환경을 더 구축해야 한다. RACES는 실행 가능한 변환을 서로 다른 위치, 조합, 과제 제시 방식으로 재사용한다.
- 모델은 외부 도구 없이 환경 설명과 입력을 바탕으로 문제를 풀고, 실행 가능한 참조 프로그램은 검증 가능한 출력을 제공한다.
- 한 환경의 출력 타입을 다른 환경의 입력 타입에 맞추면 재귀적으로 조합할 수 있지만, 실행 검증과 품질 필터링은 여전히 필요하다.
- 논문은 전이 성능의 원천으로 단순한 입력 샘플 수 증가가 아니라 구조적 다양성을 제시한다.
2 Related Work
관련 연구는 RLVR, 검증 가능한 환경 합성, 문제 조합을 다룬다. RACES는 자연어 수준에서 질문을 연결하는 대신 실행 가능한 환경 인터페이스를 조합한다.
- RLVE는 적응형 검증 가능 환경의 가치를 보여준다. SCALER와 RESYN은 합성을 자동화하지만, 여전히 환경을 개별적으로 구축한다.
- MathFusion, H1, Composition-RL은 문제나 의존 관계가 있는 연쇄를 조합한다. RACES는 표준화된 도메인 시그니처를 통해 프로그램으로 환경을 재귀적으로 조합할 수 있게 한다.
- 도메인 호환성과 런타임 필터링을 조건으로, 환경 쌍마다 어댑터를 직접 만들지 않고도 환경 수준의 조합을 재사용할 수 있다는 점에서 차별화된다.
3 Method
이 방법은 실행 가능한 환경의 의미와 모델에 과제를 제시하는 방식을 분리한다. 표준화된 인터페이스를 정의하고, 호환되는 실행 경로를 탐색하고 필터링한 뒤, 모델에 보여줄 정보와 요구할 예측 및 보상을 정하는 연산자를 적용한다.
3.1 Preliminary
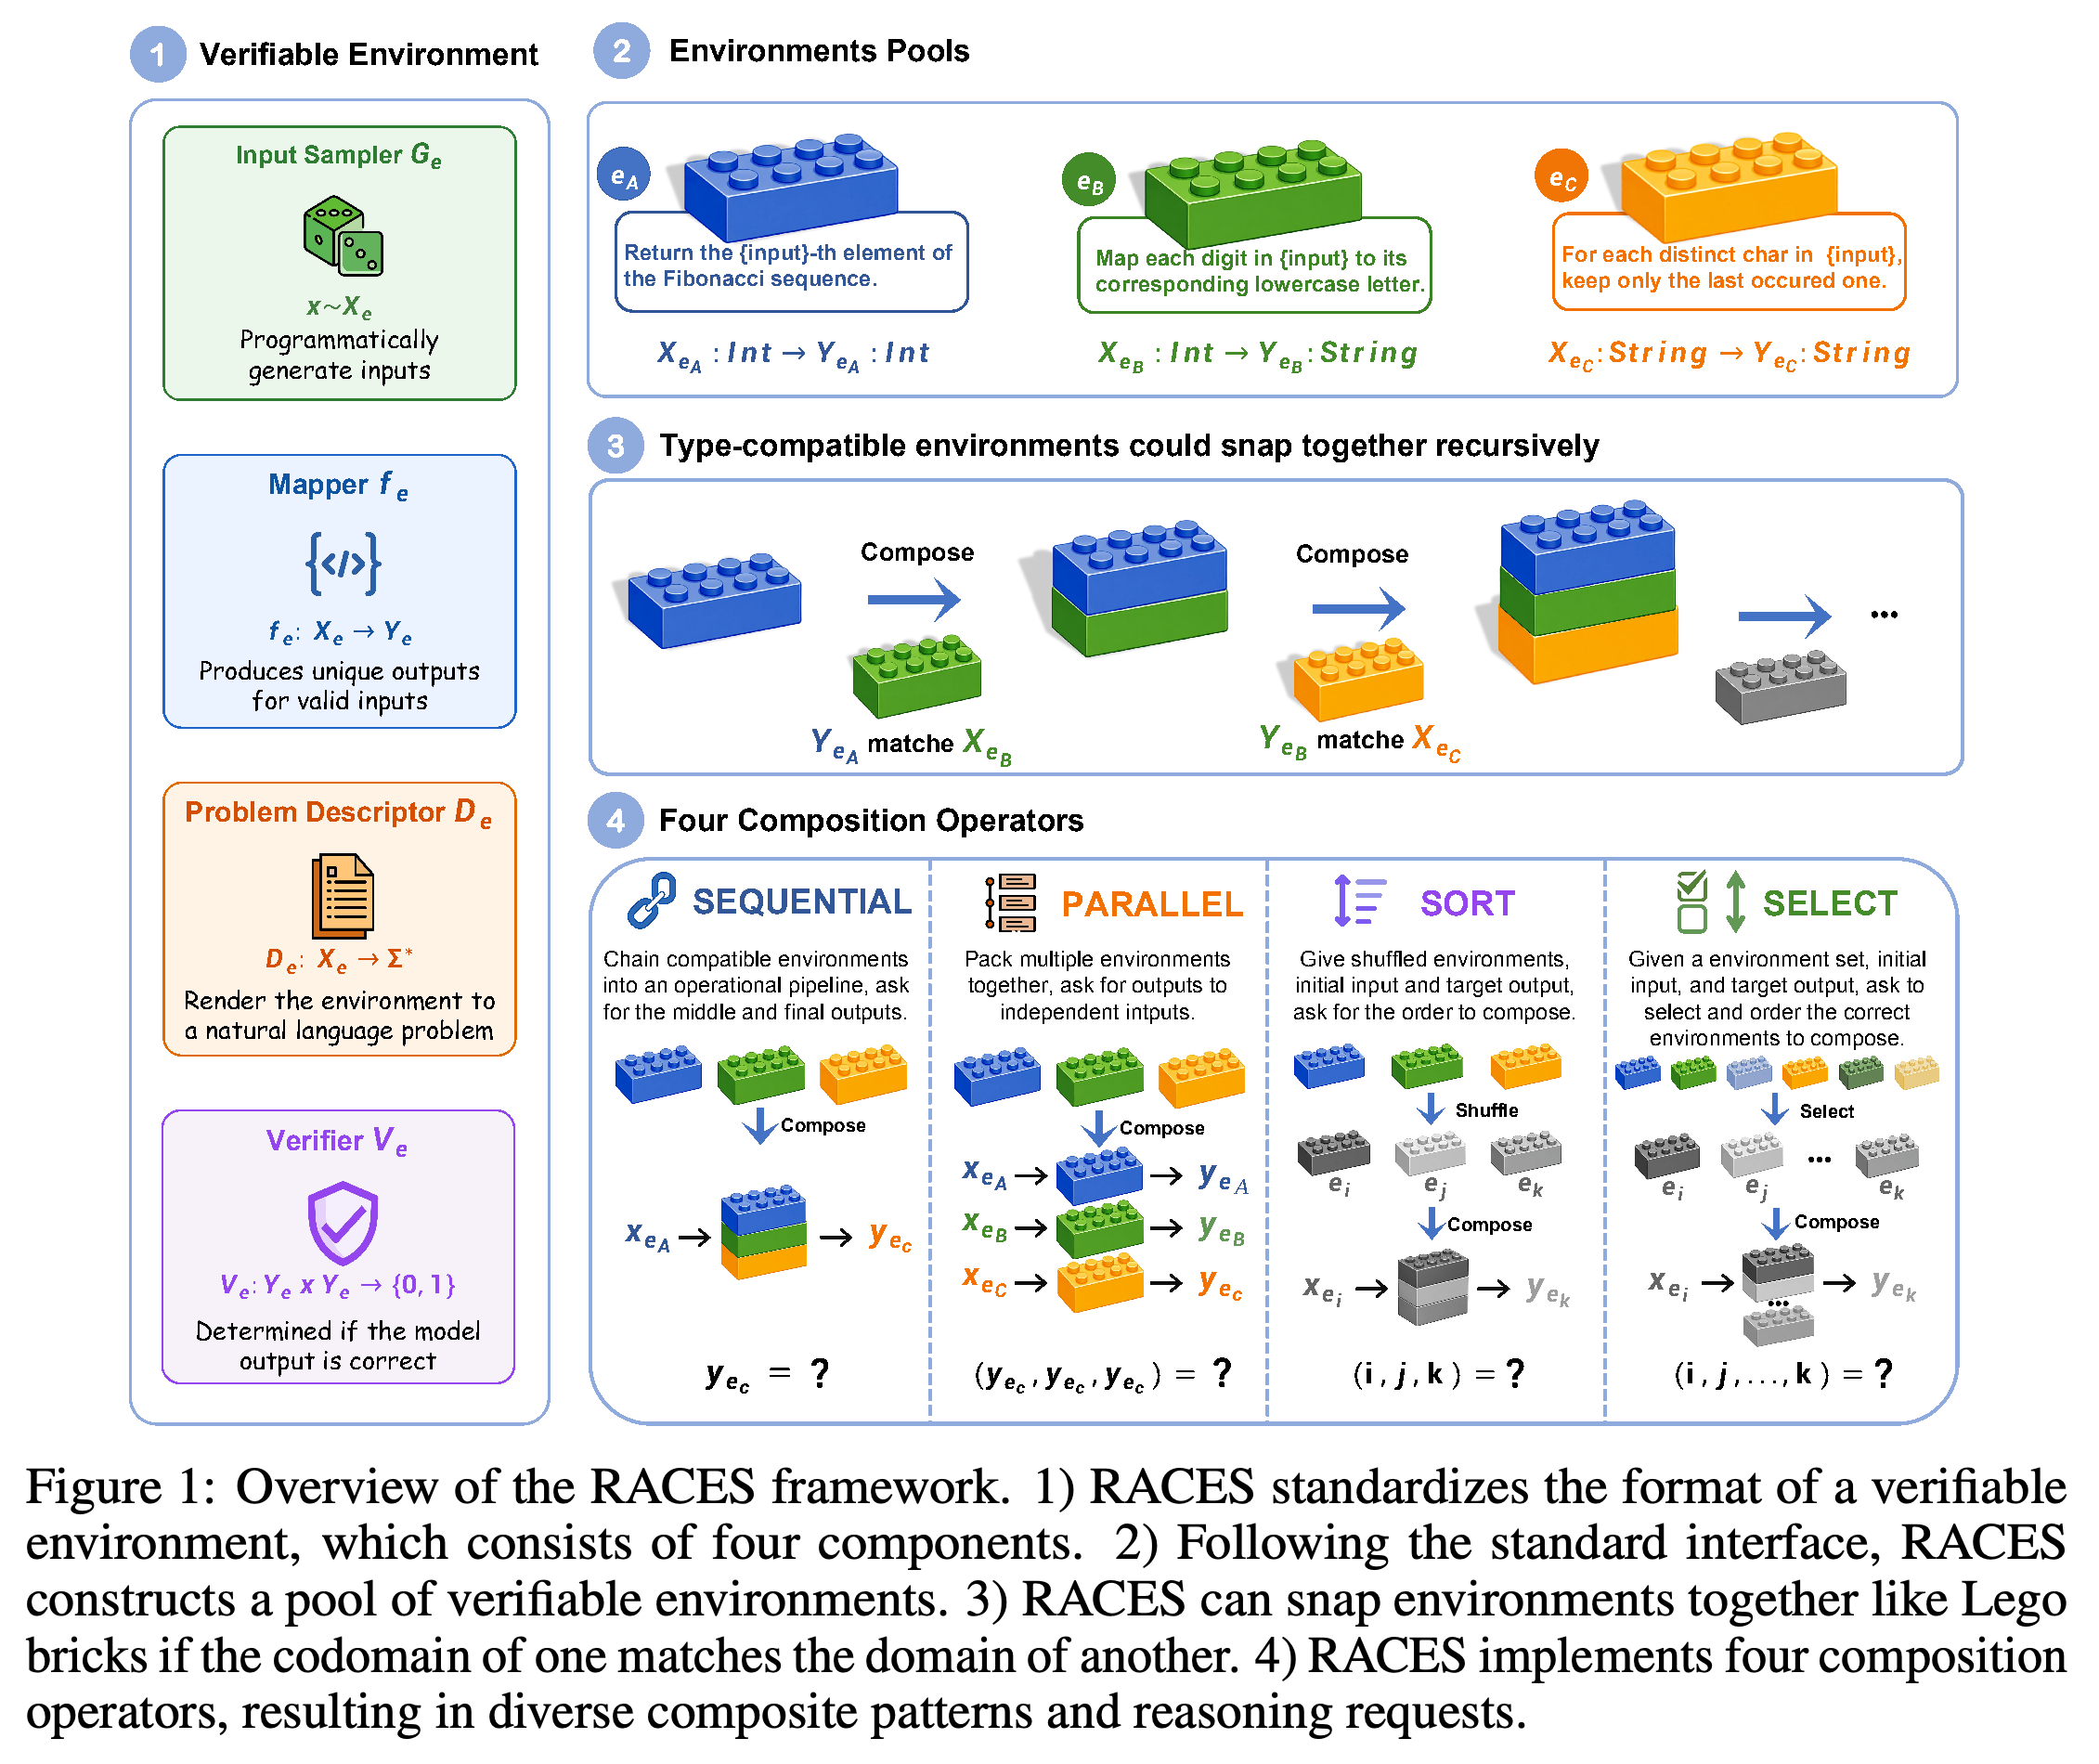
검증 가능한 환경은 (e=(G_e,f_e,D_e,V_e))로 정의한다. 실행 가능한 매핑 함수는 결정적 참조 출력을 제공하며, 나머지 구성 요소는 유효한 입력을 생성하고 자연어 문제를 구성하며 모델의 답을 검증한다.
- G_e는 X_e에서 유효한 입력을 샘플링한다. f_e: X_e → Y_e는 각 유효한 입력을 유일한 출력으로 매핑한다.
- DOMAIN SIGNATURE τ_e = (X_e, Y_e)는 조합 후보가 될 수 있는지를 결정한다.
- D_e: X_e → Σ*는 문제를 표현하고, V_e: Y_e × Y_e → {0, 1}는 예측을 참조 답과 비교한다.
3.2 Compositional Closure of Verifiable Environments
시그니처가 Y_ei = X_ej를 만족하는 환경의 합성 매핑 함수는 (f_ej ◦ f_ei)(x) = f_ej(f_ei(x))다. 결정성이 유지되며, 합성된 인터페이스는 X_ei를 Y_ej로 매핑하므로 호환되는 환경을 더 연결할 수 있다.
- 길이가 t인 연쇄의 매핑 함수는 F_πt = f_et ◦ f_e(t−1) ◦ ··· ◦ f_e1이고, 시그니처는 (X_e1, Y_et)다.
- 재귀적 폐쇄성은 유한한 환경 집합으로 구성할 수 있는 구조를 확장한다. 다만 타입이 호환되는 모든 연쇄가 실행 가능하거나 유용하다는 사실을 입증하지는 않는다.
- 구현에서는 도메인 일치를 후보 제안 방식으로 사용하고, 실제 중간 상태를 검증한다.
3.3 Implementation of Recursive Composition
RACES는 실행 가능한 경로를 무작위 너비 우선 탐색으로 찾는다. 상태는 중간값이고, 각 상태에서 나가는 간선은 그 상태와 입력 도메인이 일치하는 환경이다. Figure 1은 이 탐색·조합 과정이 표준화된 인터페이스 및 4가지 과제 연산자와 어떻게 연결되는지 보여준다.
- 상태 y_t에서 후보는 (C(y_t)={e\in\mathcal{E}:X_e=\operatorname{type}(y_t)})를 만족한다. 확장 경로는 실행과 출력 품질 검사를 통과한 경우에만 유지한다.
- 최대 깊이, 실행별 제한, 탐색 경계의 각 상태에서 허용하는 확장 수 상한으로 탐색 범위를 제한한다. 환경 사용을 고르게 분배하기 위해 남은 사용 예산을 후보 샘플링의 가중치로 사용한다.
- 경로를 찾은 뒤 연산자를 적용하므로 하나의 실행 가능한 합성 환경으로 서로 다른 예측 과제를 만들 수 있다. 연산자별 크기 샘플링은 특정한 좁은 경로 길이 범위가 학습을 지배하지 않도록 한다.
정수에서 정수로, 정수에서 문자열로, 문자열에서 문자열로 변환하는 예시는 출력·입력 인터페이스의 일치가 재귀적 조합을 가능하게 하는 방식을 보여준다. 아래 패널은 순서가 정해진 파이프라인 따르기, 독립 과제 풀기, 순서 복원하기, 순서가 있는 부분집합 선택하기를 구분한다. 이들은 재사용 가능한 실행 구성 요소로 만든 서로 다른 예측 과제다.
3.4 Composition Operators
SEQUENTIAL은 초기 입력과 순서가 정해진 환경 설명을 제시하고, 모든 중간 출력을 요구한다. 보상은 RSeq = K/t이며, K는 처음부터 연속으로 맞힌 출력의 최대 길이다. 첫 오류 이후의 예측에는 추가 보상을 주지 않는다.
- 정답 접두 구간에 대한 보상은 참조 실행 연쇄의 인과적 의존 관계를 반영한다.
- 이 과제는 변환을 연쇄적으로 수행하고 중간 상태를 유지하는 능력을 요구한다.
PARALLEL은 독립적인 환경-입력 쌍 n개를 하나의 컨텍스트에 묶고 모든 출력을 요구한다. 보상은 개별 검증 결과의 평균이므로, 한 문제에서 실패해도 다른 문제의 정답은 인정한다.
- 이 연산자는 순차적 의존 관계보다 독립적인 계산 과정을 분리하고 유지하는 능력을 평가한다.
SORT는 초기 입력, 목표 최종 출력, 순서를 섞은 환경 설명을 제공하고 순열을 요구한다. 검증기는 예측한 순서대로 실행하여 목표에 도달하면 이진 보상을 준다. 원래 순서와 달라도 유효한 순서라면 인정한다.
- 모델은 공개된 연쇄를 따르는 대신 실제로 작동하는 연산 순서를 추론해야 한다.
SELECT는 찾은 경로에 실행 가능하고 도메인이 호환되는 방해 후보를 추가하고, 모델에 서로 다른 후보를 선택하여 순서를 정하도록 요구한다. 예측한 시퀀스가 초기 입력을 목표 출력으로 매핑하면 이진 보상을 준다.
- 방해 후보는 경로 탐색 중 만난 대안에서 가져오며, 중간 상태에서 실행할 수 있다.
- 검증은 원래 경로와 정확히 일치하는지가 아니라 계산 결과를 확인한다.
4 Experiments
실험은 동일한 기본 환경 집합, 학습 인스턴스 수, RL 스텝 수를 사용하여 개별 환경 RL과 RACES를 비교한다. 주요 결과는 학습 환경 구축에 사용하지 않은 벤치마크로의 전이를 측정한다. 작은 모델을 사용한 분석에서는 학습 동향, 환경 집합 크기, 조합 깊이를 살펴본다.
4.1 Experimental Setup
주요 백본은 DeepSeek-R1-Distill-Qwen-14B와 Qwen3-14B다. 분석에서는 계산 비용을 줄이기 위해 Qwen3-4B-Instruct-2507을 사용한다. 평가는 LiveCodeBench, AIME 2024, AIME 2025, Enigmata, IFEval, LongBench-v2에서 수행한다.
- 6개 벤치마크는 코드 생성, 수학, 논리, 지시 따르기, 긴 컨텍스트 이해를 평가한다.
- AIME 2024/2025는 각각 32회, 다른 벤치마크는 각각 4회 평가하고 평균 점수를 보고한다.
- 표에서는 2개 AIME 벤치마크를 하나의 AIME 열로 합쳐 과제 열 5개를 제시한다.
주요 학습에서는 SEQUENTIAL과 PARALLEL의 조합 크기를 [2, 12]에서, SORT와 SELECT의 조합 크기를 [2, 6]에서 균등하게 샘플링한다. 분석에서는 SEQUENTIAL과 PARALLEL의 범위를 [2, 6]으로, SORT의 범위를 [2, 3]으로 줄인다. 작은 백본에서 SELECT 보상이 거의 0이므로 SELECT는 제외한다.
- 2개 설정 모두 동일한 환경 300개 집합을 사용한다. 기준선은 개별 과제를 샘플링하고, RACES는 연산자, 크기, 호환되는 환경을 샘플링한다.
- 익명화된 일부 환경은 https://anonymous.4open.science/r/Submission_of_NIPS2026_34776-B7FD 에서 제공한다.
학습은 32 × NVIDIA A100 80GB 클러스터에서 VERL, vLLM 롤아웃, GRPO를 사용한다. 클립 비율은 0.28이며 참조 정책에 대한 KL 정규화는 사용하지 않는다. 주요 실험은 300 steps와 12,800 instances를 사용하며, 배치 크기는 128, 학습률은 2e-6, 문제당 롤아웃 수는 8개, 최대 시퀀스 길이는 32K 토큰이다.
- 분석 실험은 200 steps와 6,400 instances를 사용하며, 배치 크기는 64, 최대 시퀀스 길이는 16K 토큰이다.
- 인스턴스 수와 스텝 수를 맞추면 데이터 양과 업데이트 횟수는 통제할 수 있지만, 생성 토큰 수나 총 계산 비용까지 같다는 사실은 입증하지 못한다.
4.2 Main Results
Table 1에서 RACES는 표에 제시된 모든 과제 열에서 기본 모델과 개별 환경 RL보다 높은 성능을 보인다. DeepSeek-R1-Distill-Qwen-14B는 평균 점수 51.3으로 RLindividual의 48.8과 Base의 48.2를 웃돈다. Qwen3-14B는 61.1로 각각 60.1과 58.8을 웃돈다.
- DeepSeek-R1-Distill-Qwen-14B에서 RACES는 LiveCodeBench 48.8, Enigmata 35.4, LongBench-v2 36.0, IFEval 74.6, AIME 61.7을 기록한다.
- Qwen3-14B의 해당 점수는 57.0, 49.2, 35.5, 86.7, 77.0이다.
- 결과는 구축한 환경을 넘어선 전이를 뒷받침한다. 반복 평가는 샘플링 잡음을 줄이지만, Table 1은 신뢰 구간이나 학습 시드에 따른 변동을 제공하지 않는다.
5 Analysis
분석에서는 학습 중 전이 성능, 작은 기본 환경 집합의 재사용, 조합 깊이가 최적화에 미치는 영향을 살펴본다. 대부분의 분석은 Qwen3-4B-Instruct-2507을 사용하며, 환경 집합 활용 효율 비교에는 DeepSeek-R1-Distill-Qwen-14B도 포함한다.
5.1 Performance across Training Process
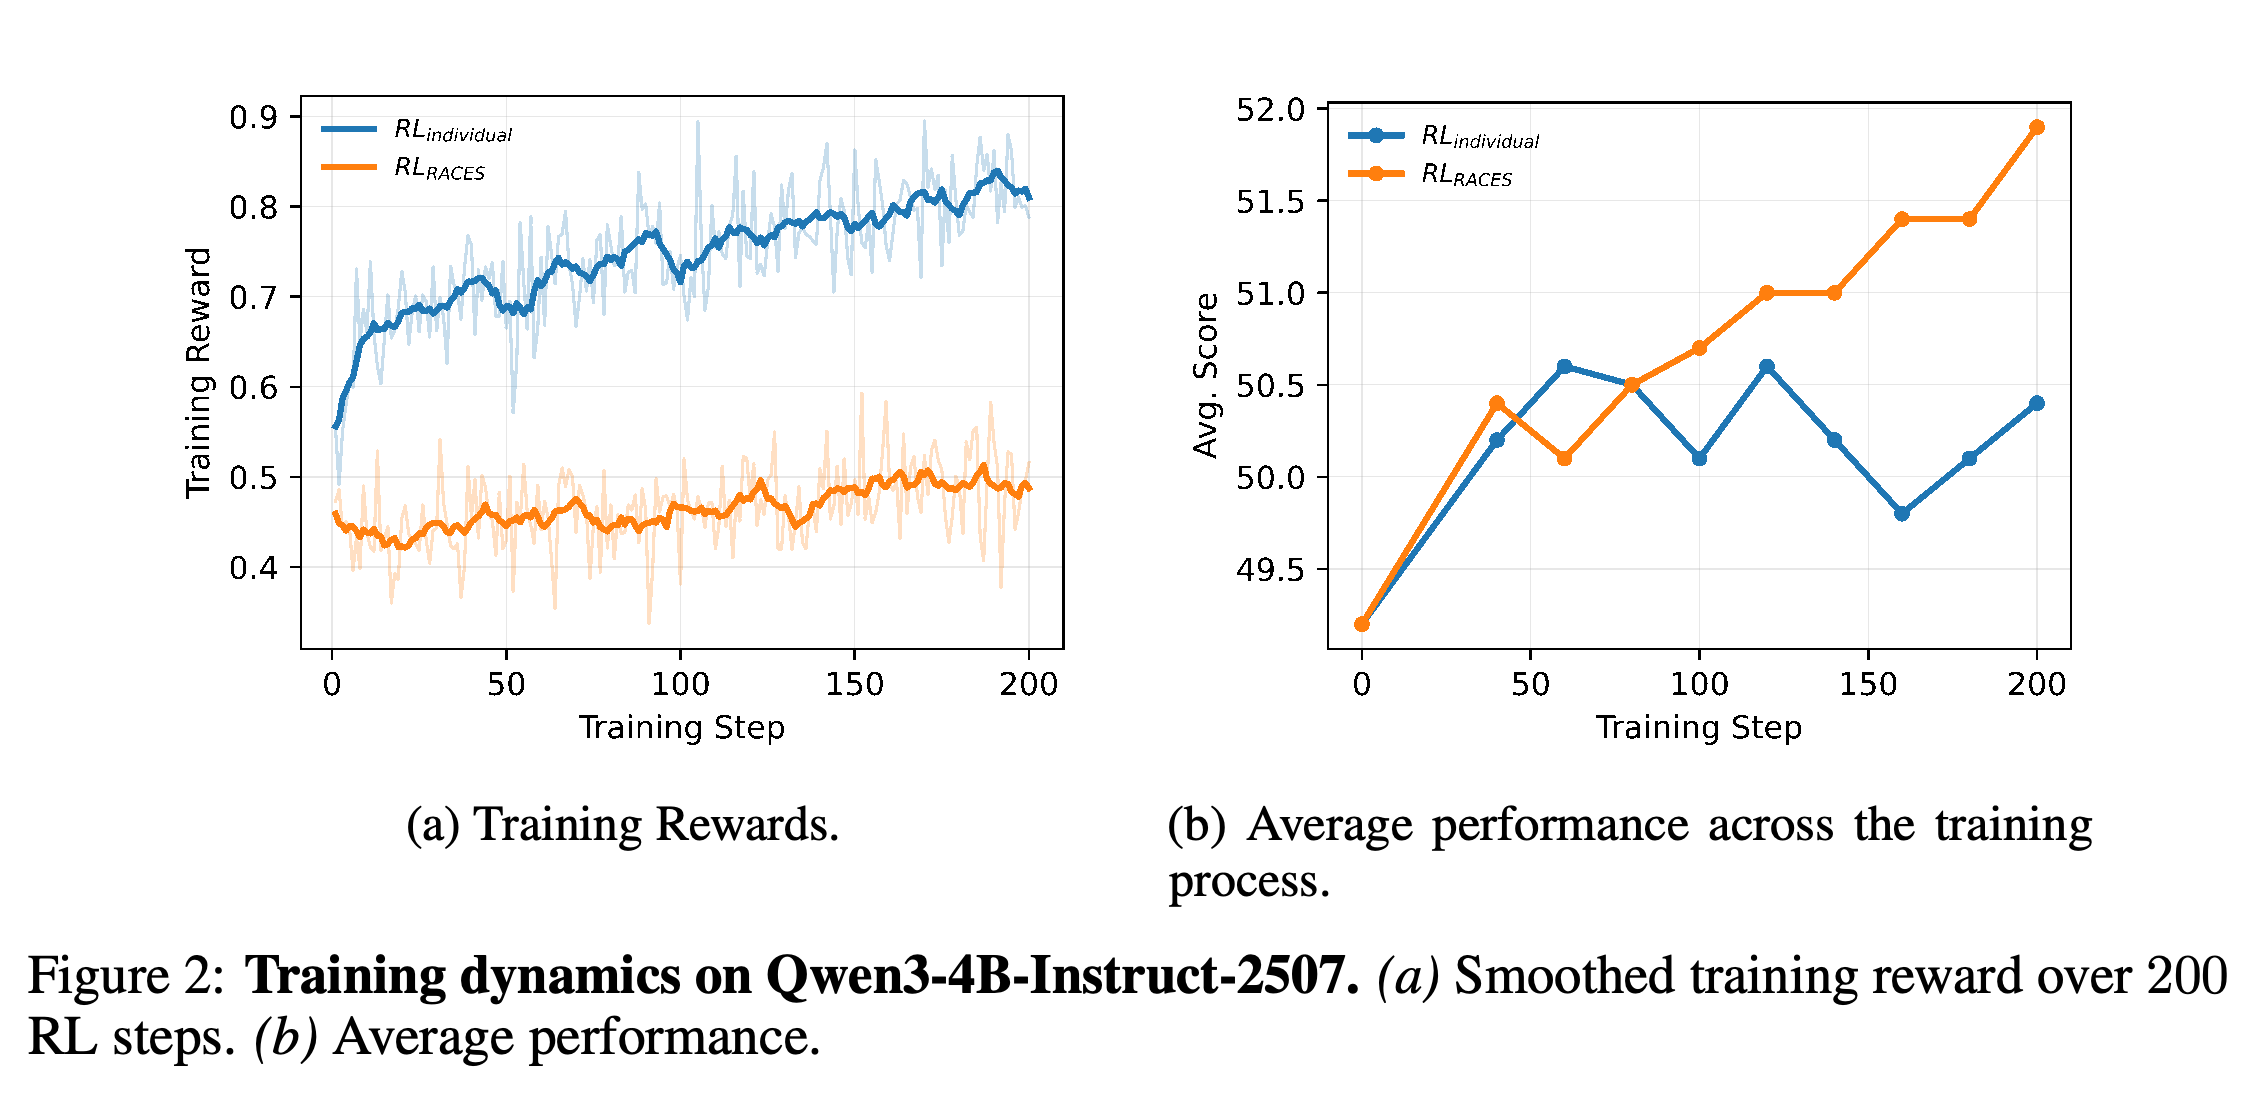
Figure 2는 학습 보상과 다운스트림 전이 성능을 구분하여 보여준다. RLindividual은 일관되게 더 높은 보상을 얻지만, RACES는 학습 후반에 벤치마크 성능이 더 크게 향상된다. 200스텝에서 평균 점수는 RACES가 51.9, RLindividual이 50.4다.
- 개별 환경 학습은 단순한 과제에 더 빠르게 적응하며, 조합 과제는 계속 풀기 어렵다.
- 높은 학습 보상이 더 좋은 전이 성능을 뜻하지는 않는다. 곡선만으로 과적합이 원인이라고 입증할 수 없으며, 어느 벤치마크 성능 추이도 계속 증가하지는 않는다.
- 보상은 서로 다른 과제 분포와 연산자 규칙에서 나오므로, 보상 크기는 추론 능력을 비교하는 공통 척도가 아니다.
개별 환경 RL은 더 높은 학습 보상을 유지하지만, RACES는 학습 후반에 벤치마크 성능이 더 크게 향상된다. 200스텝에서 RACES는 51.9로 비교 대상의 50.4를 웃돈다. 초반의 교차와 변동은 모든 체크포인트에서 일관된 우위가 아니라 후반부의 전이 성능 우위임을 보여준다.
5.2 Efficiency of Environment Utilization
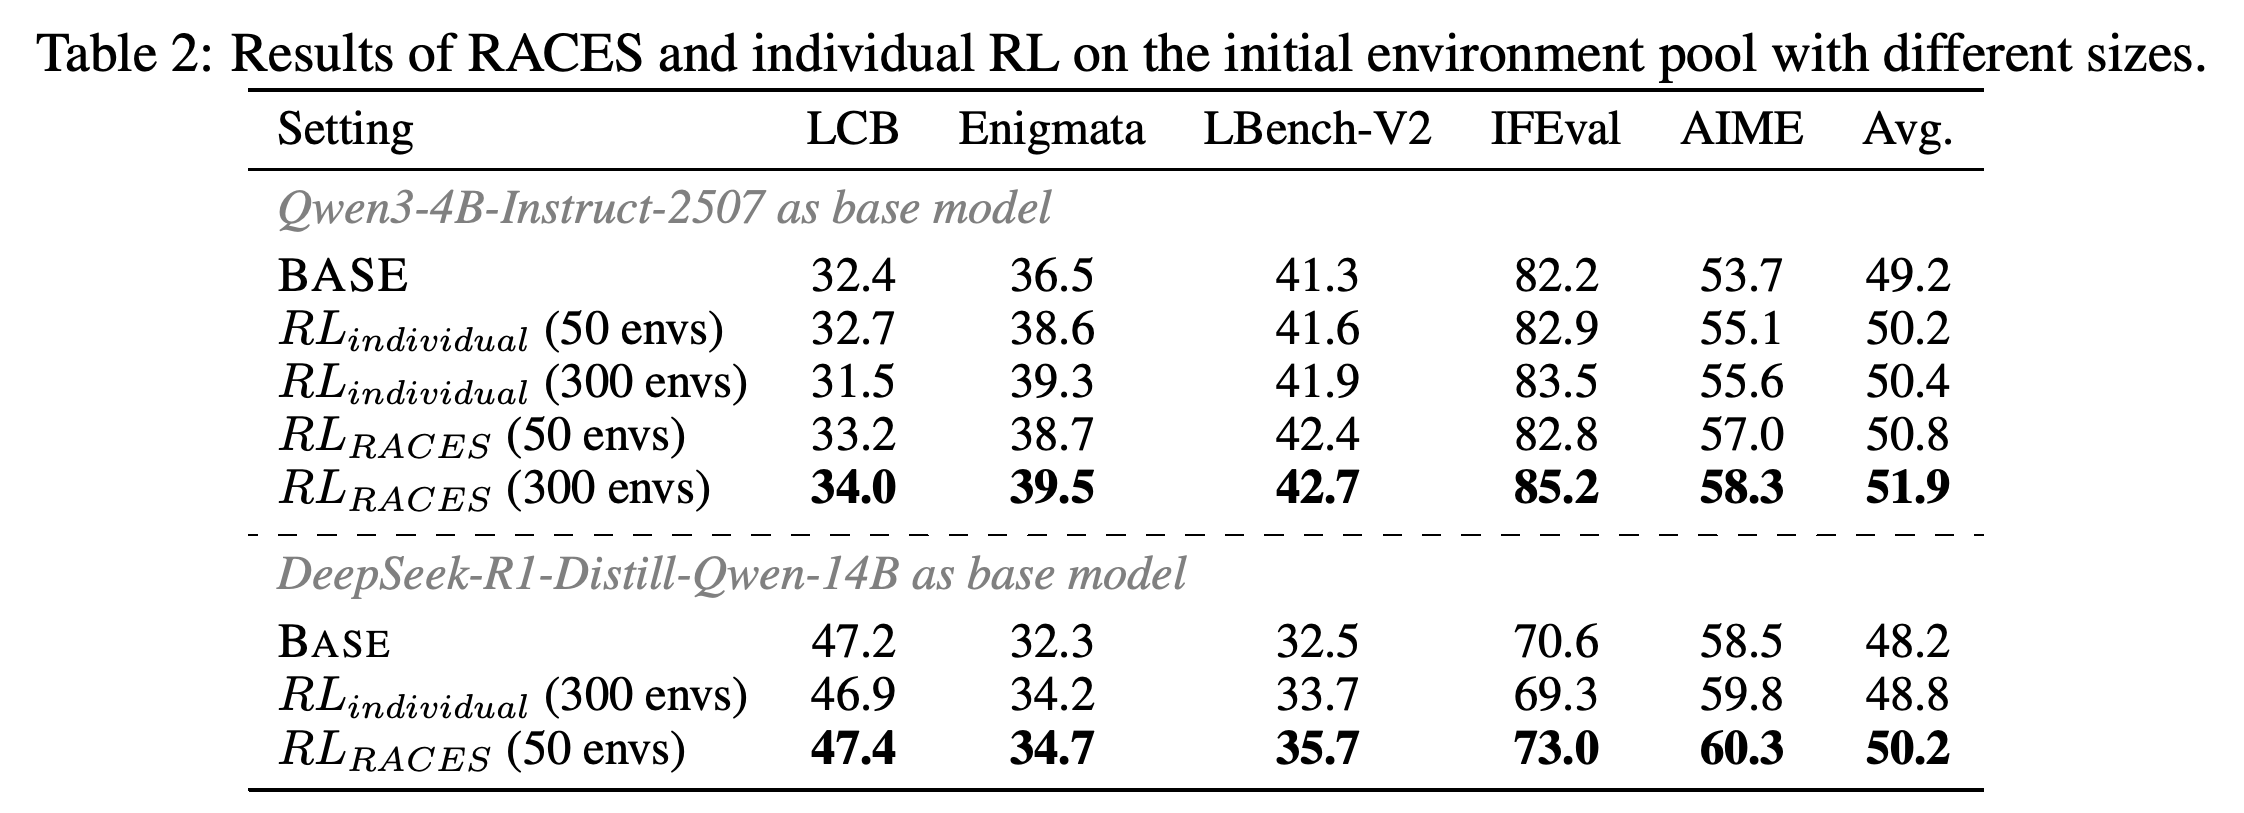
Table 2는 기본 환경 집합의 활용이 개선되었음을 보여준다. Qwen3-4B-Instruct-2507에서 환경 50개를 사용하는 RACES는 50.8로, 환경 300개를 사용하는 RLindividual의 50.4를 웃돈다. 전체 300개를 사용하는 RACES는 51.9에 도달한다.
- Qwen3-4B-Instruct-2507의 기본 모델 점수는 49.2이며, 환경 50개로 수행한 개별 RL의 점수는 50.2다.
- DeepSeek-R1-Distill-Qwen-14B에서 환경 50개를 사용하는 RACES는 50.2로, 환경 300개를 사용하는 개별 RL의 48.8을 웃돈다.
- 이는 평균 점수 비교이며, 4B 모델의 모든 열에서 성능이 향상되었다는 뜻은 아니다. 또한 전체 학습 비용이 6배 줄었다는 사실을 입증하지 않는다.
환경 50개를 사용하는 RACES는 환경 300개를 사용하는 개별 RL보다 평균 점수가 높다. Qwen3-4B-Instruct-2507에서는 50.8 대 50.4, DeepSeek-R1-Distill-Qwen-14B에서는 50.2 대 48.8이다. 4B 비교에서는 모든 과제 열에서 RACES가 우세한 것은 아니다. 이 결과는 기본 환경 집합의 재사용 개선을 뒷받침하지만, 총 구축 비용과 학습 비용은 측정하지 않았다.
5.3 Effect of Composition Size
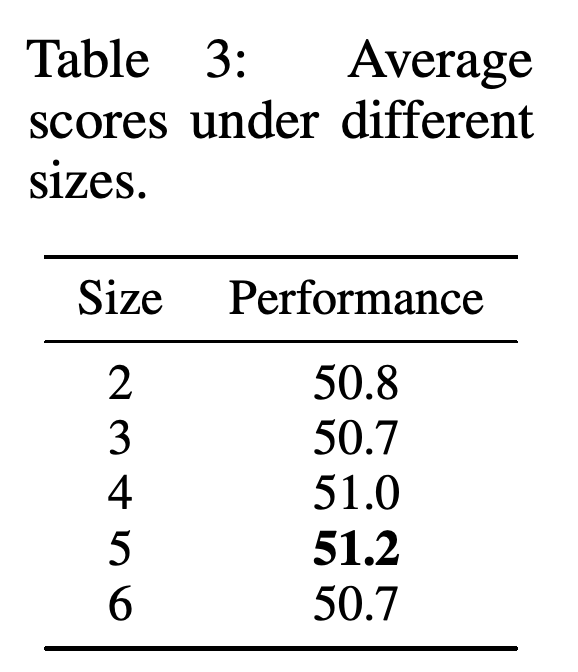
환경 집합을 300개로 고정한 SEQUENTIAL 분석은 Qwen3-4B-Instruct-2507에서 크기 2–6을 평가한다. Figure 3에서는 조합이 깊을수록 보상이 낮고 롤아웃 보상의 산포도 대체로 낮게 나타난다. Table 3의 평균 점수는 크기 2, 3, 4, 5, 6에서 각각 50.8, 50.7, 51.0, 51.2, 50.7이다.
- 이 실험에서는 크기 5가 가장 좋은 성능을 보이며, 크기 6은 크기 2보다 낮다. 깊이는 최대화하기보다 조정해야 한다.
- 본문은 크기 2에서 크기 5까지 꾸준히 향상된다고 설명하지만, 표에는 크기 3에서 점수가 하락한 결과가 있다. 결과가 뒷받침하는 관계는 비단조적이며, 평가한 크기 중 중간 깊이에서 최적 성능이 나타난다.
- Figure 3은 두 번째 지표를 보상 분산이라고 표시하지만, 캡션에서는 문제별 롤아웃 보상 표준편차의 평균으로 정의한다.
SEQUENTIAL 조합이 길어질수록 학습 보상과 롤아웃 보상 산포가 대체로 낮아지며, 이는 최적화가 더 어렵다는 해석과 부합한다. 두 번째 패널에는 보상 분산이라고 표시되어 있지만, 캡션은 그 값을 문제별 롤아웃 보상 표준편차의 평균으로 정의한다. 따라서 분산 통계량이 아니라 산포로 해석해야 한다.
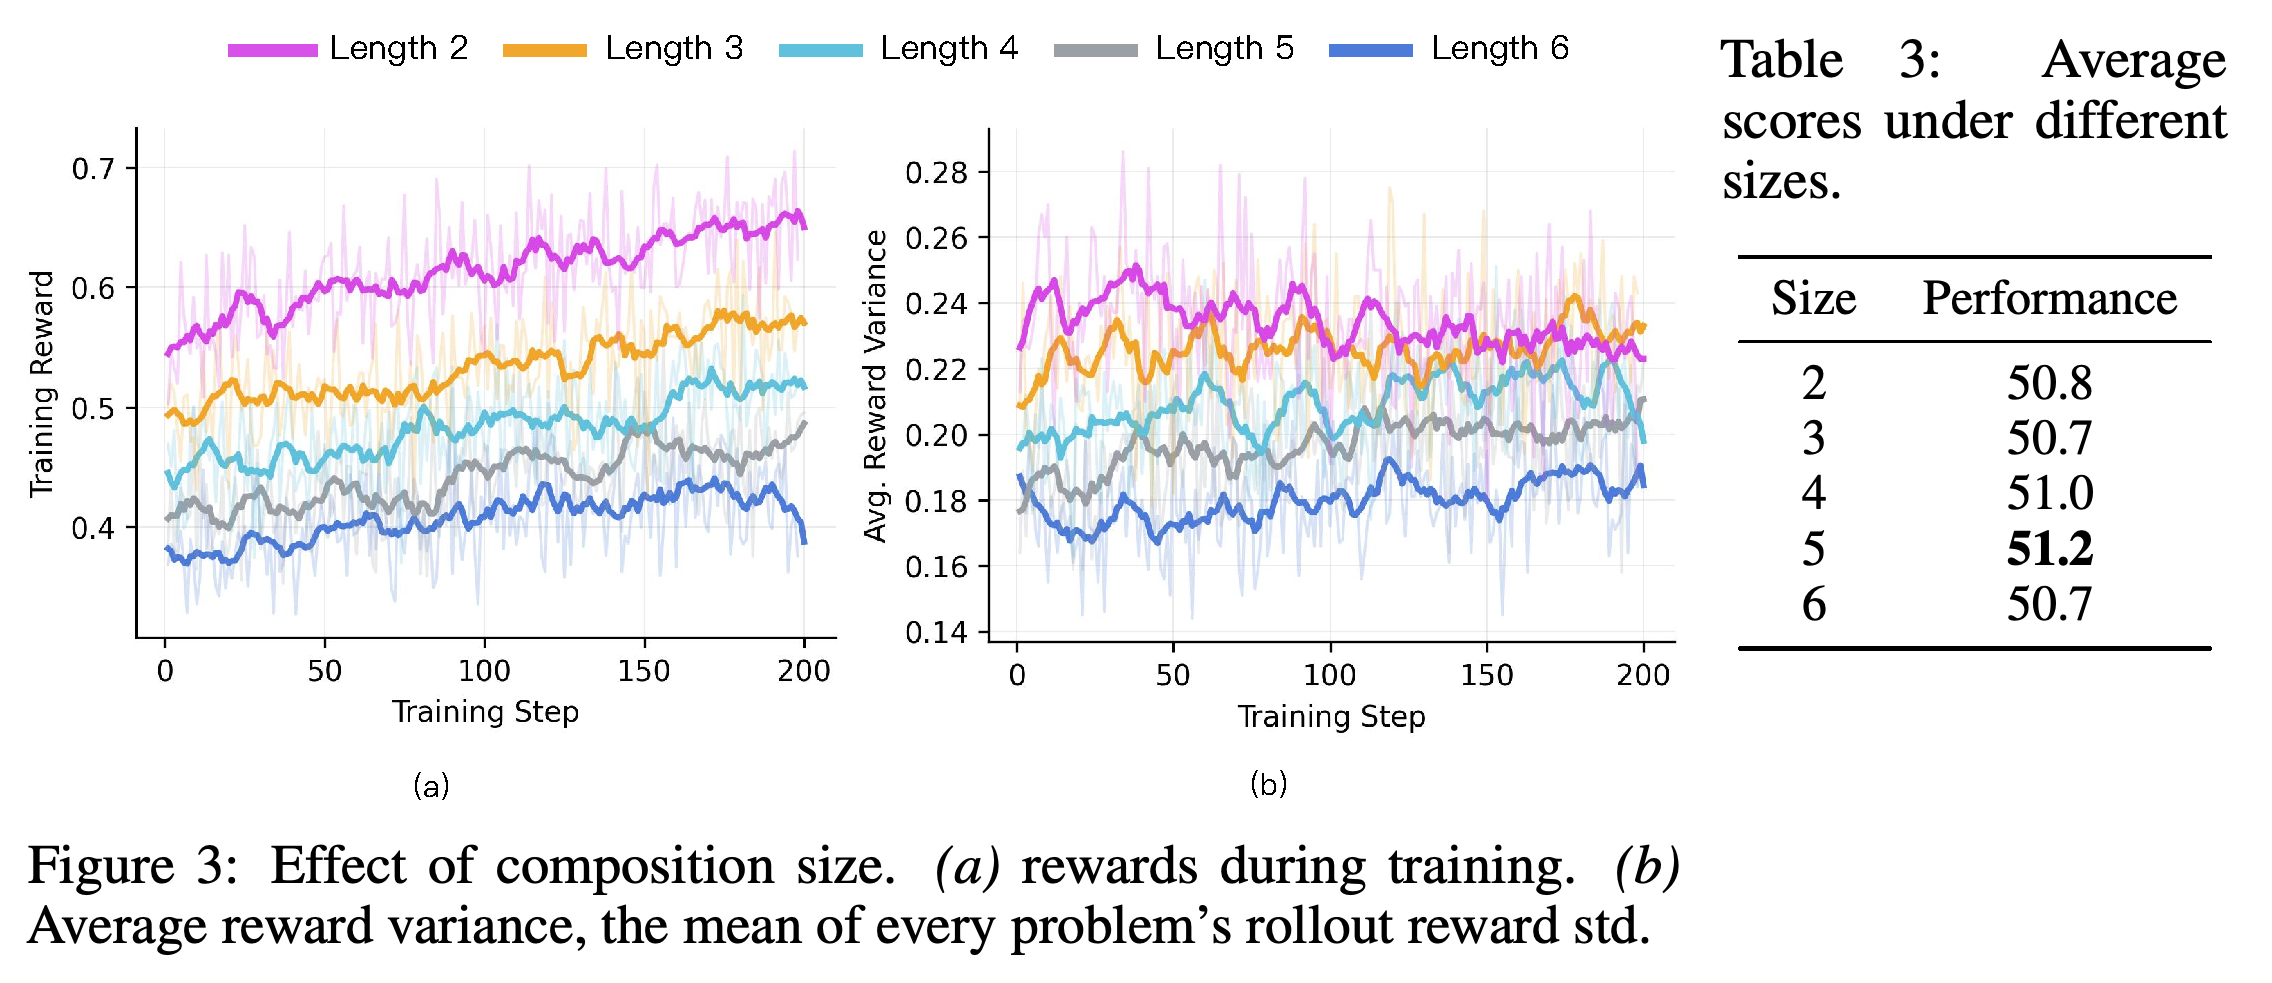
길이 2–6의 점수는 50.8, 50.7, 51.0, 51.2, 50.7이다. 평가한 크기 중 길이 5의 성능이 가장 좋지만, 길이 3과 6에서의 하락은 깊이가 늘수록 이득이 계속 증가한다는 해석과 맞지 않는다.
5.4 Pattern Analysis
3개 정성 사례는 RACES 응답이 재사용 가능한 추상화, 명시적 상태 추적, 가설 검증, 제약 전파와 관련되어 있음을 보여준다. 이 사례들은 전이 과정에서 나타날 수 있는 행동을 예시하지만, 연산자별 효과를 분리하거나 평가 집합 전체에서 그 행동이 나타나는 빈도를 입증하지는 않는다.
- AIME 격자 색칠 문제에서 Base는 변수 치환 오류를 내고, RLindividual은 빨간 변을 파란 변으로 일관성 없이 처리한다. RACES는 경우의 수를 세는 재사용 가능한 함수와 합계에 대한 2가지 검증을 사용한다.
- 리스트 변환 문제에서 기준선들은 가설 탐색에 실패한 뒤 잘못된 리스트를 반환한다. RACES 발췌문은 접미 구간 가설을 기각하고 인덱스를 추적하여 정답 출력을 반환하지만, 모든 시범 예시를 설명하는 완전한 규칙은 제시하지 않는다.
- Sum Skyscraper에서 기준선들은 불완전한 행별 탐색으로 해가 없다는 잘못된 결론에 도달한다. RACES는 열별 열거와 제약 전파를 사용하며, 발췌문은 단서 16개를 모두 검증했다고 보고한다.
6 Conclusion
논문은 표준화된 실행 가능 인터페이스가 각 환경을 독립적으로 구축하는 대신 환경을 재귀적으로 조합할 수 있게 한다고 결론짓는다. 실험은 평가한 조건에서 더 좋은 벤치마크 전이 성능과 기본 환경 집합 활용을 뒷받침한다. 깊이 분석은 과제 난도를 조절할 때 최적화 측면의 절충이 필요함을 보여준다.
부록
- A Limitations: 4가지 연산자는 대표적인 패턴을 다루지만, 조건 분기와 반복 횟수가 제한된 루프는 탐구하지 않는다. 조합 과제에는 충분한 초기 추론 능력이 필요하며, 약한 모델에서는 보상이 희소해질 수 있다. 긴 실행 기록에는 큰 컨텍스트 윈도도 필요하며, 주요 실험에서는 32K 토큰을 사용한다.
- B Declaration of LLM Usage: Claude-Sonnet-4.5가 후보 환경을 생성한 뒤, 정적 코드의 자체 일관성과 여러 샘플의 출력 일관성을 기준으로 필터링한다. 저자들은 문법 검사와 소규모 문장 수정에 제한적인 작성 보조를 사용했다고 별도로 보고한다.
- C Broader Impacts: 저자들은 재사용 가능한 검증 가능 환경이 사람의 어노테이션에 대한 의존도를 줄이고 RL 데이터 구축의 접근성을 높일 수 있다고 주장한다. 악의적 용도 변경과 에너지 소비를 위험으로 지적하고, 모델 체크포인트는 공개하지 않는다고 밝힌다. 또한 환경 300개에는 독극물이나 위험 물질 관련 내용이 없다고 보고한다.
- D Initial environments construction.: 환경 300개는 표준화된 알고리즘 문제 데이터셋, Claude-Sonnet-4.5 생성, 저자들의 수작업으로 구축하며, 45개는 알고리즘에서 유래한다. 품질 검토에서는 환경마다 입력 20개를 샘플링하고, Claude-Sonnet-4.5가 반복해서 생성한 풀이를 검증기로 확인한다. 제공된 원문은 통과율 기준이 “exceeding 95” 뒤에서 끊겨 있으므로, 완전한 값과 단위를 확인할 수 없다.
- D Initial environments construction.은 실행 필터링도 명시한다. 예외, 출력 누락, 실제 경과 시간 기준 2초 제한 초과, 원자 단계 400개를 넘게 요구하는 확장을 제외한다. 퇴화 방지 필터링은 경로 내 반복 상태나 형제 경로 간 중복 출력, 0 또는 1인 출력, 500보다 큰 정수, 길이가 100을 넘는 문자열 표현, 문자 1개만 반복하는 문자열을 제외한다. 길이가 2단계보다 짧은 경로는 버린다.
- E Case Studies for Pattern Analysis는 전체 응답 대신 프롬프트와 핵심 응답 발췌문을 제시한다. E.1 AIME: 2 × 2 Grid-Coloring은 각 단위 정사각형에 빨간 변 2개와 파란 변 2개가 있도록 단위 선분 12개를 색칠하는 경우를 묻는다. “Problem (AIME 2025), ground truth:”의 정답은 82다. “Base, variable-confusion in case-table filling”은 158을, “RLindividual, single inconsistent state update”는 83을 산출한다. “RACES, functional abstraction with two-way verification”은 x + y ∈ {0, 2}일 때 f(x, y)를 1로, x + y = 1일 때 2로 정의한 뒤, 그룹별 계산과 순차적 합산으로 합계 82를 확인한다.
- E.2 Enigmata: List-Transformation Rule Induction은 시범 예시 4개와 테스트 입력 [46, 94, 66, 98, 66, 66]을 제공한다. “Problem, ground truth:”의 정답은 [66, 66, 66]이다. “Base, broad hypothesis exploration without verification”과 “RLindividual, contradictions noted but not used”는 모두 [66, 66]을 반환한다. “RACES, index tracking and rule preservation across all demos”는 접미 구간 가설을 기각하고 반복값을 추적한 뒤 올바른 리스트를 반환한다. 다만 발췌문은 모든 시범 예시를 설명하는 완전한 규칙을 명시하지 않는다. 따라서 이 사례는 기저 함수를 검증하여 복원했다는 주장보다 해당 문제의 답을 맞혔다는 사실을 더 명확히 뒷받침한다.
- E.3 Enigmata: Sum Skyscraper Logic Puzzle은 “Problem, Sum Skyscraper 4×4”를 포함한다. 각 행과 열은 {1, 2, 3, 4}의 순열이어야 하며, 4면 모두에 보이는 건물 높이의 합을 나타내는 단서가 주어진다. “Base, visibility assumption error in row-wise casework”는 이미 찾은 유효한 행을 제외하고, “RLindividual, incomplete row enumeration”은 유효한 후보를 누락한다. 둘 다 해가 없다는 잘못된 결론을 내린다. “RACES, column-wise decomposition with cascading propagation”은 열 후보를 열거하고 행 내 중복 금지 제약을 전파하여 [[3, 2, 4, 1], [2, 3, 1, 4], [4, 1, 2, 3], [1, 4, 3, 2]]를 얻는다. 발췌문은 단서 16개를 모두 검증했다고 보고한다.
짧은 생각
핵심 기여는 조합마다 새로운 의미를 정의하지 않고도 구조적으로 다른 학습 과제를 만드는 실행 가능한 조합 인터페이스다. 동일한 환경 집합을 사용한 비교와 환경 50개 대 300개의 결과는 그 가치를 뒷받침한다. 그러나 인스턴스 수와 스텝 수가 같다고 계산 효율까지 입증되는 것은 아니며, 정성 사례도 연산자별 인과 메커니즘을 입증하지 않는다. 런타임 필터링은 타입 일치만큼 중요하다. 타입 호환성만으로는 유효하지 않거나 퇴화하거나 비용이 지나치게 큰 중간 계산을 막을 수 없다. 4B 모델에서 SELECT 보상이 거의 없고 SEQUENTIAL의 조합 크기가 6개일 때 성능이 하락한다는 결과는 과제 복잡도를 모델 능력에 맞춰야 함을 보여준다. 사실상 제한 없는 조합 공간은 구조적 가능성이다. 임의의 깊이에서도 유용한 학습 과제를 공급할 수 있다는 사실이 실험으로 입증된 것은 아니다.