


AutoCodeBench: Large Language Models are Automatic Code Benchmark Generators 요약 설명
12 Aug 2025 | Paper Review Code Generation LLM Evaluation Synthetic Data목차
- 요약
- 1 Introduction
- 2 AutoCodeBench: A Challenging, Practical, and Diverse Multilingual Benchmark
- 3 Experiments
- 3.1 Experimental Setup
- 3.2 Main Results
- 3.3 Performance Across Popular and Low-Resource Programming Languages
- 3.4 Performance Across Multi-Logic Programming Problems
- 3.5 Performance Analysis of Scaling Laws
- 3.6 Performance Analysis of Multi-Turn Refinement with Sandbox Feedback
- 3.7 AutoCodeBench-Complete: Evaluating Base Model Capabilities
- 4 Further Discussion
- 5 Related Work
- 6 Conclusion
- 부록
- 짧은 생각
이번 글에서는 AutoCodeBench: Large Language Models are Automatic Code Benchmark Generators 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 12일(Arxiv)
- Chou, Jason, Liu, Ao, Deng, Yuchi, Zeng, Zhiying, Zhang, Tao, Zhu, Haotian, Cai, Jianwei, Mao, Yue, Zhang, Chenchen, Tan, Lingyun, et al.
- Hunyuan Team, Tencent
- 논문 링크
요약
- AutoCodeBench는 많은 수작업 주석 없이 여러 프로그래밍 언어에서 어려운 코드 생성 평가 문제를 구축하는 비용 문제를 다룬다. 텍스트와 코드를 생성하는 대규모 언어 모델(LLM)을 30개 넘게 평가한 결과, Claude Opus 4가 AutoCodeBench에서 평균 Pass@1 52.4%로 가장 높은 성능을 보였다. Pass@1은 생성한 풀이 1개로 해결한 문제의 비율이다. 평가 모델의 성공 결과를 기준으로 선택한 AutoCodeBench-Lite 부분집합에서는 64.5%를 기록했다. 이 결과는 모두 답변 전에 중간 추론을 생성하는 reasoning mode에서 얻었다.
- AutoCodeGen은 먼저 풀이와 테스트 입력을 만들고, 격리된 코드 실행 환경인 다국어 샌드박스에서 실행한 뒤, 풀이와 테스트를 바탕으로 문제 설명을 작성한다. 난이도 필터링, 모델을 활용한 일관성 검사, 범주별 샘플링을 거쳐 20개 프로그래밍 언어에 걸친 문제 3,920개와 테스트 케이스 37,777개를 구성한다.
- 서로 다른 함수나 클래스를 여러 개 요구하는 multi-logic 문제에서는 모델 점수가 낮아진다. 반복 수정 실험에 사용한 3개 모델은 모두 실행 피드백으로 성능이 향상됐다. 전문 주석 작업자 6명이 6개 언어를 검토한 결과, 유효성은 87.6%로 보고됐다. 다만 경계 조건을 완전히 검사하지 않아도 유효하다고 인정하는 평가였으므로, 테스트의 완전성과 나머지 14개 언어의 유효성은 검증되지 않았다.
1 Introduction
AutoCodeBench: Large Language Models are Automatic Code Benchmark Generators는 기존 평가의 한계로 수작업 구축 비용, 좁은 프로그래밍 언어 범위, 난이도와 실용적 과제 다양성을 함께 확보하기 어렵다는 점을 제시한다. AutoCodeGen은 풀이를 먼저 생성하고 실행 가능한 테스트를 만든다. AutoCodeBench와 Lite는 문제 지시문을 보고 생성한 풀이를 평가하고 AutoCodeBench-Complete는 제공된 예시를 바탕으로 코드를 완성하는 능력을 평가한다. 논문은 다국어 실행 서비스도 공개하고 벤치마크 품질과 생성 과정에서 발생할 수 있는 편향을 검토한다.
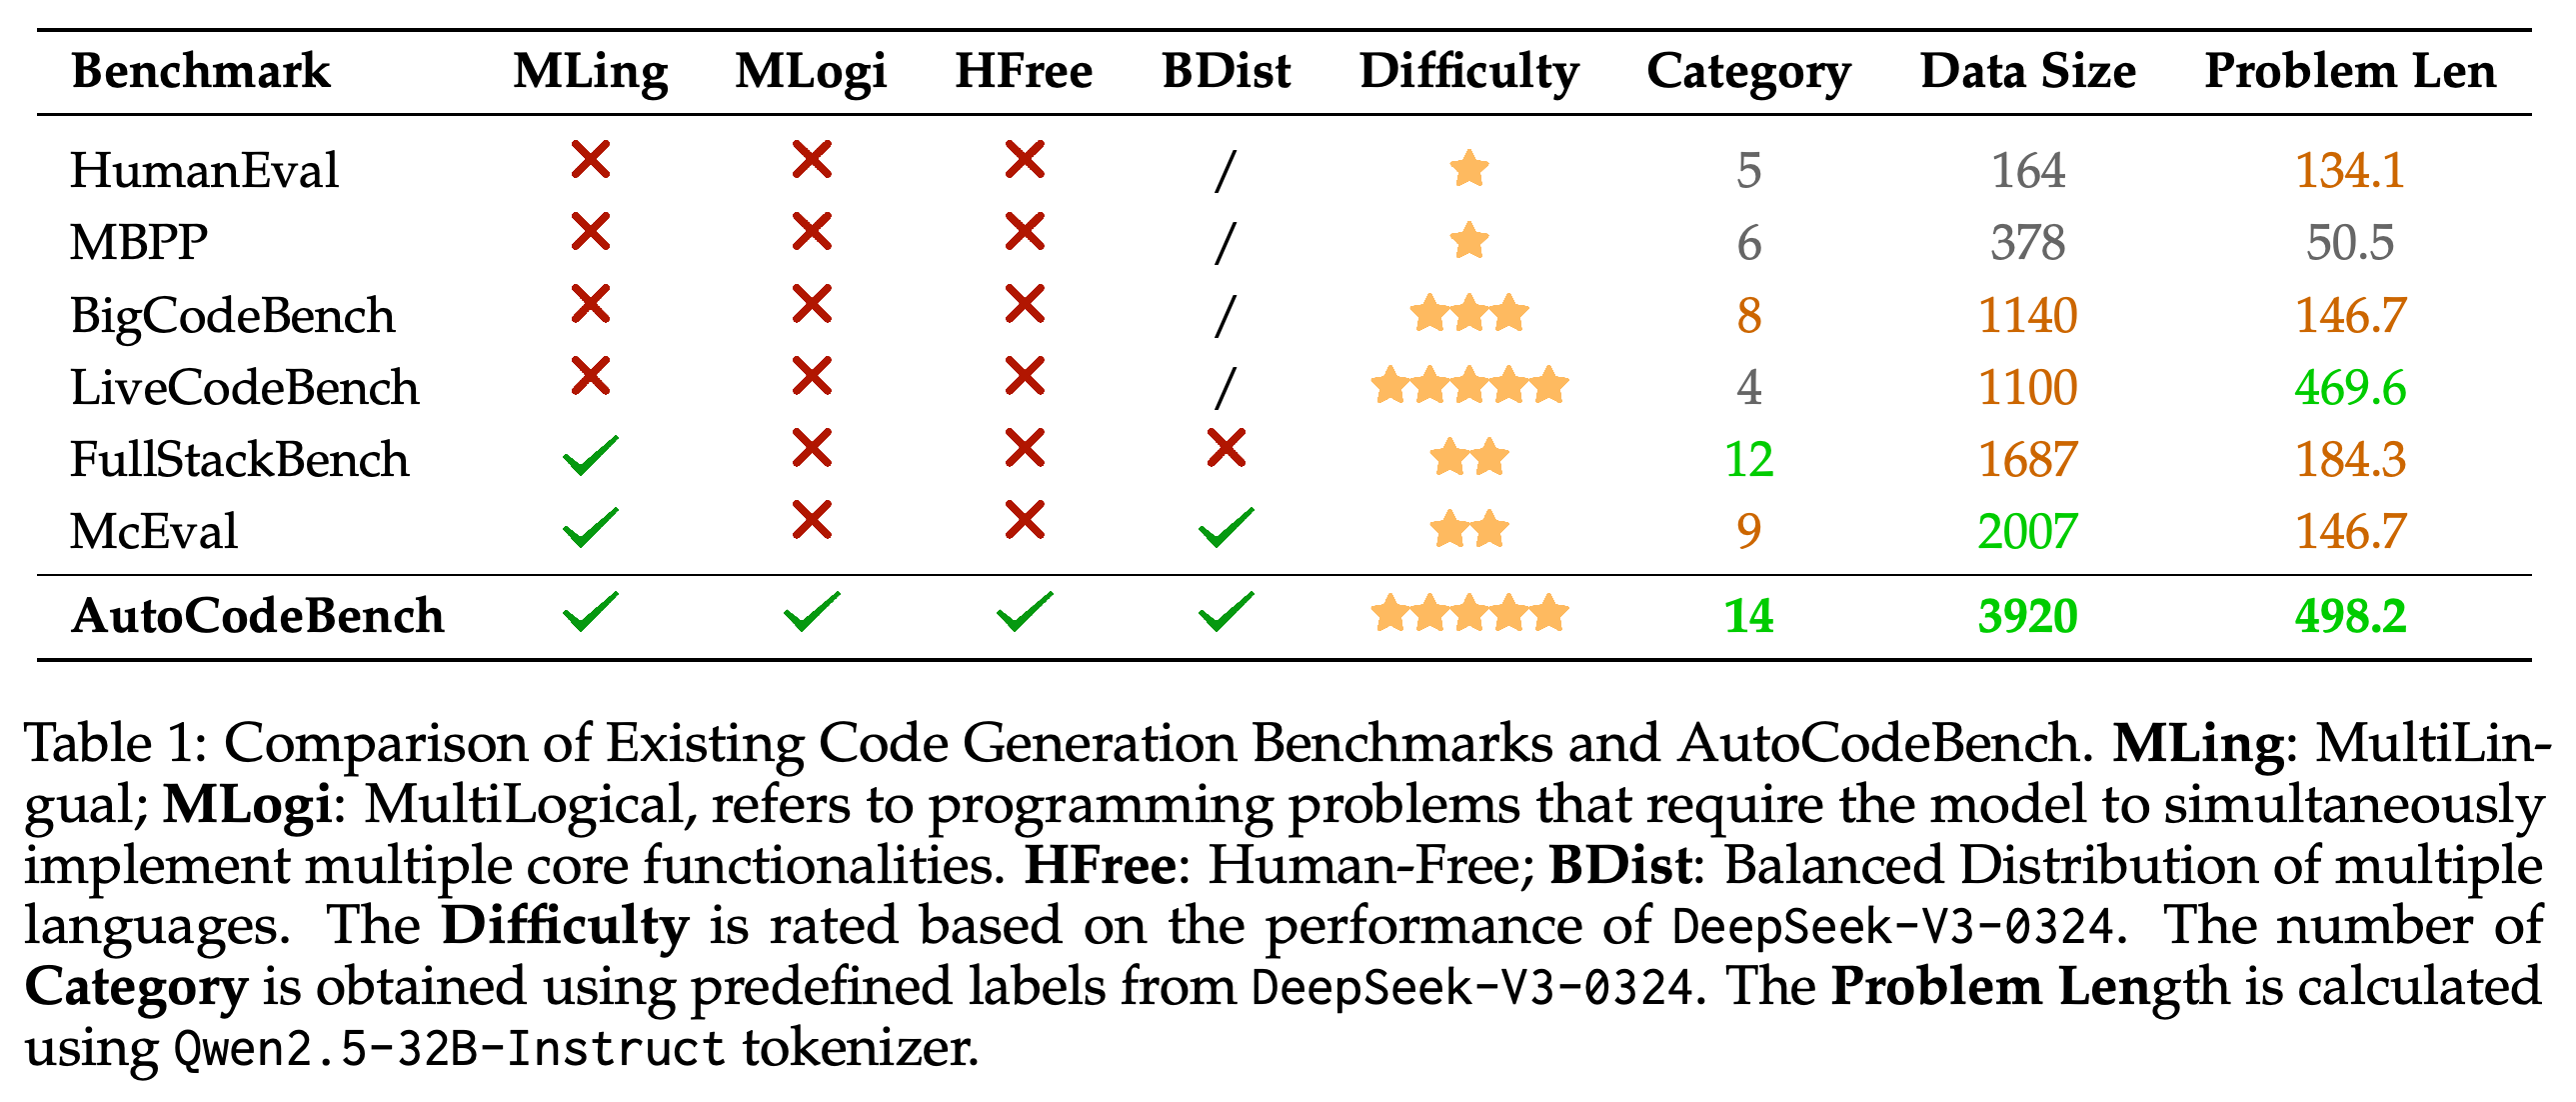
이 비교에서 AutoCodeBench는 다국어 지원, 여러 핵심 기능을 요구하는 과제, 자동 구축, 균등한 언어별 문제 수를 함께 갖춘다. 레코드 3,920개와 표시된 범주 14개는 나열된 비교 대상보다 많다. 다만 난이도 평가와 범주 할당은 모델에 의존한다.
2 AutoCodeBench: A Challenging, Practical, and Diverse Multilingual Benchmark
AutoCodeBench는 20개 프로그래밍 언어를 대체로 균등하게 포함하며 저장소에서 유래한 문제를 난이도에 따라 필터링한다. 이 절에서는 데이터셋 통계와 자동 구축 과정을 설명한다. 평가 모델이 실제로 해결한 결과를 기준으로 Lite를 선택하는 과정도 포함한다.
2.1 Data Overview
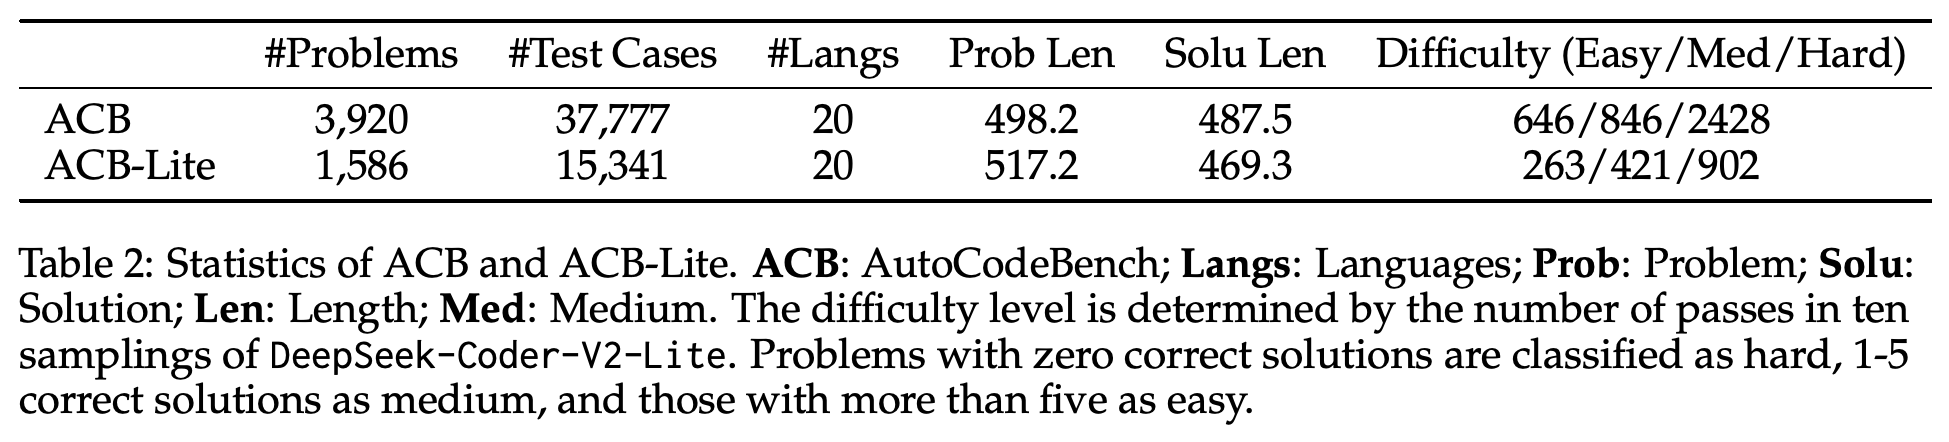
AutoCodeBench에는 문제 3,920개와 37,777 test cases가 있고, AutoCodeBench-Lite에는 문제 1,586개와 15,341 test cases가 있다. 난이도는 DeepSeek-Coder-V2-Lite의 10차례 시도를 기준으로 정의한다. 성공한 풀이가 0이면 hard, 1–5이면 medium, 5를 초과하면 easy로 분류한다. 전체 벤치마크의 easy/medium 문제 수는 646/846개이고, hard 문제 수는 2,428개다. Lite의 easy/medium 문제 수는 263/421개이고, hard 문제 수는 902개다.
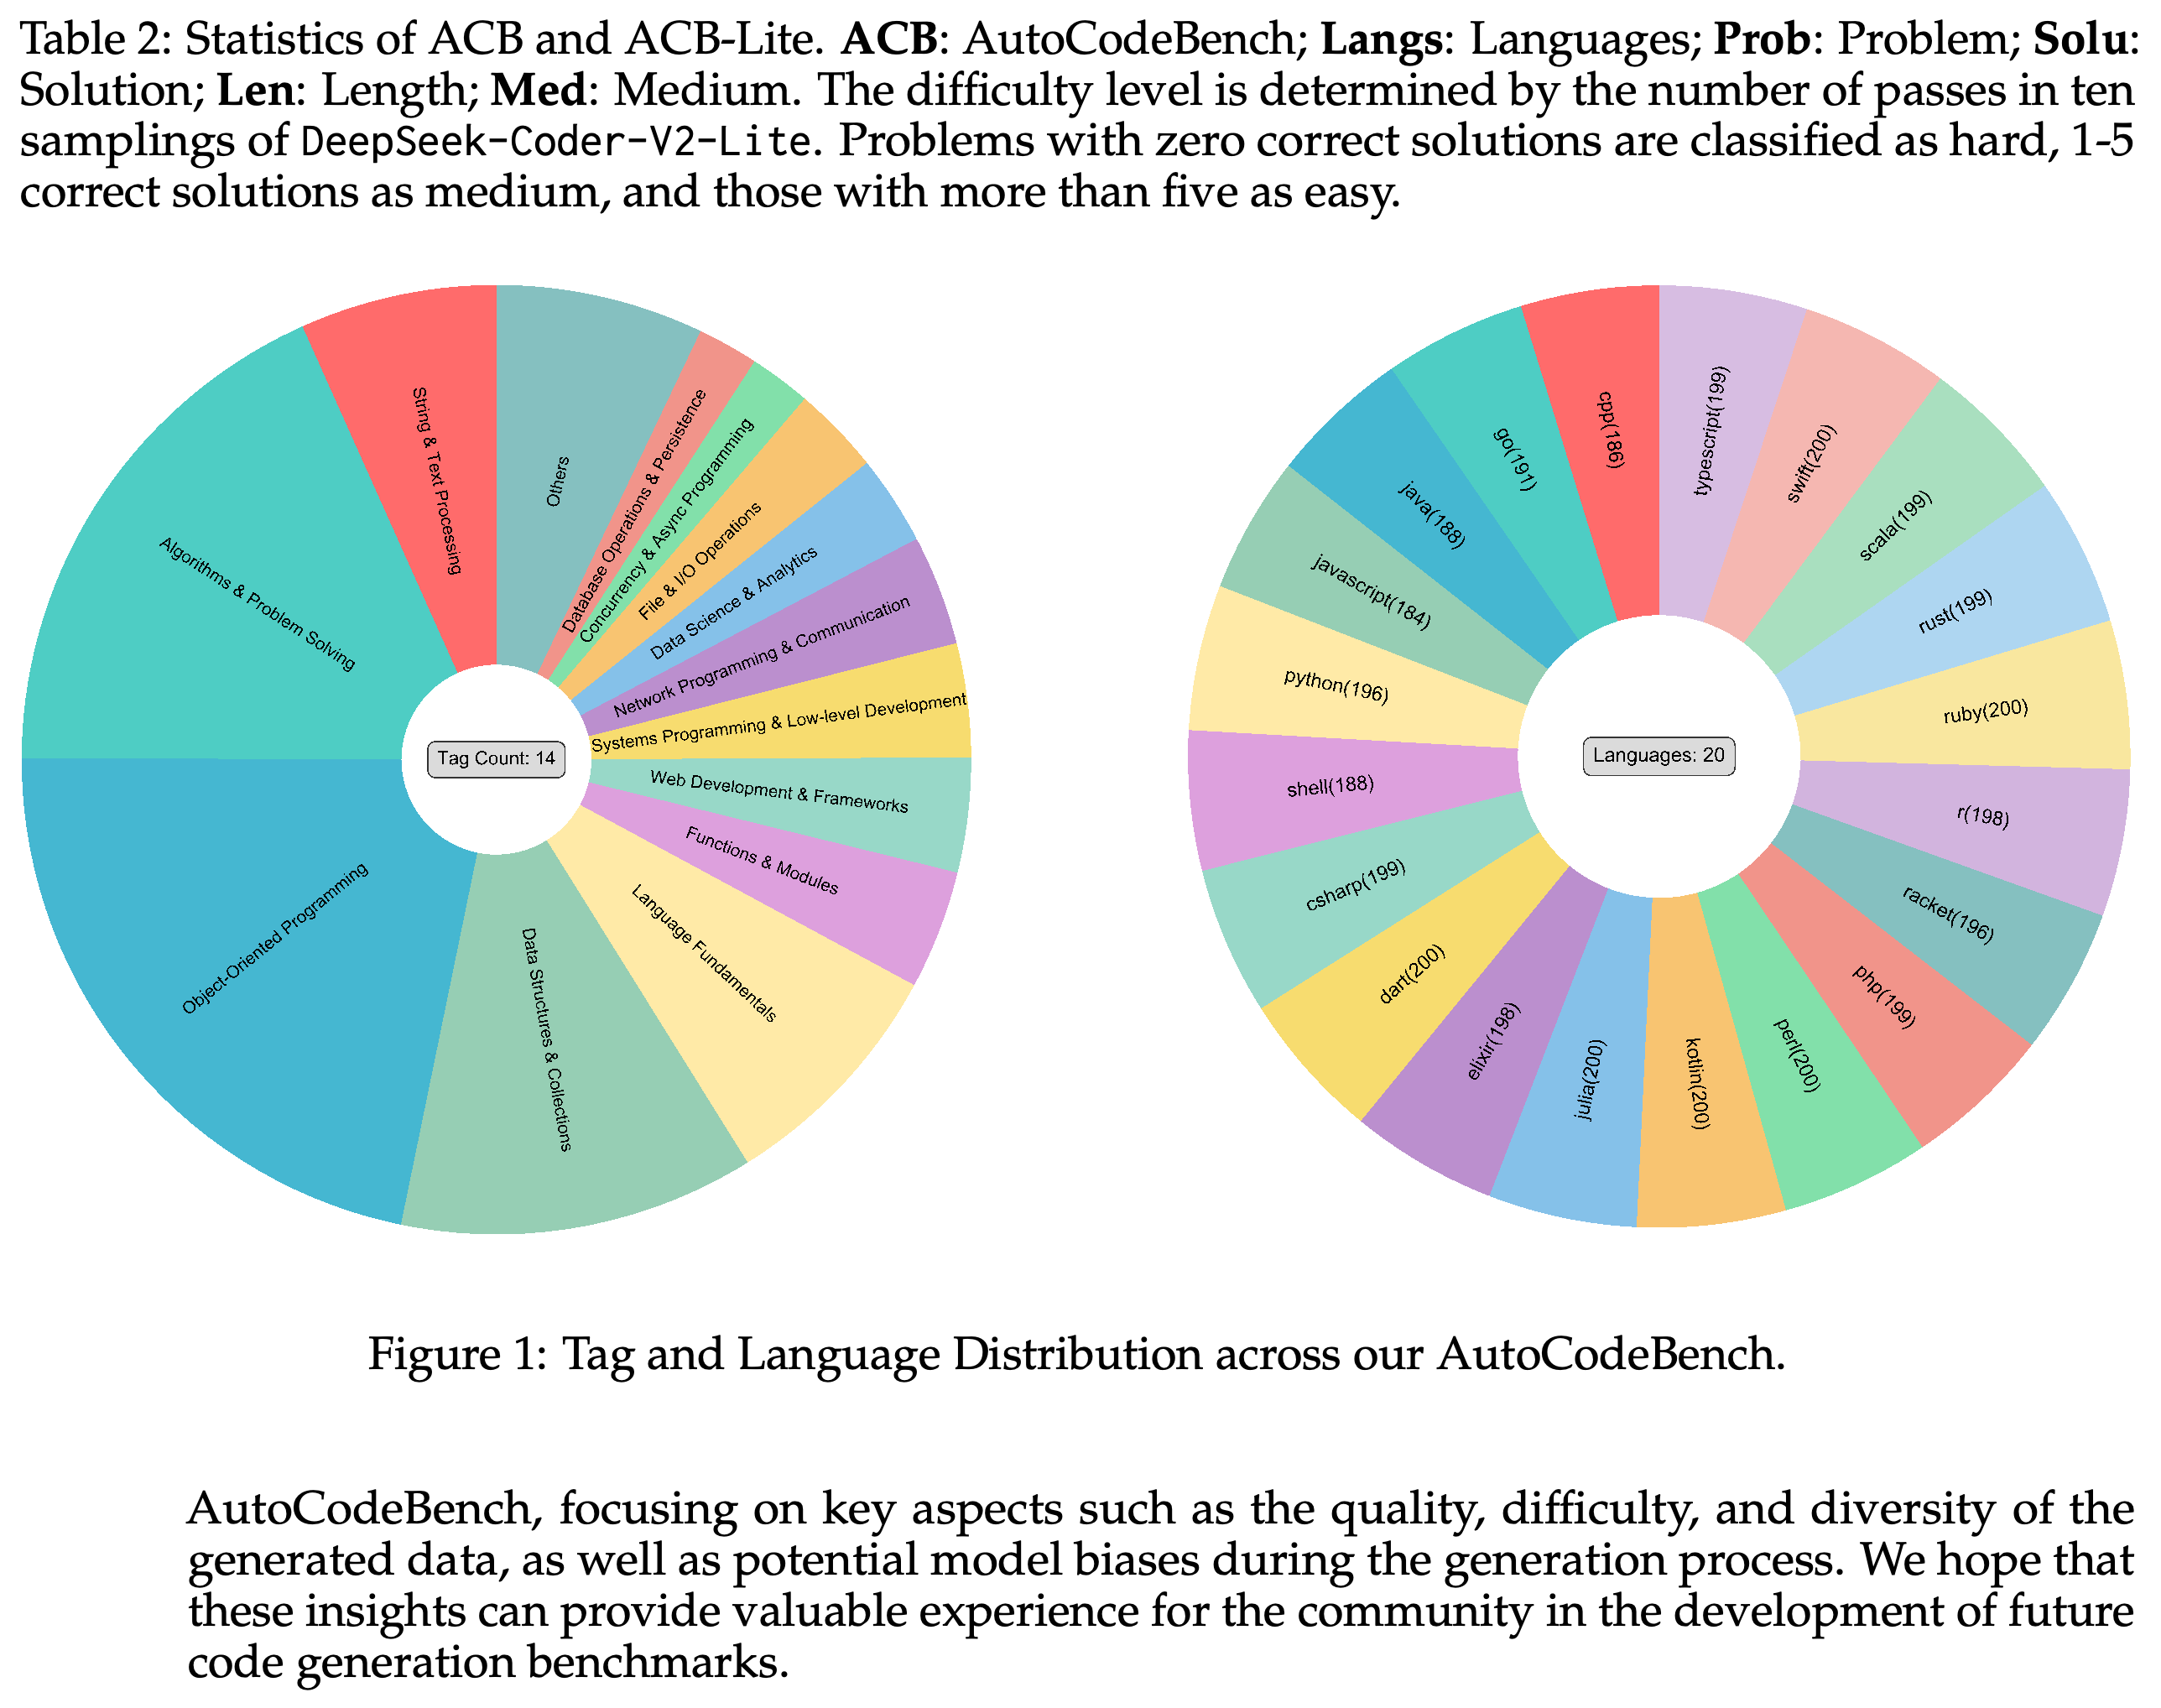
- 포함된 언어는 Python, C++, Java, JavaScript (JS), Go, Shell, C#, Dart, Elixir, Julia, Kotlin, Perl, PHP, Racket, R, Ruby, Rust, Scala, Swift, TypeScript (TS)다. 전체 벤치마크의 언어별 문제 수는 184–200개이고, Lite에서는 57–106개다.
- Claude Sonnet 4가 언어에 종속되지 않는 과제 범주 20개를 제안하고 DeepSeek-V3-0324가 범주를 할당한다. 비중이 2% 미만인 범주는 “Other”로 통합해 14개 범주를 표시한다.
- Table 2의 평균 문제/풀이 길이는 전체 벤치마크에서 498.2/487.5, Lite에서 517.2/469.3이다. Section 2.1은 문제 길이의 단위를 문자라고 설명하지만 Table 1은 텍스트를 모델 입력 토큰으로 나누는 Qwen2.5-32B-Instruct 토크나이저를 명시한다. PDF는 이 설명의 차이를 해명하지 않는다.
DeepSeek-Coder-V2-Lite의 10회 시도를 기준으로 정의한 hard 문제는 전체 벤치마크에서 3,920개 중 2,428개, Lite에서 1,586개 중 902개다. Lite는 20개 언어를 모두 유지하면서 평가량을 줄인다.
20개 언어의 문제 수는 대체로 균등하지만 과제 범주의 비중은 서로 다르다. 객체 지향 프로그래밍, 알고리즘, 자료구조가 큰 비중을 차지한다.
2.2 Automated Workflow
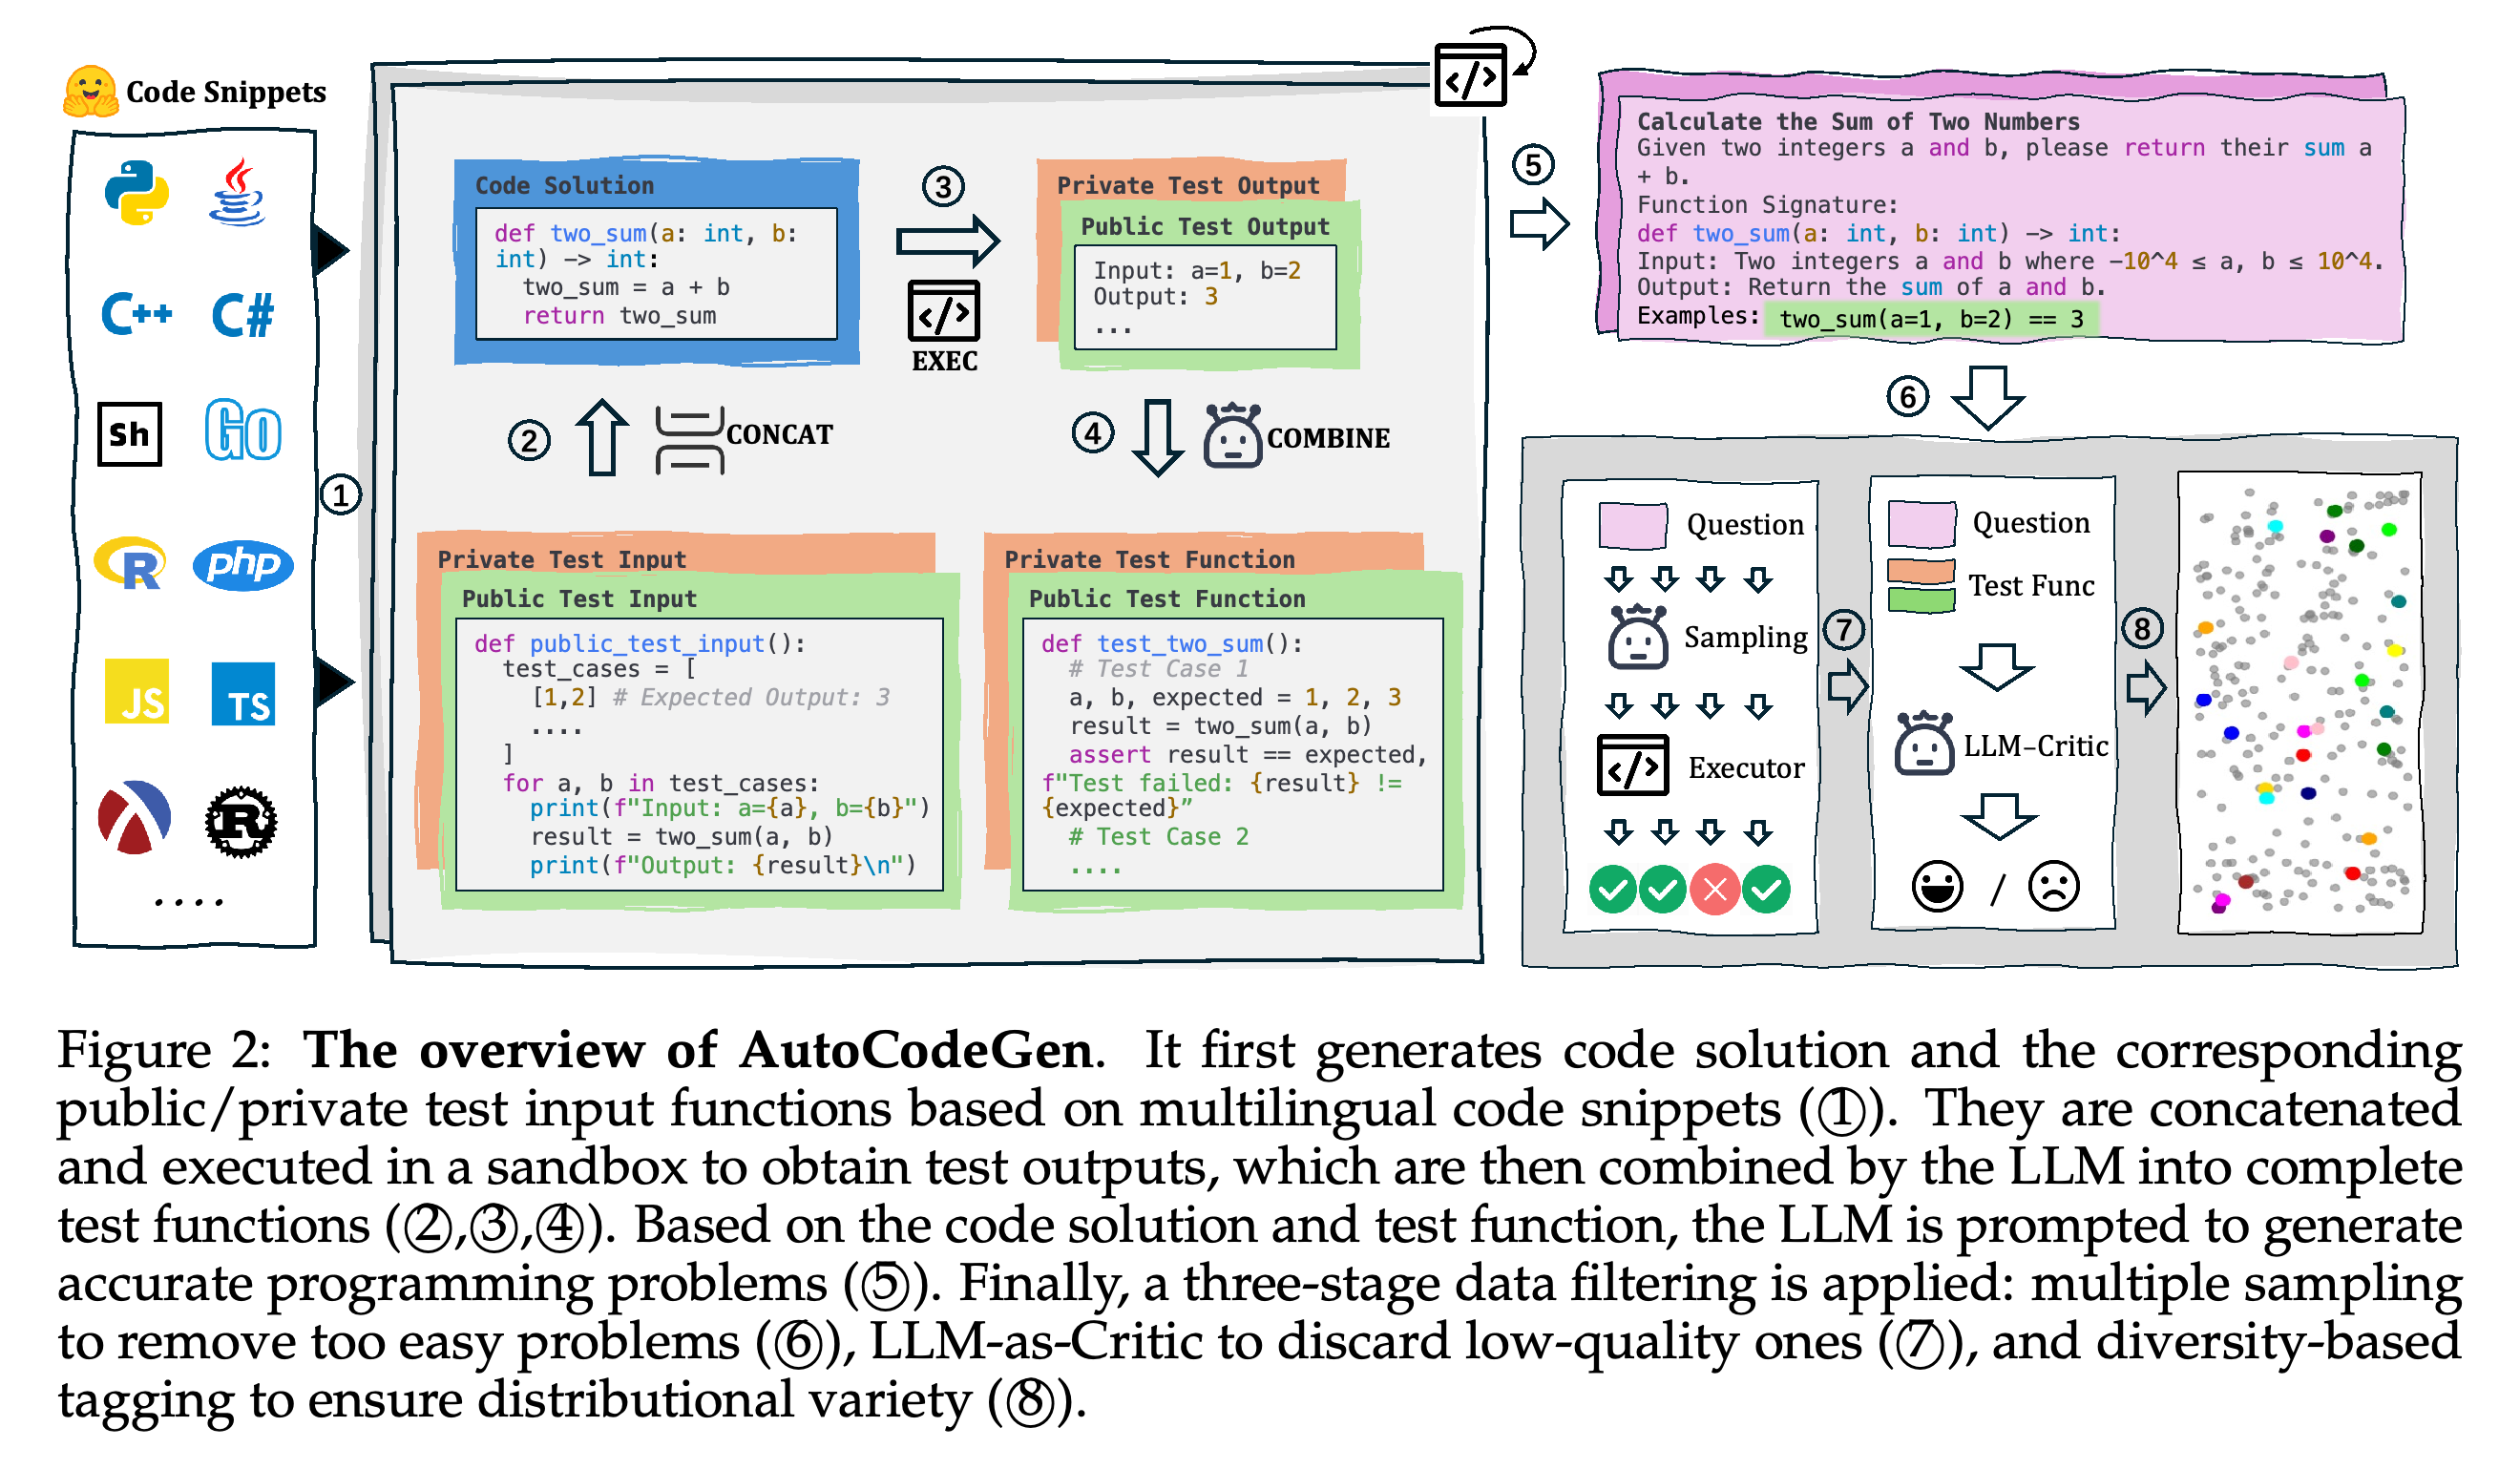
AutoCodeGen은 Code Solution Generation, Test Function Generation, Programming Problem Generation, Data Filtering의 4단계로 구성된다. 생성한 기준 풀이를 실행해 테스트의 기대 출력을 얻으므로, 모델이 출력을 직접 예측할 필요가 없다. 이 과정은 제공된 테스트 케이스에 대한 실행 일관성을 확보한다. 다만 이후의 사람 평가에서는 명세 오류가 여전히 발견됐다.
- 2.2.1 Code Solution Generation: The Stack v2에서 필터링한 교육용 코드 데이터셋 Stack-Edu가 GitHub 저장소의 함수, 클래스, 파일 단위 코드 조각을 제공한다. DeepSeek-V3-0324는 예시가 포함된 언어별 프롬프트를 사용해 독립적으로 실행 가능한 풀이를 만들고, 불필요한 로직을 제거하며 주석을 추가한다. 샌드박스는 실행 여부를 확인한다.
- 2.2.2 Test Function Generation: 공개 입력 함수에는 기본 케이스를 최대 3개 포함하고 비공개 함수에는 경계 조건이나 특이한 조건의 입력을 포함해 7개 이상의 입력을 넣는다. 시스템은 각 풀이를 입력과 함께 실행한 뒤, DeepSeek-V3-0324에 입력과 관측된 출력을 결합해 테스트 함수를 만들도록 요청한다. 이후 공개 테스트와 비공개 테스트를 다시 실행한다.
- 2.2.3 Programming Problem Generation: DeepSeek-V3-0324는 6가지 명세에 따라 설명을 작성한다. 프로그래밍 언어를 명시하고 과제를 모호하지 않게 설명하며 함수/클래스 이름을 정확하게 지정하고 입출력 타입과 범위를 제시하며 공개 예시를 포함하고 풀이 힌트를 제공하지 않는다. 각 레코드는 <programming problem, code solution, public test function, private test function>으로 구성된다.
- 2.2.4 Data Filtering: DeepSeek-Coder-V2-Lite가 10회 시도에서 모두 해결한 문제를 제거한다. 이 과정에서 Python 후보 문제의 25.1%가 제거된다. DeepSeek-R1-0528은 문제 자체가 정확하다고 가정한 상태에서 문제와 테스트의 일관성을 검사하는 LLM-as-Critic 역할을 맡는다. 함수 시그니처, 재현성, 테스트 목적, 정밀도, 예외 처리, 명시되지 않은 요구사항, 테스트 범위를 검사한다. 범주별 순환 샘플링으로 다양성을 조절한다.
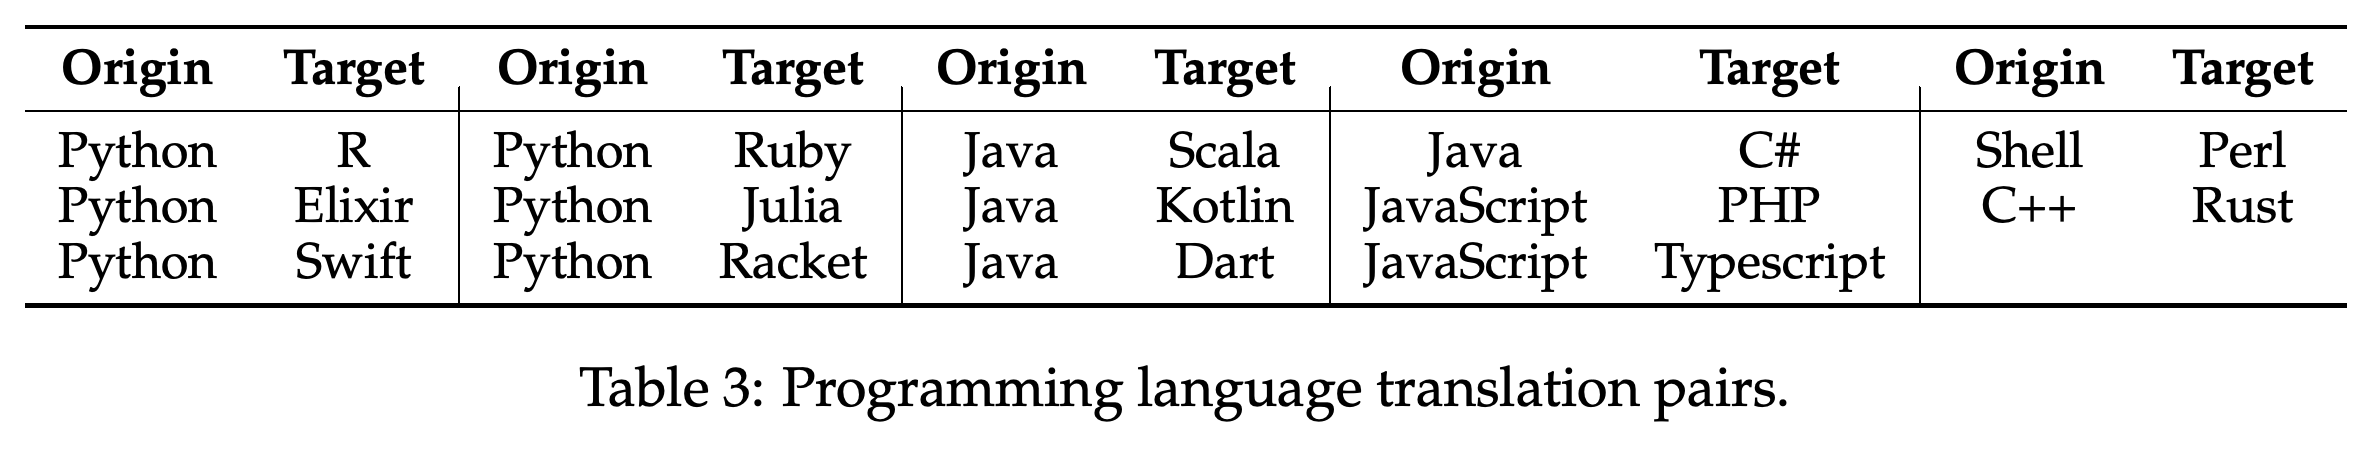
- 2.2.5 Approximate Language Translation: Python, C++, Shell, Java, JavaScript, Go는 직접 구축한다. 나머지 14개 언어는 사용하지 않은 레코드를 번역한 뒤 필터링한다. Table 3은 원본 언어와 대상 언어의 대응 관계를 제시한다.
- 2.2.6 AutoCodeBench-Lite Construction: 평가 모델들이 성공한 풀이 수를 기준으로 문제를 정렬한다. 통과 횟수가 2회 미만인 문제를 제거하고 통과 횟수가 적은 순서대로 약 1,500개를 선택해 최종적으로 문제 1,586개로 구성된 부분집합을 얻는다. 따라서 Lite 선택은 평가에 참여한 모델 집합에 따라 달라진다.
풀이와 입력을 먼저 만들고, 실행으로 출력을 얻은 뒤 테스트를 완성하고 문제를 생성한다. 마지막 샘플링, 비평, 태깅 단계는 각각 난이도, 일관성, 범주 다양성을 다룬다.
번역 관계는 Python에서 R, Elixir, Swift, Ruby, Julia, Racket으로, Java에서 Scala, Kotlin, Dart, C#으로, JavaScript에서 PHP, TypeScript로, Shell에서 Perl로, C++에서 Rust로 이어진다. 이는 14개 언어 부분집합이 어떤 언어에서 번역됐는지 보여준다.
3 Experiments
실험은 전체 성능과 언어별 성능, multi-logic 과제, 모델 크기, 추가 풀이 샘플링, 실행 오류를 활용한 반복 수정을 살펴본다. 별도의 코드 완성 실험에서는 지시 수행을 위한 사후 학습 이전의 모델인 base model을 예시 3개와 함께 평가한다.
3.1 Experimental Setup
평가는 오픈소스와 독점 모델을 30개 넘게 포함하며 오픈소스 모델의 매개변수 수는 1.5B–1T 범위다. B와 T는 각각 billion과 trillion을 뜻한다. 기본 지표는 Pass@1이다. 공통 출력 형식 프롬프트는 실행 명령, 테스트, 사용 예시 없이 풀이만 담은 Markdown 코드 블록 1개를 요청한다.
- 독점 모델과 명시된 대규모 배포 모델은 프로그램에서 서비스를 호출하는 인터페이스인 application programming interfaces (APIs)를 통해 추가 매개변수 없이 호출한다. DeepSeek-V3-0324, DeepSeek-R1-0528, Seed-Coder-8B, Qwen3 계열에는 공식 권장 매개변수를 사용한다. 나머지 모델에는 temperature를 0으로 설정하고 확률이 가장 높은 다음 토큰을 선택하는 greedy decoding을 사용한다.
- API를 사용하지 않는 모델은 논문에 명시된 모델 서빙 프레임워크 VLLM으로 실행한다. 결과는 통일된 디코딩 설정이 아닌, 논문에 보고된 각 배포 설정에서 얻은 성능을 비교한다.
3.2 Main Results
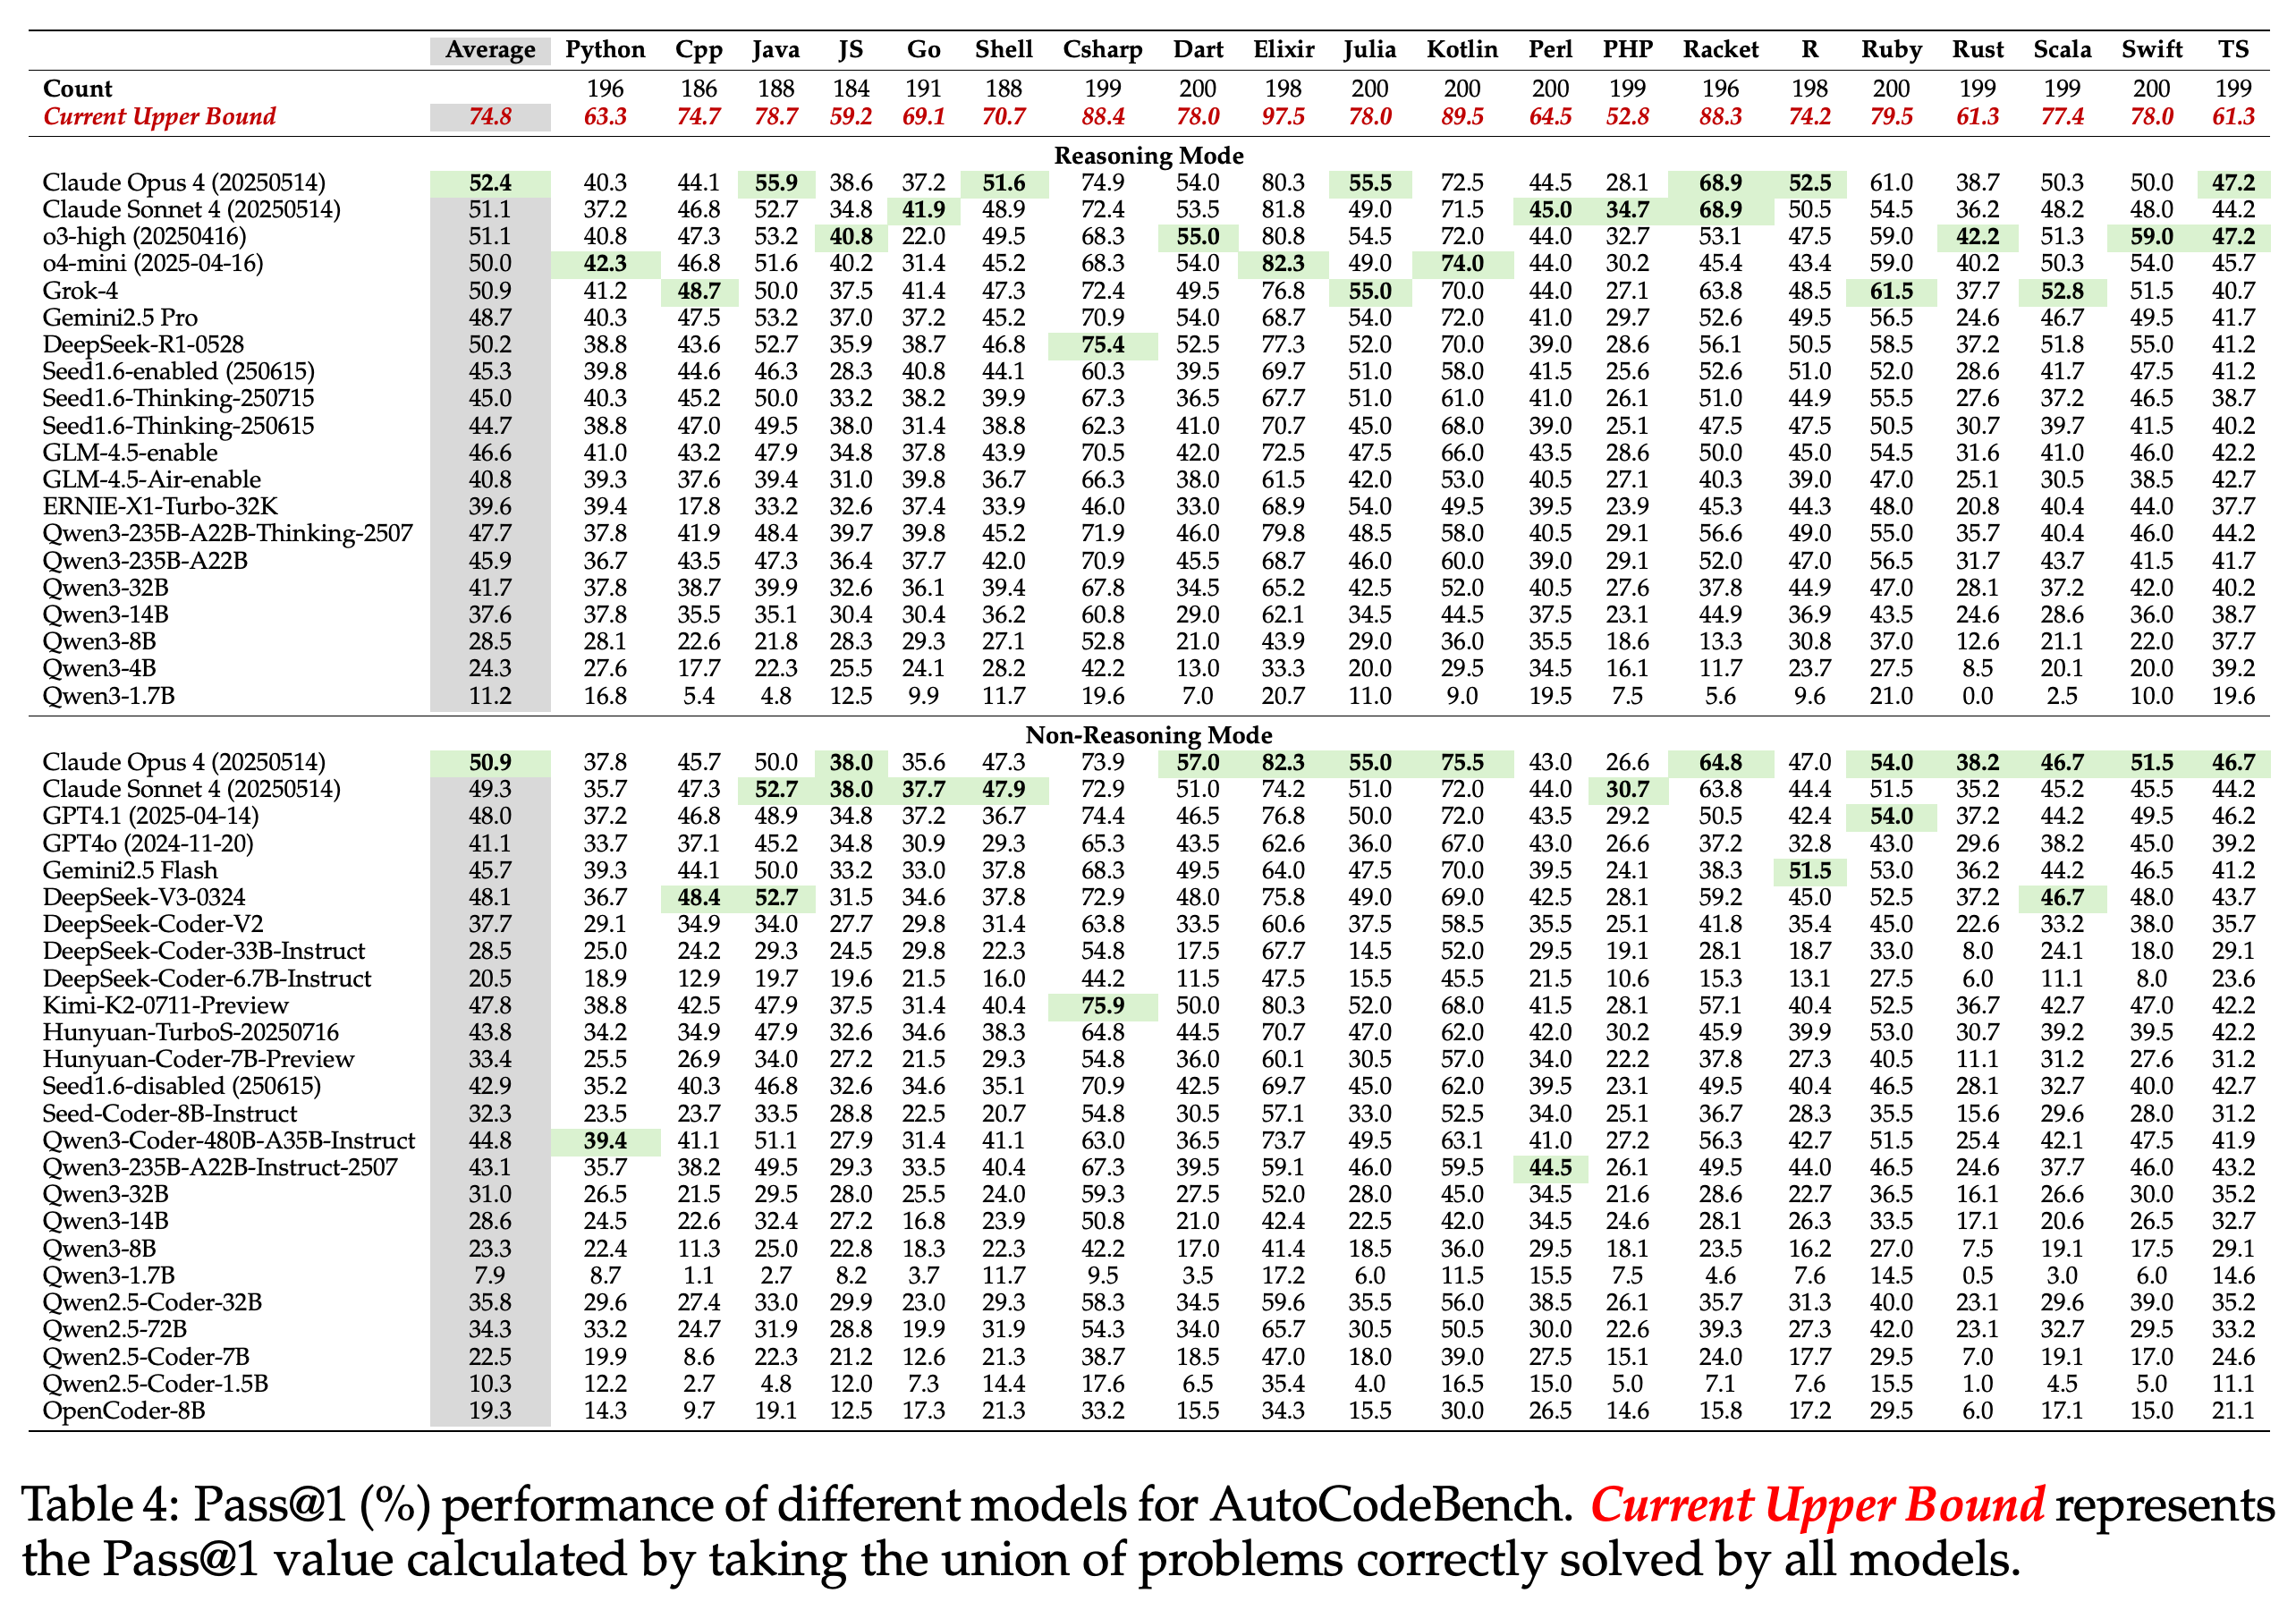
Claude Opus 4 (20250514)는 reasoning mode에서 AutoCodeBench 52.4%, Lite 64.5%로 가장 높은 성능을 보인다. 추론을 사용하지 않을 때의 점수는 각각 50.9%와 61.7%다. reasoning mode의 Claude Sonnet 4와 o3-high는 전체 벤치마크에서 모두 51.1%를 기록하고 o3-high는 Lite에서 63.2%를 기록한다. 평가한 설정 중 전체 벤치마크에서 53%를 초과한 설정은 없다.
- 보고된 비교에서는 reasoning mode가 대체로 성능을 높인다. Qwen3-32B는 전체 벤치마크에서 31.0%에서 41.7%로, Lite에서 32.3%에서 47.6%로 상승한다.
- Current Upper Bound는 평가 모델 중 어느 모델이든 해결한 문제의 합집합으로, 전체 데이터에서는 74.8%, Lite에서는 100.0%다. 이는 관측된 성공 결과가 서로 보완하는 정도를 나타낸다. 구현된 모델 선택 시스템이나 미래 모델 능력의 한계를 뜻하지 않는다.
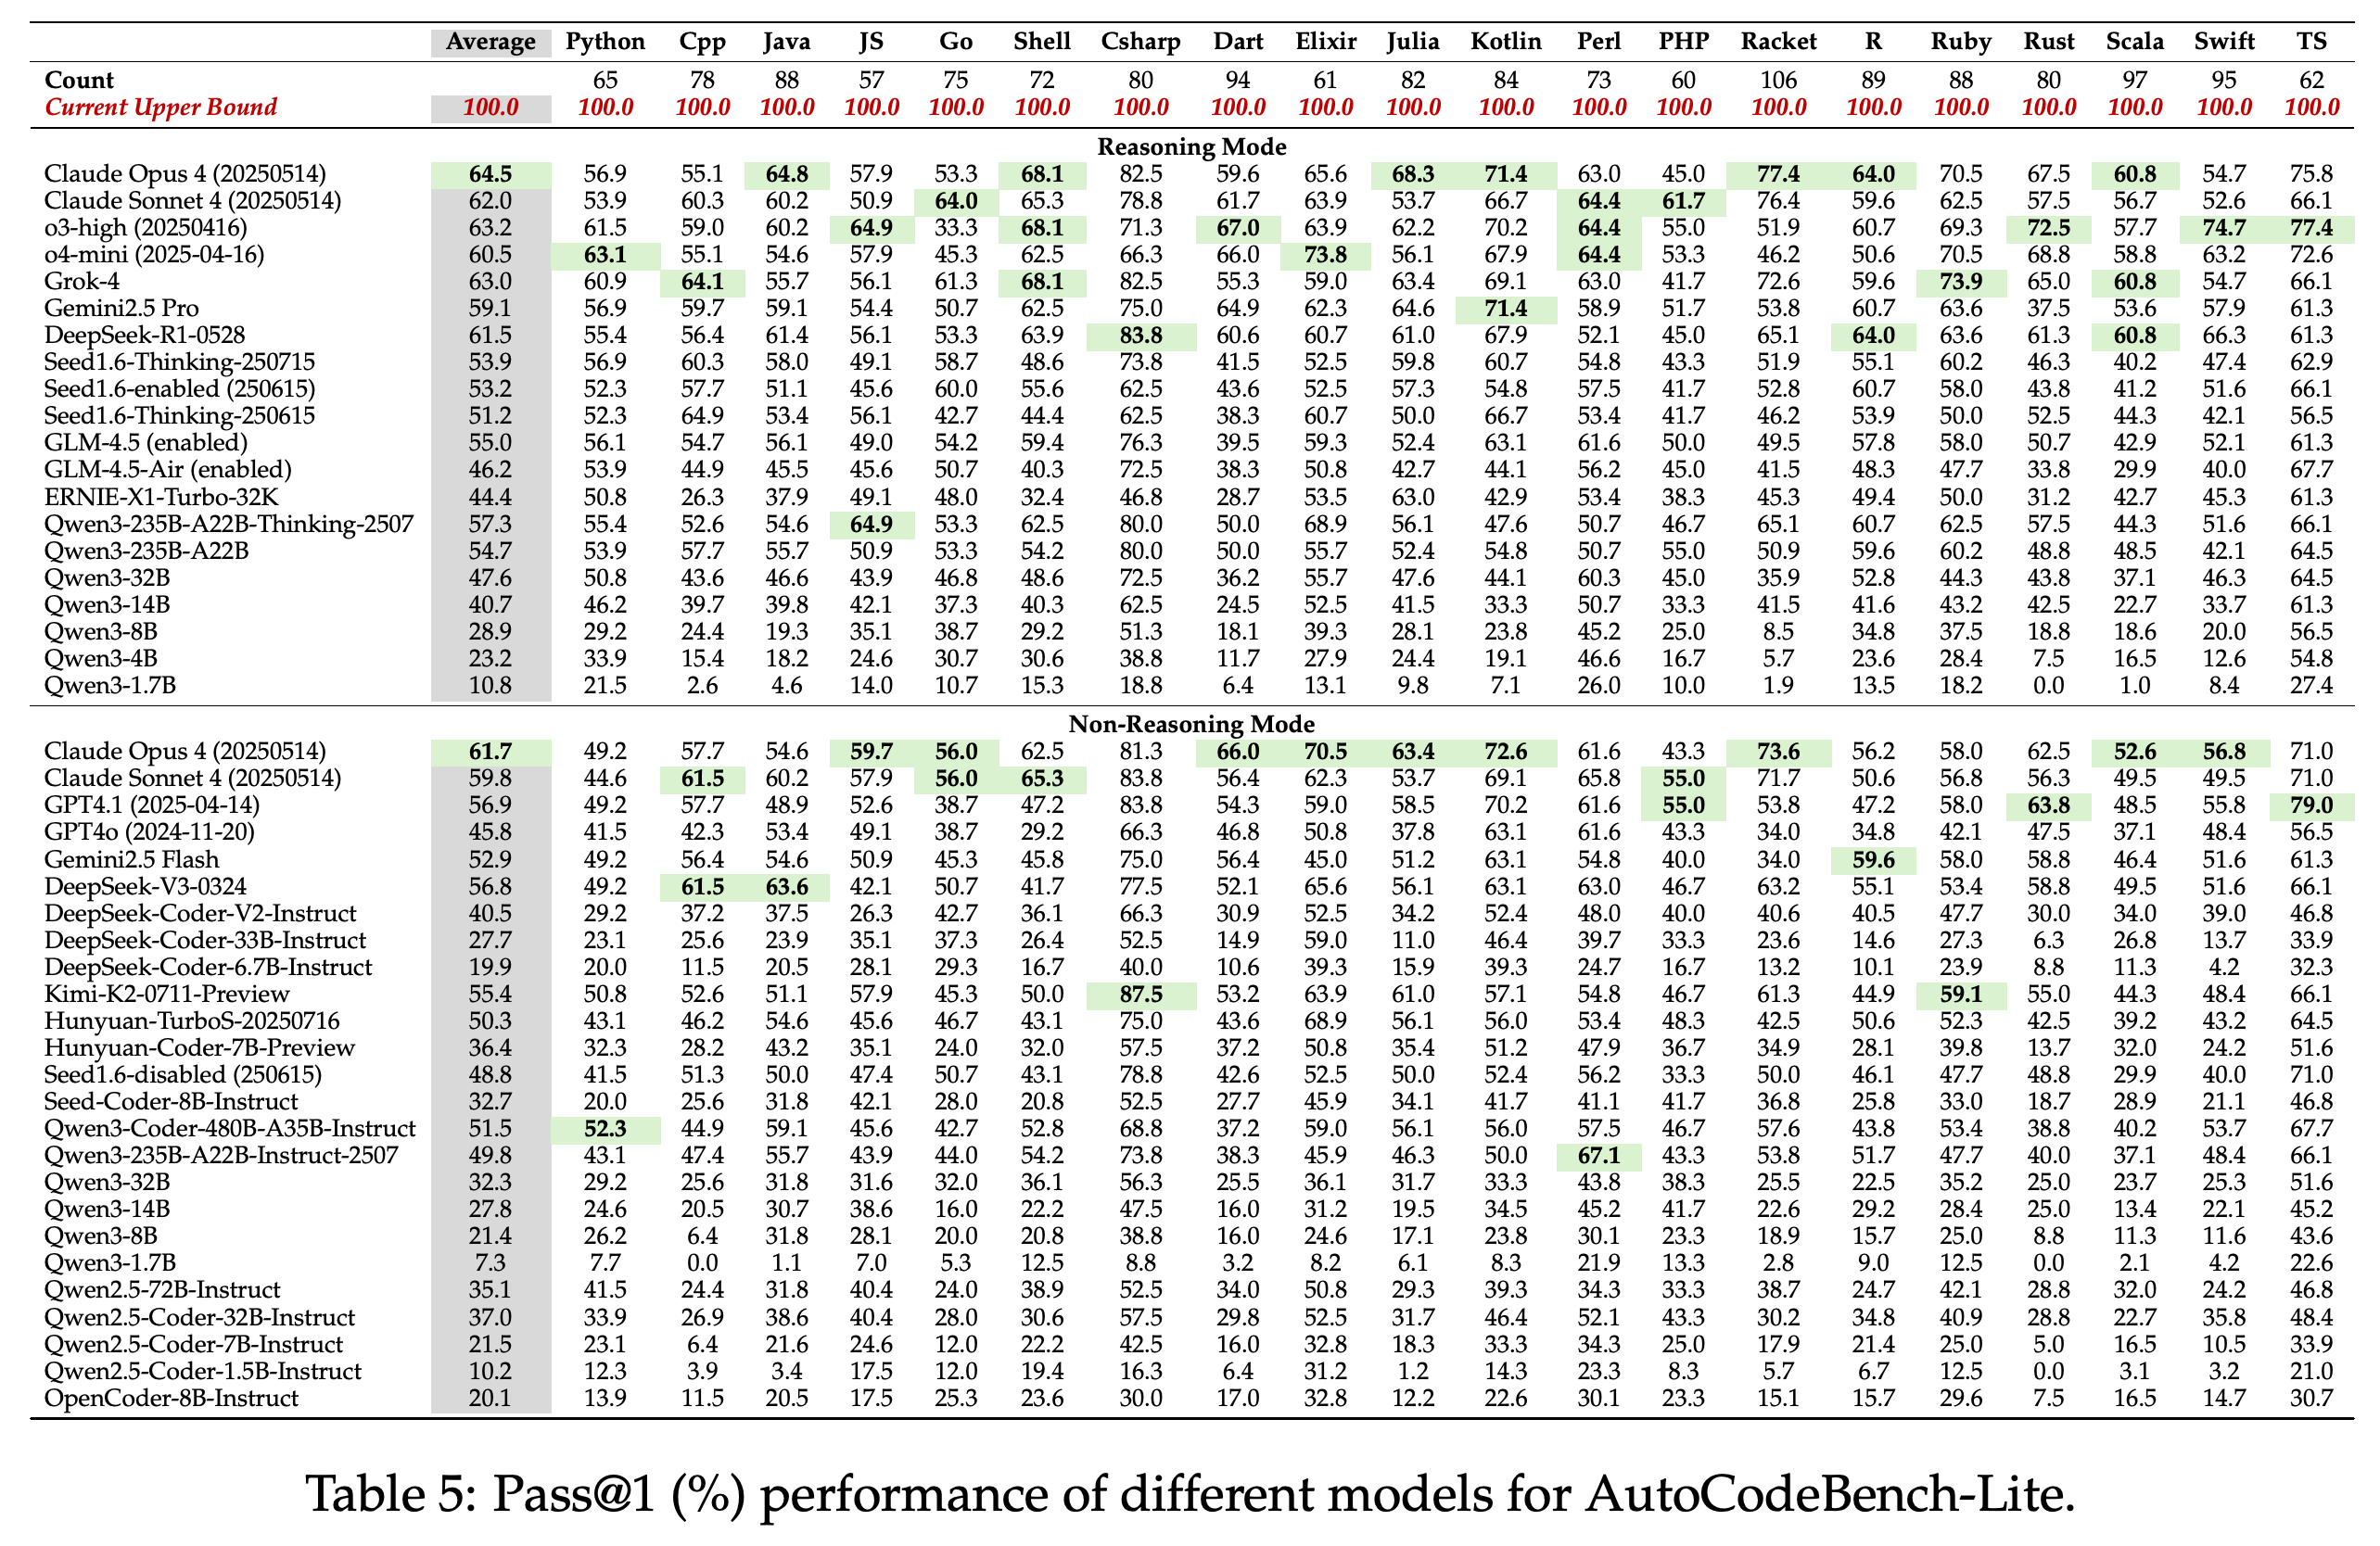
- Lite는 관측된 통과 횟수가 최소 2회인 어려운 과제를 유지한다. 합집합 기준 커버리지가 100.0%인 이유는 이 선택 방식에 있다. Lite의 높은 점수는 서로 다른 테스트 집합에서 얻은 성능을 비교한 결과다.
전체 벤치마크에서 보고된 최고 평균은 52.4%이고, 관측된 모델 성공의 합집합은 74.8%다. 언어별로 가장 높은 성능을 보이는 모델이 달라, 전체 최고 성능 모델이 모든 언어에서 우세하지는 않다.
추론을 사용하는 Claude Opus 4가 64.5%를 기록하고 o3-high가 63.2%, Grok-4가 63.0%로 뒤를 잇는다. 합집합 점수 100.0%는 평가 모델 집합이 이미 해결한 문제를 Lite가 선택한 결과다.
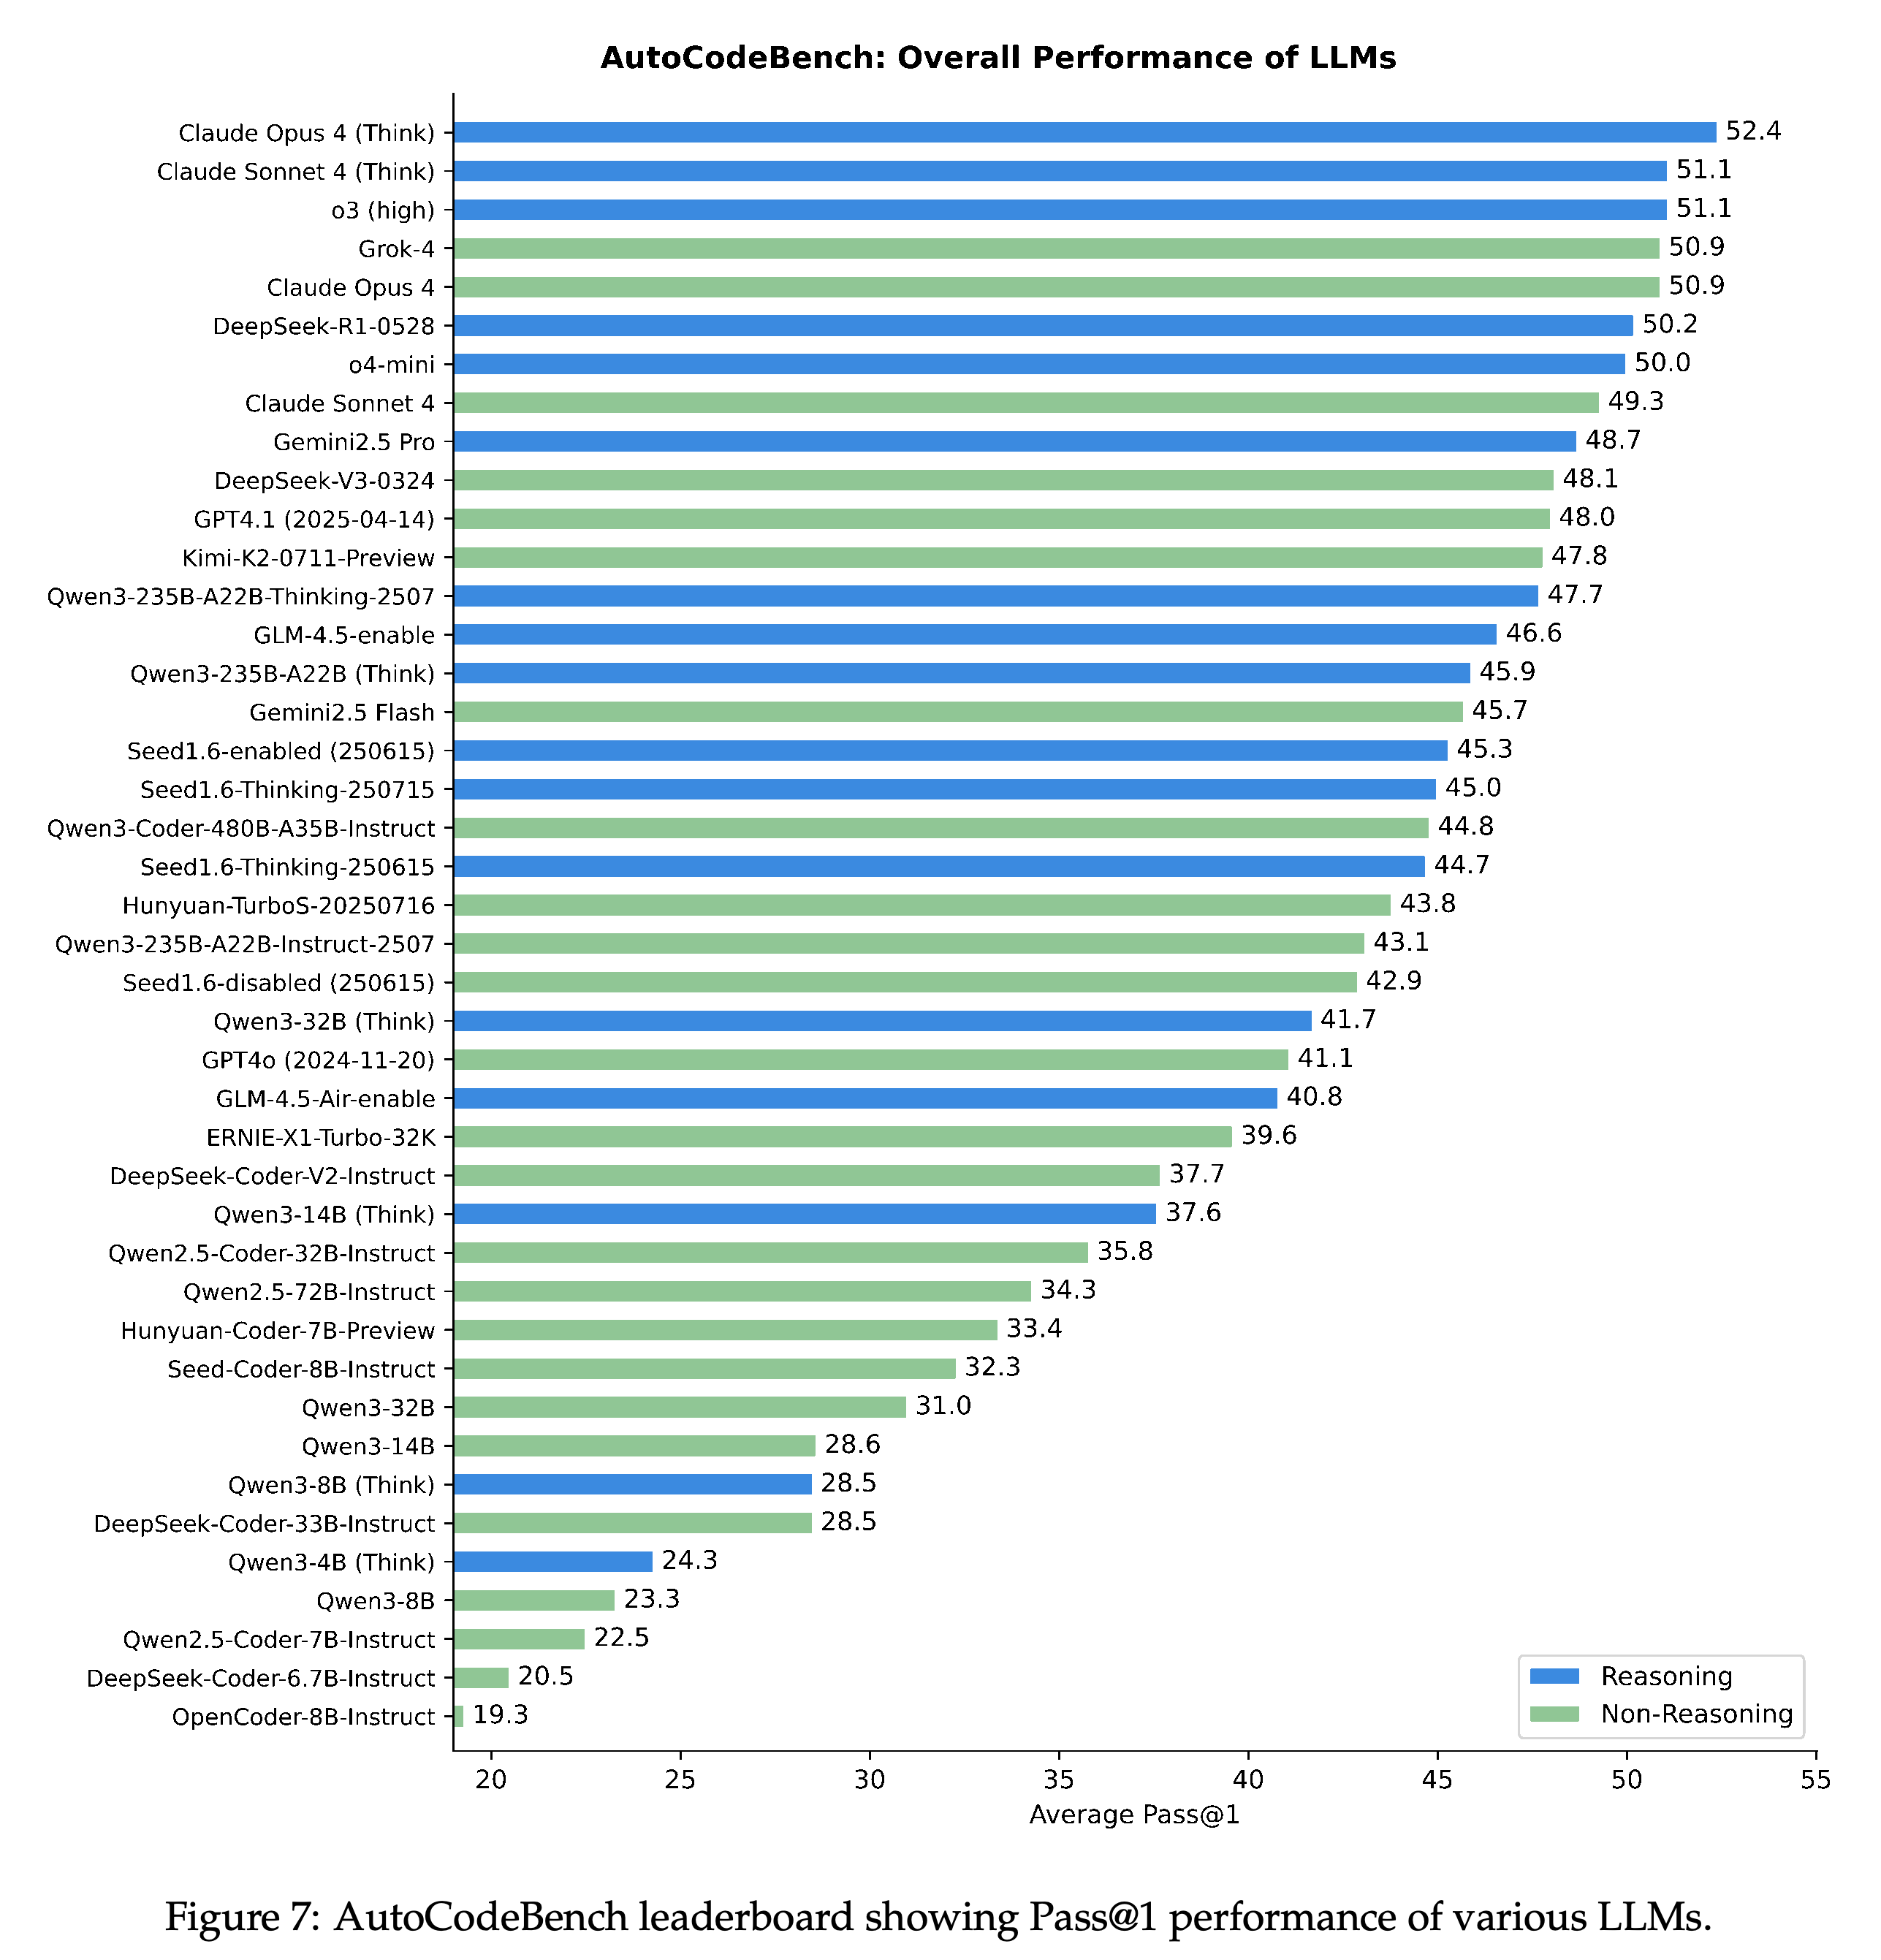
평균 점수 순위에서 최고 점수는 52.4%이며, 다른 많은 모델은 훨씬 낮은 점수를 기록한다. 추론을 사용하는 설정은 사용하지 않는 대응 설정보다 높은 순위를 차지하는 경우가 많다. 다만 추론 비용은 비교하지 않는다.
3.3 Performance Across Popular and Low-Resource Programming Languages
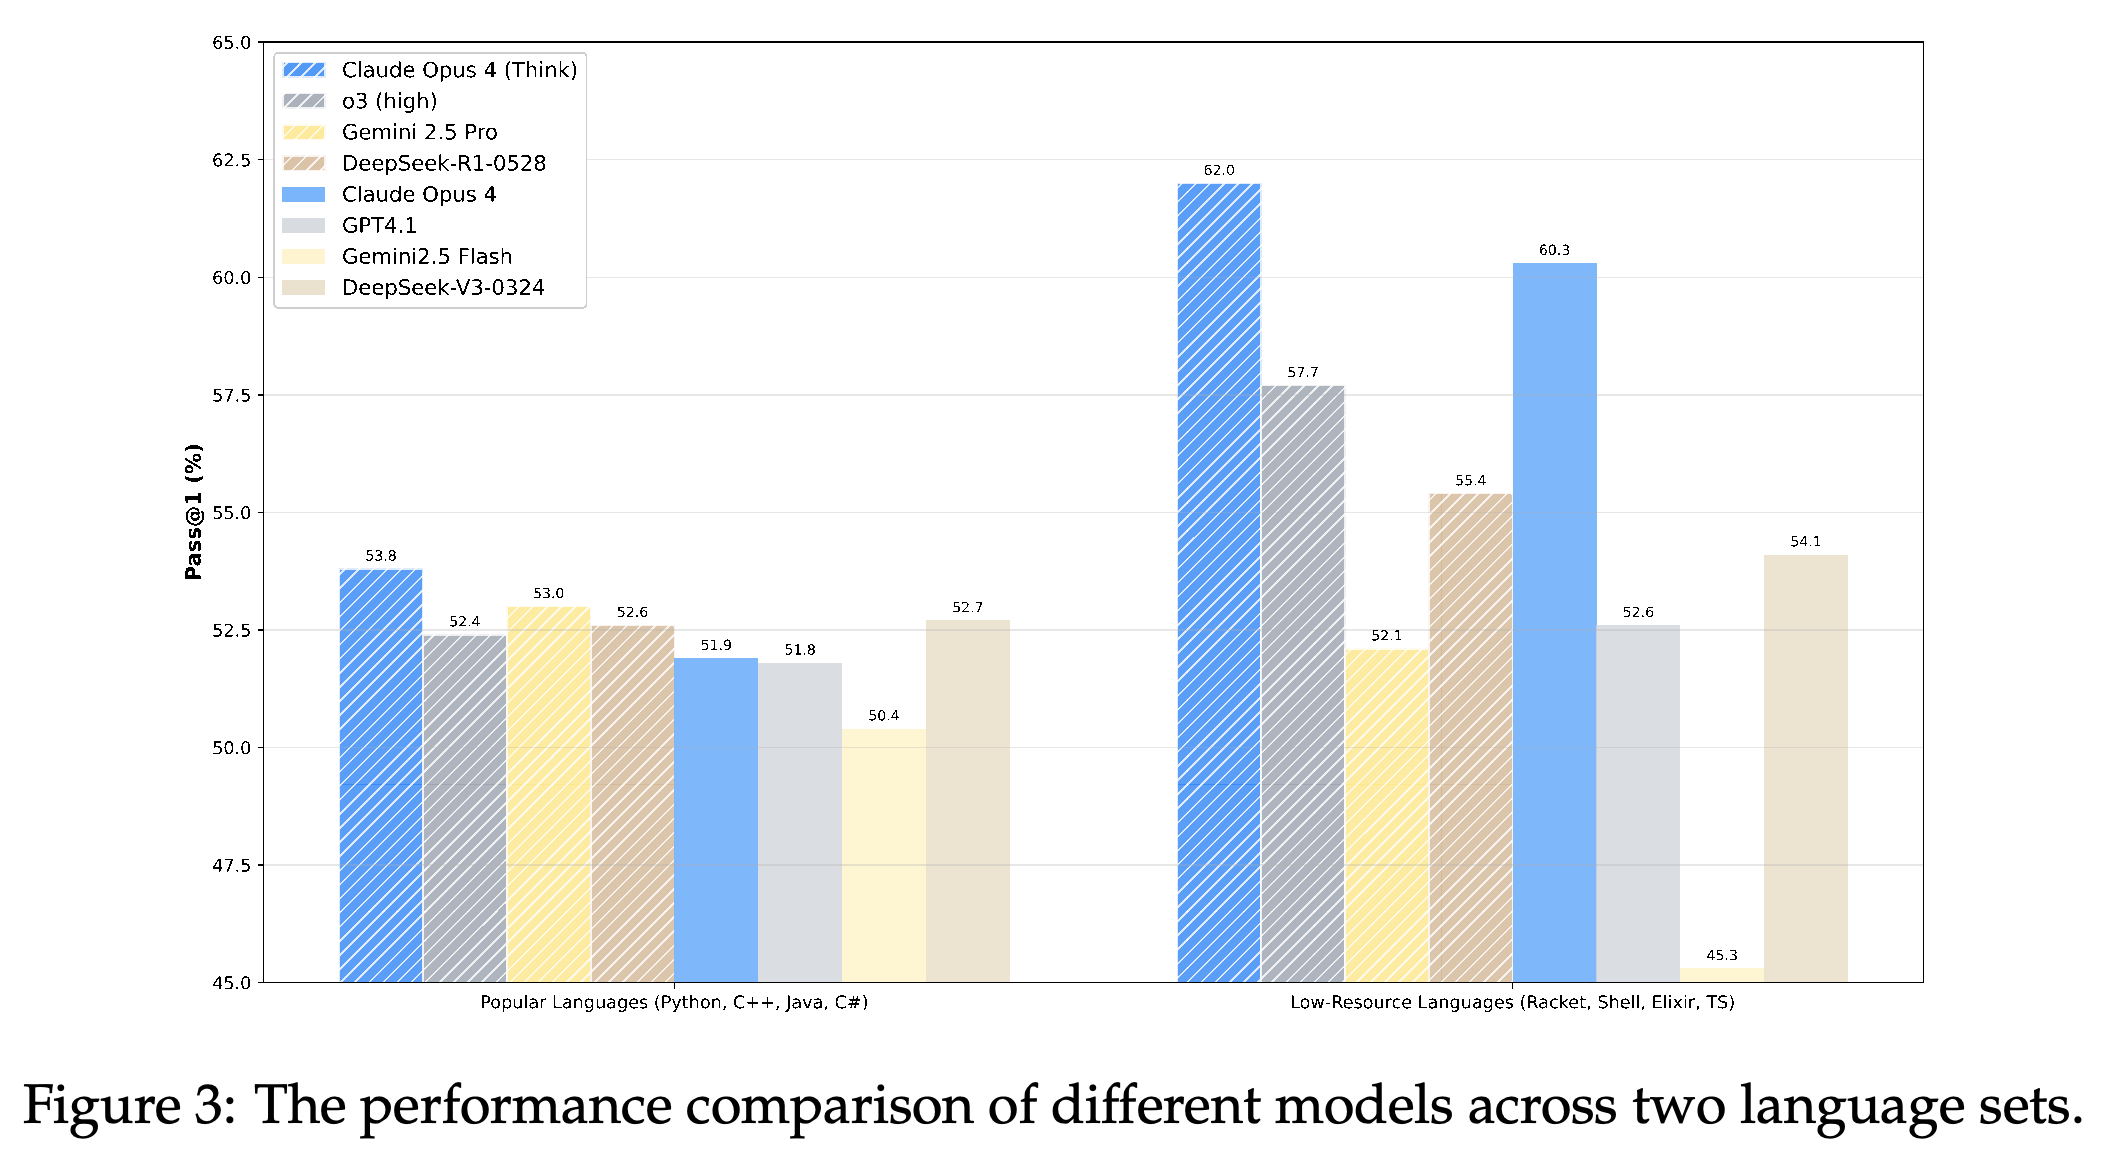
논문은 Python, C++, Java, C#을 Racket, Shell, Elixir, TypeScript로 구성한 저자 지정 저자원 언어 집합과 비교한다. 이 비교에서는 후자의 언어들을 가용 자원이 더 제한적인 언어로 취급한다. 집합은 https://tiobe.org.cn/tiobe-index/에 연결된 프로그래밍 언어 인기 지표 TIOBE Index를 바탕으로 선택한다. Figure 3에서 8개 설정의 평균 Pass@1 범위는 인기 언어 집합에서 50.4–53.8%, 저자 지정 저자원 언어 집합에서 45.3–62.0%다.
- Figure 3에서 저자 지정 저자원 언어 집합에 대한 Claude Opus 4의 점수는 추론을 사용할 때 62.0%, 사용하지 않을 때 60.3%다. 이 값은 Tables 4 또는 5의 해당 언어 열을 단순 평균한 결과와 일치하지 않는다. PDF는 이 차이를 설명하지 않는다.
- 저자들은 DeepSeek-Coder-V2-Lite가 쉬운 저자원 언어 과제보다 쉬운 인기 언어 과제를 더 효과적으로 제거할 수 있다고 제안한다. 따라서 언어별 난이도 필터링의 차이 때문에 관측된 성능 차이를 학습 데이터의 언어별 분포만으로 설명하기 어렵다.
표시된 설정의 성능 범위는 인기 언어에서 50.4–53.8%, 저자 지정 저자원 언어 집합에서 45.3–62.0%다. 후자에서 설정 간 차이가 더 크다. 다만 PDF는 이 값과 Tables 4 및 5의 해당 언어 열을 단순 평균한 값 사이의 차이를 해명하지 않는다.
3.4 Performance Across Multi-Logic Programming Problems
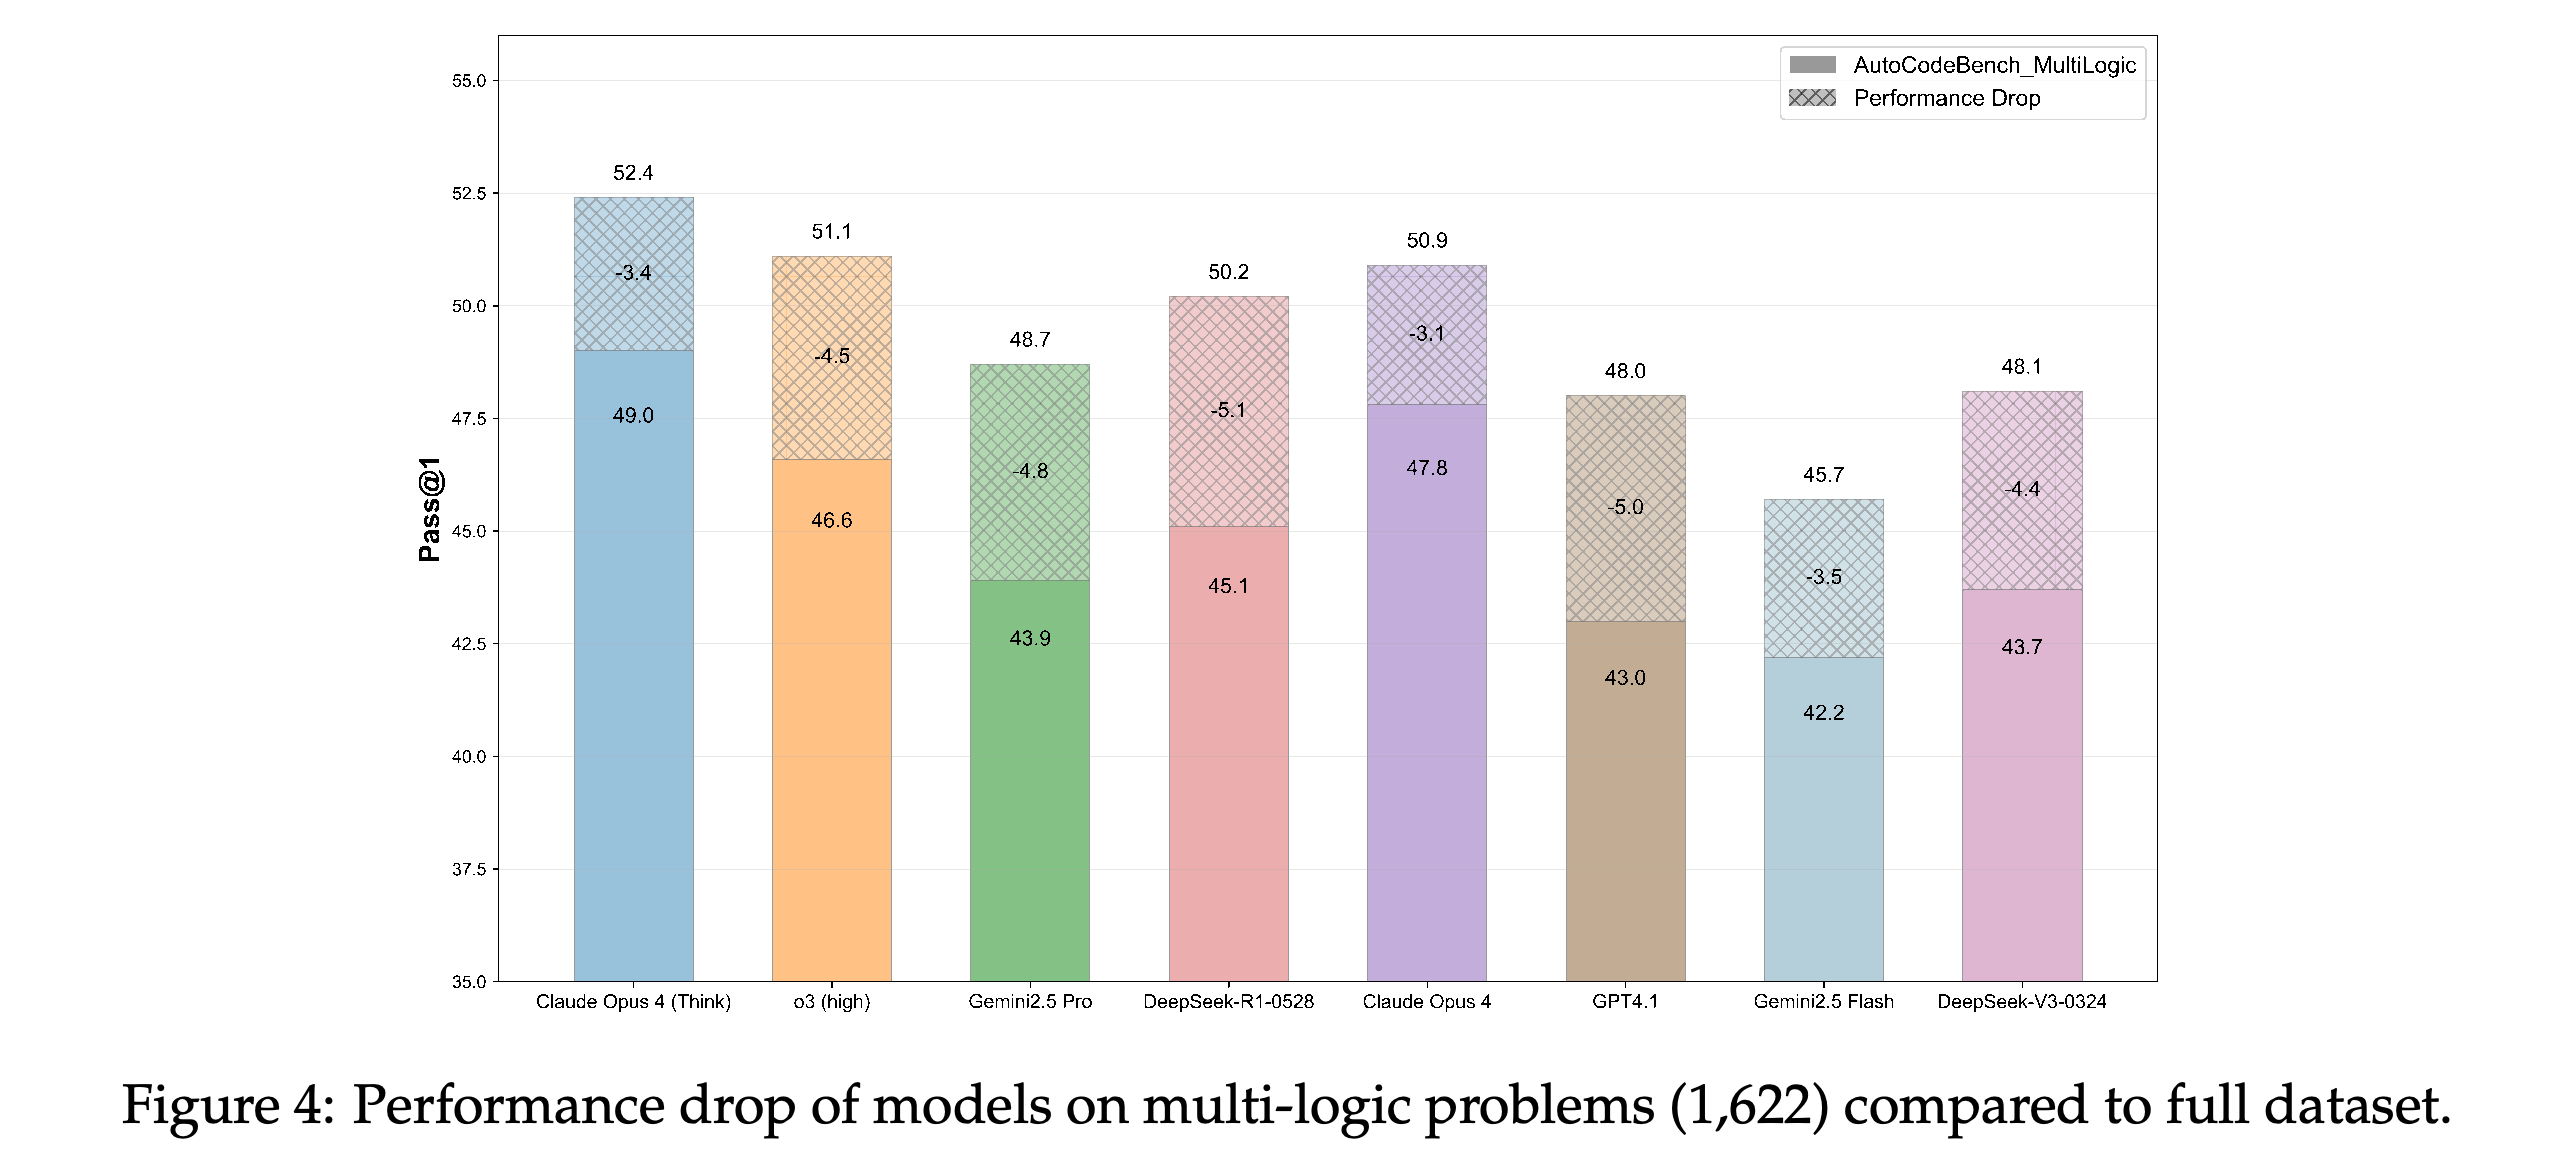
DeepSeek-V3-0324는 1개 과제에서 서로 다른 함수나 클래스를 여러 개 요구하는 multi-logic 문제 1,622개를 식별한다. 표시된 8개 설정 모두 이 부분집합에서 전체 벤치마크보다 낮은 점수를 기록한다. 추론을 사용하는 Claude Opus 4는 52.4%에서 49.0%로, DeepSeek-R1-0528은 50.2%에서 45.1%로, GPT4.1은 48.0%에서 43.0%로 하락한다.
- 이 비교는 요구사항이 여러 개인 과제에서 점수가 낮아진다는 점을 보여준다. 다만 라벨을 모델이 생성했고 다른 과제와 길이나 난이도를 맞춘 부분집합이 아니므로, 여러 요구사항 자체의 영향만 분리하지는 못한다.
표시된 모든 설정은 multi-logic 문제 1,622개에서 전체 데이터셋보다 3.1–5.1 %p 낮은 점수를 기록한다. 추론을 사용하는 Claude Opus 4가 부분집합에서 49.0%로 가장 높은 점수를 유지한다. DeepSeek-R1-0528은 표시된 설정 중 하락 폭이 5.1 points로 가장 크다.
3.5 Performance Analysis of Scaling Laws
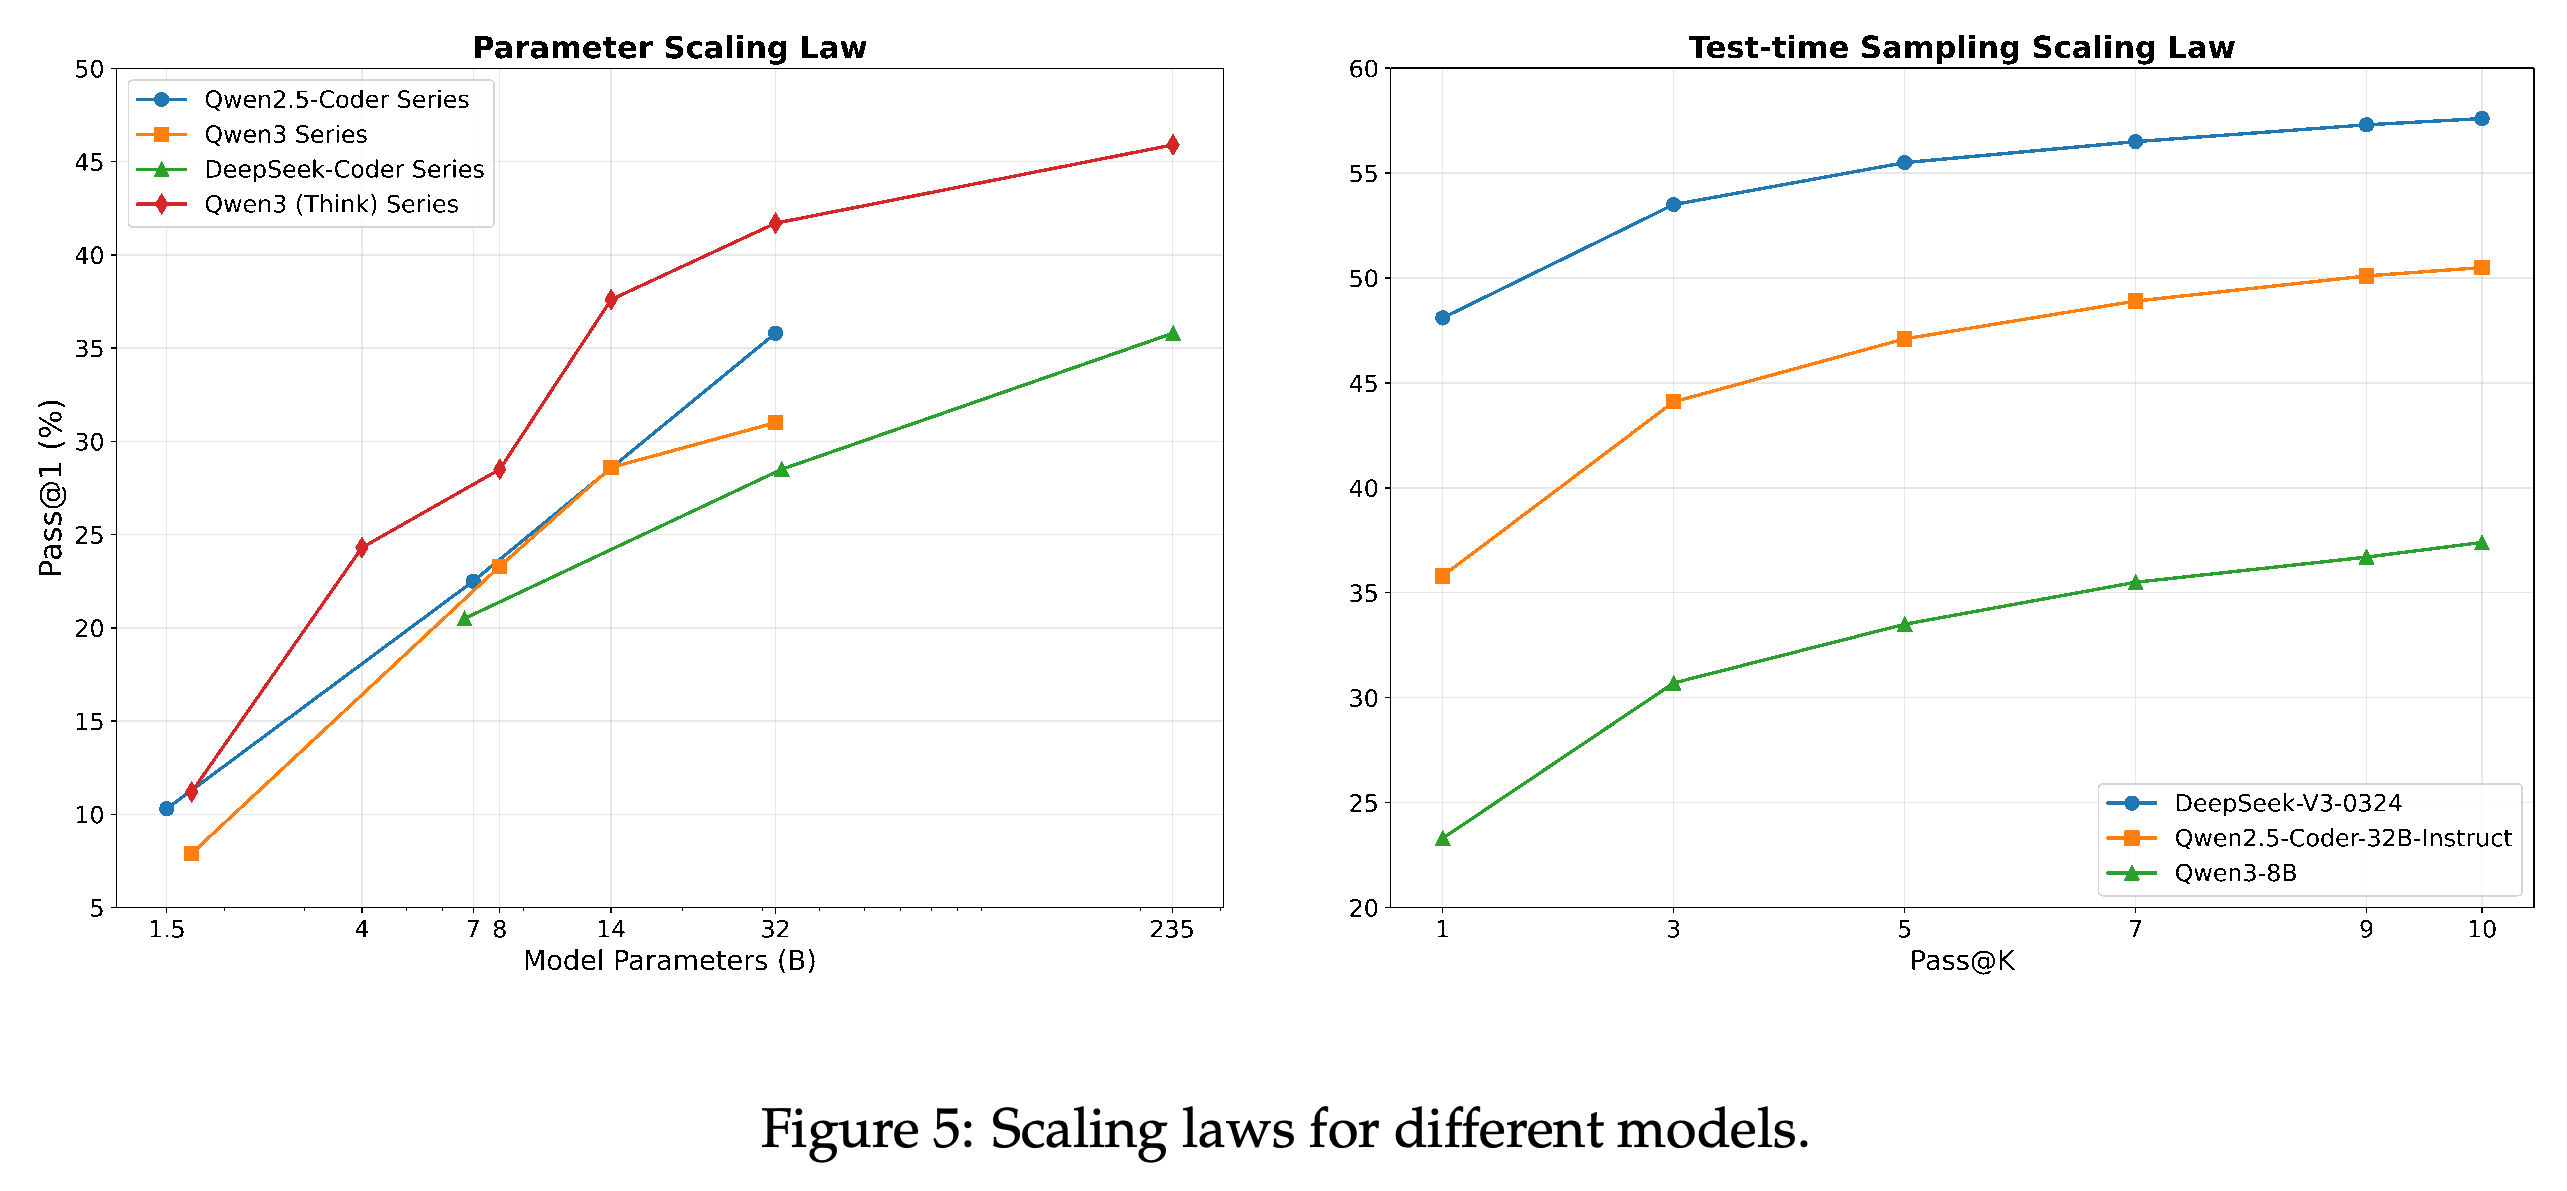
매개변수 규모에 따른 그래프에서는 선택된 Qwen2.5-Coder, Qwen3, DeepSeek-Coder, Qwen3 reasoning 계열 모두 규모가 커질수록 Pass@1이 상승한다. Qwen3 reasoning의 곡선이 가장 가파르다. 저자들은 명시적인 중간 추론 단계를 사용하는 chain-of-thought reasoning이 큰 모델에 더 유리하다는 점과 이 결과를 연결한다.
- 오른쪽 패널은 샘플링한 풀이 K개 중 최소 1개가 통과하면 성공으로 보는 Pass@K를 평가한다. DeepSeek-V3-0324, Qwen2.5-Coder-32B-Instruct, Qwen3-8B를 K = 1, 3, 5, 7, 9, 10에서 평가한다. 3개 모델 모두 샘플을 추가하면 성능이 높아지지만 K가 커질수록 증가 폭은 줄어든다.
- 그래프는 선택한 모델 계열에서 관측한 경험적 경향을 보여준다. 논문은 일반적인 스케일링 방정식을 데이터에 맞춰 추정하지 않으며 추론 전략 간 동일 비용 비교도 제시하지 않는다.
왼쪽 패널은 4개 모델 계열에서 매개변수가 늘어날 때 서로 다른 성능 변화 양상을 보여준다. 오른쪽 패널은 3개 모델에서 K를 늘리면 성능이 향상되지만 K가 클수록 증가 폭이 줄어드는 모습을 보여준다. 어느 패널도 일반적인 스케일링 방정식을 데이터에 맞춰 추정한 결과를 제시하지 않는다.
3.6 Performance Analysis of Multi-Turn Refinement with Sandbox Feedback
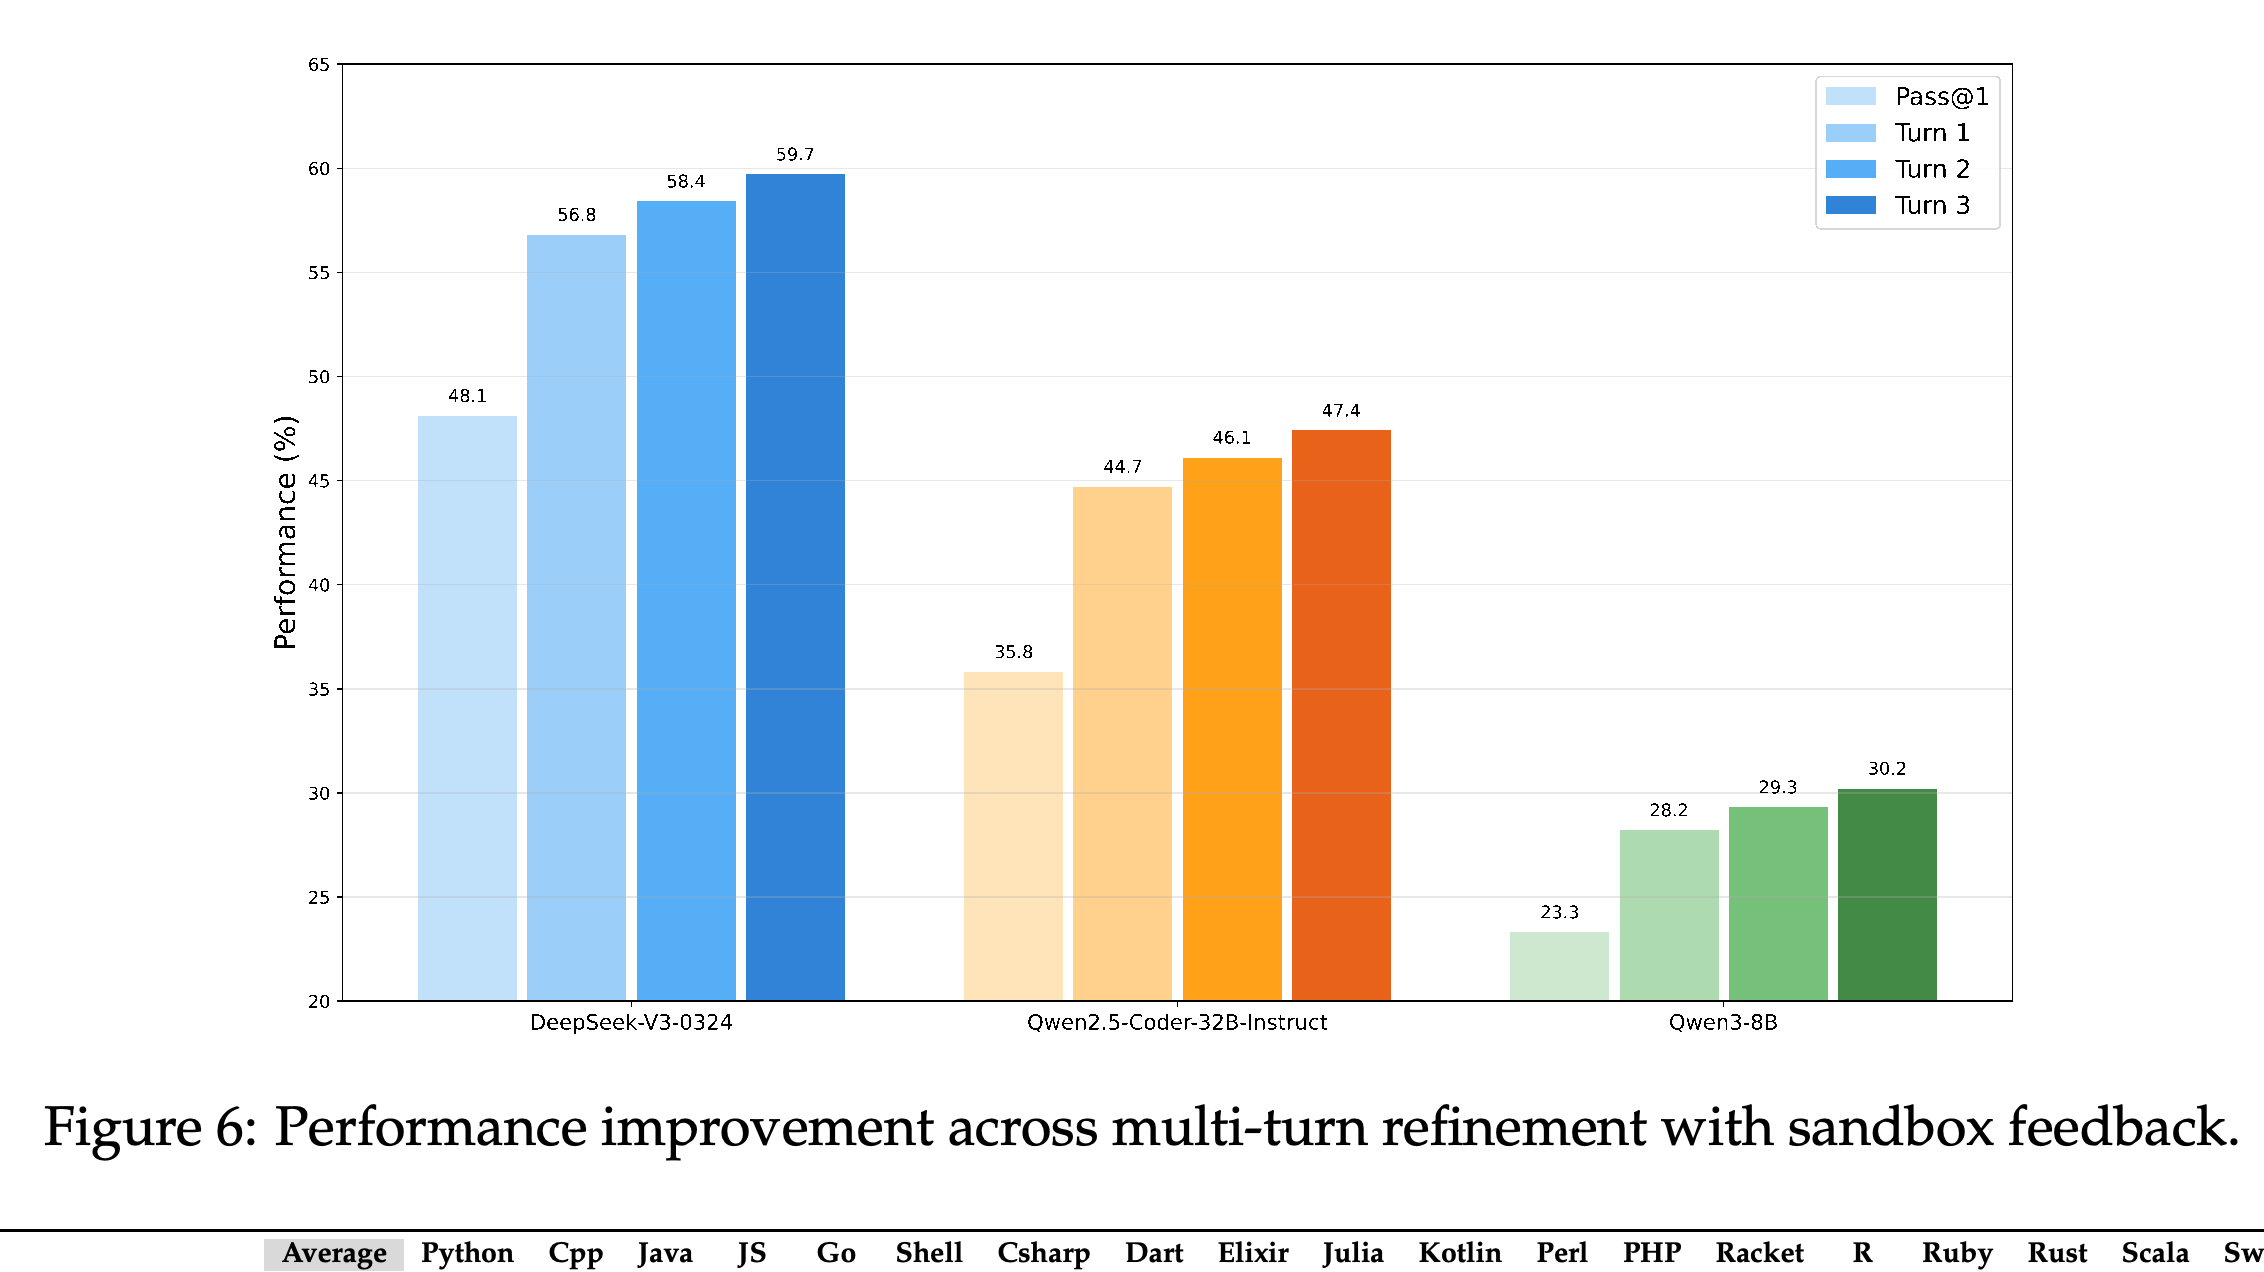
샌드박스 실행 오류를 활용해 3회 수정하면 DeepSeek-V3-0324는 48.1%에서 59.7%로, Qwen2.5-Coder-32B-Instruct는 35.8%에서 47.4%로, Qwen3-8B는 23.3%에서 30.2%로 상승한다. 실험한 절차에서는 각 모델 모두 첫 번째 수정에서 가장 큰 향상을 보인다.
- DeepSeek-V3-0324는 56.8%, 58.4%, 59.7%로, Qwen2.5-Coder-32B-Instruct는 44.7%, 46.1%, 47.4%로, Qwen3-8B는 28.2%, 29.3%, 30.2%로 차례로 상승한다.
- 반복 수정은 실행 피드백과 추가 생성 시도를 함께 제공한다. 논문에는 독립 샘플링과 비용을 맞춘 비교가 없어 각 요소의 기여를 분리할 수 없다.
실행을 활용한 반복 수정으로 3개 모델의 점수는 각각 48.1%, 35.8%, 23.3%에서 59.7%, 47.4%, 30.2%로 상승한다. 각 모델 모두 첫 번째 수정에서 가장 큰 향상을 보인다.
3.7 AutoCodeBench-Complete: Evaluating Base Model Capabilities
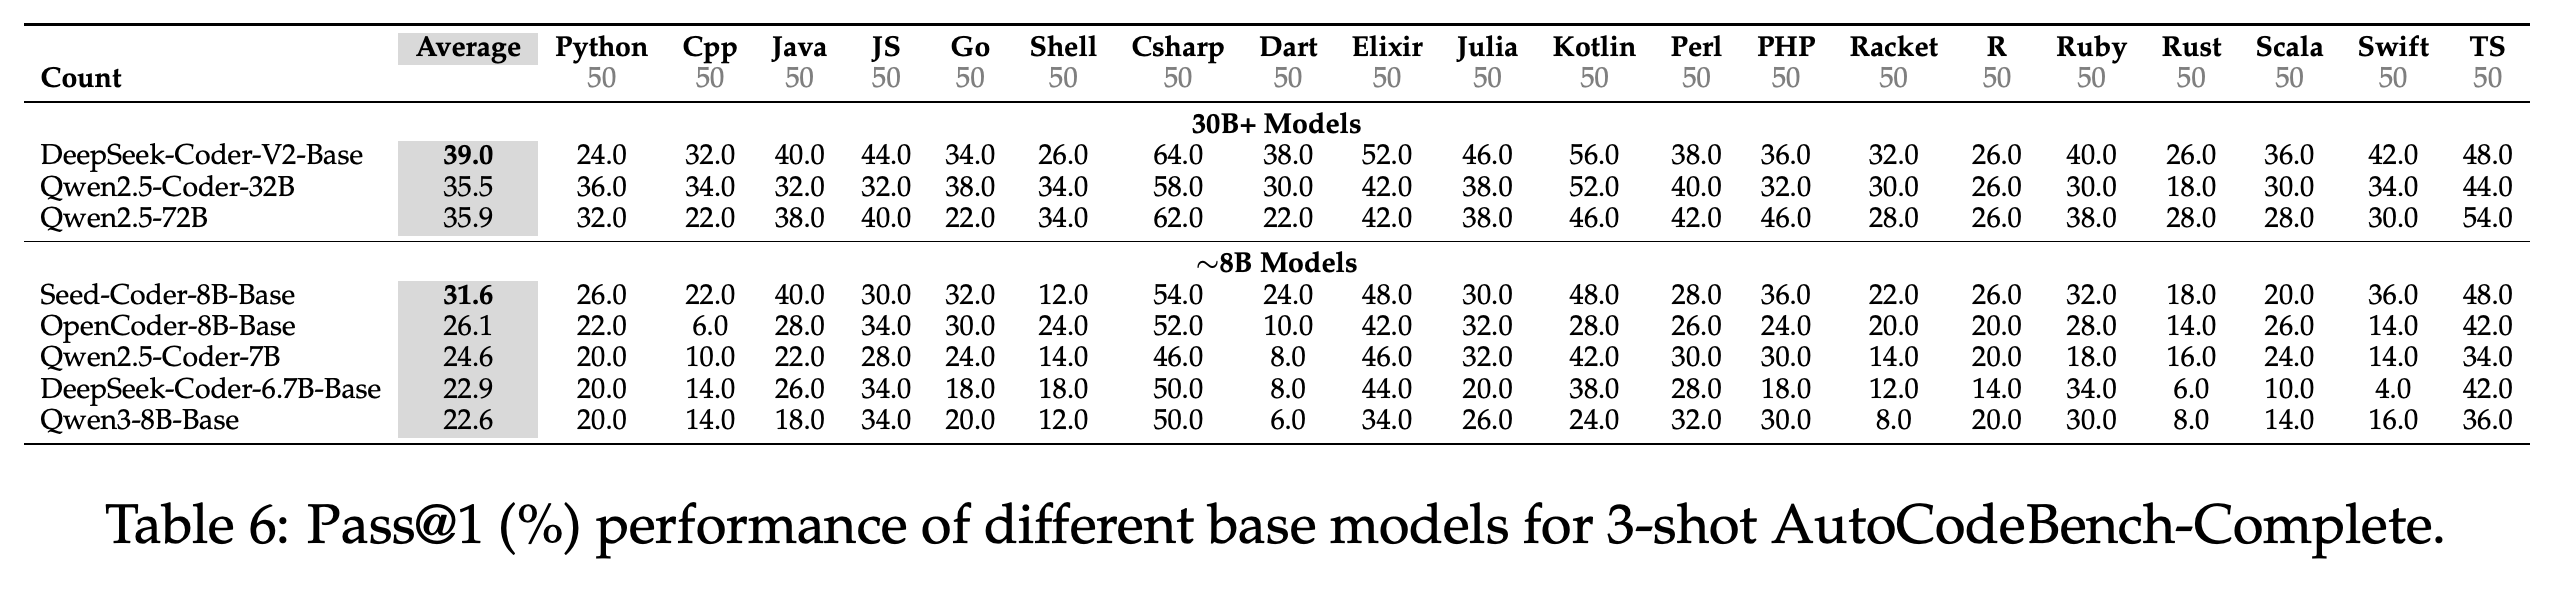
AutoCodeBench-Complete는 Lite에서 언어별로 정확히 50개씩, 총 1,000개 문제를 선택한다. 대상 문제 전에 예시 3개를 제공하는 3-shot 방식으로 코드 완성을 평가한다. DeepSeek-Coder-V2-Base는 39.0%, Qwen2.5-72B는 35.9%, Qwen2.5-Coder-32B는 35.5%를 기록한다. Seed-Coder-8B-Base는 31.6%로, 나열된 모델 중 매개변수가 8B 이하인 모델에서 가장 높은 점수를 기록한다.
- OpenCoder-8B-Base는 26.1%로 Qwen2.5-Coder-7B의 24.6%를 넘는다. 반면 지시를 따르도록 추가 학습한 instruction-tuned 버전들은 AutoCodeBench와 Lite에서 반대 순위를 보인다.
- 저자들은 다국어 사후 학습 데이터의 차이가 이 순위 역전을 설명할 수 있다고 제안한다. 결과는 순위 차이를 확인해 주지만 논문은 이 설명을 검증하기 위해 학습 말뭉치를 조사하지 않는다.
코드 완성 평가는 언어별 문제 50개와 예시 3개를 사용한다. DeepSeek-Coder-V2-Base는 39.0%로 나열된 대규모 모델 중 가장 높은 점수를 기록하고 Seed-Coder-8B-Base는 31.6%로 약 8B 규모 집단에서 가장 높은 점수를 기록한다.
4 Further Discussion
Further Discussion은 벤치마크의 유효성과 구축 모델이 유발할 수 있는 선호 편향을 살펴본다. 사람 검증은 직접 생성한 6개 언어를 대상으로 하며, 별도의 실험에서는 필터링 단계별로 5개 모델의 점수를 추적한다.
4.1 Manual Verification
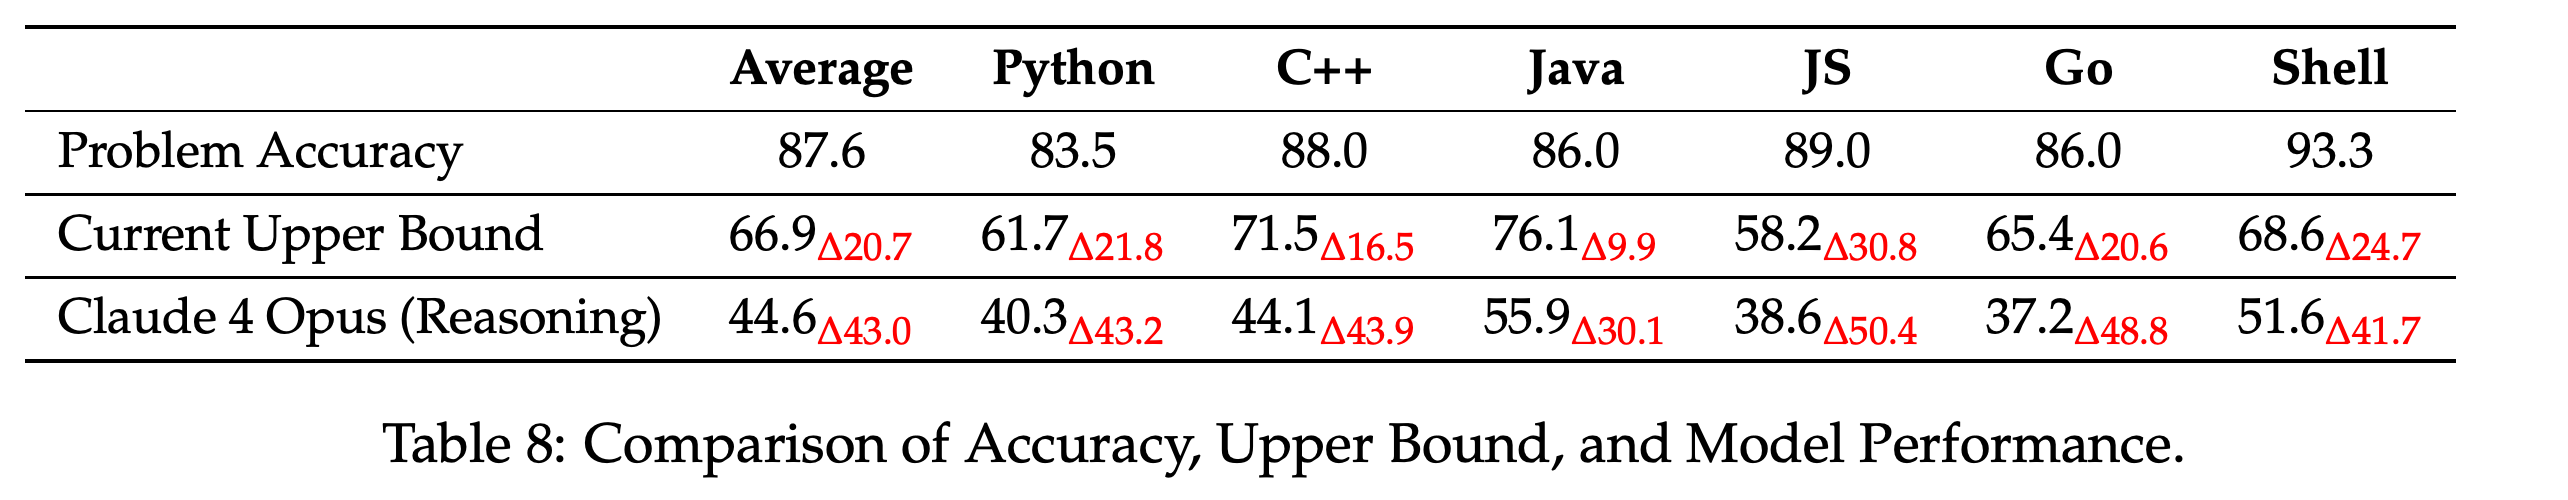
전문 주석 작업자 6명이 Python, C++, Java, JavaScript, Go, Shell의 문제 설명, 테스트 함수, DeepSeek-R1-0528의 비평을 검토해 이진 유효성 라벨을 부여한다. 보고된 평균 유효성은 87.6%이며, Python의 83.5%에서 Shell의 93.3%까지 분포한다. 해당 언어에서 모델 성공의 합집합은 66.9%이고, 추론을 사용하는 Claude Opus 4의 성능은 44.6%다.
- Table 8은 위 언어 순서대로 유효성을 83.5%, 88.0%, 86.0%, 89.0%, 86.0%, 93.3%로 보고한다. 가장 흔한 문제는 불완전한 설명으로, 함수/클래스 이름을 누락하거나 경계 조건의 출력을 명시하지 않는 경우가 포함된다.
- Appendix B는 문제 설명이 정확하다고 가정하고 경계 조건을 빠뜨린 테스트도 허용한다. 따라서 이 평가는 테스트의 정확성과 문제와의 정합성을 검사하며 모든 조건을 빠짐없이 검사하는지는 확인하지 않는다. 번역한 14개 언어도 직접 검토하지 않는다.
- 유효성과 Claude Opus 4 성능의 43.0퍼센트포인트 차이는 서로 다른 측정값을 비교한 결과다. Table 8은 유효하지 않은 레코드를 제거한 뒤 다시 계산한 모델 성능을 보고하지 않는다.
6개 언어에서 보고된 평균 유효성은 87.6%이며, 모델 성공의 합집합은 66.9%, 추론을 사용하는 Claude Opus 4의 성능은 44.6%다. 이 차이는 주석 평가의 유효성과 모델 성능을 비교한 결과다. 표는 정제한 벤치마크에서 다시 계산한 점수를 보고하지 않는다.
4.2 Hypotheses on Model Bias in the Generation Process
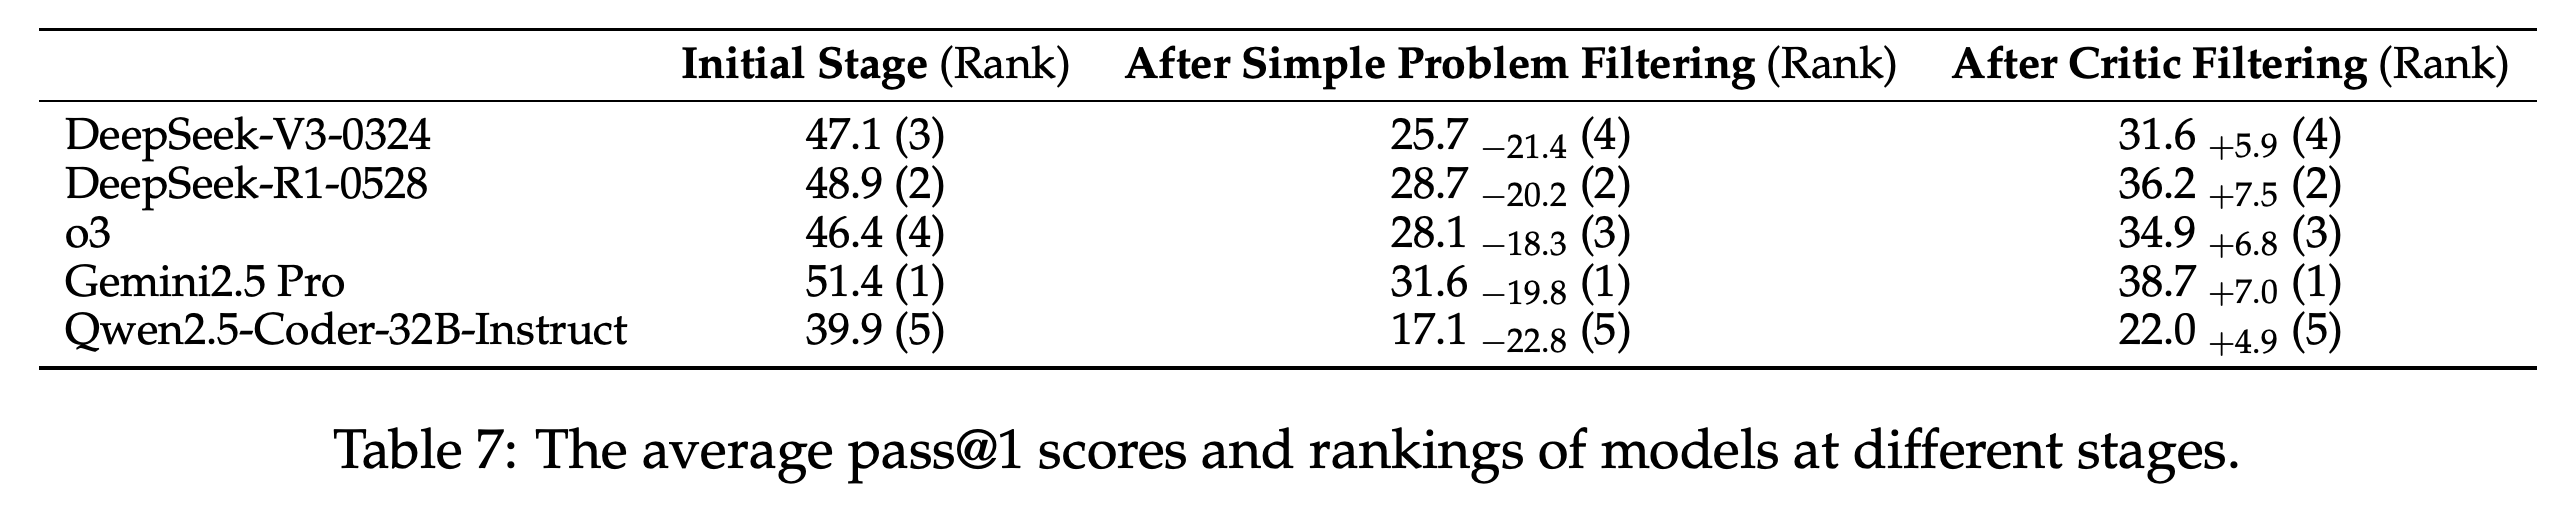
저자들은 DeepSeek를 활용한 생성과 비평이 DeepSeek 계열에 유리할 수 있는 반면, DeepSeek-Coder-V2-Lite를 사용한 난이도 필터링은 이 선호를 상쇄할 수 있다는 가설을 제시한다. Python, C++, Java, JavaScript, Go, Shell에서 추출한 레코드 3,600개를 대상으로 모델 5개를 추적한다.
- 쉬운 문제 필터링은 점수를 18.3–22.8 %p 낮춘다. 이후 critic 필터링은 4.9–7.5 points 높인다. 증가 폭은 DeepSeek-V3-0324가 5.9, DeepSeek-R1-0528이 7.5, o3가 6.8, Gemini2.5 Pro가 7.0, Qwen2.5-Coder-32B-Instruct가 4.9다.
- 3개 단계 모두에서 Gemini2.5 Pro는 1위, DeepSeek-R1-0528은 2위, Qwen2.5-Coder-32B-Instruct는 5위를 유지한다. o3는 난이도 필터링 이후 DeepSeek-V3-0324를 앞선다. 따라서 critic 필터링의 혜택이 생성 모델에 가장 크게 돌아가지는 않는다.
- 저자들은 남아 있는 유리한 편향이 미미하다고 판단한다. 다만 다른 생성 모델을 사용한 대조 실험이 없으므로, 단계별 비교로 편향의 인과적 크기를 확정할 수는 없다.
난이도 필터링은 5개 모델의 점수를 모두 낮추고, critic 필터링은 점수를 높이지만 초기 수준까지 회복시키지는 않는다. Gemini2.5 Pro는 전 과정에서 1위를 유지한다. 서로 다른 변화 양상은 필터링의 영향을 보여주지만 생성 모델 계열에 대한 편향을 분리하지는 못한다.
5 Related Work
Related Work는 AutoCodeBench를 코드 생성 벤치마크와 자동 코드 데이터 합성 연구의 맥락에서 설명한다. 기존 합성 연구 상당수가 학습 데이터를 만드는 데 비해, 이 논문은 모델과 실행 가능한 코드의 상호작용을 벤치마크 구축에 적용한다.
5.1 Code Generation Benchmarks
HumanEval과 MBPP는 짧은 Python 프로그래밍 과제로 구성된 벤치마크다. 대회 중심 벤치마크는 알고리즘 난이도를 높이고, McEval과 FullStackBench는 언어와 응용 분야의 범위를 넓힌다. 논문은 McEval이 40개 언어, FullStackBench가 16개 언어를 다룬다고 설명하며 AutoCodeBench의 특징으로 자동 구축과 대체로 균등한 언어별 문제 수를 제시한다.
- LiveCodeBench는 평가 문제와 모델 학습 데이터가 겹치는 데이터 오염을 줄이기 위해 대회 문제를 지속적으로 수집한다. 논문은 대회 문제 232개를 포함한 OJBench와 문제 10,000개를 포함한 APPS도 다룬다.
- ArtifactsBench는 텍스트와 시각 정보를 함께 사용하는 멀티모달 평가로 시각적 코드 생성을 평가하고 CodeCriticBench는 코드 비평을 평가한다. AutoCodeBench는 생성한 테스트 함수로 실행 가능한 풀이를 평가한다.
5.2 Code Data Synthesis
Evol-Instruct는 프롬프트로 기존 과제를 변형해 복잡성을 높이고, OSS-Instruct는 오픈소스 코드 조각에서 과제를 도출하며 KodCode는 자체 검증을 통해 Python 질문, 풀이, 테스트를 생성한다. Inverse-Instruct는 기존 코드에서 지시문을 도출하고 SelfCodeAlign은 생성과 검증에 동일한 base model을 사용한다.
- AutoCodeGen은 이러한 합성 연구에 실행으로 얻은 기대 출력과 풀이를 먼저 만드는 문제 생성 방식을 추가한다. 저자들은 이 워크플로로 학습 데이터를 생성하는 방안을 제안하지만 그 활용을 평가한 학습 실험은 보고하지 않는다.
6 Conclusion
논문은 AutoCodeGen, 문제 3,920개로 구성된 AutoCodeBench, Lite와 코드 완성 버전, 다국어 실행 서비스를 소개한다. 평가에서는 실험한 설정에서 multi-logic 과제의 성능이 낮고, 실행을 활용한 반복 수정으로 성능이 향상됨을 확인한다. 관련 자료는 https://autocodebench.github.io/에 연결되어 있으며 검토한 버전은 https://arxiv.org/abs/2508.09101v1이다.
부록
- A Data Category and Language Distribution Statistics는 제안된 라벨 20개를 Core Programming Concepts, Data and Algorithms, Application Domains, Advanced Topics and Tooling으로 묶는다. 제시된 비교에서 FullStackBench는 범주를 폭넓게 다루지만 언어별 문제 수가 불균등하고 McEval은 언어별 문제 수가 균등하지만 범주가 집중되어 있다. AutoCodeBench는 표시된 범주가 14개이며 언어별 문제 수가 대체로 균등하다. Lite는 표시된 범주가 13개이고 언어별 문제 수가 57–106개로, 균등성이 더 낮다.
- B Manual Verification은 모델의 도움을 받아 사람이 이름, 타입, 재현성, 논리적 정합성, 수치 정밀도, 명시되지 않은 요구사항을 평가하는 절차를 설명한다. 주석 작업자는 critic의 추론과 결과를 보며, 문제 설명이 정확하다고 가정하고 경계 조건을 완전히 검사하지 않아도 허용한다. 이러한 조건이 보고된 유효성 추정치 87.6%의 적용 범위를 정한다.
- C Multilingual Code Sandbox Service는 30개를 초과하는 프로그래밍 언어 지원, Docker 컨테이너를 통한 실행 격리, iptables 규칙을 통한 네트워크 필터링, 풀이와 테스트의 자동 통합, 동시 요청을 처리하는 Gunicorn 다중 프로세스 구성을 설명한다. HTTP 기반 프로그래밍 인터페이스와 설정 가능한 실행 환경도 제공한다. 본문은 20+개 언어를 지원한다고 밝히고, Appendix C는 더 구체적인 설명을 제공하지만 처리량 측정이나 보안 평가는 제시하지 않는다.
- D Prompts for Automated Workflow는 풀이 생성, 테스트 생성, 문제 생성, 비평, 번역 프롬프트를 제시한다. 표시된 풀이 프롬프트는 예시 케이스를 최대 2개 허용하지만 Section 2.2.2는 최대 3개를 허용한다. 테스트 프롬프트는 제공된 입력과 출력을 유지하며 문제 프롬프트는 정확한 이름과 공개 예시를 요구하고 풀이 힌트를 금지한다. 풀이 프롬프트와 테스트 프롬프트 그림에는 뒷부분이 생략되어 있어, PDF만으로는 전체 내용을 확인할 수 없다.
짧은 생각
이 구축 파이프라인은 문제 설명을 작성하기 전에 실행으로 테스트 출력을 얻는 구체적인 방법을 제공한다. 사람 검증에서는 실행 가능한 테스트가 문제 설명에 빠진 요구사항에 의존할 수 있다는 약점도 확인된다. 따라서 보고된 점수를 해석할 때는 언어에 따라 달라지는 필터링과 평가 모델에 따라 달라지는 Lite 선택을 고려해야 한다. 결과는 보고된 평가 조건에서 실험한 모델의 특성을 보여준다. 테스트가 모든 조건에서 정확하다는 점, 생성 편향이 없다는 측정 결과, 저장소 수준의 엔지니어링 능력, AutoCodeGen 데이터의 학습 효과를 입증하지는 않는다.