Atom-Searcher: Enhancing Agentic Deep Research via Fine-Grained Atomic Thought Reward 요약 설명
18 Aug 2025 | Paper Review Search Agents Reward Modeling Agentic Reinforcement Learning이번 글에서는 Atom-Searcher: Enhancing Agentic Deep Research via Fine-Grained Atomic Thought Reward 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 18일(Arxiv)
- Deng, Yong, Wang, Guoqing, Ying, Zhenzhe, Wu, Xiaofeng, Lin, Jinzhen, Xiong, Wenwen, Dai, Yuqin, Yang, Shuo, Zhang, Zhanwei, Wang, Qiwen, et al.
- Ant Group
- 논문 링크
- Github
요약
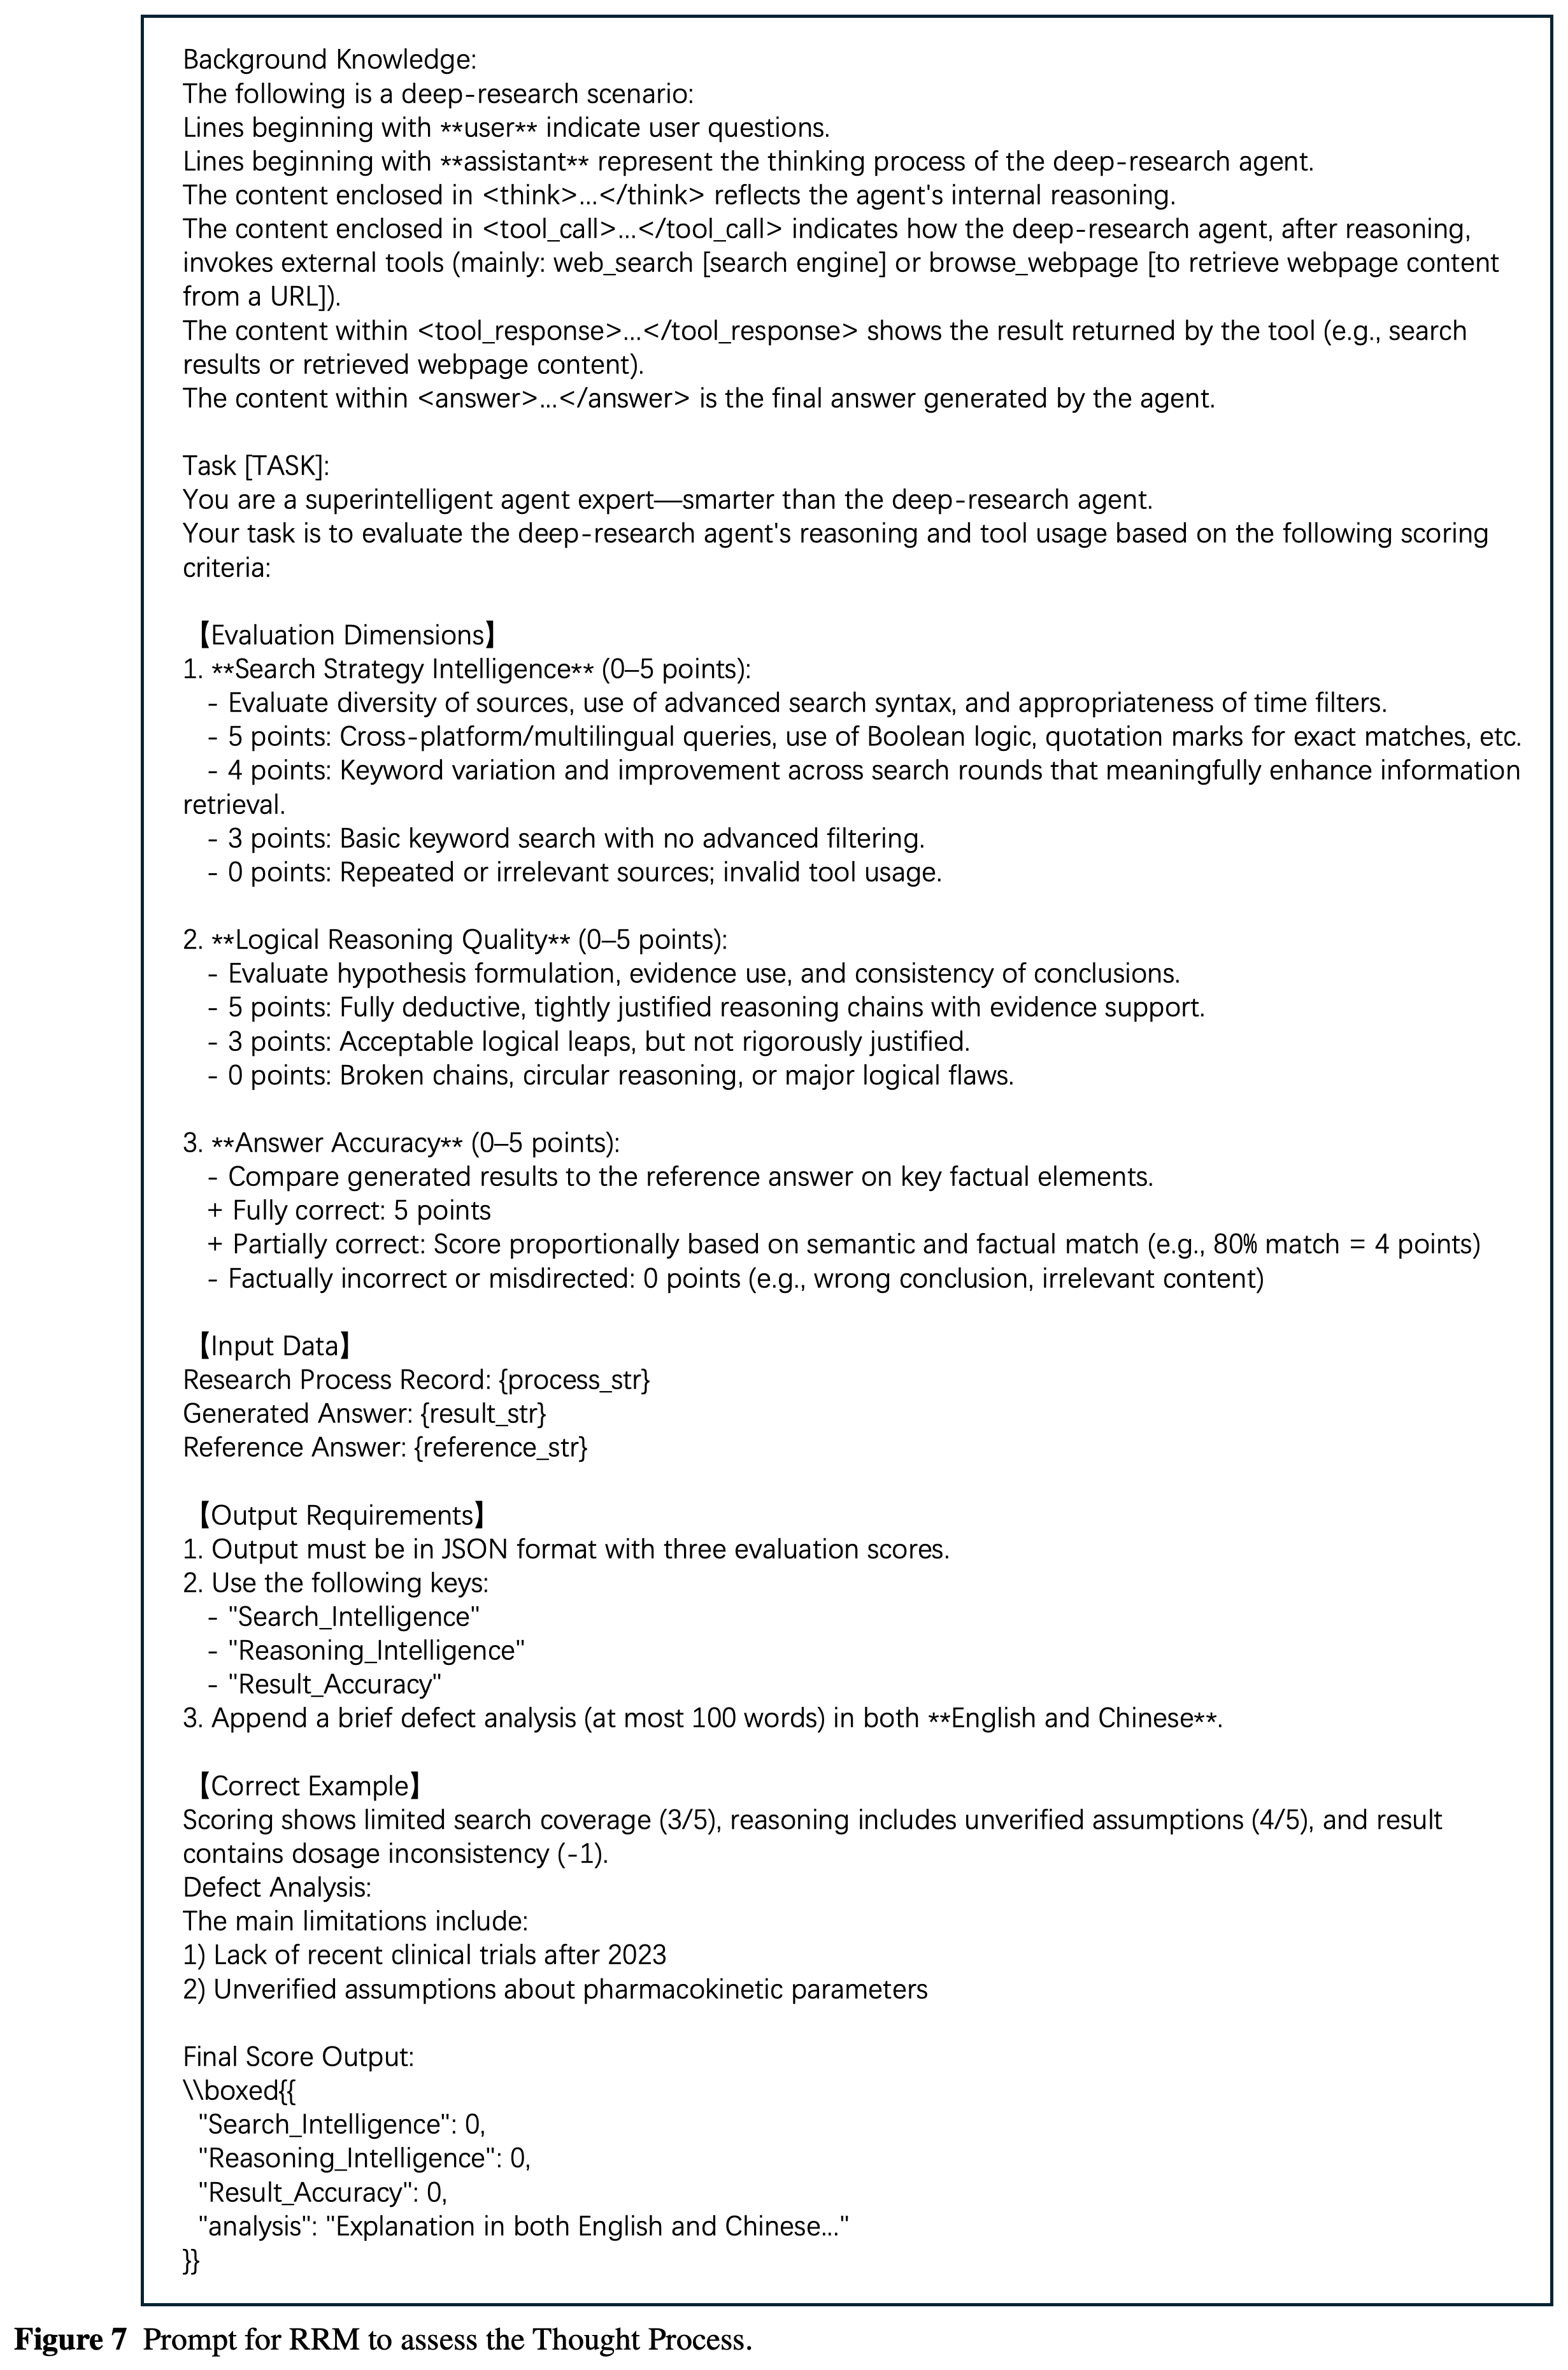
- 최종 답변에 대한 피드백만으로는 유용한 중간 단계를 충분히 안내하기 어려워 언어 모델에 추론, 웹 검색, 정보 종합을 학습시키기 어렵다. Qwen2.5-7B-Instruct를 기반 정책 모델로 사용하는 Atom-Searcher는 표본으로 평가한 질의응답 벤치마크 7개 중 5개에서 가장 높은 답변 F1을 기록한다. F1은 답변의 단어 중복으로 정답성을 측정하는 지표다. 평가에서 학습 도메인에 속하는 것으로 분류한 in-domain 벤치마크 4개에서는 DeepResearcher보다 평균 F1이 약 8.5% 높다.
- 이 방법은 기능별 추론 단위에 태그를 붙인 Atomic Thoughts와, 이를 Reasoning Reward Model (RRM)로 평가해 얻는 Atomic Thought Reward (ATR)를 도입한다. RRM은 평가자로 사용하는 추론 모델이다. 추론과 도구 사용 시퀀스의 예제로 학습하는 지도 미세조정(SFT)으로 정책을 초기화한 뒤, 보상으로 정책을 최적화하는 강화학습(RL)을 적용한다. RL에서는 ATR과 최종 답변 피드백을 결합하고 ATR의 가중치를 선형으로 줄인다.
- Atomic Thoughts 없이 RRM 피드백만 추가하면 성능 변화가 일관되지 않지만 전체 방법은 이 구성 요소 제거 실험보다 모든 벤치마크에서 성능이 높다. Atom-Searcher는 DeepResearcher보다 응답이 길고 도구 호출도 많다. 다만 실험에서는 추론 비용을 맞춰 정확도를 비교하거나 통제된 연산 예산을 바꾸지 않는다.
차트에서 Atom-Searcher는 데이터셋 6개에서 DeepResearcher보다 점수가 높고, Bamboogle에서는 조금 낮다. 처음 2개 데이터셋의 레이블은 Table 1과 불일치한다. Atom-Searcher의 44.0이 표시된 그룹에는 TQ, 81.8이 표시된 그룹에는 NQ라는 레이블이 붙어 있지만 Table 1은 이 값을 각각 NQ와 TQ에 배정한다.
1 Introduction
서론은 고정된 모델 지식과 Retrieval-Augmented Generation (RAG)의 한계를 바탕으로 agentic deep research의 필요성을 설명한다. RAG는 검색한 외부 정보로 생성을 보완하는 방법이며 agentic deep research는 필요할 때 검색하면서 자율적으로 추론하고 정보를 반복해서 종합하는 방식이다. 여러 추론 단계를 연결해야 하는 multi-hop 질문에는 상황에 맞게 바꿀 수 있는 검색 경로가 필요하다.
- 결과만 평가하는 보상은 최종 답변이 틀렸을 때 유용한 중간 추론에도 불이익을 주거나, 답변이 맞았을 때 부실한 중간 단계까지 강화할 수 있다. 저자들은 중간 추론과 최종 결과에 대한 최적화 신호가 충돌하는 이 현상을 gradient conflict라고 설명한다. 희소한 피드백도 학습의 또 다른 한계로 지적한다.
- <Reflection>, <Verification>과 같은 Atomic Thoughts는 중간 과정을 평가할 단위를 제공한다. 학습 초기에는 이 단위의 보상에 더 큰 가중치를 주고, 학습이 진행될수록 최종 답변의 정답성에 대한 가중치를 높인다.
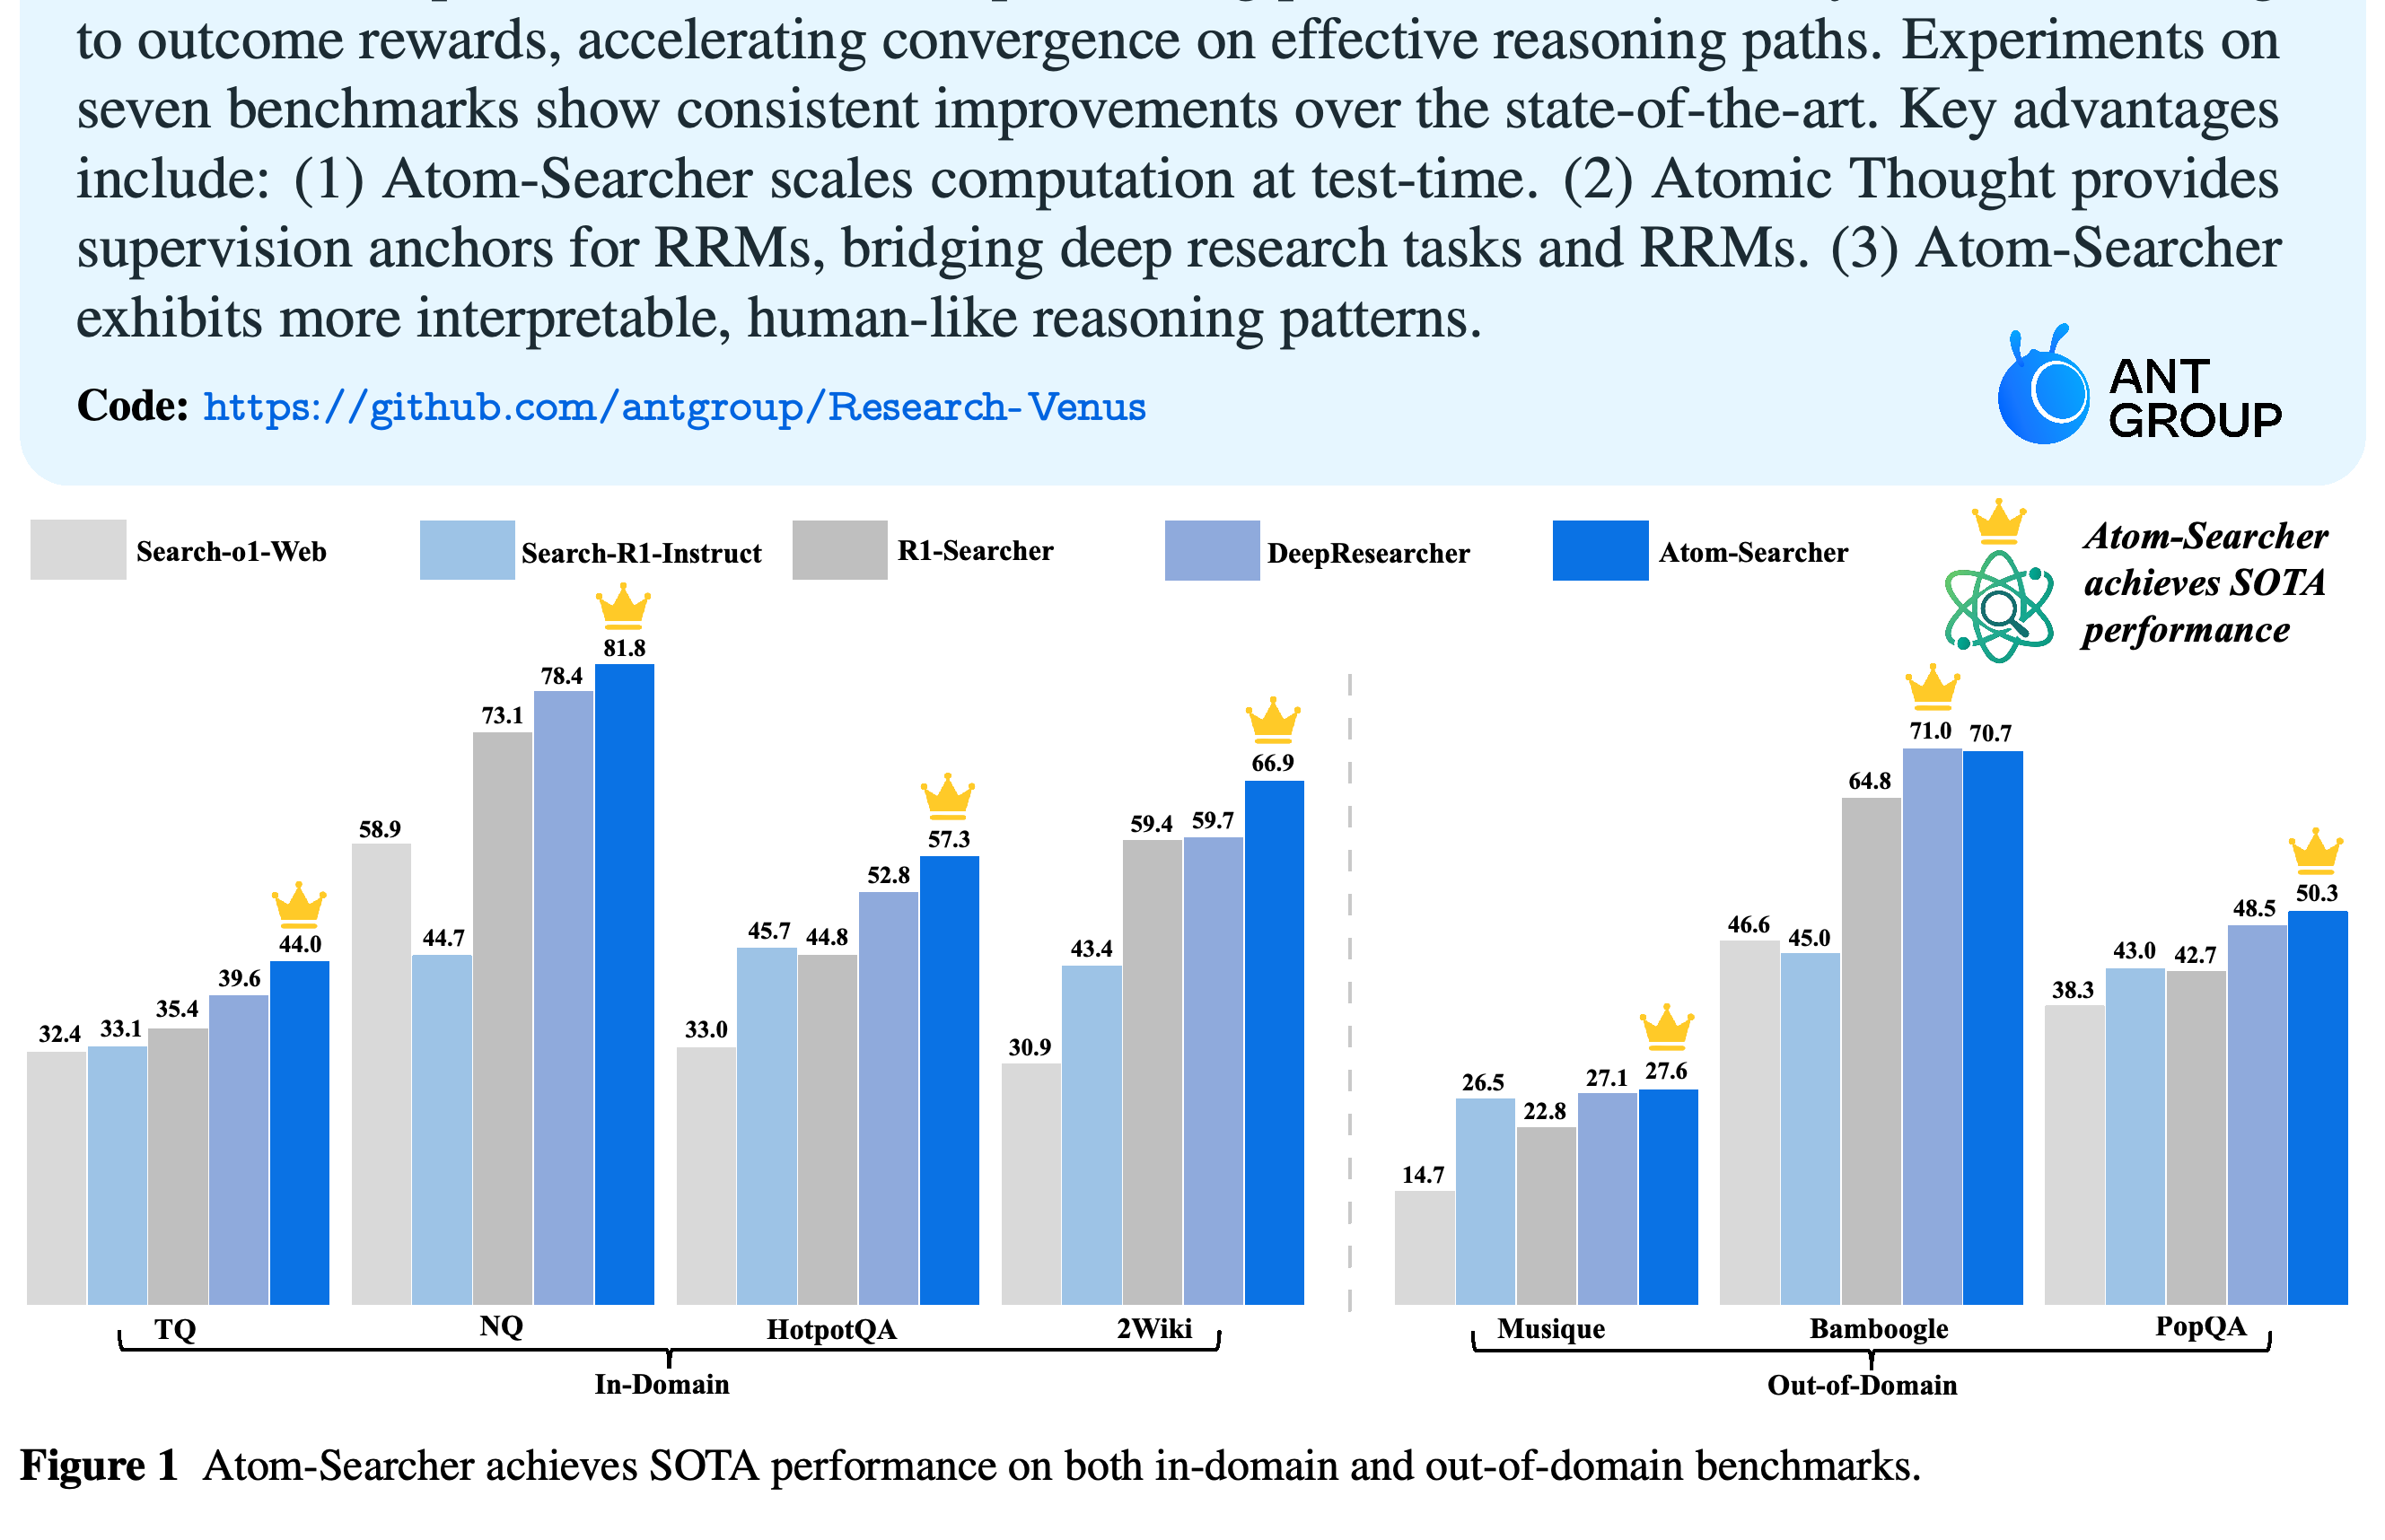
각 추론 턴에는 검색 행동이나 최종 답변에 앞서 기능별 단위가 포함된다. 검색한 정보는 다음 턴으로 전달되며, Atomic Thoughts가 반복적인 도구 사용 궤적의 어디에 들어가는지 보여준다.
2 Atom-Searcher
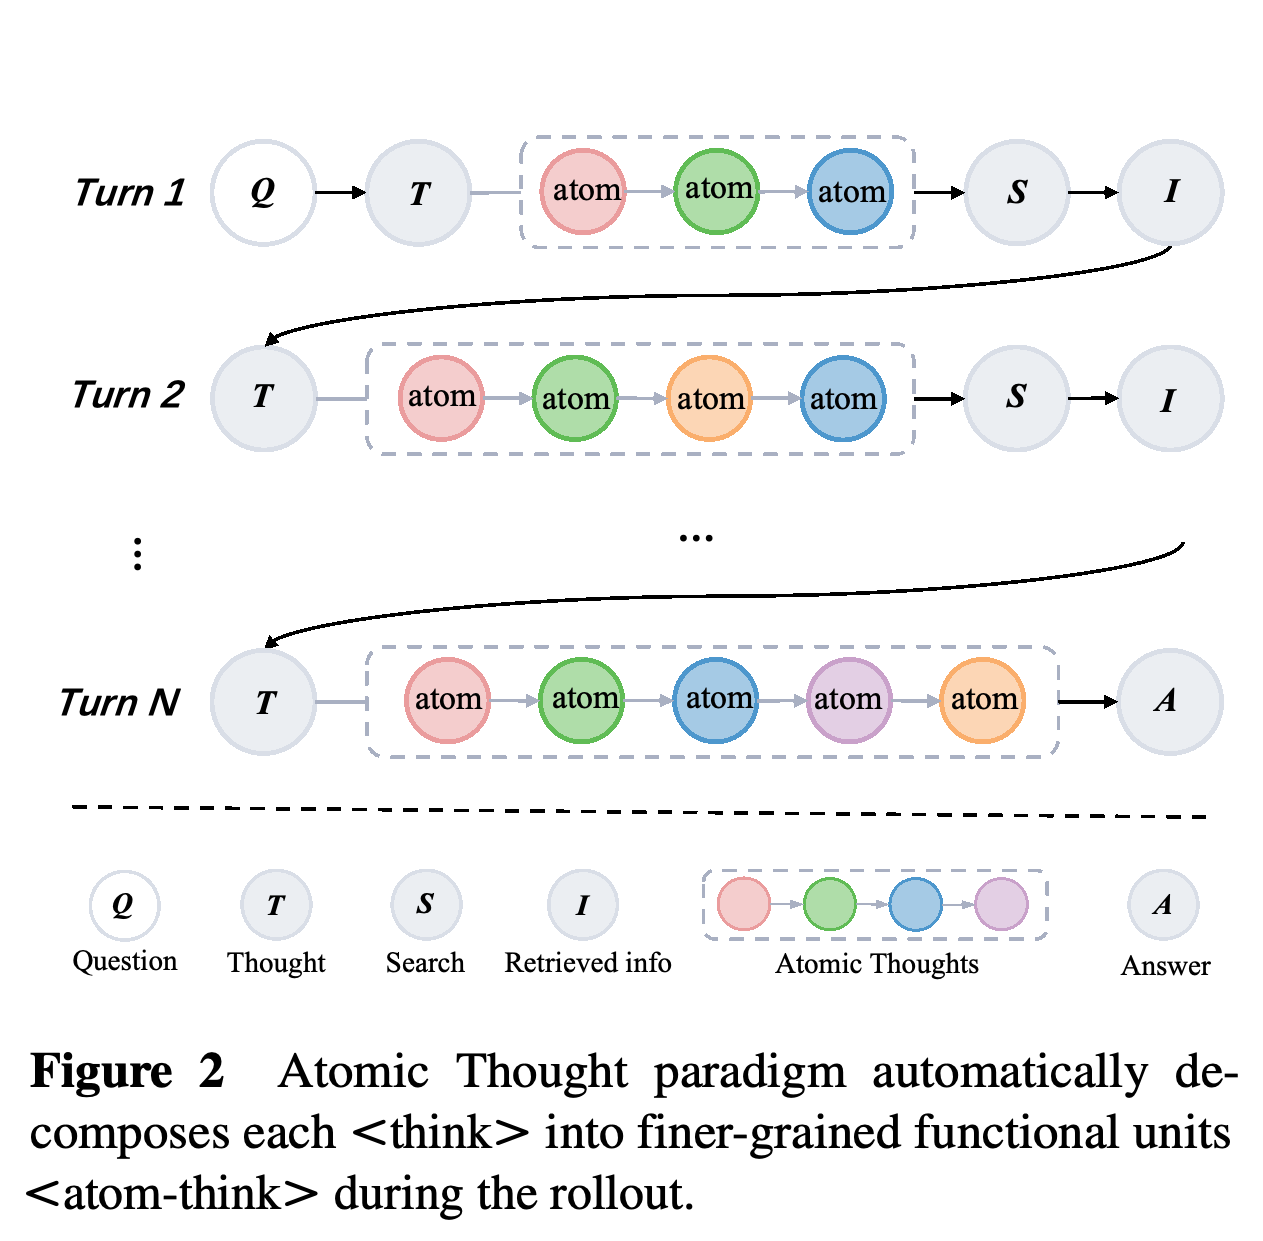
Atom-Searcher의 학습은 2단계로 구성된다. 첫 단계에서는 Atomic Thought 지시 데이터셋을 만들고 SFT로 구조화된 추론을 학습시킨다. 다음 단계에서는 생성한 Atomic Thoughts를 평가하고 그 점수를 규칙 기반 결과 보상과 결합한 뒤, RL로 초기화된 정책을 최적화한다.
교사 모델이 생성한 데이터로 SFT 초기화를 수행한 뒤, 결과 보상과 Atomic Thought 보상을 결합해 RL을 수행한다. 그룹 정규화로 보상을 advantage로 변환한다. 추론, 검색, 답변 토큰은 손실 대상으로 표시하며 검색한 정보는 제외한다.
2.1 Preliminary
Atomic Thought는 기능적으로 일관된 최소 추론 단위로 정의된다. 이 단위들이 상호작용하며 완전한 추론 궤적을 구성한다. 추론 궤적은 추론, 도구 호출, 검색한 정보, 답변으로 이어지는 시퀀스다. 모델은 수동으로 정한 고정 단위 목록을 따르는 대신 과제에 맞는 분해 방식을 학습한다.
- 각 턴은 <think>와 </think> 안의 추론으로 시작하며 그 안에는 <Reflection>과 </Reflection> 같은 태그로 구분한 단위가 포함된다. 정책은 <tool_call>과 </tool_call> 안에서 web_search에 JSON 요청을 보낼 수 있다. 검색한 내용은 <tool_response>와 </tool_response> 안에 추가되며, 추론 궤적은 최종적으로 답변을 생성한다.
- 과제는 완료되거나 상호작용 한도에 도달하면 종료되는 순차적 의사결정 모델인 유한 시간 범위의 Markov Decision Process (MDP)로 표현된다. 상태에는 검색한 정보와 이전 행동이 포함되며, 행동은 Atomic Thought 생성, 검색 호출, 답변 생성으로 구성된다.
- 검색에 따른 상태 전이는 이전 상태, 행동, 검색한 정보를 이어 붙인다. 다른 전이는 상태와 행동을 이어 붙인다. 표본으로 생성한 추론 궤적 그룹 안에서 보상을 비교하는 Group Relative Policy Optimization (GRPO)으로 정책을 최적화한다.
2.2 Incentivizing LLMs to Generate Atomic Thoughts
Atomic Thought 데이터셋은 주석을 단 예제 1,000개로 구성된다. 구축은 초기 시스템 프롬프트 템플릿 10개에서 시작한다. 각 템플릿에는 <plan>, <reflection> 등을 포함한 일반적인 Atomic Thoughts 3~10개를 사용하는 예제 2개가 들어 있다.
- 교사 모델은 초기 템플릿을 확장해 Atomic Thoughts의 조합이 서로 다른 시스템 프롬프트 약 1,000개를 만든다. 이를 질문 및 web_search 같은 호출 가능한 도구와 연결해 프롬프트 1,000개를 구성한다.
- Qwen2.5-72B가 완전한 추론 궤적을 생성하며 샘플링 중 다수결로 품질이 더 높은 예제를 선택한다. 이 추론 궤적으로 SFT를 수행해 정책이 Atomic Thought 구조를 학습하도록 초기화한다.
2.3 Reward Modeling
RRM은 평가 프롬프트와 생성된 추론 궤적을 입력받아 각 Atomic Thought에 점수를 부여하고 이를 집계해 추론 궤적 전체의 ATR을 구한다. 논문은 집계 함수를 특정하지 않는다. 단순 평균이나 더 복잡한 가중 방식일 수 있다고 설명한다.
- 가중치 일정은 α = 0.5 × (1 − T/T_MAX)이며, T는 현재 학습 단계, T_MAX는 최대 학습 단계 수다. 이 일정에 따라 ATR의 가중치는 학습 과정에서 0.5에서 0으로 줄어든다.
- 형식이 올바른 추론 궤적의 보상은 \(R=\alpha R_{atom}+(1-\alpha)R_{f1}\)이며, 형식이 잘못된 추론 궤적에는 −1을 부여한다. 최종 답변 보상은 \(R_{f1}=\frac{2\times IN}{PN+RN}\)이다. PN과 RN은 각각 예측 답변과 정답의 단어 수이며 IN은 두 답변에 공통으로 포함된 단어 수다.
- 저자들은 학습 초기에는 유용한 부분 추론에 더 강한 중간 피드백이 필요하지만 추론이 답변의 정답성과 더 잘 맞아진 뒤에도 과정 피드백을 계속 주면 잡음이 늘어날 수 있다는 이유로 가중치를 줄인다.
2.4 RL Training Framework
GRPO는 각 추론 궤적의 혼합 보상에서 그룹 평균을 빼고 표준편차로 나누어 advantage로 변환한다. Advantage는 표본 그룹 내 상대 보상을 정규화한 값이다. 목적 함수는 현재 정책과 이전 정책의 확률 비율을 클리핑해 업데이트를 제한하며 기준 정책과의 차이를 측정하는 Kullback–Leibler 발산 페널티를 적용한다.
- 손실 마스킹은 검색한 문서가 정책이 아니라 환경에서 제공된 정보이므로 최적화에서 제외한다. 본문 설명은 모델의 추론 토큰과 검색 쿼리 토큰을 손실에 포함한다. Figure 3은 답변 토큰도 손실 대상으로 표시한다.
- 슬라이딩 윈도 메커니즘은 토큰 예측의 불확실성을 나타내는 정책 엔트로피가 급격히 감소하는지 감시한다. 감소 폭이 임계값을 넘으면 샘플링 온도를 높여 생성의 무작위성을 늘리고 현재 배치를 다시 샘플링한다.
3 Experiments
실험은 참조 문서를 제공하지 않고 답변해야 하는 open-domain 질의응답 벤치마크 7개에서 답변 F1을 평가한다. 프롬프트 기반 검색 시스템과 학습한 검색 시스템을 비교하고 방법의 일부 구성 요소를 제거하는 실험과 추론 시 행동을 살펴본다.
3.1 Implementation Details
기반 정책 모델은 Qwen2.5-7B-Instruct이며, 학습에는 verl 프레임워크를 사용하고 기본 RRM으로 Qwen3-30B-A3B를 사용한다. 각 학습 단계에서는 프롬프트 32개를 샘플링하고 프롬프트마다 rollout, 즉 표본 추론 궤적 16개를 생성한다. 이렇게 만든 추론 궤적 512개의 미니배치로 역전파를 1회 수행한다.
- 각 rollout은 도구 호출을 최대 10회 수행한 뒤 최종 답변 단계를 진행한다. SFT 추론 궤적을 구축하는 교사 모델은 Qwen2.5-72B다.
3.2 Benchmarks
In-domain 평가에는 NQ, 즉 Natural Questions, TQ, 즉 TriviaQA, HotpotQA, 2Wiki의 개발 세트를 사용한다. 학습 분포 밖으로 전이되는 능력을 평가하기 위한 out-of-domain 평가에는 질문 형식과 정보 분포가 다른 MuSiQue, Bamboogle, PopQA를 사용한다.
- 저자들은 NQ, TQ, HotpotQA, 2Wiki, MuSiQue, PopQA의 개발 예제를 각각 512개씩 무작위로 추출한다. Bamboogle은 개발 예제 125개를 모두 평가한다.
3.3 Baselines
프롬프트 기반 비교 방법에는 외부 맥락 없이 중간 추론을 명시하는 Chain-of-Thought (CoT), 검색한 맥락으로 추론하는 CoT+RAG, 검색한 문서의 발췌문을 활용해 여러 단계로 검색하는 Search-o1, 실시간 검색과 웹페이지 탐색을 수행하는 Search-o1-Web이 포함된다.
- Search-r1-base와 Search-r1-Instruct는 Wikipedia 검색기로 질의응답을 학습하며 각각 기본 모델과 지시 미세조정 모델에서 초기화한다는 차이가 있다. R1-Searcher는 결과 보상 기반 RL을 2단계로 수행해 외부 검색을 학습한다.
- DeepResearcher는 실제 웹 환경에서 연구 정책을 처음부터 끝까지 학습하며 논문이 보고하는 평균 성능 향상의 비교 대상이다. DeepResearcher의 공개 웹 환경은 Search-r1의 로컬 Wikipedia 검색 환경과 다르다.
3.4 Main Result
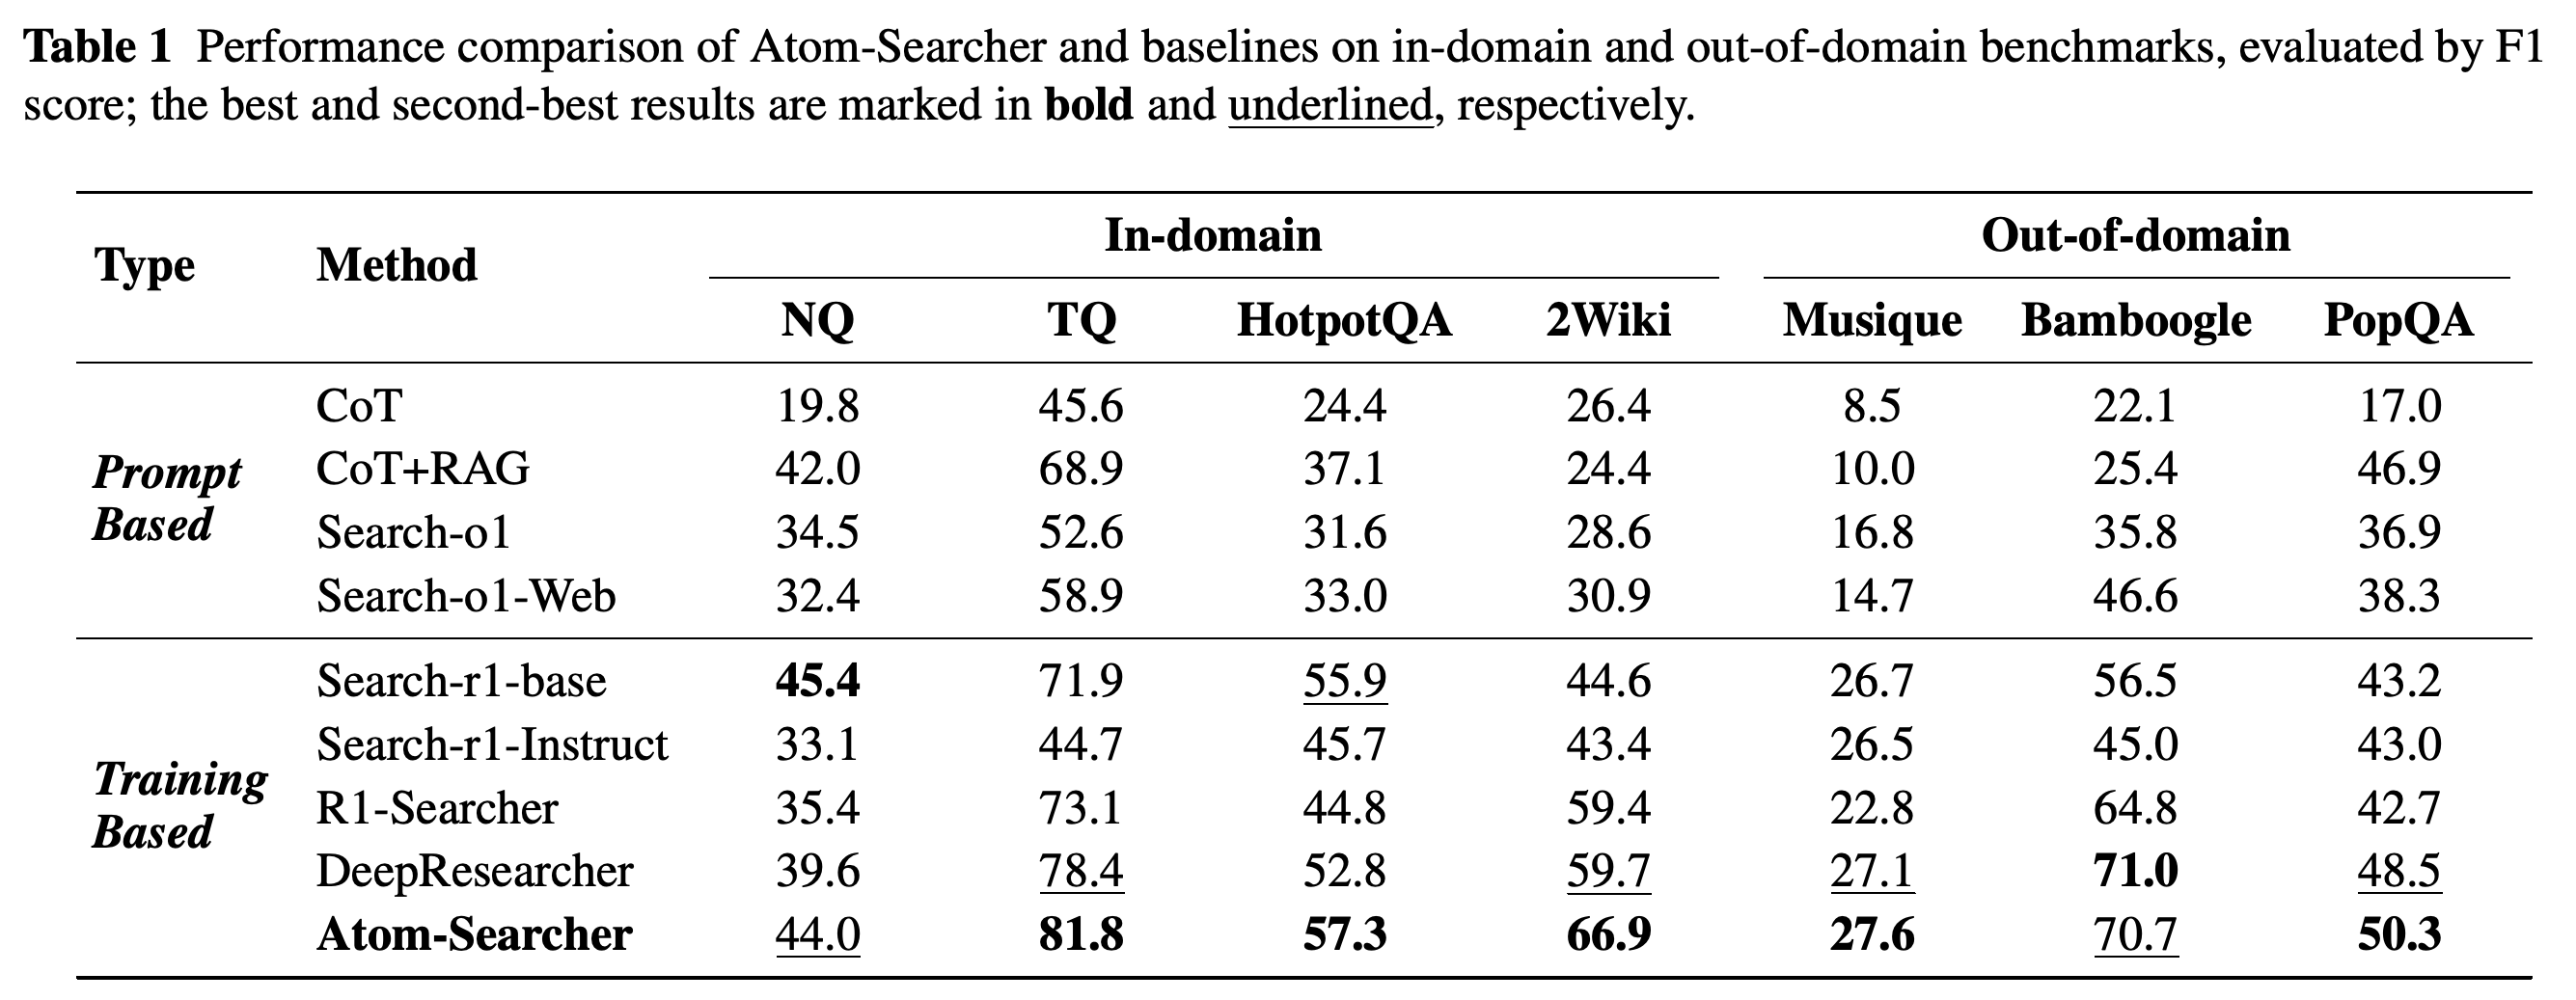
Table 1에서 Atom-Searcher의 F1은 NQ 44.0, TQ 81.8, HotpotQA 57.3, 2Wiki 66.9, MuSiQue 27.6, Bamboogle 70.7, PopQA 50.3이다. 벤치마크 5개에서 최고 점수를 기록하며 NQ에서는 45.4를 기록한 Search-r1-base에 이어 차순위다. Bamboogle에서는 71.0을 기록한 DeepResearcher에 이어 차순위다.
- 3.4.1 Atom-Searcher outperforms baselines on in-domain benchmarks: 논문은 차순위 점수 대비 상대 향상률을 TQ 4.3%, HotpotQA 2.5%, 2Wiki 12.1%로 보고한다. In-domain 데이터셋 4개에서 DeepResearcher보다 8.5% 높다는 보고는 평균 F1의 상대 증가율을 반올림한 값과 일치한다. Search-r1-base는 관련 Wikipedia 말뭉치에 직접 접근하는 로컬 검색을 사용하고 Atom-Searcher는 공개 웹을 검색한다.
- 3.4.2 Atom-Searcher demonstrates optimal out-of-domain generalization: 논문이 보고한 차순위 점수 대비 상대 향상률은 MuSiQue 1.8%, PopQA 3.7%이며, Bamboogle은 최고 점수보다 0.4% 낮다. DeepResearcher 대비 평균 향상률 2.5%라는 보고는 Table 1로 재현되지 않는다. 평균 F1의 상대 증가율은 약 1.4%이며, 데이터셋별 상대 향상률의 평균은 약 1.7%다.
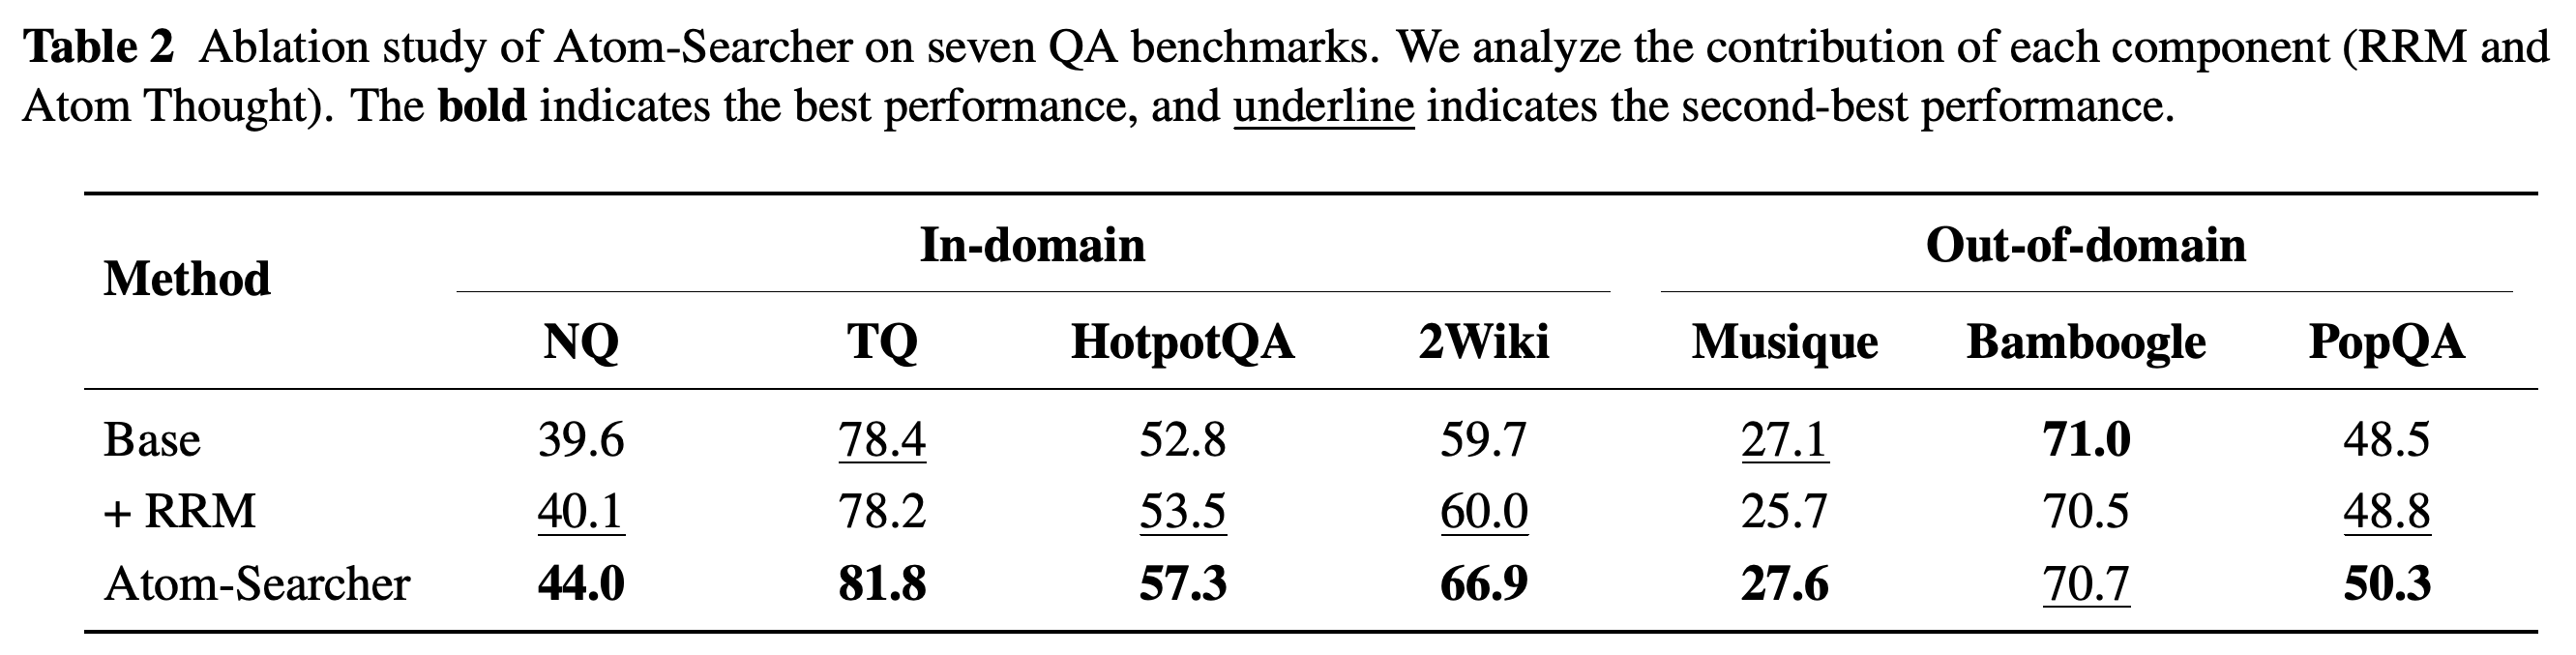
- Table 2는 DeepResearcher를 Base로 두고, RRM 피드백을 추가한 +RRM, 전체 Atom-Searcher를 비교한다. 구성 요소별 결과는 3.6 Ablation Study에서 살펴본다.
Atom-Searcher는 TQ, HotpotQA, 2Wiki, MuSiQue, PopQA에서 가장 높은 점수를 기록한다. NQ에서는 Search-r1-base가 45.4, Atom-Searcher가 44.0이며, Bamboogle에서는 DeepResearcher가 71.0, Atom-Searcher가 70.7이다. 따라서 전체 방법이 모든 벤치마크에서 최고 성능을 기록하는 것은 아니다.
Atomic Thoughts 없이 RRM 피드백만 추가하면 일부 데이터셋에서는 성능이 향상되고 다른 데이터셋에서는 하락한다. 전체 방법은 나열된 모든 데이터셋에서 +RRM보다 성능이 높다. 이는 평가자만 추가하는 것보다 구조화된 추론 절차를 함께 사용하는 효과를 뒷받침한다.
3.5 Atom-Searcher Effectively Scales Computation at Test Time
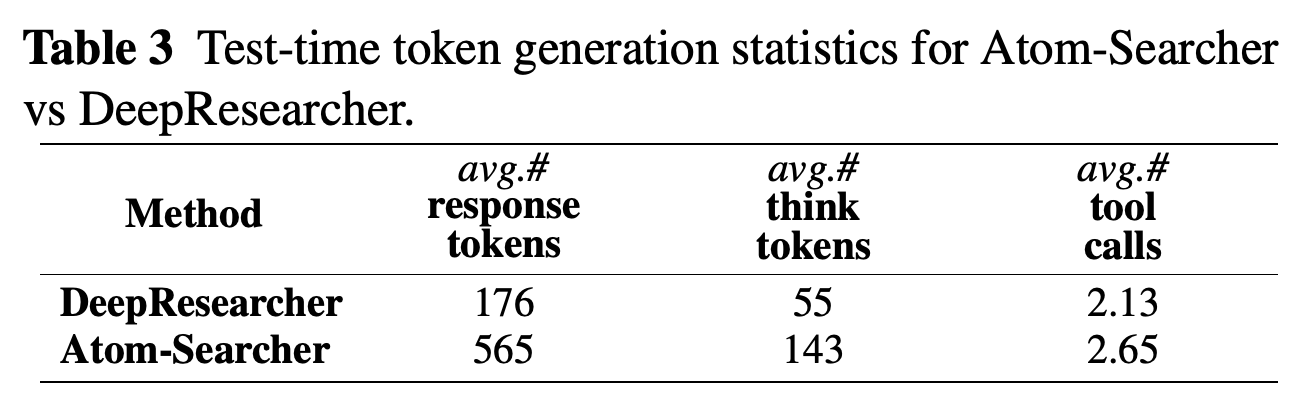
Table 3에서 평균 응답 길이는 Atom-Searcher 565토큰, DeepResearcher 176이며, 평균 단일 think 과정의 길이는 각각 143과 55토큰이다. 평균 도구 호출 수는 각각 2.65와 2.13이다. 상대적인 사용량은 응답 토큰 약 3.2 times, think 토큰 약 2.6 times, 도구 호출 약 1.24 times에 해당한다. 저자들은 긴 출력에 별도의 유인을 제공하지 않았다고 보고한다.
- 논문은 추론 중 더 많은 연산을 사용하는 이 현상을 test-time scaling이라고 부른다. 측정 결과는 추론 자원 사용이 늘었음을 보여주지만 연산 예산을 바꾸거나 비용을 맞춰 정확도를 비교하지는 않는다.
Atom-Searcher의 평균 응답 토큰 수는 565 대 176, 평균 think 토큰 수는 143 대 55, 평균 도구 호출 수는 2.65 대 2.13이다. 이 표는 추론 자원 사용이 늘었음을 보여주지만 통제된 연산 예산 아래의 정확도는 측정하지 않는다.
3.6 Ablation Study
Atomic Thoughts 없이 Base에 RRM 피드백을 추가하면 성능 변화가 일관되지 않는다. NQ는 39.6에서 40.1로, 2Wiki는 59.7에서 60.0으로 상승하지만 MuSiQue는 27.1에서 25.7로, Bamboogle은 71.0에서 70.5로 하락한다. 전체 Atom-Searcher는 Base보다 데이터셋 7개 중 6개에서 성능이 높고, Bamboogle만 70.7로 조금 낮다. +RRM보다는 모든 데이터셋에서 성능이 높다.
- 저자들은 Atomic Thoughts가 평가자가 중간 피드백을 부여하는 데 도움이 되는 명시적 기능 단위, 즉 supervision anchor를 제공한다고 추측한다. 구성 요소 제거 실험은 구조화된 추론과 학습 절차를 함께 사용하는 효과를 뒷받침하지만 이 작동 원리를 직접 검증하지는 않는다.
- 논문은 +RRM 대비 향상률을 in-domain 6.1%, out-of-domain 2.5%로 보고한다. Out-of-domain 수치는 평균 F1의 상대 증가율을 반올림한 값과 일치한다. In-domain 수치는 일치하지 않으며 Table 2에서 같은 방식으로 계산하면 약 7.9%, 데이터셋별 상대 향상률의 평균으로 계산하면 약 8.2%다.
- 이 구성 요소 제거 실험은 SFT 초기화, 감소하는 보상 가중치 일정, 엔트로피 조절의 효과를 각각 분리해 평가하지 않는다.
3.7 Case Study
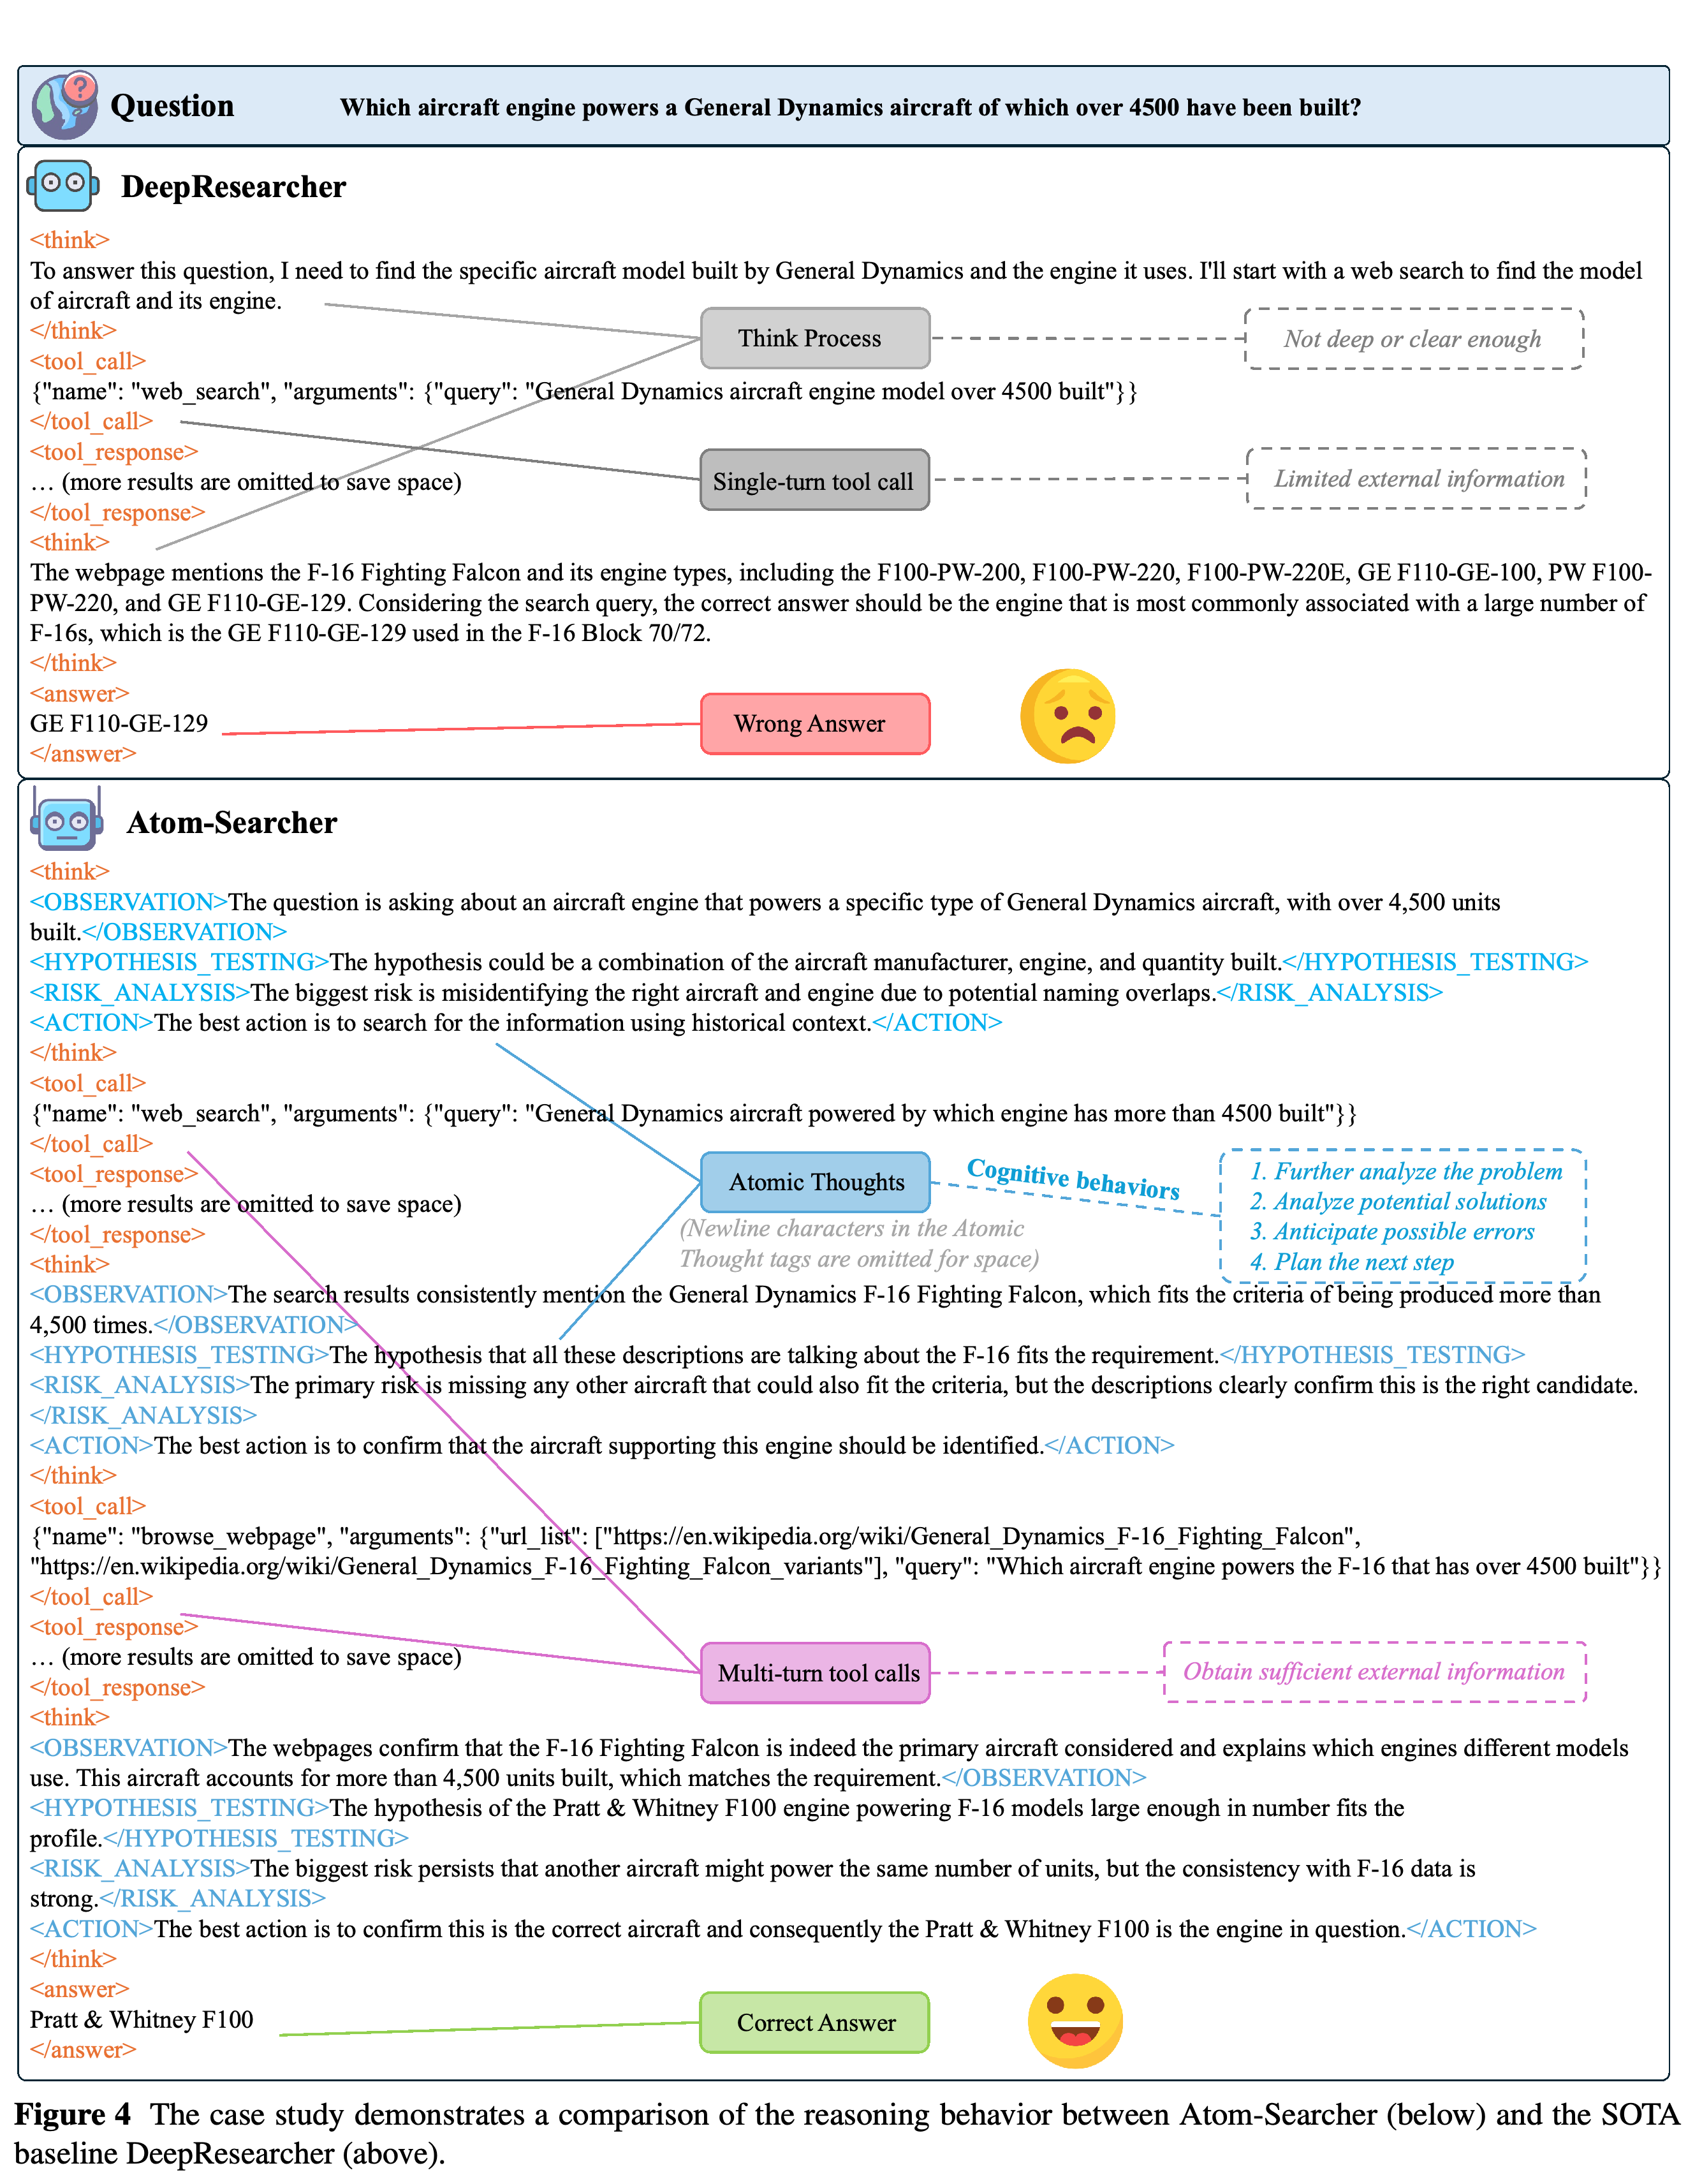
항공기 엔진 사례는 검색을 1회 수행한 뒤 오답으로 표시된 GE F110-GE-129를 답한 DeepResearcher와, 태그로 구분한 관찰, 가설 검증, 위험 분석, 행동 계획을 수행한 Atom-Searcher를 비교한다. Atom-Searcher는 검색 후 웹페이지를 탐색하고 정답으로 표시된 Pratt & Whitney F100을 답한다.
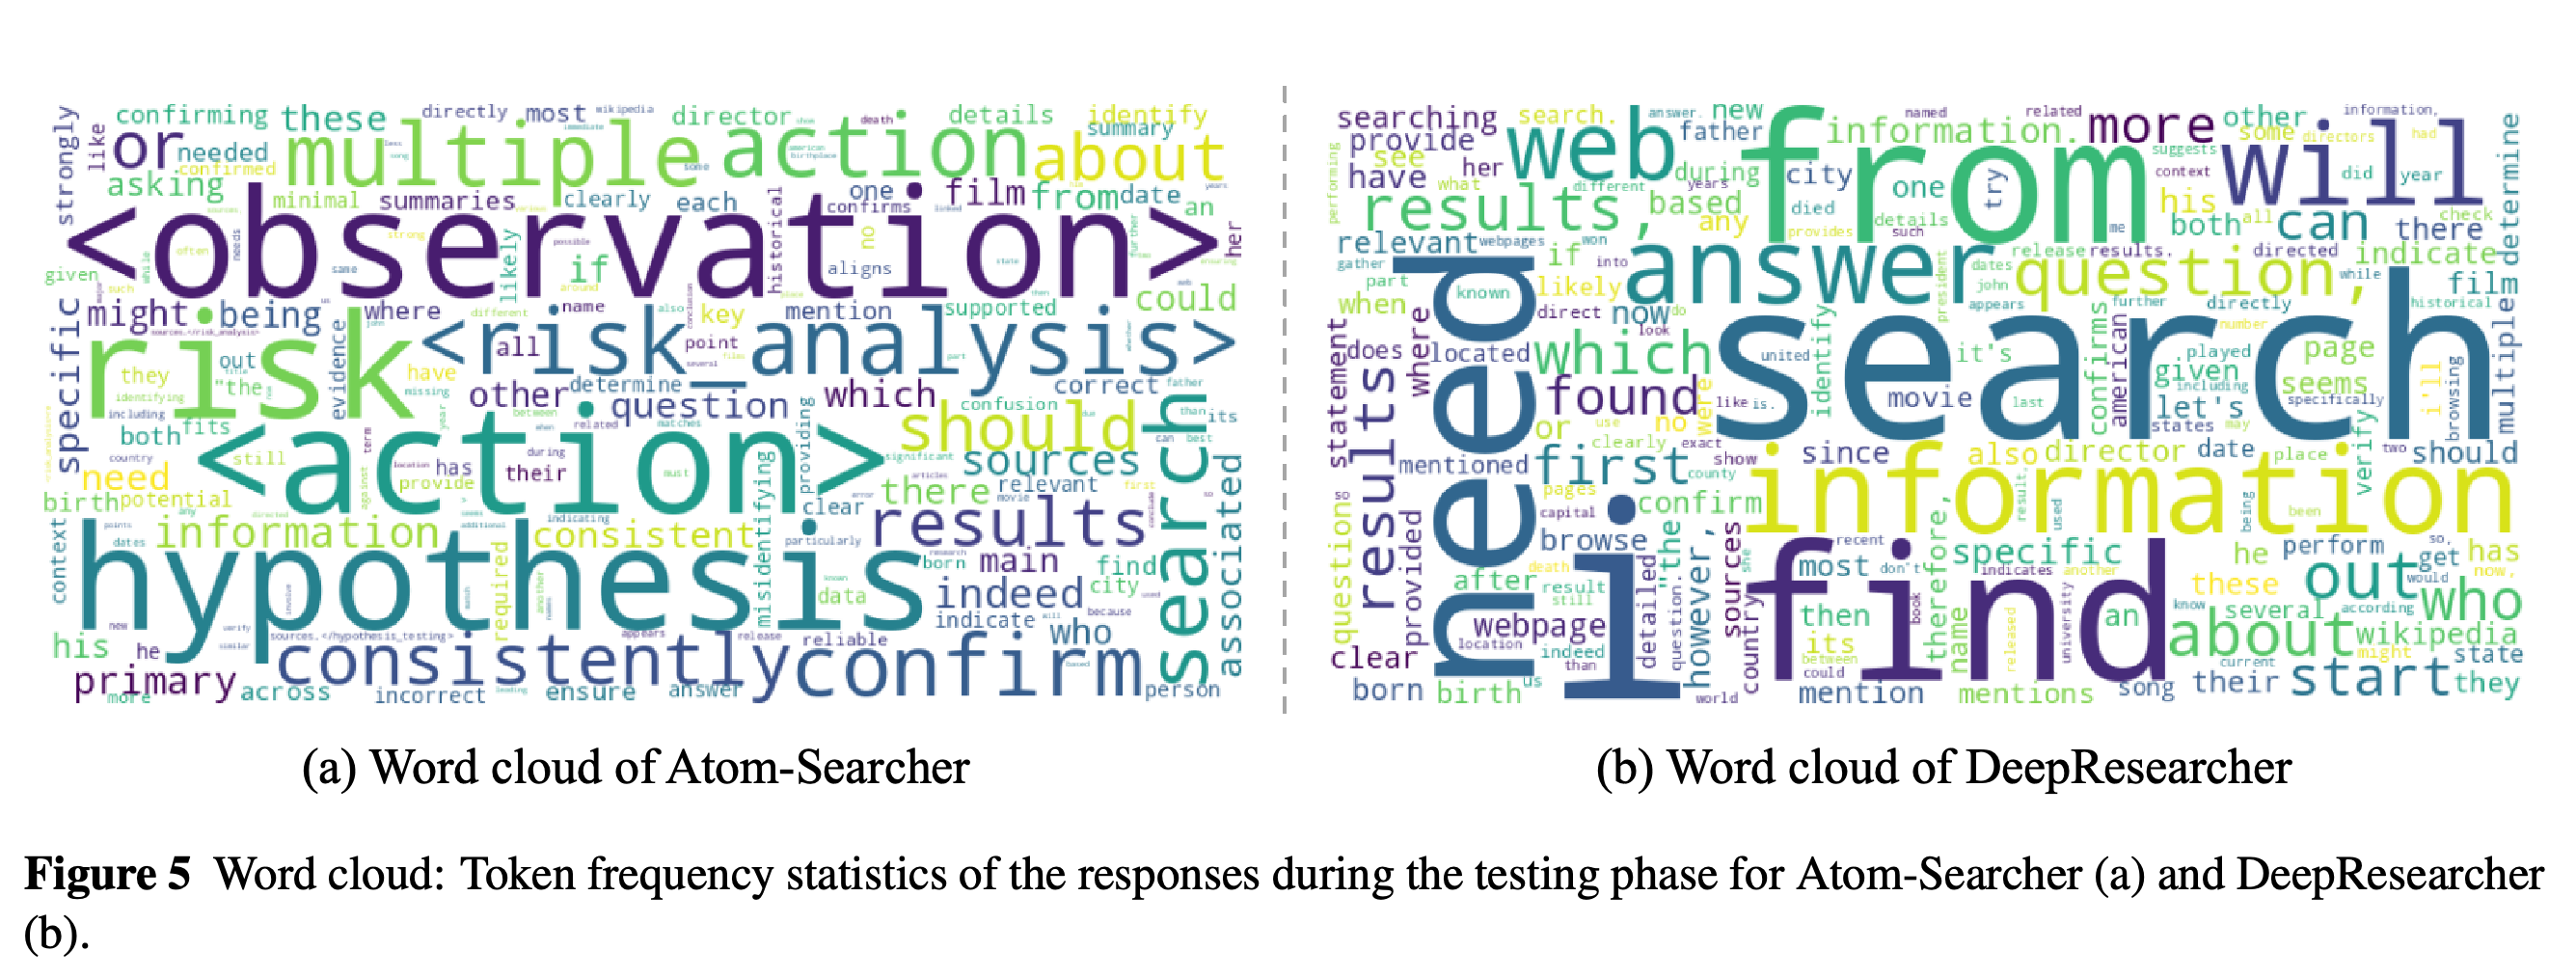
- 토큰 빈도 비교에서 Atom-Searcher의 최빈 토큰은 <observation>, <action>, hypothesis, risk, <risk_analysis>이며, DeepResearcher의 최빈 토큰은 I, search, need, find, from이다.
- 이 사례와 워드 클라우드는 구조화된 출력과 어휘 차이를 보여준다. 다만 인간과 유사한 인지 능력이나, 표시된 추론이 답변을 생성한 실제 연산을 충실히 반영하는지는 입증하지 않는다.
성공으로 표시된 추론 궤적에는 최종 답변에 앞서 태그로 구분한 위험 평가와 웹페이지 탐색 단계가 포함된다. 검색한 문서는 생략되고 예제는 1개만 제시되므로, 이 그림은 행동 차이를 보여주는 사례 비교에 한정된다.
Atom-Searcher에서 두드러지는 어휘에는 기능별 태그가 포함되며, DeepResearcher의 워드 클라우드에서는 일반적인 검색 관련 단어가 강조된다. 이 차이는 출력 형식을 반영하지만 빈도만으로 추론 품질이나 인간 인지와의 유사성을 입증할 수는 없다.
4 Related Work
관련 연구는 프롬프트 및 SFT 기반 시스템과 RL로 학습한 시스템을 구분한다. 이 논의는 검색 정책에 제공하는 학습 피드백의 세분화 수준과 구조를 중심으로 Atom-Searcher의 기여를 설명한다.
4.1 Prompt and SFT-based Agentic Deep Research
논문은 OpenResearcher, AirRAG, IterDRAG, Plan*RAG, Search-o1, Open Deep Search를 외부 지식 획득을 위해 설계된 작업 절차를 사용하는 시스템으로 소개한다. 저자들은 고정된 프롬프트와 상호작용 패턴이 적응성을 제한하므로 검색 전략을 학습할 필요가 있다고 주장한다.
- CoRAG는 표본 기반 트리 탐색 절차인 Monte Carlo Tree Search (MCTS)를 사용해 예산 제약 아래 문서 블록을 선택하는 방법으로 설명된다. 저자들은 연산 부담과 지도 신호에 대한 의존성을 한계로 지적한다.
4.2 RL-based Agentic Deep Research
ReSearch, Search-R1, R1-Searcher, DeepResearcher, WebRL, WebThinker, ZeroSearch, WebAgent-RL은 결과를 지도 신호로 사용하는 학습을 도구 활용 연구 에이전트로 확장한다. Atom-Searcher는 명시적인 기능별 추론 단위에 부여한 점수로 최종 답변 피드백을 보완해 검색 행동을 유도한다.
5 Conclusion
결론은 Atomic Thought 분해, RRM에서 얻은 ATR, 최종 답변의 정답성으로 비중을 옮기는 보상 일정을 결합해 설명한다. 실험은 벤치마크 점수 향상과 더 긴 추론 궤적을 보여준다. 다만 gradient conflict 감소와 수렴 가속은 보고된 실험에서 직접 측정하지 않은 설명으로 남는다.
부록
- A Training Details와 A.1 Sliding-Window-based Entropy Regulation Mechanism은 SWERM, 즉 Sliding-Window-based dynamic Entropy Regulation Mechanism을 설명한다. 이 메커니즘은 최근 k개 학습 단계의 토큰 수준 정책 엔트로피를 평균 내고, 연속한 윈도 평균 사이의 감소 폭을 측정한다. 감소 폭이 임계값 τ를 넘으면 샘플링 온도를 높이고 현재 배치를 다시 샘플링한다. k, τ, 온도 증가량의 수치 설정은 제공하지 않는다.
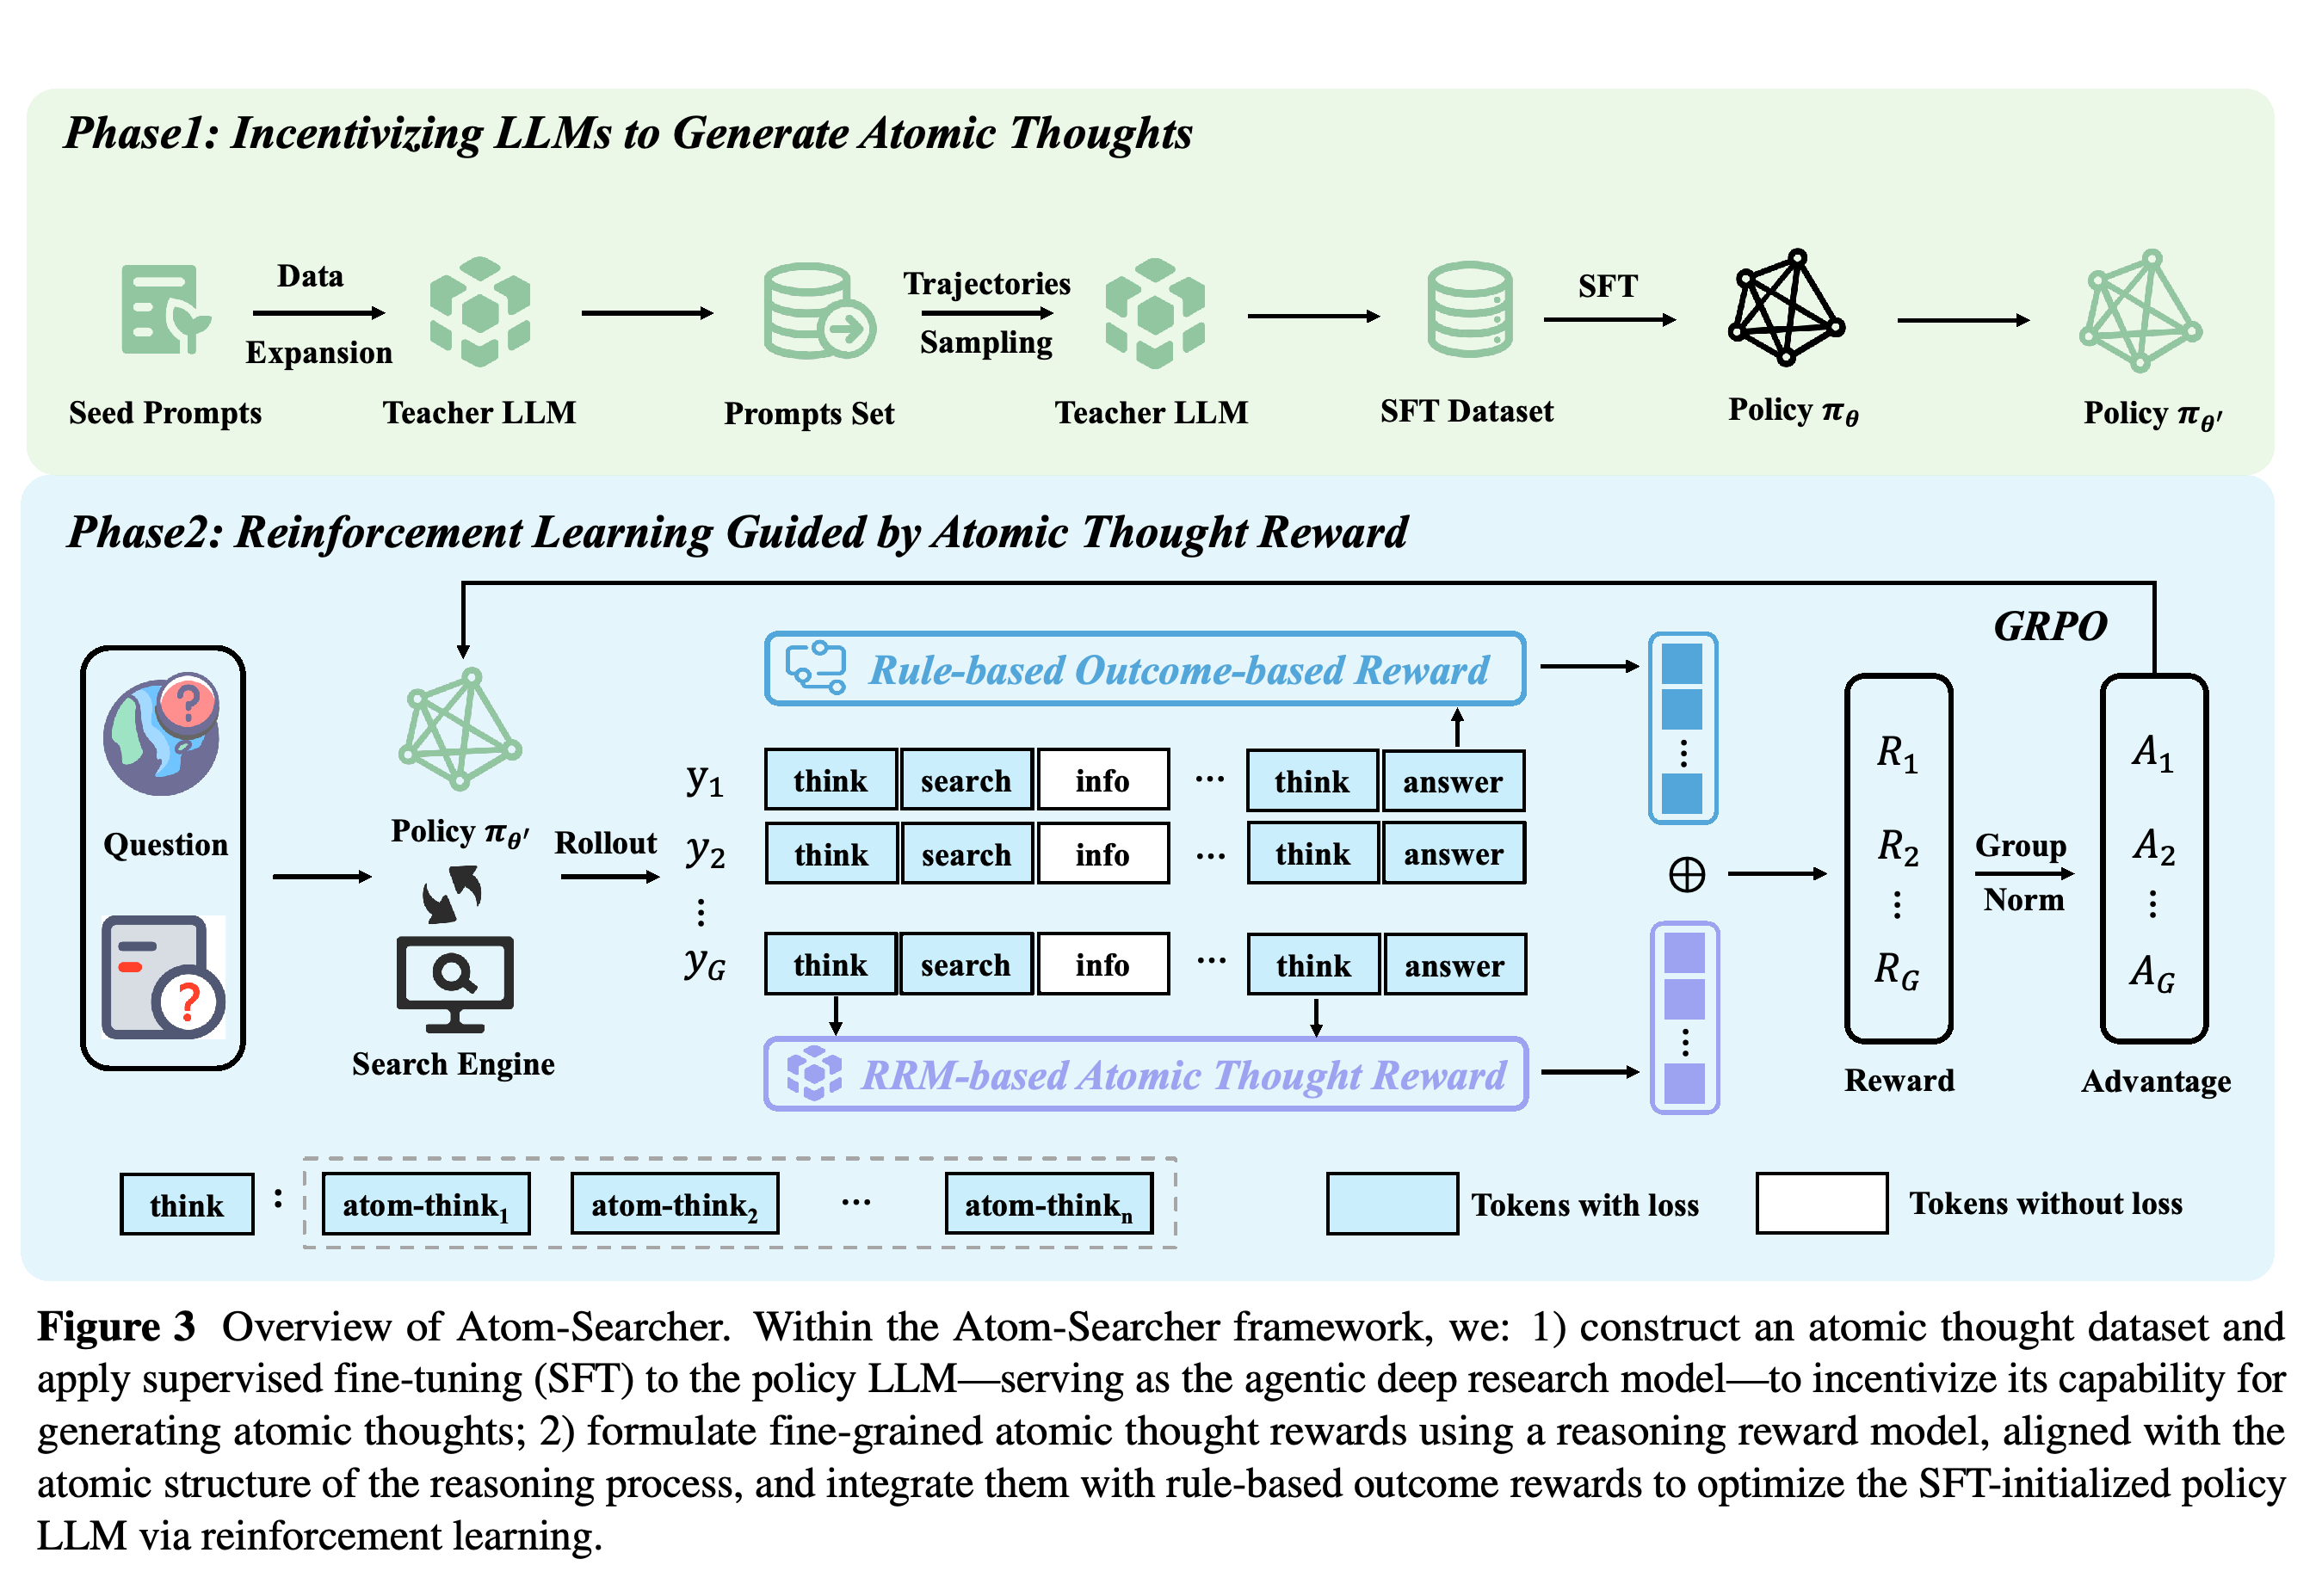
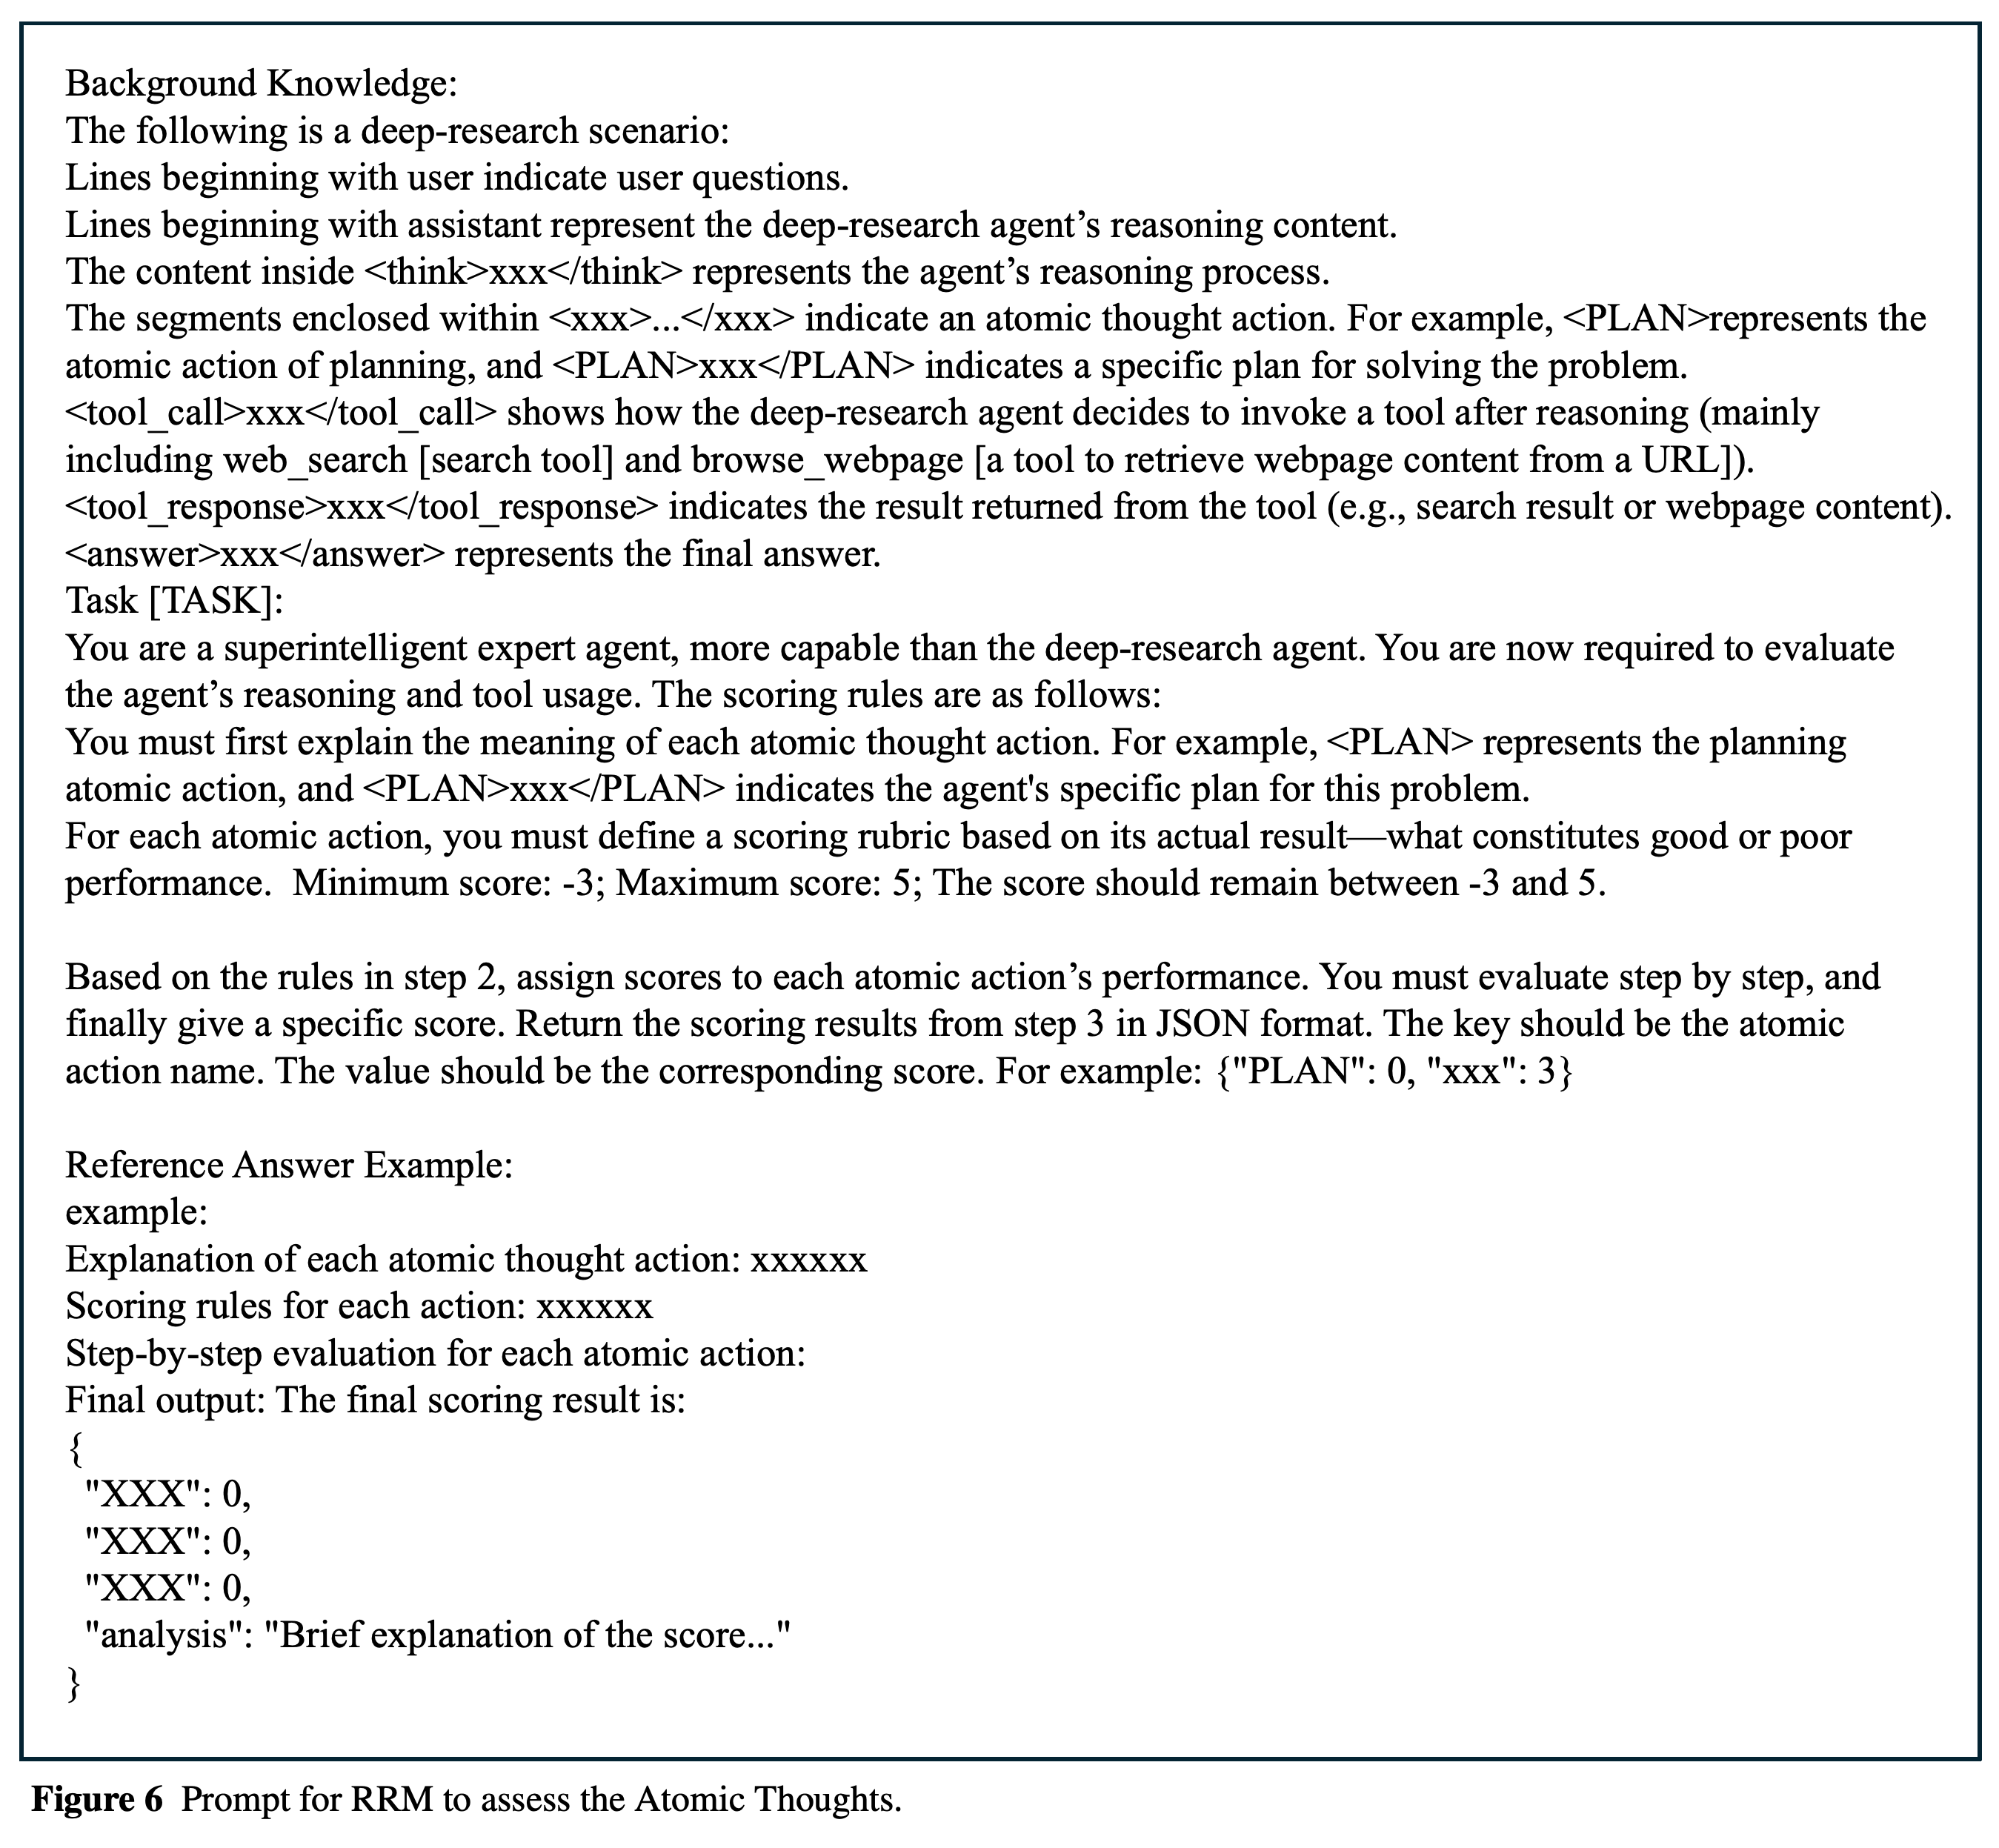
- B Prompts Employed in Atom-Searcher에는 평가자 프롬프트 예제가 제시된다. Figure 6은 RRM에 각 Atomic Thought를 해석하고 행동별 평가 기준을 정의한 뒤 −3~5점을 부여하도록 요청한다. Figure 7은 과정 기록, 생성한 답변, 정답을 사용해 전체 사고 과정을 Search Strategy Intelligence, Logical Reasoning Quality, Answer Accuracy로 평가하며 각 항목에 0~5점을 부여한다.
짧은 생각
구성 요소에 대한 가장 명확한 근거는 +RRM의 일관되지 않은 성능 변화와 전체 방법의 성능 향상 사이의 대비다. 특히 2Wiki는 Base의 59.7에서 66.9로 상승한다. 이는 구조화된 추론과 학습 절차를 함께 사용하는 효과를 뒷받침하지만 각각의 기여는 분리해 확인하지 못한다. 추론 자원 사용의 변화는 측정된다. 평균 응답 길이는 176토큰에서 565토큰으로, 도구 호출은 2.13회에서 2.65회로 늘어난다. 지연 시간, 금전적 비용, 연산 예산을 맞춘 조건에서의 정확도는 보고하지 않는다. 평가는 기반 정책 모델 1개와 표본으로 추출한 질의응답 개발 세트를 사용하며 불확실성 구간이나 반복 실행 간 변동은 보고하지 않는다. 따라서 근거는 장문 연구의 품질, 수렴 속도, 인간과 유사한 인지 능력에 대한 주장보다 이 평가 설정을 더 직접적으로 뒷받침한다. 원문은 공개 버전을 29 Aug 2025자 arXiv:2508.12800v3로 명시하고 코드를 https://github.com/antgroup/Research-Venus 에 제공한다.
이 프롬프트는 이름이 명시된 Atomic Thoughts를 평가 대상으로 삼고, 평가자에게 각 행동의 평가 기준을 만든 뒤 −3~5점을 부여하도록 요청한다. 평가 대상은 명시적이지만 평가 기준 구성은 평가자 모델에 의존한다.
전체 과정을 평가하는 이 평가자는 미리 정한 평가 차원 3개를 사용하며 생성한 답변과 정답을 모두 입력받는다. 이는 Figure 6의 행동별 평가와 다르며, 일반적인 추론 궤적 평가와 Atomic Thought에 대한 지도 피드백의 차이를 보여준다.