


WebSailor-V2: Bridging the Chasm to Proprietary Agents via Synthetic Data and Scalable Reinforcement Learning 요약 설명
16 Sep 2025 | Paper Review Search Agents Synthetic Data Agentic Reinforcement Learning목차
이번 글에서는 WebSailor-V2: Bridging the Chasm to Proprietary Agents via Synthetic Data and Scalable Reinforcement Learning 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 16일(Arxiv)
- Li, Kuan, Zhang, Zhongwang, Yin, Huifeng, Ye, Rui, Zhao, Yida, Zhang, Liwen, Ou, Litu, Zhang, Dingchu, Wu, Xixi, Wu, Jialong, et al.
- Tongyi Lab, Alibaba Group
- 논문 링크
- Project Page
요약
- WebSailor-V2는 반복적인 웹 검색과 근거 종합으로 연구 질문에 답하는 오픈소스 에이전트를 훈련하기 어렵다는 문제를 다룬다. 논문에 보고된 평가에서 Qwen3-30B-A3B 에이전트는 온라인에서 찾기 어려운 정보를 탐색하는 벤치마크인 BrowseComp-EN에서 35.3을 기록해 DeepSeek-V3.1-671B의 30.0을 앞선다. 다만 중국어 벤치마크인 BrowseComp-ZH에서는 44.1로, 해당 기준 모델의 49.2보다 낮다.
- SailorFog-QA-V2는 개체와 관계로 이루어진 네트워크인 지식 그래프에 의도적으로 촘촘한 연결과 순환 구조를 만들고, 여기서 질문과 답변(QA) 쌍을 생성한다. 연결된 노드를 따라 경로를 샘플링하는 random walk와 서로 다른 노드의 구조적 역할을 고려해 생성 과제의 범위를 넓힌다. 논문은 특정 개체, 날짜, 값을 모호한 설명으로 바꾸는 obfuscation 외에도 다른 불확실성을 도입한다고 설명하지만 추가한 불확실성 유형을 열거하지는 않는다.
- 훈련은 생성한 풀이 궤적에서 학습하는 지도 미세조정(SFT)과 보상을 통해 에이전트의 정책을 갱신하는 강화학습(RL)을 결합한다. 정책은 출력과 행동을 선택하는 규칙이다. 오프라인 Wikipedia 시뮬레이터는 알고리즘 개발을 지원하고 운영 관리 기능을 갖춘 실제 웹 환경은 최종 훈련을 지원한다. 자동 과제 합성과 필터링은 데이터 구축을 학습 중인 정책과 연결한다.
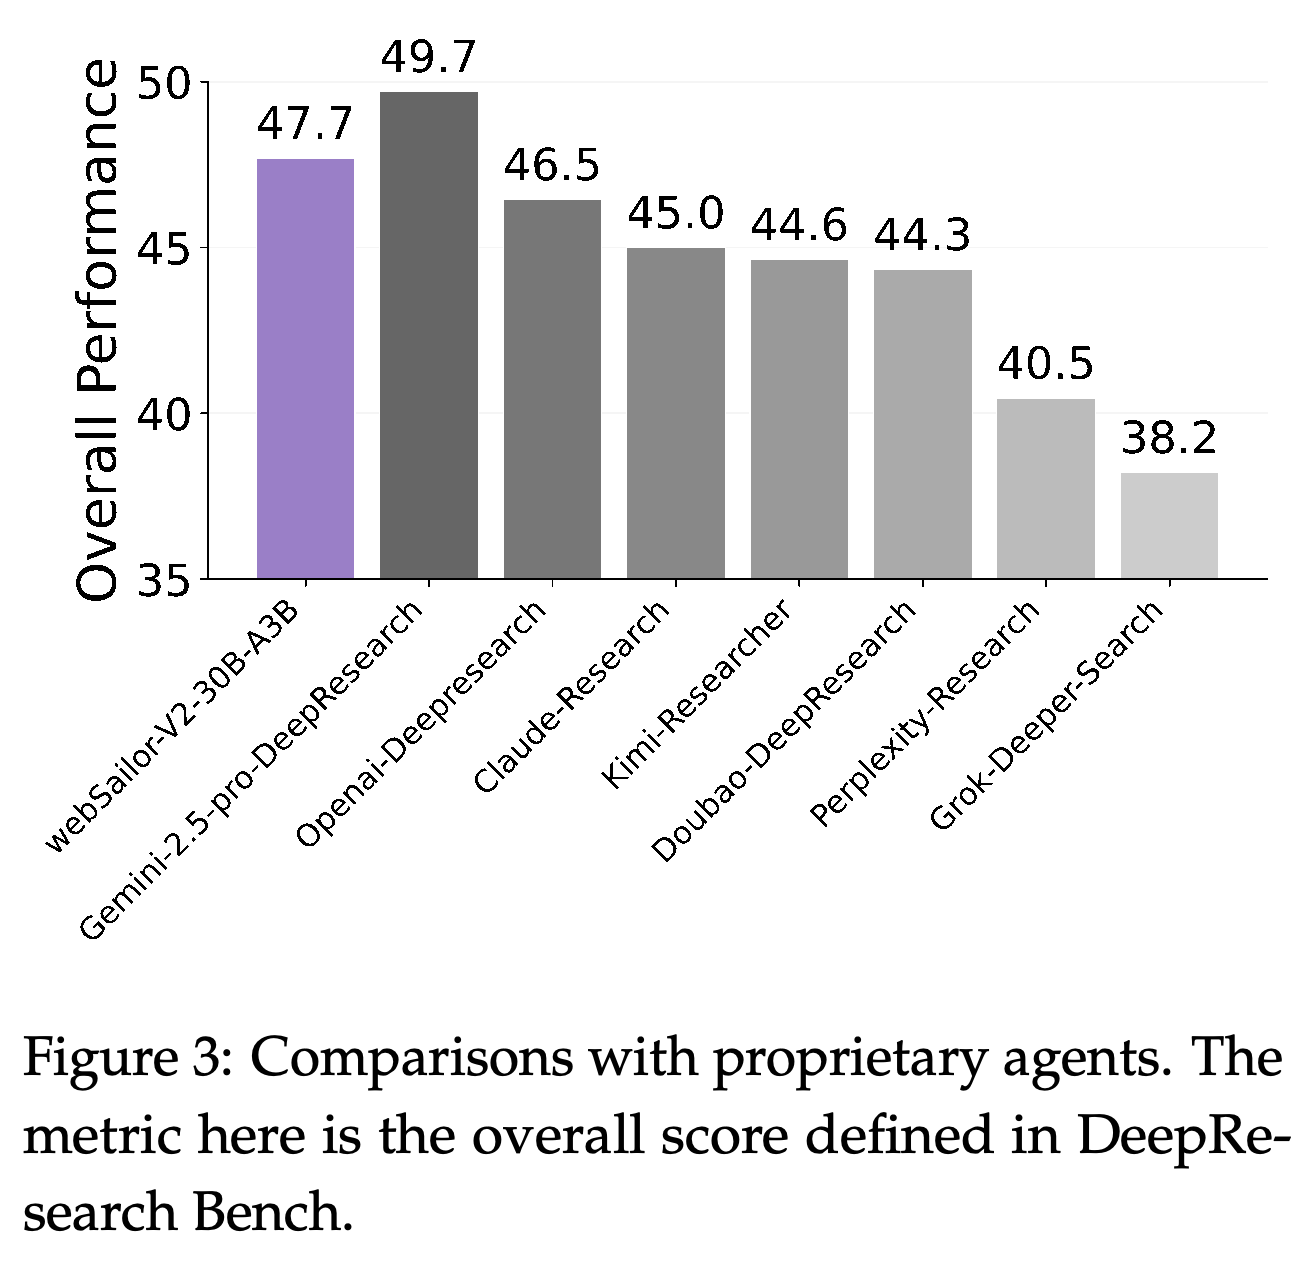
- RL은 Table 1에 보고된 5개 점수 모두를 SFT 체크포인트보다 높인다. 복잡한 검색을 평가하는 xbench-DeepSearch에서는 73.7, 도구 사용이 필요한 범용 어시스턴트를 평가하는 GAIA의 텍스트 전용 103개 사례로 구성된 부분집합에서는 74.1, 학술 및 논리 추론을 위한 전문가 질문 벤치마크인 Humanity’s Last Exam (HLE)에서는 30.6을 기록한다. 평가에는 출력 샘플링의 무작위성을 조절하는 temperature 0.85와 누적 확률 임계값으로 샘플링 범위를 제한하는 top-p 0.95를 사용하며 대규모 언어 모델(LLM) 심판이 정답 여부를 판정한다. 일부 기준 모델 점수는 웹사이트 평가나 외부 보고에서 가져온다.
- 보고된 결과는 전체 훈련 파이프라인의 효과를 뒷받침하며 평가 시 사용할 수 있는 컨텍스트와 도구 호출을 늘려 추론 예산을 확대하면 정확도가 높아진다는 점을 보여준다. 다만 그래프 밀도, 불확실성의 다양성, 환경 관리가 각각 얼마나 기여하는지는 분리하지 않는다. DeepResearch Bench 점수의 불일치, 일부 기준 모델 결과의 누락, BrowseComp 테스트 세트로 직접 훈련한 실험에 대한 설명 부족도 결과 해석에 제약을 준다.
1 Introduction
서론은 유능한 오픈소스 연구 에이전트를 개발할 때 마주치는 2가지 장애물을 제시한다. 훈련 과제가 다루는 논리 구조와 불확실성 패턴이 부족하고 대규모 웹 상호작용에서는 도구 응답에 비용이 많이 들며 신뢰성도 떨어진다. WebSailor-V2는 더 풍부한 합성 데이터와 별도의 시뮬레이션 및 실제 훈련 환경을 마련하고 자동 데이터 선별로 이들을 연결한다.
- 데이터와 정책의 피드백 루프는 훈련 양상에 따라 과제를 합성하고 필터링한다. 따라서 정책이 발전하면서 훈련 데이터의 분포도 바뀔 수 있다.
- 저자들은 후속 훈련 파이프라인을 평가할 때 특수한 계획 구조와 프롬프트 엔지니어링에 대한 의존도를 줄이기 위해 단순한 에이전트 프레임워크를 선택한다.
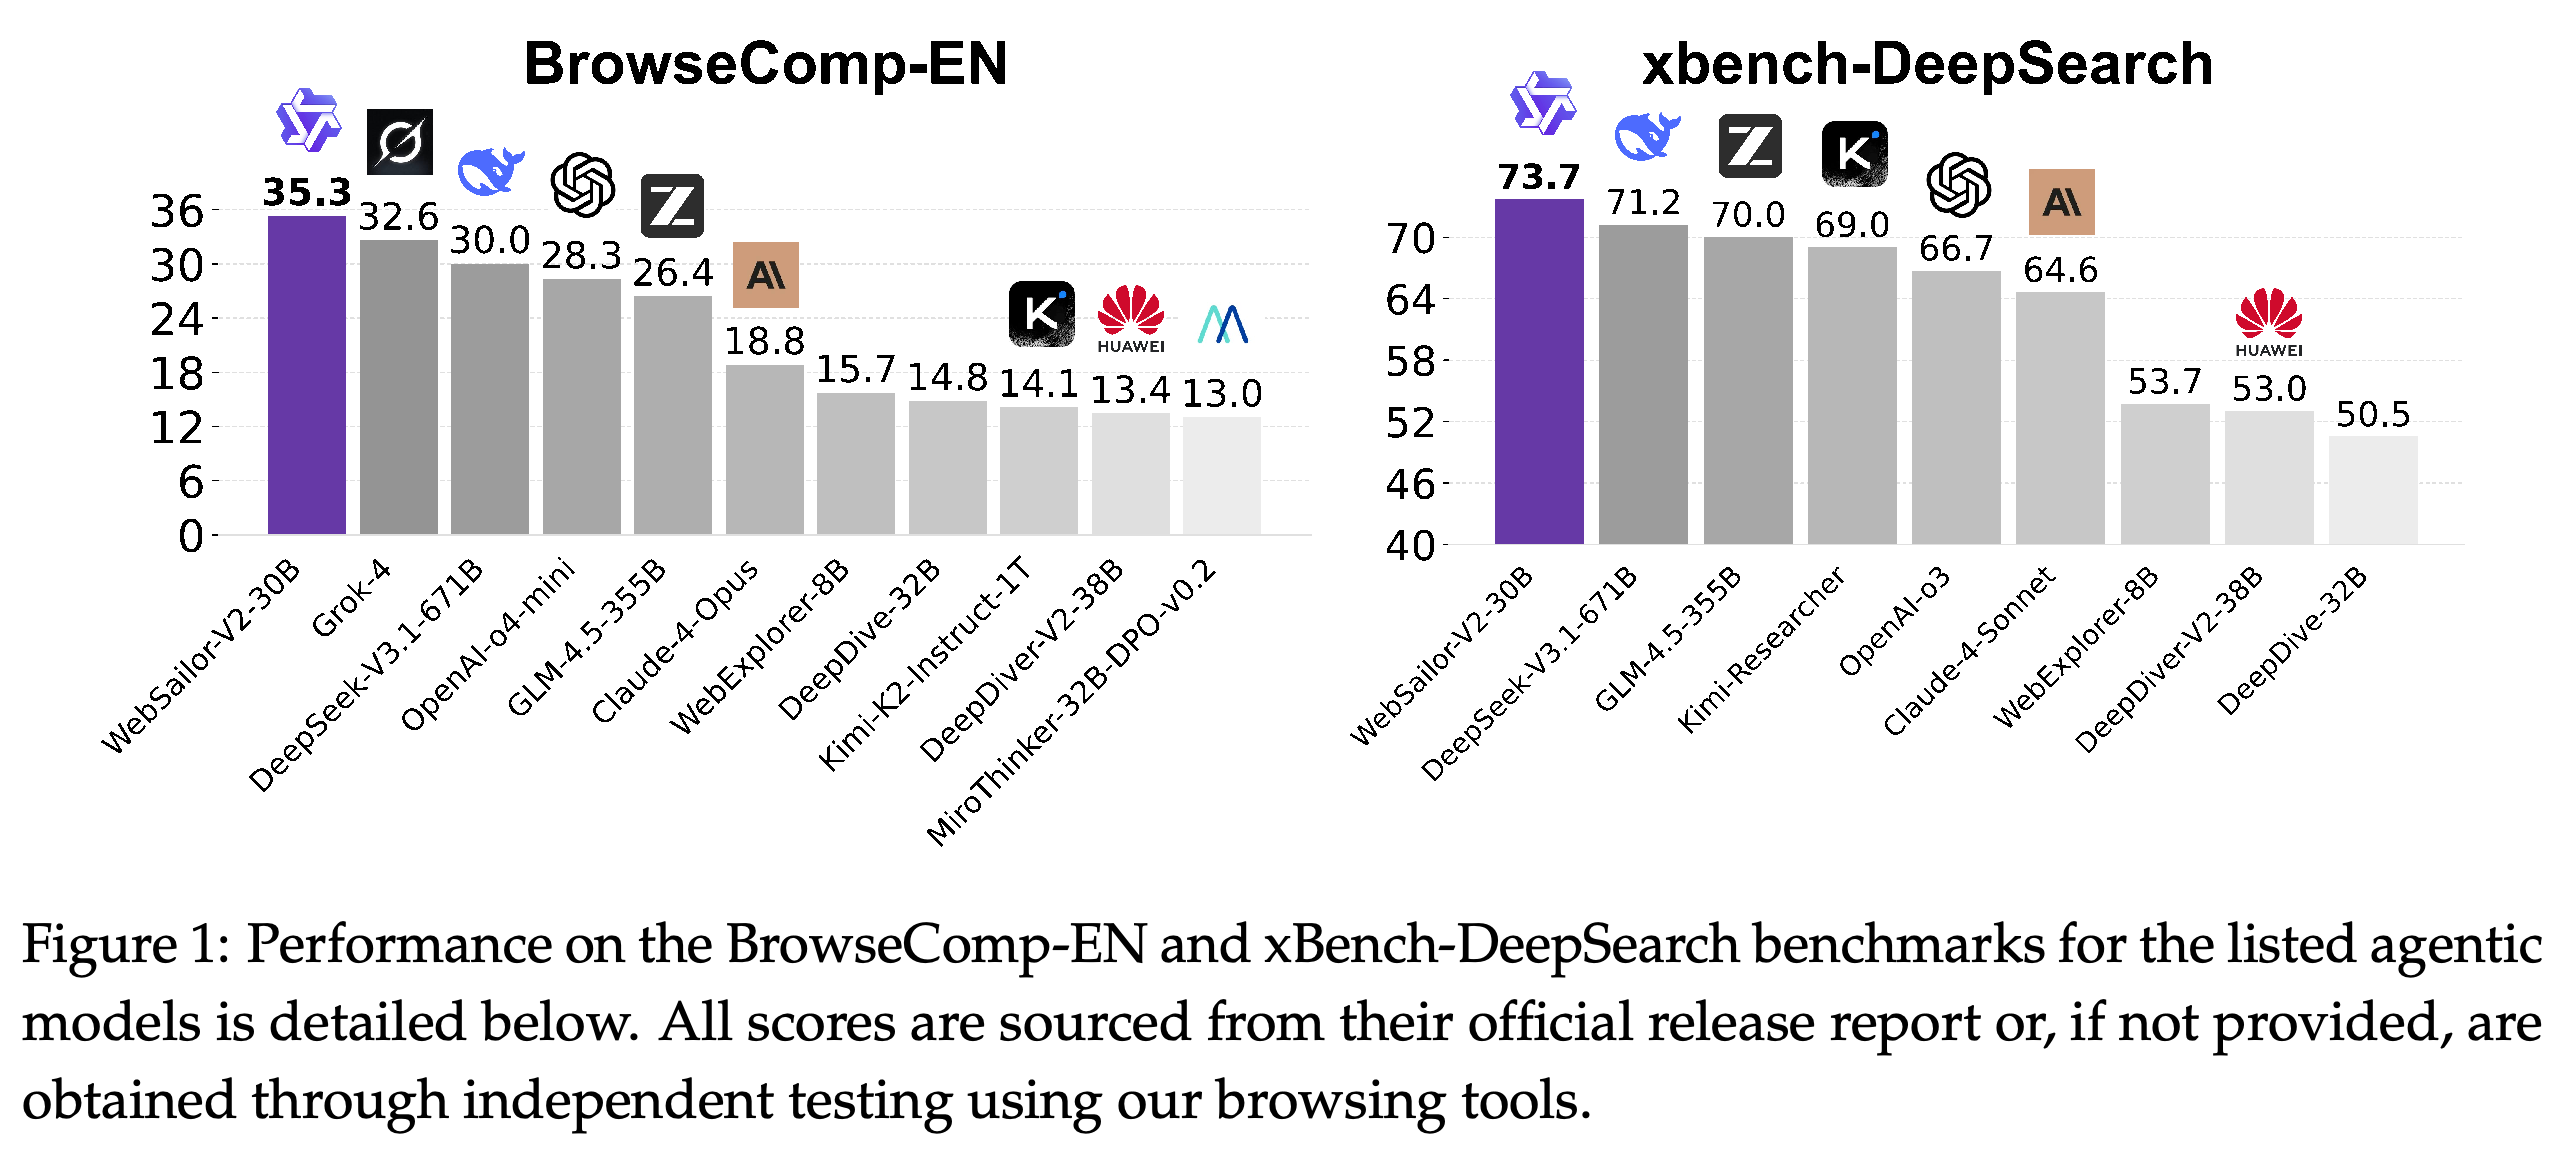
2개 차트에서 WebSailor-V2는 BrowseComp-EN 35.3, xbench-DeepSearch 73.7로 각 패널에 표시된 에이전트보다 높은 점수를 기록한다. 그러나 Table 1의 모든 기준 모델을 포함한 비교는 아니다. 해당 표의 독점 에이전트들은 BrowseComp-EN에서 35.3을 넘는다. 차트에는 출시 보고서 점수와 독립 테스트 결과도 함께 포함된다.
2 Agentic Framework
에이전트는 생각, 행동, 관찰을 번갈아 수행하는 프레임워크인 ReAct를 사용한다. 이러한 상호작용의 순서인 궤적은 H_T = (τ_0, a_0, o_0, …, τ_i, a_i, o_i, …, τ_T, a_T)로 나타낸다. 여기서 τ_i, a_i, o_i는 라운드 i의 생각, 행동, 관찰을 뜻한다. 다음 생각과 행동은 이전 컨텍스트를 조건으로 하는 정책 π(a_t, τ_t | H_{t−1})에서 샘플링한다.
- search는 검색 결과의 제목, 요약문, URL을 반환한다. visit은 웹페이지를 가져와 현재 목표에 맞게 요약한다.
- Google Scholar는 학술 검색을 지원하고 Python 인터프리터는 격리된 실행 환경인 샌드박스에서 생성한 코드를 실행한다. 최종 답변 행동은 궤적을 종료한다.
3 SailorFog-QA-V2
SailorFog-QA-V2는 실제 인터넷 정보를 바탕으로 합성 연구 과제를 만든다. 파이프라인은 촘촘한 개체 그래프를 구축하고 여기서 연결된 작은 그래프인 부분 그래프를 추출한다. 이어 다양한 정보 수집과 추론 패턴이 필요하도록 질문을 생성한다. 부분 그래프에 대해서는 Graph Pooling - gPool, DiffPool, EigenPool 설명 글을 참조하라.
3.1 Graph Construction
그래프 구축은 시작 개체에서 출발해 웹 도구로 관련 개체와 사실을 찾는다. 확장 과정에서는 노드 사이에 의도적으로 연결을 추가해 순환 구조를 만든다. 저자들이 주로 트리 형태라고 설명하는 easy-to-hard 생성 방식보다 다양한 구조를 포함하려는 접근이다. easy-to-hard 방식은 단순한 시작 질문을 점진적으로 확장한다.
- 그래프는 탐색에 사용한 쿼리와 출처 URL을 보존해, 추출한 사실과 함께 탐색 절차에 관한 정보도 제공한다.
- 질문 생성을 지원하기 위해 각 개체의 통계적 특징을 저장한다. 다만 논문은 어떤 특징을 저장하는지 명시하지 않으며 생성된 그래프의 크기와 밀도도 수치로 제시하지 않는다.
3.2 Subgraph Extraction
부분 그래프 추출에는 random walk를 사용한다. 그래프가 촘촘해지면 간선 수가 고정된 모든 부분 구조를 열거하는 것이 계산상 불가능해지기 때문이다. 저자들은 연결되어 있으면서 서로 동형이 아닌, 즉 구조가 서로 다른 부분 그래프를 수집하고 그래프 구조를 비교하는 절차인 Weisfeiler-Leman 알고리즘으로 검증한다고 설명한다.
- 모든 구조를 열거하지 않고도 다양한 구조를 포함하는 것이 목표다. 샘플링 매개변수, 구조를 얼마나 폭넓게 포함했는지에 대한 측정치, 실행 시간 비교는 보고하지 않는다.
3.3 QA Generation
질문을 생성하기 전에 파이프라인은 구조적으로 동등한 역할을 하는 노드 집합인 node orbit을 분석해, 질문의 대상이 다양한 역할에 분포하도록 한다. Obfuscation은 핵심 사실을 덜 구체적인 설명으로 바꿔 불확실성을 만든다. 이 때문에 과제를 풀려면 모호성 해소, 가설 검증, 근거 종합이 필요하다.
- 논문은 V2에서 불확실성의 정의를 추가했다고 설명하지만 추가한 유형의 분류 체계나 구체적인 예시는 제공하지 않는다.
- 이러한 세부 사항이나 구성 요소별 비교가 없으므로 그래프 구조와 불확실성 설계의 효과를 따로 평가할 수 없다.
4 Agentic Post-training
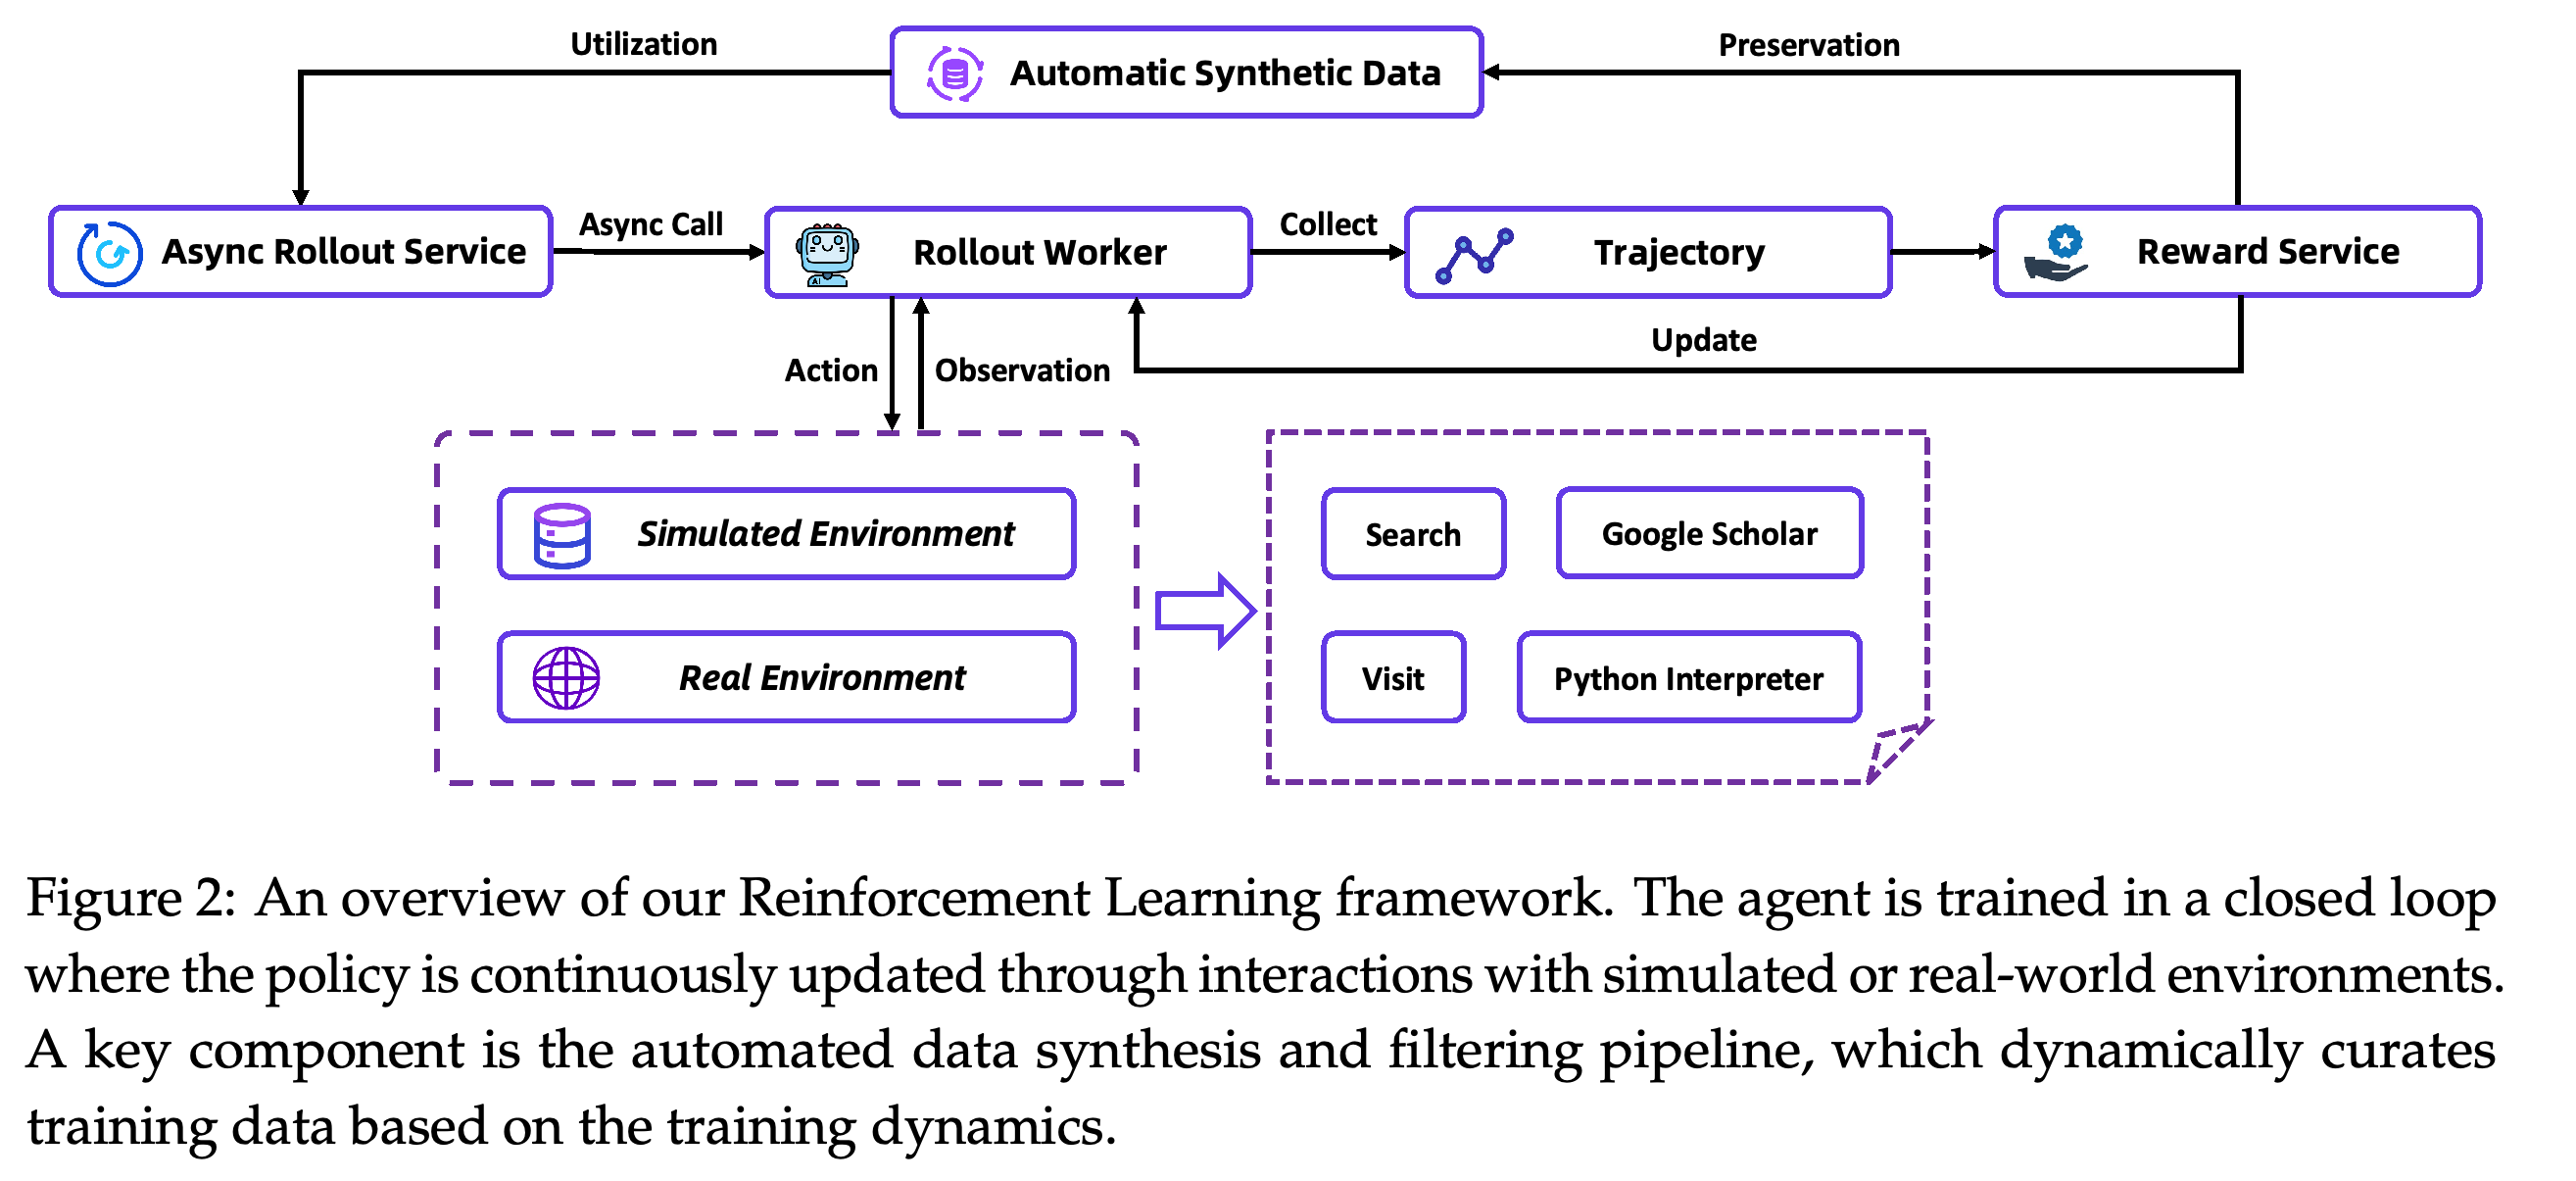
에이전트 후속 훈련은 예시 궤적에서 초기 정책을 학습하는 SFT cold start로 시작하고 이후 시뮬레이션 및 실제 환경에서 RL을 적용한다. Figure 2는 모든 작업자가 함께 끝날 때까지 기다리지 않고 에이전트 상호작용을 수집하는 비동기 rollout 수집을 보상 처리, 정책 갱신, 자동 합성 데이터 구축과 연결한다.
합성 과제는 비동기 rollout 작업자에게 전달된다. 작업자는 시뮬레이션 또는 실제 환경과 상호작용하며 보상 처리에 사용할 궤적을 수집한다. 피드백 화살표는 정책 갱신과 데이터 보존을 후속 과제 사용에 연결한다. 이는 훈련과 데이터 선별의 연계를 보여주지만 각 구성 요소의 기여를 따로 측정하지는 않는다.
4.1 SFT Cold Start
SFT 단계는 합성 SailorFog-QA-V2 과제와 오픈소스 모델이 rejection sampling으로 생성한 궤적을 사용한다. Rejection sampling은 훈련 전에 후보 풀이를 필터링하는 방식이다. 이 절에서는 Qwen3-30B-A3B-Thinking-2507을 기반 모델로 명시하고 처리할 수 있는 상호작용 이력의 양인 컨텍스트 길이를 128k로 늘린다.
- RL에서 유용한 양의 보상을 얻을 수 있을 만큼 어려운 과제를 성공적으로 수행하는 초기 정책을 확보하는 것이 목적이다.
- 논문은 SFT 데이터셋 크기, 궤적 생성에 사용한 모델의 이름, 구체적인 거부 기준을 보고하지 않는다.
4.2 Agentic Reinforcement Learning
시뮬레이션 환경은 오프라인 Wikipedia 데이터베이스, 이에 대응하는 웹 도구, 합성 훈련 및 테스트 과제를 결합한다. 실제 환경은 검색 출처, 웹페이지 파서, 코드 실행을 통합 인터페이스로 제공한다. 이 인터페이스에는 초당 쿼리 수 제한, 캐싱, 시간 초과 시 재시도, 대체 출처 사용, 비핵심 장애 발생 시 서비스 기능 축소가 포함된다.
- 자동 합성과 필터링은 훈련 양상에 따라 훈련 세트를 동적으로 조정한다. 논문은 반복 개발이 빨라지고 운영 비용이 줄어든다고 설명하지만 측정한 속도 향상이나 비용, 시뮬레이션과 실제 환경의 일치도를 검증한 결과는 보고하지 않는다.
- RL 알고리즘은 샘플링한 출력 그룹 안에서 보상을 비교하는 정책 최적화 방법인 GRPO를 수정해 사용한다. 현재 정책에서 샘플링한 on-policy 궤적, 출력 확률의 변화를 제한하는 토큰 단위 클리핑 목적함수, 비교 기준에서 해당 샘플을 제외하는 leave-one-out 전략을 사용한다고 설명한다.
- 최종 답변 전에 출력이 잘린 경우를 비롯한 일부 실패 궤적은 손실 계산에서 제외한다. 이는 요구된 출력 형식을 유지하지 못하는 format collapse를 완화하기 위한 조치다. 최적화 중 샘플링하는 훈련 예시를 바꾸는 dynamic sampling은 사용하지 않고, 대신 배치와 그룹 크기를 늘린다.
Equation (3)은 현재 정책과 샘플링 정책의 토큰 확률을 비교하는 중요도 비율을 r_{i,t}(θ) = π_θ(o_{i,t} | context) / π_{θ_old}(o_{i,t} | context)로 정의한다. 비교 기준 대비 보상인 advantage는 \(\hat{A}_{i,t}=R_i-\operatorname{mean}(\{R_i\}_{i=1}^{G})\)로 정의한다. 제시된 평균 중심화 advantage에는 본문에서 설명한 leave-one-out 추정량이 명시적으로 나타나지 않는다.
- 저자들은 BrowseComp 테스트 세트로 직접 훈련했을 때 합성 데이터를 사용한 경우보다 결과가 나빴다고도 보고한다. 합성 과제의 분포가 더 일관되어 학습하기 쉽다는 가설을 제시하지만 수치 결과나 충분한 세부 설명이 없어 이 실험이 보고된 최종 체크포인트와 어떤 관계인지 확인하기 어렵다.
5 Experiments
실험은 답변의 정답 여부, 연구 보고서 성능, 훈련 양상, 컨텍스트 및 도구 호출 예산에 대한 민감도를 평가한다. 주요 정량 비교에는 SFT와 RL 체크포인트를 모두 포함해 RL 단계 이후의 추가 향상을 보여준다.
5.1 Setup
실험 설정은 BrowseComp-EN, BrowseComp-ZH, GAIA, xbench-DeepSearch, HLE, DeepResearch Bench의 6개 벤치마크를 제시한다. DeepResearch Bench는 연구 보고서와 정보 검색을 평가한다. GAIA 평가는 텍스트 전용 검증 사례 103개로 제한되므로, 여러 입력 모달리티를 포함하는 전체 과제를 평가하지 않는다.
- 훈련 데이터는 주로 SailorFog-QA와 SailorFog-QA-V2를 결합하고 수학 및 학술 추론을 위한 IterBench로 보완한다. IterBench 참고문헌은 임시 문구인 “authors. title, 2025”로 남아 있어 출처를 추적하기 어렵다.
- 평가는 temperature 0.85와 top-p 0.95에서 단일 시도 답변 중 정답의 비율인 pass@1을 보고한다. k > 1인 pass@k에서는 k번의 시도를 생성한다. LLM 심판이 정답 여부를 판정하지만 어떤 모델을 사용했는지와 판정 절차는 명시하지 않는다.
- 일부 독점 에이전트는 웹 인터페이스로만 접근할 수 있고, 비용 제약 때문에 일부 기준 모델 결과가 누락된다. Figure 1도 공식 출시 점수와 저자들의 브라우징 도구를 사용한 독립 테스트 결과를 함께 제시한다.
5.2 Main Results
Table 1에서 SFT-to-RL 점수는 BrowseComp-EN에서 24.4에서 35.3으로, BrowseComp-ZH에서 28.3에서 44.1로, xbench-DeepSearch에서 61.7에서 73.7로, GAIA에서 66.0에서 74.1로, HLE에서 23.9에서 30.6으로 오른다. 증가 폭은 각각 10.9, 15.8, 12.0, 8.1, 6.7 %p다.
- WebSailor-V2는 Table 1에 보고된 xbench-DeepSearch, GAIA, HLE 점수에서 가장 높다. BrowseComp-EN 점수는 표에 나열된 오픈소스 기준 모델보다 높지만 OpenAI-o3의 49.7과 OpenAI DeepResearch의 51.5보다는 낮다.
- BrowseComp-ZH에서는 DeepSeek-V3.1-671B가 49.2, OpenAI-o3가 58.1을 기록해 모두 WebSailor-V2의 44.1보다 높다. 따라서 이 표는 2개 BrowseComp 벤치마크 모두에서 모든 오픈소스 에이전트를 앞선다는 본문의 주장과 모순된다.
- SFT 체크포인트도 이미 여러 훈련된 에이전트와 경쟁할 만한 성능을 보인다. 저자들은 성공적인 결과가 드물어 보상이 희소한 상황에서 강력한 cold start가 유용하다는 근거로 해석한다. 다만 RL 전에 SFT를 제거한 실험은 제공하지 않는다.
RL 체크포인트는 5개 열 모두에서 SFT보다 개선되며, 보고된 xbench-DeepSearch, GAIA, HLE 비교에서 가장 높다. BrowseComp-ZH에서는 DeepSeek-V3.1-671B의 49.2가 WebSailor-V2의 44.1보다 높다. 이는 2개 BrowseComp 벤치마크 모두에서 모든 오픈소스 에이전트를 앞선다는 인접 본문의 주장과 모순된다. 누락된 셀과 서로 다른 평가 출처 때문에 비교가 완전하지 않다.
5.3 More Comparison with Proprietary Agents in Deep-research Task
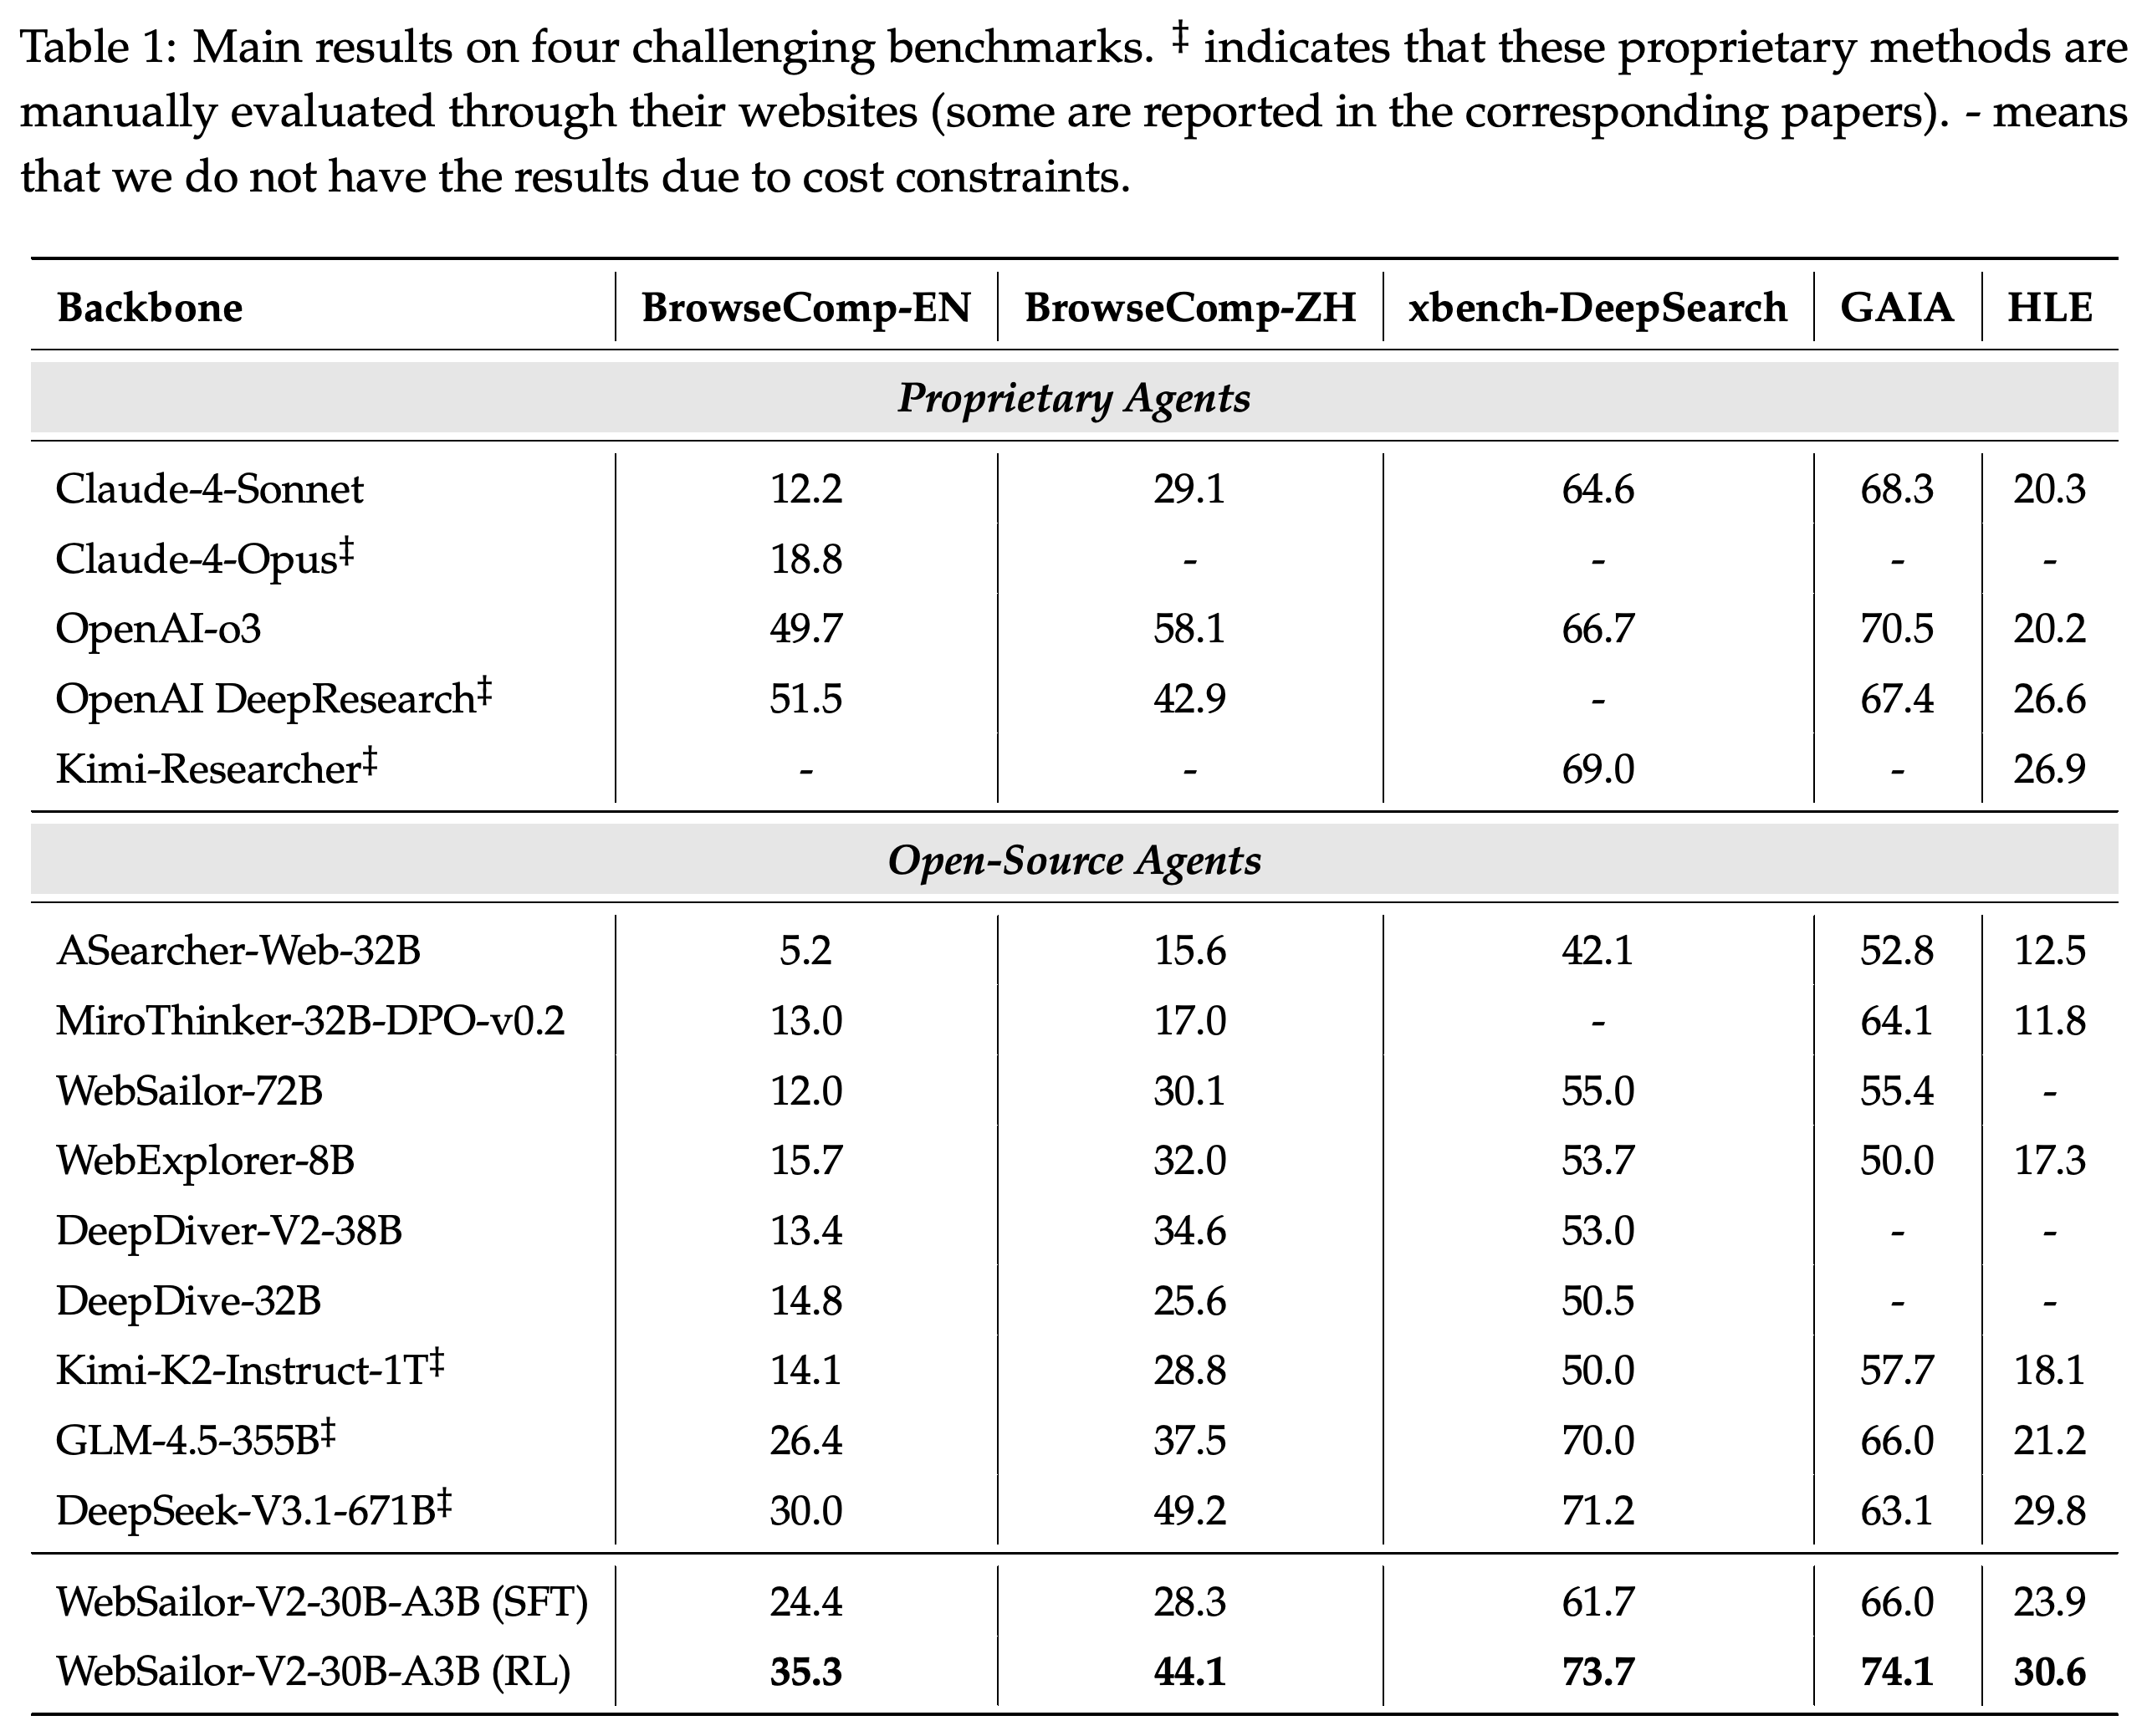
DeepResearch Bench는 연구 보고서 품질과 정보 검색 성능을 독점 연구 에이전트와 비교한다. Figure 3에서 WebSailor-V2는 47.7로 표시되어 Gemini-2.5-pro-DeepResearch의 49.7보다 낮고 OpenAI-Deepresearch의 46.5보다 높다. 그러나 함께 제시된 본문은 48.9로 보고한다.
- 이 불일치 때문에 WebSailor-V2의 정확한 점수는 확인되지 않는다. 다만 어느 값을 사용해도 표시된 에이전트 중 순위는 2위다.
- 저자들은 남은 성능 차이가 훈련 중 보고서 문체에 덜 중점을 둔 데서 비롯된다고 설명한다. 그러나 보고서의 항목별 점수나 통제된 분석으로 이 설명을 입증하지는 않는다.
차트에서 WebSailor-V2는 47.7로, Gemini-2.5-pro-DeepResearch의 49.7과 OpenAI-Deepresearch의 46.5 사이에 위치한다. 본문은 WebSailor-V2의 점수를 48.9로 보고한다. 따라서 표시된 순위는 본문과 일치하지만 정확한 점수는 확인되지 않는다.
5.4 Detailed Analyses
Figure 4는 훈련 보상이 상승하고 초기에 변동하던 BrowseComp 검증 정확도도 개선되는 모습을 보여준다. Figure 6에서 pass@1/pass@3 증가 폭은 BrowseComp-EN에서 10.9/7.5포인트, BrowseComp-ZH에서 15.8/12.2, xbench-DeepSearch에서 12.0/3.0, GAIA에서 8.1/2.9다. pass@3은 3번의 시도 안에 성공하는지를 측정한다.
- 저자들은 BrowseComp에서 1번 시도와 3번 시도의 성공률이 모두 오른 것을 전반적인 문제 해결 능력의 향상으로 해석한다. xbench-DeepSearch와 GAIA에서 pass@3 증가 폭이 더 작은 것은 첫 시도의 신뢰성이 개선된 결과로 해석한다. 이러한 패턴은 과제별 효과가 다르다는 점을 보여주지만 추론 능력을 직접 측정하지는 않는다.
BrowseComp-EN과 BrowseComp-ZH 정확도는 초기 변동 이후 개선되고 지수 이동 평균으로 평활화한 보상 곡선은 훈련 전반에 걸쳐 상승한다. 그래프는 훈련 보상과 검증 정확도가 모두 개선되는 모습을 보여주지만 신뢰구간이나 반복 실행 간 변동은 제시하지 않는다.
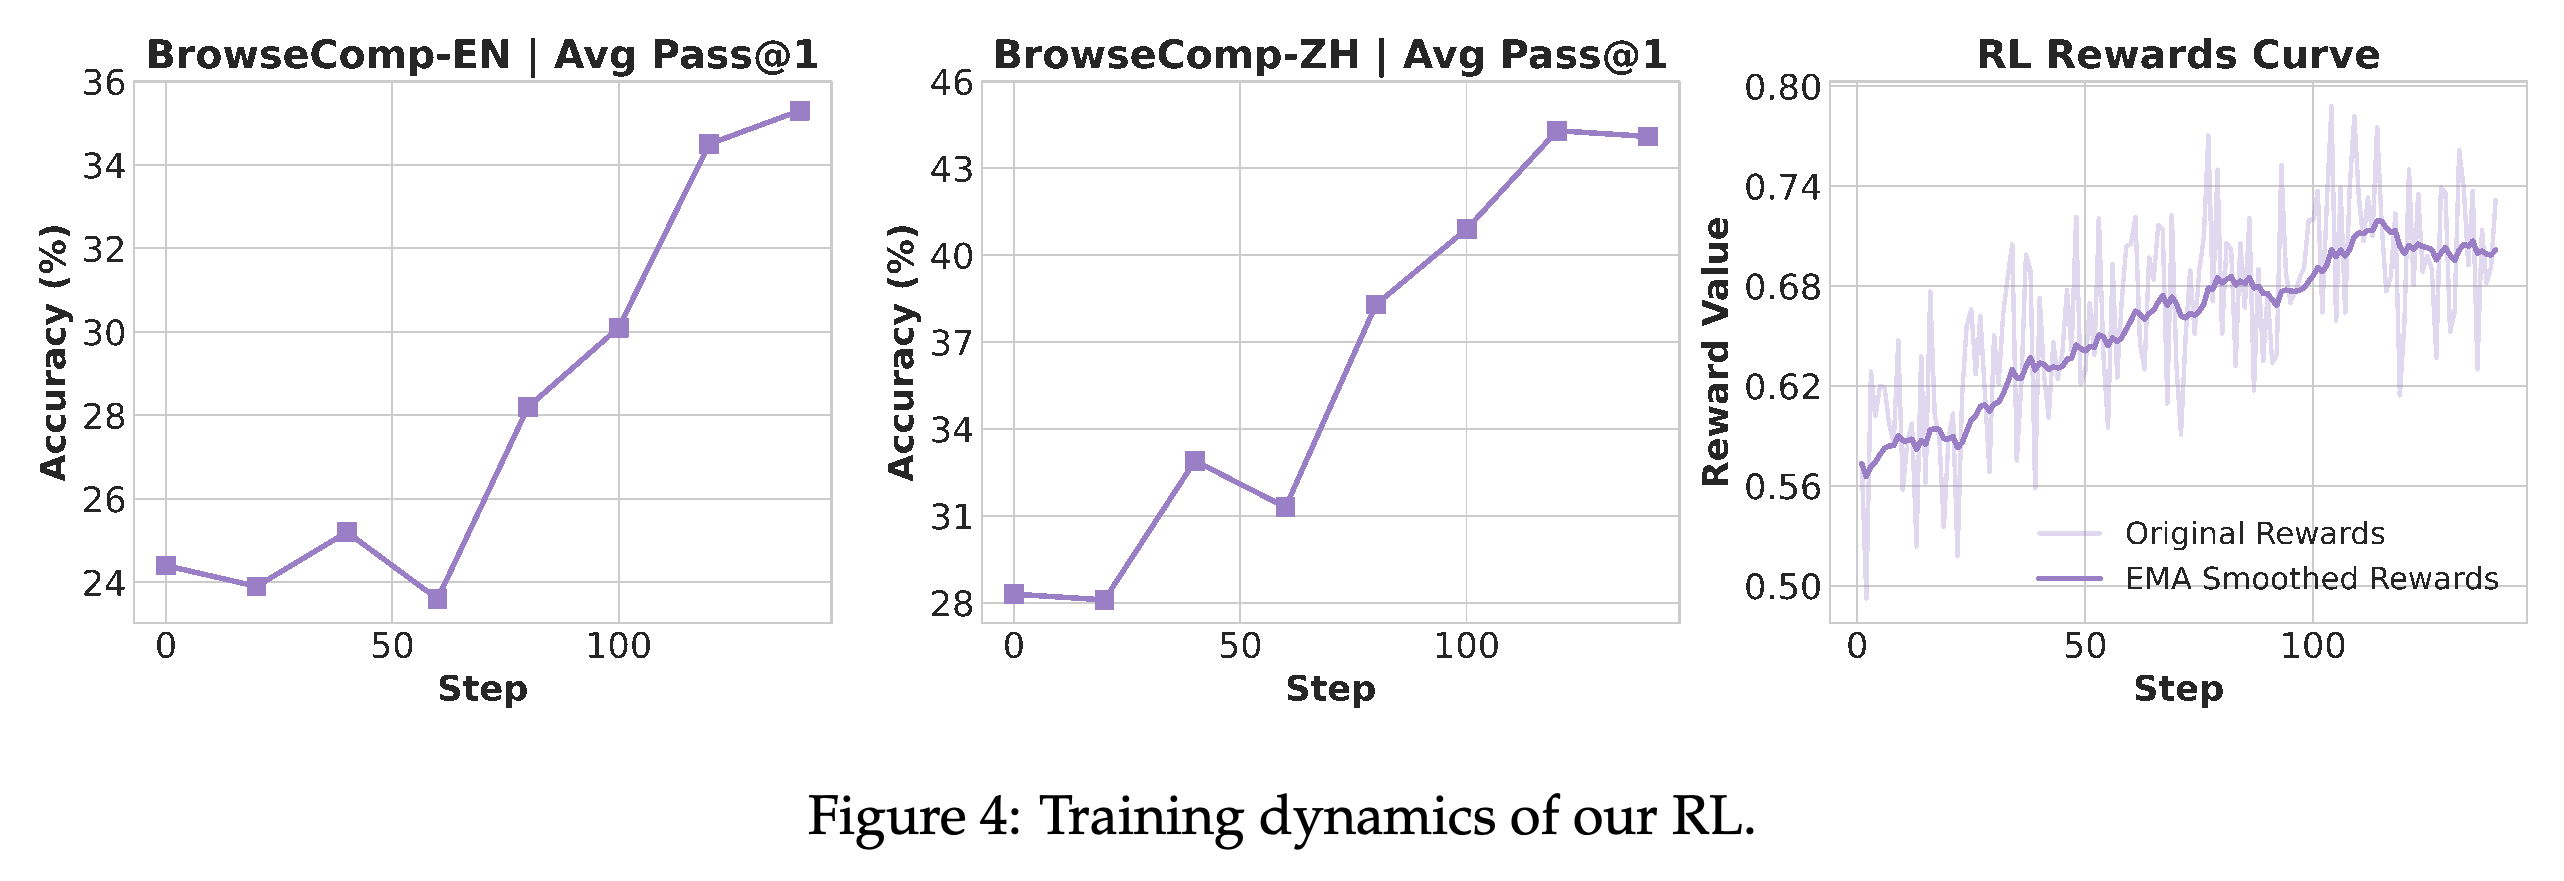
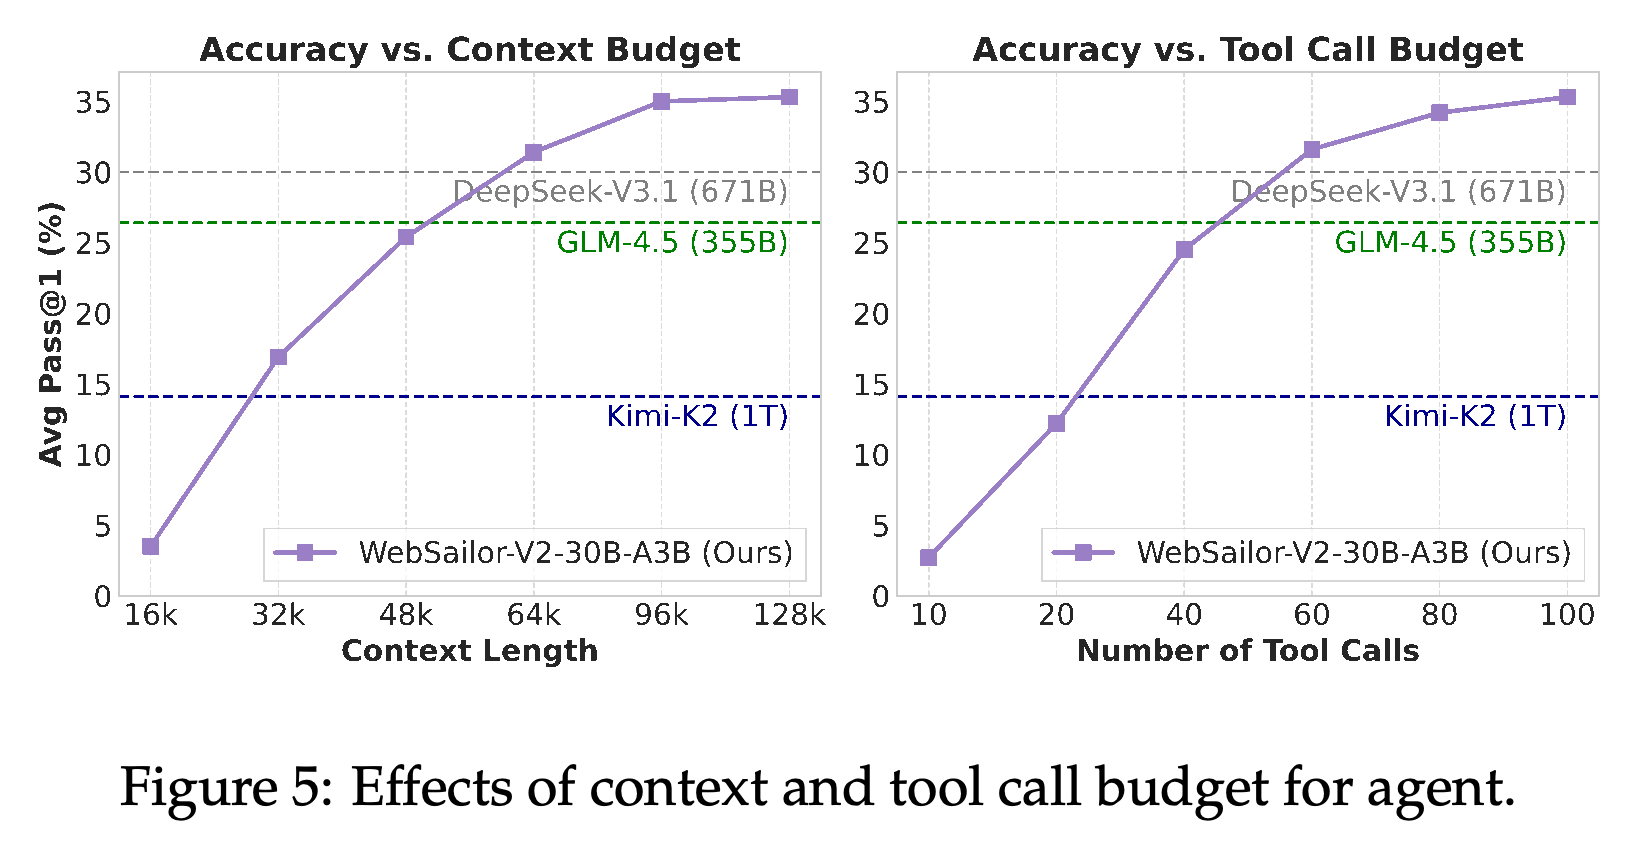
Figure 5는 컨텍스트 길이와 도구 호출 예산을 늘리면 BrowseComp-EN 정확도가 상승하다가 증가세가 둔화되는 모습을 보여준다. 에이전트는 WebSailor-V1의 32k에서 128k로 컨텍스트를 늘리고, 최대 100회의 ReAct 반복을 허용한다. 본문은 32k에서 정확도가 약 16이며, 정답을 맞힌 사례 중 거의 90%가 64k 안에서 완료된다고 보고한다.
- 예산별 곡선은 대표 정확도가 상당한 추론 자원에 의존한다는 점을 보여준다. 논문은 경쟁 에이전트와 조건을 맞춘 전체 실행 비용이나 지연 시간 비교를 제공하지 않는다.
각 패널은 추론 자원이 늘어나면 정확도가 크게 높아지고, 가장 큰 예산에서는 증가 폭이 줄어드는 모습을 보여준다. 컨텍스트 패널의 범위는 16k에서 128k, 도구 호출 패널의 범위는 10에서 100이다. 경쟁 모델 점수를 나타내는 수평선은 참조 수준을 제공하지만 같은 예산에서 비교한 결과는 아니다.
RL은 BrowseComp-EN에서 pass@1과 pass@3을 각각 10.9와 7.5포인트, BrowseComp-ZH에서 각각 15.8과 12.2 points 높인다. 해당 증가 폭은 xbench-DeepSearch에서 12.0과 3.0, GAIA에서 8.1과 2.9다. 이 벤치마크들에서는 첫 시도와 여러 시도의 성능 증가 폭 차이가 더 크다.
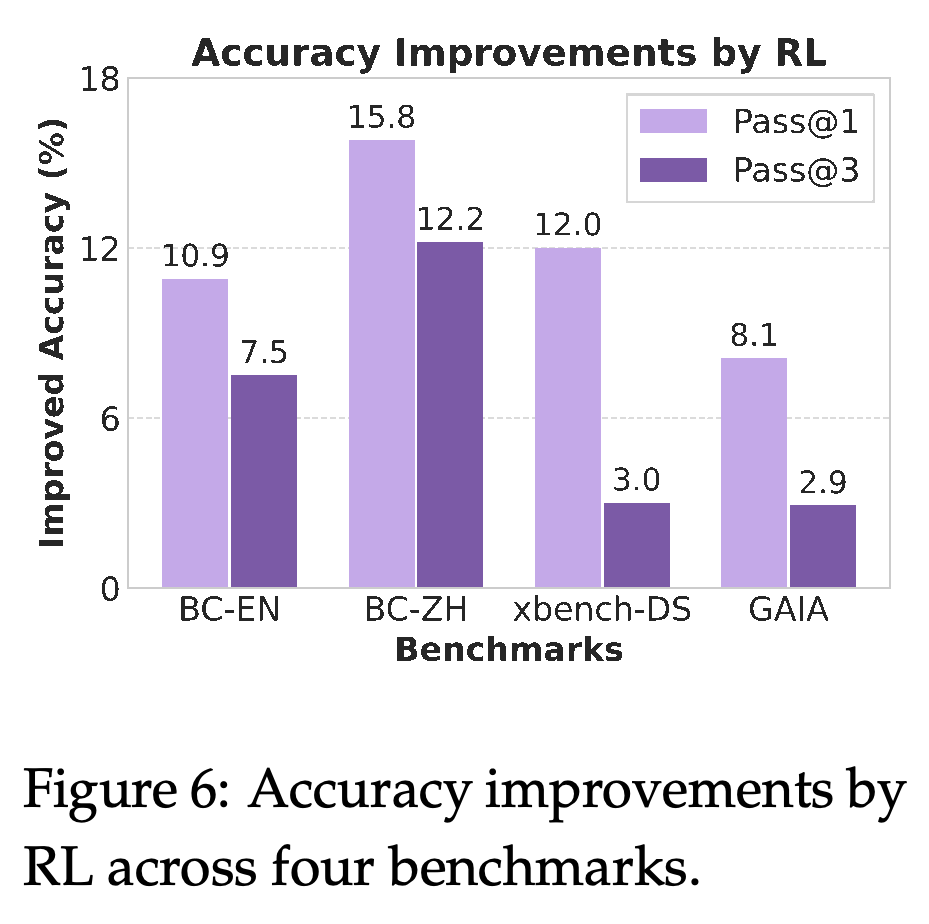
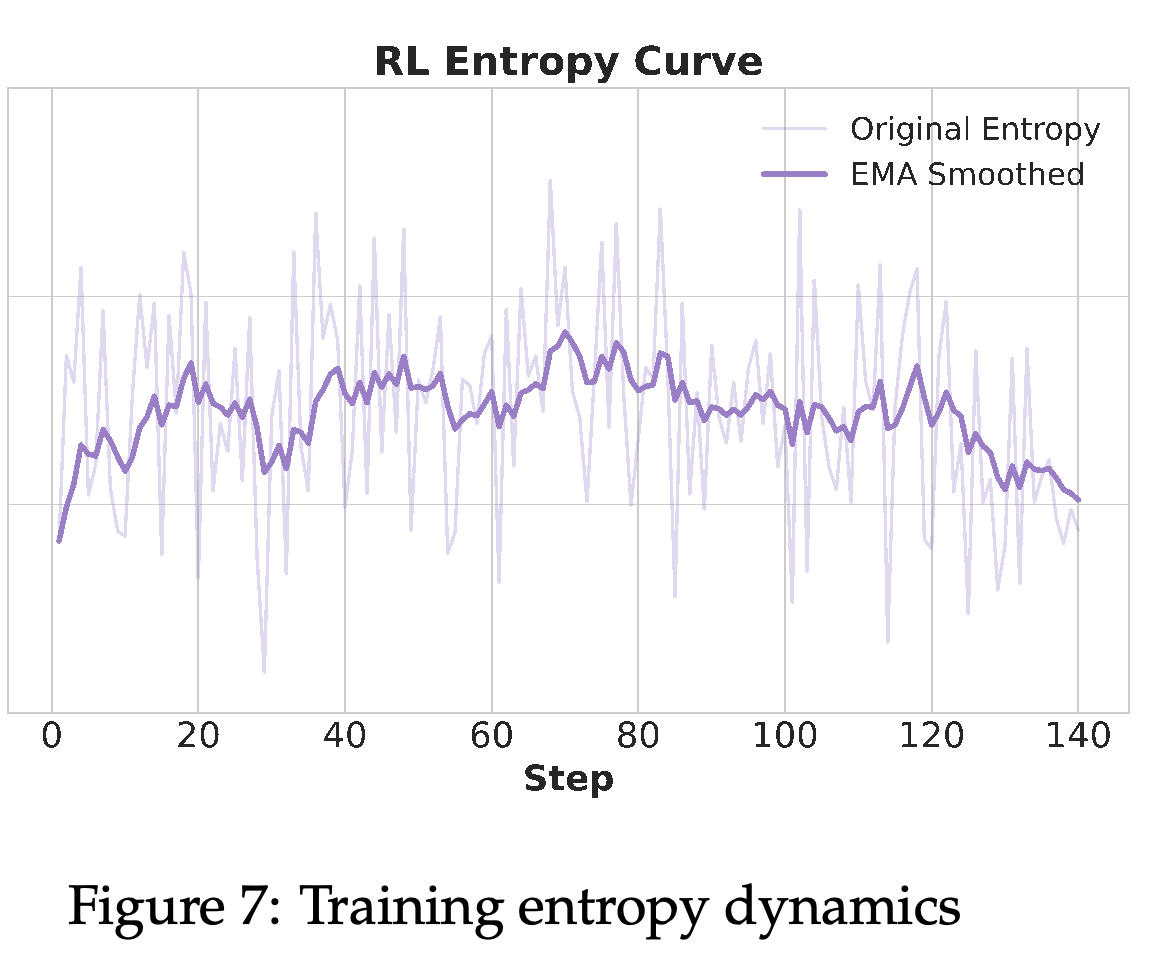
Figure 7은 정책의 출력 분포가 얼마나 불확실한지를 나타내는 정책 엔트로피가 훈련 중 비교적 높은 수준에서 변동하다가 후반에 감소하는 모습을 보여준다. 저자들은 탐색이 충분하다고 판단해 출력의 다양성을 장려하는 보상 항인 명시적 엔트로피 보너스를 구현에 포함하지 않는다.
- 저자들은 변화하는 웹 관찰이 탐색을 지속시킨다는 가설을 제시한다. 그러나 다른 조건을 맞춘 상태에서 고정된 관찰 분포와 변화하는 관찰 분포를 비교해 이 설명을 검증하지는 않는다.
평활화한 엔트로피는 훈련의 상당 부분에서 대체로 0.7–0.85 수준을 유지하다가 후반에 감소한다. 곡선은 엔트로피가 0으로 붕괴하지 않고 출력의 불확실성이 지속된다는 점을 보여준다. 다만 변화하는 웹 관찰이 이러한 양상의 원인임을 입증하지는 않는다.
6 Conclusion
결론은 WebSailor-V2를 합성 과제 구축, SFT 초기화, 통제된 환경과 운영 관리 기능을 갖춘 환경에서의 RL을 결합한 시스템 접근법으로 제시한다. 저자들은 특정 RL 알고리즘보다 데이터 품질과 환경 안정성이 더 중요하다고 주장한다. 보고된 결과는 전체 파이프라인의 성능을 보여주지만 구성 요소들의 상대적 중요성을 분리해 확인하지는 않는다.
부록
- A Related Work는 선행 연구를 데이터 구축, 에이전트 훈련 전략, 추론 방식으로 나누어 정리한다. 그래프 기반 과제 생성과 easy-to-hard 확장을 비교하고 SFT 이후 GRPO 방식의 RL을 적용하는 접근을 논의한다. 또한 복잡한 컨텍스트 관리로 인한 교란 요인을 줄이는 방법으로 표준 ReAct를 제시한다.
- B Experimental Details는 search가 쿼리마다 Google 상위 10개 결과를 반환한다고 명시한다. visit은 웹페이지를 가져오는 서비스인 Jina로 페이지를 가져오고, Qwen3-30B-A3B로 명시된 목표에 맞게 정보를 요약한다. SFT는 모델 훈련 프레임워크인 Megatron을 사용하며 배치 크기는 64, 학습률은 5e-6, 최소 학습률은 1e-10이다. 학습률을 먼저 높인 뒤 낮추는 warmup과 cosine decay 일정을 사용하고 매개변수 정규화 설정인 weight decay는 0.1이다. RL은 언어 에이전트 후속 훈련 프레임워크인 rLLM을 사용하며 temperature 1.0, top-p 1.0, 배치 크기 128, 학습률 1e-6으로 설정한다.
- C Case Study는 초기 검색 실패 이후 경영진 교체를 겨냥한 쿼리와 법인 설립, 고객 집중도, 소송에 대한 확인을 거쳐 FormFactor, Inc.를 식별하는 29단계 BrowseComp 궤적을 제시한다. 표시된 답변은 1993년 4월 15일의 법인 설립, 2008 회계연도 3분기의 경영진 교체, 2006년 매출의 47.3%를 차지한 고객 3곳, 2004년 64.8%와 2005년 72.8%를 차지한 고객 4곳, $1.5 million의 합의금이라는 조건에 부합한다. 다만 실제 도구 응답이 많이 생략되어 있어, 이 예시는 작업 절차를 보여주지만 에이전트가 받은 전체 근거를 공개하지는 않는다.
짧은 생각
ML 엔지니어 관점에서 실용적인 기여는 과제 생성, 궤적 필터링, 신뢰할 수 있는 도구 실행을 에이전트 훈련에 통합한 데 있다. SFT-to-RL 성능 향상은 Table 1의 5개 벤치마크 모두에서 개선을 보여주며, 예산별 곡선은 평가 자원이 정확도에 미치는 영향을 보여준다.
경쟁력은 벤치마크에 따라 다르다. Table 1에는 BrowseComp-ZH에서 더 강한 오픈소스 기준 모델이 있으며 BrowseComp-EN에서는 독점 에이전트가 앞선다. 개별 설계 요소를 제거하거나 바꾸는 구성 요소별 ablation, 불확실성의 정의, 데이터셋 통계, 심판의 세부 정보, 테스트 세트 훈련에 대한 설명, DeepResearch Bench 점수 불일치의 해소가 재현성과 인과적 해석을 강화할 수 있다.