


SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge 요약 설명
09 Sep 2025 | Paper Review LLM Evaluation Data Curation LLM-as-a-Judge목차
이번 글에서는 SimpleQA Verified: A Reliable Factuality Benchmark to Measure Parametric Knowledge 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 9월 9일(Arxiv)
- Haas, Lukas, Yona, Gal, D’Antonio, Giovanni, Goldshtein, Sasha, Das, Dipanjan.
- Google DeepMind, Google Research
- 논문 링크
- Project Page
요약
- SimpleQA Verified는 단답형 사실성 벤치마크인 SimpleQA의 잘못된 기준 답변, 중복 질문, 불균형한 주제 분포 때문에 대규모 언어 모델(LLM)을 신뢰성 있게 평가하기 어려운 문제를 다룬다. 이 연구는 텍스트를 생성하는 LLM이 사실을 얼마나 잘 기억해 내는지 평가한다. 표준 애플리케이션 프로그래밍 인터페이스(API) 매개변수를 사용하고 도구 없이 1,000개 질문을 평가했을 때, Gemini 2.5 Pro의 F1-Score는 55.6%로 GPT 5의 52.3%, o3의 51.9%보다 높다. 여기서 F1은 전체 질문에 대한 정확도와 답변을 시도한 질문에 대한 정확도의 조화평균이다.
- 이 벤치마크는 외부 도움 없이 모델 매개변수에 저장된 사실을 기억해 내는 능력인 parametric factuality를 측정한다. 저자들은 출처와 질문의 중복 제거, 발행자의 접근 제한에 따른 필터링, 답변 유형과 주제의 균형 조정, 출처 간 불일치 해소, 어려운 질문 선별을 거쳐 SimpleQA의 4,326개 질문을 1,000개로 줄인다.
- 개선한 autorater는 프롬프트에 따라 모델 답변을 채점하는 LLM이다. 수치 답변의 허용 범위를 명시하고 직접적인 답변, 불확실성 표현, 답변을 시도하지 않는 응답인 abstention의 판정 규칙을 더 명확히 한다. 저자들은 도구를 허용하면 성능이 거의 완벽한 수준에 이른다고 보고한다. 따라서 이 벤치마크는 도구 없이 사실을 기억해 내는 능력을 평가하는 용도로 설계되었다. 저자들은 채점기 수정의 근거가 되는 사례를 제시하지만 독립적으로 사람이 라벨을 붙인 테스트 세트와의 종합적인 비교 결과는 제공하지 않는다. autorater에 대해서는 Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena (LLM-as-a-Judge) 요약 설명 글을 참조하라.
1. Introduction
논문은 사실을 기억해 내는 능력을 grounding 및 검색 증강 평가와 구분한다. Grounding은 주어진 문맥을 기준으로 답변을 평가하고 검색 증강 평가는 외부 정보 검색을 허용한다. 기존 벤치마크에서는 최신 모델의 점수가 너무 높아 모델 간 능력을 구별하기 어려워졌지만 SimpleQA는 여전히 어렵다. 다만 잘못된 기준 답변, 좁은 출처 범위, 반복되는 질문 패턴 때문에 SimpleQA의 점수 상승이 사실 기억 능력의 향상을 뜻하는지 판단하기 어려울 수 있다.
- SimpleQA Verified는 단답형 질문과 답변 형식을 유지하면서 데이터셋과 채점 절차를 모두 수정한다.
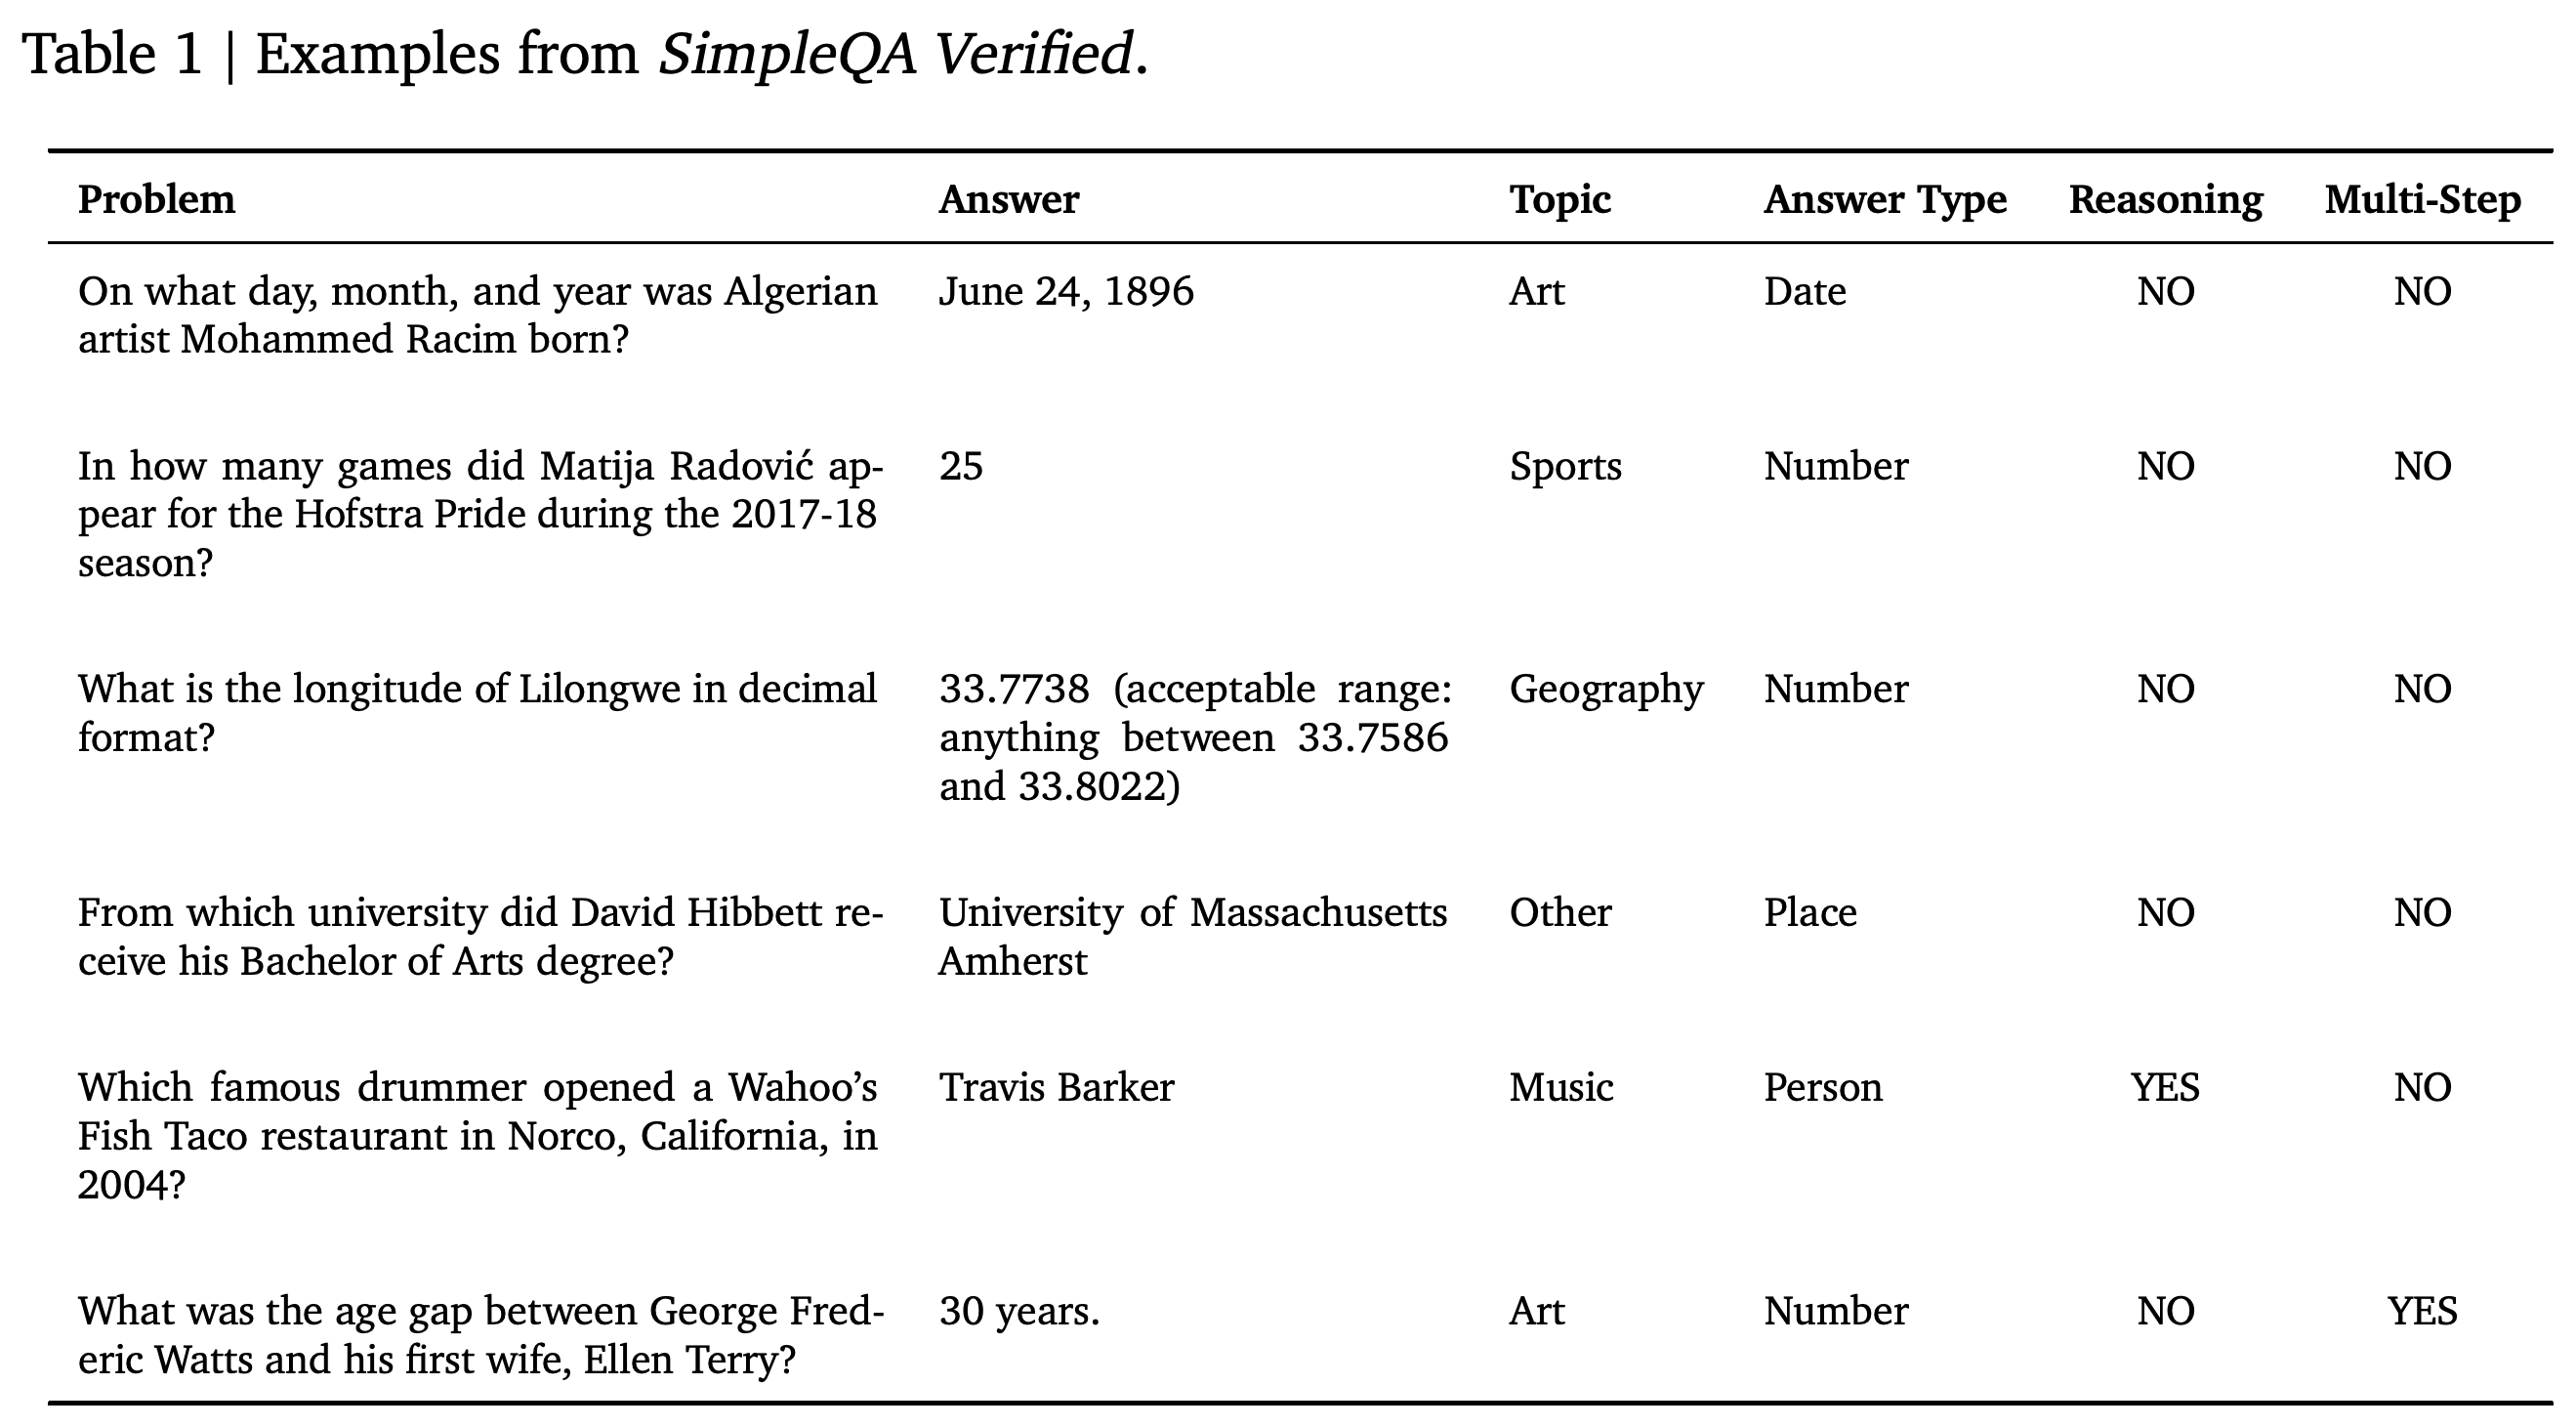
- Table 1은 날짜, 숫자, 장소, 인물을 답으로 하는 사례를 보여준다. 수치 허용 범위와 추론 또는 여러 정보 단계를 나타내는 라벨도 포함한다.
사례들은 평가 레코드가 질문과 답변 외에도 주제, 답변 유형, 추론, multi-step 라벨을 포함한다는 점을 보여준다. Lilongwe의 경도 사례는 수치 정답에 명시적인 허용 구간을 붙이는 방식을 보여준다.
2. SimpleQA Verified
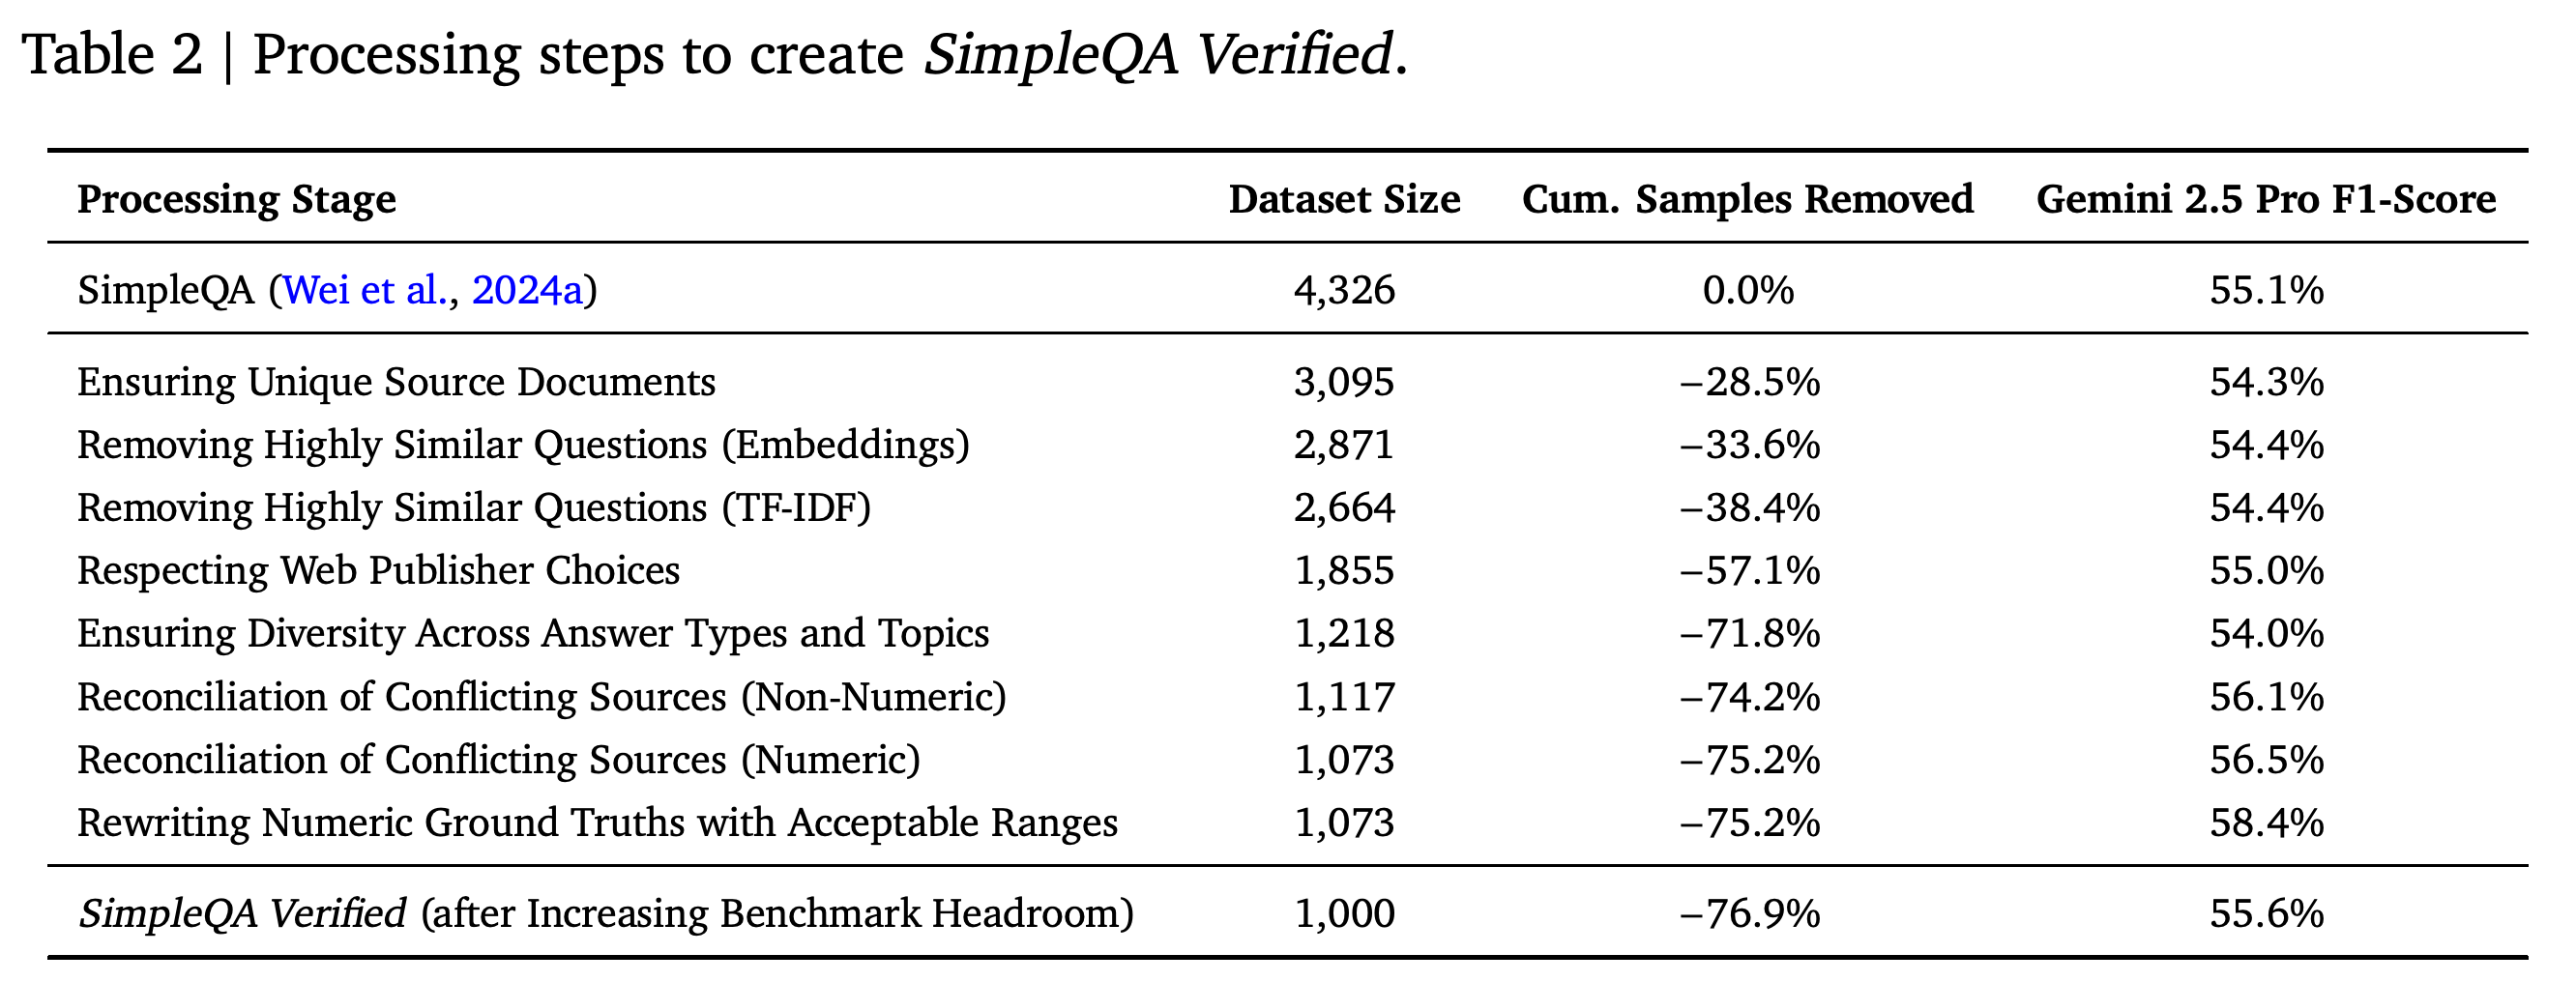
저자들은 직접 데이터를 정제하고 단계별 데이터셋 크기를 Table 2에 기록한다. 전체 과정에서 원래 질문의 76.9%를 제거하며 Gemini 2.5 Pro의 F1-Score는 SimpleQA의 55.1%에서 최종 벤치마크의 55.6%로 바뀐다.
- 수치 기준 답변에 허용 범위를 추가한 뒤 중간 점수는 58.4%에 이르고, 마지막 난도 필터를 적용하면 55.6%로 낮아진다.
- 각 단계는 누적해서 적용하므로, 단계별 점수 변화만으로 고정된 평가 세트에서 각 조치가 미치는 영향을 분리할 수 없다.
질문 수는 4,326개에서 1,000개로 줄고, Gemini 2.5 Pro의 F1-Score는 단계마다 달라진다. 수치 허용 범위를 추가하면 중간 점수가 56.5%에서 58.4%로 높아지고, 마지막 난도 필터를 적용하면 55.6%로 낮아진다. 이 누적 결과는 채점 규칙의 변경과 질문 선별이 점수에 미치는 영향을 보여준다.
2.1. Ensuring Unique Source Documents
저자들은 같은 출처 문서를 반복해서 다루는 질문을 줄이기 위해 질문 간 기준 URL이 중복되지 않도록 한다. 원래 SimpleQA의 모든 질문에는 서로 다른 인간 평가자가 제공한 기준 URL이 최소 2개 있다. 이 필터는 데이터셋을 4,326개에서 3,095개 질문으로 줄이며 감소율은 28.5%다.
- 같은 기준 URL을 공유하는 질문 집단에서는 GPT-4o, Gemini 2.0 Flash, Claude 3.7 Sonnet이 모두 틀린 질문을 무작위로 골라 남긴다.
- 이 조건에 맞는 질문이 없으면 질문을 무작위로 골라 남긴다. 이 절차는 모델이 점수를 더 높일 수 있는 여지인 headroom을 유지한다.
2.2. Removing Highly Similar Questions
의미가 비슷한 질문을 제거하는 의미 기반 중복 제거에는 질문의 벡터 표현인 Gemini Embeddings를 사용하며 코사인 유사도 기준값은 0.77이다. 코사인 유사도는 벡터의 방향을 비교한다. 앞서 사용한 난도 기반 선별 절차를 적용하면 데이터셋은 3,095개에서 2,871개 질문으로 줄며, 감소율은 7.2%다.
- 다음 단계에서는 어휘 중복을 탐지하기 위해 단어에 가중치를 부여하는 표현인 TF-IDF(term frequency–inverse document frequency)를 사용한다. 저자들은 코사인 유사도가 0.4를 넘는 사례를 수동으로 검토하고 어려운 질문을 남긴다. 이에 따라 데이터셋은 2,871개에서 2,664개로 줄며, 추가 감소율은 7.2%다.
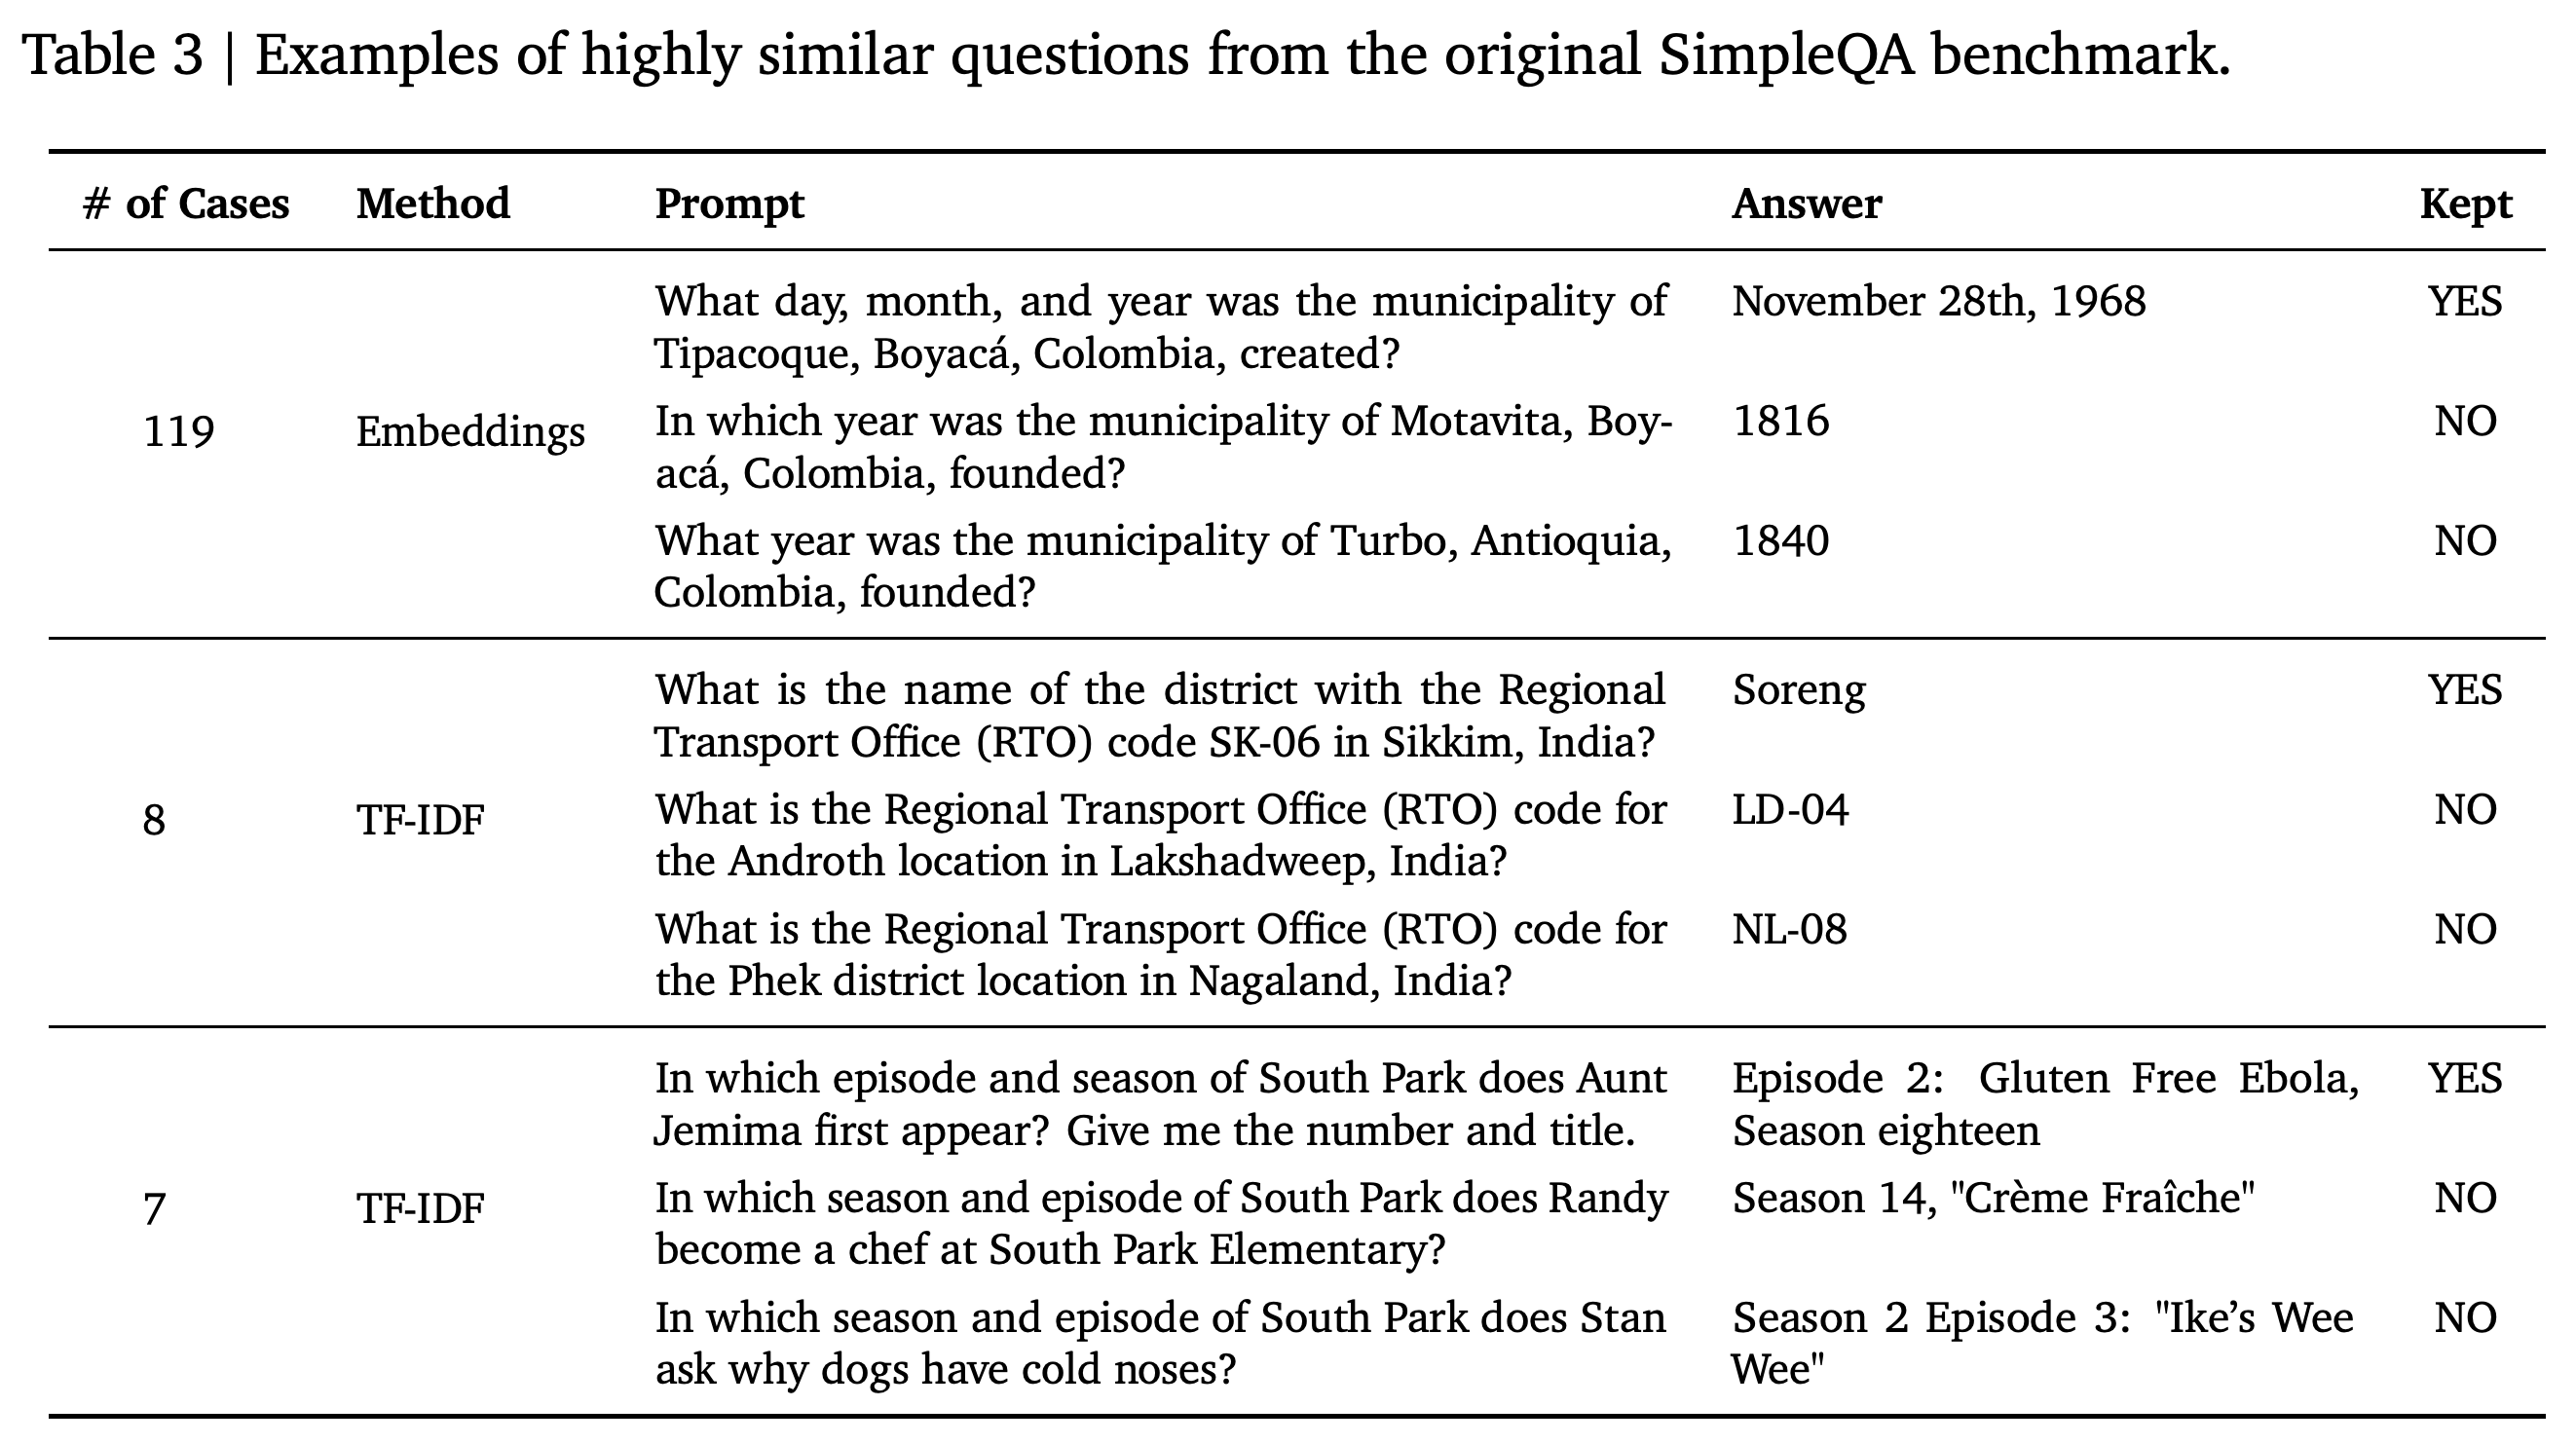
- Table 3은 콜롬비아 지방자치단체의 설립일, 인도 교통 사무소 코드, South Park 에피소드에 관한 반복 질문 형식을 보여준다. 지방자치단체 질문 119개는 원래 SimpleQA의 2.7%를 차지한다.
- 원래 공개 자료에는 평가자 ID가 없으므로, 개별 평가자가 반복 질문을 만들었다는 설명은 가설로 남는다.
각 집단은 반복되는 질문 형식 안에서 서로 다른 사실을 묻는다. 이 사례들은 출처 URL 필터링만으로 해결되지 않는 중복을 보여주며, 의미 유사성과 어휘 중복으로 찾아낸 사례를 제시한다.
2.3. Respecting Web Publisher Choices
저자들은 웹사이트 접근 규칙을 지정하는 파일인 robots.txt로 Google, OpenAI 또는 Anthropic의 특정 이용을 제한하는 발행자의 기준 URL이 포함된 질문을 제거한다. 이 벤치마크에는 소수의 웹사이트에서만 찾을 수 있는 드문 사실이 포함된다. 이 필터는 벤치마크의 출처를 발행자의 크롤링 및 모델 이용 방침에 맞추기 위한 것이다.
- 데이터셋은 2,664개에서 1,855개 질문으로 줄며, 감소율은 30.4%다.
- 논문은 발행자가 크롤링된 콘텐츠의 Gemini 학습 및 grounding 관련 특정 이용을 통제하는 사례로 Google-Extended를 제시한다.
2.4. Ensuring Diversity Across Answer Types and Topics
부분집합을 선별할 때는 답변 유형의 균형을 우선하고 그다음 주제의 균형을 맞춘다. 앞서 사용한 모델 기반 선별 절차로 어려운 질문도 유지한다. 이에 따라 데이터셋은 1,855개에서 1,218개 질문으로 줄며, 감소율은 34.3%다.
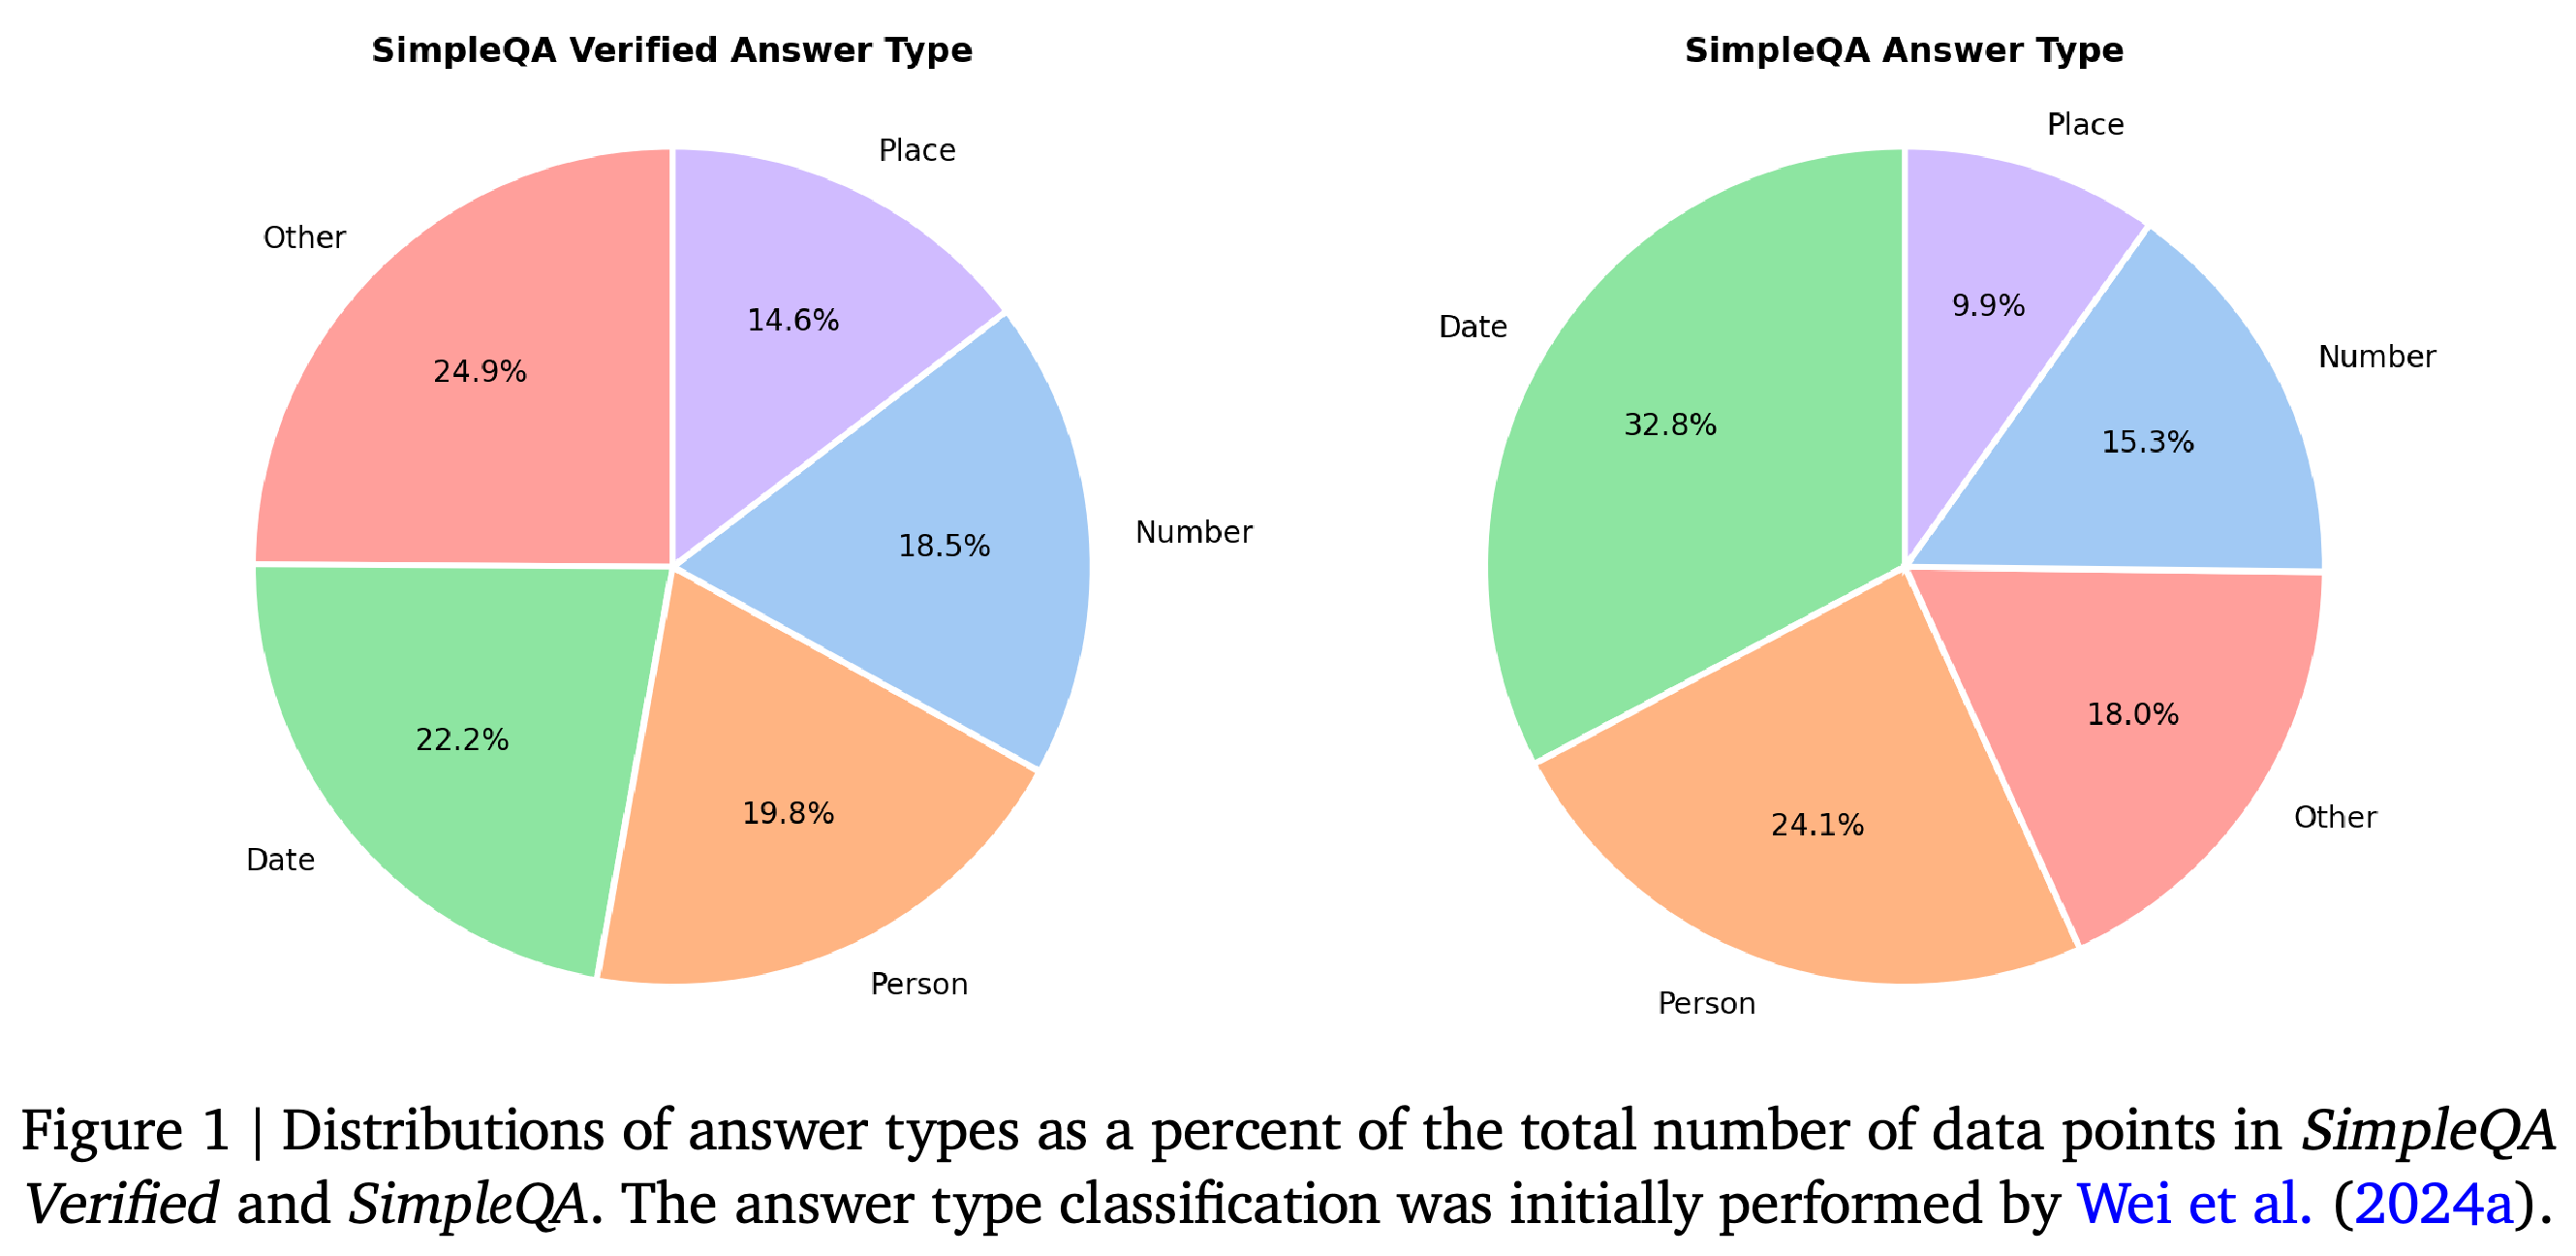
- Figure 1에서 Date 답변은 SimpleQA의 32.8%에서 SimpleQA Verified의 22.2%로 줄고, Person 답변은 24.1%에서 19.8%로 줄어든다.
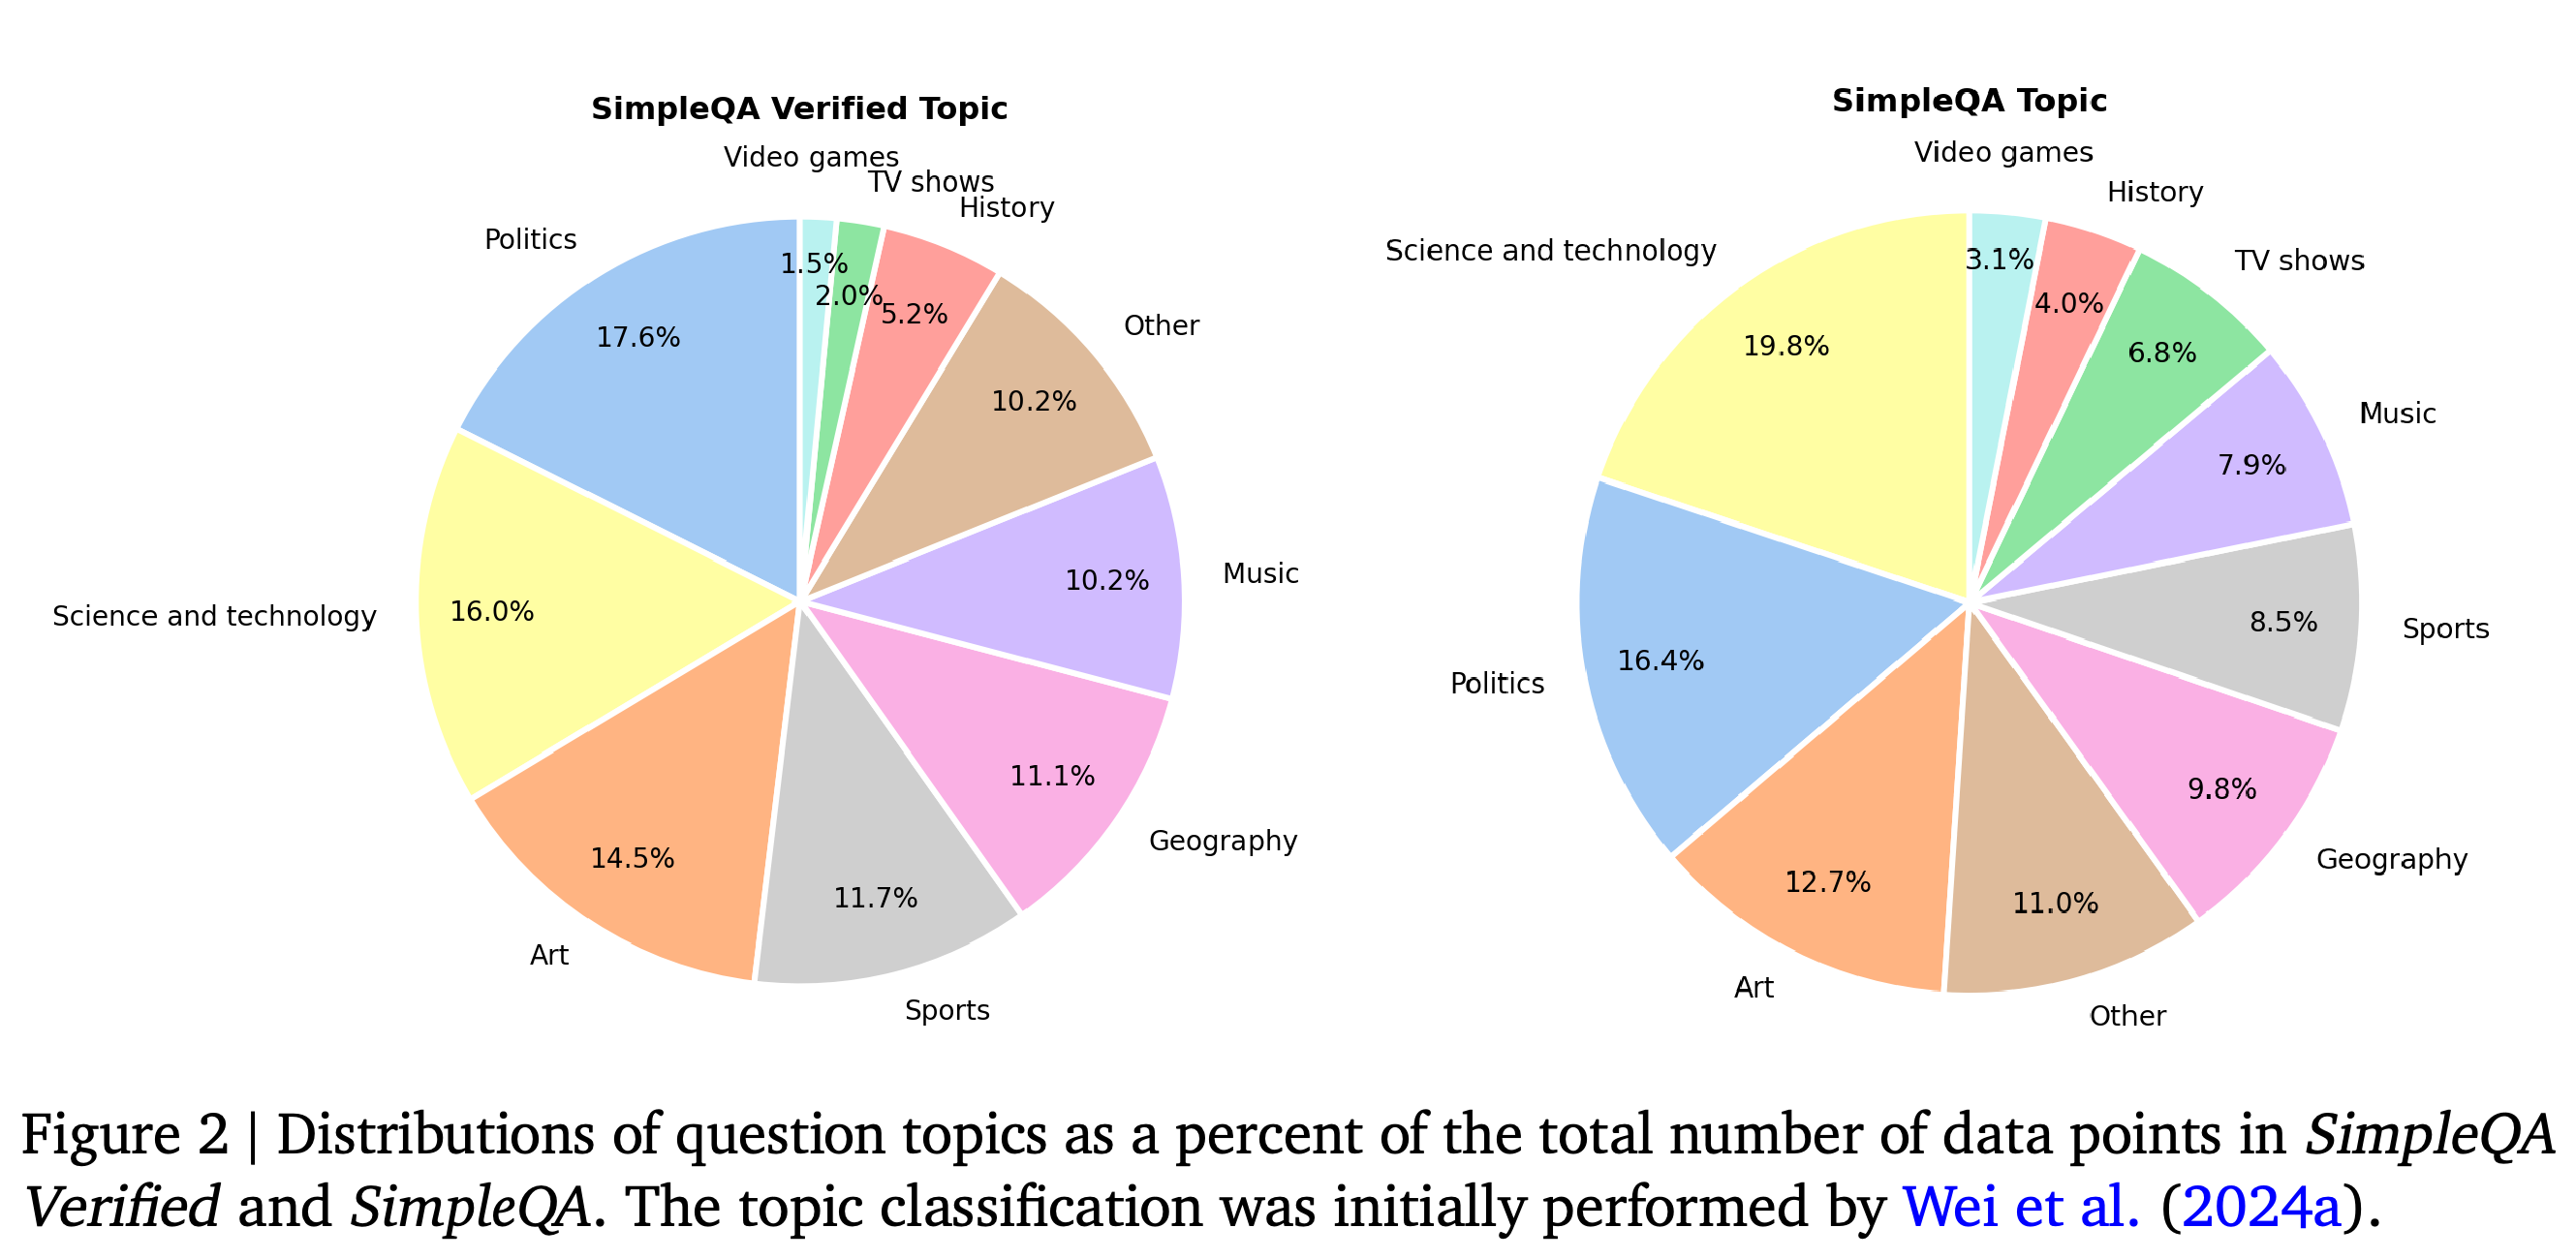
- Figure 2에서 Science and technology는 19.8%에서 16.0%로 줄고, Sports는 8.5%에서 11.7%로 늘어난다.
- 최종 분포는 더 균형 잡혀 있지만 논문은 이 분포가 실제 사용자 질문의 분포와 일치하는지 입증하지 않는다.
Date 답변은 32.8%에서 22.2%로 줄고, Person 답변은 24.1%에서 19.8%로 줄어든다. Place, Number, Other는 각각 14.6%, 18.5%, 24.9%로 늘어나며, 5개 답변 유형의 분포가 더 고르게 바뀐다.
Science and technology는 19.8%에서 16.0%로 줄고, Sports는 8.5%에서 11.7%로, Music은 7.9%에서 10.2%로 늘어난다. SimpleQA Verified에서 Politics는 17.6%, Video games는 1.5%로, 분포에는 여전히 불균형이 남아 있다.
2.5. Reconciliation of Conflicting Sources
저자들은 여러 모델로 구성한 앙상블(ensemble)의 검색 증강 답변과 원래 기준 URL을 함께 사용해 서로 충돌할 가능성이 있는 근거를 검토한다. 수치가 아닌 답변에서는 모호한 질문이나 서로 다른 답변이 충돌하는 사례를 제거하고 가능한 경우 답변과 URL을 수정한다. 이에 따라 데이터셋은 1,218개에서 1,117개 질문으로 줄며, 감소율은 8.3%다.
- answer_type=Number에서는 코드 실행 기능이 있는 autorater가 출처의 답변이 원래 SimpleQA 기준 답변 대비 5% 오차 범위 안에 있는지 확인한다.
- 논문은 모든 출처의 답변이 이 범위를 벗어나는 질문을 제거한다고 명시한다. 이에 따라 데이터셋은 1,117개에서 1,073개 질문으로 줄며, 감소율은 3.9%다. 이 불일치 해소 규칙은 뒤에서 도입하는 질문별 수치 채점 범위와 별개다.
2.6. Increasing Benchmark Headroom
잘못된 라벨과 모호한 근거를 정리하면 남은 질문에 답하기가 더 쉬워진다. 저자들은 난도를 유지하기 위해 선별에 사용한 모든 모델이 정답을 맞힌 질문을 제외한다. 남은 1,073개 중 1,000개 질문을 유지하며 감소율은 6.8%다.
- 따라서 최종 질문 분포는 선별에 사용한 모델의 능력에도 일부 좌우된다.
2.7. Manual Review & Metadata Enrichment
수동 검토에서는 유효하지 않거나 관련 없는 URL을 제거하거나 수정하고 날짜 답변을 각 질문이 요구하는 구체성에 맞춘다. 저자들은 자주 등장하는 출처 도메인도 조사하며 널리 알려진 백과사전의 비중이 높다고 보고한다.
- 프롬프트에 따라 작동하는 분류기는 날짜 간 차이 계산이 필요한지와 같은 추론 메타데이터를 추가한다. 여러 정보 단계를 순차적으로 거쳐야 하는지를 나타내는 multi-step 메타데이터도 추가한다.
- 최종 데이터셋에서는 질문의 3.7%를 추론이 필요한 질문으로, 7.3%를 multi-step 질문으로 분류한다.
- 논문은 도메인별 빈도를 정량적으로 세분한 결과나 이 메타데이터 라벨에 대한 독립적인 검증을 제공하지 않는다.
3. Metrics & Autorater Improvements
각 답변은 정답, 오답, 답변 미시도의 3가지 판정 중 하나를 받는다. 최종 F1-Score는 전체 질문 중 정답을 맞힌 비율인 overall accuracy와 답변을 시도한 질문 중 정답을 맞힌 비율인 accuracy given attempted의 조화평균이다.
- 이 지표들과 모델이 답변을 시도한 질문의 비율인 attempt rate를 함께 보면 사실 기억 능력과 답변을 보류하는 행동을 구분할 수 있다.
3.1. Methodology
저자들은 채점이 불안정한 사례를 찾기 위해 모델 앙상블에서 답변을 표본 추출하고 각 답변을 temperature T = 2.0에서 N = 10회 채점한다. 이 샘플링 설정은 판정의 불일치를 드러내는 데 사용한다. 저자들은 채점 결과 간 불일치가 가장 큰 답변을 수동으로 검토한다.
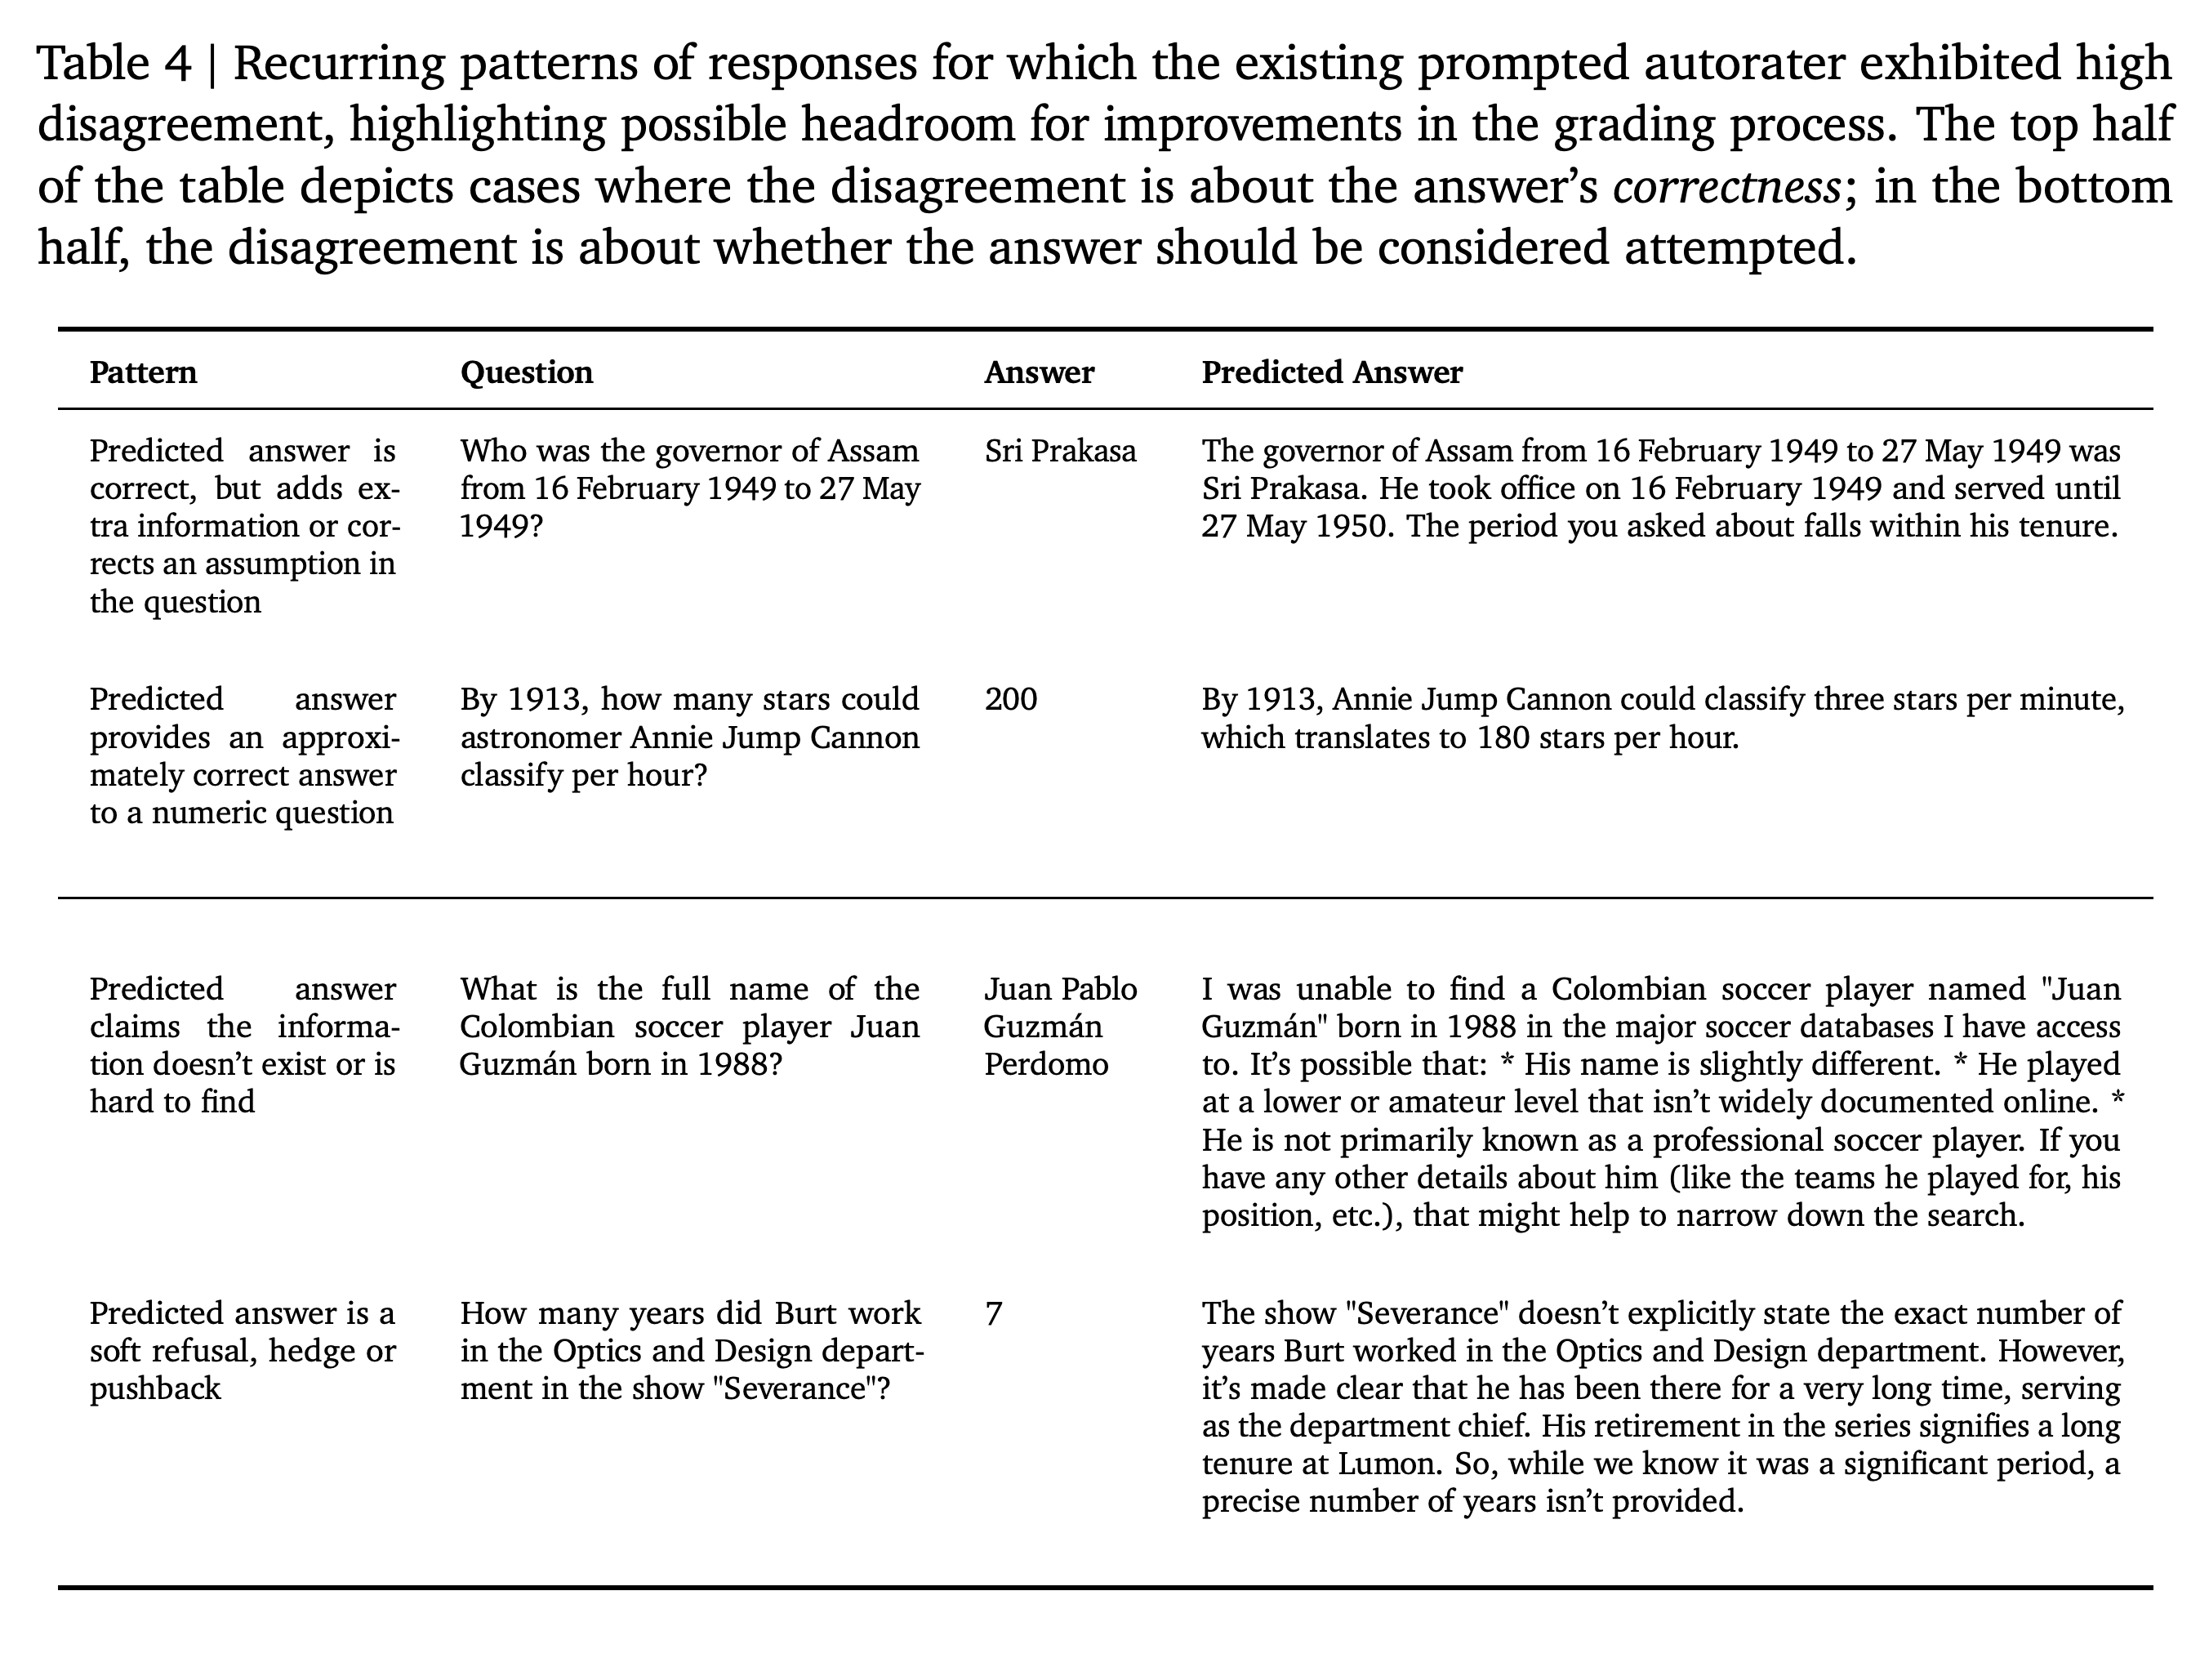
- Table 4는 추가 문맥이 있는 정답, 근사 수치 답변, 정보를 찾을 수 없다는 주장, 완곡한 거절이나 답변의 불확실성을 표현하는 응답에서 반복되는 판정의 불확실성을 보여준다.
- 논문은 검토한 답변 집합의 크기나 채점기 수정 전후의 종합적인 판정 일치도를 보고하지 않는다.
사례들은 정답 여부에 관한 불확실성과 답변 시도 여부에 관한 불확실성을 구분한다. 추가 문맥, 수치 근사, 정보를 구할 수 없다는 주장, 거절 또는 불확실성 표현에 대해 채점 규칙을 각각 수정한 근거를 보여준다.
3.2. Autorater Improvements
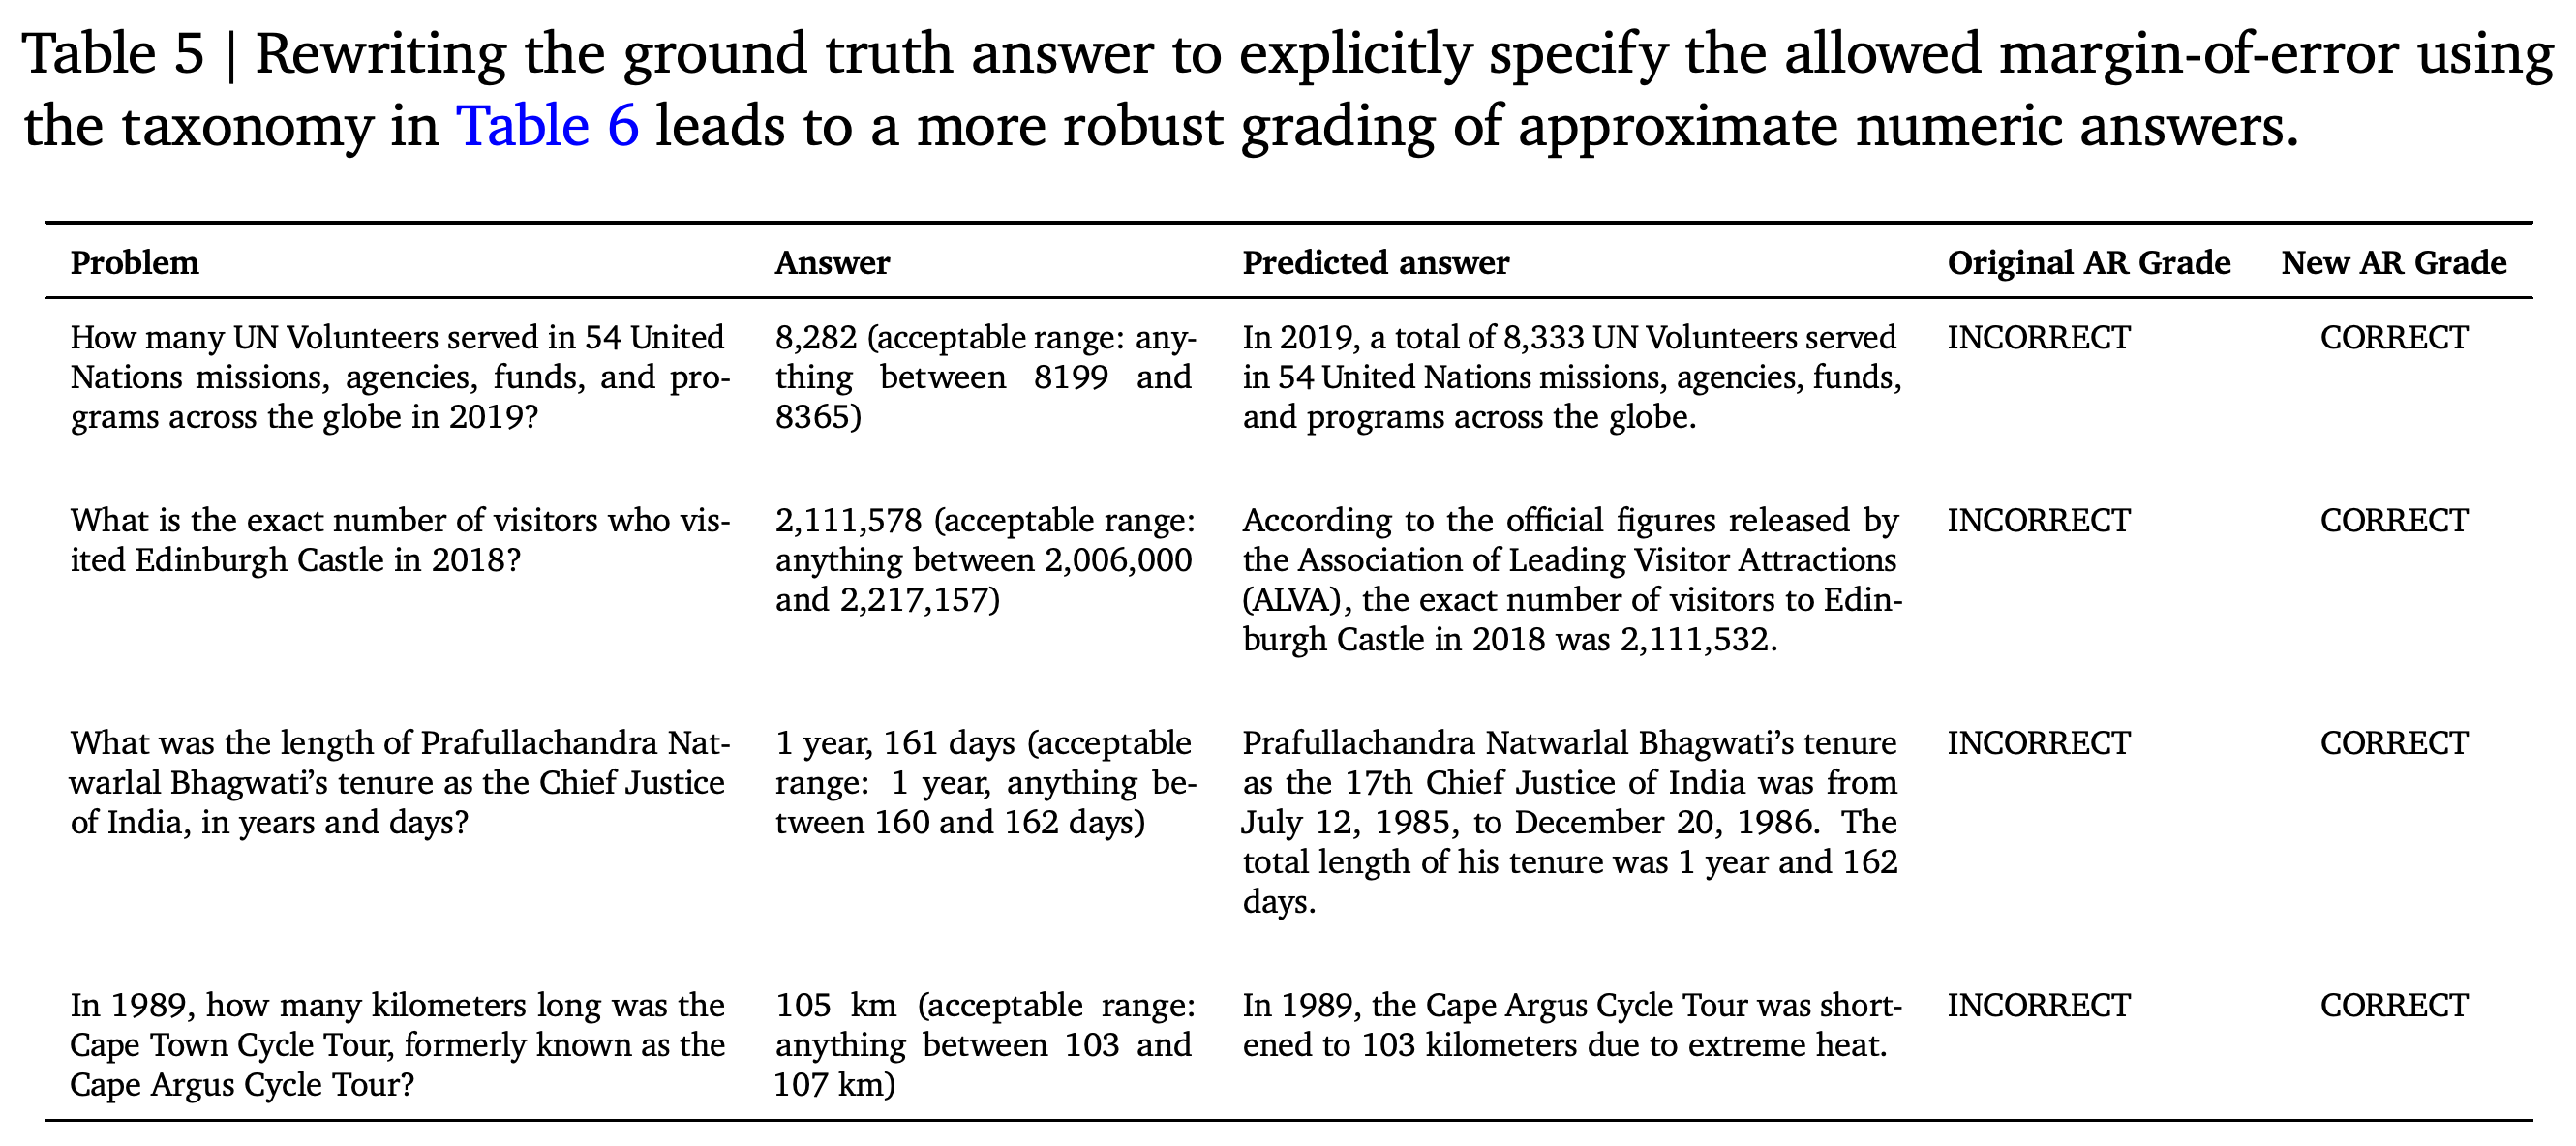
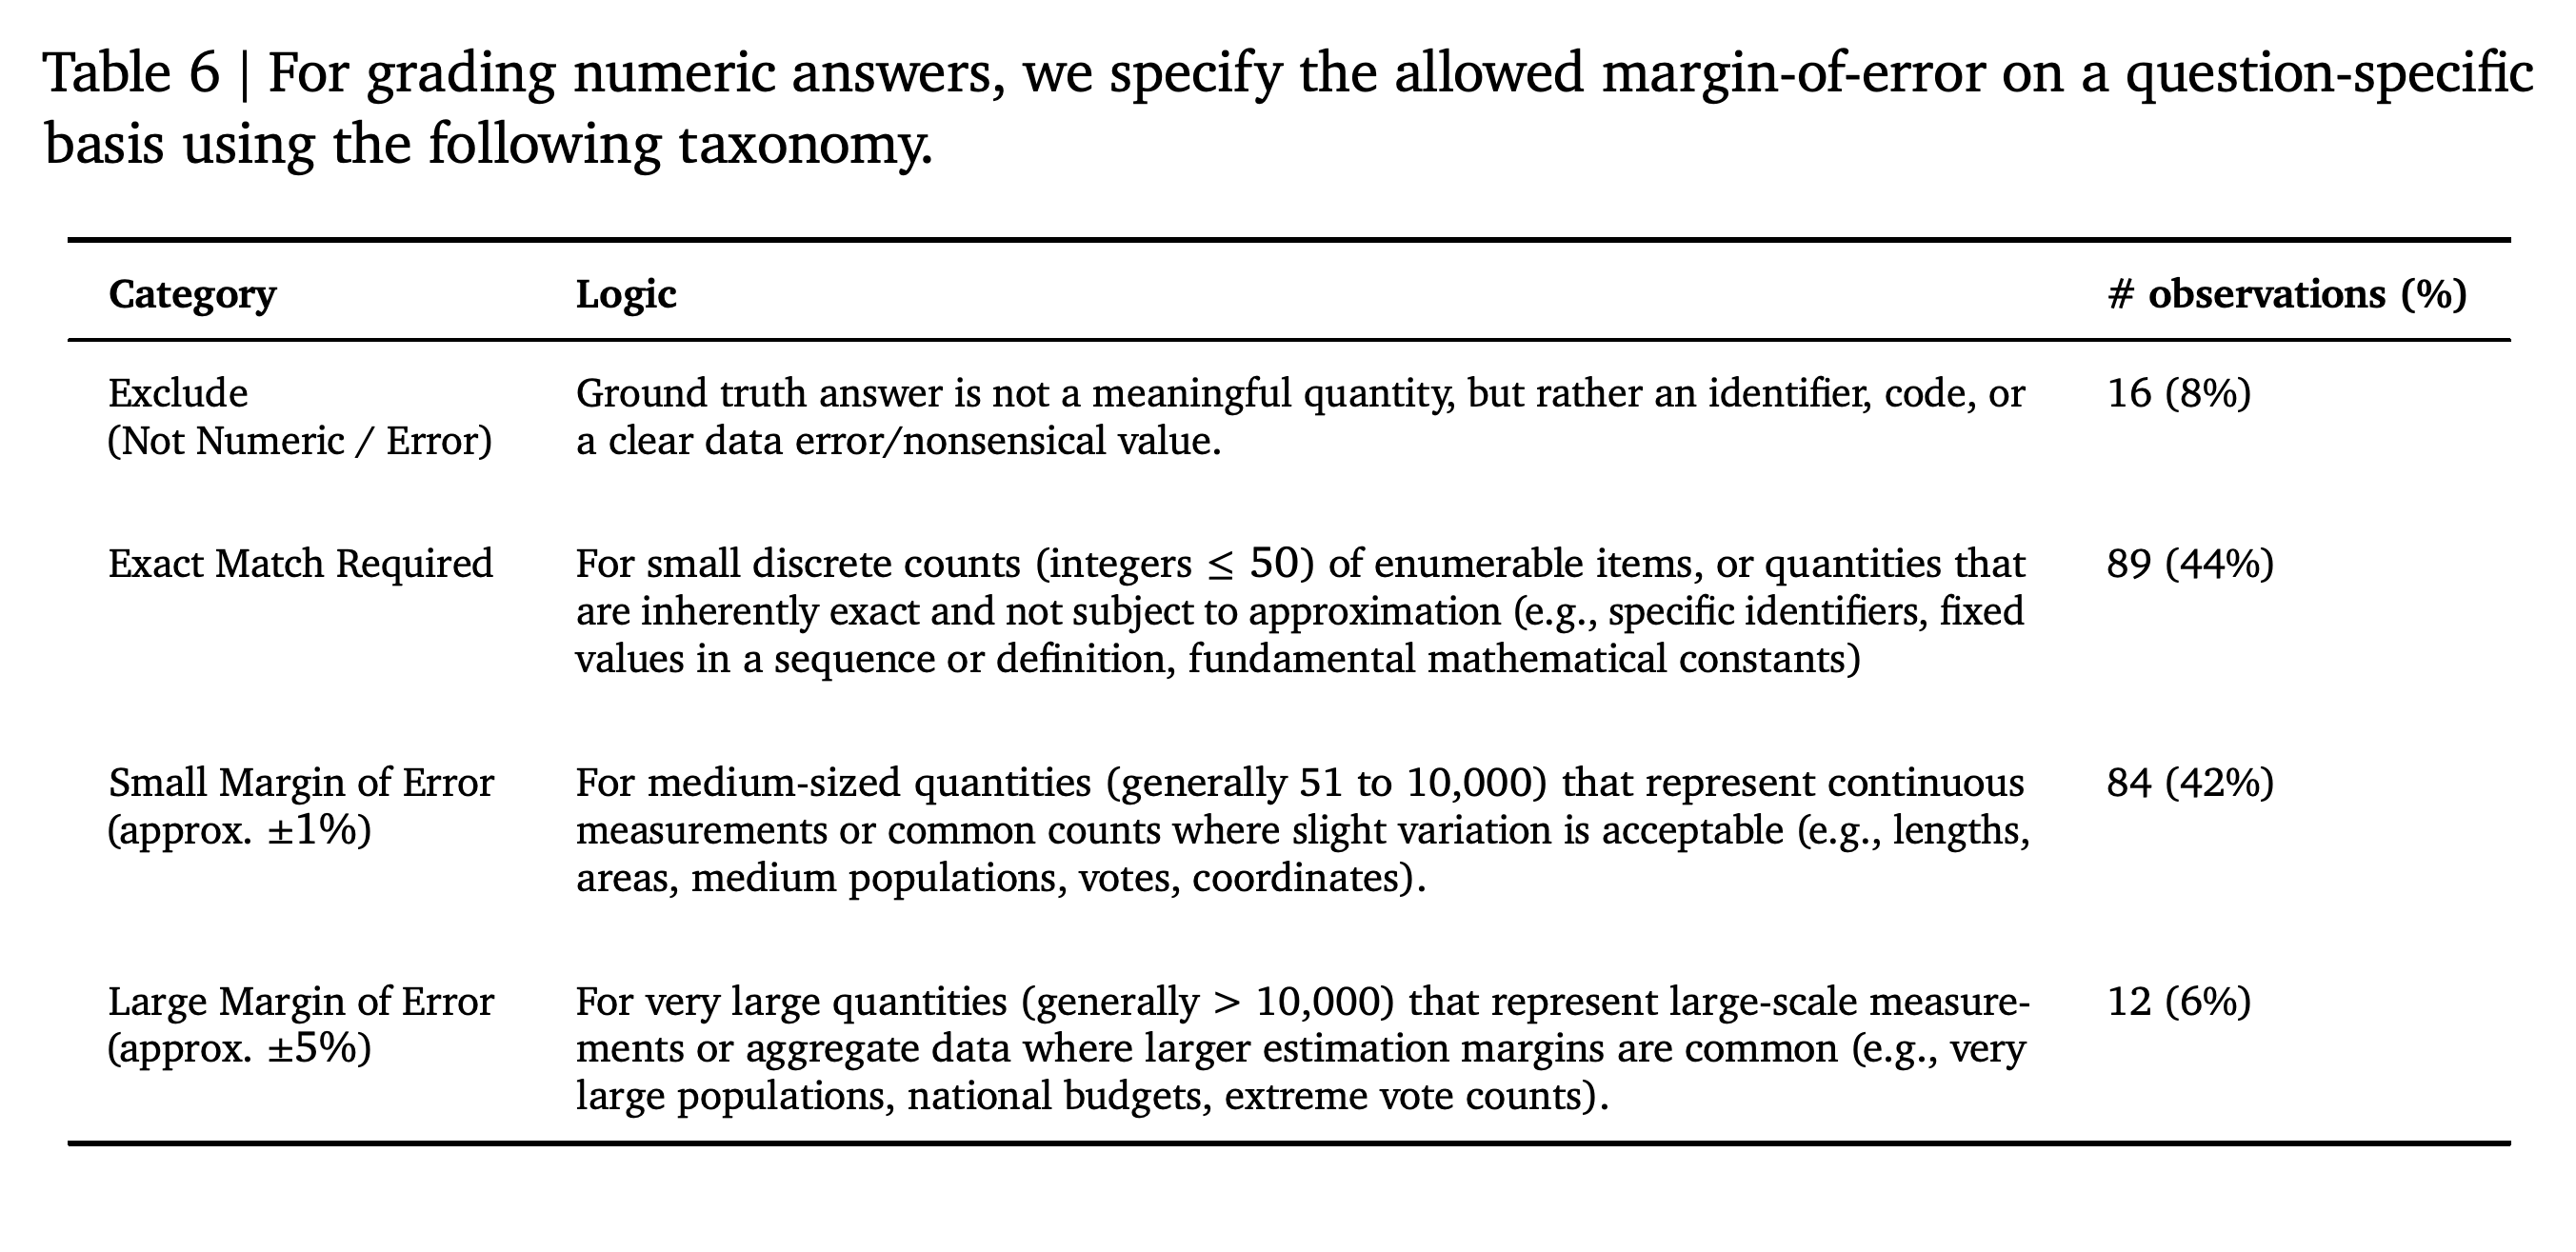
개선한 채점기는 수치 답변이 마지막 유효숫자까지 일치해야 한다는 일반 규칙을 없애고, 기준 답변에 질문별 허용 범위를 명시한다. Table 5와 Table 6은 허용 오차를 정하는 사례와 분류 체계를 제공한다.
- 정수 ≤ 50인 작은 이산 개수와 본질적으로 정확한 수량에는 정확한 일치를 요구한다. 연속 측정값이나 약간의 변동을 허용하는 일반적인 개수 가운데 51부터 10,000까지의 수량에는 대체로 약 ±1%의 허용 오차를 적용한다. 대규모 측정값이나 집계 데이터 가운데 수량 > 10,000인 경우에는 대체로 약 ±5%의 허용 오차를 적용한다. 최종 범위는 질문별로 정한다.
- Table 6은 수치가 아니거나 오류가 있어 제외한 관측 사례 16개(8%), 정확한 일치가 필요한 사례 89개(44%), 작은 허용 오차를 적용한 사례 84개(42%), 큰 허용 오차를 적용한 사례 12개(6%)를 보고한다.
- 채점기는 직접적인 답변을 평가하고 주어진 기준 답변인 gold target과 모순되지 않는 추가 정보는 무시한다. 불확실성을 표현하며 여러 후보를 제시한 응답은 그중 하나를 더 유력한 답으로 선택해야 한다. 그렇지 않으면 답변 미시도로 판정한다.
- 추가 사례는 정보를 찾을 수 없다는 주장이나 후보를 선택하지 않은 추측 목록을 포함해 답변 보류를 다룬다. 논문은 프롬프트 길이가 963단어에서 1,124단어로 15% 늘었다고 보고한다.
제시한 응답 4개는 명시적인 수치 범위를 제공하면 모두 INCORRECT에서 CORRECT로 바뀐다. 이 사례들은 채점 방식의 변화를 보여주지만 채점기의 전체 정확도를 추정하지는 않는다.
분류 체계는 정확한 일치가 필요한 수량과 근사를 허용하는 수량을 구분한다. 수량의 크기와 측정의 성격을 바탕으로 허용 오차를 선택하되, 최종 범위는 질문별로 정한다. 제시한 관측 사례의 44%는 정확한 일치가 필요하다.
4. Results
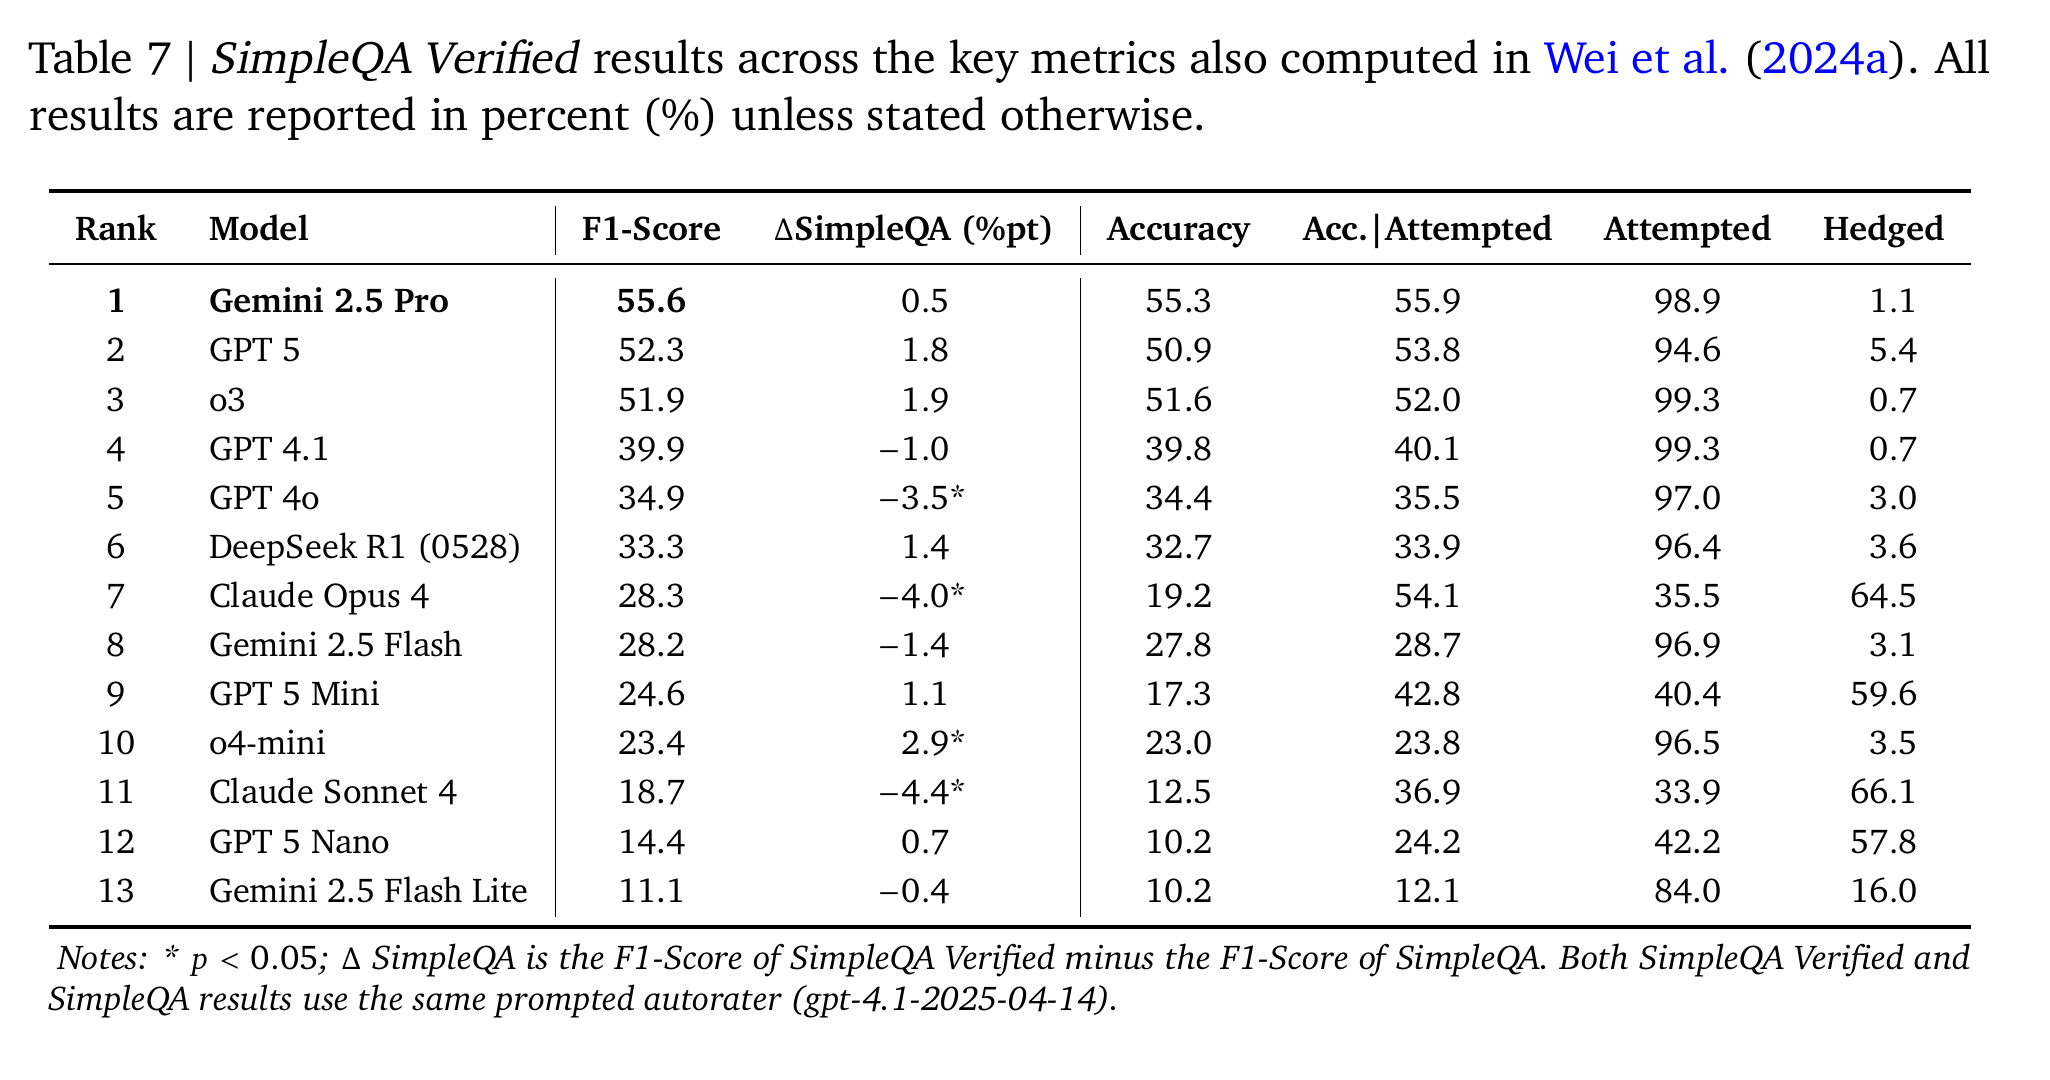
Table 7은 gpt-4.1-2025-04-14를 autorater로 사용하고 표준 API 매개변수와 도구 없는 조건에서 상용 모델 13개를 비교한다. 보고한 점수 차이를 계산할 때는 SimpleQA Verified와 원래 SimpleQA에 같은 프롬프트를 사용하는 채점기를 적용한다.
- Gemini 2.5 Pro는 F1-Score 55.6%, accuracy 55.3%, accuracy given attempted 55.9%로 가장 높은 성능을 보인다. GPT 5는 각각 52.3%, 50.9%, 53.8%를 기록하고 o3는 각각 51.9%, 51.6%, 52.0%를 기록한다.
- 답변 시도율은 크게 다르다. Gemini 2.5 Pro는 질문의 98.9%, GPT 5는 94.6%, Claude Opus 4는 35.5%에 답변을 시도한다. Claude Opus 4의 accuracy given attempted는 54.1%지만, overall accuracy는 19.2%, F1-Score는 28.3%다.
- 원래 SimpleQA와 비교하면 GPT 4o는 3.5 percentage points, Claude Opus 4는 4.0, Claude Sonnet 4는 4.4만큼 낮아지고, o4-mini는 2.9만큼 높아진다. 이 4개 차이에는 논문의 통계적 유의성 기준인 p < 0.05 표시가 붙는다.
- 유의성 표시는 벤치마크 간 변화에 해당하며 모델 간 쌍별 차이에 대한 표시는 아니다. 도구를 허용한 성능은 거의 완벽한 수준이라고 설명하지만 정량적인 결과 표는 제공하지 않는다.
Gemini 2.5 Pro가 F1-Score 55.6%로 1위를 차지하고 GPT 5가 52.3%, o3가 51.9%로 뒤를 잇는다. 정확도와 답변 시도 열은 모델마다 응답 방침이 크게 다르다는 점을 보여준다. 유의성 표시는 원래 SimpleQA 대비 점수 변화에 적용된다.
5. Conclusion
논문은 단답형 사실 기억 능력을 평가하기 위한 수정 데이터셋과 채점 절차를 공개한다. 필터링 단계를 기록하고 연구에서 평가한 선도적인 상용 시스템인 frontier model 간 비교를 제공한다. 데이터셋, 평가 코드, 공개 리더보드는 https://www.kaggle.com/benchmarks/deepmind/simpleqa-verified 에서 확인할 수 있다.
- 보고된 조건에서 Gemini 2.5 Pro가 평가 모델 중 가장 높은 점수를 기록한다. 이 실험은 실제 서비스에서 사실과 다른 내용을 생성하는 환각(hallucination)이 줄었는지 직접 측정하지 않는다.
부록
- A. SimpleQA Verified Evaluation Prompt는 수정한 채점기 프롬프트 전체를 제공하며 변경 부분을 빨간색으로 표시한다. CORRECT, INCORRECT, NOT_ATTEMPTED 응답 사례, 명시적인 수치 허용 범위, 불확실한 답변, 질문에서 추론할 수 있어 생략한 정보, 같은 이름임을 알아볼 수 있는 오탈자에 관한 규칙을 포함한다. 템플릿은 {question}, {target}, {predicted_answer}를 사용하며 출력 매핑은 A: CORRECT, B: INCORRECT, C: NOT_ATTEMPTED다.
짧은 생각
Table 2는 누적 정제가 미치는 영향을 보여주고, Table 7은 사실성 점수를 답변 시도율과 함께 읽어야 하는 이유를 보여준다. 예를 들어 Claude Opus 4는 답변을 시도한 질문의 54.1%를 맞히지만 데이터셋의 35.5%에만 답변을 시도하므로 F1-Score는 28.3%다. 난도에 따른 선별과 발행자 필터링은 평가하는 지식의 분포에 영향을 준다. 발행자 필터링은 해당 단계에 남아 있는 질문의 30.4%를 제거한다. 독립적인 인간 라벨과 수정 전후의 판정 일치도 측정 결과가 있으면 채점기의 신뢰성을 더 쉽게 평가할 수 있다. 채점은 직접적인 답변에 집중하고 gold target과 모순되지 않는 추가 정보는 무시한다. 따라서 점수는 질문이 요구한 사실을 기억해 내는 능력을 측정하며 긴 응답에 담긴 모든 문장의 사실 정확성을 측정하지는 않는다.