


Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models 요약 설명
06 Oct 2025 | Paper Review Context Engineering Agent's Memory Test-Time Adaptation목차
이번 글에서는 Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 6일(Arxiv), ICLR 2026
- Zhang, Qizheng, Hu, Changran, Upasani, Shubhangi, Ma, Boyuan, Hong, Fenglu, Kamanuru, Vamsidhar, Rainton, Jay, Wu, Chen, Ji, Mengmeng, Li, Hanchen, et al.
- Stanford University, SambaNova Systems, Inc., UC Berkeley
- 논문 링크
- Github
- Project Page
요약
- 대규모 언어 모델(LLM)은 입력 컨텍스트를 반복해서 수정할 때 유용한 전략을 잃을 수 있다. 입력 컨텍스트는 모델 가중치를 바꾸지 않고 제공하는 지시와 지식이다. Agentic Context Engineering(ACE)은 재사용 가능한 전략을 구조화된 플레이북으로 관리하는 프레임워크다. 주요 비교 실험에서는 DeepSeek-V3.1을 사용하며 선택된 적응 기준 방법 대비 평균 성능 향상은 상호작용형 코딩 에이전트 벤치마크인 AppWorld에서 10.6%포인트, 금융 벤치마크에서 8.6%포인트다.
- ACE는 작업을 수행하는 Generator, 교훈을 추출하는 Reflector, 추가할 내용을 제안하는 Curator를 통해 작업 실행, 결과 분석, 컨텍스트 수정을 분리한다. 국소적 업데이트로 기존 항목을 보존하고 플레이북을 확장하면서 주기적으로 정리하는 grow-and-refine으로 중복을 제어한다. AppWorld 구성 요소 제거 실험에서 test-normal 평균 성능은 점진적 업데이트가 없을 때 56.9에서 있을 때 70.3으로 높아진다.
- 실험 결과는 재사용 가능한 절차와 신뢰할 수 있는 피드백이 있는 작업에서 효과적인 적응이 가능함을 뒷받침한다. AppWorld에서는 감독에 사용하는 참조 정답인 ground-truth label 없이도 적응이 효과적이지만 label 없는 온라인 금융 개체 인식에서는 성능이 기본 모델보다 낮아진다. 적응 비용은 크게 줄어들 수 있다. 다만 별도의 부록 실험에서는 모델 생성 호출 수로 집계하는 적응 rollout과 평가 시 원시 입력 토큰이 더 많으므로, 효율성은 실험 조건과 서빙 조건에 따라 달라진다.
1 Introduction
서론은 컨텍스트 적응을 모델 학습 이후에 지시, 전략, 메모리 또는 사실 근거를 수정하는 과정으로 설명한다. 이러한 입력은 가중치를 바꾸지 않고도 검토하고 실행 중에 업데이트하고 모델 구성 요소 사이에서 공유할 수 있다.
- 논문은 상세한 지침을 짧고 일반적인 지시로 대체하는 경향인 brevity bias와, 전체 컨텍스트를 반복해서 재작성하면서 축적된 정보를 잃는 context collapse를 문제로 제시한다.
- 논문은 계속 갱신되는 플레이북에 상세한 전략을 보존하고 실행 중에 모델이 관련 정보를 선택하도록 제안한다.
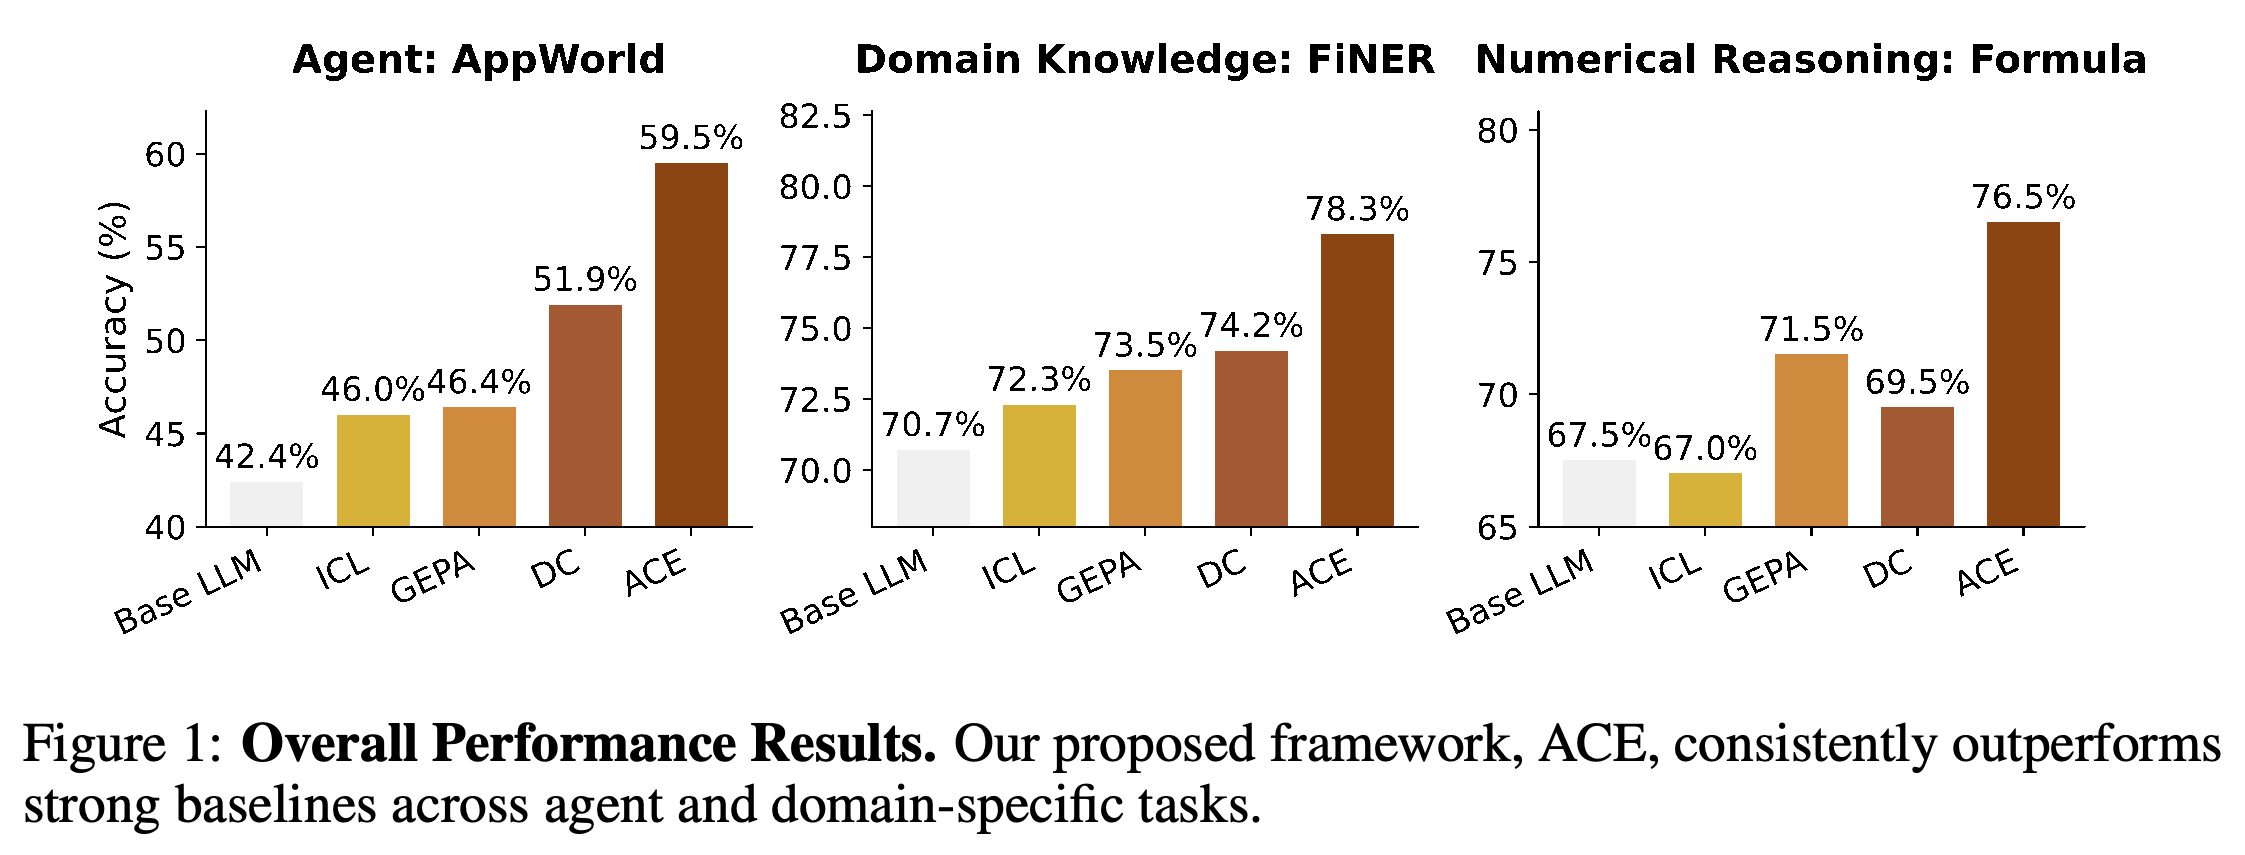
- Figure 1은 선택된 결과를 요약한다. ACE는 AppWorld에서 59.5, 금융 수치 개체 인식 작업인 FiNER에서 78.3, 금융 수치 추론 작업인 Formula에서 76.5를 달성한다. 이 값들은 서로 다른 적응 조건에서 나온 결과다.
패널은 ACE의 선택된 점수인 AppWorld 59.5, FiNER 78.3, Formula 76.5를 보여주며, 모두 표시된 기준 방법보다 높다. AppWorld는 label이 없는 온라인 ACE, FiNER는 label이 있는 오프라인 ACE, Formula는 label이 있는 온라인 ACE를 사용하므로, 패널은 서로 다른 비교 조건을 함께 제시한다.
2 Background and Motivation
배경에서는 자연어 피드백으로 모델 입력을 수정하는 방법의 2가지 실패 유형을 설명한다. 압축은 도메인의 세부 정보를 누락할 수 있고, 전체 재작성은 축적된 지식을 갑자기 지울 수 있다. 이러한 문제는 ACE가 컨텍스트를 개별 항목으로 표현하고 점진적으로 업데이트하는 방식을 도입한 배경이다.
2.1 CONTEXT Adaptation
컨텍스트 적응은 모델의 행동과 중간 결과를 기록한 실행 추적이나 검증 결과를 사용해 입력 수정에 필요한 텍스트 피드백을 생성한다. 논문은 ACE와 관련된 방법으로 실패를 성찰해 계획을 개선하는 Reflexion, gradient와 유사한 텍스트 피드백을 사용하는 TextGrad, 성찰을 통해 프롬프트를 발전시키고 선택하는 Genetic-Pareto 프롬프트 최적화 방법인 GEPA, 전략과 코드를 저장하는 적응형 외부 메모리인 Dynamic Cheatsheet(DC)를 소개한다.
- 이 방법들은 모델 가중치를 유지하면서 해석 가능한 텍스트를 통해 행동을 조정한다.
- ACE는 통찰 추출과 내용 정리를 분리하고 전체 컨텍스트 재생성을 국소적 업데이트로 대체한다.
2.2 Limitations of Existing CONTEXT Adaptation Methods
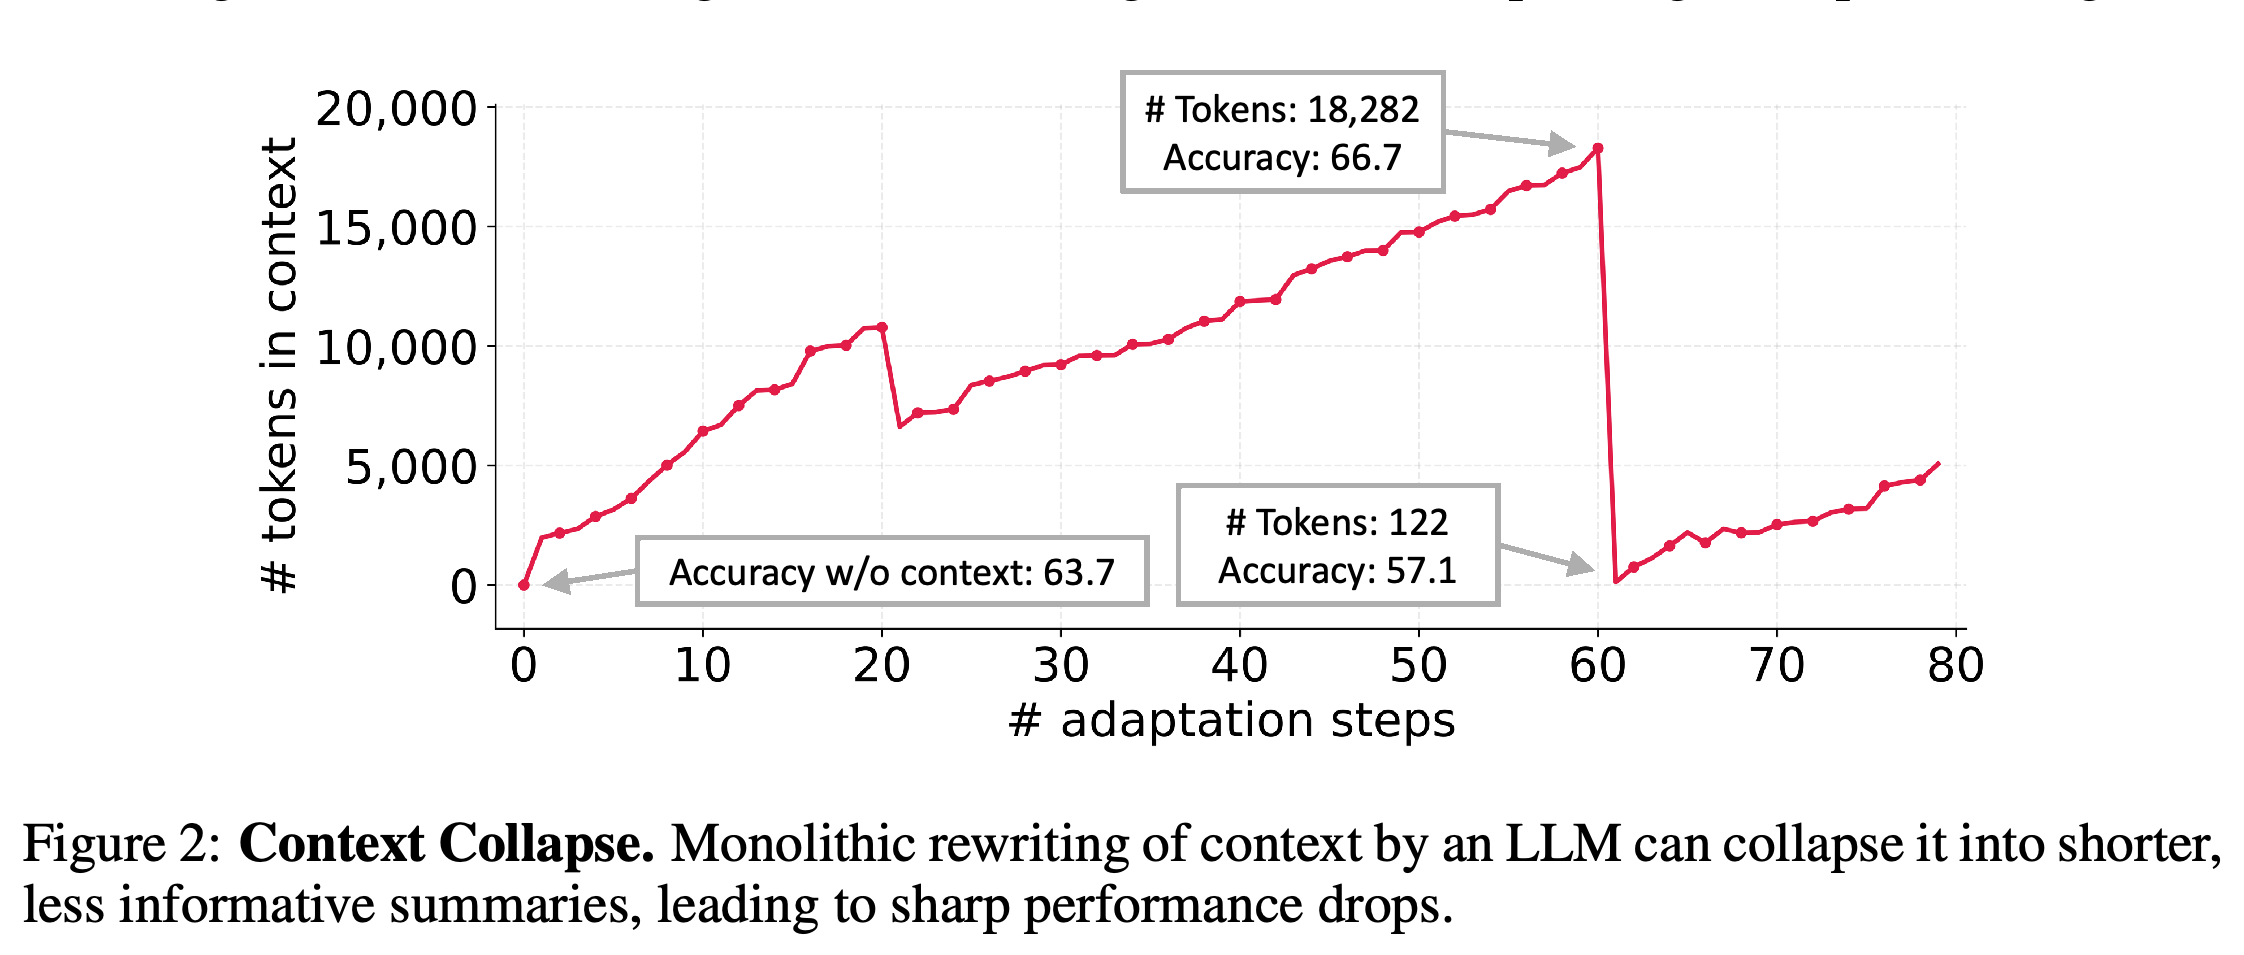
Brevity bias는 여러 단계가 필요한 작업에서 중요한 전문 규칙, 도구 사용 절차, 실패 사례를 누락할 수 있다. 논문은 DC가 축적된 컨텍스트를 반복해서 재작성하는 AppWorld 사례를 통해 context collapse를 보여준다.
- 적응 시점 60에서 컨텍스트는 18,282 tokens이고 정확도는 66.7이다. 다음 단계에서는 컨텍스트가 122 tokens로 줄고 정확도가 57.1로 떨어져, 적응하지 않았을 때의 63.7 baseline보다 낮아진다.
- 이 사례는 전체 컨텍스트 재작성의 위험을 보여주지만 작업, 모델 또는 독립 실행 전반에서 context collapse가 얼마나 자주 발생하는지는 측정하지 않는다.
컨텍스트는 단계 60에서 18,282 tokens까지 늘어난 뒤 다음 업데이트에서 122 tokens로 줄어든다. 정확도는 66.7에서 57.1로 떨어져 적응하지 않은 결과인 63.7보다 낮아진다. 이는 제시된 AppWorld 실행에서 유용한 축적 지식이 손실되었음을 보여준다.
3 Agentic CONTEXT Engineering (ACE)
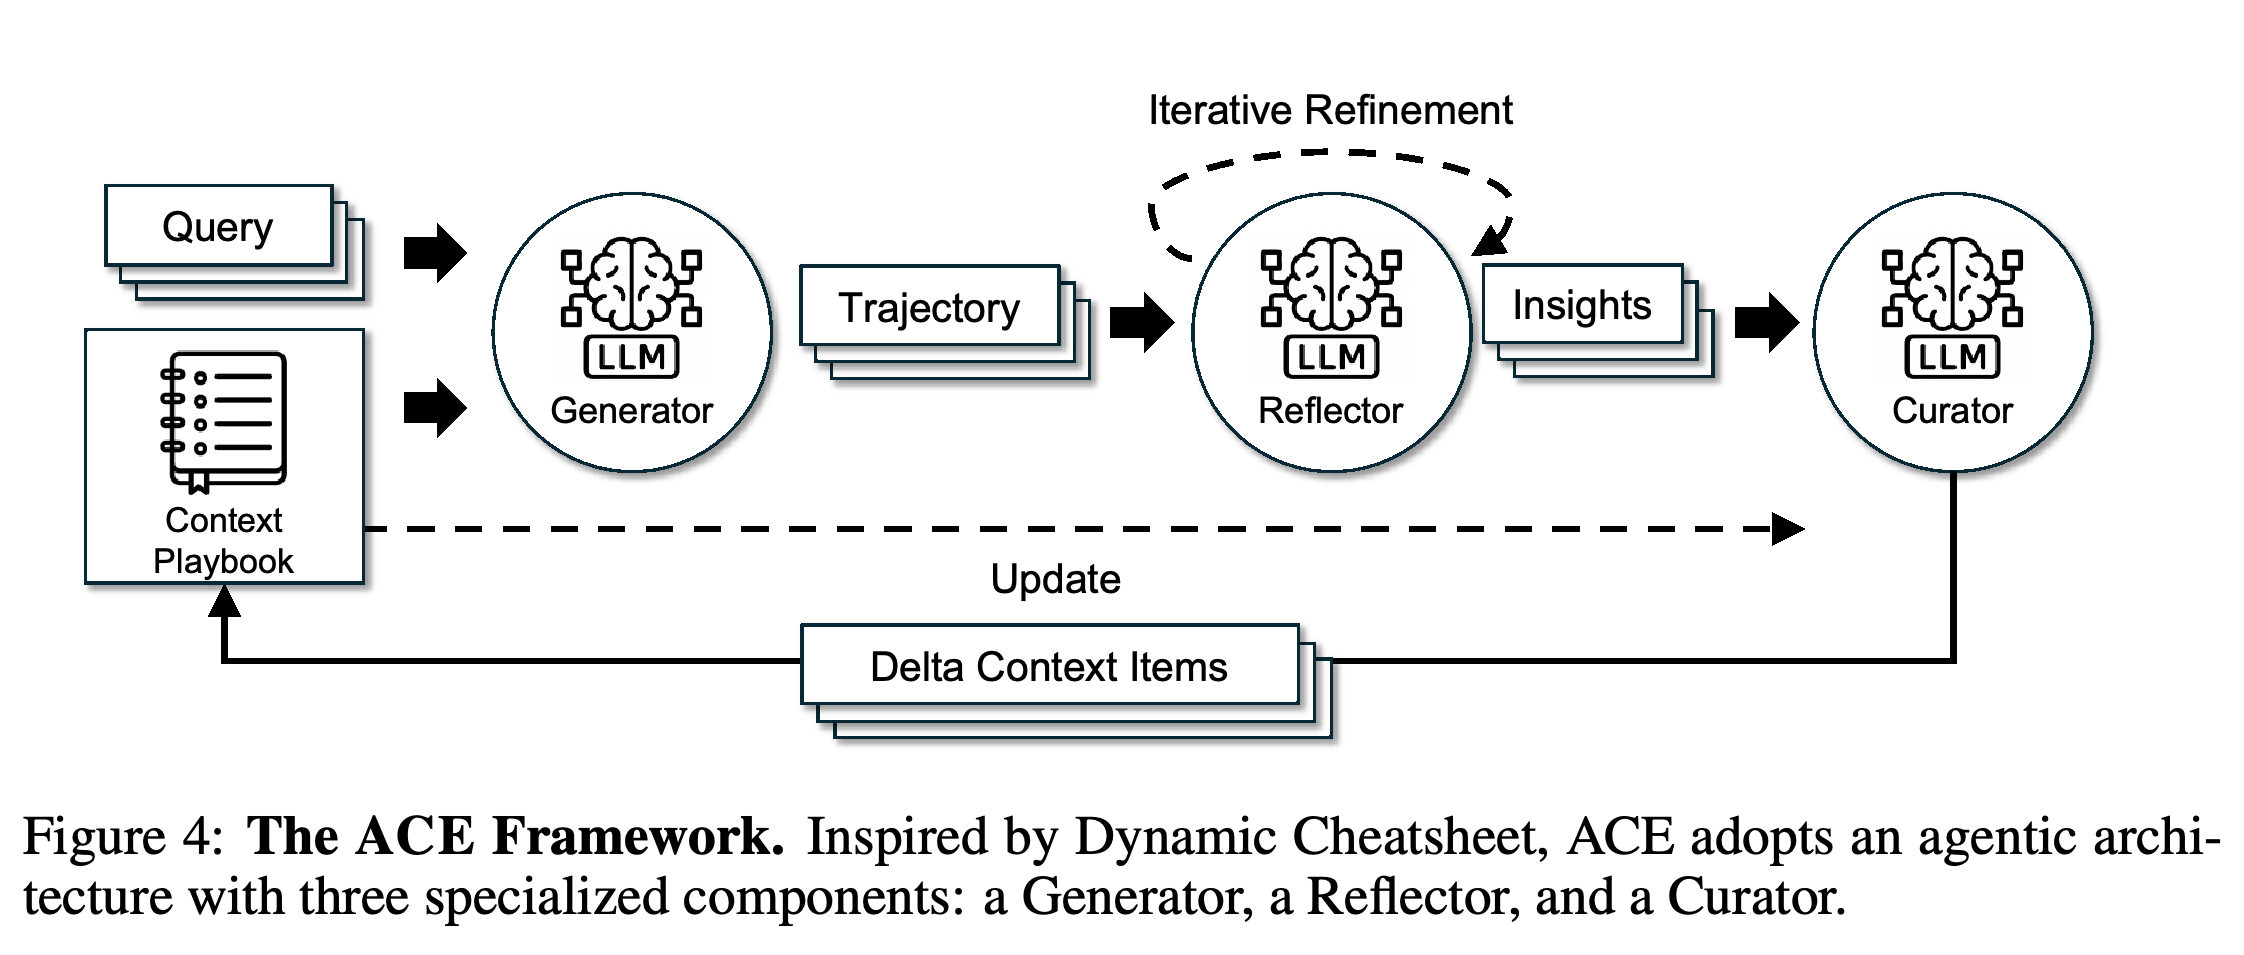
Generator는 추론과 행동의 연속인 작업 궤적을 생성하고 Reflector는 성공과 오류에서 교훈을 추출하며 Curator는 그 교훈을 구조화된 컨텍스트 추가 항목으로 변환한다. 가벼운 결정론적 로직이 추가 항목을 기존 플레이북에 병합하며 업데이트 대상이 아닌 항목은 보존한다.
- Reflector는 여러 차례 반복하면서 분석을 개선할 수 있다. 테스트 평가 전에 컨텍스트를 구성하는 오프라인 적응에서는 여러 epoch, 즉 데이터 순회에 걸쳐 학습 질의를 다시 처리할 수 있다.
- 국소적 업데이트는 병렬로 병합할 수 있지만 주요 실험의 batch size는 1이다.
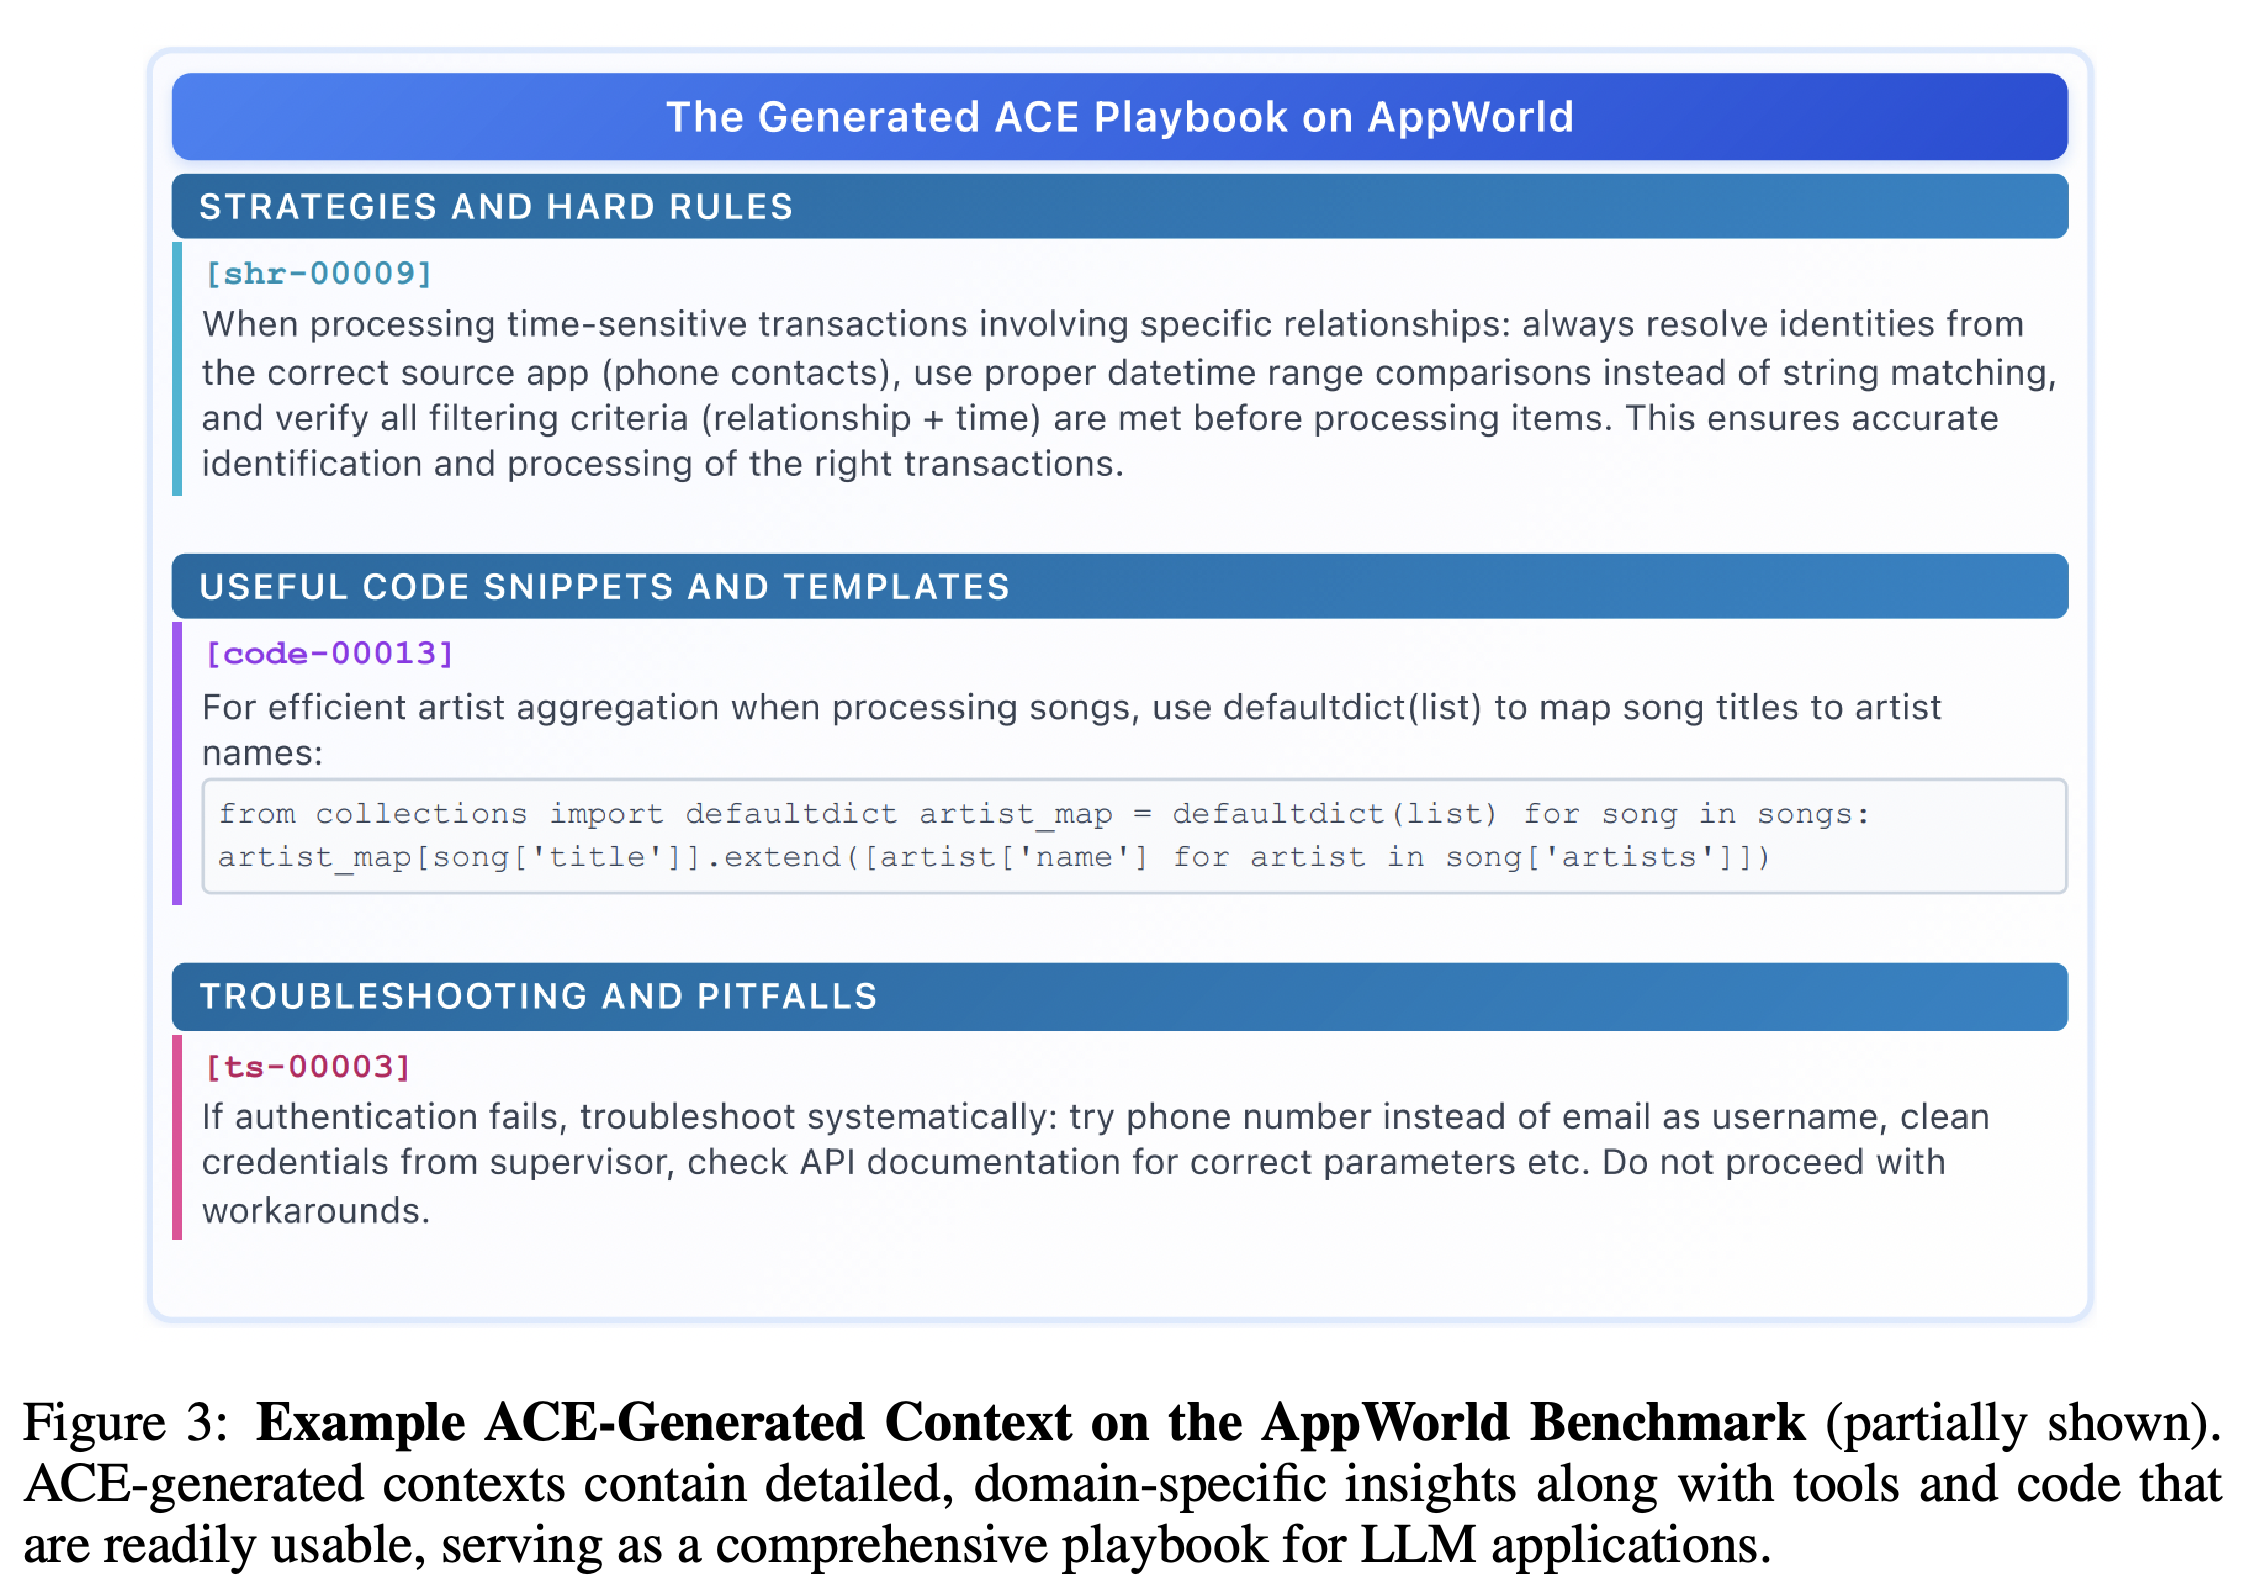
- AppWorld 플레이북의 일부에는 관계를 판별하는 규칙, 재사용 가능한 코드, 인증 문제 해결 방법이 포함되어 있으며 ACE가 보존하는 구체적인 실행 지식을 보여준다.
발췌된 플레이북은 지식을 전략과 필수 규칙, 유용한 코드 조각과 템플릿, 문제 해결 방법과 주의 사항으로 묶는다. 식별자가 있는 항목은 구체적인 관계 판별 규칙, 아티스트 집계 코드, 인증 지침을 보존하며 플레이북이 유지하는 세부 정보를 보여준다.
질의와 현재 플레이북이 Generator에 입력되고 궤적은 Reflector로 전달되며, 추출된 통찰은 Curator로 전달된다. Delta context 항목이 플레이북을 업데이트하고 Reflector는 내용 정리 전에 분석을 반복할 수 있다. 이 과정은 작업 실행, 분석, 컨텍스트 수정을 분리한다.
3.1 INCREMENTAL Delta Updates
ACE는 컨텍스트를 구조화된 bullet 항목으로 표현한다. 각 항목에는 고유 식별자, 유익하거나 유해하게 사용된 횟수를 기록하는 카운터, 재사용 가능한 작은 단위의 내용이 들어간다. 항목 추가나 변경 제안으로 이루어진 작은 집합인 delta context가 전체 프롬프트 재생성을 대체한다.
- 식별자를 통해 특정 항목을 업데이트하고 어떤 항목이 작업 실행에 도움이 되었거나 잘못된 방향으로 이끌었는지 추적할 수 있다.
- 논문은 이 표현 방식의 장점으로 국소적 편집, 관련 개별 항목의 검색, 점진적 병합, 가지치기, 중복 제거를 설명한다.
- Generator는 작업에서 사용한 항목을 식별해 Reflector가 오류를 분석하고 수정하는 데 필요한 피드백을 제공한다.
3.2 Grow-and-Refine
Grow-and-refine은 새로운 식별자가 있는 bullet 항목을 추가하고 기존 항목과 카운터를 제자리에서 업데이트한다. 중복 제거는 유사한 내용을 식별하는 수치 표현인 의미 임베딩으로 항목을 비교하고 중복 정보를 제거한다.
- 정리 과정은 각 delta 이후에 실행하거나, 모델의 입력 길이 한도인 컨텍스트 윈도를 초과했을 때 실행할 수 있다.
- 이 메커니즘은 전체 컨텍스트를 반복해서 재작성하지 않으면서 지식을 축적하고 중복을 제어한다.
4 RESULTS
평가는 에이전트 성능, 전문 추론, 구성 요소의 기여, 적응 비용을 살펴본다. Ground-truth label 없이 AppWorld 기본 에이전트보다 최대 17.1%포인트 높은 성능을 보고하며 주요 비용 비교 2가지에서 적응 지연 시간은 평균 86.9% 줄어든다.
- 오프라인 적응과 각 테스트 예측 이후에 컨텍스트를 업데이트하는 온라인 적응을 별도로 평가한다.
- 금융 실험에서는 피드백을 신뢰하기 어려울 때 실패가 발생한다. 따라서 label 없이도 효과적으로 적응할 수 있다는 주장은 피드백의 신뢰성을 함께 고려해야 한다.
4.1 TASKS and Datasets
AppWorld는 애플리케이션 함수를 호출하는 인터페이스인 application programming interface(API)를 이해하고 코드를 생성하고 애플리케이션과 상호작용하는 자율 에이전트를 test-normal과 test-challenge 분할에서 평가한다. 금융 평가에는 금융 문서의 토큰을 139개 개체 유형 중 1개로 분류하는 FiNER와 금융 개념 및 계산을 적용하는 Formula를 사용한다. 두 작업 모두 금융 보고 형식인 eXtensible Business Reporting Language(XBRL)를 다룬다.
- AppWorld는 작업 수준 완료 지표인 Task Goal Completion(TGC)과 시나리오 수준 완료 지표인 Scenario Goal Completion(SGC)을 양쪽 테스트 분할에서 보고한다.
- FiNER, Formula, 의료 진단 벤치마크인 DDXPlus는 exact-match accuracy를 사용한다. BIRD-SQL은 자연어로 Structured Query Language 데이터베이스 질의를 생성하는 text-to-SQL을 평가하며 생성된 답변을 평가하는 LLM-as-a-judge로 GPT-4o-mini를 사용한다.
- 데이터셋은 원래의 train/validation/test 분할을 유지한다. 오프라인 방법은 학습 데이터로 최적화하고 1회 시도의 정확도인 pass@1을 보고한다. 온라인 방법은 동일하게 섞인 테스트 순서에서 먼저 예측한 뒤 업데이트한다.
4.2 Baselines and Methods
기준 방법에는 적응하지 않은 모델, 입력으로 작업 시범 예제를 제공하는 In-Context Learning(ICL), 지시와 시범 예제를 함께 최적화하는 MIPROv2, GEPA, 누적 메모리를 재작성하는 cumulative mode의 DC(DC-CU)가 포함된다. AppWorld 방법들은 추론과 행동을 결합하는 에이전트 프레임워크인 공식 ReAct 구현을 공유한다.
- ICL은 모든 학습 시범 예제가 입력에 들어가면 전부 사용하고 그렇지 않으면 컨텍스트 윈도가 허용하는 만큼 사용한다. MIPROv2는 베이지안 최적화로 지시 후보와 시범 예제를 선택한다. MIPROv2와 GEPA는 auto=”heavy”로 공식 DSPy 프롬프트 최적화 구현을 사용한다.
- ACE는 3가지 역할 모두에 non-thinking DeepSeek-V3.1을 사용해 더 강한 Reflector나 Curator에서 더 약한 Generator로 지식이 전달되는 효과를 배제한다.
- 주요 ACE 실험은 batch size 1, 최대 5회의 Reflector 분석 개선, 최대 5 epoch의 오프라인 적응을 사용한다.
4.3 RESULTS on AGENT Benchmark
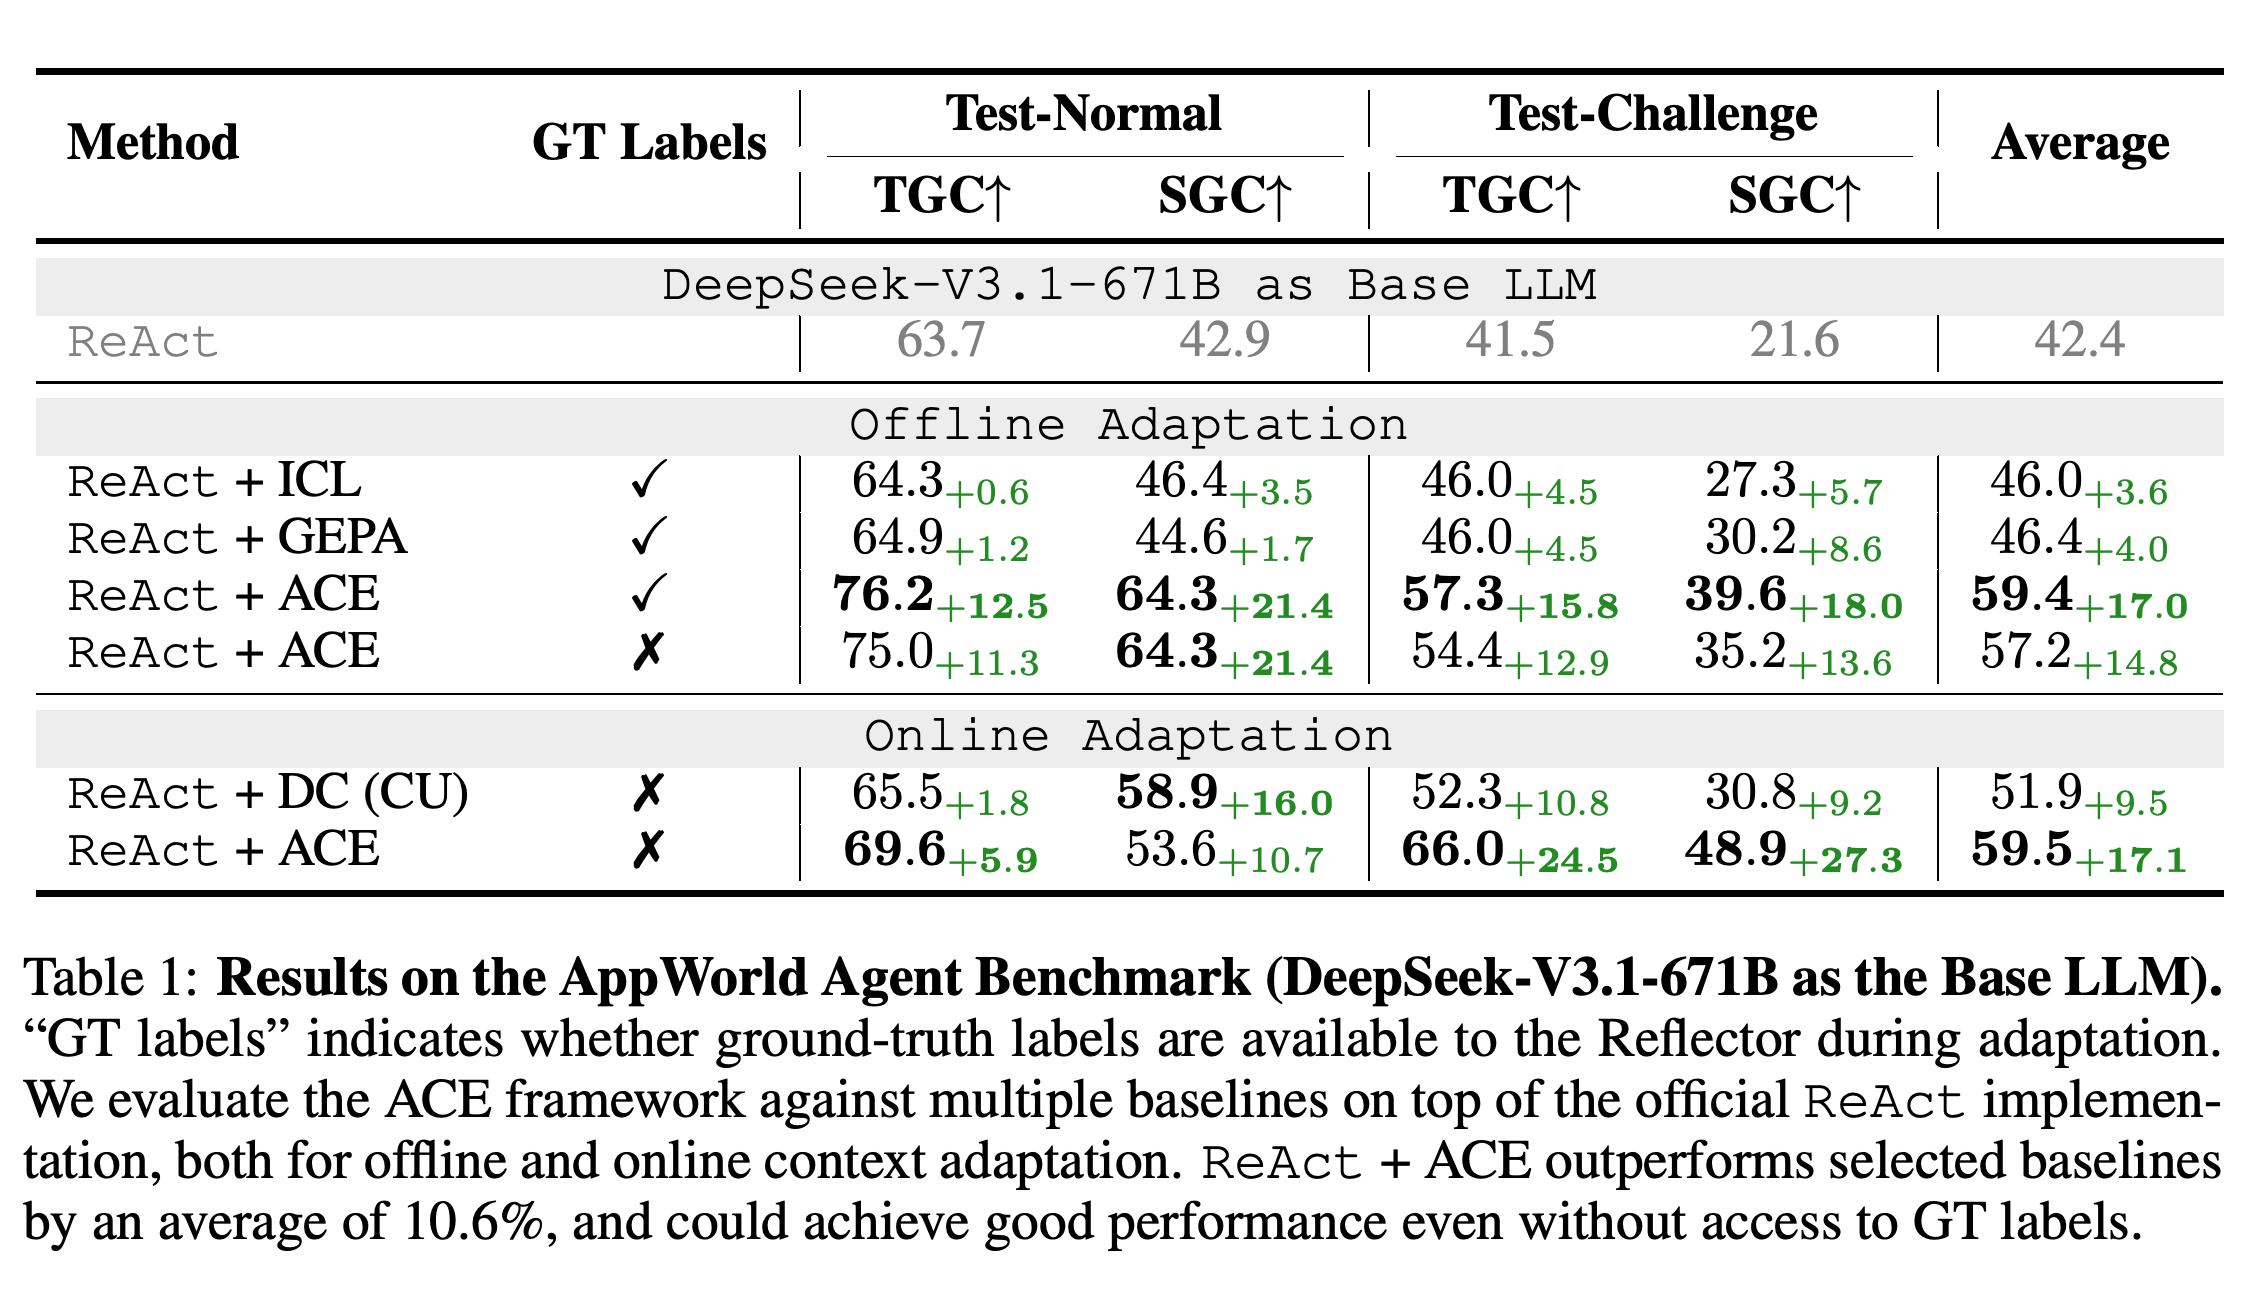
DeepSeek-V3.1-671B를 사용할 때 ground-truth label이 있는 오프라인 ACE의 AppWorld 평균은 59.4이며, ReAct는 42.4, ICL은 46.0, GEPA는 46.4다. Label이 없는 오프라인 ACE는 57.2를 달성한다. Label이 없는 온라인 ACE는 59.5로, DC-CU의 51.9보다 높다.
- 온라인 결과 59.5에는 온라인 적응 전에 플레이북을 초기화하는 offline warmup이 포함된다. 별도의 구성 요소 제거 실험에서 warmup이 없을 때의 결과는 56.1이다.
- 온라인 ACE의 test-challenge TGC/SGC는 66.0/48.9지만, test-normal SGC는 53.6으로 DC-CU의 58.9보다 낮다. 종합 성능의 우위가 모든 지표에 적용되지는 않는다.
- 2025년 9월 20일 leaderboard에서 IBM CUGA의 전체 점수는 60.3이며, 오프라인 ACE는 59.4다. 논문은 CUGA를 성능 수준을 파악하기 위한 참고 대상으로 다루며, 조건을 통제한 방법론 비교 기준으로 사용하지 않는다. 점수는 비슷한 성능 범위를 보여주지만 동등한 성능을 뜻하지는 않는다.
동일한 DeepSeek-V3.1-671B를 사용한 비교에서 오프라인 ACE 평균은 label이 있을 때 59.4, 없을 때 57.2이며, GEPA는 46.4다. 온라인 ACE는 59.5로 DC-CU의 51.9보다 높다. Test-challenge 점수는 더 높지만 test-normal 시나리오 완료 성능은 더 낮다. Table 3은 59.5 조건에 offline warmup이 포함됨을 보여준다.
4.4 RESULTS on DOMAIN-Specific Benchmark
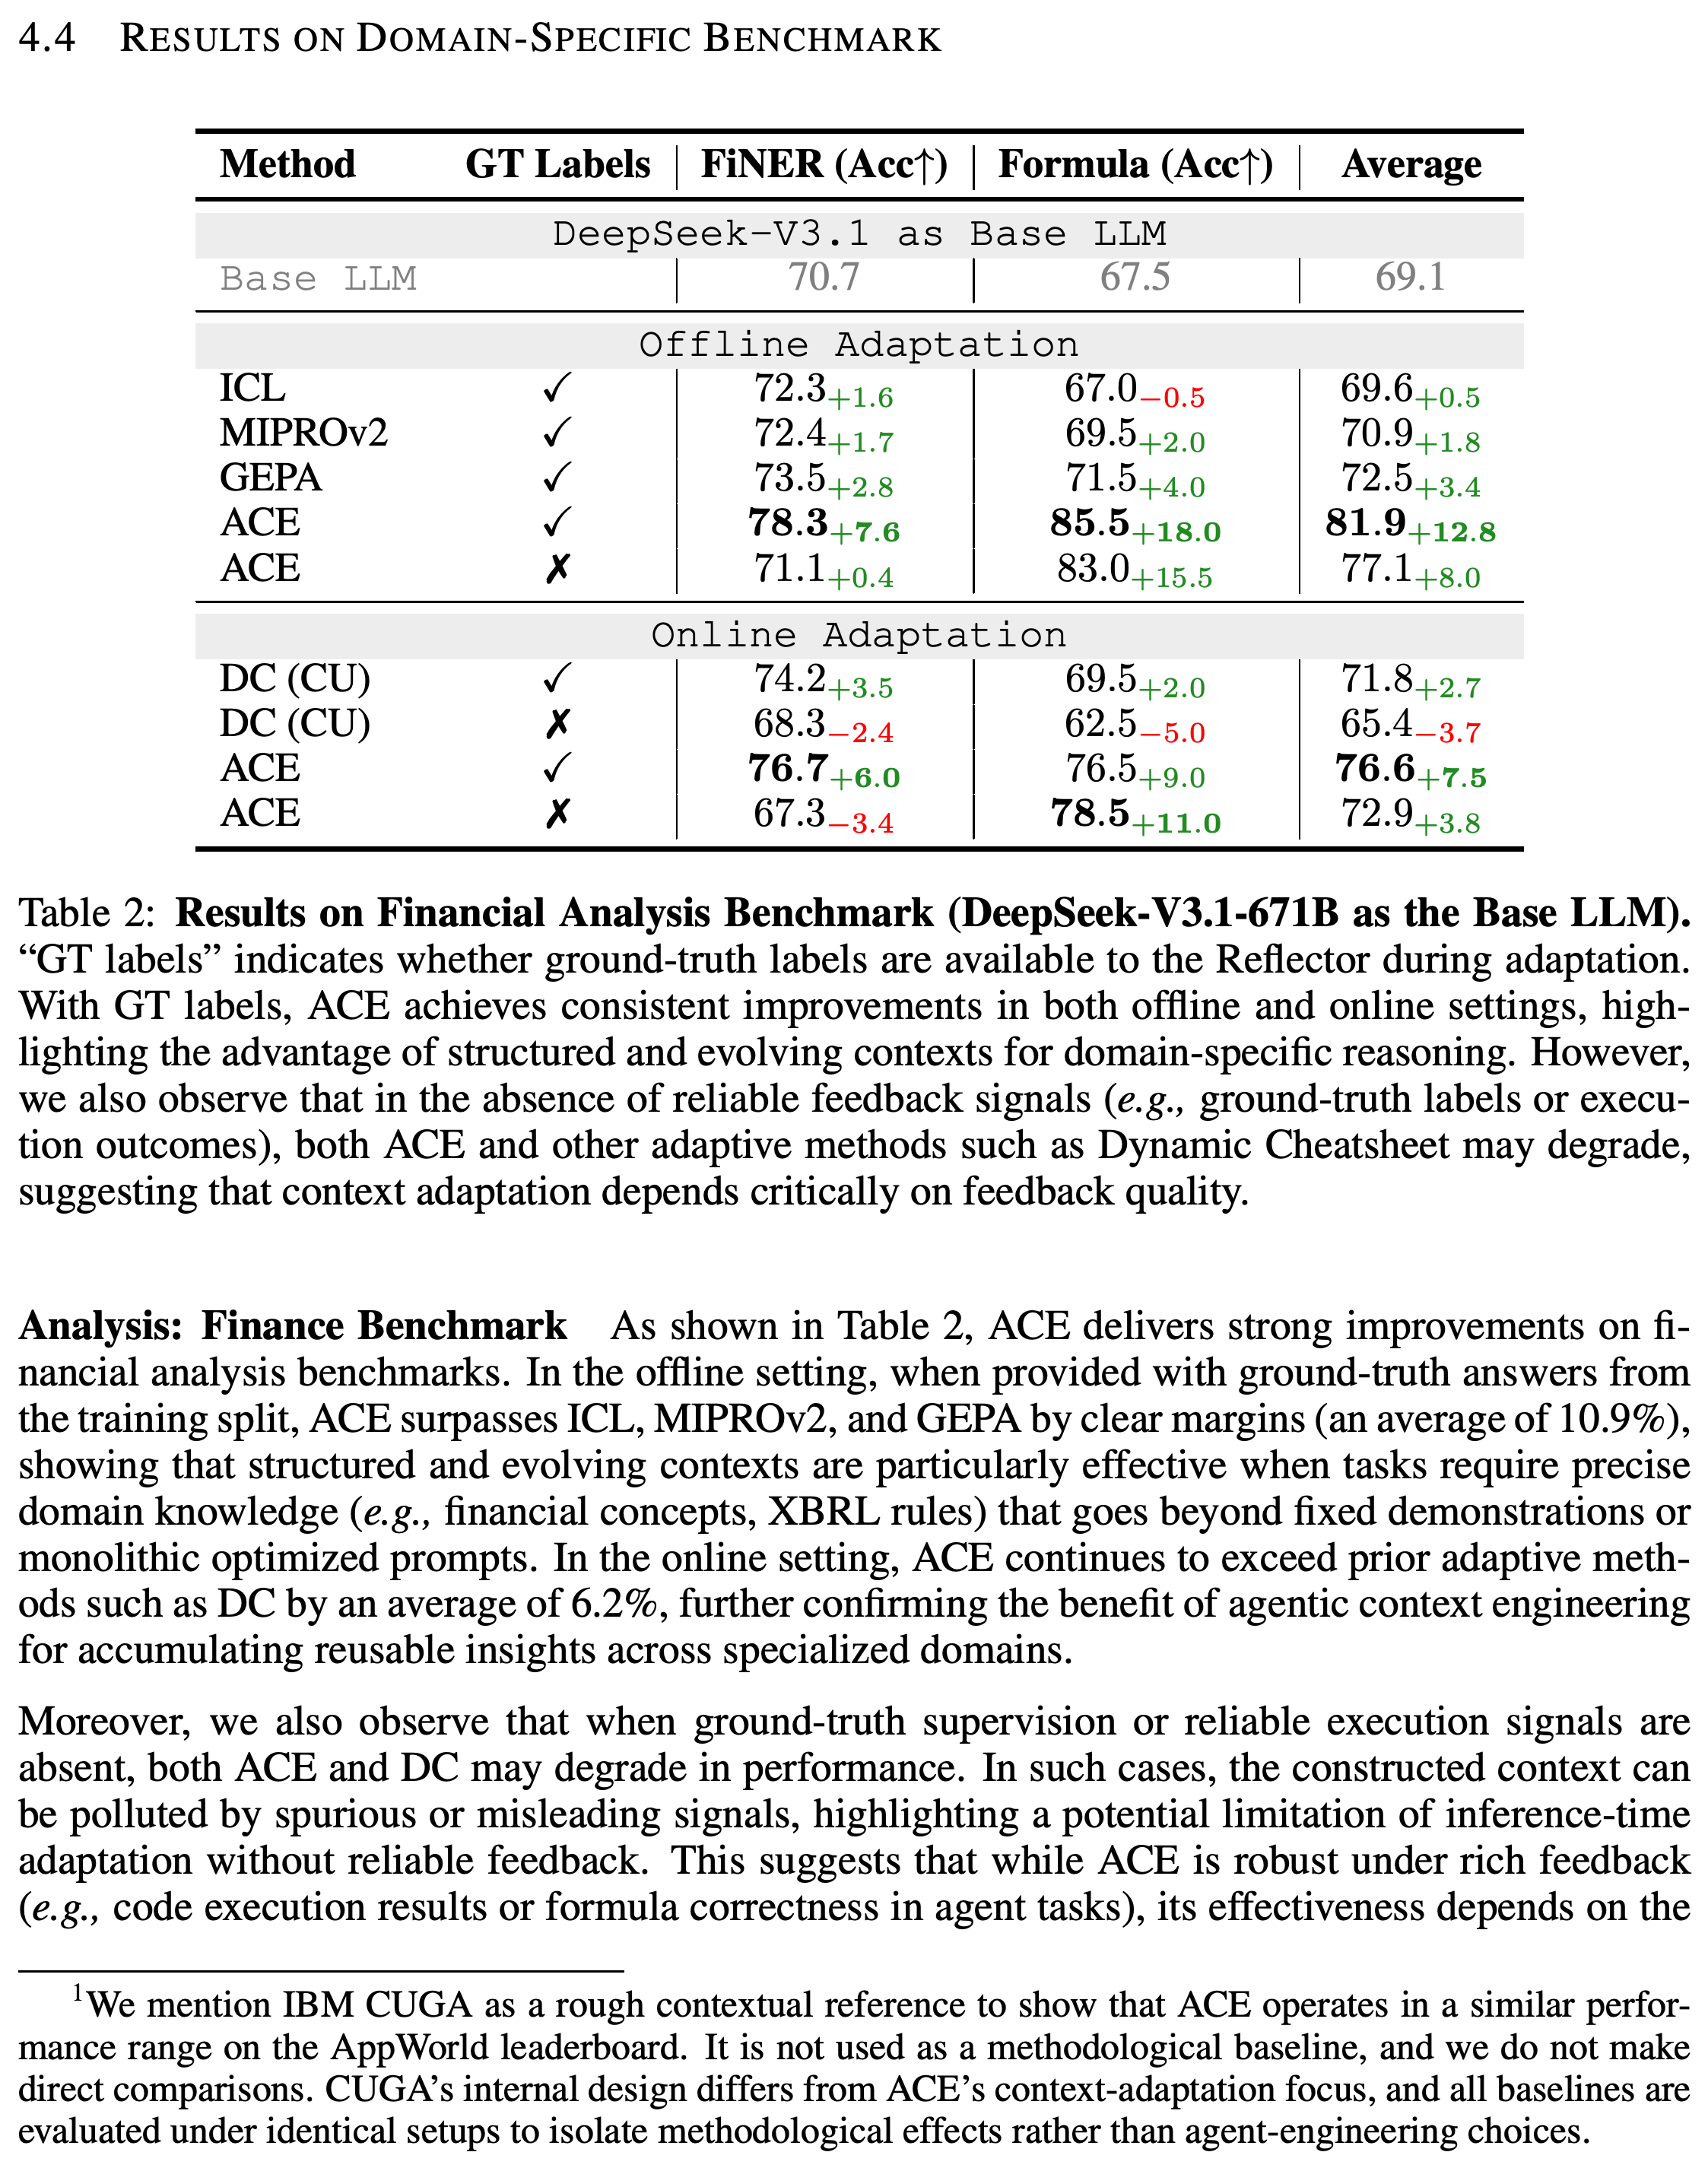
Label이 있는 오프라인 ACE는 FiNER에서 78.3, Formula에서 85.5를 달성한다. 평균은 81.9로, GEPA의 72.5와 기본 모델의 69.1보다 높다. Label이 있는 온라인 ACE의 평균은 76.6으로 DC-CU의 71.8보다 높다. Label이 없는 온라인 ACE의 평균은 72.9로, label이 없는 DC-CU의 65.4보다 높다.
- Label이 없는 온라인 ACE에서는 FiNER가 기본 모델의 70.7에서 67.3으로 떨어지는 반면, Formula는 67.5에서 78.5로 상승한다.
- 저자들은 감독이나 신뢰할 수 있는 실행 결과가 없을 때 오해를 유발하는 신호가 컨텍스트에 들어가 성능이 저하된다고 설명한다.
- 추가 오프라인 실험은 의료 진단과 text-to-SQL을 평가하며 조건과 결과는 A.2에 제시한다.
Label이 있는 오프라인 ACE의 FiNER와 Formula 평균은 81.9이며, GEPA는 72.5다. Label이 없는 온라인 ACE는 Formula를 78.5로 개선하지만 FiNER는 기본 점수 70.7에서 67.3으로 낮춘다. 동일한 적응 절차도 작업과 피드백에 따라 도움이 되거나 해로울 수 있음을 보여준다.
4.5 GENERALIZATION ACROSS LLMS
논문은 알고리즘과 프롬프트를 유지한 채 ACE의 3가지 역할 모델을 모두 GPT-OSS-120B, GPT-5.1 또는 Llama-3.3-70B-Instruct로 교체한다. 보고된 결과는 각 기본 모델보다 개선되며, 개선 폭은 모델, 작업, 감독 조건에 따라 달라진다.
- AppWorld에서 GPT-OSS-120B는 온라인 ACE를 적용하면 34.6에서 42.2로 상승한다. GPT-5.1은 test-normal에서 54.2에서 65.8로 상승한다.
- FiNER에서 Llama-3.3-70B-Instruct는 label이 있는 오프라인 ACE를 적용하면 62.5에서 64.9로, label이 없는 온라인 ACE를 적용하면 63.6으로 개선된다.
- 이 표들에서 온라인 ACE는 AppWorld 평균이 가장 높지만 금융 표에서는 label이 있는 오프라인 ACE의 성능이 더 높다. 따라서 온라인 ACE가 모든 모델에서 가장 높은 성능을 보인다는 부록의 포괄적 주장은 작업과 감독 조건을 한정해서 해석해야 한다.
4.6 ABLATION Study and SENSITIVITY ANALYSIS
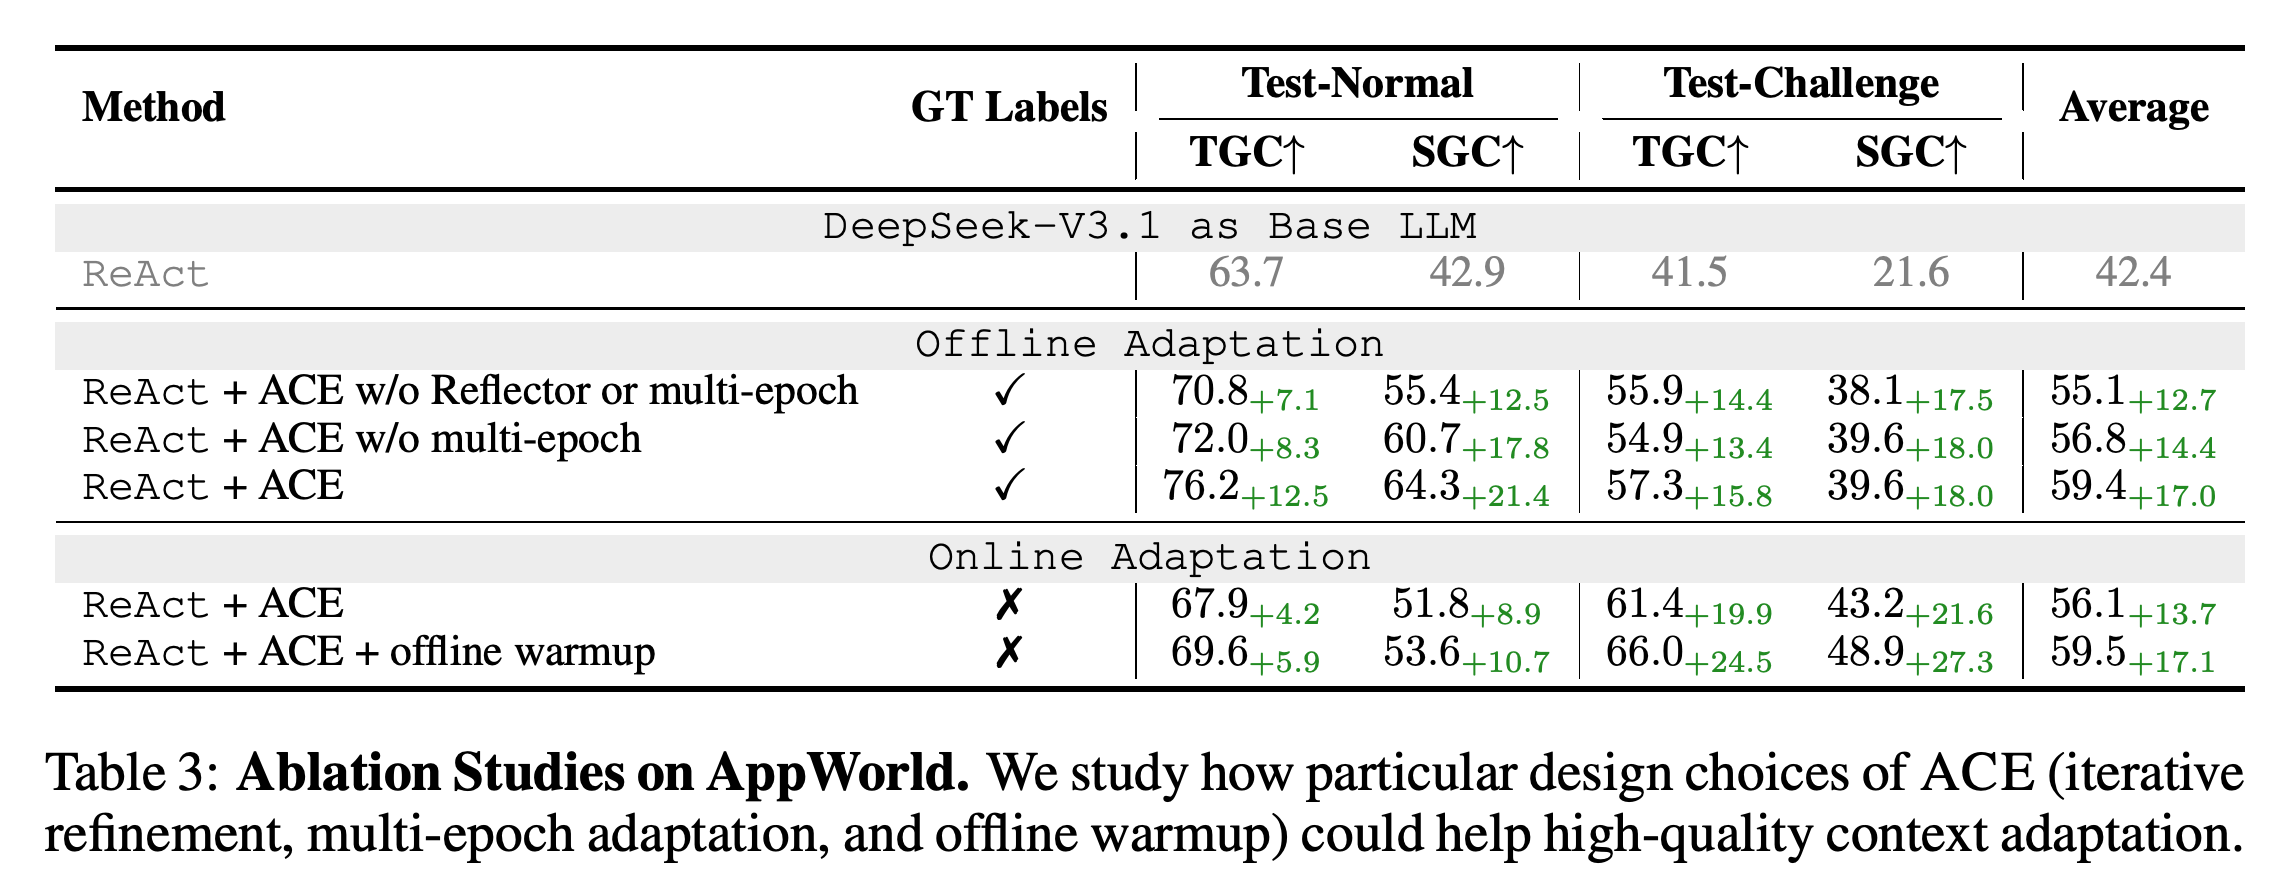
구성 요소를 제거해 기여를 측정하는 AppWorld ablation은 성찰, 여러 적응 epoch, offline warmup의 효과를 뒷받침한다. 오프라인 평균 성능은 Reflector와 여러 epoch를 모두 제외하면 55.1, 여러 epoch만 제외하면 56.8, 전체 ACE를 사용하면 59.4다. 온라인 적응 전 warmup은 평균을 56.1에서 59.5로 높인다.
- A.5는 점진적 업데이트를 직접 평가한다. Test-normal 평균 성능은 점진적 업데이트가 없을 때 56.9, 있을 때 70.3이다.
- 더 약한 Reflector를 사용하거나 간헐적으로 유해한 업데이트를 적용해도 FiNER 정확도는 기본 정확도 70.7보다 높다. 다만 모든 적응 단계에서 유해한 성찰을 적용하면 정확도가 66.7로 낮아진다.
- 적응을 제어하는 설정인 하이퍼파라미터를 시험한 결과, AppWorld 평균 성능은 성찰 5회에서 가장 높다. 컨텍스트 길이 기준을 10K에서 100K tokens까지 바꾸었을 때 FiNER 점수의 차이는 작다. 이 결과는 시험한 범위 내에서의 민감도를 보여준다.
오프라인 평균은 Reflector와 여러 epoch를 제외했을 때 55.1, Reflector는 사용하되 여러 epoch를 제외했을 때 56.8, 전체 ACE를 사용했을 때 59.4로 상승한다. Offline warmup은 온라인 평균을 56.1에서 59.5로 높이며 주요 온라인 결과의 조건을 명확히 보여준다.
4.7 COST and Speed ANALYSIS
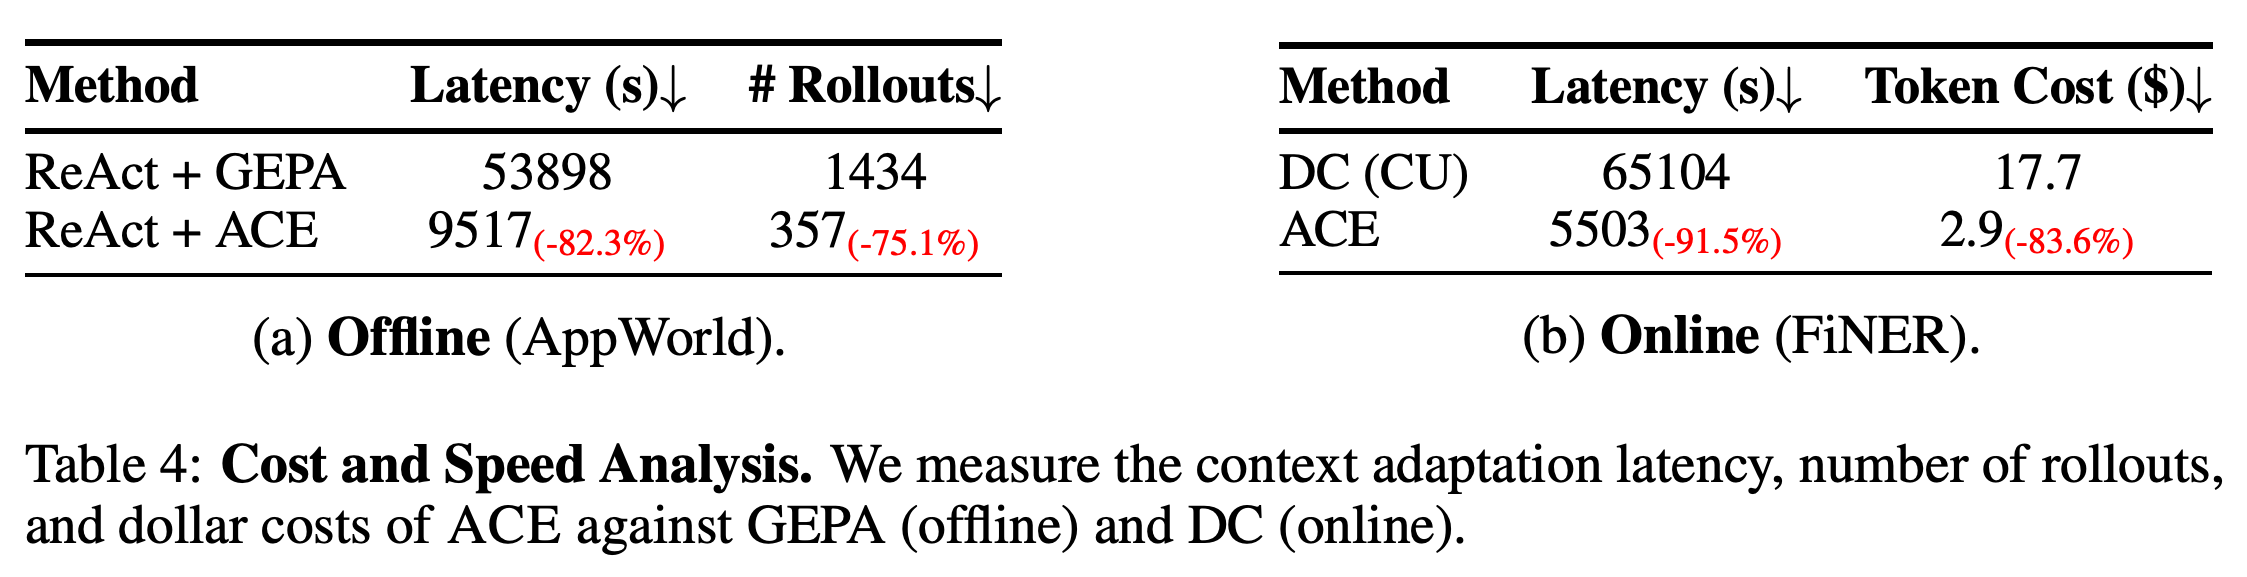
Table 4에서 오프라인 AppWorld 적응 지연 시간은 ACE가 9,517 s, GEPA가 53,898 s로 82.3% 줄어든다. Rollout은 357 대 1,434로 75.1% 줄어든다. 온라인 FiNER에서 ACE의 지연 시간은 5,503 s로 DC-CU의 65,104 s보다 짧고, 토큰 비용은 $2.9로 $17.7보다 낮다. 감소율은 각각 91.5%와 83.6%다.
- 별도의 A.3 분석은 1 epoch와 Reflector 분석 개선 1회를 사용한다. 적응 입력 토큰은 80.8%, 출력 토큰은 83.6% 적지만 ACE rollout은 2,075회로 GEPA의 1,455회보다 많다. PDF는 이 rollout 수와 Table 4의 차이를 설명하지 않는다.
- 평가에서 ACE는 원시 입력 토큰 58,623,267개를 사용하며 GEPA의 26,960,675개보다 117.4% 많다. 반면 rollout은 2,470회에서 2,354회로 줄어든다.
- GPT-5.1 프롬프트 캐싱 연구에서는 ACE 입력 토큰의 91.8%를 캐시에서 제공한다. 모든 원시 토큰에 캐시 미적용 요금을 부과하는 경우보다 청구되는 입력 토큰 비용이 82.6% 줄어든다. 이전에 계산한 attention key와 value를 재사용하는 KV cache reuse는 이러한 서빙 이점을 설명하는 데 도움이 된다. 82.6%는 GEPA 대비 비용 감소율이 아니다.
오프라인 AppWorld 적응 지연 시간은 53,898 s에서 9,517 s로, rollout은 1,434회에서 357회로 줄어든다. 별도의 온라인 FiNER 비교에서는 지연 시간이 65,104 s에서 5,503 s로, 토큰 비용이 $17.7에서 $2.9로 줄어든다. 이 측정값은 명시된 작업과 기준 방법에서의 적응에 관한 값이며 전체 서빙 비용을 나타내지는 않는다.
5 Discussion
논의에서는 경험이 축적될수록 행동을 업데이트하는 온라인 학습과 지속 학습에 컨텍스트 적응을 활용할 것을 제안한다. 사람이 읽을 수 있는 항목은 오래되거나 잘못된 특정 지식을 제거하는 selective unlearning도 가능하게 한다. 저자들은 이를 향후 연구 방향으로 논의하지만 실험으로 평가하지는 않는다.
- ACE는 모델이 작업 궤적이나 결과에서 유용한 통찰을 추출하는 능력에 의존한다. 성찰에 실패하면 잡음이 많거나 유해한 컨텍스트가 생성될 수 있다.
- 저자들은 상세한 도메인 지식, 복잡한 도구 사용, 환경별 절차가 필요한 상황을 유리한 적용 조건으로 제시한다.
- 간결한 검색 지침이나 재사용 가능한 전략 1개가 필요한 작업에서는 큰 플레이북의 효과가 작을 수 있다. 여러 출처의 근거가 필요한 질의응답 벤치마크인 HotPotQA와 고정된 전략을 사용하는 산술 게임인 Game of 24는 논의에 등장하는 예시이며 추가 ACE 평가 대상은 아니다.
Ethics Statement
윤리 성명은 구체적인 윤리 문제나 이해 상충이 없다고 선언하며 실험에 공개 벤치마크를 사용하고 인간 대상자, 민감한 데이터, 개인정보 관련 정보를 다루지 않는다고 밝힌다. 모든 실험 모델이 오픈 소스라는 설명은 확장된 GPT-5.1 실험을 반영하지 않는다.
Reproducibility Statement
저자들은 https://github.com/ace-agent/ace 에 코드를 제공하고 데이터셋, 평가 지표, 기준 방법, 하이퍼파라미터를 설명한다. 부록에는 확장 실험과 역할별 프롬프트가 포함되어 있으며 적응 절차와 실험 설정을 문서화한다.
부록
- A EXTENDED RESULTS와 A.1 GENERALIZATION ACROSS DIFFERENT LLMS는 모델별 표를 제공한다. GPT-OSS-120B의 금융 정확도 평균은 label이 있는 오프라인 ACE에서 81.2, GEPA에서 69.7이다. GPT-5.1의 평균은 각각 82.8과 73.8이다. Llama-3.3-70B-Instruct의 FiNER 개선 폭은 더 작다. GPT-5.1의 AppWorld 결과는 test-normal만 다루므로, 4개 지표를 평균한 DeepSeek-V3.1 결과와 비교하는 데 한계가 있다.
- A.2 BEYOND FINANCE: ADDITIONAL DOMAIN TASKS는 ACE와 GEPA 모두에 무작위로 추출한 학습 예제 1000개를 사용한다. GEPA는 추가로 BIRD-SQL 검증 예제 500개 또는 DDXPlus 검증 예제 372개를 사용한다. DDXPlus 정확도는 기본 모델이 75.2, GEPA가 76.4, ACE가 90.2다. BIRD-SQL 전체 점수는 같은 순서로 47.8, 52.2, 52.9지만, Moderate와 Challenging 하위 집합에서는 GEPA가 ACE보다 높다.
- A.3 FINE-GRAINED COST ANALYSIS는 ACE 1 epoch와 Reflector 분석 개선 1회를 사용해 적응과 평가를 분리한다. 적응 입력/출력 토큰 합계는 ACE가 39,250,925/307,128, GEPA가 204,076,096/1,870,188이며, rollout 합계는 각각 2,075회와 1,455회다. 질의 160개를 평가할 때 ACE는 GEPA보다 원시 입력 토큰을 더 많이 사용하고 출력 토큰도 조금 더 많이 사용한다. 따라서 서빙 비용을 해석할 때 캐싱 조건이 중요하다.
- A.4 ROBUSTNESS TO REFLECTION QUALITY는 Generator와 Curator를 DeepSeek-V3.1로 고정하고 Reflector를 바꾼다. FiNER 정확도는 GPT-OSS-120B에서 76.6, DeepSeek-V3.1에서 78.3, GPT-5.1에서 78.5이며, 기본 모델은 70.7이다. 유해한 성찰을 5, 10, 25, 50, 100단계마다 적용하면 정확도는 각각 76.1, 77.0, 77.8, 78.2, 78.2다. 모든 단계에서 성찰을 훼손하면 정확도는 66.7이다. 모순 탐지와 신뢰도가 높은 업데이트의 우선 적용을 포함한 추가 안전장치는 제안된 확장 방향이며 평가된 구성 요소는 아니다.
- A.5 ABLATION ON INCREMENTAL CONTEXT UPDATE는 AppWorld test-normal에서 오프라인 DeepSeek-V3.1을 평가한다. 점진적 업데이트가 없을 때 TGC/SGC는 67.3/46.4, 있을 때는 76.2/64.3이며, ReAct는 63.7/42.9다. 평균은 점진적 업데이트가 없을 때 56.9, 있을 때 70.3이다.
- A.6 SENSITIVITY ANALYSIS ON HYPERPARAMETER CHOICE는 성찰 반복 횟수가 1, 3, 5, 10회일 때 AppWorld test-normal 평균을 각각 61.3, 65.8, 67.6, 65.2로 보고한다. FiNER 정확도는 중복 제거 임계값이 50%, 70%, 90%일 때 각각 77.0, 73.9, 78.6이며, 가지치기 기준이 10K, 50K, 100K tokens일 때 각각 78.6, 78.4, 78.3이다. 가지치기 결과의 차이는 작지만 중복 제거 결과의 범위는 4.7%포인트다.
- B EXTENDED RELATED WORK와 B.1 AGENT MEMORY는 ACE를 지속적으로 발전하는 에이전트 메모리인 AgentFly, 궤적에서 재사용 가능한 루틴을 추출하는 Agent Workflow Memory(AWM), 연결되고 구조화된 메모리 항목을 사용하는 A-MEM, 재사용 가능한 계획을 캐시하는 Agentic Plan Caching과 함께 설명한다. ACE가 제시하는 적용 범위에는 에이전트 메모리뿐 아니라 시스템 프롬프트와 사실 근거도 포함되며, 정확도, 지연 시간, 비용을 평가한다.
- C EXTENDED DISCUSSIONS는 C.1 ACE VS. GEPA와 C.2 ACE VS. DYNAMIC CHEATSHEET (DC)에서 업데이트 표현 방식을 비교한다. GEPA는 전체 프롬프트 후보를 발전시키고 선택하며 DC는 cheatsheet를 재작성하고 ACE는 국소적 추가 항목을 생성해 항목별로 구성된 플레이북에 병합한다. C.2에서 점진적 업데이트를 제거했을 때 보고한 TGC 11.7% 감소와 SGC 27.8% 감소는 Table 18의 76.2에서 67.3, 64.3에서 46.4로의 상대적 감소율이며 %포인트 차이가 아니다.
- D APPWORLD LEADERBOARD SNAPSHOT (09/2025)는 IBM CUGA를 참고 대상으로 비교할 때 사용한 과거 leaderboard를 기록하며 https://appworld.dev/leaderboard 에서 확인할 수 있다. E THE USE OF LARGE LANGUAGE MODELS (LLMS)는 LLM을 실험과 원고 문장 다듬기에 사용했으며 원고를 처음부터 생성하는 데 사용하지 않았다고 밝힌다.
- F PROMPTS는 ICL, DC, GEPA, ACE의 AppWorld 프롬프트를 제시하고 이어서 캡션에 FINER용으로 명시된 ACE Generator, Reflector, Curator 프롬프트를 제공한다. 템플릿은 플레이북 삽입, 실행 피드백이나 ground truth를 이용한 진단, helpful/harmful/neutral 항목 태그, 새 항목을 만드는 구조화된 ADD 연산을 명시한다. 이를 통해 역할 간 정보 전달과 전체 플레이북 재생성 없이 내용을 추가하는 방식을 문서화한다.
짧은 생각
가장 분명한 기여는 컨텍스트 업데이트의 표현 방식이다. 각 항목을 독립적으로 지정하는 방식은 점진적 업데이트 제거 실험에서 직접적인 근거를 얻으며 동일한 모델을 사용한 주요 기준 방법 비교도 유용한 정보를 제공한다. 실험 결과는 반복 가능한 절차와 관찰 가능한 결과가 있는 작업에서 효과적인 적응이 가능함을 뒷받침한다. Label이 없을 때 FiNER 성능이 저하된다는 점은 피드백 품질이 구현의 핵심 고려 사항임을 보여준다.
효율성을 평가하려면 적응과 서빙을 별도로 집계해야 한다. Table 4에서는 rollout이 줄지만 A.3에서는 늘고, 평가에서는 원시 입력 토큰을 훨씬 더 많이 사용한다. 캐싱 이점은 보고된 서빙 설정에 의존한다. 제시된 결과 표에는 불확실성 구간이나 반복 실행 간 변동이 없어, 작은 점수 차이를 평가하는 데 한계가 있다.