


Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model 요약 설명
21 Oct 2025 | Paper Review Reinforcement Learning With Verifiable Rewards Mixture-of-Experts Rollout Infrastructure목차
이번 글에서는 Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 21일(Arxiv)
- Ling Team, Shen, Anqi, Li, Baihui, Hu, Bin, Jing, Bin, Chen, Cai, Huang, Chao, Zhang, Chao, Yang, Chaokun, Lin, Cheng, et al.
- Inclusion AI
- 논문 링크
- Github
요약
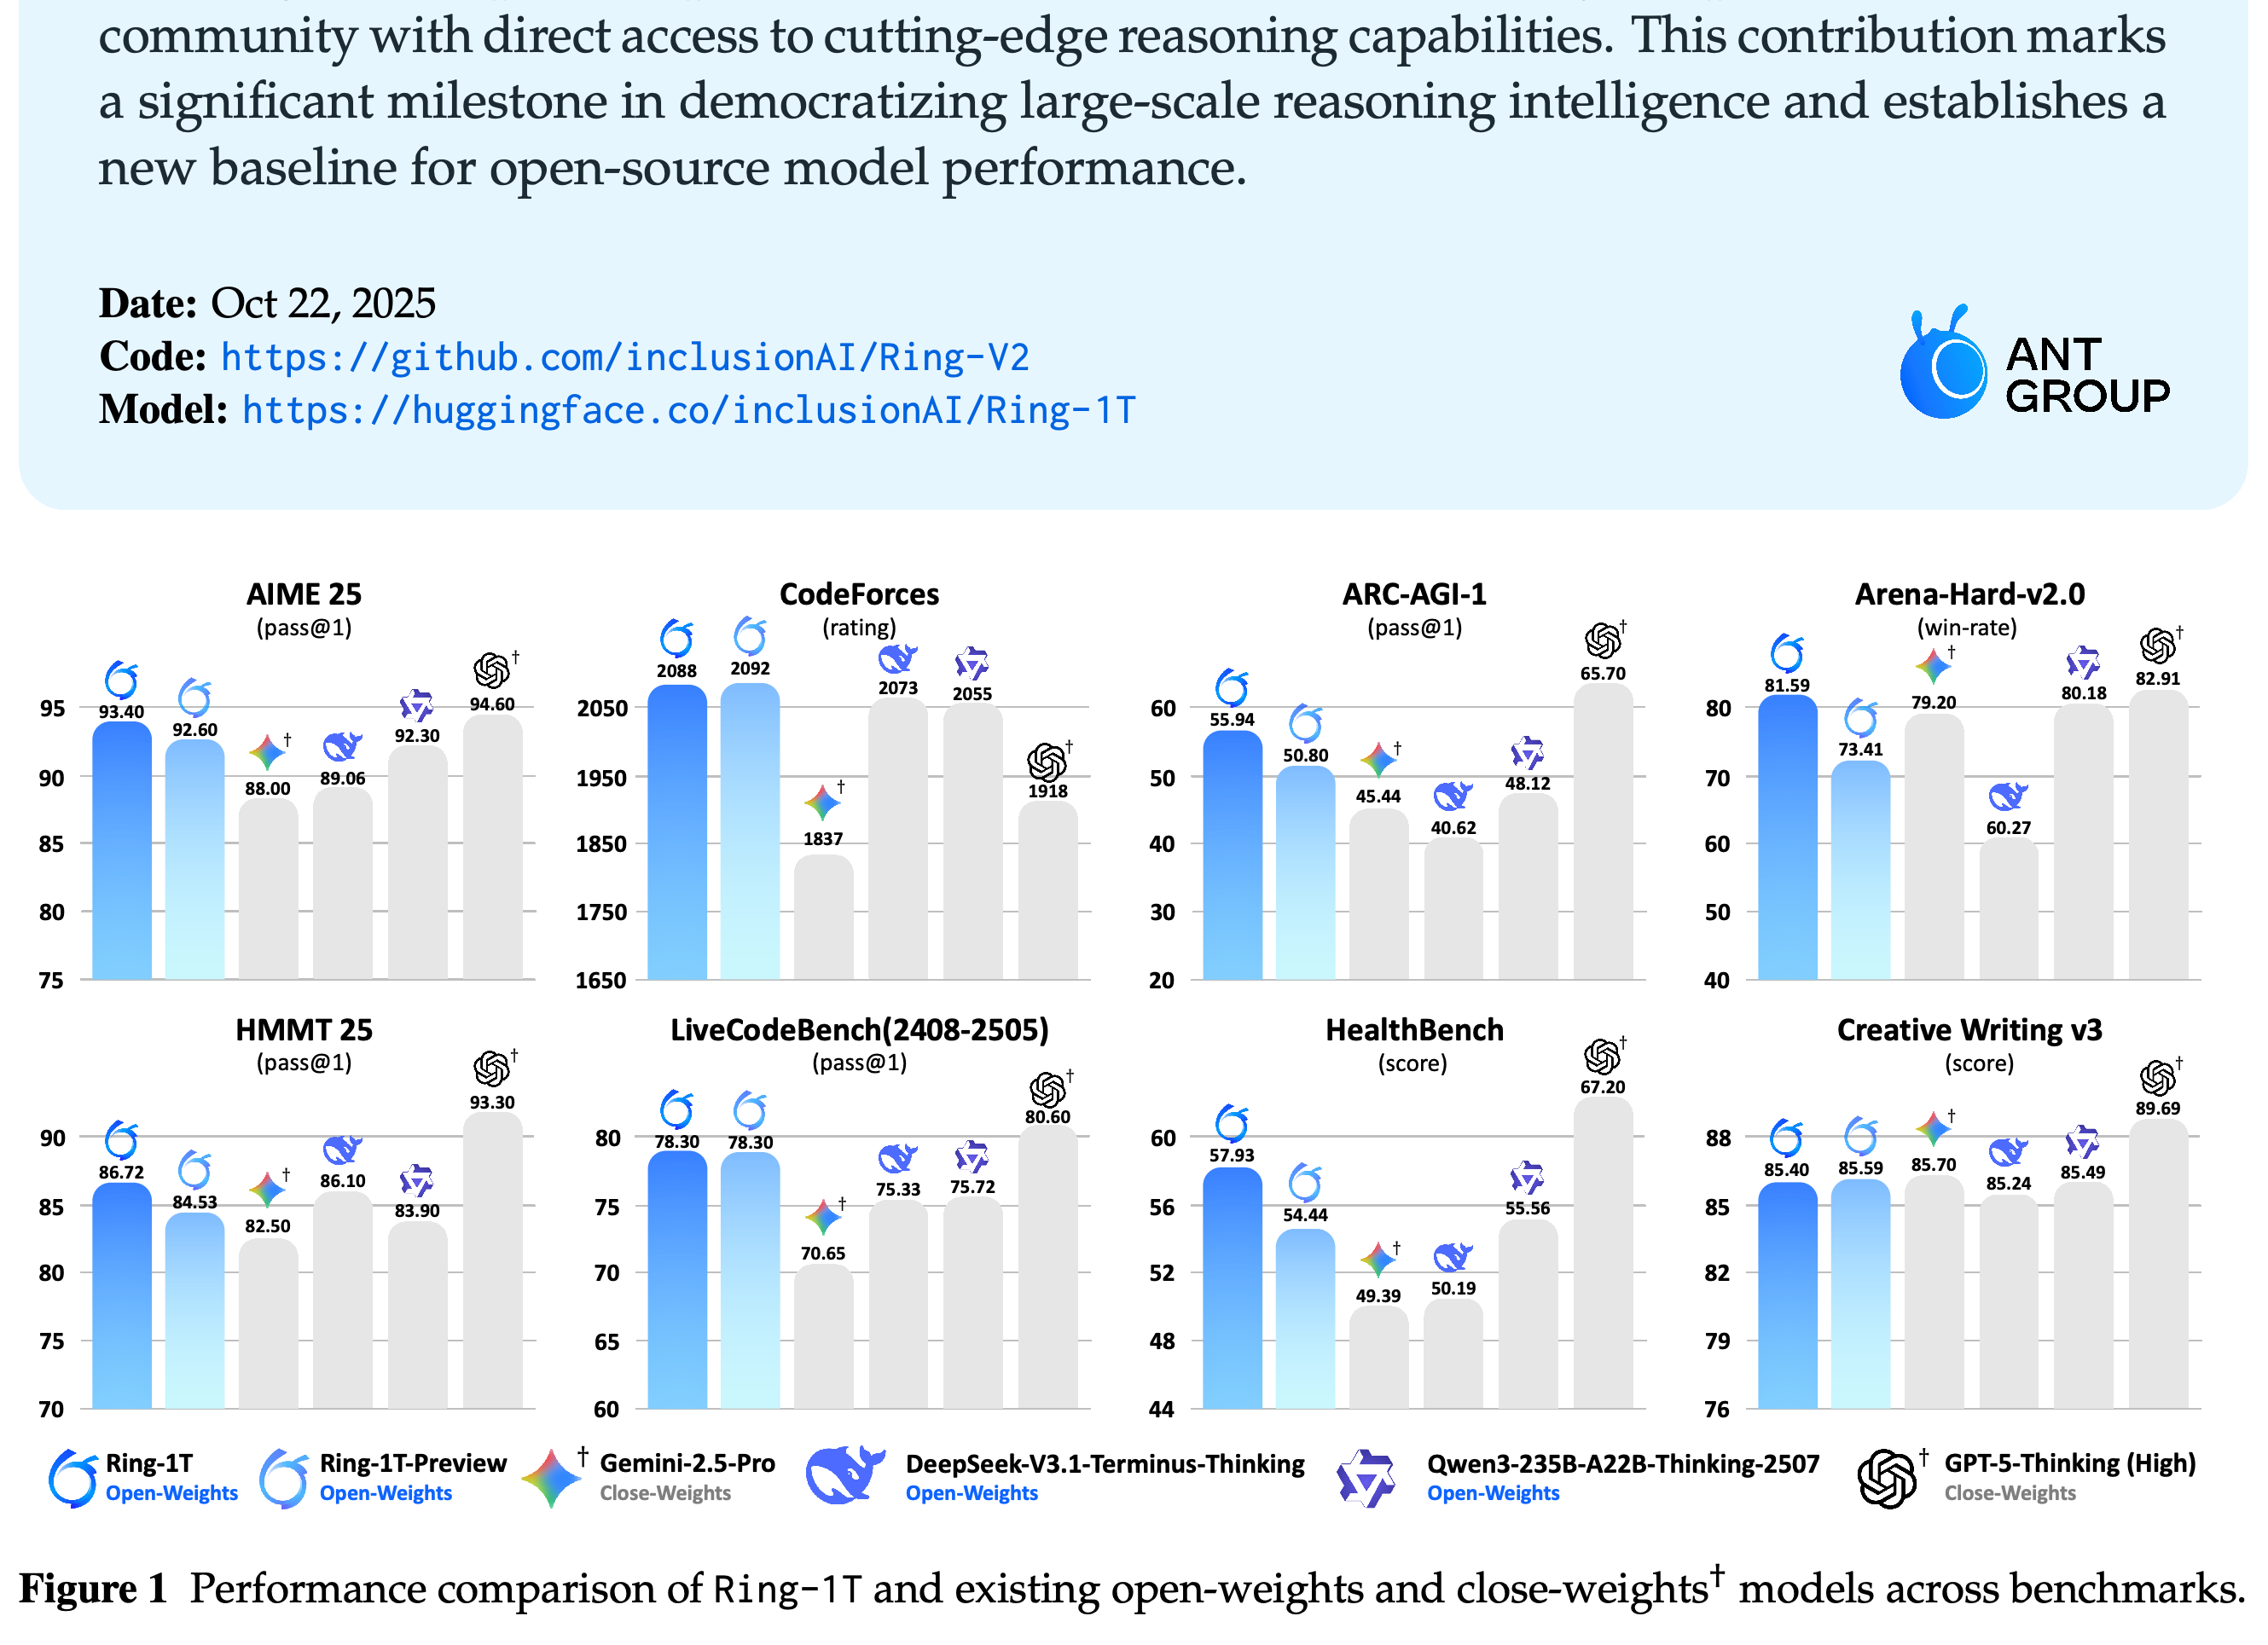
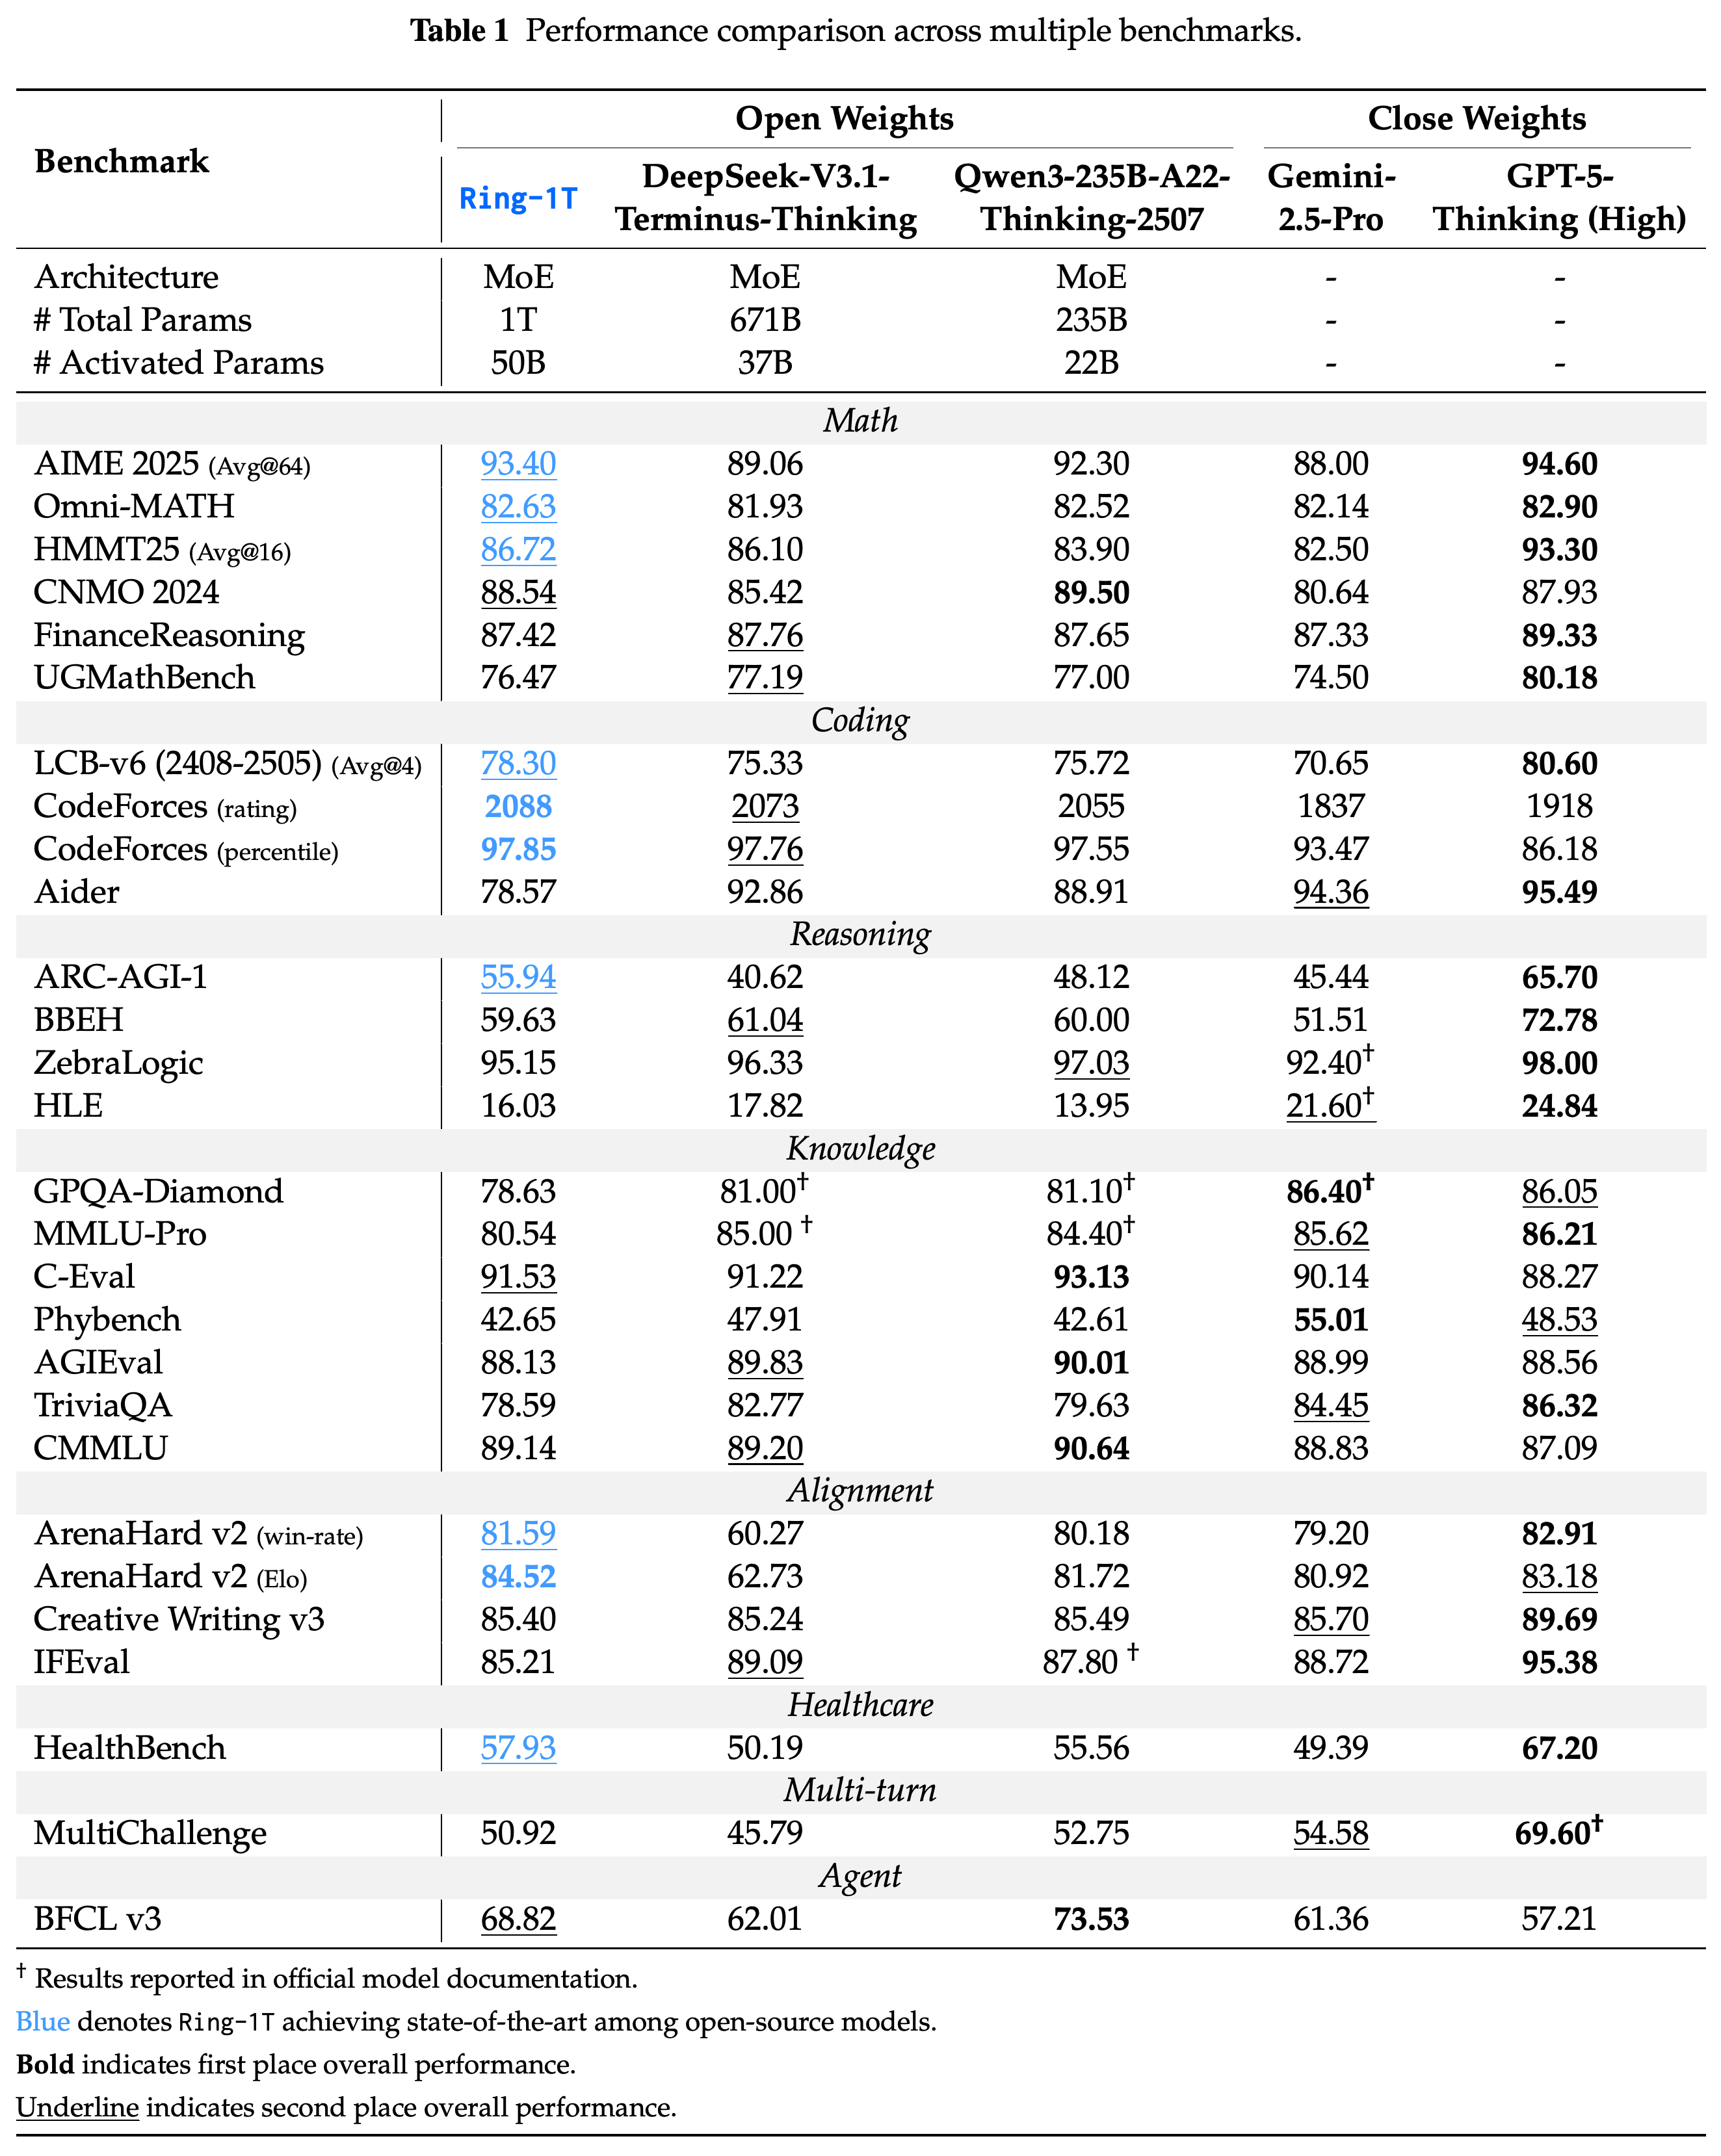
- Every Step Evolves: Scaling Reinforcement Learning for Trillion-Scale Thinking Model은 보상을 부여한 모델 출력으로 학습하는 강화학습을 1 trillion-parameter 추론 모델에 적용할 때 발생하는 불안정한 업데이트와 느린 응답 생성 문제를 다룬다. Table 1의 Avg@64 비교에서 Ring-1T는 수학 경시대회 벤치마크인 AIME 2025에서 93.40을 기록한다. Qwen3-235B-A22B-Thinking-2507은 92.30, GPT-5-Thinking (High)는 94.60을 기록한다. 이 비교는 샘플링한 응답 64개의 결과를 평균하며 기준 모델의 재현 점수와 공식 점수가 모두 있으면 더 높은 점수를 사용한다.
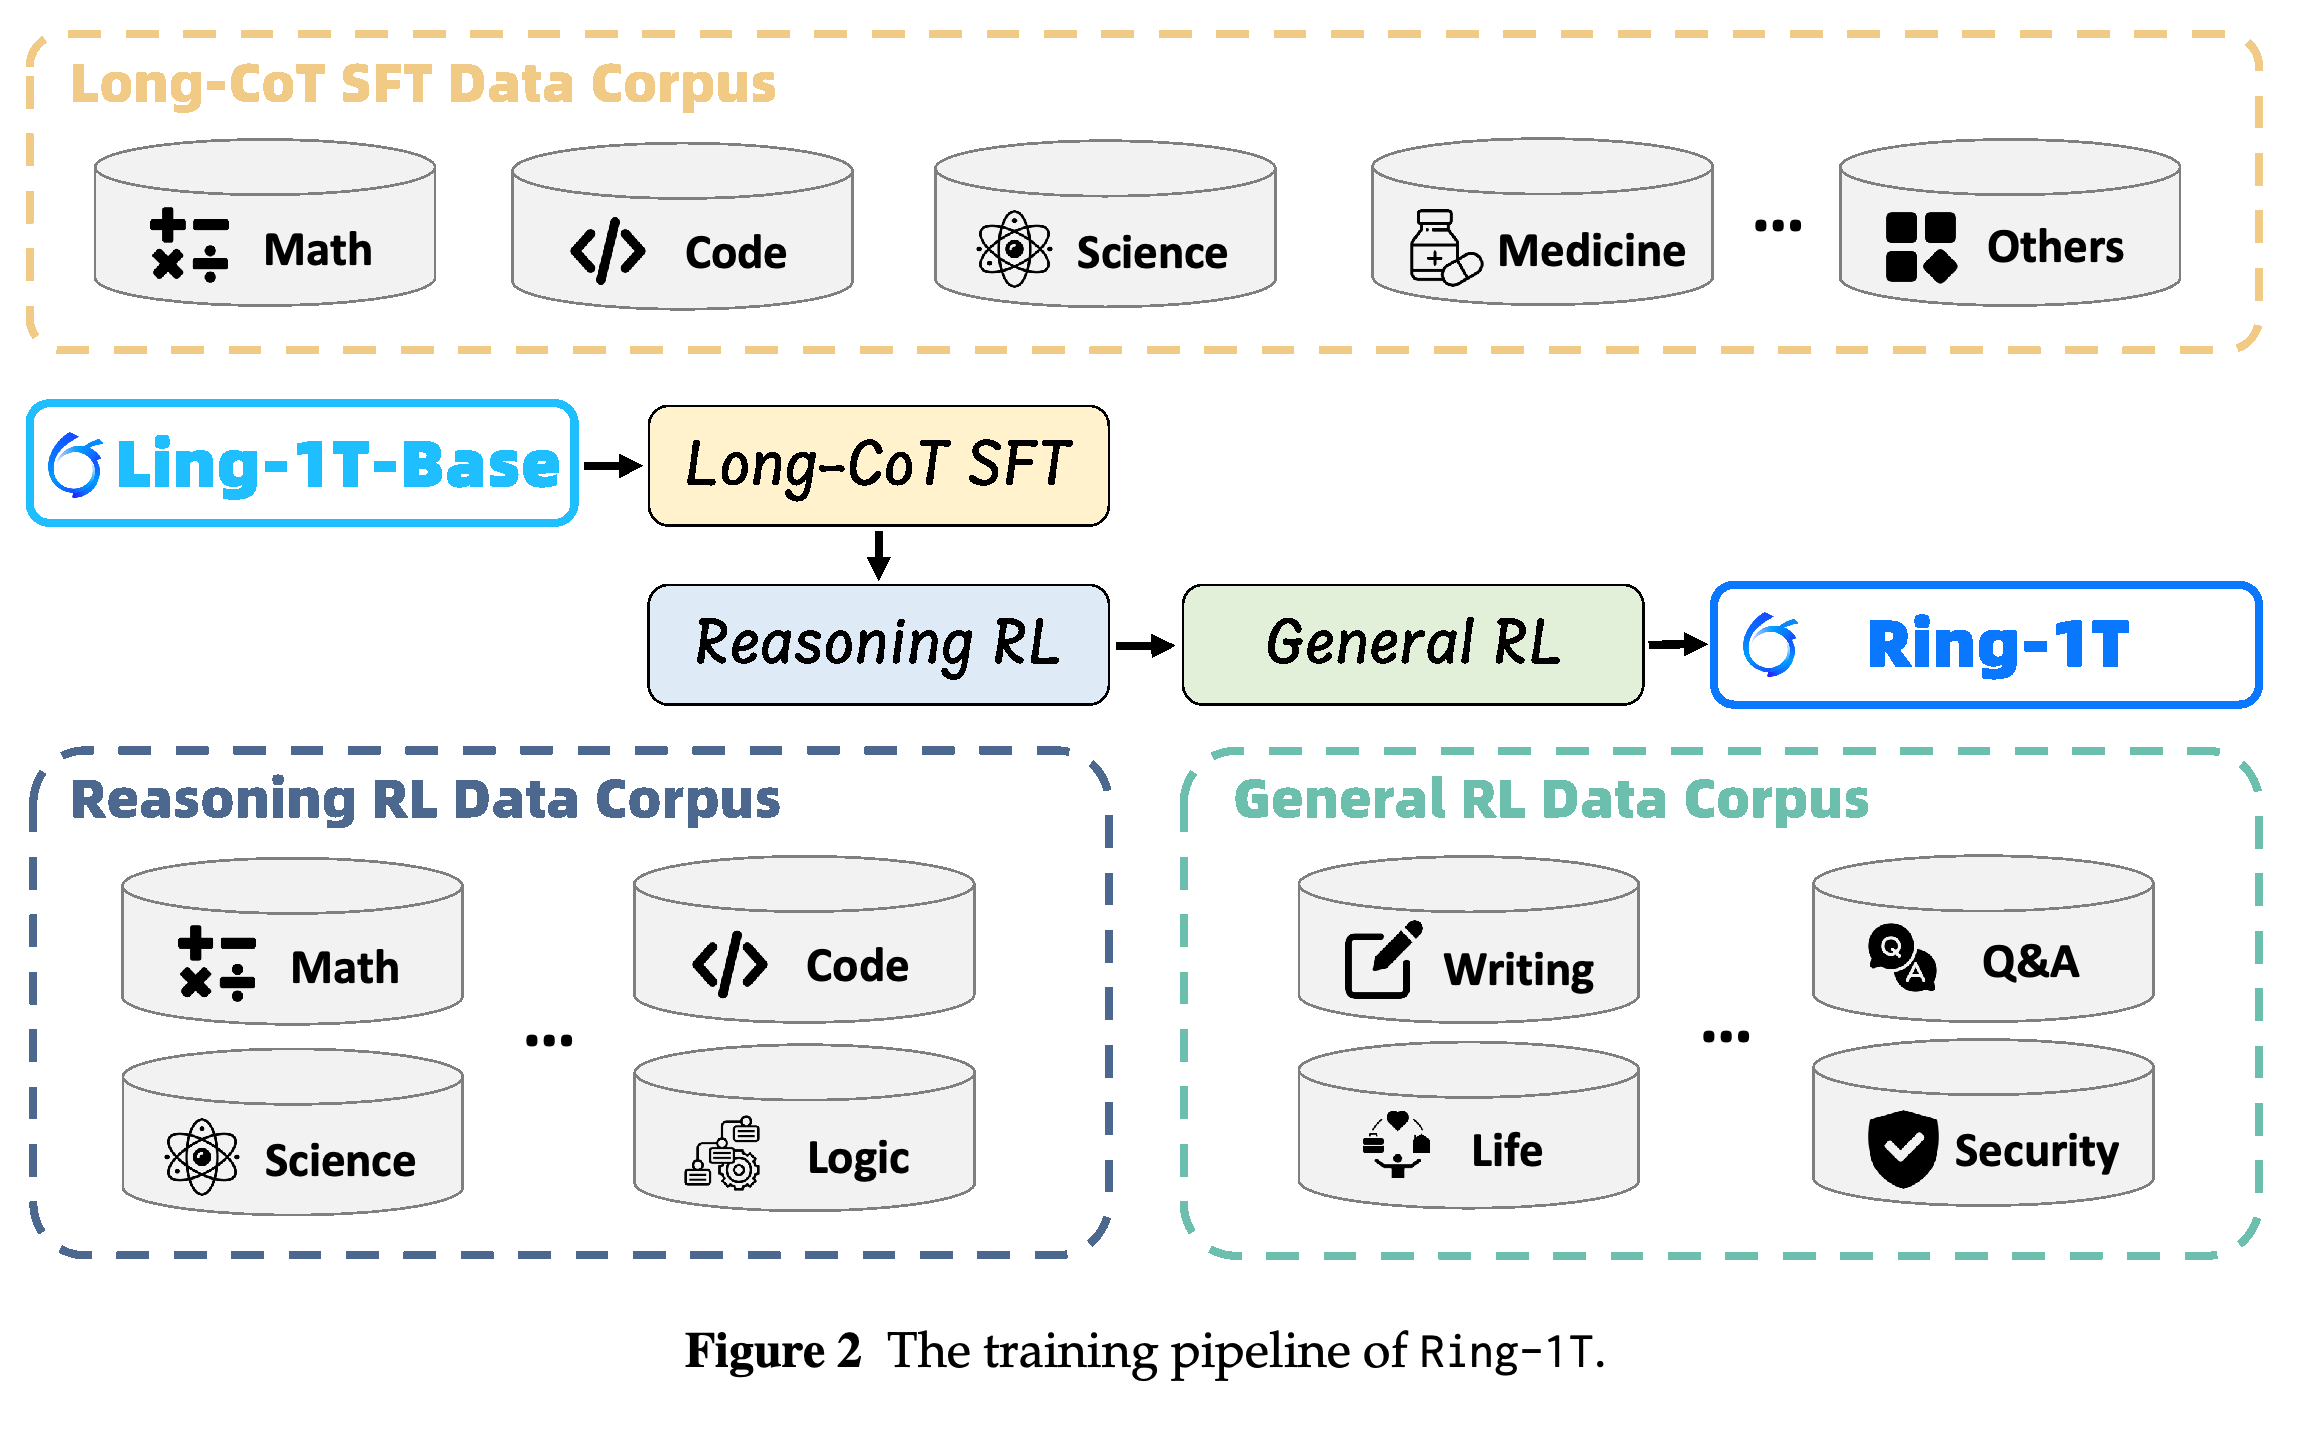
- Ring-1T의 전체 파라미터 수는 1 trillion이며, Mixture-of-Experts (MoE) 아키텍처를 통해 토큰마다 약 50 billion의 파라미터를 활성화한다. MoE는 각 토큰을 선택된 전문가 모듈로 전달한다. 학습은 긴 추론 시퀀스에 대한 지도학습, 검증 가능한 결과를 보상으로 사용하는 추론 강화학습, 인간 피드백을 반영하는 일반 강화학습으로 구성된다.
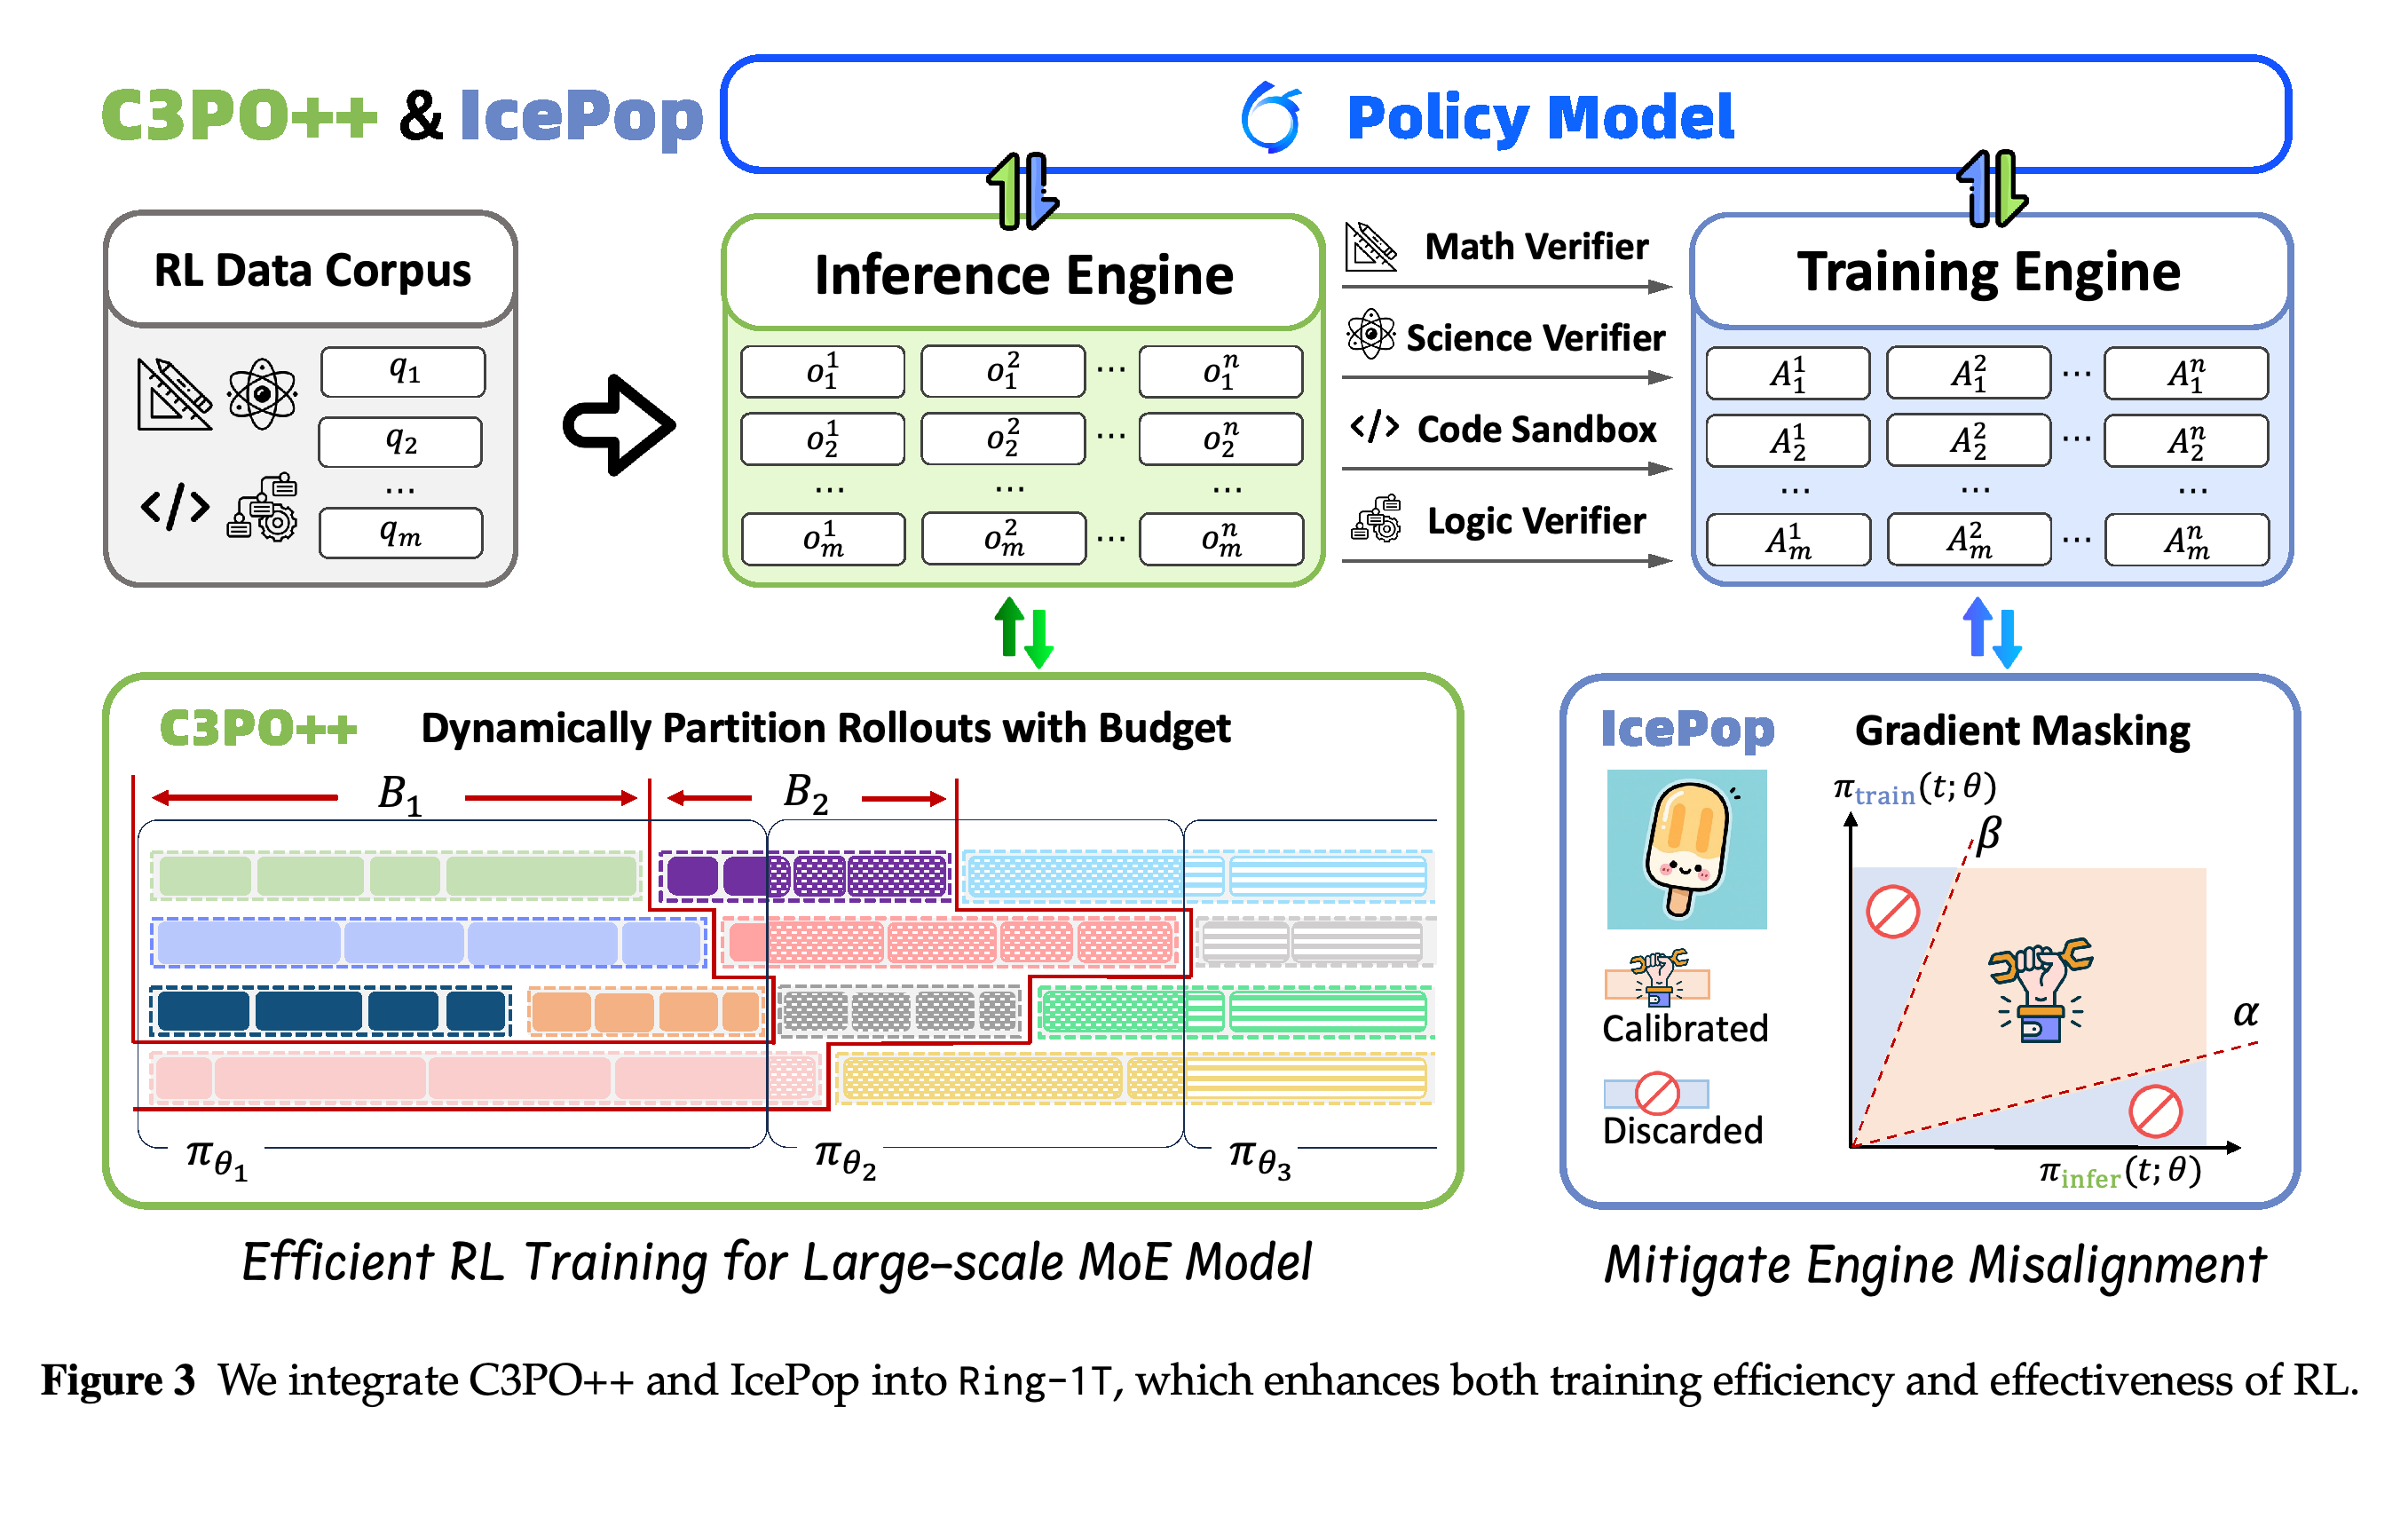
- IcePop은 학습 엔진과 추론 엔진이 부여하는 확률이 지나치게 다르면 해당 토큰의 업데이트를 억제한다. C3PO++는 토큰 예산에 따라 생성된 응답 경로인 rollout을 여러 정책 업데이트에 걸쳐 분할한다. 논문은 이 분할 기법이 없는 기준 설정과 비교해 rollout 속도 향상을 약 2.5 times, 단계당 전체 실행 속도 향상을 약 1.5 times로 보고하며 측정한 벤치마크 성능은 비슷했다고 보고한다.
- Ring-1T는 경쟁 프로그래밍 플랫폼인 CodeForces에서 레이팅 2088을 기록하고 시각적 패턴 추론 벤치마크인 ARC-AGI-1에서 55.94를 기록한다. 또한 다중 에이전트 프레임워크인 AWorld에서 International Mathematical Olympiad (IMO) 2025 문제 4개를 첫 시도에 해결한다. 소프트웨어 편집, 지식, 지시 이행, 다중 턴 평가에서는 상대적으로 낮은 점수를 보여 역량이 고르지 않음을 드러낸다.
1 Introduction
서론은 학습 불안정성과 계산 비용을 파라미터 1 trillion개를 갖춘 추론 모델의 장애 요인으로 제시한다. Ring-1T는 Ling 2.0 아키텍처를 사용하는 Ling-1T-base에서 출발한다. 보고서는 서로 연결된 기여를 제시한다. IcePop은 학습과 추론 사이의 확률 불일치를 다루고, C3PO++는 긴 응답의 생성을 스케줄링하며 ASystem은 분산 학습 인프라를 제공한다.
Ring-1T는 일부 수학, ARC-AGI-1, 선호 정렬, 의료 과제에서 나열된 다른 open-weights 모델보다 높은 점수를 기록한다. GPT-5-Thinking (High)는 해당 패널에서 더 높은 점수를 기록한다. Ring-1T-Preview의 CodeForces 레이팅은 2092로 Ring-1T의 2088보다 높으므로, 이 개요는 모든 모델을 아우르는 최고 레이팅 주장을 뒷받침하지 않는다.
2.1 Training Pipeline
제안한 방법은 3단계로 구성된다. 먼저 긴 단계별 추론 경로를 지도학습하는 Long Chain-of-Thought Supervised Fine-Tuning (Long-CoT SFT)을 수행한 뒤, 추론 강화학습과 일반 강화학습을 진행한다. 보고서는 주로 강화학습 구성 요소에 초점을 맞춘다.
- 추론 학습에는 Reinforcement Learning from Verifiable Rewards (RLVR)를 사용하며 수학, 코드, 과학, 논리에 특화된 검증을 통해 보상을 제공한다.
- 일반 학습에는 인간 선호를 반영하는 Reinforcement Learning from Human Feedback (RLHF)을 사용해 지시 이행, 글쓰기, 안전성, 사용성을 개선한다.
도식은 긴 추론 패턴의 학습, 보상 기반 추론 개선, 후속 선호 정렬을 구분한다. 각 단계에 서로 다른 데이터 코퍼스가 투입되며, 최종 모델이 전체 학습 파이프라인을 결합한 결과임을 보여준다.
2.2 Long-CoT SFT
Long-CoT SFT의 질문은 공개 저장소, 전문가가 작성한 질문, 대규모 언어 모델인 large language models (LLMs)에서 수집한다. 여기서 LLMs는 학습 예시를 합성하는 언어 생성 모델로 사용된다. 정제 과정에서는 정확히 일치하는 중복을 제거하고 유해 콘텐츠를 필터링한다. 또한 해싱과 정확한 문자열 일치로 평가 문제와 겹치는 학습 예시를 제거해 벤치마크 오염을 방지하고 제어 코드와 불필요한 Unicode 문자가 포함된 저품질 예시를 걸러낸다.
- 본문은 데이터 구성을 Mathematics 46%, 과학, 기술, 공학, 수학을 뜻하는 STEM 26%, Code 20%, Others 8%로 보고한다. Appendix D에는 이와 다른 세부 비율이 제시된다.
- 시퀀스를 64k 길이로 패킹하고 3 epochs 동안 학습한다. 학습률은 2 × 10⁻⁴이며, 학습률을 점진적으로 낮추는 cosine decay, 30단계의 warmup, 파라미터 정규화 설정인 weight decay 0.1을 사용한다.
2.3 Large-Scale Reinforcement Learning
대규모 강화학습은 불안정한 업데이트를 다루는 알고리즘과 생성 및 학습 인프라를 결합한다. IcePop은 엔진 간 불일치를 제어하고 C3PO++는 긴 응답 경로를 관리하며 ASystem은 Ring-1T 규모에서 이들을 실행하도록 지원한다.
2.3.1 RL Data
RL 데이터는 수학, 코드, 과학, 논리, 일반 과제를 포함한다. 수학 문제는 검증 가능한 풀이를 요구하고 코드 문제에는 합성한 뒤 검증한 테스트 케이스를 제공한다. 과학 질문은 객관식에서 개방형으로 변환하며 분자 이미지는 구조화된 텍스트로 변환한다.
- 논리 데이터에는 예시에서 변환 규칙을 추론하는 시각적 패턴 귀납, Sudoku 격자 퍼즐, 미로 경로 탐색, 산술 추론을 위한 24 Game, 명제 논리를 위한 Knights and Knaves가 포함된다. 생성 및 후처리 검증으로 문제를 풀 수 있고 지나치게 단순하지 않도록 한다.
- 일반 데이터는 공개 데이터셋, 인간 선호 기록, 실제 사용자 상호작용, Zhihu와 StackOverflow의 질문을 결합한다.
- 파싱, 질문 재구성, 중복 제거, 모델 기반 점수 평가, 규칙 기반 지표로 데이터를 선별한다. 샘플 메타데이터는 동적 샘플링과 도메인 간 혼합을 지원한다.
2.3.2 IcePop: Discard All Noisy Gradient Updates
IcePop은 별도의 학습 엔진과 추론 엔진 사이에 발생하는 확률 차이를 다룬다. 이 차이는 동적인 전문가 라우팅과 긴 추론 시퀀스로 인해 증폭될 수 있다. IcePop은 논문에서 기준으로 사용하는 그룹 기반 정책 최적화 기법인 GRPO를 수정한다. 학습 확률과 추론 확률의 비율로 토큰 업데이트에 가중치를 부여하고 지정한 구간을 벗어나는 업데이트를 버린다.
- 보정 비율은 k = π_train(a; θ_old) / π_infer(a; θ_old)이다. 여기서 2개의 확률은 이전 파라미터에서 학습 엔진과 추론 엔진이 각각 계산한다. 마스크는 k ∈ [α, β]일 때 M(k) = k이며, 그 외에는 0이다.
- 목적함수는 업데이트에 사용하는 확률 비율을 제한하는 정책 업데이트 클리핑 항과 분포 차이를 측정하는 참조 정책의 Kullback–Leibler (KL) 발산 항을 유지한다. 보고된 강화학습 설정에서 후자의 계수는 0.0이다.
- 불일치 누적 정리는 조건부로 성립한다. Appendix B는 매끄러움, 편향의 방향 일치, 제한된 on-policy 변화, 국소 기울기 상한을 요구하며 불일치가 임계값을 넘을 때만 곱셈적 증가를 보인다.
C3PO++는 여러 업데이트에 걸쳐 응답 경로 생성을 스케줄링하고 IcePop은 엔진 간 확률 비율에 따라 어떤 토큰 업데이트가 기울기에 기여할지 제어한다. 공유 정책과 별도의 엔진은 생성 스케줄링과 업데이트 보정의 역할을 구분해 보여준다.
2.3.3 C3PO++: Dynamically Partition Rollouts with Budget
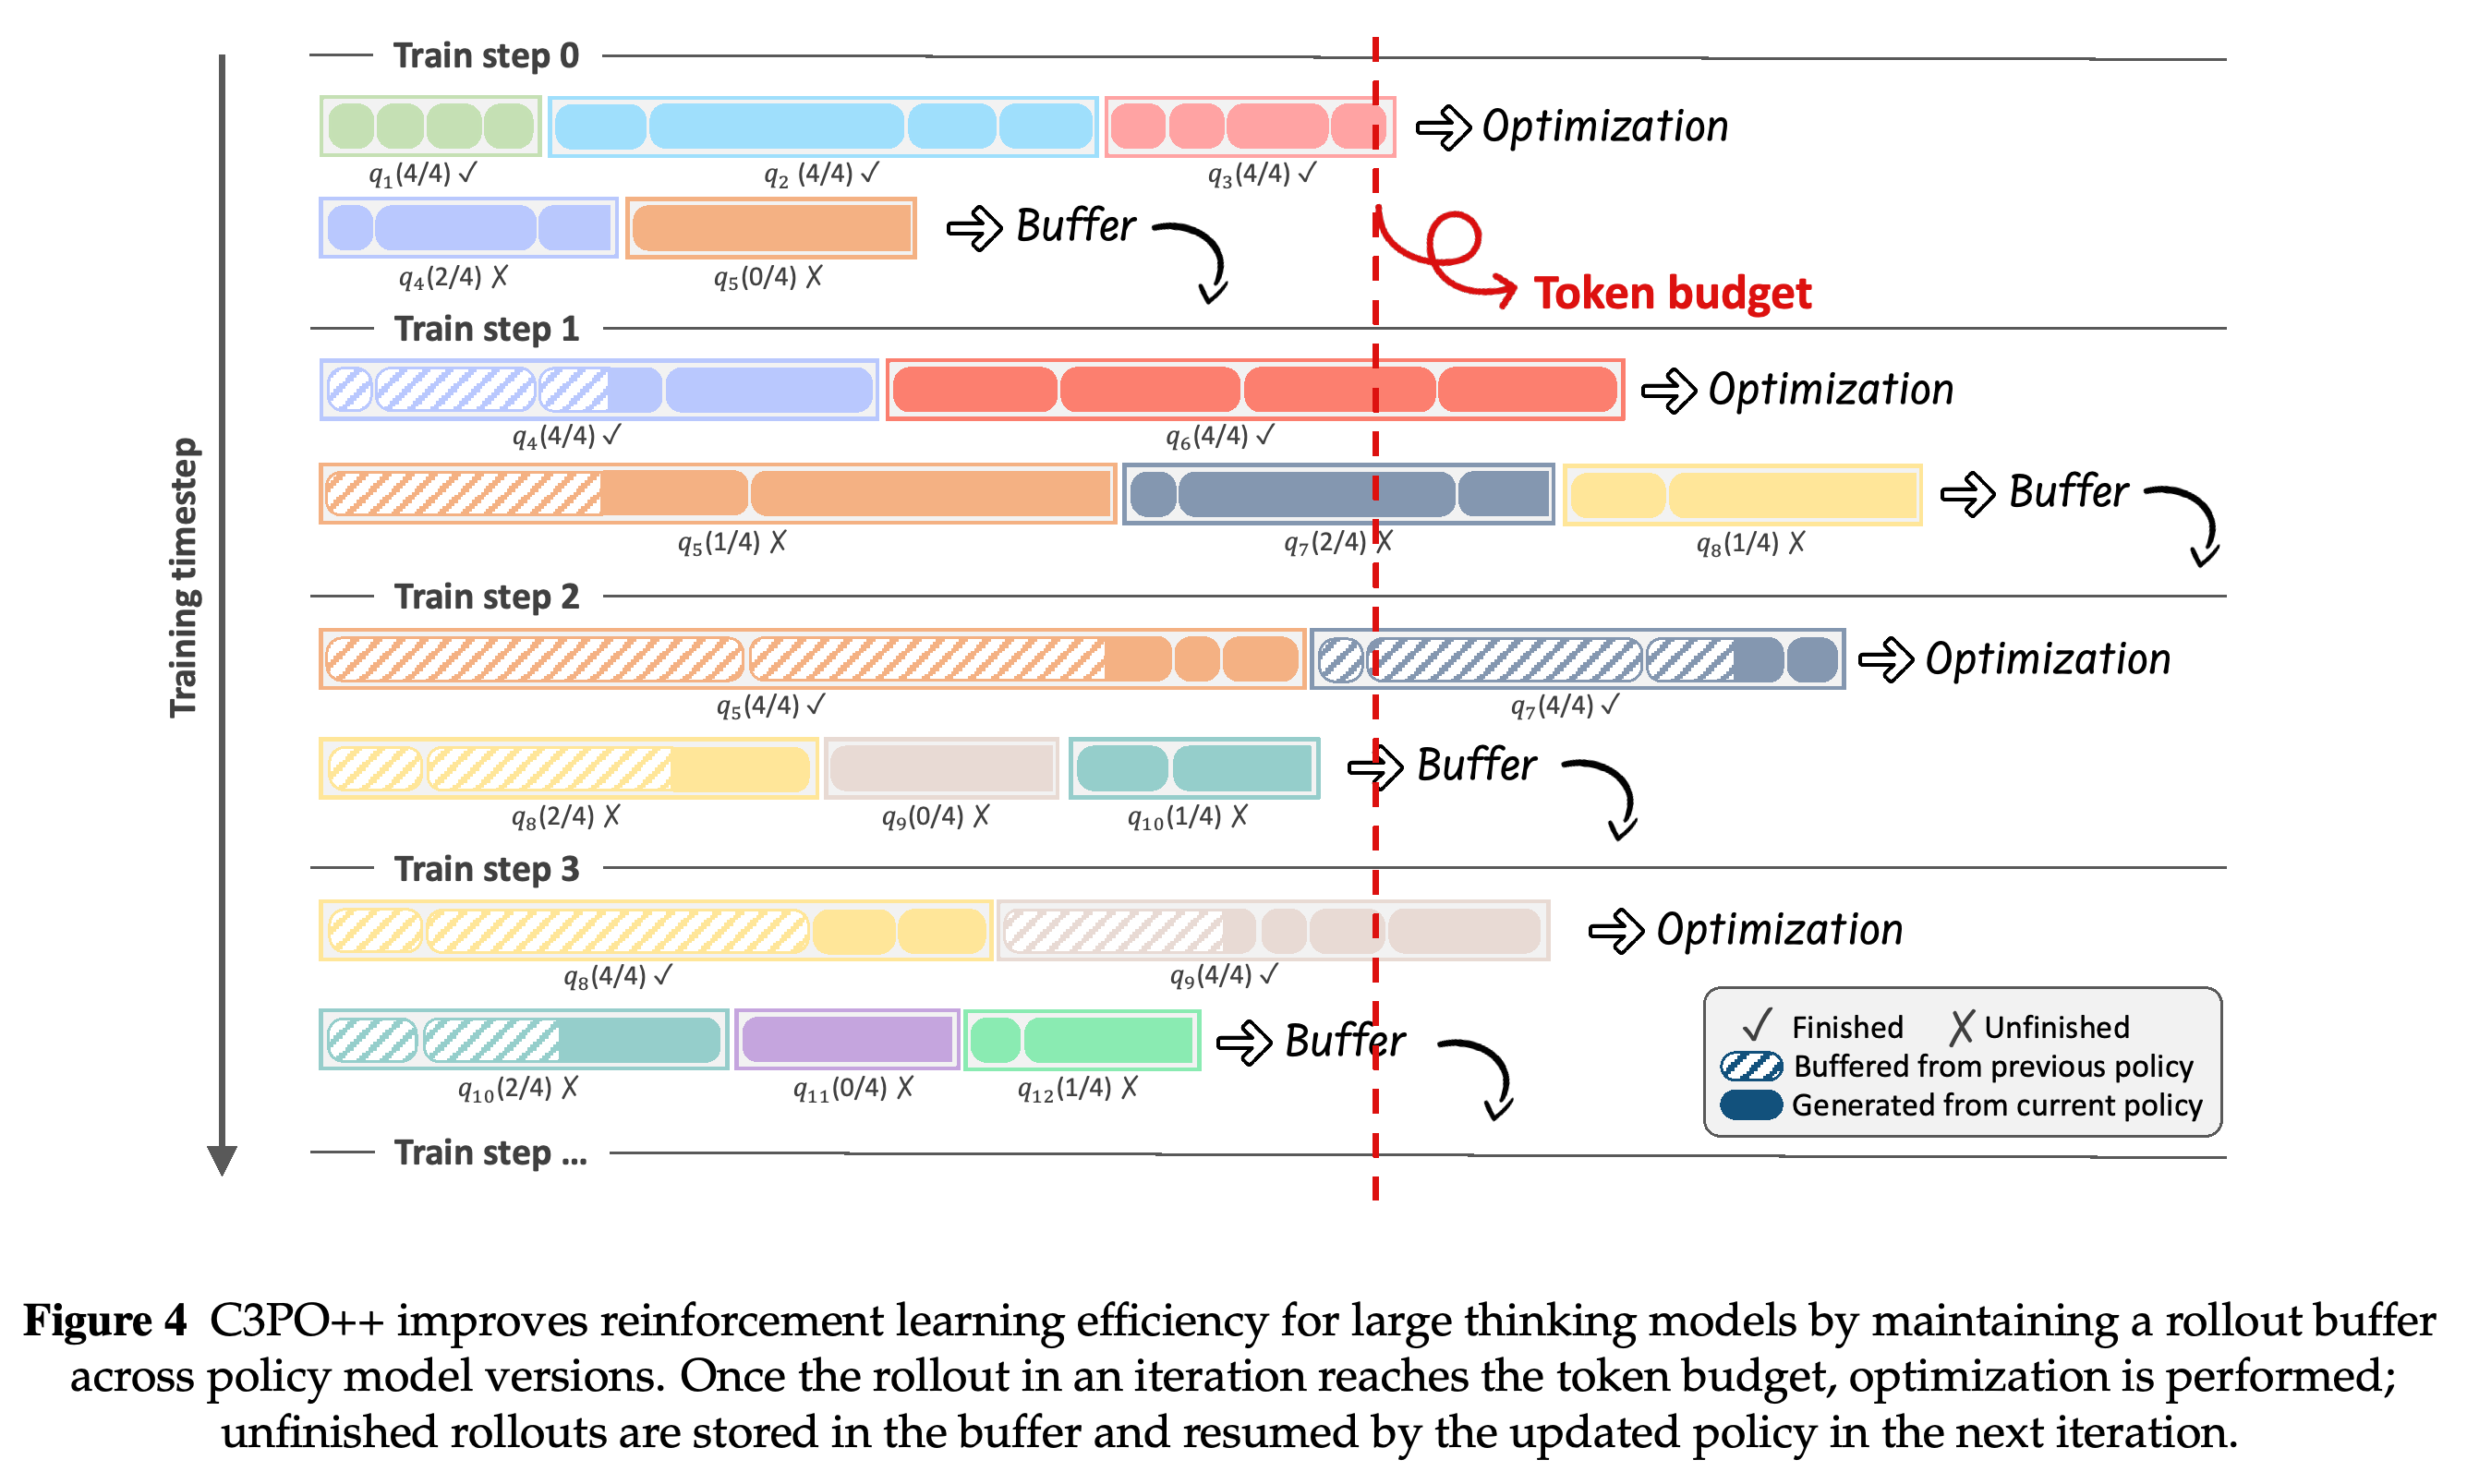
C3PO++는 병렬 응답 생성을 위한 추론 풀과 완료된 응답 경로를 위한 학습 풀을 유지한다. 완료된 경로의 토큰 수가 예산 Φ에 도달하면 모델을 업데이트한다. 미완료 경로는 버퍼에 남아 있다가 업데이트된 정책으로 생성을 재개한다.
- Algorithm 1은 각 완료 경로의 전체 길이를 토큰 카운터에 더한다. 따라서 실제 운용에서 예산은 완료된 학습 경로를 기준으로 계산된다.
- 보존 기간은 미완료 경로가 거친 분할 횟수를 센다. 임계값 σ를 초과한 경로는 제거하고 새 프롬프트로 추론 용량의 빈자리를 채운다.
- 완료된 응답에는 이전 정책 버전이 생성한 구간이 포함될 수 있으므로, 이 방법은 파라미터 업데이트를 거치면서도 응답 경로를 재사용한다.
빗금으로 표시된 버퍼 구간은 학습 단계가 바뀌어도 유지되며, 더 새로운 정책 버전이 생성을 완료한다. 학습은 완료된 응답을 사용해 진행하고 미완료 응답은 이후 생성을 이어갈 수 있도록 남겨둔다. 그 결과 여러 정책 버전이 생성한 구간을 포함하는 응답 경로가 만들어진다.
2.3.4 Training Recipe
모든 정책 최적화는 ASystem과 파라미터 업데이트 옵티마이저인 AdamW를 사용한다. β₁ = 0.9, β₂ = 0.999, weight decay 0.01을 적용하고 전문가를 선택하는 모듈의 설정인 MoE router bias를 고정한다. 추론 강화학습은 α = 0.5, β = 5인 IcePop과 C3PO++를 함께 사용한다. 학습률은 2 × 10⁻⁶, KL 계수는 0.0이며, 생성의 무작위성을 조절하는 sampling temperature는 1.0이다.
- 추론 학습의 각 단계는 서로 다른 프롬프트 480개를 사용하며 프롬프트당 rollout 8개를 생성한다. 최대 길이는 65,536토큰이다.
- 일반 강화학습은 GRPO, 학습률 3 × 10⁻⁶, KL 계수 0.0, temperature 1.0을 사용한다. 각 단계는 서로 다른 질문 80개에 대해 각각 출력 8개를 생성하며 최대 길이는 32,768토큰이다.
2.4 Experiments and Analysis
실험 및 분석에서는 벤치마크 학습 곡선과 학습 진단으로 IcePop을 평가하고 실행 시간, 보상, 벤치마크 비교로 C3PO++를 평가한다. 이 실험들은 업데이트 안정성과 rollout 효율을 각각 다루며, 전체 파이프라인 구성 요소 사이의 모든 상호작용을 분리해 평가하지는 않는다.
2.4.1 IcePop
IcePop의 예비 비교에는 전체 파라미터가 16.8B이고 활성 파라미터가 0.75B인 MoE 모델 Ring-mini-2.0을 사용하며 모든 설정에 동일한 학습 데이터셋을 적용한다. α = 0.5, β = 5인 IcePop, 권장 설정을 적용한 TIS, KL 항을 제외한 기본 GRPO를 비교한다. TIS는 엔진 간 불일치를 보정하기 위해 업데이트의 가중치를 조정하는 중요도 샘플링 기법이다.
- IcePop의 AIME25 Avg@64 곡선은 약 63에서 약 77로 상승해 약 14%포인트 개선된다. 논문은 최종 점수에서 TIS와의 차이를 상대적인 6%로 설명한다.
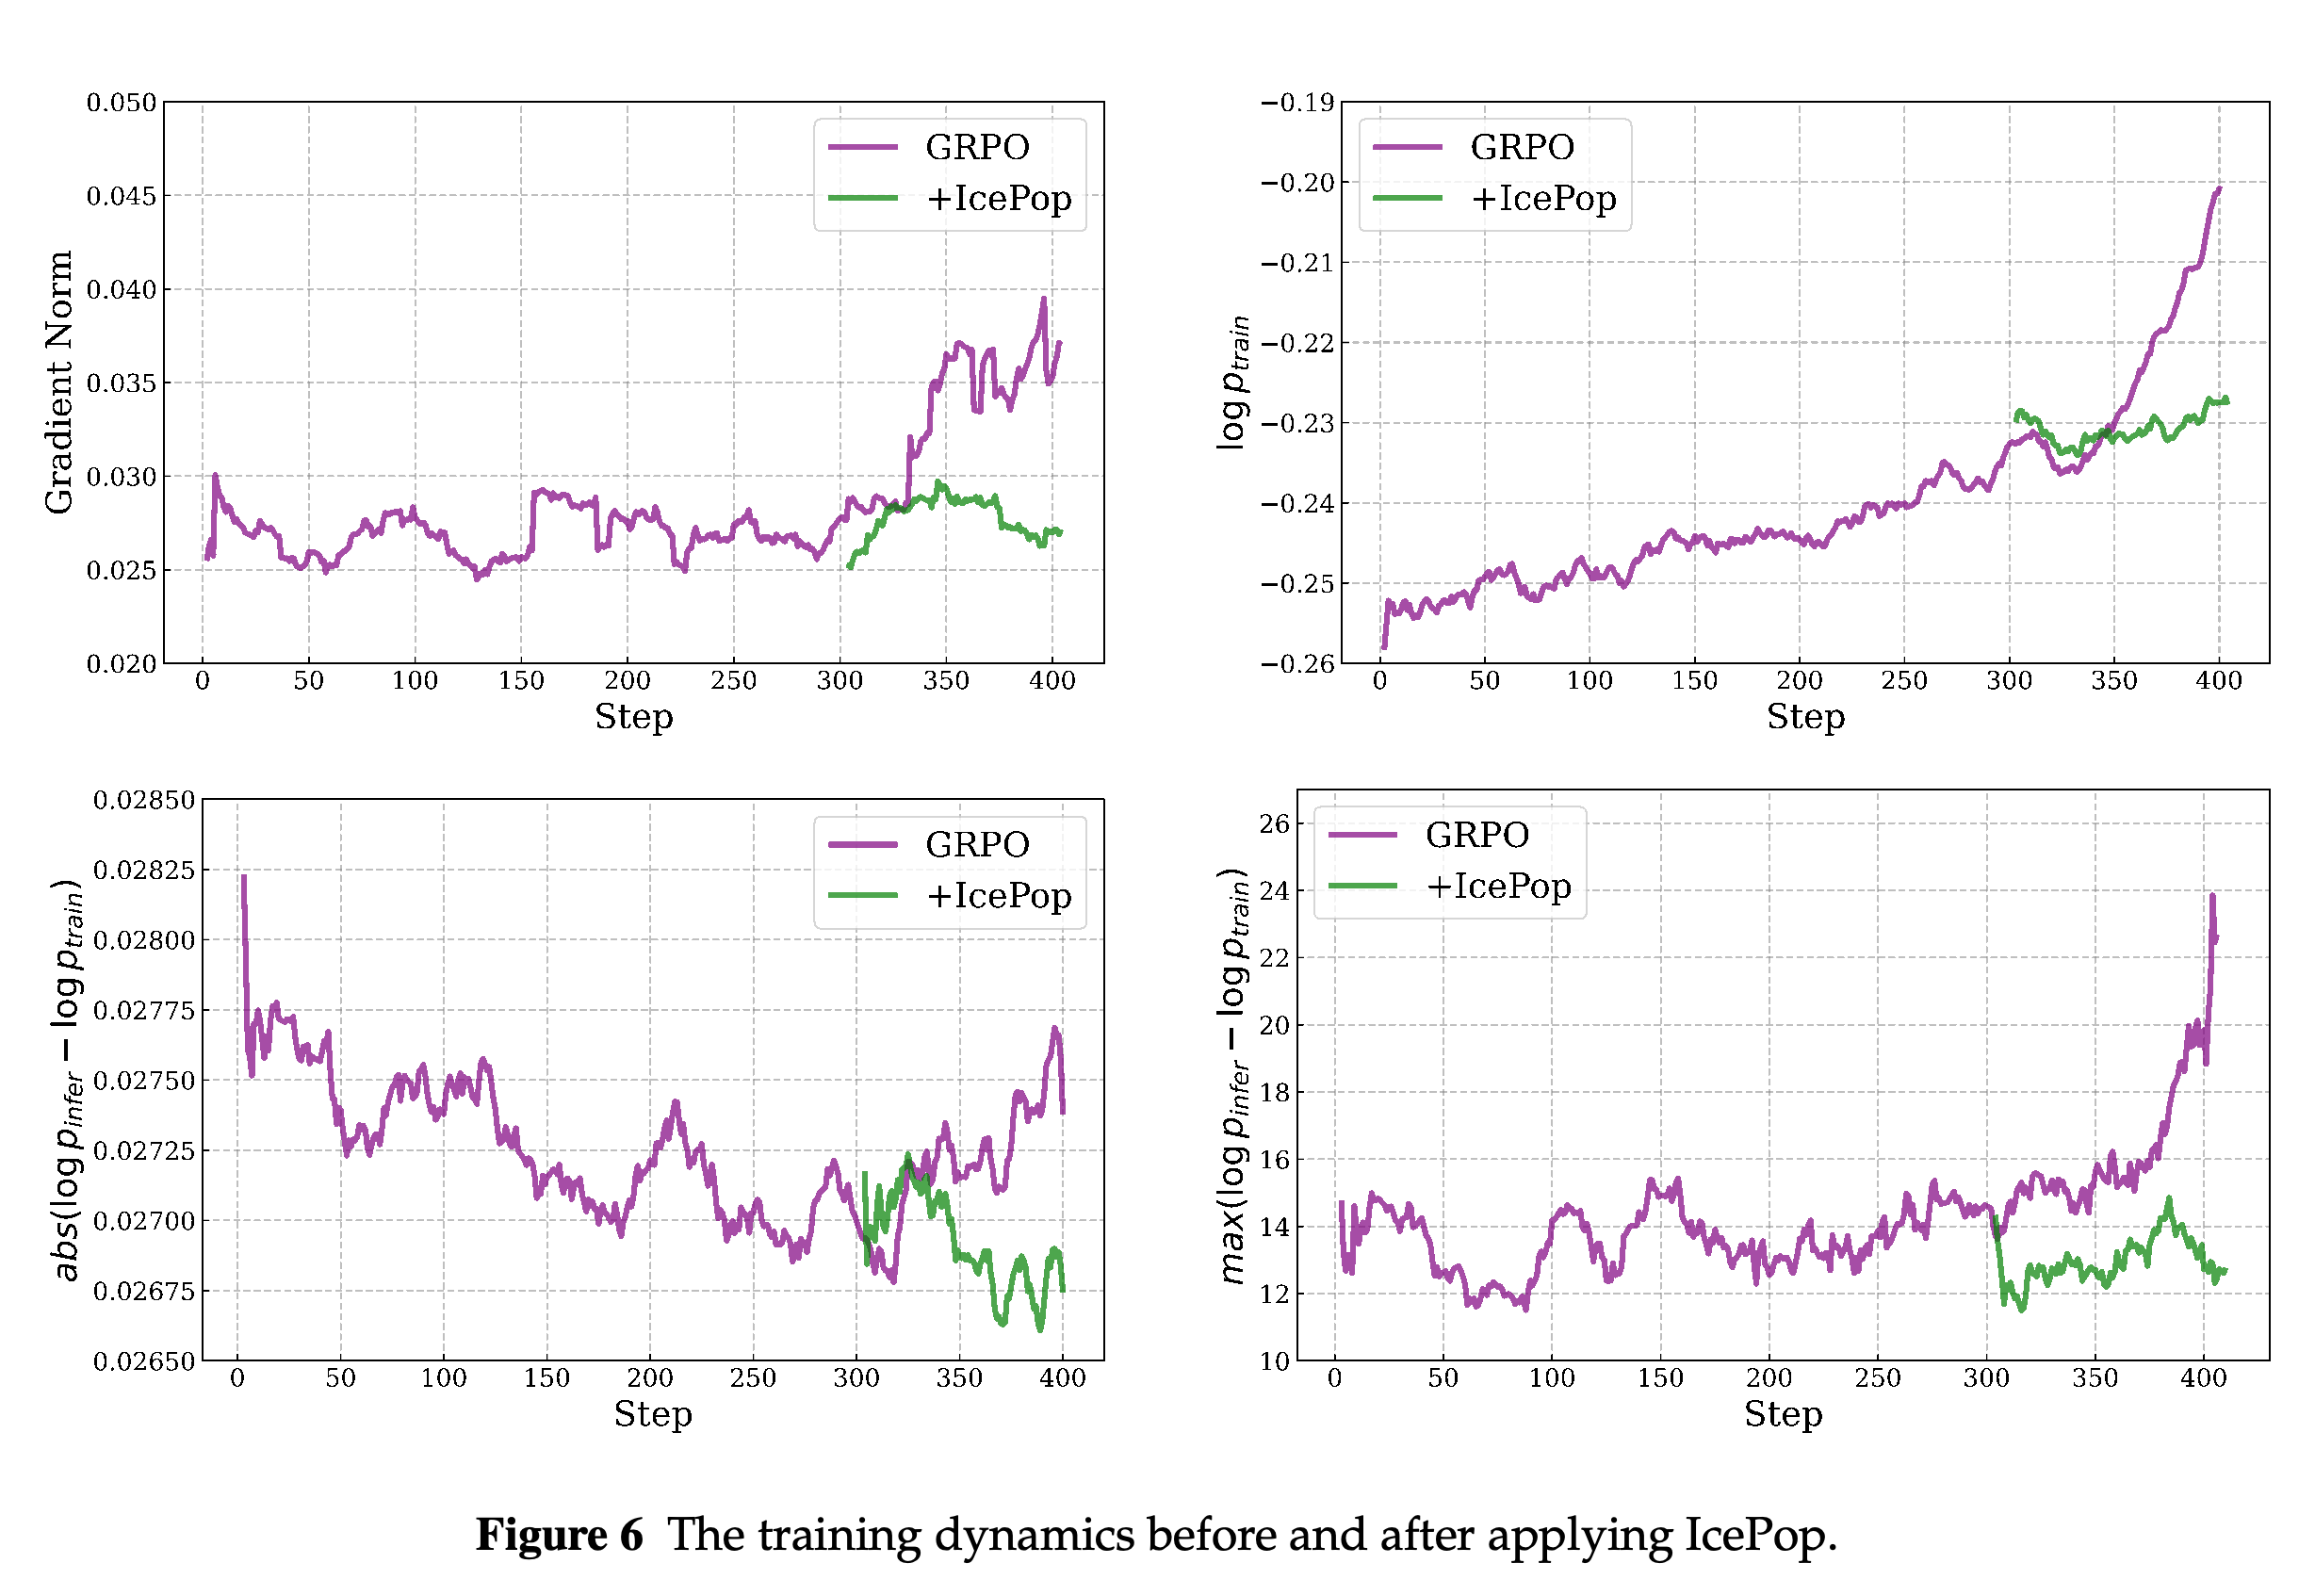
- Ring-1T에서는 IcePop과 GRPO의 곡선이 약 300단계에서 갈라진다. IcePop은 이후 파라미터 업데이트 기울기의 크기인 gradient norm과 학습 및 추론 사이의 극단적인 로그 확률 차이가 증가하는 것을 억제한다.
- 진단 그래프는 해당 실행에서 학습이 안정화되었음을 뒷받침하지만 엔진 사이의 수치적 불일치는 0이 아닌 값으로 남는다.
약 300단계에서 곡선이 갈라진 뒤, IcePop은 GRPO에서 관찰되는 학습 후반의 급격한 gradient norm 증가와 최대 로그 확률 차이 증가를 억제한다. 평균 불일치는 0이 아닌 값으로 남으며 이는 논문이 인정한 잔여 엔진 불일치와 일치한다.
2.4.2 C3PO++
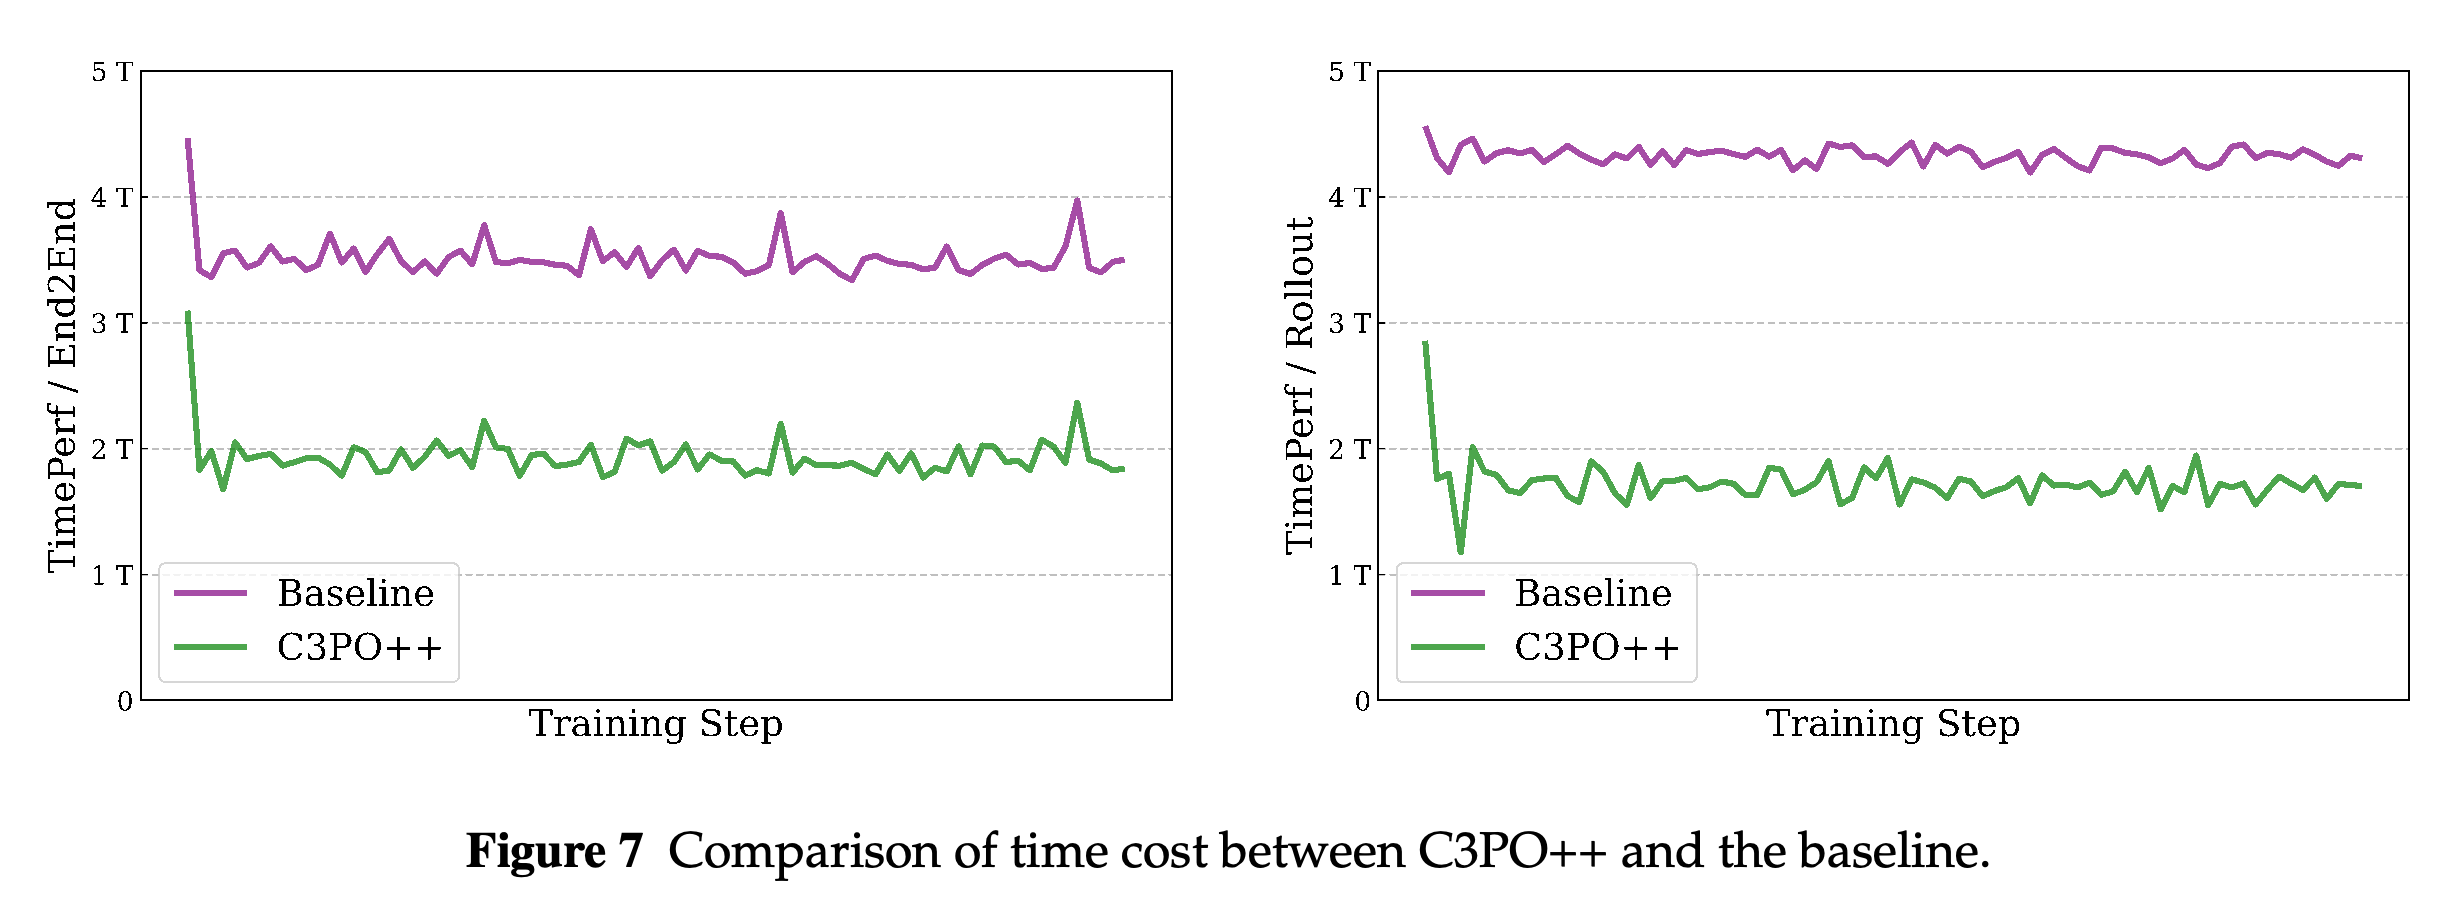
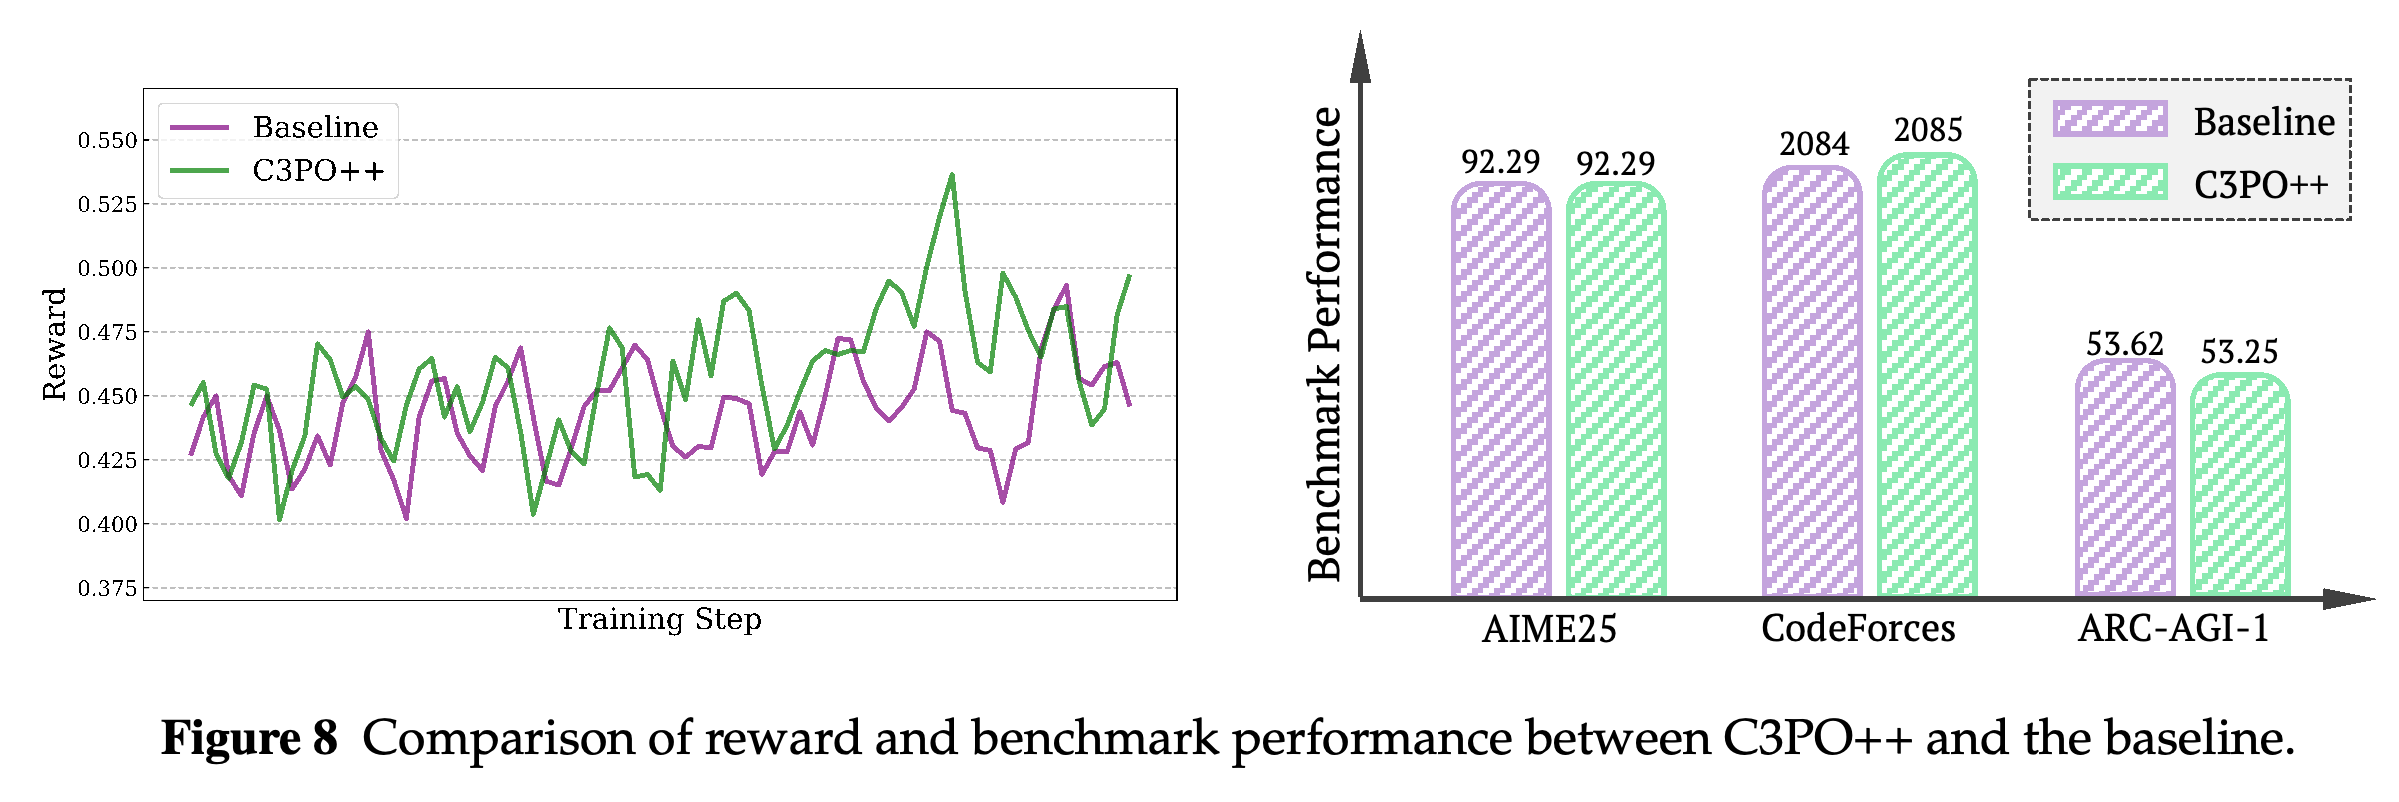
C3PO++는 예산에 따른 rollout 분할을 사용하지 않는 기준 설정과 비교된다. 본문은 rollout 속도 향상을 약 2.5 times, 단계당 전체 실행 속도 향상을 약 1.5 times로 보고하며 보상 곡선은 서로 비슷하게 움직였다고 보고한다.
- 기준 설정과 C3PO++의 점수는 각각 AIME25에서 92.29와 92.29, CodeForces에서 2084와 2085, ARC-AGI-1에서 53.62와 53.25이다.
- 이 결과는 평가한 설정에서 단계당 실행 시간을 줄이면서 비슷한 성능을 유지했음을 보여준다. 논문은 이러한 차이에 대한 신뢰구간을 보고하지 않는다.
전체 실행 시간과 rollout 시간 패널 모두에서 C3PO++는 표시된 단계 대부분에 걸쳐 기준 설정보다 낮은 값을 보인다. 본문은 rollout 속도 향상을 약 2.5 times, 전체 실행 속도 향상을 약 1.5 times로 보고한다. 그래프에 나타난 전체 실행 시간 수준은 더 큰 비율을 시사하지만 T 축에는 절대 시간이나 이 차이에 대한 설명이 없다.
보상 곡선은 상당 부분 겹친다. 벤치마크 막대그래프에서는 C3PO++ 적용 후 AIME25 점수가 같고, CodeForces 레이팅은 1점 상승하며 ARC-AGI-1은 0.37점 하락한다. 이 측정 결과는 평가한 비교에서 실행 시간이 개선되면서 비슷한 성능을 유지했음을 보여준다.
2.5 Large-Scale RL Infrastructure: ASystem
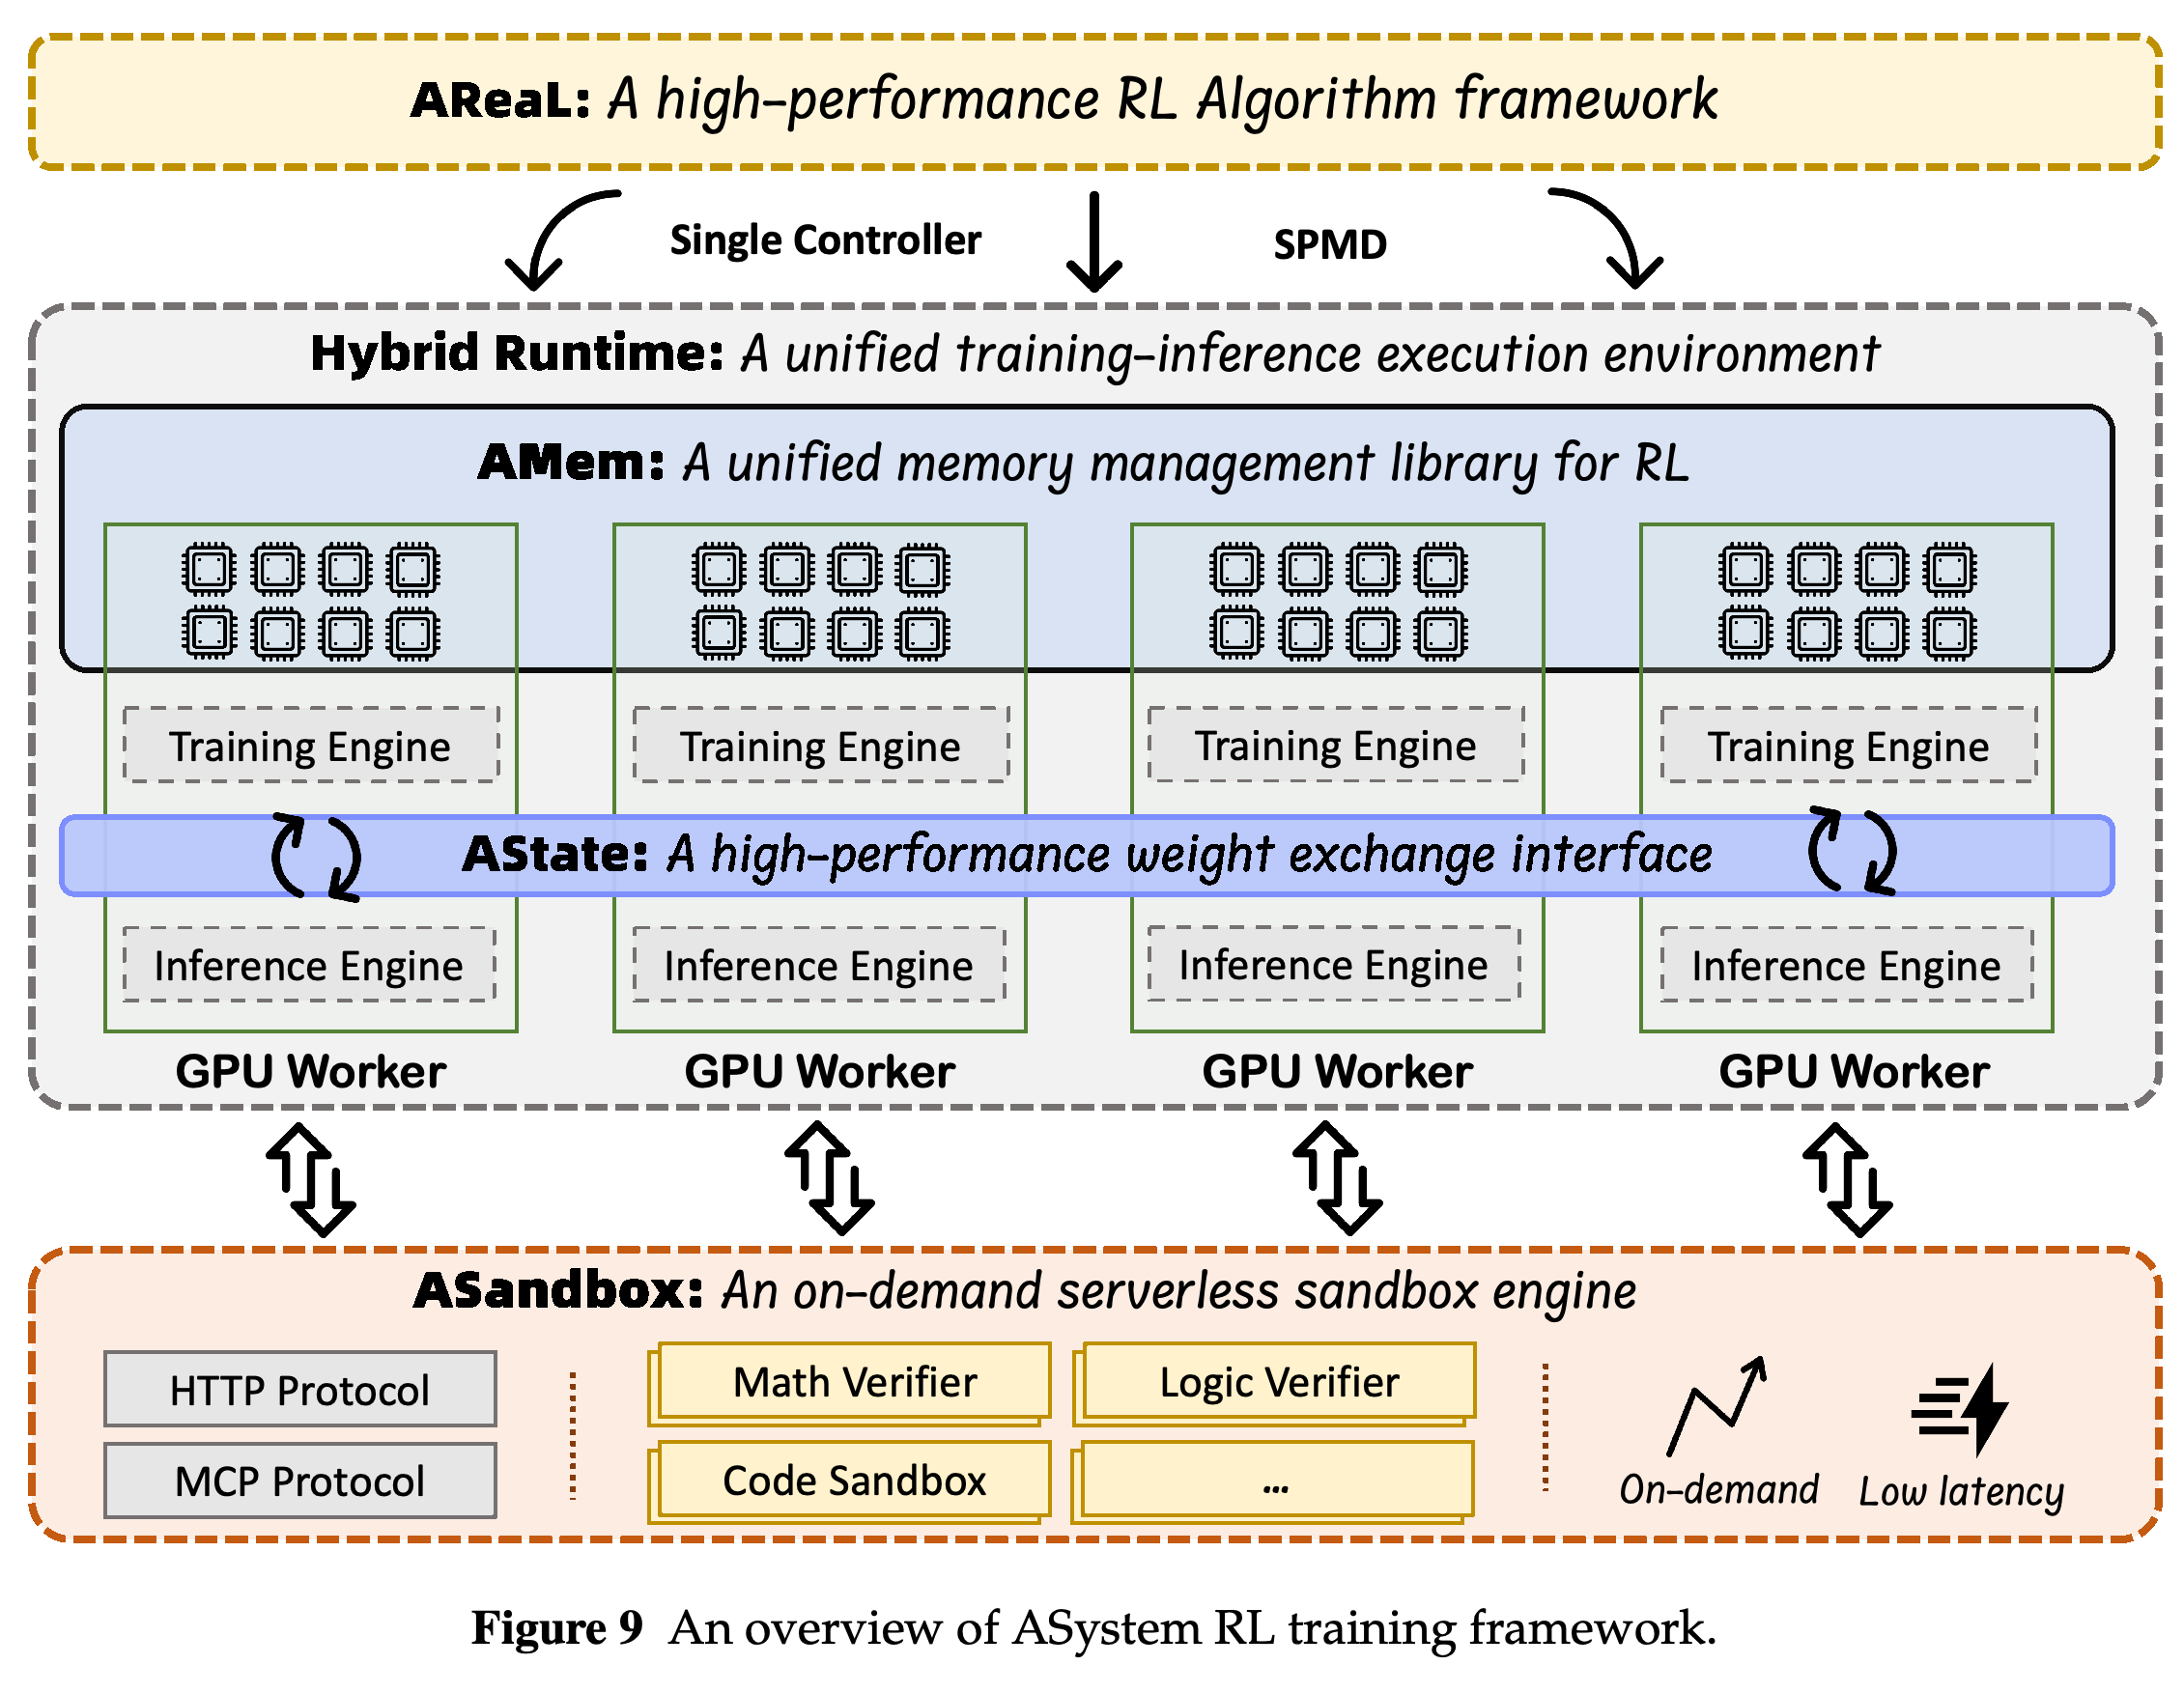
ASystem은 학습과 추론을 실행하는 Hybrid Runtime, 가속기 메모리를 관리하는 AMem, 가중치를 동기화하는 AState, 격리된 검증 환경을 제공하는 ASandbox를 결합한다. SingleController + SPMD 아키텍처는 중앙 집중형 오케스트레이션과 작업자 전반의 Single Program, Multiple Data 실행을 결합한다. 제어 흐름과 데이터 흐름을 분리하며 학습, 추론, 보상 백엔드를 교체할 수 있도록 지원한다.
- 개요는 파라미터 1 trillion개를 갖춘 모델을 10초 미만에 동기화한다고 보고하며 느려진 학습과 멈춤 상태에서 자동으로 복구하는 기능을 설명한다.
- 인프라 설명은 작동 방식과 일부 성능 주장을 제시하지만 상세한 하드웨어 구성이나 구성 요소별 확장성 벤치마크는 제공하지 않는다.
아키텍처는 AReaL에 알고리즘 오케스트레이션, Hybrid Runtime에 통합 실행, AMem에 메모리 관리, AState에 가중치 교환, ASandbox에 격리된 검증을 맡긴다. 이러한 역할 분담은 분산 학습 병목에 대응하는 방식을 설명한다. 도식 자체에는 확장성 측정 결과가 없다.
2.5.1 Hybrid Runtime: A Unified Training-Inference Execution Environment
Hybrid Runtime은 자원 스케줄링, 병렬 실행, 학습, 추론을 통합한다. AState는 모델 파라미터를 나누어 보관한 가중치 샤드 중 필요한 부분만 피어 사이에 전송하고 추론 가중치를 제자리에서 업데이트한다. 데이터 크기와 하드웨어 토폴로지에 따라 통신 전송 방식을 선택한다.
- 이 절은 파라미터 업데이트 시간이 sub-second라고 보고한다. 앞선 개요는 1 trillion 규모의 동기화 시간이 10초 미만이라고 제시하지만 보고서는 이들이 같은 작업이나 측정을 가리키는지 명시하지 않는다.
- AMem은 Memory Switching으로 학습 상태를 해제하고 복원하며 Distributed Multi-path Transfer로 대역폭을 통합한다. Unified Memory Pooling으로 가속기와 노드 전반의 메모리를 동적으로 할당한다.
2.5.2 ASandbox: An On-Demand Serverless Sandbox Engine
ASandbox는 코드 실행과 터미널 시뮬레이션 등의 검증 과제를 격리된 환경에서 실행하며 클러스터 관리 시스템인 Kubernetes와 통합된다. 논문은 runsc와 kata를 사용하는 보안 컨테이너 격리, 자동 노드 장애 감지 및 격리, 100ms 시작 시간, 5,000 QPS/200ms 처리량 사양을 보고한다. QPS는 초당 쿼리 수를 뜻한다. 다만 마지막 사양의 측정 조건은 설명하지 않는다.
2.5.3 AReaL: A High-Performance RL Algorithm Framework
AReaL은 single-controller와 SPMD 인터페이스를 제공하는 ASystem의 오픈소스 강화학습 프레임워크다. 비동기 파이프라인은 응답 경로 생성, 보상 계산, 학습을 겹쳐 실행한다. 시퀀스 패킹과 작업자 간 데이터 분산으로 패딩과 재분배 부담을 줄이며 자동 감지, 재시도, 복구로 실행 실패에 대응한다.
3 Evaluation
평가는 수학, 코딩, 논리 추론, 일반 과제에서 Ring-1T를 파라미터가 공개된 open-weights 모델 및 비공개 추론 모델과 비교한다. Table 1은 학습에서 중점을 둔 추론 과제 외의 영역까지 비교를 확장한다.
3.1 Benchmarks
벤치마크는 지식, 코딩, 수학, 추론, 인간 선호와의 정렬, 의료, 다중 턴 상호작용, 에이전트 역량의 8개 영역을 다룬다. Table 1의 비교 모델은 DeepSeek-V3.1-Terminus-Thinking, Qwen3-235B-A22B-Thinking-2507, Gemini-2.5-Pro, GPT-5-Thinking (High)다.
- 코딩 평가에는 코드 생성 벤치마크인 LiveCodeBench-v6 (2408-2505), CodeForces, 소프트웨어 편집 벤치마크인 Aider가 포함된다. CodeForces는 전문가가 설계한 테스트 케이스와 함께 Div. 2 대회 14개의 문제를 사용하며 달성 가능한 최대 레이팅은 2209다.
- 일반 평가에는 선호 정렬을 평가하는 ArenaHard v2, 의료를 평가하는 HealthBench, 다중 턴 상호작용을 평가하는 MultiChallenge, Berkeley의 함수 호출 벤치마크인 BFCL v3가 포함된다.
3.2 Evaluation Settings
AIME 2025, LiveCodeBench-v6, ARC-AGI-1, CodeForces, 수학 경시대회 벤치마크인 HMMT 2025, 논리 벤치마크인 ZebraLogic, Humanity’s Last Exam인 HLE, BFCL v3는 평가 중 사용할 수 있는 토큰 용량인 컨텍스트 윈도우를 128K로 설정한다. 기본 컨텍스트 용량이 부족한 모델은 컨텍스트 윈도우 확장 기법인 YaRN으로 확장한다. Aider, 또 다른 수학 경시대회 벤치마크인 CNMO 2024, Big-Bench Extra Hard인 BBEH는 64K를 사용하며 나머지 벤치마크는 32K를 사용한다.
- Open-weights 기준 모델에는 공식 하이퍼파라미터를 사용하고 비공개 모델에는 제공 업체가 권장하는 설정을 사용한다.
- 기준 모델의 공식 결과가 있으면 재현 점수와 공식 발표 점수 중 더 높은 값을 선택한다. 따라서 보고된 비교에는 재현 결과와 외부에서 보고된 결과가 혼합된다.
- Table 1은 AIME 2025에 Avg@64, HMMT25에 Avg@16, LiveCodeBench-v6에 Avg@4를 명시하며 각각 표시된 샘플 수에 대한 평균을 뜻한다. 반면 Figure 1은 해당 그래프를 단일 응답의 성공률인 pass@1으로 표시한다.
3.3 Results
Table 1에서 Ring-1T는 나열된 open-weights 모델 중 AIME 2025 93.40, HMMT25 86.72, LiveCodeBench-v6 78.30, ARC-AGI-1 55.94, ArenaHard v2 승률 81.59, HealthBench 57.93으로 가장 높은 점수를 기록한다. GPT-5-Thinking (High)는 이 벤치마크 모두에서 더 높은 점수를 기록한다. Ring-1T는 표의 CodeForces 비교에서 레이팅 2088과 백분위 97.85로 선두를 차지한다.
- ARC-AGI-1 점수는 DeepSeek-V3.1-Terminus-Thinking보다 15.32%포인트, Qwen3-235B-A22B-Thinking-2507보다 7.82%포인트 높다.
- AWorld에서 Ring-1T는 코드 생성이나 외부 기호 연산 도구 없이 자연어 추론으로 IMO Problems 1, 3, 4, 5를 첫 시도에 해결한다. 이는 논문이 제시한 은메달 수준의 결과에 해당한다. Problem 2의 거의 완성된 증명은 3번째 시도에 나오며, Problem 6에서는 정답 2112 대신 4048을 출력한다.
- 종합 표에는 상대적으로 낮은 결과도 나타난다. Aider는 78.57로 DeepSeek의 92.86보다 낮고, 다중 과제 지식 벤치마크인 MMLU-Pro는 80.54로 85.00보다 낮다. 지시 이행 벤치마크인 IFEval은 85.21로 89.09보다 낮으며 MultiChallenge는 50.92로 Qwen의 52.75보다 낮다.
- Figure 1에는 CodeForces 레이팅 2092인 Ring-1T-Preview가 포함된다. 따라서 Ring-1T의 최고 레이팅 주장은 Table 1에 나열된 모델에 한정된다.
전체 비교는 일부 추론 과제의 강점과 함께 소프트웨어 편집, 지식, 지시 이행, 다중 턴 평가의 상대적인 약점을 보여준다. Ring-1T는 토큰마다 50B 파라미터를 활성화하며 DeepSeek는 37B, Qwen은 22B를 활성화한다. 단검 기호가 붙은 항목은 공식 문서에서 가져온 결과다. 이러한 계산량 차이와 결과 출처의 혼합 때문에 동일한 계산량 조건에서 제안 방법의 인과적 기여를 판단하기 어렵다.
4 Conclusion
결론은 Ring-1T의 성공적인 학습을 IcePop, C3PO++, ASystem의 결합에 따른 결과로 설명한다. 보고된 실험은 파라미터 1 trillion개를 갖춘 open-weights 추론 모델의 학습 가능성과 일부 벤치마크에서의 높은 성능을 보여준다. 다만 파라미터 규모의 기여는 데이터, 알고리즘, 인프라의 기여와 분리되지 않는다.
5 Limitations & Future Work
저자들은 긴 응답의 높은 추론 비용, 학습과 추론 연산 사이에 남는 수치적 불일치, 도구 사용 등 충분히 최적화되지 않은 에이전트 역량을 한계로 제시한다. 정체성 혼동과 응답 안에서 언어를 바꾸는 linguistic code-switching도 보고하며 이를 데이터에 섞인 불순물과 부족한 정규화에 따른 현상으로 설명한다.
- 현재 어텐션 아키텍처는 긴 추론에서 여전히 비용이 높다. 향후 과제로 대안적인 어텐션 기법과 전문화된 에이전트 학습을 제안한다.
- IcePop은 불일치를 완화하지만 그 근본적인 수치적 원인을 제거하지는 않는다. 이는 학습 진단에서 불일치가 0이 아닌 값으로 남는 결과와 일치한다.
6 Contributors
표제 페이지에는 Ling Team과 Inclusion AI가 명시되며, Section 6은 기여자를 이름의 알파벳순으로 나열한다. Jun Zhou, Zhiqiang Zhang, Zujie Wen은 교신저자로 표시된다.
부록
- A Related Work에는 A.1 Stable Reinforcement Learning, A.2 Efficient Reinforcement Learning, A.3 Reinforcement Learning Infrastructure가 포함된다. IcePop의 토큰 마스킹을 응답 전체의 업데이트 비율을 계산하는 시퀀스 수준 정책 최적화 및 TIS 보정과 구분한다. C3PO++를 생성 경로를 잘라내거나 생성을 중단할 수 있는 방식과 비교하고 메모리, 동기화, 재현성 병목을 통해 ASystem의 필요성을 설명한다.
- B Theoretical Analysis for IcePop은 δ_t를 추론 분포와 학습 분포 사이의 KL 불일치로 정의하고 가정 A1–A4 아래에서 δ_(t+1) ≥ (1 + ημ)δ_t − κμ를 증명한다. 가정은 매끄러운 불일치, 불일치가 증가하는 방향과 일치하는 업데이트 편향, 제한된 on-policy 변화, 제한된 국소 기울기다. 여기서 on-policy 변화는 학습 분포에서 샘플링한 업데이트가 미치는 영향을 뜻한다. 스텝 크기는 0 < μ ≤ μ̄를 만족해야 하며, 가정은 전체 경로에서 유지되어야 한다. δ_t ≥ 2κ/η이면 하한은 δ_(t+1) ≥ (1 + ημ/2)δ_t가 된다. 이는 조건부 불일치 증폭을 보이며 IcePop의 수렴을 보장하지는 않는다.
- C Preliminary Analysis for IcePop on Ring-mini-2.0은 GRPO의 보상이 180–200단계 이후 붕괴하는 반면, IcePop과 TIS는 600단계까지 안정적으로 유지된다고 보고한다. IcePop은 TIS보다 극단적인 엔진 간 불일치가 작으며 저자들은 더 낮은 토큰 로그 확률을 더 폭넓은 탐색의 근거로 해석한다. 본문은 토큰의 약 1–2‰가 마스킹되며, 마스킹된 토큰에는 예측 불확실성이 큰 고엔트로피 토큰의 비중이 더 높다고 설명한다. 다만 Figure 12는 학습 후반에 이 범위를 넘어선다. 민감도 실험에서는 [0.5, 2.0]이 불안정한 반면, [0.5, 5.0]과 [0.4, 5.0]은 보고된 실행에서 안정적으로 유지된다.
- D Training Data Analysis는 지도학습 데이터의 세부 비율을 Math 43%, Code 18%, Physics 13%, Biology 4%로 제시한다. 이는 본문의 Mathematics 46%, Code 20%와 다르지만 설명은 없다. 추론 데이터 차트는 도메인별 비율을 Math 42.2%, Code 18.6%, Science 17.8%, Logic 21.3%로 보고하며 Very Hard 라벨의 비율은 각각 35%, 38%, 29%, 30%다. 표시된 도메인별 난도 비율의 합은 100%가 되지 않으며 부록은 부족한 비율을 설명하지 않는다.
- E IMO Case는 Problem 1에 대한 Ring-1T의 답변을 재현한다. 문제는 n ≥ 3일 때 a + b ≤ n + 1을 만족하는 모든 양의 정수 좌표점 (a, b)를 서로 다른 직선 n개로 덮되, 정확히 k개의 직선이 sunny가 되도록 하는 것이다. Sunny는 어느 좌표축과도, x + y = 0과도 평행하지 않다는 뜻이다. 재현된 답변의 Summary 안에서 a. Verdict는 k = 0, 1, 3을 제시하고 b. Method Sketch는 개수에 관한 상한과 명시적인 구성을 개괄한다. 이 소문자 라벨은 E IMO Case에 수록된 답변에 속하며 Appendix A 및 Appendix B와 구분된다.
- Detailed Solution은 Step 1: Understanding the Point Set에서 n(n + 1)/2 points로 이루어진 삼각 격자를 정의하고 Step 2: Maximum Coverage by Non-Sunny Lines에서 M(m, n) = m(2n − m + 1)/2와 U(k) = k(k + 1)/2를 주장한다. Step 3: Impossibility for Even k ≥ 2와 Step 4: Impossibility for Odd k ≥ 5는 덮을 수 있는 점의 수와 공선성에 대해 주장한 상한을 사용해 해당 경우를 배제한다. 이 논증은 재현된 모델 출력이다. 부록은 덮이지 않은 점들이 해당 상한에 필요한 삼각 구조를 갖는다고 가정할 근거를 별도로 제공하지 않는다.
- Step 5: Possibility for k = 0은 x + y = 2, …, n + 1을 사용한다. Step 6: Possibility for k = 1은 수평선 n − 1 lines와 (1, n)을 지나는 sunny 직선을 사용한다. Step 7: Possibility for k = 3은 6 points로 이루어진 삼각형 부분 격자를 남긴 뒤 기울기가 1, −1/2, −2인 직선으로 덮는다. Step 8: Completeness of Characterization은 앞서 제시한 배제와 구성을 결합하며 Final Answer는 k = 0, 1, 3을 다시 제시한다.
짧은 생각
가장 명확한 공학적 근거는 IcePop 적용 후 불일치 증가가 억제된 진단 결과와, 비슷한 과제 점수를 유지하면서 실행 시간이 줄어든 C3PO++의 학습 단계다. 더 넓은 모델 비교는 일부 추론 역량의 강점을 뒷받침하지만 활성 파라미터 수의 차이와 재현 점수 및 공식 점수가 혼합된 기준 모델 비교 때문에 성과를 제안 방법에 귀속하기 어렵다. 불확실성 추정의 부재, 설명되지 않은 데이터 비율 차이, 명시되지 않은 동기화 측정 조건은 재현성을 제한한다.
공개 자료는 모델과 구현 참고 자료인 https://huggingface.co/inclusionAI/Ring-1T 및 https://github.com/inclusionAI/Ring-V2를 제공한다. 벤치마크별 성능을 보면 응용 분야에 대한 적합성을 판단할 때 경시대회 추론, 실용적인 소프트웨어 편집, 에이전트 워크플로를 각각 평가할 필요가 있다.