


InteractComp: Evaluating Search Agents With Ambiguous Queries 요약 설명
28 Oct 2025 | Paper Review Search Agents Human-Agent Interaction Benchmark목차
이번 글에서는 InteractComp: Evaluating Search Agents With Ambiguous Queries 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 28일(Arxiv), Proceedings of the 43rd International Conference on Machine Learning, Seoul, South Korea. PMLR 306, 2026.
- Deng, Mingyi, Huang, Lijun, Fan, Yani, Kong, Fanqi, Zhang, Jiayi, Ren, Fashen, Bai, Jinyi, Yang, Fuzhen, Miao, Dayi, Yu, Zhaoyang, et al.
- DeepWisdom, The Hong Kong University of Science and Technology (Guangzhou), Peking University, Renmin University of China, University of California, Los Angeles, AgentUniverse, McGill University, Yale University
- 논문 링크
- Github
요약
- InteractComp는 행동을 통해 웹 정보를 수집하는 언어 모델인 검색 에이전트가 모호한 요청에 답하기 전에 사용자에게 부족한 정보를 물을 수 있는지 평가한다. 17개 모델 중 검색과 명확화 질문을 모두 사용할 때 최고 정확도는 GPT-5의 13.73%다. 모호성을 해소하는 맥락을 모두 제공하고 검색도 허용하면 GPT-5는 67.88%를 기록하고 OpenAI o3는 벤치마크 최고 정확도인 71.50%를 기록한다.
- 벤치마크는 사람이 직접 구성한 9개 분야의 질문 210개로 이루어지며, 영어 사례 139개와 중국어 사례 71개를 포함한다. 정답 대상과 오답 후보를 구성할 때는 덜 알려진 정답 개체에 인기 있는 대안을 대응시킨다. 이들이 공유하는 속성은 질문에 제시하고 구별에 필요한 속성은 명확화 질문에 답하는 모의 사용자에게만 제공한다.
- 질문 50개로 구성된 부분집합에서 GPT-5의 행동 예산을 라운드마다 행동 1개를 허용하는 5라운드에서 20라운드로 늘리면 정확도가 14.00%에서 20.00%로 높아진다. 명확화 질문을 의무화하면 정확도는 40.0%에 도달한다. 모의 사용자가 자유 형식으로 답하도록 하면 GPT-5의 정확도는 25.71%로 높아지지만 완전한 맥락을 제공했을 때와는 여전히 큰 차이가 난다. 이는 언제 질문할지 결정하는 능력과 무엇을 질문할지 파악하는 능력 모두에 문제가 있음을 뒷받침한다.
1. Introduction
기존 검색 평가는 완전한 질의를 제공하는 경우가 많아, 에이전트가 검색 중에 처음에 드러나지 않은 사용자 의도를 알아낼 수 있는지는 확인하기 어렵다. InteractComp는 검색 과정에 명확화 질문을 포함하고 1–2단어로 이루어진 짧고 검증 가능한 답을 사용한다. 이를 통해 에이전트가 사용자가 의도한 개체를 식별하는 데 필요한 구별 정보를 얻는지 평가한다.
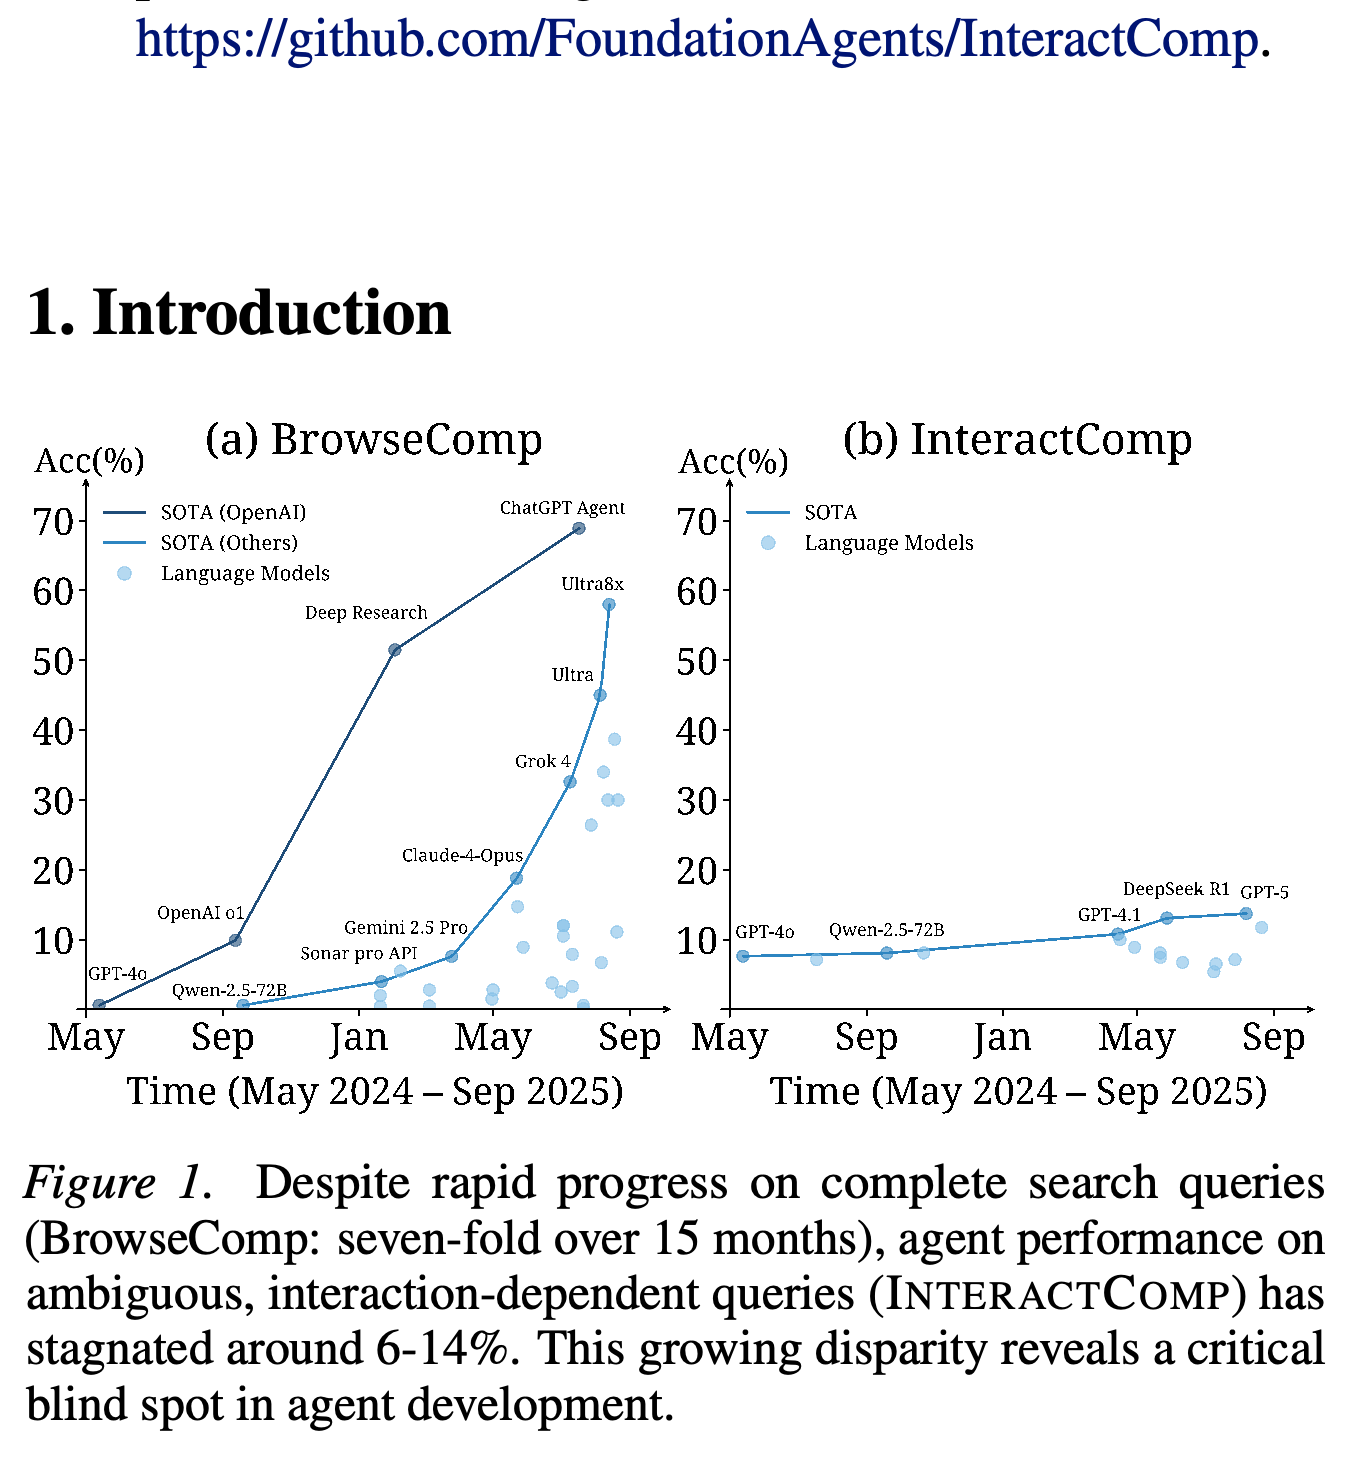
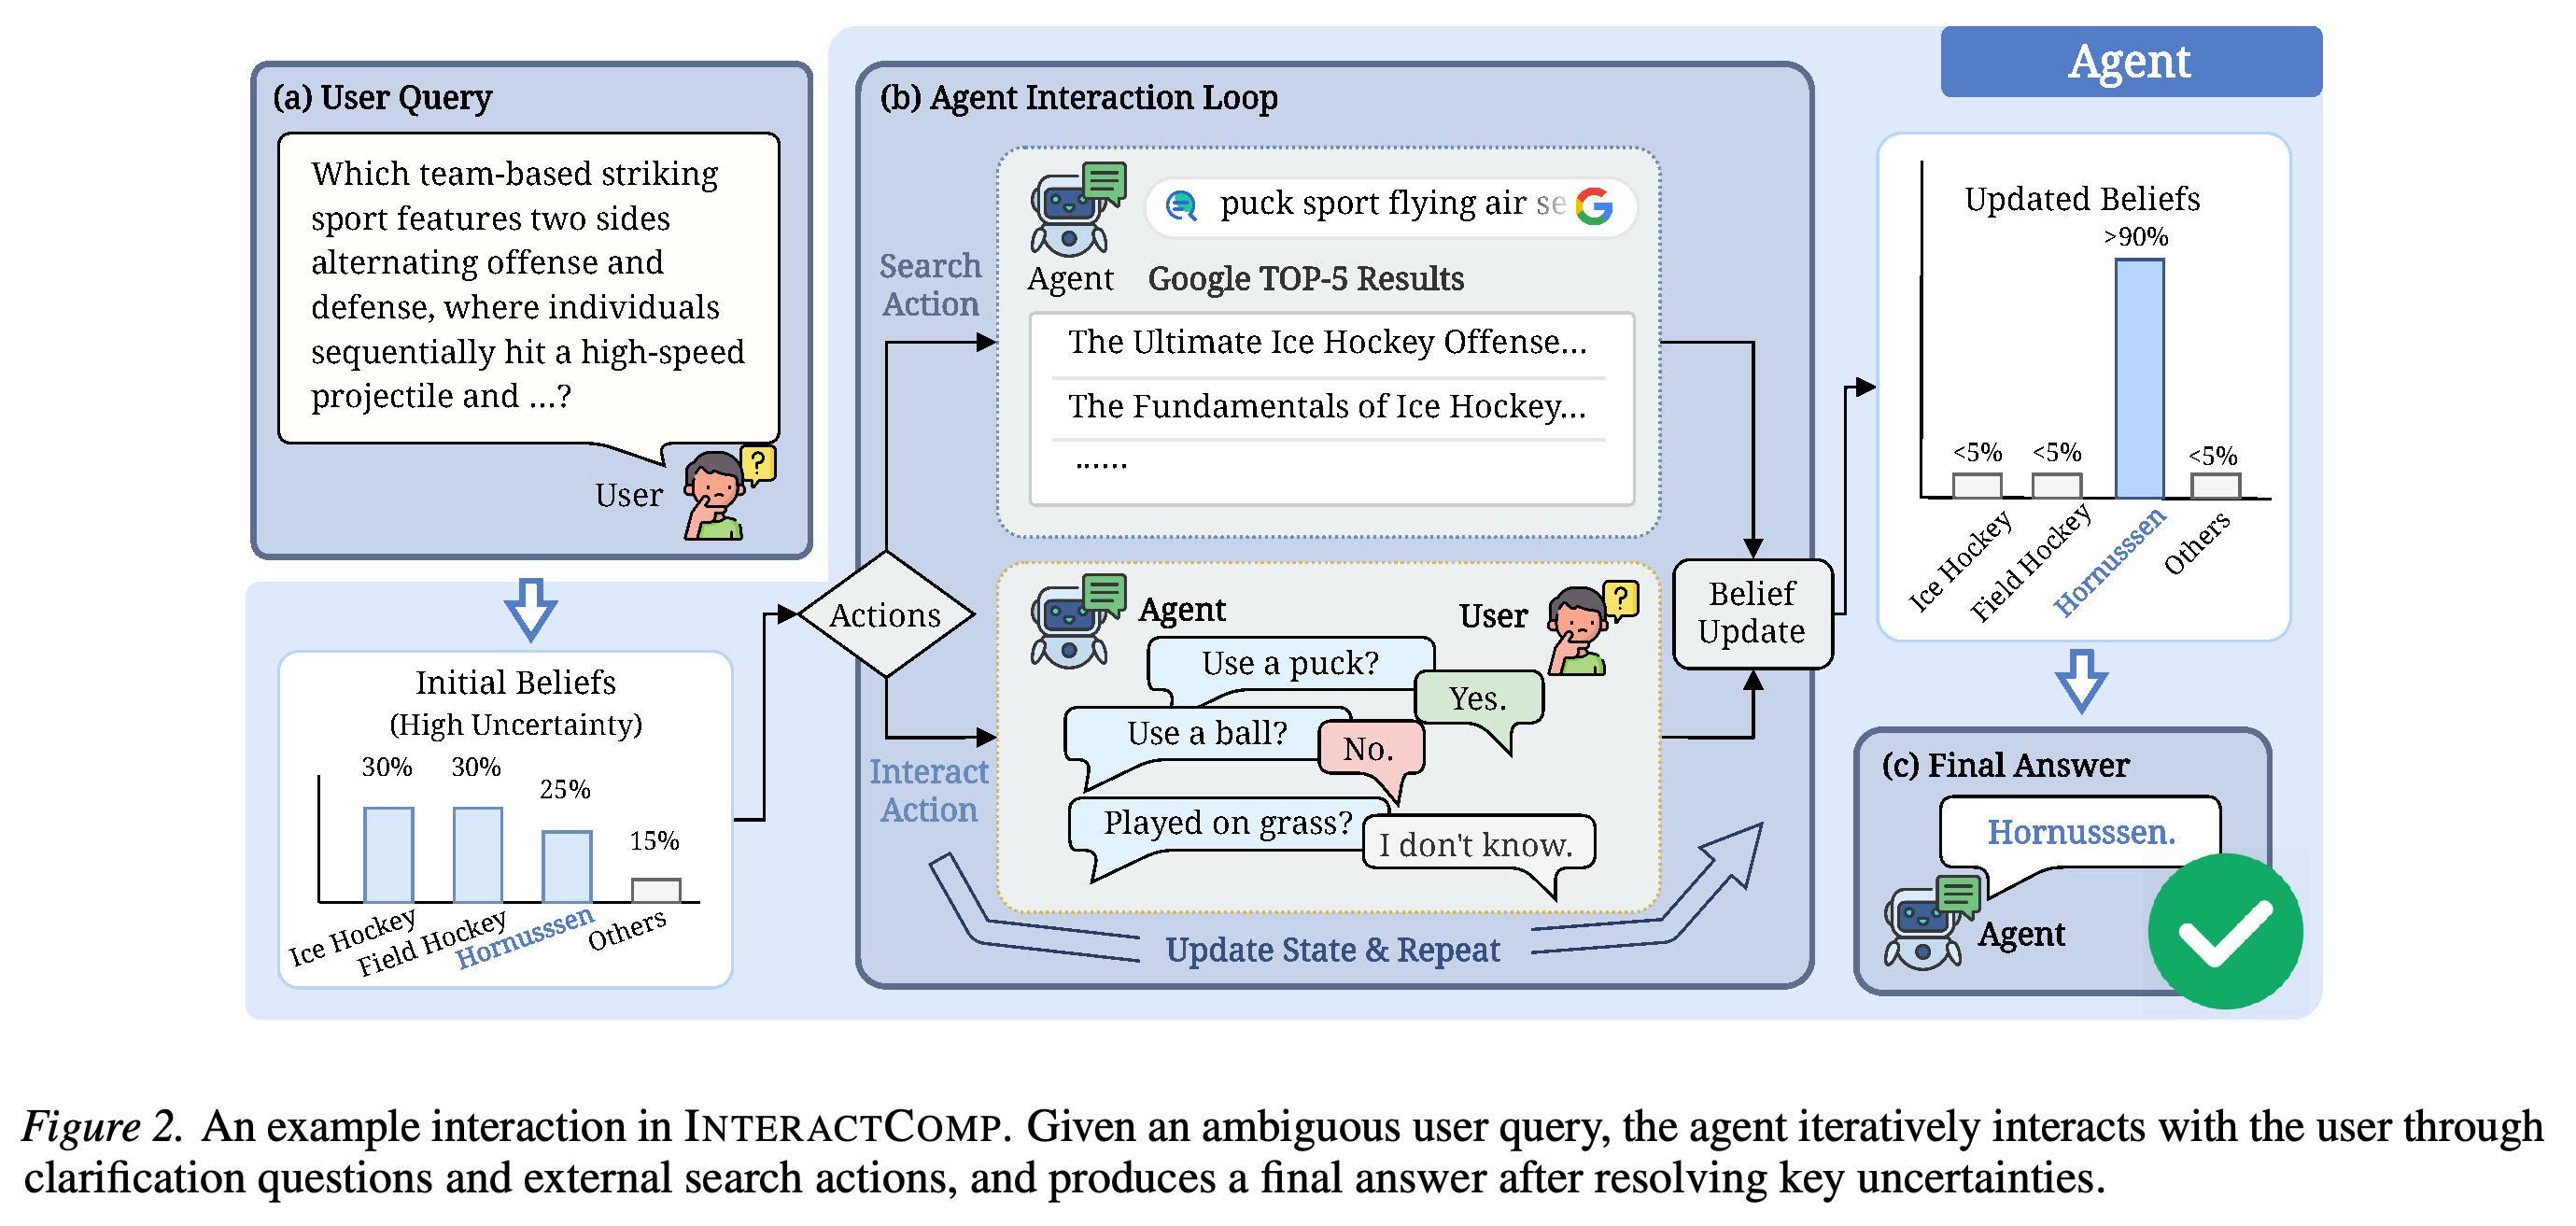
- Figure 1은 완전한 검색 질의를 평가하는 BrowseComp와 InteractComp의 과거 성능을 비교한다. Figure 2는 검색과 명확화 질문을 번갈아 수행하는 과정을 보여준다.
- 저자들은 검증 가능한 결과에서 얻은 이진 정답 신호로 학습하는 Reinforcement Learning from Verifiable Rewards (RLVR)에 이 벤치마크를 활용할 수 있다고 제안한다. 논문은 에이전트를 평가하며 이러한 학습을 실제로 입증하지는 않는다.
과거 성능을 나란히 제시한 그래프에서 완전한 질의를 사용하는 BrowseComp의 정확도는 상승하지만 InteractComp는 훨씬 완만한 추이를 보인다. 이 비교는 모호성 해소를 기존 검색 성능과 별도로 평가할 필요성을 보여주지만 추이가 달라진 원인을 규명하지는 않는다.
스포츠 사례는 하키 관련 검색 결과를 얻고도 여러 후보가 여전히 타당할 수 있음을 보여준다. 투사체가 퍽인지 공인지 묻는 명확화 질문에 따라 후보별 믿음이 달라진 뒤 최종 답을 내놓는다. 표시된 비율은 작업 과정을 설명하기 위한 예시이며 벤치마크 측정값은 아니다.
2. Related Work
논문은 BrowseComp와 도구 및 멀티미디어를 사용하는 범용 비서 평가인 GAIA 같은 검색 벤치마크를 상호작용 평가와 구분한다. 상호작용 평가에는 암묵적인 사용자 의도 이해를 평가하는 IN3와 도구, 에이전트, 사용자 간 상호작용을 평가하는 Tau-Bench가 있다. 모호성을 해소한 질문과 답의 쌍으로 구성된 데이터셋 AmbigQA와 정보 탐색을 위한 명확화 질문 연구도 관련된 모호성 문제를 다룬다. InteractComp에서는 최종 답을 검증할 수 있는 검색 과제 안에서 에이전트가 검색, 질문, 답변 중 무엇을 수행할지 선택해야 한다.
3. The INTERACTCOMP Benchmark
벤치마크는 “Easy to verify, Interact to disambiguate”라는 원칙을 따른다. 초기 질문은 여러 해석을 허용하지만 구별에 필요한 맥락을 얻으면 정답을 식별할 수 있다. 최종 사례는 사람이 구성한다. 검색 도구는 자료 조사를 지원하고 언어 모델은 최종 벤치마크를 직접 생성하는 대신 검증에 사용된다.
3.1. Task Overview
각 사례는 모호한 질문, 숨겨진 맥락, 정답, 오답 후보로 구성된다. 에이전트는 질문만 보고 search, interact, answer를 수행할 수 있다. 모의 사용자는 맥락을 보고 “yes”, “no”, “I don’t know” 중 하나로 답한다.
- 제한된 응답 방식은 특정 속성에 관한 가설을 검증하며 명확화 질문이 제한 없는 정보 검색으로 변하는 것을 막는다.
- 에이전트는 상호작용을 통해 관련된 맥락 정보를 알아내야 한다.
3.2. Data construction and Verification
3.2.1. CONSTRUCTION PROCESS에서는 덜 알려진 정답 대상과 인기 있는 오답 후보를 고른다. 공통 속성과 구별 속성을 분리한 뒤, 공통 속성으로 질문을 만들고 구별 속성은 숨겨진 맥락에 넣는다. Algorithm 1은 후보가 4개 이상이거나 이미 답할 수 있는 질문을 수정하고 정답이 유일하지 않으면 맥락을 수정한다. 사례의 타당성을 독립적으로 확인하는 교차 검증을 통과하지 못한 사례도 보완한다.
- 3.2.2. VERIFICATION PROCESS에서는 먼저 정답 대상이 명시된 모든 속성을 충족하고 질문과 맥락을 함께 보면 유효한 답이 1개뿐인지 확인한다. 유효한 대안이 있는 사례는 다시 구성한다.
- 최소 2명의 주석자가 각 질문을 바꾸어 쓰고 후보 집합이 유지되는지 확인한다. 이를 통해 표현 방식이 아니라 정보 부족 때문에 모호성이 생기는지 검증한다.
- 상호작용의 필요성은 Google 검색 결과의 첫 5페이지를 수동으로 확인하고 GPT-5, GPT-5-mini, Claude-Sonnet-4로 상호작용 없이 5라운드 시험을 수행하여 검증한다. 최소 2개 모델이 푼 사례는 수정한다. 이 검증은 모델이 상호작용으로 맥락을 얻는 능력을 평가하지 않는다.
3.3. Data Statistics
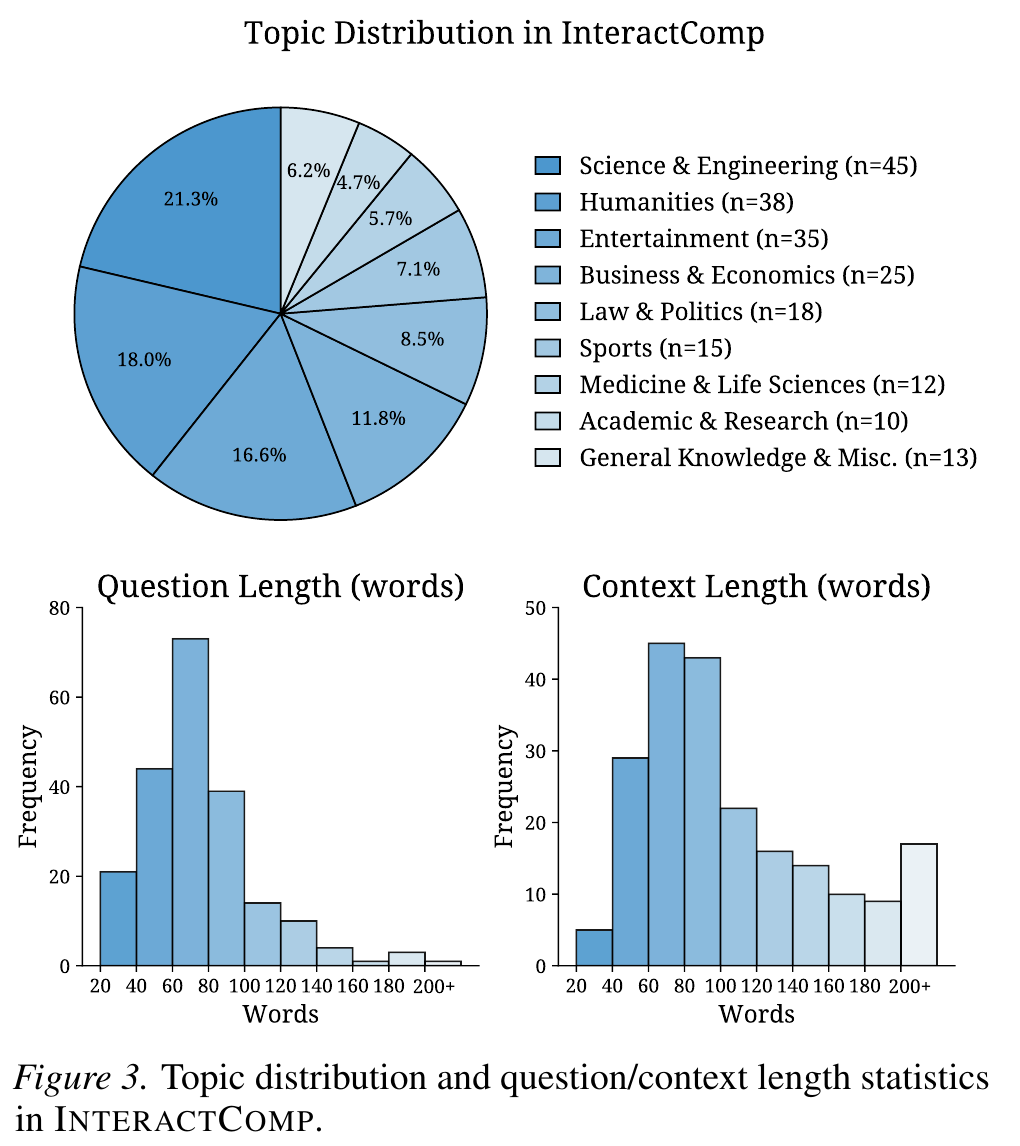
데이터셋은 9개 분야의 사례 210개로 구성되며, Science & Engineering, Humanities, Entertainment가 가장 큰 비중을 차지한다. 영어 사례는 139개(66.19%), 중국어 사례는 71개(33.81%)다. 질문은 주로 40–80단어로 이루어진다. 맥락은 약 40단어부터 200단어를 넘는 범위에 분포하며 60–100단어 구간에 가장 많이 모여 있다.
- Figure 3은 분야 구성과 질문 및 맥락의 길이 분포를 보여준다. 주제별 비중은 고르지 않다.
Science & Engineering, Humanities, Entertainment가 가장 큰 주제 집단이다. 히스토그램에서 초기 질문은 주로 40–80단어에 모여 있고, 맥락 길이는 더 넓게 분포한다. 이는 구별에 필요한 정보를 모의 사용자에게 남겨 두는 구성과 부합한다.
4. Experiments
실험은 통제된 설정을 통해 지식 회상, 웹 검색, 상호작용을 통한 명확화를 분리해 평가한다. 이후 분석에서는 행동 예산, 응답 제한, 질문 의무화, 실패 유형, 과거 모델 성능을 살펴본다.
4.1. Experimental Setup
기본 구조는 추론과 행동을 결합하는 프레임워크인 ReAct다. 설정은 Answer-only, Answer+Search, Answer+Interact, Answer+Search+Interact로 구분한다. 주요 결과를 얻기 위해 검색과 상호작용을 허용하고 사례마다 최대 10라운드를 부여하여 17개 모델을 평가한다. 지원되는 모델에서는 출력의 무작위성을 조절하는 temperature=0.6과 샘플링에서 고려할 확률 질량을 제한하는 top_p=0.95를 사용한다. GPT-4o는 temperature=1.0으로 사용자를 모사한다.
- 보고하는 지표는 평균 라운드 수, interact를 사용한 라운드의 비율인 interaction rate (IR), 정확도, 신뢰도와 실제 정답률의 차이인 calibration error (C.E.), USD(US 달러) 단위의 추정 총비용이다.
- 보정 오차 계산에는 신뢰도 구간 5개를 사용한다. Appendix B는 응답 모델에 따른 민감도, 사람과의 일치도, 상용 검색 시스템, 실행 간 일관성을 평가한다.
4.2. Main Results
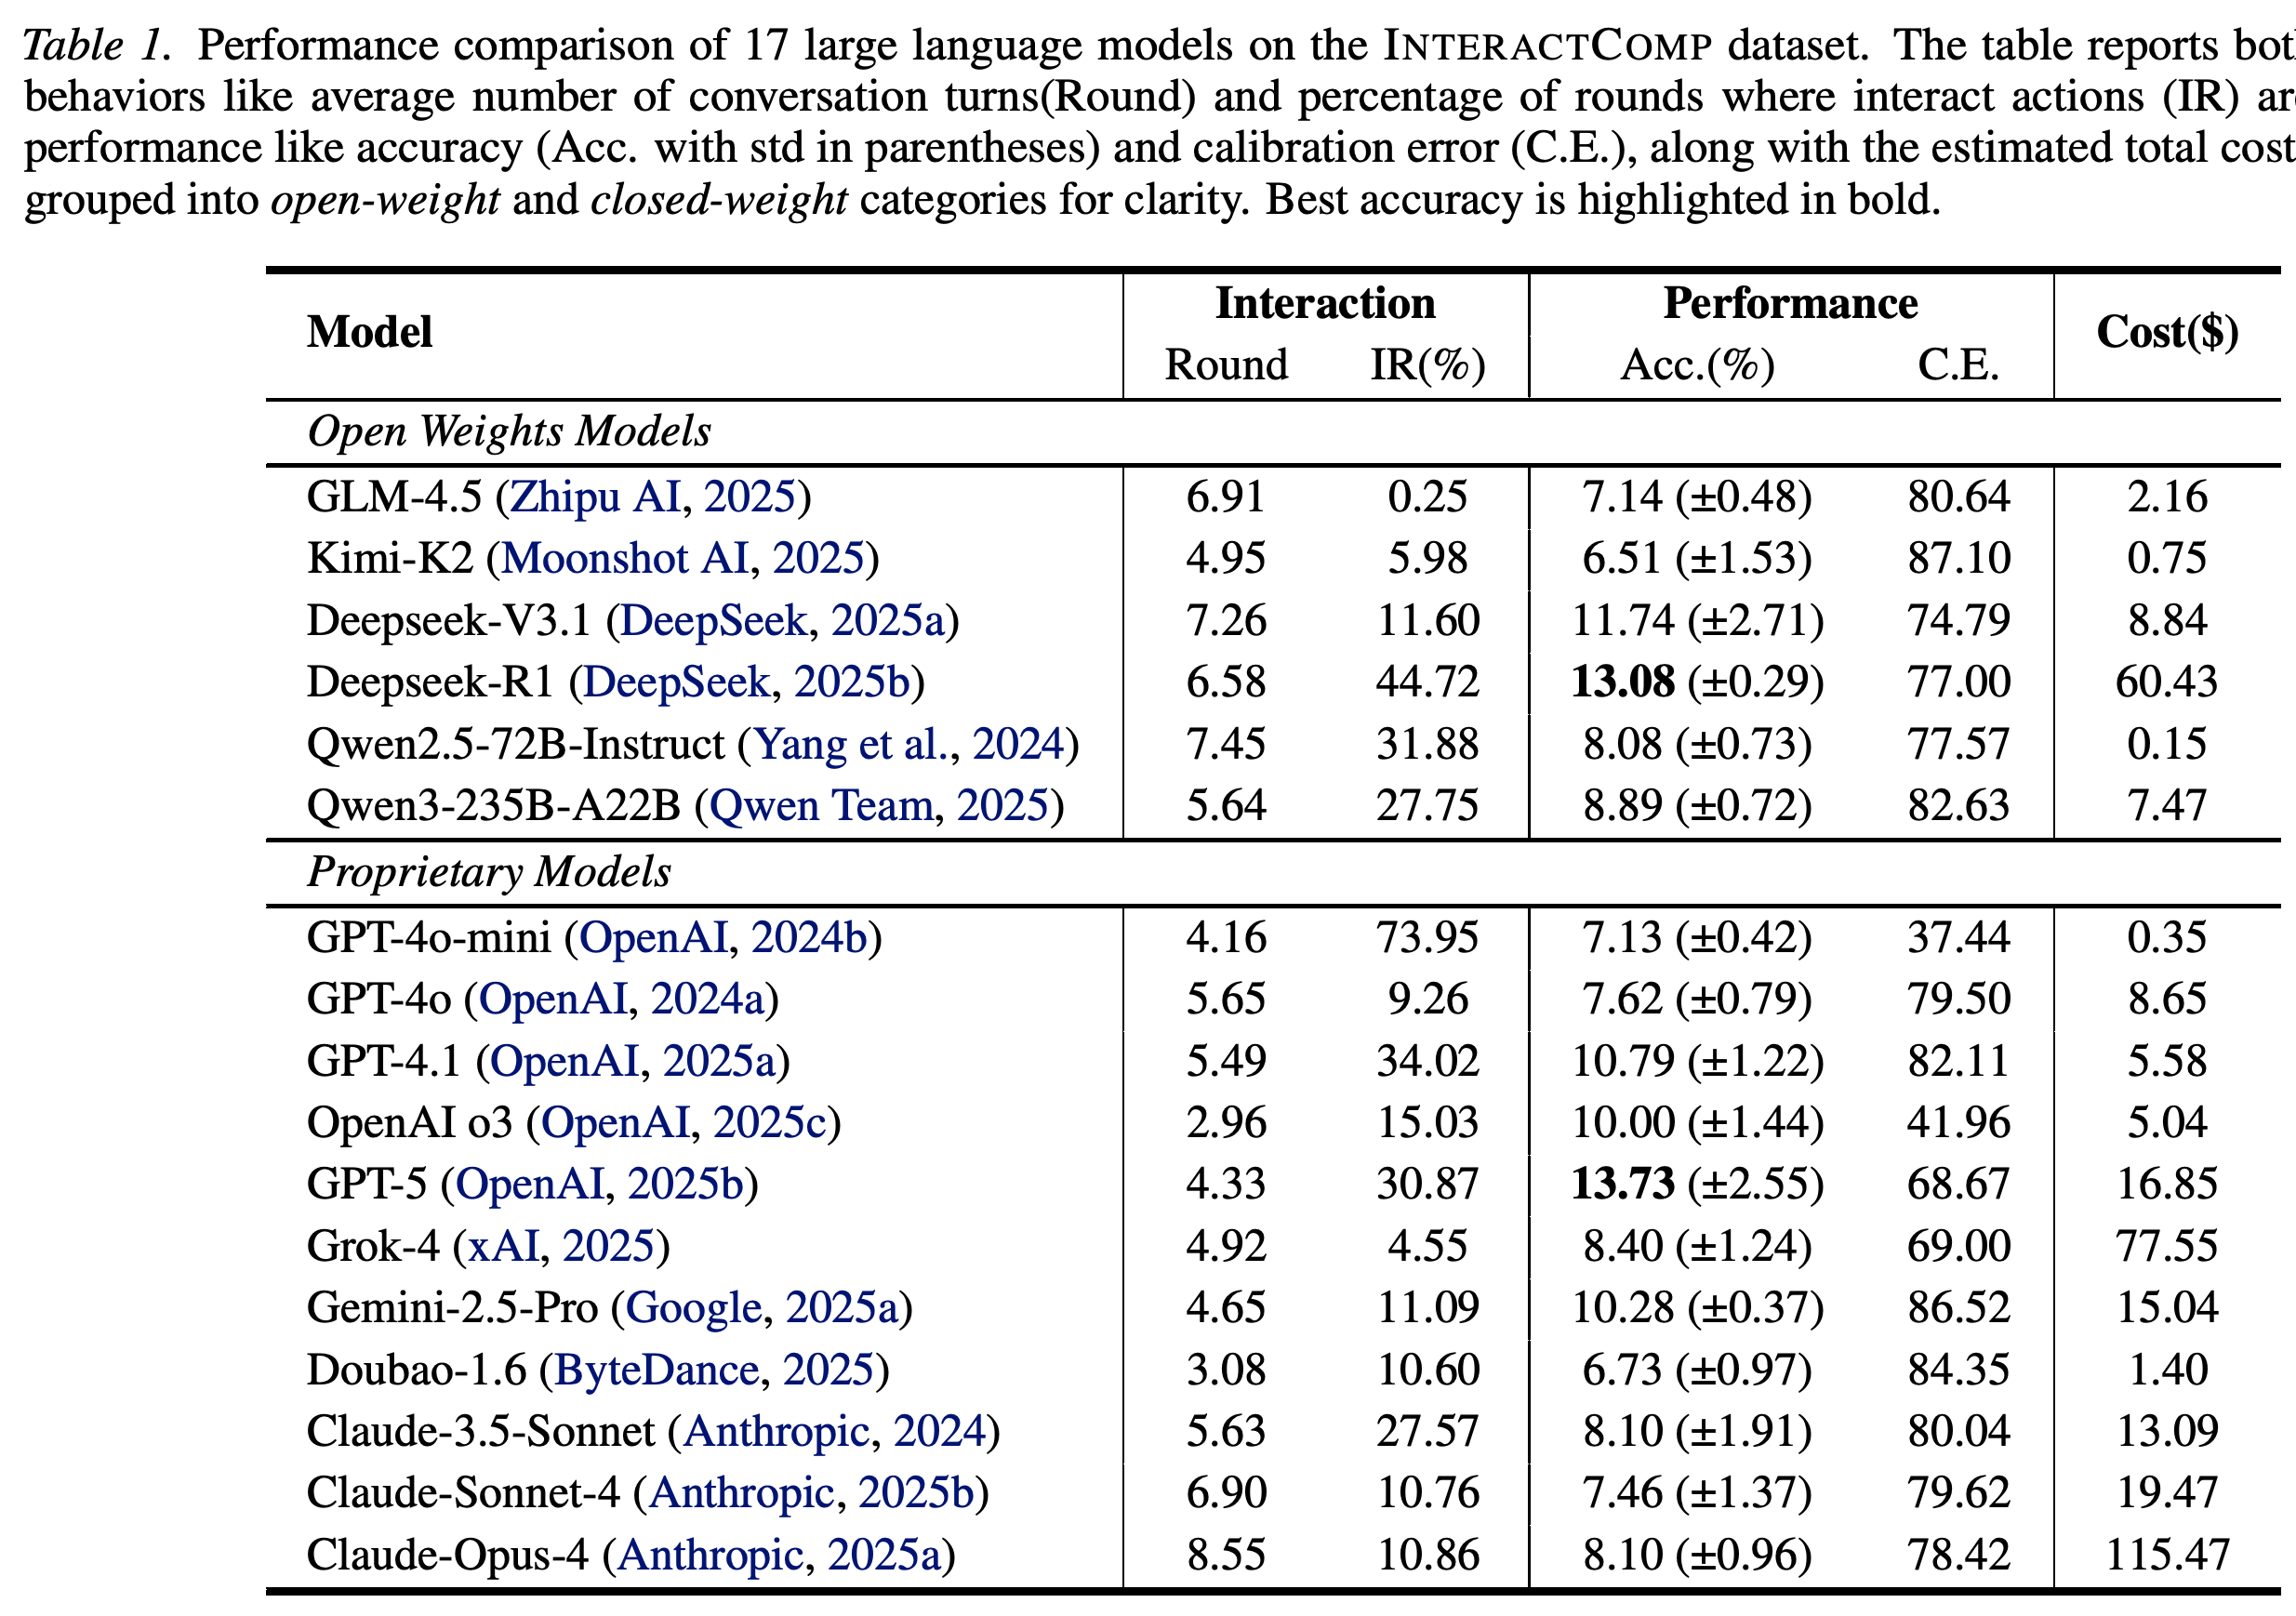
Table 1에서 GPT-5의 정확도는 13.73% (±2.55)다. 가중치가 공개된 open-weight 모델 중 최고 결과는 DeepSeek-R1의 13.08% (±0.29)다. 괄호 안 값은 실행 간 표준편차다. 상호작용 빈도는 크게 다르다. GPT-4o-mini는 라운드의 73.95%에서 상호작용하지만 정확도는 7.13%이고, GLM-4.5는 0.25%에서만 상호작용하며 정확도는 7.14%다.
- GPT-4o-mini의 C.E.는 37.44개로, 84.35를 기록한 Doubao-1.6을 비롯한 여러 모델보다 낮다. 신뢰도 보정이 더 정확해도 정답 개체를 올바르게 식별한다는 보장은 없다. 이러한 모델 간 비교만으로 질문이 보정 개선을 유발한다고 볼 수는 없다.
- 여러 모델의 정확도 차이가 몇 퍼센트포인트에 불과하므로, 논문은 정확한 순위보다 대략적인 성능 구간을 강조한다.
GPT-5는 보고된 최고 정확도인 13.73% (±2.55)를 기록하며 DeepSeek-R1은 13.08% (±0.29)를 기록한다. GPT-4o-mini의 상호작용 비율 73.95%와 정확도 7.13%는 잦은 명확화 질문만으로 성공을 보장할 수 없음을 보여준다. 추정 총비용도 모델마다 크게 다르다.
4.3. Ablation Analysis
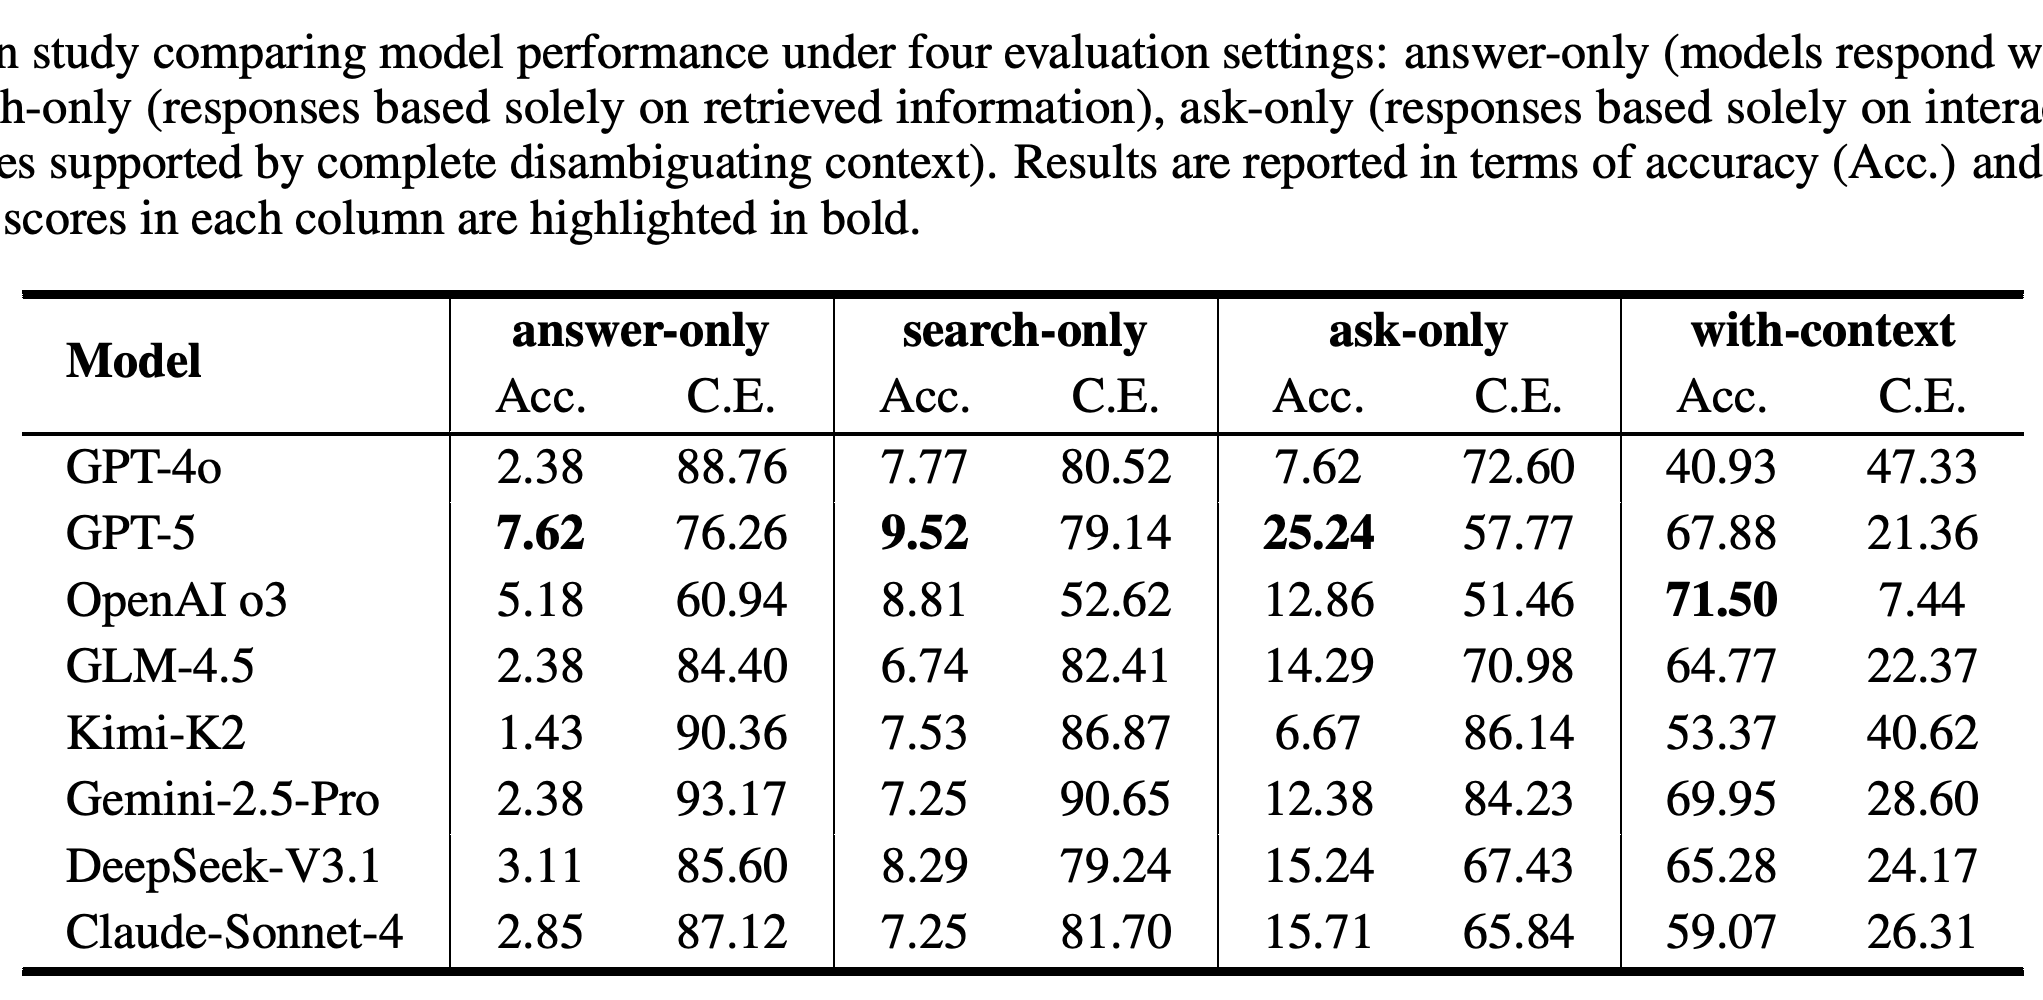
Table 2는 8개 모델에서 사용 가능한 기능을 바꾸어 성능을 비교하는 ablation 결과를 제시한다. answer-only, search-only, ask-only, with-context 조건에서 GPT-5의 정확도는 각각 7.62%, 9.52%, 25.24%, 67.88%다. OpenAI o3는 완전한 맥락을 제공하면 정확도 71.50%와 C.E. 7.44를 기록한다. Table A2는 with-context 조건에서도 검색을 허용하며 라운드 수는 1로 제한한다고 명시한다.
- 검색만 사용하는 조건의 정확도는 6.74%에서 9.52%이고, 맥락을 제공하는 조건의 정확도는 40.93%에서 71.50%다. 이 차이는 모호성을 해소할 정보의 부족이 상당한 병목임을 뒷받침한다. 추론 오류가 없다는 뜻은 아니다.
- Ask-only에서는 명확화 질문을 통해 숨겨진 속성에 접근할 수 있다. 이 조건의 성능만으로 내부 지식만으로 원래의 모호한 질문을 해결한다고 볼 수는 없으며 모든 모델에서 검색만 사용하는 조건보다 성능이 높지는 않다.
GPT-5는 검색만 사용할 때 9.52%, 상호작용만 사용할 때 25.24%, 완전한 맥락을 제공할 때 67.88%를 기록한다. OpenAI o3는 완전한 맥락 조건에서 최고 정확도인 71.50%를 기록한다. 이는 정보 획득이 주요 병목임을 뒷받침하면서도, 완전한 맥락이 모든 오류를 없애지는 못한다는 점을 보여준다.
4.4. Scaling Analysis
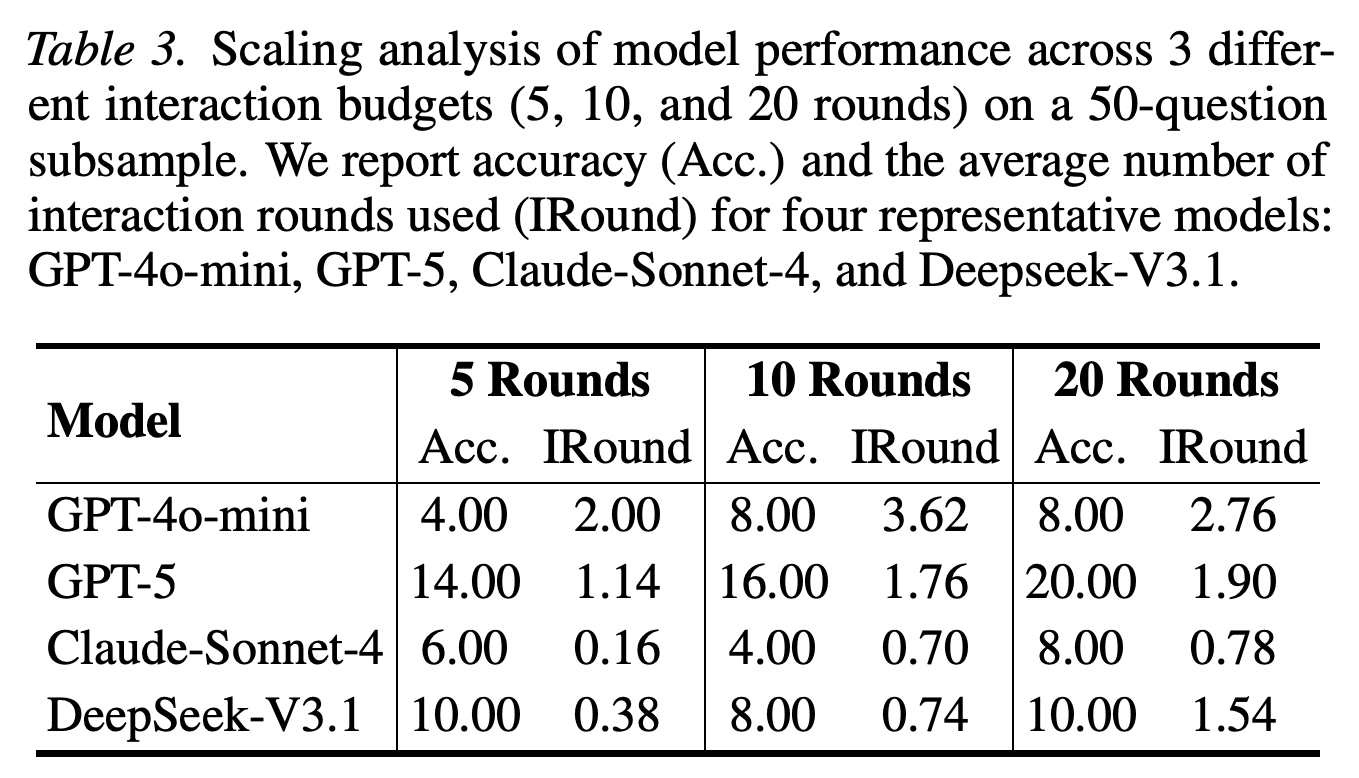
Table 3은 질문 50개의 부분집합에서 허용 라운드 수를 5, 10, 20으로 늘린다. GPT-5의 평균 명확화 질문 횟수는 1.14, 1.76, 1.90으로 증가하고 정확도는 14.00%, 16.00%, 20.00%로 높아진다. Claude-Sonnet-4는 가장 큰 예산에서도 평균 명확화 라운드 수가 0.78에 그친다.
- Figure 4(a)는 자율적으로 사용하는 행동 예산을 늘려도 개선이 제한적임을 보여준다. Figure 4(b)는 명확화 질문을 의무화했을 때의 성능을 비교한다.
- 10라운드에서 20라운드로 늘리면 GPT-4o-mini의 정확도는 8.00%로 유지되고 Claude-Sonnet-4는 4.00%에서 8.00%로, DeepSeek-V3.1은 8.00%에서 10.00%로 높아진다. 예산 증가의 효과는 크지 않으며 모델에 따라 다르다.
패널 (a)는 에이전트가 더 큰 라운드 예산을 자율적으로 사용할 때 개선이 제한적임을 보여준다. 패널 (b)는 명확화 질문을 의무화하면 개선 폭이 더 커지지만 모델마다 다르다는 점을 보여준다. 가로축은 패널 (a)에서 최대 허용 라운드 수, 패널 (b)에서 상호작용 라운드 수다. 따라서 두 패널은 동일한 예산을 사용한 비교를 입증하지 않는다.
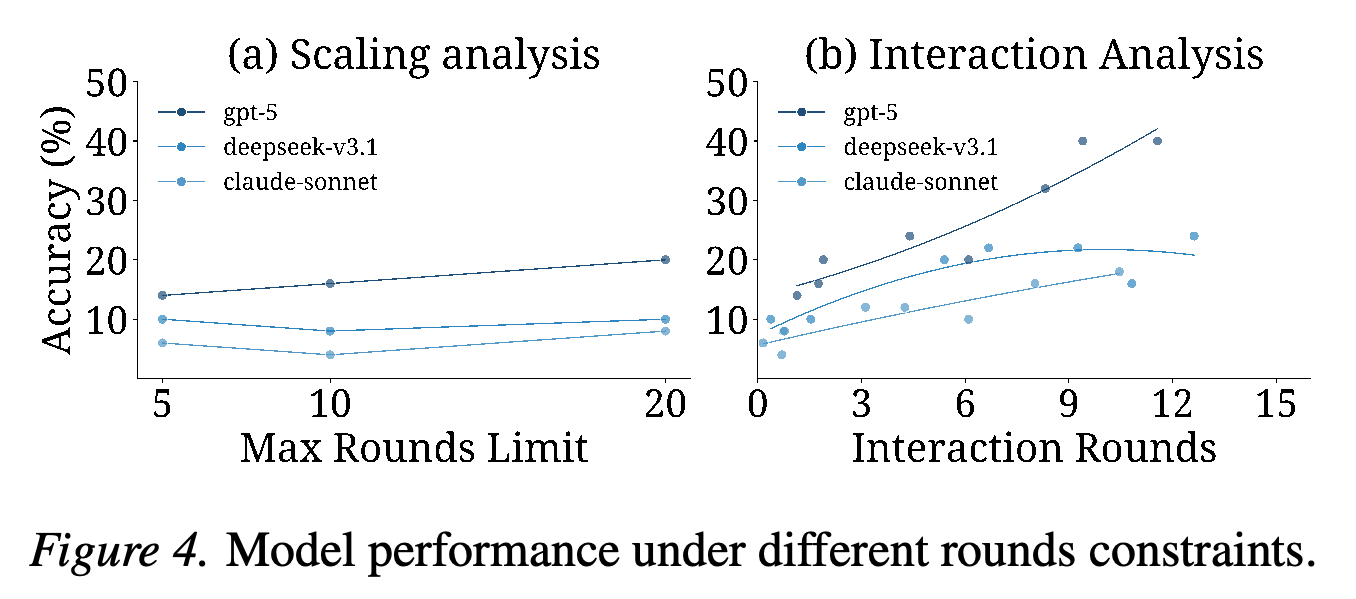
질문 50개에서 GPT-5의 예산을 4배로 늘리면 평균 명확화 질문 횟수는 1.14에서 1.90으로, 정확도는 14.00%에서 20.00%로 높아진다. 다른 모델은 변화가 더 작거나 단조롭지 않으므로, 예산 확대만으로 개선할 수 있다는 근거는 제한적이다.
4.5. Natural Language Interaction Analysis
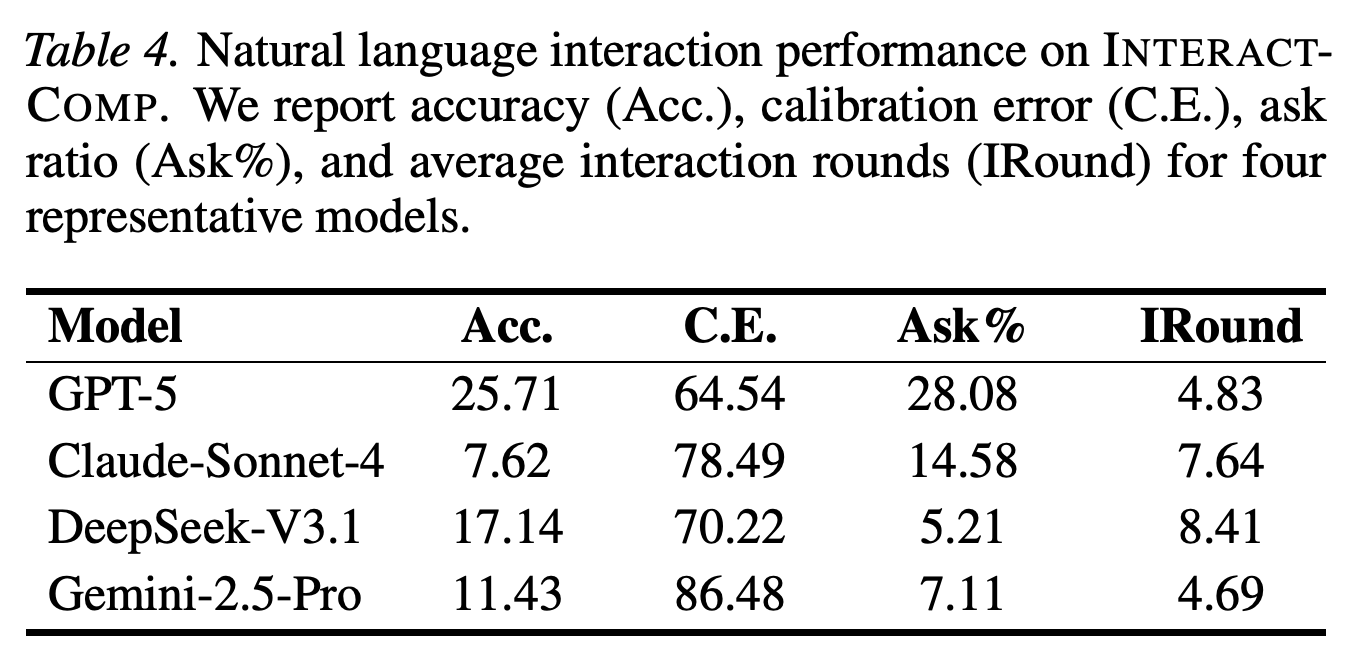
자유 형식의 자연어 응답으로 상호작용하는 askNL 변형은 검색과 명확화 질문을 허용하면서 응답 선택지를 제한하는 규칙을 없앤다. Table 4에서 GPT-5의 정확도는 25.71%, DeepSeek-V3.1은 17.14%다. 다만 GPT-5는 맥락을 제공했을 때의 67.88%보다 여전히 42.17%p 낮다.
- Claude-Sonnet-4는 7.62%, Gemini-2.5-Pro는 11.43%를 기록하므로 효과는 모델마다 다르다.
- 더 풍부한 응답을 제공해도 완전한 맥락 조건과의 차이는 해소되지 않는다. 이는 구별 속성을 알아내는 어려움이 여전히 한계로 남아 있음을 뒷받침한다.
자유 형식의 명확화 응답을 사용하면 GPT-5의 정확도는 25.71%, DeepSeek-V3.1은 17.14%다. Claude-Sonnet-4와 Gemini-2.5-Pro는 이보다 낮다. 4개 모델 모두 Table 2에 제시된 각 모델의 완전한 맥락 조건 정확도보다 낮다.
4.6. Forced Interaction Analysis
상호작용을 강제하는 조건에서는 에이전트가 답하기 전에 최소 2–10개의 명확화 질문을 해야 한다. 본문은 GPT-5가 질문 8개를 의무적으로 수행할 때 정확도 40%에 도달한다고 보고한다. 이는 가장 큰 자율적 예산 조건의 20%보다 높다. 다른 모델에서는 효과가 덜 일관되게 나타난다.
- 이 개입은 사용 가능한 명확화 질문을 충분히 활용하지 않는 것이 실패 원인 중 하나임을 뒷받침한다. 완전한 맥락 조건과의 차이가 남아 있고 효과가 모델마다 다르다는 점은 질문 선택에도 한계가 있음을 시사한다.
- Appendix C.1에서는 상호작용을 강제해도 결과가 단조롭게 개선되지 않으며 평균 상호작용 횟수가 Table A2에 명시된 10라운드 제한을 초과한다. 따라서 강제 라운드를 정확히 어떻게 집계했는지는 불분명하다.
4.7. Error Attribution Analysis
실패한 행동 시퀀스는 검색과 상호작용을 하고도 잘못된 개체를 고르는 식별 오류, 최소한의 상호작용만 하고 답하는 과신 오류, 맥락에 없는 속성이나 잘못된 개체를 묻는 비효율적 질문, 검색을 하고도 근거를 찾지 못하는 검색 실패로 분류한다. GPT-5의 실패 중 70.5%는 과신 오류로, Claude-Sonnet-4의 실패 중 87.8%는 식별 오류로 분류된다.
- Gemini-2.5-Pro의 과신 오류는 23.4%, 식별 오류는 67.6%다.
- 저자들은 언제 상호작용할지 결정하는 전략적 실패와 무엇을 물을지 결정하는 전술적 실패를 구분한다. 이 구분은 관찰된 서로 다른 실패 양상을 설명한다. 이 분석에서는 상호작용을 최소한으로 수행하는 행동을 과신으로 정의한다.
4.8. Longitudinal Study
15개월간의 과거 성능 비교에서 BrowseComp는 약 10%에서 70%로 개선되지만 InteractComp는 약 6–14%에 머문다. Figure 1은 완전한 질의를 사용하는 검색 벤치마크의 성능이 개선되는 동안 이 모호성 해소 평가에서는 비슷한 개선이 나타나지 않았음을 보여준다. 다만 차이의 원인을 분리해 규명하지는 않는다.
5. Conclusion
논문은 구별에 필요한 사용자 정보를 제공하면 더 정확히 답하는 에이전트도, 그 정보를 직접 얻는 데는 자주 실패한다고 결론짓는다. 더 나은 상호작용 정책을 학습하기 위한 신호로 검증 가능한 검색 결과를 활용하자고 제안하지만 이를 입증하는 학습 실험은 보고하지 않는다.
Impact Statement
Impact Statement는 불확실성에 따라 명확화 질문을 수행하는 방식의 활용 분야로 정보 검색, 의사결정 지원, 과제 지향 비서를 제시한다. 사용자 개인정보, 상호작용 피로, 정보 획득을 지나치게 최적화하는 문제도 강조한다. 이에 따라 정보 이득, 사용자 부담, 정확도 사이의 균형을 고려하는 평가가 필요하다고 제안한다.
부록
- A. Benchmark and Implementation Details는 A.1. Instance Example로 시작한다. 이 사례에서는 스위스의 팀 타격 스포츠인 Hornussen에 오답 후보 Baseball을 대응시킨다. 공통된 스포츠 속성으로 모호한 질문을 만들고, 플라스틱 퍽, 나무 수비판, 부채꼴 경기장 같은 숨겨진 정보로 Hornussen을 구별한다.
- A.2. Agent Implementation은 A.2.1. AGENT CONFIGURATIONS, A.2.2. SEARCH IMPLEMENTATION, A.2.3. ACTION SPACE DESIGN을 설명한다. 행동은 search(query), answer(response, confidence), interact(question)다. 검색에는 Google Search를 호출하는 애플리케이션 프로그래밍 인터페이스인 Google Serper API를 사용한다. https://google.serper.dev/search에 제한 시간 30초를 설정한 POST 요청을 보내고 상위 5개 자연 검색 결과를 반환한다. 표준 에이전트는 라운드마다 행동 1개를 수행하며 최대 10라운드를 사용할 수 있다. A.3. Responder Simulation은 숨겨진 맥락과 상호작용 기록을 사용해 3가지 응답 중 하나를 생성하며 대화의 현실성보다 진단의 명확성을 우선한다. 이어지는 A.4. Data Construction Pipeline은 공통 속성과 구별 속성으로 Hornussen 사례를 구성하는 과정을 설명한다.
- A.5. Evaluation Protocol은 동일한 맥락과 질문의 쌍을 k = 3회의 시험에 걸쳐 반복 평가한다. A.6. Calibration Error (C.E.).는 표본 수로 가중한 신뢰도와 정확도의 차이인 Expected Calibration Error (ECE)를 \(\mathrm{ECE}=\sum_{b=1}^{B}\frac{n_b}{N}\left|\mathrm{acc}_b-\mathrm{conf}_b\right|\)로 정의한다. [0,1]을 동일한 폭의 B = 5개 구간으로 나눈다. n_b는 구간 b의 표본 수, N은 전체 유효 표본 수, acc_b와 conf_b는 해당 구간의 정확도와 평균 신뢰도다. 신뢰도 값은 [0,1]로 정규화하고 유효하지 않은 값은 제외한다.
- B. Additional Robustness Analyses의 B.1. Responder Sensitivity는 질문 50개를 평가한다. GPT-4o를 답변 에이전트와 같은 모델인 matched responder로 바꾸면 GPT-5의 정확도는 14.00%에서 20.00%로 높아진다. 다만 평가한 모든 모델은 완전한 맥락 조건보다 성능이 크게 낮다. B.2. Human Validation of the Simulated Responder는 기록 100개와 주석자 2명을 사용한다. 다수 평가자의 일치도를 나타내는 Krippendorff’s α = 0.707을 얻었으며 GPT-4o와 각 주석자의 쌍별 일치도를 나타내는 Cohen’s κ는 0.756과 0.693이다. B.3. Commercial DeepResearch Systems에서는 전체 벤치마크에서 Doubao Deep Search가 10.0%, OpenAI Deep Research가 6.67%를 기록한다.
- B.4. Ranking Consistency Across Runs는 순위 일치도 지표인 Kendall’s τ를 보고한다. Trial 1회와 Trial 2, Trial 1회와 Trial 3, Trial 2회와 Trial 3을 비교한 값은 각각 0.428, 0.595, 0.557이며, 대응하는 p값은 0.020, 0.001, 0.002다. B.5. Interaction Utility Analysis는 질문 50개의 부분집합에서 질문당 평균 믿음 변화, 질문 후 정답률 증가, 유용한 질문의 비율을 측정한다. GPT-4o-mini는 질문 269개를 하고 GPT-5는 113개를 하지만 질문 후 정답률 증가는 각각 2.60%와 11.80%다. 이는 명확화 질문의 빈도와 함께 유용성도 평가해야 함을 뒷받침한다.
- C. Additional Experimental Results and Case Studies에는 C.1. Rounds Constraints Results가 포함된다. 질문을 강제했을 때 개선 정도는 고르지 않다. GPT-5는 40.0%에 도달하지만 GPT-4o-mini는 강제 설정 전반에서 2.0–6.0%에 머문다. C.2. Case Study On Failed Case.는 에이전트가 질문 4개와 검색 3회를 수행한 뒤 Hornussen 대신 “Ice Hockey.”라고 잘못 답하고 신뢰도 75를 부여한 사례를 설명한다. 질문은 퍽과 스틱의 속성에 집중하며 구별에 필요한 경기장이나 수비 장비 정보를 알아내지 못한다. 코드는 https://github.com/FoundationAgents/InteractComp에서 제공한다.
짧은 생각
가장 명확한 근거는 동일한 모델에서 완전한 맥락을 제공했을 때와 그 맥락을 직접 얻어야 할 때 나타나는 정확도 차이다. 질문 의무화와 자유 형식 응답 실험도 이를 뒷받침한다. 상호작용 횟수만으로는 성공을 예측할 수 없으므로, 에이전트가 질문하는지와 그 질문이 후보들을 구별하는지를 함께 측정해야 한다는 점을 결과가 뒷받침한다. 의도적으로 구성한 사례 210개, 고르지 않은 분야별 비중, 제한된 응답 규칙을 따르는 모의 사용자 때문에 일반화에는 한계가 있다. 사람과의 일치도는 모의 사용자를 사용자 피드백의 근사치로 활용할 근거가 된다. 여러 진단 분석은 질문 50개만 사용하며 강제 라운드 집계는 구현 설명과 상세 결과 사이에서 일관되지 않다. 정확한 모델 순위나 강제 예산의 정밀한 비교보다 큰 성능 차이를 뒷받침하는 근거가 더 확실하다.