


Adaptation of Agentic AI: A Survey of Post-Training, Memory, and Skills 요약 설명
18 Dec 2025 | Paper Review Agent Learning Agent's Memory Agentic Skills목차
- 요약
- 1 Introduction
- 2 Background
- 3 Overview of Adaptation Paradigms of Agentic AI
- 4 Agent Adaptation
- 5 Tool Adaptation
- 6 Comparison of Adaptation Paradigms
- 7 Evaluation
- 8 Applications
- 9 Opportunities
- 10 Conclusion
- 부록
- 짧은 생각
이번 글에서는 Adaptation of Agentic AI: A Survey of Post-Training, Memory, and Skills 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 18일(Arxiv)
- Jiang, Pengcheng, Lin, Jiacheng, Shi, Zhiyi, Wang, Zifeng, He, Luxi, Wu, Yichen, Zhong, Ming, Song, Peiyang, Zhang, Qizheng, Wang, Heng, et al.
- UIUC, Stanford, Princeton, Harvard, UC Berkeley, Caltech, UW, UCSD, Georgia Tech, Northwestern, TAMU, MGH, Keiji AI, Unity
- 논문 링크
- Github
요약
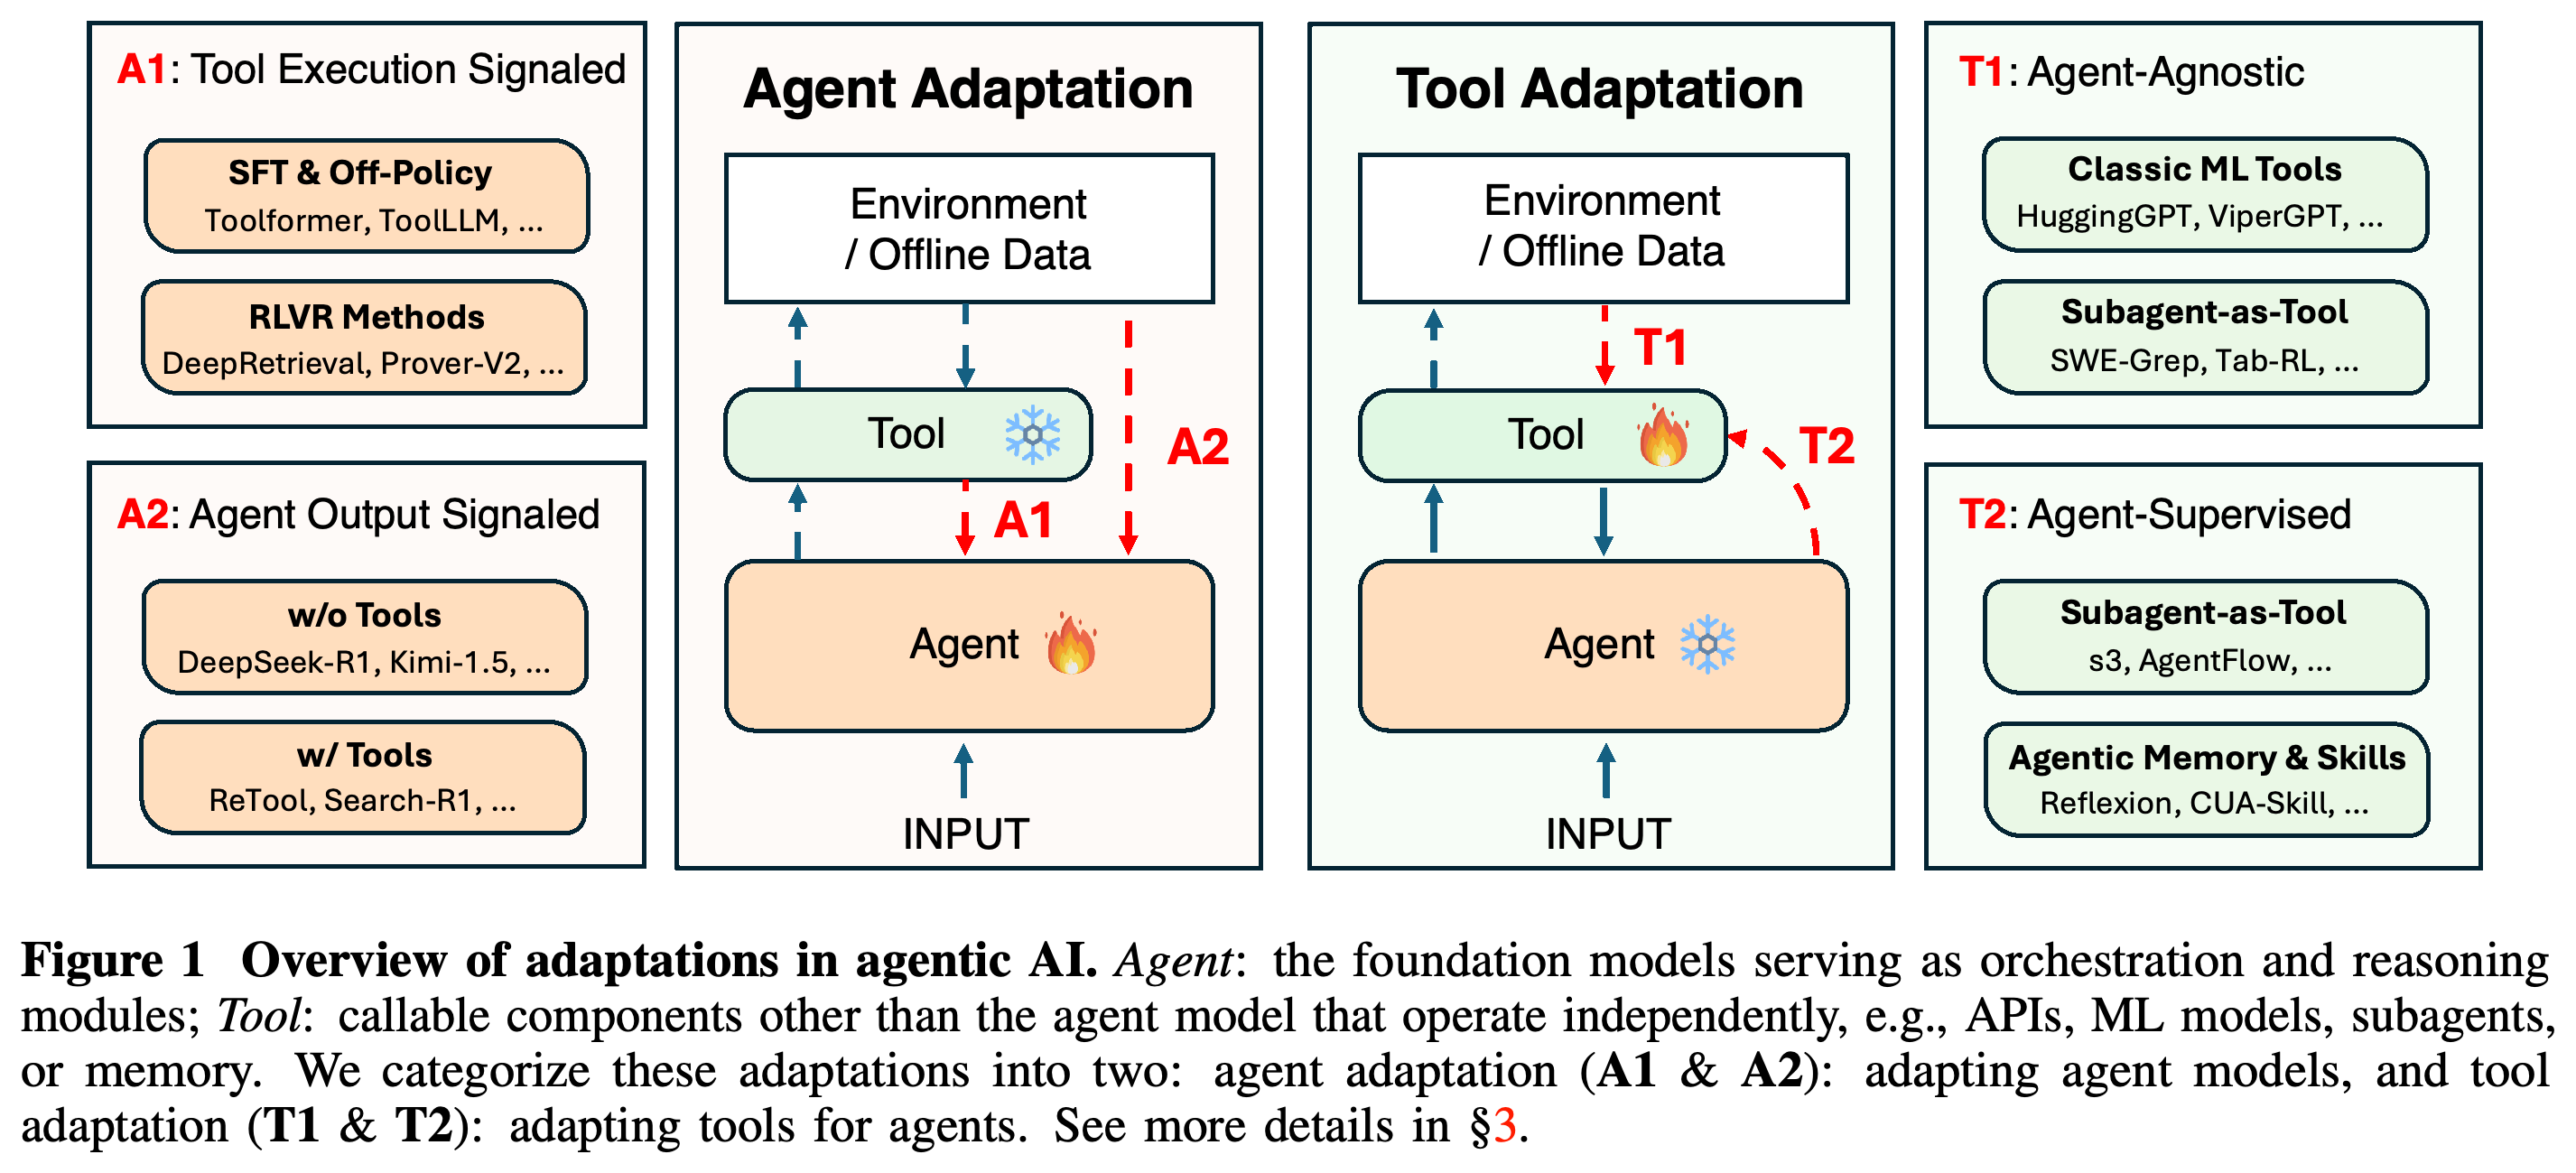
- Adaptation of Agentic AI: A Survey of Post-Training, Memory, and Skills는 에이전트 시스템에서 무엇이 바뀌고 감독 신호가 어디에서 오는지를 기준으로 2026년 초까지 발표된 문헌을 검토한다. 4가지 패러다임은 도구 실행 피드백을 사용하는 에이전트 적응(A1), 평가된 출력을 사용하는 에이전트 적응(A2), 독립적으로 학습한 도구(T1), 고정된 에이전트의 감독으로 적응하는 도구(T2)를 구분한다.
- 이 서베이는 사후 학습을 지속적 메모리 및 재사용 가능한 절차적 스킬과 연결하며, 모델 업데이트, 외부 메모리 관리, 전문화된 서브에이전트를 다룬다. 검색 사례에서는 s3가 학습 샘플 2.4k개로 평균 정확도 58.9%를 기록했다고 보고하며, Search-R1의 학습 예시는 약 170k개다. 다만 백본과 아키텍처가 달라 효율 차이를 패러다임 선택만으로 설명할 수는 없다.
- 평가 프레임워크는 실행 품질, 최종 과제 효용, 학습 동역학, 비용, 안전성, 정렬을 함께 고려한다. 패러다임 간 통제된 비교, 메모리와 스킬의 장기 평가, 안정적인 에이전트-도구 공동 적응은 여전히 미해결 과제다. 이 논문의 기여는 문헌 종합이며, 새로운 시스템을 학습하거나 통제된 실험을 수행한 연구는 아니다.
1 Introduction
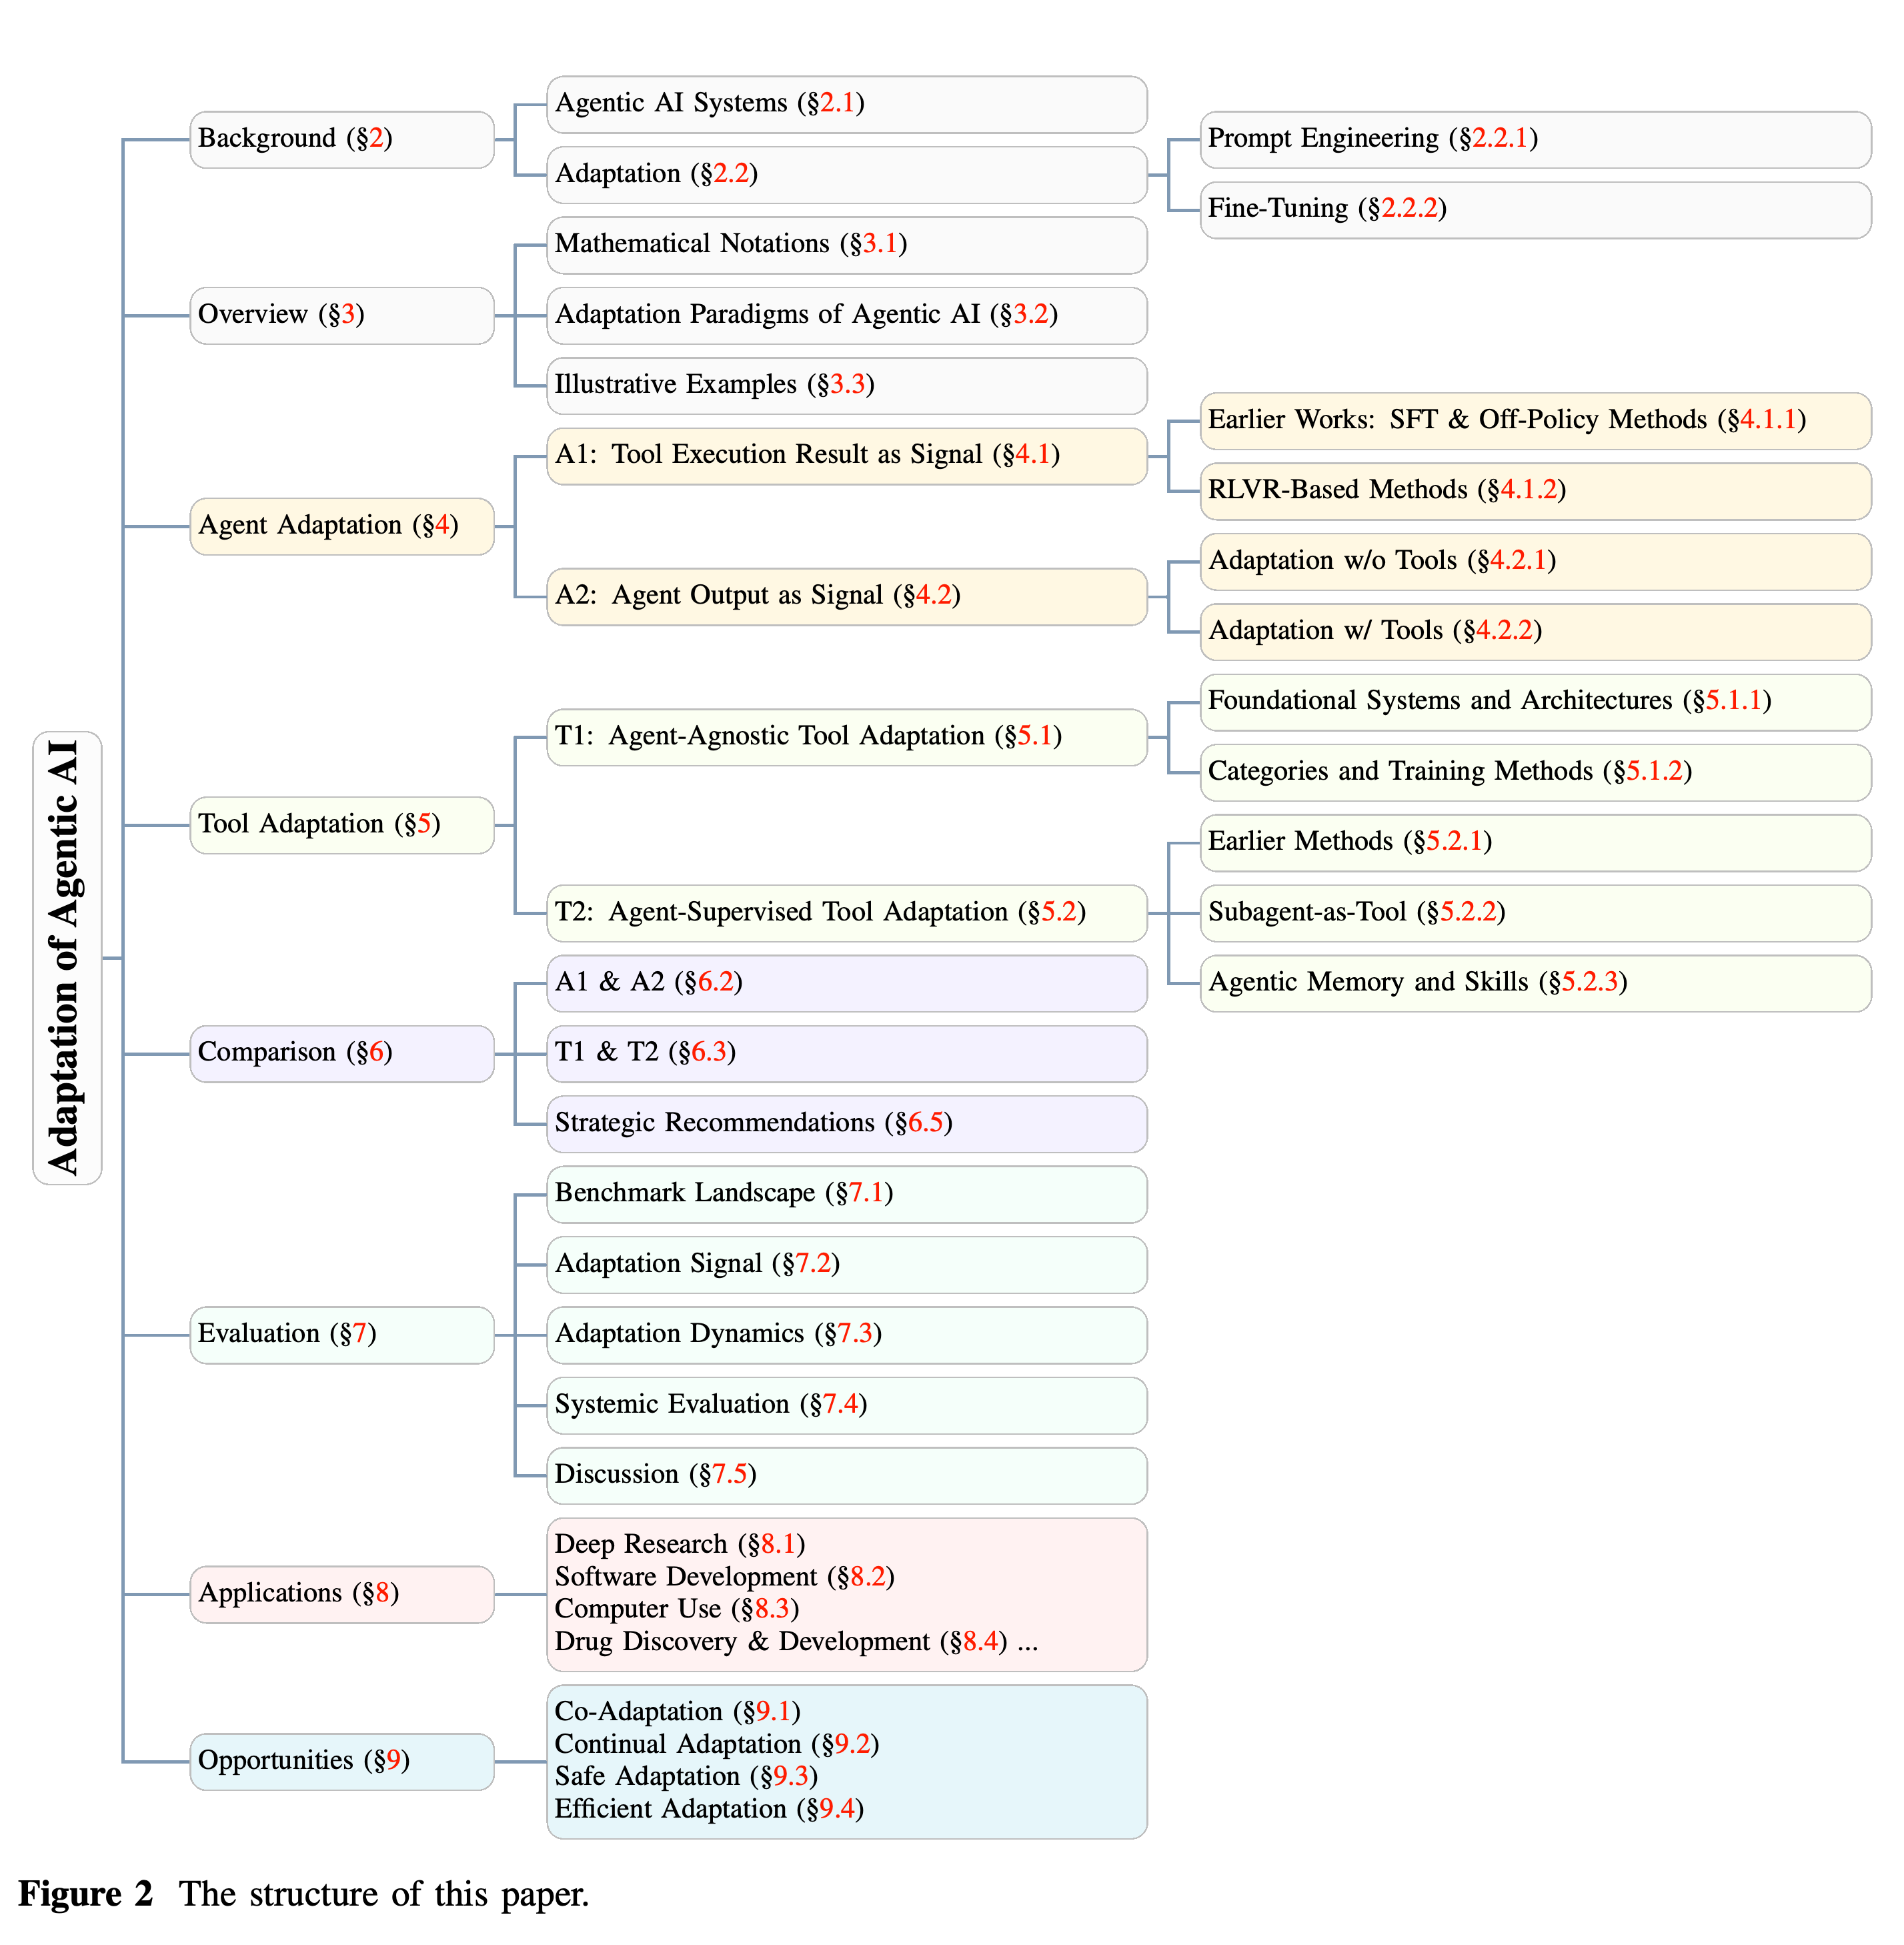
서론은 불안정한 도구 사용, 취약한 장기 계획, 도메인 추론의 부족, 낯선 환경으로의 낮은 전이 성능을 적응이 필요한 이유로 제시한다. 에이전트와 도구의 적응을 분류하면서 사후 학습, 메모리, 스킬을 연결한다. Figure 1은 분류 체계를 요약하고, Figure 2는 논문 구성을 보여준다.
- 각 방법은 주된 최적화 대상과 신호 출처에 따라 분류하며, 중첩 사례와 혼합 사례를 명시한다.
- 명시된 검토 범위는 2026년 초까지이며, 주요 머신러닝 및 NLP 학회와 arXiv 프리프린트를 중심으로 문헌을 수집한다. 방법론 문단에는 검색 질의, 선별 절차, 포함된 문헌 수를 명시하지 않는다.
이 도식은 에이전트의 변경과 호출 가능한 구성 요소의 변경을 구분하고 각각의 감독 경로를 보여준다. 메모리와 스킬을 도구 측에 배치해, 외부에 경험을 축적하는 과정을 모델 학습과 같은 프레임워크 안에 포함한다.
이 계층 구조는 분류 체계를 먼저 설명한 뒤 방법 목록, 비교, 평가, 응용, 연구 기회로 이어진다. 메모리와 스킬은 T2 안에 위치하며, 평가는 각 패러다임을 별도의 차원에서 검토한다.
2 Background
배경에서는 에이전트 시스템의 구성 요소를 정의하고 프롬프트 기반 적응과 미세 조정을 구분한다. 두 접근법은 모델의 입력 맥락과 내부 파라미터를 각각 바꾼다.
2.1 Agentic AI Systems
에이전트 AI 시스템은 파운데이션 모델에 계획, 도구 사용, 메모리를 결합해 환경 피드백을 활용하는 다단계 과제를 수행한다. 논문은 단일 에이전트 적응을 중심으로 다룬다고 명시하지만, 후반부 사례에는 다중 에이전트 조정도 포함한다.
- 정적 계획은 과제를 추론 경로로 분해한다. ReAct와 Reflexion이 보여주는 동적 계획은 관찰과 과거 결과를 바탕으로 계획을 수정한다.
- 도구 선택과 도구 출력 해석은 적응의 대상이 될 수 있다. 단기 메모리는 현재 과제를 지원하고, 장기 메모리는 세션을 넘어 지식과 경험을 유지한다.
- 메모리 설계에는 표현, 보존, 검색, 추론 과정에의 통합이 포함된다. 이 서베이는 대부분의 외부 적응형 메모리를 도구로 취급하되, 파라미터 기반 사례와 혼합 사례를 구분한다.
2.2 Adaptation
Prompt Engineering은 모델 가중치를 업데이트하지 않고 지시, 예시, 목표, 제약을 바꾼다. Fine-Tuning은 전체 미세 조정이나 LoRA와 같은 파라미터 효율적 방법으로 파라미터를 업데이트한다. SFT는 시연을 모방하고, DPO는 선호 신호를 사용하며, PPO나 GRPO는 보상이 주어지는 상호작용을 통해 행동을 최적화한다.
- 프롬프트 적응에는 추가 모델 학습이 필요하지 않다. 파라미터 업데이트는 과제별 행동을 모델에 내재화할 수 있지만 학습 자원이 필요하다.
- 논문은 LoRA가 일반적으로 1% 미만의 파라미터를 업데이트하면서 전체 미세 조정과 비슷한 품질을 달성한다고 설명한다. 이는 인용 문헌을 일반화한 설명이며, 서베이가 직접 입증한 결과는 아니다.
- RL은 완전한 시연 없이도 보상으로 학습할 수 있지만, 논문은 SFT보다 안정화하기 어렵다고 설명한다.
3 Overview of Adaptation Paradigms of Agentic AI
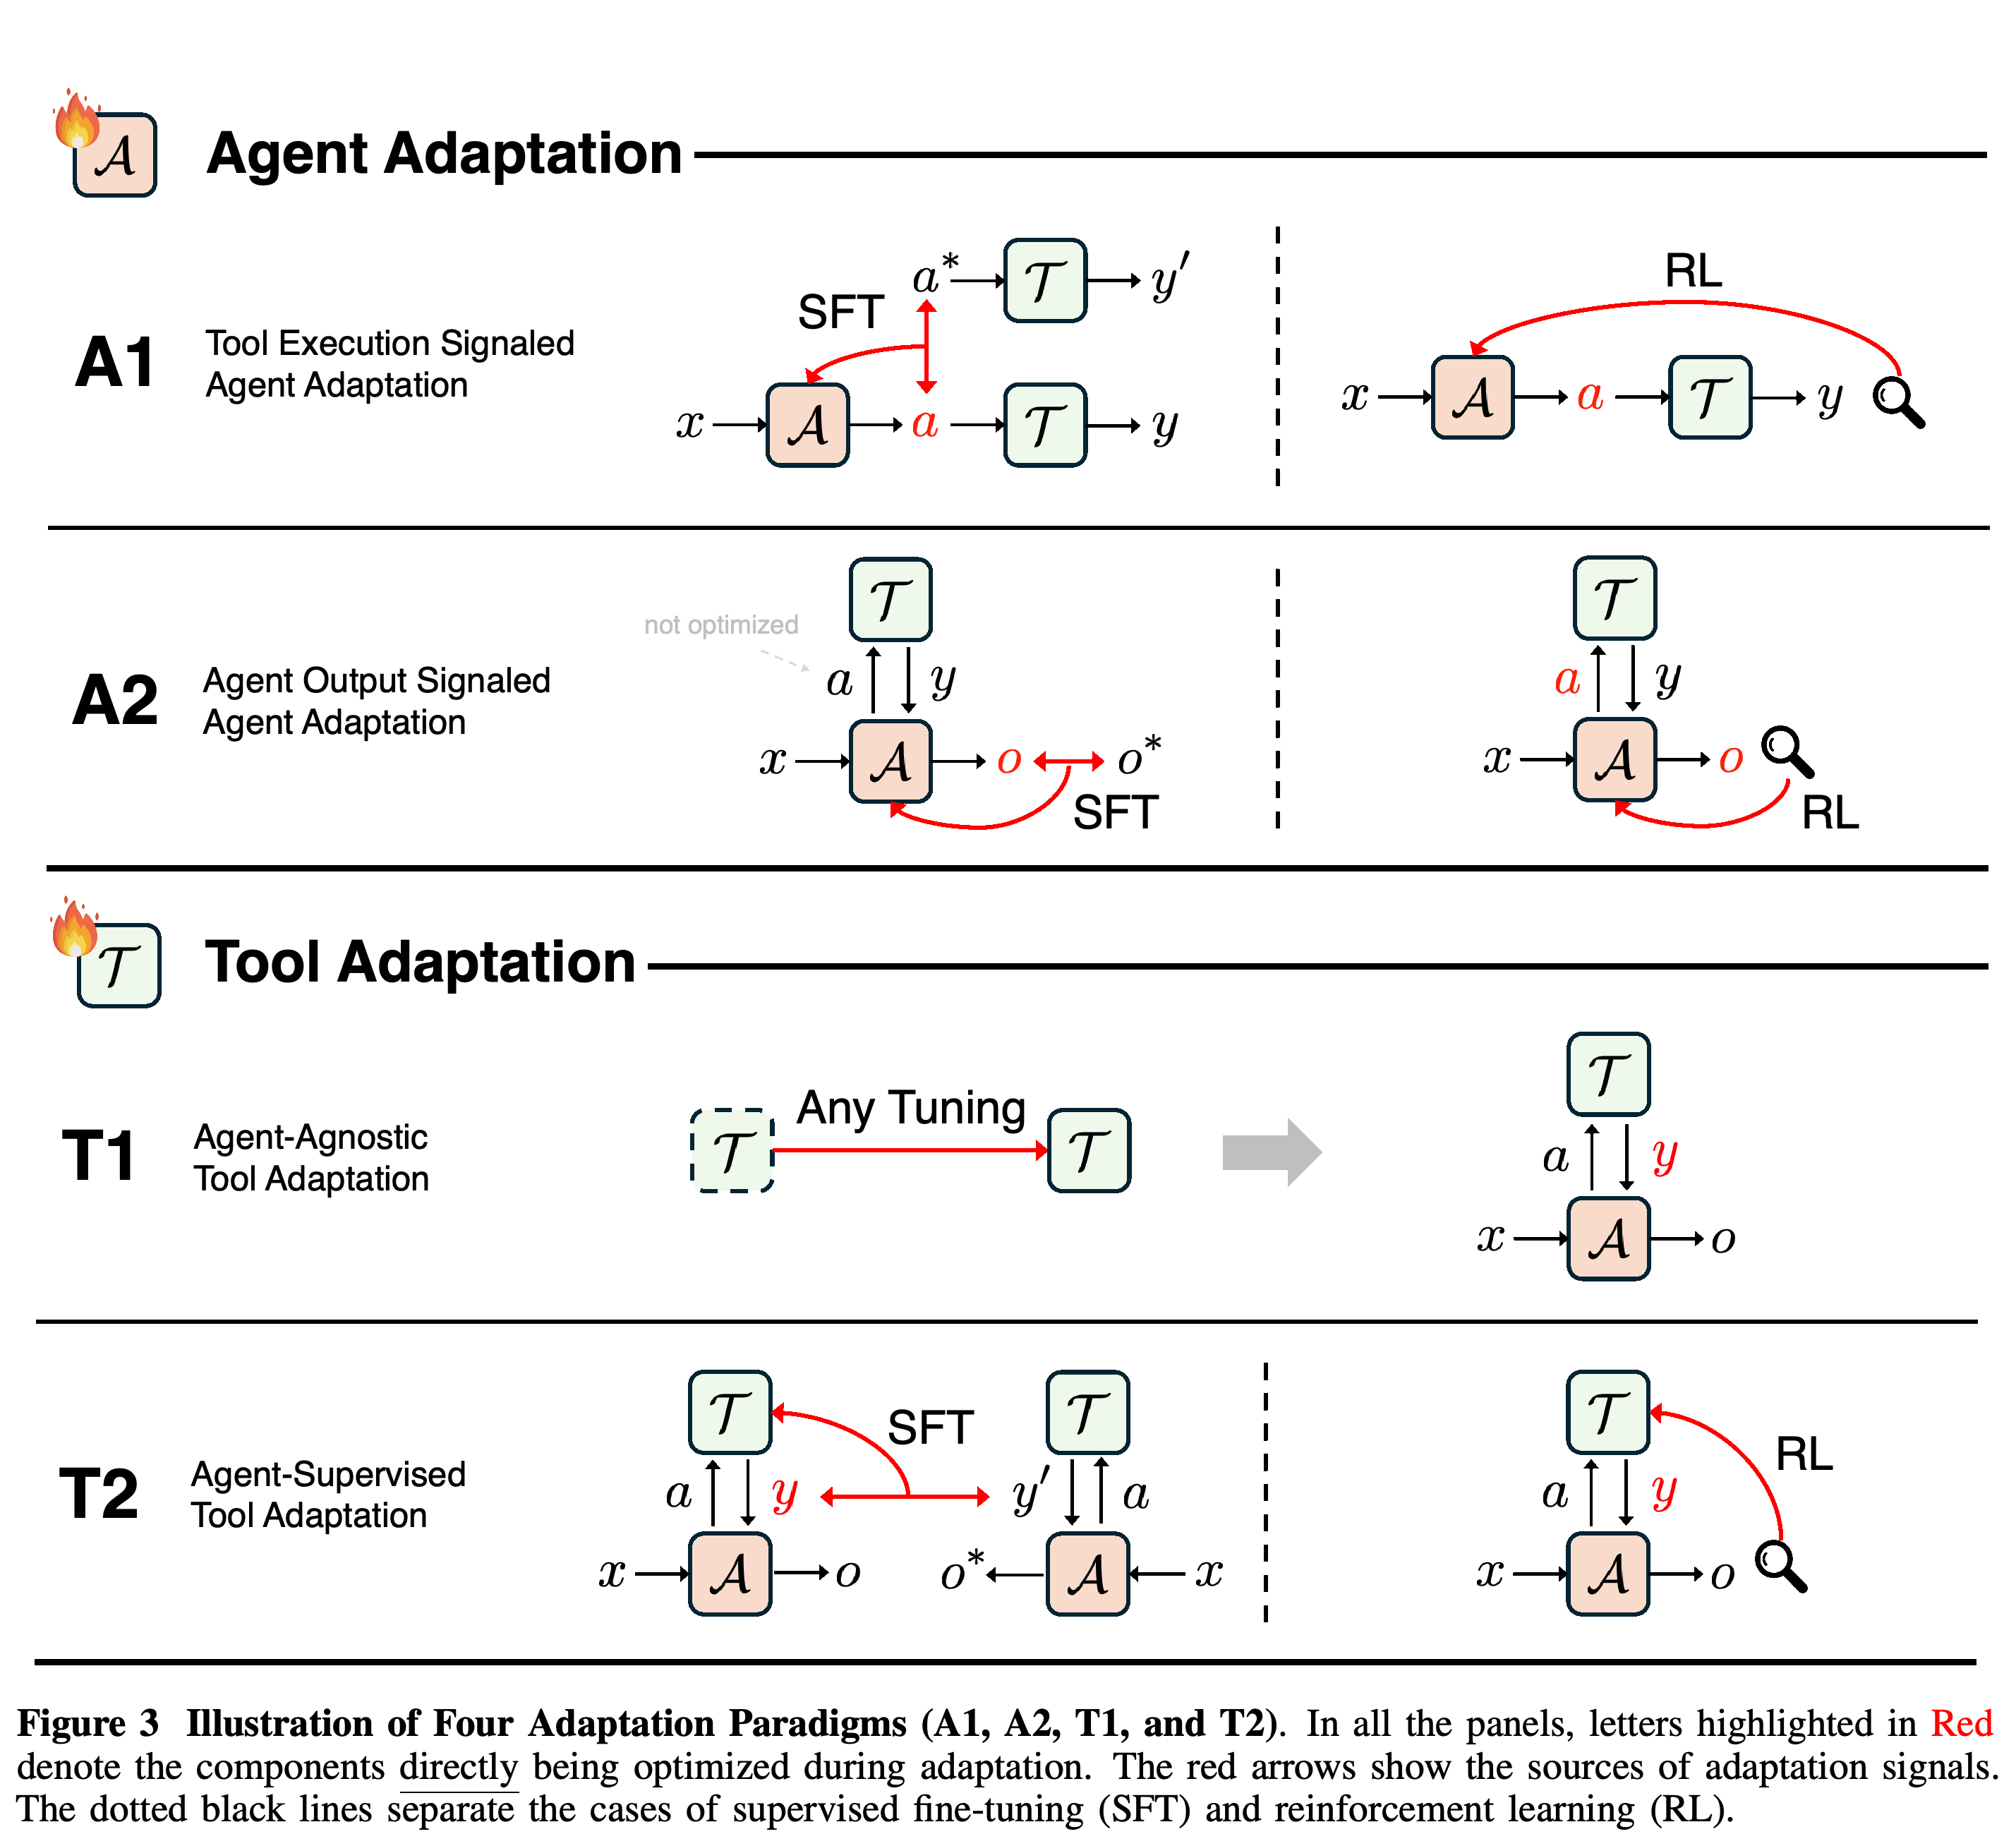
이 프레임워크는 적응하는 구성 요소와 감독 신호의 출처에 따라 방법을 분류한다. Figure 3은 SFT와 RL에서 최적화되는 구성 요소와 피드백 경로를 보여준다.
3.1 Mathematical Notations
표기 체계는 적응 대상, 데이터 출처, 목적을 구분한다. 적응 대상은 에이전트와 외부 도구이며, 데이터 출처는 오프라인 데이터와 상호작용 환경이고, 목적은 성능이나 정렬을 측정하는 지표로 표현한다. 오프라인 데이터에는 시연, 합성 궤적, 상호작용 로그가 포함될 수 있고, 환경은 온라인 피드백을 제공한다.
- 에이전트는 추론과 의사결정을 담당하는 파운데이션 모델이다. 도구에는 검색기, 계획기, 실행기, 시뮬레이터, 동적 외부 메모리가 포함된다.
- 목적에는 오프라인 학습을 위한 모방 손실과 환경 상호작용에서 사용하는 과제 성공 등의 결과 지표가 포함된다.
- 파라미터 기반 메모리와 혼합 메모리는 에이전트와 도구의 경계를 넘나들 수 있다. 따라서 어떤 파라미터나 외부 저장소가 바뀌는지에 따라 분류가 달라진다.
3.2 Four Adaptation Paradigms of Agentic AI
A1은 평가된 도구 실행 결과로 에이전트를 최적화한다. A2는 도구 사용 여부와 관계없이 에이전트의 최종 출력으로 에이전트를 최적화한다. T1은 특정 에이전트와 독립적으로 도구를 학습하고, T2는 고정된 에이전트가 후속 과제에서 얻는 효용을 높이도록 도구를 적응시킨다.
- A1 SFT는 성공한 참조 행동을 모방하고, A1 RL은 실행 결과에 보상을 부여한다. 답변 감독만으로는 도구 호출을 학습하지 못할 수 있으므로 A2 SFT는 도구 호출 모방과 최종 답변 감독을 결합할 수 있다.
- T2 감독은 최종 출력 품질로 궤적에 가중치를 부여하거나, 출력 일관성에서 도구의 학습 목표를 도출하거나, 동결된 에이전트의 최종 과제 성능에 보상을 부여할 수 있다.
- 동결된 에이전트의 출력으로 업데이트하는 외부 메모리는 주로 T2에 속하고, 독립적으로 학습한 메모리 구성 요소는 주로 T1에 속한다. 에이전트 자체 파라미터의 변경은 A1이나 A2에 속하며, 보조 파라미터의 업데이트는 경계 사례를 만든다.
강조된 경로는 도구 결과에 기반한 최적화와 에이전트 최종 출력에 기반한 최적화를 구분한다. T2는 고정된 에이전트를 거쳐 도구에 감독 신호를 전달하며, T1 학습은 해당 도구를 사용하는 호스트와 독립적이다.
3.3 Illustrative Examples
검색과 코드의 대응 사례는 같은 도구 상호작용도 보상을 어디에서 계산하느냐에 따라 다른 패러다임에 속할 수 있음을 보여준다. DeepRetrieval은 검색 품질에 보상을 부여하고, Search-R1은 최종 답변을 평가하며, ReTool은 실행한 코드를 맥락에 포함한 뒤 최종 응답에 보상을 부여한다.
- DeepSeek-R1의 코드 학습은 보상이 샌드박스 테스트 케이스 통과율에서만 나올 때 A1으로 분류한다. 이 분류는 해당 조건에 달려 있다.
- 대조 학습된 밀집 검색기는 이를 사용하는 에이전트와 독립적으로 학습했을 때 T1에 속한다. 학습된 질의 재작성 에이전트도 동결한 뒤에는 T1 도구로 사용할 수 있다.
- s3와 AgentFlow는 T2 사례다. 검색이나 계획 구성 요소가 고정된 생성기의 후속 출력 품질을 통해 학습한다.
4 Agent Adaptation
에이전트 적응은 실행 방식이나 전체 추론과 조정을 대상으로 삼을 수 있다. A1 피드백은 실행 실패를 식별하고, A2는 과제 결과에 보상을 부여하지만 중간 의사결정별 기여를 구분하기 더 어렵다. 어느 신호든 밀도는 구현 방식에 따라 달라진다.
4.1 A1: Tool Execution Result as Signal
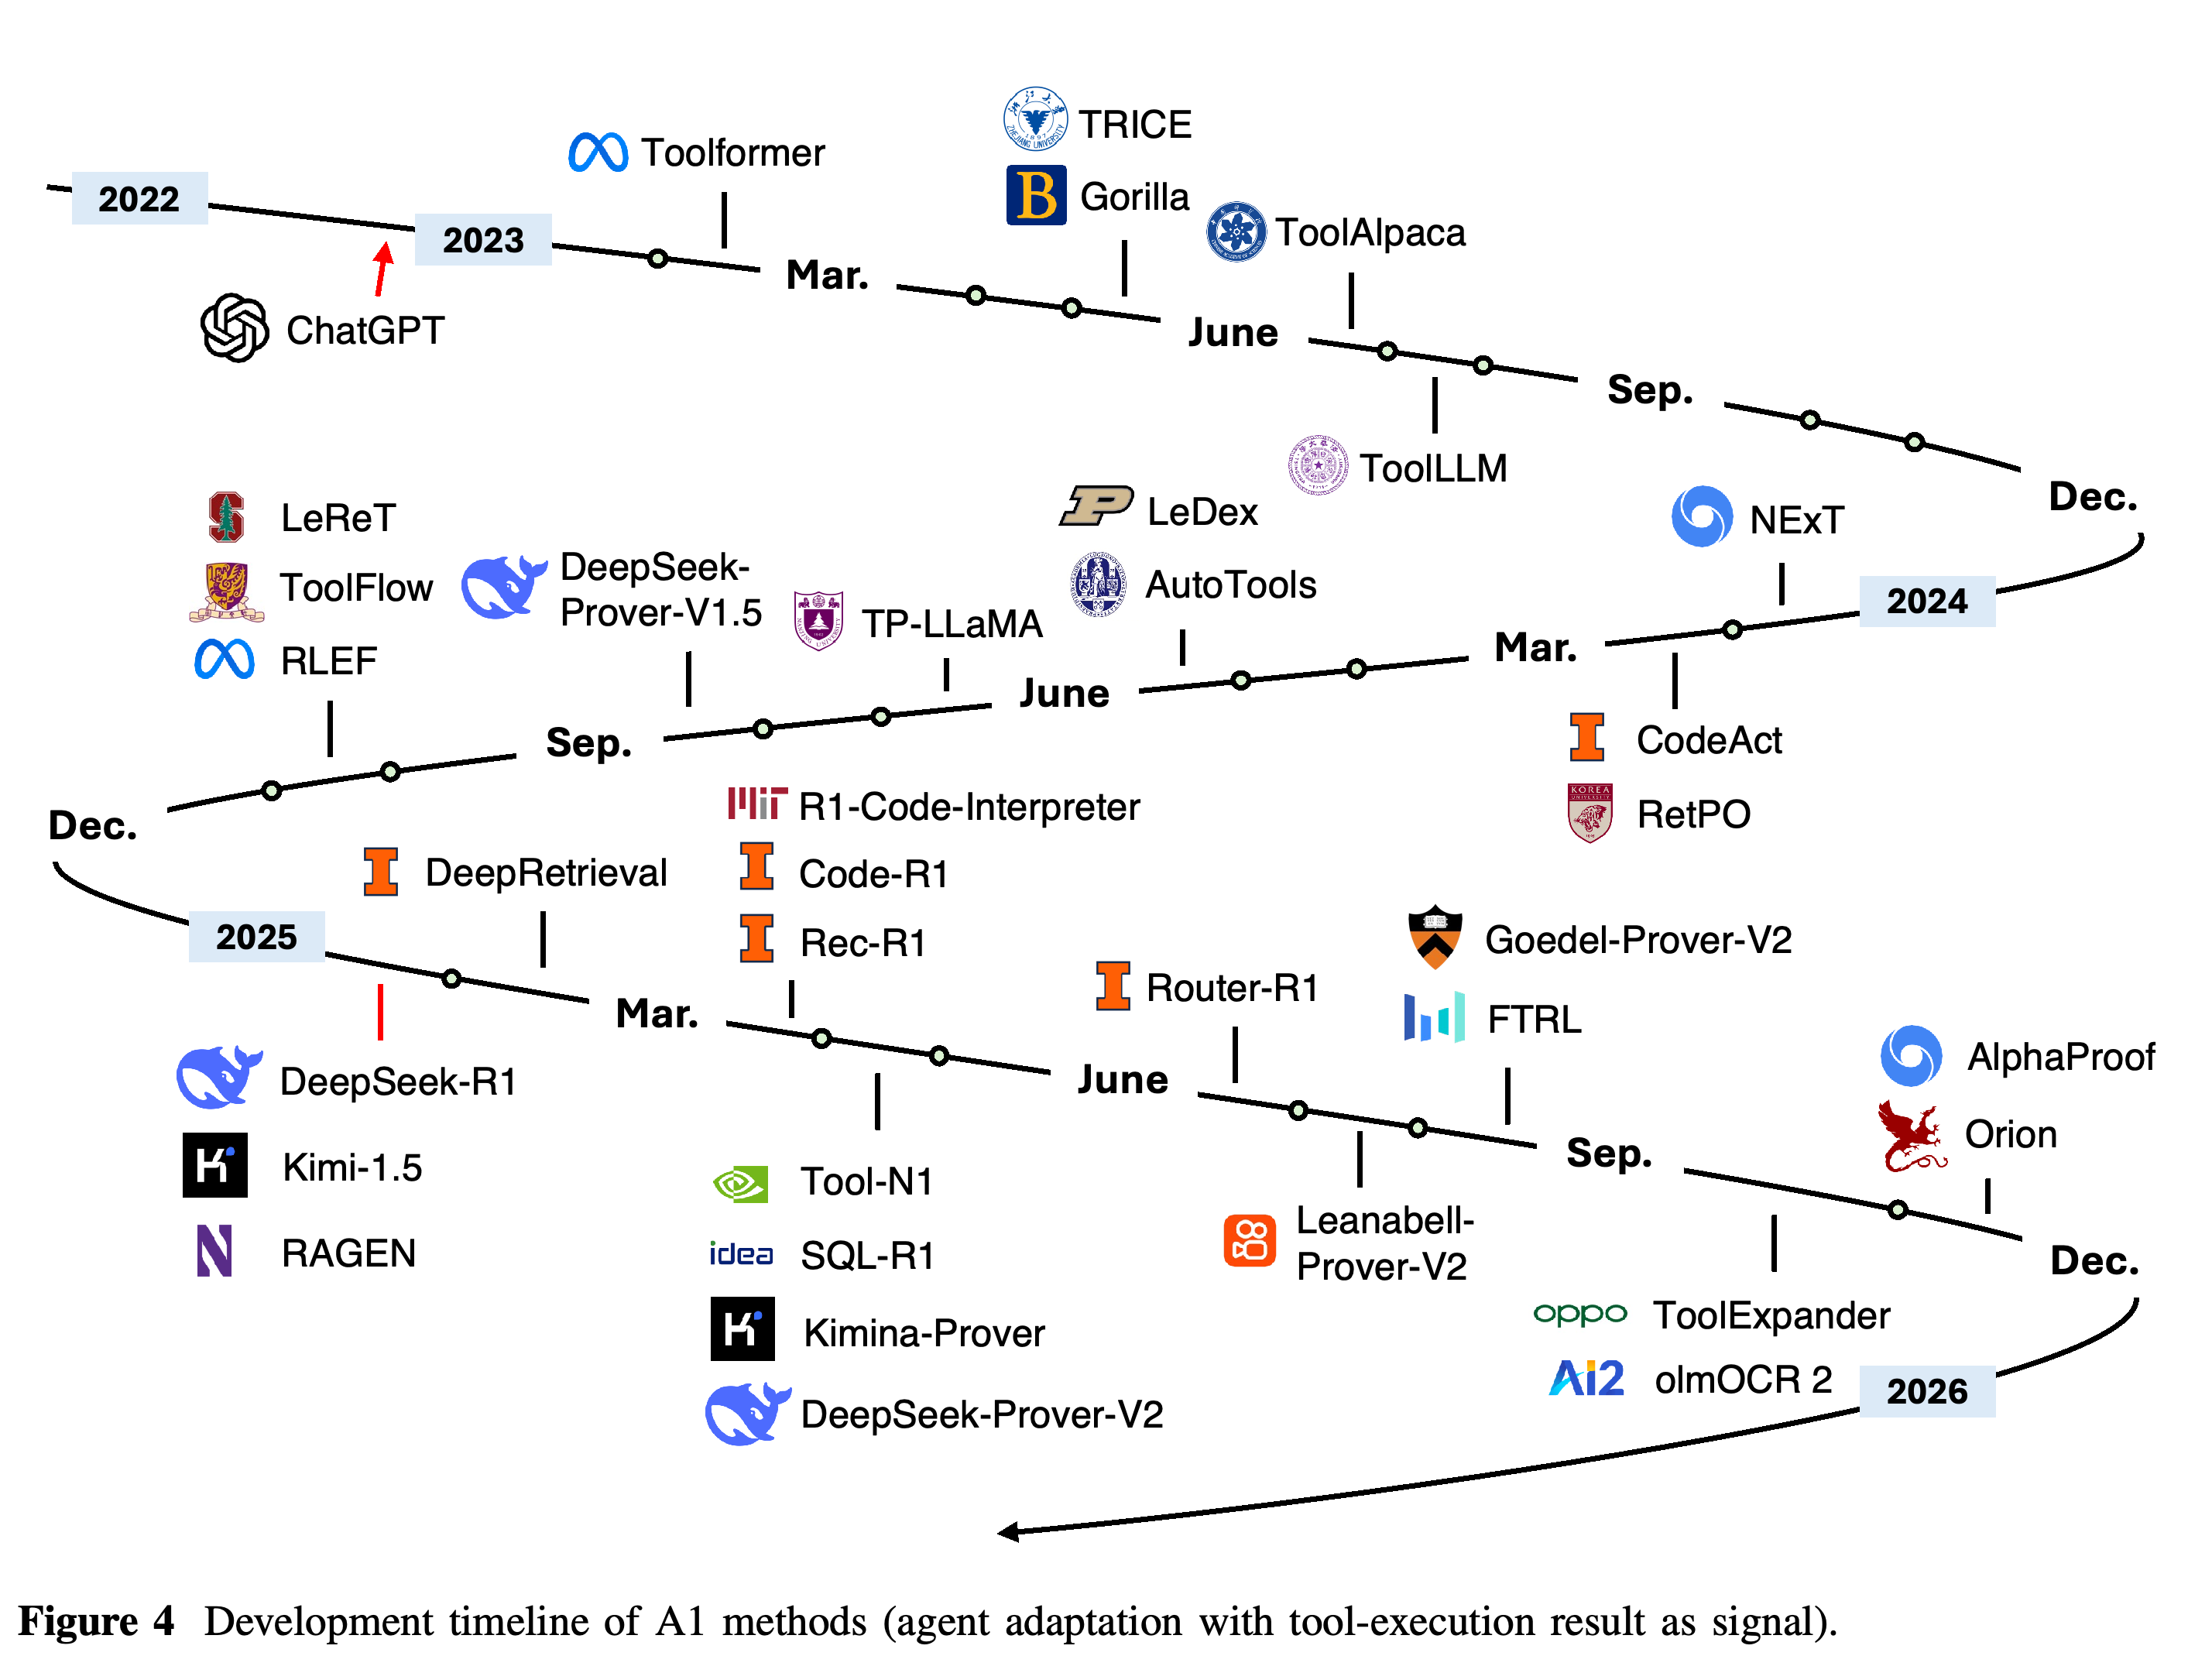
A1 방법은 평가된 도구 결과를 감독 신호로 사용한다. 다만 개별 호출의 성공만으로는 호출을 조합해 과제를 해결했다고 볼 수 없다. Figure 4와 Table 1은 검색, 코드, 형식 증명, 라우팅, SQL, 추천, OCR에 걸쳐 SFT, off-policy 선호 학습, RLVR 방법을 정리한다.
- Earlier Works: SFT & Off-Policy Methods는 정답 일치, 표준 형식 일치, 직접 실행을 기준으로 한 정렬을 구분한다. Toolformer는 우도 개선을 기준으로 호출을 선택한다. ToolAlpaca는 성공한 궤적을 유지하고, TRICE는 실행 결과를 활용한 응답의 순위를 매기며, TP-LLaMA는 실패한 분기를 비선호 예시로 사용한다.
- Gorilla는 호출 구조를 확인하는 데 AST matching을 사용하고, ToolFlow는 일관된 다중 도구 학습 데이터를 구성한다. 구조적으로 유효해도 의미상 잘못된 호출일 수 있다. CodeAct, NExT, AutoTools, LeReT, RetPO는 코드 생성, 수정, 도구 구성, 질의 재작성에 실행 정보를 사용한다.
- RLVR-Based Methods는 보상 밀도와 구성을 강조한다. DeepRetrieval은 recall 65.1% 대 24.7%를 보고한다. RLEF는 다중 턴 공개 테스트 피드백을 사용하고, Code-R1은 신뢰할 수 있는 보상 파이프라인을 우선하며, 증명 보조기는 검증 가능한 증명 상태 전이를 제공한다.
- 검토한 다중 도구 방법은 라우팅, 환경 구성, 단계별 피드백을 다룬다. 종합 논의는 rollout과 실행 비용을 고려하면서 보상 품질, 과제 및 형식 보상, KL 정규화, 커리큘럼, 샘플링을 강조한다.
이 연대기는 코드, 검색, 증명, 라우팅, OCR에 걸쳐 초기 도구 사용 학습과 이후 실행 보상 방법을 정리한다. 비교 가능한 성능이나 도입률 측정값 없이 역사적 위치를 보여준다.
이 목록은 SFT 및 off-policy 방법과 RLVR을 구분하고 과제, 도구, 백본, 튜닝 절차를 기록한다. 서로 다른 조건의 행들은 공통 실험 비교가 아니라 A1 구현 사례를 설명한다.
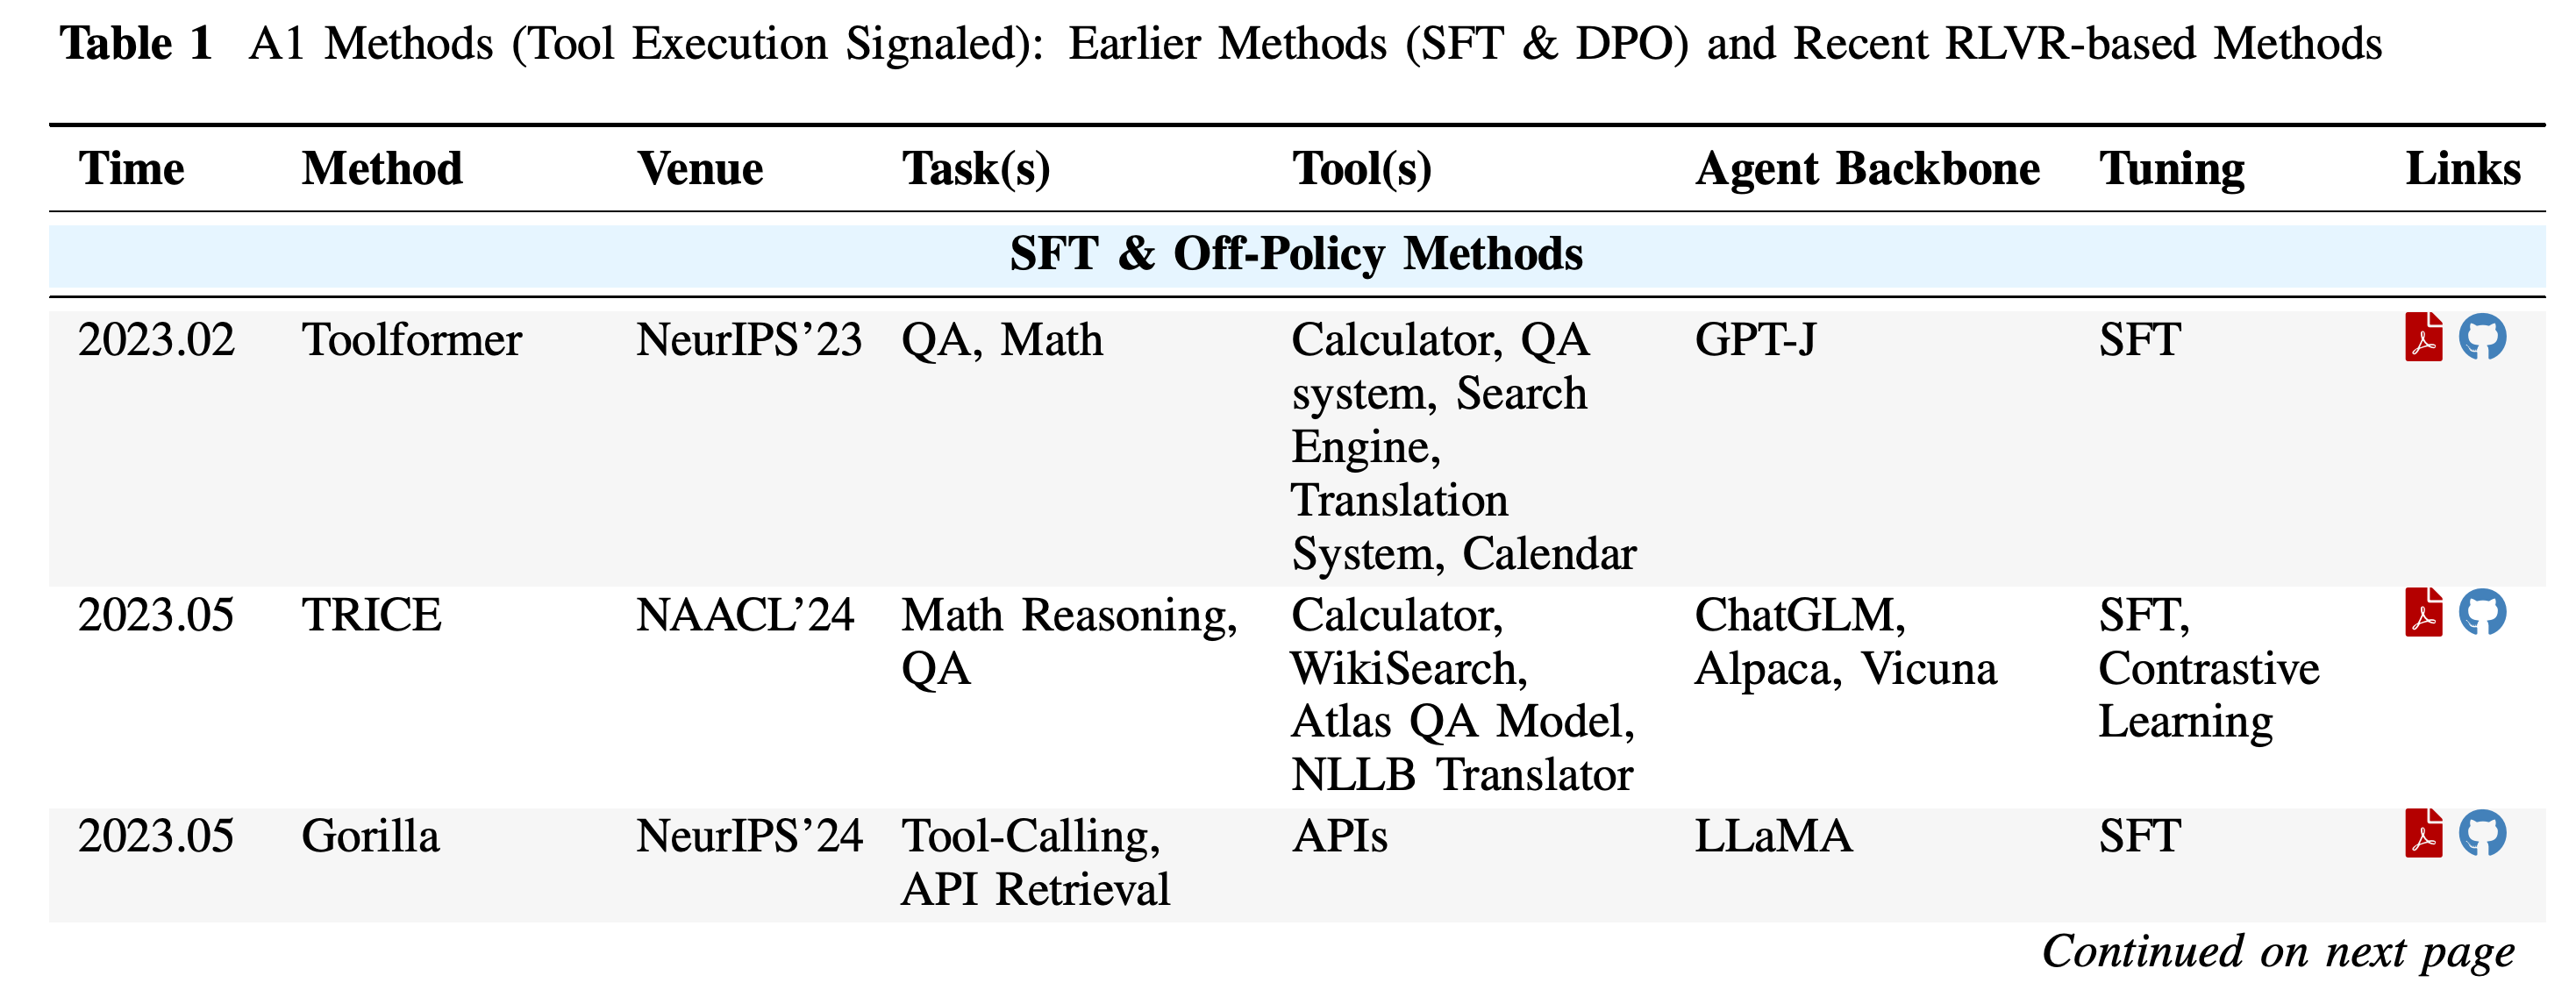
이 목록은 SFT 및 off-policy 방법과 RLVR을 구분하고 과제, 도구, 백본, 튜닝 절차를 기록한다. 서로 다른 조건의 행들은 공통 실험 비교가 아니라 A1 구현 사례를 설명한다.
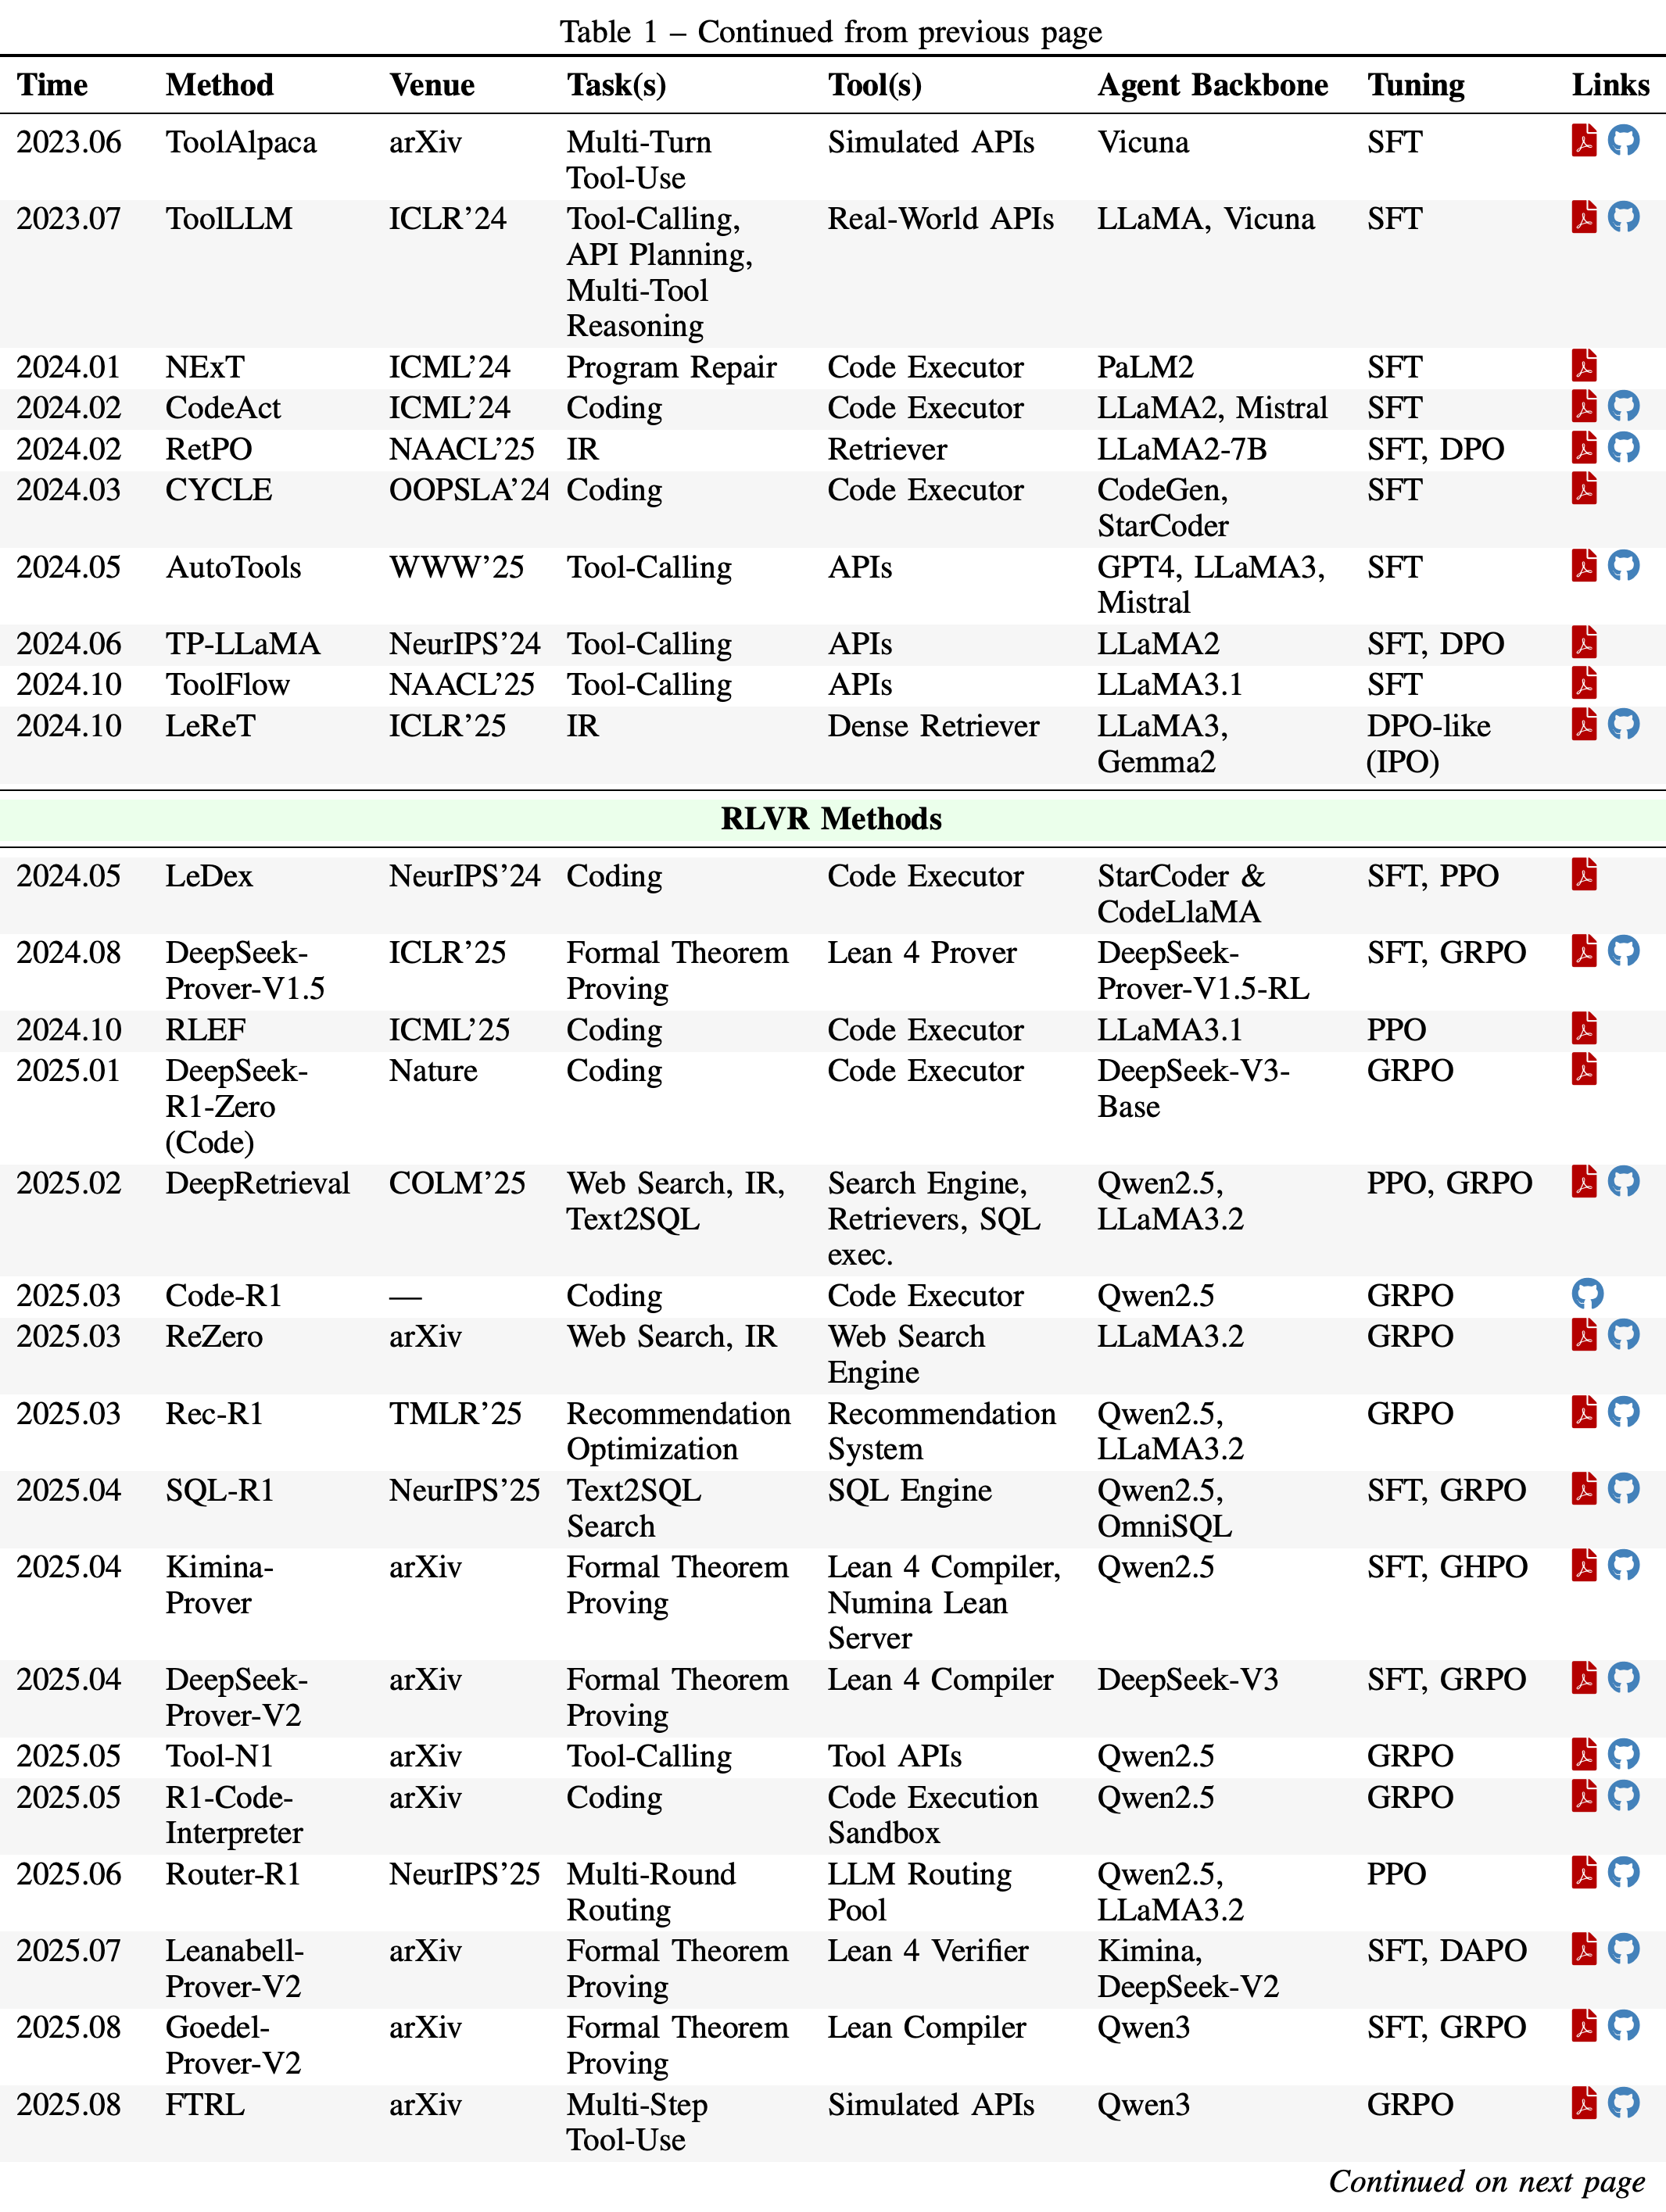
이 목록은 SFT 및 off-policy 방법과 RLVR을 구분하고 과제, 도구, 백본, 튜닝 절차를 기록한다. 서로 다른 조건의 행들은 공통 실험 비교가 아니라 A1 구현 사례를 설명한다.
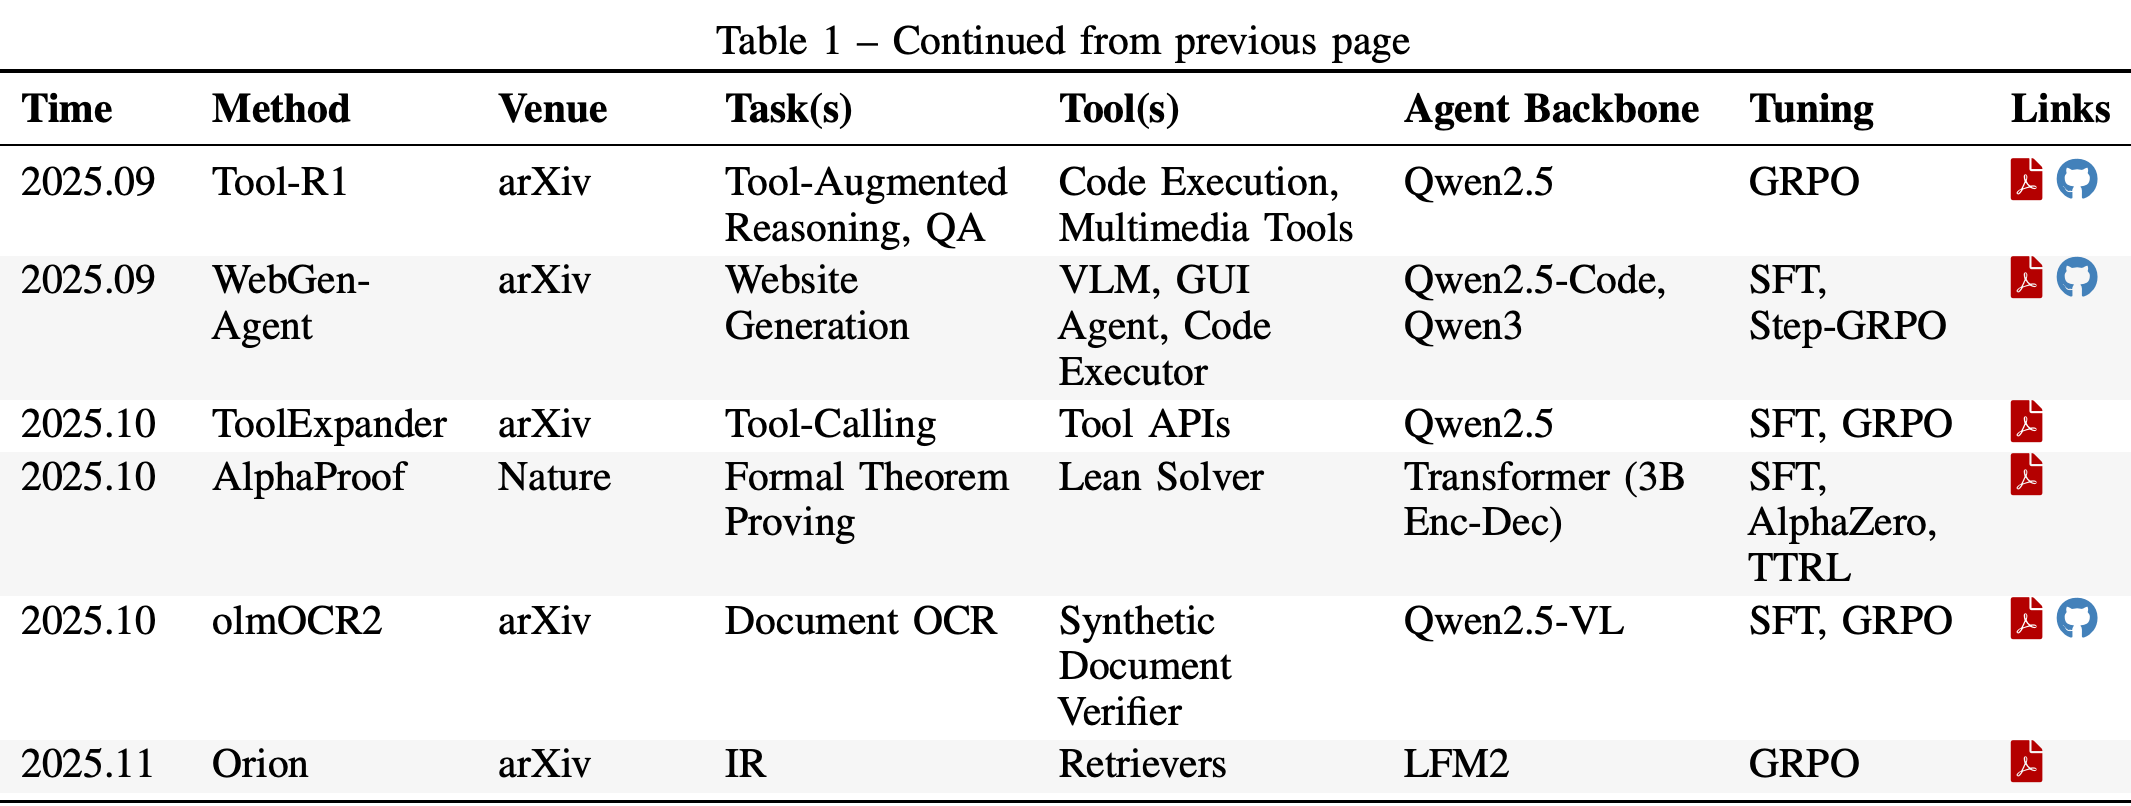
4.2 A2: Agent Output as Signal
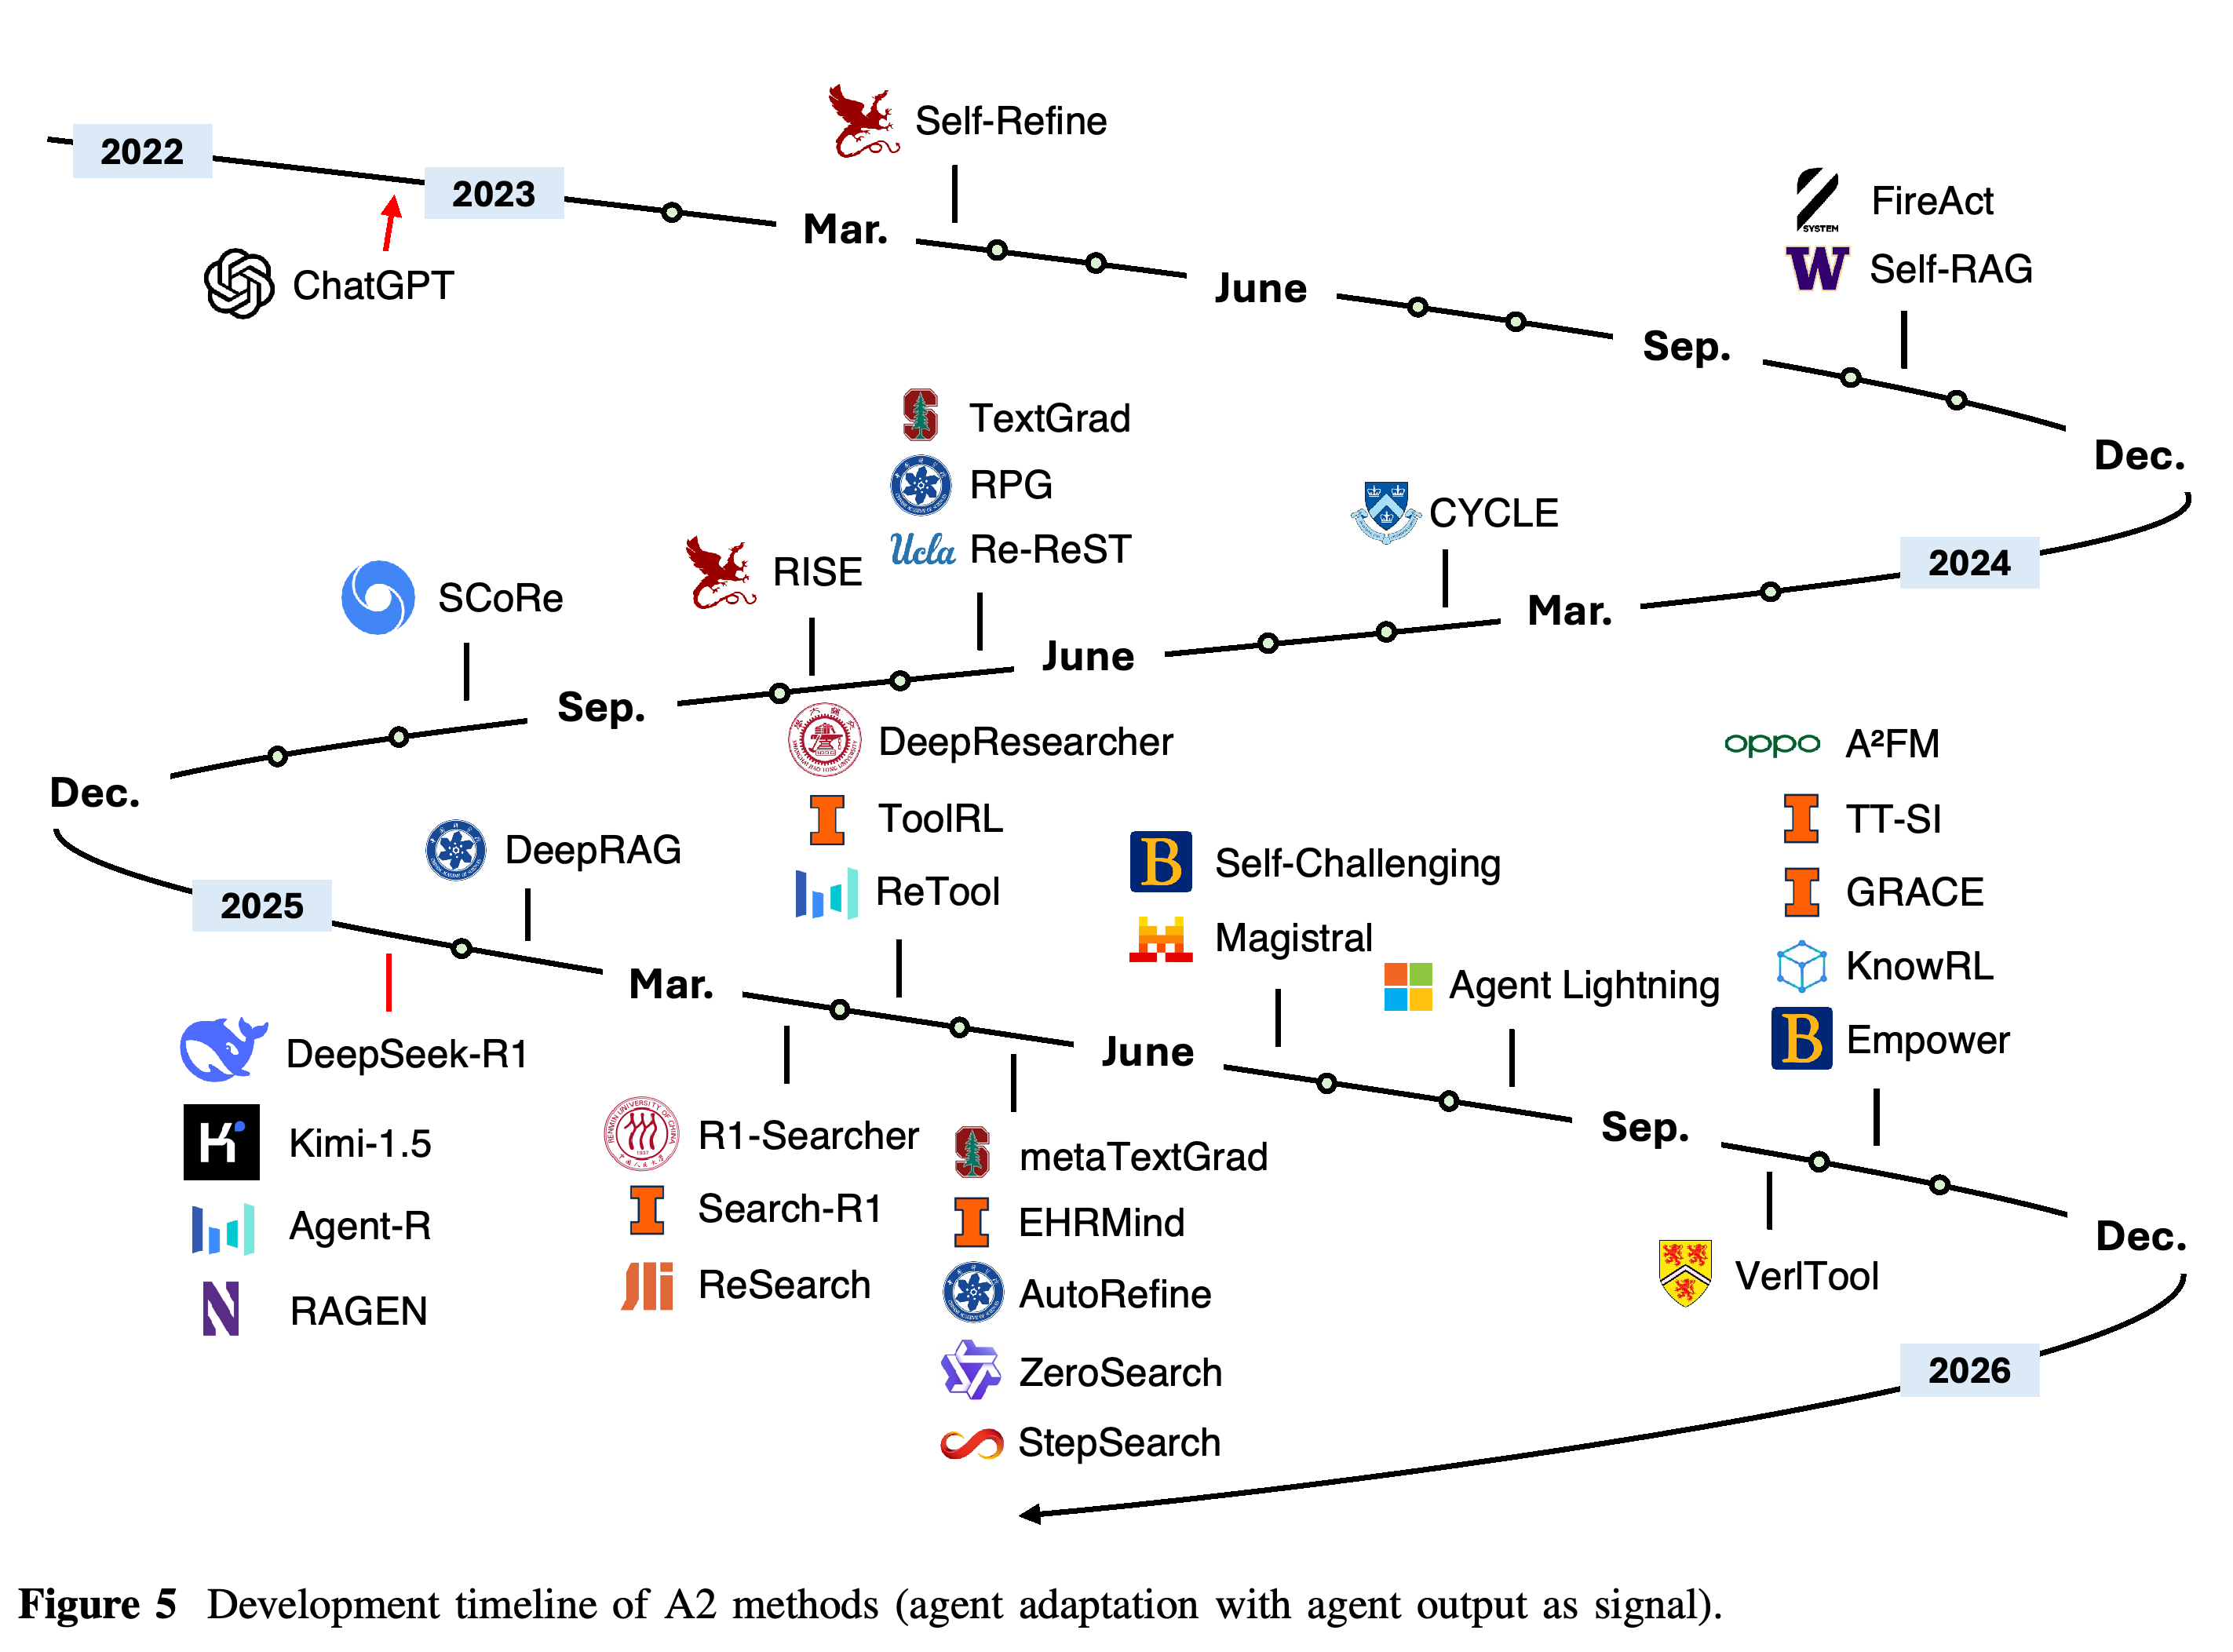
A2는 에이전트 출력에 대한 평가를 통해 추론과 도구 사용 전략을 적응시킨다. Figure 5와 Table 2는 도구가 없는 방법과, 도구를 언제 호출하고 결과를 어떻게 반영할지도 학습하는 방법을 구분한다.
- Agent Adaptation w/o Tools는 스칼라 보상 RL, 추론 시점 개선, 언어적 피드백을 다룬다. Self-Refine은 가중치를 바꾸지 않고 출력을 수정하고, SCoRe는 자기 수정을 학습하며, EHRMind는 RL 전에 SFT로 초기 학습을 수행한다.
- TextGrad는 자연어 비평으로 블랙박스 시스템을 최적화한다. 서베이는 GPT-4o의 정확도가 LEETCODE-HARD에서 26%에서 36%로, MMLU-Physics에서 91.2%에서 95.1%로 높아졌다고 보고한다. metaTextGrad는 최적화기의 프롬프트를 개선한다.
- Agent Adaptation w/ Tools는 검색, 코드 지원 추론, 커리큘럼, 성찰, 인프라를 다룬다. ReSearch는 <think>/<search>/<result> 태그를 통합하고, ReTool은 rollout에 코드 실행을 포함한다. Agent Lightning, A²FM, VerlTool은 학습이나 실행 인프라를 다룬다.
- 희소한 최종 출력 보상은 기여도 할당을 어렵게 만든다. Search-R1의 약 170k개 예시는 학습 규모의 사례이며, 검토한 시스템들은 자기 수정, 질의 개선, 적응형 검색 깊이를 보고한다.
이 연대기는 추론 시점 개선, 추론 RL, 검색 학습, 학습 인프라를 출력 신호 기반 적응으로 묶는다. 서베이의 신호 기반 분류를 공유하지만 가중치 변경 여부는 방법마다 다르다.
도구 사용 여부에 따라 방법을 묶으면 도구 사용이 추가하는 조정 문제가 드러난다. 튜닝 열은 A2가 SFT와 RL뿐 아니라 프롬프트 최적화와 테스트 시점 변경도 포함함을 보여준다.
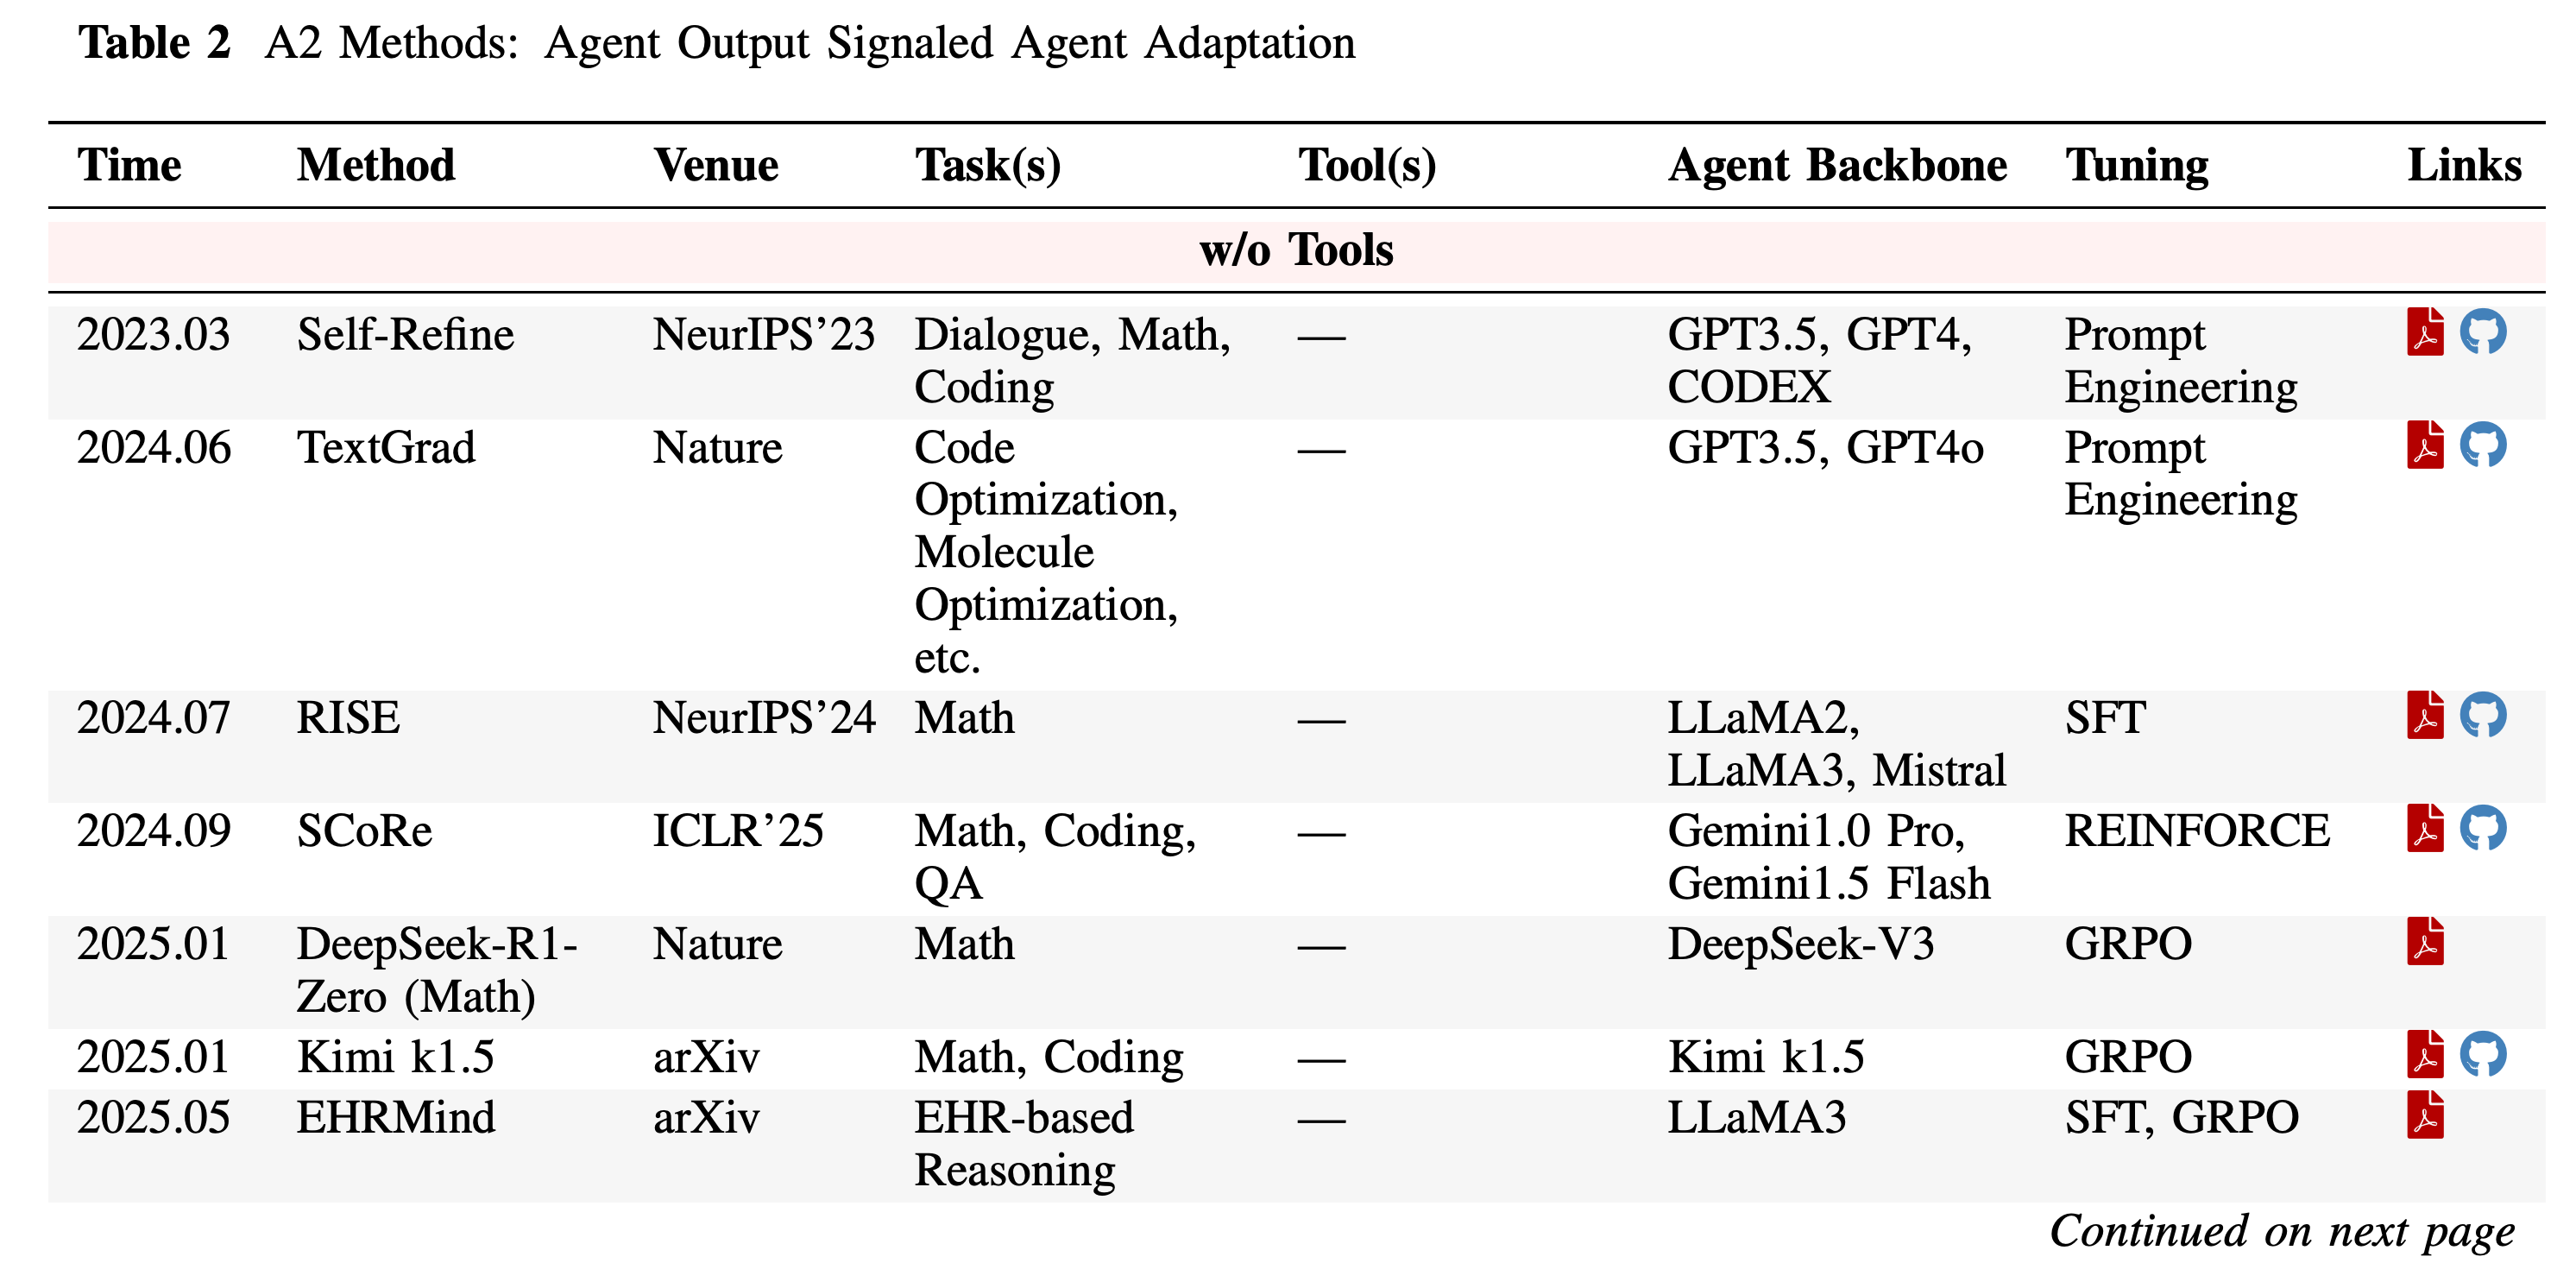
도구 사용 여부에 따라 방법을 묶으면 도구 사용이 추가하는 조정 문제가 드러난다. 튜닝 열은 A2가 SFT와 RL뿐 아니라 프롬프트 최적화와 테스트 시점 변경도 포함함을 보여준다.
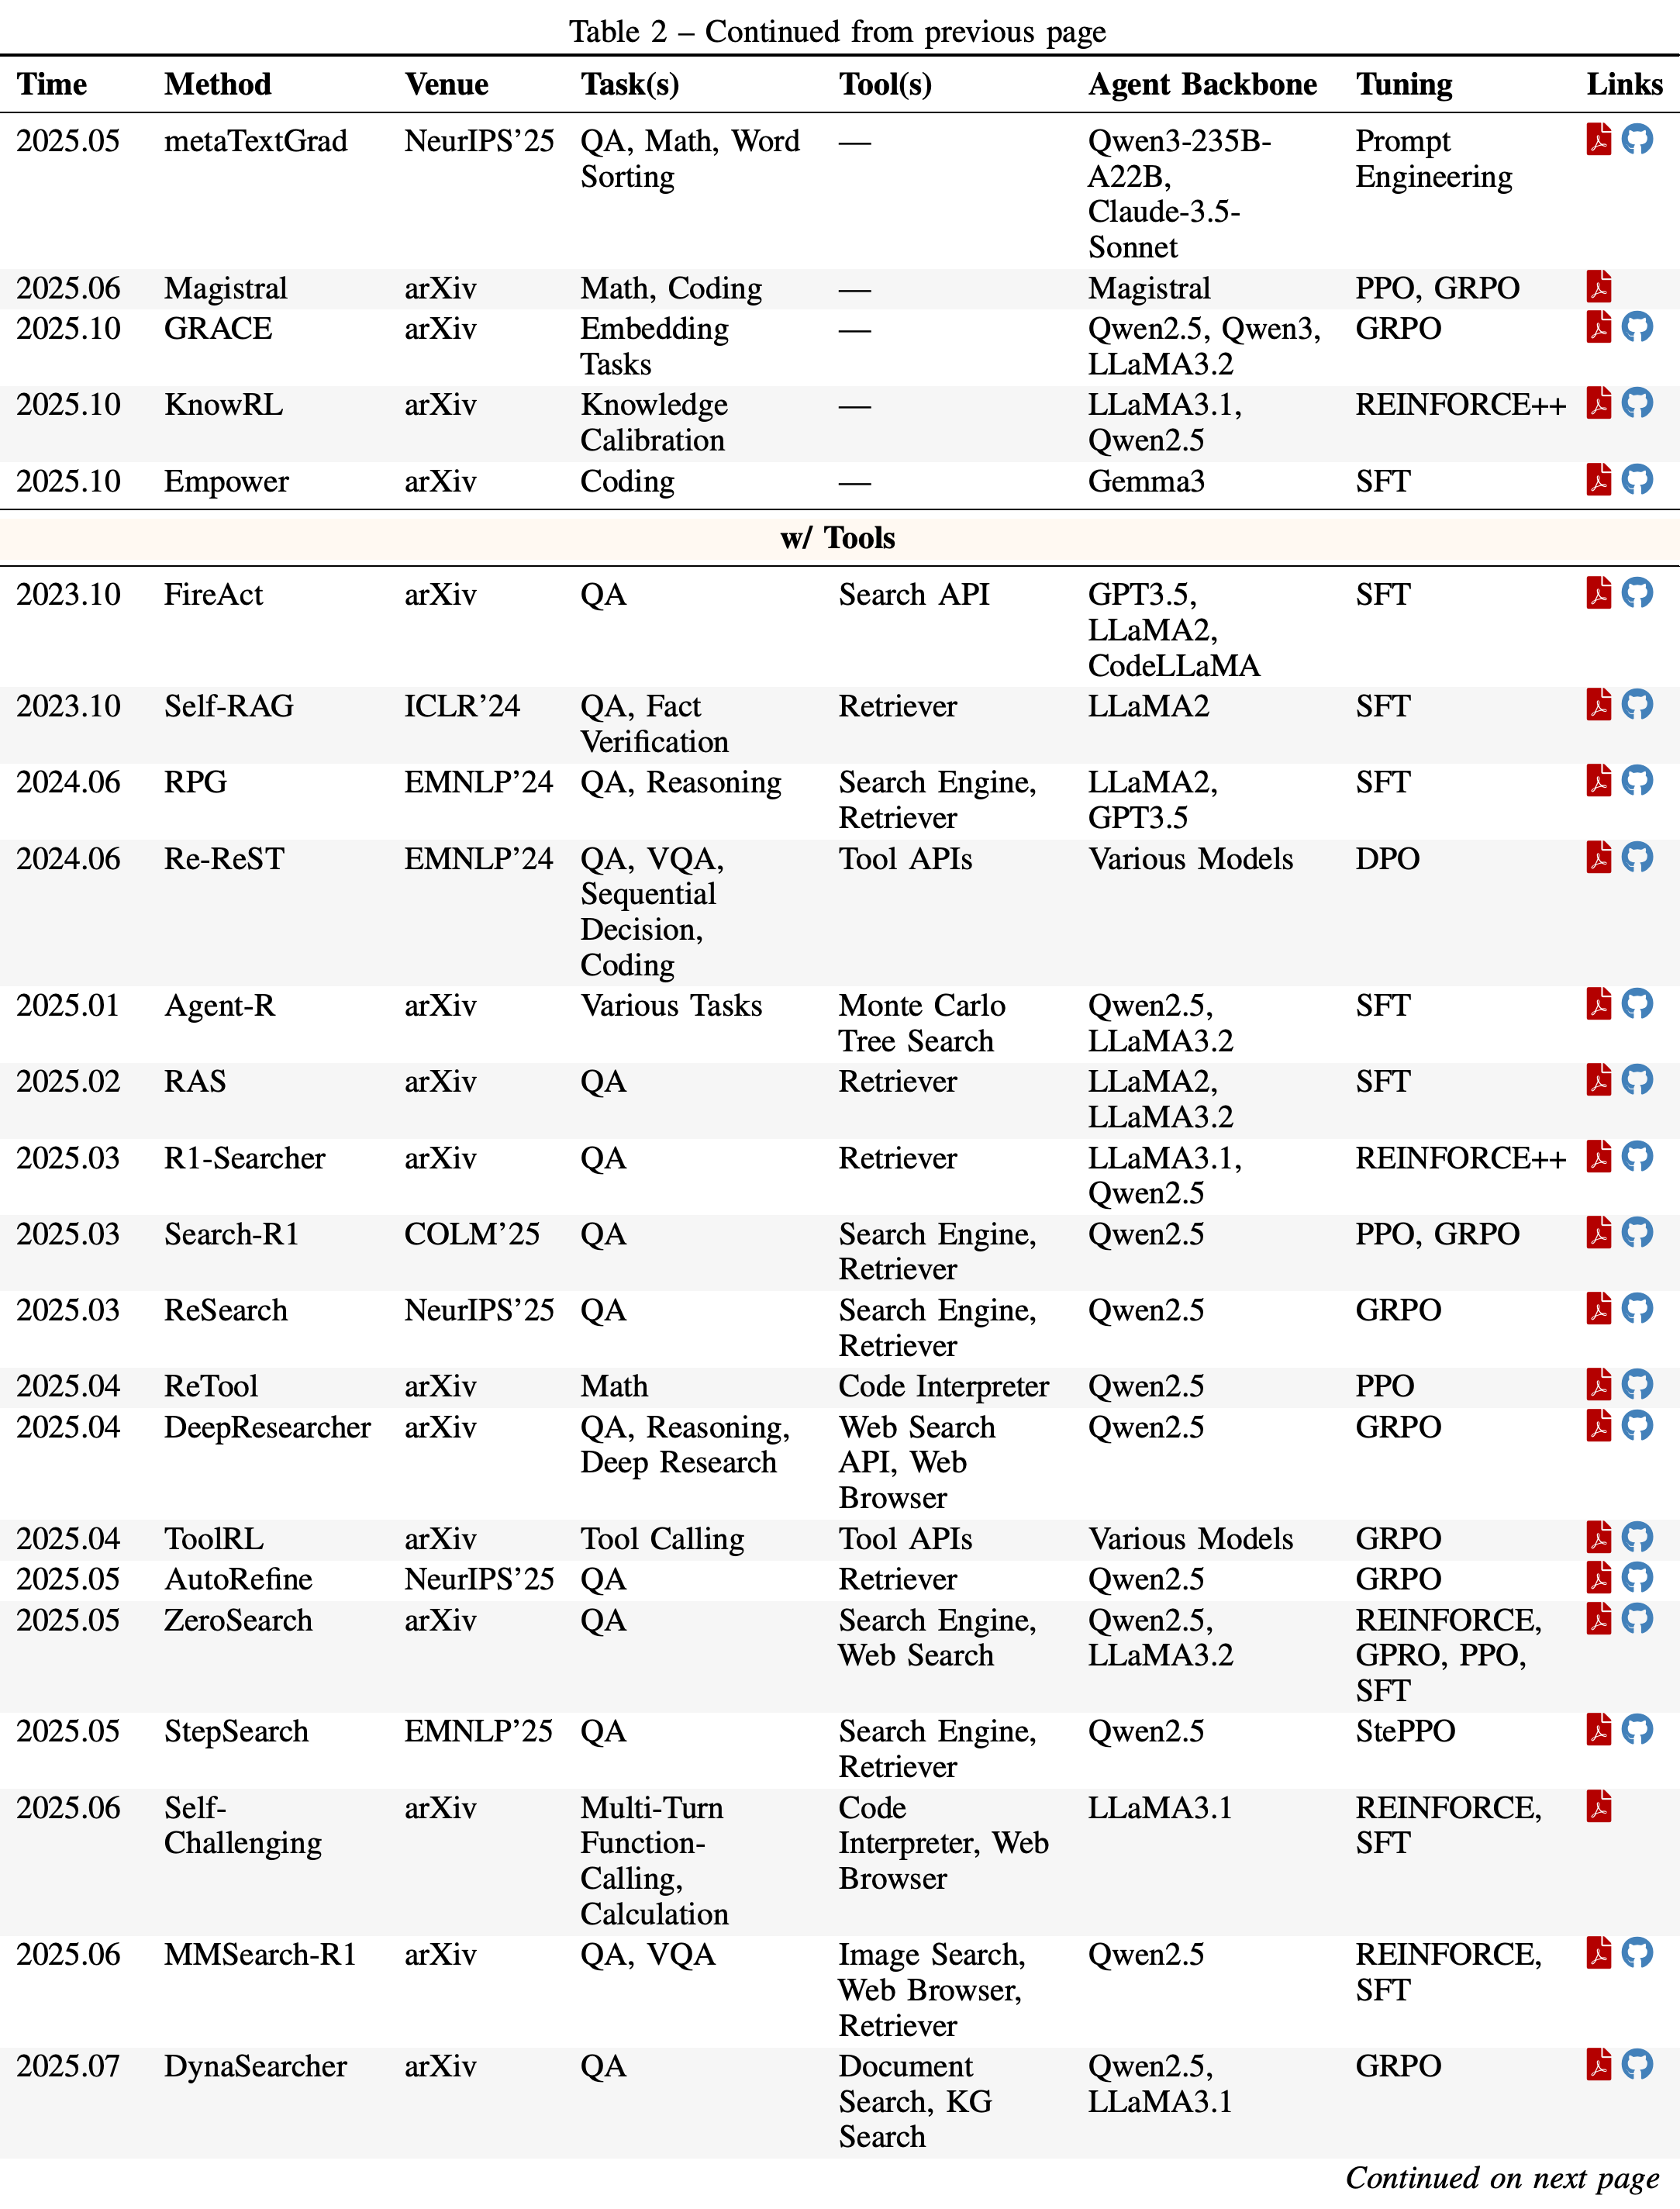
도구 사용 여부에 따라 방법을 묶으면 도구 사용이 추가하는 조정 문제가 드러난다. 튜닝 열은 A2가 SFT와 RL뿐 아니라 프롬프트 최적화와 테스트 시점 변경도 포함함을 보여준다.
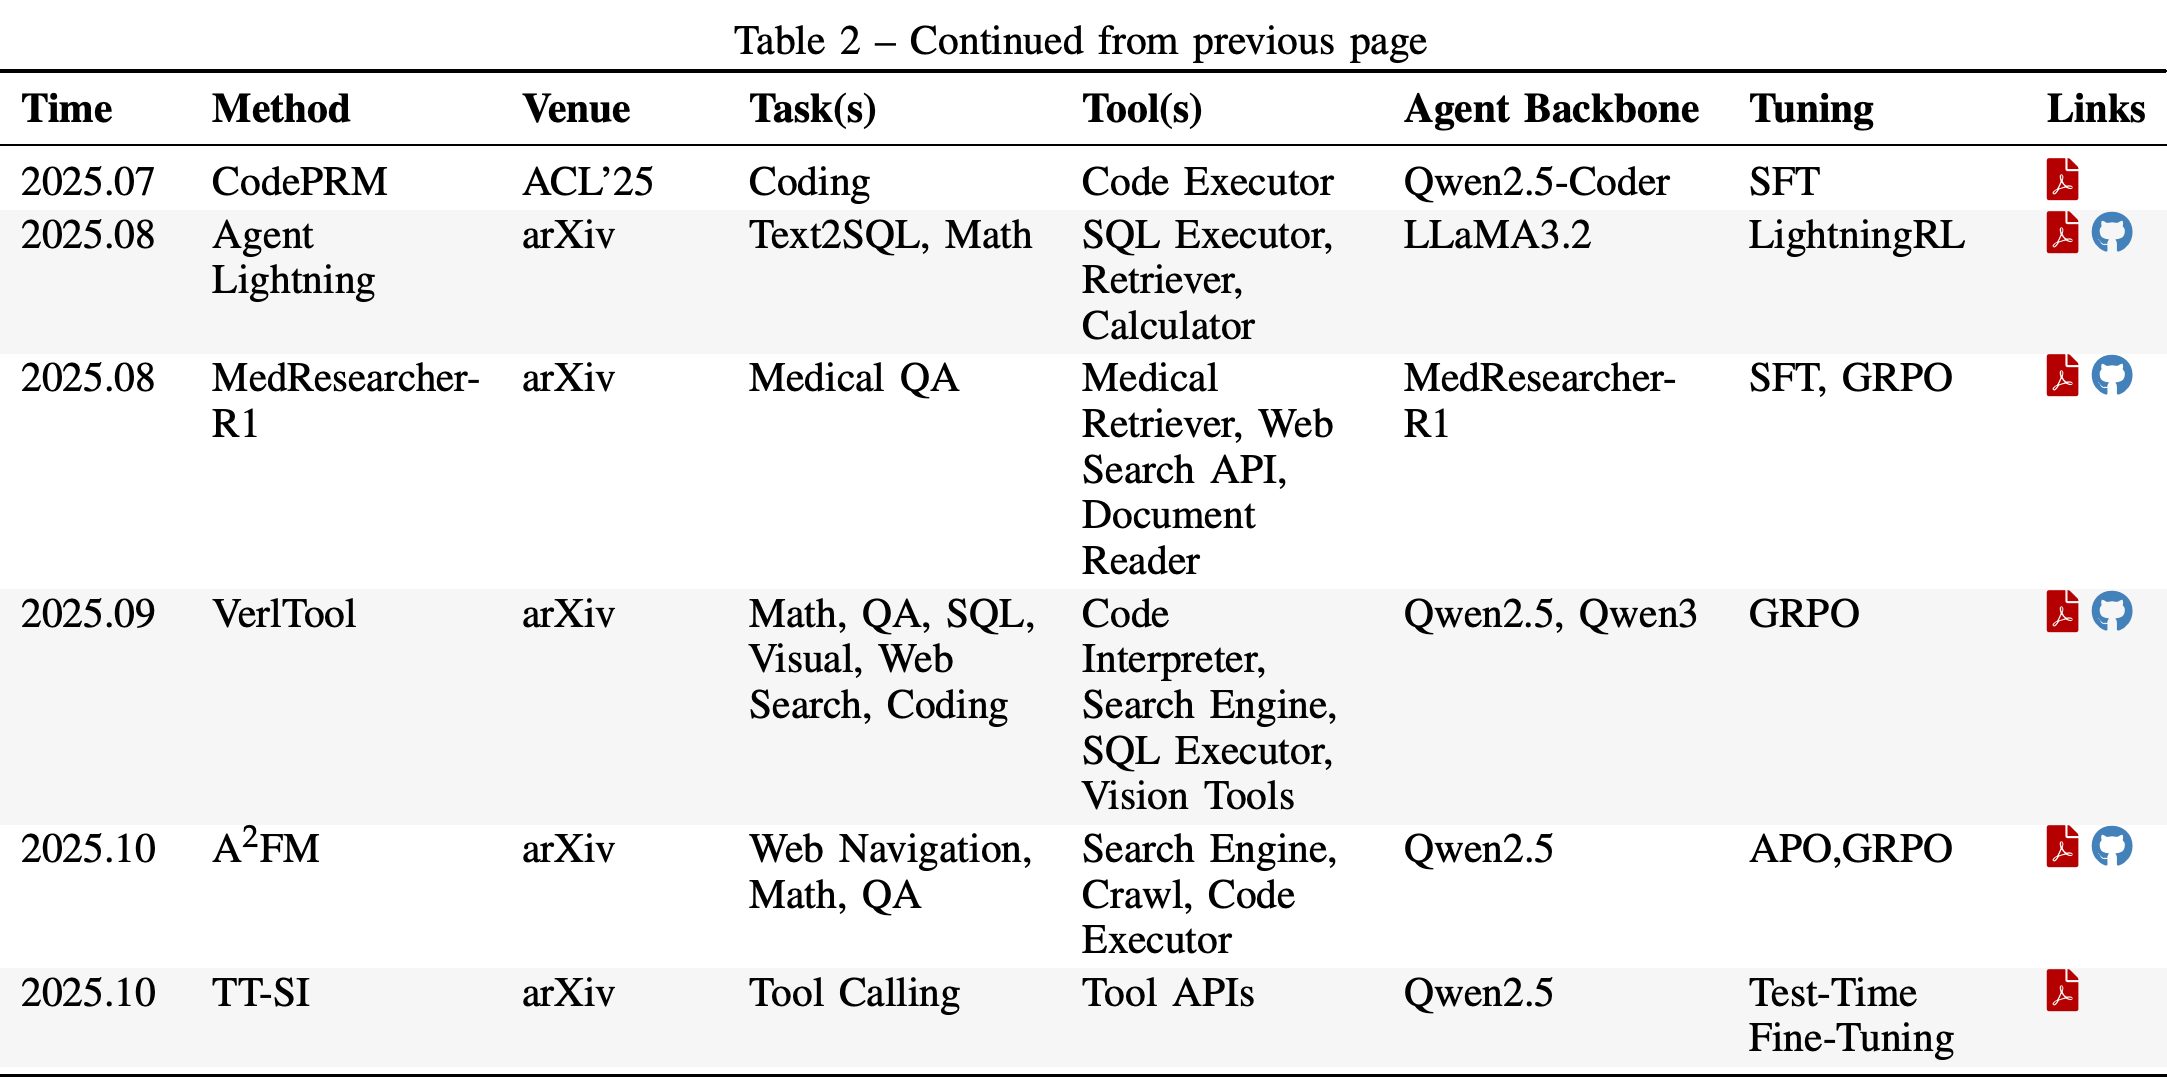
5 Tool Adaptation
도구 적응은 주 에이전트를 유지하면서 외부 구성 요소를 바꾼다. T1은 독립적으로 학습한 구성 요소를 제공하고, T2는 고정된 에이전트의 행동이나 후속 과제 결과를 이용해 해당 호스트에 맞게 구성 요소를 적응시킨다.
5.1 T1: Agent-Agnostic Tool Adaptation
T1은 동결된 에이전트가 프롬프트, 코드, 구조화된 인터페이스로 조정하는 재사용 가능 모델과 전문화된 정책을 제공한다. Foundational Systems and Architectures는 신경 연산자, HuggingGPT의 모델 선택 워크플로, ViperGPT의 Python 조합, SciToolAgent의 지식 그래프로 이를 설명한다.
- HuggingGPT는 1000+개 모델을 조정하지만 순차 호출 지연과 도구 설명에 따른 맥락 비용이 발생한다. SciToolAgent는 SciToolKG를 통해 500+개 과학 도구에 접근한다. 이들은 서로 다른 조건에서 평가된 인용 시스템 사례다.
- Categories and Training Methodologies는 비전, 음성, 코드, 검색, 과학 모델을 다룬다. 저자들은 검색 결과처럼 자동 평가가 가능한 출력이 지각적 특징보다 T2를 통해 감독하기 쉽다고 주장한다.
- MCP와 코드 실행은 도구 발견과 조합을 위한 인프라를 제공한다. 선택된 도구 정의와 간결한 실행 결과는 맥락 사용량을 줄일 수 있다. 다만 인프라만으로 구성 요소가 학습을 통해 적응했다고 볼 수는 없다.
- 질의 재작성이나 코드 생성을 학습한 에이전트는 동결한 뒤 T1 도구로 재사용할 수 있다. 이는 에이전트 학습과 모듈식 배포를 연결한다.
5.2 T2: Agent-Supervised Tool Adaptation
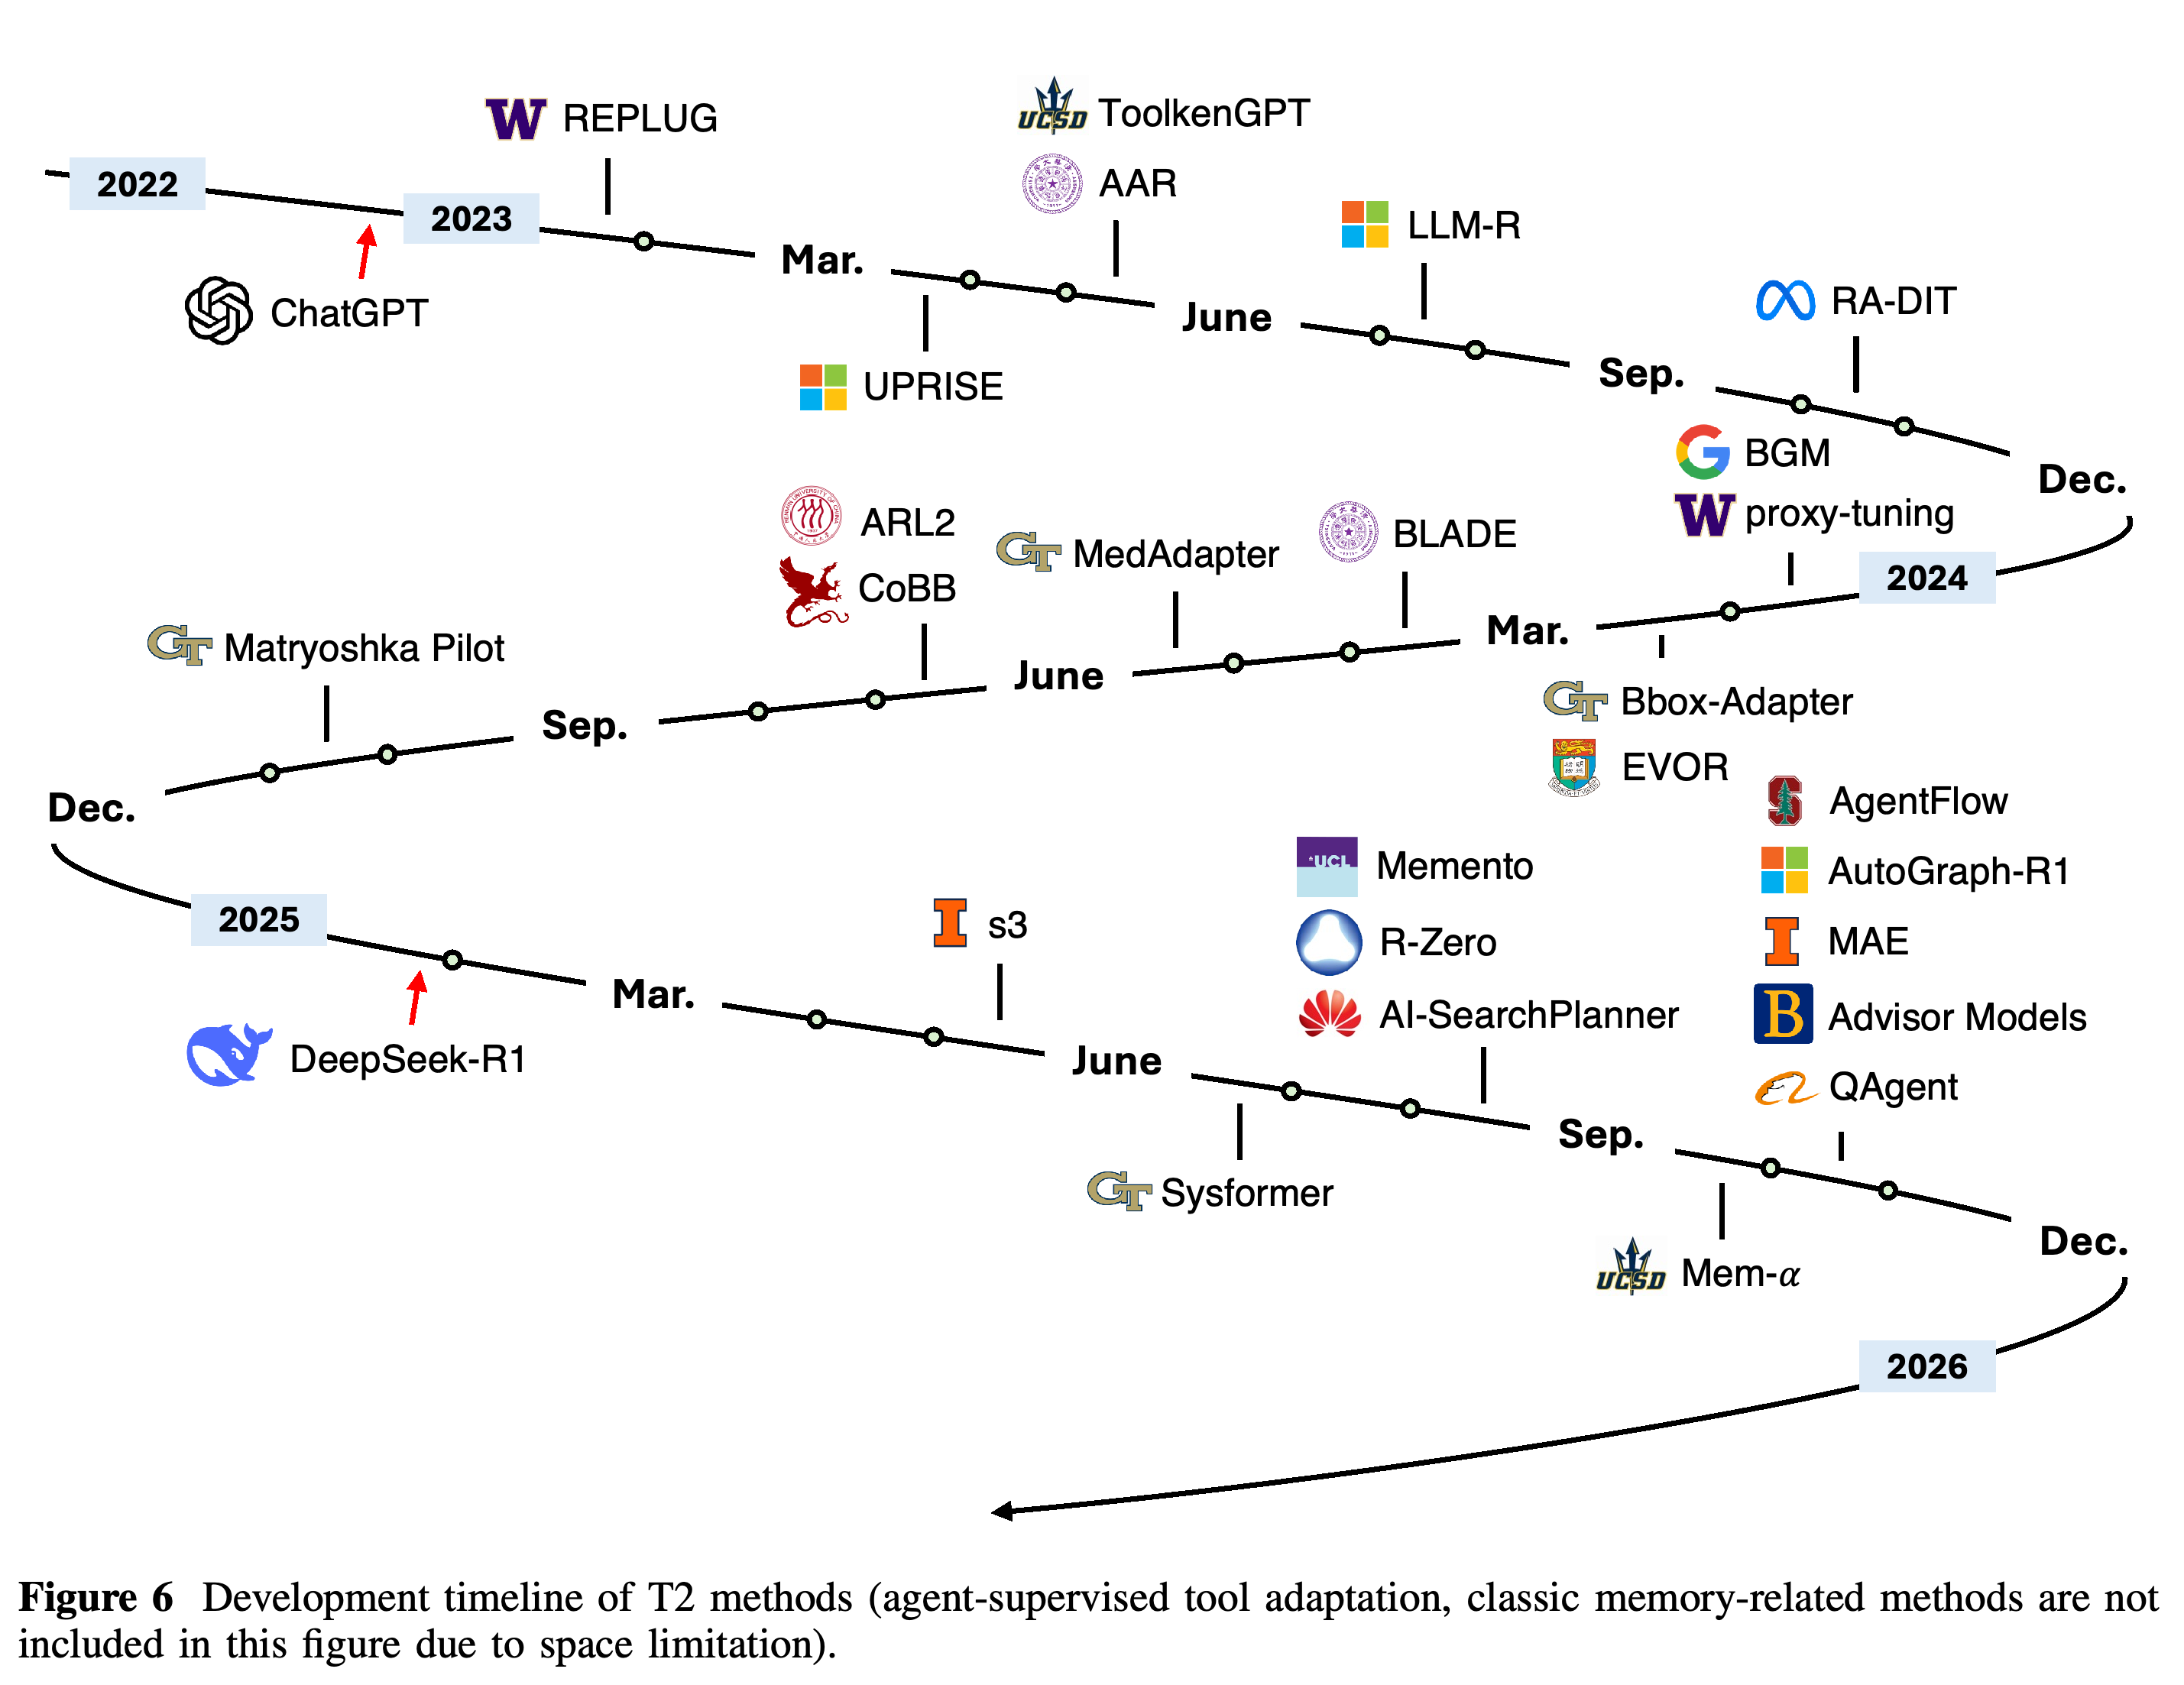
T2는 고정된 파운데이션 모델을 감독 신호의 출처로 삼아 외부 구성 요소를 적응시킨다. Figure 6과 Table 3은 perplexity 기반 검색기 정렬과 선호 학습부터 다중 턴 검색기, 계획기, 메모리 제어기까지 정리한다.
- Earlier Methods: From Proxy Signals to Structured Preferences는 REPLUG의 perplexity 기반 정렬, AAR의 검색 증강 효과를 고려한 선호, LLM-R이 표현력 높은 선호 모델을 빠른 검색기로 증류하는 방법을 다룬다. Proxy-tuning은 작은 expert와 anti-expert로 디코딩을 조정하고, UPRISE는 동결된 모델의 과제 성능을 이용해 프롬프트를 검색한다.
- BGM은 동결된 검색기와 PaLM2-S 사이에 T5-XXL 연결 모델을 두고, 합성 선호 데이터로 감독 학습을 수행한 뒤 RL을 적용한다. 서베이는 HotpotQA exact match가 35.6% 대 25.8%이며, 명시된 상대 개선율이 38%라고 보고한다.
- 단계적으로 연결된 재작성, 검색, 선택은 하위 문제를 분리하고 비용이 큰 생성을 미룰 수 있다. 오류 누적은 더 깊은 파이프라인의 한계다. 논문이 제안하는 2–3단계의 균형은 문헌을 종합한 견해이며, 깊이를 통제해 비교한 결과는 아니다.
이 연대기는 T2의 범위를 검색기 및 인터페이스 정렬에서 검색, 계획, 메모리 구성 서브에이전트로 넓힌다. 전통적인 메모리 방법을 명시적으로 생략하므로 역사적 포괄 범위에는 한계가 있다.
도구와 에이전트의 백본 열을 분리해 적응하는 모델과 감독하는 호스트를 식별한다. 여러 LLM을 포함한 시스템을 해석하고 전체 아키텍처와 학습된 구성 요소의 크기를 비교하려면 이러한 구분이 필요하다.
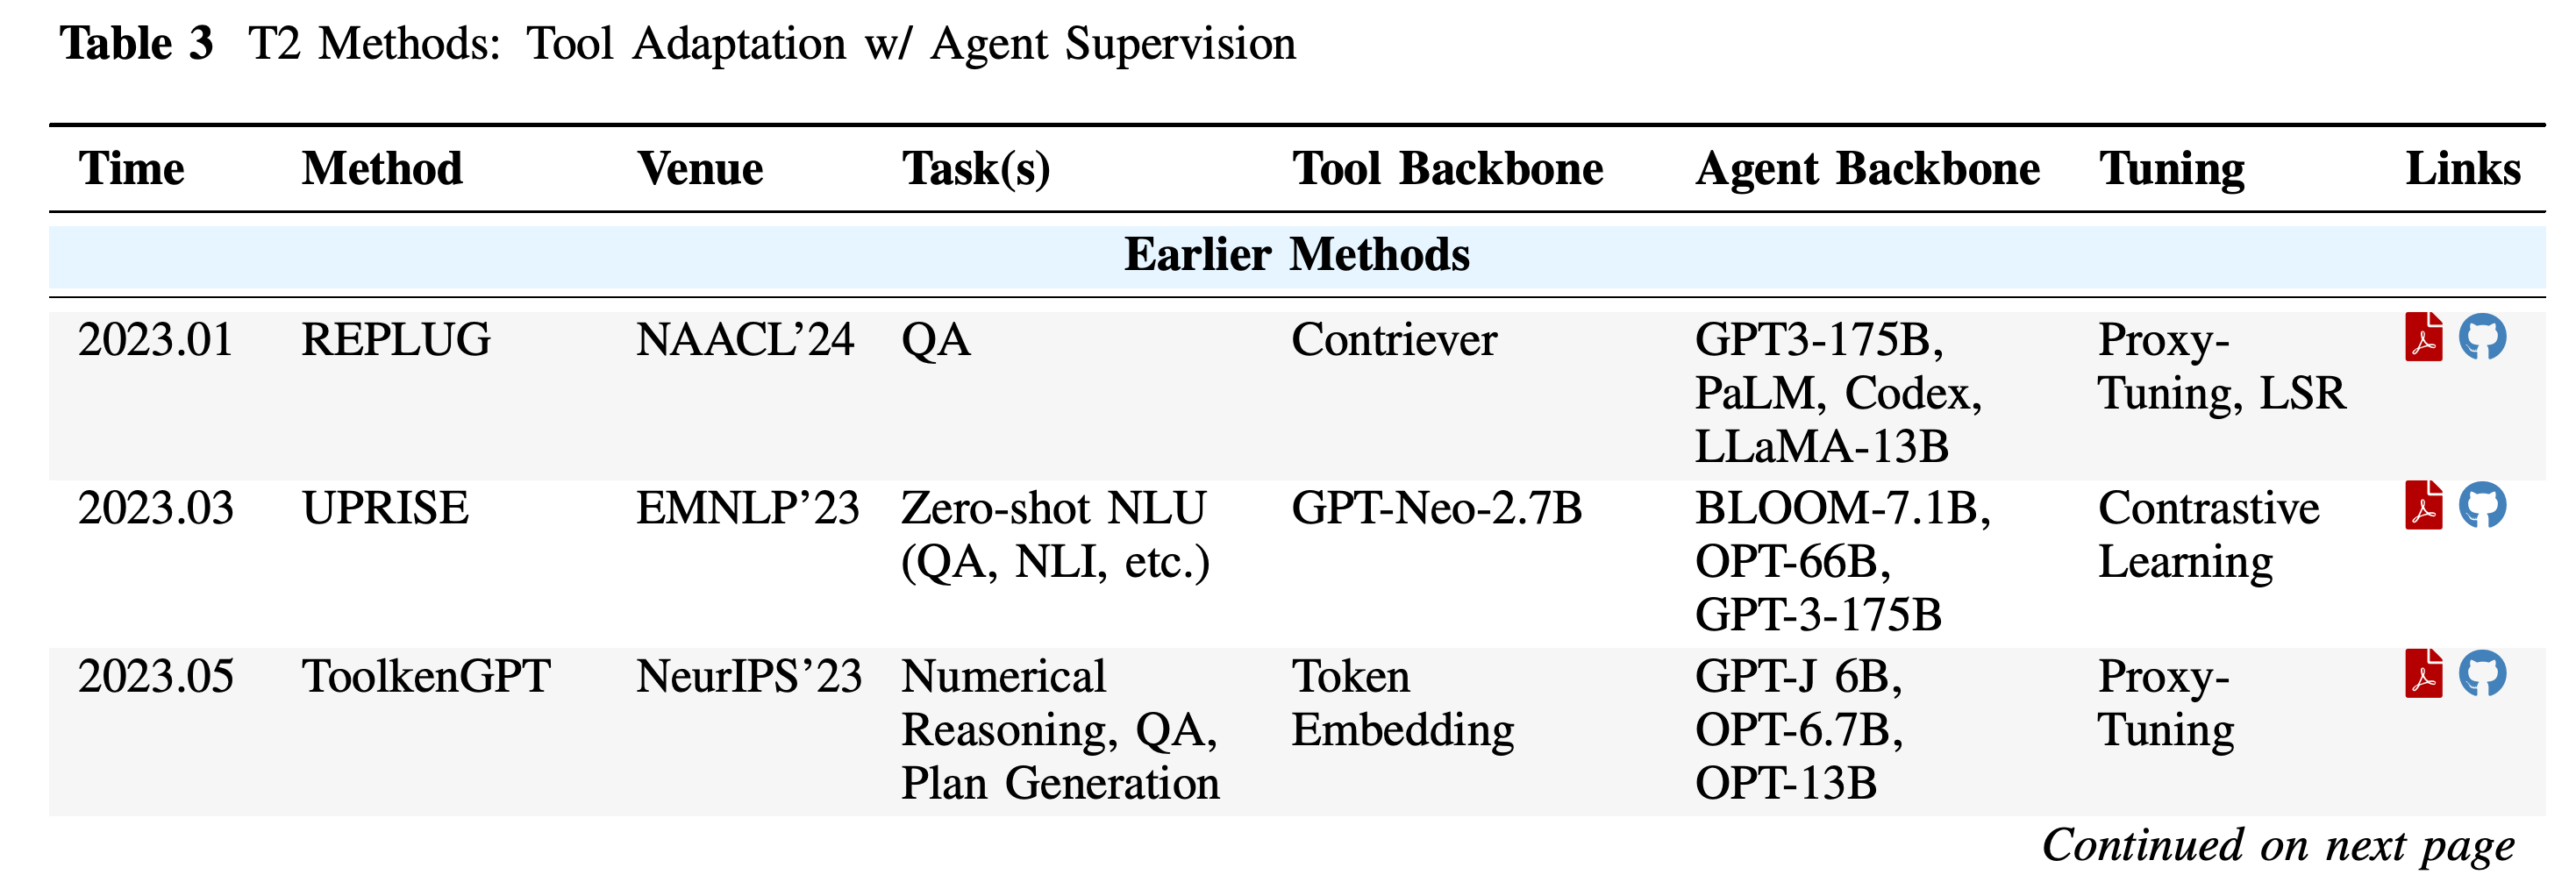
도구와 에이전트의 백본 열을 분리해 적응하는 모델과 감독하는 호스트를 식별한다. 여러 LLM을 포함한 시스템을 해석하고 전체 아키텍처와 학습된 구성 요소의 크기를 비교하려면 이러한 구분이 필요하다.
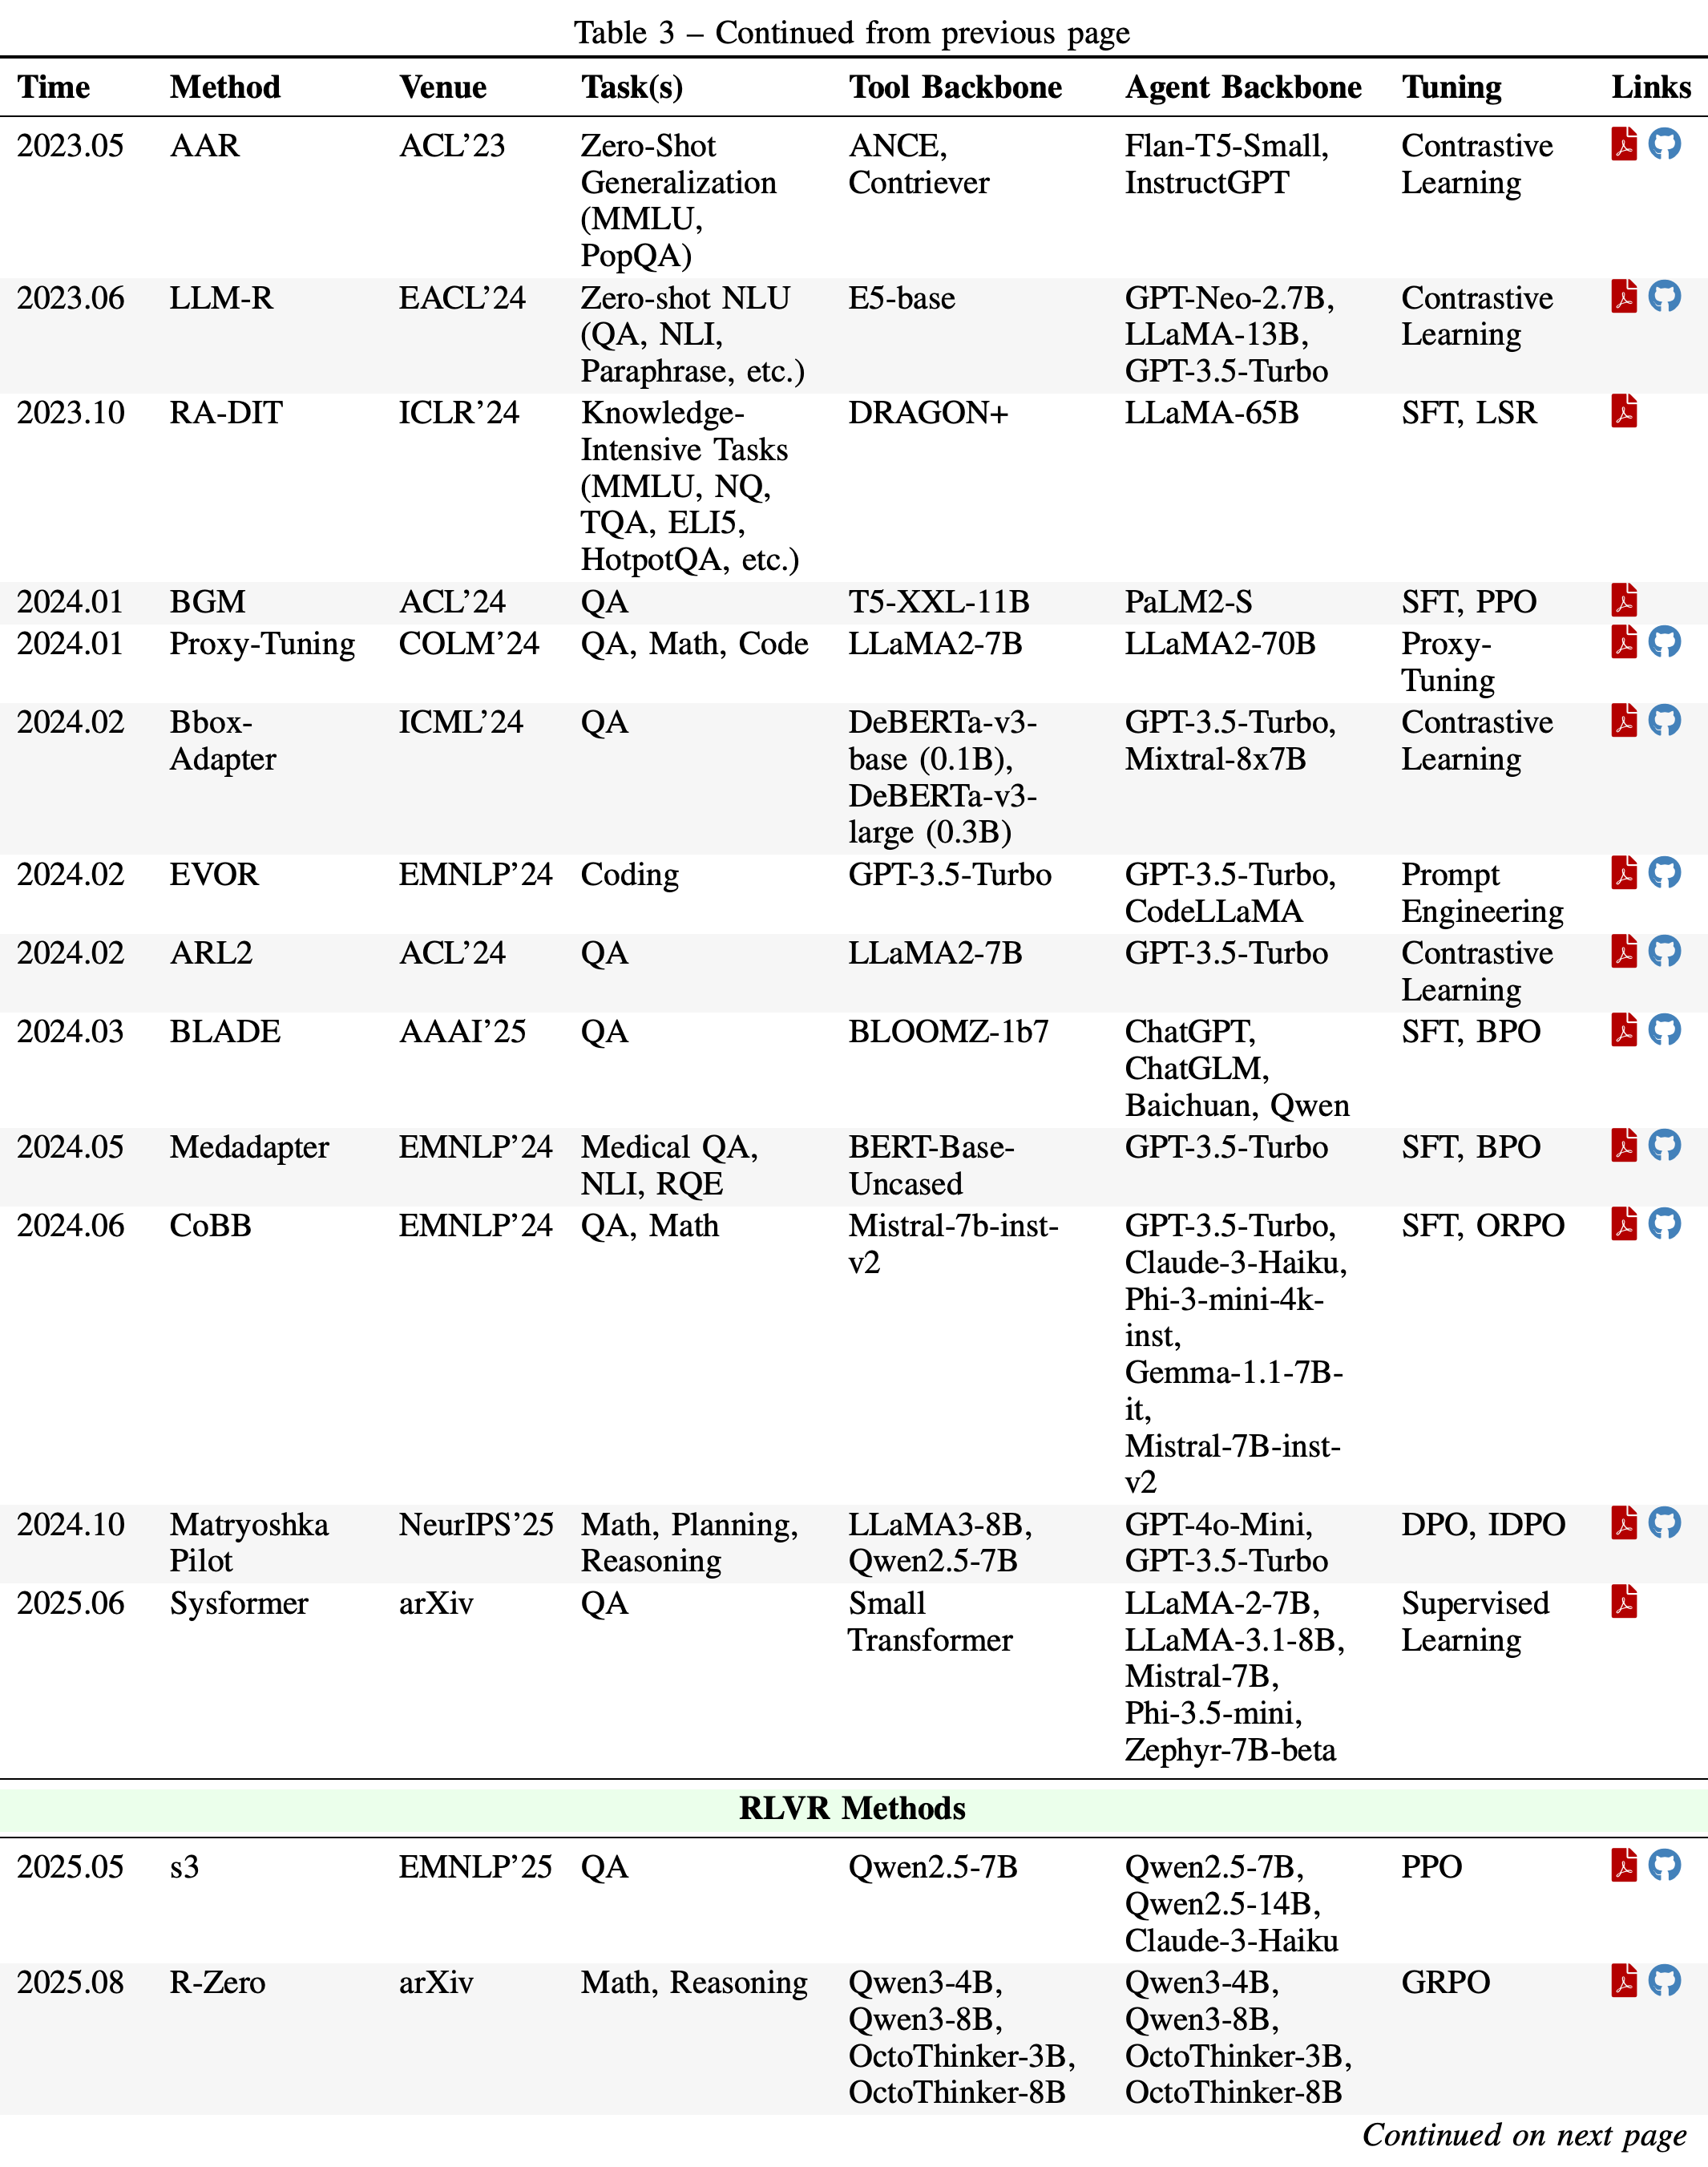
도구와 에이전트의 백본 열을 분리해 적응하는 모델과 감독하는 호스트를 식별한다. 여러 LLM을 포함한 시스템을 해석하고 전체 아키텍처와 학습된 구성 요소의 크기를 비교하려면 이러한 구분이 필요하다.
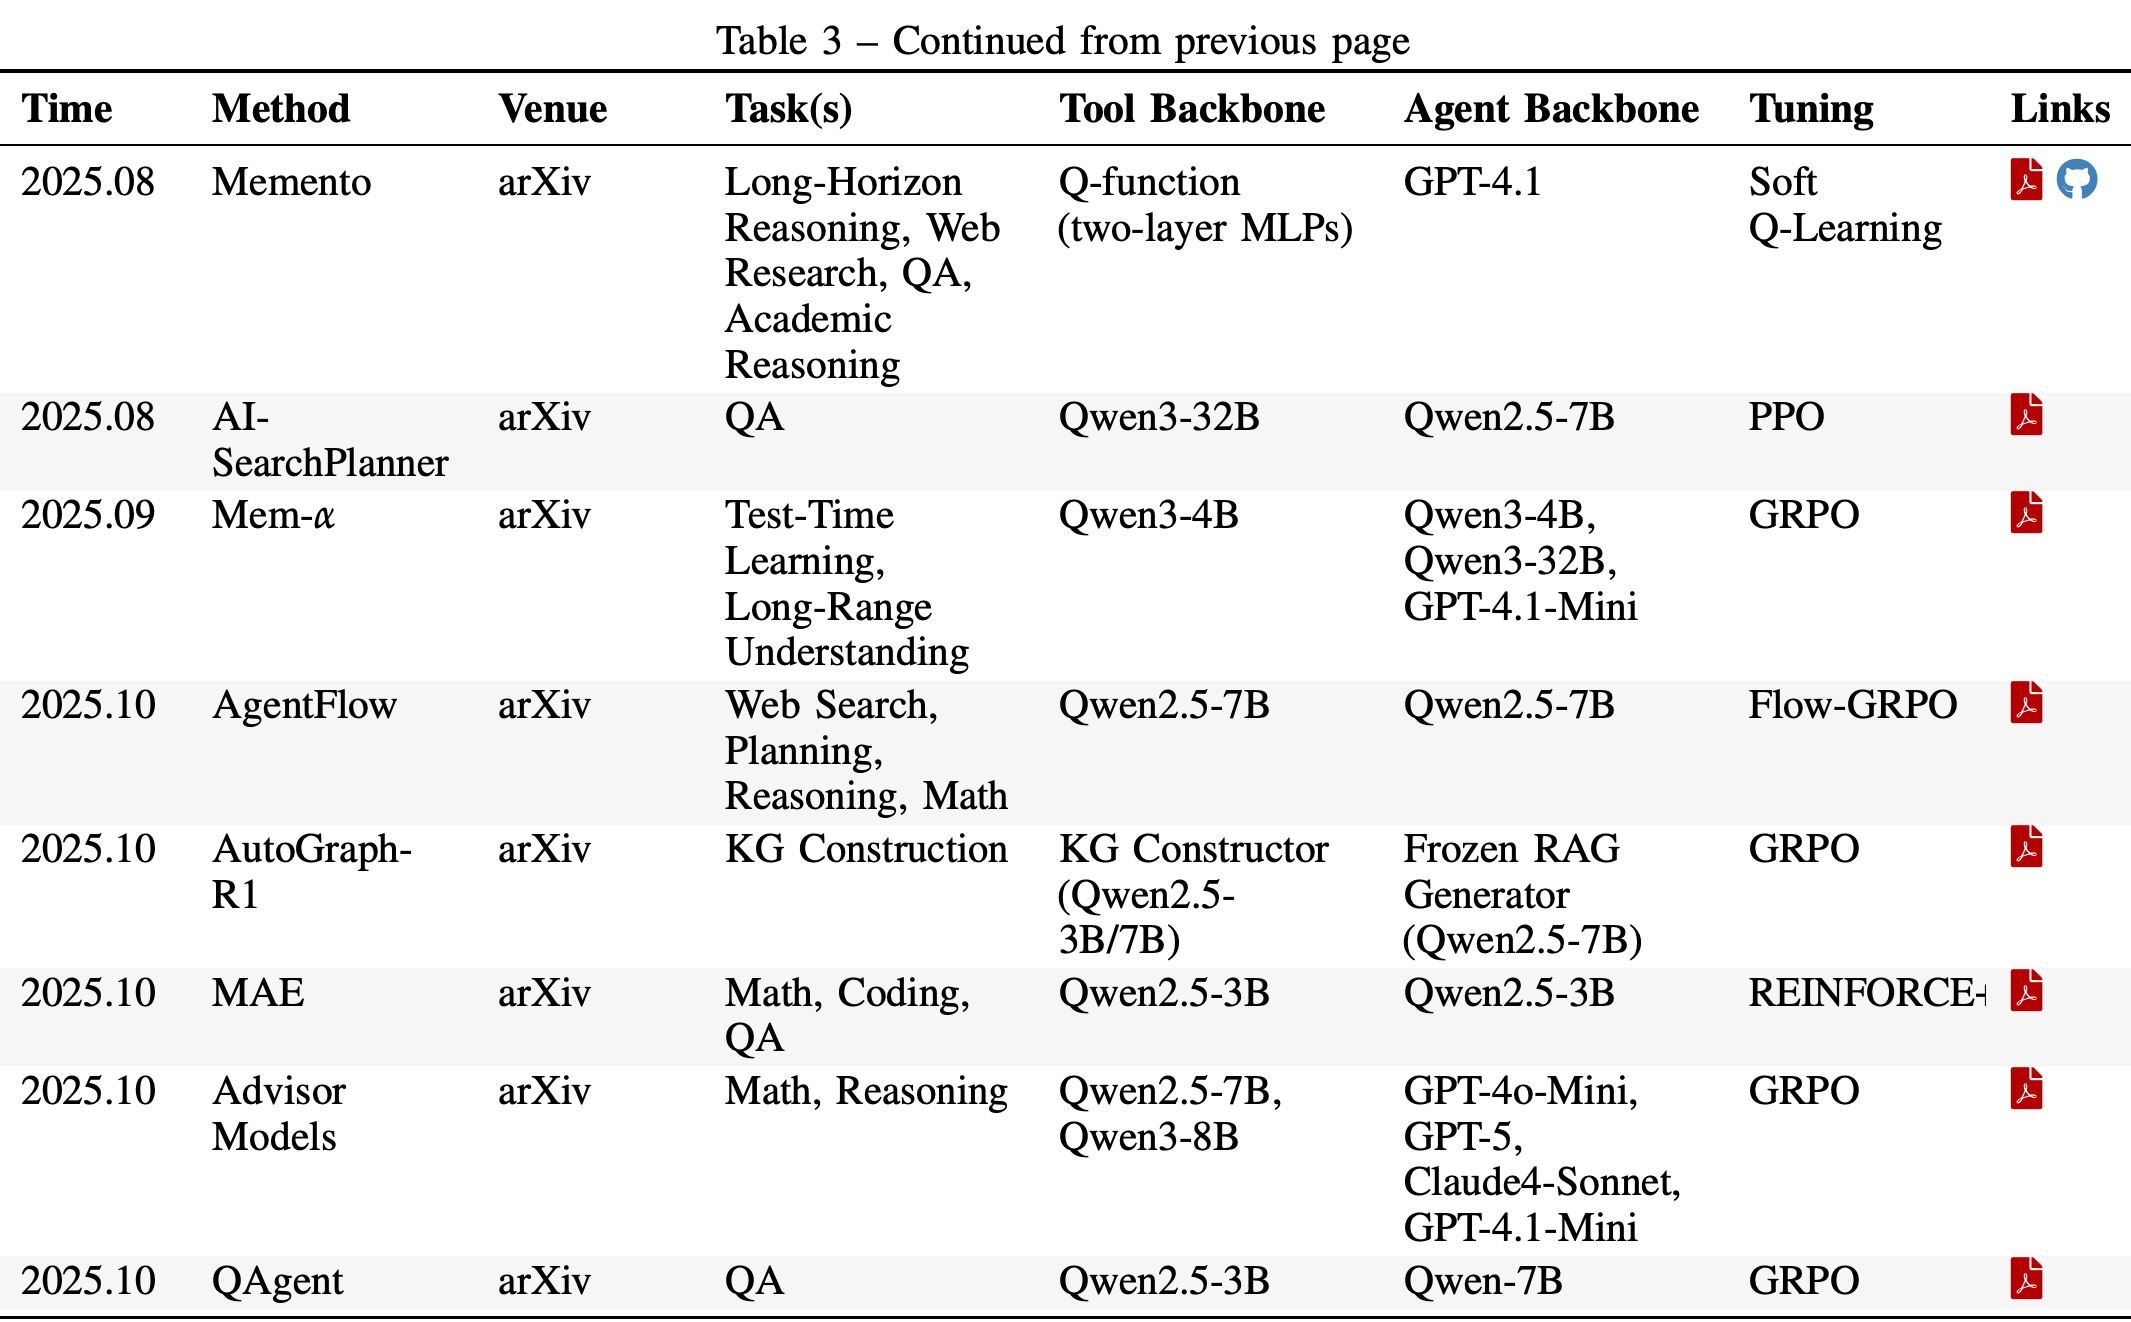
Subagent-as-Tool은 T2를 정보 획득, 메모리 구성, 제어, 조정, 과제 생성으로 확장한다. s3는 단순 검색 대비 동결된 생성기의 정확도 개선량인 Gain Beyond RAG로 7B 검색 서브에이전트를 학습한다. 서베이는 인용된 비교에서 s3가 샘플 2.4k개로 평균 정확도 58.9%를 달성했으며, Search-R1보다 데이터는 약 70배 적게 사용하고 실제 경과 시간 기준 학습은 33배 빨랐다고 보고한다.
- DynamicRAG는 어떤 문서를 전달하고 얼마나 유지할지를 학습한다. QAgent는 자체 답변에 보상을 주는 방식에서 더 강한 동결된 생성기의 답변을 평가하는 방식으로 전환해, 정보가 부족하고 쉽게 복사할 수 있는 근거를 검색하는 문제에 대응한다.
- Mem-α는 생성기와 후속 과제용 검색기를 동결하고 Qwen3-4B 메모리 기록 제어기를 학습한다. 약 30k-token 학습 시퀀스에서 400k tokens를 넘는 맥락으로 전이했다고 보고한다. AutoGraph-R1은 후속 추론 과제의 효용을 이용해 지식 그래프를 구성한다.
- AI-SearchPlanner는 결과, 과정, 비용 보상의 균형을 맞춘다. Advisor Models는 맥락별 조언을 제공하고, Matryoshka Pilot은 중간 제어 지시를 학습한다. AgentFlow는 동결된 전문가 모델들을 조정하는 7B 계획기만 Flow-GRPO로 학습하며, 검색 집약적 과제에서 57.3%, 수학 추론에서 51.5%, GAIA에서 33.1%를 보고한다.
- R-Zero는 Solver와 Challenger 단계를 번갈아 수행하고, Multi-Agent Evolve는 보조 Proposer와 Judge 역할을 학습한다. 이 사례들은 일시적으로 고정된 감독 모델과 상호작용하는 학습 구성 요소를 사용하므로, 각 학습 단계별로 분류해야 한다.
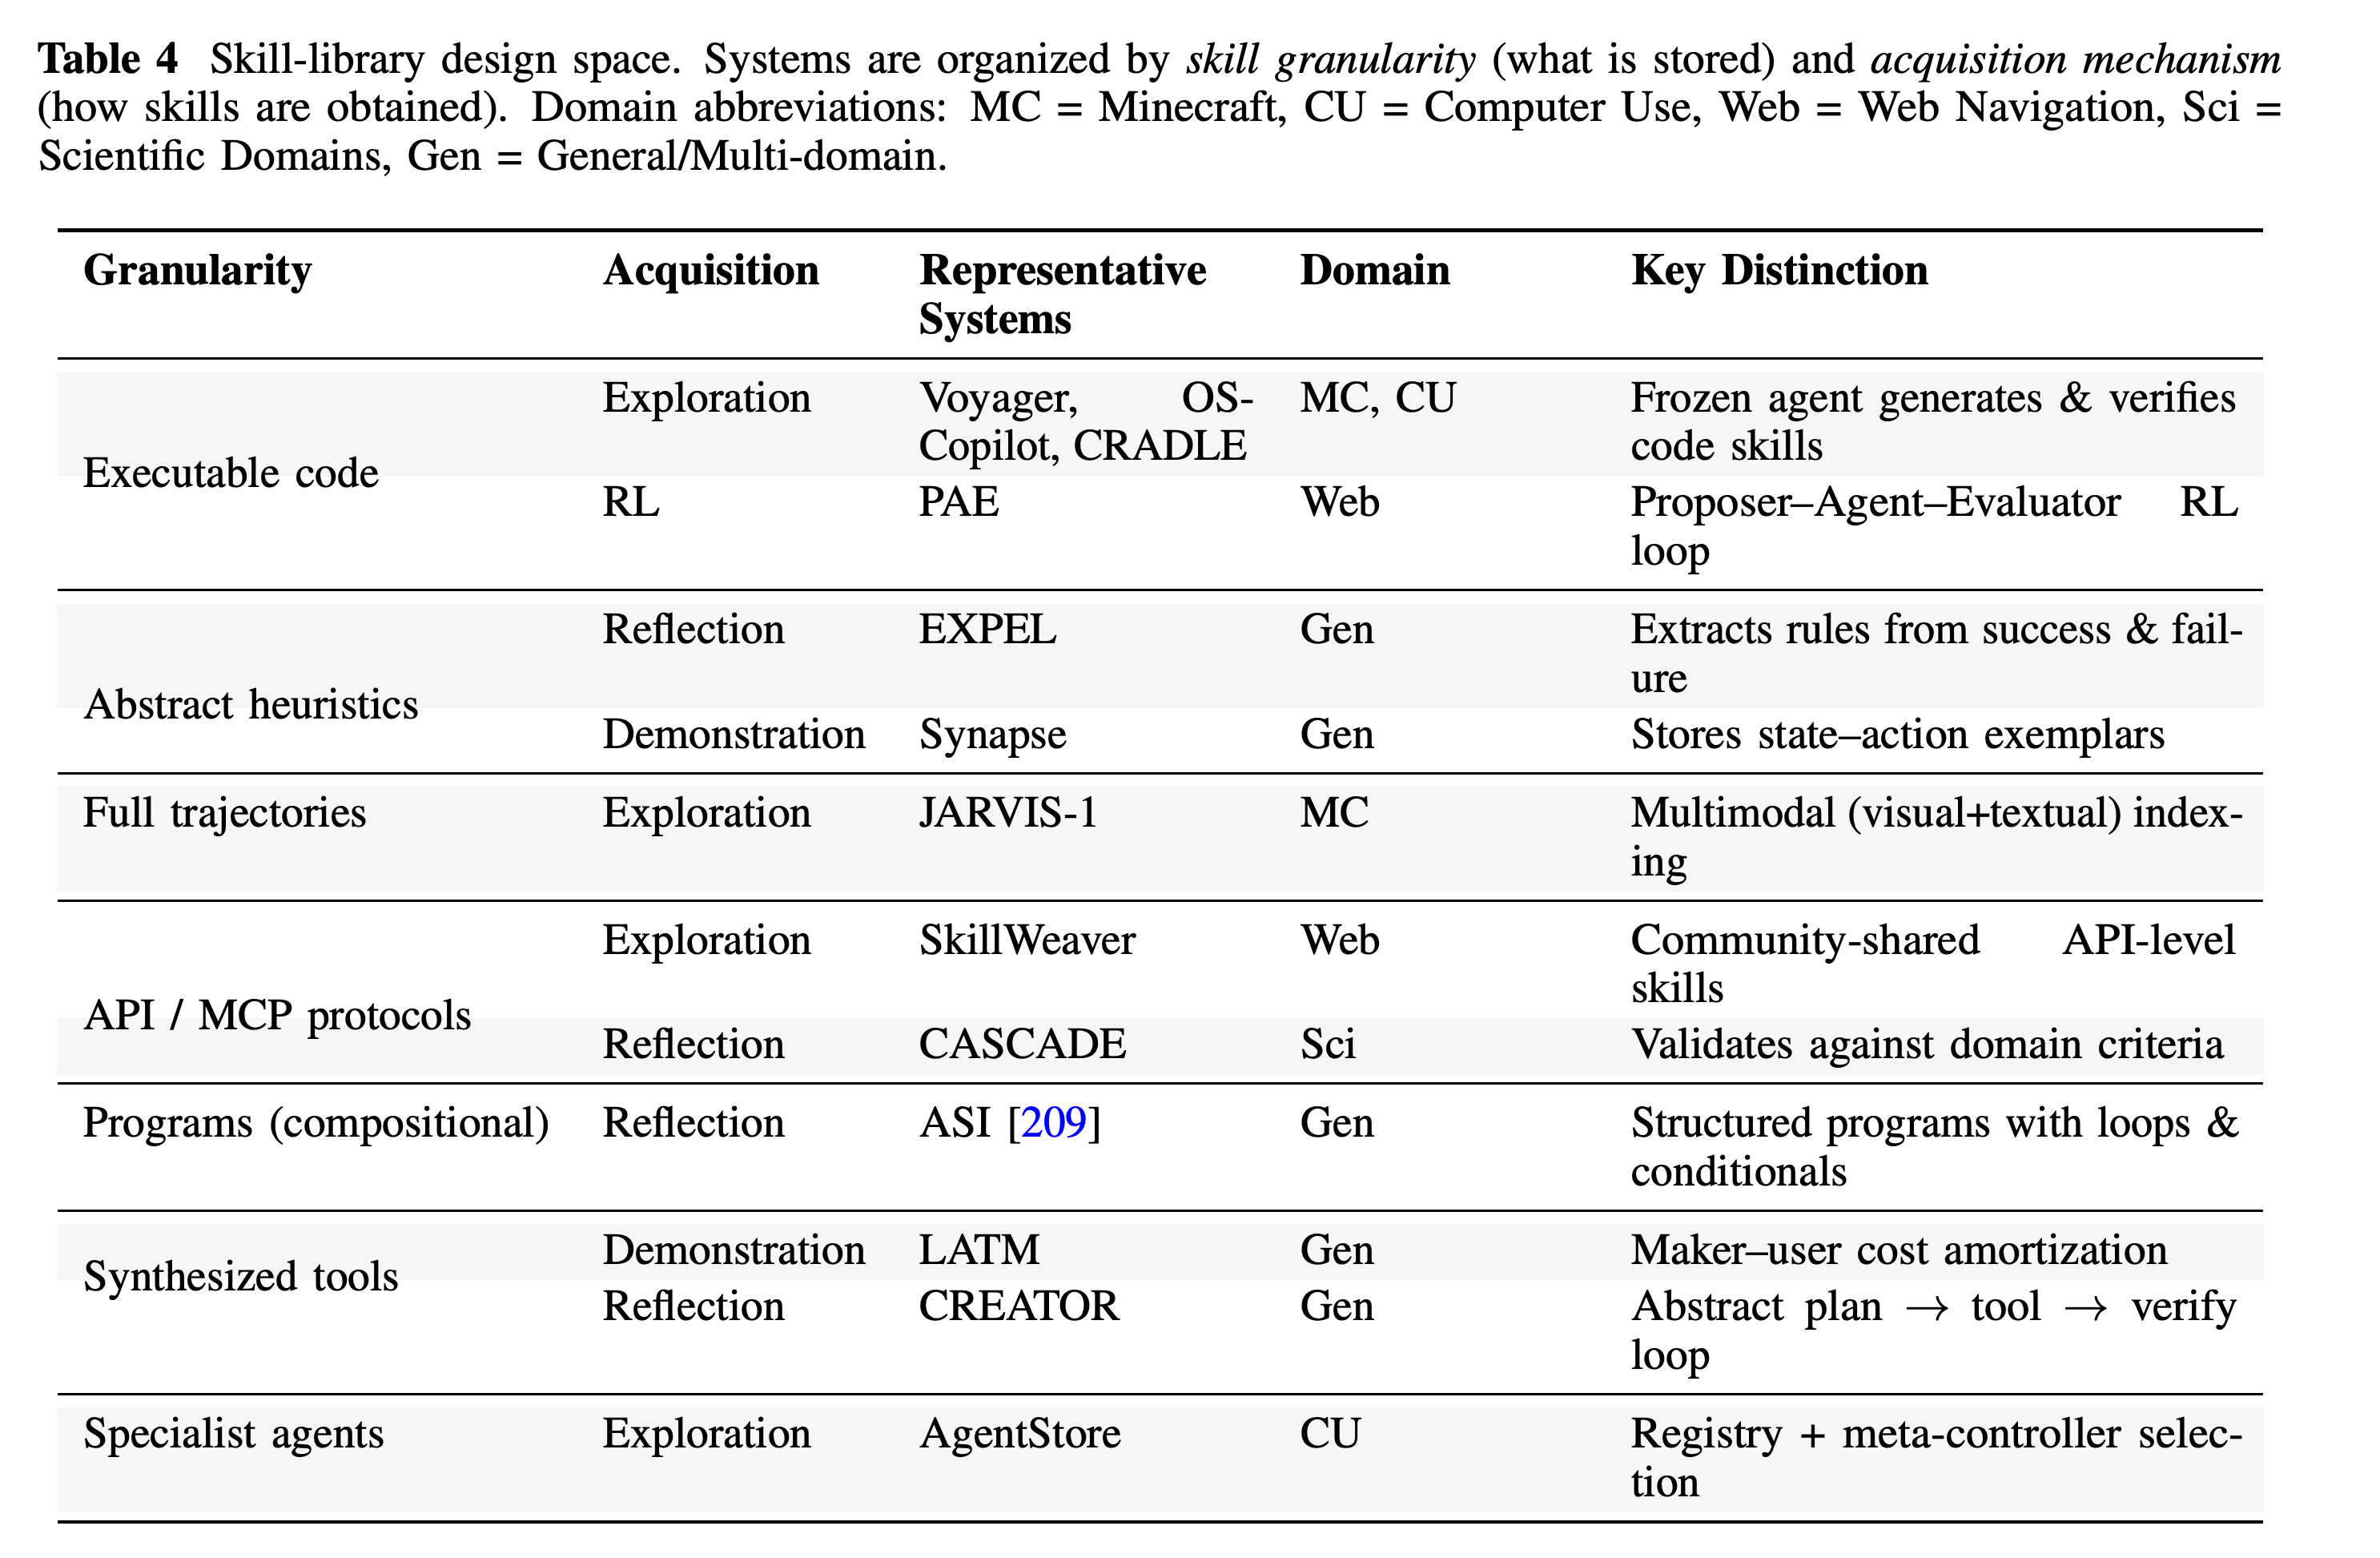
Agentic Memory and Skills는 메모리를 적응 가능한 저장 및 검색 체계로, 스킬을 시간에 따라 획득, 표현, 호출, 개선하는 절차적 내용으로 다룬다. Table 4는 실행 가능한 코드, 휴리스틱, 궤적, API 또는 MCP 프로토콜, 조합형 프로그램, 합성 도구, 전문 에이전트를 획득 메커니즘에 따라 구분한다.
- 메모리 설계에는 MemGPT와 Memory OS 같은 계층형 저장소, Generative Agents와 A-MEM 같은 성찰형 저장소, HippoRAG, AriGraph, ChatDB, Zep 같은 구조화된 저장소가 포함된다. CoALA와 인용된 forms, functions, dynamics 프레임워크는 저장 방식, 내용, 시간 범위, 업데이트 정책을 구분한다.
- Memento는 동결된 GPT-4.1 계획기를 위해 이진 과제 결과와 soft Q-learning으로 사례 검색 Q-function을 학습한다. GAIA validation에서 87.88%, GAIA test에서 79.40%, SimpleQA에서 95.0%를 보고하며, ablation에서는 분포 외 과제에서 4.7–9.6%의 절대 개선을 보인다.
- MemSkill은 메모리 연산을 발전시킨다. Dynamic Cheatsheet와 ReasoningBank는 생성기 가중치를 바꾸지 않고 테스트 시점에 전이 가능한 교훈을 정리한다. Reflexion은 텍스트 비평을 저장하고, Agent Workflow Memory는 재사용 가능한 행동 시퀀스를 유지한다.
- Voyager는 검증된 실행 가능한 스킬을 유지하며, 베이스라인의 3.3배인 고유 Minecraft 아이템 63개를 보고한다. JARVIS-1은 궤적을 유지하고, EXPEL은 휴리스틱을 추출하며, SkillWeaver는 호출 가능한 API를 저장하고, AgentStore는 전문 에이전트를 등록한다. LATM은 합성 도구 재사용으로 인스턴스별 비용을 최대 79% 줄였다고 보고한다.
- LEGOMem은 절차적 메모리를 팀으로 확장하고, ADAS는 재사용 가능한 아키텍처를 탐색한다. SayCan, ProgPrompt, Eureka, RoboGen은 스킬을 물리적 행동과 연결한다. MemWalker, ReadAgent, CoRAG, Adaptive-RAG는 저장된 정보에 대한 선택적 접근을 다룬다.
- Memory³와 Titans는 파라미터 기반 또는 혼합 경계 사례를 보여준다. ToolkenGPT는 동결된 백본에 연결된 도구 임베딩을 학습하고, UniMuR, DIFO, V2L Tokenizer, Sysformer는 적응을 표현, 모달리티 인터페이스, 시스템 프롬프트로 확장한다.
각 행은 실행 가능한 함수, 교훈, 궤적, 프로토콜, 프로그램, 합성 도구, 전문 에이전트를 저장 자원으로 구분한다. 획득 방식은 표현 방식과 독립적으로 달라지므로, 스킬 형식만으로 학습 메커니즘을 결정할 수 없다.
6 Comparison of Adaptation Paradigms
비교에서는 4가지 패러다임의 비용, 유연성, 데이터 효율, 일반화, 모듈성을 검토한다. 정량적 근거는 동일한 조건에서 4가지 패러다임을 비교한 실험이 아니라 선정된 기존 연구의 사례에서 가져온다.
6.1 A Framework for Comparison
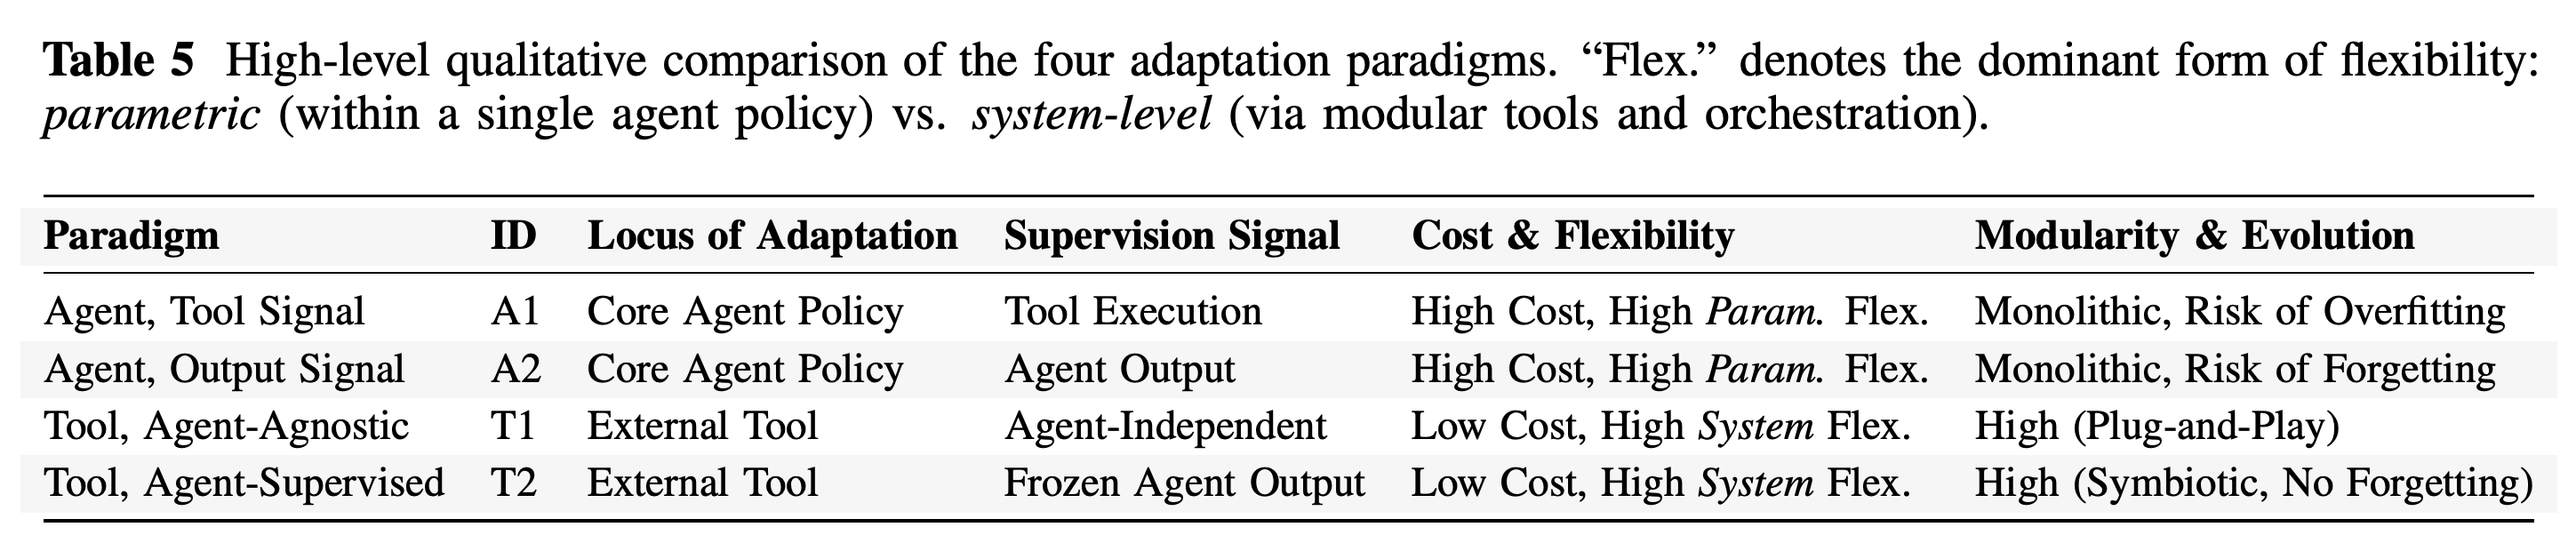
Table 5는 최적화 대상, 감독, 비용, 유연성, 모듈식 발전을 비교한다. A1과 A2는 핵심 정책을 바꿀 수 있고, T1과 T2는 호스트의 추론 능력과 한계를 유지하면서 구성 요소를 추가하거나 교체할 수 있다.
- 파라미터 유연성은 에이전트 정책의 변경을 뜻하고, 시스템 수준 유연성은 외부 능력과 그 배치의 변경을 뜻한다.
- 핵심 모델을 동결하면 해당 가중치에 대한 간섭을 막는다. 다만 도구나 메모리의 변경은 전체 시스템 성능을 바꿀 수 있다.
- 비용과 일반화에 관한 표기는 이질적인 연구에서 나타난 경향을 요약하며, 보편적 순위를 측정한 결과는 아니다. 서베이에는 프롬프트 기반 A1/A2 적응도 포함되므로, 해당 범주가 항상 가중치 업데이트를 요구하지는 않는다.
이 비교는 핵심 정책 내부의 유연성과 모듈식 도구를 통한 유연성을 구분한다. 비용과 망각 표기는 아키텍처의 경향을 요약한다. 핵심 모델의 동결은 해당 가중치의 보존을 뜻하며, 전체 시스템 성능이 그대로 유지된다는 보장까지 제공하지는 않는다.
6.2 Agent Adaptation Paradigms: A1 and A2
A1은 실행 피드백으로 도구 사용 방식을 최적화하고, A2는 출력 보상으로 추론과 조정을 최적화한다. 인용 결과에는 DeepRetrieval의 recall 65.1% 대 24.7%, R1-Code-Interpreter의 테스트 과제 37개에서 정확도 72.4%, ReSearch의 반복적 RAG 베이스라인 대비 9–22% 절대 개선, R1-Searcher의 RAG 베이스라인 대비 최대 24% 개선이 포함된다.
- A1은 중간 단계의 정확성 정보를 제공할 수 있지만, 실행 환경, 평가 기준, 보상 설계에 의존한다.
- A2는 검색 시점, 근거 통합, 전체 조정에 보상을 부여할 수 있다. 최종 보상은 편법 해결을 허용하고 실패 원인을 불분명하게 만들 수도 있다.
- 이 결과들은 서로 다른 과제, 지표, 시스템을 사용하므로 직접적인 A1-versus-A2 성능 순위를 입증하지 않는다.
6.3 Tool Adaptation Paradigms: T1 and T2
T1 graduation lifecycle은 A1이나 A2로 전문 에이전트를 학습한 뒤 파라미터를 동결하고 재사용 가능한 도구로 제공한다. T2는 고정된 호스트가 후속 과제에서 얻는 효용을 기준으로 검색, 메모리, 계획 구성 요소를 적응시킨다. 이는 호환성을 높일 수 있지만 호스트로부터의 독립성을 낮출 수 있다.
- DeepRetrieval과 SWE-Grep은 학습한 정책을 이후 재사용 가능한 도구로 제공하는 사례다.
- 제안된 T2 역할 분담은 정보 획득, 메모리 구성, 계획을 호스트의 지식과 추론에서 분리한다.
- 구성 요소의 학습 패러다임과 배포 역할은 다를 수 있다. 분류하려면 학습 단계와 시스템 경계를 명시해야 한다.
6.4 Synthesis: Data Efficiency and Modularity (A2 vs. T2)
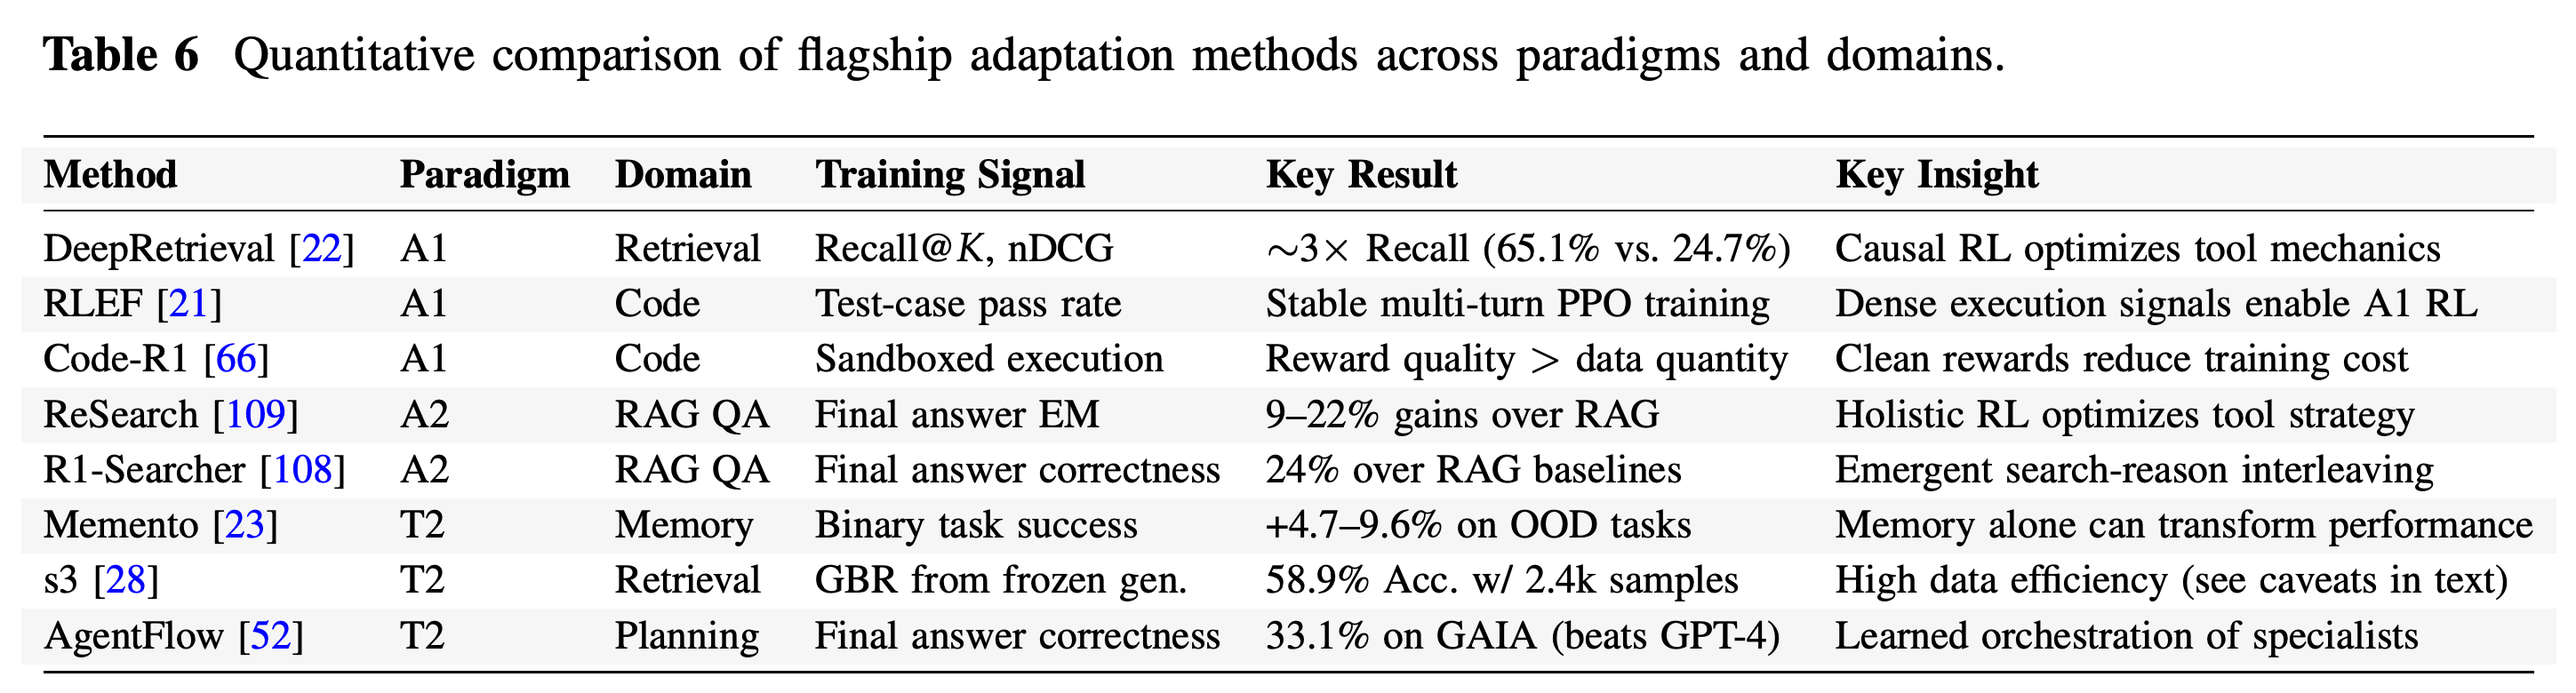
Table 6은 여러 도메인에서 선정한 결과를 모은다. 핵심 검색 사례는 Search-R1의 약 170k개 학습 예시와 s3의 예시 2.4k개 및 평균 정확도 58.9%를 비교한다. 전문 의료 QA에서는 s3가 76.6%, Search-R1이 71.8%라고 보고한다.
- Search-R1은 Qwen2.5 에이전트 전체를 업데이트한다. s3는 동결된 생성기와 함께 사용하는 7B 검색 서브에이전트를 업데이트하며, 생성기로는 Qwen2.5-7B, Qwen2.5-14B 또는 Claude-3-Haiku를 사용할 수 있다.
- 최적화 대상, 백본 구성, 아키텍처가 함께 달라지며, 학습 분포도 전이 차이를 설명할 가능성이 있다. 논문은 효율 차이를 패러다임 선택만으로 설명할 수 없다고 명시한다.
- 이 사례는 유능한 동결 호스트를 유지하면서 좁은 범위의 절차적 능력을 학습하는 방식을 조건을 맞춰 비교할 필요성을 제시한다. 모듈을 교체할 때도 새 구성 요소가 전체 시스템 행동에 미치는 영향을 평가해야 한다.
검색 recall, 답변 개선, 메모리 ablation, GAIA 점수를 각각의 관련 신호에 따라 모은다. 지표가 달라 행들의 순위를 매길 수 없으며, s3 효율 비교에도 본문에서 설명한 백본 및 아키텍처 차이에 대한 한정이 그대로 적용된다.
6.5 Strategic Recommendations
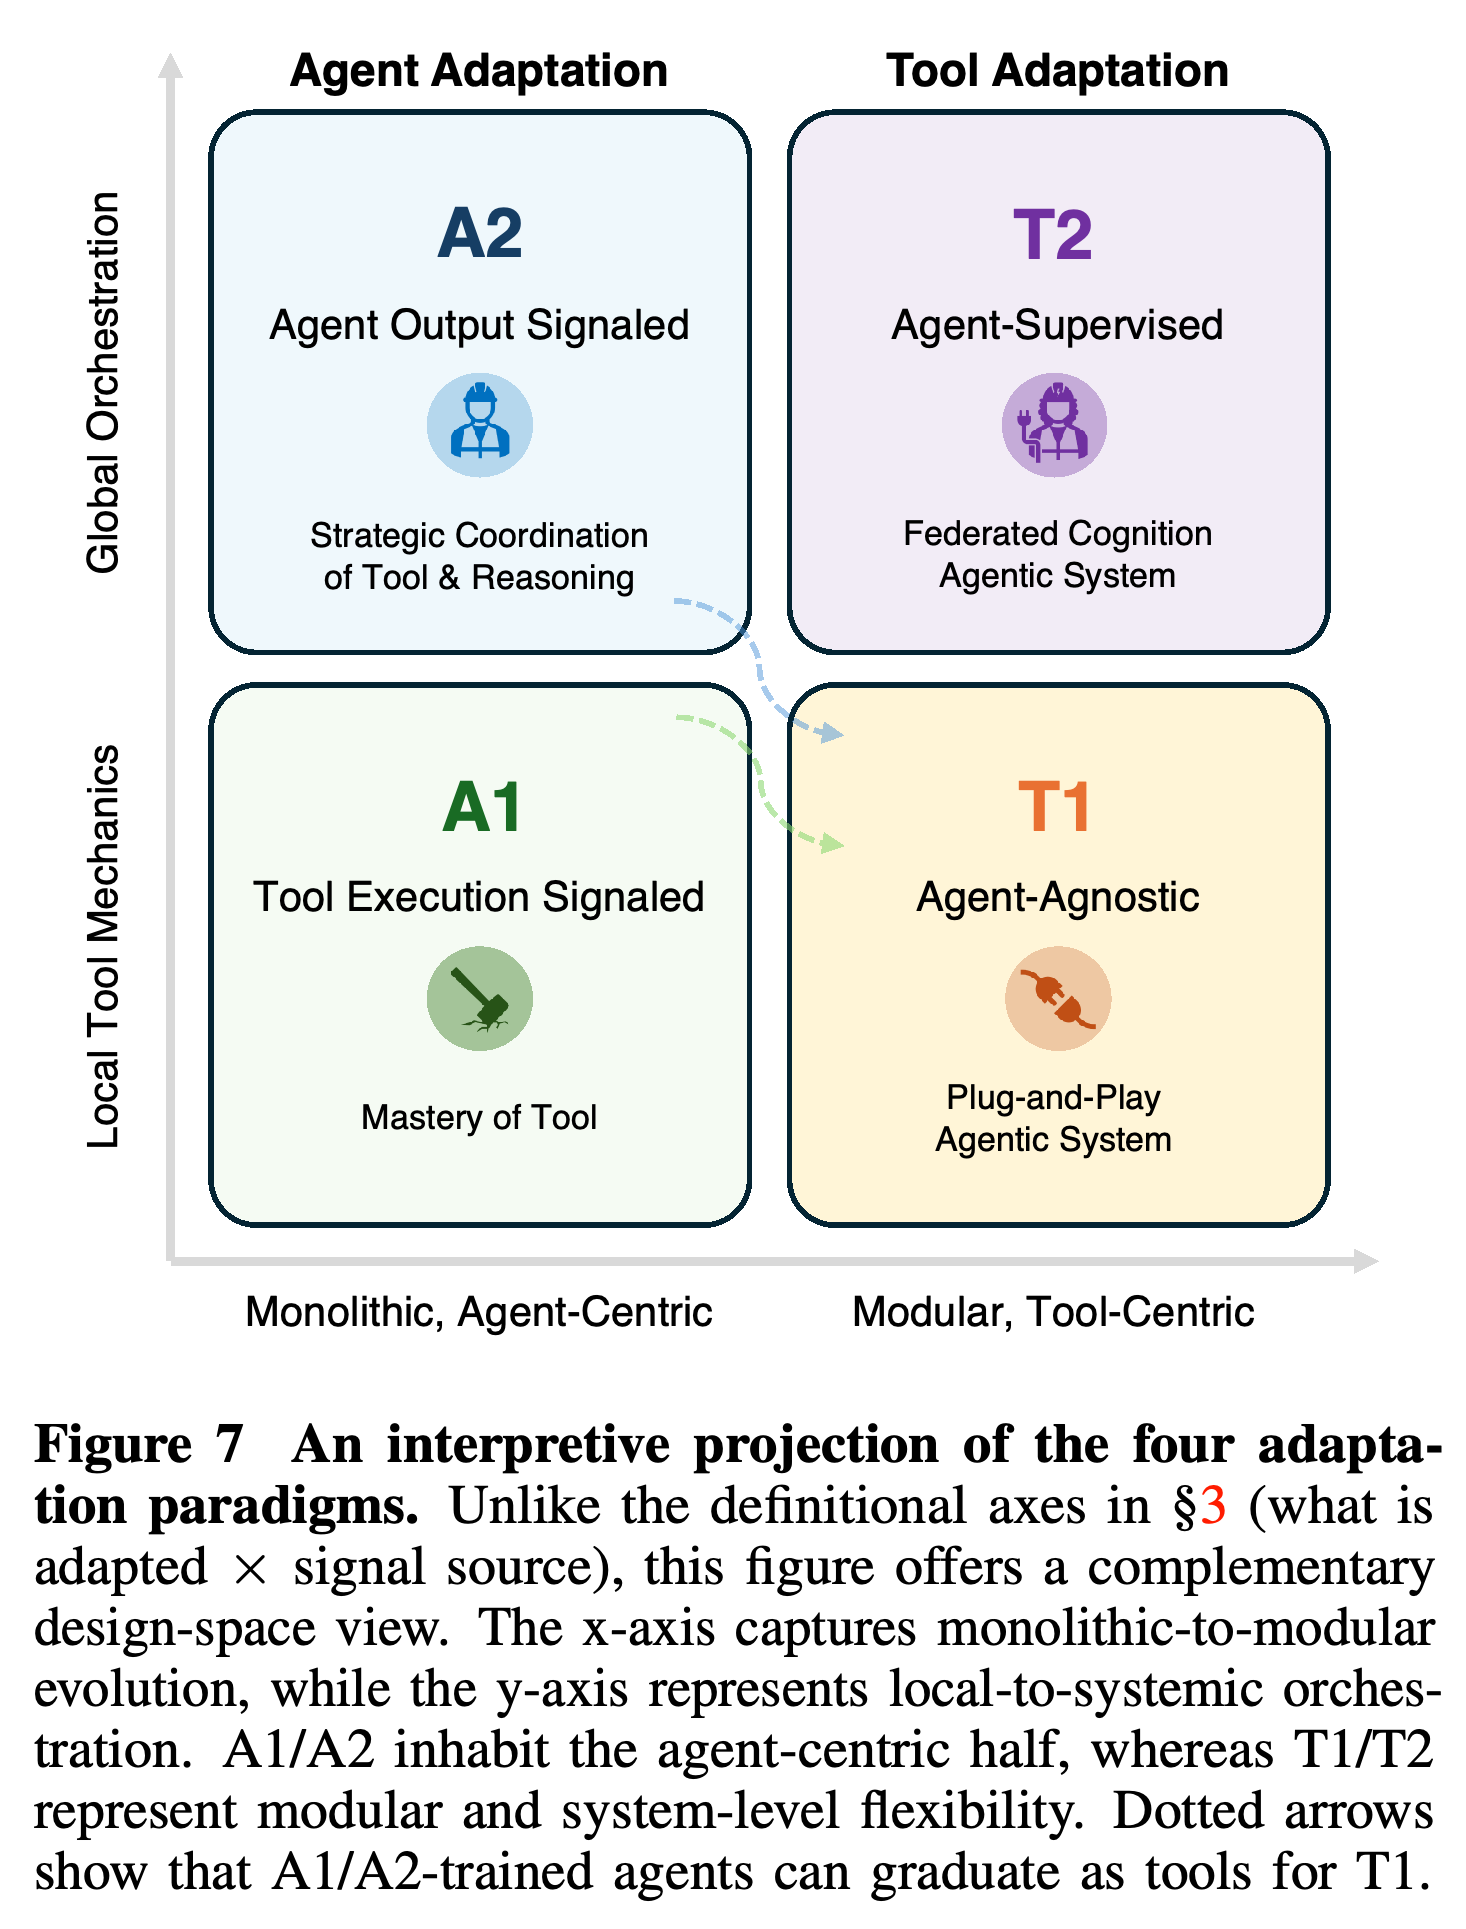
저자들은 검증 가능한 도구 사용 방식에는 A1, 통합 추론과 조정에는 A2, 재사용 가능한 구성 요소에는 T1, 호스트에 맞춘 모듈식 개선에는 T2를 권장한다. Figure 7은 이러한 선택을 국소적 조정에서 전체 조정으로 이어지는 축과 단일 모델에서 모듈식 구조로 이어지는 아키텍처 축에 배치한다. 이 해석적 축들은 분류 체계의 정의와 명시적으로 구분한다.
- A1 전문화는 인터페이스에 크게 의존할 수 있다. A2 파라미터 업데이트는 비용이 높고 기존에 학습한 행동에 영향을 줄 수 있다.
- T1 도구는 특정 호스트와 잘 정렬되지 않을 수 있다. T2는 감독하는 호스트의 품질에 의존하며, 조정 복잡성과 오류 누적 가능성을 만든다.
- 재사용 가능한 도구와 적응형 도구를 결합하고 가끔 핵심 에이전트를 업데이트하는 방식은 저자들의 권고이며, 보편적 최적해로 입증된 결과는 아니다.
이 도식은 모듈성을 조정 규모와 연결하고, 학습된 에이전트가 재사용 가능한 T1 도구가 되는 과정을 보여준다. 저자들은 이러한 해석적 축을 최적화 대상과 감독 신호 출처로 정의한 분류 체계와 명시적으로 구분한다.
7 Evaluation
평가는 적응된 시스템의 성능과 구성 요소가 학습하는 과정을 모두 다룬다. 이 절에서는 벤치마크가 다루는 범위, 감독 신호, 적응 동역학, 시스템 수준 요구 사항을 검토하고 부족한 평가 인프라를 논의한다.
7.1 Benchmark Landscape Mapped to A1/A2/T1/T2
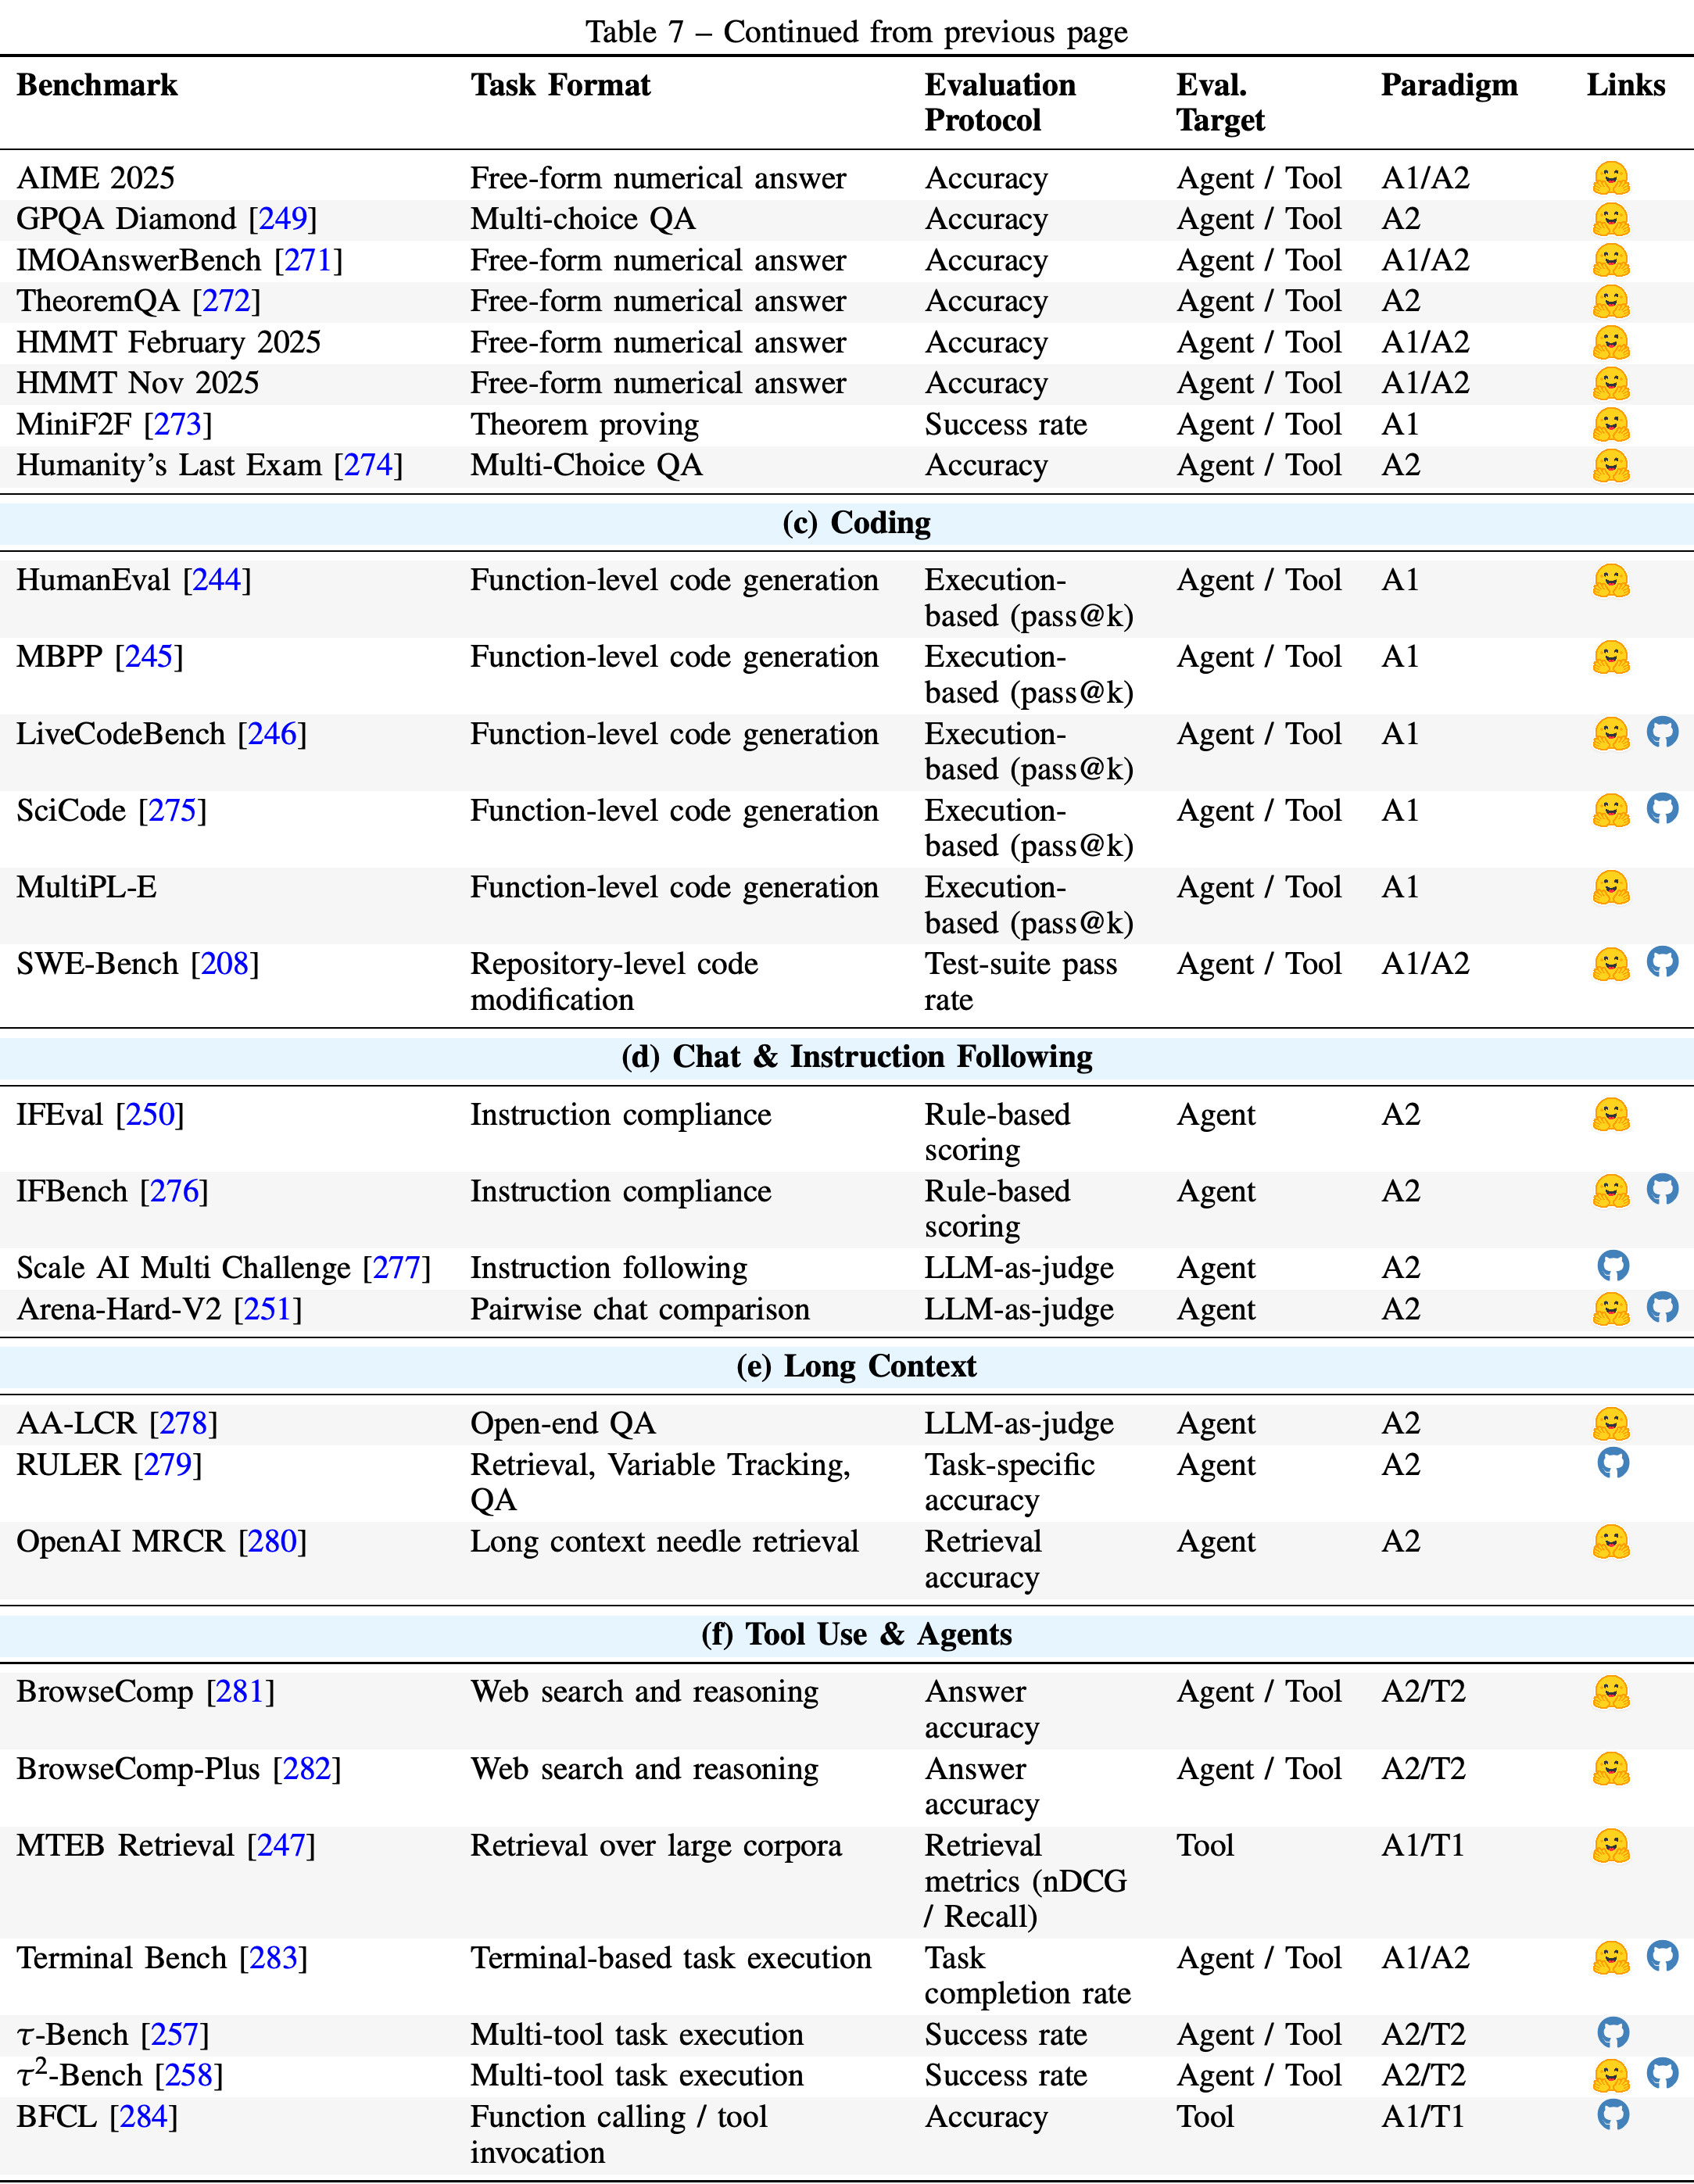
Table 7은 벤치마크를 과제 형식, 평가 프로토콜, 대상, 관련 패러다임에 연결한다. 실행 평가는 A1을, 최종 출력 평가는 A2를, 독립적인 도구 평가는 T1을 지원한다. T2 평가는 호스트를 고정한 상태에서 도구가 추가로 제공하는 이득을 측정한다.
- LongMemEval은 추출, 다중 세션 추론, 시간 추론, 지식 업데이트, 답변 유보를 평가한다. 저자들은 스킬 획득, 호출, 개선, 변화에 따른 품질 저하에 대한 평가가 부족하다고 지적한다.
- WebArena, OSWorld, τ-Bench, τ²-Bench 등의 통합 평가 모음은 현실적인 상호작용을 평가한다. 다만 최종 점수만으로는 성능 향상을 특정 적응 구성 요소에 귀속할 수 없다.
- 서베이는 T2 평가의 표준화가 상대적으로 부족하다고 설명하며, 동일한 과제 분포에서 4가지 패러다임을 모두 통제해 비교할 수 있는 평가 모음을 찾지 못했다고 밝힌다.
- AAA는 공개 프로토콜로 소통하는 평가 에이전트를 제안한다. 이를 통해 대규모로 조건을 맞춘 비교가 가능한지는 경험적 검증이 필요한 문제다.
이 목록은 과제 형식과 평가 프로토콜을 평가 대상 및 패러다임 표기에 연결한다. 여러 패러다임에 배정된 항목은 벤치마크 이름만으로 실험이 실행, 최종 효용, 도구가 추가로 제공하는 가치를 평가하는지 알 수 없는 이유를 보여준다.
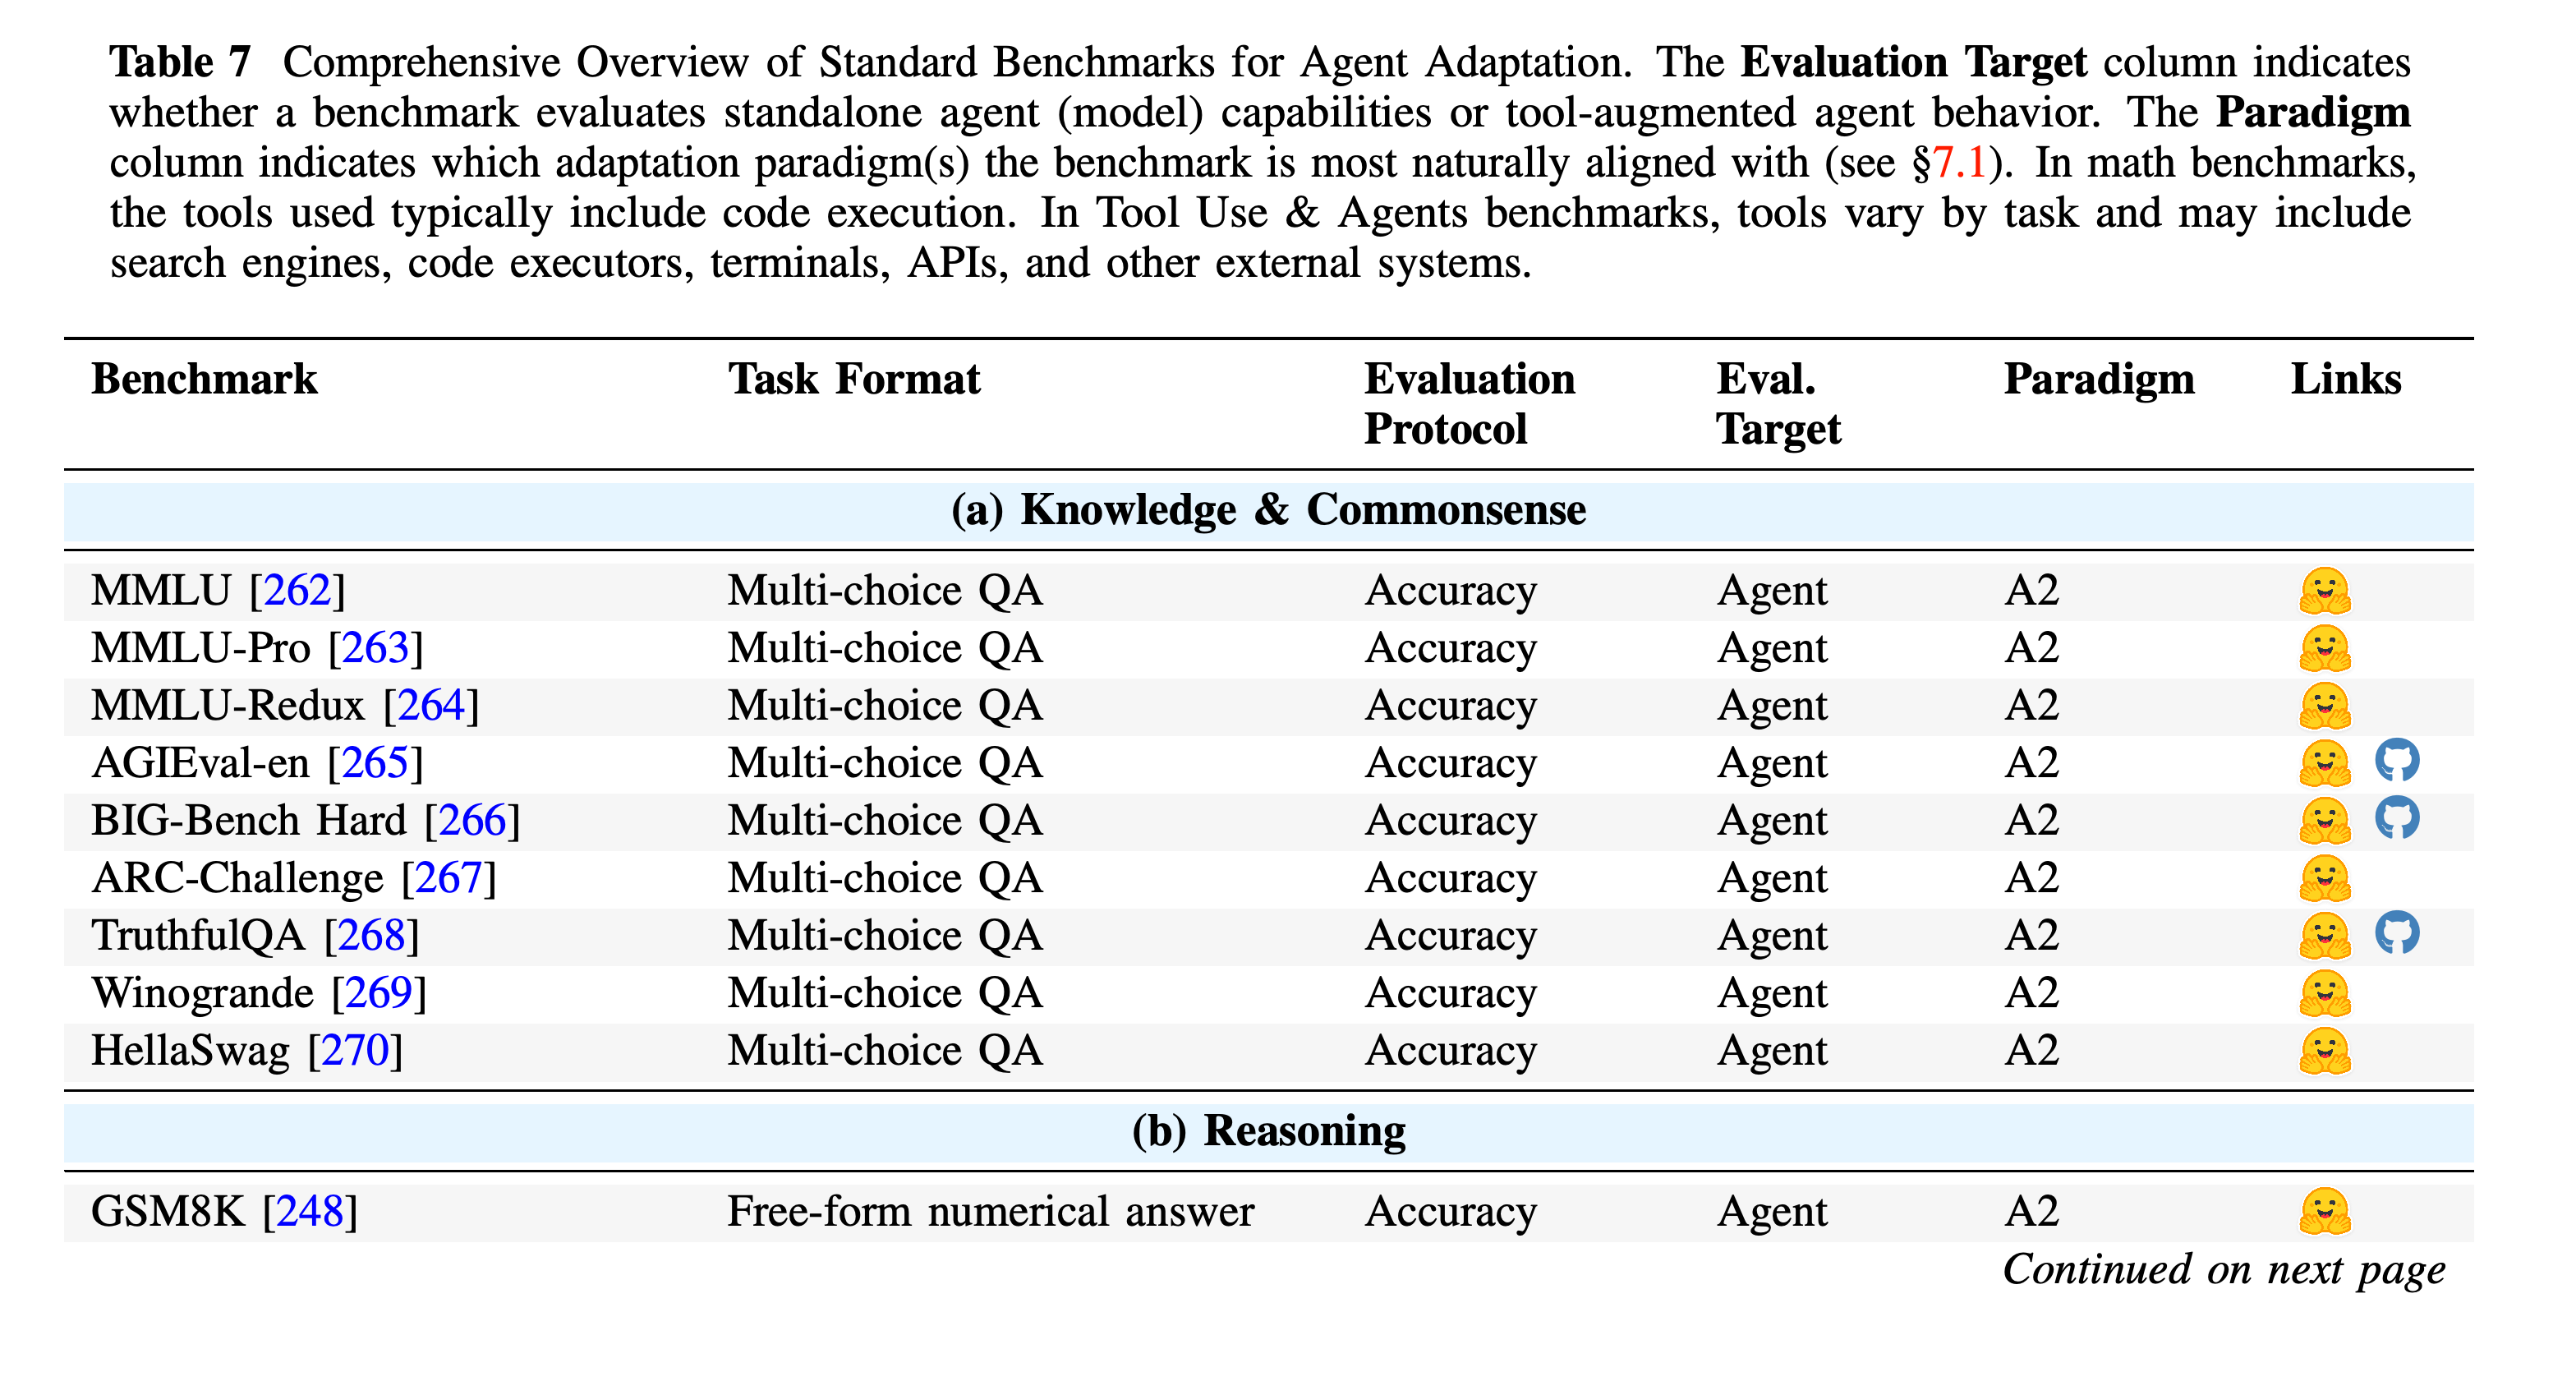
이 목록은 과제 형식과 평가 프로토콜을 평가 대상 및 패러다임 표기에 연결한다. 여러 패러다임에 배정된 항목은 벤치마크 이름만으로 실험이 실행, 최종 효용, 도구가 추가로 제공하는 가치를 평가하는지 알 수 없는 이유를 보여준다.
7.2 Evaluating the Adaptation Signal
Verifiable Execution Metrics (A1 & T1)는 pass@k, 테스트 모음 통과율, 검색 관련성, 증명 검사를 통해 도구 결과를 평가한다. Holistic Utility Metrics (A2 & T2)는 최종 답변의 정확성, 판정된 품질, 과제 완료를 평가한다. 프로그램을 통한 최종 상태 검사로도 전체 결과를 평가할 수 있다.
- 실행 지표는 국소적 진단을 지원하지만 유지보수성, 효율, 타당한 추론, 성공적인 종합을 입증하지는 않는다. 검색 recall이 높아도 후속 과제의 효용은 낮을 수 있으며, 실행 지표를 편법으로 높일 수도 있다.
- 형식 검증은 주어진 형식 명세 안에서 결정론적 검사를 제공한다. 성공 기준이 암묵적이거나 주관적인 과제까지 적용되지는 않는다.
- EM은 답변 형식과 추론 품질을 혼동할 수 있다. Math-Verify는 수학적 동치성을 검사한다. 인용된 자료의 주소는 https://github.com/huggingface/Math-Verify 이다.
- LLM-as-a-judge에는 장황한 답변 선호, 위치, 자기 출력 선호, 아첨 편향이 생길 수 있다. 대응책으로 인간 판단에 맞춘 보정과 앙상블 판정을 논의한다.
- 최종 출력 지표는 오류가 추론, 선택, 실행, 종합 중 어디에서 발생했는지 드러내지 못해 T2 도구의 기여를 구분하는 데 한계가 있다.
7.3 Evaluating the Adaptation Dynamics
적응 동역학은 최종 정확도와 함께 효율, 일반화, 안정성으로 평가해야 한다. 저자들은 예시, 토큰, 상호작용, 학습 시간, 배포 시 연산량을 함께 보고하고, 과제 간 전이와 에이전트 간 전이도 제시하도록 권장한다.
- Sample and Interaction Efficiency에는 상호작용 횟수 분포와 정확도-연산량 Pareto frontier가 포함된다. s3-versus-Search-R1 비교에는 Section 6.4에서 인정한 교란 요인이 그대로 남는다.
- Generalization and Robustness는 학습에 사용하지 않은 과제, 다른 호스트 모델, 노이즈가 있는 도구, 변화하는 인터페이스, 멀티모달 분포 변화, 조정 실패를 다룬다.
- Continual and Co-Adaptation Stability는 기존 능력 보존을 확인하는 평가 집합과 backward transfer를 권장한다. 정책 엔트로피, 업데이트별 엔트로피 변화, 도구 호출 다양성, 보상 곡선, 참조 정책과의 발산을 보조 지표로 제시한다.
- 이동 구간의 성능 분산, 기울기 부호 변화, 평형으로의 수렴은 공동 적응 지표로 제안되며 경험적 검증이 필요하다.
7.4 Systemic Evaluation
시스템 수준 평가는 과제 정확도와 별도로 비용, 안전성, 정렬을 고려한다. AgencyBench는 과제당 평균 1000000 tokens와 도구 호출 90회를 사용하는 규모 사례로 인용된다. 이는 프롬프트, 생성 출력, 도구 지연, 재시도, 학습 GPU hours를 따로 집계할 필요성을 보여준다.
- Cost and Inference-Time Compute는 토큰 또는 시간 예산 아래의 정확도를 권장한다. 지연이 큰 환경에서 T2가 유리하다는 제안은 아직 검증되지 않은 패러다임 간 가설이다.
- 안전성 평가에는 샌드박스 탐색, 보상 해킹, 학습에 사용하지 않은 보상 분포, 궤적 검사, 학습 중 반복적인 안전성 검사가 포함된다.
- 정렬에는 사용자 제약의 충실한 준수와 도구 출력이 호스트의 처리 방식에 맞는지가 포함된다. BGM의 연결 모델 결과는 에이전트-도구 호환성을 보여주는 사례다.
- 호스트 가중치를 동결해도 적응된 도구가 유발하는 위험하거나 정렬되지 않은 행동을 막지는 못한다. 안전성은 시스템 수준에서 평가해야 한다.
7.5 Discussion
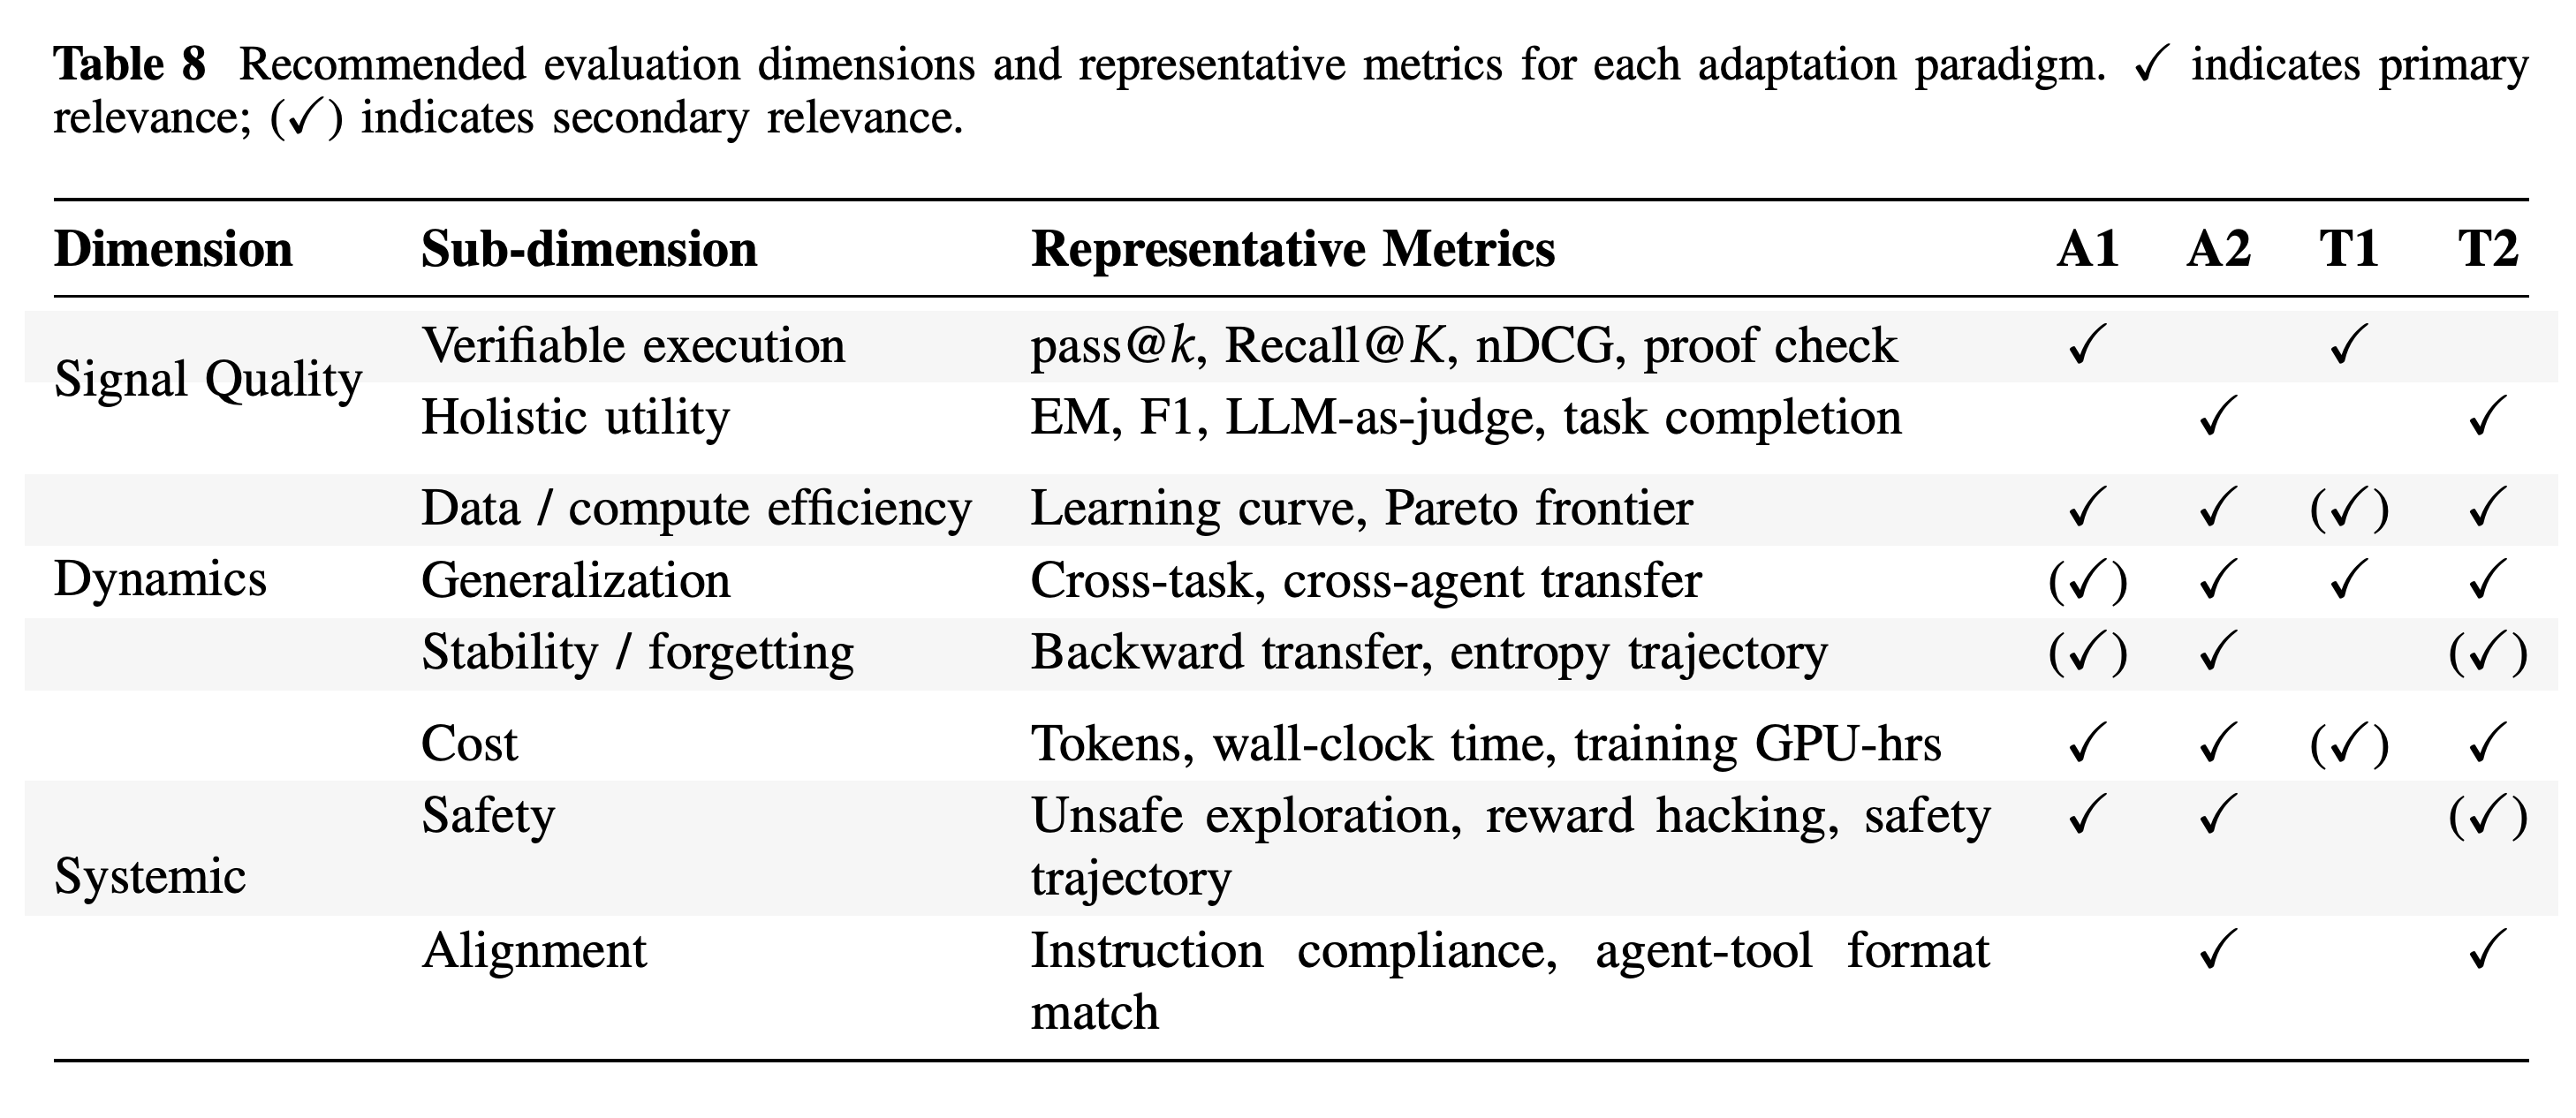
Table 8은 패러다임별 신호 품질, 동역학, 비용, 안전성, 정렬 지표를 정리한다. 논의에서는 최종 순위가 데이터 요구량, 소진된 탐색 능력, 일시적 안전성 저하, 선택한 지표에만 국한된 개선을 가릴 수 있다고 설명한다.
- 도구 중심 평가는 구성 요소 자체의 품질을 측정하고, 에이전트 중심 평가는 전체 시스템 효용을 측정한다. 반사실적 평가는 다른 요소를 고정한 채 특정 구성 요소를 바꾸지만, 교체로 에이전트 행동이 달라질 수 있다. 보완적인 민감도 분석으로 도구 품질을 점진적으로 낮추는 방법을 제안한다.
- 저자들은 최소 3개 random seed의 학습 곡선, 비용 조건별 성능, 지속 학습 환경에서 기존 능력을 평가한 결과, RL의 안전성 궤적을 권장한다.
- 향후 평가 모음은 조건을 맞춘 과제에서 패러다임을 비교하고, 멀티모달 및 다중 에이전트 환경을 포함해 지속적으로 변화하는 환경의 적응을 추적하도록 제안한다.
- 지속적으로 변화하는 벤치마크는 능력이 향상되어도 난도를 유지할 수 있지만, 반복 비용, 시간에 따라 달라지는 비교 가능성, 생성 과제의 검증 문제를 만든다. 논문은 버전이 지정된 정적 스냅샷을 함께 사용하도록 권장한다.
이 행렬은 평가를 신호 품질에서 학습 동역학과 시스템 수준 요구 사항으로 확장한다. 주된 관련성과 부차적 관련성 표시는 권장 강조점을 나타내며, 측정된 평가 범위나 표시되지 않은 차원이 무관함을 뜻하지 않는다.
8 Applications
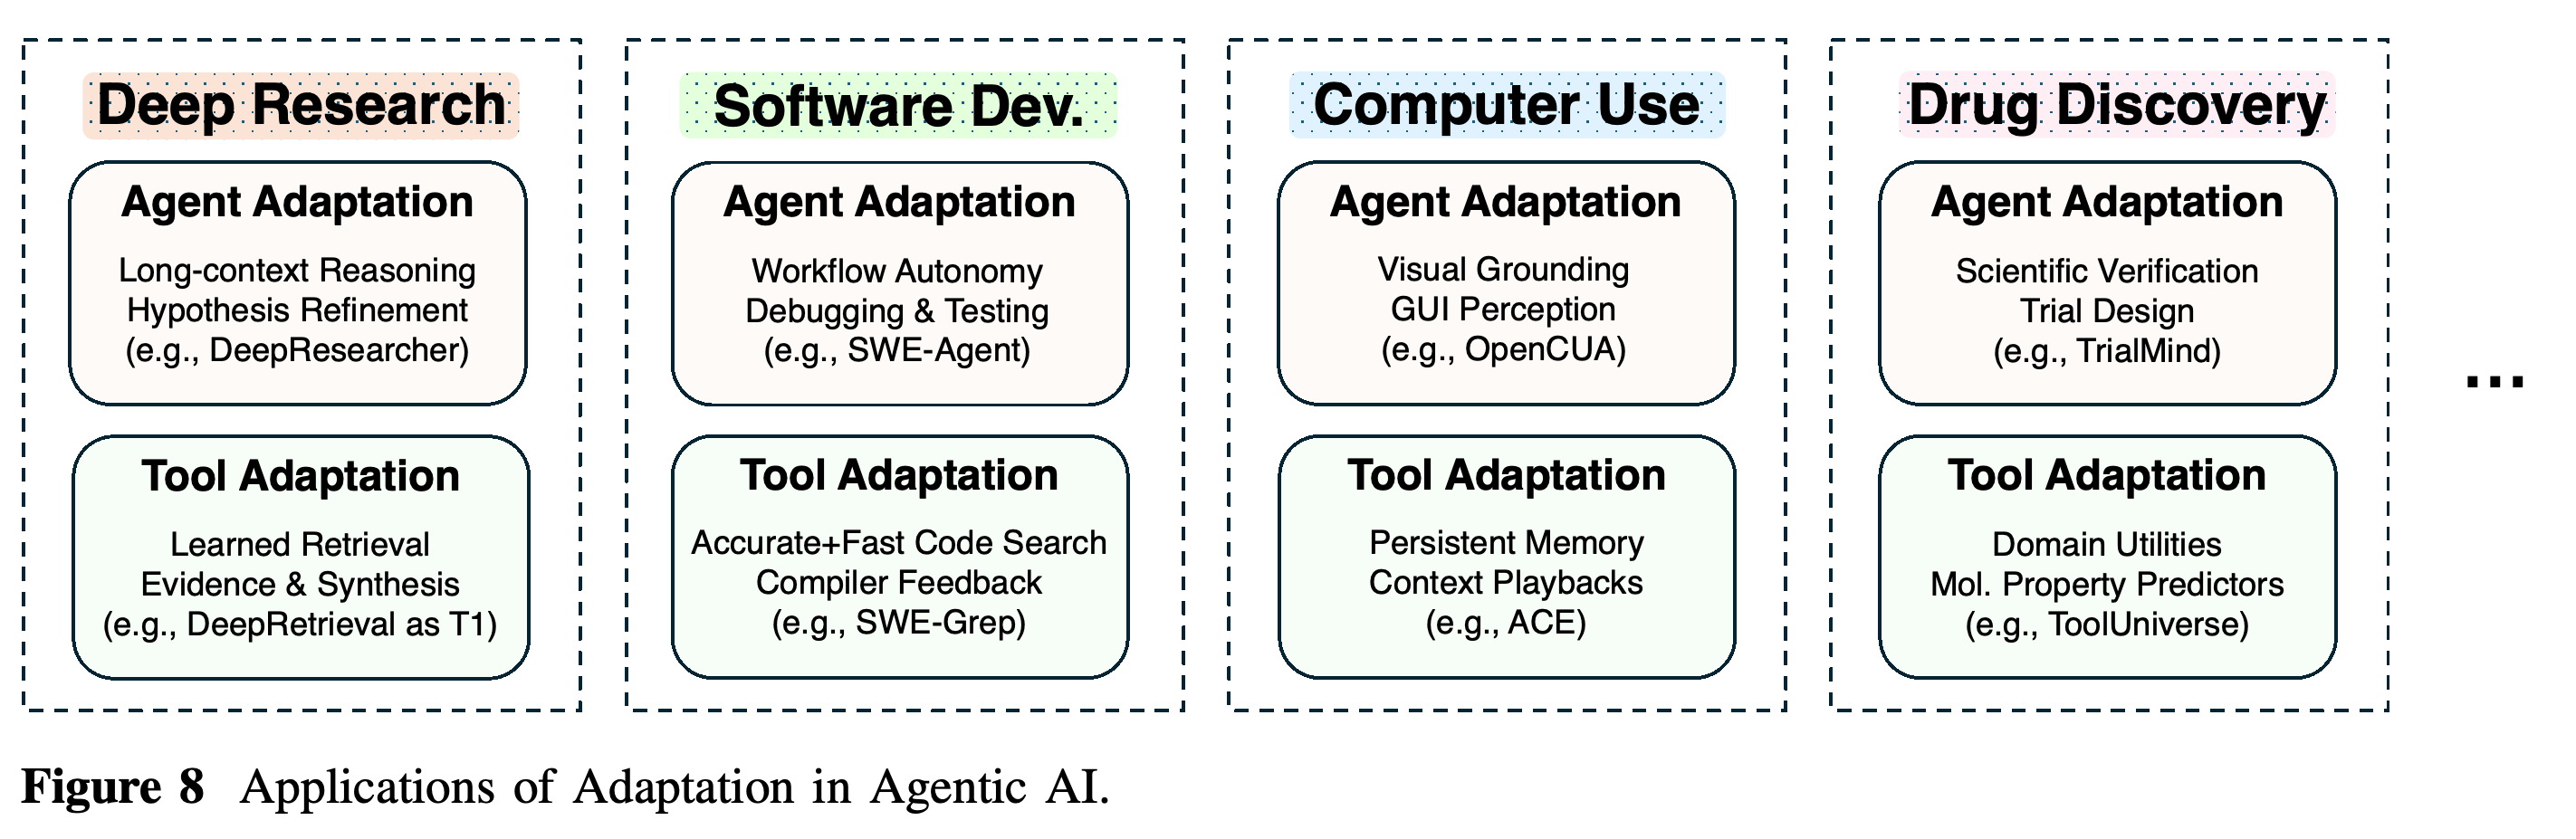
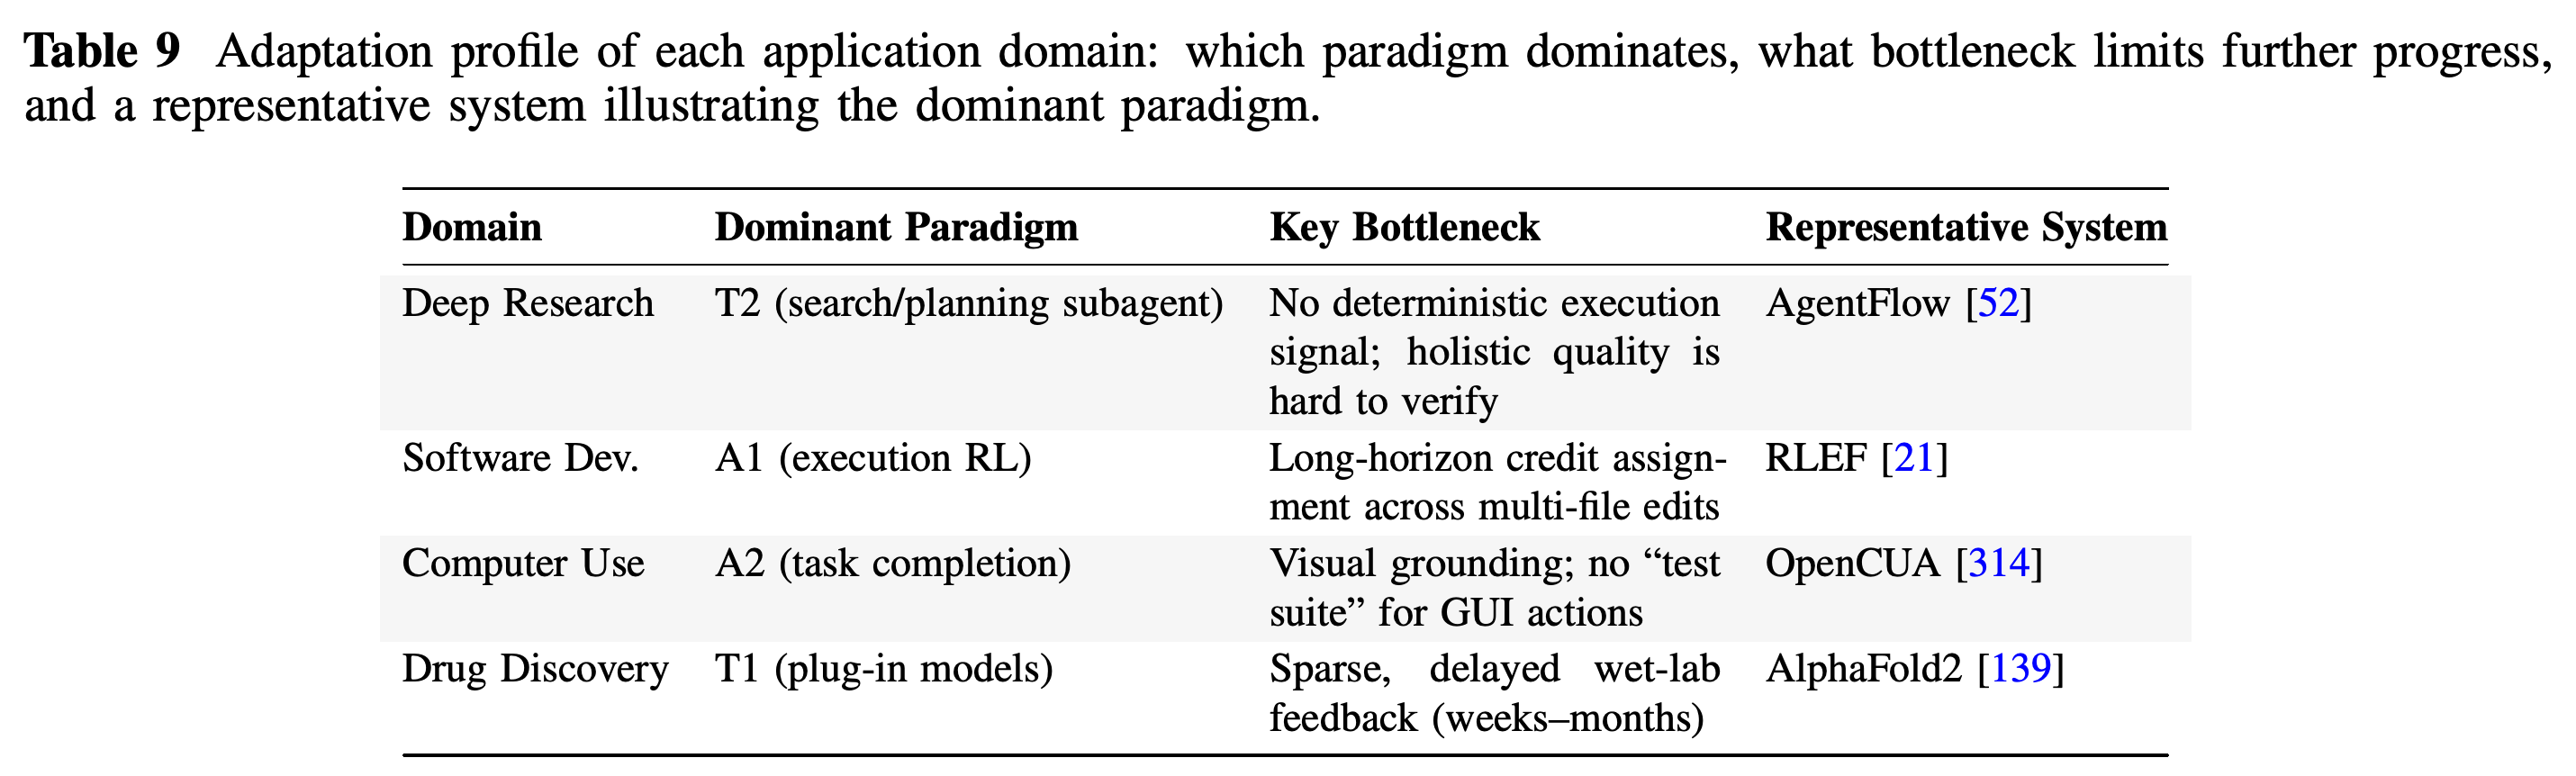
응용 절은 적응을 심층 연구, 소프트웨어 개발, 컴퓨터 사용, 신약 발견에 연결한다. Figure 8은 에이전트 측과 도구 측 요구 사항을 함께 보여주고, Table 9는 주된 패러다임을 피드백 제약 및 병목과 연결한다.
각 응용은 에이전트 측 추론 요구 사항과 도구 측 능력을 함께 제시한다. 이 연결은 서베이가 도메인에 주된 경로를 지정하더라도 완전한 시스템에서는 여러 패러다임을 결합하는 이유를 설명한다.
8.1 Deep Research
Deep Research는 반복적 검색, 검증, 종합을 장문 맥락 추론, 가설 개선, 지속적 지식 추적과 결합한다. 서베이는 전체 연구 품질을 A2에, 학습된 검색이나 계획 구성 요소를 T2에, 독립적으로 학습한 검색기를 T1에 연결한다.
- 전체 연구 품질에 결정론적 정확성 검사가 없더라도 Recall@K 같은 검색 전용 지표는 A1 피드백을 제공할 수 있다.
- 제안된 도메인 전문화 요구 사항에는 온톨로지, 데이터베이스, 검증된 계산 도구, 분야별 평가 및 안전 기준이 포함된다.
8.2 Software Development
Software Development 에이전트는 여러 단계에 걸쳐 저장소를 탐색하고, 코드를 수정하고, 디버깅하고, 변경을 검증한다. 테스트와 컴파일은 A1 학습을 지원하고, 완전한 이슈 해결은 계획과 조정에 대한 A2 평가를 지원한다.
- SWE-Agent와 OpenHands는 에이전트-컴퓨터 인터페이스와 샌드박스 개발 환경을 보여주며, SWE-Bench는 저장소 수준의 버그 수정을 평가한다.
- 서베이는 Cursor의 Tab-RL과 SWE-Grep을 도구 적응 사례로 논의한다. 전문화된 검색은 무관한 맥락을 줄일 수 있지만, SWE-Grep의 분류는 graduation 논의와 응용 절에서 서로 다르다.
- 실행 피드백이 있어도 여러 파일의 수정에 걸친 장기 기여도 할당은 여전히 병목이다.
8.3 Computer Use
Computer Use는 스크린샷과 GUI 배치에 근거해 행동을 결정하고 키보드나 마우스 조작을 조정해야 한다. OpenCUA는 인간 시연 궤적을 제공하고, AgentTrek은 웹 튜토리얼에서 궤적을 합성한 뒤 자동 평가로 선별한다.
- 저자들은 전체 과제 완료를 주로 A2에, 지속적 메모리와 맥락 관리를 T2에, 독립적으로 학습한 지각 모듈을 T1에 연결한다.
- CUA-Skill은 파라미터화된 스킬과 조합 그래프를 저장하고, ACE는 경험으로 구조화된 맥락 지침을 업데이트한다.
- 중간 GUI 행동에는 코드에서 가능한 단순한 정확성 검사가 없는 경우가 많다. 다만 최종 시스템 상태 검사로 과제 완료를 검증할 수 있다.
8.4 Drug Discovery and Development
Drug Discovery and Development는 과학적 추론을 데이터베이스, 예측 모델, 계산 도구와 결합한다. Table 9는 T1 플러그인 모델을 주된 패턴으로, 수주에서 수개월 지연되는 습식 실험 피드백을 제약으로 제시한다.
- GeneAgent는 유전자 분석에 자기 검증을 사용하고, DSWizard는 검토 가능한 분석 계획을 지원한다. 가상 연구팀은 협업 분자 설계의 사례다.
- 계산 출력은 A1 신호를 제공할 수 있지만, 가설 생성과 임상 워크플로 품질에는 더 폭넓은 A2 평가가 필요하다. TrialMind와 LEADS는 근거 검색, TrialGPT는 환자와 임상시험의 매칭, TrialGenie는 코드 실행과 프로토콜 평가의 결합을 보여준다.
- Biomni는 선별된 도구를 제공하고, ToolUniverse와 STELLA는 발전하는 도구 라이브러리를 보여준다. 새로운 과학 도구에는 도메인 전문가의 검증이 필요하다.
- 이 도메인은 4가지 패러다임을 모두 사용한다. 예측 모델 점수는 계산 피드백을 제공하지만, 실험 결과의 대리 지표로 타당한지는 별도로 평가해야 한다.
각 프로필은 적응 선택을 검증하기 어려운 연구 품질, 소프트웨어 수정의 기여 구분, 시각 정보에 근거한 행동 결정, 지연된 습식 실험 피드백과 연결한다. 주된 패러다임 표기는 저자들의 도메인 분류를 요약하며, 보완적인 메커니즘을 배제하지 않는다.
9 Opportunities
연구 기회를 다루는 절은 에이전트-도구 공동 학습, 변화하는 과제 스트림에 대한 적응, 안전한 탐색, 효율적 배포를 검토한다. 이들은 서베이에서 도출한 연구 방향이며 통합 구현의 결과는 아니다.
9.1 Co-Adaptation
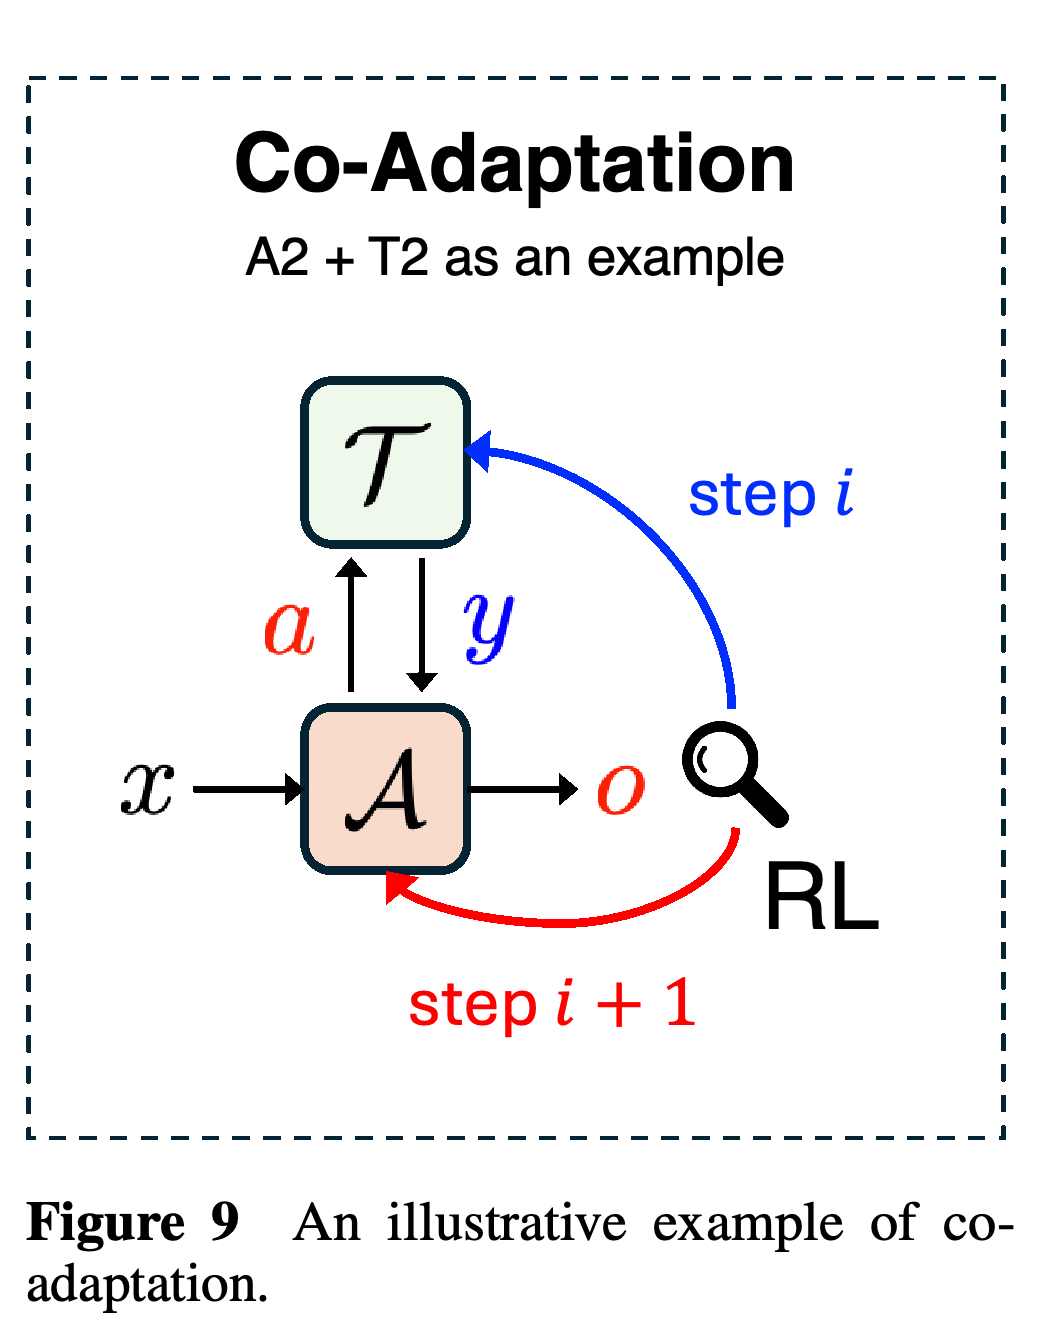
Co-Adaptation은 에이전트와 도구가 서로의 실질적 환경을 바꿀 때 함께 학습하는 방법을 다룬다. Figure 9는 A2와 T2 업데이트를 번갈아 수행하는 과정을 보여주며, 불확실한 기여도 할당과 시간에 따라 최적화 조건이 변하는 문제를 드러낸다.
- 저자들은 중앙집중식 학습, 분산 실행, 변화하는 상대 정책 아래의 조정을 포함한 공진화 알고리즘과 다중 에이전트 RL을 참고한다.
- MATPO는 단일 LLM의 서로 다른 프롬프트 역할 안에서 계획기와 작업 에이전트의 기여도 할당을 다룬다. 이러한 메커니즘을 이질적인 학습 모델로 확장하는 문제는 미해결 상태다.
- 진동, 상호 성능 저하, 조기 수렴은 가능한 실패 양상이다. 상대 학습률 조절과 평형 분석은 제안된 방향이며, 이 논문이 검증해 제공한 해결책은 아니다.
연속적인 도구와 에이전트 업데이트는 후속 출력을 사용하면서 서로 다른 구성 요소를 바꾼다. 이 예시는 수렴 근거를 보고하지 않으며, 기여도 할당과 변화하는 최적화 대상의 문제를 드러낸다.
9.2 Continual Adaptation
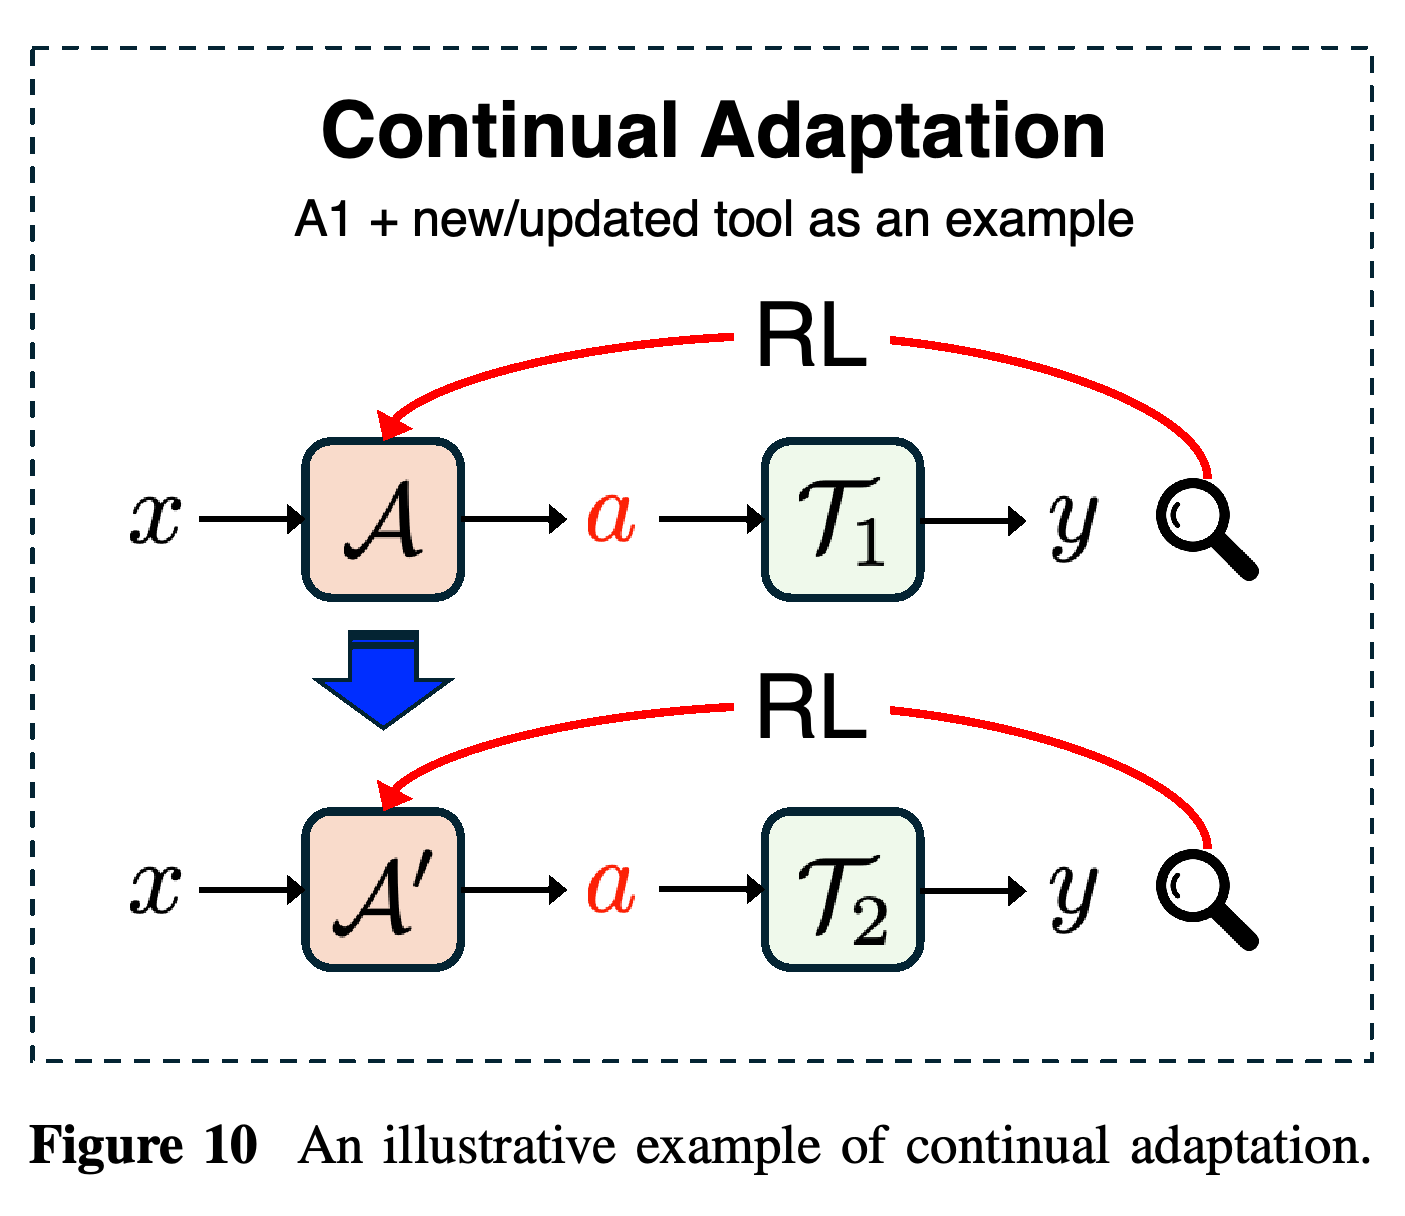
Continual Adaptation은 과거 능력을 보존하려는 파라미터 업데이트와 변화하는 외부 메모리 및 도구를 구분한다. Figure 10은 변경된 도구에 대한 적응을 보여준다. 본문은 확장되는 형식 라이브러리, 검색 인덱스, 증명 상태 메모리도 검토한다.
- 파라미터 기반 메커니즘에는 정규화, 직교 업데이트, 저랭크 어댑터, 라우팅, 모델 병합이 포함된다.
- 외부 메모리 메커니즘에는 재현할 과거 예시의 선택, 압축, 계층형 저장, 상호작용 경험의 프롬프트 기반 보존이 포함된다.
- 인용된 reverse-KL 및 on-policy 결과는 일부 환경에서 SFT보다 망각이 적음을 보여준다. 핵심 모델을 동결하면 공유 가중치 간섭을 피할 수 있지만, 메모리와 도구 품질은 별도로 평가해야 한다.
도구가 바뀌면 에이전트 정책이 작동하는 환경도 달라진다. 연속적인 적응 단계는 기존 능력의 보존 정도를 정량화하지 않으며, 이러한 의존 관계를 보여준다.
9.3 Safe Adaptation
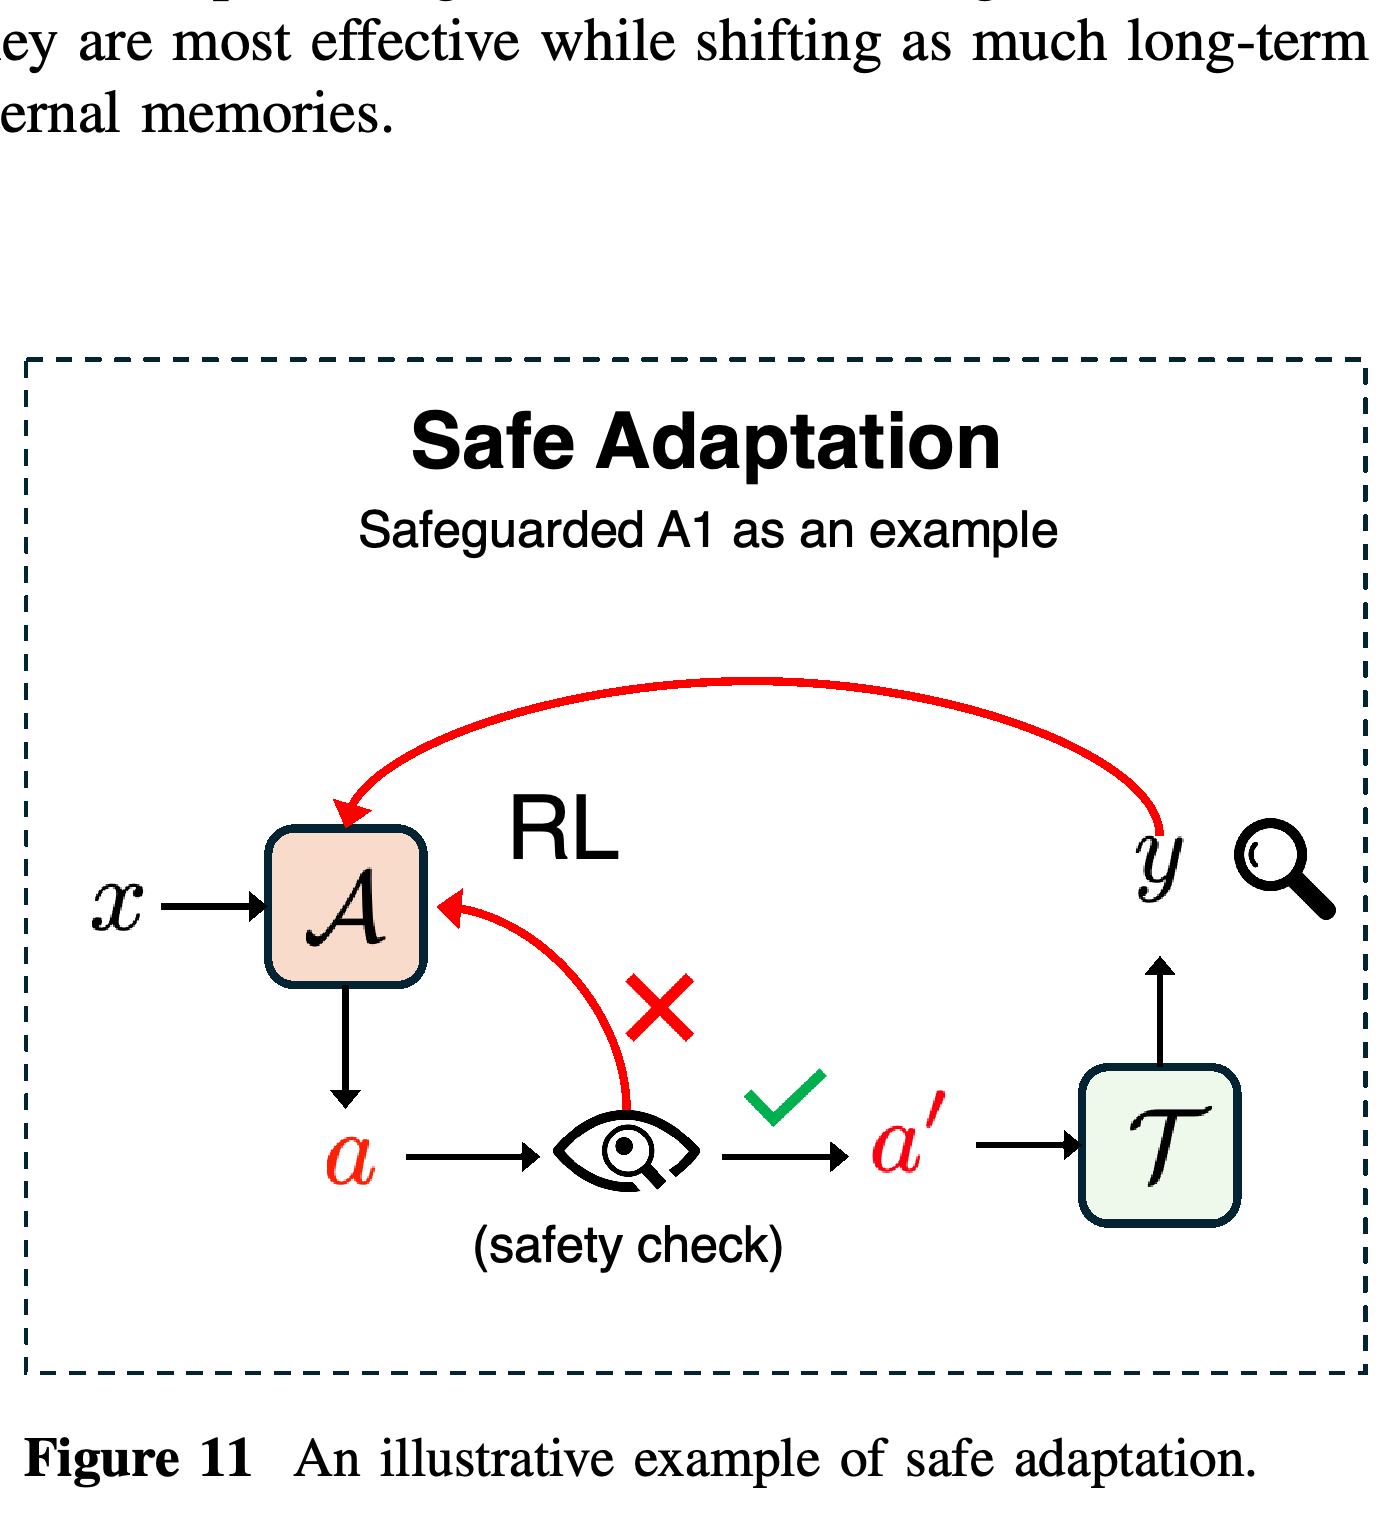
Safe Adaptation은 위험한 탐색과, 의도된 행동을 훼손하면서 보상을 높이는 악용적 최적화를 구분한다. Figure 11은 도구 실행 전에 안전 검사를 넣는다. 논의는 명세의 허점 악용, 적대적 도구, 아첨 반복을 다룬다.
- 인용 연구는 마켓플레이스 스킬의 26.1%에서 취약성을 발견하고, Skill-Inject의 공격 성공률이 최대 80%라고 보고한다. 이 수치는 해당 연구의 샘플과 평가 조건에 적용된다.
- 제안된 완화책에는 제약된 정책 최적화, 안전 차단 장치, 프로그램을 통한 결과 검사, 명세 자기 수정, 근거와 답변을 연결하는 Proof-of-Use가 포함된다.
- 검증 가능한 보상도 충분한 테스트와 명세에 의존한다. 논문의 앞선 평가 논의는 실행 지표 역시 편법으로 높일 수 있음을 설명한다.
실행 전 검사는 위험한 행동을 거부하거나 허용된 행동을 도구로 전달한다. 이후 실행 피드백으로 정책을 업데이트한다. 검사의 효과는 해당 검사가 다루는 범위와 신뢰성에 달려 있다.
9.4 Efficient Adaptation
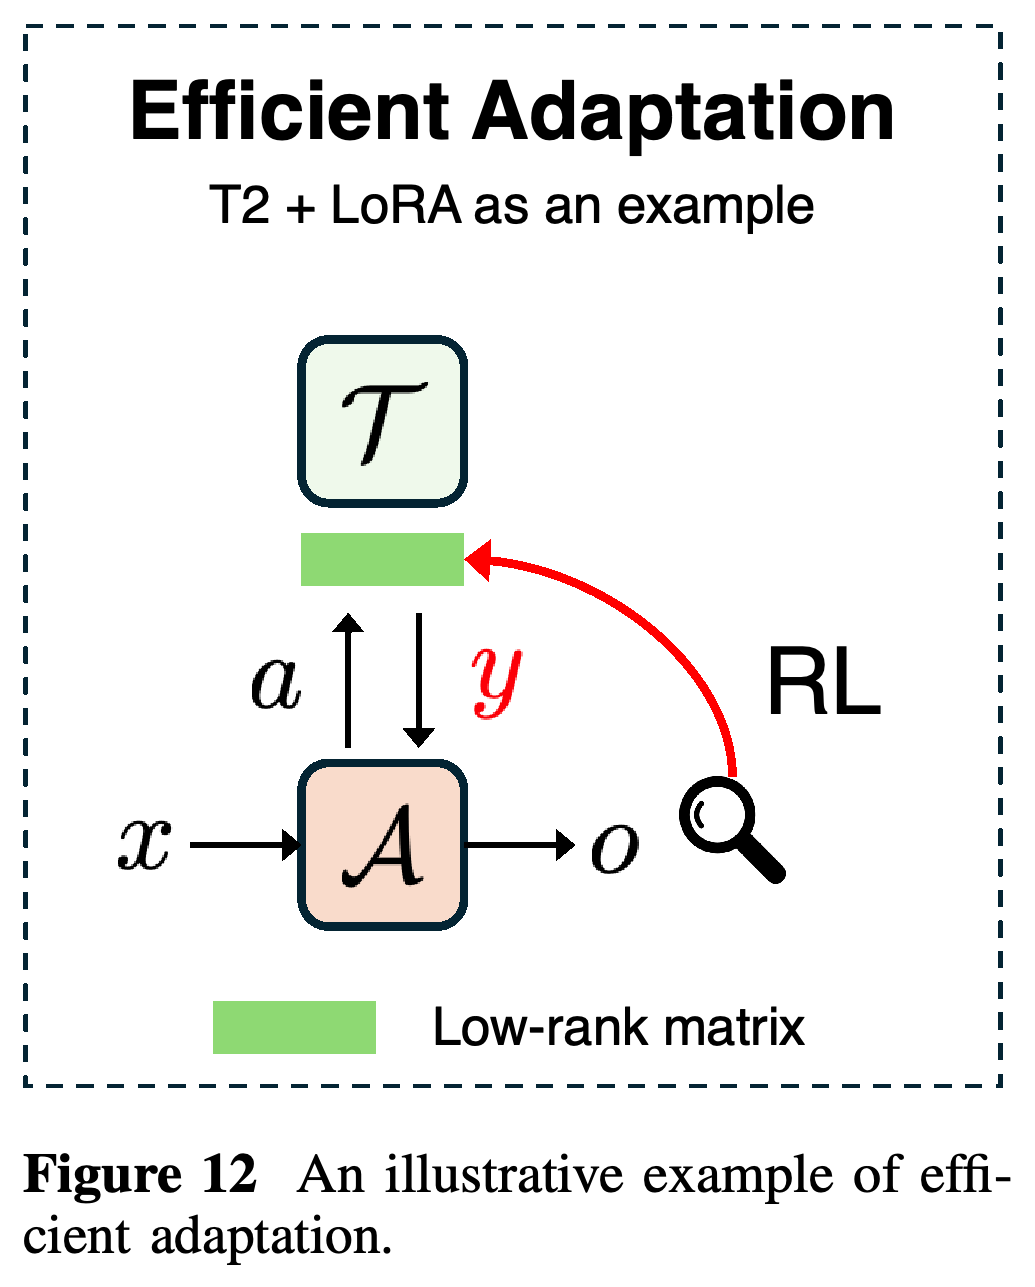
Efficient Adaptation은 파라미터 용량, 수치 정밀도, 배포 위치를 서로 다른 병목으로 다룬다. Figure 12는 저랭크 모듈을 통한 T2 적응을 보여준다. 본문은 LoRA, 양자화된 rollout, 로컬 개인화를 논의한다.
- 인용된 LoRA 연구는 선정된 RL 과제에서 작은 rank로 전체 미세 조정과 동등한 결과를 보고한다. 이것이 모든 에이전트 작업에서의 동등성을 입증하지는 않는다.
- FlashRL은 INT8 또는 FP8 rollout을 생성하고, rollout과 학습의 정밀도가 다를 때 truncated importance sampling으로 학습을 안정화한다.
- 작은 기기별 도구는 고정된 호스트를 유지하면서 로컬로 업데이트할 수 있다. 저랭크 업데이트, 양자화, 온디바이스 실행의 결합은 조합 가능한 전략으로 제시된다.
저랭크 모듈은 호스트를 고정한 채 학습 가능한 용량을 도구 측에 집중한다. 이 도식은 자원이나 정확도 개선을 측정하지 않으며, T2와 파라미터 효율적 업데이트의 결합을 보여준다.
10 Conclusion
결론은 적응을 구성 요소와 감독 신호 출처의 선택으로 다시 정리하고, A1/A2/T1/T2 안에서 사후 학습, 메모리, 스킬을 연결한다. 신호 밀도, 다차원 평가, 학습된 에이전트의 도구 재사용을 강조하면서, 패러다임 간 효율 비교가 아직 통제되지 않았음을 인정한다.
- 메모리와 스킬은 핵심 모델 밖에서도 개선할 수 있으며, 파라미터 기반 및 혼합 메커니즘은 분류 경계를 넘나든다.
- 저자들은 안정적인 추론 핵심 모델과 적응형 보조 구성 요소를 제안하고, 공동 적응, 지속적 안정성, 안전성, 배포 효율을 미해결 과제로 제시한다.
부록
- 제공된 PDF에는 별도로 표시된 부록이 없다. 결론 뒤에 References가 이어지며 마지막 페이지 번호는 89다. 검토한 버전은 날짜가 9 March 2026인 arXiv:2512.16301v3이다. 관련 저장소의 주소는 https://github.com/pat-jj/Awesome-Adaptation-of-Agentic-AI 이다.
짧은 생각
이 프레임워크는 실행 개선, 최종 종합 개선, 재사용 가능한 도구 제공, 고정된 호스트에 대한 도구 정렬을 실용적으로 구분한다. 검색과 코드의 대응 사례, 메모리 업데이트의 구분, s3-versus-Search-R1 비교에서 명시한 교란 요인이 이를 가장 명확하게 뒷받침한다. 구성 요소 자체의 품질과 후속 과제에서 추가로 제공하는 기여에는 서로 다른 평가가 필요하다. 논문이 함께 제시한 도구 평가와 시스템 평가는 이를 구분하는 구체적인 방법이다. 비용, 일반화, 망각 방지에 관한 폭넓은 주장은 이질적인 사례 연구보다 강한 근거가 필요하다. 비교 예측을 검증하려면 조건을 맞춘 실험이 필요하다. 분류상의 불일치가 남는다. SWE-Grep은 graduation을 거친 T1 도구이면서 T2 방식의 응용 사례로도 등장한다. Self-Challenging Agents는 A2에서 다뤄진 뒤 효율 논의에서는 A1로 표시된다. 분류명만 보는 것보다 학습 단계와 보상에 대한 명시적 설명이 더 신뢰할 만하다.