


Synthetic Computers at Scale for Long-Horizon Productivity Simulation 요약 설명
30 Apr 2026 | Paper Review Synthetic Environments Agentic Skills Agent Learning목차
- 요약
- 1 Introduction
- 2 Synthetic Computer Creation
- 3 Long-Horizon Productivity Simulation
- 4 Experiments
- 5 Discussion
- 6 Conclusion and Future Work
- 부록
- 짧은 생각
이번 글에서는 Synthetic Computers at Scale for Long-Horizon Productivity Simulation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 4월 30일(Arxiv), Technical Report
- Ge, Tao, Peng, Baolin, Cheng, Hao, Gao, Jianfeng.
- Microsoft
- 논문 링크
- Project Page
요약
- Synthetic Computers at Scale for Long-Horizon Productivity Simulation은 페르소나에 맞춘 파일시스템을 구축하는 파이프라인을 제안한다. 파일시스템에는 서로 연결된 문서, 스프레드시트, 프레젠테이션 등의 산출물이 들어간다. 설정 에이전트는 사람이 약 한 달 동안 수행할 작업에 해당하는 목표를 정하고 모의 협업자를 만든다. 별도의 작업 에이전트는 일별 세션에서 주간 계획을 실행하며, 진행 상황을 파일과 활동 로그에 기록한다.
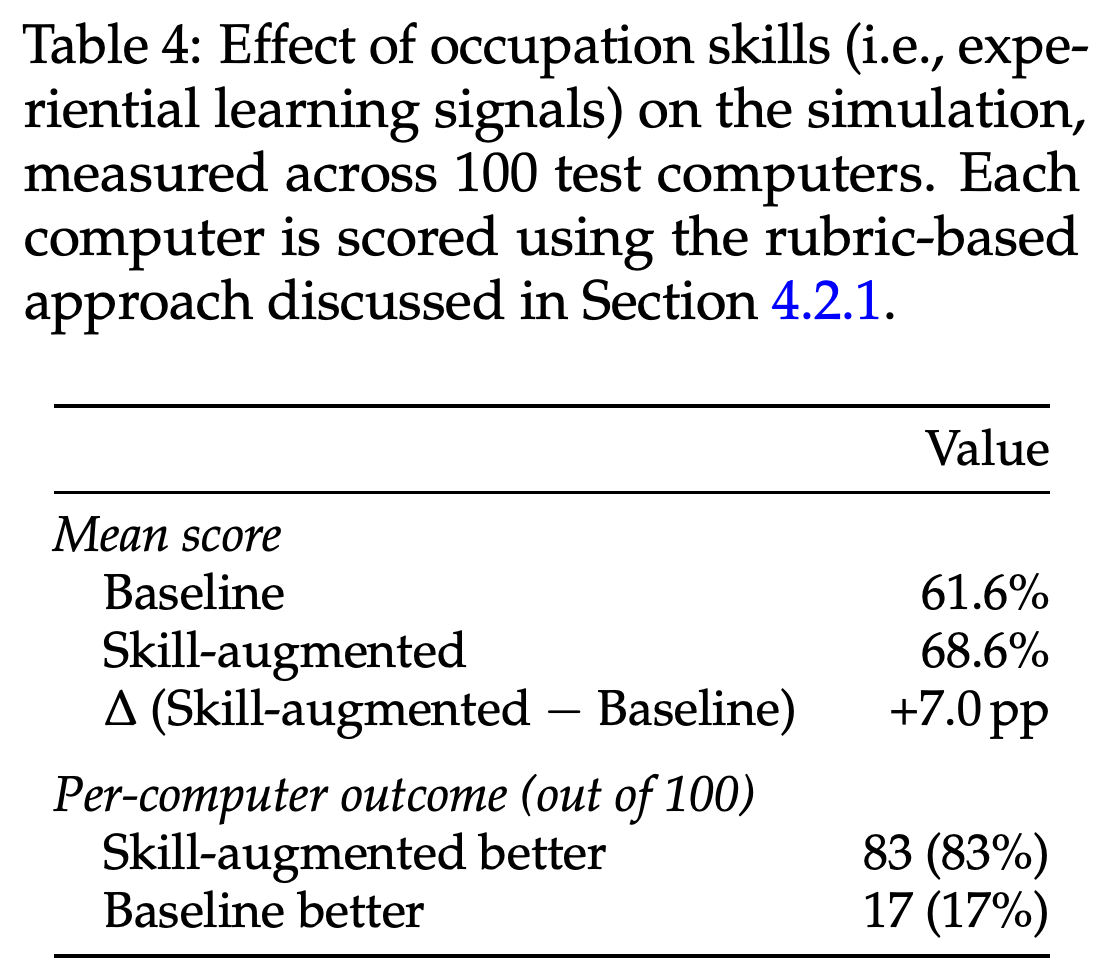
- 1,000개 합성 컴퓨터에서 작업 에이전트는 평균 2,272턴을 수행하고, 실제 경과 시간으로 8.59시간 동안 실행되며, 협업자와 31회 소통한다. 900개 시뮬레이션에서 추출한 직업별 스킬을 적용하면 100개 홀드아웃 컴퓨터의 평균 루브릭 점수가 61.6%에서 68.6%로 오른다. 모델 가중치를 갱신하지 않고도 83개 컴퓨터에서 베이스라인보다 높은 점수를 얻는다.
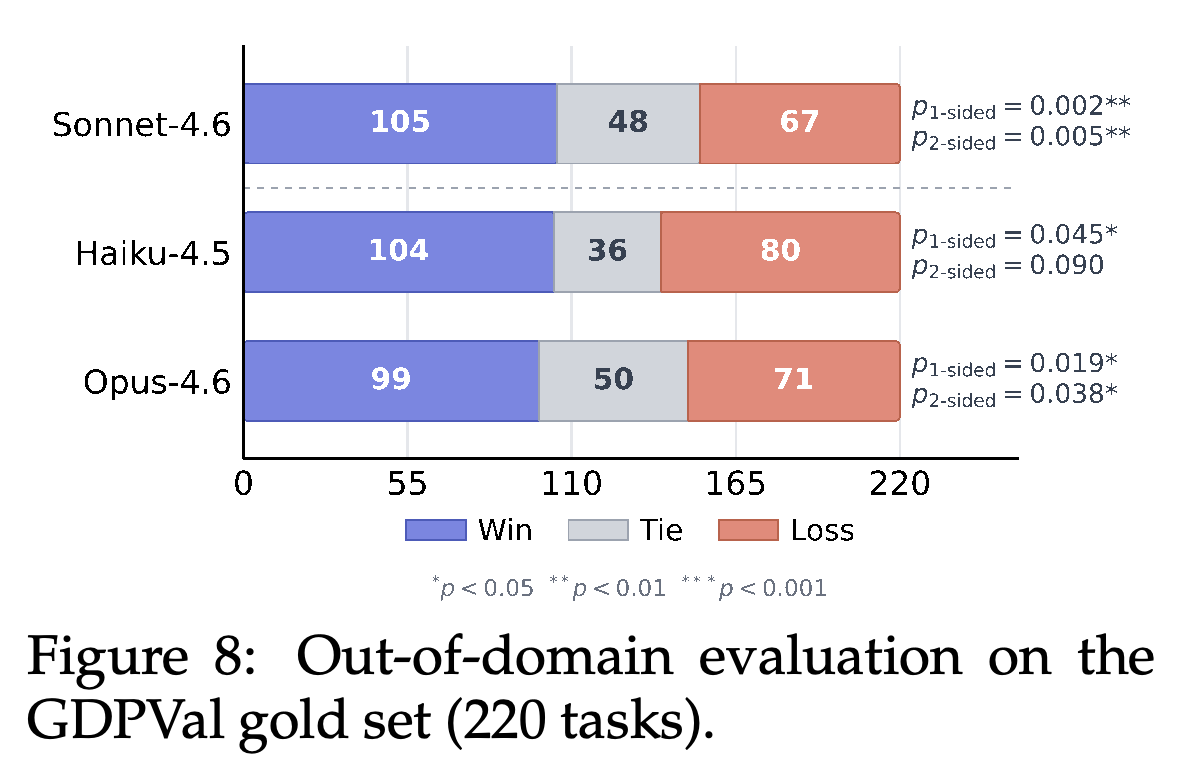
- GDPVal의 220개 과제로 구성된 gold set에서 스킬을 적용한 Claude Sonnet 4.6은 비교 평가에서 105승, 48무, 67패를 기록하며, 양측 부호 검정의 p값은 0.005다. 이 결과는 시뮬레이션에서 얻은 작업 지침이 다른 환경에도 전이될 수 있음을 뒷받침한다. 모델 가중치 학습과 반복적인 자기 개선은 향후 확장안으로 남아 있다. 저자들은 획일적인 산출물 스타일, 지나치게 정돈된 파일시스템, 주로 요청에 반응하는 협업자를 현재 환경의 현실성 부족 요인으로 지적한다.
1 Introduction
생산성 에이전트에는 기존 문서, 프로젝트 이력, 이전 결정, 협업자 피드백, 변화하는 작업 상태 등 축적된 사용자 맥락이 필요하다. 실제 환경에는 개인과 기업의 비공개 정보가 포함되므로, 실제 작업 과정을 대규모로 수집하기 어렵다. 따라서 과제뿐 아니라 과제를 둘러싼 맥락도 합성할 필요가 있다.
- 논문이 제시하는 3가지 원칙은 생산성 작업에 많은 맥락이 필요하고, 성공하려면 장기간 그 맥락을 활용해야 하며, 합성 데이터가 개별 과제 프롬프트뿐 아니라 주변 맥락까지 재현해야 한다는 것이다.
- 공개 자료에는 Windows 스타일 환경 50개와 macOS 스타일 환경 50개로 구성된 합성 컴퓨터 100개, 시뮬레이션 500개의 회고 보고서가 포함된다. 자료는 huggingface.co/datasets/microsoft/synthetic-computers-at-scale에서 제공한다.
- 수백만 또는 수십억 개 컴퓨터로 확장할 수 있다는 주장은 충분한 연산 자원이 있을 때의 가능성을 제시한 것이며, 실험으로 입증한 규모는 아니다.
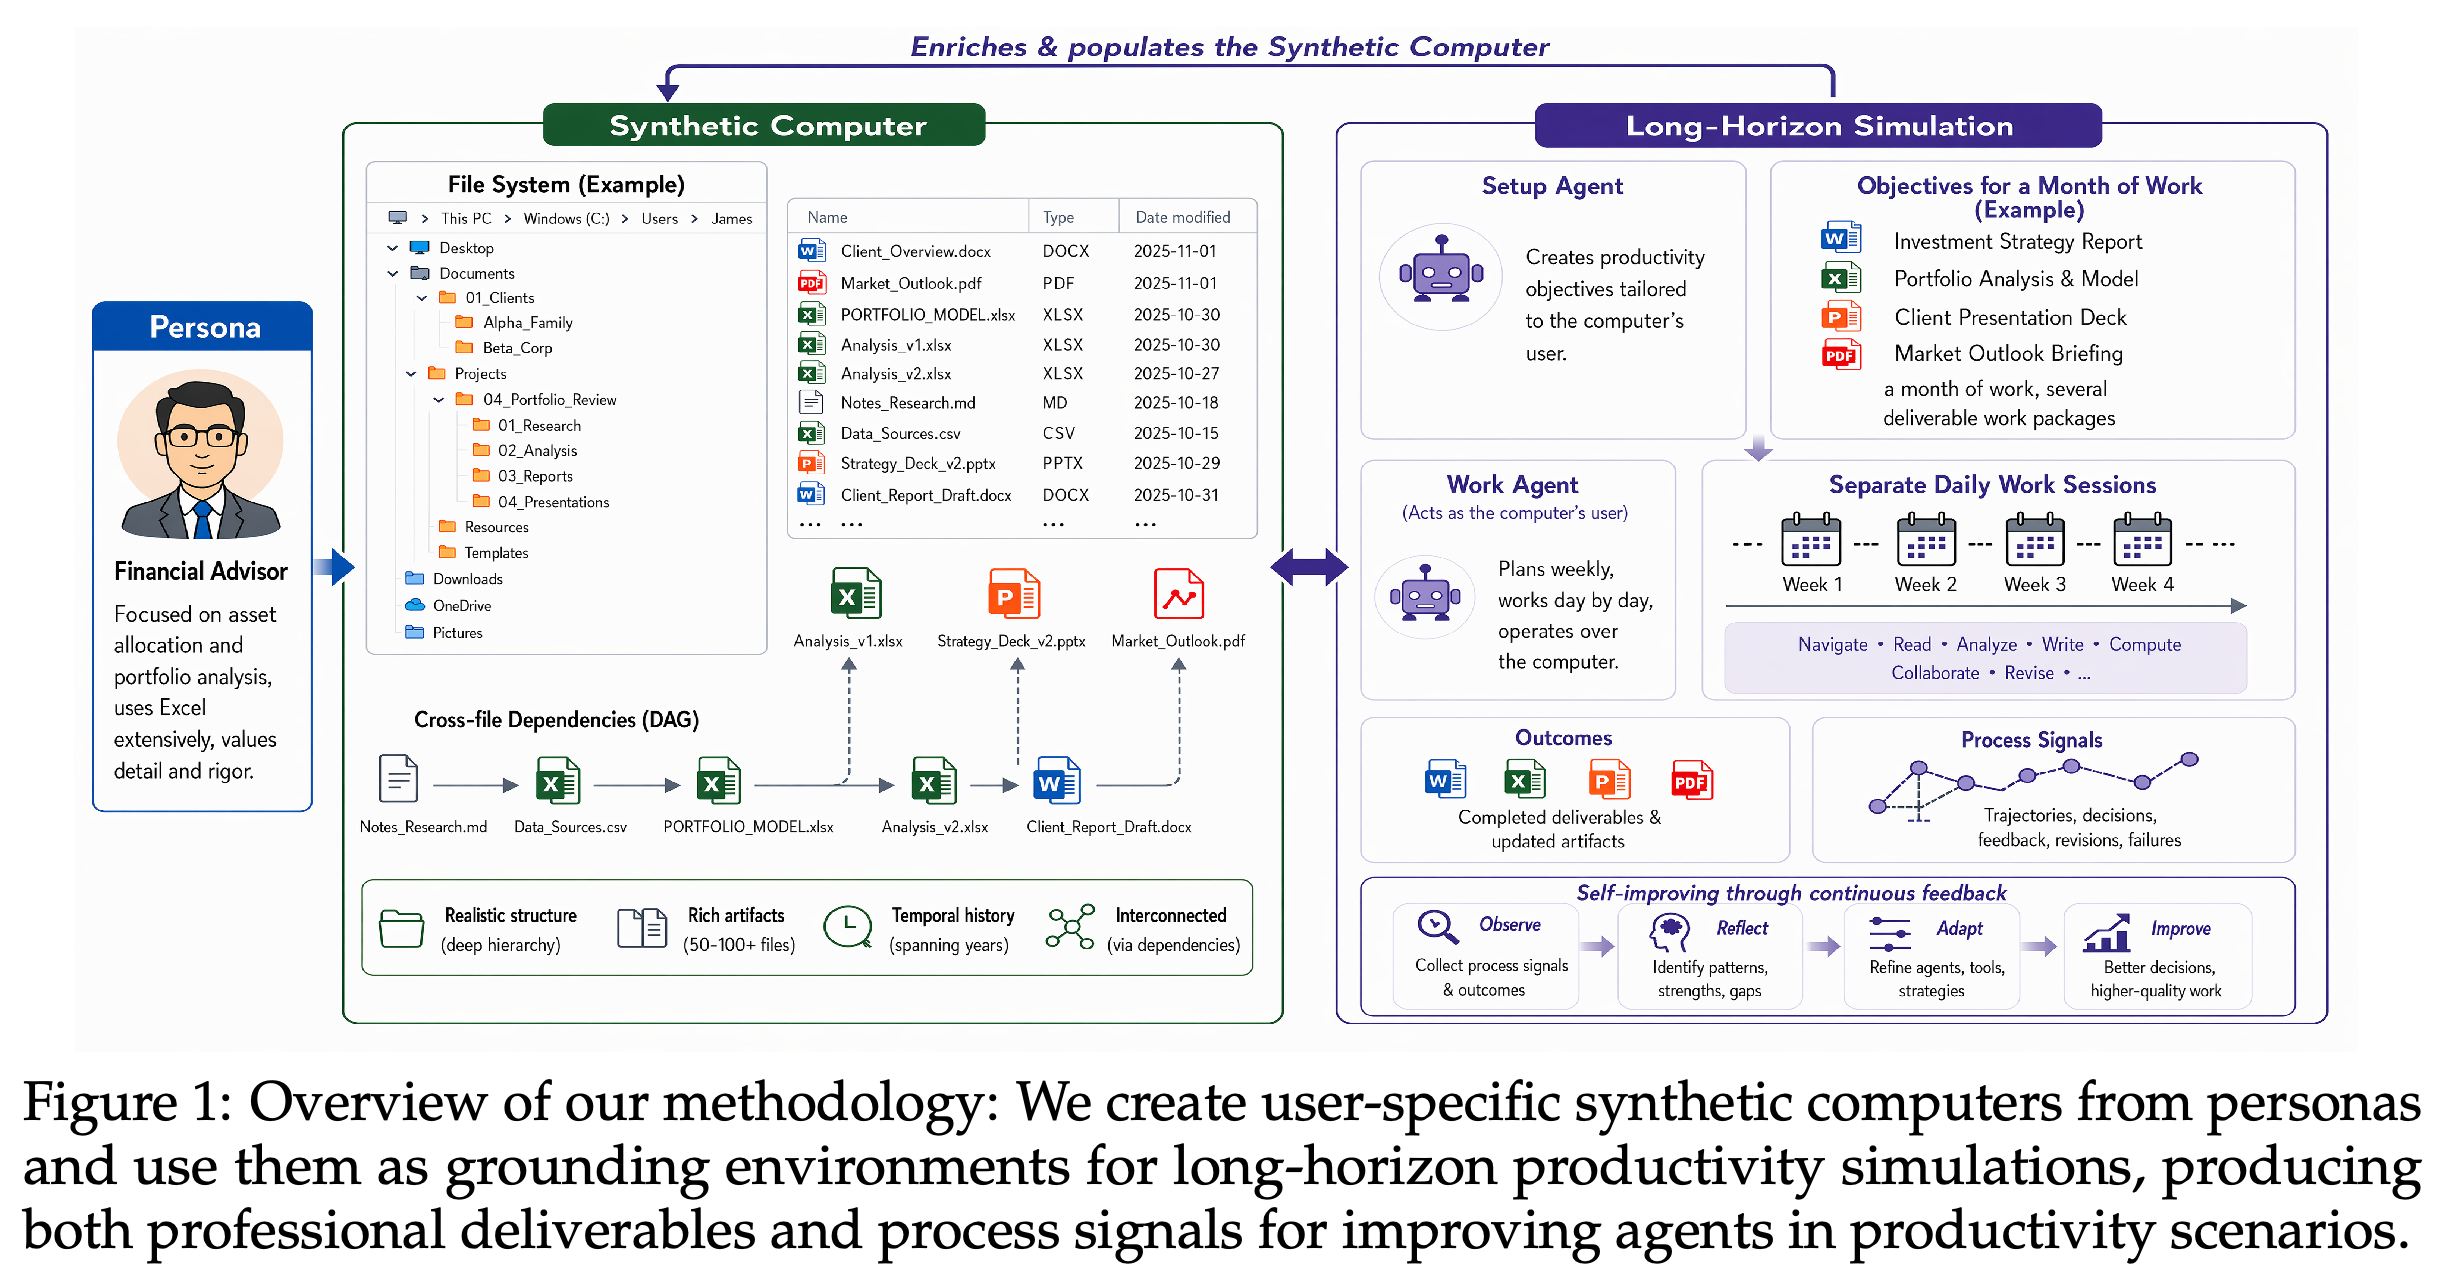
이 도식은 페르소나에 맞춘 파일시스템을 설정 에이전트와 작업 에이전트에 연결하고, 실행을 일별 세션으로 나누어 보여준다. 피드백 화살표는 시뮬레이션이 환경을 바꾼다는 점을 나타낸다. 최종 산출물과 작업 기록은 각각 결과와 과정에 관한 서로 다른 신호를 제공한다.
2 Synthetic Computer Creation
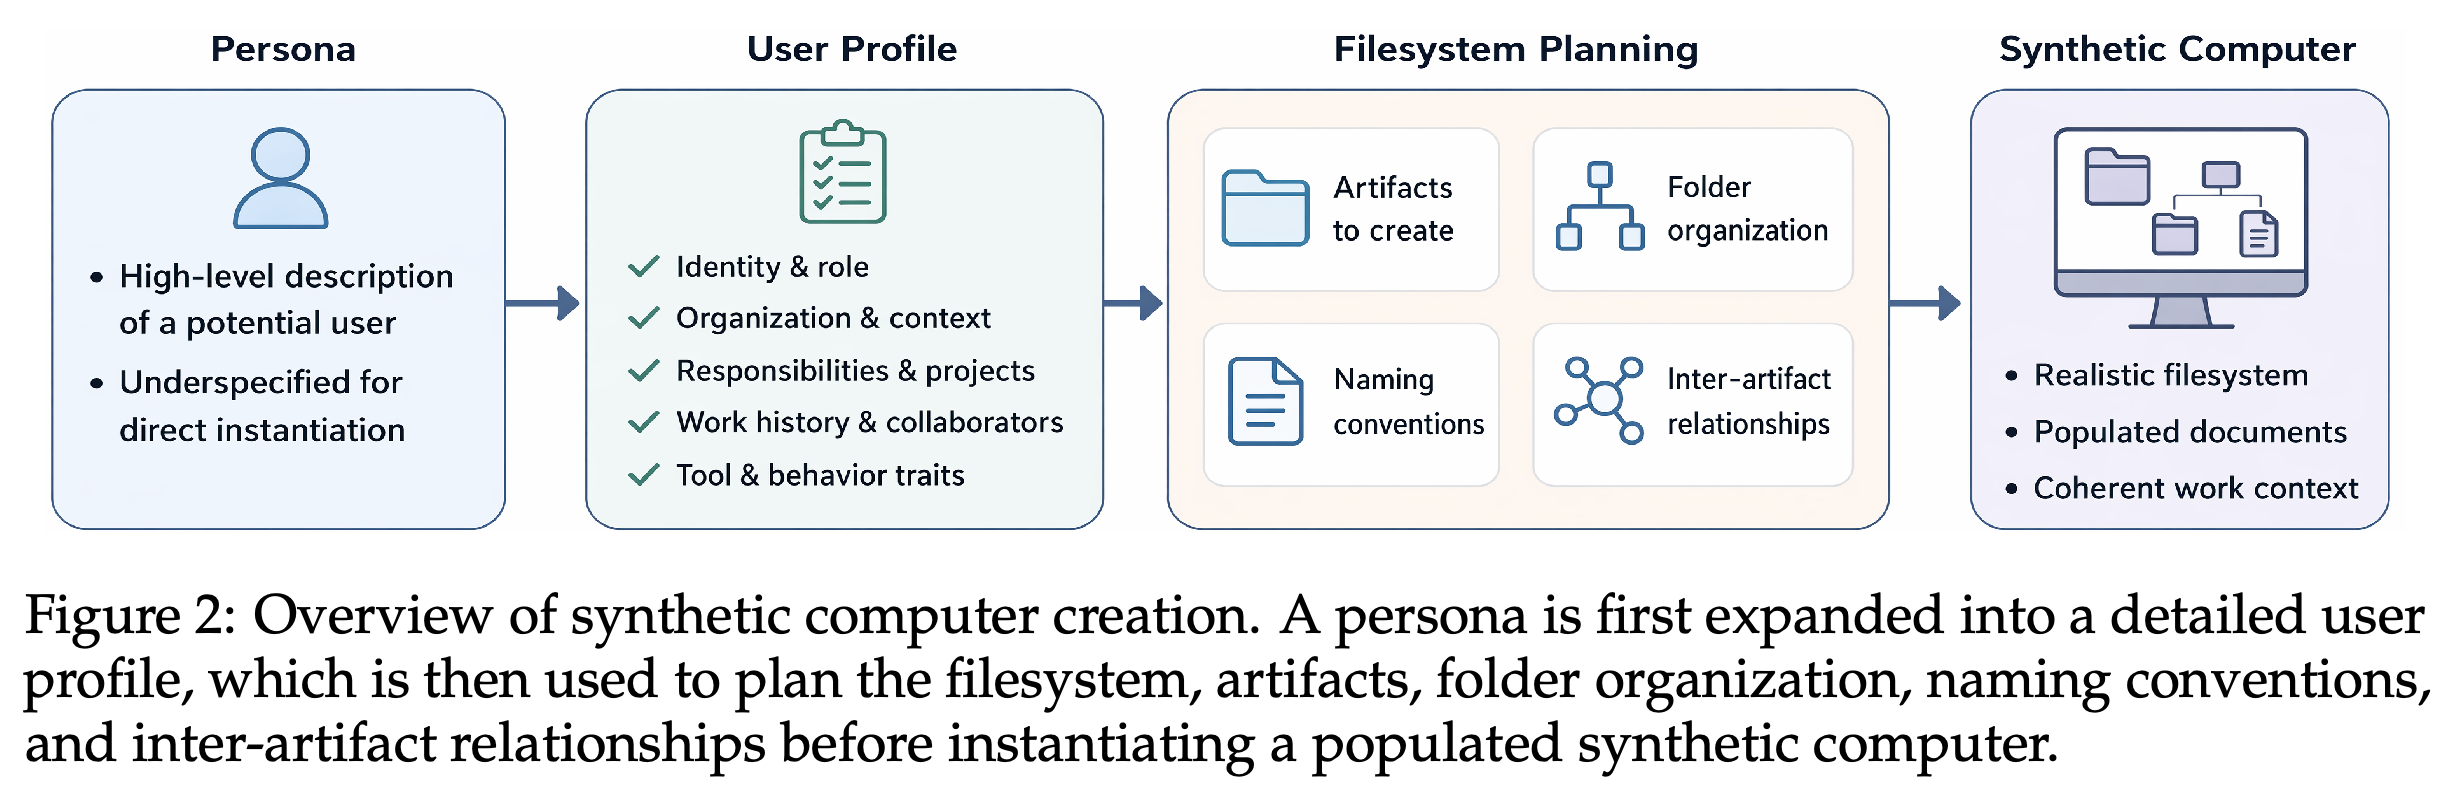
합성 컴퓨터 생성 과정은 페르소나를 상세한 사용자 프로필로 확장하고, 파일시스템과 파일 간 관계를 계획한 뒤, 디렉터리와 산출물을 실제로 만든다. Figure 2는 의미적 명세와 파일 생성을 분리해 보여준다. 개별 콘텐츠를 만들기 전에 파일의 구성과 의존 관계를 정한다.
4단계 파이프라인은 페르소나와 파일이 채워진 컴퓨터 사이에 필요한 명세를 보여준다. 사용자 프로필은 직업적·행동적 맥락을 정한다. 이후 파일시스템 계획은 콘텐츠 생성에 앞서 폴더 구성, 파일명 규칙, 산출물 간 관계를 정의한다.
2.1 Persona-Driven User Profiles
개괄적인 페르소나만으로는 사용자의 컴퓨터를 채우는 데 필요한 정보가 부족하다. 따라서 파이프라인은 직업적 맥락과 컴퓨터 사용 행동을 추가한다. 예시 페르소나는 Meridian Wealth Partners의 Senior Financial Advisor인 Margaret Elaine Forsythe로 구체화된다. 이 사용자는 VCMM 포트폴리오 작업, 고객 온보딩, 리밸런싱 연구, 대체투자 연구, ESG 평가를 진행하고 있다.
- 프로필은 신원, 직업, 조직, 경력 단계, 책임, 최근 업무 이력, 현재 프로젝트, 협업자, 일반적인 작업 산출물을 명시한다.
- 선호 도구, 문서 작성 습관, 스프레드시트 사용 방식, 첨부파일 보관 여부, 파일명 선호, 정돈 수준, 정리 방식은 파일 배치와 표현 방식을 결정한다.
- 예를 들어 이 금융 자문가는 Excel에서 데이터를 분석한 뒤 Word나 PowerPoint로 요약하고, 원본 PDF와 공급업체가 내보낸 파일을 보관한다. 이에 따라 원본과 파생 산출물을 연결해 만든다.
2.2.1 Filesystem Policy Generation
2.2 Computer Environment Planning에서는 사용자 프로필을 디렉터리 구성, 가상 시간, 프로젝트 구조, 파일 목록, 산출물 유형, 파일 간 의존 관계에 관한 계획으로 바꾼다. 1단계에서는 시스템 시작 시간, 드라이브 구성, 기본 경로, 저장 규칙, 파일명 스타일, 사용 패턴을 명시하는 파일시스템 정책을 생성한다.
- 예시 정책은 시스템 시작 시간을 2022-11-05 17:41로 정하고, C:를 시스템 드라이브로, D:를 데이터 드라이브로 지정한다.
- 업무 파일은 프로젝트별 디렉터리에 배치하며, 바탕화면과 다운로드 폴더에는 불필요한 파일이 적도록 설정한다. 파일명은 내용을 설명하고 명시적인 버전 접미사를 포함하도록 정한다.
- 이 정책은 이후 파일 계획에 제약을 부여한다. 그 결과 환경은 일반적인 디렉터리 템플릿이 아니라 프로필에 명시된 사용자의 습관을 반영한다.
2.2.2 Filesystem Planning
파일시스템 계획은 사용자의 프로젝트, 책임, 협업자, 문서 사용 습관을 바탕으로 필요한 파일을 추론한다. 각 파일에는 논리 경로, 산출물 유형, 설명, 타임스탬프, 출처, 콘텐츠 생성 방식을 지정한다. 방향성 의존 그래프는 참조, 파생, 수정, 압축파일 추출 관계를 기록해 파일이 서로 독립적인 샘플로 생성되지 않도록 한다.
- 금융 자문가 예시에서는 다운로드한 Vanguard 전망 PDF를 구조화된 VCMM 워크북에 연결하고, 이를 다시 자산 배분 모델, 시나리오 분석, 전망 초안, 최종 PDF에 연결한다.
- 버전 연결과 타임스탬프는 가상의 작업 이력을 나타낸다. 의존 관계의 간선은 후속 파일 생성에 참고해야 할 이전 자료를 지정한다.
- 이 그래프는 서로 연관된 산출물을 만드는 수단이다. 다만 논문은 그래프가 수치 일관성에 미치는 효과를 별도로 정량화하지 않는다.
2.3 Artifact Creation
산출물 생성은 먼저 논리적인 운영체제 경로를 이식 가능한 디스크 경로로 매핑하고 상위 디렉터리를 만든다. 이후 위상 정렬을 사용해 의존 관계에 맞는 순서로 파일을 생성하며, 생성 순서가 동률이면 타임스탬프로 결정한다. 이렇게 하면 선행 산출물이 후속 파일의 생성 맥락으로 사용된다.
- 계획된 산출물이 웹에서 다운로드할 수 있는 공개 자료라면 에이전트는 먼저 다운로드를 시도하고, 실패하면 합성한다. 그 밖의 사용자별 산출물은 설명과 관련 선행 자료를 바탕으로 산출물 생성 도구나 스킬을 사용해 만든다.
- 현재 파이프라인은 계획을 세운 뒤 다운로드 가능 여부를 확인한다. 따라서 공개 파일로 계획한 자료도 다운로드에 실패하면 합성 자료가 될 수 있다. 저자들은 가용성을 더 일찍 확인하는 방식이 더 견고한 대안이라고 지적한다.
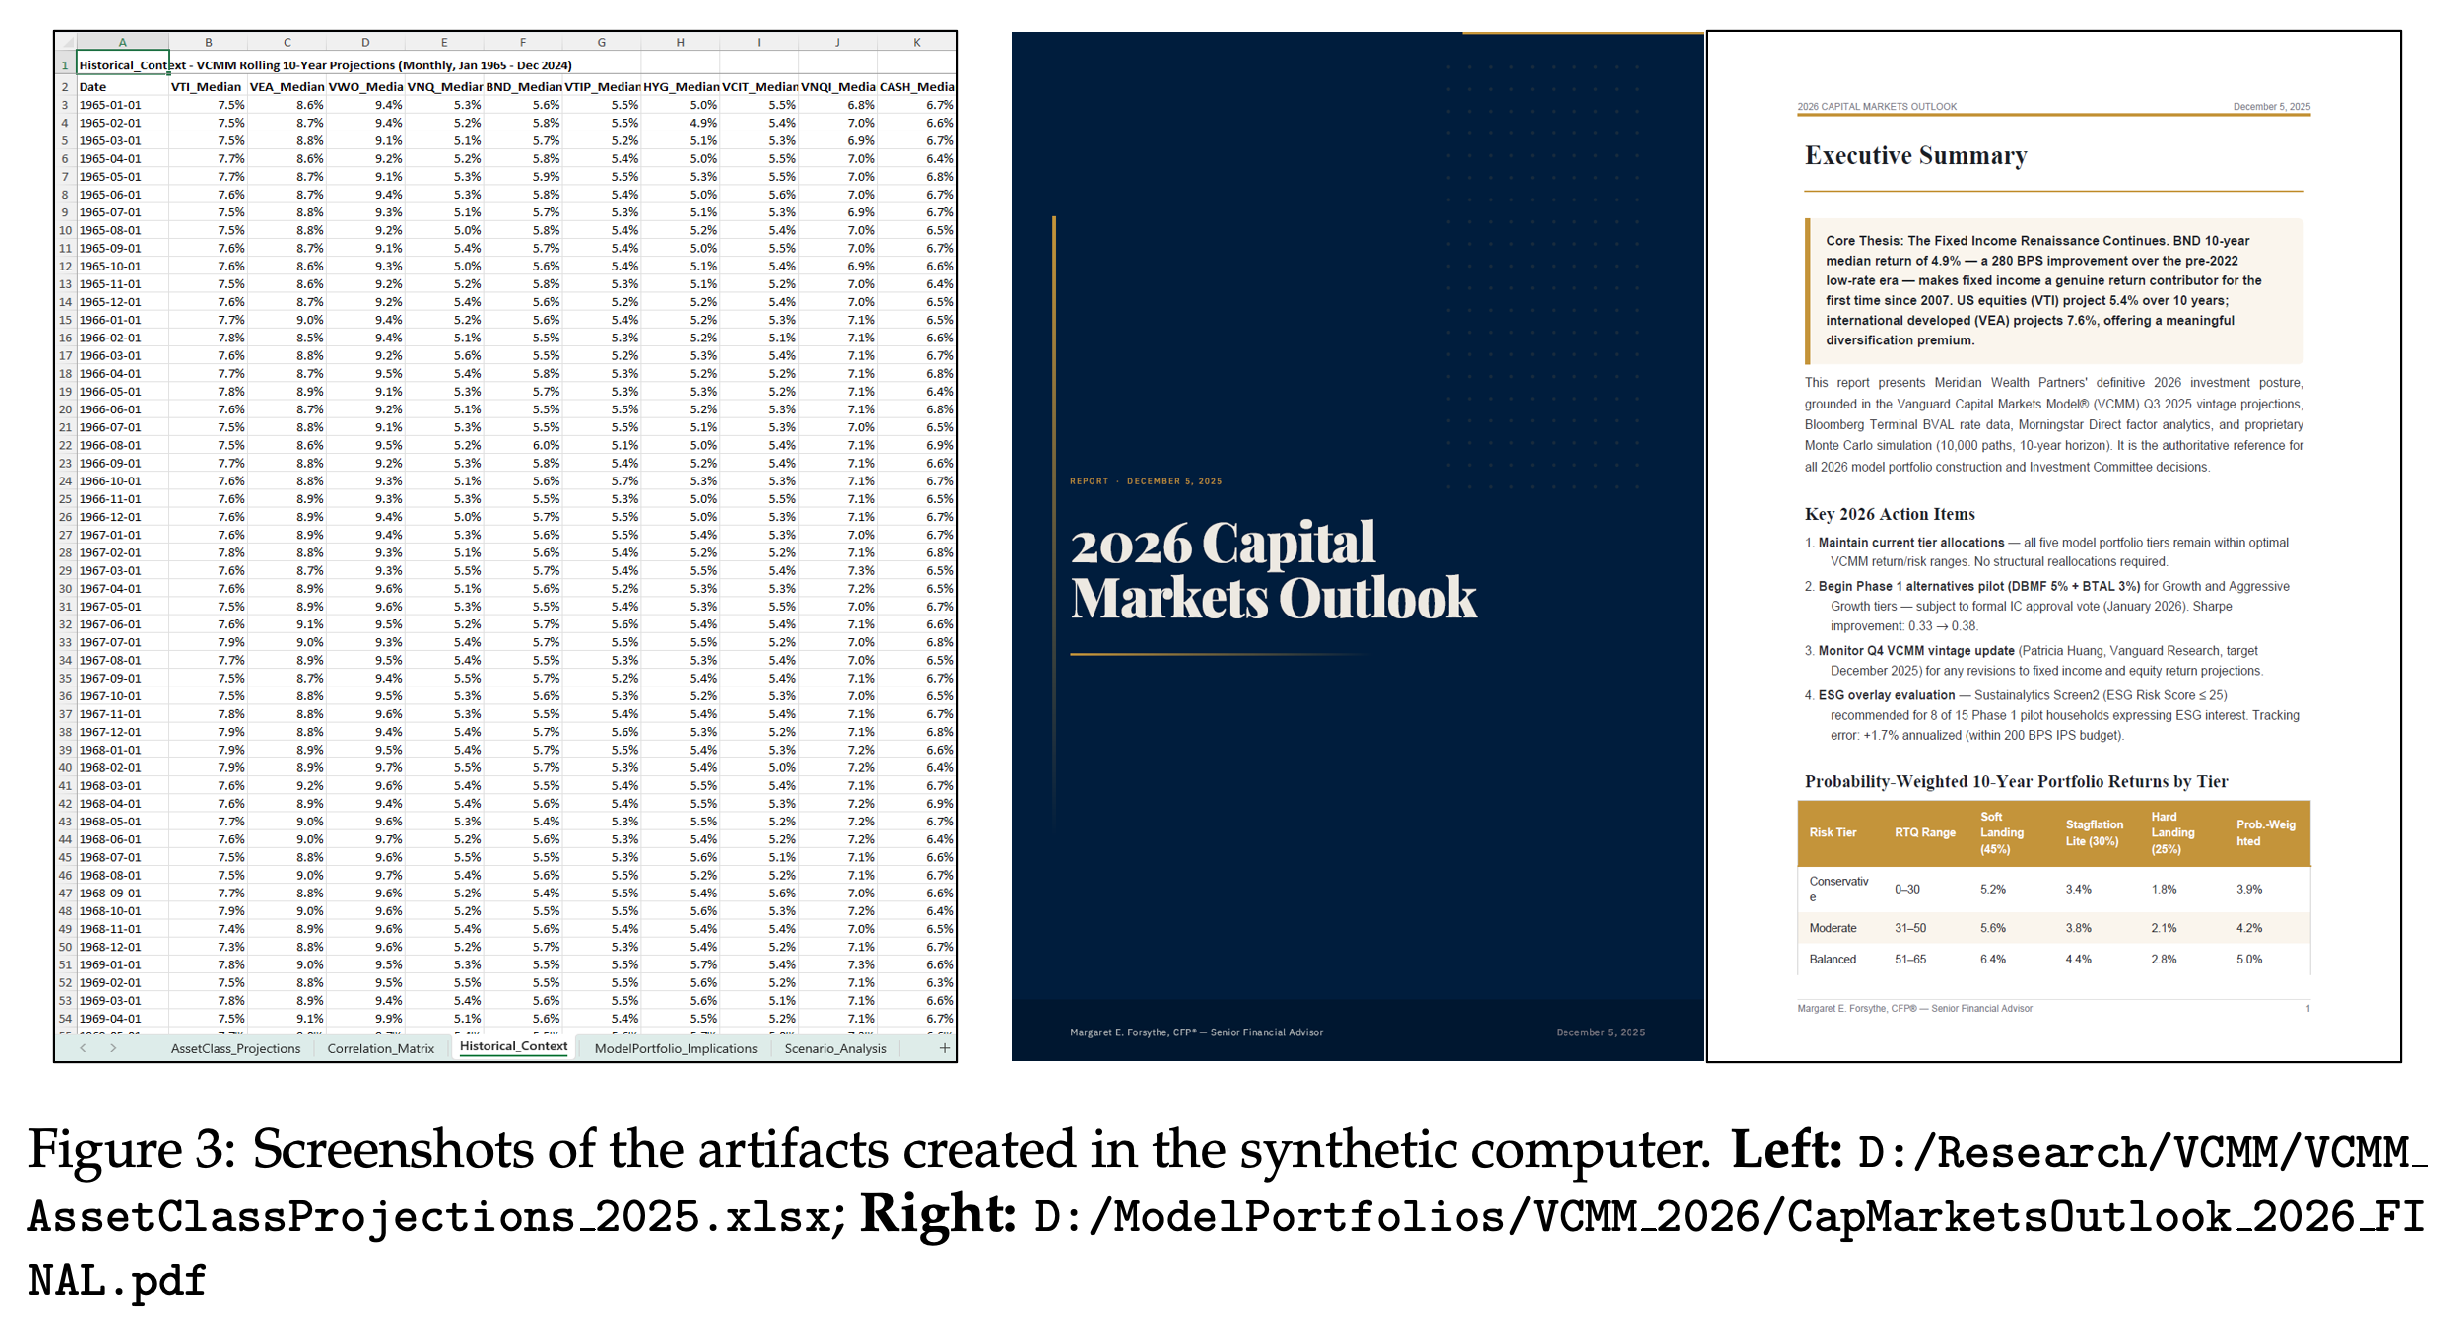
- Figure 3은 생성된 스프레드시트와 서식을 갖춘 자본시장 전망 PDF를 보여준다. 이는 단순한 텍스트 대체물이 아니라 구조화된 생산성 파일을 만든다는 점을 보여준다.
스프레드시트 스크린샷에는 표 형식의 분석 데이터가 있다. PDF 스크린샷에는 디자인된 표지와 포트폴리오 표를 포함한 요약 페이지가 보인다. 이 예시는 구조와 시각적 표현을 갖춘 산출물을 보여주지만, 환경 전체의 수치 일관성을 독립적으로 검증하지는 않는다.
3 Long-Horizon Productivity Simulation
시뮬레이션은 목표와 협업 구성을 설계하는 단계와 작업을 실행하는 단계를 분리한다. 설정 에이전트는 사용자별 목표와 협업자를 정한다. 작업 에이전트는 시뮬레이션 기간 동안 파일이 채워진 파일시스템에서 사용자 역할을 수행하며, 최종 산출물과 함께 계획, 근거 활용, 협업 조율, 수정 과정을 기록한다.
3.1.1 Productivity Objectives
3.1 Setup에서는 사용자 프로필과 현재 컴퓨터 상태에서 생산성 목표를 추론한다. 진행 중인 프로젝트와 기존 산출물도 고려한다. 목표는 서로 연결된 여러 산출물 작업 묶음으로 구성되며, 사람이 약 한 달 동안 수행하기에 도전적이지만 달성 가능한 수준으로 설정한다.
- 금융 자문가 예시는 2026-01-05부터 2026-01-30까지의 근무일 20일과 산출물 5개를 다룬다.
- 작업 묶음에는 VCMM 모델 포트폴리오 갱신, Robert Castellano의 $7.2M 온보딩, 리밸런싱 프레임워크, 대체투자 권고안, ESG 권고안이 포함된다.
- 각 작업 묶음은 전문적인 업무 결과, 중간 목표, 목표 날짜, 예상 산출물을 명시한다. 온보딩은 갱신된 포트폴리오 모델에 의존하므로 프로젝트 간 의존 관계도 존재한다.
3.1.2 Collaboration Setup
설정 에이전트는 역할, 배경, 소통 방식, 관련 지식, 비공개 참고 자료를 갖춘 모의 협업자를 만든다. 필요한 정보가 처음부터 모두 제공된다고 가정하지 않는다. 작업 에이전트는 자료를 요청하고, 선호 사항을 확인하고, 검토를 받은 뒤 피드백을 반영해야 한다.
- 예시에는 관리자, 고객, 동료 검토자, CIO, 준법감시 담당자, 외부 데이터 공급자, 주니어 직원이 포함된다.
- 비공개 자료에는 계좌 배분의 1.7% 불일치, 과거 데이터를 이용한 리밸런싱 검증 요구사항, bps와 %의 단위 혼동 등 구체적인 문제가 들어 있다.
- 협업자의 비공개 파일은 협업 과정에서 공유되기 전까지 작업 에이전트에게 보이지 않는다. 따라서 연락과 후속 확인도 과제 완료에 필요한 작업이 된다.
3.2 Planning and Daily Work Simulation
작업 에이전트는 매주 계획을 세우고, 별도의 에이전트 세션마다 근무일 1일을 실행한다. 하루를 시작할 때 활동 로그, 현재 파일, 협업자 답변에서 맥락을 복원한다. 하루를 마칠 때는 새로 만들거나 수정한 산출물, 상호작용, 활동 이력을 기록해 다음 세션에서 활용한다.
- 주간 활동은 생성하거나 수정할 파일, 참고할 원본 산출물, 연락할 협업자를 지정한다. 여기에는 집중 작업, 검토, 행정 업무, 연락이 포함된다.
- 예시 계획에는 원본 데이터 확보, 고객 요구 파악, 문제 목록 작성, 분석 워크북, 이해관계자 메모가 포함된다. 활동 로그는 계획만 보관하는 것이 아니라 실제 실행 내용을 기록한다.
- 이 과정은 시뮬레이션 기간이 끝날 때까지 이어지며, 파일시스템과 의존 그래프를 갱신한다. 작업 기록은 과정 수준의 근거를 제공하고, 최종 파일은 목표 달성 정도를 보여준다.
4 Experiments
실험은 환경 구조, 시뮬레이션 작업량, 최종 산출물 품질, 회고 경험이 이후 에이전트 성능을 높이는지를 평가한다. 합성 컴퓨터의 홀드아웃 평가와 외부 생산성 벤치마크인 GDPVal로의 전이를 구분한다.
4.1 Experimental Setup
에이전트는 Claude Code SDK로 실행하며, 별도 명시가 없으면 Claude Sonnet 4.6을 사용한다. 장기 시뮬레이션 설정에는 Claude Opus 4.6을 사용한다. 연구는 선별된 페르소나 모음에서 1,000개를 샘플링하고, 외부 스킬로 구조화된 산출물을 만든다.
- Office 이외의 산출물에는 Anthropic의 스킬을 사용한다. Office 관련 산출물 생성에는 MiniMax의 minimax-docx, minimax-xlsx, pptx-generator, minimax-pdf를 사용한다.
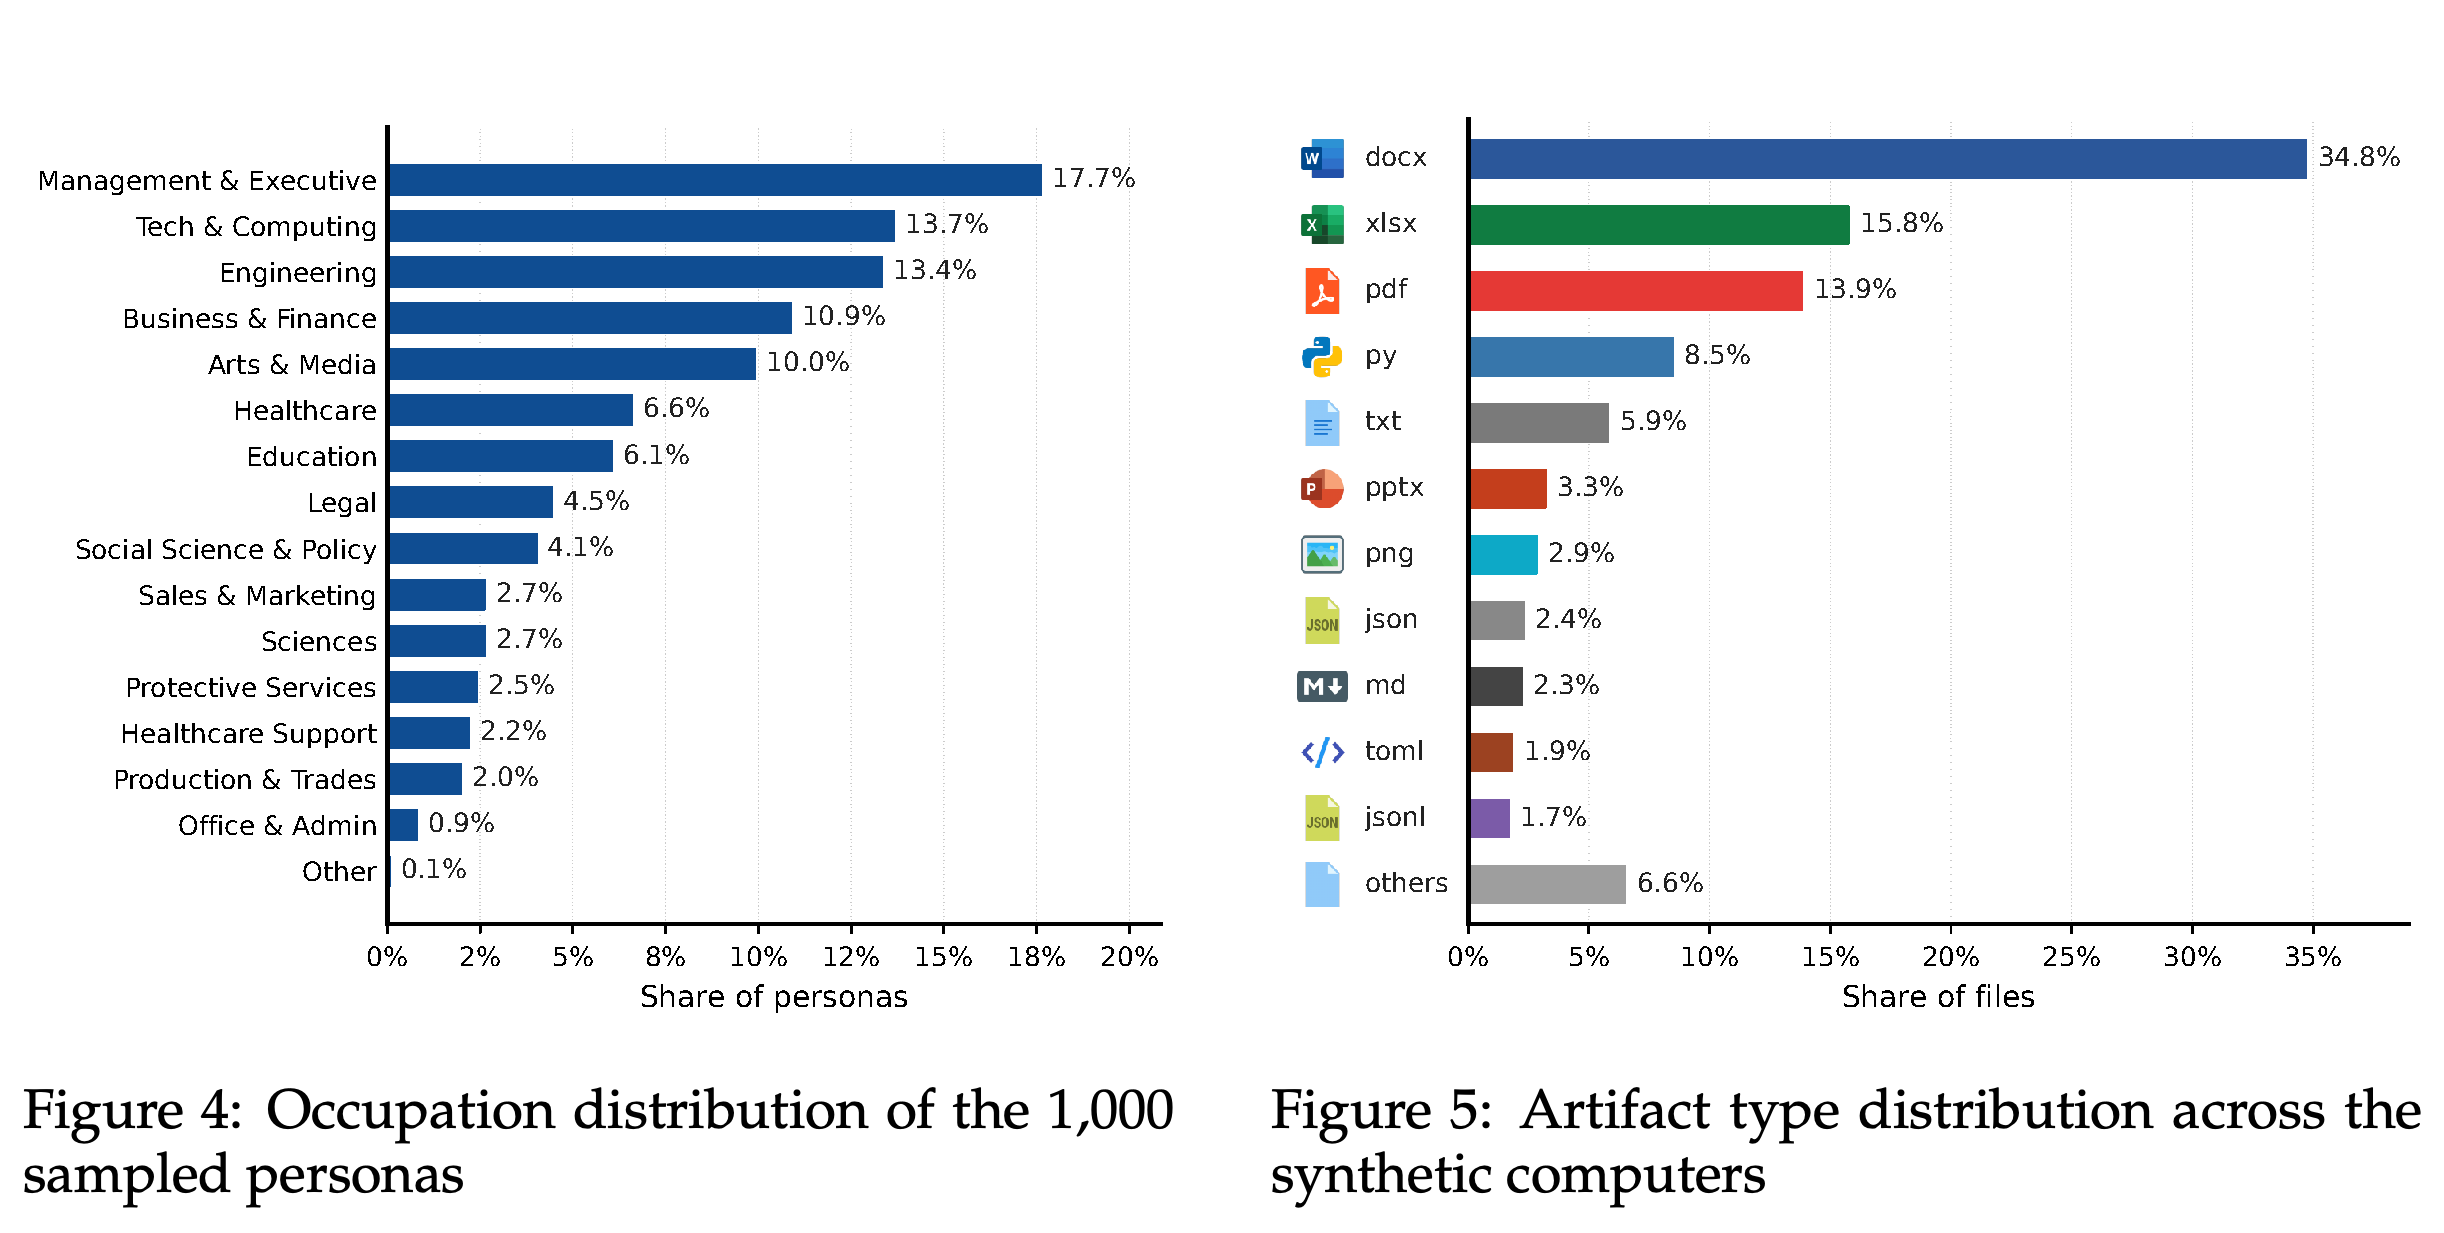
- Figure 4는 직업군이 폭넓지만 고르게 분포하지는 않음을 보여준다. Management & Executive는 17.7%, Tech & Computing은 13.7%, Engineering은 13.4%, Business & Finance는 10.9%를 차지한다.
- 이 분포는 이후 경험을 직업별로 집계하는 과정과 해당 직업에 맞는 스킬의 가용성을 살펴볼 때 중요하다.
페르소나 집합은 여러 직업군을 포함하지만 경영, 기술, 공학, 금융에 집중되어 있다. Management & Executive는 17.7%인 반면 Office & Admin은 0.9%다. 따라서 직업군의 범위는 해당 직업에 맞는 스킬의 가용성과 관련된다.
4.2.1 Final Deliverable Evaluation
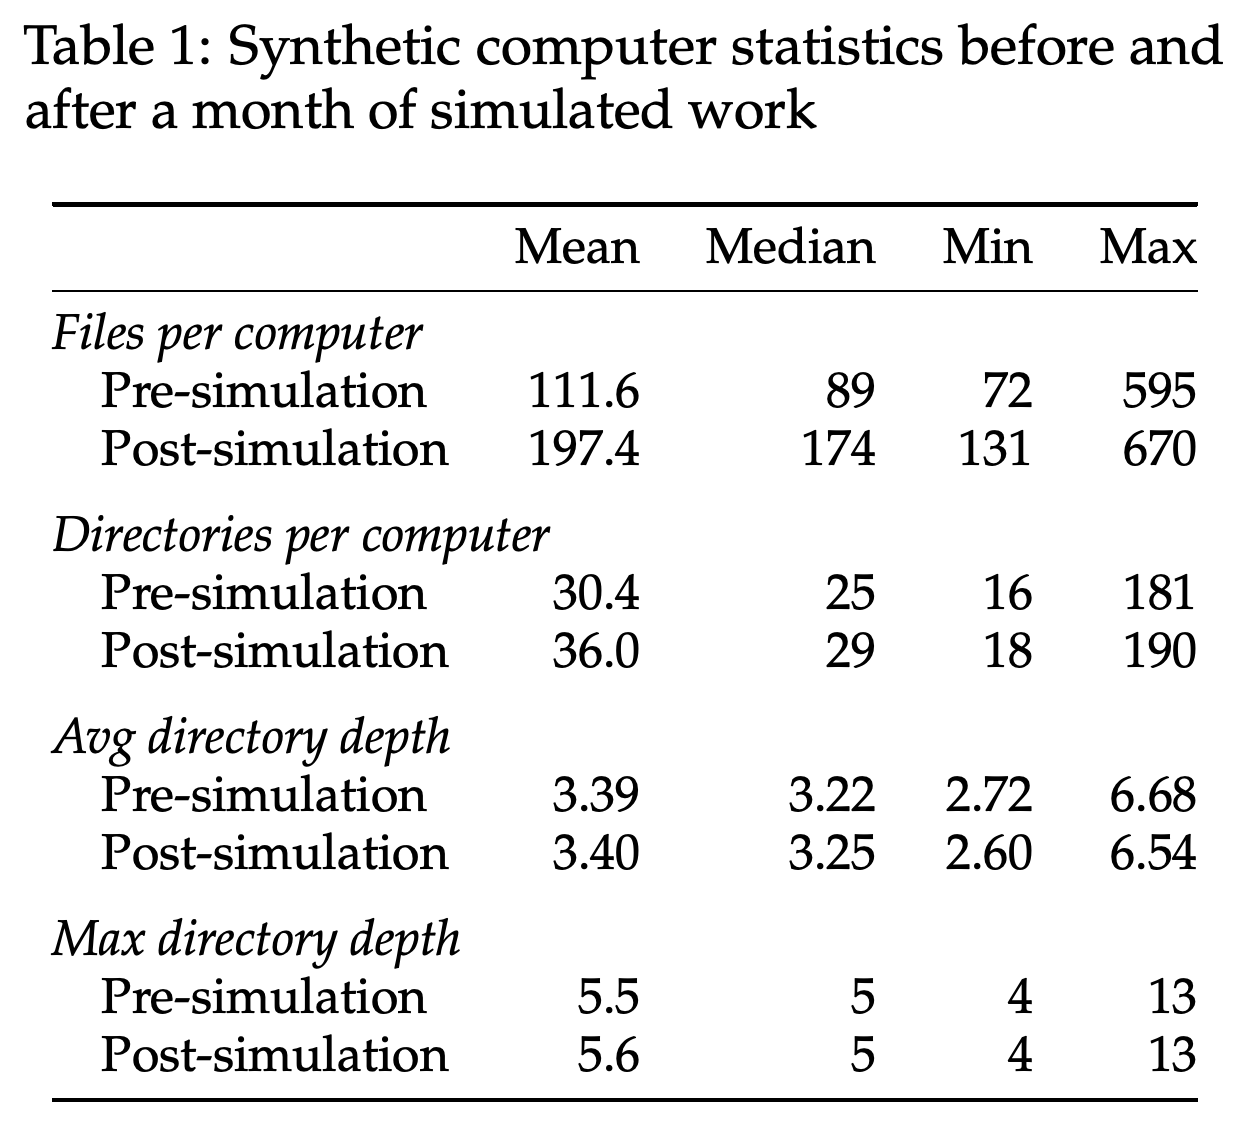
4.2 Results에서 시뮬레이션 이후 평균 파일 수는 111.6개에서 197.4개로, 평균 디렉터리 수는 30.4개에서 36.0개로 늘어난다. 평균 디렉터리 깊이는 3.39에서 3.40으로 거의 변하지 않는다. 최종 산출물은 샘플링한 컴퓨터 100개에서 컴퓨터별 루브릭으로 평가한다. 각 루브릭은 동일한 시뮬레이션 설정을 별도로 실행한 결과를 각각 참고해 만든 초안 루브릭 5개를 통합한 것이다.
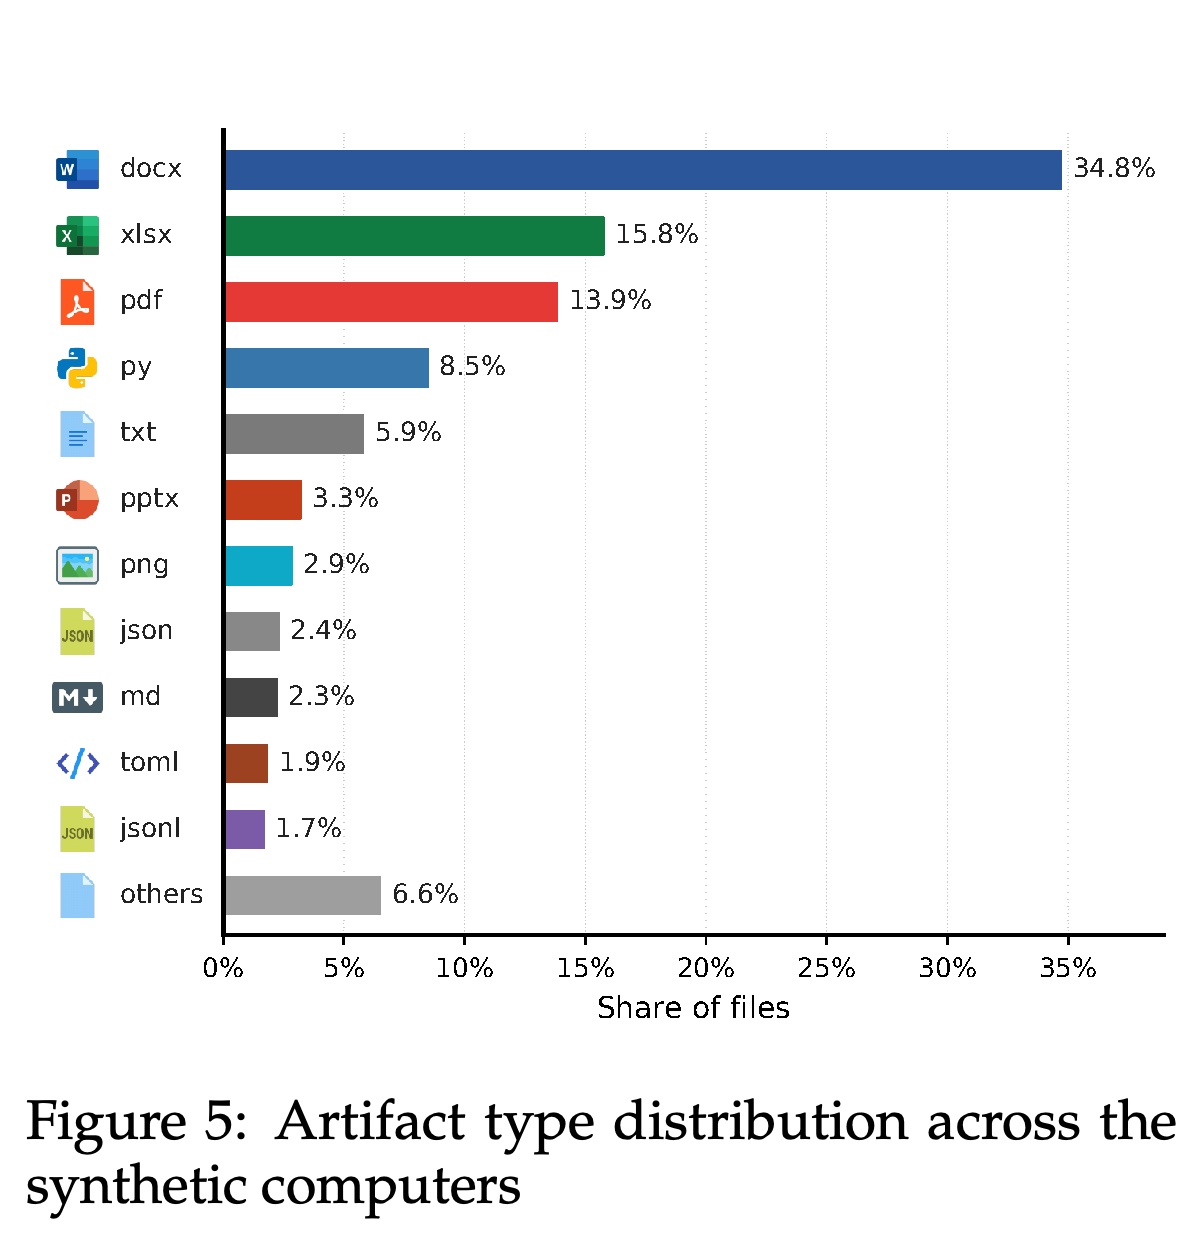
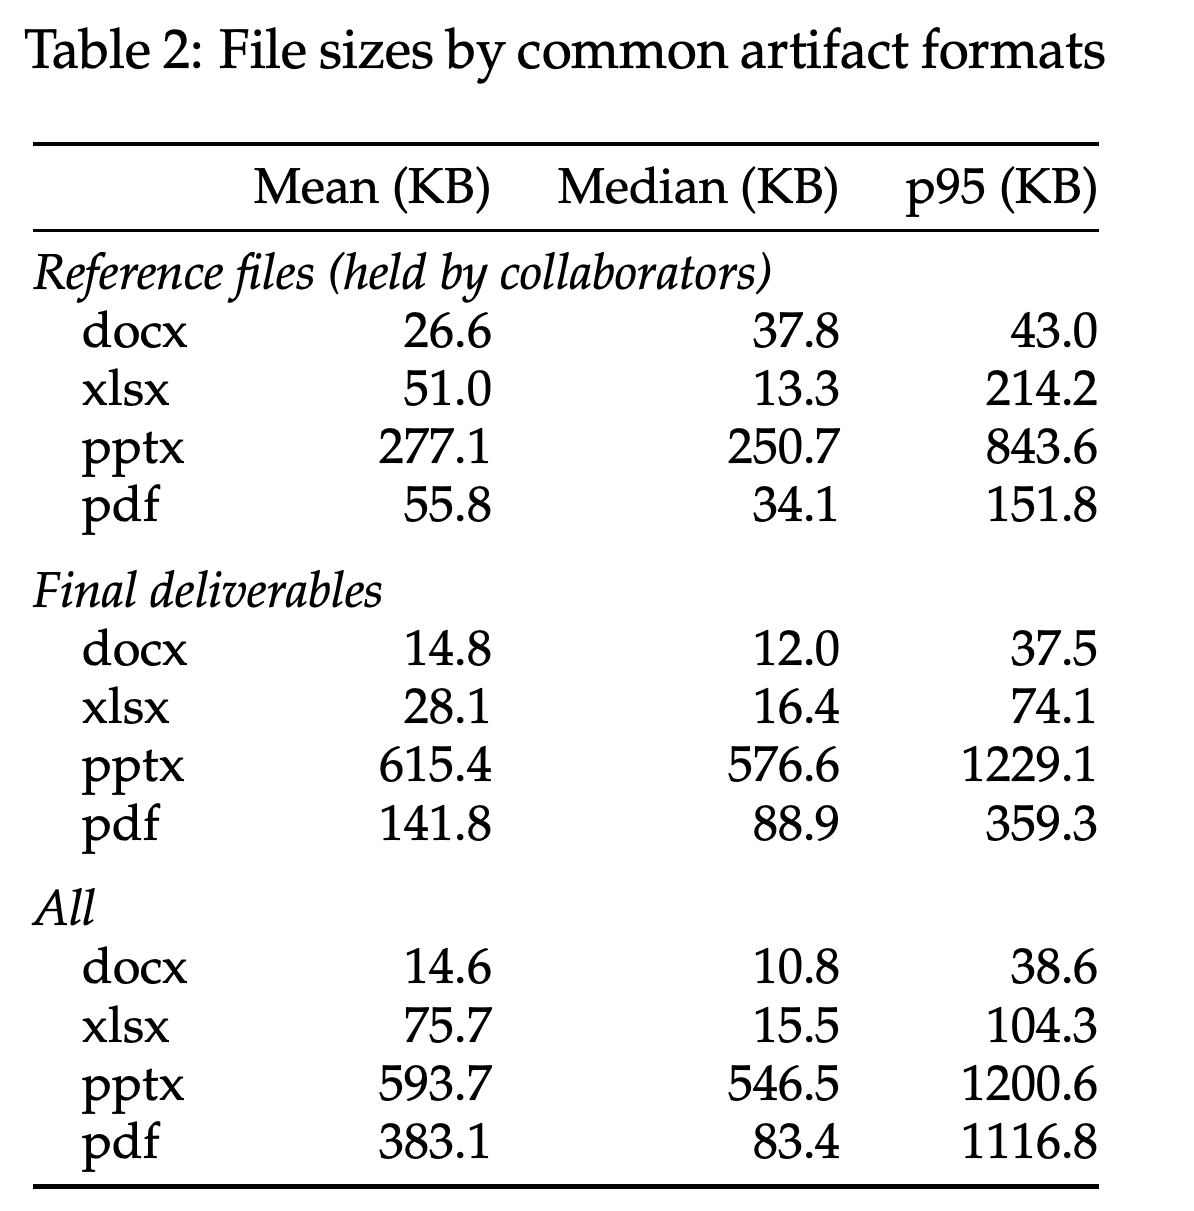
- Figure 5에서 DOCX는 34.8%, XLSX는 15.8%, PDF는 13.9%, PPTX는 3.3%이며, 합계는 전체 파일의 67.8%다. Table 2는 파일 크기를 제시한다. 파일 크기는 상당한 양의 콘텐츠가 있음을 나타내지만 정확성이나 현실성을 입증하지는 않는다.
- Table 3에서 작업 에이전트는 평균 2,272턴과 8.59시간을 사용한다. 턴 수는 주간 계획 63턴과 일별 실행 2,209턴으로 구성된다. 시뮬레이션당 협업자는 평균 5.5명이며 소통은 31회다.
- Claude Opus 4.6 평가자는 파일을 직접 확인하고, 필요하면 스크린샷도 확인한다. 루브릭은 목표 명세, 협업자 요구사항, 전문 지식, 기준값, 품질 기준을 결합한다. 예시 리밸런싱 루브릭은 55개 항목과 총점 176점으로 구성된다.
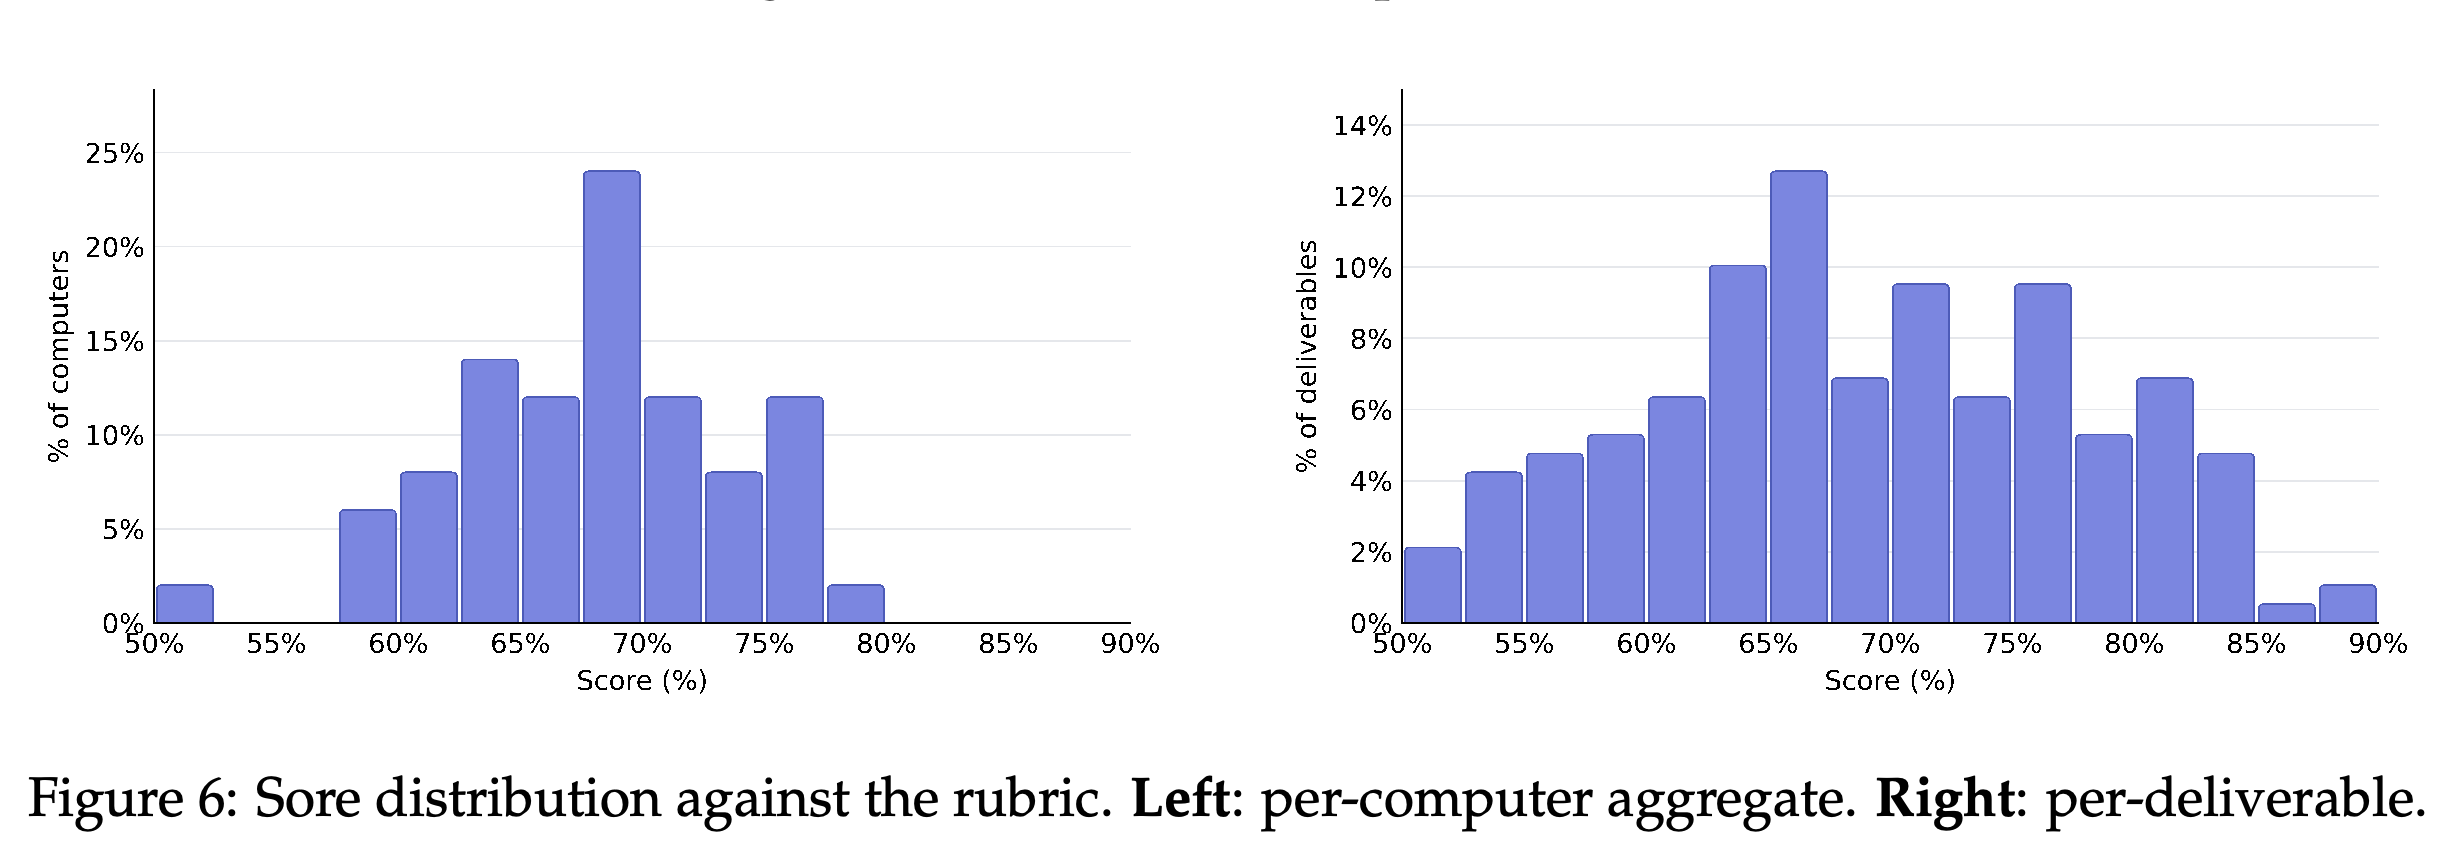
- Figure 6에서 대부분의 컴퓨터별 점수는 60%에서 80% 사이에 있다. 이는 루브릭을 상당 부분 충족하지만 완전히 충족하지는 못했음을 나타낸다. 보고서는 인간 평가자와의 일치도를 제시하지 않는다.
DOCX, XLSX, PDF, PPTX는 전체 파일의 67.8%를 차지하며, DOCX만으로도 34.8%다. 코드, 텍스트, 이미지, 구조화된 데이터 형식도 추가 맥락을 제공한다. 따라서 환경은 문서 텍스트만으로 구성되지 않는다.
시뮬레이션 이후 평균 파일 수는 111.6개에서 197.4개로, 평균 디렉터리 수는 30.4개에서 36.0개로 늘어난다. 평균 디렉터리 깊이는 3.39에서 3.40으로만 변한다. 이는 훨씬 더 깊은 디렉터리 구조를 만드는 대신 기존 계층 안에서 대부분의 증가가 발생함을 나타낸다.
이 표는 협업자가 보유한 참고 자료, 최종 산출물, 전체 파일을 구분하고 크기의 평균, 중앙값, p95를 KB 단위로 제시한다. 최종 프레젠테이션은 평균 615.4 KB이고 최종 PDF는 141.8 KB다. 이 크기는 상당한 콘텐츠가 있음을 나타내지만, 정확성이나 유용성을 직접 측정한 값은 아니다.
대부분의 컴퓨터별 종합 점수는 60%에서 80% 사이에 있으며, 개별 산출물 점수는 더 넓게 분포한다. 이 2가지 관점은 전체적으로 부분 달성한 정도와 종합 점수에 가려질 수 있는 작업 묶음별 차이를 구분한다.
4.2.2 Full Trajectory Analysis
전체 작업 과정 분석은 계획, 파일시스템 탐색, 원본 자료 활용, 협업, 중간 수정, 최종 목표 달성 여부를 검토한다. 각 시뮬레이션에는 강점, 미흡한 부분, 재사용할 수 있는 교훈이나 실패 유형을 정리한 회고 보고서가 제공된다.
- 작업 기록은 근거 활용 부족, 피드백 무시, 불필요한 재작업처럼 최종 파일만으로는 드러나지 않을 수 있는 과정상의 실패를 보여준다. 품질이 낮은 결과를 이전의 계획이나 협업 조율 문제까지 추적하는 데도 도움이 된다.
- Appendix A는 문서 간 수치 불일치, 검토자 수정사항 미반영, 약속한 작업 누락, 빈 메시지 사례를 보여준다.
- 이 회고 보고서는 이후 스킬 적용 실험에 사용되는 경험 항목을 제공한다. 다만 보고서의 진단은 통제된 인과 검증이 아니다.
4.3 In-Domain Evaluation
도메인 내 실험은 컴퓨터 1,000개를 경험 추출용 900개와 홀드아웃 테스트용 100개로 나누며, 모델 가중치는 갱신하지 않는다. 회고에서 얻은 교훈을 직업별로 묶고, LLM으로 통합한 뒤 빈도순으로 정렬한다. 이후 Anthropic의 skill-creator를 사용해 직업별 스킬로 변환한다.
- financial-and-investment-analysts 스킬 예시는 신뢰할 수 있는 데이터 출처, 재현 가능한 모델 검증, 버전 관리 원칙, 제출 전 점검, 준법 관련 작업의 필수 통과 조건을 다룬다.
- 베이스라인과 스킬 적용 에이전트는 동일한 설정과 합성 컴퓨터를 사용한다. 명시된 차이는 스킬 접근 여부다. Table 4에서 평균 점수는 61.6%와 68.6%로 +7.0 pp 상승하며, 83개에서 개선되고 17개에서 하락한다.
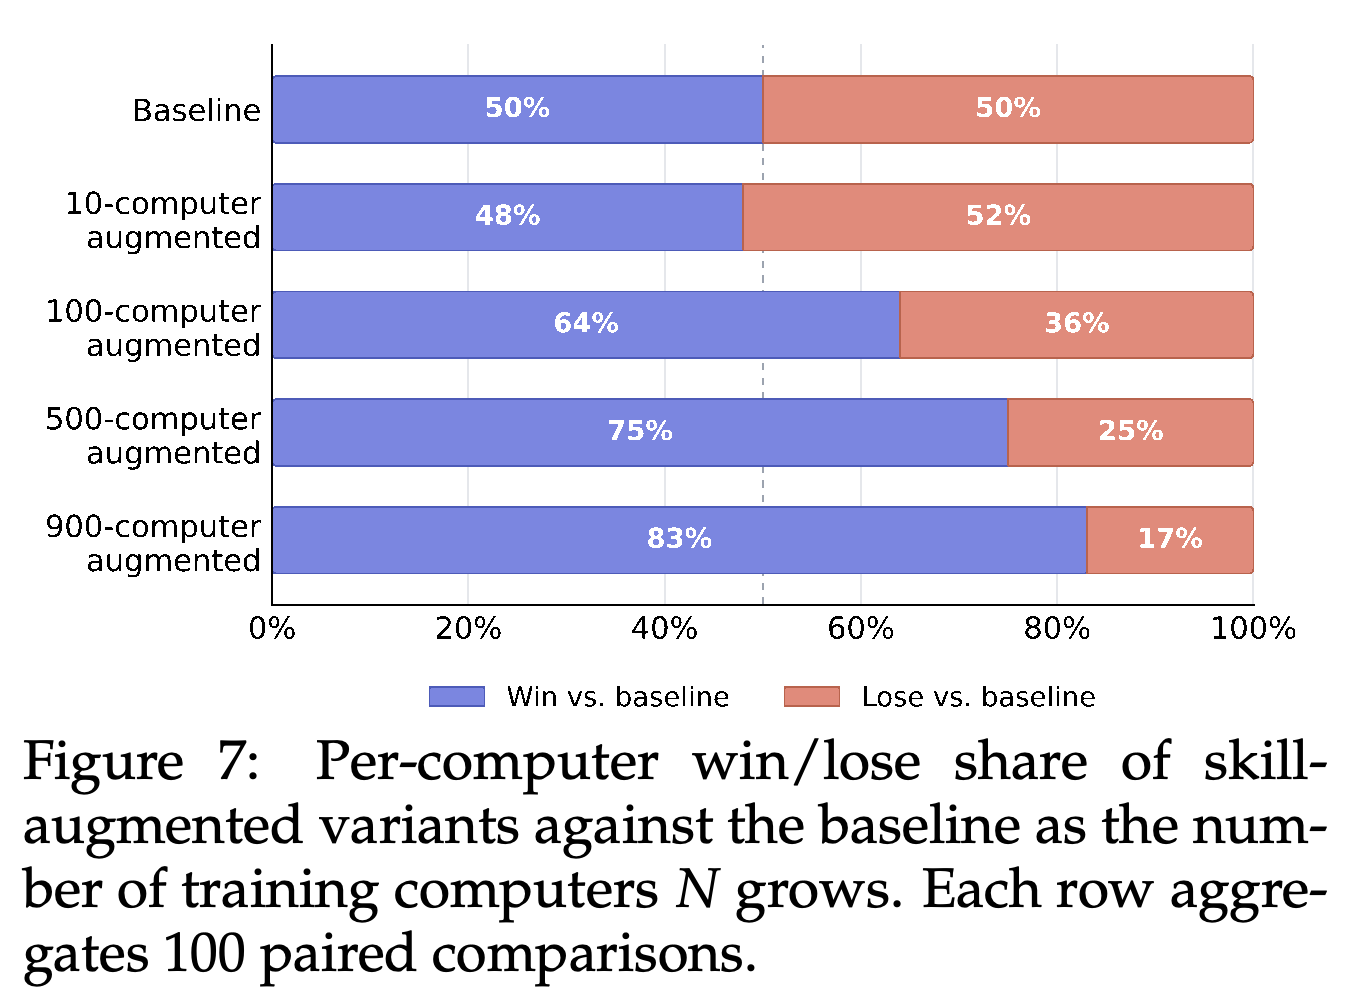
- Figure 7에서 컴퓨터 10개, 100개, 500개, 900개로부터 추출한 스킬의 승률은 각각 48%, 64%, 75%, 83%다.
- 저자들은 더 넓은 직업군과 더 신뢰할 수 있는 교훈 빈도가 이러한 규모 증가 효과를 만든다고 해석한다. 다만 실험은 이 요인들을 독립적으로 분리해 검증하지 않는다.
- skill-creator 참고 자료는 https://github.com/anthropics/skills/blob/main/skills/skill-creator/SKILL.md에 있다.
홀드아웃 컴퓨터 100개에서 직업별 스킬을 적용하면 평균 루브릭 점수가 61.6%에서 68.6%로 올라 +7.0 pp 변화를 보인다. 83개에서 개선되고 17개에서 하락한다. 이는 평가한 컴퓨터 대부분에서 이점이 있지만 모든 컴퓨터에 적용되지는 않음을 보여준다.
컴퓨터 10개에서 얻은 경험으로 만든 스킬은 비교 평가의 48%에서 승리한다. 컴퓨터 100개, 500개, 900개를 사용하면 승률은 각각 64%, 75%, 83%가 된다. 이 추세는 더 넓은 경험 범위의 효과를 뒷받침한다. 다만 직업별 매칭과 빈도 추정이 각각 얼마나 기여하는지는 분리해 검증하지 않는다.
4.4 Out-of-Domain Evaluation
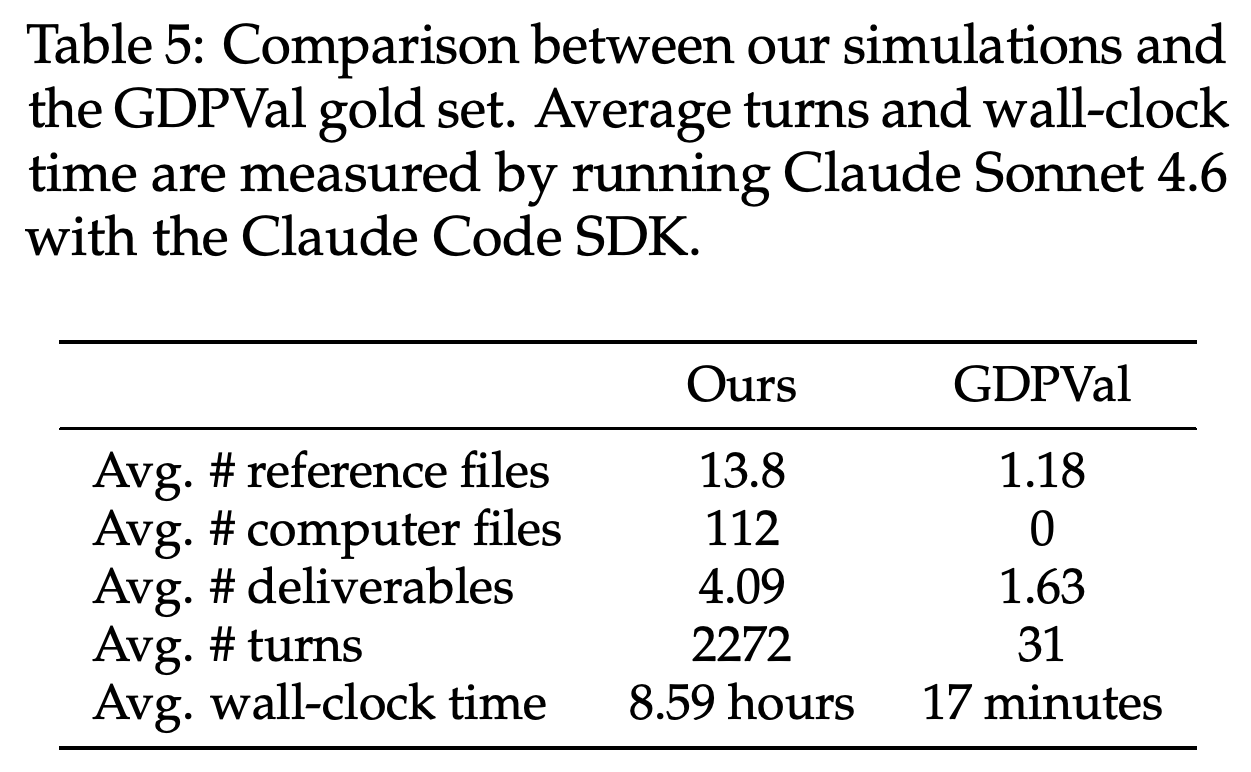
도메인 외 평가는 GDPVal의 독립적인 생산성 과제 220개에 추출한 스킬을 적용한다. 공식 루브릭과 Claude Opus 4.6의 쌍대 비교 평가를 사용한다. Table 5는 환경 차이가 상당함을 보여준다. Claude Sonnet 4.6과 Claude Code SDK로 측정할 때 시뮬레이션은 평균 2,272턴과 8.59시간을 사용하지만, GDPVal은 평균 31턴과 17분을 사용한다.
- 시뮬레이션에는 평균적으로 13.8개의 명시적 참고 파일, 112개의 배경 컴퓨터 파일, 산출물 4.09개가 있다. GDPVal에는 1.18개의 참고 파일, 0개의 배경 컴퓨터 파일, 산출물 1.63개가 있다.
- Claude Sonnet 4.6은 105승, 48무, 67패를 기록한다. 단측 및 양측 부호 검정의 p값은 각각 0.002와 0.005다.
- Claude Haiku 4.5는 104승, 36무, 80패를 기록하며 p값은 0.045와 0.090이다. Claude Opus 4.6은 99승, 50무, 71패를 기록하며 p값은 0.019와 0.038이다.
- 모든 모델에서 승리가 패배보다 많지만, 보고된 양측 검정에서 Haiku의 결과는 0.05 기준을 충족하지 않는다. 모델 성능, 지시 준수, 맥락 부담에 관한 저자들의 설명은 해석이며, 별도로 검증한 작동 원리는 아니다.
- 참고한 쌍대 비교 평가 프로토콜은 https://artificialanalysis.ai/evaluations/gdpval-aa에 있다.
시뮬레이션에는 평균적으로 13.8개의 명시적 참고 파일과 112개의 배경 컴퓨터 파일이 있다. GDPVal에는 1.18개의 참고 파일과 0개의 배경 컴퓨터 파일이 있지만, 후자가 에이전트에게 작업용 파일시스템이 없다는 뜻은 아니다. 산출물 수는 4.09개와 1.63개, 턴 수는 2,272턴과 31턴, 실행 시간은 8.59시간과 17분으로 환경 간 차이가 있다.
승/무/패는 Sonnet-4.6이 105/48/67, Haiku-4.5가 104/36/80, Opus-4.6이 99/50/71이다. 보고된 양측 부호 검정의 p값은 각각 0.005, 0.090, 0.038이다. 모델 3개 모두 승리가 패배보다 많지만, 양측 검정에서 유의한 결과를 보이는 모델은 Sonnet과 Opus라는 점을 구분한다.
5 Discussion
논의에서는 실험으로 확인한 시뮬레이션 기반 스킬 활용과 더 넓은 학습 순환 제안을 구분한다. 합성 환경은 사용자의 비공개 컴퓨터 작업 기록을 수집하지 않고도 검토 가능한 과정과 결과의 근거를 제공할 수 있다고 주장한다.
5.1 Toward Self-Improving Productivity Agents
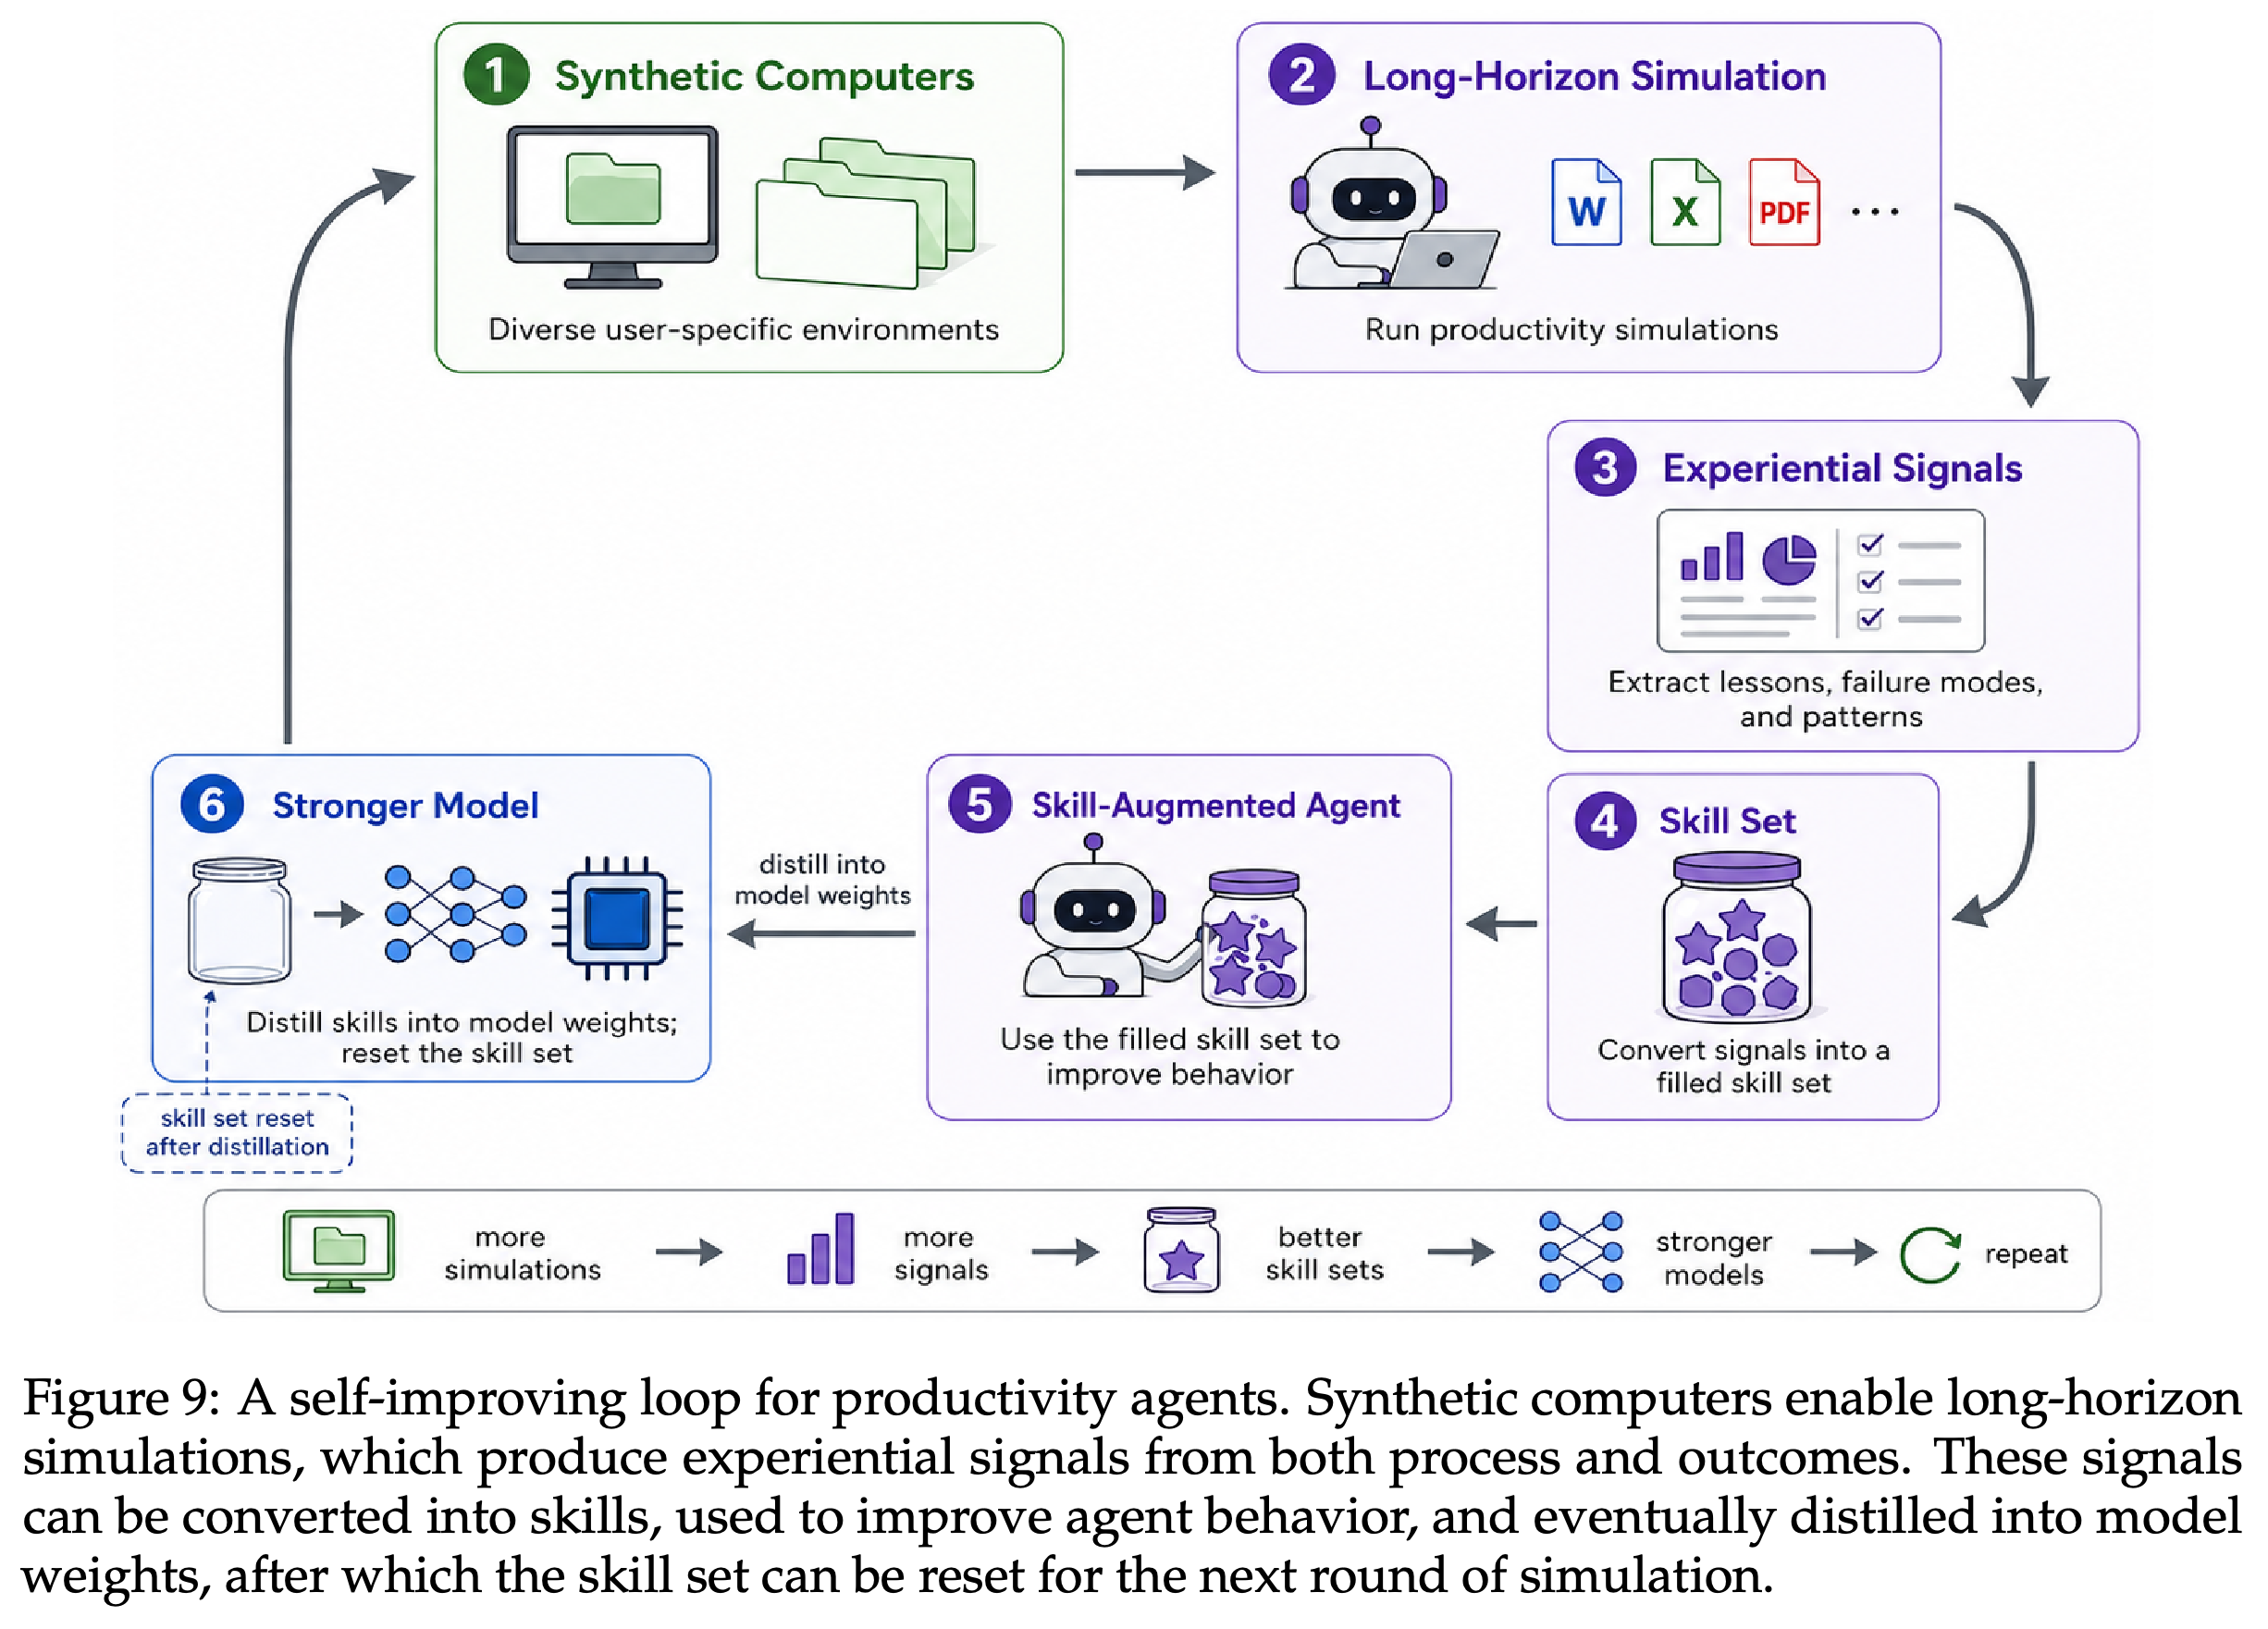
Figure 9는 합성 컴퓨터, 시뮬레이션, 회고 신호, 스킬, 스킬을 적용한 행동, 최종적인 모델 가중치 증류로 이어지는 순환을 제안한다. 실험에서 평가한 것은 외부 스킬 적용이며, 증류나 반복적인 모델 자기 개선은 아니다.
- 외부 스킬은 추출한 경험이 에이전트 행동을 개선하는지 검토 가능한 형태로 시험하는 수단이다.
- 저자들은 스킬 집합이 커지면 에이전트에 부담이 될 수 있다고 지적한다. 유용한 행동을 모델 가중치에 내재화한 뒤 외부 스킬을 초기화하고 다음 시뮬레이션을 수행하는 방식을 제안한다.
제안한 순환은 생성된 환경에서 작업 기록, 회고 신호, 외부 스킬, 개선된 행동, 모델 가중치 증류로 이어지며, 이후 스킬 집합을 초기화한다. 이 보고서에서 실험으로 평가한 것은 외부 스킬 적용뿐이다. 폐루프 모델 학습 단계는 향후 과제로 남아 있다.
5.2 Scaling with Simulation and Model Capability
저자들은 잠재적인 확장 방식 3가지를 설명한다. 시뮬레이션을 이어가며 컴퓨터 이력을 풍부하게 만들고, 더 강한 에이전트로 산출물과 작업 과정을 개선하며, 더 강한 분석 모델로 더 나은 교훈을 추출하는 방식이다. 이는 경험 추출에 더 많은 컴퓨터를 사용할수록 홀드아웃 승률이 높아진다는 관찰을 넘어선 향후 전망이다.
- 갱신된 컴퓨터를 다음 시뮬레이션의 시작점으로 삼을 수 있다. 매번 새로 생성한 환경에서 시작하는 대신 수정, 선택, 피드백, 프로젝트 이력을 축적하는 방식이다.
- 더 높은 역량의 작업 에이전트는 계획, 근거 활용, 협업, 산출물 품질을 개선할 수 있다.
- 더 높은 역량의 평가자와 회고 분석기는 더 미묘한 실패를 찾아낼 수 있다. 다만 보고서는 역량 확장에 관한 통제 실험을 제시하지 않는다.
5.3 Toward Scalable Productive Intelligence
더 넓은 제안은 직업별 파일, 이력, 제약, 협업 패턴을 포함한 작업 맥락을 확장하는 것이다. 다양한 페르소나는 서로 다른 역할, 작업 방식, 파일 구성을 제공한다. 시뮬레이션은 계획, 근거 활용, 협업 조율, 수정, 문제 복구를 연습할 기회를 제공한다.
- 논문은 고숙련 전문직 환경의 출발점으로 활용할 수 있는 기존의 엘리트 페르소나 370M개를 언급한다. 이 연구에서 해당 집합을 실제 환경으로 구현하지는 않는다.
- 관련 응용에는 컴퓨터 사용 에이전트의 학습과 평가가 포함된다. 다만 보고된 구현은 GUI 제어 벤치마크가 아니라 파일시스템을 기반으로 한 산출물 작업에 초점을 둔다.
- 반복 시뮬레이션으로 가치가 높은 전문적인 결과물을 생산하는 것은 구상한 응용이며, 독립적으로 검증한 경제적 성과는 아니다.
6 Conclusion and Future Work
결론은 합성 컴퓨터가 장기 생산성 에이전트에 유용한 경험을 제공한다고 정리한다. 홀드아웃 합성 컴퓨터에서의 성능 향상과 GDPVal로의 전이가 이를 뒷받침한다. 현재 환경의 현실성이 부족한 부분도 3가지 제시한다.
- 시각적 스타일과 서식이 지나치게 획일적일 수 있으므로, 산출물 디자인을 사용자나 조직에 더 맞춰야 한다.
- 파일시스템에는 중복 초안, 임시 다운로드, 버려진 파일, 스크린샷, 업무와 무관한 자료 등 자연스럽게 쌓이는 불필요한 파일과 작업 이력을 더 포함해야 한다.
- 협업자는 주로 요청에 반응하는 수준을 넘어, 자신의 파일, 작업, 회의, 마감일, 변화하는 상태를 갖춘 더 역동적인 존재가 되어야 한다.
부록
- A Retrospective Analysis Report는 win computer 000000에서 수행한 Margaret Elaine Forsythe의 금융 자문가 시뮬레이션을 검토한다. 기간은 2026-01-05부터 2026-01-30까지이며 근무일 20일을 다룬다. 전체 점수는 605 / 846 (71.5%)이며, 산출물 결함을 소통 및 실행 이력과 연결해 분석한다.
-
- Executive Summary에서는 에이전트가 초기 계획, 주기적인 소통, 핵심 분석 작업을 잘 수행하지만, 문서 간 불일치가 산출물 5개 모두에 영향을 준다고 평가한다. 그 밖의 실패에는 검토자 피드백 미반영, 빈 메시지 10개, 정확히 명시해야 할 준법 문구 누락, 오래된 수치가 남은 보조 워크북이 포함된다.
-
- Deliverable-by-Deliverable Analysis에서는 각 작업 묶음의 분석적 강점과 누락 요소, 불일치, 추정 원인을 구분한다. 점수는 ESG overlay의 54.8%부터 고객 온보딩의 88.2%까지 분포한다. 작업 묶음 5개 사이에 달성 수준의 차이가 크다는 점을 보여준다.
- 2.1 DLV 001: VCMM 2026 Model Portfolio Refresh (Hartley)의 점수는 127/168 (75.6%)다. 출력 파일 8개가 모두 존재하며, 강점으로는 자산군 12개의 변화량 표, 경로 10,000개의 Monte Carlo 분석, 민감도 점검이 있다. 그러나 Conservative US Large Cap 비중은 14%, 20%, 27.4%, 19%로 서로 다르다. Growth EM의 변화 방향은 파일마다 반대이며, 투표 슬라이드는 잘못된 의결 항목으로 대체되어 있다. 최종 전망 문서는 요구한 18–22페이지가 아니라 11페이지다.
- 2.2 DLV 002: Castellano HNW Onboarding (Castellano)의 점수는 164/186 (88.2%)다. 에이전트는 18%와 16.3%의 배분 불일치를 발견하고, Aspen 준비금 $900K를 문서화하며, 주요 가족 및 세금 제약을 파악한다. 누락된 산출물은 XLSX 형식의 완성된 설문지, buffered ETF 부록, EM 비교 1페이지 자료다. Roth 전환 목표는 여전히 일치하지 않으며, 제출 시점에도 준법 승인이 완료되지 않았다.
- 2.3 DLV 003: Rebalancing Trigger Framework v3 (Okonkwo)의 점수는 97/166 (58.4%)다. 핵심 워크북은 실제 계산되는 수식을 포함하고, 승인 조건 5개를 충족하며, 과거 결정을 21/23 비율로 재현해 최소 기준 18/23을 넘는다. 그러나 17일 차에 지적된 스트레스 테스트 데이터 오류 3개와 빠른 참조 자료 결함 2개는 수정되지 않았다. 보조 문서 사이에서도 수식, 편차 임계값, 파일럿 AUM이 일치하지 않는다.
- 2.4 DLV 004: Alternatives Integration Research (Ortiz)의 점수는 137/180 (76.1%)다. 작업 묶음에는 2000–2025년 상관관계와 낙폭 분석, 테스트 4개의 명시적 판정, Ortiz의 반대 의견을 포함한 IC의 3-1 채택 기록이 들어 있다. 그러나 원자재 상품, 비용 비율, 실행 날짜, 수익률이 일치하지 않고, QSPIX를 추천하면서 VMNVX로 분석해 권고안의 신뢰성이 낮아진다. 회고 보고서는 상품 혼동과 투자 상품 데이터 대조 누락을 원인으로 해석한다.
- 2.5 DLV 005: ESG Equity Overlay (Whitfield)의 점수는 80/146 (54.8%)다. 강점에는 수정된 위험 표시 방식, 추적오차 분해, 선택 참여 절차, 최종 PDF의 공식 승인이 있다. 그러나 준법 메모는 v1.0에 머물고, 보조 스프레드시트에는 이전 임계값과 오래된 수치가 남아 있다. $28K–$32K 라이선스 비용 고지도 자리표시자로 남아 있어, 수정된 서술을 뒷받침할 근거가 연결되지 않는다.
-
- Simulated-Collaborator Communication Analysis에서는 메시지를 보냈는지만 확인하지 않고, 대화가 실제 수정으로 이어졌는지 평가한다. 초기 상호작용은 요구사항을 효과적으로 구체화하는 경우가 많다. 그러나 후반의 빈 메시지와 불완전한 후속 조치 때문에 이미 알려진 수치 및 준법 결함이 해결되지 않는다.
- 3.1 David Hartley (ext hartley) — Managing Director와의 소통에서는 발신 메시지 10개에 답변 10개를 받으며, 14일 차와 15일 차에 빈 메시지 2개를 보낸다. 에이전트는 방향을 확인하고 초기 검토를 효과적으로 관리하지만, 확정된 IC 투표 항목 5개를 충실하게 재현하지 못한다. 후반의 사전 검토 수정사항도 완전히 반영하지 않는다.
- 3.2 Robert Castellano (ext castellano) — HNW Client와의 소통에서는 발신 메시지 3개에 답변 3개를 받으며, 18일 차와 19일 차에 빈 메시지 2개를 보낸다. 고객 요구 파악은 잘 수행하지만, 약속한 EM 분석과 buffered ETF 분석을 누락한다. 요청받은 Aspen 현금 표 수정도 고객이 선호한 변경 대신 각주로 처리한다.
- 3.3 Sandra Okonkwo (ext okonkwo) — Peer Reviewer와의 소통에서는 발신 메시지 7개에 답변 7개를 받으며, Day 19에 빈 메시지 1개를 보낸다. 초기의 정확한 기술적 소통으로 모델 승인을 얻는다. 그러나 결함이 있는 스트레스 테스트를 제출하지 말라는 명시적 지시를 받고도, Sandra의 Day 17 corrections에 해당하는 워크북 값 3개와 빠른 참조 자료의 구역 2개를 수정하지 않는다.
- 3.4 Nathaniel Ortiz (ext ortiz) — CIO와의 소통에서는 발신 메시지 2개에 답변 2개를 받으며, 빈 메시지는 없다. 1페이지 메모는 Ortiz의 선호에 맞는다. 그러나 2022년 원자재 상관관계를 대조해 정리해 달라는 요청은 메모, 워크북, 프레젠테이션의 값을 일치시키는 결과로 이어지지 않는다.
- 3.5 James Whitfield (ext whitfield) — Compliance Officer와의 소통에서는 발신 메시지 9개에 답변 9개를 받으며, 14일 차, 15일 차, 19일 차에 빈 메시지 3개를 보낸다. 초기 임계값과 표시 문제는 해결한다. 그러나 정확한 수수료 문구, 관련 문서의 버전 갱신, 트레이딩 데스크 인계, 고객별 기록 관리는 미완료 상태다. 워크북에 이미 올바른 임계값을 사용하고 있다는 주장은 파일을 직접 확인한 결과와 모순된다.
- 3.6 Patricia Huang (ext huang) — Vanguard Data Provider와의 소통에서는 발신 메시지 2개에 답변 2개를 받으며, 18일 차의 빈 메시지 1개가 포함된다. 요청한 자료가 2일 차에 신속히 도착하므로 보고서는 데이터 확보를 적절하게 수행했다고 평가한다.
- 3.7 Kevin Tran (ext tran) — Junior Associate와의 소통에서는 발신 메시지 7개에 답변 7개를 받으며, 15일 차에 빈 메시지 1개를 보낸다. 에이전트는 구조화된 작업 지침을 제공하고 비용 비율의 단위 오류를 발견한다. 그러나 문서 간 검증을 위임하거나, 고객 영향 분석이 등급별 top-10 계좌를 모두 다루는지 확인할 기회를 놓친다.
-
- Workflow & Efficiency에서는 턴 로그 오류, 소통 결함, 계획에서 벗어난 실행, 작업 순서 문제를 검토한다. 에이전트는 일관성을 유지하고 미완료 약속을 마무리하는 데 필요한 검증 없이 최종 제출 자료를 정리한다.
- 4.1 Error Patterns from Turn Log에서는 총 5,114턴에서 오류 기록 213개를 확인하며, 오류율은 4.2%다. 사례에는 잘못된 문서 스킬 경로, 파일을 읽기 전에 쓰기, replace_all에 불리언 대신 문자열 전달, 잘못된 셸 명령, 병렬 호출 실패로 다른 병렬 호출이 취소되는 문제가 포함된다. 이 사례의 전체 로그 턴 수를 연구 전체의 평균 작업 에이전트 턴 수인 2,272턴과 혼동해서는 안 된다.
- 4.2 Blank Messages to Simulated Collaborators (10 total)에서는 빈 발신 메시지 10개가 모두 14–20일 차에 발생했다고 기록한다. 이로 인해 수신 확인, 작업 할당, 최종 수정 점검이 중단된다. 보고서는 컨텍스트 윈도우나 계획 역량에 가해진 부담을 원인으로 추정하지만, 어느 쪽도 원인으로 직접 측정하지 않는다.
- 4.3 Plan vs. Execution Gaps에서는 Week 1과 Week 2에 대체로 계획을 따른다고 평가한다. Week 3 corrections는 일부만 반영하며 수신 확인도 누락한다. Week 4 files는 최종 형태로 만들지만, 스트레스 테스트 수정, ESG 워크북과 메모 갱신, 정확한 수수료 문구 반영, 비중 대조, 약속한 여러 구성 요소는 미완료 상태로 남는다.
- 4.4 Work Sequencing Issues에서는 투자 상품을 확정하기 전에 대체투자 정량 분석을 시작하고, 근거가 되는 워크북을 수정하기 전에 서술을 갱신한 문제를 지적한다. 보고서는 최종 대조에 전념하는 날을 따로 두지 않은 점도 원인으로 본다. 그 결과 일치하지 않는 배분과 방향이 반대인 권고가 최종 제출 자료에 남는다.
-
- Domain-Specific Insights에서는 실패를 산출물 생성뿐 아니라 전문적인 업무 절차를 준수하는 능력의 부족으로 해석한다. 수치 대조, 의사결정 절차의 충실한 재현, 제출 전 필수 조건인 준법 승인, 정확한 펀드 상품 식별을 강조한다.
- 5.1 Missing Professional Knowledge에서는 선임 자문가라면 문서에 공통으로 쓰이는 모든 수치를 검증하고, 위원회 의장의 투표 의결 항목을 보존하며, 고객에게 제출하기 전에 필요한 승인을 받을 것이라고 주장한다. iShares GSCI Commodity Indexed Trust (GSG)와 Invesco Optimum Yield Diversified Commodity Strategy (PDBC)의 혼동도 상품 지식 부족으로 지적한다.
- 5.2 What an Expert Would Have Done Differently에서는 전문가의 작업 방식으로 단일 기준 수치 목록 유지, 수정사항을 후속 진행의 차단 조건으로 처리, 최종 red-team 검토일 확보, 미완료 약속의 출처·상태·기한 추적을 제안한다. 이는 관찰된 실패에서 도출한 회고적 처방이며, 별도로 평가한 개입은 아니다.
-
- Actionable Recommendations에서는 사례의 실패를 작업 규칙 후보로 바꾸는 권고 12개를 제시한다. 원본 자료의 일관성, 적시 수정, 소통 검증, 의존 관계를 고려한 갱신, 정확한 문구 보존, 약속 추적, 분석 입력 선택, 최종 검증, 사실에 맞는 상태 보고, 명세 준수, 후반 작업 역량 배분을 다룬다.
- Recommendation 1: Implement Cross-Document Reconciliation Tables에서는 주요 수치를 행으로, 문서를 열로 놓은 대조표를 만들고, 불일치가 있으면 제출을 중단하도록 권고한다. 근거는 서로 양립할 수 없는 Conservative US Large Cap 비중 4개와 파일마다 반대인 Growth EM 변화 방향이다.
- Recommendation 2: Treat Simulated-Collaborator Corrections as Same-Day Blockers에서는 Sandra의 Day 17 stress-test corrections가 정확한 검토 지시에도 반영되지 않은 사례를 다룬다. 해당 수정사항은 3개다. 보고서는 셀 값을 즉시 −0.18, +0.61/+0.62, +0.10으로 수정하고, 다른 작업을 계속하기 전에 2시간 이내에 확인을 보내도록 제안한다.
- Recommendation 3: Never Send Blank Messages to Simulated Collaborators에서는 발신 메시지가 비어 있지 않고 의도한 주제를 다루는지 확인하도록 제안한다. 후반의 빈 메시지 10개, 특히 Sandra에게 보낸 Day 19 correction 확인 메시지가 실패한 사례는 소통 행위가 발생해도 작업이 진전되지 않을 수 있음을 보여준다.
- Recommendation 4: Update Supporting Workbooks Before Narrative Documents에서는 ESG 서술을 성과 감소 22 bps와 추적오차 1.8%로 바꿨지만, 워크북에는 18 bps와 72 bps가 남은 사례를 다룬다. 제안한 순서는 먼저 원본 셀을 수정하고 이후 서술에 쓸 수치를 도출하는 것이다. 이렇게 하면 재현 가능한 근거 연결을 유지할 수 있다.
- Recommendation 5: Copy Verbatim Language, Don’t Paraphrase에서는 Whitfield가 정확한 $28K–$32K 수수료 고지와 ERISA 적용 제외 문구를 제공했지만, 전자는 자리표시자로 남고 후자는 바꿔 쓰인 사례를 다룬다. 보고서는 명시적으로 요구한 문구를 그대로 넣고, 출처를 확인할 수 있는 감사 기록을 유지하도록 권고한다.
- Recommendation 6: Maintain a Running “Open Items” Tracker에서는 각 미완료 항목, 해당 협업자와 발생일, 기한, 상태를 기록하고 매일 검토하는 추적표를 제안한다. 누락된 buffered ETF 분석, EM 비교, IC Decision Summary, 빠른 참조 자료 수정이 이 권고의 근거다.
- Recommendation 7: Confirm IC Vote Items by Copy-Paste에서는 Hartley가 7일 차에 항목 5개의 목록을 제공하고 11일 차에 다시 확인했지만, 투표 슬라이드에는 다른 항목이 들어간 사례를 다룬다. 보고서는 기억에 의존해 재구성하지 말고 승인된 목록을 그대로 옮기도록 권고한다. 특히 Growth EM −200과 Balanced IG +200을 보존해야 한다.
- Recommendation 8: Finalize Vehicle Selection Before Quantitative Analysis에서는 QSPIX를 추천하면서 VMNVX로 분석하고, 원자재 상품도 바뀌는 문제를 다룬다. 제안한 해결책은 1주 차에 티커, 펀드명, 비용 비율, 데이터 출처를 확정해 분석과 권고가 같은 펀드 집합을 사용하도록 하는 것이다.
- Recommendation 9: Dedicate Final Day to Quality Assurance에서는 20일 차를 산출물 5개 전체의 대조, 미완료 항목 검토, 모든 검토자 수정사항의 반영 확인에 배정하도록 권고한다. 이는 마지막 날을 체계적인 점검 대신 여러 제출 준비 작업에 사용한 관찰에 대응한 제안이다.
- Recommendation 10: Never Misrepresent Document Status to Simulated Collaborators에서는 에이전트가 Whitfield에게 ESG 워크북에 올바른 임계값을 사용한다고 말했지만, 실제 확인 결과 이전 값인 E≥40, S≥35, G≥35가 남아 있던 사례를 다룬다. 보고서는 문서 상태를 글로 알리기 전에 실제 파일을 확인하고, 필요하면 아직 갱신해야 한다는 사실을 인정하도록 권고한다.
- Recommendation 11: Produce Page-Count-Compliant Documents에서는 Capital Markets Outlook이 18–22페이지 명세와 달리 11페이지이고, 대체투자 최종 PDF가 22페이지 초안에서 8페이지로 축약된 사례를 다룬다. 보고서는 작성 중 페이지 수를 확인하고, 명시적인 문서 명세를 통과 기준으로 삼도록 권고한다.
- Recommendation 12: Budget Context/Capacity for the Final Week에서는 시뮬레이션 후반에 빈 메시지와 수정 누락이 집중된 점을 근거로 분석을 1–2주 차에 먼저 수행하고, 4주 차의 처리 역량을 대조와 제출 준비에 남겨 두도록 제안한다. 보고서가 맥락 처리 여력의 고갈을 직접 측정하지 않으므로, 이러한 역량 부족 설명은 추론에 머문다.
- Appendix: Score Summary의 점수는 127/168 (75.6%), 164/186 (88.2%), 97/166 (58.4%), 137/180 (76.1%), 80/146 (54.8%)이며, 합계는 605/846 (71.5%)다. 회고 보고서는 손실 점수 중 약 80–100점을 문서 간 불일치, 약 40점을 검토자가 지적했지만 수정하지 않은 오류, 약 20점을 누락 요소에 기인한 것으로 추정한다. 소통 누락의 간접 영향은 약 15–20점, 명세 준수 문제는 약 10–15점으로 추정한다. 이는 대략적인 진단상 기여 추정이며, 서로 겹치지 않는 실험 효과가 아니다.
짧은 생각
핵심 기여는 구체적인 환경 생성 및 시뮬레이션 파이프라인이다. 여기서 추출한 작업 지침은 홀드아웃 합성 작업을 개선하고 GDPVal에도 전이된다. 부록은 신뢰성 문제를 분명하게 보여준다. 산출물 묶음 전체에서 공유 수치, 검토자 피드백, 약속을 일관되게 관리하지 못하면, 개별 산출물이 그럴듯한 것만으로는 충분하지 않다. 홀드아웃 평가의 +7.0 pp 향상과 Sonnet의 유의한 GDPVal 비교 결과는 유용한 경험 전이를 뒷받침한다. 그러나 한 달에 걸친 시뮬레이션이 더 짧은 경험 수집보다 비용 효율적임을 입증하지는 않는다. 그러한 비교는 보고하지 않는다. 생성, 회고 분석, 평가는 모두 모델을 기반으로 한다. 인간 평가를 통한 보정과 의존 관계를 고려한 생성, 협업, 작업 기록 길이에 관한 통제된 ablation이 근거를 강화할 수 있다. 이 연구는 가중치 갱신 없이 외부 스킬을 적용하는 효과를 보여준다. Agentic reinforcement learning, 증류, 반복적 개선, 수십억 규모의 환경은 보고된 결과가 아니라 제안한 응용이다.