


Toward Efficient Agents: Memory, Tool learning, and Planning 요약 설명
20 Jan 2026 | Paper Review Agent's Memory Tool Use Agent Planning목차
- 요약
- 1. Introduction
- 2. Preliminaries
- 3. Efficient Memory
- 4. Efficient Tool Use
- 5. Efficient Planning
- 6. Benchmarks
- 7. Challenges and Future Directions
- 8. Conclusion
- 부록
- 짧은 생각
이번 글에서는 Toward Efficient Agents: Memory, Tool learning, and Planning 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 1월 20일(Arxiv)
- Yang, Xiaofang, Li, Lijun, Zhou, Heng, Zhu, Tong, Qu, Xiaoye, Fan, Yuchen, Wei, Qianshan, Ye, Rui, Kang, Li, Qin, Yiran, et al.
- Shanghai Artificial Intelligence Laboratory, Fudan University, University of Science and Technology of China, Shanghai Jiaotong University, Institute of Automation, Chinese Academy of Sciences, The Chinese University of Hong Kong (Shenzhen), Hong Kong Polytechnic University, Wuhan University, Tsinghua University
- 논문 링크
- Github
- Project Page
요약
- Toward Efficient Agents: A Survey of Memory, Tool Use, and Planning은 서로 긴밀히 연결된 3가지 구성 요소인 메모리, 도구 사용, 계획을 중심으로 에이전트 효율성을 정리한다. 허용 가능한 과제 품질을 유지하면서 토큰 사용량, 지연 시간, 연산량, 상호작용을 줄이는 방법을 살펴본다.
- 반복해서 등장하는 기법에는 압축된 메모리와 선택적 검색, 비용을 고려한 도구 호출, 적응적 숙고, 제어된 탐색, 재사용 가능한 절차가 있다. 이러한 기법은 구성 요소 사이에서 비용을 이동시키거나 온라인 실행 비용을 오프라인 준비 비용으로 바꿀 수 있다. 따라서 전체 실행 궤적과 반복 과제를 기준으로 가치를 평가해야 한다.
- 이 서베이는 고정된 비용 예산에서 달성하는 성능이나 비슷한 성능을 달성하는 데 드는 비용으로 효율성을 평가한다. 새로운 알고리즘이나 통제된 비교 실험을 제시하는 대신 기존 방법과 평가 관행을 종합한다. 지표와 비용 산정 범위가 일관되지 않아 방법 간 직접 비교에는 한계가 있다.
1. Introduction
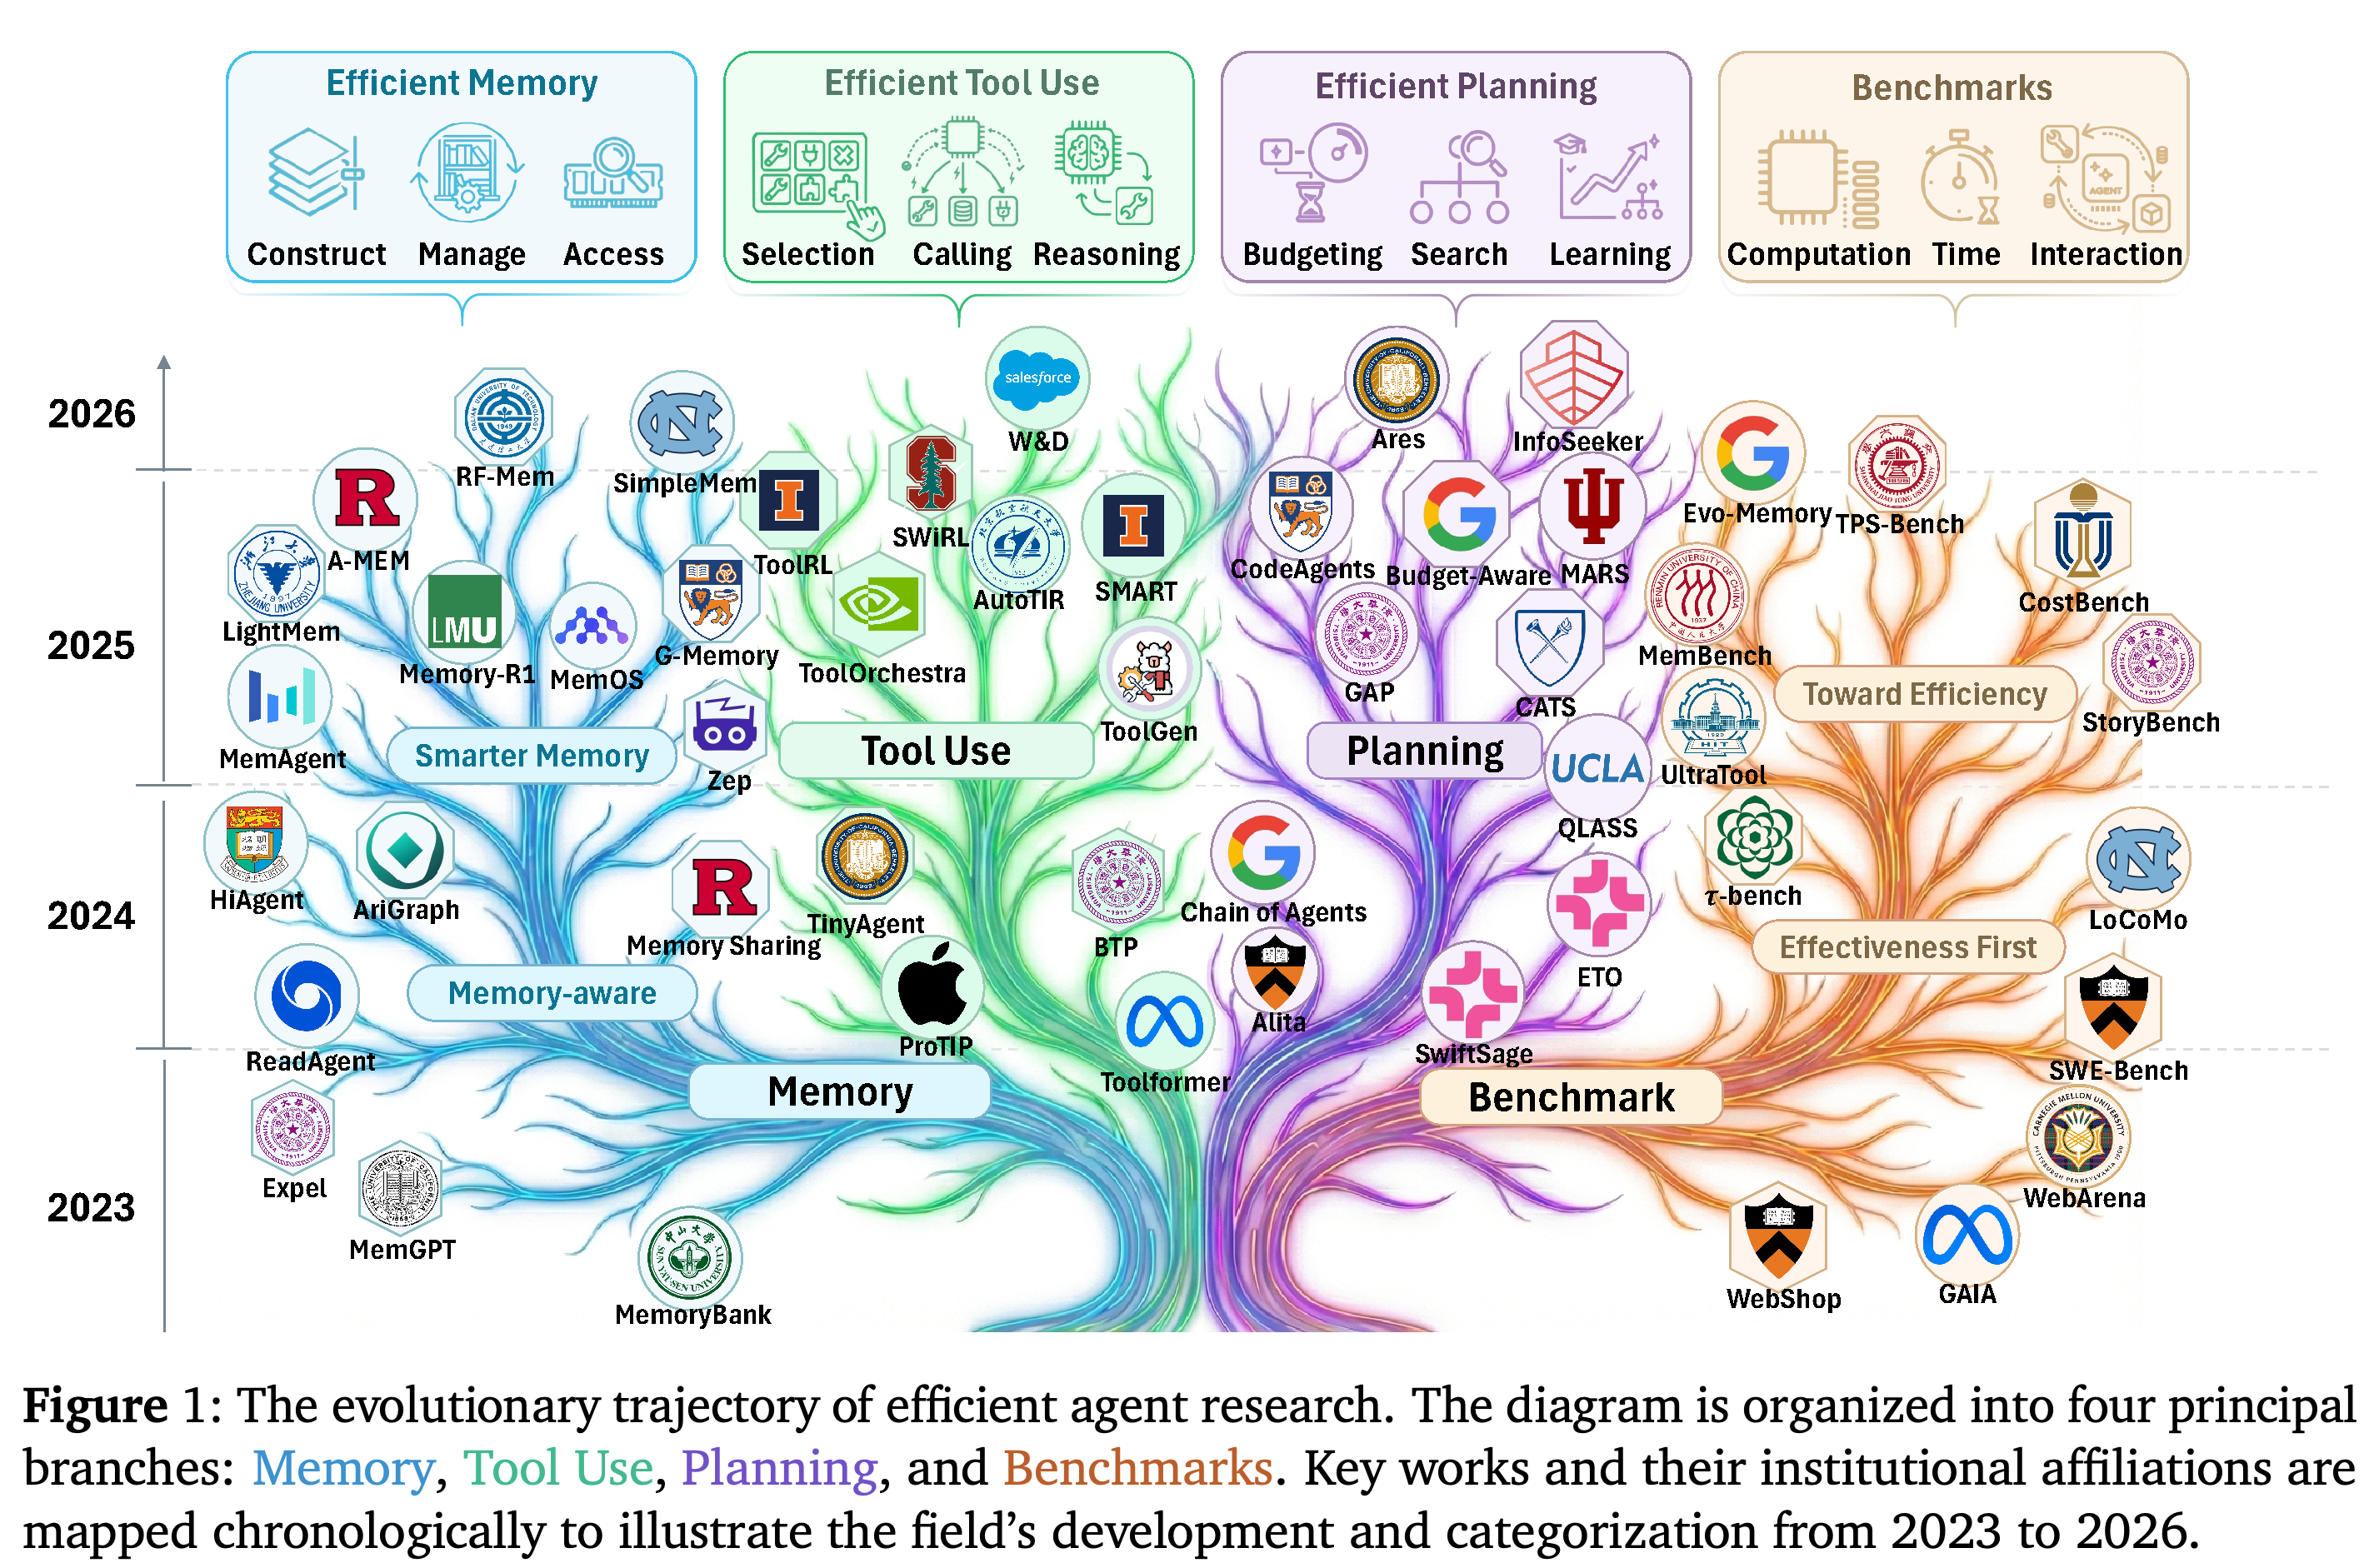
다단계 에이전트는 문맥 검색, 계획, 도구 실행, 관측 처리를 반복한다. 앞선 출력이 이후 입력으로 이어지므로, 긴 실행 궤적에서는 문맥 처리 비용, 도구 지연 시간, 재시도 비용이 누적된다. 모델 압축만으로는 이러한 비용을 해결하지 못한다. Figure 1은 2023년부터 2026년까지의 문헌을 메모리, 도구 사용, 계획, 벤치마크로 나누어 보여준다.
- 작업 흐름은 Input → [Memory → Planning → Tool Use → Observation]을 반복 → Solution으로 구성된다.
- 이 서베이는 시스템 수준에서 효율성을 정의한다. 에이전트 모듈 전반의 토큰 사용량, 추론 지연 시간, 연산 비용을 줄이면서 과제 성공률을 유지하거나 높이는 것을 뜻한다.
- 분류는 분석을 위한 구분이며 서로 배타적이지 않다. 각 방법은 주된 효율성 개선 목적에 따라 배치하고, 구성 요소 간 영향은 별도로 논의한다.
4개 분기는 대표 연구를 서베이의 구성 체계와 연결한다. 벤치마크 분기는 성능 우선 평가와 효율성 중심 신호를 구분한다. 연대기는 시간에 따른 측정 성능 향상이 아니라 문헌 분포를 보여준다.
2. Preliminaries
예비 지식에서는 에이전트와 환경의 상호작용을 모델링하고, 에이전트에 특유한 부가 비용을 일반적인 LLM 생성 비용과 구분한다. 이를 통해 실행 궤적 전체의 메모리, 외부 행동, 재시도를 효율성 산정에 포함해야 하는 이유를 설명한다.
2.1. Agent Formulation
LLM 기반 에이전트는 도구와 명시적 메모리를 추가한 부분 관측 마르코프 결정 과정으로 모델링한다: M = (S, O, A, P, R, γ; T, Ψ; Mmem, U, ρ). 환경은 잠재 상태, 관측, 행동, 전이, 보상, 할인 계수 (\gamma\in[0,1))로 구성된다. 추가된 요소는 도구 실행과 메모리 변화를 정의한다.
- T는 외부 도구 집합이며, Ψ는 호출을 실행하는 방식과 반환할 출력을 지정한다.
- Mmem은 메모리 상태 공간이고, U는 현재 메모리와 이용 가능한 정보를 다음 메모리 상태로 매핑하며, ρ는 초기화 분포다.
- 이 정식화는 상호작용을 설명하는 개념적 모델이며 새로운 최적화 알고리즘이 아니다.
2.2. From Pure LLMs to Agents
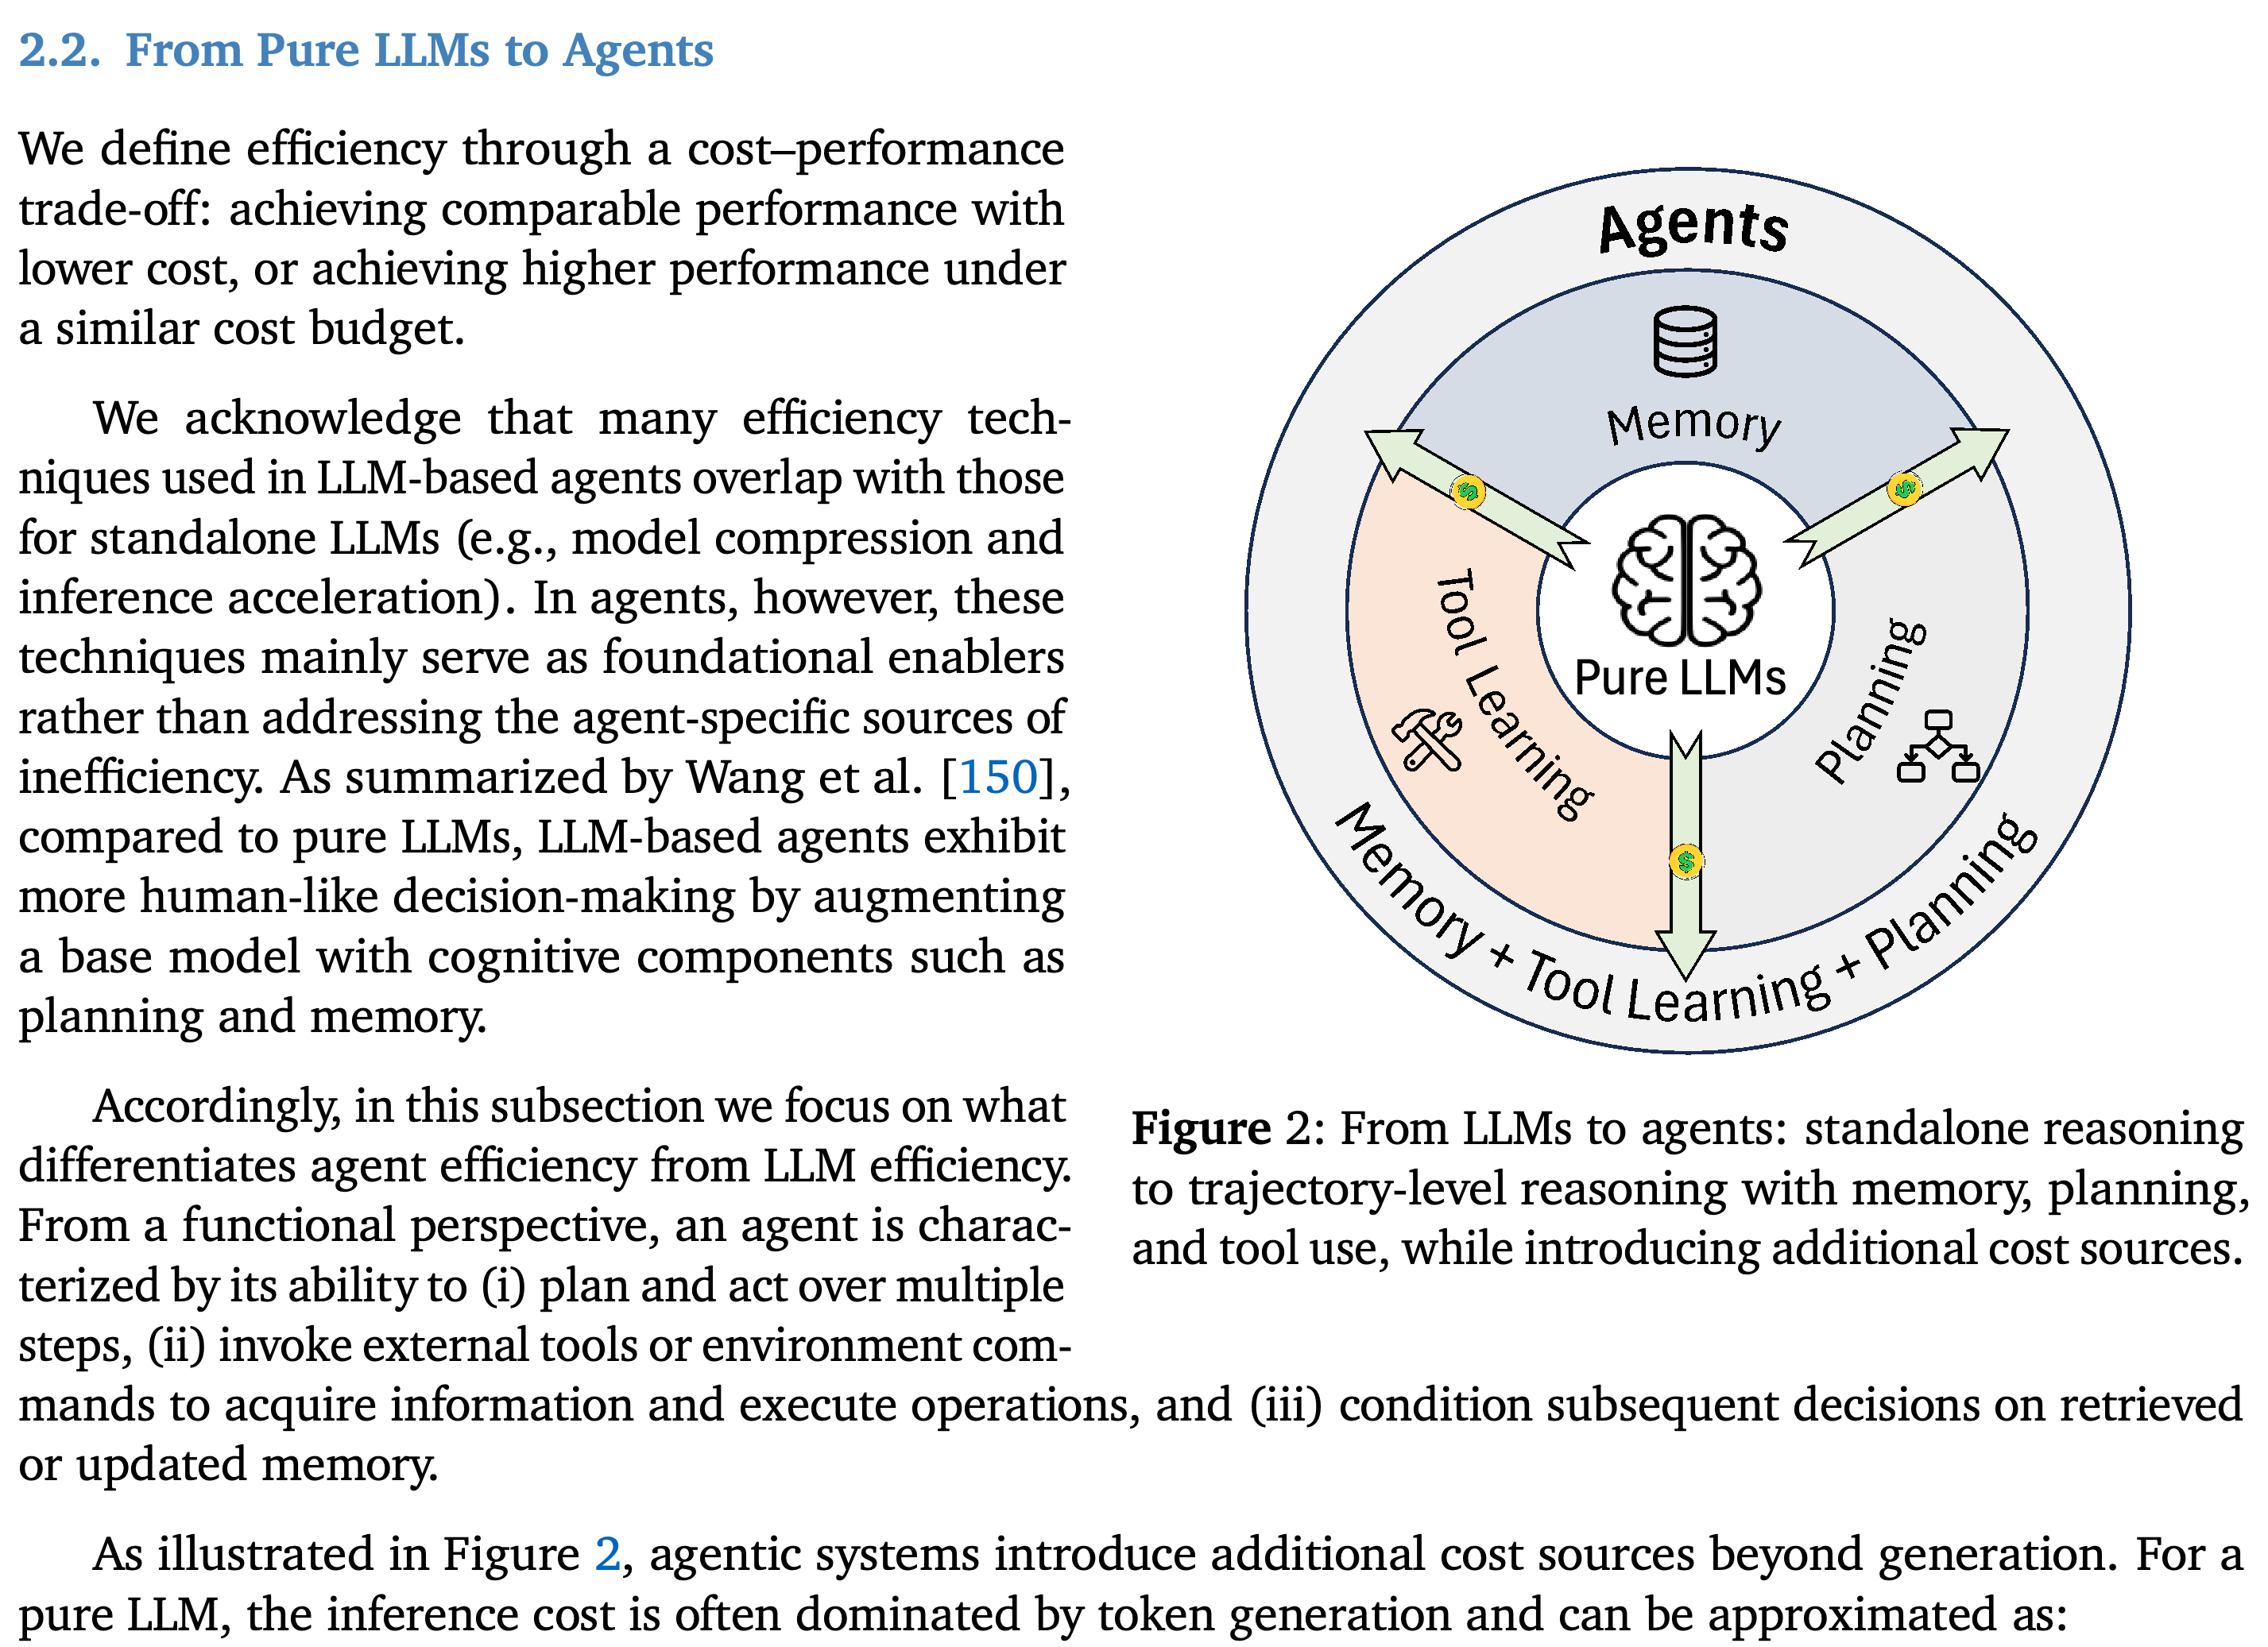
Figure 2는 독립적인 생성에서 메모리, 계획, 도구를 활용하는 실행 궤적 수준의 추론으로 확장되는 모습을 보여준다. 논문은 독립적인 생성 비용을 CostLLM ≈ α Ntok로, 에이전트 비용을 Costagent ≈ α Ntok + Itool · Costtool + Imem · Costmem + Iretry · Costretry로 근사한다. 이 식들은 추가 비용의 원인을 나타내지만, 실행 궤적에서 반복되는 연산을 명시적으로 합산하지는 않는다.
- Ntok는 생성된 추론 토큰 수이며, α는 토큰당 시간 또는 금전 비용을 나타낸다.
- Itool, Imem, Iretry는 각각 도구 호출, 메모리 접근, 재시도 여부를 나타내는 이진 지시 변수다.
- 따라서 에이전트에 특화된 최적화에는 기반 모델 가속뿐 아니라 필요한 호출을 더 정확히 선택하고 불필요한 복구를 피하는 작업도 포함된다.
그림은 순수 LLM을 중앙에 놓고 에이전트 시스템 안에서 메모리, 도구 학습, 계획이 이를 둘러싸도록 배치한다. 추가된 기능은 토큰 생성 속도만 높여서는 제거할 수 없는 비용을 만든다.
3. Efficient Memory
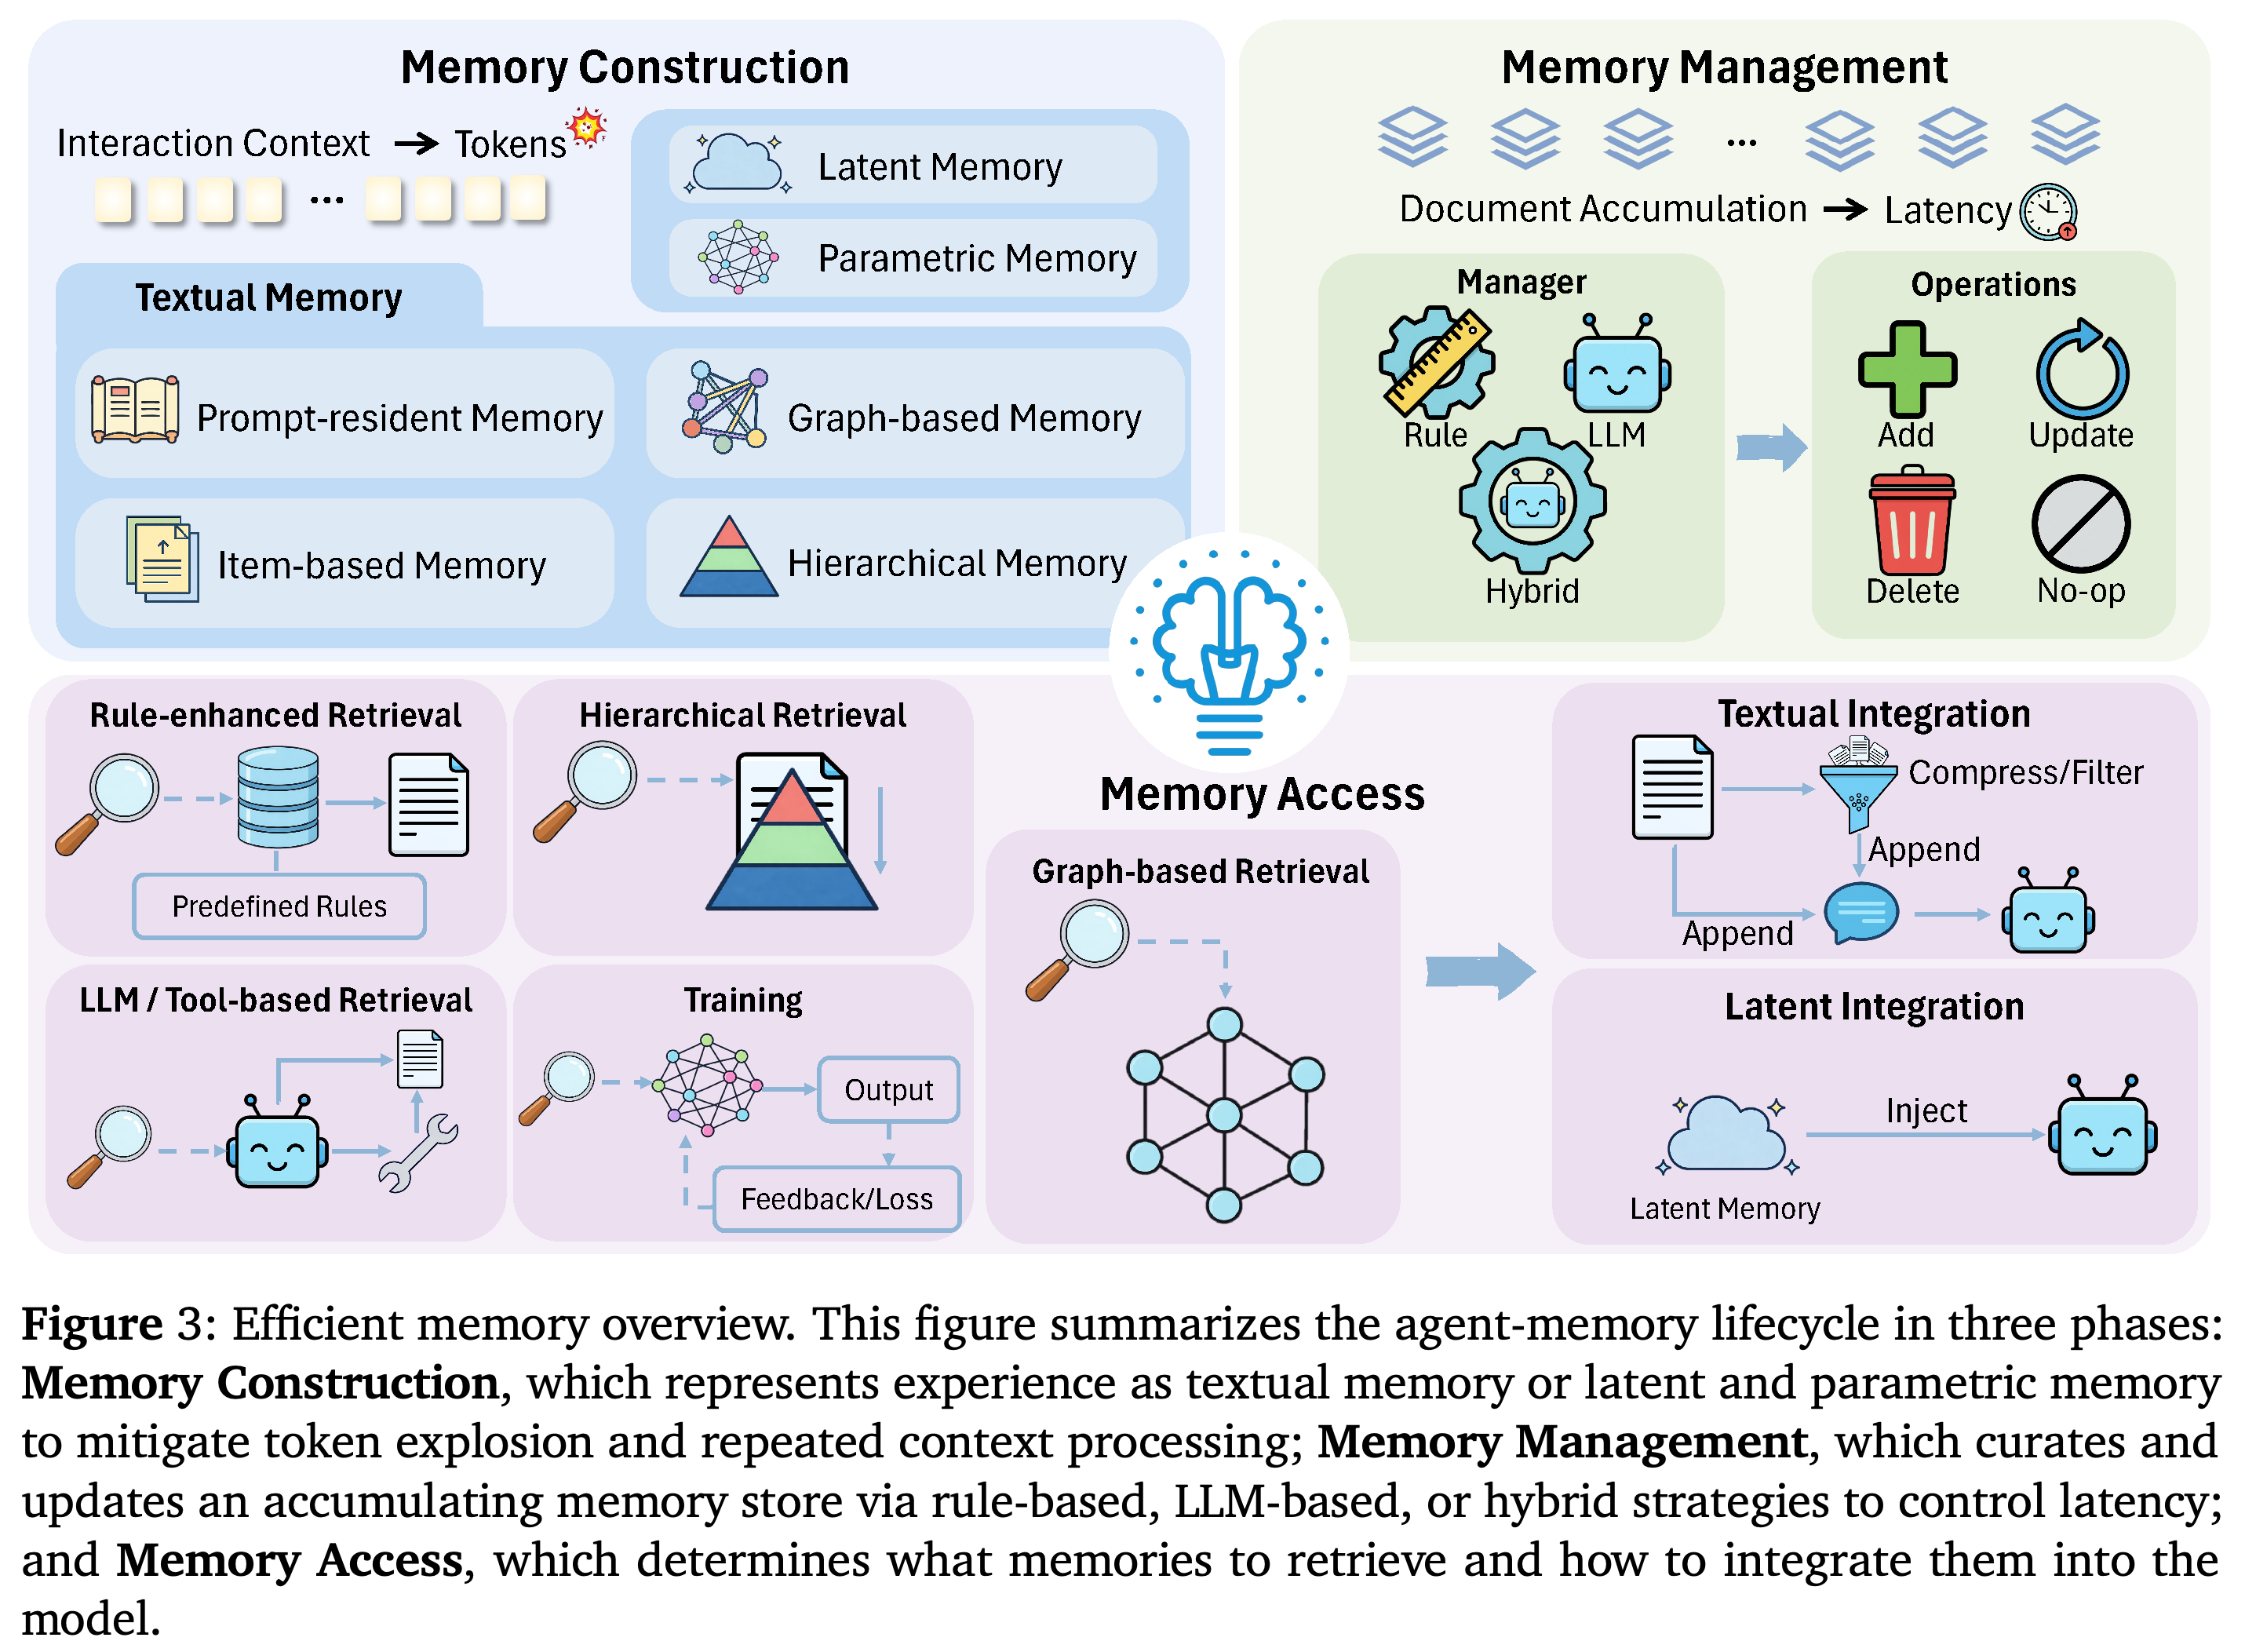
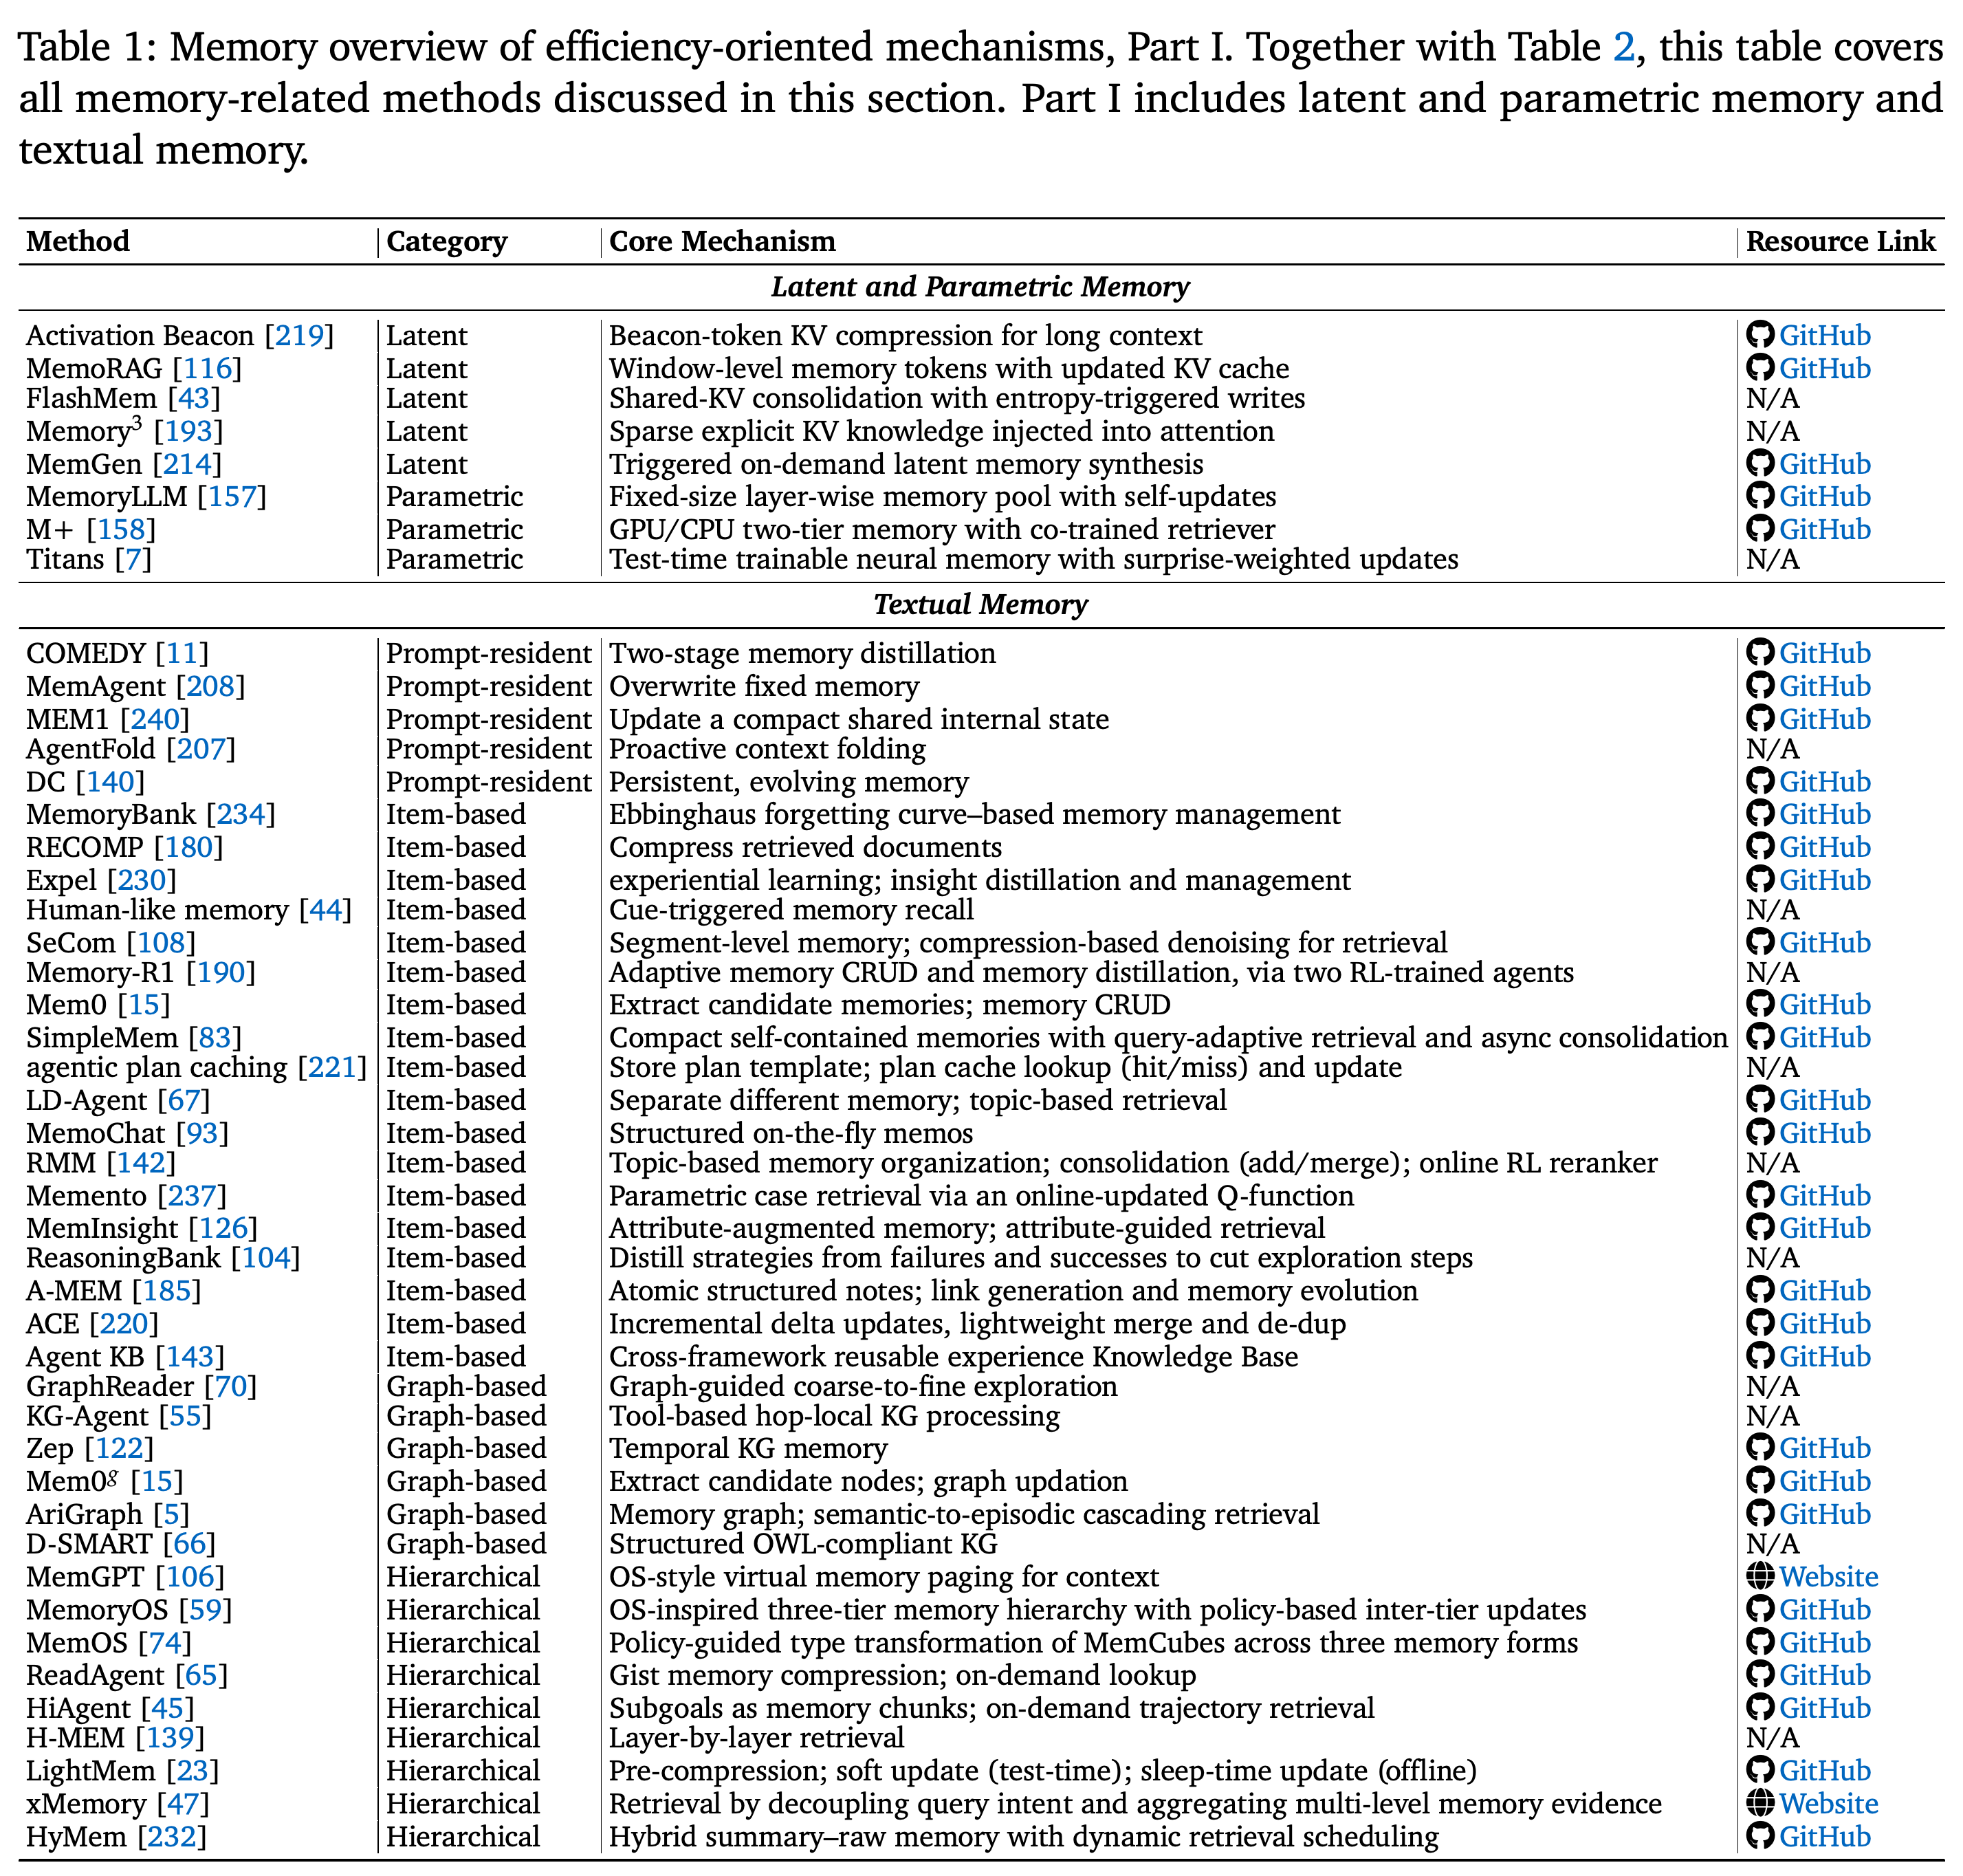
메모리는 유용한 경험을 보존해 반복적인 이력 처리, 중복 탐색, 재시도를 줄일 수 있다. Figure 3은 메모리 생애주기를 구성, 관리, 접근으로 정리한다. Table 1은 표현 방식에 따른 기법을, Table 2는 스킬과 다중 에이전트 메모리를 정리한다.
- 구성 단계는 표현 방식을 결정하므로 이후 저장, 검색, 통합 비용에 영향을 준다.
- 관리 단계는 갱신, 통합, 삭제, 보관을 통해 중복, 정보의 노후화, 메모리 증가를 제어한다.
- 접근 단계는 현재 결정에 필요한 메모리를 선택하고, 긴 프롬프트를 다시 만들지 않으면서 이를 통합한다.
도식은 표현 방식의 선택, 유지 관리 결정, 검색 기법, 통합 인터페이스를 분리한다. 이를 통해 비용 산정 단계를 구분한다. 압축된 메모리를 구성하더라도 이후 의미적 갱신이나 과도한 검색에 큰 비용이 들 수 있다.
3.1. Memory Construction
3.1.1. Latent and Parametric Memory는 활성값 공간에 정보를 저장하는 방식과 전용 메모리 모듈의 파라미터에 정보를 인코딩하는 방식을 구분한다. 두 방식 모두 전체 이력을 반복해서 직렬화하고 읽는 작업을 줄이지만, 쓰기 방식, 용량 제약, 해석 가능성, 인프라 요구 사항은 다르다.
- Activation Beacon은 원시 토큰의 KV 활성값을 beacon 토큰으로 압축한다. MemoRAG는 윈도우 수준의 메모리 토큰을 유지하고, FlashMem은 어텐션 엔트로피가 높을 때 Shared-KV 통합을 실행한다.
- Memory3는 정적 지식 베이스에서 가져온 희소한 명시적 KV 지식을 어텐션에 주입한다. 반면 MemGen은 추론 과정에서 잠재 메모리를 합성할 시점을 학습한다.
- MemoryLLM은 동결된 백본에 1B-parameter 규모의 계층별 메모리 풀을 추가하고, 백본을 통한 역전파 없이 이를 직접 갱신한다. 서베이에 따르면 M+는 GPU/CPU 계층을 활용해 GPU 메모리를 늘리지 않고 유효 보존 범위를 20K에서 160K tokens를 초과하는 수준으로 확장한다.
- Titans는 테스트 시점에 놀라움 신호로 가중한 그래디언트를 통해 신경망 메모리 모듈을 갱신한다. 따라서 쓰기 비용은 방법에 따라 다르며, 파라미터 기반 메모리가 항상 그래디언트 기반 갱신을 뜻하지는 않는다.
- 압축된 비텍스트 메모리는 토큰 재처리를 줄이지만 텍스트보다 해석과 편집이 어렵다. 과도한 압축은 결정에 필요한 세부 정보를 버릴 수 있다. M+의 보존 범위 결과는 선행 연구에서 보고한 수치이며, 이 서베이가 재현한 결과는 아니다.
3.1.2. Textual Memory는 읽을 수 있는 요약, 사건, 실행 궤적, 프로필, 계획, 기호적 사실을 저장한다. Table 1은 프롬프트 내 상주 방식, 항목 기반 방식, 그래프 기반 방식, 계층적 방식을 구분한다. 압축과 구조화는 온라인 문맥 비용을 줄일 수 있지만 구성과 유지 관리 작업을 추가한다.
- 프롬프트 내 상주 방식은 활성 문맥에 압축된 상태를 유지한다. MemAgent는 요약된 메모리를 덮어쓰고, MEM1은 <IS></IS>로 표시한 고정 길이 상태를 학습하며, AgentFold는 여러 해상도의 요약과 가장 최근의 전체 턴을 보존한다.
- 항목 기반 방식은 간결한 기록이나 재사용 가능한 전략을 추출한다. SimpleMem은 지시 대상을 명확히 해 독립적으로 이해할 수 있는 단위를 만들고, ReasoningBank는 성공과 실패에서 교훈을 추출하며, ACE는 유용성 통계가 붙은 전략 항목을 유지한다.
- 그래프 기반 방식은 국소 검색이나 다중 홉 검색을 위해 개체와 관계를 조직한다. Zep은 시간적 유효성을 추가하고, AriGraph는 의미 메모리와 에피소드 메모리를 연결하며, MAGMA는 의미, 시간, 인과, 개체 그래프를 활용한다.
- 계층적 방식은 개괄적인 정보에서 세부 정보로 접근하도록 지원한다. MemGPT는 가상 메모리 방식의 페이징을 사용하고, MemoryOS는 저장 계층을 활용하며, ReadAgent는 핵심 요약을 페이지에 연결하고, HiAgent는 하위 목표 요약으로 전체 실행 궤적을 인덱싱한다.
- 텍스트는 검토와 편집이 가능하지만 검색과 재삽입에는 여전히 자원이 든다. 정교한 구조는 필요한 정보의 위치를 더 잘 찾게 해주는 대신 인덱싱과 갱신 비용을 늘릴 수 있다.
각 행은 KV 압축, 고정 메모리 풀, 간결한 텍스트 기록, 그래프 구성, 계층적 페이징 등의 기법을 방법 분류 및 자료 링크와 함께 제시한다. 이 표는 기법 목록이며, 동일한 실험 조건이나 비용·정확도 측정에 따른 비교가 아니다.
3.2. Memory Management
메모리 관리는 누적된 저장소가 중복되고 오래된 정보로 채워져 검색 비용이 커지는 일을 방지한다. 이 절은 갱신 결정의 비용과 의미적 적응성에 따라 3.2.1. Rule-based Management, 3.2.2. LLM-based Management, 3.2.3. Hybrid Management를 구분한다.
- 규칙 기반 정책은 추가 LLM 호출 없이 최근성, 빈도, 용량, 피드백을 활용한다. MemoryBank는 Ebbinghaus 망각 곡선에서 착안한 감쇠를 사용한다. 서베이가 인용한 A-MEM 실험에서는 망각 곡선 정책이 메모리 크기와 검색 시간을 줄였지만 과제 성능도 크게 낮췄다.
- LLM 기반 연산 선택에는 Memory-R1과 Mem0의 ADD, UPDATE, DELETE, NOOP가 있다. Memory-R1은 강화학습으로 이러한 결정을 학습하고, Mem0는 유사도 검색 후 LLM에 프롬프트를 제공한다.
- A-MEM과 같은 개방형 생성 관리는 고정된 연산 집합에서 선택하는 데 그치지 않고 연결을 생성하고 관련 노트를 수정한다.
- 하이브리드 시스템은 일상적인 유지 관리에 저비용 트리거를 쓰고 의미적 통합에는 LLM을 쓴다. MemoryOS는 계층별 규칙과 LLM 갱신을 결합하고, LightMem은 온라인 소프트 갱신과 오프라인 sleep-time 통합을 결합한다.
- 하이브리드 그래프 관리는 의미적 충돌 탐지와 명시적 그래프 편집을 결합한다. 효과를 내려면 적절히 보정된 트리거, 일관된 계층별 정책, 오래된 사실을 신뢰성 있게 처리하는 방식이 필요하다.
3.3. Memory Access
메모리 접근은 3.3.1. Memory Selection과 3.3.2. Memory Integration으로 나뉜다. 선택 단계는 과도한 검색이나 문맥 증가 없이 현재 결정에 필요한 근거를 검색한다. 통합 단계는 해당 근거를 필터링, 압축, 형식화하거나 에이전트 연산에 주입한다.
- 규칙을 결합한 검색은 의미적 유사도에 최근성, 중요도, 주제 중복, 속성을 추가한다. RF-Mem은 익숙한 질의를 빠른 경로로 보내고 불확실한 질의에는 더 깊은 회상을 수행한다. SimpleMem은 질의 복잡도에 따라 검색 범위를 조정한다.
- 그래프 검색은 질의와 관련된 사실을 기준점으로 삼아 국소 하위 그래프를 확장하며, 개체·관계와 다중 홉 근거에 접근하도록 지원한다.
- LLM/도구 기반 검색은 메모리 인터페이스를 통한 능동적 탐색을 허용하지만 호출과 지연 시간을 추가한다. 서베이는 드물게 발생하더라도 오류의 영향이 커서 비용보다 정확성이 중요한 질의에 이 방식이 적합하다고 본다.
- 계층적 검색은 H-MEM, xMemory, HyMem처럼 개괄적인 구간을 먼저 찾고 연결된 세부 정보를 선택적으로 살펴본다.
- 학습 기반 검색은 유사도에만 의존하지 않고 유용성을 학습한다. RMM은 온라인 재순위 모델을 학습하고, Memento는 Q-function으로 상태·사례 쌍의 순위를 정하며, MemRL은 유사도 기반 회상과 Q-value 기반 선택을 결합한다.
- 텍스트 통합은 압축된 작업 집합, 전략 항목, 조정된 계획 템플릿을 삽입한다. RECOMP는 검색이 도움이 되지 않으면 검색 결과를 전부 생략할 수 있다. 잠재 통합은 내부 어텐션을 통해 메모리 토큰이나 KV 항목에 접근하게 하여 텍스트 재인코딩을 줄이지만 투명성은 낮아진다.
3.4. Procedural Reuse via Skills
스킬은 절차적 메모리로 다룬다. 단순히 무슨 일이 있었는지가 아니라 반복되는 상황에서 어떻게 행동할지를 인코딩한다. 효율성 이점은 반복적인 재사용에서 나오므로, 이후 계획과 도구 상호작용에서 절감하는 비용이 구성, 검색, 검증, 갱신, 가지치기 비용을 정당화해야 한다.
- Trace2Skill은 개별 실행 궤적에서 교훈을 추출하고, Skill-Pro는 비파라미터 정책 최적화를 사용하며, SkillRL은 스킬 라이브러리와 정책을 함께 재귀적으로 개선한다.
- AutoSkill은 사용자 상호작용에서 학습하고, SKILLFOUNDRY는 다양한 과학 자료에서 절차를 만든다.
- SkillLens는 관련 스킬 조각을 선택적으로 재사용하고, Graph-of-Skills는 문맥 제약 안에서 의존성을 고려한 스킬 묶음을 검색한다.
- CoEvoSkills, SkillClaw, SkillOS는 검증과 저장소의 지속적 개선을 다룬다. MemSkill은 절차 재사용을 추출, 통합, 가지치기와 같은 메모리 연산으로 확장한다.
- 검증되지 않았거나 신뢰성이 낮은 스킬 라이브러리는 문맥 비용과 오류 복구 작업을 늘릴 수 있다. 따라서 서베이는 성공한 단일 에피소드가 아니라 반복 과제를 기준으로 절차 재사용을 평가한다.
3.5. Multi-Agent Memory
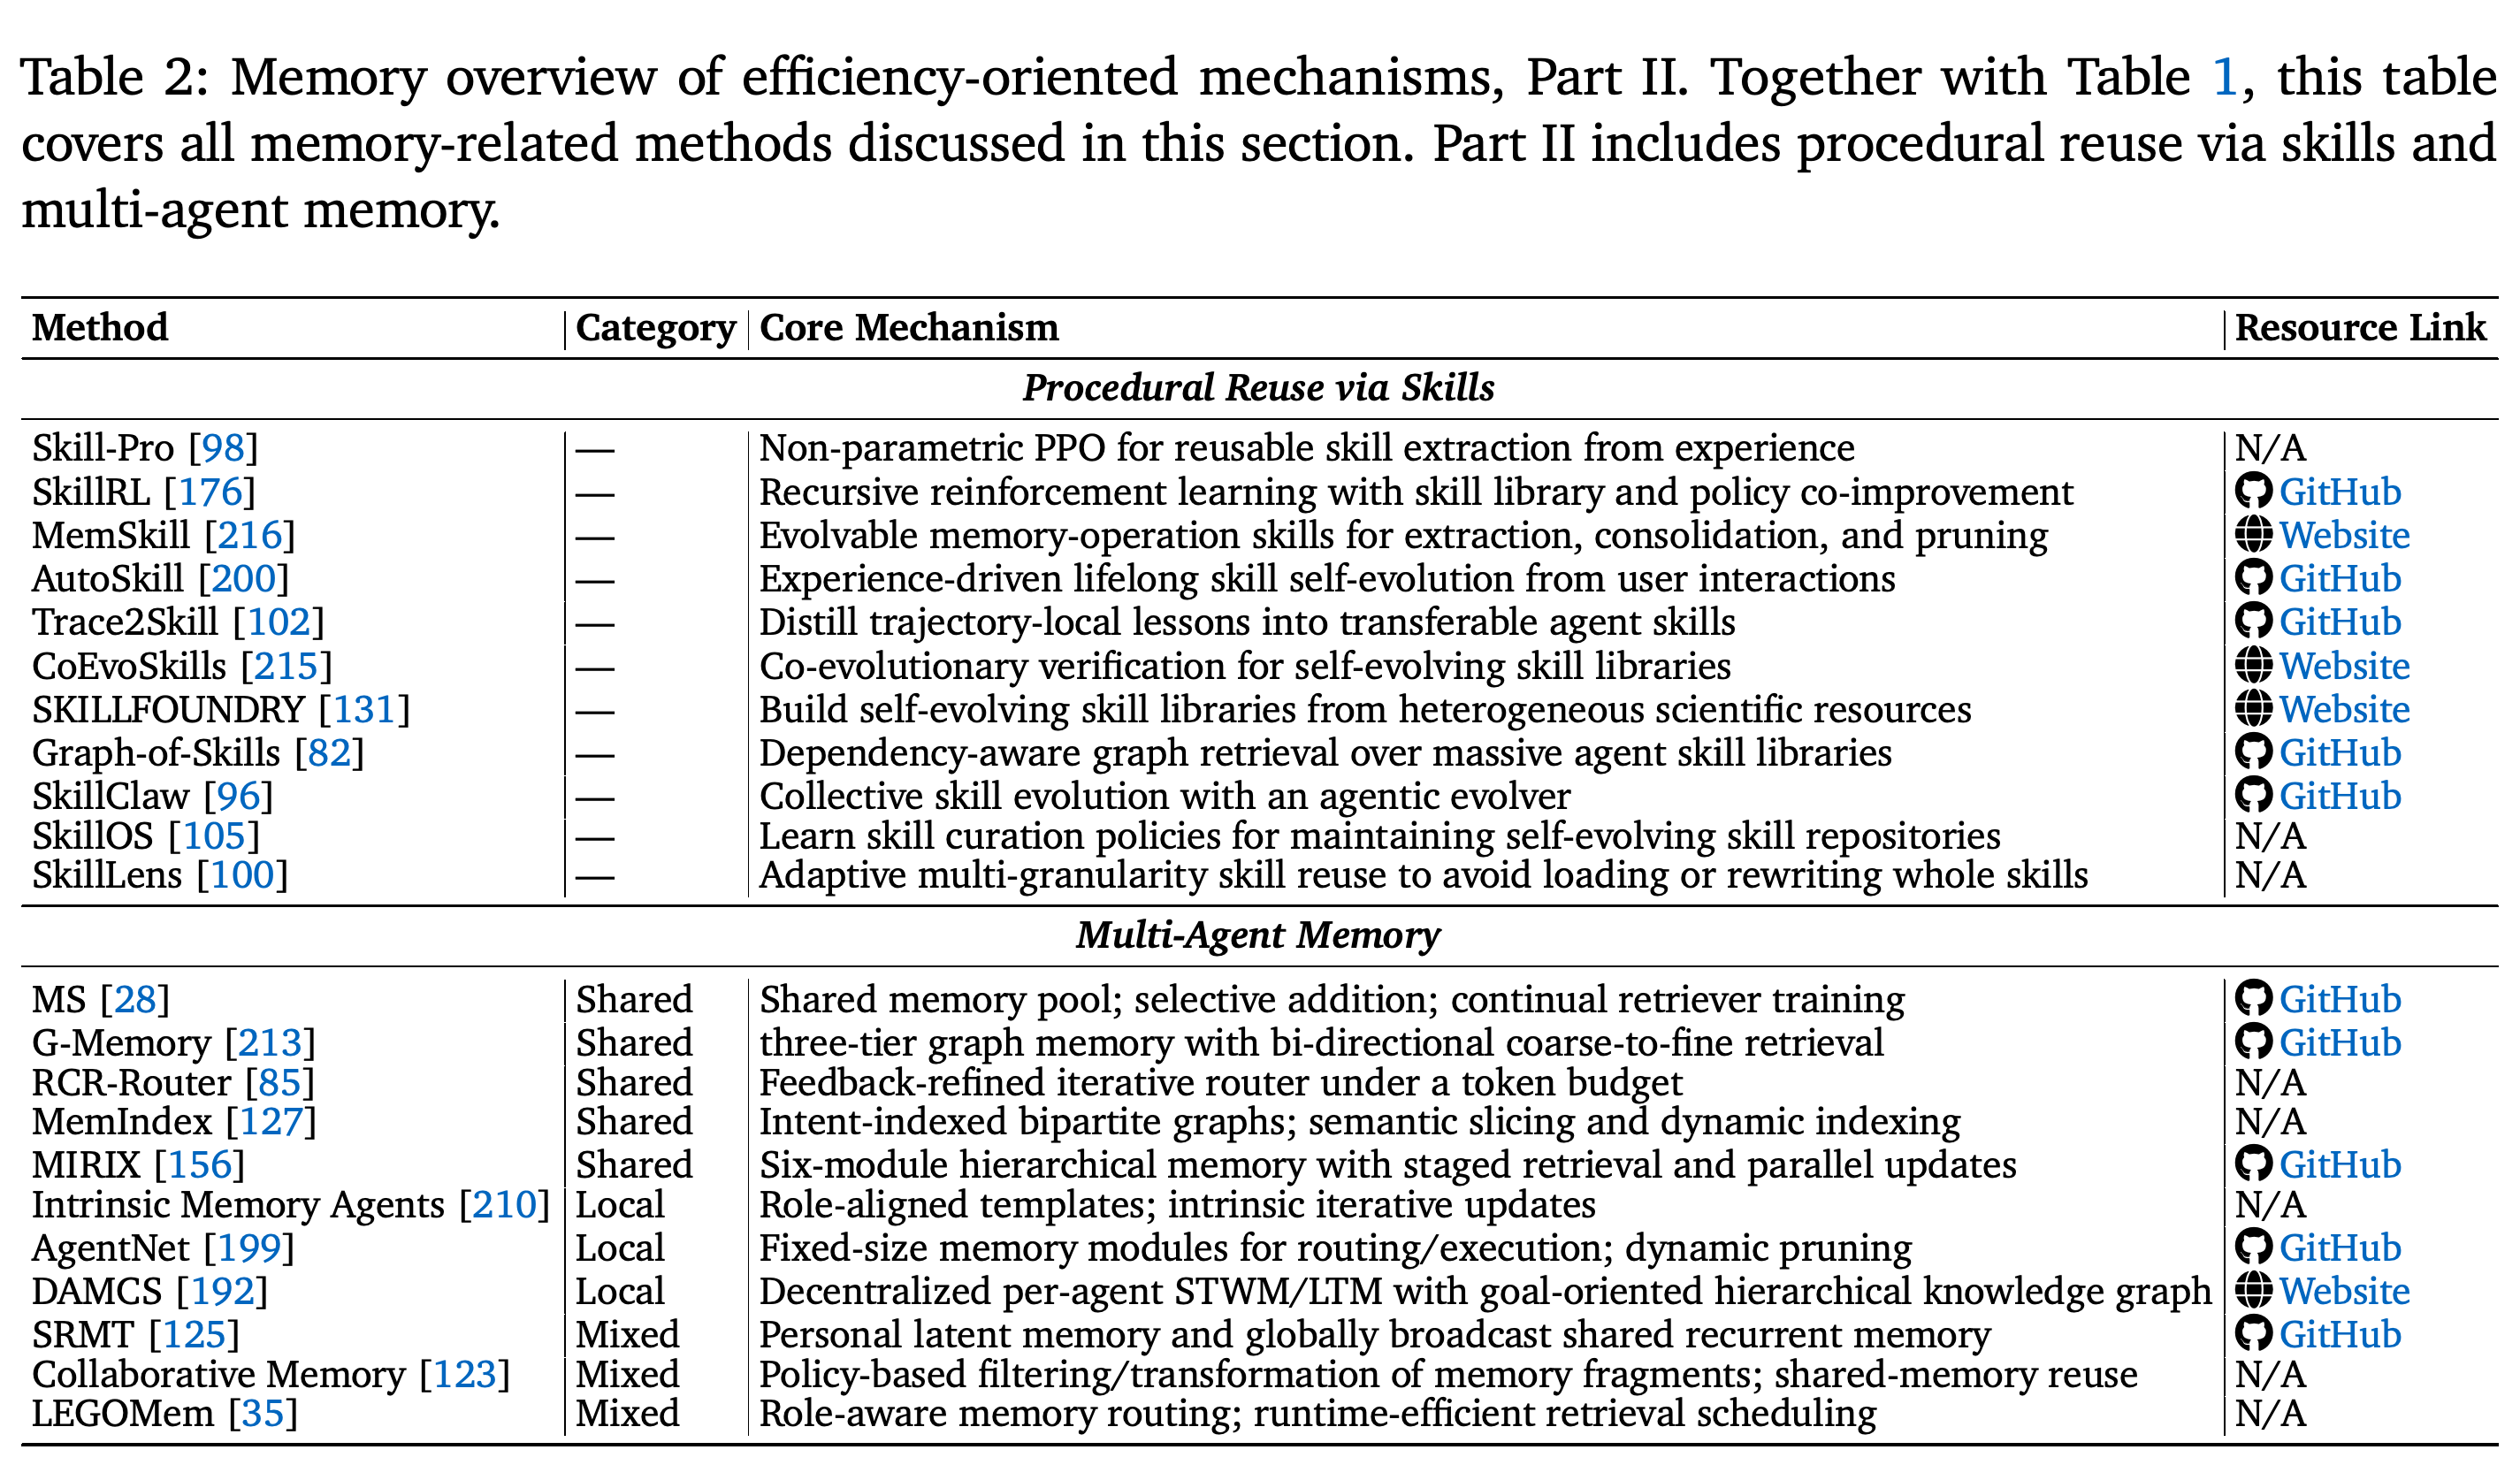
다중 에이전트 메모리에서는 설계 질문이 개별 에이전트가 무엇을 기억하는지에서 정보가 어디에 있고, 누가 접근할 수 있으며, 갱신을 어떻게 동기화하는지로 바뀐다. Table 2는 절차 재사용 방법과 함께 공유, 로컬, 혼합 저장소를 구분한다.
- 공유 메모리는 중복 탐색과 이력 재처리를 줄인다. G-Memory는 3계층 그래프 구조를 사용하고, RCR-Router는 토큰 예산에 맞춰 문맥을 배분하며, MemIndex는 의도별로 인덱싱한 이분 그래프를 사용한다.
- 잠재 표현 공유는 토큰 수준의 통신을 줄인다. LatentMAS는 잠재 작업 메모리를 공유하고, KVComm은 프리픽스 간 KV 캐시를 재사용하며, Cache-to-Cache는 학습된 융합 모듈을 통해 소스 캐시를 전달한다.
- 로컬 메모리는 역할별 문맥을 보존하고 전역 잡음을 줄인다. Intrinsic Memory Agents는 역할에 맞춘 템플릿을 사용하고, AgentNet은 고정 크기 저장소를 가지치기하며, DAMCS는 목표 지향 지식 그래프로 로컬 경험을 조직한다.
- 혼합 설계는 전문화와 재사용 사이의 균형을 맞춘다. Collaborative Memory는 출처 정보와 공유 정책을 적용하고, LEGOMem은 오케스트레이터 수준의 과제 메모리와 과제 에이전트의 하위 과제 메모리를 분리한다.
- 중앙화는 오래된 상태, 동시 쓰기 충돌, 동기화 비용을 유발할 수 있다. 로컬 격리는 작업 중복을 일으킬 수 있다. 혼합 저장소는 라우팅과 접근 제어를 더 복잡하게 만든다.
상단은 스킬 추출, 선택적 재사용, 검증, 정리를 다룬다. 하단은 공유, 로컬, 혼합 다중 에이전트 메모리를 구분한다. 팀 수준의 메모리 설계에는 압축된 표현뿐 아니라 정보 배치와 라우팅도 포함됨을 보여준다.
3.6. Discussion
메모리 논의에서는 각 연산이 미래 결정에 주는 가치가 생애주기 비용을 정당화하는지 묻는다. 압축, 유지 관리, 검색을 따로 최적화하면 비용을 줄이는 대신 다른 곳으로 옮길 수 있다.
- 인용된 LightMem 실험에서는 과도한 압축이 정확도를 낮추고, 완만한 압축은 더 많은 정보를 보존하는 대신 비용을 높인다. 압축은 요약을 단순히 짧게 만드는 데 그치지 않고 결정에 필요한 사실, 제약, 실패, 절차를 보존해야 한다.
- 온라인 갱신은 즉각적인 적응을 지원하지만 응답 지연 시간을 늘린다. 오프라인 통합은 총연산량이 비슷한 상태에서도 추론 부가 비용을 줄일 수 있지만 적응은 늦어진다.
- 평가에는 회상 정확도뿐 아니라 쓰기 비용, 갱신 빈도, 검색 지연 시간, 삽입 토큰 수, 실패 복구에서 절감한 비용을 포함해야 한다.
- 캐시된 계획, API 제약, 성공한 파라미터 선택, 실패한 분기가 이후 도구 호출과 계획 노력을 줄일 때 메모리는 더 넓은 범위에서 비용을 절감한다.
4. Efficient Tool Use
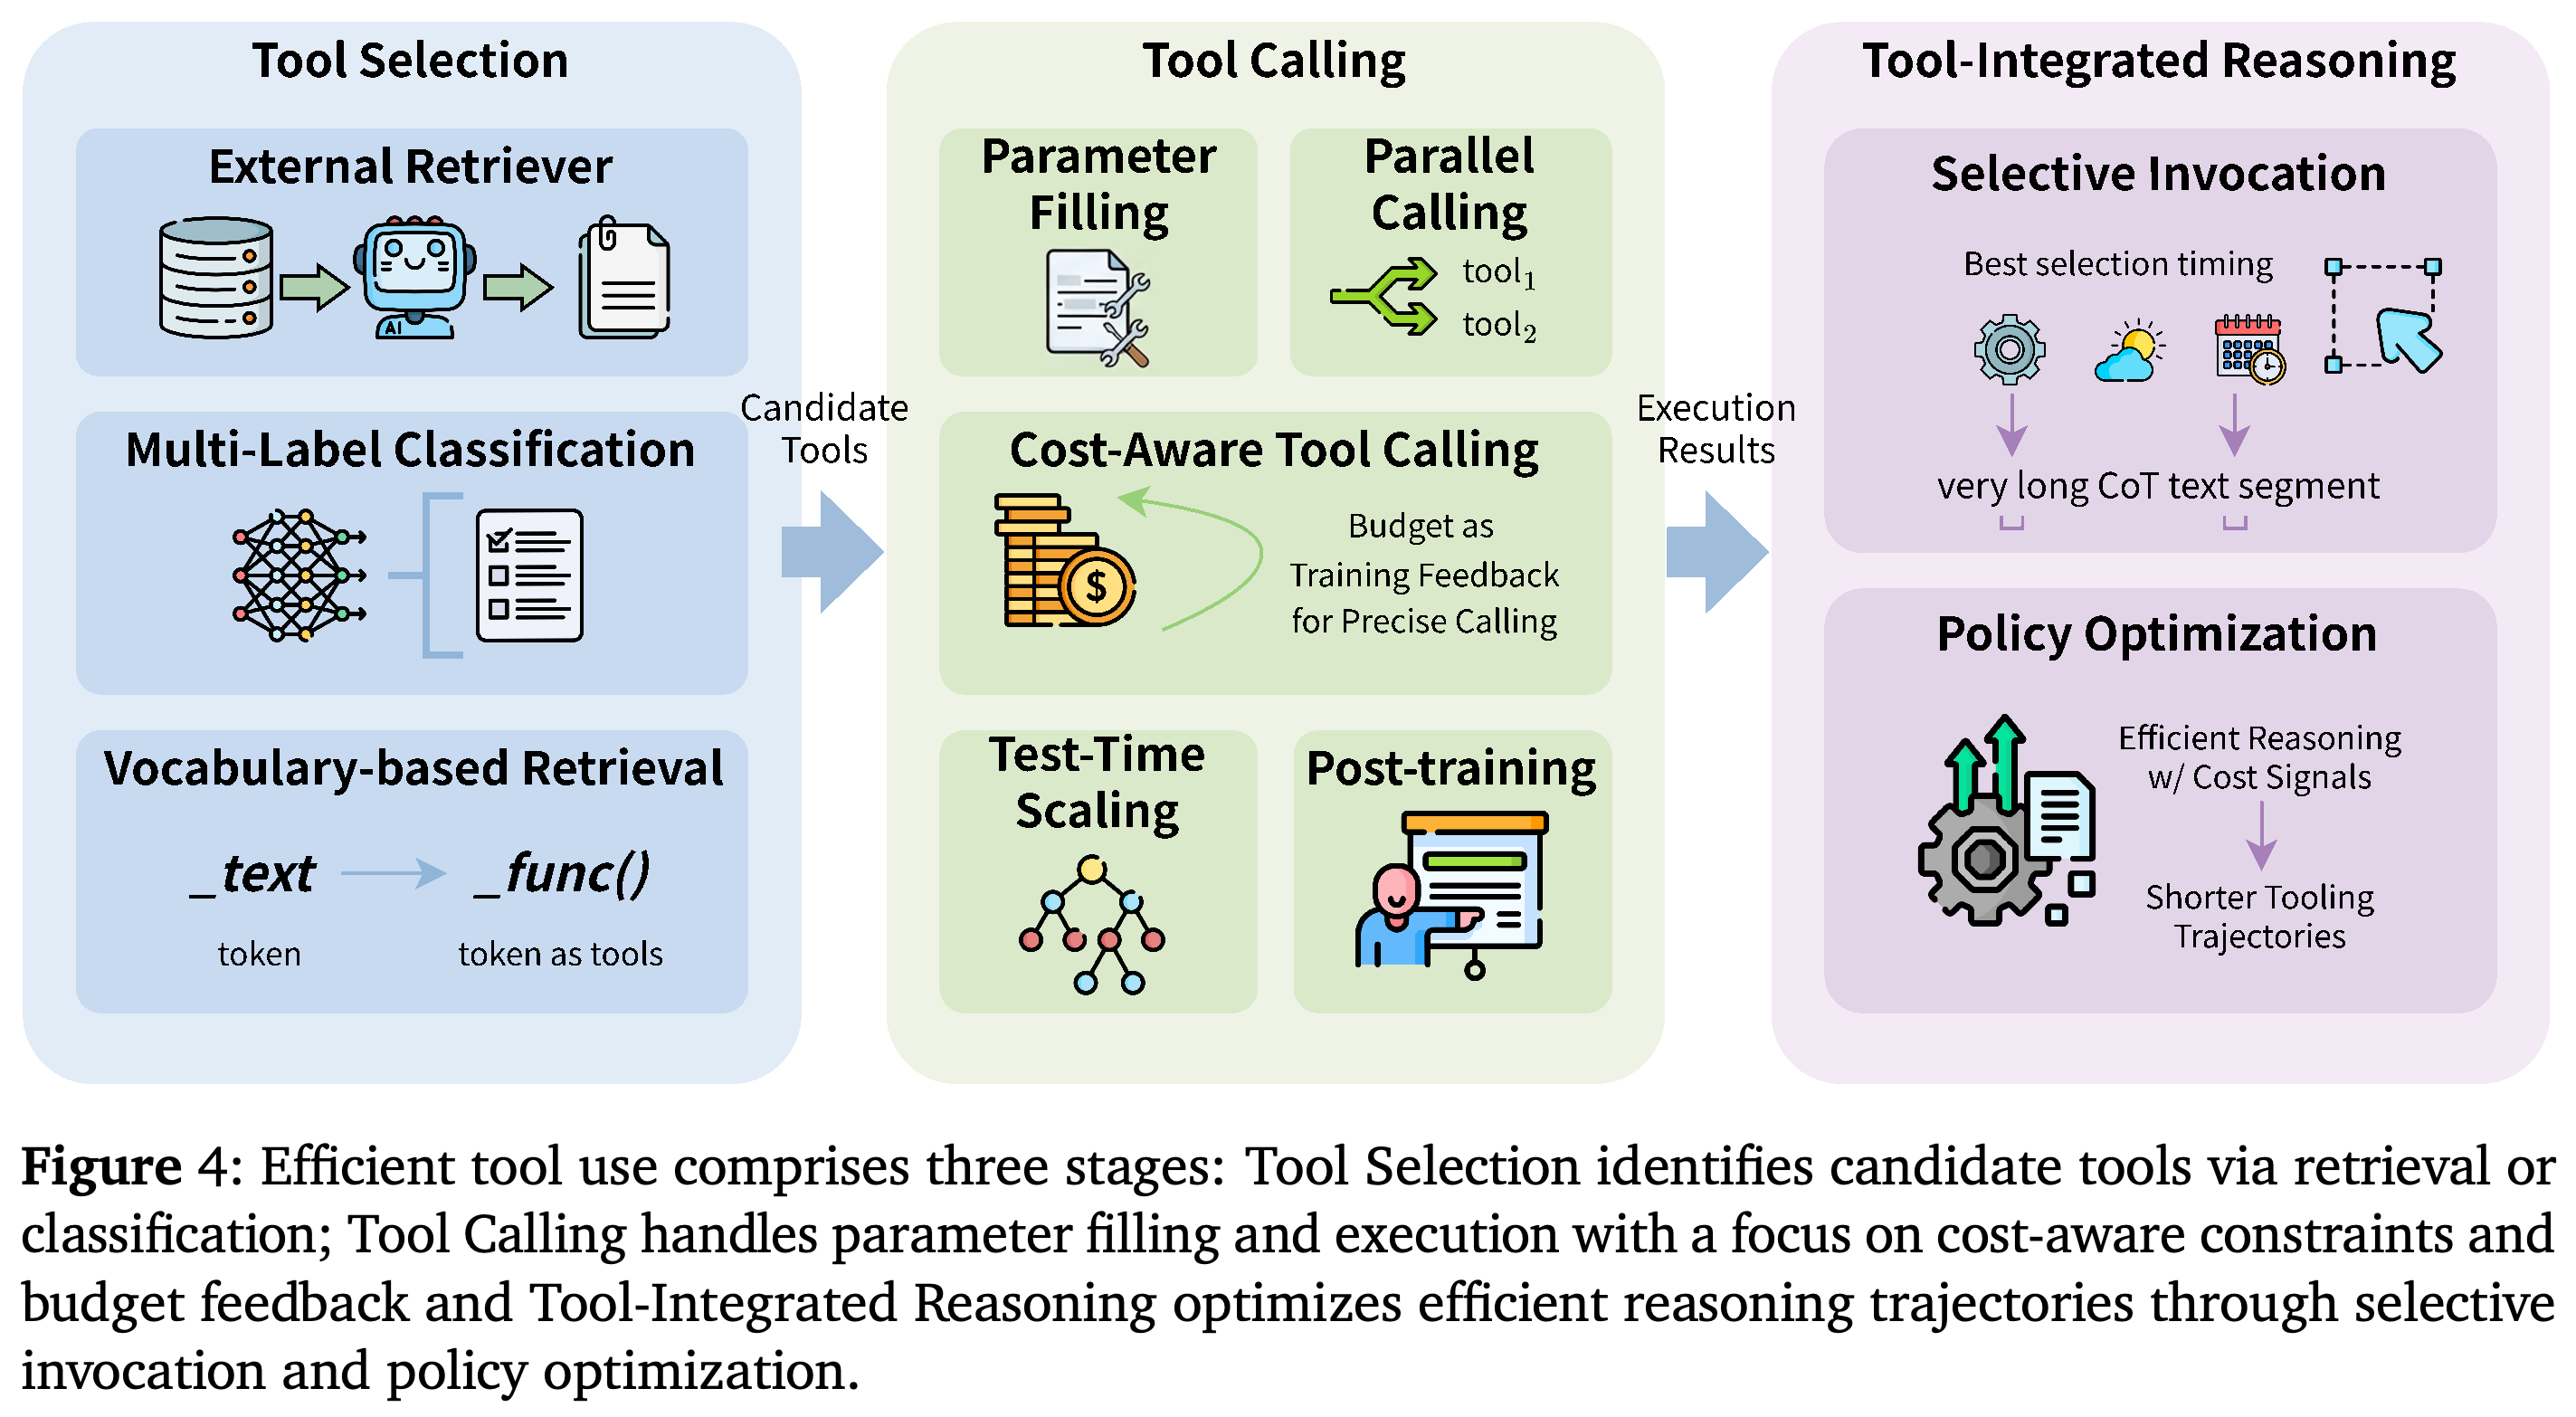
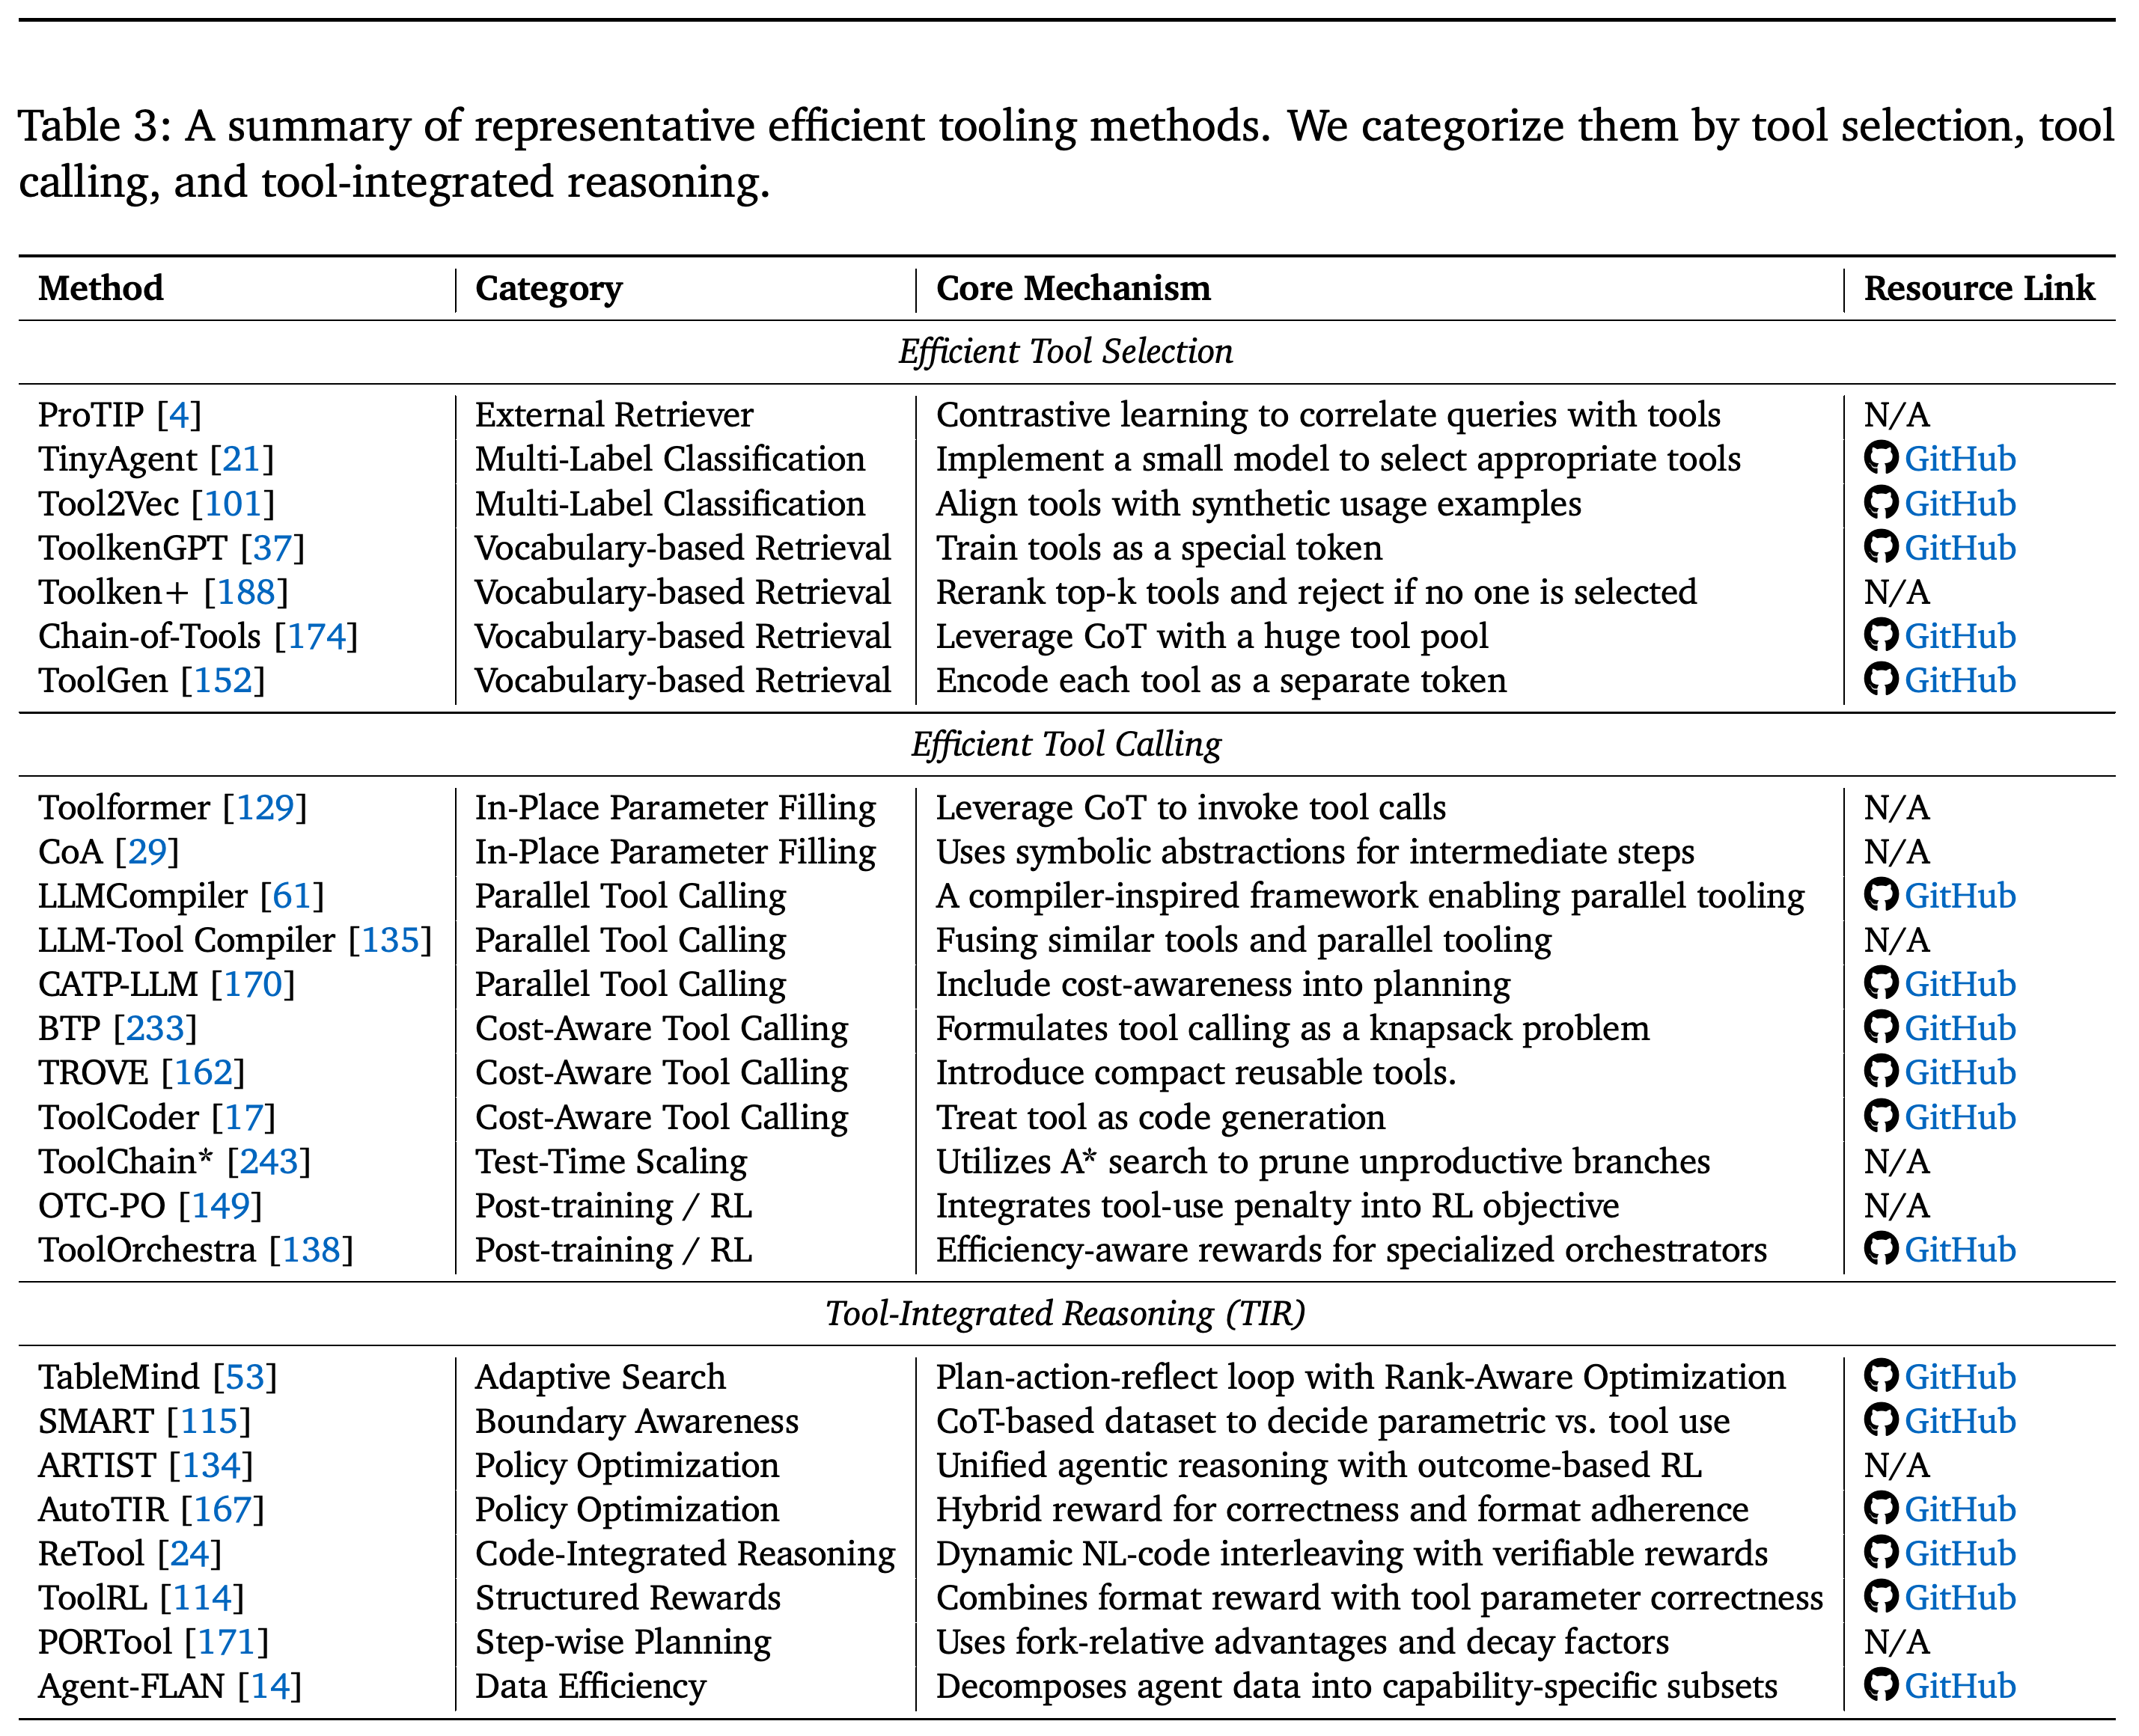
도구 사용은 비용이 큰 내부 추론을 줄일 수 있지만, 반복되는 외부 상호작용이 에이전트 비용의 대부분을 차지할 수도 있다. Figure 4는 최적화를 도구 선택, 도구 호출, 도구 통합 추론으로 나눈다. Table 3은 대표적인 방법을 이 단계별로 정리한다.
- 선택 단계는 후보 행동 공간을 좁히고 문맥에 넣는 도구 문서를 줄인다.
- 호출 단계는 파라미터 생성, 실행 스케줄링, 탐색, 예산을 고려한 오케스트레이션을 다룬다.
- 도구 통합 추론은 외부 근거나 연산이 내부 지식보다 나은 시점을 학습한다.
후보 도구와 실행 결과를 나타내는 화살표는 선택, 호출, 이후 추론을 구분한다. 예산 피드백과 정책 최적화는 효율성을 개선하는 2개 개입 지점을 보여준다. 각각 실행을 제어하는 지점과 필요한 도구만 사용하는 궤적을 학습하는 지점에 해당한다.
4.1. Tool Selection
도구 선택은 프롬프트에 수천 개의 도구 설명을 넣는 일을 피한다. 서베이는 방법을 외부 검색, 다중 레이블 분류, 어휘 기반 검색으로 나눈다. 각 방법은 낮은 지연 시간으로 접근하는 능력과 변화하는 도구 목록에 적응하는 능력 사이에서 서로 다른 절충을 택한다.
- ProTIP은 대조학습 기반 질의·도구 임베딩을 사용하고, 선택한 도구 표현을 점진적으로 빼서 명시적 분해 비용을 피한다. AnyTool은 계층적으로 검색 범위를 좁힌다. DRAFT와 ToolScope는 도구 문서와 이를 검색에 활용하는 방식을 개선한다.
- TinyAgent는 DeBERTa-v3 small을 사용하며 확률이 50%보다 높은 도구를 선택한다. 서베이에 따르면 선택한 설명만 삽입하면 프롬프트 크기를 거의 절반으로 줄일 수 있다.
- Tool2Vec은 2단계 검색과 재순위화로 고정된 도구 목록을 분류하는 방식의 한계를 다룬다. 합성 사용 예제로 임베딩을 만들어 질의와 설명 사이의 의미적 간극을 줄인다.
- ToolkenGPT는 다른 파라미터를 동결한 채 추가된 도구 임베딩을 학습한다. Toolken+는 재순위화와 거부 기능을 추가하고, ToolGen은 각 도구를 고유 토큰으로 표현한다.
- 외부 검색은 동적 도구 목록을 지원하지만 검색 비용을 추가한다. 분류와 어휘 기반 방법은 안정적인 목록에서 낮은 지연 시간으로 선택할 수 있지만, 학습 요구 사항, 호출 시점, 미관측 도구에 대한 일반화는 여전히 한계로 남는다.
4.2. Tool Calling
도구 호출은 실행 궤적 수준에서 평가한다. 계획이나 검증이 실패한 호출과 재시도를 막을 수 있기 때문이다. 이 절은 생성 중 파라미터 채우기, 병렬 실행, 비용을 고려한 정책, 효율적인 테스트 시점 탐색, 사후 학습을 다룬다.
- Toolformer는 생성 과정에 호출을 삽입하고, CoA는 중간 결과에 기호적 플레이스홀더를 사용한다. 서베이에 따르면 CoA는 Toolformer보다 성능을 높이면서 추론 시간을 30% 넘게 줄인다. 이는 인용된 연구의 결과다.
- LLMCompiler는 독립적인 호출을 병렬로 스케줄링한다. LLM-Tool Compiler는 유사한 연산도 병합한다. W&D는 추론 단계 안에서 병렬 정보 수집을 늘린다.
- BTP는 엄격한 예산 아래 도구를 배분하는 문제를 배낭 문제로 정식화하고 동적 계획법으로 푼다. 신뢰도 기반 게이팅과 재사용 가능한 함수 라이브러리도 중복 호출을 줄이는 방법이다.
- ToolChain*는 A* search로 비생산적인 분기를 가지치기한다. ToolTree는 피드백과 가지치기를 결합한 MCTS에서 착안한 탐색을 사용한다. 오케스트레이션 방법은 검색, 검증, 종료 시점도 결정하지만 자체 제어 비용이 발생한다.
- OTC-PO는 강화학습에서 도구 사용에 페널티를 부여하고, ToolOrchestra는 효율성을 고려하는 오케스트레이터를 학습한다. 학습 효율성 연구는 유효 신호가 적은 프롬프트를 걸러내고 정보가 적은 롤아웃의 샘플 수를 줄인다.
4.3. Tool-Integrated Reasoning
도구 통합 추론은 내부 지식과 필요한 외부 실행 사이의 경계를 학습한다. 지도학습 기반 준비 단계는 유효한 도구 사용 행동을 확립하고, 정책 최적화는 정확성, 형식, 파라미터, 비용 신호를 활용해 다단계 결정을 개선한다.
- TableMind는 plan-action-reflect 루프, SFT 준비 단계, Rank-Aware Policy Optimization을 사용한다. SMART는 각 호출이 필요한지 설명하고, Agent-FLAN은 학습 데이터를 능력별 하위 집합으로 나눈다.
- ARTIST는 결과 기반 RL로 학습하고, ReTool은 자연어와 실행 가능한 코드를 번갈아 사용하며, ToolRL은 형식 유효성, 정확성, 파라미터 일치를 결합한다.
- AutoTIR와 OTC-PO는 불필요한 호출을 억제한다. PORTool은 단계별 중요도와 감쇠 계수 γ를 사용해 최종 결과에 가까운 결정에 더 큰 가중치를 부여하고, 도구 호출 단계가 적은 실행을 선호한다.
- EvoTool은 Planner, Selector, Caller, Synthesizer 모듈에 오류 책임을 배분한다. ELPO는 복구 불가능해지는 최초의 오류를 찾아 국소 학습 신호로 바꾼다.
- 이러한 방법은 비용을 데이터 합성, 샌드박스 실행, 롤아웃, 기여도 할당으로 옮긴다. 잘못 설계된 목적 함수는 도구의 과다 사용이나 과소 사용, 형식 과적합, 짧지만 신뢰성이 낮은 실행 궤적을 유발할 수 있다.
목록은 검색과 도구 토큰 방법을 병렬 실행, 예산 배분, 탐색, RL 기반 추론과 구분한다. 각 행은 서로 대체 가능한 해결책이나 효율성 순위가 아니라 서로 다른 개입 지점을 설명한다.
4.4. Discussion
효율적인 도구 사용은 호출 수를 무조건 줄이는 것이 아니라 예상 이익이 비용을 정당화하는 외부 행동을 선택하는 데 있다. 이 논의는 도구의 유용성, 호출 판단의 보정, 의존성을 고려한 병렬 실행, 메모리와 계획을 통한 재사용을 연결한다.
- 자주 쓰이고 안정적인 도구에는 특화된 저지연 선택기를 사용할 수 있다. 드물게 쓰이거나 변화하는 도구에는 검색으로 접근할 수 있다.
- 과도한 호출은 자원을 낭비하고, 부족한 호출은 환각이나 유효하지 않은 행동의 위험을 높인다. 따라서 과제 품질을 총비용과 함께 비교해야 한다.
- 의존성이 허용하면 병렬 실행은 대기 시간을 줄인다. 잘못된 의존성 분석은 일관되지 않은 결과와 이를 조정하는 작업을 만들 수 있다.
- 캐시된 API 제약과 성공한 템플릿은 이후 선택과 파라미터 채우기 비용을 줄인다. 계획은 직접 추론, 도구 사용, 과제 분해 중 무엇이 적절한지 결정한다.
5. Efficient Planning
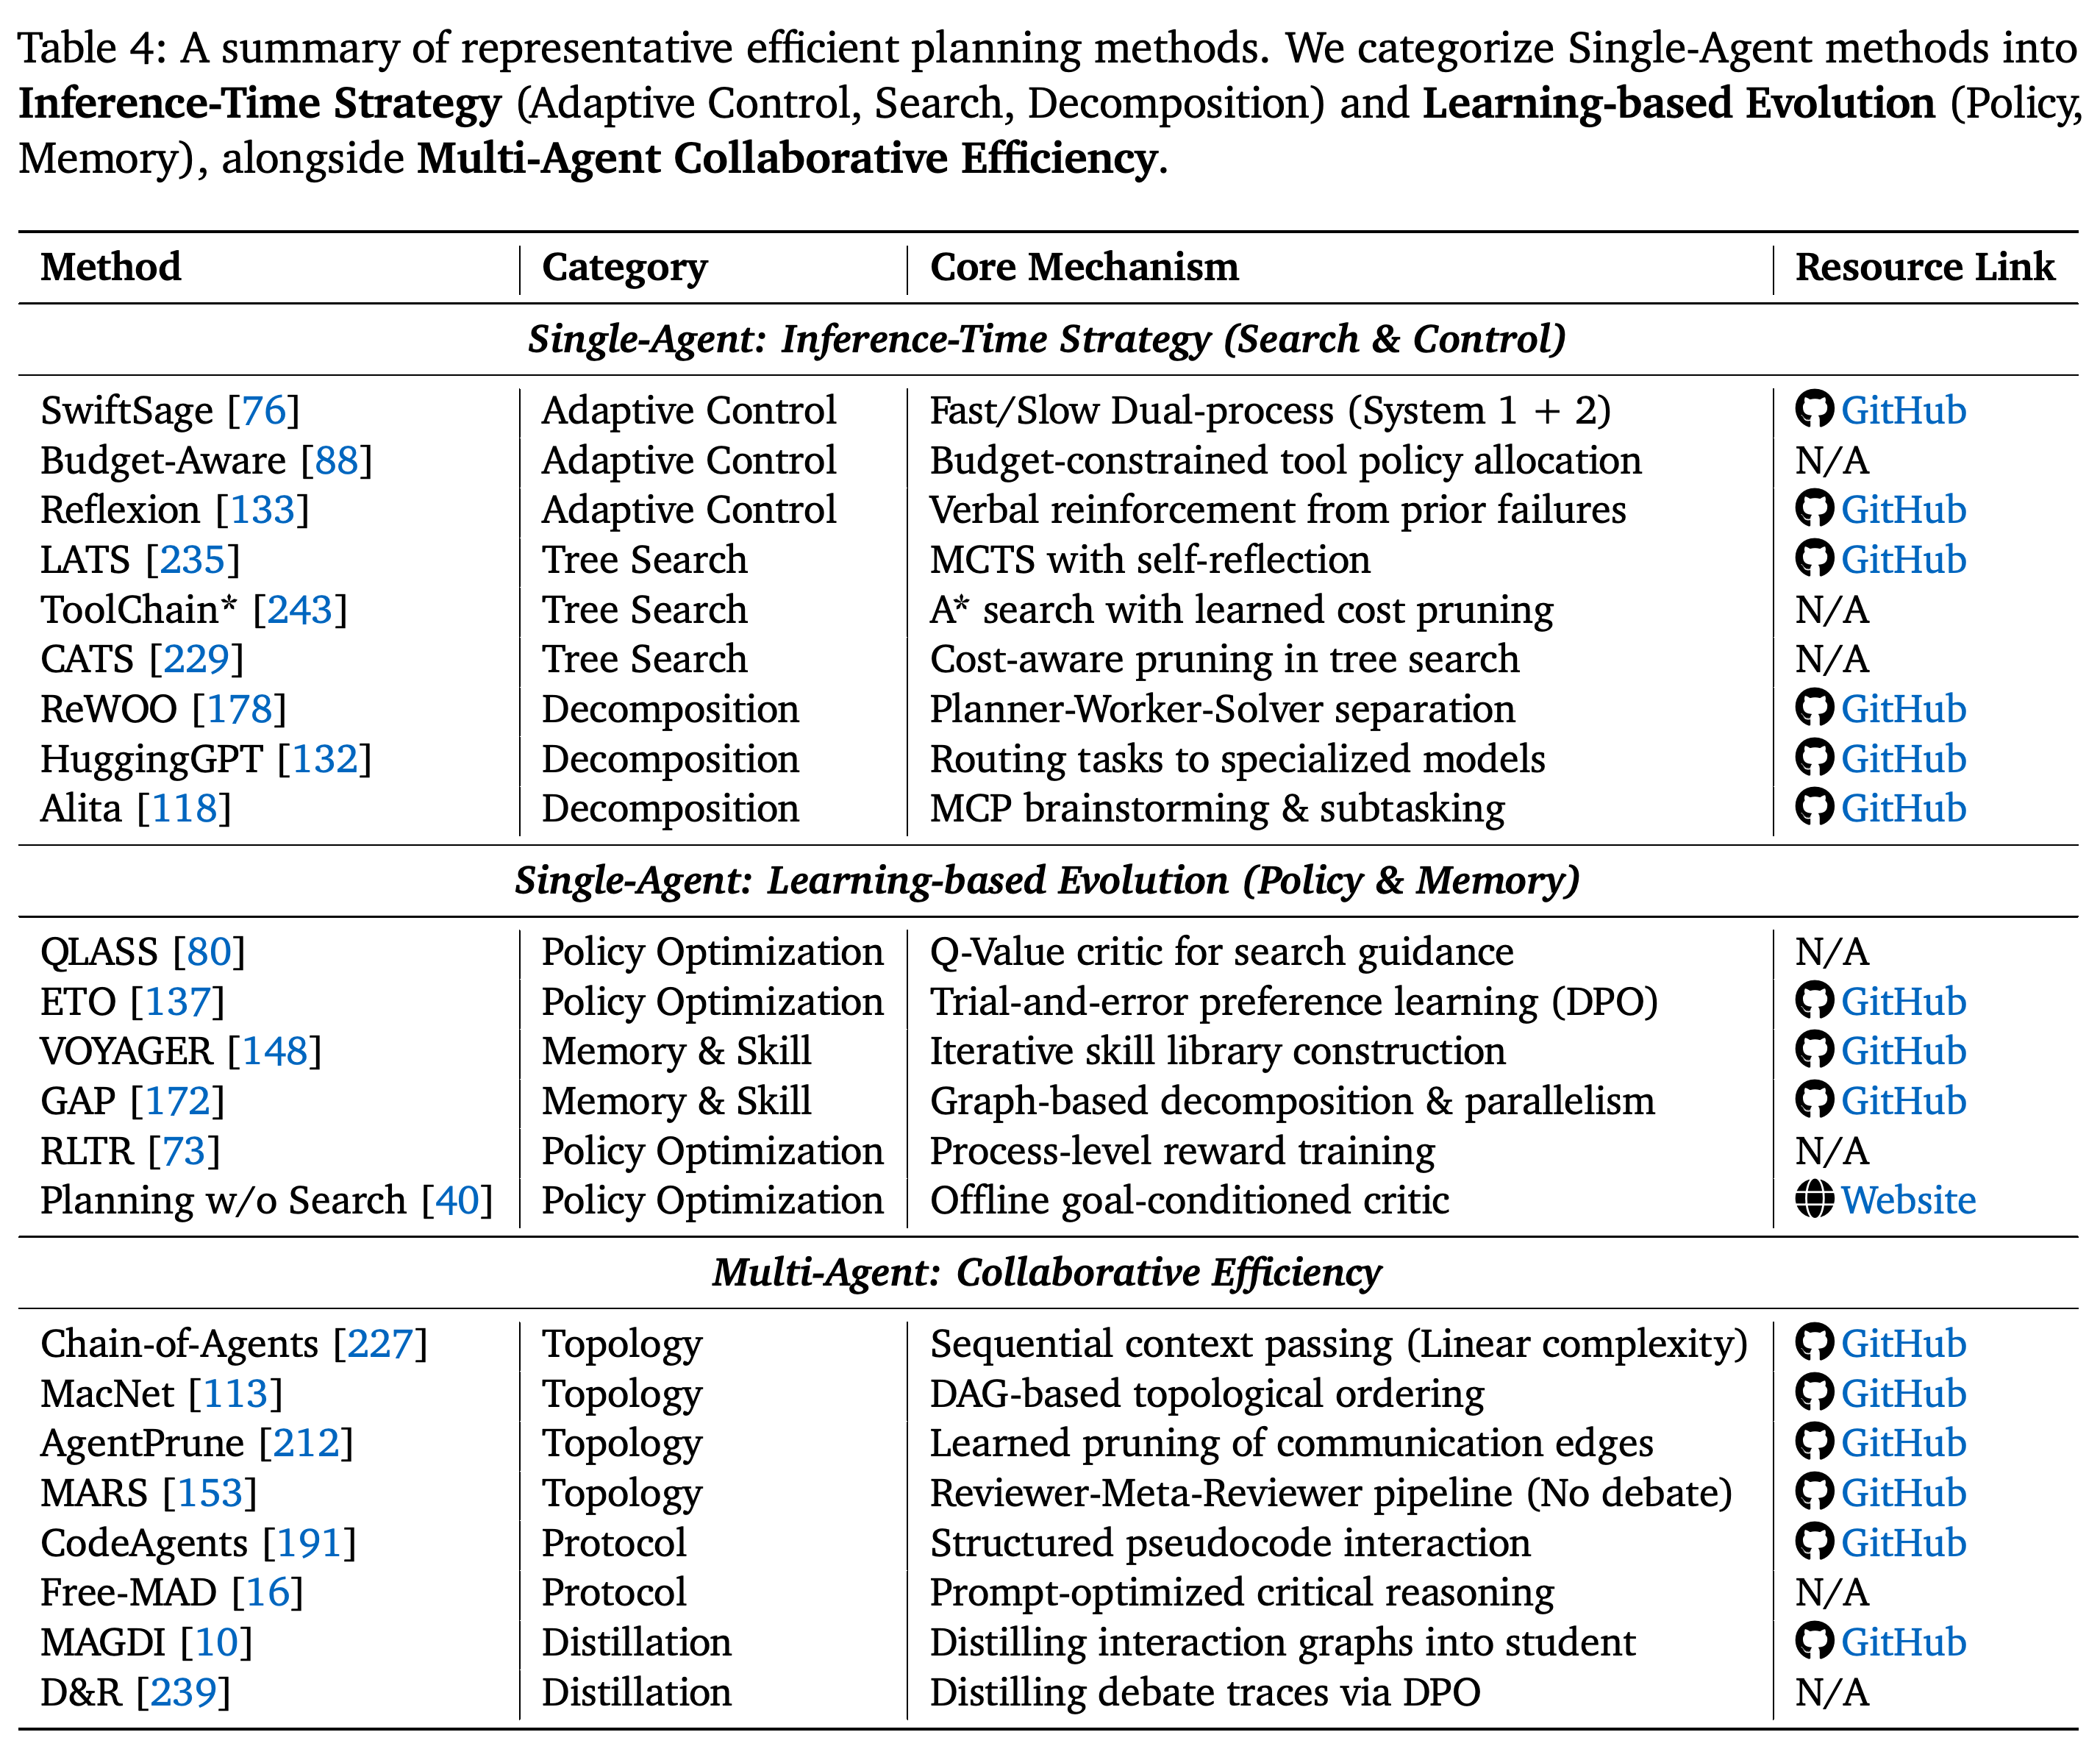
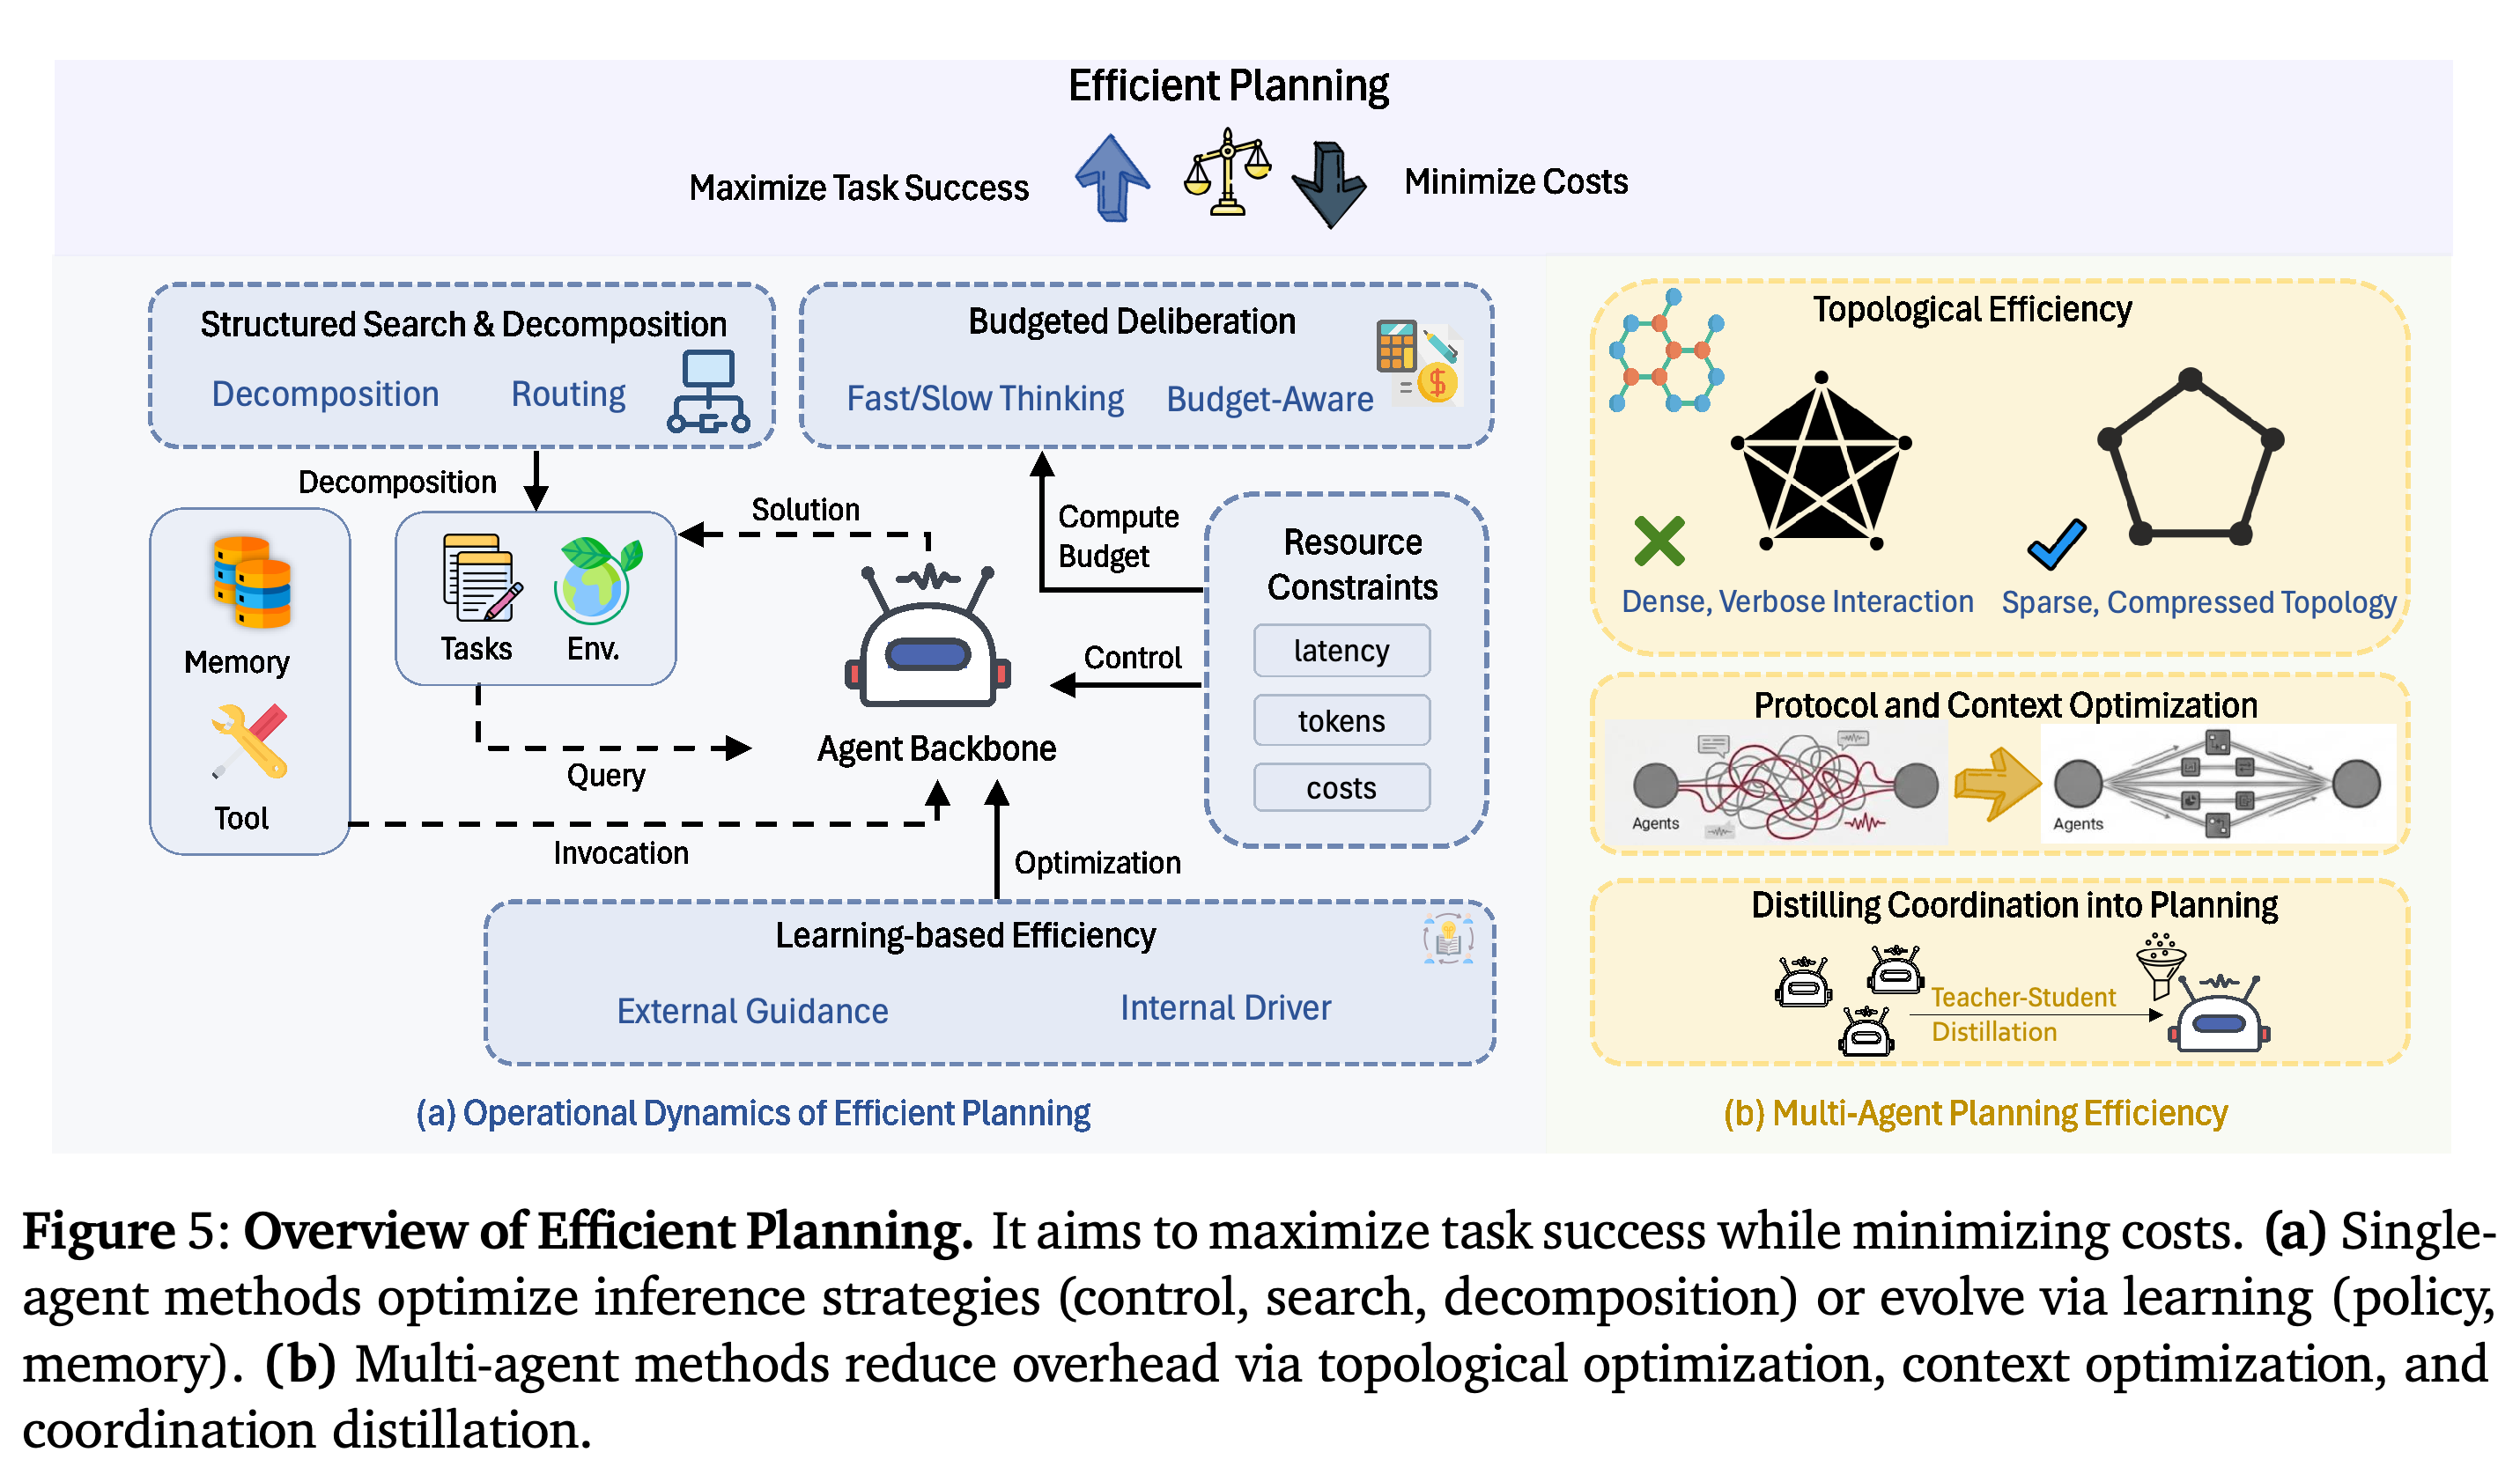
계획은 온라인 연산 배분으로 설명한다. 에이전트는 행동하기 전에 추론, 탐색, 검증, 조정에 얼마나 자원을 쓸지 결정한다. Table 4는 추론 시점 및 학습 기반 단일 에이전트 방법과 다중 에이전트 조정 방법을 정리한다. Figure 5는 이러한 선택을 자원 제약과 연결한다.
- 단일 에이전트 효율성은 실행 궤적 안에서 숙고를 제어하고 재사용 가능한 계획 능력을 발전시킨다.
- 다중 에이전트 효율성은 참여, 통신, 병렬 탐색도 제어한다.
- 긴 숙고가 비용이 큰 실패를 막는다면 효율적일 수 있다. 짧은 계획도 반복적인 복구가 필요하다면 비효율적일 수 있다.
3개 블록은 추론 시점 계획, 학습 기반 정책 또는 메모리 개선, 다중 에이전트 조정을 구분한다. 이 구성은 현재 과제에 연산을 쓰는 방법과 재사용 가능한 계획 능력을 발전시키는 방법을 분리한다.
5.1. Single-Agent Planning Efficiency
단일 에이전트 방법은 추론 시점 제어와 학습 기반 개선을 결합한다. Figure 5는 적응적 예산 배분, 구조화된 탐색, 과제 분해, 정책 또는 메모리 개선을 숙고 자원을 배분하는 상호 보완적 방법으로 제시한다.
- Adaptive Budgeting and Control: SwiftSage는 빠른 행동과 느린 계획을 분리한다. Ares는 단계마다 필요한 최소 수준의 추론 노력을 선택하고, Think Fast and Slow는 모든 단계에 비싼 추론을 적용하는 대신 인지적 깊이를 조정한다.
- Structured Search: LATS는 자기 성찰을 결합한 MCTS를 사용하고, CATS는 비용을 고려한 가지치기를 적용하며, ToolChain*는 A* search를 사용한다. 이러한 방법은 탐색을 유도하지만 분기와 평가 비용을 추가한다.
- Task Decomposition: ReWOO는 계획과 실행을 분리하고, Task-Decoupled Planning은 재계획 범위를 DAG로 구성된 하위 목표로 한정한다. 하위 과제를 전문 모델로 라우팅하면 불필요한 범용 연산을 줄일 수 있다.
- Policy Optimization: QLASS는 Q-value로 탐색을 유도하고, ETO는 시행착오 경험에 DPO를 적용하며, RLTR와 Planner-R1은 과정 수준의 보상을 제공한다. WebAnchor는 촘촘한 평가 기준 기반 보상으로 초기 계획 품질을 강조한다.
- Memory and Skill Acquisition: VOYAGER는 학습한 스킬을 재사용하고, GAP는 병렬화 가능한 행동을 식별한다. 재사용은 반복 과제의 계획 비용을 줄일 수 있지만 신뢰성 있는 저장, 검색, 유지 관리가 필요하다.
단일 에이전트 패널은 자원 제약을 예산 배분, 과제 분해, 메모리, 도구, 학습과 연결한다. 다중 에이전트 패널은 희소 토폴로지, 프로토콜/문맥 최적화, 교사·학생 증류를 조정 비용을 제어하는 별도의 방법으로 나타낸다.
5.2. Multi-Agent Collaborative Efficiency
다중 에이전트 계획에는 누가 참여하고, 무엇을 전달하며, 언제 상호작용을 끝낼지 결정하는 조정 비용이 추가된다. 서베이는 토폴로지 최적화, 프로토콜/문맥 최적화, 협업을 더 저렴한 실행으로 증류하는 방식을 구분한다.
- 토폴로지 최적화는 구조화되거나 희소한 상호작용을 통해 밀집 통신의 메시지 복잡도를 (O(N^2))에서 (O(N))에 가까워지도록 줄이려 한다. Chain-of-Agents는 순차적 문맥 전달을 사용하고, MacNet은 DAG를 활용하며, AgentPrune은 유용성이 낮은 통신 간선을 제거한다.
- MARS와 S²-MAD는 불필요한 토론을 제한한다. AgentDropout과 SafeSieve는 참여나 통신을 동적으로 줄인다. InfoSeeker는 계층적 문맥 격리와 병렬 근거 수집을 결합한다.
- 프로토콜 최적화는 주고받는 내용을 압축한다. CodeAgents는 의사코드를 사용하고, Smurfs는 실패한 분기를 버리며, 감독 메커니즘은 중복 루프를 종료한다.
- MAGDI와 SMAGDi는 상호작용 구조를 학생 모델로 증류한다. D&R은 교사·학생 토론으로 DPO용 선호도 트리를 생성한다.
- 과도한 가지치기는 유용한 이견이나 관련 문맥을 제거할 수 있다. 증류는 실행 시점의 조정을 줄이지만 준비와 학습 비용이 든다.
5.3. Discussion
계획 효율성은 행동과 그에 앞서는 연산을 관리하는 메타 제어로 해석한다. 이 논의는 깊이, 너비, 반복 사용을 통한 비용 상각을 서로 영향을 주는 축으로 보고, 종단 간 비용으로 평가해야 한다고 설명한다.
- 깊이는 개별 에이전트 안의 탐색, 성찰, 과제 분해를 제어한다. 너비는 에이전트, 분기, 후보 계획을 제어한다. 비용 상각은 유용한 추론을 정책, 스킬, 메모리에 저장해 이후 과제에서 재사용하는 방식이다.
- 핵심 미해결 문제는 종료 시점을 결정하는 데 있다. 고정된 단계 수나 토론 횟수는 숙고를 계속할 때 얻는 한계 가치를 직접 추정하지 않는다.
- 메모리와 도구는 계획에 필요한 작업을 줄일 수 있고, 계획은 메모리와 도구의 호출을 제어한다. 외부 호출, 재시도, 조정이 늘어난다면 추론 토큰 감소만으로 총비용 감소를 입증할 수 없다.
6. Benchmarks
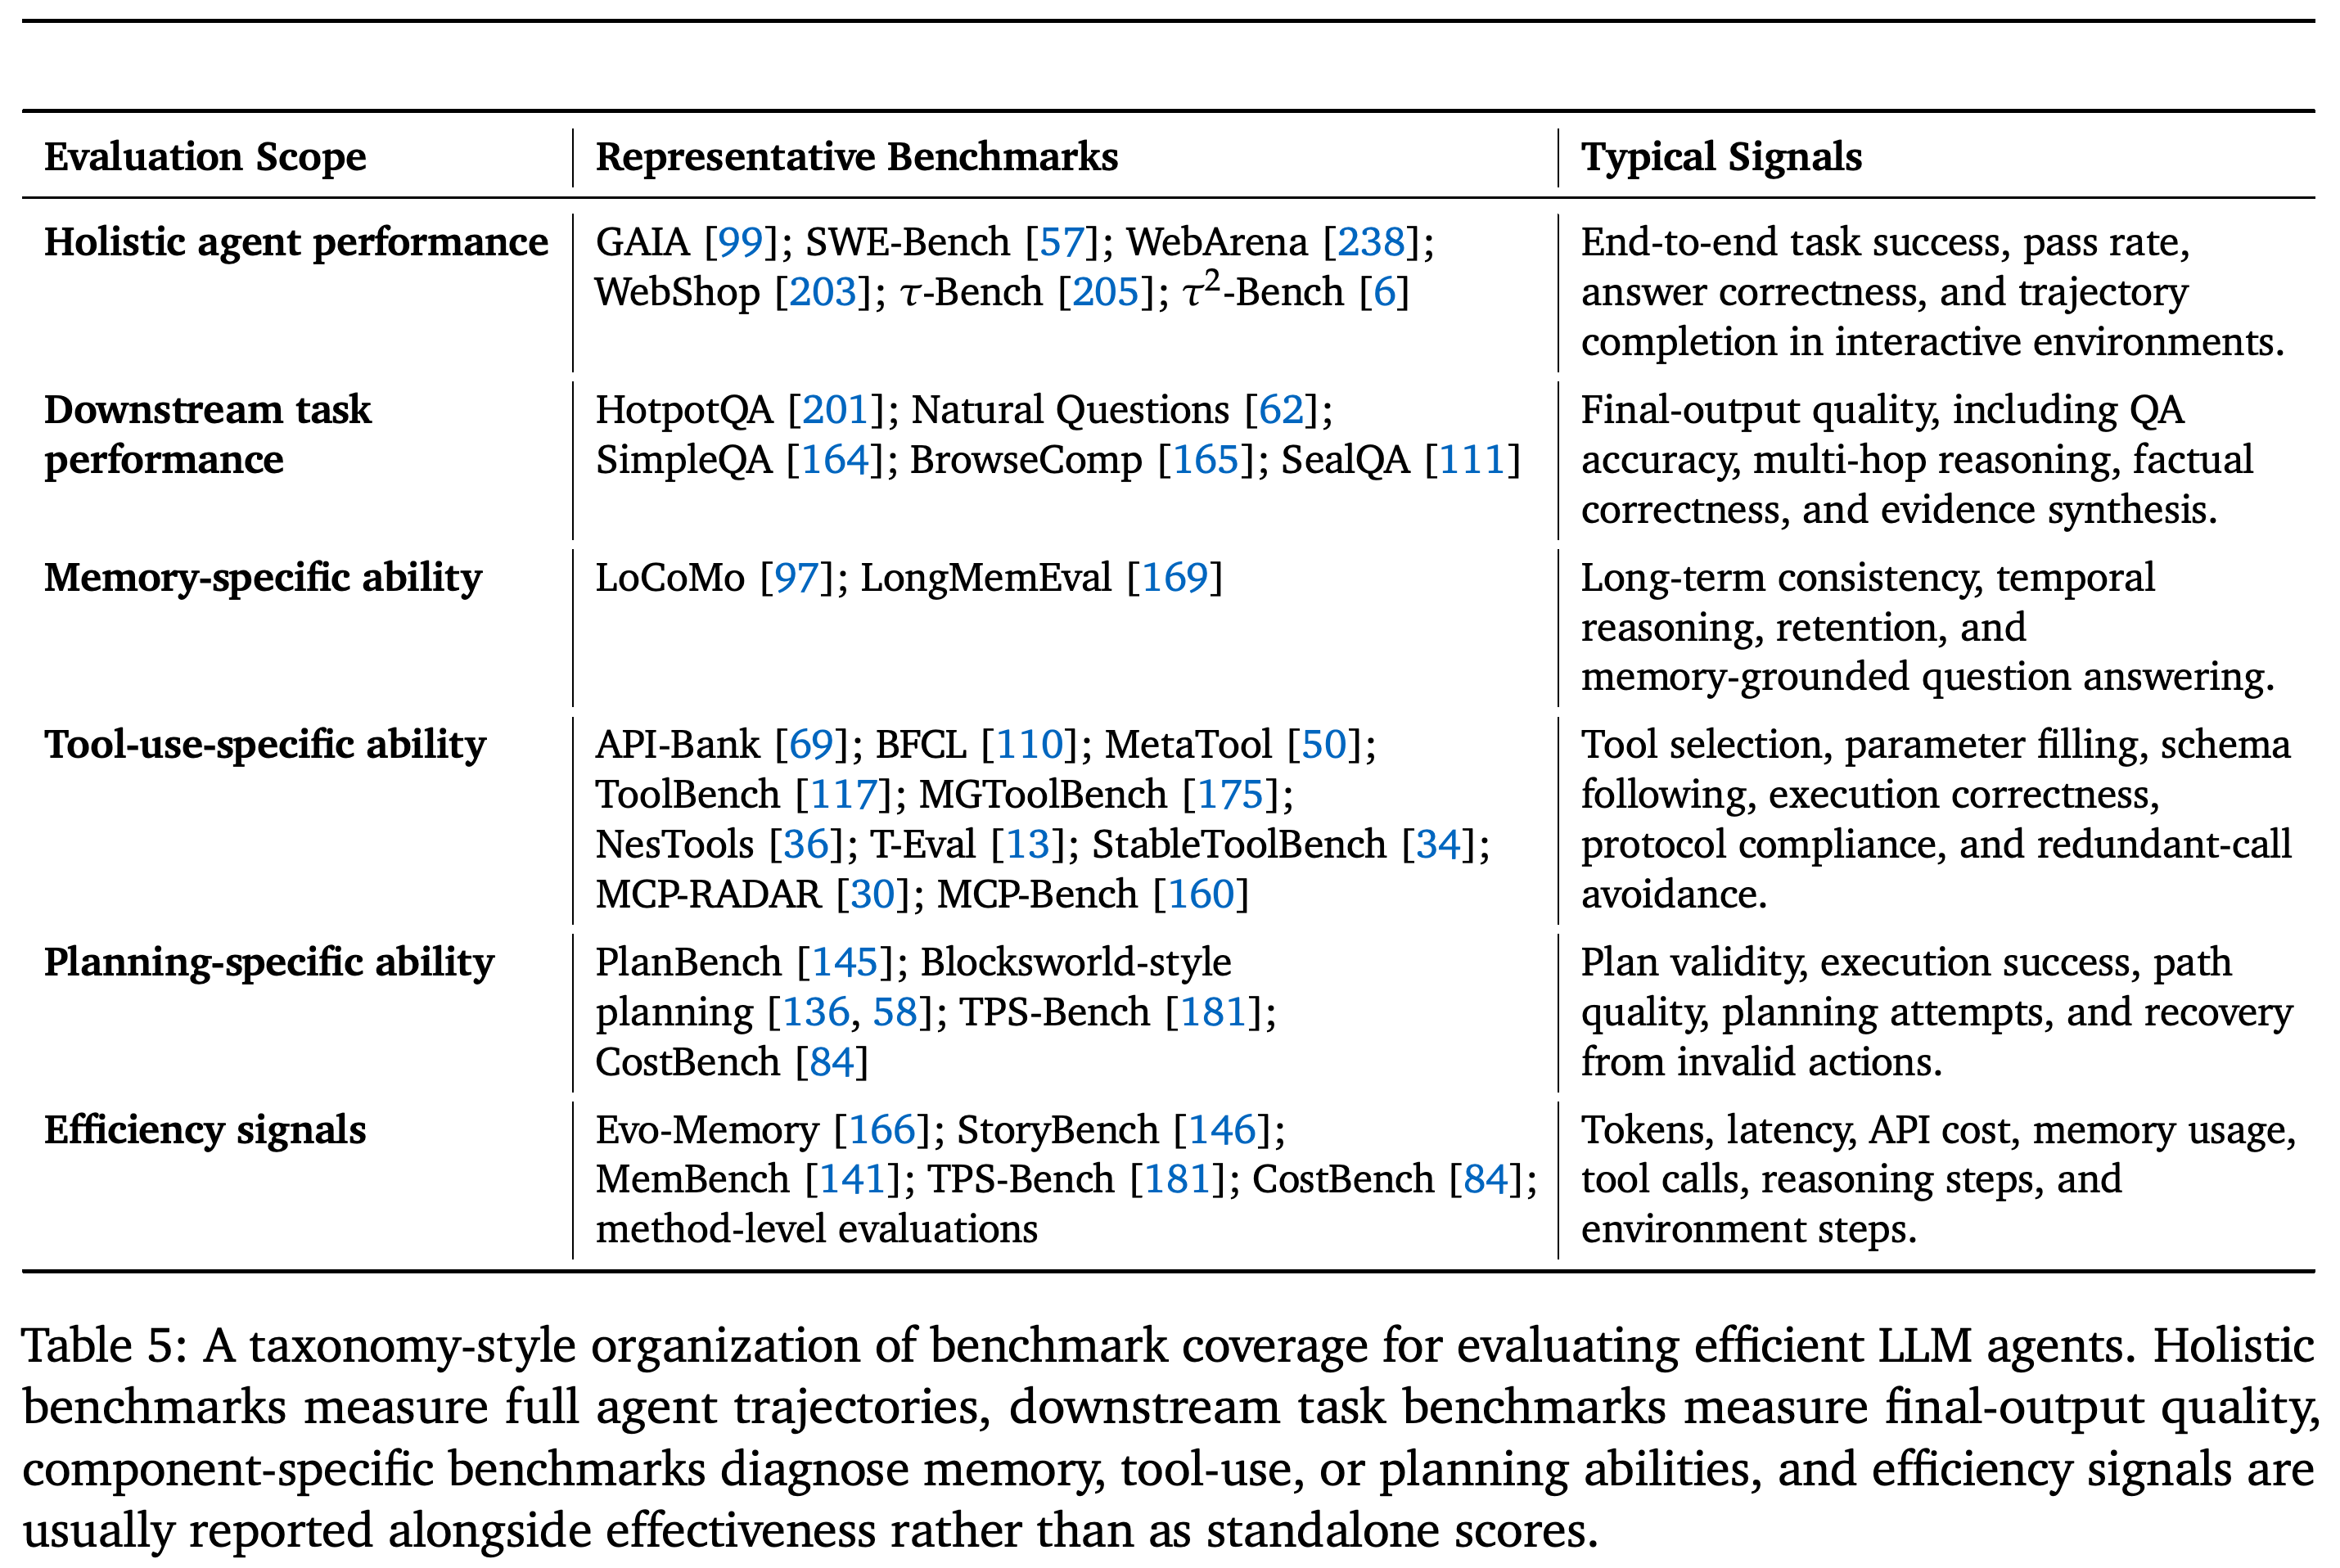
벤치마크 절은 성능 우선 프로토콜을 채택하고 성능·비용 Pareto frontier를 통해 효율성을 해석한다. 기존 벤치마크는 메모리, 도구, 계획 비용을 완전히 분리하는 경우가 드물다. 따라서 Table 5는 전체 과제, 다운스트림 출력 품질, 구성 요소 진단, 효율성 신호를 구분한다.
- 과제에 실패하는 저비용 시스템은 의미 있게 효율적이라고 보지 않는다.
- 비교할 때는 고정된 비용 예산에서 성능을 측정하거나 비슷한 과제 품질에서 비용을 측정해야 한다.
- 이 절은 평가 관행을 정리하며, 공통 벤치마크 모음을 실행하거나 새로운 리더보드를 보고하지 않는다.
6.1. Effectiveness Benchmarks
성능 벤치마크는 에이전트나 개별 구성 요소가 의도한 과제를 수행하는지 확인한다. 서베이는 완전한 상호작용 궤적 평가, 최종 출력 평가, 구성 요소별 진단을 구분한다.
- 전체 시스템 평가에는 GAIA, SWE-Bench, WebArena, WebShop, τ-Bench, τ²-Bench가 있다. 과제 성공률, 통과율, 정확성, 실행 궤적 완료 여부를 활용한다.
- 다운스트림 QA와 근거 탐색 평가에는 HotpotQA, Natural Questions, SimpleQA, BrowseComp, SealQA가 있다. 이들은 최종 출력을 측정하며, 반드시 완전한 상호작용 작업 흐름을 시험하는 것은 아니다.
- 메모리별 평가에는 LoCoMo와 LongMemEval이 있다. 정보 보존, 시간적 추론, 일관성, 메모리에 근거한 답변을 평가한다.
- 도구 진단에는 API-Bank, BFCL, MetaTool, ToolBench, MGToolBench, NesTools, T-Eval이 있다. StableToolBench는 불안정한 온라인 API를 가상 서버로 대체해 재현성을 높인다. MCP-RADAR와 MCP-Bench는 프로토콜 수준 평가를 추가한다.
- 계획 진단에는 PlanBench, Blocksworld 계열 과제, TPS-Bench, CostBench가 있다. 유효한 계획, 실행, 복구, 경로 품질, 명시적 제약을 다룬다.
열은 평가 범위, 대표 벤치마크, 일반적인 신호를 구분한다. 효율성 행은 구성 요소 및 계획 벤치마크와 겹친다. 이는 비용 측정이 독립적인 범용 점수를 이루기보다 대체로 성능 평가에 수반됨을 보여준다.
6.2. Efficiency Measurements
효율성 측정은 토큰 및 금전 비용, 시간, 하드웨어 자원, 상호작용/탐색 비용으로 나눈다. 보고된 서비스 지연 시간에서 상당한 구성이나 유지 관리 작업이 빠질 수 있으므로 비용 산정 범위를 명시해야 한다.
- 벤치마크 신호에는 Evo-Memory의 환경 단계 효율성, StoryBench의 실행 시간과 토큰 수, MemBench의 메모리 연산당 초 단위 읽기/쓰기 시간이 있다.
- TPS-Bench는 토큰 수, 종단 간 시간, 도구 호출 턴 수, cost-of-pass를 보고한다. CostBench는 Cost Gap, 경로 이탈, 유효하지 않은 도구 호출을 측정한다.
- 토큰 수는 문맥 처리와 API 비용을 근사하지만 하드웨어나 실행 시간 측정을 대체하지는 못한다. Cost-of-pass 계열 지표는 금전 지출을 성공 확률과 연결한다.
- 일부 메모리 연구는 구성 시간을 제외하고 검색과 추론의 지연 시간만 보고한다. MemoRAG는 인덱스 지연 시간과 검색 지연 시간을 구분하여 단계별 경계를 명시하는 일이 중요함을 보여준다.
- GPU 메모리, 응답당 평균 LLM 호출 수, 추론 단계 수, 시도 횟수, 탐색한 상태 수, 탐색 반복 횟수는 토큰만 보고할 때 놓칠 수 있는 부가 비용을 드러낸다.
7. Challenges and Future Directions
향후 방향은 일관된 평가, 에이전트의 잠재 추론, 배포 환경을 고려한 아키텍처, 멀티모달 에이전트에 초점을 맞춘다. 이는 연구 우선 과제이며, 서베이가 실험으로 검증한 해결책은 아니다.
- 통합된 평가에는 공통 단계 정의, 지표의 세분화 수준, 메모리·도구 사용·계획·지연 시간·실행 시간에 대한 투명한 비용 산정이 필요하다.
- 에이전트의 잠재 추론에는 독립적인 텍스트 추론을 넘어 도구, 장기 메모리, 계획, 행동 검증을 수용하는 인터페이스와 목적 함수가 필요하다.
- 실제 다중 모델 배포와 단일 모델의 역할극 파이프라인은 동일한 자원 예산에서 비교해야 한다. 오케스트레이션 비용, 지연 시간, 신뢰성이 다르기 때문이다.
- 멀티모달 에이전트에는 언어 처리 외에도 지각과 그라운딩 비용이 발생한다. 단계마다 시각 이력을 재인코딩하면 정보 보존과 지연 시간 사이의 절충이 심해진다. 지각과 그라운딩 오류도 긴 실행 궤적에서 누적될 수 있다.
8. Conclusion
서베이는 메모리, 도구 사용, 계획 전반의 효율성 중심 설계와 평가 관행을 종합한다. 반복해서 등장하는 기법을 식별하고, 공정한 비교와 재현성을 위해 표준화되고 투명한 보고가 필요하다고 강조한다.
부록
- PDF에는 부록 절이 없으며 결론 다음에 참고문헌이 이어진다. 첫 페이지에 기재된 공개 자료는 https://efficient-agents.github.io/ 와 https://github.com/yxf203/Awesome-Efficient-Agents 이다.
짧은 생각
구성 요소 전반의 비용을 함께 산정하는 관점이 특히 유용하다. 각 논의는 압축이 복구 작업을 만들고, 도구 제어가 계획 비용을 늘리며, 통신이 협업 비용의 대부분을 차지할 수 있음을 설명한다. 이러한 사례는 국소적인 비용 절감을 종단 간 효율성으로 해석하지 않고 전체 에이전트 파이프라인을 살펴봐야 한다는 주장을 뒷받침한다. 인용된 압축과 망각의 절충은 성능 우선 기준을 뒷받침한다. 핵심 정보가 사라진다면 토큰 감소나 검색 가속만으로는 충분하지 않다. 근거가 뒷받침하는 것은 설계와 평가의 틀이지 정량적 순위가 아니다. Tables 1–4는 동일한 예산에서의 결과가 아니라 기법을 요약하며, Table 5는 서로 다른 평가 범위를 정리한다. 실무 비교에서는 온라인 지연 시간과 총연산량을 구분해야 한다. 재사용 가능한 스킬이나 캐시는 구성과 유지 관리 비용을 반영할 수 있도록 충분한 반복 과제에 걸쳐 평가해야 한다.