


SWE-CI: Evaluating Agent Capabilities in Maintaining Codebases via Continuous Integration 요약 설명
04 Mar 2026 | Paper Review AI Coding Agents Software Maintenance LLM Evaluation목차
- 요약
- 1 Introduction
- 2 Measuring the Agent’s Ability to Maintain Codebase
- 3 SWE-CI
- 4 Experiments
- 5 Conclusion
- 부록
- 짧은 생각
이번 글에서는 SWE-CI: Evaluating Agent Capabilities in Maintaining Codebases via Continuous Integration 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 4일(Arxiv)
- Chen, Jialong, Xu, Xander, Wei, Hu, Chen, Chuan, Zhao, Bing.
- Sun Yat-sen University, Alibaba Group, Skylenage
- 논문 링크
- Github
요약
- SWE-CI: Evaluating Agent Capabilities in Maintaining Codebases via Continuous Integration은 개별 오류 수정이 아니라 저장소 수준에서 반복적으로 코드를 수정하는 능력을 평가한다. 100개 과제는 68개 Python 저장소에서 수집했으며, base/oracle 커밋 사이의 간격은 평균 233일과 연속된 커밋 71개다.
- Architect–Programmer 워크플로는 테스트 실패에서 점진적 요구사항을 도출하고, 현재 코드베이스를 수정한 뒤 외부 검증을 수행한다. 이 과정을 최대 20회 반복한다. EvoScore는 통과한 테스트 수의 정규화된 변화를 집계하며, 가중치 매개변수로 후반 코드베이스 상태를 더 강조할 수 있다.
- 실험은 8개 제공사의 모델 20개를 평가하며, 토큰 사용량은 10 billion tokens를 넘는다. 대부분 모델의 zero-regression rate는 0.25 미만이다. 해결에 성공한 과제에서는 모델 20개 중 15개가 인간의 oracle 코드와 비교한 Pylint 승패에서 우세하지만, 20개 모델 모두 MI 점수 비교에서는 열세다.
- SWE-CI는 연속된 수정 과정에서 진전과 회귀를 드러낸다. 다만 EvoScore는 유지보수성을 나타내는 테스트 기반 대리지표이지, 설계 품질을 직접 측정하는 지표는 아니다. 결과의 적용 범위는 Python 저장소, 의존성이 바뀌지 않는 개발 구간, 고정된 oracle 테스트 모음, 평가에 사용한 dual-agent harness로 한정된다.
1 Introduction
서론은 동일한 테스트를 통과하는 취약한 패치와 확장 가능한 구현을 스냅샷 방식의 벤치마크로는 구별할 수 없다고 주장한다. SWE-CI는 에이전트가 수정한 코드베이스를 다음 반복에서도 유지하므로, 앞선 구현 결정이 이후 개발에 영향을 미칠 수 있다.
- HumanEval, MBPP, LiveCodeBench는 함수 수준의 코드 생성을 평가하고, SWE-bench는 저장소 수준의 Issue-to-PR 작업을 평가한다. Terminal-bench와 τ-bench는 상호작용형 도구 사용으로 평가 범위를 넓힌다.
- 논문은 소프트웨어 진화 연구와 함께, 유지보수가 소프트웨어 생애주기 비용의 60%에서 80%를 차지한다는 기존 추정치를 인용한다.
- 과거 커밋은 과제의 시작점과 끝점 사이의 간격을 정한다. 평가에서 그 사이의 커밋 71개를 과거 요구사항의 순서대로 재현하지는 않는다.
2 Measuring the Agent’s Ability to Maintain Codebase
측정 체계는 요구사항 생성, 코드 수정, 궤적 점수 산정을 분리한다. 반복적인 개발 단계에서 기능적 정확성을 측정하면, 코드베이스가 후속 수정에 얼마나 적합한지 평가할 수 있다는 전제를 둔다.
- Normalized Change는 base와 oracle을 기준으로 현재 통과한 테스트 수를 상대적으로 측정한다.
- EvoScore는 에이전트가 만든 코드 진화 궤적에서 이 측정값들을 집계한다.
2.1 Task formalization
과제는 테스트 집합 T, base 코드베이스 c0, oracle 코드베이스 c*로 구성된다. 함수 require_T는 2개 코드베이스의 기능 차이를 설명하는 요구사항 문서를 생성한다. 함수 code_T는 요구사항과 코드베이스를 받아 수정된 코드베이스를 생성한다.
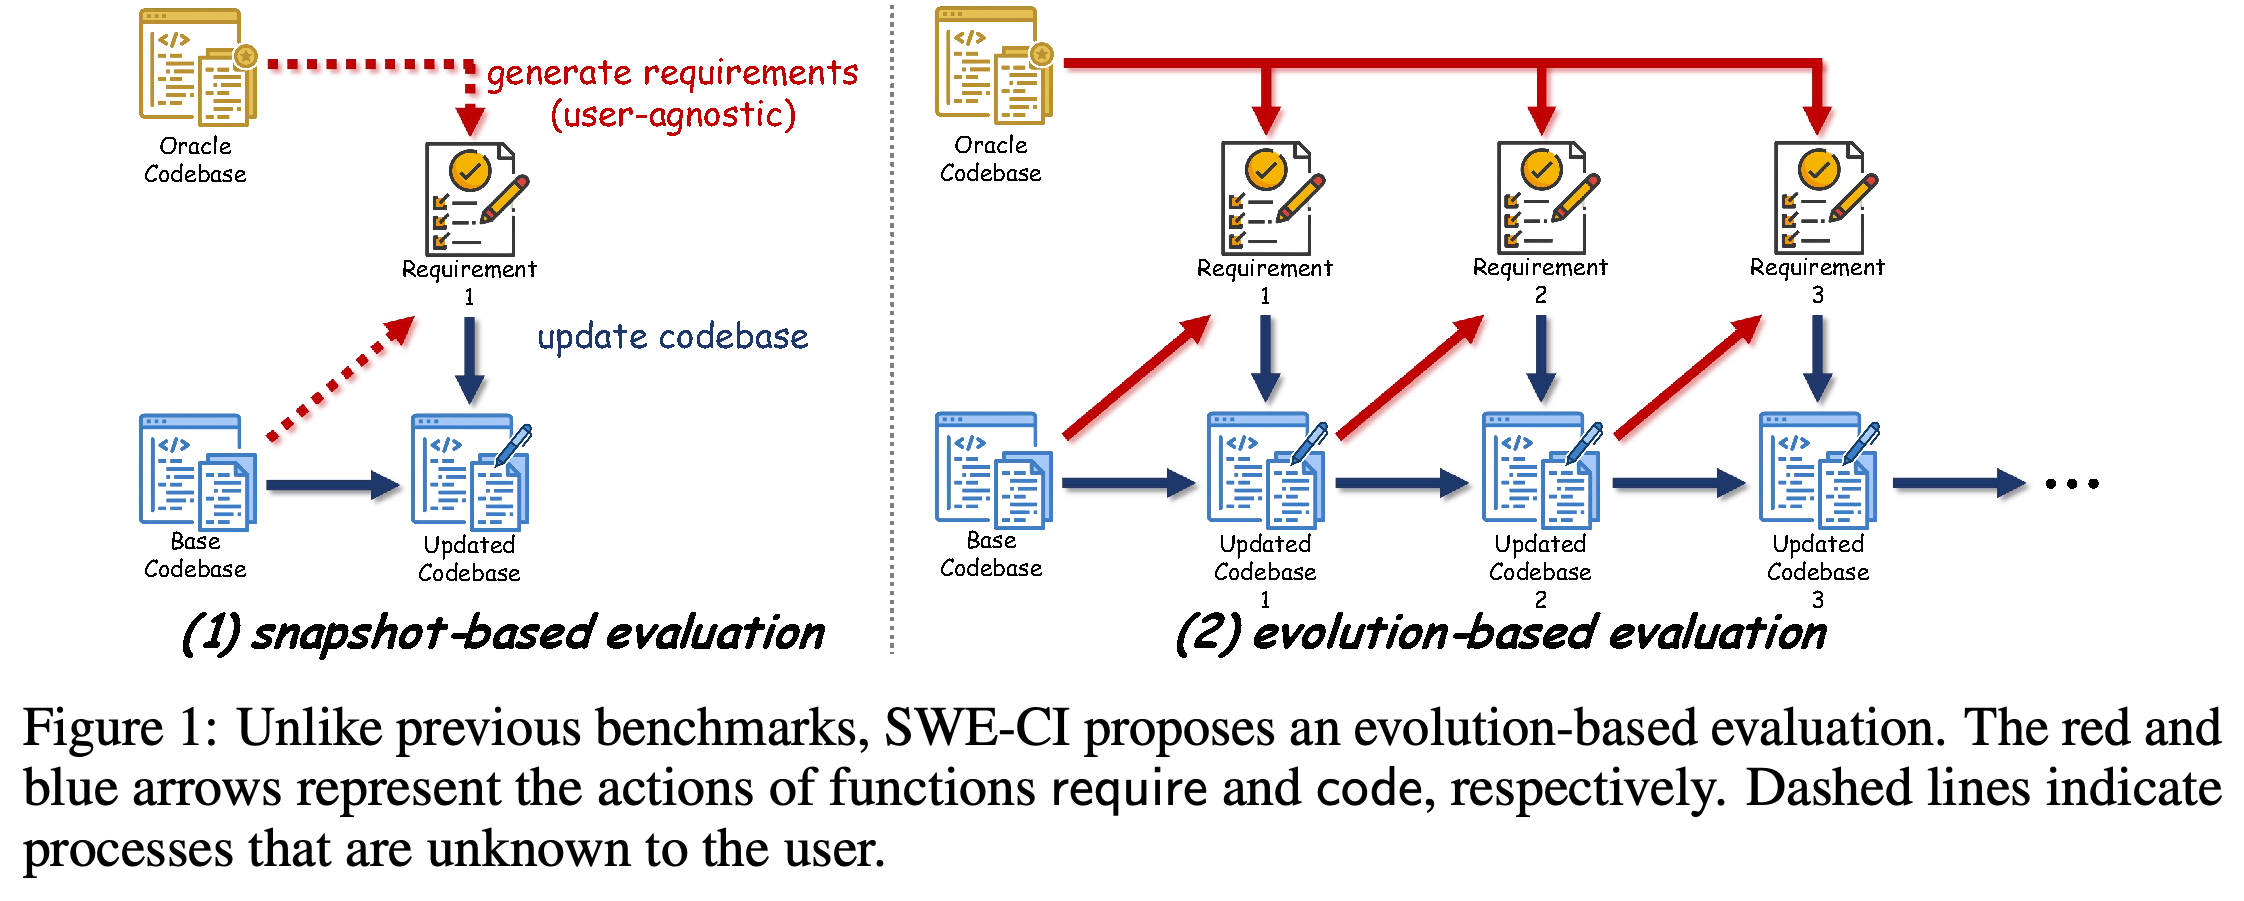
- 스냅샷 기반 평가는 base와 oracle에서 요구사항 1개를 도출한 뒤, 수정 결과를 평가한다.
- 진화 기반 평가는 현재 코드베이스와 동일한 oracle에서 요구사항을 다시 생성한다. 각 수정 결과가 다음 반복의 시작점이 된다.
- Figure 1은 수정된 코드베이스와 후속 요구사항 사이에 의존 관계가 계속 이어지는 모습을 보여준다.
스냅샷 경로는 base와 oracle에서 요구사항 1개를 생성한다. 반면 진화 경로는 수정된 코드베이스를 반복적으로 사용해 다음 요구사항을 생성한다. 상태가 계속 이어지므로 앞선 구현 결정이 이후 성능에 영향을 줄 수 있다.
2.2 Normalized Change
통과한 테스트 수는 (n(c)=\sum_{t\in T}\mathbb{I}(t,c))다. 여기서 I(t,c)는 테스트 t가 코드베이스 c에서 통과할 때만 1이다. Normalized Change는 n(c) ≥ n(c0)일 때 a(c) = (n(c) − n(c0))/(n(c*) − n(c0))이고, 그 외에는 a(c) = (n(c) − n(c0))/n(c0)이다.
- 개선량은 초기 base와 oracle 사이의 차이로 나눈다. 통과한 테스트 수가 oracle과 같아지면 a(c) = 1이다.
- base보다 악화된 정도는 처음에 통과한 테스트 수로 나눈다. 그 수가 양수일 때 통과한 테스트 수를 0으로 줄이면 a(c) = −1이다.
- 논문은 값의 범위를 [−1, 1]로 제시한다. 상한이 성립하려면 n(c) ≤ n(c*)여야 한다. 코드베이스가 oracle보다 더 많은 테스트를 통과하면 수식의 값은 1을 넘을 수 있다. 이 지표는 개별 테스트의 회귀가 아니라 통과한 테스트 수의 순변화를 추적한다.
2.3 EvoScore
수정된 코드베이스가 N개일 때 EvoScore는 e = (Σ_{i=1}^N γ^i a(ci))/(Σ_{i=1}^N γ^i)다. 정의에서는 γ ≥ 1로 정한다. γ = 1이면 Normalized Change의 평균이 되고, 값이 커질수록 후반 상태를 더 강조한다.
- 이 지표는 결함을 도입하거나 품질을 떨어뜨리지 않으면서 효과적으로 수정할 수 있는 능력이라는 ISO/IEC 25010의 유지보수성 정의에 근거한다.
- 후반에 더 큰 가중치를 주는 목적은 빠른 초기 진전뿐 아니라 후속 개발을 수월하게 하는 결정에도 보상하는 데 있다.
- EvoScore는 궤적 전반의 기능적 진전을 측정한다. 아키텍처, 요구사항 분석, 구현이 각각 얼마나 기여했는지는 분리하지 않는다.
3 SWE-CI
SWE-CI는 시간순으로 정한 base/oracle 커밋 쌍을 소스 코드와 사전 구축한 Docker 환경이 포함된 실행 가능한 유지보수 과제로 변환한다. 데이터셋은 https://huggingface.co/datasets/skylenage/SWE-CI 에서, 구현은 https://github.com/SKYLENAGE-AI/SWE-CI 에서 제공한다.
- 목표는 oracle의 소스 코드를 정확히 재현하는 것이 아니라, 테스트로 확인한 oracle의 기능을 구현하는 것이다.
- 벤치마크는 환경을 통제한 데이터 구축과 반복적인 Architect–Programmer 평가를 결합한다.
3.1 Data curation
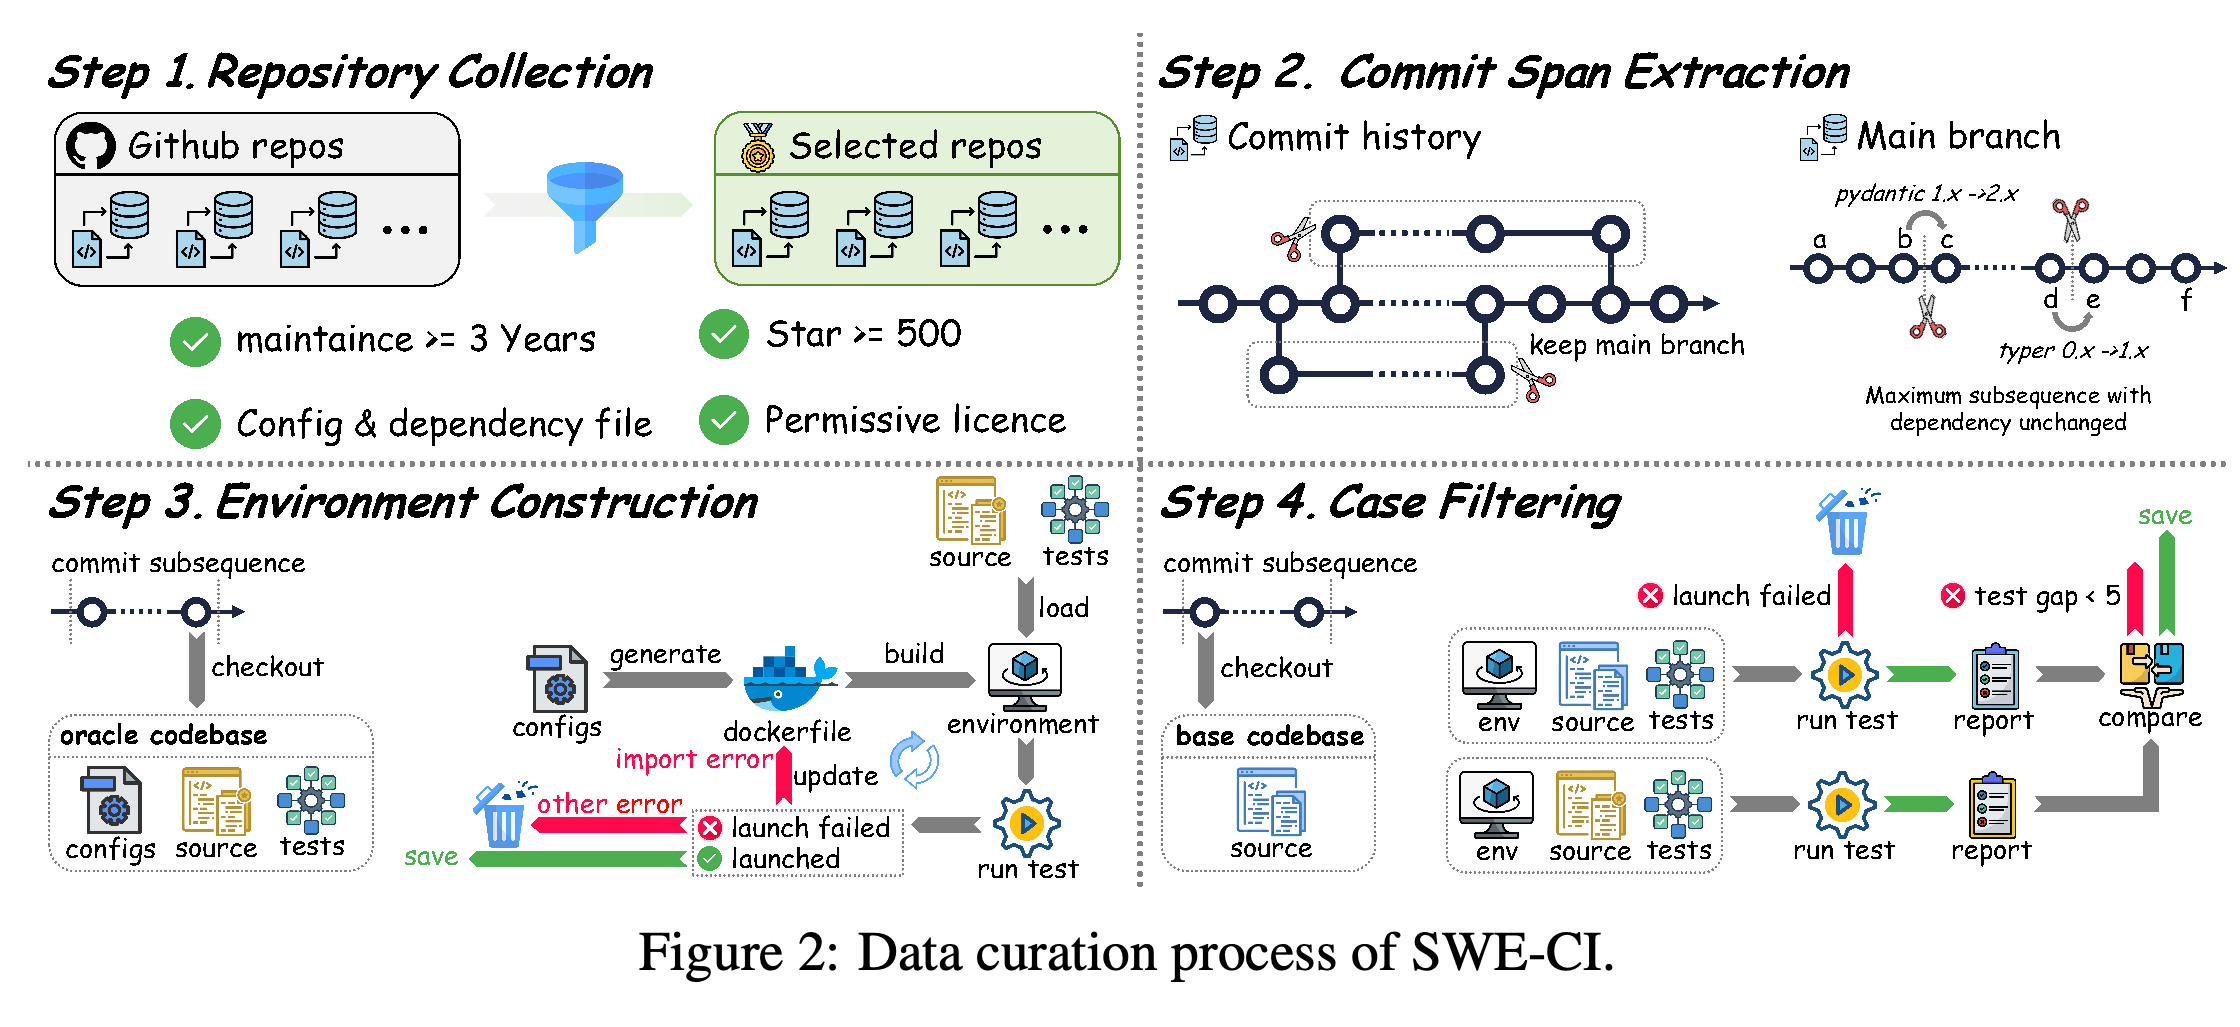
Step 1: Repository Collection에서는 최소 3년간 활발히 유지보수되었고, 스타가 500개를 넘으며, 설정 및 의존성 파일과 단위 테스트를 갖춘 Python 저장소를 남긴다. MIT나 Apache-2.0과 같은 허용적 라이선스도 요구한다. 이 단계에서 4,923개 저장소가 남는다.
Step 2: Commit Span Extraction에서는 main 브랜치를 대상으로 의존성이 바뀌지 않는 최대 연속 커밋 구간을 찾는다. 각 구간의 양 끝점이 base/oracle 후보 쌍이 된다. 수정된 줄 수가 1,000줄 미만인 쌍을 제외하면 후보 8,311개가 남는다.
- 의존성을 고정하면 양 끝점 사이의 환경 비호환성을 줄일 수 있다.
- 이 제약으로 인해 의존성 변경을 포함하는 유지보수 구간은 제외된다.
Step 3: Environment Construction에서는 oracle의 설정과 의존성으로 Dockerfile을 생성한 뒤 oracle 테스트를 실행한다. 의존성 누락으로 실행을 시작하지 못하면 Dockerfile을 자동 수정하고, 다른 원인으로 실패하면 후보를 제외한다. 이 단계에서 후보 쌍 1,458개가 남는다.
Step 4: Case Filtering에서는 oracle 테스트를 base 코드베이스에서 실행할 수 없거나, 통과한 테스트 수의 차이가 5개 미만인 쌍을 제외한다. 남은 후보 137개 중 시간 간격과 중간 커밋 수를 기준으로 상위 100개를 선택한다.
- 최종 데이터셋은 68개 저장소에서 나온 샘플 100개로 구성된다. 각 쌍의 간격은 평균 233일과 연속된 커밋 71개다.
- 최종 쌍에는 모두 테스트 파일 변경을 제외하고 최소 500줄의 소스 코드 수정이 포함된다. 이 통계는 앞선 후보 필터의 1,000줄 기준과 별개다.
- Figure 2는 동일한 테스트 모음에서 base와 oracle의 보고서를 비교하는 과정과 함께 필터링 및 환경 수정 파이프라인을 보여준다.
4단계 파이프라인은 저장소 적격성, 의존성 안정성, 실행 가능한 환경, 양 끝점 사이의 기능 차이를 기준으로 후보를 걸러낸다. 의존성 누락으로 실행을 시작하지 못하면 수정 루프를 거친다. 다른 오류, base 실행 실패, 테스트 차이가 5개 미만인 경우에는 후보를 제외한다.
3.2 Dual-agent evaluation protocol
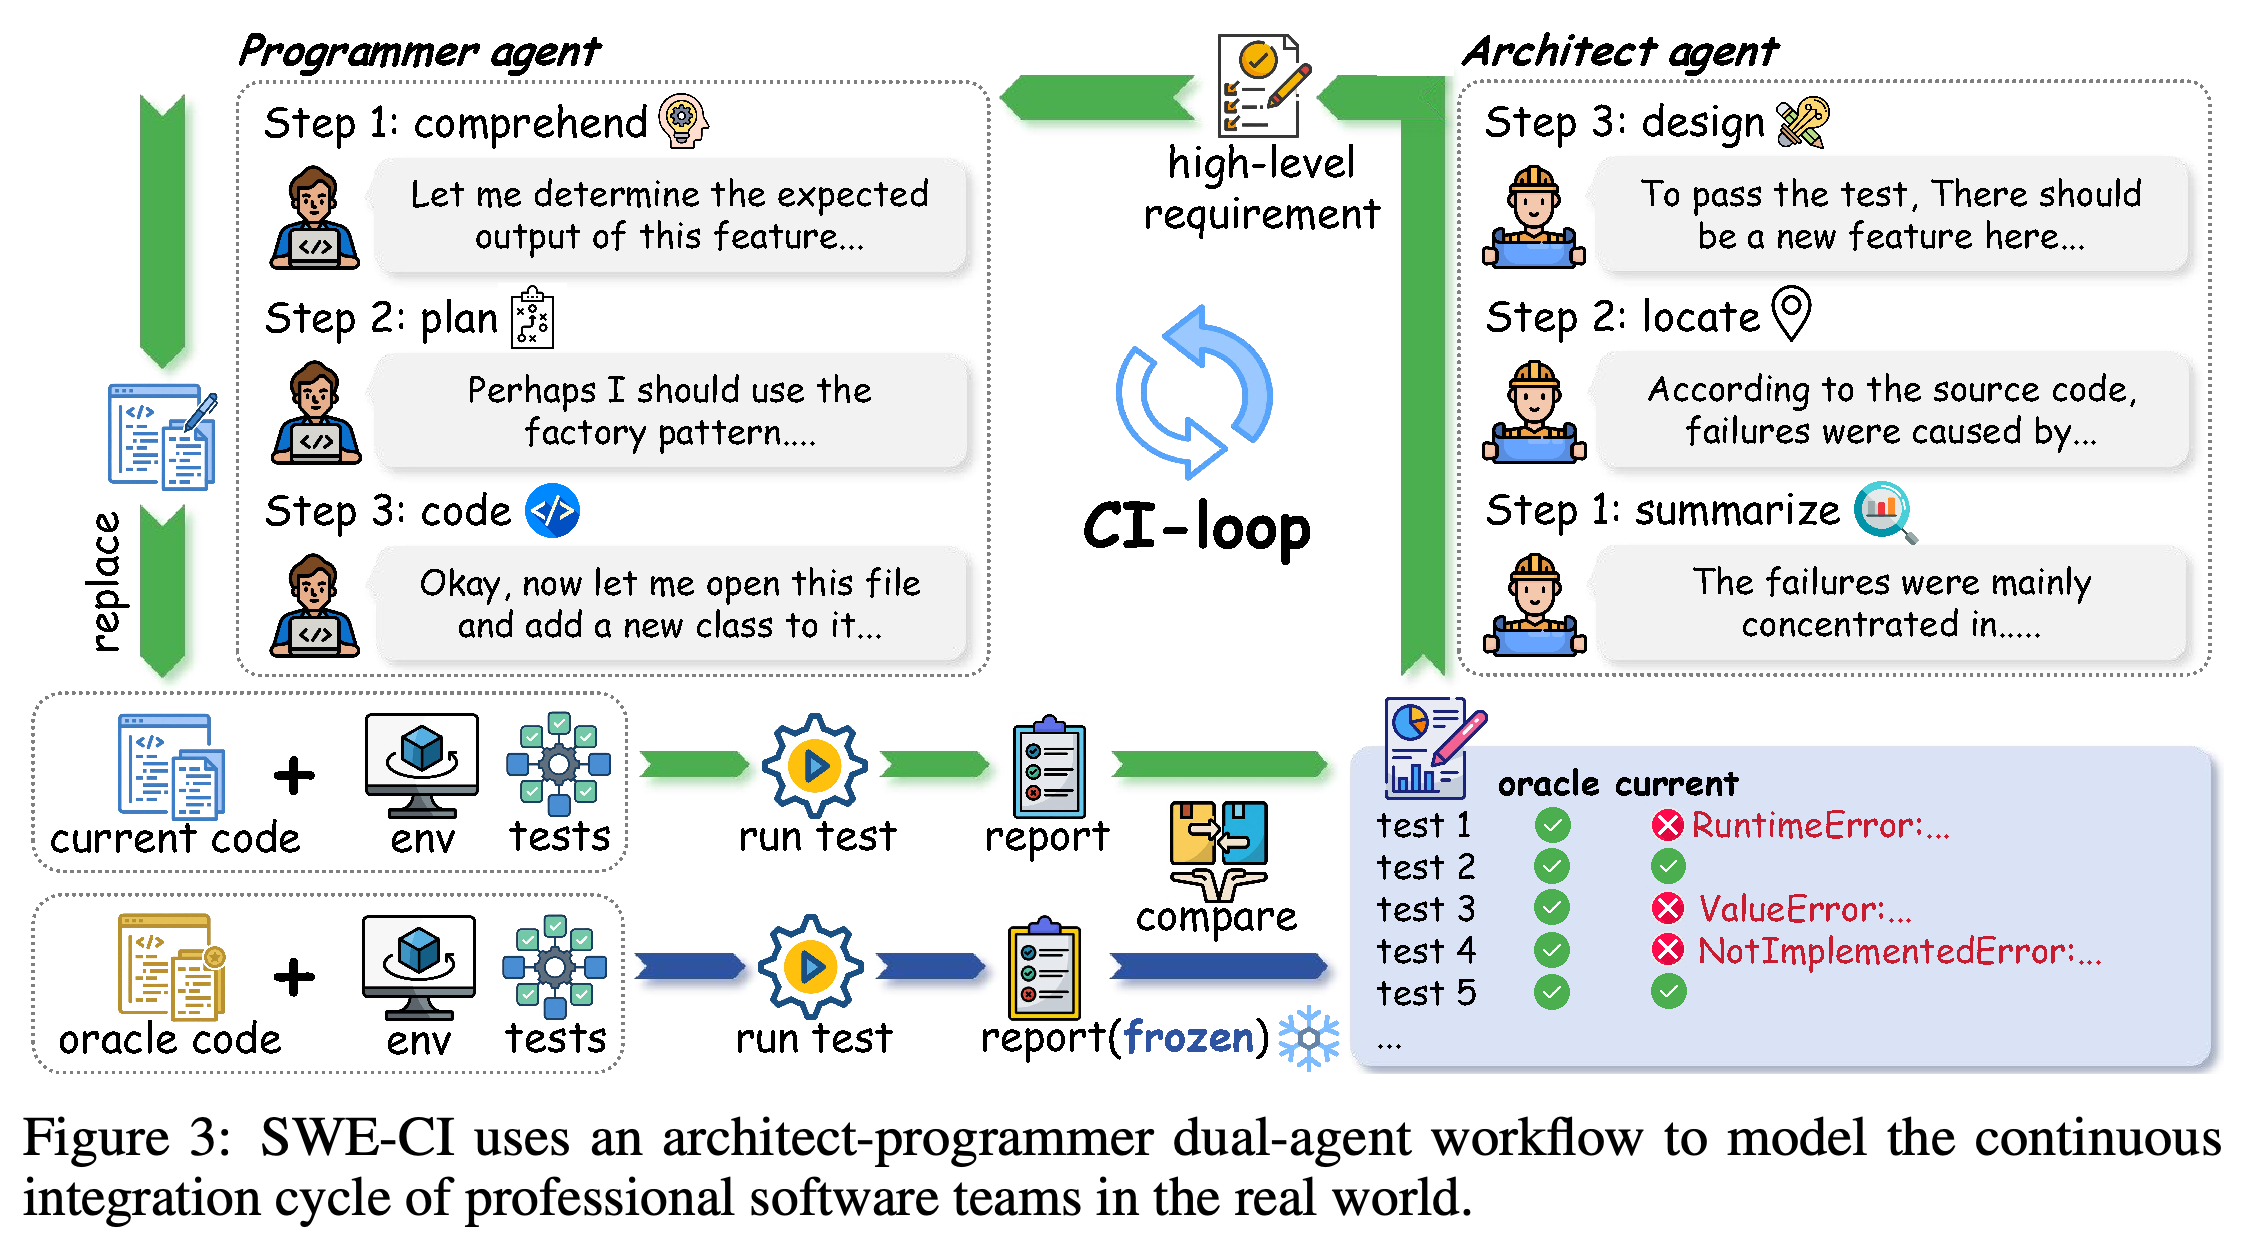
Architect는 현재 코드베이스와 oracle 사이의 테스트 차이를 바탕으로 실패를 요약하고, 구현의 부족한 부분을 찾으며, 상위 수준의 요구사항 문서를 작성한다. 각 반복에는 긴급한 요구사항을 최대 5개 포함한다. 요구사항은 구체적인 구현 지시가 아니라 기대 동작으로 표현한다.
- Programmer는 요구사항을 이해하고 구현 계획을 세운 뒤 코드베이스를 수정한다.
- Programmer는 전체 테스트 차이를 직접 입력받는 대신 정리된 요구사항 문서에 따라 작업한다. 부록에서는 관련 테스트를 살펴보는 것도 허용한다.
- Figure 3은 oracle 보고서를 고정한 상태에서 외부 검증 결과가 다음 Architect 분석으로 전달되는 과정을 보여준다.
외부 검증은 현재 코드베이스를 고정된 oracle 보고서와 비교한다. Architect는 남은 실패를 상위 수준의 요구사항으로 변환하고, Programmer는 코드를 수정한다. 이후 저장소를 초기화하지 않은 채 같은 과정을 반복한다.
4 Experiments
실험은 궤적 성능, 시간 가중치에 대한 민감도, 회귀 양상, 정적 코드 품질을 살펴본다. 8개 제공사의 20개 모델을 평가하며, 총 토큰 사용량은 10 billion을 넘는다.
- 주요 분석은 기능적 진전, 회귀 방지, 정적 코드 품질을 구분한다.
- 추가 실험은 전체 과제 성공률, 평균 턴 수, 누적 최고 진전을 보고한다.
4.1 Experiment setting
기본 harness는 iFlow CLI다. 검증에는 pytest와 pytest-json-report를 사용하며, 테스트 실행마다 제한 시간을 3600초로 둔다. 프로토콜은 최대 20회 반복을 허용한다. 별도 명시가 없으면 Architect와 Programmer는 동일한 기반 모델을 사용한다.
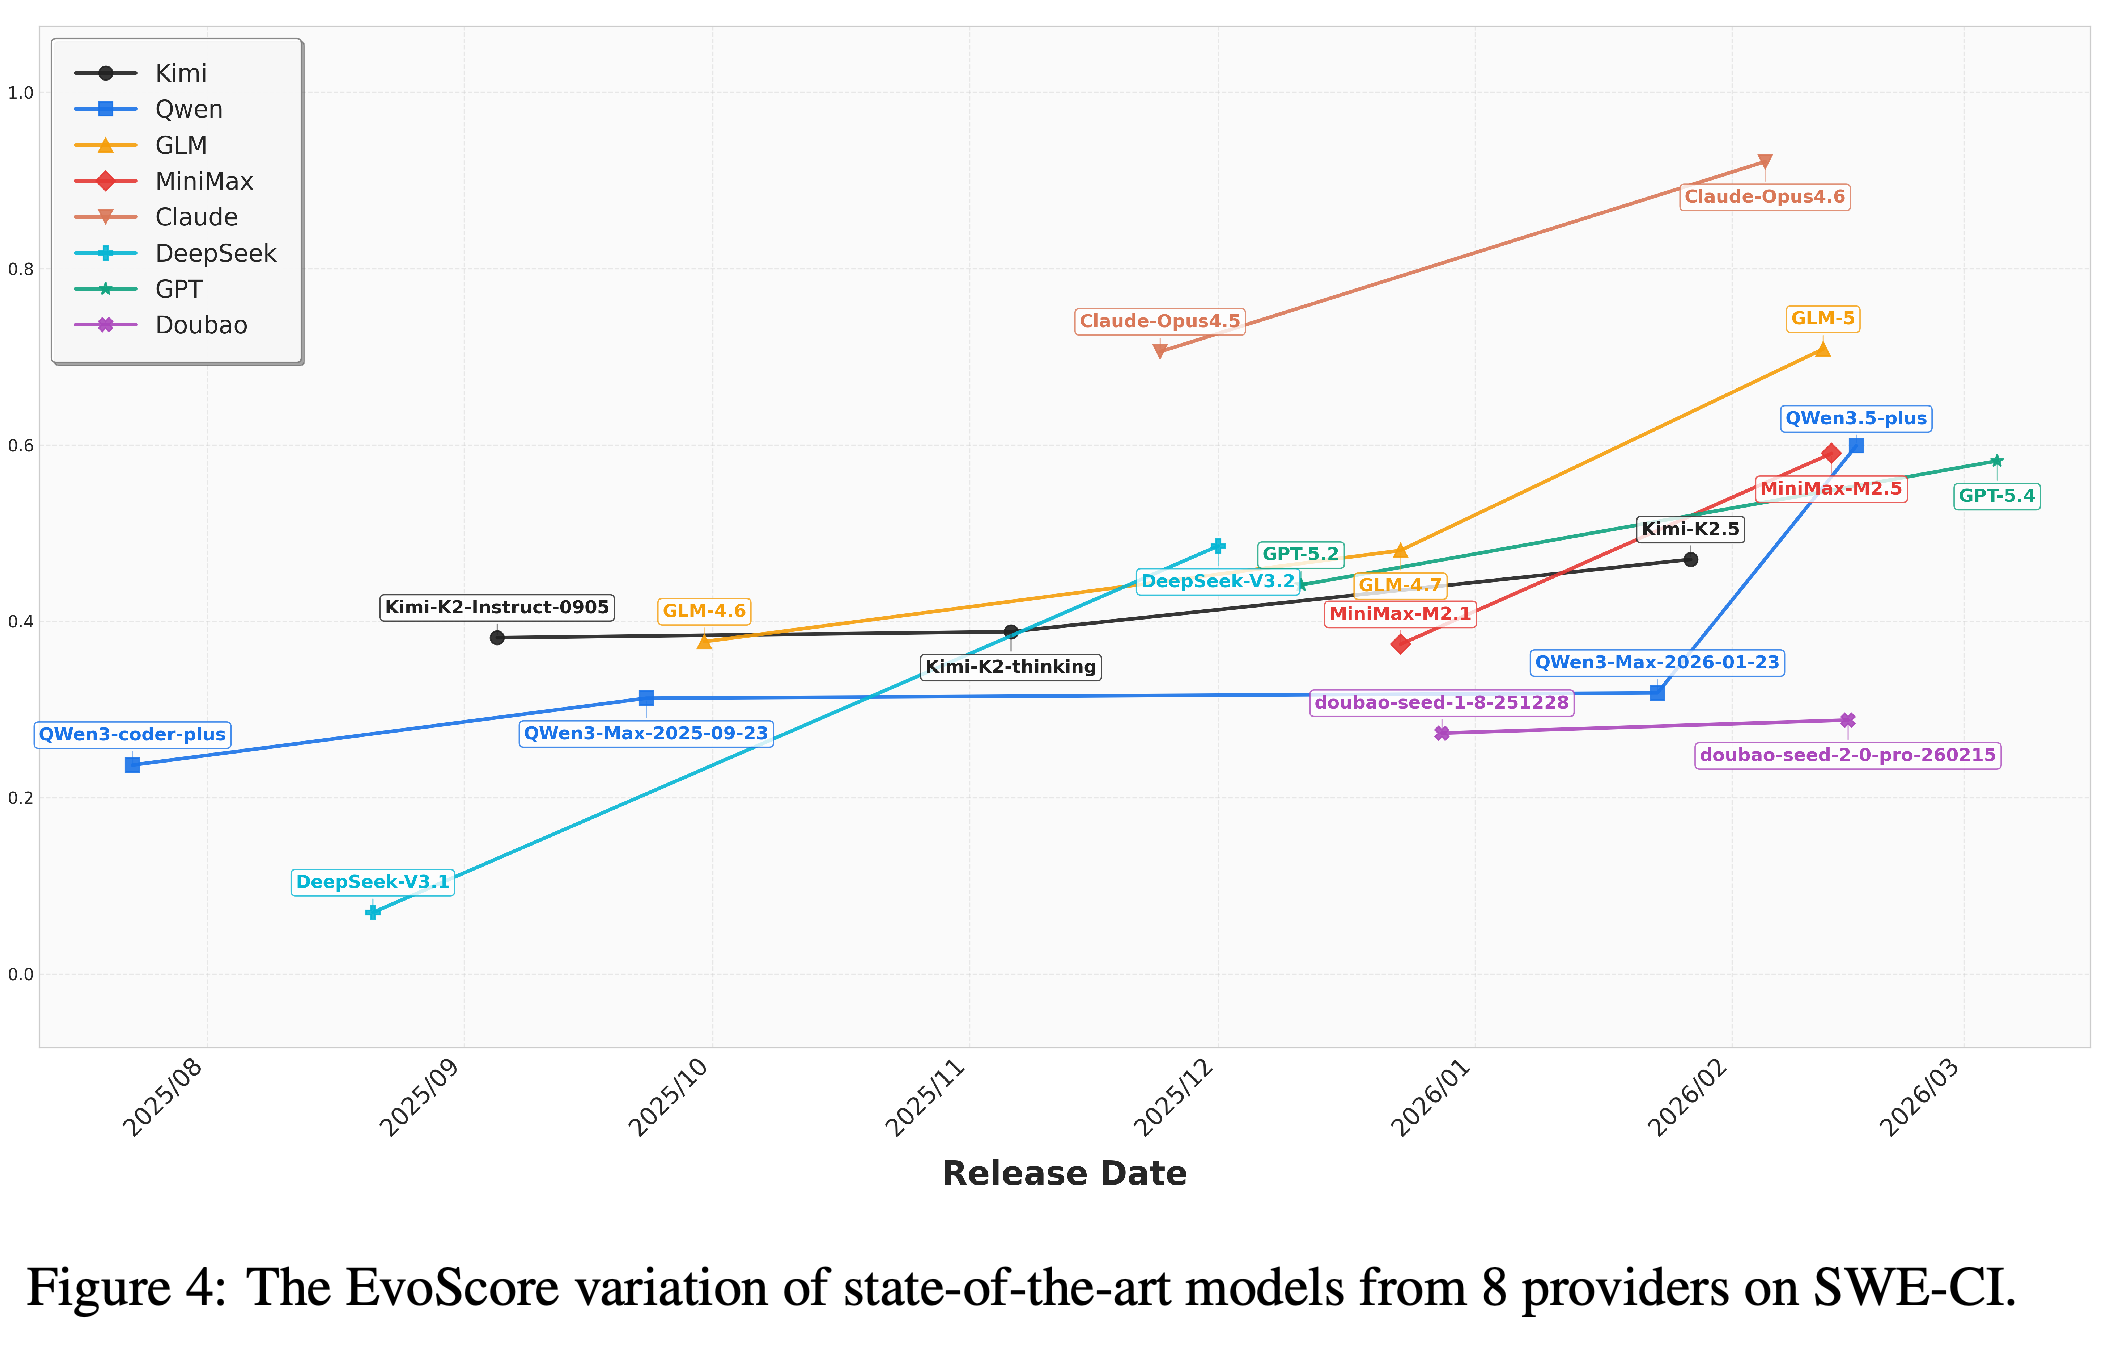
- Figure 4는 γ = 1일 때의 EvoScore를 보고한다.
- 부록의 프롬프트는 에이전트 모두 직접 테스트를 실행하지 못하도록 한다. 검증은 외부 시스템이 수행한다.
- 보고된 점수는 Programmer만의 성능이 아니라 결합된 워크플로의 성능을 나타낸다.
4.2 Maintainability
Observation 1은 각 제공사에서 평가한 모델 중 더 최근에 출시된 모델일수록 EvoScore가 높다고 보고한다. Claude Opus 계열이 선두이며 GLM-5도 높은 성능을 보인다. Figure 4는 출시일에 따른 점수를 보여준다.
- 저자들은 최근 출시 모델에서 향상 폭이 더 큰 결과를 코드 유지보수 능력의 발전이 가속되고 있다는 의미로 해석한다.
- 이 비교는 관찰적 분석이다. 학습 과정의 변화를 분리하지 않으며, 평가한 모델을 넘어 일반적인 발전 속도를 입증하지도 않는다.
γ = 1에서의 EvoScore는 각 제공사에서 평가한 모델의 출시 순서에 따라 상승한다. Claude Opus가 선두이며 GLM-5도 높은 성능을 보이는 대안에 속한다. 그래프는 출시 시점과 관련된 성능 차이를 보여주지만, 그 차이를 일으킨 학습 요인은 규명하지 않는다.
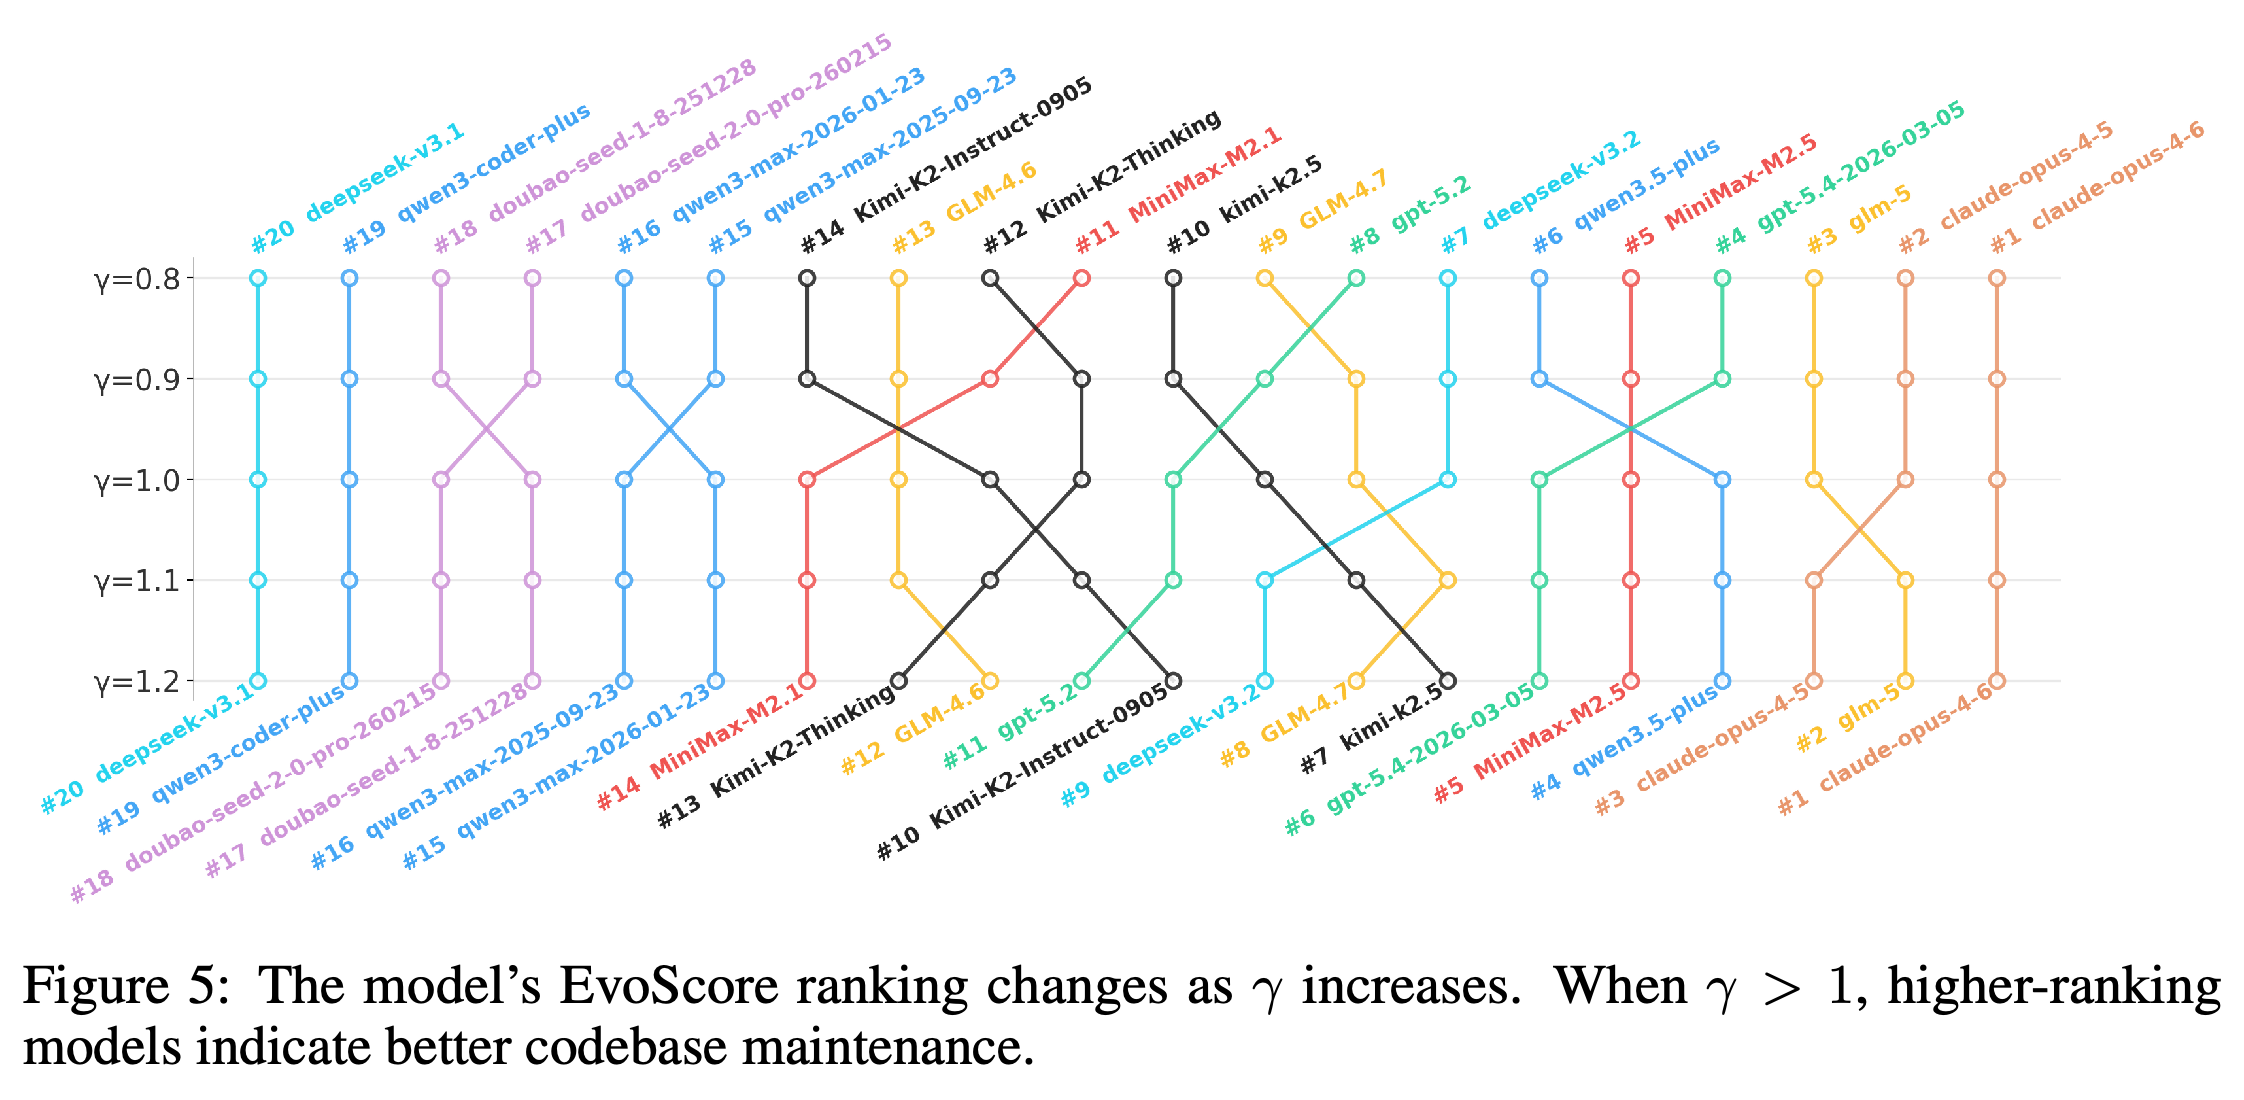
Observation 2는 순위의 민감도를 확인하기 위해 γ를 0.8에서 1.2까지 바꾼다. 후반 반복에 더 큰 가중치를 줄수록 MiniMax, GPT, DeepSeek의 순위는 대체로 하락하고 Kimi, GLM, Qwen의 순위는 대체로 상승한다. Doubao와 Claude는 비교적 안정적이다.
- 본문의 정의는 γ ≥ 1로 정하지만, 민감도 실험에서는 초반 상태를 강조하기 위해 γ < 1도 사용한다.
- Figure 5는 동일한 궤적에 가중치만 달리 적용했을 때 상대 순위가 어떻게 바뀌는지 보여준다. γ = 1.2에서도 claude-opus-4-6은 1위를 유지하고 GLM-5는 2위다.
- 제공사별 경향이 학습 전략과 관련 있다는 설명은 추측이다.
γ = 0.8, 0.9, 1.0, 1.1, 1.2에 따른 순위 궤적은 초반과 후반 진전에 대한 가중치의 민감도를 보여준다. claude-opus-4-6은 내내 1위를 유지하고, GLM-5는 3위에서 2위로 상승한다. 여러 GPT, MiniMax, DeepSeek 모델은 후반 상태에 더 큰 가중치를 줄수록 순위가 하락한다.
4.3 Regression
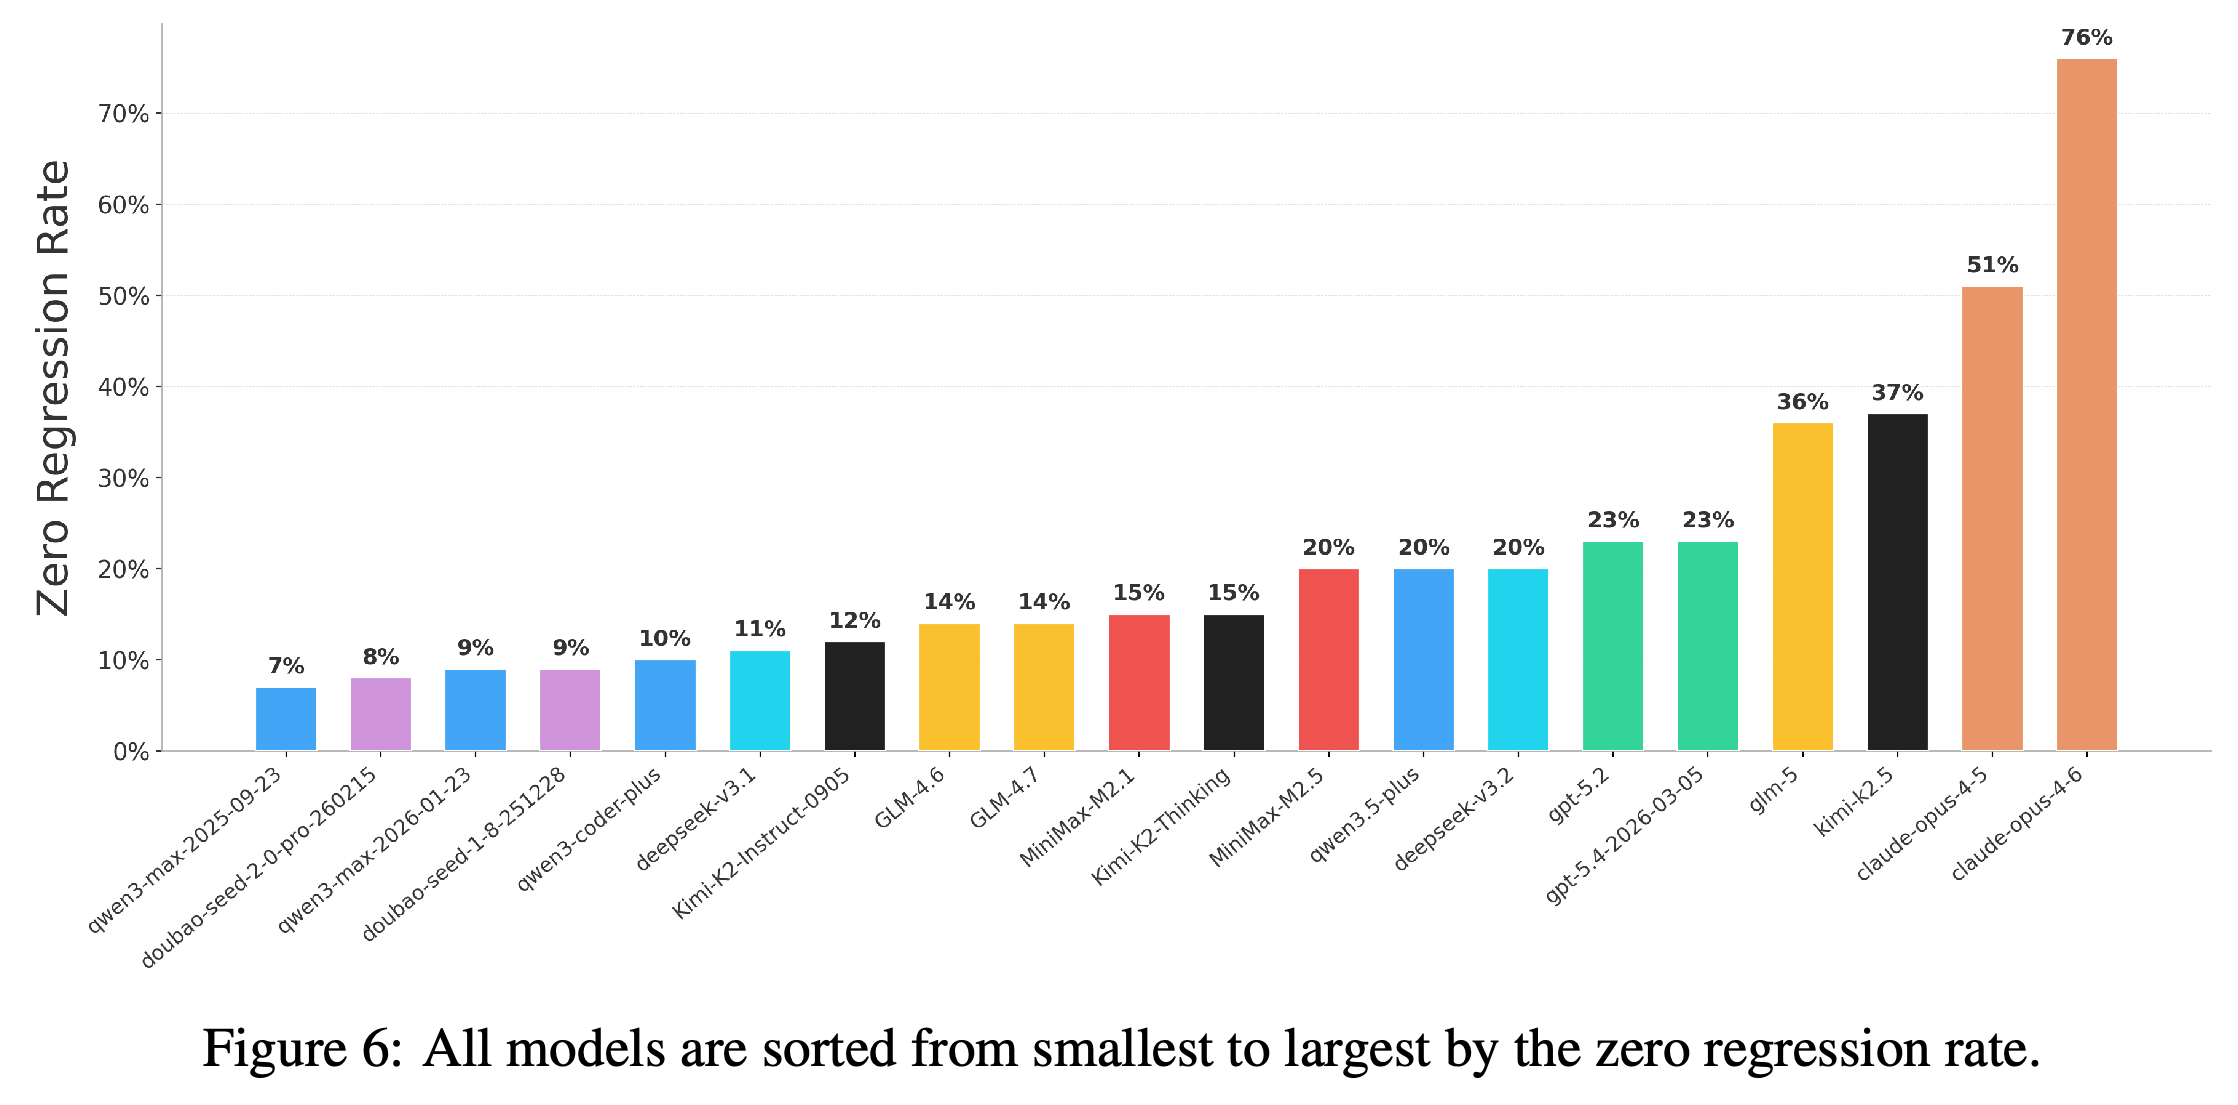
Observation 3은 zero-regression rate를 유지보수 과정 어디에서도 기존에 통과한 테스트가 실패하지 않은 샘플의 비율로 정의한다. 대부분 모델의 점수는 0.25 미만이다. Figure 6에서 claude-opus-4-5는 51%, claude-opus-4-6은 76%이며, 0.5를 넘는 모델은 이 2개뿐이다.
- 회귀를 나중에 수정하더라도 해당 궤적은 회귀가 0건인 경우로 집계되지 않는다.
- GLM-5와 kimi-k2.5는 각각 36%와 37%를 기록한다.
막대는 전체 유지보수 궤적에서 모든 회귀를 피했는지를 측정하며, 최종 성공 여부를 측정하는 것은 아니다. claude-opus-4-5와 claude-opus-4-6은 각각 51%와 76%를 기록한다. 평가한 모델 대부분은 25% 미만이다.
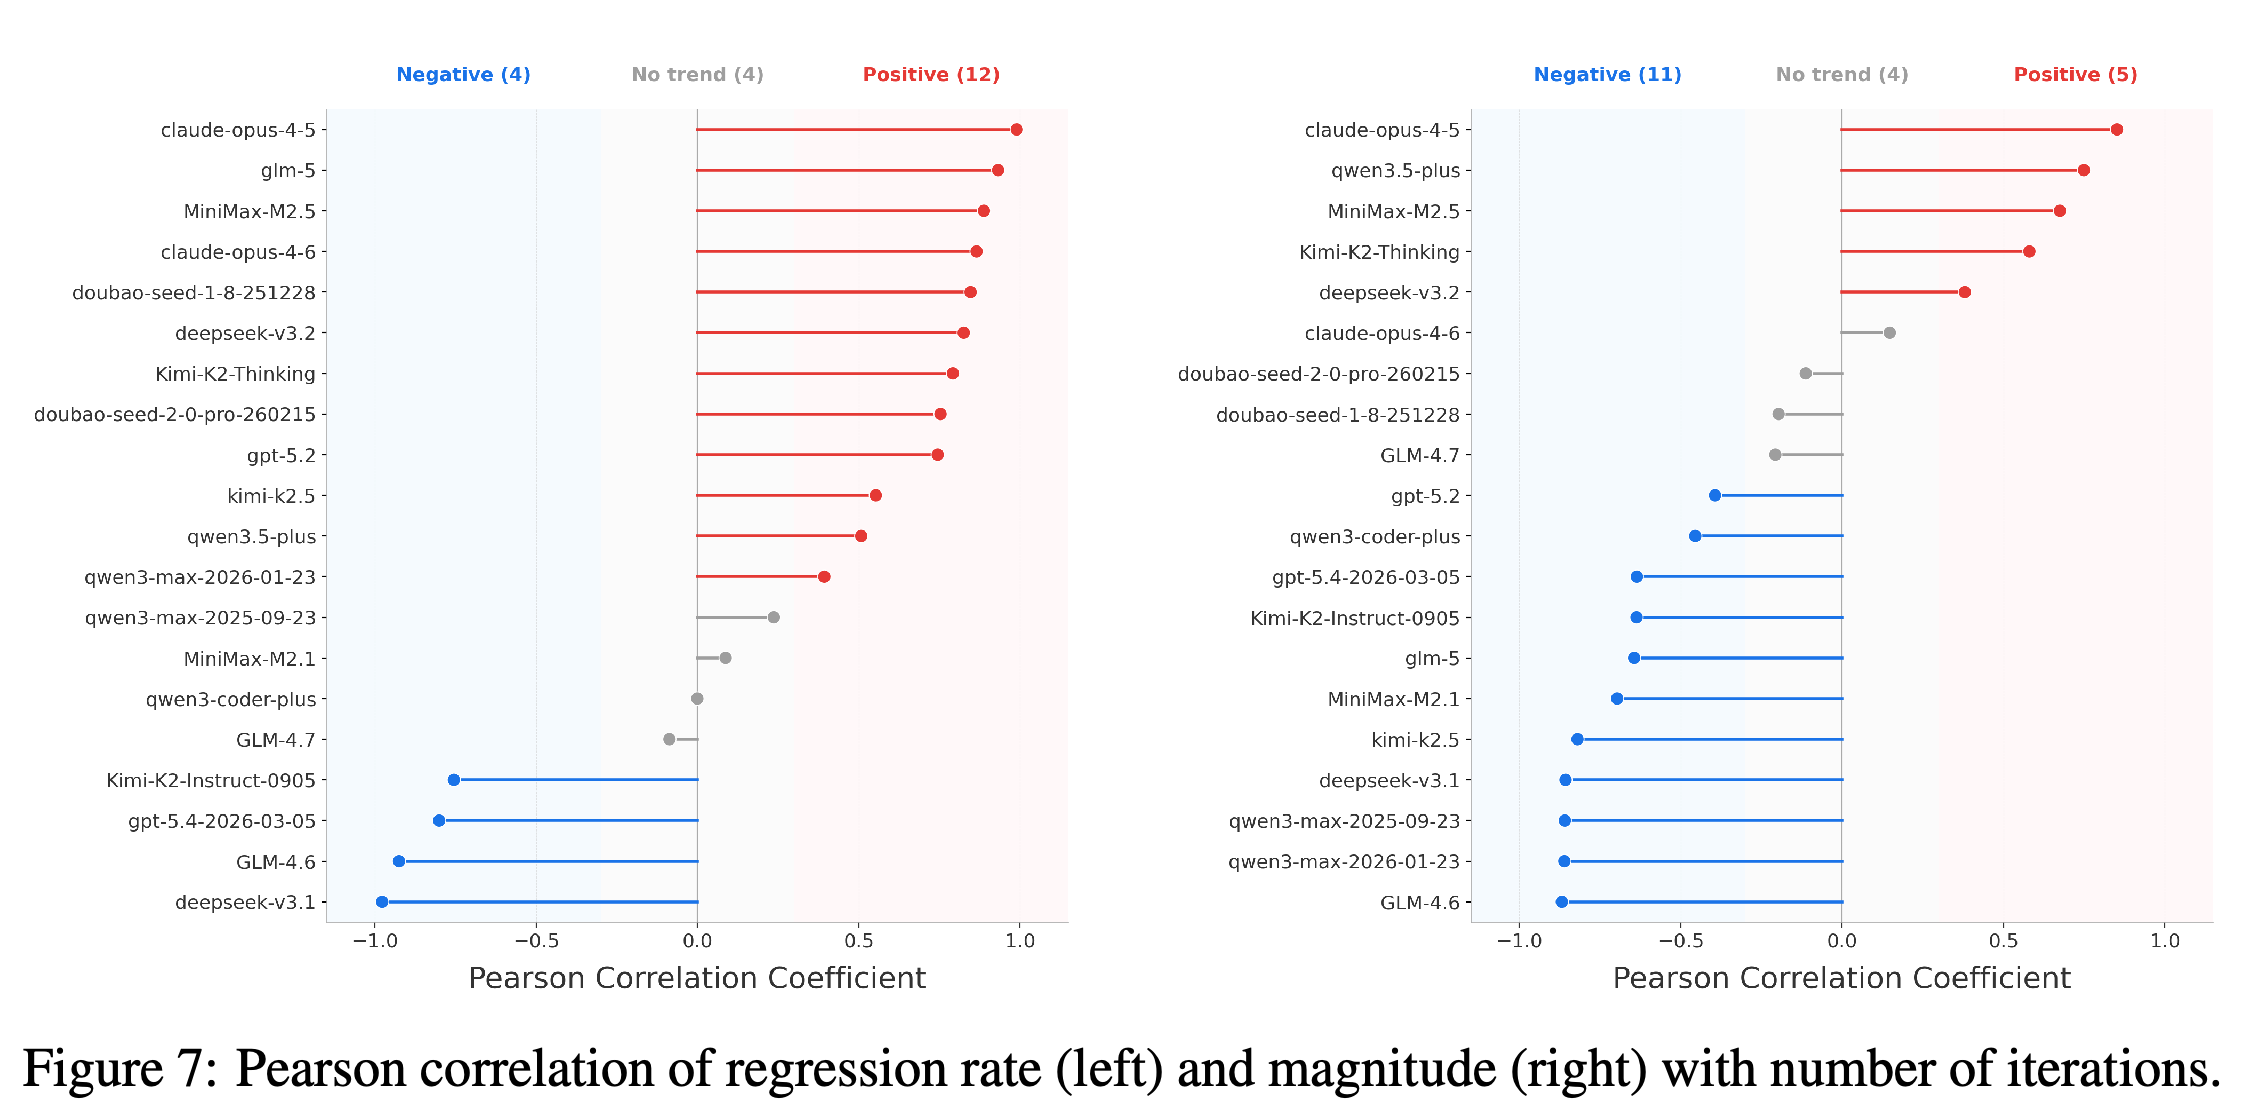
Observation 4는 반복 횟수와 회귀 발생률 또는 회귀 규모 사이의 Pearson 상관관계를 살펴본다. Figure 7은 20개 중 12개 모델의 회귀 발생률이 양의 상관관계를 보이고, 20개 중 11개 모델의 회귀 규모가 음의 상관관계를 보인다고 분류한다.
- 각각 집계한 모델 수는 후반에 회귀가 더 자주 발생하지만 규모는 작아지는 경향을 제한적으로 뒷받침한다. 모든 모델에서 동일하게 나타나는 추세는 아니다.
- 저자들은 남은 요구사항이 어려워지면서 후반 반복에서 더 국소적인 시행착오성 수정이 이루어진다고 추측한다.
- 이 상관관계는 기술 부채의 누적이 이러한 추세를 유발한다는 사실을 입증하지 않는다.
패널은 회귀 빈도와 규모를 구분한다. 12개 모델은 반복 횟수와 회귀 발생률 사이에 양의 상관관계가 있는 것으로, 11개 모델은 반복 횟수와 회귀 규모 사이에 음의 상관관계가 있는 것으로 분류된다. 이는 별도로 집계한 수이며, 모든 모델에서 같은 추세가 일관되게 나타난다는 근거는 아니다.
4.4 Coding style
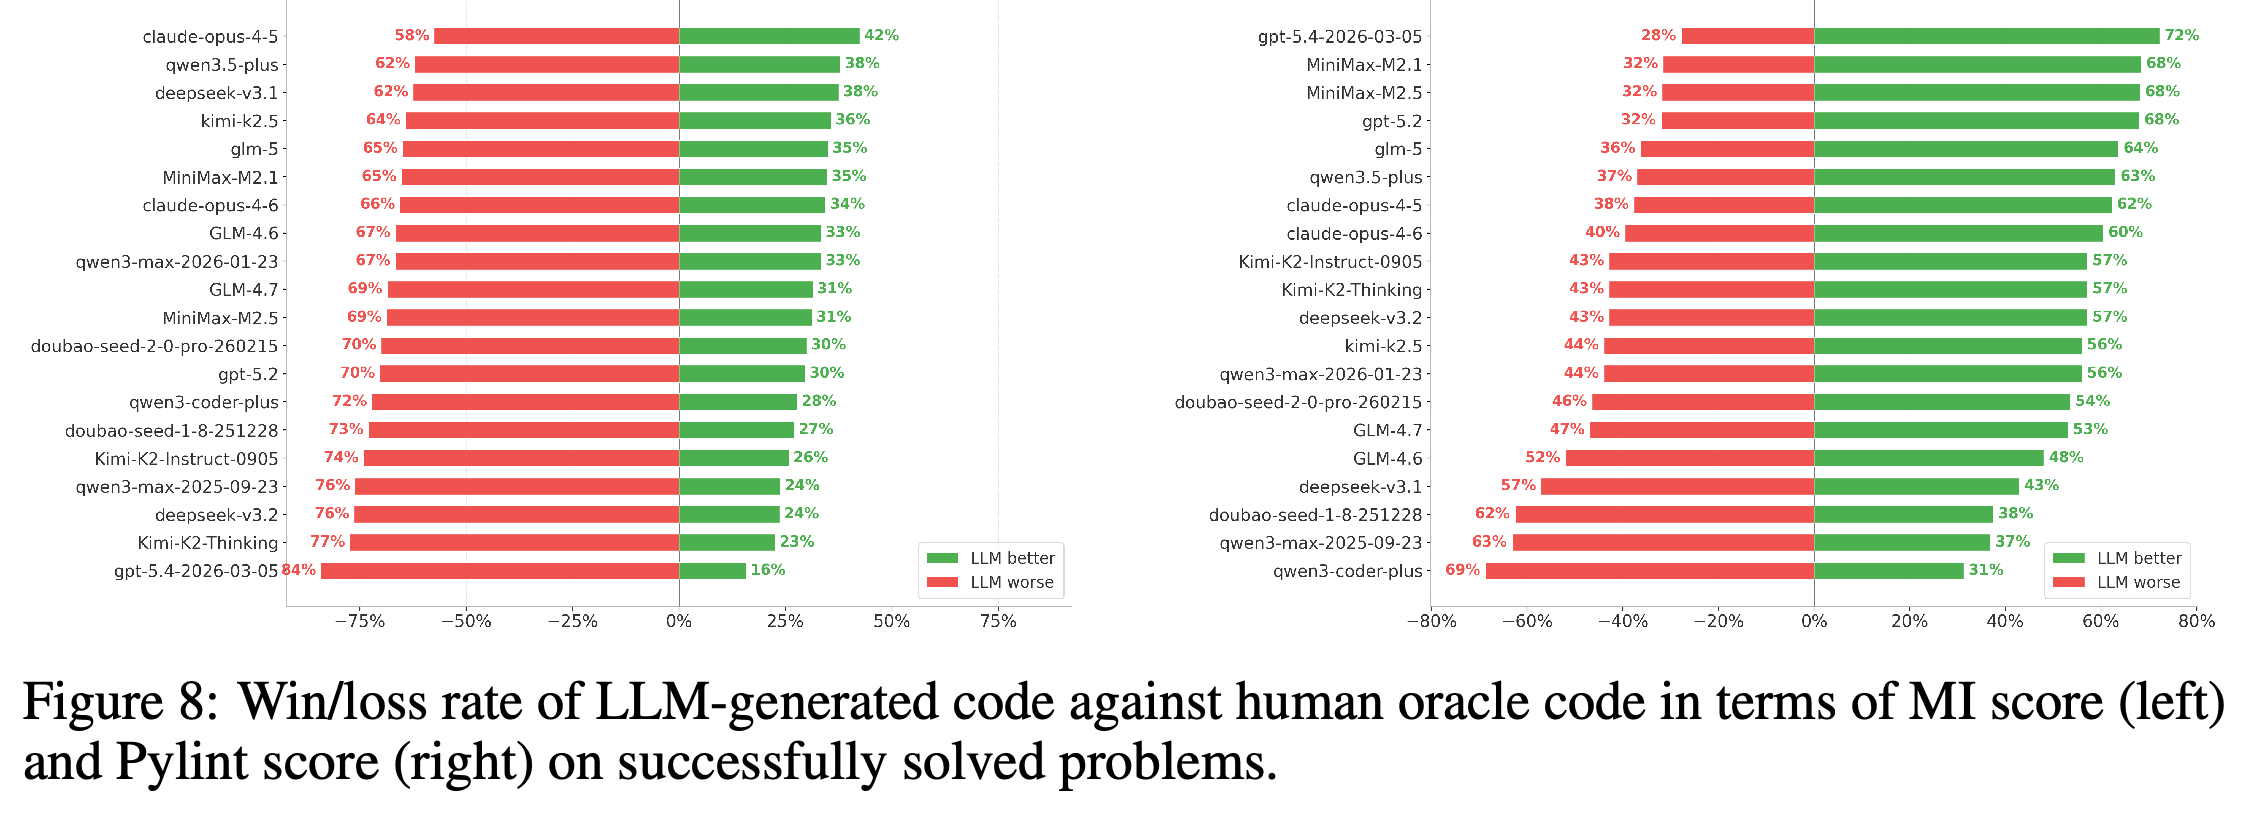
Observation 5는 해결에 성공한 과제에 한해서 에이전트가 생성한 코드와 인간의 oracle 코드를 비교한다. Figure 8에서 20개 중 15개 모델은 Pylint 승패 비교에서 우세하지만, 20개 모델 모두 MI 점수 비교에서는 열세다.
- 논문은 Pylint로 이름 지정이나 줄 길이 같은 코딩 규칙을 평가하고, MI로 순환 복잡도 등을 포함한 구조적 지표를 평가한다.
- 이 결과는 코딩 규칙에서 좋은 점수를 받더라도 선택한 유지보수성 지표에서는 좋은 점수를 받지 못할 수 있음을 보여준다.
- 이는 집계된 승패 경향이다. 생성한 모든 해결 코드의 MI가 대응하는 인간 코드보다 낮다는 근거는 아니다.
해결에 성공한 과제에서 모든 모델은 인간의 oracle 코드와 비교한 MI에서 승리보다 패배가 더 많다. 반면 15개 모델은 Pylint에서 승리가 더 많다. 이 차이는 선택한 코딩 규칙 기반 지표와 구조적 코드 지표에서의 성능을 구분한다.
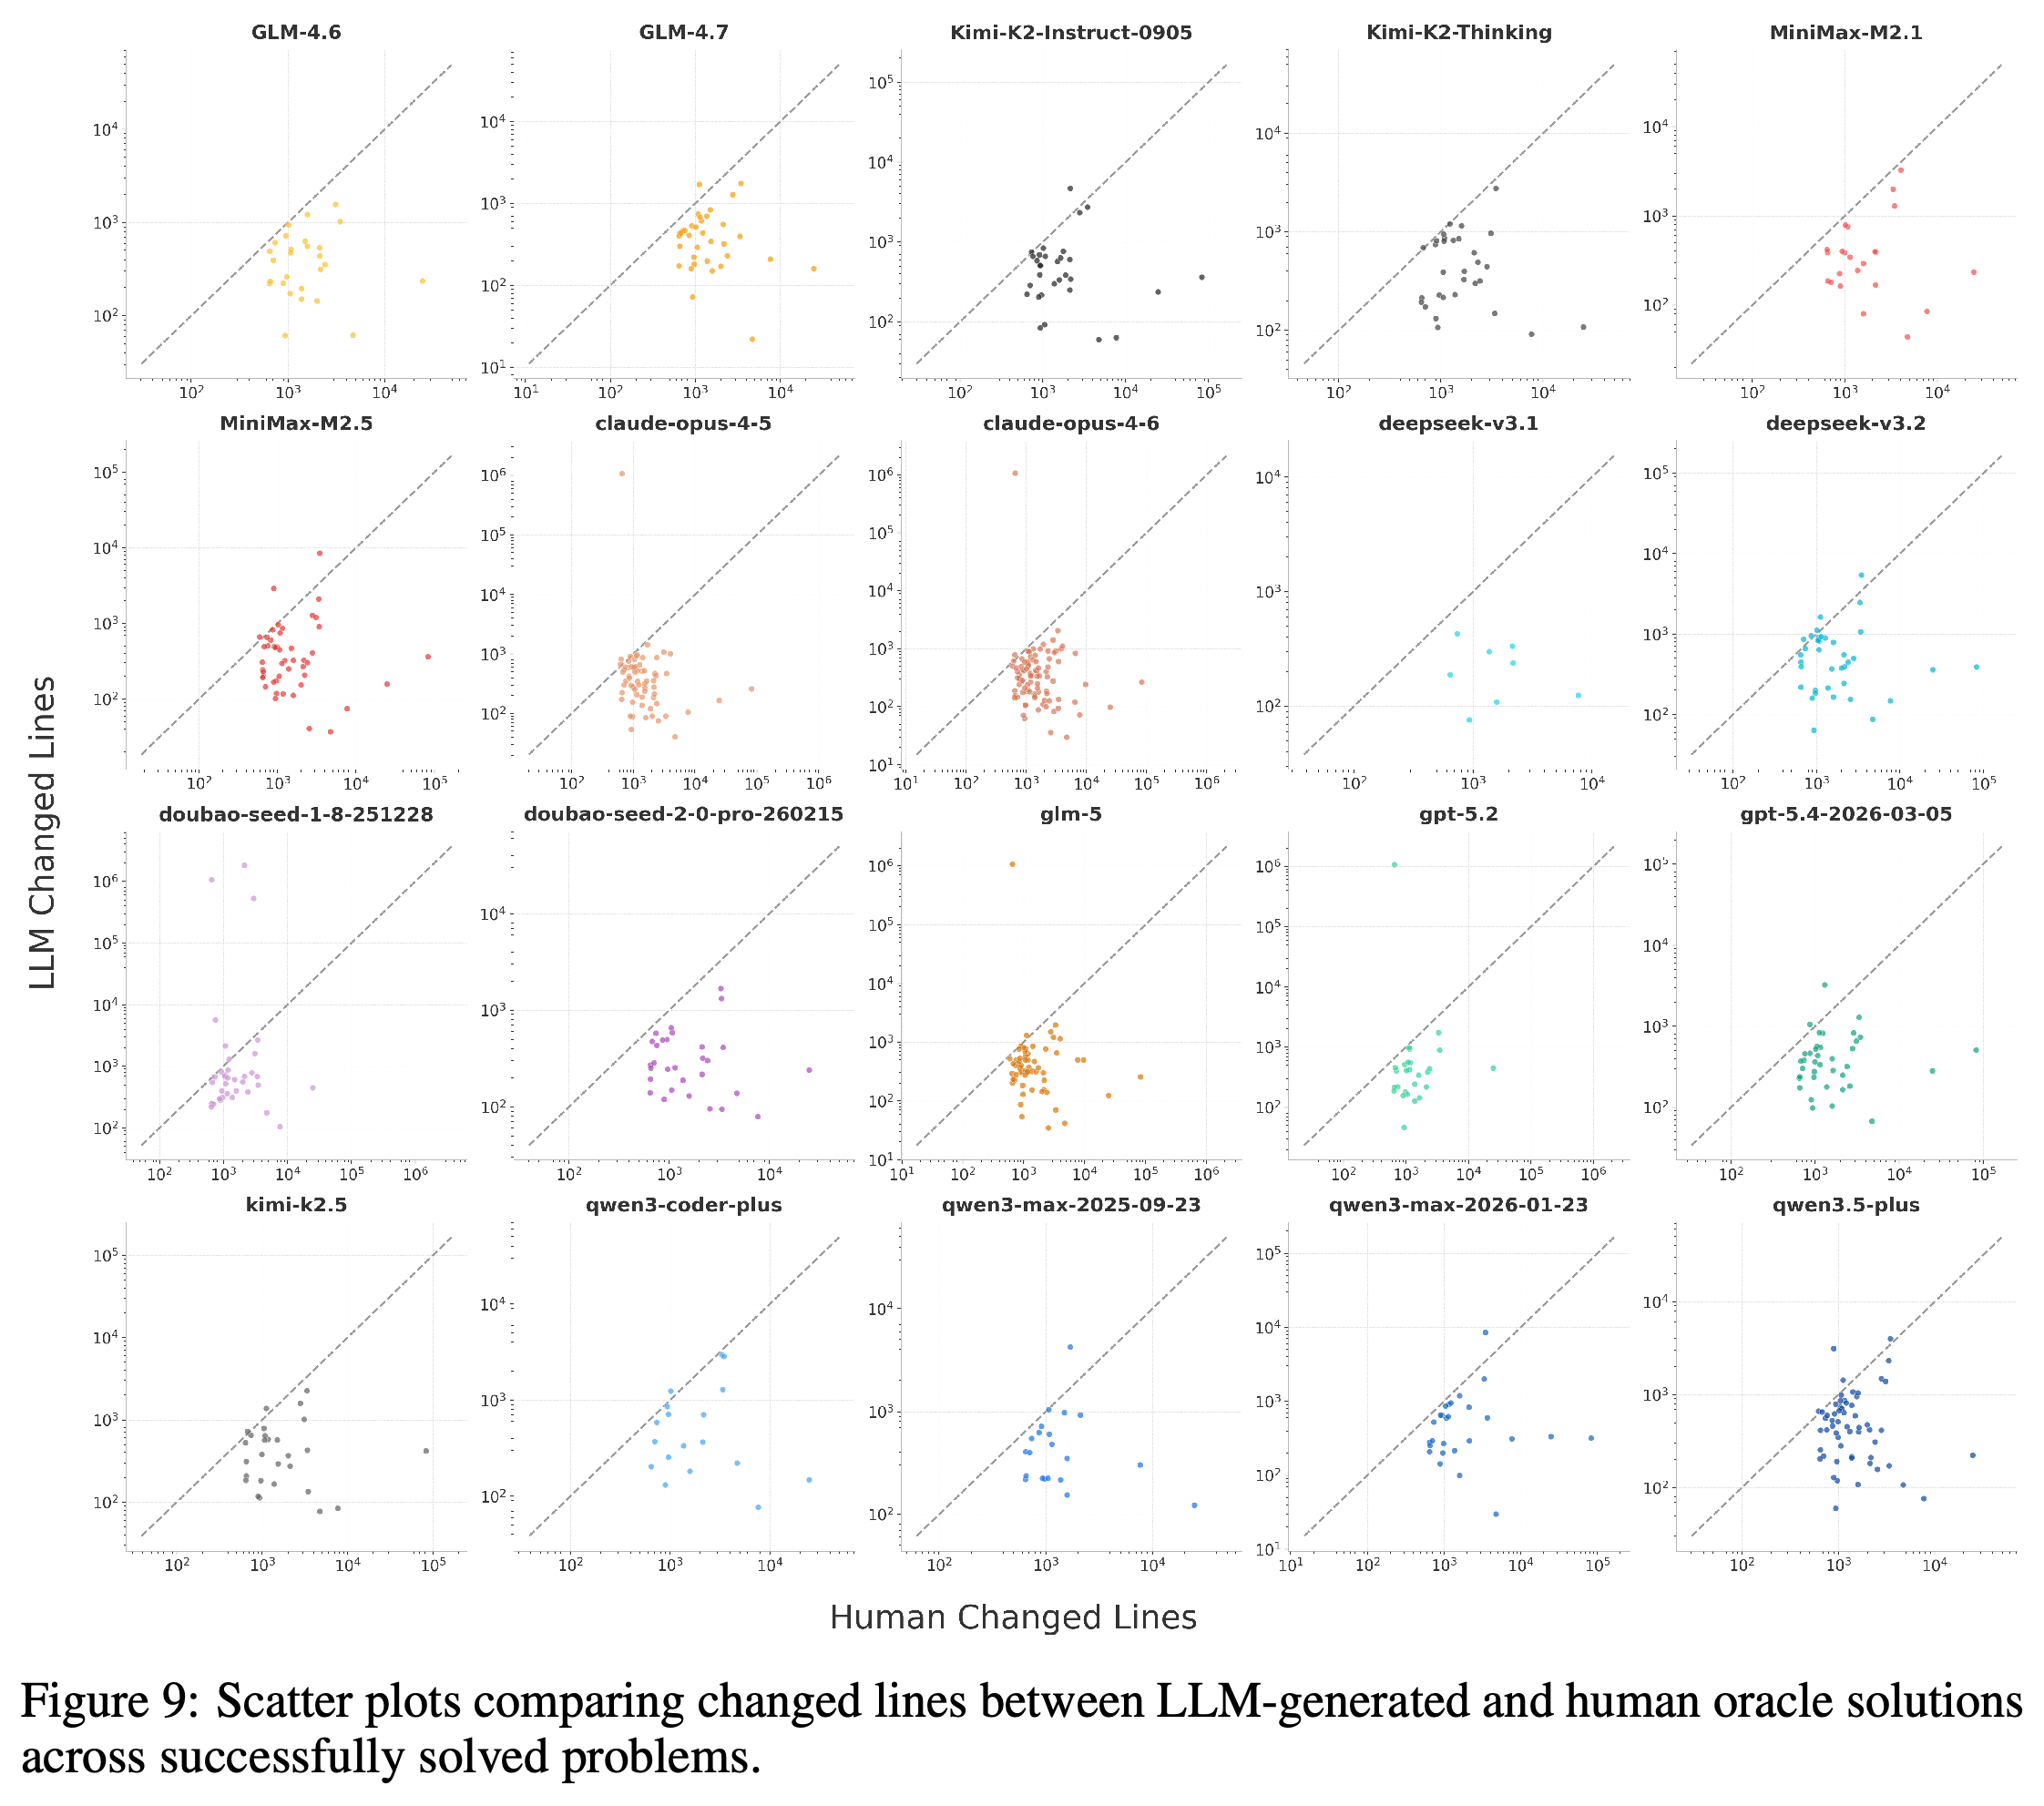
Observation 6은 해결에 성공한 과제에서 변경된 줄 수를 비교한다. Figure 9에서는 20개 모델 전반에 걸쳐 점들이 두 값이 같은 대각선 아래에 모여 있다. 이는 에이전트 패치가 과거 인간이 수행한 변경보다 대체로 작다는 뜻이다.
- 저자들은 MI 결과와 함께 작은 패치를 추상화, 캡슐화, 모듈화보다 당장의 기능 구현을 우선한 결과로 해석한다.
- 이 비교는 작은 패치가 낮은 유지보수성을 유발한다거나, 인간이 추가로 변경한 부분이 아키텍처 개선을 위한 투자였다는 사실을 입증하지 않는다.
- Programmer 프롬프트는 필요한 변경만 수행하고 범위를 확장하지 않도록 요구한다. 이 조건도 패치 크기 비교에 영향을 준다.
각 패널은 인간이 변경한 줄 수와 에이전트가 변경한 줄 수를 비교하며, 대각선은 두 값이 같은 지점을 나타낸다. 점들은 대체로 대각선 아래에 있어, 해결한 과제에서 에이전트 패치가 더 작음을 보여준다. 이 그래프는 인간이 추가로 변경한 부분의 목적이나 유지보수성 측면의 가치를 입증하지 않는다.
5 Conclusion
결론은 SWE-CI를 반복적인 코드 수정 상황에서 기능적 정확성을 평가하는 벤치마크로 제시한다. 에이전트가 최종적으로 목표 테스트를 만족하더라도, 회귀 방지는 평가한 모델 전반에서 여전히 큰 약점이다.
- 벤치마크는 상당한 저장소 진화 구간, 계속 유지되는 에이전트 수정 코드베이스, 궤적 기반 진단을 결합한다.
- 결과는 평가한 워크플로를 설명한다. 모델 자체의 능력과 요구사항 생성 및 harness의 효과를 분리하지는 않는다.
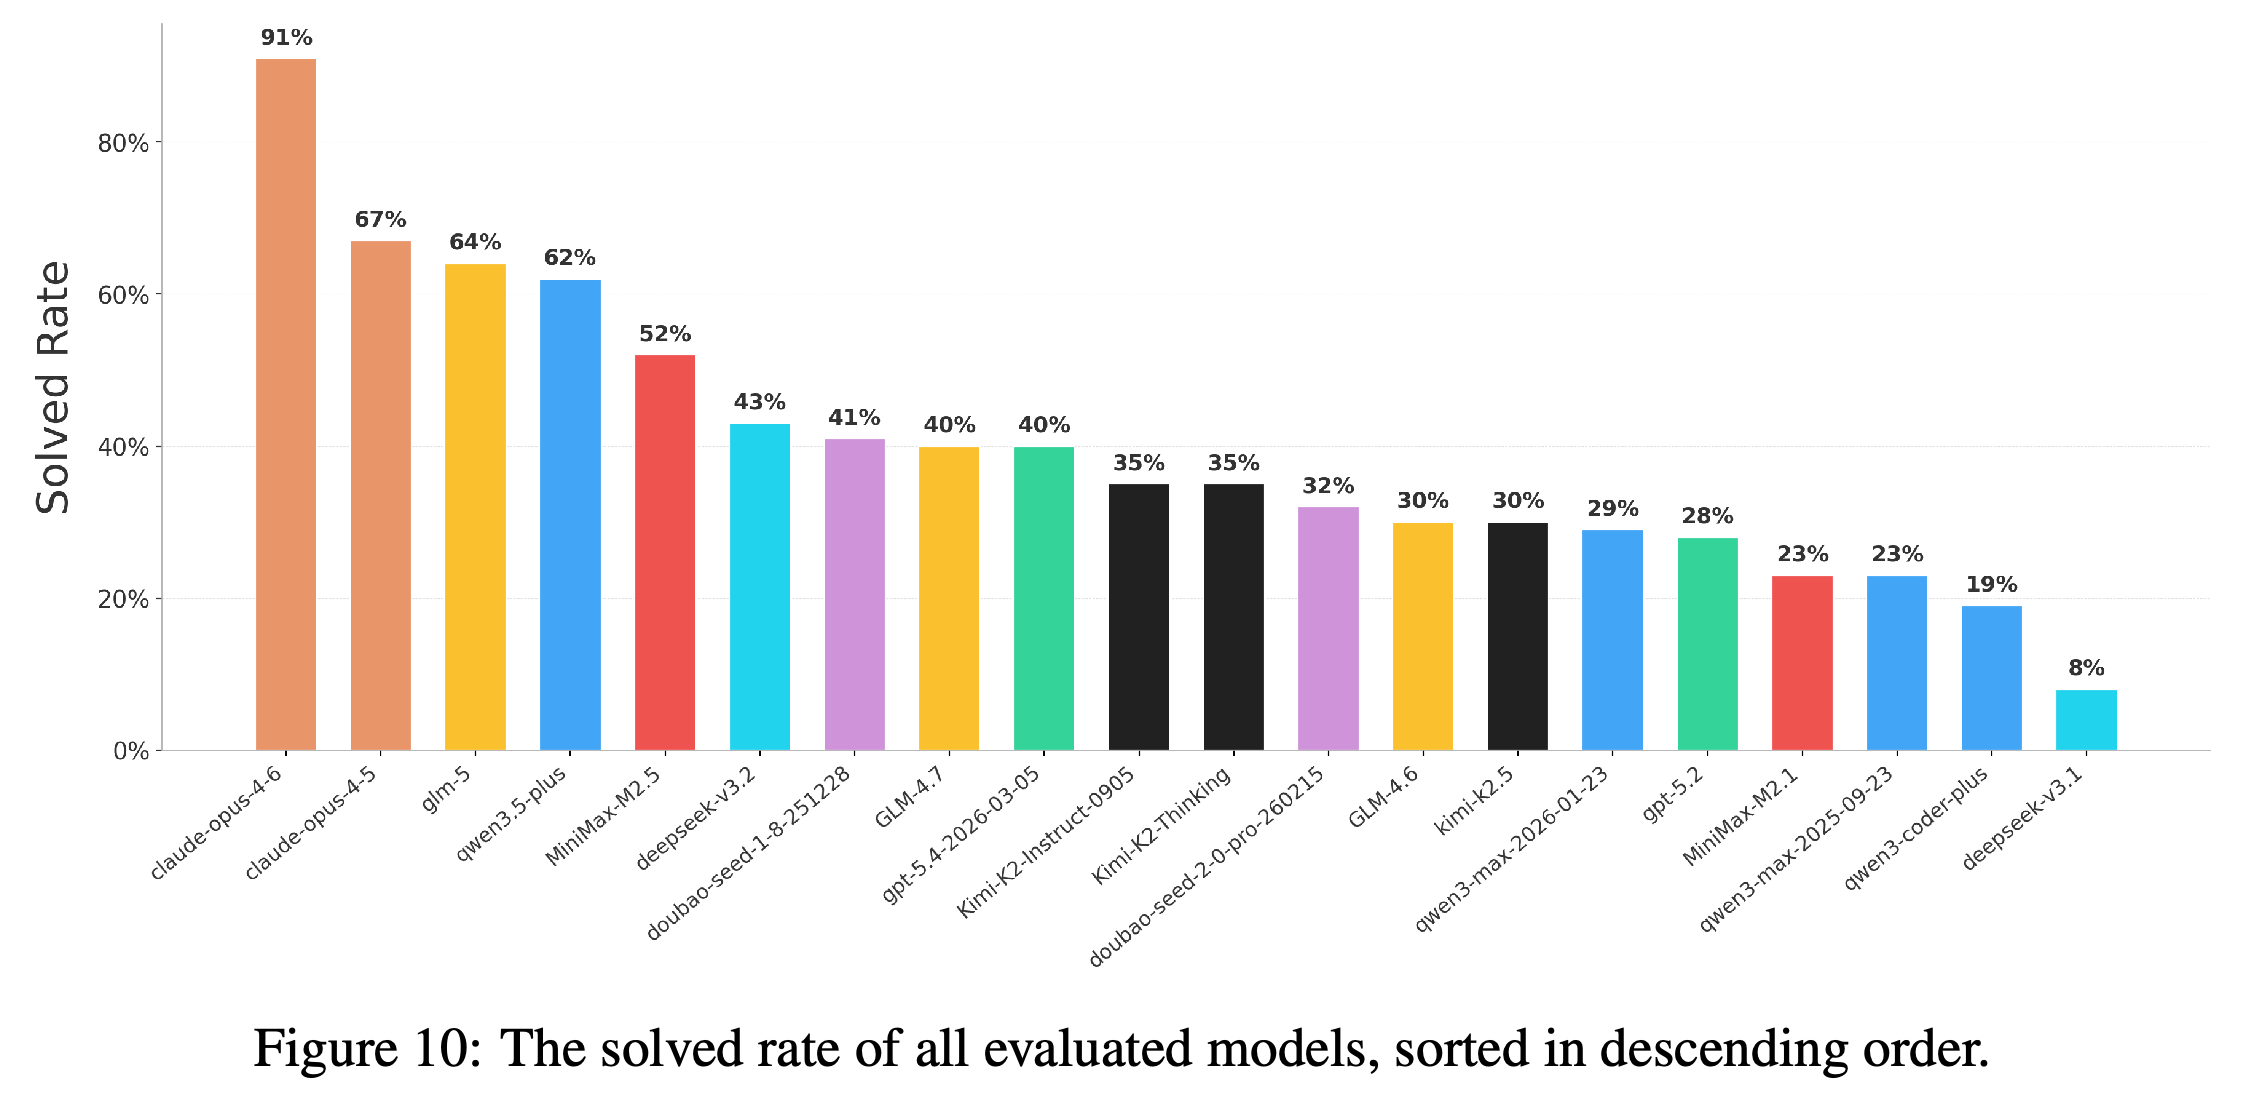
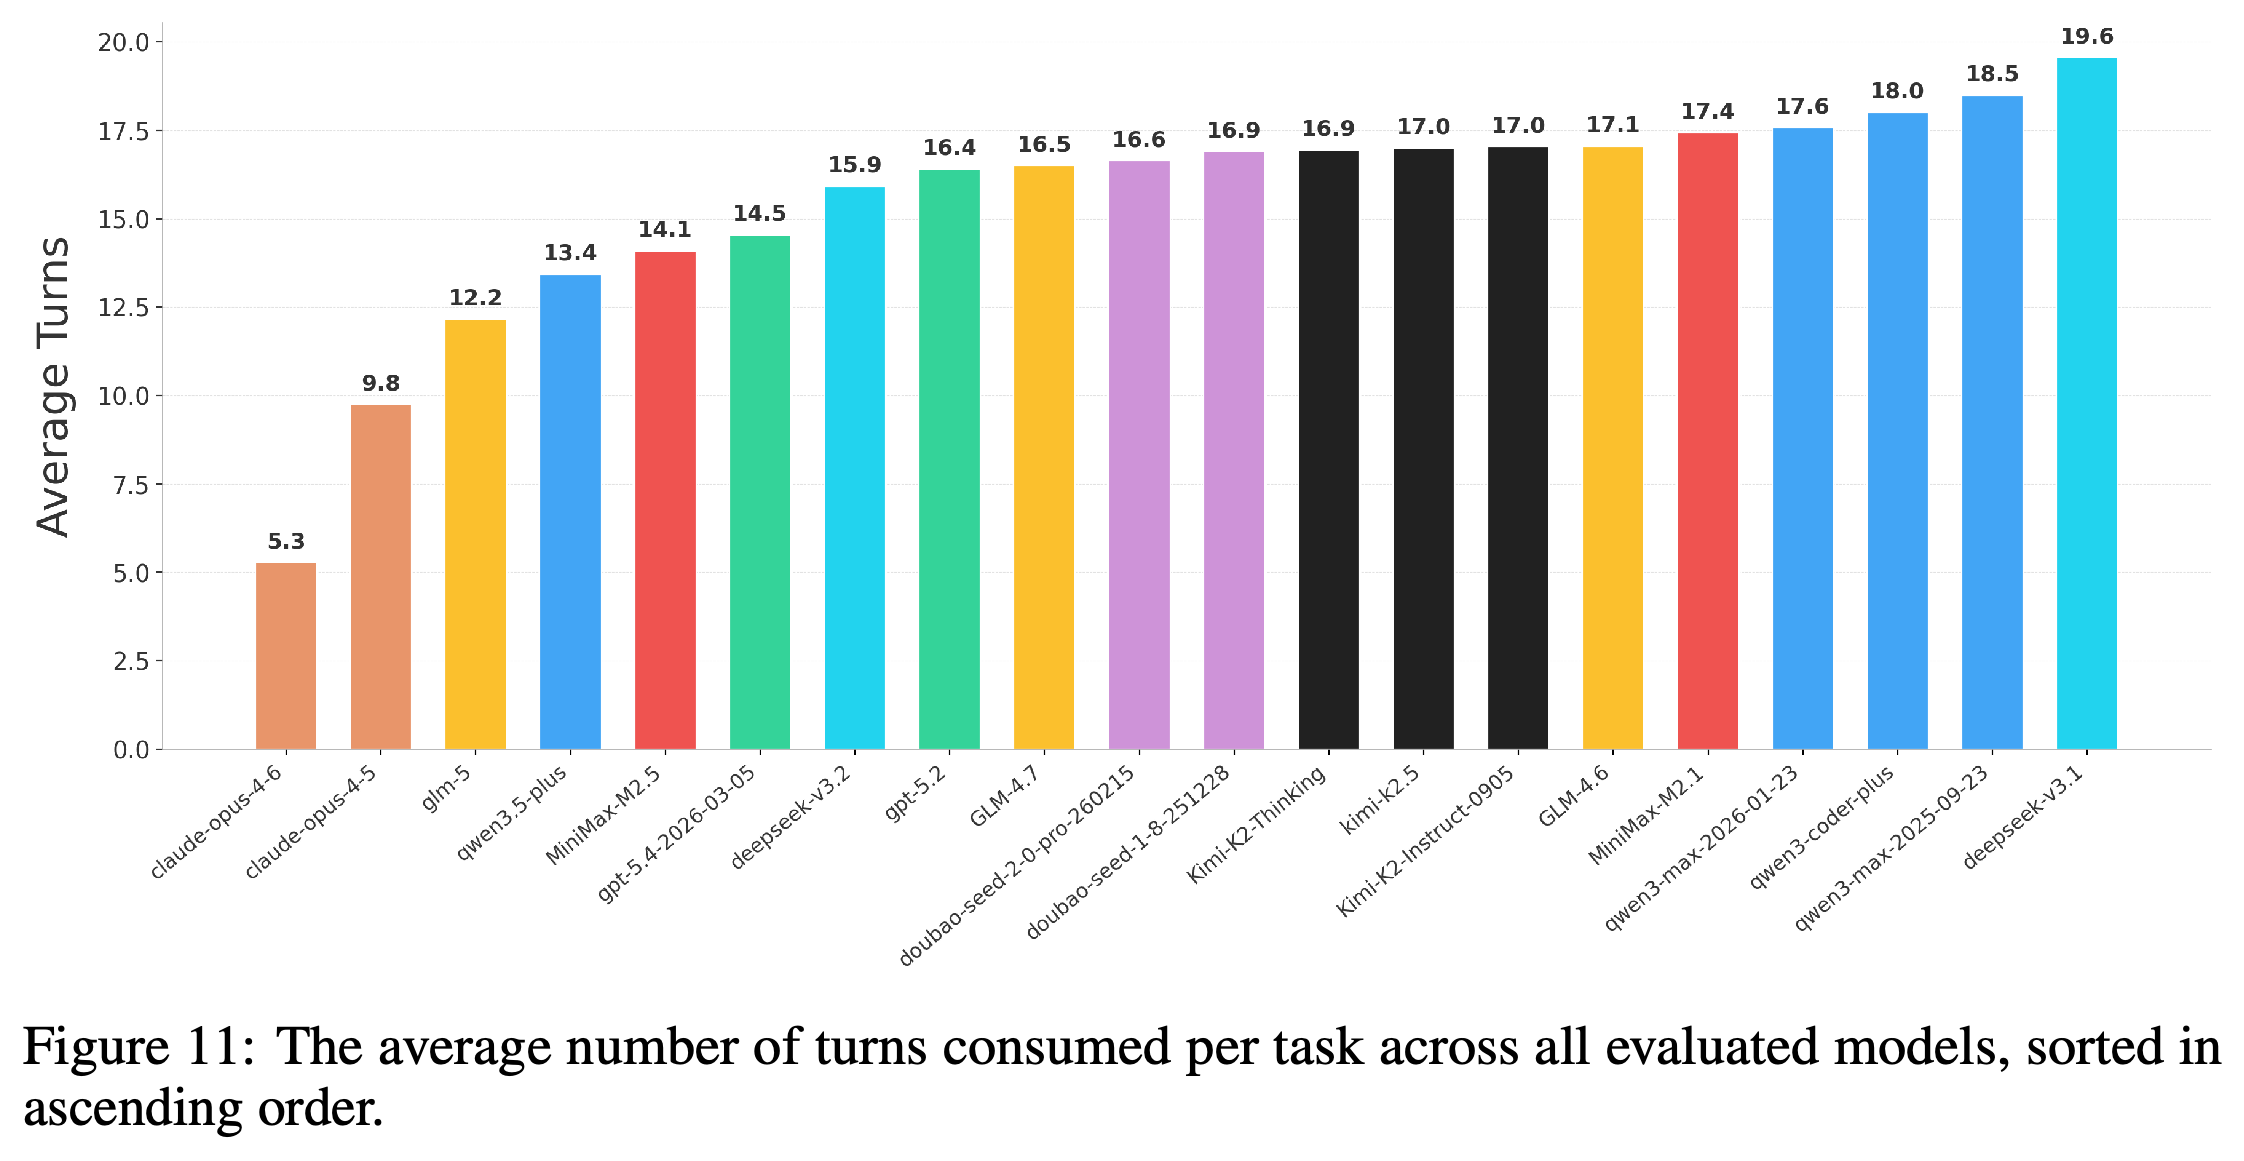
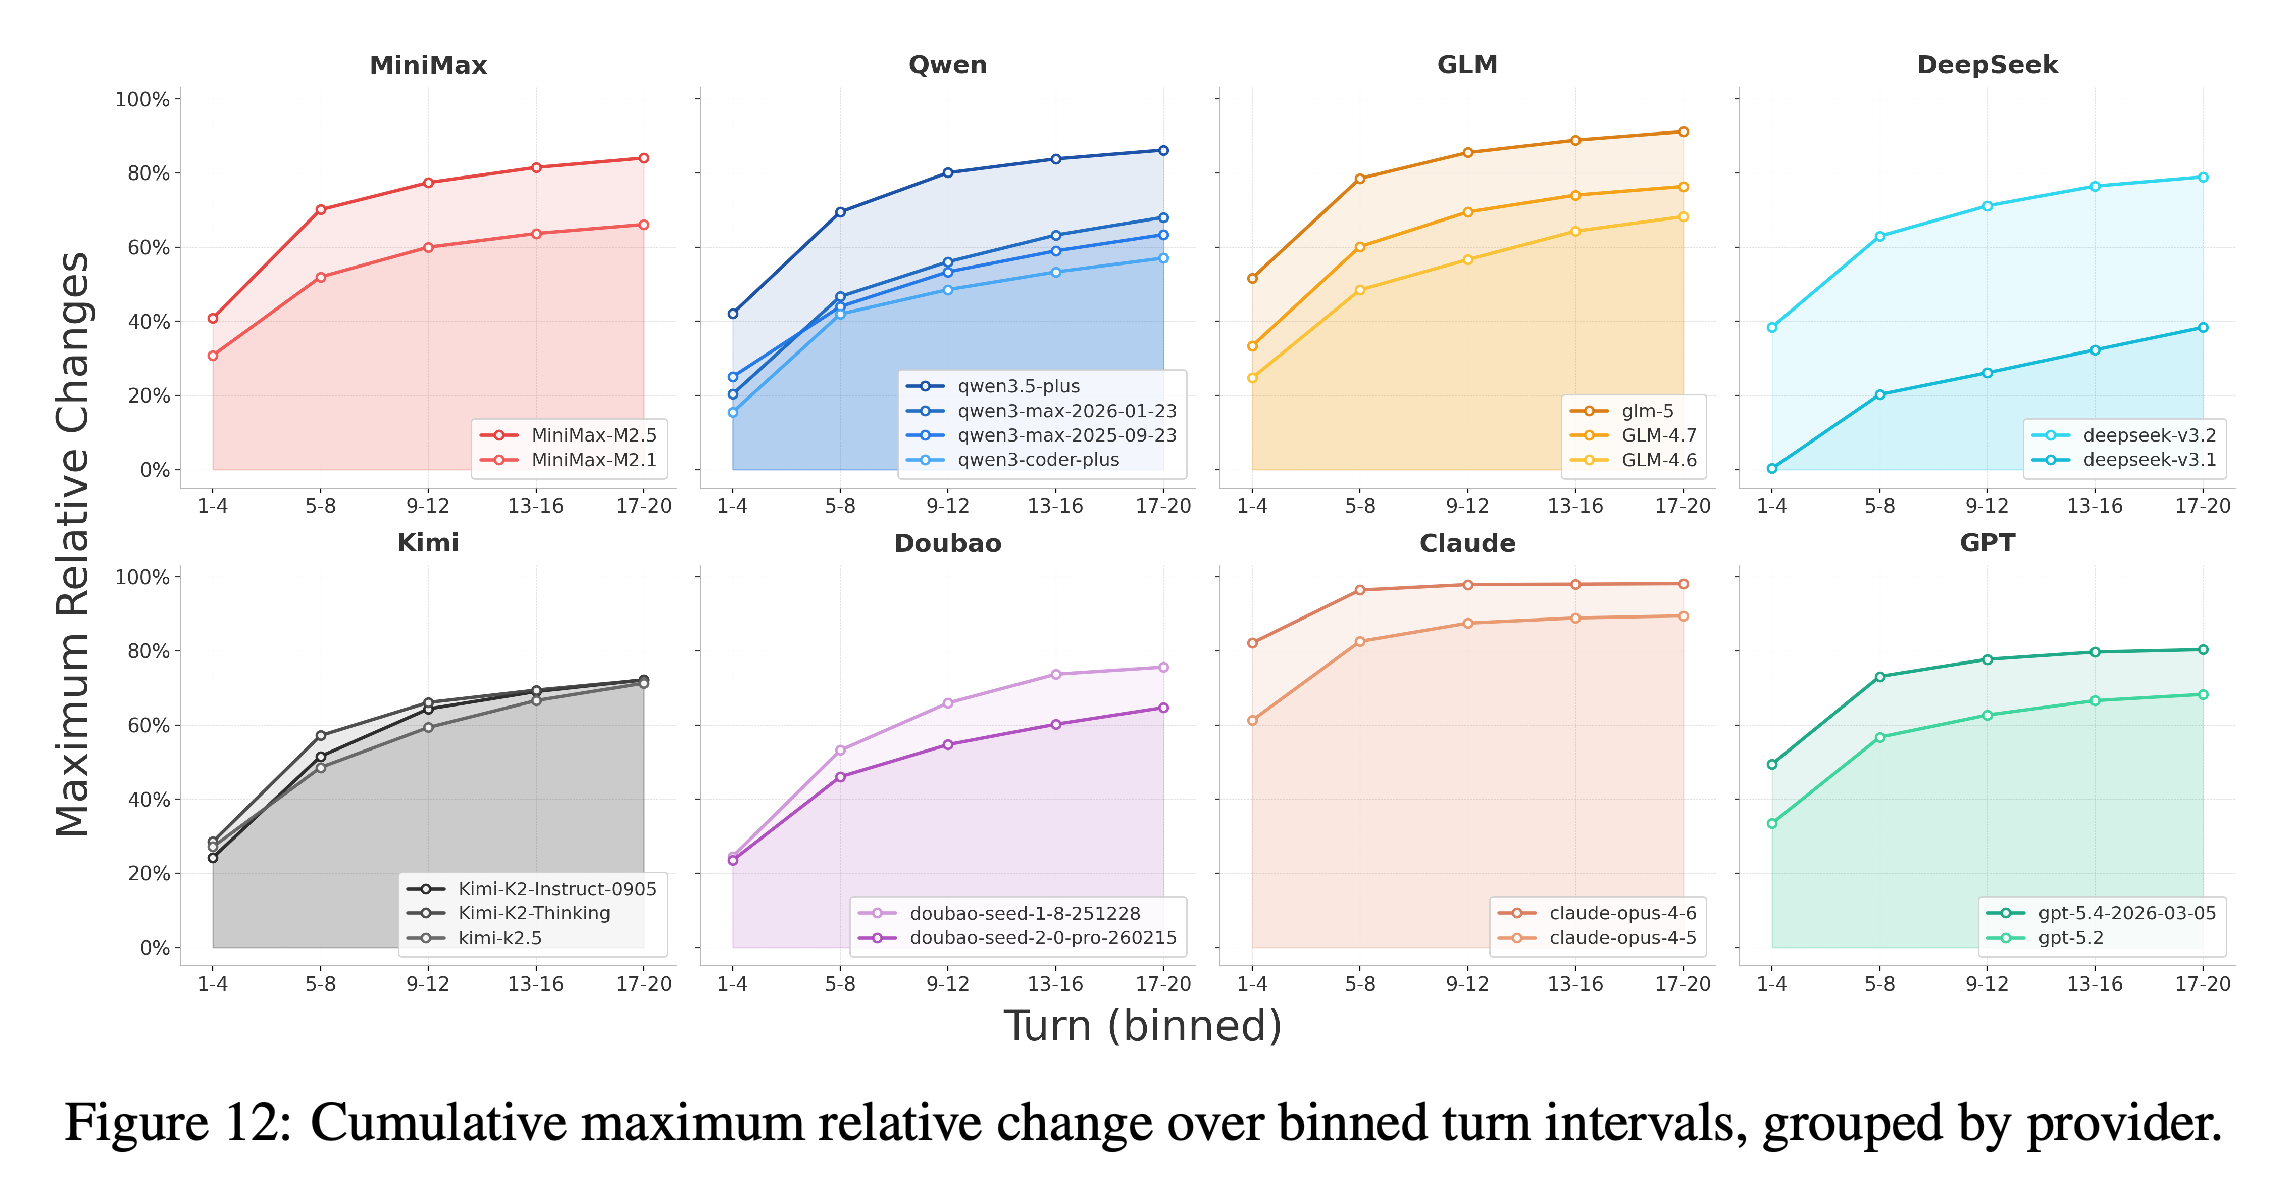
부록은 보완적인 진단을 제공한다. 대부분 모델은 과제의 50% 미만을 해결하고, 성능이 낮은 모델은 20턴 한도에 가까워지는 경향이 있다. 누적 최고 진전은 초기 1–4턴에서 이미 상당한 수준에 도달한다. Figures 10–12는 전체 과제 성공률, 턴 사용량, 연속된 턴 구간별 진전을 요약한다.
- Figure 10에서 해결률은 claude-opus-4-6이 91%, claude-opus-4-5가 67%, glm-5가 64%, qwen3.5-plus가 62%다.
- Figure 11에서 평균 턴 수는 claude-opus-4-6이 5.3턴이고 deepseek-v3.1이 19.6턴이다.
- Figure 12는 누적 최댓값을 사용하므로 곡선이 내려갈 수 없으며, 일시적인 회귀를 보여주지 않는다.
전체 과제 성공률은 claude-opus-4-6의 91%에서 deepseek-v3.1의 8%까지 분포한다. 50%를 넘는 모델은 5개뿐이다. 이 벤치마크에서 부분적인 진전은 테스트로 확인한 oracle의 기능을 완전히 복원하는 데 미치지 못하는 경우가 많다.
20턴 한도에서 평균 턴 사용량은 claude-opus-4-6의 5.3턴에서 deepseek-v3.1의 19.6턴까지 분포한다. 성능이 높은 모델은 흔히 더 일찍 마친다. 다만 모델 간 비교는 동일한 모델의 예산을 늘릴 때 얻는 이점을 측정하지 않는다.
제공사별로 묶은 곡선은 초기에 상당한 누적 진전이 있고, 이후 구간에서도 개선이 이어지지만 후반으로 갈수록 증가 폭이 대체로 작아짐을 보여준다. 이 통계는 누적 최댓값이므로 일시적인 악화를 드러내지 않는다. 따라서 회귀 분석과 함께 해석해야 한다.
부록
- A Related Work는 함수 수준의 코드 생성, 저장소 수준의 소프트웨어 엔지니어링, 장기 작업 및 진화를 고려한 평가, 소프트웨어 유지보수성 연구를 검토한다. SWE-CI를 InterCode, Commit0, LongCLI-Bench, SWE-Bench-CL, SWE-EVO와 비교하며, 에이전트가 수정한 동일한 코드베이스에서 반복적인 개발의 결과가 누적되는 과정에 초점을 둔다.
- B Additional Experiments는 3가지 진단을 추가한다. B.1 Solved rate는 마지막에 요구사항을 완전히 만족한 과제의 비율을 측정한다. 순위는 대체로 EvoScore와 일치하며, 대부분 모델은 50% 미만에 머문다. 논문은 해결률을 (\gamma\to\infty)와 연결하지만, 제시된 EvoScore 수식의 극한은 최종 Normalized Change이지 전체 과제 성공 여부를 나타내는 이진 지표가 아니다.
- B.2 Average turns는 성능이 높은 모델이 흔히 더 일찍 마치는 반면, 성능이 낮은 모델은 20턴 한도에 가까워짐을 보여준다. B.3 Maximum relative changes는 1–4, 5–8, 9–12, 13–16, 17–20턴 구간에서 누적 최고 진전을 그린다. 저자들은 초기에 큰 진전이 있고 이후 개선은 느려진다고 보고한다. 어느 분석도 동일한 모델의 반복 예산을 20회 넘게 늘리면 도움이 되는지 검증하지 않는다.
- C Prompts는 System Prompt for Architect Agent와 System Prompt for Programmer Agent를 제공한다. Architect는 /app/non-passed/summary.jsonl, 관련 테스트, 소스 코드를 살펴본 뒤 location, description, contract, acceptance 필드를 갖춘 요구사항 1개에서 5개를 /app/requirement.xml에 작성한다. 수정은 이 문서에만 허용된다.
- Programmer는 /app/requirement.xml을 읽고 관련 코드와 필요에 따라 테스트를 살펴본 뒤, /app/code/ 아래의 소스 파일을 수정한다. /app/code/tests/와 요구사항 문서는 변경하지 않는다. 에이전트 모두 직접 테스트를 실행할 수 없으며, Programmer는 개발 범위를 넓히지 말고 필요한 변경만 하도록 지시받는다.
짧은 생각
최종 성공 여부와 궤적의 안정성은 서로 다른 정보를 제공한다. claude-opus-4-6은 과제의 91%를 해결하지만, 모든 회귀를 피한 과제는 76%다. 최종 통과·실패 점수만 사용하면 코드베이스를 계속 유지하는 평가에서 드러난 회귀를 놓치게 된다.
EvoScore는 반복적인 수정에서의 진전을 측정하며, 유지보수성의 인과적 추정치는 아니다. 요구사항은 독립적으로 들어오는 미래 요청이 아니라 고정된 목표 테스트 모음에서 생성한다. 또한 대체로 동일한 모델이 요구사항 분석과 구현을 모두 수행한다. 의존성이 바뀌지 않는 구간만 남기는 필터와 Python 전용 데이터셋은 포함되는 유지보수 상황의 범위를 좁힌다. 정적 코드 비교는 시도한 모든 해결 코드가 아니라 해결에 성공한 과제만 다룬다. 논문은 신뢰구간이나 Architect, Programmer, harness의 기여를 분리하는 통제된 ablation을 보고하지 않는다.
MI와 패치 크기 결과는 간결한 에이전트 코드가 유지보수성을 희생한다는 사실을 입증하지 않는다. 과거 인간의 변경은 더 넓은 개발 과정을 포함하는 반면, Programmer 프롬프트는 필요한 최소한의 수정을 권장한다. 두 조건 모두 아키텍처 능력과 별개로 비교 결과에 영향을 줄 수 있다.