


Efficient Exploration at Scale 요약 설명
18 Mar 2026 | Paper Review Reinforcement Learning From Human Feedback Active Exploration Epistemic Neural Networks목차
- 요약
- 1. Introduction
- 2. Literature Review
- 3. Experiment Pipeline
- 4. Algorithms
- 5. Results
- 6. Conclusions and Future Work
- 부록
- 짧은 생각
이번 글에서는 Efficient Exploration at Scale 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 18일(Arxiv)
- Asghari, Seyed Mohammad, Chute, Chris, Dwaracherla, Vikranth, Lu, Xiuyuan, Jafarnia, Mehdi, Minden, Victor, Wen, Zheng, Van Roy, Benjamin.
- Google DeepMind
- 논문 링크
요약
- Efficient Exploration at Scale은 LLM 정렬에 필요한 선호도 레이블을 줄이는 방법을 연구한다. 제안 알고리즘은 보상 모델과 언어 모델을 점진적으로 갱신한다. 정책 갱신을 안정화하는 affirmative nudge에 인식적 불확실성 모델링과 불확실성 기반 응답 쌍 선택을 결합한다.
- 실험에는 Gemma 9B 정책, 내부에서 수집한 202K개 프롬프트, 실제 인간 피드백으로 학습한 Gemini 1.5 Pro-based reward model이 생성한 모의 선호도를 사용한다. Information-directed exploration은 20K개 미만의 선택으로 200K개 선택 데이터로 학습한 offline RLHF와 같은 성능을 달성한다. 이 평가 설정에서 레이블 효율이 10배 넘게 개선된다.
- 1M개 레이블에서 1,000배 개선된다는 보고는 측정 결과가 아니라 외삽 결과다. 근거는 모의 피드백과 특정 모델 및 프롬프트 파이프라인에 한정된다. 저자들은 실험을 재현하기에 충분한 세부 정보를 이 보고서에서 제공하지 않는다고 명시한다.
1. Introduction
이 연구는 선호도 데이터의 양을 단순히 늘리기보다 학습에 더 유익한 데이터를 수집하는 문제를 다룬다. 제안한 RLHF 절차는 수집되는 선택 데이터로 보상 모델을 학습하고, 그 예측을 활용해 reinforce의 변형으로 언어 모델을 갱신한다. 차별화되는 3가지 구성 요소는 affirmative nudge, epistemic neural network, information-directed exploration이다.
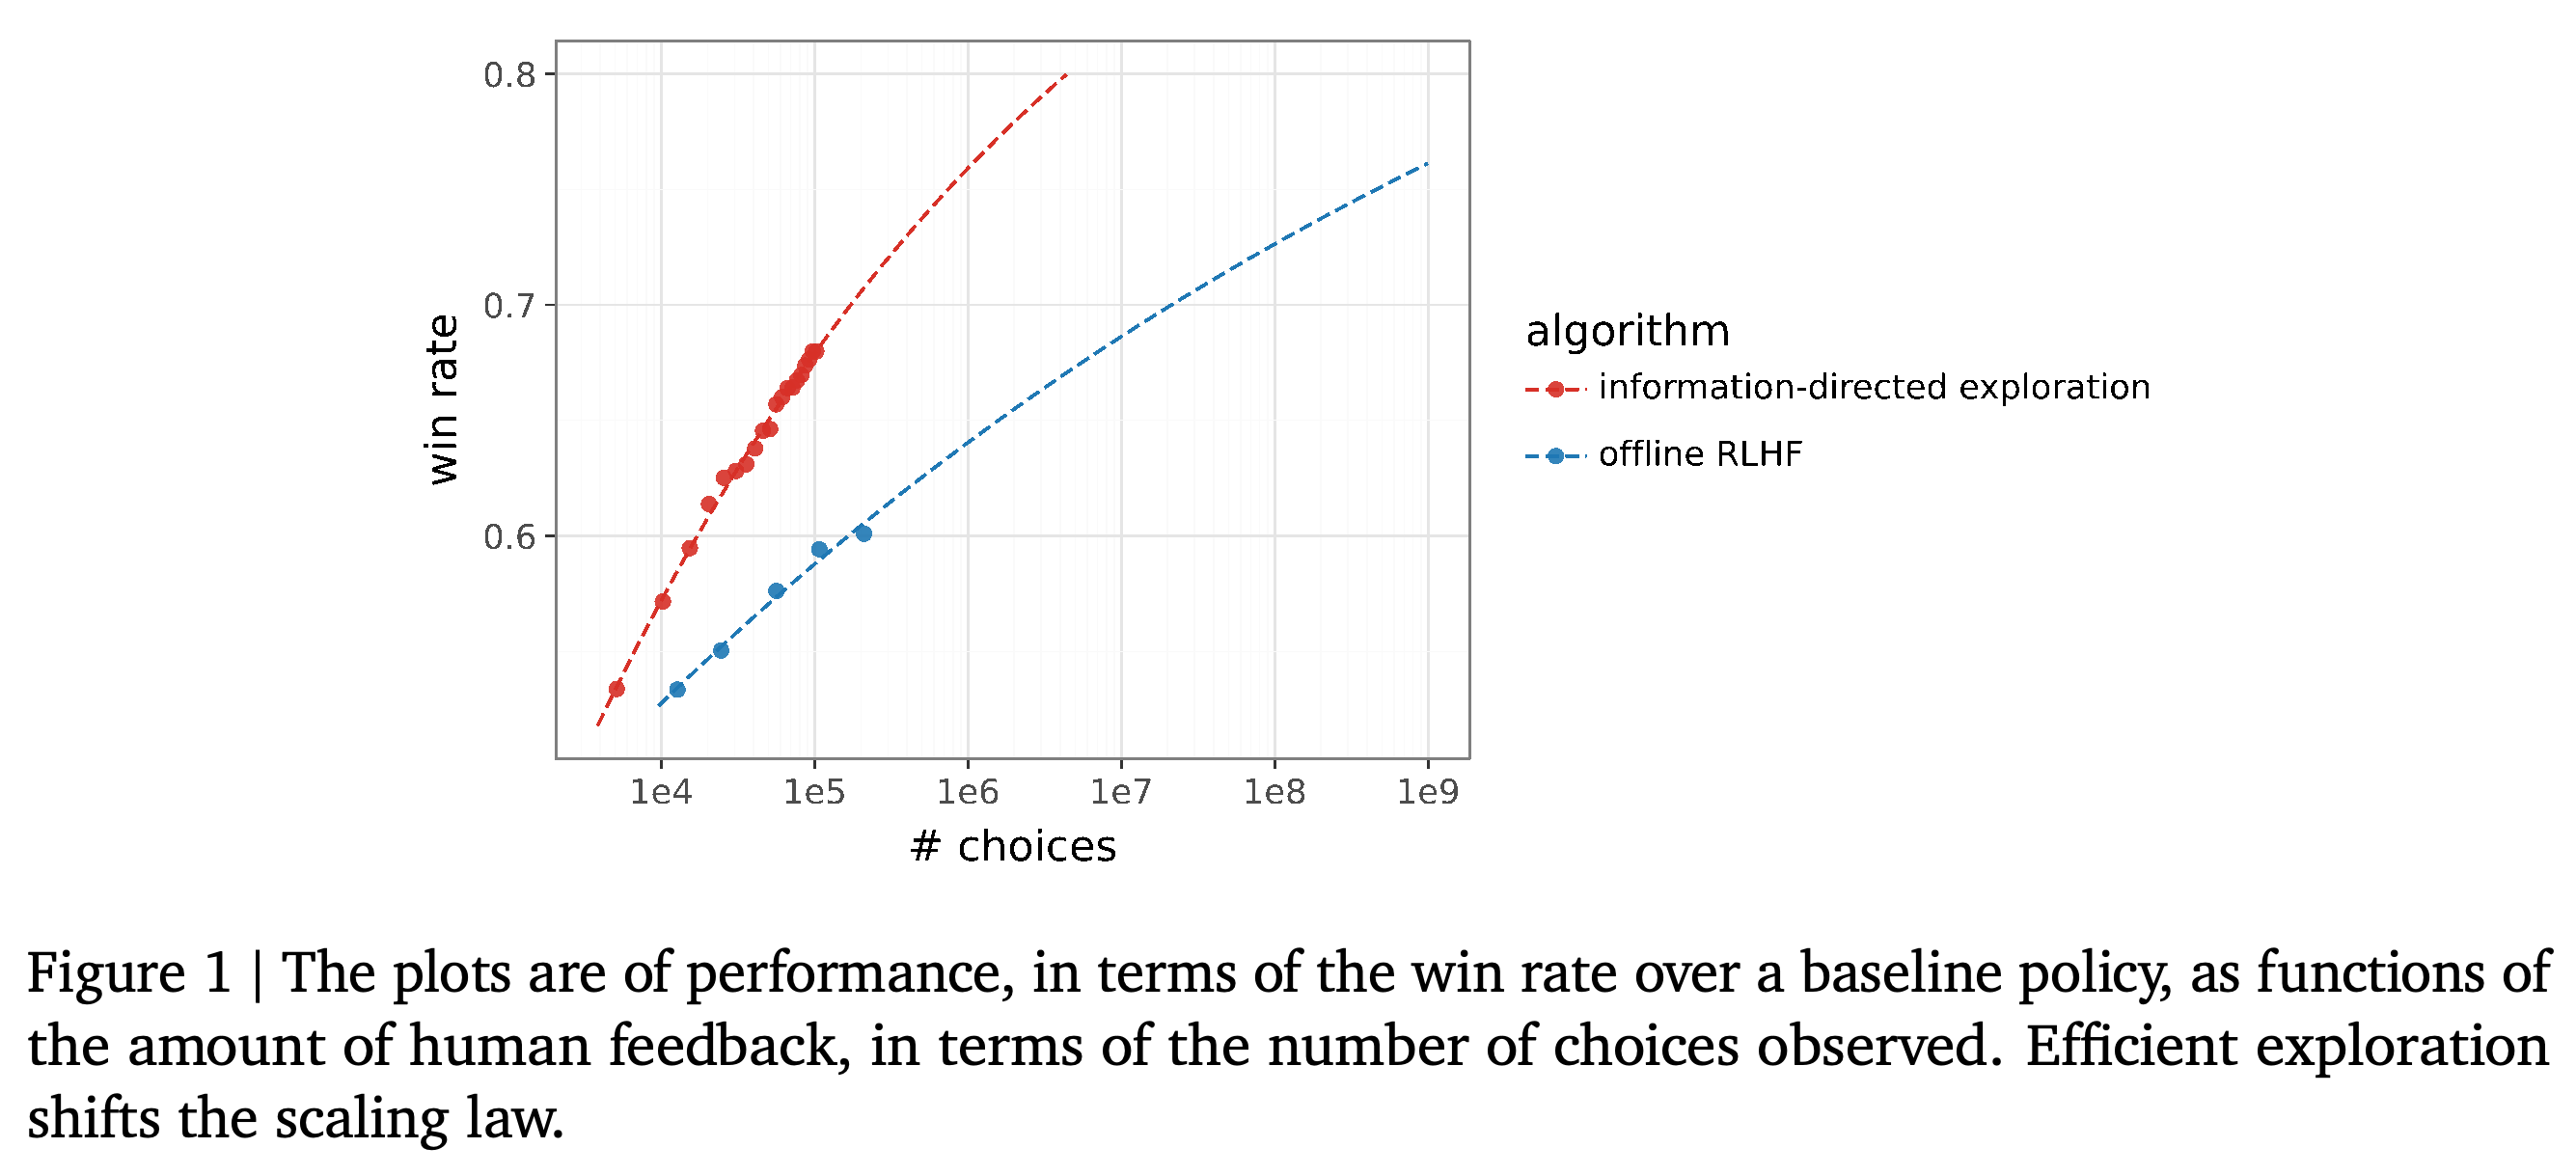
- Figure 1은 레이블 수를 나타내는 로그 축에 측정점과 외삽 곡선을 함께 표시한다. 곡선 간 차이는 레이블 효율의 개선을 보여주지만, 측정 범위에서 멀리 떨어진 부분은 추가 실험이 아니라 예측이다.
측정점은 레이블이 누적될수록 information-directed exploration이 offline RLHF보다 빠르게 개선됨을 보여준다. 가로축을 로그로 표시해 데이터에 적합한 곡선들의 추세 차이를 확인할 수 있다. 다만 선택 수가 매우 큰 영역까지 이어지는 점선은 측정한 성능이 아니라 외삽 결과다.
2. Literature Review
문헌 검토는 표본 효율적인 LLM 정렬을 온라인 적응, 능동 탐색, 스케일링 법칙과 연결한다. 이 연구들은 응답 분포가 어떻게 변하는지, 어떤 비교에 레이블을 부여하는지, 선호도 데이터의 양에 따라 정책 품질이 어떻게 달라지는지를 다룬다.
Online Adaptation.
온라인 적응은 현재 정책에서 응답을 반복적으로 수집해 샘플링 분포가 더 나은 출력으로 이동하도록 한다. 논문은 이를 고정된 정책에서 선호도를 수집하는 오프라인 방식과 대비한다. 오프라인 방식에서는 데이터가 포괄하는 범위가 좁아 이후 최적화가 제약될 수 있다. 관련 접근법으로 iterative DPO와 hybrid preference optimization을 논의한다.
Active Exploration.
능동 탐색은 불확실성을 해소할 것으로 기대되는 비교를 선택하며, 불확실성이나 다양성 지표를 자주 사용한다. 검토한 접근법에는 active contextual dueling bandits, active preference optimization, exploratory preference optimization, information-directed sampling, LLM 출력의 변동성을 불확실성의 대리 지표로 사용하는 방법이 포함된다.
- 저자들은 언어 모델을 고정한 채 불확실성을 활용해 보상 모델을 학습한 기존 연구와 자신들의 연구를 구분한다.
- 문헌 검토는 인용한 연구에서 2X에서 5X의 개선을 보고했으며, 해당 연구들이 더 제한적인 범위의 프롬프트를 사용했다고 설명한다. 이는 저자들이 연구 맥락을 비교한 것이며, 공통 벤치마크에서 평가한 결과는 아니다.
Scaling Laws.
논문은 사전 학습, 지도 미세 조정, 보상 모델만의 스케일링이 아니라 선호도 데이터의 양에 따른 RLHF 정책 전체의 성능 스케일링을 조사한다. 레이블 수를 로그 축으로 표시하면 선형 축에서 드러나지 않을 수 있는 스케일링 양상의 차이를 확인할 수 있다고 주장한다.
- 데이터에 적합한 곡선들은 관측 범위에서 서로 다른 스케일링 속도를 나타낸다. 다만 이를 훨씬 큰 데이터셋으로 확장하려면 해당 추세가 계속된다고 가정해야 한다.
3. Experiment Pipeline
실험 파이프라인은 응답 쌍에 대한 선택을 수집하고, 보상 모델과 정책을 학습하며, 적응한 정책을 고정된 기준 정책과 비교해 평가한다. 4개 알고리즘 모두 이 공통 파이프라인을 사용하지만, 모델을 갱신하는 시점과 응답 쌍을 선택하는 방식은 다르다.
3.1. Baseline and Experimentation Policies
기준 정책은 RLHF를 적용하지 않고 사전 학습과 지도 미세 조정을 거친 Gemma 9B 모델이며, 결정론적 top-1 디코딩으로 평가한다. 선호도 수집용 후보 응답에는 확률적 top-5 디코딩을 사용한다. 이 방식은 확률이 가장 높은 5개 토큰 중에서 조건부 확률에 따라 다음 토큰을 샘플링한다.
- 적응한 정책도 top-1 디코딩으로 평가한다. 따라서 보고된 승률은 탐색 중에 사용하는 확률적 응답이 아니라 결정론적 응답을 비교한 결과다.
3.2. Human Feedback Simulator
실제 인간 피드백으로 학습한 Gemini 1.5 Pro-based reward model로 인간 피드백을 모사한다. 두 응답에 부여한 보상이 R1과 R2일 때, (P = \frac{\exp(R_1)}{\exp(R_1)+\exp(R_2)})를 계산하고 (\operatorname{Bernoulli}(P))에서 선택 C를 샘플링한다.
- 저자들은 Gemma 정책보다 훨씬 큰 시뮬레이터를 사용한다. 시뮬레이터가 더 복잡한 선호 양상을 보이므로 인간 피드백에도 결과가 적용될 가능성이 더 높다고 주장한다.
- 이 실험은 인간 평가자에게서도 같은 수준의 레이블 효율 개선을 얻는다는 사실을 직접 입증하지는 않는다.
3.3. Prompts
데이터셋에는 내부 후속 학습 저장소에서 가져와 무작위로 배열한 고유 프롬프트 202K개가 포함된다. 주제는 글쓰기, 코딩, 요약, 독해, 수학, 과학, 아이디어 생성 등을 포괄한다. 학습용 프롬프트 200K개, 테스트와 하이퍼파라미터 선택용 프롬프트 1K개, 별도의 표본 외 평가용 프롬프트 1K개로 나눈다.
3.4. Gathering Feedback and Training
피드백은 프롬프트 64개로 구성된 배치 단위로 수집하며, 프롬프트마다 레이블이 있는 응답 쌍 비교를 1개 수집한다. 각 배치 이후 알고리즘은 파라미터를 갱신할 수 있다. (\theta_t)는 선택 데이터 t개 배치를 처리한 뒤의 정책 파라미터를 나타낸다.
- Figure 2는 프롬프트에서 비교할 응답 2개를 생성하고, 반환된 선택을 학습 정보로 사용하는 피드백 루프를 보여준다.
- 온라인 방법들은 내부적으로 더 큰 후보 집합을 생성하지만, 선택한 응답 쌍에만 시뮬레이터 레이블을 부여한다.
3.5. Performance Evaluation
평가에서는 동일한 표본 외 프롬프트 1K개에 대한 top-1 응답으로 적응한 정책과 원래 기준 정책을 비교한다. 보고된 승률은 적응한 응답을 시뮬레이터가 선호할 확률의 평균이다. 이진 승패를 샘플링해 얻은 경험적 승리 비율은 아니다.
- 값이 1이면 시뮬레이터가 항상 적응한 정책을 선호하고, 0이면 항상 기준 정책을 선호한다는 뜻이다.
- Figure 3은 평가 확률도 같은 피드백 시뮬레이터에서 얻는다는 점을 보여준다. 따라서 결과는 해당 시뮬레이터의 선호 함수에 종속된다.
4. Algorithms
비교 대상은 offline RLHF, periodic RLHF, online RLHF, information-directed exploration이다. 보상 모델과 정책의 파라미터 수는 대체로 비슷하고 갱신 규칙도 유사하지만, 데이터 수집 방식과 갱신 일정은 다르다.
- 각 대안은 알고리즘 설계와 하이퍼파라미터 조정을 반복하며 개발했다. 저자들은 완전히 재현 가능한 명세를 제공하기보다 핵심 메커니즘을 설명하는 것이 목적이라고 명시한다.
4.1. Reward Models and Policies
모든 보상 모델은 언어 모델의 언임베딩 행렬과 softmax를 제거한 동일한 Gemma 9B 트랜스포머 백본에서 시작한다. 무작위로 초기화한 보상 헤드가 마지막 층의 임베딩을 스칼라로 변환한다. Offline RLHF, periodic RLHF, online RLHF는 선형 헤드를 사용하고, information-directed exploration은 MLP 기반 점 추정 헤드와 앙상블 헤드를 사용한다.
- 보상 백본과 헤드는 모두 학습 대상이다. 저자들은 다른 알고리즘에서 선형 헤드를 MLP로 바꾸어도 성능이 개선되지 않았다고 보고한다.
4.2. Update Rules
보상 모델은 예측한 2개 보상에서 Bradley–Terry 선호 확률을 계산한다. 선택한 응답 Y와 선택하지 않은 응답 Y′에 대해 Y를 선택할 로그 확률을 최대화하도록 갱신한다. 배치의 그래디언트를 합산하고 클리핑한 뒤 AdamW로 적용한다.
정책 갱신에서는 보상 모델의 선호 확률에서 1/2을 뺀 값으로 응답 로그 확률의 그래디언트에 가중치를 부여한다. 지수 이동 평균 정책 앵커를 사용해 토큰별 KL 정규화도 적용한다. 그래디언트를 합산하고 클리핑한 뒤 AdamW로 적용한다.
- 앵커는 초기 SFT 모델에 고정되지 않고 변화하는 정책을 따라간다.
- 온라인 알고리즘은 작은 양의 스칼라 ε인 affirmative nudge를 더해 강화 신호를 수정한다.
4.3. Alternatives
4.3.1. Offline RLHF는 초기 top-5 정책에서 모든 선호도 응답 쌍을 독립적으로 수집해 레이블을 받고, 보상 모델을 학습한 뒤 고정된 보상 모델을 기준으로 정책을 최적화한다. 정책 최적화 중에는 변화하는 top-5 정책에서 새로운 응답 쌍을 샘플링하고 각 쌍을 양쪽 순서로 사용한다. 160회 갱신마다 체크포인트를 저장하고 테스트 세트에서 승률이 가장 높은 체크포인트를 선택한다.
4.3.2. Periodic RLHF는 (\tau = 400)개 배치마다 응답 수집 정책을 갱신한다. 이때마다 보상 모델과 정책을 원래 파라미터로 다시 초기화하고, 지금까지 누적한 모든 선택 데이터로 학습한다.
- 이 방식은 완전한 점진적 학습 없이 샘플링 분포를 갱신한다. 갱신 주기가 짧아질수록 반복적인 재학습에 따른 계산 부담이 커진다.
4.3.3. Online RLHF는 보상 모델과 정책의 점진적 갱신을 번갈아 수행한다. 정책의 강화 신호는 p(Y ⪰ Y′ | X) − 1/2 + ε가 된다. 여기서 (\epsilon)는 tanking이라고 부르는 성능 붕괴를 방지하기 위해 더하는 작은 양의 affirmative nudge다.
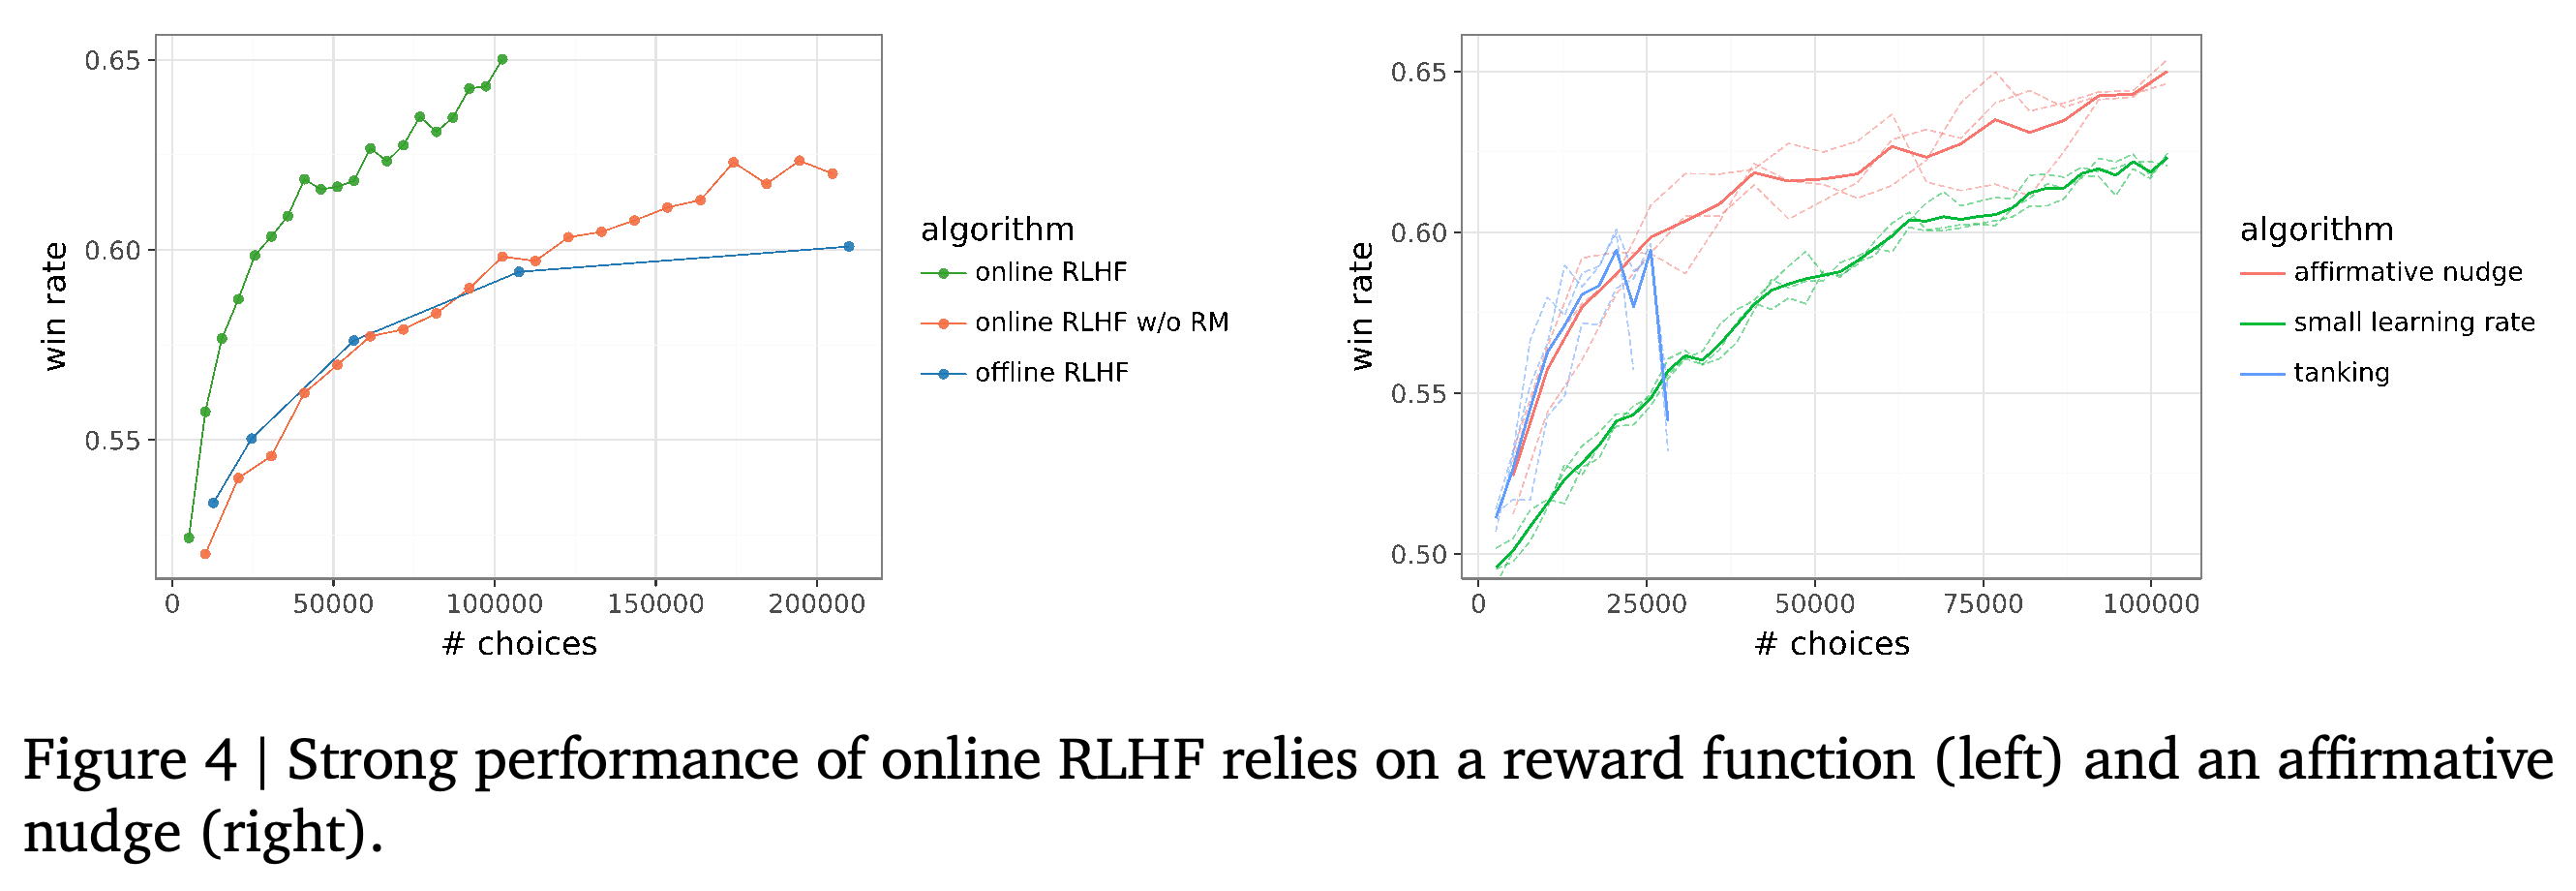
- Figure 4의 왼쪽은 저자들이 얻은 최선의 보상 모델 없는 대안이 보상 모델을 사용하는 온라인 알고리즘보다 뒤처진다는 점을 보여준다.
- Figure 4의 오른쪽은 affirmative nudge를 적용한 설정이 그림에 나타난 붕괴를 피하고, 학습률을 낮춘 대안보다 높은 성능을 낸다는 점을 보여준다. 보고서는 ε의 수치나 이 안정화에 대한 이론적 설명을 제공하지 않는다.
왼쪽 패널은 저자들의 온라인 절차에서 학습된 보상 모델을 사용하는 것이 유리하다는 근거를 보여준다. 저자들이 얻은 최선의 보상 모델 없는 대안은 개선 폭이 더 작다. 오른쪽 패널에서는 tanking 설정이 붕괴하는 반면 affirmative nudge 설정은 계속 개선되고, 학습률을 낮춘 설정은 더 낮은 성능을 보인다. 이 비교는 시험한 설정에 관한 결과이며, 모든 보상 모델 없는 방법이나 온라인 방법에 적용되는 주장은 아니다.
Online RLHF는 64개 프롬프트 각각에서 응답 16개를 샘플링하고, 레이블을 받을 응답 2개를 무작위로 선택한다. 보상 모델을 갱신한 뒤에는 질의한 쌍과 그 역순, 보상이 가장 높은 응답과 가장 낮은 응답의 쌍과 그 역순으로 정책을 갱신한다.
- 2번째 정책 갱신에는 새로운 프롬프트 64개로 구성된 배치를 사용하고, 각 프롬프트에서 응답 16개를 생성한다. 사용하는 순서 있는 쌍 4개는 최고/최저, 최저/최고, 차상위/차하위, 차하위/차상위다.
- 갱신한 보상 모델은 피드백 프롬프트마다 레이블을 부여한 단일 쌍 외에도 정책 학습용 비교를 추가로 제공한다.
4.3.4. Information-Directed Exploration의 구조는 다음과 같다. 보상 모델은 너비가 1024인 은닉층 2개와 선형 출력을 갖춘 점 추정 헤드 mlp0를 사용한다. 여기에 너비가 256인 은닉층 2개를 갖춘 고정 사전 MLP 100개와 너비가 1024인 은닉층 2개를 갖춘 학습 가능한 차분 MLP 100개를 추가한다.
- 모든 헤드는 무작위 가중치로 시작한다. 사전 네트워크와 차분 네트워크를 짝지어 무작위 사전 함수를 갖는 앙상블을 구성한다.
- Figure 5는 스칼라 보상 예측기와 epistemic neural network를 대비한다. 후자는 추가 입력 Z로 서로 다른 보상 가설을 지정한다.
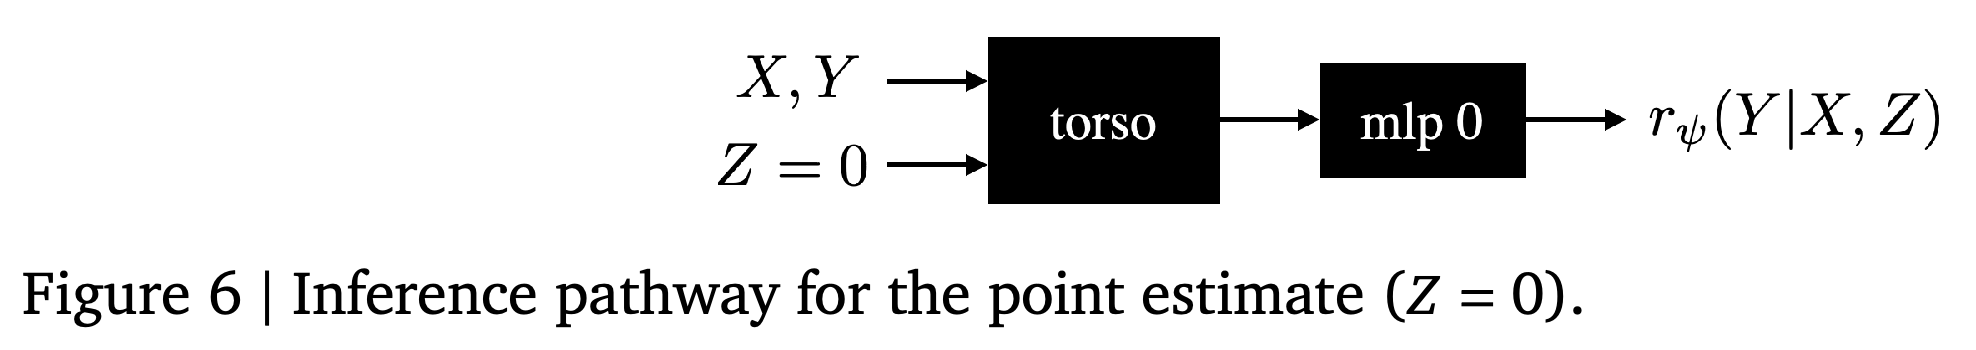
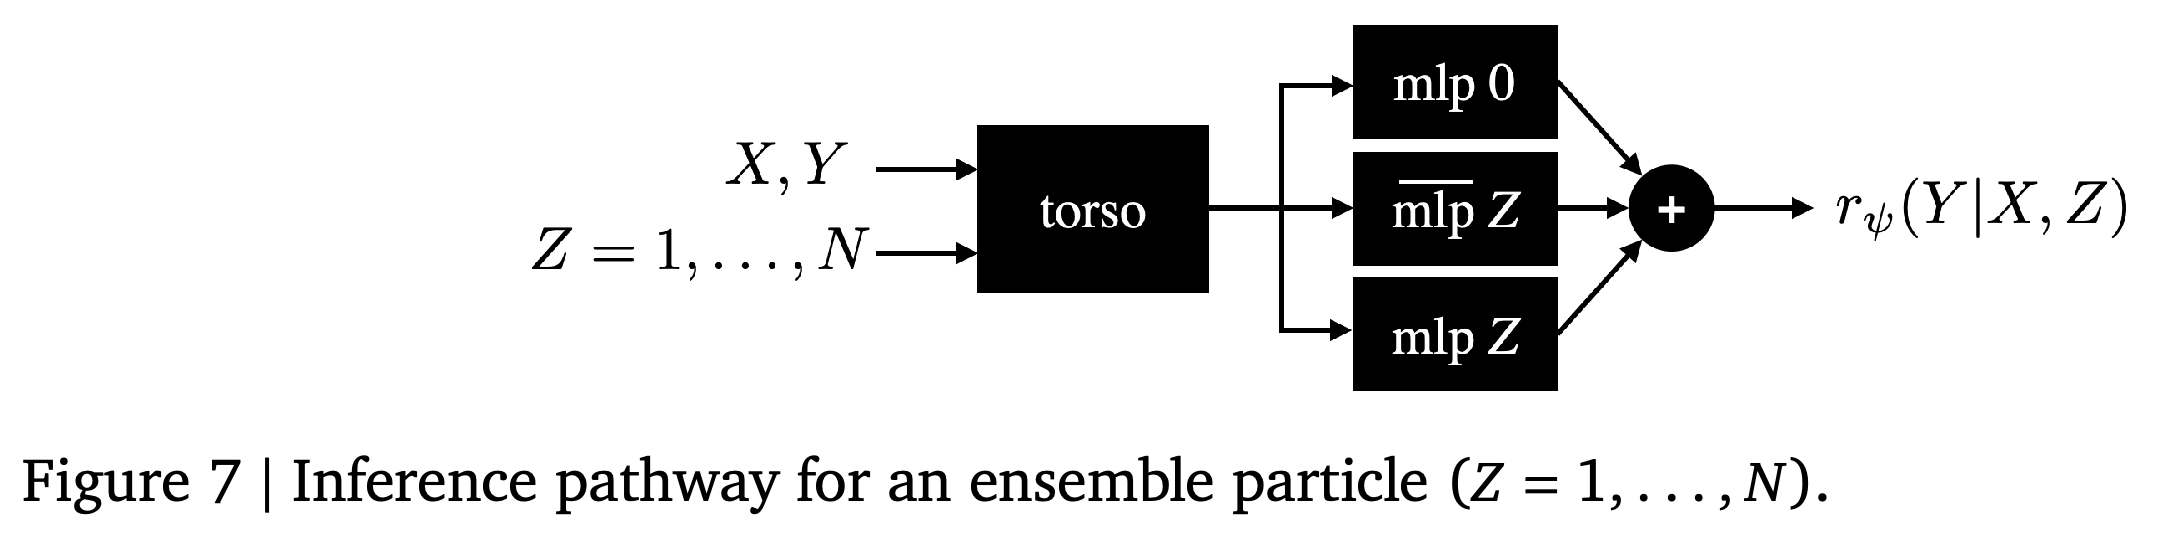
인식적 인덱스 Z는 0부터 100까지의 정수 값을 갖는다. (Z=0)이면 점 추정 경로를 사용한다. Z > 0이면 점 추정값에 해당 인덱스의 사전 헤드와 차분 헤드를 결합해 출력을 계산한다.
- Figure 6과 Figure 7은 이 경로들이 별도의 전체 보상 모델을 사용하지 않고 트랜스포머 백본을 공유하는 방식을 보여준다.
- 저자들은 추가 파라미터가 원래 약 9B개 파라미터를 가진 모델의 5%보다 훨씬 적다고 보고한다. 이 파라미터 비교는 전체 학습 비용이나 추론 비용을 정량화한 것이 아니다.
Z = 0 경로는 공유 트랜스포머 표현과 점 추정 MLP만 사용한다. 이 경로는 중심 보상 예측을 앙상블 변동을 표현하는 추가 헤드와 분리한다.
각 앙상블 입자는 같은 백본을 재사용하면서 해당 인덱스의 고정 사전 출력과 학습 가능한 차분 출력을 점 추정값에 더한다. 이 구조는 약 9B개 파라미터를 가진 전체 트랜스포머를 복제하지 않고도 여러 보상 가설을 표현한다.
질의 선택에서는 프롬프트마다 응답 16개를 생성하고, 앙상블 입자 Z = 1, …, 100에 걸쳐 후보 쌍의 선호 확률을 평가한다. 이 확률들의 분산이 가장 큰 쌍에 레이블을 부여한다. 앙상블 간 불일치를 정보 가치의 대리 지표로 사용하는 방식이다.
- 선택 기준은 개별 응답의 보상 변동 자체가 아니라 어느 응답을 선호하는지에 대한 불확실성을 다룬다.
- 프롬프트 순서는 무작위로 배열한 데이터셋의 순서로 고정된다. 이 방법은 프롬프트가 아니라 응답을 능동적으로 선택한다.
학습에서는 online RLHF와 같은 선호도 손실로 점 추정 보상 모델을 갱신하며, 이 단계에서 사전 헤드와 차분 헤드는 변경하지 않는다. 이후 백본을 고정한 채 각 차분 헤드에 해당하는 보상 출력을 사용해 헤드를 개별적으로 갱신한다. 사전 헤드는 학습하지 않는다.
- 그 밖의 정책 학습 절차는 online RLHF를 따른다. 피드백 수집에서는 응답 쌍을 무작위로 선택하는 대신 불확실성에 따라 선택한다.
5. Results
결과에서는 레이블 효율 곡선을 비교하고 스케일링 양상을 외삽하며, 선택한 응답 사례를 제시한다. 이들은 각각 측정한 정책 비교, 데이터에 적합한 곡선에 따른 예측, 응답 품질과 질의 선택에 대한 정성적 예시라는 서로 다른 종류의 근거를 제공한다.
5.1. Win Rates
Figure 8에서는 periodic RLHF와 online RLHF가 offline RLHF보다 개선된 성능을 보이고, information-directed exploration이 가장 높은 승률을 달성한다. 저자들은 information-directed exploration이 선택 20K개로 얻은 성능에 도달하려면 offline RLHF에 선택 200K개 넘게 필요하다고 보고한다. 이는 데이터 효율이 10배 넘게 개선된다는 뜻이다.
- 서론은 반대 방향의 비교도 제시한다. 탐색 레이블 20K개 미만으로 오프라인 방식의 레이블 200K개 결과와 같은 성능을 달성한다.
- Online RLHF와 information-directed exploration의 차이는 점진적 학습만으로 얻는 이점에 더해 불확실성 모델링과 질의 선택 설정이 추가 이점을 제공한다는 근거다. Figure 8에는 신뢰 구간이나 반복 실행에 따른 변동이 표시되지 않는다.
5.2. Projected Gains
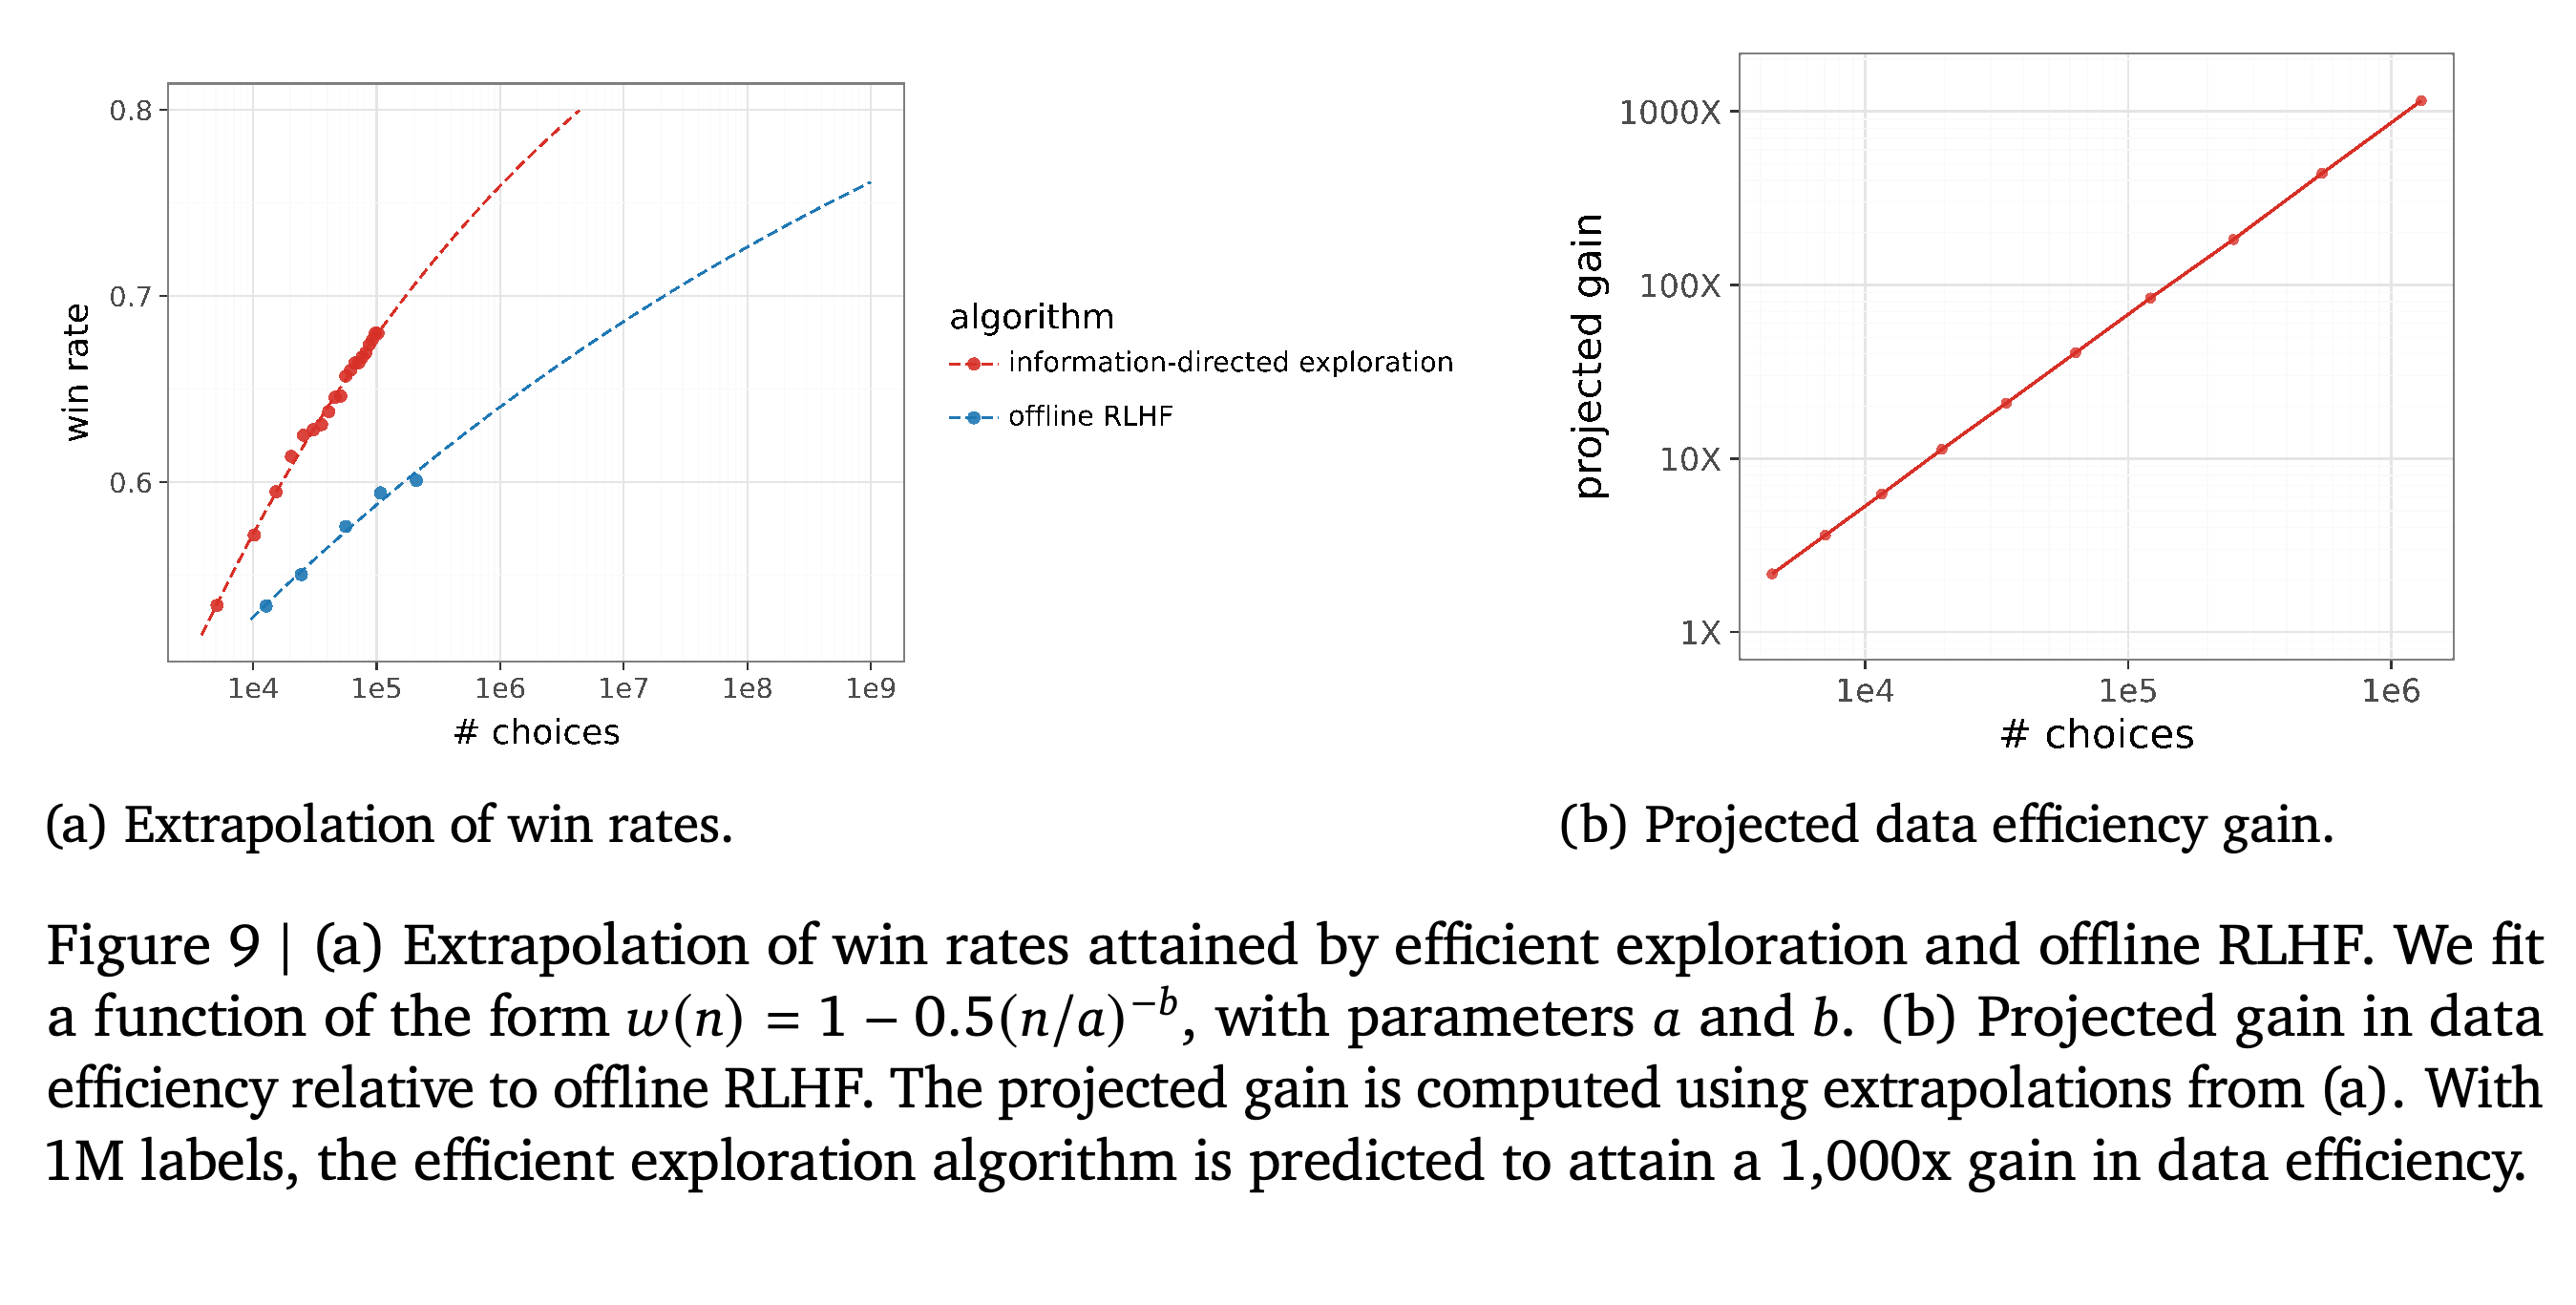
Figure 9는 파라미터 a와 b를 갖는 (w(n)=1-0.5(n/a)^{-b}) 형태의 승률 곡선을 데이터에 적합하고, 같은 성능에 필요한 데이터 양을 비교해 데이터 효율 개선을 예측한다. 외삽 결과는 information-directed exploration의 레이블 1M개가 offline RLHF의 레이블 1B개와 같은 성능을 낼 수 있다고 예측한다. 이는 약 1,000배의 개선이다.
- 이 추정은 측정한 레이블 수의 범위를 크게 넘어선다. 보고서는 적합한 파라미터 값이나 예측의 불확실성 범위를 제공하지 않는다.
- 이 예측은 더 많은 데이터에서도 적합한 스케일링 양상이 이어진다고 가정한다. 관측된 1,000배 개선은 아니다.
패널 (a)는 데이터에 적합한 승률 곡선을 측정 범위 밖으로 확장하고, 패널 (b)는 이를 같은 성능에 필요한 레이블 수의 비율로 변환한다. 따라서 탐색 레이블 1M개에서 약 1,000배라는 값은 외삽 곡선에 의존한다. 레이블 1M개와 1B개로 수행한 실험 결과가 아니다.
5.3. Simple and Extreme Instances
논문은 메커니즘을 쉽게 살펴볼 수 있도록 의도적으로 단순하고 극단적인 프롬프트와 응답 사례를 제시한다. 이 사례들은 정량적 개선이 나타날 수 있는 이유를 보여주지만, 오류 빈도나 응답 다양성을 대표성 있게 평가한 결과는 아니다.
5.4. Winning Responses
우수 응답 사례는 10 km/hr가 아니라 14 km/hr로 걸었다면 이동 거리가 20 km 늘어날 때, 실제 이동 거리를 묻는다. 선택지는 A. 50 km, B. 56 km, C. 70 km, D. 80 km다. Offline RLHF 응답은 관련 방정식을 세우지만 대수 계산에서 오류를 범해 약 33.33 km라는 결론을 낸다.
- Information-directed exploration 응답은 속도 차이 4 km/hr로부터 5 hours를 구한 뒤, 10 km/hr로 이동한 거리 50 km를 계산해 A를 선택한다.
- 이렇게 선택한 사례는 정답과 더 짧은 풀이를 보여줄 뿐, 수학적 추론 능력이 전반적으로 개선되었음을 입증하지는 않는다.
5.5. Diverse Responses
다양성 사례에서는 초기 ENN 보상 모델을 사용해 생성한 응답 16개 중 최대 분산의 infomax 쌍과 최소 분산의 infomin 쌍을 선택한다. 물 섭취에 관한 감성 분석 프롬프트에서 infomin은 “Positive.”와 “Positive sentiment.”를 비교하고, infomax는 “positive”와 “Neutral.”을 비교한다.
- 최대 분산 쌍은 사소한 표현 차이가 아니라 실질적인 분류 불일치를 드러낸다.
- 불확실성 모델이 학습되면서 기대 정보 가치도 달라진다. 이 사례들은 초기 모델의 선택을 보여주며, 각 응답 쌍의 고정된 속성을 나타내지는 않는다.
Executive Order 6102에 관한 독해 프롬프트에서 infomin 응답 2개는 모두 해당 명령이 Federal Reserve의 통화 공급 확대에 대한 제약을 제거했다는 기사 설명을 다시 서술한다. Infomax 응답들도 대체로 같은 결론에 도달하지만, 이를 뒷받침하는 설명은 상당히 다르다.
- 한 응답은 금본위제, 대공황, Proclamation 2039를 논의하며, 제공된 기사에서 뒷받침하지 않는 금 공급 축소 주장도 포함한다. 다른 응답은 기사를 인용하고 기사에 명시된 40% 금 담보 요건을 설명한다.
- 이 사례는 결론이 같더라도 불확실성 기반 비교가 추론과 텍스트 근거의 차이를 드러낼 수 있음을 보여준다. 이 사례들에 대한 정보 이득의 수치 측정은 보고하지 않는다.
6. Conclusions and Future Work
저자들은 자신들의 파이프라인에서 점진적 온라인 학습과 불확실성 기반 응답 선택이 모두 레이블 효율을 개선한다고 결론 내린다. 그림에 나타난 tanking 현상을 극복하려면 affirmative nudge가 필요하다고 판단하며, 잠재적인 1,000배 개선을 추가 연구의 동기로 삼는다.
- 제안한 알고리즘 연구 방향에는 보상 모델의 더 깊은 부분에서 불확실성을 모델링하는 방법, 언어 모델의 불확실성을 표현하는 방법, 보상 모델 정보를 활용해 정책 최적화를 개선하는 방법이 포함된다.
- 그 밖의 확장 방향으로 정보 가치가 높은 프롬프트 선택, 가치 모델을 사용하는 다중 턴 대화, 행동의 결과가 지연되어 나타나는 에이전트, AI 보조 피드백을 제안한다. 보고된 실험에서는 이러한 확장을 평가하지 않는다.
부록
- 제공된 PDF에는 부록이 없다. 결론과 감사의 글 뒤에 있는 16–18페이지는 참고문헌이며, 추가 실험 명세나 보충 결과는 제공하지 않는다.
짧은 생각
가장 강한 근거는 측정된 레이블 효율 곡선 간 차이다. 여기에는 online RLHF에서 불확실성 기반 탐색 설정으로 바꾸었을 때의 개선도 포함된다. 이 방법은 피드백 레이블과 보상 모델이 생성한 정책 학습 신호를 구분하므로, 각 레이블을 여러 갱신에 활용할 수 있다. 10배 넘는 개선은 보고된 실험이 뒷받침하지만, 핵심 수치인 1,000배는 외삽에 의존한다. 학습과 평가가 같은 선호도 시뮬레이터를 사용하고, 프롬프트는 내부 데이터이며, 중요한 하이퍼파라미터가 생략되어 있다. 이러한 조건은 독립적인 재현과 실제 인간 선호에 대한 정렬 효과의 판단을 제한한다. 프롬프트당 후보 응답 16개, 추가 정책 갱신, 불확실성 헤드 100개는 레이블 수 외에 추가 계산을 요구한다. 실제 실행 시간이나 계산량으로 정규화한 결과가 없으므로, 레이블 효율을 전체 자원 효율과 동일시해서는 안 된다.