


AutoLab: Can Frontier Models Solve Long-Horizon Auto Research and Engineering Tasks? 요약 설명
03 Jun 2026 | Paper Review AI Research Agents LLM Evaluation Harness Optimization목차
- 요약
- 1 Introduction
- 2 The AUTOLAB Benchmark
- 3 Benchmark Results
- 4 Analysis
- 5 Related Work
- 6 Conclusion
- Limitations and Broader Impact
- 부록
- 짧은 생각
이번 글에서는 AutoLab: Can Frontier Models Solve Long-Horizon Auto Research and Engineering Tasks? 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 6월 3일(Arxiv)
- Xu, Zhangchen, Chen, Junda, Huang, Yue, Jiang, Dongfu, Chen, Jiefeng, Hua, Hang, Wu, Zijian, Liu, Zheyuan, He, Zexue, Li, Lichi, et al.
- University of Washington, Stanford University, UCSB, UCSD, University of Notre Dame, Princeton University, NUS, University of Waterloo, MIT, NVIDIA, Bake AI, Google, MIT-IBM Computing Research Lab, Independent Researcher
- 논문 링크
- Github
- Project Page
요약
- AutoLab: Can Frontier Models Solve Long-Horizon Auto Research and Engineering Tasks?는 System Optimization, Puzzle & Challenge, Model Development, CUDA 커널 최적화에 걸쳐 실행 가능한 최적화 과제 36개로 구성된 AUTOLAB 벤치마크를 소개한다. 에이전트는 2–12시간의 실제 경과 시간 예산 안에서 실험을 반복하며 제공된 baseline을 개선한다. 평가는 연속 점수와 held-out 검증을 사용한다.
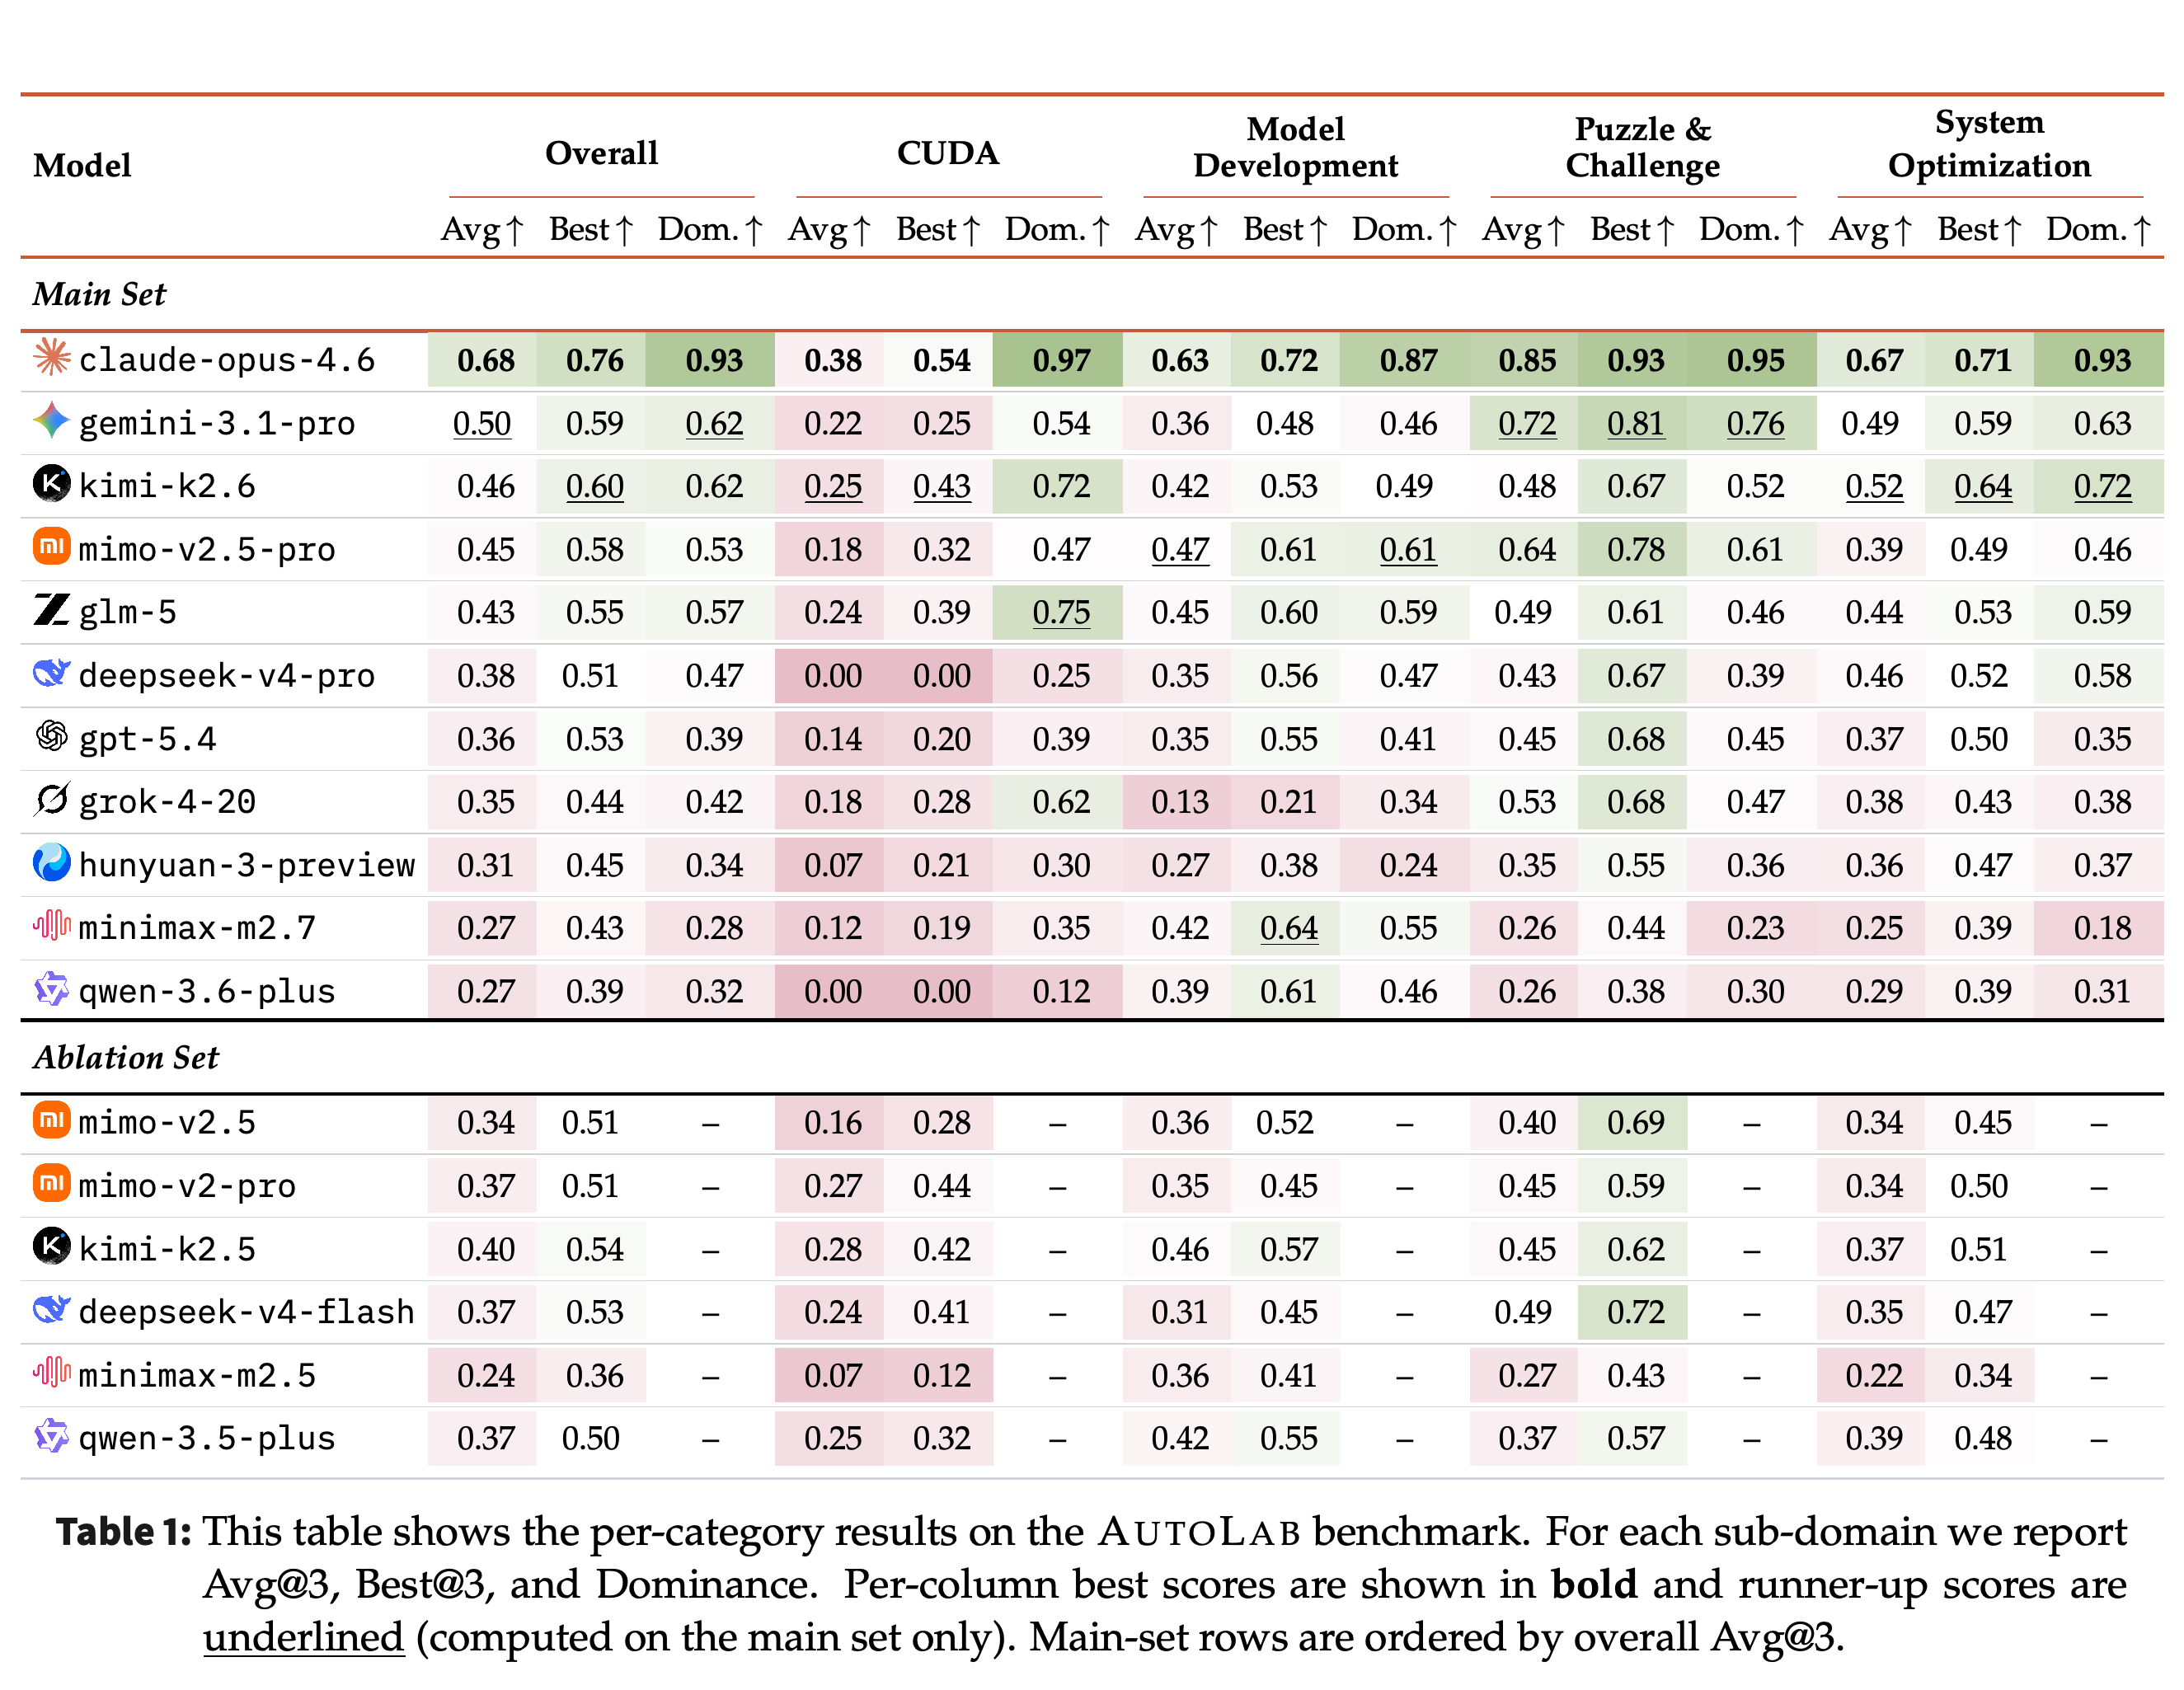
- 이 연구는 표준화된 기본 harness로 모델 17개를 평가하며, 각 모델–과제 조합에서 독립적인 실행을 3회 수행한다. 모델 11개로 구성된 주요 리더보드에서는 claude-opus-4.6이 Avg@3 = 0.68, Best@3 = 0.76, Dominance = 0.93으로 가장 높은 성능을 보인다. gemini-3.1-pro가 Avg@3 = 0.50으로 뒤를 잇는다.
- 실행 과정 분석에서는 반복적인 측정과 개선이 높은 성능과 연관되며, 실패에는 조기 제출이나 예산 소진이 자주 나타난다. 과제 25개를 대상으로 한 harness ablation에서 kimi-k2.6의 평균 점수는 pi-mono의 0.21에서 최적화 프롬프트를 적용한 mini-swe-agent*의 0.64로 바뀐다. 이는 측정된 성능이 모델–harness 구성에 크게 좌우됨을 보여 준다.
1 Introduction
연구와 엔지니어링 최적화를 수행하려면 에이전트가 산출물을 살펴보고, 변경안을 제시하고, 실험을 실행하고, 결과를 측정하며, 수 시간에 걸쳐 수정해야 한다. 논문은 단일 턴 코딩 테스트와 짧은 상호작용 벤치마크로는 지속적인 최적화 능력을 충분히 평가하기 어렵다고 주장한다. 또한 특화된 연구 시스템에서는 모델의 기여를 맞춤형 도구와 탐색 전략의 기여로부터 분리하기 어렵다고 지적한다.
- AUTOLAB은 ML 개발이나 커널 최적화만 평가하지 않고, 서로 다른 엔지니어링 분야에 공통 예산과 채점 규칙을 적용한다.
- 보고된 평가에는 실제 경과 시간 2,544시간과 8.60 billion tokens가 소모되었다. 공개 자원은 autolabhq/autolab과 autolab.moe로 명시되어 있다.
- 주요 기여는 벤치마크, 모델 17개의 표준화된 평가, 점수 0인 실행 302개를 수작업으로 검토한 실행 과정 분석이다. 지속성이 가장 중요한 예측 요인이라는 주장은 제시된 통제 실험 근거보다 강하다.
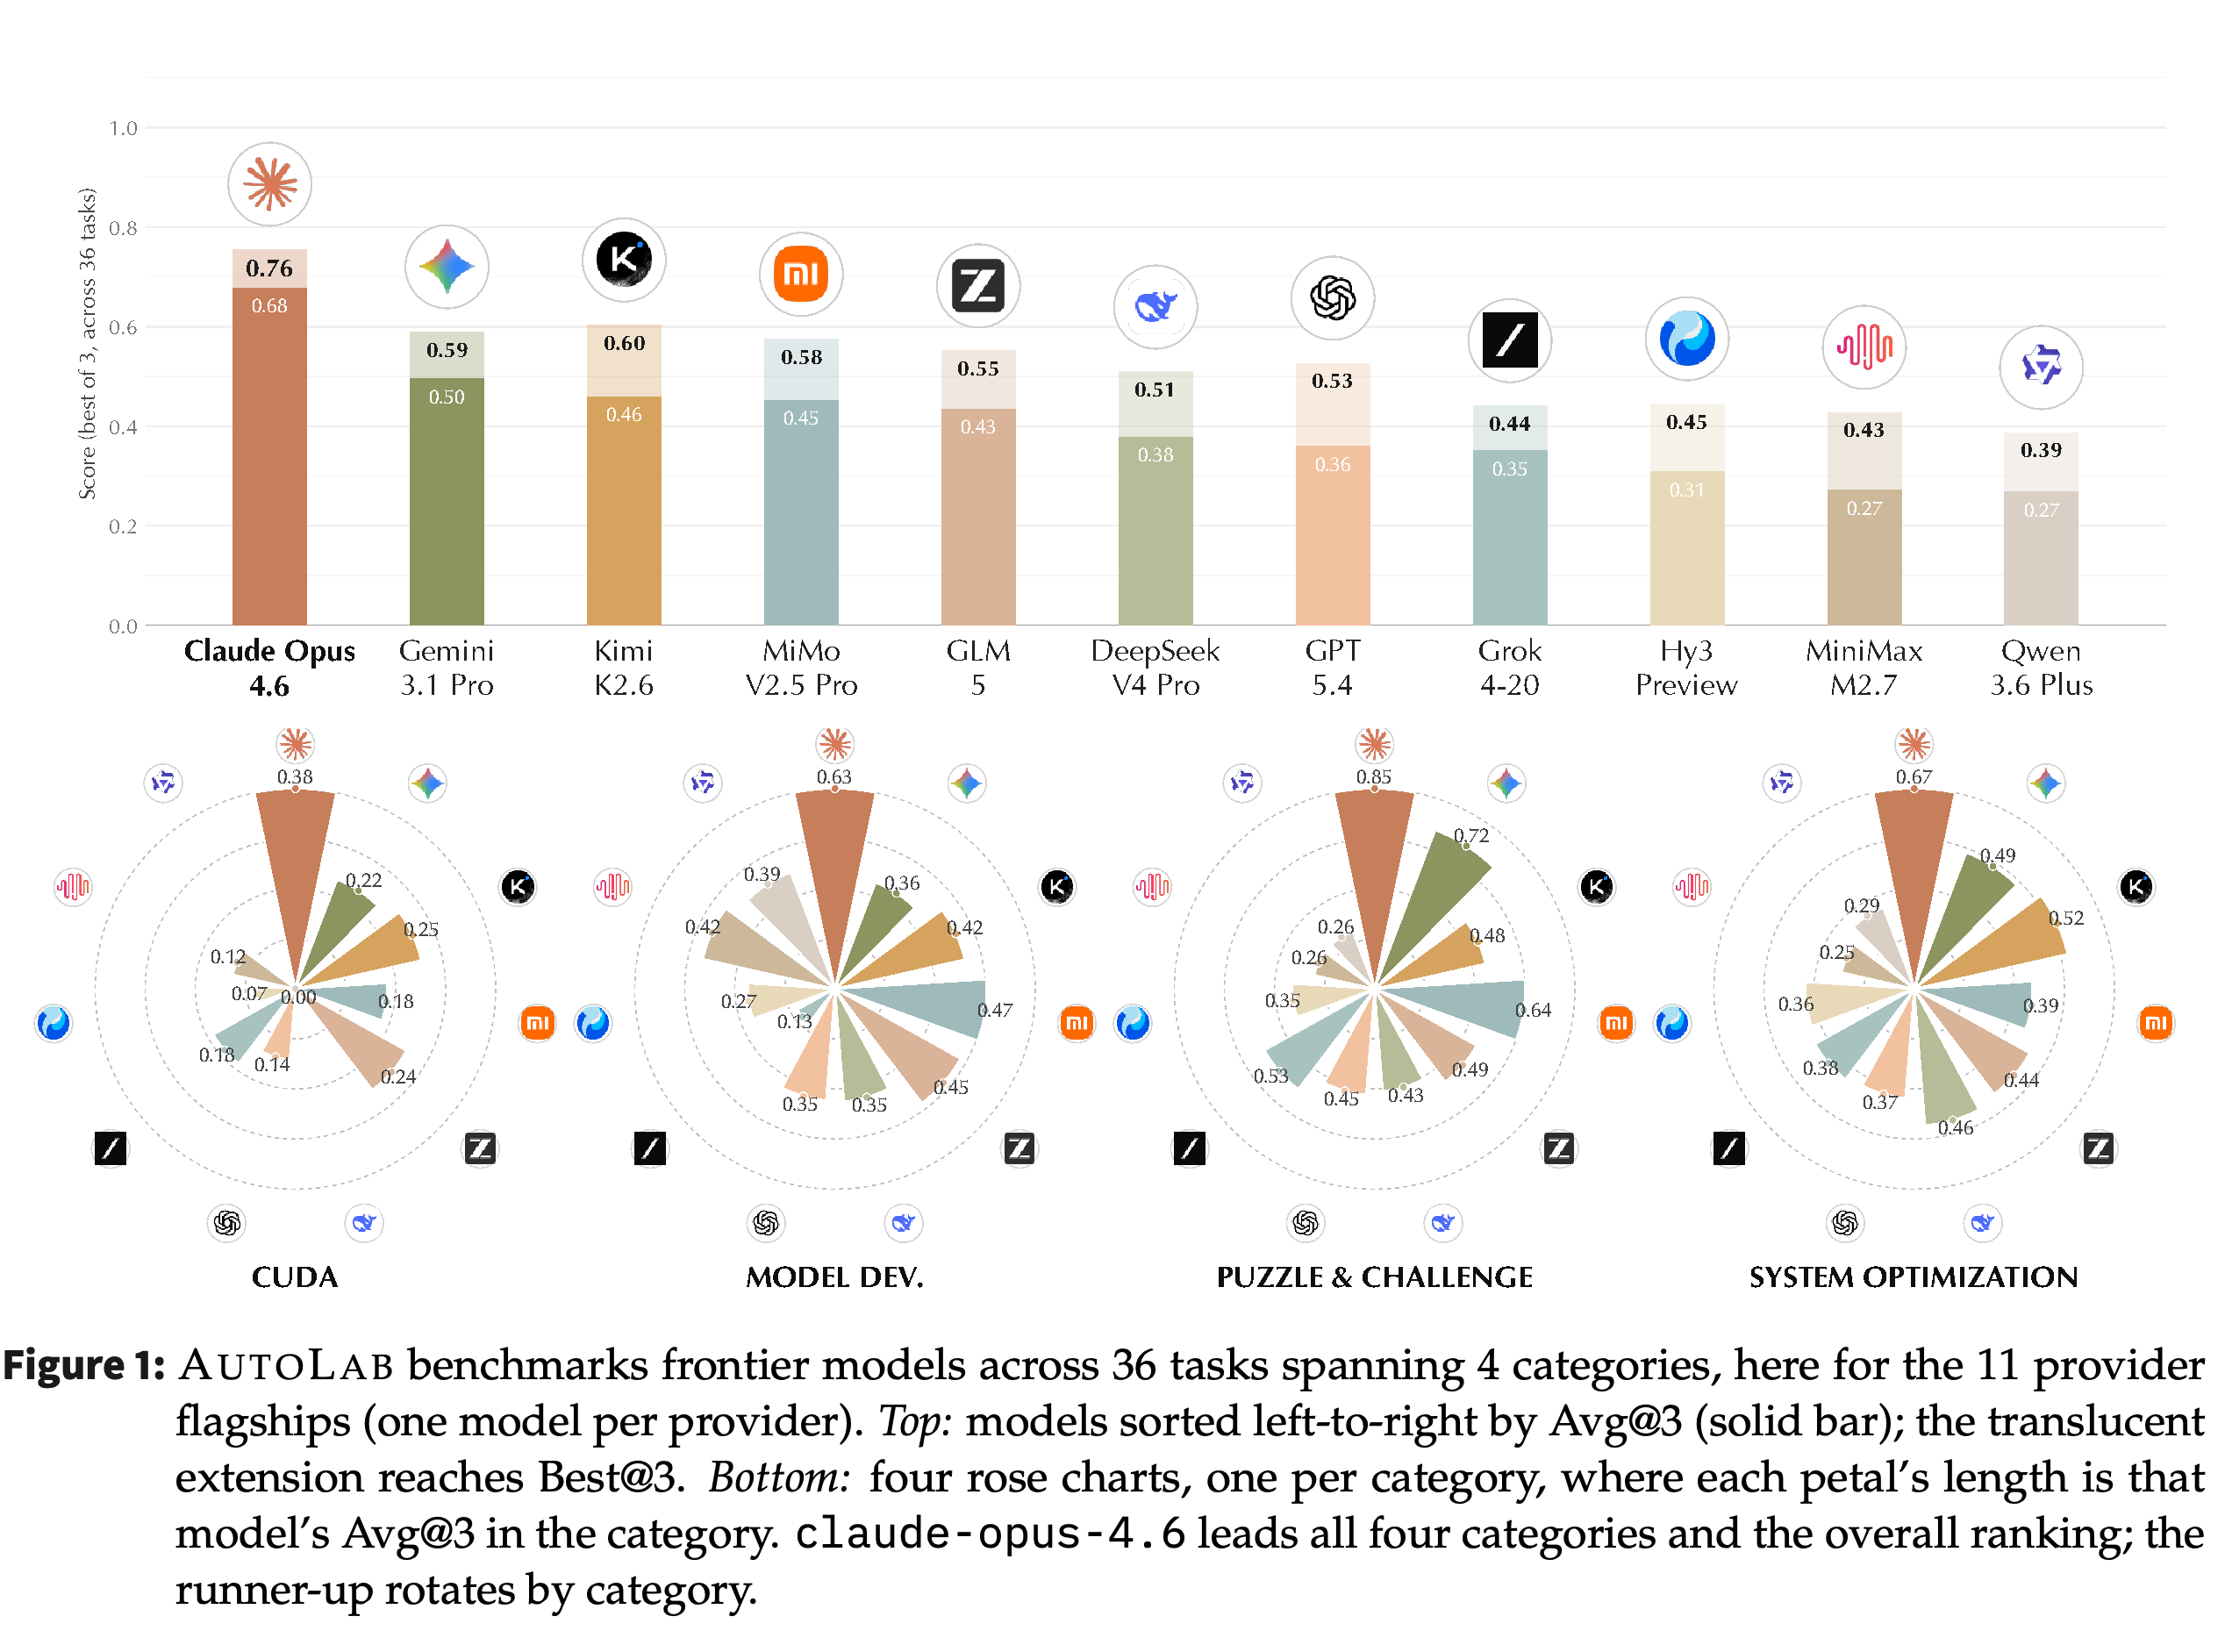
전체 막대는 claude-opus-4.6의 Avg@3 0.68과 gemini-3.1-pro의 0.50을 구분한다. 반투명 확장 부분은 실행 3회 중 최고 결과를 선택했을 때의 향상을 보여 준다. 범주별 차트에서는 분야마다 차순위 모델이 다르다. 따라서 전체 순위만 보면 모델별 특화 능력이 드러나지 않는다.
2 The AUTOLAB Benchmark
AUTOLAB은 3가지 설계 원칙을 따른다. 실험을 지속적으로 반복하고, 보정된 연속 점수를 사용하며, 편법에 강한 검증을 수행한다. 이 원칙들은 서로 다른 지표에서도 부분적인 최적화 성과를 보상하고, 구현을 개선하는 대신 성능 측정의 허점을 이용하는 편법을 제한하기 위한 것이다.
2.1 Task Formulation
각 과제는 지시문, 컨테이너화된 CPU 또는 단일 GPU 환경, 검증기, 사람이 작성한 비공개 reference 솔루션, 실제 경과 시간 예산으로 구성된다. 에이전트는 코드를 수정하고, 구현을 실행하거나 프로파일링하고, 로컬 평가를 호출하고, 중간 결과를 확인할 수 있다. 최종 채점에는 개발용 평가기가 아니라 held-out 입력을 사용한다.
- 일반적인 설계에서는 올바르지만 최적은 아닌 baseline과 개선 여지가 충분한 reference를 제공한다. 보통 System Optimization에서는 최소 한 차수 규모의 성능 향상을, Model Development에서는 통계적으로 명확한 성능 향상을 요구한다. 부록에는 예외가 명시되어 있다. flux2_klein_lora에는 OOM이 발생하기 쉬운 설정이 제공된다.
- 시간 예산은 작은 퍼즐의 2시간부터 언어 모델 개발 전 과정의 12시간까지다. 작은 학습 작업을 사용하므로 frontier 규모의 학습 비용 없이도 여러 차례 실험할 수 있다.
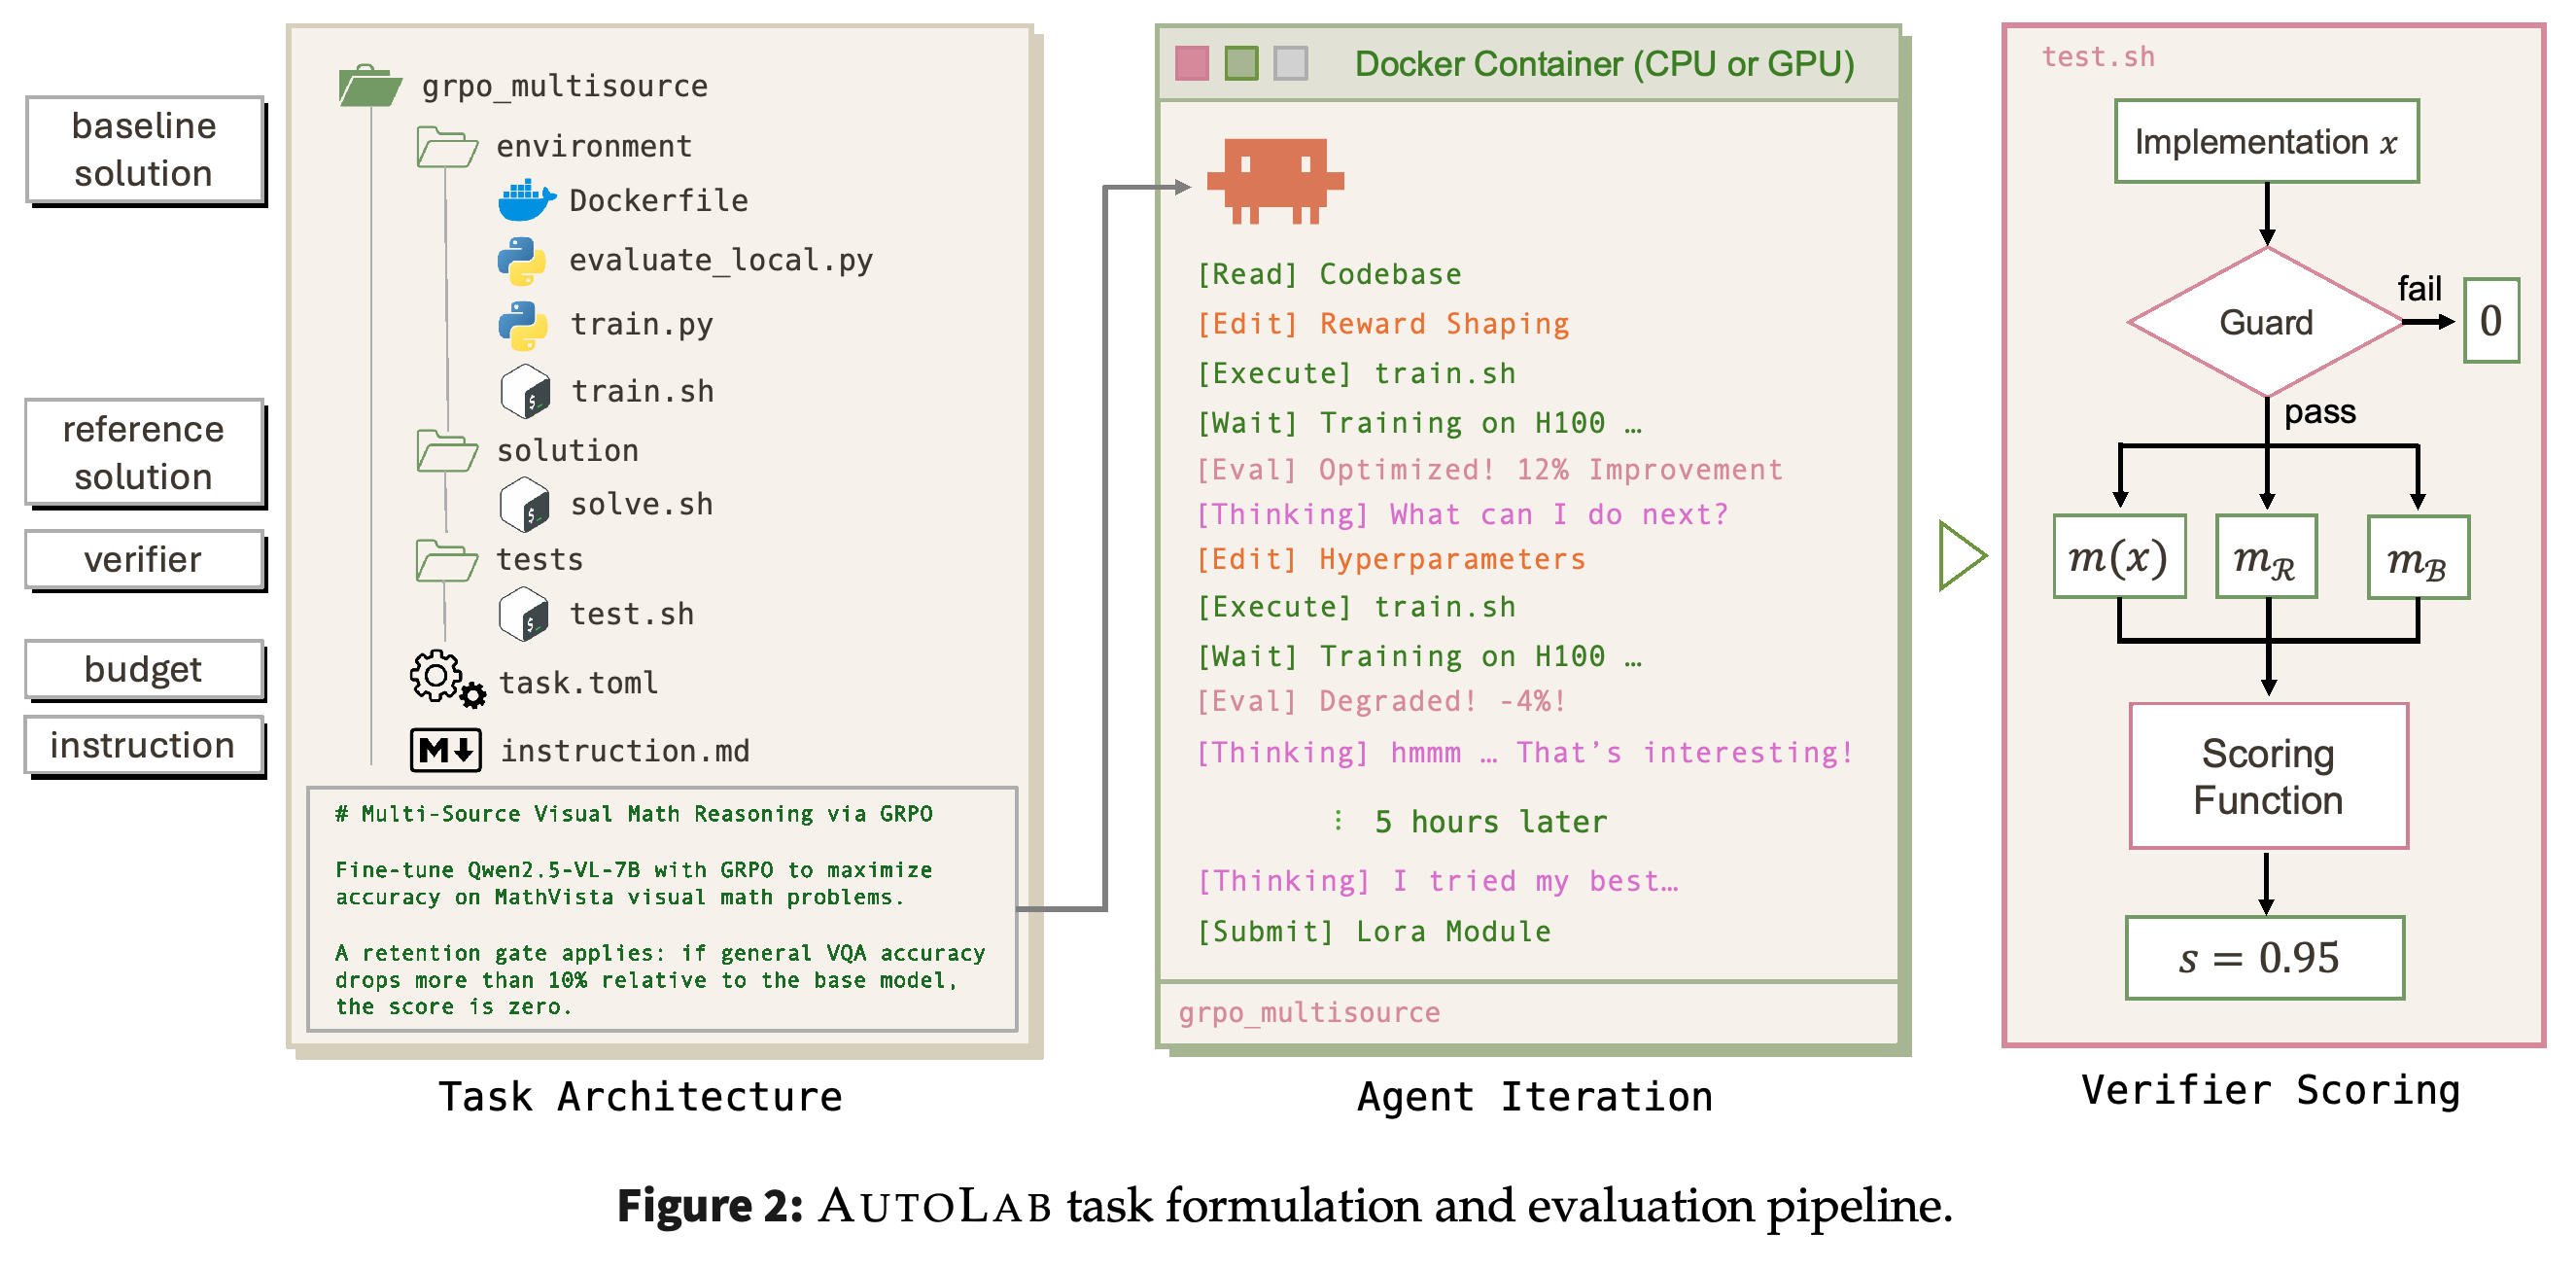
- Figure 2는 개발 중 피드백과 최종 검증을 구분한다. 검증 조건을 통과하지 못하면 최적화 지표를 채점하기 전에 점수 0을 부여한다.
이 작업 흐름은 수정 가능한 개발 산출물과 로컬 피드백을 보호된 최종 채점과 분리한다. 점수 0.95는 설명용 예시이며 보고된 실험 결과가 아니다. 통과 조건을 충족하지 못하면 지표를 정규화하기 전에 점수 0을 부여한다. 도식에서는 grpo_multisource 학습에 H100을 명시하지만, Appendix A.1은 해당 과제에 L40S를 지정한다.
값이 작을수록 좋은 지표의 log-stretch 점수는 (s(x)=\operatorname{clip}\left(\frac{1}{2}\frac{\log(m_B/m(x))}{\log(m_B/m_R)},0,1\right))이며, 기준점 기반 선형 점수는 (s(x)=\operatorname{clip}\left(\frac{m_B-m(x)}{m_B-m_R},0,1\right))이다. 여기서 m(x), mB, mR은 각각 구현, baseline, reference의 지표를 뜻한다. 값이 클수록 좋은 지표에는 방향을 바꾼 대응식을 사용한다.
- Log-stretch는 baseline에 0, reference에 0.5를 부여해 reference를 넘는 성능에도 보상할 여지를 남긴다. 최소 개선 조건이 있어 변경하지 않은 baseline에는 점수를 주지 않는다.
- 선형 채점은 baseline에 0, reference에 1.0을 부여한다. 따라서 채점 방식이 다르면 같은 수치의 점수라도 reference 대비 성능 수준이 같다고 볼 수 없다.
- 실행 시간 기준점은 벤치마크 하드웨어와 sandbox에 맞춰 보정한다. 기준값과 과제별 통과 조건은 Appendix A.2에 명시되어 있다.
2.2 Benchmark Construction
숙련된 연구자와 엔지니어가 실제로 경험한 작업에서 과제를 제안했다. 인위적인 난도보다 현실성과 다양성을 우선했다. 각 과제는 기여자와 독립적인 전문가 최소 2명과 형식 감사 에이전트의 검토를 거쳤다. 이들은 과제의 타당성, 예산 내 해결 가능성, 무결성, 측정 안정성을 평가했다.
- 최종 검증기의 held-out 입력과 reference 출력은 비공개로 보호한다. 에이전트는 로컬 개발용 평가를 계속 사용할 수 있다.
- ML 정확성 검증에는 공개 개발 데이터와 겹치지 않는 분포에서 추출한 입력을 사용한다. 별도의 적대적 감사로 편법을 탐색하며, SHA로 고정된 핵심 파일을 무단 변경하면 점수 0을 부여한다.
- 새로운 취약점이 발견되면 검증기를 수정하고 과제를 다시 검증한다. 이러한 보호 장치는 reward hacking의 기회를 줄이지만, 가능한 모든 취약점이 제거되었음을 입증하지는 않는다.
2.3 Benchmark Composition
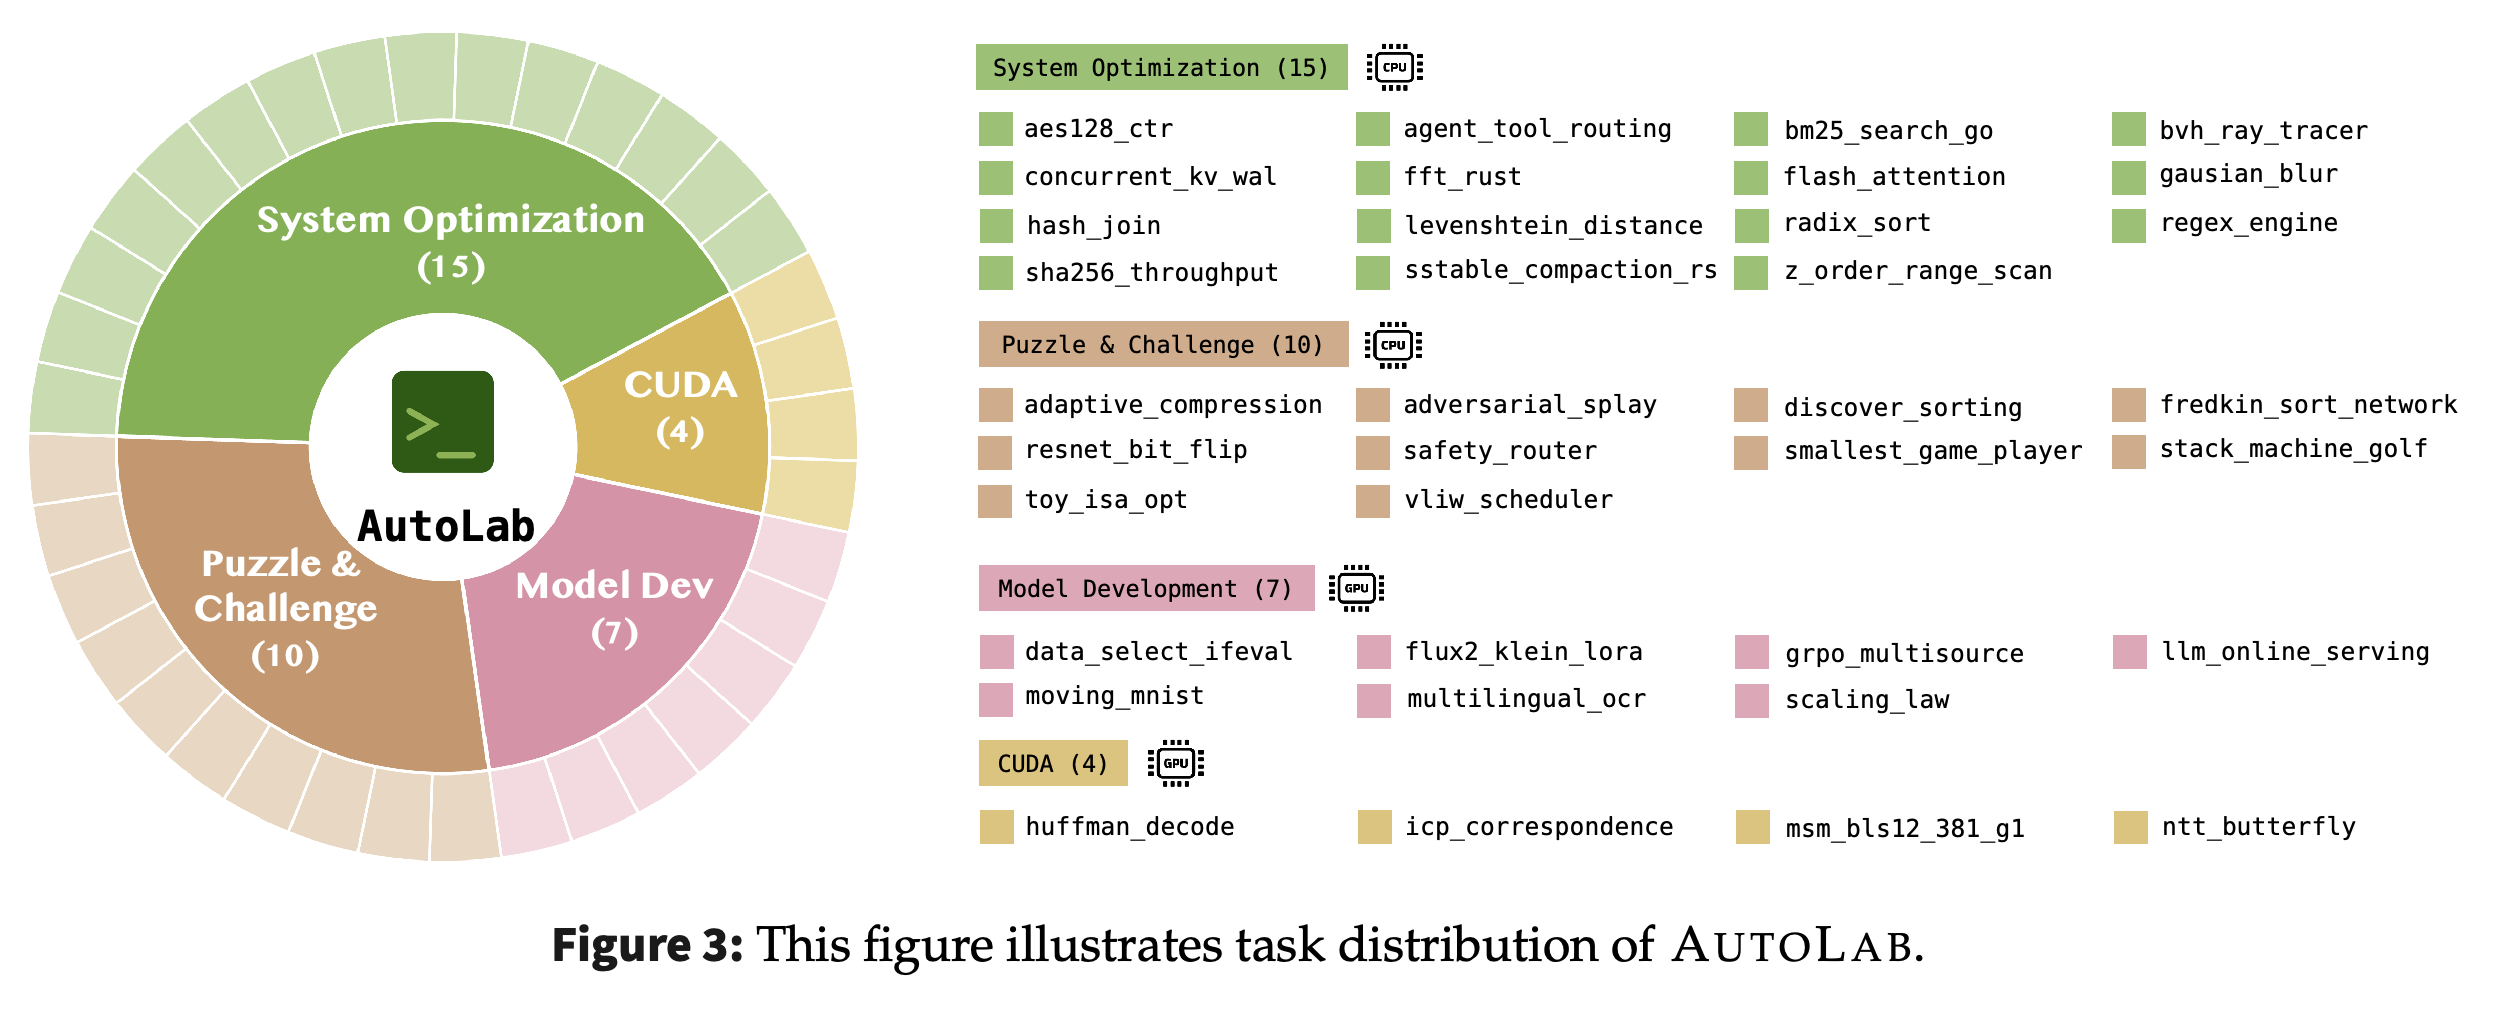
벤치마크는 System Optimization 과제 15개, Puzzle & Challenge 과제 10개, Model Development 과제 7개, CUDA 과제 4개로 구성된다. Figure 3의 분포를 보면 전체 평균에는 System Optimization 과제가 다른 어떤 범주보다 많이 반영된다.
- System Optimization은 C, C++, Rust, Go, Python의 저수준 성능 엔지니어링을 다룬다. 정렬, 해싱, 검색, 암호화, 스토리지 기본 연산 등이 포함된다.
- Puzzle & Challenge는 알고리즘적 통찰, 가역 정렬, 적대적 구성, 작은 학습 모델, 명령어 스케줄링을 중점적으로 다룬다.
- Model Development는 사전학습, 후속 학습, 데이터 선택, parameter-efficient fine-tuning, 비디오 예측, OCR, serving을 다룬다. CUDA는 암호화 기본 연산, 점군 대응점 탐색, 압축을 다룬다.
범주 비율은 System Optimization 과제 15개와 CUDA 과제 4개라는 불균등한 구성을 드러낸다. 따라서 전체 과제 평균 성능에는 CUDA보다 System Optimization이 더 큰 비중으로 반영된다. 도식에 약어나 다른 표기가 사용된 경우, 부록에서 전체 과제 식별자를 확인할 수 있다.
3 Benchmark Results
평가에서는 전체 및 범주별 결과와 함께 attention 커널 최적화 사례를 보고한다. 주요 비교 대상은 제공사별 대표 모델 11개이며, 이전 세대 또는 작은 변형 모델 6개를 추가 분석에 사용한다.
3.1 Experimental Setup
모든 모델은 HARBOR를 사용하며 기본 에이전트는 terminus-2다. CPU 과제는 16코어 / 32스레드와 64 GB RAM을 갖춘 AMD Ryzen 9 9950X 워크스테이션의 Docker에서 실행한다. GPU 과제는 H100 또는 L40S GPU를 갖춘 Modal sandbox를 사용하며, 과제 메타데이터로 CPU와 메모리 상한을 적용한다.
- 독점 모델 4개는 claude-opus-4.6, gemini-3.1-pro, gpt-5.4, grok-4-20이다. 논문은 qwen-3.6-plus, deepseek-v4-pro, glm-5, kimi-k2.6, hunyuan-3-preview, mimo-v2.5-pro, minimax-m2.7을 주요 open-weight 모델로 분류한다.
- Ablation 모델 6개는 kimi-k2.5, minimax-m2.5, mimo-v2-pro, mimo-v2.5, deepseek-v4-flash, qwen-3.5-plus다.
- 논문은 벤치마크 난도를 이유로 파라미터가 <200B인 작은 open-weight 모델을 제외한다. 따라서 작은 모델 기반 에이전트에 대한 결론에는 한계가 있다.
각 모델–과제 조합을 독립적으로 3회 실행한다. Avg@3는 실행 점수의 평균이고, Best@3는 최댓값이다. Dominance는 Avg@3를 기준으로 다른 모델과 비교한 과제별 승률의 평균이며, 동률에는 절반의 점수를 부여한다.
- Best@3는 3회 시도에서 관측된 최고 결과이지, 에이전트 능력의 상한으로 확립된 값이 아니다.
- Dominance의 범위는 [0, 1]이다. 1은 모든 과제에서 모든 상대보다 엄격히 우수함을 뜻하고, 0.5는 평균적인 상대 비교 성능을 뜻한다. 점수 차이의 크기가 아니라 과제 내 순서에 따라 결정된다.
- Table 1은 주요 모델 집합의 Dominance만 보고하며, ablation 변형 모델 6개의 Dominance는 보고하지 않는다.
3.2 Main Results
Table 1에서 claude-opus-4.6은 전체와 4개 범주 모두에서 가장 높은 성능을 보인다. 범주별 Avg@3는 CUDA 0.38, Model Development 0.63, Puzzle & Challenge 0.85, System Optimization 0.67이다. 전체 점수에서 gemini-3.1-pro보다 0.18 앞선다.
- 논문이 주요 open-weight 모델로 분류한 kimi-k2.6, mimo-v2.5-pro, glm-5의 전체 Avg@3는 각각 0.46, 0.45, 0.43으로 비슷한 수준이다.
- gpt-5.4와 grok-4-20의 점수는 각각 0.36과 0.35다. 저자들은 실행 과정 검토를 근거로 낮은 순위를 조기 종료와 연결한다. 코딩 능력의 영향을 통제해 분리한 결과는 아니다.
- deepseek-v4-flash는 0.37로 deepseek-v4-pro의 0.38과 비슷하며, CUDA와 퍼즐에서는 더 높은 성능을 보인다. gemini-3.1-pro가 가장 강한 범주는 퍼즐이다. 논문이 보고한 실행 길이 중앙값은 이 모델이 12단계, claude-opus-4.6이 57단계다.
주요 모델 행은 claude-opus-4.6이 평균 성능과 상대 비교 Dominance에서 앞선다는 점을 보여 준다. Ablation 행에서는 deepseek-v4-flash가 전체적으로 deepseek-v4-pro와 거의 같은 성능을 내면서 CUDA와 퍼즐에서는 더 높은 성능을 보인다. 따라서 이 harness에서는 모델 규모만으로 순위가 결정되지 않는다.
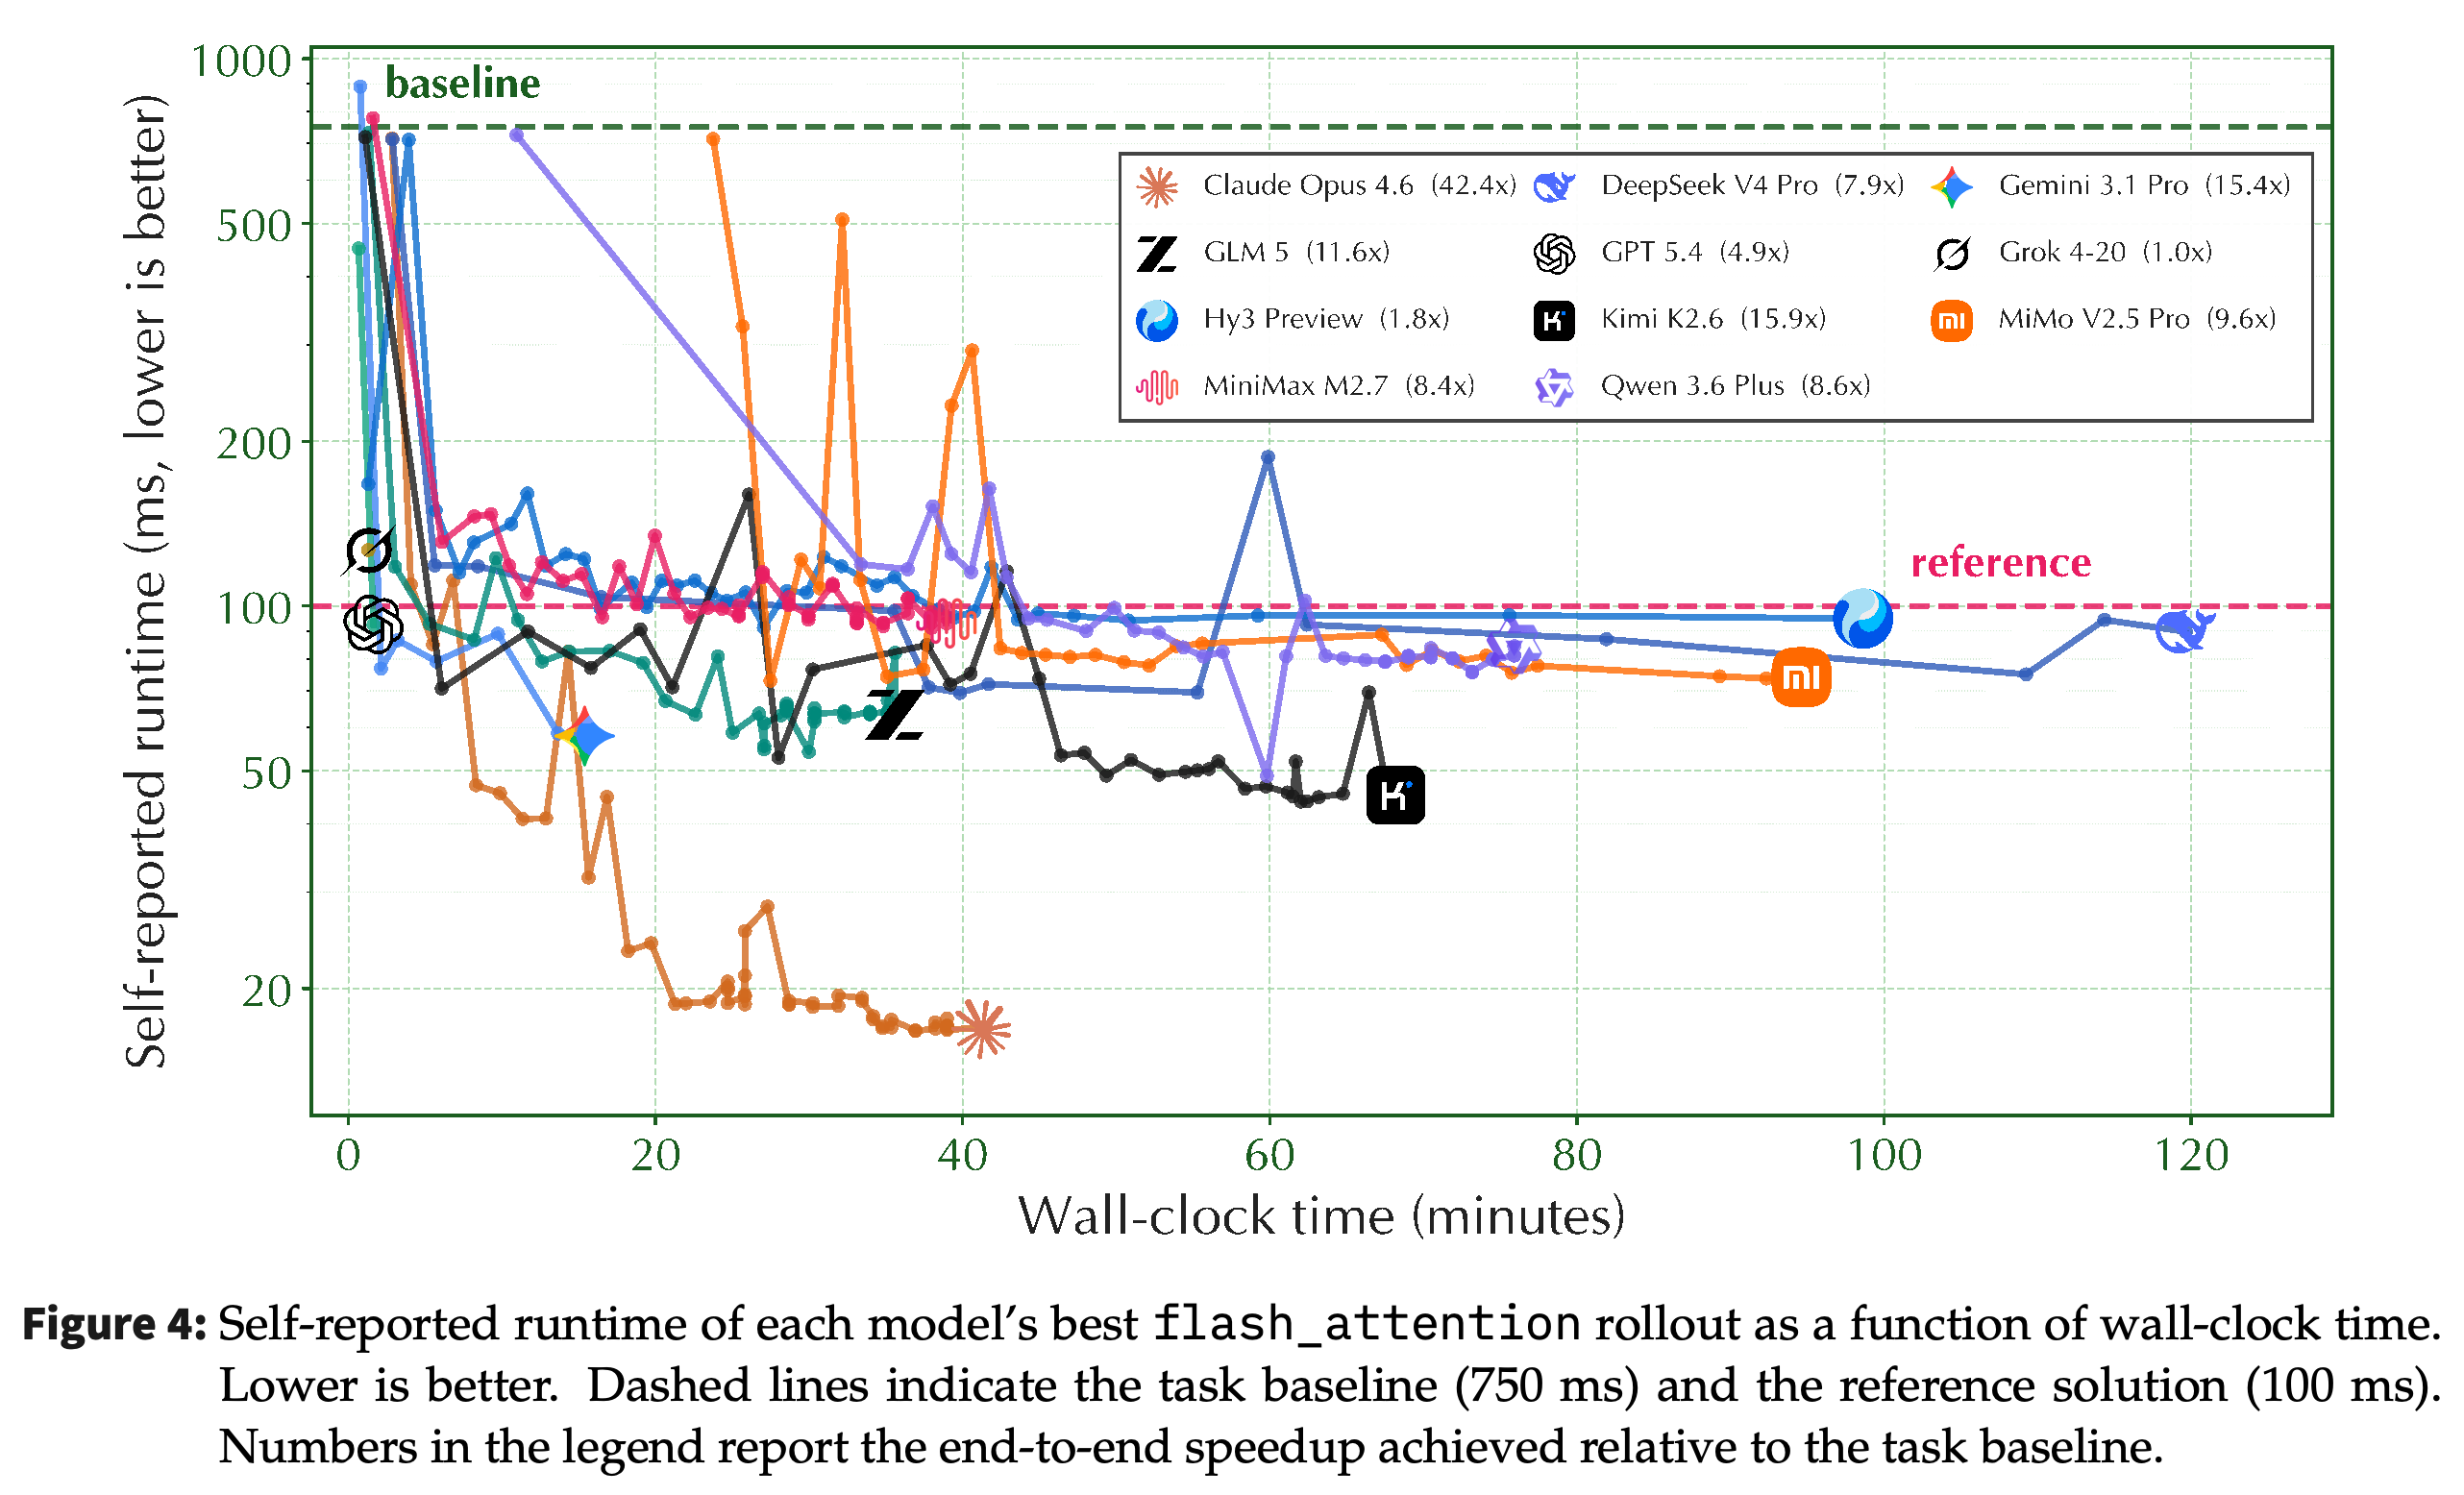
flash_attention 사례 연구는 2시간 예산의 단일 스레드 C attention 커널 과제에서 각 모델의 최고 실행을 살펴본다. claude-opus-4.6은 약 750 ms에서 시작해 약 40분 동안 피드백에 따라 44회 반복하며 18 ms에 도달한다. 보고된 속도 향상은 42.4×이며, 100 ms reference보다 빠르다.
- Figure 4는 모델이 자체 보고한 개발 중 실행 시간을 그린 것이며, 전체 held-out 점수 변화를 보여 주는 것은 아니다. 개발 행동을 설명하지만 모든 중간 구현을 독립적으로 검증하지는 않는다.
- kimi-k2.6, gemini-3.1-pro, glm-5는 약 50–80 ms에 도달한 뒤 정체된다. mimo-v2.5-pro와 deepseek-v4-pro는 단계마다 긴 추론으로 실험이 지연되며, 후자는 가장 좋은 중간 결과를 제출하지 않는다.
- qwen-3.6-plus는 더 좋은 중간 결과를 규칙 위반이라고 잘못 판단해 폐기한다. grok-4-20은 평가를 1회만 수행하고 중단한다. 이 사례는 반복 실험, 좋은 후보의 보존, 제때 제출하기, 자체 검증을 구분해 보여 준다.
claude-opus-4.6은 100 ms reference보다 훨씬 낮은 수준까지 계속 개선하지만, 여러 모델은 정체되거나 더 일찍 중단한다. 각 모델의 최고 실행에서 자체 보고한 곡선은 개발 행동을 설명한다. 모든 시점의 성능을 독립적으로 검증한 결과는 아니다.
4 Analysis
분석에서는 자원 활용, 점수 0인 실패 유형, harness 효과, 모델 세대별 변화, 실행 간 안정성을 살펴본다. 이 진단들은 일찍 멈추는 구성과 예산을 모두 쓰고도 유효한 개선 결과를 제출하지 못하는 구성을 구분한다.
4.1 Cost Analysis
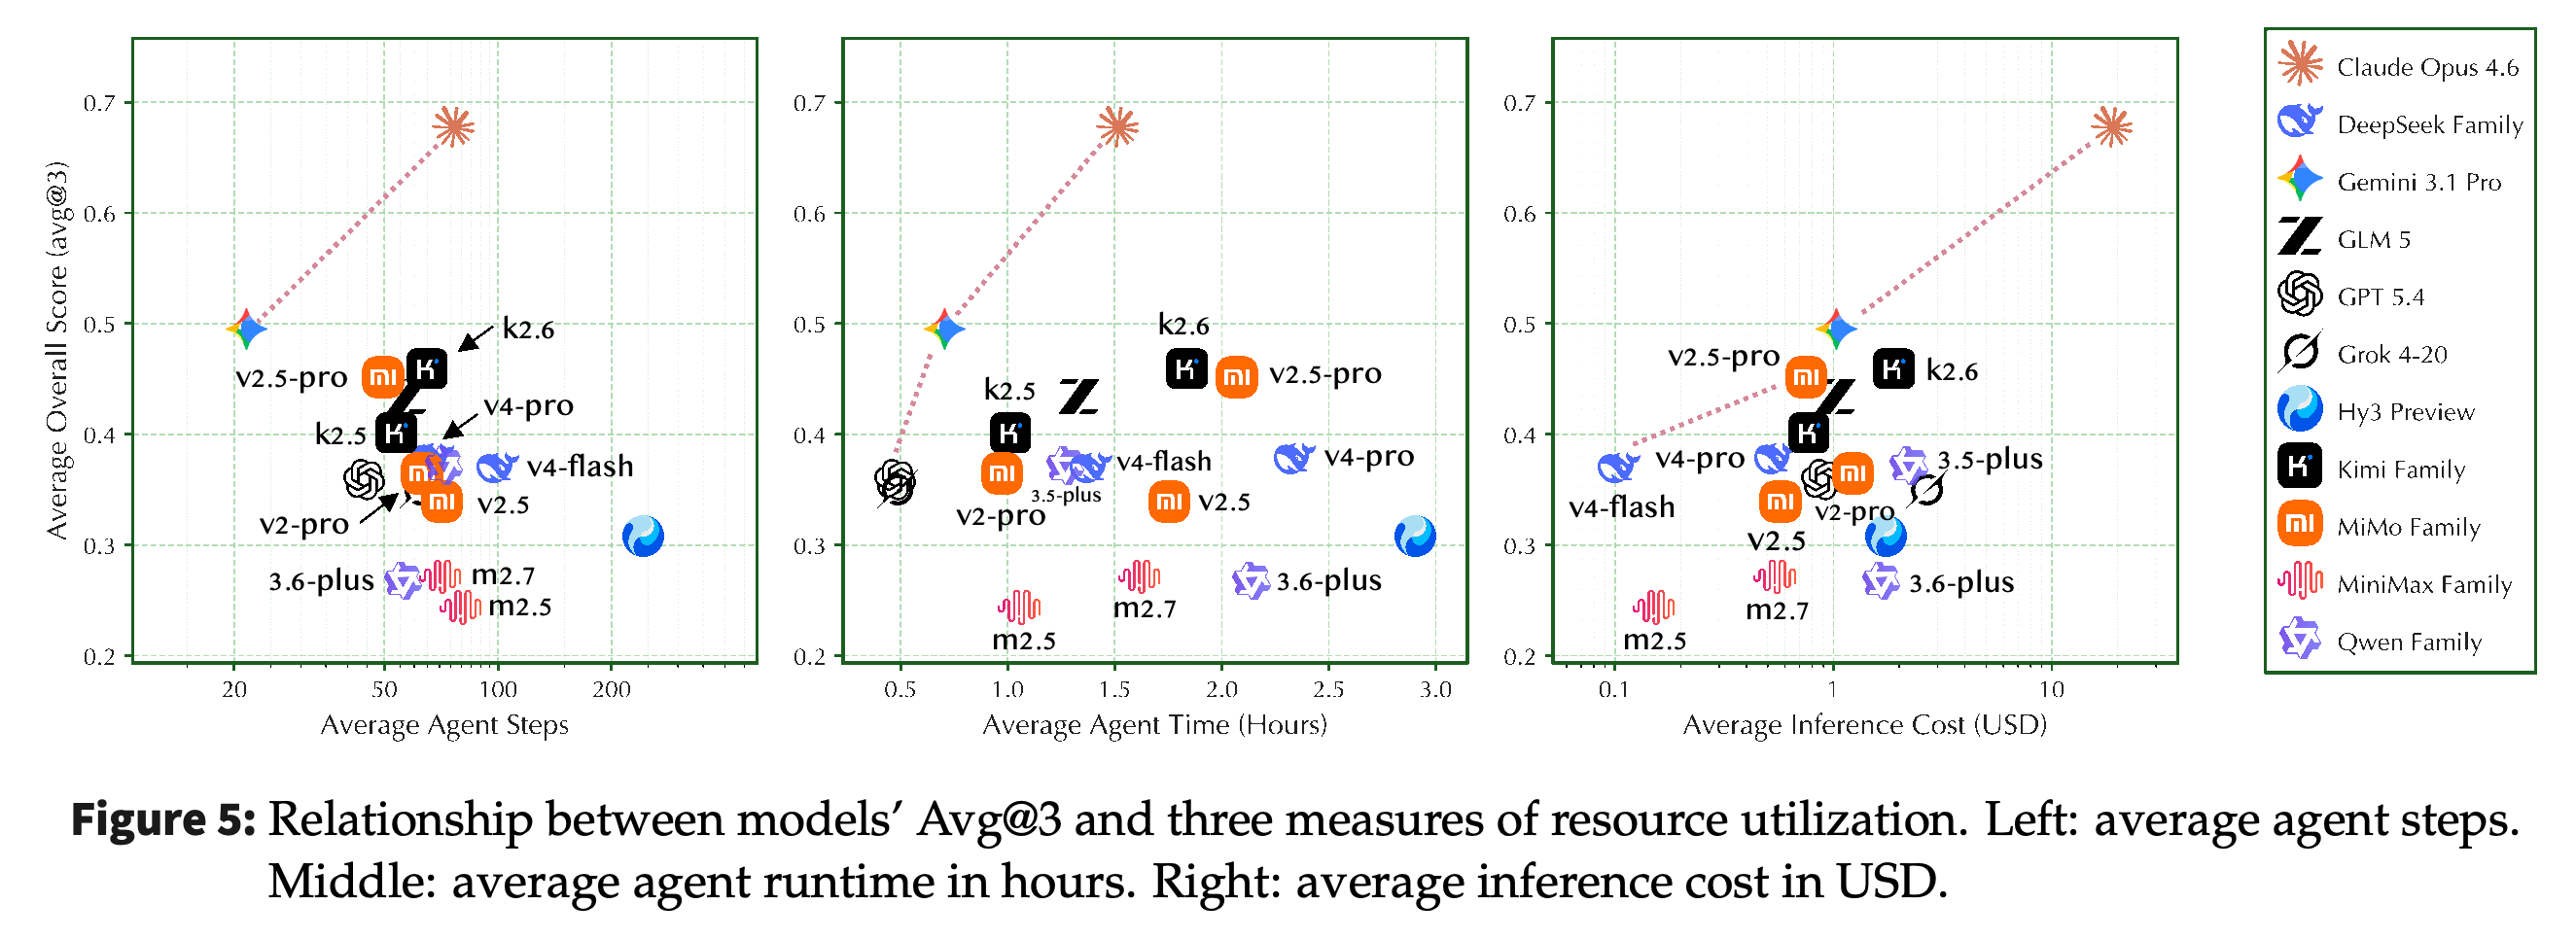
Figure 5에서 Avg@3는 에이전트 단계 수 및 실행 시간과 양의 관계를 보인다. claude-opus-4.6은 많은 반복과 함께 최고 점수를 얻는다. gpt-5.4와 grok-4-20은 조기 중단과 일치하는 짧은 실행 시간 영역에 위치한다.
- 대체로 추론 지출이 높을수록 점수도 높지만, deepseek-v4-flash와 mimo-v2.5-pro는 더 낮은 추론 비용으로도 경쟁력 있는 점수를 얻는다.
- 금액 지표는 추론 비용이며, CPU/GPU 실행과 인프라 비용까지 포함한 전체 비용은 아니다.
- 이러한 모델 간 관계만으로 실행 시간이나 단계 수를 늘리는 것 자체가 결과를 개선한다고 볼 수는 없다. 모델 품질, 행동 효율, harness 동작도 함께 달라진다.
단계 수와 실행 시간 패널은 더 많은 반복 노력이 높은 점수와 연관됨을 보여 주면서 모델 간 상당한 차이도 드러낸다. 추론 비용 패널은 더 낮은 가격으로 경쟁력 있는 성능을 내는 구성을 보여 준다. 다만 과제 실행의 전체 비용을 포함하지 않으며, 더 많은 지출의 인과적 이점을 입증하지도 않는다.
4.2 Failure Case Analysis
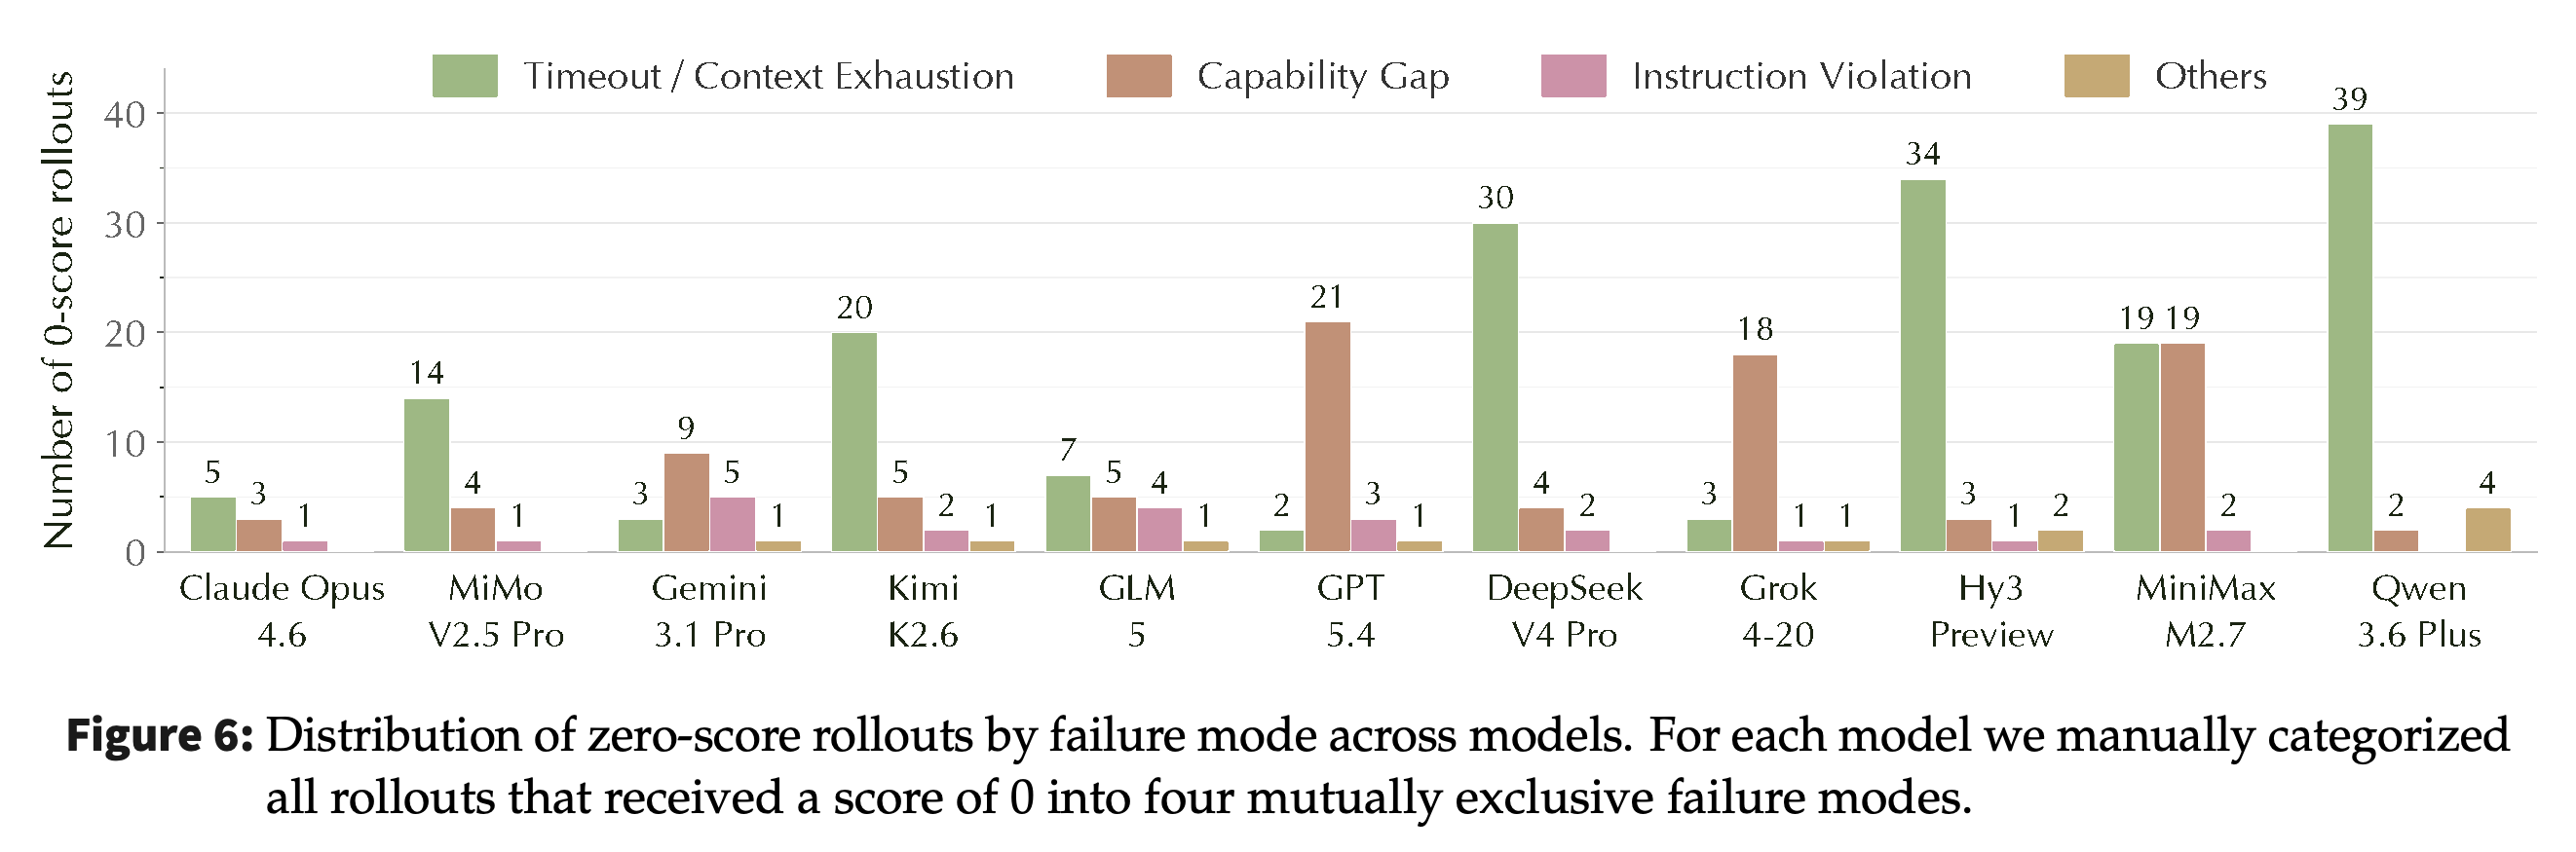
저자들은 주요 모델 11개에서 점수 0을 받은 실행 302개를 모두 수작업으로 분류한다. 범주는 서로 배타적인 4가지인 Timeout / Context Exhaustion, Capability Gap, Instruction Violation, Others다. 이 분류는 제출하지 못한 실패와 제출된 산출물이 정확성, 개선 기준, 명시적 제약을 충족하지 못한 실패를 구분한다.
- Timeout / Context Exhaustion에는 AgentTimeoutError와 1,500초 이상 걸린 개별 LLM 호출이 포함된다.
- Capability Gap에는 잘못된 출력, 불충분한 개선, 조기 포기, LoRA adapter 같은 필수 산출물 누락이 포함된다. 여러 행동적·기술적 원인을 한데 묶은 범주다.
- Instruction Violation은 금지된 API, 허용되지 않은 import, 보호 파일 수정, 작업 공간에 허용되지 않은 파일을 두는 행위를 포함한다. Others에는 서버 오류, 잘못된 응답 형식, sandbox 실패가 포함된다.
실패 검토에서는 상반된 시간 배분 패턴 2가지가 나타난다. deepseek-v4-pro, hunyuan-3-preview, qwen-3.6-plus는 자주 예산을 소진한다. 반면 gpt-5.4와 grok-4-20은 상당한 시간을 남기고 중단하는 경우가 많다. Figure 6에서 앞선 모델들의 timeout/context 실패는 각각 30건, 34건, 39건이다.
- toy_isa_opt에서 kimi-k2.6의 시도 3회는 모두 2–11단계만 수행한 뒤 시간 초과로 끝난다. CUDA에서는 deepseek-v4-pro의 시도 12회 중 9회가 10개 미만의 행동을 수행한 뒤 시간 초과로 끝난다.
- 매우 긴 추론 사슬 패턴은 평가된 모델 목록에서 open-weight 모델에만 나타난다. 이 결과가 open 모델과 closed 모델의 일반적인 차이를 입증하는 것은 아니다.
- gemini-3.1-pro와 glm-5의 지시 위반은 각각 5건과 4건이다. ntt_butterfly_cuda가 전체 지시 위반의 절반을 차지한다. 제약 준수 여부가 구현의 점수 획득 자체를 결정할 수 있음을 보여 준다.
deepseek-v4-pro, hunyuan-3-preview, qwen-3.6-plus에서는 timeout/context 실패가 가장 많다. 반면 gpt-5.4와 grok-4-20에서는 Capability Gap 실패가 가장 많다. 이 범주들은 제출에 이르지 못한 실패와 제출한 산출물이 점수 0을 받은 실패를 구분하며, 서로 다른 대응이 필요함을 보여 준다.
4.3 Harness Ablation Analysis
Harness ablation은 system_optimization과 puzzle_and_challenge의 CPU 과제 25개에서 mimo-v2.5, deepseek-v4-flash, gpt-5.4, kimi-k2.6을 다시 평가한다. terminus-2를 pi-mono 및 mini-swe-agent*와 비교한다. 별표는 측정과 수정, 검증된 제출을 계속하도록 유도하는 맞춤형 최적화 프롬프트를 뜻한다.
- 수정된 프롬프트는 baseline 확인, 개선 결과 보존, 성능 하락 시 되돌리기, 첫 성공 직후 제출하지 않기를 권장한다. 이 조건은 harness뿐 아니라 프롬프트도 바꾸므로 인터페이스 효과만 분리하지는 못한다.
- 이 부분집합에는 Model Development와 CUDA 과제가 전혀 포함되지 않는다. 여기서 얻은 순위와 비용으로 전체 36개 과제의 리더보드를 대체해서는 안 된다.
Figure 7은 모델별로 큰 harness 효과를 보여 준다. terminus-2, pi-mono, mini-swe-agent* 순서의 평균 점수는 mimo-v2.5가 0.36/0.25/0.57, deepseek-v4-flash가 0.41/0.26/0.54, gpt-5.4가 0.40/0.50/0.37, kimi-k2.6이 0.51/0.21/0.64다.
- kimi-k2.6에서 pi-mono와 mini-swe-agent*의 차이인 0.43은 주요 리더보드의 많은 모델 간 격차보다 크다.
- mini-swe-agent*는 모델 4개 중 3개에서 terminus-2보다 유리하지만, gpt-5.4는 pi-mono에서 가장 좋은 성능을 보인다. 모든 모델에서 우월한 harness는 없다.
- 평균선이 교차하고 과제별 차이도 나타난다는 점은 성능을 harness 구성에 따른 조건부 결과로 보고해야 함을 뒷받침한다.
평균선은 모든 모델에 공통된 harness 순위를 유지하지 않고 교차한다. kimi-k2.6은 pi-mono에서 0.21, mini-swe-agent*에서 0.64로 달라진다. 반면 gpt-5.4는 pi-mono에서 가장 좋은 성능을 보인다. 이는 harness와 프롬프트 구성에 대한 민감도가 모델마다 다름을 보여 준다.
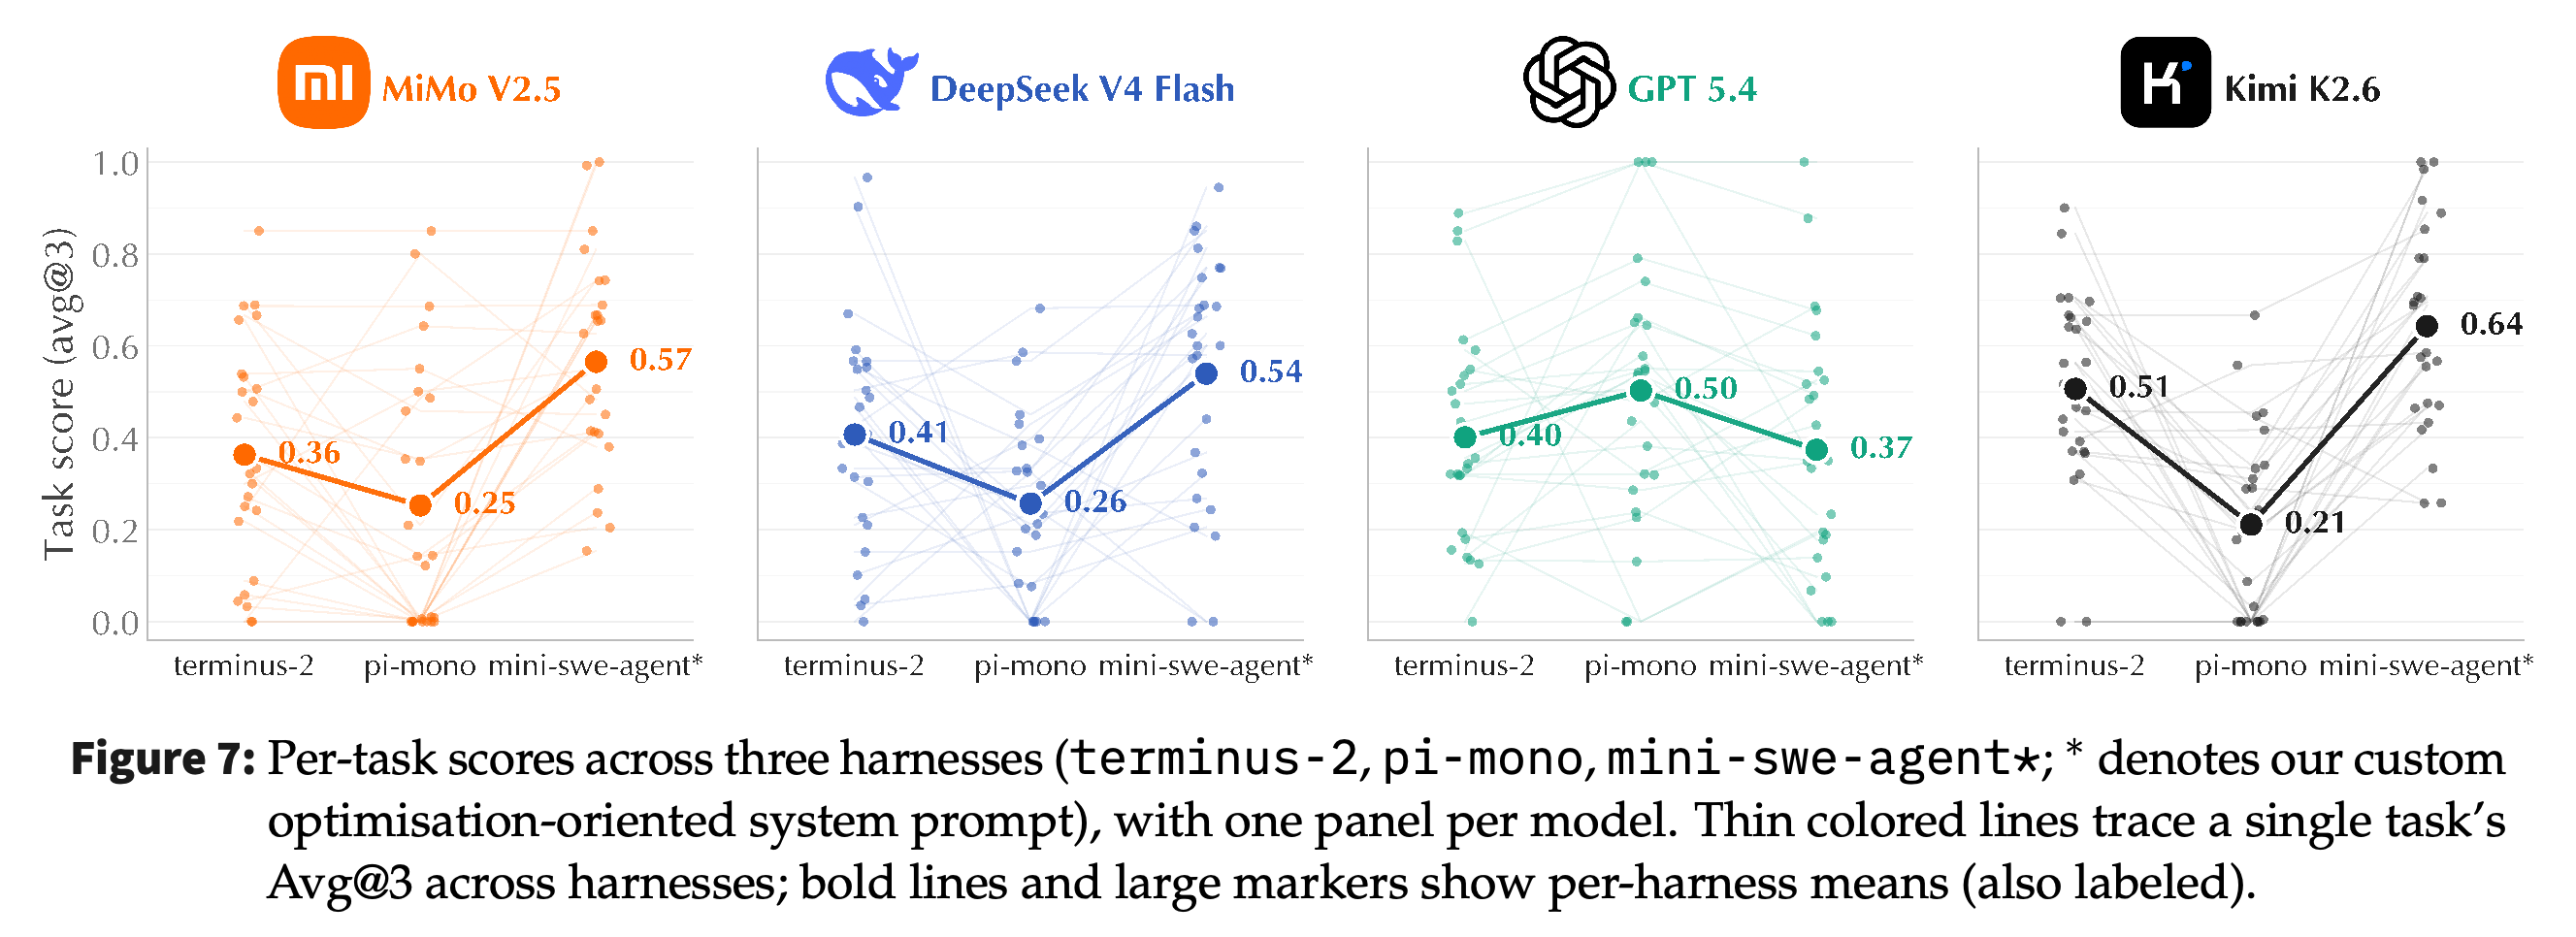
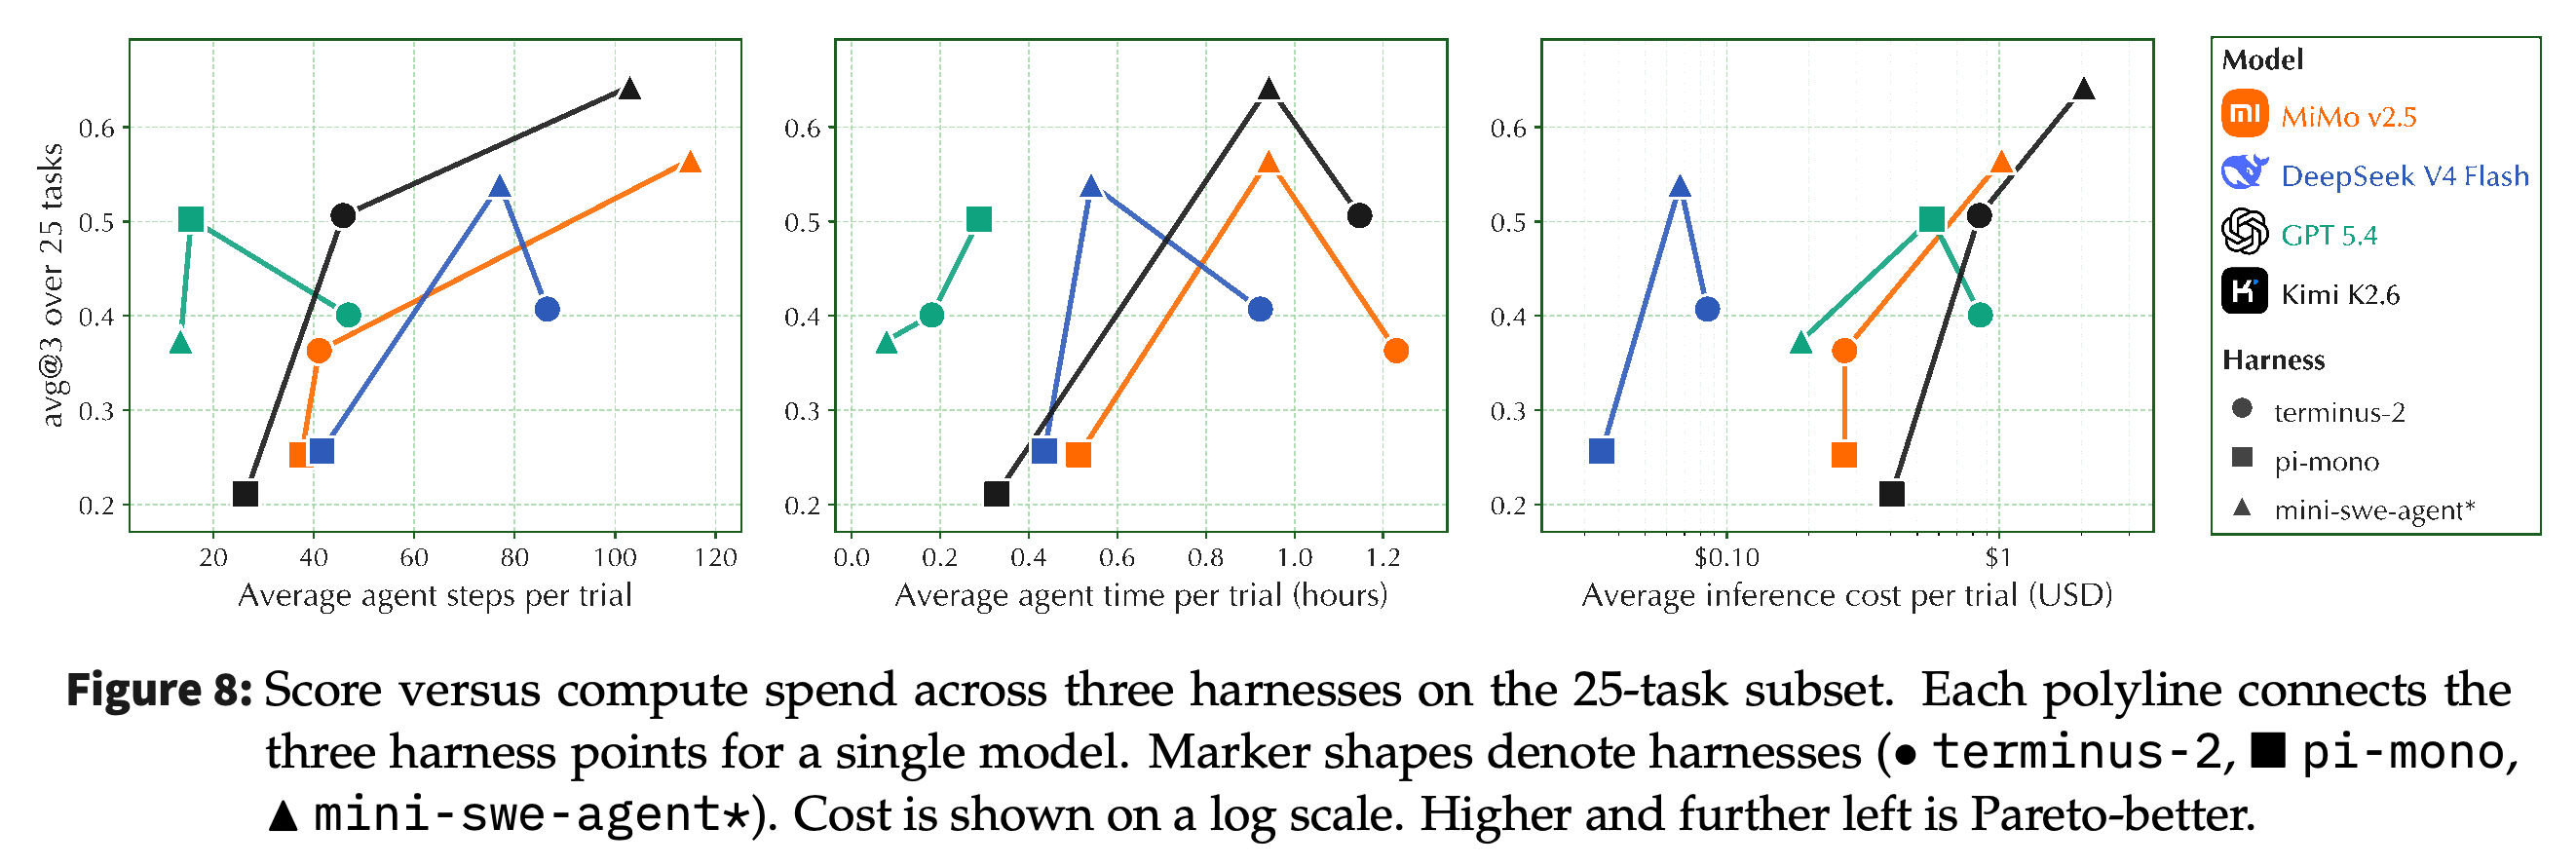
Figure 8은 harness 선택이 지출과 점수–비용 간 절충 관계도 바꾼다는 점을 보여 준다. kimi-k2.6의 추론 비용은 pi-mono에서 $0.40/trial이지만 mini-swe-agent*에서는 $2.05/trial로 증가한다. deepseek-v4-flash는 mini-swe-agent*에서 약 $0.07/trial로 평균 점수 0.54에 도달한다.
- 이 비용 비교는 평가에 사용한 API 가격과 CPU 과제 부분집합에 한정되며, 전체 실행 비용을 포함하지 않는다.
- 논문은 terminus-2 대비 변화량을 deepseek-v4-flash +0.13, mimo-v2.5 +0.20, gpt-5.4 −0.03으로 보고한다. 그러나 Figure 7에 표시된 반올림 평균값으로 계산하면 mimo-v2.5의 차이는 0.21이다.
- 저자들은 성능 향상을 시행착오를 통한 회복으로 해석한다. 다만 이 ablation은 단일 시도 추론 능력을 독립적으로 측정하거나 지속성의 기여를 분리하지는 않는다.
각 모델에서 연결된 구성들은 행동 수, 실행 시간, 추론 지출의 변화와 함께 점수가 어떻게 바뀌는지 보여 준다. 비용 패널은 최고 점수만으로 순위를 정하기보다 평가한 모델–harness 구성을 비교하는 데 근거를 제공한다.
4.4 More Analysis
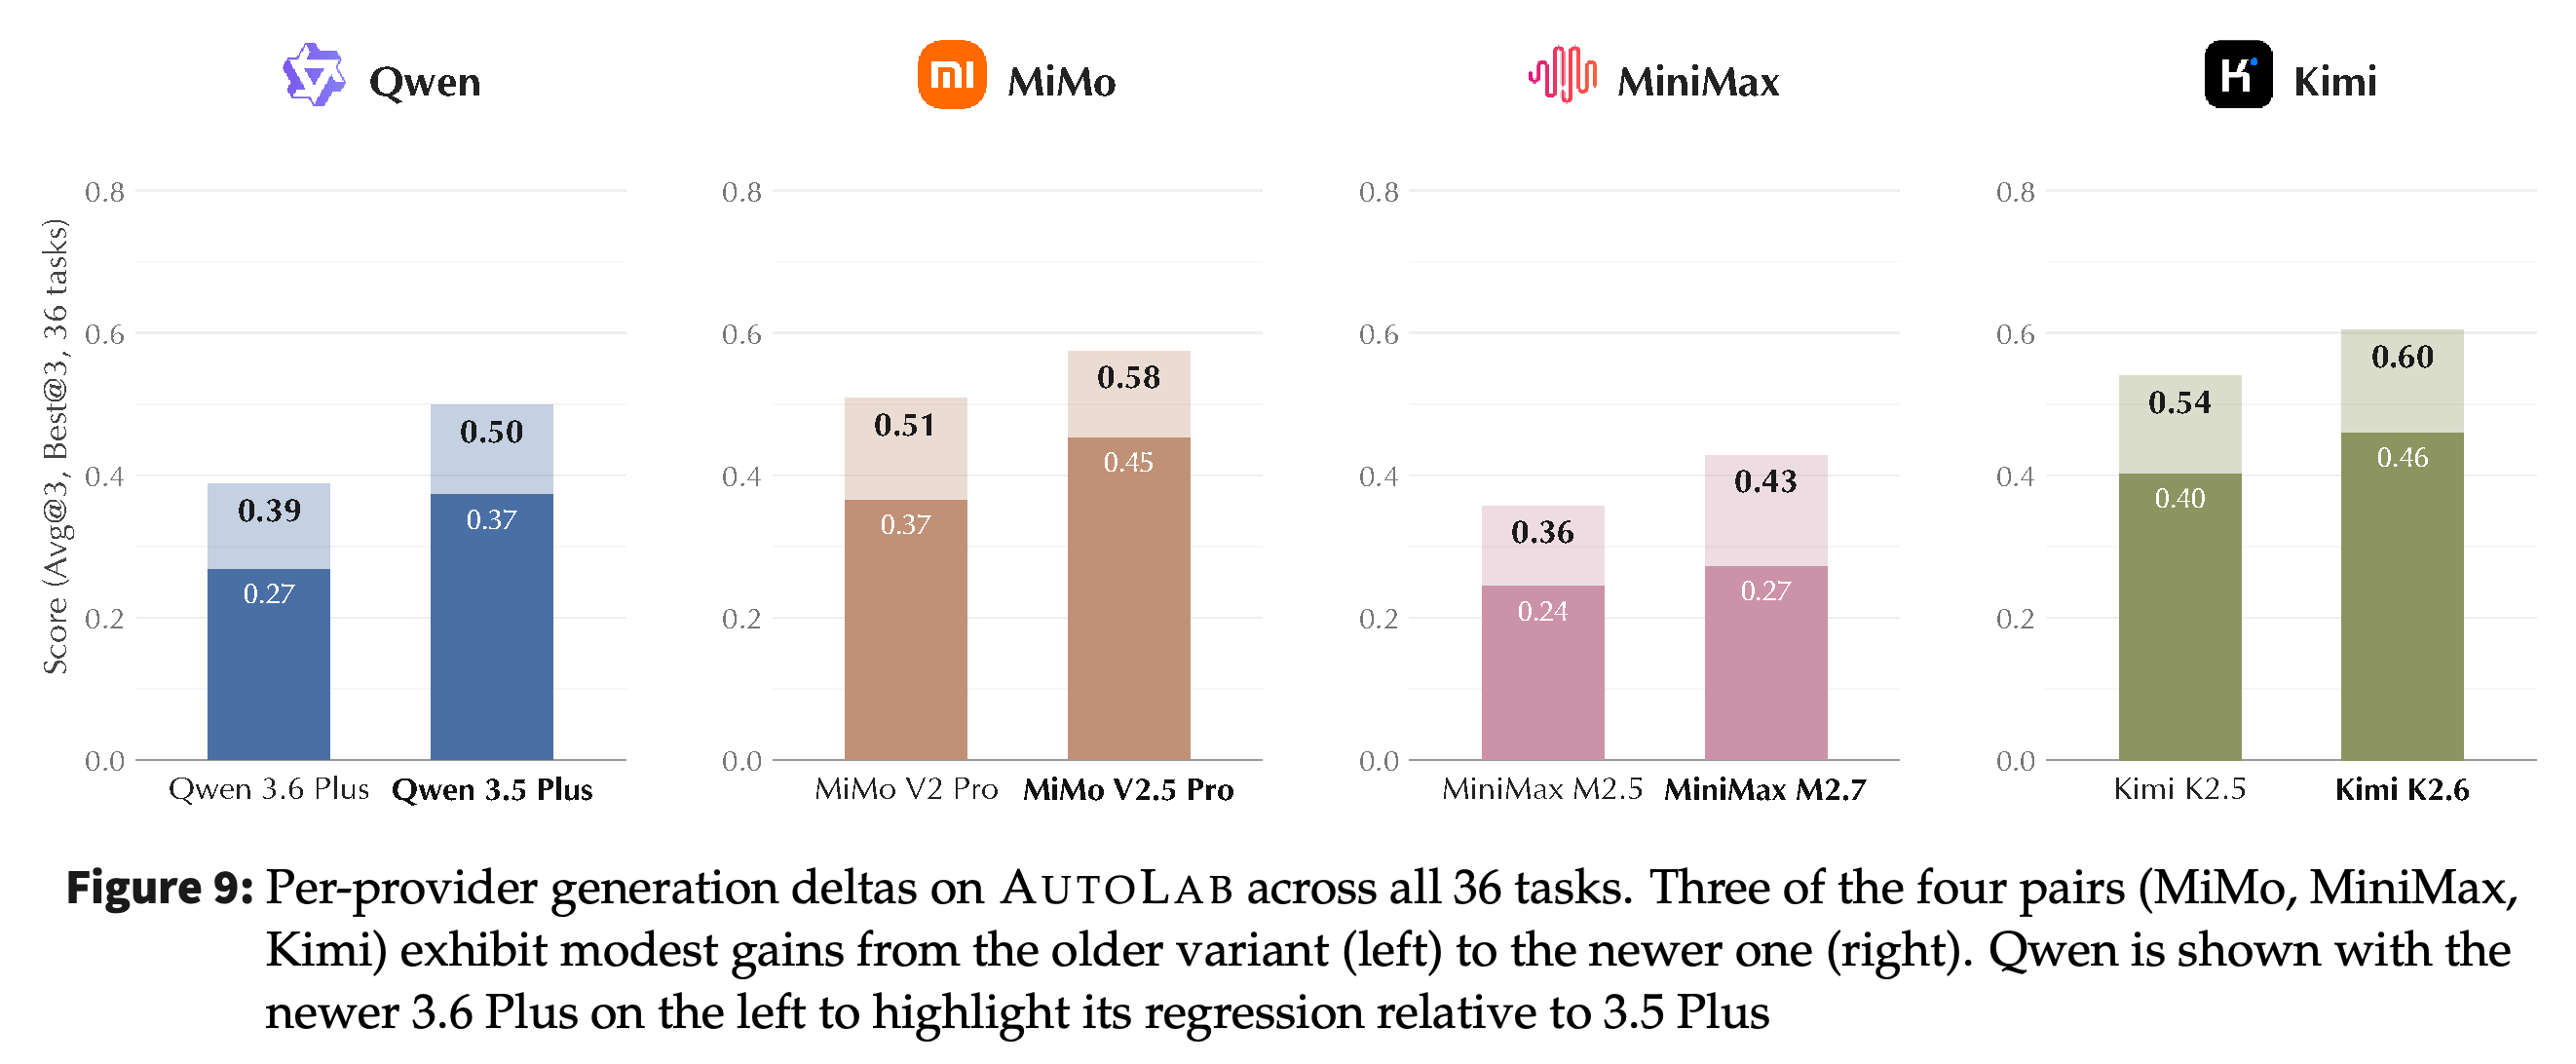
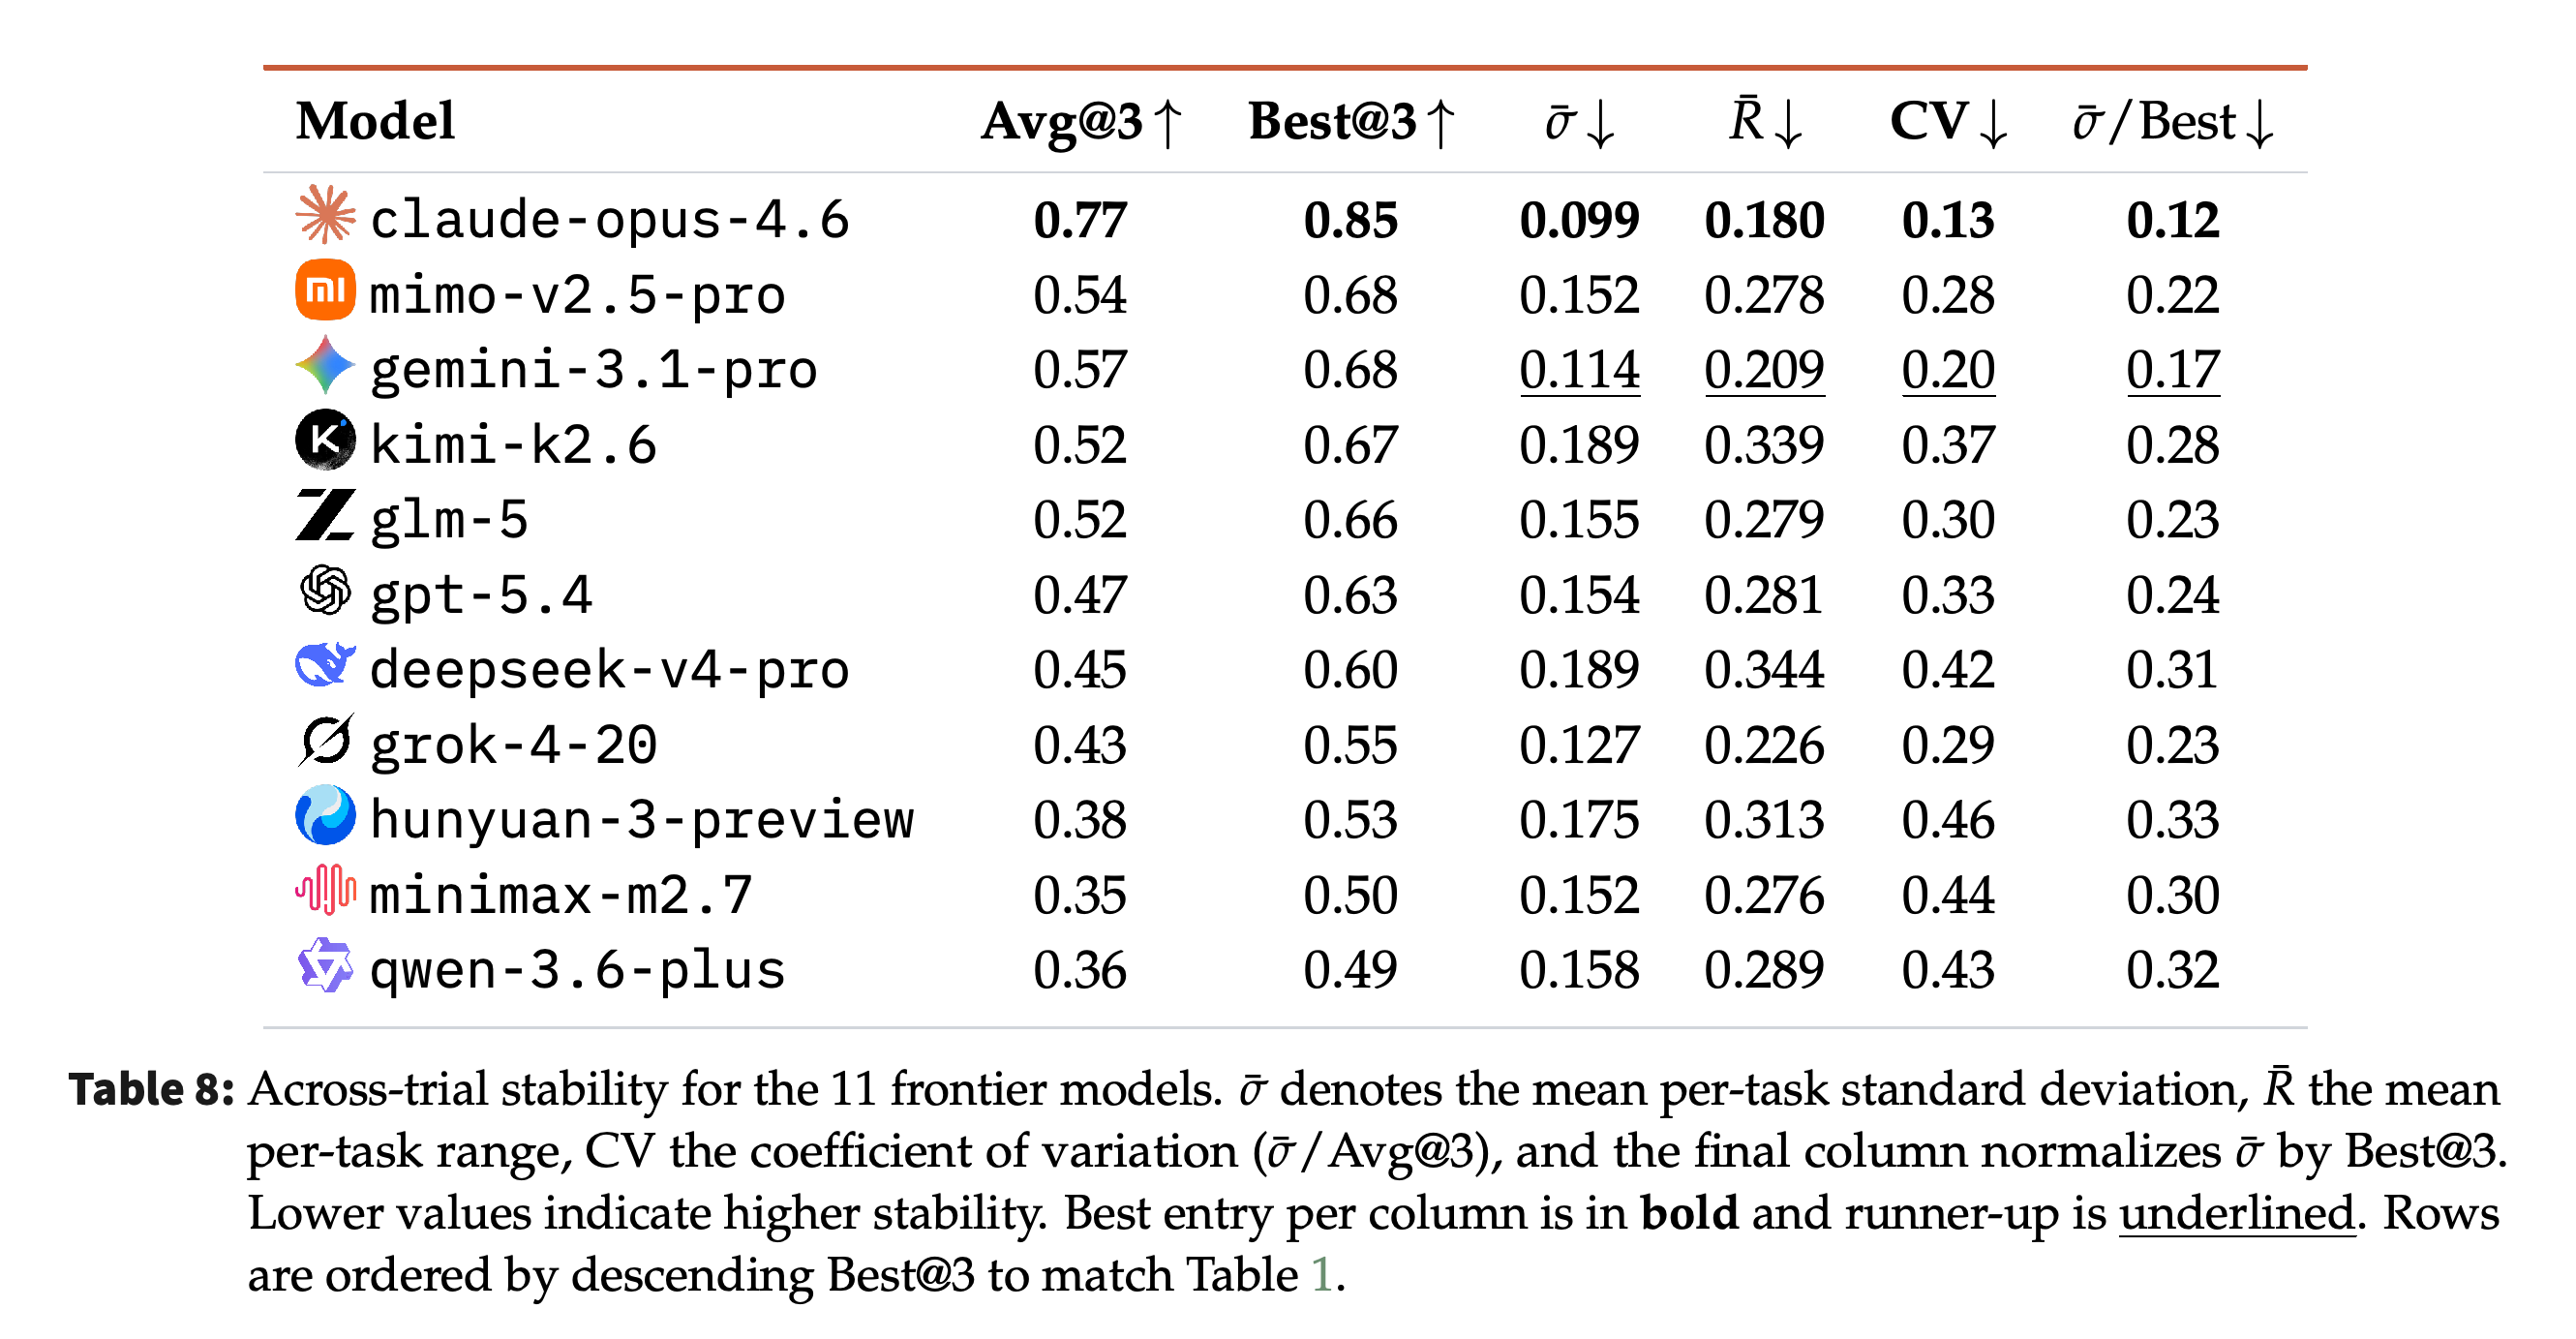
추가 분석은 terminus-2에서 모델 세대를 비교하고 3회 시도 간 산포를 정량화한다. Figure 9에서는 MiMo, MiniMax, Kimi의 전체 성능이 향상되지만 Qwen은 하락한다. Table 8에 제시된 claude-opus-4.6의 과제별 표준편차 평균은 0.099로, 표의 모델 중 가장 낮다.
- 논문은 산포가 커질수록 Best@3 − Avg@3도 커지며 Pearson r = 0.84라고 보고한다. 따라서 최고 실행만 선택하면 안정적인 구성보다 변동이 큰 구성이 더 유리해진다.
- Appendix C에는 일관되지 않은 종합 점수와 설명 예시가 있다. 이 불일치가 해명되기 전까지 해당 안정성 수치를 주요 리더보드와 구분해야 한다.
막대는 기본 harness에서 MiMo, MiniMax, Kimi의 성능 향상과 Qwen의 성능 하락을 보여 준다. Qwen은 다른 모델 쌍과 달리 최신 변형이 왼쪽에 배치되어 있다. 그림에 표시된 반올림 값으로 계산한 Qwen의 격차는 함께 제시된 본문과 약간 다르다. 본문에는 Table 1과 일치하지 않는 범주 점수도 제시되어 있다.
claude-opus-4.6은 제시된 과제별 표준편차 평균이 가장 낮다. kimi-k2.6과 deepseek-v4-pro는 가장 높은 값인 0.189로 같다. 이 표의 Avg@3와 Best@3 종합 값은 평가 범위 변경에 대한 설명 없이 주요 리더보드와 다르므로, 같은 값으로 취급해서는 안 된다.
5 Related Work
논문은 AUTOLAB을 정적 코딩 벤치마크, 상호작용형 에이전트 벤치마크, 수 시간에 걸친 ML·엔지니어링 평가 사이에 위치시킨다. 핵심 기여는 최적화 분야 4개를 포괄하는 공통 프로토콜이다. 연속 점수, 편법 방지 장치, 공통 기본 에이전트, 실행 과정 분석을 함께 제공한다.
- HumanEval, LiveCodeBench, BigCodeBench, SWE-bench는 올바른 산출물을 만드는 것과 시간에 걸쳐 실험 지표를 개선하는 것을 구분해야 하는 배경을 제공한다. GAIA, AgentBench, Terminal-Bench는 상호작용 평가를 확장한다.
- MLE-Bench, RE-Bench, PaperBench, PostTrainBench, AIRS-Bench, KernelBench, FrontierCS, Frontier-Eng는 장기 수행 과제를 다룬 더 가까운 선행 연구지만, 더 좁은 분야에 중점을 둔다.
- SWE-agent, OpenHands, Aider, The AI Scientist, SWE-Gym, R2E-Gym, MLGym은 관련 에이전트 프레임워크나 환경을 제공한다. AlphaEvolve와 AutoResearch는 맞춤형 시스템을 이용한 실험 기반 최적화를 보여 준다. 반면 AUTOLAB은 비교를 위해 공통 기본 harness를 사용한다.
6 Conclusion
AUTOLAB은 표준화된 과제와 기본 harness 조건에서도 지속적인 엔지니어링 최적화 성능에 큰 차이가 있음을 기록한다. 저자들은 코딩 능력뿐 아니라 지속적인 실험 반복, 시간 인식, harness 설계도 강조한다. 벤치마크, harness, 과제 산출물을 공개한다.
Limitations and Broader Impact
논문은 AUTOLAB의 범위를 실행 가능한 시스템과 머신러닝 작업으로 명확히 제한하며, 넓은 의미의 과학적 발견을 평가하지는 않는다. 수 시간에 걸친 실행, API 동작, GPU 작업, 주변 실행 환경 모두 결과에 영향을 준다. 따라서 실행 과정의 행동, 자원 소비, 최종 점수를 함께 보고할 필요가 있다.
- 과제 36개의 범주별 규모는 같지 않으며, CUDA 과제는 4개뿐이다. 따라서 범주별 순위와 전체 과제 평균은 서로 다른 평가 범위를 반영한다.
- 3회 시도는 일부 확률적 변동을 포착하지만, 신뢰성을 정밀하게 추정하기에는 제한적이다.
- 이 결과는 평가한 모델–에이전트 구성을 진단한다. 지속성을 인과 요인으로 분리하지도, 개방형 과학 연구의 독창성을 직접 측정하지도 않는다.
부록
- A Task Specifications와 A.1 Task Descriptions는 전체 과제 36개의 구현 언어, 난도 등급, 제약을 제공한다. tier 1은 교과서적인 고전 최적화를, tier 2는 맞춤형·분야 특화·연구형 작업을 뜻한다. System Optimization은 과제 15개로 구성된다. aes128_ctr은 AES-NI와 SIMD로 256 MiB의 단일 스레드 암호화를 가속한다. agent_tool_routing은 전체 스캔 기반 어휘 라우팅을 stdlib Python 인덱스로 바꾸면서 MRR@10 ≥ 0.82와 Recall@10 ≥ 0.94를 충족한다. bm25_search_go는 인덱스 기반 쿼리 순위 산정과 goroutine 오버헤드를 최적화한다. bvh_raytracer는 삼각형 4,096개로 구성된 장면과 638×638개의 광선을 처리하도록 캐시 친화적인 BVH를 구축한다. concurrent_kv_wal은 일관성과 내구성을 유지하면서 goroutine 4개의 경합과 I/O를 줄인다. fft_rust는 길이 32,768의 실수 신호 FFT를 최적화한다. flash_attention은 전체 attention 행렬을 할당하지 않고 n = 4096, d = 64인 attention을 타일링한다. gaussian_blur는 4096×4096 이미지에 17×17 blur를 5회 연속 적용한다. hash_join은 20K행과 5M행을 join한다. levenshtein_distance는 bit-parallel 최적화로 길이 16–64인 문자열 쌍 1,000,000개의 정확한 거리를 계산한다. radix_sort는 uint32 값 50M개를 정렬할 때 메모리 대역폭을 최적화한다. regex_engine은 haystack 100K개에 대한 순수 Rust 패턴 매칭 구조를 구축한다. sha256_throughput은 intrinsic으로 512 MiB를 해싱한다. sstable_compaction_rs는 다중 병합, 접두사 압축, 블록 경계를 최적화한다. z_order_range_scan은 스레딩이나 unsafe 없이 안전한 stdlib Rust에서 Morton 순서와 skip-step 스캔으로 사각형 영역 내 개수를 센다.
- Puzzle and Challenge는 과제 10개로 구성된다. adaptive_compression은 유효한 적응형 context mixing으로 비공개 시퀀스 계열 9개의 bits-per-byte를 최소화한다. adversarial_splay는 splay tree 회전을 최대화하는 접근 4,096개를 구성한다. discover_sorting은 입력 16개의 네트워크를 comparator 80개의 baseline에서 comparator 60개의 reference에 가깝게 줄이며, 모든 이진 입력 65,536개로 검증한다. fredkin_sort_network는 안정적인 가역 정렬 회로의 gate를 줄이면서 보조 wire를 0으로 복원한다. resnet_bit_flip은 가중치 크기 상한과 유한한 출력 조건 아래 CIFAR-10 정확도를 12% 미만으로 낮추는 float32 비트 수정 횟수를 최소화한다. safety_router는 정확도 ≥ 0.64, unsafe recall ≥ 0.66, safe recall ≥ 0.57을 유지하면서 MLP 파라미터 수를 최소화한다. smallest_game_player는 명시적 minimax/search나 하드코딩된 lookup table 없이 비공개 테스트 정확도 ≥ 95%를 만족하는 작은 Connect-3 정책을 학습한다. stack_machine_golf는 레지스터가 없는 스택 VM에서 원소 256개의 내적에 필요한 실행 명령어 수를 최소화한다. toy_isa_opt는 load와 multiplication hazard를 숨겨 원소 512개의 내적에 필요한 시뮬레이션 cycle을 최소화한다. vliw_scheduler는 의존성을 고려한 우선순위로 연산 3,000개를 3-slot bundle에 배치하며, latency는 1/3/4-cycle이다.
- Model Development는 과제 7개로 구성된다. data_select_ifeval은 IFEval을 직접 살펴보지 않고, 출처 19개의 예제 50,000개 pool에서 최대 5,000개를 선택한다. H100에서 8시간 안에 Qwen2.5-3B-Instruct LoRA 학습을 수행한다. flux2_klein_lora는 제공된 OOM 설정을 수정하면서 L40S에서 4시간 안에 이미지 15개로 FLUX.2 klein 9B LoRA를 학습한다. 이미지, 구조, 텍스트 정렬 지표를 결합한다. grpo_multisource는 L40S에서 8시간 안에 Geometry3K, MathVision, ChartQA로 Qwen2.5-VL-7B를 조정한다. 기본 모델 대비 일반 VQA 성능 ≥ 0.9를 유지하면서 MathVista를 개선한다. llm_online_serving은 H100에서 2시간 안에 gpt-oss-20b의 serving 엔진만 변경한다. 커널과 모델은 고정한 채 요청 96개의 처리량/완료 시간 역수 50/50 복합 지표를 최적화한다. moving_mnist_world_model은 H100에서 4시간 안에 clip 8,000개로 학습하고 자기회귀 10-step PSNR을 평가한다. multilingual_ocr은 L40S에서 8시간 안에 페르시아어/벵골어 이미지 9,000개로 DeepSeek-OCR을 fine-tuning하고, held-out 이미지 400개의 문자 오류율을 평가한다. scaling_law는 H100에서 12시간 안에 seq_length=1024로 WikiText-103 사전학습을 수행할 아키텍처와 학습 자원 배분을 선택한다.
- CUDA는 과제 4개로 구성되며 단일 H100을 대상으로 한다. huffman_canonical_decode_cuda는 Thrust, CUB, 압축 라이브러리 없이 lookup table과 warp 협력으로 payload가 65,536-byte인 스트림 2,048개를 디코딩한다. icp_correspondence_step_cuda는 공간 인덱스 라이브러리 없이 미리 구축된 KD-tree, 거리 조건 검사, 공분산 reduction으로 N=200,000, M=500,000인 점군을 처리한다. msm_pippenger_bls12_381_cuda는 서드파티 field/ECC 라이브러리나 커널 내부 메모리 할당 없이 Pippenger bucket과 Montgomery 산술로 점 N=262,144개의 multi-scalar multiplication을 계산한다. ntt_butterfly_cuda는 FFT 라이브러리 없이 twiddle 사전 계산, 타일링된 butterfly, 특화된 reduction을 사용한다. Goldilocks field (p=2^{64}-2^{32}+1)에서 batch=256, n=65,536인 변환을 비트 단위로 정확하고 자연 순서에 맞게 계산한다.
- A.2 Per-Task Scoring Anchors and Gates는 지표 방향, 기준점, 통과 조건을 명시한다. 정확성 검증에 실패하면 영점을 부여한다. 모든 System Optimization 및 CUDA 과제는 baseline을 넘어야 한다는 조건과 함께 log-stretch 채점을 사용한다. adaptive_compression과 adversarial_splay는 각각 5%와 1% 조건을 적용한 log-stretch를 사용한다. 나머지 퍼즐 과제와 모든 Model Development 과제는 기준점 기반 선형 채점을 사용한다. 다만 smallest_game_player와 safety_router는 (s(x)=\operatorname{clip}\left(\frac{m_B-m(x)}{m_B},0,1\right))을 사용한다. 이는 문서에 명시된 강한 솔루션 대신 파라미터가 없는 암묵적 reference 기준점을 사용하는 것과 같다. Tables 2–4 system runtime 명세는 시스템 실행 시간의 초 단위와 CUDA 실행 시간의 밀리초 단위를 구분한다. 또한 VQA 유지율 ≥ 0.9, LoRA가 없는 상태보다 높은 품질, serving 정확성 등의 품질 조건을 제시한다.
- 부록의 채점 명세에는 재현에 영향을 주는 불일치가 있다. resnet_bit_flip은 비트 수정 95개의 baseline과 40-flip reference로 설명되지만, Table 3의 기준점은 81과 1이다. scaling_law는 perplexity가 약 95와 23이라고 설명되지만, Table 4에는 25와 18이 제시된다. flux2_klein_lora는 일반적인 올바른 baseline이라는 설명과 달리 OOM이 발생하기 쉬운 설정을 제공한다. Table 4는 약 0.49인 no-LoRA 기준점과 해당 설정이 crash했을 때의 최저점 0.0을 구분한다.
- B More on Experiments와 B.1 More on Experimental Setups는 Table 5에 개발 기관과 API 제공사를 명시한다. 주요 모델 집합은 TokenRouter, Azure AI Foundry, MiniMax, Cloudflare, OpenRouter, xAI, Xiaomi를 사용하며, 각 ablation 모델의 제공사도 제시한다. B.2 Detailed Experimental Results는 Tables 6과 7에 분야별로 묶은 과제별 Avg@3와 Best@3를 제공한다. claude-opus-4.6은 fft_rust와 llm_online_serving 모두에서 0.00을 받는다. minimax-m2.7은 grpo_multisource Avg@3에서 0.93으로 가장 높다. 모든 범주에서 평균적으로 앞선다고 해서 모든 과제에서도 앞서거나 성공하는 것은 아님을 보여 준다.
- C More on Analysis와 C.1 Model Generations는 terminus-2에서 제공사 내 모델 쌍 4개를 비교한다. Figure 9에 표시된 Avg@3는 MiMo가 0.37에서 0.45, MiniMax가 0.24에서 0.27, Kimi가 0.40에서 0.46으로 증가한다. 반면 Qwen은 0.37에서 0.27로 감소하며, 범주별 향상도 균일하지 않다. 본문은 Qwen의 Avg@3와 Best@3 하락 폭을 0.09와 0.12로 보고하지만, 그림의 반올림 값으로 계산한 차이는 0.10과 0.11이다. 또한 Model Development 점수를 0.88로 제시해 Table 1의 0.39와 충돌한다. Qwen의 퍼즐 및 시스템 점수가 0에 가깝다는 설명도 Table 1의 0.26과 0.29에 맞지 않는다.
- C.2 Stability Analysis는 과제별 표준편차 평균, 범위 평균, 변동계수, Best@3로 정규화한 산포를 보고한다. 최고 실행만 평가하기보다 Avg@3를 사용하거나 시도 횟수를 늘릴 것을 권장한다. 보고된 Best@3–Avg@3 격차와 산포의 상관은 Pearson r = 0.84다. 그러나 평가 범위가 달라졌다는 설명 없이 Table 8의 종합 점수가 Table 1과 다르다. claude-opus-4.6은 0.68/0.76이 아니라 0.77/0.85로 제시된다. 예시 점수 0.85, 0.20, 0.20의 평균은 명시된 0.65가 아니라 약 0.417이다. 또한 제시된 값들은 0.099가 상위 5개 모델 중 다른 모든 모델의 산포 절반보다 작다는 주장을 뒷받침하지 않는다. 그럼에도 Table 8에서 claude-opus-4.6은 제시된 표준편차가 가장 낮으며, 다른 여러 모델에는 상당한 변동성이 나타난다.
짧은 생각
AUTOLAB의 유용한 기여는 실행 가능한 최적화 과제에 실패와 지출 진단을 결합한 것이다. 같은 점수 0이라도 조기 포기, 잘못된 출력, 제약 위반, 미제출을 뜻할 수 있다. Harness ablation은 에이전트 구성이 측정된 성능을 크게 바꾼다는 직접적인 근거를 제공한다. 동시에 리더보드를 harness와 무관한 모델 능력으로 해석하는 데 한계를 제시한다.
실행 과정은 측정에 기반한 반복이 성공적인 최적화에 자주 나타난다는 점을 뒷받침한다. 그러나 과제 전반에서 지속성이 가장 중요한 인과적 예측 요인임을 입증하지는 않는다. 정밀한 모델 선택과 신뢰성 비교를 위해서는 일관되지 않은 채점 기준점, 부록 종합 점수, 안정성 예시를 공개된 산출물과 대조해 해소해야 한다.