


Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing 요약 설명
22 Oct 2025 | Paper Review Instruction-Based Image Editing Datasets Data Curation목차
이번 글에서는 Pico-Banana-400K: A Large-Scale Dataset for Text-Guided Image Editing 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 10월 22일(Arxiv)
- Qian, Yusu, Bocek-Rivele, Eli, Song, Liangchen, Tong, Jialing, Yang, Yinfei, Lu, Jiasen, Hu, Wenze, Gan, Zhe.
- Apple
- 논문 링크
- Github
요약
- Text-guided image editing은 자연어 요청에 따라 이미지를 수정하는 작업이다. 이 작업에는 실제 사진을 바탕으로 다양성과 품질 관리를 확보한 학습 데이터가 부족하다. Pico-Banana-400K는 single-turn 편집, 성공/실패 출력 쌍, 순차 편집 세션을 합쳐 386K개의 예제를 보고한다. MagicBrush에는 사람이 주석을 단 이미지 편집 triplet이 약 10K개 있다. 이 비교는 데이터셋의 규모와 구조에 관한 것이며 편집 품질을 측정한 결과는 아니다.
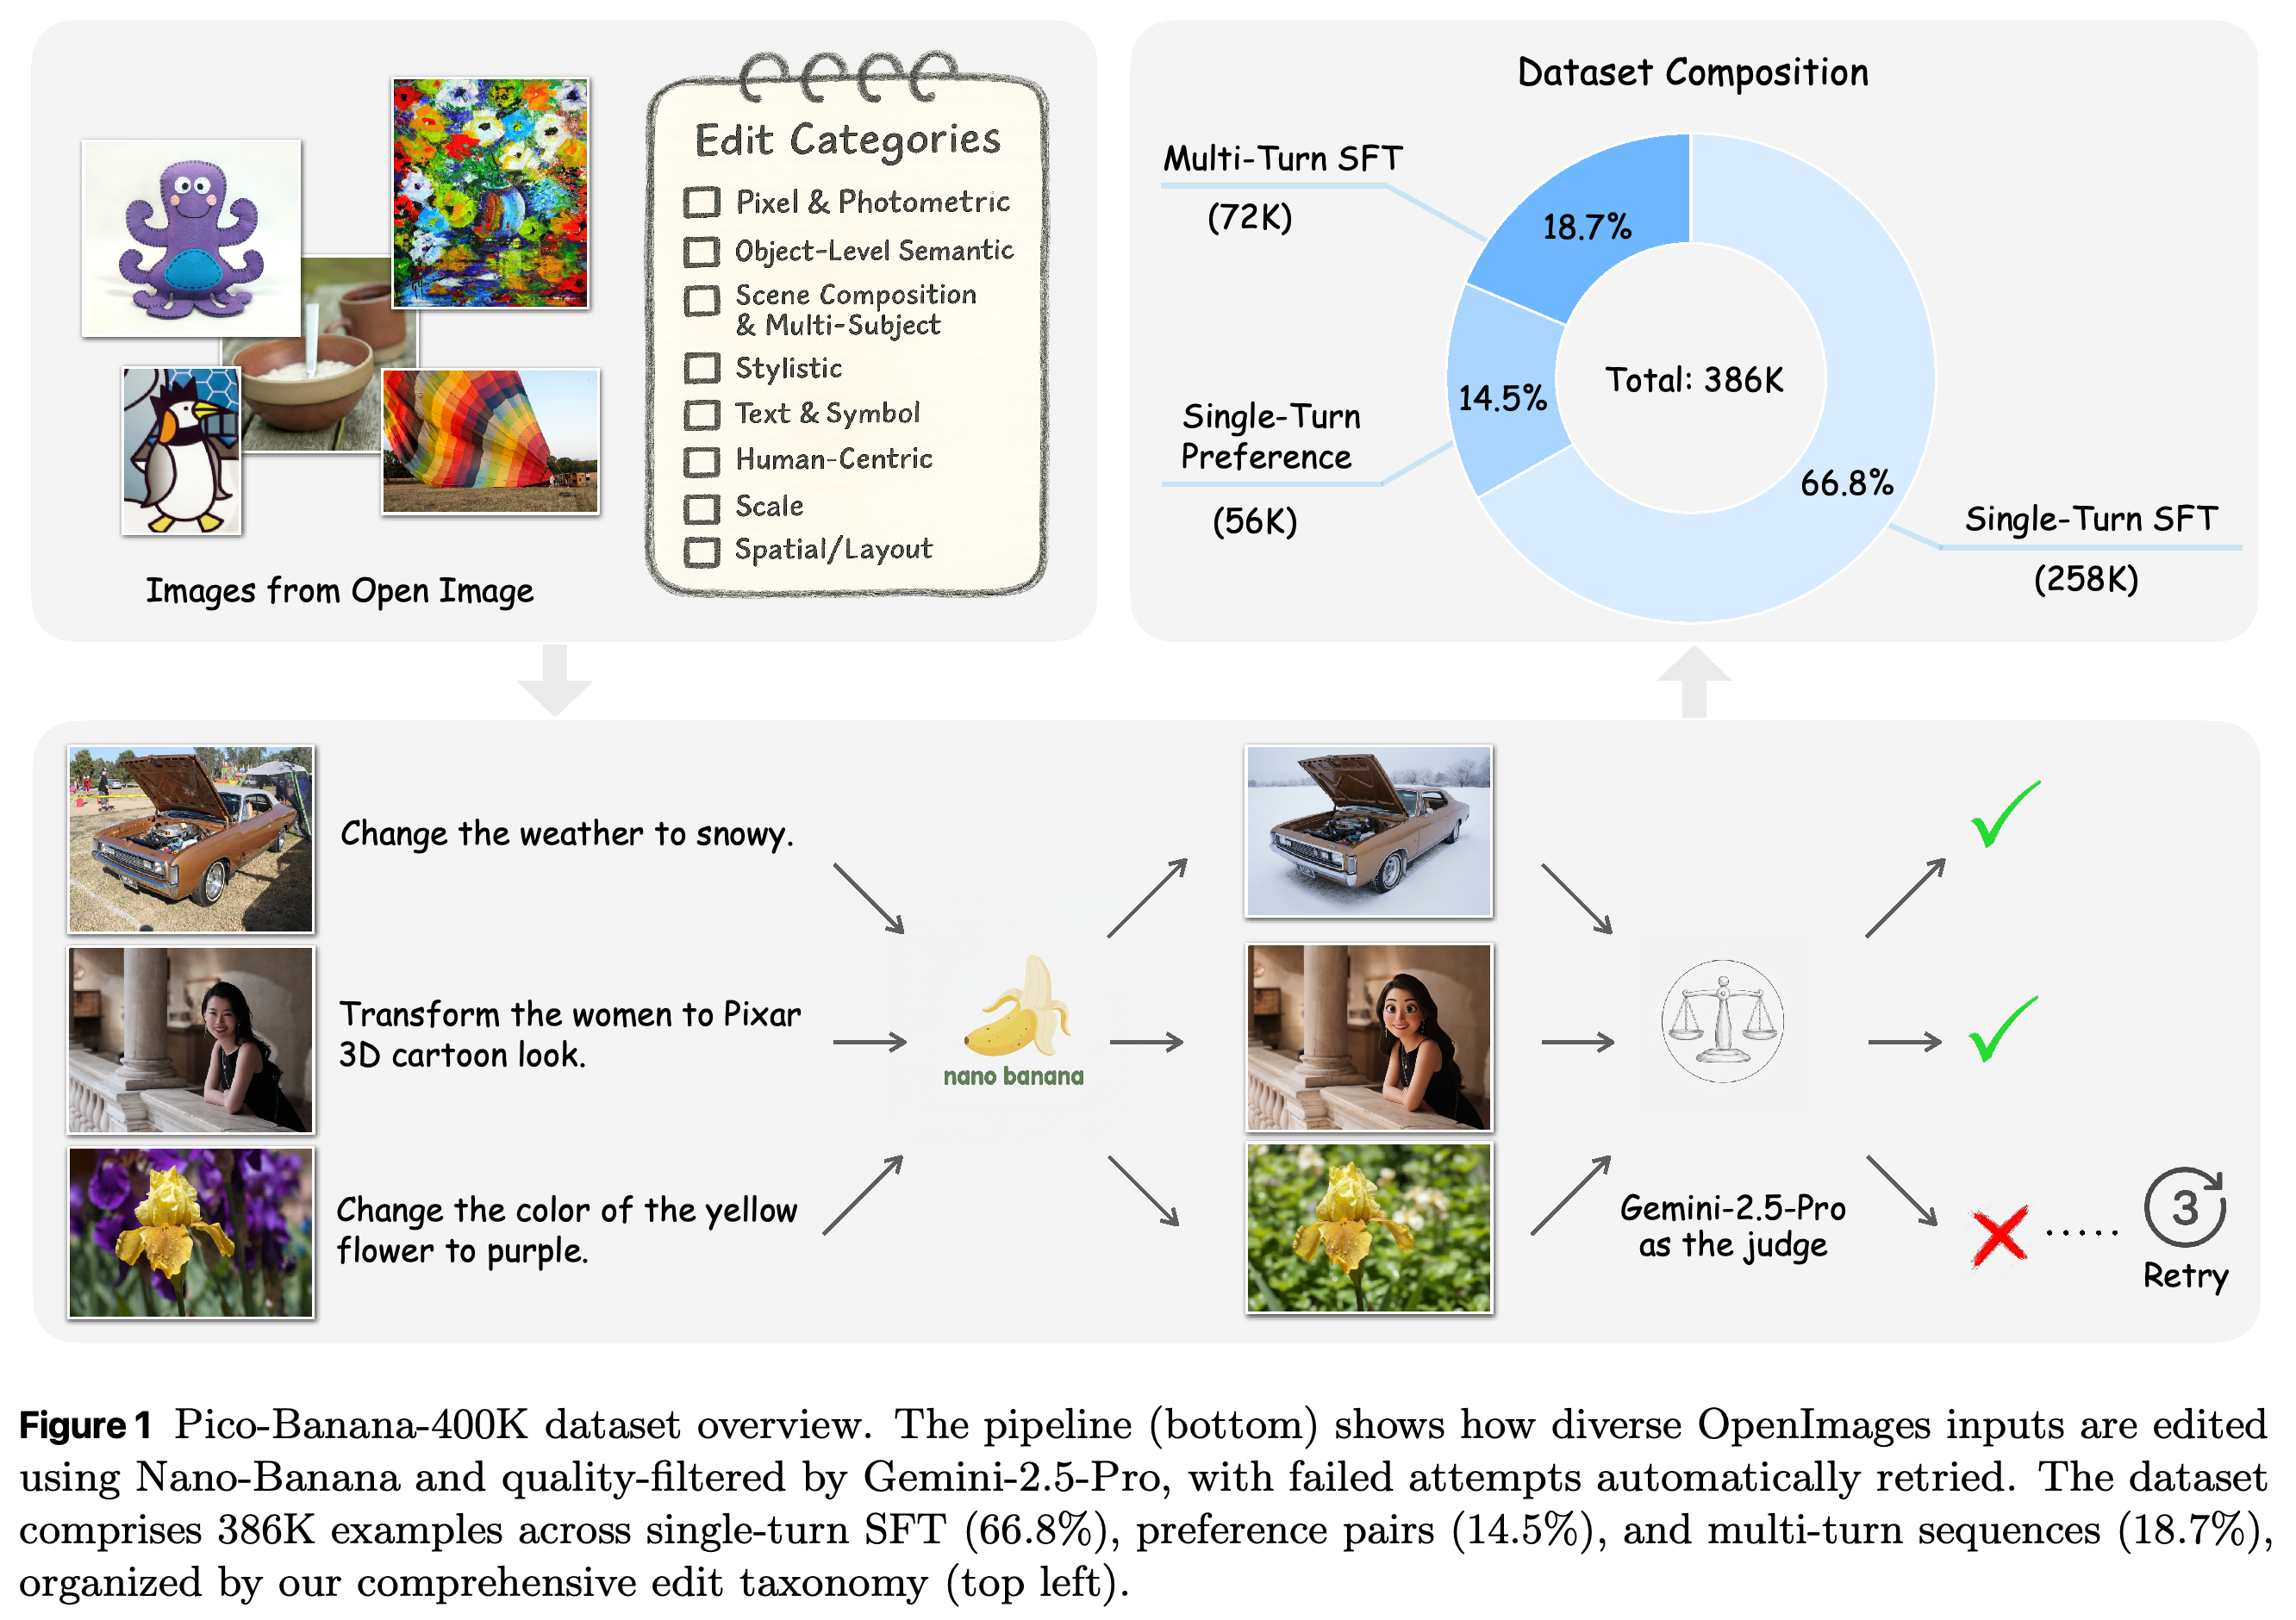
- 파이프라인은 Gemini-2.5-Flash로 instruction을 생성하고 공개 이미지 데이터셋인 OpenImages의 사진을 Nano-Banana, 즉 Gemini-2.5-Flash-Image 모델로 편집한다. 이후 Gemini-2.5-Pro를 자동 평가자로 사용해 출력을 선별한다. 편집 작업을 분류한 taxonomy는 8개 범주에 걸쳐 35개 유형을 포함한다. 보고된 구성은 instruction/입력/출력 기록으로 학습하는 single-turn supervised fine-tuning 예제 258K개, 성공 출력과 실패 출력을 연결한 preference pair 56K개, 연속 편집으로 이루어진 multi-turn 시퀀스 72K개다.
- 자동 평가 결과, 이미지의 시각적 표현을 예술 양식으로 바꾸는 강한 artistic style transfer의 성공률은 0.9340이다. 객체 위치 이동은 0.5923, 이미지에 보이는 텍스트의 글꼴 스타일이나 색상 변경은 0.5759다. 이 결과는 편집 유형별로 생성 파이프라인의 신뢰도가 어떻게 달라지는지 보여준다. 후속 모델 학습과 벤치마크 평가는 향후 과제로 남아 있다.
- 이 데이터셋은 상세한 instruction과 간결한 instruction, 채택된 편집 결과, 거부된 대안, 순차 편집 이력을 함께 제공한다. 논문은 후속 학습의 성능 향상, 자동 평가자와 사람 평가자 사이의 정량적 일치도, 기존 데이터셋과 조건을 통제한 편집 품질 비교를 보고하지 않는다.
1 Introduction
서론은 기존 편집 데이터셋의 한계로 domain shift, 즉 학습 이미지와 목표 이미지의 분포 차이, 불균등한 편집 유형 분포, 일관되지 않은 품질 관리를 지적한다. Pico-Banana-400K는 실제 사진 입력, 명시적으로 분류한 편집 유형, 자동 채점, 학습 목적에 맞춘 하위 데이터셋을 사용한다.
- 56K개의 preference 하위 데이터셋은 선호하는 출력을 생성하도록 모델을 학습하는 alignment 연구에 활용할 수 있다. 여기에는 선호 예제와 거부 예제를 사용하는 Direct Preference Optimization과 출력 품질을 채점하도록 학습하는 reward modeling이 포함된다.
- 서론은 자동 채점과 수동 검증을 언급하지만 수동 검증 절차를 정량적으로 설명하거나 자동 판정과의 일치도를 보고하지 않는다.
- Figure 1은 예제 수를 386K개로 제시하지만 제목과 서론 본문은 약 400K개라고 표현한다. 이 합계는 채택된 single-turn 편집만 센 수치가 아니라 서로 다른 유형의 기록을 합친 수치다.
이 도식은 실제 원본 이미지와 편집 범주를 생성, 자동 판정, 반복 시도로 연결한다. 구성 차트는 single-turn supervised fine-tuning 예제 258K개, preference pair 56K개, multi-turn 시퀀스 72K개를 구분해 보고된 총수 386K개를 명확히 보여준다.
2 Dataset Construction
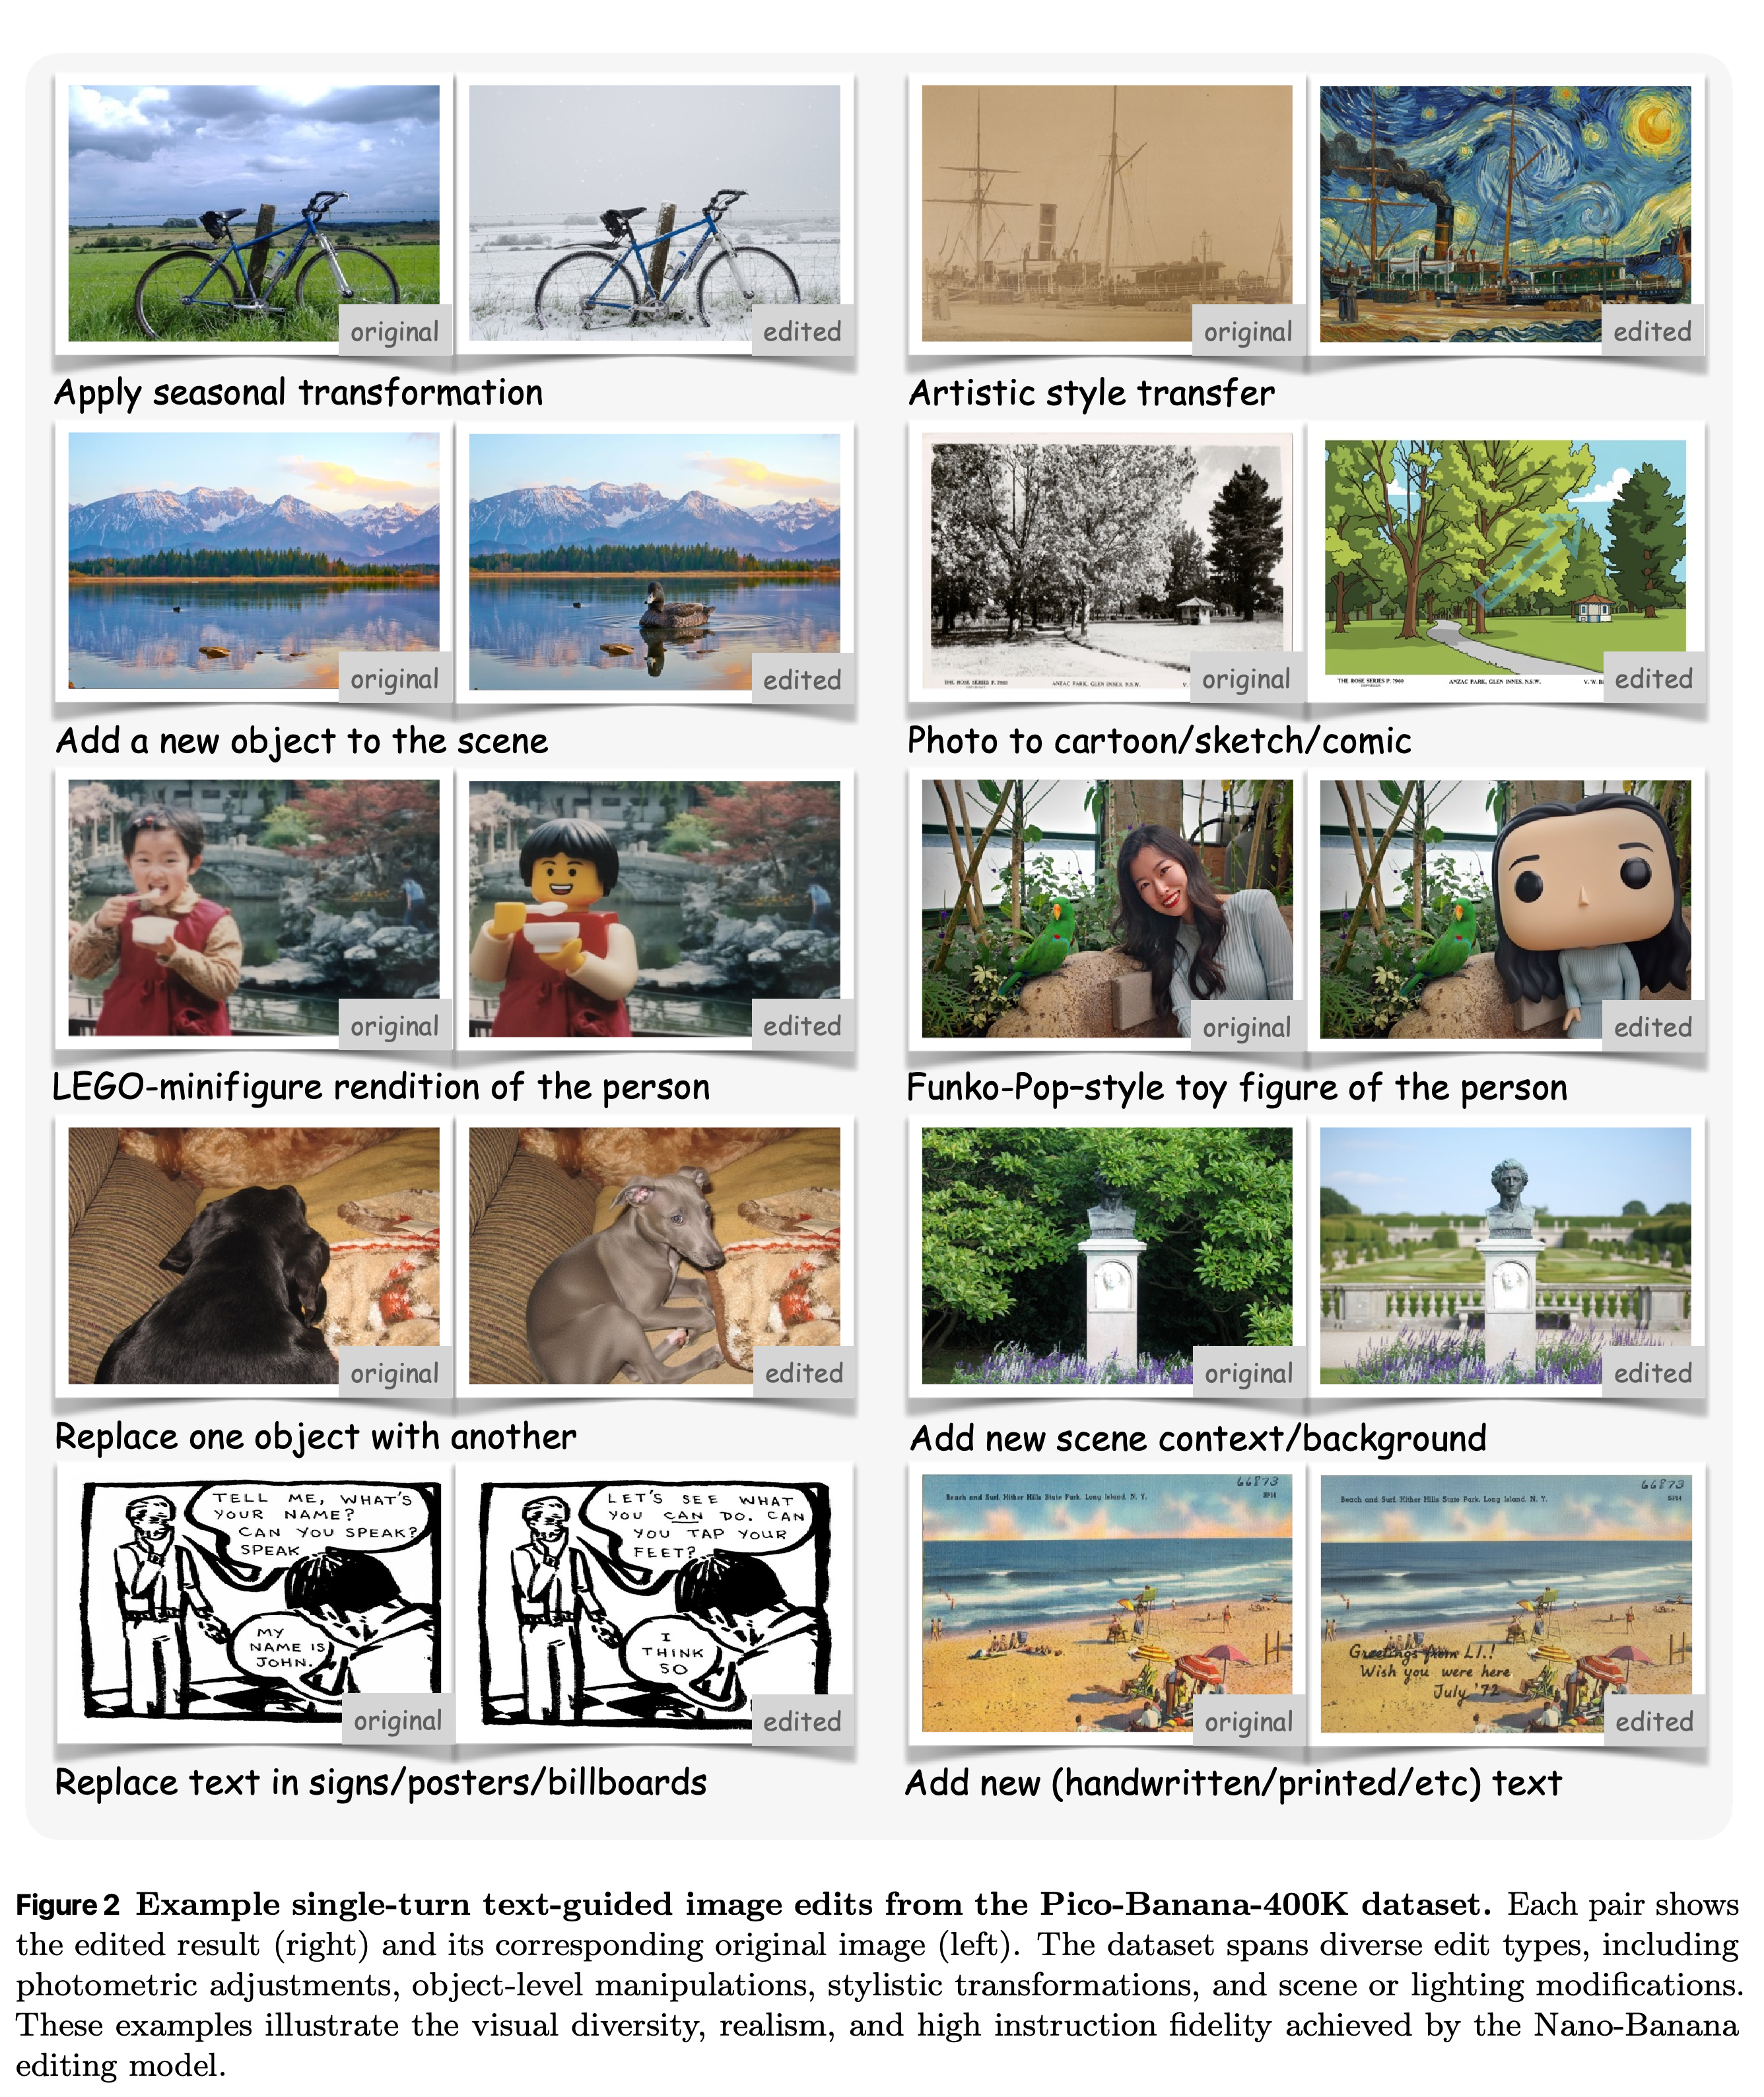
데이터셋 구축은 원본 이미지 선택과 편집 유형 분류, 2가지 instruction 변형 생성, 품질 평가를 포함한 single-turn 편집, multi-turn 시퀀스로의 확장 순서로 진행된다. Figure 2는 일부 변환 사례를 보여주며, 각주는 전체 제작 비용을 약 100K USD로 보고한다.
원본/편집 이미지 쌍은 계절, 객체, 스타일, 배경, 사람 스타일, 텍스트 변환의 일부 사례를 보여준다. 포함된 작업의 범위를 예시하지만 선정된 사례만으로 일반적인 성공률을 판단할 수는 없다.
2.1 Overview and Edit Taxonomy
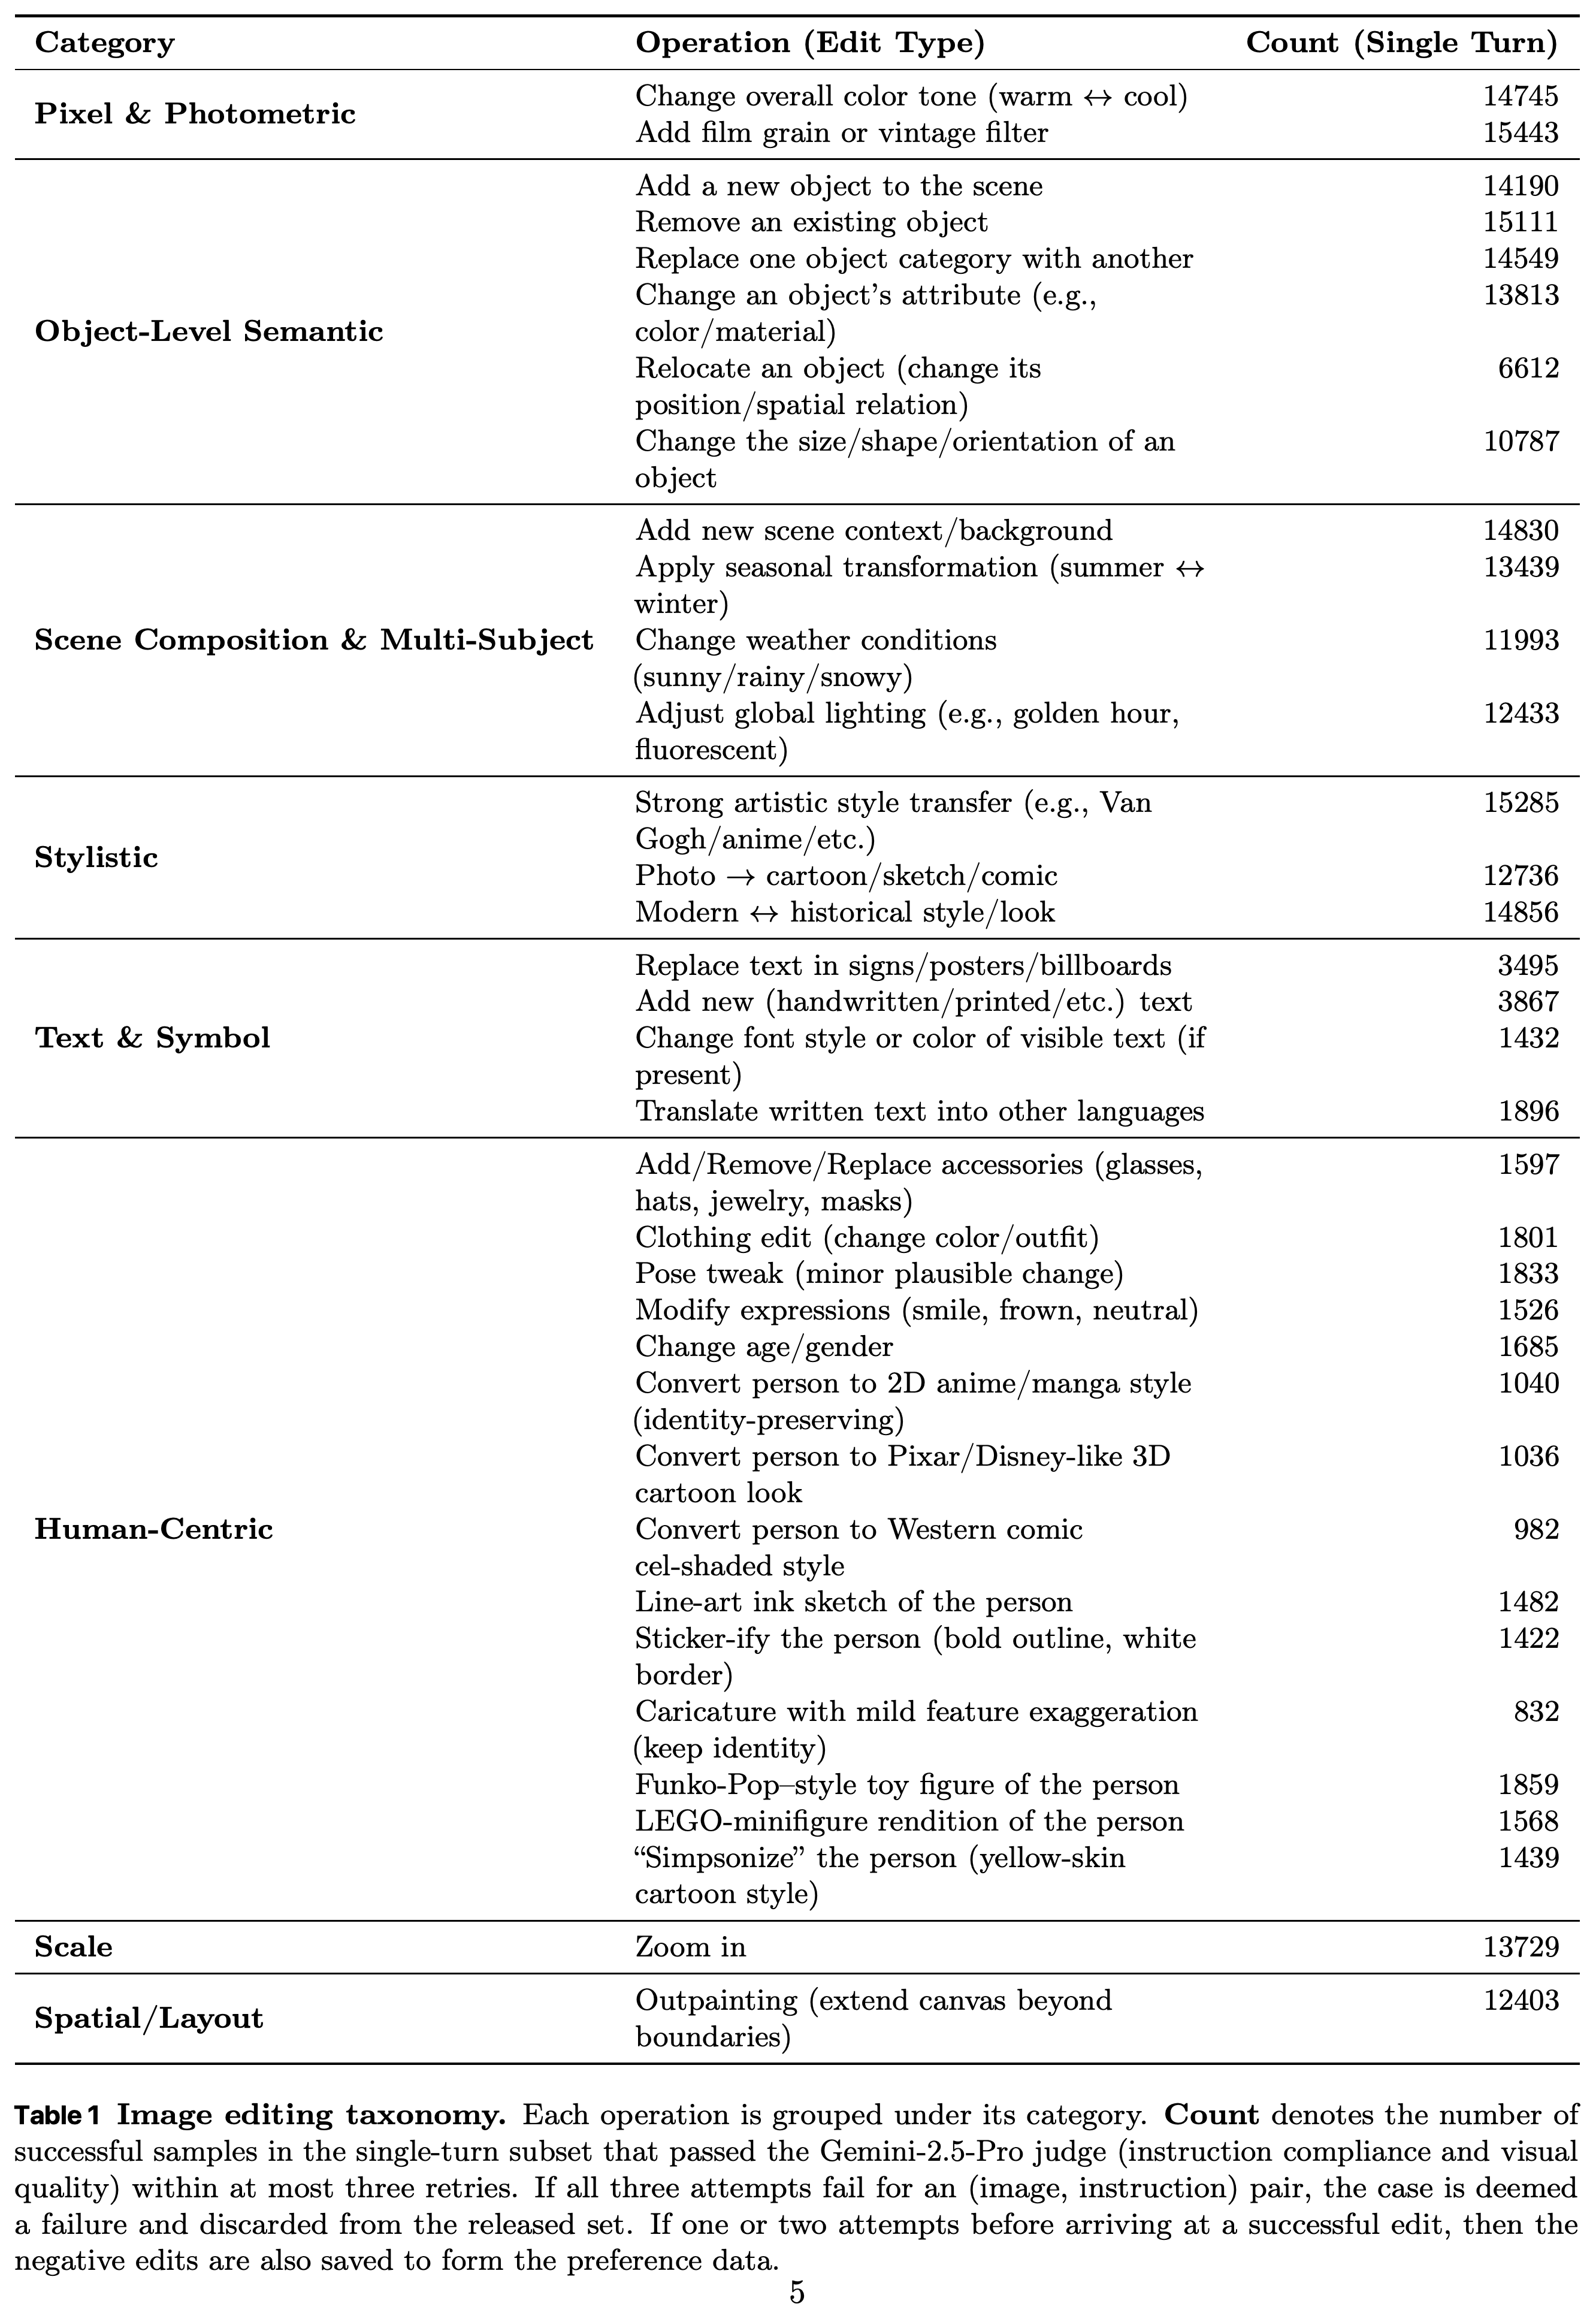
OpenImages에서 사람, 객체, 텍스트가 있는 장면을 포괄하도록 입력을 선택하고 각 이미지-instruction 쌍에 주된 편집 유형을 1개씩 부여한다. Table 1의 8개 범주는 Pixel & Photometric, Object-Level Semantic, Scene Composition & Multi-Subject, Stylistic, Text & Symbol, Human-Centric, Scale, Spatial/Layout이다. 이 범주들은 색상과 질감 변경, 객체 변경, 장면 변경, 시각적 스타일, 텍스트, 사람, 확대, 캔버스 확장을 포괄한다. 사람 중심 작업과 텍스트 관련 작업에는 범주별 입력 필터링을 적용한다.
- 밝기, 대비, 채도, 선명화, 흐림 처리는 변화가 미미하거나 불안정한 경우가 많아 제외했다.
- 객체의 원근이나 자세를 크게 바꾸는 작업은 구조적 아티팩트 때문에 제외했다. 2개 입력의 내용을 합치는 이미지 2개 합성 작업도 출력의 신뢰도가 충분하지 않아 제외했다.
- Table 1은 균등하게 배정한 수량이 아니라 채택된 샘플 수를 기록한다. 필름 그레인이나 빈티지 필터 추가는 15443개인 반면, 특징을 약하게 과장하는 캐리커처는 832개다.
이 taxonomy는 35개 작업과 각 작업에서 채택된 single-turn 샘플 수를 나열한다. 필름 그레인/빈티지는 15443개, 객체 위치 이동은 6612개, 캐리커처는 832개로 수량 차이가 크다. 함께 제시한 채택 규칙은 성공에 앞선 실패 시도가 preference 부정 예제로 전환되는 과정을 설명한다.
2.2 Instruction Generation
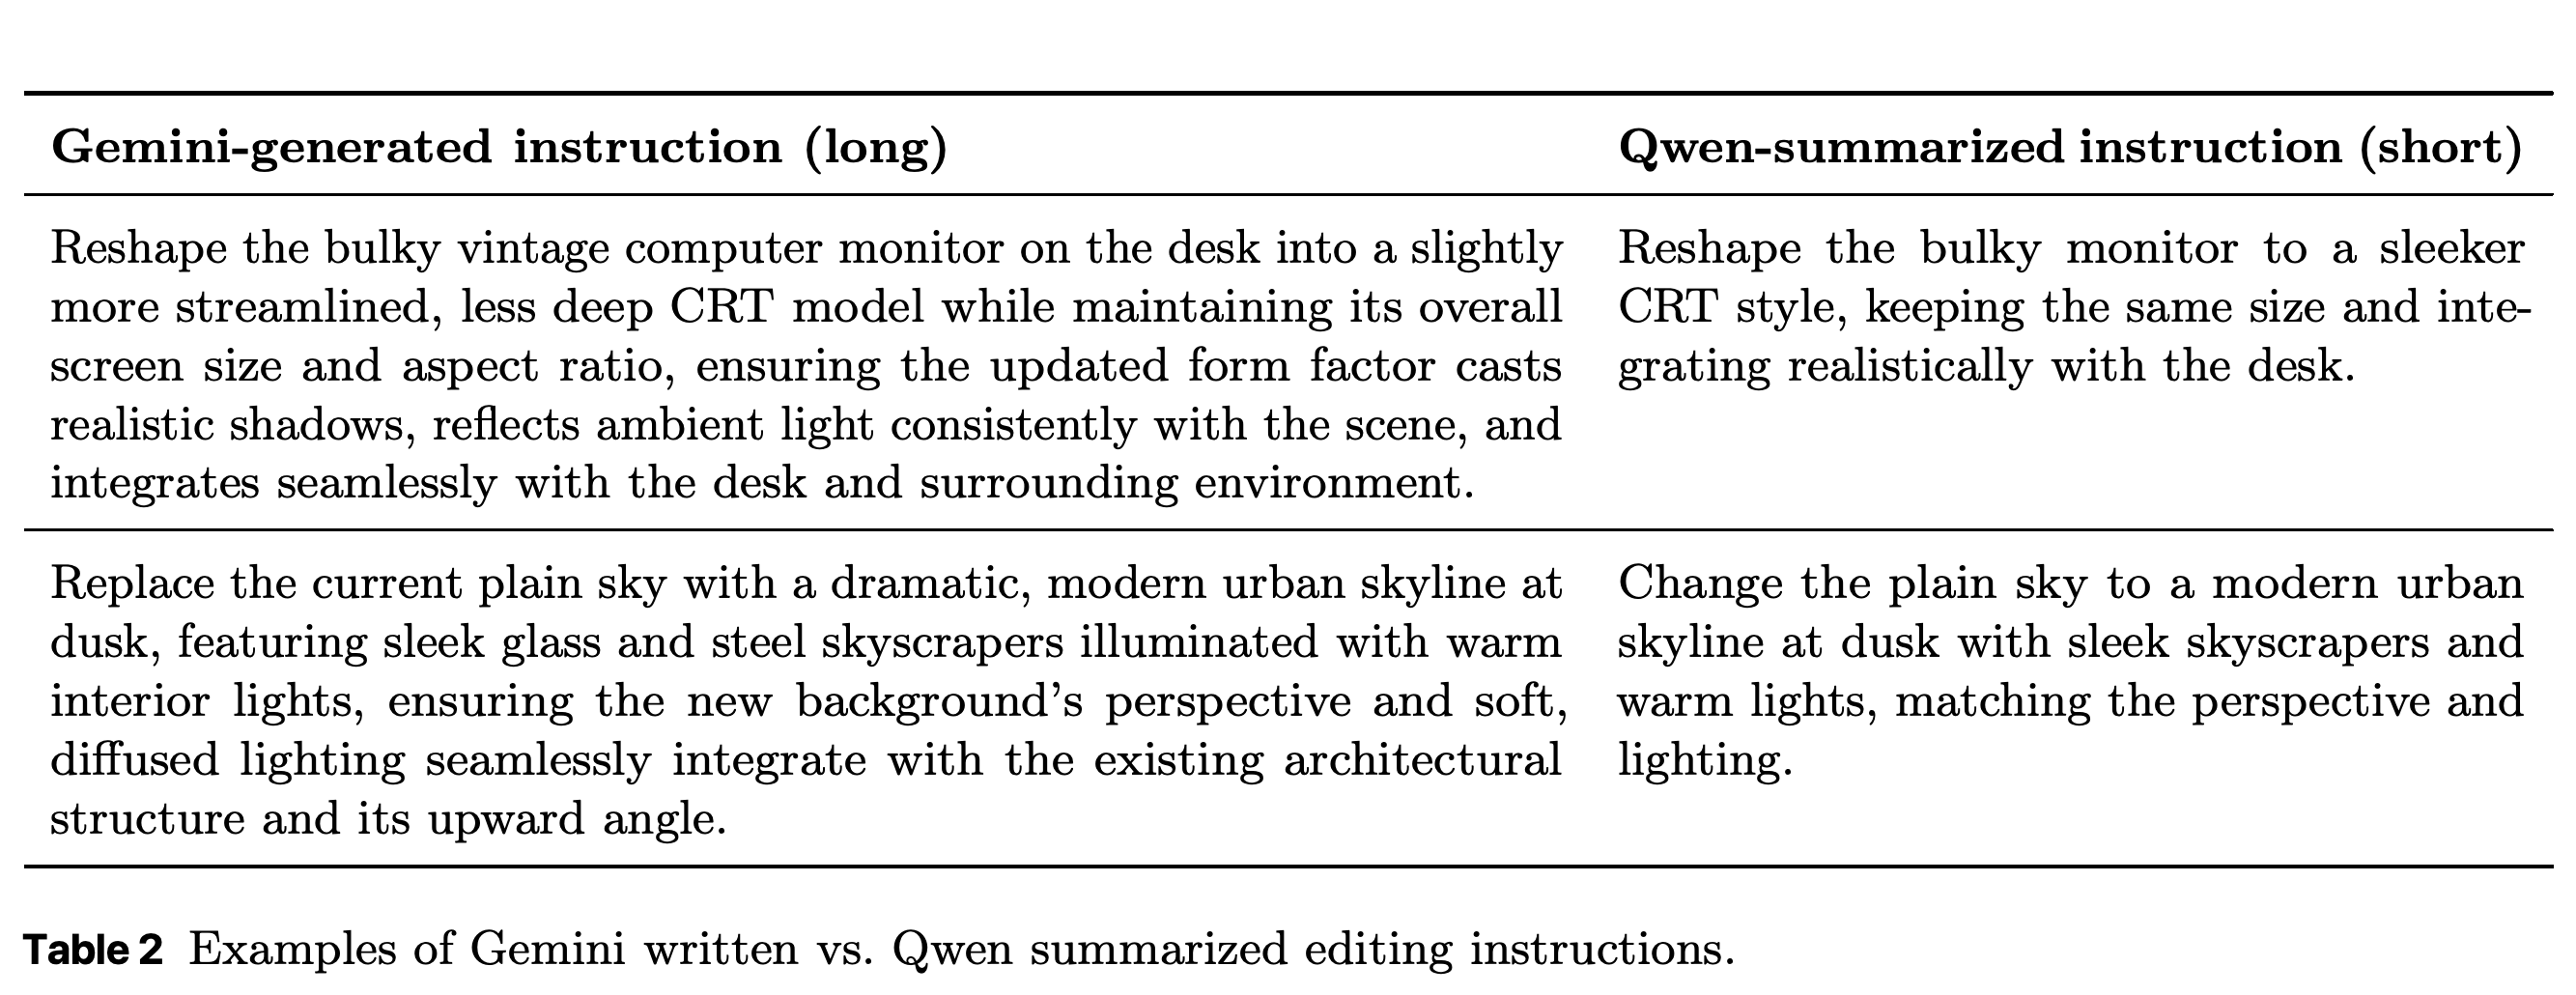
Gemini-2.5-Flash는 이미지에 보이는 객체, 색상, 위치를 바탕으로 상세한 instruction을 생성한다. Qwen2.5-7B-Instruct는 사람이 작성한 예제를 in-context demonstration으로 사용해 이를 간결한 사용자 요청 형태로 다시 쓴다. 이 예제들은 프롬프트에 제공되며, 논문은 이를 이용한 별도의 학습 업데이트를 보고하지 않는다.
- Table 2는 모니터 형태 변경과 스카이라인 교체 요청을 줄이면서 핵심 편집 내용과 일부 보존 조건을 유지한 사례를 보여준다. 논문은 다시 쓴 instruction이 원래 의미를 얼마나 충실하게 유지하는지 정량적으로 평가하지 않는다.
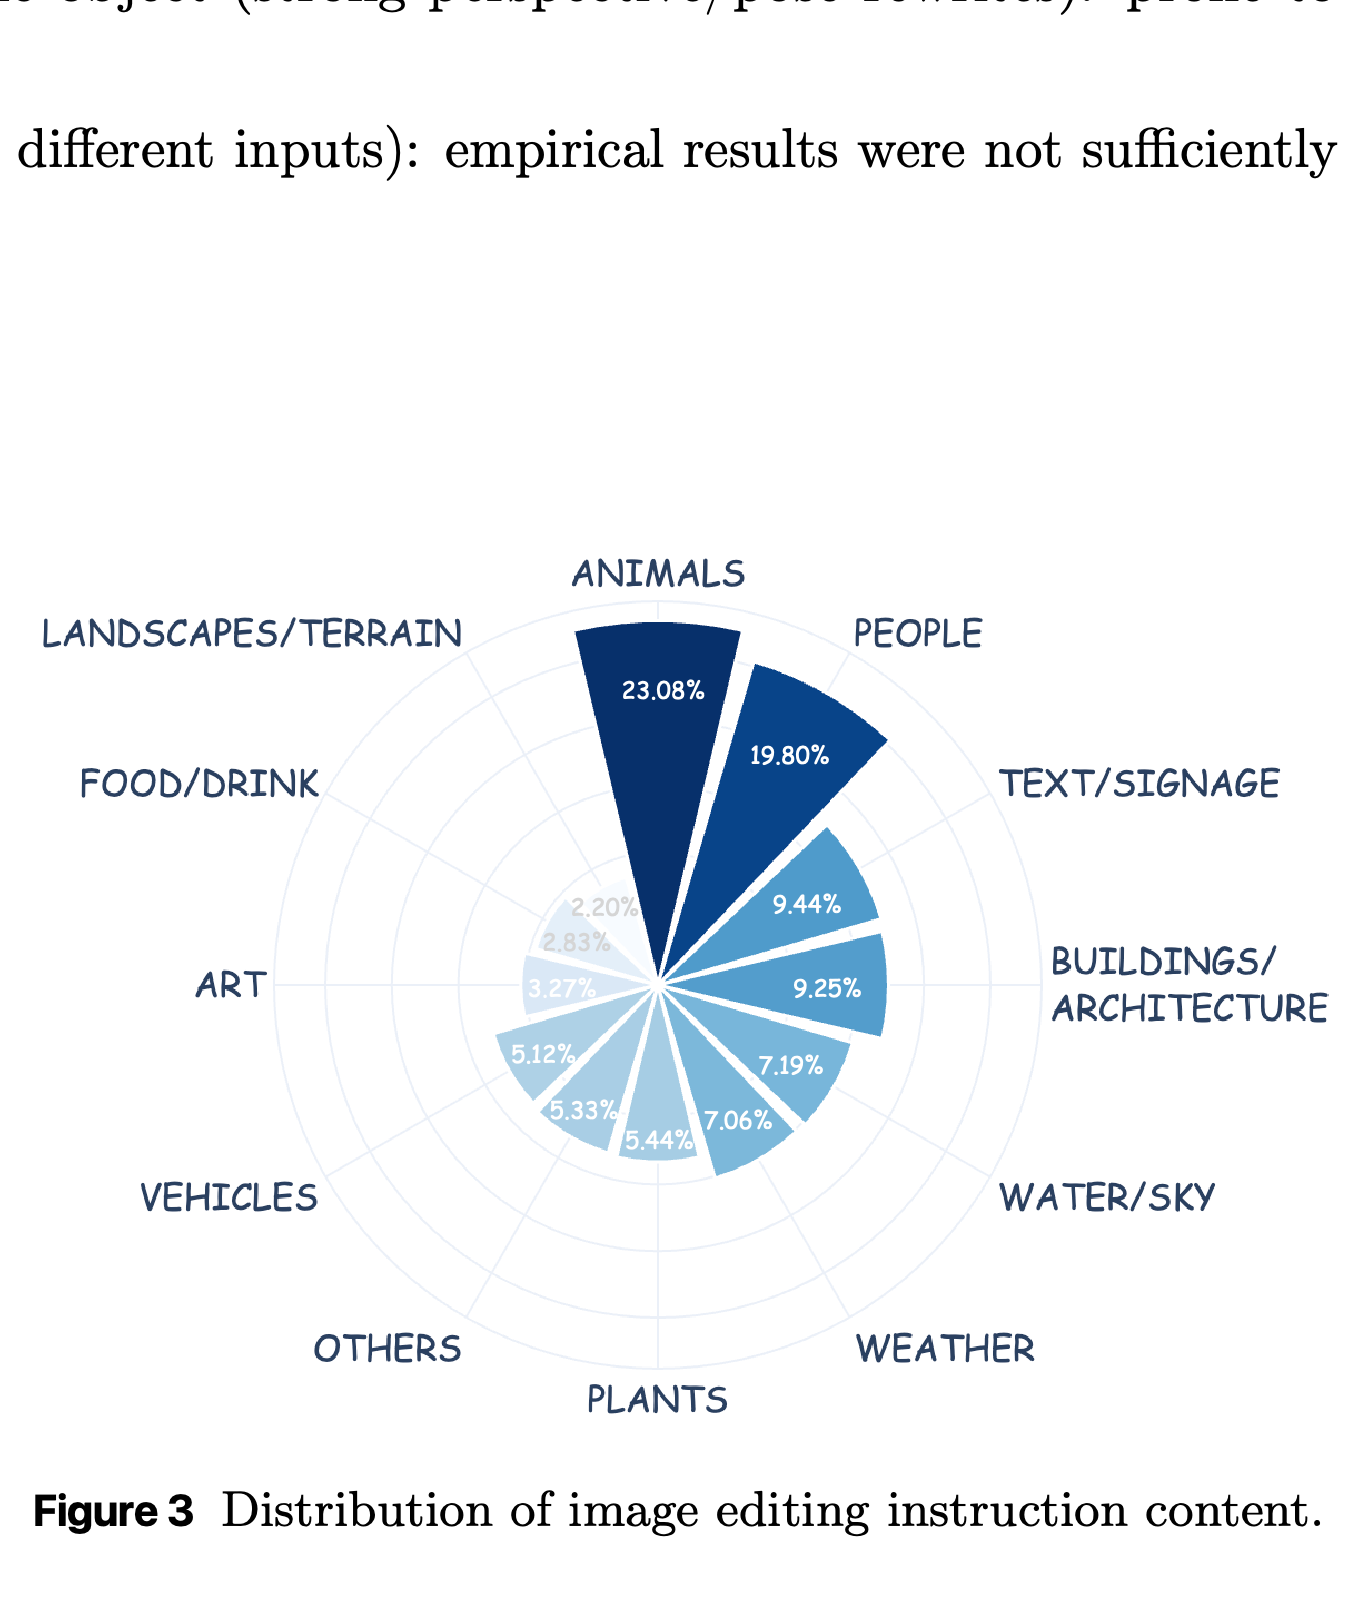
- Figure 3의 instruction 내용 범주는 키워드와 구문 매칭으로 추론하며 instruction마다 여러 라벨을 허용한다. 따라서 이 범주들은 독립적으로 주석을 단 이미지 클래스가 아니라 프롬프트에서 추출한 내용의 범위를 나타낸다.
- 서론은 모든 예제에 instruction 변형이 모두 포함된다고 설명하지만 Section 2.2는 각 예제에 이 변형들이 포함될 수 있다고 설명한다. 논문은 실제 포함 범위에 관한 이 모호함을 해소하지 않는다.
표시된 instruction 내용 비중은 동물이 23.08%, 사람이 19.80%로 가장 크며, 텍스트/표지판 9.44%, 건물/건축물 9.25%가 뒤를 잇는다. 범주를 키워드 매칭으로 정하고 여러 라벨을 허용하므로, 이 값들은 상호 배타적인 이미지 클래스가 아니라 프롬프트 범주를 집계한 결과를 나타낸다.
모니터와 스카이라인 사례는 Qwen이 Gemini가 생성한 instruction을 줄이면서 핵심 요청과 크기, 원근, 조명, 통합에 관한 일부 조건을 유지하는 방식을 보여준다. 일부 세부 조건은 사라진다. 따라서 이 사례들은 내용을 압축하는 방식을 보여주며, 모든 instruction 세부 사항을 완전히 보존했음을 입증하지는 않는다.
2.3 Single-Turn Image Editing
Nano-Banana가 각 instruction을 실행하고 Gemini-2.5-Pro가 입력 이미지와 요청을 기준으로 결과를 평가한다. 평가자는 요청한 변화가 발생했는지 평가하는 Instruction Compliance에 40%, 자연스러운 통합과 아티팩트를 평가하는 Seamlessness에 25%, 변경하지 않은 영역을 평가하는 Preservation Balance에 20%, 선명도, 색상, 노출을 평가하는 Technical Quality에 15%를 부여한다. 경험적으로 정한 약 0.7의 임계값을 초과한 점수를 받으면 결과를 채택한다.
- 논문은 Appendix B에 채점 기준을 공개하지만 최종 라벨에 대한 사람 평가와의 일치도, 임계값 민감도, 불확실성 추정치는 보고하지 않는다.
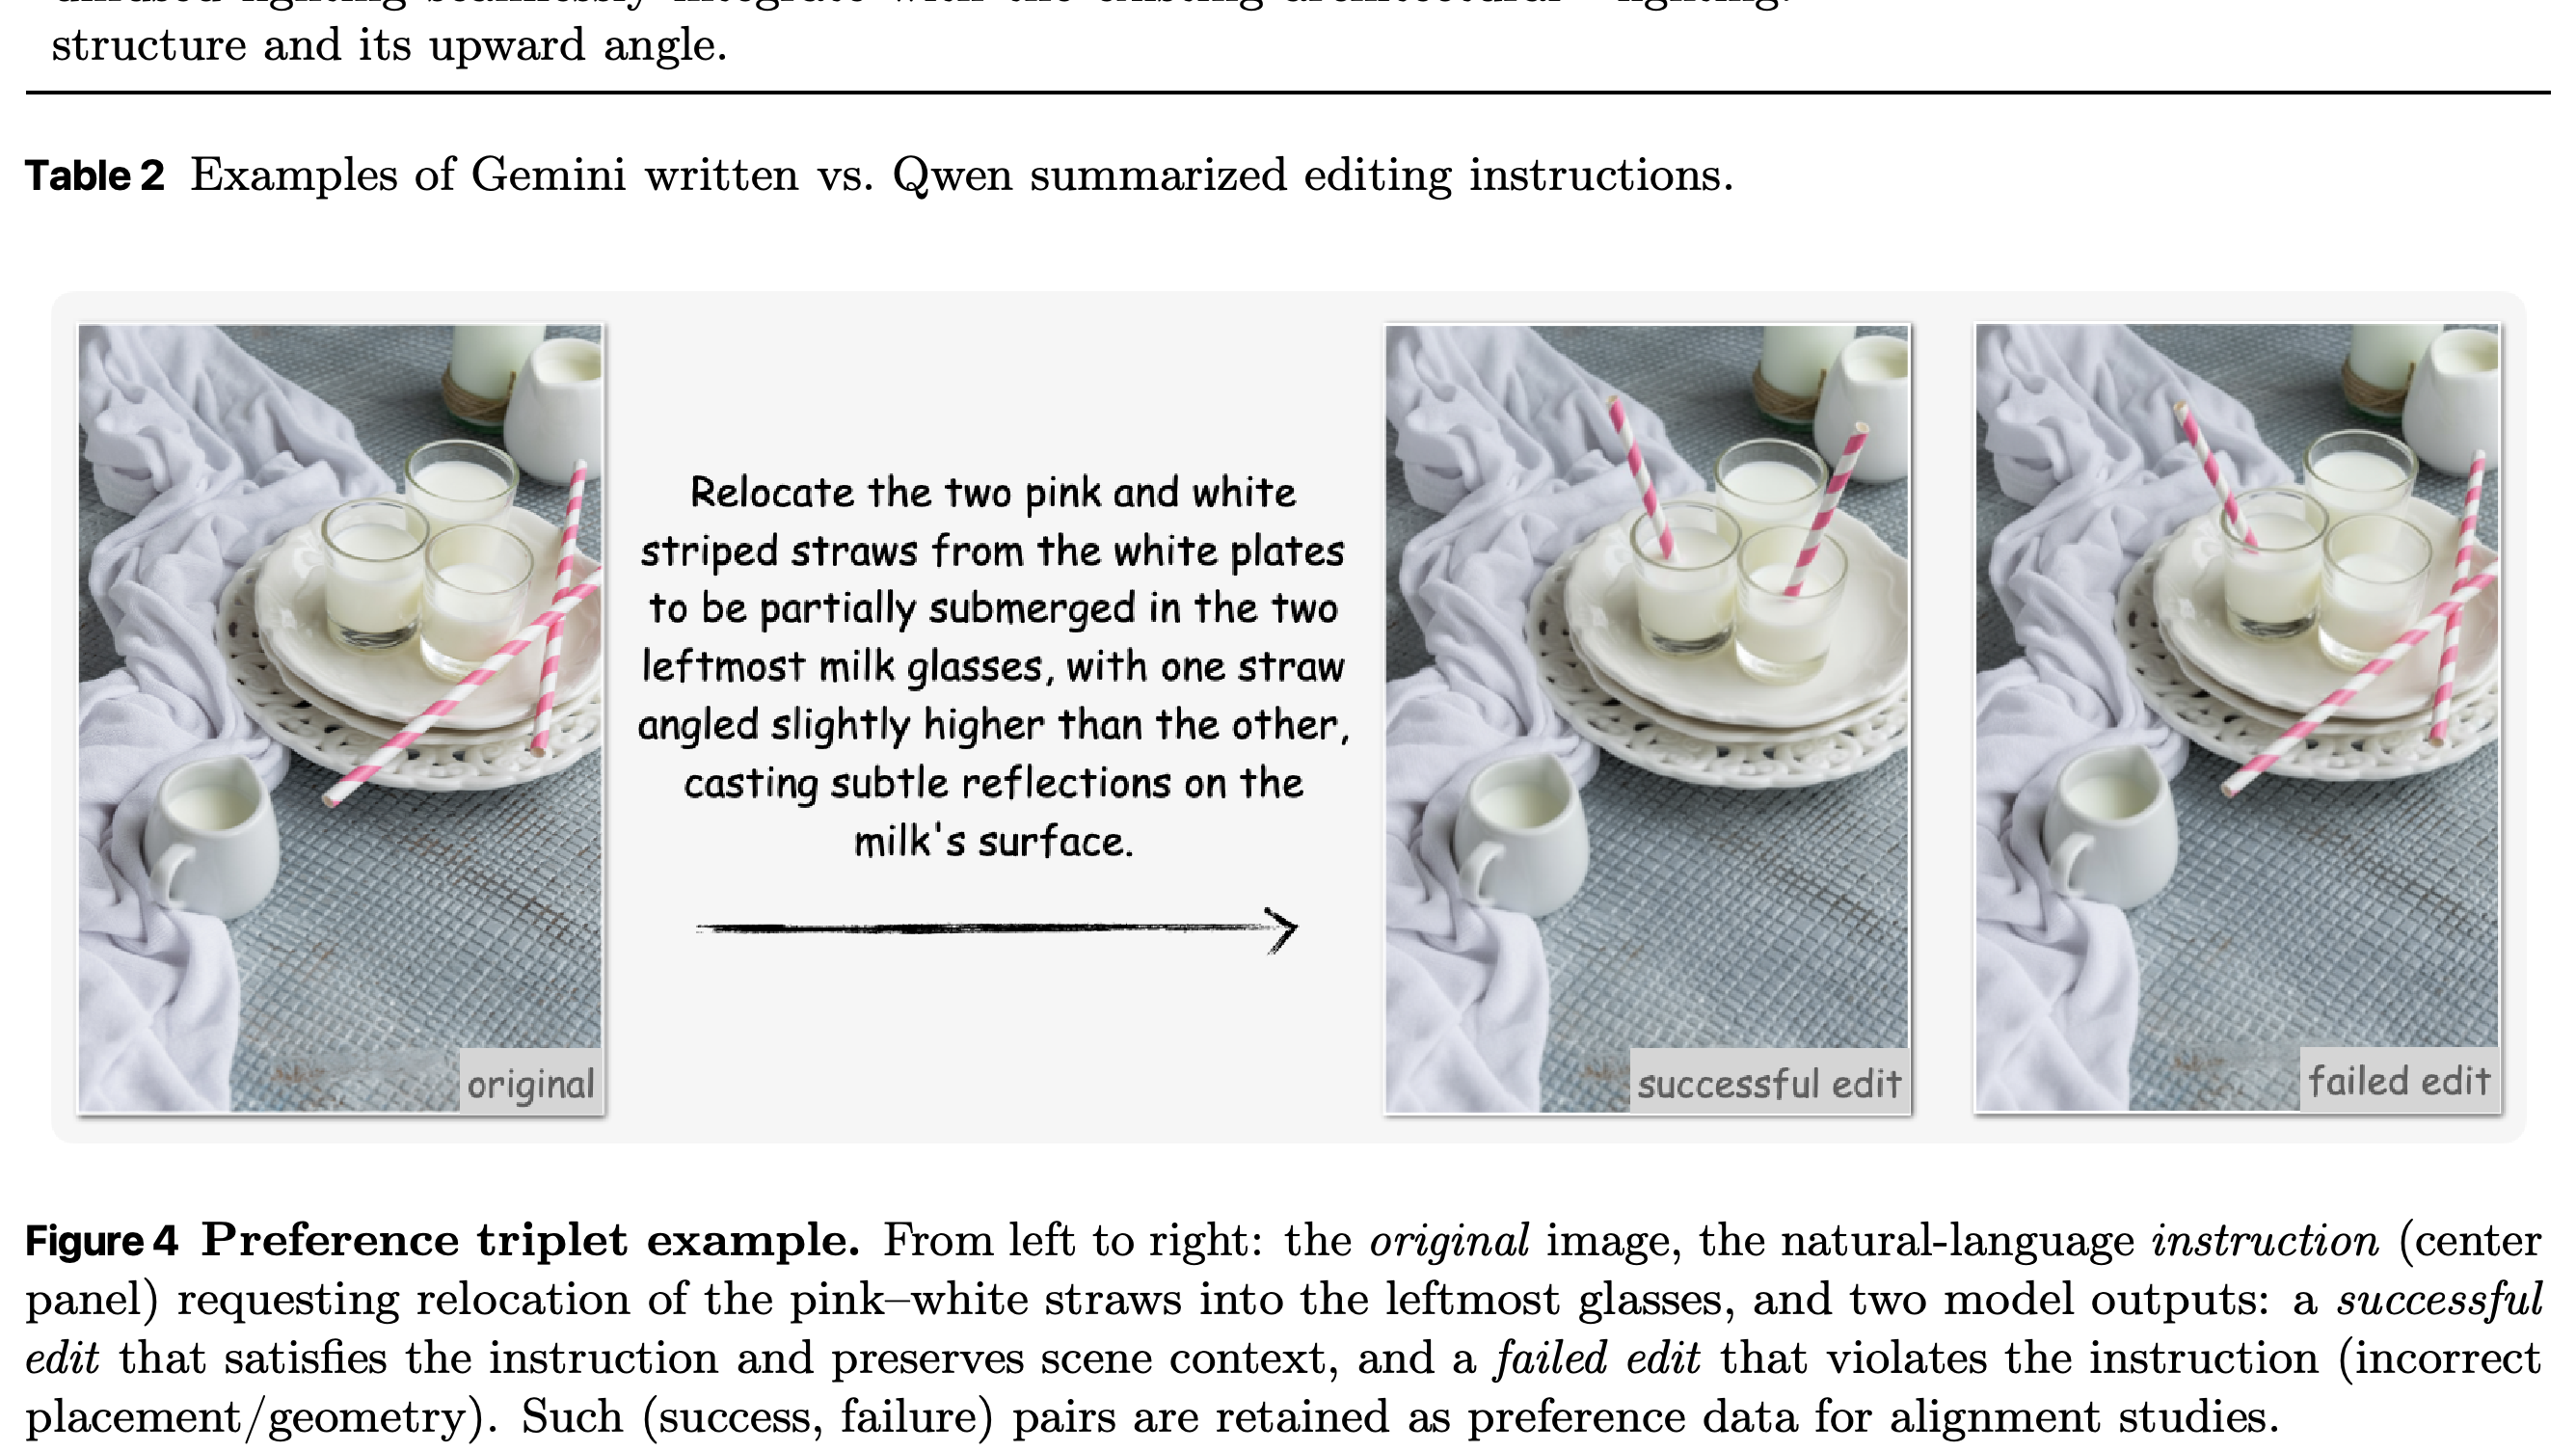
성공 출력은 약 258K개의 single-turn 하위 데이터셋을 구성한다. 실패 출력 약 56K개는 성공 대안과 짝지어 preference learning에 사용한다. 이는 동일한 요청에 대한 선호 결과와 거부 결과로 학습하는 방식이다. Table 1은 3번의 시도가 모두 실패한 사례를 폐기한다고 명시한다. 성공 출력에 앞서 발생한 실패 시도는 Figure 4처럼 부정 예제로 보관한다.
- 캡션은 ‘최대 3번의 재시도’와 ‘3번의 시도 모두’라는 표현을 함께 사용해 재시도 횟수와 전체 시도 횟수의 구분이 불명확하다.
- 따라서 보관된 부정 예제는 구축 과정에서 발생한 모든 실패 요청이 아니라, 최종적으로 성공한 요청에서 발생한 실패를 나타낸다.
성공 출력은 줄무늬 빨대 2개를 요청한 맨 왼쪽 잔들로 옮기지만 거부된 출력은 위치 이동을 완료하지 못한다. 동일한 원본 이미지와 요청을 사용하므로, instruction 준수 여부가 한 출력을 선호하는 이유로 드러난다.
2.4 Multi-Turn Image Editing
저자들은 single-turn 예제 100K개를 균등하게 샘플링하고 각 예제에 추가 편집 유형을 1–4개 무작위로 선택해 총 2–5턴의 편집 세션을 만든다. Gemini-2.5-Pro는 이미지와 편집 유형 이력을 조건으로 이전 수정 사항을 참조하는 instruction을 생성한다. 각 instruction은 현재 이미지에 적용하고 single-turn 절차로 평가한다.
- 이전 턴에서 추가한 모자의 색상을 바꾸는 요청처럼, 앞서 등장한 대상을 다시 가리키는 표현을 사용하는 coreference를 장려한다.
- 공개된 하위 데이터셋에는 multi-turn 시퀀스 72K개가 포함된다. 다만 논문은 시작 예제로 샘플링한 100K개에서 수가 줄어든 이유를 설명하지 않으며 길이별 시퀀스 성공률도 보고하지 않는다.
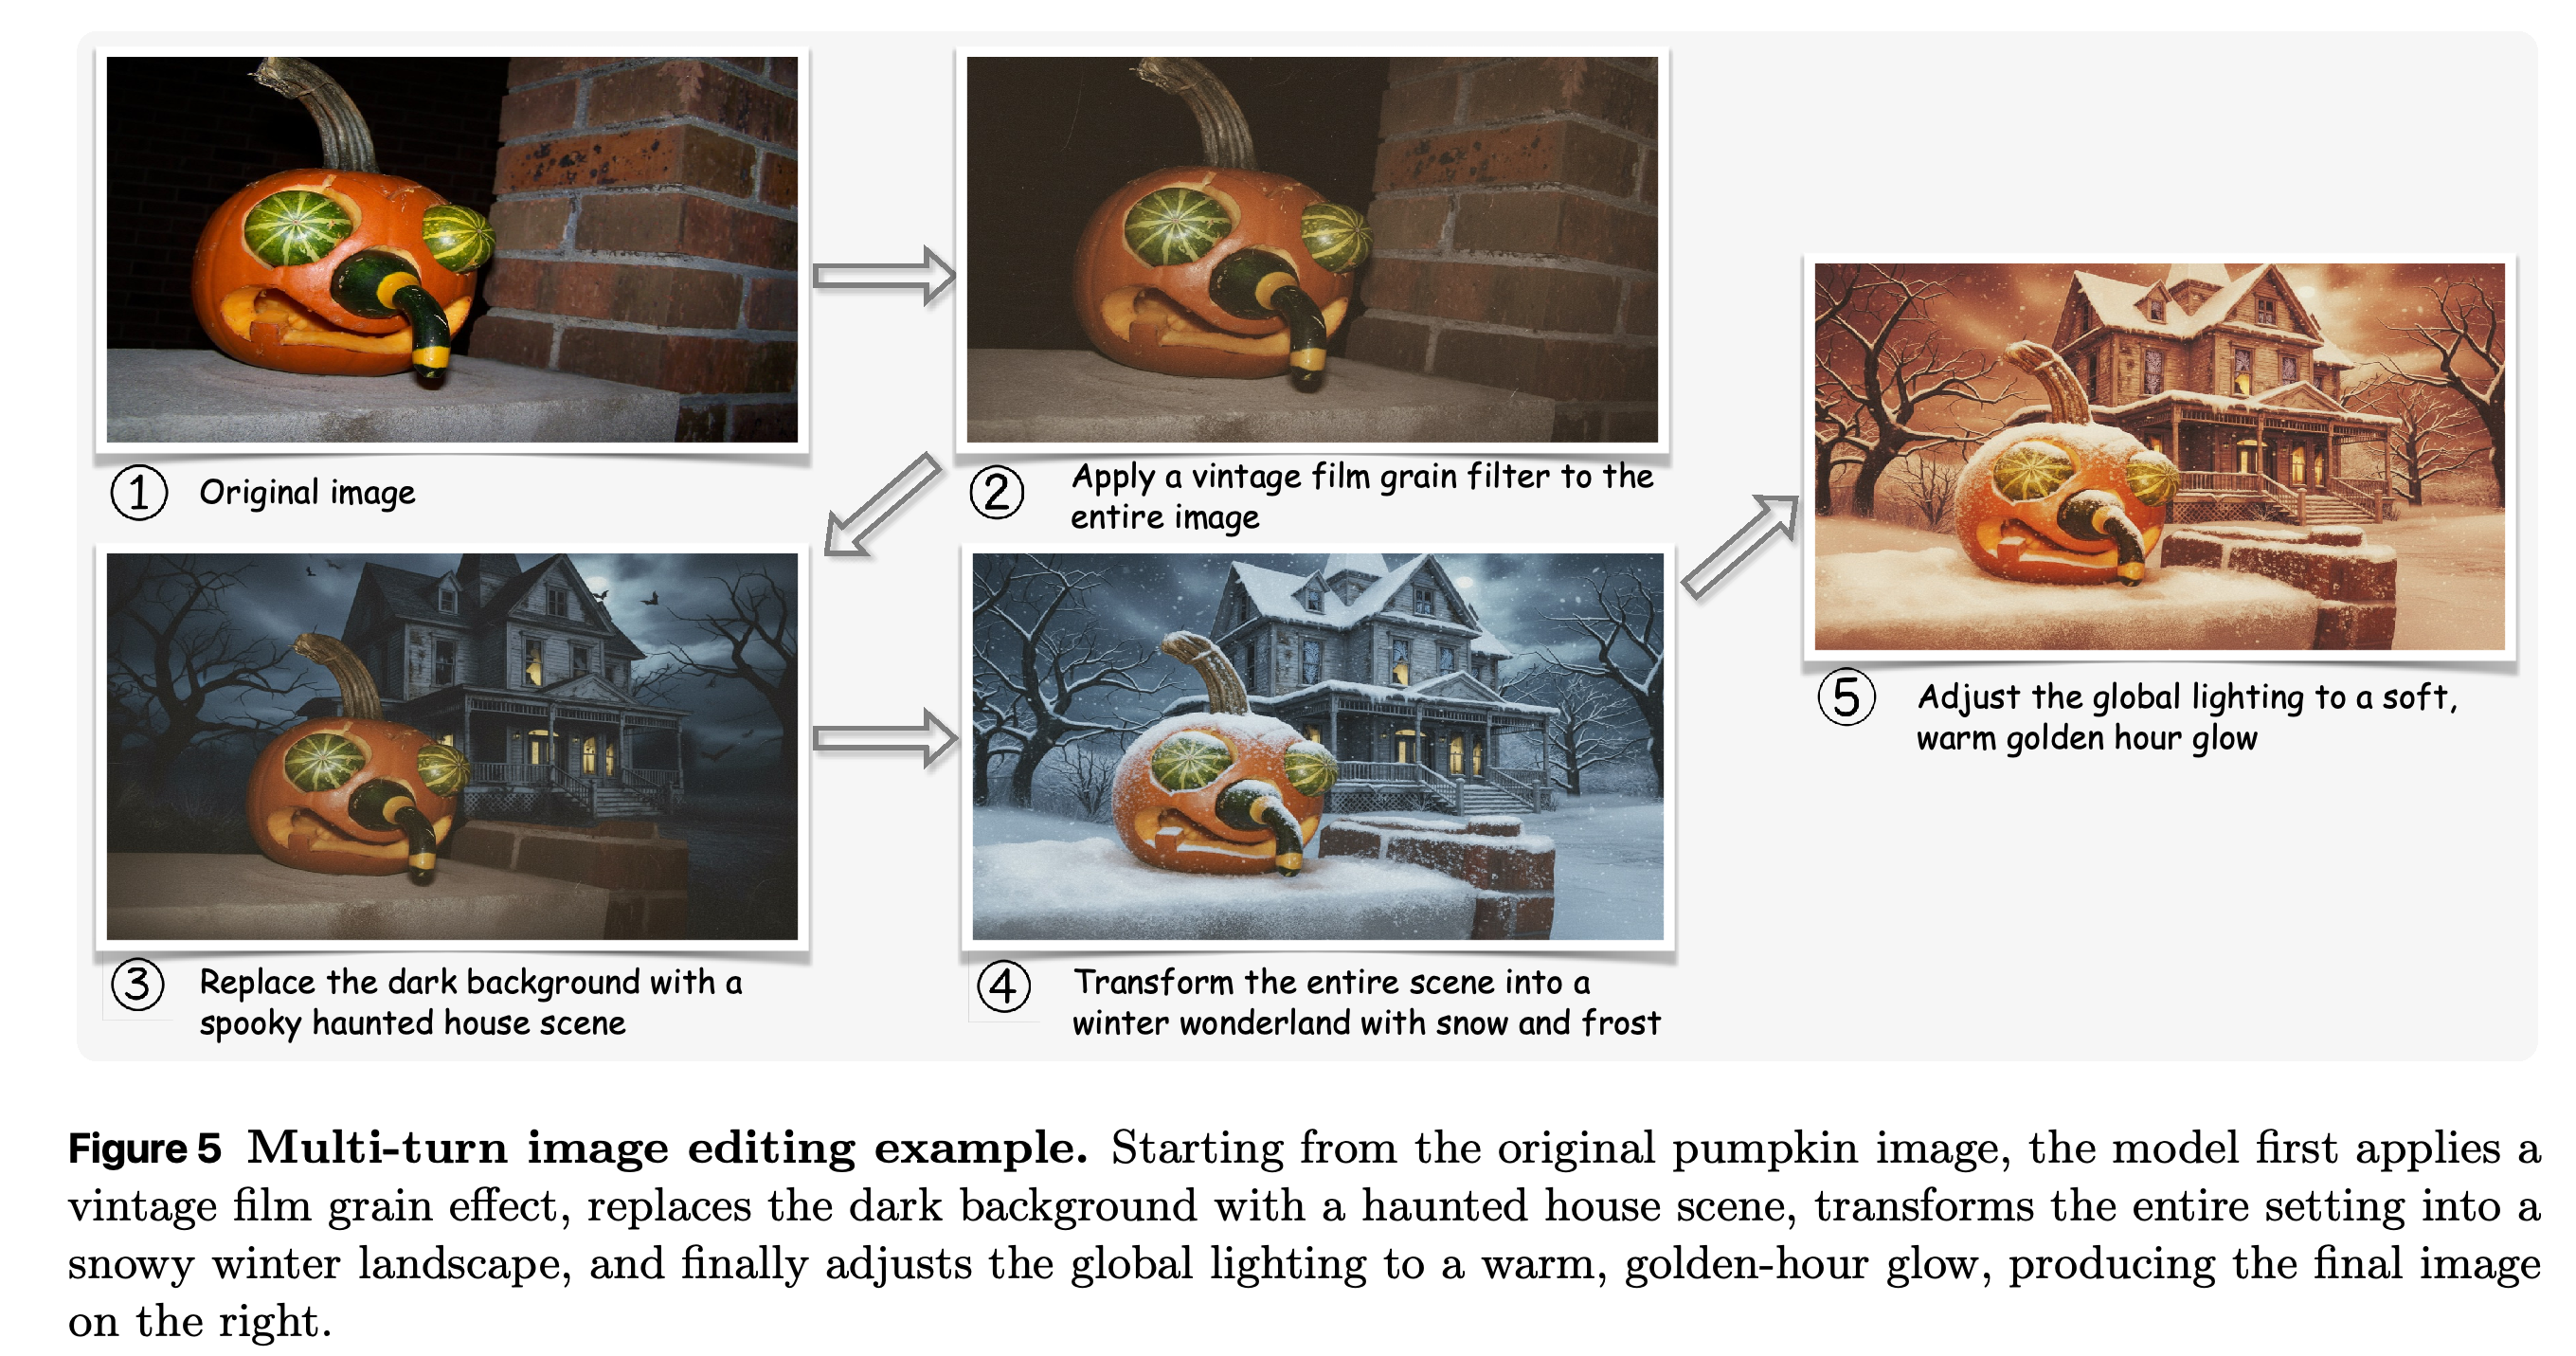
- Figure 5는 중심의 호박을 유지하면서 질감, 배경, 계절, 조명을 차례로 바꾸는 사례를 보여준다.
이 시퀀스는 알아볼 수 있는 호박을 유지하면서 필름 그레인을 적용하고 유령의 집 배경을 넣고, 눈과 서리를 추가하고 조명을 바꾼다. 각 결과가 다음 편집의 입력이 되어 4개 작업에 걸쳐 편집 상태가 누적되는 과정을 보여준다.
3 Dataset Analysis
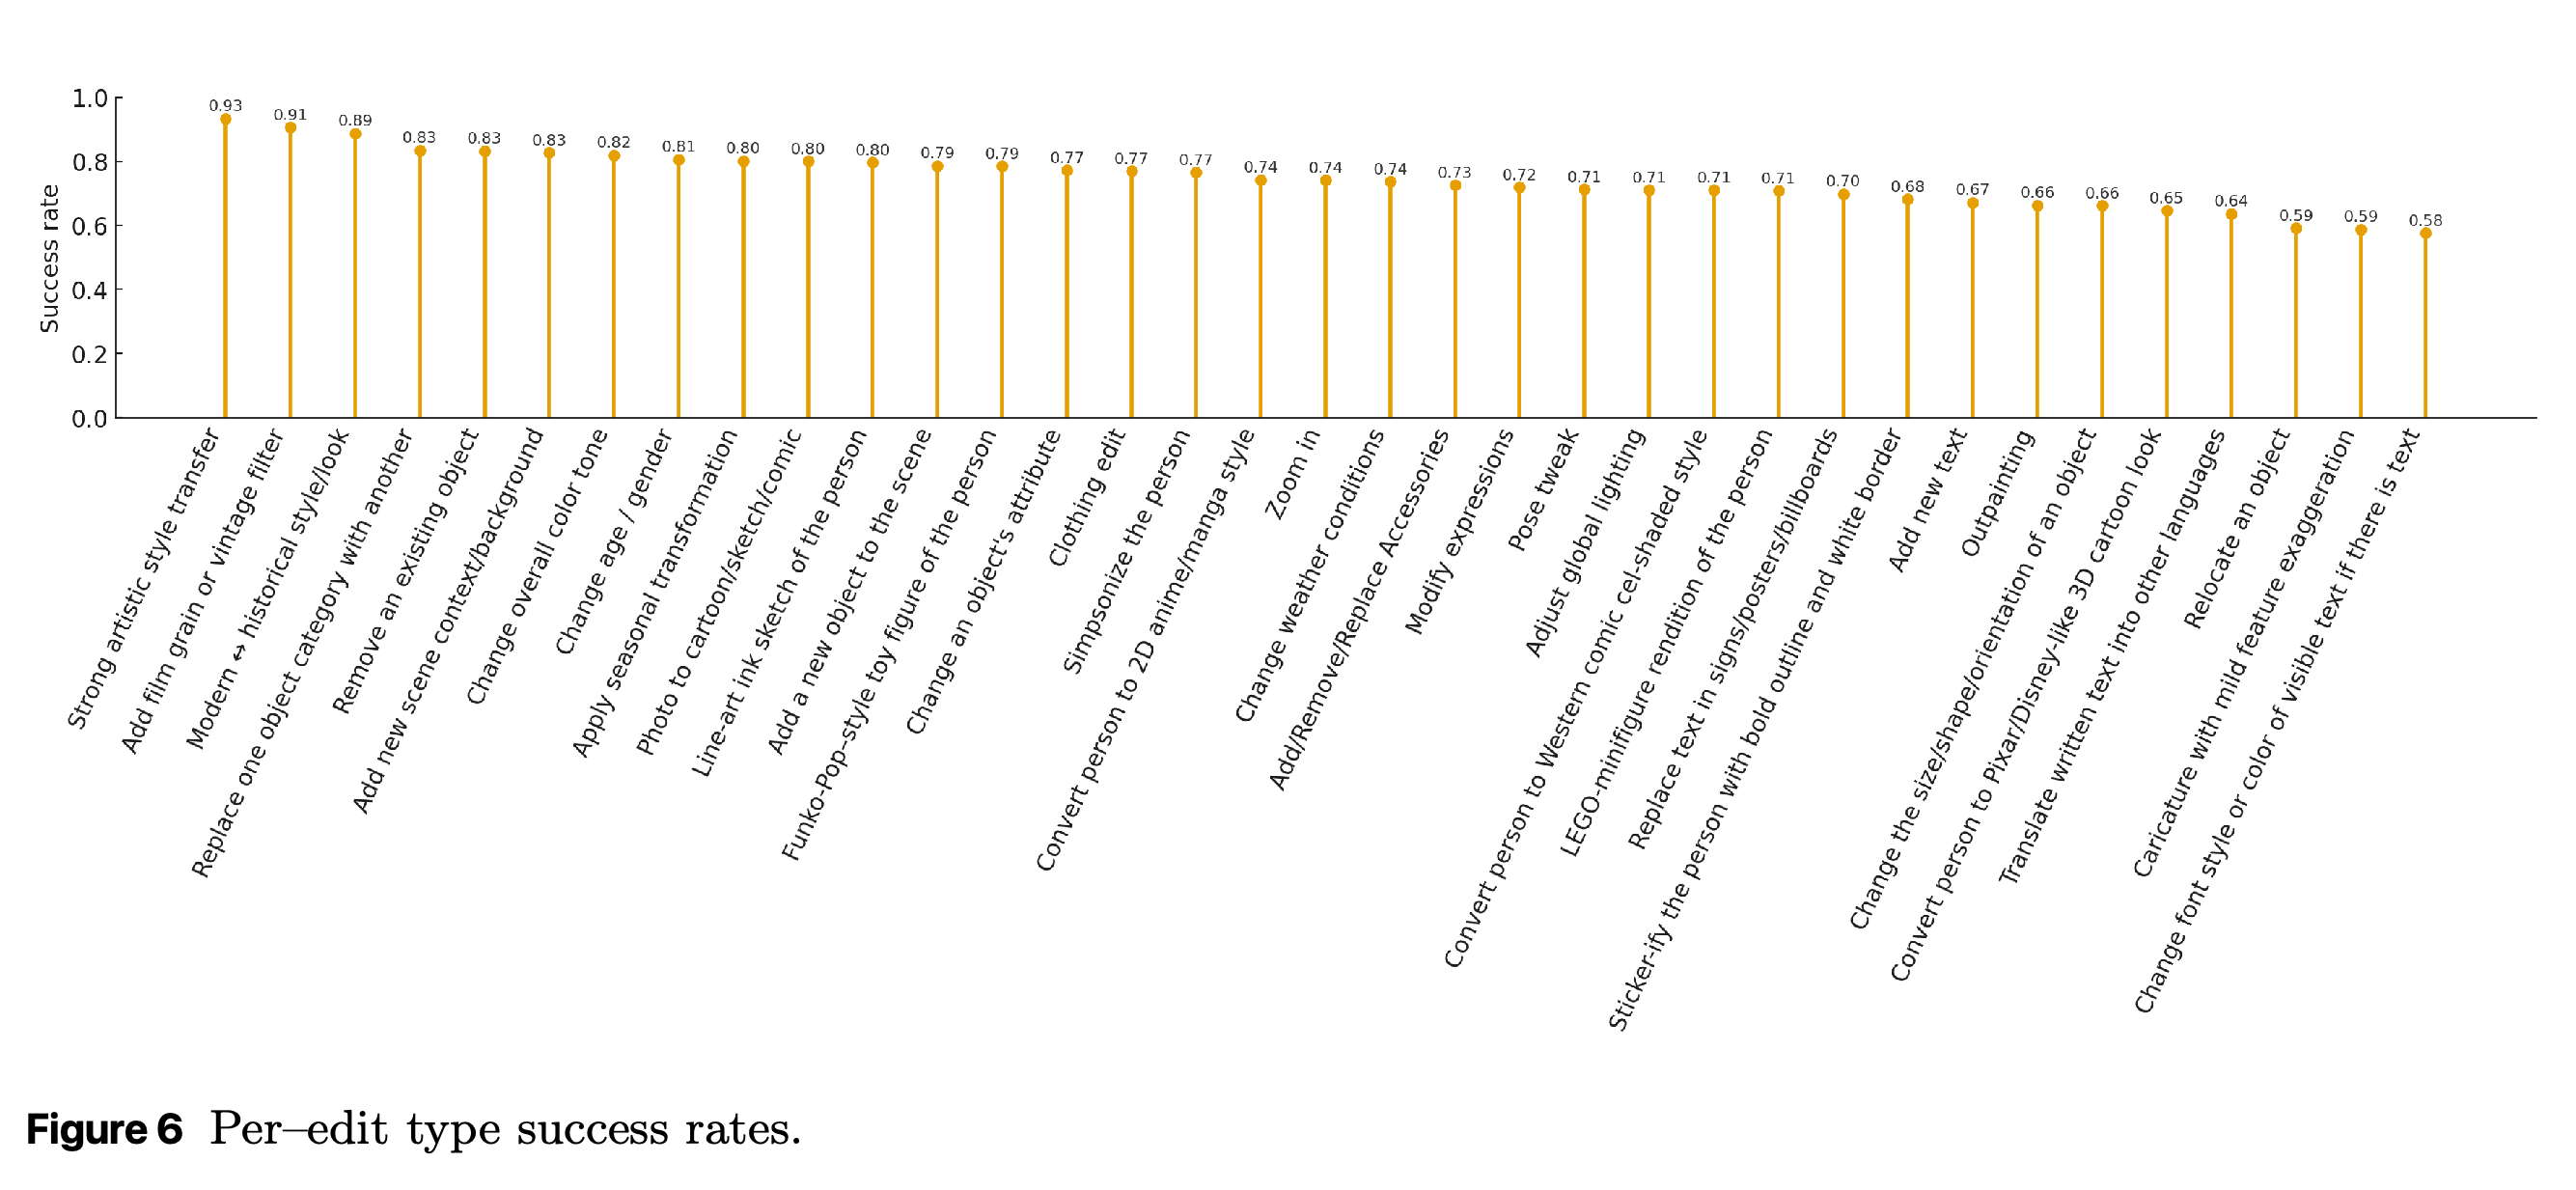
데이터셋 분석에서 성공률이 가장 높은 작업은 이미지 전체의 외관을 바꾸는 변환이다. 강한 artistic style transfer는 0.9340, 필름 그레인/빈티지는 0.9068, 현대↔역사적 스타일 변경은 0.8875다. 정밀한 조작이 덜 필요한 객체와 장면 작업도 비교적 높은 성공률을 보인다. 객체 제거는 0.8328, 객체 범주 교체는 0.8348, 계절 변경은 0.8015, 사진→만화/스케치는 0.8006이다.
- 정밀한 공간 작업은 신뢰도가 낮다. 객체 위치 이동은 0.5923, 크기/형태/방향 변경은 0.6627, 이미지 경계 바깥으로 캔버스를 확장하는 outpainting은 0.6634다.
- 이미지에 보이는 텍스트의 글꼴 스타일이나 색상 변경은 보고된 성공률 중 가장 낮은 0.5759다. Pixar/Disney풍 3D 사람 스타일 변환은 0.6463, 캐리커처는 0.5884다.
- 저자들은 실패를 부정확한 배치, 원근의 불일치, 객체 구조의 훼손, 이미지 경계의 불연속, 글자 형태나 정렬 오류, 인물 정체성의 변화와 연관 짓는다. 이 설명들은 관찰을 기술한 것이며 조건을 통제한 인과 검증 결과는 아니다.
- 저자들은 편집 위치에 관한 지침 강화, 기하 정보를 반영한 학습, 텍스트 렌더링을 위한 지도, 정체성을 유지하는 제약을 제안한다. 논문은 이 방법들의 효과를 평가하지 않는다.
성공률 순위는 이미지 전체의 스타일 변환과 정밀한 배치 또는 텍스트 렌더링이 필요한 작업 사이에 큰 차이가 있음을 보여준다. 본문은 강한 artistic style transfer의 정확한 성공률을 0.9340, 객체 위치 이동을 0.5923, 이미지에 보이는 텍스트의 글꼴 스타일이나 색상 변경을 0.5759로 제시한다. 차트는 반올림한 값을 표시하며 신뢰구간은 제공하지 않는다.
4 Related Work
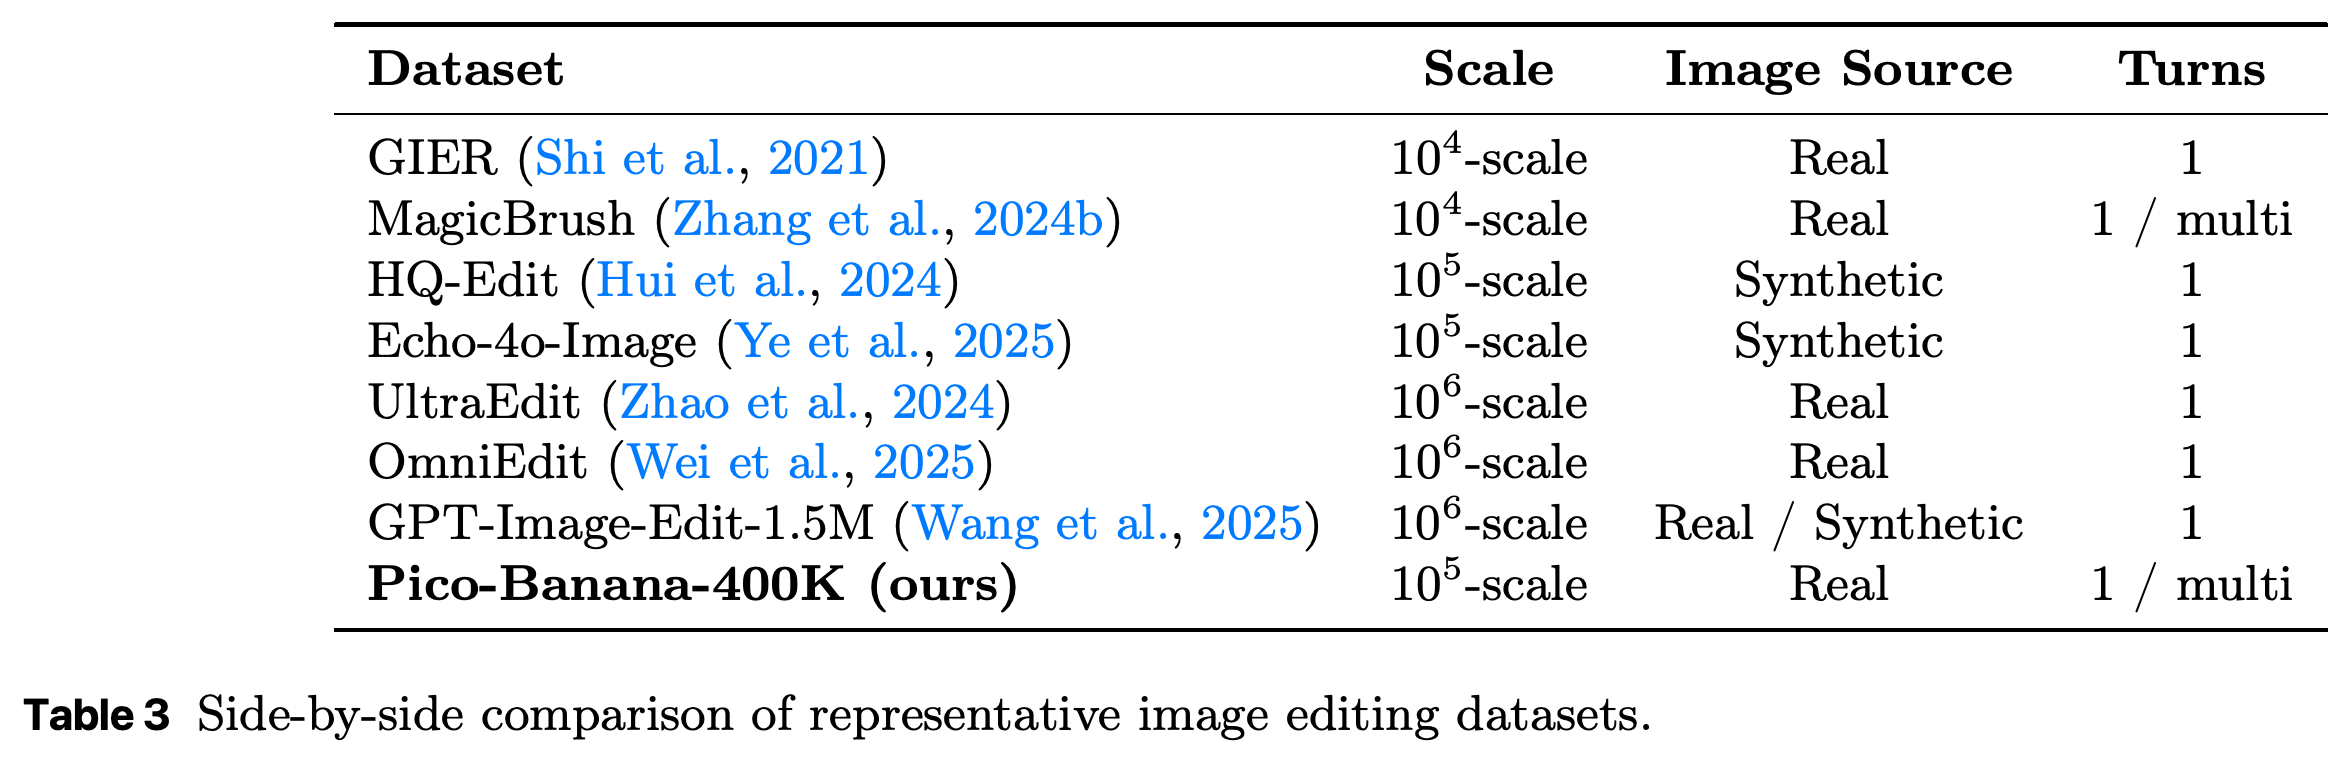
관련 연구는 실제 이미지 편집과 이미지 내용에 근거한 요청으로 만든 데이터셋, 합성 또는 혼합 파이프라인으로 확장한 데이터셋을 다룬다. 또한 재학습 없는 편집과 instruction/before/after triplet을 이용한 supervised fine-tuning을 구분한다. 이 triplet은 요청과 해당 원본 이미지, 편집 이미지를 포함한 기록이다. Table 3은 Pico-Banana-400K를 실제 원본 이미지와 single-turn 및 multi-turn 편집을 제공하는 10^5 규모 데이터셋으로 제시하고 UltraEdit, OmniEdit, GPT-Image-Edit-1.5M 같은 10^6 규모 데이터셋과 함께 비교한다.
- 저자들은 품질 필터링, 세분화된 편집 유형, preference triplet, 사람 중심 변환을 함께 제공한다는 점으로 이 데이터셋의 특징을 설명한다.
- Table 3의 “Real”은 이미지 출처를 나타낸다. Pico-Banana-400K의 편집 결과에 해당하는 목표 이미지는 모델이 생성한다.
- 이 표는 규모, 출처, 지원하는 턴을 비교한다. 공통 품질 벤치마크나 조건을 통제한 학습 비교는 제공하지 않는다.
이 비교에서 Pico-Banana-400K의 규모는 GIER와 MagicBrush보다 크고, 표에 나열된 백만 단위 데이터셋보다 작다. 또한 실제 원본 이미지를 사용하고 여러 턴을 지원한다. 표의 열은 데이터셋 구조와 출처를 비교하며 출력 품질이나 학습 효과를 측정하지 않는다.
5 Conclusion
결론은 instruction 생성 모델, 이미지 편집 모델, 검증 모델로 구성된 파이프라인을 규모를 확장할 수 있는 편집 데이터 구축 방법으로 제시하며 이미지와 메타데이터를 공개했다고 밝힌다. PDF는 https://github.com/apple/pico-banana-400k 를 제공한다. 제어 가능성, 요청한 변경 사항의 준수, 편집 이미지의 품질과 일관성을 뜻하는 시각적 충실도를 측정하는 모델 벤치마크와 학습 연구는 명시적으로 향후 과제로 남겨 둔다.
부록
- A System Prompt for Edit Instruction Generation은 Gemini-2.5-Flash의 instruction 생성 프롬프트를 공개한다. “System Prompt:”는 이미지에 보이는 객체, 색상, 위치에 근거한 자연스러운 편집 instruction을 요청하며 출력을 “prompts” 배열이 포함된 JSON 객체로 나타내도록 한다. 본문은 instruction 1개를 뜻하는 ONE instruction을 요청하지만 예시 배열에는 “<first prompt>“와 “<second prompt>“가 들어 있다.
- B System Prompt used by Gemini-2.5-Pro as a Judge는 평가 프롬프트와 “System Prompt:”의 입력 순서를 공개한다. 입력 순서는 편집 결과, 입력 이미지 또는 이미지들, 편집 instruction이다. “Evaluation Criteria (Weighted Scoring for Image Editing):”는 Edit Instruction Compliance에 40%, Editing Quality & Seamlessness에 25%, Preservation vs. Change Balance에 20%, Technical Quality에 15%를 부여한다. 프롬프트는 원본 이미지와의 비교와 함께, 임계값에 따른 채택 판정에 사용할 0.0부터 1.0까지의 최종 가중 점수도 요청한다.
짧은 생각
데이터셋의 구성은 채택된 편집, 거부된 대안, instruction 표현, 순차 편집을 각각 연구할 수 있게 한다. 보고된 style transfer 성공률 0.9340과 글꼴 스타일/색상 변경 성공률 0.5759는 작업에 따라 생성 신뢰도가 크게 달라짐을 보여준다. 신뢰도가 낮은 여러 작업은 제외되었으며 Table 1은 남은 유형 사이에도 샘플 수 차이가 크다는 점을 보여준다. 따라서 범주가 폭넓다는 사실만으로 편집 난이도까지 균형 있게 포괄한다고 볼 수는 없다. 공개된 채점 기준을 통해 결과 채택 조건을 확인할 수 있다. 독립적인 사람 검증은 라벨의 신뢰도를 평가하는 데 도움이 될 수 있으며 후속 학습 실험은 다른 편집 모델에 이 데이터셋이 주는 이점을 검증할 수 있다.