


Seedream 3.0 Technical Report 요약 설명
15 Apr 2025 | Paper Review Text-to-Image Generation Text Rendering Diffusion Acceleration목차
이번 글에서는 Seedream 3.0 Technical Report 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 4월 15일(Arxiv)
- Gao, Yu, Gong, Lixue, Guo, Qiushan, Hou, Xiaoxia, Lai, Zhichao, Li, Fanshi, Li, Liang, Lian, Xiaochen, Liao, Chao, Liu, Liyang, et al.
- ByteDance Seed
- 논문 링크
- Project Page
요약
- Seedream 3.0은 복잡한 프롬프트를 따르고, 작은 글자를 정확히 표현하며, 세밀한 고해상도 이미지를 생성하는 중국어, 영어 이미지 생성 과제를 다룬다. 중국어 프롬프트 180개와 영어 프롬프트 180개로 구성된 논문 벤치마크에서 텍스트 사용 가능 비율 94%를 달성한다. 이는 텍스트 정확성, 이미지와의 조화, 미적 품질을 기준으로 사용 가능하다고 판정한 이미지의 비율이다. Seedream 2.0의 해당 비율은 중국어 78%, 영어 86%다.
- 이 시스템은 학습 데이터 확대, 여러 해상도를 활용한 학습, 이미지와 텍스트의 위치를 함께 나타내는 위치 인코딩, 상세한 미적 묘사와 이미지-텍스트 출력에 점수를 부여하는 모델을 활용한 사후 학습을 결합한다. 최대 2048×2048 이미지를 직접 생성한다. 저자들은 이미지 품질을 유지하면서 4~8 times의 속도 향상을 달성했다고 보고하지만, 상세한 시간 비교는 제시하지 않는다.
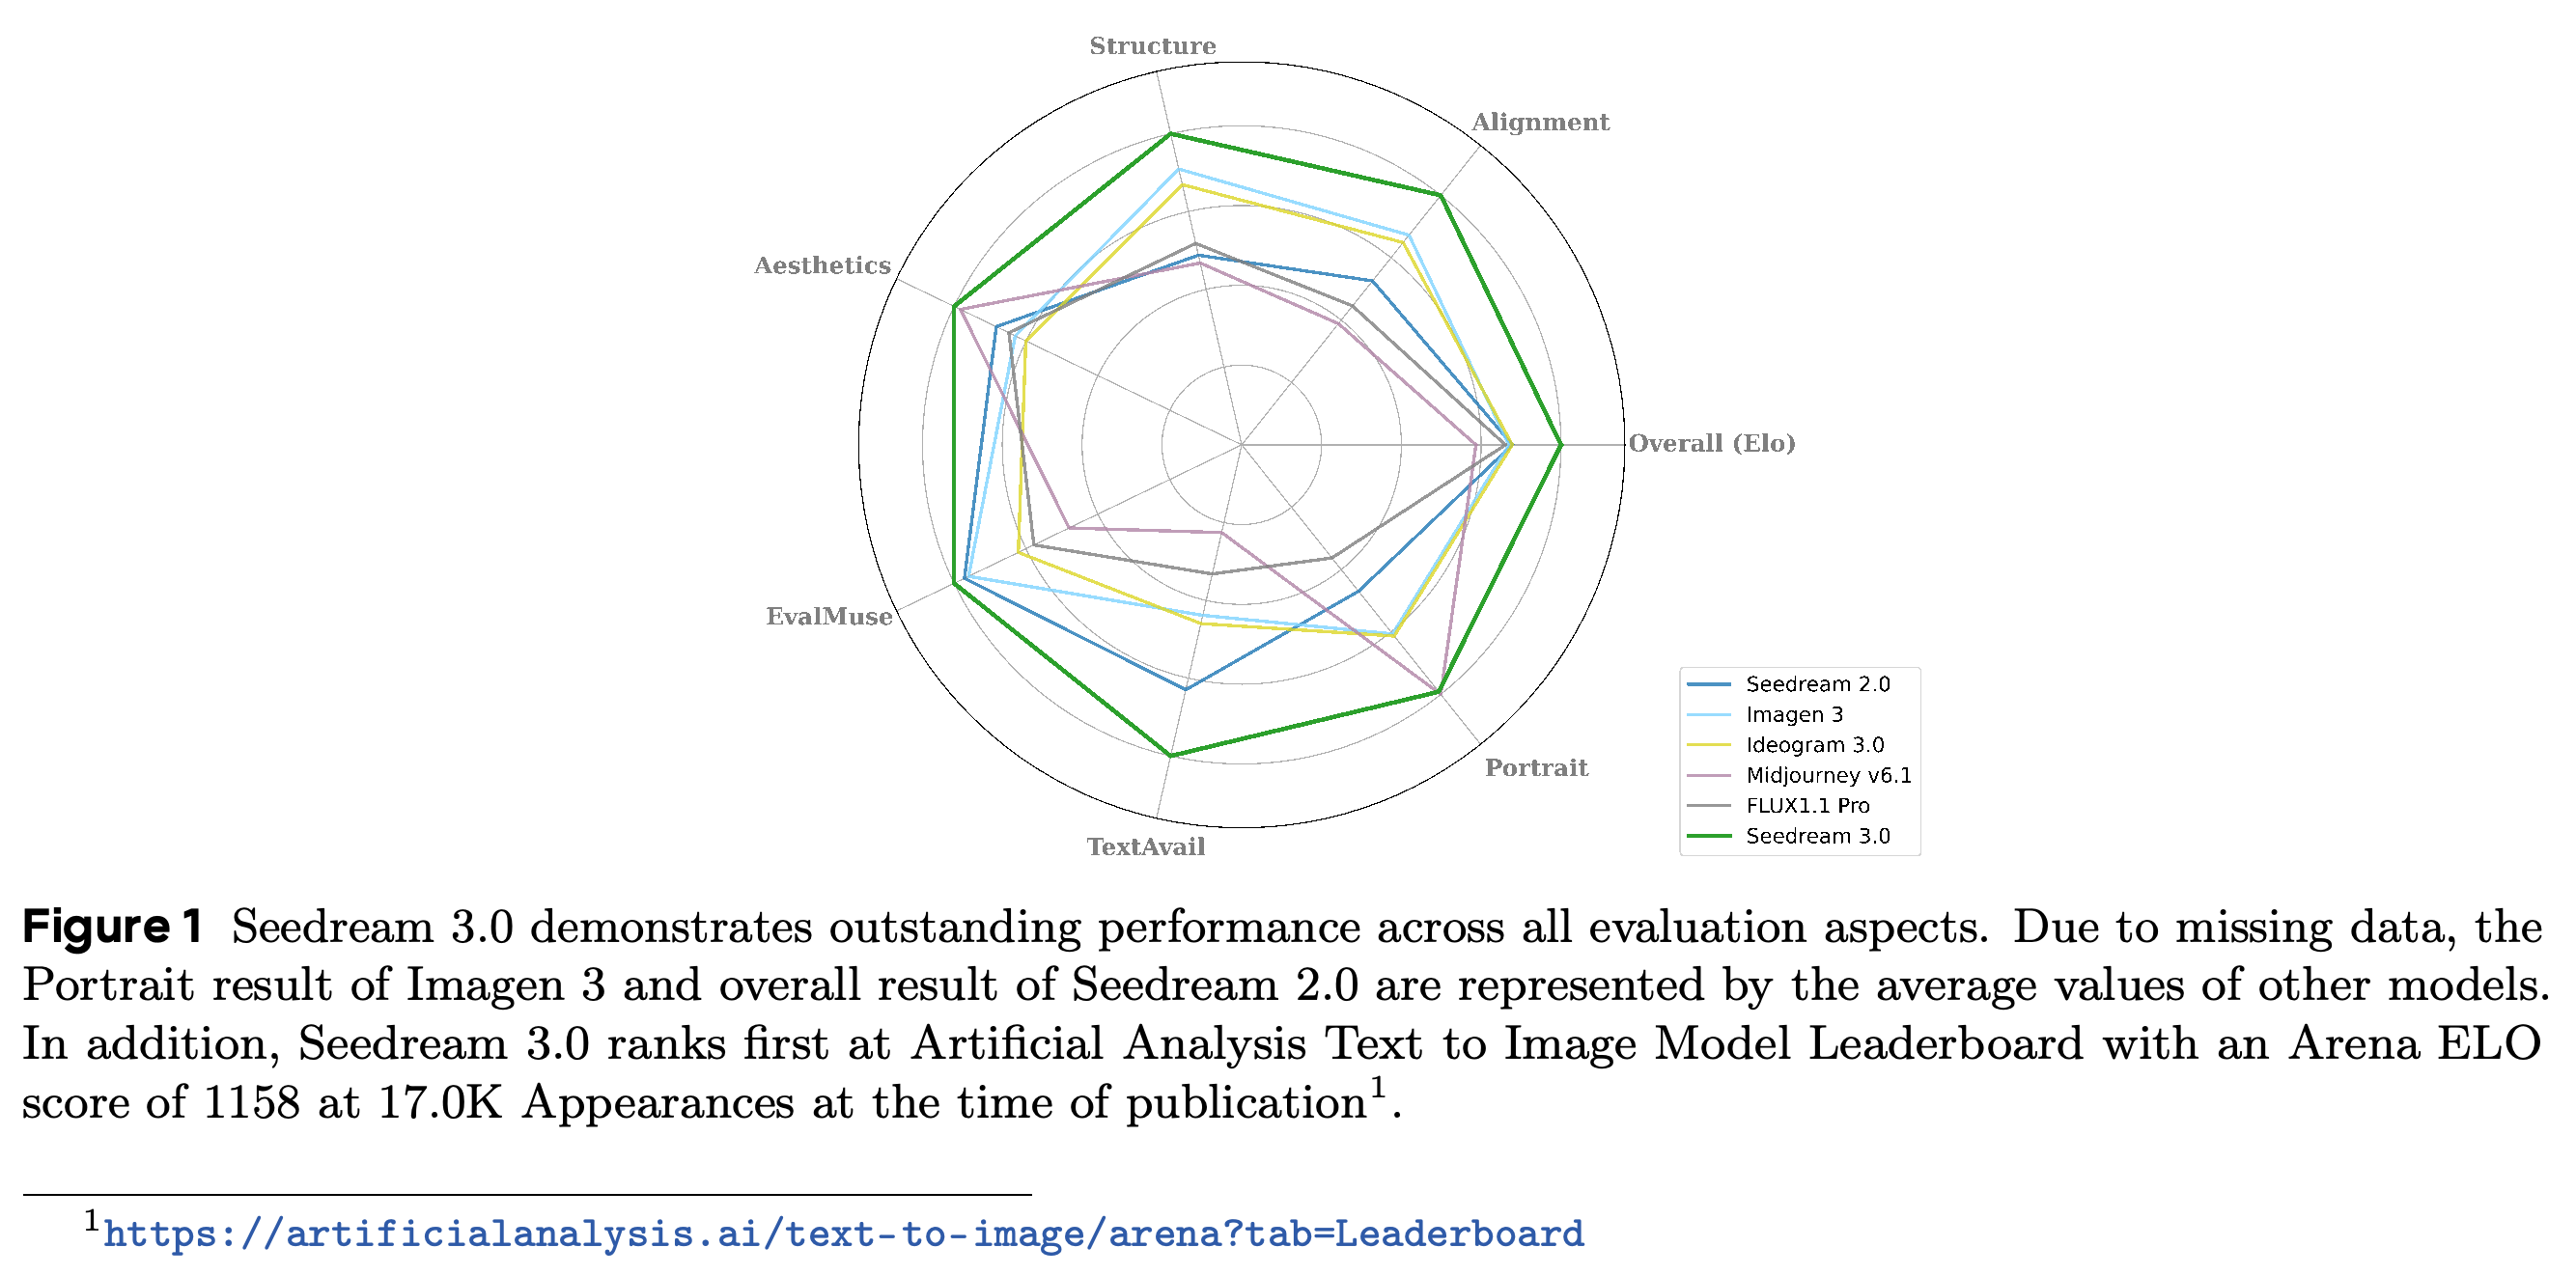
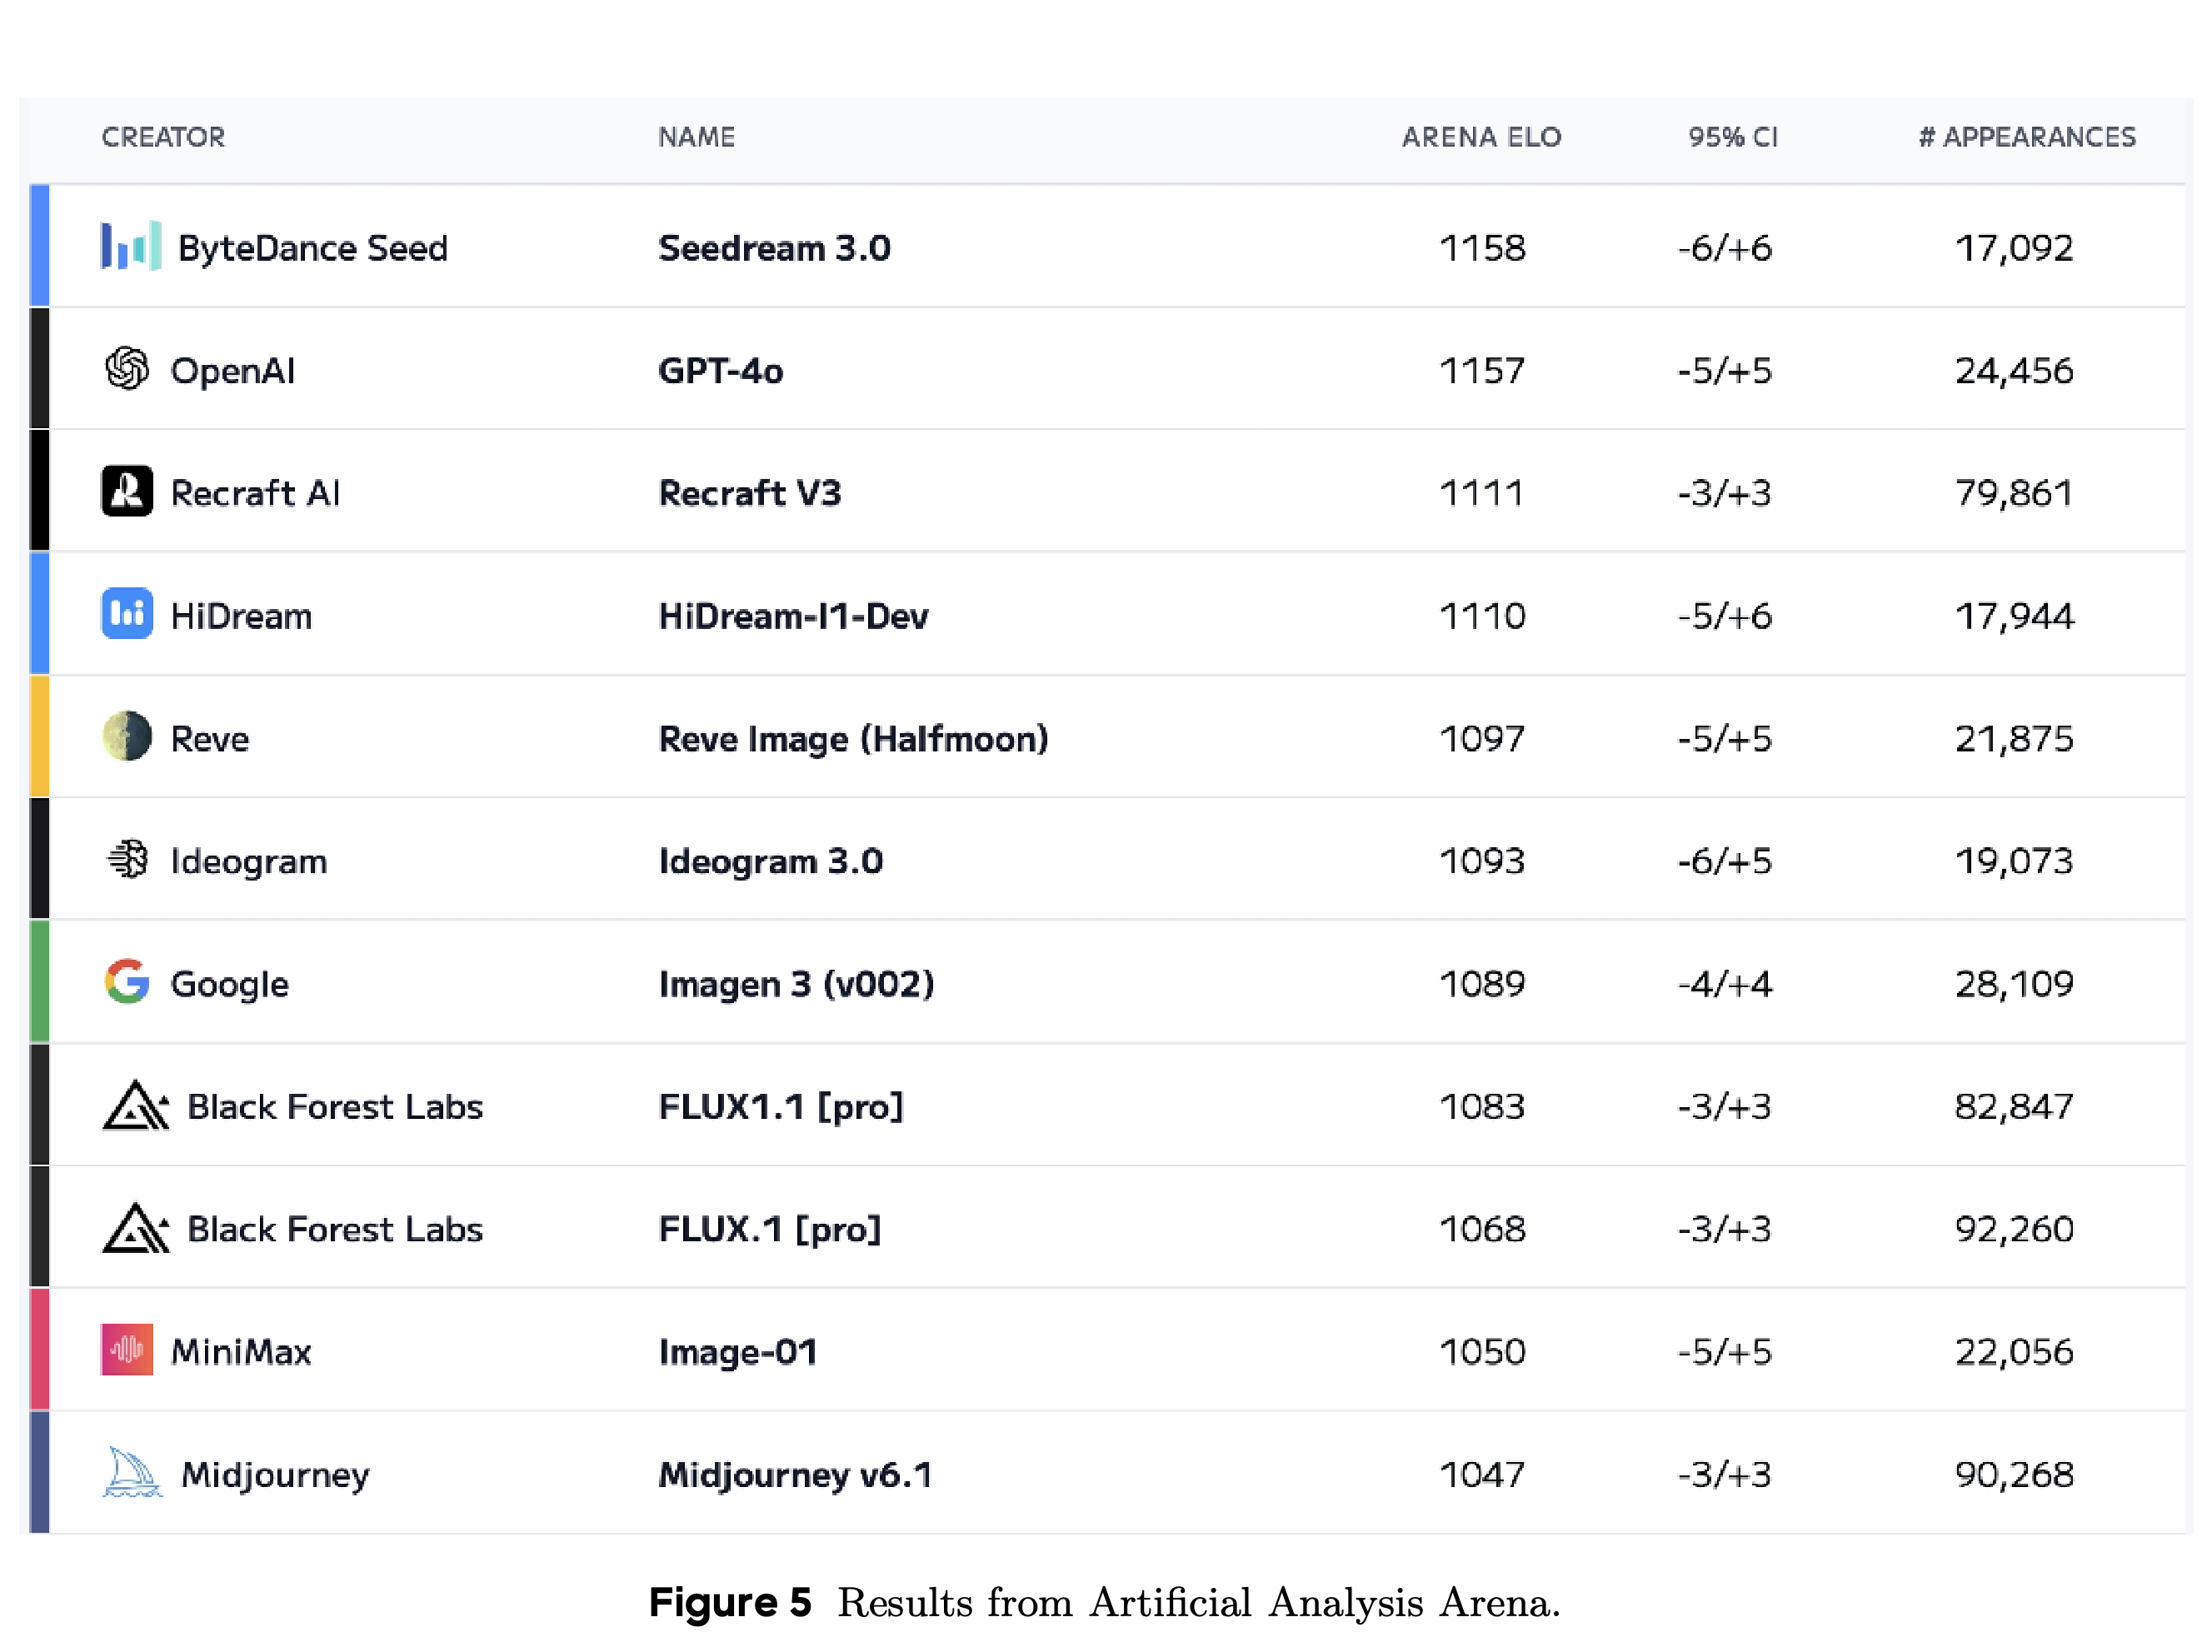
- 프롬프트 377개에 대한 전문가 평가에서는 프롬프트 준수와 구조적 정확성이 개선되었다고 보고하며, 제시된 자동 평가 지표 5개 모두에서 Seedream 3.0이 앞선다. 인물 이미지 선호도는 Midjourney v6.1과 비슷하다. 쌍별 선호도를 바탕으로 산출하는 Artificial Analysis Arena Elo 점수는 1158로 GPT-4o의 1157보다 높지만, 95% 신뢰구간이 겹친다. 별도로 제시한 GPT-4o 직접 비교는 선별한 사례를 사용한다.
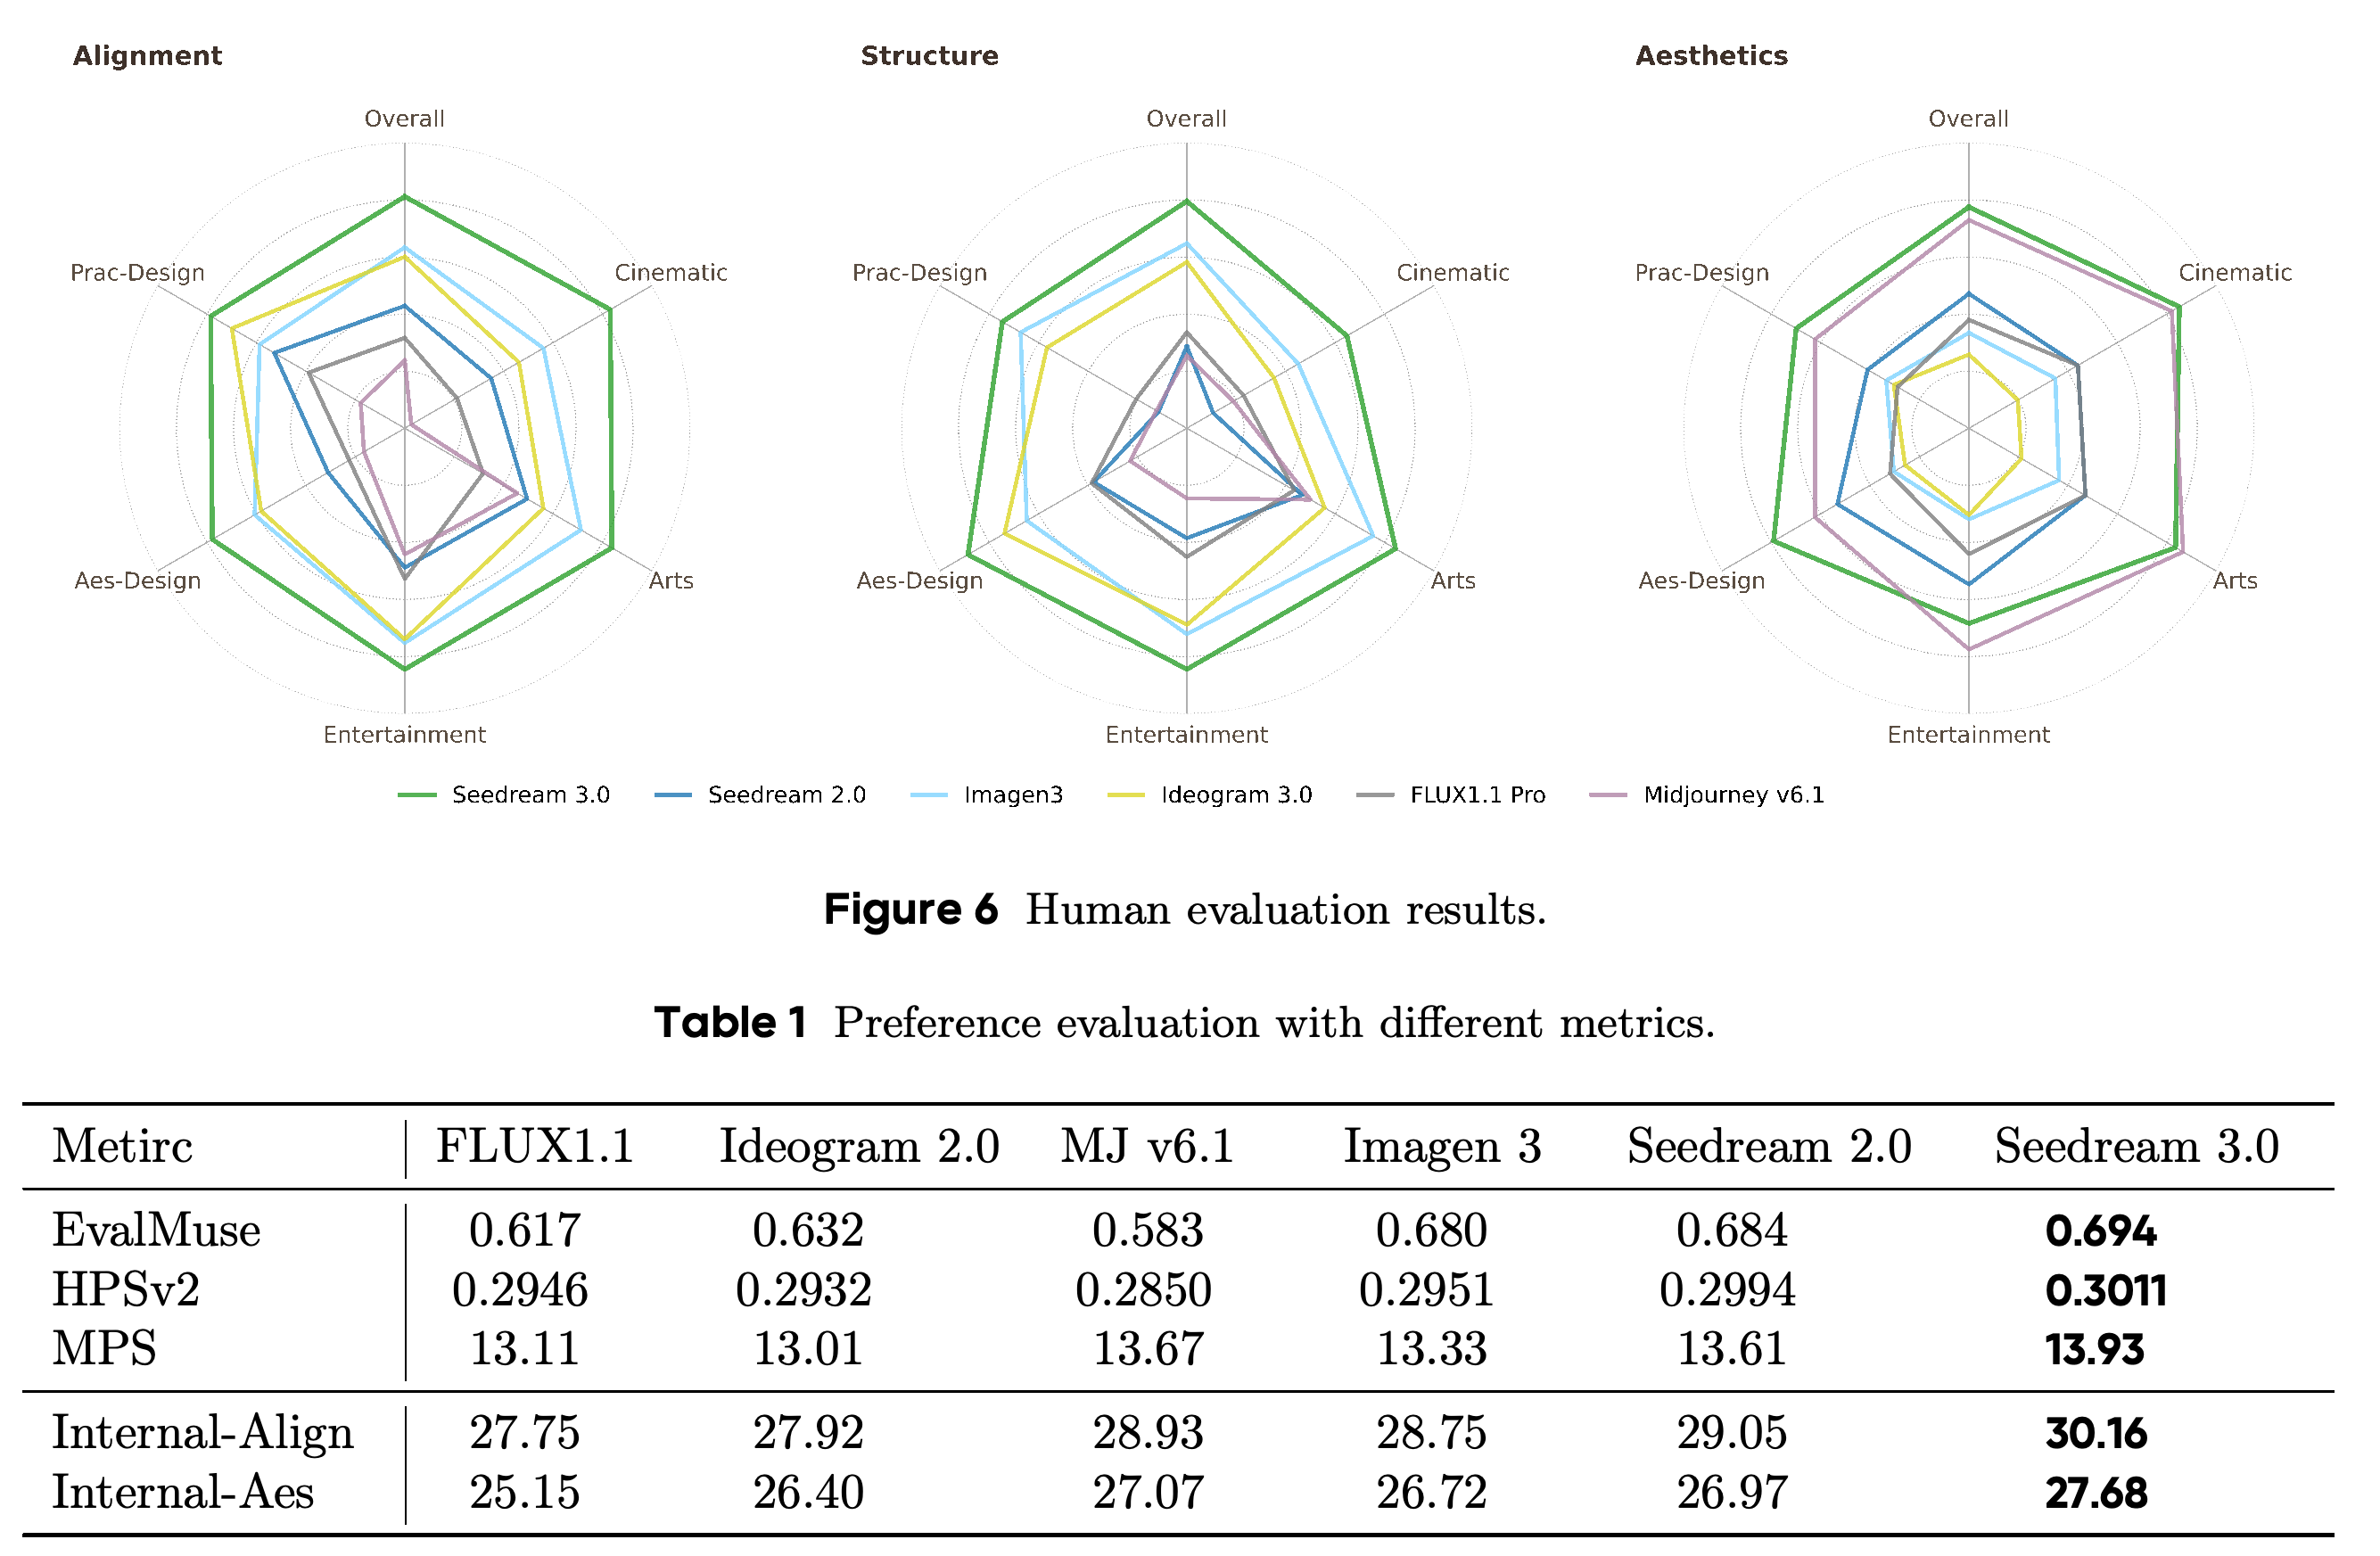
레이더 차트는 서로 다른 평가 절차에서 얻은 결과를 요약한다. Imagen 3의 인물 이미지 지점과 Seedream 2.0의 종합 지점은 다른 모델 결과의 평균이므로, 해당 좌표를 직접 비교의 근거로 사용할 수 없다.
1 Introduction
서론은 Seedream 2.0의 한계를 4가지로 정리한다. 수량과 공간 관계에 관한 프롬프트 준수, 작은 글자와 여러 줄 조판, 시각적 미감과 인물의 질감, 제한적인 기본 출력 해상도다. Seedream 3.0은 데이터 구축, 사전 학습, 사후 학습, 추론 가속을 개선해 이러한 문제를 다룬다.
- 보고서에 따르면 프롬프트를 조정하는 단계인 Prompt Engineering (PE)을 제외하면 1K 이미지 생성에 3.0초가 걸린다. 다만 이 지연 시간을 측정한 하드웨어 구성은 명시하지 않는다.
- 2025년 4월 초부터 Doubao와 Jimeng을 통해 서비스를 제공하기 시작했다. 공식 페이지는 https://team.doubao.com/tech/seedream3_0 이며, 모델 식별자는 Doubao-Seedream-3.0-t2i다.
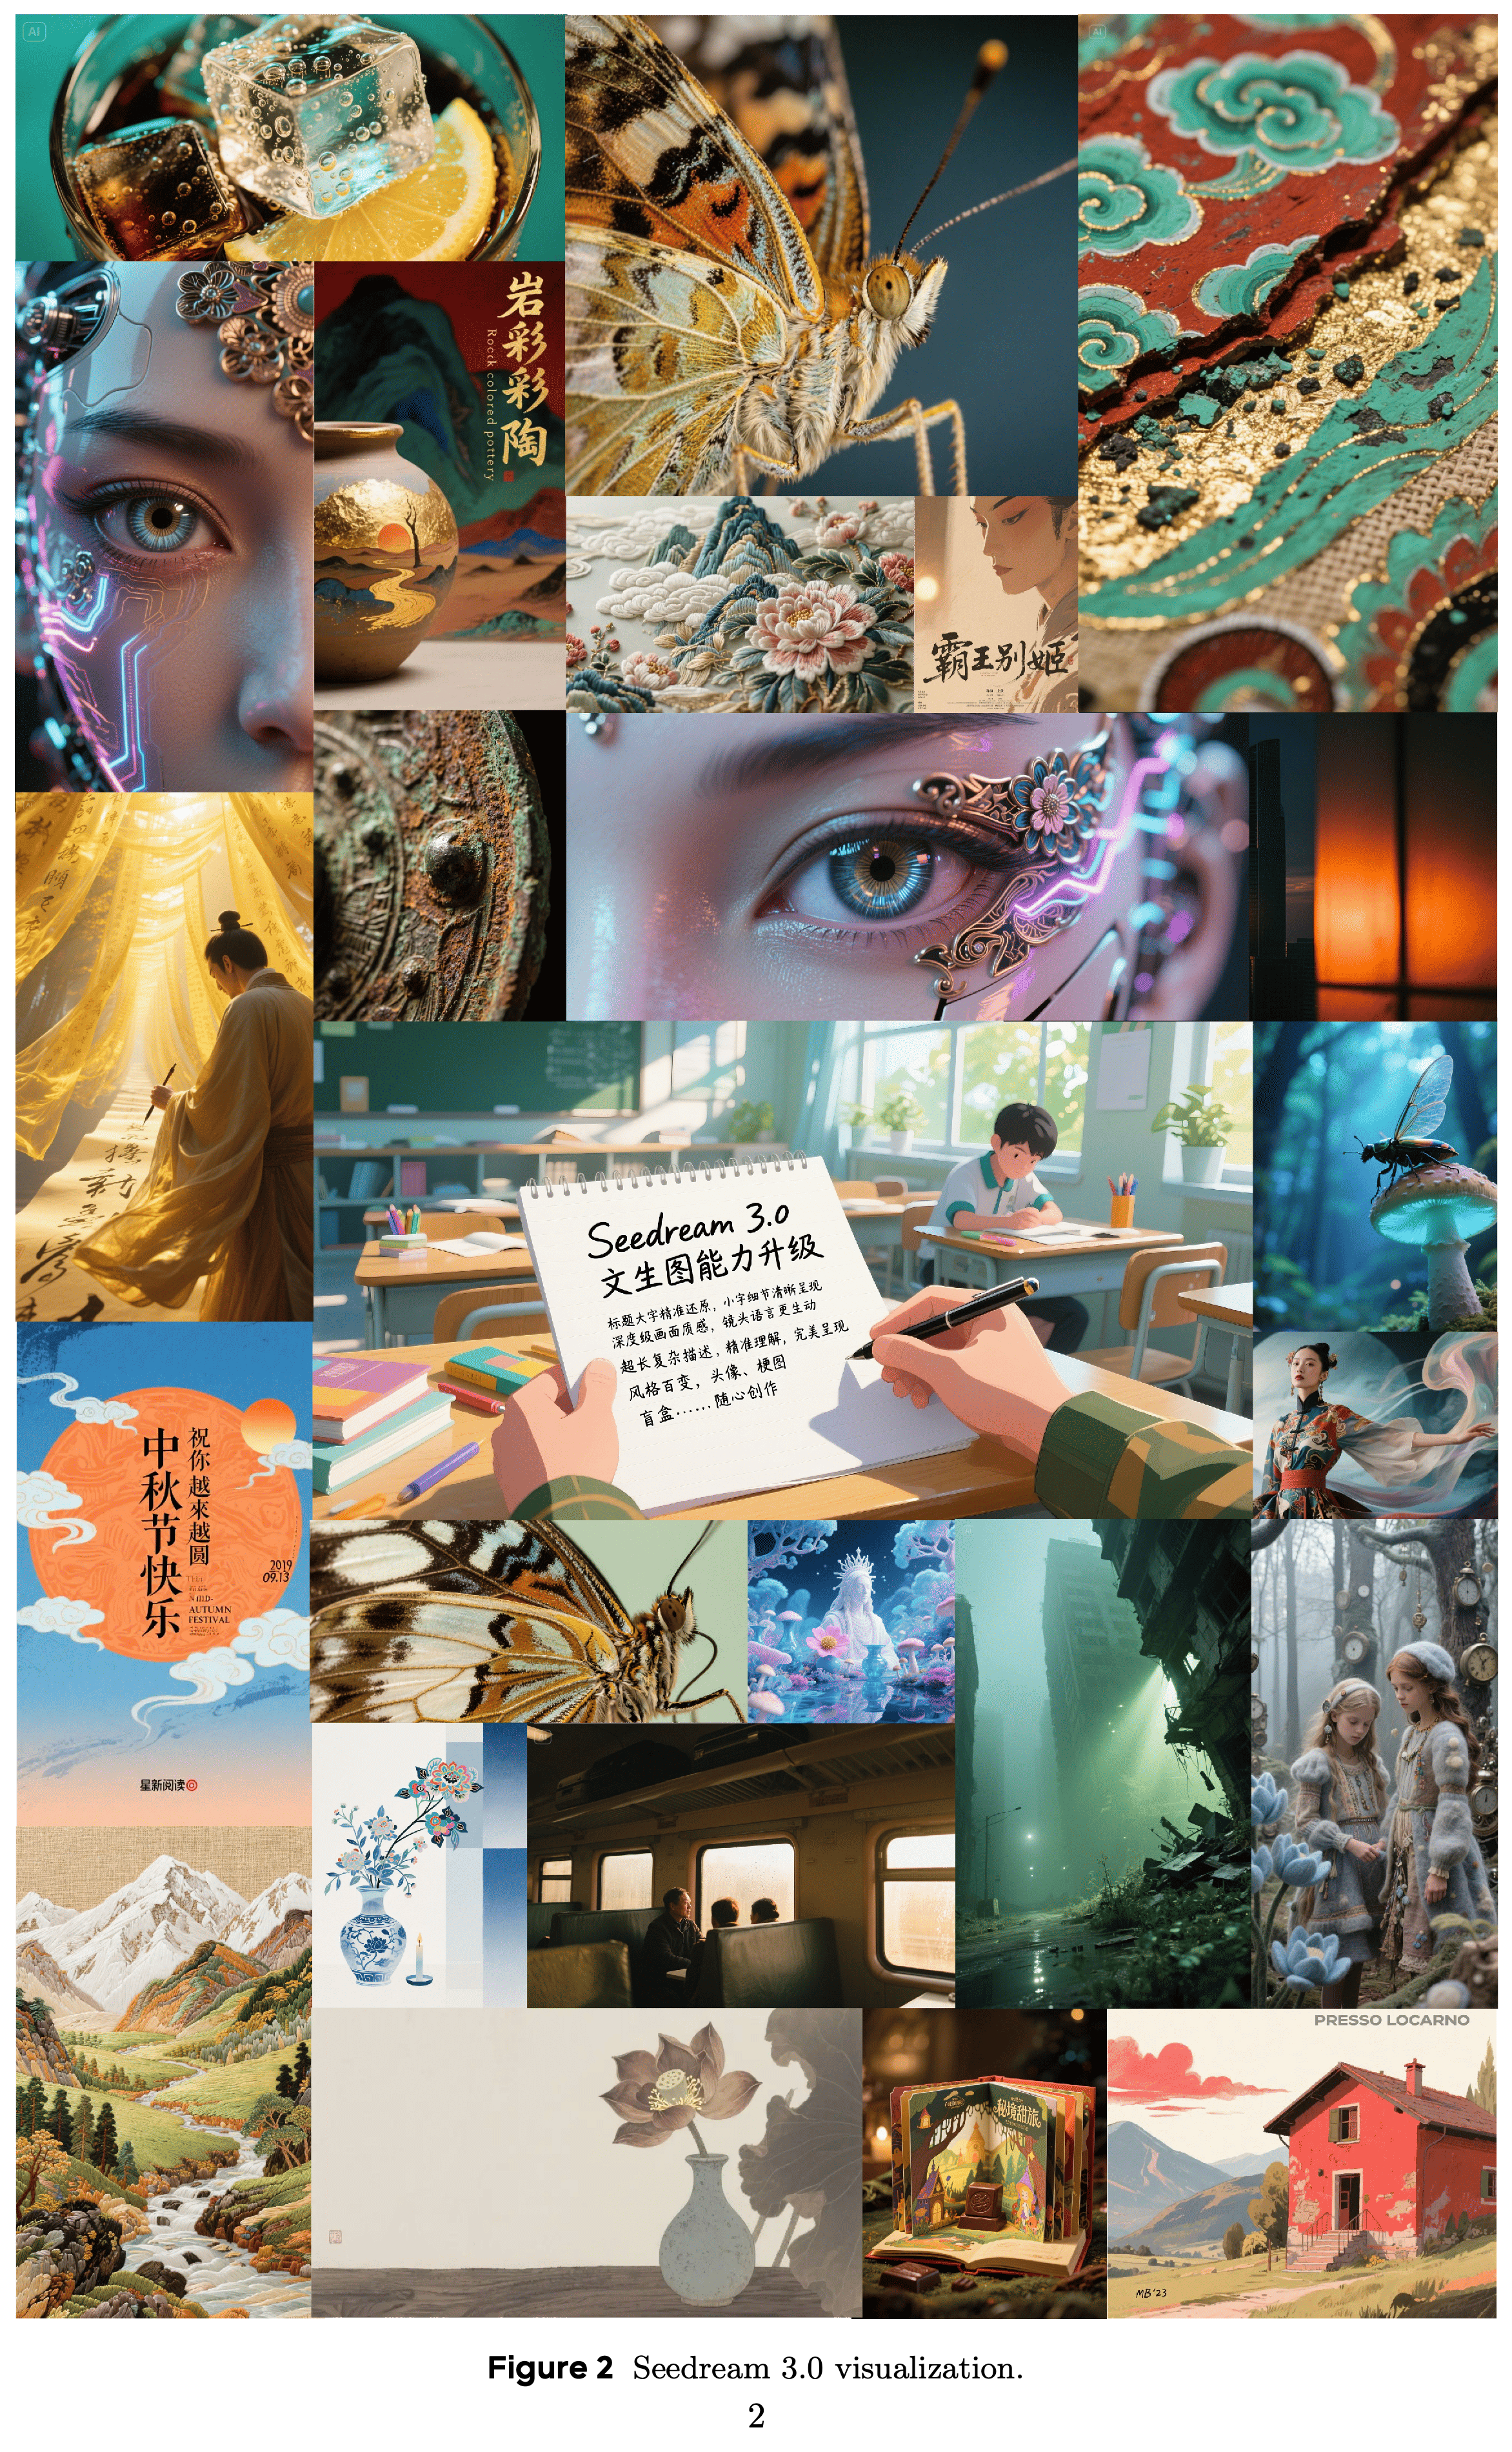
콜라주는 세밀한 질감, 중국어 타이포그래피, 사실적인 얼굴, 일러스트, 풍경을 보여준다. 목표로 하는 출력 범위를 예시하지만 프롬프트 전반의 일관성을 측정하지는 않는다.
2 Technical Details
기술 파이프라인은 결함이 있는 이미지에서 사용 가능한 영역을 활용하고, 시각 및 텍스트 학습 분포의 균형을 맞추며, 이미지와 텍스트의 공동 모델링을 개선한다. 또한 출력을 인간 선호에 맞추고 샘플링 연산량을 줄인다. 이어지는 하위 절에서 각 구성 요소를 설명하지만, 다른 조건을 통제한 제거 실험으로 개별 기여도를 정량화하지는 않는다.
2.1 Data
결함 인지 학습은 탐지된 결함이 이미지 면적의 20% 미만인 이미지를 유지한다. 이 임계값은 조정할 수 있다. 학습에 사용하는 압축 이미지 공간인 잠재 표현에서 손실을 계산할 때는 결함 영역의 기울기를 제외한다. 능동 학습으로 선별하고 사람이 주석을 단 샘플 15,000개로 학습한 탐지기가 워터마크, 겹쳐진 텍스트, 자막, 모자이크 패턴의 위치를 찾는다. 이 절차로 실제 학습에 사용할 수 있는 데이터셋이 21.7% 늘어난다.
- 이전 필터링 정책은 원본 수집 데이터의 약 35%에 해당하는 결함 포함 샘플을 제외했다. 결함 인지 학습에 따른 21.7% 확대는 전체 데이터 파이프라인이 데이터셋을 대략 배가한다는 더 포괄적인 주장과 구분된다.
- 이중 축 샘플링은 이미지를 여러 수준으로 묶는 계층적 클러스터링으로 시각 패턴의 균형을 맞춘다. 텍스트 의미의 균형은 용어 빈도와 문서 간 희소성에 따라 가중치를 부여하는 term frequency and inverse document frequency (TF-IDF)로 조정한다.
- 공유 이미지-텍스트 검색 공간은 유사도 검색을 위해 이미지와 설명 쌍을 표현한다. 특정 개념 검색, 유사도에 따른 가중 샘플링, 인접 이미지-텍스트 쌍을 활용한 데이터 개선을 지원한다. 보고서는 검색 성능이 우수하다고 주장하지만 수치 결과는 제시하지 않는다.
2.2 Model Pre-training
2.2.1 Model Architectures에서는 이미지와 텍스트 토큰을 함께 처리하는 멀티모달 확산 Transformer인 MMDiT를 유지하고 기본 모델의 파라미터 수를 늘린다. 모델 크기는 공개하지 않는다. 확산 모델은 노이즈를 추가하는 과정을 역으로 수행해 이미지를 생성한다. 혼합 해상도 학습은 해상도와 종횡비가 다른 이미지를 묶어 처리한다. 평균 해상도 256²에서 시작해 512²~2048² 이미지로 학습을 이어가며, 크기 임베딩으로 목표 해상도를 모델에 추가 입력한다.
- Cross-modality RoPE는 이미지와 텍스트 토큰에 함께 적용하는 회전 위치 임베딩이다. 텍스트를 [1,L] 형태의 2차원 시퀀스로 나타내며, L은 텍스트 시퀀스 길이다. 텍스트의 열 위치는 대응하는 이미지 위치 뒤에 연속해서 배정해 각 모달리티 내부와 모달리티 사이의 관계를 표현한다.
2.2.2 Model Training Details에서는 이미지에서 노이즈로 보간하는 경로의 속도를 학습하는 flow matching과 표현 정렬 손실(REPA)을 결합한다. REPA는 코사인 거리를 사용해 모델의 중간 특징을 사전 학습된 DINOv2-L 비전 인코더의 특징에 맞춘다. REPA 손실 가중치는 \(\lambda = 0.5\)이며, 보간식은 \(\mathbf{x}_t=(1-t)\mathbf{x}_0+t\epsilon,\quad \epsilon\sim\mathcal{N}(\mathbf{0},I)\)다.
- 여기서 x_0는 깨끗한 이미지 표현, t는 보간 타임스텝, ε는 가우시안 노이즈다. DINOv2-L은 정렬 목표로 사용할 시각 특징을 제공한다.
- 해상도 인지 타임스텝 샘플링은 정규분포 변수를 타임스텝 구간으로 변환한 logit-normal 분포에서 시작한다. 해상도가 높을수록 신호 대 잡음비가 낮은 쪽으로 분포를 이동한다. 학습에는 데이터셋의 평균 해상도를 사용하고, 추론에는 요청한 해상도와 종횡비를 사용한다.
- 저자들은 표현 정렬로 수렴이 빨라졌다고 보고하지만, 수치 비교는 제시하지 않는다.
2.3 Model Post-training
사후 학습은 사전 학습 이후 학습을 이어가는 Continuing Training (CT), 이미지-캡션 예제로 지도 학습하는 Supervised Fine-Tuning (SFT), 출력을 인간 선호에 맞추는 Human Feedback Alignment (RLHF), PE로 구성된다. 모델이 명시된 범위인 512²~2048² 이미지를 직접 생성하므로, 출력 해상도를 높이기 위한 별도 Refiner 단계는 생략한다.
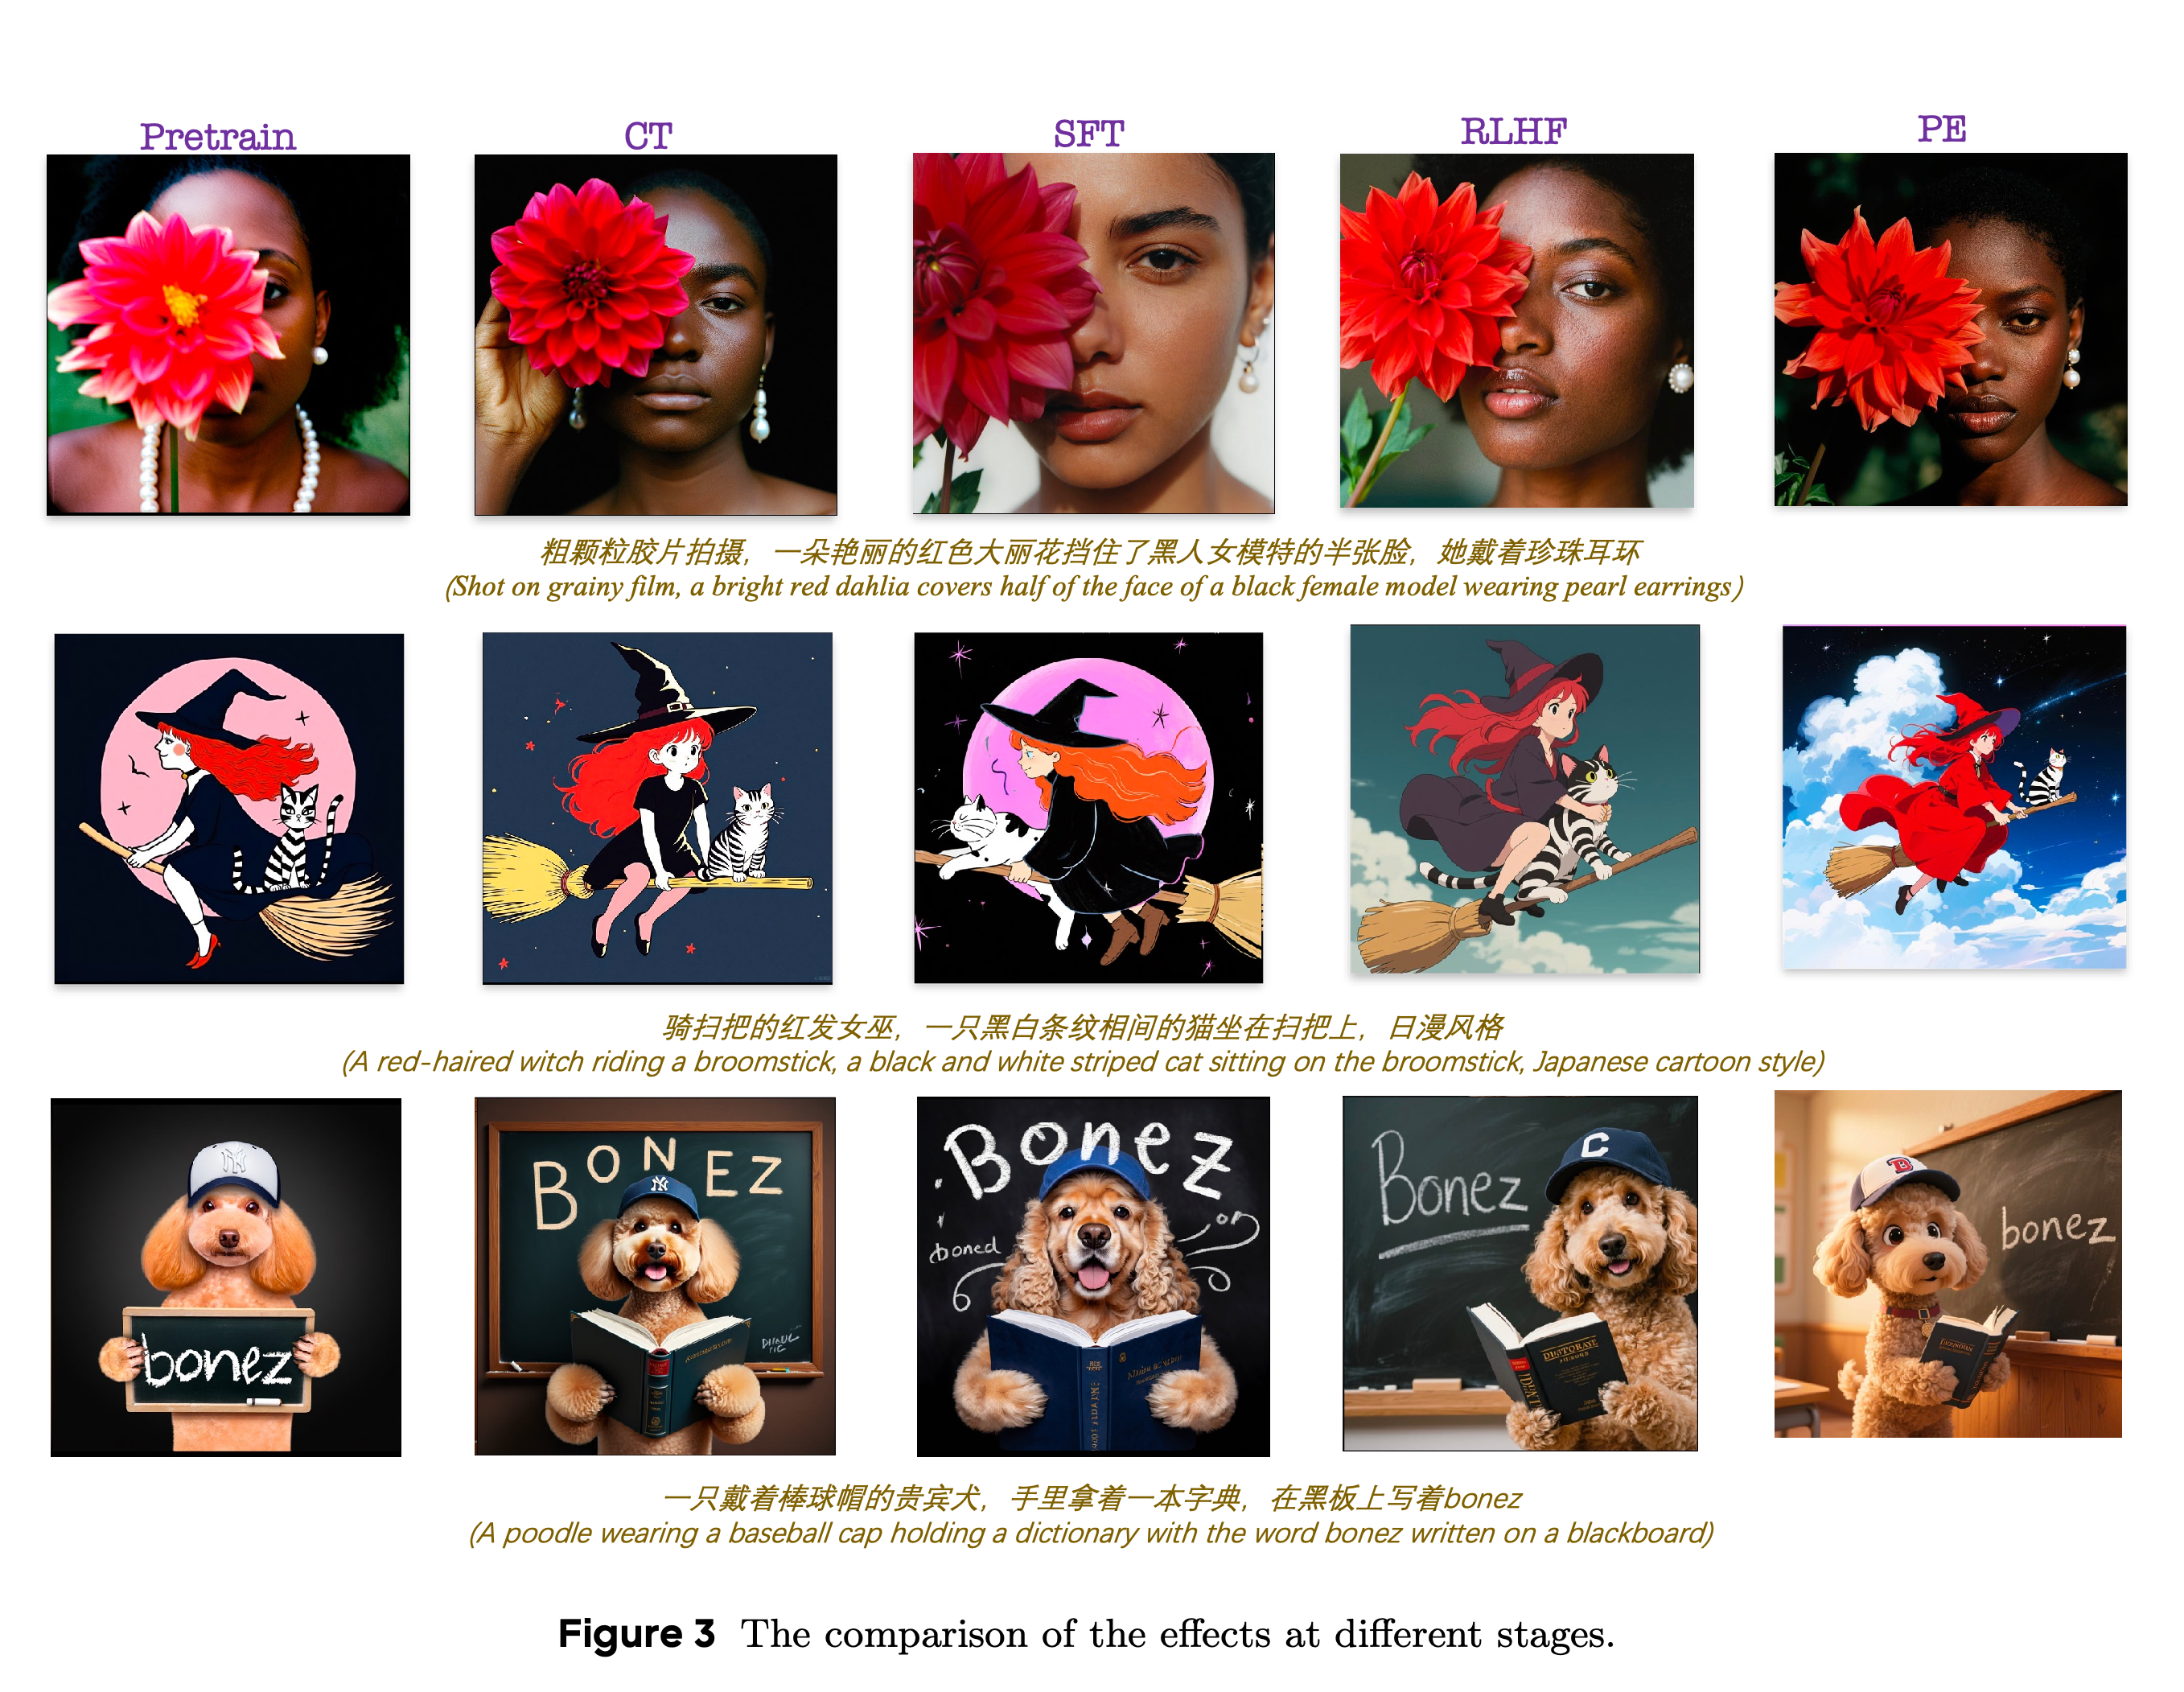
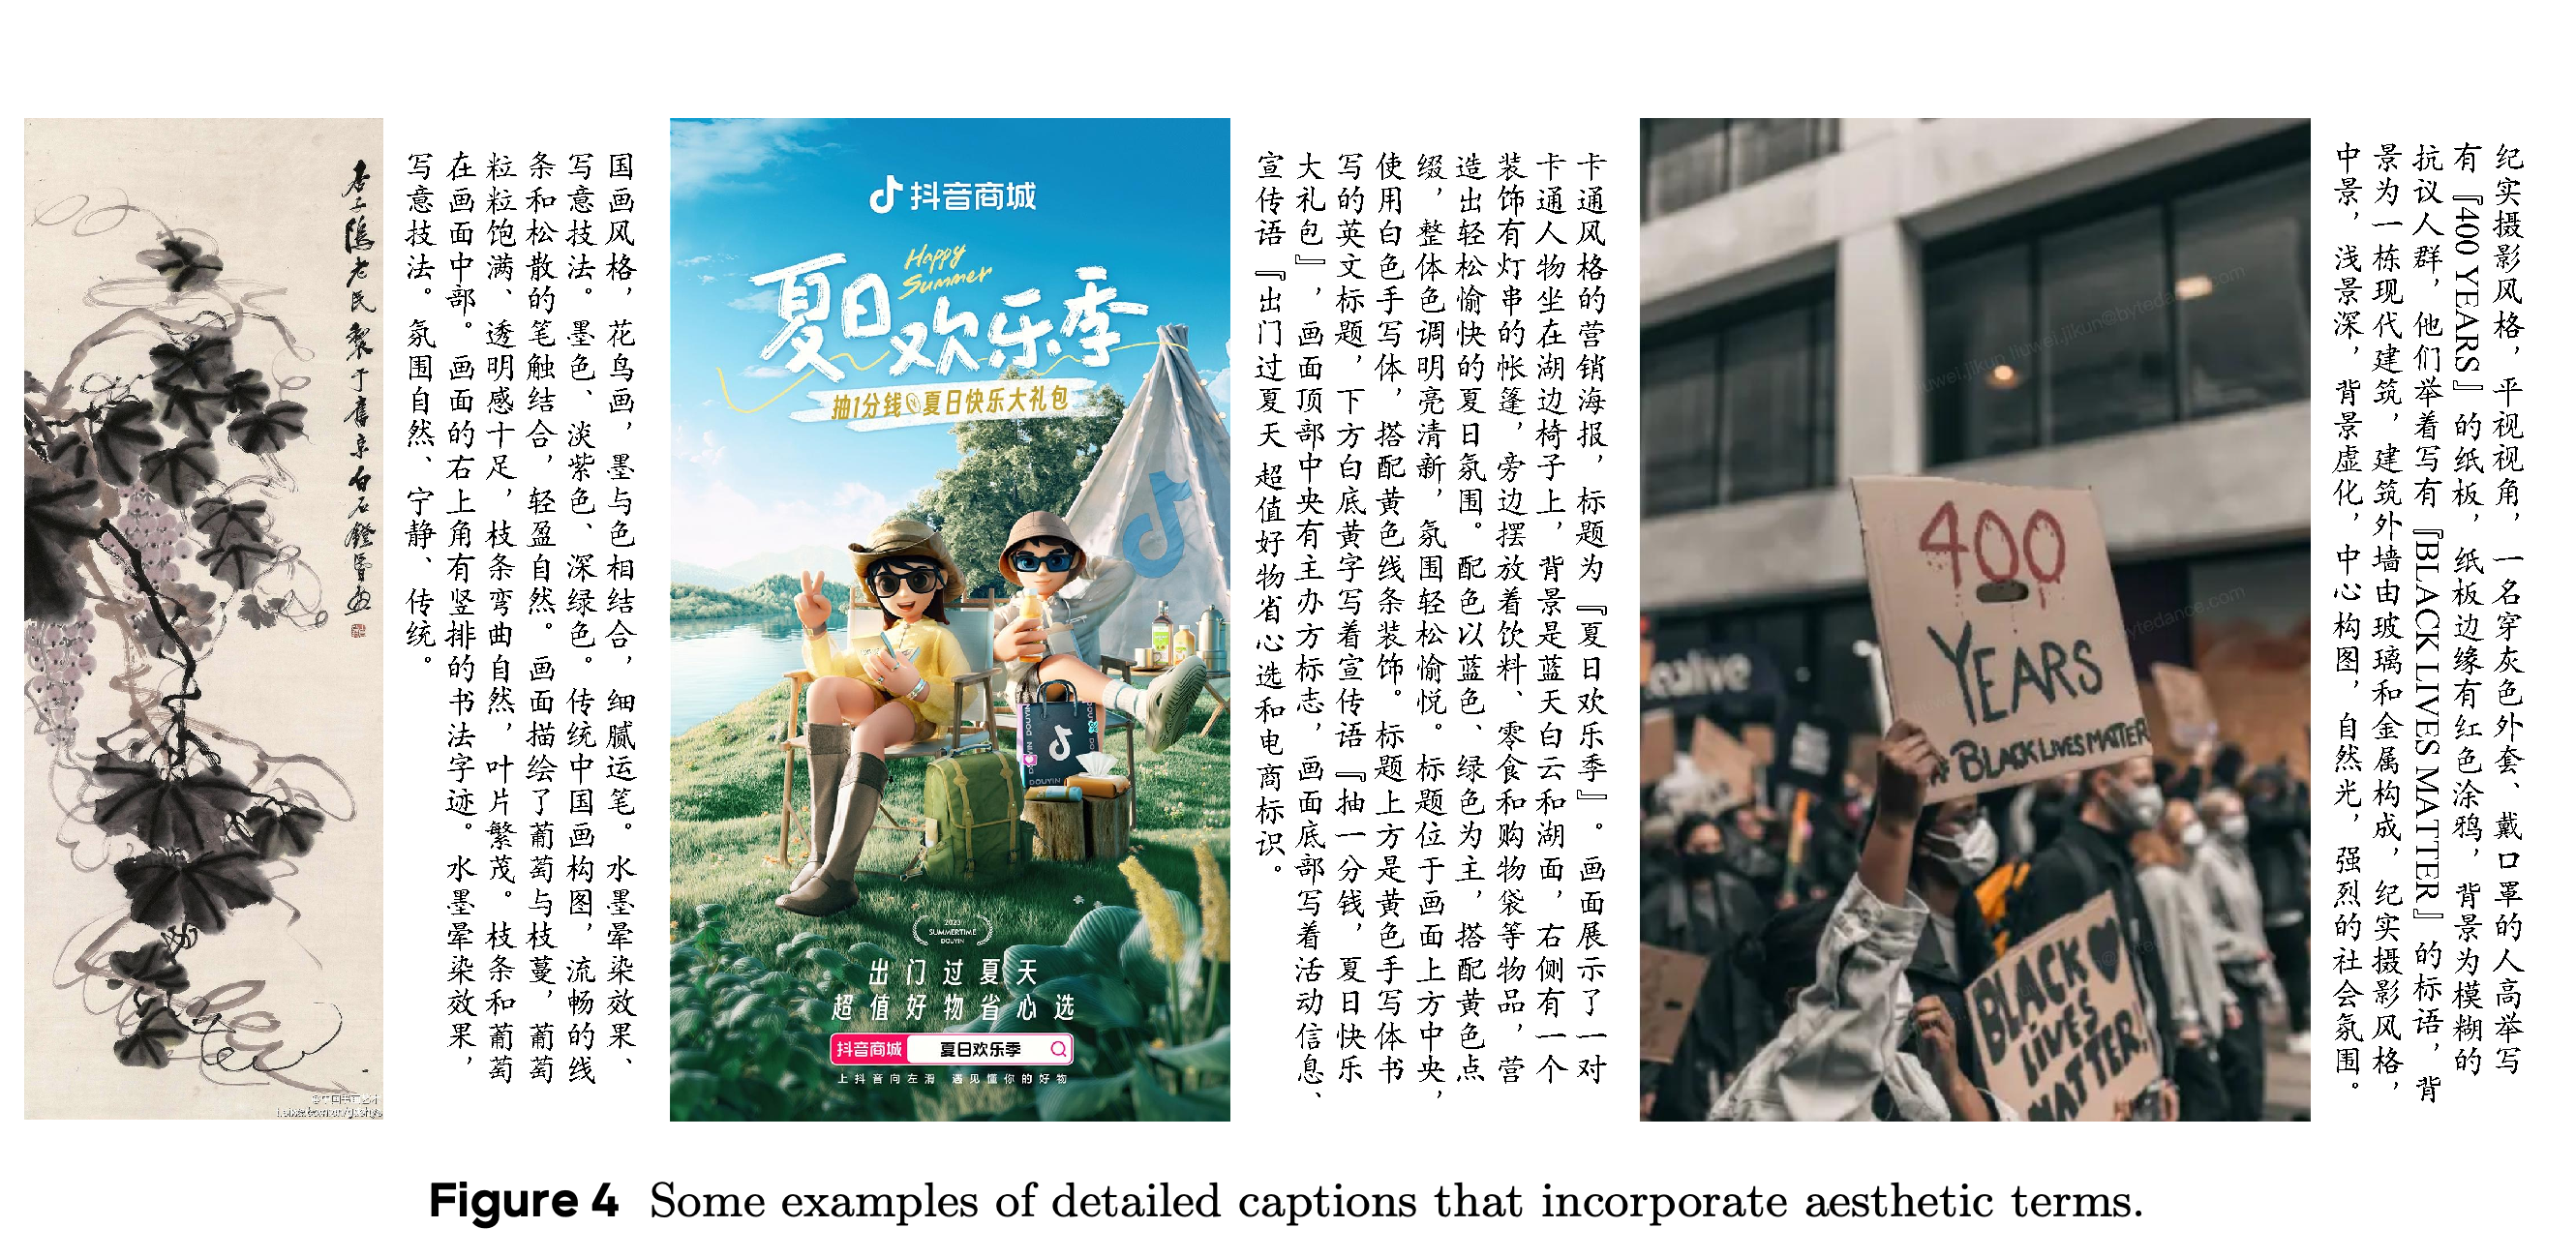
- 2.3.1 Aesthetic Caption에서는 여러 버전의 캡션 모델로 CT와 SFT 데이터의 미감, 스타일, 배치를 묘사한다. Figure 3은 학습 단계에 따른 변화를 보여주며, Figure 4는 이러한 묘사의 예시를 제시한다.
- 2.3.2 Model Training Details에서는 다양한 출력 크기에서 프롬프트를 잘 따르도록 해상도별 학습 데이터의 샘플링 비율을 조정한다.
프롬프트 3개를 Pretrain, CT, SFT, RLHF, PE 단계별로 제시해 파이프라인을 거치며 이미지의 외관과 프롬프트 준수가 어떻게 달라지는지 보여준다. 이 예시들은 각 단계의 평균 기여도를 분리해 보여주지는 않는다.
2.3.3 Reward Model Scaling에서는 기존 CLIP 이미지-텍스트 보상 모델을 이미지와 텍스트를 함께 처리하는 Vision-Language Models (VLMs)로 교체한다. 보상 모델은 선호 정렬을 유도할 점수를 부여한다. 지시문을 질의로 사용하고, 응답 토큰 “Yes”의 정규화된 확률을 보상으로 삼는다. 보상 모델의 크기는 1B에서 >20B 파라미터로 늘어난다. CLIP에 대해서는 CLIP 논문 리뷰(Learning Transferable Visual Models From Natural Language Supervision) 글을 참조하라.
- 저자들은 보상 모델이 커질수록 보상 모델링 성능이 개선된다고 보고하지만, 스케일링 곡선이나 수치 비교는 제시하지 않는다.
캡션은 구도, 색상, 매체, 배치, 장면 내용을 구체적으로 묘사한다. 계속 학습과 지도 미세 조정에 제공하는 미적 정보가 무엇인지 보여준다.
2.4 Model Acceleration
가속은 일관성 기반 이미지 생성 방법인 Hyper-SD와 샘플별로 생성 경로를 조정하는 RayFlow를 바탕으로 한다. 각 샘플은 해당 샘플에 맞는 목표 분포를 향하는 경로를 따른다. 사전 학습된 모델이 추정한 통합 노이즈 기댓값 벡터는 타임스텝 전반에 걸친 기준을 제공해, 더 적은 노이즈 제거 단계로도 생성을 안정화한다.
- 타임스텝 분포를 학습할 때는 통계적 불일치 척도인 Stochastic Stein Discrepancy (SSD)와 신경망을 결합해 학습 손실을 더 줄일 것으로 예상되는 타임스텝을 우선한다.
- 저자들은 함수 평가 횟수인 Number of Function Evaluations (NFE)가 50인 비가속 기준 모델과 같거나 더 나은 품질을 보고한다. 이는 샘플링 과정에서 모델 평가 50개를 수행한다는 뜻이다. 초록은 4~8 times의 속도 향상을 보고하지만, 본문은 가속 후 샘플링 횟수나 상세한 품질과 지연 시간 비교를 제시하지 않는다.
- 수치 정밀도를 낮추는 양자화 등 다른 가속 구성 요소는 Seedream 2.0을 따른다.
3 Model Performance
평가는 공개 선호도 투표, 전문가 평가, 자동 채점, 중국어와 영어 텍스트 렌더링 테스트, 인물 이미지 비교를 결합한다. Figure 1은 서로 다른 평가 결과를 요약하고, Figure 2는 생성된 질감, 타이포그래피, 인물 이미지, 일러스트를 보여준다.
- 요약 레이더 차트에서는 누락된 Imagen 3의 인물 이미지 결과와 Seedream 2.0의 종합 결과를 다른 모델의 평균으로 대체한다. 이 2점은 직접 측정한 값이 아니다.
3.1 Artificial Analysis Arena
Artificial Analysis Arena는 동일한 프롬프트로 생성한 이미지를 익명 선호도 비교로 평가해 순위를 매긴다. 보고된 시점에서 Seedream 3.0은 Elo 1158, 95% 신뢰구간 −6/+6, 노출 횟수 17,092회다. GPT-4o는 Elo 1157, 신뢰구간 −5/+5, 노출 횟수 24,456회다.
- Seedream 3.0의 표시된 점추정치가 가장 높지만, 1점 차이와 겹치는 신뢰구간만으로 GPT-4o보다 명확히 우수하다고 판단할 수는 없다.
- 저자들은 사실적 표현, 일러스트, 전통 미술, 인물 이미지, 집단 활동, 물리적 공간 등 대부분의 스타일과 주제 범주에서도 앞선다고 보고한다. 이 주장은 논문 발표 당시 https://artificialanalysis.ai/text-to-image/arena?tab=Leaderboard 의 리더보드에 관한 것이다.
표시된 점추정치에서 Seedream 3.0은 GPT-4o보다 Elo 1점 앞선다. 서로의 95% 신뢰구간이 겹치므로, 표시된 순서만으로 명확한 격차를 입증하기에는 부족하다.
3.2 Comprehensive Evaluation
3.2.1 Human Evaluation에서는 영화적 장면, 예술, 엔터테인먼트, 미적 디자인, 실용 디자인을 아우르는 프롬프트 377개로 구성한 Bench-377을 소개한다. 전문가는 이미지가 프롬프트를 따르는지를 뜻하는 텍스트-이미지 정합성, 구조적 정확성, 미적 품질을 평가한다. 보고된 결과에서 Seedream 3.0은 정합성과 구조에서 앞서며, 전반적인 미적 품질도 Midjourney v6.1보다 높다. 다만 예술 등 일부 범주에서는 여전히 뒤처진다.
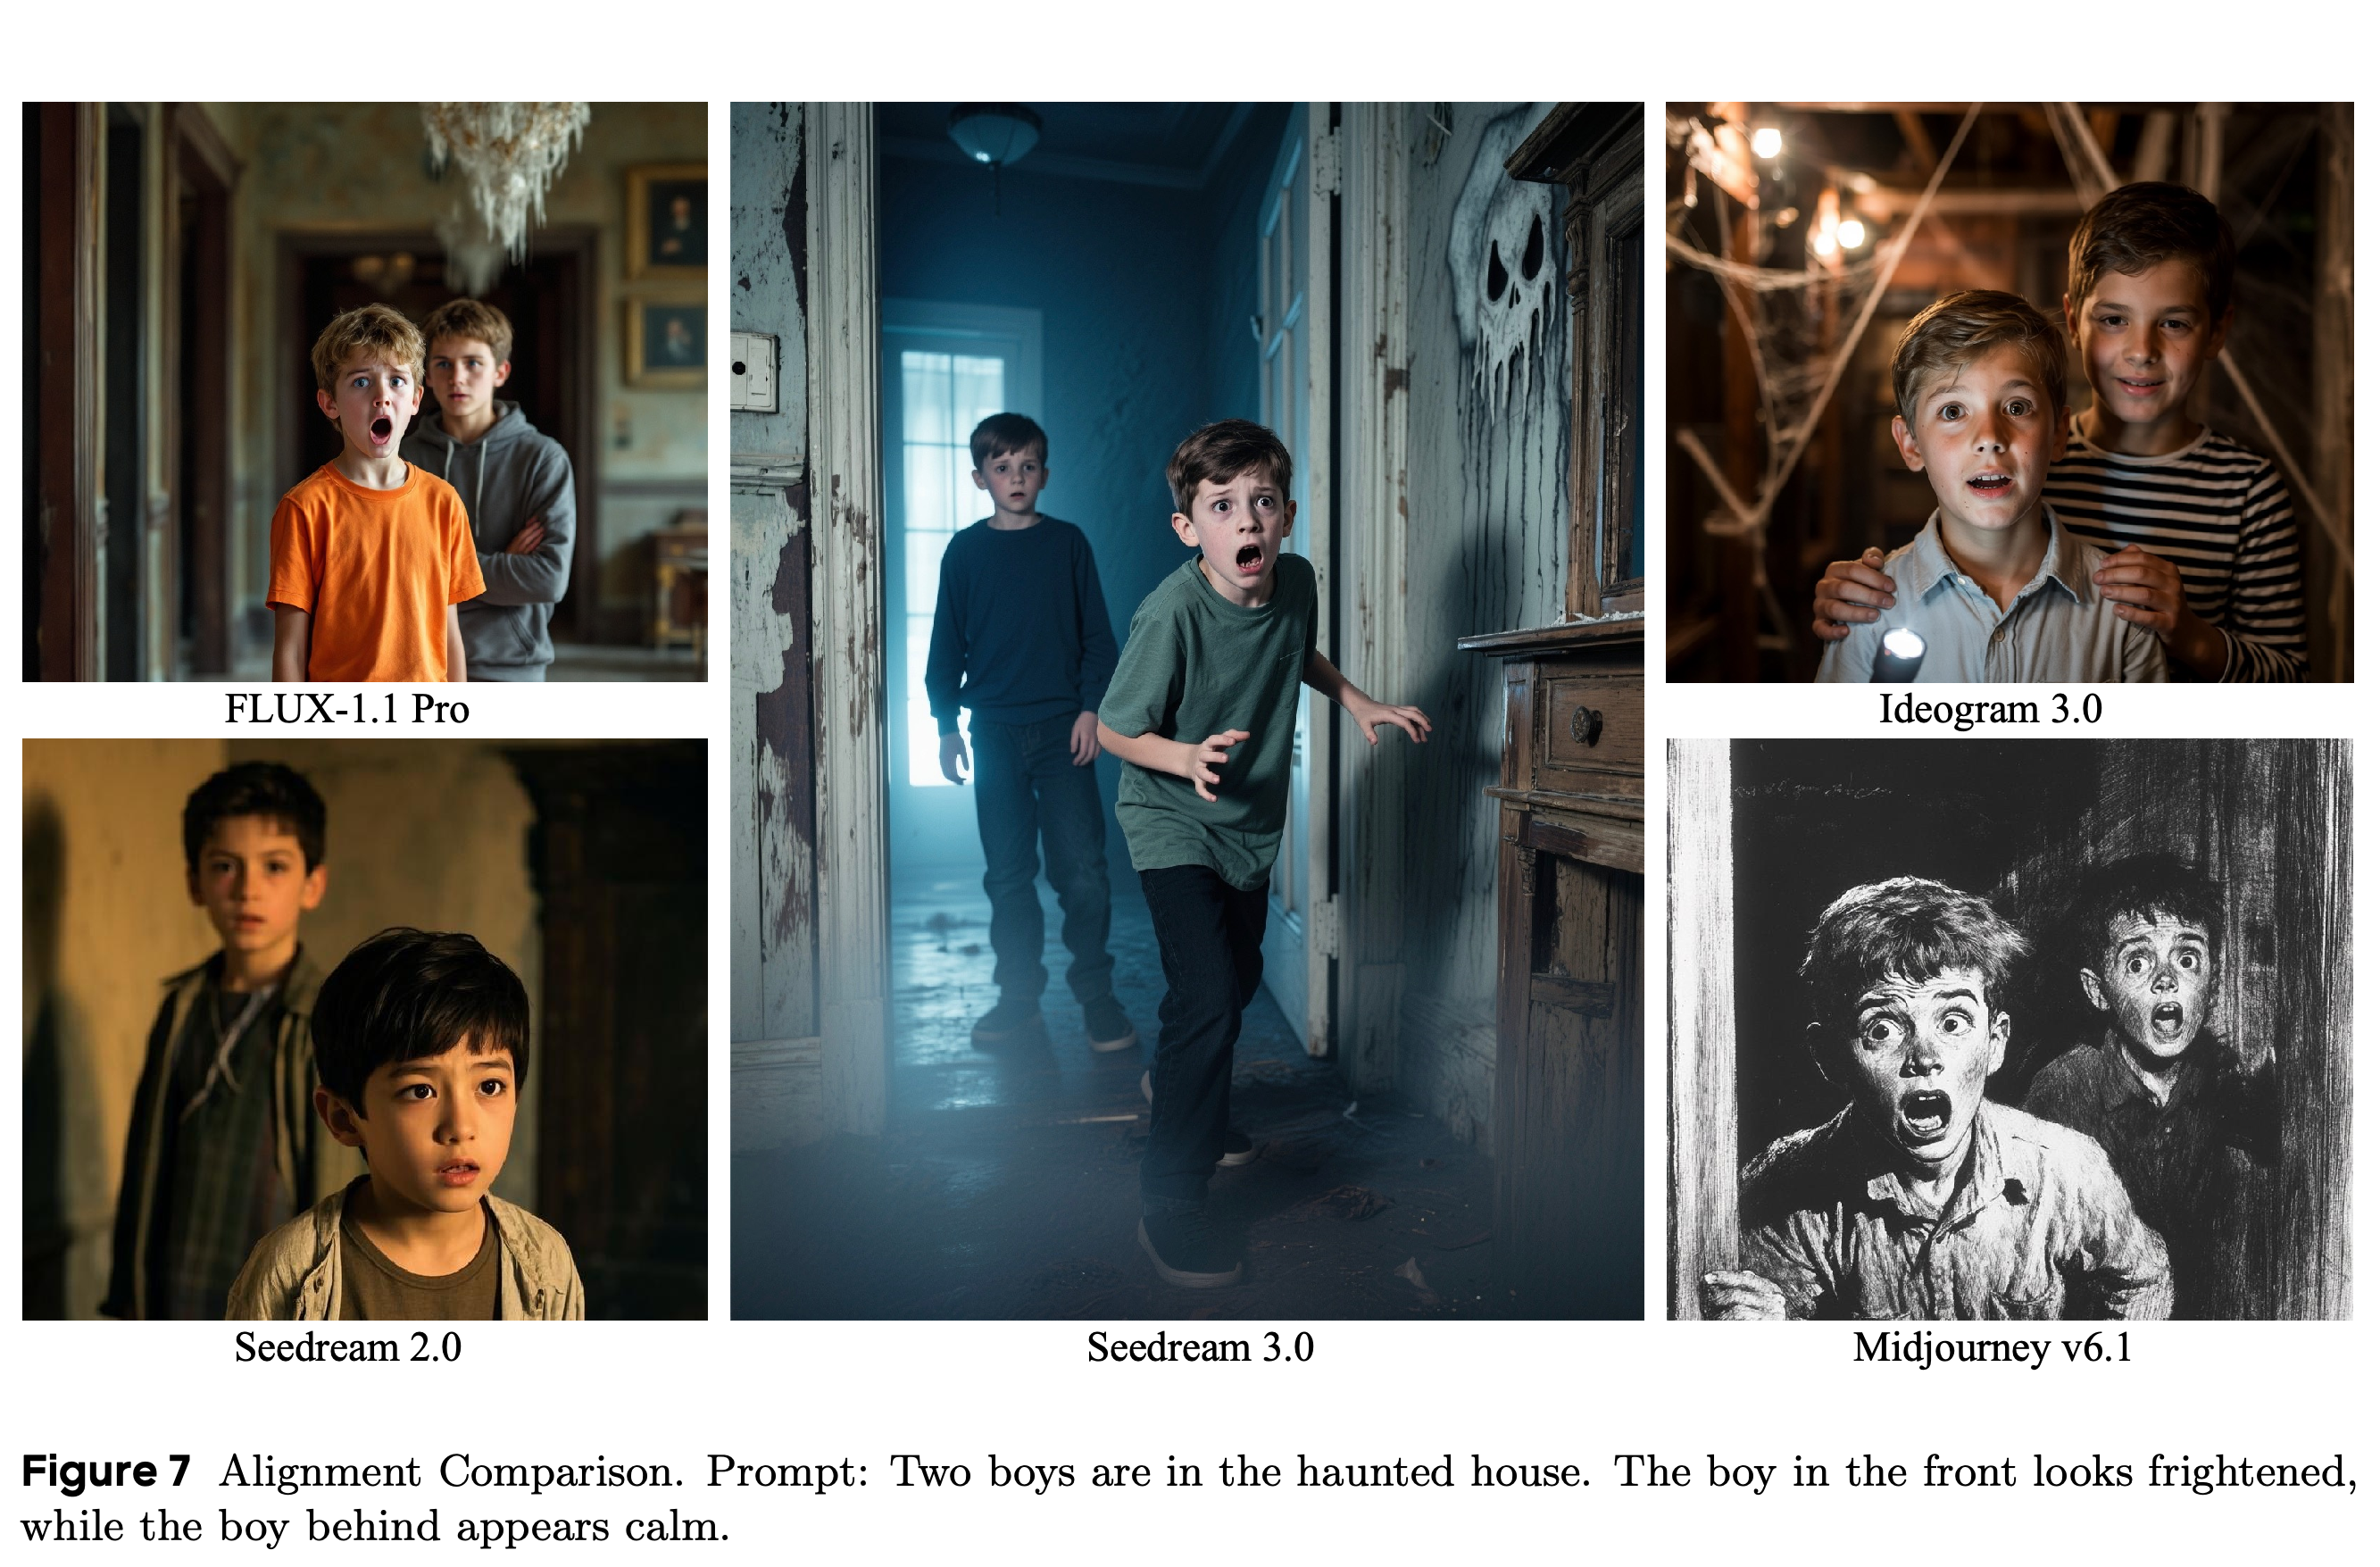
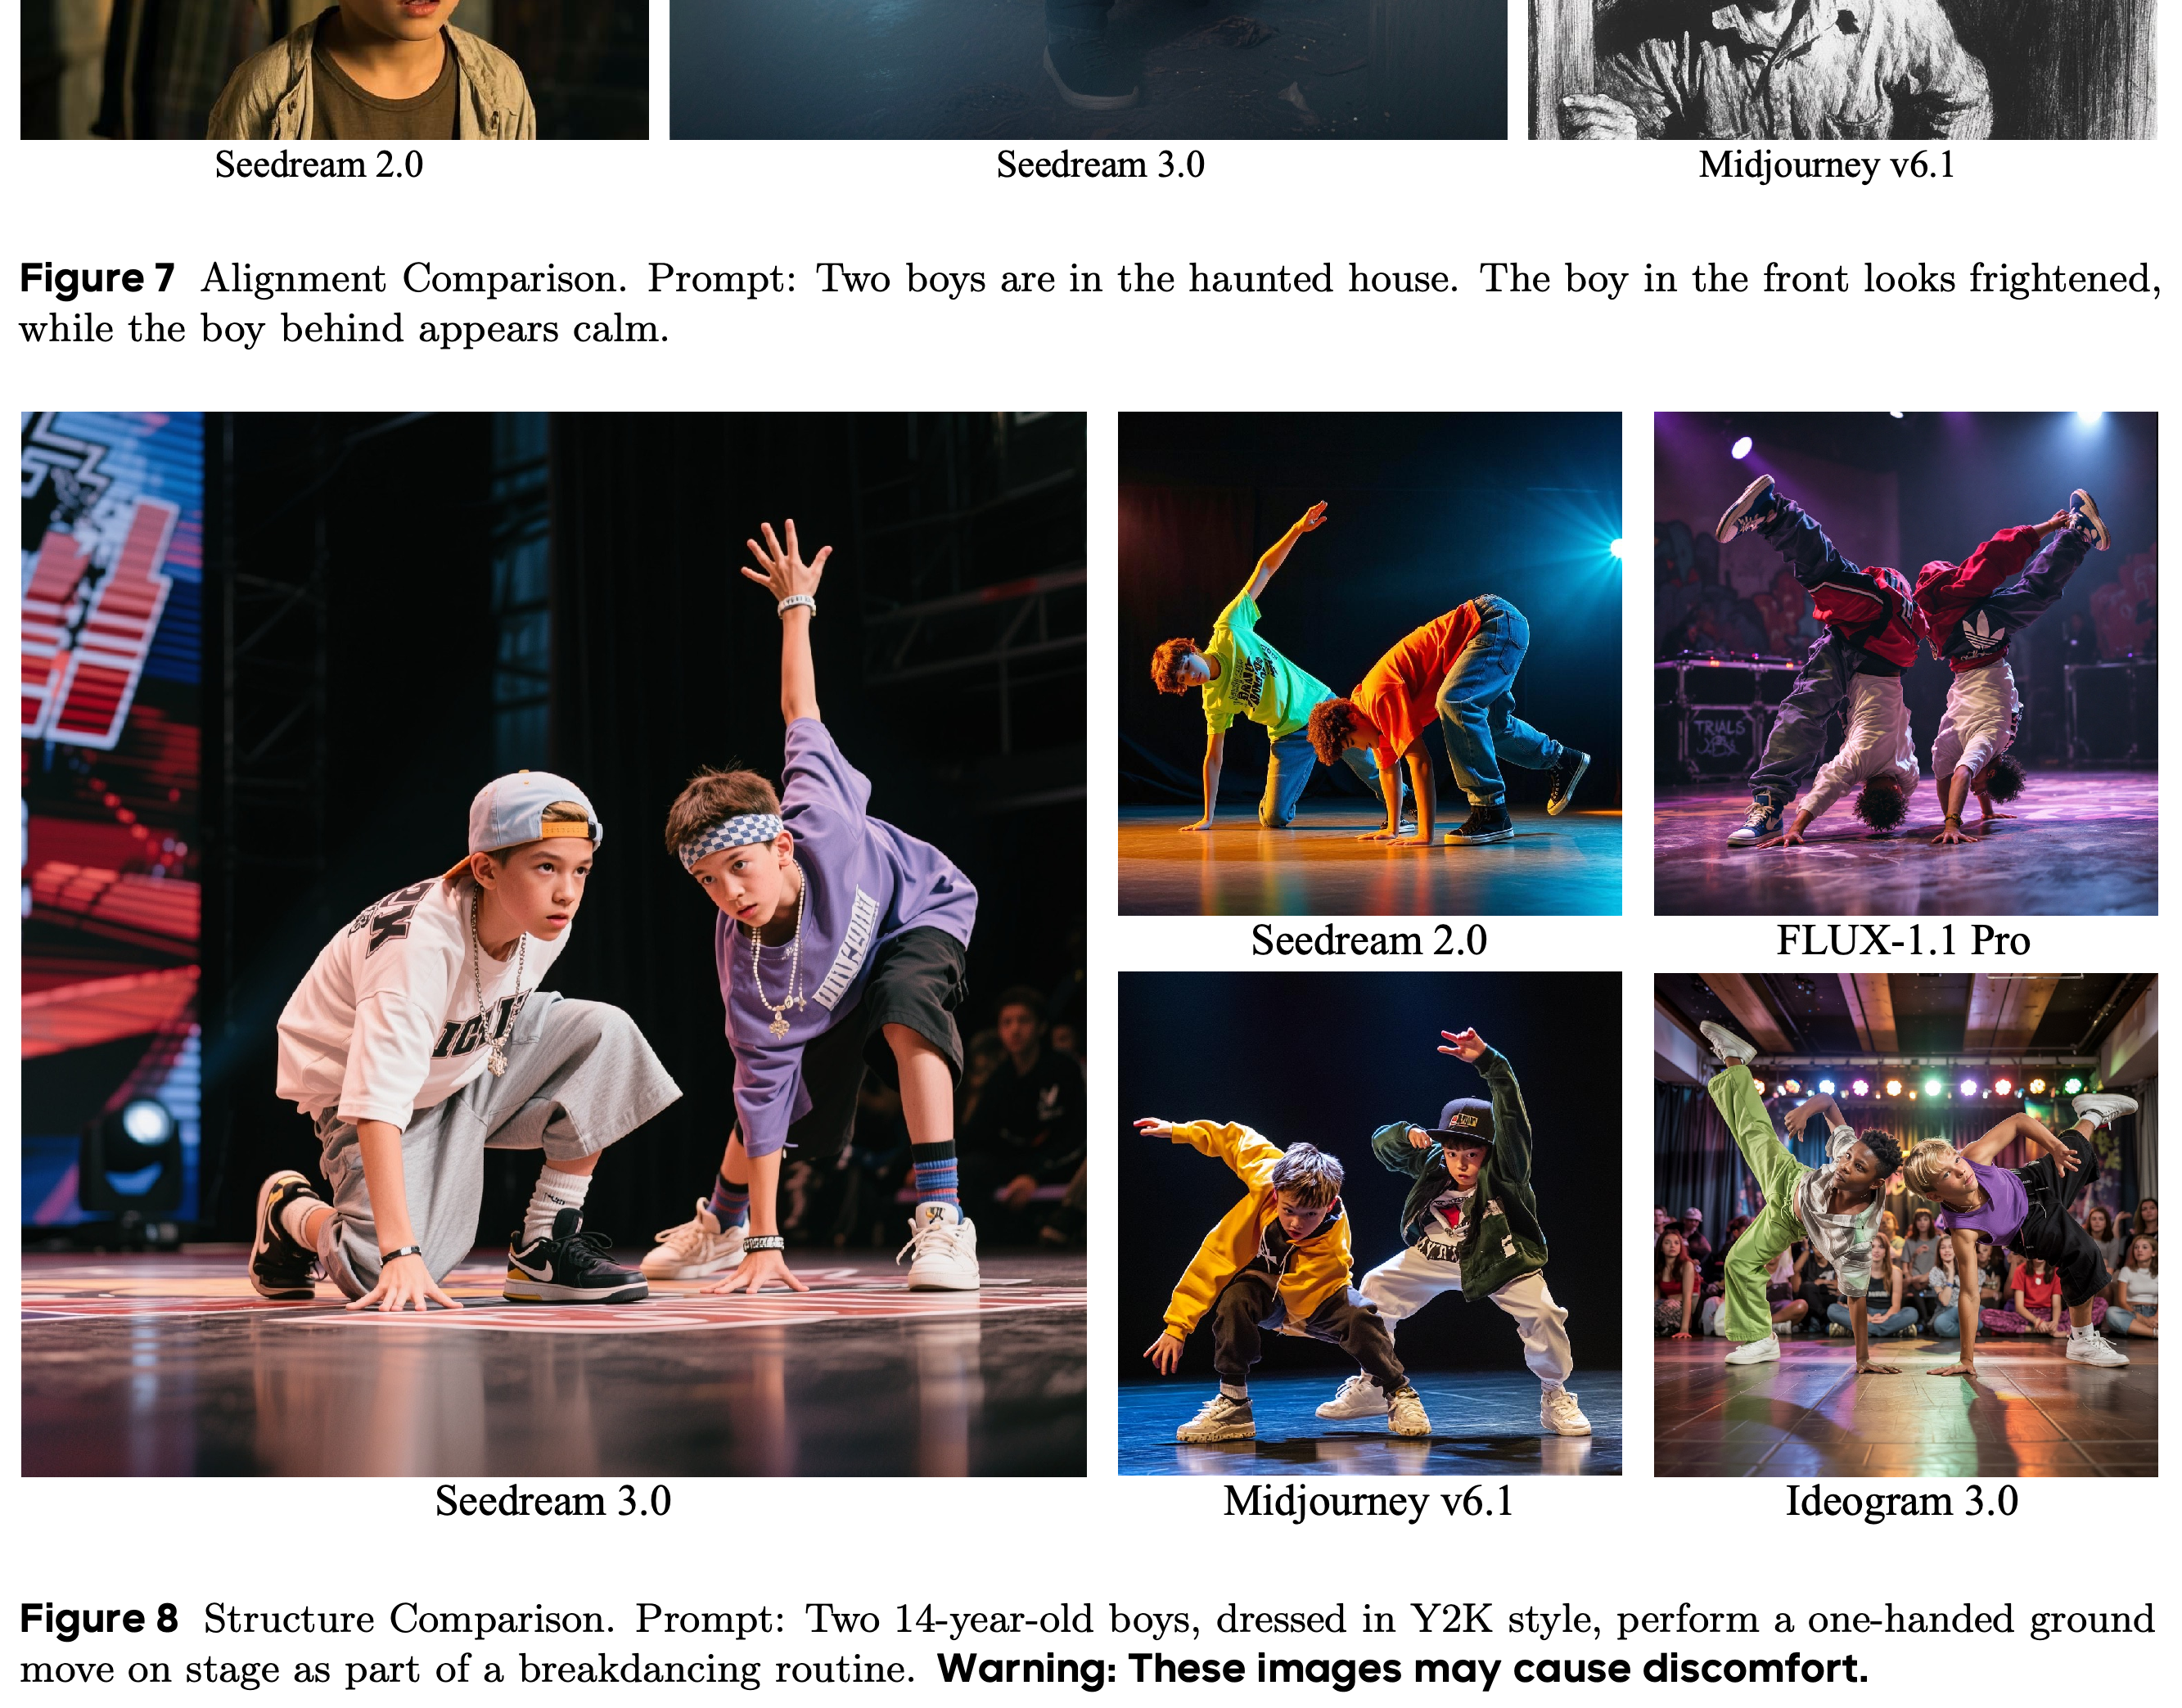
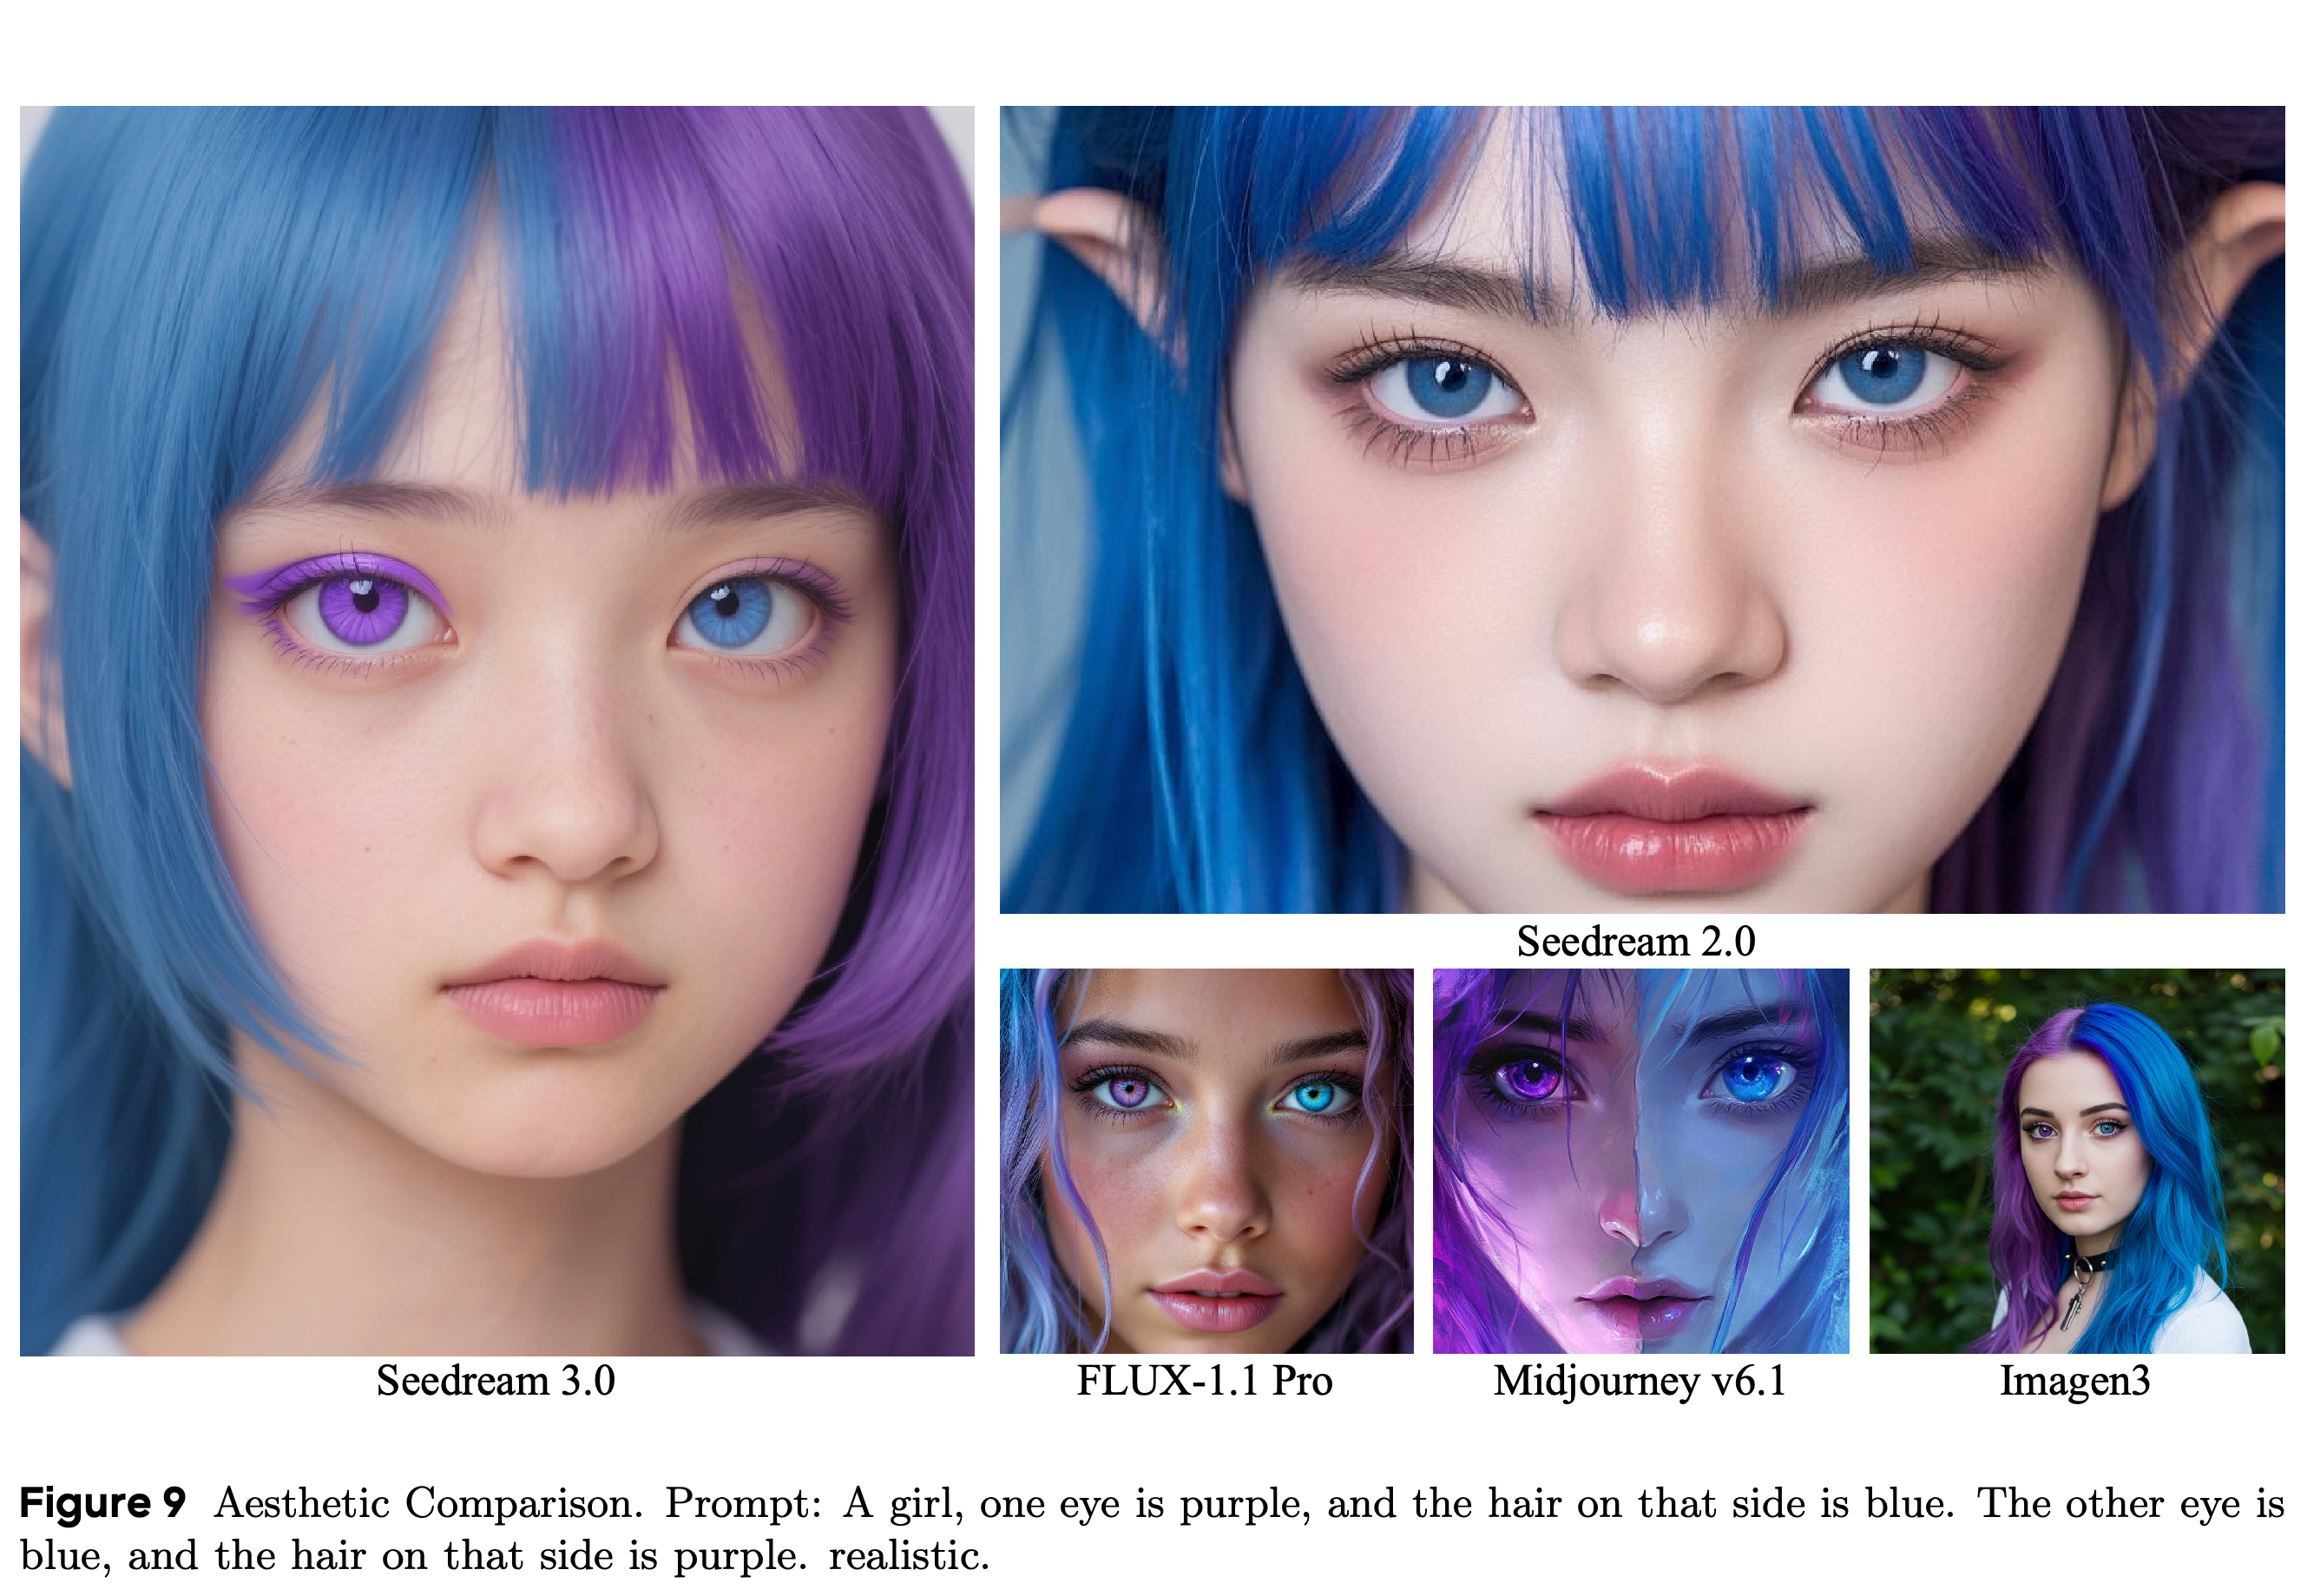
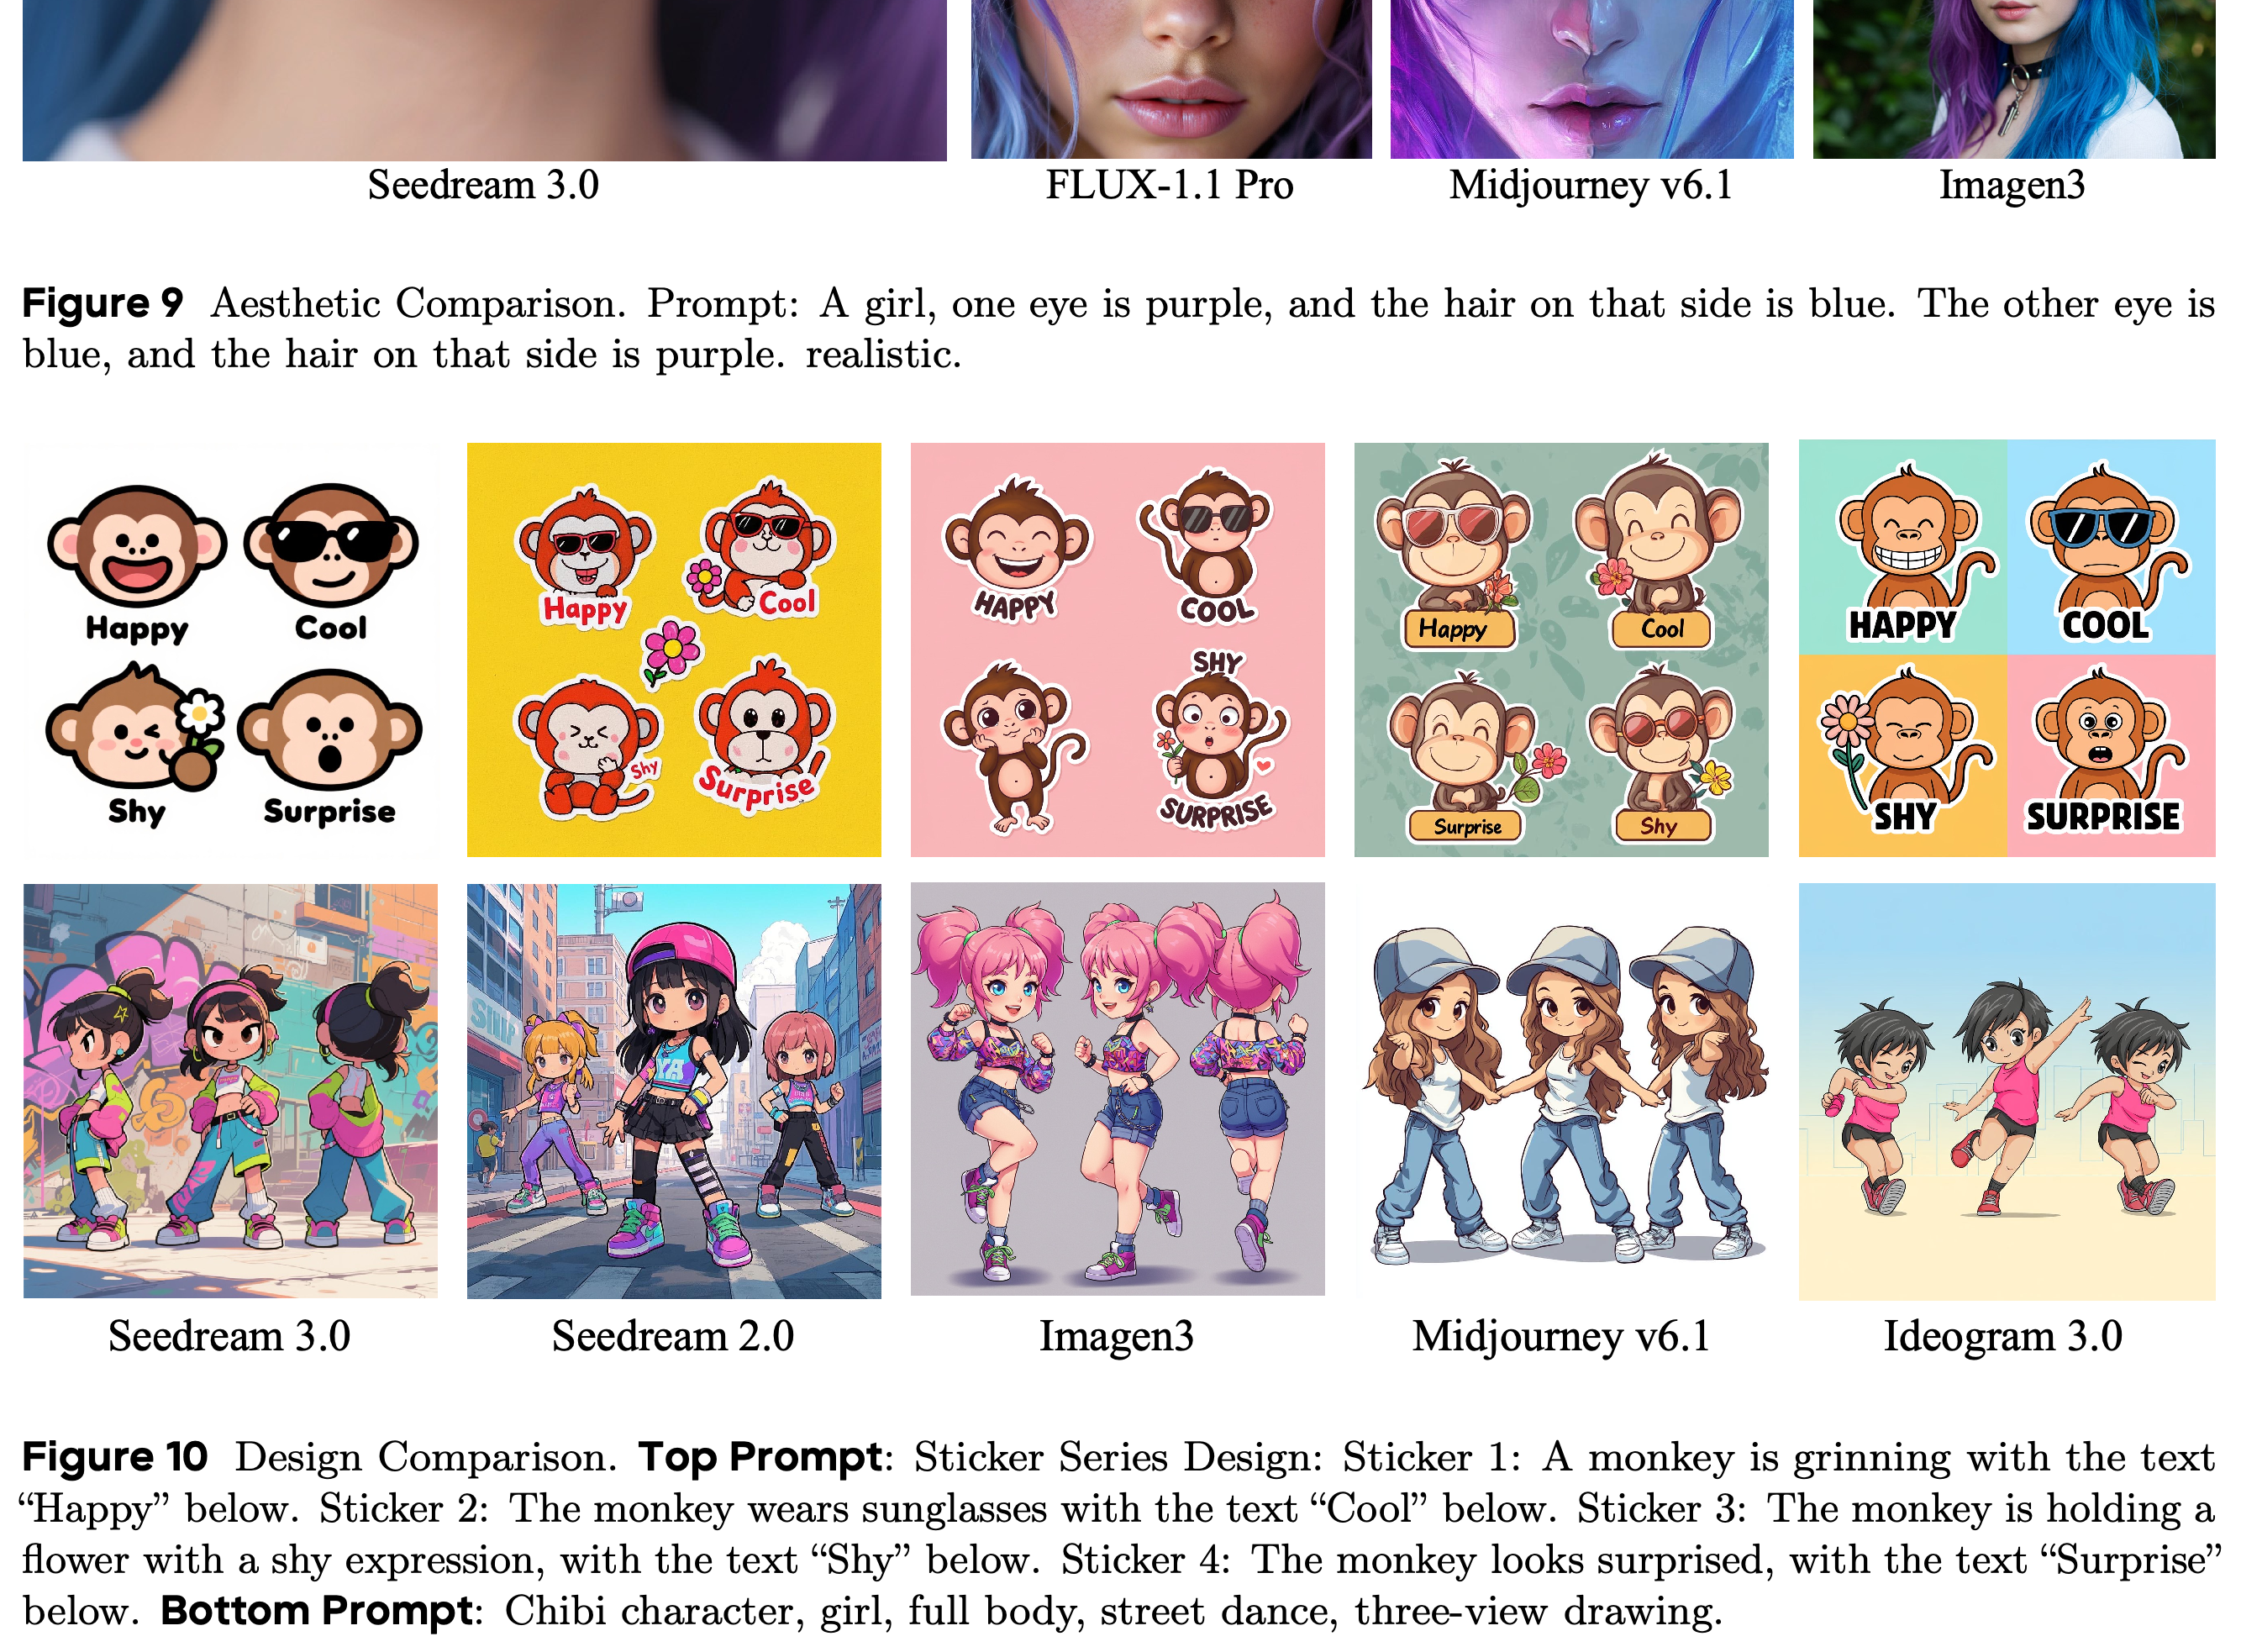
- Figures 7–10은 표정 지시 준수, 움직이는 신체의 해부학적 표현, 서로 연결된 색상 속성, 문구가 있는 스티커, 캐릭터를 3개 시점에서 그린 디자인을 보여준다. 이 사례들은 평가한 능력을 예시하지만 실패 빈도를 정량화하지는 않는다.
- 보고서는 Bench-377의 평가자 수, 평가자 간 일치도 통계, 불확실성 추정치를 제시하지 않는다.
레이더 차트는 Bench-377 시나리오 전반에서 정합성과 구조가 대체로 우세하다는 보고 결과를 보여준다. 미적 품질은 Midjourney v6.1과 더 비슷하며 시나리오에 따라 달라진다.
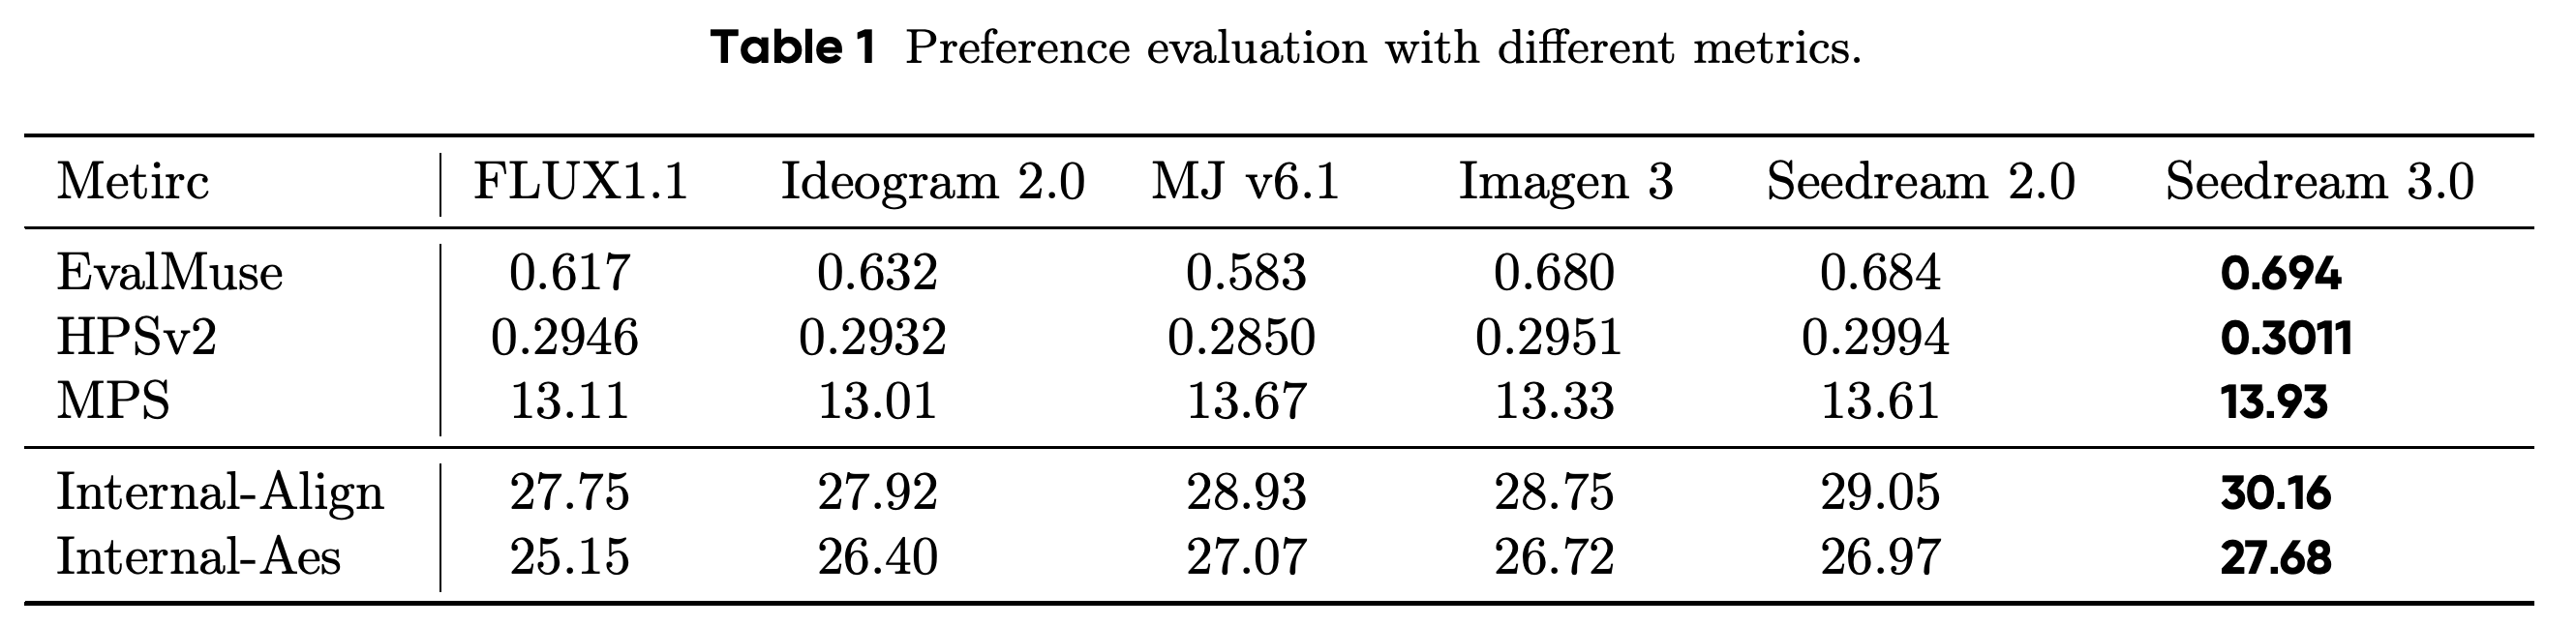
3.2.2 Automatic Evaluation에서는 제시된 모델 가운데 평가 지표 5개 모두에서 가장 높은 점수를 보고한다. 텍스트-이미지 정합성 평가기인 EvalMuse는 0.694, Human Preference Score v2인 HPSv2는 0.3011, 다차원 인간 선호 지표인 MPS는 13.93을 기록한다. 저자들의 정합성 평가기 Internal-Align과 미적 품질 평가기 Internal-Aes는 각각 30.16과 27.68을 기록한다. Seedream 2.0의 점수는 같은 순서로 0.684, 0.2994, 13.61, 29.05, 26.97이다.
- Table 1은 이전에 보고한 평가와의 연속성을 유지하기 위해 Ideogram 2.0을 사용하고, 인간 평가는 Ideogram 3.0을 사용한다.
- 표는 불확실성 없이 점추정치만 제시하므로, 표시된 순서는 확인할 수 있지만 차이의 통계적 유의성은 판단할 수 없다.
Seedream 3.0은 EvalMuse 0.694, HPSv2 0.3011을 포함해 지표 5개 모두에서 표시된 값이 가장 높다. 표에는 불확실성 추정치가 없으며, 인간 평가에 사용한 버전 대신 Ideogram 2.0을 사용한다.
프롬프트는 앞쪽 소년은 겁에 질리고 뒤쪽 소년은 침착한 모습을 요구한다. 출력은 모델이 같은 장면 안에서 서로 다른 표정과 공간적 역할을 유지하는지 보여준다.
선별된 브레이크댄스 출력은 팔다리 배치와 지면 접촉의 차이를 보여준다. 요청한 Y2K 스타일은 밀레니엄 전환기와 관련된 의류 스타일을 뜻한다.
프롬프트는 눈마다 다른 색을 지정하고, 같은 쪽 머리카락에는 눈과 반대되는 색을 지정한다. 이 예시는 사실적인 인물 이미지를 유지하면서 각 색상을 요청한 부위에 정확히 적용하는지 평가한다.
스티커 행은 표정이 “Happy”, “Cool”, “Shy”, “Surprise”에 맞는지 평가한다. 아래쪽 행은 비율을 과장한 캐릭터 표현인 chibi 캐릭터의 3개 시점을 요청해 시점 간 일관성을 평가한다.
3.3 Text Rendering
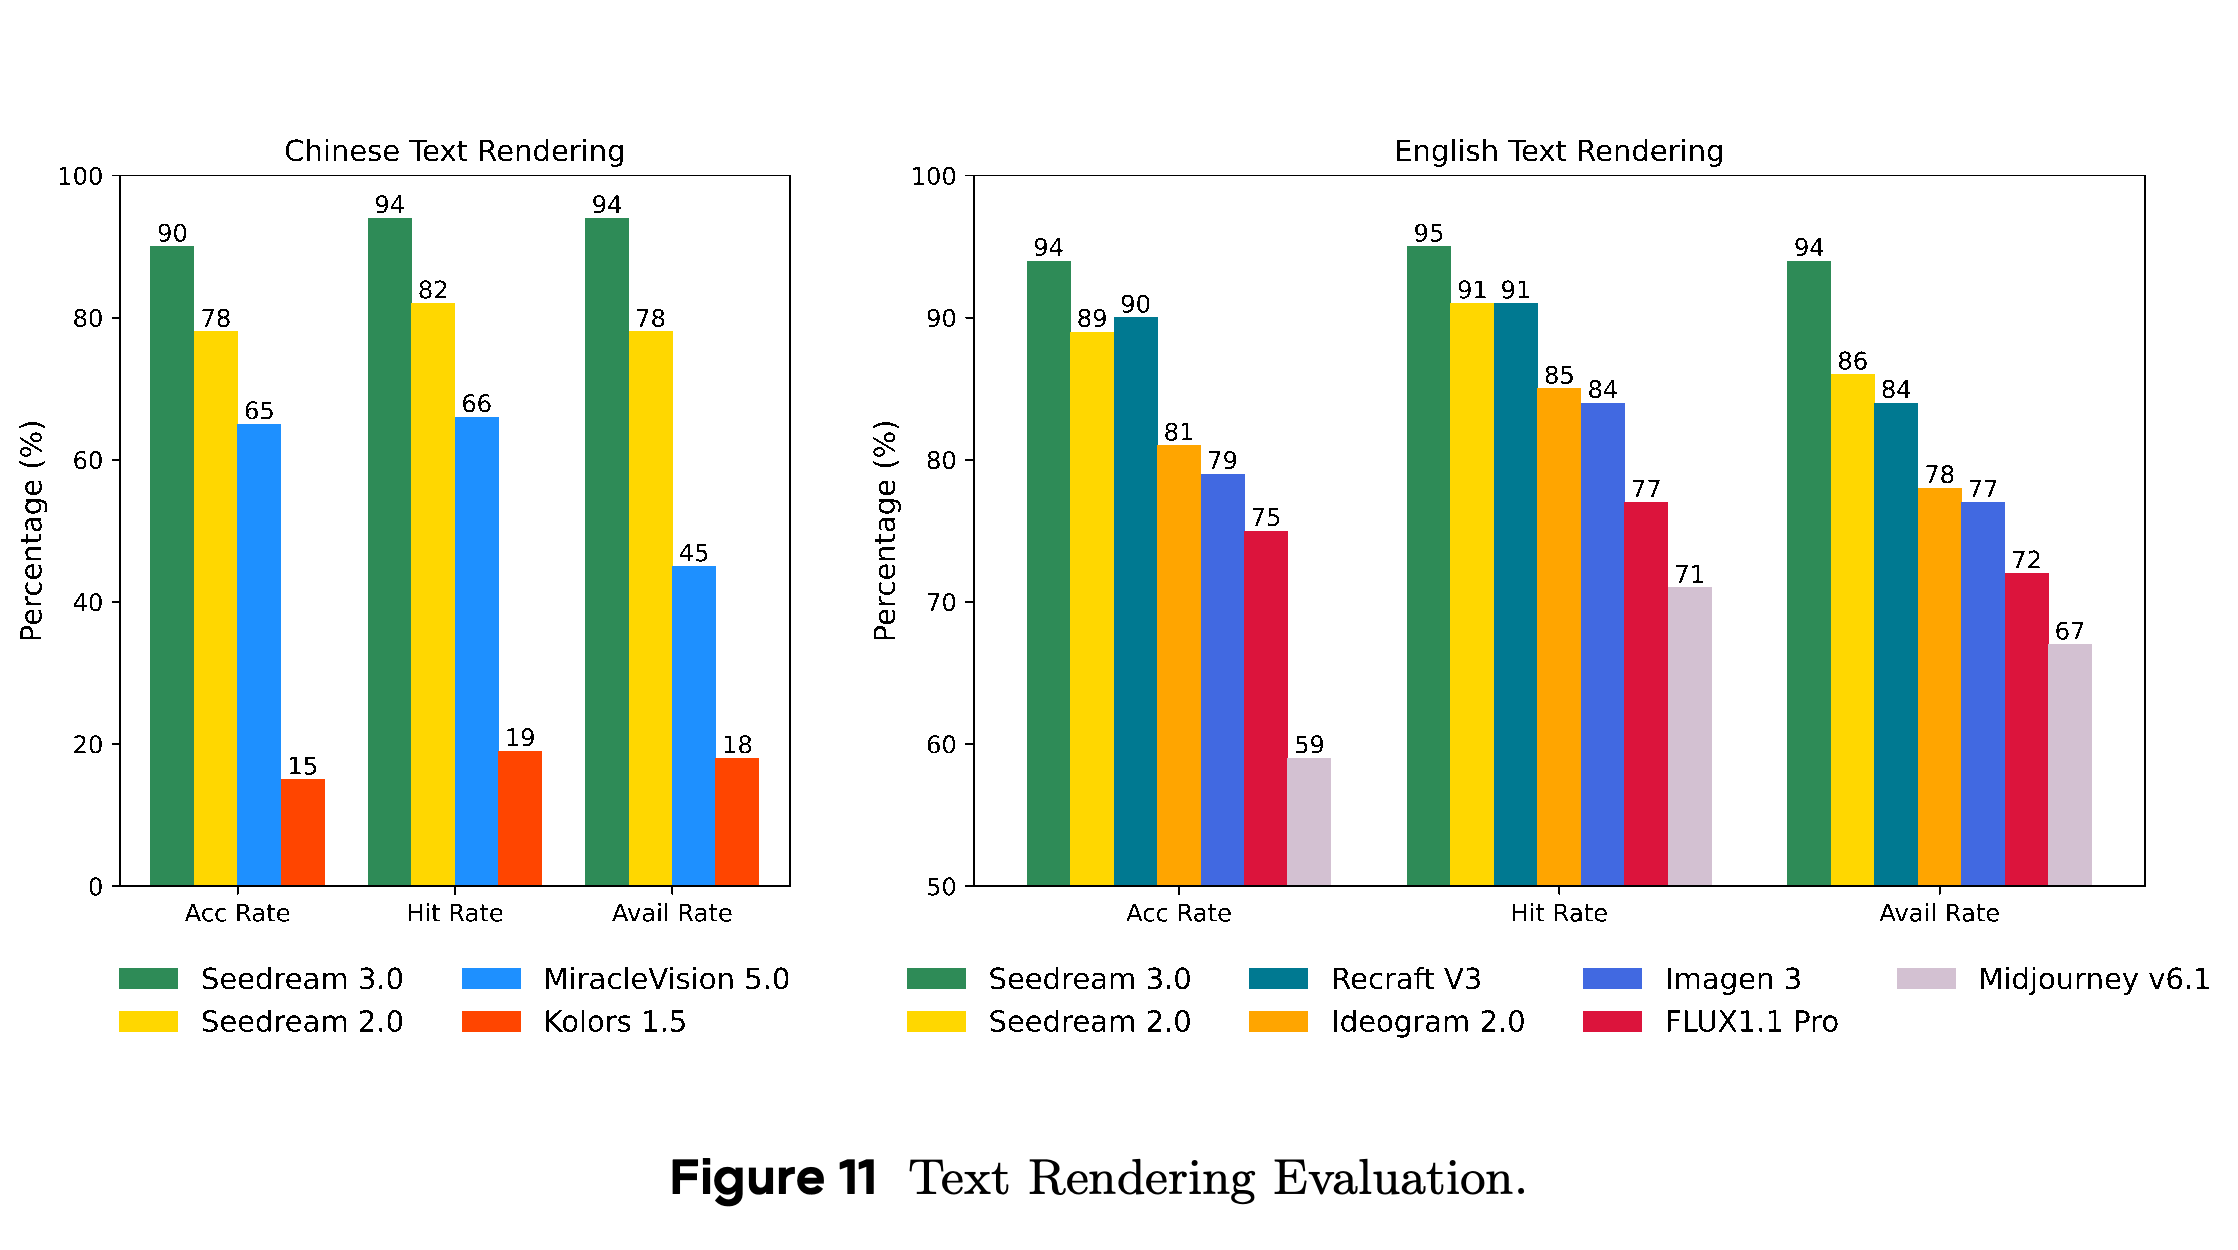
텍스트 렌더링 벤치마크는 로고, 포스터, 전자 디스플레이, 인쇄 텍스트, 손글씨를 포함하는 중국어 프롬프트 180개와 영어 프롬프트 180개로 구성된다. Seedream 3.0의 중국어 정확도, 적중률, 사용 가능 비율은 90%, 94%, 94%이며, Seedream 2.0은 78%, 82%, 78%다. 영어 결과는 94%, 95%, 94%이며, 이전 모델은 89%, 91%, 86%다.
- 정확도는 \(R_a=\left(1-\frac{N_e}{N}\right)\times100\%\)다. N은 목표 문자 수이며, N_e는 렌더링된 텍스트와 목표 텍스트를 일치시키는 데 필요한 최소 문자 편집 횟수다. 적중률은 \(R_h=\frac{N_c}{N}\times100\%\)이며, N_c는 정확히 렌더링된 문자 수다.
- 사용 가능 비율은 텍스트 정확성, 다른 콘텐츠와의 조화, 전반적인 미적 품질을 고려한다. 중국어 사용 가능 비율은 16%p, 영어 사용 가능 비율은 8%p 상승한다.
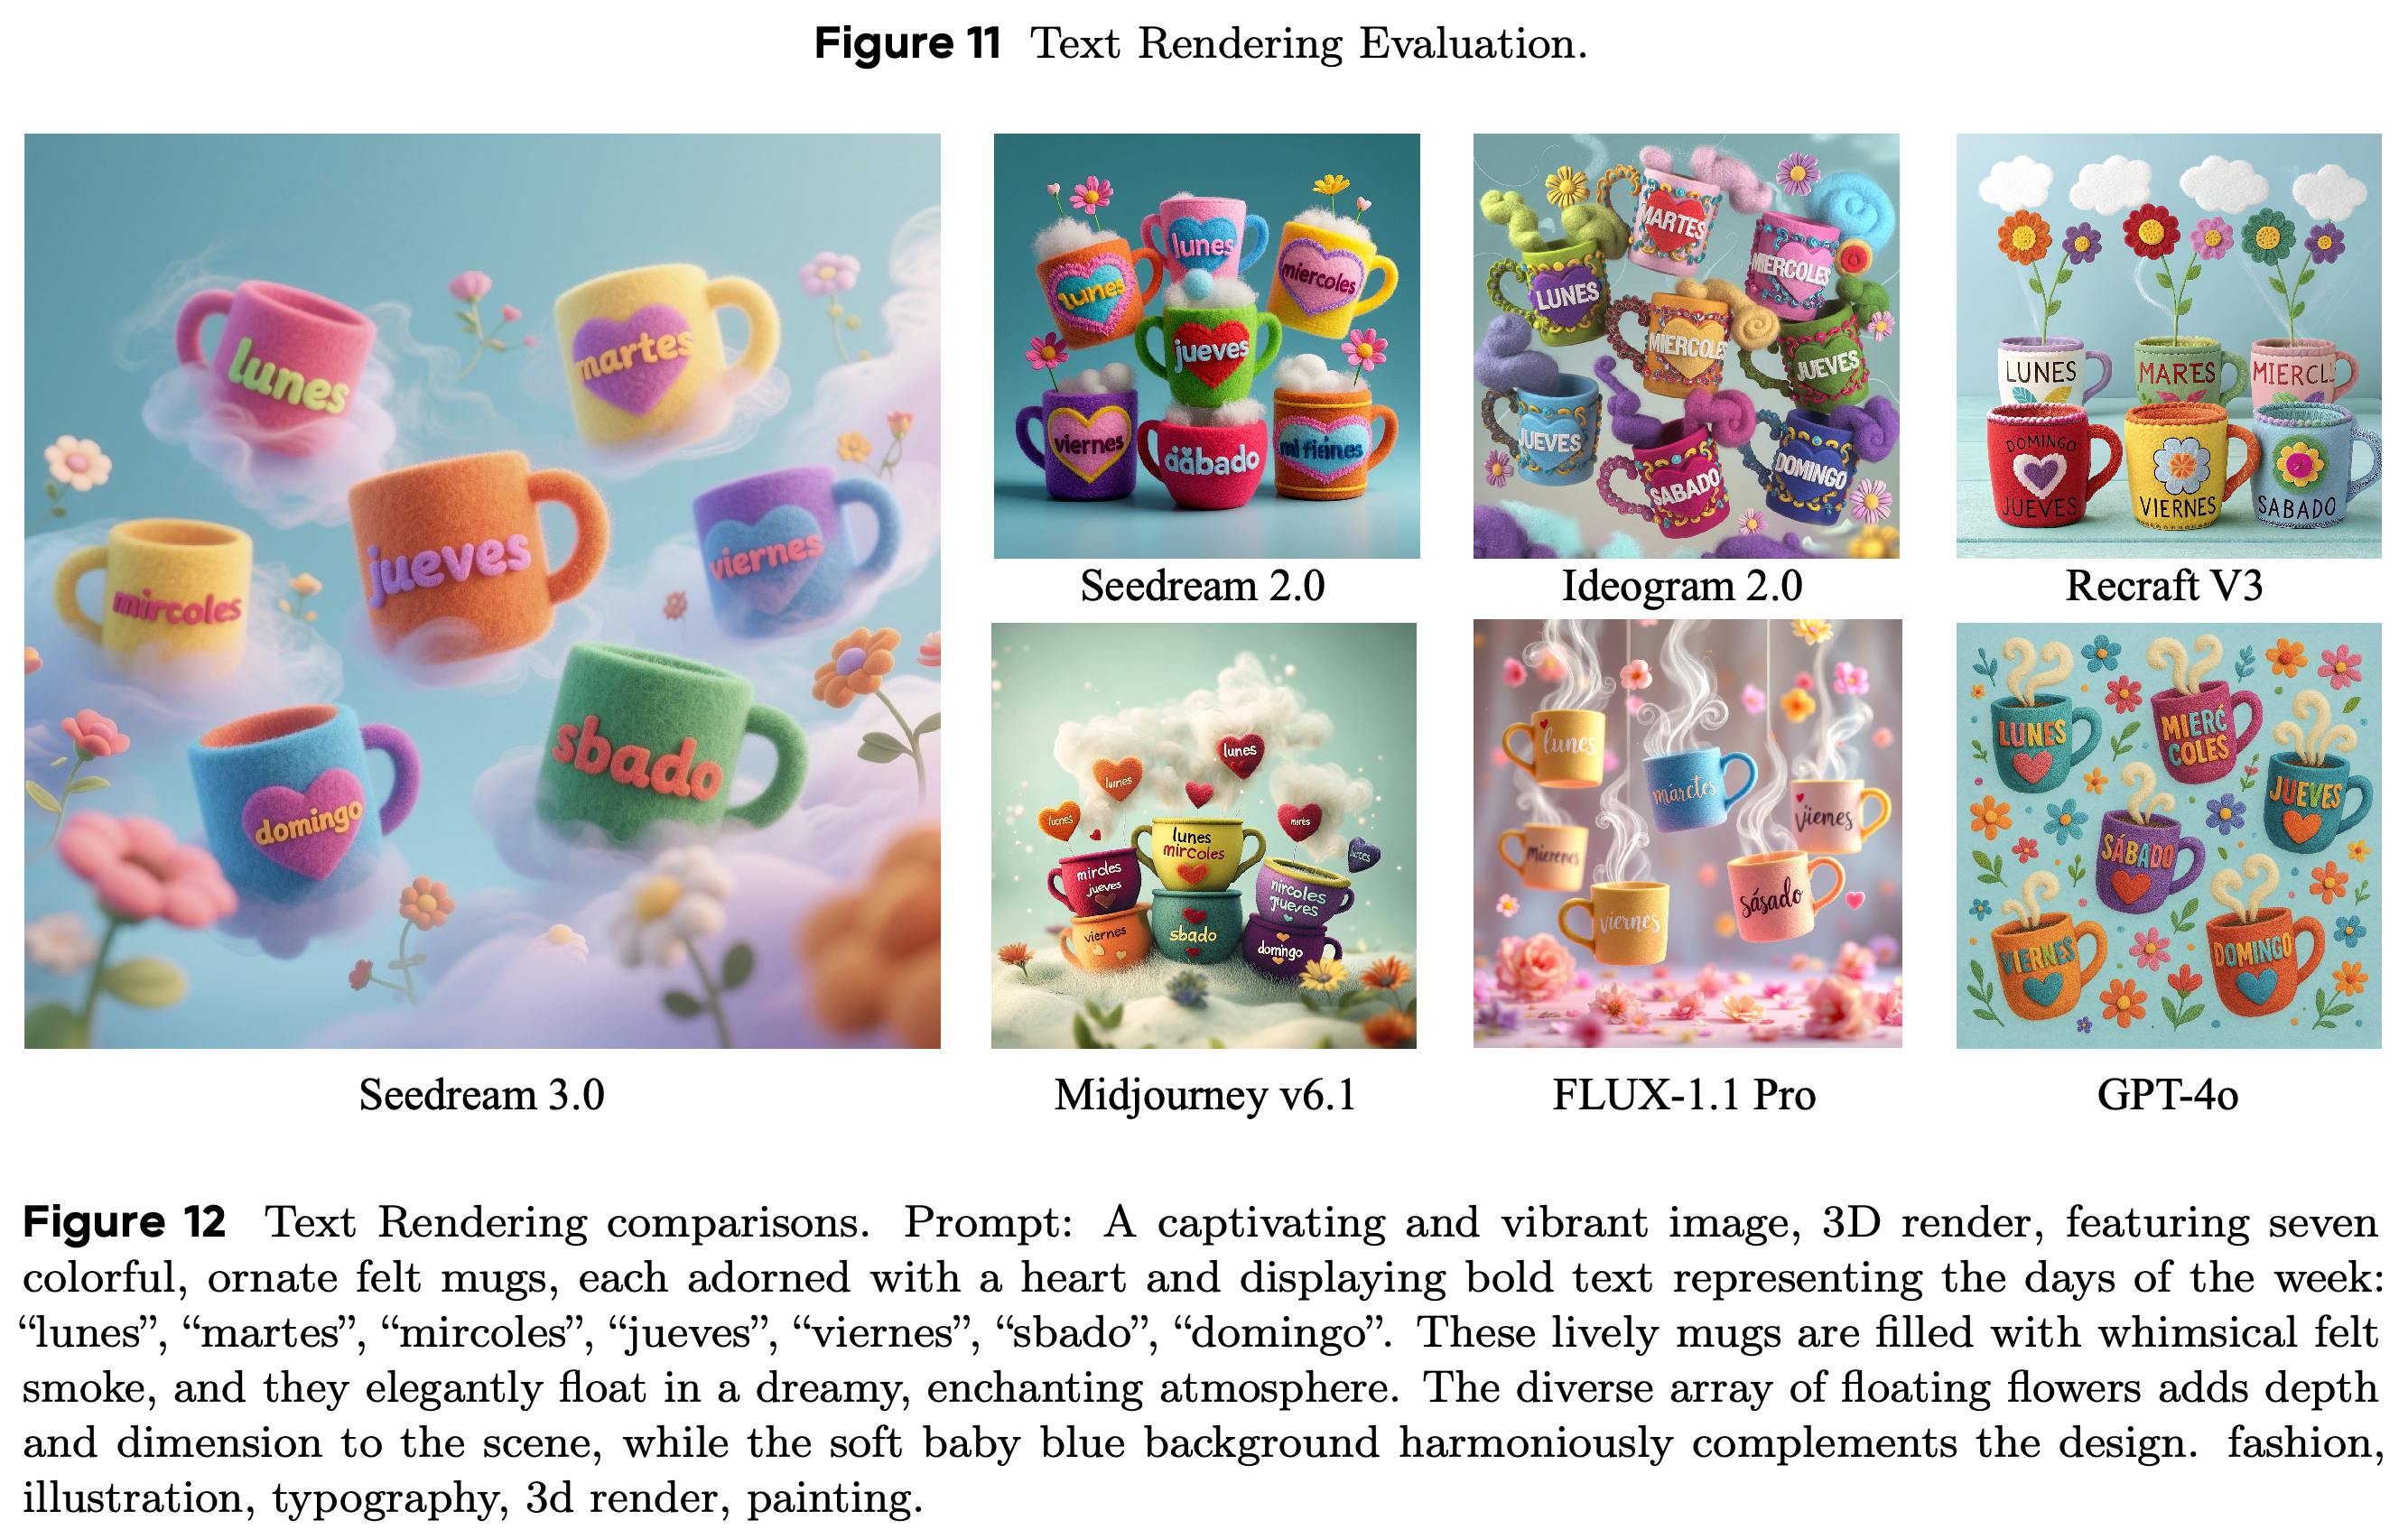
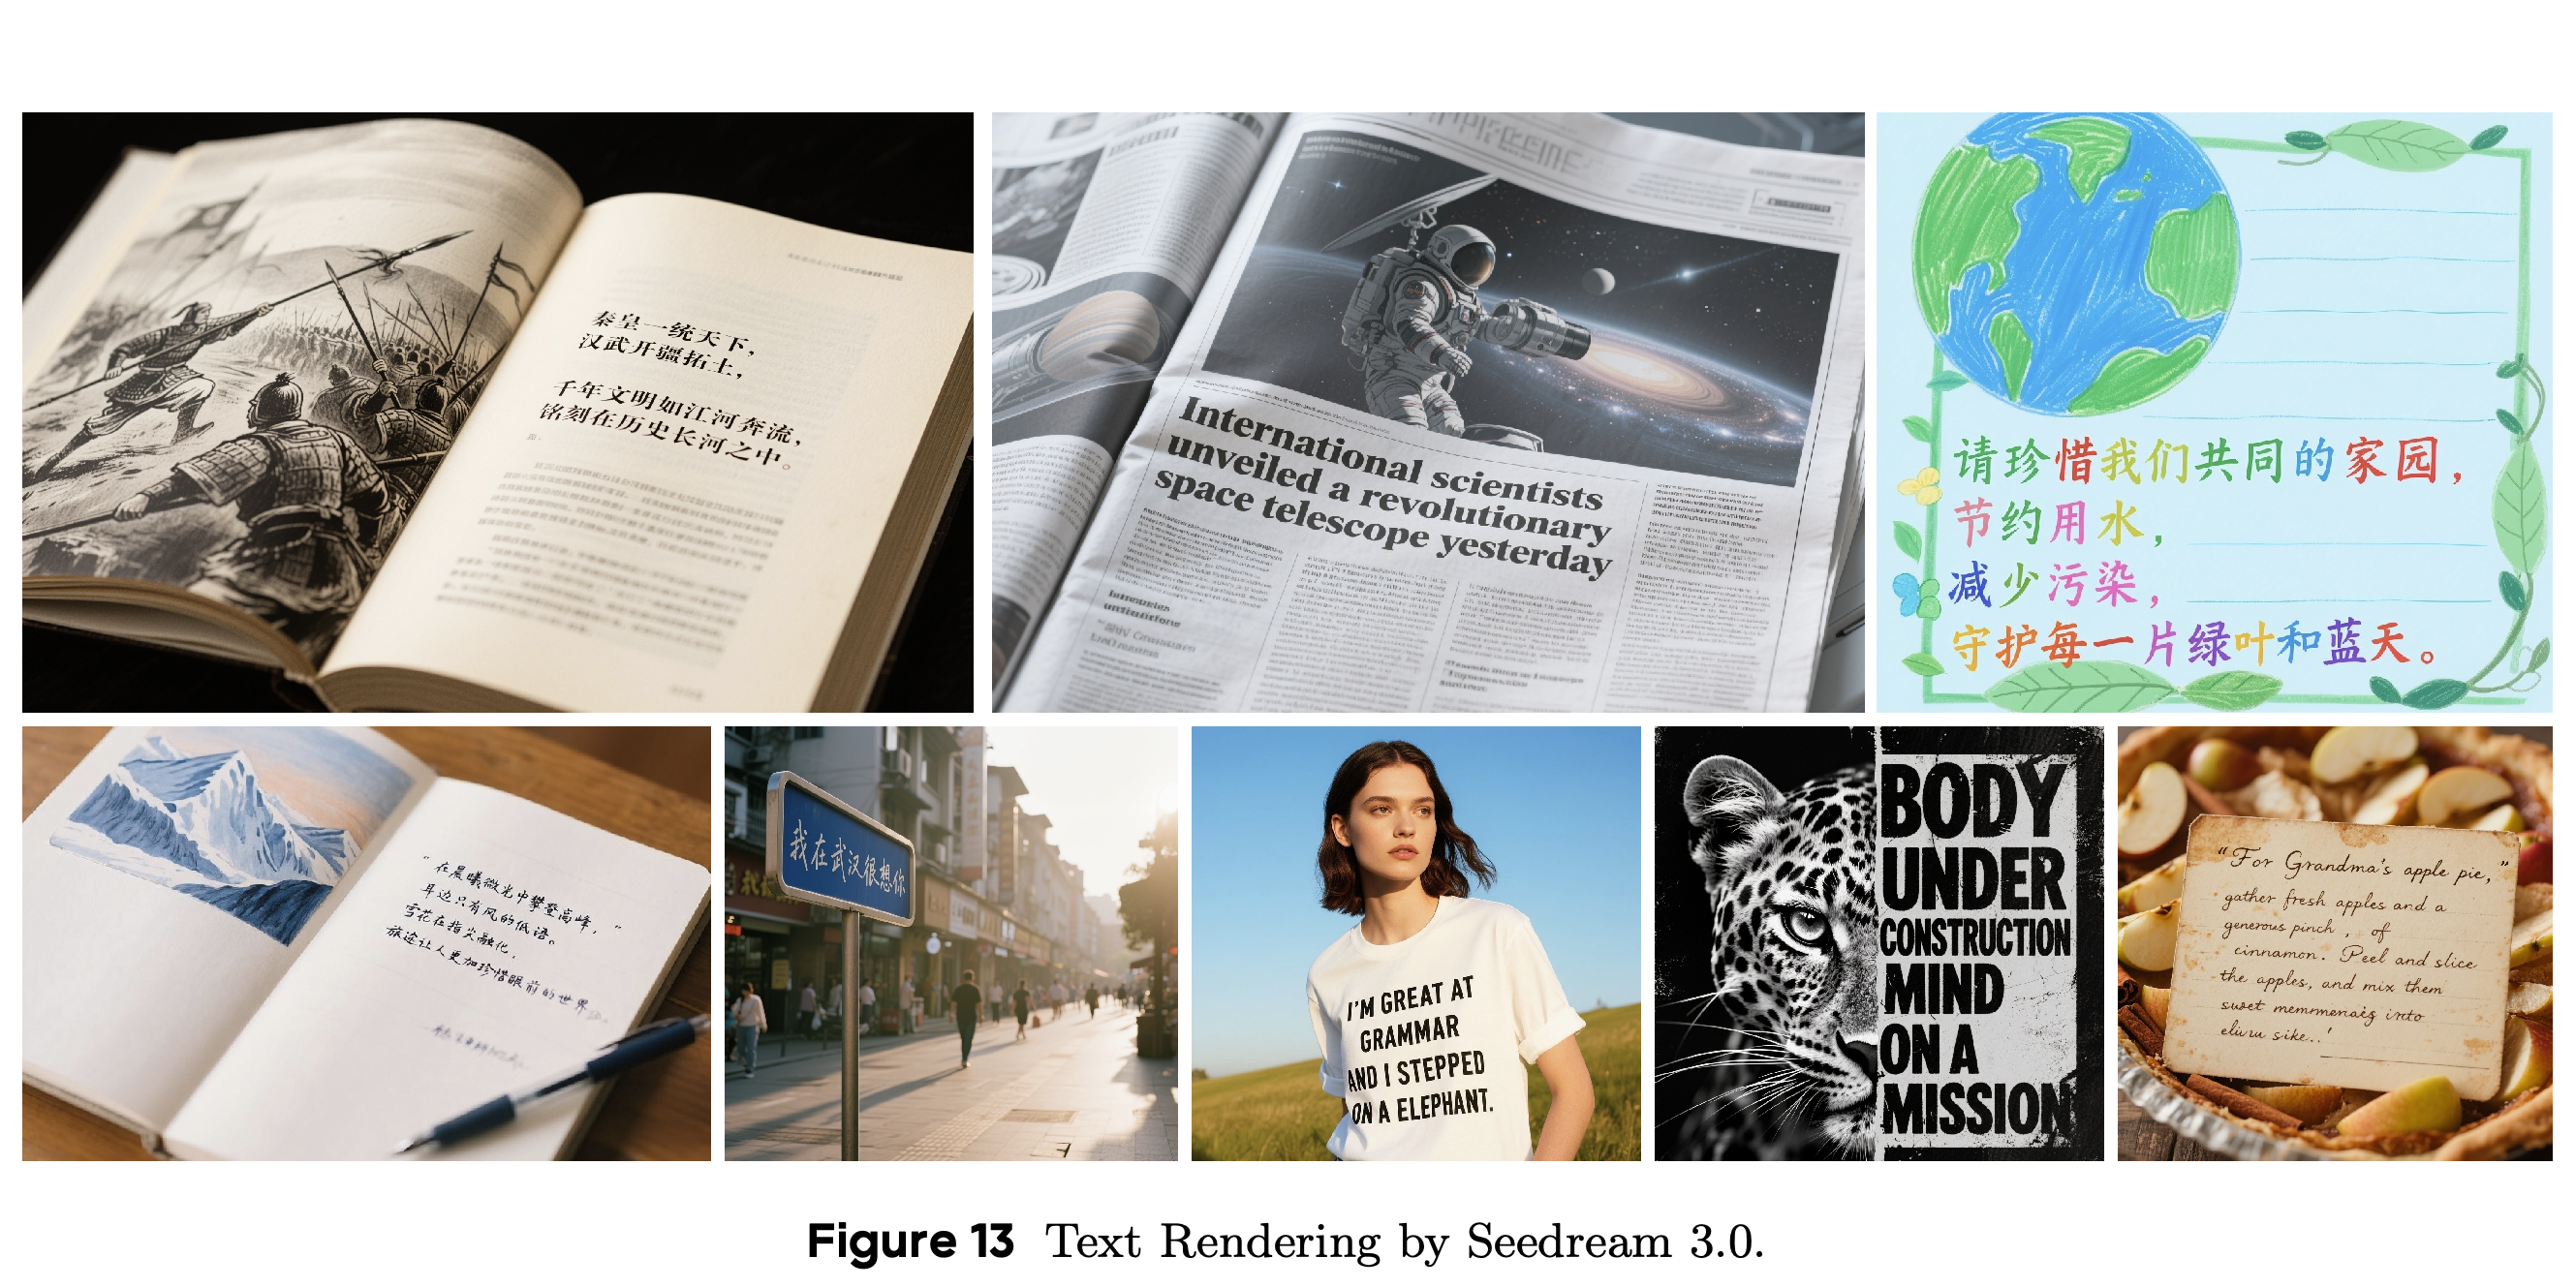
- Figures 12와 13은 여러 물체에 나누어 배치한 텍스트와 책, 신문, 의류, 표지판, 손글씨 자료에 작은 글자로 길게 쓰인 고밀도 텍스트를 보여준다. 사용 가능 비율 94%는 이 벤치마크에서 얻은 결과이며, 렌더링 실패는 여전히 발생한다.
Seedream 2.0 대비 중국어 사용 가능 비율은 78%에서 94%로, 영어 사용 가능 비율은 86%에서 94%로 높아진다. 정확도와 적중률도 개선되며, 문자 정확성과 이미지 전체의 사용 가능성을 구분해 보여준다.
머그잔 7개는 펠트 같은 외관과 일관된 구도를 유지하면서 요청한 서로 다른 문자열을 담아야 한다. “mircoles”, “sbado” 같은 철자는 원본 프롬프트에 있으므로 해당 요청을 기준으로 평가해야 한다.
예시들은 책, 신문, 의류, 표지판, 손글씨 자료에 텍스트를 배치한다. 독립된 글자 표현을 넘어 원근과 물리적 매체에 텍스트를 자연스럽게 통합하는 모습을 보여준다.
3.4 Photorealistic Portrait
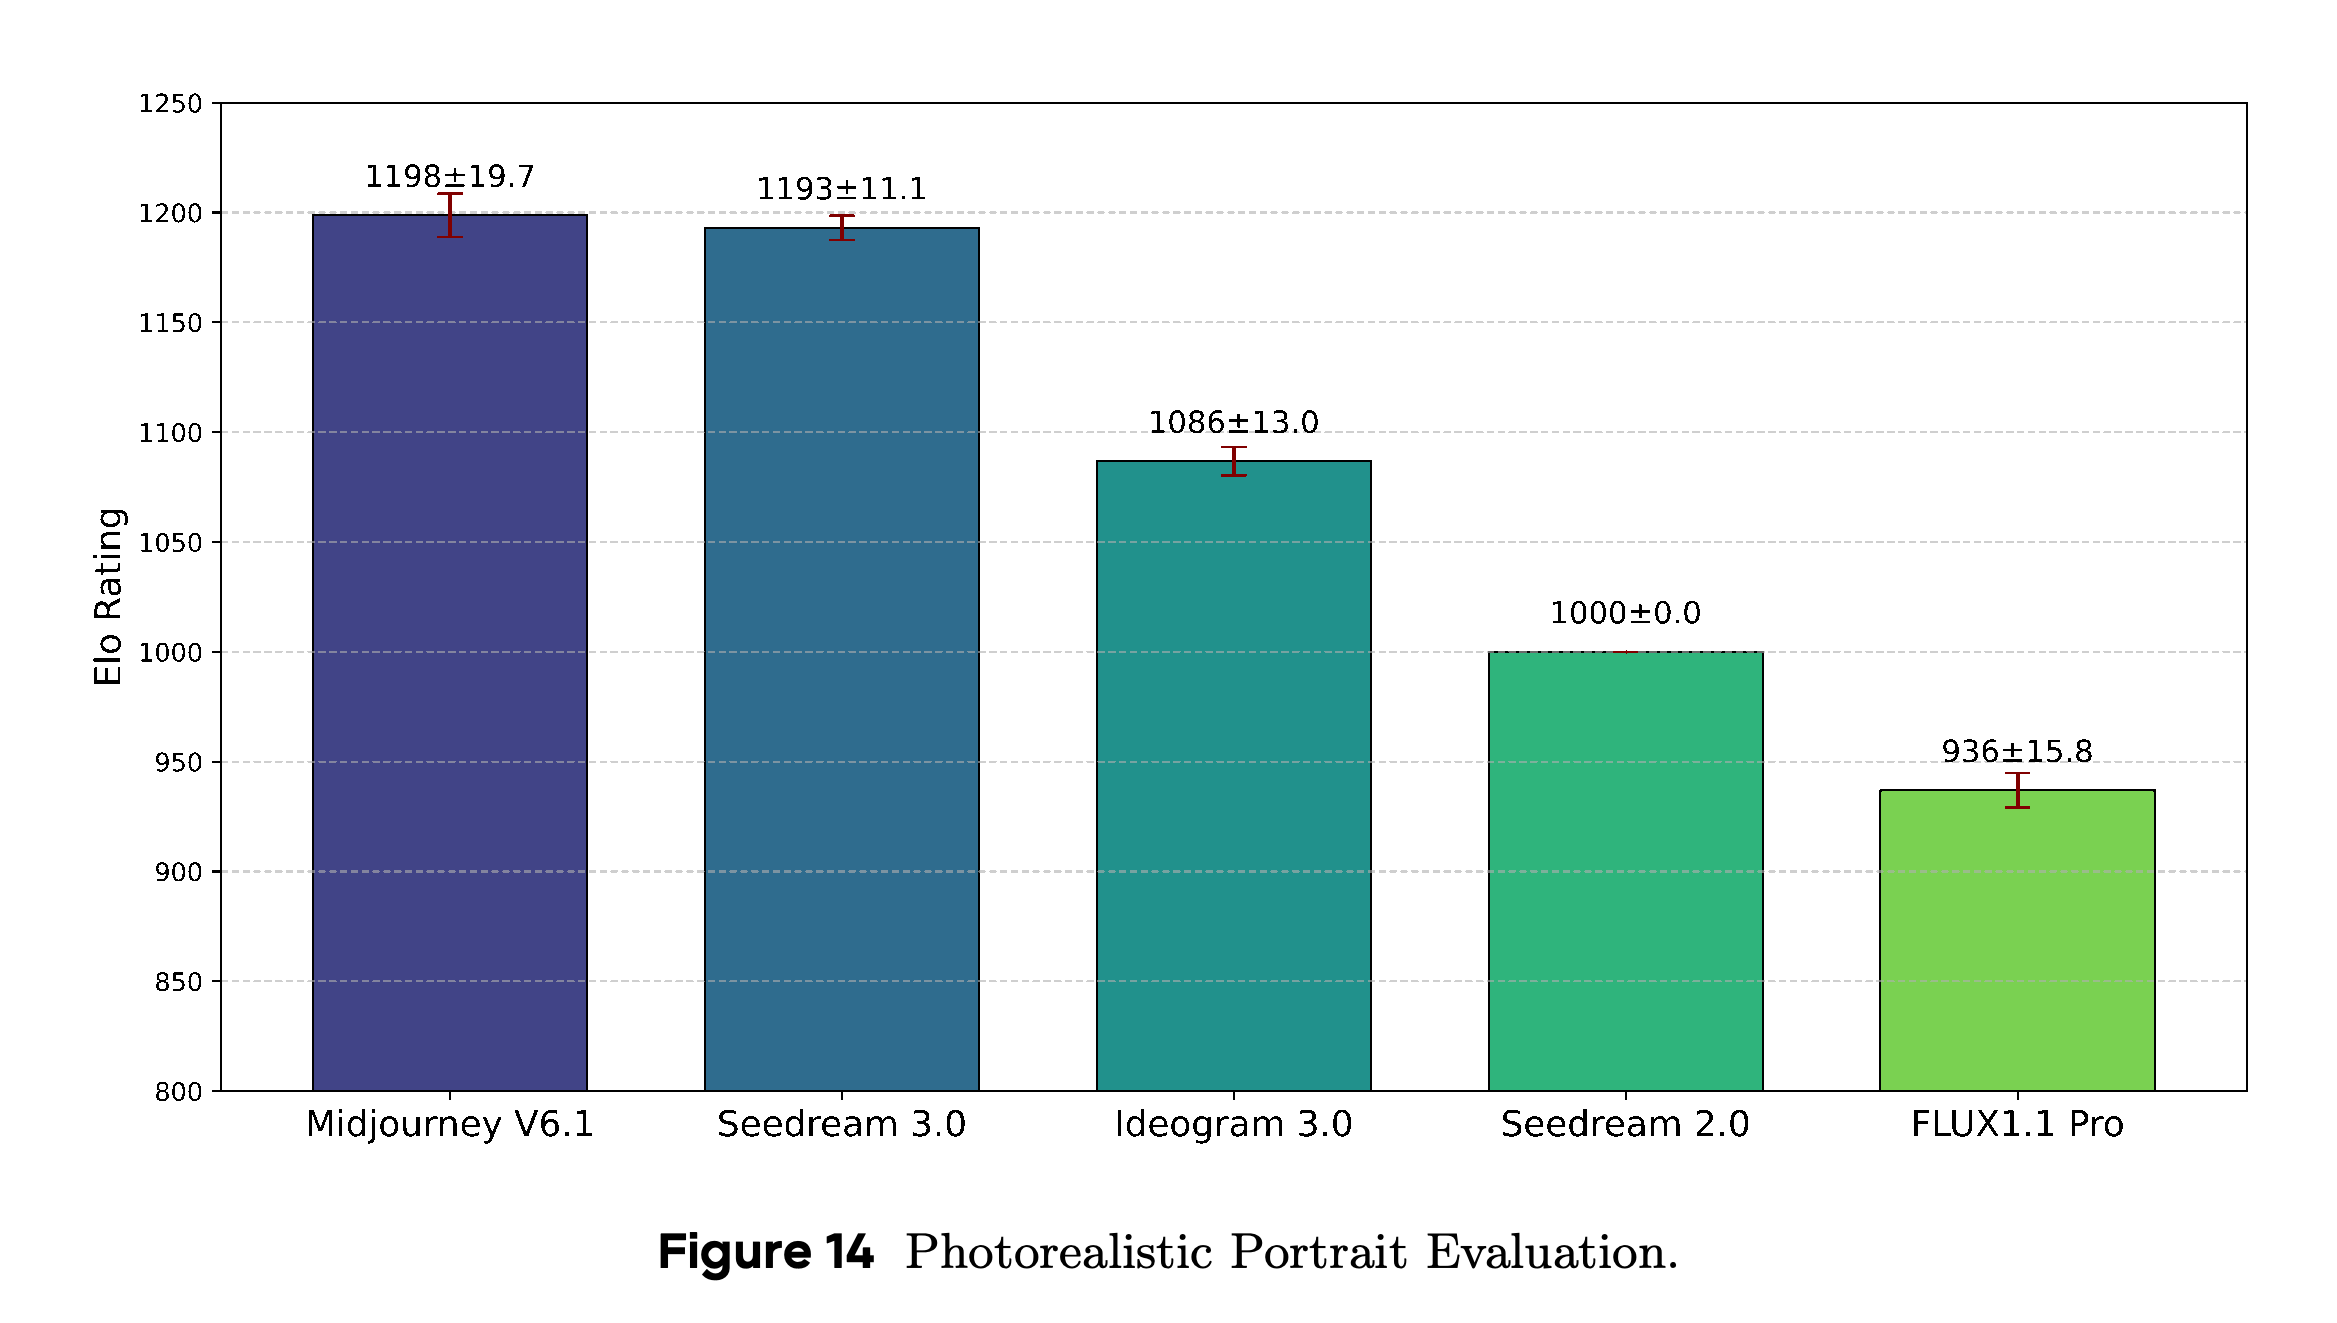
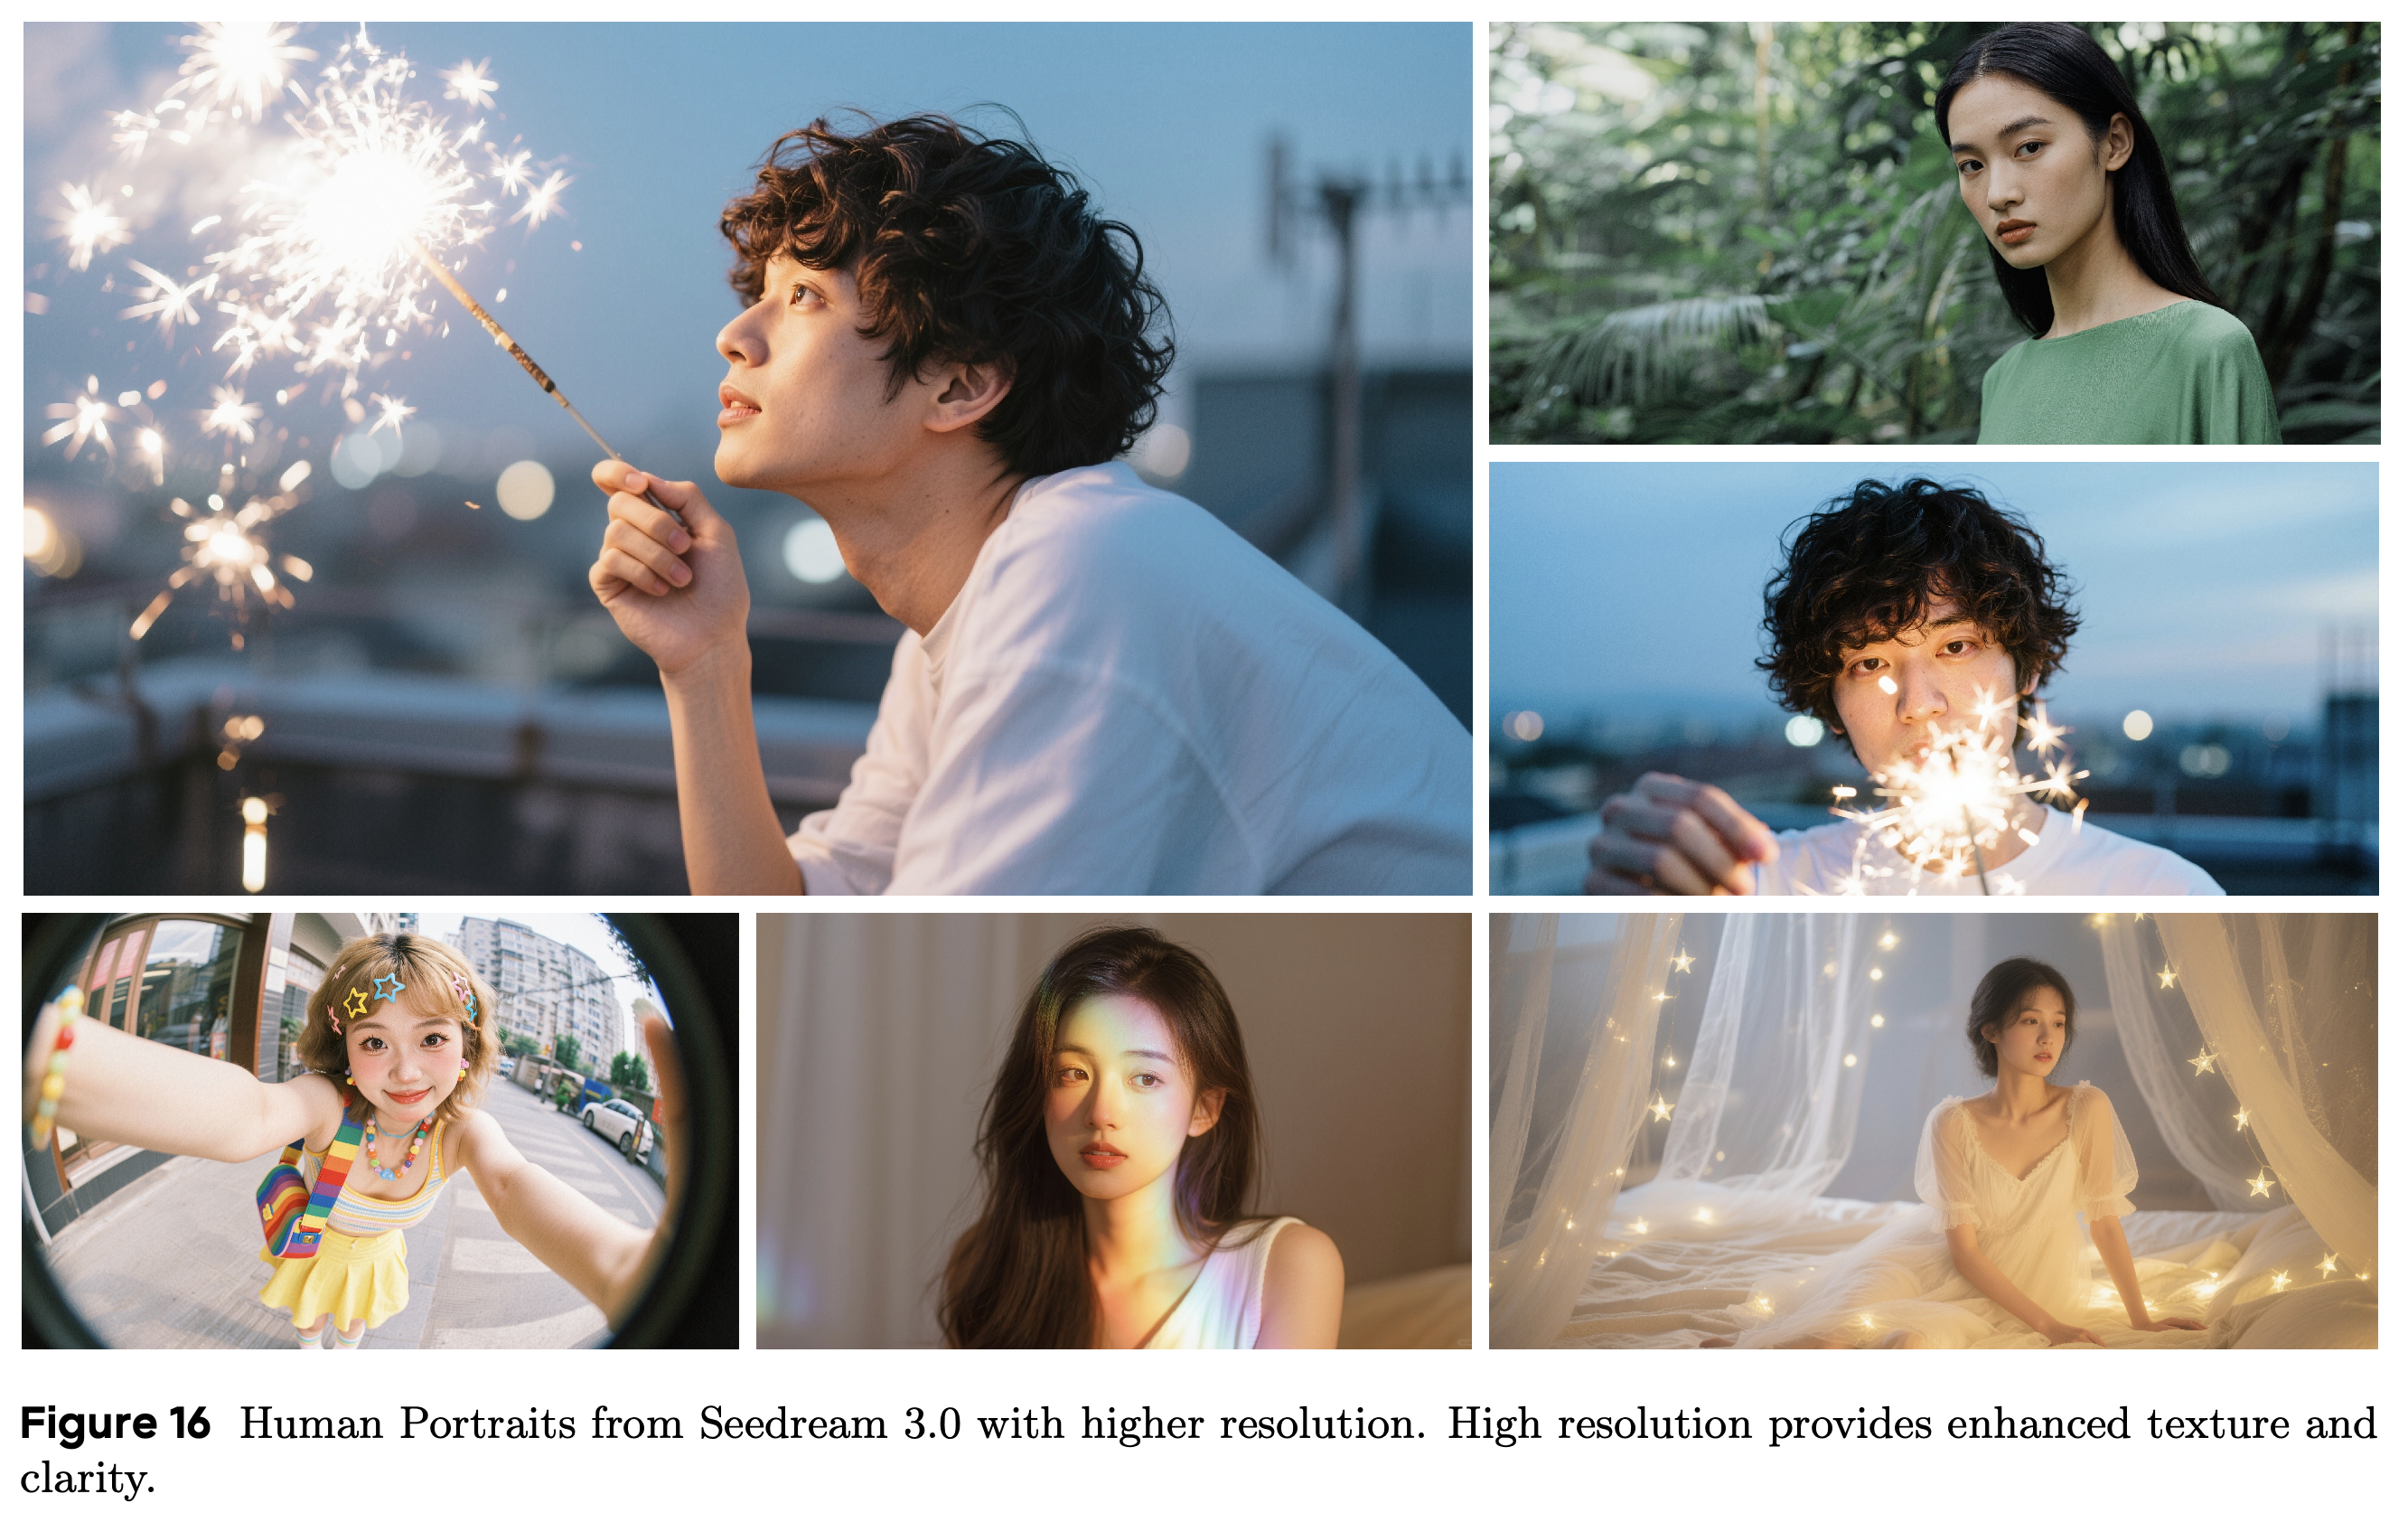
인물 이미지 평가는 표정, 자세, 시점, 머리카락, 피부 질감, 의류, 액세서리를 다루는 프롬프트 100개를 사용한다. 사실성과 감정 표현을 중심으로 공개 쌍별 비교를 50,000회 넘게 진행한다. Elo 점수는 Seedream 3.0이 1193±11.1, Midjourney v6.1이 1198±19.7이다. Ideogram 3.0은 1086±13.0, Seedream 2.0은 1000±0.0, FLUX1.1 Pro는 936±15.8이다.
- Seedream 3.0과 Midjourney v6.1은 점추정치가 비슷하고 표시된 불확실성 범위가 겹친다. 저자들은 두 모델이 모두 1위라고 설명한다. 피부 질감은 Seedream 3.0이, 감정 표현은 Midjourney가 더 뛰어나다고 평가한다.
- Midjourney 이미지는 지나치게 예술적이거나 추상적인 출력을 피하기 위해 여러 차례 생성했다. 이러한 모델별 선별 절차를 고려해 비교 결과를 해석해야 한다.
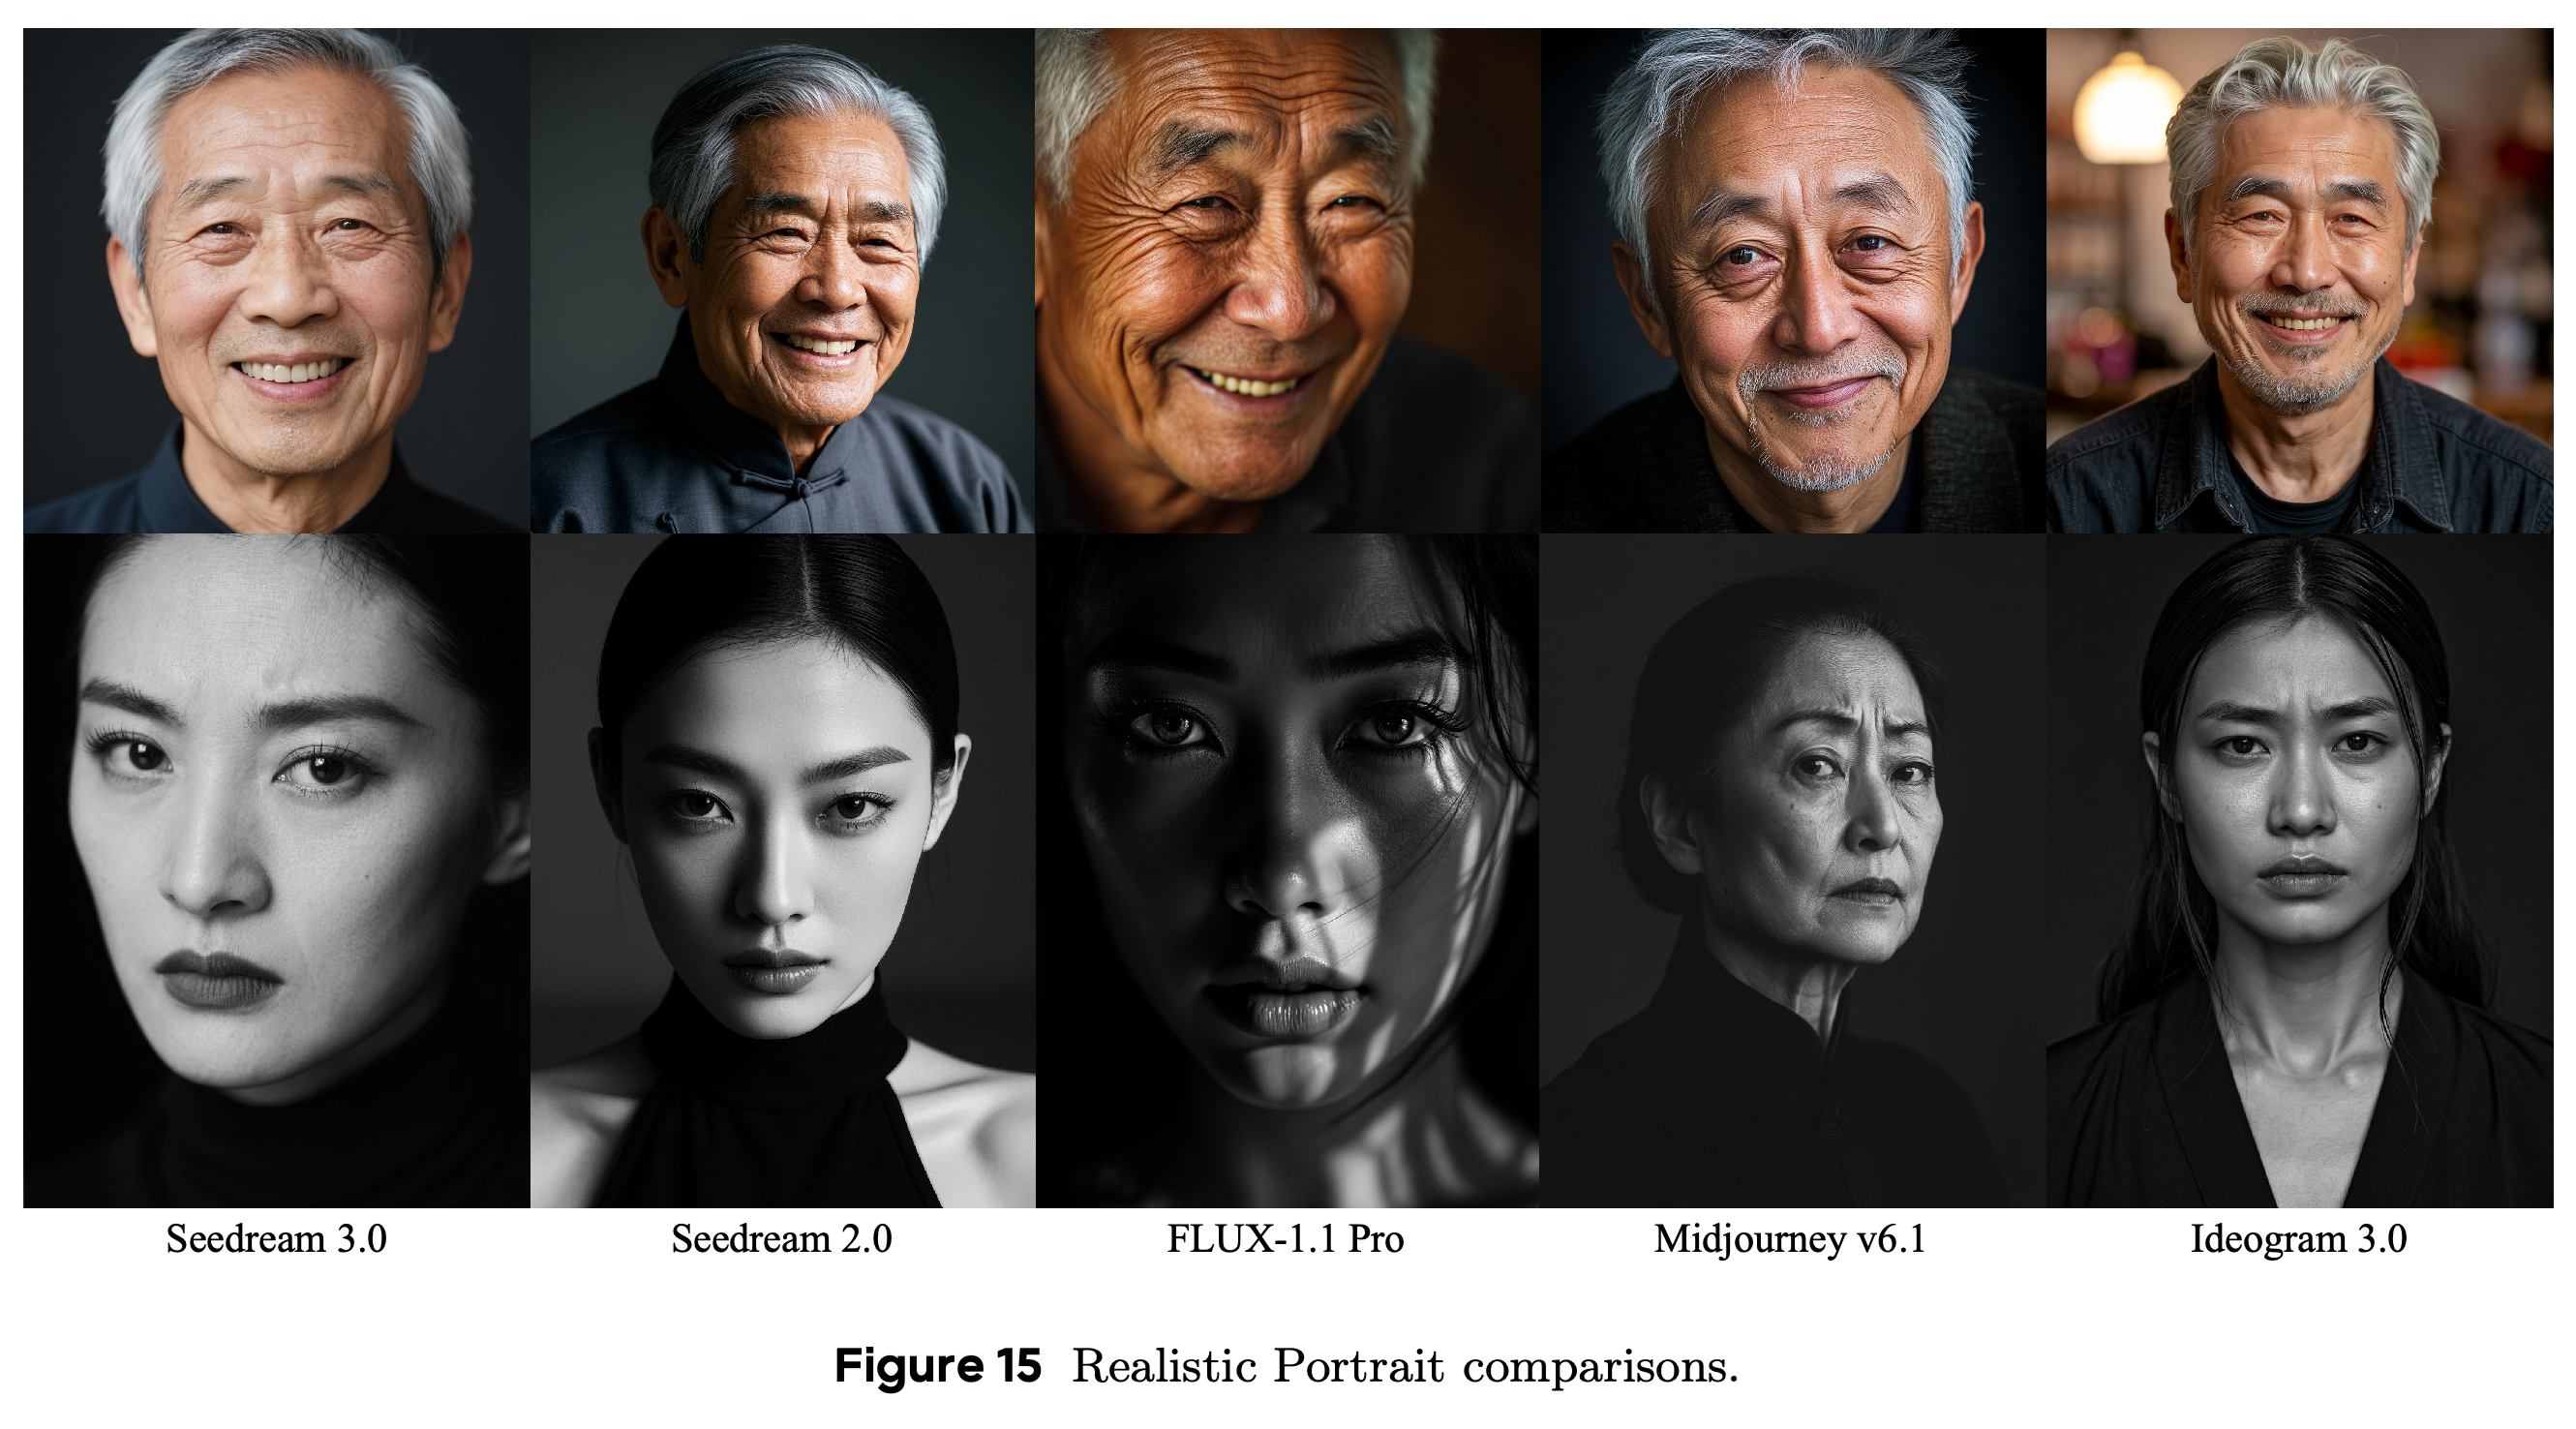
- Figures 15와 16은 인물의 질감과 2048×2048 생성을 포함한 기본 고해상도 출력을 보여준다. 해상도의 효과만 분리해 확인하는 대응 비교 실험은 제시하지 않는다.
Seedream 3.0의 1193±11.1과 Midjourney v6.1의 1198±19.7은 표시된 불확실성 범위가 겹친다. 이 인물 이미지 선호도 평가에서 두 모델의 점추정치는 제시된 다른 모델보다 상당히 높다.
인물 이미지들은 모델별 피부 질감, 조명, 표정의 차이를 보여준다. 이 요소들이 함께 달라지므로, 질감이 선호도에 기여하는 정도를 예시만으로 분리할 수는 없다.
인물 이미지들은 기본 고해상도 생성에서 다양한 조명, 구도, 세밀한 피부 표현을 보여준다. 해상도 증가의 이점을 정량화할 대응 저해상도 기준 결과는 없다.
3.5 Comparison with GPT-4o
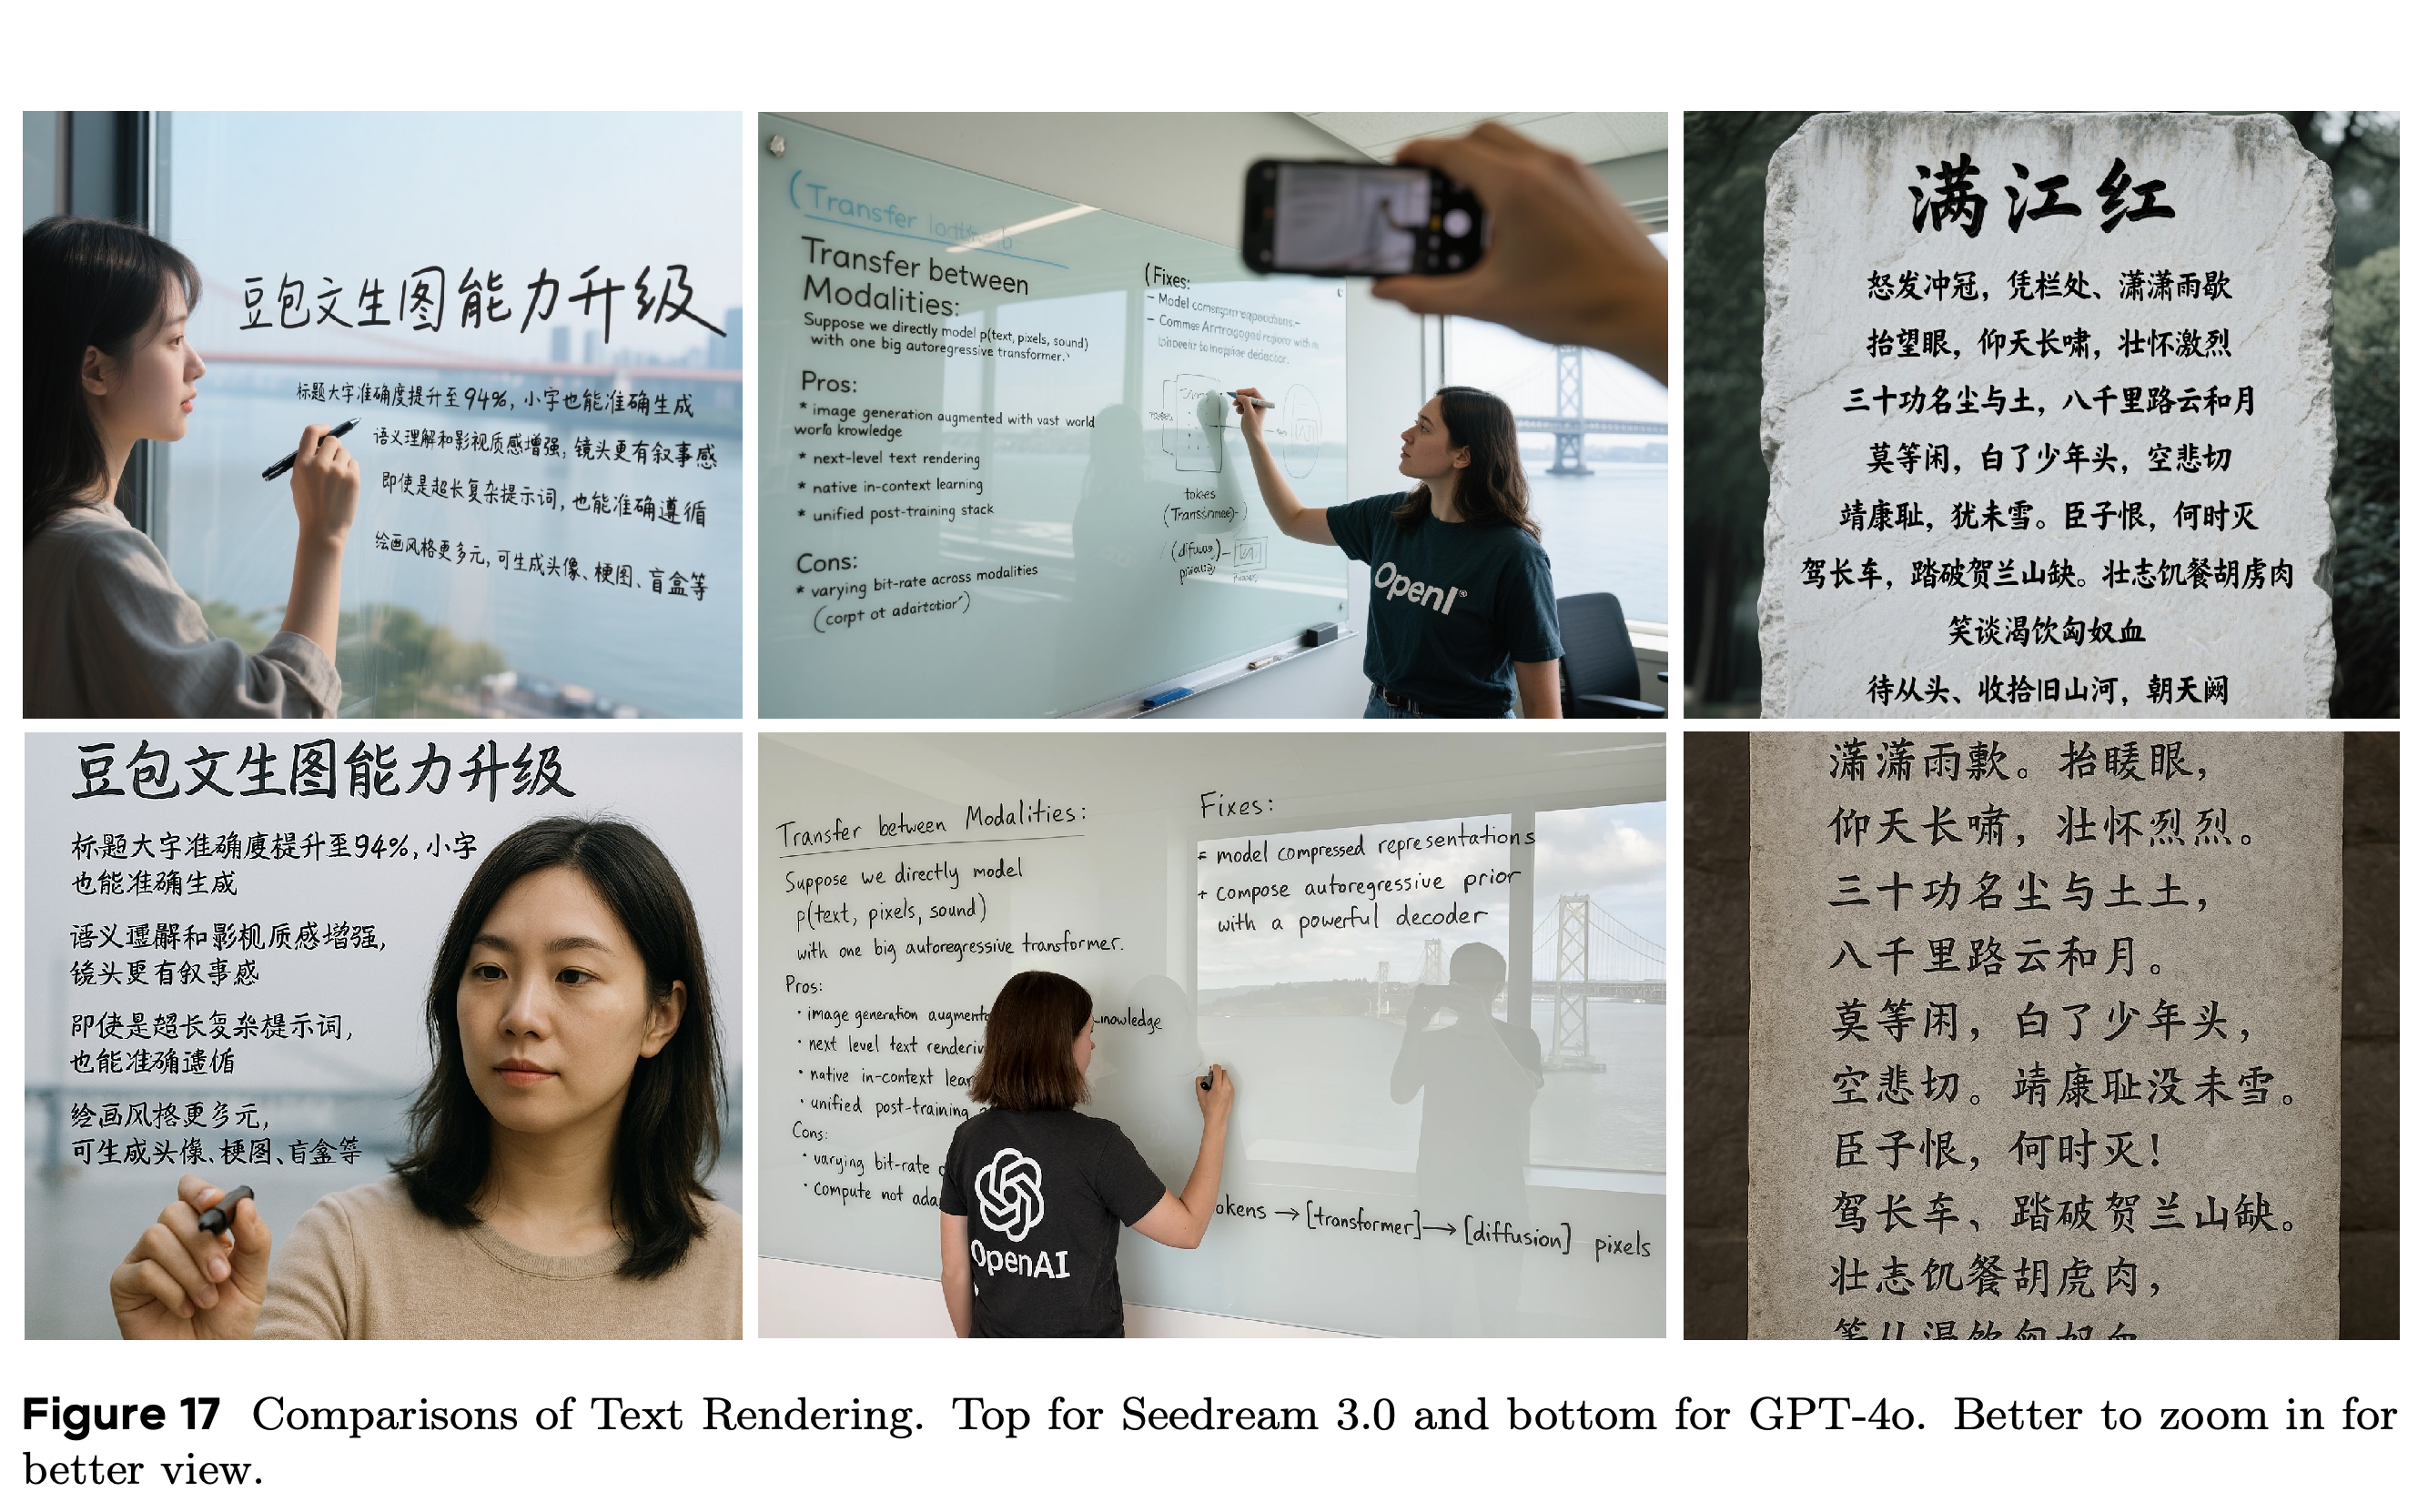
연구 당시 대규모 이미지 생성용 application programming interface (API)를 사용할 수 없었기 때문에, 보고서는 GPT-4o와의 직접 비교를 선별한 사례로 제한한다. 3.5.1 Dense Text Rendering에서 저자들은 GPT-4o가 작은 영어 글자와 일부 LaTeX 수학 조판 기호에 강점이 있다고 설명한다. 제시된 예시에서는 고밀도 중국어 텍스트, 조판, 구도에서 Seedream 3.0이 더 낫다고 평가한다.
대응 예시들은 유리, 화이트보드, 돌에 빽빽하게 쓰인 글을 비교한다. 선별한 사례에 한정된 비교이며, 중국어 텍스트와 배치에 관한 저자들의 관찰을 보여준다.
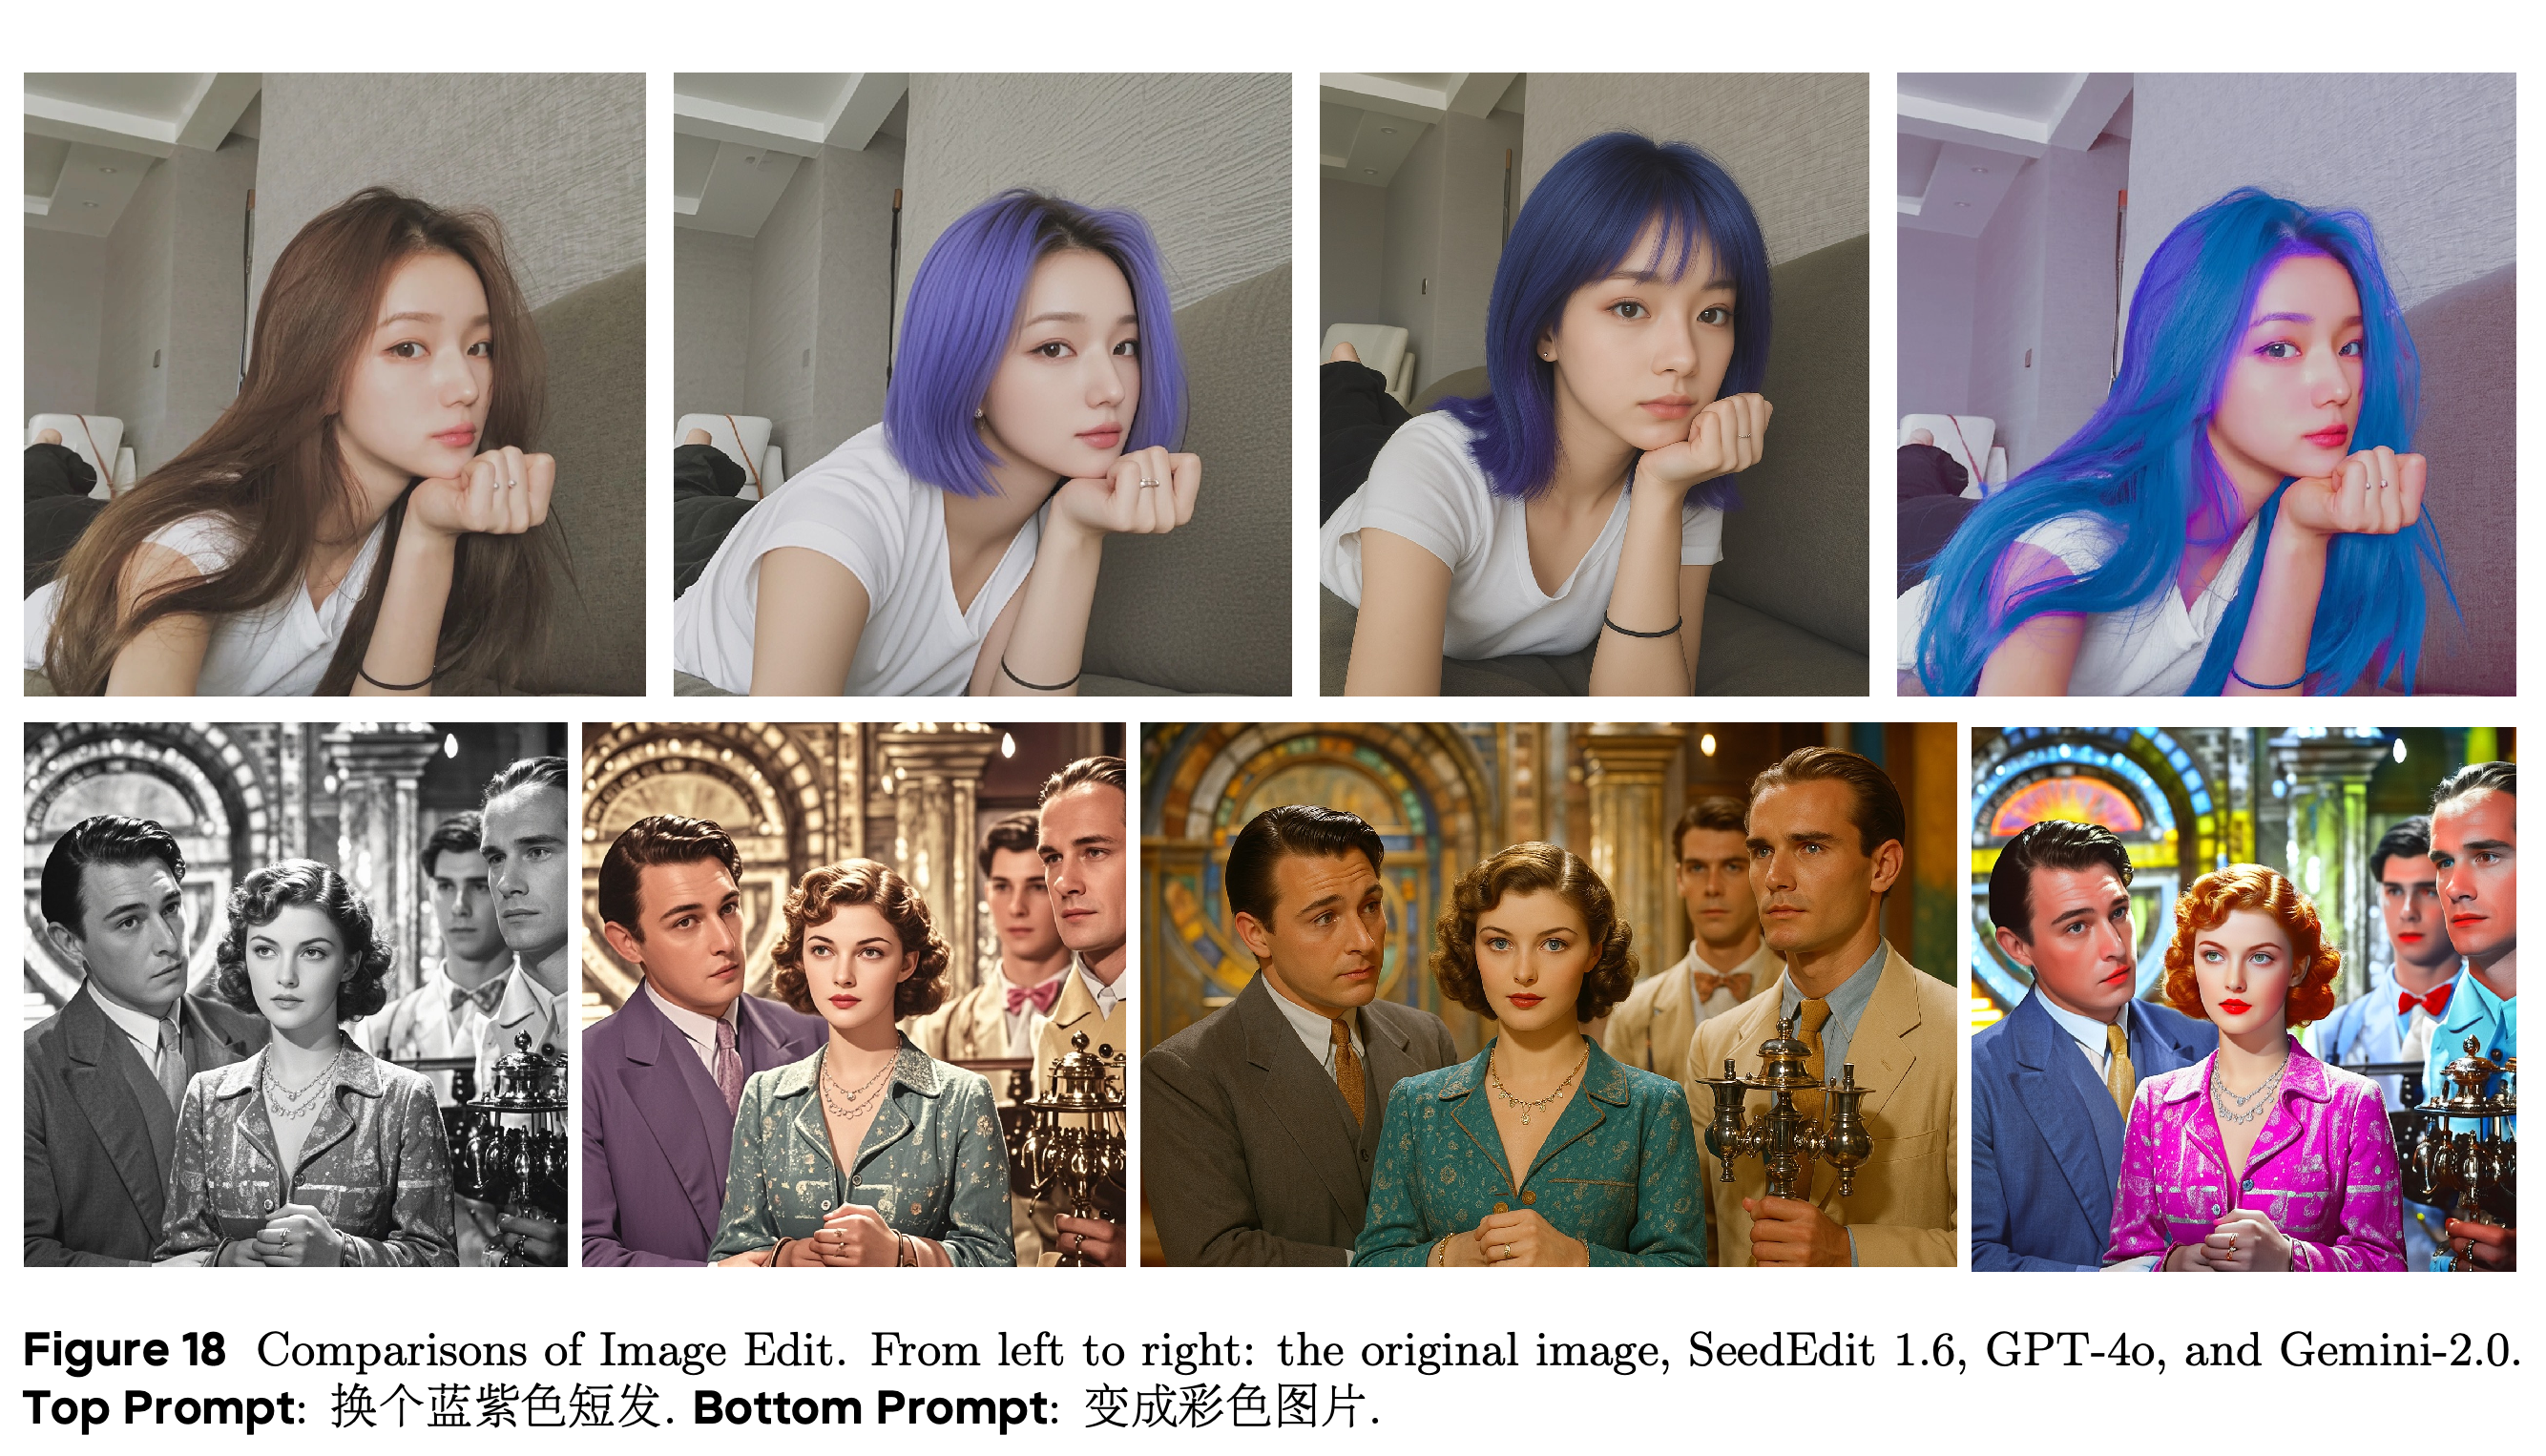
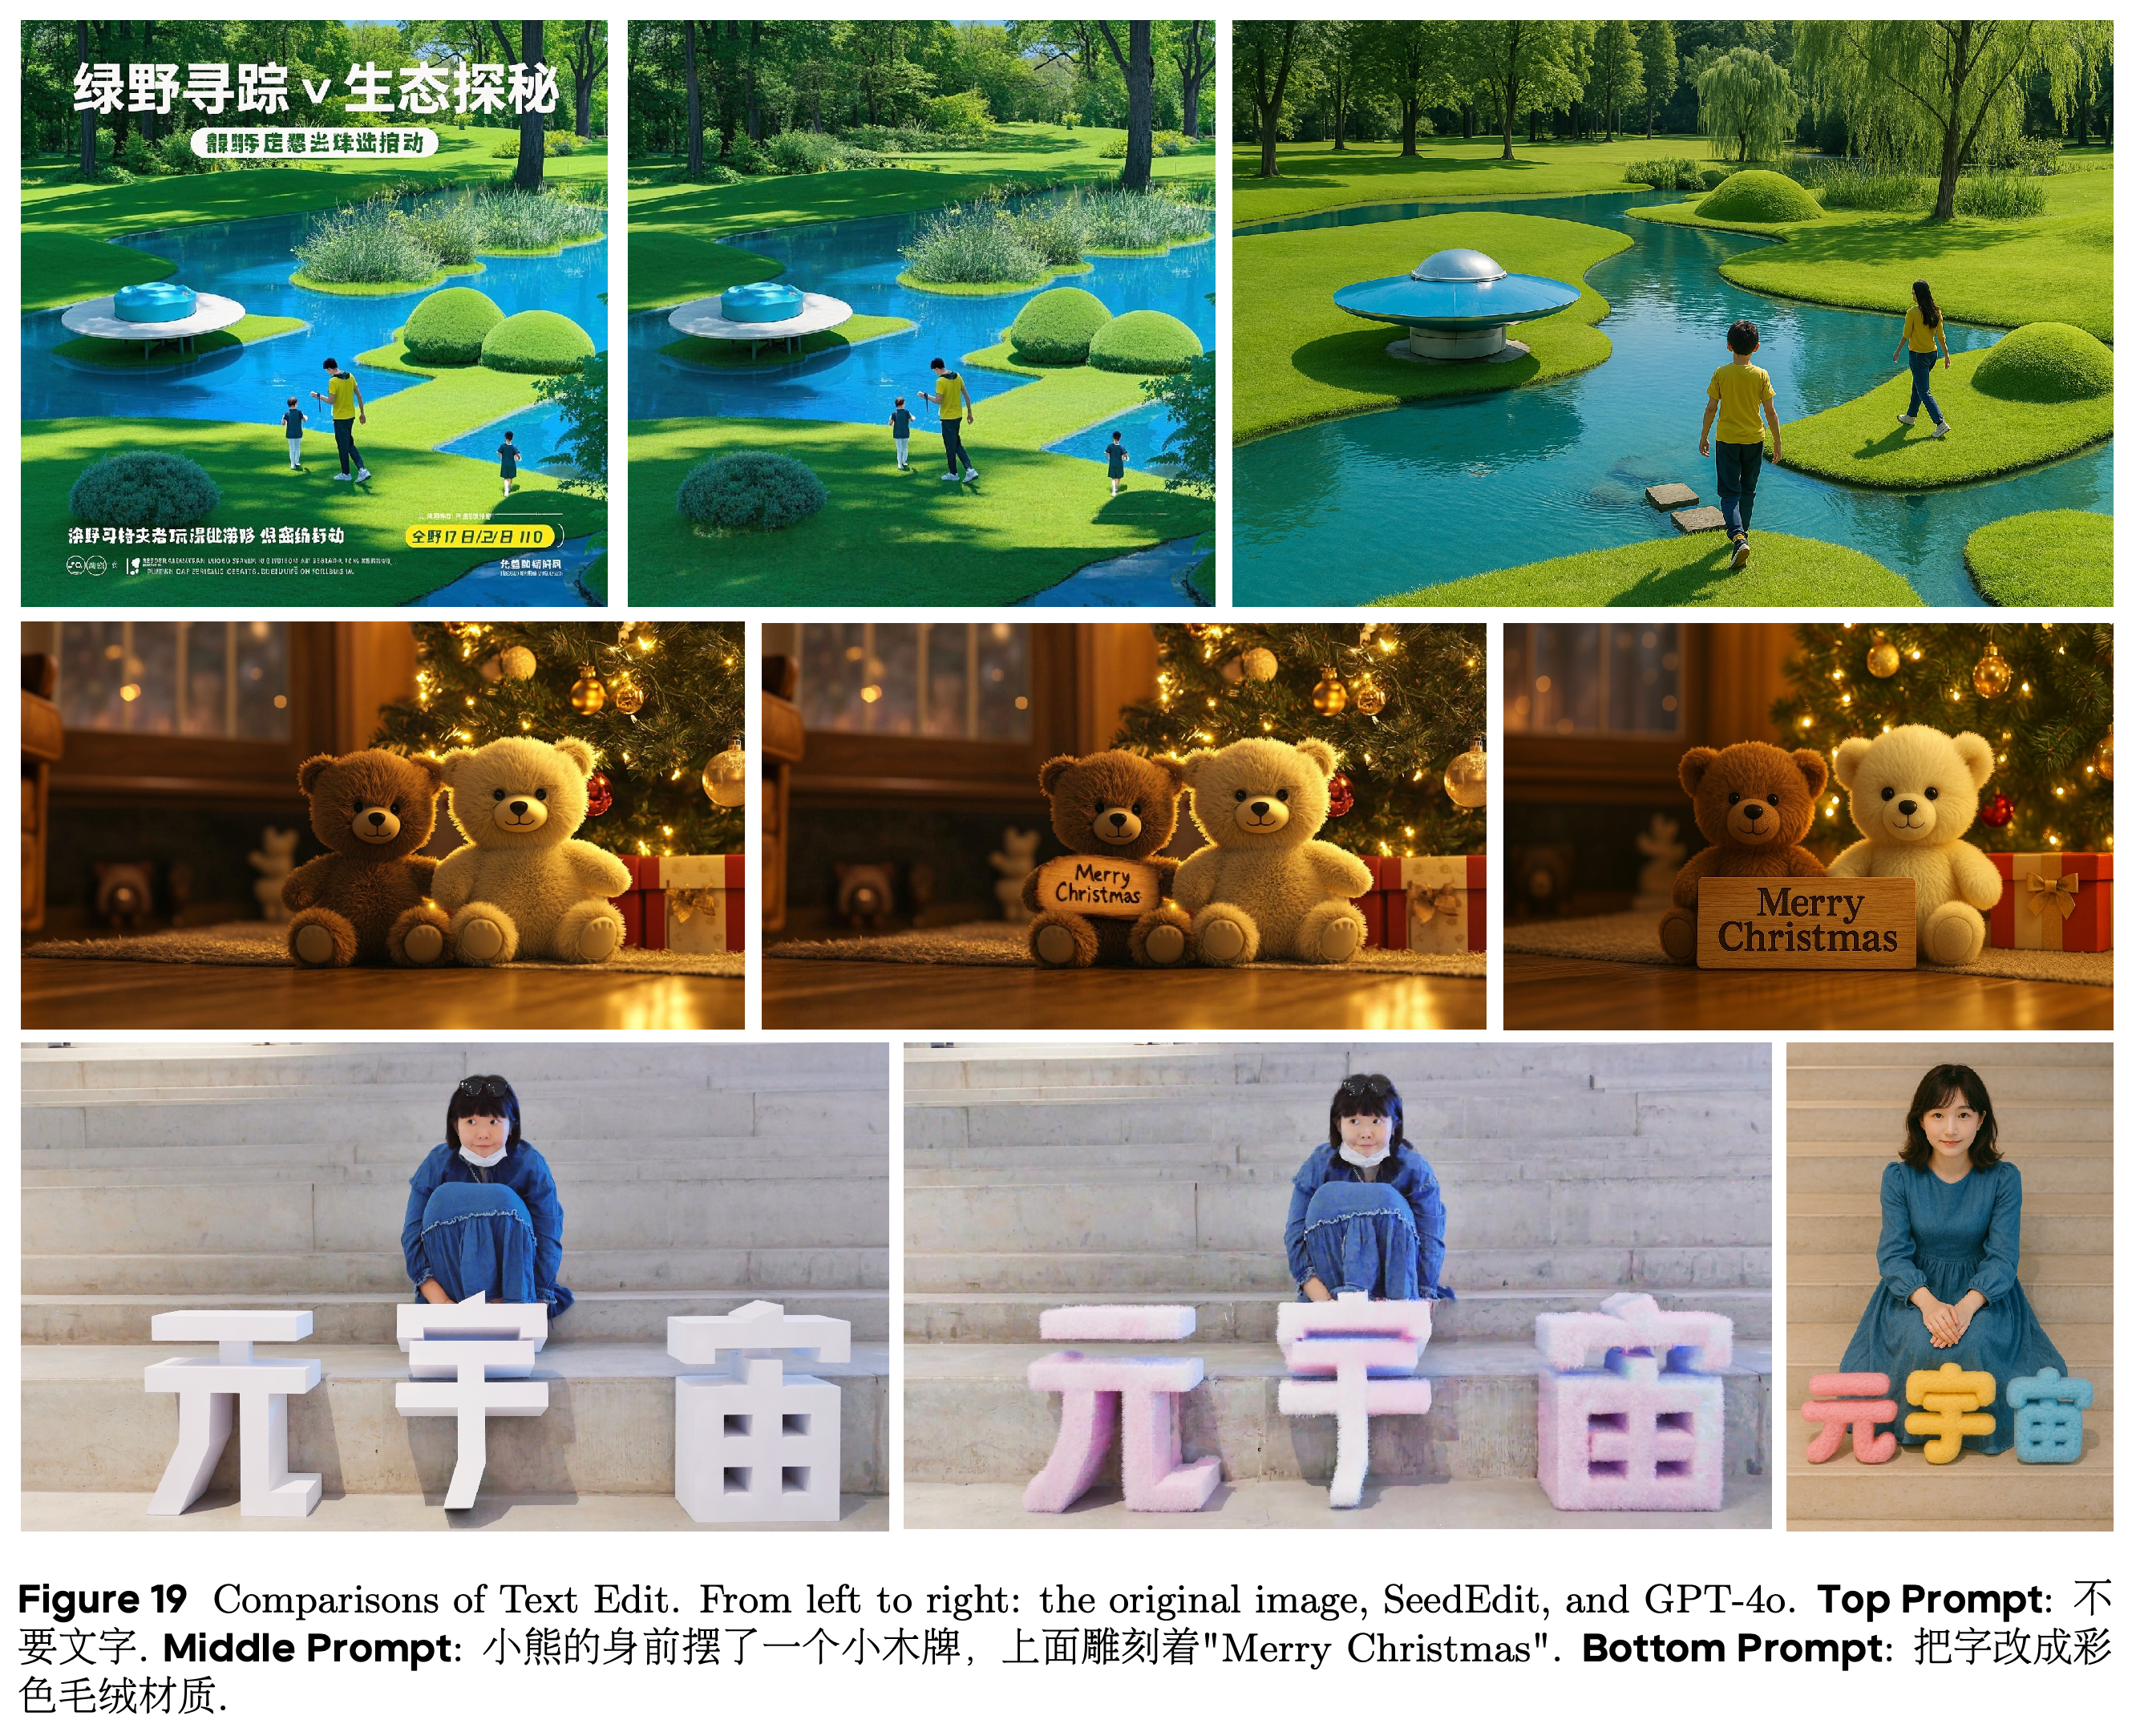
3.5.2 Image Editing에서는 Seedream에서 파생된 편집 모델 SeedEdit 1.6을 GPT-4o, Gemini-2.0과 선별된 단일 라운드 편집 사례로 비교한다. 헤어스타일 변경, 컬러화, 텍스트 제거, 텍스트 추가, 텍스트 재질 변경을 다룬다. 저자들은 인물의 정체성과 주변 이미지 내용을 보존하는 면에서 SeedEdit을 높이 평가한다.
- 보고서는 GPT-4o가 편집 요청을 유연하게 따르지만 원본 이미지를 바꾸는 경향이 있다고 설명한다. Gemini-2.0은 이미지 내용을 보존하지만 때때로 색상이 부자연스럽거나 이미지 품질이 낮아진다고 설명한다.
- SeedEdit은 여러 참조 이미지와 여러 차례에 걸친 편집에서 여전히 한계가 있다. 이러한 관찰은 파생 편집 모델에 관한 것이다.
헤어스타일 변경과 컬러화 편집은 얼굴, 장면 내용, 색상이 달라지는 양상을 보여준다. SeedEdit 1.6 예시는 Seedream 3.0에서 파생된 편집 모델을 평가한 결과다.
예시들은 텍스트 제거, 나무로 된 “Merry Christmas” 표지판 추가, 기존 글자를 다채로운 봉제 재질로 바꾸는 작업을 평가한다. 요청한 편집을 수행하는 과정에서 주변 이미지 내용도 함께 바뀔 수 있음을 보여준다.
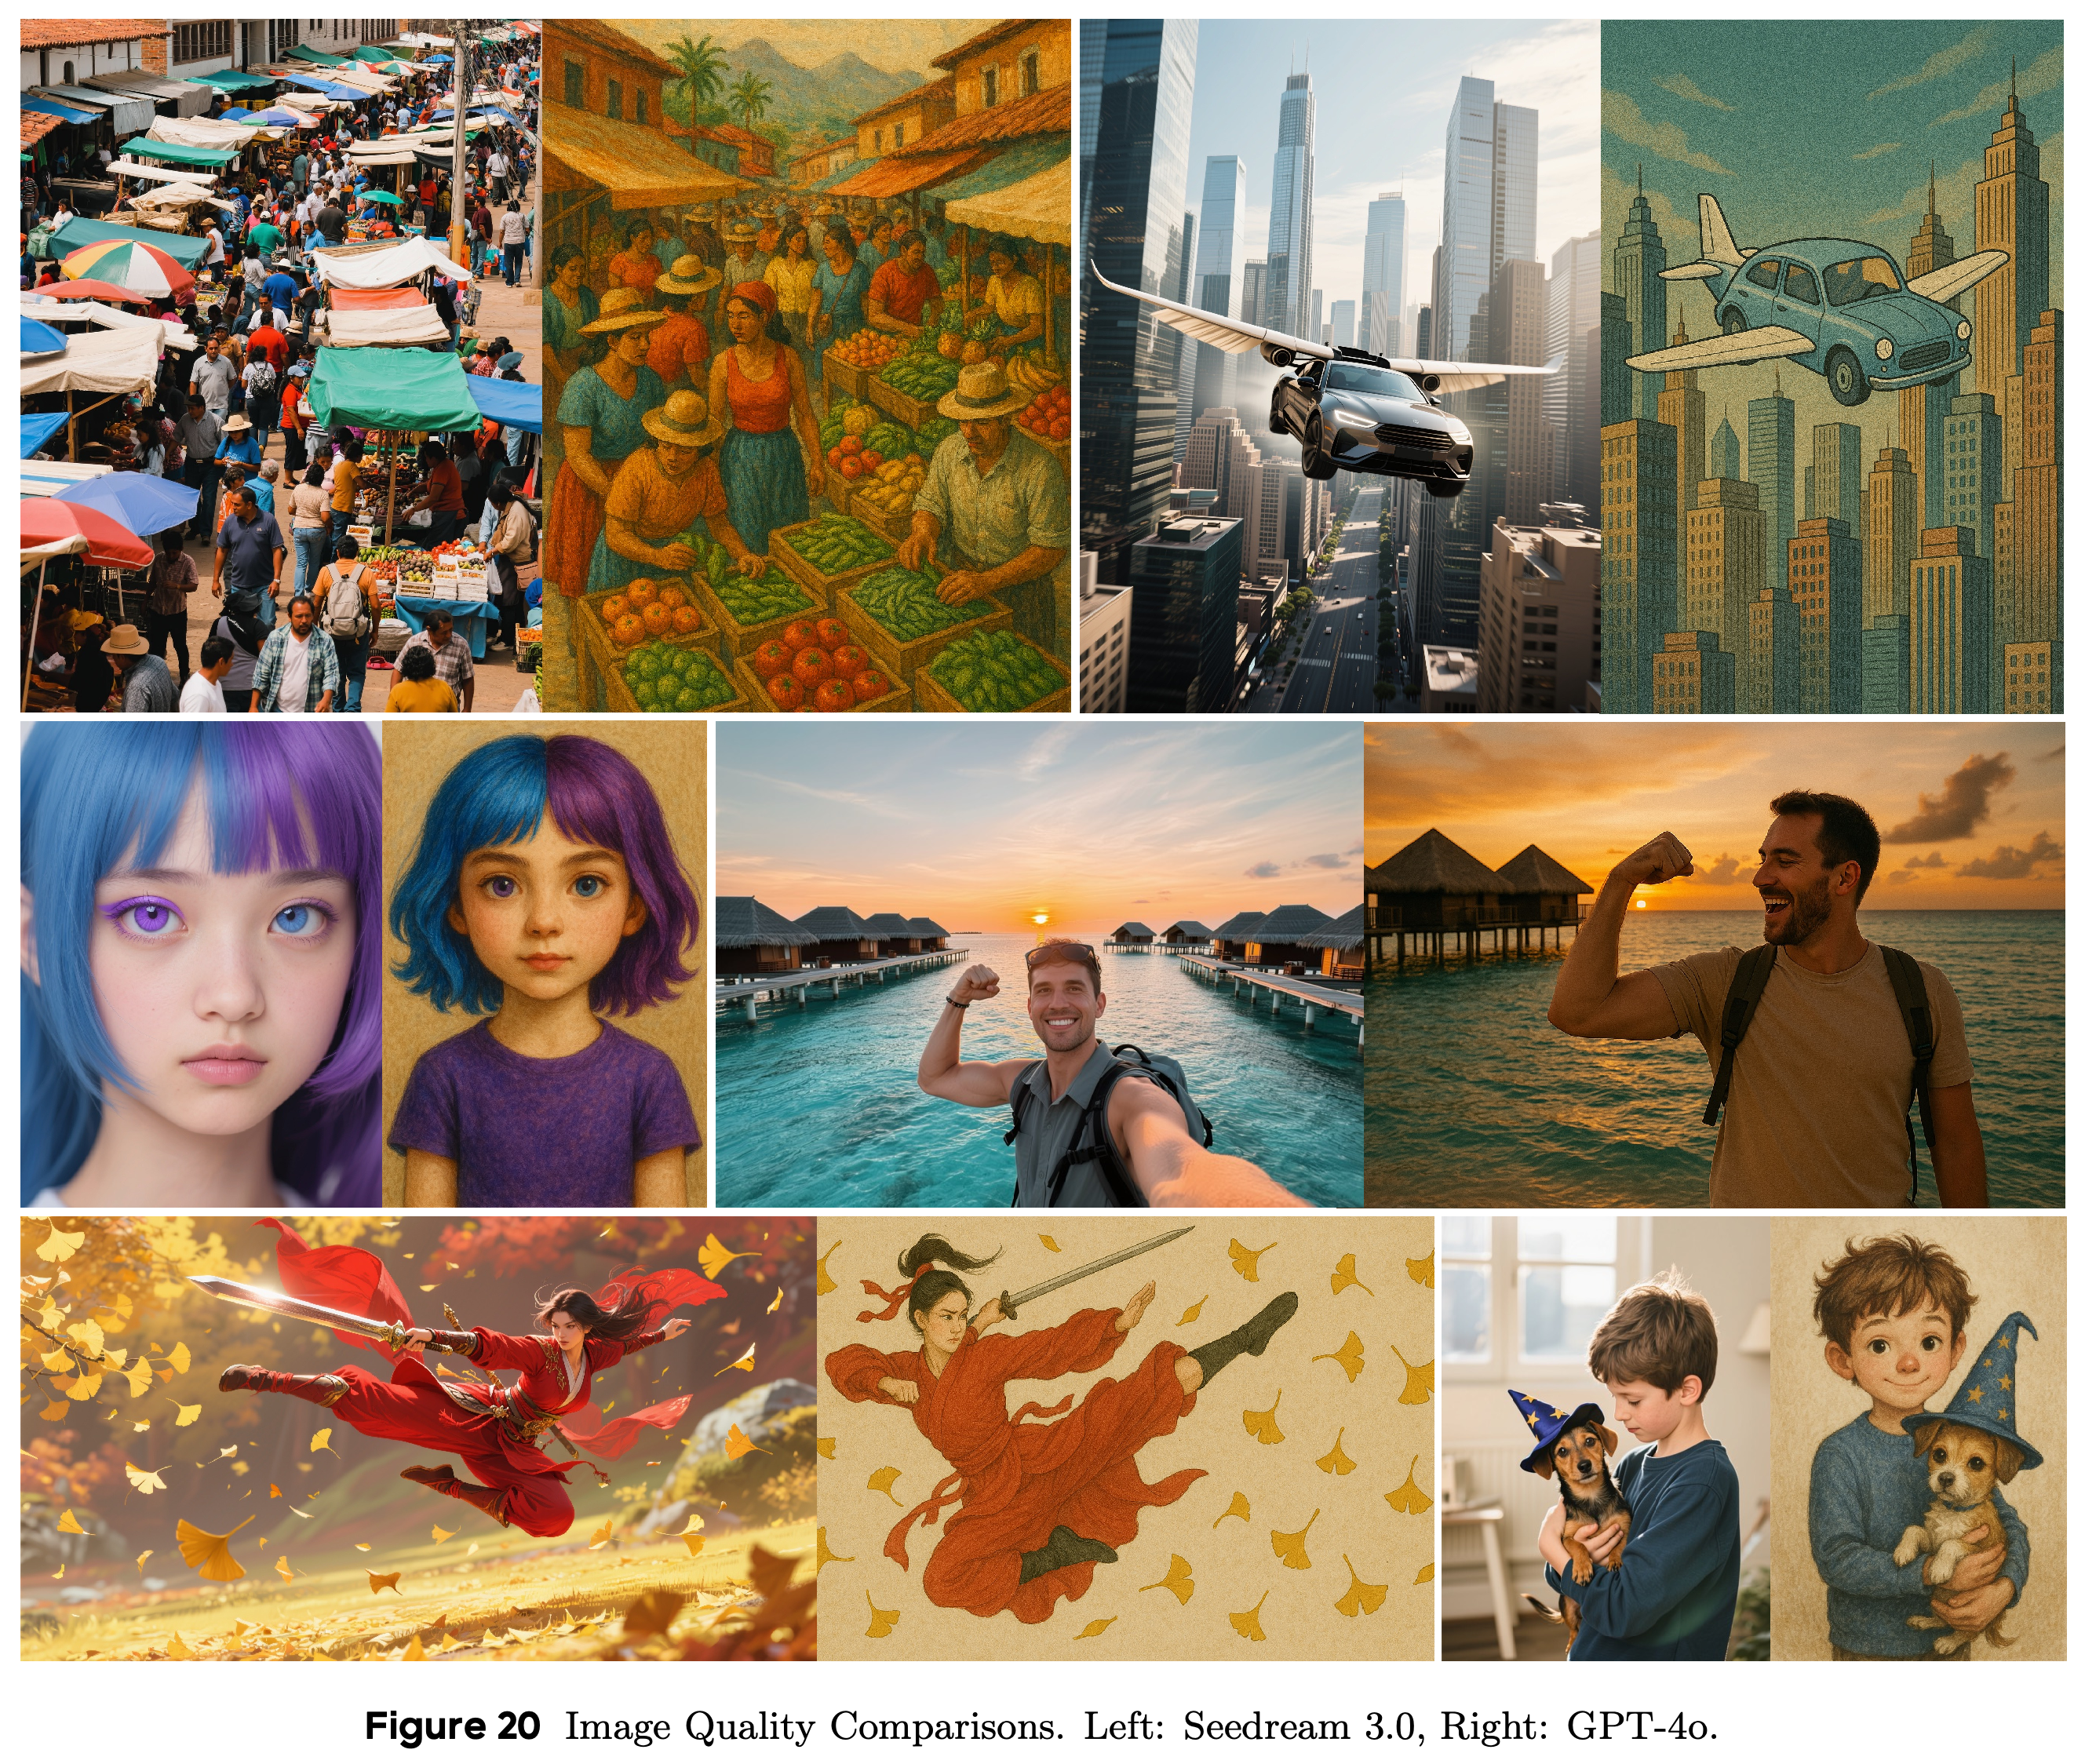
3.5.3 Generation Quality는 대응하는 생성 예시를 제시하며, 저자들은 GPT-4o 출력에서 더 어두운 노란 색조와 더 눈에 띄는 노이즈를 지적한다. 선별된 사례들은 색상, 질감, 선명도, 스타일의 차이를 보여주지만, 이러한 차이가 얼마나 자주 발생하는지에 대한 체계적인 추정치는 제공하지 않는다.
선별된 대응 예시들은 저자들의 품질 논의에서 다루는 색상, 질감, 렌더링 스타일의 차이를 보여준다. 이 사례들만으로 프롬프트 전반의 일반적인 품질 순위를 확립할 수는 없다.
4 Conclusion
결론은 프롬프트 준수, 타이포그래피, 미적 품질, 기본 고해상도 출력, 생성 속도의 개선을 전체 파이프라인에 걸친 변화의 결과로 설명한다. Doubao와 Jimeng을 통한 서비스 제공도 언급한다.
부록
- A Contributions and Acknowledgments는 A.1 Core Contributors와 A.2 Contributors 아래에 참여자를 성의 알파벳순으로 나열한다. 부록에는 기여자 명단만 있으며 추가 실험이나 구현 세부 사항은 없다.
짧은 생각
버리던 이미지에서 깨끗한 영역을 활용하고, 이미지와 텍스트의 위치 정보를 연결하며, 상세한 캡션으로 미적 특성을 학습시키는 방식은 이 보고서에서 제시하는 구체적인 엔지니어링 아이디어다. 중국어와 영어 렌더링 결과는 전체 시스템의 효과를 뒷받침한다. 다만 구성 요소별 제거 실험, 생성 모델 크기, 학습 연산량, 상세한 가속 측정치가 없어 재현성과 성능 향상의 원인 분석에는 한계가 있다. 보고된 평가는 Seedream 2.0 대비 개선을 뒷받침한다. 거의 동률인 Arena 결과와 선별된 직접 비교만으로 GPT-4o에 대한 결정적인 우위를 입증할 수는 없다.