Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players 요약 설명
27 May 2026 | Paper Review Multi-Agent World Models Interactive World Models Sparse Attention Diffusion Acceleration목차
이번 글에서는 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 5월 27일(Arxiv)
- Liu, Fangfu, He, Kai, Shen, Tianchang, Cao, Tianshi, Fidler, Sanja, Duan, Yueqi, Gao, Jun, Gilitschenski, Igor, Wang, Zian, Ren, Xuanchi.
- NVIDIA, Tsinghua University, University of Toronto, Vector Institute
- 논문 링크
- Project Page
요약
- Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players는 공유 환경에서 행동하는 에이전트들을 위해 행동 조건에 따라 동기화된 영상을 생성하는 문제를 다룬다. 모델은 에이전트별 관점과 시간에 걸쳐 일관성을 유지해야 하며, 학습된 플레이어별 슬롯 정체성 없이 각 에이전트를 독립적으로 제어할 수 있어야 한다.
- γ-World는 정단체의 꼭짓점을 이용해 에이전트마다 서로 다른 위상을 부여하는 Simplex Rotary Agent Encoding과 공유 허브 토큰을 통해 에이전트 간 통신을 수행하는 Sparse Hub Attention을 결합한다. 양방향 교사 모델, 별도로 사전 학습한 인과적 학생 모델, 조건부 Self-Forcing 증류를 통해 소수 단계의 KV 캐시 기반 스트리밍 생성을 구현하며, 보고된 속도는 24 FPS다.
- Minecraft 평가에서는 5개 평가 범주 모두에서 프레임 연결 방식과 Solaris보다 낮은 FVD와 FID를 보고한다. 정성적 예시는 추가 학습 없이 플레이어 수를 2명에서 4명으로 늘릴 수 있음을 보여준다. 4명 플레이어의 영상 생성과 실제 로봇의 협응은 정성적으로 평가하며, 모델은 기하 구조나 물리적 제약을 명시적으로 강제하지 않는다.
1. Introduction
서론에서는 영상 월드 모델을 2개가 넘는 에이전트로 확장할 때 나타나는 2가지 장애물을 제시한다. 밀집 결합 어텐션의 비용은 에이전트 수에 대해 이차적으로 증가하고, 학습된 슬롯별 정체성은 서로 교환 가능한 에이전트들을 고정된 구성에 묶는다. γ-World는 이를 정단체 기반 회전 정체성 인코딩과 허브를 통한 통신으로 대체한다.
- 공유 세계의 일관성을 유지하려면 일반적인 시간적 일관성뿐 아니라, 한 스트림에서 수행한 행동이 다른 에이전트의 관측에서도 서로 부합하는 결과를 만들어야 한다.
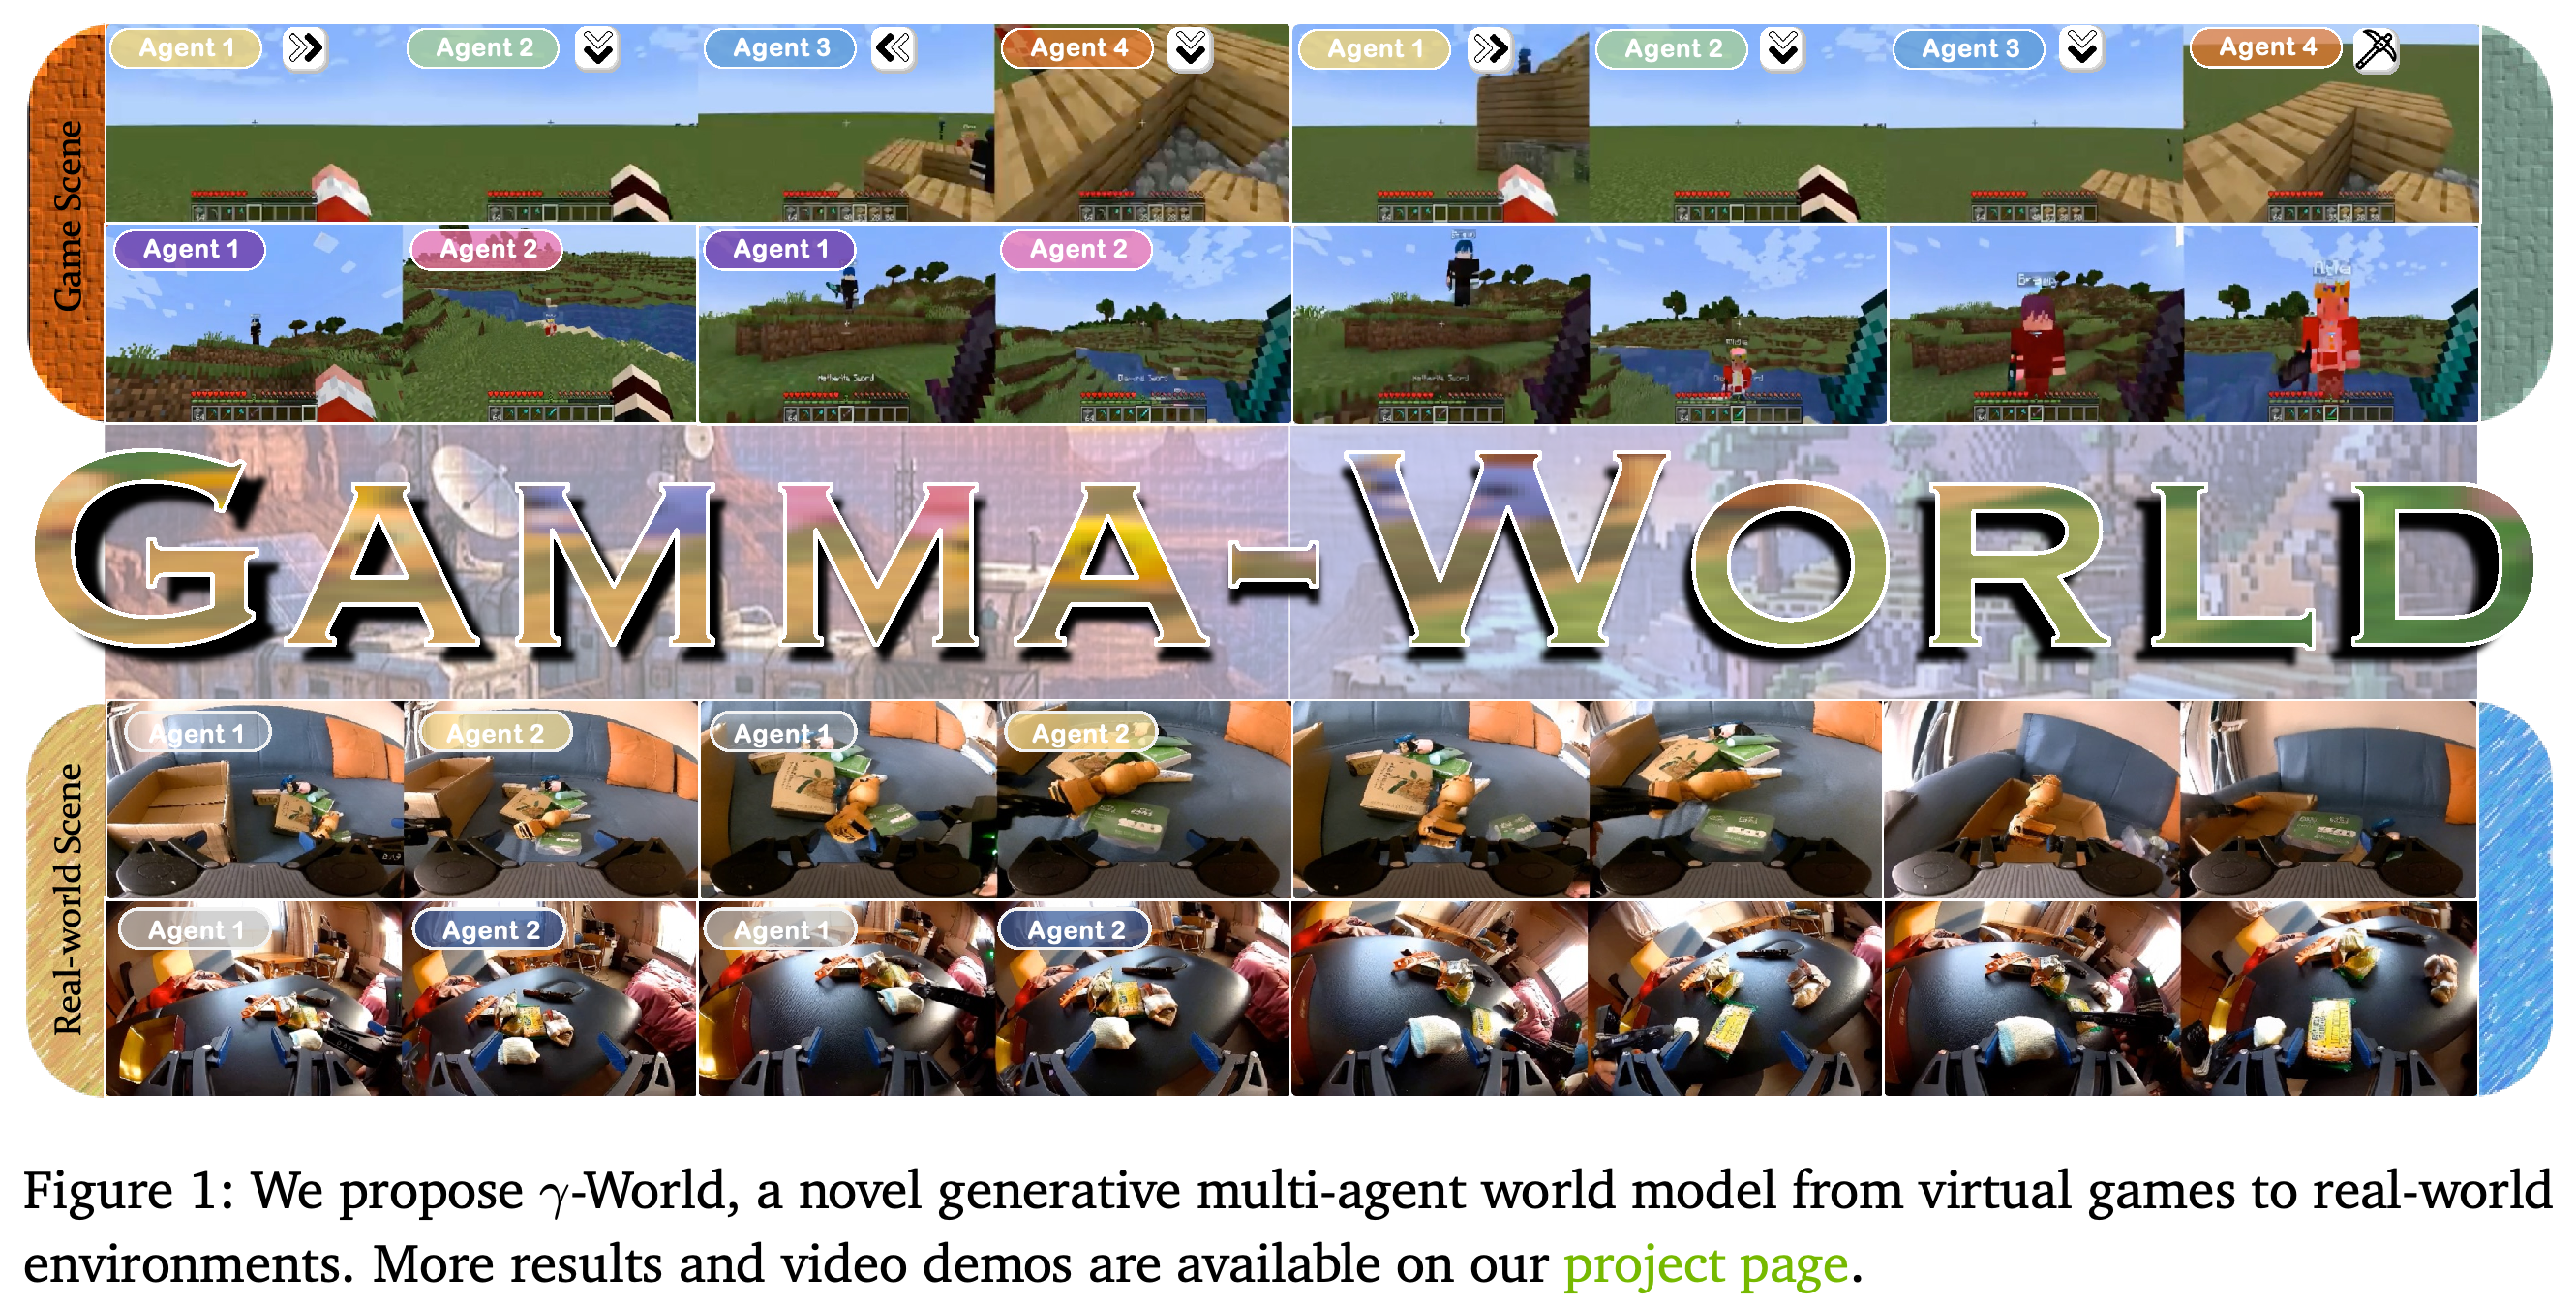
- Figure 1은 멀티플레이어 Minecraft와 실제 로봇 예시를 미리 보여준다. 프로젝트 페이지는 research.nvidia.com/gamma-world다.
이 모음은 게임플레이와 실제 로봇 예시를 구분하고, 하나로 합친 출력 대신 여러 에이전트의 관측을 제시한다. 2명 및 4명 플레이어의 게임플레이와 짝지어진 로봇 관측을 미리 보여주지만, 통제된 비교는 제공하지 않는다.
2. Related Work
관련 연구에서는 γ-World를 잠재 공간 영상 생성, 행동 조건부 영상 월드 모델, 확산 모델 증류와 연결한다. 이 논문의 기여는 새로운 영상 백본이 아니라, 기존 영상 확산 모델과 인과적 롤아웃 방법을 바탕으로 설계한 다중 에이전트 표현과 통신 방식이다.
- 영상 생성에서는 잠재 확산 모델이 효율적인 영상 합성을 제공하고, 자기회귀 방식이 시간에 따라 생성을 연장할 수 있게 한다.
- 영상 월드 모델에서는 미래 시각 관측을 직접 예측하는 모델과 계획에 사용하는 간결한 추상 상태 모델을 구분한다. 로봇, 게임, 주행, 물리 시뮬레이션 분야의 응용도 검토한다.
- 영상 확산 모델 증류에서는 적대적 방식과 점수 증류 방식을 비교한다. 이어서 CausVid의 양방향 모델에서 인과적 모델로의 전이와, 생성된 이력을 사용해 롤아웃의 노출 편향을 줄이는 Self-Forcing을 다룬다.
3. Method
목표는 동기화된 관측 및 행동 이력으로부터 P개 에이전트 각각의 다음 관측을 예측하는 것이다. 같은 시점의 관측은 동일한 세계를 서로 다른 관점에서 본 결과다. γ-World는 명시적인 에이전트 축, 회전 정체성 인코딩, 제한된 에이전트 간 어텐션을 사용해 각 스트림을 함께 생성한다.
- 초기 관측은 시각적 맥락을 제공하며, 각 에이전트는 별도의 행동 시퀀스를 제공한다.
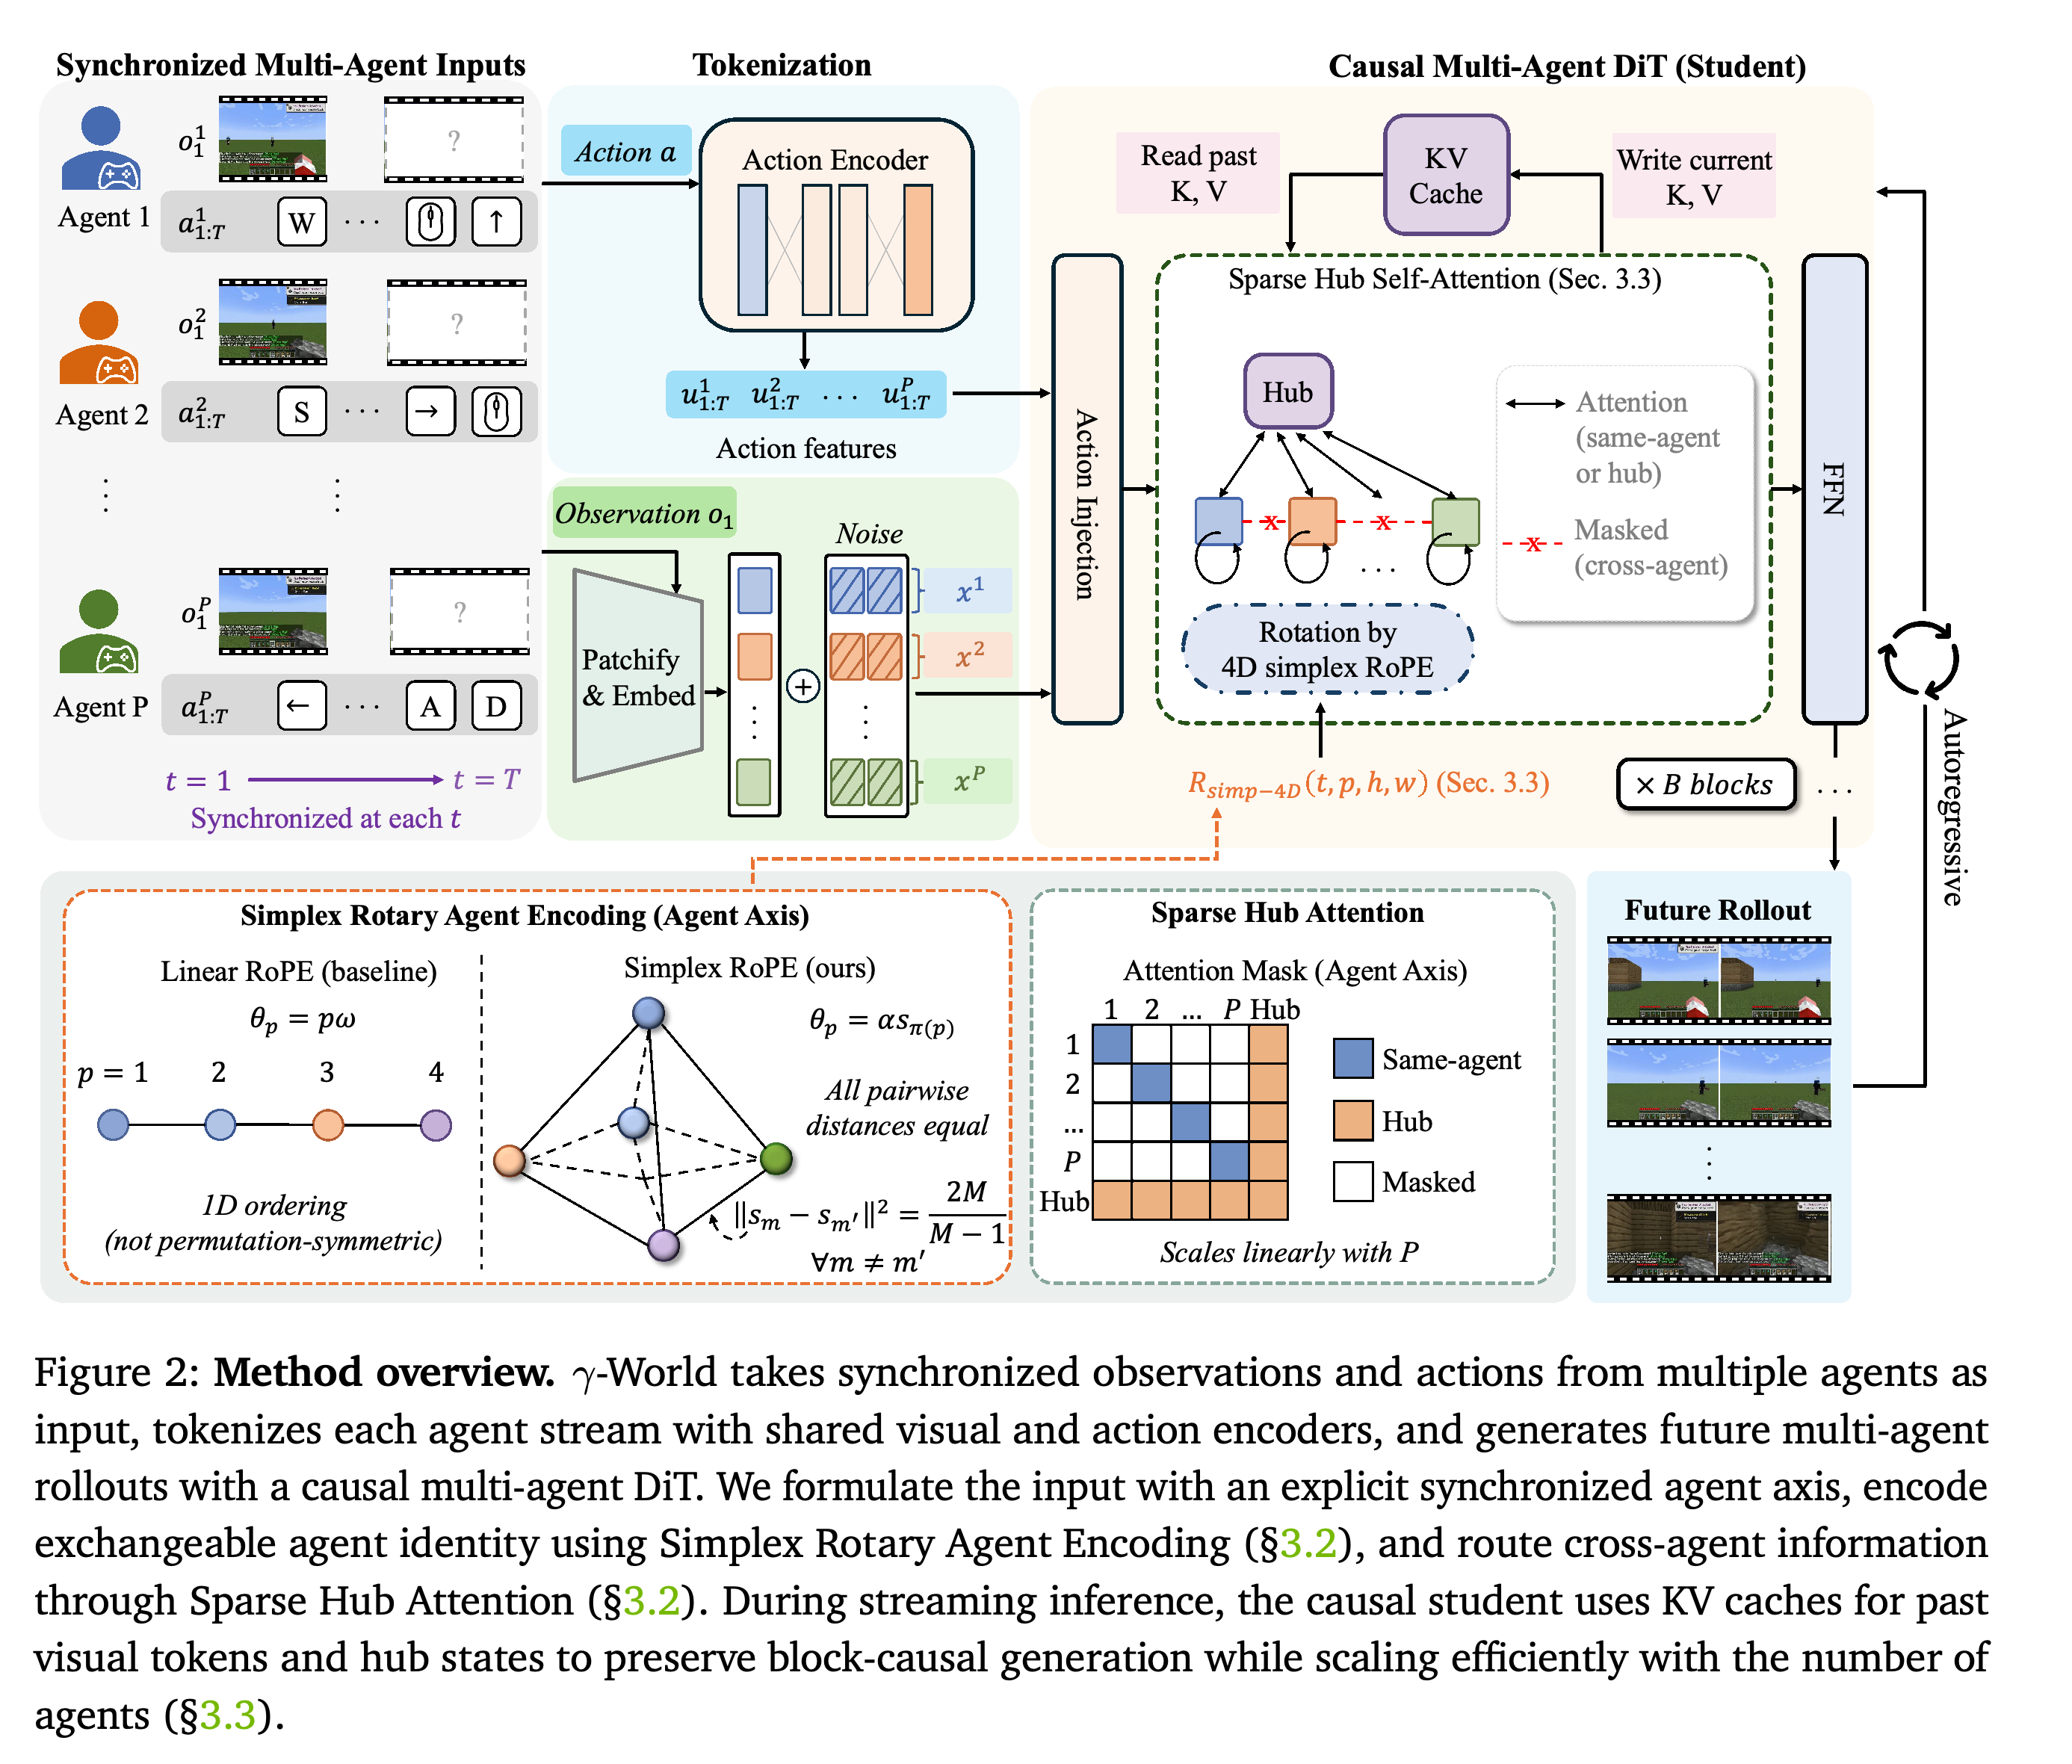
- Figure 2는 공유 시각 및 행동 토큰화가 인과적 다중 에이전트 DiT, 정단체 기반 회전, 허브를 통한 어텐션, 스트리밍 KV 캐시로 이어지는 과정을 보여준다. Section 3.3은 3단계 학습 절차를 자세히 설명한다.
이 도식은 독립적인 행동 입력이 공유 인코더를 거쳐 에이전트별 시각 스트림으로 이어지는 과정을 보여준다. 아래 패널은 정단체 기반 회전 정체성과, 에이전트 간 직접 연결을 허브 통신으로 대체하는 어텐션 마스크를 보여준다. 캐시된 시각 및 허브 상태는 이력을 다음 인과적 블록으로 전달한다.
3.1. Preliminaries
잠재 공간 영상 확산은 플로 매칭을 사용한다. 식은 zσ = (1 − σ)z0 + σε이며, ε는 가우시안 잡음이고 σ ∈ [0, 1]이다. 속도 모델은 초기 관측과 에이전트 행동을 포함한 조건 아래에서 ε − z0를 예측한다.
- 인과적 자기회귀 영상 생성에서는 시간 블록마다 독립적으로 샘플링한 잡음 수준을 부여한다. 블록 내부의 어텐션은 양방향이지만 미래 블록에는 접근할 수 없다.
- Rotary Position Embedding (RoPE)에서는 일반적인 영상 RoPE가 시간, 높이, 너비의 회전 대역을 분리한다. 다중 에이전트 모델은 이 분해된 위치 인코딩에 에이전트 대역을 추가한다.
3.2. Model Design
행동 조건화에서는 공유 인코더가 각 에이전트의 행동을 은닉 특징으로 변환한다. 계층별 투영은 자기 어텐션 전에 이 특징을 해당 에이전트와 프레임 토큰에 편향으로 더한다. 인코더와 투영을 공유하므로 에이전트 슬롯과 관계없이 같은 행동은 같은 표현을 갖는다.
- 다중 에이전트 잠재 텐서의 형태는 P × T × H × W × Cz다. 하나의 공간 캔버스를 확장하는 대신 각 스트림을 분리해 유지한다.
- 이산 제어나 여러 성분으로 구성된 제어를 임베딩한 뒤 경량 MLP로 결합한다. 행동 편향은 해당 프레임의 공간 토큰 전체에 브로드캐스트한다.
Simplex Rotary Agent Encoding은 RoPE에 에이전트 회전 대역을 추가하고, 활성 에이전트들을 고정된 정단체 풀의 서로 다른 꼭짓점에 배정한다. 풀 크기가 V일 때 구성 조건은 V ≤ dp/2 + 1이다. 꼭짓점은 단위 노름을 갖고, 꼭짓점 간 거리의 제곱은 2V/(V − 1)이며, 에이전트 각도는 θp = αsπ(p)다.
- 학습 중 무작위 단사 배정을 사용해 고정 슬롯에 대한 특화를 억제한다. 추론 시 추가 에이전트는 풀의 미사용 꼭짓점을 사용하므로, 지원 가능한 에이전트 수는 설정된 풀 크기로 제한된다.
- 구현된 풀에는 꼭짓점이 4개 있다. 학습에서는 무작위로 선택한 꼭짓점 2개를 활성화하고 에이전트 슬롯의 순서도 바꾼다.
- ReRoPE를 따라 에이전트 대역에는 저주파 시간 RoPE 차원을 사용하고, 고주파 시간 대역과 공간 대역은 유지한다. 등거리 증명은 인코딩의 기하 구조에 관한 것이며, 학습된 전체 네트워크의 순열 등변성을 증명하지는 않는다.
Sparse Hub Attention은 서로 다른 에이전트 스트림 사이의 직접 어텐션을 마스킹한다. 에이전트 토큰은 자기 스트림과 공유 허브 토큰에 어텐션을 적용하고, 허브는 모든 에이전트와 다른 허브에 어텐션을 적용한다. 이를 통해 agent → hub → agent 통신 경로를 만든다.
- 허브 연결 구조에는 블록 단위 인과성도 적용한다. 허브는 자신에게 대응하는 프레임의 시간 위상을 사용하며, 에이전트 대역과 공간 대역에는 항등 회전을 사용한다.
- 프레임당 공간 토큰 수가 L = HW일 때 밀집 어텐션의 비용은 O(P²n²L²)이고, 허브 어텐션의 비용은 O(PnL(nL + nK)) + O(nK(PnL + nK))다. n, L, K가 고정되어 있으면 P에 대해 선형이다.
- 구현에서는 잠재 프레임마다 K = 8개의 학습 가능한 허브 토큰을 사용한다. 허브는 내부 통신 상태이며 출력에서는 제거한다.
3.3. Model Training and Inference
학습은 별도로 사전 학습한 2개 모델에서 시작한다. 양방향 교사 모델은 전체 맥락을 보는 밀집 어텐션과 공유 잡음 수준 1개로 조건부 다중 에이전트 디노이징을 학습한다. 인과적 학생 모델은 블록 단위 인과적 Sparse Hub Attention으로 전체 다단계 Diffusion Forcing 학습을 수행한다.
- 양방향 교사 모델은 첫 프레임 관측과 에이전트별 행동을 조건으로 받는다. 미래 프레임과 모든 에이전트 스트림에 접근할 수 있으므로 온라인 생성에는 적합하지 않다.
- 인과적 학생 모델에서는 시간 블록마다 독립적인 잡음 수준을 부여한다. 학생 모델은 짧은 인과적 워밍업만 거치는 것이 아니라, 증류 전에 완전한 다단계 생성기로 학습한다.
조건부 Self-Forcing 증류는 distribution matching distillation (DMD)을 사용해 소수 단계 학생 모델을 자체 자기회귀 롤아웃으로 학습한다. 교사와 학생에게 동일한 첫 프레임 관측과 에이전트별 행동을 제공하므로, 분포를 일치시키는 과정에서도 지정된 조건부 생성 과제를 유지한다.
- 생성된 블록은 KV 캐시에 기록하고 이후 이력으로 재사용한다. 이는 배포 시 롤아웃 과정과 일치한다.
- KV 캐시 기반 스트리밍 추론은 에이전트별 캐시와 공유 허브 캐시를 유지한다. 에이전트는 자기 이력과 허브 상태를 읽고, 허브는 모든 에이전트의 이력과 이전 허브 상태를 읽는다.
- 논문은 24 FPS의 스트리밍 속도를 보고한다. 관점별로 잠재 프레임 24개의 이동 창을 사용해 롤아웃 길이와 관계없이 캐시 크기를 제한한다. 다만 PDF에는 24-FPS 결과의 하드웨어나 활성 에이전트 수가 명시되어 있지 않다.
4. Experiments
실험에서는 스크립트로 구성한 에피소드, 협응하는 봇, 정렬된 시각·행동 기록을 통해 동기화된 Minecraft 궤적을 수집한다. 교사와 학생은 Cosmos-Predict2.5-2B TI2V에서 시작하며, 두 에이전트 게임플레이로 학습한다. 해상도는 관점별로 320 × 480 per view다. 네 에이전트 장면에서는 학습 때보다 많은 에이전트의 영상 생성 능력을 시험한다.
- FVD와 FID는 생성된 영상 및 이미지의 분포를 평가한다. LPIPS, PSNR, SSIM은 지각 품질과 재구성 품질을 평가한다.
- 확장성 평가는 에이전트 수에 따른 DiT 지연 시간, 자기 어텐션 지연 시간, 분석적으로 계산한 자기 어텐션 FLOPs를 포함한다.
- PDF에는 데이터셋 크기, 평가 샘플 수, 5개 평가 프로토콜의 상세 정의가 명시되어 있지 않다. 이 때문에 재현성과 프로토콜별 결과 해석에 제약이 있다.
4.1. Quantitative Results
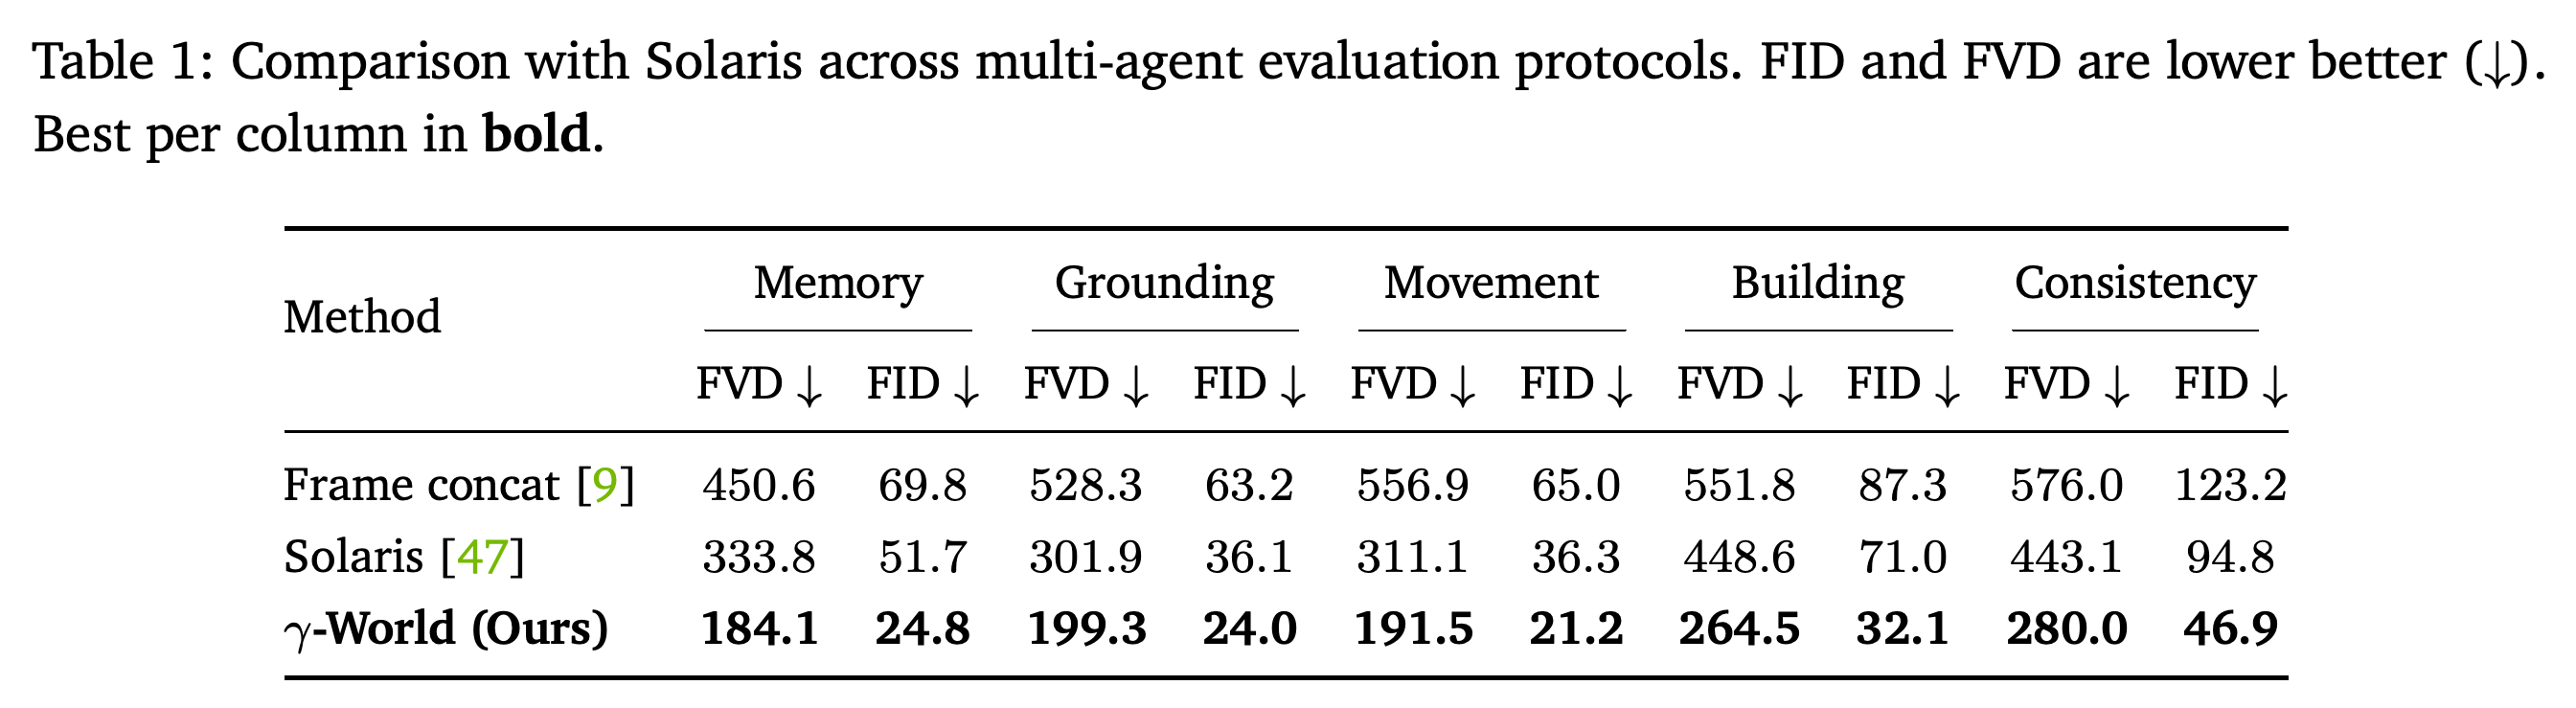
다중 에이전트 기준 모델 비교에서 Table 1은 Memory, Grounding, Movement, Building, Consistency 모두에서 γ-World가 가장 낮은 FVD와 FID를 기록했다고 보고한다. 이 순서대로 γ-World의 FVD는 184.1, 199.3, 191.5, 264.5, 280.0이며, Solaris는 333.8, 301.9, 311.1, 448.6, 443.1이다.
- γ-World의 대응하는 FID는 24.8, 24.0, 21.2, 32.1, 46.9이며, Solaris는 51.7, 36.1, 36.3, 71.0, 94.8이다.
- 프레임 연결 방식은 보고된 모든 열에서 두 방법보다 성능이 낮다.
- 이 결과는 보고된 시각적 분포 지표가 개선되었음을 보여준다. PDF에는 행동 준수나 관점 간 기하적 일관성을 직접 평가하는 별도의 수치 지표가 없다.
γ-World는 모든 평가 범주에서 2개 기준 모델보다 낮은 FVD와 FID를 기록한다. Consistency에서는 Solaris의 FVD 443.1과 FID 94.8이 각각 280.0과 46.9로 낮아진다. 다만 이는 해당 이름의 평가 프로토콜에서 측정한 시각적 분포 지표이며, 기하적 일관성을 직접 측정한 값은 아니다.
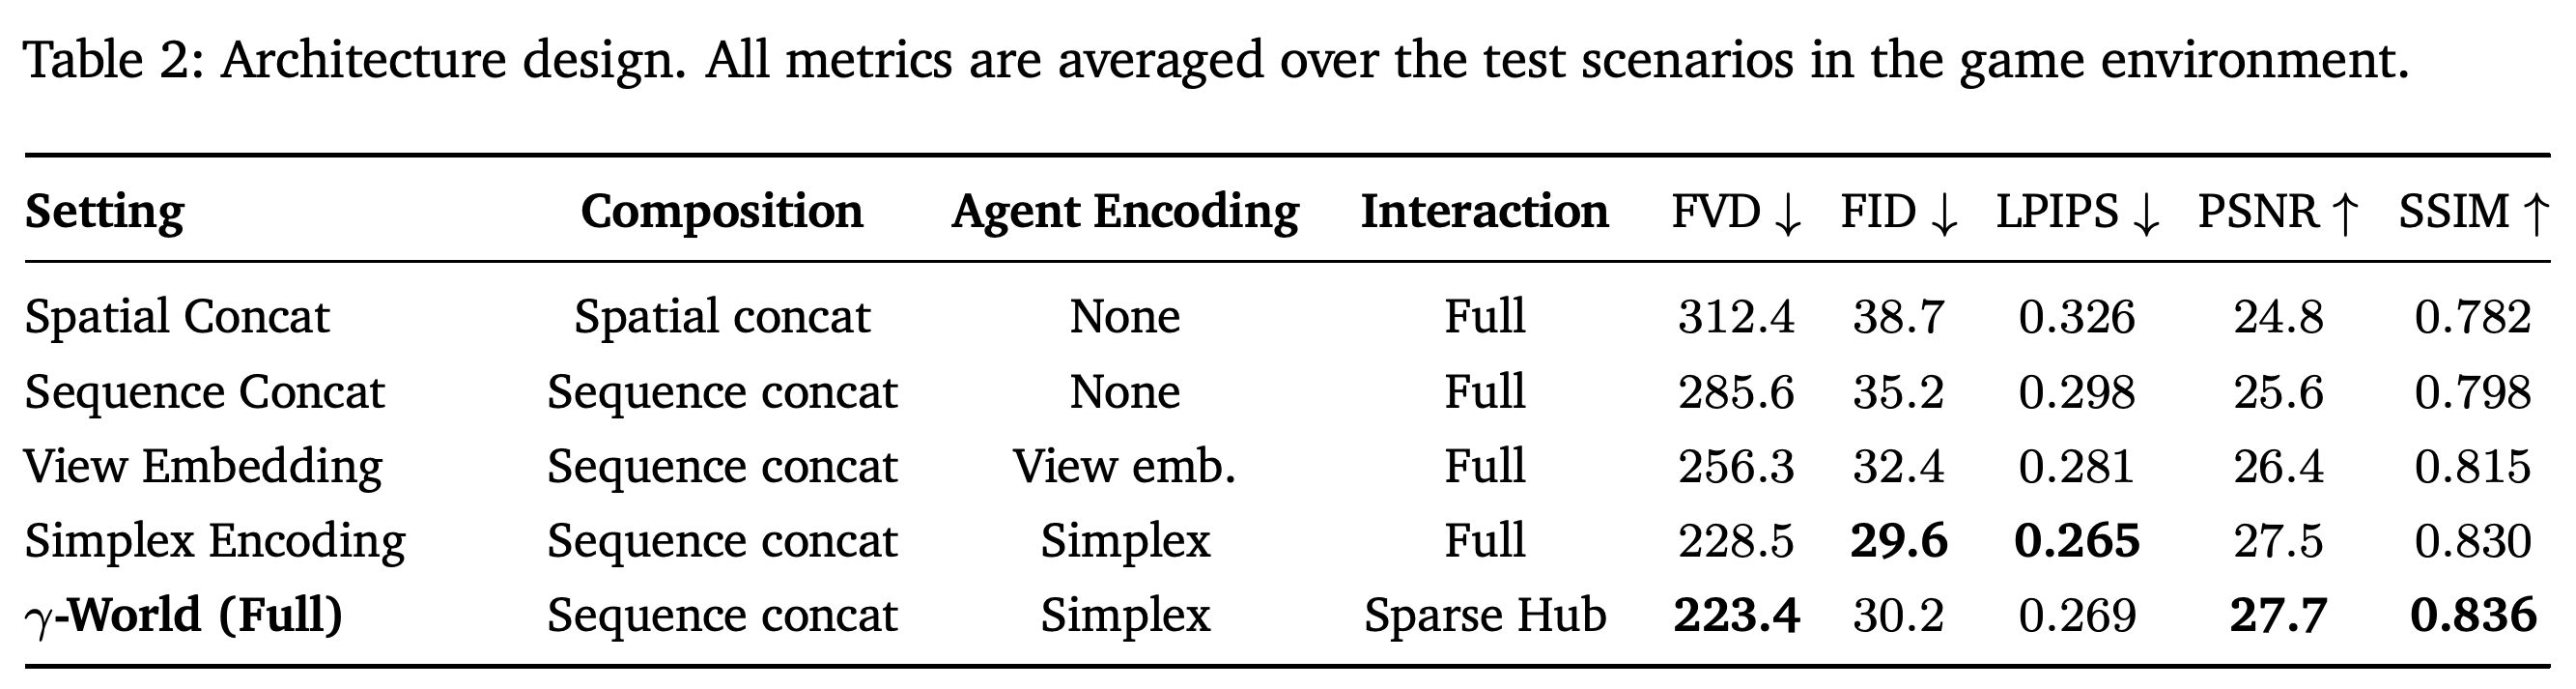
구조 어블레이션에서 Table 2는 전체 어텐션을 사용할 때 Spatial Concat의 FVD가 312.4, Sequence Concat이 285.6, 학습된 View Embedding이 256.3, Simplex Encoding이 228.5라고 보고한다. Sparse Hub Attention을 추가하면 FVD는 223.4, PSNR은 27.7, SSIM은 0.836이다.
- 스트림을 분리해 유지하면 공간 연결 방식보다 보고된 모든 지표가 개선된다. 정단체 인코딩도 학습된 뷰 임베딩보다 5개 지표 모두에서 성능이 높다.
- 허브 어텐션이 밀집 정단체 어텐션보다 모든 지표를 개선하는 것은 아니다. FID는 29.6에서 30.2로, LPIPS는 0.265에서 0.269로 바뀐다.
- 따라서 희소 설계는 모든 지표를 일률적으로 개선하기보다는 경쟁력 있는 품질을 유지한다.
이 어블레이션은 입력 구성, 정체성 인코딩, 상호작용 연결 구조를 나누어 비교한다. 정단체 인코딩은 학습된 뷰 임베딩보다 5개 지표 모두에서 성능이 높다. 밀집 정단체 어텐션을 허브로 대체하면 FVD, PSNR, SSIM은 개선되지만 FID와 LPIPS는 소폭 나빠진다.
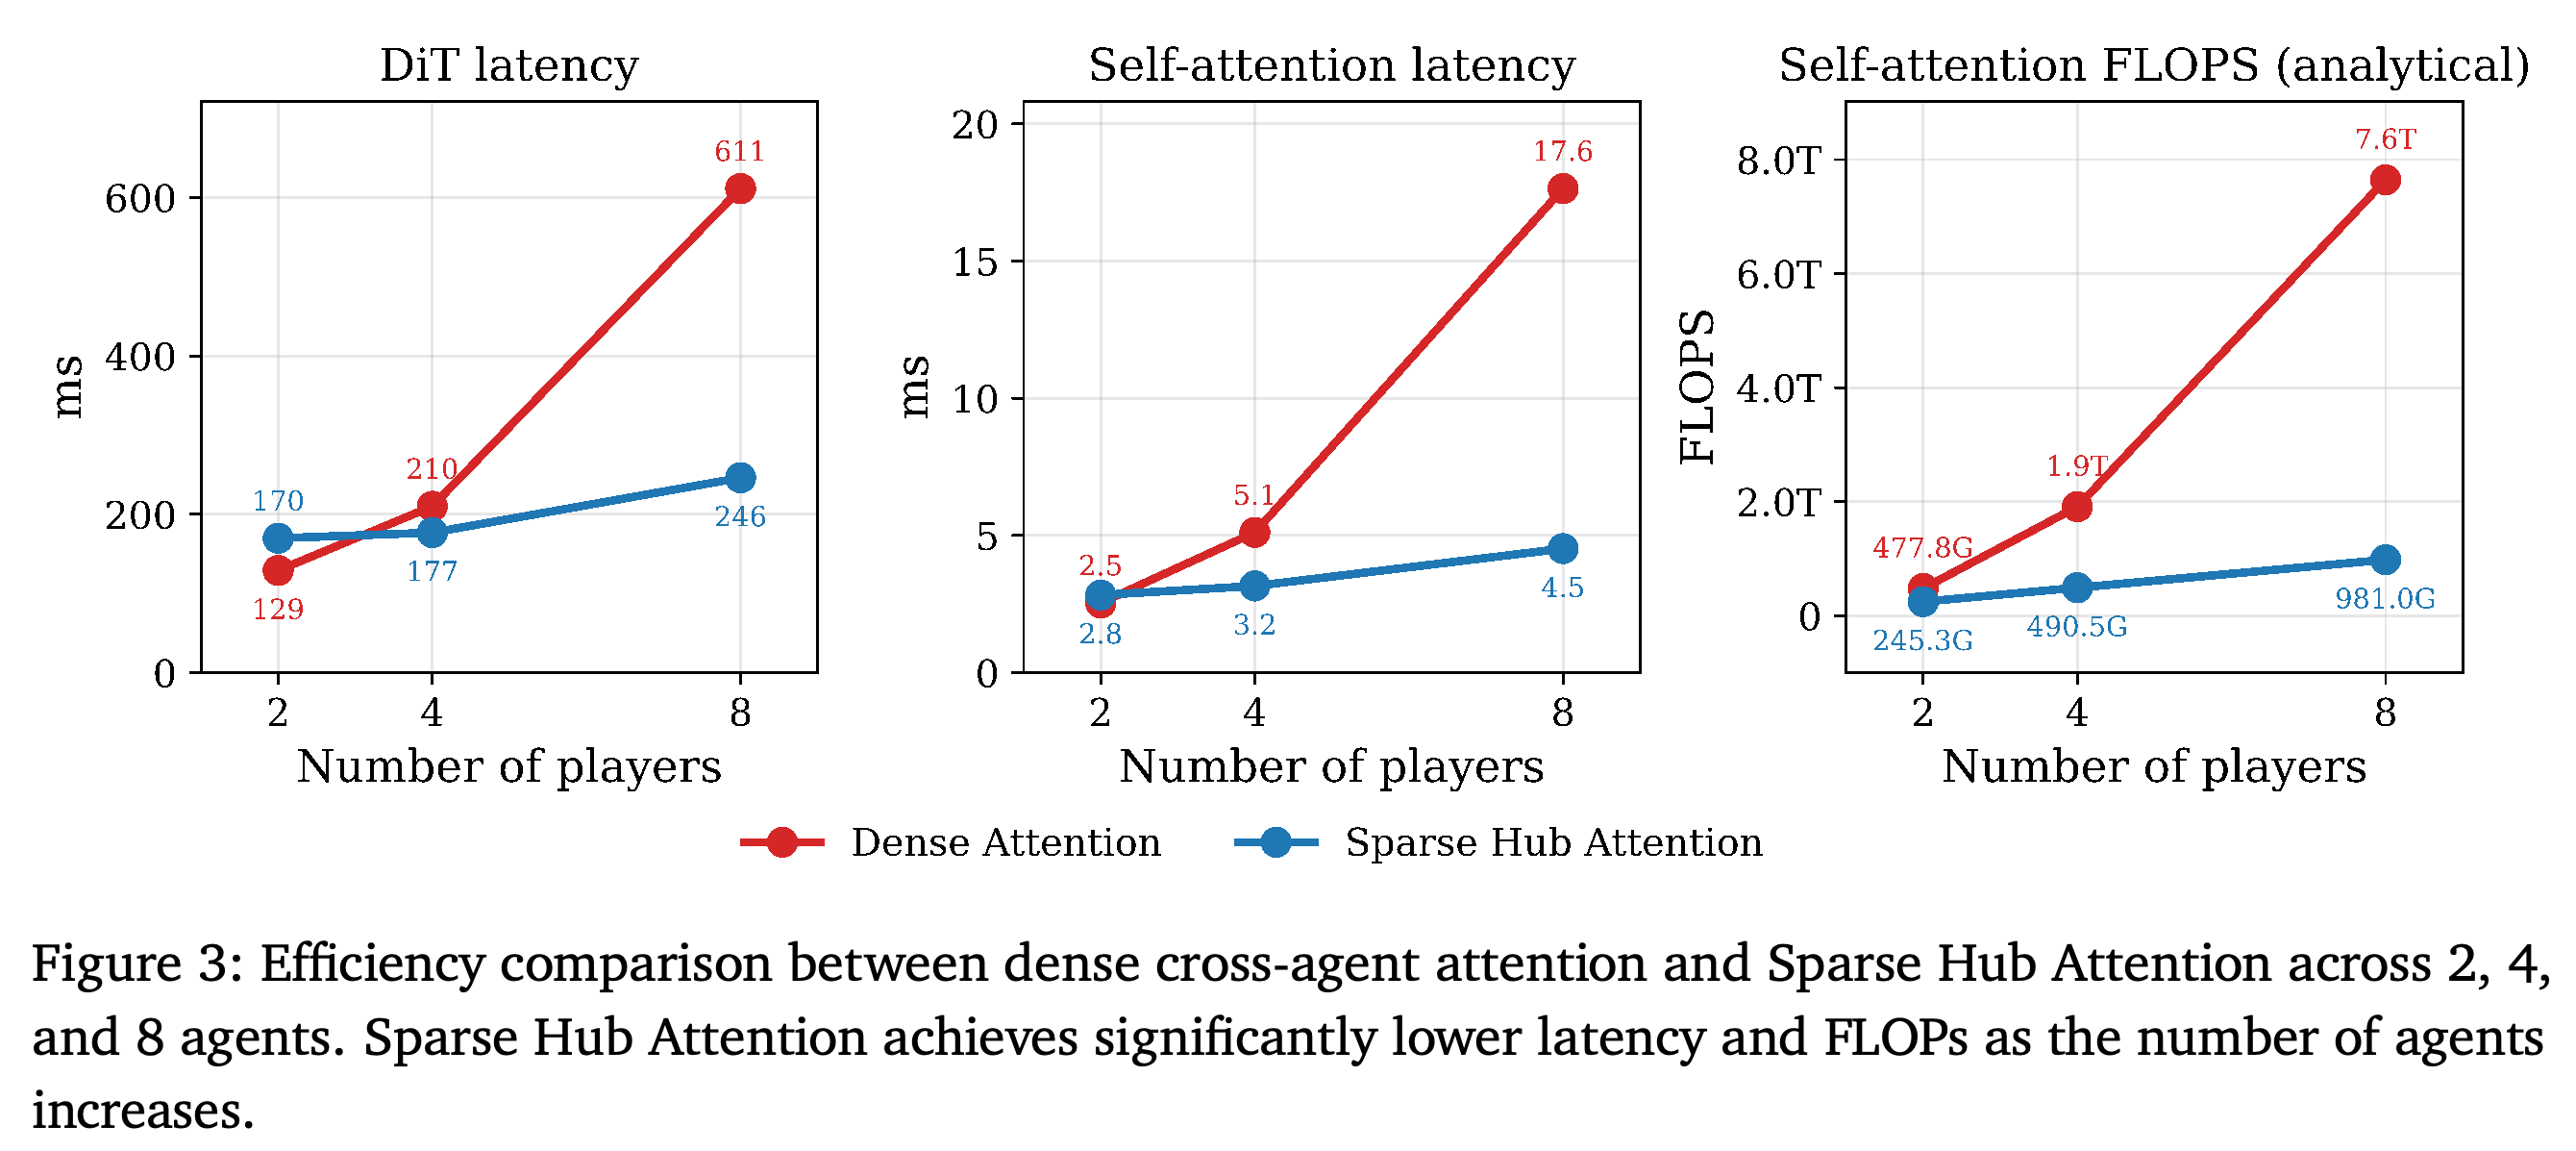
Sparse Hub Attention의 효율을 평가한 Figure 3은 전체 KV 캐시를 사용해 잠재 프레임 24개까지 생성하는 전체 롤아웃 3회의 평균 지연 시간을 보여준다. FLOPs는 평균 롤아웃 토큰 길이를 사용해 분석적으로 추정한다. 에이전트가 8개일 때 허브 어텐션은 DiT 지연 시간을 611 ms에서 246 ms로, 자기 어텐션 지연 시간을 17.6 ms에서 4.5 ms로 줄인다.
- 에이전트가 2, 4, 8개일 때 밀집 자기 어텐션의 FLOPs는 477.8G, 1.9T, 7.6T이고, 허브 어텐션은 245.3G, 490.5G, 981.0G다.
- 에이전트가 2개일 때는 희소 구현이 더 느리다. DiT 지연 시간은 희소 방식이 170 ms, 밀집 방식이 129 ms이며, 어텐션 지연 시간은 각각 2.8 ms와 2.5 ms다. 에이전트가 4개일 때 대응하는 희소 및 밀집 방식의 값은 177 ms와 210 ms, 3.2 ms와 5.1 ms다.
- 8개 에이전트 측정은 계산 성능 벤치마크이며, 8개 에이전트의 생성 품질을 검증한 근거는 아니다. 문서에 설명된 체크포인트의 정체성 풀은 최대 4개 에이전트를 지원한다.
분석적으로 계산한 FLOPs는 밀집 어텐션에서 이차적으로, 허브 연결 구조에서 선형적으로 증가한다. 측정된 지연 시간에서는 에이전트 수에 따라 우열이 바뀐다. 플레이어가 2명일 때 허브가 더 느리지만, 8명일 때는 DiT 지연 시간을 611 ms에서 246 ms로, 어텐션 지연 시간을 17.6 ms에서 4.5 ms로 줄인다.
4.2. Qualitative Results
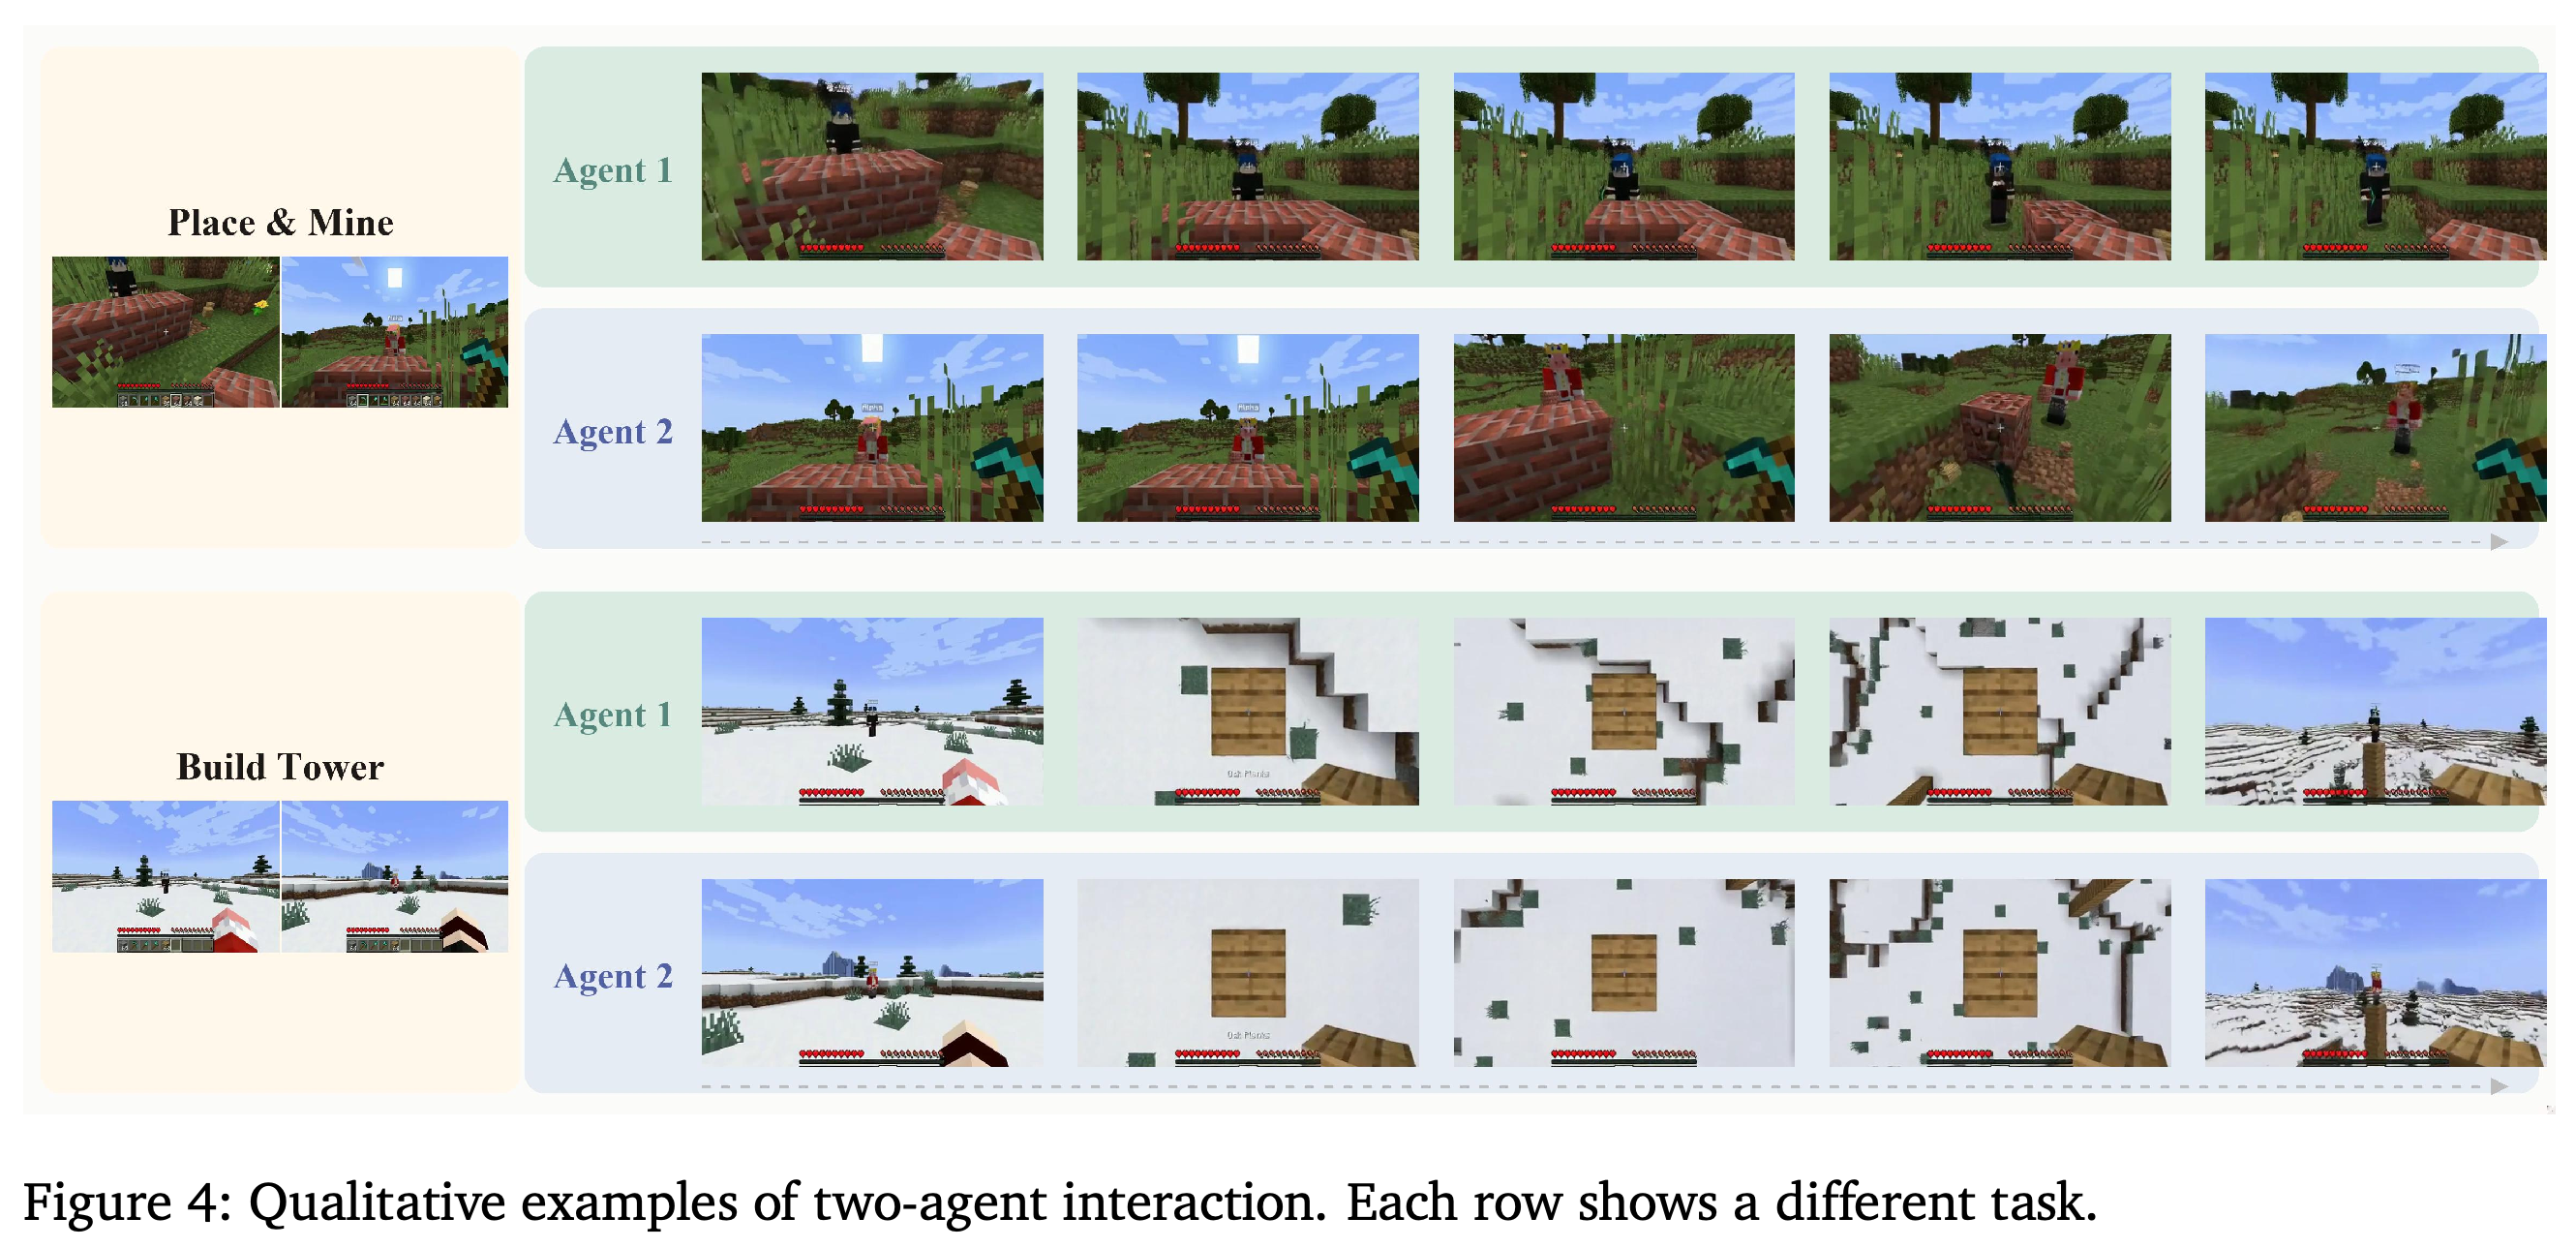
2개 에이전트 상호작용을 보여주는 Figure 4는 Place & Mine과 Build Tower의 짝지어진 롤아웃을 제시한다. 공유 장면의 변화를 서로 다른 관점에서 보여준다. 저자들은 물체와 에이전트가 다른 에이전트의 시야에서 잠시 벗어나더라도 공유 세계 안에서 일관되게 유지된다고 보고한다.
- 이 예시는 관점 간 연동을 정성적으로 뒷받침하지만, 명시적인 공유 물리 상태를 입증하거나 장기 일관성을 정량화하지는 않는다.
Place & Mine과 Build Tower 패널은 환경이 변하는 동안 2개 에이전트 스트림을 짝지어 보여준다. 관점 간 상호작용을 보여주지만, 선택된 프레임만으로 행동 준수나 장기 일관성을 정량화하지는 않는다.
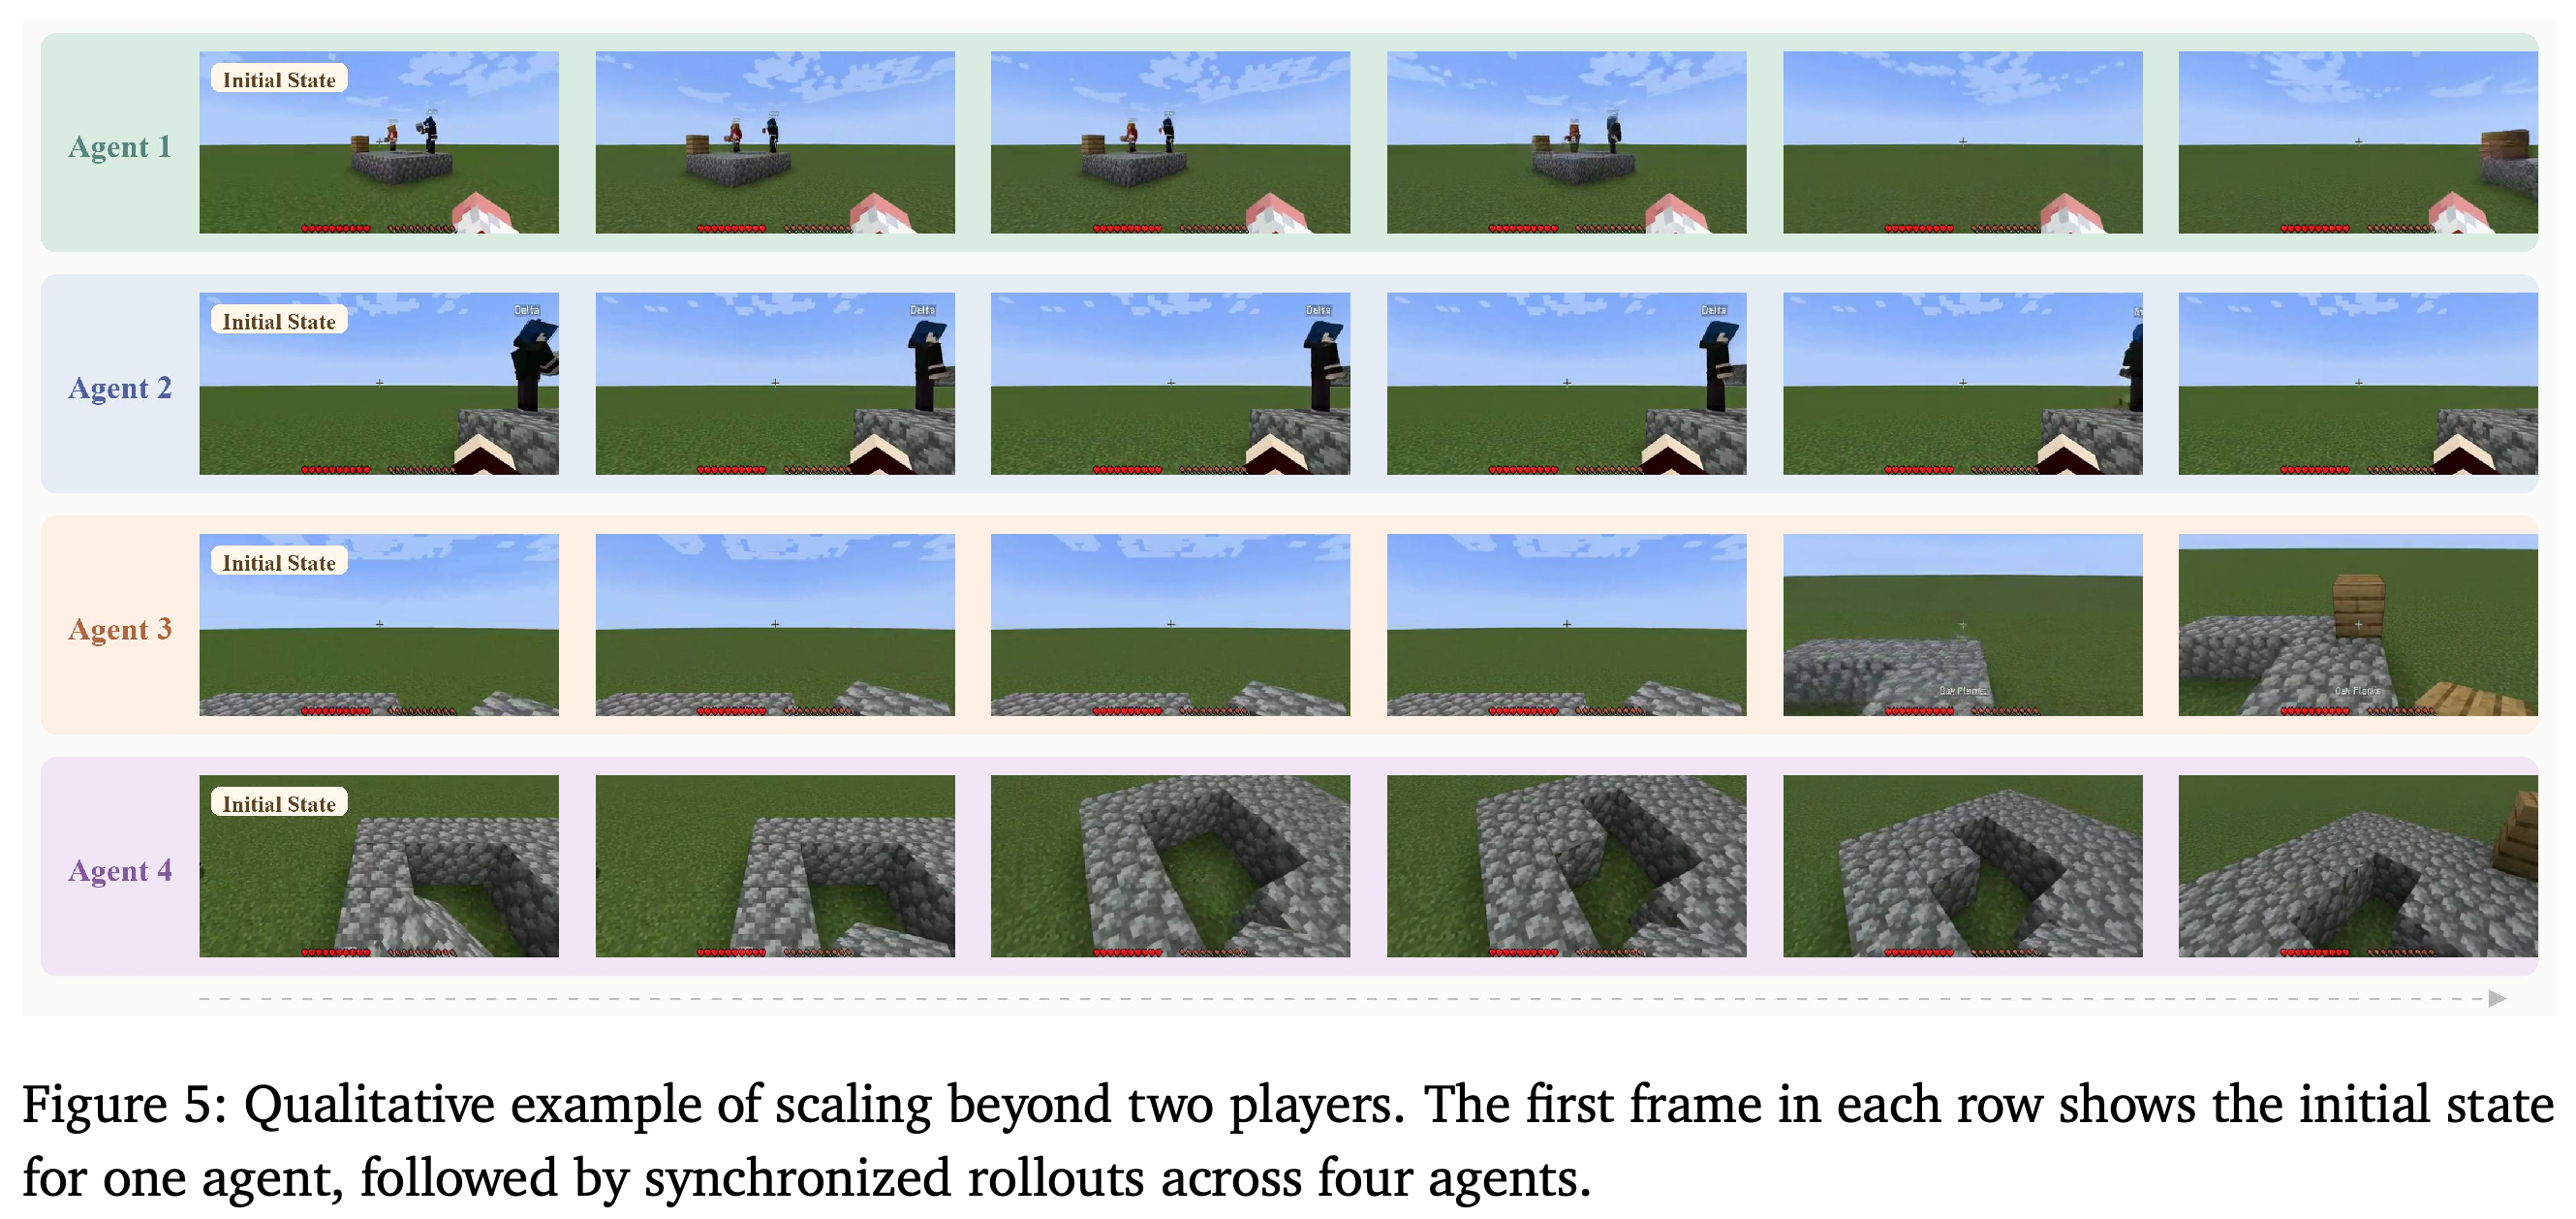
2명보다 많은 플레이어로 확장한 Figure 5는 2개 에이전트 데이터만으로 학습한 체크포인트가 생성한 4개의 동기화된 에이전트 스트림을 보여준다. 추가 에이전트는 미사용 정단체 꼭짓점을 차지하며, 허브는 트랜스포머 구조를 바꾸지 않고 통신을 제공한다.
- 이는 꼭짓점이 4개인 풀 안에서 활성 에이전트 수를 늘리는 제로샷 일반화이며, 에이전트 수를 제한 없이 확장하는 것은 아니다.
- PDF에는 4명 플레이어의 예시 롤아웃이 있지만, 별도의 4명 플레이어 정량 품질 비교는 없다.
4개 행은 초기 관측과 그 뒤에 이어지는 동기화된 생성 관측을 보여준다. 모델은 활성 에이전트 2개만으로 학습했다. 이 예시는 꼭짓점이 4개인 풀에서 추가 정체성을 활성화하는 방식을 보여주지만, 4명 플레이어의 정량 평가는 제공하지 않는다.
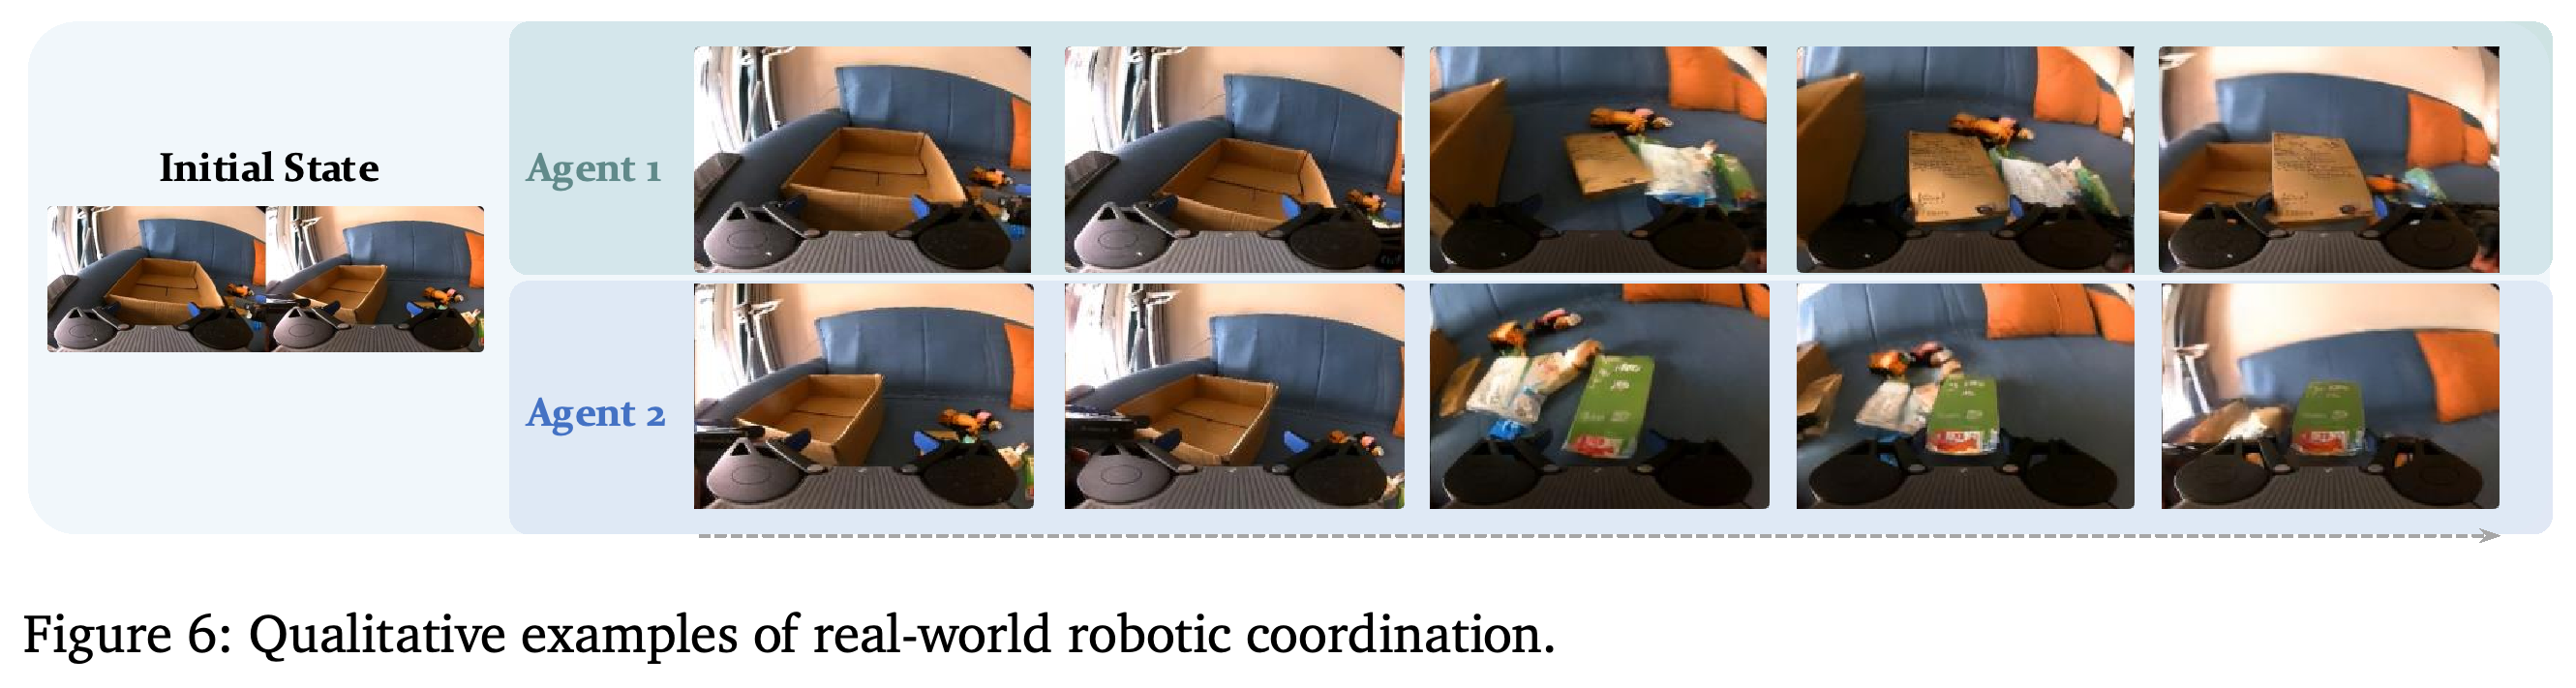
실제 로봇 응용을 보여주는 Figure 6은 RealOmin-Open Dataset을 사용하며, 왼쪽과 오른쪽 로봇 팔을 상호작용하는 2개 에이전트로 취급한다. 생성된 예시는 공유 물체 주변에서 협응하는 조작을 보여준다.
- 로봇 예시는 이 접근법을 Minecraft 밖으로 확장하지만, PDF에는 로봇 전용 정량 지표나 상세한 학습 조건이 보고되어 있지 않다.
- 이 예시는 게임플레이 체크포인트가 도메인 학습 없이 로봇에 전이된다는 사실을 입증하지 않는다.
짝지어진 스트림은 처음에 지정한 장면에서 공유 물체 주변의 로봇 조작을 보여준다. 논문은 왼쪽과 오른쪽 로봇 팔을 상호작용하는 에이전트로 취급하지만, 이 시각화는 과제 성공률이나 물리적 정확성을 측정하지 않는다.
5. Discussion
논의에서는 다중 에이전트 스트리밍 생성이 회전 정체성 인코딩, 희소 통신, 조건부 증류, KV 캐시의 결합으로 가능하다고 설명한다. 한계로는 게임과 로봇 예시에 집중된 평가, 지원 가능한 에이전트 수를 제한하는 정체성 풀, 명시적인 3D 기하 구조나 물리적 제약의 부재를 제시한다. 이러한 제약 때문에 긴 롤아웃에서는 불일치가 누적될 수 있다.
- 복잡하고 이질적이며 긴 시간 범위를 다루는 환경에서의 폭넓은 검증은 논문의 향후 과제로 남아 있다.
- 매우 많은 에이전트를 지원하려면 더 넓은 회전 대역이나 계층적 에이전트 그룹화가 필요할 수 있다. 미사용 꼭짓점을 활성화하는 방식은 기존 풀 안에서만 생성을 확장한다.
부록
- A. More Visualizations는 24초 길이의 확장된 다중 에이전트 롤아웃, 기준 모델 비교, 실제 로봇 협응을 담은 보충 영상을 설명한다. 이 영상들은 정적인 예시를 보완하지만, PDF에는 장기 일관성을 측정한 수치가 없다.
- B. Proof of Simplex Equidistance는 서로 다른 꼭짓점의 내적이 −1/(V − 1)이고 거리의 제곱이 2V/(V − 1)인 단위 노름의 정단체 꼭짓점을 유도한다. 각도 공간에서는 등거리가 정확히 성립한다. 복소 RoPE 공간에서는 일반 임베딩의 좌표별 각도 차이가 충분히 작을 때 근사적으로 성립하며, 명시된 0 패딩 중심화 원-핫 구성에서는 dp/2 ≥ V일 때 정확히 성립한다.
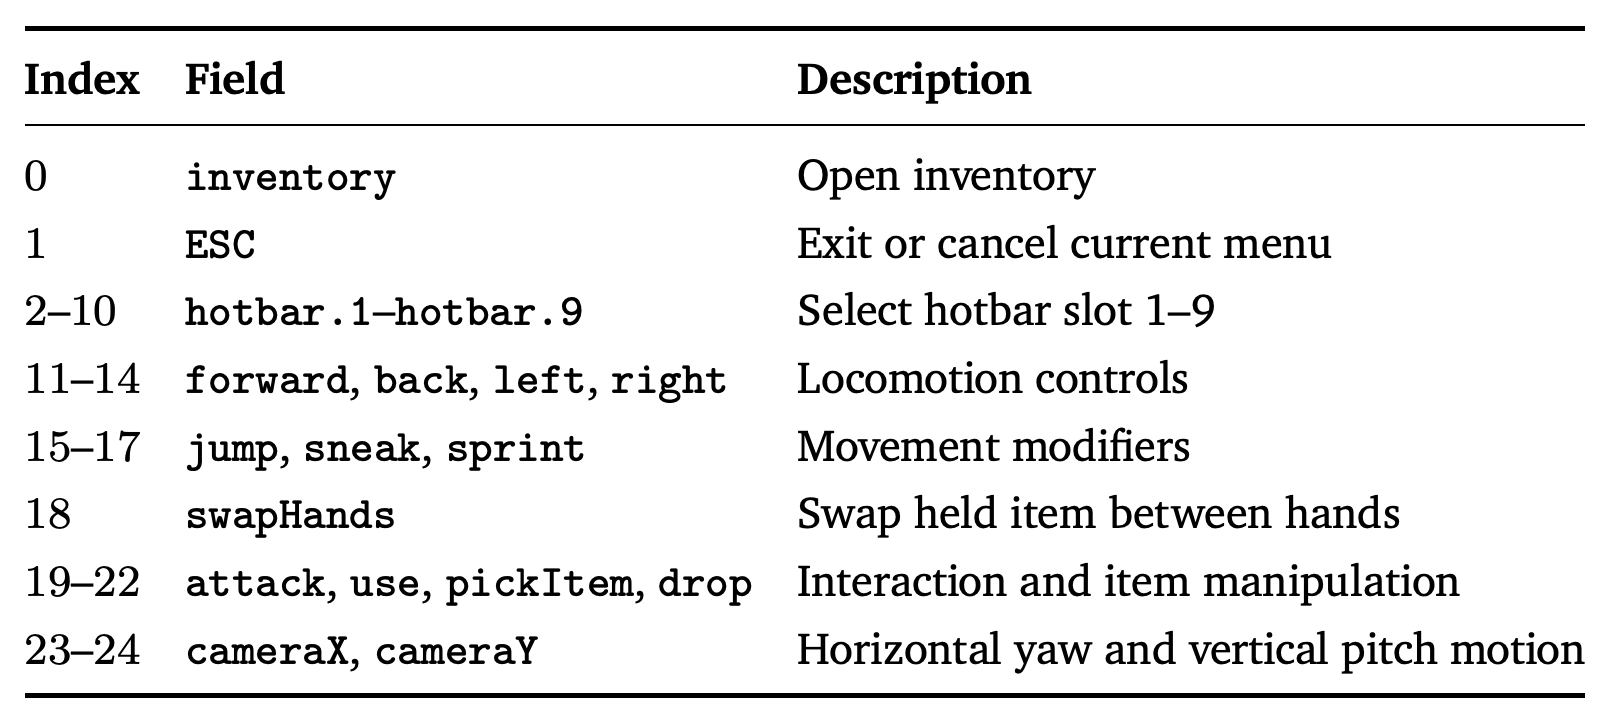
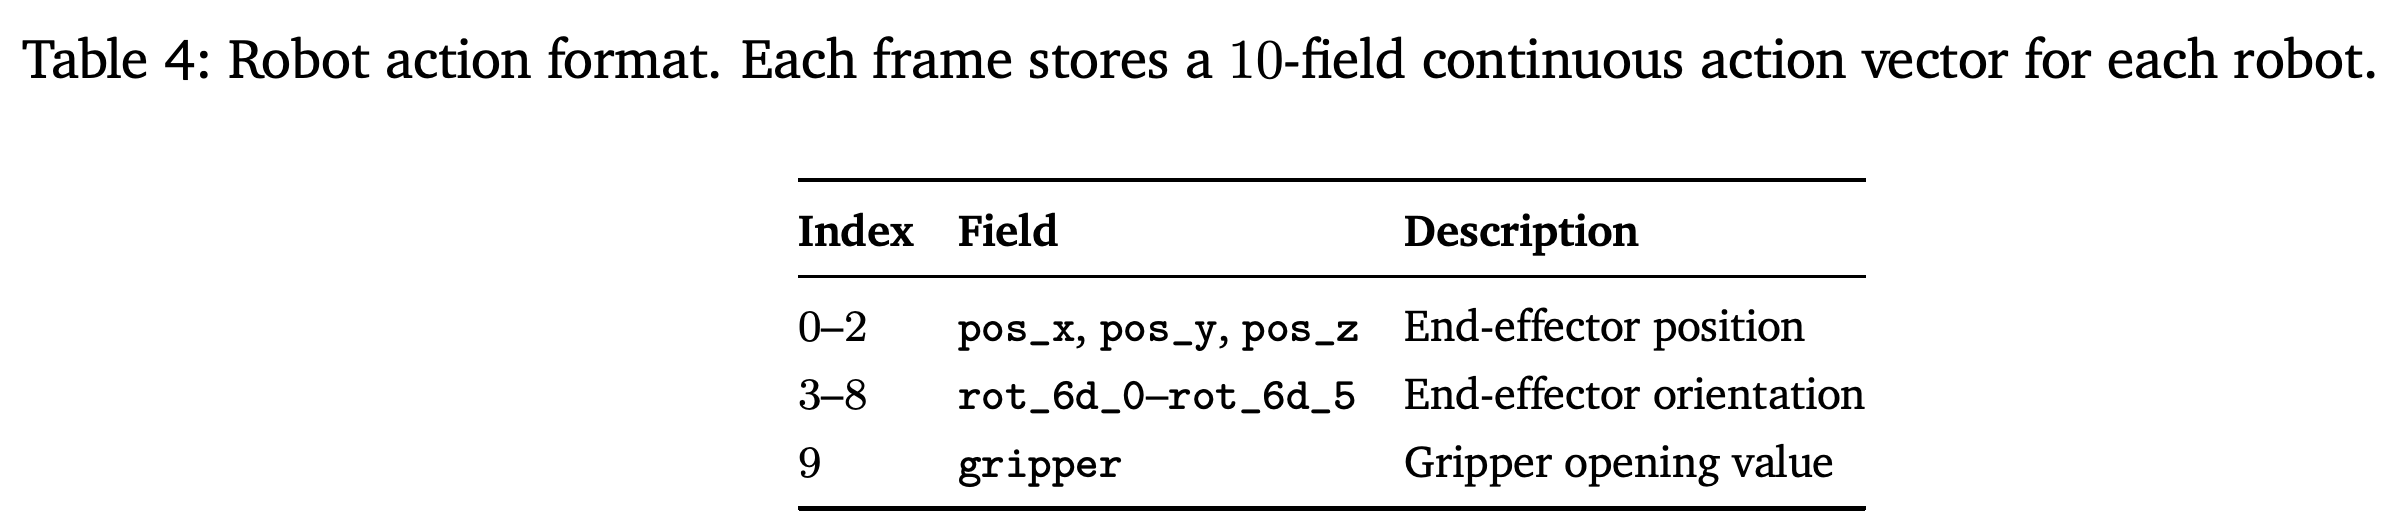
- C. More Architecture와 C.1. Action Design은 프레임에 동기화하고 에이전트마다 별도로 제공하는 도메인별 행동 기록을 명시한다. 게임 행동 형식에서 Table 3은 23개 이산 제어와 cameraX, cameraY로 구성된 25개 필드를 정의한다. 로봇 행동 형식에서 Table 4는 pos_x, pos_y, pos_z, rot_6d_0–rot_6d_5, gripper로 구성된 10개 연속 필드를 정의한다.
- D. Additional Implementation Details의 Architecture에서는 교사와 학생이 은닉 차원 2048, 트랜스포머 블록 28개, 차원 128의 어텐션 헤드 16개, MLP 비율 4, AdaLN-LoRA 랭크 256을 사용한다고 설명한다. 회전 헤드는 (t, p, h, w)에 대해 (64, 32, 16, 16)으로 분할한다. 학생은 잠재 프레임마다 허브 8개를 사용하고, 관점별로 잠재 프레임 24개의 국소 어텐션 창을 사용한다. 게임플레이 행동 인코더는 128차원의 모달리티 분기 2개, 융합 MLP, 4×-stride 1D 시간 합성곱, 은닉 차원 2048로의 투영을 사용한다.
- Stages 1 and 2 – Bidirectional teacher and causal student pretraining에서 교사는 93프레임 클립으로 10,000회 반복 학습한 뒤 189프레임 클립으로 6,000회 반복 학습한다. 학생은 93프레임 클립으로 15,000회 반복 학습한다. 각 모델은 NVIDIA GB200 32개를 사용하며, AdamW의 학습률은 3×10⁻⁵, 가중치 감쇠는 10⁻³, (β1, β2) = (0.0, 0.999)다. 워밍업은 100단계이고, 그래디언트 클리핑 기준은 0.1이다. 추론에서는 classifier-free guidance를 사용하지 않는다.
- Stage 3 – Self-Forcing distillation은 학습 가능한 학생, 교사에서 가져온 고정된 real score, 교사로 초기화한 학습 가능한 fake score를 사용한다. NVIDIA GB200 32개에서 189프레임 클립으로 400회 반복 학습한다. 디노이징 타임스텝 {1000, 750, 500, 250}에는 flow shift 5.0을 적용하고, 캐시 기록에는 맥락 잡음 수준 128을 사용하며, 생성기와 critic의 업데이트 비율은 1:4다. AdamW의 학생 및 critic 학습률은 각각 2×10⁻⁶와 4×10⁻⁷이고, 가중치 감쇠는 10⁻²이며, (β1, β2) = (0.0, 0.999)다. 추론에서는 4단계 스케줄, 학습 블록 크기, 잠재 프레임 24개의 이동 캐시 창을 유지한다.
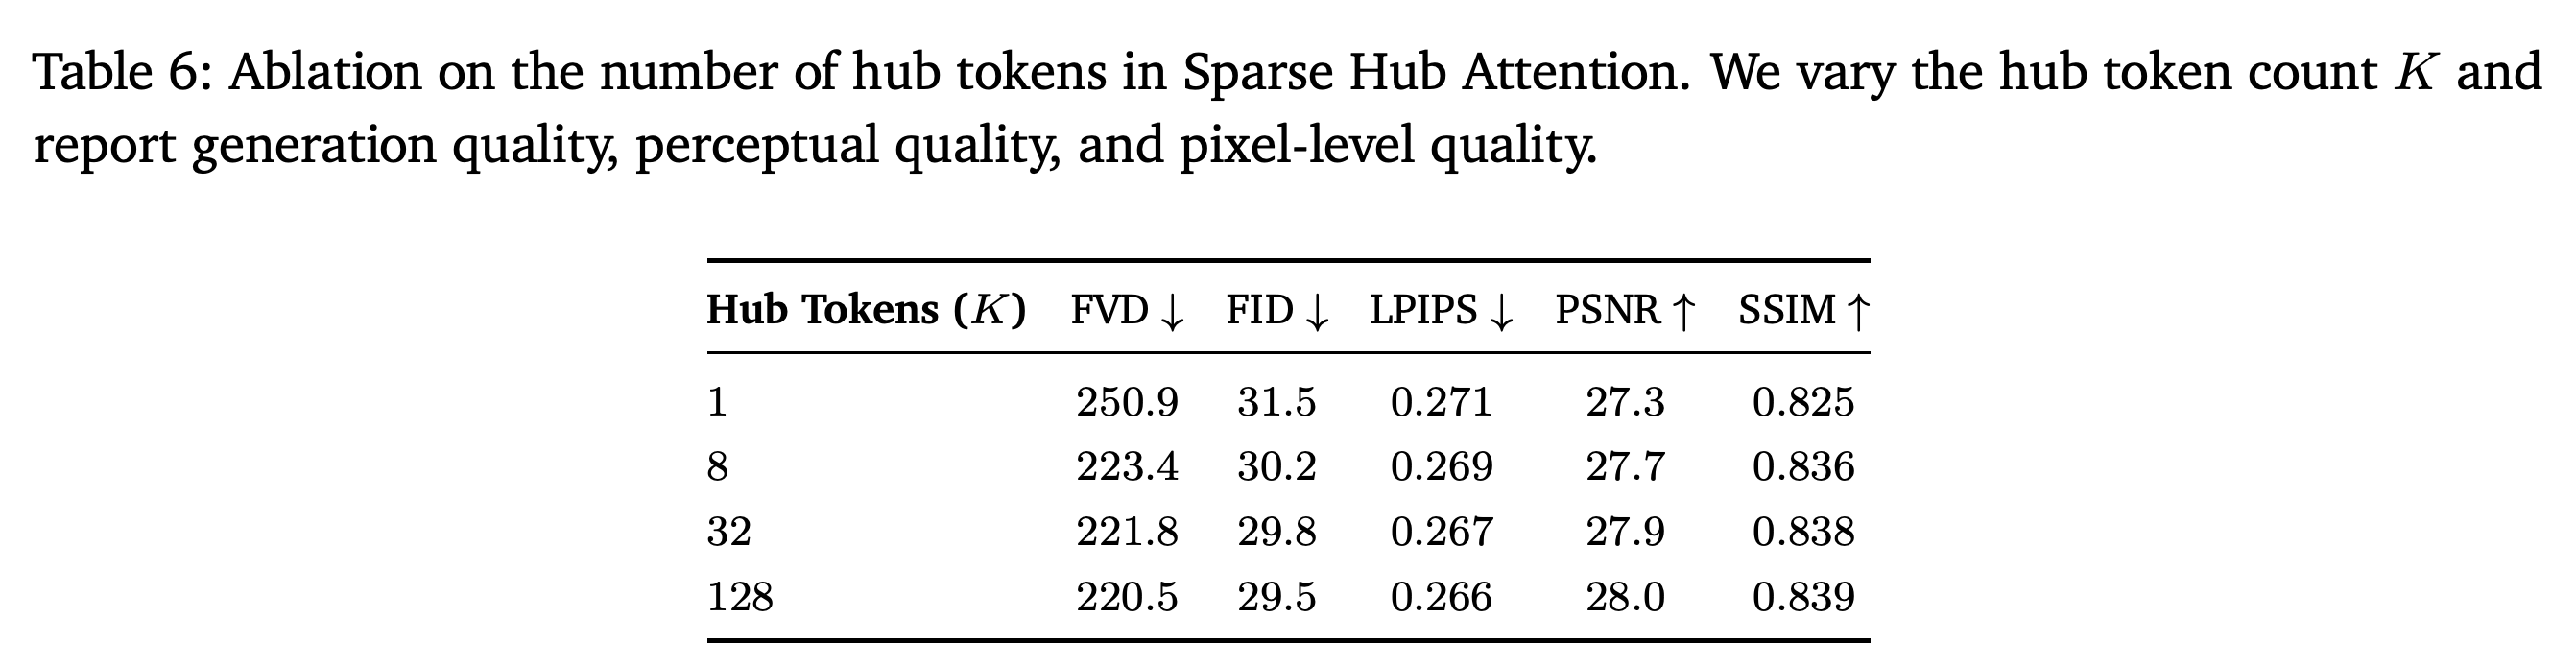
- E. Additional Ablations는 Table 5에서 모델 변형을, Table 6에서 허브 용량을 비교한다. K를 1에서 8로 늘리면 FVD가 250.9에서 223.4로 개선된다. 32와 128로 더 늘리면 각각 221.8과 220.5가 되며, 보고된 다른 지표도 개선된다. 이 실험은 K = 8을 넘어서면 품질 개선 폭이 줄어든다는 점을 보여주지만, 허브 수별 지연 시간이나 메모리는 보고하지 않는다.
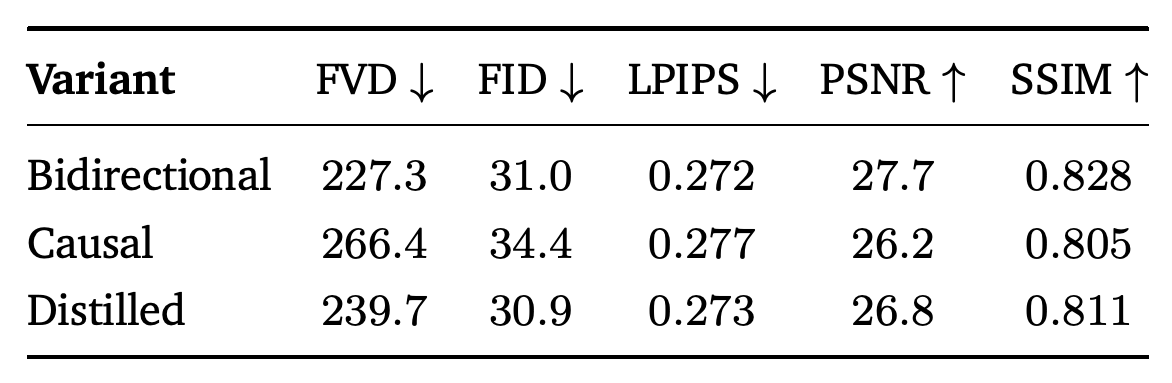
- F. More Experimental Results의 F.1. Training Stage Comparison은 증류가 인과적 생성에서 잃은 품질을 일부 회복함을 보여준다. Table 5의 FVD는 양방향 모델이 227.3, 인과적 모델이 266.4, 증류 모델이 239.7이다. 증류 모델의 FID가 30.9로 가장 낮지만, LPIPS, PSNR, SSIM은 교사 모델이 가장 좋다.
짧은 생각
가장 중요한 기여는 재사용 가능한 정체성 풀과 에이전트 수에 따른 비용을 명시적으로 제어하는 어텐션 연결 구조의 결합이다. Tables 3 and 4는 에이전트별 독립적인 조건화를 구체적으로 보여준다. Table 2와 Figure 3은 경쟁력 있는 시각적 품질과 에이전트 수가 많을 때의 계산량 감소를 보여준다. 특정 배포 환경에서 희소성이 유리한지 판단할 때는 2개 에이전트에서 발생하는 지연 시간 증가를 고려해야 한다.
인덱스 0–22는 인벤토리, 핫바 선택, 이동, 이동 방식 변경, 상호작용을 위한 이산 제어를 지정한다. 인덱스 23–24는 cameraX와 cameraY다. 각 에이전트는 시간적으로 정렬된 자체 25필드 행동 벡터를 받는다.
로봇 스키마는 연속적인 엔드 이펙터 상태를 조건으로 제공한다. 위치는 인덱스 0–2, 6D 방향은 3–8, 그리퍼 열림 정도는 인덱스 9에 해당한다. 같은 스키마를 왼쪽과 오른쪽 로봇에 각각 적용한다.
제시된 근거는 물리적으로 일관된 다중 에이전트 시뮬레이터보다 다중 관점 영상 생성기를 더 직접적으로 뒷받침한다. 4명 플레이어와 로봇 결과는 정성적이며, 평가 프로토콜은 충분히 명시되어 있지 않고, 정단체의 등거리는 전체 네트워크의 순열 등변성을 증명하지 않는다. Tables 5 and 6은 증류 품질과 허브 용량을 설명하지만, 장기적인 물리적 정확성이나 보고된 24 FPS의 배포 조건을 입증하지는 않는다.
증류는 인과적 모델의 FVD를 266.4에서 239.7로 낮추며, 양방향 모델의 227.3에 가까워지지만 도달하지는 못한다. 증류 모델의 FID는 30.9로 교사의 31.0보다 조금 좋지만, LPIPS, PSNR, SSIM은 더 나쁘다. 이는 품질이 완전히 회복된 것이 아니라 일부만 회복되었음을 보여준다.
허브 수를 늘리면 보고된 모든 지표가 개선되며, FVD 개선 폭은 K = 1에서 K = 8 사이에서 가장 크다. K를 8에서 128로 늘리면 FVD는 223.4에서 220.5로, SSIM은 0.836에서 0.839로 바뀐다. 이는 품질 개선 폭이 줄어듦을 보여주지만, 그에 따른 실행 시간 비용은 측정하지 않는다.