


Mixture of Contexts for Long Video Generation 요약 설명
28 Aug 2025 | Paper Review Long-Horizon Video Generation Sparse Attention Text-to-Video Generation목차
이번 글에서는 Mixture of Contexts for Long Video Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 8월 28일(Arxiv)
- Cai, Shengqu, Yang, Ceyuan, Zhang, Lvmin, Guo, Yuwei, Xiao, Junfei, Yang, Ziyan, Xu, Yinghao, Yang, Zhenheng, Yuille, Alan, Guibas, Leonidas, et al.
- Stanford University, ByteDance Seed, Johns Hopkins University, CUHK, ByteDance
- 논문 링크
- Project Page
요약
- 긴 영상 생성 모델은 인물의 정체성, 장면 배치, 행동을 유지하면서 dense attention의 제곱 비용을 피해야 한다. Dense attention은 텍스트나 영상 콘텐츠를 나타내는 모든 토큰 특징 쌍을 비교한다. Mixture of Contexts(MoC)는 장면 단위 context window를 사용하는 영상 생성 모델인 dense Long-Context Tuning(LCT)과 비교해, 480p, 초당 12프레임의 8개 shot으로 구성된 64초 장면에서 attention sparsity 85%와 종단 간 속도 2.2배 향상을 보고하며 보고된 품질 지표 6개 중 5개를 개선한다. Attention sparsity는 생략한 토큰 쌍 상호작용의 비율을 뜻한다.
- MoC는 노이즈 제거로 콘텐츠를 생성하는 Transformer backbone인 diffusion transformer(DiT)의 dense attention을 frame, shot, caption 경계에 맞춘 chunk 검색으로 대체한다. Shot은 컷 사이에 이어지는 연속 영상 구간이다. 관련 context를 찾는 특징인 각 query는 chunk의 mean-pooled key와 유사도가 가장 높은 top-k chunk를 선택한다. Mean-pooled key는 context 매칭에 사용하는 특징의 평균이다. Caption 토큰과 현재 shot에 반드시 접근하도록 하여 프롬프트 조건과 국소적 세부 정보를 유지하고 causal routing으로 선택적 검색 대상을 이전 chunk로 제한한다.
- 주요 비교에서 attention의 부동소수점 연산량(FLOPs)은 1.7 × 10^13에서 2.3 × 10^12로 감소한다. FLOPs는 산술 연산량을 나타낸다. 움직임의 정도를 측정하는 벤치마크 지표인 Dynamic Degree는 0.4583에서 0.5625로 높아지지만 프레임의 기술적 품질을 측정하는 Image Quality는 0.5140에서 0.5003으로 낮아진다.
- 부록은 개별 설계 요소를 바꾸는 ablation 실험으로 routing 선택을 분석하고 다른 영상 생성 backbone인 Wan-2.1-1.3B도 평가한다. 주요 긴 영상 품질 비교는 LCT 설정에 한정된다. 짧은 single-shot 영상에서는 MoC가 FLOPs를 줄여도 pooling과 토큰 수집의 부가 비용이 attention 절감분보다 커서 종단 간 실행 속도가 느려진다.
1 Introduction
Introduction은 긴 영상 생성을 선택적 회상 문제로 설명한다. 모델은 인물의 정체성과 서사의 일관성을 유지하면서 관련된 이전 사건을 다시 찾아야 한다. 시간적 중복 때문에 dense attention의 비용이 커지지만 이력을 압축하면 세부 정보가 사라질 수 있고, 고정된 sparse 패턴은 특정 query에 중요한 과거 사건에 맞춰 변하지 못한다.
- MoC는 전체 이력을 고정 크기 요약으로 대체하지 않고, 선택한 원래 context 토큰을 검색한다.
- 이 방법은 학습된 검색, 콘텐츠 경계에 맞춘 chunk 분할, 필수 caption 연결과 국소 연결, 학습 중 생략하는 상호작용의 비율을 점차 높이는 progressive sparsification을 결합한다. 보고된 속도 향상은 약 180k-token 장면에 관한 결과다.
2 Related Work
Related Work는 기존 접근법을 Long Video Generation, Sparse Attention for Video Generation, Context Learning in Visual Generation으로 분류한다. 순환 상태는 생성 단계 사이에 정보를 전달하고 계층적 keyframe은 영상의 대략적인 구조를 정하며 압축된 이력은 이전 콘텐츠를 요약한다. Sparse attention은 토큰 상호작용을 줄이고, 외부 시각 메모리는 저장된 frame이나 view를 검색한다.
- LCT는 사전 학습된 single-shot 모델을 최대 8개 shot의 공동 window로 확장하면서 dense attention을 유지하므로 가장 가까운 baseline이다.
- MoC는 attention layer 내부에서 검색을 학습한다. 일부 외부 메모리 접근법은 카메라 시점의 중첩을 기준으로 과거 view를 선택하고 시각 context 학습 방법은 참조 이미지를 생성 조건으로 사용한다.
- 이 절은 여러 sparse attention 방법을 논의하지만 주요 긴 영상 실험에서는 MoC를 LCT하고만 비교한다.
3 Method
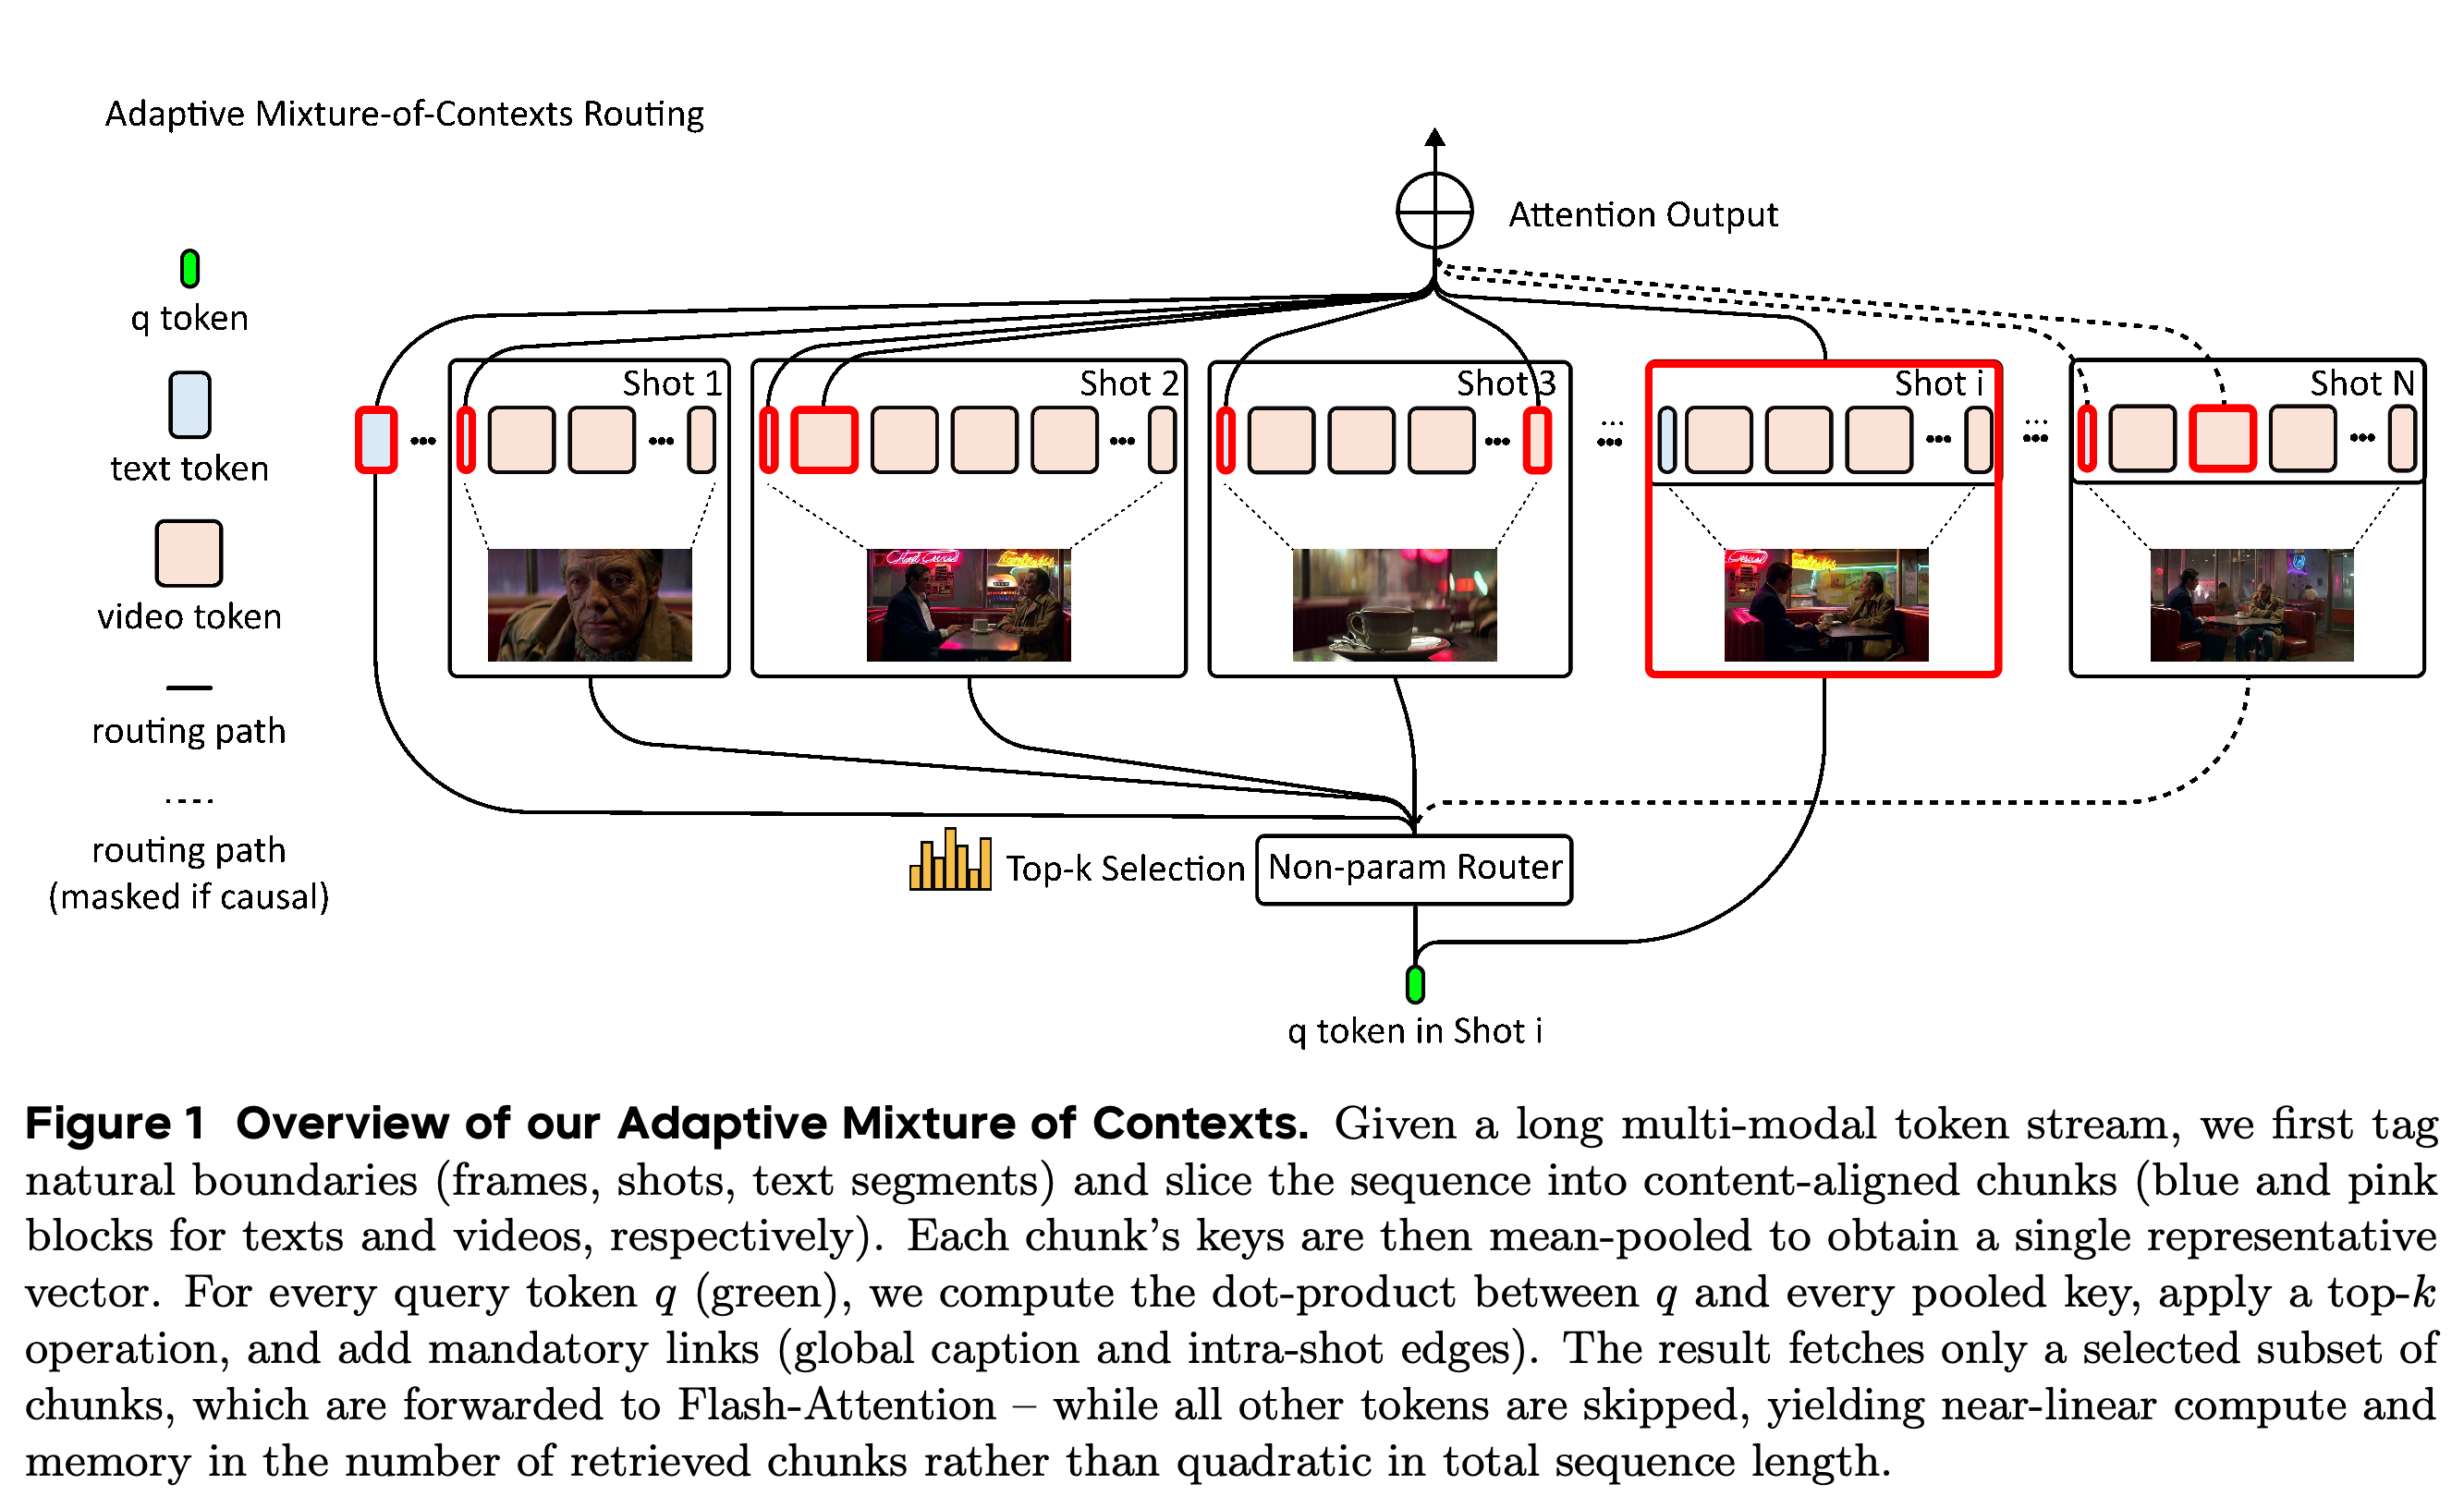
Method는 backbone의 dense attention을 관련 context를 선택하는 MoC layer로 대체하고 frame, shot, caption 경계에 따라 토큰을 분할하며 시간 순서로 선택적 검색을 제한한다. Figure 1은 attention을 계산하기 전에 동적으로 검색한 chunk를 필수 텍스트 연결 및 shot 내부 연결과 결합하는 과정을 보여준다.
도식은 선택적 검색과 필수 연결을 구분한다. Query는 pooled chunk의 점수를 계산하고 선택한 영상 토큰을 검색하면서 caption과 현재 shot에 대한 접근을 유지한다. 점선 경로는 causal masking으로 제거되는 연결을 나타낸다. Sparse context 선택이 국소 attention을 유지하면서 선택적 검색을 이전 context로 제한하는 방식을 보여준다.
3.1 Mixture of Contexts
MoC는 각 query의 특징과 각 chunk의 mean-pooled key 특징 사이의 내적으로 후보 chunk의 점수를 계산한 뒤, 선택한 chunk의 토큰에 일반적인 attention을 적용한다. Router는 별도의 파라미터를 추가하지 않는다. 입력은 모델에 이미 있는 query 및 key projection에서 가져오며, 이 projection은 fine-tuning 중에 변한다.
- Q, K, V가 각각 query, key, value 특징이고 d가 특징 차원일 때, dense attention은 Attn(Q,K,V) = Softmax(QKᵀ/√d) · V다. Value는 attention이 결합할 정보를 제공하고 Softmax는 매칭 점수를 attention 가중치로 정규화한다.
- Query q_i에 대해 선택한 위치인 routed indices Ω(q_i)를 사용하여, MoC는 Attn(q_i,K,V) = Softmax(q_i Kᵀ_{Ω(q_i)}/√d) · V_{Ω(q_i)}를 계산한다.
- Top-k 선택은 이산적이며 미분할 수 없다. 논문은 미분 가능한 top-k 선택이 아니라, 선택한 key와 value에 대한 attention의 gradient를 통해 적응이 이루어진다고 설명한다.
Context Drop-off는 선택한 chunk를 무작위로 제거하여 context가 누락되어도 견디도록 학습한다. Context Drop-in은 무작위 chunk를 추가하여 자주 사용하지 않는 경로에도 학습 신호를 제공한다. Routing은 모든 layer의 각 attention head에서 독립적으로 작동한다. Attention head는 특정 특징에 대한 attention을 병렬로 계산하는 단위다.
- Drop-off는 명시된 구간의 균등분포인 Uniform(0,p_max)에서 p_drop을 추출하고 선택한 chunk 중 floor(p_drop · k)개를 제거한다.
- Drop-in은 추가할 chunk 수를 \(m\sim\operatorname{Poisson}(\lambda)\)로 추출한다. Poisson은 λ가 제어하는 개수 분포다.
- 각 head와 layer의 routing이 독립적이므로, 개별 경로가 sparse하더라도 전체 경로가 접근하는 context의 합집합은 넓어진다.
3.2 Attention Chunking and Routing
Attention Chunking and Routing은 chunk를 영상 구조에 맞춘다. 펼쳐진 텍스트와 영상 토큰열에서 인접한 항목이 공간, 시간, shot 경계를 넘을 수 있기 때문이다. 모든 시각 query는 전체 텍스트 토큰과 자신의 shot에 계속 접근하며 선택적 검색 예산은 이러한 필수 연결 밖의 context에 사용할 수 있다.
- 텍스트 토큰은 모든 query가 항상 접근할 수 있는 토큰 집합인 attention sink 역할을 하며, 일반적으로 전체 시퀀스의 1% 미만을 차지한다.
- Shot 내부 연결은 fine-tuning 중 객체의 이동 경로, 조명의 연속성 등 국소적 단서에 대한 접근을 유지한다.
- 콘텐츠 경계에 맞춰 분할하면 pooled chunk descriptor가 컷 양쪽의 무관한 내용을 섞지 않는다.
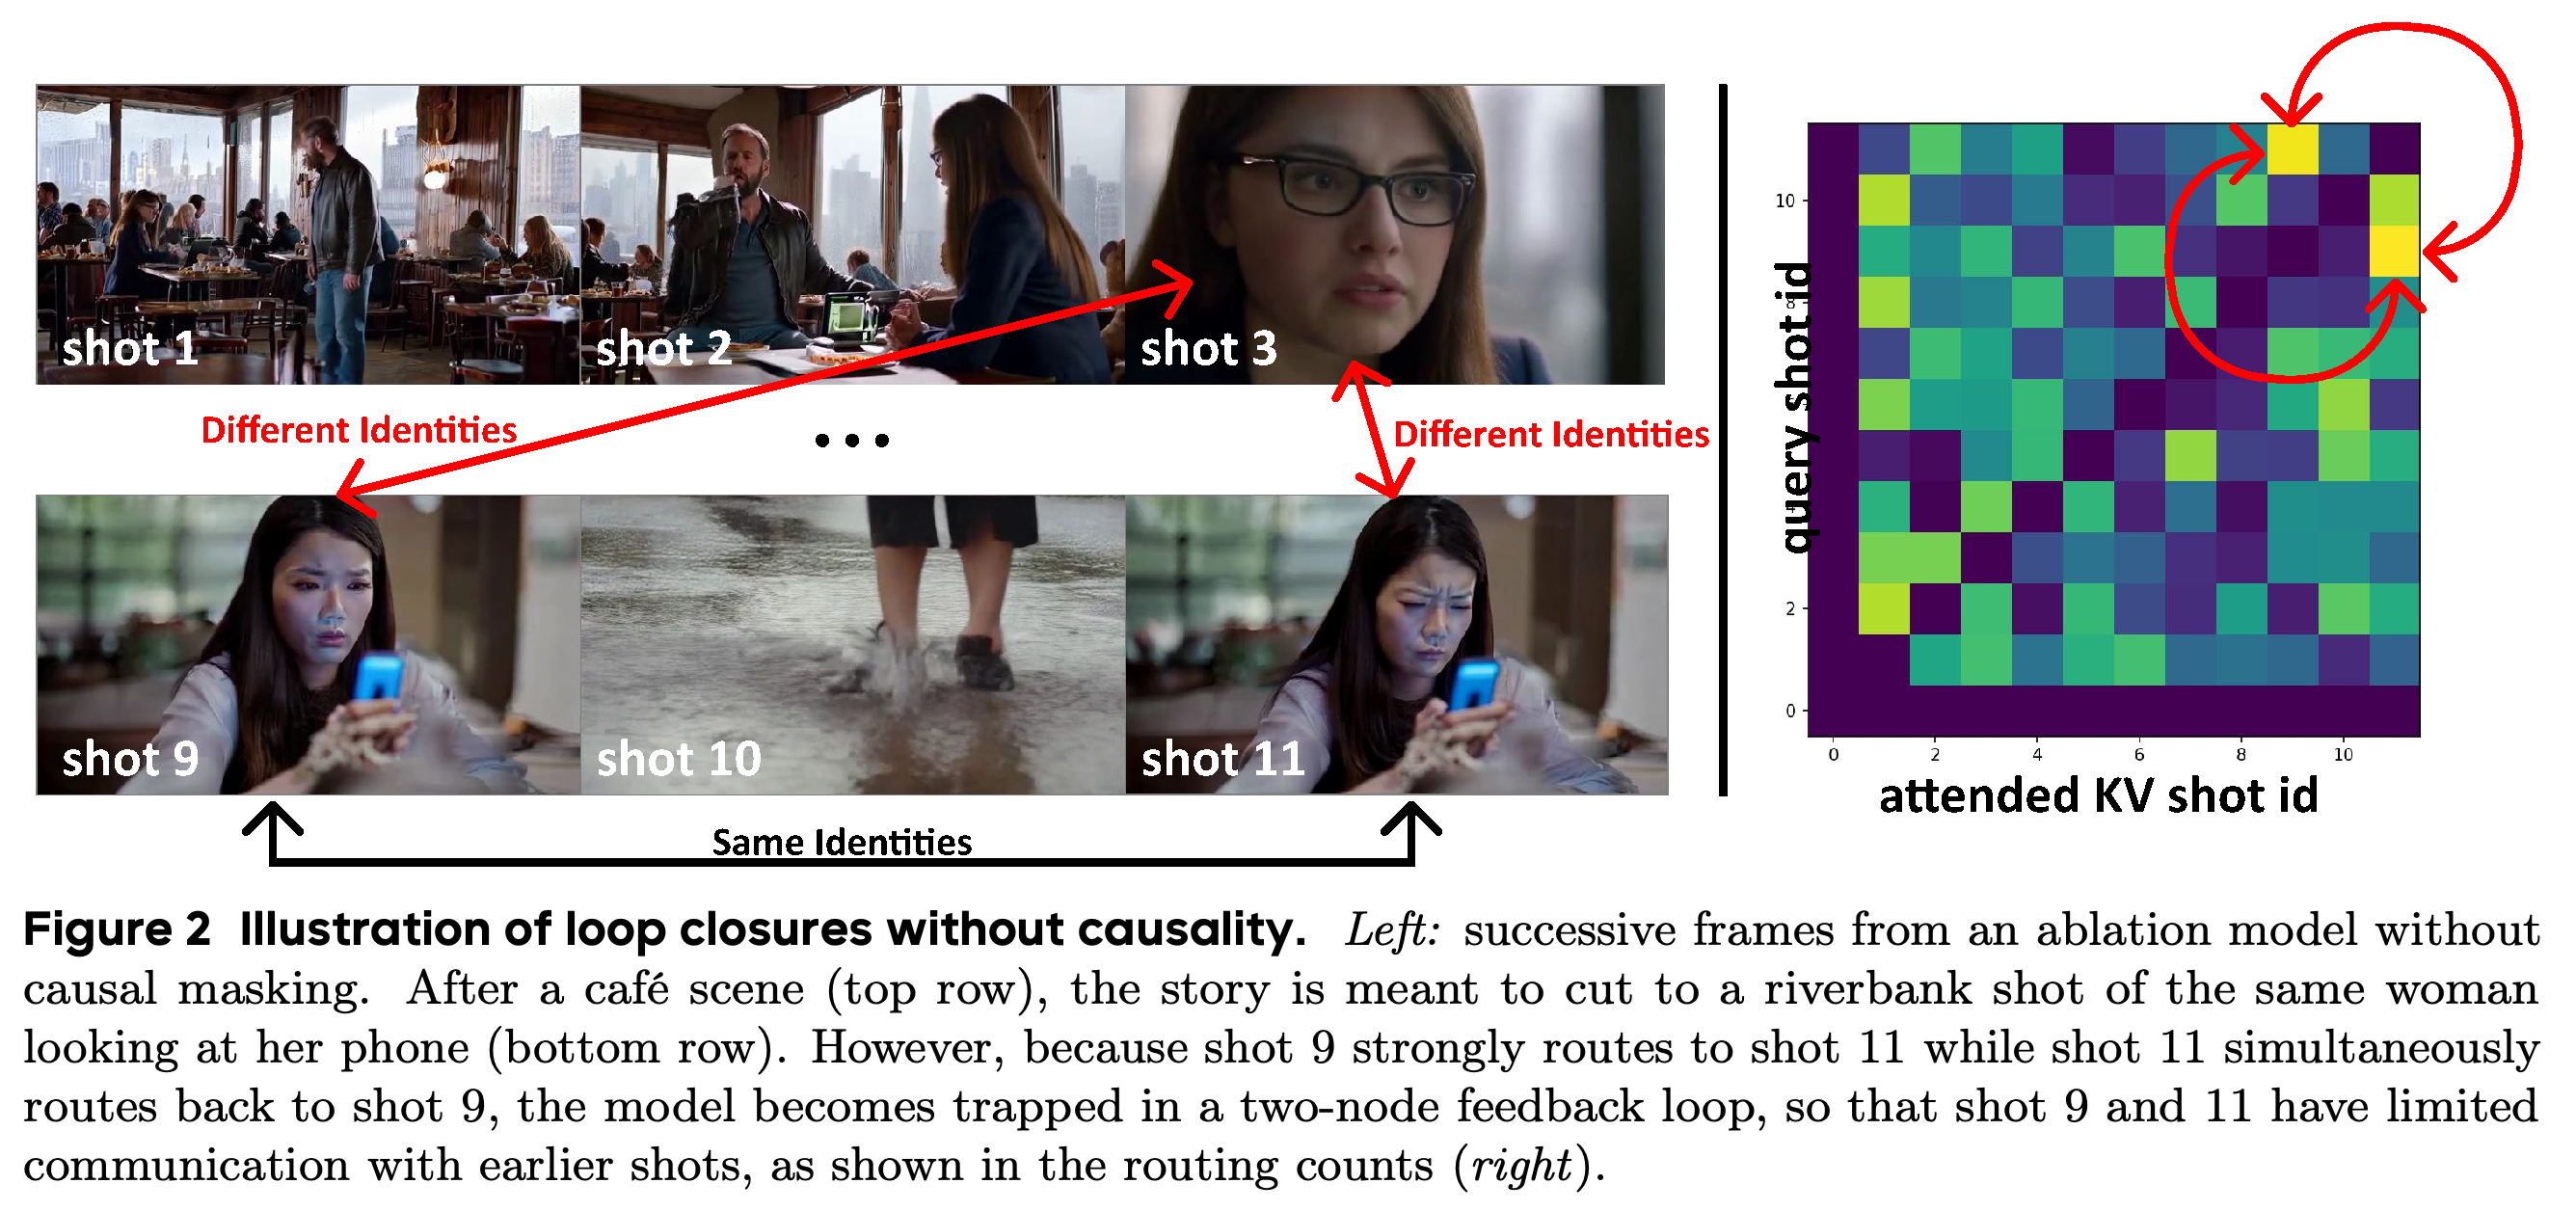
Causal routing이 없으면 2개 chunk가 서로를 선택하여 고립된 피드백 쌍을 형성하고 이전 정체성 정보에 대한 접근을 제한할 수 있다. MoC는 top-k 선택 전에 선택적 연결 \((i\to j)\quad\text{whenever }j\ge i\)를 마스킹하여, routed connection이 방향성 순환이 없는 그래프인 directed acyclic graph(DAG)를 이루도록 한다.
- Figure 2에서는 shot 9와 11이 새로 생성된 여성의 모습을 서로 일치하게 유지하지만 이전 카페 장면에 등장한 여성의 정체성은 유지하지 못한다.
- 시간적 제한은 선택적 routing에 적용되며, 필수 shot 내부 attention은 그대로 사용한다.
강변 shot끼리는 여성의 외모가 일치하지만 이전 카페 장면의 정체성과는 일치하지 않는다. Heatmap에서 shot 9와 11 사이의 강한 상호 routing은 선택적 경로가 피드백 쌍을 형성할 때 국소적 일치와 과거 정보 회상의 실패가 함께 나타날 수 있음을 보여준다.
3.3 Computation Efficiency
Computation Efficiency는 torch.bucketize와 prefix-sum 경계 테이블, 즉석 segment_reduce pooling, attention head별로 토큰을 묶는 head-major 순서의 토큰 수집을 사용하여 가변 길이 chunk routing을 전부 graphics processing unit(GPU)에서 구현한다. 선택한 query-key 그룹은 길이가 서로 다른 chunk를 처리하는 효율적인 attention kernel인 가변 길이 Flash-Attention의 단일 호출로 묶는다.
- 시퀀스 길이를 L, chunk 수를 C, 검색한 chunk 수를 k, 선택한 chunk의 평균 길이를 m̄, head 차원을 d라고 할 때, Equation (4)는 FLOPs_MoC ≈ Ld + 2LCd + 4Lkm̄d를 제시한다.
- Equation (5)는 FLOPs_dense = 4L²d를 제시한다. Routing 항은 후보 chunk 수에 따라 달라지므로, 이 식만으로 무조건적인 선형 확장을 입증할 수 없다.
- 예시 계산은 약 180k 토큰, m̄ ≈ 1024, k = 5, C = 36, d = 128을 사용하며 FLOPs를 2.32 × 10^12와 1.66 × 10^13으로 보고한다. 제시된 입력을 Equation (4)에 대입해도 보고된 MoC 추정값이 나오지 않으며 Equation (6)도 Equations (4)–(5)에서 대수적으로 도출되지 않는다. 따라서 보고된 산술 연산 절감량은 해명이 필요하며 측정된 종단 간 속도 2.2배 향상과 구분해야 한다.
4 Experiments
주요 Experiments는 사전 학습된 LCT로 MoC를 초기화한다. LCT의 backbone은 텍스트와 시각 토큰을 처리하는 diffusion Transformer인 3B-parameter multimodal diffusion transformer(MMDiT)다. Dense LCT baseline과 MoC는 장면당 여덟 개 shot으로 평가하며 각 shot은 480p, 초당 12프레임으로 8초간 이어진다. 전체 길이는 64초이고 토큰 수는 약 180k다.
- 논문은 attention 모듈을 교체한 뒤 LCT와 같은 학습 방식으로 fine-tuning했다고 보고한다.
- 생성 영상 벤치마크 모음인 VBench는 subject 및 background consistency, motion smoothness, motion extent, aesthetic quality, image quality를 측정한다. 각각 피사체와 배경의 유지, 움직임의 연속성, 움직임의 양, 시각적 매력, 프레임의 기술적 품질을 평가한다.
- 주요 결과 표에는 평가 샘플 수, 신뢰구간, 실행 간 변동이 제시되지 않는다.
Table 1은 sparsity 85%, attention FLOPs가 1.7 × 10^13에서 2.3 × 10^12로 감소한 결과, VBench 지표 6개 중 5개의 개선을 보고한다. 본문은 종단 간 속도가 2.2배 향상되었다고 보고한다. Dynamic Degree는 0.4583에서 0.5625로 높아지고, Image Quality는 0.5140에서 0.5003으로 낮아진다.
- Subject Consistency는 0.9378 → 0.9421이고, Background Consistency는 0.9526 → 0.9535다.
- Motion Smoothness는 0.9859 → 0.9920이고, Dynamic Degree는 0.4583 → 0.5625다.
- Aesthetic Quality는 0.5436 → 0.5454이고, Image Quality는 0.5140 → 0.5003다.
Sparsity 85%에서 MoC는 보고된 attention FLOPs를 1.7 × 10^13에서 2.3 × 10^12로 줄이고, subject consistency, background consistency, motion smoothness, motion extent, aesthetic quality를 개선한다. Image Quality는 0.5140에서 0.5003으로 낮아지므로, 모든 지표에서 품질이 우수한 것은 아니다.
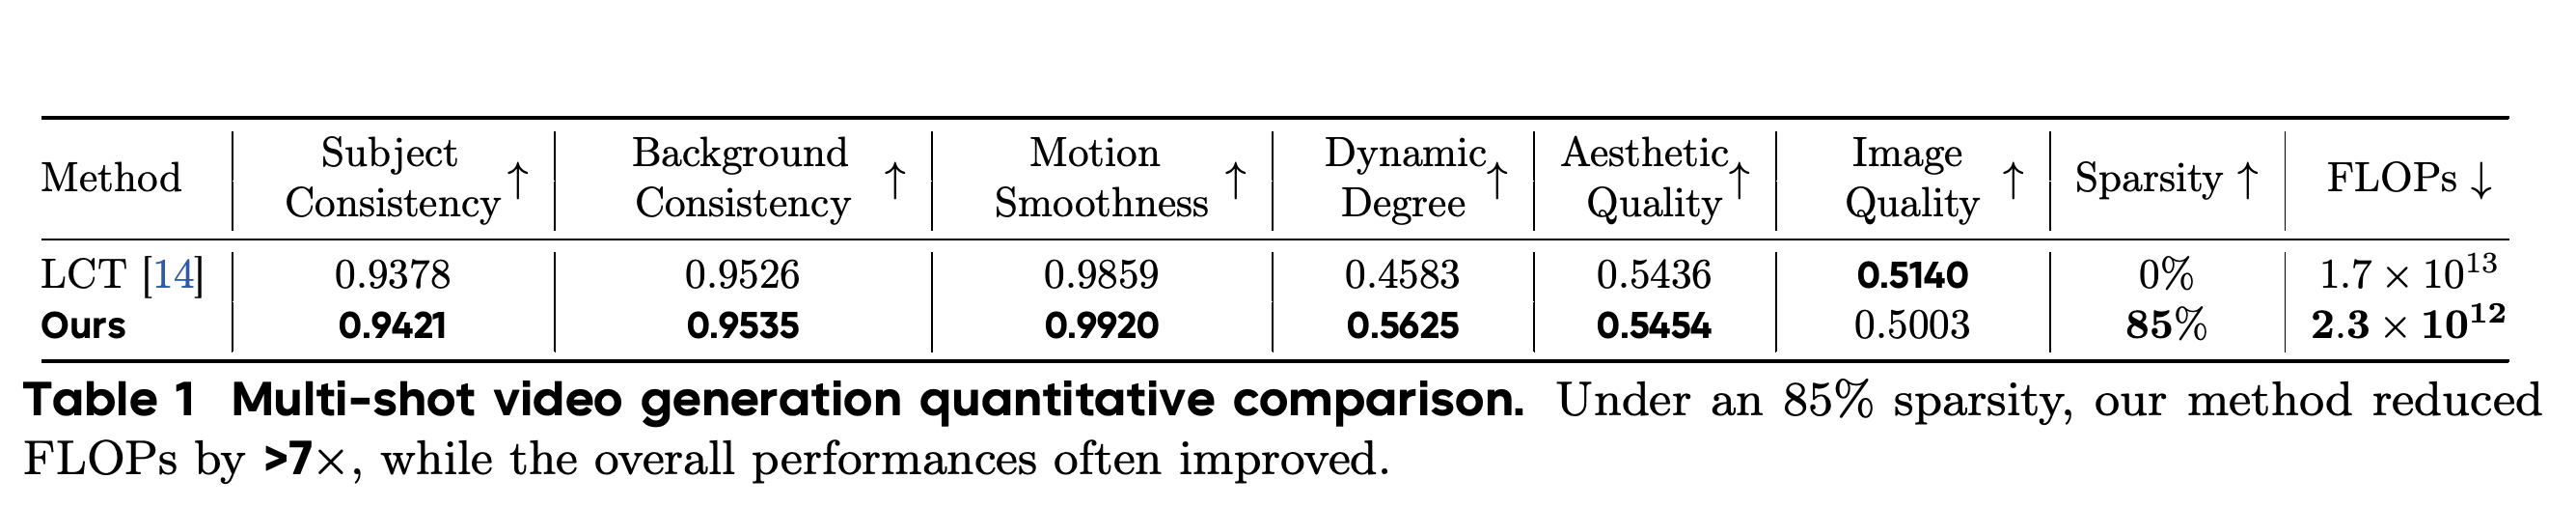
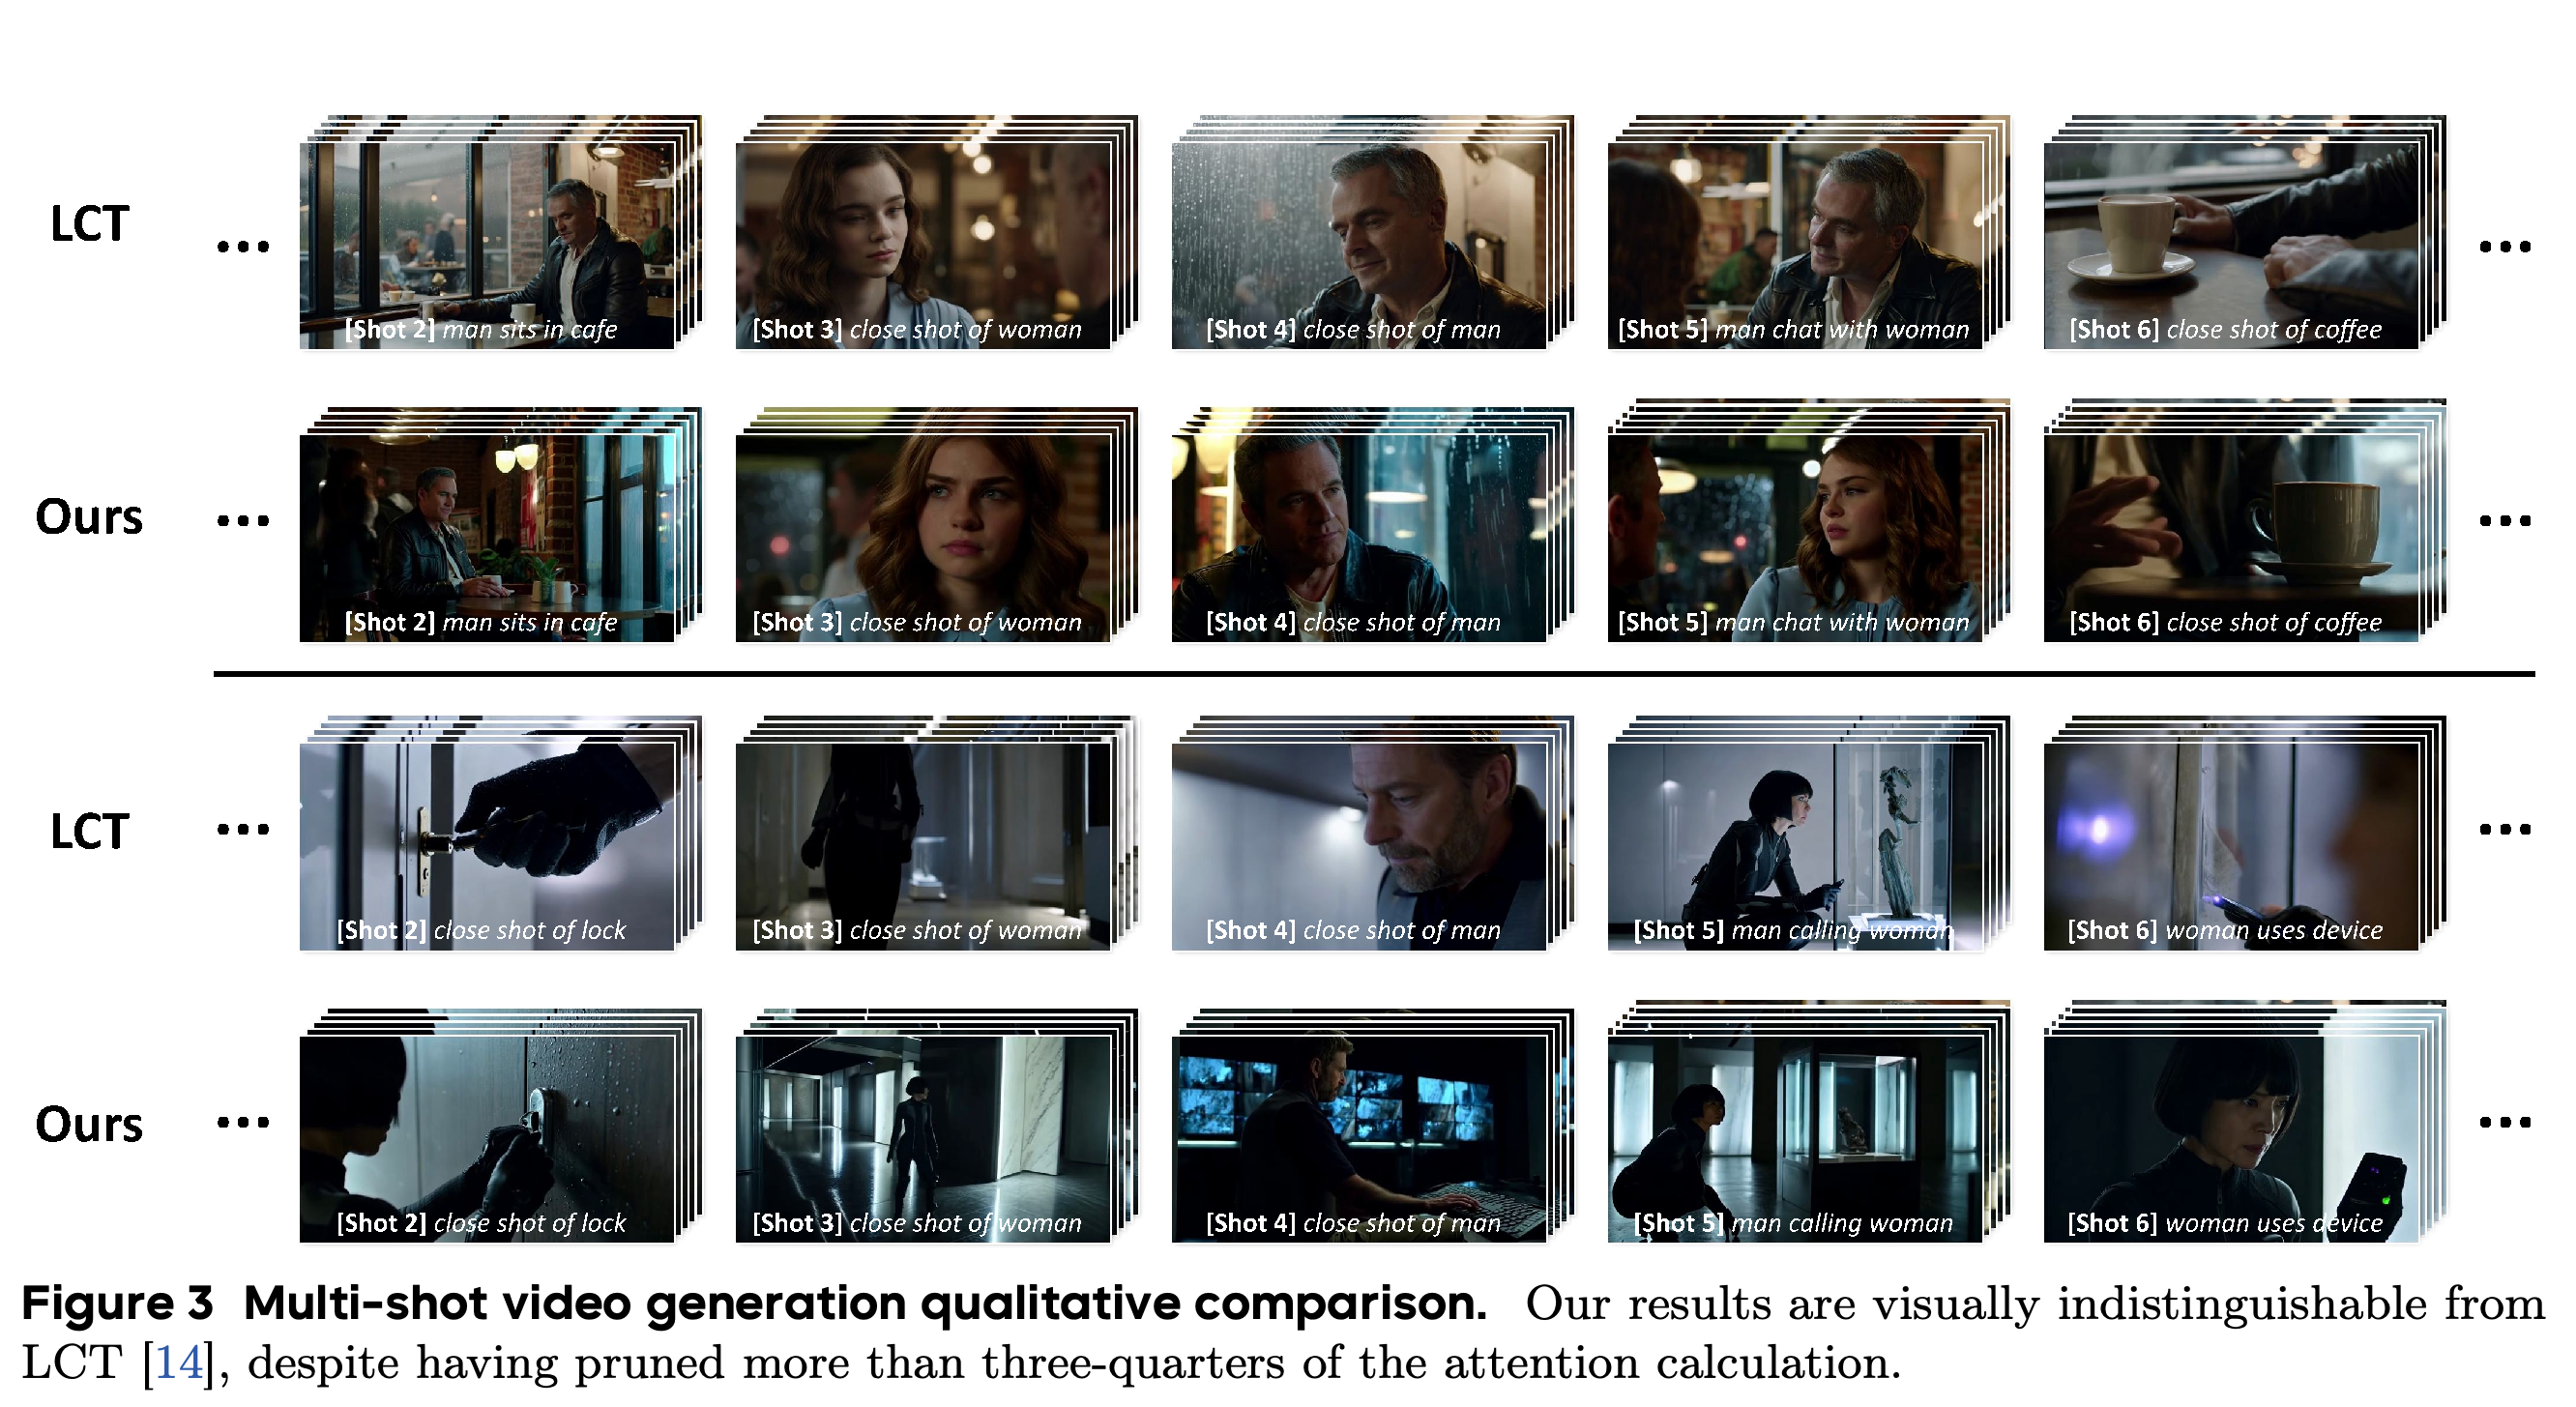
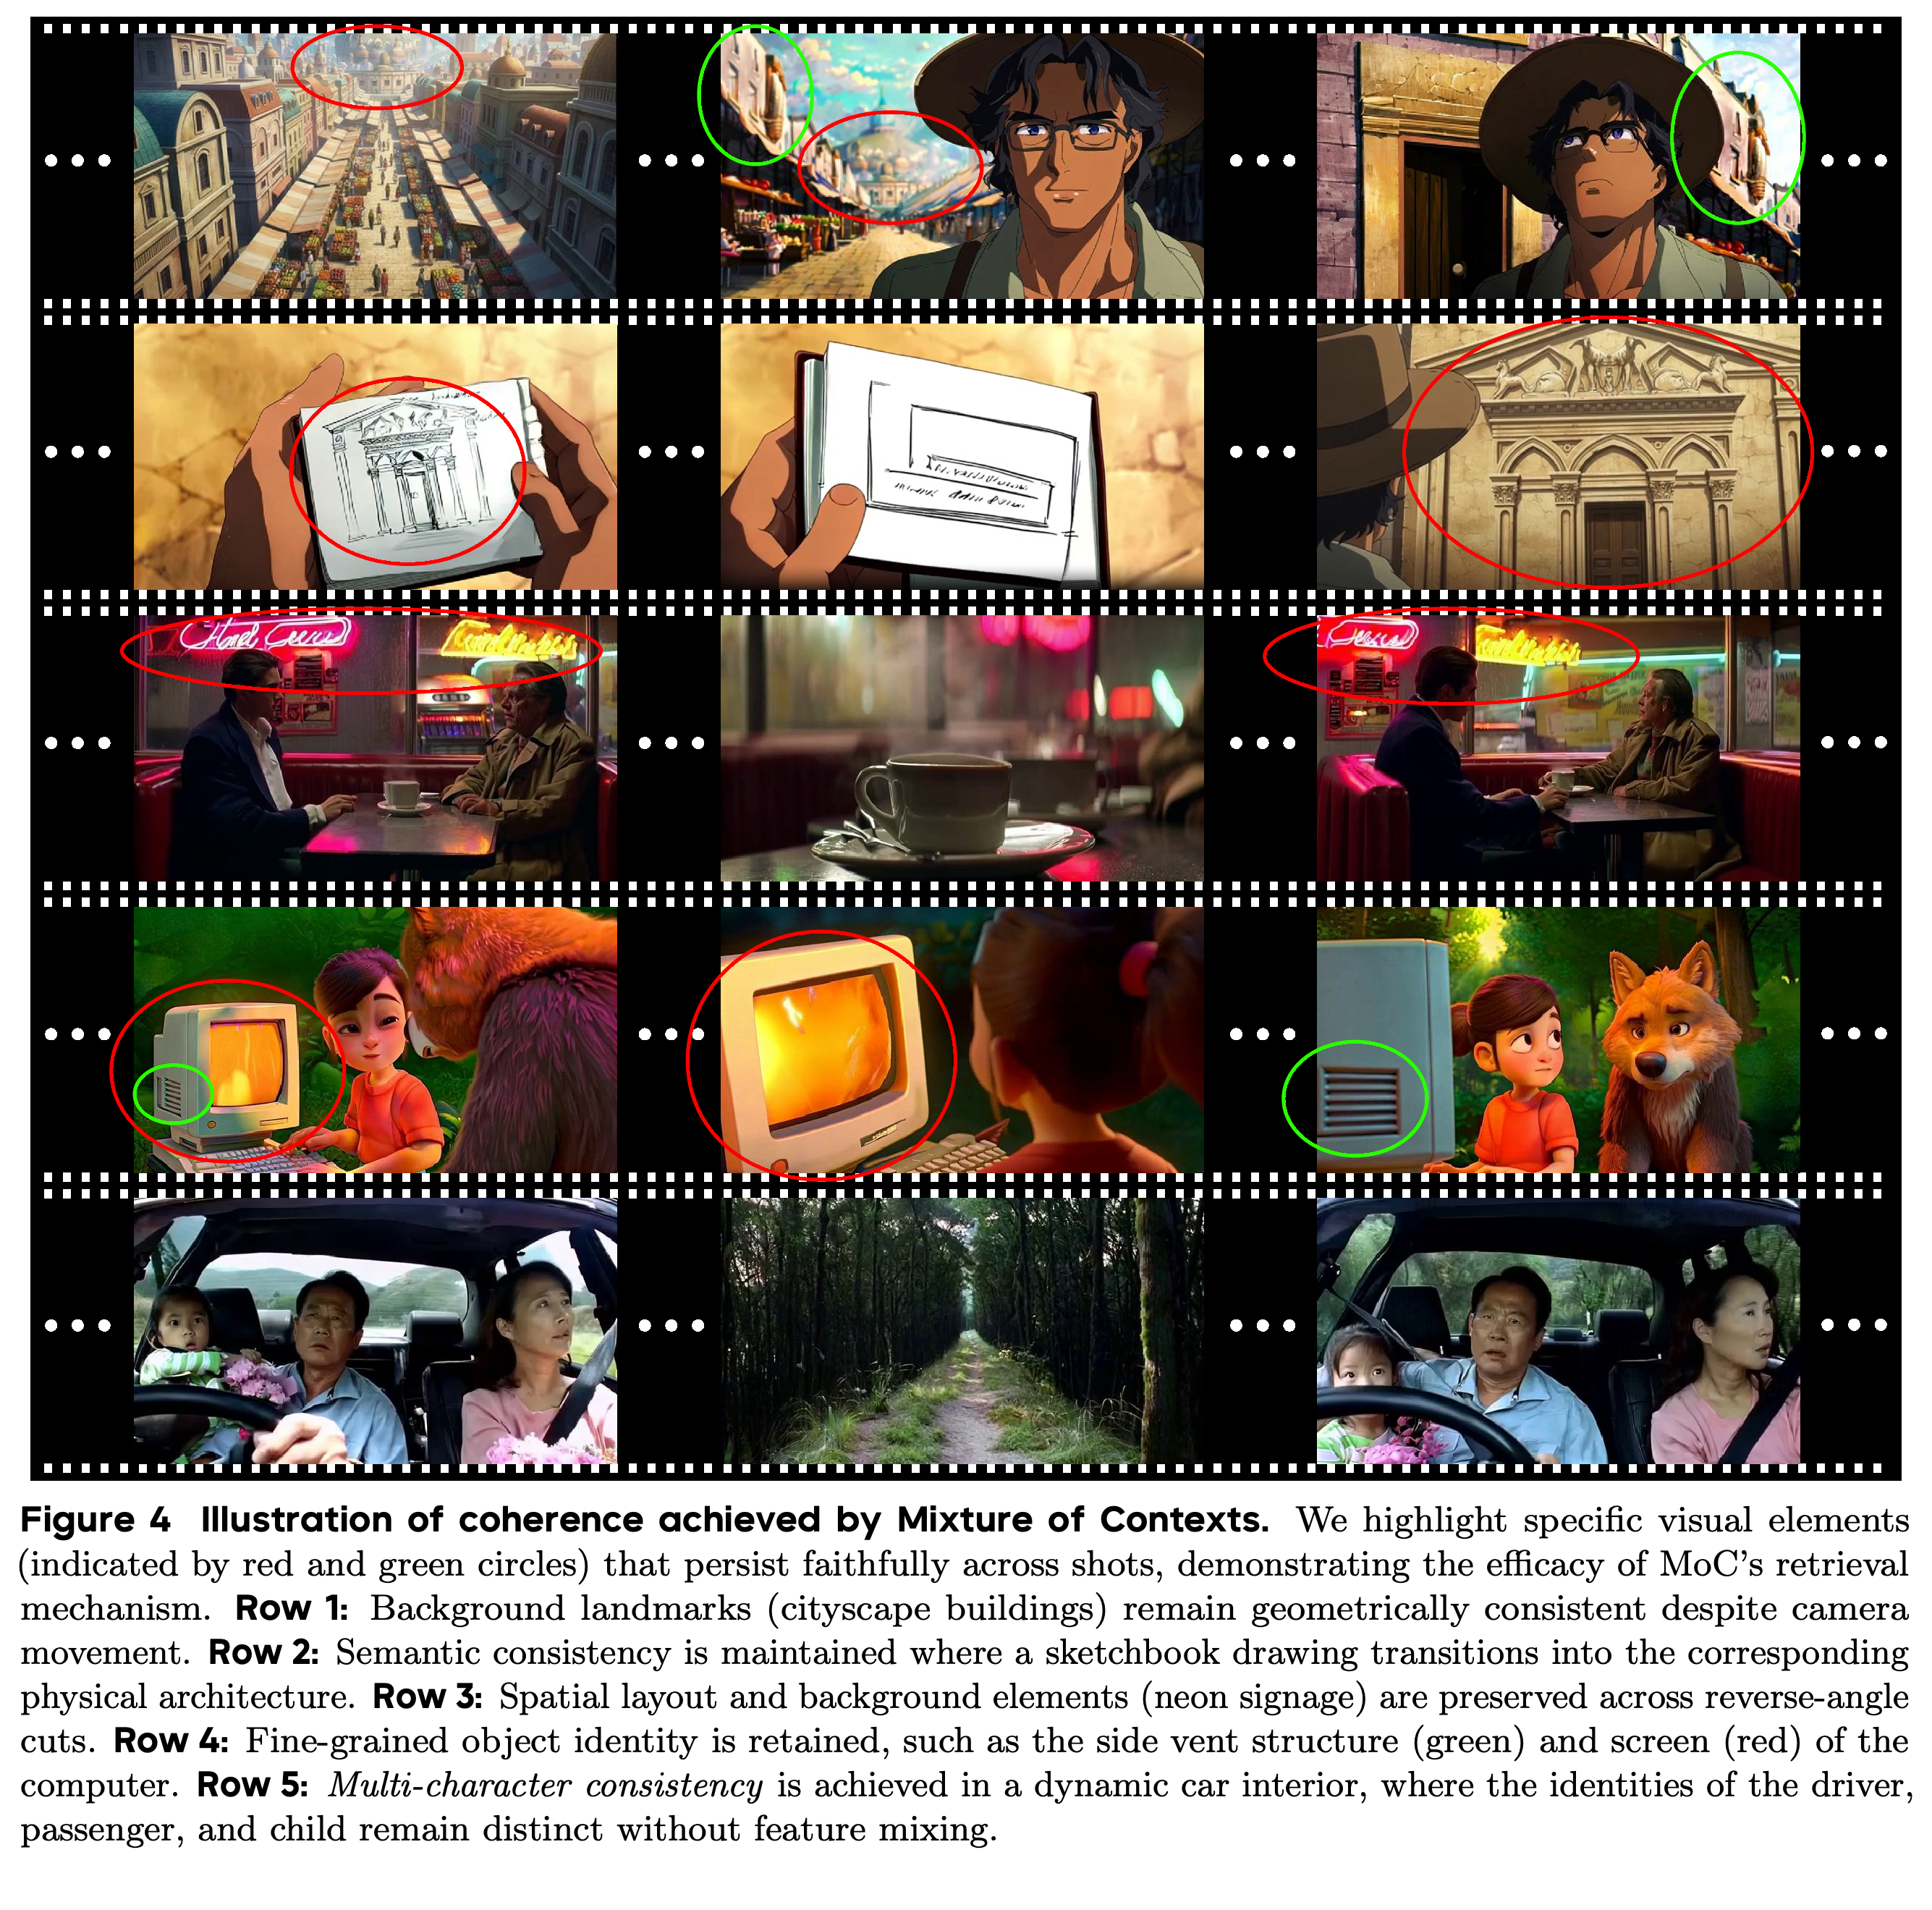
Figure 3은 카페 장면과 기기를 조작하는 시퀀스에서 dense LCT와 MoC를 비교하며 sparse attention에서도 그럴듯한 shot 단위 구성이 나타남을 보여준다. Figure 4는 컷이 바뀌어도 유지되는 랜드마크, 그림과 건물의 대응, 네온 간판, 컴퓨터 세부 요소, 서로 구별되는 인물의 선별 사례를 제시한다. 이 사례들은 일관성을 보여주지만 평가 데이터 전체에서 그러한 결과가 얼마나 자주 나타나는지는 입증하지 않는다.
대응하는 dense 및 sparse 출력은 같은 카페 장면과 기기 조작 shot 설명을 따르면서 서로 다른 시각적 결과를 생성한다. 선별한 frame은 shot 사이에 그럴듯한 인물과 배경을 보여주지만 전체 영상에서 움직임이나 실패율이 동등한지는 입증하지 못한다.
강조한 랜드마크, 간판, 컴퓨터 부품, 인물은 중간 shot과 시점 변화를 거친 뒤에도 다시 등장한다. 이 사례들은 배경의 기하 구조, 객체의 세부 정보, 그림과 건물의 대응, 여러 인물의 정체성을 보여주며, 정성적 근거를 반복 등장하는 단일 피사체 너머로 넓힌다.
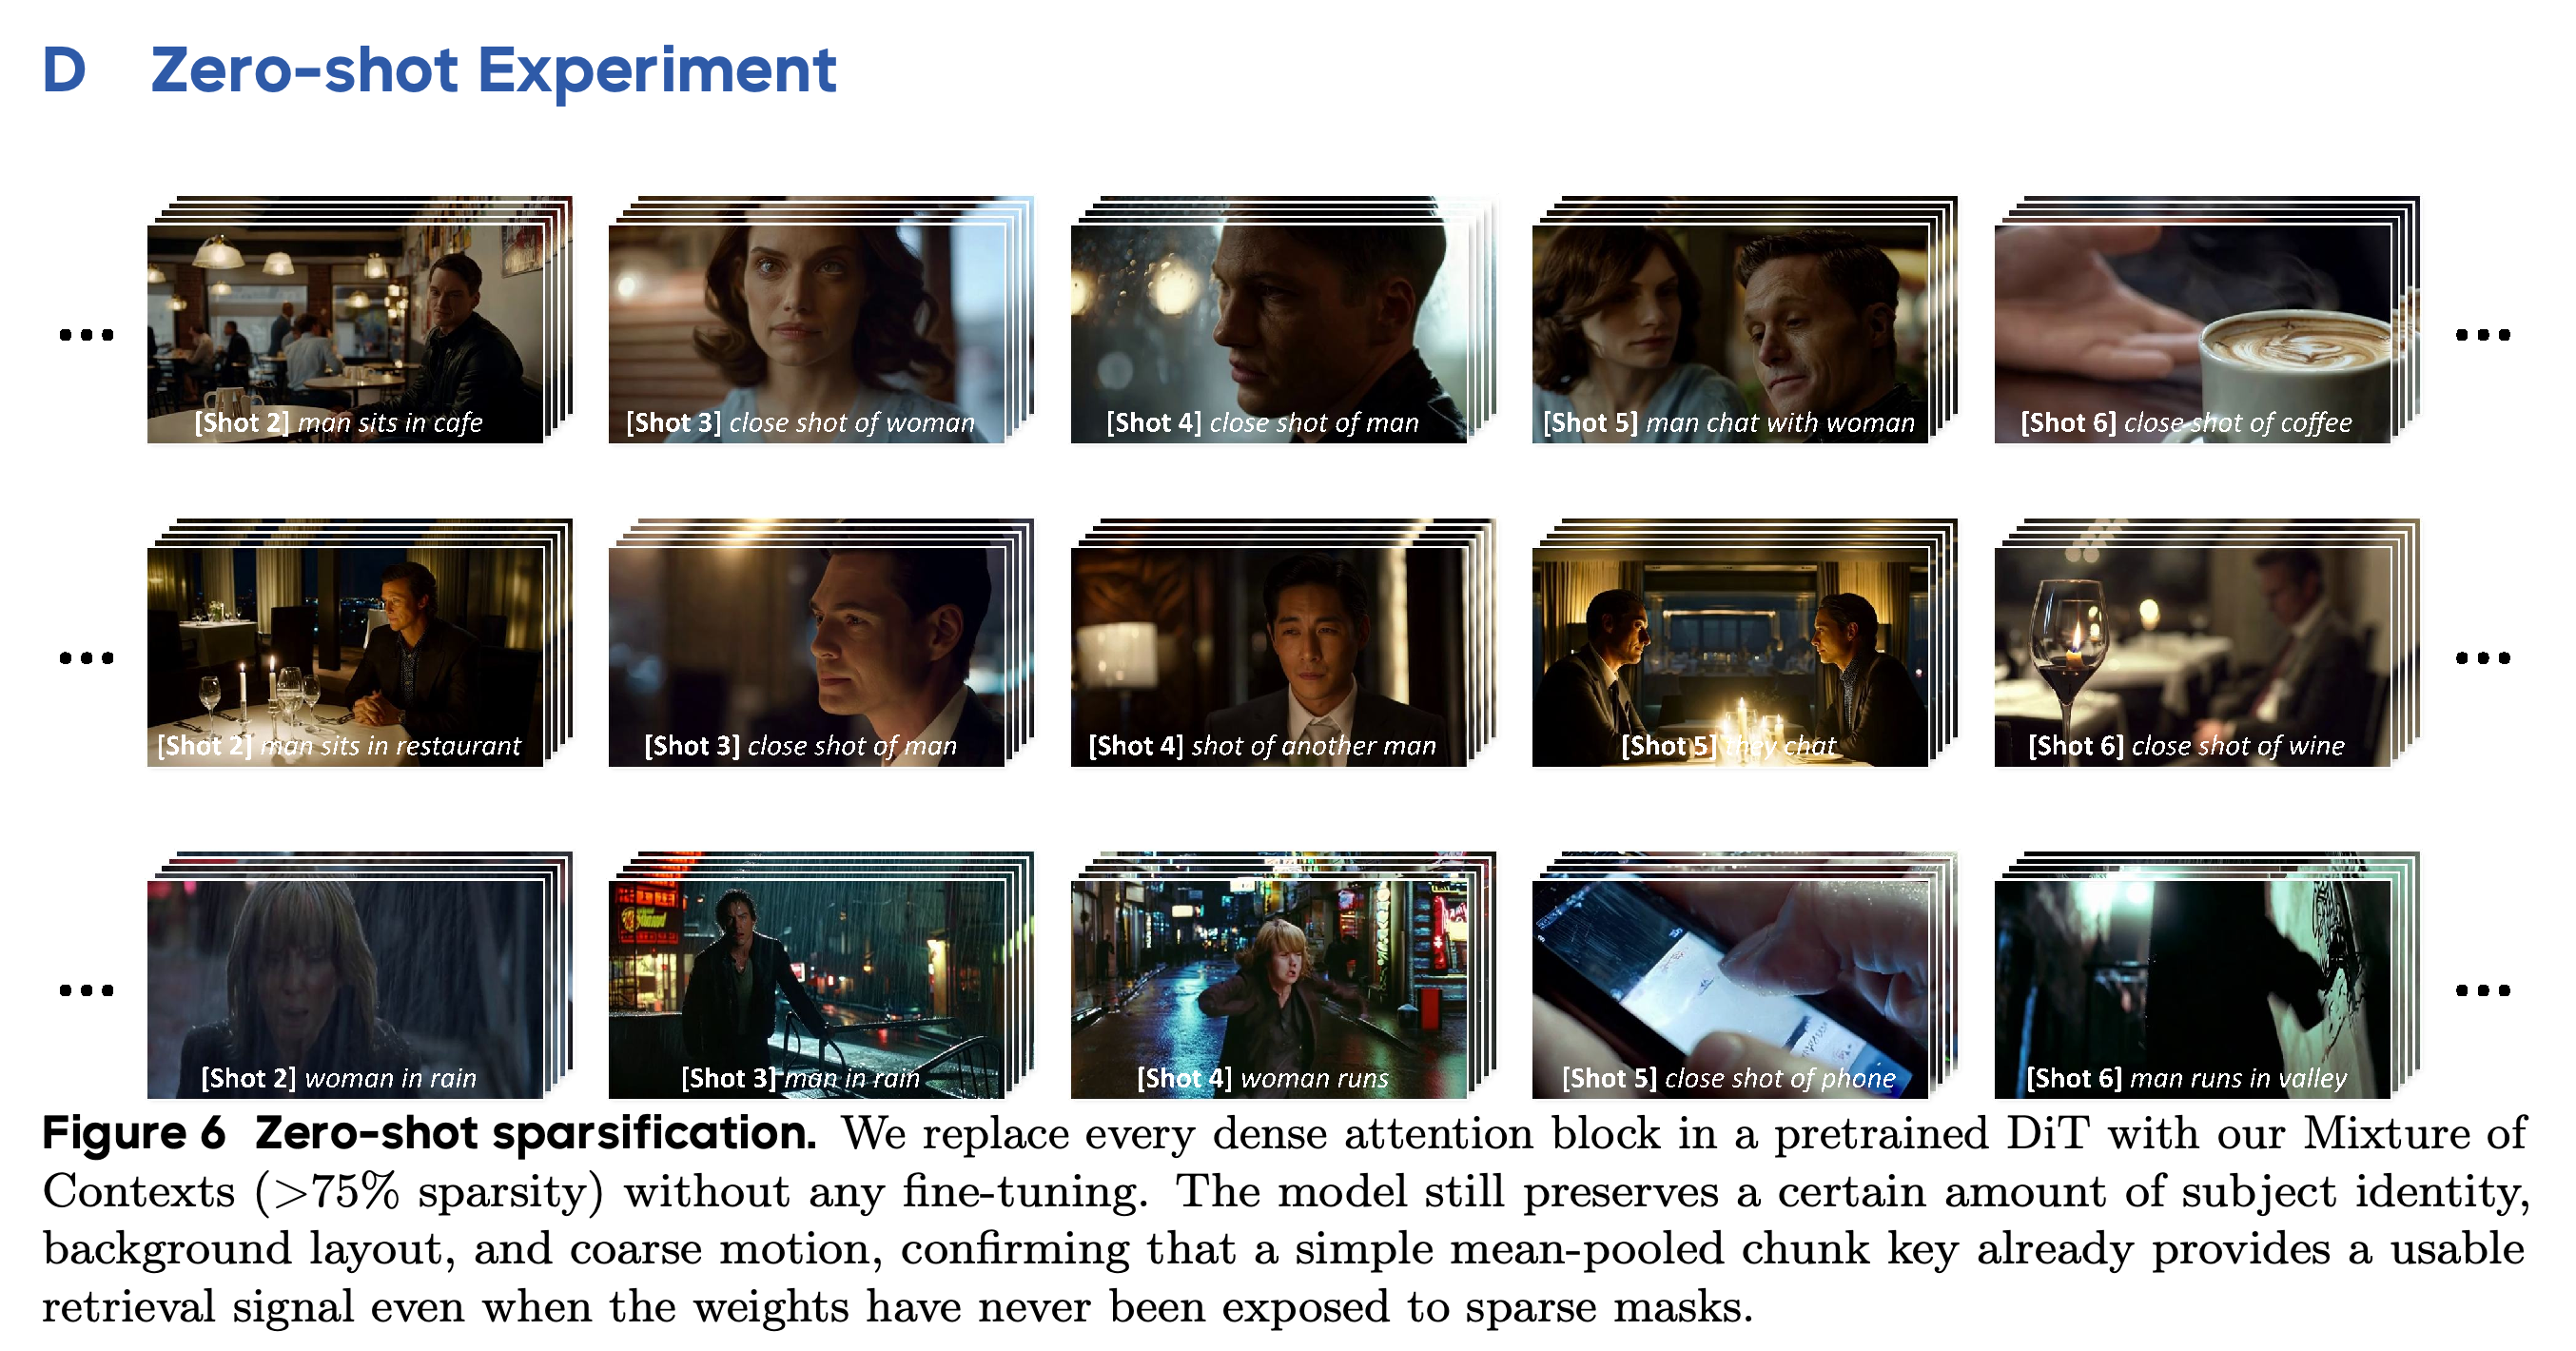
추가 실험은 구현의 확장성, 가중치를 고정한 sparsification, 짧은 영상 생성, routing 선택, 다른 backbone으로의 적용을 살펴본다. Figures 5–7과 Tables 2–5는 서로 다른 조건에서 얻은 근거를 제시하며 Appendix에서 이를 정리한다.
- Figure 5는 최대 24개 shot에서 attention 연산량과 지연 시간을 비교한다. 각 shot은 8초, 초당 12프레임, 약 23k 토큰으로 구성된다. 이는 구현 벤치마크이며 긴 영상의 생성 품질을 평가한 실험은 아니다.
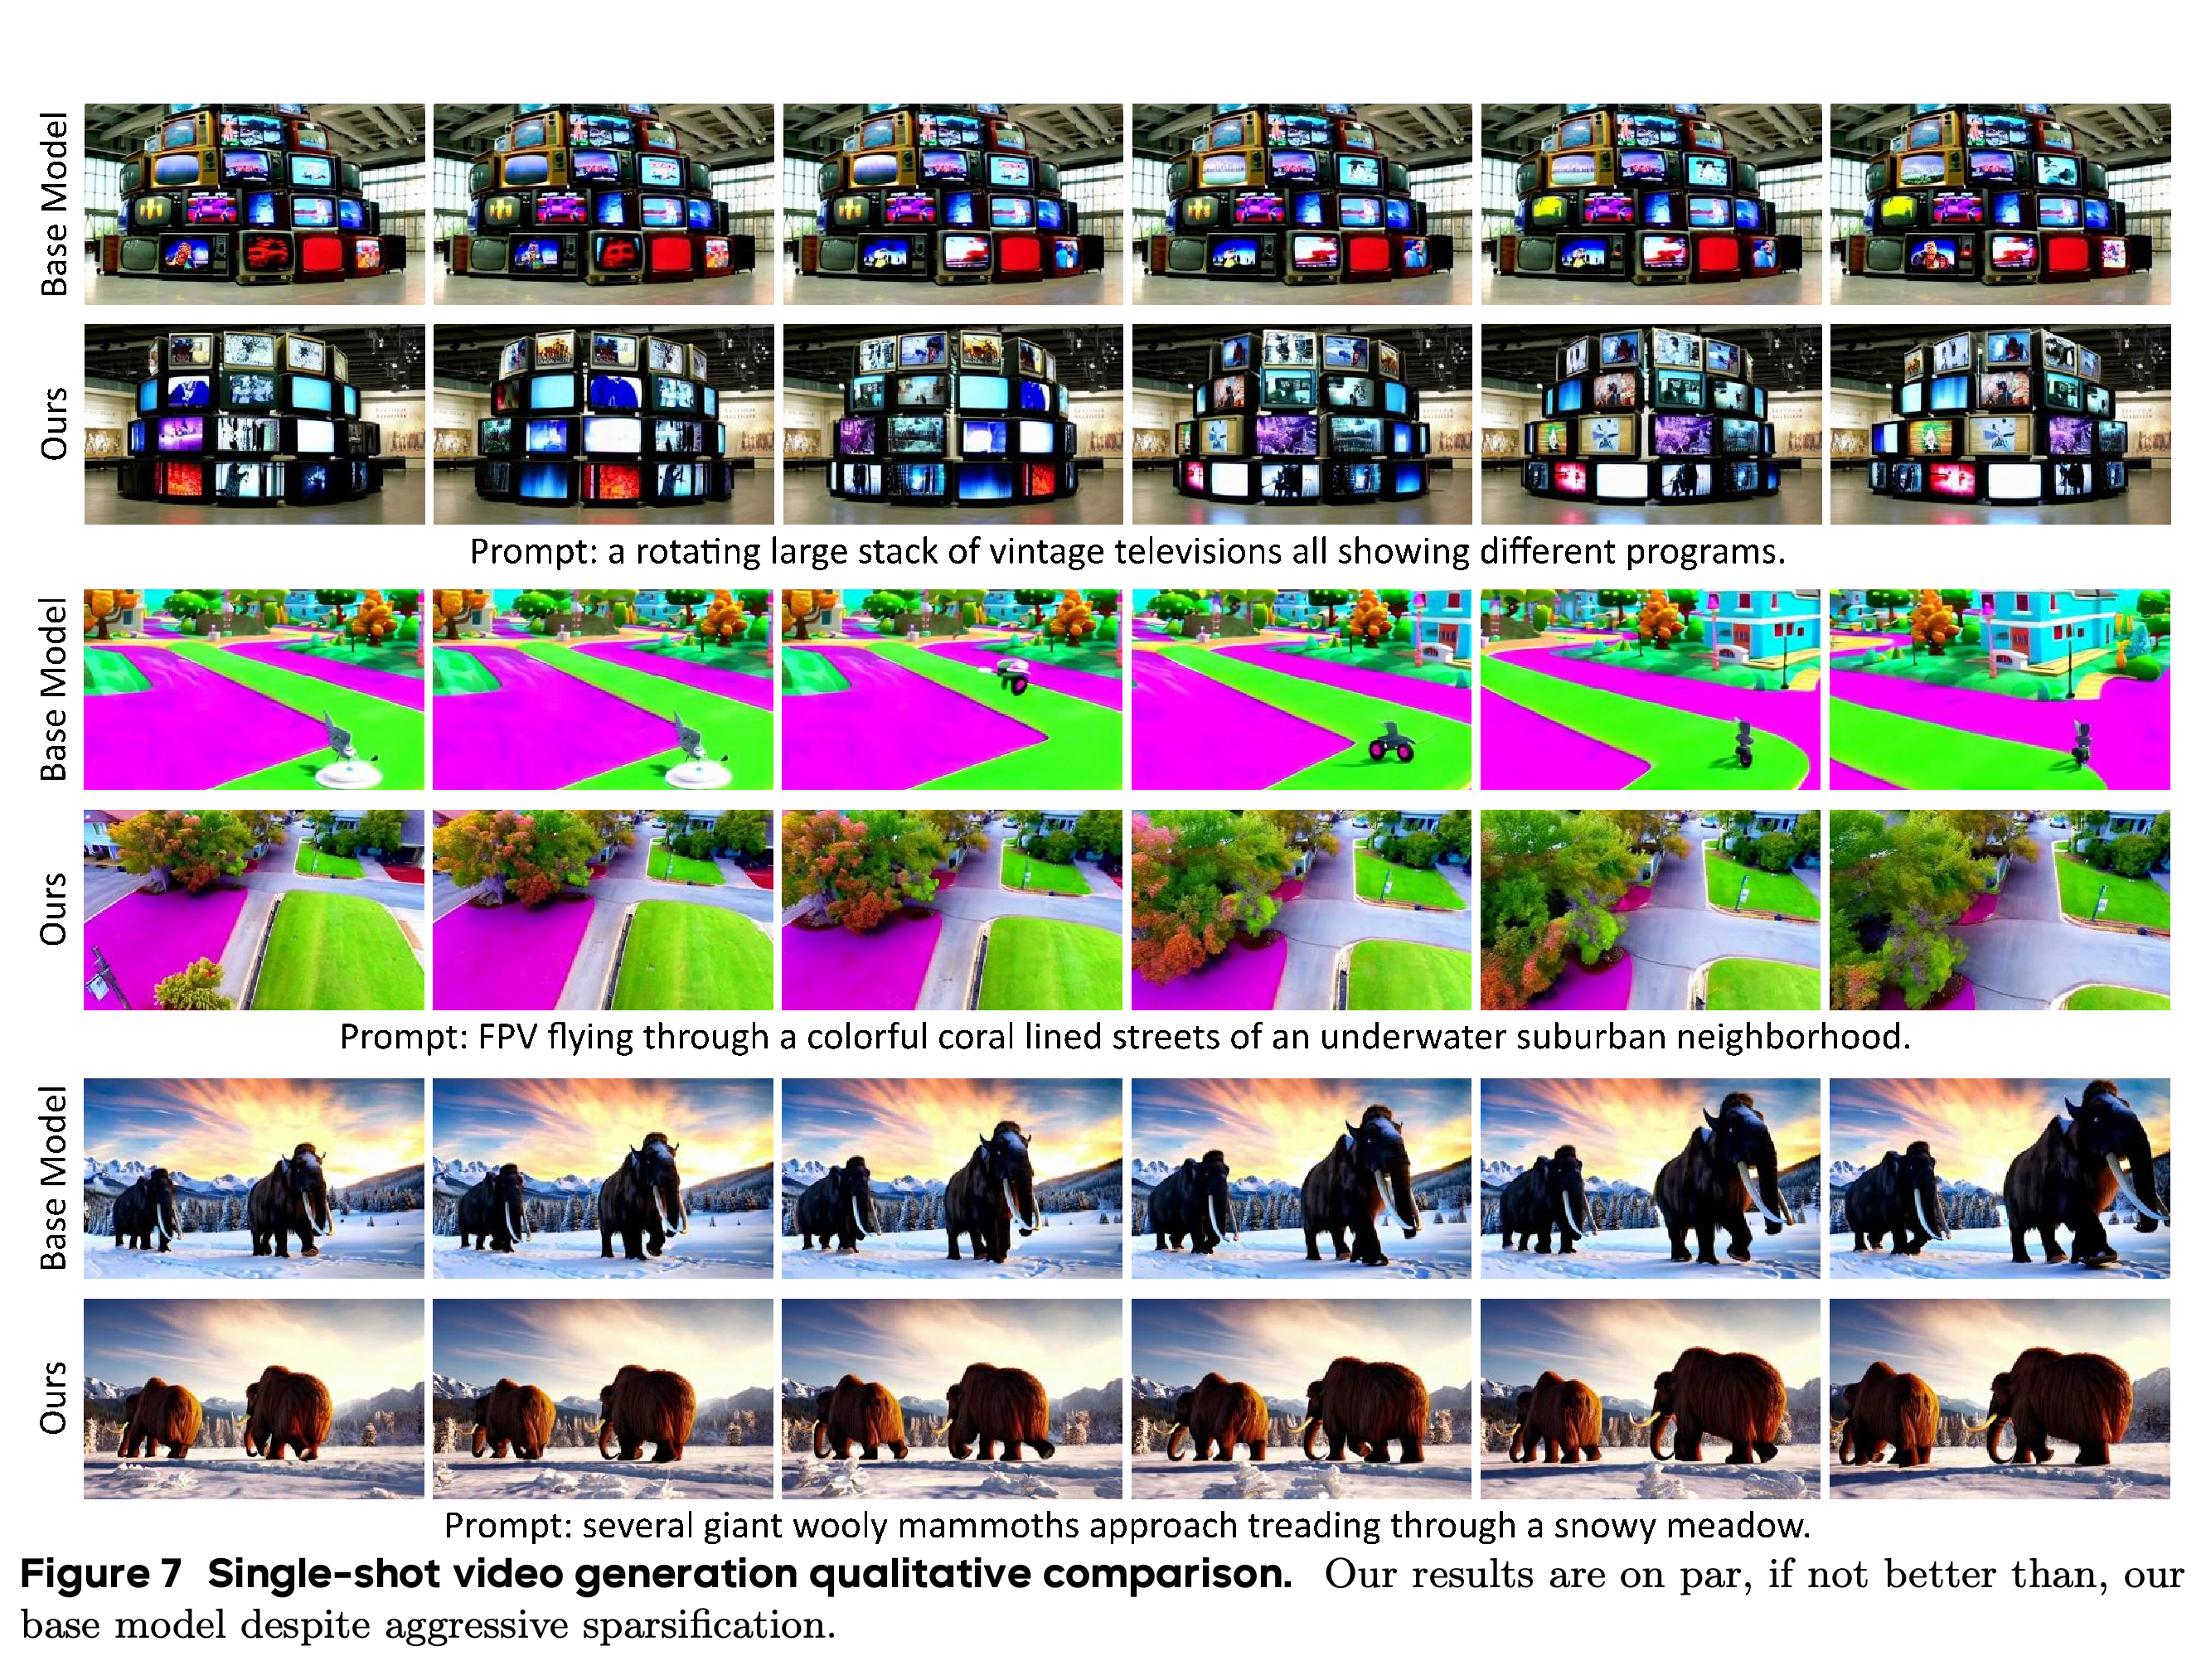
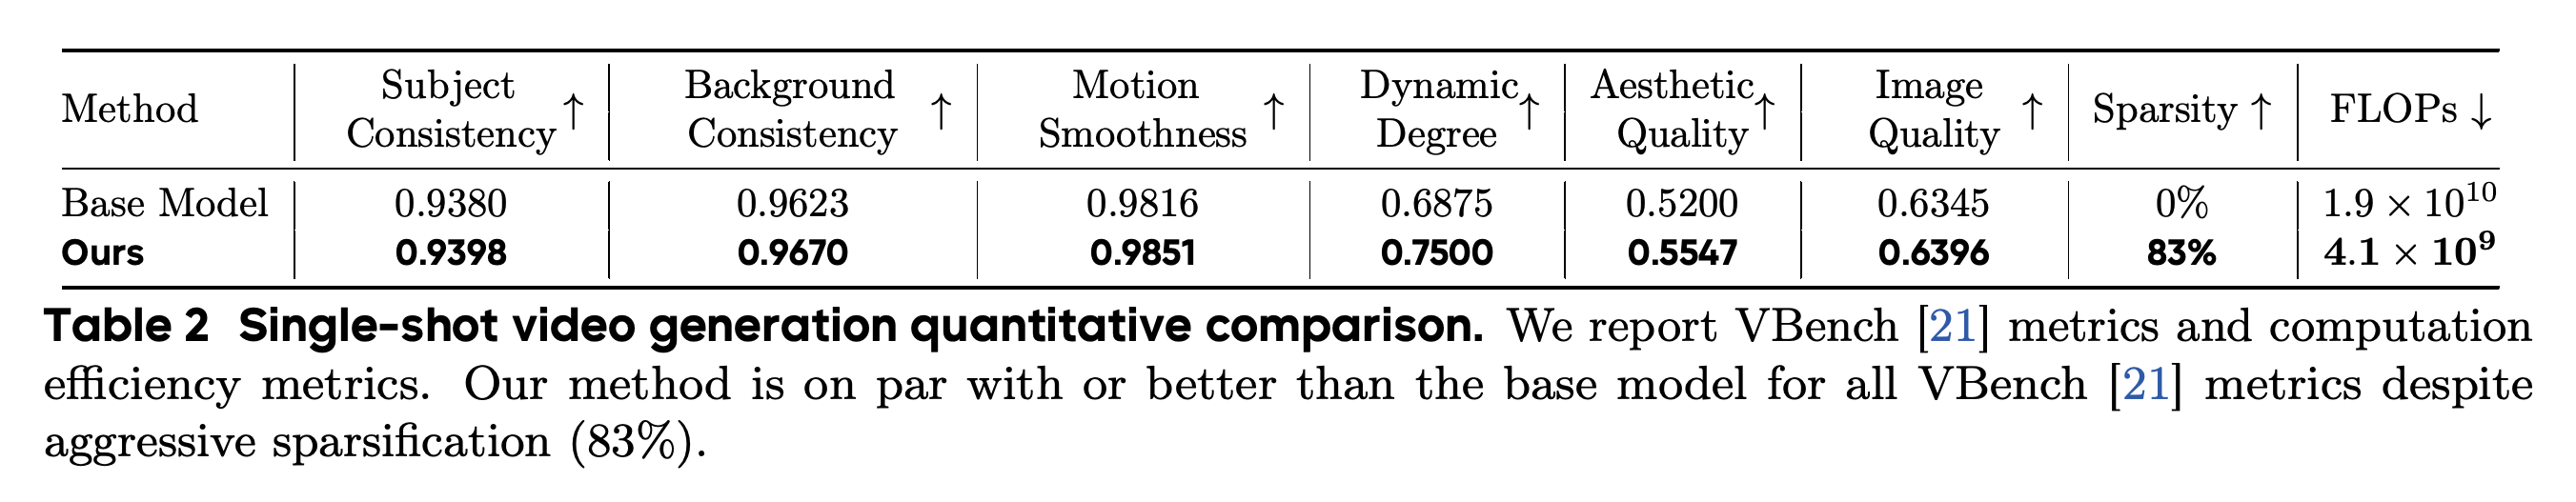
- Figure 6은 가중치를 고정한 MoC를 >75% sparsity에서 보여준다. Figure 7과 Table 2는 약 6,300 토큰으로 구성된 8초, 320×192 single-shot 영상을 다룬다. Sparsity 83%에서 품질 지표 6개가 개선되지만 종단 간 생성은 느려진다.
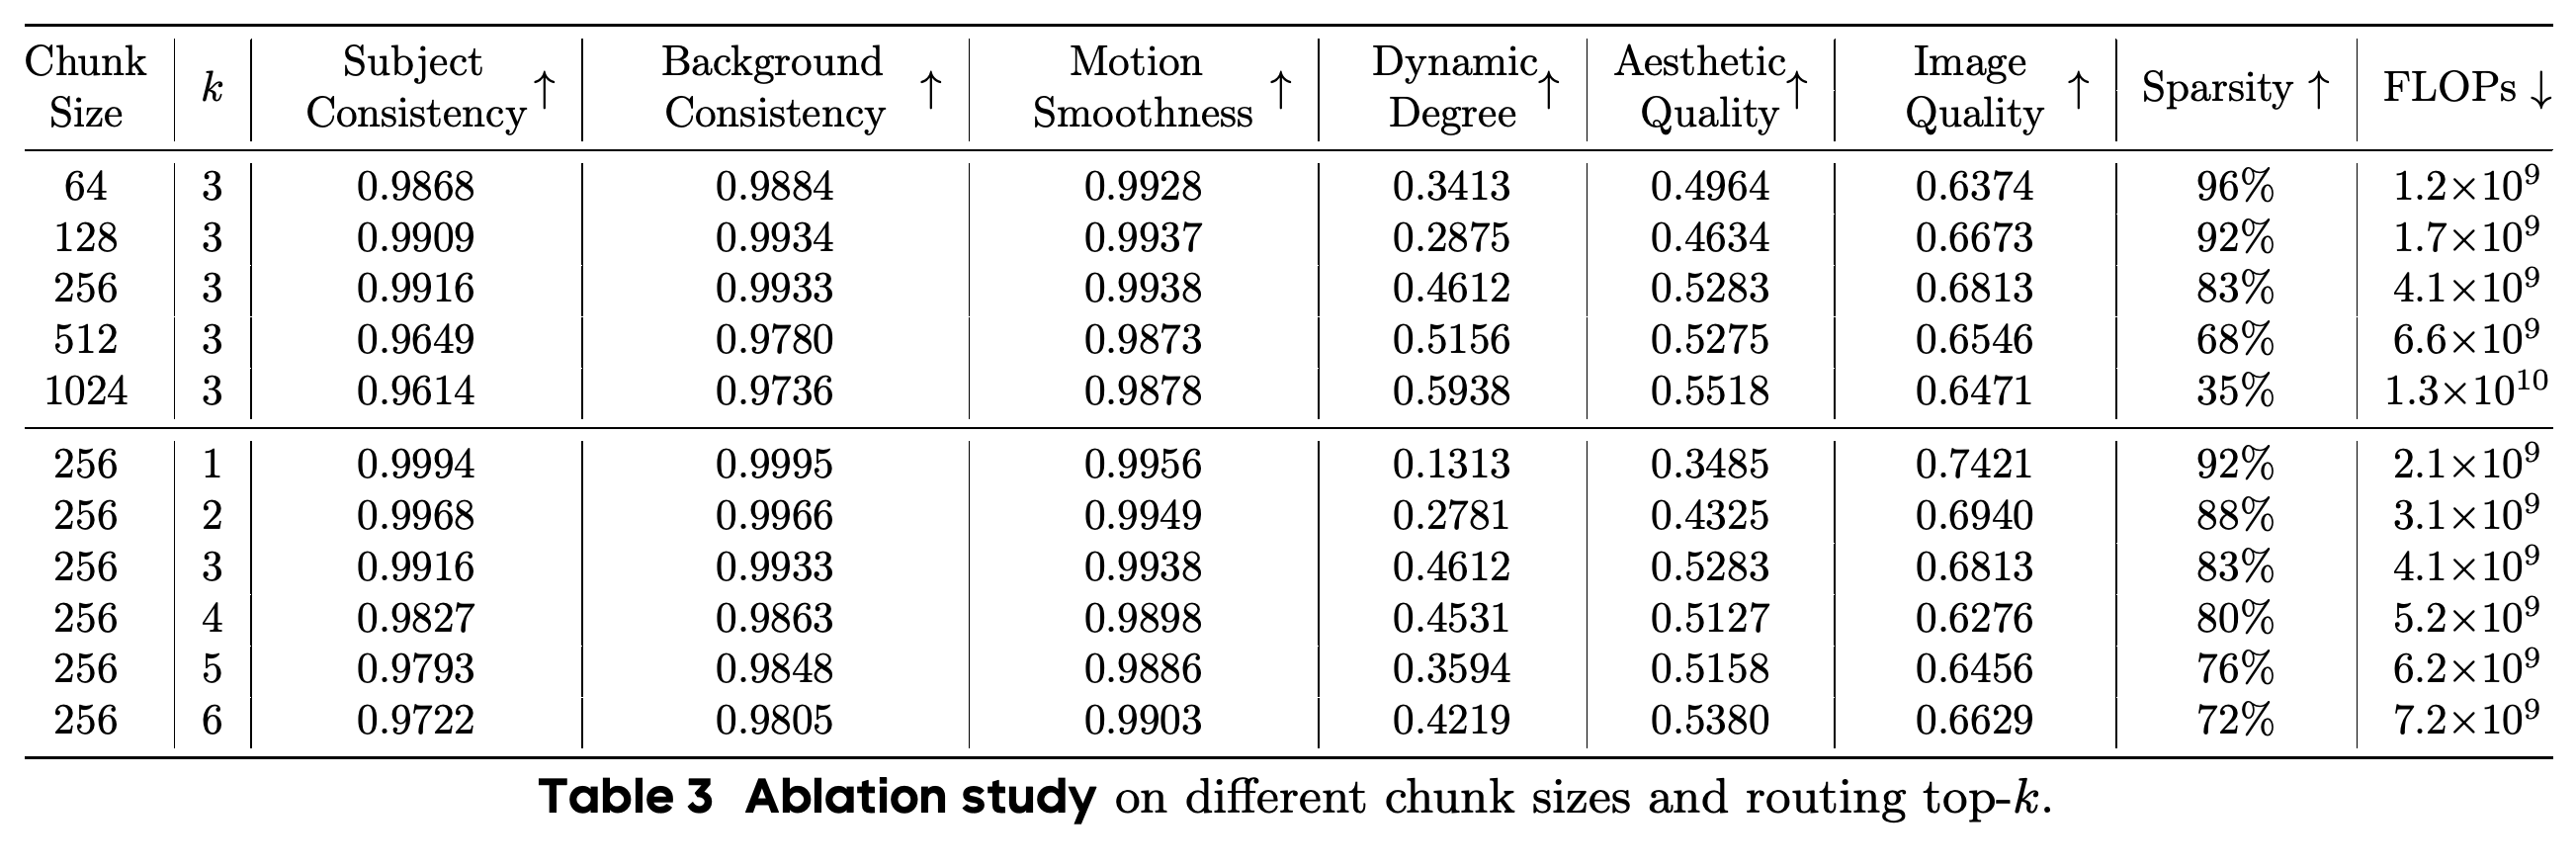
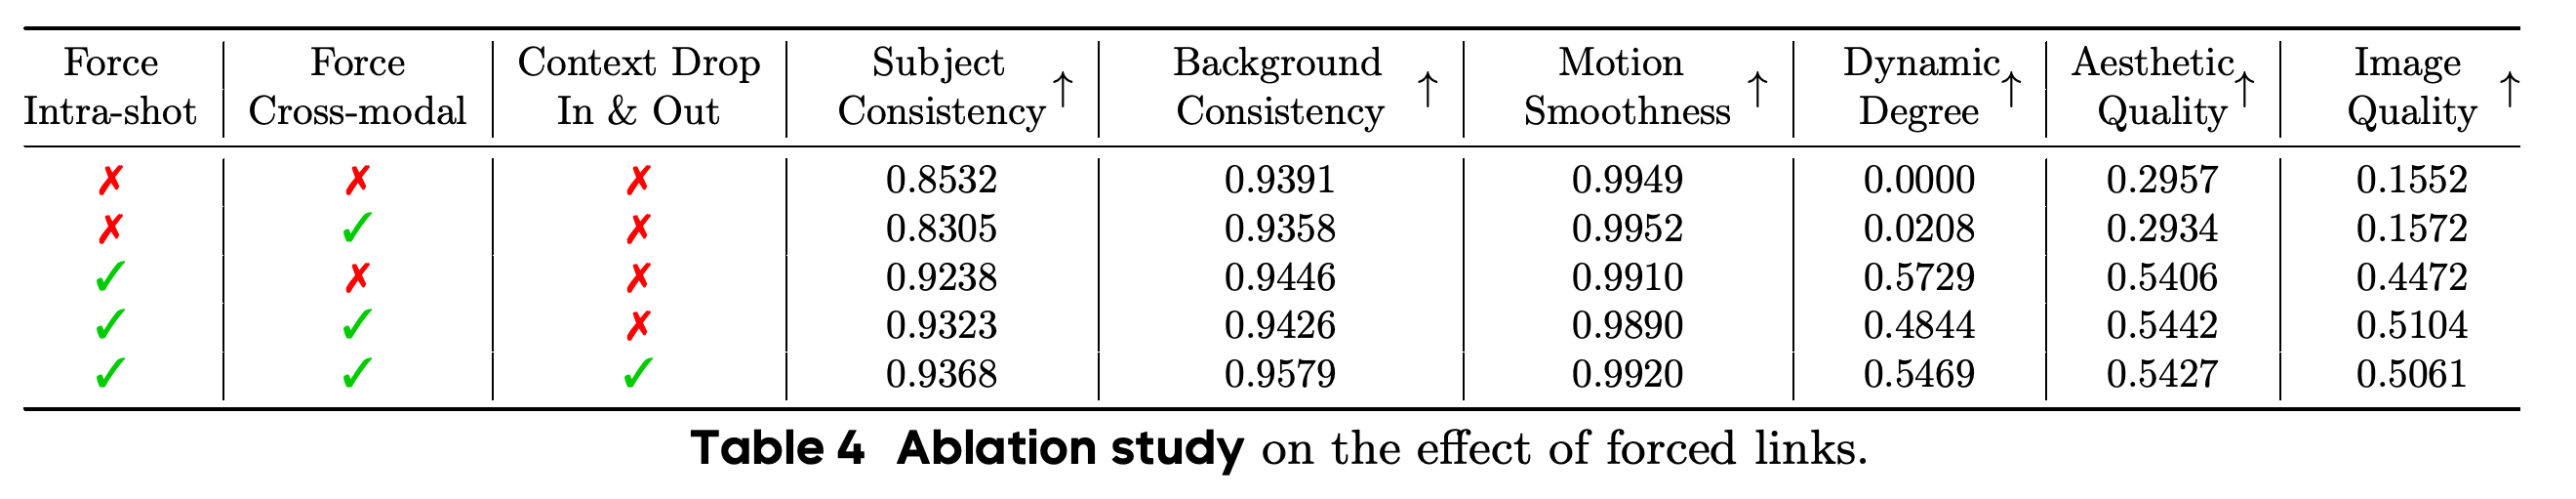
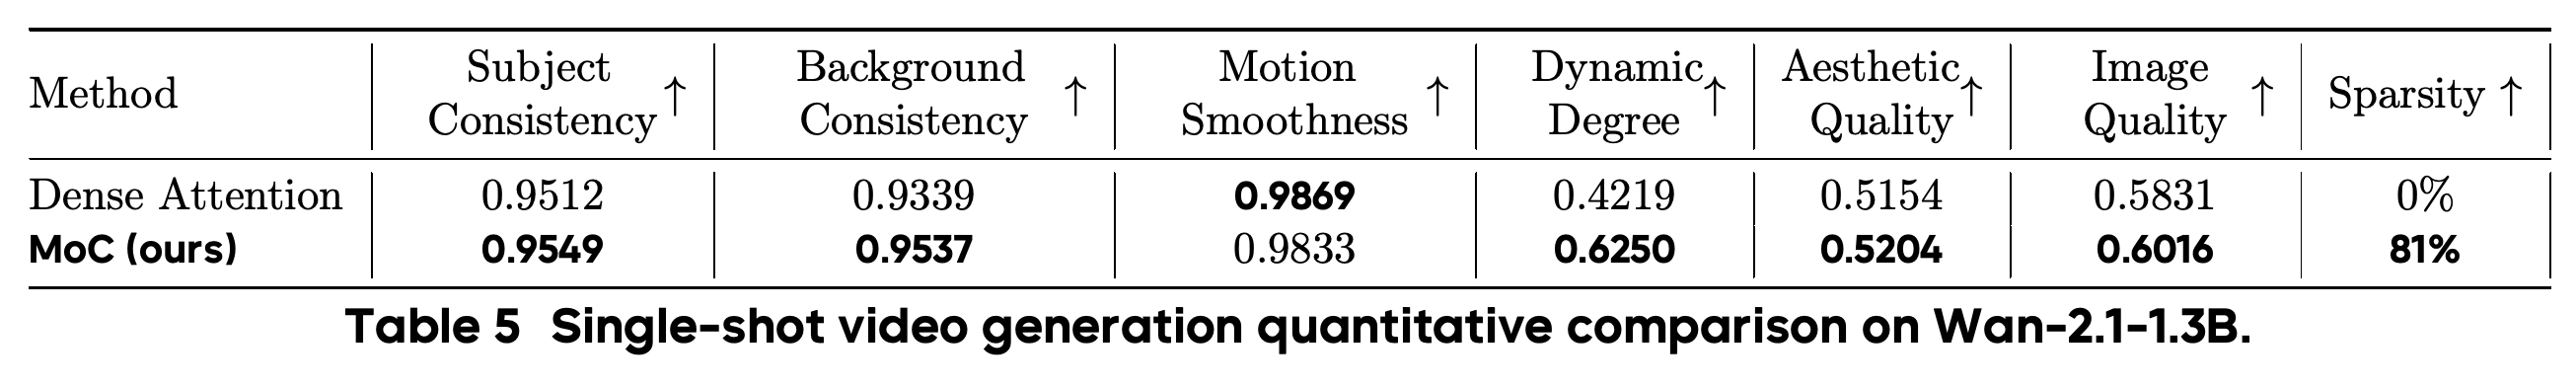
- Table 3은 chunk나 k가 매우 작을 때 움직임이 줄어드는 결과를 보여주고, Table 4는 필수 shot 내부 연결의 중요성을 보여준다. Table 5는 Wan-2.1-1.3B의 sparsity 81%에서 지표 5개가 개선되고 motion smoothness 지표 1개가 낮아지는 결과를 보고한다.
가중치를 고정한 사례는 >75% sparsity에서도 카페, 식당, 비 오는 액션 시퀀스에 걸쳐 알아볼 수 있는 인물과 배경을 유지한다. 이는 기존 특징에도 활용 가능한 검색 신호가 있음을 보여주지만 평균 품질과 fine-tuning의 이점은 정량화하지 않는다.
사례는 회전하는 텔레비전, 다채로운 동네를 통과하는 이동, 다가오는 매머드를 다룬다. 두 모델 모두 프롬프트와 관련된 알아볼 수 있는 콘텐츠를 생성한다. 짧은 영상 지표를 정성적으로 보완하지만 이 설정에서 보고된 MoC의 느린 실행 시간은 측정하지 않는다.
MoC는 sparsity 83%에서 보고된 지표 6개를 모두 개선하고 attention FLOPs를 1.9 × 10^10에서 4.1 × 10^9로 줄인다. 표는 지연 시간이 아닌 산술 연산 절감량을 보고한다. 함께 제시된 본문은 이러한 짧은 시퀀스에서 종단 간 생성이 느려진다고 설명한다.
Chunk size와 k를 바꾸는 실험은 연결 제거와 움직임 사이의 상충 관계를 보여준다. Chunk size 256에서 k = 1이면 Subject Consistency는 0.9994지만 Dynamic Degree는 0.1313이다. k = 3이면 각각 0.9916과 0.4612다. 따라서 consistency만 높게 평가하면 움직임이 적은 출력을 선호할 수 있다.
필수 shot 내부 접근이 없는 행은 텍스트 접근을 강제하고 누락된 국소 연결을 보완하는 검색 슬롯을 4개 추가해도 움직임의 정도가 거의 0이고 image quality가 매우 낮다. Shot 내부 attention을 추가하면 이러한 결과가 크게 개선된다. Cross-modal 연결과 context perturbation은 나머지 지표를 변화시키지만 모든 지표를 개선하지는 않는다.
Wan-2.1-1.3B에서 MoC는 sparsity 81%에 도달하고 지표 5개를 개선하며 Dynamic Degree는 0.4219에서 0.6250으로 높아진다. Motion Smoothness는 0.9869에서 0.9833으로 낮아져, 이 다른 backbone에서도 측정 가능한 상충 관계가 남는다.
5 Conclusion
Conclusion은 학습된 sparse routing을 내부 메모리 검색 메커니즘으로 해석하며 외부의 기하학적 검색 규칙 없이 분 단위 context를 실용적으로 처리한다고 설명한다. Limitation and Future Work는 주요 모델을 LCT 설정에서 학습하고 평가했으며 더 긴 시퀀스에서의 절감 효과는 추가 연구가 필요하다고 밝힌다.
- 구현은 범용 가변 길이 attention과 프레임워크 수준의 gather 연산을 사용하므로, 산술 연산 절감량과 실제 실행 시간 절감량 사이에 차이가 남는다.
- 개선 방향으로 chunk 구조를 반영한 sparse kernel, routing과 attention의 융합, 더 효율적인 key/value 배치, 수치 정밀도를 낮추는 quantization을 제안한다. 이들은 향후 연구 방향이다.
부록
- N개 chunk의 mean-pooled descriptor를 저장하는 데 \(O(Nd)\)가 필요하다. Chunk 선택에 사용하는 점수인 routing logit은 \(O(LN)=O(L^2/C)\)의 저장 공간을 요구한다. 여기서 C는 chunk 크기이고 \(N\approx L/C\)다. O는 점근적 증가율을 나타낸다. 부록은 torch.segment_reduce와 attention 연산의 gradient 계산을 정의하는 사용자 정의 torch.autograd.Function을 사용해 routing의 추가 메모리 사용량을 전체 GPU 메모리의 0.1% 미만으로 줄였다고 보고한다. 다만 chunk 크기를 고정하면 routing logit의 공간 복잡도는 여전히 시퀀스 길이에 대해 제곱으로 증가한다.
- B MoC Implementation Benchmark. Figure 5는 평가한 shot 수 범위에서 FlashAttention 2 [8, 9]로 구현한 full attention과 비교하여, 보고된 연산량과 측정된 지연 시간이 거의 선형으로 증가함을 보여준다. 논문은 즉석 pooling, 효율적인 gather를 위한 head-major 토큰 배치, 가변 길이 attention 그룹을 단일 kernel 호출로 묶는 구현이 이러한 결과를 낳았다고 설명한다.
- C Dataset Details. 공개 서사 영상을 장면 경계 검출기로 scene으로 나눈 뒤, shot 컷 검출 도구인 PySceneDetect로 shot을 나눈다. Multimodal 주석 모델인 Gemini-1.5는 전체 caption과 shot 단위 caption을 생성한다. 실제 multi-shot scene 약 500K개는 평균 약 5개 shot으로 구성되어 shot clip 약 2.5M개를 제공한다. 긴 single-shot 영상을 사건 단위로 분할하여 scene 단위 샘플 약 1M개를 추가한다. 전체 caption은 “[Character] [Environment] [Story]”와 “Character [ID]: [Description]” 형식을 사용한다. Shot caption은 전체 caption의 character ID를 참조하고 실제 컷에는 “[SHOT CUT]”을 붙인다.
- D Zero-shot Experiment. 저자들은 모든 가중치를 고정한 사전 학습 dense 모델에 MoC를 삽입한다. 추가 학습이 필요 없는 zero-shot 적용이며 >75% sparsity에서 선별한 출력 사례를 보여준다. Figure 6은 fine-tuning 전에도 pooled key로 유용한 context를 검색할 수 있다는 정성적 근거를 제공한다. 다만 이 절은 routing 표현을 학습하는 효과만 분리한 정량 비교를 제시하지 않는다.
- E Single-shot Short Video Generation. 320×192, 초당 12프레임의 8초 영상에서 MoC는 sparsity 83%로 native 3B MMDiT [10] baseline보다 보고된 VBench 지표 6개 [21]를 모두 개선하고 FLOPs를 1.9 × 10^10에서 4.1 × 10^9로 줄인다. Dynamic Degree는 0.6875에서 0.7500으로, Image Quality는 0.6345에서 0.6396으로 높아진다. 다만 pooling과 gather의 부가 비용 때문에 종단 간 pipeline은 느려진다.
- F Training Details. Single-shot 학습은 이미지와 영상, chunk size 256, top-k = 3, 필수 chunk 내부 연결과 텍스트 연결을 사용한다. 폐루프 동작이 관찰되지 않아 causal routing은 사용하지 않는다. Multi-shot 학습은 이미지, single-shot 영상, multi-shot 영상을 사용하며 top-k = 5와 필수 shot 내부 연결, local-prompt 연결, global-prompt 연결을 유지하면서 chunk size를 10240, 5120, 2560, 1280 순서로 줄인다. 두 설정 모두 learning rate 9e−5를 사용한다. Single-shot 학습은 10k iterations, multi-shot 학습은 20k iterations 동안 진행한다.
- G Ablation Study. Ablation은 H100 GPU 16개, learning rate 2e−5를 사용하며 single-shot 실험은 30k iterations, multi-shot 실험은 10k iterations 동안 진행한다. Table 3은 매우 작은 chunk나 작은 k가 움직임을 억제할 수 있음을 보여준다. Chunk size 256에서 Dynamic Degree는 k = 1일 때 0.1313이고 k = 3일 때 0.4612이며, 각 query는 자신의 chunk에도 추가로 접근한다. Table 4는 chunk size 5120과 k = 5를 사용한다. 필수 연결을 모두 생략하면 Dynamic Degree가 0.0000, Image Quality가 0.1552지만, 모든 연결과 Context Drop In & Out을 활성화하면 각각 0.5469와 0.5061이다. 필수 shot 내부 연결이 없는 설정에는 검색 슬롯을 4개 추가한다.
- H Wan-2.1-1.3B Experiment. MoC를 Wan-2.1-1.3B의 self-attention에만 적용하고 Vchitect [11, 33] 데이터셋에서 480p, chunk size 1560으로 sparse fine-tuning과 dense fine-tuning을 비교한다. 각 설정은 GPU 32개에서 1일, 즉 2000 iterations 동안 실행한다. Sparsity 81%에서 MoC는 지표 6개 중 5개를 개선하며 Dynamic Degree는 0.4219에서 0.6250으로 높아진다. Motion Smoothness는 0.9869에서 0.9833으로 낮아진다. 이는 다른 backbone의 single-shot 생성에 대한 근거를 제공하지만 대응하는 긴 영상 평가는 여기서 보고하지 않는다. self-attention에 대해서는 Linformer(Self-Attention with Linear Complexity) 요약 설명 글을 참조하라.
- I Outer Loop Context Routing. 먼저 coarse router가 현재 query block과 후보 segment의 mean-pooled 특징 사이의 유사도로 큰 context segment 중 top-M을 선택한다. 이어서 선택한 segment와 필수 context를 내부 MoC routing에 전달한다. 저자들은 이전 segment를 조건으로 후속 segment를 생성하는 autoregressive sampling에서 shot을 2–3 times 더 생성했다고 보고한다. 다만 이에 대응하는 품질 표나 상세한 확장성 평가 절차는 제시하지 않는다. 따라서 임의로 긴 입력에서도 안정적으로 작동한다는 주장은 제시된 정량적 근거의 범위를 넘어선다.
- J Social Impact. 저자들은 애니메이션, 다큐멘터리 제작, 교육, 시뮬레이션의 활용 가능성과 함께 허위 정보 및 동의 없는 미디어 합성의 위험을 설명한다. 접근을 제한한 공개, watermarking, 프롬프트 필터링을 권고하지만 이는 평가된 안전장치가 아니라 제안이다.
- K The Use of Large Language Models (LLMs). 저자들은 텍스트 수정에 사용하는 모델인 large language model을 문장 재표현과 문법 교정에만 사용했다고 밝히고, ICLR Author Guide를 준수했다고 선언한다. 이 진술만으로 게재 venue를 확인할 수는 없다. 제공된 논문은 arXiv:2508.21058v3이며, 프로젝트 페이지로 https://primecai.github.io/moc/를 제시한다.
짧은 생각
설계 실험은 적응적 context 선택과 필수 국소 및 텍스트 접근의 결합을 뒷받침한다. Table 4는 국소 연결이 평가한 학습 설정을 안정화함을 보여준다. Table 3은 consistency 점수를 움직임의 정도와 함께 해석해야 하는 이유를 보여준다. 매우 sparse한 설정에서는 외형을 유지하면서도 움직임을 거의 생성하지 않을 수 있다.
제시된 근거는 평가한 분 단위 설정에서 효율적인 attention 대체 방법임을 뒷받침하며 실행 시간의 이점은 시퀀스 길이에 따라 달라진다. 더 넓은 메모리 관련 주장을 뒷받침하려면 통제된 회상 측정과 학습 범위를 넘는 정량 평가가 필요하다. 정성적 사례와 outer-loop 확장은 이러한 측정치를 제공하지 않으며 예시 FLOPs 계산도 제시된 공식과의 불일치를 해명해야 한다.