


WorldPlay: Towards Long-Term Geometric Consistency for Real-Time Interactive World Modeling 요약 설명
16 Dec 2025 | Paper Review Interactive World Models Video Diffusion Models Knowledge Distillation목차
이번 글에서는 WorldPlay: Towards Long-Term Geometric Consistency for Real-Time Interactive World Modeling 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 16일(Arxiv), Proceedings of the 43rd International Conference on Machine Learning, Seoul, South Korea. PMLR 306, 2026.
- Sun, Wenqiang, Zhang, Haiyu, Wang, Haoyuan, Wu, Junta, Wang, Zehan, Wang, Zhenwei, Wang, Yunhong, Zhang, Jun, Wang, Tengfei, Guo, Chunchao.
- Hong Kong University of Science and Technology, Beihang University, Tencent Hunyuan
- 논문 링크
- Github
- Project Page
요약
- WorldPlay: Towards Long-Term Geometric Consistency for Real-Time Interactive World Modeling은 사용자가 이전 위치를 다시 방문해도 장면의 기하 구조를 유지하는 빠른 상호작용형 비디오 생성을 다룬다. 모델은 Dual Action Representation, Reconstituted Context Memory, Context Forcing을 결합해 8×H800 GPUs에서 720p 비디오를 24 FPS로 스트리밍 생성한다.
- 이산 명령과 연속 카메라 포즈를 청크 단위 자기회귀 diffusion transformer의 조건으로 함께 사용한다. 검색한 공간 메모리는 최근의 시간 문맥을 보완한다. Temporal reframing은 과거 프레임에 현재 청크와 가까운 위치 인덱스를 부여해 시간 거리에 따라 해당 프레임의 영향력이 약해지는 문제를 줄인다.
- Context Forcing은 distribution matching 과정에서 teacher와 student의 메모리 조건을 맞춰 추론을 4단계 denoising으로 줄인다. 600개 사례 평가에서 전체 모델은 장기 PSNR 18.94, SSIM 0.585, LPIPS 0.371, 회전 거리 0.332, 이동 거리 0.797을 기록하며, 이 지표 모두에서 비교한 baseline보다 우수하다.
- 실험은 평가한 시퀀스에서 재방문 일관성이 개선됨을 뒷받침하며, 실제 장면, 스타일화된 장면, 1인칭 장면, 3인칭 장면의 예시를 제시한다. 저자들은 약 30초 길이의 비디오를 생성할 수 있다고 설명한다. 남아 있는 오차 누적, 가림에 민감한 검색, 더 폭넓은 물리적 상호작용은 해결되지 않은 한계로 제시한다.
1. Introduction
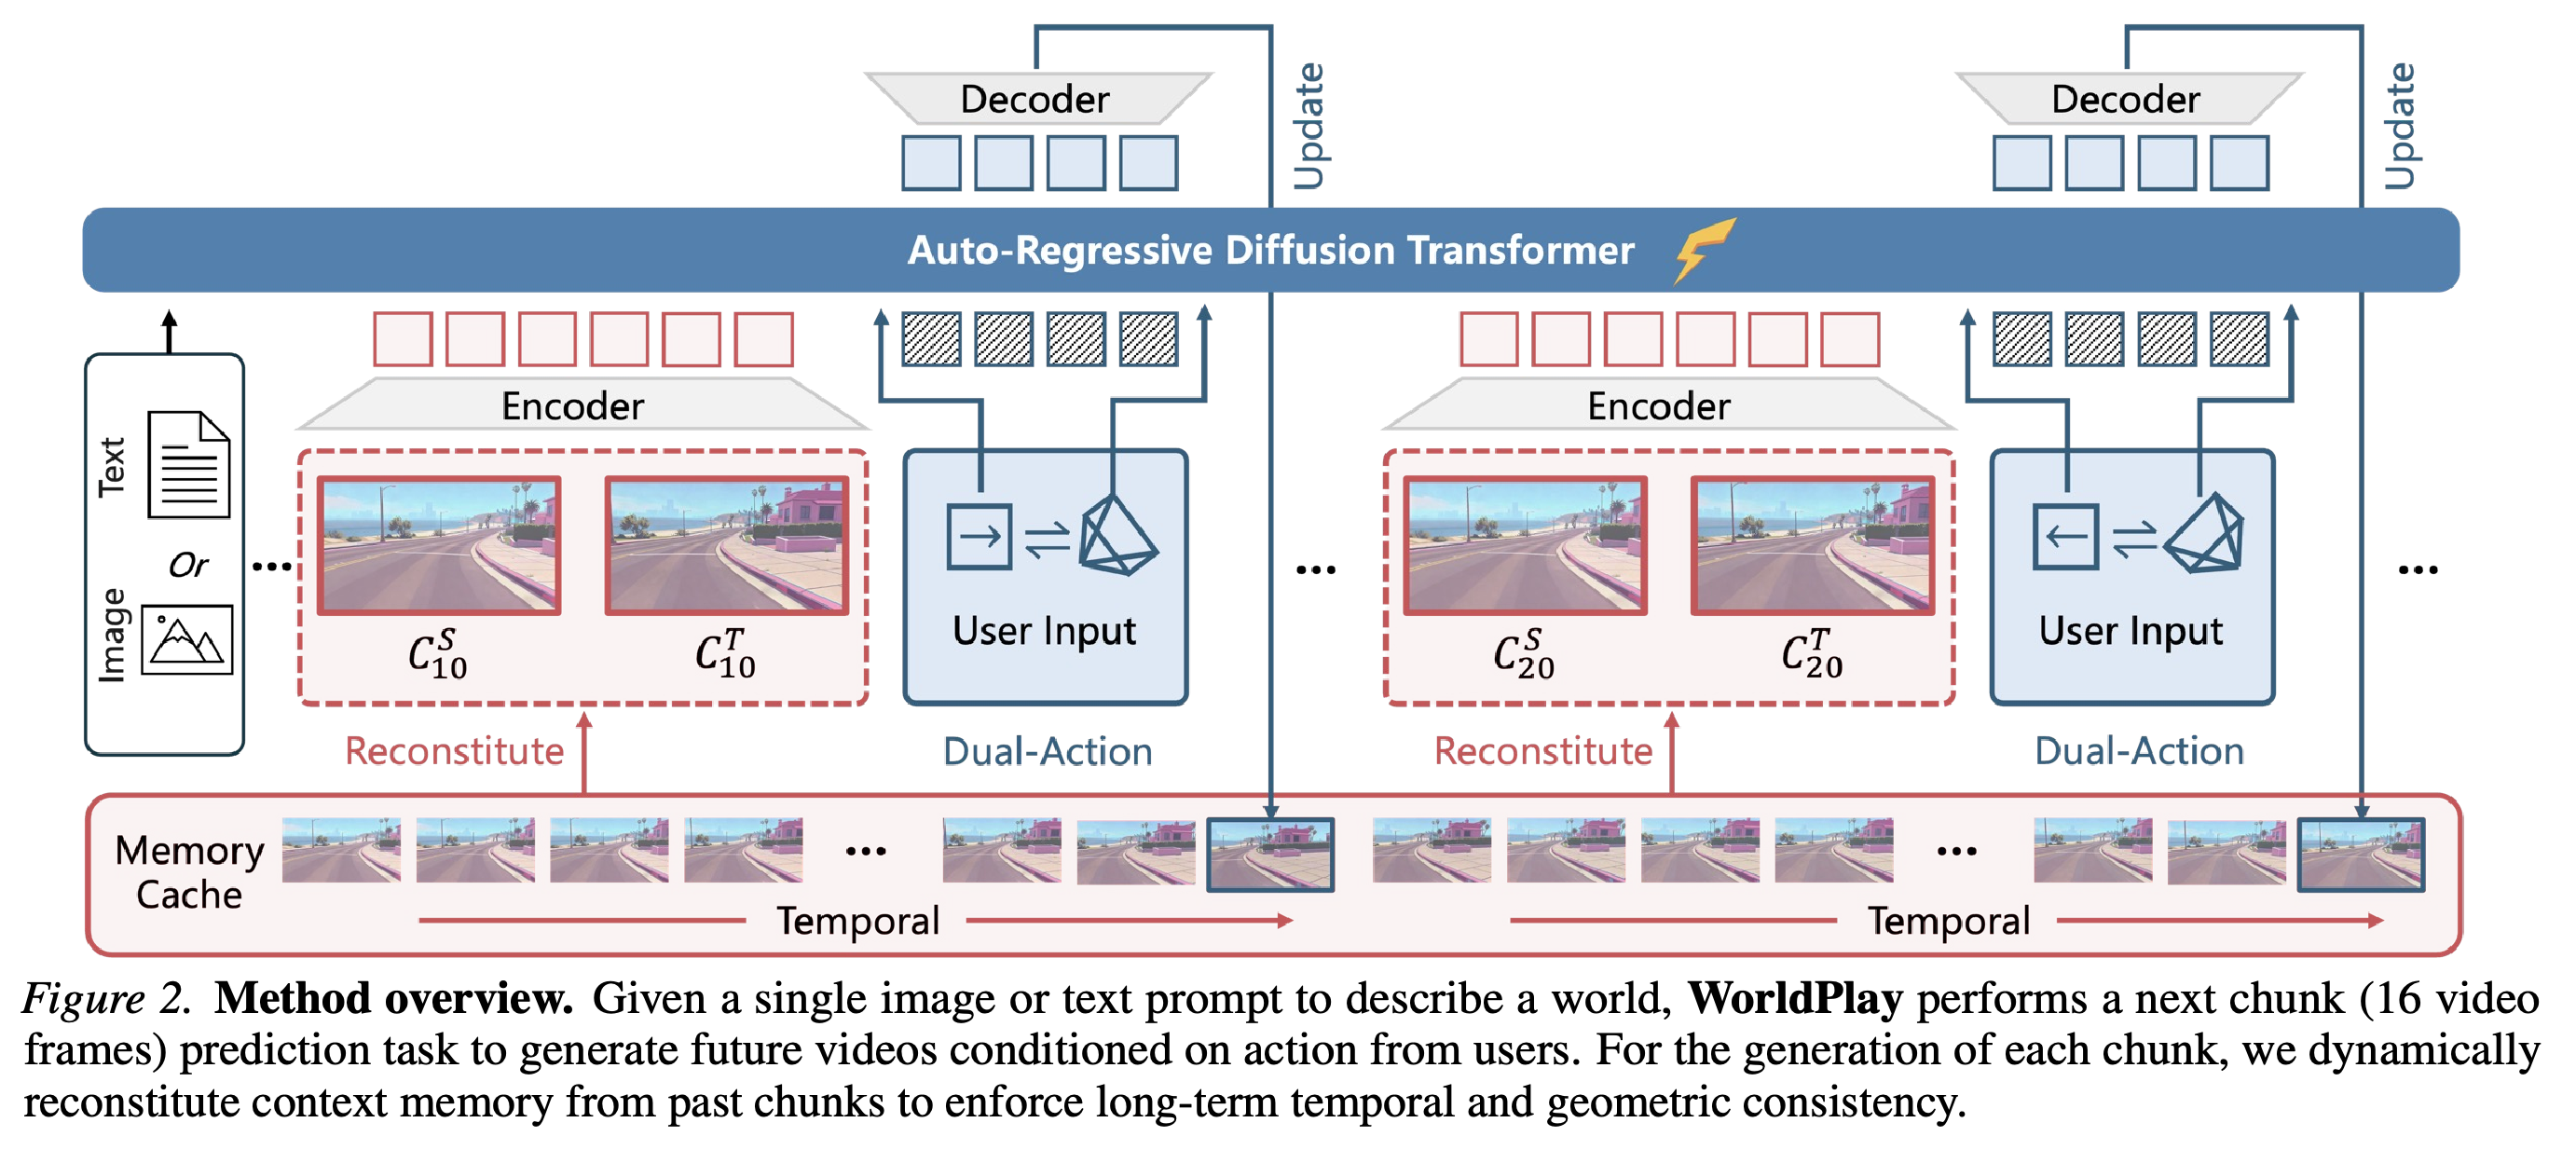
상호작용형 월드 모델링에는 사용자 행동에 대한 빠른 시각적 응답과 재방문 시에도 유지되는 장면 내용이 필요하다. 서론은 메모리를 고려하지 않는 빠른 모델과 메모리 조건 때문에 증류가 복잡해지는 모델을 구분한다. WorldPlay는 다음 청크 예측으로 이 요구를 함께 다루며, 각 청크는 비디오 프레임 16개에 해당한다.
- Dual Action Representation은 장면 규모에 적응하는 이산 제어와 정확한 공간 인덱싱을 지원하는 카메라 포즈를 결합한다.
- Reconstituted Context Memory는 관련 과거 관측을 검색하고 시간 위치를 다시 지정한다. Context Forcing은 증류 과정에서 teacher와 student의 메모리 조건을 맞춘다.
- 프로젝트 페이지는 https://3d-models.hunyuan.tencent.com/world/ 이며, 온라인 데모는 https://3d.hunyuan.tencent.com/sceneTo3D 이다.
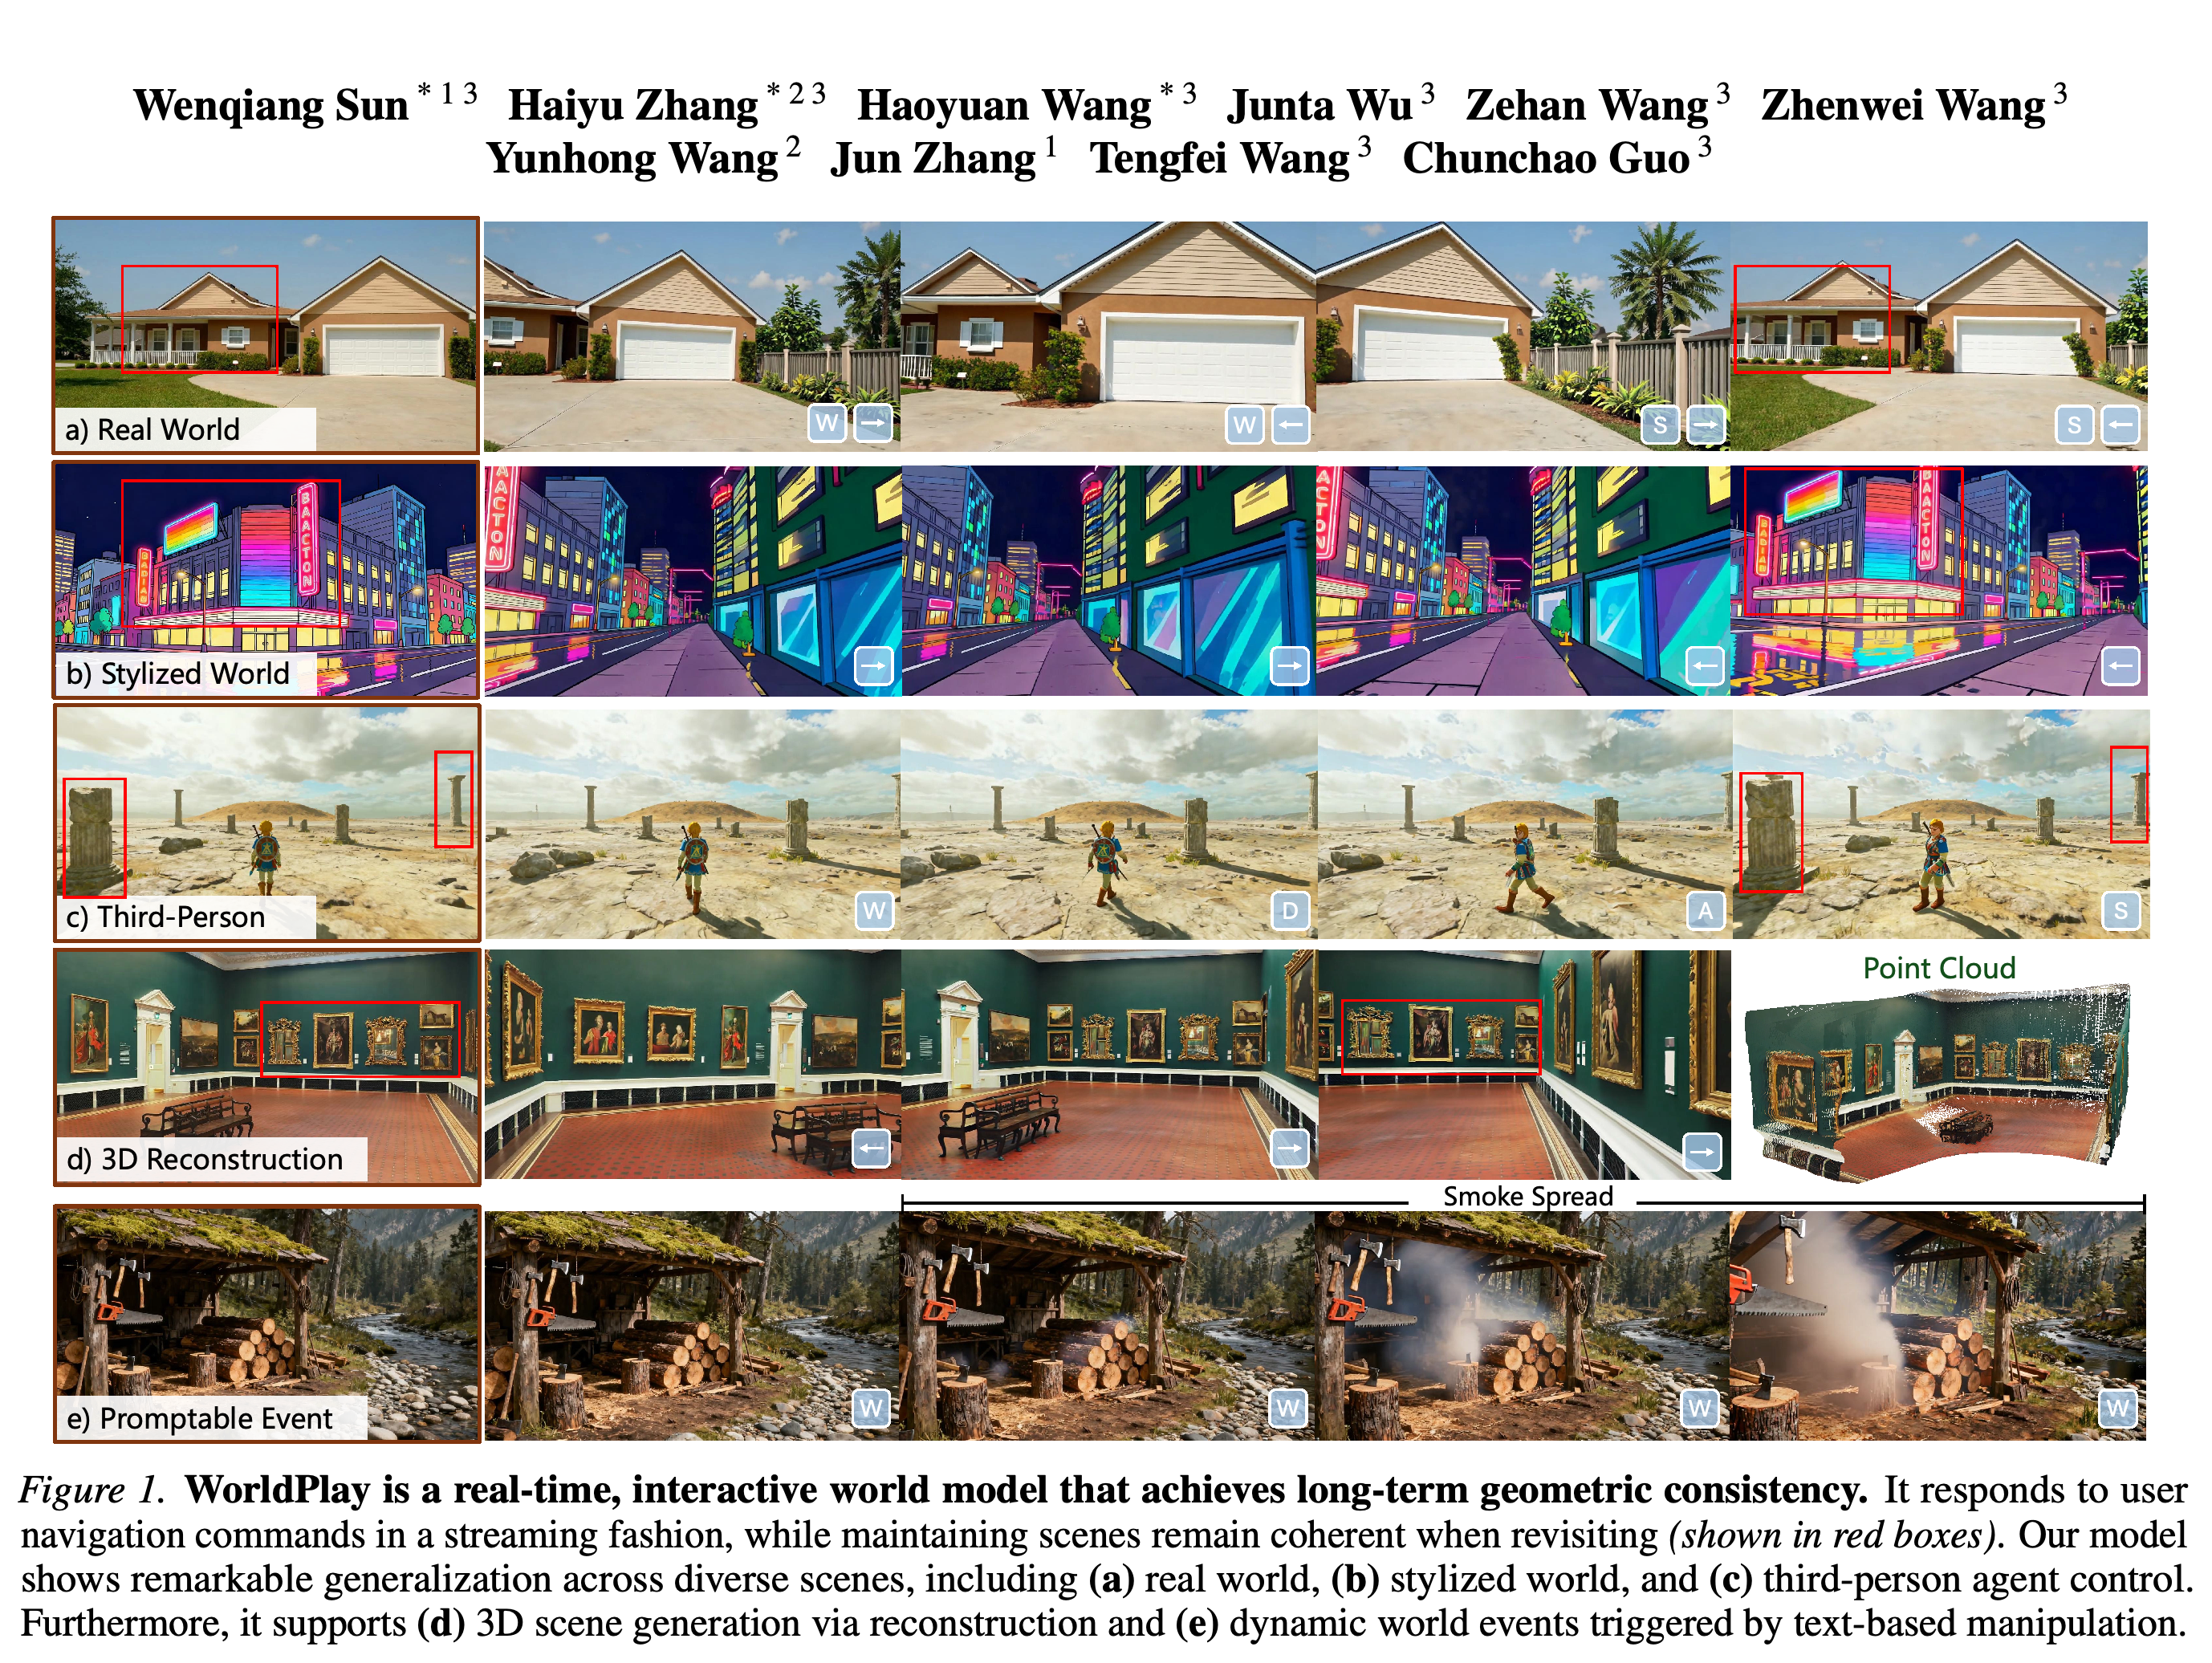
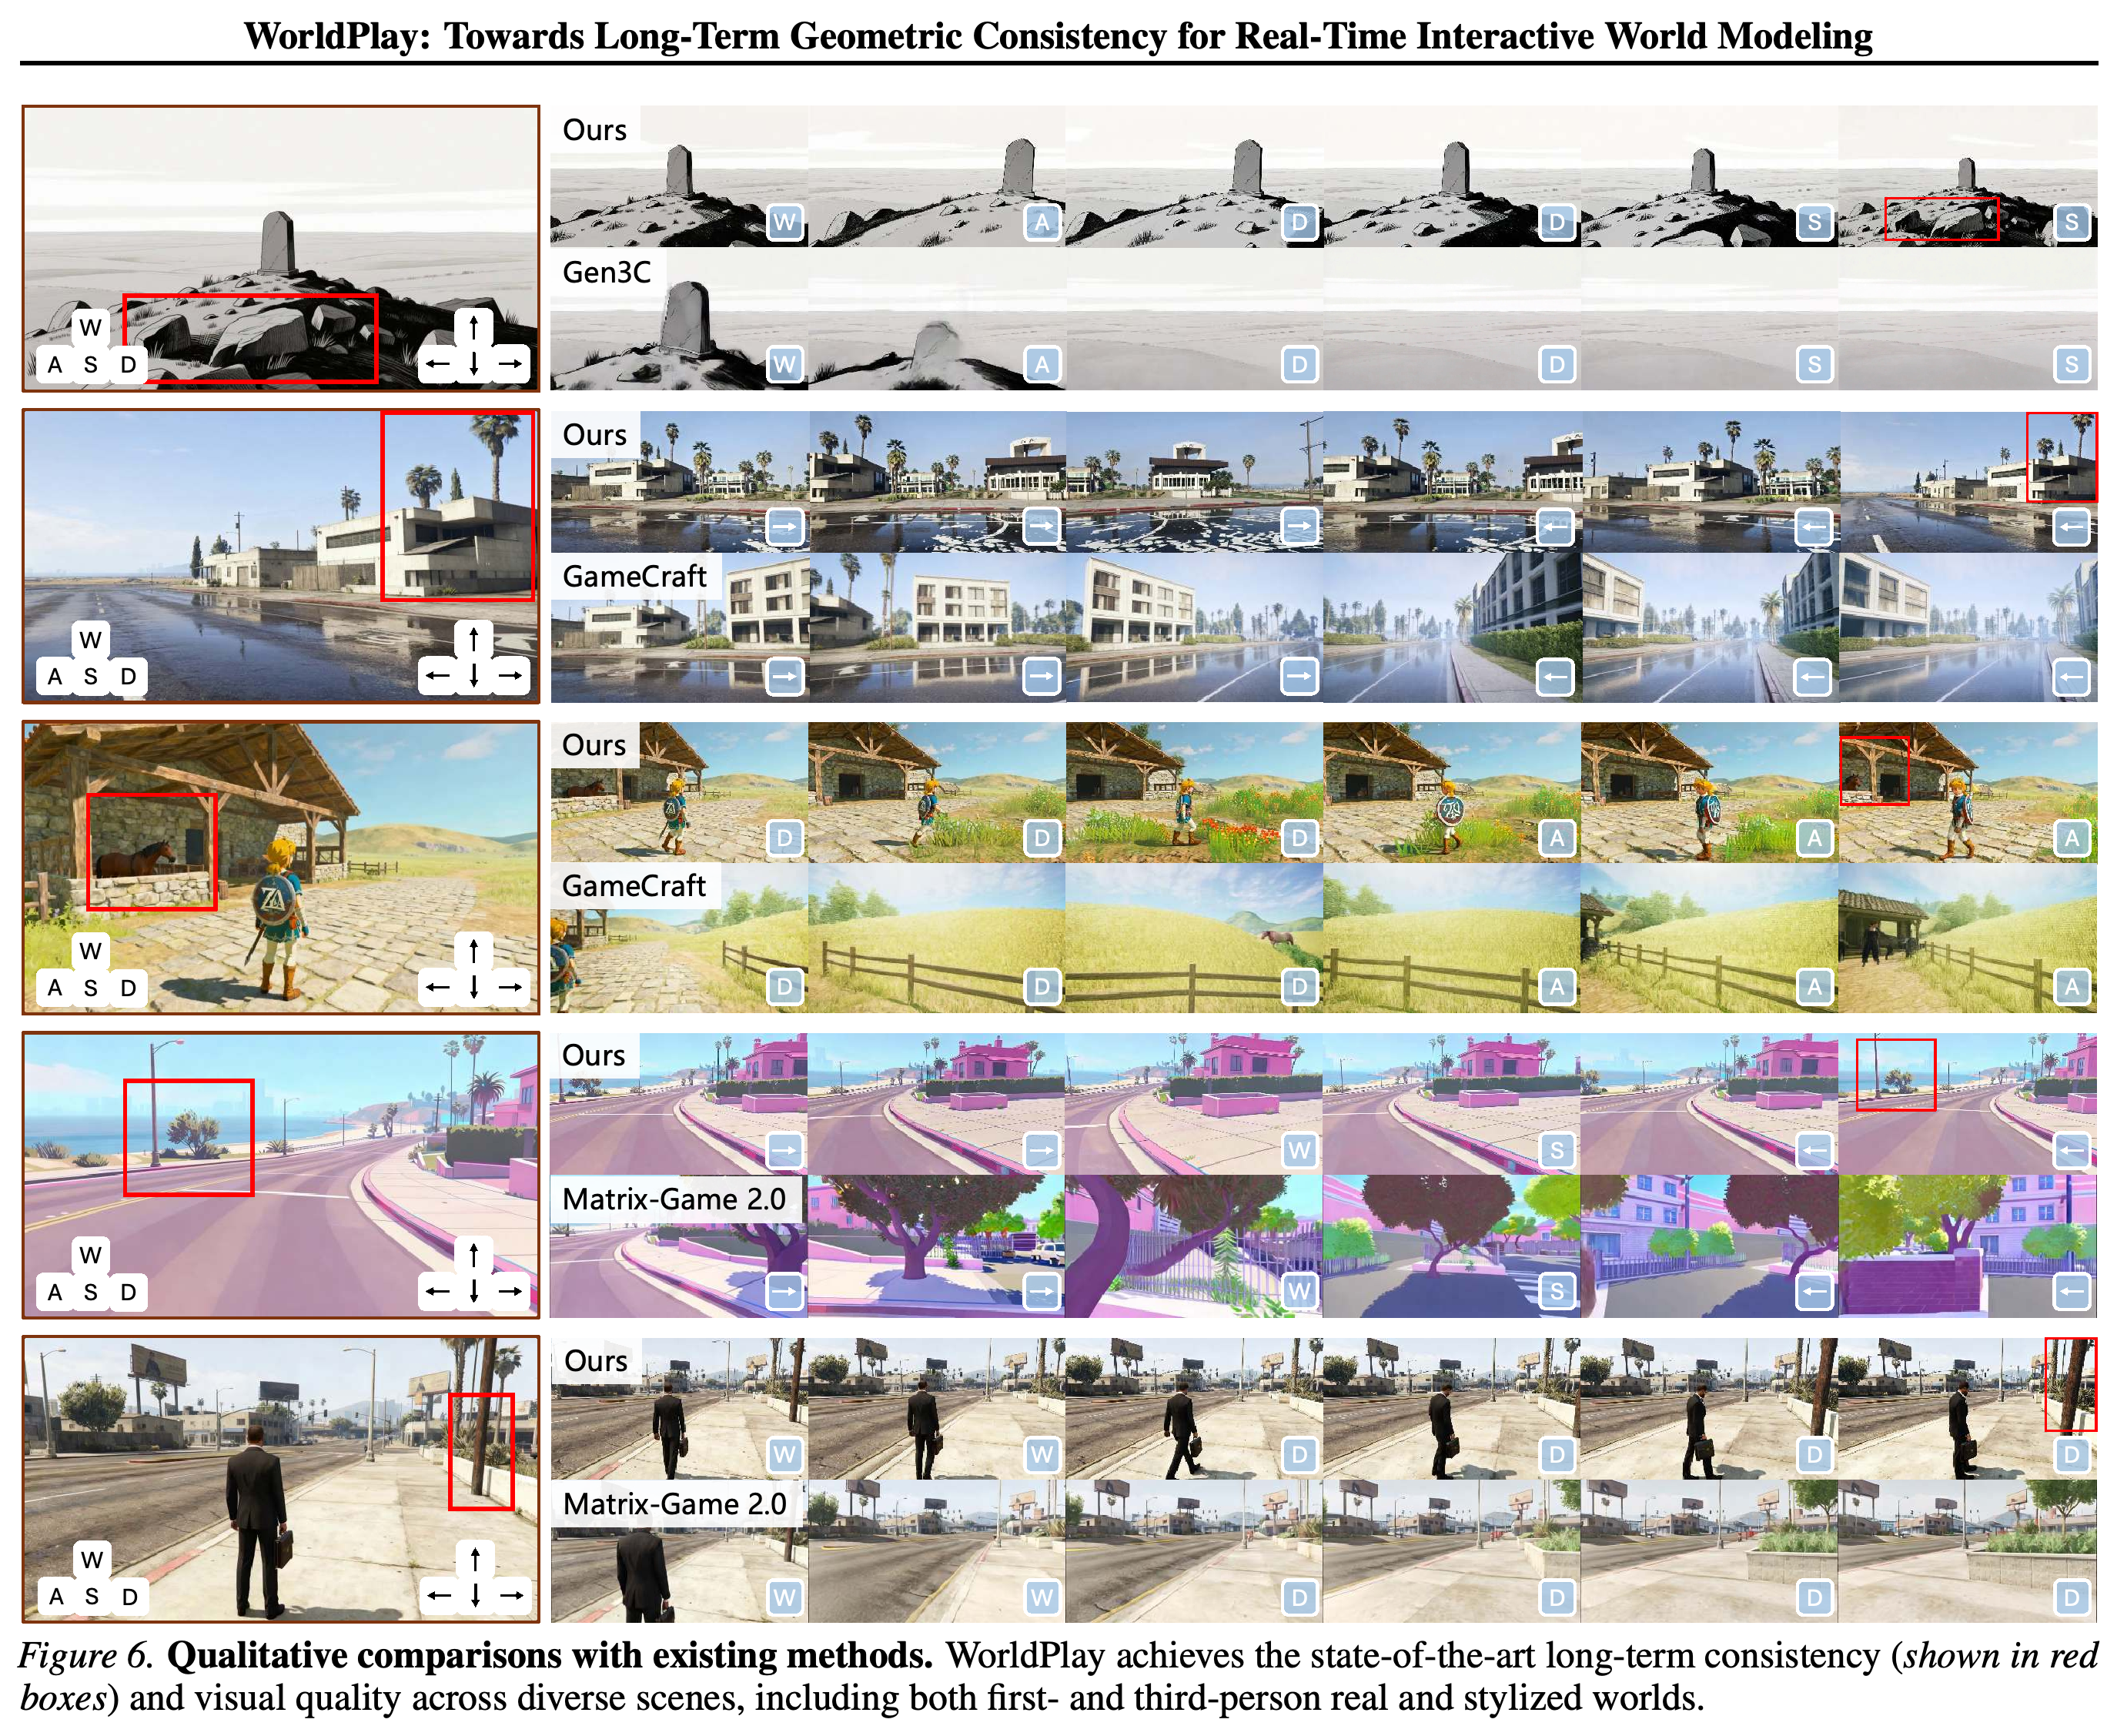
빨간 상자로 표시한 반복 시점은 실제 장면, 스타일화된 장면, 3인칭 장면에서의 재방문 일관성을 보여준다. 재구성과 연기 예시는 추가 응용을 보여주지만, 이 이미지 모음은 일관성이나 응답 지연을 정량화하지 않는다.
2. Related Work
관련 연구에서는 latent video diffusion, 자기회귀 비디오 생성, 상호작용형 월드 모델, 증류를 다룬다. 명시적인 재구성 기반 메모리는 재구성 품질에 의존하고, 암묵적 메모리는 기하학적 관련성을 기준으로 과거 관측을 검색한다. 논문은 이러한 메모리를 적은 추론 단계로 수행하는 상호작용형 생성에 적용하는 방법을 제안한다.
- CausVid는 양방향 teacher로부터 인과적 student를 증류하며, Self-Forcing은 rollout 학습을 개선해 노출 편향을 줄인다.
- WorldPlay는 teacher와 student의 메모리 문맥을 맞추는 방식으로 이 증류 설정을 확장한다.
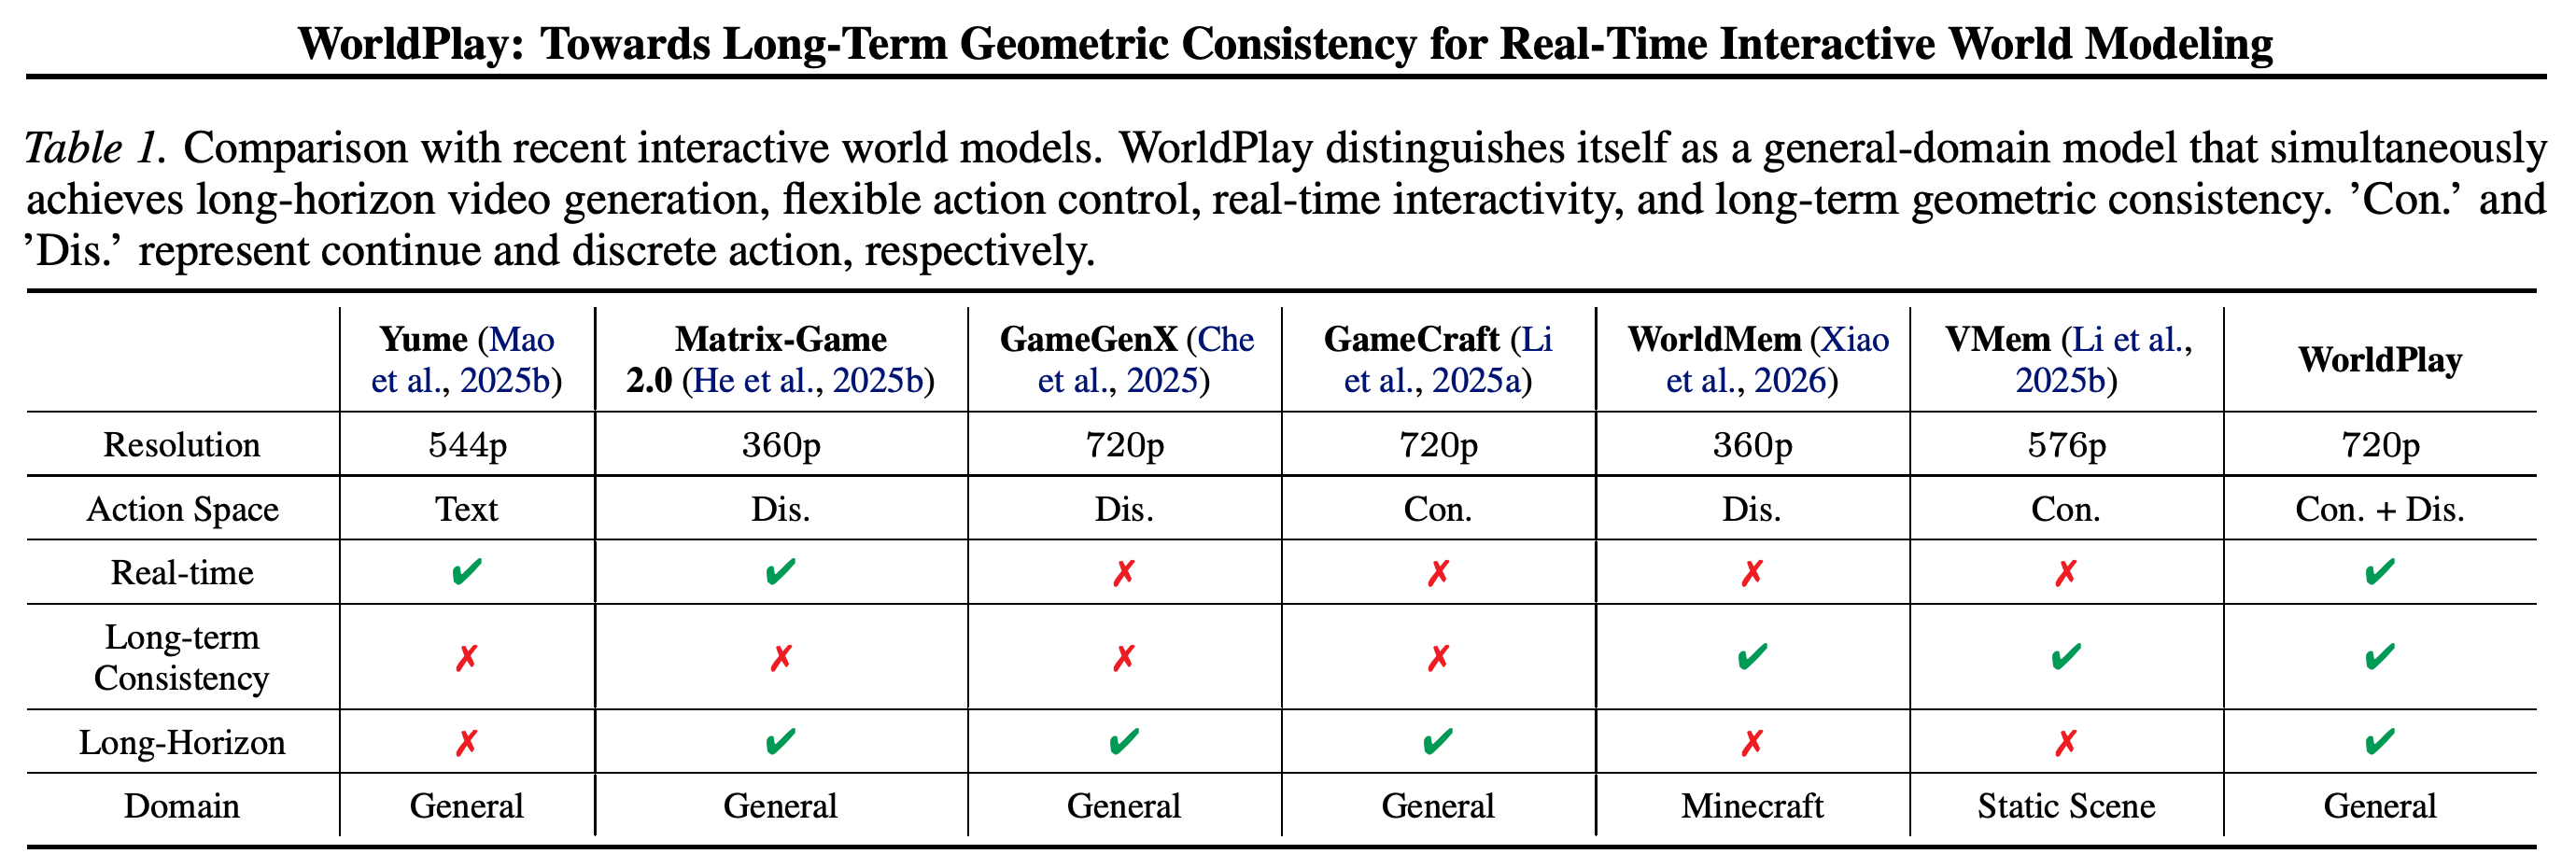
기능 비교표는 WorldPlay가 연속 및 이산 제어, 720p 출력, 실시간 동작, 장기 일관성, 일반 도메인에서의 긴 비디오 생성을 지원한다고 표시한다. 이 범주별 항목은 저자들의 주장을 요약하며, 뒤의 실험에서 정량 비교를 제공한다.
3. Method
WorldPlay는 과거 관측, 행동 이력, 현재 행동, 월드를 설명하는 텍스트 프롬프트나 이미지를 조건으로 다음 청크를 예측한다. 파이프라인은 검색한 문맥을 인코딩하고 이산 및 연속 행동 표현을 주입한다. 이후 자기회귀 diffusion transformer로 새 청크를 생성하고 출력을 메모리 캐시에 추가한다.
각 생성 블록은 재구성한 공간 및 시간 문맥을 입력받고, 생성한 출력은 캐시를 갱신한다. 이 피드백 구조는 선택한 과거 관측이 스트리밍 중 후속 청크의 조건으로 사용되는 방식을 보여준다.
3.1. Preliminaries
백본은 인과적 3D VAE와 flow matching으로 학습한 Diffusion Transformer를 사용한다. 노이즈가 없는 비디오 latent와 Gaussian noise를 선형 보간하고, 네트워크는 손실 L_FM(θ) = E[k,z₀,z₁] ||N_θ(z_k,k) − v_k||²를 사용해 그 차이를 예측하도록 학습한다. 여기서 \(v_k=z_0-z_1\)이다.
- 시간 latent 4개가 청크 1개를 구성하며, 이를 프레임 16개로 디코딩할 수 있다. 전체 시퀀스 attention 대신 block causal attention을 사용한다.
- 학습에서는 청크마다 서로 다른 노이즈 수준을 부여해 후속 청크를 자기회귀 방식으로 예측하도록 한다.
3.2. Dual Action Representation for Control
이산 입력은 규모가 다른 장면에서도 자연스러운 이동을 제공하지만, 이전 카메라 위치를 정확히 식별하지는 못한다. 연속 포즈는 해당 위치를 제공하지만, 규모 차이 때문에 학습이 어려워진다. WorldPlay는 2가지 표현을 결합해 제어와 공간 검색을 지원한다.
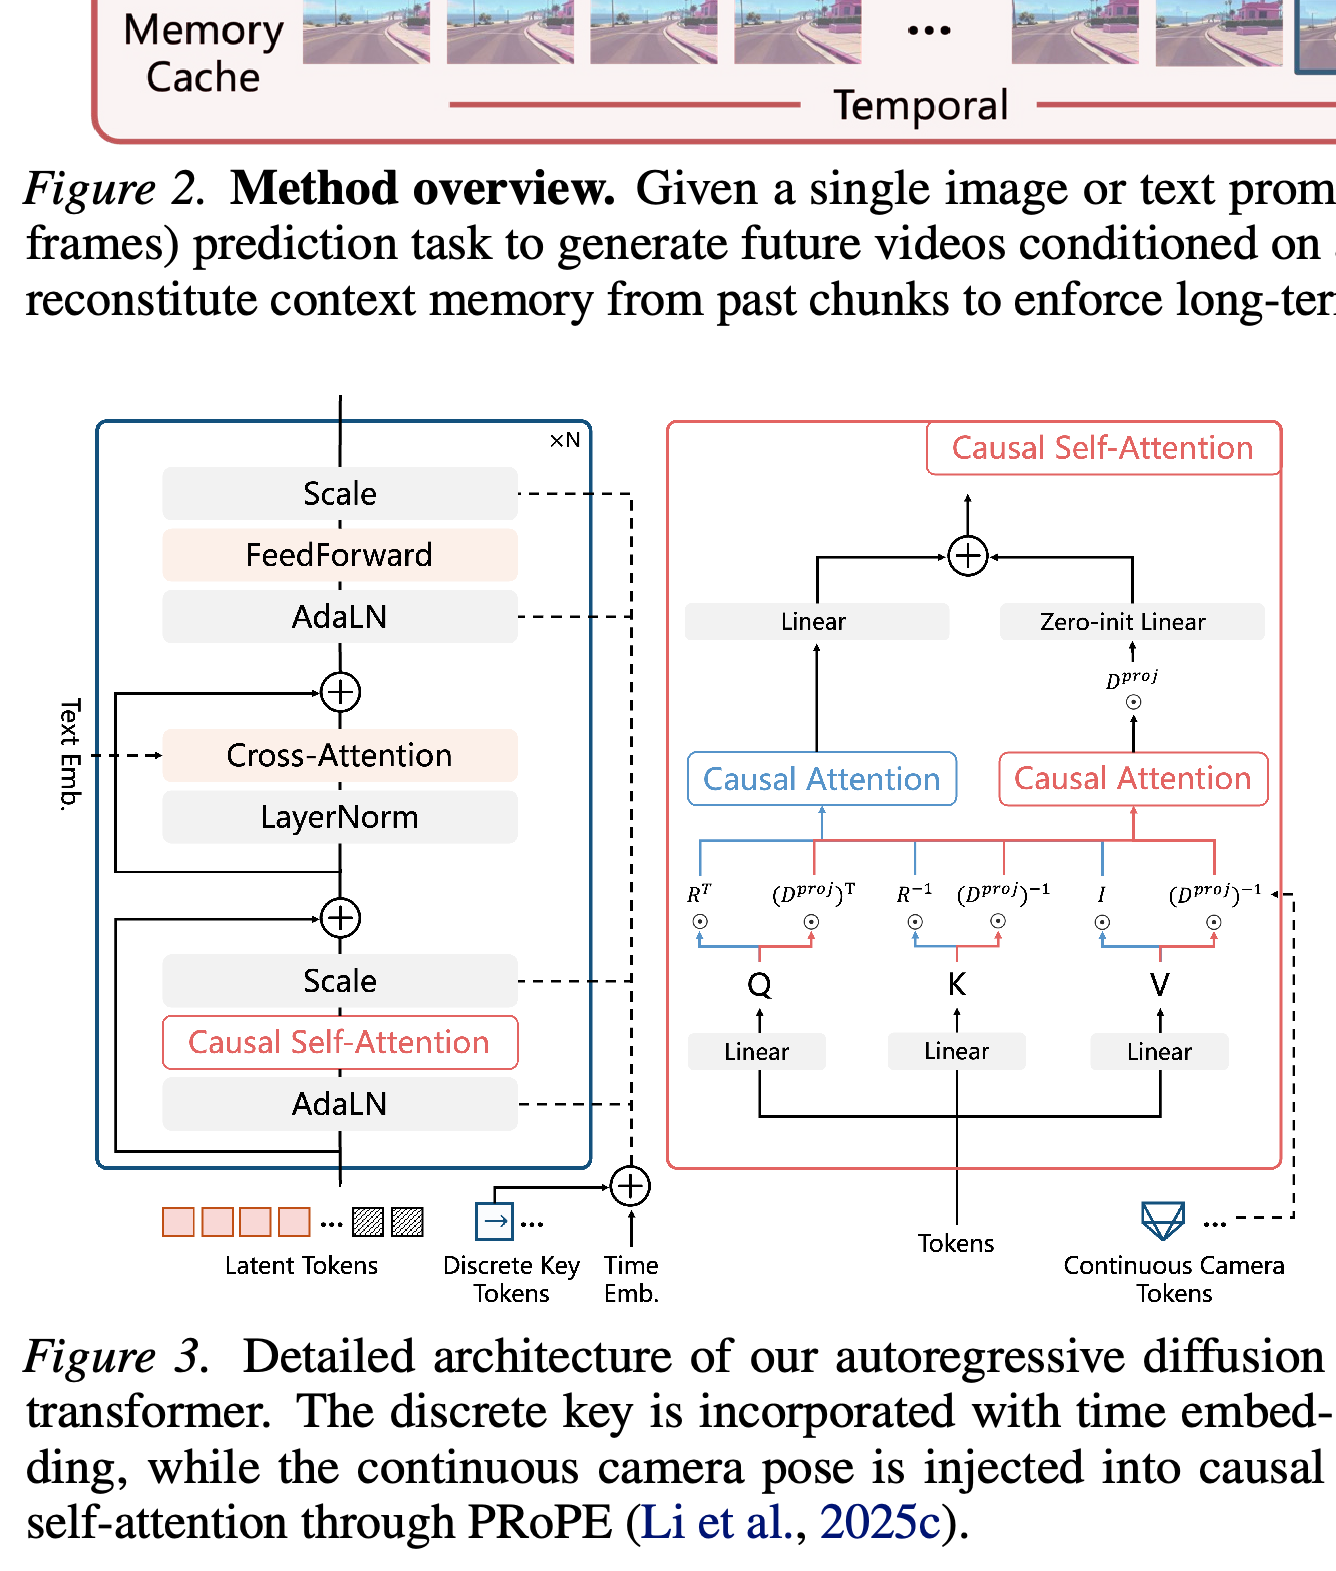
- 위치 인코딩과 0으로 초기화한 MLP로 이산 키를 인코딩하고, 이를 DiT 블록을 조절하는 timestep embedding에 포함한다.
- PRoPE는 카메라 내부 및 외부 파라미터를 사용해 카메라 절두체 사이의 관계를 causal self-attention에 주입한다. self-attention에 대해서는 이 글을 참조하라.
- 카메라 조건 attention 분기는 0으로 초기화한 projection을 거쳐 원래 attention 출력에 더해진다.
이산 키 토큰은 time embedding에 합쳐지고, 카메라 정보는 별도의 PRoPE 분기를 통해 causal self-attention에 들어간다. 따라서 2가지 행동 표현은 transformer의 서로 다른 부분에 조건을 제공한다.
3.3. Reconstituted Context Memory for Consistency
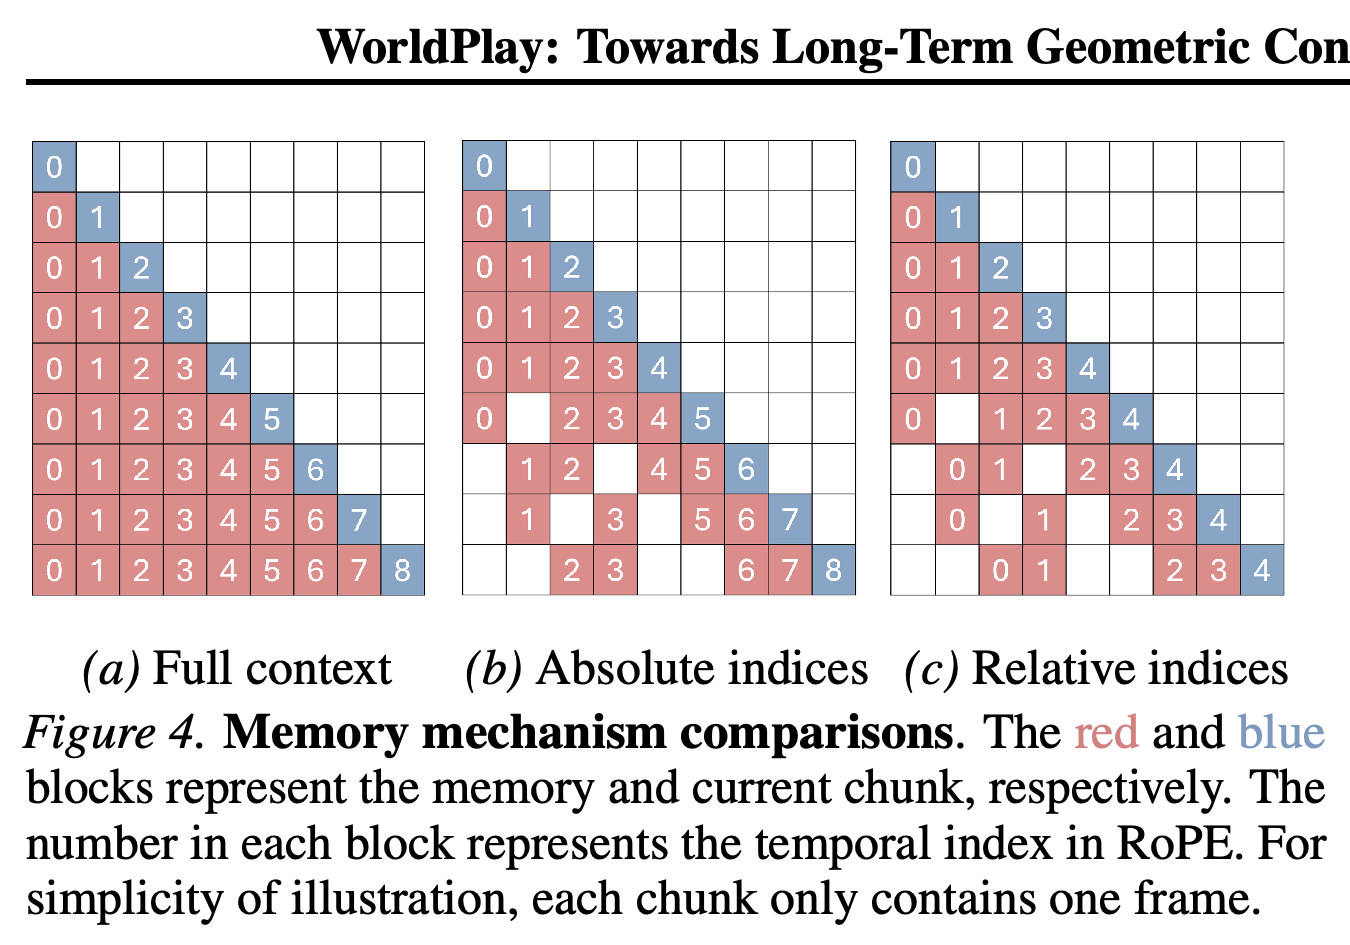
Reconstituted Context Memory는 시간적 연속성을 위해 최근 청크를 선택하고, 공간적 일관성을 위해 인접하지 않은 과거 관측을 선택한다. 공간 메모리를 선택할 때는 시야 중첩과 카메라 거리를 함께 사용한다. 이를 통해 모든 과거 프레임을 조건으로 사용할 때 발생하는 연산량과 중복을 피한다.
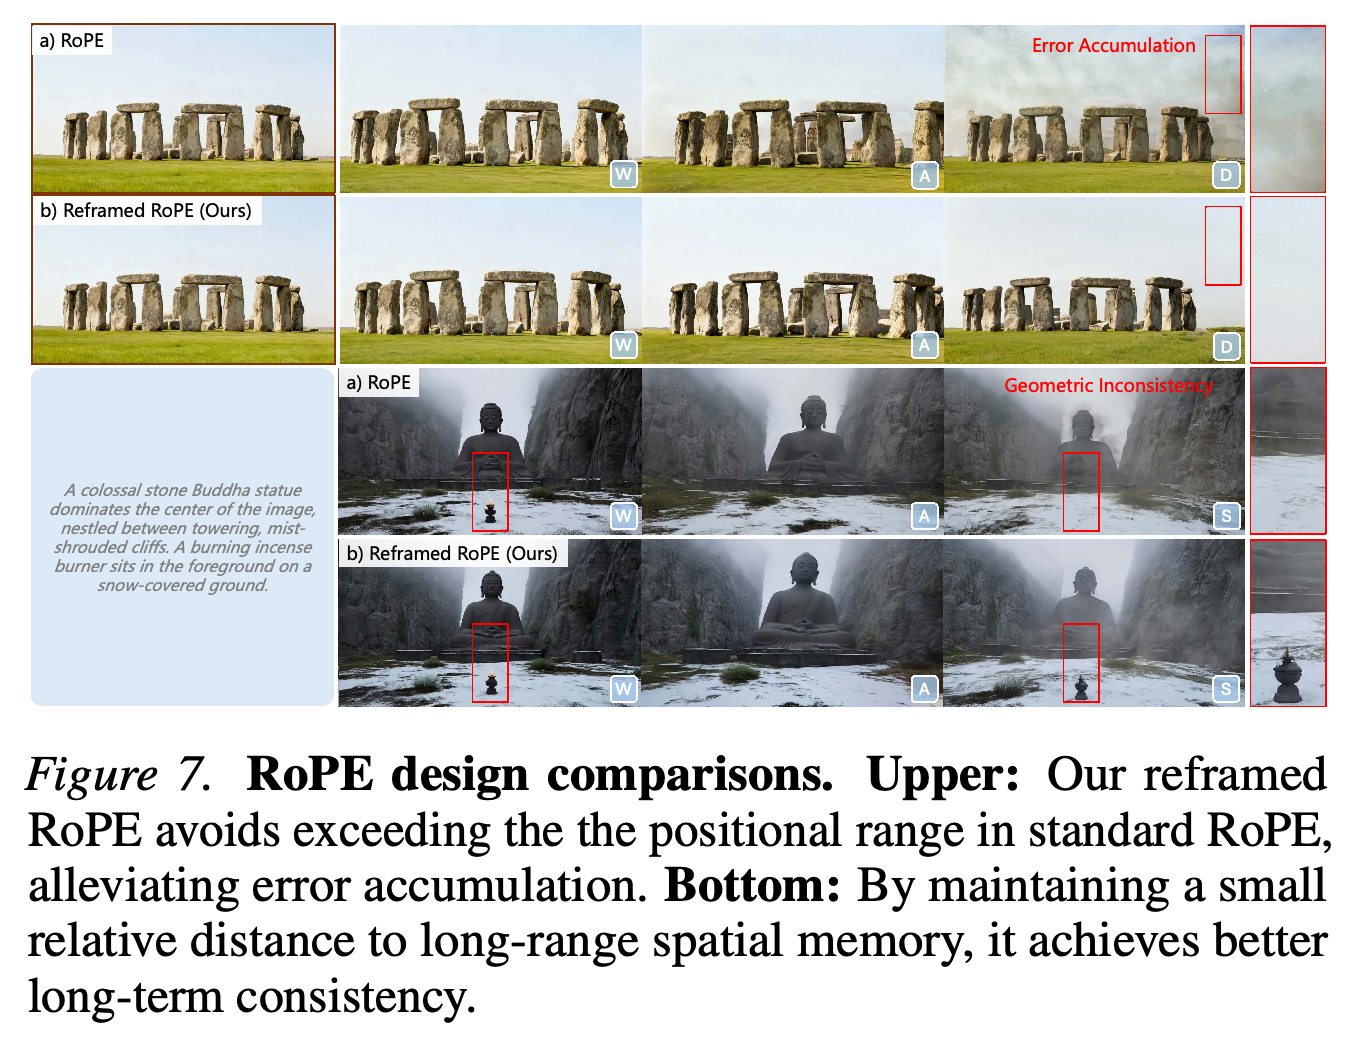
- 일반적인 절대 RoPE 인덱스에서는 오래된 메모리와 현재 예측 사이의 거리가 점점 커진다. 이 거리가 학습한 위치 범위를 벗어날 수 있으며, 메모리의 영향력도 약해질 수 있다.
- Temporal Reframing은 실제 경과 시간과 관계없이 현재 청크와 작고 일정한 상대 거리를 유지하도록 문맥 위치를 동적으로 다시 지정한다.
전체 문맥은 이력이 늘어날수록 커지고, 선택한 메모리에 절대 인덱스를 유지하면 큰 시간 간격이 남는다. 상대 인덱스를 다시 지정하면 검색한 관측이 현재 청크 가까이에 위치한다. 이 비교는 메모리 선택과 선택한 메모리의 위치 처리를 구분한다.
3.4. Context Forcing
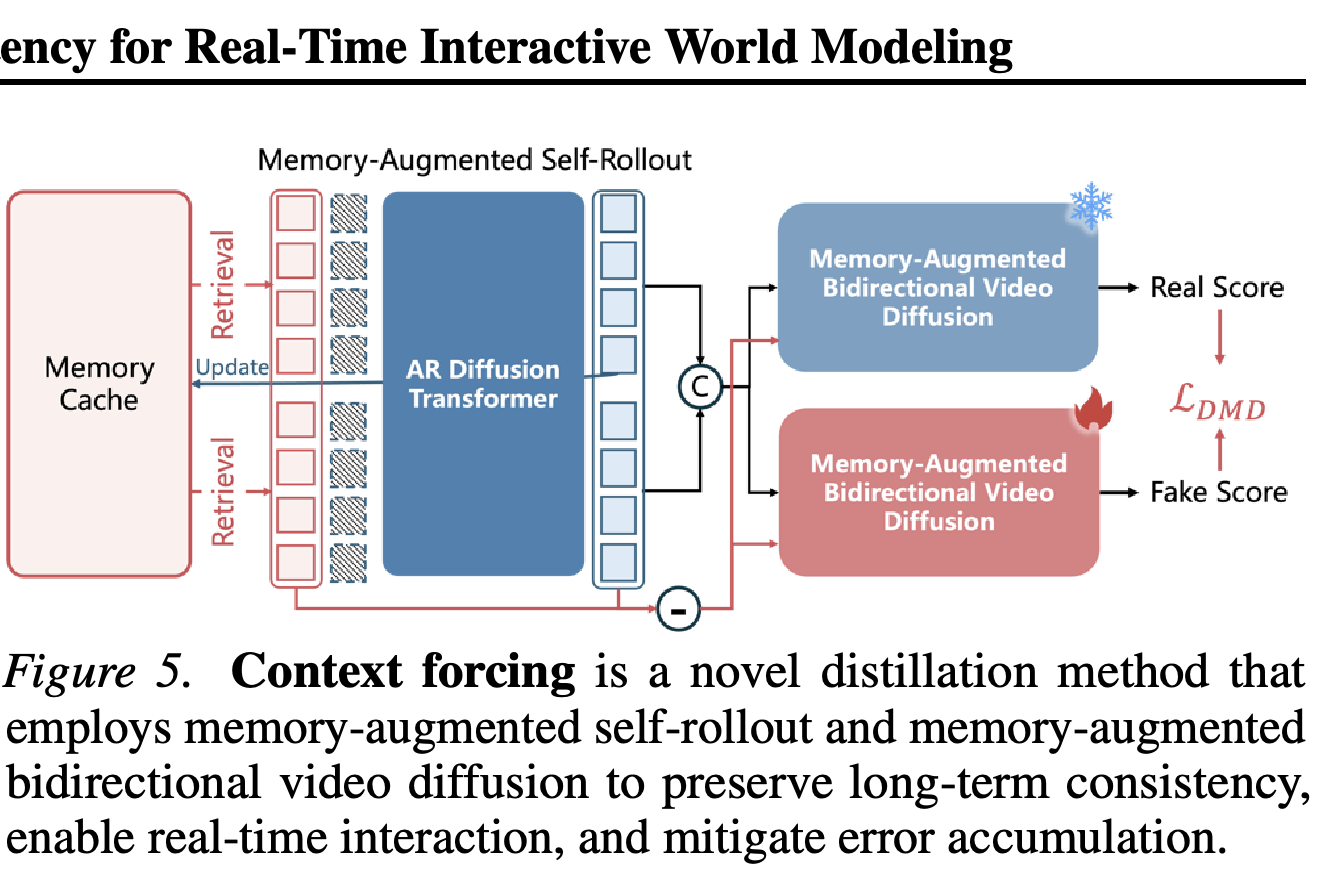
Context Forcing은 메모리를 사용하는 인과적 student와 양방향 teacher 사이의 조건부 분포 불일치를 해결한다. Student는 재구성한 메모리를 조건으로 청크 4개를 자체 rollout한다. Teacher는 이에 대응하는 메모리 문맥에서 해당 rollout 청크들을 제외한 내용을 입력받는다.
- 메모리 조건을 맞추면 teacher가 긴 비디오 전체를 처리하지 않아도 distribution matching을 수행할 수 있다.
- 점진적 증류는 학습 중 rollout 길이를 늘리며, 4단계 denoising을 사용하는 student를 만든다.
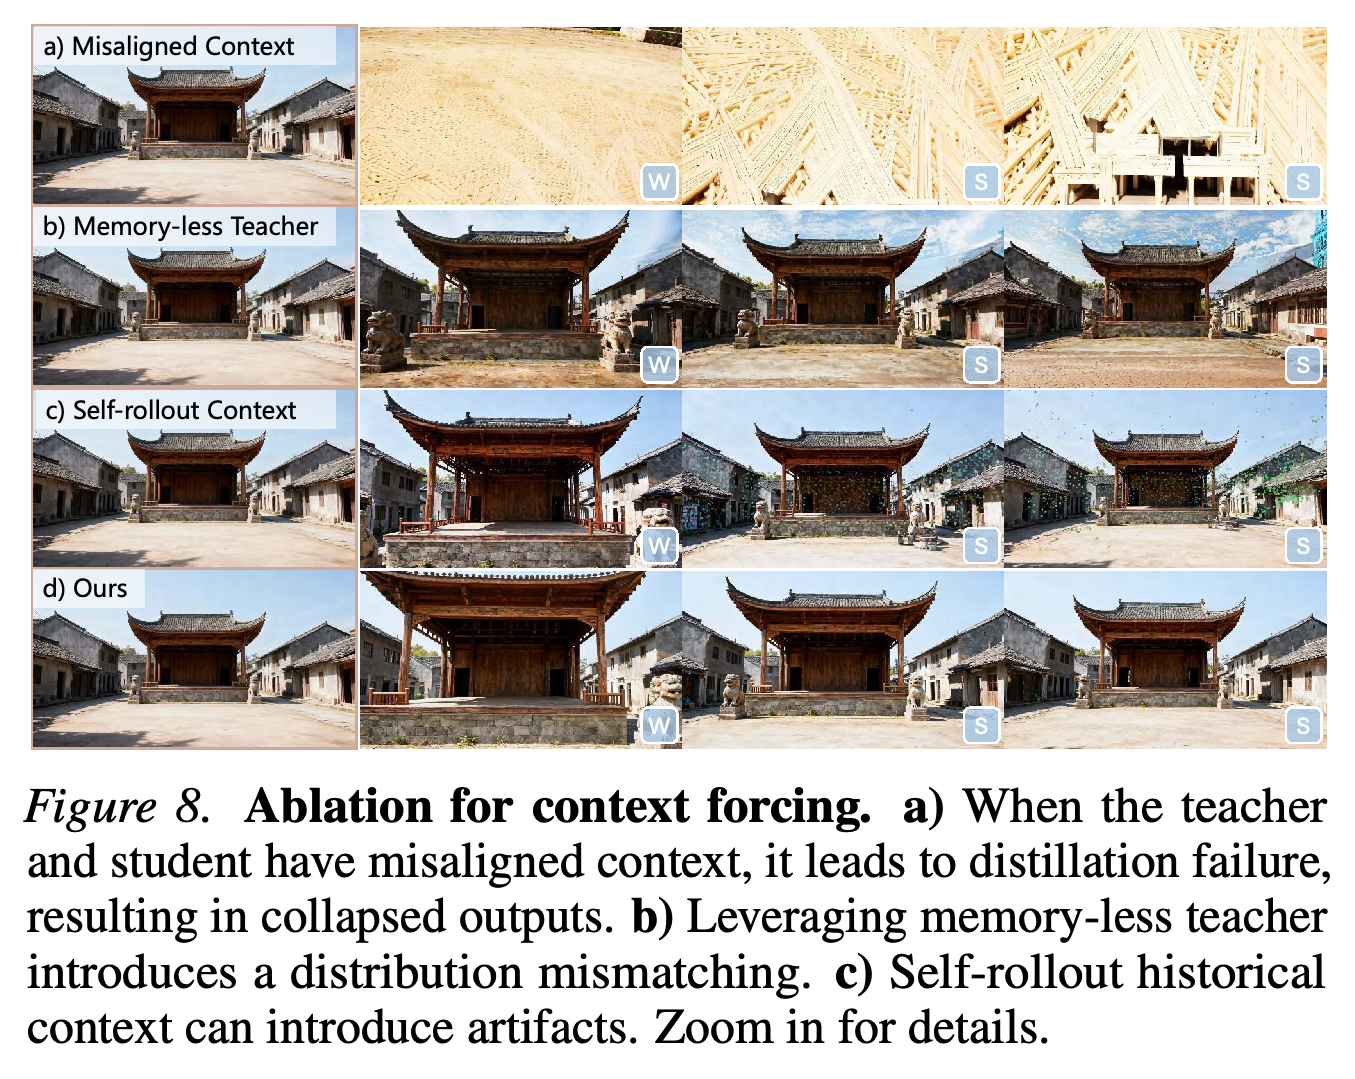
- 과거 문맥은 실제 비디오에서 샘플링한다. Ablation에서는 자체 생성한 과거 문맥을 사용할 때 아티팩트가 나타난다. 저자들은 teacher가 노이즈가 없는 메모리로 학습되었기 때문이라고 설명한다.
자기회귀 rollout은 동결한 real-score 양방향 모델과 학습 가능한 fake-score 양방향 모델이 평가할 샘플을 생성한다. 메모리 조건을 맞추면 이들의 score 비교를 student의 메모리 조건부 생성에 적용할 수 있다.
3.5. Streaming Generation with Real-Time Latency
보고된 720p에서의 24 FPS는 8×H800 GPUs에서 Context Forcing과 배포 최적화를 함께 적용한 결과다. Sequence parallelism과 attention parallelism은 청크 토큰을 여러 장치에 분산한다. 점진적 VAE 디코딩은 NVIDIA Triton Inference Framework를 통해 작은 프레임 배치를 스트리밍한다.
- Sage Attention, float quantization, 행렬 곱셈 양자화, KV caching은 추론 비용을 줄인다.
- 논문은 이 하드웨어 구성에서의 처리량을 보고하지만, 종단 간 입력 지연이나 첫 프레임 출력까지 걸리는 시간의 수치는 제공하지 않는다.
4. Experiments
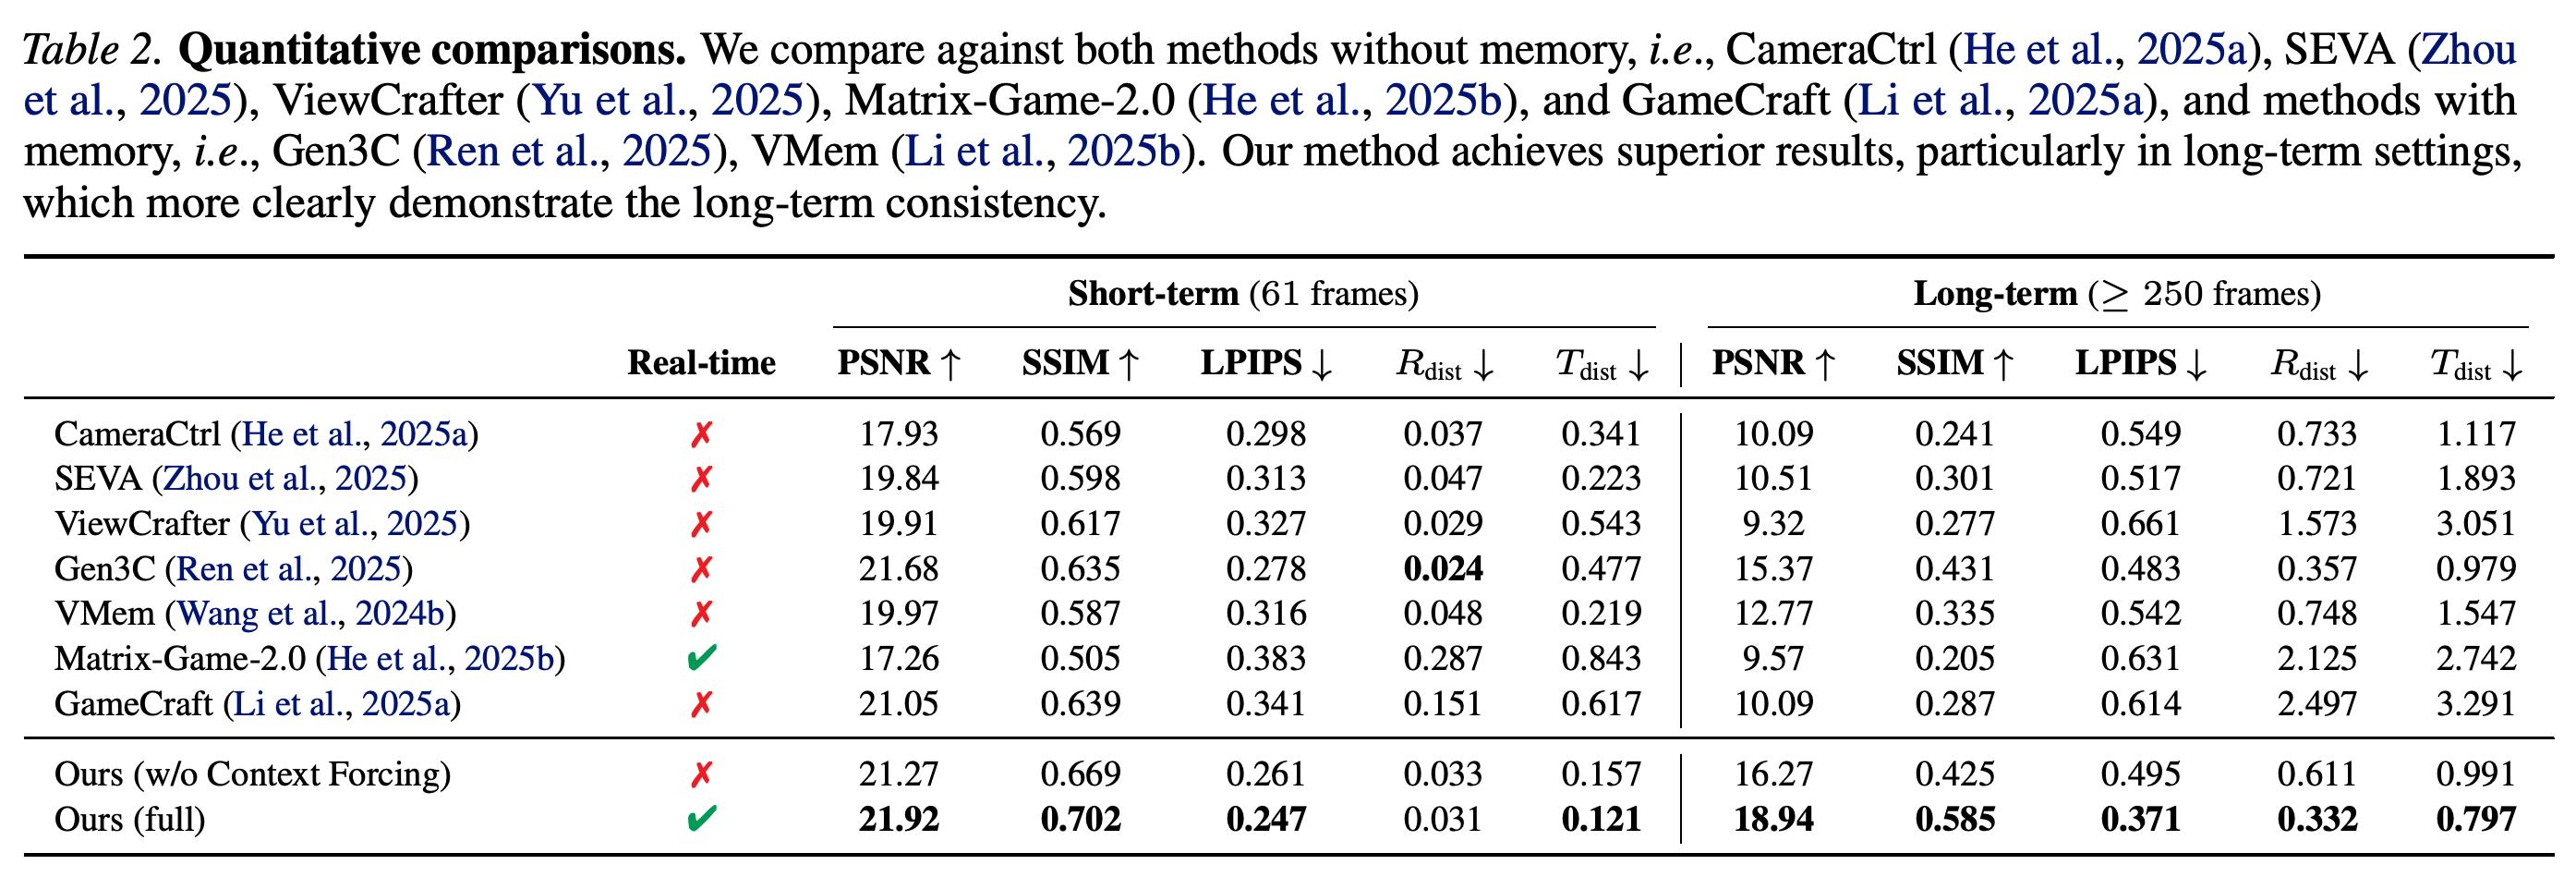
학습에는 실제 및 합성 비디오 샘플 약 320K개를 사용한다. 주요 테스트 세트는 DL3DV, 게임 비디오, AI 생성 이미지에서 가져온 사례 600개로 구성한다. 단기 평가는 61프레임, 장기 평가는 최소 250프레임에 걸쳐 수행한다.
- 단기 비디오는 참조 카메라 궤적을 따르며, 생성한 프레임을 정답 프레임과 비교한다.
- 장기 평가는 순환 궤적을 사용하며, 복귀 경로의 프레임을 처음 지나갈 때 생성한 대응 프레임과 비교한다.
- PSNR, SSIM, LPIPS는 시각적 일치도를 측정한다. ViPE로 생성한 비디오의 카메라 포즈를 추정해 회전 및 이동 오차를 계산한다. 첫 포즈를 항등 변환으로 설정하고 가장 먼 프레임을 기준으로 이동 스케일을 정규화한다.
- Baseline은 CameraCtrl, SEVA, ViewCrafter, Matrix-Game-2.0, GameCraft, Gen3C, VMem이다.
4.1. Main Result
전체 모델은 단기 PSNR 21.92, SSIM 0.702, LPIPS 0.247, 회전 거리 0.031, 이동 거리 0.121을 기록한다. 시각적 지표와 이동 오차에서는 비교한 방법 중 가장 우수하다. 단기 회전 거리는 Gen3C가 0.024로 가장 낮으며, ViewCrafter가 0.029로 뒤를 잇는다.
- 장기 설정에서 WorldPlay는 각각 18.94, 0.585, 0.371, 0.332, 0.797을 기록하며, 5개 지표 모두에서 비교한 baseline보다 우수하다.
- Context Forcing을 제외하면 장기 PSNR은 16.27, SSIM은 0.425, LPIPS는 0.495, 회전 거리는 0.611, 이동 거리는 0.991이다. 증류한 모델은 각 지표를 모두 개선한다.
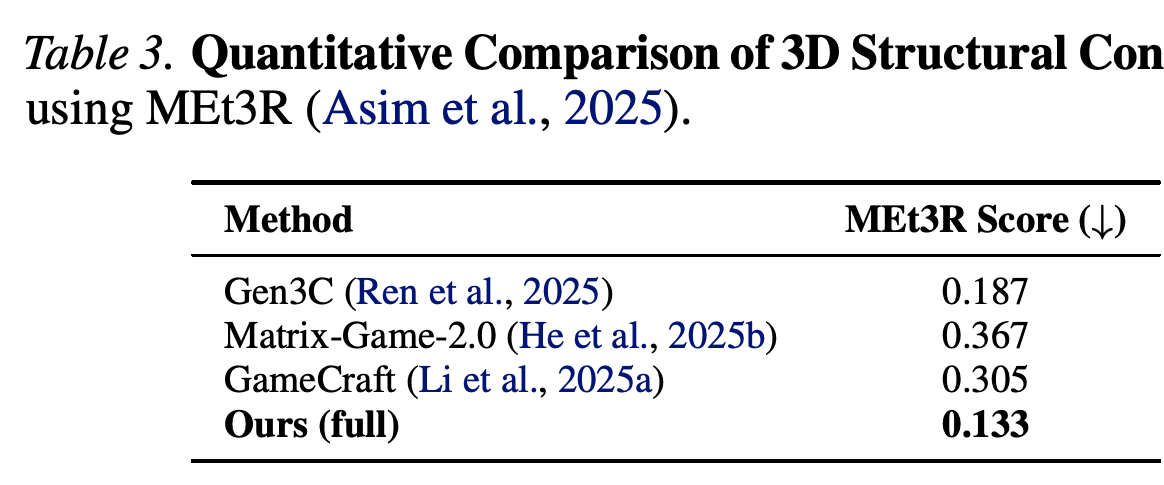
- MEt3R 구조 일관성 점수는 WorldPlay가 0.133, Gen3C가 0.187, Matrix-Game-2.0이 0.367, GameCraft가 0.305이다. 점수가 낮을수록 일관성이 높다.
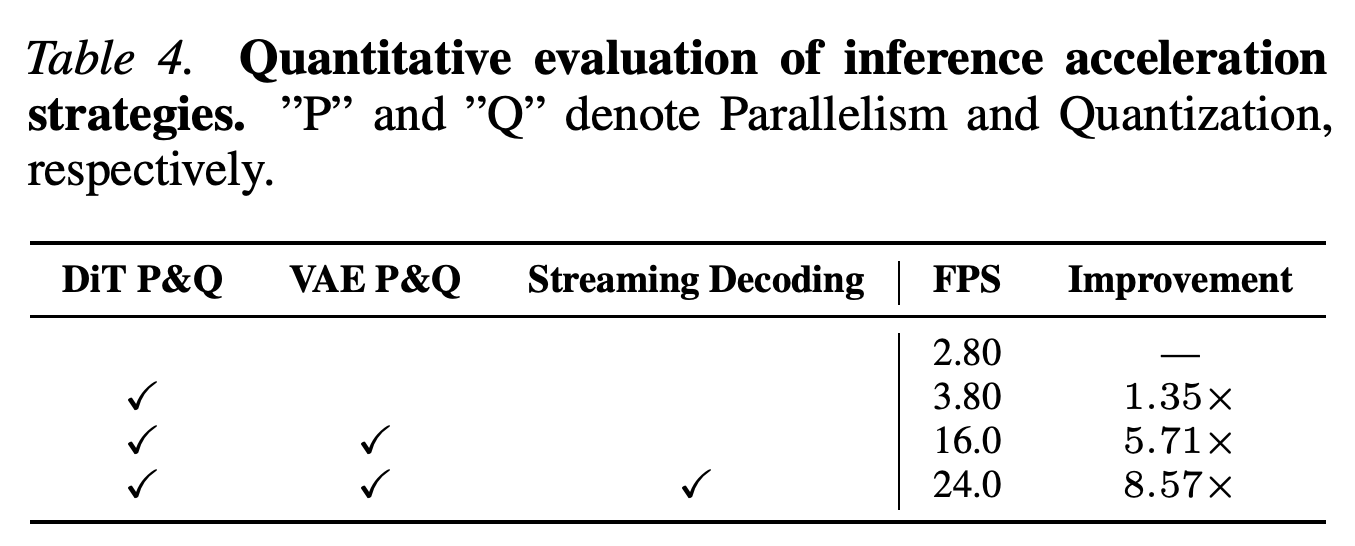
- 가속 측정에서 처리량은 DiT 병렬화와 양자화로 2.80 FPS에서 3.80 FPS로, 대응하는 VAE 최적화로 16.0 FPS로, 스트리밍 디코딩으로 24.0 FPS로 증가한다.
WorldPlay는 장기 지표 5개 모두에서 비교한 방법보다 우수하며, Context Forcing을 제외한 버전보다 각 지표를 개선한다. 단기 회전 거리는 0.031로, Gen3C의 0.024와 ViewCrafter의 0.029보다 높다.
제시한 행동 시퀀스에서 WorldPlay를 Gen3C, GameCraft, Matrix-Game 2.0과 비교한다. 빨간 상자는 WorldPlay가 복귀 시 유지한 장면 요소를 표시한다. 정량 재방문 결과와 함께 일부 정성적 예시를 보여준다.
WorldPlay의 MEt3R 점수 0.133은 Gen3C의 0.187을 포함해 제시한 baseline 3개보다 모두 낮다. 이 지표는 처음 지나갈 때와 재방문할 때의 대응 프레임 사이에서 구조적 일치도를 평가한다.
단계별 측정에서 VAE 병렬화와 양자화는 처리량을 3.80 FPS에서 16.0 FPS로 높이고, 스트리밍 디코딩은 이를 24.0 FPS로 높인다. 전체 구성의 처리량은 2.80 FPS 대비 8.57배다. 표는 병렬화와 양자화의 효과를 분리하지 않는다.
4.2. Ablation
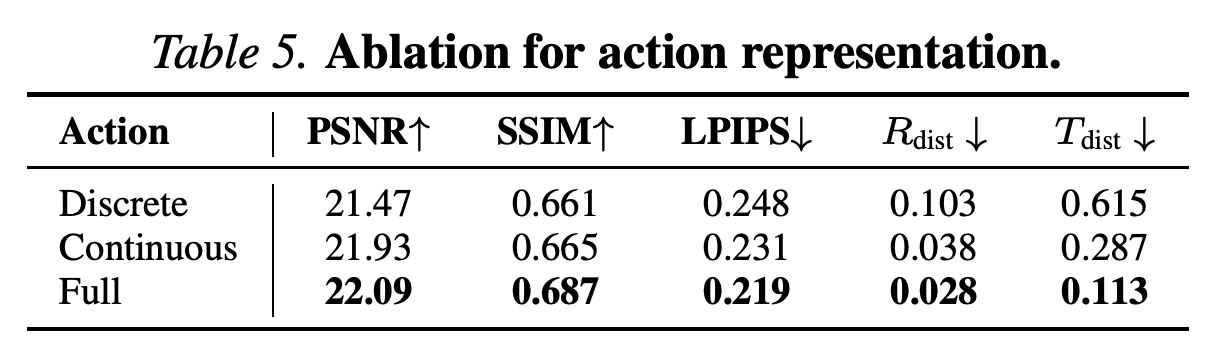
Ablation은 이산 및 연속 행동의 결합, 시간 위치 재지정, 증류 중 메모리 정렬의 효과를 뒷받침한다. 이산 및 연속 행동을 결합하면 회전 거리 0.028과 이동 거리 0.113을 기록한다. 이산 행동만 사용하면 각각 0.103과 0.615이며, 연속 행동만 사용하면 각각 0.038과 0.287이다.
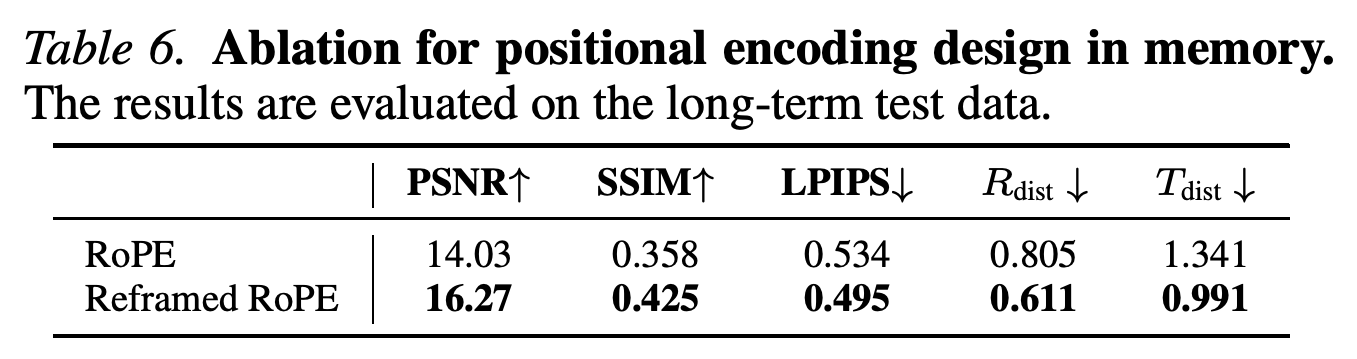
- 장기 데이터에서 Reframed RoPE는 PSNR을 14.03에서 16.27로, SSIM을 0.358에서 0.425로, LPIPS를 0.534에서 0.495로, 회전 거리를 0.805에서 0.611로, 이동 거리를 1.341에서 0.991로 개선한다.
- Teacher 메모리를 latent 단위로 선택하면 청크 기반 student와 문맥이 어긋나며, 정성적 실험에서 출력이 붕괴한다.
- 메모리가 없는 teacher는 재방문 일관성을 약화시키며, 자체 생성한 과거 문맥은 아티팩트를 유발한다. 이러한 문맥 대안은 정성적으로 제시되며, 각 대안에 대한 수치 ablation 표는 제공하지 않는다.
결합한 행동 조건은 PSNR 22.09와 이동 거리 0.113을 포함해 보고한 모든 열에서 가장 좋은 값을 기록한다. 이산 조건만 사용할 때 포즈 오차가 더 크다는 결과는 연속 공간 정보 추가를 뒷받침한다.
Reframed RoPE는 일반 RoPE 대비 장기 지표 5개를 모두 개선한다. PSNR은 14.03에서 16.27로, 이동 거리는 1.341에서 0.991로 개선된다. Temporal reframing을 적용하면 시각적 일치도와 추정한 포즈 정확도가 모두 개선된다.
위쪽 예시는 일반 RoPE에서 발생하는 시각적 품질 저하를 보여주고, 아래쪽 예시는 재방문 후 달라진 장면 세부 요소를 강조한다. Reframed RoPE는 선택한 세부 요소를 더 잘 보존하며, 위치 인코딩의 수치 ablation을 보완한다.
정렬되지 않은 문맥은 출력 붕괴를 일으키고, 메모리가 없는 teacher와 자체 생성한 과거 문맥에서는 일관성이나 외형 유지에 실패한 예시가 나타난다. 마지막 행은 선택한 학습 설계를 보여주지만, 대안들의 효과 크기를 수치로 제시하지는 않는다.
4.3. Application
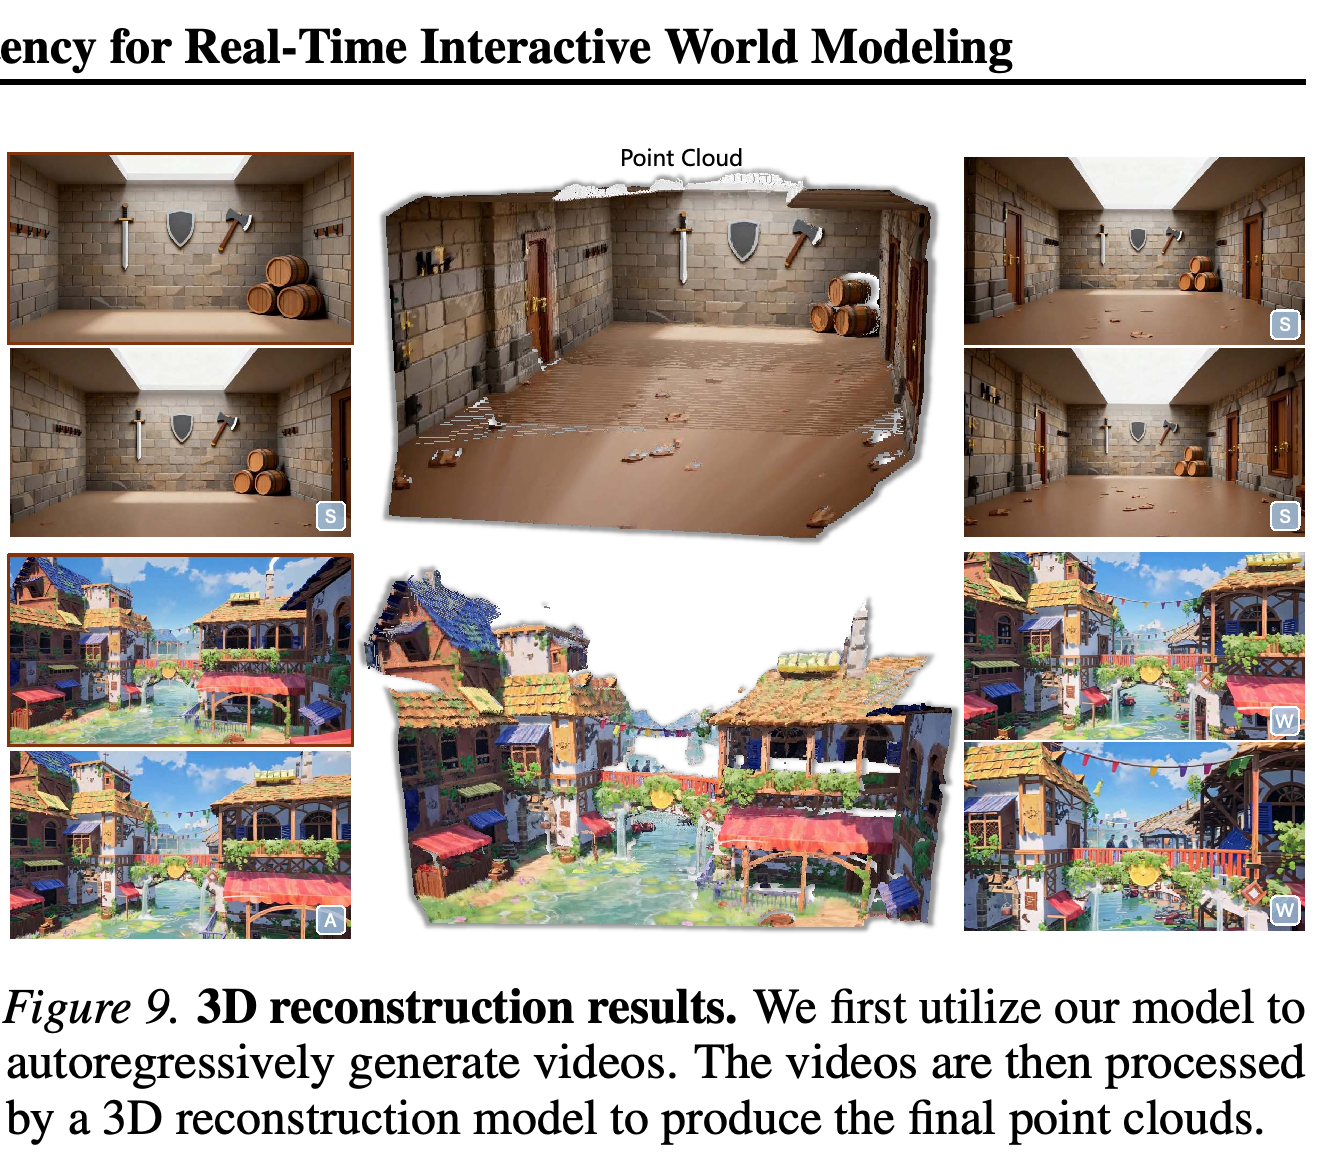
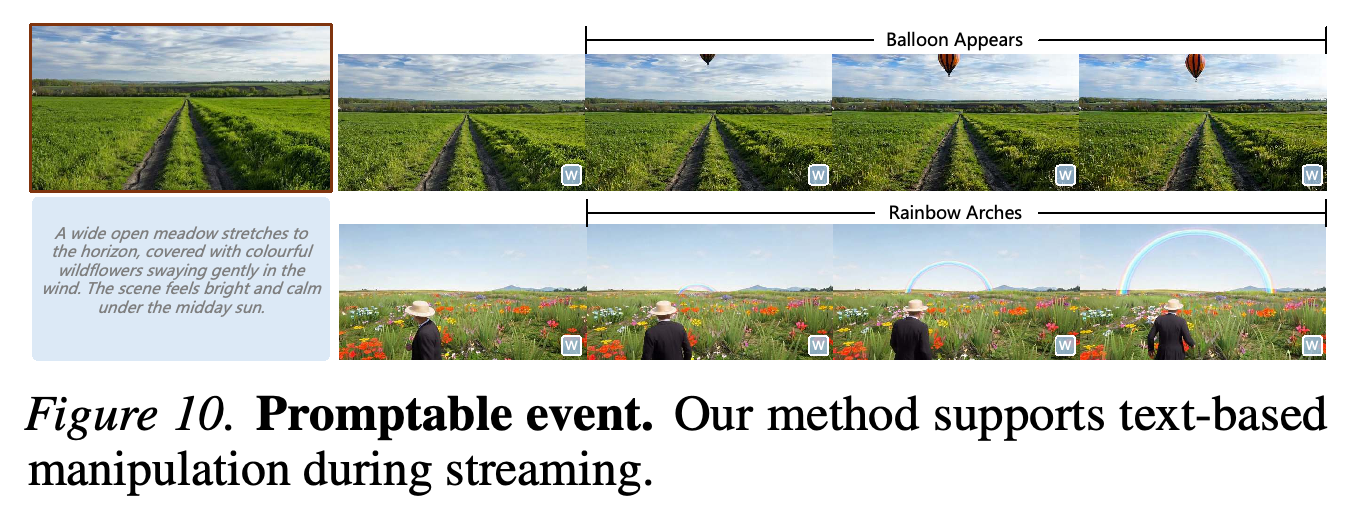
생성한 비디오를 별도의 feed-forward 3D 재구성 모델에 입력해 포인트 클라우드를 만들 수 있다. 스트리밍 중 텍스트 프롬프트를 바꿔 환경 변화나 객체 출현을 유도할 수도 있으며, 연기, 풍선, 무지개 등의 예시를 제시한다.
- 재구성 예시는 생성한 다중 시점 관측을 후속 작업에 활용하는 방법을 보여준다. 포인트 클라우드는 별도의 재구성 모델이 생성한다.
- 프롬프트로 지정한 이벤트는 시각적으로 시연하지만, 이벤트가 올바르게 발생하는지를 별도로 정량 평가하지는 않는다.
생성한 실내 및 스타일화된 실외 시점에서 재구성한 포인트 클라우드는 비디오가 별도의 재구성 모델에 관측을 제공할 수 있음을 보여준다. 예시는 이 응용을 시연하며, 재구성 정확도는 측정하지 않는다.
시퀀스는 탐색을 이어가는 동안 풍선이 나타나고 무지개가 형성되는 모습을 보여준다. 텍스트 변경이 이후 스트리밍 내용에 미치는 영향을 시연하지만, benchmark 전반에서 이벤트 신뢰성을 측정하지는 않는다.
5. Conclusion
결론에서는 상호작용형 비디오 월드 모델링을 위한 행동 제어, 메모리 검색, 증류를 종합한다. 명시한 한계는 약 30초의 생성 길이, 해결되지 않은 자기회귀 오차 누적, 제한된 상호작용 유형, 심한 가림 상황에서의 시야 기반 검색 실패다.
- 생성 길이를 분이나 시간 단위로 효율적으로 확장하는 일은 여전히 과제다.
- 다중 에이전트 상호작용과 복잡한 물리 동역학은 실험으로 입증한 능력이 아니라 제안한 확장 방향이다.
Impact Statement
Impact Statement는 Machine Learning의 발전을 목표로 한다고 밝히며, 잠재적인 사회적 영향을 인정한다. 다만 저자들이 구체적인 논의가 필요하다고 판단하는 영향은 제시하지 않는다. 응용 분야별 위험 분석이나 완화 방안 평가도 제공하지 않는다.
부록
- A. Training and Inference Details: 모델은 사전 학습한 DiT 기반 video diffusion 백본, 청크당 latent 4개, 시간 메모리 청크 3개, 공간 메모리 청크 1개를 사용하며, 첫 청크를 attention sink로 사용한다. Stage One: Action Control에서는 양방향 모델을 30K회 학습하고, 자기회귀 모델을 추가로 30K회 학습한다. 프레임 61개, Adam, 학습률 1e−5, 배치 크기 64를 사용한다.
- Stage Two: Memory에서는 최대 latent 160개, 즉 프레임 637개로 구성한 시퀀스로 양방향 모델과 자기회귀 모델 2개를 학습한다. 생성 노이즈는 [0,1], 메모리 노이즈는 [0,0.2]에서 샘플링하며, 손실은 생성 시퀀스에 대해서만 계산한다. Stage Three: Context Forcing에서는 rollout 길이를 점진적으로 늘리며 2K회 학습한다. 배치 크기는 64, student 학습률은 1e−6, fake-score 모델 학습률은 2e−7이다. Algorithms 1 and 2는 KV Cache를 사용하는 학습과 추론 절차를 명시한다. 추론 시 포즈만 입력하면 상대 변환에 임계값을 적용해 이산 행동으로 변환하며, 이산 행동만 입력하면 미리 정의한 상대 변환을 사용해 포즈로 변환한다.
- B. Dataset: 클립 320K개는 Sekai 클립 40K개(12.5%), DL3DV-derived 클립 60K개(18.75%), UE 렌더링 클립 50K개(15.625%), 게임 녹화 170K개(53.125%)로 구성한다. 처리 과정에는 움직이는 객체가 밀집한 장면 필터링, 재구성과 맞춤형 재방문 렌더링, Difix3D+ 보정, 설명 텍스트 주석, ViPE 포즈 추정이 포함된다. 누락된 이산 행동은 카메라 포즈 성분에 임계값을 적용해 도출한다. 비디오는 30~40초 클립으로 나누고, 포즈 추정치는 4프레임마다 서브샘플링한다. 프레임 간 움직임의 Peak-to-Median Ratio가 5.0을 넘는 클립은 제외한다.
- C. Additional Experimental Results, C.1. More Qualitative Results, C.2. Long Video Generation: 추가 예시는 복합 이동, 회전과 이동의 교대, 사람 및 동물 에이전트 제어를 보여준다. 재방문 예시는 프레임 1과 프레임 252를 비교하며, 추가 예시는 프레임 637개에 걸쳐 제시한다. 부록은 비디오가 길어져도 청크당 생성 시간이 일정하다고 설명하지만, 비디오 길이에 따른 지연 시간을 수치 곡선으로 제시하지는 않는다.
- C.3. Comparison of Models under Context Forcing: student와 양방향 teacher는 각각 함수 평가 100회를 사용하고, 증류한 모델은 4회를 사용한다. Teacher는 PSNR 19.31, SSIM 0.599, LPIPS 0.383, 회전 거리 0.209, 이동 거리 0.717을 기록한다. 증류한 모델은 각각 18.94, 0.585, 0.371, 0.332, 0.797을 기록한다. 증류는 원래 student의 모든 제시 지표를 개선하지만, teacher는 PSNR, SSIM, 포즈 정확도에서 우위를 유지한다.
- C.4. Ablation for Memory Size: 공간 메모리 청크 3개와 시간 메모리 청크 1개를 사용하면 PSNR은 16.41이며, 공간 청크 1개와 시간 청크 3개를 사용하면 16.27이다. 후자 구성은 SSIM, LPIPS, 회전 거리, 이동 거리가 더 좋다. 저자들은 인접한 청크 사이에서 공간 메모리 선택은 달라지는 반면 시간 문맥은 겹치기 때문에, 공간 메모리를 늘리면 teacher 문맥이 커질 수 있다고 설명한다.
- C.5. Evaluation on VBench는 같은 초기 이미지와 행동으로 생성한 비디오를 레이더 차트로 비교한다. 저자들은 일관성, 움직임의 부드러움, 장면 일반화에서 우위를 보고한다. C.6. Evaluation on WorldScore는 이미지, 텍스트 프롬프트, 카메라 궤적이 있는 정적 환경 사례 2,000개를 사용한다. WorldPlay는 Voyager의 77.62보다 높은 79.74로 최고 평균을 기록한다. 다만 WonderWorld는 카메라 제어, 콘텐츠 정렬, 3D 일관성 점수가 더 높으며, Voyager도 콘텐츠 정렬 점수가 더 높다.
- D. User Study: 평가자 30명이 동일한 초기 이미지와 행동으로 생성한 비디오를 짝지어 비교한다. Benchmark 사례 300개와 맞춤형 궤적 300개를 사용한다. 증류한 모델의 선호율은 GameCraft 대비 88.5%, Matrix-Game-2.0 대비 78.4%, ViewCrafter 대비 92.1%, Gen3C 대비 72.9%다. 양방향 teacher와의 비교에서는 증류한 모델 선호율이 48.1%, teacher 선호율이 51.9%이므로, 보고된 결과에서는 teacher의 선호율이 더 높다.
- E. Additional Applications, E.1. Promptable Event: 텍스트 프롬프트를 바꾸면 KV-recache로 캐시한 key–value 상태를 갱신한다. 이는 움직임과 시각적 연속성을 유지하면서 이전 프롬프트 정보를 제거하기 위한 처리다. 시연에는 날씨 변화, 불길 발생, 새로운 객체나 캐릭터 출현이 포함된다. E.2. Video Continuation은 초기 클립의 움직임, 외형, 조명과 일관된 후속 내용을 보여주지만, 비디오 이어 생성에 대한 별도의 수치 benchmark는 제공하지 않는다.
짧은 생각
증류 중 메모리 조건을 맞추는 방법은 실험 근거가 충분하다. Student 비교에서는 장기 지표 5개가 모두 개선되며, 정성적 ablation에서는 다른 문맥 설계의 실패를 보여준다. 보고된 24 FPS에는 8×H800 GPUs가 필요하며, 생성 길이가 약 30초이므로 훨씬 긴 상호작용 세션에서의 지속성은 검증되지 않았다. 순환 경로 비교는 이전에 생성한 시점과의 일치도를 평가하며, MEt3R은 픽셀 유사도 외에 구조적 근거를 더한다. 이러한 측정만으로 지속적으로 유지되는 3D 월드의 정확성을 독립적으로 입증하지는 못한다. 포즈 오차는 ViPE 추정에 의존한다. 데이터 처리 과정에서 포즈 추정 실패를 언급한 만큼, 이 오차를 정확한 카메라 제어 성능으로 해석할 때 주의가 필요하다. 증류한 모델은 원래 student를 개선하고 여러 baseline과의 사용자 비교에서 우세하지만, 양방향 teacher는 정량 지표 4개에서 우위를 유지하며 짝지은 비교에서 선호율 51.9%를 얻는다.