


PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation 요약 설명
31 Dec 2025 | Paper Review Text-to-Video Generation Direct Preference Optimization Physical Reasoning목차
이번 글에서는 PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2025년 12월 31일(Arxiv)
- Cai, Yuanhao, Li, Kunpeng, Jia, Menglin, Wang, Jialiang, Sun, Junzhe, Liang, Feng, Chen, Weifeng, Juefei-Xu, Felix, Wang, Chu, Thabet, Ali, et al.
- Meta Superintelligence Labs, Johns Hopkins University, Meta BizAI, CUHK
- 논문 링크
- Github
- Project Page
요약
- PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation은 추론 시 프롬프트를 확장하지 않고 물리적 개연성을 높이는 사후 학습을 연구한다. 물리적 상호작용이 풍부한 실제 영상을 선별하는 과정과 실제 영상은 승자, 생성 영상은 패자로 취급하는 선호 목적함수를 결합한다.
- PhyAugPipe는 텍스트-영상 쌍 백만 개를 필터링해 PhyVidGen-135K를 구성하고, 학습용으로 17K 쌍을 재표본추출한다. PhyGDPO는 그룹 단위 Plackett–Luce 목적함수에서 계산 가능한 대리 목적함수를 도출한다. Physics-Guided Rewarding (PGR)으로 어려운 샘플을 강조하고, LoRA-Switch Reference (LoRA-SR)로 정책과 참조 모델이 동결된 백본을 공유하도록 한다.
- Wan2.1-14B를 사후 학습하면 VideoPhy2 전체 점수는 0.1288에서 0.1627로, 어려운 행동 점수는 0.0111에서 0.0500으로 오른다. PhyGenBench 평균 성능은 0.55로, VideoDPO의 0.54보다 높다. 사람의 선호 평가와 평가 모델을 바꾼 실험도 사람이 느끼는 물리적 개연성의 개선을 뒷받침한다. 다만 목적함수나 평가 결과가 물리적 정확성을 보장하지는 않는다.
1 Introduction
서론은 시각적 품질과 물리적으로 일관된 움직임 및 상호작용을 구분한다. 그래픽스 기반 감독은 복잡한 실제 장면으로 확장하기 어렵고, 프롬프트 확장은 오류를 낼 수 있는 외부 추론에 의존한다고 지적한다. 지도 학습에는 개연성이 낮은 생성을 억제할 명시적인 부정 예시가 없다는 점도 강조한다.
- 제안 방법은 물리적 상호작용이 풍부한 선호 데이터의 부족, 생성 영상을 승자로 삼을 때의 신뢰성 문제와 개별 쌍에 한정된 비교, 전체 참조 모델을 복제하는 메모리 비용을 다룬다.
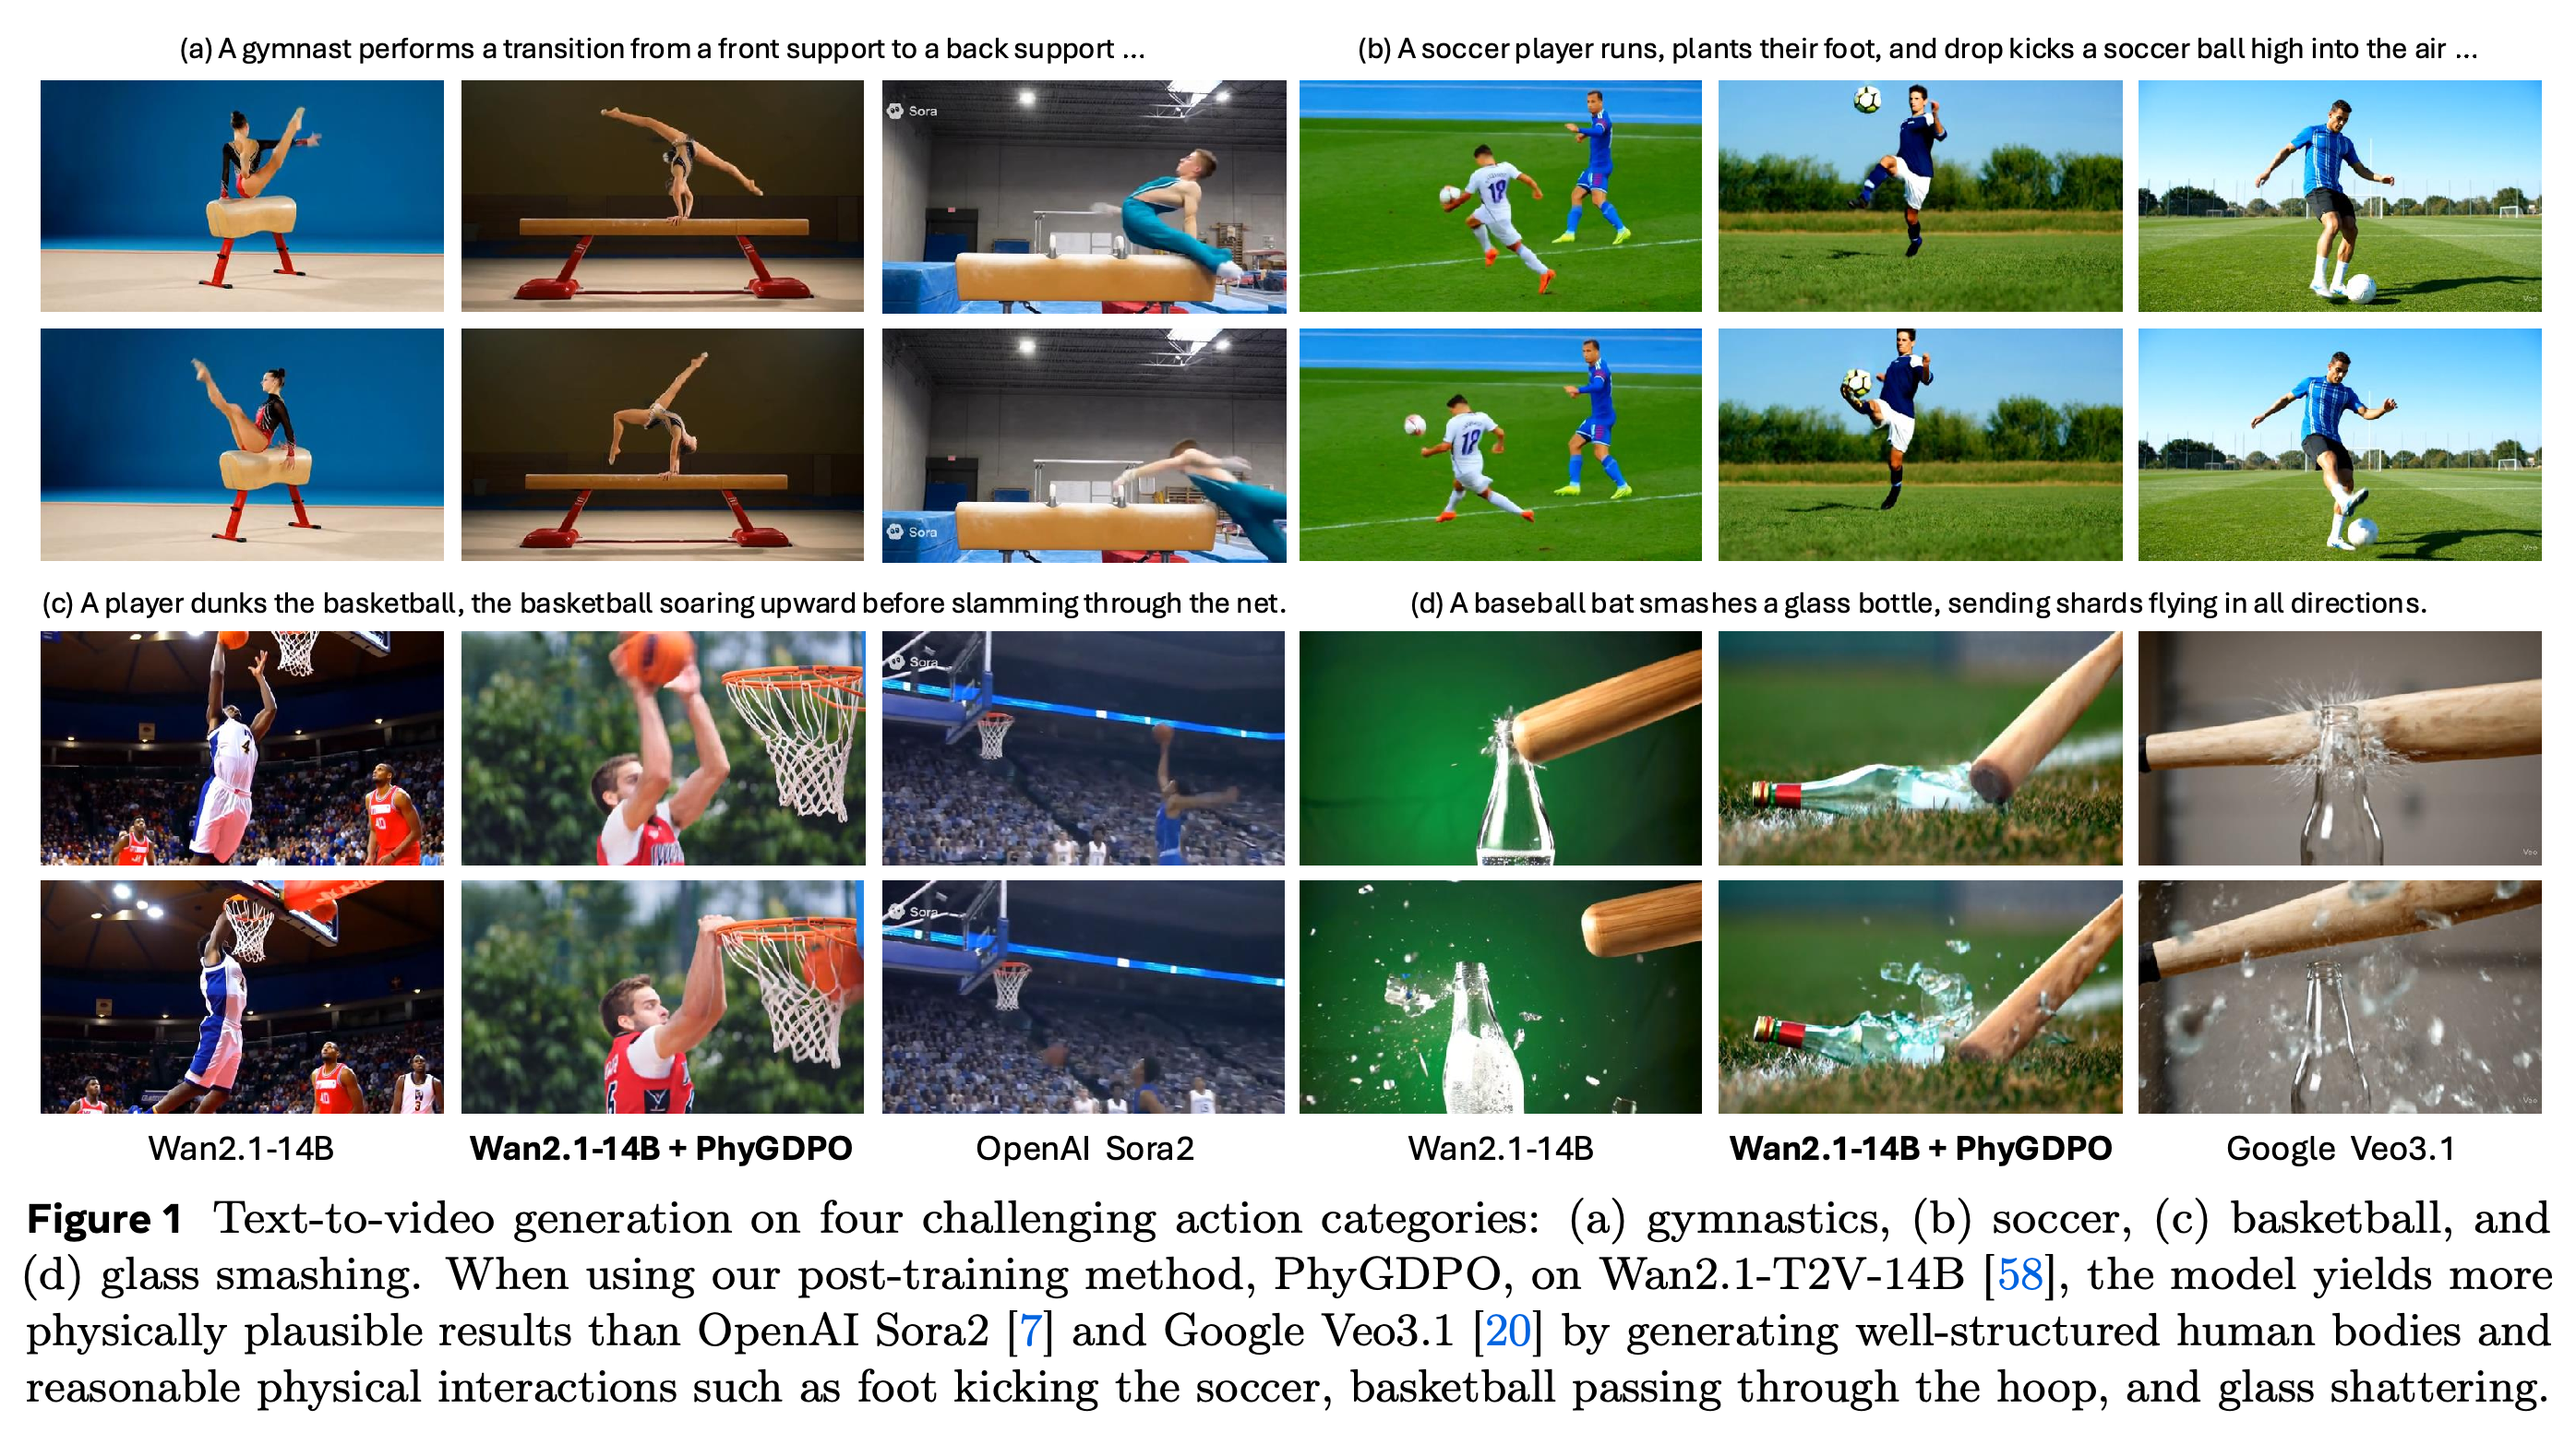
- Figure 1은 선별된 체조, 축구, 농구, 유리 깨기 예시로 문제를 제시한다. 이 예시들은 눈에 보이는 실패 양상을 보여 주지만, 폐쇄형 모델보다 전반적으로 우수하다는 근거는 아니다.
선별된 프레임 쌍은 신체 구조, 팔다리-물체 접촉, 공-골대 상호작용, 유리 파손의 구체적인 실패 양상을 드러낸다. 물리 중심 사후 학습의 필요성을 제시하지만, 예시만으로 방법 간 성공률을 입증하지는 못한다.
2 Method
이 방법은 데이터 구축과 선호 기반 사후 학습을 결합한다. PhyAugPipe는 물리적 상호작용에 관한 정보를 충분히 담은 실제 영상을 선별한다. PhyGDPO는 각 선별 영상과 동일한 원래 프롬프트로 생성한 대안 영상을 비교한다.
- VLM은 데이터 준비와 선호 가중치 설정에 필요한 필터링 점수와 난도 점수를 제공한다. 추론 시에는 VLM이 생성한 물리 설명이 필요하지 않다.
- 실제 촬영 영상이 승자 레이블을 결정한다. VLM 점수는 샘플 선별과 가중치를 제어할 뿐, 승자를 선택하지 않는다.
2.1 Physics-Augmented Video Data Construction
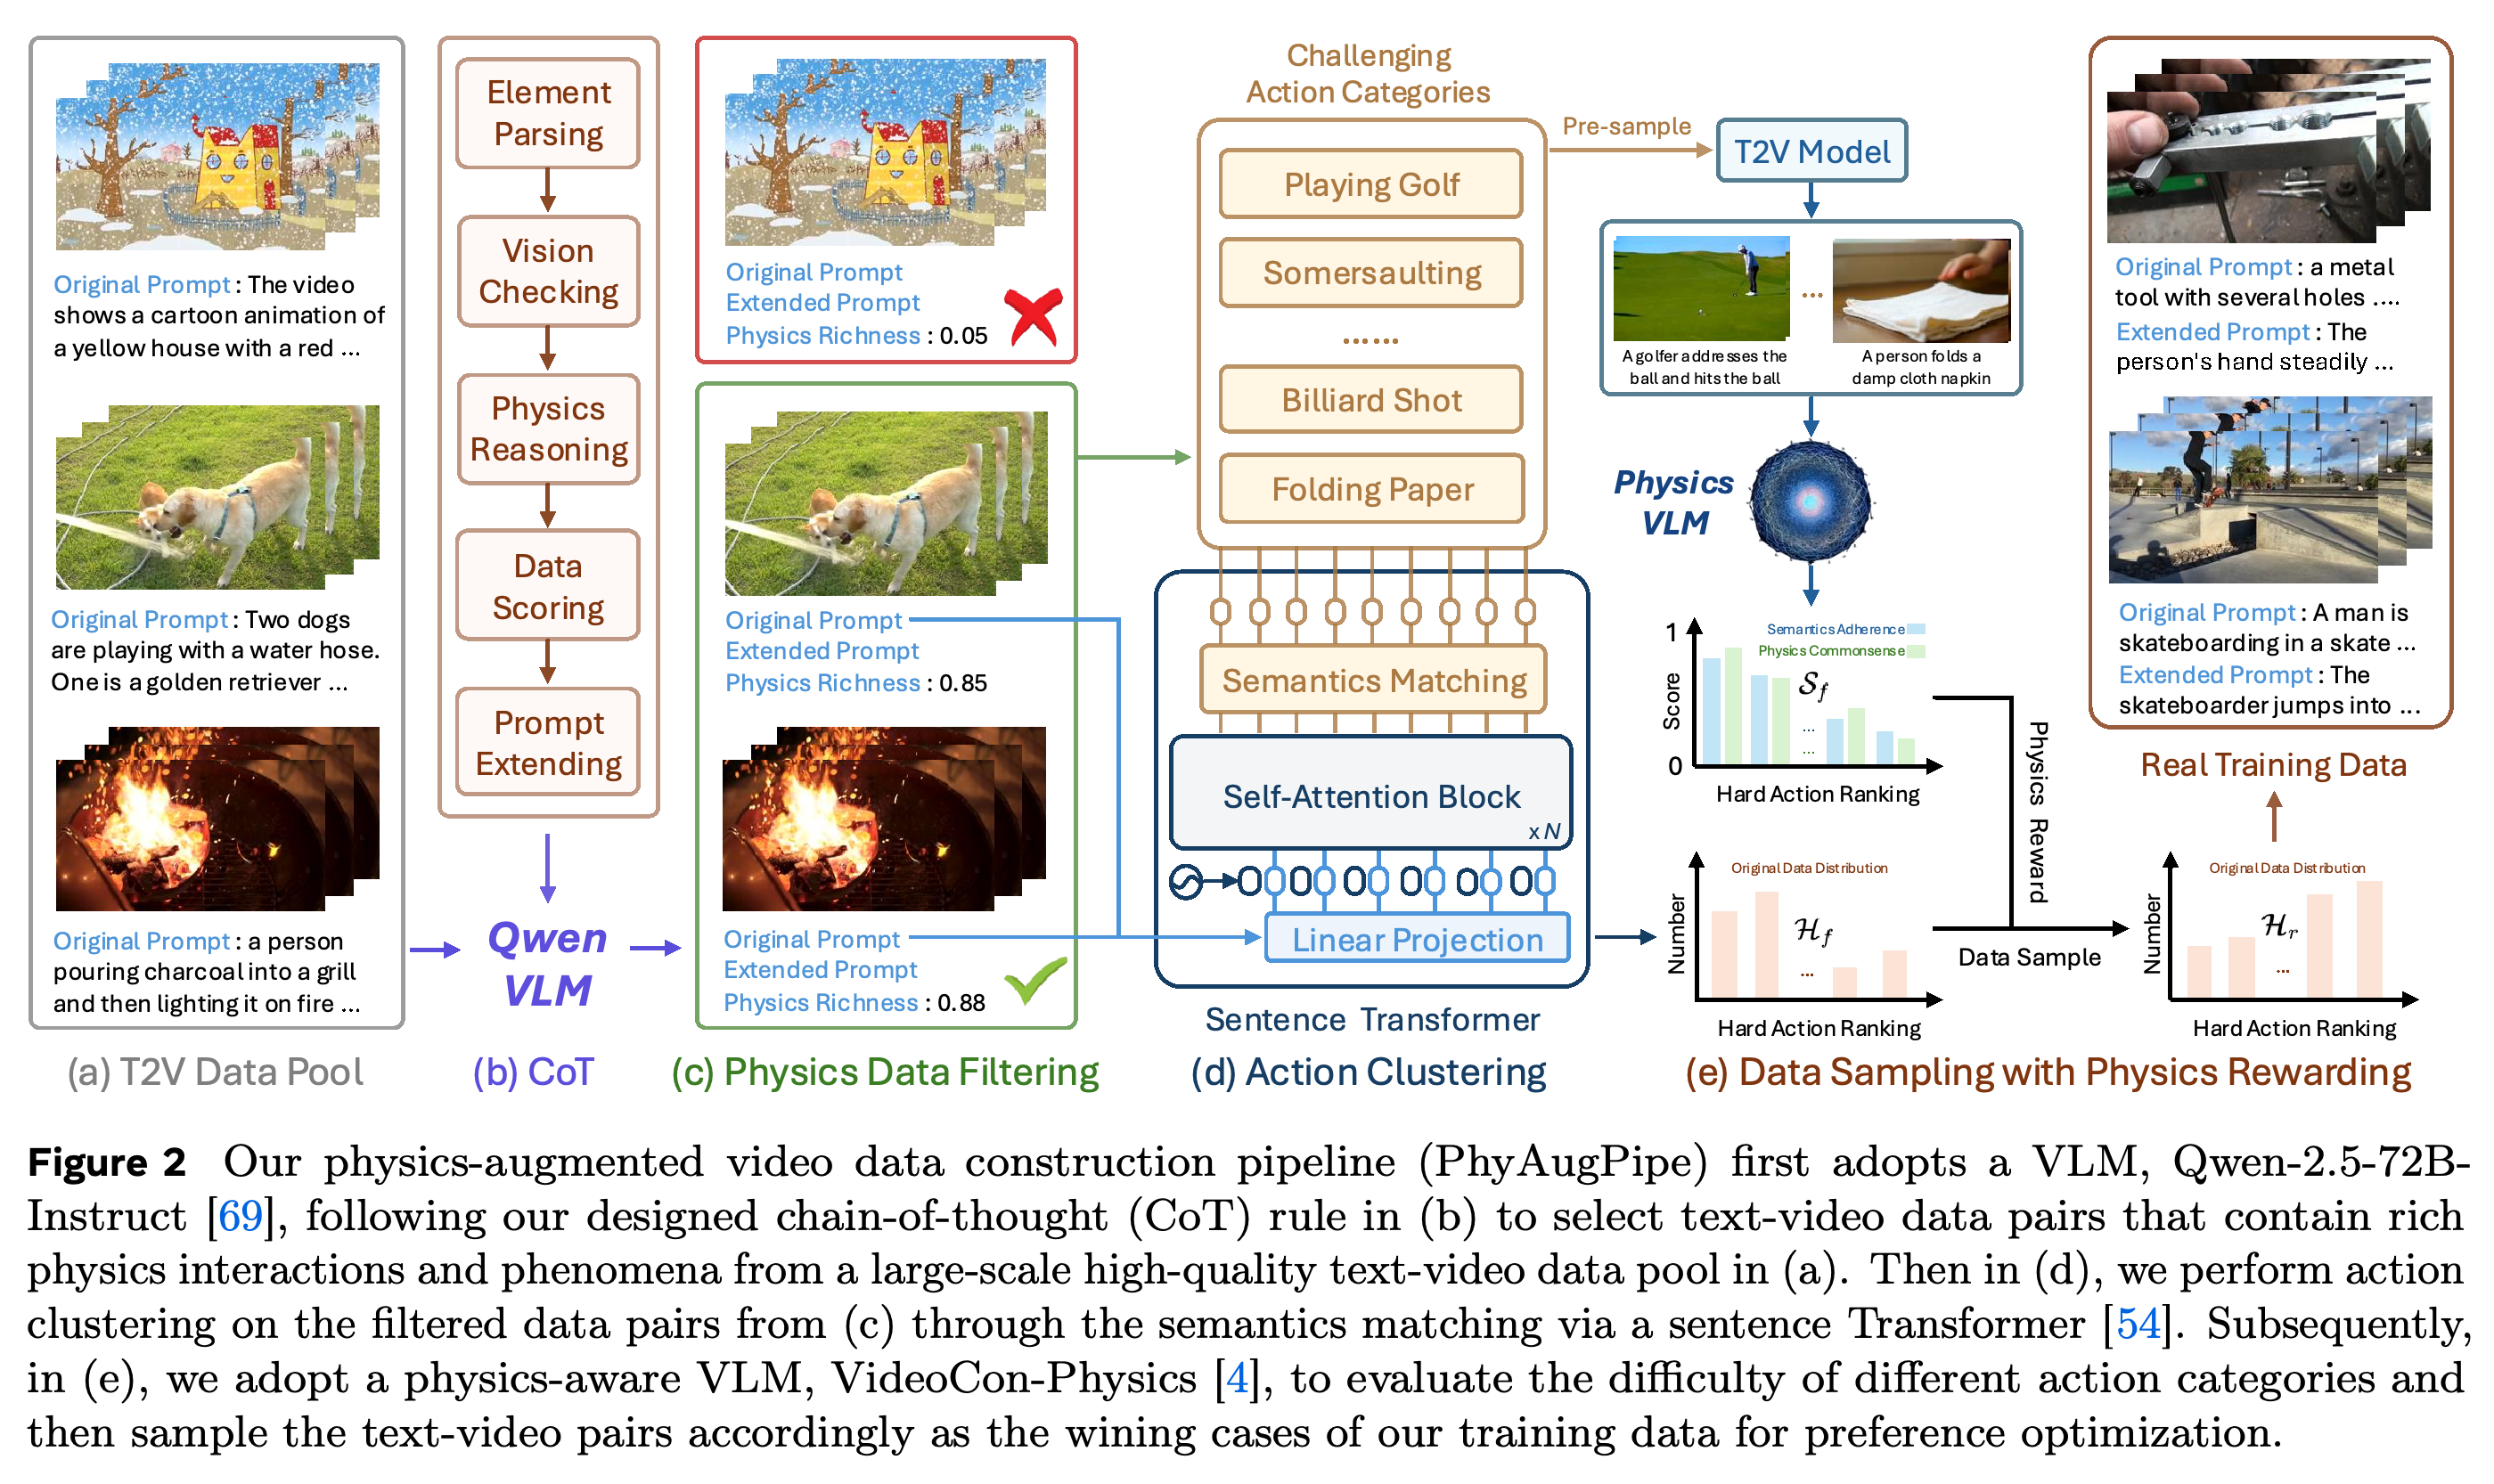
Data Filtering with CoT는 Qwen2.5-72B-Instruct로 개체, 행동, 힘, 결과를 추출하고 영상 프레임과 대조한다. 이어 인과적 상호작용을 추론하고 [0, 1] 범위의 physics_richness를 부여한다. Algorithm 1은 physics_richness ≥ 0.60일 때 physics_label = 1로 설정하고, 확장 프롬프트를 최대 100단어로 제한한다.
- 점수 규칙은 명시적인 상호작용과 명확한 인과관계에 보상을 주고, 카메라 움직임, 스타일화, 사건이 끝난 뒤의 정적인 장면에는 감점을 적용한다.
- 확장 프롬프트는 다른 연구에 활용할 수 있도록 보관한다. 다만 PhyGDPO는 재작성 오류나 편향을 피하기 위해 사람이 작성한 원래 프롬프트를 사용한다.
Action Clustering via Semantics Matching은 sentence Transformer로 필터링된 프롬프트를 사전에 정의한 어려운 행동 범주에 배정한다. Data Sampling with Physics Rewarding은 기본 생성 모델의 성능이 낮은 범주에 더 많은 실제 영상 예시를 할당한다. Figure 2는 이 과정을 요약한다.
- 각 범주에서는 의미적으로 일치하는 top-nc 대표 예시의 프롬프트를 사용해 VideoCon-Physics로 생성 난도를 평가한다. 각 생성 영상의 의미 준수 점수와 물리적 상식 점수를 평균낸 뒤, 범주별로 다시 평균내어 Sf(k)를 구한다.
- 표본추출 규칙은 dk = 1 − Sf(k), rk = exp(τ dk), Hr(k) = min(Hf(k), N rk / Σj rj)를 사용한다. 상한을 두어 각 범주에서 보유한 예시 수보다 많이 추출하지 않도록 한다.
파이프라인은 물리적 상호작용의 풍부함을 기준으로 한 필터링과 난도를 고려한 할당을 분리한다. 정보가 적은 장면을 제외하고, 남은 프롬프트를 행동 의미에 따라 묶는다. 이어 생성 모델의 물리 및 의미 점수가 낮은 행동에 학습 데이터 분포를 더 집중시킨다.
2.2 Physics-Aware Groupwise Direct Preference Optimization
Groupwise Probability는 Plackett–Luce 모델을 사용해 m개의 생성 패자와 비교한 실제 승자의 softmax 확률을 부여한다. DPO 보상 매개변수화를 대입하고 프롬프트에 의존하는 분배함수 항을 소거하면, 정책과 참조 모델의 로그 우도 비율에 기반한 그룹 단위 손실을 얻는다.
- fθ(x, c) = log(pθ(x|c)/pψ(x|c))로 두면 Eq. (4)는 LGDPO = E[log(1 + Σj exp(β(fθ(x0lj, c) − fθ(x0w, c))))]가 된다. 생성 대안의 상대적 우위가 클수록 페널티가 커진다.
- 이 식은 후보 그룹에서 승자가 선택될 확률을 모델링한다. 생성 패자들 사이의 전체 순위는 필요하지 않다.
논문은 2단계를 거쳐 효율적인 대리 목적함수를 도출한다. 먼저 Jensen 부등식으로 여러 타임스텝에 걸친 식의 상한을 단일 타임스텝 손실로 구한다. 이어 다른 부등식으로 그룹 단위 식을 가중 쌍별 항의 합으로 바꾼다. 따라서 매 반복에서 모든 그룹 구성원을 평가하는 대신 승자-패자 쌍 1개와 타임스텝 1개를 표본추출할 수 있다.
- 중간 단계의 단일 타임스텝 그룹 목적함수에도 2m + 2개의 모델 평가가 필요하다. 승자와 m개의 패자 각각에 대한 정책 및 참조 모델 평가를 포함한 수다.
- 핵심 부등식은 0 < αj ≤ 1과 γj ≥ 1/αj 아래에서 성립하는 1 + Σj exp(xj) ≤ Πj(1 + exp(αj xj))γj다. Eq. (8)은 이 상한을 −mγj log σ(αjβT(Δkw − Δklj))의 기댓값으로 표현한다. 계수 m은 패자 인덱스 j를 균등하게 표본추출하는 데서 나온다.
- 학습은 원래의 그룹 단위 우도를 직접 최적화하지 않고, 그 상한인 대리 목적함수를 최적화한다. 논문은 이 상한이 원래 손실에 얼마나 가까운지 보고하지 않는다.
Physics-Guided Rewarding은 각 생성 패자의 정규화된 의미 준수 점수와 물리적 상식 점수를 난도 vj = 1 − (sjsa + sjpc)/2로 변환한다. Sigmoid 함수는 점수가 낮은 샘플에서 선호 비교의 첨예도 αj와 손실 가중치 γj를 높이면서 두 계수를 정해진 범위 안에 유지한다.
- Eq. (9)는 αj = αmin + (1 − αmin)σ(κα(vj − bα))와 γj = [1 + λσ(κγ(vj − bγ))]/αmin을 사용한다.
- 0 < αmin ≤ 1과 λ ≥ 0이면 αj ≥ αmin이고 γj ≥ 1/αmin ≥ 1/αj이므로 부등식의 계수 제약을 만족한다. 보고된 설정도 이 조건을 충족한다.
- 난도는 프롬프트 준수와 물리적 개연성을 결합하므로 PGR은 물리적 특성만을 평가하는 보상이 아니다. 계수를 높인다고 모든 샘플의 기울기가 반드시 커지는 것도 아니다.
Flow Matching Probabilistic Modeling은 rectified-flow 보간 xt = (1 − t)x0 + tx1을 사용한다. x1은 N(0, I)에서 추출하고 목표 속도는 x1 − x0으로 둔다. 잡음이 소멸하는 Gaussian 근사를 통해 정책과 참조 모델의 전이 로그 비율을 각 모델의 속도 예측 오차 제곱 간 차이로 바꾼다.
- 최종 Eq. (13)의 목적함수는 L = E[−mγj log σ(−αjβT[(ℓθw − ℓψw) − (ℓθlj − ℓψlj)])]다. 참조 모델 대비 정책의 오차 개선이 생성 패자보다 실제 승자에서 더 커지도록 유도한다.
- Gaussian 근사에서 나온 척도 h²/(2ε)는 β에 흡수한다. 이로써 결정론적 rectified-flow 전이를 근사적으로 확률 해석할 수 있다.
- Eq. (5)는 최종 영상의 로그 우도 비율을 전이 로그 비율의 합과 동일시한다. 이 합은 직접적으로는 궤적의 우도 비율을 나타낸다. 논문은 이를 최종 영상의 비율과 동일시하는 데 필요한 주변화 과정을 도출하지 않는다.
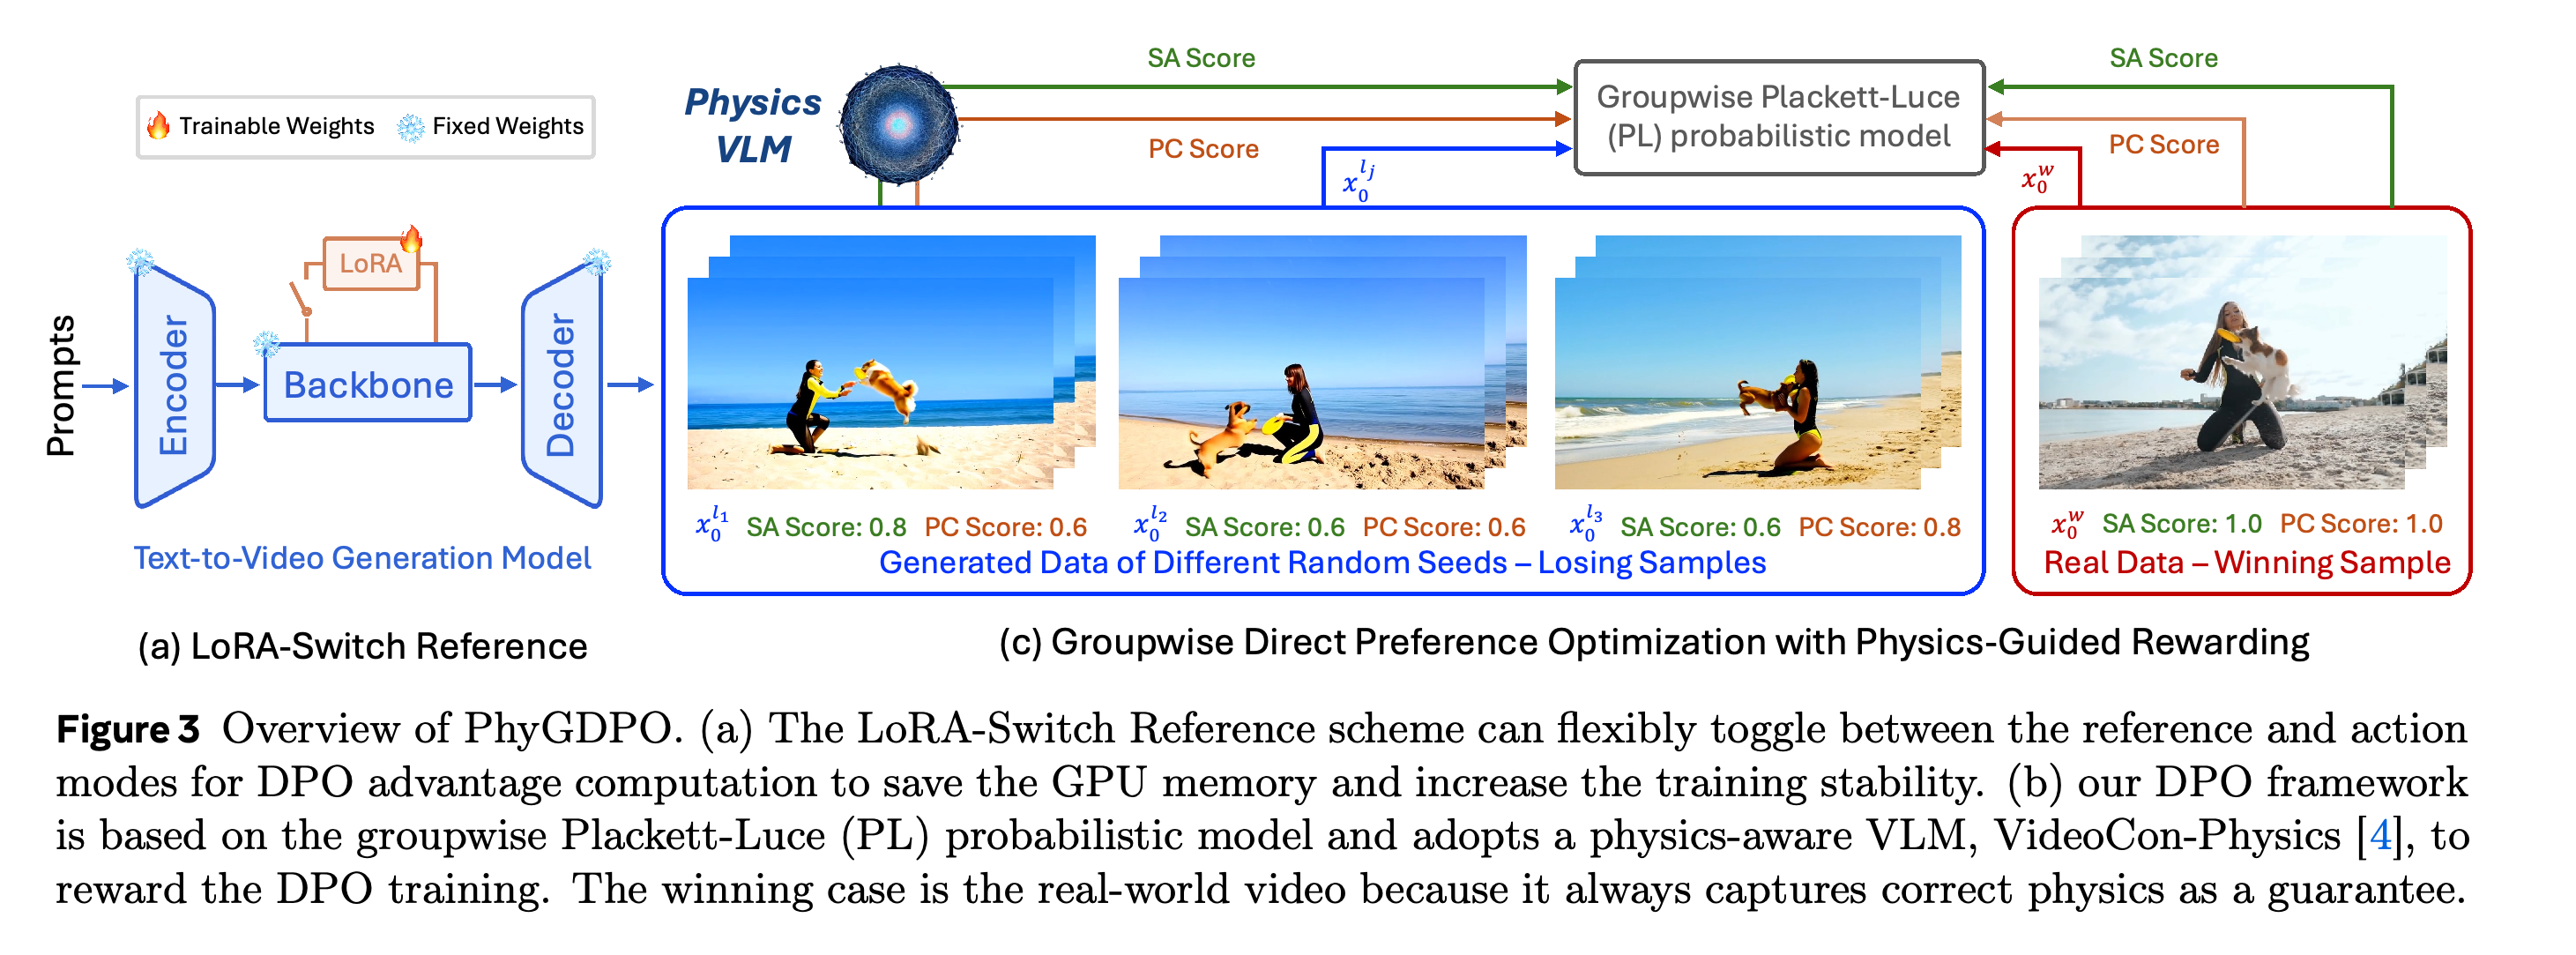
LoRA-Switch Reference는 백본을 동결하고 각 self-attention 층의 query, key, value, output 투영에 학습 가능한 LoRA 모듈을 붙인다. 환경 관리자는 참조 모델 평가 시 어댑터를 끄고 정책 평가 시 켠다. 따라서 별도의 전체 백본이 필요하지 않다. self-attention에 대해서는 이 글을 참조하라.
- Eq. (14)는 Y = X(W + 1action(α/r)BA)⊤를 사용한다. 1action = 0이면 참조 모델을, 1action = 1이면 학습 가능한 정책을 선택한다.
- Figure 3은 공유 백본 구조를 실제 영상 승자, 서로 다른 시드로 생성한 여러 패자, VLM 기반 샘플 가중치와 연결해 보여 준다.
- 이 설계는 학습 가능한 매개변수 수와 참조 모델 복제를 모두 줄인다. 따라서 성능 제거 실험은 적응 방식과 참조 공유를 결합한 구성을 평가한다.
도식은 2가지 역할을 구분한다. 실제 촬영 영상은 승자 레이블을 고정하고, VLM 점수는 생성 대안의 가중치를 조절한다. 정책과 참조 모델의 평가는 동결된 백본을 공유하며, LoRA 모듈은 정책에만 활성화한다.
3 Experiment
실험에서는 고품질 텍스트-영상 쌍 백만 개를 필터링해 물리적 상호작용이 풍부한 135K 쌍을 얻는다. 이어 행동 군집화와 보상 기반 재표본추출로 학습용 17K 쌍을 구성한다. Wan2.1-14B는 이 17K 프롬프트에서 서로 다른 무작위 시드로 대안을 생성하고, VideoCon-Physics가 생성 영상을 평가한다.
- 표본추출 예산은 N = 20000이지만, 재표본추출한 최종 데이터셋은 17K 쌍이다. 범주별 규칙이 추출량을 가용 데이터 수로 제한한다.
- 평가에는 VideoPhy2와 PhyGenBench의 짧고 확장하지 않은 프롬프트를 사용한다. 논문은 패자 그룹 크기 m의 구체적인 수치를 명시하지 않는다.
VideoPhy2-AutoRater는 의미 준수와 물리적 상식을 1~5 척도로 평가한다. 보고 점수는 두 점수가 모두 ≥ 4인 영상의 비율이다. PhyGenBench는 GPT-4o, CLIP, InternVideo2, VideoLLaVA를 사용해 4개 영역의 27개 물리 법칙에 걸쳐 필요한 현상의 발생, 순서, 자연스러움을 평가한다.
- VideoPhy2-AutoRater는 학습 예시를 평가하는 VideoCon-Physics와 다른 모델이므로 학습 평가기에 대한 직접적인 의존을 줄인다.
- 이 벤치마크들은 모델의 판단으로 물리적 개연성을 평가한다. 물리량이나 보존 법칙의 잔차를 측정하지는 않는다.
Wan2.1-14B는 PyTorch에서 BF16 혼합 정밀도와 sublinear memory training을 사용해 사후 학습한다. 8개의 H100 GPU에서 배치 크기 8로 10K 스텝을 학습하며 6일이 걸린다. 학습 및 추론 해상도는 480×832다.
- AdamW는 β1 = 0.9, β2 = 0.999, weight decay 0.01을 사용한다. Cosine annealing은 학습률을 1e−5에서 1e−6으로 낮춘다.
- 보고된 설정은 τ = 3, N = 20000, αmin = 0.5, kγ = 2.0, bγ = 0.4, λ = 0.6, kα = 5.0, bα = 0.5다. LoRA rank와 scale factor는 모두 48이다.
3.1 Comparison with State-of-the-Art Methods
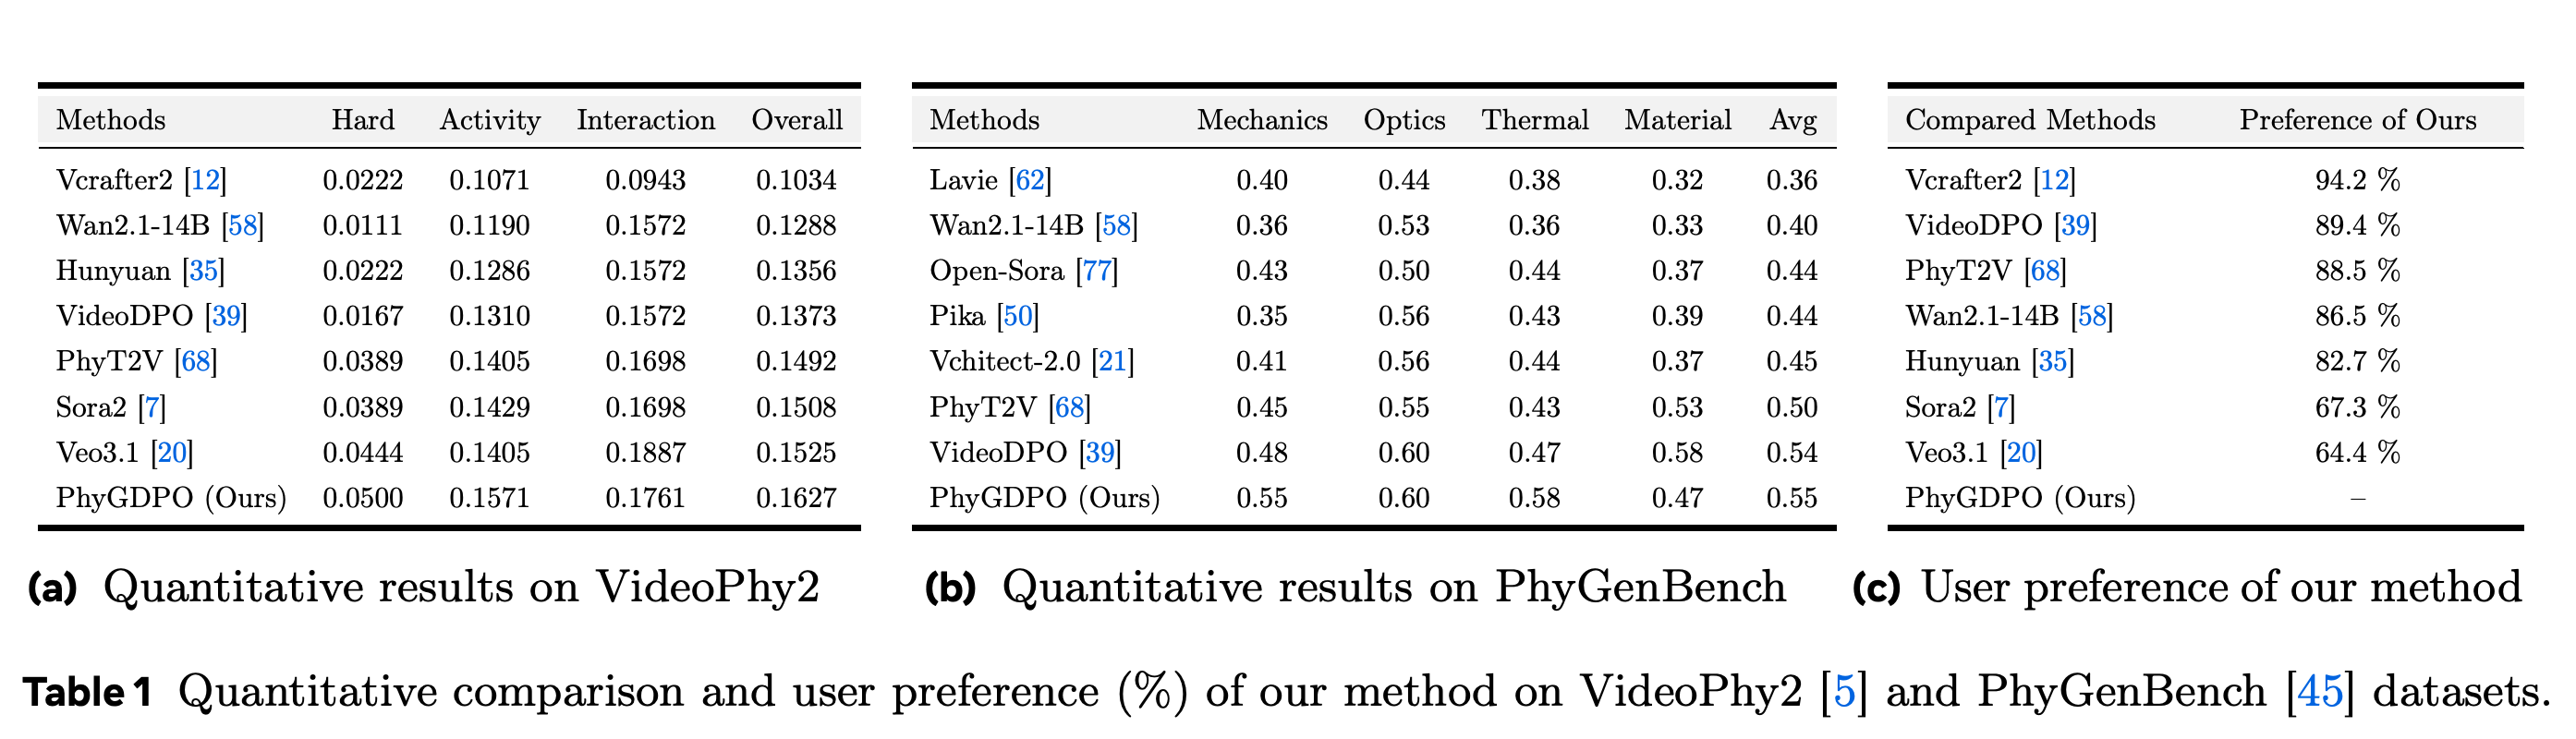
Table 1에서 PhyGDPO의 VideoPhy2 전체 점수는 0.1627로 가장 높다. Wan2.1-14B는 0.1288, VideoDPO는 0.1373, PhyT2V는 0.1492, Sora2는 0.1508, Veo3.1은 0.1525다. PhyGDPO의 어려운 행동 점수는 0.0500이지만 모든 평가 항목에서 선두는 아니다. Interaction에서는 Veo3.1이 0.1887로 PhyGDPO의 0.1761보다 높다.
- 어려운 행동 점수는 기본 모델의 0.0111의 약 4.5배다. 다만 두 평가 임계값을 모두 충족하는 절대 비율은 여전히 낮다.
- PhyGenBench에서 PhyGDPO는 Avg = 0.55로 VideoDPO의 0.54와 PhyT2V의 0.50보다 높다. Mechanics는 0.55, Thermal은 0.58로 선두이며, Optics는 0.60으로 VideoDPO와 같다. Material은 0.47로 VideoDPO의 0.58보다 낮다.
- 표는 전반적인 개선을 뒷받침한다. 다만 PhyGenBench 평균에서 VideoDPO에 대한 우위는 작고, 자동 벤치마크 점수에는 불확실성 추정치가 없다.
사용자 연구에는 104명이 참여하며, 각 참가자는 VideoPhy2의 24개 프롬프트와 PhyGenBench의 24개 프롬프트로 48회의 평가를 수행한다. 참가자는 물리 법칙을 더 잘 따르는 영상을 선택한다. 동일 프롬프트의 비교는 익명으로 진행하고 순서를 무작위로 배정한다. 논문이 보고한 95% 신뢰구간의 폭은 ±2.4%를 넘지 않는다.
- Table 1에서 PhyGDPO 선호율은 Vcrafter2 대비 94.2%, VideoDPO 대비 89.4%, PhyT2V 대비 88.5%, Wan2.1-14B 대비 86.5%, Hunyuan 대비 82.7%, Sora2 대비 67.3%, Veo3.1 대비 64.4%다.
- 사람의 판단은 단일 VLM 평가기와의 일치를 넘어, 사람이 느끼는 물리적 사실감의 개선을 뒷받침한다. 다만 물리적 추론을 시각적 일관성이나 다른 지각 단서와 분리하지는 않는다.
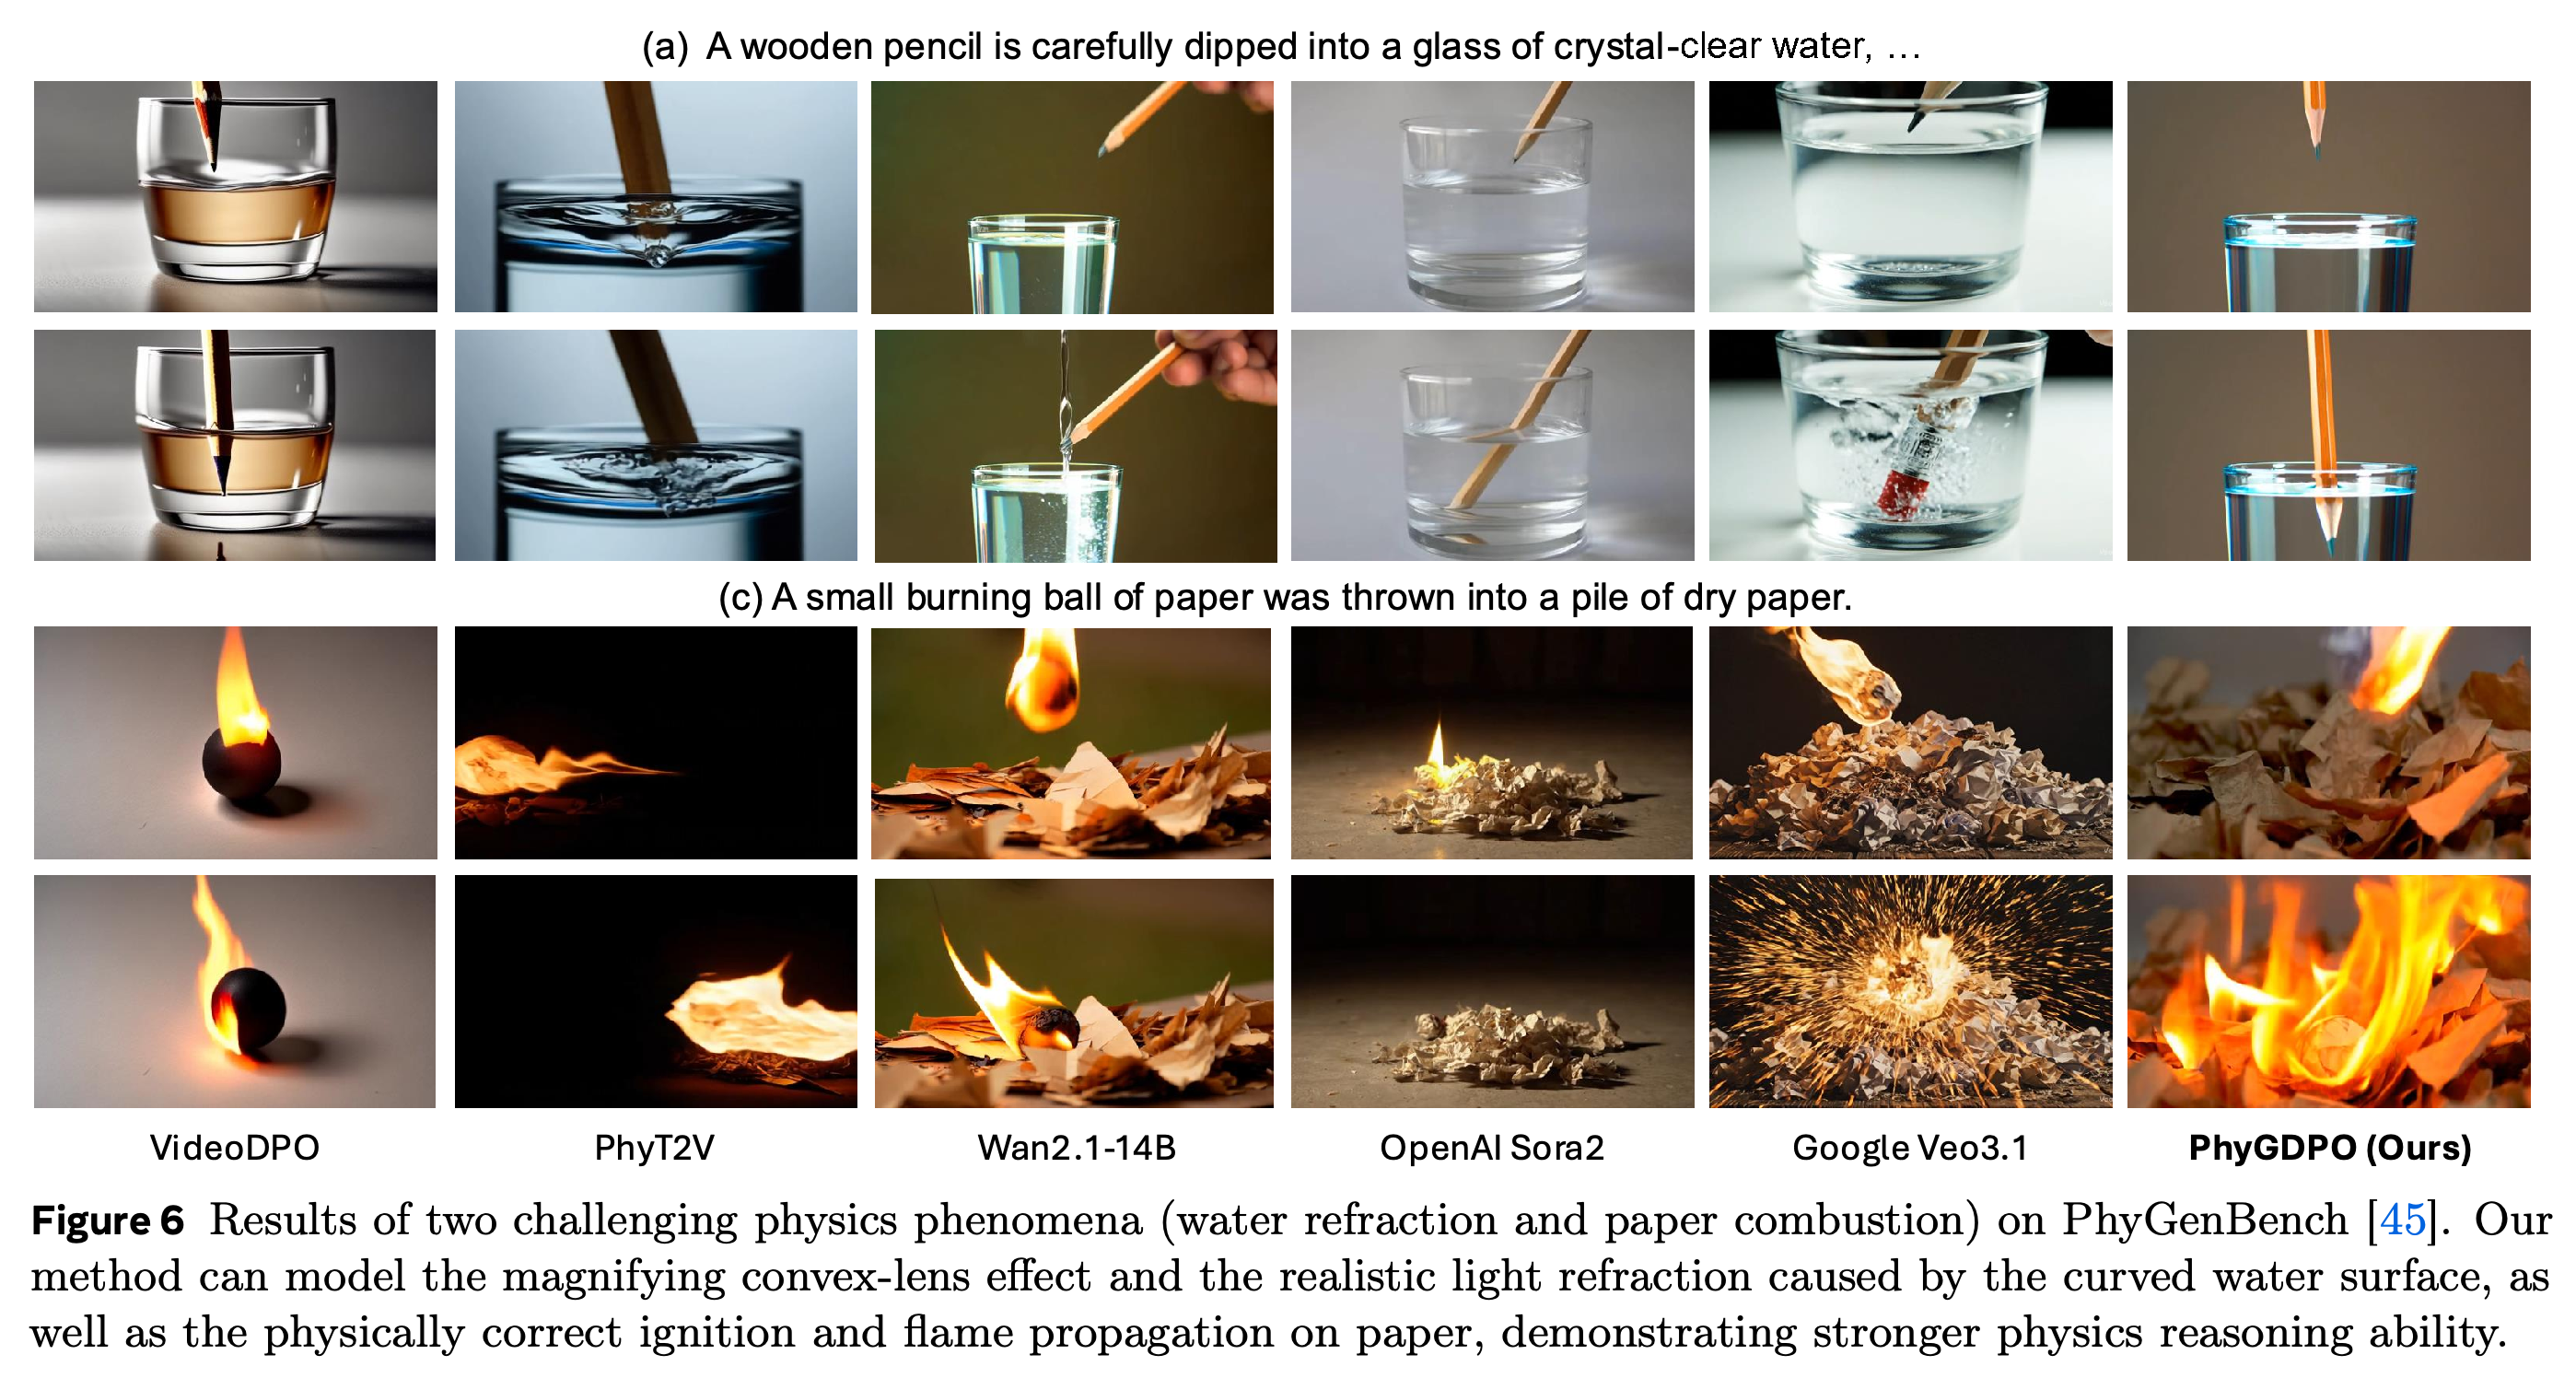
정성 비교는 사람의 행동, 물체 상호작용, 물리 현상을 다룬다. Figures 4와 5는 체조, 폴로, 스쿼시, 핸드스프링의 선별된 시퀀스를 보여 준다. Figure 6은 물의 굴절과 종이 연소로 비교 범위를 넓힌다.
- 예시들은 이미지 품질만이 아니라 신체 형태의 연속성, 도구나 팔다리와 물체 사이의 접촉, 개연성 있는 사건 진행을 강조한다.
- 제시된 프레임은 이러한 행동을 보여 주지만 시간에 따른 동역학을 온전히 입증할 수는 없다. 영상 결과는 https://caiyuanhao1998.github.io/project/PhyGDPO에서 확인할 수 있다.
체조는 어려운 동작 중 신체 형태의 연속성을 시험하고, 폴로는 기수, 말, 말렛, 공 사이의 협응을 시험한다. 선별된 PhyGDPO 프레임은 의도한 상호작용 개선을 보여 주지만, 그 빈도를 정량화하지는 않는다.
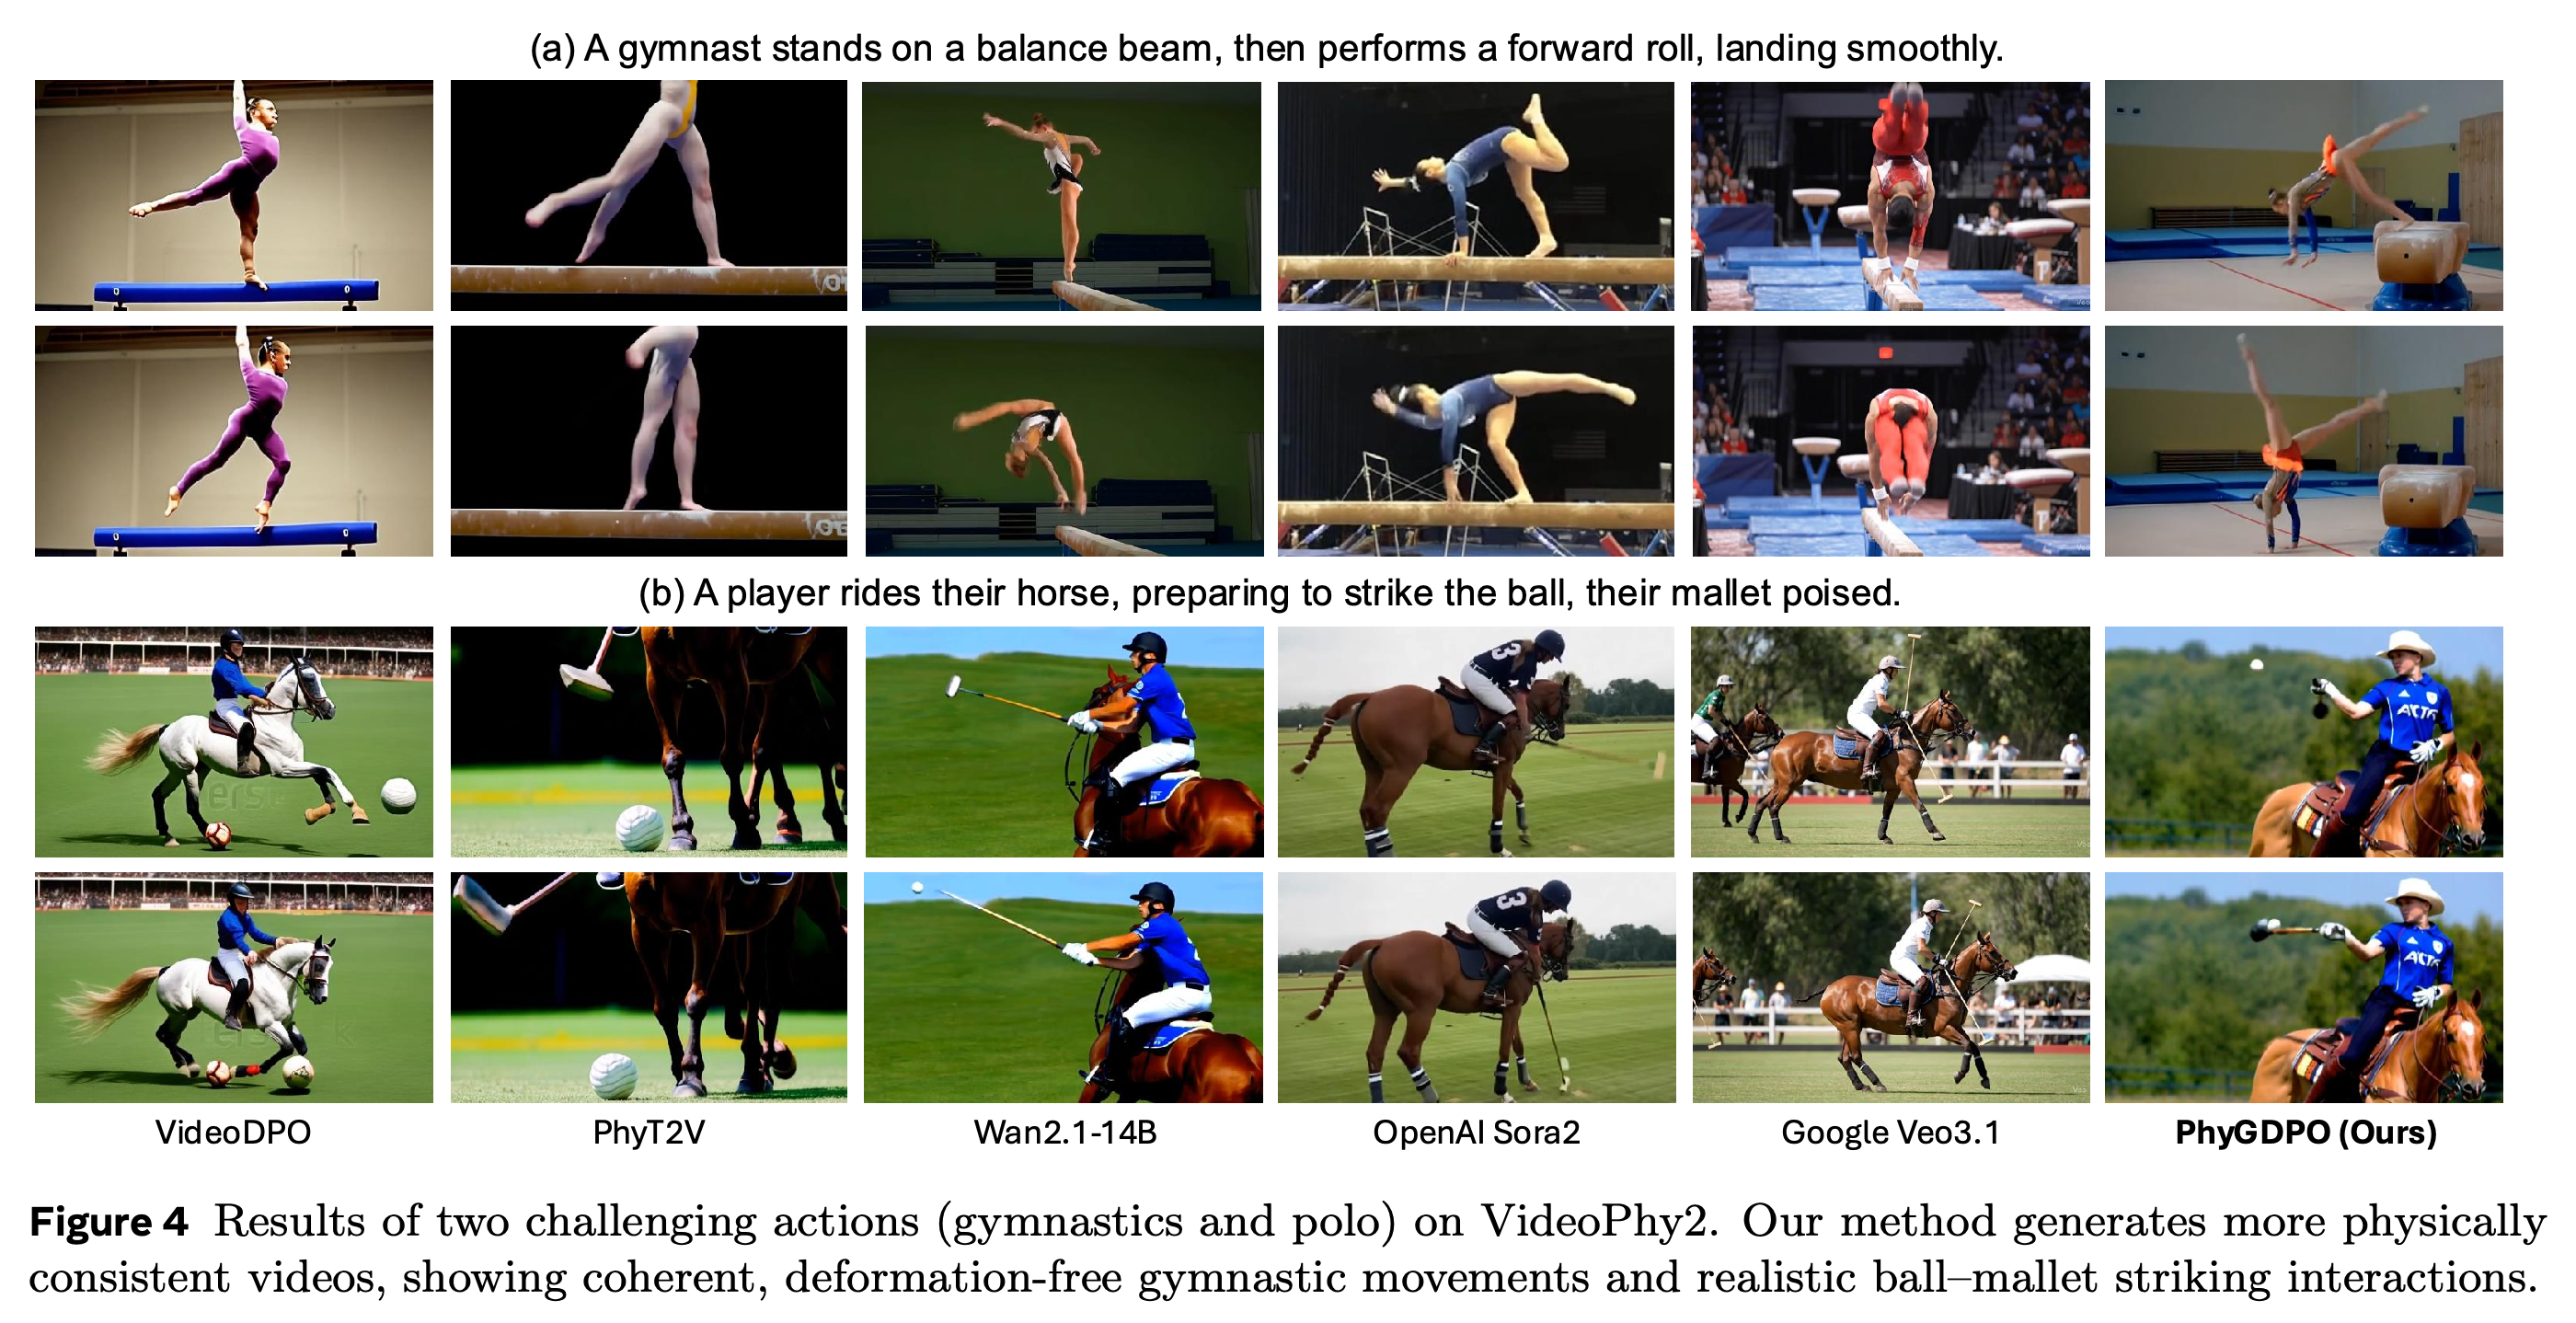
스쿼시 예시는 라켓-공 접촉에, 핸드스프링 예시는 플랫폼 주변에서의 조화로운 신체 움직임에 초점을 둔다. 사용자 입력 예시는 벤치마크 프롬프트 밖으로 정성 근거를 넓히지만, 체계적인 일반화 시험은 아니다.
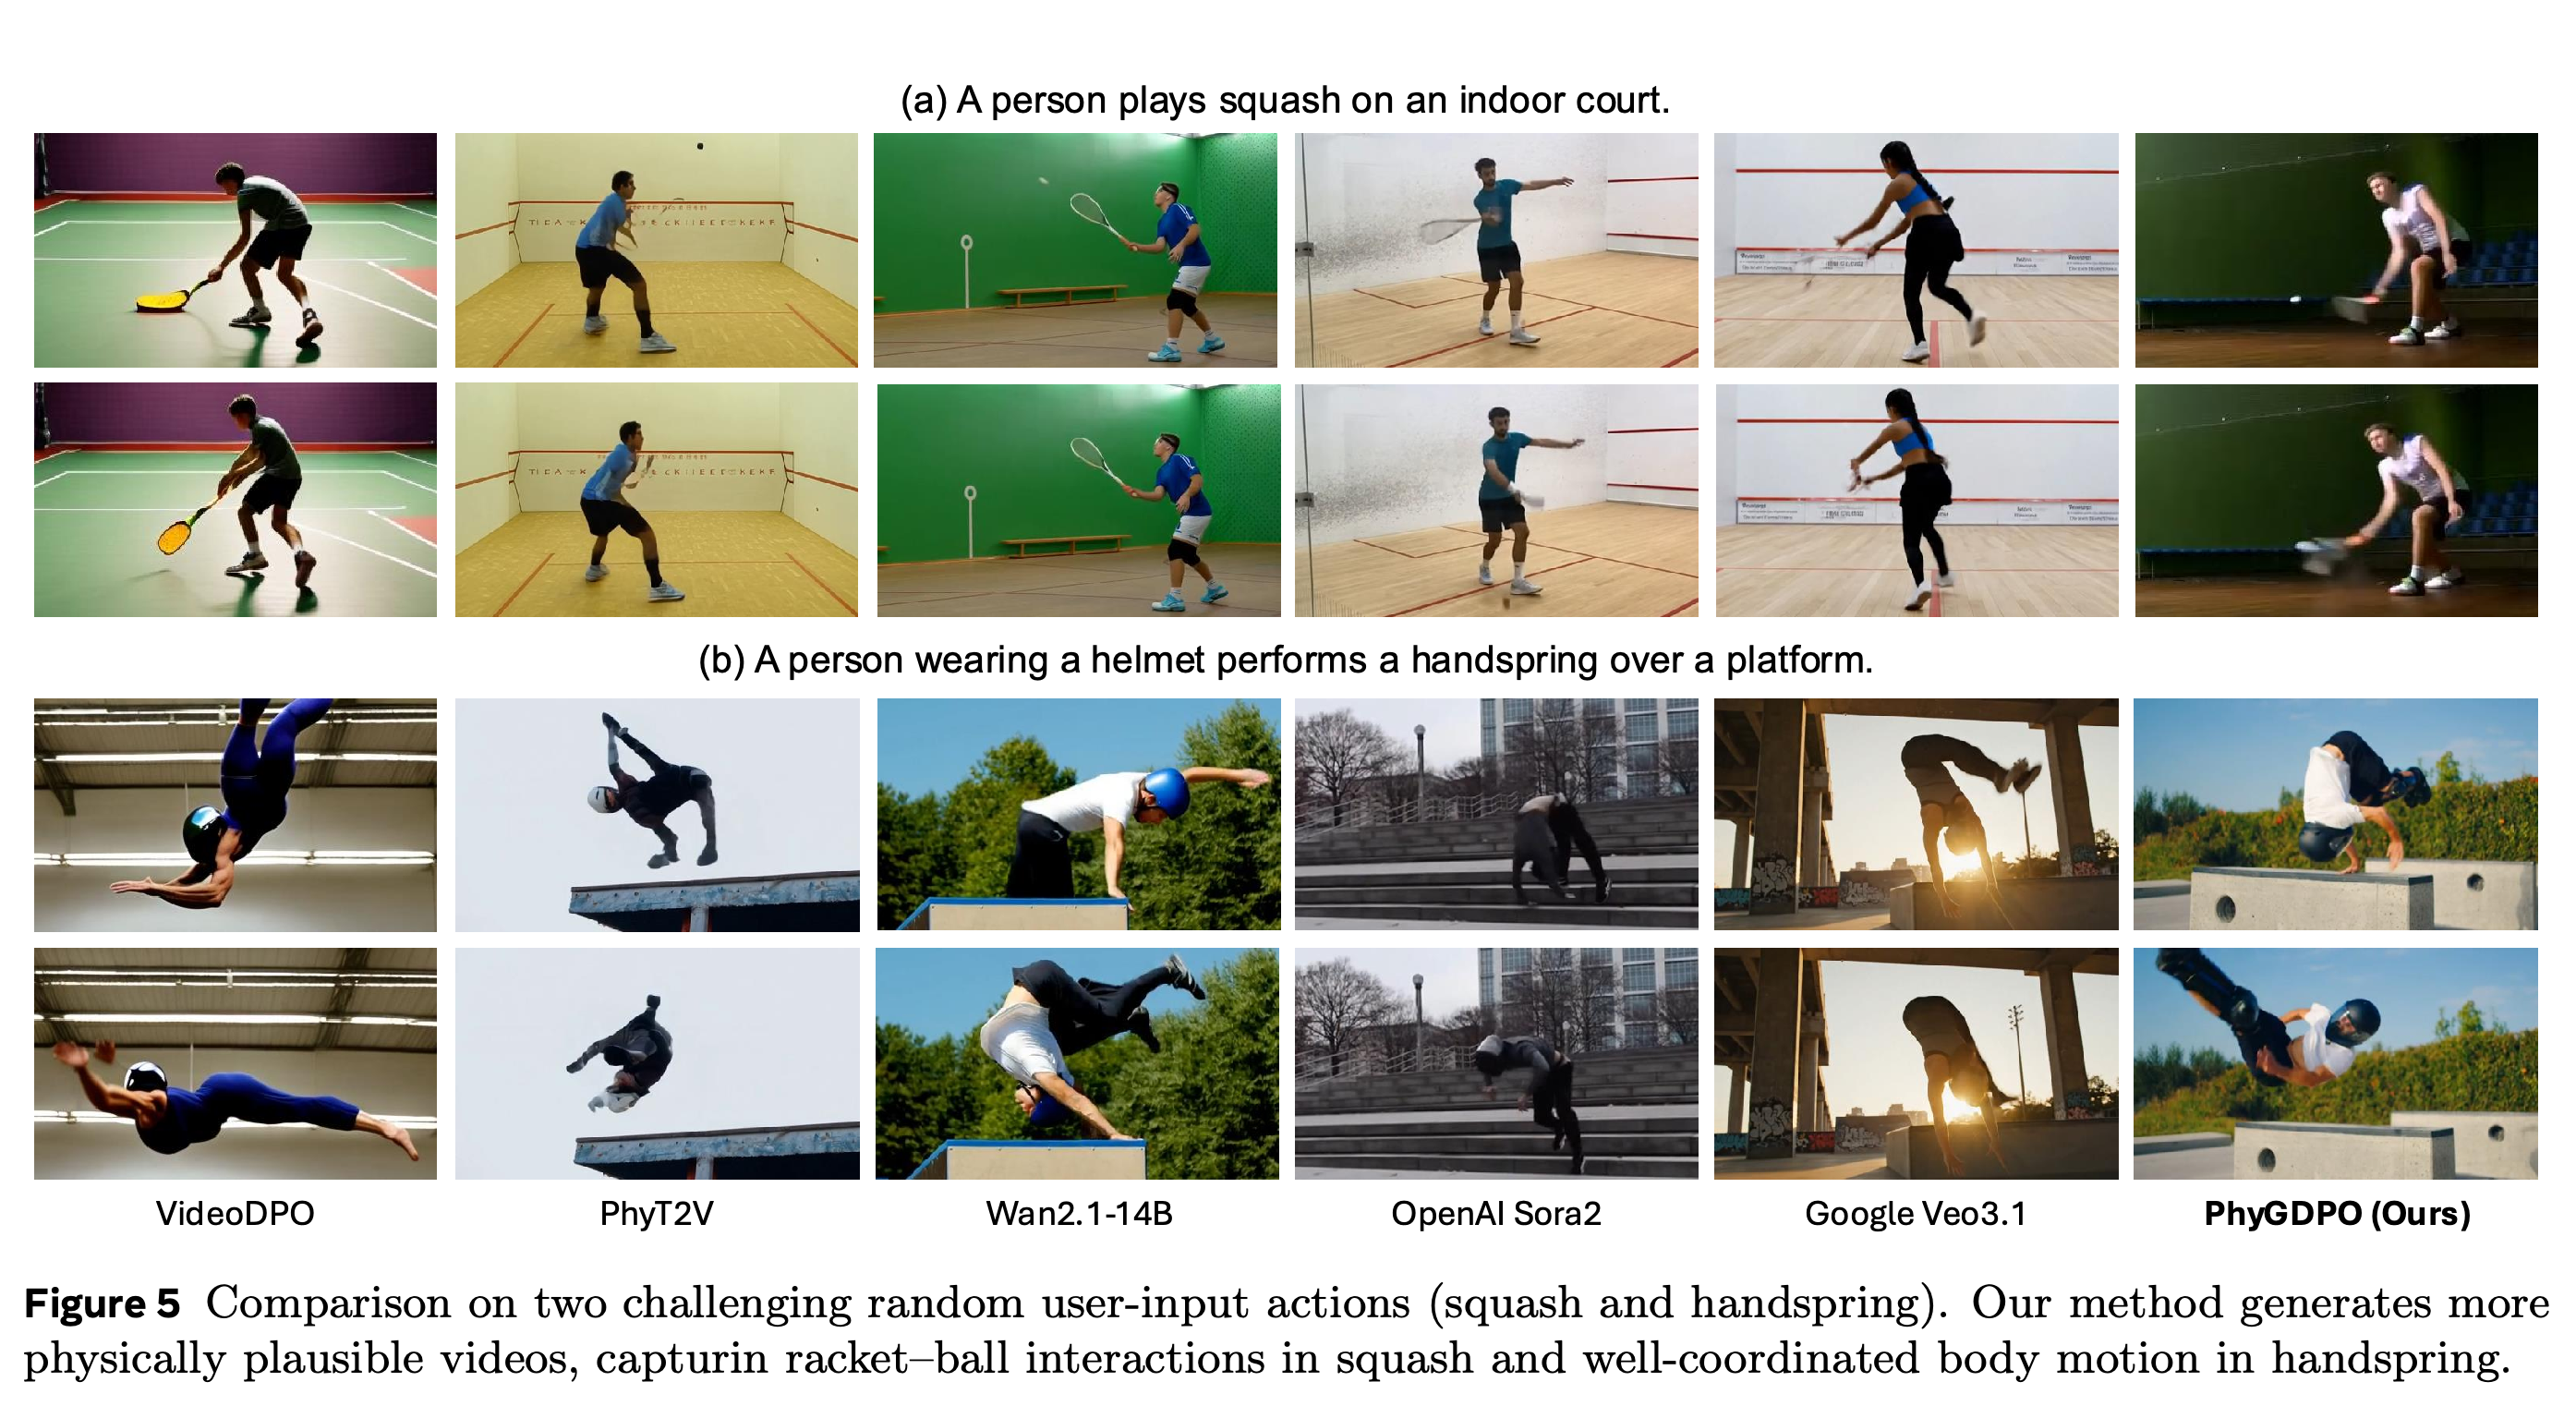
PhyGDPO는 보고된 전체 벤치마크 점수에서 선두이며, 나열된 모든 사람 대상 비교에서 더 높은 선호를 얻는다. 다만 영역별 결과는 주장의 범위를 제한한다. VideoPhy2 Interaction에서는 Veo3.1이, PhyGenBench Material에서는 VideoDPO가 선두다. PhyGenBench 평균에서 VideoDPO에 대한 우위는 0.01에 불과하다.
예시들은 연필이 물에 들어갈 때의 광학적 외관 변화와 불타는 종이가 마른 종이에 닿을 때의 사건 진행을 시험한다. 저자들이 주장하는 굴절과 화염 전파의 개선을 보여 주지만, 광학이나 연소를 정량적으로 측정하지는 않는다.
3.2 Ablation Study
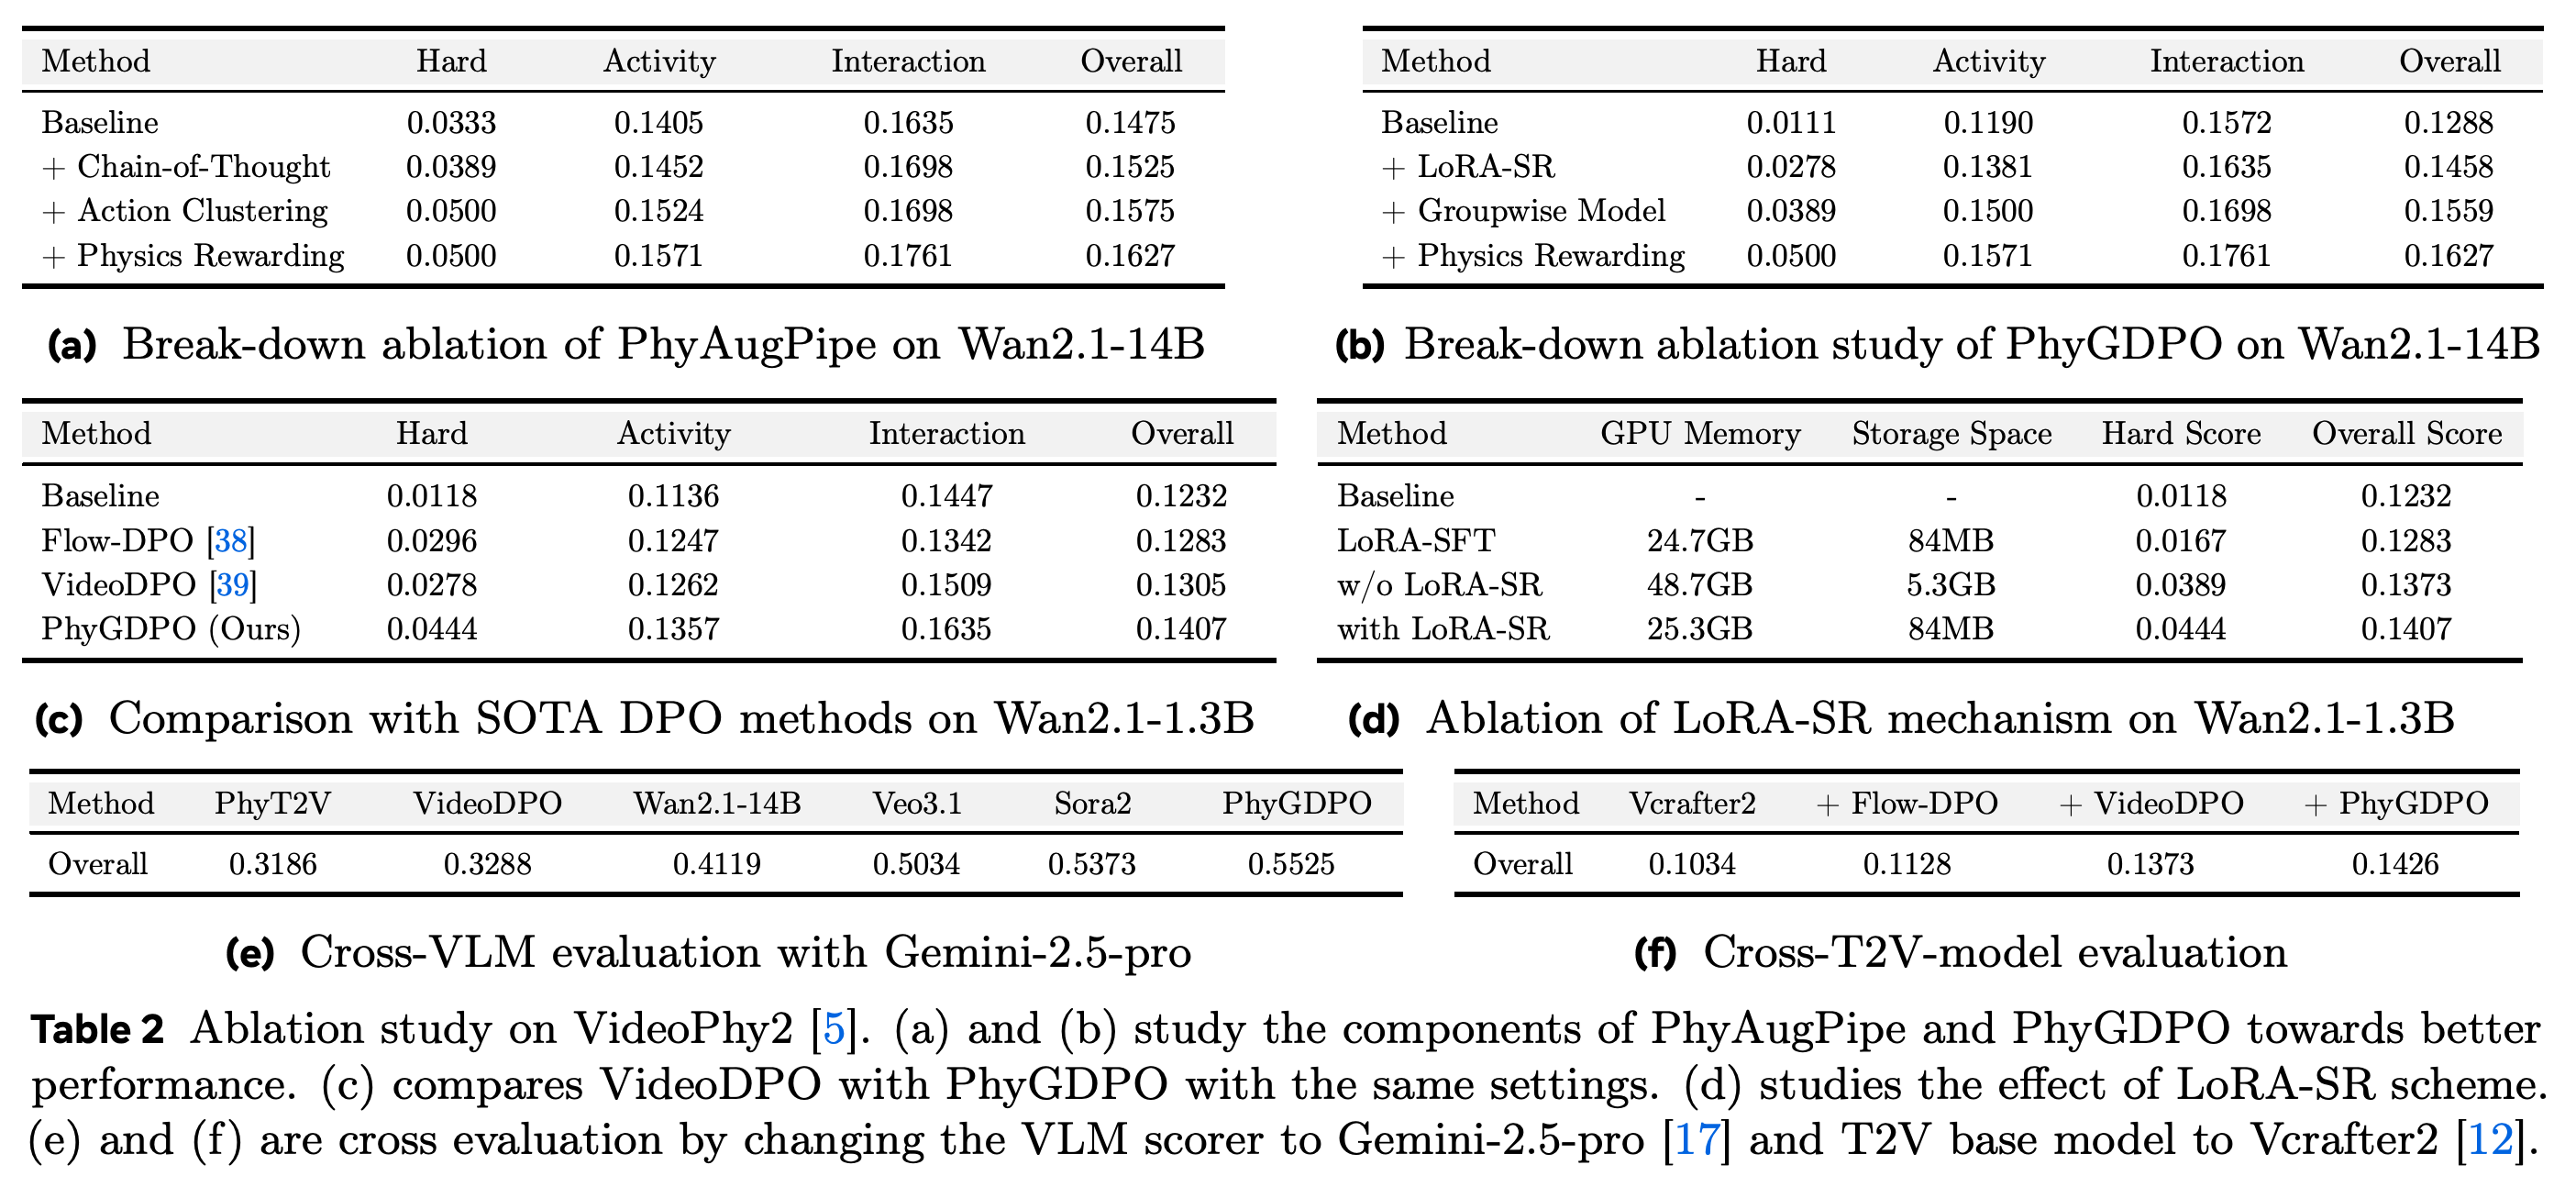
Table 2a는 선택한 학습 예시 수를 고정하고, 무작위 데이터로 PhyGDPO를 학습한 기준선에 CoT 필터링, 행동 군집화, 보상 기반 표본추출을 차례로 추가한다. VideoPhy2 전체 점수는 0.1475에서 0.1525, 0.1575, 0.1627로 오른다. 어려운 행동 점수는 0.0333에서 0.0500으로 오른다.
- 이 비교는 데이터셋 크기뿐 아니라 데이터 선별과 할당도 유용하다는 점을 뒷받침한다.
- 누적 방식의 제거 실험이므로, 모든 구성요소 간 상호작용을 평가하지는 않는다. 각 구성요소가 직전 구성에 더하는 기여를 측정한다.
Table 2b는 Wan2.1-14B에 LoRA-SR, 그룹 단위 모델링, 물리 보상을 차례로 추가한다. 전체 점수는 0.1288에서 0.1458, 0.1559, 0.1627로 오른다. Figure 7은 테니스공이 비현실적으로 가라앉거나 튀지 않고 더 안정적으로 떠 있는 예시로 이 변화를 보여 준다.
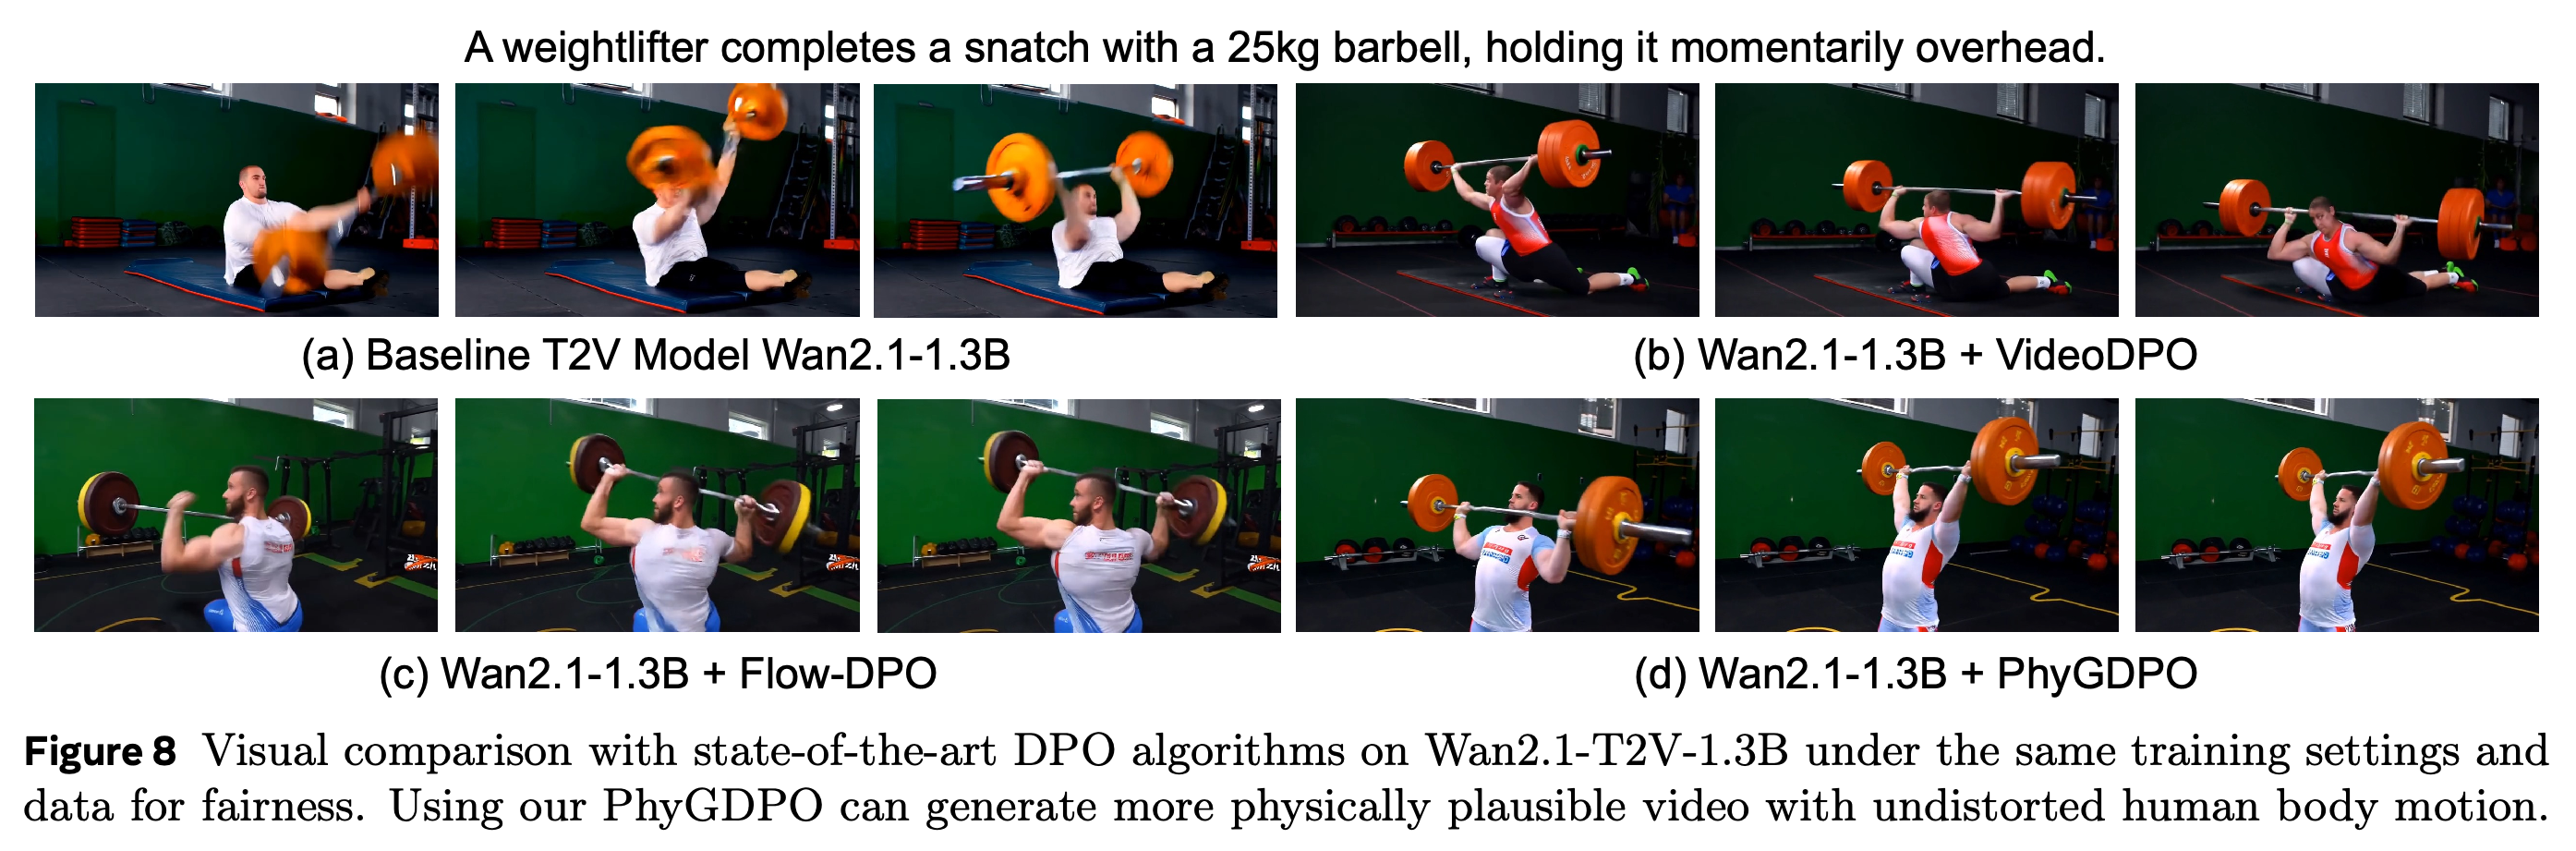
- Wan2.1-1.3B에서 동일한 데이터와 학습 설정을 사용한 Table 2c의 전체 점수는 Flow-DPO가 0.1283, VideoDPO가 0.1305, PhyGDPO가 0.1407이다.
- 어려운 행동 점수는 각각 0.0296, 0.0278, 0.0444다. Figure 8은 25kg 바벨을 명시한 프롬프트의 선별된 역도 예시로 이 비교를 보여 준다.
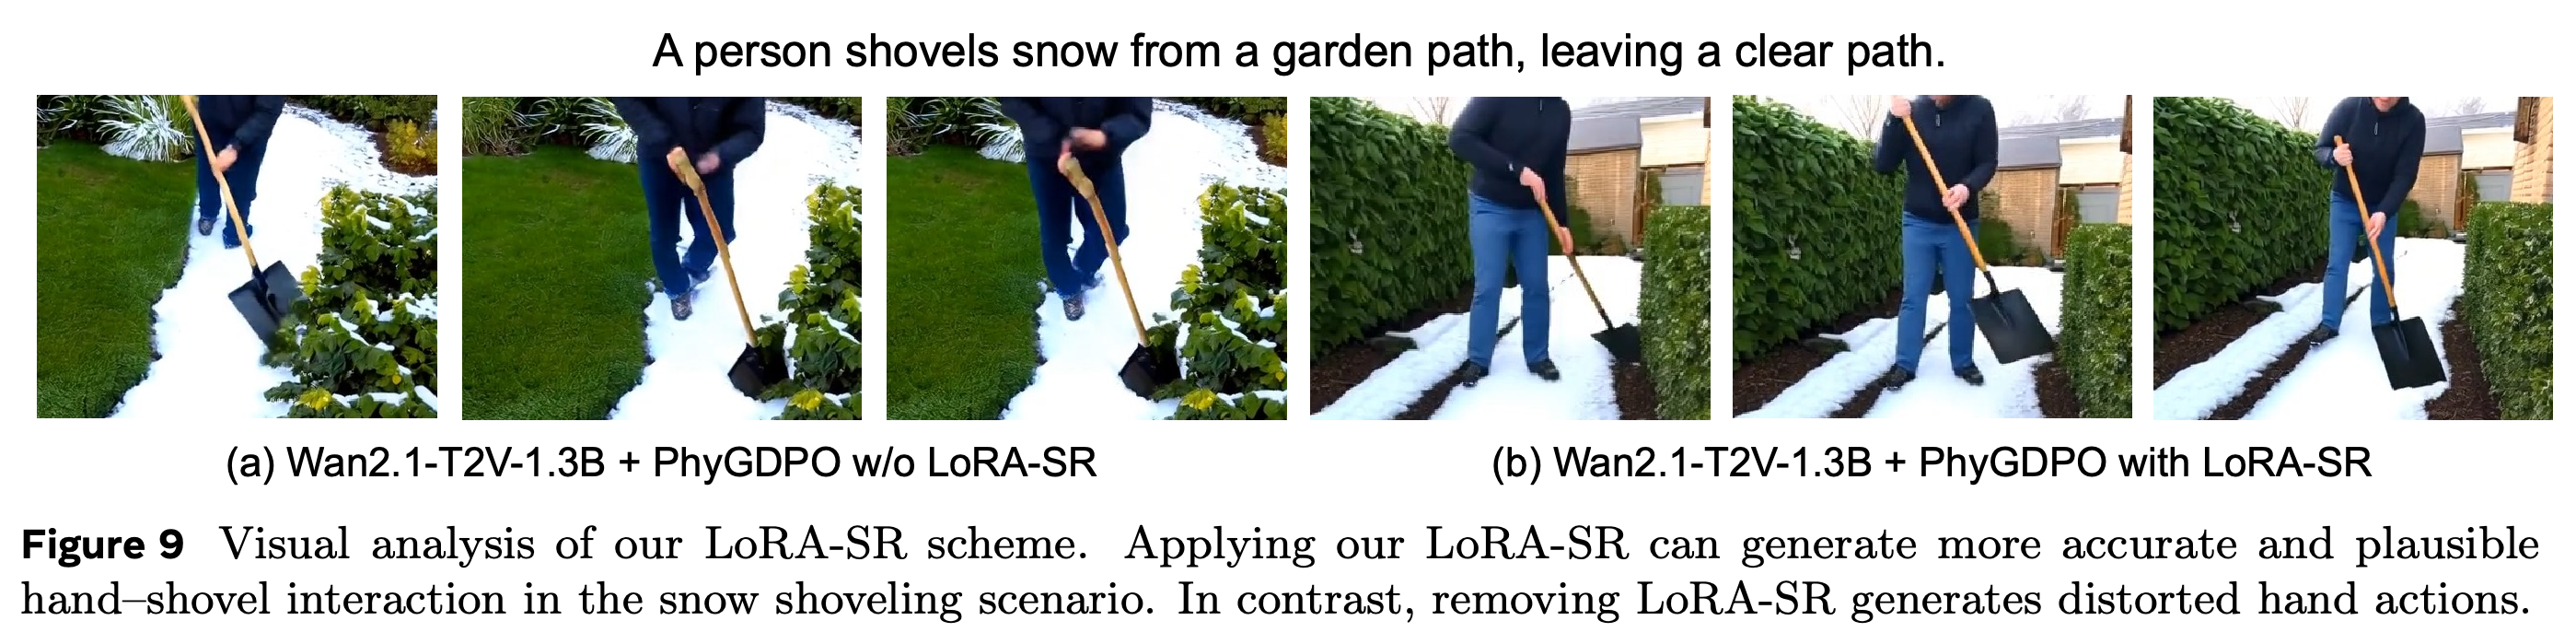
Table 2d에서 Wan2.1-1.3B에 LoRA-SR을 적용하면 GPU 메모리는 48.7GB에서 25.3GB로, 가중치 저장 용량은 5.3GB에서 84MB로 줄어든다. 전체 점수는 0.1373에서 0.1407로 오른다. Figure 9는 눈을 삽으로 치우는 예시에서 개선된 손-삽 상호작용을 보여 준다.
- LoRA-SFT는 24.7GB와 84MB를 사용하지만 전체 점수는 0.1283, 어려운 행동 점수는 0.0167에 그친다. PhyGDPO는 각각 0.1407과 0.0444다.
- 본문은 메모리가 44% 감소했다고 주장하지만, 표에 제시된 48.7GB와 25.3GB에 맞지 않는다. 표의 절대값이 더 명확한 근거다.
- LoRA-SR 적용 여부를 비교할 때 참조 모델 저장 방식뿐 아니라 갱신 매개변수화도 달라진다. 따라서 성능 차이를 참조 모드 전환만의 효과로 볼 수 없다.
평가 모델이나 생성 모델을 바꾼 교차 평가에서도 이 방법은 전반적인 우위를 유지한다. Table 2e의 Gemini-2.5-pro 전체 점수는 PhyGDPO가 0.5525, Sora2가 0.5373, Veo3.1이 0.5034다. Table 2f에서는 Vcrafter2 + PhyGDPO가 0.1426, Vcrafter2 + VideoDPO가 0.1373이다.
- 다른 평가기를 사용한 결과는 개선이 VideoPhy2-AutoRater에만 국한되지 않음을 뒷받침한다. 다만 두 평가 모두 VLM 판단에 의존한다.
- 설정을 맞춘 Vcrafter2 실험은 주요 Wan2.1 백본 이외에도 적용할 수 있음을 뒷받침한다. Table 2는 데이터, 목적함수, 효율성 제거 실험과 함께 이러한 교차 평가를 정리한다.
6개 패널은 데이터 선별, 누적 목적함수 변경, 설정을 맞춘 DPO 비교, 어댑터 효율성, 대체 평가기, 다른 백본을 평가한다. 가장 명확한 효율성 근거는 GPU 메모리가 48.7GB에서 25.3GB로, 저장 공간이 5.3GB에서 84MB로 바뀐 절대값이다.
테니스공 시퀀스는 누적 제거 실험을 보여 준다. 전체 방법은 공이 가라앉거나 과도하게 튀는 구성보다 수면에서 더 안정적으로 떠 있는 모습을 보인다. 이는 부력과 관련된 행동을 묘사하지만 부력을 측정하지는 않는다.
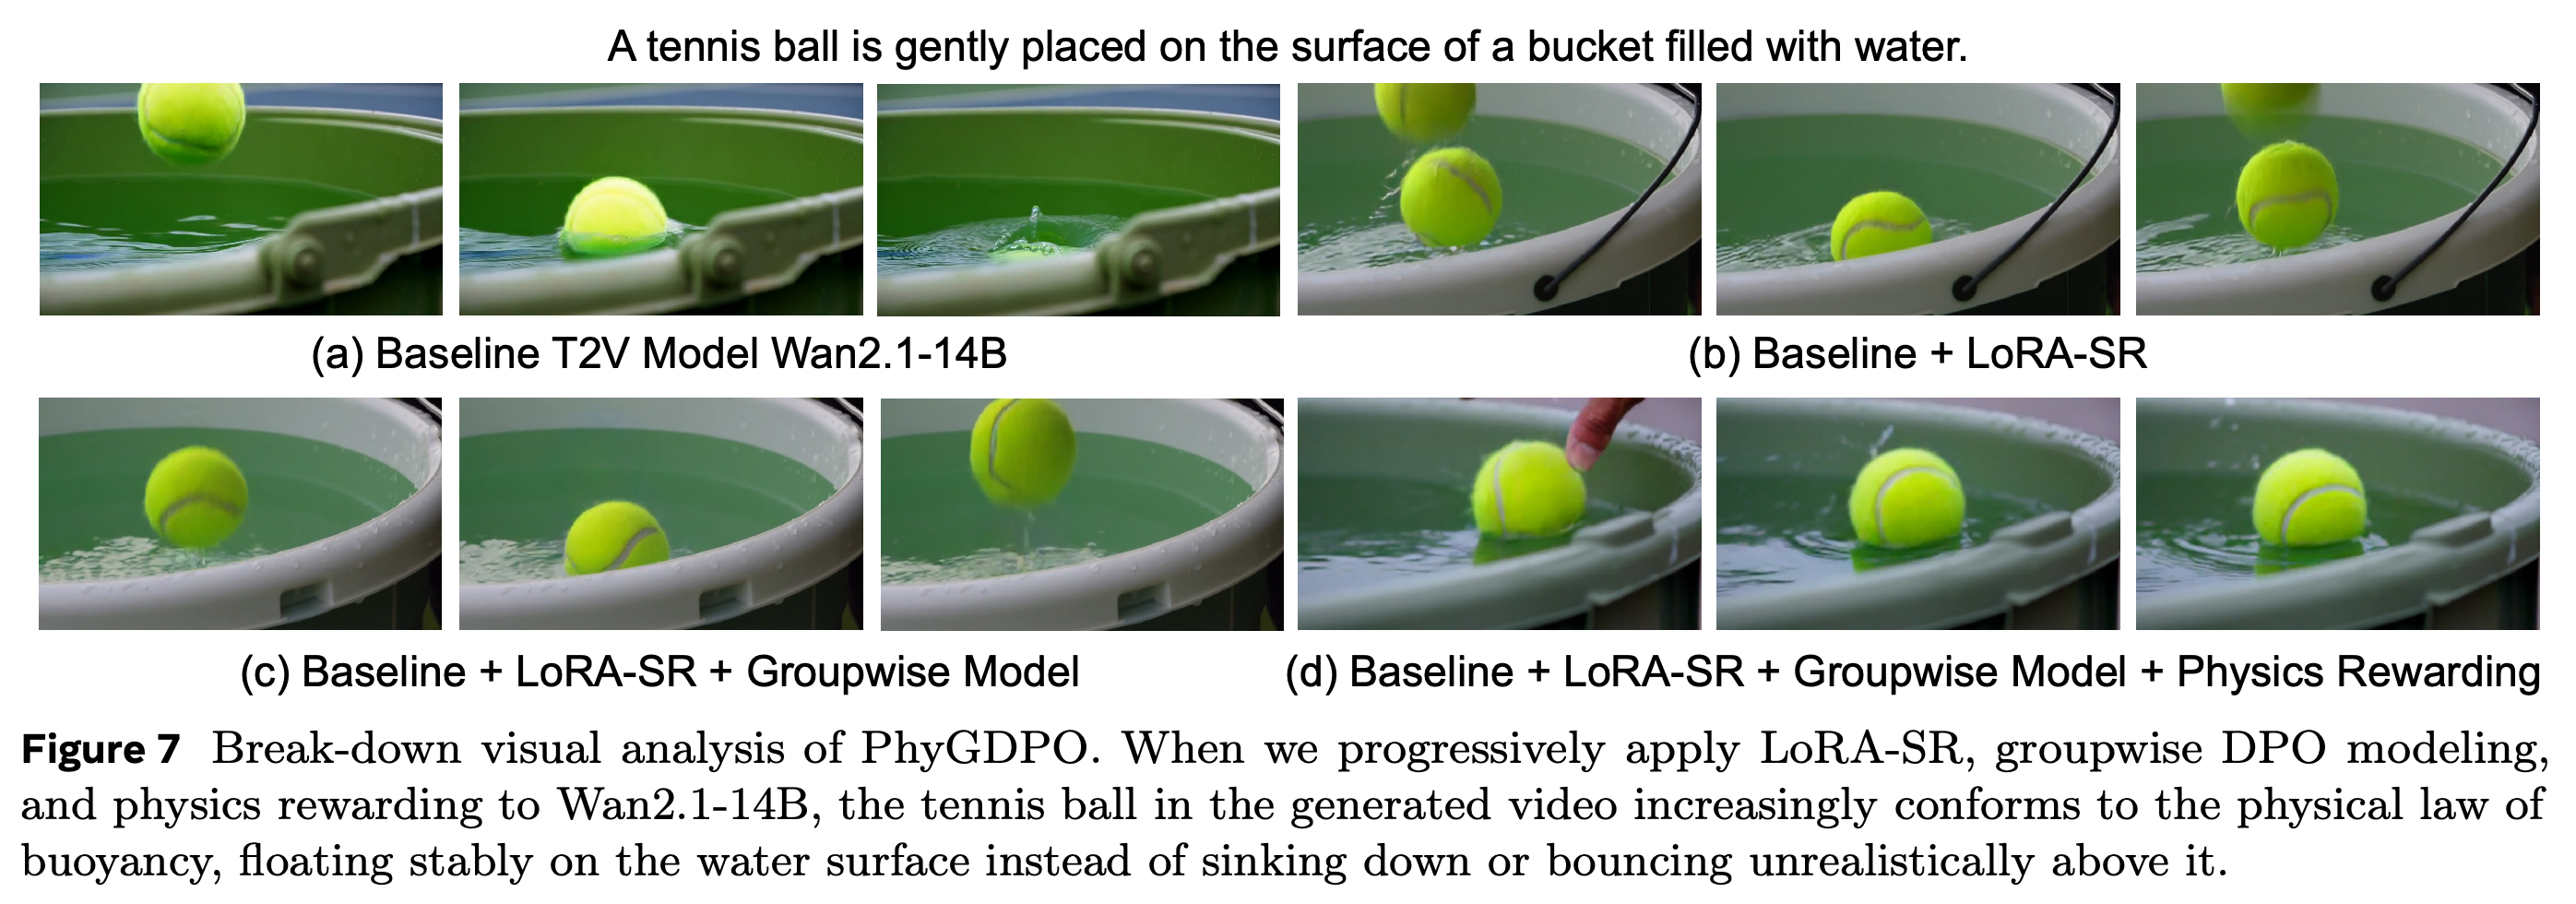
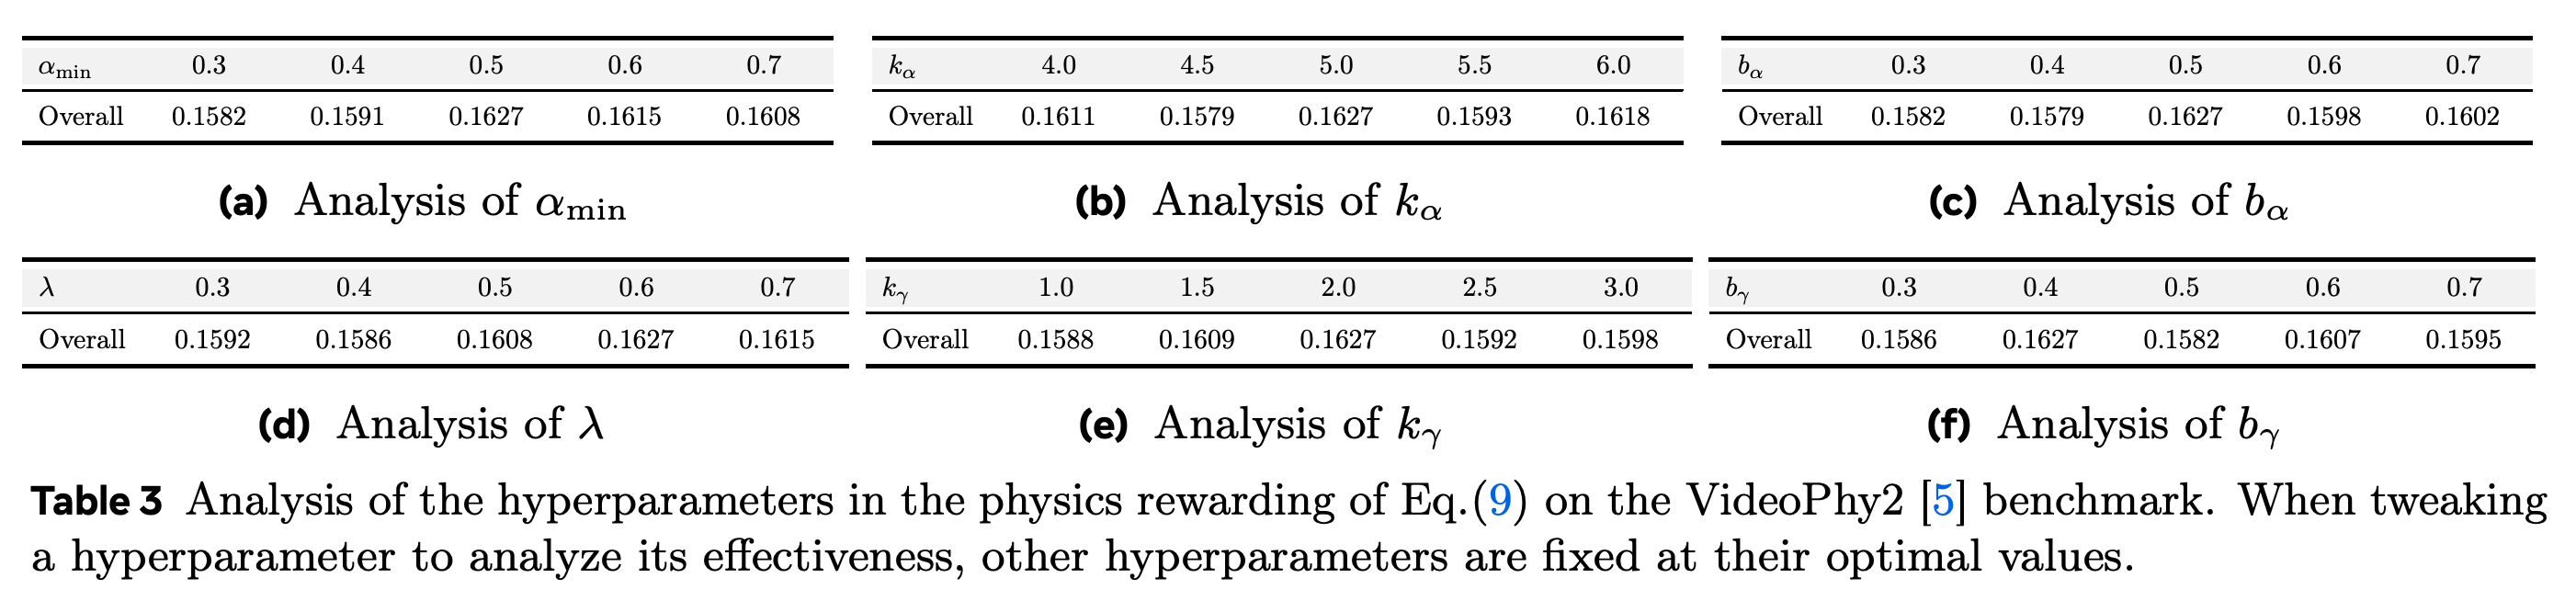
Table 3은 다른 PGR 하이퍼파라미터를 선택한 값으로 고정하고, 한 번에 1개씩 바꾼다. 보고된 최선의 설정은 αmin = 0.5, kα = 5.0, bα = 0.5, λ = 0.6, kγ = 2.0, bγ = 0.4이며, 전체 점수는 0.1627이다.
- 시험한 전체 점수 범위는 0.1579~0.1627이며, 모두 Table 2a에서 보상 기반 데이터 표본추출을 제외한 구성의 0.1575보다 높다. 이 비교는 최적화 단계의 PGR만을 분리하지 않는다. 해당 요소의 누적 제거 실험은 Table 2b에 제시된다.
- 이 표는 국소적인 민감도 근거를 제공한다. 하이퍼파라미터를 함께 탐색하거나 작은 점수 차이의 불확실성을 분석한 결과는 아니다.
각 패널은 선택한 구성 주변에서 보상 매개변수를 1개씩 바꾼다. 제시된 모든 점수는 0.1575보다 높지만, 작은 차이에 대한 불확실성 추정치는 없다. 따라서 이 표는 정확한 매개변수 최적성보다는 국소적인 민감도 평가를 뒷받침한다.
동일한 Wan2.1-T2V-1.3B 백본, 학습 데이터, 설정을 사용하므로 폐쇄형 모델 비교보다 더 통제된 예시다. PhyGDPO 시퀀스는 머리 위로 들어 올리는 동작을 더 일관되게 보여 준다. 다만 명시된 25kg 하중을 시각 평가로 물리적으로 검증하지는 않는다.
적용 여부 비교는 눈을 치우는 동안의 손 형태와 삽 접촉을 강조한다. LoRA-SR 학습 구성의 정성적 이점을 보여 주지만, 참조 공유와 갱신을 어댑터로 제한하는 효과를 분리할 수는 없다.
4 Related Work
관련 연구 절은 text-to-video 모델링과 선호 최적화를 다룬다. PhyGDPO를 실제 영상의 선호 감독으로 물리적 개연성을 높이는 사후 학습 방법으로 설명하며, 추론 시 프롬프트 확장이 필요하지 않다는 점을 강조한다.
4.1 Text-to-Video Generation Models
논문은 diffusion 잡음이나 flow-matching 속도장을 예측하는 Transformer 기반 영상 생성 모델을 검토한다. 물리 법칙과 현상에 대한 LLM 생성 설명을 반복 생성이나 미세 조정에 사용하는 DiffPhy 및 PhyT2V와 PhyGDPO를 대비한다.
- PhyGDPO도 데이터 준비 중에는 VLM 추론을 사용한다. 다만 학습에는 원래 프롬프트를 유지하고, 추론 시에는 프롬프트 확장을 요구하지 않는다.
- 실험은 생성 결과를 측정한다. 모델이 내부적으로 물리 추론 과정을 습득했는지를 직접 시험하지는 않는다.
4.2 Direct Preference Optimization
DPO 논의는 언어 모델의 선호 정렬에서 이미지용 DiffusionDPO와 영상용 VideoDPO로 이어지는 발전을 살펴본다. PhyGDPO는 주로 미적 선호를 정렬하는 대신 물리적 개연성, 실제 영상 승자, 그룹 단위 목적함수에서 도출한 감독, 공유 백본 참조 모델을 강조한다.
- 통제된 방법 비교에서는 Wan2.1-1.3B에 동일한 학습 데이터와 설정을 적용해 Flow-DPO, VideoDPO, PhyGDPO를 비교한다.
- LoRA-SR 제거 실험은 평가한 구성에서 메모리 절감 주장을 뒷받침한다. 모든 기존 DPO 구현이 전체 모델 복제를 요구한다는 근거는 아니다.
5 Conclusion
결론은 PhyAugPipe, PhyVidGen-135K, PGR과 LoRA-SR을 포함한 PhyGDPO를 물리적으로 일관된 영상 생성을 위한 통합 사후 학습 방법으로 제시한다. 실험은 추론 시 LLM 프롬프트 확장 없이 벤치마크 점수와 사람의 선호가 개선되었다고 보고한다. 보고된 학습에는 재표본추출한 17K 쌍을 사용한다.
부록
- Mathematical proof for Ineq. (8)은 부록 제목의 번호와 달리 본문의 Eq. (7)에 해당하는 곱 부등식을 증명한다. 0 < αj ≤ 1에서 t의 αj승이 오목하므로 (u + v)αj ≤ uαj + vαj가 성립한다. u = 1, v = exp(xj)를 대입하고 γj ≥ 1/αj를 적용하면 각 exp(xj)의 상한을 음이 아닌 aj로 구할 수 있다. Πj(1 + aj)를 전개하면 음이 아닌 고차항만 추가되므로 그룹 단위 식을 쌍별 항으로 바꾸는 상한이 성립한다.
짧은 생각
가장 강한 근거는 물리 중심 데이터 선별, 실제 영상과 생성 영상 사이의 선호 감독, 메모리 효율적인 적응을 결합한 결과에서 나온다. 설정을 맞춘 Flow-DPO 및 VideoDPO 비교, 사람의 선호, 별도의 VLM 평가기는 선별된 정성 예시만 제시하는 것보다 설득력 있는 근거를 제공한다.
해석의 핵심 한계는 물리적 개연성의 개선과 물리 학습의 보장 사이에 차이가 있다는 점이다. 실제 촬영 영상은 물리적으로 근거 있는 관측을 제공하지만, 생성 영상보다 이를 선호하도록 학습하면 외관, 촬영 특성, 프롬프트 적합성에도 보상을 줄 수 있다. 평가는 이러한 신호를 분리하지 않으며, 정량 측정으로 물리 법칙을 시험하지도 않는다. 어려운 사례는 여전히 해결되지 않는다. 어려운 행동 출력 중 VideoPhy2의 두 임계값을 모두 만족하는 비율은 0.0500에 불과하다. VideoPhy2 Interaction과 PhyGenBench Material에서는 경쟁 방법보다 낮은 점수를 보인다. 그룹 크기 m의 구체적인 수치가 없어 재현성에 한계가 있다. 메모리 감소율이 표와 맞지 않고, Figures 7과 8의 예시를 본문에서 Figure 9로 지칭하는 등 보고에도 불일치가 있다. 사용자 연구 절차는 기준선 8개를 언급하지만 Table 1c에는 경쟁 방법 7개가 나열된다. 48회의 평가에서 기준선을 반복 선택하지 않는다는 설명도 불명확하다. 비교 배정을 명확히 하면 근거를 더 쉽게 검토할 수 있다.