


RbtAct: Rebuttal as Supervision for Actionable Review Feedback Generation 요약 설명
10 Mar 2026 | Paper Review Peer Review Generation Direct Preference Optimization Supervised Fine-Tuning목차
- 요약
- 1 Introduction
- 2 Related Work
- 3 Review and Rebuttal Mapping
- 4 Methodology
- 5 Experiments
- 6 Conclusion
- Limitations
- 부록
- 짧은 생각
이번 글에서는 RbtAct: Rebuttal as Supervision for Actionable Review Feedback Generation 논문의 핵심 포인트만 간단히 정리한다.
- 2026년 3월 10일(Arxiv)
- Wu, Sihong, Ma, Yiling, Zhao, Yilun, Hu, Tiansheng, Jiang, Owen, Patwardhan, Manasi, Cohan, Arman.
- Yale University, New York University, TCS Research
- 논문 링크
- Github
요약
- RBTACT는 관점 조건부 세그먼트 단위 리뷰 피드백 생성을 목표로 한다. 논문과 요청된 관점을 입력받아 초점이 명확한 약점이나 질문 1개를 생성한다. 학습 신호는 저자의 rebuttal에서 얻는다. 수정했다고 보고한 응답과 연결된 코멘트를 계획, 모호한 약속, 방어, 회피와 연결된 코멘트와 구분한다.
- 저자들은 ICLR 2024 논문 4,825편에서 리뷰–rebuttal 매핑 75,542개를 수집해 RMR-75K를 구축한다. 지도학습 예제 13,300개로 Llama-3.1-8B-Instruct를 학습한 뒤, 같은 논문과 관점 안에서만 구성한 선호 쌍 21,822개로 Direct Preference Optimization을 수행한다. 지도학습에 대해서는 이 글을 참조하라.
- ICLR 2025 평가 데이터에서 RBTACT는 평균 Actionability 점수가 가장 높다. 인간 평가에서는 3.46/5, GPT-5-chat 평가에서는 3.38/5를 기록한다. 보고된 인간 평가의 대응 검정은 SFT-only 대비 개선을 뒷받침하지만 GPT-5-chat 대비 개선은 뒷받침하지 않는다. 저자의 수정 수용 여부는 실행 가능하고 과학적으로 가치 있는 피드백을 측정하는 불완전한 대리 지표다.
1 Introduction
이 논문은 유창한 AI 생성 리뷰에서도 원고를 개선할 구체적인 절차가 부족할 수 있다는 문제를 다룬다. RBTACT는 여러 내용이 섞인 전체 리뷰를 하나의 학습 단위로 삼지 않는다. 대신 개별 약점과 질문을 분리하고, 각 코멘트에 대한 저자 응답과 연결한다.
- Rebuttal은 생성된 코멘트에 대한 명시적인 인간 순위가 아니라, 저자가 보고한 수정 수용 여부를 바탕으로 암묵적인 선호를 제공한다.
- 관점 조건화는 Experiments와 Writing 같은 논점을 구분해 초점이 명확한 정렬과 평가를 지원한다.
- 주요 기여는 세그먼트 생성 과제, 레이블이 부여된 리뷰–rebuttal 데이터셋, SFT-to-DPO 학습 파이프라인이다.
2 Related Work
관련 연구는 동료 심사 데이터셋과 피드백 생성 방법으로 나누어 다룬다. RBTACT는 rebuttal을 수집하거나 담화를 분석하는 데서 더 나아가, 저자 응답을 생성 모델의 학습에 활용한다.
Peer Review Datasets.
PeerRead와 NLPeer는 원고와 리뷰를 수집하며, ReviewMT, Review-5K, DeepReview-13K는 리뷰어 모델 학습을 지원한다. Rebuttal을 포함하는 자료로는 PRRCA, MOPRD, Re2, DISAPERE, JitsuPeer가 있다. RMR-75K는 이와 달리 피드백 생성을 위한 관점 및 영향 레이블과 함께 대규모 항목별 정렬을 제공한다.
- DISAPERE는 문장 단위 담화 주석이 달린 리뷰–rebuttal 쌍 506개를 포함하며, 주석 단위와 규모 모두 RMR-75K와 다르다.
- ARIES는 코멘트를 원고 수정 내용과 연결한다. 반면 RBTACT는 코멘트를 rebuttal 구간과 연결하고 응답 범주에서 학습 선호를 도출한다.
Review Generation.
기존 리뷰 생성 시스템은 구체성을 높이기 위해 프롬프팅, 파인튜닝, 구조화된 파이프라인, 다중 에이전트 협업을 활용한다. ReAct는 실행 가능성과 의도에 레이블을 부여하고, ARIES는 실제 반영된 수정을 연구하며, MARG는 전문화된 에이전트로 실행 가능한 코멘트를 생성한다. RBTACT는 rebuttal에서 보고된 행동으로부터 선호를 도출한다.
3 Review and Rebuttal Mapping
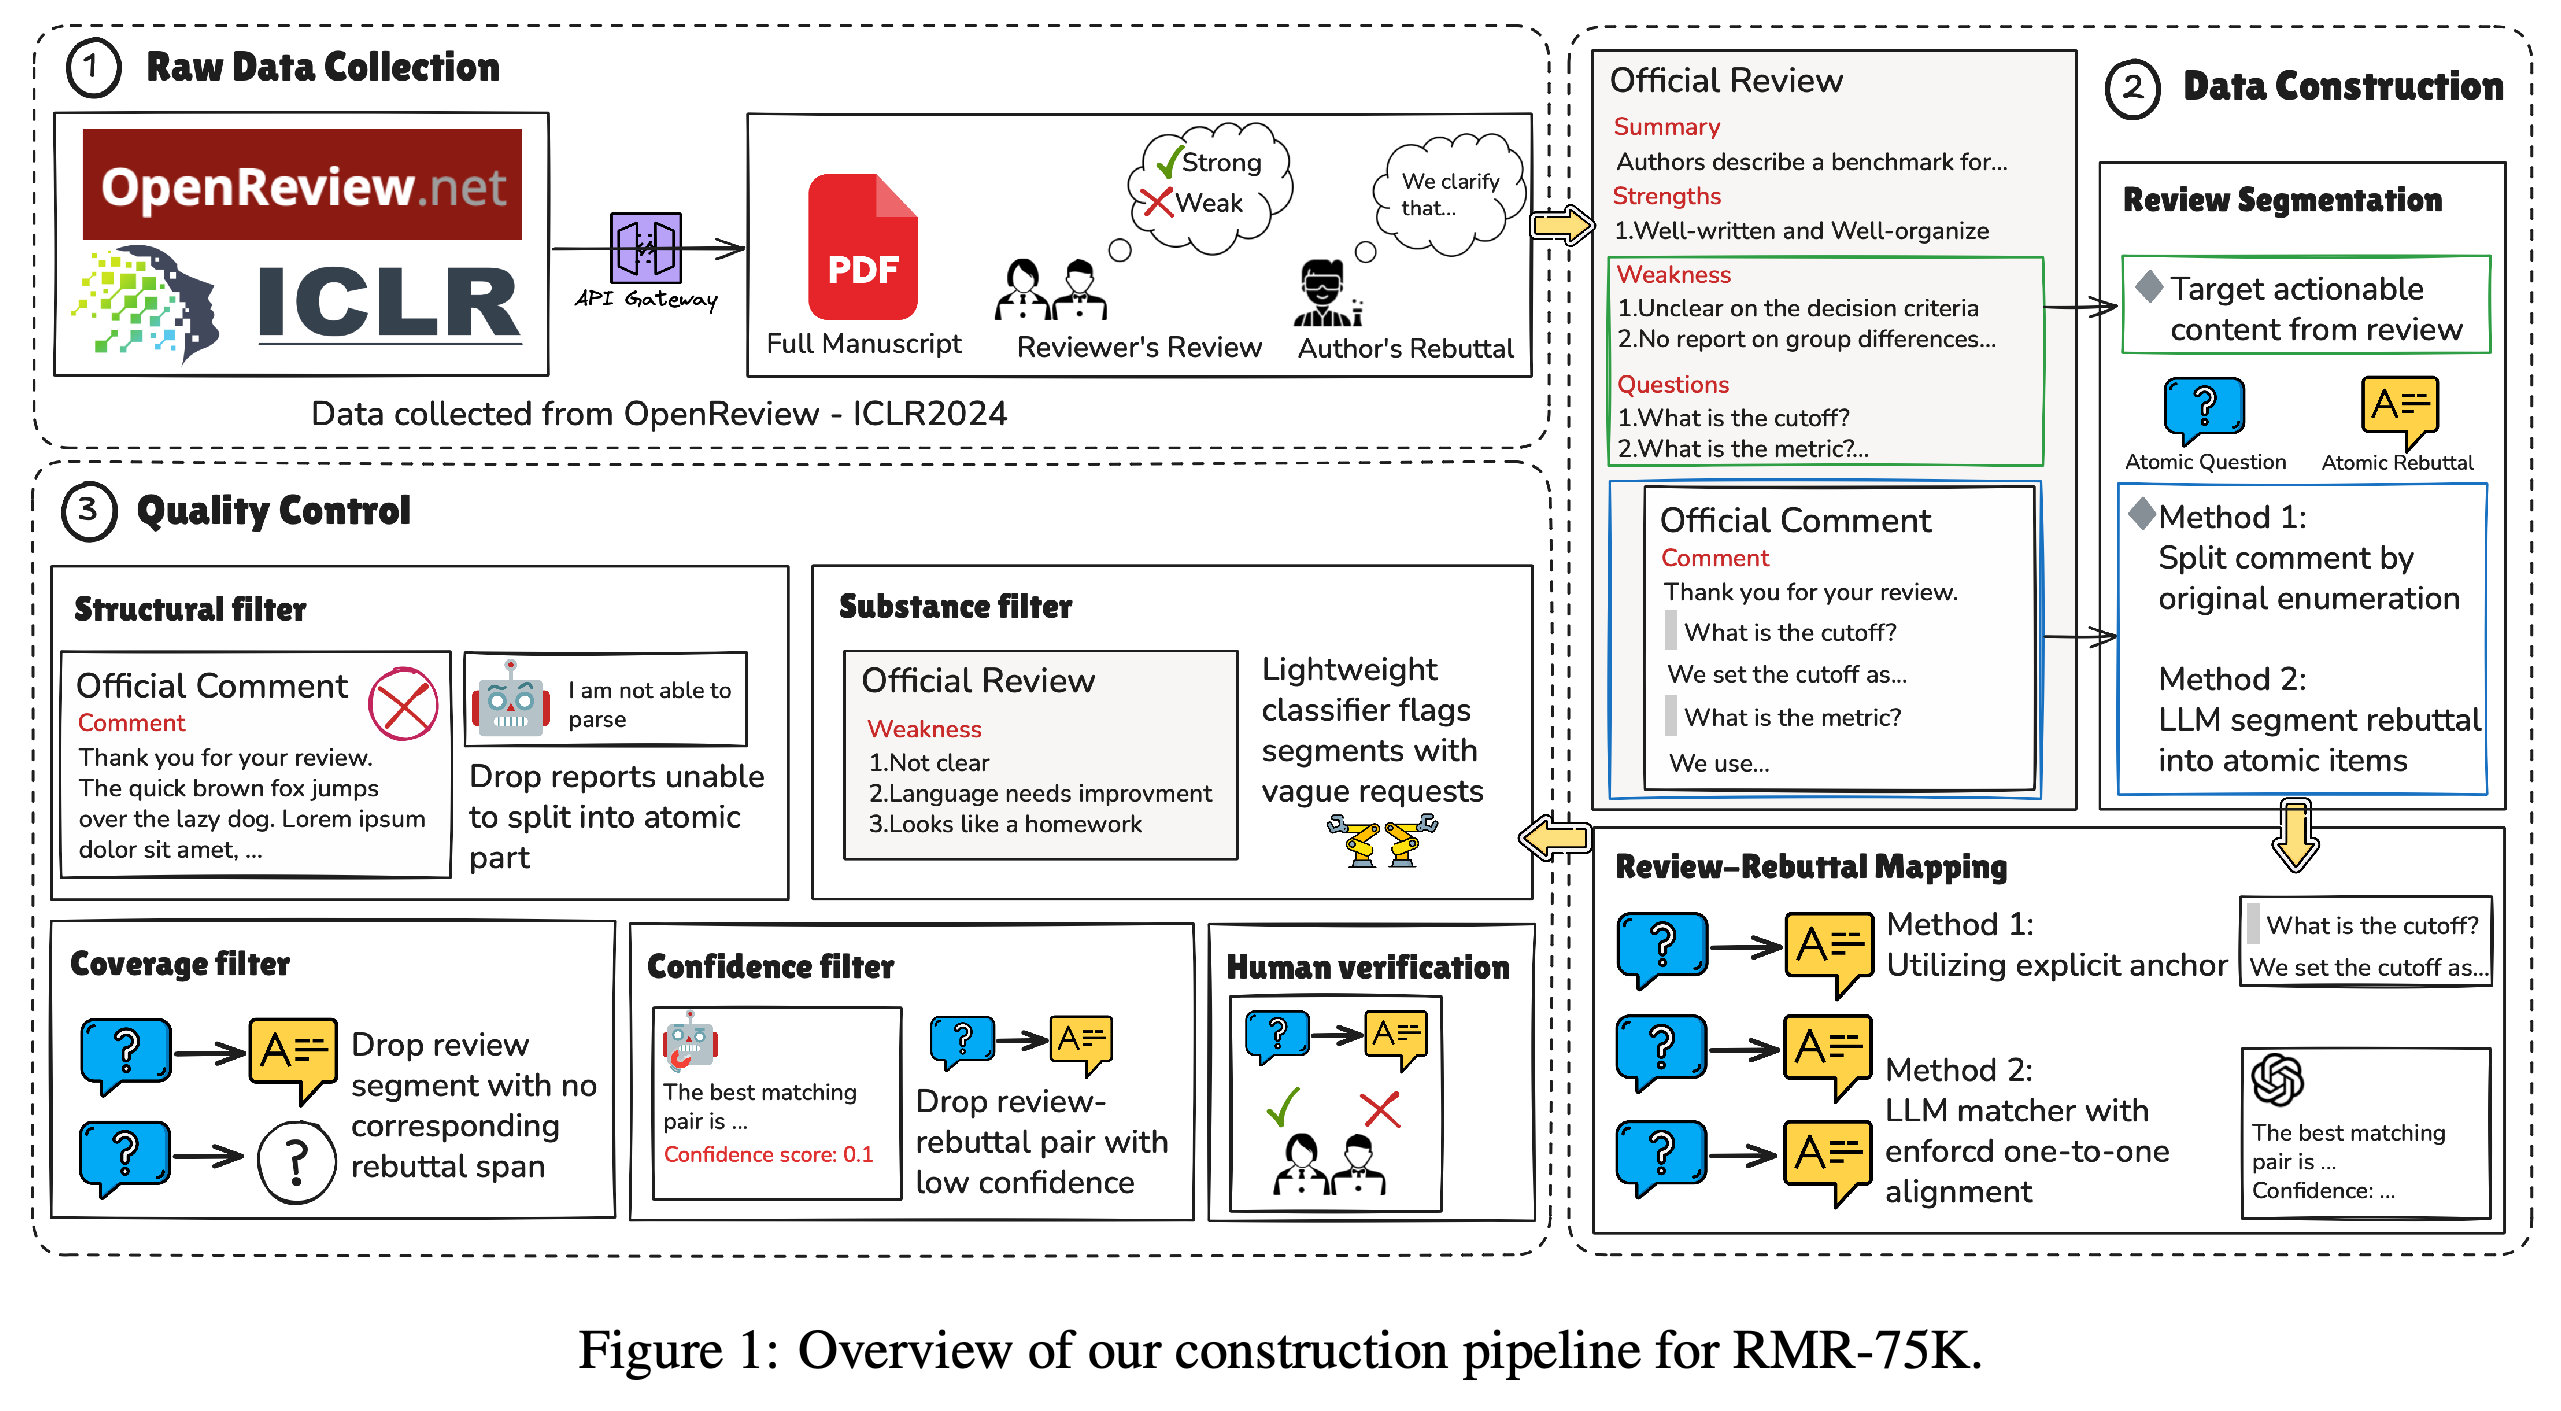
Review-Map-Rebuttal의 약자인 RMR-75K는 개별 리뷰 논점을 이에 답하는 저자 응답 구간과 연결한다. Figure 1은 수집, 분할, 정렬, 필터링, 인간 검증을 요약한다. 이후 학습에 쓰이는 선호 신호는 이러한 전처리 단계에 의존한다.
이 파이프라인에서 정렬 품질은 학습의 전제 조건이다. 공개 저자 응답을 수집하고, 비판 단위를 분리하고, 구간을 매칭한 뒤, 신뢰하기 어렵거나 내용이 실질적이지 않은 쌍을 제외한다. 매칭되지 않은 논점은 보존된 학습 코퍼스에 들어가지 않는다.
3.1 Review–Rebuttal Source Data Collection
원천 코퍼스는 공식 OpenReview API로 수집한 ICLR 2024 제출 논문으로 구성된다. 원고 PDF는 MinerU로 Markdown으로 변환한다. 보존된 레코드에는 논문 전문, 전체 리뷰와 자유 형식 코멘트, 저자의 rebuttal 스레드가 포함된다.
- 여러 저자 응답 메시지는 시간순으로 이어 붙여 논문별 응답 문서 1개로 만든다.
- 학습 코퍼스는 학회의 1개 연도 자료를 다루며, 여러 학회나 학문 분야를 포괄하는 표본은 아니다.
3.2 Dataset Construction
데이터셋 구축 과정에서는 리뷰를 약점·질문 세그먼트로, rebuttal을 후보 응답 구간으로 분해한다. 최종 정렬은 일대일이다. 각 리뷰 세그먼트와 rebuttal 구간은 보존된 쌍에 최대 1번만 등장할 수 있다.
- 각 매핑 쌍은 리뷰 세그먼트, 이에 답하는 rebuttal 구간, [0, 1] 범위의 신뢰도 점수로 구성된다.
- 리뷰 분할에서는 기존 번호나 글머리표가 있으면 이를 그대로 세그먼트로 사용한다. 그렇지 않으면 GPT-5가 Weaknesses와 Questions를 개별 논점을 담은 비판 단위로 나눈다.
- 리뷰–rebuttal 매핑에서는 명시적 참조와 인용을 이용한 휴리스틱 단계를 먼저 수행한 뒤, LLM으로 의미 기반 구간 매칭을 수행한다. 신뢰도가 높은 순서로 탐욕적 매칭을 진행하며, 동점인 매칭은 버린다.
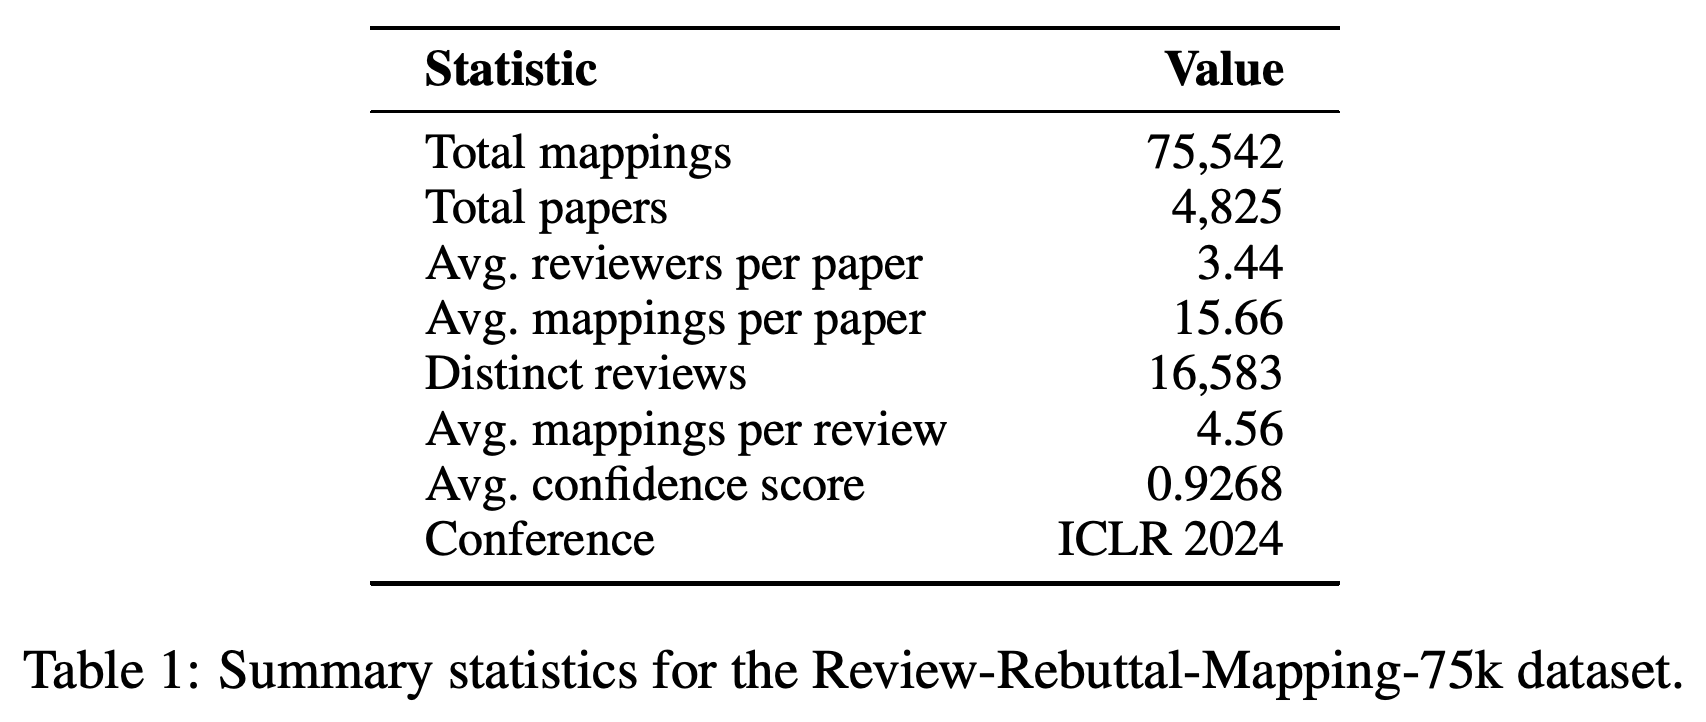
- Table 1은 매핑 75,542개, 논문 4,825편, 고유 리뷰 16,583개, 리뷰어 밀도 3.44 reviewers per paper, 매핑 밀도 15.66 mappings per paper, 리뷰당 매핑 4.56개, 평균 신뢰도 0.9268을 보고한다.
리뷰와 논문마다 여러 논점이 매핑되어 같은 논문 안에서 선호를 비교할 후보를 제공한다. 평균 신뢰도 0.9268은 자동 매칭 모델의 점수이며, 독립적으로 측정한 정렬 정확도가 아니다.
3.3 Cleaning and Quality Control
정제와 품질 관리에서는 내용이 실질적이고 정렬 신뢰도가 높은 논점을 보존한다. 불안정한 분할, 근거가 부족한 매칭, 질문을 되풀이할 뿐인 응답은 제거한다. 신뢰도 임계값은 τ로 표기하지만 수치는 보고하지 않는다.
- 구조 필터는 항목 구분이 드러나지 않고 안정적인 개별 논점으로도 나눌 수 없는 리뷰를 제외한다.
- 포괄성 필터는 신뢰도 ≥ τ를 충족하는 타당한 rebuttal 구간이 없는 세그먼트를 제거한다.
- 신뢰도 필터는 보존할 쌍이 임계값을 충족하도록 한다. 질문에 답하지 않고 반복하는 구간은 제거한다.
- 내용 필터는 세그먼트가 실질적인 문제나 권고를 제시하도록 한다.
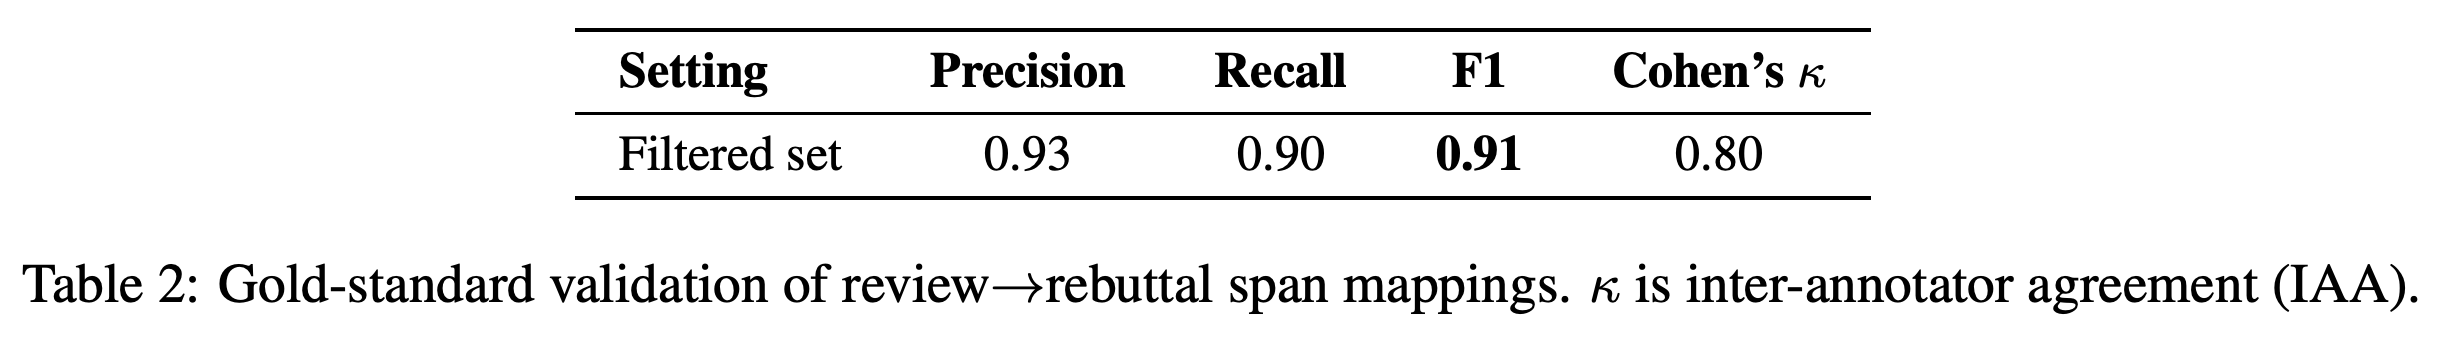
- 인간 검증에서는 주석자 2명이 논문 60편에서 보존된 세그먼트 944개를 독립적으로 정렬한다. 이후 조정을 거쳐 정답 구간을 만든다. 올바른 정렬의 기준은 토큰 수준 IoU ≥ 0.5다.
- Table 2는 Precision 0.93, Recall 0.90, F1 0.91, 조정 전 Cohen’s κ 0.80을 보고한다. 이 결과는 필터링된 표본의 정렬을 검증하며, 파이프라인이 제외한 논점을 얼마나 포괄하는지는 검증하지 않는다.
Precision 0.93, Recall 0.90, F1 0.91은 토큰 수준 IoU ≥ 0.5 기준에서 필터링된 표본 내 매칭의 신뢰성을 뒷받침한다. Cohen’s κ = 0.80은 조정 전 주석자 간 일치도를 측정하며, 모델–인간 일치도가 아니다.
4 Methodology
RBTACT는 먼저 지도 파인튜닝으로 관점별 세그먼트 생성을 학습한 뒤, DPO로 저자의 수정 수용 수준이 높은 코멘트를 선호하도록 학습한다. Rebuttal은 학습 레이블과 선호를 결정하는 데 쓰인다. 생성 시에는 논문과 요청된 관점만 필요하다.
4.1 Task Definition
이 과제는 논문 전문과 목표 관점 1개를 입력받아 초점이 명확한 약점이나 질문 1개를 출력한다. 7개 관점은 Experiments, Writing, Presentation, Theory, Novelty, Reproducibility, Evaluation이다.
- 리뷰 관점 레이블은 GPT-5가 자동으로 부여한다. 인간 표본 검증에서는 정확도 약 92%와 Cohen’s κ = 0.81을 보고한다. Writing과 Presentation, Experiments와 Evaluation 사이에서 혼동이 자주 발생한다.
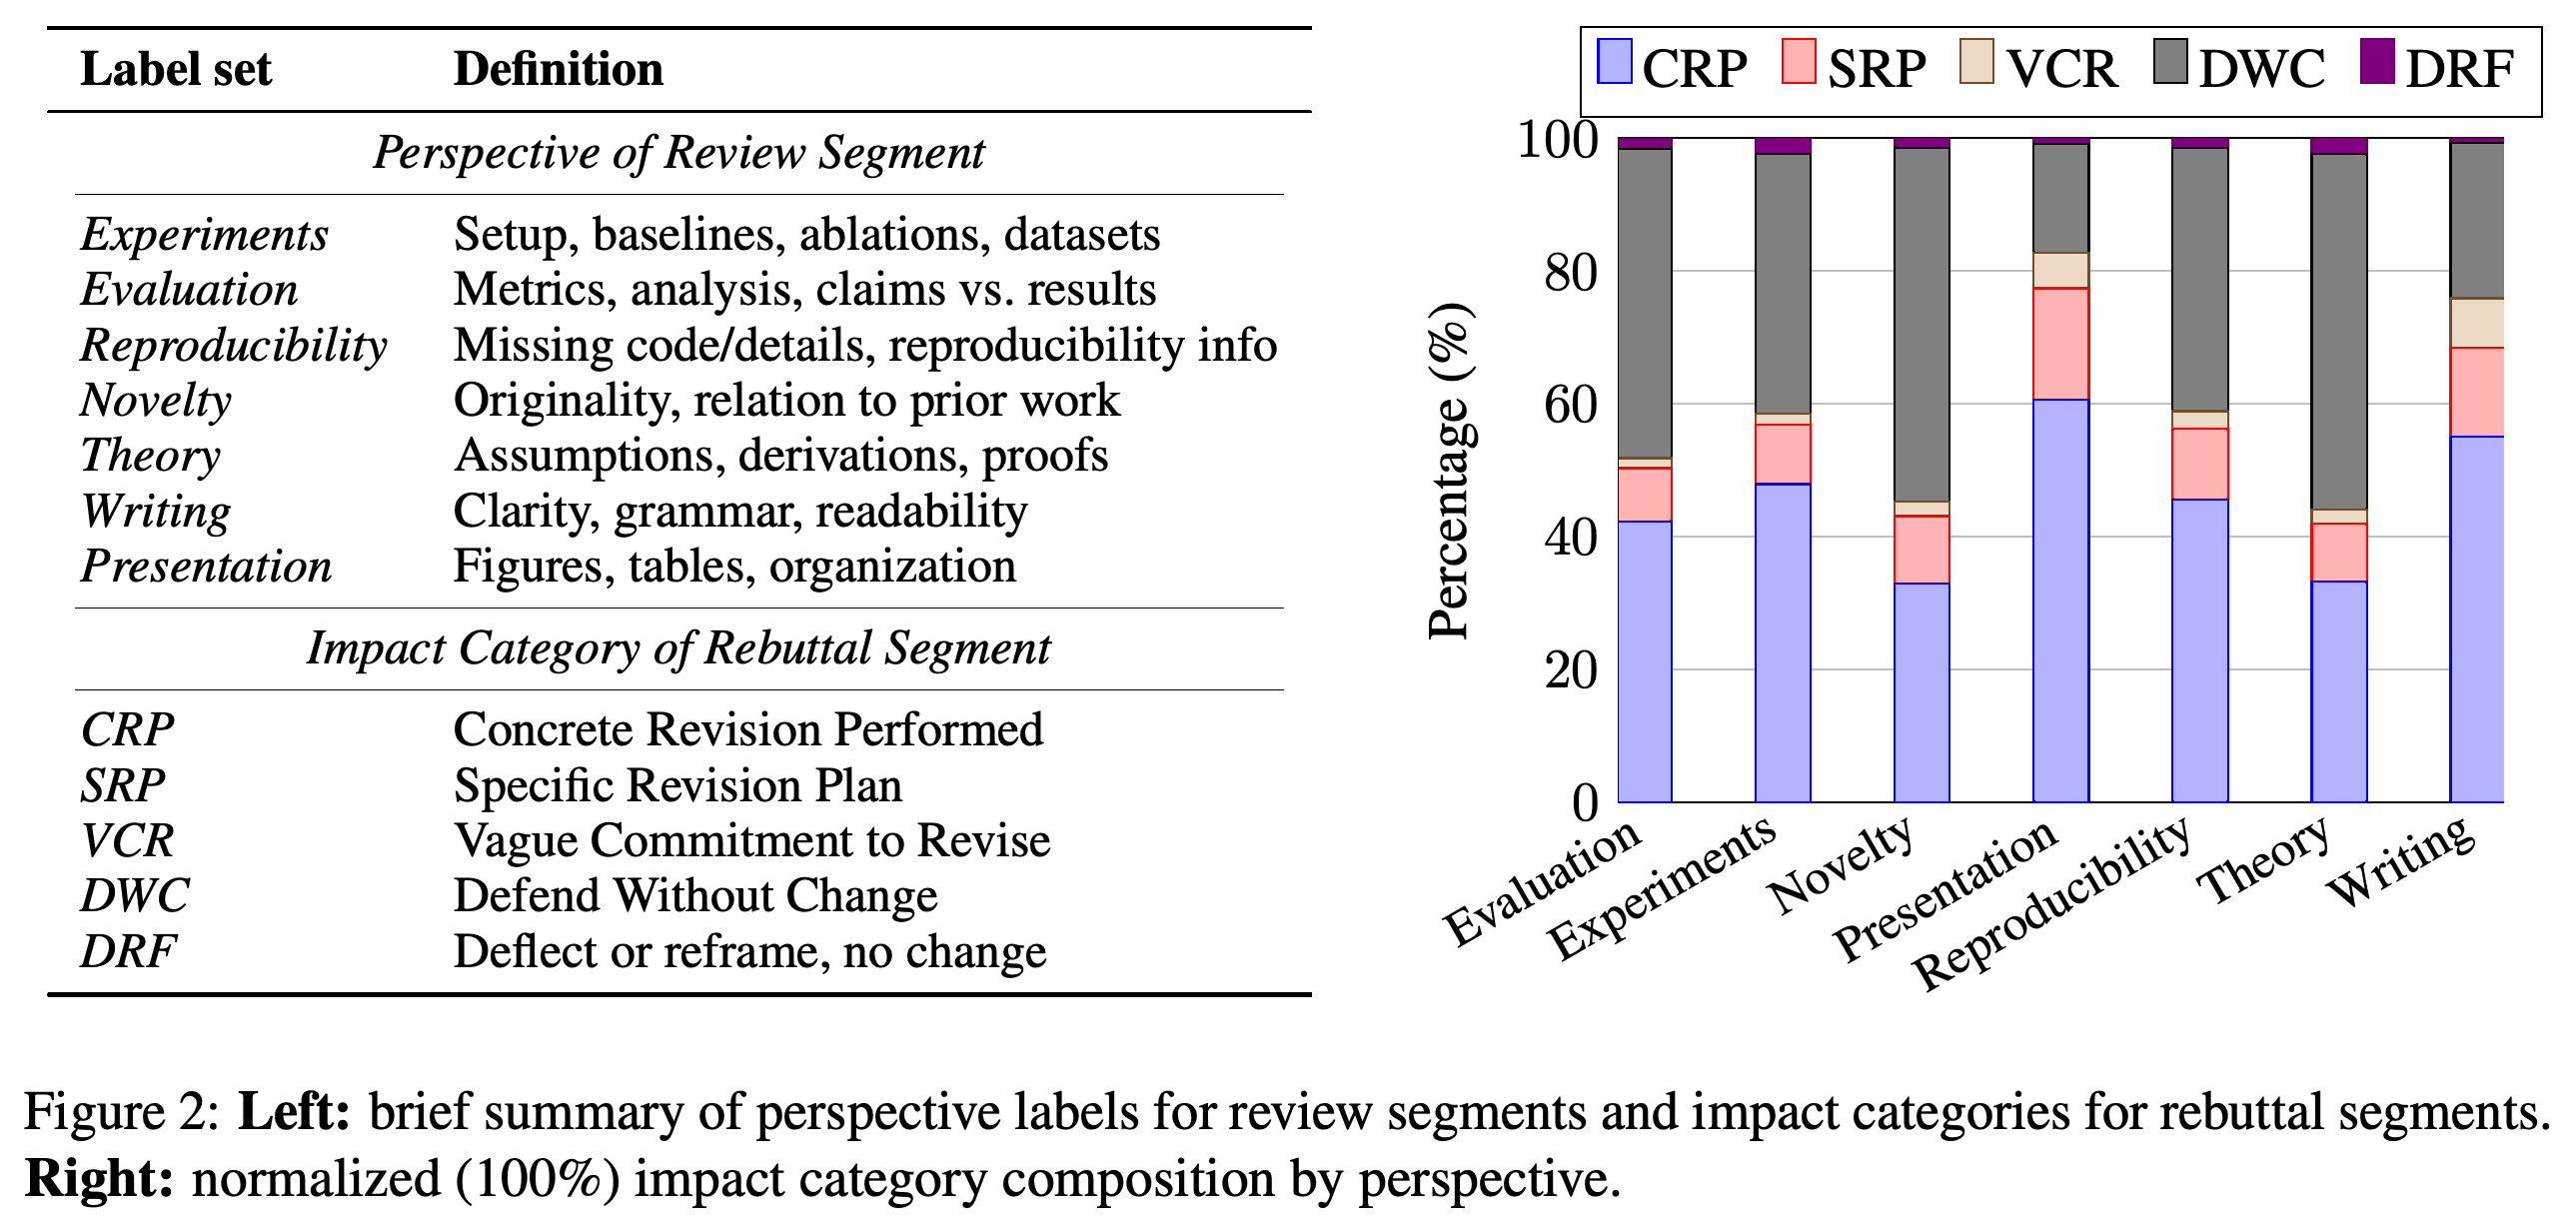
- Rebuttal 영향 범주를 Actionability 신호로 사용한다. 범주는 Concrete Revision Performed (CRP), Specific Revision Plan (SRP), Vague Commitment to Revise (VCR), Defend Without Change (DWC), Deflect/Reframe (DRF)다.
- 영향 레이블은 조정된 인간 레이블 대비 정확도 89%와 주석자 간 κ = 0.79를 기록한다. 이 레이블은 독립적으로 검증된 원고 변경이 아니라 rebuttal 내용을 나타낸다.
- Figure 2에서는 Writing과 Presentation의 수정 비중이 더 높고, Theory와 Novelty의 방어 비중이 더 높다.
수정 수용 여부는 관점에 따라 달라진다. Presentation과 Writing에는 수정 응답이 더 자주 나타나고, Novelty와 Theory에는 방어 응답이 더 자주 나타난다. 이는 같은 관점 안에서 쌍을 구성하는 방식을 뒷받침하며, 수정 빈도를 보편적인 품질 지표로 해석해서는 안 됨을 보여준다.
4.2 Training Dataset Construction
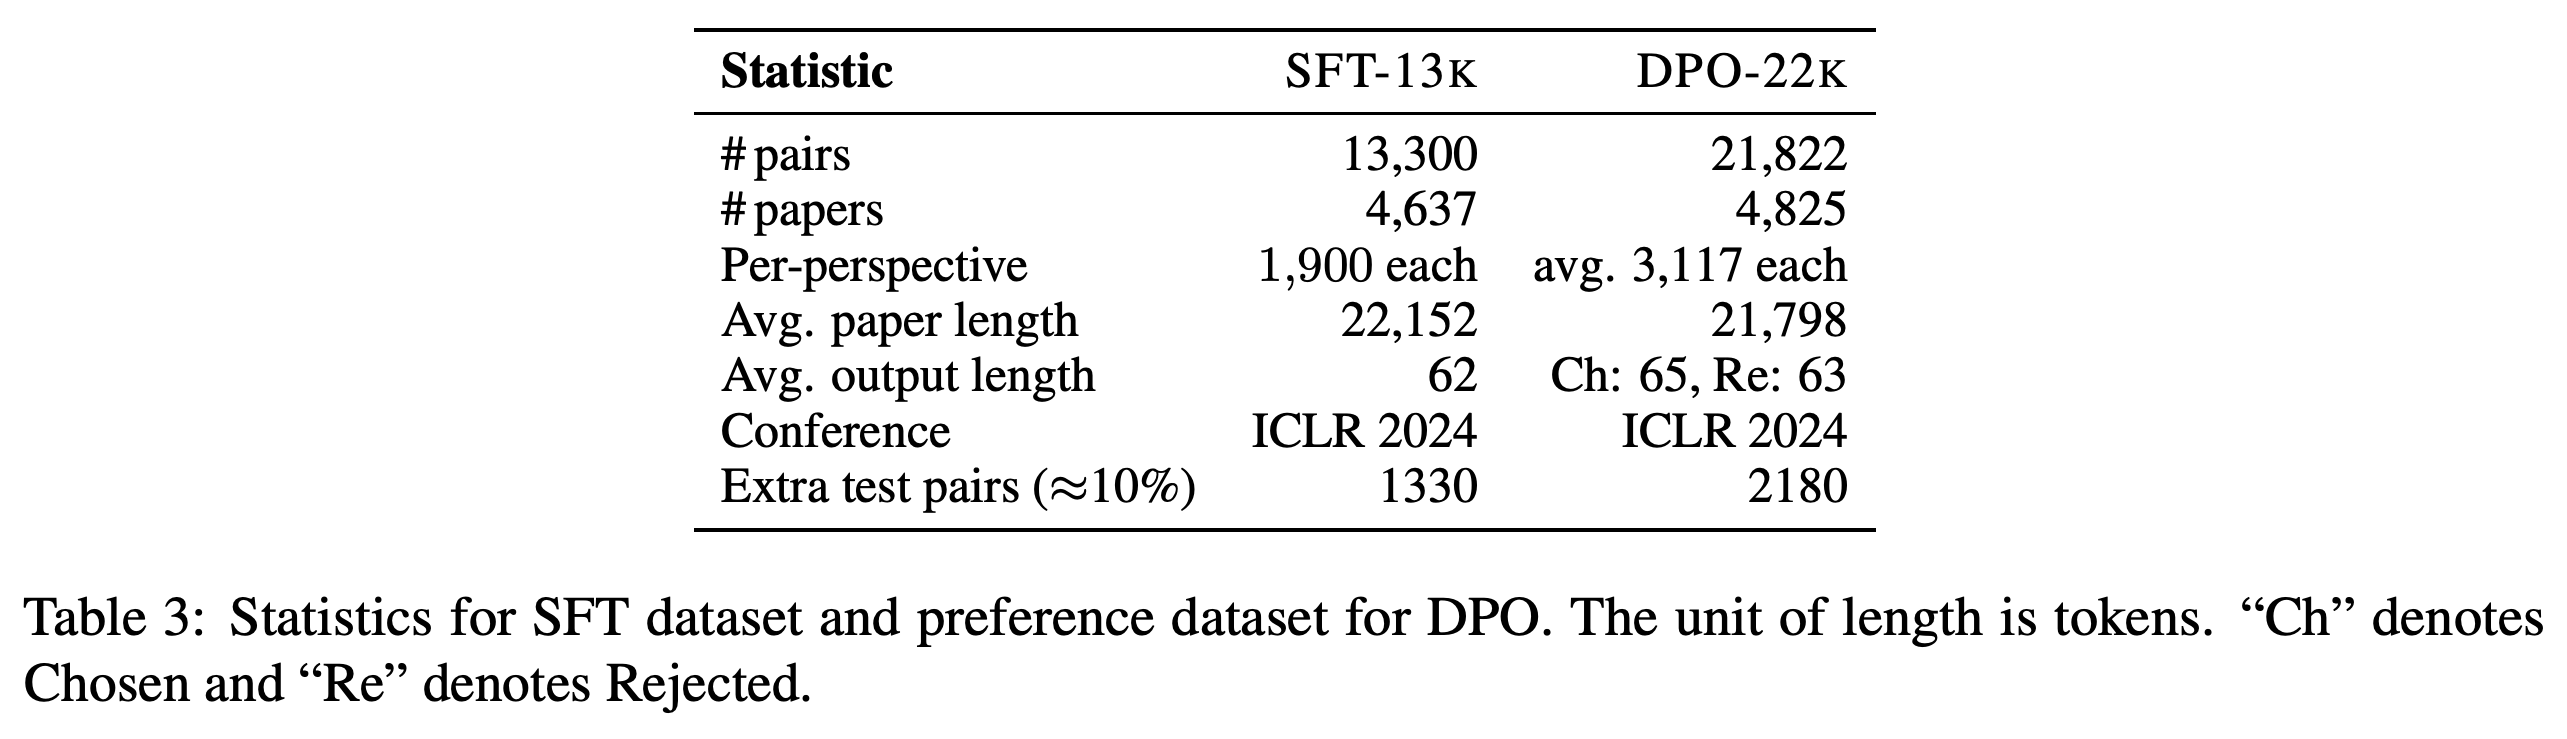
REVIEWSEG-SFT-13K는 논문 4,637편에서 얻은 논문–관점/세그먼트 예제 13,300개를 포함하며, 관점마다 정확히 1,900개가 있다. REVIEWPREF-DPO-22K는 논문 4,825편에서 얻은 선호 쌍 21,822개를 포함하며, 관점당 평균 3,117쌍이다.
- SFT 데이터의 목표 출력은 매핑 코퍼스에서 선택한 인간 리뷰어 세그먼트다. 논문과 출력의 평균 길이는 각각 22,152토큰과 62토큰이다.
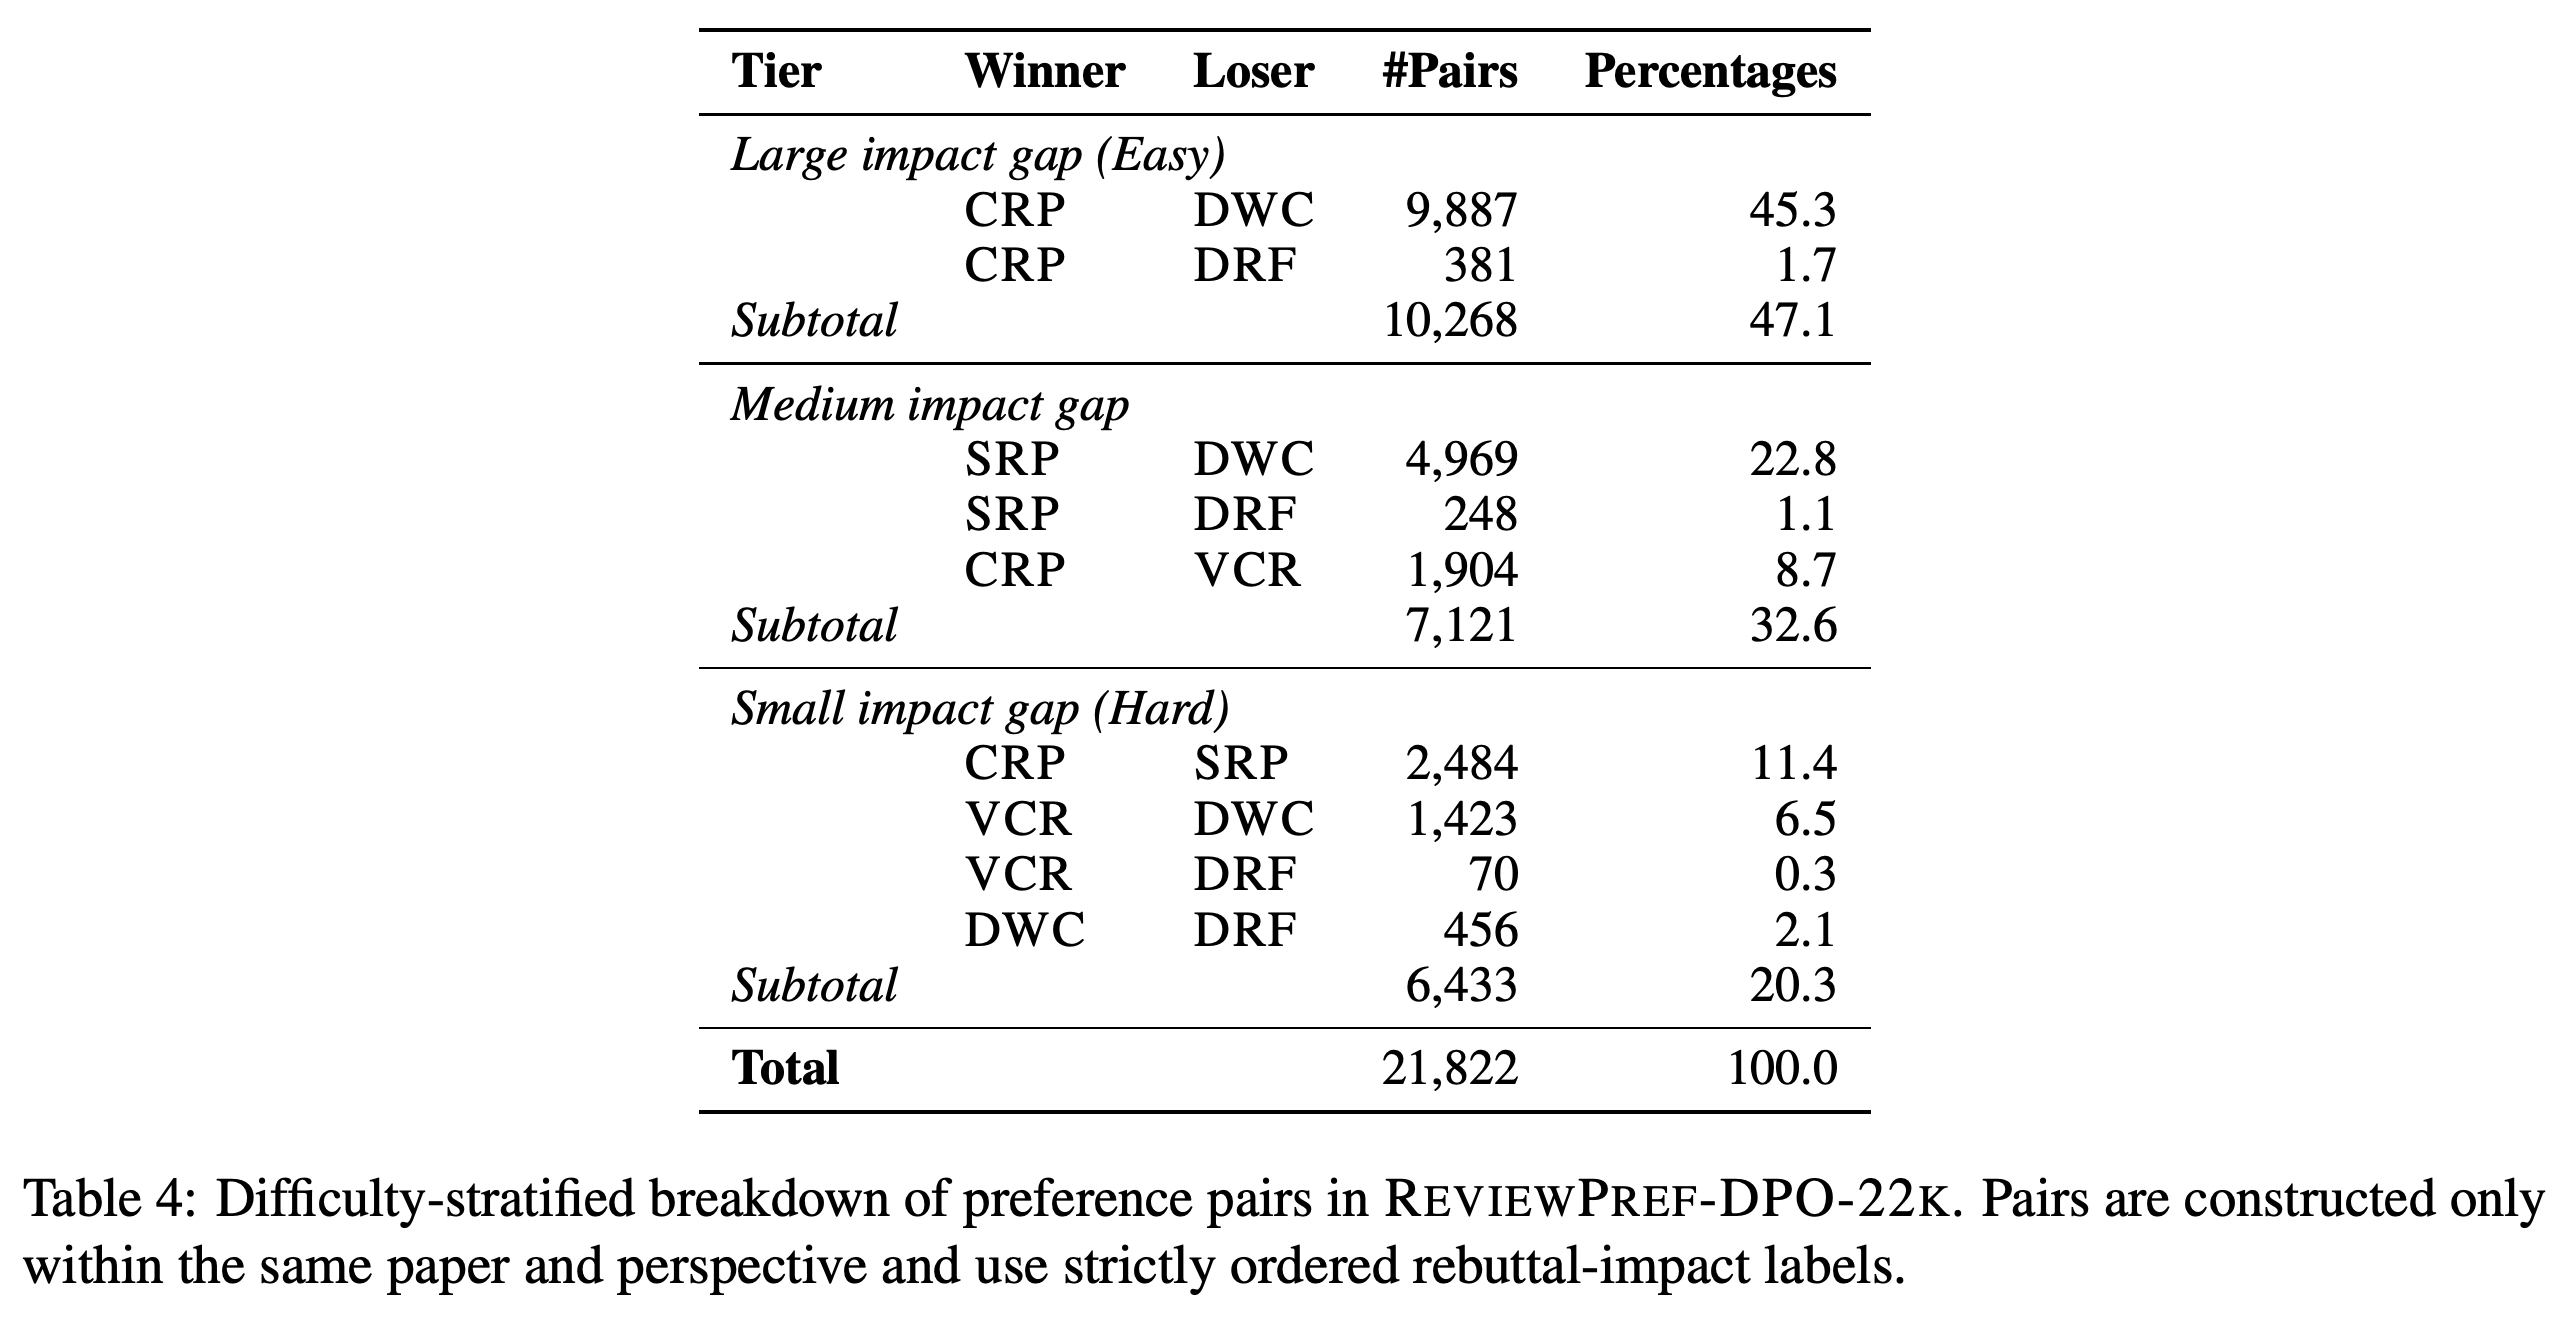
- 선호 데이터에서는 같은 논문과 관점에 속하고 영향 레이블이 다른 코멘트만 비교한다. 순서는 CRP > SRP > VCR > DWC > DRF다.
- 쌍의 수는 논문과 관점 간에 균형을 맞추고, 개별 세그먼트의 재사용 횟수는 제한한다. 영향 차이가 큰 쌍, 중간인 쌍, 작은 쌍은 서로 다른 선호 학습 난도를 제공한다.
- Table 3은 추가 SFT 테스트 쌍 1,330개와 추가 DPO 테스트 쌍 2,180개도 제시한다. 각각 해당 학습 세트 크기의 약 10%다.
- Table 4는 차이가 큰 쌍 10,268개(47.1%)와 중간인 쌍 7,121개(32.6%)를 보고한다. 차이가 작은 쌍의 소계는 6,433개(20.3%)로 인쇄되어 있지만, 나열된 행의 합은 4,433개다. 후자의 값이 전체 합계 21,822개와 일치한다.
학습 예제는 긴 원고 문맥과 짧은 출력을 결합한다. 평균 논문 길이는 21,000토큰을 넘지만 평균 코멘트 길이는 62–65토큰이다. SFT는 관점별 수가 정확히 균형을 이루며, DPO는 동일한 개수가 아니라 평균적인 관점별 분포를 보고한다.
영향 차이가 큰 비교가 가장 많으며, 특히 CRP 대 DWC가 9,887쌍이다. 인쇄된 작은 차이 소계 6,433쌍은 해당 행들의 합 4,433쌍과 맞지 않는다. 행의 합은 전체 합계 21,822쌍과 일치한다.
4.3 Policy Optimization
Direct Preference Optimization은 고정된 SFT 체크포인트를 참조 정책으로 사용하며, 별도의 보상 모델 없이 쌍별 선호를 학습한다. 손실은 L_DPO(θ) = −E[log σ(β(Δθ,ref(x, yw) − Δθ,ref(x, yℓ)))]이며, Δθ,ref(x, y) = log πθ(y | x) − log πref(y | x)다.
- 선호되는 출력은 연결된 rebuttal의 영향 범주가 더 높은 리뷰 코멘트다. 이 순서가 해당 코멘트의 문제 심각도나 과학적 중요도가 더 높다는 뜻은 아니다.
- 안정화를 위해 목적 함수에 선호 예제의 음의 로그 우도를 더한다. L(θ) = L_DPO(θ) + λE[−log πθ(yw | x)]이며, λ = 0.1로 설정해 관점 제어가 학습 중 달라지는 정도를 제한한다.
- 논문은 β > 0이 선호의 선명도를 조절한다고 정의하지만, 보고된 학습 설정에는 그 수치가 없다.
4.4 Training Details
두 단계 모두 NVIDIA H200 141GB GPU에서 bf16 연산으로 Llama-3.1-8B-Instruct를 학습한다. SFT는 3 epochs, 4,989 steps 동안 학습률 1.0×10⁻⁴로 학습하며 약 120시간이 걸린다. DPO는 2 epochs, 2,728 steps 동안 학습률 1.0×10⁻⁵로 학습하며 약 203시간이 걸린다. 두 단계 모두 코사인 스케줄링을 사용한다.
- Appendix C는 LLaMA-Factory와 q,k,v,o,gate,up,down 투영에 적용한 LoRA를 명시한다. 랭크는 SFT에서 8, DPO에서 16이다.
- 문맥 한도는 32,768토큰이며 생성 한도는 512토큰이다. Table 9는 유효 배치 크기 8과 16을 장치당 배치 크기와 그래디언트 누적 횟수의 곱으로 정의한다.
- DPO는 긴 논문 문맥을 처리하기 위해 FlashAttention-2, DeepSpeed ZeRO-2, 그래디언트 체크포인팅, 4비트 양자화된 고정 참조 모델을 함께 사용한다.
5 Experiments
실험은 인간 평점, LLM 개별 평점, LLM 쌍별 판정, 참조 중첩 지표로 9개 시스템을 비교한다. 평가 대상은 세그먼트 품질이며, 전체 리뷰의 품질이나 수정된 원고에서 관찰된 개선은 아니다.
5.1 Baselines
베이스라인은 RBTACT-SFT, 프롬프팅한 GPT-5-chat·DeepSeek-V3.2·Llama-3.1-70B·Qwen-3-32B, 과제에 맞게 조정한 MARG·LimGen·DeepReviewer-14B다. 각 시스템은 논문 텍스트와 요청된 관점을 입력받으며, 최종 출력은 리뷰 세그먼트 1개로 통일한다.
- 파인튜닝한 SFT-only 모델인 RBTACT-SFT는 rebuttal에서 도출한 DPO의 추가 기여를 분리해 평가한다.
- 프롬프팅한 LLM에는 공통 베이스라인 프롬프트를 사용해 약점, 질문, 제안을 1~3문장으로 작성하도록 요청한다.
- 다른 방법 중 MARG는 리더의 최종 종합 내용을 사용하고, 필요하면 첫 글머리표 항목을 사용한다. LimGen은 첫 한계와 이에 대응하는 제안을 사용한다.
- DeepReviewer-14B는 외부 도구 없이 실행한다. 전체 리뷰를 생성하면 고정된 제목 기반 추출 규칙으로 해당 하위 절과 첫 문단을 선택한다.
- 이러한 조정은 출력 단위를 통일하지만, 더 긴 리뷰나 여러 코멘트를 생성하도록 설계된 시스템을 제한된 형태로 평가한다.
5.2 Evaluation Protocol
평가 세트는 ICLR 2025 논문 700편으로 구성된다. 관점마다 논문–관점 사례 100개가 있으며, 각 사례의 참조는 인간 세그먼트 1개다. 저자들은 학습 원천과의 중복을 줄이기 위해 ICLR 2024 논문의 재제출본을 제외한다.
- 인간 평가에서는 각자 주요 ML 학회에서 완료한 리뷰 수가 ≥2인 PhD 수준 또는 고년차 대학원생 주석자 세 명이 논문 50편에 대한 익명 출력 아홉 개를 평가한다. Actionability, Specificity, Groundedness, Relevance, Helpfulness를 1–5 척도로 평가하고, 주석자 간 점수를 평균한다.
- 인간 평가 인터페이스는 리뷰 2개 중 어느 쪽이 더 유용한지도 묻고 동점을 허용한다. 본문은 출력 9개를 무작위로 구성한 3쌍으로 설명하므로, 전체 제시 방식은 명확하지 않다.
- LLM-as-a-Judge 평가에서는 GPT-5-chat이 논문 105편을 평가해 9개 시스템에 대한 개별 평가 945건을 산출한다. 별도로 세그먼트 쌍의 Actionability도 비교한다.
- LLM 쌍별 평가 프롬프트는 인간 인터페이스와 달리 동점 없이 승자를 고르게 한다. 후보별 명시적 점수 대신 선택과 근거를 요청한다.
5.3 Experiment Results
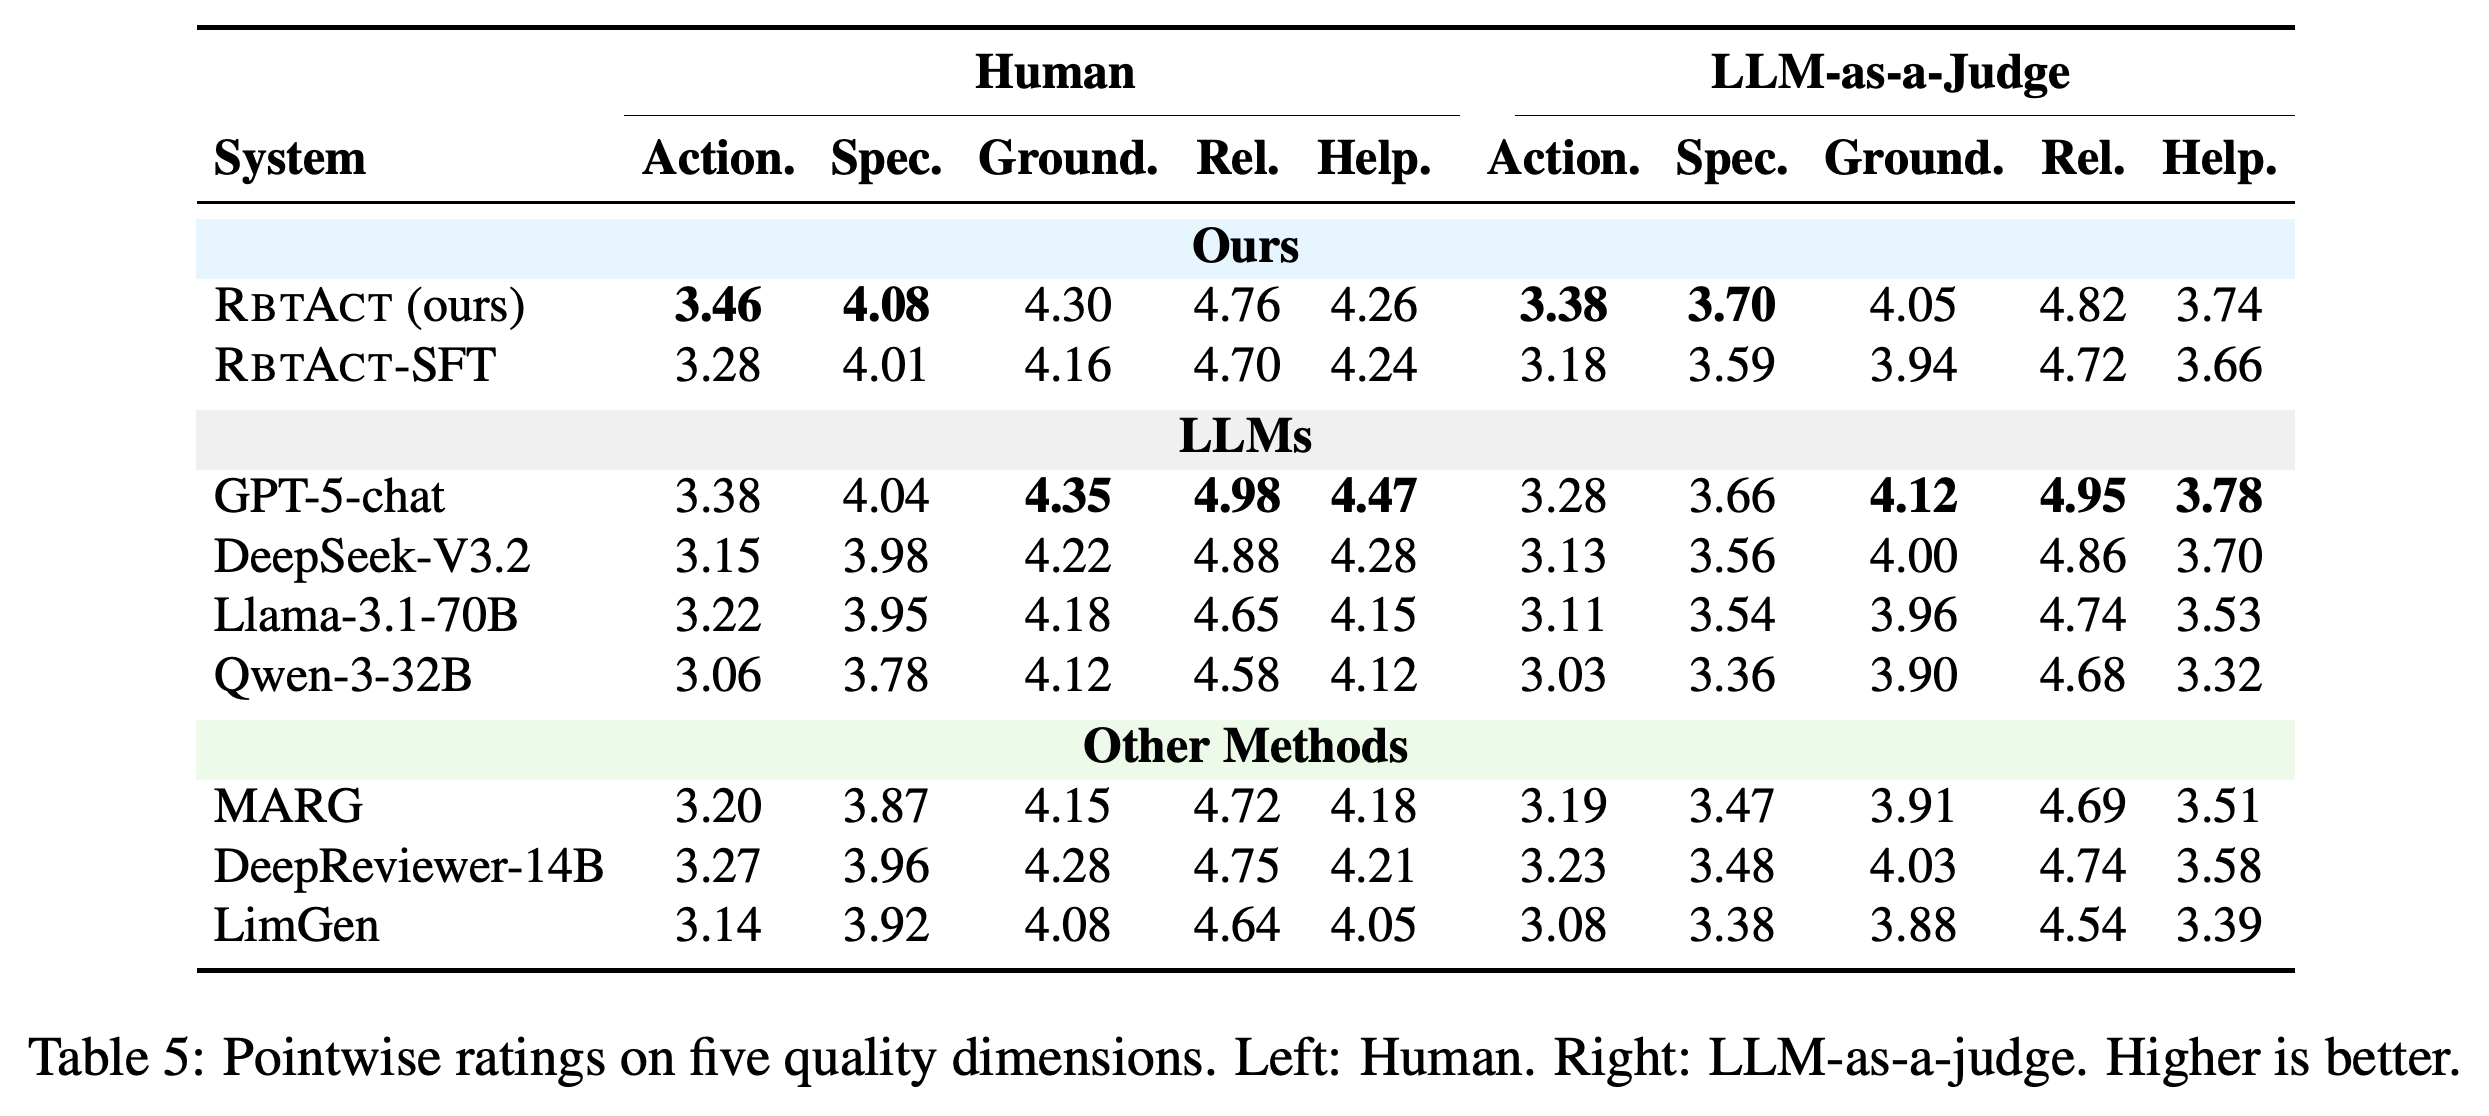
Table 5에서 RBTACT는 두 평가 모두 평균 Actionability와 Specificity가 가장 높다. 인간 점수는 3.46과 4.08이며, LLM 점수는 3.38과 3.70이다. 인간 및 LLM Actionability는 RBTACT-SFT가 3.28과 3.18, GPT-5-chat이 3.38과 3.28이다.
- 인간 평가에서 GPT-5-chat은 Groundedness, Relevance, Helpfulness가 더 높다. 점수는 각각 4.35, 4.98, 4.47이며, RBTACT는 4.30, 4.76, 4.26이다.
- LLM-as-a-judge 개별 평가에서도 GPT-5-chat이 이 항목들을 앞선다. 점수는 4.12, 4.95, 3.78이며, RBTACT는 4.05, 4.82, 3.74다.
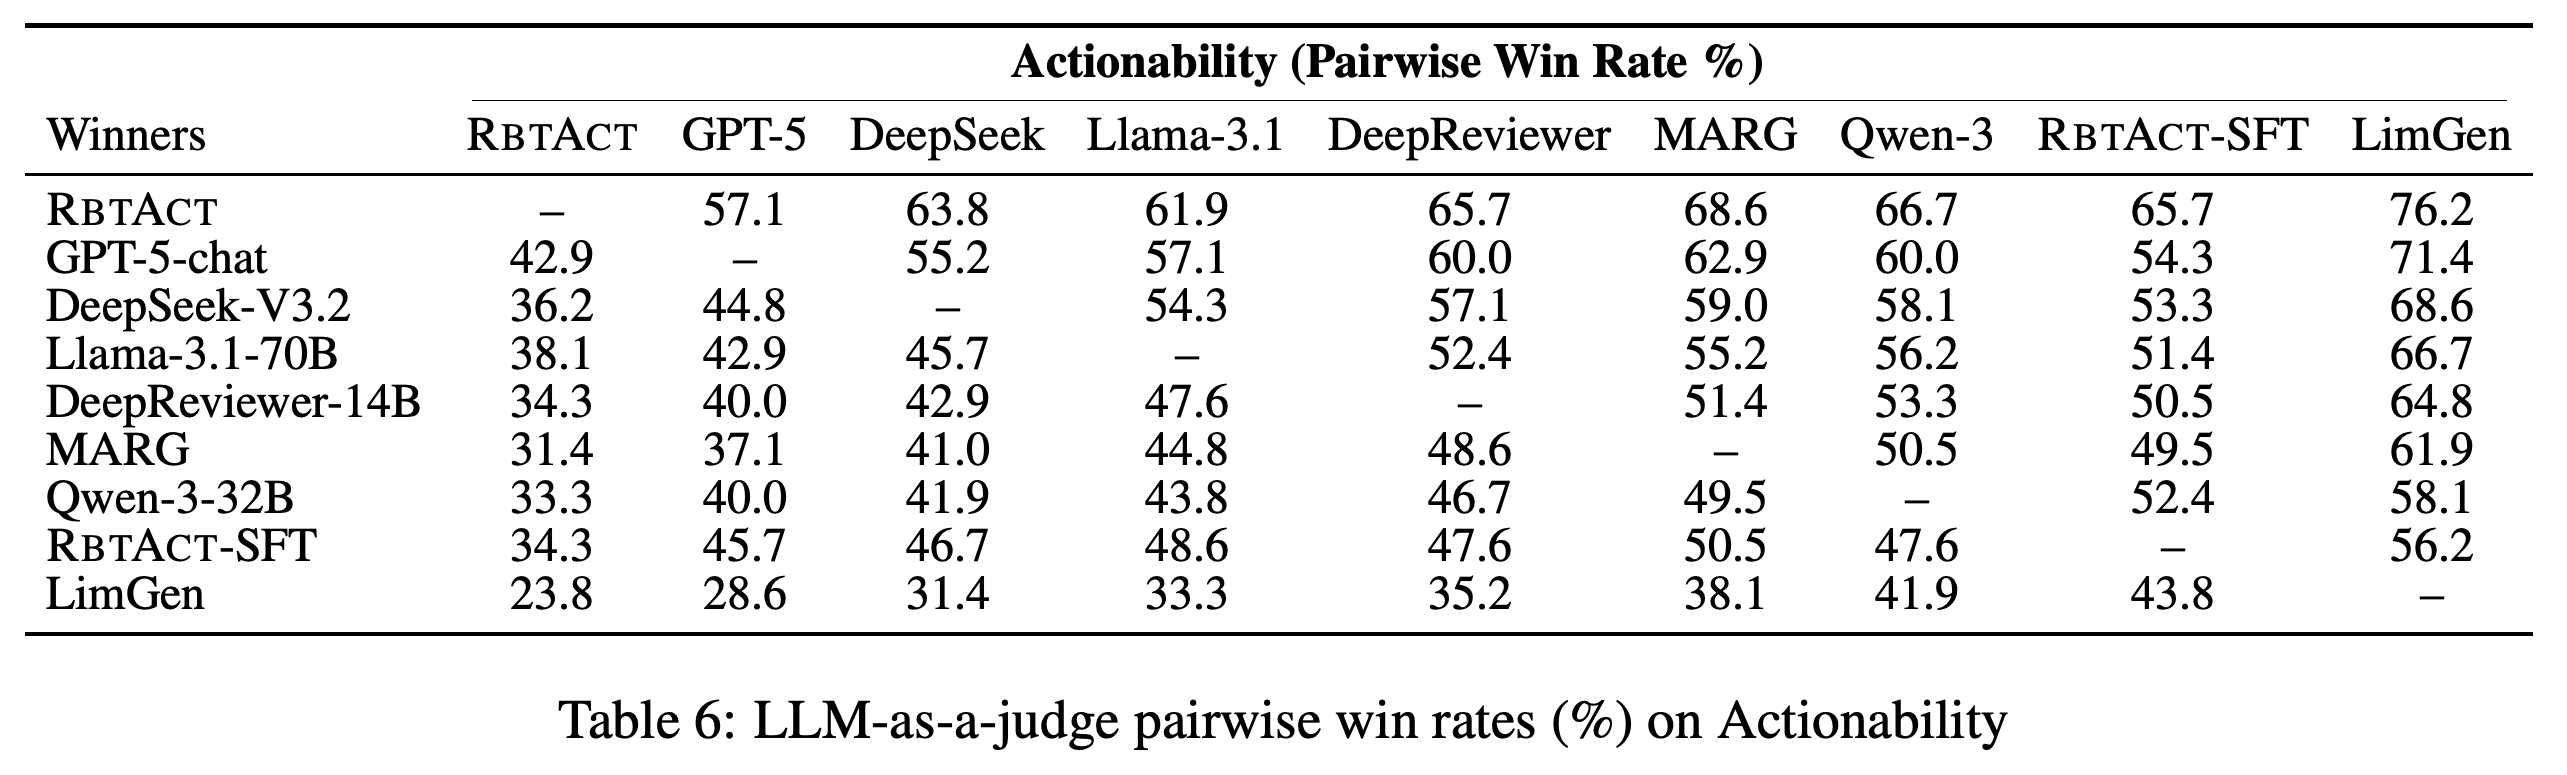
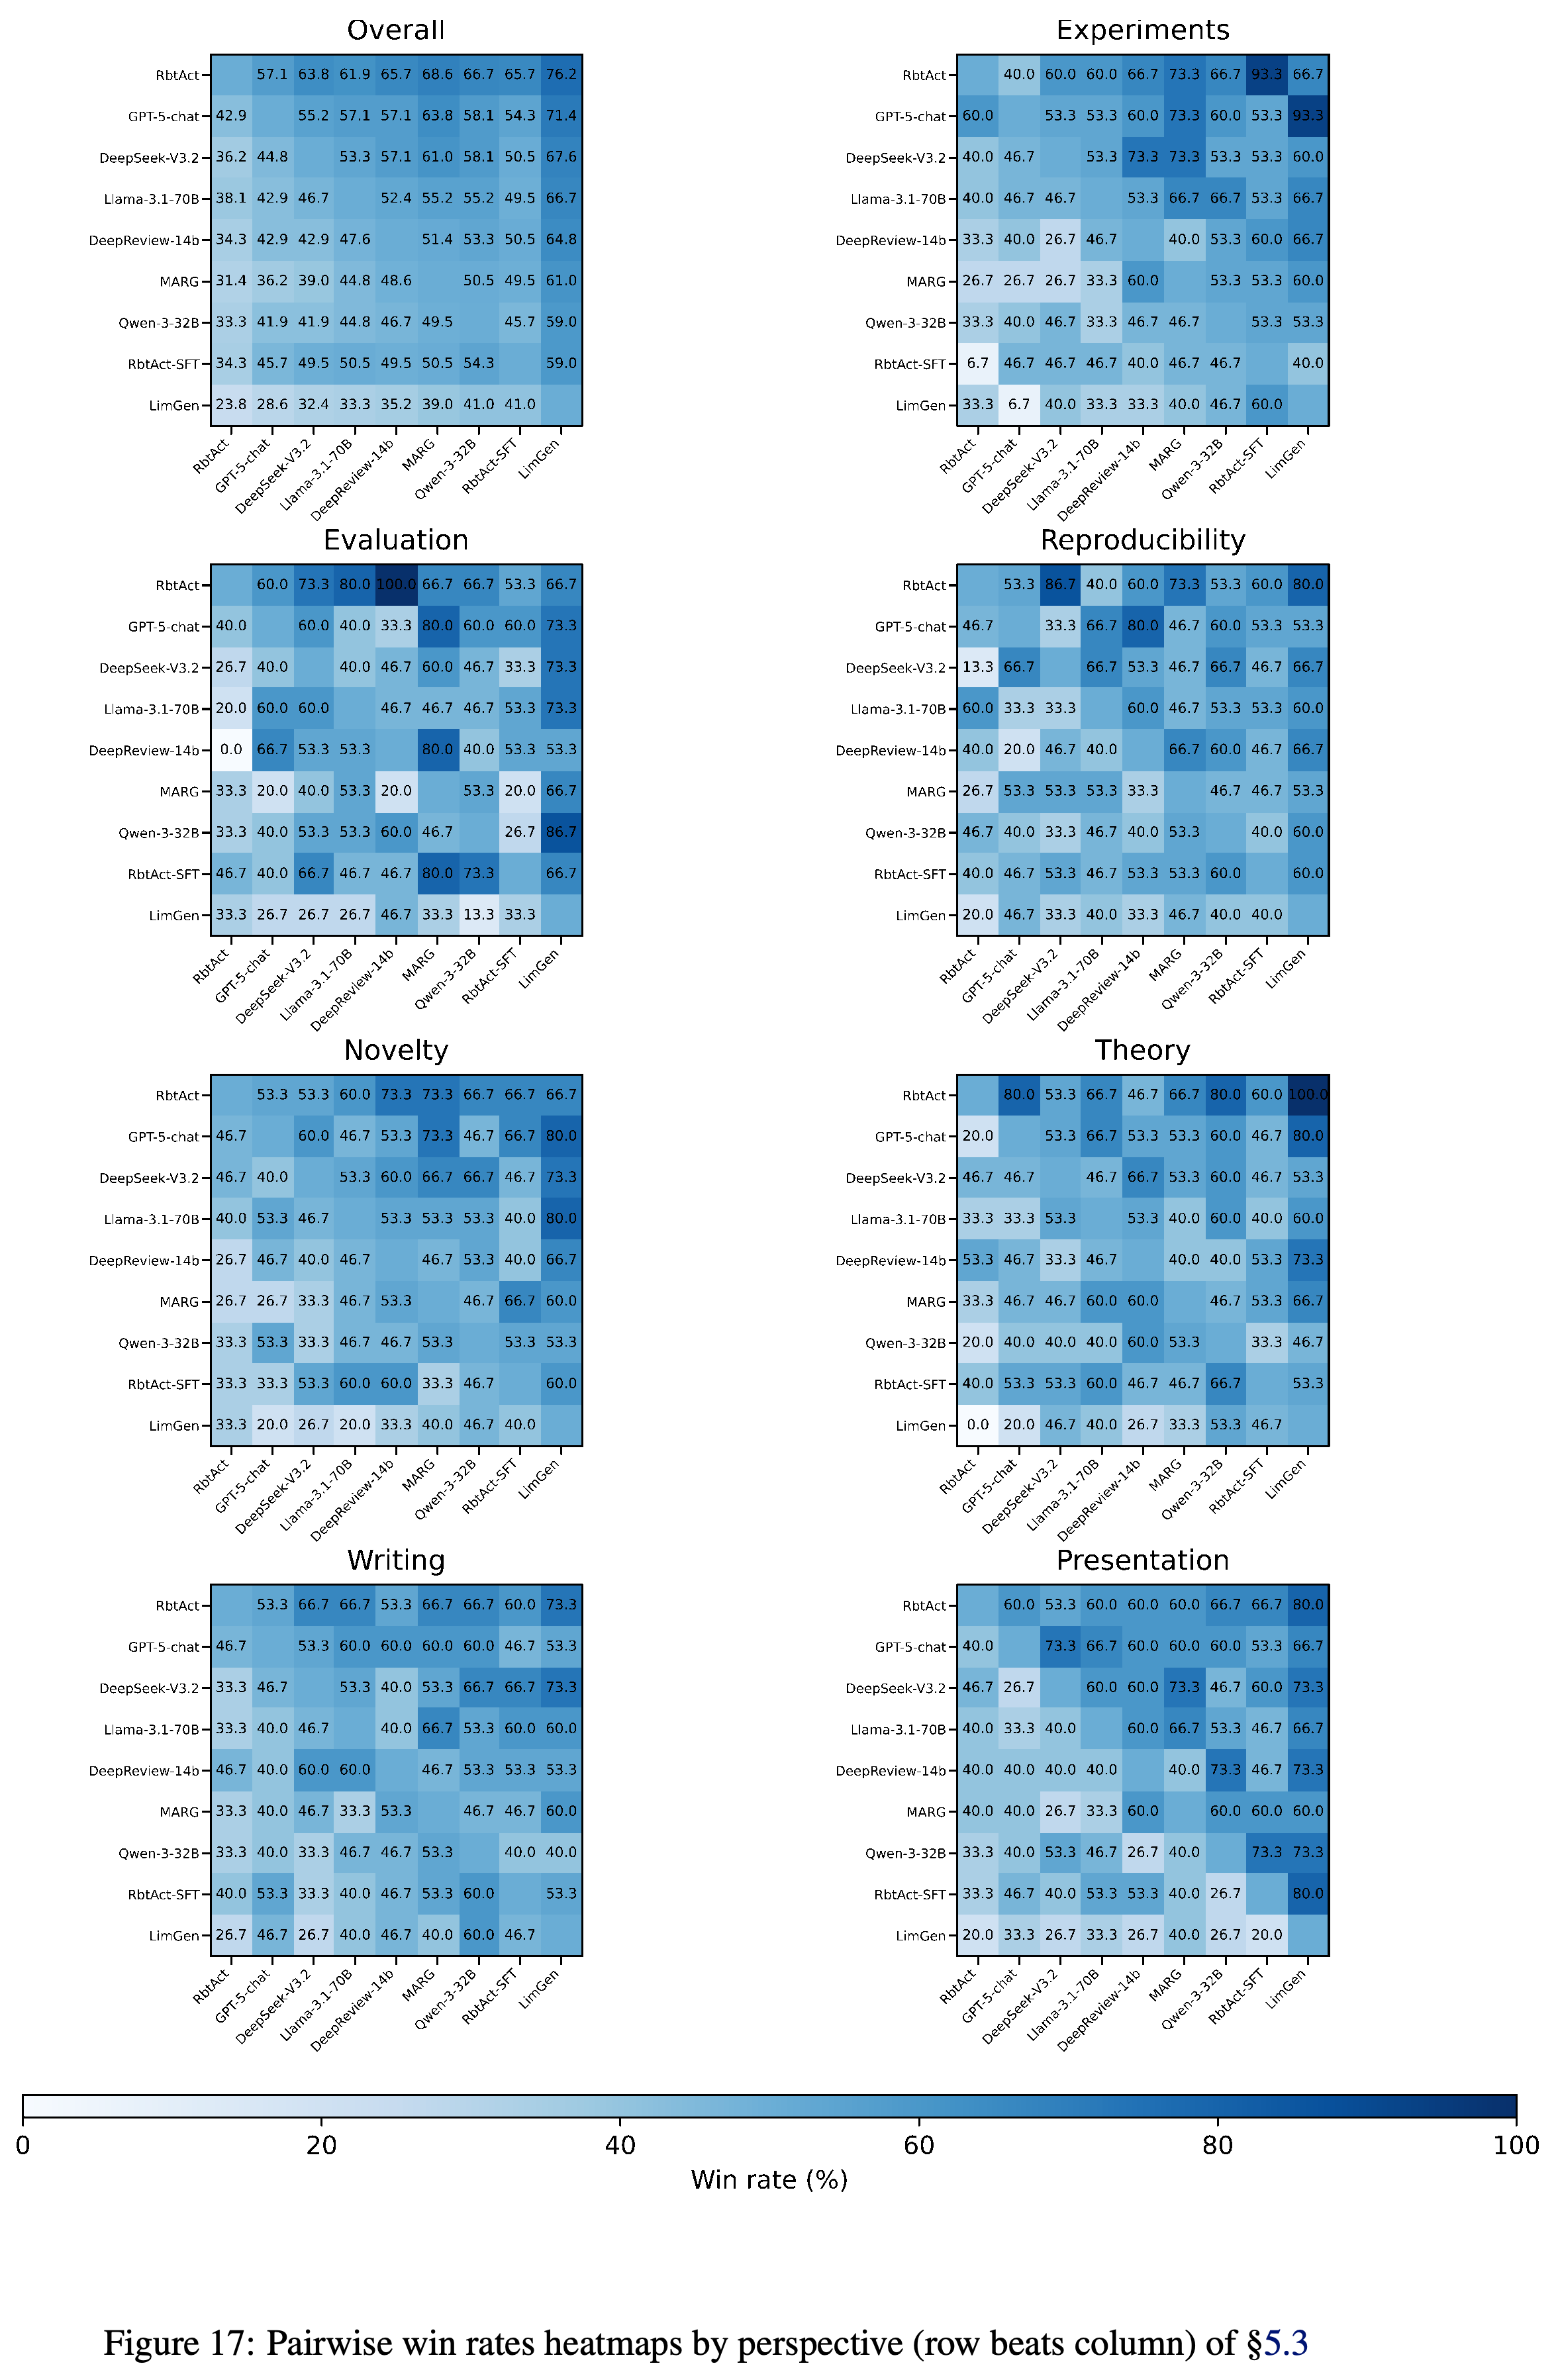
- LLM-as-a-judge 쌍별 평가의 Table 6은 RBTACT의 승률을 GPT-5-chat 대비 57.1%, RBTACT-SFT 대비 65.7%, LimGen 대비 76.2%로 보고한다.
- Figure 17은 결과가 관점에 따라 달라짐을 보여준다. RBTACT는 전체적으로 우세하지만 GPT-5-chat과의 Experiments 비교에서는 승률이 40.0%다. 전체 히트맵의 일부 베이스라인 간 값은 Table 6과 다르다.
- 인간–LLM 일치도에서 모델 수준 Actionability 순위는 Spearman’s ρ = 0.94, Kendall’s τb = 0.87을 기록한다. 논문 20편 × 모델 9개의 대응 항목 점수에서는 Spearman’s ρ = 0.52다. 따라서 높은 순위 일치도와 중간 수준의 항목별 일치도가 함께 나타난다.
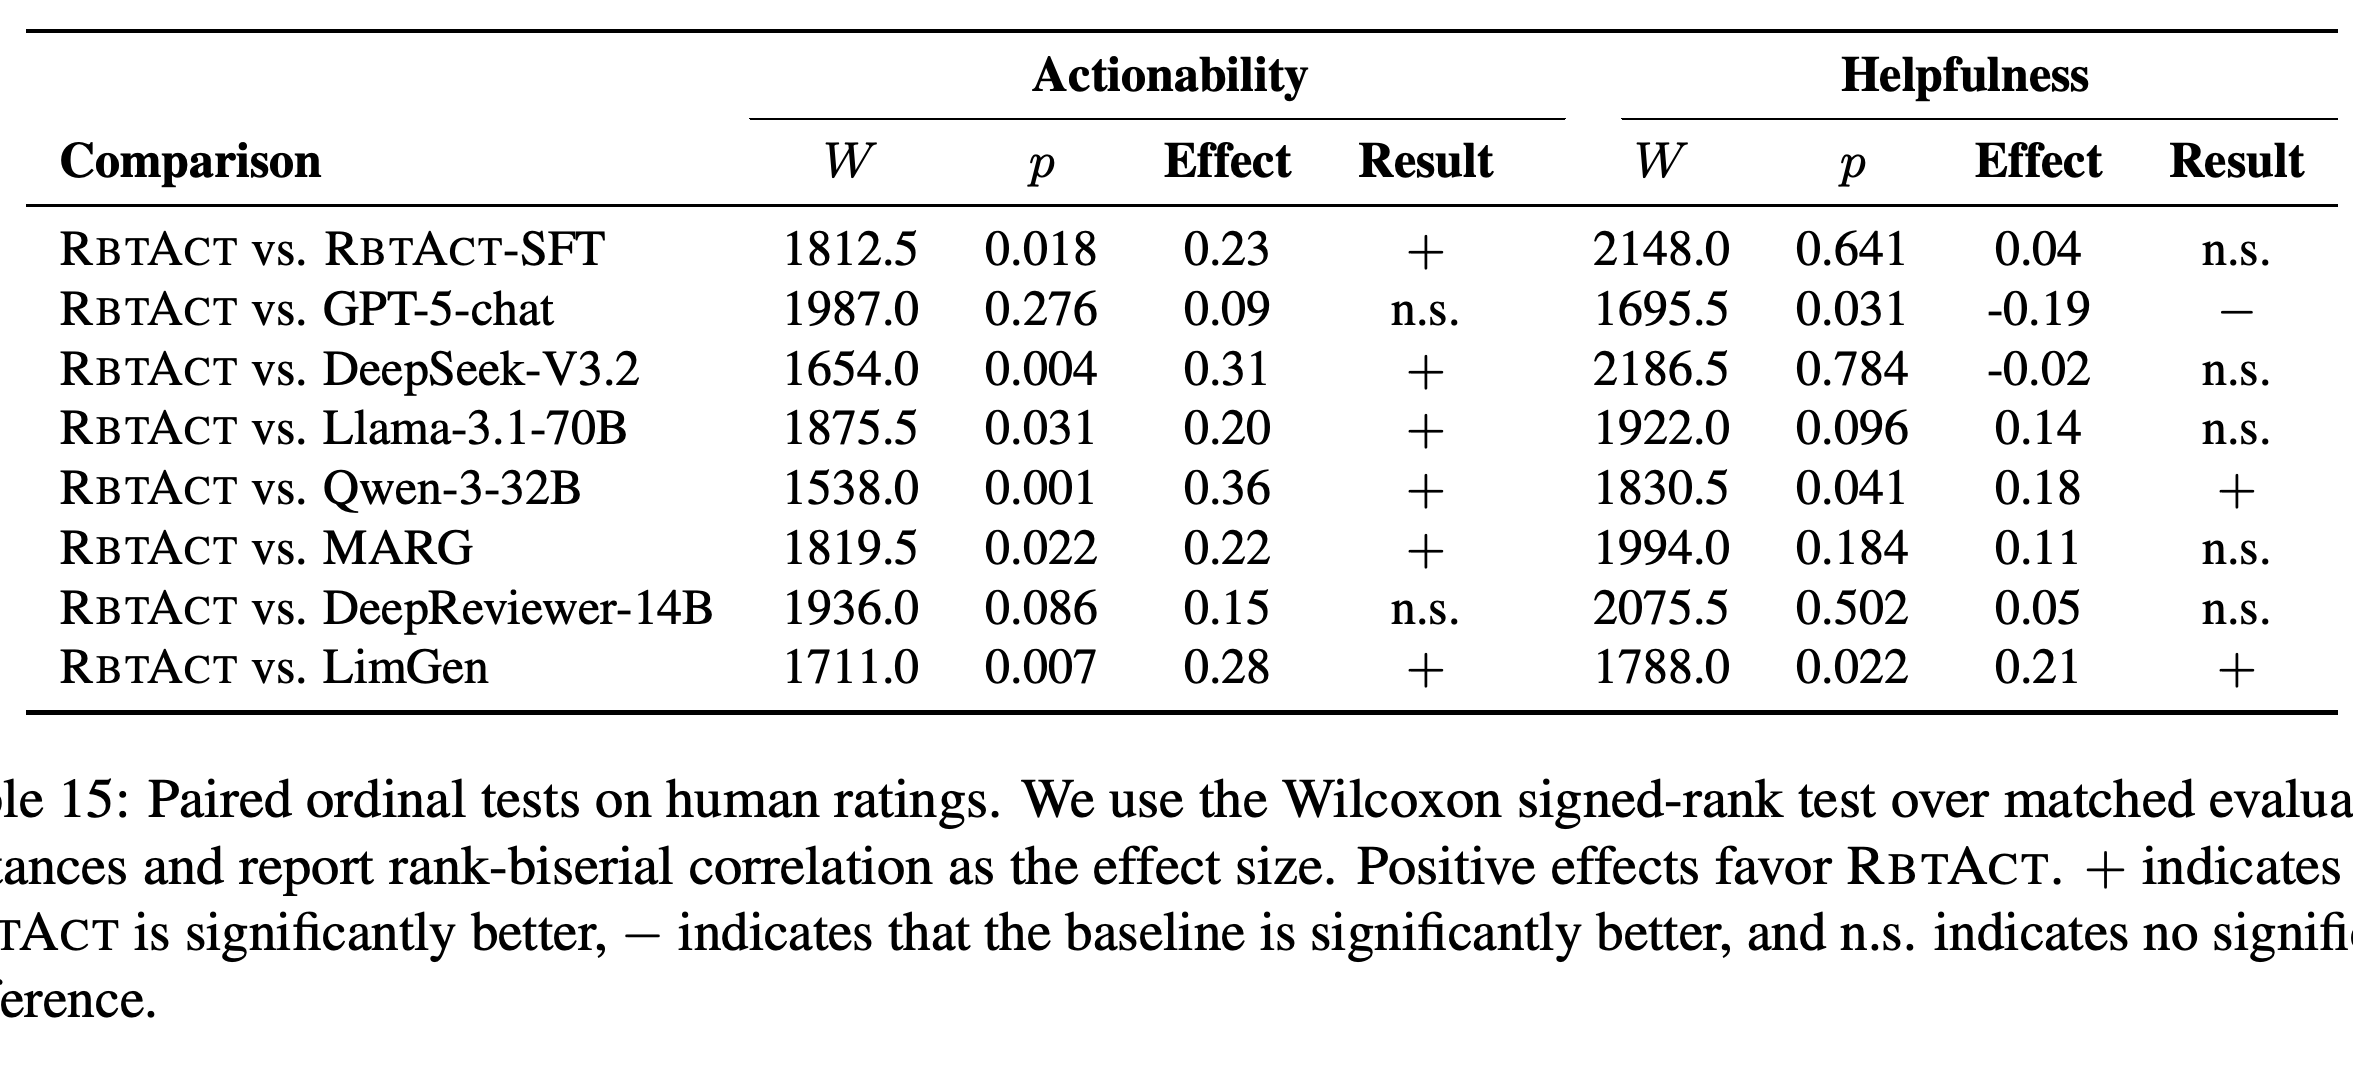
- Appendix F.3은 RBTACT-SFT 대비 Actionability 우위를 p = 0.018과 rank-biserial 효과 크기 0.23으로 보고한다. 보고된 검정에서 GPT-5-chat(p = 0.276) 및 DeepReviewer-14B(p = 0.086)와의 차이는 유의하지 않다. 다중 비교 보정은 설명하지 않는다.
RBTACT는 두 평가 방식 모두에서 평균 Actionability와 Specificity가 가장 높다. 반면 GPT-5-chat은 Groundedness, Relevance, Helpfulness에서 앞선다. 따라서 이 결과는 전체적인 우세가 아니라 항목별 성과를 보여준다.
RBTACT는 각 베이스라인과의 강제 선택 Actionability 비교에서 절반 넘게 승리하며, GPT-5-chat 대비 승률은 57.1%다. 이는 LLM 평가자 1개의 판정이므로, 유의한 인간 선호 차이로 해석해서는 안 된다.
보고된 대응 검정은 SFT 대비 Actionability 개선을 뒷받침하지만, GPT-5-chat이나 DeepReviewer-14B 대비 개선은 뒷받침하지 않는다. 또한 GPT-5-chat보다 Helpfulness가 낮다고 보고한다. PDF는 다중 비교 보정을 설명하지 않는다.
전체 우위가 모든 관점에서 동일하게 나타나지는 않는다. GPT-5-chat 대비 RBTACT의 승률은 Experiments에서 40.0%, Theory에서 80.0%다. 전체 패널의 일부 베이스라인 간 값이 Table 6과 달라, 두 결과 제시는 완전히 일치하지 않는다.
5.4 Automatic Evaluation
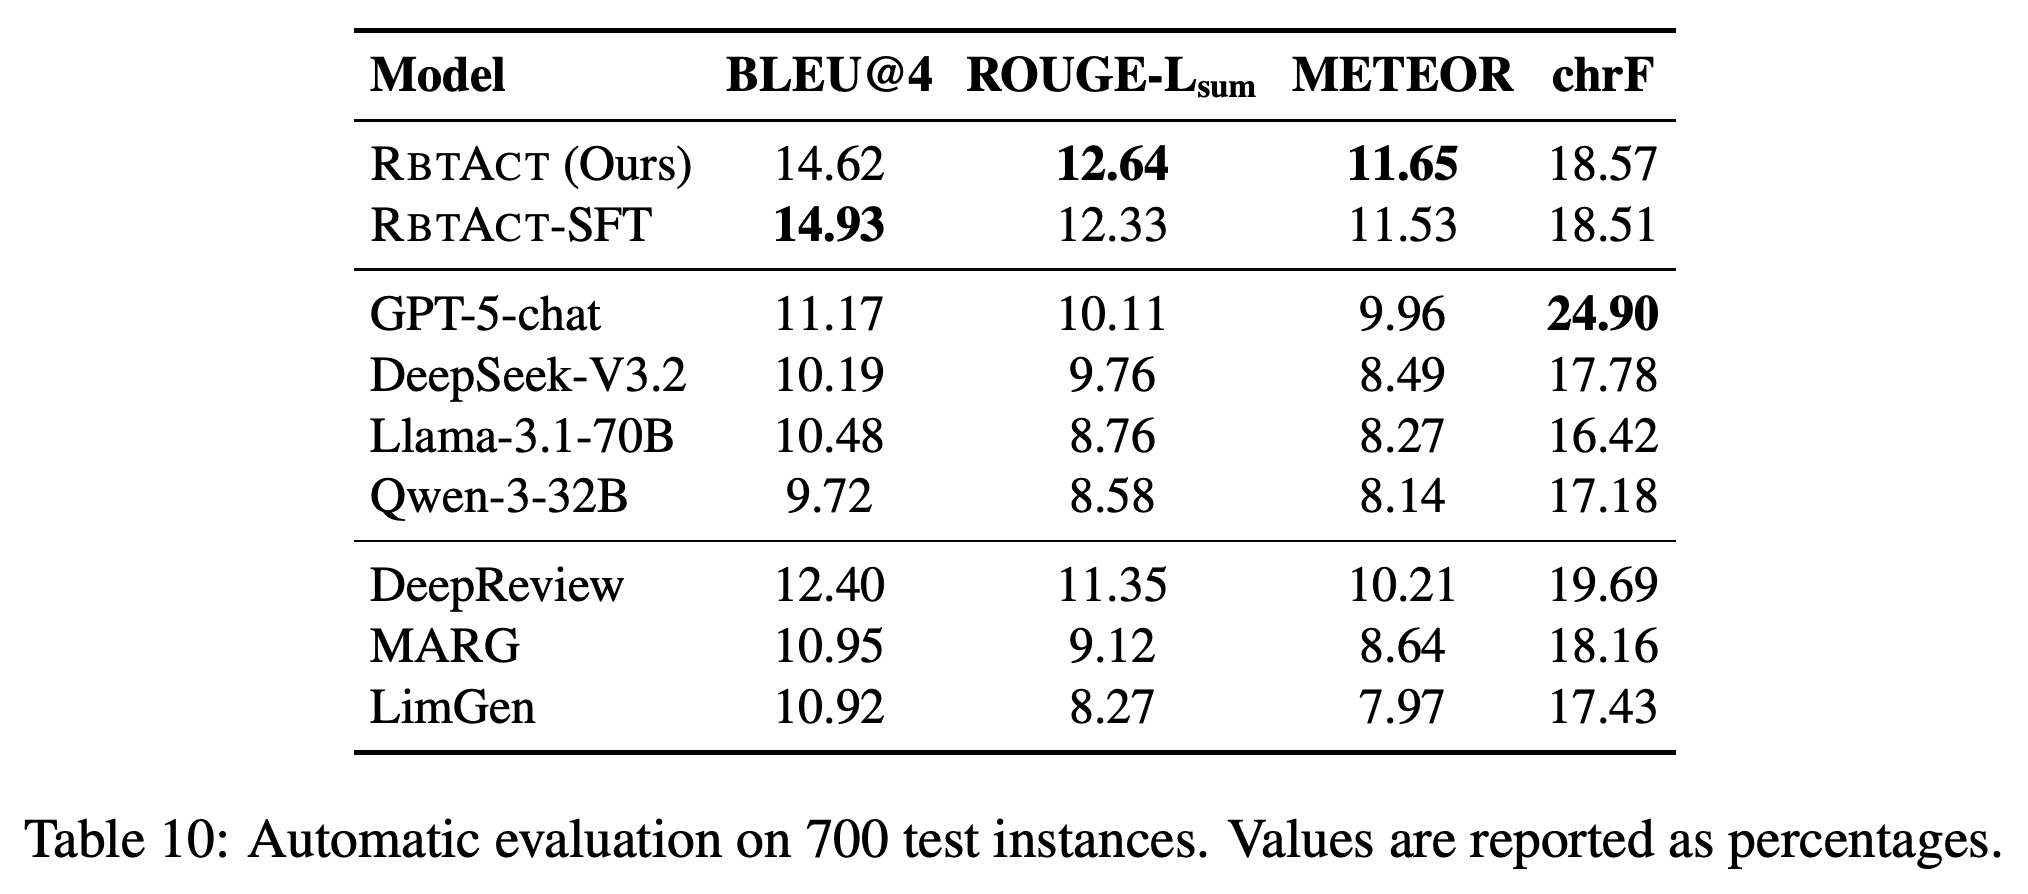
자동 평가는 전체 700개 사례에서 생성 코멘트를 인간 참조 1개와 비교하며 BLEU@4, ROUGE-Lsum (F1), METEOR, chrF를 사용한다. Table 10에서 RBTACT는 ROUGE-Lsum 12.64와 METEOR 11.65로 가장 높다. BLEU@4는 RBTACT-SFT가 14.93으로 가장 높고, chrF는 GPT-5-chat이 24.90으로 가장 높다.
- RBTACT는 BLEU@4 14.62와 chrF 18.57을 기록한다. 표의 모든 값은 백분율로 보고한다.
- SFT-to-DPO 과정에서 나타나는 작은 중첩 점수 변화는 실행 가능성을 직접 측정하지 않는다. 타당한 비판도 단일 참조 코멘트와 크게 다를 수 있다.
DPO는 SFT보다 ROUGE-Lsum과 METEOR를 조금 높이지만 BLEU@4는 조금 낮춘다. chrF는 GPT-5-chat이 가장 높다. 이는 참조 유사도 순위가 지표에 따라 달라지며 실행 가능성을 직접 측정하지 않음을 보여준다.
5.5 Case Study
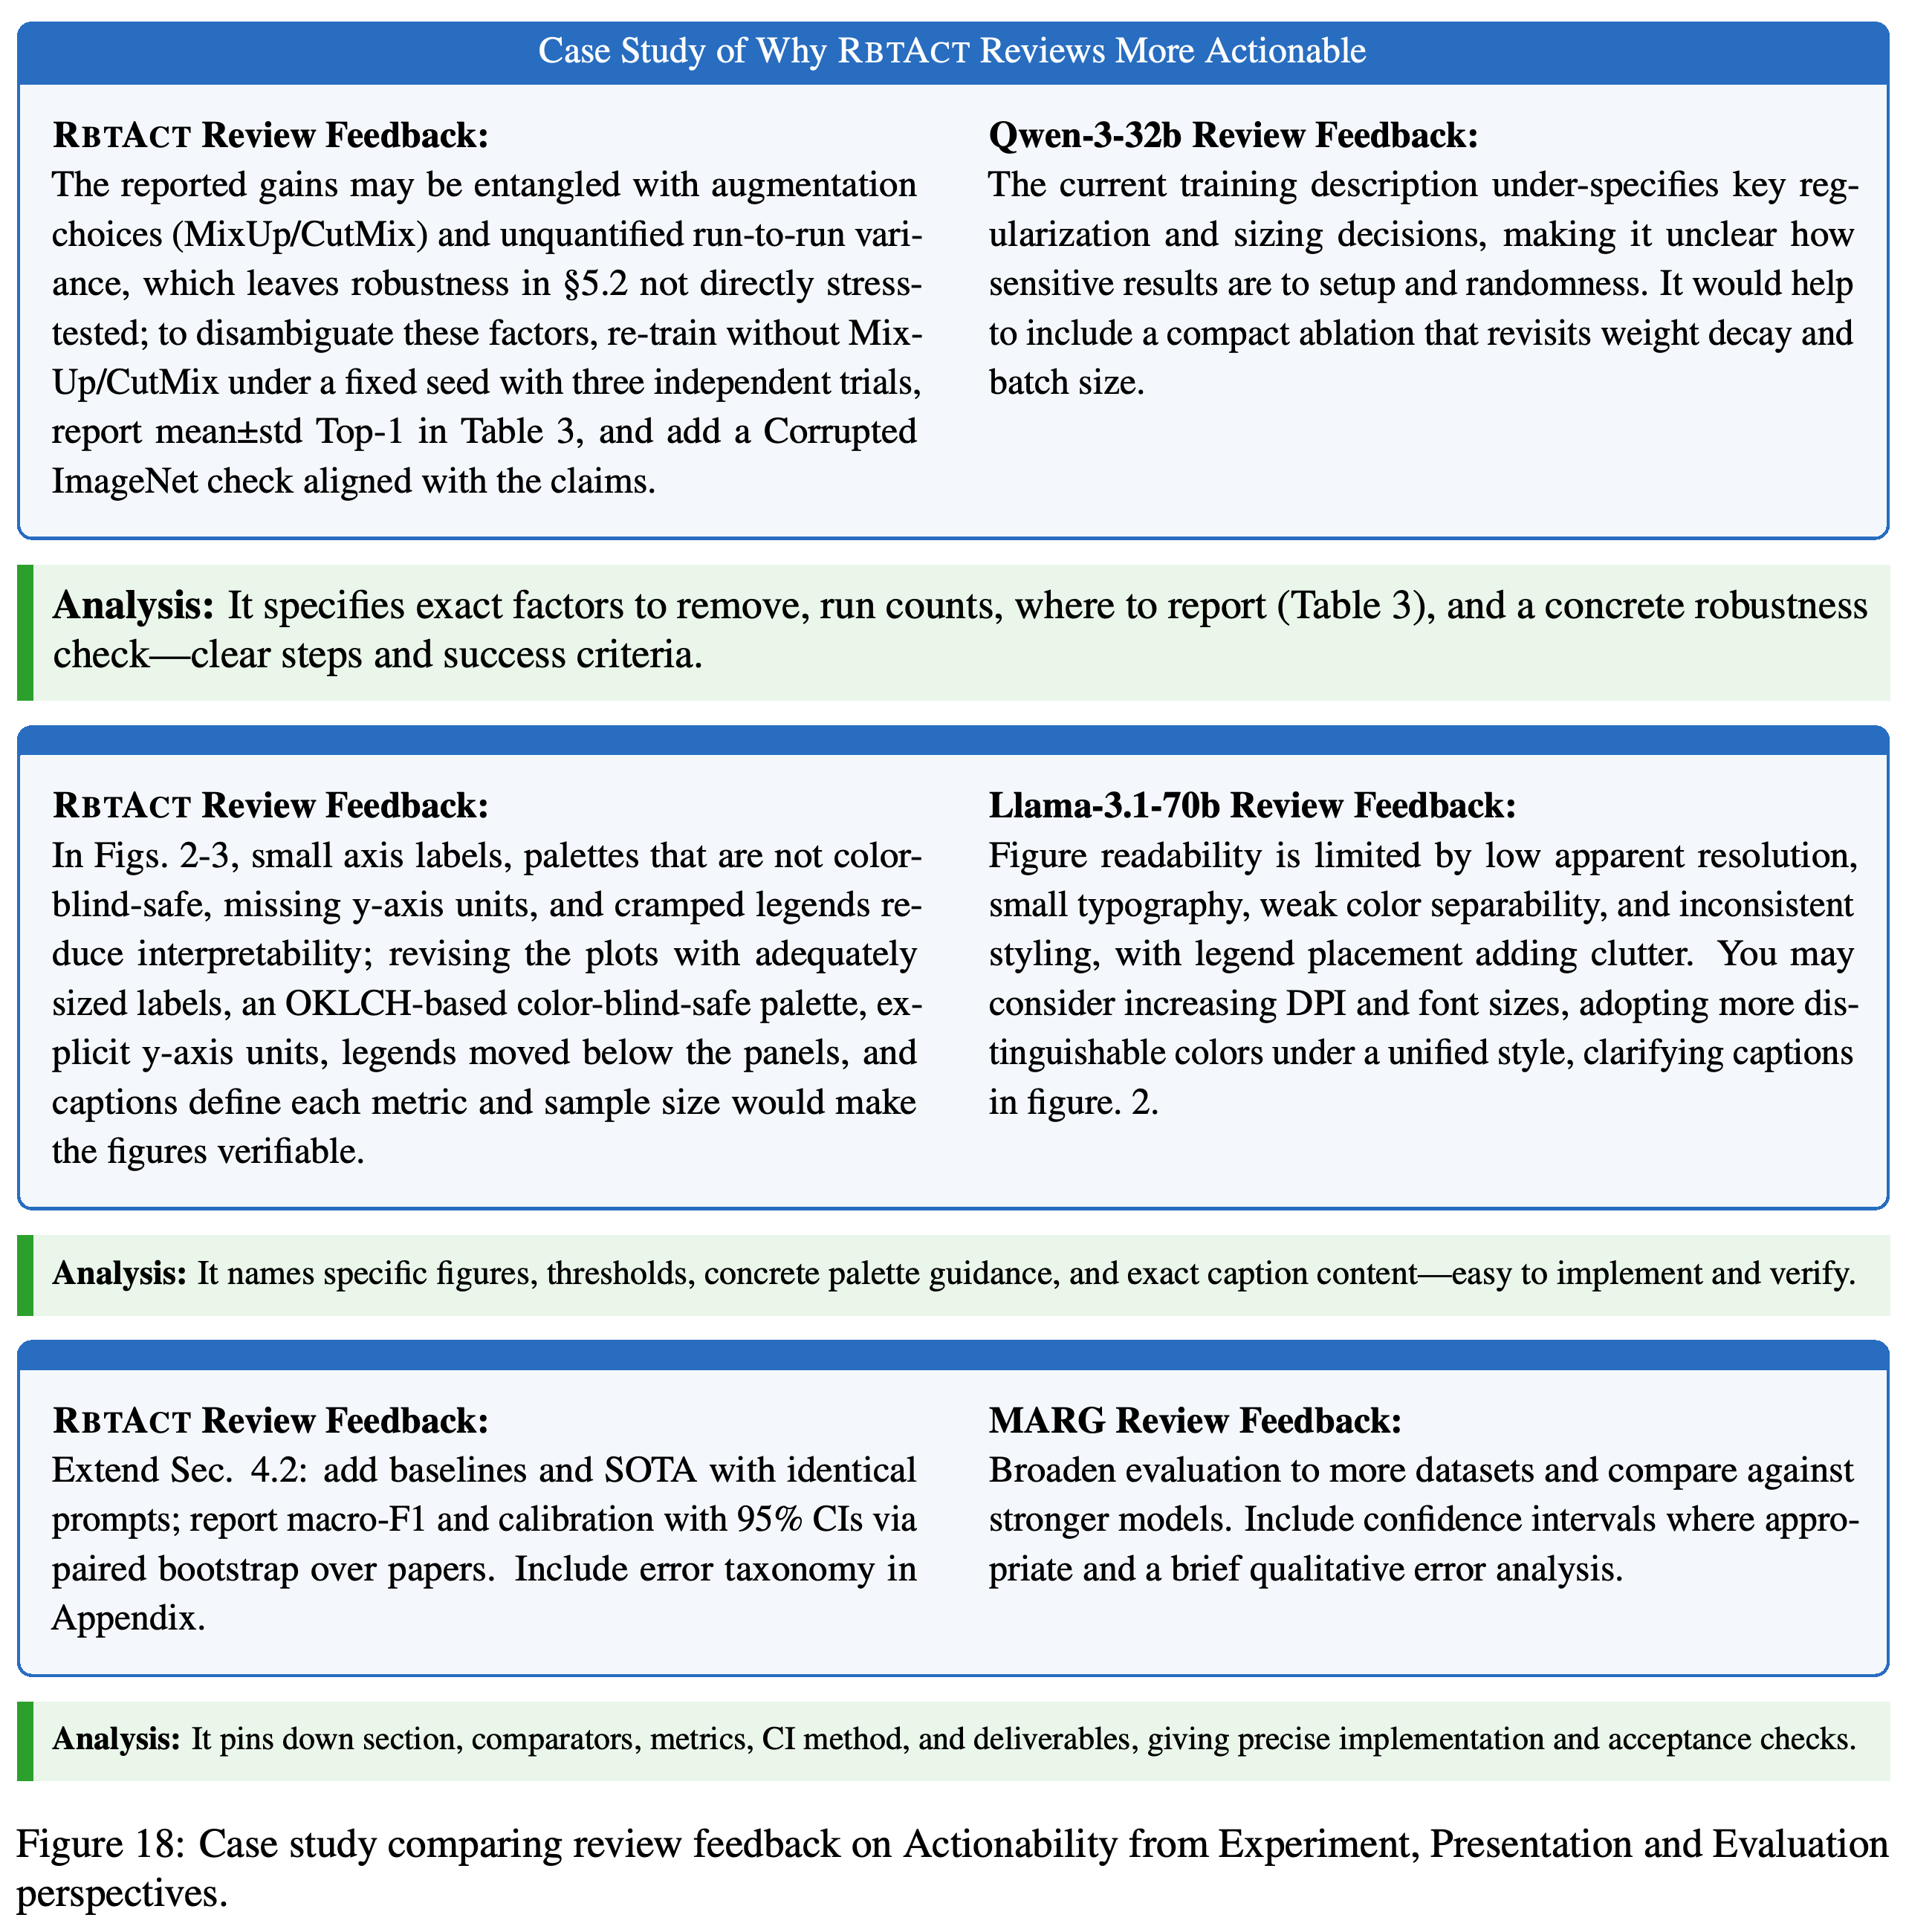
Figure 18은 Experiments, Presentation, Evaluation 예시로 학습이 유도하는 출력 형식을 보여준다. RBTACT는 변경할 요소, 결과를 보고할 위치, 지표, 절차를 명시한다. 반면 비교 코멘트는 더 포괄적인 권고를 제시한다.
- Experiments 예시는 고정 시드에서 MixUp/CutMix 없이 재학습하고 독립 시행 3회를 수행하도록 요청한다. 또한 Table 3에 mean±std Top-1을 보고하고 Corrupted ImageNet으로 확인하도록 요청한다.
- Presentation 예시는 Figs. 2–3을 지목하고 더 큰 레이블, 명시적인 y축 단위, 패널 아래 범례, 지표와 표본 크기를 정의한 캡션, OKLCH 기반 색각 이상 친화적 팔레트를 요청한다.
- Evaluation 예시는 Sec. 4.2, 베이스라인과 SOTA에 동일한 프롬프트 적용, macro-F1과 calibration, 논문 단위 대응 부트스트랩으로 산출한 95% CI, Appendix의 오류 분류 체계를 명시한다. 부트스트랩에 대해서는 이 글을 참조하라.
- 선택된 사례는 명시적인 지시를 보여주지만, 실행 가능성이나 근거를 독립적으로 검증하지는 않는다. 첫 예시의 고정 시드 표현도 시행 간 변동이 어디서 생기는지는 명시하지 않는다.
예시들은 실험 요인, 보고 위치, 그림 수정, 지표, 신뢰구간 절차를 명시해 학습 목표를 보여준다. 이러한 구체성은 Actionability를 보여주지만, 지시의 정확성이나 실행 가능성을 검증하지는 않는다.
5.6 Summary
결과는 8B 규모에서 rebuttal 기반 학습이 Actionability를 개선하며 Specificity도 경쟁력 있음을 뒷받침한다. 더 넓은 의미에서 동등한 성능을 주장하려면 단서를 달아야 한다. GPT-5-chat은 개별 평가의 Groundedness, Relevance, Helpfulness가 더 높으며, 인간 평가의 Helpfulness 우위는 보고된 대응 검정으로도 뒷받침된다.
- Appendix F.1은 관점을 심각도의 대리 지표로 사용한다. 주요 주제 매핑의 DWC는 45.4%로, 부차적 주제의 20.9%보다 높다. 그래도 CRP+SRP 수정 수용 비율은 50.7%다. 이는 실질적인 주제를 포괄함을 보여주지만, 문제 심각도를 직접 측정한 결과는 아니다.
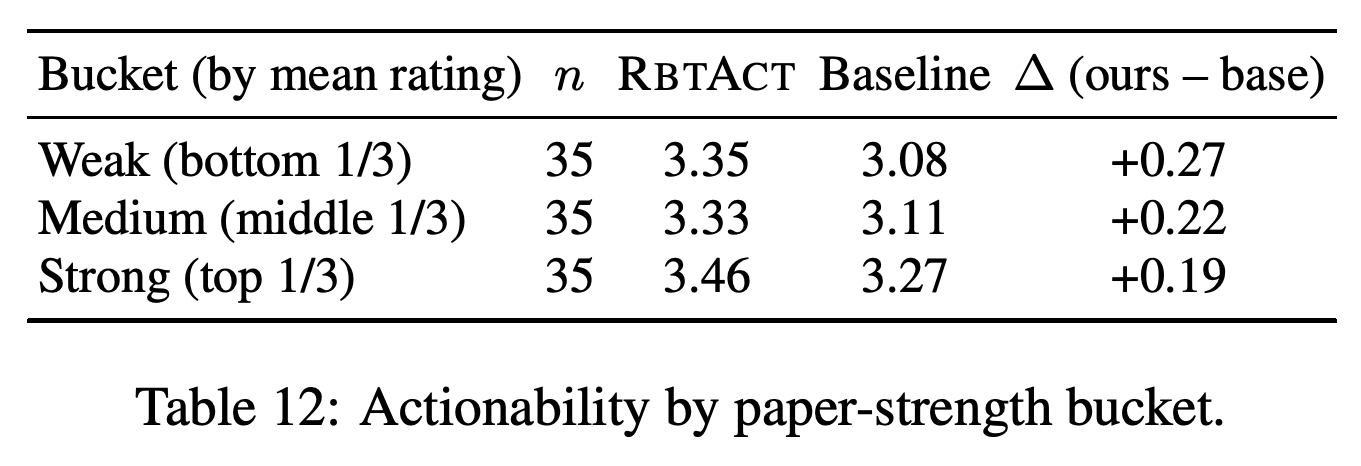
- 논문 수준별 삼분위 그룹에는 각각 논문 35편이 있다. Table 12는 Actionability 개선 폭을 Weak +0.27, Medium +0.22, Strong +0.19로 보고하지만, 비교한 베이스라인 시스템을 명시하지 않는다.
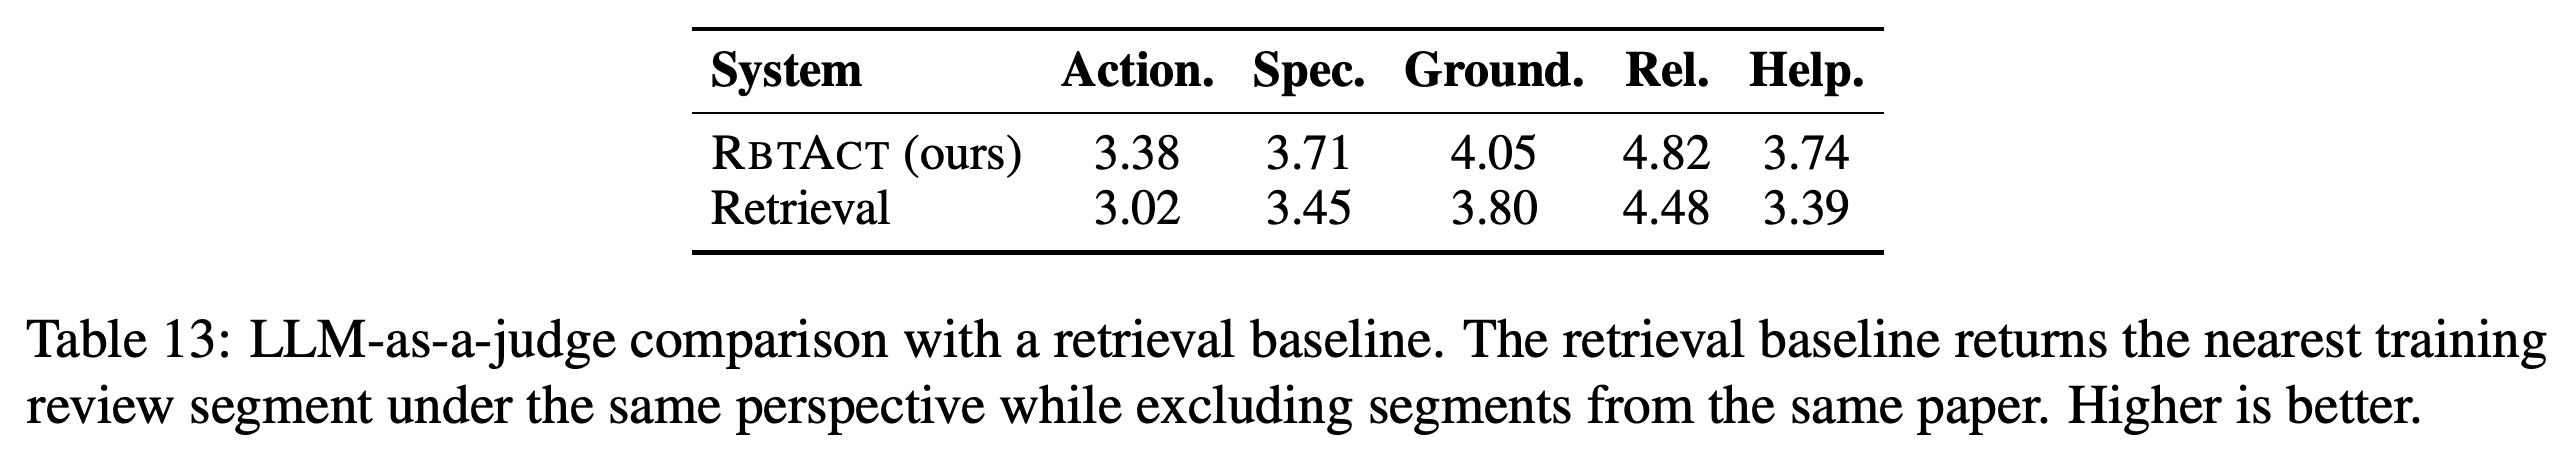
- 같은 관점의 최근접 이웃 검색 베이스라인은 LLM Actionability가 3.02로 RBTACT의 3.38보다 낮고, 전체 5개 항목에서 뒤처진다. 이는 해당 직접 재사용 베이스라인보다 학습된 생성이 낫다는 근거다.
논문 35편으로 구성된 각 수준별 그룹에서 보고된 Actionability 차이는 양수이며, 낮은 평가를 받은 논문에서 가장 크다. 비교 대상은 Baseline으로만 표기되어 있으므로, 이 표만으로는 각 그룹에서 RBTACT가 어느 시스템을 앞서는지 알 수 없다.
동일 관점의 최근접 이웃 검색은 평가한 5개 항목 모두에서 RBTACT보다 낮다. Actionability도 3.02로 RBTACT의 3.38보다 낮다. 이는 직접 재사용보다 생성을 통한 적응이 낫다는 근거다. 여기서는 RBTACT의 Specificity가 Table 5의 3.70이 아니라 3.71로 인쇄되어 있다.
6 Conclusion
결론은 rebuttal을 초점이 명확한 피드백의 학습 신호로 제시하고, RbtAct 식별자 아래 RMR-75K와 코드의 공개를 알린다. 실험은 평가된 세그먼트 품질의 개선을 뒷받침한다. 하지만 생성 코멘트가 더 나은 수정을 유발하거나 최종 과학적 타당성을 높인다는 점은 보여주지 않는다.
Limitations
논문은 rebuttal이 장기적인 실행보다 단기적인 저자의 수정 수용을 측정하며, 전략적인 약속이나 유보를 포함할 수 있음을 인정한다. 공개 OpenReview rebuttal, 컴퓨터 과학, 영어를 넘어 일반화할 수 있는지는 불확실하다. 현재 설정에는 원고, 코드, 데이터 산출물에 대한 엄밀한 검증도 없다.
- 저자의 방어가 정당할 수 있으며, 수용한 수정이 쉽거나 가치가 낮은 문제를 다룰 수도 있다. 따라서 영향 범주의 순서는 과학적 가치를 직접 측정하는 기준이 아니라 잡음이 있는 선호 가정이다.
- 응답이 있고 신뢰도 높게 정렬된 세그먼트만 남기면 어렵거나 무시된 논점이 제외될 수 있다. 정렬 검증은 이러한 제외를 평가하지 않는다.
- 정밀한 지시도 실행 불가능할 수 있다. 생성된 수정 계획을 실제로 실행하는지는 평가하지 않는다.
부록
- A Review and Rebuttal Mapping Details는 “Large Language Models as Tool Makers”의 매핑 2개와 전처리 프롬프트를 제공한다. A.1 Example of Mapping은 추출된 응답 구간을 보여주며, A.2 Prompts for Review Segment and Mapping은 분할과 원문 그대로의 추출을 설명한다. 매핑 프롬프트는 여러 논점에 같은 응답을 복사할 수 있도록 허용하지만, 본문의 방법은 최종 정렬을 일대일로 제한한다. 따라서 명시된 제약을 지키려면 후처리가 필요하다.
- B Label Details는 B.1 Detailed Definition of Perspective labels and Impact Categories에서 정의를, B.2 Perspective and Impact Category Distribution에서 개수를 제공한다. Experiments가 매핑 25,160개로 가장 크다. 전체 범주별 수치는 CRP 33,502개 / 44.3%, SRP 7,574개 / 10.0%, VCR 2,046개 / 2.7%, DWC 31,047개 / 41.1%, DRF 1,373개 / 1.8%다. B.3 Prompt for labeling perspectives는 생성에 쓰는 7개 관점 외에 Miscellaneous를 포함한다. 또한 짧은 근거를 작성한다는 본문 설명과 달리 범주 이름만 요청한다. B.4 Prompt for labeling impact categories는 완료된 수정이나 제공된 산출물을 계획, 모호한 약속, 방어, 회피와 구분한다.
- C Additional Training Details는 Framework and hardware., Memory and speed optimizations., Schedules.를 다룬다. LLaMA-Factory, H200 GPU, LoRA 어댑터, 긴 문맥 DPO 설정을 기록한다. Table 9는 두 단계 모두 LoRA α = 16과 dropout = 0.05를 명시한다. SFT와 DPO의 warmup 비율은 각각 0.10과 0.05이며, 장치당 배치 크기는 1, 누적 횟수는 각각 8과 16이다. 보고된 학습은 전체 파라미터 파인튜닝이 아니라 파라미터 효율적인 어댑터 튜닝이다.
- D Evaluation Details는 D.1 Baseline Prompt와 D.2 Baseline Adaptation Details를 제공한다. 후자는 MARG., LimGen., DeepReviewer-14B.를 다루며, 출력에 코멘트가 여러 개 있을 때 사용하는 결정적 추출 규칙도 포함한다. D.3 Human Expert Evaluation Protocol은 D.3.1 Interface에서 쌍별 유용성 선호와 후보별 평점을 구분한다. D.3.2 Dimension Rubrics (Concise)는 실행 가능한 절차, 정확한 지목, 증거의 뒷받침, 관점 일치, 건설적 유용성을 구분한다. D.4 LLM-as-a-Judge Evaluation은 개별 점수와 강제 선택 방식의 Actionability 비교를 설명하며, D.5 Automatic Evaluation은 중첩 지표를 보고한다. GPT-5-chat은 경쟁 생성 모델이면서 보고된 유일한 LLM 평가자다.
- E Case Study는 Figure 18의 비교 3개를 제시한다. 이 예시들은 명시적인 요인, 위치, 지표, 신뢰구간 절차, 산출물이 포괄적인 권고를 구체적인 지시로 바꾸는 방식을 보여준다. 하지만 선택된 예시일 뿐, 개선 정도를 대표하는 추정치는 아니다.
- F Additional Analyses는 F.1 Severity and Paper-Strength Analyses.에서 관점 기반 심각도와 OpenReview 평점 삼분위를 살펴본다. F.1.1은 Experiments, Evaluation, Theory, Novelty, Reproducibility를 주요 주제로 묶는다. F.1.2 Setup.과 Interpretation.은 논문 수준별 그룹 모두에서 개선을 보고하지만 비교 대상을 명시하지 않는다. F.2 Retrieval Baseline Analysis는 테스트 논문을 인코딩하고, 같은 논문을 제외한 동일 관점의 학습 코멘트를 검색한 뒤, rebuttal에 접근하지 않고 가장 가까운 코멘트를 반환한다. F.3 Ordinal-Aware Analysis of Human Ratings는 중앙값, IQR, 점수 ≥4 비율, 통합 분포 기반 ridit 점수, 대응 Wilcoxon 검정을 보고한다. RBTACT의 Actionability 중앙값은 4이며 모든 베이스라인은 3이다. 평점의 52%가 ≥4다. SFT와의 Helpfulness 차이는 유의하지 않지만(p = 0.641), GPT-5-chat은 유의하게 더 높다(p = 0.031, 효과 크기 −0.19). 또한 Table 14의 일부 평균은 Table 5와 다르다.
짧은 생각
유용한 방법론적 기여는 같은 논문과 관점 안에서 비교를 유지하면서 리뷰어–저자 상호작용에서 선호를 얻는다는 점이다. SFT만 사용한 비교 실험과 인간 평가의 대응 검정은 이 신호가 추가적인 Actionability 개선을 제공함을 뒷받침한다. 하지만 GPT-5-chat보다 우수하다거나 과학적으로 가장 중요한 논점을 선택한다는 근거는 아니다. 저자의 수정 의지는 비판의 타당성 및 가치와 다르다. 관점 기반 심각도 분석은 주제 포괄성을 다루지만 이 차이를 해소하지는 않는다. 관찰된 원고 변경과 산출물 수준 검증은 참조 중첩이나 선택된 예시보다 의도한 성과를 더 직접적으로 시험할 수 있다. 상당한 구현 세부사항을 제공하지만, 보고되지 않은 수치 설정과 표 내부의 불일치는 정확한 재현을 제한한다.