


2025년 6월 AI 논문 동향
30 Jun 2025 | Paper Review Monthly Papers Agent System Optimization Camera-Controlled Video Generation Hierarchical Language Modeling목차
이달의 트렌드
이 글은 2025년 6월에 처음 공개된 논문을 나중에 정리한 회고다. Sekai 요약은 보존된 2025년 11월 9일자 v3 개정본을 사용하므로, 해당 결과가 6월 당시 공개되어 있었다는 뜻은 아니다.
2025년 6월에 선정된 3편의 논문은 모델이 작업과 정보를 구성하는 방식을 개선한다는 공통점을 갖는다. SwarmAgentic은 각각 책임과 지침을 부여한 언어 모델 에이전트 팀을 탐색하고, Sekai는 1인칭 영상에 환경 설명과 시간에 따른 카메라의 위치 및 방향을 나타내는 카메라 궤적을 결합하며, Autoregressive U-Net은 여러 크기의 단위로 텍스트 표현을 학습한 뒤 바이트를 차례로 예측한다. 이 연구들은 시스템 구조, 학습에 제공하는 감독 정보, 표현 단위의 크기를 과제 성능을 개선하는 서로 다른 방법으로 검토한다. 1, 2, 3
주요 결과는 비교 조건에 따라 해석해야 한다. SwarmAgentic은 여행 계획의 전체 요건을 충족하는 성공률을 높이지만, 비교 방법과 탐색에 사용한 토큰 수, 호출 수, 금전적 비용을 맞추지는 않는다. Sekai는 기존 모델을 추가로 학습하는 미세 조정을 통해 카메라 궤적 추종 성능을 높이지만, 일반 비디오 생성 결과는 미세 조정하지 않은 기준 모델 없이 학습 체크포인트끼리 비교한다. Autoregressive U-Net은 연산량을 통제한 실험에서 강력한 고정 어휘 기준 모델과 전반적으로 비슷한 성능을 보이지만, 일부 동일 데이터 비교에서는 더 큰 모델이나 더 많은 연산량을 사용한다. 이 결과들은 구체적인 설계 선택을 뒷받침하지만, 탐색 효율, 지속적인 상호작용 탐색, 측정한 학습 규모를 넘어선 성능 향상은 확인하지 못한다.
2025년 6월의 주요 논문
1. SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence
- https://arxiv.org/abs/2506.15672v1
- SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence 요약 설명
- SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence는 에이전트 지침과 워크플로를 함께 탐색한다. 워크플로는 에이전트를 연결하는 실행 단계와 정보 흐름이다. 각 후보가 이전에 찾은 최적 해와 집단 전체의 최적 해를 참고하는 집단 탐색 기법인 Particle Swarm Optimization을 구조화된 언어 설명에 적용한다. 대규모 언어 모델은 실패를 진단하고 텍스트 수정안을 만들어 에이전트와 협업 방식을 변경한다.
- GPT-4o로 실행했을 때, 사용자 제약을 따르는 여행 계획 벤치마크인 TravelPlanner에서 최종 통과율 32.2%를 기록한다. 에이전트 코드를 탐색하는 비교 방법인 Automated Design of Agentic Systems (ADAS)는 8.9%를 기록한다. 이는 23.3%포인트 상승이며, 논문은 상대적 향상률을 261.8%로 보고한다. SwarmAgentic은 후보 시스템 5개와 최적화 반복 10회를 사용하고, ADAS에는 최대 30회의 반복을 허용한다. 이 설정만으로 탐색 비용이 같다고 볼 수는 없다.
- 구성 요소 실험은 행동과 협업 방식을 함께 최적화하는 접근을 가장 분명하게 뒷받침한다. Creative Writing 사례 20개에서 워크플로 재구성을 제거하면 전체 시스템의 점수가 8.8에서 6.7로 낮아지고, 에이전트 수준의 적응을 제거하면 7.3으로 낮아진다. 모델 간 전이는 Creative Writing에서 평가한다. 불확실성 추정이 없고, 중복된 탐색 설정의 점수가 서로 다르며, 한 Gemini 조건에 대한 설명도 일치하지 않아 효율과 견고성을 더 강하게 주장하기 어렵다. 공개된 프롬프트에도 모듈화된 워크플로 규칙이 포함되어 있다.
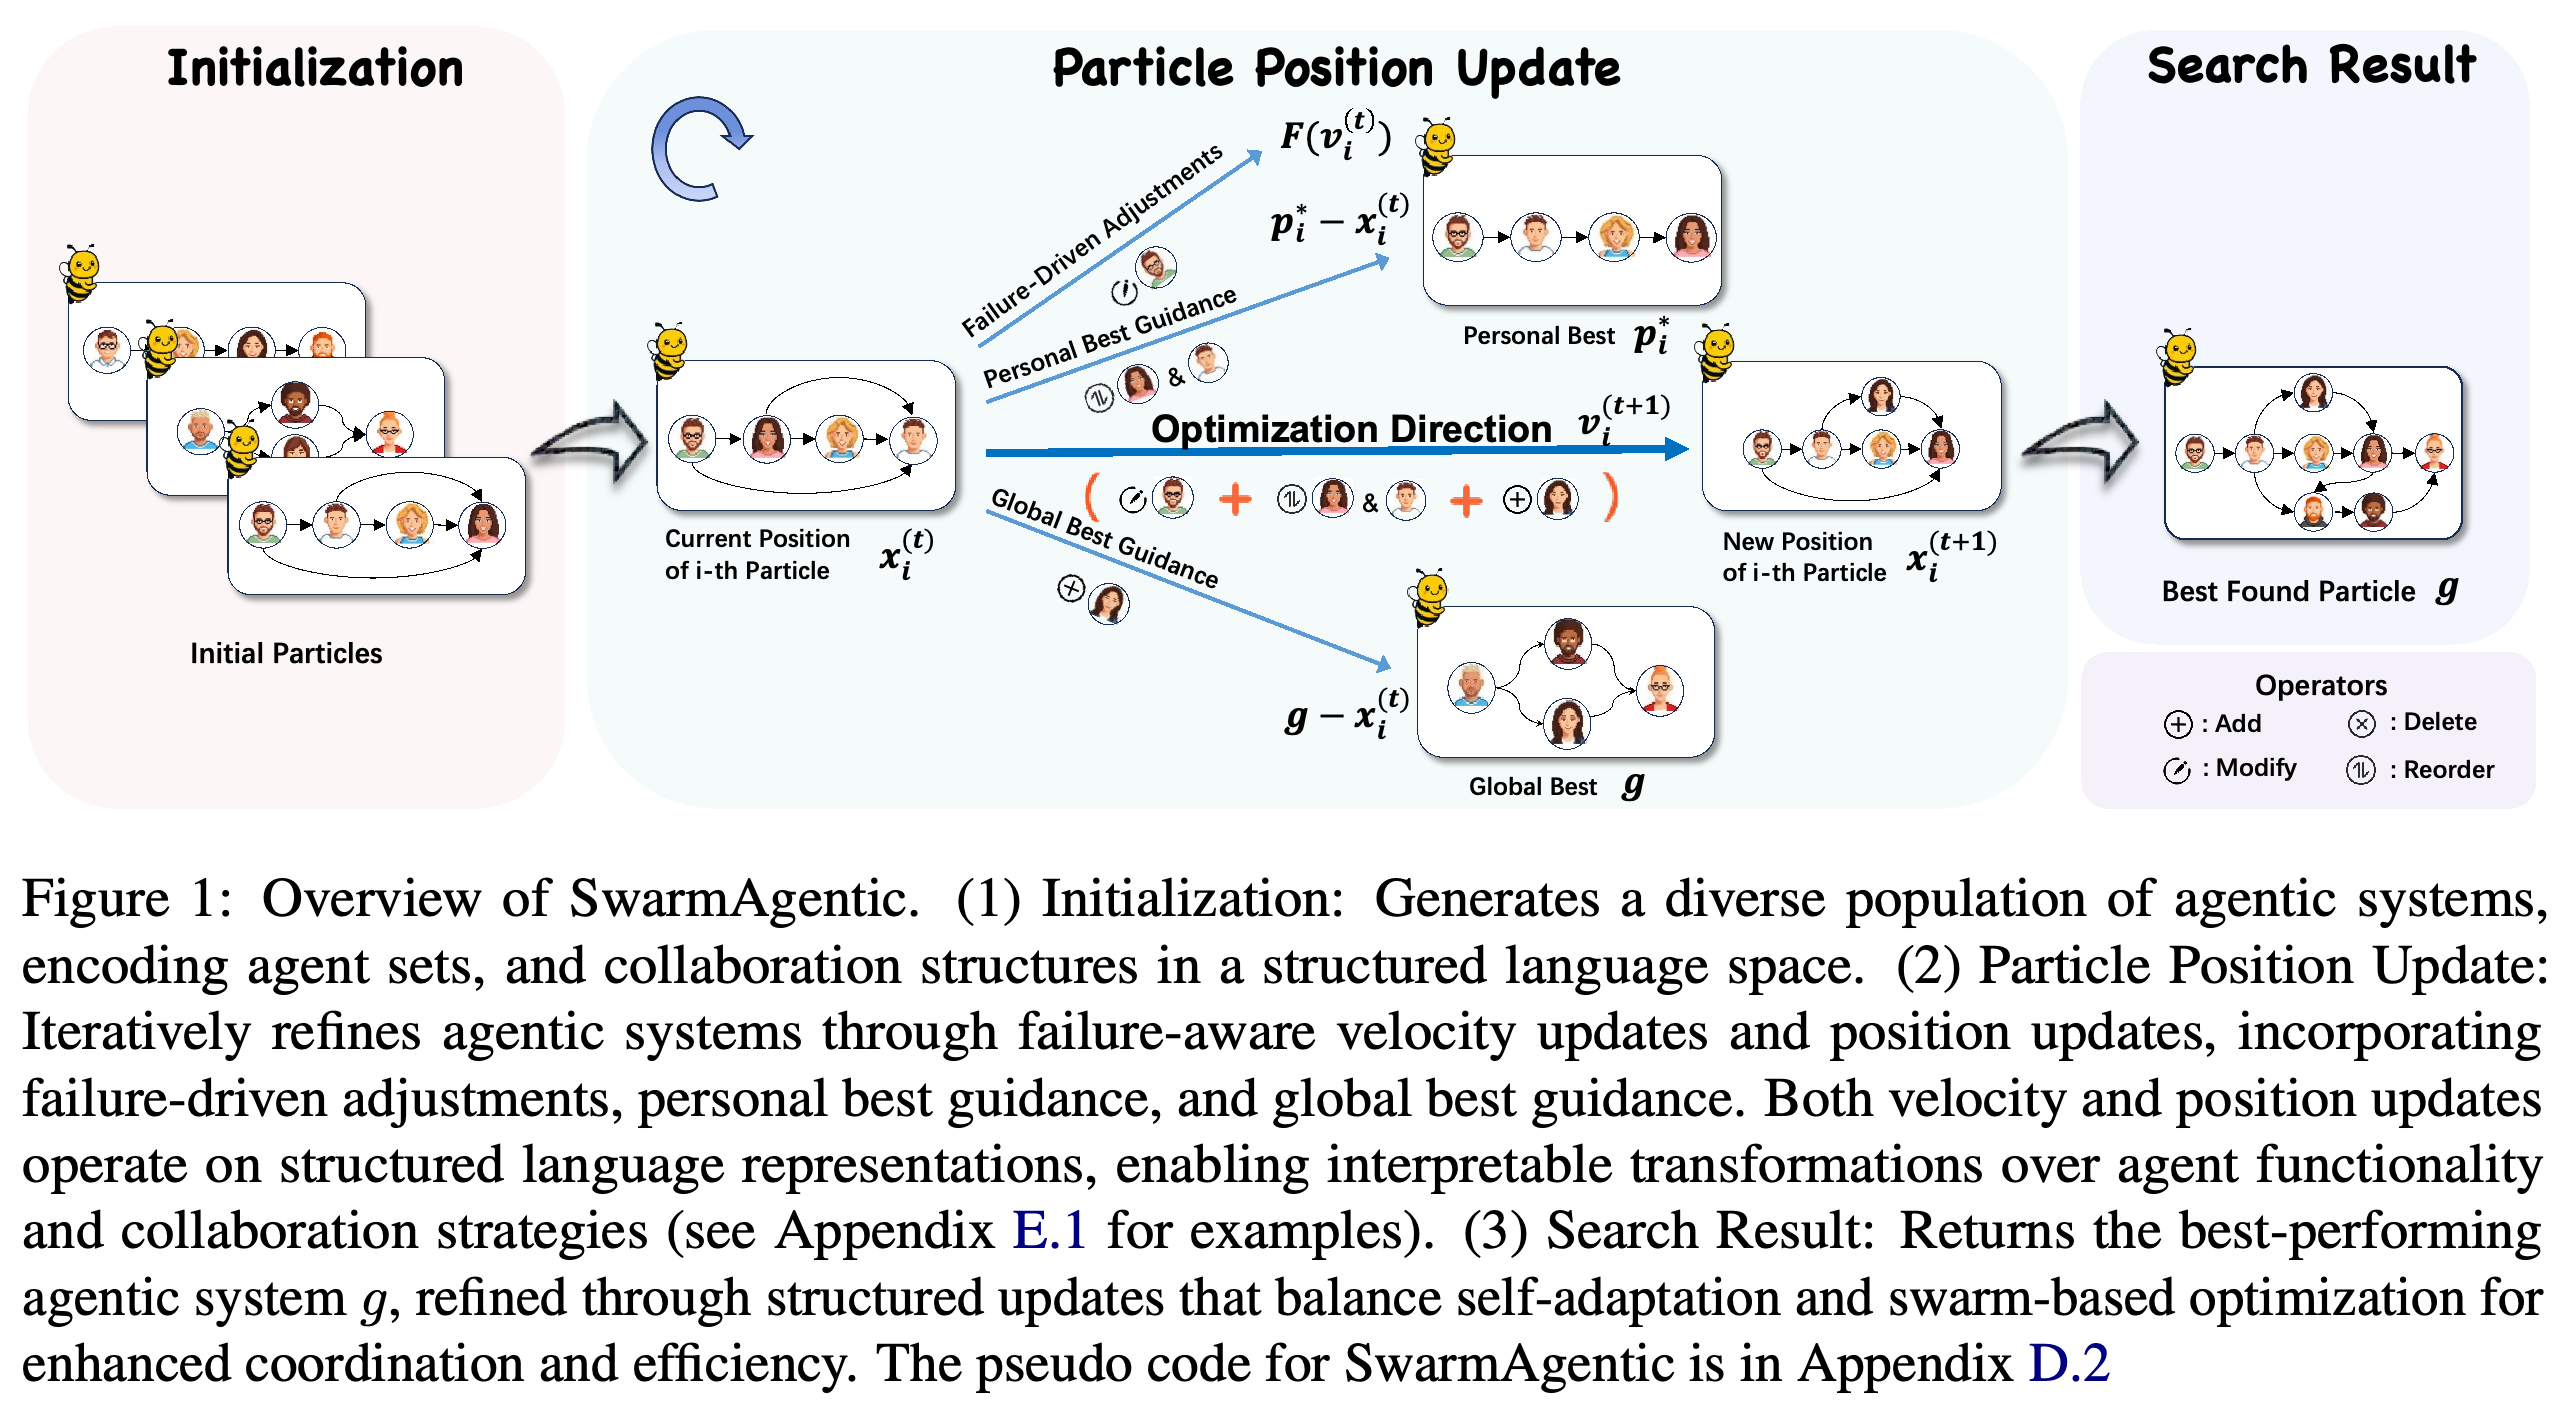
SwarmAgentic의 초기화, 언어 기반 입자 갱신, 최적 시스템 선택
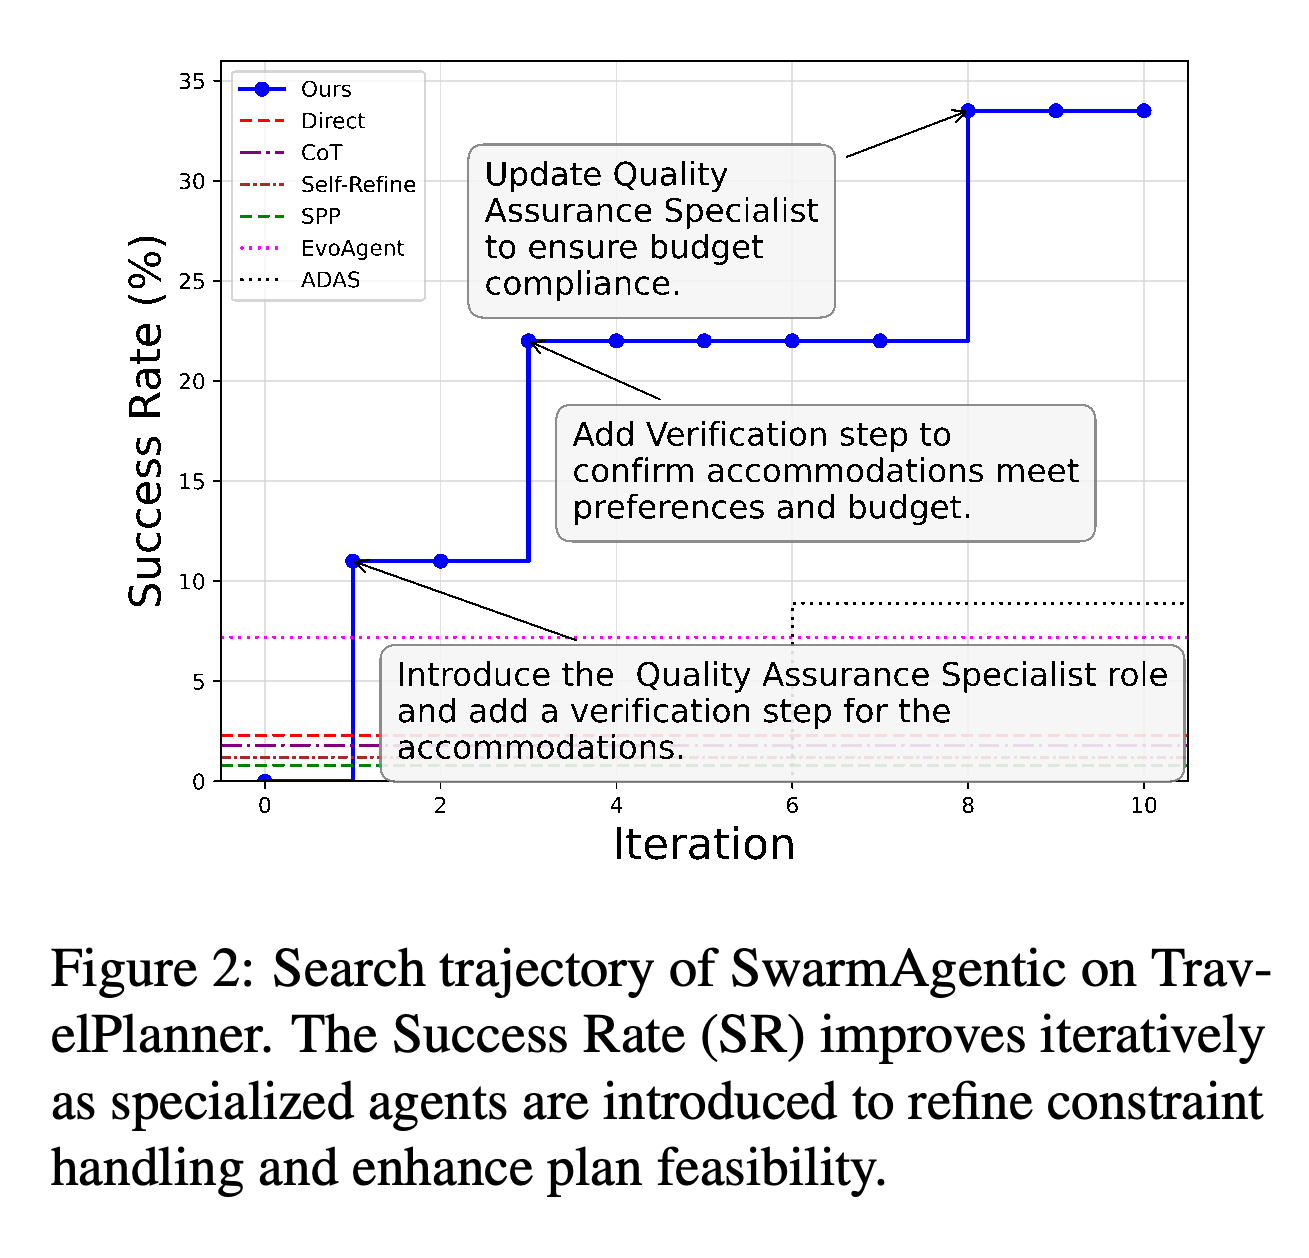
에이전트와 검증 변경 사항을 주석으로 표시한 TravelPlanner 탐색 과정
2. Sekai: A Video Dataset towards World Exploration
- https://arxiv.org/abs/2506.15675v3
- Sekai: A Video Dataset towards World Exploration 요약 설명
- Sekai: A Video Dataset towards World Exploration은 도보 및 드론 영상에 위치, 환경 레이블, 캡션, 카메라 궤적을 제공한다. Figure 2는 101개 국가와 지역, 750개가 넘는 도시를 포괄하는 Sekai-Real 5,064시간과 Lushfoil Photography Sim에서 수집한 Sekai-Game 36시간을 보고한다. 실제 영상의 카메라 궤적은 영상에서 추정하고, 게임의 카메라 위치와 방향은 직접 기록한다. 품질과 다양성을 고려한 샘플링으로 400시간의 학습 부분집합인 Sekai-Real-HQ를 구성한다.
- 카메라 조건부 비디오 생성 모델인 Wan2.1-Fun-V1.1-1.3B-Control-Camera를 Sekai-Real 드론 영상으로 미세 조정하면 이동 오차가 28.32에서 17.19로, 회전 오차가 27.2에서 19.89로 감소한다. Sekai-Game으로 미세 조정하면 같은 오차가 각각 7.64에서 4.22로, 8.36에서 6.22로 감소한다. 오차가 낮을수록 요청한 카메라 움직임과 추정된 움직임이 더 가깝다는 뜻이며, 물리 단위는 명시되어 있지 않다. 카메라 움직임 추정 시스템인 MegaSaM이 실제 영상의 학습 주석과 생성 영상의 평가 궤적을 모두 제공하므로, 기하 정확도를 독립적으로 입증하는 데에는 한계가 있다.
- 주석 검증에서는 표본 영상 500개 중 위치 문제가 발견된 비율이 5% 미만이며, 사례 500개에서 범주 주석 일치율이 90%를 넘는다고 보고한다. 범주 분석에서는 실내 장면을 제외한다. 생성 평가는 선정된 테스트 클립 50개를 사용한다. 일반 비디오 생성 실험은 초당 16프레임의 49프레임 클립을 사용하며, 미세 조정하지 않은 기준 모델 없이 미세 조정 체크포인트끼리 비교한다. 지속적인 이동과 장소 재방문은 평가하지 않으며, 영상 길이 통계가 일치하지 않아 데이터셋 집계의 일부도 불분명하다.
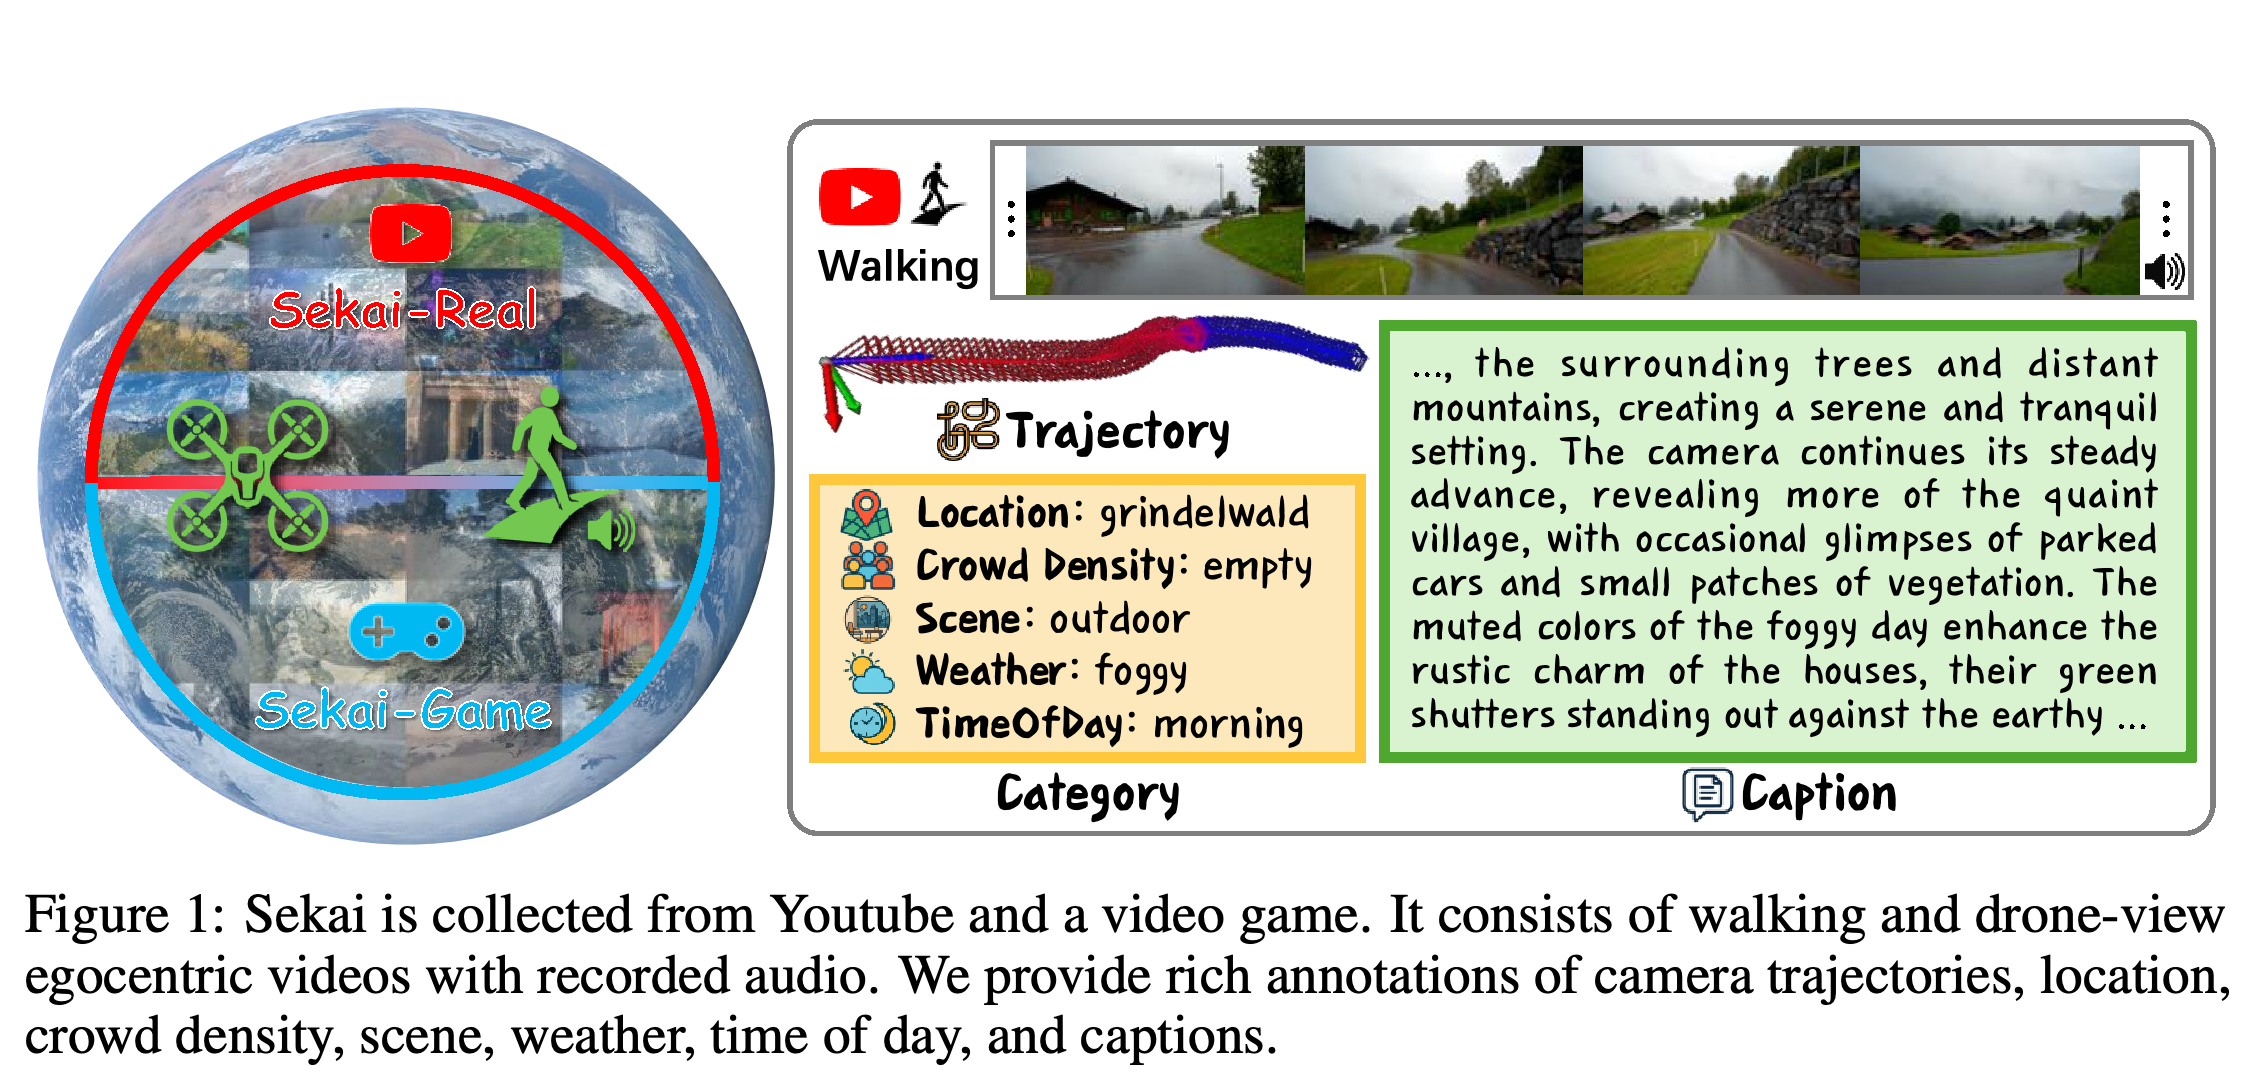
실제 및 게임 영상 출처와 카메라, 범주, 캡션 주석 예시
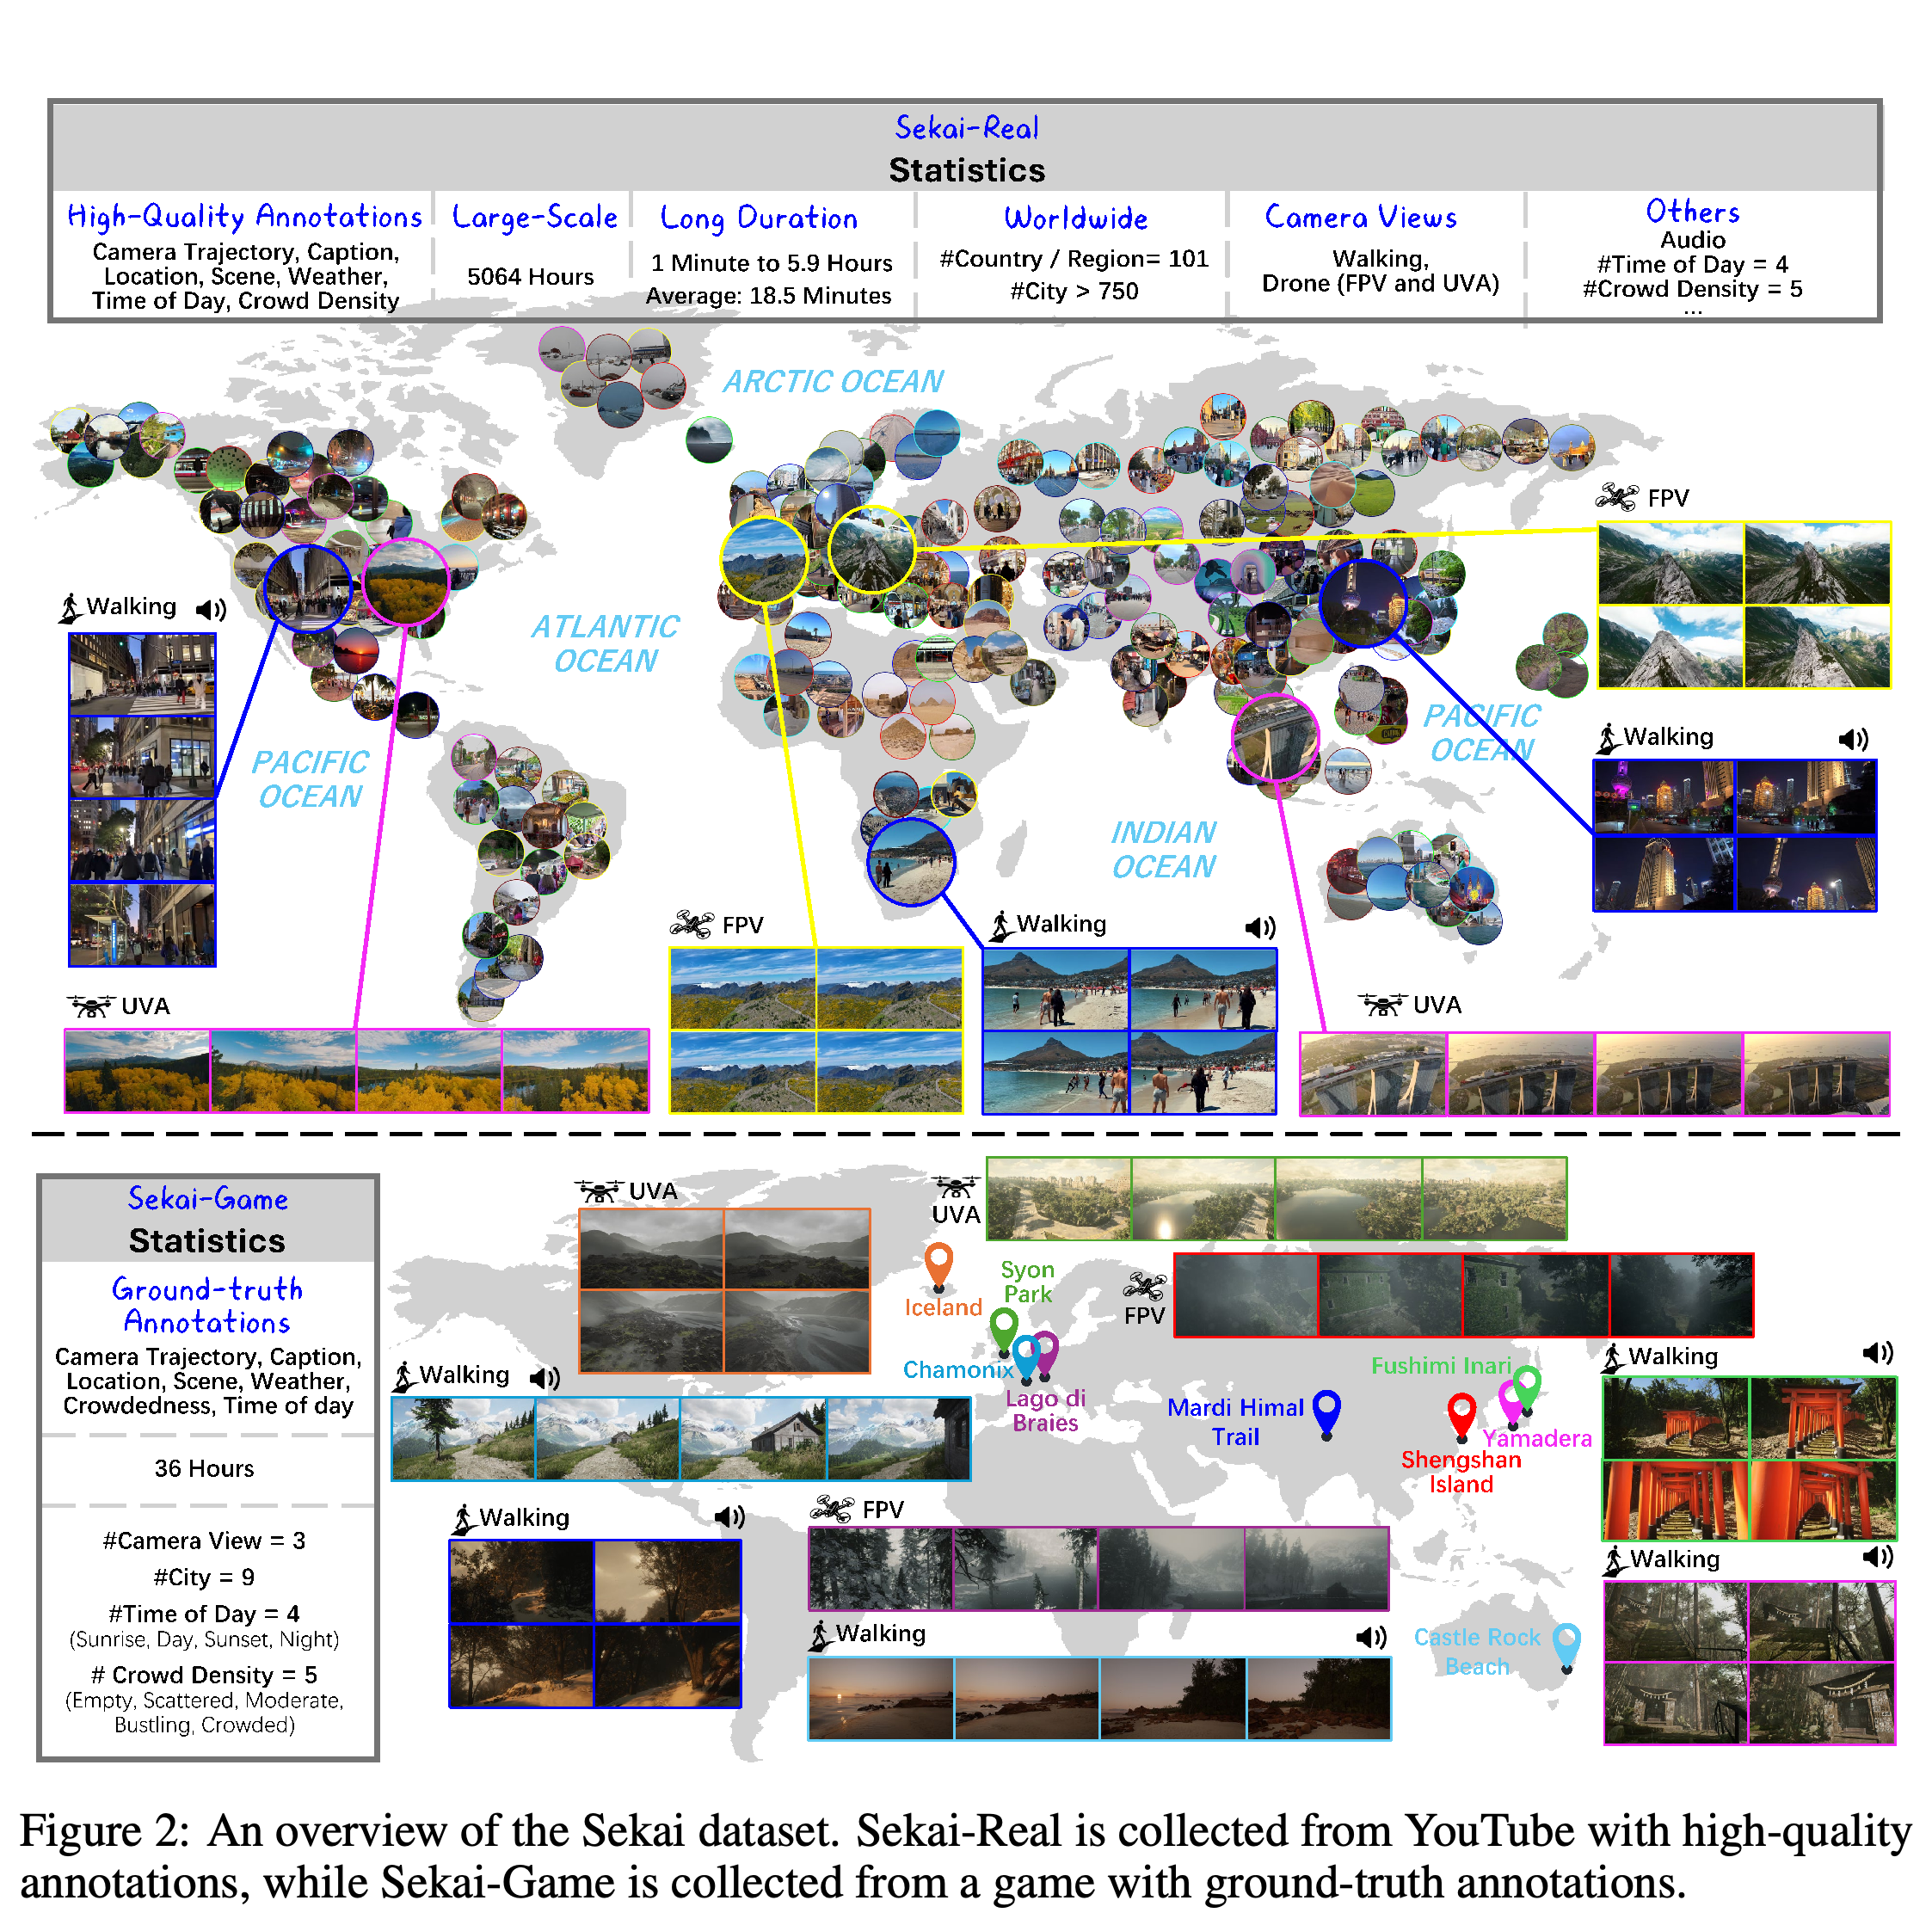
Sekai-Real과 Sekai-Game의 지리적 범위, 샘플 시퀀스, 수집 통계
3. From Bytes to Ideas: Language Modeling with Autoregressive U-Nets
- https://arxiv.org/abs/2506.14761v1
- From Bytes to Ideas: Language Modeling with Autoregressive U-Nets 요약 설명
- From Bytes to Ideas: Language Modeling with Autoregressive U-Nets는 바이트 시퀀스를 더 큰 단위의 문맥 표현으로 압축한 뒤 다음 바이트를 예측하도록 다시 확장하는 Autoregressive U-Net (AU-Net)을 제안한다. Skip connection은 세밀한 표현을 후속 층에 직접 전달한다. 계층 구조는 바이트, 단어, 2단어, 4단어 단위를 처리할 수 있지만, 경계는 미리 정한 텍스트 패턴 규칙을 따른다. 따라서 표현을 학습하면서도 수동으로 지정한 분할 방식을 유지하며, 공백 기반 규칙은 라틴 문자에 적합하다.
- LLaMa 3 기준 370B 토큰에 해당하는 데이터로 학습하면, AU-Net 3은 객관식 벤치마크인 Hellaswag에서 72.9 ± 0.9를 기록한다. 자주 등장하는 바이트열을 반복해서 병합해 어휘를 구성하는 Byte-Pair Encoding (BPE)은 70.2 ± 0.9를 기록한다. Table 2는 양쪽 학습 비용을 연산량 척도인 부동소수점 연산 횟수 (FLOPs) 기준으로 모두 4e21로 반올림해 표기하지만, Table 10은 AU-Net 3을 4.0e21, BPE를 3.6e21로 기재한다. 연산량 스케일링 실험에서는 여러 과제에서 BPE와 전반적으로 비슷한 성능을 보이지만, 평가 범위 상단에서는 지식과 수학 추론 성능이 여전히 낮다.
- 실용적인 이점은 과제와 계층 깊이에 따라 달라진다. 60B 토큰에 해당하는 데이터 조건에서 AU-Net 3의 파라미터 수는 2.5B로 BPE의 1.8B보다 많으며, H100 80GB 하드웨어에서 장치당 학습 처리량은 초당 180k 바이트로 BPE의 210k 바이트보다 낮다. 단어와 문자 조작 벤치마크인 CUTE에서 AU-Net 2는 답이 목표와 정확히 일치하는 비율인 문자 단위 exact-match 정확도를 39.3에서 42.7로 높이지만, 단어 단위 정확도는 36.9에서 33.1로 낮아진다. 공백 기반 경계가 명확하지 않은 언어를 처리하는 데에는 한계가 남으며, 생성 속도 실측 결과는 제공하지 않는다.
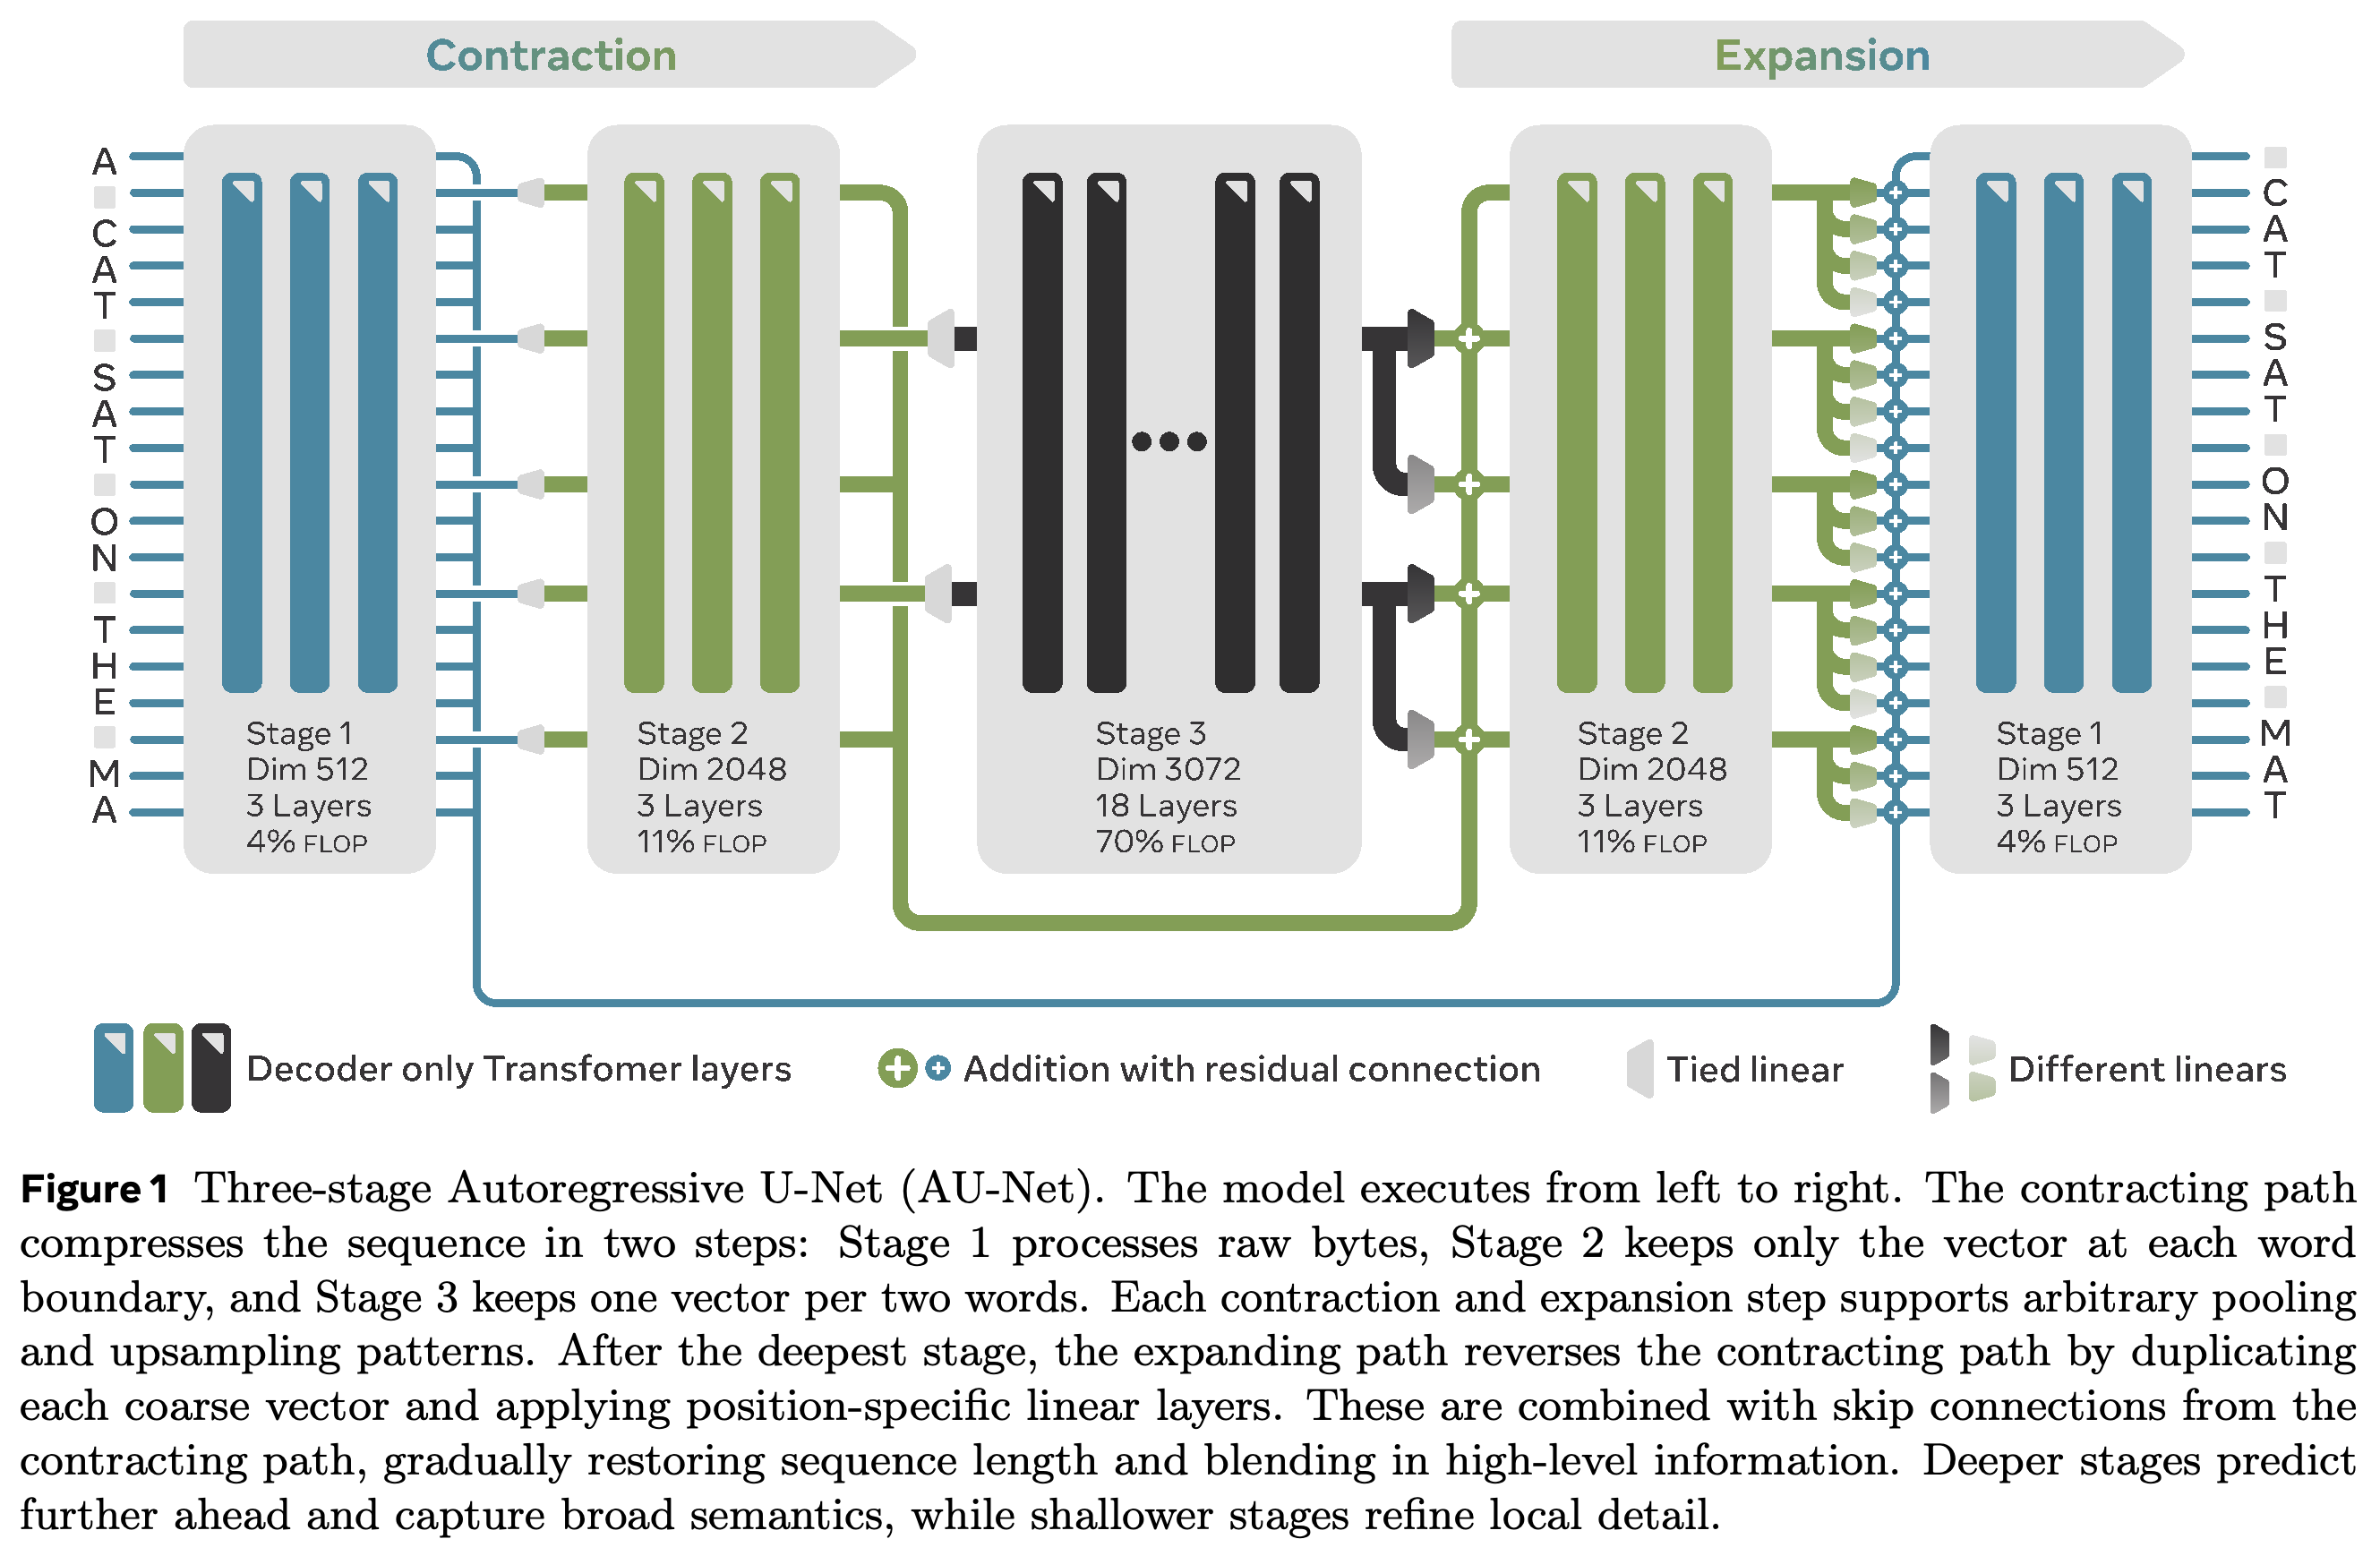
바이트, 단어, 2단어 표현과 축소 경로, 확장 경로, skip connection을 갖춘 3단계 AU-Net
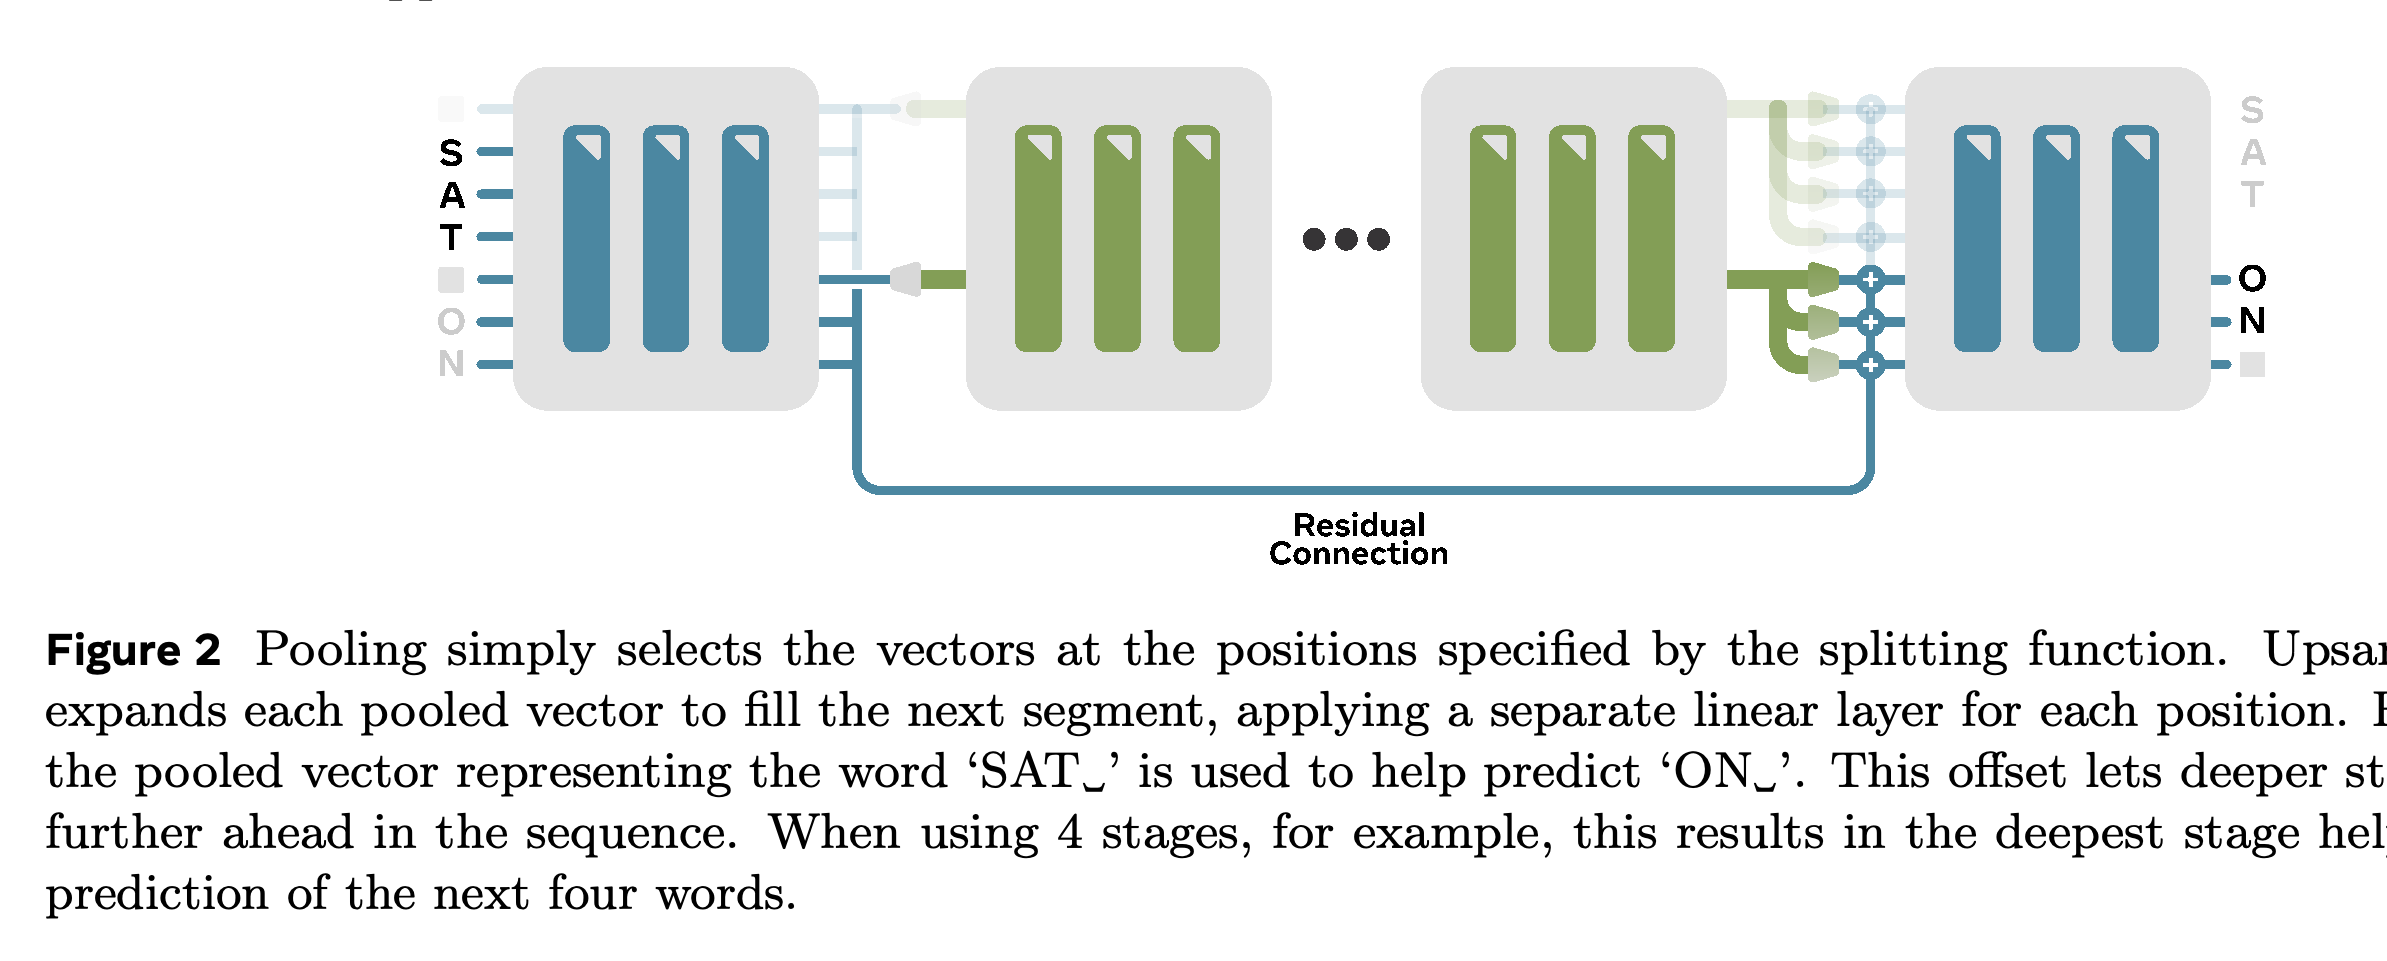
경계 기반 pooling과 다음 구간으로의 위치별 확장
출처
[1] SwarmAgentic: Towards Fully Automated Agentic System Generation via Swarm Intelligence
[2] Sekai: A Video Dataset towards World Exploration
[3] From Bytes to Ideas: Language Modeling with Autoregressive U-Nets